
LeetCode Go · 哈希表(5)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
2229. 检查数组是否连贯 🔒
题目、示例与约束
给你一个整数数组 nums ,如果 nums 是一个 连贯数组 ,则返回 true ,否则返回 false 。
如果数组包含 [x, x + n - 1] 范围内的所有数字(包括 x 和 x + n - 1 ),则该数组为连贯数组;其中 x 是数组中最小的数,n 是数组的长度。
示例 1:
输入:nums = [1,3,4,2]
输出:true
解释:
最小值是 1 ,数组长度为 4 。
范围 [x, x + n - 1] 中的所有值都出现在 nums 中:[1, 1 + 4 - 1] = [1, 4] = (1, 2, 3, 4) 。
因此,nums 是一个连贯数组。
示例 2:
输入:nums = [1,3]
输出:false
解释:
最小值是 1 ,数组长度为 2 。
范围 [x, x + n - 1] 中的所有值没有都出现在 nums 中:[1, 1 + 2 - 1] = [1, 2] = (1, 2) 。
因此,nums 不是一个连贯数组。
示例 3:
输入:nums = [3,5,4]
输出:true
解释:
最小值是 3 ,数组长度为 3 。
范围 [x, x + n - 1] 中的所有值都出现在 nums 中:[3, 3 + 3 - 1] = [3, 5] = (3,4,5) 。
因此,nums 是一个连贯数组。
提示:
1 <= nums.length <= 1050 <= nums[i] <= 105
方法一:哈希表 · Go 实现
思考
判断数组能否排成一段连续整数。排序后检查相邻差是否均为 需要 。 ,可以过,但连续性还有更便宜的充要条件:元素互异,且最大值减最小值加一恰好等于长度。
用集合去重并同时取最小、最大。三量相等当且仅当原数组是某段连续区间的一个排列。
我们可以用一个哈希表 来存储数组 中的所有元素,用两个变量 和 分别表示数组中的最小值和最大值。
如果数组中的所有元素都不相同,且数组的长度等于最大值和最小值之间的差值加 ,那么数组就是连贯数组,返回 ;否则返回 。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func isConsecutive(nums []int) bool {
	s := map[int]bool{}
	mi, mx := nums[0], 0
	for _, x := range nums {
		if s[x] {
			return false
		}
		s[x] = true
		mi = min(mi, x)
		mx = max(mx, x)
	}
	return mx-mi+1 == len(nums)
}2248. 多个数组求交集
题目、示例与约束
给你一个二维整数数组 nums ,其中 nums[i] 是由 不同 正整数组成的一个非空数组,按 升序排列 返回一个数组,数组中的每个元素在 nums 所有数组 中都出现过。
示例 1:
输入:nums = [[3,1,2,4,5],[1,2,3,4],[3,4,5,6]]
输出:[3,4]
解释:
nums[0] = [3,1,2,4,5],nums[1] = [1,2,3,4],nums[2] = [3,4,5,6],在 nums 中每个数组中都出现的数字是 3 和 4 ,所以返回 [3,4] 。
示例 2:
输入:nums = [[1,2,3],[4,5,6]]
输出:[]
解释:
不存在同时出现在 nums[0] 和 nums[1] 的整数,所以返回一个空列表 [] 。
提示:
1 <= nums.length <= 10001 <= sum(nums[i].length) <= 10001 <= nums[i][j] <= 1000nums[i]中的所有值 互不相同
方法一:计数 · Go 实现
思考
求同时出现在每一个子数组中的数,并升序输出。各子数组内部元素互异,值域为 。逐对做集合交也可以,但多次分配集合没有必要。
开长度为 的计数数组,每在一个子数组中见到 就给 加一。最后 等于子数组个数的那些 即为交集,按下标输出已有序。
遍历数组 nums,对于每个数组 arr,统计数组 arr 中每个数字出现的次数,然后遍历计数数组,统计出现次数等于数组 nums 的长度的数字,即为答案。
时间复杂度 ,空间复杂度 。其中 为数组 nums 中数字的总数。
func intersection(nums [][]int) (ans []int) {
	cnt := [1001]int{}
	for _, arr := range nums {
		for _, x := range arr {
			cnt[x]++
		}
	}
	for x, v := range cnt {
		if v == len(nums) {
			ans = append(ans, x)
		}
	}
	return
}
方法二 · Go 实现
思考
方法一扫完再收集答案。计数过程中一旦 达到子数组个数,就可以立刻把 放入答案,少一次整表扫描。最后再排序即可。值域不大,两种写法时间同阶。
func intersection(nums [][]int) (ans []int) {
	cnt := map[int]int{}
	for _, arr := range nums {
		for _, x := range arr {
			cnt[x]++
			if cnt[x] == len(nums) {
				ans = append(ans, x)
			}
		}
	}
	sort.Ints(ans)
	return
}2273. 移除字母异位词后的结果数组
题目、示例与约束
给你一个下标从 0 开始的字符串数组 words ,其中 words[i] 由小写英文字符组成。
在一步操作中,需要选出任一下标 i ,从 words 中 删除 words[i] 。其中下标 i 需要同时满足下述两个条件:
0 < i < words.lengthwords[i - 1]和words[i]是 字母异位词 。
只要可以选出满足条件的下标,就一直执行这个操作。
在执行所有操作后,返回 words 。可以证明,按任意顺序为每步操作选择下标都会得到相同的结果。
字母异位词 是由重新排列源单词的字母得到的一个新单词,所有源单词中的字母通常恰好只用一次。例如,"dacb" 是 "abdc" 的一个字母异位词。
示例 1:
输入:words = ["abba","baba","bbaa","cd","cd"]
输出:["abba","cd"]
解释:
获取结果数组的方法之一是执行下述步骤:
- 由于 words[2] = "bbaa" 和 words[1] = "baba" 是字母异位词,选择下标 2 并删除 words[2] 。
  现在 words = ["abba","baba","cd","cd"] 。
- 由于 words[1] = "baba" 和 words[0] = "abba" 是字母异位词,选择下标 1 并删除 words[1] 。
  现在 words = ["abba","cd","cd"] 。
- 由于 words[2] = "cd" 和 words[1] = "cd" 是字母异位词,选择下标 2 并删除 words[2] 。
  现在 words = ["abba","cd"] 。
无法再执行任何操作,所以 ["abba","cd"] 是最终答案。
示例 2:
输入:words = ["a","b","c","d","e"]
输出:["a","b","c","d","e"]
解释:
words 中不存在互为字母异位词的两个相邻字符串,所以无需执行任何操作。
提示:
1 <= words.length <= 1001 <= words[i].length <= 10words[i]由小写英文字母组成
方法一:模拟 · Go 实现
思考
反复删除与前一个词互为字母异位词的词,直到相邻都不是。词数与词长都很小,一次从左到右保留「与答案末尾不是异位词」的词即可,因为删除不影响更早已经合法的相邻对。
先放入 ,其后仅当 判定不是异位词时追加。 用计数数组比较,长度不同则一定保留。
我们首先将 加入答案数组,然后从 开始遍历,如果 和 不是字母异位词,我们就将 加入答案数组。
问题转换为判断两个字符串是否是字母异位词,我们定义一个辅助函数 来实现这个功能。如果 和 不是字母异位词,我们就返回 ,否则返回 。
在函数 中,我们首先判断 和 的长度是否相等,如果不相等,我们就返回 。否则,我们用一个长度为 的数组 来统计 中每个字符出现的次数,然后遍历 中的每个字符,将 减 ,如果 小于 ,我们就返回 。如果正常遍历完 中的每个字符,说明 和 是字母异位词,我们返回 。
时间复杂度 ,空间复杂度 。其中 是数组 的长度,而 是字符集,这里是小写英文字母,所以 。
func removeAnagrams(words []string) []string {
	ans := []string{words[0]}
	check := func(s, t string) bool {
		if len(s) != len(t) {
			return true
		}
		cnt := [26]int{}
		for _, c := range s {
			cnt[c-'a']++
		}
		for _, c := range t {
			cnt[c-'a']--
			if cnt[c-'a'] < 0 {
				return true
			}
		}
		return false
	}
	for i, t := range words[1:] {
		if check(words[i], t) {
			ans = append(ans, t)
		}
	}
	return ans
}2283. 判断一个数的数字计数是否等于数位的值
题目、示例与约束
给你一个下标从 0 开始长度为 n 的字符串 num ,它只包含数字。
如果对于 每个 0 <= i < n 的下标 i ,都满足数位 i 在 num 中出现了 num[i]次,那么请你返回 true ,否则返回 false 。
示例 1:
输入:num = "1210"
输出:true
解释:
num[0] = '1' 。数字 0 在 num 中出现了一次。
num[1] = '2' 。数字 1 在 num 中出现了两次。
num[2] = '1' 。数字 2 在 num 中出现了一次。
num[3] = '0' 。数字 3 在 num 中出现了零次。
"1210" 满足题目要求条件,所以返回 true 。
示例 2:
输入:num = "030"
输出:false
解释:
num[0] = '0' 。数字 0 应该出现 0 次,但是在 num 中出现了两次。
num[1] = '3' 。数字 1 应该出现 3 次,但是在 num 中出现了零次。
num[2] = '0' 。数字 2 在 num 中出现了 0 次。
下标 0 和 1 都违反了题目要求,所以返回 false 。
提示:
n == num.length1 <= n <= 10num只包含数字。
方法一:计数 + 枚举 · Go 实现
思考
要求 等于数字 在串中的出现次数。长度至多 ,先计数再按下标核对即可。
统计各位,再检查 是否等于 。
我们可以用一个长度为 的数组 统计字符串 中每个数字出现的次数,然后再枚举字符串 中的每个数字,判断其出现的次数是否等于该数字本身。如果对于所有的数字都满足这个条件,那么返回 ,否则返回 。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度,而 是数字的取值范围,即 。
func digitCount(num string) bool {
	cnt := [10]int{}
	for _, c := range num {
		cnt[c-'0']++
	}
	for i, c := range num {
		if int(c-'0') != cnt[i] {
			return false
		}
	}
	return true
}2284. 最多单词数的发件人
题目、示例与约束
给你一个聊天记录,共包含 n 条信息。给你两个字符串数组 messages 和 senders ,其中 messages[i] 是 senders[i] 发出的一条 信息 。
一条 信息 是若干用单个空格连接的 单词 ,信息开头和结尾不会有多余空格。发件人的 单词计数 是这个发件人总共发出的 单词数 。注意,一个发件人可能会发出多于一条信息。
请你返回发出单词数 最多 的发件人名字。如果有多个发件人发出最多单词数,请你返回 字典序 最大的名字。
注意:
- 字典序里,大写字母小于小写字母。
"Alice"和"alice"是不同的名字。
示例 1:
输入:messages = ["Hello userTwooo","Hi userThree","Wonderful day Alice","Nice day userThree"], senders = ["Alice","userTwo","userThree","Alice"]
输出:"Alice"
解释:Alice 总共发出了 2 + 3 = 5 个单词。
userTwo 发出了 2 个单词。
userThree 发出了 3 个单词。
由于 Alice 发出单词数最多,所以我们返回 "Alice" 。
示例 2:
输入:messages = ["How is leetcode for everyone","Leetcode is useful for practice"], senders = ["Bob","Charlie"]
输出:"Charlie"
解释:Bob 总共发出了 5 个单词。
Charlie 总共发出了 5 个单词。
由于最多单词数打平,返回字典序最大的名字,也就是 Charlie 。
提示:
n == messages.length == senders.length1 <= n <= 1041 <= messages[i].length <= 1001 <= senders[i].length <= 10messages[i]包含大写字母、小写字母和' '。messages[i]中所有单词都由 单个空格 隔开。messages[i]不包含前导和后缀空格。senders[i]只包含大写英文字母和小写英文字母。
方法一:哈希表 + 枚举 · Go 实现
思考
统计每人发出的单词总数,取最大者;并列时取字典序更大的名字。消息数 ,按空格切分即可,不必建复杂结构。
单词数等于空格数加一。哈希表累加后遍历,同时用当前最优名字做并列比较。
我们可以用一个哈希表 记录每个发件人的单词数,然后遍历哈希表找到单词数最多的发件人,如果有多个发件人发出最多单词数,我们返回字典序最大的名字。
时间复杂度 ,空间复杂度 ,其中 是消息的数量,而 是所有消息的总长度。
func largestWordCount(messages []string, senders []string) string {
	cnt := make(map[string]int)
	for i, message := range messages {
		v := strings.Count(message, " ") + 1
		cnt[senders[i]] += v
	}

	ans := senders[0]
	for k, v := range cnt {
		if cnt[ans] < v || (cnt[ans] == v && ans < k) {
			ans = k
		}
	}
	return ans
}2287. 重排字符形成目标字符串
题目、示例与约束
给你两个下标从 0 开始的字符串 s 和 target 。你可以从 s 取出一些字符并将其重排,得到若干新的字符串。
从 s 中取出字符并重新排列,返回可以形成 target 的 最大 副本数。
示例 1:
输入:s = "ilovecodingonleetcode", target = "code"
输出:2
解释:
对于 "code" 的第 1 个副本,选取下标为 4 、5 、6 和 7 的字符。
对于 "code" 的第 2 个副本,选取下标为 17 、18 、19 和 20 的字符。
形成的字符串分别是 "ecod" 和 "code" ,都可以重排为 "code" 。
可以形成最多 2 个 "code" 的副本,所以返回 2 。
示例 2:
输入:s = "abcba", target = "abc"
输出:1
解释:
选取下标为 0 、1 和 2 的字符,可以形成 "abc" 的 1 个副本。
可以形成最多 1 个 "abc" 的副本,所以返回 1 。
注意,尽管下标 3 和 4 分别有额外的 'a' 和 'b' ,但不能重用下标 2 处的 'c' ,所以无法形成 "abc" 的第 2 个副本。
示例 3:
输入:s = "abbaccaddaeea", target = "aaaaa"
输出:1
解释:
选取下标为 0 、3 、6 、9 和 12 的字符,可以形成 "aaaaa" 的 1 个副本。
可以形成最多 1 个 "aaaaa" 的副本,所以返回 1 。
提示:
1 <= s.length <= 1001 <= target.length <= 10s和target由小写英文字母组成
注意:本题与 1189. “气球” 的最大数量 相同。
方法一:计数 · Go 实现
思考
用 中的字母复制 尽量多次,字母不能重复使用。 ,瓶颈是 中需求最多、相对供给最少的那个字母。
分别计数后,对 的每种字母取 的最小值。
我们统计字符串 和 中每个字符出现的次数,记为 和 。对于 中的每个字符,我们计算 中该字符出现的次数除以 中该字符出现的次数,取最小值即可。
时间复杂度 ,空间复杂度 。其中 和 分别是字符串 和 的长度。而 是字符集的大小,本题中 。
func rearrangeCharacters(s string, target string) int {
	var cnt1, cnt2 [26]int
	for _, c := range s {
		cnt1[c-'a']++
	}
	for _, c := range target {
		cnt2[c-'a']++
	}
	ans := 100
	for i, v := range cnt2 {
		if v > 0 {
			ans = min(ans, cnt1[i]/v)
		}
	}
	return ans
}2295. 替换数组中的元素
题目、示例与约束
给你一个下标从 0 开始的数组 nums ,它包含 n 个 互不相同 的正整数。请你对这个数组执行 m 个操作,在第 i 个操作中,你需要将数字 operations[i][0] 替换成 operations[i][1] 。
题目保证在第 i 个操作中:
operations[i][0]在nums中存在。operations[i][1]在nums中不存在。
请你返回执行完所有操作后的数组。
示例 1:
输入:nums = [1,2,4,6], operations = [[1,3],[4,7],[6,1]]
输出:[3,2,7,1]
解释:我们对 nums 执行以下操作:
- 将数字 1 替换为 3 。nums 变为 [3,2,4,6] 。
- 将数字 4 替换为 7 。nums 变为 [3,2,7,6] 。
- 将数字 6 替换为 1 。nums 变为 [3,2,7,1] 。
返回最终数组 [3,2,7,1] 。
示例 2:
输入:nums = [1,2], operations = [[1,3],[2,1],[3,2]]
输出:[2,1]
解释:我们对 nums 执行以下操作:
- 将数字 1 替换为 3 。nums 变为 [3,2] 。
- 将数字 2 替换为 1 。nums 变为 [3,1] 。
- 将数字 3 替换为 2 。nums 变为 [2,1] 。
返回最终数组 [2,1] 。
提示:
n == nums.lengthm == operations.length1 <= n, m <= 105nums中所有数字 互不相同 。operations[i].length == 21 <= nums[i], operations[i][0], operations[i][1] <= 106- 在执行第
i个操作时,operations[i][0]在nums中存在。 - 在执行第
i个操作时,operations[i][1]在nums中不存在。
方法一:哈希表 · Go 实现
思考
每次把数组中的 换成尚未出现的 ,操作达 。线性查找 的位置会超时。值互不相同,可用哈希表记下值到下标的映射。
执行 时改 ,并把 设为同一位置。无需删除 ,因为后续不会再操作旧值。
我们先用哈希表 记录数组 中每个数字的下标,然后遍历操作数组 ,对于每个操作 ,我们将 在 中的下标 对应的数字替换为 ,并更新 中 的下标为 。
最后返回 即可。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 的长度和操作数组 的长度。
func arrayChange(nums []int, operations [][]int) []int {
	d := map[int]int{}
	for i, x := range nums {
		d[x] = i
	}
	for _, op := range operations {
		x, y := op[0], op[1]
		nums[d[x]] = y
		d[y] = d[x]
	}
	return nums
}2301. 替换字符后匹配
题目、示例与约束
给你两个字符串 s 和 sub 。同时给你一个二维字符数组 mappings ,其中 mappings[i] = [oldi, newi] 表示你可以将 sub 中任意数目的 oldi 字符替换为 newi 。sub 中每个字符 不能 被替换超过一次。
如果使用 mappings 替换 0 个或者若干个字符,可以将 sub 变成 s 的一个子字符串,请你返回 true,否则返回 false 。
一个 子字符串 是字符串中连续非空的字符序列。
示例 1:
输入:s = "fool3e7bar", sub = "leet", mappings = [["e","3"],["t","7"],["t","8"]]
输出:true
解释:将 sub 中第一个 'e' 用 '3' 替换,将 't' 用 '7' 替换。
现在 sub = "l3e7" ,它是 s 的子字符串,所以我们返回 true 。
示例 2:
输入:s = "fooleetbar", sub = "f00l", mappings = [["o","0"]]
输出:false
解释:字符串 "f00l" 不是 s 的子串且没有可以进行的修改。
注意我们不能用 'o' 替换 '0' 。
示例 3:
输入:s = "Fool33tbaR", sub = "leetd", mappings = [["e","3"],["t","7"],["t","8"],["d","b"],["p","b"]]
输出:true
解释:将 sub 里第一个和第二个 'e' 用 '3' 替换,用 'b' 替换 sub 里的 'd' 。
得到 sub = "l33tb" ,它是 s 的子字符串,所以我们返回 true 。
提示:
1 <= sub.length <= s.length <= 50000 <= mappings.length <= 1000mappings[i].length == 2oldi != newis和sub只包含大写和小写英文字母和数字。oldi和newi是大写、小写字母或者是个数字。
方法一:哈希表 + 枚举 · Go 实现
思考
映射只允许一步替换,因此判断 能否对准 的某一段,只需按长度枚举起点并逐位核验。 ,对齐次数与子串长度之积约为 ,可以接受。
同一字符可能对应多个新字符,逐次扫描映射表会重复工作。将每个旧字符的可达集合收入哈希表后,对齐时 查询「相等或可替换」即可。
我们先用哈希表 记录每个字符可以替换成的字符集合。
然后我们枚举 中所有长度为 长度的子串,判断字符串 是否可以通过替换得到该子串,如果可以则返回 true,否则枚举下一个子串。
枚举结束,说明 无法通过替换得到 中的任何子串,返回 false。
时间复杂度 ,空间复杂度 。其中 和 分别是字符串 和 的长度,而 是字符集的大小。
func matchReplacement(s string, sub string, mappings [][]byte) bool {
	d := map[byte]map[byte]bool{}
	for _, e := range mappings {
		if d[e[0]] == nil {
			d[e[0]] = map[byte]bool{}
		}
		d[e[0]][e[1]] = true
	}
	for i := 0; i < len(s)-len(sub)+1; i++ {
		ok := true
		for j := 0; j < len(sub) && ok; j++ {
			a, b := s[i+j], sub[j]
			if a != b && !d[b][a] {
				ok = false
			}
		}
		if ok {
			return true
		}
	}
	return false
}
方法二:数组 + 枚举 · Go 实现
思考
方法一用哈希集合存储映射,常数受散列影响。字符集仅为大小写字母与数字,因此改用 的布尔数组标记可达关系,查询与空间均变为下标访问,算法流程不变。
由于字符集只包含大写和小写英文字母和数字,因此我们可以直接用一个 的数组 记录每个字符可以替换成的字符集合。
时间复杂度 ,空间复杂度 。
func matchReplacement(s string, sub string, mappings [][]byte) bool {
	d := [128][128]bool{}
	for _, e := range mappings {
		d[e[0]][e[1]] = true
	}
	for i := 0; i < len(s)-len(sub)+1; i++ {
		ok := true
		for j := 0; j < len(sub) && ok; j++ {
			a, b := s[i+j], sub[j]
			if a != b && !d[b][a] {
				ok = false
			}
		}
		if ok {
			return true
		}
	}
	return false
}2309. 兼具大小写的最好英文字母
题目、示例与约束
给你一个由英文字母组成的字符串 s ,请你找出并返回 s 中的 最好 英文字母。返回的字母必须为大写形式。如果不存在满足条件的字母,则返回一个空字符串。
最好 英文字母的大写和小写形式必须 都 在 s 中出现。
英文字母 b 比另一个英文字母 a 更好 的前提是:英文字母表中,b 在 a 之 后 出现。
示例 1:
输入:s = "lEeTcOdE"
输出:"E"
解释:
字母 'E' 是唯一一个大写和小写形式都出现的字母。
示例 2:
输入:s = "arRAzFif"
输出:"R"
解释:
字母 'R' 是大写和小写形式都出现的最好英文字母。
注意 'A' 和 'F' 的大写和小写形式也都出现了,但是 'R' 比 'F' 和 'A' 更好。
示例 3:
输入:s = "AbCdEfGhIjK"
输出:""
解释:
不存在大写和小写形式都出现的字母。
提示:
1 <= s.length <= 1000s由小写和大写英文字母组成
方法一:哈希表 + 枚举 · Go 实现
思考
长度不超过 ,需要同时出现大小写的最大字母。将出现过的字符放入集合后,从 到 检查即可,第一次命中便是答案。
集合保证大小写各一次哈希查询。若都不存在,返回空串。
我们先用哈希表 记录字符串 中出现的所有字母,然后从大写字母表的最后一个字母开始枚举,如果当前字母的大写和小写形式都在 中,则返回该字母。
枚举结束后,如果没有找到符合条件的字母,则返回空字符串。
时间复杂度 ,空间复杂度 。其中 和 分别是字符串 的长度和字符集的大小。
func greatestLetter(s string) string {
	ss := map[rune]bool{}
	for _, c := range s {
		ss[c] = true
	}
	for c := 'Z'; c >= 'A'; c-- {
		if ss[c] && ss[rune(c+32)] {
			return string(c)
		}
	}
	return ""
}
方法二:位运算(空间优化) · Go 实现
思考
方法一占用与字符集同阶的额外空间。字母只有 个,可用两个整型掩码分别记录大小写出现位,再取交。最高的置位对应最大字母,从而把空间压到常数。
我们可以用两个整数 和 分别记录字符串 中出现的小写字母和大写字母,其中 的第 位表示第 个小写字母是否出现,而 的第 位表示第 个大写字母是否出现。
然后我们将 和 进行与运算,得到的结果 的第 位表示第 个字母的大小写是否同时出现。
接下来我们只要获取 的二进制表示中最高位的 的位置,将其转换为对应的大写字母即可。如果所有二进制位都不为 ,说明不存在大小写同时出现的字母,返回空字符串。
时间复杂度 ,其中 是字符串 的长度。空间复杂度 。
func greatestLetter(s string) string {
	mask1, mask2 := 0, 0
	for _, c := range s {
		if unicode.IsLower(c) {
			mask1 |= 1 << (c - 'a')
		} else {
			mask2 |= 1 << (c - 'A')
		}
	}
	mask := mask1 & mask2
	if mask == 0 {
		return ""
	}
	return string(byte(bits.Len(uint(mask))-1) + 'A')
}2325. 解密消息
题目、示例与约束
给你字符串 key 和 message ,分别表示一个加密密钥和一段加密消息。解密 message 的步骤如下:
- 使用
key中 26 个英文小写字母第一次出现的顺序作为替换表中的字母 顺序 。 - 将替换表与普通英文字母表对齐,形成对照表。
- 按照对照表 替换
message中的每个字母。 - 空格
' '保持不变。
- 例如,
key = "happy boy"(实际的加密密钥会包含字母表中每个字母 至少一次),据此,可以得到部分对照表('h' -> 'a'、'a' -> 'b'、'p' -> 'c'、'y' -> 'd'、'b' -> 'e'、'o' -> 'f')。
返回解密后的消息。
示例 1:
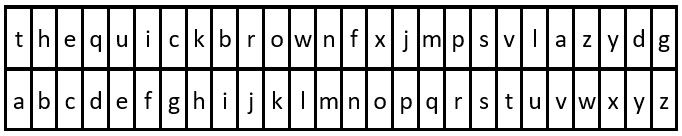
输入:key = "the quick brown fox jumps over the lazy dog", message = "vkbs bs t suepuv"
输出:"this is a secret"
解释:对照表如上图所示。
提取 "the quick brown fox jumps over the lazy dog" 中每个字母的首次出现可以得到替换表。
示例 2:
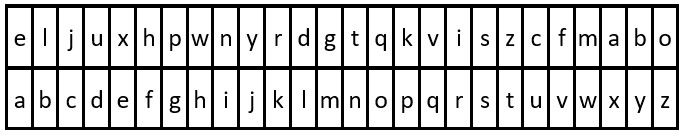
输入:key = "eljuxhpwnyrdgtqkviszcfmabo", message = "zwx hnfx lqantp mnoeius ycgk vcnjrdb"
输出:"the five boxing wizards jump quickly"
解释:对照表如上图所示。
提取 "eljuxhpwnyrdgtqkviszcfmabo" 中每个字母的首次出现可以得到替换表。
提示:
26 <= key.length <= 2000key由小写英文字母及' '组成key包含英文字母表中每个字符('a'到'z')至少一次1 <= message.length <= 2000message由小写英文字母和' '组成
方法一:数组或哈希表 · Go 实现
思考
密钥按首次出现的字母依次对应 。 与 均不超过 ,建表后替换即可。
用哈希表记下每个字母第一次出现时分到的明文,空格保持空格。遍历 按表写出译文,避免对每个字符重新扫描密钥。
我们可以使用数组或哈希表 存储对照表,然后遍历 message 中的每个字符,将其替换为对应的字符即可。
时间复杂度 ,空间复杂度 。其中 和 分别为 key 和 message 的长度;而 为字符集大小。
func decodeMessage(key string, message string) string {
	d := [128]byte{}
	d[' '] = ' '
	for i, j := 0, 0; i < len(key); i++ {
		if d[key[i]] == 0 {
			d[key[i]] = byte('a' + j)
			j++
		}
	}
	ans := []byte(message)
	for i, c := range ans {
		ans[i] = d[c]
	}
	return string(ans)
}2341. 数组能形成多少数对
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums 。在一步操作中,你可以执行以下步骤:
- 从
nums选出 两个 相等的 整数 - 从
nums中移除这两个整数,形成一个 数对
请你在 nums 上多次执行此操作直到无法继续执行。
返回一个下标从 0 开始、长度为 2 的整数数组 answer 作为答案,其中 answer[0] 是形成的数对数目,answer[1] 是对 nums 尽可能执行上述操作后剩下的整数数目。
示例 1:
输入:nums = [1,3,2,1,3,2,2]
输出:[3,1]
解释:
nums[0] 和 nums[3] 形成一个数对,并从 nums 中移除,nums = [3,2,3,2,2] 。
nums[0] 和 nums[2] 形成一个数对,并从 nums 中移除,nums = [2,2,2] 。
nums[0] 和 nums[1] 形成一个数对,并从 nums 中移除,nums = [2] 。
无法形成更多数对。总共形成 3 个数对,nums 中剩下 1 个数字。
示例 2:
输入:nums = [1,1]
输出:[1,0]
解释:nums[0] 和 nums[1] 形成一个数对,并从 nums 中移除,nums = [] 。
无法形成更多数对。总共形成 1 个数对,nums 中剩下 0 个数字。
示例 3:
输入:nums = [0]
输出:[0,1]
解释:无法形成数对,nums 中剩下 1 个数字。
提示:
1 <= nums.length <= 1000 <= nums[i] <= 100
方法一:计数 · Go 实现
思考
相同数字两两成对,求对数与剩余个数。 ,计数后整除即可。
统计每个值的出现次数,对数为各 之和,剩余为 。
我们可以统计数组 中每个数字 出现的次数,记录在哈希表或数组 中。
然后遍历 ,对于每个数字 ,如果 出现的次数 大于 ,则可以从数组中选出两个 形成一个数对,我们将 除以 向下取整,即可得到当前数字 可以形成的数对数目,然后我们累加这个数目到变量 中。
最后剩余的个数为数组 的长度减去可以形成的数对数目乘以 ,即 。
答案为 。
时间复杂度 ,空间复杂度 。其中 为数组 的长度;而 为数组 中数字的范围,本题中 。
func numberOfPairs(nums []int) []int {
	cnt := [101]int{}
	for _, x := range nums {
		cnt[x]++
	}
	s := 0
	for _, v := range cnt {
		s += v / 2
	}
	return []int{s, len(nums) - s*2}
}2347. 最好的扑克手牌
题目、示例与约束
给你一个整数数组 ranks 和一个字符数组 suit 。你有 5 张扑克牌,第 i 张牌大小为 ranks[i] ,花色为 suits[i] 。
下述是从好到坏你可能持有的 手牌类型 :
"Flush":同花,五张相同花色的扑克牌。"Three of a Kind":三条,有 3 张大小相同的扑克牌。"Pair":对子,两张大小一样的扑克牌。"High Card":高牌,五张大小互不相同的扑克牌。
请你返回一个字符串,表示给定的 5 张牌中,你能组成的 最好手牌类型 。
注意:返回的字符串 大小写 需与题目描述相同。
示例 1:
输入:ranks = [13,2,3,1,9], suits = ["a","a","a","a","a"]
输出:"Flush"
解释:5 张扑克牌的花色相同,所以返回 "Flush" 。
示例 2:
输入:ranks = [4,4,2,4,4], suits = ["d","a","a","b","c"]
输出:"Three of a Kind"
解释:第一、二和四张牌组成三张相同大小的扑克牌,所以得到 "Three of a Kind" 。
注意我们也可以得到 "Pair" ,但是 "Three of a Kind" 是更好的手牌类型。
有其他的 3 张牌也可以组成 "Three of a Kind" 手牌类型。
示例 3:
输入:ranks = [10,10,2,12,9], suits = ["a","b","c","a","d"]
输出:"Pair"
解释:第一和第二张牌大小相同,所以得到 "Pair" 。
我们无法得到 "Flush" 或者 "Three of a Kind" 。
提示:
ranks.length == suits.length == 51 <= ranks[i] <= 13'a' <= suits[i] <= 'd'- 任意两张扑克牌不会同时有相同的大小和花色。
方法一:计数 · Go 实现
思考
五张牌判定同花、三条、对子或高牌,按优先级只返回一种。牌数固定,计数即可。
先看花色是否全同;再用点数频次判断是否存在 或恰好 。都不满足则为高牌。
我们可以先遍历数组 ,判断相邻两个元素是否均相等,如果是,则返回 "Flush"。
接下来,我们用哈希表或数组 统计每张牌的数量:
- 如果有任意一张牌的数量等于 ,返回
"Three of a Kind"; - 否则,如果有任意一张牌的数量等于 ,返回
"Pair"; - 否则,返回
"High Card"。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func bestHand(ranks []int, suits []byte) string {
	flush := true
	for i := 1; i < 5 && flush; i++ {
		flush = suits[i] == suits[i-1]
	}
	if flush {
		return "Flush"
	}
	cnt := [14]int{}
	pair := false
	for _, x := range ranks {
		cnt[x]++
		if cnt[x] == 3 {
			return "Three of a Kind"
		}
		pair = pair || cnt[x] == 2
	}
	if pair {
		return "Pair"
	}
	return "High Card"
}2352. 相等行列对
题目、示例与约束
给你一个下标从 0 开始、大小为 n x n 的整数矩阵 grid ,返回满足 Ri 行和 Cj 列相等的行列对 (Ri, Cj) 的数目。
如果行和列以相同的顺序包含相同的元素(即相等的数组),则认为二者是相等的。
示例 1:
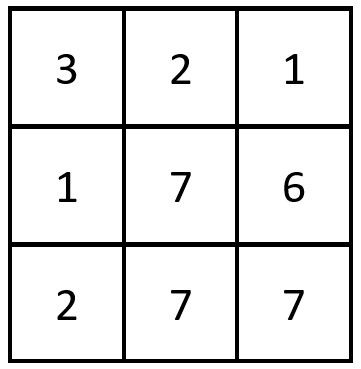
输入:grid = [[3,2,1],[1,7,6],[2,7,7]]
输出:1
解释:存在一对相等行列对:
- (第 2 行,第 1 列):[2,7,7]
示例 2:
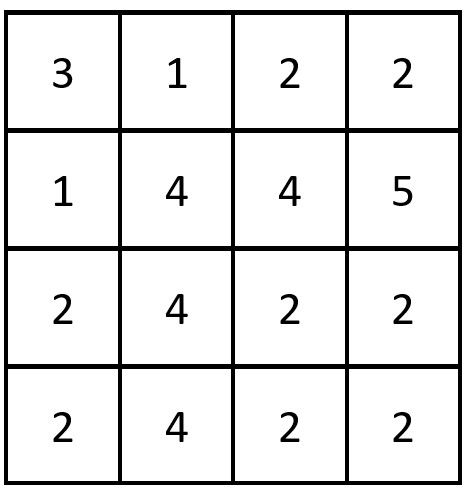
输入:grid = [[3,1,2,2],[1,4,4,5],[2,4,2,2],[2,4,2,2]]
输出:3
解释:存在三对相等行列对:
- (第 0 行,第 0 列):[3,1,2,2]
- (第 2 行, 第 2 列):[2,4,2,2]
- (第 3 行, 第 2 列):[2,4,2,2]
提示:
n == grid.length == grid[i].length1 <= n <= 2001 <= grid[i][j] <= 105
方法一:模拟 · Go 实现
思考
统计与某行完全相同的列的对数。 ,三重循环比较一行与一列的 个位置可以接受。
枚举行 、列 ,用 判断 。无需先哈希整行,实现与题意一致。
我们直接将矩阵 的每一行和每一列进行比较,如果相等,那么就是一对相等行列对,答案加一。
时间复杂度 ,其中 为矩阵 的行数或列数。空间复杂度 。
func equalPairs(grid [][]int) (ans int) {
	for i := range grid {
		for j := range grid {
			ok := 1
			for k := range grid {
				if grid[i][k] != grid[k][j] {
					ok = 0
					break
				}
			}
			ans += ok
		}
	}
	return
}2363. 合并相似的物品
题目、示例与约束
给你两个二维整数数组 items1 和 items2 ,表示两个物品集合。每个数组 items 有以下特质:
items[i] = [valuei, weighti]其中valuei表示第i件物品的 价值 ,weighti表示第i件物品的 重量 。items中每件物品的价值都是 唯一的 。
请你返回一个二维数组 ret,其中 ret[i] = [valuei, weighti], weighti 是所有价值为 valuei 物品的 重量之和 。
注意:ret 应该按价值 升序 排序后返回。
示例 1:
输入:items1 = [[1,1],[4,5],[3,8]], items2 = [[3,1],[1,5]]
输出:[[1,6],[3,9],[4,5]]
解释:
value = 1 的物品在 items1 中 weight = 1 ,在 items2 中 weight = 5 ,总重量为 1 + 5 = 6 。
value = 3 的物品在 items1 中 weight = 8 ,在 items2 中 weight = 1 ,总重量为 8 + 1 = 9 。
value = 4 的物品在 items1 中 weight = 5 ,总重量为 5 。
所以,我们返回 [[1,6],[3,9],[4,5]] 。
示例 2:
输入:items1 = [[1,1],[3,2],[2,3]], items2 = [[2,1],[3,2],[1,3]]
输出:[[1,4],[2,4],[3,4]]
解释:
value = 1 的物品在 items1 中 weight = 1 ,在 items2 中 weight = 3 ,总重量为 1 + 3 = 4 。
value = 2 的物品在 items1 中 weight = 3 ,在 items2 中 weight = 1 ,总重量为 3 + 1 = 4 。
value = 3 的物品在 items1 中 weight = 2 ,在 items2 中 weight = 2 ,总重量为 2 + 2 = 4 。
所以,我们返回 [[1,4],[2,4],[3,4]] 。
示例 3:
输入:items1 = [[1,3],[2,2]], items2 = [[7,1],[2,2],[1,4]]
输出:[[1,7],[2,4],[7,1]]
解释:
value = 1 的物品在 items1 中 weight = 3 ,在 items2 中 weight = 4 ,总重量为 3 + 4 = 7 。
value = 2 的物品在 items1 中 weight = 2 ,在 items2 中 weight = 2 ,总重量为 2 + 2 = 4 。
value = 7 的物品在 items2 中 weight = 1 ,总重量为 1 。
所以,我们返回 [[1,7],[2,4],[7,1]] 。
提示:
1 <= items1.length, items2.length <= 1000items1[i].length == items2[i].length == 21 <= valuei, weighti <= 1000items1中每个valuei都是 唯一的 。items2中每个valuei都是 唯一的 。
方法一:哈希表或数组 · Go 实现
思考
两份清单按价值合并重量。价值范围与长度均不超过 ,哈希累计后排序即可。
遍历两份 累加到计数器,再按价值升序输出键值对。
我们可以用哈希表或数组 cnt 统计 items1 和 items2 中每个物品的总重量,然后从小到大遍历价值,将每个价值以及对应的总重量加入结果数组即可。
时间复杂度 ,空间复杂度 。其中 和 分别是 items1 和 items2 的长度。
func mergeSimilarItems(items1 [][]int, items2 [][]int) (ans [][]int) {
	cnt := [1010]int{}
	for _, x := range items1 {
		cnt[x[0]] += x[1]
	}
	for _, x := range items2 {
		cnt[x[0]] += x[1]
	}
	for i, x := range cnt {
		if x > 0 {
			ans = append(ans, []int{i, x})
		}
	}
	return
}2365. 任务调度器 II
题目、示例与约束
给你一个下标从 0 开始的正整数数组 tasks ,表示需要 按顺序 完成的任务,其中 tasks[i] 表示第 i 件任务的 类型 。
同时给你一个正整数 space ,表示一个任务完成 后 ,另一个 相同 类型任务完成前需要间隔的 最少 天数。
在所有任务完成前的每一天,你都必须进行以下两种操作中的一种:
- 完成
tasks中的下一个任务 - 休息一天
请你返回完成所有任务所需的 最少 天数。
示例 1:
输入:tasks = [1,2,1,2,3,1], space = 3
输出:9
解释:
9 天完成所有任务的一种方法是:
第 1 天:完成任务 0 。
第 2 天:完成任务 1 。
第 3 天:休息。
第 4 天:休息。
第 5 天:完成任务 2 。
第 6 天:完成任务 3 。
第 7 天:休息。
第 8 天:完成任务 4 。
第 9 天:完成任务 5 。
可以证明无法少于 9 天完成所有任务。
示例 2:
输入:tasks = [5,8,8,5], space = 2
输出:6
解释:
6 天完成所有任务的一种方法是:
第 1 天:完成任务 0 。
第 2 天:完成任务 1 。
第 3 天:休息。
第 4 天:休息。
第 5 天:完成任务 2 。
第 6 天:完成任务 3 。
可以证明无法少于 6 天完成所有任务。
提示:
1 <= tasks.length <= 1051 <= tasks[i] <= 1091 <= space <= tasks.length
方法一:哈希表 + 模拟 · Go 实现
思考
相同任务之间至少间隔 天,任务必须按给定顺序完成。 ,不能真的插入空闲日模拟日历。
哈希表记下每种任务下一次允许执行的日期。当前日加一后与该日期取最大,再把下次允许日写成 。
我们可以用哈希表 记录每个任务下一次可以被执行的时间,初始时 中的所有值都为 ,用变量 记录当前时间。
遍历数组 ,对于每个任务 ,当前时间 加一,表示从上一次执行任务到现在已经过去了一天,如果此时 ,说明任务 需要在第 天才能被执行,因此我们更新当前时间 。然后更新 的值为 ,表示任务 下一次可以被执行的时间为 。
遍历结束后,将 返回即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func taskSchedulerII(tasks []int, space int) (ans int64) {
	day := map[int]int64{}
	for _, task := range tasks {
		ans++
		if ans < day[task] {
			ans = day[task]
		}
		day[task] = ans + int64(space) + 1
	}
	return
}2395. 和相等的子数组
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums ,判断是否存在 两个 长度为 2 的子数组且它们的 和 相等。注意,这两个子数组起始位置的下标必须 不相同 。
如果这样的子数组存在,请返回 true,否则返回 false 。
子数组 是一个数组中一段连续非空的元素组成的序列。
示例 1:
输入:nums = [4,2,4]
输出:true
解释:元素为 [4,2] 和 [2,4] 的子数组有相同的和 6 。
示例 2:
输入:nums = [1,2,3,4,5]
输出:false
解释:没有长度为 2 的两个子数组和相等。
示例 3:
输入:nums = [0,0,0]
输出:true
解释:子数组 [nums[0],nums[1]] 和 [nums[1],nums[2]] 的和相等,都为 0 。
注意即使子数组的元素相同,这两个子数组也视为不相同的子数组,因为它们在原数组中的起始位置不同。
提示:
2 <= nums.length <= 1000-109 <= nums[i] <= 109
方法一:哈希表 · Go 实现
思考
是否存在两个长度恰为 的不同子数组和相等。 ,记录相邻对的和即可。
扫过 和,若和已在集合中则找到;否则插入。无需更长子数组。
我们可以遍历数组 ,用哈希表 记录数组中每两个相邻元素的和,如果当前两个元素的和已经在哈希表中出现过,则返回 true,否则将当前两个元素的和加入哈希表中。
遍历结束后,说明没有找到满足条件的两个子数组,返回 false。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func findSubarrays(nums []int) bool {
	vis := map[int]bool{}
	for i, b := range nums[1:] {
		x := nums[i] + b
		if vis[x] {
			return true
		}
		vis[x] = true
	}
	return false
}2399. 检查相同字母间的距离
题目、示例与约束
给你一个下标从 0 开始的字符串 s ,该字符串仅由小写英文字母组成,s 中的每个字母都 恰好 出现 两次 。另给你一个下标从 0 开始、长度为 26 的的整数数组 distance 。
字母表中的每个字母按从 0 到 25 依次编号(即,'a' -> 0, 'b' -> 1, 'c' -> 2, ... , 'z' -> 25)。
在一个 匀整 字符串中,第 i 个字母的两次出现之间的字母数量是 distance[i] 。如果第 i 个字母没有在 s 中出现,那么 distance[i] 可以 忽略 。
如果 s 是一个 匀整 字符串,返回 true ;否则,返回 false 。
示例 1:
输入:s = "abaccb", distance = [1,3,0,5,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0]
输出:true
解释:
- 'a' 在下标 0 和下标 2 处出现,所以满足 distance[0] = 1 。
- 'b' 在下标 1 和下标 5 处出现,所以满足 distance[1] = 3 。
- 'c' 在下标 3 和下标 4 处出现,所以满足 distance[2] = 0 。
注意 distance[3] = 5 ,但是由于 'd' 没有在 s 中出现,可以忽略。
因为 s 是一个匀整字符串,返回 true 。
示例 2:
输入:s = "aa", distance = [1,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0]
输出:false
解释:
- 'a' 在下标 0 和 1 处出现,所以两次出现之间的字母数量为 0 。
但是 distance[0] = 1 ,s 不是一个匀整字符串。
提示:
2 <= s.length <= 52s仅由小写英文字母组成s中的每个字母恰好出现两次distance.length == 260 <= distance[i] <= 50
方法一:数组或哈希表 · Go 实现
思考
每个字母恰好出现两次,需验证中间隔的字符数等于 中的给定值。 至多 ,记下上次下标即可。
第一次记下位置,第二次比较间距;不符则失败。未在串中出现的字母不必检查。
我们可以用哈希表 记录每个字母出现的下标,然后遍历哈希表,判断每个字母的下标之差是否等于 distance 中对应的值。如果出现不等的情况,直接返回 false。如果遍历结束后,没有出现不等的情况,返回 true。
时间复杂度 ,其中 为字符串 的长度。空间复杂度 ,其中 为字符集,这里为小写字母集合。
func checkDistances(s string, distance []int) bool {
	d := [26]int{}
	for i, c := range s {
		c -= 'a'
		if d[c] > 0 && i-d[c] != distance[c] {
			return false
		}
		d[c] = i + 1
	}
	return true
}2404. 出现最频繁的偶数元素
题目、示例与约束
给你一个整数数组 nums ,返回出现最频繁的偶数元素。
如果存在多个满足条件的元素,只需要返回 最小 的一个。如果不存在这样的元素,返回 -1 。
示例 1:
输入:nums = [0,1,2,2,4,4,1]
输出:2
解释:
数组中的偶数元素为 0、2 和 4 ,在这些元素中,2 和 4 出现次数最多。
返回最小的那个,即返回 2 。
示例 2:
输入:nums = [4,4,4,9,2,4]
输出:4
解释:4 是出现最频繁的偶数元素。
示例 3:
输入:nums = [29,47,21,41,13,37,25,7]
输出:-1
解释:不存在偶数元素。
提示:
1 <= nums.length <= 20000 <= nums[i] <= 105
方法一:哈希表 · Go 实现
思考
,扫描一遍即可统计偶数频次。需要同时满足「次数最多」与「值最小」,不必排序:用哈希表计数后遍历键值对,次数更大或次数相同但数值更小时更新答案。
我们用哈希表 统计所有偶数元素出现的次数,然后找出出现次数最多且值最小的偶数元素。
时间复杂度 ,空间复杂度 。其中 是数组的长度。
func mostFrequentEven(nums []int) int {
	cnt := map[int]int{}
	for _, x := range nums {
		if x%2 == 0 {
			cnt[x]++
		}
	}
	ans, mx := -1, 0
	for x, v := range cnt {
		if mx < v || (mx == v && x < ans) {
			ans, mx = x, v
		}
	}
	return ans
}2418. 按身高排序
题目、示例与约束
给你一个字符串数组 names ,和一个由 互不相同 的正整数组成的数组 heights 。两个数组的长度均为 n 。
对于每个下标 i,names[i] 和 heights[i] 表示第 i 个人的名字和身高。
请按身高 降序 顺序返回对应的名字数组 names 。
示例 1:
输入:names = ["Mary","John","Emma"], heights = [180,165,170]
输出:["Mary","Emma","John"]
解释:Mary 最高,接着是 Emma 和 John 。
示例 2:
输入:names = ["Alice","Bob","Bob"], heights = [155,185,150]
输出:["Bob","Alice","Bob"]
解释:第一个 Bob 最高,然后是 Alice 和第二个 Bob 。
提示:
n == names.length == heights.length1 <= n <= 1031 <= names[i].length <= 201 <= heights[i] <= 105names[i]由大小写英文字母组成heights中的所有值互不相同
方法一:排序 · Go 实现
思考
,按身高降序排列姓名即可。身高互不相同,排序关键字唯一。为保持姓名与身高对应,对下标按 降序排序,再按下标取姓名。
根据题目描述,我们可以创建一个长度为 的下标数组 ,其中 。然后我们对 中的每个下标按照 中对应的身高降序排序,最后遍历排序后的 中的每个下标 ,将 加入答案数组即可。
我们也可以创建一个长度为 的数组 ,数组中每个元素是一个二元组 ,然后我们对 按照身高降序排序。最后遍历排序后的 中的每个元素 ,将 加入答案数组即可。
时间复杂度 ,空间复杂度 。其中 是数组 和 的长度。
func sortPeople(names []string, heights []int) (ans []string) {
	n := len(names)
	idx := make([]int, n)
	for i := range idx {
		idx[i] = i
	}
	sort.Slice(idx, func(i, j int) bool { return heights[idx[j]] < heights[idx[i]] })
	for _, i := range idx {
		ans = append(ans, names[i])
	}
	return
}
方法二 · Go 实现
思考
方法一已用下标数组完成排序。也可以把身高与姓名绑成二元组后按身高降序排序,省去显式下标数组,语义相同。
func sortPeople(names []string, heights []int) []string {
	n := len(names)
	arr := make([][2]int, n)
	for i, h := range heights {
		arr[i] = [2]int{h, i}
	}
	sort.Slice(arr, func(i, j int) bool { return arr[i][0] > arr[j][0] })
	ans := make([]string, n)
	for i, x := range arr {
		ans[i] = names[x[1]]
	}
	return ans
}2423. 删除字符使频率相同
题目、示例与约束
给你一个下标从 0 开始的字符串 word ,字符串只包含小写英文字母。你需要选择 一个 下标并 删除 下标处的字符,使得 word 中剩余每个字母出现 频率 相同。
如果删除一个字母后,word 中剩余所有字母的出现频率都相同,那么返回 true ,否则返回 false 。
注意:
- 字母
x的 频率 是这个字母在字符串中出现的次数。 - 你 必须 恰好删除一个字母,不能一个字母都不删除。
示例 1:
输入:word = "abcc"
输出:true
解释:选择下标 3 并删除该字母:word 变成 "abc" 且每个字母出现频率都为 1 。
示例 2:
输入:word = "aazz"
输出:false
解释:我们必须删除一个字母,所以要么 "a" 的频率变为 1 且 "z" 的频率为 2 ,要么两个字母频率反过来。所以不可能让剩余所有字母出现频率相同。
提示:
2 <= word.length <= 100word只包含小写英文字母。
方法一:计数 + 枚举 · Go 实现
思考
,删除哪一个字符可以枚举。频次是否「全部相同」只取决于 个计数,不必每次重扫字符串。
先统计各字母次数,再对每个出现过的字母试减一,看剩余正频次是否恰有一种。还原后试下一个。
我们先用哈希表或者一个长度为 的数组 统计字符串中每个字母出现的次数。
接下来,枚举 个字母,如果字母 在字符串中出现过,我们将其出现次数减一,然后判断剩余的字母出现次数是否相同。如果相同,返回 true,否则将 的出现次数加一,继续枚举下一个字母。
枚举结束,说明无法通过删除一个字母使得剩余字母出现次数相同,返回 false。
时间复杂度 ,空间复杂度 ,其中 为字符串 的长度,而 为字符集的大小,本题中 。
func equalFrequency(word string) bool {
	cnt := [26]int{}
	for _, c := range word {
		cnt[c-'a']++
	}
	for i := range cnt {
		if cnt[i] > 0 {
			cnt[i]--
			x := 0
			ok := true
			for _, v := range cnt {
				if v == 0 {
					continue
				}
				if x > 0 && v != x {
					ok = false
					break
				}
				x = v
			}
			if ok {
				return true
			}
			cnt[i]++
		}
	}
	return false
}2451. 差值数组不同的字符串
题目、示例与约束
给你一个字符串数组 words ,每一个字符串长度都相同,令所有字符串的长度都为 n 。
每个字符串 words[i] 可以被转化为一个长度为 n - 1 的 差值整数数组 difference[i] ,其中对于 0 <= j <= n - 2 有 difference[i][j] = words[i][j+1] - words[i][j] 。注意两个字母的差值定义为它们在字母表中 位置 之差,也就是说 'a' 的位置是 0 ,'b' 的位置是 1 ,'z' 的位置是 25 。
- 比方说,字符串
"acb"的差值整数数组是[2 - 0, 1 - 2] = [2, -1]。
words 中所有字符串 除了一个字符串以外 ,其他字符串的差值整数数组都相同。你需要找到那个不同的字符串。
请你返回 words中 差值整数数组 不同的字符串。
示例 1:
输入:words = ["adc","wzy","abc"]
输出:"abc"
解释:
- "adc" 的差值整数数组是 [3 - 0, 2 - 3] = [3, -1] 。
- "wzy" 的差值整数数组是 [25 - 22, 24 - 25]= [3, -1] 。
- "abc" 的差值整数数组是 [1 - 0, 2 - 1] = [1, 1] 。
不同的数组是 [1, 1],所以返回对应的字符串,"abc"。
示例 2:
输入:words = ["aaa","bob","ccc","ddd"]
输出:"bob"
解释:除了 "bob" 的差值整数数组是 [13, -13] 以外,其他字符串的差值整数数组都是 [0, 0] 。
提示:
3 <= words.length <= 100n == words[i].length2 <= n <= 20words[i]只含有小写英文字母。
方法一:哈希表模拟 · Go 实现
思考
差值数组由相邻字符 ASCII 差构成,除一个单词外其余相同。单词数与长度都很小,把每个差值元组映射到单词列表,长度为 的那一组即答案。
我们用哈希表 维护字符串的差值数组和字符串的映射关系,其中差值数组为字符串的相邻字符的差值构成的数组。由于题目保证了除了一个字符串以外,其他字符串的差值数组都相同,因此我们只需要找到差值数组不同的字符串即可。
时间复杂度 ,空间复杂度 。其中 和 分别为字符串的长度和字符串的个数。
func oddString(words []string) string {
	d := map[string][]string{}
	for _, s := range words {
		m := len(s)
		cs := make([]byte, m-1)
		for i := 0; i < m-1; i++ {
			cs[i] = s[i+1] - s[i]
		}
		t := string(cs)
		d[t] = append(d[t], s)
	}
	for _, ss := range d {
		if len(ss) == 1 {
			return ss[0]
		}
	}
	return ""
}2453. 摧毁一系列目标
题目、示例与约束
给你一个下标从 0 开始的数组 nums ,它包含若干正整数,表示数轴上你需要摧毁的目标所在的位置。同时给你一个整数 space 。
你有一台机器可以摧毁目标。给机器 输入 nums[i] ,这台机器会摧毁所有位置在 nums[i] + c * space 的目标,其中 c 是任意非负整数。你想摧毁 nums 中 尽可能多 的目标。
请你返回在摧毁数目最多的前提下,nums[i] 的 最小值 。
示例 1:
输入:nums = [3,7,8,1,1,5], space = 2
输出:1
解释:如果我们输入 nums[3] ,我们可以摧毁位于 1,3,5,7,9,... 这些位置的目标。
这种情况下, 我们总共可以摧毁 5 个目标(除了 nums[2])。
没有办法摧毁多于 5 个目标,所以我们返回 nums[3] 。
示例 2:
输入:nums = [1,3,5,2,4,6], space = 2
输出:1
解释:输入 nums[0] 或者 nums[3] 都会摧毁 3 个目标。
没有办法摧毁多于 3 个目标。
由于 nums[0] 是最小的可以摧毁 3 个目标的整数,所以我们返回 1 。
示例 3:
输入:nums = [6,2,5], space = 100
输出:2
解释:无论我们输入哪个数字,都只能摧毁 1 个目标。输入的最小整数是 nums[1] 。
提示:
1 <= nums.length <= 1051 <= nums[i] <= 1091 <= space <= 109
方法一:取模 + 枚举 · Go 实现
思考
从种子 出发可摧毁所有 ,即同一余数类。 ,按 计数,次数最多的一类摧毁最多;同类中取最小 作为种子。
我们遍历数组 ,用哈希表 统计每个数模 后的余数出现的次数。次数越多,意味着可以摧毁的目标越多。我们找到最多次数的组,取组中的最小值即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func destroyTargets(nums []int, space int) int {
	cnt := map[int]int{}
	for _, v := range nums {
		cnt[v%space]++
	}
	ans, mx := 0, 0
	for _, v := range nums {
		t := cnt[v%space]
		if t > mx || (t == mx && v < ans) {
			ans = v
			mx = t
		}
	}
	return ans
}2459. 通过移动项目到空白区域来排序数组 🔒
题目、示例与约束
给定一个大小为 n 的整数数组 nums,其中包含从 0 到 n - 1 (包含边界) 的 每个 元素。从 1 到 n - 1 的每一个元素都代表一项目,元素 0 代表一个空白区域。
在一个操作中,您可以将 任何 项目移动到空白区域。如果所有项目的编号都是 升序 的,并且空格在数组的开头或结尾,则认为 nums 已排序。
例如,如果 n = 4,则 nums 按以下条件排序:
nums = [0,1,2,3]或nums = [1,2,3,0]
...否则被认为是无序的。
返回排序 nums 所需的最小操作数。
示例 1:
输入: nums = [4,2,0,3,1]
输出: 3
解释:
- 将项目 2 移动到空白区域。现在,nums =[4,0,2,3,1]。
- 将项目 1 移动到空白区域。现在,nums =[4,1,2,3,0]。
- 将项目 4 移动到空白区域。现在,nums =[0,1,2,3,4]。
可以证明,3 是所需的最小操作数。
示例 2:
输入: nums = [1,2,3,4,0]
输出: 0
解释: nums 已经排序了,所以返回 0。
示例 3:
输入: nums = [1,0,2,4,3]
输出: 2
解释:
- 将项目 2 移动到空白区域。现在,nums =[1,2,0,4,3]。
- 将项目 3 移动到空白区域。现在,nums =[1,2,3,4,0]。
可以证明,2 是所需的最小操作数。
提示:
n == nums.length2 <= n <= 1050 <= nums[i] < nnums的所有值都是 唯一 的。
方法一:置换环 · Go 实现
思考
每次只能与空位交换,本质是置换环上的归位。空位在环内时长度为 的环需 次,否则需 次。目标可以是 或 。
枚举环并按「空位不在环内」累计 ,若空位错位则空位必在某环中,总数减 。两种目标取较小者。
一个长度为 的置换环,如果 在环中,那么交换次数为 ,否则交换次数为 。
我们找到所有置换环,先按照交换次数为 计算总的次数,然后判断 是否错位,若是,说明 在置换环中,那么总的次数减 。
这里 可以在 位置,也可以在 位置,我们取这两种情况的最小值。
时间复杂度 ,空间复杂度 。其中 为数组长度。
func sortArray(nums []int) int {
	n := len(nums)
	f := func(nums []int, k int) int {
		vis := make([]bool, n)
		cnt := 0
		for i, v := range nums {
			if i == v || vis[i] {
				continue
			}
			cnt++
			j := i
			for !vis[j] {
				vis[j] = true
				cnt++
				j = nums[j]
			}
		}
		if nums[k] != k {
			cnt -= 2
		}
		return cnt
	}
	a := f(nums, 0)
	arr := make([]int, n)
	for i, v := range nums {
		arr[i] = (v - 1 + n) % n
	}
	b := f(arr, n-1)
	return min(a, b)
}2475. 数组中不等三元组的数目
题目、示例与约束
给你一个下标从 0 开始的正整数数组 nums 。请你找出并统计满足下述条件的三元组 (i, j, k) 的数目:
0 <= i < j < k < nums.lengthnums[i]、nums[j]和nums[k]两两不同 。- 换句话说:
nums[i] != nums[j]、nums[i] != nums[k]且nums[j] != nums[k]。
- 换句话说:
返回满足上述条件三元组的数目。
示例 1:
输入:nums = [4,4,2,4,3]
输出:3
解释:下面列出的三元组均满足题目条件:
- (0, 2, 4) 因为 4 != 2 != 3
- (1, 2, 4) 因为 4 != 2 != 3
- (2, 3, 4) 因为 2 != 4 != 3
共计 3 个三元组,返回 3 。
注意 (2, 0, 4) 不是有效的三元组,因为 2 > 0 。
示例 2:
输入:nums = [1,1,1,1,1]
输出:0
解释:不存在满足条件的三元组,所以返回 0 。
提示:
3 <= nums.length <= 1001 <= nums[i] <= 1000
方法一:暴力枚举 · Go 实现
思考
,三元组下标有序即可。三重循环比较三数互不相等,约束很小,可以接受。
我们可以直接枚举所有的三元组 ,统计所有符合条件的数量。
时间复杂度 ,其中 为数组 的长度。空间复杂度 。
func unequalTriplets(nums []int) (ans int) {
	n := len(nums)
	for i := 0; i < n; i++ {
		for j := i + 1; j < n; j++ {
			for k := j + 1; k < n; k++ {
				if nums[i] != nums[j] && nums[j] != nums[k] && nums[i] != nums[k] {
					ans++
				}
			}
		}
	}
	return
}
方法二:排序 + 枚举中间元素 + 二分查找 · Go 实现
思考
方法一已是 。排序后相等值相邻:枚举中间下标 ,左侧严格小于 的个数与右侧严格大于的个数之积即贡献。两次二分即可定位边界。
我们也可以先对数组 进行排序。
然后遍历 ,枚举中间元素 ,利用二分查找,在 左侧找到最近的下标 ,使得 成立;在 右侧找到最近的下标 ,使得 成立。那么以 作为中间元素,且符合条件的三元组数量为 ,累加到答案中。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func unequalTriplets(nums []int) (ans int) {
	sort.Ints(nums)
	n := len(nums)
	for j := 1; j < n-1; j++ {
		i := sort.Search(j, func(h int) bool { return nums[h] >= nums[j] }) - 1
		k := sort.Search(n, func(h int) bool { return h > j && nums[h] > nums[j] })
		if i >= 0 && k < n {
			ans += (i + 1) * (n - k)
		}
	}
	return
}
方法三:哈希表 · Go 实现
思考
方法二仍付排序与二分。三元组只要求三值两两不同,与下标无关,故按值计数:枚举中间值的次数 ,左侧已扫过的个数 ,右侧 ,累加 。线性。
我们还可以使用哈希表 来统计数组 中每个元素的数量。
然后遍历哈希表 ,枚举中间元素的个数 ,左侧元素个数记为 ,那么右侧元素个数有 ,此时符合条件的三元组数量为 ,累加到答案中。接着更新 ,继续枚举中间元素的个数 。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func unequalTriplets(nums []int) (ans int) {
	cnt := map[int]int{}
	for _, v := range nums {
		cnt[v]++
	}
	a, n := 0, len(nums)
	for _, b := range cnt {
		c := n - a - b
		ans += a * b * c
		a += b
	}
	return
}2531. 使字符串中不同字符的数目相等
题目、示例与约束
给你两个下标从 0 开始的字符串 word1 和 word2 。
一次 移动 由以下两个步骤组成:
- 选中两个下标
i和j,分别满足0 <= i < word1.length和0 <= j < word2.length, - 交换
word1[i]和word2[j]。
如果可以通过 恰好一次 移动,使 word1 和 word2 中不同字符的数目相等,则返回 true ;否则,返回 false 。
示例 1:
输入:word1 = "ac", word2 = "b"
输出:false
解释:交换任何一组下标都会导致第一个字符串中有 2 个不同的字符,而在第二个字符串中只有 1 个不同字符。
示例 2:
输入:word1 = "abcc", word2 = "aab"
输出:true
解释:交换第一个字符串的下标 2 和第二个字符串的下标 0 。之后得到 word1 = "abac" 和 word2 = "cab" ,各有 3 个不同字符。
示例 3:
输入:word1 = "abcde", word2 = "fghij"
输出:true
解释:无论交换哪一组下标,两个字符串中都会有 5 个不同字符。
提示:
1 <= word1.length, word2.length <= 105word1和word2仅由小写英文字母组成。
方法一:计数 + 枚举 · Go 实现
思考
必须交换恰好一个字符,使两串的不同字母个数相等。字符串很长,但字母只有 种,真正影响答案的是频次而非位置。
先统计两侧频次与种类数 。枚举从第一串拿出的 与从第二串拿出的 :相同则种类不变,只需 ;不同则按“该字母是否因此消失或新出现”修正两侧种类,相等即成功。
我们先用两个长度为 的数组 和 分别记录字符串 和 中每个字符的出现次数。
然后我们分别统计 和 中不同字符的个数,分别记为 和 。
接下来我们枚举 中的每个字符 和 中的每个字符 ,如果 ,那么我们只需要判断 和 是否相等;否则,我们需要判断 和 是否相等。如果相等,那么我们就找到了一种方案,返回 。
如果我们枚举完所有的字符都没有找到合适的方案,那么我们就返回 。
时间复杂度 ,其中 和 分别是字符串 和 的长度,而 是字符集,本题中字符集为小写字母,所以 。
func isItPossible(word1 string, word2 string) bool {
	cnt1 := [26]int{}
	cnt2 := [26]int{}
	x, y := 0, 0
	for _, c := range word1 {
		cnt1[c-'a']++
		if cnt1[c-'a'] == 1 {
			x++
		}
	}
	for _, c := range word2 {
		cnt2[c-'a']++
		if cnt2[c-'a'] == 1 {
			y++
		}
	}
	for i := range cnt1 {
		for j := range cnt2 {
			if cnt1[i] > 0 && cnt2[j] > 0 {
				if i == j {
					if x == y {
						return true
					}
				} else {
					a := x
					if cnt1[i] == 1 {
						a--
					}
					if cnt1[j] == 0 {
						a++
					}

					b := y
					if cnt2[j] == 1 {
						b--
					}
					if cnt2[i] == 0 {
						b++
					}

					if a == b {
						return true
					}
				}
			}
		}
	}
	return false
}2605. 从两个数字数组里生成最小数字
题目、示例与约束
nums1 和 nums2 ,每个数组中的元素 互不相同 ,请你返回 最小 的数字,两个数组都 至少 包含这个数字的某个数位。
示例 1:
输入:nums1 = [4,1,3], nums2 = [5,7]
输出:15
解释:数字 15 的数位 1 在 nums1 中出现,数位 5 在 nums2 中出现。15 是我们能得到的最小数字。
示例 2:
输入:nums1 = [3,5,2,6], nums2 = [3,1,7]
输出:3
解释:数字 3 的数位 3 在两个数组中都出现了。
提示:
1 <= nums1.length, nums2.length <= 91 <= nums1[i], nums2[i] <= 9- 每个数组中,元素 互不相同 。
方法一:枚举 · Go 实现
思考
答案至多两位,且每位分别来自两个数组。两数组长度不超过 ,枚举全部数对即可覆盖「取公共数字」与「拼接两个不同数字」两种形态。
若 则一位数字 优于任何两位;否则比较 与 。全程维护最小值。
我们观察发现,如果数组 和 中有相同的数字,那么相同数字中的最小值一定是最小的数字。否则我们取 中的数字 和 中的数字 ,将 和 拼接成两个数字,取其中较小的数字即可。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 和 的长度。
func minNumber(nums1 []int, nums2 []int) int {
	ans := 100
	for _, a := range nums1 {
		for _, b := range nums2 {
			if a == b {
				ans = min(ans, a)
			} else {
				ans = min(ans, min(a*10+b, b*10+a))
			}
		}
	}
	return ans
}
方法二:哈希表或数组 + 枚举 · Go 实现
思考
方法一对每个数对都比较一次。公共数字一旦存在,最小公共值就是答案,不必再看拼接;若不存在,只需两侧最小值拼接。
用集合求交后取 ,或直接取 与 拼接,将双重循环降为线性扫描。
我们可以用哈希表或数组记录数组 和 中的数字,然后枚举 ,如果 在两个数组中都出现了,那么 就是最小的数字。否则我们取 中的数字 和 中的数字 ,将 和 拼接成两个数字,取其中较小的数字即可。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 和 的长度;而 是数组 和 中数字的范围,本题中 。
func minNumber(nums1 []int, nums2 []int) int {
	s1 := [10]bool{}
	s2 := [10]bool{}
	for _, x := range nums1 {
		s1[x] = true
	}
	for _, x := range nums2 {
		s2[x] = true
	}
	a, b := 0, 0
	for i := 1; i < 10; i++ {
		if s1[i] && s2[i] {
			return i
		}
		if a == 0 && s1[i] {
			a = i
		}
		if b == 0 && s2[i] {
			b = i
		}
	}
	return min(a*10+b, b*10+a)
}
方法三:位运算 · Go 实现
思考
数字只在 到 ,集合可用位掩码代替。两掩码按位与非空则最低位置即最小公共数字;否则分别取两侧最低位拼接。
与方法二同一观察,只是把哈希集合换成常数空间的位运算。
由于数字的范围是 ,我们可以用一个长度为 的二进制数来表示数组 和 中的数字。我们用 表示数组 中的数字,用 表示数组 中的数字。
如果 和 进行按位与得到的数字 不等于 ,那么我们提取 中最后一位 所在的位置,即为最小的数字。
否则,我们分别提取 和 中最后一位 所在的位置,分别记为 和 ,那么最小的数字就是 。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 和 的长度。
func minNumber(nums1 []int, nums2 []int) int {
	var mask1, mask2 uint
	for _, x := range nums1 {
		mask1 |= 1 << x
	}
	for _, x := range nums2 {
		mask2 |= 1 << x
	}
	if mask := mask1 & mask2; mask != 0 {
		return bits.TrailingZeros(mask)
	}
	a, b := bits.TrailingZeros(mask1), bits.TrailingZeros(mask2)
	return min(a*10+b, b*10+a)
}2610. 转换二维数组
题目、示例与约束
给你一个整数数组 nums 。请你创建一个满足以下条件的二维数组:
- 二维数组应该 只 包含数组
nums中的元素。 - 二维数组中的每一行都包含 不同 的整数。
- 二维数组的行数应尽可能 少 。
返回结果数组。如果存在多种答案,则返回其中任何一种。
请注意,二维数组的每一行上可以存在不同数量的元素。
示例 1:
输入:nums = [1,3,4,1,2,3,1]
输出:[[1,3,4,2],[1,3],[1]]
解释:根据题目要求可以创建包含以下几行元素的二维数组:
- 1,3,4,2
- 1,3
- 1
nums 中的所有元素都有用到,并且每一行都由不同的整数组成,所以这是一个符合题目要求的答案。
可以证明无法创建少于三行且符合题目要求的二维数组。
示例 2:
输入:nums = [1,2,3,4]
输出:[[4,3,2,1]]
解释:nums 中的所有元素都不同,所以我们可以将其全部保存在二维数组中的第一行。
提示:
1 <= nums.length <= 2001 <= nums[i] <= nums.length
方法一:数组或哈希表 · Go 实现
思考
同一行不得出现重复值,行数应尽量少。出现次数最多的值决定最少行数,若按行贪心放置,需反复查找当前行是否已含该值。 尚可,但次数已知时不必搜索。
值 出现 次时,必然占用前 行各一次。按频次把 依次写入第 行,即可同时满足无重复与行数最少。
我们先用一个数组或者哈希表 统计数组 中每个元素出现的次数。
然后遍历 ,对于每个元素 ,我们将其添加到答案列表中的第 行,第 行,第 行,...,第 行。
最后返回答案列表即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func findMatrix(nums []int) (ans [][]int) {
	n := len(nums)
	cnt := make([]int, n+1)
	for _, x := range nums {
		cnt[x]++
	}
	for x, v := range cnt {
		for j := 0; j < v; j++ {
			if len(ans) <= j {
				ans = append(ans, []int{})
			}
			ans[j] = append(ans[j], x)
		}
	}
	return
}2661. 找出叠涂元素
题目、示例与约束
给你一个下标从 0 开始的整数数组 arr 和一个 m x n 的整数 矩阵 mat 。arr 和 mat 都包含范围 [1,m * n] 内的 所有 整数。
从下标 0 开始遍历 arr 中的每个下标 i ,并将包含整数 arr[i] 的 mat 单元格涂色。
请你找出 arr 中第一个使得 mat 的某一行或某一列都被涂色的元素,并返回其下标 i 。
示例 1:
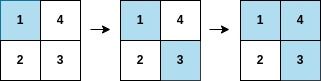
输入:arr = [1,3,4,2], mat = [[1,4],[2,3]]
输出:2
解释:遍历如上图所示,arr[2] 在矩阵中的第一行或第二列上都被涂色。
示例 2:
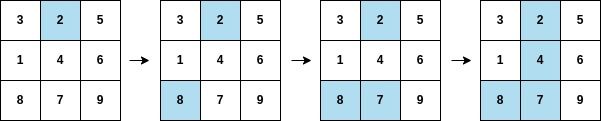
输入:arr = [2,8,7,4,1,3,5,6,9], mat = [[3,2,5],[1,4,6],[8,7,9]]
输出:3
解释:遍历如上图所示,arr[3] 在矩阵中的第二列上都被涂色。
提示:
m == mat.lengthn = mat[i].lengtharr.length == m * n1 <= m, n <= 1051 <= m * n <= 1051 <= arr[i], mat[r][c] <= m * narr中的所有整数 互不相同mat中的所有整数 互不相同
方法一:哈希表 + 数组计数 · Go 实现
思考
按 顺序涂色,问何时首次出现整行或整列涂满。每次检查整行整列, 时会重复扫描。
先把每个值映射到坐标,再用行、列计数:涂到 则对应计数加一,达到列数或行数即完成。第一次满足时的下标即答案。
我们用一个哈希表 记录每个元素在矩阵 中的位置,即 ,定义两个数组 和 分别记录每行和每列已经涂色的元素个数。
遍历数组 ,对于每个元素 ,我们找到其在矩阵 中的位置 ,然后将 和 分别加一,如果 或 ,说明第 行或第 列已经被涂色,那么 就是我们要找的元素,返回 即可。
时间复杂度 ,空间复杂度 。其中 和 分别是矩阵 的行数和列数。
func firstCompleteIndex(arr []int, mat [][]int) int {
	m, n := len(mat), len(mat[0])
	idx := map[int][2]int{}
	for i := range mat {
		for j := range mat[i] {
			idx[mat[i][j]] = [2]int{i, j}
		}
	}
	row := make([]int, m)
	col := make([]int, n)
	for k := 0; ; k++ {
		x := idx[arr[k]]
		i, j := x[0], x[1]
		row[i]++
		col[j]++
		if row[i] == n || col[j] == m {
			return k
		}
	}
}2670. 找出不同元素数目差数组
题目、示例与约束
给你一个下标从 0 开始的数组 nums ,数组长度为 n 。
nums 的 不同元素数目差 数组可以用一个长度为 n 的数组 diff 表示,其中 diff[i] 等于前缀 nums[0, ..., i] 中不同元素的数目 减去 后缀 nums[i + 1, ..., n - 1] 中不同元素的数目。
返回 nums 的 不同元素数目差 数组。
注意 nums[i, ..., j] 表示 nums 的一个从下标 i 开始到下标 j 结束的子数组(包含下标 i 和 j 对应元素)。特别需要说明的是,如果 i > j ,则 nums[i, ..., j] 表示一个空子数组。
示例 1:
输入:nums = [1,2,3,4,5]
输出:[-3,-1,1,3,5]
解释:
对于 i = 0,前缀中有 1 个不同的元素,而在后缀中有 4 个不同的元素。因此,diff[0] = 1 - 4 = -3 。
对于 i = 1,前缀中有 2 个不同的元素,而在后缀中有 3 个不同的元素。因此,diff[1] = 2 - 3 = -1 。
对于 i = 2,前缀中有 3 个不同的元素,而在后缀中有 2 个不同的元素。因此,diff[2] = 3 - 2 = 1 。
对于 i = 3,前缀中有 4 个不同的元素,而在后缀中有 1 个不同的元素。因此,diff[3] = 4 - 1 = 3 。
对于 i = 4,前缀中有 5 个不同的元素,而在后缀中有 0 个不同的元素。因此,diff[4] = 5 - 0 = 5 。
示例 2:
输入:nums = [3,2,3,4,2]
输出:[-2,-1,0,2,3]
解释:
对于 i = 0,前缀中有 1 个不同的元素,而在后缀中有 3 个不同的元素。因此,diff[0] = 1 - 3 = -2 。
对于 i = 1,前缀中有 2 个不同的元素,而在后缀中有 3 个不同的元素。因此,diff[1] = 2 - 3 = -1 。
对于 i = 2,前缀中有 2 个不同的元素,而在后缀中有 2 个不同的元素。因此,diff[2] = 2 - 2 = 0 。
对于 i = 3,前缀中有 3 个不同的元素,而在后缀中有 1 个不同的元素。因此,diff[3] = 3 - 1 = 2 。
对于 i = 4,前缀中有 3 个不同的元素,而在后缀中有 0 个不同的元素。因此,diff[4] = 3 - 0 = 3 。
提示:
1 <= n == nums.length <= 501 <= nums[i] <= 50
方法一:哈希表 + 预处理后缀 · Go 实现
思考
每位要前缀不同数减后缀不同数。若每个 都重建两个集合, 勉强,但重复计数可预处理。
先自右向左用集合得到后缀不同数 ,再自左向右维护前缀集合,答案为 。
我们可以预处理出一个后缀数组 ,其中 表示后缀 中不同元素的数目,在预处理过程中,我们使用一个哈希表 来维护后缀中出现过的元素,这样我们就可以在 的时间内查询后缀中不同元素的数目。
预处理完后缀数组 后,我们清空哈希表 ,然后再次遍历数组 ,用哈希表 来维护前缀中出现过的元素,那么位置 的答案就是 中不同元素的数目减去 ,即 。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func distinctDifferenceArray(nums []int) []int {
	n := len(nums)
	suf := make([]int, n+1)
	s := map[int]bool{}
	for i := n - 1; i >= 0; i-- {
		s[nums[i]] = true
		suf[i] = len(s)
	}
	ans := make([]int, n)
	s = map[int]bool{}
	for i, x := range nums {
		s[x] = true
		ans[i] = len(s) - suf[i+1]
	}
	return ans
}2682. 找出转圈游戏输家
题目、示例与约束
n 个朋友在玩游戏。这些朋友坐成一个圈,按 顺时针方向 从 1 到 n 编号。准确的说,从第 i 个朋友的位置开始顺时针移动 1 步会到达第 (i + 1) 个朋友的位置(1 <= i < n),而从第 n 个朋友的位置开始顺时针移动 1 步会回到第 1 个朋友的位置。
游戏规则如下:
第 1 个朋友接球。
- 接着,第
1个朋友将球传给距离他顺时针方向k步的朋友。 - 然后,接球的朋友应该把球传给距离他顺时针方向
2 * k步的朋友。 - 接着,接球的朋友应该把球传给距离他顺时针方向
3 * k步的朋友,以此类推。
换句话说,在第 i 轮中持有球的那位朋友需要将球传递给距离他顺时针方向 i * k 步的朋友。
当某个朋友第 2 次接到球时,游戏结束。
在整场游戏中没有接到过球的朋友是 输家 。
给你参与游戏的朋友数量 n 和一个整数 k ,请按升序排列返回包含所有输家编号的数组 answer 作为答案。
示例 1:
输入:n = 5, k = 2
输出:[4,5]
解释:以下为游戏进行情况:
1)第 1 个朋友接球,第 1 个朋友将球传给距离他顺时针方向 2 步的玩家 —— 第 3 个朋友。
2)第 3 个朋友将球传给距离他顺时针方向 4 步的玩家 —— 第 2 个朋友。
3)第 2 个朋友将球传给距离他顺时针方向 6 步的玩家 —— 第 3 个朋友。
4)第 3 个朋友接到两次球,游戏结束。
示例 2:
输入:n = 4, k = 4
输出:[2,3,4]
解释:以下为游戏进行情况:
1)第 1 个朋友接球,第 1 个朋友将球传给距离他顺时针方向 4 步的玩家 —— 第 1 个朋友。
2)第 1 个朋友接到两次球,游戏结束。
提示:
1 <= k <= n <= 50
方法一:模拟 · Go 实现
思考
按步长 在环上传球,直至某人第二次接到。 ,模拟到重复即可。访问数组标记接过球的人,循环结束时未标记者即输家,编号改回 起。
我们用一个数组 vis 记录每个朋友是否接到过球,初始时所有朋友都没有接到过球。然后我们按照题目描述的规则模拟游戏的过程,直到某个朋友第二次接到球为止。
在模拟过程中,我们用两个变量 和 分别表示当前持球的朋友编号和当前传球的步长。初始时 ,表示第一个朋友接到球。每次传球时,我们将 更新为 ,表示下一个接球的朋友编号,然后将 更新为 ,表示下一次传球的步长。当某个朋友第二次接到球时,游戏结束。
最后我们遍历数组 vis,将没有接到过球的朋友编号加入答案数组中即可。
时间复杂度 ,空间复杂度 。其中 是朋友的数量。
func circularGameLosers(n int, k int) (ans []int) {
	vis := make([]bool, n)
	for i, p := 0, 1; !vis[i]; p++ {
		vis[i] = true
		i = (i + p*k) % n
	}
	for i, x := range vis {
		if !x {
			ans = append(ans, i+1)
		}
	}
	return
}继续阅读
- 实践案例
- 实践案例
- 实践案例