
LeetCode Go · 哈希表(4)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
1781. 所有子字符串美丽值之和
题目、示例与约束
一个字符串的 美丽值 定义为:出现频率最高字符与出现频率最低字符的出现次数之差。
- 比方说,
"abaacc"的美丽值为3 - 1 = 2。
给你一个字符串 s ,请你返回它所有子字符串的 美丽值 之和。
示例 1:
输入:s = "aabcb"
输出:5
解释:美丽值不为零的字符串包括 ["aab","aabc","aabcb","abcb","bcb"] ,每一个字符串的美丽值都为 1 。
示例 2:
输入:s = "aabcbaa"
输出:17
提示:
1 <= s.length <= 500s只包含小写英文字母。
方法一:枚举 + 计数 · Go 实现
思考
子串美丽值是最高频减去最低频。 ,枚举全部 个子串可行。
固定左端,向右加入字符并维护计数表,每次用 累加。
枚举每个子串的起点位置 ,找到以该起点位置的字符为左端点的所有子串,然后计算每个子串的美丽值,累加到答案中。
时间复杂度 ,空间复杂度 。其中 为字符串的长度,而 为字符集的大小。本题中 。
func beautySum(s string) (ans int) {
	for i := range s {
		cnt := [26]int{}
		for j := i; j < len(s); j++ {
			cnt[s[j]-'a']++
			mi, mx := 1000, 0
			for _, v := range cnt {
				if v > 0 {
					if mi > v {
						mi = v
					}
					if mx < v {
						mx = v
					}
				}
			}
			ans += mx - mi
		}
	}
	return
}
方法二 · Go 实现
思考
方法一每次扫描计数表取最大最小。再维护频次的频次,以及当前 ,加入字符后 调整两端,省去内层对 的扫描。
func beautySum(s string) (ans int) {
	n := len(s)
	for i := 0; i < n; i++ {
		cnt := [26]int{}
		freq := map[int]int{}
		mi, mx := 1, 1
		for j := i; j < n; j++ {
			k := int(s[j] - 'a')
			freq[cnt[k]]--
			cnt[k]++
			freq[cnt[k]]++

			if cnt[k] == 1 {
				mi = 1
			}
			if freq[mi] == 0 {
				mi++
			}
			if cnt[k] > mx {
				mx = cnt[k]
			}
			ans += mx - mi
		}
	}
	return
}1790. 仅执行一次字符串交换能否使两个字符串相等
题目、示例与约束
给你长度相等的两个字符串 s1 和 s2 。一次 字符串交换 操作的步骤如下:选出某个字符串中的两个下标(不必不同),并交换这两个下标所对应的字符。
如果对 其中一个字符串 执行 最多一次字符串交换 就可以使两个字符串相等,返回 true ;否则,返回 false 。
示例 1:
输入:s1 = "bank", s2 = "kanb"
输出:true
解释:例如,交换 s2 中的第一个和最后一个字符可以得到 "bank"
示例 2:
输入:s1 = "attack", s2 = "defend"
输出:false
解释:一次字符串交换无法使两个字符串相等
示例 3:
输入:s1 = "kelb", s2 = "kelb"
输出:true
解释:两个字符串已经相等,所以不需要进行字符串交换
示例 4:
输入:s1 = "abcd", s2 = "dcba"
输出:false
提示:
1 <= s1.length, s2.length <= 100s1.length == s2.lengths1和s2仅由小写英文字母组成
方法一:计数 · Go 实现
思考
至多交换 中两个位置使其等于 。差异位置只能是 个(已相等)或 个(正好互换)。
扫描记下至多两处不同的字符对:超过两处,或第二处不能与第一处对调,则失败。恰好一处不同也无法靠一次交换修复。
我们用变量 记录两个字符串中相同位置字符不同的个数,两个字符串若满足题目要求,那么 一定为 或 。另外用两个字符变量 和 记录两个字符串中相同位置字符不同的字符。
同时遍历两个字符串,对于相同位置的两个字符 和 ,如果 ,那么 自增 。如果此时 大于 ,或者 为 且 或 ,那么直接返回 false。注意记录一下 和 。
遍历结束,若 ,返回 true。
时间复杂度 ,其中 为字符串长度。空间复杂度 。
func areAlmostEqual(s1 string, s2 string) bool {
	cnt := 0
	var c1, c2 byte
	for i := range s1 {
		a, b := s1[i], s2[i]
		if a != b {
			cnt++
			if cnt > 2 || (cnt == 2 && (a != c2 || b != c1)) {
				return false
			}
			c1, c2 = a, b
		}
	}
	return cnt != 1
}1796. 字符串中第二大的数字
题目、示例与约束
给你一个混合字符串 s ,请你返回 s 中 第二大 的数字,如果不存在第二大的数字,请你返回 -1 。
混合字符串 由小写英文字母和数字组成。
示例 1:
输入:s = "dfa12321afd"
输出:2
解释:出现在 s 中的数字包括 [1, 2, 3] 。第二大的数字是 2 。
示例 2:
输入:s = "abc1111"
输出:-1
解释:出现在 s 中的数字只包含 [1] 。没有第二大的数字。
提示:
1 <= s.length <= 500s只包含小写英文字母和(或)数字。
方法一:一次遍历 · Go 实现
思考
只要数字中严格第二大的值,没有则 。一遍扫描维护最大 与次大 即可。
遇到更大数字则次大接过原最大;介于两者之间则只更新次大。
我们定义 和 分别表示字符串中出现的最大数字和第二大数字,初始时 。
遍历字符串 ,如果当前字符是数字,我们将其转换为数字 ,如果 ,说明 是当前出现的最大数字,我们将 更新为 ,并将 更新为 ;如果 ,说明 是当前出现的第二大数字,我们将 更新为 。
遍历结束,返回 即可。
时间复杂度 ,其中 为字符串 的长度。空间复杂度 。
func secondHighest(s string) int {
	a, b := -1, -1
	for _, c := range s {
		if c >= '0' && c <= '9' {
			v := int(c - '0')
			if v > a {
				b, a = a, v
			} else if v > b && v < a {
				b = v
			}
		}
	}
	return b
}
方法二:位运算 · Go 实现
思考
也可以用十位掩码记录出现过的数字,再从高位找第二个置位,不必同时维护两个变量。
我们可以用一个整数 来标识字符串中出现的数字,其中 的第 位表示数字 是否出现过。
遍历字符串 ,如果当前字符是数字,我们将其转换为数字 ,将 的第 个二进制位的值置为 。
最后,我们从高位向低位遍历 ,找到第二个为 的二进制位,其对应的数字即为第二大数字。如果不存在第二大数字,返回 。
时间复杂度 ,其中 为字符串 的长度。空间复杂度 。
func secondHighest(s string) int {
	mask := 0
	for _, c := range s {
		if c >= '0' && c <= '9' {
			mask |= 1 << int(c-'0')
		}
	}
	for i, cnt := 9, 0; i >= 0; i-- {
		if mask>>i&1 == 1 {
			cnt++
			if cnt == 2 {
				return i
			}
		}
	}
	return -1
}1805. 字符串中不同整数的数目
题目、示例与约束
给你一个字符串 word ,该字符串由数字和小写英文字母组成。
请你用空格替换每个不是数字的字符。例如,"a123bc34d8ef34" 将会变成 " 123 34 8 34" 。注意,剩下的这些整数为(相邻彼此至少有一个空格隔开):"123"、"34"、"8" 和 "34" 。
返回对 word 完成替换后形成的 不同 整数的数目。
只有当两个整数的 不含前导零 的十进制表示不同, 才认为这两个整数也不同。
示例 1:
输入:word = "a123bc34d8ef34"
输出:3
解释:不同的整数有 "123"、"34" 和 "8" 。注意,"34" 只计数一次。
示例 2:
输入:word = "leet1234code234"
输出:2
示例 3:
输入:word = "a1b01c001"
输出:1
解释:"1"、"01" 和 "001" 视为同一个整数的十进制表示,因为在比较十进制值时会忽略前导零的存在。
提示:
1 <= word.length <= 1000word由数字和小写英文字母组成
方法一:双指针 + 模拟 · Go 实现
思考
需要统计字符串中由数字组成的整数种类,且前导零不改变数值。若先抽出全部数字段再转成整数,段长可达整个串,会溢出。
用双指针划出每一段连续数字,先跳过前导零,再把剩余子串(全零时为空串)放入哈希集合。集合大小即为不同整数的个数,全程只需线性扫描,不必做数值转换。
遍历字符串 word,找到每个整数的起始位置和结束位置,截取出这一个子串,将其存入哈希表 中。
遍历结束,返回哈希表 的大小即可。
注意,每个子串所表示的整数可能很大,我们不能直接将其转为整数。因此,我们可以去掉每个子串的前导零之后,再存入哈希表。
时间复杂度 ,空间复杂度 。其中 为字符串 word 的长度。
func numDifferentIntegers(word string) int {
	s := map[string]struct{}{}
	n := len(word)
	for i := 0; i < n; i++ {
		if word[i] >= '0' && word[i] <= '9' {
			for i < n && word[i] == '0' {
				i++
			}
			j := i
			for j < n && word[j] >= '0' && word[j] <= '9' {
				j++
			}
			s[word[i:j]] = struct{}{}
			i = j
		}
	}
	return len(s)
}1807. 替换字符串中的括号内容
题目、示例与约束
给你一个字符串 s ,它包含一些括号对,每个括号中包含一个 非空 的键。
- 比方说,字符串
"(name)is(age)yearsold"中,有 两个 括号对,分别包含键"name"和"age"。
你知道许多键对应的值,这些关系由二维字符串数组 knowledge 表示,其中 knowledge[i] = [keyi, valuei] ,表示键 keyi 对应的值为 valuei 。
你需要替换 所有 的括号对。当你替换一个括号对,且它包含的键为 keyi 时,你需要:
- 将
keyi和括号用对应的值valuei替换。 - 如果从
knowledge中无法得知某个键对应的值,你需要将keyi和括号用问号"?"替换(不需要引号)。
knowledge 中每个键最多只会出现一次。s 中不会有嵌套的括号。
请你返回替换 所有 括号对后的结果字符串。
示例 1:
输入:s = "(name)is(age)yearsold", knowledge = [["name","bob"],["age","two"]]
输出:"bobistwoyearsold"
解释:
键 "name" 对应的值为 "bob" ,所以将 "(name)" 替换为 "bob" 。
键 "age" 对应的值为 "two" ,所以将 "(age)" 替换为 "two" 。
示例 2:
输入:s = "hi(name)", knowledge = [["a","b"]]
输出:"hi?"
解释:由于不知道键 "name" 对应的值,所以用 "?" 替换 "(name)" 。
示例 3:
输入:s = "(a)(a)(a)aaa", knowledge = [["a","yes"]]
输出:"yesyesyesaaa"
解释:相同的键在 s 中可能会出现多次。
键 "a" 对应的值为 "yes" ,所以将所有的 "(a)" 替换为 "yes" 。
注意,不在括号里的 "a" 不需要被替换。
提示:
1 <= s.length <= 1050 <= knowledge.length <= 105knowledge[i].length == 21 <= keyi.length, valuei.length <= 10s只包含小写英文字母和圆括号'('和')'。s中每一个左圆括号'('都有对应的右圆括号')'。s中每对括号内的键都不会为空。s中不会有嵌套括号对。keyi和valuei只包含小写英文字母。knowledge中的keyi不会重复。
方法一:哈希表 + 模拟 · Go 实现
思考
括号对中的键需要替换为知识库中的值,缺失则改为
'?'。若对每个括号都线性扫描 ,在串长与词条数均达 时会超时。先把 建成哈希表,再从左到右扫描 :遇
'('找到匹配的')',用键查询表并写入答案;其余字符原样追加。每个字符访问常数次,替换在期望 内完成。
我们先用哈希表 记录 knowledge 中的键值对。
然后遍历字符串 ,如果当前字符是左括号 '(',则从当前位置开始向后遍历,直到遇到右括号 ')',此时括号内的字符串即为键,我们在哈希表 中查找该键对应的值,如果找到了,则将该值替换到括号内,否则替换为 '?'。
时间复杂度 ,空间复杂度 。其中 和 分别为字符串 和列表 knowledge 的长度,而 为 knowledge 中所有字符串的长度之和。
func evaluate(s string, knowledge [][]string) string {
	d := map[string]string{}
	for _, v := range knowledge {
		d[v[0]] = v[1]
	}
	var ans strings.Builder
	for i := 0; i < len(s); i++ {
		if s[i] == '(' {
			j := i + 1
			for s[j] != ')' {
				j++
			}
			if v, ok := d[s[i+1:j]]; ok {
				ans.WriteString(v)
			} else {
				ans.WriteByte('?')
			}
			i = j
		} else {
			ans.WriteByte(s[i])
		}
	}
	return ans.String()
}1817. 查找用户活跃分钟数
题目、示例与约束
给你用户在 LeetCode 的操作日志,和一个整数 k 。日志用一个二维整数数组 logs 表示,其中每个 logs[i] = [IDi, timei] 表示 ID 为 IDi 的用户在 timei 分钟时执行了某个操作。
多个用户 可以同时执行操作,单个用户可以在同一分钟内执行 多个操作 。
指定用户的 用户活跃分钟数(user active minutes,UAM) 定义为用户对 LeetCode 执行操作的 唯一分钟数 。 即使一分钟内执行多个操作,也只能按一分钟计数。
请你统计用户活跃分钟数的分布情况,统计结果是一个长度为 k 且 下标从 1 开始计数 的数组 answer ,对于每个 j(1 <= j <= k),answer[j] 表示 用户活跃分钟数 等于 j 的用户数。
返回上面描述的答案数组 answer 。
示例 1:
输入:logs = [[0,5],[1,2],[0,2],[0,5],[1,3]], k = 5
输出:[0,2,0,0,0]
解释:
ID=0 的用户执行操作的分钟分别是:5 、2 和 5 。因此,该用户的用户活跃分钟数为 2(分钟 5 只计数一次)
ID=1 的用户执行操作的分钟分别是:2 和 3 。因此,该用户的用户活跃分钟数为 2
2 个用户的用户活跃分钟数都是 2 ,answer[2] 为 2 ,其余 answer[j] 的值都是 0
示例 2:
输入:logs = [[1,1],[2,2],[2,3]], k = 4
输出:[1,1,0,0]
解释:
ID=1 的用户仅在分钟 1 执行单个操作。因此,该用户的用户活跃分钟数为 1
ID=2 的用户执行操作的分钟分别是:2 和 3 。因此,该用户的用户活跃分钟数为 2
1 个用户的用户活跃分钟数是 1 ,1 个用户的用户活跃分钟数是 2
因此,answer[1] = 1 ,answer[2] = 1 ,其余的值都是 0
提示:
1 <= logs.length <= 1040 <= IDi <= 1091 <= timei <= 105k的取值范围是[用户的最大用户活跃分钟数, 105]
方法一:哈希表 · Go 实现
思考
UAM 是用户在不同分钟上操作的去重次数,要按该次数统计有多少用户。同一用户同一分钟可能多次出现,若不去重会把次数算大。
用哈希表把每个用户映射到操作时间的集合,集合大小即其 UAM。再按 下标写入长度为 的答案数组。日志扫描一遍即可。
我们用哈希表 记录每个用户的所有去重操作时间,然后遍历哈希表,统计每个用户的用户活跃分钟数,最后统计每个用户活跃分钟数的分布情况。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func findingUsersActiveMinutes(logs [][]int, k int) []int {
	d := map[int]map[int]bool{}
	for _, log := range logs {
		i, t := log[0], log[1]
		if _, ok := d[i]; !ok {
			d[i] = make(map[int]bool)
		}
		d[i][t] = true
	}
	ans := make([]int, k)
	for _, ts := range d {
		ans[len(ts)-1]++
	}
	return ans
}1832. 判断句子是否为全字母句
题目、示例与约束
全字母句 指包含英语字母表中每个字母至少一次的句子。
给你一个仅由小写英文字母组成的字符串 sentence ,请你判断 sentence 是否为 全字母句 。
如果是,返回 true ;否则,返回 false 。
示例 1:
输入:sentence = "thequickbrownfoxjumpsoverthelazydog"
输出:true
解释:sentence 包含英语字母表中每个字母至少一次。
示例 2:
输入:sentence = "leetcode"
输出:false
提示:
1 <= sentence.length <= 1000sentence由小写英语字母组成
方法一:数组或哈希表 · Go 实现
思考
判断句子是否包含全部 个小写字母。线性扫描即可,关键是如何记录出现过的字母。
把字符放入集合,最后看大小是否为 。集合去重后长度恰好对应字母种类。
遍历字符串 sentence,用数组或哈希表记录出现过的字母,最后判断数组或哈希表中是否有 个字母即可。
时间复杂度 ,空间复杂度 。其中 为字符串 sentence 的长度,而 为字符集大小。本题中 。
func checkIfPangram(sentence string) bool {
	vis := [26]bool{}
	for _, c := range sentence {
		vis[c-'a'] = true
	}
	for _, v := range vis {
		if !v {
			return false
		}
	}
	return true
}
方法二:位运算 · Go 实现
思考
方法一使用哈希集合,额外空间随字符集变化。字母只有 个,可用整数 的第 位标记字母 是否出现,最后判断是否等于 ,空间降为常数。
我们也可以用一个整数 记录出现过的字母,其中 的第 位表示第 个字母是否出现过。
最后判断 的二进制表示中是否有 个 ,也即判断 是否等于 。若是,返回 true,否则返回 false。
时间复杂度 ,其中 为字符串 sentence 的长度。空间复杂度 。
func checkIfPangram(sentence string) bool {
	mask := 0
	for _, c := range sentence {
		mask |= 1 << int(c-'a')
	}
	return mask == 1<<26-1
}1897. 重新分配字符使所有字符串都相等
题目、示例与约束
给你一个字符串数组 words(下标 从 0 开始 计数)。
在一步操作中,需先选出两个 不同 下标 i 和 j,其中 words[i] 是一个非空字符串,接着将 words[i] 中的 任一 字符移动到 words[j] 中的 任一 位置上。
如果执行任意步操作可以使 words 中的每个字符串都相等,返回 true ;否则,返回 false 。
示例 1:
输入:words = ["abc","aabc","bc"] 输出:true 解释:将words[1] 中的第一个'a' 移动到words[2] 的最前面。 使words[1]= "abc" 且 words[2] = "abc" 。 所有字符串都等于 "abc" ,所以返回true。
示例 2:
输入:words = ["ab","a"]
输出:false
解释:执行操作无法使所有字符串都相等。
提示:
1 <= words.length <= 1001 <= words[i].length <= 100words[i]由小写英文字母组成
方法一:计数 · Go 实现
思考
可在单词之间任意搬移字符,问能否使所有单词相同。最终每个单词拿到的字符多重集必须一样,故每种字符的总数须能被单词数整除。
统计全部字符频次,检查每个频次是否为 的倍数。
根据题目描述,只要每个字符的出现次数能被字符串数组的长度整除,就可以通过移动字符使所有字符串相等。
因此,我们用哈希表或者一个长度为 的整数数组 统计每个字符出现的次数,最后判断是否每个字符的出现次数能被字符串数组的长度整除即可。
时间复杂度 ,空间复杂度 。其中 为数组 中所有字符串的长度之和,而 为字符集,这里为小写字母集合,所以 。
func makeEqual(words []string) bool {
	cnt := [26]int{}
	for _, w := range words {
		for _, c := range w {
			cnt[c-'a']++
		}
	}
	n := len(words)
	for _, v := range cnt {
		if v%n != 0 {
			return false
		}
	}
	return true
}1935. 可以输入的最大单词数
题目、示例与约束
键盘出现了一些故障,有些字母键无法正常工作。而键盘上所有其他键都能够正常工作。
给你一个由若干单词组成的字符串 text ,单词间由单个空格组成(不含前导和尾随空格);另有一个字符串 brokenLetters ,由所有已损坏的不同字母键组成,返回你可以使用此键盘完全输入的 text 中单词的数目。
示例 1:
输入:text = "hello world", brokenLetters = "ad"
输出:1
解释:无法输入 "world" ,因为字母键 'd' 已损坏。
示例 2:
输入:text = "leet code", brokenLetters = "lt"
输出:1
解释:无法输入 "leet" ,因为字母键 'l' 和 't' 已损坏。
示例 3:
输入:text = "leet code", brokenLetters = "e"
输出:0
解释:无法输入任何单词,因为字母键 'e' 已损坏。
提示:
1 <= text.length <= 1040 <= brokenLetters.length <= 26text由若干用单个空格分隔的单词组成,且不含任何前导和尾随空格- 每个单词仅由小写英文字母组成
brokenLetters由 互不相同 的小写英文字母组成
方法一:数组或哈希表 · Go 实现
思考
一个单词能打出,当且仅当它不含任何损坏字母。先把损坏字母放入集合,再对 按空格分词。
对每个词检查全部字符均不在集合中,计数即可。字母表大小为常数,总时间与文本长度线性。
我们可以用哈希表或者一个长度为 的数组 来记录所有损坏的字母键。
然后,我们遍历字符串 中的每个单词 ,如果 中的某个字母 在 中出现过,那么说明这个单词无法输入,答案不需要加一,否则答案需要加一。
遍历结束后,返回答案即可。
时间复杂度 ,空间复杂度 ,其中 是字符串 的长度,而 是字母表的大小,本题中 。
func canBeTypedWords(text string, brokenLetters string) (ans int) {
	s := [26]bool{}
	for _, c := range brokenLetters {
		s[c-'a'] = true
	}
	for _, w := range strings.Split(text, " ") {
		for _, c := range w {
			if s[c-'a'] {
				ans--
				break
			}
		}
		ans++
	}
	return
}1940. 排序数组之间的最长公共子序列 🔒
题目、示例与约束
给定一个由整数数组组成的数组 arrays,其中 arrays[i] 是 严格递增 排序的,返回一个 所有 数组均包含的 最长公共子序列 的整数数组。
子序列 是从另一个序列派生出来的序列,删除一些元素或不删除任何元素,而不改变其余元素的顺序。
示例1:
输入: arrays = [[1,3,4],
               [1,4,7,9]]
输出: [1,4]
解释: 这两个数组中的最长子序列是[1,4]。
示例 2:
输入: arrays = [[2,3,6,8],
               [1,2,3,5,6,7,10],
               [2,3,4,6,9]]
输出: [2,3,6]
解释: 这三个数组中的最长子序列是 [2,3,6]。
示例 3:
输入: arrays = [[1,2,3,4,5],
               [6,7,8]]
输出: []
解释: 这两个数组之间没有公共子序列。
限制条件:
2 <= arrays.length <= 1001 <= arrays[i].length <= 1001 <= arrays[i][j] <= 100arrays[i]是严格递增排序.
方法一:计数 · Go 实现
思考
多路归并求公共子序列在数组个数较多时实现繁琐。值域仅为 ,且每行严格递增,一个值至多在每行出现一次。
统计每个值在多少行中出现,出现次数等于行数者即为全体公共元素,按值从小到大输出即最长公共子序列。
我们注意到,元素的范围是 ,我们可以用一个长度为 的数组 来记录每个元素出现的次数。
由于数组 中的每个数组都是严格递增排序的,因此,公共子序列的元素必然是单调递增,并且这些元素的出现次数都等于 的长度。
因此,我们可以遍历 中的每个数组,统计每个元素的出现次数,最后,从小到大遍历 的每个元素,如果出现次数等于 的长度,那么这个元素就是公共子序列的元素之一,我们将其加入答案数组中。
遍历结束后,返回答案数组即可。
时间复杂度 ,空间复杂度 。其中 为元素的范围,本题中 ,而 为数组所有元素的个数。
func longestCommonSubsequence(arrays [][]int) (ans []int) {
	cnt := [101]int{}
	for _, row := range arrays {
		for _, x := range row {
			cnt[x]++
		}
	}
	for x, v := range cnt {
		if v == len(arrays) {
			ans = append(ans, x)
		}
	}
	return
}1941. 检查是否所有字符出现次数相同
题目、示例与约束
给你一个字符串 s ,如果 s 是一个 好 字符串,请你返回 true ,否则请返回 false 。
如果 s 中出现过的 所有 字符的出现次数 相同 ,那么我们称字符串 s 是 好 字符串。
示例 1:
输入:s = "abacbc"
输出:true
解释:s 中出现过的字符为 'a','b' 和 'c' 。s 中所有字符均出现 2 次。
示例 2:
输入:s = "aaabb"
输出:false
解释:s 中出现过的字符为 'a' 和 'b' 。
'a' 出现了 3 次,'b' 出现了 2 次,两者出现次数不同。
提示:
1 <= s.length <= 1000s只包含小写英文字母。
方法一:计数 · Go 实现
思考
只需比较各字母频次是否一致。计数后看频次集合是否恰有一个值。
一次遍历即可,字符集为小写字母。
我们用一个哈希表或者一个长度为 的数组 记录字符串 中每个字符出现的次数。
接下来遍历 中的每个值,判断所有非零值是否相等即可。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度;而 是字符集大小,本题中字符集为小写英文字母,因此 。
func areOccurrencesEqual(s string) bool {
	cnt := [26]int{}
	for _, c := range s {
		cnt[c-'a']++
	}
	v := 0
	for _, x := range cnt {
		if x == 0 {
			continue
		}
		if v > 0 && v != x {
			return false
		}
		v = x
	}
	return true
}1982. 从子集的和还原数组
题目、示例与约束
存在一个未知数组需要你进行还原,给你一个整数 n 表示该数组的长度。另给你一个数组 sums ,由未知数组中全部 2n 个 子集的和 组成(子集中的元素没有特定的顺序)。
返回一个长度为 n 的数组 ans 表示还原得到的未知数组。如果存在 多种 答案,只需返回其中 任意一个 。
如果可以由数组 arr 删除部分元素(也可能不删除或全删除)得到数组 sub ,那么数组 sub 就是数组 arr 的一个 子集 。sub 的元素之和就是 arr 的一个 子集的和 。一个空数组的元素之和为 0 。
注意:生成的测试用例将保证至少存在一个正确答案。
示例 1:
输入:n = 3, sums = [-3,-2,-1,0,0,1,2,3]
输出:[1,2,-3]
解释:[1,2,-3] 能够满足给出的子集的和:
- []:和是 0
- [1]:和是 1
- [2]:和是 2
- [1,2]:和是 3
- [-3]:和是 -3
- [1,-3]:和是 -2
- [2,-3]:和是 -1
- [1,2,-3]:和是 0
注意,[1,2,-3] 的任何排列和 [-1,-2,3] 的任何排列都会被视作正确答案。
示例 2:
输入:n = 2, sums = [0,0,0,0]
输出:[0,0]
解释:唯一的正确答案是 [0,0] 。
示例 3:
输入:n = 4, sums = [0,0,5,5,4,-1,4,9,9,-1,4,3,4,8,3,8]
输出:[0,-1,4,5]
解释:[0,-1,4,5] 能够满足给出的子集的和。
提示:
1 <= n <= 15sums.length == 2n-104 <= sums[i] <= 104
方法一:有序集合 · Go 实现
思考
给定 个子集和,要还原原数组。和可能为负,先整体平移使最小者为 ,有序集合中下一个最小元必是数组中尚未确定的正元素。
每确定一个数,就从多重集中删去「旧子集和加上该数」的那些和。最后若平移量本身是某子集和,则把对应元素取负还原。
把子集和平移到非负,用有序集合反复取出当前最小元素作为数组下一项。
func recoverArray(n int, sums []int) []int {
	m := -slices.Min(sums)
	rbt := redblacktree.NewWithIntComparator()
	merge := func(key int, value int) {
		if v, ok := rbt.Get(key); ok {
			nxt := v.(int) + value
			if nxt == 0 {
				rbt.Remove(key)
			} else {
				rbt.Put(key, nxt)
			}
		} else {
			rbt.Put(key, value)
		}
	}
	for _, x := range sums {
		merge(x+m, 1)
	}
	ans := make([]int, n)
	merge(ans[0], -1)
	ans[0] = rbt.Left().Key.(int)
	for i := 1; i < n; i++ {
		for j := 0; j < 1<<i; j++ {
			if j>>(i-1)&1 == 1 {
				s := 0
				for k := 0; k < i; k++ {
					if j>>k&1 == 1 {
						s += ans[k]
					}
				}
				merge(s, -1)
			}
		}
		ans[i] = rbt.Left().Key.(int)
	}
	for i := 0; i < 1<<n; i++ {
		s := 0
		for j := 0; j < n; j++ {
			if i>>j&1 == 1 {
				s += ans[j]
			}
		}
		if s == m {
			for j := 0; j < n; j++ {
				if i>>j&1 == 1 {
					ans[j] = -ans[j]
				}
			}
			break
		}
	}
	return ans

}
方法二:排序 + 计数 · Go 实现
思考
有序集合每次删除需对数开销。排序后最大两和之差即当前最大绝对值 ,再按计数把和拆成「不含 」与「含 」两半,符号由哪一半含 决定。
排序后用相邻差还原下一个绝对值,再用计数把子集和拆成两半。
func recoverArray(n int, sums []int) (ans []int) {
	sort.Ints(sums)
	for i := n; i > 0; i-- {
		k := 1 << i
		d := sums[k-1] - sums[k-2]
		cnt := map[int]int{}
		for _, s := range sums[:k] {
			cnt[s]++
		}
		sums1, sums2 := []int{}, []int{}
		sign := 1
		for _, s := range sums[:k] {
			if cnt[s] == 0 {
				continue
			}
			cnt[s]--
			cnt[s+d]--
			sums1 = append(sums1, s)
			sums2 = append(sums2, s+d)
			if s+d == 0 {
				sign = -1
			}
		}
		ans = append(ans, sign*d)
		if sign == -1 {
			sums1 = sums2
		}
		sums = sums1
	}
	return
}1995. 统计特殊四元组
题目、示例与约束
给你一个 下标从 0 开始 的整数数组 nums ,返回满足下述条件的 不同 四元组 (a, b, c, d) 的 数目 :
nums[a] + nums[b] + nums[c] == nums[d],且a < b < c < d
示例 1:
输入:nums = [1,2,3,6]
输出:1
解释:满足要求的唯一一个四元组是 (0, 1, 2, 3) 因为 1 + 2 + 3 == 6 。
示例 2:
输入:nums = [3,3,6,4,5]
输出:0
解释:[3,3,6,4,5] 中不存在满足要求的四元组。
示例 3:
输入:nums = [1,1,1,3,5]
输出:4
解释:满足要求的 4 个四元组如下:
- (0, 1, 2, 3): 1 + 1 + 1 == 3
- (0, 1, 3, 4): 1 + 1 + 3 == 5
- (0, 2, 3, 4): 1 + 1 + 3 == 5
- (1, 2, 3, 4): 1 + 1 + 3 == 5
提示:
4 <= nums.length <= 501 <= nums[i] <= 100
方法一:暴力枚举 · Go 实现
思考
,四重循环枚举 并判断和式,时间可接受。
四重循环枚举 。
func countQuadruplets(nums []int) int {
	ans, n := 0, len(nums)
	for a := 0; a < n-3; a++ {
		for b := a + 1; b < n-2; b++ {
			for c := b + 1; c < n-1; c++ {
				for d := c + 1; d < n; d++ {
					if nums[a]+nums[b]+nums[c] == nums[d] {
						ans++
					}
				}
			}
		}
	}
	return ans
}
方法二:哈希表 · Go 实现
思考
四重循环常数偏大。从右固定 ,哈希统计其右侧 的值,再枚举 查询 的出现次数,降为 。
从右往左枚举 ,用哈希表统计右侧 的取值,再枚举 。
func countQuadruplets(nums []int) int {
	ans, n := 0, len(nums)
	counter := make([]int, 310)
	for c := n - 2; c > 1; c-- {
		counter[nums[c+1]]++
		for a := 0; a < c-1; a++ {
			for b := a + 1; b < c; b++ {
				ans += counter[nums[a]+nums[b]+nums[c]]
			}
		}
	}
	return ans
}
方法三:哈希表(枚举优化) · Go 实现
思考
仍可再降一重:从右枚举 ,把所有 ( )计入哈希,再枚举 查询 ,总时间 。
枚举 ,维护 的出现次数,将复杂度再降一维。
func countQuadruplets(nums []int) int {
	ans, n := 0, len(nums)
	counter := make([]int, 310)
	for b := n - 3; b > 0; b-- {
		c := b + 1
		for d := c + 1; d < n; d++ {
			if nums[d] >= nums[c] {
				counter[nums[d]-nums[c]]++
			}
		}
		for a := 0; a < b; a++ {
			ans += counter[nums[a]+nums[b]]
		}
	}
	return ans
}2006. 差的绝对值为 K 的数对数目
题目、示例与约束
给你一个整数数组 nums 和一个整数 k ,请你返回数对 (i, j) 的数目,满足 i < j 且 |nums[i] - nums[j]| == k 。
|x| 的值定义为:
- 如果
x >= 0,那么值为x。 - 如果
x < 0,那么值为-x。
示例 1:
输入:nums = [1,2,2,1], k = 1
输出:4
解释:差的绝对值为 1 的数对为:
- [1,2,2,1]
- [1,2,2,1]
- [1,2,2,1]
- [1,2,2,1]
示例 2:
输入:nums = [1,3], k = 3
输出:0
解释:没有任何数对差的绝对值为 3 。
示例 3:
输入:nums = [3,2,1,5,4], k = 2
输出:3
解释:差的绝对值为 2 的数对为:
- [3,2,1,5,4]
- [3,2,1,5,4]
- [3,2,1,5,4]
提示:
1 <= nums.length <= 2001 <= nums[i] <= 1001 <= k <= 99
方法一:暴力枚举 · Go 实现
思考
,枚举全部 并判断绝对值是否为 ,次数约 ,约束允许。值域与 都很小,这一方法不依赖额外结构。
双重循环直接对应题目定义,实现与正确性都直观。
我们注意到,数组 的长度不超过 ,因此我们可以枚举所有的数对 ,其中 ,并判断 是否等于 ,是则答案加一。
最后返回答案即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func countKDifference(nums []int, k int) int {
	n := len(nums)
	ans := 0
	for i := 0; i < n; i++ {
		for j := i + 1; j < n; j++ {
			if abs(nums[i]-nums[j]) == k {
				ans++
			}
		}
	}
	return ans
}

func abs(x int) int {
	if x > 0 {
		return x
	}
	return -x
}
方法二:哈希表或数组 · Go 实现
思考
方法一对每个数对都扫描一次,虽能通过,但仍是平方。注意到只需统计差值恰为 的个数,对当前 ,此前出现的 与 均可配对。
为此边遍历边用计数器累加,再写入 ,避免重复计数且只需线性时间。
我们可以使用哈希表或数组记录数组 中每个数出现的次数,然后枚举数组 中的每个数 ,判断 和 是否在数组 中,是则答案加上 和 出现的次数之和。
最后返回答案即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func countKDifference(nums []int, k int) (ans int) {
	cnt := [110]int{}
	for _, num := range nums {
		if num >= k {
			ans += cnt[num-k]
		}
		if num+k <= 100 {
			ans += cnt[num+k]
		}
		cnt[num]++
	}
	return
}2023. 连接后等于目标字符串的字符串对
题目、示例与约束
给你一个 数字 字符串数组 nums 和一个 数字 字符串 target ,请你返回 nums[i] + nums[j] (两个字符串连接)结果等于 target 的下标 (i, j) (需满足 i != j)的数目。
示例 1:
输入:nums = ["777","7","77","77"], target = "7777"
输出:4
解释:符合要求的下标对包括:
- (0, 1):"777" + "7"
- (1, 0):"7" + "777"
- (2, 3):"77" + "77"
- (3, 2):"77" + "77"
示例 2:
输入:nums = ["123","4","12","34"], target = "1234"
输出:2
解释:符合要求的下标对包括
- (0, 1):"123" + "4"
- (2, 3):"12" + "34"
示例 3:
输入:nums = ["1","1","1"], target = "11"
输出:6
解释:符合要求的下标对包括
- (0, 1):"1" + "1"
- (1, 0):"1" + "1"
- (0, 2):"1" + "1"
- (2, 0):"1" + "1"
- (1, 2):"1" + "1"
- (2, 1):"1" + "1"
提示:
2 <= nums.length <= 1001 <= nums[i].length <= 1002 <= target.length <= 100nums[i]和target只包含数字。nums[i]和target不含有任何前导 0 。
方法一:枚举 · Go 实现
思考
且串长短,枚举有序对 做拼接比较即可。 允许同一字符串用两次仅当它在数组中出现两次。
双重循环对应题目定义,无需预处理。
遍历数组 nums,对于每个 ,枚举所有 ,如果 且 ,则答案加一。
时间复杂度 ,其中 和 分别为数组 nums 和字符串 target 的长度。空间复杂度 。
func numOfPairs(nums []string, target string) (ans int) {
	for i, a := range nums {
		for j, b := range nums {
			if i != j && a+b == target {
				ans++
			}
		}
	}
	return ans
}
方法二:哈希表 · Go 实现
思考
方法一每次拼接耗时与 有关,在 、 同阶时偏慢。合法对必是 的某个前缀加对应后缀。
先统计每个串的出现次数,再枚举切分点。前后缀相同须用 ,以免同一下标配对。
我们可以用哈希表统计数组 nums 中每个字符串出现的次数,然后遍历字符串 target 的所有前缀和后缀,如果前缀和后缀都在哈希表中,则答案加上它们出现的次数的乘积。
时间复杂度 ,空间复杂度 。其中 和 分别为数组 nums 和字符串 target 的长度。
func numOfPairs(nums []string, target string) (ans int) {
	cnt := map[string]int{}
	for _, x := range nums {
		cnt[x]++
	}
	for i := 1; i < len(target); i++ {
		a, b := target[:i], target[i:]
		if a != b {
			ans += cnt[a] * cnt[b]
		} else {
			ans += cnt[a] * (cnt[a] - 1)
		}
	}
	return
}2053. 数组中第 K 个独一无二的字符串
题目、示例与约束
独一无二的字符串 指的是在一个数组中只出现过 一次 的字符串。
给你一个字符串数组 arr 和一个整数 k ,请你返回 arr 中第 k 个 独一无二的字符串 。如果 少于 k 个独一无二的字符串,那么返回 空字符串 "" 。
注意,按照字符串在原数组中的 顺序 找到第 k 个独一无二字符串。
示例 1:
输入:arr = ["d","b","c","b","c","a"], k = 2
输出:"a"
解释:
arr 中独一无二字符串包括 "d" 和 "a" 。
"d" 首先出现,所以它是第 1 个独一无二字符串。
"a" 第二个出现,所以它是 2 个独一无二字符串。
由于 k == 2 ,返回 "a" 。
示例 2:
输入:arr = ["aaa","aa","a"], k = 1
输出:"aaa"
解释:
arr 中所有字符串都是独一无二的,所以返回第 1 个字符串 "aaa" 。
示例 3:
输入:arr = ["a","b","a"], k = 3
输出:""
解释:
唯一一个独一无二字符串是 "b" 。由于少于 3 个独一无二字符串,我们返回空字符串 "" 。
提示:
1 <= k <= arr.length <= 10001 <= arr[i].length <= 5arr[i]只包含小写英文字母。
方法一:哈希表 + 计数 · Go 实现
思考
「独特」指全局只出现一次。 ,先计数再按原序扫第二次,遇到频次为 则 减一,减到 即为答案。
两次线性扫描,无需额外下标结构。
我们可以用一个哈希表 记录每个字符串出现的次数,然后再遍历一次数组,对于每个字符串,如果它出现的次数为 ,那么就将 减一,直到 减为 ,返回当前字符串即可。
时间复杂度 ,空间复杂度 ,其中 为数组 所有字符串的长度之和。
func kthDistinct(arr []string, k int) string {
	cnt := map[string]int{}
	for _, s := range arr {
		cnt[s]++
	}
	for _, s := range arr {
		if cnt[s] == 1 {
			k--
			if k == 0 {
				return s
			}
		}
	}
	return ""
}2062. 统计字符串中的元音子字符串
题目、示例与约束
子字符串 是字符串中的一个连续(非空)的字符序列。
元音子字符串 是 仅 由元音('a'、'e'、'i'、'o' 和 'u')组成的一个子字符串,且必须包含 全部五种 元音。
给你一个字符串 word ,统计并返回 word 中 元音子字符串的数目 。
示例 1:
输入:word = "aeiouu"
输出:2
解释:下面列出 word 中的元音子字符串(斜体加粗部分):
- "aeiouu"
- "aeiouu"
示例 2:
输入:word = "unicornarihan"
输出:0
解释:word 中不含 5 种元音,所以也不会存在元音子字符串。
示例 3:
输入:word = "cuaieuouac"
输出:7
解释:下面列出 word 中的元音子字符串(斜体加粗部分):
- "cuaieuouac"
- "cuaieuouac"
- "cuaieuouac"
- "cuaieuouac"
- "cuaieuouac"
- "cuaieuouac"
- "cuaieuouac"
示例 4:
输入:word = "bbaeixoubb"
输出:0
解释:所有包含全部五种元音的子字符串都含有辅音,所以不存在元音子字符串。
提示:
1 <= word.length <= 100word仅由小写英文字母组成
方法一:暴力枚举 + 哈希表 · Go 实现
思考
,子串 可全部检查。元音子串须只含元音且五种都出现。固定左端向右扩,遇辅音则该左端结束;越界集合大小为 时计一。
哈希集合维护当前窗口出现过的元音。
我们可以枚举子字符串的左端点 ,对于当前左端点,维护一个哈希表,记录当前子字符串中出现的元音字母,然后枚举右端点 ,如果当前右端点对应的字母不是元音字母,则跳出循环,否则将当前右端点对应的字母加入哈希表,如果哈希表中的元素个数为 ,则说明当前子字符串是一个元音子字符串,将结果加 。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度;而 为字符集大小,本题中 。
func countVowelSubstrings(word string) int {
	ans, n := 0, len(word)
	for i := range word {
		t := map[byte]bool{}
		for j := i; j < n; j++ {
			c := word[j]
			if !(c == 'a' || c == 'e' || c == 'i' || c == 'o' || c == 'u') {
				break
			}
			t[c] = true
			if len(t) == 5 {
				ans++
			}
		}
	}
	return ans
}2068. 检查两个字符串是否几乎相等
题目、示例与约束
如果两个字符串 word1 和 word2 中从 'a' 到 'z' 每一个字母出现频率之差都 不超过 3 ,那么我们称这两个字符串 word1 和 word2 几乎相等 。
给你两个长度都为 n 的字符串 word1 和 word2 ,如果 word1 和 word2 几乎相等 ,请你返回 true ,否则返回 false 。
一个字母 x 的出现 频率 指的是它在字符串中出现的次数。
示例 1:
输入:word1 = "aaaa", word2 = "bccb"
输出:false
解释:字符串 "aaaa" 中有 4 个 'a' ,但是 "bccb" 中有 0 个 'a' 。
两者之差为 4 ,大于上限 3 。
示例 2:
输入:word1 = "abcdeef", word2 = "abaaacc"
输出:true
解释:word1 和 word2 中每个字母出现频率之差至多为 3 :
- 'a' 在 word1 中出现了 1 次,在 word2 中出现了 4 次,差为 3 。
- 'b' 在 word1 中出现了 1 次,在 word2 中出现了 1 次,差为 0 。
- 'c' 在 word1 中出现了 1 次,在 word2 中出现了 2 次,差为 1 。
- 'd' 在 word1 中出现了 1 次,在 word2 中出现了 0 次,差为 1 。
- 'e' 在 word1 中出现了 2 次,在 word2 中出现了 0 次,差为 2 。
- 'f' 在 word1 中出现了 1 次,在 word2 中出现了 0 次,差为 1 。
示例 3:
输入:word1 = "cccddabba", word2 = "babababab"
输出:true
解释:word1 和 word2 中每个字母出现频率之差至多为 3 :
- 'a' 在 word1 中出现了 2 次,在 word2 中出现了 4 次,差为 2 。
- 'b' 在 word1 中出现了 2 次,在 word2 中出现了 5 次,差为 3 。
- 'c' 在 word1 中出现了 3 次,在 word2 中出现了 0 次,差为 3 。
- 'd' 在 word1 中出现了 2 次,在 word2 中出现了 0 次,差为 2 。
提示:
n == word1.length == word2.length1 <= n <= 100word1和word2都只包含小写英文字母。
方法一:计数 · Go 实现
思考
两串等长且 ,比较 个字母的频次差是否都不超过 。用一个计数器对 加、对 减,最后看绝对值。
我们可以创建一个长度为 的数组 ,记录两个字符串中每个字母出现的次数之差。最后遍历 ,如果有任意一个字母出现的次数之差大于 ,则返回 false,否则返回 true。
时间复杂度 ,空间复杂度 。其中 是字符串的长度;而 是字符集的大小,本题中 。
func checkAlmostEquivalent(word1 string, word2 string) bool {
	cnt := [26]int{}
	for _, c := range word1 {
		cnt[c-'a']++
	}
	for _, c := range word2 {
		cnt[c-'a']--
	}
	for _, x := range cnt {
		if x > 3 || x < -3 {
			return false
		}
	}
	return true
}2085. 统计出现过一次的公共字符串
题目、示例与约束
给你两个字符串数组 words1 和 words2 ,请你返回在两个字符串数组中 都恰好出现一次 的字符串的数目。
示例 1:
输入:words1 = ["leetcode","is","amazing","as","is"], words2 = ["amazing","leetcode","is"]
输出:2
解释:
- "leetcode" 在两个数组中都恰好出现一次,计入答案。
- "amazing" 在两个数组中都恰好出现一次,计入答案。
- "is" 在两个数组中都出现过,但在 words1 中出现了 2 次,不计入答案。
- "as" 在 words1 中出现了一次,但是在 words2 中没有出现过,不计入答案。
所以,有 2 个字符串在两个数组中都恰好出现了一次。
示例 2:
输入:words1 = ["b","bb","bbb"], words2 = ["a","aa","aaa"]
输出:0
解释:没有字符串在两个数组中都恰好出现一次。
示例 3:
输入:words1 = ["a","ab"], words2 = ["a","a","a","ab"]
输出:1
解释:唯一在两个数组中都出现一次的字符串是 "ab" 。
提示:
1 <= words1.length, words2.length <= 10001 <= words1[i].length, words2[j].length <= 30words1[i]和words2[j]都只包含小写英文字母。
方法一:哈希表计数 · Go 实现
思考
要在两个数组中都恰好出现一次的单词。分别计数后,遍历一侧,检查自身与另一侧频次是否均为 。
线性于两数组长度。
我们可以用两个哈希表 和 分别统计两个字符串数组中每个字符串出现的次数,然后遍历其中一个哈希表,如果某个字符串在另一个哈希表中出现了一次,且在当前哈希表中也出现了一次,则答案加一。
时间复杂度 ,空间复杂度 。其中 和 分别是两个字符串数组的长度。
func countWords(words1 []string, words2 []string) (ans int) {
	cnt1 := map[string]int{}
	cnt2 := map[string]int{}
	for _, w := range words1 {
		cnt1[w]++
	}
	for _, w := range words2 {
		cnt2[w]++
	}
	for w, v := range cnt1 {
		if v == 1 && cnt2[w] == 1 {
			ans++
		}
	}
	return
}2094. 找出 3 位偶数
题目、示例与约束
给你一个整数数组 digits ,其中每个元素是一个数字(0 - 9)。数组中可能存在重复元素。
你需要找出 所有 满足下述条件且 互不相同 的整数:
- 该整数由
digits中的三个元素按 任意 顺序 依次连接 组成。 - 该整数不含 前导零
- 该整数是一个 偶数
例如,给定的 digits 是 [1, 2, 3] ,整数 132 和 312 满足上面列出的全部条件。
将找出的所有互不相同的整数按 递增顺序 排列,并以数组形式返回。
示例 1:
输入:digits = [2,1,3,0]
输出:[102,120,130,132,210,230,302,310,312,320]
解释:
所有满足题目条件的整数都在输出数组中列出。
注意,答案数组中不含有 奇数 或带 前导零 的整数。
示例 2:
输入:digits = [2,2,8,8,2]
输出:[222,228,282,288,822,828,882]
解释:
同样的数字(0 - 9)在构造整数时可以重复多次,重复次数最多与其在 digits 中出现的次数一样。
在这个例子中,数字 8 在构造 288、828 和 882 时都重复了两次。
示例 3:
输入:digits = [3,7,5]
输出:[]
解释:
使用给定的 digits 无法构造偶数。
提示:
3 <= digits.length <= 1000 <= digits[i] <= 9
方法一:计数 + 枚举 · Go 实现
思考
用
digits中的数字组成无前导零的三位偶数,并去重排序。三位偶数只有 个,枚举它们再核对频次,比排列数字更直接。先统计
digits的 次数,对 的偶数拆位比较计数。
我们先统计 中每个数字出现的次数,记录在数组或哈希表 中。
然后,我们在 的范围内枚举所有的偶数,判断这个偶数的每一位数字是否都不超过 中对应的数字的次数。如果是,则将这个偶数加入答案数组中。
最后,返回答案数组。
时间复杂度 ,其中 是目标偶数的位数,本题中 。忽略答案的空间消耗,空间复杂度 。
func findEvenNumbers(digits []int) (ans []int) {
	cnt := [10]int{}
	for _, x := range digits {
		cnt[x]++
	}
	for x := 100; x < 1000; x += 2 {
		cnt1 := [10]int{}
		for y := x; y > 0; y /= 10 {
			cnt1[y%10]++
		}
		ok := true
		for i := 0; i < 10 && ok; i++ {
			ok = cnt[i] >= cnt1[i]
		}
		if ok {
			ans = append(ans, x)
		}
	}
	return
}2103. 环和杆
题目、示例与约束
总计有 n 个环,环的颜色可以是红、绿、蓝中的一种。这些环分别穿在 10 根编号为 0 到 9 的杆上。
给你一个长度为 2n 的字符串 rings ,表示这 n 个环在杆上的分布。rings 中每两个字符形成一个 颜色位置对 ,用于描述每个环:
- 第
i对中的 第一个 字符表示第i个环的 颜色('R'、'G'、'B')。 - 第
i对中的 第二个 字符表示第i个环的 位置,也就是位于哪根杆上('0'到'9')。
例如,"R3G2B1" 表示:共有 n == 3 个环,红色的环在编号为 3 的杆上,绿色的环在编号为 2 的杆上,蓝色的环在编号为 1 的杆上。
找出所有集齐 全部三种颜色 环的杆,并返回这种杆的数量。
示例 1:
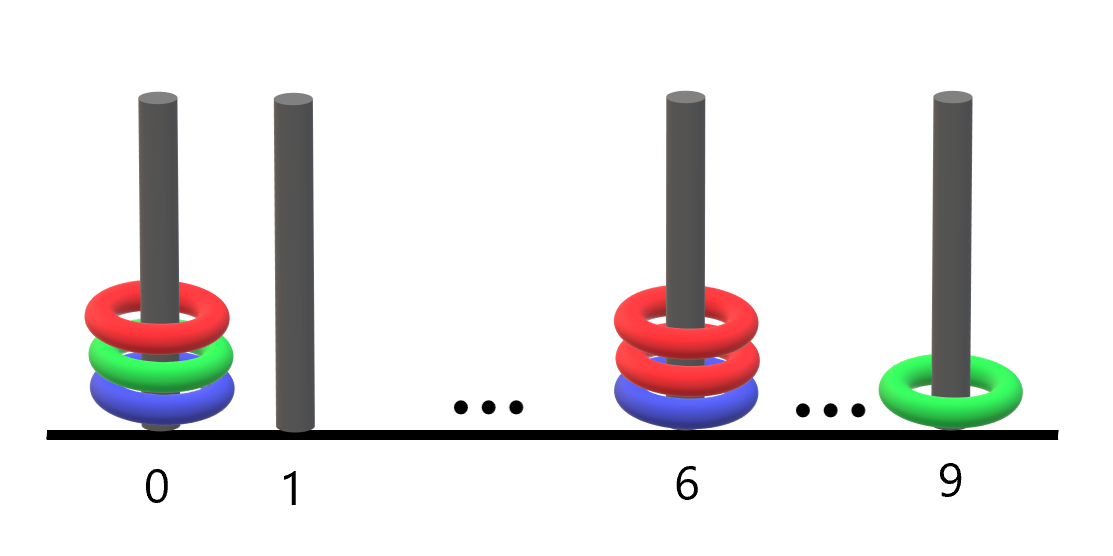
输入:rings = "B0B6G0R6R0R6G9"
输出:1
解释:
- 编号 0 的杆上有 3 个环,集齐全部颜色:红、绿、蓝。
- 编号 6 的杆上有 3 个环,但只有红、蓝两种颜色。
- 编号 9 的杆上只有 1 个绿色环。
因此,集齐全部三种颜色环的杆的数目为 1 。
示例 2:
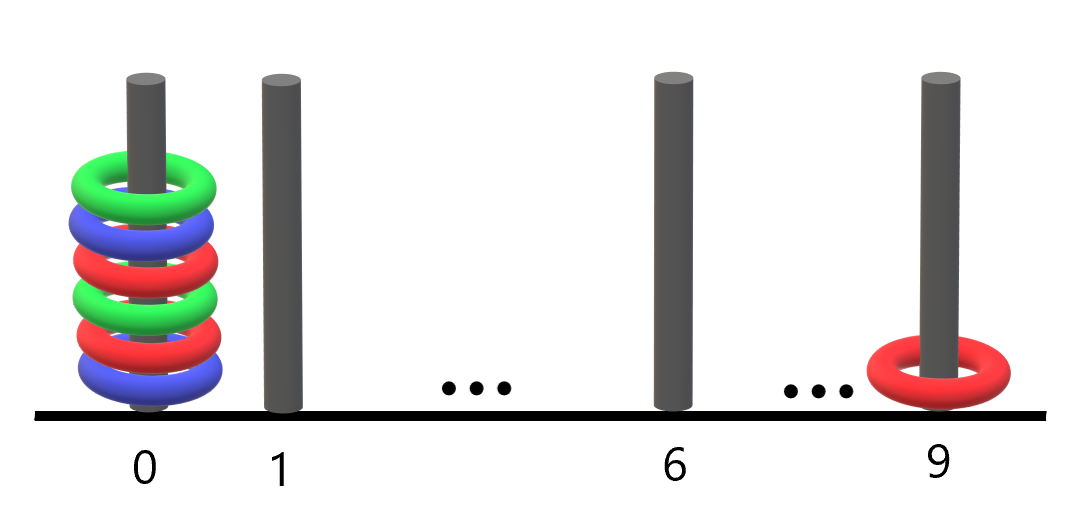
输入:rings = "B0R0G0R9R0B0G0"
输出:1
解释:
- 编号 0 的杆上有 6 个环,集齐全部颜色:红、绿、蓝。
- 编号 9 的杆上只有 1 个红色环。
因此,集齐全部三种颜色环的杆的数目为 1 。
示例 3:
输入:rings = "G4"
输出:0
解释:
只给了一个环,因此,不存在集齐全部三种颜色环的杆。
提示:
rings.length == 2 * n1 <= n <= 100- 如
i是 偶数 ,则rings[i]的值可以取'R'、'G'或'B'(下标从 0 开始计数) - 如
i是 奇数 ,则rings[i]的值可以取'0'到'9'中的一个数字(下标从 0 开始计数)
方法一:位运算 · Go 实现
思考
每根杆只需知道红、绿、蓝是否都出现过。若对 根杆各扫描整串 再分别判断三种颜色,重复遍历过多,且字符串长度为偶数、颜色与杆号成对出现,适合一次扫描完成。
三种颜色是互不重叠的布尔标记,可用三位二进制分别表示。将
'R','G','B'映射为 ,对第 根杆做按位或,则集齐三色当且仅当掩码为 。为此用长度为 的数组 按对读取 ,最后统计值为 的杆数。
我们可以用一个长度为 的数组 来表示每根杆上的环的颜色情况,其中 表示第 根杆上的环的颜色情况,如果第 根杆上有红色、绿色、蓝色的环,那么 的二进制表示为 ,即 。
我们遍历字符串 ,对于每个颜色位置对 ,其中 表示环的颜色, 表示环所在的杆的编号,我们将 对应的二进制位进行置位,即 ,其中 表示颜色 对应的二进制位。
最后我们统计 中值为 的元素的个数,即为集齐全部三种颜色环的杆的数目。
时间复杂度 ,空间复杂度 ,其中 表示字符串 的长度,而 表示字符集的大小。
func countPoints(rings string) (ans int) {
	d := ['Z']int{'R': 1, 'G': 2, 'B': 4}
	mask := [10]int{}
	for i, n := 0, len(rings); i < n; i += 2 {
		c := rings[i]
		j := int(rings[i+1] - '0')
		mask[j] |= d[c]
	}
	for _, x := range mask {
		if x == 7 {
			ans++
		}
	}
	return
}2133. 检查是否每一行每一列都包含全部整数
题目、示例与约束
对一个大小为 n x n 的矩阵而言,如果其每一行和每一列都包含从 1 到 n 的 全部 整数(含 1 和 n),则认为该矩阵是一个 有效 矩阵。
给你一个大小为 n x n 的整数矩阵 matrix ,请你判断矩阵是否为一个有效矩阵:如果是,返回 true ;否则,返回 false 。
示例 1:
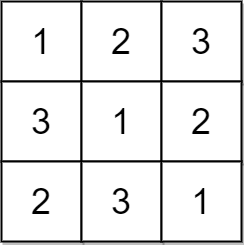
输入:matrix = [[1,2,3],[3,1,2],[2,3,1]]
输出:true
解释:在此例中,n = 3 ,每一行和每一列都包含数字 1、2、3 。
因此,返回 true 。
示例 2:
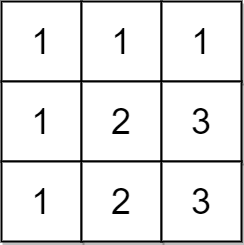
输入:matrix = [[1,1,1],[1,2,3],[1,2,3]]
输出:false
解释:在此例中,n = 3 ,但第一行和第一列不包含数字 2 和 3 。
因此,返回 false 。
提示:
n == matrix.length == matrix[i].length1 <= n <= 1001 <= matrix[i][j] <= n
方法一:哈希表 · Go 实现
思考
矩阵应在每一行、每一列都恰好包含 各一次。 ,逐行逐列检查集合大小是否为 即可,无需更重的结构。
行直接取 ,列用转置;集合去重后长度为 当且仅当该行(列)无重复,从而必是 的排列(题目保证元素在该范围内)。
对 中每一序列验证即可。
遍历矩阵的每一行和每一列,使用哈希表记录每个数字是否出现过,如果某一行或某一列中有数字重复出现,则返回 false,否则返回 true。
时间复杂度 ,空间复杂度 。其中 为矩阵的大小。
func checkValid(matrix [][]int) bool {
	n := len(matrix)
	for _, row := range matrix {
		vis := make([]bool, n+1)
		for _, x := range row {
			if vis[x] {
				return false
			}
			vis[x] = true
		}
	}
	for j := 0; j < n; j++ {
		vis := make([]bool, n+1)
		for i := 0; i < n; i++ {
			if vis[matrix[i][j]] {
				return false
			}
			vis[matrix[i][j]] = true
		}
	}
	return true
}2150. 找出数组中的所有孤独数字
题目、示例与约束
给你一个整数数组 nums 。如果数字 x 在数组中仅出现 一次 ,且没有 相邻 数字(即,x + 1 和 x - 1)出现在数组中,则认为数字 x 是 孤独数字 。
返回 nums 中的 所有 孤独数字。你可以按 任何顺序 返回答案。
示例 1:
输入:nums = [10,6,5,8]
输出:[10,8]
解释:
- 10 是一个孤独数字,因为它只出现一次,并且 9 和 11 没有在 nums 中出现。
- 8 是一个孤独数字,因为它只出现一次,并且 7 和 9 没有在 nums 中出现。
- 5 不是一个孤独数字,因为 6 出现在 nums 中,反之亦然。
因此,nums 中的孤独数字是 [10, 8] 。
注意,也可以返回 [8, 10] 。
示例 2:
输入:nums = [1,3,5,3]
输出:[1,5]
解释:
- 1 是一个孤独数字,因为它只出现一次,并且 0 和 2 没有在 nums 中出现。
- 5 是一个孤独数字,因为它只出现一次,并且 4 和 6 没有在 nums 中出现。
- 3 不是一个孤独数字,因为它出现两次。
因此,nums 中的孤独数字是 [1, 5] 。
注意,也可以返回 [5, 1] 。
提示:
1 <= nums.length <= 1050 <= nums[i] <= 106
方法一:哈希表 · Go 实现
思考
孤独数字出现恰好一次,且相邻整数都不在数组中。排序后看左右邻居需要处理重复与边界,哈希计数可一次完成三项条件。
先统计频次,再筛选 且 、 均未出现的键。
时间和空间均为 。
我们用一个哈希表 记录每个数字出现的次数,然后遍历哈希表,对于每个数字及其出现次数 ,如果 且 且 ,则 是一个孤独数字,将其加入答案数组中。
遍历结束后,返回答案数组即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func findLonely(nums []int) (ans []int) {
	cnt := map[int]int{}
	for _, x := range nums {
		cnt[x]++
	}
	for x, v := range cnt {
		if v == 1 && cnt[x-1] == 0 && cnt[x+1] == 0 {
			ans = append(ans, x)
		}
	}
	return
}2154. 将找到的值乘以 2
题目、示例与约束
给你一个整数数组 nums ,另给你一个整数 original ,这是需要在 nums 中搜索的第一个数字。
接下来,你需要按下述步骤操作:
- 如果在
nums中找到original,将original乘以 2 ,得到新original(即,令original = 2 * original)。 - 否则,停止这一过程。
- 只要能在数组中找到新
original,就对新original继续 重复 这一过程。
返回 original 的 最终 值。
示例 1:
输入:nums = [5,3,6,1,12], original = 3
输出:24
解释:
- 3 能在 nums 中找到。3 * 2 = 6 。
- 6 能在 nums 中找到。6 * 2 = 12 。
- 12 能在 nums 中找到。12 * 2 = 24 。
- 24 不能在 nums 中找到。因此,返回 24 。
示例 2:
输入:nums = [2,7,9], original = 4
输出:4
解释:
- 4 不能在 nums 中找到。因此,返回 4 。
提示:
1 <= nums.length <= 10001 <= nums[i], original <= 1000
方法一:哈希表 · Go 实现
思考
只要 仍在数组中就乘 。数组长度与值域有限,乘二很快超出集合。线性查找每次 ,最坏乘若干次仍可接受,但哈希可把存在性降到均摊 。
把 放入集合,循环左移 直到不在集合中。
答案即最终的 。
我们用一个哈希表 记录数组 中的所有数字。
接下来,我们从 开始,如果 在 中,我们将 乘以 ,直到 不在 中,返回 。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func findFinalValue(nums []int, original int) int {
	s := map[int]bool{}
	for _, x := range nums {
		s[x] = true
	}
	for s[original] {
		original <<= 1
	}
	return original
}2168. 每个数字的频率都相同的不同子字符串的数量 🔒
题目、示例与约束
s,返回 s 中 不同子字符串数量,其中的每一个数字出现的频率都相同。
示例1:
输入: s = "1212"
输出: 5
解释: 符合要求的子串有 "1", "2", "12", "21", "1212".
要注意,尽管"12"在s中出现了两次,但在计数的时候只计算一次。
示例 2:
输入: s = "12321"
输出: 9
解释: 符合要求的子串有 "1", "2", "3", "12", "23", "32", "21", "123", "321".
解释:
1 <= s.length <= 1000s只包含阿拉伯数字.
方法一 · Go 实现
思考
统计有多少个不同子串,其出现过的数字频次都相等。 ,子串 个,每个再扫一遍数字为三次方,偏慢。
十个数字的前缀计数可 得到任一区间的频次向量,再判断非零频次是否都相同。用集合去重子串本身。
枚举 ,前缀差检验通过则把 加入集合。
func equalDigitFrequency(s string) int {
	n := len(s)
	presum := make([][]int, n+1)
	for i := range presum {
		presum[i] = make([]int, 10)
	}
	for i, c := range s {
		presum[i+1][c-'0']++
		for j := 0; j < 10; j++ {
			presum[i+1][j] += presum[i][j]
		}
	}
	check := func(i, j int) bool {
		v := make(map[int]bool)
		for k := 0; k < 10; k++ {
			cnt := presum[j+1][k] - presum[i][k]
			if cnt > 0 {
				v[cnt] = true
			}
			if len(v) > 1 {
				return false
			}
		}
		return true
	}
	vis := make(map[string]bool)
	for i := 0; i < n; i++ {
		for j := i; j < n; j++ {
			if check(i, j) {
				vis[s[i:j+1]] = true
			}
		}
	}
	return len(vis)
}2186. 制造字母异位词的最小步骤数 II
题目、示例与约束
给你两个字符串 s 和 t 。在一步操作中,你可以给 s 或者 t 追加 任一字符 。
返回使 s 和 t 互为 字母异位词 所需的最少步骤数。
字母异位词 指字母相同但是顺序不同(或者相同)的字符串。
示例 1:
输入:s = "leetcode", t = "coats"
输出:7
解释:
- 执行 2 步操作,将 "as" 追加到 s = "leetcode" 中,得到 s = "leetcodeas" 。
- 执行 5 步操作,将 "leede" 追加到 t = "coats" 中,得到 t = "coatsleede" 。
"leetcodeas" 和 "coatsleede" 互为字母异位词。
总共用去 2 + 5 = 7 步。
可以证明,无法用少于 7 步操作使这两个字符串互为字母异位词。
示例 2:
输入:s = "night", t = "thing"
输出:0
解释:给出的字符串已经互为字母异位词。因此,不需要任何进一步操作。
提示:
1 <= s.length, t.length <= 2 * 105s和t由小写英文字符组成
方法一:计数 · Go 实现
思考
每一步可在任一串中插入一个字符,最少步数等于两串要变成同一多重集合所需补充的字符数,即各字母频次差的绝对值之和。
用 的计数减去 的计数,对每个字母取绝对值后求和。
一次遍历即可。
func minSteps(s string, t string) int {
	cnt := make([]int, 26)
	for _, c := range s {
		cnt[c-'a']++
	}
	for _, c := range t {
		cnt[c-'a']--
	}
	ans := 0
	for _, v := range cnt {
		ans += abs(v)
	}
	return ans
}

func abs(x int) int {
	if x < 0 {
		return -x
	}
	return x
}2190. 数组中紧跟 key 之后出现最频繁的数字
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums ,同时给你一个整数 key ,它在 nums 出现过。
统计 在 nums 数组中紧跟着 key 后面出现的不同整数 target 的出现次数。换言之,target 的出现次数为满足以下条件的 i 的数目:
0 <= i <= n - 2nums[i] == key且nums[i + 1] == target。
请你返回出现 最多 次数的 target 。测试数据保证出现次数最多的 target 是唯一的。
示例 1:
输入:nums = [1,100,200,1,100], key = 1
输出:100
解释:对于 target = 100 ,在下标 1 和 4 处出现过 2 次,且都紧跟着 key 。
没有其他整数在 key 后面紧跟着出现,所以我们返回 100 。
示例 2:
输入:nums = [2,2,2,2,3], key = 2
输出:2
解释:对于 target = 2 ,在下标 1 ,2 和 3 处出现过 3 次,且都紧跟着 key 。
对于 target = 3 ,在下标 4 出出现过 1 次,且紧跟着 key 。
target = 2 是紧跟着 key 之后出现次数最多的数字,所以我们返回 2 。
提示:
2 <= nums.length <= 10001 <= nums[i] <= 1000- 测试数据保证答案是唯一的。
方法一:遍历计数 · Go 实现
思考
统计每个紧跟在 之后的值出现次数,返回最频繁者(保证唯一)。一次扫描相邻对即可。
对 的相邻对,若左元等于 则给右元计数,并维护当前最大值对应的答案。
哈希表大小不超过值域。
我们用一个哈希表或数组 记录每个 出现的次数,用一个变量 维护 出现的最大次数,初始时 。
遍历数组 ,如果 ,则 出现的次数 加一,如果此时 ,则更新 ,并更新答案 。
遍历结束后,返回答案 。
时间复杂度 ,空间复杂度 。其中 和 分别为数组 的长度和数组 中元素的最大值。
func mostFrequent(nums []int, key int) (ans int) {
	cnt := [1001]int{}
	mx := 0
	for i, x := range nums[1:] {
		if nums[i] == key {
			cnt[x]++
			if mx < cnt[x] {
				mx = cnt[x]
				ans = x
			}
		}
	}
	return
}2201. 统计可以提取的工件
题目、示例与约束
存在一个 n x n 大小、下标从 0 开始的网格,网格中埋着一些工件。给你一个整数 n 和一个下标从 0 开始的二维整数数组 artifacts ,artifacts 描述了矩形工件的位置,其中 artifacts[i] = [r1i, c1i, r2i, c2i] 表示第 i 个工件在子网格中的填埋情况:
(r1i, c1i)是第i个工件 左上 单元格的坐标,且(r2i, c2i)是第i个工件 右下 单元格的坐标。
你将会挖掘网格中的一些单元格,并清除其中的填埋物。如果单元格中埋着工件的一部分,那么该工件这一部分将会裸露出来。如果一个工件的所有部分都都裸露出来,你就可以提取该工件。
给你一个下标从 0 开始的二维整数数组 dig ,其中 dig[i] = [ri, ci] 表示你将会挖掘单元格 (ri, ci) ,返回你可以提取的工件数目。
生成的测试用例满足:
- 不存在重叠的两个工件。
- 每个工件最多只覆盖
4个单元格。 dig中的元素互不相同。
示例 1:
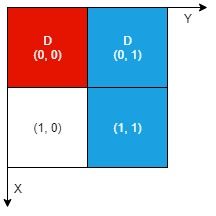
输入:n = 2, artifacts = [[0,0,0,0],[0,1,1,1]], dig = [[0,0],[0,1]]
输出:1
解释:
不同颜色表示不同的工件。挖掘的单元格用 'D' 在网格中进行标记。
有 1 个工件可以提取,即红色工件。
蓝色工件在单元格 (1,1) 的部分尚未裸露出来,所以无法提取该工件。
因此,返回 1 。
示例 2:
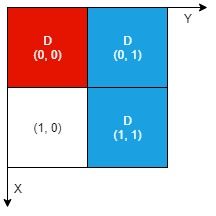
输入:n = 2, artifacts = [[0,0,0,0],[0,1,1,1]], dig = [[0,0],[0,1],[1,1]]
输出:2
解释:红色工件和蓝色工件的所有部分都裸露出来(用 'D' 标记),都可以提取。因此,返回 2 。
提示:
1 <= n <= 10001 <= artifacts.length, dig.length <= min(n2, 105)artifacts[i].length == 4dig[i].length == 20 <= r1i, c1i, r2i, c2i, ri, ci <= n - 1r1i <= r2ic1i <= c2i- 不存在重叠的两个工件
- 每个工件 最多 只覆盖
4个单元格 dig中的元素互不相同
方法一:哈希表 · Go 实现
思考
一件文物可取出,当且仅当其矩形内每个格子都已被挖到。若对每次挖掘都去改写 网格,再对每件文物扫描其格子, 且挖掘次数可达 ,网格本身可以承受,但文物至多占四个格子,不必真的铺开整张图。
挖掘位置互不相同,适合放入哈希集合 。对每件文物枚举其 中的格子,全部落在 中则答案加一。文物格子总数与挖掘次数同阶,时间 。
我们可以用哈希表 记录所有挖掘的单元格,然后遍历所有工件,判断工件的所有部分是否都在哈希表中,若是则可以提取该工件,答案加一。
时间复杂度 ,空间复杂度 ,其中 是工件的数量,而 是挖掘的单元格的数量。
func digArtifacts(n int, artifacts [][]int, dig [][]int) (ans int) {
	s := map[int]bool{}
	for _, p := range dig {
		s[p[0]*n+p[1]] = true
	}
	check := func(a []int) int {
		x1, y1, x2, y2 := a[0], a[1], a[2], a[3]
		for x := x1; x <= x2; x++ {
			for y := y1; y <= y2; y++ {
				if !s[x*n+y] {
					return 0
				}
			}
		}
		return 1
	}
	for _, a := range artifacts {
		ans += check(a)
	}
	return
}2215. 找出两数组的不同
题目、示例与约束
给你两个下标从 0 开始的整数数组 nums1 和 nums2 ,请你返回一个长度为 2 的列表 answer ,其中:
answer[0]是nums1中所有 不 存在于nums2中的 不同 整数组成的列表。answer[1]是nums2中所有 不 存在于nums1中的 不同 整数组成的列表。
注意:列表中的整数可以按 任意 顺序返回。
示例 1:
输入:nums1 = [1,2,3], nums2 = [2,4,6]
输出:[[1,3],[4,6]]
解释:
对于 nums1 ,nums1[1] = 2 出现在 nums2 中下标 0 处,然而 nums1[0] = 1 和 nums1[2] = 3 没有出现在 nums2 中。因此,answer[0] = [1,3]。
对于 nums2 ,nums2[0] = 2 出现在 nums1 中下标 1 处,然而 nums2[1] = 4 和 nums2[2] = 6 没有出现在 nums1 中。因此,answer[1] = [4,6]。
示例 2:
输入:nums1 = [1,2,3,3], nums2 = [1,1,2,2]
输出:[[3],[]]
解释:
对于 nums1 ,nums1[2] 和 nums1[3] 没有出现在 nums2 中。由于 nums1[2] == nums1[3] ,二者的值只需要在 answer[0] 中出现一次,故 answer[0] = [3]。
nums2 中的每个整数都在 nums1 中出现,因此,answer[1] = [] 。
提示:
1 <= nums1.length, nums2.length <= 1000-1000 <= nums1[i], nums2[i] <= 1000
方法一:哈希表 · Go 实现
思考
要分别给出只在 中出现、以及只在 中出现的不同元素。若对每个值都去另一数组线性查找, 可以过,但重复元素会被反复判断。
先把两个数组转成集合,去重后做差: 与 。哈希集合上的成员判断是期望常数时间,一次遍历即可。
我们定义两个哈希表 和 分别存储数组 和 中的元素。然后遍历 中的每个元素,如果该元素不在 中,那么将其加入到答案的第一个列表中。同理,遍历 中的每个元素,如果该元素不在 中,那么将其加入到答案的第二个列表中。
时间复杂度 ,空间复杂度 。其中 是数组的长度。
func findDifference(nums1 []int, nums2 []int) [][]int {
	s1, s2 := make(map[int]bool), make(map[int]bool)
	for _, v := range nums1 {
		s1[v] = true
	}
	for _, v := range nums2 {
		s2[v] = true
	}
	ans := make([][]int, 2)
	for v := range s1 {
		if !s2[v] {
			ans[0] = append(ans[0], v)
		}
	}
	for v := range s2 {
		if !s1[v] {
			ans[1] = append(ans[1], v)
		}
	}
	return ans
}2225. 找出输掉零场或一场比赛的玩家
题目、示例与约束
给你一个整数数组 matches 其中 matches[i] = [winneri, loseri] 表示在一场比赛中 winneri 击败了 loseri 。
返回一个长度为 2 的列表 answer :
answer[0]是所有 没有 输掉任何比赛的玩家列表。answer[1]是所有恰好输掉 一场 比赛的玩家列表。
两个列表中的值都应该按 递增 顺序返回。
注意:
- 只考虑那些参与 至少一场 比赛的玩家。
- 生成的测试用例保证 不存在 两场比赛结果 相同 。
示例 1:
输入:matches = [[1,3],[2,3],[3,6],[5,6],[5,7],[4,5],[4,8],[4,9],[10,4],[10,9]]
输出:[[1,2,10],[4,5,7,8]]
解释:
玩家 1、2 和 10 都没有输掉任何比赛。
玩家 4、5、7 和 8 每个都输掉一场比赛。
玩家 3、6 和 9 每个都输掉两场比赛。
因此,answer[0] = [1,2,10] 和 answer[1] = [4,5,7,8] 。
示例 2:
输入:matches = [[2,3],[1,3],[5,4],[6,4]]
输出:[[1,2,5,6],[]]
解释:
玩家 1、2、5 和 6 都没有输掉任何比赛。
玩家 3 和 4 每个都输掉两场比赛。
因此,answer[0] = [1,2,5,6] 和 answer[1] = [] 。
提示:
1 <= matches.length <= 105matches[i].length == 21 <= winneri, loseri <= 105winneri != loseri- 所有
matches[i]互不相同
方法一:哈希表 + 排序 · Go 实现
思考
要列出从未输过、以及恰好输过一场的选手,并各自升序。比赛场次达 ,选手编号也达 ,不宜开稠密数组再扫完全部编号。只关心出现过的人,输场次数是唯一需要累计的量。
哈希表 记下每人的败场:胜者若尚未出现则置 ,败者加一。再按编号排序后,把败场为 或 的人分别放入两个列表。排序决定时间 。
我们用一个哈希表 记录每个玩家输掉的比赛场次。
然后遍历哈希表,将输掉 场比赛的玩家放入 ,将输掉 场比赛的玩家放入 。
最后将 和 按照升序排序,返回结果。
时间复杂度 ,空间复杂度 。其中 为比赛场次数。
func findWinners(matches [][]int) [][]int {
	cnt := map[int]int{}
	for _, e := range matches {
		if _, ok := cnt[e[0]]; !ok {
			cnt[e[0]] = 0
		}
		cnt[e[1]]++
	}
	ans := make([][]int, 2)
	for x, v := range cnt {
		if v < 2 {
			ans[v] = append(ans[v], x)
		}
	}
	sort.Ints(ans[0])
	sort.Ints(ans[1])
	return ans
}继续阅读
- 实践案例
- 实践案例
- 实践案例