
LeetCode Go · 哈希表(6)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
2711. 对角线上不同值的数量差
题目、示例与约束
给你一个下标从 0 开始、大小为 m x n 的二维矩阵 grid ,请你求解大小同样为 m x n 的答案矩阵 answer 。
矩阵 answer 中每个单元格 (r, c) 的值可以按下述方式进行计算:
- 令
topLeft[r][c]为矩阵grid中单元格(r, c)左上角对角线上 不同值 的数量。 - 令
bottomRight[r][c]为矩阵grid中单元格(r, c)右下角对角线上 不同值 的数量。
然后 answer[r][c] = |topLeft[r][c] - bottomRight[r][c]| 。
返回矩阵 answer 。
矩阵对角线 是从最顶行或最左列的某个单元格开始,向右下方向走到矩阵末尾的对角线。
如果单元格 (r1, c1) 和单元格 (r, c) 属于同一条对角线且 r1 < r ,则单元格 (r1, c1) 属于单元格 (r, c) 的左上对角线。类似地,可以定义右下对角线。
示例 1:
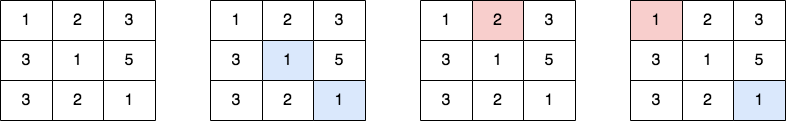
输入:grid = [[1,2,3],[3,1,5],[3,2,1]]
输出:[[1,1,0],[1,0,1],[0,1,1]]
解释:第 1 个图表示最初的矩阵 grid 。
第 2 个图表示对单元格 (0,0) 计算,其中蓝色单元格是位于右下对角线的单元格。
第 3 个图表示对单元格 (1,2) 计算,其中红色单元格是位于左上对角线的单元格。
第 4 个图表示对单元格 (1,1) 计算,其中蓝色单元格是位于右下对角线的单元格,红色单元格是位于左上对角线的单元格。
- 单元格 (0,0) 的右下对角线包含 [1,1] ,而左上对角线包含 [] 。对应答案是 |1 - 0| = 1 。
- 单元格 (1,2) 的右下对角线包含 [] ,而左上对角线包含 [2] 。对应答案是 |0 - 1| = 1 。
- 单元格 (1,1) 的右下对角线包含 [1] ,而左上对角线包含 [1] 。对应答案是 |1 - 1| = 0 。
其他单元格的对应答案也可以按照这样的流程进行计算。
示例 2:
输入:grid = [[1]]
输出:[[0]]
解释:- 单元格 (0,0) 的右下对角线包含 [] ,左上对角线包含 [] 。对应答案是 |0 - 0| = 0 。
提示:
m == grid.lengthn == grid[i].length1 <= m, n, grid[i][j] <= 50
方法一:模拟 · Go 实现
思考
每个格子的答案是左上对角与右下对角上不同值个数之差的绝对值。矩阵边长不超过 ,对每个格子沿两条对角扫描并入集合,总代价为 ,可以接受。
不必预处理整条对角:以 为起点分别向左上、右下走,用集合去重后取模长之差即可。
我们可以按照题目描述的流程模拟,计算出每个单元格的左上角对角线上不同值的数量 和右下角对角线上不同值的数量 ,然后计算它们的差值 。
时间复杂度 ,空间复杂度 。
func differenceOfDistinctValues(grid [][]int) [][]int {
	m, n := len(grid), len(grid[0])
	ans := make([][]int, m)
	for i := range grid {
		ans[i] = make([]int, n)
		for j := range grid[i] {
			x, y := i, j
			s := map[int]bool{}
			for x > 0 && y > 0 {
				x, y = x-1, y-1
				s[grid[x][y]] = true
			}
			tl := len(s)
			x, y = i, j
			s = map[int]bool{}
			for x+1 < m && y+1 < n {
				x, y = x+1, y+1
				s[grid[x][y]] = true
			}
			br := len(s)
			ans[i][j] = abs(tl - br)
		}
	}
	return ans
}

func abs(x int) int {
	if x < 0 {
		return -x
	}
	return x
}2716. 最小化字符串长度
题目、示例与约束
给你一个下标从 0 开始的字符串 s ,重复执行下述操作 任意 次:
- 在字符串中选出一个下标
i,并使c为字符串下标i处的字符。并在i左侧(如果有)和 右侧(如果有)各 删除 一个距离i最近 的字符c。
请你通过执行上述操作任意次,使 s 的长度 最小化 。
返回一个表示 最小化 字符串的长度的整数。
示例 1:
输入:s = "aaabc"
输出:3
解释:在这个示例中,s 等于 "aaabc" 。我们可以选择位于下标 1 处的字符 'a' 开始。接着删除下标 1 左侧最近的那个 'a'(位于下标 0)以及下标 1 右侧最近的那个 'a'(位于下标 2)。执行操作后,字符串变为 "abc" 。继续对字符串执行任何操作都不会改变其长度。因此,最小化字符串的长度是 3 。
示例 2:
输入:s = "cbbd"
输出:3
解释:我们可以选择位于下标 1 处的字符 'b' 开始。下标 1 左侧不存在字符 'b' ,但右侧存在一个字符 'b'(位于下标 2),所以会删除位于下标 2 的字符 'b' 。执行操作后,字符串变为 "cbd" 。继续对字符串执行任何操作都不会改变其长度。因此,最小化字符串的长度是 3 。
示例 3:
输入:s = "dddaaa"
输出:2
解释:我们可以选择位于下标 1 处的字符 'd' 开始。接着删除下标 1 左侧最近的那个 'd'(位于下标 0)以及下标 1 右侧最近的那个 'd'(位于下标 2)。执行操作后,字符串变为 "daaa" 。继续对新字符串执行操作,可以选择位于下标 2 的字符 'a' 。接着删除下标 2 左侧最近的那个 'a'(位于下标 1)以及下标 2 右侧最近的那个 'a'(位于下标 3)。执行操作后,字符串变为 "da" 。继续对字符串执行任何操作都不会改变其长度。因此,最小化字符串的长度是 2 。
提示:
1 <= s.length <= 100s仅由小写英文字母组成
方法一:哈希表 · Go 实现
思考
操作是删掉某字符两侧与之相同的出现,最终长度等于无法再删时剩下的字符数。模拟删除需要反复扫描,而一次操作并不会消灭某种字符的全部出现。
每种字符无论出现多少次,最终恰好留下一个。因此答案就是不同字符的个数,对 建集合取大小即可。
题目实际上可以转化为求字符串中不同字符的个数,因此,我们只需要统计字符串中不同字符的个数即可。
时间复杂度 ,其中 是字符串 的长度。空间复杂度 ,其中 是字符集,这里是小写英文字母,因此 。
func minimizedStringLength(s string) int {
	ss := map[rune]struct{}{}
	for _, c := range s {
		ss[c] = struct{}{}
	}
	return len(ss)
}2718. 查询后矩阵的和
题目、示例与约束
给你一个整数 n 和一个下标从 0 开始的 二维数组 queries ,其中 queries[i] = [typei, indexi, vali] 。
一开始,给你一个下标从 0 开始的 n x n 矩阵,所有元素均为 0 。每一个查询,你需要执行以下操作之一:
- 如果
typei == 0,将第indexi行的元素全部修改为vali,覆盖任何之前的值。 - 如果
typei == 1,将第indexi列的元素全部修改为vali,覆盖任何之前的值。
请你执行完所有查询以后,返回矩阵中所有整数的和。
示例 1:
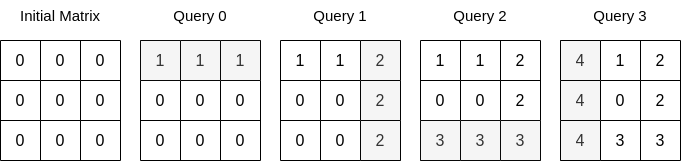
输入:n = 3, queries = [[0,0,1],[1,2,2],[0,2,3],[1,0,4]]
输出:23
解释:上图展示了每个查询以后矩阵的值。所有操作执行完以后,矩阵元素之和为 23 。
示例 2:
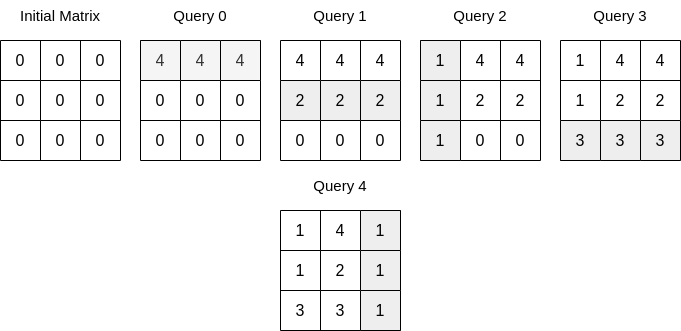
输入:n = 3, queries = [[0,0,4],[0,1,2],[1,0,1],[0,2,3],[1,2,1]]
输出:17
解释:上图展示了每一个查询操作之后的矩阵。所有操作执行完以后,矩阵元素之和为 17 。
提示:
1 <= n <= 1041 <= queries.length <= 5 * 104queries[i].length == 30 <= typei <= 10 <= indexi < n0 <= vali <= 105
方法一:哈希表 · Go 实现
思考
对 矩阵依次执行行、列赋值,求最终元素和。 可达 ,物化矩阵不可行;同一行或列只保留最后一次赋值。
倒序扫描查询:首次遇到的行(列)才真正生效,它覆盖的格子数是尚未被列(行)占用的剩余宽度。用两个集合记下已生效的行、列,把 乘上剩余格数累加。
由于每一行、每一列的值取决于最后一次的修改,因此,我们不妨倒序遍历所有的查询,使用哈希表 和 记录有哪些行和列被修改过。
对于每一次查询 :
- 如果 ,那么我们判断第 行是否被修改过,如果没有,那么我们将 累加到答案中,其中 表示 的大小,然后将 加入 中;
- 如果 ,那么我们判断第 列是否被修改过,如果没有,那么我们将 累加到答案中,其中 表示 的大小,然后将 加入 中。
最后返回答案。
时间复杂度 ,空间复杂度 。其中 表示查询的次数。
func matrixSumQueries(n int, queries [][]int) (ans int64) {
	row, col := map[int]bool{}, map[int]bool{}
	m := len(queries)
	for k := m - 1; k >= 0; k-- {
		t, i, v := queries[k][0], queries[k][1], queries[k][2]
		if t == 0 {
			if !row[i] {
				ans += int64(v * (n - len(col)))
				row[i] = true
			}
		} else {
			if !col[i] {
				ans += int64(v * (n - len(row)))
				col[i] = true
			}
		}
	}
	return
}2744. 最大字符串配对数目
题目、示例与约束
给你一个下标从 0 开始的数组 words ,数组中包含 互不相同 的字符串。
如果字符串 words[i] 与字符串 words[j] 满足以下条件,我们称它们可以匹配:
- 字符串
words[i]等于words[j]的反转字符串。 0 <= i < j < words.length
请你返回数组 words 中的 最大 匹配数目。
注意,每个字符串最多匹配一次。
示例 1:
输入:words = ["cd","ac","dc","ca","zz"]
输出:2
解释:在此示例中,我们可以通过以下方式匹配 2 对字符串:
- 我们将第 0 个字符串与第 2 个字符串匹配,因为 word[0] 的反转字符串是 "dc" 并且等于 words[2]。
- 我们将第 1 个字符串与第 3 个字符串匹配,因为 word[1] 的反转字符串是 "ca" 并且等于 words[3]。
可以证明最多匹配数目是 2 。
示例 2:
输入:words = ["ab","ba","cc"]
输出:1
解释:在此示例中,我们可以通过以下方式匹配 1 对字符串:
- 我们将第 0 个字符串与第 1 个字符串匹配,因为 words[1] 的反转字符串 "ab" 与 words[0] 相等。
可以证明最多匹配数目是 1 。
示例 3:
输入:words = ["aa","ab"]
输出:0
解释:这个例子中,无法匹配任何字符串。
提示:
1 <= words.length <= 50words[i].length == 2words包含的字符串互不相同。words[i]只包含小写英文字母。
方法一:哈希表 · Go 实现
思考
两个互为反转且下标不同的字符串可配成一对,每个字符串至多用一次。排序后双指针匹配可行,但字符串长度为 ,在线统计更直接。
从左到右扫描:当前串的反转若已出现则配成一对,再把当前串计入哈希表。因每个串只用一次,计数取到即配对。
我们可以用哈希表 来存储数组 中每个字符串的反转字符串出现的次数。
遍历数组 ,对于每个字符串 ,我们将其反转字符串 的出现次数加到答案中,然后将 的出现次数加 。
最后返回答案。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func maximumNumberOfStringPairs(words []string) (ans int) {
	cnt := map[int]int{}
	for _, w := range words {
		a, b := int(w[0]-'a'), int(w[1]-'a')
		ans += cnt[b<<5|a]
		cnt[a<<5|b]++
	}
	return
}2763. 所有子数组中不平衡数字之和
题目、示例与约束
一个长度为 n 下标从 0 开始的整数数组 arr 的 不平衡数字 定义为,在 sarr = sorted(arr) 数组中,满足以下条件的下标数目:
0 <= i < n - 1,和sarr[i+1] - sarr[i] > 1
这里,sorted(arr) 表示将数组 arr 排序后得到的数组。
给你一个下标从 0 开始的整数数组 nums ,请你返回它所有 子数组 的 不平衡数字 之和。
子数组指的是一个数组中连续一段 非空 的元素序列。
示例 1:
输入:nums = [2,3,1,4]
输出:3
解释:总共有 3 个子数组有非 0 不平衡数字:
- 子数组 [3, 1] ,不平衡数字为 1 。
- 子数组 [3, 1, 4] ,不平衡数字为 1 。
- 子数组 [1, 4] ,不平衡数字为 1 。
其他所有子数组的不平衡数字都是 0 ,所以所有子数组的不平衡数字之和为 3 。
示例 2:
输入:nums = [1,3,3,3,5]
输出:8
解释:总共有 7 个子数组有非 0 不平衡数字:
- 子数组 [1, 3] ,不平衡数字为 1 。
- 子数组 [1, 3, 3] ,不平衡数字为 1 。
- 子数组 [1, 3, 3, 3] ,不平衡数字为 1 。
- 子数组 [1, 3, 3, 3, 5] ,不平衡数字为 2 。
- 子数组 [3, 3, 3, 5] ,不平衡数字为 1 。
- 子数组 [3, 3, 5] ,不平衡数字为 1 。
- 子数组 [3, 5] ,不平衡数字为 1 。
其他所有子数组的不平衡数字都是 0 ,所以所有子数组的不平衡数字之和为 8 。
提示:
1 <= nums.length <= 10001 <= nums[i] <= nums.length
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
方法一:枚举
由于 至多为 ,我们可以从左到右枚举子数组左端点 ,然后从 开始向右枚举子数组右端点 。一边枚举 ,一边维护不平衡度 :
- 如果 之前出现过,那么子数组排序后必然会和另一个 相邻, 不变;
- 如果 之前没出现过,那么看 和 是否出现过:
- 都没有, 加一;
- 只有一个, 不变;
- 两个都有, 减一。
遍历过程中,累加 ,即为答案。
复杂度分析
- 时间复杂度:,其中 为 的长度。
- 空间复杂度:。
方法二:贡献法
视频讲解见【周赛 352】第四题。
考察 能为答案贡献多少不平衡数字。换句话说,有多少个包含 的子数组,
为了避免重复统计,不妨规定只考察 和比 小的最大的数,它们之间是否会产生贡献。
如果还考察 和比 大的最小的数 ,那么在考察 的时候, 和 之间又统计了一遍。
有以下几种情况:
- 是子数组的最小值,这种情况不能计入贡献。
- 如果子数组中有 ,这种情况不能计入贡献。
- 如果子数组中没有 和 ,那么 会产生一个贡献。
- 如果子数组中没有 ,但是有 呢?比如某个子数组为 ,第一个 会和 算一次贡献,第二个 如果又和 又算了一次贡献,那么就重复统计了。为了避免重复统计,下面规定每个 向右计算子数组范围时,只
复杂度分析
- 时间复杂度:,其中 为 的长度。
- 空间复杂度:。
思考题
把 sarr[i+1] - sarr[i] > 1 改成 sarr[i+1] - sarr[i] > k 要怎么做?欢迎在评论区发表你的思路。
// https://space.bilibili.com/206214
func sumImbalanceNumbers(nums []int) (ans int) {
	n := len(nums)
	for i, x := range nums {
		vis := make([]int, n+2)
		vis[x] = 1
		cnt := 0
		for j := i + 1; j < n; j++ {
			if x := nums[j]; vis[x] == 0 {
				cnt--
				cnt += 1 ^ vis[x-1] // 巧妙的是,如果 x 左边没有任何数字,这也算也是对的
				cnt += 1 ^ vis[x+1]
				vis[x] = 1
			}
			ans += cnt
		}
	}
	return
}

func min(a, b int) int {
	if b < a {
		return b
	}
	return a
}2766. 重新放置石块
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums ,表示一些石块的初始位置。再给你两个长度 相等 下标从 0 开始的整数数组 moveFrom 和 moveTo 。
在 moveFrom.length 次操作内,你将改变石块的位置。在第 i 次操作中,你将位置在 moveFrom[i] 的所有石块移到位置 moveTo[i] 。
完成这些操作后,请你按升序返回所有 有 石块的位置。
注意:
- 如果一个位置至少有一个石块,我们称这个位置 有 石块。
- 一个位置可能会有多个石块。
示例 1:
输入:nums = [1,6,7,8], moveFrom = [1,7,2], moveTo = [2,9,5]
输出:[5,6,8,9]
解释:一开始,石块在位置 1,6,7,8 。
第 i = 0 步操作中,我们将位置 1 处的石块移到位置 2 处,位置 2,6,7,8 有石块。
第 i = 1 步操作中,我们将位置 7 处的石块移到位置 9 处,位置 2,6,8,9 有石块。
第 i = 2 步操作中,我们将位置 2 处的石块移到位置 5 处,位置 5,6,8,9 有石块。
最后,至少有一个石块的位置为 [5,6,8,9] 。
示例 2:
输入:nums = [1,1,3,3], moveFrom = [1,3], moveTo = [2,2]
输出:[2]
解释:一开始,石块在位置 [1,1,3,3] 。
第 i = 0 步操作中,我们将位置 1 处的石块移到位置 2 处,有石块的位置为 [2,2,3,3] 。
第 i = 1 步操作中,我们将位置 3 处的石块移到位置 2 处,有石块的位置为 [2,2,2,2] 。
由于 2 是唯一有石块的位置,我们返回 [2] 。
提示:
1 <= nums.length <= 1051 <= moveFrom.length <= 105moveFrom.length == moveTo.length1 <= nums[i], moveFrom[i], moveTo[i] <= 109- 测试数据保证在进行第
i步操作时,moveFrom[i]处至少有一个石块。
方法一:哈希表 · Go 实现
思考
每次把某一位置上的全部石子移到另一位置,求最终有石子的位置。同一位置可堆叠,数组模拟移动需要反复查找。
用集合保存有石子的坐标:移出时删除起点,移入时加入终点。最后排序输出。
我们用一个哈希表 记录所有有石块的位置,初始时 中包含 中的所有元素。然后我们遍历 和 ,每次将 从 中移除,再将 添加到 中。最后我们将 中的元素排序后返回即可。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func relocateMarbles(nums []int, moveFrom []int, moveTo []int) (ans []int) {
	pos := map[int]bool{}
	for _, x := range nums {
		pos[x] = true
	}
	for i, f := range moveFrom {
		t := moveTo[i]
		pos[f] = false
		pos[t] = true
	}
	for x, ok := range pos {
		if ok {
			ans = append(ans, x)
		}
	}
	sort.Ints(ans)
	return
}2768. 黑格子的数目
题目、示例与约束
给你两个整数 m 和 n ,表示一个下标从 0 开始的 m x n 的网格图。
给你一个下标从 0 开始的二维整数矩阵 coordinates ,其中 coordinates[i] = [x, y] 表示坐标为 [x, y] 的格子是 黑色的 ,所有没出现在 coordinates 中的格子都是 白色的。
一个块定义为网格图中 2 x 2 的一个子矩阵。更正式的,对于左上角格子为 [x, y] 的块,其中 0 <= x < m - 1 且 0 <= y < n - 1 ,包含坐标为 [x, y] ,[x + 1, y] ,[x, y + 1] 和 [x + 1, y + 1] 的格子。
请你返回一个下标从 0 开始长度为 5 的整数数组 arr ,arr[i] 表示恰好包含 i 个 黑色 格子的块的数目。
示例 1:
输入:m = 3, n = 3, coordinates = [[0,0]] 输出:[3,1,0,0,0] 解释:网格图如下:只有 1 个块有一个黑色格子,这个块是左上角为 [0,0] 的块。 其他 3 个左上角分别为 [0,1] ,[1,0] 和 [1,1] 的块都有 0 个黑格子。 所以我们返回 [3,1,0,0,0] 。
示例 2:
输入:m = 3, n = 3, coordinates = [[0,0],[1,1],[0,2]] 输出:[0,2,2,0,0] 解释:网格图如下:有 2 个块有 2 个黑色格子(左上角格子分别为 [0,0] 和 [0,1])。 左上角为 [1,0] 和 [1,1] 的两个块,都有 1 个黑格子。 所以我们返回 [0,2,2,0,0] 。
提示:
2 <= m <= 1052 <= n <= 1050 <= coordinates.length <= 104coordinates[i].length == 20 <= coordinates[i][0] < m0 <= coordinates[i][1] < ncoordinates中的坐标对两两互不相同。
方法一:哈希表计数 · Go 实现
思考
统计每个 块中黑格个数的直方图。块数为 ,矩阵可达 ,不能扫全部块。
每个黑格只影响以其为角的至多四个块。用哈希表给这些块的黑格数加一,再按出现的次数填 , 为总块数减表的大小。
对于每个 的子矩阵,我们可以用其左上角的坐标 来表示它。
而对于每个黑格子 ,它对 个子矩阵的贡献为 ,即矩阵 , , , 。
因此,我们遍历所有的黑格子,然后累计每个子矩阵中黑格子的个数,记录在哈希表 中。
最后,我们遍历 中的所有值(大于 ),统计其出现的次数,记录在答案数组 中,而 则表示没有黑格子的子矩阵的个数,值为 。
时间复杂度 ,空间复杂度 ,其中 为 的长度。
func countBlackBlocks(m int, n int, coordinates [][]int) []int64 {
	cnt := map[int64]int{}
	dirs := [5]int{0, 0, -1, -1, 0}
	for _, e := range coordinates {
		x, y := e[0], e[1]
		for k := 0; k < 4; k++ {
			i, j := x+dirs[k], y+dirs[k+1]
			if i >= 0 && i < m-1 && j >= 0 && j < n-1 {
				cnt[int64(i*n+j)]++
			}
		}
	}
	ans := make([]int64, 5)
	ans[0] = int64((m - 1) * (n - 1))
	for _, x := range cnt {
		ans[x]++
		ans[0]--
	}
	return ans
}2780. 合法分割的最小下标
题目、示例与约束
如果在长度为 m 的整数数组 arr 中 超过一半 的元素值为 x,那么我们称 x 是 支配元素 。
给你一个下标从 0 开始长度为 n 的整数数组 nums ,数据保证它含有一个 支配 元素。
你需要在下标 i 处将 nums 分割成两个数组 nums[0, ..., i] 和 nums[i + 1, ..., n - 1] ,如果一个分割满足以下条件,我们称它是 合法 的:
0 <= i < n - 1nums[0, ..., i]和nums[i + 1, ..., n - 1]的支配元素相同。
这里, nums[i, ..., j] 表示 nums 的一个子数组,它开始于下标 i ,结束于下标 j ,两个端点都包含在子数组内。特别地,如果 j < i ,那么 nums[i, ..., j] 表示一个空数组。
请你返回一个 合法分割 的 最小 下标。如果合法分割不存在,返回 -1 。
示例 1:
输入:nums = [1,2,2,2]
输出:2
解释:我们将数组在下标 2 处分割,得到 [1,2,2] 和 [2] 。
数组 [1,2,2] 中,元素 2 是支配元素,因为它在数组中出现了 2 次,且 2 * 2 > 3 。
数组 [2] 中,元素 2 是支配元素,因为它在数组中出现了 1 次,且 1 * 2 > 1 。
两个数组 [1,2,2] 和 [2] 都有与 nums 一样的支配元素,所以这是一个合法分割。
下标 2 是合法分割中的最小下标。
示例 2:
输入:nums = [2,1,3,1,1,1,7,1,2,1]
输出:4
解释:我们将数组在下标 4 处分割,得到 [2,1,3,1,1] 和 [1,7,1,2,1] 。
数组 [2,1,3,1,1] 中,元素 1 是支配元素,因为它在数组中出现了 3 次,且 3 * 2 > 5 。
数组 [1,7,1,2,1] 中,元素 1 是支配元素,因为它在数组中出现了 3 次,且 3 * 2 > 5 。
两个数组 [2,1,3,1,1] 和 [1,7,1,2,1] 都有与 nums 一样的支配元素,所以这是一个合法分割。
下标 4 是所有合法分割中的最小下标。
示例 3:
输入:nums = [3,3,3,3,7,2,2]
输出:-1
解释:没有合法分割。
提示:
1 <= nums.length <= 1051 <= nums[i] <= 109nums有且只有一个支配元素。
方法一:哈希表 · Go 实现
思考
合法分割要求左右两段的支配元素相同。支配元素是出现次数严格过半者,整个数组的支配元素若存在则唯一,分割后也必须是它。
先用计数找出全局众数 及其频次,再扫前缀累计 的次数,当左右两段都严格过半时返回当前下标。
我们用哈希表统计每个元素出现的次数,然后找出出现次数最多的元素 ,即为支配元素。要使得分割后的两个数组中都有支配元素,且支配元素相同,那么支配元素一定是 。
接下来,我们只需要遍历数组 ,累加前缀中 的出现次数 ,并判断 在后缀中出现的次数是否满足要求即可。如果满足要求,那么当前下标 就是一个可行的分割下标,我们只需要选择所有可行分割下标中最小的那个即可。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func minimumIndex(nums []int) int {
	x, cnt := 0, 0
	freq := map[int]int{}
	for _, v := range nums {
		freq[v]++
		if freq[v] > cnt {
			x, cnt = v, freq[v]
		}
	}
	cur := 0
	for i, v := range nums {
		i++
		if v == x {
			cur++
			if cur*2 > i && (cnt-cur)*2 > len(nums)-i {
				return i - 1
			}
		}
	}
	return -1
}2784. 检查数组是否是好的
题目、示例与约束
给你一个整数数组 nums ,如果它是数组 base[n] 的一个排列,我们称它是个 好 数组。
base[n] = [1, 2, ..., n - 1, n, n] (换句话说,它是一个长度为 n + 1 且包含 1 到 n - 1 恰好各一次,包含 n 两次的一个数组)。比方说,base[1] = [1, 1] ,base[3] = [1, 2, 3, 3] 。
如果数组是一个好数组,请你返回 true ,否则返回 false 。
注意:数组的排列是这些数字按任意顺序排布后重新得到的数组。
示例 1:
输入:nums = [2, 1, 3]
输出:false
解释:因为数组的最大元素是 3 ,唯一可以构成这个数组的 base[n] 对应的 n = 3 。但是 base[3] 有 4 个元素,但数组 nums 只有 3 个元素,所以无法得到 base[3] = [1, 2, 3, 3] 的排列,所以答案为 false 。
示例 2:
输入:nums = [1, 3, 3, 2]
输出:true
解释:因为数组的最大元素是 3 ,唯一可以构成这个数组的 base[n] 对应的 n = 3 ,可以看出数组是 base[3] = [1, 2, 3, 3] 的一个排列(交换 nums 中第二个和第四个元素)。所以答案为 true 。
示例 3:
输入:nums = [1, 1]
输出:true
解释:因为数组的最大元素是 1 ,唯一可以构成这个数组的 base[n] 对应的 n = 1,可以看出数组是 base[1] = [1, 1] 的一个排列。所以答案为 true 。
示例 4:
输入:nums = [3, 4, 4, 1, 2, 1]
输出:false
解释:因为数组的最大元素是 4 ,唯一可以构成这个数组的 base[n] 对应的 n = 4 。但是 base[n] 有 5 个元素而 nums 有 6 个元素。所以答案为 false 。
提示:
1 <= nums.length <= 1001 <= num[i] <= 200
方法一:计数 · Go 实现
思考
好数组应是 各一次再加上两个 ,其中 。排序后与构造出的基准数组比较可行,但只需频次。
计数后检查 恰好出现两次,且 到 均至少出现一次(长度已固定,等价于各一次)。
我们可以用一个哈希表或数组 记录数组 中每个元素出现的次数。然后我们判断是否满足以下条件:
- ,即数组中最大的元素出现了两次;
- 对于 ,均满足 ,即数组中除了最大的元素外,其他元素都只出现了一次。
如果满足以上两个条件,那么数组 是一个好数组,否则不是。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func isGood(nums []int) bool {
	n := len(nums) - 1
	cnt := [201]int{}
	for _, x := range nums {
		cnt[x]++
	}
	if cnt[n] != 2 {
		return false
	}
	for i := 1; i < n; i++ {
		if cnt[i] != 1 {
			return false
		}
	}
	return true
}2808. 使循环数组所有元素相等的最少秒数
题目、示例与约束
给你一个下标从 0 开始长度为 n 的数组 nums 。
每一秒,你可以对数组执行以下操作:
- 对于范围在
[0, n - 1]内的每一个下标i,将nums[i]替换成nums[i],nums[(i - 1 + n) % n]或者nums[(i + 1) % n]三者之一。
注意,所有元素会被同时替换。
请你返回将数组 nums 中所有元素变成相等元素所需要的 最少 秒数。
示例 1:
输入:nums = [1,2,1,2]
输出:1
解释:我们可以在 1 秒内将数组变成相等元素:
- 第 1 秒,将每个位置的元素分别变为 [nums[3],nums[1],nums[3],nums[3]] 。变化后,nums = [2,2,2,2] 。
1 秒是将数组变成相等元素所需要的最少秒数。
示例 2:
输入:nums = [2,1,3,3,2]
输出:2
解释:我们可以在 2 秒内将数组变成相等元素:
- 第 1 秒,将每个位置的元素分别变为 [nums[0],nums[2],nums[2],nums[2],nums[3]] 。变化后,nums = [2,3,3,3,3] 。
- 第 2 秒,将每个位置的元素分别变为 [nums[1],nums[1],nums[2],nums[3],nums[4]] 。变化后,nums = [3,3,3,3,3] 。
2 秒是将数组变成相等元素所需要的最少秒数。
示例 3:
输入:nums = [5,5,5,5]
输出:0
解释:不需要执行任何操作,因为一开始数组中的元素已经全部相等。
提示:
1 <= n == nums.length <= 1051 <= nums[i] <= 109
方法一:枚举 · Go 实现
思考
最终相等的值必为数组中已出现的某个 。每个 每秒向两侧扩散一格,环上耗时由相邻两个 的最大间距(含首尾相接)的一半决定。按值收集下标后枚举每种 ,取最小的 。
我们假设最终所有元素都变成了 ,那么 一定是数组中的某个元素。
数字 每一秒都可以向左右两边扩展一位,如果有多个相同的 ,那么扩展完整个数组所需要的时间,就取决于相邻两个 之间的最大间距。
因此,我们枚举每个元素作为最终的 ,计算出每个 中相邻两个元素之间的最大间距,记为 ,那么最终答案就是 。
时间复杂度 ,空间复杂度 。其中 是数组的长度。
func minimumSeconds(nums []int) int {
	d := map[int][]int{}
	for i, x := range nums {
		d[x] = append(d[x], i)
	}
	ans := 1 << 30
	n := len(nums)
	for _, idx := range d {
		m := len(idx)
		t := idx[0] + n - idx[m-1]
		for i := 1; i < m; i++ {
			t = max(t, idx[i]-idx[i-1])
		}
		ans = min(ans, t/2)
	}
	return ans
}2815. 数组中的最大数对和
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums 。请你从 nums 中找出和 最大 的一对数,且这两个数数位上最大的数字相等。
返回最大和,如果不存在满足题意的数字对,返回 -1 。
示例 1:
输入:nums = [51,71,17,24,42]
输出:88
解释:
i = 1 和 j = 2 ,nums[i] 和 nums[j] 数位上最大的数字相等,且这一对的总和 71 + 17 = 88 。
i = 3 和 j = 4 ,nums[i] 和 nums[j] 数位上最大的数字相等,且这一对的总和 24 + 42 = 66 。
可以证明不存在其他数对满足数位上最大的数字相等,所以答案是 88 。
示例 2:
输入:nums = [1,2,3,4]
输出:-1
解释:不存在数对满足数位上最大的数字相等。
提示:
2 <= nums.length <= 1001 <= nums[i] <= 104
方法一:枚举 · Go 实现
思考
,枚举所有数对并比较十进制最大数位即可判断是否合法。无需先按最大数位分组再取最大的两个数。
我们先初始化答案变量 。接下来,直接枚举所有的数对 ,其中 ,并计算它们的和 。如果 比 更大,并且 和 的最大数字相同,那么我们就用 更新 。
时间复杂度 ,其中 是数组的长度,而 是数组中的最大值。
func maxSum(nums []int) int {
	ans := -1
	f := func(x int) int {
		y := 0
		for ; x > 0; x /= 10 {
			y = max(y, x%10)
		}
		return y
	}
	for i, x := range nums {
		for _, y := range nums[i+1:] {
			if v := x + y; ans < v && f(x) == f(y) {
				ans = v
			}
		}
	}
	return ans
}2840. 判断通过操作能否让字符串相等 II
题目、示例与约束
给你两个字符串 s1 和 s2 ,两个字符串长度都为 n ,且只包含 小写 英文字母。
你可以对两个字符串中的 任意一个 执行以下操作 任意 次:
- 选择两个下标
i和j,满足i < j且j - i是 偶数,然后 交换 这个字符串中两个下标对应的字符。
如果你可以让字符串 s1 和 s2 相等,那么返回 true ,否则返回 false 。
示例 1:
输入:s1 = "abcdba", s2 = "cabdab"
输出:true
解释:我们可以对 s1 执行以下操作:
- 选择下标 i = 0 ,j = 2 ,得到字符串 s1 = "cbadba" 。
- 选择下标 i = 2 ,j = 4 ,得到字符串 s1 = "cbbdaa" 。
- 选择下标 i = 1 ,j = 5 ,得到字符串 s1 = "cabdab" = s2 。
示例 2:
输入:s1 = "abe", s2 = "bea"
输出:false
解释:无法让两个字符串相等。
提示:
n == s1.length == s2.length1 <= n <= 105s1和s2只包含小写英文字母。
方法一:计数 · Go 实现
思考
操作仍只能交换同奇偶下标,与上一题相同,只是长度更大。偶数位与奇数位各自可任意重排,两组计数相等即可。
我们观察题目中的操作,可以发现,如果字符串的两个下标 和 的奇偶性相同,那么它们可以通过交换改变顺序。
因此,我们可以统计两个字符串中奇数下标的字符的出现次数,以及偶数下标的字符的出现次数,如果两个字符串的统计结果相同,那么我们就可以通过操作使得两个字符串相等。
时间复杂度 ,空间复杂度 。其中 是字符串的长度,而 是字符集。
相似题目:
func checkStrings(s1 string, s2 string) bool {
	cnt := [2][26]int{}
	for i := 0; i < len(s1); i++ {
		cnt[i&1][s1[i]-'a']++
		cnt[i&1][s2[i]-'a']--
	}
	for i := 0; i < 26; i++ {
		if cnt[0][i] != 0 || cnt[1][i] != 0 {
			return false
		}
	}
	return true
}2898. 最大线性股票得分 🔒
题目、示例与约束
给定一个 1-indexed 整数数组 prices,其中 prices[i] 是第 i 天某只股票的价格。你的任务是 线性 地选择 prices 中的一些元素。
一个选择 indexes,其中 indexes 是一个 1-indexed 整数数组,长度为 k,是数组 [1, 2, ..., n] 的子序列,如果以下条件成立,那么它是 线性 的:
- 对于每个
1 < j <= k,prices[indexes[j]] - prices[indexes[j - 1]] == indexes[j] - indexes[j - 1]。
数组的 子序列 是经由原数组删除一些元素(可能不删除)而产生的新数组,且删除不改变其余元素相对顺序。
选择 indexes 的 得分 等于以下数组的总和:[prices[indexes[1]], prices[indexes[2]], ..., prices[indexes[k]]。
返回 线性选择的 最大得分。
示例 1:
输入: prices = [1,5,3,7,8]
输出: 20
解释: 我们可以选择索引[2,4,5]。我们可以证明我们的选择是线性的:
对于j = 2,我们有:
indexes[2] - indexes[1] = 4 - 2 = 2。
prices[4] - prices[2] = 7 - 5 = 2。
对于j = 3,我们有:
indexes[3] - indexes[2] = 5 - 4 = 1。
prices[5] - prices[4] = 8 - 7 = 1。
元素的总和是:prices[2] + prices[4] + prices[5] = 20。
可以证明线性选择的最大和是20。
示例 2:
输入: prices = [5,6,7,8,9]
输出: 35
解释: 我们可以选择所有索引[1,2,3,4,5]。因为每个元素与前一个元素的差异恰好为1,所以我们的选择是线性的。
所有元素的总和是35,这是每个选择的最大可能总和。
提示:
1 <= prices.length <= 1051 <= prices[i] <= 109
方法一:哈希表 · Go 实现
思考
线性股票要求 为常数。按 分组并累加组内价格,最大组和即为最高线性得分。
我们可以将式子进行变换,得到:
题目实际上求的是相同的 下,所有 的和的最大值和。
因此,我们可以用一个哈希表 来存储 下,所有 的和,最后取哈希表中的最大值即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func maxScore(prices []int) (ans int64) {
	cnt := map[int]int{}
	for i, x := range prices {
		cnt[x-i] += x
	}
	for _, v := range cnt {
		ans = max(ans, int64(v))
	}
	return
}2933. 高访问员工
题目、示例与约束
给你一个长度为 n 、下标从 0 开始的二维字符串数组 access_times 。对于每个 i(0 <= i <= n - 1 ),access_times[i][0] 表示某位员工的姓名,access_times[i][1] 表示该员工的访问时间。access_times 中的所有条目都发生在同一天内。
访问时间用 四位 数字表示, 符合 24 小时制 ,例如 "0800" 或 "2250" 。
如果员工在 同一小时内 访问系统 三次或更多 ,则称其为 高访问 员工。
时间间隔正好相差一小时的时间 不 被视为同一小时内。例如,"0815" 和 "0915" 不属于同一小时内。
一天开始和结束时的访问时间不被计算为同一小时内。例如,"0005" 和 "2350" 不属于同一小时内。
以列表形式,按任意顺序,返回所有 高访问 员工的姓名。
示例 1:
输入:access_times = [["a","0549"],["b","0457"],["a","0532"],["a","0621"],["b","0540"]]
输出:["a"]
解释:"a" 在时间段 [05:32, 06:31] 内有三条访问记录,时间分别为 05:32 、05:49 和 06:21 。
但是 "b" 的访问记录只有两条。
因此,答案是 ["a"] 。
示例 2:
输入:access_times = [["d","0002"],["c","0808"],["c","0829"],["e","0215"],["d","1508"],["d","1444"],["d","1410"],["c","0809"]]
输出:["c","d"]
解释:"c" 在时间段 [08:08, 09:07] 内有三条访问记录,时间分别为 08:08 、08:09 和 08:29 。
"d" 在时间段 [14:10, 15:09] 内有三条访问记录,时间分别为 14:10 、14:44 和 15:08 。
然而,"e" 只有一条访问记录,因此不能包含在答案中,最终答案是 ["c","d"] 。
示例 3:
输入:access_times = [["cd","1025"],["ab","1025"],["cd","1046"],["cd","1055"],["ab","1124"],["ab","1120"]]
输出:["ab","cd"]
解释:"ab"在时间段 [10:25, 11:24] 内有三条访问记录,时间分别为 10:25 、11:20 和 11:24 。
"cd" 在时间段 [10:25, 11:24] 内有三条访问记录,时间分别为 10:25 、10:46 和 10:55 。
因此,答案是 ["ab","cd"] 。
提示:
1 <= access_times.length <= 100access_times[i].length == 21 <= access_times[i][0].length <= 10access_times[i][0]仅由小写英文字母组成。access_times[i][1].length == 4access_times[i][1]采用24小时制表示时间。access_times[i][1]仅由数字'0'到'9'组成。
方法一:哈希表 + 排序 · Go 实现
思考
高访问指一小时内至少三次访问。按员工分组后,将 换成当日分钟数并排序,则「存在连续三次落在 分钟内」等价于 。
哈希表收集每人的时间戳,排序后做一次线性检查。 ,分组与排序的开销可忽略。
我们用一个哈希表 来存储每个员工的所有访问时间,其中键为员工的姓名,值为一个整数数组,表示该员工的所有访问时间,该时间为从当天 00:00 开始的分钟数。
对于每个员工,我们将其所有访问时间按照从小到大的顺序进行排序。然后我们遍历该员工的所有访问时间,如果存在连续的三个访问时间 ,满足 ,则该员工为高访问员工,我们将其姓名加入答案数组中。
最后,返回答案数组即可。
时间复杂度 ,空间复杂度 。其中 为访问记录的数量。
func findHighAccessEmployees(access_times [][]string) (ans []string) {
	d := map[string][]int{}
	for _, e := range access_times {
		name, s := e[0], e[1]
		h, _ := strconv.Atoi(s[:2])
		m, _ := strconv.Atoi(s[2:])
		t := h*60 + m
		d[name] = append(d[name], t)
	}
	for name, ts := range d {
		sort.Ints(ts)
		for i := 2; i < len(ts); i++ {
			if ts[i]-ts[i-2] < 60 {
				ans = append(ans, name)
				break
			}
		}
	}
	return
}2956. 找到两个数组中的公共元素
题目、示例与约束
给你两个下标从 0 开始的整数数组 nums1 和 nums2 ,它们分别含有 n 和 m 个元素。请你计算以下两个数值:
answer1:使得nums1[i]在nums2中出现的下标i的数量。answer2:使得nums2[i]在nums1中出现的下标i的数量。
返回 [answer1, answer2]。
示例 1:
输入:nums1 = [2,3,2], nums2 = [1,2]
输出:[2,1]
解释:
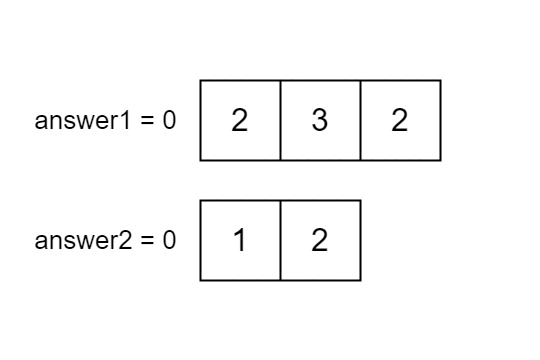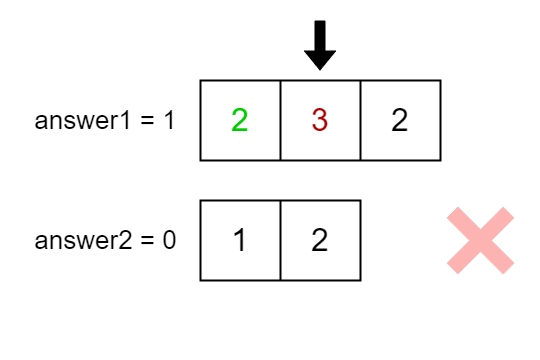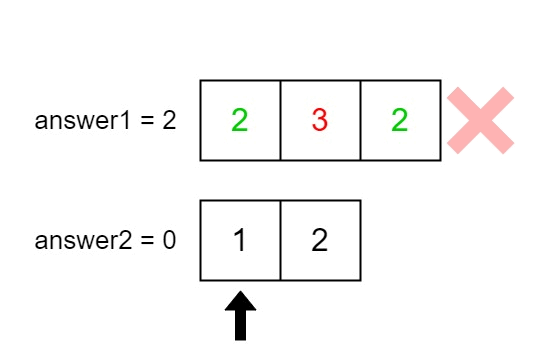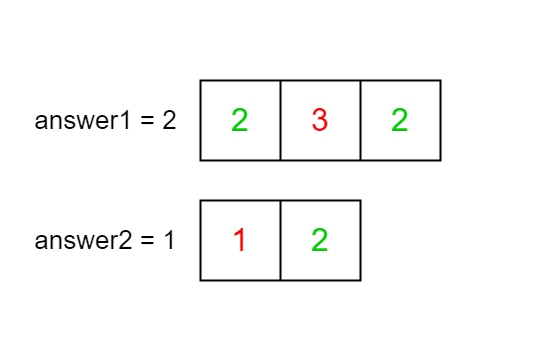
示例 2:
输入:nums1 = [4,3,2,3,1], nums2 = [2,2,5,2,3,6]
输出:[3,4]
解释:
nums1 中下标在 1,2,3 的元素在 nums2 中也存在。所以 answer1 为 3。
nums2 中下标在 0,1,3,4 的元素在 nums1 中也存在。所以 answer2 为 4。
示例 3:
输入:nums1 = [3,4,2,3], nums2 = [1,5]
输出:[0,0]
解释:
nums1 和 nums2 中没有相同的数字,所以答案是 [0,0]。
提示:
n == nums1.lengthm == nums2.length1 <= n, m <= 1001 <= nums1[i], nums2[i] <= 100
方法一:哈希表或数组 · Go 实现
思考
分别统计「 中值也出现在 」与反向的个数,是成员查询而非下标对应。 ,先把两侧建成集合,再各扫一遍计数。
值域 ,数组标记与哈希集合等价。返回二元组即可。
我们可以用两个哈希表或数组 和 分别记录两个数组中出现的元素。
接下来,我们创建一个长度为 的数组 ,其中 表示 中出现在 中的元素个数, 表示 中出现在 中的元素个数。
然后,我们遍历数组 中的每个元素 ,如果 在 中出现过,则将 加一。接着,我们遍历数组 中的每个元素 ,如果 在 中出现过,则将 加一。
最后,我们返回数组 即可。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 和 的长度。
func findIntersectionValues(nums1 []int, nums2 []int) []int {
	s1 := [101]int{}
	s2 := [101]int{}
	for _, x := range nums1 {
		s1[x] = 1
	}
	for _, x := range nums2 {
		s2[x] = 1
	}
	ans := make([]int, 2)
	for _, x := range nums1 {
		ans[0] += s2[x]
	}
	for _, x := range nums2 {
		ans[1] += s1[x]
	}
	return ans
}2964. 可被整除的三元组数量 🔒
题目、示例与约束
nums 和一个整数 d,请返回满足 i < j < k 且 (nums[i] + nums[j] + nums[k]) % d == 0 的三元组 (i, j, k) 的数量。
示例 1:
输入:nums = [3,3,4,7,8], d = 5
输出:3
解释:可以被5整除的三元组有:(0, 1, 2),(0, 2, 4),(1, 2, 4)。其他没有其他能被5整除的三元组。因此,答案是3。
示例 2:
输入:nums = [3,3,3,3], d = 3
输出:4
解释:这里选择的任何三元组的和都是9,可以被3整除。因此,答案是所有三元组的总数,即4。
示例 3:
输入:nums = [3,3,3,3], d = 6
输出:0
解释:这里选择的任何三元组的和都是9,不能被6整除。因此,答案是0。
提示:
1 <= nums.length <= 10001 <= nums[i] <= 1091 <= d <= 109
方法一:哈希表 + 枚举 · Go 实现
思考
统计 且和被 整除的三元组。 中等时 偏慢,可枚举后两个下标,用哈希表查询已出现的 的补数。
先加答案再把 插入,保证 。
我们可以用哈希表 记录 出现的次数,然后枚举 和 ,计算使得等式 成立的 的值,即 ,并将其出现次数累加到答案中。然后我们将 的出现次数加一。继续枚举 和 ,直到 到达数组末尾。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func divisibleTripletCount(nums []int, d int) (ans int) {
	n := len(nums)
	cnt := map[int]int{}
	for j := 0; j < n; j++ {
		for k := j + 1; k < n; k++ {
			x := (d - (nums[j]+nums[k])%d) % d
			ans += cnt[x]
		}
		cnt[nums[j]%d]++
	}
	return
}2975. 移除栅栏得到的正方形田地的最大面积
题目、示例与约束
有一个大型的 (m - 1) x (n - 1) 矩形田地,其两个对角分别是 (1, 1) 和 (m, n) ,田地内部有一些水平栅栏和垂直栅栏,分别由数组 hFences 和 vFences 给出。
水平栅栏为坐标 (hFences[i], 1) 到 (hFences[i], n),垂直栅栏为坐标 (1, vFences[i]) 到 (m, vFences[i]) 。
返回通过 移除 一些栅栏(可能不移除)所能形成的最大面积的 正方形 田地的面积,或者如果无法形成正方形田地则返回 -1。
由于答案可能很大,所以请返回结果对 109 + 7 取余 后的值。
注意:田地外围两个水平栅栏(坐标 (1, 1) 到 (1, n) 和坐标 (m, 1) 到 (m, n) )以及两个垂直栅栏(坐标 (1, 1) 到 (m, 1) 和坐标 (1, n) 到 (m, n) )所包围。这些栅栏 不能 被移除。
示例 1:
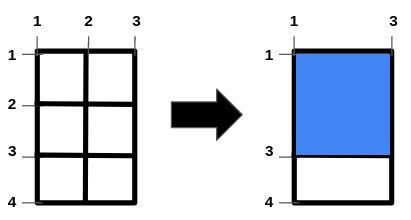
输入:m = 4, n = 3, hFences = [2,3], vFences = [2]
输出:4
解释:移除位于 2 的水平栅栏和位于 2 的垂直栅栏将得到一个面积为 4 的正方形田地。
示例 2:
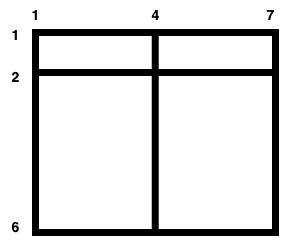
输入:m = 6, n = 7, hFences = [2], vFences = [4]
输出:-1
解释:可以证明无法通过移除栅栏形成正方形田地。
提示:
3 <= m, n <= 1091 <= hFences.length, vFences.length <= 6001 < hFences[i] < m1 < vFences[i] < nhFences和vFences中的元素是唯一的。
方法一:枚举 · Go 实现
思考
正方形要求某两条横栏间距等于某两条纵栏间距(含边界 与 、 )。栏数 ,枚举一对横栏、一对纵栏可行。先把所有横距、纵距分别投入集合,再取交集的最大元素。
本身可达 ,不能建网格。无公共距则返回 ,否则平方取模。
我们可以枚举 中的任意两条水平栅栏 和 ,计算 和 之间的距离 ,记录在哈希表 中,然后枚举 中的任意两条垂直栅栏 和 ,计算 和 之间的距离 ,记录在哈希表 中,最后遍历哈希表 ,如果 中的某个距离 在哈希表 中也存在,那么说明存在一个正方形田地,其边长为 ,面积为 ,我们只需要取最大的 ,求 即可。
时间复杂度 ,空间复杂度 。其中 和 分别是 和 的长度。
func maximizeSquareArea(m int, n int, hFences []int, vFences []int) int {
	f := func(nums []int, k int) map[int]bool {
		nums = append(nums, 1, k)
		sort.Ints(nums)
		s := map[int]bool{}
		for i := 0; i < len(nums); i++ {
			for j := 0; j < i; j++ {
				s[nums[i]-nums[j]] = true
			}
		}
		return s
	}
	hs := f(hFences, m)
	vs := f(vFences, n)
	ans := 0
	for h := range hs {
		if vs[h] {
			ans = max(ans, h)
		}
	}
	if ans > 0 {
		return ans * ans % (1e9 + 7)
	}
	return -1
}2996. 大于等于顺序前缀和的最小缺失整数
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums 。
如果一个前缀 nums[0..i] 满足对于 1 <= j <= i 的所有元素都有 nums[j] = nums[j - 1] + 1 ,那么我们称这个前缀是一个 顺序前缀 。特殊情况是,只包含 nums[0] 的前缀也是一个 顺序前缀 。
请你返回 nums 中没有出现过的 最小 整数 x ,满足 x 大于等于 最长 顺序前缀的和。
示例 1:
输入:nums = [1,2,3,2,5]
输出:6
解释:nums 的最长顺序前缀是 [1,2,3] ,和为 6 ,6 不在数组中,所以 6 是大于等于最长顺序前缀和的最小整数。
示例 2:
输入:nums = [3,4,5,1,12,14,13]
输出:15
解释:nums 的最长顺序前缀是 [3,4,5] ,和为 12 ,12、13 和 14 都在数组中,但 15 不在,所以 15 是大于等于最长顺序前缀和的最小整数。
提示:
1 <= nums.length <= 501 <= nums[i] <= 50
方法一:模拟 · Go 实现
思考
最长顺序前缀是从下标 起的连续递增段,其和为 ,再找不在数组中的最小 的整数。 ,先扫描前缀和,再用集合判断 是否出现。
值域很小,线性递增即可碰到缺口。
我们先求出数组 的最长顺序前缀和 ,然后从 开始枚举整数 ,如果 不在数组 中,那么 就是答案。
由于题目中 ,我们可以用一个长度为 的数组(或者哈希表)来记录数组中出现过的整数,从而快速判断一个整数是否在数组 中。
时间复杂度 ,空间复杂度 。其中 是数组 的长度,而 是数组元素的上限,本题中 。
func missingInteger(nums []int) int {
	s := nums[0]
	for j := 1; j < len(nums) && nums[j] == nums[j-1]+1; j++ {
		s += nums[j]
	}

	const m = 51
	st := make([]bool, m)
	for _, x := range nums {
		st[x] = true
	}

	for s < m && st[s] {
		s++
	}
	return s
}3005. 最大频率元素计数
题目、示例与约束
给你一个由 正整数 组成的数组 nums 。
返回数组 nums 中所有具有 最大 频率的元素的 总频率 。
元素的 频率 是指该元素在数组中出现的次数。
示例 1:
输入:nums = [1,2,2,3,1,4]
输出:4
解释:元素 1 和 2 的频率为 2 ,是数组中的最大频率。
因此具有最大频率的元素在数组中的数量是 4 。
示例 2:
输入:nums = [1,2,3,4,5]
输出:5
解释:数组中的所有元素的频率都为 1 ,是最大频率。
因此具有最大频率的元素在数组中的数量是 5 。
提示:
1 <= nums.length <= 1001 <= nums[i] <= 100
方法一:计数 · Go 实现
思考
,统计频次后按定义求和即可。需要的是「达到最高频次的那些元素的频次之和」,而非这样的元素种类数。
先得到每个值的出现次数,再取最大值 ,最后把所有等于 的次数相加。
一次计数、一次扫描最大值即可,哈希表或数组均可。
我们可以用一个哈希表或数组 记录每个元素出现的次数。
然后我们遍历 ,找到出现次数最多的元素,记其出现次数为 ,累加出现次数等于 的元素的出现次数,即为答案。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func maxFrequencyElements(nums []int) (ans int) {
	cnt := [101]int{}
	for _, x := range nums {
		cnt[x]++
	}
	mx := -1
	for _, x := range cnt {
		if mx < x {
			mx, ans = x, x
		} else if mx == x {
			ans += x
		}
	}
	return
}3020. 子集中元素的最大数量
题目、示例与约束
给你一个 正整数 数组 nums 。
你需要从数组中选出一个满足下述条件的子集:
- 你可以将选中的元素放置在一个下标从 0 开始的数组中,并使其遵循以下模式:
[x, x2, x4, ..., xk/2, xk, xk/2, ..., x4, x2, x](注意,k可以是任何 非负 的 2 的幂)。例如,[2, 4, 16, 4, 2]和[3, 9, 3]都符合这一模式,而[2, 4, 8, 4, 2]则不符合。
返回满足这些条件的子集中,元素数量的 最大值 。
示例 1:
输入:nums = [5,4,1,2,2]
输出:3
解释:选择子集 {4,2,2} ,将其放在数组 [2,4,2] 中,它遵循该模式,且 22 == 4 。因此答案是 3 。
示例 2:
输入:nums = [1,3,2,4]
输出:1
解释:选择子集 {1},将其放在数组 [1] 中,它遵循该模式。因此答案是 1 。注意我们也可以选择子集 {2} 、{4} 或 {3} ,可能存在多个子集都能得到相同的答案。
提示:
2 <= nums.length <= 1051 <= nums[i] <= 109
方法一:哈希表 + 枚举 · Go 实现
思考
子集须排成 ,长度为奇数, 。枚举所有子集不可行。
链由反复平方确定,中间元素只出现一次,其余每个值需要偶数次。从每个 沿平方走,直到次数不足 。
的平方链退化,单独按「尽量取奇数长度」处理。哈希表提供 次数查询。
我们用一个哈希表 记录数组 中每个元素出现的次数。对于每个元素 ,我们可以将其不断平方,直到其值在哈希表 中的出现次数小于 为止。此时,我们判断 在哈希表 中的出现次数是否为 ,如果是则说明 仍然可以被选入子集中,否则我们需要从子集中删除一个元素,确保子集个数为奇数。然后我们更新答案。继续枚举下一个元素。
注意我们需要特殊处理 的情况。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 的长度和数组 中的最大值。
func maximumLength(nums []int) (ans int) {
	cnt := map[int]int{}
	for _, x := range nums {
		cnt[x]++
	}
	ans = cnt[1] - (cnt[1]%2 ^ 1)
	delete(cnt, 1)
	for x := range cnt {
		t := 0
		for cnt[x] > 1 {
			x = x * x
			t += 2
		}
		if cnt[x] > 0 {
			t += 1
		} else {
			t -= 1
		}
		ans = max(ans, t)
	}
	return
}3039. 进行操作使字符串为空
题目、示例与约束
给你一个字符串 s 。
请你进行以下操作直到 s 为 空 :
- 每次操作 依次 遍历
'a'到'z',如果当前字符出现在s中,那么删除出现位置 最早 的该字符(如果存在的话)。
例如,最初 s = "aabcbbca"。我们执行下述操作:
- 移除下划线的字符
s = "aabcbbca"。结果字符串为s = "abbca"。 - 移除下划线的字符
s = "abbca"。结果字符串为s = "ba"。 - 移除下划线的字符
s = "ba"。结果字符串为s = ""。
请你返回进行 最后 一次操作 之前 的字符串 s 。在上面的例子中,答案是 "ba"。
示例 1:
输入:s = "aabcbbca"
输出:"ba"
解释:已经在题目描述中解释。
示例 2:
输入:s = "abcd"
输出:"abcd"
解释:我们进行以下操作:
- 删除 s = "abcd" 中加粗加斜字符,得到字符串 s = "" 。
进行最后一次操作之前的字符串为 "abcd" 。
提示:
1 <= s.length <= 5 * 105s只包含小写英文字母。
方法一:哈希表或数组 · Go 实现
思考
每轮删除每种字符的第一次出现,问最后一轮删掉的字符按原顺序组成的串。 。
最后一轮删除的,恰是出现次数等于全局最大次数的那些字符,且取它们各自最后一次出现。
统计频次与最后位置后,按原串顺序收集「频次为最大且位于最后一次出现」的字符。
我们用一个哈希表或数组 记录字符串 中每个字符的出现次数,用一个哈希表或数组 记录字符串 中每个字符最后一次出现的位置。字符串 中出现次数最多的字符的出现次数记为 。
然后我们遍历字符串 ,如果当前字符的出现次数等于 且当前字符所在位置等于该字符最后一次出现的位置,那么我们将当前字符加入答案中。
遍历结束后,返回答案即可。
时间复杂度 ,空间复杂度 ,其中 是字符串 的长度,而 是字符集,本题中 为小写英文字母。
func lastNonEmptyString(s string) string {
	cnt := [26]int{}
	last := [26]int{}
	mx := 0
	for i, c := range s {
		c -= 'a'
		cnt[c]++
		last[c] = i
		mx = max(mx, cnt[c])
	}
	ans := []rune{}
	for i, c := range s {
		if cnt[c-'a'] == mx && last[c-'a'] == i {
			ans = append(ans, c)
		}
	}
	return string(ans)
}3046. 分割数组
题目、示例与约束
给你一个长度为 偶数 的整数数组 nums 。你需要将这个数组分割成 nums1 和 nums2 两部分,要求:
nums1.length == nums2.length == nums.length / 2。nums1应包含 互不相同 的元素。nums2也应包含 互不相同 的元素。
如果能够分割数组就返回 true ,否则返回 false 。
示例 1:
输入:nums = [1,1,2,2,3,4]
输出:true
解释:分割 nums 的可行方案之一是 nums1 = [1,2,3] 和 nums2 = [1,2,4] 。
示例 2:
输入:nums = [1,1,1,1]
输出:false
解释:分割 nums 的唯一可行方案是 nums1 = [1,1] 和 nums2 = [1,1] 。但 nums1 和 nums2 都不是由互不相同的元素构成。因此,返回 false 。
提示:
1 <= nums.length <= 100nums.length % 2 == 01 <= nums[i] <= 100
方法一:计数 · Go 实现
思考
把数组分成两个等长子集,各自元素互异。 。
每个值最多出现两次,才能分别放进两个子集;出现三次则必在某一侧重复。
因此只需看最大频次是否小于 。
根据题意,我们需要将数组分成两部分,每部分的元素都是互不相同的。因此,我们可以统计数组中每个元素的出现次数,如果某个元素出现的次数大于等于 次,那么就无法满足题意。否则,我们可以将数组分成两部分。
时间复杂度 ,空间复杂度 。其中 是数组的长度。
func isPossibleToSplit(nums []int) bool {
	cnt := [101]int{}
	for _, x := range nums {
		cnt[x]++
		if cnt[x] >= 3 {
			return false
		}
	}
	return true
}3071. 在矩阵上写出字母 Y 所需的最少操作次数
题目、示例与约束
给你一个下标从 0 开始、大小为 n x n 的矩阵 grid ,其中 n 为奇数,且 grid[r][c] 的值为 0 、1 或 2 。
如果一个单元格属于以下三条线中的任一一条,我们就认为它是字母 Y 的一部分:
- 从左上角单元格开始到矩阵中心单元格结束的对角线。
- 从右上角单元格开始到矩阵中心单元格结束的对角线。
- 从中心单元格开始到矩阵底部边界结束的垂直线。
当且仅当满足以下全部条件时,可以判定矩阵上写有字母 Y :
- 属于 Y 的所有单元格的值相等。
- 不属于 Y 的所有单元格的值相等。
- 属于 Y 的单元格的值与不属于Y的单元格的值不同。
每次操作你可以将任意单元格的值改变为 0 、1 或 2 。返回在矩阵上写出字母 Y 所需的 最少 操作次数。
示例 1:
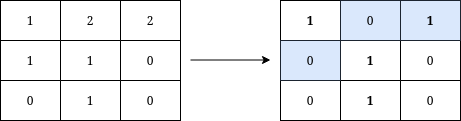
输入:grid = [[1,2,2],[1,1,0],[0,1,0]]
输出:3
解释:将在矩阵上写出字母 Y 需要执行的操作用蓝色高亮显示。操作后,所有属于 Y 的单元格(加粗显示)的值都为 1 ,而不属于 Y 的单元格的值都为 0 。
可以证明,写出 Y 至少需要进行 3 次操作。
示例 2:
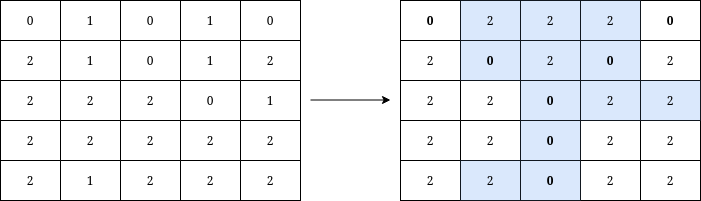
输入:grid = [[0,1,0,1,0],[2,1,0,1,2],[2,2,2,0,1],[2,2,2,2,2],[2,1,2,2,2]]
输出:12
解释:将在矩阵上写出字母 Y 需要执行的操作用蓝色高亮显示。操作后,所有属于 Y 的单元格(加粗显示)的值都为 0 ,而不属于 Y 的单元格的值都为 2 。
可以证明,写出 Y 至少需要进行 12 次操作。
提示:
3 <= n <= 49n == grid.length == grid[i].length0 <= grid[i][j] <= 2n为奇数。
方法一:计数 · Go 实现
思考
把 Y 上的格子写成同一值 ,其余格子写成另一值 ,求最少改写。 且为奇数,Y 的几何形状固定。
每种颜色在 Y 内、Y 外的计数确定后, 只有 种搭配,改写次数为总格数减去保留的两色计数。
一遍区分 Y 与非 Y 并计数,再枚举 取最小 。
我们用两个长度为 的数组 cnt1 和 cnt2 分别记录属于 Y 的单元格和不属于 Y 的单元格的值的个数。然后我们枚举 i 和 j,分别表示属于 Y 的单元格和不属于 Y 的单元格的值,计算出最少操作次数。
时间复杂度 ,其中 是矩阵的大小。空间复杂度 。
func minimumOperationsToWriteY(grid [][]int) int {
	n := len(grid)
	cnt1 := [3]int{}
	cnt2 := [3]int{}
	for i, row := range grid {
		for j, x := range row {
			a := i == j && i <= n/2
			b := i+j == n-1 && i <= n/2
			c := j == n/2 && i >= n/2
			if a || b || c {
				cnt1[x]++
			} else {
				cnt2[x]++
			}
		}
	}
	ans := n * n
	for i := 0; i < 3; i++ {
		for j := 0; j < 3; j++ {
			if i != j {
				ans = min(ans, n*n-cnt1[i]-cnt2[j])
			}
		}
	}
	return ans
}3078. 矩阵中的字母数字模式匹配 I 🔒
题目、示例与约束
给定一个二维整数矩阵 board 和一个二维字符矩阵 pattern。其中 0 <= board[r][c] <= 9 并且 pattern 的每个元素是一个数字或一个小写英文字母。
你的任务是找到 匹配 board 的子矩阵 pattern。
如果我们能用一些数字(每个 不同 的字母对应 不同 的数字)替换 pattern 中包含的字母使得结果矩阵与整数矩阵 part 相同,我们称整数矩阵 part 与 pattern 匹配。换句话说,
- 这两个矩阵具有相同的维数。
- 如果
pattern[r][c]是一个数字,那么part[r][c]必须是 相同的 数字。 - 如果
pattern[r][c]是一个字母x:- 对于每个
pattern[i][j] == x,part[i][j]一定与part[r][c]相同。 - 对于每个
pattern[i][j] != x,part[i][j]一定与part[r][c]不同。
- 对于每个
返回一个长度为 2 的数组,包含匹配 pattern 的 board 的子矩阵左上角的行号和列号。如果有多个这样的子矩阵,返回行号更小的子矩阵。如果依然有多个,则返回列号更小的子矩阵。如果没有符合的答案,返回 [-1, -1]。
示例 1:
| 1 | 2 | 2 |
| 2 | 2 | 3 |
| 2 | 3 | 3 |
| a | b |
| b | b |
输入:board = [[1,2,2],[2,2,3],[2,3,3]], pattern = ["ab","bb"]
输出:[0,0]
解释:如果我们考虑这个映射:"a" -> 1 并且 "b" -> 2;左上角为 (0,0) 的子矩阵与上面的矩阵中加粗的相匹配。
注意左上角为 (1,1) 的子矩阵同样匹配,但它在另一个之后出现,所以我们返回 [0,0]。
示例 2:
| 1 | 1 | 2 |
| 3 | 3 | 4 |
| 6 | 6 | 6 |
| a | b |
| 6 | 6 |
输入:board = [[1,1,2],[3,3,4],[6,6,6]], pattern = ["ab","66"]
输出:[1,1]
解释:如果我们考虑这个映射:"a" -> 3 并且 "b" -> 4;左上角为 (1,1) 的子矩阵与上面的矩阵中加粗的匹配。
注意 "a" 和 "b" 对应的值必须不同,左上角为 (1,0) 的子矩阵不匹配。因此,我们返回 [1,1]。
示例 3:
| 1 | 2 |
| 2 | 1 |
| x | x |
输入:board = [[1,2],[2,1]], pattern = ["xx"]
输出:[-1,-1]
解释: 由于匹配子矩阵的值必须相同,因此不存在匹配。因此,我们返回 [-1,-1]。
提示:
1 <= board.length <= 501 <= board[i].length <= 500 <= board[i][j] <= 91 <= pattern.length <= 501 <= pattern[i].length <= 50pattern[i][j]表示为一个数字的字符串或一个小写英文字母。
方法一:枚举 · Go 实现
思考
模式中的字母表示未知数字且须双向一致,数字则须相等。棋盘与模式都不超过 ,枚举对齐位置可行。
每个左上角用两张映射表检查字母与数字的一一对应,遇数字格直接比较。
按行优先枚举 ,第一次匹配成功即返回。
我们不妨记 和 分别为矩阵 board 的行数和列数,记 和 分别为矩阵 pattern 的行数和列数。
我们可以从小到大枚举矩阵 board 中的每一个可能的子矩阵的左上角位置 ,然后判断以 为左上角的 的子矩阵是否与 pattern 匹配。如果找到了一个匹配的子矩阵,我们就返回 。否则,我们返回 。
时间复杂度 ,其中 和 分别是矩阵 board 的行数和列数,而 和 分别是矩阵 pattern 的行数和列数。空间复杂度 ,其中 是字符集,本题中 包括数字和小写字母,因此 。
func findPattern(board [][]int, pattern []string) []int {
	m, n := len(board), len(board[0])
	r, c := len(pattern), len(pattern[0])
	check := func(i, j int) bool {
		d1 := [26]int{}
		d2 := [10]int{}
		for a := 0; a < r; a++ {
			for b := 0; b < c; b++ {
				x, y := i+a, j+b
				if pattern[a][b] >= '0' && pattern[a][b] <= '9' {
					v := int(pattern[a][b] - '0')
					if v != board[x][y] {
						return false
					}
				} else {
					v := int(pattern[a][b] - 'a')
					if d1[v] > 0 && d1[v]-1 != board[x][y] {
						return false
					}
					if d2[board[x][y]] > 0 && d2[board[x][y]]-1 != v {
						return false
					}
					d1[v] = board[x][y] + 1
					d2[board[x][y]] = v + 1
				}
			}
		}
		return true
	}
	for i := 0; i < m-r+1; i++ {
		for j := 0; j < n-c+1; j++ {
			if check(i, j) {
				return []int{i, j}
			}
		}
	}
	return []int{-1, -1}
}3083. 字符串及其反转中是否存在同一子字符串
题目、示例与约束
给你一个字符串 s ,请你判断字符串 s 是否存在一个长度为 2 的子字符串,在 s 反转后的字符串中也出现。
如果存在这样的子字符串,返回 true;如果不存在,返回 false 。
示例 1:
输入:s = "leetcode"
输出:true
解释:子字符串 "ee" 的长度为 2,它也出现在 reverse(s) == "edocteel" 中。
示例 2:
输入:s = "abcba"
输出:true
解释:所有长度为 2 的子字符串 "ab"、"bc"、"cb"、"ba" 也都出现在 reverse(s) == "abcba" 中。
示例 3:
输入:s = "abcd"
输出:false
解释:字符串 s 中不存在满足「在其反转后的字符串中也出现」且长度为 2 的子字符串。
提示:
1 <= s.length <= 100- 字符串
s仅由小写英文字母组成。
方法一:哈希表或数组 · Go 实现
思考
,长度为 的子串种类有限。存在某个长为 的片段同时出现在 与 的反转中即可。
先把反转串的所有相邻对放进集合,再扫原串的相邻对做查询。
一次建集、一次查询,均为线性。
我们可以用一个哈希表或者二维数组 来存储字符串 反转后的所有长度为 的子字符串。
然后我们遍历字符串 ,对于每一个长度为 的子字符串,我们判断它是否在 中出现过,是则返回 true。否则,遍历结束后返回 false。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度;而 为字符串 的字符集,本题中 为小写英文字母,所以 。
func isSubstringPresent(s string) bool {
	st := [26][26]bool{}
	for i := 0; i < len(s)-1; i++ {
		st[s[i+1]-'a'][s[i]-'a'] = true
	}
	for i := 0; i < len(s)-1; i++ {
		if st[s[i]-'a'][s[i+1]-'a'] {
			return true
		}
	}
	return false
}3104. 查找最长的自包含子串 🔒
题目、示例与约束
给定字符串 s,你需要找到 s 的 最长自包含 子串 的长度。
如果 s 的一个子串 t 满足 t != s 且 t 中的每一个字符在 s 的剩余部分都不存在,则被称为是 自包含 的。
如果存在 s 的最长自包含子串,返回它的长度,否则返回 -1。
示例 1:
输入:s = "abba"
输出:2
解释:
让我们检查子串 "bb"。你可以发现子串外没有其它 "b"。因此答案为 2。
示例 2:
输入:s = "abab"
输出:-1
解释:
我们选择的每一个子串都不满足描述的特点(子串内外包含有一些字母)。所以答案是 -1。
示例 3:
输入:s = "abacd"
输出:4
解释:
让我们检查子串 "abac"。子串之外只有一个字母 "d"。子串内没有 "d",所以它满足条件并且答案为 4。
提示:
2 <= s.length <= 5 * 104s只包含小写英文字母。
方法一:枚举 · Go 实现
思考
自包含子串要求其中每个字符的全部出现都落在该区间内,且不能是整个串。枚举全部子串再检查 个字符的首末位置,时间为 ,偏大。
合法区间的左端必是某个字符的首次出现:再往左扩只会引入新字符或其更早出现,破坏自包含。字符种类至多 ,以首次出现为左端的候选很少。
为此记录每个字符的首末下标,枚举左端 ,向右推进 并维护必须覆盖到的最右位置 。一旦某字符的首次出现落在 左侧便停止;当 且区间不是全集时更新最长长度。
我们注意到,满足条件的子串的开头一定是某个字符第一次出现的位置。
因此,我们可以用两个数组或哈希表 first 和 last 分别记录每个字符第一次和最后一次出现的位置。
接下来,我们枚举每个字符 c,假设 c 第一次出现的位置是 ,最后一次出现的位置是 ,那么我们可以从 开始向后遍历,对于每个位置 ,我们找到 第一次出现的位置 和最后一次出现的位置 ,如果 ,说明 在 的左边,不符合枚举条件,我们可以直接退出循环。否则,我们更新 。如果 且 ,我们更新答案为 。
最后返回答案即可。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度;而 是字符集的大小,本题中字符集为小写字母,所以 。
func maxSubstringLength(s string) int {
	first := [26]int{}
	last := [26]int{}
	for i := range first {
		first[i] = -1
	}
	n := len(s)
	for i, c := range s {
		j := int(c - 'a')
		if first[j] == -1 {
			first[j] = i
		}
		last[j] = i
	}
	ans := -1
	for k := 0; k < 26; k++ {
		i := first[k]
		if i == -1 {
			continue
		}
		mx := last[k]
		for j := i; j < n; j++ {
			a, b := first[s[j]-'a'], last[s[j]-'a']
			if a < i {
				break
			}
			mx = max(mx, b)
			if mx == j && j-i+1 < n {
				ans = max(ans, j-i+1)
			}
		}
	}
	return ans
}3120. 统计特殊字母的数量 I
题目、示例与约束
给你一个字符串 word。如果 word 中同时存在某个字母的小写形式和大写形式,则称这个字母为 特殊字母 。
返回 word 中 特殊字母 的数量。
示例 1:
输入:word = "aaAbcBC"
输出:3
解释:
word 中的特殊字母是 'a'、'b' 和 'c'。
示例 2:
输入:word = "abc"
输出:0
解释:
word 中不存在大小写形式同时出现的字母。
示例 3:
输入:word = "abBCab"
输出:1
解释:
word 中唯一的特殊字母是 'b'。
提示:
1 <= word.length <= 50word仅由小写和大写英文字母组成。
方法一:哈希表或数组 · Go 实现
思考
特殊字母指同一字母的大小写均出现过。若对每个字母再扫一遍原串,重复访问达 。
只需知道每个字符是否出现,集合一次扫描即可回答全部 对查询。
因此先把 放入集合,再枚举
a/A至z/Z,大小写同时存在则计数加一。
我们用一个哈希表或数组 来记录字符串 中出现的字符。然后遍历 个字母,如果小写字母和大写字母都在 中出现,则特殊字符的数量加一。
最后返回特殊字符的数量即可。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度;而 为字符集大小,本题中 。
func numberOfSpecialChars(word string) (ans int) {
	s := make([]bool, 'z'+1)
	for _, c := range word {
		s[c] = true
	}
	for i := 0; i < 26; i++ {
		if s['a'+i] && s['A'+i] {
			ans++
		}
	}
	return
}3121. 统计特殊字母的数量 II
题目、示例与约束
给你一个字符串 word。如果 word 中同时出现某个字母 c 的小写形式和大写形式,并且 每个 小写形式的 c 都出现在第一个大写形式的 c 之前,则称字母 c 是一个 特殊字母 。
返回 word 中 特殊字母 的数量。
示例 1:
输入:word = "aaAbcBC"
输出:3
解释:
特殊字母是 'a'、'b' 和 'c'。
示例 2:
输入:word = "abc"
输出:0
解释:
word 中不存在特殊字母。
示例 3:
输入:word = "AbBCab"
输出:0
解释:
word 中不存在特殊字母。
提示:
1 <= word.length <= 2 * 105word仅由小写和大写英文字母组成。
方法一:哈希表或数组 · Go 实现
思考
本题还要求全部小写出现都在该字母首次大写之前。只判断存在性会把后出现的小写误算进去。
每个字母只需比较「最后一次小写」与「第一次大写」的下标。一次遍历即可记下这两个位置。
为此维护 与 ,再枚举 对字母,当 存在、 存在且前者更左时计入答案。
我们定义两个哈希表或数组 和 ,用于存储每个字母第一次出现的位置和最后一次出现的位置。
然后我们遍历字符串 ,更新 和 。
最后我们遍历所有的小写字母和大写字母,如果 存在且 存在且 ,则说明字母 是一个特殊字母,将答案加一。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度;而 为字符集大小,本题中 。
func numberOfSpecialChars(word string) (ans int) {
	first := make([]int, 'z'+1)
	last := make([]int, 'z'+1)
	for i, c := range word {
		if first[c] == 0 {
			first[c] = i + 1
		}
		last[c] = i + 1
	}
	for i := 0; i < 26; i++ {
		if last['a'+i] > 0 && last['a'+i] < first['A'+i] {
			ans++
		}
	}
	return
}3137. K 周期字符串需要的最少操作次数
题目、示例与约束
给你一个长度为 n 的字符串 word 和一个整数 k ,其中 k 是 n 的因数。
在一次操作中,你可以选择任意两个下标 i 和 j,其中 0 <= i, j < n ,且这两个下标都可以被 k 整除,然后用从 j 开始的长度为 k 的子串替换从 i 开始的长度为 k 的子串。也就是说,将子串 word[i..i + k - 1] 替换为子串 word[j..j + k - 1] 。
返回使 word 成为 K 周期字符串 所需的 最少 操作次数。
如果存在某个长度为 k 的字符串 s,使得 word 可以表示为任意次数连接 s ,则称字符串 word 是 K 周期字符串 。例如,如果 word == "ababab",那么 word 就是 s = "ab" 时的 2 周期字符串 。
示例 1:
输入:word = "leetcodeleet", k = 4
输出:1
解释:可以选择 i = 4 和 j = 0 获得一个 4 周期字符串。这次操作后,word 变为 "leetleetleet" 。
示例 2:
输入:word = "leetcoleet", k = 2
输出:3
解释:可以执行以下操作获得一个 2 周期字符串。
| i | j | word |
|---|---|---|
| 0 | 2 | etetcoleet |
| 4 | 0 | etetetleet |
| 6 | 0 | etetetetet |
提示:
1 <= n == word.length <= 1051 <= k <= word.lengthk能整除word.length。word仅由小写英文字母组成。
方法一:计数 · Go 实现
思考
每次把长 的一块换成另一块,目标是整串由同一块重复而成。枚举目标块再计算替换次数与块数成正比。
操作次数等于块数减去保留次数最多的那种块。统计各块出现次数即可,不必真的改写字符串。
按步长 切片后用计数器取最大值,返回 减去该最大值。
我们可以将字符串 word 按照长度为 的子串进行分组,然后统计每个子串出现的次数,最后返回 减去出现次数最多的子串的次数即可。
时间复杂度 ,空间复杂度 。其中 为字符串 word 的长度。
func minimumOperationsToMakeKPeriodic(word string, k int) int {
	cnt := map[string]int{}
	n := len(word)
	mx := 0
	for i := 0; i < n; i += k {
		s := word[i : i+k]
		cnt[s]++
		mx = max(mx, cnt[s])
	}
	return n/k - mx
}3138. 同位字符串连接的最小长度
题目、示例与约束
给你一个字符串 s ,它由某个字符串 t 和若干 t 的 同位字符串 连接而成。
请你返回字符串 t 的 最小 可能长度。
同位字符串 指的是重新排列一个字符串的字母得到的另外一个字符串。例如,"aab","aba" 和 "baa" 是 "aab" 的同位字符串。
示例 1:
输入:s = "abba"
输出:2
解释:
一个可能的字符串 t 为 "ba" 。
示例 2:
输入:s = "cdef"
输出:4
解释:
一个可能的字符串 t 为 "cdef" ,注意 t 可能等于 s 。
示例 3:
输入:s = "abcbcacabbaccba"
输出:3
提示:
1 <= s.length <= 105s只包含小写英文字母。
方法一:枚举 · Go 实现
思考
原串由若干相同字母表的块拼接而成,所求为最短块长。块长必须整除 ,从小到大试即可,至多试因子个数次。
若长度为 的块合法,则每段的字符计数乘 应等于全串计数。一次 扫描可验证。
因此先统计全串 ,再枚举整除 的 并检查每段。第一个通过者即为最短 。
根据题目描述,字符串 的长度一定是 的长度的因子,我们可以从小到大枚举字符串 的长度 ,然后检查是否满足题目要求,如果满足则返回。因此,问题转化为如何检查字符串 的长度 是否满足题目要求。
我们首先统计字符串 中每个字符出现的次数,记录在数组或哈希表 中。
然后,我们定义一个函数 ,用来检查字符串 的长度 是否满足题目要求。我们可以遍历字符串 ,每次取长度为 的子串,然后统计每个字符出现的次数,如果每个字符出现的次数乘以 不等于 中的值,则返回 。遍历结束,如果都满足,则返回 。
时间复杂度 ,其中 是字符串 的长度,而 是 的因子个数。空间复杂度 ,其中 是字符集,本题中为小写字母集合。
func minAnagramLength(s string) int {
	n := len(s)
	cnt := [26]int{}
	for _, c := range s {
		cnt[c-'a']++
	}
	check := func(k int) bool {
		for i := 0; i < n; i += k {
			cnt1 := [26]int{}
			for j := i; j < i+k; j++ {
				cnt1[s[j]-'a']++
			}
			for j, v := range cnt {
				if cnt1[j]*(n/k) != v {
					return false
				}
			}
		}
		return true
	}
	for i := 1; ; i++ {
		if n%i == 0 && check(i) {
			return i
		}
	}
}继续阅读
- 实践案例
- 实践案例
- 实践案例