
LeetCode Go · 哈希表(3)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
1207. 独一无二的出现次数
题目、示例与约束
给你一个整数数组 arr,如果每个数的出现次数都是独一无二的,就返回 true;否则返回 false。
示例 1:
输入:arr = [1,2,2,1,1,3]
输出:true
解释:在该数组中,1 出现了 3 次,2 出现了 2 次,3 只出现了 1 次。没有两个数的出现次数相同。
示例 2:
输入:arr = [1,2]
输出:false
示例 3:
输入:arr = [-3,0,1,-3,1,1,1,-3,10,0]
输出:true
提示:
1 <= arr.length <= 1000-1000 <= arr[i] <= 1000
方法一:哈希表 · Go 实现
思考
,统计每个值的出现次数后检查这些次数是否互不相同即可。哈希表一次遍历得到频次,再将频次放入集合:集合大小等于不同数值的个数,当且仅当每个频次只出现一次。
我们用哈希表 统计数组 中每个数的出现次数,然后用哈希表 统计出现次数的种类,最后判断 和 的大小是否相等即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func uniqueOccurrences(arr []int) bool {
	cnt := map[int]int{}
	for _, x := range arr {
		cnt[x]++
	}
	vis := map[int]bool{}
	for _, v := range cnt {
		if vis[v] {
			return false
		}
		vis[v] = true
	}
	return true
}1224. 最大相等频率
题目、示例与约束
给你一个正整数数组 nums,请你帮忙从该数组中找出能满足下面要求的 最长 前缀,并返回该前缀的长度:
- 从前缀中 恰好删除一个 元素后,剩下每个数字的出现次数都相同。
如果删除这个元素后没有剩余元素存在,仍可认为每个数字都具有相同的出现次数(也就是 0 次)。
示例 1:
输入:nums = [2,2,1,1,5,3,3,5]
输出:7
解释:对于长度为 7 的子数组 [2,2,1,1,5,3,3],如果我们从中删去 nums[4] = 5,就可以得到 [2,2,1,1,3,3],里面每个数字都出现了两次。
示例 2:
输入:nums = [1,1,1,2,2,2,3,3,3,4,4,4,5]
输出:13
提示:
2 <= nums.length <= 1051 <= nums[i] <= 105
方法一:数组或哈希表 · Go 实现
思考
需找最长前缀,删除恰好一个元素后其余值的出现次数全部相同。 ,不能对每个前缀重新统计。
维护值的频次 与「频次的频次」 ,以及当前最大频次 。前缀合法当且仅当:全是 ;或次数只有 与 且恰有一个值达到 ;或除一个只出现一次的值外全是 。
从左到右更新两个计数器,每步用 与 在 内检验三种形态,记录满足条件的最大下标。
我们用 记录 中每个元素 出现的次数,而 记录每个次数出现的次数,元素出现的最大次数用 表示。
遍历 :
- 若最大次数 ,说明当前前缀中每个数字均出现 次,删除任意一个后,都满足剩余数字次数相同;
- 若所有数字出现的次数均为 和 ,并且只有一个数字的出现次数为 ,那么我们删除出现 次数的一个数字,剩余数字次数均为 ,满足条件;
- 若除了一个数字,其它所有数字出现次数均为 次,那么我们删除出现一次的数字,剩余数字次数均为 ,满足条件。
时间复杂度 ,空间复杂度 。其中 表示 数组的长度。
func maxEqualFreq(nums []int) int {
	cnt := map[int]int{}
	ccnt := map[int]int{}
	ans, mx := 0, 0
	for i, v := range nums {
		i++
		if cnt[v] > 0 {
			ccnt[cnt[v]]--
		}
		cnt[v]++
		mx = max(mx, cnt[v])
		ccnt[cnt[v]]++
		if mx == 1 {
			ans = i
		} else if ccnt[mx]*mx+ccnt[mx-1]*(mx-1) == i && ccnt[mx] == 1 {
			ans = i
		} else if ccnt[mx]*mx+1 == i && ccnt[1] == 1 {
			ans = i
		}
	}
	return ans
}1275. 找出井字棋的获胜者
题目、示例与约束
井字棋 是由两个玩家 A 和 B 在 3 x 3 的棋盘上进行的游戏。井字棋游戏的规则如下:
- 玩家轮流将棋子放在空方格 (
' ') 上。 - 第一个玩家
A总是用'X'作为棋子,而第二个玩家B总是用'O'作为棋子。 'X'和'O'只能放在空方格中,而不能放在已经被占用的方格上。- 只要有 3 个相同的(非空)棋子排成一条直线(行、列、对角线)时,游戏结束。
- 如果所有方块都放满棋子(不为空),游戏也会结束。
- 游戏结束后,棋子无法再进行任何移动。
给你一个数组 moves,其中 moves[i] = [rowi, coli] 表示第 i 次移动在 grid[rowi][coli]。如果游戏存在获胜者(A 或 B),就返回该游戏的获胜者;如果游戏以平局结束,则返回 "Draw";如果仍会有行动(游戏未结束),则返回 "Pending"。
你可以假设 moves 都 有效(遵循 井字棋 规则),网格最初是空的,A 将先行动。
示例 1:
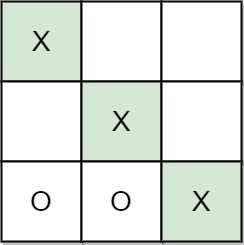
输入:moves = [[0,0],[2,0],[1,1],[2,1],[2,2]]
输出:"A"
解释:"A" 获胜,他总是先走。
示例 2:
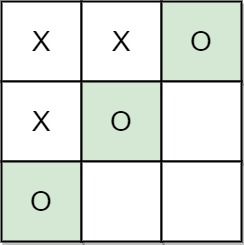
输入:moves = [[0,0],[1,1],[0,1],[0,2],[1,0],[2,0]]
输出:"B"
解释:"B" 获胜。
示例 3:
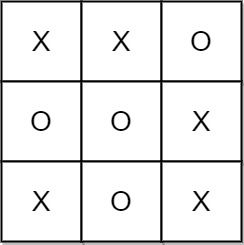
输入:moves = [[0,0],[1,1],[2,0],[1,0],[1,2],[2,1],[0,1],[0,2],[2,2]]
输出:"Draw"
解释:由于没有办法再行动,游戏以平局结束。
提示:
1 <= moves.length <= 9moves[i].length == 20 <= moves[i][j] <= 2moves里没有重复的元素。moves遵循井字棋的规则。
方法一:判断最后一个落棋的人能否获胜 · Go 实现
思考
合法且某人获胜后不会再下,故只需检查最后落子方是否已连成三。从后向前隔步取该方棋子,累计行、列、对角次数,达到 即胜。否则满 步为平局,未满则未结束。
由于 moves 都有效,也即是说,不存在某个人获胜后,其他人仍然落棋的情况。因此,只需判断最后一个落棋的人能否获胜即可。
我们用一个长度为 的数组 cnt 记录行、列以及对角线的落棋次数。其中 分别表示第 行的落棋次数,而 分别表示第 列的落棋次数,另外 和 分别表示两条对角线的落棋次数。落棋过程中,如果某个人在某一行、列或对角线上落棋次数达到 次,则该人获胜。
如果最后一个落棋的人没有获胜,那么我们判断棋盘是否已满,如果已满,则平局;否则,游戏尚未结束。
时间复杂度 ,空间复杂度 。其中 为 moves 的长度。
func tictactoe(moves [][]int) string {
	n := len(moves)
	cnt := [8]int{}
	for k := n - 1; k >= 0; k -= 2 {
		i, j := moves[k][0], moves[k][1]
		cnt[i]++
		cnt[j+3]++
		if i == j {
			cnt[6]++
		}
		if i+j == 2 {
			cnt[7]++
		}
		if cnt[i] == 3 || cnt[j+3] == 3 || cnt[6] == 3 || cnt[7] == 3 {
			if k%2 == 0 {
				return "A"
			}
			return "B"
		}
	}
	if n == 9 {
		return "Draw"
	}
	return "Pending"
}1331. 数组序号转换
题目、示例与约束
给你一个整数数组 arr ,请你将数组中的每个元素替换为它们排序后的序号。
序号代表了一个元素有多大。序号编号的规则如下:
- 序号从 1 开始编号。
- 一个元素越大,那么序号越大。如果两个元素相等,那么它们的序号相同。
- 每个数字的序号都应该尽可能地小。
示例 1:
输入:arr = [40,10,20,30]
输出:[4,1,2,3]
解释:40 是最大的元素。 10 是最小的元素。 20 是第二小的数字。 30 是第三小的数字。
示例 2:
输入:arr = [100,100,100]
输出:[1,1,1]
解释:所有元素有相同的序号。
示例 3:
输入:arr = [37,12,28,9,100,56,80,5,12]
输出:[5,3,4,2,8,6,7,1,3]
提示:
0 <= arr.length <= 105-109 <= arr[i] <= 109
方法一:离散化 · Go 实现
思考
把每个值换成从 起的名次,相等则同名。直接对原数组两两比较是平方级, 。名次只取决于去重后的有序位置:排序去重得到 ,再对每个 二分其在 中的秩。
我们先复制一个数组 ,然后对其进行排序并去重,得到一个长度为 且严格单调递增的数组。
然后我们遍历原数组 ,对于其中的每个元素 ,我们利用二分查找得到 在 中的位置,那么该位置加一就是 的排名。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func arrayRankTransform(arr []int) (ans []int) {
	t := make([]int, len(arr))
	copy(t, arr)
	sort.Ints(t)
	m := 0
	for i, x := range t {
		if i == 0 || x != t[i-1] {
			t[m] = x
			m++
		}
	}
	t = t[:m]
	for _, x := range arr {
		ans = append(ans, sort.SearchInts(t, x)+1)
	}
	return
}1347. 制造字母异位词的最小步骤数
题目、示例与约束
给你两个长度相等的字符串 s 和 t。每一个步骤中,你可以选择将 t 中的 任一字符 替换为 另一个字符。
返回使 t 成为 s 的字母异位词的最小步骤数。
字母异位词 指字母相同,但排列不同(也可能相同)的字符串。
示例 1:
输出:s = "bab", t = "aba"
输出:1
提示:用 'b' 替换 t 中的第一个 'a',t = "bba" 是 s 的一个字母异位词。
示例 2:
输出:s = "leetcode", t = "practice"
输出:5
提示:用合适的字符替换 t 中的 'p', 'r', 'a', 'i' 和 'c',使 t 变成 s 的字母异位词。
示例 3:
输出:s = "anagram", t = "mangaar"
输出:0
提示:"anagram" 和 "mangaar" 本身就是一组字母异位词。
示例 4:
输出:s = "xxyyzz", t = "xxyyzz"
输出:0
示例 5:
输出:s = "friend", t = "family"
输出:4
提示:
1 <= s.length <= 50000s.length == t.lengths和t只包含小写英文字母
方法一:计数 · Go 实现
思考
等长串 改成 的字母异位词,每次改一个字符。需要改的次数等于 相对 多出来的字符数。先统计 的频次,再扫 :每见到一个字符就减一,减成负数说明该字符在 中超额,计入一步。
我们可以使用一个哈希表或者数组 来统计字符串 中每个字符出现的次数,然后遍历字符串 ,对于每个字符,我们在 中将其出现的次数减一,如果减一后的值小于 ,说明这个字符在字符串 中出现的次数比在字符串 中多,我们需要将这个字符替换掉,将答案加一。
遍历结束后,返回答案即可。
时间复杂度 ,空间复杂度 ,其中 和 分别是字符串 和 的长度,而 是字符集的大小,本题中字符集为小写字母,因此 。
func minSteps(s string, t string) (ans int) {
	cnt := [26]int{}
	for _, c := range s {
		cnt[c-'a']++
	}
	for _, c := range t {
		cnt[c-'a']--
		if cnt[c-'a'] < 0 {
			ans++
		}
	}
	return
}1365. 有多少小于当前数字的数字
题目、示例与约束
给你一个数组 nums,对于其中每个元素 nums[i],请你统计数组中比它小的所有数字的数目。
换而言之,对于每个 nums[i] 你必须计算出有效的 j 的数量,其中 j 满足 j != i 且 nums[j] < nums[i] 。
以数组形式返回答案。
示例 1:
输入:nums = [8,1,2,2,3]
输出:[4,0,1,1,3]
解释:
对于 nums[0]=8 存在四个比它小的数字:(1,2,2 和 3)。
对于 nums[1]=1 不存在比它小的数字。
对于 nums[2]=2 存在一个比它小的数字:(1)。
对于 nums[3]=2 存在一个比它小的数字:(1)。
对于 nums[4]=3 存在三个比它小的数字:(1,2 和 2)。
示例 2:
输入:nums = [6,5,4,8]
输出:[2,1,0,3]
示例 3:
输入:nums = [7,7,7,7]
输出:[0,0,0,0]
提示:
2 <= nums.length <= 5000 <= nums[i] <= 100
方法一:排序 + 二分查找 · Go 实现
思考
对每个 统计严格更小的元素个数。双重循环在 可过,但排序后 的名次就是答案。复制一份升序数组,再对每个 二分第一个不小于它的位置,该下标即更小元素个数。
我们可以将数组 复制一份,记为 ,然后对 进行升序排序。
接下来,对于 中的每个元素 ,我们可以通过二分查找的方法找到第一个大于等于 的元素的下标 ,那么 就是比 小的元素的个数,我们将 存入答案数组中即可。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func smallerNumbersThanCurrent(nums []int) (ans []int) {
	arr := make([]int, len(nums))
	copy(arr, nums)
	sort.Ints(arr)
	for i, x := range nums {
		nums[i] = sort.SearchInts(arr, x)
	}
	return nums
}
方法二:计数排序 + 前缀和 · Go 实现
思考
值域只有 ,不必比较排序。计数后再做前缀和, 即为小于 的个数,线性扫一遍原数组即可作答,去掉 的排序。
我们注意到数组 中的元素的范围是 ,因此我们可以使用计数排序的方法,先统计数组 中每个元素的个数。然后对计数数组进行前缀和计算,最后遍历数组 ,对于每个元素 ,我们直接将计数数组中下标为 的元素的值加入答案数组即可。
时间复杂度 ,空间复杂度 ,其中 和 分别是数组 的长度和最大值。
func smallerNumbersThanCurrent(nums []int) (ans []int) {
	cnt := [102]int{}
	for _, x := range nums {
		cnt[x+1]++
	}
	for i := 1; i < len(cnt); i++ {
		cnt[i] += cnt[i-1]
	}
	for _, x := range nums {
		ans = append(ans, cnt[x])
	}
	return
}1366. 通过投票对团队排名
题目、示例与约束
现在有一个特殊的排名系统,依据参赛团队在投票人心中的次序进行排名,每个投票者都需要按从高到低的顺序对参与排名的所有团队进行排位。
排名规则如下:
- 参赛团队的排名次序依照其所获「排位第一」的票的多少决定。如果存在多个团队并列的情况,将继续考虑其「排位第二」的票的数量。以此类推,直到不再存在并列的情况。
- 如果在考虑完所有投票情况后仍然出现并列现象,则根据团队字母的字母顺序进行排名。
给你一个字符串数组 votes 代表全体投票者给出的排位情况,请你根据上述排名规则对所有参赛团队进行排名。
请你返回能表示按排名系统 排序后 的所有团队排名的字符串。
示例 1:
输入:votes = ["ABC","ACB","ABC","ACB","ACB"]
输出:"ACB"
解释:
A 队获得五票「排位第一」,没有其他队获得「排位第一」,所以 A 队排名第一。
B 队获得两票「排位第二」,三票「排位第三」。
C 队获得三票「排位第二」,两票「排位第三」。
由于 C 队「排位第二」的票数较多,所以 C 队排第二,B 队排第三。
示例 2:
输入:votes = ["WXYZ","XYZW"]
输出:"XWYZ"
解释:
X 队在并列僵局打破后成为排名第一的团队。X 队和 W 队的「排位第一」票数一样,但是 X 队有一票「排位第二」,而 W 没有获得「排位第二」。
示例 3:
输入:votes = ["ZMNAGUEDSJYLBOPHRQICWFXTVK"]
输出:"ZMNAGUEDSJYLBOPHRQICWFXTVK"
解释:只有一个投票者,所以排名完全按照他的意愿。
提示:
1 <= votes.length <= 10001 <= votes[i].length <= 26votes[i].length == votes[j].lengthfor0 <= i, j < votes.lengthvotes[i][j]是英文 大写 字母votes[i]中的所有字母都是唯一的votes[0]中出现的所有字母 同样也 出现在votes[j]中,其中1 <= j < votes.length
方法一:计数 + 自定义排序 · Go 实现
思考
多名候选人按各排名上的得票依次比较,并列再按字母。直接对每对候选人扫全部选票是 。先按人统计每个名次的票数向量,再对该向量与字母的相反序做一次排序,向量较大者靠前。
对于每个候选人,我们可以统计他在每个排位上的票数,然后根据不同的排位依次比较票数,票数相同则比较字母。
时间复杂度 ,空间复杂度 。其中 是 的长度,而 是候选人的数量,即 的长度。
func rankTeams(votes []string) string {
	m := len(votes[0])
	cnt := [26][27]int{}
	for _, vote := range votes {
		for i, ch := range vote {
			cnt[ch-'A'][i]++
		}
	}
	s := []rune(votes[0])
	sort.Slice(s, func(i, j int) bool {
		a, b := s[i]-'A', s[j]-'A'
		for k := 0; k < m; k++ {
			if cnt[a][k] != cnt[b][k] {
				return cnt[a][k] > cnt[b][k]
			}
		}
		return s[i] < s[j]
	})
	return string(s)
}1370. 上升下降字符串
题目、示例与约束
给你一个字符串 s ,请你根据下面的算法重新构造字符串:
- 从
s中选出 最小 的字符,将它 接在 结果字符串的后面。 - 从
s剩余字符中选出比上一个添加字符更大的 最小 字符,将它 接在 结果字符串后面。 - 重复步骤 2 ,直到你没法从
s中选择字符。 - 从
s中选出 最大 的字符,将它 接在 结果字符串的后面。 - 从
s剩余字符中选出比上一个添加字符更小的 最大 字符,将它 接在 结果字符串后面。 - 重复步骤 5 ,直到你没法从
s中选择字符。 - 重复步骤 1 到 6 ,直到
s中所有字符都已经被选过。
在任何一步中,如果最小或者最大字符不止一个 ,你可以选择其中任意一个,并将其添加到结果字符串。
请你返回将 s 中字符重新排序后的 结果字符串 。
示例 1:
输入:s = "aaaabbbbcccc"
输出:"abccbaabccba"
解释:第一轮的步骤 1,2,3 后,结果字符串为 result = "abc"
第一轮的步骤 4,5,6 后,结果字符串为 result = "abccba"
第一轮结束,现在 s = "aabbcc" ,我们再次回到步骤 1
第二轮的步骤 1,2,3 后,结果字符串为 result = "abccbaabc"
第二轮的步骤 4,5,6 后,结果字符串为 result = "abccbaabccba"
示例 2:
输入:s = "rat"
输出:"art"
解释:单词 "rat" 在上述算法重排序以后变成 "art"
提示:
1 <= s.length <= 500s只包含小写英文字母。
方法一:计数 + 模拟 · Go 实现
思考
反复「从小到大各取一个未用完的字符,再从大到小各取一个」。字符集只有 个,先计数,再沿 与 交替扫描,有剩余则取一个,直到用完 个字符。
我们先用一个哈希表或者一个长度为 的数组 统计字符串 中每个字符出现的次数。
然后,我们枚举字母 ,对于当前枚举到的字母 ,如果 ,我们就将字母 接在答案字符串的末尾,并将 减一。我们重复这一步骤,直到 。随后我们逆序枚举字母 ,执行类似的操作。如果答案字符串的长度等于 的长度,那么我们就完成了所有的拼接操作。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度,而 是字符集,本题中字符集为所有小写字母,因此 。
func sortString(s string) string {
	cnt := [26]int{}
	for _, c := range s {
		cnt[c-'a']++
	}
	n := len(s)
	ans := make([]byte, 0, n)
	for len(ans) < n {
		for i := 0; i < 26; i++ {
			if cnt[i] > 0 {
				ans = append(ans, byte(i)+'a')
				cnt[i]--
			}
		}
		for i := 25; i >= 0; i-- {
			if cnt[i] > 0 {
				ans = append(ans, byte(i)+'a')
				cnt[i]--
			}
		}
	}
	return string(ans)
}1394. 找出数组中的幸运数
题目、示例与约束
在整数数组中,如果一个整数的出现频次和它的数值大小相等,我们就称这个整数为「幸运数」。
给你一个整数数组 arr,请你从中找出并返回一个幸运数。
- 如果数组中存在多个幸运数,只需返回 最大 的那个。
- 如果数组中不含幸运数,则返回 -1 。
示例 1:
输入:arr = [2,2,3,4]
输出:2
解释:数组中唯一的幸运数是 2 ,因为数值 2 的出现频次也是 2 。
示例 2:
输入:arr = [1,2,2,3,3,3]
输出:3
解释:1、2 以及 3 都是幸运数,只需要返回其中最大的 3 。
示例 3:
输入:arr = [2,2,2,3,3]
输出:-1
解释:数组中不存在幸运数。
示例 4:
输入:arr = [5]
输出:-1
示例 5:
输入:arr = [7,7,7,7,7,7,7]
输出:7
提示:
1 <= arr.length <= 5001 <= arr[i] <= 500
方法一:计数 · Go 实现
思考
幸运数是出现次数等于自身的值,求最大者。计数后遍历键值对,留下 的最大 ,没有则 。
我们可以用哈希表或数组 统计 中每个数字出现的次数,然后遍历 ,找到满足 的最大的 即可。如果没有这样的 ,则返回 。
时间复杂度 ,空间复杂度 。其中 为 的长度。
func findLucky(arr []int) int {
	cnt := [501]int{}
	for _, x := range arr {
		cnt[x]++
	}
	for x := len(cnt) - 1; x > 0; x-- {
		if x == cnt[x] {
			return x
		}
	}
	return -1
}1410. HTML 实体解析器
题目、示例与约束
「HTML 实体解析器」 是一种特殊的解析器,它将 HTML 代码作为输入,并用字符本身替换掉所有这些特殊的字符实体。
HTML 里这些特殊字符和它们对应的字符实体包括:
- 双引号:字符实体为
",对应的字符是"。 - 单引号:字符实体为
',对应的字符是'。 - 与符号:字符实体为
&,对应对的字符是&。 - 大于号:字符实体为
>,对应的字符是>。 - 小于号:字符实体为
<,对应的字符是<。 - 斜线号:字符实体为
⁄,对应的字符是/。
给你输入字符串 text ,请你实现一个 HTML 实体解析器,返回解析器解析后的结果。
示例 1:
输入:text = "& is an HTML entity but &ambassador; is not."
输出:"& is an HTML entity but &ambassador; is not."
解释:解析器把字符实体 & 用 & 替换
示例 2:
输入:text = "and I quote: "...""
输出:"and I quote: \"...\""
示例 3:
输入:text = "Stay home! Practice on Leetcode :)"
输出:"Stay home! Practice on Leetcode :)"
示例 4:
输入:text = "x > y && x < y is always false"
输出:"x > y && x < y is always false"
示例 5:
输入:text = "leetcode.com⁄problemset⁄all"
输出:"leetcode.com/problemset/all"
提示:
1 <= text.length <= 10^5- 字符串可能包含 256 个ASCII 字符中的任意字符。
方法一:哈希表 + 模拟 · Go 实现
思考
实体最长为 个字符,且种类固定。 时,从每个位置尝试匹配长度为 ~ 的前缀即可,无需通用解析器。
用哈希表保存实体到字符的映射。扫描时若 命中某实体则替换并跳过,否则输出当前字符。这样
&gt;会按最长(实为先匹配到的实体)正确拆成&与gt;。
我们可以使用哈希表来存储每个字符实体对应的字符,然后遍历字符串,当遇到字符实体时,我们就将其替换为对应的字符。
时间复杂度 ,空间复杂度 。其中 是字符串的长度,而 是字符实体的总长度。
func entityParser(text string) string {
d := map[string]string{
""": "\"",
"'": "'",
"&": "&",
">": ">",
"<": "<",
"⁄": "/",
}
var ans strings.Builder
i, n := 0, len(text)
for i < n {
found := false
for l := 1; l < 8; l++ {
j := i + l
if j <= n {
t := text[i:j]
if val, ok := d[t]; ok {
ans.WriteString(val)
i = j
found = true
break
}
}
}
if !found {
ans.WriteByte(text[i])
i++
}
}
return ans.String()
}1418. 点菜展示表
题目、示例与约束
给你一个数组 orders,表示客户在餐厅中完成的订单,确切地说, orders[i]=[customerNamei,tableNumberi,foodItemi] ,其中 customerNamei 是客户的姓名,tableNumberi 是客户所在餐桌的桌号,而 foodItemi 是客户点的餐品名称。
请你返回该餐厅的 点菜展示表 。在这张表中,表中第一行为标题,其第一列为餐桌桌号 “Table” ,后面每一列都是按字母顺序排列的餐品名称。接下来每一行中的项则表示每张餐桌订购的相应餐品数量,第一列应当填对应的桌号,后面依次填写下单的餐品数量。
注意:客户姓名不是点菜展示表的一部分。此外,表中的数据行应该按餐桌桌号升序排列。
示例 1:
输入:orders = [["David","3","Ceviche"],["Corina","10","Beef Burrito"],["David","3","Fried Chicken"],["Carla","5","Water"],["Carla","5","Ceviche"],["Rous","3","Ceviche"]]
输出:[["Table","Beef Burrito","Ceviche","Fried Chicken","Water"],["3","0","2","1","0"],["5","0","1","0","1"],["10","1","0","0","0"]]
解释:
点菜展示表如下所示:
Table,Beef Burrito,Ceviche,Fried Chicken,Water
3    ,0           ,2      ,1            ,0
5    ,0           ,1      ,0            ,1
10   ,1           ,0      ,0            ,0
对于餐桌 3:David 点了 "Ceviche" 和 "Fried Chicken",而 Rous 点了 "Ceviche"
而餐桌 5:Carla 点了 "Water" 和 "Ceviche"
餐桌 10:Corina 点了 "Beef Burrito"
示例 2:
输入:orders = [["James","12","Fried Chicken"],["Ratesh","12","Fried Chicken"],["Amadeus","12","Fried Chicken"],["Adam","1","Canadian Waffles"],["Brianna","1","Canadian Waffles"]]
输出:[["Table","Canadian Waffles","Fried Chicken"],["1","2","0"],["12","0","3"]]
解释:
对于餐桌 1:Adam 和 Brianna 都点了 "Canadian Waffles"
而餐桌 12:James, Ratesh 和 Amadeus 都点了 "Fried Chicken"
示例 3:
输入:orders = [["Laura","2","Bean Burrito"],["Jhon","2","Beef Burrito"],["Melissa","2","Soda"]]
输出:[["Table","Bean Burrito","Beef Burrito","Soda"],["2","1","1","1"]]
提示:
1 <= orders.length <= 5 * 10^4orders[i].length == 31 <= customerNamei.length, foodItemi.length <= 20customerNamei和foodItemi由大小写英文字母及空格字符' '组成。tableNumberi是1到500范围内的整数。
方法一:哈希表 + 排序 · Go 实现
思考
点菜单给出的是零散三元组,输出却要求按桌号升序、菜名字典序排成二维表。 ,先聚合再排序即可,不必在读取时维护有序结构。
用哈希表按桌收集菜名,用集合记下全部菜品。菜名排序后作为表头,再按桌号遍历,对每桌计数并按表头填数量。
我们可以用一个哈希表 来存储每张餐桌点的菜品,用一个集合 来存储所有的菜品。
遍历 ,将每张餐桌点的菜品存入 和 中。
然后我们将 排序,得到 。
接下来,我们构建答案数组 ,首先将标题行 加入 ,然后遍历排序后的 ,对于每张餐桌,我们用一个计数器 来统计每种菜品的数量,然后构建一行 ,将其加入 。
最后返回 。
时间复杂度 ,空间复杂度 。其中 是数组 的长度,而 和 分别表示菜品种类数和餐桌数。
func displayTable(orders [][]string) [][]string {
	tables := make(map[int]map[string]int)
	items := make(map[string]bool)
	for _, order := range orders {
		table, _ := strconv.Atoi(order[1])
		foodItem := order[2]
		if tables[table] == nil {
			tables[table] = make(map[string]int)
		}
		tables[table][foodItem]++
		items[foodItem] = true
	}
	sortedItems := make([]string, 0, len(items))
	for item := range items {
		sortedItems = append(sortedItems, item)
	}
	sort.Strings(sortedItems)
	ans := [][]string{}
	header := append([]string{"Table"}, sortedItems...)
	ans = append(ans, header)
	tableNums := make([]int, 0, len(tables))
	for table := range tables {
		tableNums = append(tableNums, table)
	}
	sort.Ints(tableNums)
	for _, table := range tableNums {
		row := []string{strconv.Itoa(table)}
		for _, item := range sortedItems {
			count := tables[table][item]
			row = append(row, strconv.Itoa(count))
		}
		ans = append(ans, row)
	}
	return ans
}1426. 数元素 🔒
题目、示例与约束
给你一个整数数组 arr, 对于元素 x ,只有当 x + 1 也在数组 arr 里时,才能记为 1 个数。
如果数组 arr 里有重复的数,每个重复的数单独计算。
示例 1:
输入:arr = [1,2,3]
输出:2
解释:1 和 2 被计算次数因为 2 和 3 在数组 arr 里。
示例 2:
输入:arr = [1,1,3,3,5,5,7,7]
输出:0
解释:所有的数都不算, 因为数组里没有 2、4、6、8。
提示:
1 <= arr.length <= 10000 <= arr[i] <= 1000
方法一:计数 · Go 实现
思考
,对每个 扫描是否存在 即可,但重复元素会被重复查找。先计数,再对每个出现过的 ,若 也出现,则把 的次数计入答案。
我们可以用一个哈希表或数组 记录数组 中的每个数出现的次数,然后遍历 中的每个数 ,如果 也在 中,那么就将 加到答案中。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func countElements(arr []int) (ans int) {
	mx := slices.Max(arr)
	cnt := make([]int, mx+1)
	for _, x := range arr {
		cnt[x]++
	}
	for x := 0; x < mx; x++ {
		if cnt[x+1] > 0 {
			ans += cnt[x]
		}
	}
	return
}1436. 旅行终点站
题目、示例与约束
给你一份旅游线路图,该线路图中的旅行线路用数组 paths 表示,其中 paths[i] = [cityAi, cityBi] 表示该线路将会从 cityAi 直接前往 cityBi 。请你找出这次旅行的终点站,即没有任何可以通往其他城市的线路的城市。
题目数据保证线路图会形成一条不存在循环的线路,因此恰有一个旅行终点站。
示例 1:
输入:paths = [["London","New York"],["New York","Lima"],["Lima","Sao Paulo"]]
输出:"Sao Paulo"
解释:从 "London" 出发,最后抵达终点站 "Sao Paulo" 。本次旅行的路线是 "London" -> "New York" -> "Lima" -> "Sao Paulo" 。
示例 2:
输入:paths = [["B","C"],["D","B"],["C","A"]]
输出:"A"
解释:所有可能的线路是:
"D" -> "B" -> "C" -> "A".
"B" -> "C" -> "A".
"C" -> "A".
"A".
显然,旅行终点站是 "A" 。
示例 3:
输入:paths = [["A","Z"]]
输出:"Z"
提示:
1 <= paths.length <= 100paths[i].length == 21 <= cityAi.length, cityBi.length <= 10cityAi != cityBi- 所有字符串均由大小写英文字母和空格字符组成。
方法一:哈希表 · Go 实现
思考
路径构成一条从某城出发、终点不再出发的链。 ,把所有起点放入集合,再找不在集合中的终点,即为唯一汇点。
根据题目描述,终点一定不会出现在所有 中,因此,我们可以先遍历一遍 ,将所有 放入一个集合 中,然后再遍历一遍 ,找到不在 中的 即可。
时间复杂度 ,空间复杂度 。其中 为 的长度。
func destCity(paths [][]string) string {
	s := map[string]bool{}
	for _, p := range paths {
		s[p[0]] = true
	}
	for _, p := range paths {
		if !s[p[1]] {
			return p[1]
		}
	}
	return ""
}1452. 收藏清单
题目、示例与约束
给你一个数组 favoriteCompanies ,其中 favoriteCompanies[i] 是第 i 名用户收藏的公司清单(下标从 0 开始)。
请找出不是其他任何人收藏的公司清单的子集的收藏清单,并返回该清单下标。下标需要按升序排列。
示例 1:
输入:favoriteCompanies = [["leetcode","google","facebook"],["google","microsoft"],["google","facebook"],["google"],["amazon"]]
输出:[0,1,4]
解释:
favoriteCompanies[2]=["google","facebook"] 是 favoriteCompanies[0]=["leetcode","google","facebook"] 的子集。
favoriteCompanies[3]=["google"] 是 favoriteCompanies[0]=["leetcode","google","facebook"] 和 favoriteCompanies[1]=["google","microsoft"] 的子集。
其余的收藏清单均不是其他任何人收藏的公司清单的子集,因此,答案为 [0,1,4] 。
示例 2:
输入:favoriteCompanies = [["leetcode","google","facebook"],["leetcode","amazon"],["facebook","google"]]
输出:[0,1]
解释:favoriteCompanies[2]=["facebook","google"] 是 favoriteCompanies[0]=["leetcode","google","facebook"] 的子集,因此,答案为 [0,1] 。
示例 3:
输入:favoriteCompanies = [["leetcode"],["google"],["facebook"],["amazon"]]
输出:[0,1,2,3]
提示:
1 <= favoriteCompanies.length <= 1001 <= favoriteCompanies[i].length <= 5001 <= favoriteCompanies[i][j].length <= 20favoriteCompanies[i]中的所有字符串 各不相同 。- 用户收藏的公司清单也 各不相同 ,也就是说,即便我们按字母顺序排序每个清单,
favoriteCompanies[i] != favoriteCompanies[j]仍然成立。 - 所有字符串仅包含小写英文字母。
方法一:哈希表 · Go 实现
思考
、每人至多 家公司,公司名较长。把公司映射成整数后用集合表示清单,再双重循环用子集运算判断是否被他人包含。
清单互不相同,因此只需检查是否存在 使 。
我们可以将每个公司映射到一个唯一的整数,然后对于每个人,我们将他们收藏的公司转换为整数集合,最后判断是否存在一个人的收藏公司是另一个人的子集。
时间复杂度 ,空间复杂度 。其中 和 分别是 favoriteCompanies 的长度和每个公司清单的平均长度,而 是每个公司的平均长度。
func peopleIndexes(favoriteCompanies [][]string) (ans []int) {
	n := len(favoriteCompanies)
	d := make(map[string]int)
	idx := 0
	nums := make([]map[int]struct{}, n)

	for i := 0; i < n; i++ {
		nums[i] = make(map[int]struct{})
		for _, s := range favoriteCompanies[i] {
			if _, ok := d[s]; !ok {
				d[s] = idx
				idx++
			}
			nums[i][d[s]] = struct{}{}
		}
	}

	check := func(a, b map[int]struct{}) bool {
		for x := range a {
			if _, ok := b[x]; !ok {
				return false
			}
		}
		return true
	}
	for i := 0; i < n; i++ {
		ok := true
		for j := 0; j < n && ok; j++ {
			if i != j && check(nums[i], nums[j]) {
				ok = false
			}
		}
		if ok {
			ans = append(ans, i)
		}
	}

	return
}1460. 通过翻转子数组使两个数组相等
题目、示例与约束
给你两个长度相同的整数数组 target 和 arr 。每一步中,你可以选择 arr 的任意 非空子数组 并将它翻转。你可以执行此过程任意次。
如果你能让 arr 变得与 target 相同,返回 True;否则,返回 False 。
示例 1:
输入:target = [1,2,3,4], arr = [2,4,1,3]
输出:true
解释:你可以按照如下步骤使 arr 变成 target:
1- 翻转子数组 [2,4,1] ,arr 变成 [1,4,2,3]
2- 翻转子数组 [4,2] ,arr 变成 [1,2,4,3]
3- 翻转子数组 [4,3] ,arr 变成 [1,2,3,4]
上述方法并不是唯一的,还存在多种将 arr 变成 target 的方法。
示例 2:
输入:target = [7], arr = [7]
输出:true
解释:arr 不需要做任何翻转已经与 target 相等。
示例 3:
输入:target = [3,7,9], arr = [3,7,11]
输出:false
解释:arr 没有数字 9 ,所以无论如何也无法变成 target 。
提示:
target.length == arr.length1 <= target.length <= 10001 <= target[i] <= 10001 <= arr[i] <= 1000
方法一:排序 · Go 实现
思考
任意子数组翻转等价于可以任意重排。 ,两数组排序后相等当且仅当能互变。
如果两个数组排序后相等,那么它们可以通过翻转子数组变成相等的数组。
因此,我们只需要对两个数组进行排序,然后判断排序后的数组是否相等即可。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func canBeEqual(target []int, arr []int) bool {
	sort.Ints(target)
	sort.Ints(arr)
	return reflect.DeepEqual(target, arr)
}
方法二:计数 · Go 实现
思考
方法一花费 。值域仅为 ~ ,比较频次即可,线性判定。
我们注意到,题目中给出的数组元素的范围是 ,因此我们可以使用两个长度为 的数组 cnt1 和 cnt2 分别记录数组 target 和 arr 中每个元素出现的次数。最后判断两个数组是否相等即可。
我们也可以只用一个数组 cnt,遍历数组 target 和 arr,对于 target[i],我们将 cnt[target[i]] 加一,对于 arr[i],我们将 cnt[arr[i]] 减一。最后判断数组 cnt 中的所有元素是否都为 。
时间复杂度 ,空间复杂度 。其中 是数组 的长度,而 是数组元素的范围,本题中 。
func canBeEqual(target []int, arr []int) bool {
	cnt1 := make([]int, 1001)
	cnt2 := make([]int, 1001)
	for _, v := range target {
		cnt1[v]++
	}
	for _, v := range arr {
		cnt2[v]++
	}
	return reflect.DeepEqual(cnt1, cnt2)
}1487. 保证文件名唯一
题目、示例与约束
给你一个长度为 n 的字符串数组 names 。你将会在文件系统中创建 n 个文件夹:在第 i 分钟,新建名为 names[i] 的文件夹。
由于两个文件 不能 共享相同的文件名,因此如果新建文件夹使用的文件名已经被占用,系统会以 (k) 的形式为新文件夹的文件名添加后缀,其中 k 是能保证文件名唯一的 最小正整数 。
返回长度为 n 的字符串数组,其中 ans[i] 是创建第 i 个文件夹时系统分配给该文件夹的实际名称。
示例 1:
输入:names = ["pes","fifa","gta","pes(2019)"]
输出:["pes","fifa","gta","pes(2019)"]
解释:文件系统将会这样创建文件名:
"pes" --> 之前未分配,仍为 "pes"
"fifa" --> 之前未分配,仍为 "fifa"
"gta" --> 之前未分配,仍为 "gta"
"pes(2019)" --> 之前未分配,仍为 "pes(2019)"
示例 2:
输入:names = ["gta","gta(1)","gta","avalon"]
输出:["gta","gta(1)","gta(2)","avalon"]
解释:文件系统将会这样创建文件名:
"gta" --> 之前未分配,仍为 "gta"
"gta(1)" --> 之前未分配,仍为 "gta(1)"
"gta" --> 文件名被占用,系统为该名称添加后缀 (k),由于 "gta(1)" 也被占用,所以 k = 2 。实际创建的文件名为 "gta(2)" 。
"avalon" --> 之前未分配,仍为 "avalon"
示例 3:
输入:names = ["onepiece","onepiece(1)","onepiece(2)","onepiece(3)","onepiece"]
输出:["onepiece","onepiece(1)","onepiece(2)","onepiece(3)","onepiece(4)"]
解释:当创建最后一个文件夹时,最小的正有效 k 为 4 ,文件名变为 "onepiece(4)"。
示例 4:
输入:names = ["wano","wano","wano","wano"]
输出:["wano","wano(1)","wano(2)","wano(3)"]
解释:每次创建文件夹 "wano" 时,只需增加后缀中 k 的值即可。
示例 5:
输入:names = ["kaido","kaido(1)","kaido","kaido(1)"]
输出:["kaido","kaido(1)","kaido(2)","kaido(1)(1)"]
解释:注意,如果含后缀文件名被占用,那么系统也会按规则在名称后添加新的后缀 (k) 。
提示:
1 <= names.length <= 5 * 10^41 <= names[i].length <= 20names[i]由小写英文字母、数字和/或圆括号组成。
方法一:哈希表 · Go 实现
思考
,需按出现顺序分配不冲突的文件名。哈希表记下每个名字下一次可尝试的后缀 ,冲突则试 直到未占用,并更新该前缀的下一个 。
我们可以用哈希表 记录每个文件夹的最小可用编号,其中 表示文件夹 的最小可用编号为 。初始时, 中没有任何文件夹,因此 为空。
接下来遍历文件夹数组,对于每个文件名 :
- 如果 在 中,说明文件夹 已经存在,我们需要找到一个新的文件夹名字。我们可以不断地尝试 ,其中 从 开始,直到找到一个文件夹名字 不存在于 中为止。我们将 加入 中,并将 更新为 。然后我们将 更新为 。
- 如果 不在 中,我们可以直接将 加入 中,并将 更新为 。
- 接着我们将 加入答案数组。然后继续遍历下一个文件名。
遍历完所有文件名后,我们即可得到答案数组。
在以下代码实现中,我们直接修改文件名数组 ,而不使用额外的答案数组。
时间复杂度 ,空间复杂度 ,其中 为数组 中所有文件名的长度之和。
func getFolderNames(names []string) []string {
	d := map[string]int{}
	for i, name := range names {
		if k, ok := d[name]; ok {
			for {
				newName := fmt.Sprintf("%s(%d)", name, k)
				if d[newName] == 0 {
					d[name] = k + 1
					names[i] = newName
					break
				}
				k++
			}
		}
		d[names[i]] = 1
	}
	return names
}1496. 判断路径是否相交
题目、示例与约束
给你一个字符串 path,其中 path[i] 的值可以是 'N'、'S'、'E' 或者 'W',分别表示向北、向南、向东、向西移动一个单位。
你从二维平面上的原点 (0, 0) 处开始出发,按 path 所指示的路径行走。
如果路径在任何位置上与自身相交,也就是走到之前已经走过的位置,请返回 true ;否则,返回 false 。
示例 1:
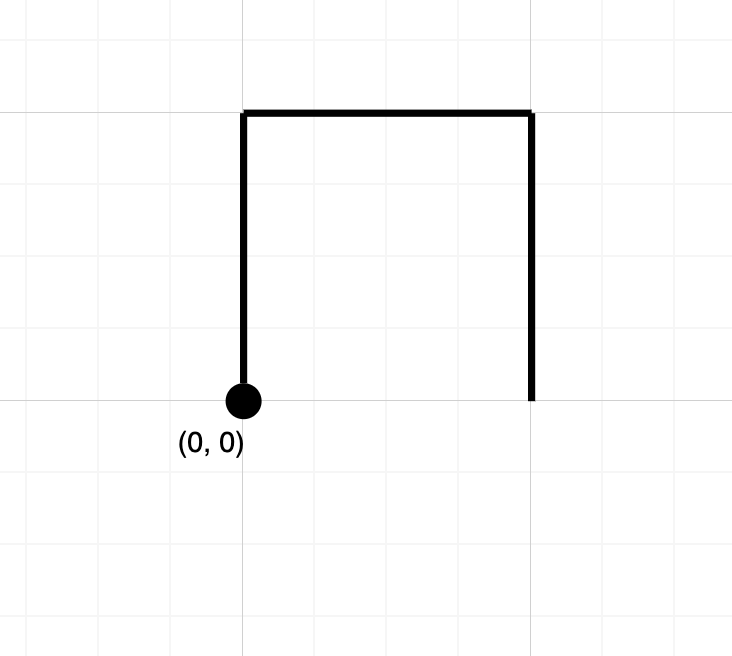
输入:path = "NES"
输出:false
解释:该路径没有在任何位置相交。
示例 2:
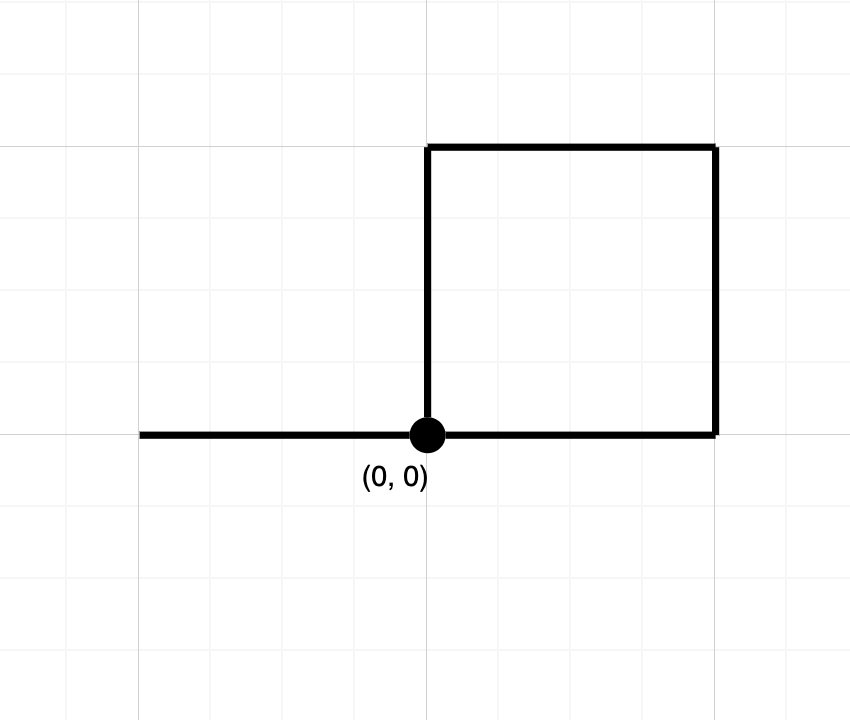
输入:path = "NESWW"
输出:true
解释:该路径经过原点两次。
提示:
1 <= path.length <= 104path[i]为'N'、'S'、'E'或'W'
方法一:哈希表 · Go 实现
思考
,模拟行走并把访问过的格点放入集合。若下一步已在集合中则路径相交。
我们可以用一个哈希表 记录路径上的点。初始时 中只有原点 。
遍历字符串 ,对于每个字符 ,根据 的值更新当前位置 ,然后判断 是否在 中,如果在,则返回 true,否则将 加入 中。
遍历结束后,返回 false。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度。
func isPathCrossing(path string) bool {
	i, j := 0, 0
	vis := map[int]bool{0: true}
	for _, c := range path {
		switch c {
		case 'N':
			i--
		case 'S':
			i++
		case 'E':
			j++
		case 'W':
			j--
		}
		if vis[i*20000+j] {
			return true
		}
		vis[i*20000+j] = true
	}
	return false
}1497. 检查数组对是否可以被 k 整除
题目、示例与约束
给你一个整数数组 arr 和一个整数 k ,其中数组长度是偶数,值为 n 。
现在需要把数组恰好分成 n / 2 对,以使每对数字的和都能够被 k 整除。
如果存在这样的分法,请返回 true ;否则,返回 false。
示例 1:
输入:arr = [1,2,3,4,5,10,6,7,8,9], k = 5
输出:true
解释:划分后的数字对为 (1,9),(2,8),(3,7),(4,6) 以及 (5,10) 。
示例 2:
输入:arr = [1,2,3,4,5,6], k = 7
输出:true
解释:划分后的数字对为 (1,6),(2,5) 以及 (3,4) 。
示例 3:
输入:arr = [1,2,3,4,5,6], k = 10
输出:false
解释:无法在将数组中的数字分为三对的同时满足每对数字和能够被 10 整除的条件。
提示:
arr.length == n1 <= n <= 105n为偶数-109 <= arr[i] <= 1091 <= k <= 105
方法一:统计余数 · Go 实现
思考
两数之和能被 整除当且仅当余数之和为 或 。 ,统计 的频次:余数 必须成对,其余 与 个数须相等( 为偶数时 亦须成对,等式同样覆盖)。
两个数 和 的和能被 整除,当且仅当这两个数分别对 取模的结果之和能被 整除。
因此,我们可以统计数组中每个数对 取模的结果,即余数,记录在数组 中。然后我们遍历数组 ,对于范围在 的每个数 ,如果 和 的值不相等,说明无法将数组中的数字分为 对,使得每对数字的和都能被 整除。如果 的值不是偶数,也说明无法将数组中的数字分为 对,使得每对数字的和都能被 整除。
时间复杂度 ,其中 为数组 的长度。空间复杂度 。
func canArrange(arr []int, k int) bool {
	cnt := make([]int, k)
	for _, x := range arr {
		cnt[(x%k+k)%k]++
	}
	for i := 1; i < k; i++ {
		if cnt[i] != cnt[k-i] {
			return false
		}
	}
	return cnt[0]%2 == 0
}1540. K 次操作转变字符串
题目、示例与约束
给你两个字符串 s 和 t ,你的目标是在 k 次操作以内把字符串 s 转变成 t 。
在第 i 次操作时(1 <= i <= k),你可以选择进行如下操作:
- 选择字符串
s中满足1 <= j <= s.length且之前未被选过的任意下标j(下标从 1 开始),并将此位置的字符切换i次。 - 不进行任何操作。
切换 1 个字符的意思是用字母表中该字母的下一个字母替换它(字母表环状接起来,所以 'z' 切换后会变成 'a')。第 i 次操作意味着该字符应切换 i 次
请记住任意一个下标 j 最多只能被操作 1 次。
如果在不超过 k 次操作内可以把字符串 s 转变成 t ,那么请你返回 true ,否则请你返回 false 。
示例 1:
输入:s = "input", t = "ouput", k = 9
输出:true
解释:第 6 次操作时,我们将 'i' 切换 6 次得到 'o' 。第 7 次操作时,我们将 'n' 切换 7 次得到 'u' 。
示例 2:
输入:s = "abc", t = "bcd", k = 10
输出:false
解释:我们需要将每个字符切换 1 次才能得到 t 。我们可以在第 1 次操作时将 'a' 切换成 'b' ,但另外 2 个字母在剩余操作中无法再转变为 t 中对应字母。
示例 3:
输入:s = "aab", t = "bbb", k = 27
输出:true
解释:第 1 次操作时,我们将第一个 'a' 切换 1 次得到 'b' 。在第 27 次操作时,我们将第二个字母 'a' 切换 27 次得到 'b' 。
提示:
1 <= s.length, t.length <= 10^50 <= k <= 10^9s和t只包含小写英文字母。
方法一:计数 · Go 实现
思考
把 变成 ,第 次操作只能把某个字符沿字母表循环前进 位,且每个 至多用一次。 、 ,不能模拟每一次操作。
长度不同则无解。每位的最小移位 确定,相同 必须错开使用 。第 个同类需要 步,只要该值不超过 即可。移位 无需操作。
我们首先判断字符串 和字符串 的长度是否相等,如果不相等,直接返回 false。
如果相等,我们可以统计每个位置的字符需要操作的最小次数,即 表示最小操作次数为 的字符的个数。
如果有 个字符需要操作 次,那么我们需要 次操作才能将这些字符转换为 中对应的字符。因此,我们在 $[1,..25] 范围内枚举 ,如果 ,说明我们无法将所有字符转换为 中对应的字符,返回 false。
否则,枚举结束后,说明我们可以将所有字符转换为 中对应的字符,返回 true。
时间复杂度 ,空间复杂度 ,其中 为字符串 和 的长度;而 为字符集大小,本题中 。
func canConvertString(s string, t string, k int) bool {
	if len(s) != len(t) {
		return false
	}
	cnt := [26]int{}
	for i := range s {
		x := (t[i] - s[i] + 26) % 26
		cnt[x]++
	}
	for i := 1; i < 26; i++ {
		if i+26*(cnt[i]-1) > k {
			return false
		}
	}
	return true
}1554. 只有一个不同字符的字符串 🔒
题目、示例与约束
给定一个字符串列表 dict ,其中所有字符串的长度都相同。
当存在两个字符串在相同索引处只有一个字符不同时,返回 true ,否则返回 false 。
示例 1:
输入:dict = ["abcd","acbd", "aacd"]
输出:true
解释:字符串 "abcd" 和 "aacd" 只在索引 1 处有一个不同的字符。
示例 2:
输入:dict = ["ab","cd","yz"]
输出:false
示例 3:
输入:dict = ["abcd","cccc","abyd","abab"]
输出:true
提示:
dict中的字符数小于或等于105。dict[i].length == dict[j].lengthdict[i]是互不相同的。dict[i]只包含小写英文字母。
方法一 · Go 实现
思考
判断是否存在恰好相差一位的两个词。词数与长度之积不超过 ,两两比较每位是平方级。
把每个词的每一位依次换成通配符,得到「忽略该位」的模式。若某模式已在集合中出现,则存在另一词与当前词只在该位不同。哈希集合保证均摊常数查询。
func differByOne(dict []string) bool {
	s := make(map[string]bool)
	for _, word := range dict {
		for i := range word {
			t := word[:i] + "*" + word[i+1:]
			if s[t] {
				return true
			}
			s[t] = true
		}
	}
	return false
}1604. 警告一小时内使用相同员工卡大于等于三次的人
题目、示例与约束
力扣公司的员工都使用员工卡来开办公室的门。每当一个员工使用一次他的员工卡,安保系统会记录下员工的名字和使用时间。如果一个员工在一小时时间内使用员工卡的次数大于等于三次,这个系统会自动发布一个 警告 。
给你字符串数组 keyName 和 keyTime ,其中 [keyName[i], keyTime[i]] 对应一个人的名字和他在 某一天 内使用员工卡的时间。
使用时间的格式是 24小时制 ,形如 "HH:MM" ,比方说 "23:51" 和 "09:49" 。
请你返回去重后的收到系统警告的员工名字,将它们按 字典序升序 排序后返回。
请注意 "10:00" - "11:00" 视为一个小时时间范围内,而 "22:51" - "23:52" 不被视为一小时时间范围内。
示例 1:
输入:keyName = ["daniel","daniel","daniel","luis","luis","luis","luis"], keyTime = ["10:00","10:40","11:00","09:00","11:00","13:00","15:00"]
输出:["daniel"]
解释:"daniel" 在一小时内使用了 3 次员工卡("10:00","10:40","11:00")。
示例 2:
输入:keyName = ["alice","alice","alice","bob","bob","bob","bob"], keyTime = ["12:01","12:00","18:00","21:00","21:20","21:30","23:00"]
输出:["bob"]
解释:"bob" 在一小时内使用了 3 次员工卡("21:00","21:20","21:30")。
提示:
1 <= keyName.length, keyTime.length <= 105keyName.length == keyTime.lengthkeyTime格式为 "HH:MM" 。- 保证
[keyName[i], keyTime[i]]形成的二元对 互不相同 。 1 <= keyName[i].length <= 10keyName[i]只包含小写英文字母。
方法一:哈希表 + 排序 · Go 实现
思考
记录数达 ,若对每名员工枚举所有长度为 的时间三元组,在打卡集中时仍可能落到较大常数。题目要求的是「一小时内至少三次」,等价于排序后存在间隔至多为 分钟的连续三次打卡。
按人聚合时间并把 换成分钟数后排序,则只需检查 。
哈希表 收集每人的时间列表;次数不足三次者跳过,命中警报的姓名最后再按字典序排序。
我们先用哈希表 记录每个员工的所有打卡时间。
然后遍历哈希表,对于每个员工,我们先判断员工的打卡次数是否大于等于 3,如果不是,则跳过该员工。否则,我们将该员工的所有打卡时间按照时间先后排序,然后遍历排序后的打卡时间,判断下标距离为 的两个时间是否在同一小时内,如果是,则将该员工加入答案数组。
最后,将答案数组按照字典序排序,即可得到答案。
时间复杂度 ,空间复杂度 。其中 是打卡记录的数量。
func alertNames(keyName []string, keyTime []string) (ans []string) {
	d := map[string][]int{}
	for i, name := range keyName {
		var a, b int
		fmt.Sscanf(keyTime[i], "%d:%d", &a, &b)
		t := a*60 + b
		d[name] = append(d[name], t)
	}
	for name, ts := range d {
		n := len(ts)
		if n > 2 {
			sort.Ints(ts)
			for i := 0; i < n-2; i++ {
				if ts[i+2]-ts[i] <= 60 {
					ans = append(ans, name)
					break
				}
			}
		}
	}
	sort.Strings(ans)
	return
}1624. 两个相同字符之间的最长子字符串
题目、示例与约束
给你一个字符串 s,请你返回 两个相同字符之间的最长子字符串的长度 ,计算长度时不含这两个字符。如果不存在这样的子字符串,返回 -1 。
子字符串 是字符串中的一个连续字符序列。
示例 1:
输入:s = "aa"
输出:0
解释:最优的子字符串是两个 'a' 之间的空子字符串。
示例 2:
输入:s = "abca"
输出:2
解释:最优的子字符串是 "bc" 。
示例 3:
输入:s = "cbzxy"
输出:-1
解释:s 中不存在出现出现两次的字符,所以返回 -1 。
示例 4:
输入:s = "cabbac"
输出:4
解释:最优的子字符串是 "abba" ,其他的非最优解包括 "bb" 和 "" 。
提示:
1 <= s.length <= 300s只含小写英文字母
方法一:数组 · Go 实现
思考
两个相同字符之间的子串长度,由这个字符第一次出现和某次更靠后出现的位置差决定。字符串虽然不长,但只要记下每个字母第一次出现的下标,扫一遍就能得到最大间距。
再次遇到某个字符时,用当前位置减去首次下标再减一来更新答案,并且不要覆盖第一次的下标,这样跨度才最大。
字符串只含小写字母,用长度为 的数组记下首次位置即可;如果没有任何字符出现两次,答案保持 。
由于字符串 只含小写英文字母,我们可以用一个长度为 的数组 记录每个字符第一次出现的位置,初始时数组元素均为 。
遍历字符串 中每个下标为 的字符 ,令 为 相对字母 a 的偏移。若 ,说明这是 第一次出现,令 ;否则用 更新答案,即 。
时间复杂度 ,空间复杂度 。其中 为字符串长度, 为字符集大小,本题中 。
func maxLengthBetweenEqualCharacters(s string) int {
	d := make([]int, 26)
	for i := range d {
		d[i] = -1
	}
	ans := -1
	for i := range s {
		j := int(s[i] - 'a')
		if d[j] == -1 {
			d[j] = i
		} else {
			ans = max(ans, i-d[j]-1)
		}
	}
	return ans
}1630. 等差子数组
题目、示例与约束
如果一个数列由至少两个元素组成,且每两个连续元素之间的差值都相同,那么这个序列就是 等差数列 。更正式地,数列 s 是等差数列,只需要满足:对于每个有效的 i , s[i+1] - s[i] == s[1] - s[0] 都成立。
例如,下面这些都是 等差数列 :
1, 3, 5, 7, 9
7, 7, 7, 7
3, -1, -5, -9
下面的数列 不是等差数列 :
1, 1, 2, 5, 7
给你一个由 n 个整数组成的数组 nums,和两个由 m 个整数组成的数组 l 和 r,后两个数组表示 m 组范围查询,其中第 i 个查询对应范围 [l[i], r[i]] 。所有数组的下标都是 从 0 开始 的。
返回 boolean 元素构成的答案列表 answer 。如果子数组 nums[l[i]], nums[l[i]+1], ... , nums[r[i]] 可以 重新排列 形成 等差数列 ,answer[i] 的值就是 true;否则answer[i] 的值就是 false 。
示例 1:
输入:nums =[4,6,5,9,3,7], l =[0,0,2], r =[2,3,5]输出:[true,false,true]解释: 第 0 个查询,对应子数组 [4,6,5] 。可以重新排列为等差数列 [6,5,4] 。 第 1 个查询,对应子数组 [4,6,5,9] 。无法重新排列形成等差数列。 第 2 个查询,对应子数组[5,9,3,7] 。可以重新排列为等差数列[3,5,7,9] 。
示例 2:
输入:nums = [-12,-9,-3,-12,-6,15,20,-25,-20,-15,-10], l = [0,1,6,4,8,7], r = [4,4,9,7,9,10]
输出:[false,true,false,false,true,true]
提示:
n == nums.lengthm == l.lengthm == r.length2 <= n <= 5001 <= m <= 5000 <= l[i] < r[i] < n-105 <= nums[i] <= 105
方法一:数学 + 模拟 · Go 实现
思考
每次查询要判断子数组能否重排成等差数列, ,对每个区间排序检查公差可行,但更直接的是用最值确定公差再验证每一项是否出现。
子数组最小、最大值分别为首末项,若 不能被 整除则不可能;否则公差 固定,只需集合中包含 。
对每组 建集合并按上述检验,得到布尔数组。
我们设计一个函数 ,用于判断子数组 是否可以重新排列形成等差数列。
函数 的实现逻辑如下:
- 首先,我们计算子数组的长度 ,并将子数组中的元素放入集合 中,方便后续的查找;
- 然后,我们获取子数组中的最小值 和最大值 ,如果 不能被 整除,那么子数组不可能形成等差数列,直接返回 ;否则,我们计算等差数列的公差 ;
- 接下来从 开始,依次计算等差数列中第 项元素,如果第 项元素 不在集合 中,那么子数组不可能形成等差数列,直接返回 ;否则,当我们遍历完所有的元素,说明子数组可以重新排列形成等差数列,返回 。
在主函数中,我们遍历所有的查询,对于每个查询 和 ,我们调用函数 判断子数组是否可以重新排列形成等差数列,将结果存入答案数组中。
时间复杂度 ,空间复杂度 。其中 和 分别为数组 的长度以及查询的组数。
func checkArithmeticSubarrays(nums []int, l []int, r []int) (ans []bool) {
	check := func(nums []int, l, r int) bool {
		s := map[int]struct{}{}
		n := r - l + 1
		a1, an := 1<<30, -(1 << 30)
		for _, x := range nums[l : r+1] {
			s[x] = struct{}{}
			if a1 > x {
				a1 = x
			}
			if an < x {
				an = x
			}
		}
		if (an-a1)%(n-1) != 0 {
			return false
		}
		d := (an - a1) / (n - 1)
		for i := 1; i < n; i++ {
			if _, ok := s[a1+(i-1)*d]; !ok {
				return false
			}
		}
		return true
	}
	for i := range l {
		ans = append(ans, check(nums, l[i], r[i]))
	}
	return
}1636. 按照频率将数组升序排序
题目、示例与约束
给你一个整数数组 nums ,请你将数组按照每个值的频率 升序 排序。如果有多个值的频率相同,请你按照数值本身将它们 降序 排序。
请你返回排序后的数组。
示例 1:
输入:nums = [1,1,2,2,2,3]
输出:[3,1,1,2,2,2]
解释:'3' 频率为 1,'1' 频率为 2,'2' 频率为 3 。
示例 2:
输入:nums = [2,3,1,3,2]
输出:[1,3,3,2,2]
解释:'2' 和 '3' 频率都为 2 ,所以它们之间按照数值本身降序排序。
示例 3:
输入:nums = [-1,1,-6,4,5,-6,1,4,1]
输出:[5,-1,4,4,-6,-6,1,1,1]
提示:
1 <= nums.length <= 100-100 <= nums[i] <= 100
方法一:数组或哈希表计数 · Go 实现
思考
排序关键字是频次升序、频次相同则数值降序。 ,先计数再自定义排序即可。
哈希表(或平移后的数组)得到 ,排序键取 。
用数组或者哈希表统计 nums 中每个数字出现的次数,由于题目中数字的范围是 ,我们可以直接创建一个大小为 的数组来统计。
然后对 nums 按照数字出现次数升序排序,如果出现次数相同,则按照数字降序排序。
时间复杂度为 ,空间复杂度 。其中 为数组 nums 的长度。
func frequencySort(nums []int) []int {
	cnt := make([]int, 201)
	for _, v := range nums {
		cnt[v+100]++
	}
	sort.Slice(nums, func(i, j int) bool {
		a, b := nums[i]+100, nums[j]+100
		return cnt[a] < cnt[b] || cnt[a] == cnt[b] && a > b
	})
	return nums
}1640. 能否连接形成数组
题目、示例与约束
给你一个整数数组 arr ,数组中的每个整数 互不相同 。另有一个由整数数组构成的数组 pieces,其中的整数也 互不相同 。请你以 任意顺序 连接 pieces 中的数组以形成 arr 。但是,不允许 对每个数组 pieces[i] 中的整数重新排序。
如果可以连接 pieces 中的数组形成 arr ,返回 true ;否则,返回 false 。
示例 1:
输入:arr = [15,88], pieces = [[88],[15]] 输出:true 解释:依次连接[15]和[88]
示例 2:
输入:arr = [49,18,16], pieces = [[16,18,49]]
输出:false
解释:即便数字相符,也不能重新排列 pieces[0]
示例 3:
输入:arr = [91,4,64,78], pieces = [[78],[4,64],[91]] 输出:true 解释:依次连接[91]、[4,64]和[78]
提示:
1 <= pieces.length <= arr.length <= 100sum(pieces[i].length) == arr.length1 <= pieces[i].length <= arr.length1 <= arr[i], pieces[i][j] <= 100arr中的整数 互不相同pieces中的整数 互不相同(也就是说,如果将pieces扁平化成一维数组,数组中的所有整数互不相同)
方法一:暴力枚举 · Go 实现
思考
零件内部顺序固定且元素互异,只需沿 依次找到以当前值为首的零件并核对整段。 ,每次线性查找零件即可。
指针 扫描 ,在 中找首元素等于 的一段,匹配失败则无法拼接。
遍历 arr,在 pieces 中找到首元素等于当前 arr[i] 的数组项,如果找不到,直接返回 false。
如果找到了,我们记数组项为 pieces[k],然后继续往后遍历 arr[i] 和 pieces[k],直至 pieces[k] 遍历完或者元素不等。
遍历结束,返回 true。
func canFormArray(arr []int, pieces [][]int) bool {
	for i := 0; i < len(arr); {
		k := 0
		for k < len(pieces) && pieces[k][0] != arr[i] {
			k++
		}
		if k == len(pieces) {
			return false
		}
		j := 0
		for j < len(pieces[k]) && arr[i] == pieces[k][j] {
			i, j = i+1, j+1
		}
	}
	return true
}
方法二:哈希表 · Go 实现
思考
方法一每次扫描全部零件。元素互异,可用首元素映射到整段零件,查找降为 。
哈希表 ,再按段比较 是否等于 。
创建一个哈希表,键为 pieces 中每个数组项的首元素,值为数组项。
遍历 arr,如果当前元素在哈希表中不存在,直接返回 false;否则,取出哈希表中对应的数组项,判断其与 arr 中的元素是否相等,如果不相等,直接返回 false。
否则,遍历结束,返回 true。
时间复杂度 ,空间复杂度 。其中 为 arr 的长度。
func canFormArray(arr []int, pieces [][]int) bool {
	d := map[int][]int{}
	for _, p := range pieces {
		d[p[0]] = p
	}
	for i := 0; i < len(arr); {
		p, ok := d[arr[i]]
		if !ok {
			return false
		}
		for _, v := range p {
			if arr[i] != v {
				return false
			}
			i++
		}
	}
	return true
}1657. 确定两个字符串是否接近
题目、示例与约束
如果可以使用以下操作从一个字符串得到另一个字符串,则认为两个字符串 接近 :
- 操作 1:交换任意两个 现有 字符。
- 例如,
abcde -> aecdb
- 例如,
- 操作 2:将一个 现有 字符的每次出现转换为另一个 现有 字符,并对另一个字符执行相同的操作。
- 例如,
aacabb -> bbcbaa(所有a转化为b,而所有的b转换为a)
- 例如,
你可以根据需要对任意一个字符串多次使用这两种操作。
给你两个字符串,word1 和 word2 。如果 word1 和 word2 接近 ,就返回 true ;否则,返回 false 。
示例 1:
输入:word1 = "abc", word2 = "bca"
输出:true
解释:2 次操作从 word1 获得 word2 。
执行操作 1:"abc" -> "acb"
执行操作 1:"acb" -> "bca"
示例 2:
输入:word1 = "a", word2 = "aa"
输出:false
解释:不管执行多少次操作,都无法从 word1 得到 word2 ,反之亦然。
示例 3:
输入:word1 = "cabbba", word2 = "abbccc"
输出:true
解释:3 次操作从 word1 获得 word2 。
执行操作 1:"cabbba" -> "caabbb"
执行操作 2:"caabbb" -> "baaccc"
执行操作 2:"baaccc" -> "abbccc"
提示:
1 <= word1.length, word2.length <= 105word1和word2仅包含小写英文字母
方法一:计数 + 排序 · Go 实现
思考
操作一交换任意两字符,操作二把某种字母整体改成另一种。前者不改变字母集合与频次数组的多重集合,后者在字母集合不变时可以重排频次。
因此两串接近当且仅当字母种类相同,且频次排序后相等。
各做一次计数,比较键集合与排序后的值列表。
根据题目描述,两个字符串接近,需要同时满足以下两个条件:
- 字符串
word1和word2包含的字母种类必须相同; - 将字符串
word1和word2的所有字符出现次数排序,得到的两个数组必须相同。
因此,我们可以先用数组或哈希表分别统计 word1 和 word2 中每种字母出现的次数,然后比较两者是否相同,不相同则提前返回 false。
否则,我们将对应的次数排序,然后依次比较对应位置的两个次数是否相同,不同则返回 false。
遍历结束,返回 true。
时间复杂度 ,空间复杂度 。其中 和 分别为字符串 word1 和 word2 的长度,而 是字母种类。本题中 。
func closeStrings(word1 string, word2 string) bool {
	cnt1 := make([]int, 26)
	cnt2 := make([]int, 26)
	for _, c := range word1 {
		cnt1[c-'a']++
	}
	for _, c := range word2 {
		cnt2[c-'a']++
	}
	if !slices.EqualFunc(cnt1, cnt2, func(v1, v2 int) bool { return (v1 == 0) == (v2 == 0) }) {
		return false
	}
	sort.Ints(cnt1)
	sort.Ints(cnt2)
	return slices.Equal(cnt1, cnt2)
}1711. 大餐计数
题目、示例与约束
大餐 是指 恰好包含两道不同餐品 的一餐,其美味程度之和等于 2 的幂。
你可以搭配 任意 两道餐品做一顿大餐。
给你一个整数数组 deliciousness ,其中 deliciousness[i] 是第 i 道餐品的美味程度,返回你可以用数组中的餐品做出的不同 大餐 的数量。结果需要对 109 + 7 取余。
注意,只要餐品下标不同,就可以认为是不同的餐品,即便它们的美味程度相同。
示例 1:
输入:deliciousness = [1,3,5,7,9]
输出:4
解释:大餐的美味程度组合为 (1,3) 、(1,7) 、(3,5) 和 (7,9) 。
它们各自的美味程度之和分别为 4 、8 、8 和 16 ,都是 2 的幂。
示例 2:
输入:deliciousness = [1,1,1,3,3,3,7]
输出:15
解释:大餐的美味程度组合为 3 种 (1,1) ,9 种 (1,3) ,和 3 种 (1,7) 。
提示:
1 <= deliciousness.length <= 1050 <= deliciousness[i] <= 220
方法一:哈希表 + 枚举二的幂 · Go 实现
思考
两数之和为 的幂的无序对,若枚举全部下标对则需 。 不可行。
元素上界为 ,可能的幂次只有 个。对每个已出现的数 ,枚举幂 并在哈希表中查 。
边遍历边把 写入计数表,只与左侧配对,避免重复。答案对 取模。
根据题意,我们需要统计数组中两个数的和为 的幂的组合数。直接暴力枚举所有的组合数,时间复杂度为 ,肯定会超时。
我们可以遍历数组,用哈希表 维护数组中每个元素 出现的次数。
对于每个元素,我们从小到大枚举二的幂次方 作为两数之和,将哈希表中 出现的次数累加到答案中。然后将当前元素 出现的次数加一。
遍历结束后,返回答案即可。
时间复杂度 ,其中 是数组 deliciousness 的长度,而 是元素的上限,对于本题,上限 。
我们也可以先用哈希表 统计数组中每个元素出现的次数。
然后从小到大枚举二的幂次方 作为两数之和,对于每个 ,遍历哈希表每个键值对 ,如果 也在哈希表中,且 ,则答案加上 ;如果 ,则答案加上 。
最后,将答案除以 之后,模 ,返回即可。
时间复杂度与上面的方法相同。
func countPairs(deliciousness []int) (ans int) {
	mx := slices.Max(deliciousness) << 1
	const mod int = 1e9 + 7
	cnt := map[int]int{}
	for _, d := range deliciousness {
		for s := 1; s <= mx; s <<= 1 {
			ans = (ans + cnt[s-d]) % mod
		}
		cnt[d]++
	}
	return
}
方法二 · Go 实现
思考
方法一按元素顺序边扫边查。也可以先统计全部频次,再枚举幂与哈希表中的 ,用 成对累加。
当 时用 ,否则用 ;每对被算两次,最后右移一位再取模。复杂度同为 。
func countPairs(deliciousness []int) (ans int) {
	cnt := map[int]int{}
	for _, d := range deliciousness {
		cnt[d]++
	}
	const mod int = 1e9 + 7
	for i := 0; i < 22; i++ {
		s := 1 << i
		for a, m := range cnt {
			b := s - a
			if n, ok := cnt[b]; ok {
				if a == b {
					ans += m * (m - 1)
				} else {
					ans += m * n
				}
			}
		}
	}
	ans >>= 1
	return ans % mod
}1726. 同积元组
题目、示例与约束
给你一个由 不同 正整数组成的数组 nums ,请你返回满足 a * b = c * d 的元组 (a, b, c, d) 的数量。其中 a、b、c 和 d 都是 nums 中的元素,且 a != b != c != d 。
示例 1:
输入:nums = [2,3,4,6]
输出:8
解释:存在 8 个满足题意的元组:
(2,6,3,4) , (2,6,4,3) , (6,2,3,4) , (6,2,4,3)
(3,4,2,6) , (4,3,2,6) , (3,4,6,2) , (4,3,6,2)
示例 2:
输入:nums = [1,2,4,5,10]
输出:16
解释:存在 16 个满足题意的元组:
(1,10,2,5) , (1,10,5,2) , (10,1,2,5) , (10,1,5,2)
(2,5,1,10) , (2,5,10,1) , (5,2,1,10) , (5,2,10,1)
(2,10,4,5) , (2,10,5,4) , (10,2,4,5) , (10,2,5,4)
(4,5,2,10) , (4,5,10,2) , (5,4,2,10) , (5,4,10,2)
提示:
1 <= nums.length <= 10001 <= nums[i] <= 104nums中的所有元素 互不相同
方法一:组合数 + 哈希表 · Go 实现
思考
满足 的互异四元组,每个乘积若对应 对,则可组成 组,每组对应 个有序元组。 ,枚举所有无序对可行。
用哈希表统计每个乘积出现的对数,再把 左移三位累加。
假设存在 组数,对于其中任意两组数 和 ,均满足 的条件,则这样的组合一共有 个。
根据题意每一组满足上述条件的组合可以构成 个满足题意的元组,故将各个相同乘积的组合数乘以 相加(等价于:左移 位)即可得到结果。
时间复杂度 ,空间复杂度 。其中 为数组长度。
func tupleSameProduct(nums []int) int {
	cnt := map[int]int{}
	for i := 1; i < len(nums); i++ {
		for j := 0; j < i; j++ {
			x := nums[i] * nums[j]
			cnt[x]++
		}
	}
	ans := 0
	for _, v := range cnt {
		ans += v * (v - 1) / 2
	}
	return ans << 3
}1748. 唯一元素的和
题目、示例与约束
给你一个整数数组 nums 。数组中唯一元素是那些只出现 恰好一次 的元素。
请你返回 nums 中唯一元素的 和 。
示例 1:
输入:nums = [1,2,3,2]
输出:4
解释:唯一元素为 [1,3] ,和为 4 。
示例 2:
输入:nums = [1,1,1,1,1]
输出:0
解释:没有唯一元素,和为 0 。
示例 3 :
输入:nums = [1,2,3,4,5]
输出:15
解释:唯一元素为 [1,2,3,4,5] ,和为 15 。
提示:
1 <= nums.length <= 1001 <= nums[i] <= 100
方法一:计数 · Go 实现
思考
只把恰好出现一次的元素求和。值域与长度均不超过 ,计数后筛频次为 的键即可。
我们可以用数组或哈希表 cnt 统计数组 nums 中每个数字出现的次数,然后遍历 cnt,对于出现次数为 1 的数字,将其加入答案。
遍历结束后,返回答案即可。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 nums 的长度和 nums 中的最大值。
func sumOfUnique(nums []int) (ans int) {
	cnt := [101]int{}
	for _, x := range nums {
		cnt[x]++
	}
	for x := 0; x < 101; x++ {
		if cnt[x] == 1 {
			ans += x
		}
	}
	return
}
方法二 · Go 实现
思考
方法一先完整计数再求和。值域很小,也可一遍扫描:首次出现时加入答案,第二次再减去,之后忽略。省去第二次遍历。
func sumOfUnique(nums []int) (ans int) {
	cnt := [101]int{}
	for _, x := range nums {
		cnt[x]++
		if cnt[x] == 1 {
			ans += x
		} else if cnt[x] == 2 {
			ans -= x
		}
	}
	return
}1772. 按受欢迎程度排列功能 🔒
题目、示例与约束
给定一个字符串数组 features ,其中 features[i] 是一个单词,描述你最近参与开发的项目中一个功能的名称。你调查了用户喜欢哪些功能。另给定一个字符串数组 responses,其中 responses[i] 是一个包含以空格分隔的一系列单词的字符串。
你想要按照受欢迎程度排列这些功能。 严格地说,令 appearances(word) 是满足 responses[i] 中包含单词 word 的 i 的个数,则当 appearances(features[x]) > appearances(features[y]) 时,第 x 个功能比第 y 个功能更受欢迎。
返回一个数组 sortedFeatures ,包含按受欢迎程度排列的功能名称。当第 x 个功能和第 y 个功能的受欢迎程度相同且 x < y 时,你应当将第 x 个功能放在第 y 个功能之前。
示例 1:
输入:features = ["cooler","lock","touch"], responses = ["i like cooler cooler","lock touch cool","locker like touch"]
输出:["touch","cooler","lock"]
解释:appearances("cooler") = 1,appearances("lock") = 1,appearances("touch") = 2。由于 "cooler" 和 "lock" 都出现了 1 次,且 "cooler" 在原数组的前面,所以 "cooler" 也应该在结果数组的前面。
示例 2:
输入:features = ["a","aa","b","c"], responses = ["a","a aa","a a a a a","b a"]
输出:["a","aa","b","c"]
提示:
1 <= features.length <= 1041 <= features[i].length <= 10features不包含重复项。features[i]由小写字母构成。1 <= responses.length <= 1021 <= responses[i].length <= 103responses[i]由小写字母和空格组成。responses[i]不包含两个连续的空格。responses[i]没有前置或后置空格。
方法一:哈希表 + 自定义排序 · Go 实现
思考
流行度是出现在多少条回复中(同一回复内重复只计一次)。稳定地按流行度降序排 。
对每条回复用集合去重后累加计数;排序键取 ,相同次数保持原相对次序。
我们遍历 responses,对于 responses[i] 中的每个单词,我们用一个哈希表 vis 暂存。接下来将 vis 中的单词记录到哈希表 cnt 中,记录每个单词出现的次数。
接下来,采用自定义排序,将 features 中的单词按照出现次数从大到小排序,如果出现次数相同,则按照出现的下标从小到大排序。
时间复杂度 ,其中 为 features 的长度。
func sortFeatures(features []string, responses []string) []string {
	cnt := map[string]int{}
	for _, s := range responses {
		vis := map[string]bool{}
		for _, w := range strings.Split(s, " ") {
			if !vis[w] {
				cnt[w]++
				vis[w] = true
			}
		}
	}
	sort.SliceStable(features, func(i, j int) bool { return cnt[features[i]] > cnt[features[j]] })
	return features
}继续阅读
- 实践案例
- 实践案例
- 实践案例