
LeetCode Go · 回溯与搜索(2)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
385. 迷你语法分析器
题目、示例与约束
给定一个字符串 s 表示一个整数嵌套列表,实现一个解析它的语法分析器并返回解析的结果 NestedInteger 。
列表中的每个元素只可能是整数或整数嵌套列表
示例 1:
输入:s = "324",
输出:324
解释:你应该返回一个 NestedInteger 对象,其中只包含整数值 324。
示例 2:
输入:s = "[123,[456,[789]]]",
输出:[123,[456,[789]]]
解释:返回一个 NestedInteger 对象包含一个有两个元素的嵌套列表:
1. 一个 integer 包含值 123
2. 一个包含两个元素的嵌套列表:
    i.  一个 integer 包含值 456
    ii. 一个包含一个元素的嵌套列表
         a. 一个 integer 包含值 789
提示:
1 <= s.length <= 5 * 104s由数字、方括号"[]"、负号'-'、逗号','组成- 用例保证
s是可解析的NestedInteger - 输入中的所有值的范围是
[-106, 106]
方法一:递归 · Go 实现
思考
把嵌套列表的字符串解析成
NestedInteger。文法是整数或[元素,…,元素],可用递归下降。空串或
[]返回空列表;不以[开头则整段是整数。否则在深度为 的逗号(或末尾)处切开,递归解析每段并add。深度随括号增减,保证切在顶层。
我们首先判断字符串 是否为空或是一个空列表,如果是的话,直接返回一个空的 NestedInteger 即可。如果 是一个整数,我们直接返回一个包含这个整数的 NestedInteger。否则,我们从左到右遍历字符串 ,如果当前深度为 ,并且遇到了逗号或者字符串 的末尾,则我们截取出一个子串并递归调用函数解析该子串,将返回值加入到列表中。否则,如果当前遇到了左括号,我们将深度加 ,并继续遍历。如果遇到了右括号,我们将深度减 ,继续遍历。
遍历结束后,返回答案。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度。
/**
 * // This is the interface that allows for creating nested lists.
 * // You should not implement it, or speculate about its implementation
 * type NestedInteger struct {
 * }
 *
 * // Return true if this NestedInteger holds a single integer, rather than a nested list.
 * func (n NestedInteger) IsInteger() bool {}
 *
 * // Return the single integer that this NestedInteger holds, if it holds a single integer
 * // The result is undefined if this NestedInteger holds a nested list
 * // So before calling this method, you should have a check
 * func (n NestedInteger) GetInteger() int {}
 *
 * // Set this NestedInteger to hold a single integer.
 * func (n *NestedInteger) SetInteger(value int) {}
 *
 * // Set this NestedInteger to hold a nested list and adds a nested integer to it.
 * func (n *NestedInteger) Add(elem NestedInteger) {}
 *
 * // Return the nested list that this NestedInteger holds, if it holds a nested list
 * // The list length is zero if this NestedInteger holds a single integer
 * // You can access NestedInteger's List element directly if you want to modify it
 * func (n NestedInteger) GetList() []*NestedInteger {}
 */
func deserialize(s string) *NestedInteger {
	ans := &NestedInteger{}
	if s == "" || s == "[]" {
		return ans
	}
	if s[0] != '[' {
		v, _ := strconv.Atoi(s)
		ans.SetInteger(v)
		return ans
	}
	depth := 0
	for i, j := 1, 1; i < len(s); i++ {
		if depth == 0 && (s[i] == ',' || i == len(s)-1) {
			(*ans).Add(*deserialize(s[j:i]))
			j = i + 1
		} else if s[i] == '[' {
			depth++
		} else if s[i] == ']' {
			depth--
		}
	}
	return ans
}
方法二:栈 · Go 实现
思考
递归依赖调用栈。改为显式栈:遇
[压入新列表,遇数字累积,遇,/]把整数或子列表挂到栈顶。右括号且栈深于 时弹出并加入外层。避免递归深度。
我们可以使用栈来模拟递归的过程。
我们首先判断字符串 是否是一个整数,如果是,直接返回一个包含这个整数的 NestedInteger。否则,我们从左到右遍历字符串 ,对于当前遍历到的字符 :
- 如果 是负号,我们将负号标识置为
true; - 如果 是数字,我们将数字加入到当前数字 中,其中 的初始值为 ;
- 如果 是左括号,我们将一个新的
NestedInteger压入栈中; - 如果 是右括号或者逗号,我们判断当前字符的前一个字符是否是数字,如果是,我们根据负号标识将当前数字 加入到栈顶的
NestedInteger中,然后将负号标识置为false,当前数字 重置为 。如果 是右括号,并且当前栈的大小大于 ,我们将栈顶的NestedInteger出栈,将其加入到栈顶的NestedInteger中。
遍历结束后,返回栈顶的 NestedInteger 即可。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度。
/**
 * // This is the interface that allows for creating nested lists.
 * // You should not implement it, or speculate about its implementation
 * type NestedInteger struct {
 * }
 *
 * // Return true if this NestedInteger holds a single integer, rather than a nested list.
 * func (n NestedInteger) IsInteger() bool {}
 *
 * // Return the single integer that this NestedInteger holds, if it holds a single integer
 * // The result is undefined if this NestedInteger holds a nested list
 * // So before calling this method, you should have a check
 * func (n NestedInteger) GetInteger() int {}
 *
 * // Set this NestedInteger to hold a single integer.
 * func (n *NestedInteger) SetInteger(value int) {}
 *
 * // Set this NestedInteger to hold a nested list and adds a nested integer to it.
 * func (n *NestedInteger) Add(elem NestedInteger) {}
 *
 * // Return the nested list that this NestedInteger holds, if it holds a nested list
 * // The list length is zero if this NestedInteger holds a single integer
 * // You can access NestedInteger's List element directly if you want to modify it
 * func (n NestedInteger) GetList() []*NestedInteger {}
 */
func deserialize(s string) *NestedInteger {
	if s[0] != '[' {
		v, _ := strconv.Atoi(s)
		ans := NestedInteger{}
		ans.SetInteger(v)
		return &ans
	}
	stk := []*NestedInteger{}
	x := 0
	neg := false
	for i, c := range s {
		if c == '-' {
			neg = true
		} else if c >= '0' && c <= '9' {
			x = x*10 + int(c-'0')
		} else if c == '[' {
			stk = append(stk, &NestedInteger{})
		} else if c == ',' || c == ']' {
			if s[i-1] >= '0' && s[i-1] <= '9' {
				if neg {
					x = -x
				}
				t := NestedInteger{}
				t.SetInteger(x)
				stk[len(stk)-1].Add(t)
			}
			x = 0
			neg = false
			if c == ']' && len(stk) > 1 {
				t := stk[len(stk)-1]
				stk = stk[:len(stk)-1]
				stk[len(stk)-1].Add(*t)
			}
		}
	}
	return stk[0]
}388. 文件的最长绝对路径
题目、示例与约束
假设有一个同时存储文件和目录的文件系统。下图展示了文件系统的一个示例:
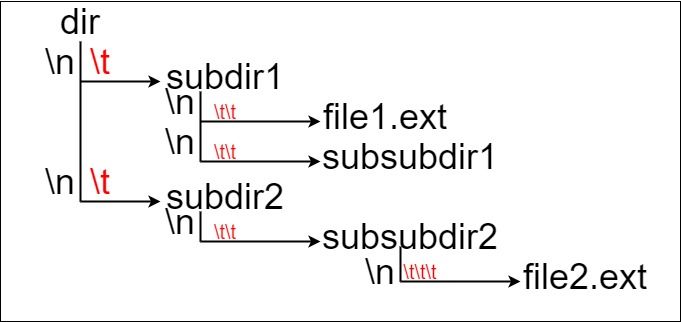
这里将 dir 作为根目录中的唯一目录。dir 包含两个子目录 subdir1 和 subdir2 。subdir1 包含文件 file1.ext 和子目录 subsubdir1;subdir2 包含子目录 subsubdir2,该子目录下包含文件 file2.ext 。
在文本格式中,如下所示(⟶表示制表符):
dir
⟶ subdir1
⟶ ⟶ file1.ext
⟶ ⟶ subsubdir1
⟶ subdir2
⟶ ⟶ subsubdir2
⟶ ⟶ ⟶ file2.ext
如果是代码表示,上面的文件系统可以写为 "dir\n\tsubdir1\n\t\tfile1.ext\n\t\tsubsubdir1\n\tsubdir2\n\t\tsubsubdir2\n\t\t\tfile2.ext" 。'\n' 和 '\t' 分别是换行符和制表符。
文件系统中的每个文件和文件夹都有一个唯一的 绝对路径 ,即必须打开才能到达文件/目录所在位置的目录顺序,所有路径用 '/' 连接。上面例子中,指向 file2.ext 的 绝对路径 是 "dir/subdir2/subsubdir2/file2.ext" 。每个目录名由字母、数字和/或空格组成,每个文件名遵循 name.extension 的格式,其中 name 和 extension由字母、数字和/或空格组成。
给定一个以上述格式表示文件系统的字符串 input ,返回文件系统中 指向 文件 的 最长绝对路径 的长度 。 如果系统中没有文件,返回 0。
示例 1:
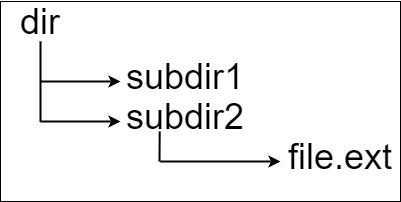
输入:input = "dir\n\tsubdir1\n\tsubdir2\n\t\tfile.ext"
输出:20
解释:只有一个文件,绝对路径为 "dir/subdir2/file.ext" ,路径长度 20
示例 2:
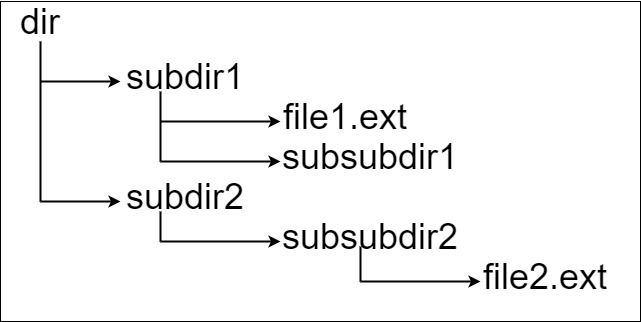
输入:input = "dir\n\tsubdir1\n\t\tfile1.ext\n\t\tsubsubdir1\n\tsubdir2\n\t\tsubsubdir2\n\t\t\tfile2.ext"
输出:32
解释:存在两个文件:
"dir/subdir1/file1.ext" ,路径长度 21
"dir/subdir2/subsubdir2/file2.ext" ,路径长度 32
返回 32 ,因为这是最长的路径
示例 3:
输入:input = "a"
输出:0
解释:不存在任何文件
示例 4:
输入:input = "file1.txt\nfile2.txt\nlongfile.txt"
输出:12
解释:根目录下有 3 个文件。
因为根目录中任何东西的绝对路径只是名称本身,所以答案是 "longfile.txt" ,路径长度为 12
提示:
1 <= input.length <= 104input可能包含小写或大写的英文字母,一个换行符'\n',一个制表符'\t',一个点'.',一个空格' ',和数字。
方法一 · Go 实现
思考
由制表符表示的目录树求最长文件绝对路径。按行模拟进目录即可,无需建整棵树。
栈保存各层目录路径长度。当前缩进浅于栈则弹出。非文件则压入「父长度+1+本名」;文件则用该长度更新答案。点号判定文件。
func lengthLongestPath(input string) int {
	i, n := 0, len(input)
	ans := 0
	var stk []int
	for i < n {
		ident := 0
		for ; input[i] == '\t'; i++ {
			ident++
		}

		cur, isFile := 0, false
		for ; i < n && input[i] != '\n'; i++ {
			cur++
			if input[i] == '.' {
				isFile = true
			}
		}
		i++

		// popd
		for len(stk) > 0 && len(stk) > ident {
			stk = stk[:len(stk)-1]
		}

		if len(stk) > 0 {
			cur += stk[len(stk)-1] + 1
		}

		// pushd
		if !isFile {
			stk = append(stk, cur)
			continue
		}

		ans = max(ans, cur)
	}
	return ans
}401. 二进制手表
题目、示例与约束
二进制手表顶部有 4 个 LED 代表 小时(0-11),底部的 6 个 LED 代表 分钟(0-59)。每个 LED 代表一个 0 或 1,最低位在右侧。
- 例如,下面的二进制手表读取
"4:51"。
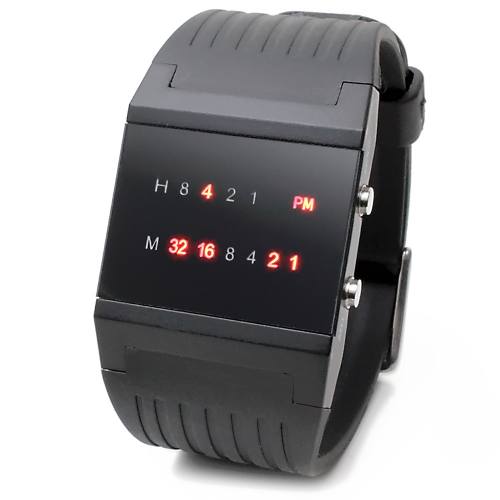
给你一个整数 turnedOn ,表示当前亮着的 LED 的数量,返回二进制手表可以表示的所有可能时间。你可以 按任意顺序 返回答案。
小时不会以零开头:
- 例如,
"01:00"是无效的时间,正确的写法应该是"1:00"。
分钟必须由两位数组成,可能会以零开头:
- 例如,
"10:2"是无效的时间,正确的写法应该是"10:02"。
示例 1:
输入:turnedOn = 1
输出:["0:01","0:02","0:04","0:08","0:16","0:32","1:00","2:00","4:00","8:00"]
示例 2:
输入:turnedOn = 9
输出:[]
提示:
0 <= turnedOn <= 10
方法一:枚举组合 · Go 实现
思考
小时取值 、分钟取值 ,合法时分只有 种。题目要求点亮的灯数等于二进制中 的个数之和,因此直接枚举每一对 并统计 的个数即可。
规模为常数,不必按灯位做组合再验证时分是否合法;先枚举合法读数、再对照 ,实现更短。
题目可以转换为求 和 的所有可能组合。
合法组合需要满足的条件是 的二进制形式中 1 的个数加上 的二进制形式中 1 的个数,结果等于 。
时间复杂度 ,空间复杂度 。
func readBinaryWatch(turnedOn int) []string {
	var ans []string
	for i := 0; i < 12; i++ {
		for j := 0; j < 60; j++ {
			if bits.OnesCount(uint(i))+bits.OnesCount(uint(j)) == turnedOn {
				ans = append(ans, fmt.Sprintf("%d:%02d", i, j))
			}
		}
	}
	return ans
}
方法二:二进制枚举 · Go 实现
思考
方法一按合法时分枚举。也可以把 盏灯看成 的位掩码:高 位为时、低 位为分,再过滤 、 且 等于 。
一层循环即与灯位一一对应,语义更贴近「选哪些灯」,渐近复杂度不变。
我们可以利用 个二进制位表示手表,其中前 位代表小时,后 位代表分钟。枚举 中的每个数,判断其二进制表示中 1 的个数是否等于 ,如果是,则将其转换为时间格式加入答案中。
时间复杂度 ,空间复杂度 。
func readBinaryWatch(turnedOn int) []string {
	var ans []string
	for i := 0; i < 1<<10; i++ {
		h, m := i>>6, i&0b111111
		if h < 12 && m < 60 && bits.OnesCount(uint(i)) == turnedOn {
			ans = append(ans, fmt.Sprintf("%d:%02d", h, m))
		}
	}
	return ans
}407. 接雨水 II
题目、示例与约束
给你一个 m x n 的矩阵,其中的值均为非负整数,代表二维高度图每个单元的高度,请计算图中形状最多能接多少体积的雨水。
示例 1:
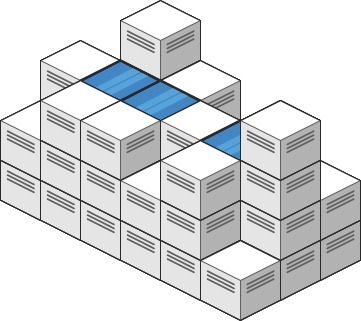
输入: heightMap = [[1,4,3,1,3,2],[3,2,1,3,2,4],[2,3,3,2,3,1]]
输出: 4
解释: 下雨后,雨水将会被上图蓝色的方块中。总的接雨水量为1+2+1=4。
示例 2:
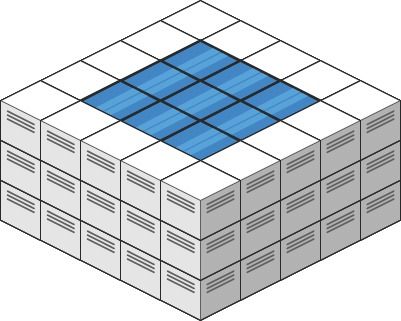
输入: heightMap = [[3,3,3,3,3],[3,2,2,2,3],[3,2,1,2,3],[3,2,2,2,3],[3,3,3,3,3]]
输出: 10
提示:
m == heightMap.lengthn == heightMap[i].length1 <= m, n <= 2000 <= heightMap[i][j] <= 2 * 104
方法一:优先队列(小根堆) · Go 实现
思考
一维接雨水可用左右最高柱,二维无法用两根指针。水从边界溢出,某格最终水位由「从边界进入的最低瓶颈」决定。
把边界高度放入小根堆并向内扩展:弹出当前最低围栏 ,邻格若更矮则积 ,再以 作为新围栏入堆。
小根堆保证先处理最矮瓶颈,水位单调不降,每个格子只入堆一次。
接雨水问题的变种,由于矩阵的边界上的高度是确定的,因此可以将矩阵的边界上的高度加入优先队列,然后从优先队列中取出最小的高度,然后将其四周的高度与其比较,如果四周的高度小于当前高度,则可以接雨水,接雨水的体积为当前高度减去四周的高度,然后将较大的高度加入优先队列,重复上述过程,直到优先队列为空。
时间复杂度 ,空间复杂度 。其中 和 分别为矩阵的行数和列数。
func trapRainWater(heightMap [][]int) (ans int) {
	m, n := len(heightMap), len(heightMap[0])
	pq := hp{}
	vis := make([][]bool, m)
	for i, row := range heightMap {
		vis[i] = make([]bool, n)
		for j, v := range row {
			if i == 0 || i == m-1 || j == 0 || j == n-1 {
				heap.Push(&pq, tuple{v, i, j})
				vis[i][j] = true
			}
		}
	}
	dirs := []int{-1, 0, 1, 0, -1}
	for len(pq) > 0 {
		p := heap.Pop(&pq).(tuple)
		for k := 0; k < 4; k++ {
			x, y := p.i+dirs[k], p.j+dirs[k+1]
			if x >= 0 && x < m && y >= 0 && y < n && !vis[x][y] {
				ans += max(0, p.v-heightMap[x][y])
				vis[x][y] = true
				heap.Push(&pq, tuple{max(p.v, heightMap[x][y]), x, y})
			}
		}
	}
	return
}

type tuple struct{ v, i, j int }
type hp []tuple

func (h hp) Len() int           { return len(h) }
func (h hp) Less(i, j int) bool { return h[i].v < h[j].v }
func (h hp) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)        { *h = append(*h, v.(tuple)) }
func (h *hp) Pop() any { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }411. 最短独占单词缩写 🔒
题目、示例与约束
通过将任意数量的 不相邻 子字符串替换为它们的长度,可以完成对字符串的 缩写 。 例如,像 "substitution" 这样的字符串可以缩写为(但不限于):
"s10n"("s ubstitutio n")"sub4u4"("sub stit u tion")"12"("substitution")"su3i1u2on"("su bst i t u ti on")"substitution"(不替换子字符串)
注意:"s55n" ("s ubsti tutio n") 不是 "substitution" 的有效缩写形式,因为它试图替换两个相邻的子字符串。
缩写的 长度 是未被替换的字母数加上被替换的字符串数。例如,缩写 "s10n" 的长度为 3(2 个字母 + 1 个子字符串),而 "su3i1u2on" 的长度为 9(6 个字母 + 3 子字符串)。
给你一个目标字符串 target 和一个字符串数组 dictionary 作为字典,为 target 找出并返回一个 最短 长度的缩写字符串,同时这个缩写字符串 不是 字典 dictionary 中其他字符串的缩写形式。如果有多个有效答案,可以返回其中任意一个。
示例 1:
输入:target = "apple", dictionary = ["blade"]
输出:"a4"
解释:"apple" 的最短缩写形式为 "5" ,但这也是 "blade" 的缩写形式之一。
下一组最短缩写是 "a4" 和 "4e" ,其中 "4e" 也是 "blade" 的缩写形式之一,而 "a4" 不是。
因此,返回 "a4" 。
示例 2:
输入:target = "apple", dictionary = ["blade","plain","amber"]
输出:"1p3"
解释:"5" 同时是 "apple" 和字典中所有单词的缩写形式。
"a4" 同时是 "apple" 和 "amber" 的缩写形式。
"4e" 同时是 "apple" 和 "blade" 的缩写形式。
"1p3"、"2p2" 和 "3l1" 是 "apple" 的下一组最短缩写形式。
因为它们不是字典中其他单词的缩写形式,返回其中任意一个都是正确的。
提示:
target.length == mdictionary.length == n1 <= m <= 210 <= n <= 10001 <= dictionary[i].length <= 100- 如果
n > 0,那么log2(n) + m <= 21 target和dictionary[i]仅包含小写字符dictionary不包含target。
方法一:Go 解法(本站整理) · Go 实现
本站根据题意与 Doocs 参考思路整理为 Go,非上游原文。按 CC BY-SA 4.0 共享。
根据题意补写位掩码解法。仅比较与目标等长的字典词;每个词记录与目标不同的位置。保留字母的掩码必须与每个差异掩码相交,才能排除所有字典词。枚举保留掩码,按“字母数+连续缩写段数”计算长度,注意 10 仍只算一个缩写段。设目标长 m、等长词数 n,时间 O((m+n)·2^m),空间 O(n+m)。题目约束 log₂(n)+m≤21 保证枚举量可控;没有等长词时直接返回长度。
import "strconv"

func minAbbreviation(target string, dictionary []string) string {
	m := len(target)
	diffs := []int{}
	for _, word := range dictionary {
		if len(word) != m {
			continue
		}
		d := 0
		for i := 0; i < m; i++ {
			if target[i] != word[i] {
				d |= 1 << i
			}
		}
		diffs = append(diffs, d)
	}
	if len(diffs) == 0 {
		return strconv.Itoa(m)
	}
	best, bestMask := m+1, 0
	for mask := 0; mask < 1<<m; mask++ {
		valid := true
		for _, d := range diffs {
			if mask&d == 0 {
				valid = false
				break
			}
		}
		if !valid {
			continue
		}
		cost := 0
		inRun := false
		for i := 0; i < m; i++ {
			if mask>>i&1 != 0 {
				cost++
				inRun = false
			} else if !inRun {
				cost++
				inRun = true
			}
		}
		if cost < best {
			best, bestMask = cost, mask
		}
	}
	ans := ""
	run := 0
	for i := 0; i < m; i++ {
		if bestMask>>i&1 == 0 {
			run++
			continue
		}
		if run > 0 {
			ans += strconv.Itoa(run)
			run = 0
		}
		ans += target[i : i+1]
	}
	if run > 0 {
		ans += strconv.Itoa(run)
	}
	return ans
}417. 太平洋大西洋水流问题
题目、示例与约束
有一个 m × n 的矩形岛屿,与 太平洋 和 大西洋 相邻。 “太平洋” 处于大陆的左边界和上边界,而 “大西洋” 处于大陆的右边界和下边界。
这个岛被分割成一个由若干方形单元格组成的网格。给定一个 m x n 的整数矩阵 heights , heights[r][c] 表示坐标 (r, c) 上单元格 高于海平面的高度 。
岛上雨水较多,如果相邻单元格的高度 小于或等于 当前单元格的高度,雨水可以直接向北、南、东、西流向相邻单元格。水可以从海洋附近的任何单元格流入海洋。
返回网格坐标 result 的 2D 列表 ,其中 result[i] = [ri, ci] 表示雨水从单元格 (ri, ci) 流动 既可流向太平洋也可流向大西洋 。
示例 1:
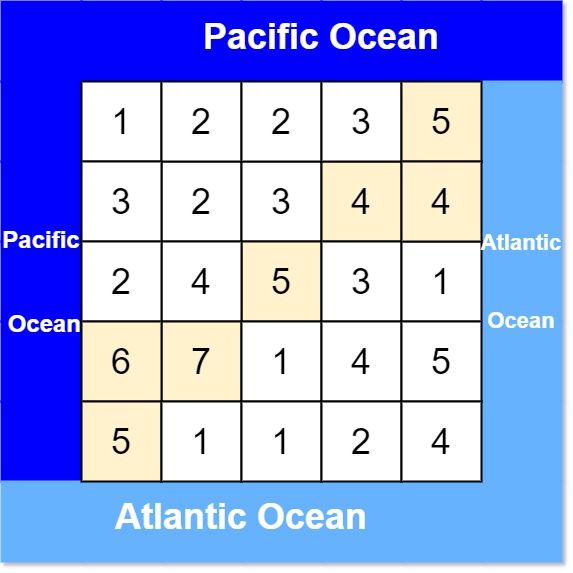
输入: heights = [[1,2,2,3,5],[3,2,3,4,4],[2,4,5,3,1],[6,7,1,4,5],[5,1,1,2,4]]
输出: [[0,4],[1,3],[1,4],[2,2],[3,0],[3,1],[4,0]]
示例 2:
输入: heights = [[2,1],[1,2]]
输出: [[0,0],[0,1],[1,0],[1,1]]
提示:
m == heights.lengthn == heights[r].length1 <= m, n <= 2000 <= heights[r][c] <= 105
方法一:BFS · Go 实现
思考
从每个格子沿下降路径流向海洋,同一格子会被反复搜索。 ,正向搜索重复过多。
水往低处流的逆过程,是从海洋向「高度不低于当前」的格子爬。从太平洋、大西洋的边界分别 BFS,两份访问集合的交即为答案。
逆流时邻格高度需 当前高度;从边界出发保证到达的格子一定能流回对应海洋。
我们可以从太平洋和大西洋的边界出发,分别进行广度优先搜索(BFS),找到所有能够流向太平洋和大西洋的单元格。最后,我们取两个结果的交集,即为既能流向太平洋又能流向大西洋的单元格。
具体地,我们定义一个队列 来存储所有与太平洋相邻的单元格,并定义一个布尔矩阵 来记录哪些单元格能够流向太平洋。类似地,我们定义队列 和布尔矩阵 来处理大西洋。初始时,我们将所有与太平洋相邻的单元格加入队列 ,并将它们在 中标记为已访问。同样地,将所有与大西洋相邻的单元格加入队列 ,并在 中标记为已访问。
然后,我们分别对 和 进行 BFS。在每次 BFS 中,我们从队列中取出一个单元格 ,并检查它的四个相邻单元格 。如果相邻单元格在矩阵范围内,且未被访问过,并且其高度不小于当前单元格的高度(即水可以流向该单元格),我们将其加入队列并标记为已访问。
最后,我们遍历整个矩阵,找出同时在 和 中被标记为已访问的单元格,这些单元格即为答案。
时间复杂度 ,空间复杂度 。其中 和 分别是矩阵的行数和列数。
func pacificAtlantic(heights [][]int) [][]int {
	m, n := len(heights), len(heights[0])
	vis1 := make([][]bool, m)
	vis2 := make([][]bool, m)
	for i := range vis1 {
		vis1[i] = make([]bool, n)
		vis2[i] = make([]bool, n)
	}
	q1, q2 := [][2]int{}, [][2]int{}
	dirs := [5]int{-1, 0, 1, 0, -1}

	for i := 0; i < m; i++ {
		q1 = append(q1, [2]int{i, 0})
		vis1[i][0] = true
		q2 = append(q2, [2]int{i, n - 1})
		vis2[i][n-1] = true
	}
	for j := 0; j < n; j++ {
		q1 = append(q1, [2]int{0, j})
		vis1[0][j] = true
		q2 = append(q2, [2]int{m - 1, j})
		vis2[m-1][j] = true
	}

	bfs := func(q [][2]int, vis [][]bool) {
		for len(q) > 0 {
			x, y := q[0][0], q[0][1]
			q = q[1:]
			for k := 0; k < 4; k++ {
				nx, ny := x+dirs[k], y+dirs[k+1]
				if nx >= 0 && nx < m && ny >= 0 && ny < n &&
					!vis[nx][ny] && heights[nx][ny] >= heights[x][y] {
					vis[nx][ny] = true
					q = append(q, [2]int{nx, ny})
				}
			}
		}
	}

	bfs(q1, vis1)
	bfs(q2, vis2)

	var ans [][]int
	for i := 0; i < m; i++ {
		for j := 0; j < n; j++ {
			if vis1[i][j] && vis2[i][j] {
				ans = append(ans, []int{i, j})
			}
		}
	}
	return ans
}419. 棋盘上的战舰
题目、示例与约束
给你一个大小为 m x n 的矩阵 board 表示棋盘,其中,每个单元格可以是一艘战舰 'X' 或者是一个空位 '.' ,返回在棋盘 board 上放置的 舰队 的数量。
舰队 只能水平或者垂直放置在 board 上。换句话说,舰队只能按 1 x k(1 行,k 列)或 k x 1(k 行,1 列)的形状放置,其中 k 可以是任意大小。两个舰队之间至少有一个水平或垂直的空格分隔 (即没有相邻的舰队)。
示例 1:

输入:board = [["X",".",".","X"],[".",".",".","X"],[".",".",".","X"]]
输出:2
示例 2:
输入:board = [["."]]
输出:0
提示:
m == board.lengthn == board[i].length1 <= m, n <= 200board[i][j]是'.'或'X'
进阶:你可以实现一次扫描算法,并只使用 O(1) 额外空间,并且不修改 board 的值来解决这个问题吗?
方法一:直接遍历 · Go 实现
思考
战舰横放或竖放且彼此不相邻。深度优先搜索可以染色整艘舰,但会改图或占用额外标记。题目进阶要求一次遍历、常数空间。
每艘舰有唯一的「左上角」:该 的上方与左方都不是 。统计这样的格子即可。
不相邻保证一艘舰只有一个左上角,不会漏计或重计。
我们可以遍历矩阵,找到每个战舰的左上角,即当前位置为 X 且上方和左方都不是 X 的位置,将答案加一。
遍历结束后,返回答案即可。
时间复杂度 ,其中 和 分别是矩阵的行数和列数。空间复杂度 。
func countBattleships(board [][]byte) (ans int) {
	for i, row := range board {
		for j, c := range row {
			if c == '.' {
				continue
			}
			if i > 0 && board[i-1][j] == 'X' {
				continue
			}
			if j > 0 && board[i][j-1] == 'X' {
				continue
			}
			ans++
		}
	}
	return
}433. 最小基因变化
题目、示例与约束
基因序列可以表示为一条由 8 个字符组成的字符串,其中每个字符都是 'A'、'C'、'G' 和 'T' 之一。
假设我们需要调查从基因序列 start 变为 end 所发生的基因变化。一次基因变化就意味着这个基因序列中的一个字符发生了变化。
- 例如,
"AACCGGTT" --> "AACCGGTA"就是一次基因变化。
另有一个基因库 bank 记录了所有有效的基因变化,只有基因库中的基因才是有效的基因序列。(变化后的基因必须位于基因库 bank 中)
给你两个基因序列 start 和 end ,以及一个基因库 bank ,请你找出并返回能够使 start 变化为 end 所需的最少变化次数。如果无法完成此基因变化,返回 -1 。
注意:起始基因序列 start 默认是有效的,但是它并不一定会出现在基因库中。
示例 1:
输入:start = "AACCGGTT", end = "AACCGGTA", bank = ["AACCGGTA"]
输出:1
示例 2:
输入:start = "AACCGGTT", end = "AAACGGTA", bank = ["AACCGGTA","AACCGCTA","AAACGGTA"]
输出:2
示例 3:
输入:start = "AAAAACCC", end = "AACCCCCC", bank = ["AAAACCCC","AAACCCCC","AACCCCCC"]
输出:3
提示:
start.length == 8end.length == 80 <= bank.length <= 10bank[i].length == 8start、end和bank[i]仅由字符['A', 'C', 'G', 'T']组成
方法一:BFS · Go 实现
思考
一次突变只改一个字符且必须落在基因库中,求最少步数。这是无权图最短路,深度搜索得不到最小步数。
从起始基因 BFS,每步扫描库中尚未访问、恰好相差一位的串。第一次到达终点的深度即为答案;队列空则不可达。
库规模很小,按差一位建边即可,不必枚举四个字母的每一位替换。访问集合避免重复入队。
我们定义一个队列 q,用于存储当前基因序列以及变化的次数,定义一个集合 vis,用于存储已经访问过的基因序列。初始时,将起始基因序列 start 加入队列 q,并将其加入集合 vis。
然后,我们不断从队列 q 中取出一个基因序列,如果该基因序列等于目标基因序列,则返回当前的变化次数。否则,我们遍历基因库 bank,计算当前基因序列与基因库中的基因序列的差异值,如果差异值为 ,且基因库中的基因序列没有被访问过,则将其加入队列 q,并将其加入集合 vis。
如果队列 q 为空,说明无法完成基因变化,返回 。
时间复杂度 ,空间复杂度 。其中 和 分别表示基因序列的长度和基因库的长度,而 表示基因序列的字符集大小,本题中 。
func minMutation(startGene string, endGene string, bank []string) int {
	type pair struct {
		s     string
		depth int
	}
	q := []pair{pair{startGene, 0}}
	vis := map[string]bool{startGene: true}
	for len(q) > 0 {
		p := q[0]
		q = q[1:]
		if p.s == endGene {
			return p.depth
		}
		for _, next := range bank {
			diff := 0
			for i := 0; i < len(startGene); i++ {
				if p.s[i] != next[i] {
					diff++
				}
			}
			if diff == 1 && !vis[next] {
				vis[next] = true
				q = append(q, pair{next, p.depth + 1})
			}
		}
	}
	return -1
}463. 岛屿的周长
题目、示例与约束
给定一个 row x col 的二维网格地图 grid ,其中:grid[i][j] = 1 表示陆地, grid[i][j] = 0 表示水域。
网格中的格子 水平和垂直 方向相连(对角线方向不相连)。整个网格被水完全包围,但其中恰好有一个岛屿(或者说,一个或多个表示陆地的格子相连组成的岛屿)。
岛屿中没有“湖”(“湖” 指水域在岛屿内部且不和岛屿周围的水相连)。格子是边长为 1 的正方形。网格为长方形,且宽度和高度均不超过 100 。计算这个岛屿的周长。
示例 1:
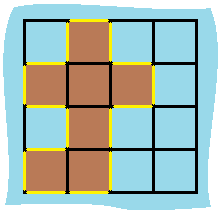
输入:grid = [[0,1,0,0],[1,1,1,0],[0,1,0,0],[1,1,0,0]]
输出:16
解释:它的周长是上面图片中的 16 个黄色的边
示例 2:
输入:grid = [[1]]
输出:4
示例 3:
输入:grid = [[1,0]]
输出:4
提示:
row == grid.lengthcol == grid[i].length1 <= row, col <= 100grid[i][j]为0或1
方法一 · Go 实现
思考
岛屿四连通,周长是陆地边减去与邻格共享的边。对每个陆地查四邻需要处理边界。
每块陆地先加 ;若下方或右方也是陆地,这条边被共享两次,减 。只看下与右,每条内部边恰好统计一次。
不必建图或 DFS,一次网格扫描即得周长。
func islandPerimeter(grid [][]int) int {
	m, n := len(grid), len(grid[0])
	ans := 0
	for i := 0; i < m; i++ {
		for j := 0; j < n; j++ {
			if grid[i][j] == 1 {
				ans += 4
				if i < m-1 && grid[i+1][j] == 1 {
					ans -= 2
				}
				if j < n-1 && grid[i][j+1] == 1 {
					ans -= 2
				}
			}
		}
	}
	return ans
}489. 扫地机器人 🔒
题目、示例与约束
房间中的某个位置上有一个机器人,你需要控制它清扫房间。房间被建模为一个 m x n 的二进制网格,其中 0 表示单元格中有障碍物,1 表示空单元格。
机器人从一个未知的空单元格开始出发,并且你无法访问网格,但你可以使用给定的 API Robot 控制机器人。
你的任务是使用机器人清扫整个房间(即清理房间中的每个空单元格)。机器人具有四个给定的API,可以前进、向左转或向右转。每次转弯 90 度。
当机器人试图移动到一个存在障碍物的单元格时,它的碰撞传感器会检测到障碍物,并停留在当前单元格。
设计一个算法,使用下述 API 清扫整个房间:
interface Robot {
  // 若下一个单元格为空,则返回 true ,并移动至该单元格。
  // 若下一个单元格为障碍物,则返回 false ,并停留在当前单元格。
  boolean move();

  // 在调用 turnLeft/turnRight 后机器人会停留在当前单元格。
  // 每次转弯 90 度。
  void turnLeft();
  void turnRight();

  // 清理当前单元格。
  void clean();
}
注意 扫地机器人的初始方向向上。你可以假定网格的四周都被墙包围。
自定义测试:
输入只用于初始化房间和机器人的位置。你需要「盲解」这个问题。换而言之,你必须在对房间和机器人位置一无所知的情况下,只使用 4 个给出的 API 解决问题。
示例 1:
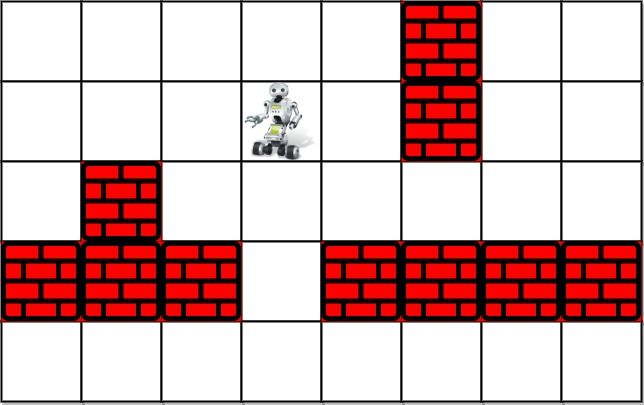
输入:room = [[1,1,1,1,1,0,1,1],[1,1,1,1,1,0,1,1],[1,0,1,1,1,1,1,1],[0,0,0,1,0,0,0,0],[1,1,1,1,1,1,1,1]], row = 1, col = 3
输出:Robot cleaned all rooms.
解释:
房间内的所有单元格用 0 或 1 填充。
0 表示障碍物,1 表示可以通过。
机器人从 row=1, col=3 的初始位置出发。
在左上角的一行以下,三列以右。
示例 2:
输入:room = [[1]], row = 0, col = 0
输出:Robot cleaned all rooms.
提示:
m == room.lengthn == room[i].length1 <= m <= 1001 <= n <= 200room[i][j]为0或1.0 <= row < m0 <= col < nroom[row][col] == 1- 所有空单元格都可以从起始位置出发访问到。
方法一:DFS · Go 实现
思考
房间地图未知,只能通过机器人接口移动、转向与清扫。不能随机走,否则无法保证覆盖且难以回到起点。
把起点当作 ,DFS 四个方向:未访问且 成功则走进去递归;四个方向试完后原地掉头走回父格,再转回原来朝向。
访问集合按相对坐标去重。回溯必须先转 再 ,否则朝向与坐标会和递归栈不一致。
我们不妨假设机器人的初始位置为 ,方向为 。我们将初始位置进行打扫,并标记为已访问。然后,我们依次选择上、右、下、左四个方向进行探索,每次探索前都先判断是否已经访问过,如果没有访问过,我们就朝着该方向前进一步,然后递归探索。如果已经访问过,我们就顺时针旋转 ,然后继续探索下一个方向。当我们探索完所有的方向后,我们需要回到上一个位置,这时我们只需要顺时针旋转 ,然后前进一步,再顺时针旋转 即可。
时间复杂度 ,空间复杂度 。其中 和 分别是房间的数量以及障碍物的数量。
/**
 * // This is the robot's control interface.
 * // You should not implement it, or speculate about its implementation
 * type Robot struct {
 * }
 *
 * // Returns true if the cell in front is open and robot moves into the cell.
 * // Returns false if the cell in front is blocked and robot stays in the current cell.
 * func (robot *Robot) Move() bool {}
 *
 * // Robot will stay in the same cell after calling TurnLeft/TurnRight.
 * // Each turn will be 90 degrees.
 * func (robot *Robot) TurnLeft() {}
 * func (robot *Robot) TurnRight() {}
 *
 * // Clean the current cell.
 * func (robot *Robot) Clean() {}
 */

func cleanRoom(robot *Robot) {
	vis := map[[2]int]bool{}
	dirs := [5]int{-1, 0, 1, 0, -1}
	var dfs func(int, int, int)
	dfs = func(i, j, d int) {
		vis[[2]int{i, j}] = true
		robot.Clean()
		for k := 0; k < 4; k++ {
			nd := (d + k) % 4
			x, y := i+dirs[nd], j+dirs[nd+1]
			if !vis[[2]int{x, y}] && robot.Move() {
				dfs(x, y, nd)
				robot.TurnRight()
				robot.TurnRight()
				robot.Move()
				robot.TurnRight()
				robot.TurnRight()
			}
			robot.TurnRight()
		}
	}
	dfs(0, 0, 0)
}490. 迷宫 🔒
题目、示例与约束
0 表示)和墙(用 1 表示)组成的迷宫 maze 中有一个球。球可以途经空地向 上、下、左、右 四个方向滚动,且在遇到墙壁前不会停止滚动。当球停下时,可以选择向下一个方向滚动。
给你一个大小为 m x n 的迷宫 maze ,以及球的初始位置 start 和目的地 destination ,其中 start = [startrow, startcol] 且 destination = [destinationrow, destinationcol] 。请你判断球能否在目的地停下:如果可以,返回 true ;否则,返回 false 。
你可以 假定迷宫的边缘都是墙壁(参考示例)。
示例 1:
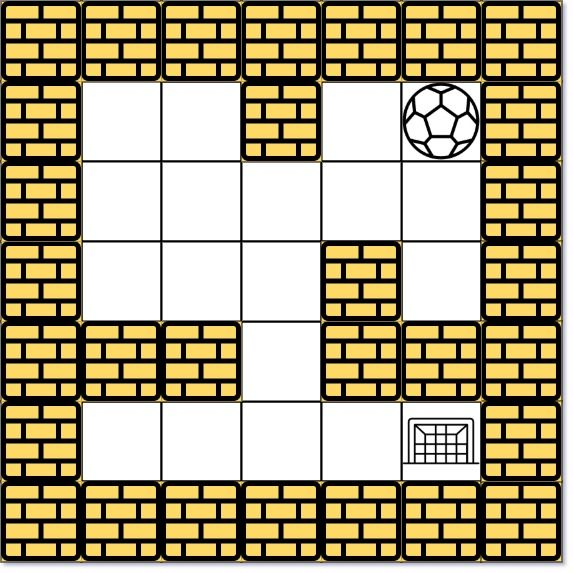
输入:maze = [[0,0,1,0,0],[0,0,0,0,0],[0,0,0,1,0],[1,1,0,1,1],[0,0,0,0,0]], start = [0,4], destination = [4,4]
输出:true
解释:一种可能的路径是 : 左 -> 下 -> 左 -> 下 -> 右 -> 下 -> 右。
示例 2:
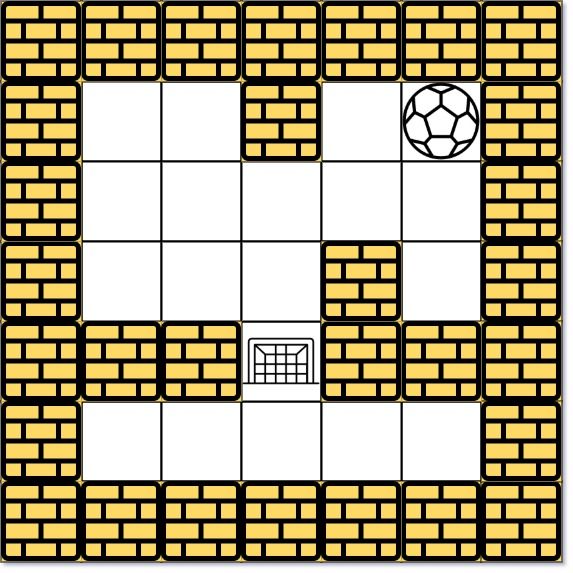
输入:maze = [[0,0,1,0,0],[0,0,0,0,0],[0,0,0,1,0],[1,1,0,1,1],[0,0,0,0,0]], start = [0,4], destination = [3,2]
输出:false
解释:不存在能够使球停在目的地的路径。注意,球可以经过目的地,但无法在那里停驻。
示例 3:
输入:maze = [[0,0,0,0,0],[1,1,0,0,1],[0,0,0,0,0],[0,1,0,0,1],[0,1,0,0,0]], start = [4,3], destination = [0,1]
输出:false
提示:
m == maze.lengthn == maze[i].length1 <= m, n <= 100maze[i][j]is0or1.start.length == 2destination.length == 20 <= startrow, destinationrow < m0 <= startcol, destinationcol < n- 球和目的地都在空地上,且初始时它们不在同一位置
- 迷宫 至少包括 2 块空地
方法一:DFS · Go 实现
思考
球沿一个方向滚到墙前才停下,判断能否停在终点。逐步走格会把「路过」和「停下」混在一起。
DFS:从当前停点沿四向一直滚到障碍或边界,对停点递归。访问数组标记停点,避免重复。终点被访问过则可达。
内层 只滚动、不标记路过的格子,状态空间是停点而不是每一个空格。
从起点沿四个方向滚到墙前,深度优先搜索所有能停下来的格子。
func hasPath(maze [][]int, start []int, destination []int) bool {
	m, n := len(maze), len(maze[0])
	vis := make([][]bool, m)
	for i := range vis {
		vis[i] = make([]bool, n)
	}
	var dfs func(i, j int)
	dfs = func(i, j int) {
		if vis[i][j] {
			return
		}
		vis[i][j] = true
		if i == destination[0] && j == destination[1] {
			return
		}
		dirs := []int{-1, 0, 1, 0, -1}
		for k := 0; k < 4; k++ {
			x, y := i, j
			a, b := dirs[k], dirs[k+1]
			for x+a >= 0 && x+a < m && y+b >= 0 && y+b < n && maze[x+a][y+b] == 0 {
				x += a
				y += b
			}
			dfs(x, y)
		}
	}
	dfs(start[0], start[1])
	return vis[destination[0]][destination[1]]
}
方法二:BFS · Go 实现
思考
方法一用递归。同样的滚动规则改成队列 BFS:停点入队,滚到终点可提前返回。无递归深度,适合只问可达性。
同样沿四个方向滚动,用队列广搜到达终点的停靠点。
func hasPath(maze [][]int, start []int, destination []int) bool {
	m, n := len(maze), len(maze[0])
	vis := make([][]bool, m)
	for i := range vis {
		vis[i] = make([]bool, n)
	}
	vis[start[0]][start[1]] = true
	q := [][]int{start}
	dirs := []int{-1, 0, 1, 0, -1}
	for len(q) > 0 {
		i, j := q[0][0], q[0][1]
		q = q[1:]
		for k := 0; k < 4; k++ {
			x, y := i, j
			a, b := dirs[k], dirs[k+1]
			for x+a >= 0 && x+a < m && y+b >= 0 && y+b < n && maze[x+a][y+b] == 0 {
				x += a
				y += b
			}
			if x == destination[0] && y == destination[1] {
				return true
			}
			if !vis[x][y] {
				vis[x][y] = true
				q = append(q, []int{x, y})
			}
		}
	}
	return false
}491. 非递减子序列
题目、示例与约束
给你一个整数数组 nums ,找出并返回所有该数组中不同的递增子序列,递增子序列中 至少有两个元素 。你可以按 任意顺序 返回答案。
数组中可能含有重复元素,如出现两个整数相等,也可以视作递增序列的一种特殊情况。
示例 1:
输入:nums = [4,6,7,7]
输出:[[4,6],[4,6,7],[4,6,7,7],[4,7],[4,7,7],[6,7],[6,7,7],[7,7]]
示例 2:
输入:nums = [4,4,3,2,1]
输出:[[4,4]]
提示:
1 <= nums.length <= 15-100 <= nums[i] <= 100
方法一:DFS · Go 实现
思考
所有长度至少为 的非严格递增子序列,且结果不能重复。数组未排序,不能先排序再选。
DFS 到下标 :若 则可选入;仅当 才走「不选」分支。后者避免「跳过一个值再选相同值」与「选了再继续」重复。
初值为足够小的哨兵,保证第一个数总能被选。长度大于 才收录。
DFS 递归枚举每个数字选中或不选中,这里需要满足两个条件:
- 子序列需要递增(非严格递增),因此序列的后一个数要大于等于前一个数;
- 子序列需要去重,这里重复的问题在于前后两个数相等并且不选中的情况,我们只在前后两个数不等的情况下,执行不选中的操作即可达到去重的效果。
func findSubsequences(nums []int) [][]int {
	var ans [][]int
	var dfs func(u, last int, t []int)
	dfs = func(u, last int, t []int) {
		if u == len(nums) {
			if len(t) > 1 {
				ans = append(ans, slices.Clone(t))
			}
			return
		}
		if nums[u] >= last {
			t = append(t, nums[u])
			dfs(u+1, nums[u], t)
			t = t[:len(t)-1]
		}
		if nums[u] != last {
			dfs(u+1, last, t)
		}
	}
	var t []int
	dfs(0, -1000, t)
	return ans
}529. 扫雷游戏
题目、示例与约束
让我们一起来玩扫雷游戏!
给你一个大小为 m x n 二维字符矩阵 board ,表示扫雷游戏的盘面,其中:
'M'代表一个 未挖出的 地雷,'E'代表一个 未挖出的 空方块,'B'代表没有相邻(上,下,左,右,和所有4个对角线)地雷的 已挖出的 空白方块,- 数字(
'1'到'8')表示有多少地雷与这块 已挖出的 方块相邻, 'X'则表示一个 已挖出的 地雷。
给你一个整数数组 click ,其中 click = [clickr, clickc] 表示在所有 未挖出的 方块('M' 或者 'E')中的下一个点击位置(clickr 是行下标,clickc 是列下标)。
根据以下规则,返回相应位置被点击后对应的盘面:
- 如果一个地雷(
'M')被挖出,游戏就结束了- 把它改为'X'。 - 如果一个 没有相邻地雷 的空方块(
'E')被挖出,修改它为('B'),并且所有和其相邻的 未挖出 方块都应该被递归地揭露。 - 如果一个 至少与一个地雷相邻 的空方块(
'E')被挖出,修改它为数字('1'到'8'),表示相邻地雷的数量。 - 如果在此次点击中,若无更多方块可被揭露,则返回盘面。
示例 1:
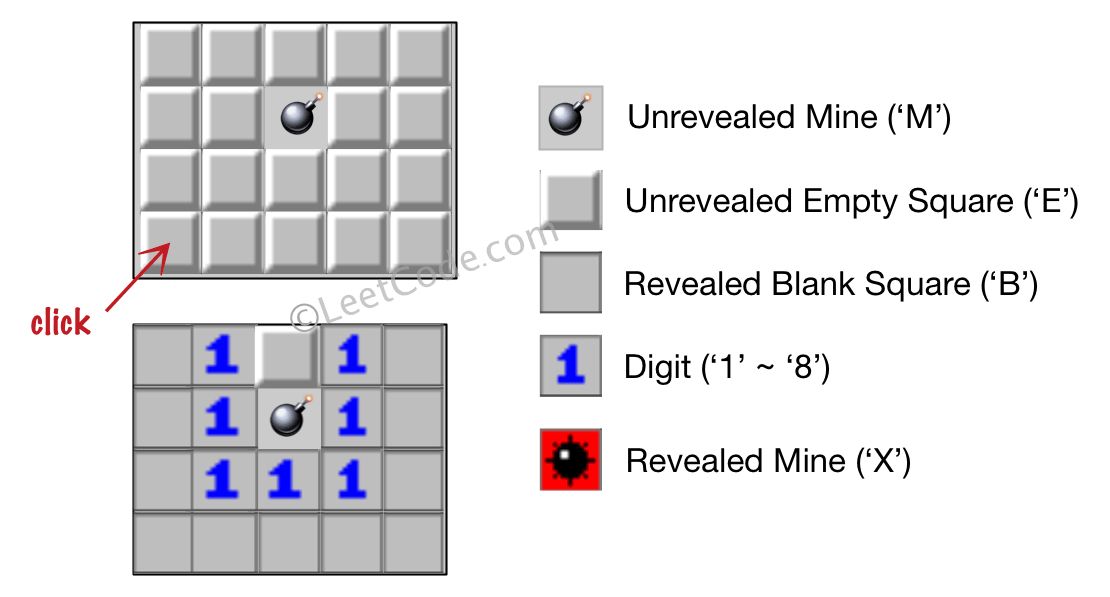
输入:board = [["E","E","E","E","E"],["E","E","M","E","E"],["E","E","E","E","E"],["E","E","E","E","E"]], click = [3,0]
输出:[["B","1","E","1","B"],["B","1","M","1","B"],["B","1","1","1","B"],["B","B","B","B","B"]]
示例 2:
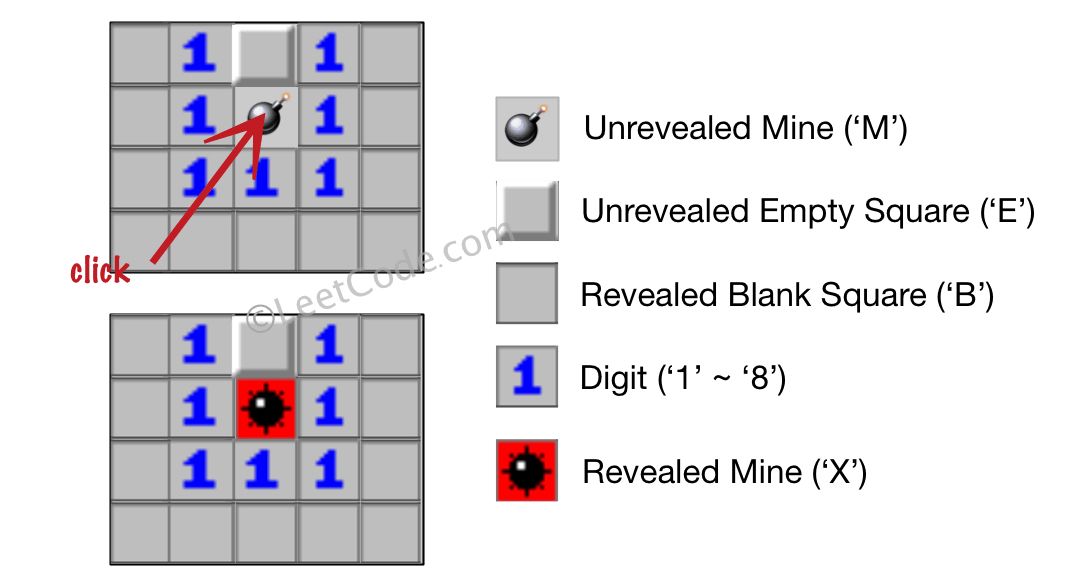
输入:board = [["B","1","E","1","B"],["B","1","M","1","B"],["B","1","1","1","B"],["B","B","B","B","B"]], click = [1,2]
输出:[["B","1","E","1","B"],["B","1","X","1","B"],["B","1","1","1","B"],["B","B","B","B","B"]]
提示:
m == board.lengthn == board[i].length1 <= m, n <= 50board[i][j]为'M'、'E'、'B'或数字'1'到'8'中的一个click.length == 20 <= clickr < m0 <= clickc < nboard[clickr][clickc]为'M'或'E'
方法一:DFS · Go 实现
思考
扫雷规则是:点到雷则标
X;否则统计八邻地雷数,有雷则写成数字,无数则标B并向四周空白继续展开。模拟一次点击即可,不必搜索整盘。点中
M直接改X。否则 DFS:先数邻雷,有则写数字并停止,否则写B并对相邻E递归。每个格子至多展开一次,保证不会重复搜索。
我们记 ,如果 等于 'M',那么直接将 的值改为 'X' 即可。否则,我们需要统计 周围的地雷数量 ,如果 不为 ,那么将 的值改为 的字符串形式。否则,将 的值改为 'B',并且递归地搜索处理 周围的未挖出的方块。
时间复杂度 ,空间复杂度 。其中 和 分别是二维数组 的行数和列数。
func updateBoard(board [][]byte, click []int) [][]byte {
	m, n := len(board), len(board[0])
	i, j := click[0], click[1]

	var dfs func(i, j int)
	dfs = func(i, j int) {
		cnt := 0
		for x := i - 1; x <= i+1; x++ {
			for y := j - 1; y <= j+1; y++ {
				if x >= 0 && x < m && y >= 0 && y < n && board[x][y] == 'M' {
					cnt++
				}
			}
		}
		if cnt > 0 {
			board[i][j] = byte(cnt + '0')
			return
		}
		board[i][j] = 'B'
		for x := i - 1; x <= i+1; x++ {
			for y := j - 1; y <= j+1; y++ {
				if x >= 0 && x < m && y >= 0 && y < n && board[x][y] == 'E' {
					dfs(x, y)
				}
			}
		}
	}

	if board[i][j] == 'M' {
		board[i][j] = 'X'
	} else {
		dfs(i, j)
	}
	return board
}565. 数组嵌套
题目、示例与约束
索引从0开始长度为N的数组A,包含0到N - 1的所有整数。找到最大的集合S并返回其大小,其中 S[i] = {A[i], A[A[i]], A[A[A[i]]], ... }且遵守以下的规则。
假设选择索引为i的元素A[i]为S的第一个元素,S的下一个元素应该是A[A[i]],之后是A[A[A[i]]]... 以此类推,不断添加直到S出现重复的元素。
示例 1:
输入: A = [5,4,0,3,1,6,2]
输出: 4
解释:
A[0] = 5, A[1] = 4, A[2] = 0, A[3] = 3, A[4] = 1, A[5] = 6, A[6] = 2.

其中一种最长的 S[K]:
S[0] = {A[0], A[5], A[6], A[2]} = {5, 6, 2, 0}
提示:
1 <= nums.length <= 1050 <= nums[i] < nums.lengthA中不含有重复的元素。
方法一:图 · Go 实现
思考
指向 ,形成若干互不相交的环。套的长度就是环长。从每个下标走环即可,但同一环不要重复走。
访问数组标记走过的下标;从尚未访问的起点沿指针走一圈并计数。环不相交,因此每个下标至多访问一次,最长环即答案。
嵌套数组最终一定会形成一个环,在枚举 的过程中,可以用 数组剪枝,避免重复枚举同一个环。
时间复杂度 ,空间复杂度 。
func arrayNesting(nums []int) int {
	n := len(nums)
	vis := make([]bool, n)
	ans := 0
	for i := 0; i < n; i++ {
		if vis[i] {
			continue
		}
		cur, m := nums[i], 1
		vis[cur] = true
		for nums[cur] != nums[i] {
			cur = nums[cur]
			m++
			vis[cur] = true
		}
		if m > ans {
			ans = m
		}
	}
	return ans
}
方法二:原地标记 · Go 实现
思考
方法一额外用了 访问数组。值域恰为 ,可用哨兵 原地标记已访问。
沿环把经过的 写成 ,同时计数。遇到 说明此位置已属于算过的环。空间降为常数,语义与方法一相同。
由于 元素均在 之间,因此,对于访问过的元素,我们可以令 ,从而省略 数组。
时间复杂度 ,空间复杂度 。
func arrayNesting(nums []int) int {
	ans, n := 0, len(nums)
	for i := range nums {
		cnt, j := 0, i
		for nums[j] != n {
			k := nums[j]
			nums[j] = n
			j = k
			cnt++
		}
		if ans < cnt {
			ans = cnt
		}
	}
	return ans
}672. 灯泡开关 Ⅱ
题目、示例与约束
房间中有 n 只已经打开的灯泡,编号从 1 到 n 。墙上挂着 4 个开关 。
这 4 个开关各自都具有不同的功能,其中:
- 开关 1 :反转当前所有灯的状态(即开变为关,关变为开)
- 开关 2 :反转编号为偶数的灯的状态(即
0, 2, 4, ...) - 开关 3 :反转编号为奇数的灯的状态(即
1, 3, ...) - 开关 4 :反转编号为
j = 3k + 1的灯的状态,其中k = 0, 1, 2, ...(即1, 4, 7, 10, ...)
你必须 恰好 按压开关 presses 次。每次按压,你都需要从 4 个开关中选出一个来执行按压操作。
给你两个整数 n 和 presses ,执行完所有按压之后,返回 不同可能状态 的数量。
示例 1:
输入:n = 1, presses = 1
输出:2
解释:状态可以是:
- 按压开关 1 ,[关]
- 按压开关 2 ,[开]
示例 2:
输入:n = 2, presses = 1
输出:3
解释:状态可以是:
- 按压开关 1 ,[关, 关]
- 按压开关 2 ,[开, 关]
- 按压开关 3 ,[关, 开]
示例 3:
输入:n = 3, presses = 1
输出:4
解释:状态可以是:
- 按压开关 1 ,[关, 关, 关]
- 按压开关 2 ,[开, 关, 开]
- 按压开关 3 ,[关, 开, 关]
- 按压开关 4 ,[关, 开, 开]
提示:
1 <= n <= 10000 <= presses <= 1000
方法一:位运算 · Go 实现
思考
四个按钮对灯做异或翻转,灯数 与次数 都不大。同一按钮偶数次等于没按,且 与 状态永远相同。
只需前 盏。枚举 个按钮的奇偶掩码,次数不超过 且奇偶相同,模拟异或后对灯态去重。
观察灯泡开关随按钮操作的变化规律,我们可以发现,位置 与 的灯泡,开关状态始终保持一致,因此,我们只需要考虑最多前 个灯泡的开关状态。
另外,对于每个按钮,若操作偶数次,相当于没执行操作;若操作奇数次,相当于操作了 次。同时,不同按钮操作的先后顺序,也不影响结果。
题目有 个按钮,每个按钮有“操作偶数次”和“操作奇数次”两种状态,因此总共有 种按钮状态。
二进制枚举按钮的状态 mask,若当前状态满足题目 presses 的限制,我们可以通过位运算,模拟操作对应按钮,最终得到灯泡的状态 ,去重后的 的数量就是答案。
时空复杂度均为常数级别。
func flipLights(n int, presses int) int {
	if n > 6 {
		n = 6
	}
	ops := []int{0b111111, 0b010101, 0b101010, 0b100100}
	vis := map[int]bool{}
	for mask := 0; mask < 1<<4; mask++ {
		cnt := bits.OnesCount(uint(mask))
		if cnt <= presses && cnt%2 == presses%2 {
			t := 0
			for i, op := range ops {
				if mask>>i&1 == 1 {
					t ^= op
				}
			}
			t &= 1<<6 - 1
			t >>= (6 - n)
			vis[t] = true
		}
	}
	return len(vis)
}675. 为高尔夫比赛砍树
题目、示例与约束
你被请来给一个要举办高尔夫比赛的树林砍树。树林由一个 m x n 的矩阵表示, 在这个矩阵中:
0表示障碍,无法触碰1表示地面,可以行走比 1 大的数表示有树的单元格,可以行走,数值表示树的高度
每一步,你都可以向上、下、左、右四个方向之一移动一个单位,如果你站的地方有一棵树,那么你可以决定是否要砍倒它。
你需要按照树的高度从低向高砍掉所有的树,每砍过一颗树,该单元格的值变为 1(即变为地面)。
你将从 (0, 0) 点开始工作,返回你砍完所有树需要走的最小步数。 如果你无法砍完所有的树,返回 -1 。
可以保证的是,没有两棵树的高度是相同的,并且你至少需要砍倒一棵树。
示例 1:
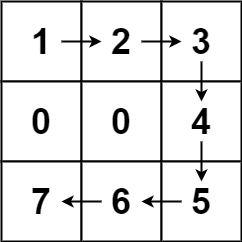
输入:forest = [[1,2,3],[0,0,4],[7,6,5]]
输出:6
解释:沿着上面的路径,你可以用 6 步,按从最矮到最高的顺序砍掉这些树。
示例 2:
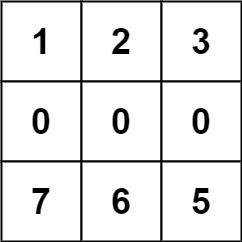
输入:forest = [[1,2,3],[0,0,0],[7,6,5]]
输出:-1
解释:由于中间一行被障碍阻塞,无法访问最下面一行中的树。
示例 3:
输入:forest = [[2,3,4],[0,0,5],[8,7,6]]
输出:6
解释:可以按与示例 1 相同的路径来砍掉所有的树。
(0,0) 位置的树,可以直接砍去,不用算步数。
提示:
m == forest.lengthn == forest[i].length1 <= m, n <= 500 <= forest[i][j] <= 109
方法一:BFS + 优先队列(A* 算法) · Go 实现
思考
必须按树高递增砍完,高度互异。总路程是相邻目标之间最短路之和。网格可达 ,朴素 BFS 多次尚可,障碍多时可用估价加速。
先收集并按高度排序,再对相邻两点做 A*:堆键为已走路程加曼哈顿估价。终点首次出堆即最短;不可达返回 。
题目的一个关键信息是“所有树的高度都不同”,要按照从小到大的顺序依次砍树,因此,我们先遍历树林,找出所有树及对应的坐标点。然后将树按照高度升序排列。
接下来就是找相邻两个点之间的最短距离。可以用 BFS,A* 算法优化搜索。
A* 算法主要思想如下:
- 将 BFS 队列转换为优先队列(小根堆);
- 队列中的每个元素为
(dist[state] + f(state), state),dist[state]表示从起点到当前 state 的距离,f(state)表示从当前 state 到终点的估计距离,这两个距离之和作为堆排序的依据; - 当终点第一次出队时,说明找到了从起点到终点的最短路径,直接返回对应的 step;
f(state)是估价函数,并且估价函数要满足f(state) <= g(state),其中g(state)表示 state 到终点的真实距离;- A* 算法只能保证终点第一次出队时,即找到了一条从起点到终点的最小路径,不能保证其他点出队时也是从起点到当前点的最短路径。
var dirs = [][]int{{-1, 0}, {1, 0}, {0, -1}, {0, 1}}

type tree struct {
	height int
	pos    int
}

func cutOffTree(forest [][]int) int {
	row, col := len(forest), len(forest[0])
	f := func(a, b int) int {
		return abs(a/col-b/col) + abs(a%col-b%col)
	}
	bfs := func(start, end int) int {
		q := hp{{f(start, end), start}}
		heap.Init(&q)
		dist := map[int]int{start: 0}
		for q.Len() > 0 {
			state := heap.Pop(&q).(pair).pos
			if state == end {
				return dist[state]
			}
			step := dist[state]
			for k := 0; k < 4; k++ {
				x, y := state/col+dirs[k][0], state%col+dirs[k][1]
				if x >= 0 && x < row && y >= 0 && y < col && forest[x][y] != 0 {
					nxt := x*col + y
					if d, ok := dist[nxt]; !ok || d > step+1 {
						dist[nxt] = step + 1
						heap.Push(&q, pair{dist[nxt] + f(nxt, end), nxt})
					}
				}
			}
		}
		return -1
	}

	var trees []tree
	for i := 0; i < row; i++ {
		for j := 0; j < col; j++ {
			if forest[i][j] > 1 {
				trees = append(trees, tree{forest[i][j], i*col + j})
			}
		}
	}
	sort.Slice(trees, func(i, j int) bool {
		return trees[i].height < trees[j].height
	})

	ans, start := 0, 0
	for _, t := range trees {
		step := bfs(start, t.pos)
		if step == -1 {
			return -1
		}
		ans += step
		start = t.pos
	}
	return ans
}

func abs(x int) int {
	if x < 0 {
		return -x
	}
	return x
}

type pair struct{ prio, pos int }
type hp []pair

func (h hp) Len() int           { return len(h) }
func (h hp) Less(i, j int) bool { return h[i].prio < h[j].prio }
func (h hp) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)        { *h = append(*h, v.(pair)) }
func (h *hp) Pop() any { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }679. 24 点游戏
题目、示例与约束
给定一个长度为4的整数数组 cards 。你有 4 张卡片,每张卡片上都包含一个范围在 [1,9] 的数字。您应该使用运算符 ['+', '-', '*', '/'] 和括号 '(' 和 ')' 将这些卡片上的数字排列成数学表达式,以获得值24。
你须遵守以下规则:
- 除法运算符
'/'表示实数除法,而不是整数除法。- 例如,
4 /(1 - 2 / 3)= 4 /(1 / 3)= 12。
- 例如,
- 每个运算都在两个数字之间。特别是,不能使用
“-”作为一元运算符。- 例如,如果
cards =[1,1,1,1],则表达式“-1 -1 -1 -1”是 不允许 的。
- 例如,如果
- 你不能把数字串在一起
- 例如,如果
cards =[1,2,1,2],则表达式“12 + 12”无效。
- 例如,如果
如果可以得到这样的表达式,其计算结果为 24 ,则返回 true ,否则返回 false 。
示例 1:
输入: cards = [4, 1, 8, 7]
输出: true
解释: (8-4) * (7-1) = 24
示例 2:
输入: cards = [1, 2, 1, 2]
输出: false
提示:
cards.length == 41 <= cards[i] <= 9
方法一:DFS · Go 实现
思考
四张牌用加减乘除算到 ,中间可任意加括号。牌只有四张,状态空间很小。
每次任取两数做四则得到新数,与剩余数组成更短序列再递归;只剩一个数时与 比较(浮点容差)。除数 跳过。
我们设计一个函数 ,其中 表示当前的数字序列,函数返回一个布尔值,表示是否存在一种排列方式,使得这个数字序列可以得到 。
如果 的长度为 ,那么只有当这个数字等于 时,我们才返回 ,否则返回 。
否则,我们可以枚举 中的任意两个数 和 作为左右两个操作数,枚举 和 之间的运算符 ,那么 的结果就可以作为新的数字序列的一个元素,我们将其加入到新的数字序列中,并从 中移除 和 ,然后递归地调用 函数,如果返回 ,那么我们就找到了一种排列方式,使得这个数字序列可以得到 ,我们就返回 。
如果枚举完所有的情况都没有返回 ,那么我们就返回 。
func judgePoint24(cards []int) bool {
	ops := [4]rune{'+', '-', '*', '/'}
	nums := make([]float64, len(cards))
	for i, num := range cards {
		nums[i] = float64(num)
	}
	var dfs func([]float64) bool
	dfs = func(nums []float64) bool {
		n := len(nums)
		if n == 1 {
			return math.Abs(nums[0]-24) < 1e-6
		}
		ok := false
		for i := 0; i < n; i++ {
			for j := 0; j < n; j++ {
				if i != j {
					var nxt []float64
					for k := 0; k < n; k++ {
						if k != i && k != j {
							nxt = append(nxt, nums[k])
						}
					}
					for _, op := range ops {
						switch op {
						case '/':
							if nums[j] == 0 {
								continue
							}
							nxt = append(nxt, nums[i]/nums[j])
						case '*':
							nxt = append(nxt, nums[i]*nums[j])
						case '+':
							nxt = append(nxt, nums[i]+nums[j])
						case '-':
							nxt = append(nxt, nums[i]-nums[j])
						}
						ok = ok || dfs(nxt)
						if ok {
							return true
						}
						nxt = nxt[:len(nxt)-1]
					}
				}
			}
		}
		return ok
	}

	return dfs(nums)
}681. 最近时刻 🔒
题目、示例与约束
给定一个形如 "HH:MM" 表示的时刻 time ,利用当前出现过的数字构造下一个距离当前时间最近的时刻。每个出现数字都可以被无限次使用。
你可以认为给定的字符串一定是合法的。例如, "01:34" 和 "12:09" 是合法的,“1:34” 和 “12:9” 是不合法的。
示例 1:
输入: "19:34"
输出: "19:39"
解释: 利用数字 1, 9, 3, 4 构造出来的最近时刻是 19:39,是 5 分钟之后。
结果不是 19:33 因为这个时刻是 23 小时 59 分钟之后。
示例 2:
输入: "23:59"
输出: "22:22"
解释: 利用数字 2, 3, 5, 9 构造出来的最近时刻是 22:22。
答案一定是第二天的某一时刻,所以选择可构造的最小时刻。
提示:
time.length == 5time为有效时间,格式为"HH:MM".0 <= HH < 240 <= MM < 60
方法一:Go 解法(本站整理) · Go 实现
本站根据题意与 Doocs 参考思路整理为 Go,非上游原文。按 CC BY-SA 4.0 共享。
从当前时间的下一分钟开始,最多检查一天的 1440 个候选。只要时、分的四位数字都出现在原时间中就返回;取模自动处理跨午夜,至少能在一天后回到原时间。时间 O(1440),空间 O(1)。
import "fmt"

func nextClosestTime(time string) string {
	allowed := [10]bool{}
	for i := range time {
		if time[i] != ':' {
			allowed[time[i]-'0'] = true
		}
	}
	start := int(time[0]-'0')*600 + int(time[1]-'0')*60 + int(time[3]-'0')*10 + int(time[4]-'0')
	for delta := 1; delta <= 1440; delta++ {
		v := (start + delta) % 1440
		h, m := v/60, v%60
		if allowed[h/10] && allowed[h%10] && allowed[m/10] && allowed[m%10] {
			return fmt.Sprintf("%02d:%02d", h, m)
		}
	}
	return time
}733. 图像渲染
题目、示例与约束
有一幅以 m x n 的二维整数数组表示的图画 image ,其中 image[i][j] 表示该图画的像素值大小。你也被给予三个整数 sr , sc 和 color 。你应该从像素 image[sr][sc] 开始对图像进行上色 填充 。
为了完成 上色工作:
- 从初始像素开始,将其颜色改为
color。 - 对初始坐标的 上下左右四个方向上 相邻且与初始像素的原始颜色同色的像素点执行相同操作。
- 通过检查与初始像素的原始颜色相同的相邻像素并修改其颜色来继续 重复 此过程。
- 当 没有 其它原始颜色的相邻像素时 停止 操作。
最后返回经过上色渲染 修改 后的图像 。
示例 1:
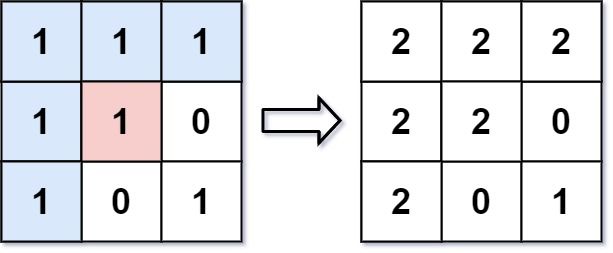
(sr,sc)=(1,1) (即红色像素),在路径上所有符合条件的像素点的颜色都被更改成相同的新颜色(即蓝色像素)。示例 2:
提示:
m == image.lengthn == image[i].length1 <= m, n <= 500 <= image[i][j], color < 2160 <= sr < m0 <= sc < n
方法一:DFS · Go 实现
思考
从起点把四连通的同色像素改成目标色。网格规模有限,一次遍历即可。起点颜色已是目标色时不应再走,否则会无限重入。
连通块是图上的四邻域,深度优先把每个仍为原色 的邻居改掉即可,改色本身兼作访问标记。
先记下 ,仅当它与 不同时从 递归。时间与连通块大小成正比。
我们记初始像素的颜色为 ,如果 不等于目标颜色 ,我们就从 开始深度优先搜索,将所有符合条件的像素点的颜色都更改成目标颜色。
时间复杂度 ,空间复杂度 。其中 和 分别为二维数组 的行数和列数。
func floodFill(image [][]int, sr int, sc int, color int) [][]int {
	m, n := len(image), len(image[0])
	oc := image[sr][sc]
	if oc == color {
		return image
	}

	dirs := []int{-1, 0, 1, 0, -1}

	var dfs func(i, j int)
	dfs = func(i, j int) {
		image[i][j] = color
		for k := 0; k < 4; k++ {
			x, y := i+dirs[k], j+dirs[k+1]
			if x >= 0 && x < m && y >= 0 && y < n && image[x][y] == oc {
				dfs(x, y)
			}
		}
	}

	dfs(sr, sc)
	return image
}
方法二:BFS · Go 实现
思考
方法一用递归,连通块很大时栈深与网格同阶。同一连通只需改层序扩展。
队列从起点出发,弹出后把仍为 的四邻改色入队。渐近复杂度相同,避免递归栈。
我们首先判断初始像素的颜色是否等于目标颜色,如果等于,直接返回原图像。否则,我们可以使用广度优先搜索的方法,从 开始,将所有符合条件的像素点的颜色都更改成目标颜色。
具体地,我们定义一个队列 ,将初始像素 加入队列。然后我们不断从队列中取出像素点 ,将其颜色更改成目标颜色,并将其上下左右四个方向上与初始像素的原始颜色相同的像素点加入队列。直到队列为空,我们就完成了图像的渲染。
时间复杂度 ,空间复杂度 。其中 和 分别为二维数组 的行数和列数。
func floodFill(image [][]int, sr int, sc int, color int) [][]int {
	if image[sr][sc] == color {
		return image
	}
	oc := image[sr][sc]
	q := [][]int{[]int{sr, sc}}
	image[sr][sc] = color
	dirs := []int{-1, 0, 1, 0, -1}
	for len(q) > 0 {
		p := q[0]
		q = q[1:]
		for k := 0; k < 4; k++ {
			x, y := p[0]+dirs[k], p[1]+dirs[k+1]
			if x >= 0 && x < len(image) && y >= 0 && y < len(image[0]) && image[x][y] == oc {
				q = append(q, []int{x, y})
				image[x][y] = color
			}
		}
	}
	return image
}749. 隔离病毒
题目、示例与约束
病毒扩散得很快,现在你的任务是尽可能地通过安装防火墙来隔离病毒。
假设世界由 m x n 的二维矩阵 isInfected 组成, isInfected[i][j] == 0 表示该区域未感染病毒,而 isInfected[i][j] == 1 表示该区域已感染病毒。可以在任意 2 个相邻单元之间的共享边界上安装一个防火墙(并且只有一个防火墙)。
每天晚上,病毒会从被感染区域向相邻未感染区域扩散,除非被防火墙隔离。现由于资源有限,每天你只能安装一系列防火墙来隔离其中一个被病毒感染的区域(一个区域或连续的一片区域),且该感染区域对未感染区域的威胁最大且 保证唯一 。
你需要努力使得最后有部分区域不被病毒感染,如果可以成功,那么返回需要使用的防火墙个数; 如果无法实现,则返回在世界被病毒全部感染时已安装的防火墙个数。
示例 1:
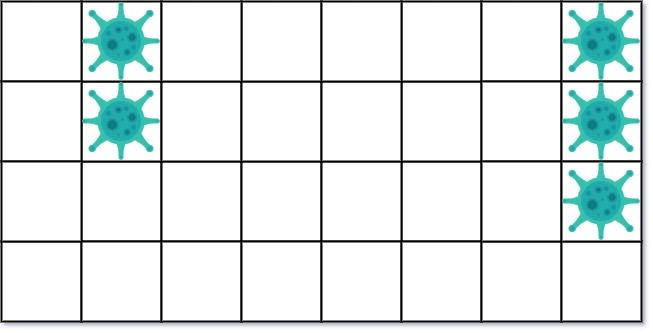
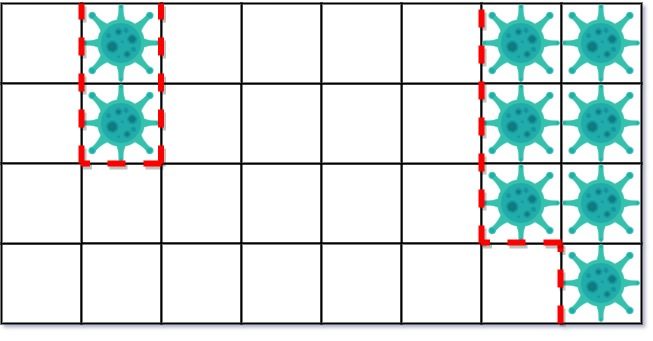
输入: isInfected = [[0,1,0,0,0,0,0,1],[0,1,0,0,0,0,0,1],[0,0,0,0,0,0,0,1],[0,0,0,0,0,0,0,0]] 输出: 10 解释:一共有两块被病毒感染的区域。 在第一天,添加 5 墙隔离病毒区域的左侧。病毒传播后的状态是:第二天,在右侧添加 5 个墙来隔离病毒区域。此时病毒已经被完全控制住了。
示例 2:
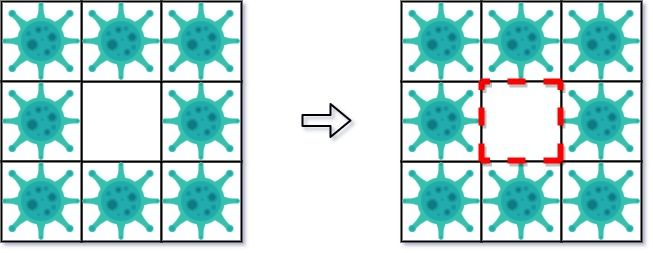
输入: isInfected = [[1,1,1],[1,0,1],[1,1,1]]
输出: 4
解释: 虽然只保存了一个小区域,但却有四面墙。
注意,防火墙只建立在两个不同区域的共享边界上。
示例 3:
输入: isInfected = [[1,1,1,0,0,0,0,0,0],[1,0,1,0,1,1,1,1,1],[1,1,1,0,0,0,0,0,0]]
输出: 13
解释: 在隔离右边感染区域后,隔离左边病毒区域只需要 2 个防火墙。
提示:
m == isInfected.lengthn == isInfected[i].length1 <= m, n <= 50isInfected[i][j]is either0or1- 在整个描述的过程中,总有一个相邻的病毒区域,它将在下一轮 严格地感染更多未受污染的方块
方法一:DFS 暴力模拟 · Go 实现
思考
每夜未隔离的病毒会扩散一圈,我们每晚只能给威胁最大的连通块围墙。网格不大,按回合模拟:找块、选块、封墙、扩散。
「威胁」指即将感染的未感染格子数,周长则是所需墙数。DFS 收集每块的格子、边界集合与墙数。
对边界集合最大的块把格子标成已隔离并累加墙数,其余块把边界染成感染,然后进入下一夜,直到没有活跃病毒。
DFS 找到每个病毒区域 areas[i],同时记录每个区域边界节点 boundaries[i] 以及周长 c[i]。
接着对威胁最大的病毒区域进行隔离,累加所需的防火墙数量。
剩余的病毒区域向外感染一个区域。
func containVirus(isInfected [][]int) int {
	m, n := len(isInfected), len(isInfected[0])
	ans := 0
	dirs := []int{-1, 0, 1, 0, -1}
	max := func(boundaries []map[int]bool) int {
		idx := 0
		mx := len(boundaries[0])
		for i, v := range boundaries {
			t := len(v)
			if mx < t {
				mx = t
				idx = i
			}
		}
		return idx
	}

	for {
		vis := make([][]bool, m)
		for i := range vis {
			vis[i] = make([]bool, n)
		}
		areas := []map[int]bool{}
		boundaries := []map[int]bool{}
		c := []int{}

		var dfs func(i, j int)
		dfs = func(i, j int) {
			vis[i][j] = true
			idx := len(areas) - 1
			areas[idx][i*n+j] = true
			for k := 0; k < 4; k++ {
				x, y := i+dirs[k], j+dirs[k+1]
				if x >= 0 && x < m && y >= 0 && y < n {
					if isInfected[x][y] == 1 && !vis[x][y] {
						dfs(x, y)
					} else if isInfected[x][y] == 0 {
						c[idx]++
						boundaries[idx][x*n+y] = true
					}
				}
			}
		}

		for i, row := range isInfected {
			for j, v := range row {
				if v == 1 && !vis[i][j] {
					areas = append(areas, map[int]bool{})
					boundaries = append(boundaries, map[int]bool{})
					c = append(c, 0)
					dfs(i, j)
				}
			}
		}
		if len(areas) == 0 {
			break
		}
		idx := max(boundaries)
		ans += c[idx]
		for t, area := range areas {
			if t == idx {
				for v := range area {
					i, j := v/n, v%n
					isInfected[i][j] = -1
				}
			} else {
				for v := range area {
					i, j := v/n, v%n
					for k := 0; k < 4; k++ {
						x, y := i+dirs[k], j+dirs[k+1]
						if x >= 0 && x < m && y >= 0 && y < n && isInfected[x][y] == 0 {
							isInfected[x][y] = 1
						}
					}
				}
			}
		}

	}
	return ans
}752. 打开转盘锁
题目、示例与约束
你有一个带有四个圆形拨轮的转盘锁。每个拨轮都有10个数字: '0', '1', '2', '3', '4', '5', '6', '7', '8', '9' 。每个拨轮可以自由旋转:例如把 '9' 变为 '0','0' 变为 '9' 。每次旋转都只能旋转一个拨轮的一位数字。
锁的初始数字为 '0000' ,一个代表四个拨轮的数字的字符串。
列表 deadends 包含了一组死亡数字,一旦拨轮的数字和列表里的任何一个元素相同,这个锁将会被永久锁定,无法再被旋转。
字符串 target 代表可以解锁的数字,你需要给出解锁需要的最小旋转次数,如果无论如何不能解锁,返回 -1 。
示例 1:
输入:deadends = ["0201","0101","0102","1212","2002"], target = "0202"
输出:6
解释:
可能的移动序列为 "0000" -> "1000" -> "1100" -> "1200" -> "1201" -> "1202" -> "0202"。
注意 "0000" -> "0001" -> "0002" -> "0102" -> "0202" 这样的序列是不能解锁的,
因为当拨动到 "0102" 时这个锁就会被锁定。
示例 2:
输入: deadends = ["8888"], target = "0009"
输出:1
解释:把最后一位反向旋转一次即可 "0000" -> "0009"。
示例 3:
输入: deadends = ["8887","8889","8878","8898","8788","8988","7888","9888"], target = "8888"
输出:-1
解释:无法旋转到目标数字且不被锁定。
提示:
1 <= deadends.length <= 500deadends[i].length == 4target.length == 4target不在deadends之中target和deadends[i]仅由若干位数字组成
方法一:朴素 BFS · Go 实现
思考
四位转盘每次转动一位,避开死亡数字,求到目标的最少步数。状态空间 ,每点至多 个邻居,最短路即 BFS。
死亡数字与已访问点一并加入集合,避免入队。起点本身若在死亡集合中则无解;目标为
0000则零步。按层扩展,邻居由四位各自 (环形)生成。第一次到达目标的层数即答案。
直接用朴素 BFS。
func openLock(deadends []string, target string) int {
	if target == "0000" {
		return 0
	}
	s := make(map[string]bool)
	for _, d := range deadends {
		s[d] = true
	}
	if s["0000"] {
		return -1
	}
	q := []string{"0000"}
	s["0000"] = true
	ans := 0
	next := func(t string) []string {
		s := []byte(t)
		var res []string
		for i, b := range s {
			s[i] = b - 1
			if s[i] < '0' {
				s[i] = '9'
			}
			res = append(res, string(s))
			s[i] = b + 1
			if s[i] > '9' {
				s[i] = '0'
			}
			res = append(res, string(s))
			s[i] = b
		}
		return res
	}
	for len(q) > 0 {
		ans++
		for n := len(q); n > 0; n-- {
			p := q[0]
			q = q[1:]
			for _, t := range next(p) {
				if target == t {
					return ans
				}
				if !s[t] {
					q = append(q, t)
					s[t] = true
				}
			}
		}
	}
	return -1
}
方法二:双向 BFS · Go 实现
思考
单向 BFS 可能扩展近半个状态空间。起点与终点已知,两端同时扩展,在中间相遇即可得到最短路,队列更短。
每次选当前更小的一侧扩一层;若邻居已在对侧出现,步数相加即答案。死亡数字两侧都跳过。
本题也可以用双向 BFS 优化搜索空间,从而提升效率。
双向 BFS 是 BFS 常见的一个优化方法,主要实现思路如下:
- 创建两个队列 q1, q2 分别用于“起点 -> 终点”、“终点 -> 起点”两个方向的搜索;
- 创建两个哈希表 m1, m2 分别记录访问过的节点以及对应的扩展次数(步数);
- 每次搜索时,优先选择元素数量较少的队列进行搜索扩展,如果在扩展过程中,搜索到另一个方向已经访问过的节点,说明找到了最短路径;
- 只要其中一个队列为空,说明当前方向的搜索已经进行不下去了,说明起点到终点不连通,无需继续搜索。
while q1 and q2:
    if len(q1) <= len(q2):
        # 优先选择较少元素的队列进行扩展
        extend(m1, m2, q1)
    else:
        extend(m2, m1, q2)


def extend(m1, m2, q):
    # 新一轮扩展
    for _ in range(len(q)):
        p = q.popleft()
        step = m1[p]
        for t in next(p):
            if t in m1:
                # 此前已经访问过
                continue
            if t in m2:
                # 另一个方向已经搜索过,说明找到了一条最短的连通路径
                return step + 1 + m2[t]
            q.append(t)
m1[t] = step + 1func openLock(deadends []string, target string) int {
if target == "0000" {
return 0
}
s := make(map[string]bool)
for _, d := range deadends {
s[d] = true
}
if s["0000"] {
return -1
}
next := func(t string) []string {
s := []byte(t)
var res []string
for i, b := range s {
s[i] = b - 1
if s[i] < '0' {
s[i] = '9'
}
res = append(res, string(s))
s[i] = b + 1
if s[i] > '9' {
s[i] = '0'
}
res = append(res, string(s))
s[i] = b
}
return res
}
extend := func(m1, m2 map[string]int, q *[]string) int {
for n := len(*q); n > 0; n-- {
p := (*q)[0]
*q = (*q)[1:]
step, _ := m1[p]
for _, t := range next(p) {
if s[t] {
continue
}
if _, ok := m1[t]; ok {
continue
}
if v, ok := m2[t]; ok {
return step + 1 + v
}
m1[t] = step + 1
*q = append(*q, t)
}
}
return -1
}
bfs := func() int {
q1 := []string{"0000"}
q2 := []string{target}
m1 := map[string]int{"0000": 0}
m2 := map[string]int{target: 0}
for len(q1) > 0 && len(q2) > 0 {
t := -1
if len(q1) <= len(q2) {
t = extend(m1, m2, &q1)
} else {
t = extend(m2, m1, &q2)
}
if t != -1 {
return t
}
}
return -1
}
return bfs()
}756. 金字塔转换矩阵
题目、示例与约束
你正在把积木堆成金字塔。每个块都有一个颜色,用一个字母表示。每一行的块比它下面的行 少一个块 ,并且居中。
为了使金字塔美观,只有特定的 三角形图案 是允许的。一个三角形的图案由 两个块 和叠在上面的 单个块 组成。模式是以三个字母字符串的列表形式 allowed 给出的,其中模式的前两个字符分别表示左右底部块,第三个字符表示顶部块。
- 例如,
"ABC"表示一个三角形图案,其中一个“C”块堆叠在一个'A'块(左)和一个'B'块(右)之上。请注意,这与"BAC"不同,"B"在左下角,"A"在右下角。
你从作为单个字符串给出的底部的一排积木 bottom 开始,必须 将其作为金字塔的底部。
在给定 bottom 和 allowed 的情况下,如果你能一直构建到金字塔顶部,使金字塔中的 每个三角形图案 都是在 allowed 中的,则返回 true ,否则返回 false 。
示例 1:
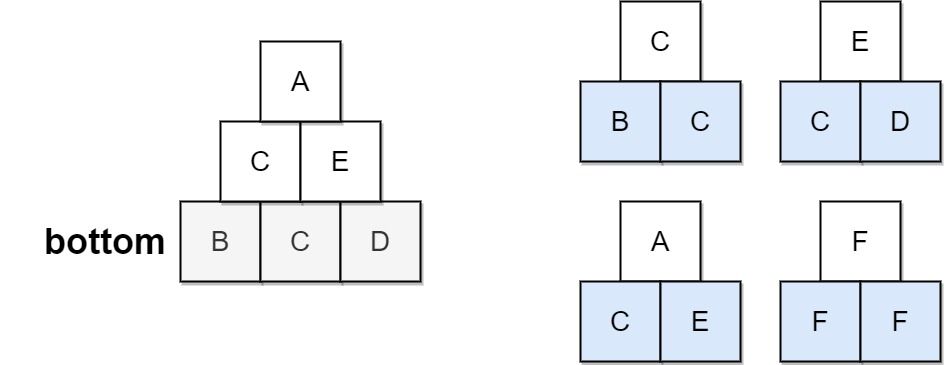
输入:bottom = "BCD", allowed = ["BCC","CDE","CEA","FFF"]
输出:true
解释:允许的三角形图案显示在右边。
从最底层(第 3 层)开始,我们可以在第 2 层构建“CE”,然后在第 1 层构建“A”。
金字塔中有三种三角形图案,分别是 “BCC”、“CDE” 和 “CEA”。都是允许的。
示例 2:
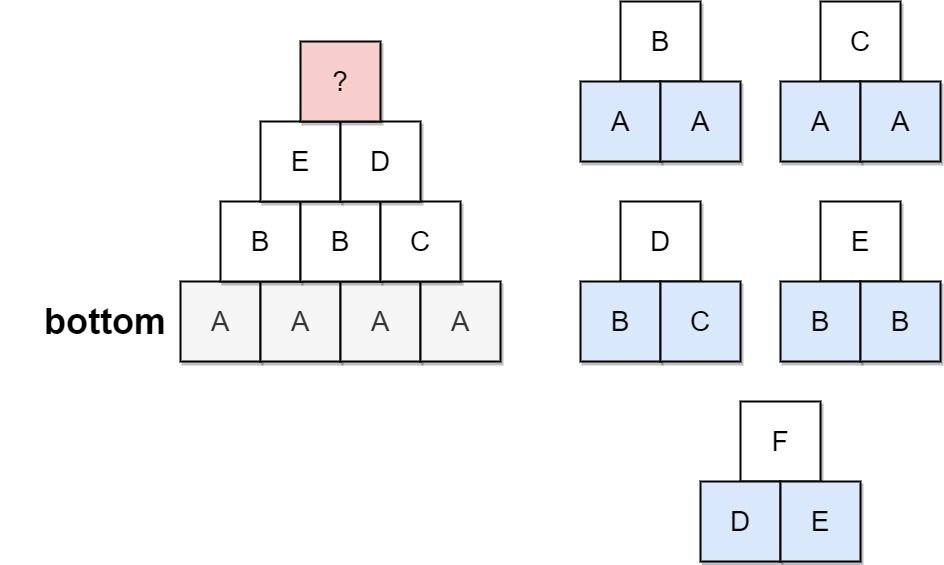
输入:bottom = "AAAA", allowed = ["AAB","AAC","BCD","BBE","DEF"]
输出:false
解释:允许的三角形图案显示在右边。
从最底层(即第 4 层)开始,创造第 3 层有多种方法,但如果尝试所有可能性,你便会在创造第 1 层前陷入困境。
提示:
2 <= bottom.length <= 60 <= allowed.length <= 216allowed[i].length == 3- 所有输入字符串中的字母来自集合
{'A', 'B', 'C', 'D', 'E', 'F'}。 -
allowed中所有值都是 唯一的
方法一:记忆化搜索 · Go 实现
思考
底层长度不超过 ,允许的三元组有限。自底向上枚举每一层的所有合法顶,层短但分支仍会重复同一剩余串。
相邻两块决定上一层对应位置的候选字母,一层的全部候选做笛卡尔积,得到所有可能的上一层字符串。
记忆化 :长度为 则成功;某对相邻无候选则失败;否则对 出的每一层递归。
我们定义一个哈希表 来存储允许的三角形图案,其中键为两个字符,值为对应的字符列表,表示两个字符可以组成一个三角形图案,三角形图案的顶部为值列表的每一项。
从最底层开始,对于每一层的每两个相邻的字符,如果它们可以组成一个三角形图案,那么就将三角形图案的顶部字符加入到下一层的对应位置的字符列表中,然后对下一层进行递归处理。
当递归到只有一个字符时,说明已经成功构建到金字塔顶部,返回 。如果在某一层的某两个相邻字符无法组成三角形图案,则返回 。
func pyramidTransition(bottom string, allowed []string) bool {
	d := make([][]int, 7)
	for i := 0; i < 7; i++ {
		d[i] = make([]int, 7)
	}

	for _, s := range allowed {
		a := int(s[0] - 'A')
		b := int(s[1] - 'A')
		c := int(s[2] - 'A')
		d[a][b] |= 1 << c
	}

	f := make(map[string]bool)

	var dfs func(s string, t []byte) bool
	dfs = func(s string, t []byte) bool {
		if len(s) == 1 {
			return true
		}
		if len(t)+1 == len(s) {
			return dfs(string(t), []byte{})
		}

		key := s + "." + string(t)
		if v, ok := f[key]; ok {
			return v
		}

		i := len(t)
		a := int(s[i] - 'A')
		b := int(s[i+1] - 'A')
		cs := d[a][b]

		for c := 0; c < 7; c++ {
			if (cs>>c)&1 == 1 {
				t = append(t, byte('A'+c))
				if dfs(s, t) {
					f[key] = true
					return true
				}
				t = t[:len(t)-1]
			}
		}

		f[key] = false
		return false
	}

	return dfs(bottom, []byte{})
}784. 字母大小写全排列
题目、示例与约束
给定一个字符串 s ,通过将字符串 s 中的每个字母转变大小写,我们可以获得一个新的字符串。
返回 所有可能得到的字符串集合 。以 任意顺序 返回输出。
示例 1:
输入:s = "a1b2"
输出:["a1b2", "a1B2", "A1b2", "A1B2"]
示例 2:
输入: s = "3z4"
输出: ["3z4","3Z4"]
提示:
1 <= s.length <= 12s由小写英文字母、大写英文字母和数字组成
方法一:DFS · Go 实现
思考
每个字母可改大小写,数字不动,输出全部串。长度短,回溯即可。
走到字母时先保持原样继续,再异或 翻转大小写走第二支;数字只有一支。到达末尾收集。
由于 中的每个字母都可以转换为大写或小写,因此可以使用 DFS 深度优先搜索的方法,枚举所有可能的情况。
具体地,从左到右遍历字符串 ,对于遍历到的每个字母,可以选择将其转变为大写或小写,然后继续遍历后面的字母。当遍历到字符串的末尾时,得到一个转换方案,将该方案加入答案即可。
转变大小写的方法可以使用位运算实现。对于一个字母,小写形式与大写形式的 ASCII 码之差为 ,因此,我们可以通过将该字母的 ASCII 码与 进行异或运算来实现大小写转换。
时间复杂度 ,其中 是字符串 的长度。对于每个字母,我们可以选择将其转换为大写或小写,因此一共有 种转换方案。对于每种转换方案,我们需要 的时间生成一个新的字符串。
func letterCasePermutation(s string) (ans []string) {
	t := []byte(s)
	var dfs func(int)
	dfs = func(i int) {
		if i >= len(t) {
			ans = append(ans, string(t))
			return
		}
		dfs(i + 1)
		if t[i] >= 'A' {
			t[i] ^= 32
			dfs(i + 1)
		}
	}

	dfs(0)
	return ans
}
方法二:二进制枚举 · Go 实现
思考
回溯按位置展开。字母个数为 时方案恰为 ,可用一个整数的比特表示第 个字母用小写还是大写。
枚举 ,按位决定每个字母的大小写,数字原样抄写。
对于一个字母,我们可以将其转换为大写或小写,因此对于每个字母,我们可以使用一个二进制位表示其转换的方案,其中 表示小写,而 表示大写。
我们先统计字符串 中字母的个数,记为 ,那么一共有 种转换方案,我们可以使用二进制数的每一位表示每个字母的转换方案,从 到 进行枚举。
具体地,我们可以使用一个变量 表示当前枚举到的二进制数,其中 的第 位表示第 个字母的转换方案。即 的第 位为 表示第 个字母转换为小写,而 的第 位为 表示第 个字母转换为大写。
时间复杂度 ,其中 是字符串 的长度。对于每个字母,我们可以选择将其转换为大写或小写,因此一共有 种转换方案。对于每种转换方案,我们需要 的时间生成一个新的字符串。
func letterCasePermutation(s string) (ans []string) {
	n := 0
	for _, c := range s {
		if c >= 'A' {
			n++
		}
	}
	for i := 0; i < 1<<n; i++ {
		j := 0
		t := []rune{}
		for _, c := range s {
			if c >= 'A' {
				if ((i >> j) & 1) == 1 {
					c = unicode.ToLower(c)
				} else {
					c = unicode.ToUpper(c)
				}
				j++
			}
			t = append(t, c)
		}
		ans = append(ans, string(t))
	}
	return ans
}815. 公交路线
题目、示例与约束
给你一个数组 routes ,表示一系列公交线路,其中每个 routes[i] 表示一条公交线路,第 i 辆公交车将会在上面循环行驶。
- 例如,路线
routes[0] = [1, 5, 7]表示第0辆公交车会一直按序列1 -> 5 -> 7 -> 1 -> 5 -> 7 -> 1 -> ...这样的车站路线行驶。
现在从 source 车站出发(初始时不在公交车上),要前往 target 车站。 期间仅可乘坐公交车。
求出 最少乘坐的公交车数量 。如果不可能到达终点车站,返回 -1 。
示例 1:
输入:routes = [[1,2,7],[3,6,7]], source = 1, target = 6
输出:2
解释:最优策略是先乘坐第一辆公交车到达车站 7 , 然后换乘第二辆公交车到车站 6 。
示例 2:
输入:routes = [[7,12],[4,5,15],[6],[15,19],[9,12,13]], source = 15, target = 12
输出:-1
提示:
1 <= routes.length <= 500.1 <= routes[i].length <= 105routes[i]中的所有值 互不相同sum(routes[i].length) <= 1050 <= routes[i][j] < 1060 <= source, target < 106
方法一:BFS · Go 实现
思考
每次乘坐一辆公交可到达该线路上的任意站点,求最少乘坐次数。按站点逐步走边会把同一辆车重复展开;站点与线路规模较大,应把「换乘」作为 BFS 的一层。
先建站点到线路的倒排。队列中存站点与已乘车次数,每条线路只展开一次,把它的全部未访问站点入队。这样每辆车至多处理一遍。
我们首先判断 和 是否相同,如果相同则直接返回 。
然后我们使用一个哈希表 来构建站点到公交线路的映射。对于每一条公交线路,我们遍历其经过的所有站点,将每个站点映射到该公交线路,即 为经过站点 的所有公交线路。
接着我们判断 和 是否在站点映射中,如果不在则返回 。
我们使用一个队列 来进行广度优先搜索,队列中的每个元素为一个二元组 ,表示当前站点 和到达当前站点所需的公交次数 。
我们初始化一个集合 来记录已经访问过的公交线路,一个集合 来记录已经访问过的站点。然后我们将 加入到 中,并将 加入到队列 中。
接下来我们开始广度优先搜索,当队列 不为空时,我们取出队列的第一个元素,即当前站点 和到达当前站点所需的公交次数 。
如果当前站点 是目标站点 ,我们返回到达目标站点所需的公交次数 。
否则,我们遍历经过当前站点的所有公交线路,对于每一条公交线路,我们遍历该线路上的所有站点,如果某个站点 没有被访问过,则将其加入到 中,并将 加入到队列 中。
最后,如果无法到达目标站点,则返回 。
时间复杂度 ,空间复杂度 ,其中 为所有公交线路上的站点总数。
func numBusesToDestination(routes [][]int, source int, target int) int {
	if source == target {
		return 0
	}

	// 使用 map 构建站点到公交线路的映射
	g := make(map[int][]int)
	for i, route := range routes {
		for _, stop := range route {
			g[stop] = append(g[stop], i)
		}
	}

	// 如果 source 或 target 不在站点映射中,返回 -1
	if g[source] == nil || g[target] == nil {
		return -1
	}

	// 初始化队列和访问集合
	q := list.New()
	q.PushBack([2]int{source, 0})
	visBus := make(map[int]bool)
	visStop := make(map[int]bool)
	visStop[source] = true

	// 开始广度优先搜索
	for q.Len() > 0 {
		front := q.Front()
		q.Remove(front)
		stop, busCount := front.Value.([2]int)[0], front.Value.([2]int)[1]

		// 如果当前站点是目标站点,返回所需的公交次数
		if stop == target {
			return busCount
		}

		// 遍历经过当前站点的所有公交线路
		for _, bus := range g[stop] {
			if !visBus[bus] {
				visBus[bus] = true
				// 遍历该线路上的所有站点
				for _, nextStop := range routes[bus] {
					if !visStop[nextStop] {
						visStop[nextStop] = true
						q.PushBack([2]int{nextStop, busCount + 1})
					}
				}
			}
		}
	}

	return -1 // 如果无法到达目标站点,返回
}816. 模糊坐标
题目、示例与约束
我们有一些二维坐标,如 "(1, 3)" 或 "(2, 0.5)",然后我们移除所有逗号,小数点和空格,得到一个字符串S。返回所有可能的原始字符串到一个列表中。
原始的坐标表示法不会存在多余的零,所以不会出现类似于"00", "0.0", "0.00", "1.0", "001", "00.01"或一些其他更小的数来表示坐标。此外,一个小数点前至少存在一个数,所以也不会出现“.1”形式的数字。
最后返回的列表可以是任意顺序的。而且注意返回的两个数字中间(逗号之后)都有一个空格。
示例 1:
输入: "(123)"
输出: ["(1, 23)", "(12, 3)", "(1.2, 3)", "(1, 2.3)"]
示例 2:
输入: "(00011)"
输出:  ["(0.001, 1)", "(0, 0.011)"]
解释:
0.0, 00, 0001 或 00.01 是不被允许的。
示例 3:
输入: "(0123)"
输出: ["(0, 123)", "(0, 12.3)", "(0, 1.23)", "(0.1, 23)", "(0.1, 2.3)", "(0.12, 3)"]
示例 4:
输入: "(100)"
输出: [(10, 0)]
解释:
1.0 是不被允许的。
提示:
4 <= S.length <= 12.S[0]= "(",S[S.length - 1]= ")", 且字符串S中的其他元素都是数字。
方法一:暴力模拟 · Go 实现
思考
在括号内插入逗号与可选小数点,枚举所有合法坐标。串长不超过 ,枚举逗号位置后再枚举小数点位置即可。
一段数字合法当且仅当整数部分无前导零(单独的 除外),小数部分无后导零。对左右两段分别生成合法写法再两两组合。
枚举纵坐标的起始位置,然后分别获取横、纵坐标的所有可能的表示形式,最后将横、纵坐标的所有可能的表示形式组合起来。
我们将一个坐标值 或 按照小数点的位置分成左右两部分,那么两部分应该满足以下条件:
- 左半部分不能以 0 开头,除非左半部分只有 0;
- 右半部分不能以 0 结尾。
时间复杂度 ,其中 为字符串 的长度。
func ambiguousCoordinates(s string) []string {
	f := func(i, j int) []string {
		res := []string{}
		for k := 1; k <= j-i; k++ {
			l, r := s[i:i+k], s[i+k:j]
			ok := (l == "0" || l[0] != '0') && (r == "" || r[len(r)-1] != '0')
			if ok {
				t := ""
				if k < j-i {
					t = "."
				}
				res = append(res, l+t+r)
			}
		}
		return res
	}

	n := len(s)
	ans := []string{}
	for i := 2; i < n-1; i++ {
		for _, x := range f(1, i) {
			for _, y := range f(i, n-1) {
				ans = append(ans, "("+x+", "+y+")")
			}
		}
	}
	return ans
}842. 将数组拆分成斐波那契序列
题目、示例与约束
给定一个数字字符串 num,比如 "123456579",我们可以将它分成「斐波那契式」的序列 [123, 456, 579]。
形式上,斐波那契式 序列是一个非负整数列表 f,且满足:
0 <= f[i] < 231,(也就是说,每个整数都符合 32 位 有符号整数类型)f.length >= 3- 对于所有的
0 <= i < f.length - 2,都有f[i] + f[i + 1] = f[i + 2]
另外,请注意,将字符串拆分成小块时,每个块的数字一定不要以零开头,除非这个块是数字 0 本身。
返回从 num 拆分出来的任意一组斐波那契式的序列块,如果不能拆分则返回 []。
示例 1:
输入:num = "1101111"
输出:[11,0,11,11]
解释:输出 [110,1,111] 也可以。
示例 2:
输入: num = "112358130"
输出: []
解释: 无法拆分。
示例 3:
输入:"0123"
输出:[]
解释:每个块的数字不能以零开头,因此 "01","2","3" 不是有效答案。
提示:
1 <= num.length <= 200num中只含有数字
方法一:回溯 + 剪枝 · Go 实现
思考
把数字串拆成至少三项的斐波那契序列,且每项为 位整数。串长 ,前两项确定后其余被完全决定,适合回溯。
枚举下一项的结束位置,禁止前导零,超上界或已大于前两项之和则剪枝。已有两项时必须恰好等于其和。搜到末尾且长度大于 即成功。
我们设计一个函数 ,表示从字符串 的第 个字符开始拆分,拆分出的斐波那契式序列是否满足题目要求。如果满足,我们就返回 ,否则返回 。
函数 的具体实现如下:
如果 等于字符串 的长度,说明我们已经拆分完整个字符串,此时我们只需要判断拆分出的序列的长度是否大于 即可。如果大于 ,说明我们找到了一组满足题目要求的斐波那契式序列,返回 ;否则返回 。
如果 小于字符串 的长度,我们需要枚举拆分出的第一个数 ,如果 的长度大于 ,且以 开头,说明 不是一个合法的数,我们直接返回 。否则我们将 转换成十进制数,如果 大于 ,或者 大于 的最后两个数之和,直接返回 。如果 的长度小于 ,或者 等于 的最后两个数之和,我们将 加入到 中,然后继续拆分字符串 的后面的部分,如果返回 ,说明我们找到了一组满足题目要求的斐波那契式序列,返回 ;否则我们将 从 中移除,然后继续枚举拆分出的第一个数 。
时间复杂度 ,空间复杂度 。其中 和 分别是字符串 的长度和整型数的最大值。
func splitIntoFibonacci(num string) []int {
	n := len(num)
	ans := []int{}
	var dfs func(int) bool
	dfs = func(i int) bool {
		if i == n {
			return len(ans) > 2
		}
		x := 0
		for j := i; j < n; j++ {
			if j > i && num[i] == '0' {
				break
			}
			x = x*10 + int(num[j]-'0')
			if x > math.MaxInt32 || (len(ans) > 1 && x > ans[len(ans)-1]+ans[len(ans)-2]) {
				break
			}
			if len(ans) < 2 || x == ans[len(ans)-1]+ans[len(ans)-2] {
				ans = append(ans, x)
				if dfs(j + 1) {
					return true
				}
				ans = ans[:len(ans)-1]
			}
		}
		return false
	}
	dfs(0)
	return ans
}854. 相似度为 K 的字符串
题目、示例与约束
对于某些非负整数 k ,如果交换 s1 中两个字母的位置恰好 k 次,能够使结果字符串等于 s2 ,则认为字符串 s1 和 s2 的 相似度为 k 。
给你两个字母异位词 s1 和 s2 ,返回 s1 和 s2 的相似度 k 的最小值。
示例 1:
输入:s1 = "ab", s2 = "ba"
输出:1
示例 2:
输入:s1 = "abc", s2 = "bca"
输出:2
提示:
1 <= s1.length <= 20s2.length == s1.lengths1和s2只包含集合{'a', 'b', 'c', 'd', 'e', 'f'}中的小写字母s2是s1的一个字母异位词
方法一:BFS · Go 实现
思考
每次交换 中两个字符,使之变成 ,求最少次数。二者为异位词且长度 ,字母种类很少,应把整串当状态做 BFS。
扩展时只交换「当前第一处不匹配」与后面某个能补上该位的字符,避免无用交换。层数即最少交换次数。
本题实际上是一类经典的问题:求解最小操作次数。从一个初始状态 ,经过最少 次状态转换,变成目标状态 。字符串长度不超过 ,我们考虑使用 BFS 搜索来求解。
首先将初始状态 入队,用哈希表 vis 记录所有访问过的状态。
接下来每一轮,都是将队列中的所有状态转换到下一个状态,当遇到目标状态 时,当前状态转换的轮数就是答案。
我们发现,题目的重点在于如何进行状态转换。对于本题,转换操作就是交换一个字符串中两个位置的字符。如果当前字符串 与 不相等,那么我们应该在 中找到一个位置 ,满足 并且 ,然后交换 和 。这样可以使得状态最接近于目标状态。这里的状态转换可以参考以下代码中的 next() 函数。
复杂度分析:BFS 剪枝不讨论时空复杂度。
func kSimilarity(s1 string, s2 string) int {
	next := func(s string) []string {
		i := 0
		res := []string{}
		for ; s[i] == s2[i]; i++ {
		}
		for j := i + 1; j < len(s1); j++ {
			if s[j] == s2[i] && s[j] != s2[j] {
				res = append(res, s[:i]+string(s[j])+s[i+1:j]+string(s[i])+s[j+1:])
			}
		}
		return res
	}

	q := []string{s1}
	vis := map[string]bool{s1: true}
	ans := 0
	for {
		for i := len(q); i > 0; i-- {
			s := q[0]
			q = q[1:]
			if s == s2 {
				return ans
			}
			for _, nxt := range next(s) {
				if !vis[nxt] {
					vis[nxt] = true
					q = append(q, nxt)
				}
			}
		}
		ans++
	}
}
方法二:A* 算法(进阶) · Go 实现
思考
普通 BFS 按层扩展,未匹配位数的一半是可采纳启发:一次交换最多修正两位。用 优先出队。
邻居生成与方法一相同,松弛条件仍是边权 。启发不会高估,最优性保持,错位较少的串会更早出队。
A* 搜索算法(A* 读作 A-star),简称 A* 算法,是一种在图形平面上,对于有多个节点的路径求出最低通过成本的算法。它属于图遍历和最佳优先搜索算法(英文:Best-first search),亦是 BFS 的改进。
A* 算法主要步骤如下:
- 将方法一中的 BFS 队列转换为优先队列(小根堆);
- 队列中的每个元素为
(dist[s] + f(s), s),dist[s]表示从初始状态 到当前状态 的距离,f(s)表示从当前状态 到目标状态 的估计距离,这两个距离之和作为堆排序的依据; - 当终点第一次出队时,说明找到了从起点 到终点 的最短路径,直接返回对应的距离;
f(s)是估价函数,并且估价函数要满足f(s) <= g(s),其中g(s)表示 到终点 的真实距离;
需要注意的是,A* 算法只能保证终点第一次出队时,即找到了一条从起点到终点的最小路径,不能保证其他点出队时也是从起点到当前点的最短路径。
复杂度分析:启发式搜索不讨论时空复杂度。
func kSimilarity(s1 string, s2 string) int {
	next := func(s string) []string {
		i := 0
		res := []string{}
		for ; s[i] == s2[i]; i++ {
		}
		for j := i + 1; j < len(s1); j++ {
			if s[j] == s2[i] && s[j] != s2[j] {
				res = append(res, s[:i]+string(s[j])+s[i+1:j]+string(s[i])+s[j+1:])
			}
		}
		return res
	}

	f := func(s string) int {
		cnt := 0
		for i := range s {
			if s[i] != s2[i] {
				cnt++
			}
		}
		return (cnt + 1) >> 1
	}

	q := hp{pair{f(s1), s1}}
	dist := map[string]int{s1: 0}
	for {
		s := heap.Pop(&q).(pair).s
		if s == s2 {
			return dist[s]
		}
		for _, nxt := range next(s) {
			if v, ok := dist[nxt]; !ok || v > dist[s]+1 {
				dist[nxt] = dist[s] + 1
				heap.Push(&q, pair{dist[nxt] + f(nxt), nxt})
			}
		}
	}
}

type pair struct {
	v int
	s string
}
type hp []pair

func (h hp) Len() int { return len(h) }
func (h hp) Less(i, j int) bool {
	a, b := h[i], h[j]
	return a.v < b.v
}
func (h hp) Swap(i, j int) { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)   { *h = append(*h, v.(pair)) }
func (h *hp) Pop() any { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }864. 获取所有钥匙的最短路径
题目、示例与约束
给定一个二维网格 grid ,其中:
- '.' 代表一个空房间
- '#' 代表一堵墙
- '@' 是起点
- 小写字母代表钥匙
- 大写字母代表锁
我们从起点开始出发,一次移动是指向四个基本方向之一行走一个单位空间。我们不能在网格外面行走,也无法穿过一堵墙。如果途经一个钥匙,我们就把它捡起来。除非我们手里有对应的钥匙,否则无法通过锁。
假设 k 为 钥匙/锁 的个数,且满足 1 <= k <= 6,字母表中的前 k 个字母在网格中都有自己对应的一个小写和一个大写字母。换言之,每个锁有唯一对应的钥匙,每个钥匙也有唯一对应的锁。另外,代表钥匙和锁的字母互为大小写并按字母顺序排列。
返回获取所有钥匙所需要的移动的最少次数。如果无法获取所有钥匙,返回 -1 。
示例 1:
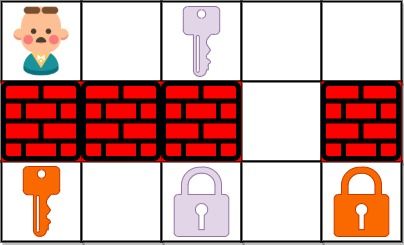
输入:grid = ["@.a..","###.#","b.A.B"]
输出:8
解释:目标是获得所有钥匙,而不是打开所有锁。
示例 2:
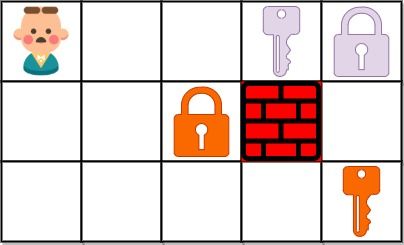
输入:grid = ["@..aA","..B#.","....b"]
输出:6
示例 3:
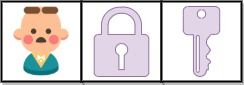
输入: grid = ["@Aa"]
输出: -1
提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 30grid[i][j]只含有'.','#','@','a'-'f'以及'A'-'F'- 钥匙的数目范围是
[1, 6] - 每个钥匙都对应一个 不同 的字母
- 每个钥匙正好打开一个对应的锁
方法一:状态压缩 + BFS · Go 实现
思考
网格中取齐全部钥匙,锁挡住没有对应钥匙的路径。钥匙至多 把、网格 ,位置加钥匙集合构成可 BFS 的状态。
状态 表示坐标与已持钥匙。遇墙或未开锁则跳过,拾到钥匙就置位。 为全集时的层数即最短步数。
根据题意,我们需要从起点出发,往上下左右四个方向走,获取所有钥匙,最后返回获取所有钥匙所需要的移动的最少次数。若无法获取所有钥匙,返回 。
首先,我们遍历二维网格,找到起点位置 ,并统计钥匙的个数 。
然后,我们可以使用广度优先搜索 来解决本题。由于钥匙的个数范围是 ,我们可以用一个二进制数来表示钥匙的状态,其中第 位为 表示第 把钥匙已经获取到了,为 表示第 把钥匙还没有获取到。
比如,以下例子中,共有 个二进制位为 ,也就表示有 'b', 'c', 'd', 'f' 把钥匙已经获取到了。
1 0 1 1 1 0
^   ^ ^ ^
f   d c b
我们定义一个队列 来存储当前位置以及当前拥有的钥匙的状态,即 ,其中 表示当前位置, 表示当前拥有的钥匙的状态,即 的第 位为 表示当前拥有第 把钥匙,否则表示当前没有第 把钥匙。
另外,定义哈希表或数组 记录当前位置以及当前拥有的钥匙的状态是否已经被访问过,如果访问过,则不需要再次访问。 表示当前位置为 ,当前拥有的钥匙的状态为 时,是否已经被访问过。
我们从起点 出发,将其加入队列 ,并将 置为 ,表示起点位置以及拥有的钥匙的状态为 时已经被访问过。
在广度优先搜索的过程中,我们每次从队首取出一个位置 ,并判断当前位置是否为终点,即当前位置是否拥有所有的钥匙,即 的二进制表示中的 的个数是否为 。如果是,将当前步数作为答案返回。
否则,我们从当前位置出发,往上下左右四个方向走,如果可以走到下一个位置 ,则将 加入队列 ,其中 表示下一个位置的钥匙的状态。
这里 首先需要满足在网格范围内,即 且 。其次,如果 位置是墙壁,即 grid[x][y] == '#',或者 位置是锁,但我们没有对应的钥匙,即 grid[x][y] >= 'A' && grid[x][y] <= 'F' && (state >> (grid[x][y] - 'A') & 1) == 0),则不能走到位置 。否则,我们可以走到位置 。
搜索结束,没能找到所有的钥匙,返回 。
时间复杂度 ,空间复杂度 。其中 和 分别为网格的行数和列数,而 为钥匙的个数。
func shortestPathAllKeys(grid []string) int {
	m, n := len(grid), len(grid[0])
	var k, si, sj int
	for i, row := range grid {
		for j, c := range row {
			if c >= 'a' && c <= 'z' {
				// 累加钥匙数量
				k++
			} else if c == '@' {
				// 起点
				si, sj = i, j
			}
		}
	}
	type tuple struct{ i, j, state int }
	q := []tuple{tuple{si, sj, 0}}
	vis := map[tuple]bool{tuple{si, sj, 0}: true}
	dirs := []int{-1, 0, 1, 0, -1}
	ans := 0
	for len(q) > 0 {
		for t := len(q); t > 0; t-- {
			p := q[0]
			q = q[1:]
			i, j, state := p.i, p.j, p.state
			// 找到所有钥匙,返回当前步数
			if state == 1<<k-1 {
				return ans
			}
			// 往四个方向搜索
			for h := 0; h < 4; h++ {
				x, y := i+dirs[h], j+dirs[h+1]
				// 在边界范围内
				if x >= 0 && x < m && y >= 0 && y < n {
					c := grid[x][y]
					// 是墙,或者是锁,但此时没有对应的钥匙,无法通过
					if c == '#' || (c >= 'A' && c <= 'Z' && (state>>(c-'A')&1 == 0)) {
						continue
					}
					nxt := state
					// 是钥匙,更新状态
					if c >= 'a' && c <= 'z' {
						nxt |= 1 << (c - 'a')
					}
					// 此状态未访问过,入队
					if !vis[tuple{x, y, nxt}] {
						vis[tuple{x, y, nxt}] = true
						q = append(q, tuple{x, y, nxt})
					}
				}
			}
		}
		// 步数加一
		ans++
	}
	return -1
}909. 蛇梯棋
题目、示例与约束
给你一个大小为 n x n 的整数矩阵 board ,方格按从 1 到 n2 编号,编号遵循 转行交替方式 ,从左下角开始 (即,从 board[n - 1][0] 开始)的每一行改变方向。
你一开始位于棋盘上的方格 1。每一回合,玩家需要从当前方格 curr 开始出发,按下述要求前进:
- 选定目标方格
next,目标方格的编号在范围[curr + 1, min(curr + 6, n2)]。- 该选择模拟了掷 六面体骰子 的情景,无论棋盘大小如何,玩家最多只能有 6 个目的地。
- 传送玩家:如果目标方格
next处存在蛇或梯子,那么玩家会传送到蛇或梯子的目的地。否则,玩家传送到目标方格next。 - 当玩家到达编号
n2的方格时,游戏结束。
如果 board[r][c] != -1 ,位于 r 行 c 列的棋盘格中可能存在 “蛇” 或 “梯子”。那个蛇或梯子的目的地将会是 board[r][c]。编号为 1 和 n2 的方格不是任何蛇或梯子的起点。
注意,玩家在每次掷骰的前进过程中最多只能爬过蛇或梯子一次:就算目的地是另一条蛇或梯子的起点,玩家也 不能 继续移动。
- 举个例子,假设棋盘是
[[-1,4],[-1,3]],第一次移动,玩家的目标方格是2。那么这个玩家将会顺着梯子到达方格3,但 不能 顺着方格3上的梯子前往方格4。(简单来说,类似飞行棋,玩家掷出骰子点数后移动对应格数,遇到单向的路径(即梯子或蛇)可以直接跳到路径的终点,但如果多个路径首尾相连,也不能连续跳多个路径)
返回达到编号为 n2 的方格所需的最少掷骰次数,如果不可能,则返回 -1。
示例 1:
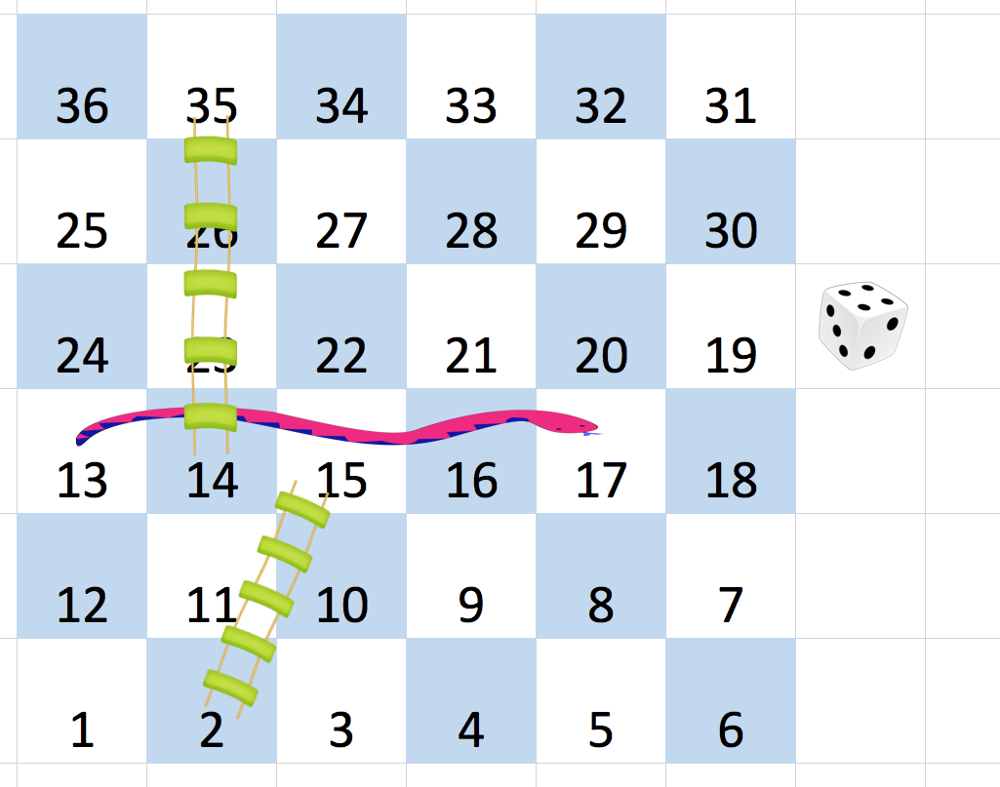
输入:board = [[-1,-1,-1,-1,-1,-1],[-1,-1,-1,-1,-1,-1],[-1,-1,-1,-1,-1,-1],[-1,35,-1,-1,13,-1],[-1,-1,-1,-1,-1,-1],[-1,15,-1,-1,-1,-1]]
输出:4
解释:
首先,从方格 1 [第 5 行,第 0 列] 开始。
先决定移动到方格 2 ,并必须爬过梯子移动到到方格 15 。
然后决定移动到方格 17 [第 3 行,第 4 列],必须爬过蛇到方格 13 。
接着决定移动到方格 14 ,且必须通过梯子移动到方格 35 。
最后决定移动到方格 36 , 游戏结束。
可以证明需要至少 4 次移动才能到达最后一个方格,所以答案是 4 。
示例 2:
输入:board = [[-1,-1],[-1,3]]
输出:1
提示:
n == board.length == board[i].length2 <= n <= 20board[i][j]的值是-1或在范围[1, n2]内- 编号为
1和n2的方格上没有蛇或梯子
方法一:BFS · Go 实现
思考
棋盘边长 ,格子至多 。求最少掷骰次数,属于无权最短路。编号按蛇形映射到坐标,遇蛇或梯子则强制传送到目的地。
从 开始按层 BFS,每格至多入队一次;走到 时的层数即为答案,否则返回 。
我们可以使用广度优先搜索的方法,从起点开始,每次向前走 1 到 6 步,然后判断是否有蛇或梯子,如果有,就走到蛇或梯子的目的地,否则就走到下一个方格。
具体地,我们使用一个队列 来存储当前可以到达的方格编号,初始时将编号 放入队列。同时我们使用一个集合 来记录已经到达过的方格,避免重复访问,初始时将编号 加入集合 。
在每一次的操作中,我们取出队首的方格编号 ,如果 是终点,那么我们就可以返回当前的步数。否则我们将 向前走 到 步,设新的编号为 ,如果 落在棋盘外,那么我们就直接跳过。否则,我们需要找到 对应的行和列,由于行的编号是从下到上递减的,而列的编号与行的奇偶性有关,因此我们需要进行一些计算得到 对应的行和列。
如果 对应的方格上有蛇或梯子,那么我们需要额外走到蛇或梯子的目的地,设其为 。如果 没有被访问过,我们就将 加入队列和集合中,这样我们就可以继续进行广度优先搜索。
如果我们最终无法到达终点,那么我们就返回 。
时间复杂度 ,空间复杂度 。其中 是棋盘的边长。
func snakesAndLadders(board [][]int) int {
	n := len(board)
	q := []int{1}
	m := n * n
	vis := make([]bool, m+1)
	vis[1] = true

	for ans := 0; len(q) > 0; ans++ {
		for k := len(q); k > 0; k-- {
			x := q[0]
			q = q[1:]
			if x == m {
				return ans
			}
			for y := x + 1; y <= min(x+6, m); y++ {
				i, j := (y-1)/n, (y-1)%n
				if i%2 == 1 {
					j = n - j - 1
				}
				i = n - i - 1
				z := y
				if board[i][j] != -1 {
					z = board[i][j]
				}
				if !vis[z] {
					vis[z] = true
					q = append(q, z)
				}
			}
		}
	}
	return -1
}934. 最短的桥
题目、示例与约束
给你一个大小为 n x n 的二元矩阵 grid ,其中 1 表示陆地,0 表示水域。
岛 是由四面相连的 1 形成的一个最大组,即不会与非组内的任何其他 1 相连。grid 中 恰好存在两座岛 。
你可以将任意数量的 0 变为 1 ,以使两座岛连接起来,变成 一座岛 。
返回必须翻转的 0 的最小数目。
示例 1:
输入:grid = [[0,1],[1,0]]
输出:1
示例 2:
输入:grid = [[0,1,0],[0,0,0],[0,0,1]]
输出:2
示例 3:
输入:grid = [[1,1,1,1,1],[1,0,0,0,1],[1,0,1,0,1],[1,0,0,0,1],[1,1,1,1,1]]
输出:1
提示:
n == grid.length == grid[i].length2 <= n <= 100grid[i][j]为0或1grid中恰有两个岛
方法一:DFS + BFS · Go 实现
思考
恰有两座岛,最少翻转次数等于两岛之间的最短距离。先 DFS 把其中一座岛全部入队并标成已访,再从这圈陆地向外 BFS 扩张水域;第一次碰到另一座岛时的层数即为答案。
题目求解的是最小翻转次数,使得两个岛屿相连,实际上等价于求解两个岛屿之间的最短距离。
因此,我们可以先通过 DFS 将其中一个岛屿的所有点找出来,放到一个队列 中。然后通过 BFS 一层层向外扩展,直至碰到另一个岛屿,此时将当前扩展的层数作为答案返回即可。
在 DFS 和 BFS 搜索的过程中,我们直接将已经访问过的点标记为 ,这样就不会重复访问。
时间复杂度 ,空间复杂度 。其中 为矩阵的行数或列数。
func shortestBridge(grid [][]int) (ans int) {
	n := len(grid)
	dirs := []int{-1, 0, 1, 0, -1}
	type pair struct{ i, j int }
	q := []pair{}
	var dfs func(int, int)
	dfs = func(i, j int) {
		grid[i][j] = 2
		q = append(q, pair{i, j})
		for k := 0; k < 4; k++ {
			x, y := i+dirs[k], j+dirs[k+1]
			if x >= 0 && x < n && y >= 0 && y < n && grid[x][y] == 1 {
				dfs(x, y)
			}
		}
	}
	for i, x := 0, 1; i < n && x == 1; i++ {
		for j := 0; j < n; j++ {
			if grid[i][j] == 1 {
				dfs(i, j)
				x = 0
				break
			}
		}
	}
	for {
		for i := len(q); i > 0; i-- {
			p := q[0]
			q = q[1:]
			for k := 0; k < 4; k++ {
				x, y := p.i+dirs[k], p.j+dirs[k+1]
				if x >= 0 && x < n && y >= 0 && y < n {
					if grid[x][y] == 1 {
						return
					}
					if grid[x][y] == 0 {
						grid[x][y] = 2
						q = append(q, pair{x, y})
					}
				}
			}
		}
		ans++
	}
}继续阅读
- 实践案例
- 实践案例
- 实践案例