
LeetCode Go · 回溯与搜索(1)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
17. 电话号码的字母组合
题目、示例与约束
给定一个仅包含数字 2-9 的字符串,返回所有它能表示的字母组合。答案可以按 任意顺序 返回。
给出数字到字母的映射如下(与电话按键相同)。注意 1 不对应任何字母。
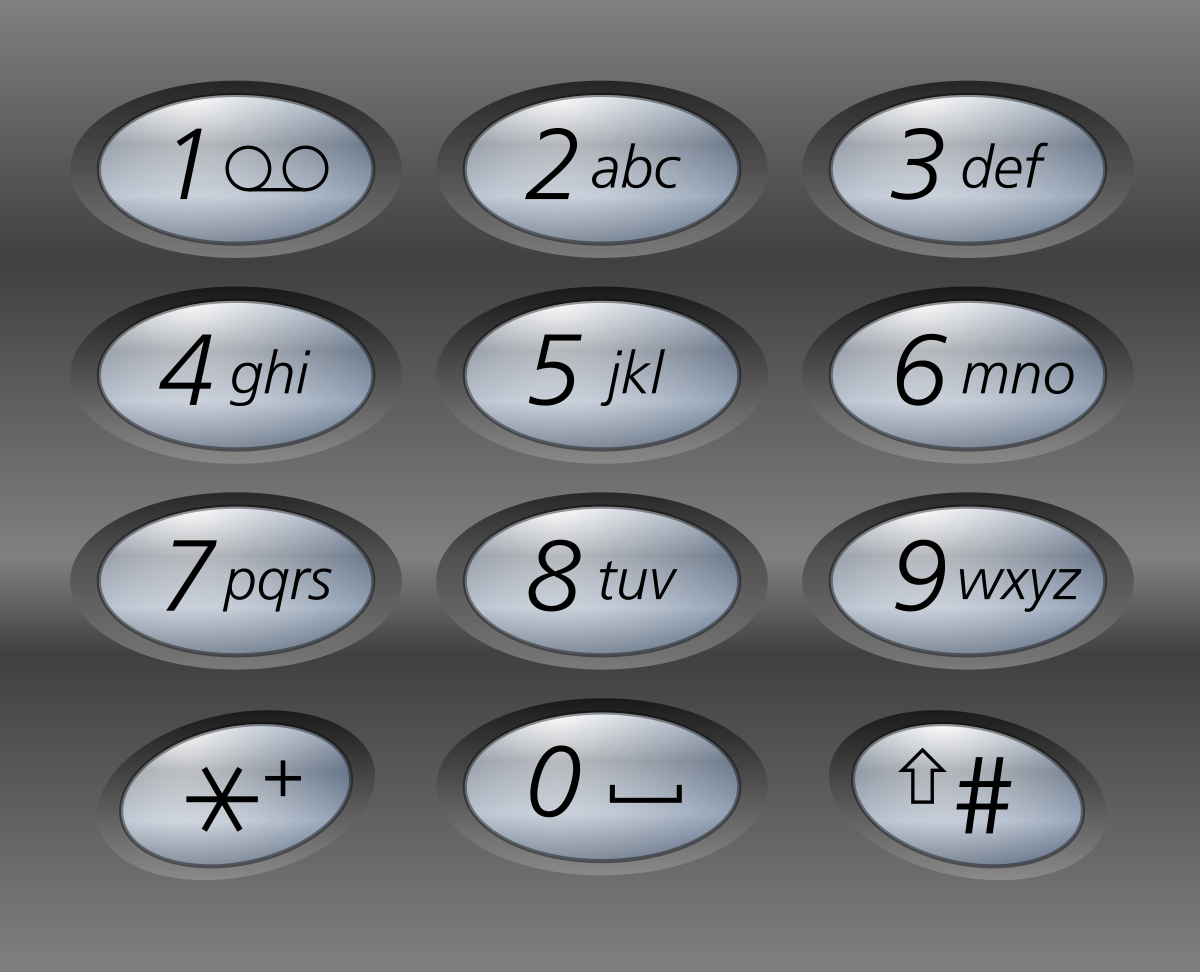
示例 1:
输入:digits = "23"
输出:["ad","ae","af","bd","be","bf","cd","ce","cf"]
示例 2:
输入:digits = "2"
输出:["a","b","c"]
提示:
1 <= digits.length <= 4digits[i]是范围['2', '9']的一个数字。
方法一:遍历 · Go 实现
思考
数字长度 ,答案至多 种,枚举全部组合在复杂度上可以接受。本质是若干字母集合的笛卡尔积;若手写 层循环,则 不固定时无法写出。
从空串出发,每读入一位数字,就把当前所有前缀与该位对应字母再拼接一遍,得到新的前缀表。这相当于按层展开笛卡尔积。因此用数组保存数字到字母的映射,从只含空串的列表出发逐位扩展;输入为空时返回空列表。
我们先用一个数组或者哈希表存储每个数字对应的字母,然后遍历每个数字,将其对应的字母与之前的结果进行组合,得到新的结果。
时间复杂度 。空间复杂度 。其中 是输入数字的长度。
func letterCombinations(digits string) []string {
	ans := []string{}
	if len(digits) == 0 {
		return ans
	}
	ans = append(ans, "")
	d := []string{"abc", "def", "ghi", "jkl", "mno", "pqrs", "tuv", "wxyz"}
	for _, i := range digits {
		s := d[i-'2']
		t := []string{}
		for _, a := range ans {
			for _, b := range s {
				t = append(t, a+string(b))
			}
		}
		ans = t
	}
	return ans
}
方法二:DFS · Go 实现
思考
方法一已经能枚举全部答案,但每一层都新开一张前缀表,中间字符串占用的空间始终是 。
若只沿一条路径向下走、走完再回溯,额外空间可以压到 ,即递归深度与路径长度。为此按下标深度优先搜索:选定当前数字的一个字母后推进,返回时撤销选择。答案集合不变,只是生成方式从按层扩展改为一条路径走到底。
我们可以使用深度优先搜索的方法,枚举所有可能的字母组合。假设当前已经产生了一部分字母组合,但是还有一些数字没有被穷举到,此时我们取出下一个数字所对应的字母,然后依次枚举这个数字所对应的每一个字母,将它们添加到前面已经产生的字母组合后面,形成所有可能的组合。
时间复杂度 。空间复杂度 。其中 是输入数字的长度。
func letterCombinations(digits string) (ans []string) {
	d := []string{"abc", "def", "ghi", "jkl", "mno", "pqrs", "tuv", "wxyz"}
	t := []rune{}
	var dfs func(int)
	dfs = func(i int) {
		if i >= len(digits) {
			ans = append(ans, string(t))
			return
		}
		for _, c := range d[digits[i]-'2'] {
			t = append(t, c)
			dfs(i + 1)
			t = t[:len(t)-1]
		}
	}
	if len(digits) == 0 {
		return
	}
	dfs(0)
	return
}37. 解数独
题目、示例与约束
编写一个程序,通过填充空格来解决数独问题。
数独的解法需 遵循如下规则:
- 数字
1-9在每一行只能出现一次。 - 数字
1-9在每一列只能出现一次。 - 数字
1-9在每一个以粗实线分隔的3x3宫内只能出现一次。(请参考示例图)
数独部分空格内已填入了数字,空白格用 '.' 表示。
示例 1:
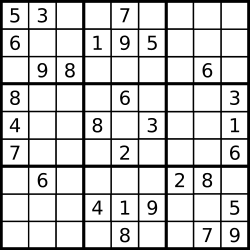
输入:board = [["5","3",".",".","7",".",".",".","."],["6",".",".","1","9","5",".",".","."],[".","9","8",".",".",".",".","6","."],["8",".",".",".","6",".",".",".","3"],["4",".",".","8",".","3",".",".","1"],["7",".",".",".","2",".",".",".","6"],[".","6",".",".",".",".","2","8","."],[".",".",".","4","1","9",".",".","5"],[".",".",".",".","8",".",".","7","9"]]
输出:[["5","3","4","6","7","8","9","1","2"],["6","7","2","1","9","5","3","4","8"],["1","9","8","3","4","2","5","6","7"],["8","5","9","7","6","1","4","2","3"],["4","2","6","8","5","3","7","9","1"],["7","1","3","9","2","4","8","5","6"],["9","6","1","5","3","7","2","8","4"],["2","8","7","4","1","9","6","3","5"],["3","4","5","2","8","6","1","7","9"]]
解释:输入的数独如上图所示,唯一有效的解决方案如下所示:
提示:
board.length == 9board[i].length == 9board[i][j]是一位数字或者'.'- 题目数据 保证 输入数独仅有一个解
方法一:回溯 · Go 实现
思考
空格最多八十余个,每个有 种填法,直接枚举全部填法不可行。必须在违反行、列、宫约束时立即停止。
与「有效的数独」相同,反复扫描棋盘以检查某数字是否已用,代价较高。我们可以先将已填数字记入 、 、 ,再只对空格列表 做搜索。
处理第 个空格,枚举尚未占用的 ,写入后递归;找到解后用 截断,不再继续换数。回溯时恢复占用标记,成功路径上棋盘中的数字予以保留。
我们用数组 , , 分别记录每一行、每一列、每个 3x3 宫格中数字是否出现过。如果数字 在第 行、第 列、第 个 3x3 宫格中出现过,那么 , , 都为 。
我们遍历 中的每一个空格,枚举它可以填入的数字 ,如果 在当前行、当前列、当前 3x3 宫格中没有出现过,那么我们就可以尝试填入数字 ,并继续搜索下一个空格。如果搜索到最后,所有空格填充完毕,那么就说明找到了一个可行解。
func solveSudoku(board [][]byte) {
	var row, col [9][9]bool
	var block [3][3][9]bool
	var t [][2]int
	ok := false
	for i := 0; i < 9; i++ {
		for j := 0; j < 9; j++ {
			if board[i][j] == '.' {
				t = append(t, [2]int{i, j})
			} else {
				v := int(board[i][j] - '1')
				row[i][v], col[j][v], block[i/3][j/3][v] = true, true, true
			}
		}
	}
	var dfs func(int)
	dfs = func(k int) {
		if k == len(t) {
			ok = true
			return
		}
		i, j := t[k][0], t[k][1]
		for v := 0; v < 9; v++ {
			if !row[i][v] && !col[j][v] && !block[i/3][j/3][v] {
				row[i][v], col[j][v], block[i/3][j/3][v] = true, true, true
				board[i][j] = byte(v + '1')
				dfs(k + 1)
				row[i][v], col[j][v], block[i/3][j/3][v] = false, false, false
			}
			if ok {
				return
			}
		}
	}
	dfs(0)
}39. 组合总和
题目、示例与约束
给你一个 无重复元素 的整数数组 candidates 和一个目标整数 target ,找出 candidates 中可以使数字和为目标数 target 的 所有 不同组合 ,并以列表形式返回。你可以按 任意顺序 返回这些组合。
candidates 中的 同一个 数字可以 无限制重复被选取 。如果至少一个数字的被选数量不同,则两种组合是不同的。
对于给定的输入,保证和为 target 的不同组合数少于 150 个。
示例 1:
输入:candidates = [2,3,6,7], target = 7
输出:[[2,2,3],[7]]
解释:
2 和 3 可以形成一组候选,2 + 2 + 3 = 7 。注意 2 可以使用多次。
7 也是一个候选, 7 = 7 。
仅有这两种组合。
示例 2:
输入: candidates = [2,3,5], target = 8
输出: [[2,2,2,2],[2,3,3],[3,5]]
示例 3:
输入: candidates = [2], target = 1
输出: []
提示:
1 <= candidates.length <= 302 <= candidates[i] <= 40candidates的所有元素 互不相同1 <= target <= 40
方法一:排序 + 剪枝 + 回溯 · Go 实现
思考
对每个数无限次选用或不选,搜完所有和为 的序列,在 、 时,若不剪枝会搜出大量超过目标和的路径,且不同顺序会被当成不同组合。
组合与顺序无关,同一组数只应出现一次。因此先排序,搜索时只从当前下标向右选取,避免排列重复。排序后若剩余 已小于 ,其后元素更大,整支可以停止。 从 起枚举 ,递归仍从 开始,表示该数还能再用。
我们可以先对数组进行排序,方便剪枝。
接下来,我们设计一个函数 ,表示从下标 开始搜索,且剩余目标值为 ,其中 和 都是非负整数,当前搜索路径为 ,答案为 。
在函数 中,我们先判断 是否为 ,如果是,则将当前搜索路径 加入答案 中,然后返回。如果 ,说明当前下标及后面的下标的元素都大于剩余目标值 ,路径不合法,直接返回。否则,我们从下标 开始搜索,搜索的下标范围是 ,其中 为数组 的长度。在搜索的过程中,我们将当前下标的元素加入搜索路径 ,递归调用函数 ,递归结束后,将当前下标的元素从搜索路径 中移除。
在主函数中,我们只要调用函数 ,即可得到答案。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。由于剪枝,实际的时间复杂度要远小于 。
相似题目:
func combinationSum(candidates []int, target int) (ans [][]int) {
	sort.Ints(candidates)
	t := []int{}
	var dfs func(i, s int)
	dfs = func(i, s int) {
		if s == 0 {
			ans = append(ans, slices.Clone(t))
			return
		}
		if s < candidates[i] {
			return
		}
		for j := i; j < len(candidates); j++ {
			t = append(t, candidates[j])
			dfs(j, s-candidates[j])
			t = t[:len(t)-1]
		}
	}
	dfs(0, target)
	return
}
方法二:排序 + 剪枝 + 回溯(写法二) · Go 实现
思考
方法一用循环枚举「下一个选谁」,已经剪枝正确,搜索树是多叉的。我们也可以对当前位置做选或不选:不选则下标变为 ,选则留在 (允许重复使用当前数)。搜索树形状不同,答案相同,只是实现换成二叉树展开。
我们也可以将函数 的实现逻辑改为另一种写法。在函数 中,我们先判断 是否为 ,如果是,则将当前搜索路径 加入答案 中,然后返回。如果 或者 ,路径不合法,直接返回。否则,我们考虑两种情况,一种是不选当前下标的元素,即递归调用函数 ,另一种是选当前下标的元素,即递归调用函数 。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。由于剪枝,实际的时间复杂度要远小于 。
func combinationSum(candidates []int, target int) (ans [][]int) {
	sort.Ints(candidates)
	t := []int{}
	var dfs func(i, s int)
	dfs = func(i, s int) {
		if s == 0 {
			ans = append(ans, slices.Clone(t))
			return
		}
		if i >= len(candidates) || s < candidates[i] {
			return
		}
		dfs(i+1, s)
		t = append(t, candidates[i])
		dfs(i, s-candidates[i])
		t = t[:len(t)-1]
	}
	dfs(0, target)
	return
}40. 组合总和 II
题目、示例与约束
给定一个候选人编号的集合 candidates 和一个目标数 target ,找出 candidates 中所有可以使数字和为 target 的组合。
candidates 中的每个数字在每个组合中只能使用 一次 。
注意:解集不能包含重复的组合。
示例 1:
输入: candidates =[10,1,2,7,6,1,5], target =8, 输出: [ [1,1,6], [1,2,5], [1,7], [2,6] ]
示例 2:
输入: candidates = [2,5,2,1,2], target = 5,
输出:
[
[1,2,2],
[5]
]
提示:
1 <= candidates.length <= 1001 <= candidates[i] <= 501 <= target <= 30
方法一:排序 + 剪枝 + 回溯 · Go 实现
思考
与上一题不同,每个数只能使用一次,且 中含有重复值。若不处理重复,同一组数会按不同下标组合被搜索多次。 、 ,更需要剪枝。
因此先排序,使相同数字相邻。同一层中若 且值与前一个相同,说明该值已经作为本层选择搜索过,可以直接跳过。递归改为 ,表示该下标用过就不能再用;若剩余 小于当前值,则整支停止。
我们可以先对数组进行排序,方便剪枝以及跳过重复的数字。
接下来,我们设计一个函数 ,表示从下标 开始搜索,且剩余目标值为 ,其中 和 都是非负整数,当前搜索路径为 ,答案为 。
在函数 中,我们先判断 是否为 ,如果是,则将当前搜索路径 加入答案 中,然后返回。如果 ,或者 ,说明当前路径不合法,直接返回。否则,我们从下标 开始搜索,搜索的下标范围是 ,其中 为数组 的长度。在搜索的过程中,如果 并且 ,说明当前数字与上一个数字相同,我们可以跳过当前数字,因为上一个数字已经搜索过了。否则,我们将当前数字加入搜索路径 中,然后递归调用函数 ,然后将当前数字从搜索路径 中移除。
在主函数中,我们只要调用函数 ,即可得到答案。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。由于剪枝,实际的时间复杂度要远小于 。
相似题目:
func combinationSum2(candidates []int, target int) (ans [][]int) {
	sort.Ints(candidates)
	t := []int{}
	var dfs func(i, s int)
	dfs = func(i, s int) {
		if s == 0 {
			ans = append(ans, slices.Clone(t))
			return
		}
		if i >= len(candidates) || s < candidates[i] {
			return
		}
		for j := i; j < len(candidates); j++ {
			if j > i && candidates[j] == candidates[j-1] {
				continue
			}
			t = append(t, candidates[j])
			dfs(j+1, s-candidates[j])
			t = t[:len(t)-1]
		}
	}
	dfs(0, target)
	return
}
方法二:排序 + 剪枝 + 回溯(写法二) · Go 实现
思考
方法一已经在循环中跳过同层重复值,去重与多叉枚举写在同一层。我们也可以改成选或不选:选当前 则下标加一;不选则一次跳过整段等于 的数,避免同一组合被不同下标复现。复杂度不变,只是把去重写到「不选」那一支。
我们也可以将函数 的实现逻辑改为另一种写法。如果我们选择当前数字,那么我们将当前数字加入搜索路径 中,然后递归调用函数 ,然后将当前数字从搜索路径 中移除。如果我们不选择当前数字,那么我们可以跳过与当前数字相同的所有数字,然后递归调用函数 ,其中 为第一个与当前数字不同的数字的下标。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。由于剪枝,实际的时间复杂度要远小于 。
func combinationSum2(candidates []int, target int) (ans [][]int) {
	sort.Ints(candidates)
	t := []int{}
	var dfs func(i, s int)
	dfs = func(i, s int) {
		if s == 0 {
			ans = append(ans, slices.Clone(t))
			return
		}
		if i >= len(candidates) || s < candidates[i] {
			return
		}
		x := candidates[i]
		t = append(t, x)
		dfs(i+1, s-x)
		t = t[:len(t)-1]
		for i < len(candidates) && candidates[i] == x {
			i++
		}
		dfs(i, s)
	}
	dfs(0, target)
	return
}46. 全排列
题目、示例与约束
给定一个不含重复数字的数组 nums ,返回其 所有可能的全排列 。你可以 按任意顺序 返回答案。
示例 1:
输入:nums = [1,2,3]
输出:[[1,2,3],[1,3,2],[2,1,3],[2,3,1],[3,1,2],[3,2,1]]
示例 2:
输入:nums = [0,1]
输出:[[0,1],[1,0]]
示例 3:
输入:nums = [1]
输出:[[1]]
提示:
1 <= nums.length <= 6-10 <= nums[i] <= 10nums中的所有整数 互不相同
方法一:DFS(回溯) · Go 实现
思考
,排列共 个,规模允许全部枚举。调用语言自带的全排列,或写死若干层循环,都可以生成结果;但 不固定,循环层数无法预先写死。
每个位置须选一个尚未使用的数,重复使用会破坏排列,因此需要标记。生成过程是「按位置填数」,自然对应深度优先搜索。
为此用布尔数组标记已选下标,按位置递归填写:未使用则放入当前位并继续,返回后撤销标记。 很小,时间 与输出规模相符。
我们设计一个函数 表示已经填完了前 个位置,现在需要填第 个位置。枚举所有可能的数,如果这个数没有被填过,就填入这个数,然后继续填下一个位置,直到填完所有的位置。
时间复杂度 ,其中 是数组的长度。一共有 个排列,每个排列需要 的时间来构造。
相似题目:
func permute(nums []int) (ans [][]int) {
	n := len(nums)
	t := make([]int, n)
	vis := make([]bool, n)
	var dfs func(int)
	dfs = func(i int) {
		if i == n {
			ans = append(ans, slices.Clone(t))
			return
		}
		for j, x := range nums {
			if !vis[j] {
				vis[j] = true
				t[i] = x
				dfs(i + 1)
				vis[j] = false
			}
		}
	}
	dfs(0)
	return
}47. 全排列 II
题目、示例与约束
给定一个可包含重复数字的序列 nums ,按任意顺序 返回所有不重复的全排列。
示例 1:
输入:nums = [1,1,2]
输出:
[[1,1,2],
 [1,2,1],
 [2,1,1]]
示例 2:
输入:nums = [1,2,3]
输出:[[1,2,3],[1,3,2],[2,1,3],[2,3,1],[3,1,2],[3,2,1]]
提示:
1 <= nums.length <= 8-10 <= nums[i] <= 10
方法一:排序 + 回溯 · Go 实现
思考
若直接套上一题的回溯,再用集合去除重复结果,当 且数组含相同数字时,搜索树会被复制多份,事后去重既慢又费空间。
两个相同的数在同一层交换顺序,得到的仍是同一个排列。因此相同值在同一层只应被选择一次。
为此先让相等的数相邻,并在同一层跳过「前一个相同值尚未使用」的情况。每个位置上每种值只展开一次,生成的都是不重复排列。
我们可以先对数组进行排序,这样就可以将重复的数字放在一起,方便我们进行去重。
然后,我们设计一个函数 ,表示当前需要填写第 个位置的数。函数的具体实现如下:
- 如果 ,说明我们已经填写完毕,将当前排列加入答案数组中,然后返回。
- 否则,我们枚举第 个位置的数 ,其中 的范围是 。我们需要保证 没有被使用过,并且与前面枚举的数不同,这样才能保证当前排列不重复。如果满足条件,我们就可以填写 ,并继续递归地填写下一个位置,即调用 。在递归调用结束后,我们需要将 标记为未使用,以便于进行后面的枚举。
在主函数中,我们首先对数组进行排序,然后调用 ,即从第 0 个位置开始填写,最终返回答案数组即可。
时间复杂度 ,空间复杂度 。其中 是数组的长度。需要进行 次枚举,每次枚举需要 的时间来判断是否重复。另外,我们需要一个标记数组来标记每个位置是否被使用过,因此空间复杂度为 。
相似题目:
func permuteUnique(nums []int) (ans [][]int) {
	slices.Sort(nums)
	n := len(nums)
	t := make([]int, n)
	vis := make([]bool, n)
	var dfs func(int)
	dfs = func(i int) {
		if i == n {
			ans = append(ans, slices.Clone(t))
			return
		}
		for j := 0; j < n; j++ {
			if vis[j] || (j > 0 && nums[j] == nums[j-1] && !vis[j-1]) {
				continue
			}
			vis[j] = true
			t[i] = nums[j]
			dfs(i + 1)
			vis[j] = false
		}
	}
	dfs(0)
	return
}51. N 皇后
题目、示例与约束
按照国际象棋的规则,皇后可以攻击与之处在同一行或同一列或同一斜线上的棋子。
n 皇后问题 研究的是如何将 n 个皇后放置在 n×n 的棋盘上,并且使皇后彼此之间不能相互攻击。
给你一个整数 n ,返回所有不同的 n 皇后问题 的解决方案。
每一种解法包含一个不同的 n 皇后问题 的棋子放置方案,该方案中 'Q' 和 '.' 分别代表了皇后和空位。
示例 1:
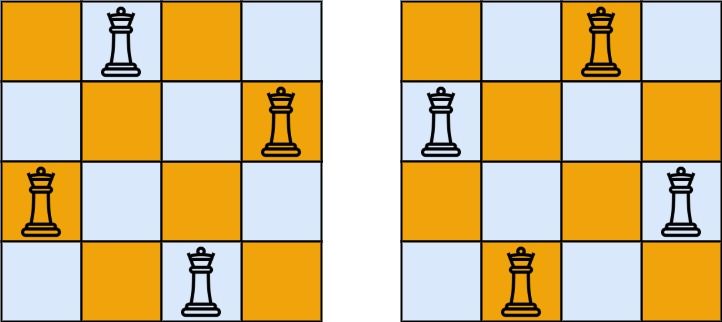
输入:n = 4
输出:[[".Q..","...Q","Q...","..Q."],["..Q.","Q...","...Q",".Q.."]]
解释:如上图所示,4 皇后问题存在两个不同的解法。
示例 2:
输入:n = 1
输出:[["Q"]]
提示:
1 <= n <= 9
方法一:DFS(回溯) · Go 实现
思考
皇后不能同行、同列或同对角线。若枚举列的全排列再检查对角线, 时至多 种排列可以搜完,但冲突往往在中途已经出现,等到整盘放完才验证会浪费大量搜索,棋盘字符串也只能在叶子处构造。
一行恰好一个皇后之后,冲突只可能来自同列或同对角线。同一列、同一正对角线 、同一反对角线 都可以用数组在 时间内查询与更新。
为此我们按行搜索,只在三个标记均空闲时落子,并在棋盘上同步写入,回溯时撤销标记。
我们定义三个数组 , 和 ,分别表示列、正对角线和反对角线上的是否有皇后,如果位置 有皇后,那么 , 和 都为 。另外,我们用一个数组 记录当前棋盘的状态,初始时 中的所有元素都是 '.'。
接下来,我们定义一个函数 ,表示从第 行开始放置皇后。
在 中,如果 ,说明我们已经完成了所有皇后的放置,我们将当前 放入答案数组中,递归结束。
否则,我们枚举当前行的每一列 ,如果位置 没有皇后,即 , 和 都为 ,那么我们可以放置皇后,即把 改为 'Q',并将 , 和 都置为 ,然后继续搜索下一行,即调用 ,递归结束后,我们需要将 改回 '.' 并将 , 和 都置为 。
在主函数中,我们调用 开始递归,最后返回答案数组即可。
时间复杂度 ,空间复杂度 。其中 是题目给定的整数。
func solveNQueens(n int) (ans [][]string) {
	col := make([]int, n)
	dg := make([]int, n<<1)
	udg := make([]int, n<<1)
	t := make([][]byte, n)
	for i := range t {
		t[i] = make([]byte, n)
		for j := range t[i] {
			t[i][j] = '.'
		}
	}
	var dfs func(int)
	dfs = func(i int) {
		if i == n {
			tmp := make([]string, n)
			for i := range tmp {
				tmp[i] = string(t[i])
			}
			ans = append(ans, tmp)
			return
		}
		for j := 0; j < n; j++ {
			if col[j]+dg[i+j]+udg[n-i+j] == 0 {
				col[j], dg[i+j], udg[n-i+j] = 1, 1, 1
				t[i][j] = 'Q'
				dfs(i + 1)
				t[i][j] = '.'
				col[j], dg[i+j], udg[n-i+j] = 0, 0, 0
			}
		}
	}
	dfs(0)
	return
}52. N 皇后 II
题目、示例与约束
n 皇后问题 研究的是如何将 n 个皇后放置在 n × n 的棋盘上,并且使皇后彼此之间不能相互攻击。
给你一个整数 n ,返回 n 皇后问题 不同的解决方案的数量。
示例 1:
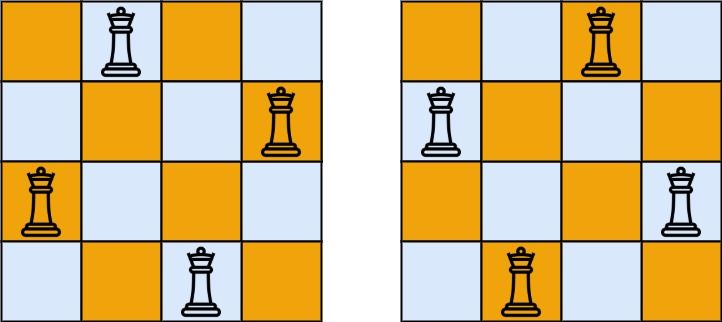
输入:n = 4
输出:2
解释:如上图所示,4 皇后问题存在两个不同的解法。
示例 2:
输入:n = 1
输出:1
提示:
1 <= n <= 9
方法一:回溯 · Go 实现
思考
本题只要求方案数,不必输出棋盘。若先构造全部解再计数, 可以完成,但字符串与棋盘拷贝都是多余开销。
约束与 N 皇后相同:每行恰好一个皇后,列与两条对角线互不冲突,仍可用数组 标记占用。
因此同样按行回溯,到达第 行时将计数加一即可,无需维护棋盘。
我们设计一个函数 ,表示从第 行开始搜索,搜索到的结果累加到答案中。
在第 行,我们枚举第 行的每一列,如果当前列不与前面已经放置的皇后发生冲突,那么我们就可以放置一个皇后,然后继续搜索下一行,即调用 。
如果发生冲突,那么我们就跳过当前列,继续枚举下一列。
判断是否发生冲突,我们需要用三个数组分别记录每一列、每一条正对角线、每一条反对角线是否已经放置了皇后。
具体地,我们用 数组记录每一列是否已经放置了皇后,用 数组记录每一条正对角线是否已经放置了皇后,用 数组记录每一条反对角线是否已经放置了皇后。
时间复杂度 ,空间复杂度 。其中 是皇后的数量。
func totalNQueens(n int) (ans int) {
	cols := [10]bool{}
	dg := [20]bool{}
	udg := [20]bool{}
	var dfs func(int)
	dfs = func(i int) {
		if i == n {
			ans++
			return
		}
		for j := 0; j < n; j++ {
			a, b := i+j, i-j+n
			if cols[j] || dg[a] || udg[b] {
				continue
			}
			cols[j], dg[a], udg[b] = true, true, true
			dfs(i + 1)
			cols[j], dg[a], udg[b] = false, false, false
		}
	}
	dfs(0)
	return
}77. 组合
题目、示例与约束
给定两个整数 n 和 k,返回范围 [1, n] 中所有可能的 k 个数的组合。
你可以按 任何顺序 返回答案。
示例 1:
输入:n = 4, k = 2
输出:
[
  [2,4],
  [3,4],
  [2,3],
  [1,2],
  [1,3],
  [1,4],
]
示例 2:
输入:n = 1, k = 1
输出:[[1]]
提示:
1 <= n <= 201 <= k <= n
方法一:回溯(两种方式) · Go 实现
思考
若先枚举 的全部 个子集,再留下长度为 的,则大量长度不符的子集被白白生成。 ,时间上可以接受,但搜索可以更早剪枝。
组合与顺序无关,每个数字只决定选或不选,路径长度达到 即可停止。因此设计 处理数字 :先将其放入路径再递归 ,回溯后走「不选」分支。另一种写法是在剩余数字中枚举下一个 ,两种搜索树形状不同,答案相同;下面代码采用前一种。
我们设计一个函数 ,表示从数字 开始搜索,当前搜索路径为 ,答案为 。
函数 的执行逻辑如下:
- 如果当前搜索路径 的长度等于 ,则将当前搜索路径加入答案,然后返回。
- 如果 ,则说明搜索已经结束,返回。
- 否则,我们可以选择将数字 加入搜索路径 ,然后继续搜索,即执行 ,然后将数字 从搜索路径 中移除;或者不将数字 加入搜索路径 ,直接执行 。
以上做法实际上是枚举当前数字选或者不选,然后递归地搜索下一个数字。我们也可以枚举下一个要选择的数字 ,其中 ,如果下一个要选择的数字是 ,那么我们将数字 加入搜索路径 ,然后继续搜索,即执行 ,接着将数字 从搜索路径 中移除。
在主函数中,我们从数字 开始搜索,即执行 。
时间复杂度 ,空间复杂度 。其中 表示组合数。
相似题目:
func combine(n int, k int) (ans [][]int) {
	t := []int{}
	var dfs func(int)
	dfs = func(i int) {
		if len(t) == k {
			ans = append(ans, slices.Clone(t))
			return
		}
		if i > n {
			return
		}
		t = append(t, i)
		dfs(i + 1)
		t = t[:len(t)-1]
		dfs(i + 1)
	}
	dfs(1)
	return
}
方法二 · Go 实现
思考
方法一按「选或不选」走到深度 ,不选的那一支仍会把后面的数字走完。
方法二改为枚举下一个被选中的 ,递归深度等于已经选出的个数,搜索树更贴近长度为 的组合。答案不变,只是把剩余候选用循环展开。
func combine(n int, k int) (ans [][]int) {
	t := []int{}
	var dfs func(int)
	dfs = func(i int) {
		if len(t) == k {
			ans = append(ans, slices.Clone(t))
			return
		}
		if i > n {
			return
		}
		for j := i; j <= n; j++ {
			t = append(t, j)
			dfs(j + 1)
			t = t[:len(t)-1]
		}
	}
	dfs(1)
	return
}78. 子集
题目、示例与约束
给你一个整数数组 nums ,数组中的元素 互不相同 。返回该数组所有可能的子集(幂集)。
解集 不能 包含重复的子集。你可以按 任意顺序 返回解集。
示例 1:
输入:nums = [1,2,3]
输出:[[],[1],[2],[1,2],[3],[1,3],[2,3],[1,2,3]]
示例 2:
输入:nums = [0]
输出:[[],[0]]
提示:
1 <= nums.length <= 10-10 <= nums[i] <= 10nums中的所有元素 互不相同
方法一:DFS(回溯) · Go 实现
思考
每个元素只有选与不选两种可能,子集共 个。 ,全部列出即可。
递归可以按元素下标展开这棵决策树:从下标 出发,先不选 ,再选中并回溯弹出。当 时将当前路径拷入答案。题目保证元素互不相同,因此不会产生重复子集。
我们设计一个函数 ,表示从数组的第 个元素开始搜索所有子集。函数 的执行逻辑如下:
- 如果 ,表示当前已经搜索结束,将当前得到的子集 加入答案数组 中,然后返回;
- 否则,我们可以选择不选择当前元素,直接执行 ;也可以选择当前元素,即把当前元素 加入子集 ,然后执行 ,注意要在执行 以后再将 从子集 中移除(回溯)。
在主函数中,我们调用 ,即从数组的第一个元素开始搜索所有子集。最后返回答案数组 即可。
时间复杂度 ,空间复杂度 。其中 为数组的长度。一共有 个子集,每个子集需要 的时间来构造。
func subsets(nums []int) (ans [][]int) {
	t := []int{}
	var dfs func(int)
	dfs = func(i int) {
		if i == len(nums) {
			ans = append(ans, append([]int(nil), t...))
			return
		}
		dfs(i + 1)
		t = append(t, nums[i])
		dfs(i + 1)
		t = t[:len(t)-1]
	}
	dfs(0)
	return
}
方法二:二进制枚举 · Go 实现
思考
方法一依靠递归栈把「选 / 不选」展开,调用开销与递归深度均为 。
很小,也可以把每个子集对应成 中的一个掩码:第 位为 则收入 。少一层函数调用,时间复杂度同为 。
我们也可以使用二进制枚举的方法得到所有的子集。
我们可以使用 个二进制数来表示 个元素的所有子集,对于当前二进制数 ,如果第 位为 ,表示选择了第 个元素,否则表示不选择第 个元素。
时间复杂度 ,空间复杂度 。其中 为数组的长度。一共有 个子集,每个子集需要 的时间来构造。
func subsets(nums []int) (ans [][]int) {
	n := len(nums)
	for mask := 0; mask < 1<<n; mask++ {
		t := []int{}
		for i, x := range nums {
			if mask>>i&1 == 1 {
				t = append(t, x)
			}
		}
		ans = append(ans, t)
	}
	return
}79. 单词搜索
题目、示例与约束
给定一个 m x n 二维字符网格 board 和一个字符串单词 word 。如果 word 存在于网格中,返回 true ;否则,返回 false 。
单词必须按照字母顺序,通过相邻的单元格内的字母构成,其中“相邻”单元格是那些水平相邻或垂直相邻的单元格。同一个单元格内的字母不允许被重复使用。
示例 1:
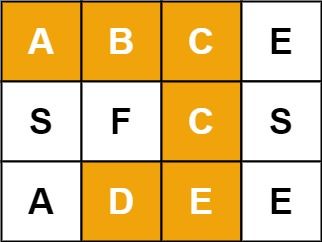
输入:board = [['A','B','C','E'],['S','F','C','S'],['A','D','E','E']], word = "ABCCED"
输出:true
示例 2:
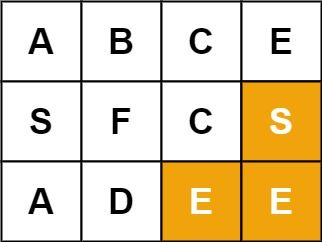
输入:board = [['A','B','C','E'],['S','F','C','S'],['A','D','E','E']], word = "SEE"
输出:true
示例 3:
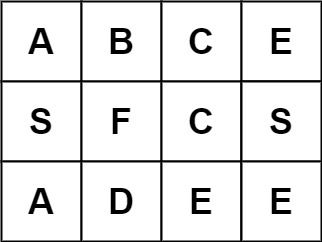
输入:board = [['A','B','C','E'],['S','F','C','S'],['A','D','E','E']], word = "ABCB"
输出:false
提示:
m == board.lengthn = board[i].length1 <= m, n <= 61 <= word.length <= 15board和word仅由大小写英文字母组成
进阶:你可以使用搜索剪枝的技术来优化解决方案,使其在 board 更大的情况下可以更快解决问题?
方法一:DFS(回溯) · Go 实现
思考
若从每个格子出发走出长度为 的路径再比对,网格至多 、 ,不及时剪枝则搜索量过大。必须边走边比较,失配立刻返回,且同一格子不能使用两次。
路径必须与 逐字符对齐,因此搜索状态可以写成 :当前位置 对齐 。匹配后将格子改为
'0'防止重入,再向四邻搜索 ,返回时还原。字母本身不是'0',因此不必另开访问数组。枚举每一个起点,任一成功即可。
我们可以枚举网格的每一个位置 作为搜索的起点,然后从起点开始进行深度优先搜索,如果可以搜索到单词的末尾,就说明单词存在,否则说明单词不存在。
因此,我们设计一个函数 ,表示从网格的 位置出发,且从单词的第 个字符开始搜索,是否能够搜索成功。函数 的执行步骤如下:
- 如果 ,说明已经搜索到单词的最后一个字符,此时只需要判断网格 位置的字符是否等于 ,如果相等则说明单词存在,否则说明单词不存在。无论单词是否存在,都无需继续往下搜索,因此直接返回结果。
- 否则,如果 字符不等于网格 位置的字符,说明本次搜索失败,直接返回
false。 - 否则,我们将网格 位置的字符暂存于 中,然后将此位置的字符修改为一个特殊字符
'0',代表此位置的字符已经被使用过,防止之后搜索时重复使用。然后我们从 位置的上、下、左、右四个方向分别出发,去搜索网格中第 个字符,如果四个方向有任何一个方向搜索成功,就说明搜索成功,否则说明搜索失败,此时我们需要还原网格 位置的字符,即把 放回网格 位置(回溯)。
在主函数中,我们枚举网格中的每一个位置 作为起点,如果调用 返回 true,就说明单词存在,否则说明单词不存在,返回 false。
时间复杂度 ,空间复杂度 。其中 和 分别是网格的行数和列数;而 是字符串 的长度。
func exist(board [][]byte, word string) bool {
	m, n := len(board), len(board[0])
	var dfs func(int, int, int) bool
	dfs = func(i, j, k int) bool {
		if k == len(word)-1 {
			return board[i][j] == word[k]
		}
		if board[i][j] != word[k] {
			return false
		}
		dirs := [5]int{-1, 0, 1, 0, -1}
		c := board[i][j]
		board[i][j] = '0'
		for u := 0; u < 4; u++ {
			x, y := i+dirs[u], j+dirs[u+1]
			if x >= 0 && x < m && y >= 0 && y < n && board[x][y] != '0' && dfs(x, y, k+1) {
				return true
			}
		}
		board[i][j] = c
		return false
	}
	for i := 0; i < m; i++ {
		for j := 0; j < n; j++ {
			if dfs(i, j, 0) {
				return true
			}
		}
	}
	return false
}89. 格雷编码
题目、示例与约束
2n 个整数组成的序列,其中:
- 每个整数都在范围
[0, 2n - 1]内(含0和2n - 1) - 第一个整数是
0 - 一个整数在序列中出现 不超过一次
- 每对 相邻 整数的二进制表示 恰好一位不同 ,且
- 第一个 和 最后一个 整数的二进制表示 恰好一位不同
给你一个整数 n ,返回任一有效的 n 位格雷码序列 。
示例 1:
输入:n = 2
输出:[0,1,3,2]
解释:
[0,1,3,2] 的二进制表示是 [00,01,11,10] 。
- 00 和 01 有一位不同
- 01 和 11 有一位不同
- 11 和 10 有一位不同
- 10 和 00 有一位不同
[0,2,3,1] 也是一个有效的格雷码序列,其二进制表示是 [00,10,11,01] 。
- 00 和 10 有一位不同
- 10 和 11 有一位不同
- 11 和 01 有一位不同
- 01 和 00 有一位不同
示例 2:
输入:n = 1
输出:[0,1]
提示:
1 <= n <= 16
方法一:二进制码转格雷码 · Go 实现
思考
从 出发回溯,每次翻转一个尚未使用的比特,直到得到 个数,可以构造出一条格雷码序列。 搜索能完成,但要显式判重,还要保证首尾也只差一位。
其实不必搜索。二进制反射格雷码有闭式: 对应 。该公式保证相邻整数的码只差一位,且 与 也只差最高位。
因此直接把 映射过去即可得到答案。
格雷码是我们在工程中常会遇到的一种编码方式,它的基本的特点就是任意两个相邻的代码只有一位二进制数不同。
二进制码转换成二进制格雷码,其法则是保留二进制码的最高位作为格雷码的最高位,而次高位格雷码为二进制码的高位与次高位相异或,而格雷码其余各位与次高位的求法相类似。
假设某个二进制数表示为 ,其格雷码表示为 。最高位保留,所以 ;而其它各位 ,其中 。
因此,对于一个整数 ,我们可以用函数 得到其格雷码:
int gray(x) {
    return x ^ (x >> 1);
}
我们直接将 这些整数映射成对应的格雷码,即可得到答案数组。
时间复杂度 ,其中 为题目给定的整数。忽略答案的空间消耗,空间复杂度 。
func grayCode(n int) (ans []int) {
	for i := 0; i < 1<<n; i++ {
		ans = append(ans, i^(i>>1))
	}
	return
}90. 子集 II
题目、示例与约束
给你一个整数数组 nums ,其中可能包含重复元素,请你返回该数组所有可能的 子集(幂集)。
解集 不能 包含重复的子集。返回的解集中,子集可以按 任意顺序 排列。
示例 1:
输入:nums = [1,2,2]
输出:[[],[1],[1,2],[1,2,2],[2],[2,2]]
示例 2:
输入:nums = [0]
输出:[[],[0]]
提示:
1 <= nums.length <= 10-10 <= nums[i] <= 10
方法一:排序 + DFS · Go 实现
思考
与「子集」一样做选或不选的 DFS,可以直接收集全部子集。存在重复元素时,同一多重集(例如 )会出现多次。 ,子集个数本身不多,却不满足「解集不能包含重复子集」。
相同值的不同下标被当成了不同选择。先排序使相同值相邻;在「不选」的那条分支上跳过后续相等元素,每种多重集便只生成一次。
排序后的 DFS 先选 ,回溯后再跳过所有等于 的位置继续。选几个相同值由递归深度决定,不会并列出两份相同子集。
我们可以先对数组 进行排序,方便去重。
然后,我们设计一个函数 ,表示当前从第 个元素开始搜索子集。函数 的执行逻辑如下:
如果 ,说明已经搜索完所有元素,将当前子集加入答案数组中,递归结束。
如果 ,将第 个元素加入子集,执行 ,然后将第 个元素从子集中移除。接下来,我们判断第 个元素是否和下一个元素相同,如果相同,则循环跳过该元素,直到找到第一个和第 个元素不同的元素,执行 。
最后,我们只需要调用 ,返回答案数组即可。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func subsetsWithDup(nums []int) (ans [][]int) {
	slices.Sort(nums)
	n := len(nums)
	t := []int{}
	var dfs func(int)
	dfs = func(i int) {
		if i >= n {
			ans = append(ans, slices.Clone(t))
			return
		}
		t = append(t, nums[i])
		dfs(i + 1)
		t = t[:len(t)-1]
		for i+1 < n && nums[i+1] == nums[i] {
			i++
		}
		dfs(i + 1)
	}
	dfs(0)
	return
}
方法二:排序 + 二进制枚举 · Go 实现
思考
方法一已经去重,但递归依赖调用栈,跳过相同值的逻辑也写在回溯里。 ,也可以直接枚举 个掩码。
将「选或不选」改成二进制位: 的第 位表示是否选 。若选了 却没选 、且两值相同,说明跳过了靠前的相同值,属于重复方案,应丢弃。时间同阶,写成一层循环即可。
与方法一类似,我们先对数组 进行排序,方便去重。
接下来,我们在 的范围内枚举一个二进制数 ,其中 的二进制表示是一个 位的位串,如果 的第 位为 ,表示选择 ,为 表示不选择 。注意,如果 的 位为 ,且 ,则说明在当前枚举到的方案中,第 个元素和第 个元素相同,为了避免重复,我们跳过这种情况。否则,我们将 对应的子集加入答案数组中。
枚举结束后,我们返回答案数组即可。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func subsetsWithDup(nums []int) (ans [][]int) {
	sort.Ints(nums)
	n := len(nums)
	for mask := 0; mask < 1<<n; mask++ {
		t := []int{}
		ok := true
		for i := 0; i < n; i++ {
			if mask>>i&1 == 1 {
				if i > 0 && mask>>(i-1)&1 == 0 && nums[i] == nums[i-1] {
					ok = false
					break
				}
				t = append(t, nums[i])
			}
		}
		if ok {
			ans = append(ans, t)
		}
	}
	return
}93. 复原 IP 地址
题目、示例与约束
有效 IP 地址 正好由四个整数(每个整数位于 0 到 255 之间组成,且不能含有前导 0),整数之间用 '.' 分隔。
- 例如:
"0.1.2.201"和"192.168.1.1"是 有效 IP 地址,但是"0.011.255.245"、"192.168.1.312"和"192.168@1.1"是 无效 IP 地址。
给定一个只包含数字的字符串 s ,用以表示一个 IP 地址,返回所有可能的有效 IP 地址,这些地址可以通过在 s 中插入 '.' 来形成。你 不能 重新排序或删除 s 中的任何数字。你可以按 任何 顺序返回答案。
示例 1:
输入:s = "25525511135"
输出:["255.255.11.135","255.255.111.35"]
示例 2:
输入:s = "0000"
输出:["0.0.0.0"]
示例 3:
输入:s = "101023"
输出:["1.0.10.23","1.0.102.3","10.1.0.23","10.10.2.3","101.0.2.3"]
提示:
1 <= s.length <= 20s仅由数字组成
方法一:DFS · Go 实现
思考
合法 IP 必须切成恰好四段,每段取值在 – 且不能有前导零。 ,枚举三个切点在时间上可行,但前导零、越界、段数不足等边界分散在三重循环里,实现容易疏漏。
更自然的结构是回溯:从位置 起尝试取 – 位作为下一段,合法再继续往下切。段数恰为 且字符串用尽才收入答案;段数已满或下标越界则停止。非法前缀尽早剪掉。
我们定义一个函数 ,表示从字符串 的第 位开始,搜索能够组成的 IP 地址列表。
函数 的执行步骤如下:
如果 大于等于字符串 的长度,说明已经完成了四段 IP 地址的拼接,判断是否满足四段 IP 地址的要求,如果满足则将当前 加入答案。
如果 小于字符串 的长度,此时还需要拼接 地址的一段,此时需要确定这一段 地址的值。如果该值大于 ,或者当前位置 为 且 之后的若干位的数值大于 ,则说明不满足要求,直接返回。否则,将其加入 地址列表,并继续搜索下一段 地址。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度。
func restoreIpAddresses(s string) (ans []string) {
	n := len(s)
	t := []string{}
	var dfs func(int)
	dfs = func(i int) {
		if i >= n && len(t) == 4 {
			ans = append(ans, strings.Join(t, "."))
			return
		}
		if i >= n || len(t) == 4 {
			return
		}
		x := 0
		for j := i; j < i+3 && j < n; j++ {
			x = x*10 + int(s[j]-'0')
			if x > 255 || (j > i && s[i] == '0') {
				break
			}
			t = append(t, s[i:j+1])
			dfs(j + 1)
			t = t[:len(t)-1]
		}
	}
	dfs(0)
	return
}126. 单词接龙 II
题目、示例与约束
按字典 wordList 完成从单词 beginWord 到单词 endWord 转化,一个表示此过程的 转换序列 是形式上像 beginWord -> s1 -> s2 -> ... -> sk 这样的单词序列,并满足:
- 每对相邻的单词之间仅有单个字母不同。
- 转换过程中的每个单词
si(1 <= i <= k)必须是字典wordList中的单词。注意,beginWord不必是字典wordList中的单词。 sk == endWord
给你两个单词 beginWord 和 endWord ,以及一个字典 wordList 。请你找出并返回所有从 beginWord 到 endWord 的 最短转换序列 ,如果不存在这样的转换序列,返回一个空列表。每个序列都应该以单词列表 [beginWord, s1, s2, ..., sk] 的形式返回。
示例 1:
输入:beginWord = "hit", endWord = "cog", wordList = ["hot","dot","dog","lot","log","cog"]
输出:[["hit","hot","dot","dog","cog"],["hit","hot","lot","log","cog"]]
解释:存在 2 种最短的转换序列:
"hit" -> "hot" -> "dot" -> "dog" -> "cog"
"hit" -> "hot" -> "lot" -> "log" -> "cog"
示例 2:
输入:beginWord = "hit", endWord = "cog", wordList = ["hot","dot","dog","lot","log"]
输出:[]
解释:endWord "cog" 不在字典 wordList 中,所以不存在符合要求的转换序列。
提示:
1 <= beginWord.length <= 5endWord.length == beginWord.length1 <= wordList.length <= 500wordList[i].length == beginWord.lengthbeginWord、endWord和wordList[i]由小写英文字母组成beginWord != endWordwordList中的所有单词 互不相同
方法一 · Go 实现
思考
不但要最短变换序列,还要列出全部最短路径。单词最长 ,词表不超过 ,最短路层数有限,但路径条数可能很多。
单向 BFS 按层扩展,同时记下每个词的前驱集合:只有与当前层距离相等的边才收入,以保证路径最短。到达终点后,从终点沿前驱回溯即可还原所有最短序列。
func findLadders(beginWord string, endWord string, wordList []string) [][]string {
	var ans [][]string
	words := make(map[string]bool)
	for _, word := range wordList {
		words[word] = true
	}
	if !words[endWord] {
		return ans
	}
	words[beginWord] = false
	dist := map[string]int{beginWord: 0}
	prev := map[string]map[string]bool{}
	q := []string{beginWord}
	found := false
	step := 0
	for len(q) > 0 && !found {
		step++
		for i := len(q); i > 0; i-- {
			p := q[0]
			q = q[1:]
			chars := []byte(p)
			for j := 0; j < len(chars); j++ {
				ch := chars[j]
				for k := 'a'; k <= 'z'; k++ {
					chars[j] = byte(k)
					t := string(chars)
					if v, ok := dist[t]; ok {
						if v == step {
							prev[t][p] = true
						}
					}
					if !words[t] {
						continue
					}
					if len(prev[t]) == 0 {
						prev[t] = make(map[string]bool)
					}
					prev[t][p] = true
					words[t] = false
					q = append(q, t)
					dist[t] = step
					if endWord == t {
						found = true
					}
				}
				chars[j] = ch
			}
		}
	}
	var dfs func(path []string, begin, cur string)
	dfs = func(path []string, begin, cur string) {
		if cur == beginWord {
			cp := make([]string, len(path))
			copy(cp, path)
			ans = append(ans, cp)
			return
		}
		for k := range prev[cur] {
			path = append([]string{k}, path...)
			dfs(path, beginWord, k)
			path = path[1:]
		}
	}
	if found {
		path := []string{endWord}
		dfs(path, beginWord, endWord)
	}
	return ans
}127. 单词接龙
题目、示例与约束
字典 wordList 中从单词 beginWord 到 endWord 的 转换序列 是一个按下述规格形成的序列 beginWord -> s1 -> s2 -> ... -> sk:
- 每一对相邻的单词只差一个字母。
- 对于
1 <= i <= k时,每个si都在wordList中。注意,beginWord不需要在wordList中。 sk == endWord
给你两个单词 beginWord 和 endWord 和一个字典 wordList ,返回 从 beginWord 到 endWord 的 最短转换序列 中的 单词数目 。如果不存在这样的转换序列,返回 0 。
示例 1:
输入:beginWord = "hit", endWord = "cog", wordList = ["hot","dot","dog","lot","log","cog"]
输出:5
解释:一个最短转换序列是 "hit" -> "hot" -> "dot" -> "dog" -> "cog", 返回它的长度 5。
示例 2:
输入:beginWord = "hit", endWord = "cog", wordList = ["hot","dot","dog","lot","log"]
输出:0
解释:endWord "cog" 不在字典中,所以无法进行转换。
提示:
1 <= beginWord.length <= 10endWord.length == beginWord.length1 <= wordList.length <= 5000wordList[i].length == beginWord.lengthbeginWord、endWord和wordList[i]由小写英文字母组成beginWord != endWordwordList中的所有字符串 互不相同
方法一:BFS · Go 实现
思考
求最短变换长度,每次只改一个字母且必须在词表中。词表可达 、词长 ,枚举全部路径不可行。无权图的最短路用 BFS:对当前词的每个位置试 个字母,命中词表则入队并删除,避免重复入队。
BFS 最小步数模型。本题可以用朴素 BFS,也可以用双向 BFS 优化搜索空间,从而提升效率。
双向 BFS 是 BFS 常见的一个优化方法,主要实现思路如下:
- 创建两个队列 q1, q2 分别用于“起点 -> 终点”、“终点 -> 起点”两个方向的搜索;
- 创建两个哈希表 m1, m2 分别记录访问过的节点以及对应的扩展次数(步数);
- 每次搜索时,优先选择元素数量较少的队列进行搜索扩展,如果在扩展过程中,搜索到另一个方向已经访问过的节点,说明找到了最短路径;
- 只要其中一个队列为空,说明当前方向的搜索已经进行不下去了,说明起点到终点不连通,无需继续搜索。
while q1 and q2:
    if len(q1) <= len(q2):
        # 优先选择较少元素的队列进行扩展
        extend(m1, m2, q1)
    else:
        extend(m2, m1, q2)


def extend(m1, m2, q):
    # 新一轮扩展
    for _ in range(len(q)):
        p = q.popleft()
        step = m1[p]
        for t in next(p):
            if t in m1:
                # 此前已经访问过
                continue
            if t in m2:
                # 另一个方向已经搜索过,说明找到了一条最短的连通路径
                return step + 1 + m2[t]
            q.append(t)
m1[t] = step + 1func ladderLength(beginWord string, endWord string, wordList []string) int {
words := make(map[string]bool)
for _, word := range wordList {
words[word] = true
}
q := []string{beginWord}
ans := 1
for len(q) > 0 {
ans++
for i := len(q); i > 0; i-- {
s := q[0]
q = q[1:]
chars := []byte(s)
for j := 0; j < len(chars); j++ {
ch := chars[j]
for k := 'a'; k <= 'z'; k++ {
chars[j] = byte(k)
t := string(chars)
if !words[t] {
continue
}
if t == endWord {
return ans
}
q = append(q, t)
words[t] = false
}
chars[j] = ch
}
}
}
return 0
}方法二:双向 BFS · Go 实现
思考
方法一词表较大时,单向搜索的前沿可能很宽。从起终点同时扩张,每次选更小的一侧扩展,两侧访问集合相交即为最短长度,搜索空间通常更小。
从起点和终点同时广搜,两侧相遇即得到最短转换序列长度。
func ladderLength(beginWord string, endWord string, wordList []string) int {
	words := make(map[string]bool)
	for _, word := range wordList {
		words[word] = true
	}
	if !words[endWord] {
		return 0
	}

	q1, q2 := []string{beginWord}, []string{endWord}
	m1, m2 := map[string]int{beginWord: 0}, map[string]int{endWord: 0}
	extend := func() int {
		for i := len(q1); i > 0; i-- {
			s := q1[0]
			step, _ := m1[s]
			q1 = q1[1:]
			chars := []byte(s)
			for j := 0; j < len(chars); j++ {
				ch := chars[j]
				for k := 'a'; k <= 'z'; k++ {
					chars[j] = byte(k)
					t := string(chars)
					if !words[t] {
						continue
					}
					if _, ok := m1[t]; ok {
						continue
					}
					if v, ok := m2[t]; ok {
						return step + 1 + v
					}
					q1 = append(q1, t)
					m1[t] = step + 1
				}
				chars[j] = ch
			}
		}
		return -1
	}
	for len(q1) > 0 && len(q2) > 0 {
		if len(q1) > len(q2) {
			m1, m2 = m2, m1
			q1, q2 = q2, q1
		}
		t := extend()
		if t != -1 {
			return t + 1
		}
	}
	return 0
}216. 组合总和 III
题目、示例与约束
找出所有相加之和为 n 的 k 个数的组合,且满足下列条件:
- 只使用数字1到9
- 每个数字 最多使用一次
返回 所有可能的有效组合的列表 。该列表不能包含相同的组合两次,组合可以以任何顺序返回。
示例 1:
输入: k = 3, n = 7
输出: [[1,2,4]]
解释:
1 + 2 + 4 = 7
没有其他符合的组合了。
示例 2:
输入: k = 3, n = 9
输出: [[1,2,6], [1,3,5], [2,3,4]]
解释:
1 + 2 + 6 = 9
1 + 3 + 5 = 9
2 + 3 + 4 = 9
没有其他符合的组合了。
示例 3:
输入: k = 4, n = 1
输出: []
解释: 不存在有效的组合。
在[1,9]范围内使用4个不同的数字,我们可以得到的最小和是1+2+3+4 = 10,因为10 > 1,没有有效的组合。
提示:
2 <= k <= 91 <= n <= 60
方法一:剪枝 + 回溯(两种方式) · Go 实现
思考
从 到 中选 个数使其和为 ,全集很小,可以全部枚举。按数字递增决策“选或不选”,并在剩余和、已选个数或数字越界时剪枝。
函数 表示当前考虑到 、剩余和为 ,选 则递归 ,否则 。
我们设计一个函数 ,表示当前枚举到数字 ,还剩下和为 的数字需要枚举,当前搜索路径为 ,答案为 。
函数 的执行逻辑如下:
方式一:
- 如果 ,且当前搜索路径 的长度为 ,说明找到了一组答案,将 加入 中,然后返回。
- 如果 或者 或者当前搜索路径 的长度大于 ,说明当前搜索路径不可能是答案,直接返回。
- 否则,我们可以选择将数字 加入搜索路径 中,然后继续搜索,即执行 ,搜索完成后,将 从搜索路径 中移除;我们也可以选择不将数字 加入搜索路径 中,直接执行 。
func combinationSum3(k int, n int) (ans [][]int) {
	t := []int{}
	var dfs func(i, s int)
	dfs = func(i, s int) {
		if s == 0 {
			if len(t) == k {
				ans = append(ans, slices.Clone(t))
			}
			return
		}
		if i > 9 || i > s || len(t) >= k {
			return
		}
		t = append(t, i)
		dfs(i+1, s-i)
		t = t[:len(t)-1]
		dfs(i+1, s)
	}
	dfs(1, n)
	return
}func combinationSum3(k int, n int) (ans [][]int) {
t := []int{}
var dfs func(i, s int)
dfs = func(i, s int) {
if s == 0 {
if len(t) == k {
ans = append(ans, slices.Clone(t))
}
return
}
if i > 9 || i > s || len(t) >= k {
return
}
for j := i; j <= 9; j++ {
t = append(t, j)
dfs(j+1, s-j)
t = t[:len(t)-1]
}
}
dfs(1, n)
return
}方法二:二进制枚举 · Go 实现
思考
回溯依赖递归栈。 到 只有 个子集,可用长度为 的二进制掩码枚举。
若掩码中 的个数为 且对应数字之和为 ,则收集该子集。
我们可以用一个长度为 的二进制整数表示数字 到 的选取情况,其中二进制整数的第 位表示数字 是否被选取,如果第 位为 ,则表示数字 被选取,否则表示数字 没有被选取。
我们在 范围内枚举二进制整数,对于当前枚举到的二进制整数 ,如果 的二进制表示中 的个数为 ,且 的二进制表示中 所对应的数字之和为 ,则说明 对应的数字选取方案是一组答案。我们将 对应的数字选取方案加入答案即可。
时间复杂度 ,空间复杂度 。
相似题目:
func combinationSum3(k int, n int) (ans [][]int) {
	for mask := 0; mask < 1<<9; mask++ {
		if bits.OnesCount(uint(mask)) == k {
			t := []int{}
			s := 0
			for i := 0; i < 9; i++ {
				if mask>>i&1 == 1 {
					s += i + 1
					t = append(t, i+1)
				}
			}
			if s == n {
				ans = append(ans, t)
			}
		}
	}
	return
}254. 因子的组合 🔒
题目、示例与约束
整数可以被看作是其因子的乘积。
例如:
8 = 2 x 2 x 2;
  = 2 x 4.
请实现一个函数,该函数接收一个整数 n 并返回该整数所有的因子组合。
注意:
- 你可以假定 n 为永远为正数。
- 因子必须大于 1 并且小于 n。
示例 1:
输入: 1
输出: []
示例 2:
输入: 37
输出: []
示例 3:
输入: 12
输出:
[
  [2, 6],
  [2, 2, 3],
  [3, 4]
]
示例 4:
输入: 32
输出:
[
  [2, 16],
  [2, 2, 8],
  [2, 2, 2, 4],
  [2, 2, 2, 2, 2],
  [2, 4, 4],
  [4, 8]
]
提示:
1 <= n <= 107
方法一:回溯 · Go 实现
思考
把 拆成至少两个因子,顺序不敏感,应按非降序搜索以免重复。从当前最小因子 枚举到 。
先把“已选因子加上剩余 ”收为一种方案,再尝试因子 并递归 。
我们设计函数 ,其中 表示当前待分解的数, 表示当前分解的数的最大因子,函数的作用是将 分解为若干个因子,其中每个因子都不小于 ,并将所有分解结果保存到 中。
在函数 中,我们从 开始枚举 的因子 ,如果 是 的因子,那么我们将 加入当前分解结果,然后继续分解 ,即调用函数 。
时间复杂度 。
func getFactors(n int) [][]int {
	t := []int{}
	ans := [][]int{}
	var dfs func(n, i int)
	dfs = func(n, i int) {
		if len(t) > 0 {
			ans = append(ans, append(slices.Clone(t), n))
		}
		for j := i; j <= n/j; j++ {
			if n%j == 0 {
				t = append(t, j)
				dfs(n/j, j)
				t = t[:len(t)-1]
			}
		}
	}
	dfs(n, 2)
	return ans
}267. 回文排列 II 🔒
题目、示例与约束
给定一个字符串 s ,返回 其重新排列组合后可能构成的所有回文字符串,并去除重复的组合 。
你可以按 任意顺序 返回答案。如果 s 不能形成任何回文排列时,则返回一个空列表。
示例 1:
输入: s ="aabb"输出:["abba", "baab"]
示例 2:
输入: s ="abc"输出:[]
提示:
1 <= s.length <= 16s仅由小写英文字母组成
方法一:回溯 · Go 实现
思考
先判定能否构成回文:奇数次字符超过一个则无解。留下至多一个中心字符,其余按成对字母向外扩展。
回溯 :选一个仍剩至少两个的字符,左右各放一个,直到长度等于原串。
回文排列需要满足至多有一个字符出现奇数次数。若不满足条件,答案提前返回。
找到出现奇数次的字符,作为中间字符(可以为空),分别向两边扩展,构造回文串。若串的长度与原串长度相等,将该串添加到答案中。
时间复杂度 。其中 为字符串 的长度。
func generatePalindromes(s string) []string {
	cnt := map[byte]int{}
	for i := range s {
		cnt[s[i]]++
	}
	mid := ""
	ans := []string{}
	for k, v := range cnt {
		if v%2 == 1 {
			if mid != "" {
				return ans
			}
			mid = string(k)
		}
	}
	var dfs func(t string)
	dfs = func(t string) {
		if len(t) == len(s) {
			ans = append(ans, t)
			return
		}
		for k, v := range cnt {
			if v > 1 {
				cnt[k] -= 2
				c := string(k)
				dfs(c + t + c)
				cnt[k] += 2
			}
		}
	}
	dfs(mid)
	return ans
}282. 给表达式添加运算符
题目、示例与约束
给定一个仅包含数字 0-9 的字符串 num 和一个目标值整数 target ,在 num 的数字之间添加 二元 运算符(不是一元)+、- 或 * ,返回 所有 能够得到 target 的表达式。
注意,返回表达式中的操作数 不应该 包含前导零。
注意,一个数字可以包含多个数位。
示例 1:
输入: num = "123", target = 6
输出: ["1+2+3", "1*2*3"]
解释: “1*2*3” 和 “1+2+3” 的值都是6。
示例 2:
输入: num = "232", target = 8
输出: ["2*3+2", "2+3*2"]
解释: “2*3+2” 和 “2+3*2” 的值都是8。
示例 3:
输入: num = "3456237490", target = 9191
输出: []
解释: 表达式 “3456237490” 无法得到 9191 。
提示:
1 <= num.length <= 10num仅含数字-231 <= target <= 231 - 1
方法一:Go 解法(本站整理) · Go 实现
本站根据题意与 Doocs 参考思路整理为 Go,非上游原文。按 CC BY-SA 4.0 共享。
回溯枚举每段数字,记录表达式总值与最后一个乘法项。追加乘法时撤销旧乘法项再加新积,从而满足乘法优先级;多位数字不能以零开头。使用 int64 保存中间值。设数字串长为 n,时间 O(n·4^n),不计输出的递归和表达式空间 O(n²)。
func addOperators(num string, target int) []string {
	ans := []string{}
	var dfs func(int, int64, int64, string)
	dfs = func(pos int, total, last int64, expr string) {
		if pos == len(num) {
			if total == int64(target) {
				ans = append(ans, expr)
			}
			return
		}
		var value int64
		for end := pos; end < len(num); end++ {
			if end > pos && num[pos] == '0' {
				break
			}
			value = value*10 + int64(num[end]-'0')
			part := num[pos : end+1]
			if pos == 0 {
				dfs(end+1, value, value, part)
			} else {
				dfs(end+1, total+value, value, expr+"+"+part)
				dfs(end+1, total-value, -value, expr+"-"+part)
				dfs(end+1, total-last+last*value, last*value, expr+"*"+part)
			}
		}
	}
	dfs(0, 0, 0, "")
	return ans
}286. 墙与门 🔒
题目、示例与约束
你被给定一个 m × n 的二维网格 rooms ,网格中有以下三种可能的初始化值:
-1表示墙或是障碍物0表示一扇门INF无限表示一个空的房间。然后,我们用231 - 1 = 2147483647代表INF。你可以认为通往门的距离总是小于2147483647的。
你要给每个空房间位上填上该房间到 最近门的距离 ,如果无法到达门,则填 INF 即可。
示例 1:
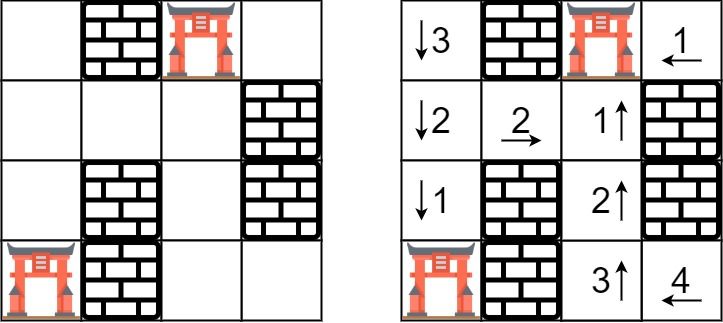
输入:rooms = [[2147483647,-1,0,2147483647],[2147483647,2147483647,2147483647,-1],[2147483647,-1,2147483647,-1],[0,-1,2147483647,2147483647]]
输出:[[3,-1,0,1],[2,2,1,-1],[1,-1,2,-1],[0,-1,3,4]]
示例 2:
输入:rooms = [[-1]]
输出:[[-1]]
示例 3:
输入:rooms = [[2147483647]]
输出:[[2147483647]]
示例 4:
输入:rooms = [[0]]
输出:[[0]]
提示:
m == rooms.lengthn == rooms[i].length1 <= m, n <= 250rooms[i][j]是-1、0或231 - 1
方法一 · Go 实现
思考
每个空房间要到最近的门。从每个空房间单独 BFS 会重复访问。多源 BFS 从全部门同时出发,第一次到达即为最短距离。
把门入队后按层扩展,只填尚未赋值的空房间。
func wallsAndGates(rooms [][]int) {
	m, n := len(rooms), len(rooms[0])
	var q [][]int
	for i := 0; i < m; i++ {
		for j := 0; j < n; j++ {
			if rooms[i][j] == 0 {
				q = append(q, []int{i, j})
			}
		}
	}
	d := 0
	dirs := []int{-1, 0, 1, 0, -1}
	for len(q) > 0 {
		d++
		for i := len(q); i > 0; i-- {
			p := q[0]
			q = q[1:]
			for j := 0; j < 4; j++ {
				x, y := p[0]+dirs[j], p[1]+dirs[j+1]
				if x >= 0 && x < m && y >= 0 && y < n && rooms[x][y] == math.MaxInt32 {
					rooms[x][y] = d
					q = append(q, []int{x, y})
				}
			}
		}
	}
}291. 单词规律 II 🔒
题目、示例与约束
给你一种规律 pattern 和一个字符串 s,请你判断 s 是否和 pattern 的规律相匹配。
如果存在单个字符到 非空 字符串的 双射映射 ,那么字符串 s 匹配 pattern ,即:如果 pattern 中的每个字符都被它映射到的字符串替换,那么最终的字符串则为 s 。双射 意味着映射双方一一对应,不会存在两个字符映射到同一个字符串,也不会存在一个字符分别映射到两个不同的字符串。
示例 1:
输入:pattern = "abab", s = "redblueredblue"
输出:true
解释:一种可能的映射如下:
'a' -> "red"
'b' -> "blue"
示例 2:
输入:pattern = "aaaa", s = "asdasdasdasd"
输出:true
解释:一种可能的映射如下:
'a' -> "asd"
示例 3:
输入:pattern = "aabb", s = "xyzabcxzyabc"
输出:false
提示:
1 <= pattern.length, s.length <= 20pattern和s由小写英文字母组成
方法一 · Go 实现
思考
模式字符对应的单词长度不固定,不能按空格切开。需枚举每个模式字符匹配的子串,并保持双向唯一。
尝试把 配给 :已有映射须一致,否则在子串未被占用时绑定并继续,失败则回溯。
func wordPatternMatch(pattern string, s string) bool {
	m, n := len(pattern), len(s)
	vis := map[string]bool{}
	d := map[byte]string{}
	var dfs func(i, j int) bool
	dfs = func(i, j int) bool {
		if i == m && j == n {
			return true
		}
		if i == m || j == n || m-i > n-j {
			return false
		}
		c := pattern[i]
		for k := j + 1; k <= n; k++ {
			t := s[j:k]
			if v, ok := d[c]; ok && v == t {
				if dfs(i+1, k) {
					return true
				}
			}
			if _, ok := d[c]; !ok && !vis[t] {
				d[c] = t
				vis[t] = true
				if dfs(i+1, k) {
					return true
				}
				delete(d, c)
				vis[t] = false
			}
		}
		return false
	}
	return dfs(0, 0)
}301. 删除无效的括号
题目、示例与约束
给你一个由若干括号和字母组成的字符串 s ,删除最小数量的无效括号,使得输入的字符串有效。
返回所有可能的结果。答案可以按 任意顺序 返回。
示例 1:
输入:s = "()())()"
输出:["(())()","()()()"]
示例 2:
输入:s = "(a)())()"
输出:["(a())()","(a)()()"]
示例 3:
输入:s = ")("
输出:[""]
提示:
1 <= s.length <= 25s由小写英文字母以及括号'('和')'组成s中至多含20个括号
方法一:DFS + 剪枝 · Go 实现
思考
合法串须删除最少括号且枚举全部最优结果。若对每个括号独立选择删或不删,长度为 时分支过多,且多数路径删除次数并不最小。
先扫描得到必须删除的左、右括号下界 、 。搜索时维护剩余删除额度与当前左右括号计数:剩余字符不足以删完、或右括号已多于左括号,则剪枝。每个位置优先尝试删除(额度允许时),再选择保留,并用集合去重。因此只展开删除次数恰好为最小的路径。
我们首先处理得到字符串 待删除的左、右括号的最小数量,分别记为 和 。
然后我们设计一个递归函数 dfs(i, l, r, lcnt, rcnt, t),其中:
i表示当前处理到字符串 的第 个字符;l和r分别表示剩余待删除的左、右括号的数量;t表示当前得到的字符串;lcnt和rcnt分别表示当前得到的字符串中左、右括号的数量。
递归函数的逻辑如下:
- 如果
i等于字符串 的长度,且l和r都等于 ,则将t加入答案数组中; - 如果剩余的待处理字符数 小于剩余待删除的左右括号数量 ,或者当前得到的字符串中的左括号数量小于右括号数量,直接返回;
- 如果当前字符是左括号,我们可以选择删除或者保留,如果删除,需要满足 ,然后递归调用
dfs(i+1, l-1, r, lcnt, rcnt, t); - 如果当前字符是右括号,我们可以选择删除或者保留,如果删除,需要满足 ,然后递归调用
dfs(i+1, l, r-1, lcnt, rcnt, t); - 如果选择保留当前字符,我们需要判断当前字符是左括号、右括号还是字母。如果是左括号,我们需要更新
lcnt,如果是右括号,我们需要更新rcnt,然后递归调用dfs(i+1, l, r, lcnt, rcnt, t+s[i])。
我们调用 dfs(0, l, r, 0, 0, ""),搜索所有可能的字符串。
最后返回去重后的答案数组即可。
时间复杂度 ,空间复杂度 。长度为 的字符串有 种可能的删除方式,每种删除方式需要 的时间复制字符串。因此总时间复杂度为 。
func removeInvalidParentheses(s string) []string {
	vis := map[string]bool{}
	l, r, n := 0, 0, len(s)
	for _, c := range s {
		if c == '(' {
			l++
		} else if c == ')' {
			if l > 0 {
				l--
			} else {
				r++
			}
		}
	}
	var dfs func(i, l, r, lcnt, rcnt int, t string)
	dfs = func(i, l, r, lcnt, rcnt int, t string) {
		if i == n {
			if l == 0 && r == 0 {
				vis[t] = true
			}
			return
		}
		if n-i < l+r || lcnt < rcnt {
			return
		}
		if s[i] == '(' && l > 0 {
			dfs(i+1, l-1, r, lcnt, rcnt, t)
		}
		if s[i] == ')' && r > 0 {
			dfs(i+1, l, r-1, lcnt, rcnt, t)
		}
		x, y := 0, 0
		if s[i] == '(' {
			x = 1
		} else if s[i] == ')' {
			y = 1
		}
		dfs(i+1, l, r, lcnt+x, rcnt+y, t+string(s[i]))
	}
	dfs(0, l, r, 0, 0, "")
	ans := make([]string, 0, len(vis))
	for v := range vis {
		ans = append(ans, v)
	}
	return ans
}302. 包含全部黑色像素的最小矩形 🔒
题目、示例与约束
图片在计算机处理中往往是使用二维矩阵来表示的。
给你一个大小为 m x n 的二进制矩阵 image 表示一张黑白图片,0 代表白色像素,1 代表黑色像素。
黑色像素相互连接,也就是说,图片中只会有一片连在一块儿的黑色像素。像素点是水平或竖直方向连接的。
给你两个整数 x 和 y 表示某一个黑色像素的位置,请你找出包含全部黑色像素的最小矩形(与坐标轴对齐),并返回该矩形的面积。
你必须设计并实现一个时间复杂度低于 O(mn) 的算法来解决此问题。
示例 1:
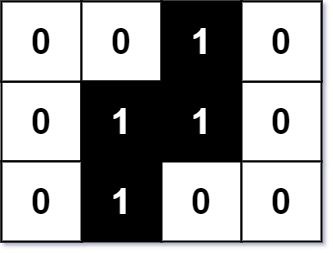
输入:image = [["0","0","1","0"],["0","1","1","0"],["0","1","0","0"]], x = 0, y = 2
输出:6
示例 2:
输入:image = [["1"]], x = 0, y = 0
输出:1
提示:
m == image.lengthn == image[i].length1 <= m, n <= 100image[i][j]为'0'或'1'1 <= x < m1 <= y < nimage[x][y] == '1'image中的黑色像素仅形成一个 组件
方法一 · Go 实现
思考
黑色像素构成一个轴对齐矩形,求包围它的最小面积。从给定黑点出发四向搜索或整图扫描均可,但 较大时线性扫遍所有格子偏慢。
注意到,某一行(列)是否含黑像素关于行号(列号)呈「先无后有」或「先有后无」的单调性,且已知一点 必在矩形内。为此对上、下、左、右四条边界分别二分:判断中位行/列是否出现
'1',即可把边界收到 量级,面积为高乘宽。
func minArea(image [][]byte, x int, y int) int {
	m, n := len(image), len(image[0])
	left, right := 0, x
	for left < right {
		mid := (left + right) >> 1
		c := 0
		for c < n && image[mid][c] == '0' {
			c++
		}
		if c < n {
			right = mid
		} else {
			left = mid + 1
		}
	}
	u := left
	left, right = x, m-1
	for left < right {
		mid := (left + right + 1) >> 1
		c := 0
		for c < n && image[mid][c] == '0' {
			c++
		}
		if c < n {
			left = mid
		} else {
			right = mid - 1
		}
	}
	d := left
	left, right = 0, y
	for left < right {
		mid := (left + right) >> 1
		r := 0
		for r < m && image[r][mid] == '0' {
			r++
		}
		if r < m {
			right = mid
		} else {
			left = mid + 1
		}
	}
	l := left
	left, right = y, n-1
	for left < right {
		mid := (left + right + 1) >> 1
		r := 0
		for r < m && image[r][mid] == '0' {
			r++
		}
		if r < m {
			left = mid
		} else {
			right = mid - 1
		}
	}
	r := left
	return (d - u + 1) * (r - l + 1)
}306. 累加数
题目、示例与约束
累加数 是一个字符串,组成它的数字可以形成累加序列。
一个有效的 累加序列 必须 至少 包含 3 个数。除了最开始的两个数以外,序列中的每个后续数字必须是它之前两个数字之和。
给你一个只包含数字 '0'-'9' 的字符串,编写一个算法来判断给定输入是否是 累加数 。如果是,返回 true ;否则,返回 false 。
说明:累加序列里的数,除数字 0 之外,不会 以 0 开头,所以不会出现 1, 2, 03 或者 1, 02, 3 的情况。
示例 1:
输入:"112358"输出:true 解释:累加序列为:1, 1, 2, 3, 5, 8。1 + 1 = 2, 1 + 2 = 3, 2 + 3 = 5, 3 + 5 = 8
示例 2:
输入:"199100199"输出:true 解释:累加序列为:1, 99, 100, 199。1 + 99 = 100, 99 + 100 = 199
提示:
1 <= num.length <= 35num仅由数字(0-9)组成
进阶:你计划如何处理由过大的整数输入导致的溢出?
方法一 · Go 实现
思考
累加数由至少三个数拼接而成,且从第三项起每项等于前两项之和。数字串长度有限,前两个加数的划分一旦确定,其后序列便被唯一决定。
枚举前两个数的结束位置,跳过含前导零的划分,再递归验证剩余前缀是否恰为二者之和。若某次切分匹配,则滚动到下一对继续;串耗尽则成立。长度约束使枚举规模可接受。
func isAdditiveNumber(num string) bool {
	n := len(num)
	var dfs func(a, b int64, num string) bool
	dfs = func(a, b int64, num string) bool {
		if num == "" {
			return true
		}
		if a+b > 0 && num[0] == '0' {
			return false
		}
		for i := 1; i < min(len(num)+1, 19); i++ {
			c, _ := strconv.ParseInt(num[:i], 10, 64)
			if a+b == c {
				if dfs(b, c, num[i:]) {
					return true
				}
			}
		}
		return false
	}
	for i := 1; i < min(n-1, 19); i++ {
		for j := i + 1; j < min(n, i+19); j++ {
			if i > 1 && num[0] == '0' {
				break
			}
			if j-i > 1 && num[i] == '0' {
				continue
			}
			a, _ := strconv.ParseInt(num[:i], 10, 64)
			b, _ := strconv.ParseInt(num[i:j], 10, 64)
			if dfs(a, b, num[j:]) {
				return true
			}
		}
	}
	return false
}317. 离建筑物最近的距离 🔒
题目、示例与约束
给你一个 m × n 的网格,值为 0 、 1 或 2 ,其中:
- 每一个
0代表一块你可以自由通过的 空地 - 每一个
1代表一个你不能通过的 建筑 - 每个
2标记一个你不能通过的 障碍
你想要在一块空地上建造一所房子,在 最短的总旅行距离 内到达所有的建筑。你只能上下左右移动。
返回到该房子的 最短旅行距离 。如果根据上述规则无法建造这样的房子,则返回 -1 。
总旅行距离 是朋友们家到聚会地点的距离之和。
示例 1:
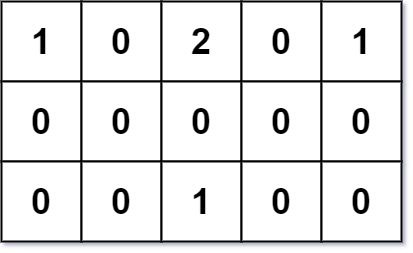
输入:grid = [[1,0,2,0,1],[0,0,0,0,0],[0,0,1,0,0]] 输出:7 解析:给定三个建筑物 (0,0)、(0,4) 和(2,2) 以及一个位于(0,2) 的障碍物。 由于总距离之和 3+3+1=7 最优,所以位置(1,2)是符合要求的最优地点。 故返回7。
示例 2:
输入: grid = [[1,0]]
输出: 1
示例 3:
输入: grid = [[1]]
输出: -1
提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 50grid[i][j]是0,1或2grid中 至少 有 一幢 建筑
方法一 · Go 实现
思考
空地到所有房屋的距离之和最小,且路径不能穿过房屋或障碍。若对每个空地做一次多源搜索,房屋多时空地次数过多。
改为从每座房屋 BFS,把到达每个空地的距离累加到 ,并把访问次数记入 。最终只在 等于房屋总数的空地上取 最小者;若无一格被全部房屋触及则返回 。
func shortestDistance(grid [][]int) int {
	m, n := len(grid), len(grid[0])
	var q [][]int
	total := 0
	cnt := make([][]int, m)
	dist := make([][]int, m)
	for i := range cnt {
		cnt[i] = make([]int, n)
		dist[i] = make([]int, n)
	}
	dirs := []int{-1, 0, 1, 0, -1}
	for i := 0; i < m; i++ {
		for j := 0; j < n; j++ {
			if grid[i][j] == 1 {
				total++
				q = append(q, []int{i, j})
				vis := make([]bool, m*n)
				d := 0
				for len(q) > 0 {
					d++
					for k := len(q); k > 0; k-- {
						p := q[0]
						q = q[1:]
						for l := 0; l < 4; l++ {
							x, y := p[0]+dirs[l], p[1]+dirs[l+1]
							if x >= 0 && x < m && y >= 0 && y < n && grid[x][y] == 0 && !vis[x*n+y] {
								cnt[x][y]++
								dist[x][y] += d
								q = append(q, []int{x, y})
								vis[x*n+y] = true
							}
						}
					}
				}
			}
		}
	}

	ans := math.MaxInt32
	for i := 0; i < m; i++ {
		for j := 0; j < n; j++ {
			if grid[i][j] == 0 && cnt[i][j] == total {
				if ans > dist[i][j] {
					ans = dist[i][j]
				}
			}
		}
	}
	if ans == math.MaxInt32 {
		return -1
	}
	return ans
}320. 列举单词的全部缩写 🔒
题目、示例与约束
单词的 广义缩写词 可以通过下述步骤构造:先取任意数量的 不重叠、不相邻 的子字符串,再用它们各自的长度进行替换。
- 例如,
"abcde"可以缩写为:"a3e"("bcd"变为"3")"1bcd1"("a"和"e"都变为"1")"5"("abcde"变为"5")"abcde"(没有子字符串被代替)
- 然而,这些缩写是 无效的 :
"23"("ab"变为"2","cde"变为"3")是无效的,因为被选择的字符串是相邻的"22de"("ab"变为"2","bc"变为"2") 是无效的,因为被选择的字符串是重叠的
给你一个字符串 word ,返回 一个由 word 的所有可能 广义缩写词 组成的列表 。按 任意顺序 返回答案。
示例 1:
输入:word = "word"
输出:["4","3d","2r1","2rd","1o2","1o1d","1or1","1ord","w3","w2d","w1r1","w1rd","wo2","wo1d","wor1","word"]
示例 2:
输入:word = "a"
输出:["1","a"]
提示:
1 <= word.length <= 15word仅由小写英文字母组成
方法一:DFS · Go 实现
思考
每个字符可保留或并入一段连续省略的数字。 ,全部方案可枚举。
处理后缀:要么保留 再递归,要么把 收成数字并接上 (若还有)与更短后缀。空后缀返回 作为拼接基底。
我们设计一个函数 ,表示对于字符串 ,返回其所有可能的缩写。
函数 的执行逻辑如下:
如果 ,说明已经处理完了字符串 ,直接返回一个空字符串组成的列表。
否则,我们可以选择保留 ,然后对 返回的列表中的每个字符串前面添加 ,将得到的结果添加到答案中。
我们也可以选择删除 及其后面的若干个字符,假设我们删除了 ,那么第 个字符不删除,然后对 返回的列表中的每个字符串前面添加 ,将得到的结果添加到答案中。
最后,我们在主函数中调用 即可。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度。
func generateAbbreviations(word string) []string {
	n := len(word)
	var dfs func(int) []string
	dfs = func(i int) []string {
		if i >= n {
			return []string{""}
		}
		ans := []string{}
		for _, s := range dfs(i + 1) {
			ans = append(ans, word[i:i+1]+s)
		}
		for j := i + 1; j <= n; j++ {
			for _, s := range dfs(j + 1) {
				p := ""
				if j < n {
					p = word[j : j+1]
				}
				ans = append(ans, strconv.Itoa(j-i)+p+s)
			}
		}
		return ans
	}
	return dfs(0)
}
方法二:二进制枚举 · Go 实现
思考
递归按位置分支,结构与 种取舍一一对应。用二进制位表示「该位是否省略」,连续 压成计数、遇到 则写出字母。实现改为迭代,避免递归栈。
由于字符串 的长度不超过 ,因此我们可以使用二进制枚举的方法枚举所有的缩写。我们用一个长度为 的二进制数 表示一种缩写方式,其中 表示保留对应的字符,而 表示删除对应的字符。我们在 的范围内枚举所有 ,并将其转换成对应的缩写,添加到答案列表中即可。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度。
func generateAbbreviations(word string) (ans []string) {
	n := len(word)
	for i := 0; i < 1<<n; i++ {
		s := &strings.Builder{}
		cnt := 0
		for j := 0; j < n; j++ {
			if i>>j&1 == 1 {
				cnt++
			} else {
				if cnt > 0 {
					s.WriteString(strconv.Itoa(cnt))
					cnt = 0
				}
				s.WriteByte(word[j])
			}
		}
		if cnt > 0 {
			s.WriteString(strconv.Itoa(cnt))
		}
		ans = append(ans, s.String())
	}
	return
}339. 嵌套列表加权和 🔒
题目、示例与约束
给定一个嵌套的整数列表 nestedList ,每个元素要么是整数,要么是列表。同时,列表中元素同样也可以是整数或者是另一个列表。
整数的 深度 是其在列表内部的嵌套层数。例如,嵌套列表 [1,[2,2],[[3],2],1] 中每个整数的值就是其深度。
请返回该列表按深度加权后所有整数的总和。
示例 1:
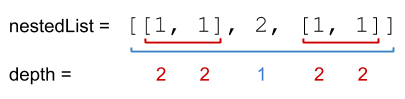
输入:nestedList = [[1,1],2,[1,1]]
输出:10
解释:因为列表中有四个深度为 2 的 1 ,和一个深度为 1 的 2。
示例 2:
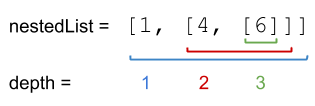
输入:nestedList = [1,[4,[6]]]
输出:27
解释:一个深度为 1 的 1,一个深度为 2 的 4,一个深度为 3 的 6。所以,1 + 4*2 + 6*3 = 27。
示例 3:
输入:nestedList = [0]
输出:0
提示:
1 <= nestedList.length <= 50- 嵌套列表中整数的值在范围
[-100, 100]内 - 任何整数的最大 深度 都小于或等于
50
方法一:Go 解法(本站整理) · Go 实现
本站根据题意与 Doocs 参考思路整理为 Go,非上游原文。按 CC BY-SA 4.0 共享。
按深度优先遍历列表。整数贡献为自身值乘当前深度,子列表以深度加一递归。设整数与列表节点共 N 个、最大嵌套深度 D,时间 O(N),递归空间 O(D)。NestedInteger 及 IsInteger、GetInteger、GetList 方法由平台提供;测试使用相同接口的桩。
func depthSum(nestedList []*NestedInteger) int {
	var visit func([]*NestedInteger, int) int
	visit = func(items []*NestedInteger, depth int) int {
		sum := 0
		for _, item := range items {
			if item.IsInteger() {
				sum += item.GetInteger() * depth
			} else {
				sum += visit(item.GetList(), depth+1)
			}
		}
		return sum
	}
	return visit(nestedList, 1)
}364. 嵌套列表加权和 II 🔒
题目、示例与约束
给你一个整数嵌套列表 nestedList ,每一个元素要么是一个整数,要么是一个列表(这个列表中的每个元素也同样是整数或列表)。
整数的 深度 取决于它位于多少个列表内部。例如,嵌套列表 [1,[2,2],[[3],2],1] 的每个整数的值都等于它的 深度 。令 maxDepth 是任意整数的 最大深度 。
整数的 权重 为 maxDepth - (整数的深度) + 1 。
将 nestedList 列表中每个整数先乘权重再求和,返回该加权和。
示例 1:
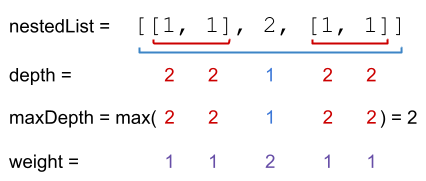
输入:nestedList = [[1,1],2,[1,1]]
输出:8
解释:4 个 1 在深度为 1 的位置, 一个 2 在深度为 2 的位置。
1*1 + 1*1 + 2*2 + 1*1 + 1*1 = 8
示例 2:
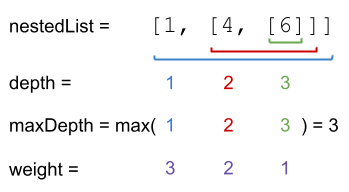
输入:nestedList = [1,[4,[6]]]
输出:17
解释:一个 1 在深度为 3 的位置, 一个 4 在深度为 2 的位置,一个 6 在深度为 1 的位置。
1*3 + 4*2 + 6*1 = 17
提示:
1 <= nestedList.length <= 50- 嵌套列表中整数的值在范围
[-100, 100] - 任意整数的最大 深度 小于等于
50 - 没有空列表
方法一:DFS · Go 实现
思考
与 339 相反,权重为 。先求最大深度再二次遍历亦可。一次 DFS 同时累加所有整数之和 与带深度加权和 。
目标为 。DFS 更新 ,遇整数则累加 与 。
我们不妨假设整数分别为 ,它们的深度分别为 ,最大深度为 ,那么答案就是:
即:
如果我们记所有整数的和为 ,所有整数乘以深度的和为 ,那么答案就是:
因此,我们设计一个函数 ,表示从 开始,深度为 开始搜索,函数 的执行过程如下:
- 我们先更新 ;
- 如果 是一个整数,那么我们更新 , ;
- 否则,我们递归地遍历 的每一个元素 ,调用 。
我们遍历整个列表,对于每一个元素 ,我们调用 ,最终返回 即可。
时间复杂度 ,空间复杂度 。其中 为整数的个数。
/**
 * // This is the interface that allows for creating nested lists.
 * // You should not implement it, or speculate about its implementation
 * type NestedInteger struct {
 * }
 *
 * // Return true if this NestedInteger holds a single integer, rather than a nested list.
 * func (n NestedInteger) IsInteger() bool {}
 *
 * // Return the single integer that this NestedInteger holds, if it holds a single integer
 * // The result is undefined if this NestedInteger holds a nested list
 * // So before calling this method, you should have a check
 * func (n NestedInteger) GetInteger() int {}
 *
 * // Set this NestedInteger to hold a single integer.
 * func (n *NestedInteger) SetInteger(value int) {}
 *
 * // Set this NestedInteger to hold a nested list and adds a nested integer to it.
 * func (n *NestedInteger) Add(elem NestedInteger) {}
 *
 * // Return the nested list that this NestedInteger holds, if it holds a nested list
 * // The list length is zero if this NestedInteger holds a single integer
 * // You can access NestedInteger's List element directly if you want to modify it
 * func (n NestedInteger) GetList() []*NestedInteger {}
 */
func depthSumInverse(nestedList []*NestedInteger) int {
	var maxDepth, ws, s int
	var dfs func(*NestedInteger, int)
	dfs = func(x *NestedInteger, d int) {
		maxDepth = max(maxDepth, d)
		if x.IsInteger() {
			ws += x.GetInteger() * d
			s += x.GetInteger()
		} else {
			for _, y := range x.GetList() {
				dfs(y, d+1)
			}
		}
	}
	for _, x := range nestedList {
		dfs(x, 1)
	}
	return (maxDepth+1)*s - ws
}365. 水壶问题
题目、示例与约束
有两个水壶,容量分别为 x 和 y 升。水的供应是无限的。确定是否有可能使用这两个壶准确得到 target 升。
你可以:
- 装满任意一个水壶
- 清空任意一个水壶
- 将水从一个水壶倒入另一个水壶,直到接水壶已满,或倒水壶已空。
示例 1:
输入: x = 3,y = 5,target = 4
输出: true
解释:
按照以下步骤操作,以达到总共 4 升水:
1. 装满 5 升的水壶(0, 5)。
2. 把 5 升的水壶倒进 3 升的水壶,留下 2 升(3, 2)。
3. 倒空 3 升的水壶(0, 2)。
4. 把 2 升水从 5 升的水壶转移到 3 升的水壶(2, 0)。
5. 再次加满 5 升的水壶(2, 5)。
6. 从 5 升的水壶向 3 升的水壶倒水直到 3 升的水壶倒满。5 升的水壶里留下了 4 升水(3, 4)。
7. 倒空 3 升的水壶。现在,5 升的水壶里正好有 4 升水(0, 4)。
参考:来自著名的 "Die Hard"
示例 2:
输入: x = 2, y = 6, target = 5
输出: false
示例 3:
输入: x = 1, y = 2, target = 3
输出: true
解释:同时倒满两个水壶。现在两个水壶中水的总量等于 3。
提示:
1 <= x, y, target <= 103
方法一:DFS · Go 实现
思考
两壶容量 ,问能否得到总量 。贝祖定理给出 为 的倍数即可,也可用状态搜索验证。状态数为 ,容量不大时可行。
表示两壶当前水量。已访问则失败;某一壶或总和为 则成功。否则尝试加满、倒空、相互倾倒。从 出发。
我们不妨记 为 , 为 , 为 。
接下来,我们设计一个函数 ,表示当前 中有 升水, 中有 升水,是否可以得到 升水。
函数 的执行过程如下:
- 如果 已经被访问过,返回 。
- 如果 或者 或者 ,返回 。
- 如果我们给 倒满水,或者给 倒满水,或者将 清空,或者将 清空,可以得到 升水,返回 。
- 如果我们将 中的水倒入 ,或者将 中的水倒入 ,可以得到 升水,返回 。
答案即为 。
时间复杂度 ,空间复杂度 。其中 和 分别为 和 。
func canMeasureWater(x int, y int, z int) bool {
	type pair struct{ x, y int }
	vis := map[pair]bool{}
	var dfs func(int, int) bool
	dfs = func(i, j int) bool {
		st := pair{i, j}
		if vis[st] {
			return false
		}
		vis[st] = true
		if i == z || j == z || i+j == z {
			return true
		}
		if dfs(x, j) || dfs(i, y) || dfs(0, j) || dfs(i, 0) {
			return true
		}
		a := min(i, y-j)
		b := min(j, x-i)
		return dfs(i-a, j+a) || dfs(i+b, j-b)
	}
	return dfs(0, 0)
}继续阅读
- 实践案例
- 实践案例
- 实践案例