
LeetCode Go · 回溯与搜索(3)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
949. 给定数字能组成的最大时间
题目、示例与约束
给定一个由 4 位数字组成的数组,返回可以设置的符合 24 小时制的最大时间。
24 小时格式为 "HH:MM" ,其中 HH 在 00 到 23 之间,MM 在 00 到 59 之间。最小的 24 小时制时间是 00:00 ,而最大的是 23:59 。从 00:00 (午夜)开始算起,过得越久,时间越大。
以长度为 5 的字符串,按 "HH:MM" 格式返回答案。如果不能确定有效时间,则返回空字符串。
示例 1:
输入:arr = [1,2,3,4]
输出:"23:41"
解释:有效的 24 小时制时间是 "12:34","12:43","13:24","13:42","14:23","14:32","21:34","21:43","23:14" 和 "23:41" 。这些时间中,"23:41" 是最大时间。
示例 2:
输入:arr = [5,5,5,5]
输出:""
解释:不存在有效的 24 小时制时间,因为 "55:55" 无效。
示例 3:
输入:arr = [0,0,0,0]
输出:"00:00"
示例 4:
输入:arr = [0,0,1,0]
输出:"10:00"
提示:
arr.length == 40 <= arr[i] <= 9
方法二:暴力枚举(全排列) · Go 实现
思考
枚举时分是常数级,也可以直接枚举四个下标的排列构造时分,合法者取最大。排列数 ,同样可接受。
枚举 4 个数字的排列,判断构成的时分是否合法,并取最大值。
时间复杂度 ,空间复杂度 。
func largestTimeFromDigits(arr []int) string {
	ans := -1
	for i := 0; i < 4; i++ {
		for j := 0; j < 4; j++ {
			for k := 0; k < 4; k++ {
				if i != j && j != k && i != k {
					h := arr[i]*10 + arr[j]
					m := arr[k]*10 + arr[6-i-j-k]
					if h < 24 && m < 60 {
						ans = max(ans, h*60+m)
					}
				}
			}
		}
	}
	if ans < 0 {
		return ""
	}
	return fmt.Sprintf("%02d:%02d", ans/60, ans%60)
}967. 连续差相同的数字
题目、示例与约束
返回所有长度为 n 且满足其每两个连续位上的数字之间的差的绝对值为 k 的 非负整数 。
请注意,除了 数字 0 本身之外,答案中的每个数字都 不能 有前导零。例如,01 有一个前导零,所以是无效的;但 0 是有效的。
你可以按 任何顺序 返回答案。
示例 1:
输入:n = 3, k = 7
输出:[181,292,707,818,929]
解释:注意,070 不是一个有效的数字,因为它有前导零。
示例 2:
输入:n = 2, k = 1
输出:[10,12,21,23,32,34,43,45,54,56,65,67,76,78,87,89,98]
示例 3:
输入:n = 2, k = 0
输出:[11,22,33,44,55,66,77,88,99]
示例 4:
输入:n = 2, k = 2
输出:[13,20,24,31,35,42,46,53,57,64,68,75,79,86,97]
提示:
2 <= n <= 90 <= k <= 9
方法一:DFS · Go 实现
思考
构造 位整数,相邻数位差的绝对值为 。 ,从最高位 出发 DFS,下一位为 (落在 内); 时只走一次以免重复。达到 位后收入答案。
我们可以枚举所有长度为 的数字的第一个数字,然后使用深度优先搜索的方法,递归地构造所有符合条件的数字。
具体地,我们首先定义一个边界值 ,表示我们需要构造的数字的最小值。然后,我们从 到 枚举第一个数字,对于每一个数字 ,我们递归地构造以 为第一个数字的长度为 的数字。
时间复杂度 ,其中 表示数字集合,本题中 。空间复杂度 。
func numsSameConsecDiff(n int, k int) (ans []int) {
	bounary := int(math.Pow10(n - 1))
	var dfs func(int)
	dfs = func(x int) {
		if x >= bounary {
			ans = append(ans, x)
			return
		}
		last := x % 10
		if last+k < 10 {
			dfs(x*10 + last + k)
		}
		if k > 0 && last-k >= 0 {
			dfs(x*10 + last - k)
		}
	}
	for i := 1; i < 10; i++ {
		dfs(i)
	}
	return
}980. 不同路径 III
题目、示例与约束
在二维网格 grid 上,有 4 种类型的方格:
1表示起始方格。且只有一个起始方格。2表示结束方格,且只有一个结束方格。0表示我们可以走过的空方格。-1表示我们无法跨越的障碍。
返回在四个方向(上、下、左、右)上行走时,从起始方格到结束方格的不同路径的数目。
每一个无障碍方格都要通过一次,但是一条路径中不能重复通过同一个方格。
示例 1:
输入:[[1,0,0,0],[0,0,0,0],[0,0,2,-1]]
输出:2
解释:我们有以下两条路径:
1. (0,0),(0,1),(0,2),(0,3),(1,3),(1,2),(1,1),(1,0),(2,0),(2,1),(2,2)
2. (0,0),(1,0),(2,0),(2,1),(1,1),(0,1),(0,2),(0,3),(1,3),(1,2),(2,2)
示例 2:
输入:[[1,0,0,0],[0,0,0,0],[0,0,0,2]]
输出:4
解释:我们有以下四条路径:
1. (0,0),(0,1),(0,2),(0,3),(1,3),(1,2),(1,1),(1,0),(2,0),(2,1),(2,2),(2,3)
2. (0,0),(0,1),(1,1),(1,0),(2,0),(2,1),(2,2),(1,2),(0,2),(0,3),(1,3),(2,3)
3. (0,0),(1,0),(2,0),(2,1),(2,2),(1,2),(1,1),(0,1),(0,2),(0,3),(1,3),(2,3)
4. (0,0),(1,0),(2,0),(2,1),(1,1),(0,1),(0,2),(0,3),(1,3),(1,2),(2,2),(2,3)
示例 3:
输入:[[0,1],[2,0]]
输出:0
解释:
没有一条路能完全穿过每一个空的方格一次。
请注意,起始和结束方格可以位于网格中的任意位置。
提示:
1 <= grid.length * grid[0].length <= 20
方法一:回溯 · Go 实现
思考
从起点走到终点且途经每一个无障碍格恰好一次。格子至多 ,可回溯。先统计空格并定位起点,DFS 四向扩展,用访问集合避免重复;落到终点时仅当步数等于空格数加一才计一条路径。
我们可以先遍历整个网格,找出起点 ,并且统计空白格的数量 。
接下来,我们可以从起点开始搜索,得到所有的路径数。我们设计一个函数 表示从 出发,且当前已经走过的单元格数量为 的路径数。
在函数中,我们首先判断当前单元格是否为终点,如果是,则判断 是否等于 ,如果是,则说明当前路径是一条有效路径,返回 ,否则返回 。
如果当前单元格不是终点,则我们枚举当前单元格的上下左右四个邻接单元格,如果邻接单元格未被访问过,则我们将该邻接单元格标记为已访问,然后继续搜索从该邻接单元格出发的路径数,搜索完成后,我们再将该邻接单元格标记为未访问。在搜索完成后,我们返回所有邻接单元格的路径数之和。
最后,我们返回从起点出发的路径数即可,即 。
时间复杂度 ,空间复杂度 。其中 和 分别为网格的行数和列数。
func uniquePathsIII(grid [][]int) int {
	m, n := len(grid), len(grid[0])
	cnt := 0
	vis := make([][]bool, m)
	x, y := 0, 0
	for i, row := range grid {
		vis[i] = make([]bool, n)
		for j, v := range row {
			if v == 0 {
				cnt++
			} else if v == 1 {
				x, y = i, j
			}
		}
	}
	dirs := [5]int{-1, 0, 1, 0, -1}
	var dfs func(i, j, k int) int
	dfs = func(i, j, k int) int {
		if grid[i][j] == 2 {
			if k == cnt+1 {
				return 1
			}
			return 0
		}
		ans := 0
		for h := 0; h < 4; h++ {
			x, y := i+dirs[h], j+dirs[h+1]
			if x >= 0 && x < m && y >= 0 && y < n && !vis[x][y] && grid[x][y] != -1 {
				vis[x][y] = true
				ans += dfs(x, y, k+1)
				vis[x][y] = false
			}
		}
		return ans
	}
	vis[x][y] = true
	return dfs(x, y, 0)
}994. 腐烂的橘子
题目、示例与约束
在给定的 m x n 网格 grid 中,每个单元格可以有以下三个值之一:
- 值
0代表空单元格; - 值
1代表新鲜橘子; - 值
2代表腐烂的橘子。
每分钟,腐烂的橘子 周围 4 个方向上相邻 的新鲜橘子都会腐烂。
返回 直到单元格中没有新鲜橘子为止所必须经过的最小分钟数。如果不可能,返回 -1 。
示例 1:
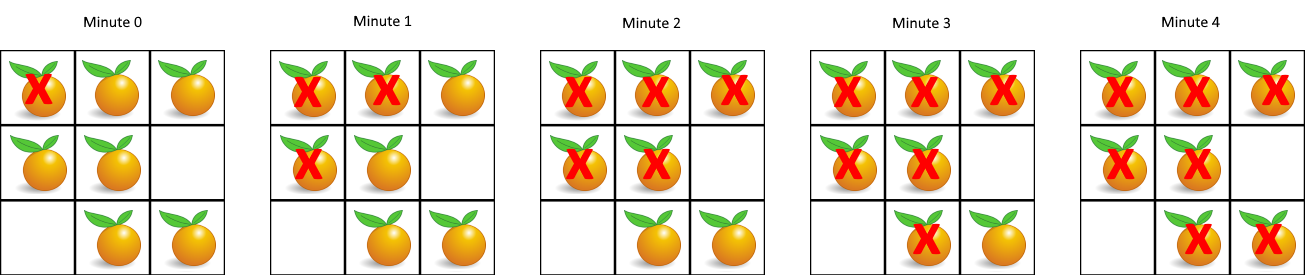
输入:grid = [[2,1,1],[1,1,0],[0,1,1]]
输出:4
示例 2:
输入:grid = [[2,1,1],[0,1,1],[1,0,1]]
输出:-1
解释:左下角的橘子(第 2 行, 第 0 列)永远不会腐烂,因为腐烂只会发生在 4 个方向上。
示例 3:
输入:grid = [[0,2]]
输出:0
解释:因为 0 分钟时已经没有新鲜橘子了,所以答案就是 0 。
提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 10grid[i][j]仅为0、1或2
方法一:BFS · Go 实现
思考
腐烂每分钟向四邻扩散,求全部变烂的最短时间。多源同时扩散,属于无权最短路。先把所有烂橘入队并统计鲜橘,按层 BFS;鲜橘计数归零时的层数即为答案,队列空仍有鲜橘则返回 。
我们首先遍历一遍整个网格,统计出新鲜橘子的数量,记为 ,并且将所有腐烂的橘子的坐标加入队列 中。
接下来,我们进行广度优先搜索,每一轮搜索,我们将队列中的所有腐烂的橘子向四个方向腐烂新鲜橘子,直到队列为空或者新鲜橘子的数量为 为止。
最后,如果新鲜橘子的数量为 ,则返回当前的轮数,否则返回 。
时间复杂度 ,空间复杂度 。其中 和 分别是网格的行数和列数。
func orangesRotting(grid [][]int) int {
	m, n := len(grid), len(grid[0])
	q := [][2]int{}
	cnt := 0
	for i, row := range grid {
		for j, x := range row {
			if x == 1 {
				cnt++
			} else if x == 2 {
				q = append(q, [2]int{i, j})
			}
		}
	}
	dirs := [5]int{-1, 0, 1, 0, -1}
	for ans := 1; len(q) > 0 && cnt > 0; ans++ {
		for k := len(q); k > 0; k-- {
			p := q[0]
			q = q[1:]
			for d := 0; d < 4; d++ {
				x, y := p[0]+dirs[d], p[1]+dirs[d+1]
				if x >= 0 && x < m && y >= 0 && y < n && grid[x][y] == 1 {
					grid[x][y] = 2
					q = append(q, [2]int{x, y})
					if cnt--; cnt == 0 {
						return ans
					}
				}
			}
		}
	}
	if cnt > 0 {
		return -1
	}
	return 0
}1034. 边界着色
题目、示例与约束
给你一个大小为 m x n 的整数矩阵 grid ,表示一个网格。另给你三个整数 row、col 和 color 。网格中的每个值表示该位置处的网格块的颜色。
如果两个方块在任意 4 个方向上相邻,则称它们 相邻 。
如果两个方块具有相同的颜色且相邻,它们则属于同一个 连通分量 。
连通分量的边界 是指连通分量中满足下述条件之一的所有网格块:
- 在上、下、左、右任意一个方向上与不属于同一连通分量的网格块相邻
- 在网格的边界上(第一行/列或最后一行/列)
请你使用指定颜色 color 为所有包含网格块 grid[row][col] 的 连通分量的边界 进行着色。
并返回最终的网格 grid 。
示例 1:
输入:grid = [[1,1],[1,2]], row = 0, col = 0, color = 3
输出:[[3,3],[3,2]]
示例 2:
输入:grid = [[1,2,2],[2,3,2]], row = 0, col = 1, color = 3
输出:[[1,3,3],[2,3,3]]
示例 3:
输入:grid = [[1,1,1],[1,1,1],[1,1,1]], row = 1, col = 1, color = 2
输出:[[2,2,2],[2,1,2],[2,2,2]]
提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 501 <= grid[i][j], color <= 10000 <= row < m0 <= col < n
方法一:DFS · Go 实现
思考
先找出与 同色的连通块,再判断每个格子是否在块的边界上, 时一次搜索足够。边界格子要么贴着网格外缘,要么有异色邻居。
深度优先遍历该连通块,对每个格子检查四邻:越界或颜色不同则当前格是边界,改为 。访问标记防止重复进入。
从给定起点出发搜完即完成重着色。
我们从位置 出发,利用 DFS 搜索所有颜色为 的网格块,如果该网格块的某个相邻位置的颜色不为 ,或者该网格块在网格的边界上,则将该网格块的颜色改为 。
时间复杂度 ,空间复杂度 。其中 和 分别是网格的行数和列数。
func colorBorder(grid [][]int, row int, col int, color int) [][]int {
	m, n := len(grid), len(grid[0])
	vis := make([][]bool, m)
	for i := range vis {
		vis[i] = make([]bool, n)
	}
	dirs := [5]int{-1, 0, 1, 0, -1}
	var dfs func(int, int, int)
	dfs = func(i, j, c int) {
		vis[i][j] = true
		for k := 0; k < 4; k++ {
			x, y := i+dirs[k], j+dirs[k+1]
			if x >= 0 && x < m && y >= 0 && y < n {
				if !vis[x][y] {
					if grid[x][y] == c {
						dfs(x, y, c)
					} else {
						grid[i][j] = color
					}
				}
			} else {
				grid[i][j] = color
			}
		}
	}
	dfs(row, col, grid[row][col])
	return grid
}1036. 逃离大迷宫
题目、示例与约束
在一个 106 x 106 的网格中,每个网格上方格的坐标为 (x, y) 。
现在从源方格 source = [sx, sy] 开始出发,意图赶往目标方格 target = [tx, ty] 。数组 blocked 是封锁的方格列表,其中每个 blocked[i] = [xi, yi] 表示坐标为 (xi, yi) 的方格是禁止通行的。
每次移动,都可以走到网格中在四个方向上相邻的方格,只要该方格 不 在给出的封锁列表 blocked 上。同时,不允许走出网格。
只有在可以通过一系列的移动从源方格 source 到达目标方格 target 时才返回 true。否则,返回 false。
示例 1:
输入:blocked = [[0,1],[1,0]], source = [0,0], target = [0,2]
输出:false
解释:
从源方格无法到达目标方格,因为我们无法在网格中移动。
无法向北或者向东移动是因为方格禁止通行。
无法向南或者向西移动是因为不能走出网格。
示例 2:
输入:blocked = [], source = [0,0], target = [999999,999999]
输出:true
解释:
因为没有方格被封锁,所以一定可以到达目标方格。
提示:
0 <= blocked.length <= 200blocked[i].length == 20 <= xi, yi < 106source.length == target.length == 20 <= sx, sy, tx, ty < 106source != target- 题目数据保证
source和target不在封锁列表内
方法一:DFS · Go 实现
思考
网格为 ,不能建图。障碍至多 个,它们围住的区域面积不超过 ,因此从一点出发只要走到足够多的格子,就说明没有被围死。
分别从起点与终点做深度优先:碰到对方则通路存在;访问数超过该上界则已绕出包围。两侧都能走出去(或相遇)才算可逃。
障碍放入集合以便 判断,搜索空间与障碍规模的平方同阶。
题目相当于在一个 的网格中,给定源点和目标点,以及一小部分被封锁的点,问是否可以从源点到达目标点。
由于被封锁的点数量很少,最终能封锁的区域大小不超过 ,因此,我们可以从源点和目标点出发,进行深度优先搜索,直到搜索到目标点或者搜索到的点数超过 ,如果都满足,则返回 。否则返回 。
时间复杂度 ,空间复杂度 ,其中 是被封锁的区域的大小,本题中 。
func isEscapePossible(blocked [][]int, source []int, target []int) bool {
	const n = 1_000_000
	m := len(blocked) * len(blocked) / 2
	dirs := [5]int{-1, 0, 1, 0, -1}

	f := func(i, j int) int64 {
		return int64(i*n + j)
	}

	s := make(map[int64]bool)
	for _, b := range blocked {
		s[f(b[0], b[1])] = true
	}

	var dfs func(sx, sy, tx, ty int, vis map[int64]bool) bool
	dfs = func(sx, sy, tx, ty int, vis map[int64]bool) bool {
		key := f(sx, sy)
		vis[key] = true
		if len(vis) > m {
			return true
		}
		for k := 0; k < 4; k++ {
			x, y := sx+dirs[k], sy+dirs[k+1]
			if x >= 0 && x < n && y >= 0 && y < n {
				if x == tx && y == ty {
					return true
				}
				key := f(x, y)
				if !s[key] && !vis[key] && dfs(x, y, tx, ty, vis) {
					return true
				}
			}
		}
		return false
	}

	sx, sy := source[0], source[1]
	tx, ty := target[0], target[1]
	return dfs(sx, sy, tx, ty, map[int64]bool{}) && dfs(tx, ty, sx, sy, map[int64]bool{})
}1079. 活字印刷
题目、示例与约束
你有一套活字字模 tiles,其中每个字模上都刻有一个字母 tiles[i]。返回你可以印出的非空字母序列的数目。
注意:本题中,每个活字字模只能使用一次。
示例 1:
输入:"AAB"
输出:8
解释:可能的序列为 "A", "B", "AA", "AB", "BA", "AAB", "ABA", "BAA"。
示例 2:
输入:"AAABBC"
输出:188
示例 3:
输入:"V"
输出:1
提示:
1 <= tiles.length <= 7tiles由大写英文字母组成
方法一:计数 + 回溯 · Go 实现
思考
不同序列由字母的可重排列组成, ,全排列规模可接受,但相同字母会重复计数。应按剩余次数搜索而非按位置。
枚举当前还剩正数的字母,选用一次后递归,每次选用都对应一个非空序列。
回溯加减计数,入口对整袋字母的频次调用一次。
我们先用一个哈希表或数组 统计每个字母出现的次数。
接下来定义一个函数 ,表示当前剩余字母的计数为 时,能够组成的不同序列的个数。
在 中,我们枚举 中每个大于 的值 ,将 减 表示使用了这个字母,序列个数加 ,然后进行下一层搜索,在搜索结束后,累加返回的序列个数,然后将 加 。最后返回序列个数。
时间复杂度 ,空间复杂度 。其中 为字母种类数。
func numTilePossibilities(tiles string) int {
	cnt := [26]int{}
	for _, c := range tiles {
		cnt[c-'A']++
	}
	var dfs func(cnt [26]int) int
	dfs = func(cnt [26]int) (res int) {
		for i, x := range cnt {
			if x > 0 {
				res++
				cnt[i]--
				res += dfs(cnt)
				cnt[i]++
			}
		}
		return
	}
	return dfs(cnt)
}1087. 花括号展开 🔒
题目、示例与约束
给定一个表示单词列表的字符串 s 。单词中的每个字母都有一个或多个选项。
- 如果有一个选项,则字母按原样表示。
- 如果有多个选项,则用大括号分隔选项。例如,
"{a,b,c}"表示选项["a", "b", "c"]。
例如,如果 s = "a{b,c}" ,第一个字符总是 'a' ,但第二个字符可以是 'b' 或 'c' 。原来的列表是 ["ab", "ac"] 。
请你 按字典顺序 ,返回所有以这种方式形成的单词。
示例 1:
输入:s = "{a,b}c{d,e}f"
输出:["acdf","acef","bcdf","bcef"]
示例 2:
输入:s = "abcd"
输出:["abcd"]
提示:
1 <= S.length <= 50s由括号'{}',','和小写英文字母组成。s保证是一个有效的输入。- 没有嵌套的大括号。
- 在一对连续的左括号和右括号内的所有字符都是不同的。
方法一:Go 实现(灵茶山艾府) · Go 实现
本站根据 Go 源码整理,非作者原文。
思路:把表达式拆成若干位置的候选字符集合;普通字符单独成组,花括号内的字符排序。深度优先搜索依次从每组选择一个字符,填入复用的缓冲区;到达末尾时复制成字符串。各组选项已排序,因此生成顺序就是字典序。
复杂度:设输入长度为 n,展开后的字符串长度为 L,第 i 组有 r_i 个选项,输出条数为 P=∏r_i。时间为 O(n+∑r_i log r_i+PL);不计输出的辅助空间为 O(n+L),包含输出为 O(n+PL)。
import "sort"

// github.com/EndlessCheng/codeforces-go
func expand(s string) (ans []string) {
	a := [][]byte{}
	for i, n := 0, len(s); i < n; i++ {
		if s[i] != '{' {
			a = append(a, []byte{s[i]})
			continue
		}
		b := []byte{}
		for i++; ; i++ {
			b = append(b, s[i])
			i++
			if s[i] == '}' {
				break
			}
		}
		sort.Slice(b, func(i, j int) bool { return b[i] < b[j] })
		a = append(a, b)
	}
	t := make([]byte, len(a))
	var f func(int)
	f = func(p int) {
		if p == len(a) {
			ans = append(ans, string(t))
			return
		}
		for _, b := range a[p] {
			t[p] = b
			f(p + 1)
		}
	}
	f(0)
	return
}1088. 易混淆数 II 🔒
题目、示例与约束
易混淆数(Confusing Number)指的是一个数字在整体旋转 180° 以后,能够得到一个和原来 不同 的数,且 新数字的每一位都应该是有效的。
本题我们会将数字旋转 180° 来生成一个新的数字。
- 当
0,1,6,8,9旋转180°以后,我们得到的新数字分别为0,1,9,8,6。 - 当
2,3,4,5,7旋转180°后,是 无法 得到任何数字的。
请注意,在旋转一个数字之后,我们可以忽略前导零。
- 例如,在旋转
8000之后,我们有0008,它被认为只是8。
给出正整数 n,请你返回 [1, n] 范围内的 易混淆数 的数量 。
示例 1:
输入:n = 20
输出:6
解释:易混淆数为 [6,9,10,16,18,19]。
6 转换为 9
9 转换为 6
10 转换为 01 也就是 1
16 转换为 91
18 转换为 81
19 转换为 61
示例 2:
输入:n = 100
输出:19
解释:易混淆数为 [6,9,10,16,18,19,60,61,66,68,80,81,86,89,90,91,98,99,100]。
提示:
1 <= n <= 109
方法一:数位 DP · Go 实现
思考
统计 中旋转后变成不同数的个数, ,不能枚举。可旋转的数位只有 ,应按位构造合法数字再判断是否易混淆。
数位 DFS 从高到低填写,仅枚举映射表非 的数位,并受 的上界约束。到达末位后用与 相同的旋转比较判定。
同时用于填写与
check,前导零作为数值 自然处理。
我们先将数字 转成字符串 。
接下来,我们定义一个函数 ,用来判断 在旋转 之后是否变成了一个不同的数。如果 在旋转 之后变成了一个不同的数,那么我们就称 是一个易混淆数。
然后,我们定义另一个函数 ,用于搜索从高位到低位的每一位。其中:
- 参数 表示当前搜索到的位置,初始时为 ;
- 参数 表示当前搜索的数是否受到上界的限制,初始时为 ;
- 参数 表示当前搜索的数,初始时为 。
在 中,如果 ,那么我们就判断 是否是一个易混淆数,如果是则返回 ,否则返回 。
否则,我们计算出当前位置上的数字的上界 ,然后枚举当前位置上的数字 ,如果 在旋转 之后不是一个数字,那么我们就直接跳过这个数字。否则,我们将 更新为 ,并根据 的值决定下一步搜索的时候是否受到上界的限制,最后将答案返回。
最终的答案即为 。
时间复杂度 ,空间复杂度 。其中 表示 的位数。
func confusingNumberII(n int) int {
	d := [10]int{0, 1, -1, -1, -1, -1, 9, -1, 8, 6}
	s := strconv.Itoa(n)
	check := func(x int) bool {
		y := 0
		for t := x; t > 0; t /= 10 {
			v := t % 10
			y = y*10 + d[v]
		}
		return x != y
	}
	var dfs func(pos int, limit bool, x int) int
	dfs = func(pos int, limit bool, x int) (ans int) {
		if pos >= len(s) {
			if check(x) {
				return 1
			}
			return 0
		}
		up := 9
		if limit {
			up = int(s[pos] - '0')
		}
		for i := 0; i <= up; i++ {
			if d[i] != -1 {
				ans += dfs(pos+1, limit && i == up, x*10+i)
			}
		}
		return
	}
	return dfs(0, true, 0)
}1091. 二进制矩阵中的最短路径
题目、示例与约束
给你一个 n x n 的二进制矩阵 grid 中,返回矩阵中最短 畅通路径 的长度。如果不存在这样的路径,返回 -1 。
二进制矩阵中的 畅通路径 是一条从 左上角 单元格(即,(0, 0))到 右下角 单元格(即,(n - 1, n - 1))的路径,该路径同时满足下述要求:
- 路径途经的所有单元格的值都是
0。 - 路径中所有相邻的单元格应当在 8 个方向之一 上连通(即,相邻两单元之间彼此不同且共享一条边或者一个角)。
畅通路径的长度 是该路径途经的单元格总数。
示例 1:
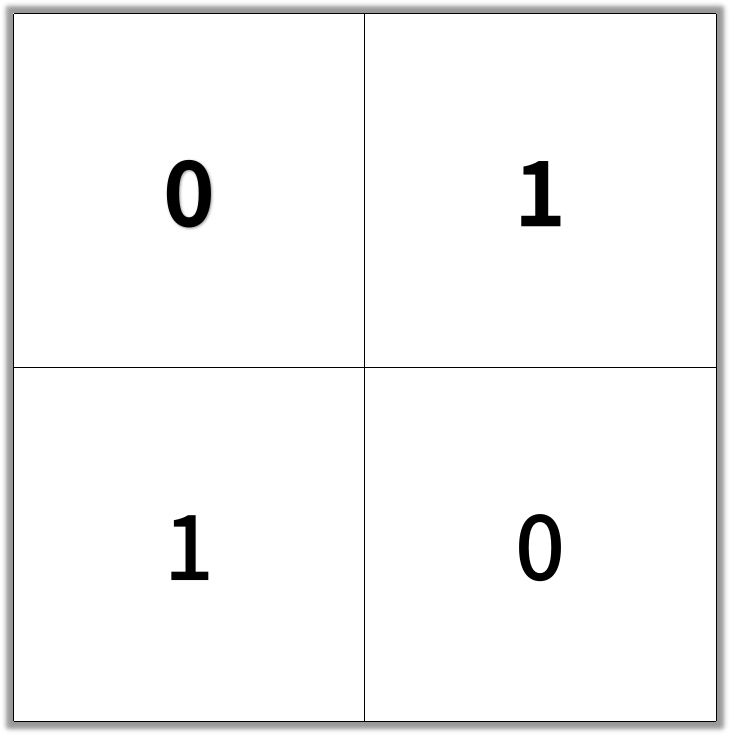
输入:grid = [[0,1],[1,0]]
输出:2
示例 2:
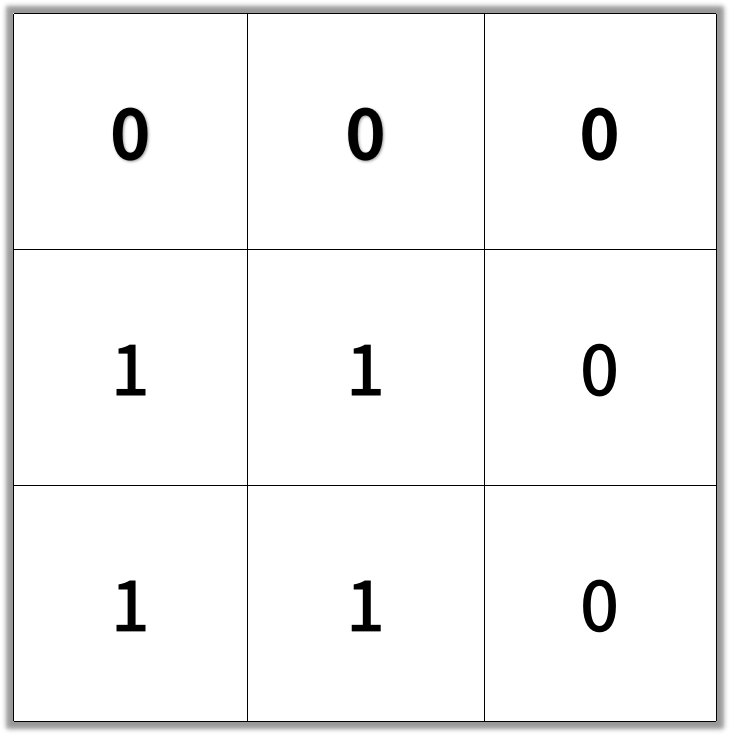
输入:grid = [[0,0,0],[1,1,0],[1,1,0]]
输出:4
示例 3:
输入:grid = [[1,0,0],[1,1,0],[1,1,0]]
输出:-1
提示:
n == grid.lengthn == grid[i].length1 <= n <= 100grid[i][j]为0或1
方法一:BFS · Go 实现
思考
八连通最短路,边权均为 ,广度优先按层即得最少步数。 ,网格可以当访问标记。起点若为 则无路。
把 入队并改为 ,每层扩展八邻域中仍为 的格子。到达 时当前层号即为答案。
队列空仍未到达则返回 。
根据题目描述,一条畅通路径是从左上角单元格 到右下角单元格 的路径,且路径上所有单元格的值都是 。
因此,如果左上角单元格 的值为 ,则不存在满足要求的路径,直接返回 。
否则,我们创建一个队列 ,将左上角单元格 加入队列,并且将其标记为已访问,即把 的值置为 ,然后开始广度优先搜索。
在每一轮搜索中,我们每次取出队首节点 ,如果 为右下角单元格 ,则路径长度为当前的搜索轮数,直接返回。否则,我们将当前节点的所有未被访问过的相邻节点加入队列,并且将它们标记为已访问。每一轮搜索结束后,我们将搜索轮数增加 。然后继续执行上述过程,直到队列为空或者找到目标节点。
如果在搜索结束后,我们仍然没有到达右下角的节点,那么说明右下角的节点不可达,返回 。
时间复杂度 ,空间复杂度 。其中 是给定的二进制矩阵的边长。
func shortestPathBinaryMatrix(grid [][]int) int {
	if grid[0][0] == 1 {
		return -1
	}
	n := len(grid)
	grid[0][0] = 1
	q := [][2]int{{0, 0}}
	for ans := 1; len(q) > 0; ans++ {
		for k := len(q); k > 0; k-- {
			p := q[0]
			i, j := p[0], p[1]
			q = q[1:]
			if i == n-1 && j == n-1 {
				return ans
			}
			for x := i - 1; x <= i+1; x++ {
				for y := j - 1; y <= j+1; y++ {
					if x >= 0 && x < n && y >= 0 && y < n && grid[x][y] == 0 {
						grid[x][y] = 1
						q = append(q, [2]int{x, y})
					}
				}
			}
		}
	}
	return -1
}1096. 花括号展开 II
题目、示例与约束
如果你熟悉 Shell 编程,那么一定了解过花括号展开,它可以用来生成任意字符串。
花括号展开的表达式可以看作一个由 花括号、逗号 和 小写英文字母 组成的字符串,定义下面几条语法规则:
- 如果只给出单一的元素
x,那么表达式表示的字符串就只有"x"。R(x) = {x}- 例如,表达式
"a"表示字符串"a"。 - 而表达式
"w"就表示字符串"w"。
- 例如,表达式
- 当两个或多个表达式并列,以逗号分隔,我们取这些表达式中元素的并集。
R({e_1,e_2,...}) = R(e_1) ∪ R(e_2) ∪ ...- 例如,表达式
"{a,b,c}"表示字符串"a","b","c"。 - 而表达式
"{{a,b},{b,c}}"也可以表示字符串"a","b","c"。
- 例如,表达式
- 要是两个或多个表达式相接,中间没有隔开时,我们从这些表达式中各取一个元素依次连接形成字符串。
R(e_1 + e_2) = {a + b for (a, b) in R(e_1) × R(e_2)}- 例如,表达式
"{a,b}{c,d}"表示字符串"ac","ad","bc","bd"。
- 例如,表达式
- 表达式之间允许嵌套,单一元素与表达式的连接也是允许的。
- 例如,表达式
"a{b,c,d}"表示字符串"ab","ac","ad"。 - 例如,表达式
"a{b,c}{d,e}f{g,h}"可以表示字符串"abdfg", "abdfh", "abefg", "abefh", "acdfg", "acdfh", "acefg", "acefh"。
- 例如,表达式
给出表示基于给定语法规则的表达式 expression,返回它所表示的所有字符串组成的有序列表。
假如你希望以「集合」的概念了解此题,也可以通过点击 “显示英文描述” 获取详情。
示例 1:
输入:expression = "{a,b}{c,{d,e}}"
输出:["ac","ad","ae","bc","bd","be"]
示例 2:
输入:expression = "{{a,z},a{b,c},{ab,z}}"
输出:["a","ab","ac","z"]
解释:输出中 不应 出现重复的组合结果。
提示:
1 <= expression.length <= 60expression[i]由'{','}',','或小写英文字母组成- 给出的表达式
expression用以表示一组基于题目描述中语法构造的字符串
方法一:递归 · Go 实现
思考
表达式含并、连接与多层花括号,求展开后的去重有序集合。表达式长 ,可递归把最内层花括号展开后拼回再处理。
找到第一个
}及其匹配的{,前缀 、选项 、后缀 拼成 继续递归;不再含括号则加入集合。集合去重后排序输出。
我们设计一个递归函数 ,用于处理表达式 ,并将结果存入集合 中。
对于表达式 ,我们首先找到第一个右花括号的位置 ,如果找不到,说明 中没有右花括号,即 为单一元素,直接将 加入集合 中即可。
否则,我们从位置 开始往左找到第一个左花括号的位置 ,此时 和 分别为 的前缀和后缀,记为 和 。而 为 中花括号内的部分,即 中的子表达式,我们将其按照逗号分割成多个字符串 ,然后对每个 ,我们将 拼接成新的表达式,递归调用 函数处理新的表达式,即 。
最后,我们将集合 中的元素按照字典序排序,即可得到答案。
时间复杂度 ,空间复杂度 ,其中 为表达式 的长度。最坏时间出现在 这种逐层套上三路并集的表达式上:每增加 个字符,递归树就大约变成原来的 倍,各层字符串长度之和为 。连续拼接的 会生成 个长度为 的字符串,去重后的结果集占 空间,排序它们的开销是 ,仍低于上面的时间上界。递归栈深度为 ,栈上字符串共 。
func braceExpansionII(expression string) []string {
	s := map[string]struct{}{}
	var dfs func(string)
	dfs = func(exp string) {
		j := strings.Index(exp, "}")
		if j == -1 {
			s[exp] = struct{}{}
			return
		}
		i := strings.LastIndex(exp[:j], "{")
		a, c := exp[:i], exp[j+1:]
		for _, b := range strings.Split(exp[i+1:j], ",") {
			dfs(a + b + c)
		}
	}
	dfs(expression)
	ans := make([]string, 0, len(s))
	for k := range s {
		ans = append(ans, k)
	}
	sort.Strings(ans)
	return ans
}
方法二:语法分析 · Go 实现
思考
方法一每选中一个选项,就把还没展开的后缀再复制一份递归处理。像 这样层层嵌套时,同一段后缀被重复扫描,时间达到 ,不同单词却可能只有常数个。
逗号只出现在花括号里,表示并;括号外相邻的因子表示连接。按这个文法从左到右解析,每个子表达式只求一次集合。
因子是一段连续小写字母,或一对花括号中的表达式。连接把当前集合与因子集合做笛卡尔积,逗号把若干连接结果取并。哈希集合负责去重,全部解析完再按字典序排序。
记表达式为 。从下标 出发定义两个函数。
解析若干个 的并集:先解析一个 ,若后面是逗号,就跳过逗号再解析下一个 ,把集合并进去,直到遇到 } 或结尾。
解析若干个因子的连接,初始集合为 。若当前字符是 {,则递归解析内部的 并跳过匹配的 };否则读出一段连续小写字母。然后把当前集合与该因子的集合做笛卡尔积。遇到逗号、} 或结尾时返回。
最后对 的结果按字典序排序。同一段子表达式只解析一次,方法一里把后缀复制到每一支再重扫的开销不再出现。
时间复杂度 ,空间复杂度 ,其中 为表达式长度。最坏情况是连续拼接的 {a,b,c},需要生成 个长度为 的字符串;构造这些字符串是 ,排序是 。嵌套的三路并集在本方法里每层集合大小为 ,时间只需 。
func braceExpansionII(expression string) []string {
	exp := expression
	i := 0
	var parseExpr func() map[string]struct{}
	var parseTerm func() map[string]struct{}
	parseExpr = func() map[string]struct{} {
		res := parseTerm()
		for i < len(exp) && exp[i] == ',' {
			i++
			for w := range parseTerm() {
				res[w] = struct{}{}
			}
		}
		return res
	}
	parseTerm = func() map[string]struct{} {
		res := map[string]struct{}{"": {}}
		for i < len(exp) && exp[i] != ',' && exp[i] != '}' {
			cur := map[string]struct{}{}
			if exp[i] == '{' {
				i++
				cur = parseExpr()
				i++
			} else {
				j := i + 1
				for j < len(exp) && exp[j] >= 'a' && exp[j] <= 'z' {
					j++
				}
				cur[exp[i:j]] = struct{}{}
				i = j
			}
			nxt := map[string]struct{}{}
			for a := range res {
				for b := range cur {
					nxt[a+b] = struct{}{}
				}
			}
			res = nxt
		}
		return res
	}
	all := parseExpr()
	ans := make([]string, 0, len(all))
	for w := range all {
		ans = append(ans, w)
	}
	sort.Strings(ans)
	return ans
}1197. 进击的骑士 🔒
题目、示例与约束
一个坐标可以从 -infinity 延伸到 +infinity 的 无限大的 棋盘上,你的 骑士 驻扎在坐标为 [0, 0] 的方格里。
骑士的走法和中国象棋中的马相似,走 “日” 字:即先向左(或右)走 1 格,再向上(或下)走 2 格;或先向左(或右)走 2 格,再向上(或下)走 1 格。
每次移动,他都可以按图示八个方向之一前进。
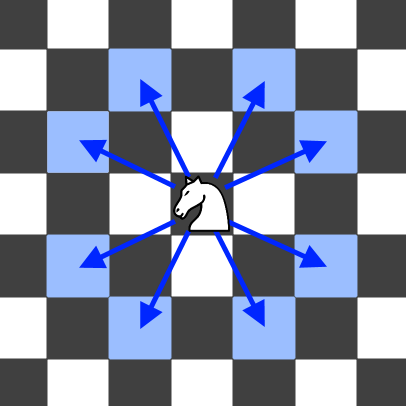
返回 骑士前去征服坐标为 [x, y] 的部落所需的最小移动次数 。本题确保答案是一定存在的。
示例 1:
输入:x = 2, y = 1
输出:1
解释:[0, 0] → [2, 1]
示例 2:
输入:x = 5, y = 5
输出:4
解释:[0, 0] → [2, 1] → [4, 2] → [3, 4] → [5, 5]
提示:
-300 <= x, y <= 3000 <= |x| + |y| <= 300
方法一:BFS · Go 实现
思考
骑士每步八向跳跃,最少步数即网格最短路。从 做 BFS,首次到达 的层数即答案。坐标范围有限,哈希记录访问避免重复入队。对称性虽可缩小象限,朴素 BFS 已能通过。
BFS 最短路模型。本题搜索空间不大,可以直接使用朴素 BFS,以下题解中还提供了双向 BFS 的题解代码,仅供参考。
双向 BFS 是 BFS 常见的一个优化方法,主要实现思路如下:
- 创建两个队列 q1, q2 分别用于“起点 -> 终点”、“终点 -> 起点”两个方向的搜索;
- 创建两个哈希表 m1, m2 分别记录访问过的节点以及对应的扩展次数(步数);
- 每次搜索时,优先选择元素数量较少的队列进行搜索扩展,如果在扩展过程中,搜索到另一个方向已经访问过的节点,说明找到了最短路径;
- 只要其中一个队列为空,说明当前方向的搜索已经进行不下去了,说明起点到终点不连通,无需继续搜索。
func minKnightMoves(x int, y int) int {
	x, y = x+310, y+310
	ans := 0
	q := [][]int{{310, 310}}
	vis := make([][]bool, 700)
	for i := range vis {
		vis[i] = make([]bool, 700)
	}
	dirs := [][]int{{-2, 1}, {-1, 2}, {1, 2}, {2, 1}, {2, -1}, {1, -2}, {-1, -2}, {-2, -1}}
	for len(q) > 0 {
		for k := len(q); k > 0; k-- {
			p := q[0]
			q = q[1:]
			if p[0] == x && p[1] == y {
				return ans
			}
			for _, dir := range dirs {
				c, d := p[0]+dir[0], p[1]+dir[1]
				if !vis[c][d] {
					vis[c][d] = true
					q = append(q, []int{c, d})
				}
			}
		}
		ans++
	}
	return -1
}
方法二:双向 BFS · Go 实现
思考
方法一从单侧扩展,距原点较远时队列更宽。双向 BFS 从起点与终点同时扩展,优先推进更短的一侧,两侧访问集合相交即为最短路,扩展结点数通常更少。
从起点和终点同时广搜骑士跳,两侧相遇即最少步数。
func minKnightMoves(x int, y int) int {
	if x == 0 && y == 0 {
		return 0
	}
	n := 700
	x, y = x+310, y+310
	q1, q2 := []int{310*700 + 310}, []int{x*n + y}
	m1, m2 := map[int]int{310*700 + 310: 0}, map[int]int{x*n + y: 0}
	dirs := [][]int{{-2, 1}, {-1, 2}, {1, 2}, {2, 1}, {2, -1}, {1, -2}, {-1, -2}, {-2, -1}}
	extend := func() int {
		for k := len(q1); k > 0; k-- {
			p := q1[0]
			q1 = q1[1:]
			i, j := p/n, p%n
			step := m1[i*n+j]
			for _, dir := range dirs {
				x, y := i+dir[0], j+dir[1]
				t := x*n + y
				if _, ok := m1[t]; ok {
					continue
				}
				if v, ok := m2[t]; ok {
					return step + 1 + v
				}
				m1[t] = step + 1
				q1 = append(q1, t)
			}
		}
		return -1
	}
	for len(q1) > 0 && len(q2) > 0 {
		if len(q1) <= len(q2) {
			q1, q2 = q2, q1
			m1, m2 = m2, m1
		}
		t := extend()
		if t != -1 {
			return t
		}
	}
	return -1
}1210. 穿过迷宫的最少移动次数
题目、示例与约束
你还记得那条风靡全球的贪吃蛇吗?
我们在一个 n*n 的网格上构建了新的迷宫地图,蛇的长度为 2,也就是说它会占去两个单元格。蛇会从左上角((0, 0) 和 (0, 1))开始移动。我们用 0 表示空单元格,用 1 表示障碍物。蛇需要移动到迷宫的右下角((n-1, n-2) 和 (n-1, n-1))。
每次移动,蛇可以这样走:
- 如果没有障碍,则向右移动一个单元格。并仍然保持身体的水平/竖直状态。
- 如果没有障碍,则向下移动一个单元格。并仍然保持身体的水平/竖直状态。
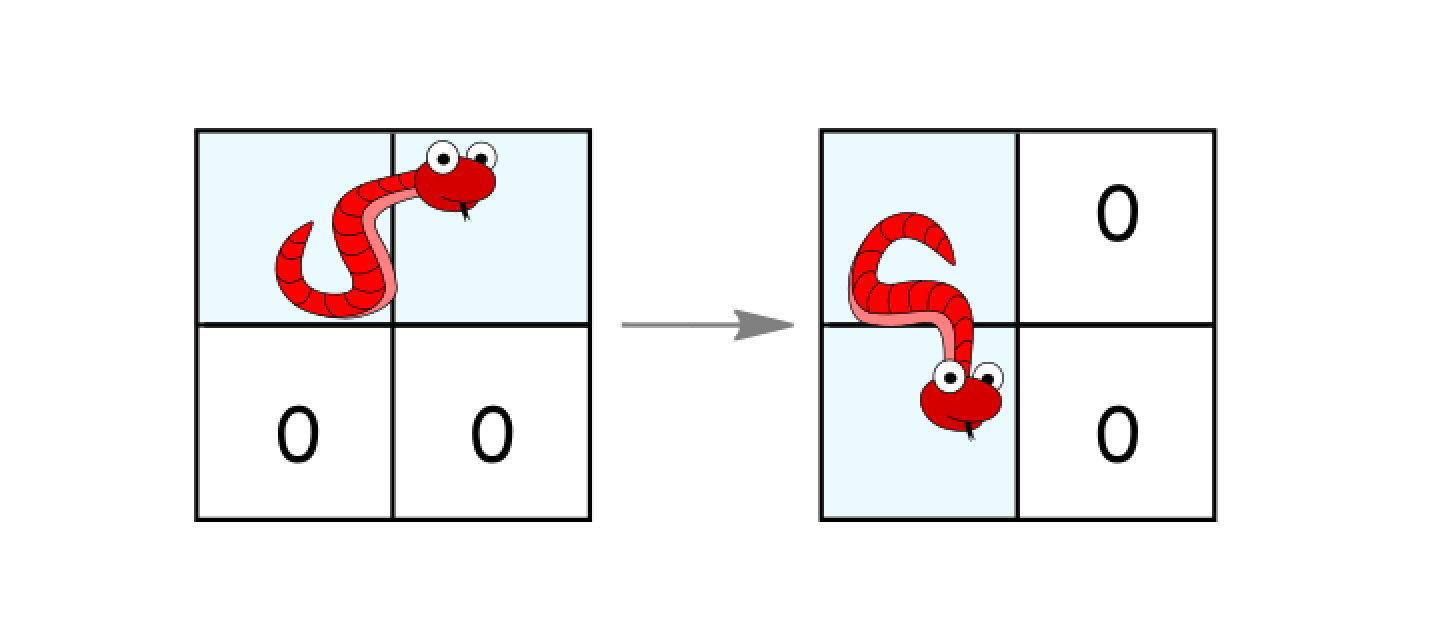
- 如果它处于水平状态并且其下面的两个单元都是空的,就顺时针旋转 90 度。蛇从(
(r, c)、(r, c+1))移动到 ((r, c)、(r+1, c))。
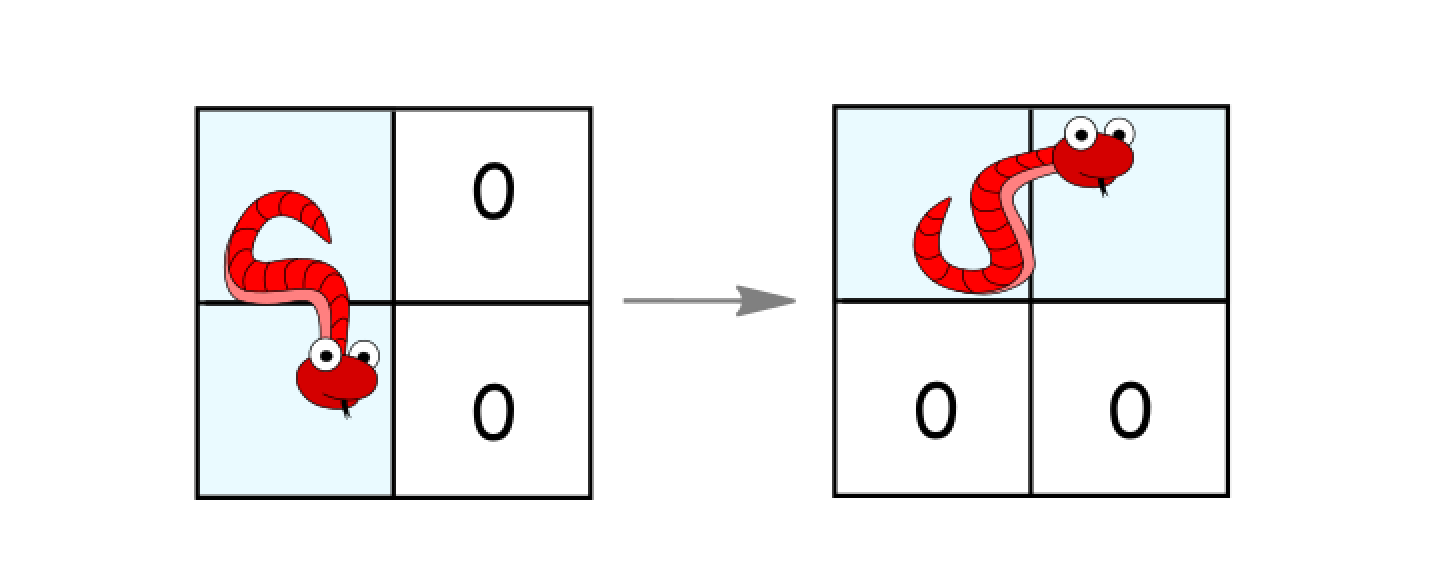
- 如果它处于竖直状态并且其右面的两个单元都是空的,就逆时针旋转 90 度。蛇从(
(r, c)、(r+1, c))移动到((r, c)、(r, c+1))。
返回蛇抵达目的地所需的最少移动次数。
如果无法到达目的地,请返回 -1。
示例 1:
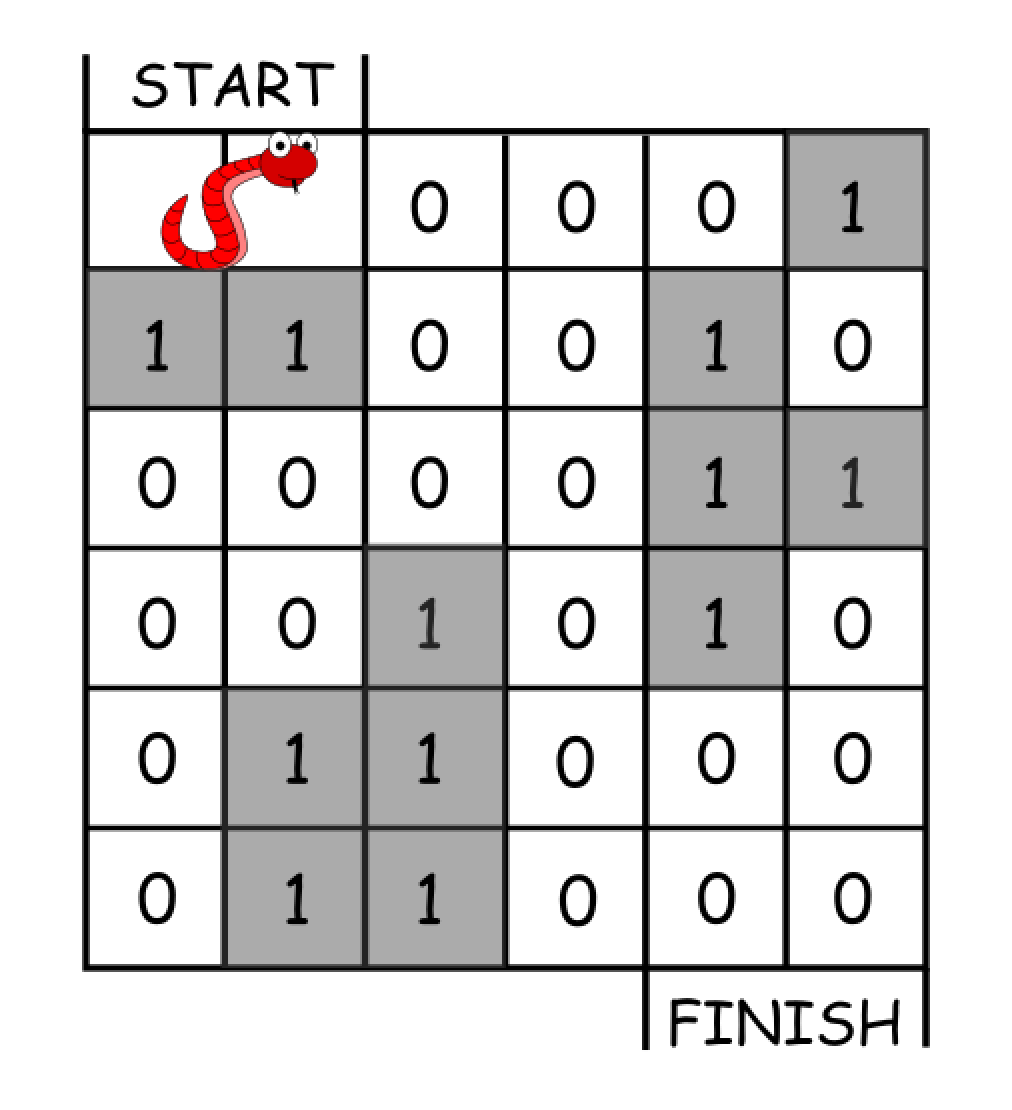
输入:grid = [[0,0,0,0,0,1],
               [1,1,0,0,1,0],
               [0,0,0,0,1,1],
               [0,0,1,0,1,0],
               [0,1,1,0,0,0],
               [0,1,1,0,0,0]]
输出:11
解释:
一种可能的解决方案是 [右, 右, 顺时针旋转, 右, 下, 下, 下, 下, 逆时针旋转, 右, 下]。
示例 2:
输入:grid = [[0,0,1,1,1,1],
               [0,0,0,0,1,1],
               [1,1,0,0,0,1],
               [1,1,1,0,0,1],
               [1,1,1,0,0,1],
               [1,1,1,0,0,0]]
输出:9
提示:
2 <= n <= 1000 <= grid[i][j] <= 1- 蛇保证从空单元格开始出发。
方法一:BFS · Go 实现
思考
蛇有平移与旋转,状态为尾部格子与朝向。 ,状态数 ,求最少步数适合 BFS。
每步可向右或向下平移(头尾同时移动且不越界、不撞墙);水平时可顺时针立起,垂直时可逆时针倒下,前提是旋转扫过的格子为空。把二维坐标压成一维下标后,用 去重。
队列存 ,按层扩展;到达 时的层数即答案。BFS 保证首次到达为目标最短路径。
题目求的是蛇从起始位置到达目标位置的最少移动次数,我们考虑使用广度优先搜索 来求解。
我们定义以下数据结构或变量:
- 队列 :存储蛇的当前位置,每个位置是一个二元组 ,其中 表示蛇的尾部位置,而 表示蛇的头部位置。初始时,我们将位置 加入队列 中。如果我们将二维迷宫扁平化成一个一维数组,那么位置 就表示一维数组下标为 和 的两个单元格。
- 目标位置 :值固定为 ,即二维迷宫的最后一行的最后两个单元格。
- 数组或集合 :存储蛇的当前位置状态是否已经被访问过,每个状态是一个二元组 ,其中 表示蛇的尾部位置;而 表示蛇当前所处的状态,取值为 或 ,分别表示蛇的水平状态和垂直状态。初始时将起始位置 的状态加入集合 中。
- 答案变量 :存储蛇从起始位置到达目标位置的移动次数,初始时为 。
我们使用广度优先搜索来求解,每次从队列 中取出一个位置,判断该位置是否为目标位置 ,如果是,则直接返回答案变量 。如果不是,则将该位置的下一个可能的位置加入队列 中,并将该位置加入 中。注意,这里的下一个位置可能是蛇的水平状态或垂直状态,我们需要分别判断(具体见以下代码注释)。在每一轮搜索结束后,答案变量 自增 。
最后,如果队列 为空,说明无法从起始位置到达目标位置,返回 。
时间复杂度 ,空间复杂度 。其中 是二维迷宫的行数或列数。
func minimumMoves(grid [][]int) int {
	n := len(grid)
	type pair struct{ a, b int }
	target := pair{n*n - 2, n*n - 1}
	q := []pair{pair{0, 1}}
	vis := make([][2]bool, n*n)
	vis[0][0] = true

	move := func(i1, j1, i2, j2 int) {
		if i1 >= 0 && i1 < n && j1 >= 0 && j1 < n && i2 >= 0 && i2 < n && j2 >= 0 && j2 < n {
			a, b := i1*n+j1, i2*n+j2
			status := 1
			if i1 == i2 {
				status = 0
			}
			if !vis[a][status] && grid[i1][j1] == 0 && grid[i2][j2] == 0 {
				q = append(q, pair{a, b})
				vis[a][status] = true
			}
		}
	}

	ans := 0
	for len(q) > 0 {
		for k := len(q); k > 0; k-- {
			p := q[0]
			q = q[1:]
			if p == target {
				return ans
			}
			a, b := p.a, p.b
			i1, j1 := a/n, a%n
			i2, j2 := b/n, b%n
			// 尝试向右平移(保持身体水平/垂直状态)
			move(i1, j1+1, i2, j2+1)
			// 尝试向下平移(保持身体水平/垂直状态)
			move(i1+1, j1, i2+1, j2)
			// 当前处于水平状态,且 grid[i1 + 1][j2] 无障碍,尝试顺时针旋转90°
			if i1 == i2 && i1+1 < n && grid[i1+1][j2] == 0 {
				move(i1, j1, i1+1, j1)
			}
			// 当前处于垂直状态,且 grid[i2][j1 + 1] 无障碍,尝试逆时针旋转90°
			if j1 == j2 && j1+1 < n && grid[i2][j1+1] == 0 {
				move(i1, j1, i1, j1+1)
			}
		}
		ans++
	}
	return -1
}1215. 步进数 🔒
题目、示例与约束
如果一个整数上的每一位数字与其相邻位上的数字的绝对差都是 1,那么这个数就是一个「步进数」。
例如,321 是一个 步进数,而 421 不是。
给你两个整数,low 和 high,请你找出在 [low, high] 范围内的所有 步进数,并返回 排序后 的结果。
示例 1:
输入:low = 0, high = 21
输出:[0,1,2,3,4,5,6,7,8,9,10,12,21]
示例 2:
输入:low = 10, high = 15
输出:[10,12]
提示:
0 <= low <= high <= 2 * 109
方法一:BFS · Go 实现
思考
可达 ,逐个检验每个整数是否为步进数不可行。步进数的下一位只能是末位 ,因此可由 按广度优先向后扩展,生成量远小于值域。
队列中的数按数值增大顺序出队;超过 即可停止。落在 的数收入答案; 需单独处理。BFS 既保证递增输出,也避免重复生成。
首先,如果 为 ,那么我们需要将 加入答案中。
接下来,我们创建一个队列 ,并将 加入队列中。然后我们不断从队列中取出元素,记当前元素为 ,如果 大于 ,那么我们就停止搜索;如果 在 的范围内,那么我们将 加入答案中。然后,我们需要将 的最后一位数字记为 ,如果 ,那么我们将 加入队列中;如果 ,那么我们将 加入队列中。重复上述操作,直到队列为空。
时间复杂度 ,空间复杂度 ,其中 为 的位数。
func countSteppingNumbers(low int, high int) []int {
	ans := []int{}
	if low == 0 {
		ans = append(ans, 0)
	}
	q := []int{1, 2, 3, 4, 5, 6, 7, 8, 9}
	for len(q) > 0 {
		v := q[0]
		q = q[1:]
		if v > high {
			break
		}
		if v >= low {
			ans = append(ans, v)
		}
		x := v % 10
		if x > 0 {
			q = append(q, v*10+x-1)
		}
		if x < 9 {
			q = append(q, v*10+x+1)
		}
	}
	return ans
}1219. 黄金矿工
题目、示例与约束
你要开发一座金矿,地质勘测学家已经探明了这座金矿中的资源分布,并用大小为 m * n 的网格 grid 进行了标注。每个单元格中的整数就表示这一单元格中的黄金数量;如果该单元格是空的,那么就是 0。
为了使收益最大化,矿工需要按以下规则来开采黄金:
- 每当矿工进入一个单元,就会收集该单元格中的所有黄金。
- 矿工每次可以从当前位置向上下左右四个方向走。
- 每个单元格只能被开采(进入)一次。
- 不得开采(进入)黄金数目为
0的单元格。 - 矿工可以从网格中 任意一个 有黄金的单元格出发或者是停止。
示例 1:
输入:grid = [[0,6,0],[5,8,7],[0,9,0]]
输出:24
解释:
[[0,6,0],
 [5,8,7],
 [0,9,0]]
一种收集最多黄金的路线是:9 -> 8 -> 7。
示例 2:
输入:grid = [[1,0,7],[2,0,6],[3,4,5],[0,3,0],[9,0,20]]
输出:28
解释:
[[1,0,7],
 [2,0,6],
 [3,4,5],
 [0,3,0],
 [9,0,20]]
一种收集最多黄金的路线是:1 -> 2 -> 3 -> 4 -> 5 -> 6 -> 7。
提示:
1 <= grid.length, grid[i].length <= 150 <= grid[i][j] <= 100- 最多 25 个单元格中有黄金。
方法一:DFS · Go 实现
思考
网格至多 ,含金格子不超过 ,穷举所有不重复路径可行。路径不能回头,且须从任意含金格出发取最大和。
DFS 进入格子时把金币置零表示占用,向四邻递归并累加,回溯时恢复。从每个格子启动一次,取全局最大。现场修改兼作访问标记,避免额外集合。
我们可以枚举每个格子作为起点,然后从起点开始进行深度优先搜索。在搜索的过程中,每遇到一个非零的格子,就将其变成零,并继续搜索。当无法继续搜索时,计算当前的路径的黄金总数,然后将当前的格子变回非零的格子,从而进行回溯。
时间复杂度 ,其中 是每条路径的最大长度。由于每个格子最多只能被访问一次,因此时间复杂度不会超过 。空间复杂度 。
func getMaximumGold(grid [][]int) (ans int) {
	m, n := len(grid), len(grid[0])
	var dfs func(i, j int) int
	dfs = func(i, j int) int {
		if i < 0 || i >= m || j < 0 || j >= n || grid[i][j] == 0 {
			return 0
		}
		v := grid[i][j]
		grid[i][j] = 0
		ans := 0
		dirs := []int{-1, 0, 1, 0, -1}
		for k := 0; k < 4; k++ {
			ans = max(ans, v+dfs(i+dirs[k], j+dirs[k+1]))
		}
		grid[i][j] = v
		return ans
	}
	for i := 0; i < m; i++ {
		for j := 0; j < n; j++ {
			ans = max(ans, dfs(i, j))
		}
	}
	return
}1236. 网络爬虫 🔒
题目、示例与约束
给定一个网址 startUrl 和一个接口 HtmlParser ,请你实现一个网络爬虫,以实现爬取同 startUrl 拥有相同 域名 的全部链接。
该爬虫得到的全部网址可以 任何顺序 返回结果。
你的网络爬虫应当按照如下模式工作:
- 自页面
startUrl开始爬取 - 调用
HtmlParser.getUrls(url)来获得给定url网址中的全部链接 - 同一个链接最多只爬取一次
- 只浏览 域名 与
startUrl相同 的链接集合
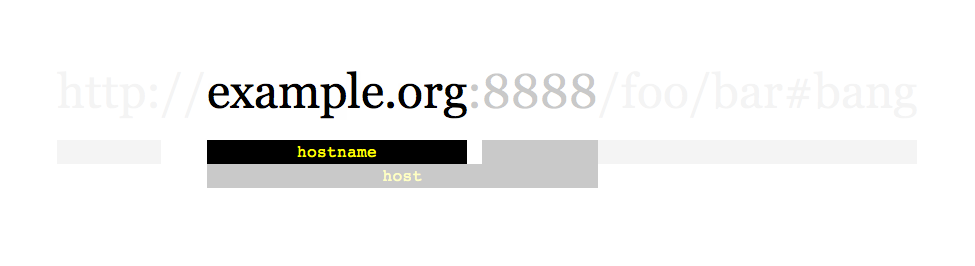
如上所示的一个网址,其域名为 example.org。简单起见,你可以假设所有的网址都采用 http协议 并没有指定 端口。例如,网址 http://leetcode.com/problems 和 http://leetcode.com/contest 是同一个域名下的,而网址 http://example.org/test 和 http://example.com/abc 是不在同一域名下的。
HtmlParser 接口定义如下:
interface HtmlParser {
  // 返回给定 url 对应的页面中的全部 url 。
  public List<String> getUrls(String url);
}
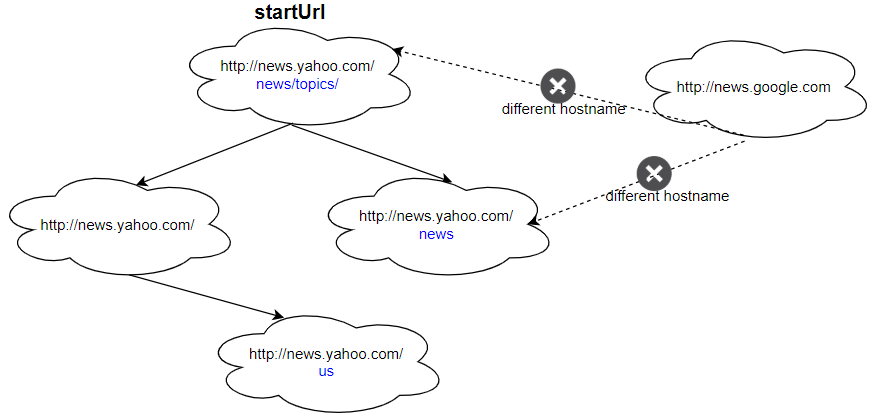
下面是两个实例,用以解释该问题的设计功能,对于自定义测试,你可以使用三个变量 urls, edges 和 startUrl。注意在代码实现中,你只可以访问 startUrl ,而 urls 和 edges 不可以在你的代码中被直接访问。
注意:将尾随斜线“/”的相同网址视为不同的网址。例如,“http://news.yahoo.com” 和 “http://news.yahoo.com/” 是不同的网址。
示例 1:
输入:
urls = [
  "http://news.yahoo.com",
  "http://news.yahoo.com/news",
  "http://news.yahoo.com/news/topics/",
  "http://news.google.com",
  "http://news.yahoo.com/us"
]
edges = [[2,0],[2,1],[3,2],[3,1],[0,4]]
startUrl = "http://news.yahoo.com/news/topics/"
输出:[
  "http://news.yahoo.com",
  "http://news.yahoo.com/news",
  "http://news.yahoo.com/news/topics/",
  "http://news.yahoo.com/us"
]
示例 2:

输入:
urls = [
  "http://news.yahoo.com",
  "http://news.yahoo.com/news",
  "http://news.yahoo.com/news/topics/",
  "http://news.google.com"
]
edges = [[0,2],[2,1],[3,2],[3,1],[3,0]]
startUrl = "http://news.google.com"
输出:["http://news.google.com"]
解释:startUrl 链接到所有其他不共享相同域名的页面。
提示:
1 <= urls.length <= 10001 <= urls[i].length <= 300startUrl为urls中的一个。- 域名的长为1到63个字符(包括点),只能包含从‘a’到‘z’的ASCII字母、‘0’到‘9’的数字以及连字符即减号(‘-’)。
- 域名不会以连字符即减号(‘-’)开头或结尾。
- 关于域名有效性的约束可参考: https://en.wikipedia.org/wiki/Hostname#Restrictions_on_valid_hostnames
- 你可以假定url库中不包含重复项。
方法一 · Go 实现
思考
只能访问与起点同主机的 URL,页面数不超过 。从起点沿 展开是图遍历,同一 URL 不应重复抓取。
用集合记录已访问;DFS 进入未见过的地址后,只对主机名相同的出边继续。主机名取自 之后到下一斜杠的一段。集合去重,主机判断限制搜索范围。
/**
 * // This is HtmlParser's API interface.
 * // You should not implement it, or speculate about its implementation
 * type HtmlParser struct {
 *     func GetUrls(url string) []string {}
 * }
 */

func crawl(startUrl string, htmlParser HtmlParser) []string {
	var ans []string
	vis := make(map[string]bool)
	var dfs func(url string)
	host := func(url string) string {
		return strings.Split(url[7:], "/")[0]
	}
	dfs = func(url string) {
		if vis[url] {
			return
		}
		vis[url] = true
		ans = append(ans, url)
		for _, next := range htmlParser.GetUrls(url) {
			if host(next) == host(url) {
				dfs(next)
			}
		}
	}
	dfs(startUrl)
	return ans
}1238. 循环码排列
题目、示例与约束
给你两个整数 n 和 start。你的任务是返回任意 (0,1,2,,...,2^n-1) 的排列 p,并且满足:
p[0] = startp[i]和p[i+1]的二进制表示形式只有一位不同p[0]和p[2^n -1]的二进制表示形式也只有一位不同
示例 1:
输入:n = 2, start = 3
输出:[3,2,0,1]
解释:这个排列的二进制表示是 (11,10,00,01)
     所有的相邻元素都有一位是不同的,另一个有效的排列是 [3,1,0,2]
示例 2:
输入:n = 3, start = 2
输出:[2,6,7,5,4,0,1,3]
解释:这个排列的二进制表示是 (010,110,111,101,100,000,001,011)
提示:
1 <= n <= 160 <= start < 2^n
方法一:二进制码转格雷码 · Go 实现
思考
相邻(含首尾)只差一位,这正是格雷码的定义。标准构造 给出 的一条格雷码回路。 ,枚举全部码字可行。
生成完整序列后找到 的位置并旋转,使首项为 且圆形相邻关系不变。
我们观察题目中的排列,可以发现,它的二进制表示中,任意两个(包括首尾)相邻的数只有一位二进制数不同。这种编码方式就是格雷码,它是我们在工程中会遇到的一种编码方式。
二进制码转换成二进制格雷码,其法则是保留二进制码的最高位作为格雷码的最高位,而次高位格雷码为二进制码的高位与次高位相异或,而格雷码其余各位与次高位的求法相类似。
假设某个二进制数表示为 ,其格雷码表示为 。最高位保留,所以 ;而其它各位 ,其中 。
因此,对于一个整数 ,我们可以用函数 得到其格雷码:
int gray(x) {
    return x ^ (x >> 1);
}
我们可以直接将 这些整数转换成对应的格雷码数组,然后找到 在格雷码数组中的位置,将格雷码数组从该位置开始截取,再将截取的部分拼接到格雷码数组的前面,就得到了题目要求的排列。
时间复杂度 ,空间复杂度 。其中 为题目给定的整数。
func circularPermutation(n int, start int) []int {
	g := make([]int, 1<<n)
	j := 0
	for i := range g {
		g[i] = i ^ (i >> 1)
		if g[i] == start {
			j = i
		}
	}
	return append(g[j:], g[:j]...)
}
方法二:转换优化 · Go 实现
思考
方法一先生成再旋转。 仍相邻只差一位,且 时恰为 ,故可直接按 映射,省去查找与拼接。
由于 ,那么 ,而 与 只有一个二进制位不同,所以 与 也只有一个二进制位不同。
因此,我们也可以直接将 这些整数转换成对应的 ,即可得到首项为 的格雷码排列。
时间复杂度 ,其中 为题目给定的整数。忽略答案的空间消耗,空间复杂度 。
func circularPermutation(n int, start int) (ans []int) {
	for i := 0; i < 1<<n; i++ {
		ans = append(ans, i^(i>>1)^start)
	}
	return
}1239. 串联字符串的最大长度
题目、示例与约束
给定一个字符串数组 arr,字符串 s 是将 arr 的含有 不同字母 的 子序列 字符串 连接 所得的字符串。
请返回所有可行解 s 中最长长度。
子序列 是一种可以从另一个数组派生而来的数组,通过删除某些元素或不删除元素而不改变其余元素的顺序。
示例 1:
输入:arr = ["un","iq","ue"]
输出:4
解释:所有可能的串联组合是:
- ""
- "un"
- "iq"
- "ue"
- "uniq" ("un" + "iq")
- "ique" ("iq" + "ue")
最大长度为 4。
示例 2:
输入:arr = ["cha","r","act","ers"]
输出:6
解释:可能的解答有 "chaers" 和 "acters"。
示例 3:
输入:arr = ["abcdefghijklmnopqrstuvwxyz"]
输出:26
提示:
1 <= arr.length <= 161 <= arr[i].length <= 26arr[i]中只含有小写英文字母
方法一:状态压缩 + 位运算 · Go 实现
思考
拼接子序列中字符不得重复, 长度不超过 ,子集 可枚举。字母仅 个,一个整数的比特即可表示已用字符。
从空掩码出发,对每个自身无重复的串,与已有掩码按位与为零才合并。答案为所有可达掩码的比特数最大值。位运算把集合运算变成常数时间的与、或。
由于题目要求子序列的字符不能重复,字符都是小写字母,因此,我们可以用一个长度为 的二进制整数来表示一个子序列,其中第 位为 表示子序列中含有滴 个字符,为 表示不含有第 个字符。
我们可以用一个数组 来存储所有满足条件的子序列的状态,初始时 中只有一个元素 。
然后我们遍历数组 ,对于每个字符串 ,我们用一个整数 来表示 的状态,然后我们遍历数组 ,对于每个状态 ,如果 和 之间没有相同的字符,那么我们将 和 的并集加入到 中,并更新答案。
最后我们返回答案即可。
时间复杂度 ,空间复杂度 ,其中 是字符串数组的长度,而 是字符串数组中所有字符串的长度之和。
func maxLength(arr []string) (ans int) {
	s := []int{0}
	for _, t := range arr {
		x := 0
		for _, c := range t {
			b := int(c - 'a')
			if (x>>b)&1 == 1 {
				x = 0
				break
			}
			x |= 1 << b
		}
		if x > 0 {
			for i := len(s) - 1; i >= 0; i-- {
				y := s[i]
				if (x & y) == 0 {
					s = append(s, x|y)
					ans = max(ans, bits.OnesCount(uint(x|y)))
				}
			}
		}
	}
	return ans
}1240. 铺瓷砖
题目、示例与约束
给定一个大小为 n x m 的长方形,返回贴满矩形所需的整数边正方形的最小数量。
示例 1:
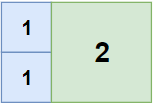
输入:n = 2, m = 3 输出:3解释:需要 3个正方形来覆盖长方形。2个1x1 的正方形1个2x2 的正方形
示例 2:
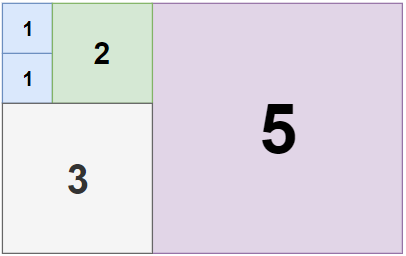
输入:n = 5, m = 8
输出:5
示例 3:
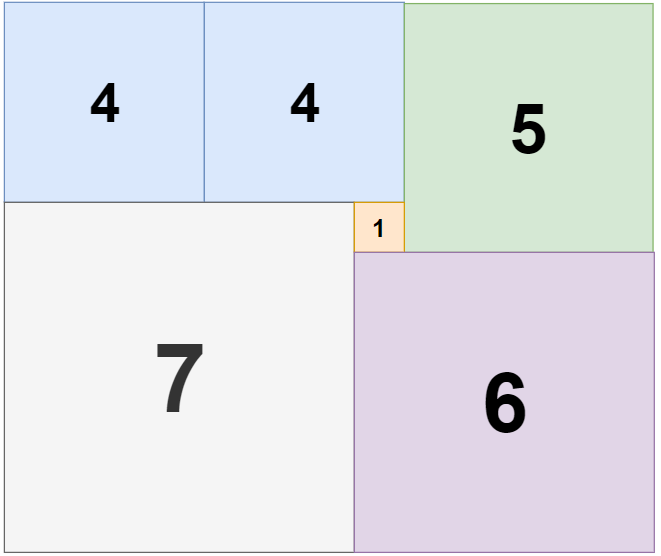
输入:n = 11, m = 13
输出:6
提示:
1 <= n, m <= 13
方法一:递归回溯 + 状态压缩 · Go 实现
思考
用尽量少的正方形铺满 矩形, ,状态可用每行一个比特掩码表示占用。朴素切分方案过多,但可用已用块数剪枝。
按行优先扫描第一个空格,枚举从该格能放下的边长,写入 后递归下一空位;回溯时异或清除。若当前块数已不优于已知答案则停止。状态压缩使「是否占用」成为位运算,回溯保证覆盖完整。
我们可以按位置进行递归回溯,过程中我们用一个变量 记录当前使用的瓷砖数。
- 如果 ,即第 行已经被完全填充,则递归到下一行,即 。
- 如果 ,则表示所有位置都已经被填充,我们更新答案并返回。
- 如果当前位置 已经被填充,则直接递归到下一个位置 。
- 否则,我们枚举当前位置 可以填充的最大正方形的边长 ,并将当前位置 到 的位置全部填充,然后递归到下一个位置 。在回溯时,我们需要将当前位置 到 的位置全部清空。
由于每个位置只有两种状态:填充或者未填充,因此我们可以使用一个整数来表示当前位置的状态。我们使用一个长度为 的整数数组 ,其中 表示第 行的状态。如果 的第 位为 ,则表示第 行第 列已经被填充,否则表示未填充。
func tilingRectangle(n int, m int) int {
	ans := n * m
	filled := make([]int, n)
	var dfs func(i, j, t int)
	dfs = func(i, j, t int) {
		if j == m {
			i++
			j = 0
		}
		if i == n {
			ans = t
			return
		}
		if filled[i]>>j&1 == 1 {
			dfs(i, j+1, t)
		} else if t+1 < ans {
			var r, c int
			for k := i; k < n; k++ {
				if filled[k]>>j&1 == 1 {
					break
				}
				r++
			}
			for k := j; k < m; k++ {
				if filled[i]>>k&1 == 1 {
					break
				}
				c++
			}
			mx := min(r, c)
			for w := 1; w <= mx; w++ {
				for k := 0; k < w; k++ {
					filled[i+w-1] |= 1 << (j + k)
					filled[i+k] |= 1 << (j + w - 1)
				}
				dfs(i, j+w, t+1)
			}
			for x := i; x < i+mx; x++ {
				for y := j; y < j+mx; y++ {
					filled[x] ^= 1 << y
				}
			}
		}
	}
	dfs(0, 0, 0)
	return ans
}
方法二 · Go 实现
思考
方法一从小到大放置正方形。较大块更能立刻降低剩余空洞,对 的剪枝更早生效。方法二先铺满当前位置能放的最大正方形,再从大到小收缩边框并继续搜索,转移集合相同,只是枚举顺序利于剪枝。
func tilingRectangle(n int, m int) int {
	ans := n * m
	filled := make([]int, n)
	var dfs func(i, j, t int)
	dfs = func(i, j, t int) {
		if j == m {
			i++
			j = 0
		}
		if i == n {
			ans = t
			return
		}
		if filled[i]>>j&1 == 1 {
			dfs(i, j+1, t)
		} else if t+1 < ans {
			var r, c int
			for k := i; k < n; k++ {
				if filled[k]>>j&1 == 1 {
					break
				}
				r++
			}
			for k := j; k < m; k++ {
				if filled[i]>>k&1 == 1 {
					break
				}
				c++
			}
			mx := min(r, c)
			for x := i; x < i+mx; x++ {
				for y := j; y < j+mx; y++ {
					filled[x] |= 1 << y
				}
			}
			for w := mx; w > 0; w-- {
				dfs(i, j+w, t+1)
				for k := 0; k < w; k++ {
					filled[i+w-1] ^= 1 << (j + k)
					if k < w-1 {
						filled[i+k] ^= 1 << (j + w - 1)
					}
				}
			}
		}
	}
	dfs(0, 0, 0)
	return ans
}1263. 推箱子
题目、示例与约束
「推箱子」是一款风靡全球的益智小游戏,玩家需要将箱子推到仓库中的目标位置。
游戏地图用大小为 m x n 的网格 grid 表示,其中每个元素可以是墙、地板或者是箱子。
现在你将作为玩家参与游戏,按规则将箱子 'B' 移动到目标位置 'T' :
- 玩家用字符
'S'表示,只要他在地板上,就可以在网格中向上、下、左、右四个方向移动。 - 地板用字符
'.'表示,意味着可以自由行走。 - 墙用字符
'#'表示,意味着障碍物,不能通行。 - 箱子仅有一个,用字符
'B'表示。相应地,网格上有一个目标位置'T'。 - 玩家需要站在箱子旁边,然后沿着箱子的方向进行移动,此时箱子会被移动到相邻的地板单元格。记作一次「推动」。
- 玩家无法越过箱子。
返回将箱子推到目标位置的最小 推动 次数,如果无法做到,请返回 -1。
示例 1:
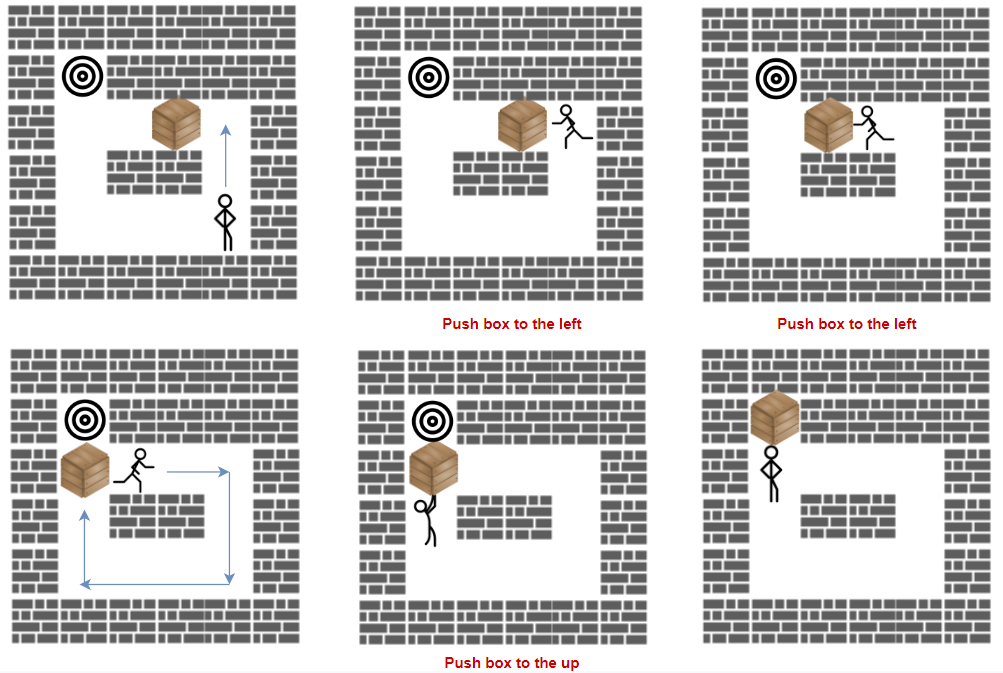
输入:grid = [["#","#","#","#","#","#"],
             ["#","T","#","#","#","#"],
             ["#",".",".","B",".","#"],
             ["#",".","#","#",".","#"],
             ["#",".",".",".","S","#"],
             ["#","#","#","#","#","#"]]
输出:3
解释:我们只需要返回推箱子的次数。
示例 2:
输入:grid = [["#","#","#","#","#","#"],
             ["#","T","#","#","#","#"],
             ["#",".",".","B",".","#"],
             ["#","#","#","#",".","#"],
             ["#",".",".",".","S","#"],
             ["#","#","#","#","#","#"]]
输出:-1
示例 3:
输入:grid = [["#","#","#","#","#","#"],
             ["#","T",".",".","#","#"],
             ["#",".","#","B",".","#"],
             ["#",".",".",".",".","#"],
             ["#",".",".",".","S","#"],
             ["#","#","#","#","#","#"]]
输出:5
解释:向下、向左、向左、向上再向上。
提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 20grid仅包含字符'.','#','S','T', 以及'B'。grid中'S','B'和'T'各只能出现一个。
方法一:双端队列 + BFS · Go 实现
思考
推动箱子的次数要最少,人自己走路不计。状态是人与箱的位置, ,状态数可接受。人走向箱子旁是零代价,推一步代价为 ,适合 0-1 BFS。
双端队列:人单独移动时 不变,状态放入队头;人走进箱子格并沿同方向推出一格时 ,放入队尾。到达箱子在 时的 即最少推次。0-1 BFS 保证先处理零代价边。
我们把玩家的位置和箱子的位置看成一个状态,即 ,其中 是玩家的位置,而 是箱子的位置。在代码实现上,我们定义一个函数 ,它将二维坐标 映射到一个一维的状态编号,即 ,其中 是网格的列数。那么玩家和箱子的状态就是 。
我们首先遍历网格,找到玩家和箱子的初始位置,记为 和 。
然后,我们定义一个双端队列 ,其中每个元素都是一个三元组 ,表示玩家位于 ,箱子位于 ,并且已经进行了 次推动。初始时,我们将 加入队列 。
另外,我们用一个二维数组 记录每个状态是否已经访问过,初始时 标记为已访问。
接下来,我们开始进行广度优先搜索。
在每一步搜索中,我们取出队头元素 ,并检查是否满足 ,如果是,说明箱子已经被推到目标位置,此时将 作为答案返回即可。
否则,我们枚举玩家的下一步移动方向,玩家新的位置记为 ,如果 是一个合法的位置,我们判断此时 是否与箱子的位置 相同:
- 如果相同,说明当前玩家到达了箱子的位置,并且推动箱子往前走了一步。箱子新的位置为 ,如果 是一个合法的位置,且状态 没有被访问过,那么我们就将 加入队列 的末尾,并将 标记为已访问。
- 如果不同,说明当前玩家没有推动箱子,那么我们只需要判断状态 是否被访问过,如果没有被访问过,那么我们就将 加入队列 的头部,并将 标记为已访问。
继续进行广度优先搜索,直到队列为空为止。
注意,如果推动箱子,那么推动次数 需要加 ,并且新的状态加入到队列 的末尾;如果没推动箱子,那么推动次数 不变,新的状态加入到队列 的头部。
最后,如果没有找到合法的推动方案,那么返回 。
时间复杂度 ,空间复杂度 。其中 和 分别是网格的行数和列数。
func minPushBox(grid [][]byte) int {
	m, n := len(grid), len(grid[0])
	var si, sj, bi, bj int
	for i, row := range grid {
		for j, c := range row {
			if c == 'S' {
				si, sj = i, j
			} else if c == 'B' {
				bi, bj = i, j
			}
		}
	}
	f := func(i, j int) int {
		return i*n + j
	}
	check := func(i, j int) bool {
		return i >= 0 && i < m && j >= 0 && j < n && grid[i][j] != '#'
	}
	q := [][]int{[]int{f(si, sj), f(bi, bj), 0}}
	vis := make([][]bool, m*n)
	for i := range vis {
		vis[i] = make([]bool, m*n)
	}
	vis[f(si, sj)][f(bi, bj)] = true
	dirs := [5]int{-1, 0, 1, 0, -1}
	for len(q) > 0 {
		p := q[0]
		q = q[1:]
		si, sj, bi, bj = p[0]/n, p[0]%n, p[1]/n, p[1]%n
		d := p[2]
		if grid[bi][bj] == 'T' {
			return d
		}
		for k := 0; k < 4; k++ {
			sx, sy := si+dirs[k], sj+dirs[k+1]
			if !check(sx, sy) {
				continue
			}
			if sx == bi && sy == bj {
				bx, by := bi+dirs[k], bj+dirs[k+1]
				if !check(bx, by) || vis[f(sx, sy)][f(bx, by)] {
					continue
				}
				vis[f(sx, sy)][f(bx, by)] = true
				q = append(q, []int{f(sx, sy), f(bx, by), d + 1})
			} else if !vis[f(sx, sy)][f(bi, bj)] {
				vis[f(sx, sy)][f(bi, bj)] = true
				q = append([][]int{[]int{f(sx, sy), f(bi, bj), d}}, q...)
			}
		}
	}
	return -1
}1284. 转化为全零矩阵的最少反转次数
题目、示例与约束
给你一个 m x n 的二进制矩阵 mat。每一步,你可以选择一个单元格并将它反转(反转表示 0 变 1 ,1 变 0 )。如果存在和它相邻的单元格,那么这些相邻的单元格也会被反转。相邻的两个单元格共享同一条边。
请你返回将矩阵 mat 转化为全零矩阵的最少反转次数,如果无法转化为全零矩阵,请返回 -1 。
二进制矩阵 的每一个格子要么是 0 要么是 1 。
全零矩阵 是所有格子都为 0 的矩阵。
示例 1:
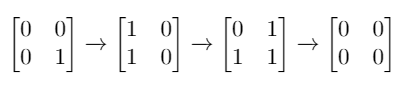
输入:mat = [[0,0],[0,1]]
输出:3
解释:一个可能的解是反转 (1, 0),然后 (0, 1) ,最后是 (1, 1) 。
示例 2:
输入:mat = [[0]]
输出:0
解释:给出的矩阵是全零矩阵,所以你不需要改变它。
示例 3:
输入:mat = [[1,0,0],[1,0,0]]
输出:-1
解释:该矩阵无法转变成全零矩阵
提示:
m == mat.lengthn == mat[0].length1 <= m <= 31 <= n <= 3mat[i][j]是 0 或 1 。
方法一:状态压缩 + BFS · Go 实现
思考
翻转一格会连带四邻, ,全部状态不超过 。求最少翻转次数即最短路。把矩阵压成整数,每次枚举翻转位置并异或自身与邻居,BFS 到 的层数即答案。
func minFlips(mat [][]int) int {
	m, n := len(mat), len(mat[0])
	state := 0
	for i, row := range mat {
		for j, v := range row {
			if v == 1 {
				state |= 1 << (i*n + j)
			}
		}
	}
	q := []int{state}
	vis := map[int]bool{state: true}
	ans := 0
	dirs := []int{0, -1, 0, 1, 0, 0}
	for len(q) > 0 {
		for t := len(q); t > 0; t-- {
			state = q[0]
			if state == 0 {
				return ans
			}
			q = q[1:]
			for i := 0; i < m; i++ {
				for j := 0; j < n; j++ {
					nxt := state
					for k := 0; k < 5; k++ {
						x, y := i+dirs[k], j+dirs[k+1]
						if x < 0 || x >= m || y < 0 || y >= n {
							continue
						}
						if (nxt & (1 << (x*n + y))) != 0 {
							nxt -= 1 << (x*n + y)
						} else {
							nxt |= 1 << (x*n + y)
						}
					}
					if !vis[nxt] {
						vis[nxt] = true
						q = append(q, nxt)
					}
				}
			}
		}
		ans++
	}
	return -1
}1293. 网格中的最短路径
题目、示例与约束
给你一个 m * n 的网格,其中每个单元格不是 0(空)就是 1(障碍物)。每一步,您都可以在空白单元格中上、下、左、右移动。
如果您 最多 可以消除 k 个障碍物,请找出从左上角 (0, 0) 到右下角 (m-1, n-1) 的最短路径,并返回通过该路径所需的步数。如果找不到这样的路径,则返回 -1 。
示例 1:
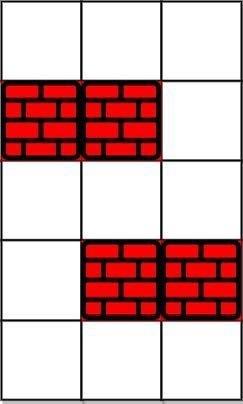
输入: grid = [[0,0,0],[1,1,0],[0,0,0],[0,1,1],[0,0,0]], k = 1
输出:6
解释:
不消除任何障碍的最短路径是 10。
消除位置 (3,2) 处的障碍后,最短路径是 6 。该路径是 (0,0) -> (0,1) -> (0,2) -> (1,2) -> (2,2) -> (3,2) -> (4,2).
示例 2:
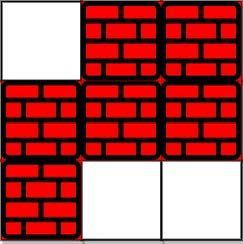
输入:grid = [[0,1,1],[1,1,1],[1,0,0]], k = 1
输出:-1
解释:我们至少需要消除两个障碍才能找到这样的路径。
提示:
grid.length == mgrid[0].length == n1 <= m, n <= 401 <= k <= m*ngrid[i][j]是0或1grid[0][0] == grid[m-1][n-1] == 0
方法一 · Go 实现
思考
网格最短路但可消除至多 个障碍。 ,状态需带剩余消除次数。普通 BFS 的层数即步数;若 已足够走曼哈顿捷径则直接返回。
队列存 ,空格沿用 ,障碍则 。同一格子不同剩余次数视为不同状态。BFS 保证首次到达终点为最短。
func shortestPath(grid [][]int, k int) int {
	m, n := len(grid), len(grid[0])
	if k >= m+n-3 {
		return m + n - 2
	}
	q := [][]int{[]int{0, 0, k}}
	vis := make([][][]bool, m)
	for i := range vis {
		vis[i] = make([][]bool, n)
		for j := range vis[i] {
			vis[i][j] = make([]bool, k+1)
		}
	}
	vis[0][0][k] = true
	dirs := []int{-1, 0, 1, 0, -1}
	ans := 0
	for len(q) > 0 {
		ans++
		for i := len(q); i > 0; i-- {
			p := q[0]
			q = q[1:]
			k = p[2]
			for j := 0; j < 4; j++ {
				x, y := p[0]+dirs[j], p[1]+dirs[j+1]
				if x >= 0 && x < m && y >= 0 && y < n {
					if x == m-1 && y == n-1 {
						return ans
					}
					if grid[x][y] == 0 && !vis[x][y][k] {
						q = append(q, []int{x, y, k})
						vis[x][y][k] = true
					} else if grid[x][y] == 1 && k > 0 && !vis[x][y][k-1] {
						q = append(q, []int{x, y, k - 1})
						vis[x][y][k-1] = true
					}
				}
			}
		}
	}
	return -1
}1306. 跳跃游戏 III
题目、示例与约束
给定一个非负整数数组 arr,你最开始位于该数组的起始下标 start 处。当你位于下标 i 处时,你可以跳到 i + arr[i] 或者 i - arr[i]。
请你判断自己是否能够跳到对应元素值为 0 的 任一 下标处。
注意,不管是什么情况下,你都无法跳到数组之外。
示例 1:
输入:arr = [4,2,3,0,3,1,2], start = 5
输出:true
解释:
到达值为 0 的下标 3 有以下可能方案:
下标 5 -> 下标 4 -> 下标 1 -> 下标 3
下标 5 -> 下标 6 -> 下标 4 -> 下标 1 -> 下标 3
示例 2:
输入:arr = [4,2,3,0,3,1,2], start = 0
输出:true
解释:
到达值为 0 的下标 3 有以下可能方案:
下标 0 -> 下标 4 -> 下标 1 -> 下标 3
示例 3:
输入:arr = [3,0,2,1,2], start = 2
输出:false
解释:无法到达值为 0 的下标 1 处。
提示:
1 <= arr.length <= 5 * 1040 <= arr[i] < arr.length0 <= start < arr.length
方法一:BFS · Go 实现
思考
从 每次跳到 ,询问能否到达值为 的下标。 ,若对同一位置反复搜索,会在环上空转。每个下标最多进入一次队列即可判定可达性。
将问题看作有向图上的可达:出队时若值为 则成功;否则把该格标为已访问(写入 ),再把合法且未访问的两步入队。访问标记兼作剪枝,保证 。
我们可以使用 BFS 来判断是否能够到达值为 的下标。
定义一个队列 ,用于存储当前能够到达的下标。初始时,将 下标入队。
当队列不为空时,取出队首下标 ,如果 ,则返回 true。否则,我们将下标 标记为已访问,如果 和 在数组范围内且未被访问过,则将其入队,继续搜索。
最后,如果队列为空,说明无法到达值为 的下标,返回 false。
时间复杂度 ,空间复杂度 。其中 为数组长度。
func canReach(arr []int, start int) bool {
	q := []int{start}
	for len(q) > 0 {
		i := q[0]
		q = q[1:]
		if arr[i] == 0 {
			return true
		}
		x := arr[i]
		arr[i] = -1
		for _, j := range []int{i + x, i - x} {
			if j >= 0 && j < len(arr) && arr[j] >= 0 {
				q = append(q, j)
			}
		}
	}
	return false
}1307. 口算难题
题目、示例与约束
给你一个方程,左边用 words 表示,右边用 result 表示。
你需要根据以下规则检查方程是否可解:
- 每个字符都会被解码成一位数字(0 - 9)。
- 每对不同的字符必须映射到不同的数字。
- 每个
words[i]和result都会被解码成一个没有前导零的数字。 - 左侧数字之和(
words)等于右侧数字(result)。
如果方程可解,返回 True,否则返回 False。
示例 1:
输入:words = ["SEND","MORE"], result = "MONEY"
输出:true
解释:映射 'S'-> 9, 'E'->5, 'N'->6, 'D'->7, 'M'->1, 'O'->0, 'R'->8, 'Y'->'2'
所以 "SEND" + "MORE" = "MONEY" ,  9567 + 1085 = 10652
示例 2:
输入:words = ["SIX","SEVEN","SEVEN"], result = "TWENTY"
输出:true
解释:映射 'S'-> 6, 'I'->5, 'X'->0, 'E'->8, 'V'->7, 'N'->2, 'T'->1, 'W'->'3', 'Y'->4
所以 "SIX" + "SEVEN" + "SEVEN" = "TWENTY" ,  650 + 68782 + 68782 = 138214
示例 3:
输入:words = ["LEET","CODE"], result = "POINT"
输出:false
解释:不存在任何可能的映射满足该方程,因此我们返回 false。
请注意,两个不同的字符不能映射到同一个数字。
提示:
2 <= words.length <= 51 <= words[i].length, results.length <= 7words[i], result只含有大写英文字母- 表达式中使用的不同字符数最大为 10
方法一 · Go 实现
思考
将字母映射到互异数字,使竖式成立,且前导零不合法。不同字母至多 个,穷举全部排列再验算整式,排列数为 量级,再乘上每次验算的位数,偏紧。
按列从低位向高位处理,可以把进位作为约束提前剪枝:当前列各加数位减去结果位,加上旧进位后,个位必须为 才能进入下一列。已有映射则直接代入;尚未映射则枚举空闲数字,并禁止多位数字的前导零。全部列处理完时进位应为 。
func isSolvable(words []string, result string) bool {
	words = append(words, result)
	totalRows := len(words)
	totalCols := 0
	for _, w := range words {
		if len(w) > totalCols {
			totalCols = len(w)
		}
	}
	letToDig := map[byte]int{}
	digToLet := [10]byte{}
	for i := range digToLet {
		digToLet[i] = '-'
	}
	var isAnyMapping func(row, col, bal int) bool
	isAnyMapping = func(row, col, bal int) bool {
		if col == totalCols {
			return bal == 0
		}
		if row == totalRows {
			return bal%10 == 0 && isAnyMapping(0, col+1, bal/10)
		}
		w := words[row]
		if col >= len(w) {
			return isAnyMapping(row+1, col, bal)
		}
		letter := w[len(w)-1-col]
		sign := 1
		if row == totalRows-1 {
			sign = -1
		}
		if d, ok := letToDig[letter]; ok && (d != 0 || (d == 0 && len(w) == 1) || col != len(w)-1) {
			return isAnyMapping(row+1, col, bal+sign*d)
		}
		for i := 0; i < 10; i++ {
			if digToLet[i] == '-' && (i != 0 || (i == 0 && len(w) == 1) || col != len(w)-1) {
				digToLet[i] = letter
				letToDig[letter] = i
				if isAnyMapping(row+1, col, bal+sign*letToDig[letter]) {
					return true
				}
				digToLet[i] = '-'
				delete(letToDig, letter)
			}
		}
		return false
	}
	return isAnyMapping(0, 0, 0)
}1345. 跳跃游戏 IV
题目、示例与约束
给你一个整数数组 arr ,你一开始在数组的第一个元素处(下标为 0)。
每一步,你可以从下标 i 跳到下标 i + 1 、i - 1 或者 j :
i + 1需满足:i + 1 < arr.lengthi - 1需满足:i - 1 >= 0j需满足:arr[i] == arr[j]且i != j
请你返回到达数组最后一个元素的下标处所需的 最少操作次数 。
注意:任何时候你都不能跳到数组外面。
示例 1:
输入:arr = [100,-23,-23,404,100,23,23,23,3,404]
输出:3
解释:那你需要跳跃 3 次,下标依次为 0 --> 4 --> 3 --> 9 。下标 9 为数组的最后一个元素的下标。
示例 2:
输入:arr = [7]
输出:0
解释:一开始就在最后一个元素处,所以你不需要跳跃。
示例 3:
输入:arr = [7,6,9,6,9,6,9,7]
输出:1
解释:你可以直接从下标 0 处跳到下标 7 处,也就是数组的最后一个元素处。
提示:
1 <= arr.length <= 5 * 104-108 <= arr[i] <= 108
方法一 · Go 实现
思考
每步可到相邻下标或任一等值下标,求到末尾的最少步数。 ,同一值的下标列表若反复遍历会退化。按层 BFS,出队时把 以及同值下标入队,并用 清空该值的列表,保证每条同值边只用一次。
func minJumps(arr []int) int {
	g := map[int][]int{}
	for i, x := range arr {
		g[x] = append(g[x], i)
	}
	n := len(arr)
	q := []int{0}
	vis := make([]bool, n)
	vis[0] = true
	for ans := 0; ; ans++ {
		for k := len(q); k > 0; k-- {
			i := q[0]
			q = q[1:]
			if i == n-1 {
				return ans
			}
			for _, j := range g[arr[i]] {
				if !vis[j] {
					vis[j] = true
					q = append(q, j)
				}
			}
			g[arr[i]] = nil
			for _, j := range []int{i - 1, i + 1} {
				if 0 <= j && j < n && !vis[j] {
					vis[j] = true
					q = append(q, j)
				}
			}
		}
	}
}1415. 长度为 n 的开心字符串中字典序第 k 小的字符串
题目、示例与约束
一个 「开心字符串」定义为:
- 仅包含小写字母
['a', 'b', 'c']. - 对所有在
1到s.length - 1之间的i,满足s[i] != s[i + 1](字符串的下标从 1 开始)。
比方说,字符串 "abc","ac","b" 和 "abcbabcbcb" 都是开心字符串,但是 "aa","baa" 和 "ababbc" 都不是开心字符串。
给你两个整数 n 和 k ,你需要将长度为 n 的所有开心字符串按字典序排序。
请你返回排序后的第 k 个开心字符串,如果长度为 n 的开心字符串少于 k 个,那么请你返回 空字符串 。
示例 1:
输入:n = 1, k = 3
输出:"c"
解释:列表 ["a", "b", "c"] 包含了所有长度为 1 的开心字符串。按照字典序排序后第三个字符串为 "c" 。
示例 2:
输入:n = 1, k = 4
输出:""
解释:长度为 1 的开心字符串只有 3 个。
示例 3:
输入:n = 3, k = 9
输出:"cab"
解释:长度为 3 的开心字符串总共有 12 个 ["aba", "abc", "aca", "acb", "bab", "bac", "bca", "bcb", "cab", "cac", "cba", "cbc"] 。第 9 个字符串为 "cab"
示例 4:
输入:n = 2, k = 7
输出:""
示例 5:
输入:n = 10, k = 100
输出:"abacbabacb"
提示:
1 <= n <= 101 <= k <= 100
方法一:DFS · Go 实现
思考
,每位至多 种合法后继(首位 种),开心串总数不超过 ,按字典序 DFS 生成后取第 个即可。
当前串长为 时收入答案;已凑满 个则剪枝。相邻字符必须不同,字符集仅为 。
我们用一个字符串 来记录当前的字符串,初始时为空字符串。然后,我们设计一个函数 ,用来生成所有长度为 的开心字符串。
函数 的具体实现如下:
- 如果当前字符串的长度等于 ,则将当前字符串加入答案数组 中,然后返回;
- 如果答案数组的长度大于等于 ,则直接返回;
- 否则,我们遍历字符集 ,对于每个字符 ,如果当前字符串为空,或者当前字符串的最后一个字符不等于 ,则将字符 加入当前字符串,然后递归调用 ,递归结束后,将当前字符串的最后一个字符删除。
最后,我们判断答案数组的长度是否小于 ,如果是,则返回空字符串,否则返回答案数组的第 个元素。
时间复杂度 ,空间复杂度 。其中 为字符串长度。
func getHappyString(n int, k int) string {
    ans := []string{}
    var s []byte

    var dfs func()
    dfs = func() {
        if len(s) == n {
            ans = append(ans, string(s))
            return
        }
        if len(ans) >= k {
            return
        }
        for c := byte('a'); c <= 'c'; c++ {
            if len(s) == 0 || s[len(s)-1] != c {
                s = append(s, c)
                dfs()
                s = s[:len(s)-1]
            }
        }
    }

    dfs()
    if len(ans) < k {
        return ""
    }
    return ans[k-1]
}
方法二:数学 · Go 实现
思考
方法一生成了至多全部开心串。固定前缀后,剩余 位各有 种选择,分支大小为 ,可直接按 跳过整段,不必枚举。
先判断 是否超过总数 。随后从左到右枚举与上一位不同的字母,用剩余计数决定写入还是把 减去该分支。
我们可以直接计算出第 个开心字符串是什么,而不需要生成所有的开心字符串。
从长度为 的开心字符串的第一个字符串开始,我们可以计算出每个字符的位置应该是什么。
对于长度为 的开心字符串,第一个字符有 种选择,第二个字符有 种选择(不能和第一个字符相同),第三个字符也有 种选择(不能和第二个字符相同),以此类推,直到第 个字符也有 种选择(不能和第 个字符相同)。因此,长度为 的开心字符串的总数为 。
如果 大于长度为 的开心字符串的总数,那么我们直接返回空字符串。
否则,我们从第一个字符开始,依次计算每个字符的位置应该是什么。对于第 个字符,我们枚举字符集 ,如果当前字符串的最后一个字符不等于 ,则计算出剩余的开心字符串的总数,如果 小于等于剩余的开心字符串的总数,那么我们就将字符 加入当前字符串,然后继续计算下一个字符的位置;否则,我们就将 减去剩余的开心字符串的总数,然后继续枚举下一个字符。
时间复杂度 ,空间复杂度 。其中 为字符串长度。
func getHappyString(n int, k int) string {
	if k > 3*(1<<(n-1)) {
		return ""
	}
	cs := "abc"
	ans := make([]byte, 0, n)
	for i := 0; i < n; i++ {
		remain := 1 << (n - i - 1)
		for j := 0; j < len(cs); j++ {
			c := cs[j]
			if len(ans) > 0 && ans[len(ans)-1] == c {
				continue
			}
			if k <= remain {
				ans = append(ans, c)
				break
			}
			k -= remain
		}
	}
	return string(ans)
}1593. 拆分字符串使唯一子字符串的数目最大
题目、示例与约束
给你一个字符串 s ,请你拆分该字符串,并返回拆分后唯一子字符串的最大数目。
字符串 s 拆分后可以得到若干 非空子字符串 ,这些子字符串连接后应当能够还原为原字符串。但是拆分出来的每个子字符串都必须是 唯一的 。
注意:子字符串 是字符串中的一个连续字符序列。
示例 1:
输入:s = "ababccc"
输出:5
解释:一种最大拆分方法为 ['a', 'b', 'ab', 'c', 'cc'] 。像 ['a', 'b', 'a', 'b', 'c', 'cc'] 这样拆分不满足题目要求,因为其中的 'a' 和 'b' 都出现了不止一次。
示例 2:
输入:s = "aba"
输出:2
解释:一种最大拆分方法为 ['a', 'ba'] 。
示例 3:
输入:s = "aa"
输出:1
解释:无法进一步拆分字符串。
提示:
-
1 <= s.length <= 16 -
s仅包含小写英文字母
方法一:回溯 + 剪枝 · Go 实现
思考
把字符串拆成尽量多段互不相同的子串。 ,回溯全部拆法可行,但若当前段数加上剩余字符数已不超过已知答案,继续搜也不会更优。
从下标 枚举下一段结束位置 ,仅当 尚未用过时纳入集合并递归。用集合判重,并用 剪枝。
我们定义一个哈希表 ,用于存储当前已经拆分出的子字符串。然后我们使用深度优先搜索的方式,尝试将字符串 拆分成若干个唯一的子字符串。
具体地,我们设计一个函数 ,表示我们正在考虑将 进行拆分。
在函数 中,我们首先判断如果当前已经拆分出的子字符串的数量加上剩余的字符数小于等于当前的答案,那么我们就没有必要继续拆分,直接返回。如果 ,那么说明我们已经完成了对整个字符串的拆分,我们更新答案为当前的子字符串数量和答案的较大值。否则,我们枚举当前子字符串的结束位置 (不包括 ),并判断 是否已经被拆分出来。如果没有被拆分出来,我们将其加入到哈希表 中,并继续递归地考虑拆分剩余的部分。在递归调用结束后,我们需要将 从哈希表 中移除。
最后,我们返回答案。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度。
func maxUniqueSplit(s string) (ans int) {
	st := map[string]bool{}
	n := len(s)
	var dfs func(int)
	dfs = func(i int) {
		if len(st)+n-i <= ans {
			return
		}
		if i >= n {
			ans = max(ans, len(st))
			return
		}
		for j := i + 1; j <= n; j++ {
			if t := s[i:j]; !st[t] {
				st[t] = true
				dfs(j)
				delete(st, t)
			}
		}
	}
	dfs(0)
	return
}1601. 最多可达成的换楼请求数目
题目、示例与约束
我们有 n 栋楼,编号从 0 到 n - 1 。每栋楼有若干员工。由于现在是换楼的季节,部分员工想要换一栋楼居住。
给你一个数组 requests ,其中 requests[i] = [fromi, toi] ,表示一个员工请求从编号为 fromi 的楼搬到编号为 toi 的楼。
一开始 所有楼都是满的,所以从请求列表中选出的若干个请求是可行的需要满足 每栋楼员工净变化为 0 。意思是每栋楼 离开 的员工数目 等于 该楼 搬入 的员工数数目。比方说 n = 3 且两个员工要离开楼 0 ,一个员工要离开楼 1 ,一个员工要离开楼 2 ,如果该请求列表可行,应该要有两个员工搬入楼 0 ,一个员工搬入楼 1 ,一个员工搬入楼 2 。
请你从原请求列表中选出若干个请求,使得它们是一个可行的请求列表,并返回所有可行列表中最大请求数目。
示例 1:
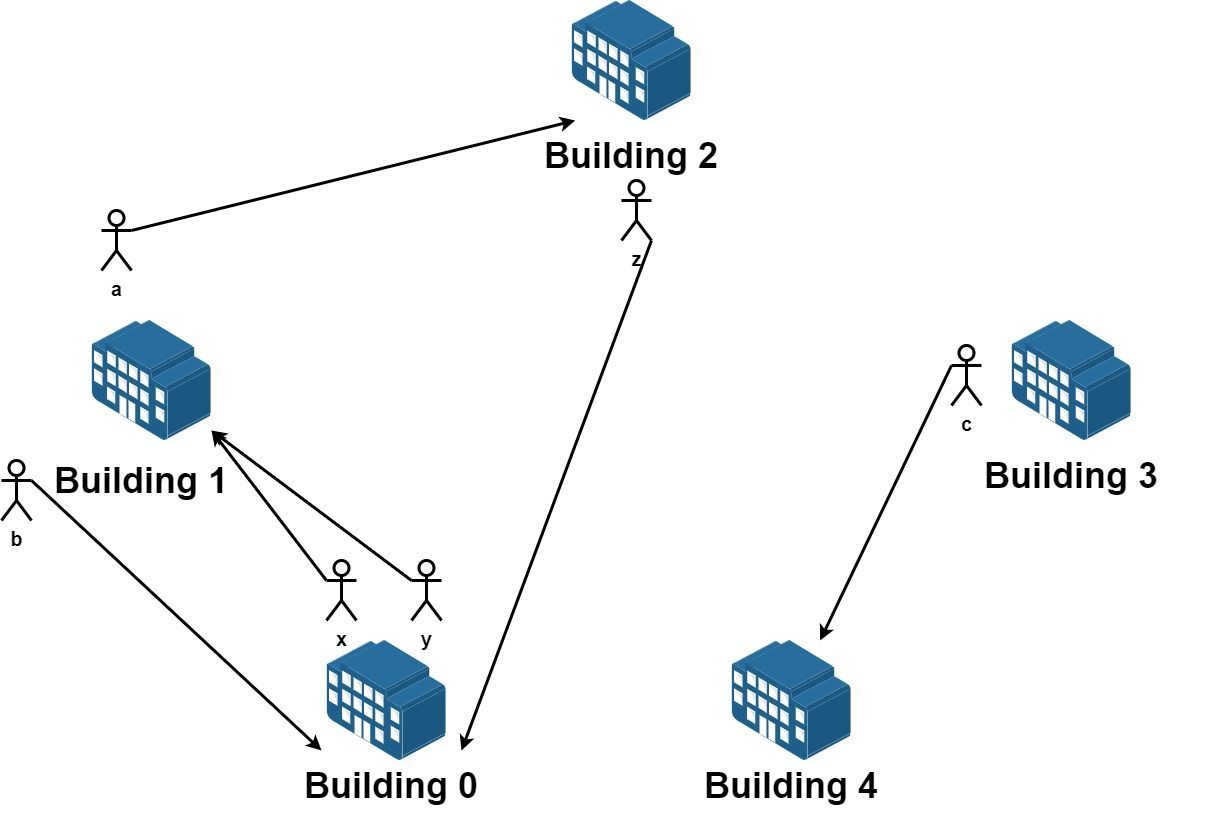
输入:n = 5, requests = [[0,1],[1,0],[0,1],[1,2],[2,0],[3,4]]
输出:5
解释:请求列表如下:
从楼 0 离开的员工为 x 和 y ,且他们都想要搬到楼 1 。
从楼 1 离开的员工为 a 和 b ,且他们分别想要搬到楼 2 和 0 。
从楼 2 离开的员工为 z ,且他想要搬到楼 0 。
从楼 3 离开的员工为 c ,且他想要搬到楼 4 。
没有员工从楼 4 离开。
我们可以让 x 和 b 交换他们的楼,以满足他们的请求。
我们可以让 y,a 和 z 三人在三栋楼间交换位置,满足他们的要求。
所以最多可以满足 5 个请求。
示例 2:
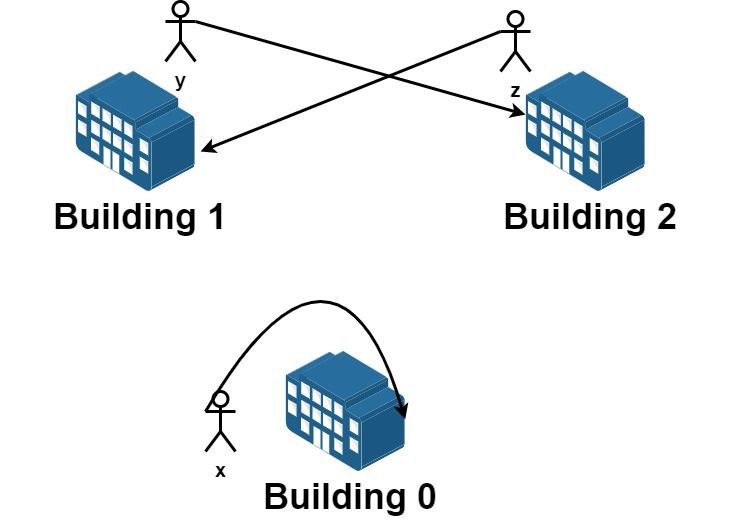
输入:n = 3, requests = [[0,0],[1,2],[2,1]]
输出:3
解释:请求列表如下:
从楼 0 离开的员工为 x ,且他想要回到原来的楼 0 。
从楼 1 离开的员工为 y ,且他想要搬到楼 2 。
从楼 2 离开的员工为 z ,且他想要搬到楼 1 。
我们可以满足所有的请求。
示例 3:
输入:n = 4, requests = [[0,3],[3,1],[1,2],[2,0]]
输出:4
提示:
1 <= n <= 201 <= requests.length <= 16requests[i].length == 20 <= fromi, toi < n
方法一:二进制枚举 · Go 实现
思考
请求条数 ,若对每条请求决定是否采纳,状态空间仅为 ,再对每栋楼核对净流入是否为零,复杂度可以接受。
可行方案的充要条件是每栋楼的迁入次数等于迁出次数,不必显式模拟人员移动。
因此枚举掩码 ,用 作为采纳条数;仅当条数优于当前答案时才检查各楼计数是否全零,从而在保证正确性的同时减少无效校验。
我们注意到,换楼请求列表长度不超过 ,因此我们可以使用二进制枚举的方法枚举所有的换楼请求列表。具体地,我们可以使用一个长度为 的二进制数来表示一种换楼请求列表,其中第 位为 表示第 个换楼请求被选中,为 表示第 个换楼请求不被选中。
我们在 的范围内枚举所有的二进制数,对于每个二进制数 ,我们先算出它的二进制表示中有多少个 ,记为 ,如果 比当前答案 大,那么我们再判断 是否是一个可行的换楼请求列表。如果是,那么我们就用 更新答案 。判断 是否是一个可行的换楼请求列表,只需要判断对于每个楼,它的净流入量是否为 即可。
时间复杂度 ,空间复杂度 。其中 和 分别是换楼请求列表的长度和楼的数量。
func maximumRequests(n int, requests [][]int) (ans int) {
	m := len(requests)
	check := func(mask int) bool {
		cnt := make([]int, n)
		for i, r := range requests {
			if mask>>i&1 == 1 {
				f, t := r[0], r[1]
				cnt[f]--
				cnt[t]++
			}
		}
		for _, v := range cnt {
			if v != 0 {
				return false
			}
		}
		return true
	}
	for mask := 0; mask < 1<<m; mask++ {
		cnt := bits.OnesCount(uint(mask))
		if ans < cnt && check(mask) {
			ans = cnt
		}
	}
	return
}1625. 执行操作后字典序最小的字符串
题目、示例与约束
给你一个字符串 s 以及两个整数 a 和 b 。其中,字符串 s 的长度为偶数,且仅由数字 0 到 9 组成。
你可以在 s 上按任意顺序多次执行下面两个操作之一:
- 累加:将
a加到s中所有下标为奇数的元素上(下标从 0 开始)。当数字超过9时,从0重新循环计算。例如,s = "3456"且a = 5,则执行此操作后s变成"3951"。 - 轮转:将
s向右轮转b位。例如,s = "3456"且b = 1,则执行此操作后s变成"6345"。
请你返回在 s 上执行上述操作任意次后可以得到的 字典序最小 的字符串。
如果两个字符串长度相同,那么字符串 a 字典序比字符串 b 小可以这样定义:在 a 和 b 出现不同的第一个位置上,字符串 a 中的字符出现在字母表中的时间早于 b 中的对应字符。例如,"0158” 字典序比 "0190" 小,因为不同的第一个位置是在第三个字符,显然 '5' 出现在 '9' 之前。
示例 1:
输入:s = "5525", a = 9, b = 2 输出:"2050" 解释:执行操作如下: 初态:"5525" 轮转:"2555" 累加:"2454" 累加:"2353" 轮转:"5323" 累加:"5222" 累加:"5121" 轮转:"2151" 累加:"2050" 无法获得字典序小于 "2050" 的字符串。
示例 2:
输入:s = "74", a = 5, b = 1 输出:"24" 解释:执行操作如下: 初态:"74" 轮转:"47" 累加:"42" 轮转:"24" 无法获得字典序小于 "24" 的字符串。
示例 3:
输入:s = "0011", a = 4, b = 2
输出:"0011"
解释:无法获得字典序小于 "0011" 的字符串。
提示:
2 <= s.length <= 100s.length是偶数s仅由数字0到9组成1 <= a <= 91 <= b <= s.length - 1
方法一:BFS · Go 实现
思考
累加与轮转可反复施加,状态图的每个结点至多两条出边。字符串长度不超过 且仅含数字,可达状态远小于 ,可用 BFS 穷尽。
从 出发,对奇数位统一加 (模 )以及右旋 位,用集合去重,遍历中维护字典序最小串。
本题数据规模较小,我们可以使用 BFS 暴力搜索所有可能的状态,然后取字典序最小的状态即可。
func findLexSmallestString(s string, a int, b int) string {
	q := []string{s}
	vis := map[string]bool{s: true}
	ans := s
	n := len(s)
	for len(q) > 0 {
		s = q[0]
		q = q[1:]
		if ans > s {
			ans = s
		}
		t1 := []byte(s)
		for i := 1; i < n; i += 2 {
			t1[i] = byte((int(t1[i]-'0')+a)%10 + '0')
		}
		t2 := s[n-b:] + s[:n-b]
		for _, t := range []string{string(t1), t2} {
			if !vis[t] {
				vis[t] = true
				q = append(q, t)
			}
		}
	}
	return ans
}
方法二:枚举 · Go 实现
思考
方法一按图搜索,队列与哈希有额外开销。累加周期为 ,轮转周期不超过 ,且 为偶数时累加只影响奇数位。
因此先枚举至多 次轮转,再对奇数位枚举 次累加;若 为奇数,偶数位也可累加,再套一层 次枚举,直接取最小串。
我们观察发现,对于累加操作,数字最多累加 次,就会回到原来的状态;对于轮转操作,字符串最多轮转 次,也会回到原来的状态。
因此,轮转操作最多产生 种状态,如果轮转位数 为偶数,累加操作只会对奇数位数字产生影响,因此总共产生 种状态;如果轮转位数 为奇数,累加操作既会对奇数位数字产生影响,也会对偶数位数字产生影响,因此总共产生 种状态。
所以,我们直接枚举所有的字符串状态,取字典序最小的状态即可。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度。
func findLexSmallestString(s string, a int, b int) string {
	n := len(s)
	ans := s
	for _ = range s {
		s = s[n-b:] + s[:n-b]
		cs := []byte(s)
		for j := 0; j < 10; j++ {
			for k := 1; k < n; k += 2 {
				cs[k] = byte((int(cs[k]-'0')+a)%10 + '0')
			}
			if b&1 == 1 {
				for p := 0; p < 10; p++ {
					for k := 0; k < n; k += 2 {
						cs[k] = byte((int(cs[k]-'0')+a)%10 + '0')
					}
					s = string(cs)
					if ans > s {
						ans = s
					}
				}
			} else {
				s = string(cs)
				if ans > s {
					ans = s
				}
			}
		}
	}
	return ans
}1654. 到家的最少跳跃次数
题目、示例与约束
有一只跳蚤的家在数轴上的位置 x 处。请你帮助它从位置 0 出发,到达它的家。
跳蚤跳跃的规则如下:
- 它可以 往前 跳恰好
a个位置(即往右跳)。 - 它可以 往后 跳恰好
b个位置(即往左跳)。 - 它不能 连续 往后跳
2次。 - 它不能跳到任何
forbidden数组中的位置。
跳蚤可以往前跳 超过 它的家的位置,但是它 不能跳到负整数 的位置。
给你一个整数数组 forbidden ,其中 forbidden[i] 是跳蚤不能跳到的位置,同时给你整数 a, b 和 x ,请你返回跳蚤到家的最少跳跃次数。如果没有恰好到达 x 的可行方案,请你返回 -1 。
示例 1:
输入:forbidden = [14,4,18,1,15], a = 3, b = 15, x = 9
输出:3
解释:往前跳 3 次(0 -> 3 -> 6 -> 9),跳蚤就到家了。
示例 2:
输入:forbidden = [8,3,16,6,12,20], a = 15, b = 13, x = 11
输出:-1
示例 3:
输入:forbidden = [1,6,2,14,5,17,4], a = 16, b = 9, x = 7
输出:2
解释:往前跳一次(0 -> 16),然后往回跳一次(16 -> 7),跳蚤就到家了。
提示:
1 <= forbidden.length <= 10001 <= a, b, forbidden[i] <= 20000 <= x <= 2000forbidden中所有位置互不相同。- 位置
x不在forbidden中。
方法一:BFS · Go 实现
思考
前跳 、后跳 且不能连续后跳,还有禁止坐标,求到 的最少步数。状态是(位置,上一步是否可后跳),边权均为 ,适合 BFS。
位置可能越过 再回来,需要右界:综合 与禁区范围,取 即可覆盖所有有用状态。
队列存 , 表示可以后跳;访问过的 不再入队,禁区与越界丢弃。
我们可以将跳蚤的位置和跳跃方向作为状态,使用 BFS 搜索最短路径。本题比较关键的地方在于确定右边界,即跳蚤最远能跳到哪里。
如果 ,即往前跳的距离大于往后跳的距离,那么如果跳蚤在位置大于 的地方,它就不能再往前跳了,因为跳蚤不能连续往后跳两次,如果继续往前跳,那么永远无法跳到 的位置。因此,如果 ,那么右边界可以是 。
如果 ,即往前跳的距离小于往后跳的距离,那么如果跳蚤所在的位置减去 超过 ,此时选择往后跳,否则往前跳。因此,如果 ,那么右边界不超过 。
综上,我们可以将右边界设置为 。
接下来,我们使用 BFS 搜索最短路径。我们使用一个队列,初始时将跳蚤的位置和跳跃方向作为状态加入队列。每次从队列中取出一个状态,如果该状态的位置等于 ,那么我们就找到了一条从初始状态到达目标状态的路径,返回当前的步数即可。否则,我们将当前状态的下一个状态加入队列,下一个状态有两种情况:
- 往前跳,跳跃方向为 ;
- 当前跳跃方向为 时,往后跳,跳跃方向为 。
注意,我们需要判断下一个状态是否合法,即下一个状态的位置不超过右边界,且不在禁止的位置中,且未被访问过。
如果队列为空,说明无法到达目标位置,返回 。
时间复杂度 ,空间复杂度 。其中 是右边界,本题中 。
func minimumJumps(forbidden []int, a int, b int, x int) (ans int) {
	s := map[int]bool{}
	for _, v := range forbidden {
		s[v] = true
	}
	q := [][2]int{[2]int{0, 1}}
	const n = 6000
	vis := make([][2]bool, n)
	vis[0][1] = true
	for ; len(q) > 0; ans++ {
		for t := len(q); t > 0; t-- {
			p := q[0]
			q = q[1:]
			i, k := p[0], p[1]
			if i == x {
				return
			}
			nxt := [][2]int{[2]int{i + a, 1}}
			if k&1 == 1 {
				nxt = append(nxt, [2]int{i - b, 0})
			}
			for _, e := range nxt {
				j, l := e[0], e[1]
				if j >= 0 && j < n && !s[j] && !vis[j][l] {
					q = append(q, [2]int{j, l})
					vis[j][l] = true
				}
			}
		}
	}
	return -1
}继续阅读
- 实践案例
- 实践案例
- 实践案例