
LeetCode Go · 树与二叉树(6)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
1617. 统计子树中城市之间最大距离
题目、示例与约束
给你 n 个城市,编号为从 1 到 n 。同时给你一个大小为 n-1 的数组 edges ,其中 edges[i] = [ui, vi] 表示城市 ui 和 vi 之间有一条双向边。题目保证任意城市之间只有唯一的一条路径。换句话说,所有城市形成了一棵 树 。
一棵 子树 是城市的一个子集,且子集中任意城市之间可以通过子集中的其他城市和边到达。两个子树被认为不一样的条件是至少有一个城市在其中一棵子树中存在,但在另一棵子树中不存在。
对于 d 从 1 到 n-1 ,请你找到城市间 最大距离 恰好为 d 的所有子树数目。
请你返回一个大小为 n-1 的数组,其中第 d 个元素(下标从 1 开始)是城市间 最大距离 恰好等于 d 的子树数目。
请注意,两个城市间距离定义为它们之间需要经过的边的数目。
示例 1:
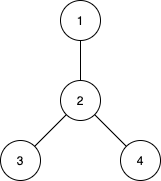
输入:n = 4, edges = [[1,2],[2,3],[2,4]]
输出:[3,4,0]
解释:
子树 {1,2}, {2,3} 和 {2,4} 最大距离都是 1 。
子树 {1,2,3}, {1,2,4}, {2,3,4} 和 {1,2,3,4} 最大距离都为 2 。
不存在城市间最大距离为 3 的子树。
示例 2:
输入:n = 2, edges = [[1,2]]
输出:[1]
示例 3:
输入:n = 3, edges = [[1,2],[2,3]]
输出:[2,1]
提示:
2 <= n <= 15edges.length == n-1edges[i].length == 21 <= ui, vi <= n- 题目保证
(ui, vi)所表示的边互不相同。
方法一:二进制枚举 + BFS 或 DFS · Go 实现
思考
城市数 ,子集只有 个。一个子集构成子树当且仅当诱导子图连通;其最大距离即该子树直径。
连通性可用一次 DFS/BFS 看是否走完整点集:把掩码中访问过的位置清掉,结束时掩码为零则连通。直径则用树上两次搜索:先任取一点找到最远点,再从该点出发得最长路径。
跳过单点掩码,对每个至少两点的 做上述检验,将直径 计入 。
我们注意到 ,因此可以考虑使用二进制枚举的方法枚举所有的子树。而子树中节点的最大距离,其实就是子树中两个节点之间的最长路径,也即是树的直径,求解树的直径一般可以使用 DFS 或 BFS,先找到树直径的一个端点,然后再从该端点出发,找到树的另一个端点,这两个端点之间的路径长度就是树的直径。
接下来,我们详细说明具体的代码实现。
我们先根据数组 构建出邻接表 ,其中 表示节点 的所有邻接节点。
用一个二进制数 表示子树,其中 的第 位为 表示节点 在子树中,否则表示节点 不在子树中。每个节点都有两种状态,即在子树中或不在子树中,有 个节点,因此一共有 种状态。
接下来,我们在 的范围内枚举子树 ,对于每个子树:
如果 的二进制表示中只有一个二进制位为 ,即 ,则跳过该 ,因为这些 表示的子树只有一个节点,不符合题意;
否则,我们找到 的二进制表示中最高位的二进制位为 的位置,记为 。然后从节点 出发,通过深度优先搜索或者广度优先搜索,找到树直径的一个端点 ,然后我们再从节点 出发,同样通过深度优先搜索或者广度优先搜索,过程中记录下最大距离 。
当走到最深的节点时,即可得知树的直径。此时我们更新答案数组 ,将 的值加 。注意,这里是 ,因为题目中的最大距离是从 开始计数的。
最后,枚举完所有的子树,返回答案数组 即可。
时间复杂度 ,空间复杂度 。其中 为节点个数。
func countSubgraphsForEachDiameter(n int, edges [][]int) []int {
	g := make([][]int, n)
	for _, e := range edges {
		u, v := e[0]-1, e[1]-1
		g[u] = append(g[u], v)
		g[v] = append(g[v], u)
	}
	ans := make([]int, n-1)
	var msk, nxt, mx int
	var dfs func(int, int)
	dfs = func(u, d int) {
		msk ^= 1 << u
		if mx < d {
			mx, nxt = d, u
		}
		for _, v := range g[u] {
			if msk>>v&1 == 1 {
				dfs(v, d+1)
			}
		}
	}
	for mask := 1; mask < 1<<n; mask++ {
		if mask&(mask-1) == 0 {
			continue
		}
		msk, mx = mask, 0
		cur := bits.Len(uint(msk)) - 1
		dfs(cur, 0)
		if msk == 0 {
			msk, mx = mask, 0
			dfs(nxt, 0)
			ans[mx-1]++
		}
	}
	return ans
}
方法二 · Go 实现
思考
方法一用递归 DFS 求直径。同一套「清掩码判连通 + 两次最远点」也可以改成按层 BFS,避免递归深度并明确层次即距离。
算法结构不变,仅把搜索实现换成队列。
func countSubgraphsForEachDiameter(n int, edges [][]int) []int {
	g := make([][]int, n)
	for _, e := range edges {
		u, v := e[0]-1, e[1]-1
		g[u] = append(g[u], v)
		g[v] = append(g[v], u)
	}
	ans := make([]int, n-1)
	var msk, nxt int
	bfs := func(u int) int {
		d := -1
		q := []int{u}
		msk ^= 1 << u
		for len(q) > 0 {
			d++
			for k := len(q); k > 0; k-- {
				u = q[0]
				q = q[1:]
				nxt = u
				for _, v := range g[u] {
					if msk>>v&1 == 1 {
						msk ^= 1 << v
						q = append(q, v)
					}
				}
			}
		}
		return d
	}
	for mask := 1; mask < 1<<n; mask++ {
		if mask&(mask-1) == 0 {
			continue
		}
		msk = mask
		cur := bits.Len(uint(msk)) - 1
		bfs(cur)
		if msk == 0 {
			msk = mask
			mx := bfs(nxt)
			ans[mx-1]++
		}
	}
	return ans
}1644. 二叉树的最近公共祖先 II 🔒
题目、示例与约束
给定一棵二叉树的根节点 root,返回给定节点 p 和 q 的最近公共祖先(LCA)节点。如果 p 或 q 之一 不存在 于该二叉树中,返回 null。树中的每个节点值都是互不相同的。
根据维基百科中对最近公共祖先节点的定义:“两个节点 p 和 q 在二叉树 T 中的最近公共祖先节点是 后代节点 中既包括 p 又包括 q 的最深节点(我们允许 一个节点为自身的一个后代节点 )”。一个节点 x 的 后代节点 是节点 x 到某一叶节点间的路径中的节点 y。
示例 1:
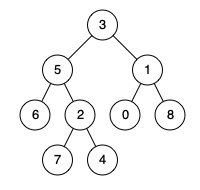
输入: root = [3,5,1,6,2,0,8,null,null,7,4], p = 5, q = 1
输出: 3
解释: 节点 5 和 1 的共同祖先节点是 3。
示例 2:
输入: root = [3,5,1,6,2,0,8,null,null,7,4], p = 5, q = 4
输出: 5
解释: 节点 5 和 4 的共同祖先节点是 5。根据共同祖先节点的定义,一个节点可以是自身的后代节点。
示例 3:
输入: root = [3,5,1,6,2,0,8,null,null,7,4], p = 5, q = 10
输出: null
解释: 节点 10 不存在于树中,所以返回 null。
提示:
- 树中节点个数的范围是
[1, 104] -109 <= Node.val <= 109- 所有节点的值
Node.val互不相同 p != q
进阶: 在不检查节点是否存在的情况下,你可以遍历树找出最近公共祖先节点吗?
方法一:Go 解法(本站整理) · Go 实现
基于 Doocs 后序遍历参考改写。每个子树返回两位掩码,分别表示是否出现指针 p、q;后序首次得到 3 的节点就是最低公共祖先。必须继续遍历目标节点的孩子,且只有两节点确实存在才返回答案。n 为节点数,h 为树高,时间 O(n),递归空间 O(h)。平台 TreeNode 为 struct { Val int; Left, Right *TreeNode };比较节点身份而不是数值。
出处:Doocs 原题与题解,固定提交 91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011;题意、参考及本 Go 改写采用 CC BY-SA 4.0。
// 题意与参考:Doocs LeetCode,CC BY-SA 4.0。
// https://github.com/doocs/leetcode/blob/91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011/solution/1600-1699/1644.Lowest%20Common%20Ancestor%20of%20a%20Binary%20Tree%20II/README.md
// Go 实现与测试沿用 CC BY-SA 4.0;来源性质见配套说明。
func lowestCommonAncestor(root, p, q *TreeNode) *TreeNode {
	var ans *TreeNode
	var dfs func(*TreeNode) uint8
	dfs = func(n *TreeNode) uint8 {
		if n == nil {
			return 0
		}
		mask := dfs(n.Left) | dfs(n.Right)
		if n == p {
			mask |= 1
		}
		if n == q {
			mask |= 2
		}
		if mask == 3 && ans == nil {
			ans = n
		}
		return mask
	}
	dfs(root)
	return ans
}1650. 二叉树的最近公共祖先 III 🔒
题目、示例与约束
给定一棵二叉树中的两个节点 p 和 q,返回它们的最近公共祖先节点(LCA)。
每个节点都包含其父节点的引用(指针)。Node 的定义如下:
class Node {
    public int val;
    public Node left;
    public Node right;
    public Node parent;
}
根据维基百科中对最近公共祖先节点的定义:“两个节点 p 和 q 在二叉树 T 中的最近公共祖先节点是后代节点中既包括 p 又包括 q 的最深节点(我们允许一个节点为自身的一个后代节点)”。一个节点 x 的后代节点是节点 x 到某一叶节点间的路径中的节点 y。
示例 1:
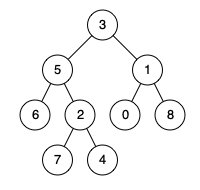
输入: root = [3,5,1,6,2,0,8,null,null,7,4], p = 5, q = 1
输出: 3
解释: 节点 5 和 1 的最近公共祖先是 3。
示例 2:
输入: root = [3,5,1,6,2,0,8,null,null,7,4], p = 5, q = 4
输出: 5
解释: 节点 5 和 4 的最近公共祖先是 5,根据定义,一个节点可以是自身的最近公共祖先。
示例 3:
输入: root = [1,2], p = 1, q = 2
输出: 1
提示:
- 树中节点个数的范围是
[2, 105]。 -109 <= Node.val <= 109- 所有的
Node.val都是互不相同的。 p != qp和q存在于树中。
方法一:哈希表 · Go 实现
思考
结点带有父指针,不必从根向下搜索。从 走到根的链上所有点都是 的祖先,再从 上走,第一个落在该集合中的点即 LCA。
哈希表 记录 到根的路径,随后沿 的父链查找。空间与深度同阶。
我们用一个哈希表 记录从节点 开始到根节点的路径上的所有节点,接下来从节点 开始往根节点方向遍历,如果遇到一个节点存在于哈希表 中,那么该节点就是 和 的最近公共祖先节点,直接返回即可。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for Node.
 * type Node struct {
 *     Val int
 *     Left *Node
 *     Right *Node
 *     Parent *Node
 * }
 */

func lowestCommonAncestor(p *Node, q *Node) *Node {
	vis := map[*Node]bool{}
	for node := p; node != nil; node = node.Parent {
		vis[node] = true
	}
	for node := q; ; node = node.Parent {
		if vis[node] {
			return node
		}
	}
}
方法二:双指针 · Go 实现
思考
方法一额外存整条链。两指针分别从 向上,走尽则跳到对方起点,相遇点就是 LCA,与链表相交同一思路,空间 。
我们可以用两个指针 和 分别指向节点 和 ,然后分别往根节点方向遍历,当 和 相遇时,就是 和 的最近公共祖先节点。否则,如果指针 遍历到了根节点,那么我们就让它指向节点 ,指针 同理。这样,当两个指针相遇时,就是 和 的最近公共祖先节点。
时间复杂度 ,其中 是二叉树的节点数。空间复杂度 。
/**
 * Definition for Node.
 * type Node struct {
 *     Val int
 *     Left *Node
 *     Right *Node
 *     Parent *Node
 * }
 */

func lowestCommonAncestor(p *Node, q *Node) *Node {
	a, b := p, q
	for a != b {
		if a.Parent != nil {
			a = a.Parent
		} else {
			a = q
		}
		if b.Parent != nil {
			b = b.Parent
		} else {
			b = p
		}
	}
	return a
}1660. 纠正二叉树 🔒
题目、示例与约束
你有一棵二叉树,这棵二叉树有个小问题,其中有且只有一个无效节点,它的右子节点错误地指向了与其在同一层且在其右侧的一个其他节点。
给定一棵这样的问题二叉树的根节点 root ,将该无效节点及其所有子节点移除(除被错误指向的节点外),然后返回新二叉树的根结点。
自定义测试用例:
测试用例的输入由三行组成:
TreeNode rootint fromNode(在correctBinaryTree中不可见)int toNode(在correctBinaryTree中不可见)
当以 root 为根的二叉树被解析后,值为 fromNode 的节点 TreeNode 将其右子节点指向值为 toNode 的节点 TreeNode 。然后, root 传入 correctBinaryTree 的参数中。
示例 1:
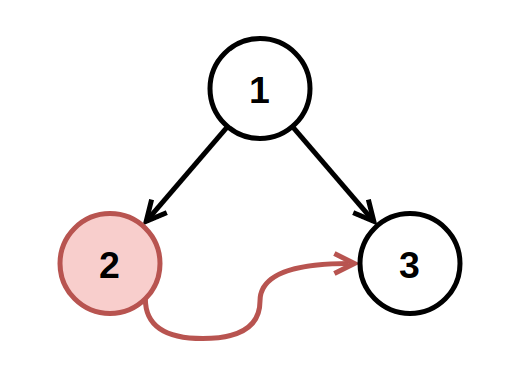
输入: root = [1,2,3], fromNode = 2, toNode = 3
输出: [1,null,3]
解释: 值为 2 的节点是无效的,所以移除之。
示例 2:
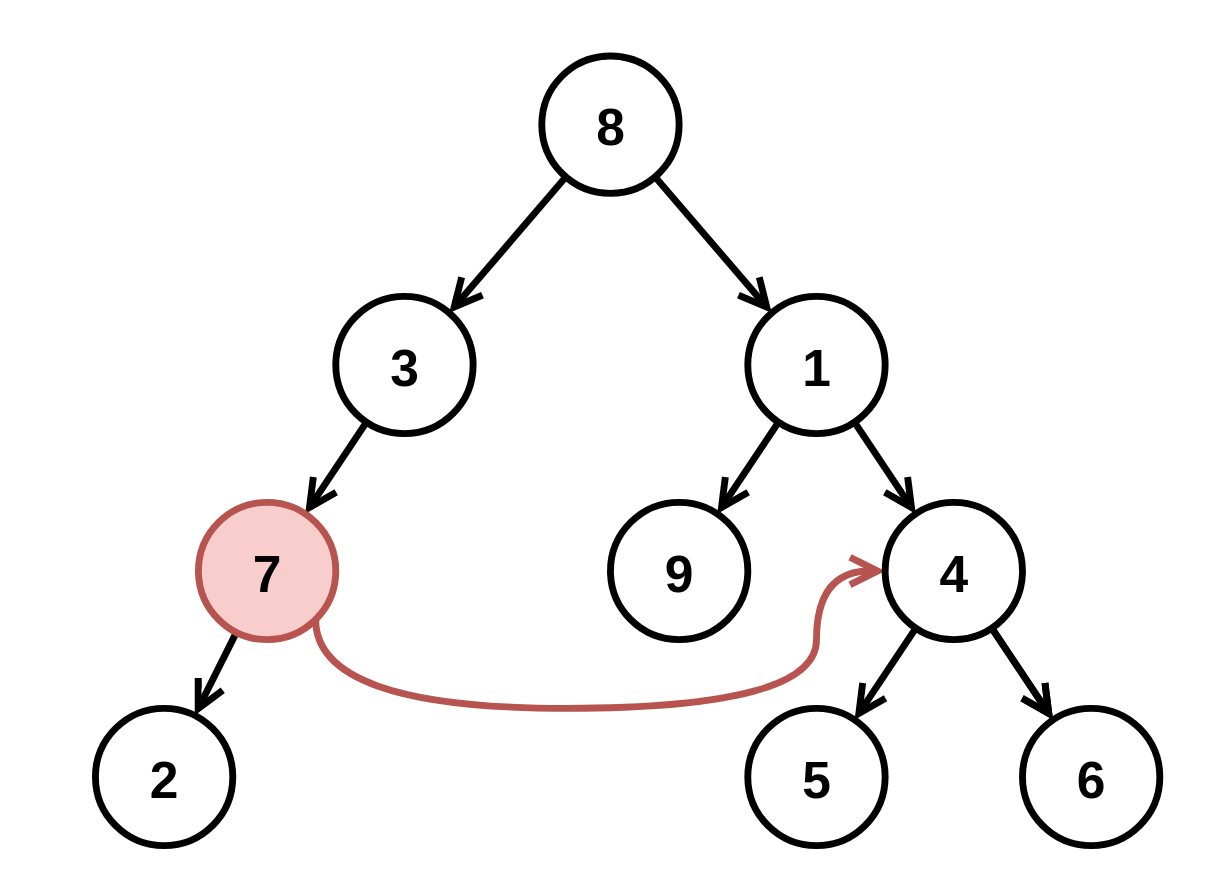
输入: root = [8,3,1,7,null,9,4,2,null,null,null,5,6], fromNode = 7, toNode = 4
输出: [8,3,1,null,null,9,4,null,null,5,6]
解释: 值为 7 的节点是无效的,所以移除这个节点及其子节点 2。
提示:
- 树中节点个数的范围是
[3, 104]。 -109 <= Node.val <= 109- 所有的
Node.val都是互不相同的。 fromNode != toNodefromNode和toNode将出现在树中的同一层。toNode在fromNode的右侧。fromNode.right在测试用例的树中建立后为null。
方法一:Go 解法(本站整理) · Go 实现
基于 Doocs 从右到左 DFS 参考改写。合法树中,当前节点的右孩子不可能已经访问;错误链接指向同层右侧节点,因此优先处理右子树后,该目标已经在集合中。检测到这种链接就返回 nil,连同错误节点的真正后代一起移除,不递归错误边。n 为节点数,时间与集合空间 O(n),递归栈 O(h)。平台 TreeNode 为 struct { Val int; Left, Right *TreeNode }。
出处:Doocs 原题与题解,固定提交 91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011;题意、参考及本 Go 改写采用 CC BY-SA 4.0。
// 题意与参考:Doocs LeetCode,CC BY-SA 4.0。
// https://github.com/doocs/leetcode/blob/91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011/solution/1600-1699/1660.Correct%20a%20Binary%20Tree/README.md
// Go 实现与测试沿用 CC BY-SA 4.0;来源性质见配套说明。
func correctBinaryTree(root *TreeNode) *TreeNode {
	seen := map[*TreeNode]bool{}
	var dfs func(*TreeNode) *TreeNode
	dfs = func(n *TreeNode) *TreeNode {
		if n == nil || seen[n.Right] {
			return nil
		}
		seen[n] = true
		n.Right = dfs(n.Right)
		n.Left = dfs(n.Left)
		return n
	}
	return dfs(root)
}1666. 改变二叉树的根节点 🔒
题目、示例与约束
给定一棵二叉树的根节点 root 和一个叶节点 leaf ,更改二叉树,使得 leaf 为新的根节点。
你可以按照下列步骤修改从 leaf 到 root 的路径中除 root 外的每个节点 cur :
- 如果
cur有左子节点,则该子节点变为cur的右子节点。注意我们保证cur至多有一个子节点。 cur的原父节点变为cur的左子节点。
返回修改后新树的根节点。
注意:确保你的答案在操作后正确地设定了 Node.parent (父节点)指针,否则会被判为错误答案。
示例 1:
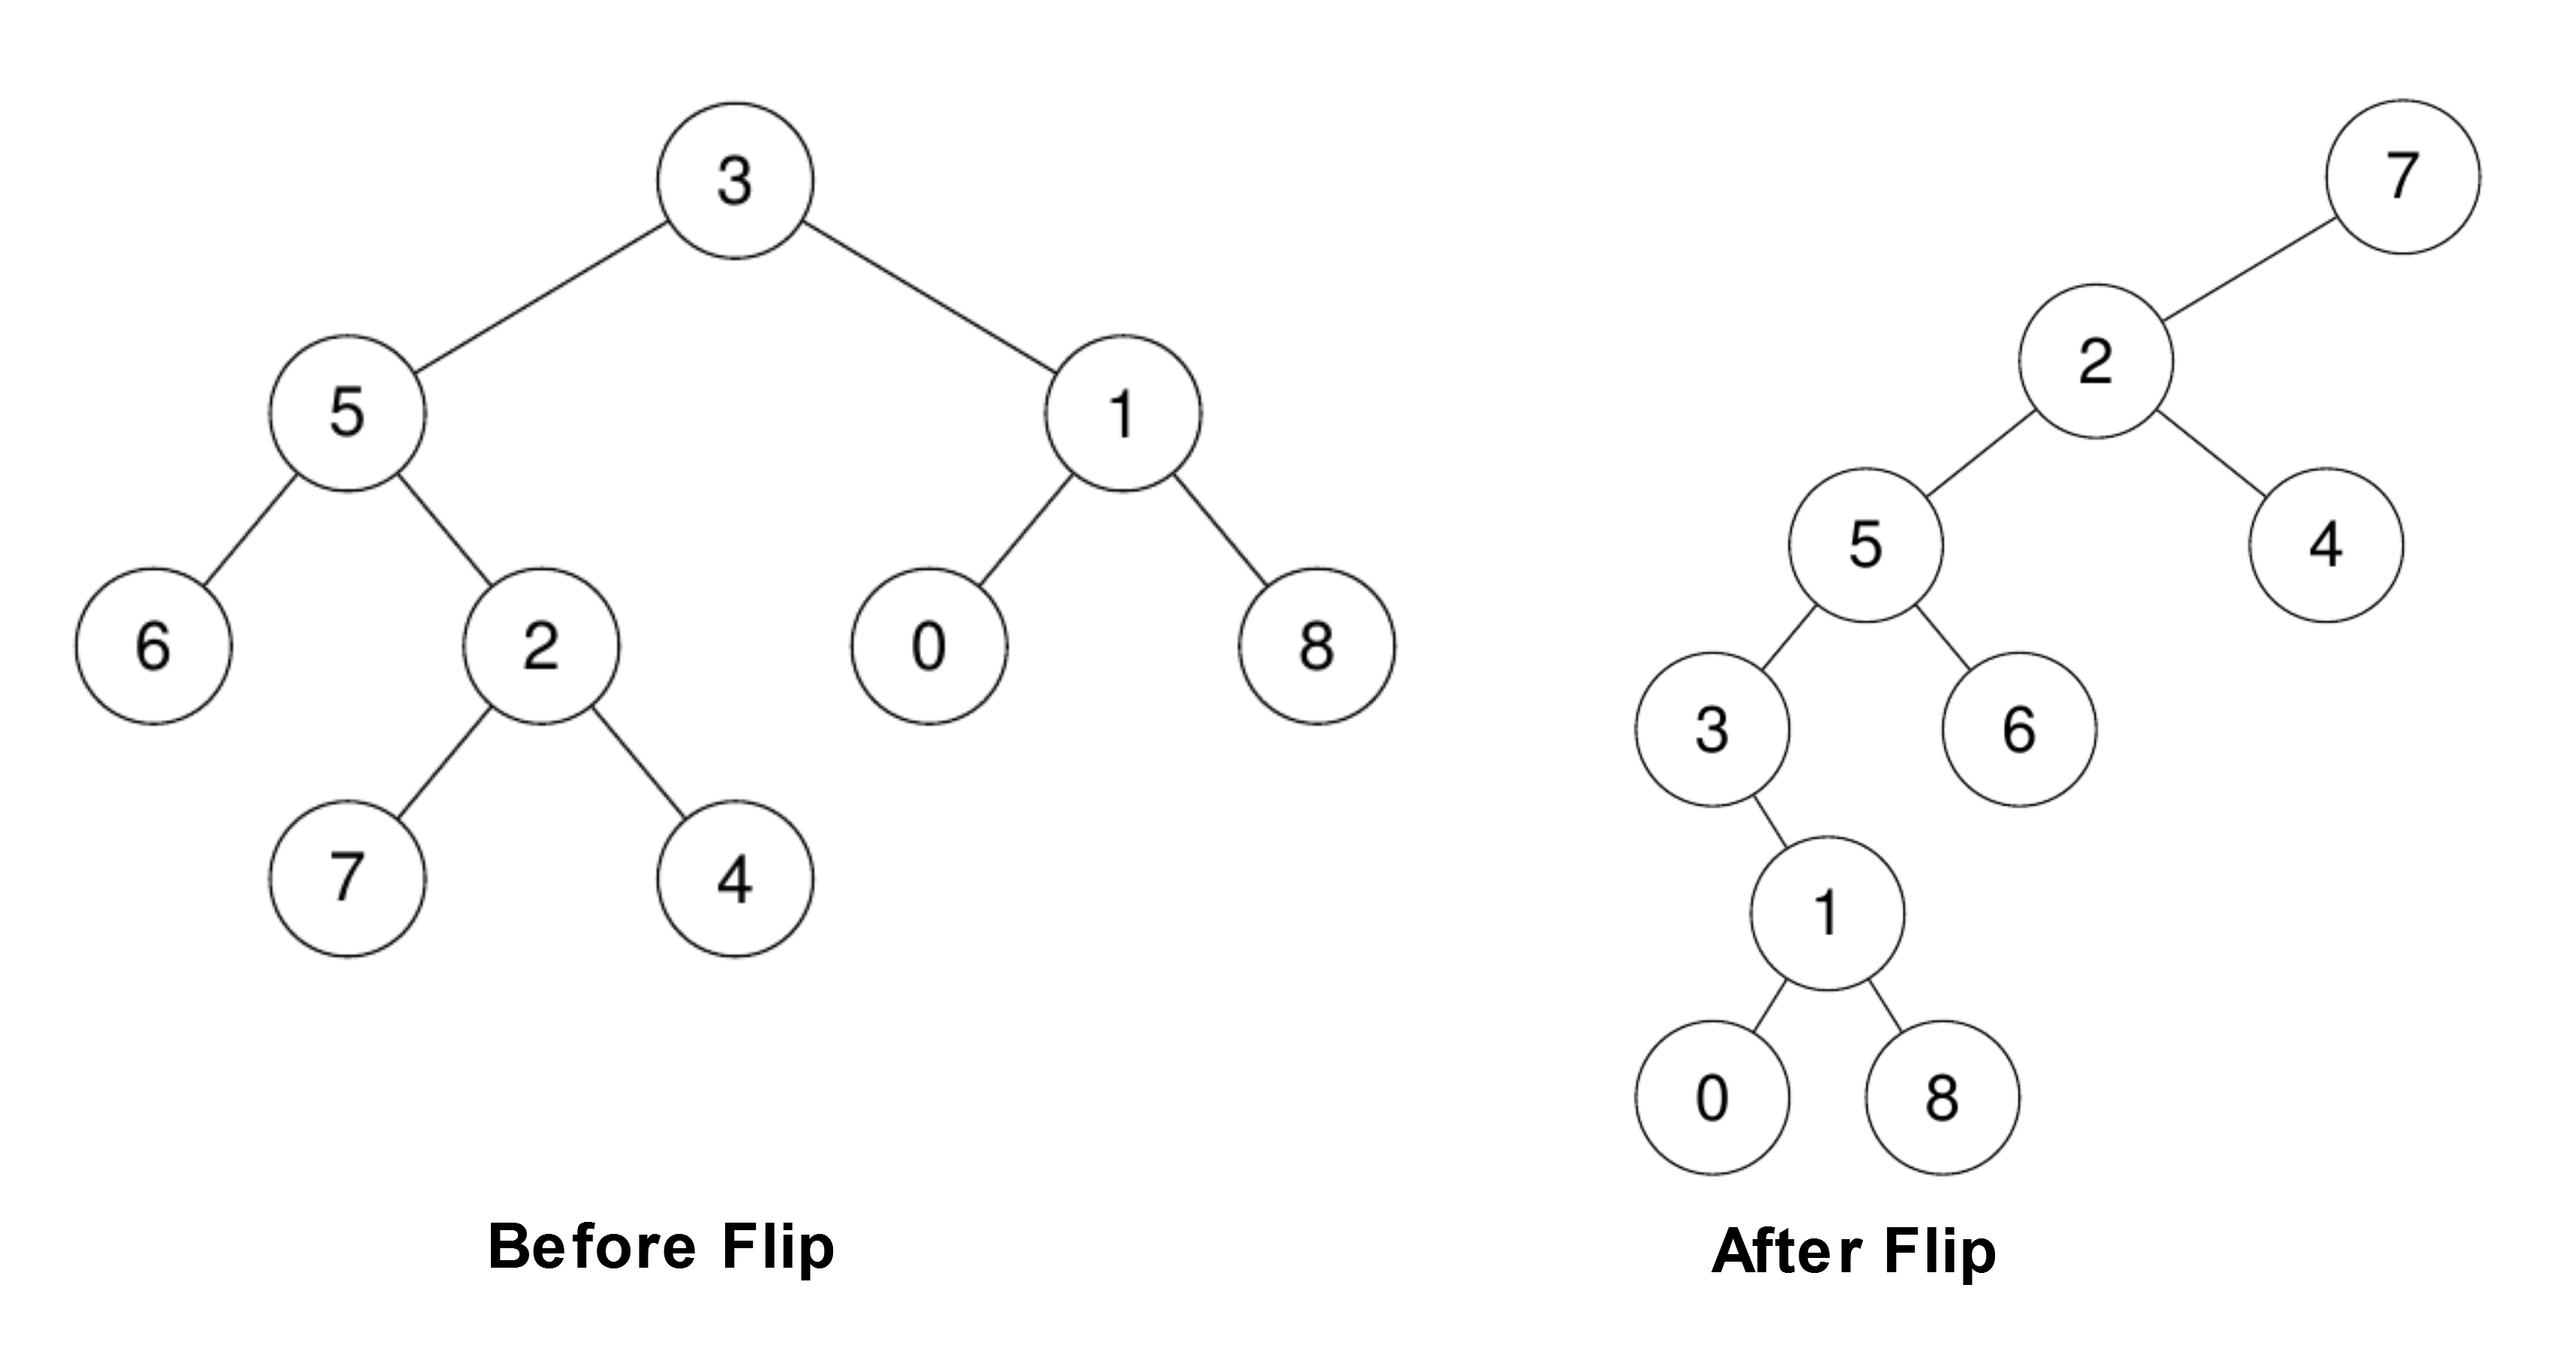
输入: root = [3,5,1,6,2,0,8,null,null,7,4], leaf = 7
输出: [7,2,null,5,4,3,6,null,null,null,1,null,null,0,8]
示例 2:
输入: root = [3,5,1,6,2,0,8,null,null,7,4], leaf = 0
输出: [0,1,null,3,8,5,null,null,null,6,2,null,null,7,4]
提示:
- 树中节点的个数在范围
[2, 100]内。 -109 <= Node.val <= 109- 所有的
Node.val都是唯一的。 leaf存在于树中。
方法一:Go 解法(本站整理) · Go 实现
基于 Doocs 父链翻转参考改写。从 leaf 沿原 Parent 向上走,先保存祖父;把原左孩子挪到右侧,再令原父成为当前左孩子,同时断开父节点到当前节点的旧边。最后将新根 Parent 置空。沿路径自底向上处理时,原来通向叶子的边已被断开,当前节点至多剩下一个不在路径上的原孩子,因此移动不会覆盖另一棵子树。h 为路径长度,时间 O(h),额外空间 O(1)。平台 Node 为 struct { Val int; Left, Right, Parent *Node };原树原地修改。
出处:Doocs 原题与题解,固定提交 91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011;题意、参考及本 Go 改写采用 CC BY-SA 4.0。
// 题意与参考:Doocs LeetCode,CC BY-SA 4.0。
// https://github.com/doocs/leetcode/blob/91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011/solution/1600-1699/1666.Change%20the%20Root%20of%20a%20Binary%20Tree/README.md
// Go 实现与测试沿用 CC BY-SA 4.0;来源性质见配套说明。
func flipBinaryTree(root, leaf *Node) *Node {
	cur, parent := leaf, leaf.Parent
	for cur != root {
		grand := parent.Parent
		if cur.Left != nil {
			cur.Right = cur.Left
		}
		cur.Left = parent
		parent.Parent = cur
		if parent.Left == cur {
			parent.Left = nil
		} else if parent.Right == cur {
			parent.Right = nil
		}
		cur, parent = parent, grand
	}
	leaf.Parent = nil
	return leaf
}1676. 二叉树的最近公共祖先 IV 🔒
题目、示例与约束
给定一棵二叉树的根节点 root 和 TreeNode 类对象的数组(列表) nodes,返回 nodes 中所有节点的最近公共祖先(LCA)。数组(列表)中所有节点都存在于该二叉树中,且二叉树中所有节点的值都是互不相同的。
我们扩展二叉树的最近公共祖先节点在维基百科上的定义:“对于任意合理的 i 值, n 个节点 p1 、 p2、...、 pn 在二叉树 T 中的最近公共祖先节点是后代中包含所有节点 pi 的最深节点(我们允许一个节点是其自身的后代)”。一个节点 x 的后代节点是节点 x 到某一叶节点间的路径中的节点 y。
示例 1:
输入: root = [3,5,1,6,2,0,8,null,null,7,4], nodes = [4,7]
输出: 2
解释: 节点 4 和 7 的最近公共祖先是 2。
示例 2:
输入: root = [3,5,1,6,2,0,8,null,null,7,4], nodes = [1]
输出: 1
解释: 单个节点的最近公共祖先是该节点本身。
示例 3:
输入: root = [3,5,1,6,2,0,8,null,null,7,4], nodes = [7,6,2,4]
输出: 5
解释: 节点 7、6、2 和 4 的最近公共祖先节点是 5。
示例 4:
输入: root = [3,5,1,6,2,0,8,null,null,7,4], nodes = [0,1,2,3,4,5,6,7,8]
输出: 3
解释: 树中所有节点的最近公共祖先是根节点。
提示:
- 树中节点个数的范围是
[1, 104]。 -109 <= Node.val <= 109- 所有的
Node.val都是互不相同的。 - 所有的
nodes[i]都存在于该树中。 - 所有的
nodes[i]都是互不相同的。
方法一:Go 解法(本站整理) · Go 实现
基于 Doocs 集合加后序 LCA 参考改写。把所有目标节点指针放入集合,DFS 遇到目标直接返回;左右均找到目标则返回当前节点,否则返回非空一侧。题目保证所有目标均在树中,因此目标本身可覆盖其后代目标。n 为节点数,k 为目标数,h 为树高,时间 O(n+k),额外空间 O(k+h)。平台 TreeNode 为 struct { Val int; Left, Right *TreeNode }。
出处:Doocs 原题与题解,固定提交 91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011;题意、参考及本 Go 改写采用 CC BY-SA 4.0。
// 题意与参考:Doocs LeetCode,CC BY-SA 4.0。
// https://github.com/doocs/leetcode/blob/91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011/solution/1600-1699/1676.Lowest%20Common%20Ancestor%20of%20a%20Binary%20Tree%20IV/README.md
// Go 实现与测试沿用 CC BY-SA 4.0;来源性质见配套说明。
func lowestCommonAncestor(root *TreeNode, nodes []*TreeNode) *TreeNode {
	wanted := map[*TreeNode]bool{}
	for _, n := range nodes {
		wanted[n] = true
	}
	var dfs func(*TreeNode) *TreeNode
	dfs = func(n *TreeNode) *TreeNode {
		if n == nil || wanted[n] {
			return n
		}
		a, b := dfs(n.Left), dfs(n.Right)
		if a != nil && b != nil {
			return n
		}
		if a != nil {
			return a
		}
		return b
	}
	return dfs(root)
}1740. 找到二叉树中的距离 🔒
题目、示例与约束
给定一棵二叉树的根节点 root 以及两个整数 p 和 q ,返回该二叉树中值为 p 的结点与值为 q 的结点间的 距离 。
两个结点间的 距离 就是从一个结点到另一个结点的路径上边的数目。
示例 1:
输入:root = [3,5,1,6,2,0,8,null,null,7,4], p = 5, q = 0
输出:3
解释:在 5 和 0 之间有 3 条边:5-3-1-0
示例 2:
输入:root = [3,5,1,6,2,0,8,null,null,7,4], p = 5, q = 7
输出:2
解释:在 5 和 7 之间有 2 条边:5-2-7
示例 3:
输入:root = [3,5,1,6,2,0,8,null,null,7,4], p = 5, q = 5
输出:0
解释:一个结点与它本身之间的距离为 0
提示:
- 树中结点个数的范围在
[1, 104]. 0 <= Node.val <= 109- 树中所有结点的值都是唯一的.
p和q是树中结点的值.
方法一 · Go 实现
思考
树上两点距离等于各自到最近公共祖先的深度之和。结点值唯一,可先找 LCA 再量深度。
递归:命中 或 或空则返回;左右都非空则为分叉点。再从该点 DFS 到 、 的深度并相加。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func findDistance(root *TreeNode, p int, q int) int {
	var lca func(root *TreeNode, p int, q int) *TreeNode
	lca = func(root *TreeNode, p int, q int) *TreeNode {
		if root == nil || root.Val == p || root.Val == q {
			return root
		}
		left, right := lca(root.Left, p, q), lca(root.Right, p, q)
		if left == nil {
			return right
		}
		if right == nil {
			return left
		}
		return root
	}
	var dfs func(root *TreeNode, v int) int
	dfs = func(root *TreeNode, v int) int {
		if root == nil {
			return -1
		}
		if root.Val == v {
			return 0
		}
		left, right := dfs(root.Left, v), dfs(root.Right, v)
		if left == -1 && right == -1 {
			return -1
		}
		return 1 + max(left, right)
	}
	g := lca(root, p, q)
	return dfs(g, p) + dfs(g, q)
}1766. 互质树
题目、示例与约束
给你一个 n 个节点的树(也就是一个无环连通无向图),节点编号从 0 到 n - 1 ,且恰好有 n - 1 条边,每个节点有一个值。树的 根节点 为 0 号点。
给你一个整数数组 nums 和一个二维数组 edges 来表示这棵树。nums[i] 表示第 i 个点的值,edges[j] = [uj, vj] 表示节点 uj 和节点 vj 在树中有一条边。
当 gcd(x, y) == 1 ,我们称两个数 x 和 y 是 互质的 ,其中 gcd(x, y) 是 x 和 y 的 最大公约数 。
从节点 i 到 根 最短路径上的点都是节点 i 的祖先节点。一个节点 不是 它自己的祖先节点。
请你返回一个大小为 n 的数组 ans ,其中 ans[i]是离节点 i 最近的祖先节点且满足 nums[i] 和 nums[ans[i]] 是 互质的 ,如果不存在这样的祖先节点,ans[i] 为 -1 。
示例 1:
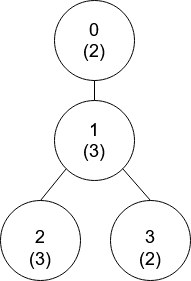
输入:nums = [2,3,3,2], edges = [[0,1],[1,2],[1,3]]
输出:[-1,0,0,1]
解释:上图中,每个节点的值在括号中表示。
- 节点 0 没有互质祖先。
- 节点 1 只有一个祖先节点 0 。它们的值是互质的(gcd(2,3) == 1)。
- 节点 2 有两个祖先节点,分别是节点 1 和节点 0 。节点 1 的值与它的值不是互质的(gcd(3,3) == 3)但节点 0 的值是互质的(gcd(2,3) == 1),所以节点 0 是最近的符合要求的祖先节点。
- 节点 3 有两个祖先节点,分别是节点 1 和节点 0 。它与节点 1 互质(gcd(3,2) == 1),所以节点 1 是离它最近的符合要求的祖先节点。
示例 2:
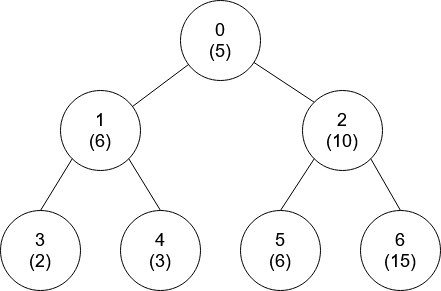
输入:nums = [5,6,10,2,3,6,15], edges = [[0,1],[0,2],[1,3],[1,4],[2,5],[2,6]]
输出:[-1,0,-1,0,0,0,-1]
提示:
nums.length == n1 <= nums[i] <= 501 <= n <= 105edges.length == n - 1edges[j].length == 20 <= uj, vj < nuj != vj
方法一:预处理 + 枚举 + 栈 + 回溯 · Go 实现
思考
对每个结点找最近的、路径上值与之互质的祖先。 但值域只有 ,可为每个值维护出现栈。
预处理 的互质对。DFS 时对 的每个互质值看栈顶,取深度最大者即为答案。
进入子树前把当前 压入 的栈,回溯弹出,保证栈顶总是最近祖先。
由于题目中 的取值范围为 ,因此我们可以预处理出每个数的所有互质数,记录在数组 中,其中 表示 的所有互质数。
接下来我们可以使用回溯的方法,从根节点开始遍历整棵树,对于每个节点 ,我们可以通过 数组得到 的所有互质数。然后我们枚举 的所有互质数,找到已经出现过的且深度最大的祖先节点 ,即为 的最近的互质祖先节点。这里我们可以用一个长度为 的栈数组 来获取每个出现过的值 的节点以及其深度。每个栈 的栈顶元素就是最近的深度最大的祖先节点。
时间复杂度 ,空间复杂度 。其中 为节点个数,而 为 的最大值,本题中 。
func getCoprimes(nums []int, edges [][]int) []int {
	n := len(nums)
	g := make([][]int, n)
	f := [51][]int{}
	type pair struct{ first, second int }
	stks := [51][]pair{}
	for _, e := range edges {
		u, v := e[0], e[1]
		g[u] = append(g[u], v)
		g[v] = append(g[v], u)
	}
	for i := 1; i < 51; i++ {
		for j := 1; j < 51; j++ {
			if gcd(i, j) == 1 {
				f[i] = append(f[i], j)
			}
		}
	}
	ans := make([]int, n)
	var dfs func(i, fa, depth int)
	dfs = func(i, fa, depth int) {
		t, k := -1, -1
		for _, v := range f[nums[i]] {
			stk := stks[v]
			if len(stk) > 0 && stk[len(stk)-1].second > k {
				t, k = stk[len(stk)-1].first, stk[len(stk)-1].second
			}
		}
		ans[i] = t
		for _, j := range g[i] {
			if j != fa {
				stks[nums[i]] = append(stks[nums[i]], pair{i, depth})
				dfs(j, i, depth+1)
				stks[nums[i]] = stks[nums[i]][:len(stks[nums[i]])-1]
			}
		}
	}
	dfs(0, -1, 0)
	return ans
}

func gcd(a, b int) int {
	if b == 0 {
		return a
	}
	return gcd(b, a%b)
}
方法二:预处理 + 枚举 + 显式栈 · Go 实现
思考
对每个结点找最近的、路径上值与之互质的祖先。 ,值域只有 ,可为每个值维护祖先栈。从根递归进入孩子,链上的调用深度就是 ,会超出递归栈。
预处理 的互质对。访问节点时对 的每个互质值看栈顶,取深度最大者即为答案。
显式栈保存 。走向孩子前把 压入 的栈,该孩子处理完再弹出,栈顶始终是最近祖先。
由于题目中 的取值范围为 ,因此我们可以预处理出每个数的所有互质数,记录在数组 中,其中 表示 的所有互质数。
接下来用显式栈从根做先序遍历。对于每个节点 ,枚举 的所有互质数,在对应栈的栈顶中取深度最大的祖先 ,即为最近的互质祖先。栈数组 长度为 , 记录当前根路径上值为 的节点及其深度。走向孩子前把 压入 ,该孩子处理完后再弹出。
时间复杂度 ,空间复杂度 。其中 为节点个数,而 为 的最大值,本题中 。
func getCoprimes(nums []int, edges [][]int) []int {
	n := len(nums)
	g := make([][]int, n)
	f := [51][]int{}
	type pair struct{ first, second int }
	stks := [51][]pair{}
	for _, e := range edges {
		u, v := e[0], e[1]
		g[u] = append(g[u], v)
		g[v] = append(g[v], u)
	}
	for i := 1; i < 51; i++ {
		for j := 1; j < 51; j++ {
			if gcd(i, j) == 1 {
				f[i] = append(f[i], j)
			}
		}
	}
	ans := make([]int, n)
	type frame struct{ i, fa, depth, k int }
	stk := []frame{{0, -1, 0, 0}}
	for len(stk) > 0 {
		cur := &stk[len(stk)-1]
		i, fa, depth, k := cur.i, cur.fa, cur.depth, cur.k
		if k == 0 {
			t, mx := -1, -1
			for _, v := range f[nums[i]] {
				s := stks[v]
				if len(s) > 0 && s[len(s)-1].second > mx {
					t, mx = s[len(s)-1].first, s[len(s)-1].second
				}
			}
			ans[i] = t
		} else {
			jprev := g[i][k-1]
			if jprev != fa {
				stks[nums[i]] = stks[nums[i]][:len(stks[nums[i]])-1]
			}
		}
		for k < len(g[i]) && g[i][k] == fa {
			k++
		}
		if k == len(g[i]) {
			stk = stk[:len(stk)-1]
			continue
		}
		j := g[i][k]
		cur.k = k + 1
		stks[nums[i]] = append(stks[nums[i]], pair{i, depth})
		stk = append(stk, frame{j, i, depth + 1, 0})
	}
	return ans
}

func gcd(a, b int) int {
	if b == 0 {
		return a
	}
	return gcd(b, a%b)
}1902. 给定二叉搜索树的插入顺序求深度 🔒
题目、示例与约束
给定一个从 0 开始索引的整数类型数组 order ,其长度为 n,是从 1 到 n 的所有整数的一个排列,表示插入到一棵二叉搜索树的顺序。
二叉搜索树的定义如下:
- 一个节点的左子树只包含键值小于该节点键值的节点。
- 一个节点的右子树只包含键值大于该节点键值的节点。
- 左子树和右子树须均为二叉搜索树。
该二叉搜索树的构造方式如下:
order[0]将成为该二叉搜索树的根。- 所有后续的元素均在维持二叉搜索树性质的前提下作为任何已存在节点的子节点插入。
返回该二叉搜索树的深度。
一棵二叉树的深度是从根节点到最远叶节点的最长路径所经节点的个数。
示例 1:
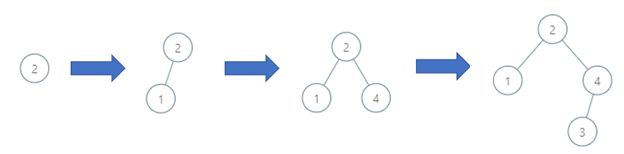
输入: order = [2,1,4,3]
输出: 3
解释: 该二叉搜索树的深度为 3,路径为 2->4->3。
示例 2:
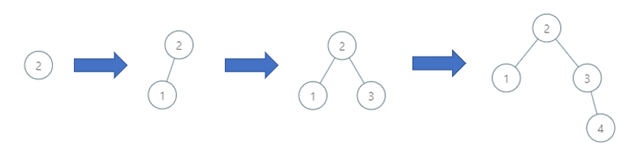
输入: order = [2,1,3,4]
输出: 3
解释: 该二叉搜索树的深度为 3,路径为 2->3->4。
示例 3:
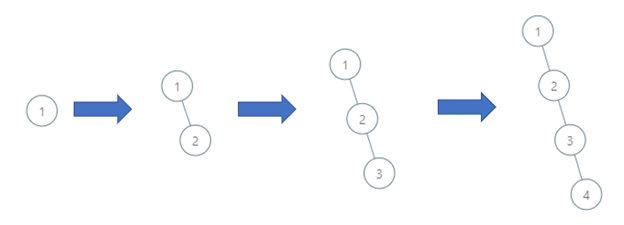
输入: order = [1,2,3,4]
输出: 4
解释: 该二叉搜索树的深度为 4,路径为 1->2->3->4。
提示:
n == order.length1 <= n <= 105order是从1到n的整数的一个排列。
方法一:Go 解法(本站整理) · Go 实现
基于 Doocs 前驱/后继深度参考改写。插入 v 时,父节点是已插入值中前驱与后继里较深的一个,所以 depth[v] = 1 + max(depth[pred], depth[succ])。Go 标准库没有 SortedDict,利用输入是 1..n 的排列,用树状数组记录已插入标记,并以二进制提升查询第 k 个已插入值。不存在的邻居深度取零。n 为序列长度,时间 O(n log n),空间 O(n)。入口 maxDepthBST,输入不修改。
出处:Doocs 原题与题解,固定提交 91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011;题意、参考及本 Go 改写采用 CC BY-SA 4.0。
// 题意与参考:Doocs LeetCode,CC BY-SA 4.0。
// https://github.com/doocs/leetcode/blob/91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011/solution/1900-1999/1902.Depth%20of%20BST%20Given%20Insertion%20Order/README.md
// Go 实现与测试沿用 CC BY-SA 4.0;来源性质见配套说明。
func maxDepthBST(order []int) int {
	n := len(order)
	bit := make([]int, n+1)
	depth := make([]int, n+1)
	prefix := func(i int) int {
		s := 0
		for i > 0 {
			s += bit[i]
			i -= i & -i
		}
		return s
	}
	kth := func(k int) int {
		idx := 0
		step := 1
		for step <= n {
			step <<= 1
		}
		for step >>= 1; step > 0; step >>= 1 {
			next := idx + step
			if next <= n && bit[next] < k {
				idx = next
				k -= bit[next]
			}
		}
		return idx + 1
	}
	ans := 0
	for count, v := range order {
		rank := prefix(v - 1)
		d := 0
		if rank > 0 {
			d = depth[kth(rank)]
		}
		if rank < count {
			if x := depth[kth(rank+1)]; x > d {
				d = x
			}
		}
		depth[v] = d + 1
		if d+1 > ans {
			ans = d + 1
		}
		for i := v; i <= n; i += i & -i {
			bit[i]++
		}
	}
	return ans
}1932. 合并多棵二叉搜索树
题目、示例与约束
给你 n 个 二叉搜索树的根节点 ,存储在数组 trees 中(下标从 0 开始),对应 n 棵不同的二叉搜索树。trees 中的每棵二叉搜索树 最多有 3 个节点 ,且不存在值相同的两个根节点。在一步操作中,将会完成下述步骤:
- 选择两个 不同的 下标
i和j,要求满足在trees[i]中的某个 叶节点 的值等于trees[j]的 根节点的值 。 - 用
trees[j]替换trees[i]中的那个叶节点。 - 从
trees中移除trees[j]。
如果在执行 n - 1 次操作后,能形成一棵有效的二叉搜索树,则返回结果二叉树的 根节点 ;如果无法构造一棵有效的二叉搜索树,返回 null 。
二叉搜索树是一种二叉树,且树中每个节点均满足下述属性:
- 任意节点的左子树中的值都 严格小于 此节点的值。
- 任意节点的右子树中的值都 严格大于 此节点的值。
叶节点是不含子节点的节点。
示例 1:

输入:trees = [[2,1],[3,2,5],[5,4]] 输出:[3,2,5,1,null,4] 解释: 第一步操作中,选出 i=1 和 j=0 ,并将 trees[0] 合并到 trees[1] 中。 删除 trees[0] ,trees = [[3,2,5,1],[5,4]] 。在第二步操作中,选出 i=0 和 j=1 ,将 trees[1] 合并到 trees[0] 中。 删除 trees[1] ,trees = [[3,2,5,1,null,4]] 。
结果树如上图所示,为一棵有效的二叉搜索树,所以返回该树的根节点。
示例 2:

输入:trees = [[5,3,8],[3,2,6]] 输出:[] 解释: 选出 i=0 和 j=1 ,然后将 trees[1] 合并到 trees[0] 中。 删除 trees[1] ,trees = [[5,3,8,2,6]] 。结果树如上图所示。仅能执行一次有效的操作,但结果树不是一棵有效的二叉搜索树,所以返回 null 。
示例 3:

输入:trees = [[5,4],[3]]
输出:[]
解释:无法执行任何操作。
提示:
n == trees.length1 <= n <= 5 * 104- 每棵树中节点数目在范围
[1, 3]内。 - 输入数据的每个节点可能有子节点但不存在子节点的子节点
trees中不存在两棵树根节点值相同的情况。- 输入中的所有树都是 有效的二叉树搜索树 。
1 <= TreeNode.val <= 5 * 104.
方法一:Go 实现(灵茶山艾府) · Go 实现
本站根据 Go 源码整理,非作者原文。
思路:利用输入小树最多只有根和直接孩子的条件,以节点值建立根节点索引,并标记所有叶子值;重复叶子值直接拒绝。最终根必须是唯一一个未作为叶子出现的根。从它递归构建:若孩子值对应另一棵树的根,就接入该树,同时传递严格的大小边界检查搜索树顺序。最后要求实际接入的树数等于输入树数。
复杂度:设小树数为 t,值域数组长度为 U(源码为 50001)。数组初始化和遍历总时间为 O(U+t),辅助空间为 O(U+t),其中递归栈最坏为 O(t)。实现会原地修改节点的孩子指针。
import . "github.com/EndlessCheng/codeforces-go/leetcode/testutil"

// github.com/EndlessCheng/codeforces-go
const mx int = 5e4 + 1

func canMerge(trees []*TreeNode) *TreeNode {
	isSub := [mx]bool{}      // 对于根节点,需要知道其是否为另一棵二叉搜索树的子节点
	roots := [mx]*TreeNode{} // 对于子节点,我们需要知道其数值所对应的二叉搜索树的根节点是哪个
	for _, rt := range trees {
		if rt.Left != nil {
			if isSub[rt.Left.Val] { // 由于二叉搜索树上不能有两个值相同的节点,所以 trees 中也不能有两个值相同的叶节点
				return nil
			}
			isSub[rt.Left.Val] = true
		}
		if rt.Right != nil {
			if isSub[rt.Right.Val] {
				return nil
			}
			isSub[rt.Right.Val] = true
		}
		roots[rt.Val] = rt
	}

	var root *TreeNode
	for _, rt := range trees {
		if !isSub[rt.Val] { // 根节点不应是另一棵二叉搜索树的子节点,否则二叉搜索树上会出现两个值相同的节点
			if root != nil { // 根节点应只有一个,否则会构成森林
				return nil
			}
			root = rt
		}
	}
	if root == nil { // 未找到根节点
		return nil
	}

	cnt := 0
	// 一边构建,一边判断是否合法
	var build func(*TreeNode, int, int) *TreeNode
	build = func(node *TreeNode, l, r int) *TreeNode {
		cnt++
		if node.Left != nil {
			if node.Left.Val <= l {
				return nil
			}
			if lo := roots[node.Left.Val]; lo != nil {
				node.Left = build(lo, l, node.Val)
				if node.Left == nil {
					return nil
				}
			}
		}
		if node.Right != nil {
			if node.Right.Val >= r {
				return nil
			}
			if ro := roots[node.Right.Val]; ro != nil {
				node.Right = build(ro, node.Val, r)
				if node.Right == nil {
					return nil
				}
			}
		}
		return node
	}
	root = build(root, 0, mx)
	if cnt == len(trees) { // 所有 trees[i] 均参与构建二叉搜索树
		return root
	}
	return nil
}1973. 值等于子节点值之和的节点数量 🔒
题目、示例与约束
给定一颗二叉树的根节点 root ,返回满足条件:节点的值等于该节点所有子节点的值之和 的节点的数量。
一个节点 x 的 子节点 是指从节点 x 出发,到所有叶子节点路径上的节点。没有子节点的节点的子节点和视为 0 。
示例 1:
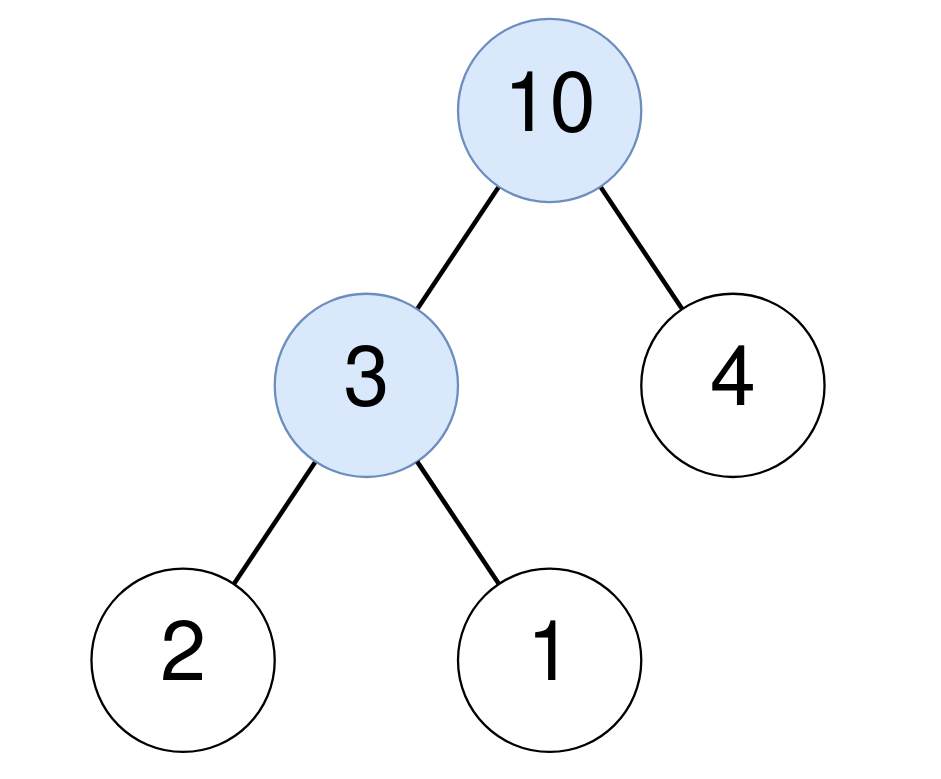
输入: root = [10,3,4,2,1]
输出: 2
解释:
对于值为10的节点: 其子节点之和为: 3+4+2+1 = 10。
对于值为3的节点:其子节点之和为: 2+1 = 3。
示例 2:
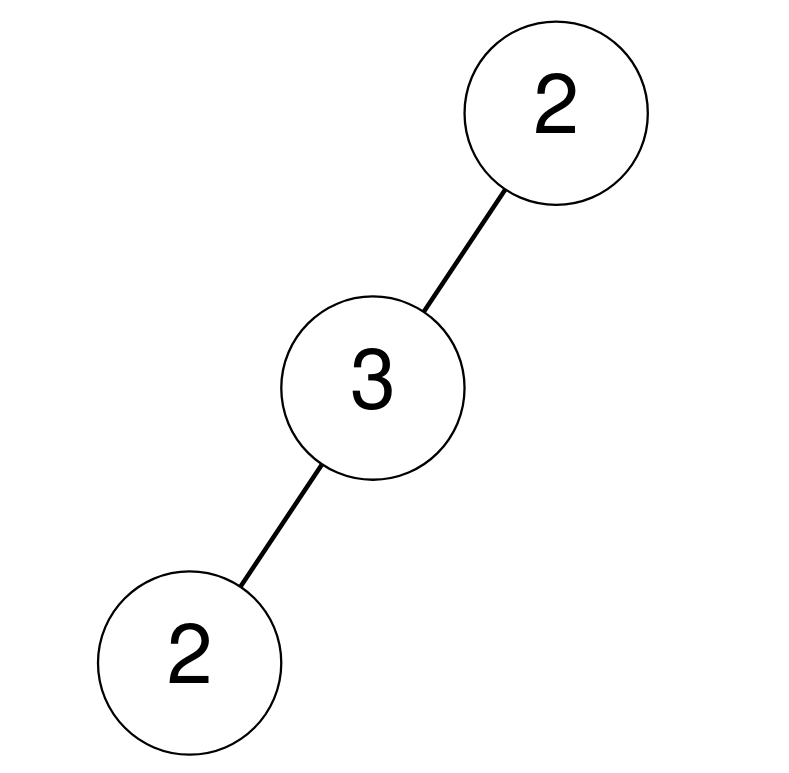
输入: root = [2,3,null,2,null]
输出: 0
解释:
没有节点满足其值等于子节点之和。
示例 3:
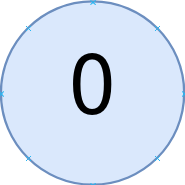
输入: root = [0]
输出: 1
解释:
对于值为0的节点:因为它没有子节点,所以自己点之和为0。
提示:
- 树中节点的数量范围:
[1, 105] 0 <= Node.val <= 105
方法一:递归 · Go 实现
思考
每个结点要与其全部子孙之和比较。若对每个结点再遍历子树,总时间为平方级。
一次后序 DFS 返回子树和:左右之和等于结点值则计数加一,并向上返回「自身加左右」。整树一遍即可。
我们设计一个函数 ,该函数返回以 为根节点的子树的所有节点值之和。函数 的执行过程如下:
- 如果 为空,返回 ;
- 否则,我们递归地计算 的左子树和右子树的节点值之和,记为 和 ;如果 ,说明以 为根节点的子树满足条件,我们将答案加 ;最后,返回 。
然后我们调用函数 ,返回答案即可。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func equalToDescendants(root *TreeNode) (ans int) {
	var dfs func(*TreeNode) int
	dfs = func(root *TreeNode) int {
		if root == nil {
			return 0
		}
		l, r := dfs(root.Left), dfs(root.Right)
		if l+r == root.Val {
			ans++
		}
		return root.Val + l + r
	}
	dfs(root)
	return
}
方法二:显式栈 · Go 实现
思考
每个结点要和它全部子孙的值之和比较。若对每个结点再单独遍历子树,总时间是平方级。后序遍历在离开结点时已经知道左右子树的和,一次遍历就能判断并向上汇总。
可以到 。后序先走进左孩子,一条左链会让递归在子树和算完之前溢出。结点值最大 ,整棵子树的和可以到 ,32 位整数装不下。
子孙和只在左右子树都处理完之后才知道。显式栈用状态把“先展开孩子”和“孩子都已返回”分开,弹出完成标记时读取左右子树和。和数用 64 位整数保存,左右之和等于结点值就计数,再把自身加进去交给父结点。
每个结点入栈一次。空孩子的和视为 。
我们用显式栈做后序遍历。栈中每个元素是结点和状态:状态 先压入完成标记,再压入右孩子和左孩子;状态 表示左右子树都已求出子树和。弹出完成标记后,取出左子树和 与右子树和 。若 ,答案加一。该结点的子树和为 ,存下来给父结点使用。空孩子的和为 。子树和用 64 位整数, 个不超过 的结点相加不会溢出。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func equalToDescendants(root *TreeNode) (ans int) {
	sub := map[*TreeNode]int{}
	type frame struct {
		node  *TreeNode
		state int
	}
	stk := []frame{}
	if root != nil {
		stk = append(stk, frame{root, 0})
	}
	for len(stk) > 0 {
		cur := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		node := cur.node
		if cur.state == 0 {
			stk = append(stk, frame{node, 1})
			if node.Right != nil {
				stk = append(stk, frame{node.Right, 0})
			}
			if node.Left != nil {
				stk = append(stk, frame{node.Left, 0})
			}
			continue
		}
		l, r := 0, 0
		if node.Left != nil {
			l = sub[node.Left]
		}
		if node.Right != nil {
			r = sub[node.Right]
		}
		if l+r == node.Val {
			ans++
		}
		sub[node] = node.Val + l + r
	}
	return
}2005. 斐波那契树的移除子树游戏 🔒
题目、示例与约束
斐波那契树是一种按这种规则函数 order(n) 创建的二叉树:
order(0)是空树。order(1)是一棵只有一个节点的二叉树。order(n)是一棵根节点的左子树为order(n - 2)、右子树为order(n - 1)的二叉树。
Alice 和 Bob 在玩一种关于斐波那契树的游戏,由 Alice 先手。在每个回合中,每个玩家选择一个节点,然后移除该节点及其子树。只能删除根节点 root 的玩家输掉这场游戏。
给定一个整数 n,假定两名玩家都按最优策略进行游戏,若 Alice 赢得这场游戏,返回 true 。若 Bob 赢得这场游戏,返回 false 。
一棵二叉树的子树 tree 是由 tree 中某个节点及其所有后代节点组成的树。树 tree 也可当作自身的子树。
示例 1:
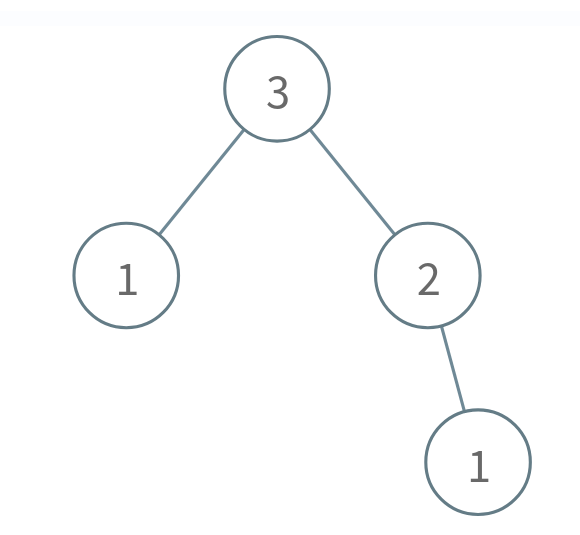
输入: n = 3
输出: true
解释:
Alice 移除右子树中的节点 1。
Bob 要么移除左子树中的 1,要么移除右子树中的 2。
Alice 可以移除 Bob 未移除的任意节点。
Bob 只能删除根节点 3,所以 Bob 输了。
返回 true,因为 Alice 赢了。
示例 2:
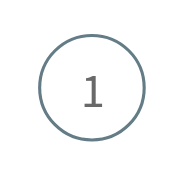
输入: n = 1
输出: false
解释:
Alice 只能移除根节点 1, 所以 Alice 输了。
返回 false,因为 Alice 输了。
示例 3:
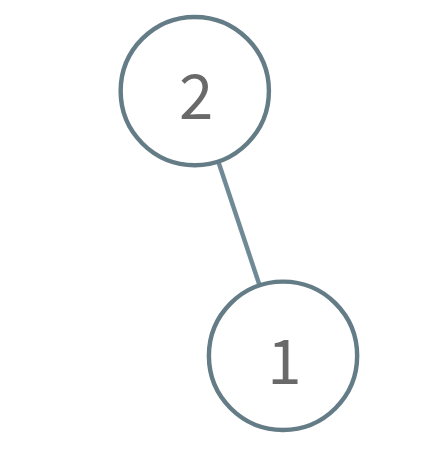
输入: n = 2
输出: true
解释:
Alice 删除节点 1.
Bob 只能删除根节点 2,所以 Bob 输了。
返回 true,因为 Alice 赢了。
提示:
1 <= n <= 100
方法一:Go 解法(本站整理) · Go 实现
根据题意整理:源文没有非空代码。把必败的“删除整棵树根”视为不能走的操作,问题成为根的两棵子树上的普通删除博弈。令 g(n) 为允许删根的 n 阶斐波那契树的 Sprague-Grundy 值;空树 g(0)=0,单点 g(1)=1。根下是两个独立游戏,异或值为 g(n-2) XOR g(n-1);增加一个可删除的根把所有后继的值平移一并增加终局 0,故 g(n)=1+(g(n-2) XOR g(n-1))。原题先手获胜当且仅当两个孩子的异或非零,即 g(n)≠1。n≤100,时间 O(n),空间 O(1),数值在此范围适合 Go int。入口 findGameWinner;小树测试直接枚举合法删子树操作,无需实际构造巨大树。
出处:Doocs 原题与题解,固定提交 91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011;题意、参考及本 Go 改写采用 CC BY-SA 4.0。
// 题意与参考:Doocs LeetCode,CC BY-SA 4.0。
// https://github.com/doocs/leetcode/blob/91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011/solution/2000-2099/2005.Subtree%20Removal%20Game%20with%20Fibonacci%20Tree/README.md
// Go 实现与测试沿用 CC BY-SA 4.0;来源性质见配套说明。
func findGameWinner(n int) bool {
	a, b := 0, 1
	for i := 2; i <= n; i++ {
		a, b = b, 1+(a^b)
	}
	return b != 1
}2049. 统计最高分的节点数目
题目、示例与约束
给你一棵根节点为 0 的 二叉树 ,它总共有 n 个节点,节点编号为 0 到 n - 1 。同时给你一个下标从 0 开始的整数数组 parents 表示这棵树,其中 parents[i] 是节点 i 的父节点。由于节点 0 是根,所以 parents[0] == -1 。
一个子树的 大小 为这个子树内节点的数目。每个节点都有一个与之关联的 分数 。求出某个节点分数的方法是,将这个节点和与它相连的边全部 删除 ,剩余部分是若干个 非空 子树,这个节点的 分数 为所有这些子树 大小的乘积 。
请你返回有 最高得分 节点的 数目 。
示例 1:
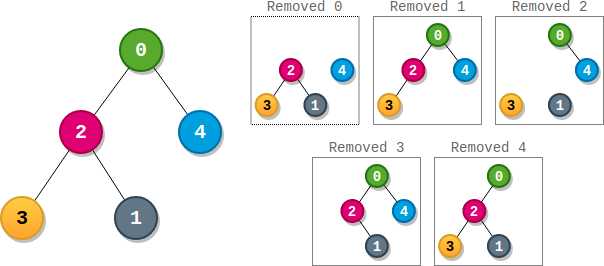
输入:parents = [-1,2,0,2,0]
输出:3
解释:
- 节点 0 的分数为:3 * 1 = 3
- 节点 1 的分数为:4 = 4
- 节点 2 的分数为:1 * 1 * 2 = 2
- 节点 3 的分数为:4 = 4
- 节点 4 的分数为:4 = 4
最高得分为 4 ,有三个节点得分为 4 (分别是节点 1,3 和 4 )。
示例 2:
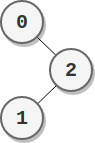
输入:parents = [-1,2,0]
输出:2
解释:
- 节点 0 的分数为:2 = 2
- 节点 1 的分数为:2 = 2
- 节点 2 的分数为:1 * 1 = 1
最高分数为 2 ,有两个节点分数为 2 (分别为节点 0 和 1 )。
提示:
n == parents.length2 <= n <= 105parents[0] == -1- 对于
i != 0,有0 <= parents[i] <= n - 1 parents表示一棵二叉树。
方法一:DFS · Go 实现
思考
去掉结点后,分数为各连通块大小之积。 ,需一次遍历得到所有分数。子树大小在 DFS 回溯时可知,补集大小为 。
建出孩子邻接表,从根 DFS:把各孩子子树大小相乘,若还有上方块再乘 。同步维护最高分及其出现次数。
我们先根据给定的父节点数组 parents 构建图 ,其中 表示节点 的所有子节点。定义变量 表示最高得分的节点数目,变量 表示最高得分。
然后,我们设计一个函数 ,它的作用是计算节点 的分数,并返回以节点 为根的子树的节点数目。
函数 的计算过程如下:
我们首先初始化变量 ,表示以节点 为根的子树的节点数目;变量 ,表示以节点 初始分数。
接下来,我们遍历节点 的所有子节点 ,如果 不是节点 的父节点 ,那么我们递归调用 ,并将返回值累乘到 中,同时将返回值累加到 中。
遍历完子节点后,如果 ,那么我们将 累乘到 中。
然后,我们判断 是否小于 ,如果小于,那么我们将 更新为 ,并将 更新为 ;如果等于,那么我们将 更新为 。
最后,我们返回 。
最终,我们调用 ,并返回 。
时间复杂度 ,空间复杂度 。其中 是节点数目。
func countHighestScoreNodes(parents []int) (ans int) {
	n := len(parents)
	g := make([][]int, n)
	for i := 1; i < n; i++ {
		g[parents[i]] = append(g[parents[i]], i)
	}
	mx := 0
	var dfs func(i, fa int) int
	dfs = func(i, fa int) int {
		cnt, score := 1, 1
		for _, j := range g[i] {
			if j != fa {
				t := dfs(j, i)
				cnt += t
				score *= t
			}
		}
		if n-cnt > 0 {
			score *= n - cnt
		}
		if mx < score {
			mx = score
			ans = 1
		} else if mx == score {
			ans++
		}
		return cnt
	}
	dfs(0, -1)
	return
}
方法二:显式栈 · Go 实现
思考
去掉结点后,分数是各连通块大小的乘积。 可以到 。一条链上第一次递归总是走向唯一的孩子,深度就是 ,会超出默认递归上限。
分数要等每个孩子的子树大小都确定后才能相乘,结点上方剩余部分的大小是 减去这棵子树的大小。
因此用显式栈做后序。进入结点时先压入离开标记,再压入孩子。离开时把各孩子的子树大小相乘,若还有上方的块再乘 ,并维护最高分及其出现次数。
我们先根据给定的父节点数组 parents 构建图 ,其中 表示节点 的所有子节点。定义变量 表示最高得分的节点数目,变量 表示最高得分。
用显式栈从根结点 做后序遍历。进入一个结点时,先压入该结点的离开标记,再压入它的孩子,这样孩子会先处理完。离开时,各孩子的子树大小已经写好。初始化 、 。把每个孩子的子树大小累乘到 ,并累加到 。如果 ,再把 累乘到 。若 大于 ,则把 更新为 、 更新为 ;若相等,则把 加 。最后把 记为当前结点的子树大小。
时间复杂度 ,空间复杂度 。其中 是节点数目。
func countHighestScoreNodes(parents []int) (ans int) {
	n := len(parents)
	g := make([][]int, n)
	for i := 1; i < n; i++ {
		g[parents[i]] = append(g[parents[i]], i)
	}
	mx := 0
	sz := make([]int, n)
	stk := [][3]int{{0, -1, 0}}
	for len(stk) > 0 {
		cur := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		i, fa, state := cur[0], cur[1], cur[2]
		if state == 0 {
			stk = append(stk, [3]int{i, fa, 1})
			for _, j := range g[i] {
				if j != fa {
					stk = append(stk, [3]int{j, i, 0})
				}
			}
		} else {
			cnt, score := 1, 1
			for _, j := range g[i] {
				if j != fa {
					t := sz[j]
					cnt += t
					score *= t
				}
			}
			if n-cnt > 0 {
				score *= n - cnt
			}
			if mx < score {
				mx = score
				ans = 1
			} else if mx == score {
				ans++
			}
			sz[i] = cnt
		}
	}
	return
}2096. 从二叉树一个节点到另一个节点每一步的方向
题目、示例与约束
给你一棵 二叉树 的根节点 root ,这棵二叉树总共有 n 个节点。每个节点的值为 1 到 n 中的一个整数,且互不相同。给你一个整数 startValue ,表示起点节点 s 的值,和另一个不同的整数 destValue ,表示终点节点 t 的值。
请找到从节点 s 到节点 t 的 最短路径 ,并以字符串的形式返回每一步的方向。每一步用 大写 字母 'L' ,'R' 和 'U' 分别表示一种方向:
'L'表示从一个节点前往它的 左孩子 节点。'R'表示从一个节点前往它的 右孩子 节点。'U'表示从一个节点前往它的 父 节点。
请你返回从 s 到 t 最短路径 每一步的方向。
示例 1:
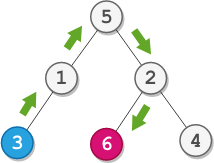
输入:root = [5,1,2,3,null,6,4], startValue = 3, destValue = 6
输出:"UURL"
解释:最短路径为:3 → 1 → 5 → 2 → 6 。
示例 2:
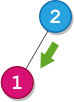
输入:root = [2,1], startValue = 2, destValue = 1
输出:"L"
解释:最短路径为:2 → 1 。
提示:
- 树中节点数目为
n。 2 <= n <= 1051 <= Node.val <= n- 树中所有节点的值 互不相同 。
1 <= startValue, destValue <= nstartValue != destValue
方法一:最近公共祖先 + DFS · Go 实现
思考
从起点到终点的路径必经过 LCA。向上一律走
U,再沿 LCA 到终点的左右孩子走L/R。 ,三次遍历可接受。先求 LCA,再两次 DFS 记录从 LCA 到两端的方向串,把去程改成等长的
U后拼接。
我们可以先找到节点 和 的最近公共祖先,记为 ,然后分别从 出发,找到 和 的路径。那么从 到 的路径就是 的个数,从 到 的路径就是 的路径,最后将这两个路径拼接起来即可。
时间复杂度 ,空间复杂度 。其中 为二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func getDirections(root *TreeNode, startValue int, destValue int) string {
	var lca func(node *TreeNode, p, q int) *TreeNode
	lca = func(node *TreeNode, p, q int) *TreeNode {
		if node == nil || node.Val == p || node.Val == q {
			return node
		}
		left := lca(node.Left, p, q)
		right := lca(node.Right, p, q)
		if left != nil && right != nil {
			return node
		}
		if left != nil {
			return left
		}
		return right
	}
	var dfs func(node *TreeNode, x int, path *[]byte) bool
	dfs = func(node *TreeNode, x int, path *[]byte) bool {
		if node == nil {
			return false
		}
		if node.Val == x {
			return true
		}
		*path = append(*path, 'L')
		if dfs(node.Left, x, path) {
			return true
		}
		(*path)[len(*path)-1] = 'R'
		if dfs(node.Right, x, path) {
			return true
		}
		*path = (*path)[:len(*path)-1]
		return false
	}

	node := lca(root, startValue, destValue)
	pathToStart := []byte{}
	pathToDest := []byte{}
	dfs(node, startValue, &pathToStart)
	dfs(node, destValue, &pathToDest)
	return string(bytes.Repeat([]byte{'U'}, len(pathToStart))) + string(pathToDest)
}
方法二:最近公共祖先 + DFS(优化) · Go 实现
思考
方法一先找 LCA 再走两遍。从根到两端的路径共享一段前缀,去掉该前缀后剩余即「回到 LCA 再下去」。少一次 LCA 专用搜索。
两次 DFS 得到方向串,对齐公共前缀长度 ,答案为 个
U加终点后缀。
我们可以从 出发,找到 和 的路径,记为 和 ,然后去除 和 的最长公共前缀,此时 的路径长度就是答案中 的个数,而 的路径就是答案中的路径,我们只需要将这两个路径拼接起来即可。
时间复杂度 ,空间复杂度 。其中 为二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func getDirections(root *TreeNode, startValue int, destValue int) string {
	var dfs func(node *TreeNode, x int, path *[]byte) bool
	dfs = func(node *TreeNode, x int, path *[]byte) bool {
		if node == nil {
			return false
		}
		if node.Val == x {
			return true
		}
		*path = append(*path, 'L')
		if dfs(node.Left, x, path) {
			return true
		}
		(*path)[len(*path)-1] = 'R'
		if dfs(node.Right, x, path) {
			return true
		}
		*path = (*path)[:len(*path)-1]
		return false
	}

	pathToStart := []byte{}
	pathToDest := []byte{}
	dfs(root, startValue, &pathToStart)
	dfs(root, destValue, &pathToDest)
	i := 0
	for i < len(pathToStart) && i < len(pathToDest) && pathToStart[i] == pathToDest[i] {
		i++
	}
	return string(bytes.Repeat([]byte{'U'}, len(pathToStart)-i)) + string(pathToDest[i:])
}
方法三:显式栈求最近公共祖先 · Go 实现
思考
从起点到终点的最短路径一定经过二者的最近公共祖先。祖先之上的每一步都是
U,从祖先到终点再按左右孩子记L或R。 可以到 ,三次线性遍历都在时限内。求祖先和记录方向都先走进左孩子。一条左链的长度可以到 ,递归会在方向串写完之前溢出。
最近公共祖先要等左右子树都返回后才能决定:两边都找到目标时当前结点就是祖先,否则把非空的一侧传上去。显式栈用状态把“先展开左右孩子”和“孩子都已返回”分开,弹出完成标记时再做这个选择。方向搜索同样先压入回退标记,再压左孩子;左子树失败后把路径末尾改成
R并搜索右孩子,找到目标就停。起点到祖先的方向串长度就是
U的个数,拼上祖先到终点的方向串。
我们用显式栈找到节点 和 的最近公共祖先,记为 。栈里的状态 展开左右孩子,状态 在两侧都返回后决定祖先:两侧都非空则当前结点是祖先,否则取非空的一侧。然后再用同一个栈从 出发,先向左记录 L,左子树没有目标时把末尾改成 R 继续向右,找到目标即停止。从 回到 的步数就是 U 的个数,接上从 到 的方向串。
时间复杂度 ,空间复杂度 。其中 为二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func getDirections(root *TreeNode, startValue int, destValue int) string {
	lca := func(root *TreeNode, p, q int) *TreeNode {
		ret := map[*TreeNode]*TreeNode{}
		stk := [][2]interface{}{{root, 0}}
		for len(stk) > 0 {
			cur := stk[len(stk)-1]
			stk = stk[:len(stk)-1]
			node, _ := cur[0].(*TreeNode)
			state := cur[1].(int)
			if state == 0 {
				if node == nil {
					continue
				}
				if node.Val == p || node.Val == q {
					ret[node] = node
					continue
				}
				stk = append(stk, [2]interface{}{node, 1}, [2]interface{}{node.Right, 0}, [2]interface{}{node.Left, 0})
			} else {
				var left, right *TreeNode
				if node.Left != nil {
					left = ret[node.Left]
				}
				if node.Right != nil {
					right = ret[node.Right]
				}
				if left != nil && right != nil {
					ret[node] = node
				} else if left != nil {
					ret[node] = left
				} else {
					ret[node] = right
				}
			}
		}
		return ret[root]
	}
	dfs := func(start *TreeNode, x int, path *[]byte) bool {
		stk := [][2]interface{}{{start, 0}}
		for len(stk) > 0 {
			cur := stk[len(stk)-1]
			stk = stk[:len(stk)-1]
			node, _ := cur[0].(*TreeNode)
			state := cur[1].(int)
			if state == 0 {
				if node == nil {
					continue
				}
				if node.Val == x {
					return true
				}
				*path = append(*path, 'L')
				stk = append(stk, [2]interface{}{node, 1}, [2]interface{}{node.Left, 0})
			} else if state == 1 {
				(*path)[len(*path)-1] = 'R'
				stk = append(stk, [2]interface{}{node, 2}, [2]interface{}{node.Right, 0})
			} else {
				*path = (*path)[:len(*path)-1]
			}
		}
		return false
	}

	node := lca(root, startValue, destValue)
	pathToStart := []byte{}
	pathToDest := []byte{}
	dfs(node, startValue, &pathToStart)
	dfs(node, destValue, &pathToDest)
	return string(bytes.Repeat([]byte{'U'}, len(pathToStart))) + string(pathToDest)
}
方法四:显式栈对齐根路径 · Go 实现
思考
方法一仍然单独求一次最近公共祖先,再从祖先出发走两遍。从根到两端的路径共享一段前缀,去掉这段前缀就等于先回到祖先再向下,那一次专门的祖先搜索可以省掉。
两次方向搜索仍可能沿着一条长度为 的链往下走,所以同样放进显式栈:先压回退标记,再压左孩子,左子树失败后把末尾改成
R。对齐公共前缀长度 之后,答案是 个
U加上终点路径的后缀。
我们用显式栈从 出发,分别找到 和 的方向串,记为 和 。栈在向左失败后把路径末尾改成 R 再向右,因此方向串与原先的深度优先搜索一致。去掉二者的最长公共前缀后, 剩下的长度就是答案中 U 的个数, 剩下的部分就是向下的方向,把两段拼接起来即可。
时间复杂度 ,空间复杂度 。其中 为二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func getDirections(root *TreeNode, startValue int, destValue int) string {
	dfs := func(start *TreeNode, x int, path *[]byte) bool {
		stk := [][2]interface{}{{start, 0}}
		for len(stk) > 0 {
			cur := stk[len(stk)-1]
			stk = stk[:len(stk)-1]
			node, _ := cur[0].(*TreeNode)
			state := cur[1].(int)
			if state == 0 {
				if node == nil {
					continue
				}
				if node.Val == x {
					return true
				}
				*path = append(*path, 'L')
				stk = append(stk, [2]interface{}{node, 1}, [2]interface{}{node.Left, 0})
			} else if state == 1 {
				(*path)[len(*path)-1] = 'R'
				stk = append(stk, [2]interface{}{node, 2}, [2]interface{}{node.Right, 0})
			} else {
				*path = (*path)[:len(*path)-1]
			}
		}
		return false
	}

	pathToStart := []byte{}
	pathToDest := []byte{}
	dfs(root, startValue, &pathToStart)
	dfs(root, destValue, &pathToDest)
	i := 0
	for i < len(pathToStart) && i < len(pathToDest) && pathToStart[i] == pathToDest[i] {
		i++
	}
	return string(bytes.Repeat([]byte{'U'}, len(pathToStart)-i)) + string(pathToDest[i:])
}2196. 根据描述创建二叉树
题目、示例与约束
给你一个二维整数数组 descriptions ,其中 descriptions[i] = [parenti, childi, isLefti] 表示 parenti 是 childi 在 二叉树 中的 父节点,二叉树中各节点的值 互不相同 。此外:
- 如果
isLefti == 1,那么childi就是parenti的左子节点。 - 如果
isLefti == 0,那么childi就是parenti的右子节点。
请你根据 descriptions 的描述来构造二叉树并返回其 根节点 。
测试用例会保证可以构造出 有效 的二叉树。
示例 1:
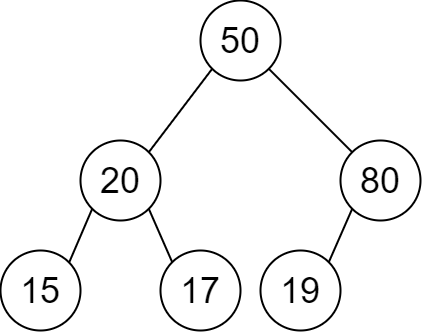
输入:descriptions = [[20,15,1],[20,17,0],[50,20,1],[50,80,0],[80,19,1]]
输出:[50,20,80,15,17,19]
解释:根节点是值为 50 的节点,因为它没有父节点。
结果二叉树如上图所示。
示例 2:
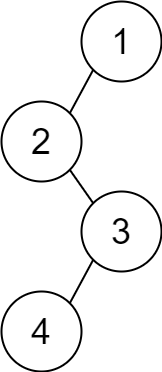
输入:descriptions = [[1,2,1],[2,3,0],[3,4,1]]
输出:[1,2,null,null,3,4]
解释:根节点是值为 1 的节点,因为它没有父节点。
结果二叉树如上图所示。
提示:
1 <= descriptions.length <= 104descriptions[i].length == 31 <= parenti, childi <= 1050 <= isLefti <= 1descriptions所描述的二叉树是一棵有效二叉树
方法一:哈希表 · Go 实现
思考
描述给出每条父—子边及左右,需还原二叉树。结点值唯一,父结点可能尚未出现,需按需创建。根是唯一没有作为孩子出现的结点。
哈希表按值存结点,集合记录所有孩子。扫一遍描述连边,再用结点键集减去孩子集得到根。
时间和空间均为描述条数的线性。
我们可以用一个哈希表 来存储所有节点,其中键为节点的值,值为节点本身,用一个集合 来存储所有的子节点。
遍历 ,对于每个描述 ,如果 不在 中,我们就将 加入 ,并初始化一个值为 的节点。如果 不在 中,我们就将 加入 ,并初始化一个值为 的节点。然后我们将 加入 。
如果 为真,我们就将 作为 的左子节点,否则我们就将 作为 的右子节点。
最后,我们遍历 ,如果某个节点的值不在 中,那么这个节点就是根节点,我们返回这个节点。
时间复杂度 ,空间复杂度 。其中 是 的长度。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func createBinaryTree(descriptions [][]int) *TreeNode {
	nodes := map[int]*TreeNode{}
	children := map[int]bool{}
	for _, d := range descriptions {
		parent, child, isLeft := d[0], d[1], d[2]
		if _, ok := nodes[parent]; !ok {
			nodes[parent] = &TreeNode{Val: parent}
		}
		if _, ok := nodes[child]; !ok {
			nodes[child] = &TreeNode{Val: child}
		}
		if isLeft == 1 {
			nodes[parent].Left = nodes[child]
		} else {
			nodes[parent].Right = nodes[child]
		}
		children[child] = true
	}
	for k, v := range nodes {
		if _, ok := children[k]; !ok {
			return v
		}
	}
	return nil
}2236. 判断根结点是否等于子结点之和
题目、示例与约束
给你一个 二叉树 的根结点 root,该二叉树由恰好 3 个结点组成:根结点、左子结点和右子结点。
如果根结点值等于两个子结点值之和,返回 true ,否则返回 false 。
示例 1:

输入:root = [10,4,6]
输出:true
解释:根结点、左子结点和右子结点的值分别是 10 、4 和 6 。
由于 10 等于 4 + 6 ,因此返回 true 。
示例 2:

输入:root = [5,3,1]
输出:false
解释:根结点、左子结点和右子结点的值分别是 5 、3 和 1 。
由于 5 不等于 3 + 1 ,因此返回 false 。
提示:
- 树只包含根结点、左子结点和右子结点
-100 <= Node.val <= 100
方法一:直接判断 · Go 实现
思考
树恰好三个节点。只需比较根值是否等于左右孩子之和,常数时间即可,不必遍历或递归。
我们直接判断根节点的值是否等于左右子节点的值之和即可。
时间复杂度 ,空间复杂度 。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func checkTree(root *TreeNode) bool {
	return root.Val == root.Left.Val+root.Right.Val
}2265. 统计值等于子树平均值的节点数
题目、示例与约束
给你一棵二叉树的根节点 root ,找出并返回满足要求的节点数,要求节点的值等于其 子树 中值的 平均值 。
注意:
n个元素的平均值可以由n个元素 求和 然后再除以n,并 向下舍入 到最近的整数。root的 子树 由root和它的所有后代组成。
示例 1:
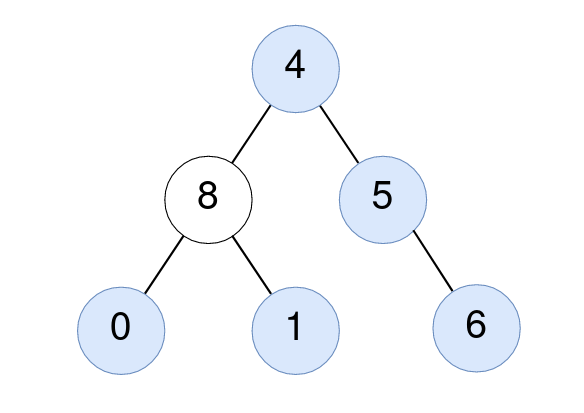
输入:root = [4,8,5,0,1,null,6]
输出:5
解释:
对值为 4 的节点:子树的平均值 (4 + 8 + 5 + 0 + 1 + 6) / 6 = 24 / 6 = 4 。
对值为 5 的节点:子树的平均值 (5 + 6) / 2 = 11 / 2 = 5 。
对值为 0 的节点:子树的平均值 0 / 1 = 0 。
对值为 1 的节点:子树的平均值 1 / 1 = 1 。
对值为 6 的节点:子树的平均值 6 / 1 = 6 。
示例 2:
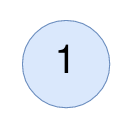
输入:root = [1]
输出:1
解释:对值为 1 的节点:子树的平均值 1 / 1 = 1。
提示:
- 树中节点数目在范围
[1, 1000]内 0 <= Node.val <= 1000
方法一:DFS · Go 实现
思考
统计子树平均值(向下取整)等于自身值的节点。 ,对每个节点再扫一遍子树会重复。一次后序遍历即可带回子树和与节点数。
返回 ,当前节点的平均为 ,与 比较后累加答案。空树返回 。
我们设计一个函数 ,它的作用是计算以当前节点为根的子树的和以及节点个数。
函数 的执行过程如下:
- 如果当前节点为空,返回 。
- 否则,我们递归计算左右子树的和以及节点个数,分别记为 和 。那么,以当前节点为根的子树的和 和节点个数 分别为 和 。如果 ,则说明当前节点满足题目要求,我们将答案 自增 。
- 最后,函数 返回 和 。
我们初始化答案 为 ,然后调用 函数,最后返回答案 。
时间复杂度 ,空间复杂度 。其中 表示二叉树的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func averageOfSubtree(root *TreeNode) (ans int) {
	var dfs func(root *TreeNode) (int, int)
	dfs = func(root *TreeNode) (int, int) {
		if root == nil {
			return 0, 0
		}
		ls, ln := dfs(root.Left)
		rs, rn := dfs(root.Right)
		s, n := ls+rs+root.Val, ln+rn+1
		if s/n == root.Val {
			ans++
		}
		return s, n
	}
	dfs(root)
	return
}2277. 树中最接近路径的节点 🔒
题目、示例与约束
给定一个正整数 n,表示树中的节点数,编号从 0 到 n - 1 (含边界)。还给定一个长度为 n - 1 的二维整数数组 edges,其中 edges[i] = [node1i, node2i] 表示有一条 双向 边连接树中的 node1i 和 node2i。
给定一个长度为 m ,下标从 0 开始 的整数数组 query,其中 query[i] = [starti, endi, nodei] 意味着对于第 i 个查询,您的任务是从 starti 到 endi 的路径上找到 最接近 nodei 的节点。
返回长度为 m 的整数数组 answer,其中 answer[i] 是第 i 个查询的答案。
示例 1:
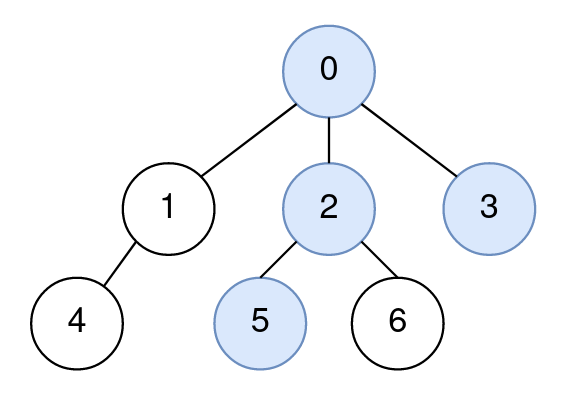
输入: n = 7, edges = [[0,1],[0,2],[0,3],[1,4],[2,5],[2,6]], query = [[5,3,4],[5,3,6]]
输出: [0,2]
解释:
节点 5 到节点 3 的路径由节点 5、2、0、3 组成。
节点 4 到节点 0 的距离为 2。
节点 0 是距离节点 4 最近的路径上的节点,因此第一个查询的答案是 0。
节点 6 到节点 2 的距离为 1。
节点 2 是距离节点 6 最近的路径上的节点,因此第二个查询的答案是 2。
示例 2:
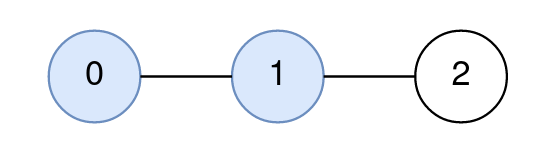
输入: n = 3, edges = [[0,1],[1,2]], query = [[0,1,2]]
输出: [1]
解释:
从节点 0 到节点 1 的路径由节点 0,1 组成。
节点 2 到节点 1 的距离为 1。
节点 1 是距离节点 2 最近的路径上的节点,因此第一个查询的答案是 1。
示例 3:
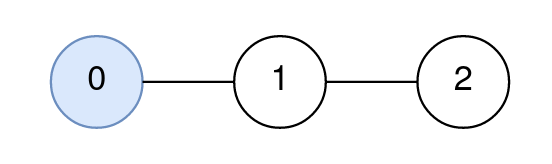
输入: n = 3, edges = [[0,1],[1,2]], query = [[0,0,0]]
输出: [0]
解释:
节点 0 到节点 0 的路径由节点 0 组成。
因为 0 是路径上唯一的节点,所以第一个查询的答案是0。
提示:
1 <= n <= 1000edges.length == n - 1edges[i].length == 20 <= node1i, node2i <= n - 1node1i != node2i1 <= query.length <= 1000query[i].length == 30 <= starti, endi, nodei <= n - 1-
这个图是一个树。
方法一:Go 解法(本站整理) · Go 实现
根据题意整理:源文没有非空实现。树上点 node 到路径 start-end 的投影是三个两两 LCA 中深度最大的节点。先迭代遍历建立深度和倍增祖先表,每个询问计算 LCA(start,end)、LCA(start,node)、LCA(end,node),取最深者。n 为节点数,q 为询问数,时间 O((n+q) log n),空间 O(n log n)。入口 closestNode,节点编号为 0..n-1;n=1 也适用。
出处:Doocs 原题与题解,固定提交 91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011;题意、参考及本 Go 改写采用 CC BY-SA 4.0。
// 题意与参考:Doocs LeetCode,CC BY-SA 4.0。
// https://github.com/doocs/leetcode/blob/91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011/solution/2200-2299/2277.Closest%20Node%20to%20Path%20in%20Tree/README.md
// Go 实现与测试沿用 CC BY-SA 4.0;来源性质见配套说明。
import "math/bits"

func closestNode(n int, edges, query [][]int) []int {
	graph := make([][]int, n)
	for _, e := range edges {
		graph[e[0]] = append(graph[e[0]], e[1])
		graph[e[1]] = append(graph[e[1]], e[0])
	}
	log := bits.Len(uint(n))
	up := make([][]int, log)
	for i := range up {
		up[i] = make([]int, n)
	}
	depth := make([]int, n)
	queue := []int{0}
	for head := 0; head < len(queue); head++ {
		u := queue[head]
		for _, v := range graph[u] {
			if v == up[0][u] {
				continue
			}
			depth[v] = depth[u] + 1
			up[0][v] = u
			for j := 1; j < log; j++ {
				up[j][v] = up[j-1][up[j-1][v]]
			}
			queue = append(queue, v)
		}
	}
	lca := func(a, b int) int {
		if depth[a] < depth[b] {
			a, b = b, a
		}
		diff := depth[a] - depth[b]
		for j := 0; j < log; j++ {
			if diff&(1<<j) != 0 {
				a = up[j][a]
			}
		}
		if a == b {
			return a
		}
		for j := log - 1; j >= 0; j-- {
			if up[j][a] != up[j][b] {
				a, b = up[j][a], up[j][b]
			}
		}
		return up[0][a]
	}
	ans := make([]int, len(query))
	for i, q := range query {
		a, b, c := lca(q[0], q[1]), lca(q[0], q[2]), lca(q[1], q[2])
		if depth[b] > depth[a] {
			a = b
		}
		if depth[c] > depth[a] {
			a = c
		}
		ans[i] = a
	}
	return ans
}2313. 二叉树中得到结果所需的最少翻转次数 🔒
题目、示例与约束
给定二叉树的根 root,具有以下属性:
- 叶节点 的值为
0或1,分别表示false和true。 - 非叶节点的值为
2、3、4、5,分别表示布尔运算OR,AND,XOR,NOT。
您还将得到一个布尔型 result,这是 root 节点的期望 评价 结果。
对节点的评价计算如下:
- 如果节点是叶节点,则评价是节点的 值,即
true或false. - 否则, 将其值的布尔运算应用于子节点的 评价,该节点的 评价 即为布尔运算后的结果。
在一个操作中,您可以 翻转 一个叶节点,这将导致一个 false 节点变为 true 节点,一个 true 节点变为 false 节点。
返回需要执行的最小操作数,以使 root 的评价得到 result。可以证明,总有办法达到 result。
叶节点 是没有子节点的节点。
注意: NOT 节点只有左孩子或只有右孩子,但其他非叶节点同时拥有左孩子和右孩子。
示例 1:
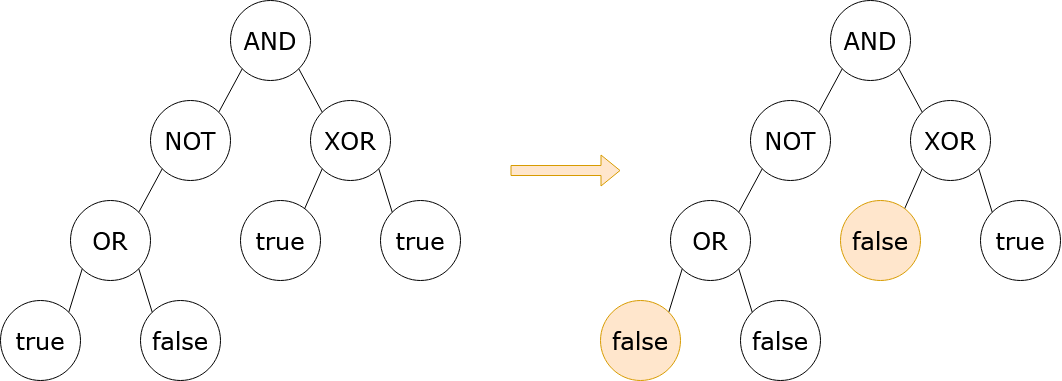
输入: root = [3,5,4,2,null,1,1,1,0], result = true
输出: 2
解释:
可以证明,至少需要翻转 2 个节点才能使树的 root 评价为 true。上面的图显示了实现这一目标的一种方法。
示例 2:
输入: root = [0], result = false
输出: 0
解释:
树的 root 的评价已经为 false,所以 0 个节点必须翻转。
提示:
- 树中的节点数在
[1, 105]范围内。 0 <= Node.val <= 5OR,AND,XOR节点有2个子节点。NOT只有一个1子节点。- 叶节点的值为
0或1. - 非叶节点的值为
2,3,4,5.
方法一:树形 DP + 分情况讨论 · Go 实现
思考
每个叶子可翻 ,内部结点是逻辑运算。对每个叶子尝试翻转再求值,状态数为指数级,树至多上千结点时不可行。
一棵子树对答案的贡献只体现为把它算成假或真的最少翻转。自底向上返回二元组:代价做成 与做成 。按结点类型(叶、 、 、 、 )组合左右儿子的四种或两种情形,根上取目标真值对应的那一维。
我们定义一个函数 ,它的返回值是一个长度为 的数组,其中第一个表示将 节点的值变成 false 所需要的最少翻转次数,第二个表示将 节点的值变成 true 所需要的最少翻转次数。那么答案为 。
函数 的实现如下:
如果 为空,那么返回 。
否则,我们记 的值为 ,左子树的返回值为 ,右子树的返回值为 ,然后分情况讨论:
- 如果 ,那么返回 。
- 如果 ,即布尔运算符是
OR,为了使 的值为false,我们需要将左右子树的值都变成false,因此返回值的第一个元素为 ;为了使 的值为true,我们需要将左右子树的值中至少有一个变成true,因此返回值的第二个元素为 。 - 如果 ,即布尔运算符是
AND,为了使 的值为false,我们需要将左右子树的值中至少有一个变成false,因此返回值的第一个元素为 ;为了使 的值为true,我们需要将左右子树的值都变成true,因此返回值的第二个元素为 。 - 如果 ,即布尔运算符是
XOR,为了使 的值为false,我们需要将左右子树的值同为false或同为true,因此返回值的第一个元素为 ;为了使 的值为true,我们需要将左右子树的值不同,因此返回值的第二个元素为 。 - 如果 ,即布尔运算符是
NOT,为了使 的值为false,我们需要将左右子树的值中至少有一个变成true,因此返回值的第一个元素为 ;为了使 的值为true,我们需要将左右子树的值中至少有一个变成false,因此返回值的第二个元素为 。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func minimumFlips(root *TreeNode, result bool) int {
	var dfs func(*TreeNode) (int, int)
	dfs = func(root *TreeNode) (int, int) {
		if root == nil {
			return 1 << 30, 1 << 30
		}
		x := root.Val
		if x < 2 {
			return x, x ^ 1
		}
		l0, l1 := dfs(root.Left)
		r0, r1 := dfs(root.Right)
		var a, b int
		if x == 2 {
			a = l0 + r0
			b = min(l0+r1, min(l1+r0, l1+r1))
		} else if x == 3 {
			a = min(l0+r0, min(l0+r1, l1+r0))
			b = l1 + r1
		} else if x == 4 {
			a = min(l0+r0, l1+r1)
			b = min(l0+r1, l1+r0)
		} else {
			a = min(l1, r1)
			b = min(l0, r0)
		}
		return a, b
	}
	a, b := dfs(root)
	if result {
		return b
	}
	return a
}2322. 从树中删除边的最小分数
题目、示例与约束
存在一棵无向连通树,树中有编号从 0 到 n - 1 的 n 个节点, 以及 n - 1 条边。
给你一个下标从 0 开始的整数数组 nums ,长度为 n ,其中 nums[i] 表示第 i 个节点的值。另给你一个二维整数数组 edges ,长度为 n - 1 ,其中 edges[i] = [ai, bi] 表示树中存在一条位于节点 ai 和 bi 之间的边。
删除树中两条 不同 的边以形成三个连通组件。对于一种删除边方案,定义如下步骤以计算其分数:
- 分别获取三个组件 每个 组件中所有节点值的异或值。
- 最大 异或值和 最小 异或值的 差值 就是这一种删除边方案的分数。
- 例如,三个组件的节点值分别是:
[4,5,7]、[1,9]和[3,3,3]。三个异或值分别是4 ^ 5 ^ 7 = 6、1 ^ 9 = 8和3 ^ 3 ^ 3 = 3。最大异或值是8,最小异或值是3,分数是8 - 3 = 5。
返回在给定树上执行任意删除边方案可能的 最小 分数。
示例 1:
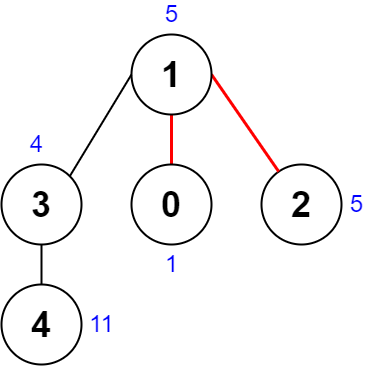
输入:nums = [1,5,5,4,11], edges = [[0,1],[1,2],[1,3],[3,4]]
输出:9
解释:上图展示了一种删除边方案。
- 第 1 个组件的节点是 [1,3,4] ,值是 [5,4,11] 。异或值是 5 ^ 4 ^ 11 = 10 。
- 第 2 个组件的节点是 [0] ,值是 [1] 。异或值是 1 = 1 。
- 第 3 个组件的节点是 [2] ,值是 [5] 。异或值是 5 = 5 。
分数是最大异或值和最小异或值的差值,10 - 1 = 9 。
可以证明不存在分数比 9 小的删除边方案。
示例 2:
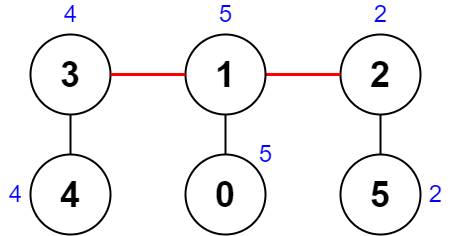
输入:nums = [5,5,2,4,4,2], edges = [[0,1],[1,2],[5,2],[4,3],[1,3]]
输出:0
解释:上图展示了一种删除边方案。
- 第 1 个组件的节点是 [3,4] ,值是 [4,4] 。异或值是 4 ^ 4 = 0 。
- 第 2 个组件的节点是 [1,0] ,值是 [5,5] 。异或值是 5 ^ 5 = 0 。
- 第 3 个组件的节点是 [2,5] ,值是 [2,2] 。异或值是 2 ^ 2 = 0 。
分数是最大异或值和最小异或值的差值,0 - 0 = 0 。
无法获得比 0 更小的分数 0 。
提示:
n == nums.length3 <= n <= 10001 <= nums[i] <= 108edges.length == n - 1edges[i].length == 20 <= ai, bi < nai != biedges表示一棵有效的树
方法一:DFS + 子树异或和 · Go 实现
思考
删两条边得到三块,分数为三块异或和的极差。 ,枚举边对再各算一遍异或过于笨重。整树异或 固定,一块的异或等于其子树异或。
先指定一条被删边,得到含根块异或 。再在该块内 DFS,每个子树异或 对应第二条删除。三块即为 、 、 。枚举根与邻边覆盖所有无序边对。
我们记树的异或和为 ,即 。
接下来,枚举 的每个点 作为树的根节点,将根节点与某个子节点 相连的边作为第一条被删除的边。这样我们就获得了两个连通块,我们记包含根节点 的连通块的异或和为 ,然后我们对包含根节点 的连通块进行 DFS,计算出每个子树的异或和,记每次 DFS 计算出的子树异或和为 。那么三个连通块的异或和分别为 , 和 。我们需要计算这三个异或和的最大值和最小值,记为 和 ,那么对于枚举的每一种情况,得到的分数为 。求所有情况的最小值作为答案。
计算每个子树的异或和可以通过 DFS 实现。定义一个函数 ,表示从节点 开始 DFS,而 是节点 的父节点。函数返回值为以节点 为根的子树的异或和。
时间复杂度 ,空间复杂度 。其中 是树的节点数。
func minimumScore(nums []int, edges [][]int) int {
	n := len(nums)
	g := make([][]int, n)
	for _, e := range edges {
		a, b := e[0], e[1]
		g[a] = append(g[a], b)
		g[b] = append(g[b], a)
	}
	s, s1 := 0, 0
	ans := math.MaxInt32
	for _, x := range nums {
		s ^= x
	}
	var dfs func(i, fa int) int
	dfs = func(i, fa int) int {
		res := nums[i]
		for _, j := range g[i] {
			if j != fa {
				res ^= dfs(j, i)
			}
		}
		return res
	}
	var dfs2 func(i, fa int) int
	dfs2 = func(i, fa int) int {
		res := nums[i]
		for _, j := range g[i] {
			if j != fa {
				s2 := dfs2(j, i)
				res ^= s2
				mx := max(s^s1, s2, s1^s2)
				mn := min(s^s1, s2, s1^s2)
				ans = min(ans, mx-mn)
			}
		}
		return res
	}
	for i := 0; i < n; i++ {
		for _, j := range g[i] {
			s1 = dfs(i, j)
			dfs2(i, j)
		}
	}
	return ans
}
方法二:显式栈 + 子树异或和 · Go 实现
思考
删去两条边会得到三个连通块,分数是这三块异或和的极差。 ,若对每对边都重新遍历整棵树,常数会偏大。整树异或 是定值,删去一条边后,一侧连通块的异或等于按该边定向后的子树异或。先枚举第一条被删边,求出含当前根的那一块异或 ,再把该块里每个子树异或 当作第二条删除,三块就是 、 和 。沿一条链递归计算这些子树异或时,调用深度等于节点数,在 时会超出 Python 的递归上限。因此栈中保存 :状态 先压入退出标记再压入子节点,状态 在子树异或就绪后写回当前节点。第一次栈求出 ,第二次栈对每个子树 更新极差。
我们记树的异或和为 ,即 。
接下来,枚举 的每个点 ,并把 与某个邻接点 之间的边当作第一条被删除的边。这样得到两个连通块。记包含 的连通块的异或和为 ,再在这块里面求出每个子树的异或和 。三个连通块的异或和分别是 、 和 。它们的最大值与最小值之差就是当前删边方案的分数,答案取所有方案的最小值。枚举每个点及其每条邻边,可以覆盖所有无序边对。
子树异或用显式栈按后序计算。栈中元素是 。状态为 时先压入退出标记,再压入除父节点以外的邻接点;状态为 时把各子树异或与自身值异或,得到以当前节点为根的子树异或。第一次栈只取包含 、且不经过 的那一块异或 。第二次栈在算出每个子树异或 后,用上面的三个值更新答案。子节点的处理顺序不影响极差。
时间复杂度 ,空间复杂度 。其中 是树的节点数。
func minimumScore(nums []int, edges [][]int) int {
	n := len(nums)
	g := make([][]int, n)
	for _, e := range edges {
		a, b := e[0], e[1]
		g[a] = append(g[a], b)
		g[b] = append(g[b], a)
	}
	s := 0
	for _, x := range nums {
		s ^= x
	}
	componentXor := func(root, ban int) int {
		sub := make([]int, n)
		stk := [][3]int{{root, ban, 0}}
		for len(stk) > 0 {
			cur := stk[len(stk)-1]
			stk = stk[:len(stk)-1]
			i, fa, state := cur[0], cur[1], cur[2]
			if state == 0 {
				stk = append(stk, [3]int{i, fa, 1})
				for _, j := range g[i] {
					if j != fa {
						stk = append(stk, [3]int{j, i, 0})
					}
				}
			} else {
				res := nums[i]
				for _, j := range g[i] {
					if j != fa {
						res ^= sub[j]
					}
				}
				sub[i] = res
			}
		}
		return sub[root]
	}
	collect := func(root, ban, s1 int) int {
		ans := math.MaxInt32
		sub := make([]int, n)
		stk := [][3]int{{root, ban, 0}}
		for len(stk) > 0 {
			cur := stk[len(stk)-1]
			stk = stk[:len(stk)-1]
			i, fa, state := cur[0], cur[1], cur[2]
			if state == 0 {
				stk = append(stk, [3]int{i, fa, 1})
				for _, j := range g[i] {
					if j != fa {
						stk = append(stk, [3]int{j, i, 0})
					}
				}
			} else {
				res := nums[i]
				for _, j := range g[i] {
					if j != fa {
						s2 := sub[j]
						res ^= s2
						mx := max(s^s1, s2, s1^s2)
						mn := min(s^s1, s2, s1^s2)
						ans = min(ans, mx-mn)
					}
				}
				sub[i] = res
			}
		}
		return ans
	}
	ans := math.MaxInt32
	for i := 0; i < n; i++ {
		for _, j := range g[i] {
			s1 := componentXor(i, j)
			ans = min(ans, collect(i, j, s1))
		}
	}
	return ans
}2331. 计算布尔二叉树的值
题目、示例与约束
给你一棵 完整二叉树 的根,这棵树有以下特征:
- 叶子节点 要么值为
0要么值为1,其中0表示False,1表示True。 - 非叶子节点 要么值为
2要么值为3,其中2表示逻辑或OR,3表示逻辑与AND。
计算 一个节点的值方式如下:
- 如果节点是个叶子节点,那么节点的 值 为它本身,即
True或者False。 - 否则,计算 两个孩子的节点值,然后将该节点的运算符对两个孩子值进行 运算 。
返回根节点 root 的布尔运算值。
完整二叉树 是每个节点有 0 个或者 2 个孩子的二叉树。
叶子节点 是没有孩子的节点。
示例 1:
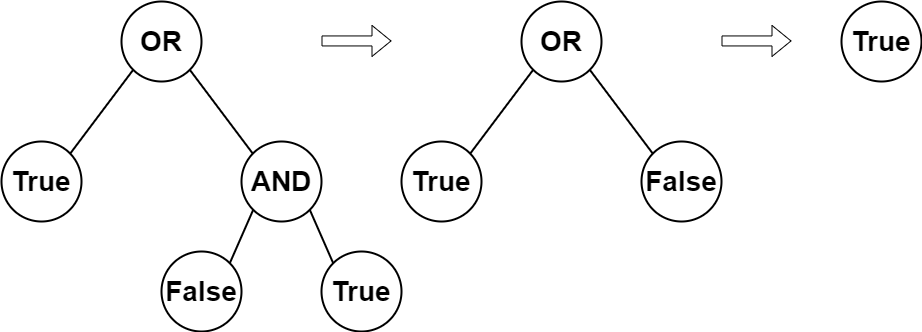
输入:root = [2,1,3,null,null,0,1]
输出:true
解释:上图展示了计算过程。
AND 与运算节点的值为 False AND True = False 。
OR 运算节点的值为 True OR False = True 。
根节点的值为 True ,所以我们返回 true 。
示例 2:
输入:root = [0]
输出:false
解释:根节点是叶子节点,且值为 false,所以我们返回 false 。
提示:
- 树中节点数目在
[1, 1000]之间。 0 <= Node.val <= 3- 每个节点的孩子数为
0或2。 - 叶子节点的值为
0或1。 - 非叶子节点的值为
2或3。
方法一:递归 · Go 实现
思考
叶子为真假,内部结点是或与与。树至多 个结点,按定义求值即可。
左子为空则返回叶子布尔值;否则对左右子树递归后按结点值选择 或 。每个结点访问一次。
我们可以使用递归的方式来求解本题。
对于当前节点 :
- 如果其左孩子为空,说明当前节点是叶子节点。如果当前节点的值为 ,则返回 ,否则返回 ;
- 如果当前节点的值为 ,则返回其左孩子和右孩子的递归结果的逻辑或,否则返回其左孩子和右孩子的递归结果的逻辑与。
时间复杂度 ,空间复杂度 。其中 为二叉树的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func evaluateTree(root *TreeNode) bool {
	if root.Left == nil {
		return root.Val == 1
	}
	if root.Val == 2 {
		return evaluateTree(root.Left) || evaluateTree(root.Right)
	} else {
		return evaluateTree(root.Left) && evaluateTree(root.Right)
	}
}2378. 选择边来最大化树的得分 🔒
题目、示例与约束
给定一个 加权 树,由 n 个节点组成,从 0 到 n - 1。
该树以节点 0 为 根,用大小为 n 的二维数组 edges 表示,其中 edges[i] = [pari, weighti] 表示节点 pari 是节点 i 的 父 节点,它们之间的边的权重等于 weighti。因为根结点 没有 父结点,所以有 edges[0] = [-1, -1]。
从树中选择一些边,使所选的两条边都不 相邻,所选边的权值之 和 最大。
返回所选边的 最大 和。
注意:
- 你可以 不选择 树中的任何边,在这种情况下权值和将为
0。 - 如果树中的两条边
Edge1和Edge2有一个 公共 节点,它们就是 相邻 的。- 换句话说,如果
Edge1连接节点a和b,Edge2连接节点b和c,它们是相邻的。
- 换句话说,如果
示例 1:
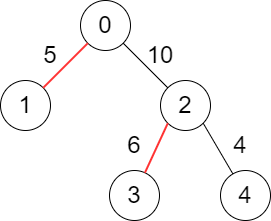
输入: edges = [[-1,-1],[0,5],[0,10],[2,6],[2,4]]
输出: 11
解释: 上面的图表显示了我们必须选择红色的边。
总分是 5 + 6 = 11.
可以看出,没有更好的分数可以获得。
示例 2:
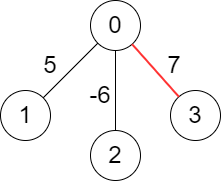
输入: edges = [[-1,-1],[0,5],[0,-6],[0,7]]
输出: 7
解释: 我们选择权值为 7 的边。
注意,我们不能选择一条以上的边,因为所有的边都是彼此相邻的。
提示:
n == edges.length1 <= n <= 105edges[i].length == 2par0 == weight0 == -1i >= 1时0 <= pari <= n - 1。pari != ii >= 1时-106 <= weighti <= 106。edges表示有效的树。
方法一:树形 DP · Go 实现
思考
在树中选一组不相邻的边使权和最大。 与树同阶时,选或不选一条边只影响其两端。
返回二元组:连向父边被选时的最大权和,以及不被选时的最大权和。前者只能累加儿子「不选父边」的值;后者可在至多一个儿子上改选「选父边」并加上该边权。
我们设计一个函数 ,表示以节点 为根的子树中,选择一些边,使得所选的两条边都不相邻,所选边的权值之和最大。该函数返回了两个值 ,第一个值 表示当前节点 与其父节点之间的边被选中时,所选边的权值之和;第二个值 表示当前节点 与其父节点之间的边不被选中时,所选边的权值之和。
我们可以发现,对于当前节点 :
- 如果 与父节点的边被选择,则它与子节点的所有边都不能被选择,那么当前节点的 值就是其所有子节点的 值之和;
- 如果 与父节点的边没被选择,那么可以选择它与子节点的最多一条边,那么当前节点的 值就是其选中的子节点的 值与未选中的子节点的 值之和,再加上 与选中的子节点之间的边的权值。
我们调用 函数,返回的第二个值即为答案,即当前根节点不与父节点之间的边被选中时,所选边的权值之和。
时间复杂度 ,空间复杂度 。其中 为节点数。
func maxScore(edges [][]int) int64 {
	n := len(edges)
	g := make([][][2]int, n)
	for i := 1; i < n; i++ {
		p, w := edges[i][0], edges[i][1]
		g[p] = append(g[p], [2]int{i, w})
	}
	var dfs func(int) [2]int
	dfs = func(i int) [2]int {
		var a, b, t int
		for _, e := range g[i] {
			j, w := e[0], e[1]
			s := dfs(j)
			a += s[1]
			b += s[1]
			t = max(t, s[0]-s[1]+w)
		}
		b += t
		return [2]int{a, b}
	}
	return int64(dfs(0)[1])
}
方法二:树形 DP + 显式栈 · Go 实现
思考
在树中选一组不相邻的边,使权和最大。 ,从根递归决定每条边选或不选,链上的调用深度就是 ,会超出递归栈。
每个节点只要两个量:连向父节点的边被选中时的最大权和 ,以及这条边不选时的最大权和 。父边被选中时,通向孩子的边都不能选, 是各孩子 的和;父边不选时,最多再选一条通向孩子的边,增益是该孩子的 减去 再加上边权,取增益最大的一条。
显式栈按 做后序。进入时先压出栈标记再压孩子,离开时写下 和 。根没有父边,答案是根的 。
对每个节点 计算两个值 。 表示节点 与其父节点之间的边被选中时,子树里所选边的权值之和; 表示这条边不被选中时的权值之和。用显式栈从根做后序,离开节点时再写这两个值。
对于当前节点 :
- 如果 与父节点的边被选择,则它与子节点的所有边都不能被选择,那么 就是其所有子节点的 值之和;
- 如果 与父节点的边没被选择,那么可以选择它与子节点的最多一条边,那么 就是选中的那个子节点的 与其余子节点的 之和,再加上对应边的权值。增益为负时这条边不选。
根没有父边,答案是根的 。
时间复杂度 ,空间复杂度 。其中 为节点数。
func maxScore(edges [][]int) int64 {
	n := len(edges)
	g := make([][][2]int, n)
	for i := 1; i < n; i++ {
		p, w := edges[i][0], edges[i][1]
		g[p] = append(g[p], [2]int{i, w})
	}
	down := make([][2]int, n)
	stk := [][2]int{{0, 0}}
	for len(stk) > 0 {
		cur := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		i, state := cur[0], cur[1]
		if state == 0 {
			stk = append(stk, [2]int{i, 1})
			for _, e := range g[i] {
				stk = append(stk, [2]int{e[0], 0})
			}
		} else {
			var a, b, t int
			for _, e := range g[i] {
				j, w := e[0], e[1]
				x, y := down[j][0], down[j][1]
				a += y
				b += y
				t = max(t, x-y+w)
			}
			b += t
			down[i] = [2]int{a, b}
		}
	}
	return int64(down[0][1])
}2385. 感染二叉树需要的总时间
题目、示例与约束
给你一棵二叉树的根节点 root ,二叉树中节点的值 互不相同 。另给你一个整数 start 。在第 0 分钟,感染 将会从值为 start 的节点开始爆发。
每分钟,如果节点满足以下全部条件,就会被感染:
- 节点此前还没有感染。
- 节点与一个已感染节点相邻。
返回感染整棵树需要的分钟数。
示例 1:
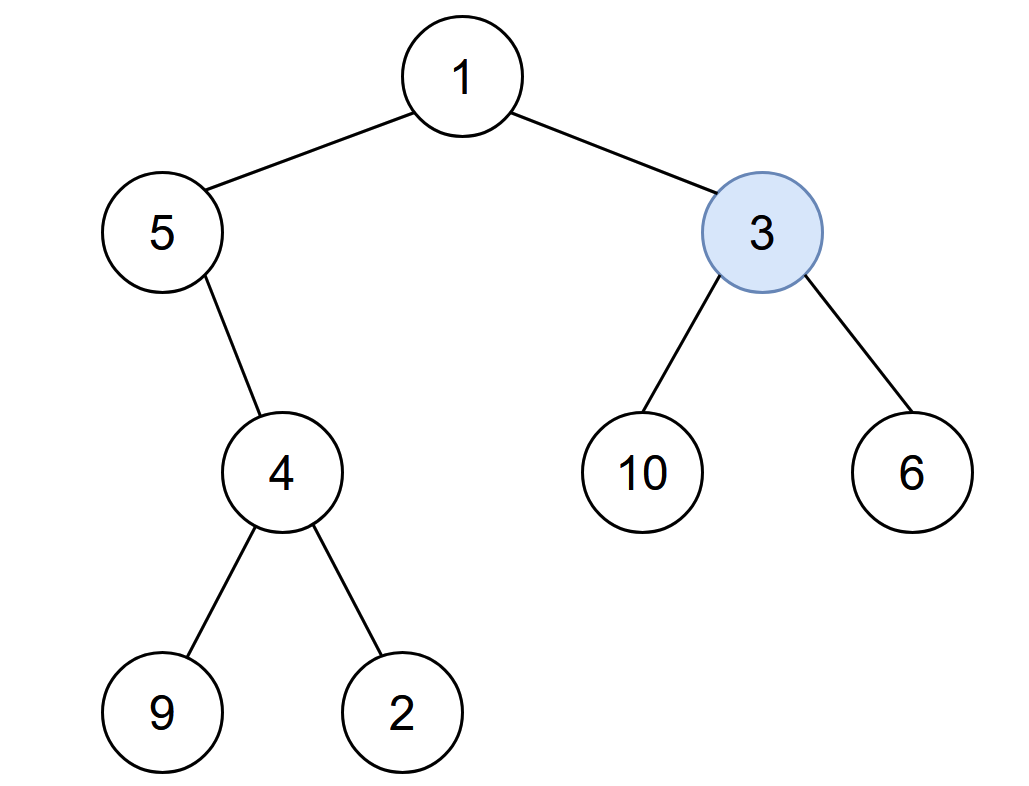
输入:root = [1,5,3,null,4,10,6,9,2], start = 3
输出:4
解释:节点按以下过程被感染:
- 第 0 分钟:节点 3
- 第 1 分钟:节点 1、10、6
- 第 2 分钟:节点5
- 第 3 分钟:节点 4
- 第 4 分钟:节点 9 和 2
感染整棵树需要 4 分钟,所以返回 4 。
示例 2:
输入:root = [1], start = 1
输出:0
解释:第 0 分钟,树中唯一一个节点处于感染状态,返回 0 。
提示:
- 树中节点的数目在范围
[1, 105]内 1 <= Node.val <= 105- 每个节点的值 互不相同
- 树中必定存在值为
start的节点
方法一:两次 DFS · Go 实现
思考
感染沿树边向父子扩散,时间为从 出发的最远距离。树至多 结点,需要显式父边。
第一次 DFS 建成无向邻接表,第二次从 再 DFS 取最深深度。两次均为线性。
我们先通过一次 建图,得到一个邻接表 ,其中 表示与节点 相连的所有节点。
然后,我们以 作为起点,通过 搜索整棵树,找到最远距离,即为答案。
时间复杂度 ,空间复杂度 。其中 为二叉树的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func amountOfTime(root *TreeNode, start int) int {
	g := map[int][]int{}
	var dfs func(*TreeNode, *TreeNode)
	dfs = func(node, fa *TreeNode) {
		if node == nil {
			return
		}
		if fa != nil {
			g[node.Val] = append(g[node.Val], fa.Val)
			g[fa.Val] = append(g[fa.Val], node.Val)
		}
		dfs(node.Left, node)
		dfs(node.Right, node)
	}
	var dfs2 func(int, int) int
	dfs2 = func(node, fa int) (ans int) {
		for _, nxt := range g[node] {
			if nxt != fa {
				ans = max(ans, 1+dfs2(nxt, node))
			}
		}
		return
	}
	dfs(root, nil)
	return dfs2(start, -1)
}
方法二:显式栈 · Go 实现
思考
感染沿父子边扩散,整棵树被感染的时间等于从 出发的最远距离。先沿树记下这些边,再从起点求深度,在较短的树上是对的。
结点个数可达 。左链使两次遍历都按结点个数递归,调用栈会溢出。
两次遍历都只依赖当前结点和父结点,而一个结点的深度等于其余邻接点深度的最大值再加一。这些量可以放在显式栈旁边,不必占用返回帧。
第一趟栈把每条父子边写入无向邻接表,结点值互不相同,直接作为键。第二趟栈进入结点后压入邻接点,退出时用邻接点的深度更新当前深度。 上记下的深度就是答案。
我们用显式栈先序遍历二叉树。遇到一条父子边,就把两端的结点值互相加入邻接表 。结点值互不相同,可以直接作为图的键。
再从 做一次显式栈上的后序遍历。进入结点时压入退出标记以及除父结点以外的邻接点;退出时,当前深度取这些邻接点深度的最大值再加一。 的深度即为答案。
时间复杂度 ,空间复杂度 。其中 为二叉树的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func amountOfTime(root *TreeNode, start int) int {
	g := map[int][]int{}
	type frame struct {
		node, fa *TreeNode
	}
	stk := []frame{{root, nil}}
	for len(stk) > 0 {
		cur := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		node, fa := cur.node, cur.fa
		if node == nil {
			continue
		}
		if fa != nil {
			g[node.Val] = append(g[node.Val], fa.Val)
			g[fa.Val] = append(g[fa.Val], node.Val)
		}
		stk = append(stk, frame{node.Right, node}, frame{node.Left, node})
	}
	dist := map[int]int{}
	type step struct {
		node, fa, state int
	}
	walk := []step{{start, -1, 0}}
	for len(walk) > 0 {
		cur := walk[len(walk)-1]
		walk = walk[:len(walk)-1]
		node, fa, state := cur.node, cur.fa, cur.state
		nxts := g[node]
		if state == 0 {
			walk = append(walk, step{node, fa, 1})
			for i := len(nxts) - 1; i >= 0; i-- {
				if nxt := nxts[i]; nxt != fa {
					walk = append(walk, step{nxt, node, 0})
				}
			}
			continue
		}
		best := 0
		for _, nxt := range nxts {
			if nxt != fa {
				best = max(best, 1+dist[nxt])
			}
		}
		dist[node] = best
	}
	return dist[start]
}2415. 反转二叉树的奇数层
题目、示例与约束
给你一棵 完美 二叉树的根节点 root ,请你反转这棵树中每个 奇数 层的节点值。
- 例如,假设第 3 层的节点值是
[2,1,3,4,7,11,29,18],那么反转后它应该变成[18,29,11,7,4,3,1,2]。
反转后,返回树的根节点。
完美 二叉树需满足:二叉树的所有父节点都有两个子节点,且所有叶子节点都在同一层。
节点的 层数 等于该节点到根节点之间的边数。
示例 1:
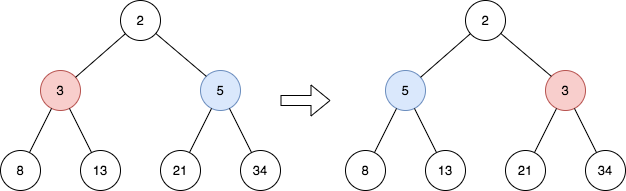
输入:root = [2,3,5,8,13,21,34]
输出:[2,5,3,8,13,21,34]
解释:
这棵树只有一个奇数层。
在第 1 层的节点分别是 3、5 ,反转后为 5、3 。
示例 2:
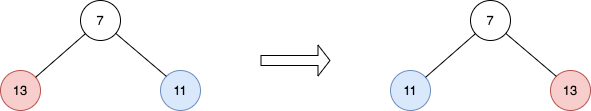
输入:root = [7,13,11]
输出:[7,11,13]
解释:
在第 1 层的节点分别是 13、11 ,反转后为 11、13 。
示例 3:
输入:root = [0,1,2,0,0,0,0,1,1,1,1,2,2,2,2]
输出:[0,2,1,0,0,0,0,2,2,2,2,1,1,1,1]
解释:奇数层由非零值组成。
在第 1 层的节点分别是 1、2 ,反转后为 2、1 。
在第 3 层的节点分别是 1、1、1、1、2、2、2、2 ,反转后为 2、2、2、2、1、1、1、1 。
提示:
- 树中的节点数目在范围
[1, 214]内 0 <= Node.val <= 105root是一棵 完美 二叉树
方法一:BFS · Go 实现
思考
完美二叉树层内节点连续,反转奇数层只需交换该层从两端向中间的节点值。层序遍历自然按层给出节点序列,不必改指针。
用队列 BFS:层号为奇数时在队列两端交换 ,再把下一层子女入队。时间与节点数线性。
我们可以使用广度优先搜索的方法,用一个队列 来存储每一层的节点,用一个变量 记录当前层数。若 为奇数,则将当前层的节点值反转。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func reverseOddLevels(root *TreeNode) *TreeNode {
	q := []*TreeNode{root}
	for i := 0; len(q) > 0; i++ {
		t := []*TreeNode{}
		for k := len(q); k > 0; k-- {
			node := q[0]
			q = q[1:]
			if i%2 == 1 {
				t = append(t, node)
			}
			if node.Left != nil {
				q = append(q, node.Left)
				q = append(q, node.Right)
			}
		}
		for l, r := 0, len(t)-1; l < r; l, r = l+1, r-1 {
			t[l].Val, t[r].Val = t[r].Val, t[l].Val
		}
	}
	return root
}2440. 创建价值相同的连通块
题目、示例与约束
有一棵 n 个节点的无向树,节点编号为 0 到 n - 1 。
给你一个长度为 n 下标从 0 开始的整数数组 nums ,其中 nums[i] 表示第 i 个节点的值。同时给你一个长度为 n - 1 的二维整数数组 edges ,其中 edges[i] = [ai, bi] 表示节点 ai 与 bi 之间有一条边。
你可以 删除 一些边,将这棵树分成几个连通块。一个连通块的 价值 定义为这个连通块中 所有 节点 i 对应的 nums[i] 之和。
你需要删除一些边,删除后得到的各个连通块的价值都相等。请返回你可以删除的边数 最多 为多少。
示例 1:
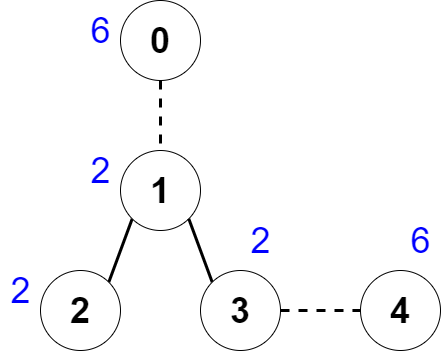
输入:nums = [6,2,2,2,6], edges = [[0,1],[1,2],[1,3],[3,4]]
输出:2
解释:上图展示了我们可以删除边 [0,1] 和 [3,4] 。得到的连通块为 [0] ,[1,2,3] 和 [4] 。每个连通块的价值都为 6 。可以证明没有别的更好的删除方案存在了,所以答案为 2 。
示例 2:
输入:nums = [2], edges = []
输出:0
解释:没有任何边可以删除。
提示:
1 <= n <= 2 * 104nums.length == n1 <= nums[i] <= 50edges.length == n - 1edges[i].length == 20 <= edges[i][0], edges[i][1] <= n - 1edges表示一棵合法的树。
方法一:枚举连通块的个数 · Go 实现
思考
删边后各连通块权和必须相等,故块数 必须整除总和 ,且单块目标 不小于最大点权。 ,从大到小枚举合法 。
树上 DFS 累加子树和:等于 则视为切下并向上返回 ;超过 则失败。根返回 即划分成功,答案为 。
假设连通块的个数为 ,那么要删除的边数为 ,每个连通块的价值为 ,其中 为 所有节点的值之和。
我们从大到小枚举 ,如果存在一个 ,使得 是整数,并且得到的每个连通块的价值都相等,那么直接返回 。其中 的初始值为 ,记 为 中的最大值。
关键点在于判断对于给定的 ,是否能划分出若干子树,使得每棵子树的价值都为 。
这里我们通过 dfs 函数来判断,从上到下递归遍历求出各个子树的价值,如果子树价值和恰好为 ,说明此时划分成功,我们将价值置为 返回给上一层,表示此子树可以与父节点断开。如果子树价值之和大于 ,说明此时划分失败,我们返回 ,表示无法划分。
时间复杂度 ,其中 和 分别为 的长度和 所有节点的值之和。
func componentValue(nums []int, edges [][]int) int {
	s, mx := 0, slices.Max(nums)
	for _, x := range nums {
		s += x
	}
	n := len(nums)
	g := make([][]int, n)
	for _, e := range edges {
		a, b := e[0], e[1]
		g[a] = append(g[a], b)
		g[b] = append(g[b], a)
	}
	t := 0
	var dfs func(int, int) int
	dfs = func(i, fa int) int {
		x := nums[i]
		for _, j := range g[i] {
			if j != fa {
				y := dfs(j, i)
				if y == -1 {
					return -1
				}
				x += y
			}
		}
		if x > t {
			return -1
		}
		if x < t {
			return x
		}
		return 0
	}
	for k := min(n, s/mx); k > 1; k-- {
		if s%k == 0 {
			t = s / k
			if dfs(0, -1) == 0 {
				return k - 1
			}
		}
	}
	return 0
}
方法二:枚举 + 显式栈 · Go 实现
思考
删边之后每个连通块的价值和必须相同,因此块数 必须整除总和 ,目标值 也不能小于最大点权。 ,从大到小枚举满足这两个条件的 是可行的;若对每个 都从根递归累加子树,链上的调用深度就是 ,会超出递归栈。
某个 能否划分,只取决于后序离开节点时子树还剩下多少价值。子节点都处理完以后,当前点权加上尚未切开的子树和:恰好等于 就记成 ,表示这条边可以删掉;小于 就把剩余和交给父节点;大于 则这个 失败。
显式栈按 模拟这次后序。进入节点时先压出栈标记、再压子节点,离开时按上面的规则写入剩余和。根的剩余和为 说明整棵树被切成若干价值和为 的块,此时删除的边数是 。
假设连通块的个数为 ,那么要删除的边数为 ,每个连通块的价值为 ,其中 为 所有节点的值之和。
我们从大到小枚举 ,如果存在一个 ,使得 是整数,并且得到的每个连通块的价值都相等,那么直接返回 。其中 的初始值为 ,记 为 中的最大值。
关键点在于判断对于给定的 ,是否能划分出若干子树,使得每棵子树的价值都为 。
这里用显式栈做后序遍历来判断。离开一个节点时,把它的点权与尚未切开的子树和相加:和恰好为 时记为 ,表示该子树可以与父节点断开;和小于 时把剩余和留给父节点;和大于 时划分失败。根的剩余和为 即划分成功。
时间复杂度 ,空间复杂度 ,其中 和 分别为 的长度和 所有节点的值之和。
func componentValue(nums []int, edges [][]int) int {
	s, mx := 0, slices.Max(nums)
	for _, x := range nums {
		s += x
	}
	n := len(nums)
	g := make([][]int, n)
	for _, e := range edges {
		a, b := e[0], e[1]
		g[a] = append(g[a], b)
		g[b] = append(g[b], a)
	}
	check := func(t int) bool {
		sz := make([]int, n)
		stk := [][3]int{{0, -1, 0}}
		for len(stk) > 0 {
			cur := stk[len(stk)-1]
			stk = stk[:len(stk)-1]
			i, fa, state := cur[0], cur[1], cur[2]
			if state == 0 {
				stk = append(stk, [3]int{i, fa, 1})
				for _, j := range g[i] {
					if j != fa {
						stk = append(stk, [3]int{j, i, 0})
					}
				}
			} else {
				x := nums[i]
				for _, j := range g[i] {
					if j != fa {
						x += sz[j]
					}
				}
				if x > t {
					return false
				}
				if x == t {
					sz[i] = 0
				} else {
					sz[i] = x
				}
			}
		}
		return sz[0] == 0
	}
	for k := min(n, s/mx); k > 1; k-- {
		if s%k == 0 && check(s/k) {
			return k - 1
		}
	}
	return 0
}2445. 值为 1 的节点数 🔒
题目、示例与约束
有一个 无向 树,有 n 个节点,节点标记为从 1 到 n ,还有 n - 1 条边。给定整数 n。标记为 v 的节点的父节点是标记为 floor (v / 2) 的节点。树的根节点是标记为 1 的节点。
- 例如,如果
n = 7,那么标记为3的节点将标记floor(3 / 2) = 1的节点作为其父节点,标记为7的节点将标记floor(7 / 2) = 3的节点作为其父节点。
你还得到一个整数数组 queries。最初,每个节点的值都是 0。对于每个查询 queries[i],您应该翻转节点标记为 queries[i] 的子树中的所有值。
在 处理完所有查询后,返回值为 1 的节点总数。
注意:
- 翻转节点的值意味着值为
0的节点变为1,反之亦然。 floor(x)相当于将x舍入到最接近的整数。
示例 1:
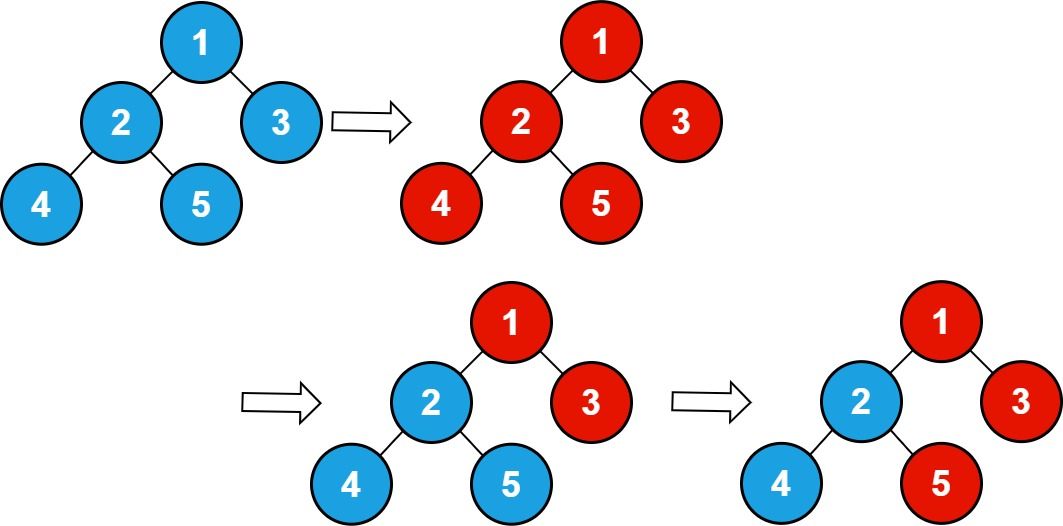
输入: n = 5 , queries = [1,2,5]
输出: 3
解释: 上图显示了执行查询后的树结构及其状态。蓝色节点表示值 0,红色节点表示值 1。
在处理查询之后,有三个红色节点 (值为 1 的节点): 1、3、5。
示例 2:
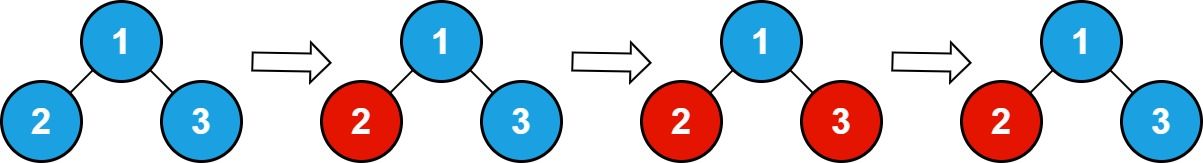
输入: n = 3, queries = [2,3,3]
输出: 1
解释: 上图显示了执行查询后的树结构及其状态。蓝色节点表示值 0,红色节点表示值 1。
在处理查询之后,有一个红色节点 (值为 1 的节点): 2。
提示:
1 <= n <= 1051 <= queries.length <= 1051 <= queries[i] <= n
方法一:模拟 · Go 实现
思考
完全二叉树中一次查询翻转某点及其整棵子树。同一节点查询偶数次抵消,故先按查询次数奇偶过滤。
对奇数次查询的根做一次 DFS 翻转子树。节点至多 ,每位查询根只处理一次,再统计值为 的个数。
根据题意,我们可以模拟每次查询的过程,即将查询节点及其子树的节点值反转。最后统计节点值为 1 的节点个数即可。
这里有一个优化点,每个节点及其对应的子树,如果经过了偶数次查询,那么节点值不会发生变化,因此我们可以记录每个节点的查询次数,对于奇数次查询的节点及其子树,才进行反转。
时间复杂度 ,空间复杂度 。其中 为节点个数。
func numberOfNodes(n int, queries []int) int {
	tree := make([]int, n+1)
	cnt := make([]int, n+1)
	for _, v := range queries {
		cnt[v]++
	}
	var dfs func(int)
	dfs = func(i int) {
		if i > n {
			return
		}
		tree[i] ^= 1
		dfs(i << 1)
		dfs(i<<1 | 1)
	}
	for i, v := range cnt {
		if v%2 == 1 {
			dfs(i)
		}
	}
	ans := 0
	for _, v := range tree {
		ans += v
	}
	return ans
}2458. 移除子树后的二叉树高度
题目、示例与约束
给你一棵 二叉树 的根节点 root ,树中有 n 个节点。每个节点都可以被分配一个从 1 到 n 且互不相同的值。另给你一个长度为 m 的数组 queries 。
你必须在树上执行 m 个 独立 的查询,其中第 i 个查询你需要执行以下操作:
- 从树中 移除 以
queries[i]的值作为根节点的子树。题目所用测试用例保证queries[i]不 等于根节点的值。
返回一个长度为 m 的数组 answer ,其中 answer[i] 是执行第 i 个查询后树的高度。
注意:
- 查询之间是独立的,所以在每个查询执行后,树会回到其 初始 状态。
- 树的高度是从根到树中某个节点的 最长简单路径中的边数 。
示例 1:
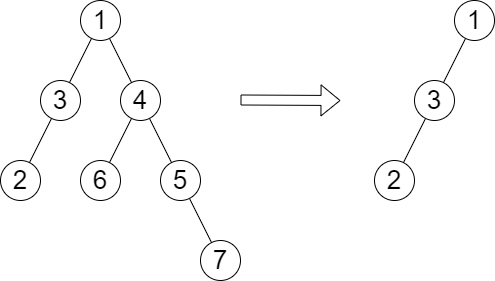
输入:root = [1,3,4,2,null,6,5,null,null,null,null,null,7], queries = [4]
输出:[2]
解释:上图展示了从树中移除以 4 为根节点的子树。
树的高度是 2(路径为 1 -> 3 -> 2)。
示例 2:
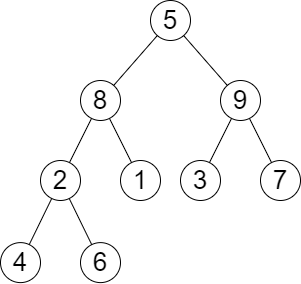
输入:root = [5,8,9,2,1,3,7,4,6], queries = [3,2,4,8]
输出:[3,2,3,2]
解释:执行下述查询:
- 移除以 3 为根节点的子树。树的高度变为 3(路径为 5 -> 8 -> 2 -> 4)。
- 移除以 2 为根节点的子树。树的高度变为 2(路径为 5 -> 8 -> 1)。
- 移除以 4 为根节点的子树。树的高度变为 3(路径为 5 -> 8 -> 2 -> 6)。
- 移除以 8 为根节点的子树。树的高度变为 2(路径为 5 -> 9 -> 3)。
提示:
- 树中节点的数目是
n 2 <= n <= 1051 <= Node.val <= n- 树中的所有值 互不相同
m == queries.length1 <= m <= min(n, 104)1 <= queries[i] <= nqueries[i] != root.val
方法一:两次 DFS · Go 实现
思考
每次删除一个非根子树后问树高, 、 ,不能每次重算。删去 后的高度,是根到其他叶子的最长链,等于「经过 的兄弟侧」与「祖先上其他分叉」的较大者。
第一次 DFS 记下每棵子树高度 。第二次带着「删除当前点后的高度 」下行:进入左子时, 与「当前深度 右子高度」取大;右子对称。结果写入 。
我们先通过一次 DFS 遍历的深度,存放在哈希表 中,其中 表示节点 的深度。
然后我们设计一个函数 ,其中:
root表示当前节点;depth表示当前节点的深度;rest表示删除当前节点后,树的高度。
函数的计算逻辑如下:
如果节点为空,直接返回。否则,我们将 depth 加 ,然后将 rest 保存在 res 中。
接着递归遍历左右子树。
递归左子树前,我们计算从根节点到当前节点右子树最深节点的就,即 ,然后将其与 rest 比较,取较大值作为左子树的 rest。
递归右子树前,我们计算从根节点到当前节点左子树最深节点的就,即 ,然后将其与 rest 比较,取较大值作为右子树的 rest。
最后返回每个查询节点对应的结果值即可。
时间复杂度 ,空间复杂度 。其中 和 分别是树的节点数和查询数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func treeQueries(root *TreeNode, queries []int) (ans []int) {
	d := map[*TreeNode]int{}
	var f func(*TreeNode) int
	f = func(root *TreeNode) int {
		if root == nil {
			return 0
		}
		l, r := f(root.Left), f(root.Right)
		d[root] = 1 + max(l, r)
		return d[root]
	}
	f(root)
	res := make([]int, len(d)+1)
	var dfs func(*TreeNode, int, int)
	dfs = func(root *TreeNode, depth, rest int) {
		if root == nil {
			return
		}
		depth++
		res[root.Val] = rest
		dfs(root.Left, depth, max(rest, depth+d[root.Right]))
		dfs(root.Right, depth, max(rest, depth+d[root.Left]))
	}
	dfs(root, -1, 0)
	for _, v := range queries {
		ans = append(ans, res[v])
	}
	return
}2471. 逐层排序二叉树所需的最少操作数目
题目、示例与约束
给你一个 值互不相同 的二叉树的根节点 root 。
在一步操作中,你可以选择 同一层 上任意两个节点,交换这两个节点的值。
返回每一层按 严格递增顺序 排序所需的最少操作数目。
节点的 层数 是该节点和根节点之间的路径的边数。
示例 1 :
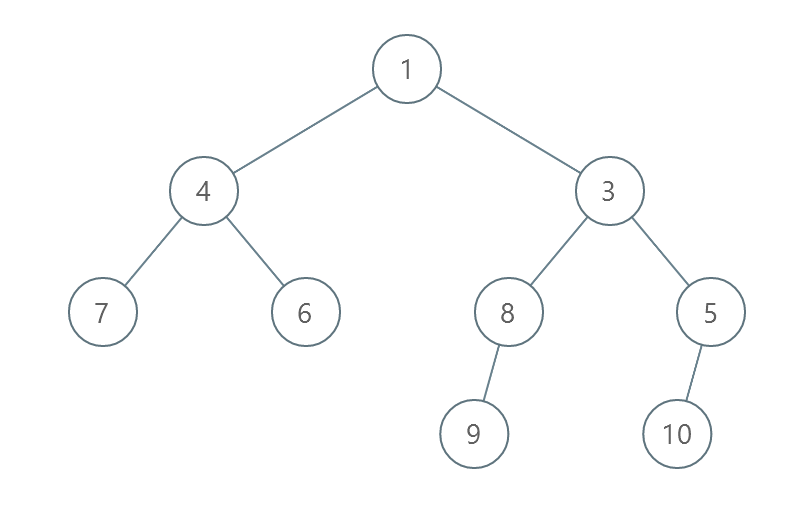
输入:root = [1,4,3,7,6,8,5,null,null,null,null,9,null,10]
输出:3
解释:
- 交换 4 和 3 。第 2 层变为 [3,4] 。
- 交换 7 和 5 。第 3 层变为 [5,6,8,7] 。
- 交换 8 和 7 。第 3 层变为 [5,6,7,8] 。
共计用了 3 步操作,所以返回 3 。
可以证明 3 是需要的最少操作数目。
示例 2 :
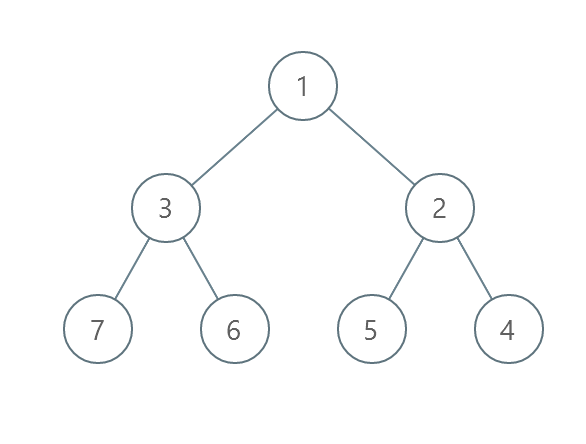
输入:root = [1,3,2,7,6,5,4]
输出:3
解释:
- 交换 3 和 2 。第 2 层变为 [2,3] 。
- 交换 7 和 4 。第 3 层变为 [4,6,5,7] 。
- 交换 6 和 5 。第 3 层变为 [4,5,6,7] 。
共计用了 3 步操作,所以返回 3 。
可以证明 3 是需要的最少操作数目。
示例 3 :
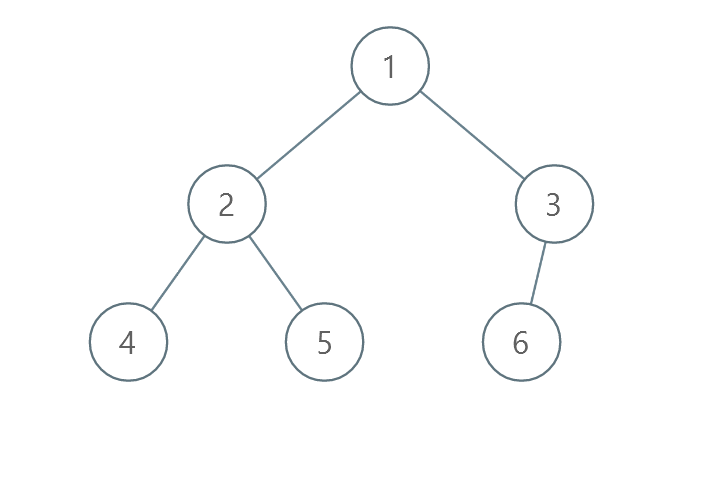
输入:root = [1,2,3,4,5,6]
输出:0
解释:每一层已经按递增顺序排序,所以返回 0 。
提示:
- 树中节点的数目在范围
[1, 105]。 1 <= Node.val <= 105- 树中的所有值 互不相同 。
方法一:BFS + 离散化 + 元素交换 · Go 实现
思考
每层独立排序,操作是交换任意两值。最少交换次数等于置换中「不在循环里的错位」所形成的循环长度之和减循环个数,即把排列还原为恒等的交换次数。
BFS 取层;层内离散化到 后,对每个位置沿 交换直到归位并计数。
我们先通过 BFS 遍历二叉树,找到每一层的节点值,然后对每一层的节点值进行排序,如果排序后的节点值与原节点值不同,则说明需要交换元素,交换元素的次数即为该层需要的操作数。
时间复杂度 。其中 为二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func minimumOperations(root *TreeNode) (ans int) {
	f := func(t []int) int {
		var alls []int
		for _, v := range t {
			alls = append(alls, v)
		}
		sort.Ints(alls)
		m := make(map[int]int)
		for i, v := range alls {
			m[v] = i
		}
		for i := range t {
			t[i] = m[t[i]]
		}
		res := 0
		for i := range t {
			for t[i] != i {
				t[i], t[t[i]] = t[t[i]], t[i]
				res++
			}
		}
		return res
	}

	q := []*TreeNode{root}
	for len(q) > 0 {
		t := []int{}
		for n := len(q); n > 0; n-- {
			node := q[0]
			q = q[1:]
			t = append(t, node.Val)
			if node.Left != nil {
				q = append(q, node.Left)
			}
			if node.Right != nil {
				q = append(q, node.Right)
			}
		}
		ans += f(t)
	}
	return
}2476. 二叉搜索树最近节点查询
题目、示例与约束
给你一个 二叉搜索树 的根节点 root ,和一个由正整数组成、长度为 n 的数组 queries 。
请你找出一个长度为 n 的 二维 答案数组 answer ,其中 answer[i] = [mini, maxi] :
mini是树中小于等于queries[i]的 最大值 。如果不存在这样的值,则使用-1代替。maxi是树中大于等于queries[i]的 最小值 。如果不存在这样的值,则使用-1代替。
返回数组 answer 。
示例 1 :
输入:root = [6,2,13,1,4,9,15,null,null,null,null,null,null,14], queries = [2,5,16]
输出:[[2,2],[4,6],[15,-1]]
解释:按下面的描述找出并返回查询的答案:
- 树中小于等于 2 的最大值是 2 ,且大于等于 2 的最小值也是 2 。所以第一个查询的答案是 [2,2] 。
- 树中小于等于 5 的最大值是 4 ,且大于等于 5 的最小值是 6 。所以第二个查询的答案是 [4,6] 。
- 树中小于等于 16 的最大值是 15 ,且大于等于 16 的最小值不存在。所以第三个查询的答案是 [15,-1] 。
示例 2 :
输入:root = [4,null,9], queries = [3]
输出:[[-1,4]]
解释:树中不存在小于等于 3 的最大值,且大于等于 3 的最小值是 4 。所以查询的答案是 [-1,4] 。
提示:
- 树中节点的数目在范围
[2, 105]内 1 <= Node.val <= 106n == queries.length1 <= n <= 1051 <= queries[i] <= 106
方法一:中序遍历 + 二分查找 · Go 实现
思考
BST 中序即为有序数组。 ,对每个查询在有序数组上二分:不超过 的最大者与不小于 的最小者,越界填 。
由于题目中给出的是一棵二叉搜索树,因此我们可以通过中序遍历得到一个有序数组,然后对于每个查询,我们可以通过二分查找得到小于等于该查询值的最大值和大于等于该查询值的最小值。
时间复杂度 ,空间复杂度 。其中 和 分别是二叉搜索树中的节点数和查询数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func closestNodes(root *TreeNode, queries []int) (ans [][]int) {
	nums := []int{}
	var dfs func(*TreeNode)
	dfs = func(root *TreeNode) {
		if root == nil {
			return
		}
		dfs(root.Left)
		nums = append(nums, root.Val)
		dfs(root.Right)
	}
	dfs(root)
	for _, x := range queries {
		i := sort.SearchInts(nums, x+1) - 1
		j := sort.SearchInts(nums, x)
		mi, mx := -1, -1
		if i >= 0 {
			mi = nums[i]
		}
		if j < len(nums) {
			mx = nums[j]
		}
		ans = append(ans, []int{mi, mx})
	}
	return
}2509. 查询树中环的长度
题目、示例与约束
给你一个整数 n ,表示你有一棵含有 2n - 1 个节点的 完全二叉树 。根节点的编号是 1 ,树中编号在[1, 2n - 1 - 1] 之间,编号为 val 的节点都有两个子节点,满足:
- 左子节点的编号为
2 * val - 右子节点的编号为
2 * val + 1
给你一个长度为 m 的查询数组 queries ,它是一个二维整数数组,其中 queries[i] = [ai, bi] 。对于每个查询,求出以下问题的解:
- 在节点编号为
ai和bi之间添加一条边。 - 求出图中环的长度。
- 删除节点编号为
ai和bi之间新添加的边。
注意:
- 环 是开始和结束于同一节点的一条路径,路径中每条边都只会被访问一次。
- 环的长度是环中边的数目。
- 在树中添加额外的边后,两个点之间可能会有多条边。
请你返回一个长度为 m 的数组 answer ,其中 answer[i] 是第 i 个查询的结果。
示例 1:
输入:n = 3, queries = [[5,3],[4,7],[2,3]]
输出:[4,5,3]
解释:上图是一棵有 23 - 1 个节点的树。红色节点表示添加额外边后形成环的节点。
- 在节点 3 和节点 5 之间添加边后,环为 [5,2,1,3] ,所以第一个查询的结果是 4 。删掉添加的边后处理下一个查询。
- 在节点 4 和节点 7 之间添加边后,环为 [4,2,1,3,7] ,所以第二个查询的结果是 5 。删掉添加的边后处理下一个查询。
- 在节点 2 和节点 3 之间添加边后,环为 [2,1,3] ,所以第三个查询的结果是 3 。删掉添加的边。
示例 2:
输入:n = 2, queries = [[1,2]]
输出:[2]
解释:上图是一棵有 22 - 1 个节点的树。红色节点表示添加额外边后形成环的节点。
- 在节点 1 和节点 2 之间添加边后,环为 [2,1] ,所以第一个查询的结果是 2 。删掉添加的边。
提示:
2 <= n <= 30m == queries.length1 <= m <= 105queries[i].length == 21 <= ai, bi <= 2n - 1ai != bi
方法一:求最近公共祖先 · Go 实现
思考
完全二叉树中加边 形成的环长等于 到 的路径长度加一。若对每个查询建树再求距离, 可达 ,节点数为 ,建树本身不可接受。
父结点编号为 ,即右移一位。两结点沿父指针上移,始终先移动编号较大者,直至相遇,所走步数加一即为环长。这正是完全二叉树中求 LCA 的过程。
对于每次查询,我们找出 , 两个节点的最近公共祖先,并且记录向上走的步数,那么此次查询的答案就是步数加一。
求最近公共祖先时,如果 ,那么我们将 往父节点移动;如果 ,我们将 往其父节点移动。过程中累计步数,直至 。
时间复杂度 。其中 为数组 queries 的长度。
func cycleLengthQueries(n int, queries [][]int) []int {
	ans := []int{}
	for _, q := range queries {
		a, b := q[0], q[1]
		t := 1
		for a != b {
			if a > b {
				a >>= 1
			} else {
				b >>= 1
			}
			t++
		}
		ans = append(ans, t)
	}
	return ans
}继续阅读
- 实践案例
- 实践案例
- 实践案例