
LeetCode Go · 树与二叉树(5)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
1214. 查找两棵二叉搜索树之和 🔒
题目、示例与约束
给出两棵二叉搜索树的根节点 root1 和 root2 ,请你从两棵树中各找出一个节点,使得这两个节点的值之和等于目标值 Target。
如果可以找到返回 True,否则返回 False。
示例 1:
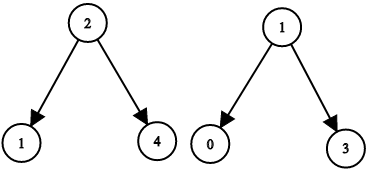
输入:root1 = [2,1,4], root2 = [1,0,3], target = 5
输出:true
解释:2 加 3 和为 5 。
示例 2:
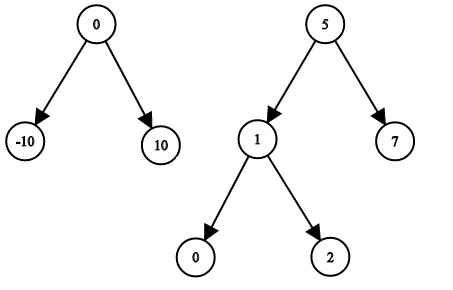
输入:root1 = [0,-10,10], root2 = [5,1,7,0,2], target = 18
输出:false
提示:
- 每棵树上节点数在
[1, 5000]范围内。 -109 <= Node.val, target <= 109
方法一:中序遍历 + 双指针 · Go 实现
思考
在一棵 BST 中查找 需 次检索,节点数达 可以接受,但要处理两棵树的配对。中序遍历得到两个有序数组后,问题化为有序数组的两数之和。
两指针分居 左端与 右端:和偏小则左指针右移,和偏大则右指针左移。BST 的中序保证有序,双指针保证线性配对。
我们分别对两棵树进行中序遍历,得到两个有序数组 和 ,然后使用双指针的方法判断是否存在两个数的和为目标值。双指针判断方法如下:
初始化两个指针 和 ,分别指向数组 的左边界和数组 的右边界;
每次比较 与目标值的大小。如果 ,则返回 true;否则,如果 ,则 右移一位;否则,如果 ,则 左移一位。
时间复杂度 ,空间复杂度 。其中 和 分别为两棵树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func twoSumBSTs(root1 *TreeNode, root2 *TreeNode, target int) bool {
	nums := [2][]int{}
	var dfs func(*TreeNode, int)
	dfs = func(root *TreeNode, i int) {
		if root == nil {
			return
		}
		dfs(root.Left, i)
		nums[i] = append(nums[i], root.Val)
		dfs(root.Right, i)
	}
	dfs(root1, 0)
	dfs(root2, 1)
	i, j := 0, len(nums[1])-1
	for i < len(nums[0]) && j >= 0 {
		x := nums[0][i] + nums[1][j]
		if x == target {
			return true
		}
		if x < target {
			i++
		} else {
			j--
		}
	}
	return false
}1257. 最小公共区域 🔒
题目、示例与约束
给你一些区域列表 regions ,每个列表的第一个区域都 直接 包含这个列表内所有其他区域。
如果一个区域 x 直接包含区域 y,并且区域 y 直接包含区域 z,那么说区域 x 间接 包含区域 z。请注意,区域 x 也 间接 包含所有在 y 中 间接 包含的区域。
很自然地,如果区域 x 包含区域 y ,那么区域 x 比区域 y 大。同时根据定义,区域 x 包含自身。
给定两个区域 region1 和 region2 ,找到同时包含这两个区域的 最小 区域。
数据同样保证最小区域一定存在。
示例 1:
输入:
regions = [["Earth","North America","South America"],
["North America","United States","Canada"],
["United States","New York","Boston"],
["Canada","Ontario","Quebec"],
["South America","Brazil"]],
region1 = "Quebec",
region2 = "New York"
输出:"North America"
示例 2:
输入:regions = [["Earth", "North America", "South America"],["North America", "United States", "Canada"],["United States", "New York", "Boston"],["Canada", "Ontario", "Quebec"],["South America", "Brazil"]], region1 = "Canada", region2 = "South America"
输出:"Earth"
提示:
2 <= regions.length <= 1042 <= regions[i].length <= 201 <= regions[i][j].length, region1.length, region2.length <= 20region1 != region2regions[i][j],region1和region2由英语字母组成。- 输入保证存在一个区域直接或间接包含所有其他区域。
方法一:哈希表 · Go 实现
思考
区域形成树,求两区域的最近公共祖先。 ,反复向上跳可以接受。子到父的映射由每条区域列表的首元素给出。
从 走到根,路径放入集合;再从 向上,第一个落在集合中的节点即为所求。哈希表存父指针,集合判定首次相交。
我们可以用一个哈希表 来存储每个区域的父区域,然后从 开始,不断向上找到所有的父区域,直到根区域,将这些区域放入集合 中。然后从 开始,不断向上找到第一个在 中的区域,即为最小公共区域。
时间复杂度 ,空间复杂度 。其中 为区域列表 的长度。
func findSmallestRegion(regions [][]string, region1 string, region2 string) string {
	g := make(map[string]string)

	for _, r := range regions {
		x := r[0]
		for _, y := range r[1:] {
			g[y] = x
		}
	}

	s := make(map[string]bool)
	for x := region1; x != ""; x = g[x] {
		s[x] = true
	}

	x := region2
	for g[x] != "" && !s[x] {
		x = g[x]
	}

	return x
}1273. 删除树节点 🔒
题目、示例与约束
给你一棵以节点 0 为根节点的树,定义如下:
- 节点的总数为
nodes个; - 第
i个节点的值为value[i]; - 第
i个节点的父节点是parent[i]。
请你删除节点值之和为 0 的每一棵子树。
在完成所有删除之后,返回树中剩余节点的数目。
示例 1:
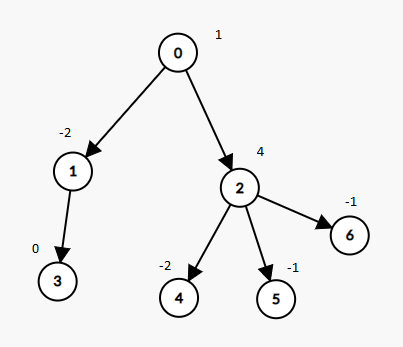
输入:nodes = 7, parent = [-1,0,0,1,2,2,2], value = [1,-2,4,0,-2,-1,-1]
输出:2
示例 2:
输入:nodes = 7, parent = [-1,0,0,1,2,2,2], value = [1,-2,4,0,-2,-1,-2]
输出:6
示例 3:
输入:nodes = 5, parent = [-1,0,1,0,0], value = [-672,441,18,728,378]
输出:5
示例 4:
输入:nodes = 5, parent = [-1,0,0,1,1], value = [-686,-842,616,-739,-746]
输出:5
提示:
1 <= nodes <= 10^4parent.length == nodes0 <= parent[i] <= nodes - 1parent[0] == -1表示节点0是树的根。value.length == nodes-10^5 <= value[i] <= 10^5- 题目输入数据 保证 是一棵 有效的树 。
方法一:DFS · Go 实现
思考
子树权和为 则整棵子树删除。 ,自底向上一次 DFS 即可:先汇总子女的权与残存节点数,若本子树权和为 则残存数置 。返回根的残存数。后序保证删子再决定父亲。
我们先将树转换成图 ,其中 表示节点 的所有子节点。
然后我们设计一个函数 ,表示以节点 为根的子树的节点数目和权值之和。那么答案就是 。
在这个函数中,我们递归地计算出以每个子节点 为根的子树的节点数目和权值之和,然后将这些值进行累加,如果累加后的值为零,那么我们就将这个子树的节点数目置为零。最后我们返回以节点 为根的子树的节点数目和权值之和。
时间复杂度 ,空间复杂度 。其中 是树的节点数目。
func deleteTreeNodes(nodes int, parent []int, value []int) int {
	g := make([][]int, nodes)
	for i := 1; i < nodes; i++ {
		g[parent[i]] = append(g[parent[i]], i)
	}
	type pair struct{ s, n int }
	var dfs func(int) pair
	dfs = func(i int) pair {
		s, m := value[i], 1
		for _, j := range g[i] {
			t := dfs(j)
			s += t.s
			m += t.n
		}
		if s == 0 {
			m = 0
		}
		return pair{s, m}
	}
	return dfs(0).n
}
方法二:显式栈 · Go 实现
思考
子树权和为 则整棵子树删除。 ,自底向上汇总一次即可:先汇总子女的权与残存节点数,若本子树权和为 则残存数置 。从根递归进入孩子,链上的调用深度就是 ,会超出递归栈。
显式栈按 做后序。进入时先压出栈标记再压孩子,离开时把子女的权和残存数累加到自己;和为 则残存数置 。答案是根的残存数。
我们先将树转换成图 ,其中 表示节点 的所有子节点。
然后用显式栈做后序遍历。离开节点 时,把每个子节点的权值和残存节点数累加进来。如果累加后的权值为零,就把这个子树的残存节点数置为零。答案是根节点的残存节点数。
时间复杂度 ,空间复杂度 。其中 是树的节点数目。
func deleteTreeNodes(nodes int, parent []int, value []int) int {
	g := make([][]int, nodes)
	for i := 1; i < nodes; i++ {
		g[parent[i]] = append(g[parent[i]], i)
	}
	sum := make([]int, nodes)
	cnt := make([]int, nodes)
	stk := [][2]int{{0, 0}}
	for len(stk) > 0 {
		cur := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		i, state := cur[0], cur[1]
		if state == 0 {
			stk = append(stk, [2]int{i, 1})
			for _, j := range g[i] {
				stk = append(stk, [2]int{j, 0})
			}
		} else {
			s, m := value[i], 1
			for _, j := range g[i] {
				s += sum[j]
				m += cnt[j]
			}
			if s == 0 {
				m = 0
			}
			sum[i] = s
			cnt[i] = m
		}
	}
	return cnt[0]
}1302. 层数最深叶子节点的和
题目、示例与约束
给你一棵二叉树的根节点 root ,请你返回 层数最深的叶子节点的和 。
示例 1:
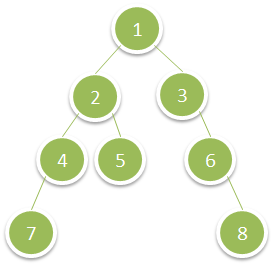
输入:root = [1,2,3,4,5,null,6,7,null,null,null,null,8]
输出:15
示例 2:
输入:root = [6,7,8,2,7,1,3,9,null,1,4,null,null,null,5]
输出:19
提示:
- 树中节点数目在范围
[1, 104]之间。 1 <= Node.val <= 100
方法一:BFS · Go 实现
思考
最深一层叶子的和,可以先求树高再扫一遍累加,但两次遍历并无必要。层序遍历按深度推进,每一层的节点值和都可以在出队时当场求出。
队列为空时所记录的那一层,恰为最深一层。为此用队列存放当前层,逐层覆盖 ,遍历结束时 即为最深叶子之和。
我们可以使用广度优先搜索,逐层遍历二叉树,并在遍历到每一层时计算该层的节点值之和。遍历完成后,返回最后一层的节点值之和。
时间复杂度 ,空间复杂度 。其中 是树中节点的数目。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func deepestLeavesSum(root *TreeNode) (ans int) {
	q := []*TreeNode{root}
	for len(q) > 0 {
		ans = 0
		for k := len(q); k > 0; k-- {
			node := q[0]
			q = q[1:]
			ans += node.Val
			if node.Left != nil {
				q = append(q, node.Left)
			}
			if node.Right != nil {
				q = append(q, node.Right)
			}
		}
	}
	return
}
方法二:DFS · Go 实现
思考
广度优先需要与最宽一层成正比的额外空间。若改为递归,只需在下降时携带深度:等于当前最大深度则累加,超过则重置和与最大深度。一次遍历即可同时维护最深叶子之和。
我们可以使用深度优先搜索,递归遍历二叉树,并在遍历的过程中记录当前节点的深度,以及最大深度和最深叶子节点的和。遍历到当前节点时,如果当前节点的深度等于最大深度,则将当前节点的值加到最深叶子节点的和中;如果当前节点的深度大于最大深度,则将最大深度更新为当前节点的深度,并将最深叶子节点的和更新为当前节点的值。
时间复杂度 ,空间复杂度 。其中 是树中节点的数目。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func deepestLeavesSum(root *TreeNode) int {
	ans, mx := 0, 0
	var dfs func(*TreeNode, int)
	dfs = func(root *TreeNode, i int) {
		if root == nil {
			return
		}
		if i == mx {
			ans += root.Val
		} else if i > mx {
			mx = i
			ans = root.Val
		}
		dfs(root.Left, i+1)
		dfs(root.Right, i+1)
	}
	dfs(root, 1)
	return ans
}1305. 两棵二叉搜索树中的所有元素
题目、示例与约束
给你 root1 和 root2 这两棵二叉搜索树。请你返回一个列表,其中包含 两棵树 中的所有整数并按 升序 排序。.
示例 1:
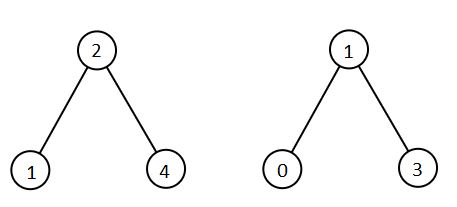
输入:root1 = [2,1,4], root2 = [1,0,3]
输出:[0,1,1,2,3,4]
示例 2:
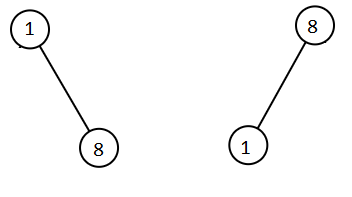
输入:root1 = [1,null,8], root2 = [8,1]
输出:[1,1,8,8]
提示:
- 每棵树的节点数在
[0, 5000]范围内 -105 <= Node.val <= 105
方法一:DFS + 归并 · Go 实现
思考
两棵 BST 的全部节点值需要排成非递减序列。收集后整体排序为 ,没有用到有序性。中序遍历一棵 BST 已得到有序序列,因此分别中序得到 、 ,再按归并两路有序数组的方式合并,线性即可完成。
由于两棵树都是二叉搜索树,所以我们可以通过中序遍历得到两棵树的节点值序列 和 ,然后使用双指针归并两个有序数组,得到最终的答案。
时间复杂度 ,空间复杂度 。其中 和 分别是两棵树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func getAllElements(root1 *TreeNode, root2 *TreeNode) (ans []int) {
	var dfs func(*TreeNode, *[]int)
	dfs = func(root *TreeNode, nums *[]int) {
		if root == nil {
			return
		}
		dfs(root.Left, nums)
		*nums = append(*nums, root.Val)
		dfs(root.Right, nums)
	}
	a, b := []int{}, []int{}
	dfs(root1, &a)
	dfs(root2, &b)
	i, j := 0, 0
	m, n := len(a), len(b)
	for i < m && j < n {
		if a[i] < b[j] {
			ans = append(ans, a[i])
			i++
		} else {
			ans = append(ans, b[j])
			j++
		}
	}
	for ; i < m; i++ {
		ans = append(ans, a[i])
	}
	for ; j < n; j++ {
		ans = append(ans, b[j])
	}
	return
}1315. 祖父节点值为偶数的节点和
题目、示例与约束
给你一棵二叉树,请你返回满足以下条件的所有节点的值之和:
- 该节点的祖父节点的值为偶数。(一个节点的祖父节点是指该节点的父节点的父节点。)
如果不存在祖父节点值为偶数的节点,那么返回 0 。
示例:

输入:root = [6,7,8,2,7,1,3,9,null,1,4,null,null,null,5]
输出:18
解释:图中红色节点的祖父节点的值为偶数,蓝色节点为这些红色节点的祖父节点。
提示:
- 树中节点的数目在
1到10^4之间。 - 每个节点的值在
1到100之间。
方法一:DFS · Go 实现
思考
累加「祖父为偶数」的节点值。自底向上再回头找祖父,需要额外存父指针。自顶向下传递父节点的值:当前节点的父值为偶数时,其两个孩子恰为祖父为偶数的节点,直接加到答案里,再把自身值传给子树。根没有祖父,传入奇数占位即可。
我们设计一个函数 ,表示以 为根节点,并且 的父节点的值为 的子树中,满足条件的节点的值之和。那么答案就是 。
函数 的执行过程如下:
- 如果 为空,返回 。
- 否则,我们递归计算 的左子树和右子树的答案,即 和 ,累加到答案中。如果 为偶数,此时我们判断 的左孩子和右孩子是否存在,如果存在,我们将它们的值累加到答案中。
- 最后返回答案。
时间复杂度 ,空间复杂度 。其中 为节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func sumEvenGrandparent(root *TreeNode) int {
	var dfs func(*TreeNode, int) int
	dfs = func(root *TreeNode, x int) int {
		if root == nil {
			return 0
		}
		ans := dfs(root.Left, root.Val) + dfs(root.Right, root.Val)
		if x%2 == 0 {
			if root.Left != nil {
				ans += root.Left.Val
			}
			if root.Right != nil {
				ans += root.Right.Val
			}
		}
		return ans
	}
	return dfs(root, 1)
}1325. 删除给定值的叶子节点
题目、示例与约束
给你一棵以 root 为根的二叉树和一个整数 target ,请你删除所有值为 target 的 叶子节点 。
注意,一旦删除值为 target 的叶子节点,它的父节点就可能变成叶子节点;如果新叶子节点的值恰好也是 target ,那么这个节点也应该被删除。
也就是说,你需要重复此过程直到不能继续删除。
示例 1:
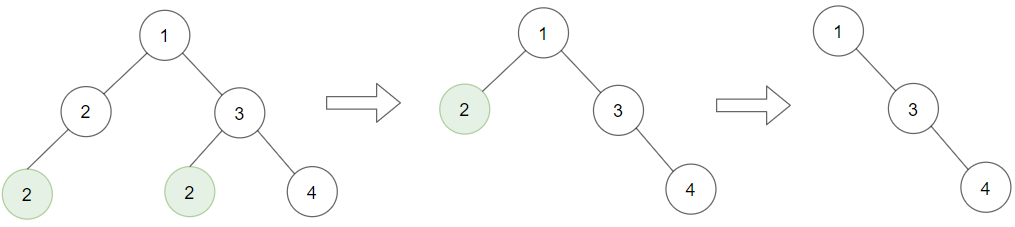
输入:root = [1,2,3,2,null,2,4], target = 2
输出:[1,null,3,null,4]
解释:
上面左边的图中,绿色节点为叶子节点,且它们的值与 target 相同(同为 2 ),它们会被删除,得到中间的图。
有一个新的节点变成了叶子节点且它的值与 target 相同,所以将再次进行删除,从而得到最右边的图。
示例 2:
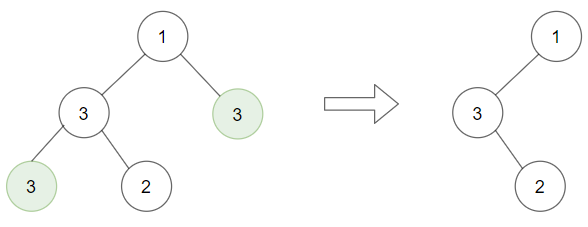
输入:root = [1,3,3,3,2], target = 3
输出:[1,3,null,null,2]
示例 3:
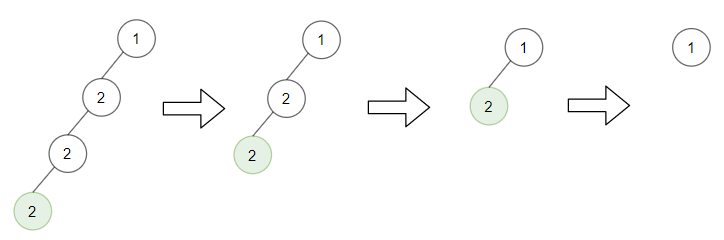
输入:root = [1,2,null,2,null,2], target = 2
输出:[1]
解释:每一步都删除一个绿色的叶子节点(值为 2)。
提示:
- 树中节点数量的范围是
[1, 3000]。 1 <= Node.val, target <= 1000
方法一:递归 · Go 实现
思考
删除值为 的叶子,删除后新产生的同类叶子也要删。先序直接判断会漏掉「删子树后自身才成为叶子」的节点。因此后序处理:先递归左右子树,再判断当前节点是否变为目标叶子;若是则返回空,否则保留。一次后序即可把连锁删除做完。
我们先判断 节点是否为空,若为空,则返回空。
否则,递归地处理 的左右子树,即调用 root.left = removeLeafNodes(root.left, target) 和 root.right = removeLeafNodes(root.right, target)。
然后判断 节点是否为叶子节点,即判断 和 是否为空,且 是否等于 。若是,则返回空,否则返回 。
时间复杂度 ,空间复杂度 。其中 为二叉树的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func removeLeafNodes(root *TreeNode, target int) *TreeNode {
	if root == nil {
		return nil
	}
	root.Left = removeLeafNodes(root.Left, target)
	root.Right = removeLeafNodes(root.Right, target)
	if root.Left == nil && root.Right == nil && root.Val == target {
		return nil
	}
	return root
}1339. 分裂二叉树的最大乘积
题目、示例与约束
给你一棵二叉树,它的根为 root 。请你删除 1 条边,使二叉树分裂成两棵子树,且它们子树和的乘积尽可能大。
由于答案可能会很大,请你将结果对 10^9 + 7 取模后再返回。
示例 1:
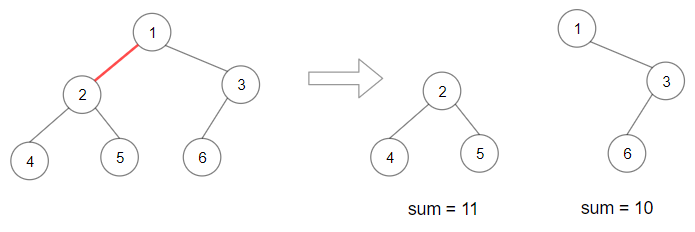
输入:root = [1,2,3,4,5,6]
输出:110
解释:删除红色的边,得到 2 棵子树,和分别为 11 和 10 。它们的乘积是 110 (11*10)
示例 2:
输入:root = [1,null,2,3,4,null,null,5,6]
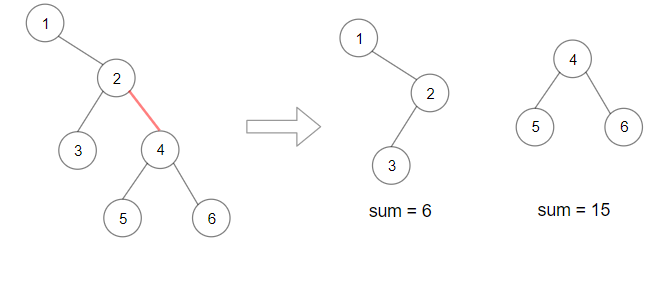
输出:90
解释:移除红色的边,得到 2 棵子树,和分别是 15 和 6 。它们的乘积为 90 (15*6)
示例 3:
输入:root = [2,3,9,10,7,8,6,5,4,11,1]
输出:1025
示例 4:
输入:root = [1,1]
输出:1
提示:
- 每棵树最多有
50000个节点,且至少有2个节点。 - 每个节点的值在
[1, 10000]之间。
方法一:两次 DFS · Go 实现
思考
删一条边把树分成两棵,最大化子树和之积。枚举边时若每次重算两棵和,会到平方级。整树和 固定后,一条边对应的乘积就是 ,其中 是一侧子树和。先 DFS 求 ,再 DFS 枚举每个子树和并更新乘积。
我们可以用两次 DFS 来解决这个问题。
第一次,我们用一个 函数递归求出整棵树所有节点的和,记为 。
第二次,我们用一个 函数递归遍历每个节点,求出以当前节点为根的子树的节点和 ,那么当前节点与其父节点分裂后两棵子树的节点和分别为 和 ,它们的乘积为 ,我们遍历所有节点,求出乘积的最大值,即为答案。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func maxProduct(root *TreeNode) (ans int) {
	const mod = 1e9 + 7
	var sum func(*TreeNode) int
	sum = func(root *TreeNode) int {
		if root == nil {
			return 0
		}
		return root.Val + sum(root.Left) + sum(root.Right)
	}
	s := sum(root)
	var dfs func(*TreeNode) int
	dfs = func(root *TreeNode) int {
		if root == nil {
			return 0
		}
		t := root.Val + dfs(root.Left) + dfs(root.Right)
		if t < s {
			ans = max(ans, t*(s-t))
		}
		return t
	}
	dfs(root)
	ans %= mod
	return
}1367. 二叉树中的链表
题目、示例与约束
给你一棵以 root 为根的二叉树和一个 head 为第一个节点的链表。
如果在二叉树中,存在一条一直向下的路径,且每个点的数值恰好一一对应以 head 为首的链表中每个节点的值,那么请你返回 True ,否则返回 False 。
一直向下的路径的意思是:从树中某个节点开始,一直连续向下的路径。
示例 1:
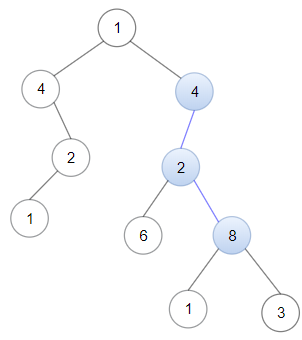
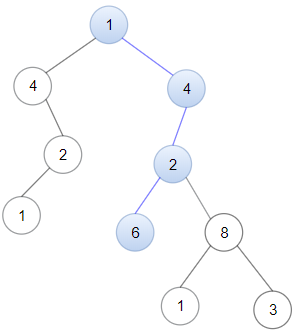
输入:head = [4,2,8], root = [1,4,4,null,2,2,null,1,null,6,8,null,null,null,null,1,3]
输出:true
解释:树中蓝色的节点构成了与链表对应的子路径。
示例 2:
输入:head = [1,4,2,6], root = [1,4,4,null,2,2,null,1,null,6,8,null,null,null,null,1,3]
输出:true
示例 3:
输入:head = [1,4,2,6,8], root = [1,4,4,null,2,2,null,1,null,6,8,null,null,null,null,1,3]
输出:false
解释:二叉树中不存在一一对应链表的路径。
提示:
- 二叉树和链表中的每个节点的值都满足
1 <= node.val <= 100。 - 链表包含的节点数目在
1到100之间。 - 二叉树包含的节点数目在
1到2500之间。
方法一:递归 · Go 实现
思考
判断链表是否沿某条向下路径连续出现。链表与树规模不大,可在每个树节点尝试一次匹配。 要求从当前格起一路相等;主函数则对每个起点调用它,并递归左右子树换起点。链表空则匹配成功,树空或值不等则失败。
我们设计一个递归函数 ,表示链表 是否是以 为起点的路径上的节点值一一对应的子路径。函数 的逻辑如下:
- 如果链表 为空,说明链表已经遍历完了,返回
true; - 如果二叉树 为空,说明二叉树已经遍历完了,但链表还没遍历完,返回
false; - 如果二叉树 的值与链表 的值不相等,返回
false; - 否则,返回 或 。
我们在主函数中,对二叉树的每个节点调用 ,只要有一个返回 true,就说明链表是二叉树的子路径,返回 true;如果所有节点都返回 false,说明链表不是二叉树的子路径,返回 false。
时间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func isSubPath(head *ListNode, root *TreeNode) bool {
	if root == nil {
		return false
	}
	return dfs(head, root) || isSubPath(head, root.Left) || isSubPath(head, root.Right)
}

func dfs(head *ListNode, root *TreeNode) bool {
	if head == nil {
		return true
	}
	if root == nil || head.Val != root.Val {
		return false
	}
	return dfs(head.Next, root.Left) || dfs(head.Next, root.Right)
}1372. 二叉树中的最长交错路径
题目、示例与约束
给你一棵以 root 为根的二叉树,二叉树中的交错路径定义如下:
- 选择二叉树中 任意 节点和一个方向(左或者右)。
- 如果前进方向为右,那么移动到当前节点的的右子节点,否则移动到它的左子节点。
- 改变前进方向:左变右或者右变左。
- 重复第二步和第三步,直到你在树中无法继续移动。
交错路径的长度定义为:访问过的节点数目 - 1(单个节点的路径长度为 0 )。
请你返回给定树中最长 交错路径 的长度。
示例 1:
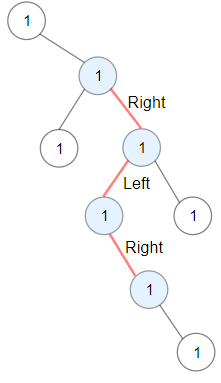
输入:root = [1,null,1,1,1,null,null,1,1,null,1,null,null,null,1,null,1]
输出:3
解释:蓝色节点为树中最长交错路径(右 -> 左 -> 右)。
示例 2:
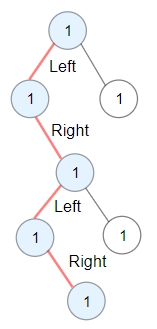
输入:root = [1,1,1,null,1,null,null,1,1,null,1]
输出:4
解释:蓝色节点为树中最长交错路径(左 -> 右 -> 左 -> 右)。
示例 3:
输入:root = [1]
输出:0
提示:
- 每棵树最多有
50000个节点。 - 每个节点的值在
[1, 100]之间。
方法一:DFS · Go 实现
思考
之字形路径须左右交替下降。从每个节点、每种方向重新搜索会重复子树。DFS 时携带「若下一步向左/向右,当前已有的交错长度」: 表示到达本节点时最后一步向左的长度, 同理向右。进入左孩子时新的向左长度是 ,向右长度清零;右孩子对称。全程维护最大值。
时间复杂度 ,其中 是树中节点的个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func longestZigZag(root *TreeNode) int {
	ans := 0
	var dfs func(root *TreeNode, l, r int)
	dfs = func(root *TreeNode, l, r int) {
		if root == nil {
			return
		}
		ans = max(ans, max(l, r))
		dfs(root.Left, r+1, 0)
		dfs(root.Right, 0, l+1)
	}
	dfs(root, 0, 0)
	return ans
}
方法二:显式栈 · Go 实现
思考
交错路径必须左右交替下降。从每个结点带着到达时最后一步向左的长度 、向右的长度 向下递归,左孩子接上 并把向右长度清零,右孩子对称,可以在较短的树上求出最长交错路径。
结点个数可达 。一条链会按结点个数递归,调用栈会溢出。
每个结点的 和 只由父结点的另一步决定,答案又只取全程最大值,不需要等子树返回。
因此用显式栈保存结点以及到达它的 、 。弹出后更新答案,再把右孩子、左孩子连同新的长度压入栈。左孩子后压入,因而先被处理。
我们用显式栈遍历二叉树。栈中每个元素保存当前结点,以及到达该结点时最后一步向左、向右的交错长度 和 。
弹出一个结点后,用 更新答案。若存在左孩子,则它的向左长度为 、向右长度为 ;右孩子的向右长度为 、向左长度为 。根结点的 和 都是 。
时间复杂度 ,空间复杂度 。其中 是树中节点的个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func longestZigZag(root *TreeNode) int {
	ans := 0
	type frame struct {
		node *TreeNode
		l, r int
	}
	stk := []frame{{root, 0, 0}}
	for len(stk) > 0 {
		cur := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		if cur.node == nil {
			continue
		}
		ans = max(ans, max(cur.l, cur.r))
		stk = append(stk, frame{cur.node.Right, 0, cur.l + 1}, frame{cur.node.Left, cur.r + 1, 0})
	}
	return ans
}1373. 二叉搜索子树的最大键值和
题目、示例与约束
给你一棵以 root 为根的 二叉树 ,请你返回 任意 二叉搜索子树的最大键值和。
二叉搜索树的定义如下:
- 任意节点的左子树中的键值都 小于 此节点的键值。
- 任意节点的右子树中的键值都 大于 此节点的键值。
- 任意节点的左子树和右子树都是二叉搜索树。
示例 1:
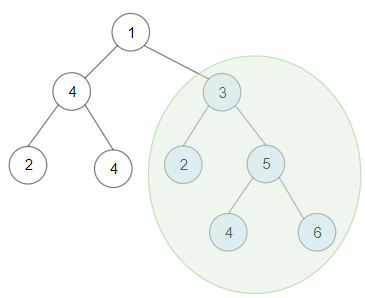
输入:root = [1,4,3,2,4,2,5,null,null,null,null,null,null,4,6]
输出:20
解释:键值为 3 的子树是和最大的二叉搜索树。
示例 2:
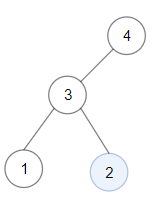
输入:root = [4,3,null,1,2]
输出:2
解释:键值为 2 的单节点子树是和最大的二叉搜索树。
示例 3:
输入:root = [-4,-2,-5]
输出:0
解释:所有节点键值都为负数,和最大的二叉搜索树为空。
示例 4:
输入:root = [2,1,3]
输出:6
示例 5:
输入:root = [5,4,8,3,null,6,3]
输出:7
提示:
- 每棵树有
1到40000个节点。 - 每个节点的键值在
[-4 * 10^4 , 4 * 10^4]之间。
方法一:DFS · Go 实现
思考
求任意子树中,本身为 BST 的那些子树的最大节点和。自顶向下验证 BST 会对同一子树重复判断。后序返回四元组:是否为 BST、最小、最大、子树和。左右都是 BST 且 时,当前树合法,用其和更新答案。空树视为合法,最小为正无穷、最大为负无穷。
判断一棵树是否是二叉搜索树,需要满足以下四个条件:
- 左子树是二叉搜索树;
- 右子树是二叉搜索树;
- 左子树的最大值小于根节点的值;
- 右子树的最小值大于根节点的值。
因此,我们设计一个函数 ,函数的返回值是一个四元组 ,其中:
- 数字 表示以 为根的树是否是二叉搜索树。如果是二叉搜索树,则 ;否则 ;
- 数字 表示以 为根的树的最小值;
- 数字 表示以 为根的树的最大值;
- 数字 表示以 为根的树的所有节点的和。
函数 的执行逻辑如下:
如果 为空节点,则返回 ,表示空树是二叉搜索树,最小值和最大值分别为正无穷和负无穷,节点和为 。
否则,递归计算 的左子树和右子树,分别得到 和 ,然后判断 节点是否满足二叉搜索树的条件。
如果满足 且 且 ,则以 为根的树是二叉搜索树,节点和 。我们更新答案 ,并返回 。
否则,以 为根的树不是二叉搜索树,我们返回 。
我们在主函数中调用 ,执行完毕后,答案即为 。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func maxSumBST(root *TreeNode) (ans int) {
	const inf = 1 << 30
	var dfs func(root *TreeNode) [4]int
	dfs = func(root *TreeNode) [4]int {
		if root == nil {
			return [4]int{1, inf, -inf, 0}
		}
		l, r := dfs(root.Left), dfs(root.Right)
		if l[0] == 1 && r[0] == 1 && l[2] < root.Val && root.Val < r[1] {
			s := l[3] + r[3] + root.Val
			ans = max(ans, s)
			return [4]int{1, min(l[1], root.Val), max(r[2], root.Val), s}
		}
		return [4]int{}
	}
	dfs(root)
	return
}1376. 通知所有员工所需的时间
题目、示例与约束
公司里有 n 名员工,每个员工的 ID 都是独一无二的,编号从 0 到 n - 1。公司的总负责人通过 headID 进行标识。
在 manager 数组中,每个员工都有一个直属负责人,其中 manager[i] 是第 i 名员工的直属负责人。对于总负责人,manager[headID] = -1。题目保证从属关系可以用树结构显示。
公司总负责人想要向公司所有员工通告一条紧急消息。他将会首先通知他的直属下属们,然后由这些下属通知他们的下属,直到所有的员工都得知这条紧急消息。
第 i 名员工需要 informTime[i] 分钟来通知它的所有直属下属(也就是说在 informTime[i] 分钟后,他的所有直属下属都可以开始传播这一消息)。
返回通知所有员工这一紧急消息所需要的 分钟数 。
示例 1:
输入:n = 1, headID = 0, manager = [-1], informTime = [0]
输出:0
解释:公司总负责人是该公司的唯一一名员工。
示例 2:
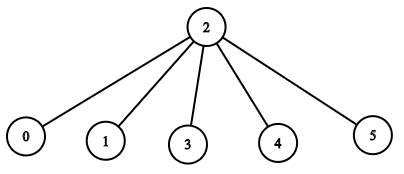
输入:n = 6, headID = 2, manager = [2,2,-1,2,2,2], informTime = [0,0,1,0,0,0]
输出:1
解释:id = 2 的员工是公司的总负责人,也是其他所有员工的直属负责人,他需要 1 分钟来通知所有员工。
上图显示了公司员工的树结构。
提示:
1 <= n <= 10^50 <= headID < nmanager.length == n0 <= manager[i] < nmanager[headID] == -1informTime.length == n0 <= informTime[i] <= 1000- 如果员工
i没有下属,informTime[i] == 0。 - 题目 保证 所有员工都可以收到通知。
方法一:DFS · Go 实现
思考
树形汇报关系下,从负责人把消息传到全员的时间,边权为该员工的通知耗时。 ,不能对每个叶子单独累加路径。建出下属邻接表后, 为 通知完其整棵下属树的时间,等于 加上各直接下属 的最大者。答案为 。
我们先根据 数组构建邻接表 ,其中 表示员工 的所有直接下属。
接下来,我们设计一个函数 ,表示从员工 开始,将消息通知给他的所有下属(包括直接下属、间接下属)所需要的时间,那么答案就是 。
在函数 中,我们需要遍历 的所有直接下属 ,对于每个下属,员工 需要将消息通知给他,这需要花费 的时间,而他的所有下属需要将消息通知给他们的下属,这需要花费 的时间,取 的最大值作为函数 的返回值即可。
时间复杂度 ,空间复杂度 。其中 为员工数量。
func numOfMinutes(n int, headID int, manager []int, informTime []int) int {
	g := make([][]int, n)
	for i, x := range manager {
		if x != -1 {
			g[x] = append(g[x], i)
		}
	}
	var dfs func(int) int
	dfs = func(i int) (ans int) {
		for _, j := range g[i] {
			ans = max(ans, dfs(j)+informTime[i])
		}
		return
	}
	return dfs(headID)
}
方法二:显式栈 · Go 实现
思考
公司的汇报关系是一棵以负责人为根的树,一条边的耗时是该员工的通知时间。 ,从负责人递归统计每棵下属树的耗时,链上的调用深度就是 ,会超出递归栈。
员工 通知完整棵下属树的时间,等于他自己的通知耗时加上直接下属中最慢的那一棵。叶子没有下属,时间是 。这个值只依赖子节点已经算完的结果。
显式栈从 出发,按 做后序。进入时先压出栈标记再压下属,离开时取 的最大值。负责人的时间就是答案。
我们先根据 数组构建邻接表 ,其中 表示员工 的所有直接下属。
员工 通知完整棵下属树所需的时间,等于 加上各直接下属对应时间的最大值;没有下属时这个时间是 。用显式栈从 做后序,离开节点时写入该时间。答案就是负责人的时间。
时间复杂度 ,空间复杂度 。其中 为员工数量。
func numOfMinutes(n int, headID int, manager []int, informTime []int) int {
	g := make([][]int, n)
	for i, x := range manager {
		if x != -1 {
			g[x] = append(g[x], i)
		}
	}
	time := make([]int, n)
	stk := [][2]int{{headID, 0}}
	for len(stk) > 0 {
		cur := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		i, state := cur[0], cur[1]
		if state == 0 {
			stk = append(stk, [2]int{i, 1})
			for _, j := range g[i] {
				stk = append(stk, [2]int{j, 0})
			}
		} else {
			ans := 0
			for _, j := range g[i] {
				ans = max(ans, time[j]+informTime[i])
			}
			time[i] = ans
		}
	}
	return time[headID]
}1379. 找出克隆二叉树中的相同节点
题目、示例与约束
给你两棵二叉树,原始树 original 和克隆树 cloned,以及一个位于原始树 original 中的目标节点 target。
其中,克隆树 cloned 是原始树 original 的一个 副本 。
请找出在树 cloned 中,与 target 相同 的节点,并返回对该节点的引用(在 C/C++ 等有指针的语言中返回 节点指针,其他语言返回节点本身)。
注意:你 不能 对两棵二叉树,以及 target 节点进行更改。只能 返回对克隆树 cloned 中已有的节点的引用。
示例 1:
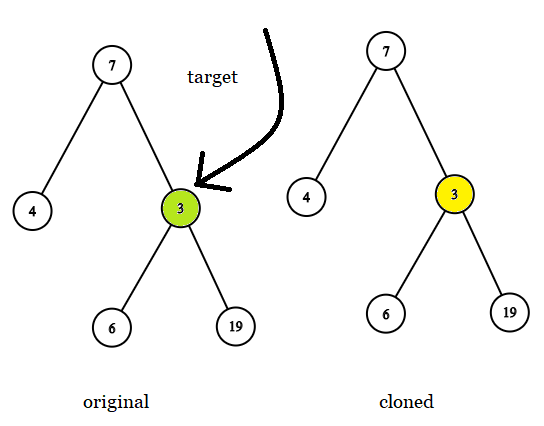
输入: tree = [7,4,3,null,null,6,19], target = 3
输出: 3
解释: 上图画出了树 original 和 cloned。target 节点在树 original 中,用绿色标记。答案是树 cloned 中的黄颜色的节点(其他示例类似)。
示例 2:
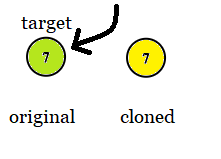
输入: tree = [7], target =  7
输出: 7
示例 3:
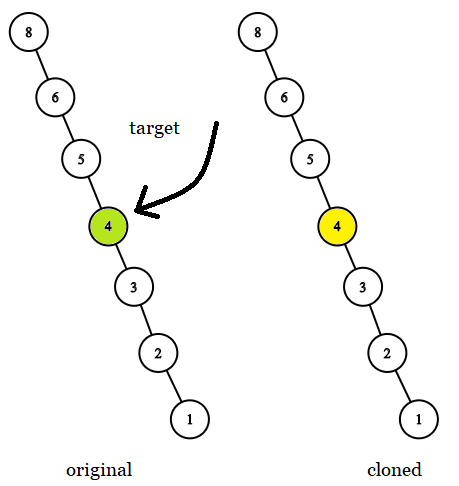
输入: tree = [8,null,6,null,5,null,4,null,3,null,2,null,1], target = 4
输出: 4
提示:
- 树中节点的数量范围为
[1, 104]。 - 同一棵树中,没有值相同的节点。
target节点是树original中的一个节点,并且不会是null。
进阶:如果树中允许出现值相同的节点,将如何解答?
方法一:Go 解法(本站整理) · Go 实现
基于 Doocs 参考改写:将 Python 同步 DFS 改写为 Go。对原树和克隆树同时走相同的左右路径;原树当前指针等于 target 时,直接返回克隆树同位置的已有节点。使用指针身份而不是值比较,因此进阶中的重复值也正确;不创建答案节点、不修改任何输入节点。
变量与复杂度:N 为节点总数,H 为树高;original、cloned 为同步访问位置。时间 O(N),递归栈 O(H),最坏退化链为 O(N)。Go 的可增长 goroutine 栈可处理题目 10⁴ 节点的链。
平台接口:getTargetCopy(original, cloned, target *TreeNode) *TreeNode;TreeNode 由平台提供,字段 Val int、Left/Right *TreeNode,仅测试文件定义此类型。
出处与许可:基于 Doocs 原题及参考资料,固定提交 91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011;Go 代码及本说明按 CC BY-SA 4.0 共享。
// 依据 Doocs/leetcode 题目与参考资料进行 Go 改写/整理。
// 来源:https://github.com/doocs/leetcode/blob/91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011/solution/1300-1399/1379.Find%20a%20Corresponding%20Node%20of%20a%20Binary%20Tree%20in%20a%20Clone%20of%20That%20Tree/README.md
// 许可:CC BY-SA 4.0,https://creativecommons.org/licenses/by-sa/4.0/

func getTargetCopy(original, cloned, target *TreeNode) *TreeNode {
	if original == nil {
		return nil
	}
	if original == target {
		return cloned
	}
	if found := getTargetCopy(original.Left, cloned.Left, target); found != nil {
		return found
	}
	return getTargetCopy(original.Right, cloned.Right, target)
}1382. 将二叉搜索树变平衡
题目、示例与约束
给你一棵二叉搜索树,请你返回一棵 平衡后 的二叉搜索树,新生成的树应该与原来的树有着相同的节点值。如果有多种构造方法,请你返回任意一种。
如果一棵二叉搜索树中,每个节点的两棵子树高度差不超过 1 ,我们就称这棵二叉搜索树是 平衡的 。
示例 1:
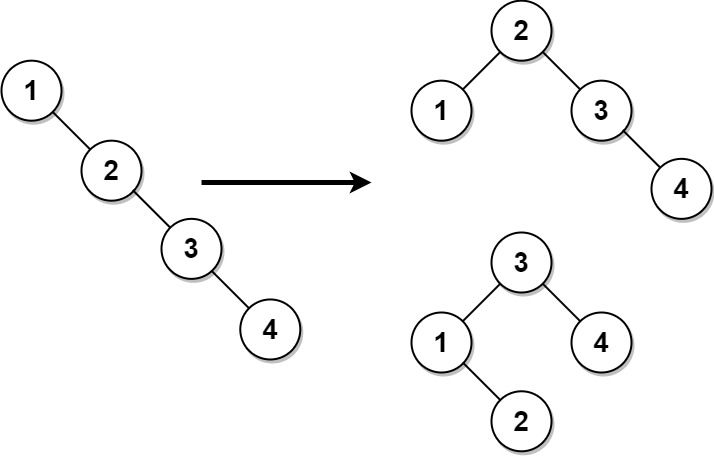
输入:root = [1,null,2,null,3,null,4,null,null]
输出:[2,1,3,null,null,null,4]
解释:这不是唯一的正确答案,[3,1,4,null,2,null,null] 也是一个可行的构造方案。
示例 2:
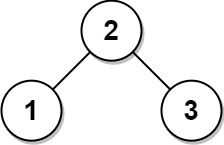
输入: root = [2,1,3]
输出: [2,1,3]
提示:
- 树节点的数目在
[1, 104]范围内。 1 <= Node.val <= 105
方法一:中序遍历 + 构造平衡二叉树 · Go 实现
思考
把 BST 改造成平衡树,中序序列不变。中序得到有序数组后,每次取中点为根、左右区间递归建树,高度即为 ,仍是一棵 BST。
由于原树是一棵二叉搜索树,因此我们可以将其中序遍历的结果保存在一个数组 中,然后我们设计一个函数 ,它用来构造 中下标范围 内的平衡二叉搜索树,那么答案就是 。
函数 的执行逻辑如下:
- 如果 ,那么平衡二叉搜索树为空,返回空节点;
- 否则,我们取 作为根节点,然后递归构建左子树和右子树,返回根节点。
时间复杂度 ,空间复杂度 。其中 是二叉搜索树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func balanceBST(root *TreeNode) *TreeNode {
	ans := []int{}
	var dfs func(*TreeNode)
	dfs = func(root *TreeNode) {
		if root == nil {
			return
		}
		dfs(root.Left)
		ans = append(ans, root.Val)
		dfs(root.Right)
	}
	var build func(i, j int) *TreeNode
	build = func(i, j int) *TreeNode {
		if i > j {
			return nil
		}
		mid := (i + j) >> 1
		left := build(i, mid-1)
		right := build(mid+1, j)
		return &TreeNode{Val: ans[mid], Left: left, Right: right}
	}
	dfs(root)
	return build(0, len(ans)-1)
}1430. 判断给定的序列是否是二叉树从根到叶的路径 🔒
题目、示例与约束
给定一个二叉树,我们称从根节点到任意叶节点的任意路径中的节点值所构成的序列为该二叉树的一个 “有效序列” 。检查一个给定的序列是否是给定二叉树的一个 “有效序列” 。
我们以整数数组 arr 的形式给出这个序列。从根节点到任意叶节点的任意路径中的节点值所构成的序列都是这个二叉树的 “有效序列” 。
示例 1:
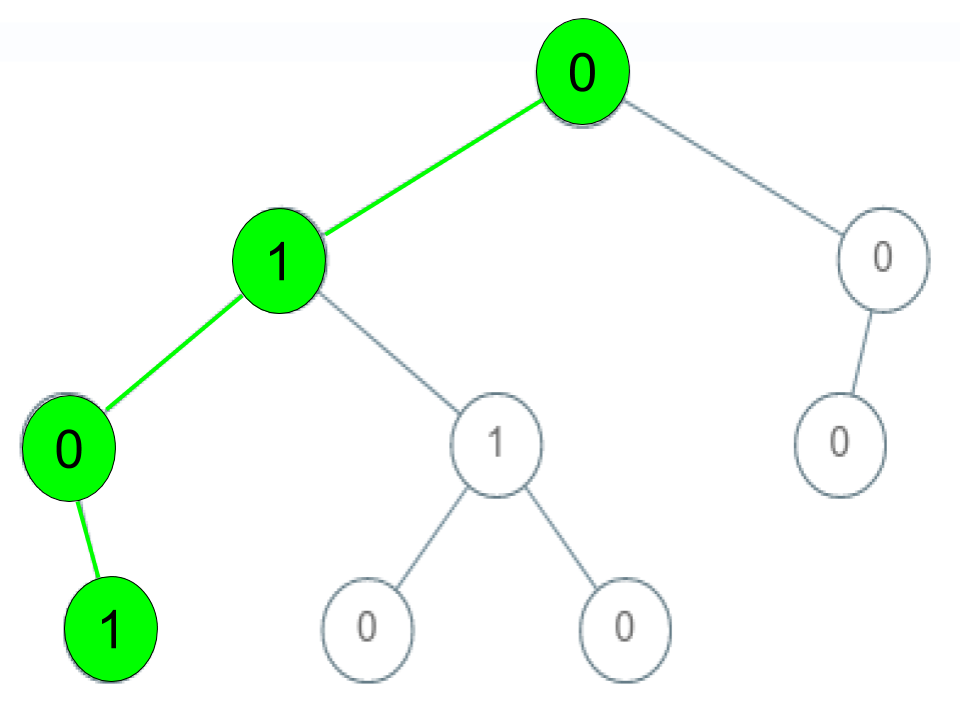
输入:root = [0,1,0,0,1,0,null,null,1,0,0], arr = [0,1,0,1]
输出:true
解释:
路径 0 -> 1 -> 0 -> 1 是一个“有效序列”(图中的绿色节点)。
其他的“有效序列”是:
0 -> 1 -> 1 -> 0
0 -> 0 -> 0
示例 2:
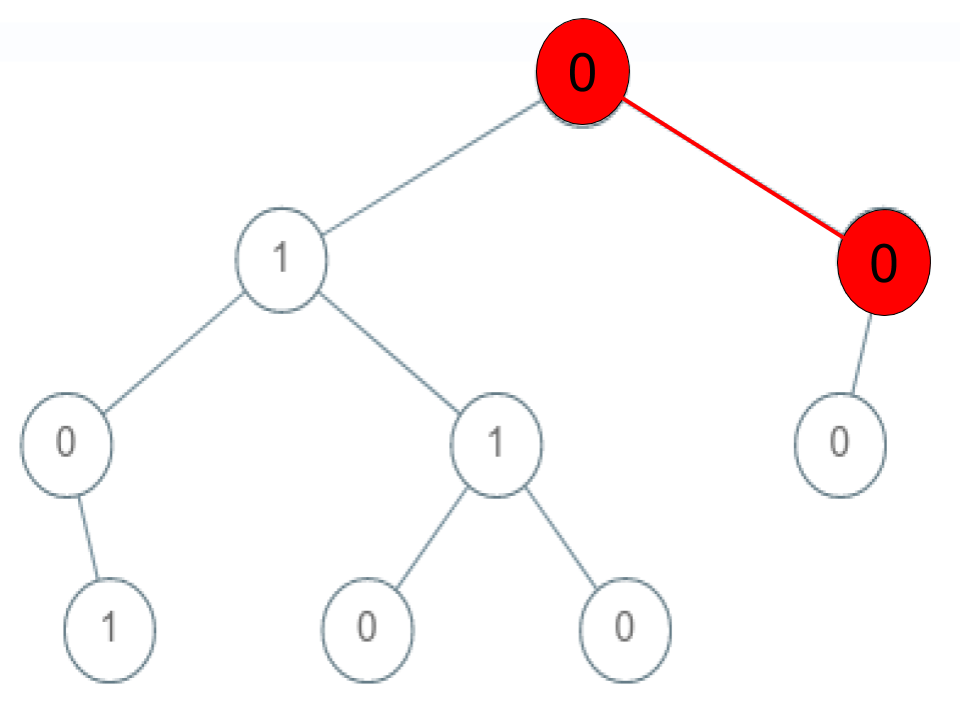
输入:root = [0,1,0,0,1,0,null,null,1,0,0], arr = [0,0,1]
输出:false
解释:路径 0 -> 0 -> 1 不存在,所以这不是一个“序列”。
示例 3:
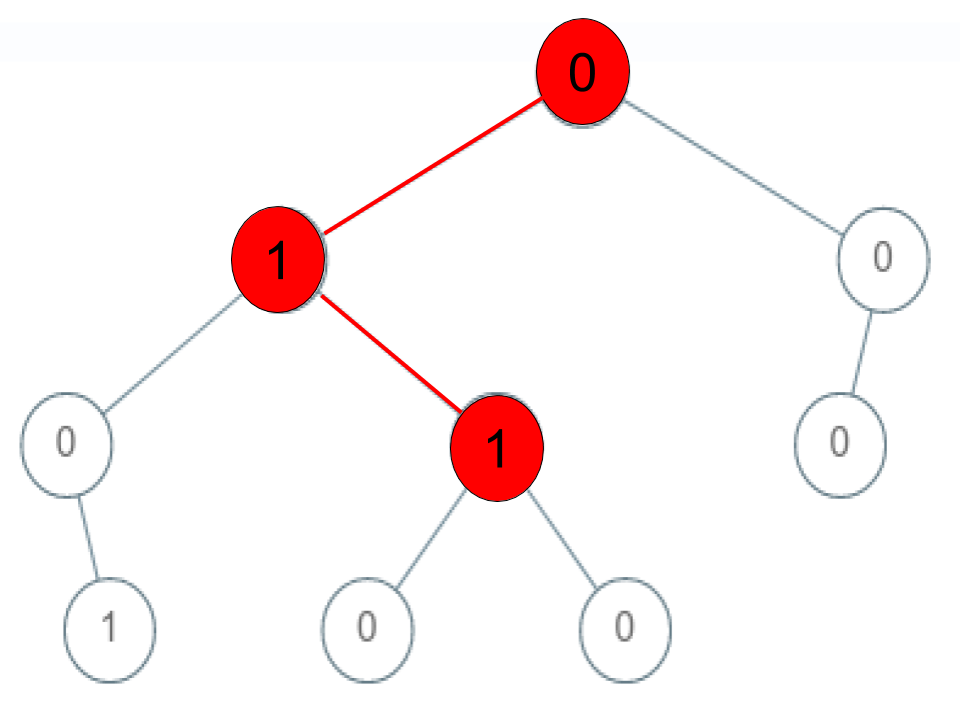
输入:root = [0,1,0,0,1,0,null,null,1,0,0], arr = [0,1,1]
输出:false
解释:路径 0 -> 1 -> 1 是一个序列,但不是一个“有效序列”(译者注:因为序列的终点不是叶节点)。
提示:
1 <= arr.length <= 50000 <= arr[i] <= 9- 每个节点的值的取值范围是
[0 - 9]
方法一:DFS · Go 实现
思考
要判断 是否恰好对应一条根到叶路径。 与 至多 ,从根沿左右孩子各试一次即可,失败分支立即返回。
要求当前值等于 。走到数组末位时必须同时是叶子,否则继续左右子树。空节点或值不匹配则失败。
根据题目,我们设计一个递归函数 ,表示从当前节点 开始,且当前已经遍历到数组的第 个元素,是否存在一条从根节点到叶子节点的路径,且路径上的元素与数组中的元素一一对应。那么答案就是 。
在递归函数中,如果当前节点为空,或者当前节点的值与数组中的值不相等,那么直接返回 。如果当前节点是叶子节点,且当前节点的值与数组中的值相等,那么返回 是否等于数组的长度减 。否则,返回 或者 。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func isValidSequence(root *TreeNode, arr []int) bool {
	var dfs func(root *TreeNode, u int) bool
	dfs = func(root *TreeNode, u int) bool {
		if root == nil || root.Val != arr[u] {
			return false
		}
		if u == len(arr)-1 {
			return root.Left == nil && root.Right == nil
		}
		return dfs(root.Left, u+1) || dfs(root.Right, u+1)
	}
	return dfs(root, 0)
}1443. 收集树上所有苹果的最少时间
题目、示例与约束
给你一棵有 n 个节点的无向树,节点编号为 0 到 n-1 ,它们中有一些节点有苹果。通过树上的一条边,需要花费 1 秒钟。你从 节点 0 出发,请你返回最少需要多少秒,可以收集到所有苹果,并回到节点 0 。
无向树的边由 edges 给出,其中 edges[i] = [fromi, toi] ,表示有一条边连接 from 和 toi 。除此以外,还有一个布尔数组 hasApple ,其中 hasApple[i] = true 代表节点 i 有一个苹果,否则,节点 i 没有苹果。
示例 1:
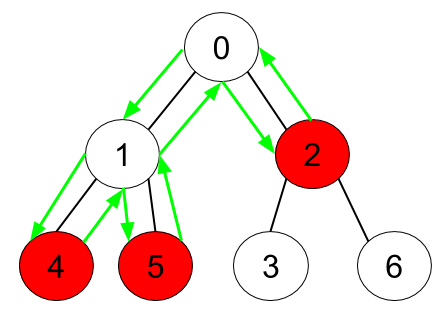
输入:n = 7, edges = [[0,1],[0,2],[1,4],[1,5],[2,3],[2,6]], hasApple = [false,false,true,false,true,true,false]
输出:8
解释:上图展示了给定的树,其中红色节点表示有苹果。一个能收集到所有苹果的最优方案由绿色箭头表示。
示例 2:
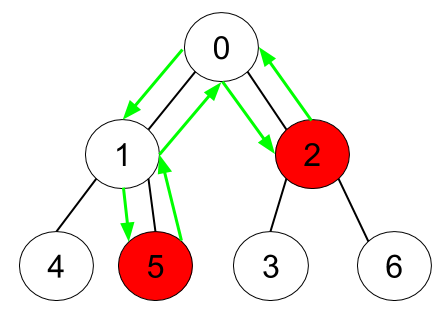
输入:n = 7, edges = [[0,1],[0,2],[1,4],[1,5],[2,3],[2,6]], hasApple = [false,false,true,false,false,true,false]
输出:6
解释:上图展示了给定的树,其中红色节点表示有苹果。一个能收集到所有苹果的最优方案由绿色箭头表示。
示例 3:
输入:n = 7, edges = [[0,1],[0,2],[1,4],[1,5],[2,3],[2,6]], hasApple = [false,false,false,false,false,false,false]
输出:0
提示:
1 <= n <= 10^5edges.length == n - 1edges[i].length == 20 <= ai < bi <= n - 1hasApple.length == n
方法一:DFS · Go 实现
思考
必须从 出发收集全部苹果并返回,每条边走两次(去和回)。 ,只能一遍 DFS。
子树内若既无苹果、子孙也不需继续走,则不必进入。对孩子递归得到的边权(进入该孩子记 )求和,仅当本节点有苹果或子树代价非零时,才把进入边的代价加上返回。根的进入代价为 。
func minTime(n int, edges [][]int, hasApple []bool) int {
	vis := make([]bool, n)
	g := make([][]int, n)
	for _, e := range edges {
		u, v := e[0], e[1]
		g[u] = append(g[u], v)
		g[v] = append(g[v], u)
	}
	var dfs func(int, int) int
	dfs = func(u, cost int) int {
		if vis[u] {
			return 0
		}
		vis[u] = true
		nxt := 0
		for _, v := range g[u] {
			nxt += dfs(v, 2)
		}
		if !hasApple[u] && nxt == 0 {
			return 0
		}
		return cost + nxt
	}
	return dfs(0, 0)
}
方法二:显式栈 · Go 实现
思考
必须从 出发收集全部苹果并返回,每条用到的边走两次。 ,从根递归统计每棵子树的往返代价,链上的调用深度就是 ,会超出递归栈。
一棵子树如果自己没有苹果、子孙也不需要再走,就不必进入。孩子都处理完以后,把各孩子的往返代价相加;当前点有苹果或这个和不为 时,再加上进入当前点的代价,根是 ,其余点是 。
显式栈按 做后序。进入时先压出栈标记再压孩子,离开时按上面的规则写入往返代价。根的代价就是答案。
func minTime(n int, edges [][]int, hasApple []bool) int {
	g := make([][]int, n)
	for _, e := range edges {
		u, v := e[0], e[1]
		g[u] = append(g[u], v)
		g[v] = append(g[v], u)
	}
	cost := make([]int, n)
	stk := [][3]int{{0, -1, 0}}
	for len(stk) > 0 {
		cur := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		u, fa, state := cur[0], cur[1], cur[2]
		if state == 0 {
			stk = append(stk, [3]int{u, fa, 1})
			for _, v := range g[u] {
				if v != fa {
					stk = append(stk, [3]int{v, u, 0})
				}
			}
		} else {
			nxt := 0
			for _, v := range g[u] {
				if v != fa {
					nxt += cost[v]
				}
			}
			if hasApple[u] || nxt > 0 {
				if u == 0 {
					cost[u] = nxt
				} else {
					cost[u] = nxt + 2
				}
			}
		}
	}
	return cost[0]
}1448. 统计二叉树中好节点的数目
题目、示例与约束
给你一棵根为 root 的二叉树,请你返回二叉树中好节点的数目。
「好节点」X 定义为:从根到该节点 X 所经过的节点中,没有任何节点的值大于 X 的值。
示例 1:
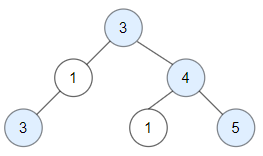
输入:root = [3,1,4,3,null,1,5]
输出:4
解释:图中蓝色节点为好节点。
根节点 (3) 永远是个好节点。
节点 4 -> (3,4) 是路径中的最大值。
节点 5 -> (3,4,5) 是路径中的最大值。
节点 3 -> (3,1,3) 是路径中的最大值。
示例 2:
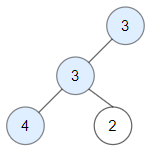
输入:root = [3,3,null,4,2]
输出:3
解释:节点 2 -> (3, 3, 2) 不是好节点,因为 "3" 比它大。
示例 3:
输入:root = [1]
输出:1
解释:根节点是好节点。
提示:
- 二叉树中节点数目范围是
[1, 10^5]。 - 每个节点权值的范围是
[-10^4, 10^4]。
方法一:DFS · Go 实现
思考
好节点要求根到该点路径上没有更大的值。 ,在 DFS 中下传路径最大值 ,当前值不小于 则计数并更新 。
我们设计一个函数 ,表示从当前节点 开始搜索好节点,其中 表示从根节点到当前节点的路径(不包括当前节点)上的最大值。
函数 的执行逻辑如下:
如果 为空,说明搜索结束,直接返回;
否则,我们判断 与 的大小关系。如果 ,说明 是好节点,答案加一,并且我们需要更新 的值为 。
接下来,我们递归调用 和 。
在主函数中,我们调用 ,其中 表示负无穷,因为题目中说明了每个节点权值的范围是 ,所以 肯定是一个比所有节点权值都小的值,这样就能保证 一定会把根节点 算作好节点。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func goodNodes(root *TreeNode) (ans int) {
	var dfs func(*TreeNode, int)
	dfs = func(root *TreeNode, mx int) {
		if root == nil {
			return
		}
		if mx <= root.Val {
			ans++
			mx = root.Val
		}
		dfs(root.Left, mx)
		dfs(root.Right, mx)
	}
	dfs(root, -10001)
	return
}
方法二:显式栈 · Go 实现
思考
好节点要求从根到该点的路径上没有更大的值。 可以到 ,下传路径最大值 ,当前值不小于 就计数并更新 ,一次遍历就能数完。
搜索先进入左孩子。一条左链的长度可以到 ,递归会在计数完成前溢出。每个结点只和自己路径上的最大值比较,左右孩子互不影响。
待访问的结点可以连同到达它之前的 放进显式栈。弹出后若当前值不小于 就计数,并把 更新为当前值,再把右孩子和左孩子连同这个 压栈。左孩子后压入,因此先被处理。
初始 小于结点值的下界 ,根一定被算作好节点。每个结点入栈一次。
我们用显式栈从根开始统计好节点。栈中每个元素是一个结点,以及从根到它的父结点路径上的最大值 。弹出结点后,若结点为空则跳过;若 ,答案加一,并把 更新为当前结点的值。随后先压入右孩子,再压入左孩子,二者都带上更新后的 。初始 小于题目给出的最小结点值 ,因此根一定被计入。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func goodNodes(root *TreeNode) (ans int) {
	stk := []struct {
		node *TreeNode
		mx   int
	}{{root, -10001}}
	for len(stk) > 0 {
		cur := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		node, mx := cur.node, cur.mx
		if node == nil {
			continue
		}
		if mx <= node.Val {
			ans++
			mx = node.Val
		}
		stk = append(stk, struct {
			node *TreeNode
			mx   int
		}{node.Right, mx}, struct {
			node *TreeNode
			mx   int
		}{node.Left, mx})
	}
	return
}1457. 二叉树中的伪回文路径
题目、示例与约束
给你一棵二叉树,每个节点的值为 1 到 9 。我们称二叉树中的一条路径是 「伪回文」的,当它满足:路径经过的所有节点值的排列中,存在一个回文序列。
请你返回从根到叶子节点的所有路径中 伪回文 路径的数目。
示例 1:
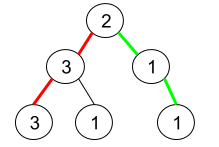
输入:root = [2,3,1,3,1,null,1]
输出:2
解释:上图为给定的二叉树。总共有 3 条从根到叶子的路径:红色路径 [2,3,3] ,绿色路径 [2,1,1] 和路径 [2,3,1] 。
     在这些路径中,只有红色和绿色的路径是伪回文路径,因为红色路径 [2,3,3] 存在回文排列 [3,2,3] ,绿色路径 [2,1,1] 存在回文排列 [1,2,1] 。
示例 2:
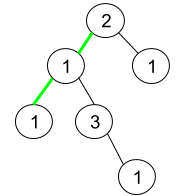
输入:root = [2,1,1,1,3,null,null,null,null,null,1]
输出:1
解释:上图为给定二叉树。总共有 3 条从根到叶子的路径:绿色路径 [2,1,1] ,路径 [2,1,3,1] 和路径 [2,1] 。
     这些路径中只有绿色路径是伪回文路径,因为 [2,1,1] 存在回文排列 [1,2,1] 。
示例 3:
输入:root = [9]
输出:1
提示:
- 给定二叉树的节点数目在范围
[1, 105]内 1 <= Node.val <= 9
方法一:DFS + 位运算 · Go 实现
思考
路径可重排成回文,当且仅当奇数次字符至多一个。节点值在 ~ , ,用 位掩码的异或记录奇偶。
走到叶子时若 至多一位为 (即 )则计一条。DFS 下传掩码,左右子树方案相加。
一条路径是伪回文路径,当且仅当该路径经过的节点值的出现次数为奇数的数字为 个或 个。
由于二叉树节点值的范围为 到 ,因此对于每一条从根到叶子的路径,我们可以用一个长度为 的二进制数 表示当前路径经过的节点值的出现状态,其中 的第 位为 ,表示当前路径上节点值 的出现次数为奇数,否则表示其出现次数为偶数。那么,如果一条路径是伪回文路径,需要满足 ,其中 表示按位与运算。
基于以上分析,我们可以使用深度优先搜索的方法计算路径数。我们定义一个函数 ,表示从当前 节点开始,且当前节点的状态为 的所有伪回文路径的个数。那么答案就是 。
函数 的执行逻辑如下:
如果 为空,则返回 ;
否则,令 ,其中 表示按位异或运算。
如果 是叶子节点,那么如果 ,返回 ,否则返回 ;
如果 不是叶子节点,返回 。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func pseudoPalindromicPaths(root *TreeNode) int {
	var dfs func(*TreeNode, int) int
	dfs = func(root *TreeNode, mask int) int {
		if root == nil {
			return 0
		}
		mask ^= 1 << root.Val
		if root.Left == nil && root.Right == nil {
			if mask&(mask-1) == 0 {
				return 1
			}
			return 0
		}
		return dfs(root.Left, mask) + dfs(root.Right, mask)
	}
	return dfs(root, 0)
}
方法二:显式栈 + 位运算 · Go 实现
思考
一条从根到叶子的路径能重排成回文,当且仅当奇数次出现的数字至多一个。结点值只在 到 , 可以到 ,用一个 位掩码的异或记下每个数字出现次数的奇偶。
走到叶子时检查掩码,再把左右子树的方案数相加,递归就能数完。搜索先进入左孩子,一条左链的长度可以到 ,调用栈会在叶子判定之前溢出。掩码只依赖从根到当前结点的路径,左右孩子互不影响。
因此把结点和到达它之前的掩码放进显式栈。弹出后把当前值异或进掩码;叶子上若 就计一条,否则先压右孩子再压左孩子,都带上更新后的掩码。
每个结点入栈一次,叶子上的计数之和就是伪回文路径的条数。
一条路径是伪回文路径,当且仅当该路径经过的节点值的出现次数为奇数的数字为 个或 个。
由于二叉树节点值的范围为 到 ,因此对于每一条从根到叶子的路径,我们可以用一个长度为 的二进制数 表示当前路径经过的节点值的出现状态,其中 的第 位为 ,表示当前路径上节点值 的出现次数为奇数,否则表示其出现次数为偶数。那么,如果一条路径是伪回文路径,需要满足 ,其中 表示按位与运算。
我们用显式栈从根出发。栈中每个元素是结点和到达该结点之前的掩码。弹出后令 。若当前结点是叶子,且 ,答案加一。否则先把右孩子、再把左孩子连同更新后的掩码压栈,空孩子不入栈。左孩子后压入,因此先被处理。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func pseudoPalindromicPaths(root *TreeNode) (ans int) {
	stk := []struct {
		node *TreeNode
		mask int
	}{{root, 0}}
	for len(stk) > 0 {
		cur := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		node, mask := cur.node, cur.mask
		if node == nil {
			continue
		}
		mask ^= 1 << node.Val
		if node.Left == nil && node.Right == nil {
			if mask&(mask-1) == 0 {
				ans++
			}
		} else {
			stk = append(stk, struct {
				node *TreeNode
				mask int
			}{node.Right, mask}, struct {
				node *TreeNode
				mask int
			}{node.Left, mask})
		}
	}
	return
}1469. 寻找所有的独生节点 🔒
题目、示例与约束
二叉树中,如果一个节点是其父节点的唯一子节点,则称这样的节点为 “独生节点” 。二叉树的根节点不会是独生节点,因为它没有父节点。
给定一棵二叉树的根节点 root ,返回树中 所有的独生节点的值所构成的数组 。数组的顺序 不限 。
示例 1:
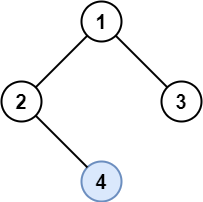
输入:root = [1,2,3,null,4]
输出:[4]
解释:浅蓝色的节点是唯一的独生节点。
节点 1 是根节点,不是独生的。
节点 2 和 3 有共同的父节点,所以它们都不是独生的。
示例 2:
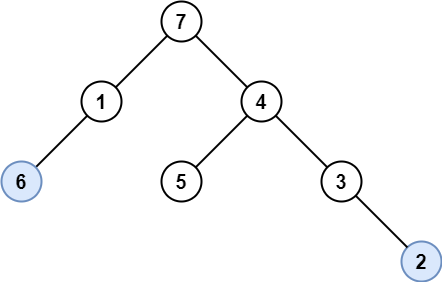
输入:root = [7,1,4,6,null,5,3,null,null,null,null,null,2]
输出:[6,2]
输出:浅蓝色的节点是独生节点。
请谨记,顺序是不限的。 [2,6] 也是一种可接受的答案。
示例 3:
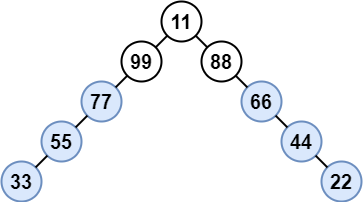
输入:root = [11,99,88,77,null,null,66,55,null,null,44,33,null,null,22]
输出:[77,55,33,66,44,22]
解释:节点 99 和 88 有共同的父节点,节点 11 是根节点。
其他所有节点都是独生节点。
提示:
tree中节点个数的取值范围是[1, 1000]。1 <= Node.val <= 106
方法一:DFS · Go 实现
思考
独生节点是唯一孩子。 ,DFS 时若仅有左或仅有右,把该孩子的值记下,再继续遍历。叶子与空节点直接返回。
我们可以使用深度优先搜索遍历整棵树,设计一个函数 ,它的作用是遍历树中的每个节点,如果当前节点是独生节点,那么将其值加入答案数组中。函数 的执行过程如下:
- 如果当前节点为空,或者当前节点是叶子节点,即当前节点的左右子节点都为空,那么直接返回。
- 如果当前节点的左子节点为空,那么将当前节点的右子节点是独生节点,将其值加入答案数组中。
- 如果当前节点的右子节点为空,那么将当前节点的左子节点是独生节点,将其值加入答案数组中。
- 递归遍历当前节点的左子节点和右子节点。
时间复杂度 ,空间复杂度 。其中 是二叉树中节点的个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
 func getLonelyNodes(root *TreeNode) (ans []int) {
	var dfs func(*TreeNode)
	dfs = func(root *TreeNode) {
		if root == nil || (root.Left == root.Right) {
			return
		}
		if root.Left == nil {
			ans = append(ans, root.Right.Val)
		}
		if root.Right == nil {
			ans = append(ans, root.Left.Val)
		}
		dfs(root.Left)
		dfs(root.Right)
	}
	dfs(root)
	return
}1485. 克隆含随机指针的二叉树 🔒
题目、示例与约束
给你一个二叉树,树中每个节点都含有一个附加的随机指针,该指针可以指向树中的任何节点或者指向空(null)。
请返回该树的 深拷贝 。
该树的输入/输出形式与普通二叉树相同,每个节点都用 [val, random_index] 表示:
val:表示Node.val的整数random_index:随机指针指向的节点(在输入的树数组中)的下标;如果未指向任何节点,则为null。
该树以 Node 类的形式给出,而你需要以 NodeCopy 类的形式返回克隆得到的树。NodeCopy 类和Node 类定义一致。
示例 1:
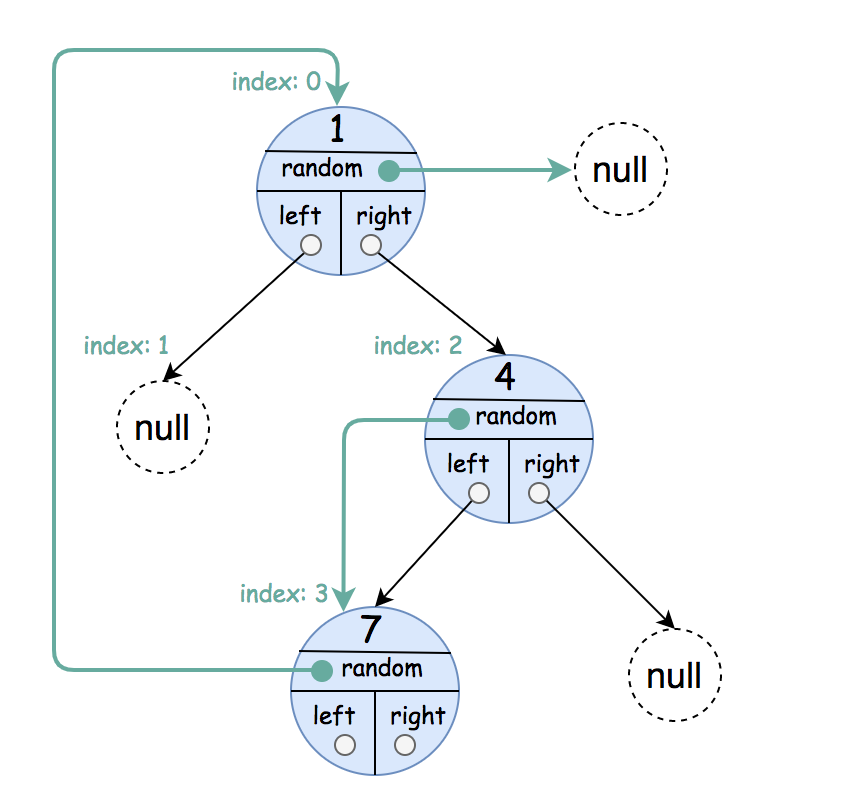
输入:root = [[1,null],null,[4,3],[7,0]]
输出:[[1,null],null,[4,3],[7,0]]
解释:初始二叉树为 [1,null,4,7] 。
节点 1 的随机指针指向 null,所以表示为 [1, null] 。
节点 4 的随机指针指向 7,所以表示为 [4, 3] 其中 3 是树数组中节点 7 对应的下标。
节点 7 的随机指针指向 1,所以表示为 [7, 0] 其中 0 是树数组中节点 1 对应的下标。
示例 2:
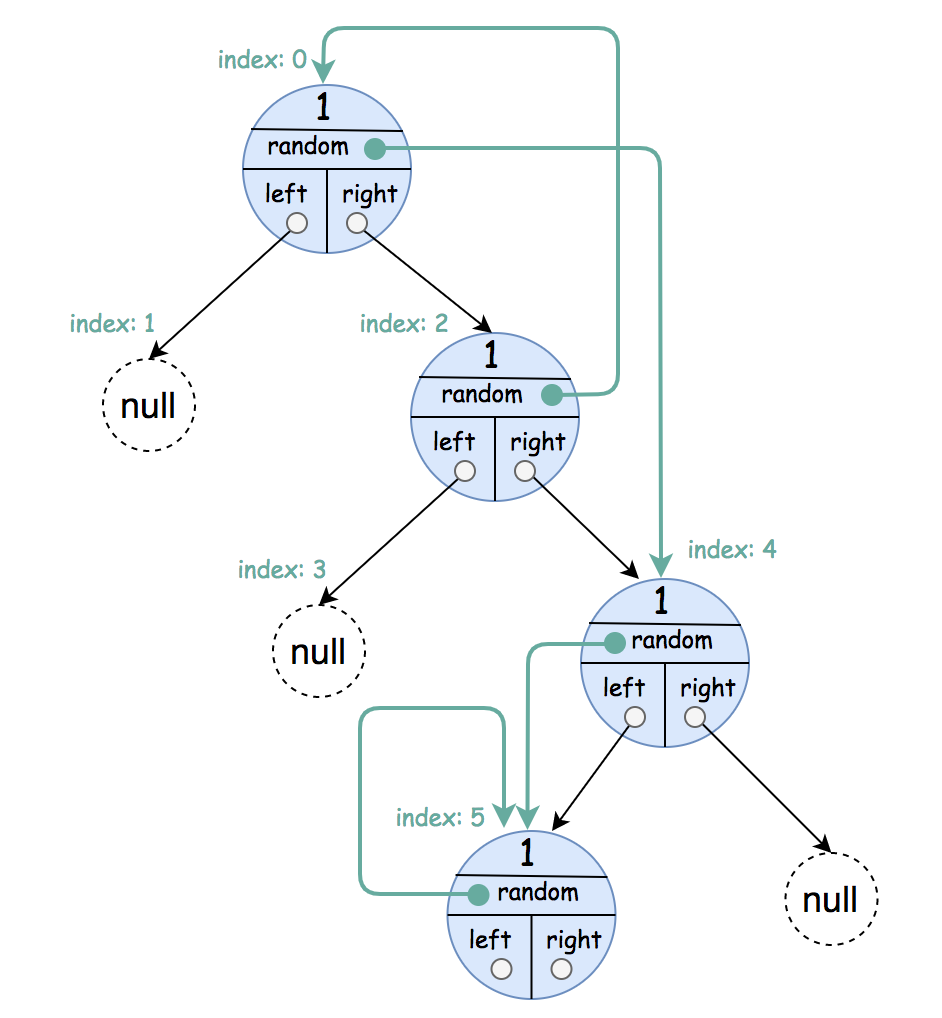
输入:root = [[1,4],null,[1,0],null,[1,5],[1,5]]
输出:[[1,4],null,[1,0],null,[1,5],[1,5]]
解释:节点的随机指针可以指向它自身。
示例 3:

输入:root = [[1,6],[2,5],[3,4],[4,3],[5,2],[6,1],[7,0]]
输出:[[1,6],[2,5],[3,4],[4,3],[5,2],[6,1],[7,0]]
提示:
tree中节点数目范围是[0, 1000]- 每个节点的值的范围是
[1, 10^6]
方法一:哈希表 + DFS · Go 实现
思考
除左右孩子外还有 ,可能指向任意已访问或未访问节点,朴素递归会在环上死循环或重复复制。
用哈希表记下原节点到副本的映射:先建副本并写入表,再递归左、右、 。已复制的节点直接返回映射,保证同一原节点只生成一份。
我们用哈希表 记录原树中每个节点与其拷贝节点的对应关系,然后进行深度优先搜索。
定义函数 ,返回节点 的拷贝。过程如下:
- 若 为空,返回空;
- 若 已在 中,返回 ;
- 否则创建拷贝节点 ,令 ,再分别递归处理 的左子节点、右子节点和 指针;
- 最后返回 。
主函数返回 。
时间复杂度 ,空间复杂度 。其中 是节点数量。
/**
 * Definition for a Node.
 * type Node struct {
 *     Val int
 *     Left *Node
 *     Right *Node
 *     Random *Node
 * }
 */

func copyRandomBinaryTree(root *Node) *NodeCopy {
	seen := make(map[*Node]*NodeCopy)
	var dfs func(root *Node) *NodeCopy
	dfs = func(root *Node) *NodeCopy {
		if root == nil {
			return nil
		}
		if v, ok := seen[root]; ok {
			return v
		}
		copy := &NodeCopy{Val: root.Val}
		seen[root] = copy
		copy.Left = dfs(root.Left)
		copy.Right = dfs(root.Right)
		copy.Random = dfs(root.Random)
		return copy
	}
	return dfs(root)
}1490. 克隆 N 叉树 🔒
题目、示例与约束
给定一棵 N 叉树的根节点 root ,返回该树的深拷贝(克隆)。
N 叉树的每个节点都包含一个值( int )和子节点的列表( List[Node] )。
class Node {
    public int val;
    public List<Node> children;
}
N 叉树的输入序列用层序遍历表示,每组子节点用 null 分隔(见示例)。
示例 1:
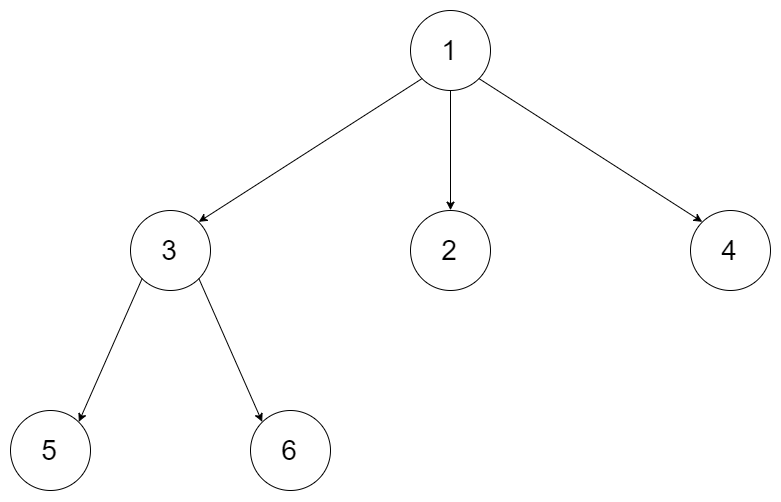
输入:root = [1,null,3,2,4,null,5,6]
输出:[1,null,3,2,4,null,5,6]
示例 2:
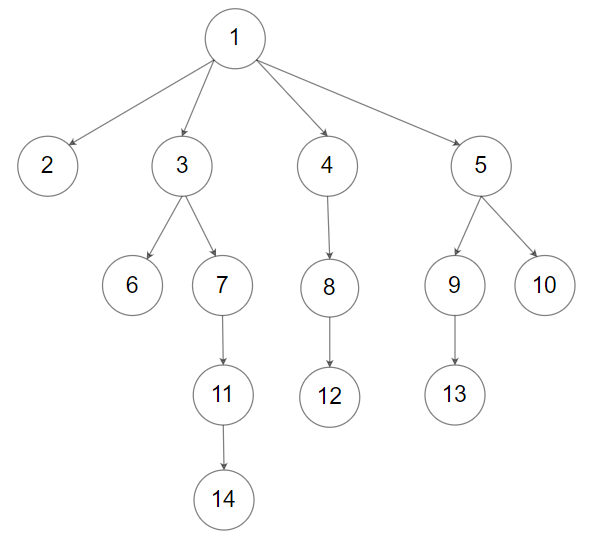
输入:root = [1,null,2,3,4,5,null,null,6,7,null,8,null,9,10,null,null,11,null,12,null,13,null,null,14]
输出:[1,null,2,3,4,5,null,null,6,7,null,8,null,9,10,null,null,11,null,12,null,13,null,null,14]
提示:
- 给定的 N 叉树的深度小于或等于
1000。 - 节点的总个数在
[0, 104]之间
进阶:你的解决方案可以适用于克隆图问题吗?
方法一:递归 · Go 实现
思考
N 叉树无随机指针,深拷贝即复制结点值并递归复制全部孩子。结点至多 ,一次遍历即可。空结点返回空。
我们可以用递归的方法来实现 N 叉树的深拷贝。
对于当前节点,如果为空,则返回空;否则,创建一个新节点,其值为当前节点的值,然后对当前节点的每个子节点递归调用该函数,将返回值作为新节点的子节点。最后返回新节点即可。
时间复杂度 ,空间复杂度 。其中 为 N 叉树的节点个数。
/**
 * Definition for a Node.
 * type Node struct {
 *     Val int
 *     Children []*Node
 * }
 */

func cloneTree(root *Node) *Node {
	if root == nil {
		return nil
	}
	children := []*Node{}
	for _, child := range root.Children {
		children = append(children, cloneTree(child))
	}
	return &Node{root.Val, children}
}1506. 找到 N 叉树的根节点 🔒
题目、示例与约束
给定一棵 N 叉树 的所有节点在一个数组 Node[] tree 中,树中每个节点都有 唯一的值 。
找到并返回 N 叉树的 根节点 。
自定义测试:
N 叉树的输入序列为其层序遍历序列,每组子节点用 null 分隔(见示例)。
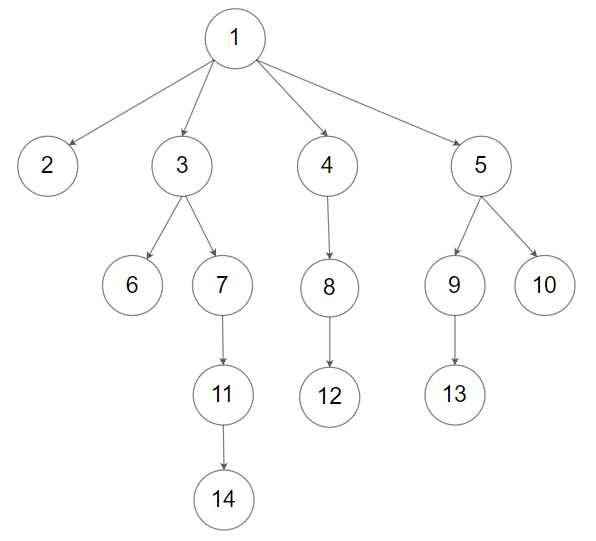
上图中的 N 叉树的序列化描述为 [1,null,2,3,4,5,null,null,6,7,null,8,null,9,10,null,null,11,null,12,null,13,null,null,14] 。
测试将以下列方式进行:
- 输入数据的形式为树的序列化描述。
- 驱动程序代码将根据序列化的输入数据构造树,并以任意顺序将每个
Node对象放入一个数组中。 - 驱动程序代码将把数组传递给
findRoot,你所编写的函数应该在数组中查找并返回根Node对象。 - 驱动程序代码将接受返回的
Node对象并对其进行序列化。如果序列化的结果和输入数据 相同 ,则测试 通过 。
示例 1:
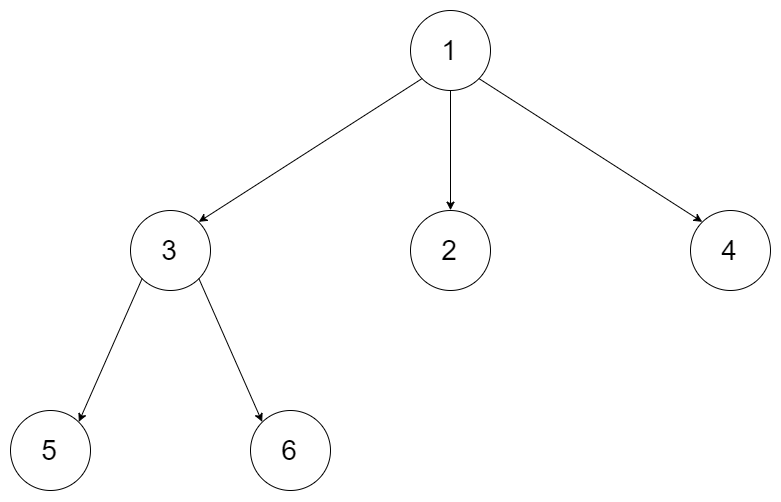
输入:tree = [1,null,3,2,4,null,5,6]
输出:[1,null,3,2,4,null,5,6]
解释:来自输入数据的树如上所示。
驱动程序代码创建树,并以任意顺序向 findRoot 提供 Node 对象。
例如,传递的数组可以是 [Node(5),Node(4),Node(3),Node(6),Node(2),Node(1)] 或 [Node(2),Node(6),Node(1),Node(3),Node(5),Node(4)] 。
findRoot 函数应该返回根 Node(1) ,驱动程序代码将序列化它并与输入数据进行比较。
输入数据和序列化的 Node(1) 相同,因此测试通过。
示例 2:
输入:tree = [1,null,2,3,4,5,null,null,6,7,null,8,null,9,10,null,null,11,null,12,null,13,null,null,14]
输出:[1,null,2,3,4,5,null,null,6,7,null,8,null,9,10,null,null,11,null,12,null,13,null,null,14]
提示:
- 节点的总个数在
[1, 5*10^4]之间。 - 每个节点都有唯一的值。
进阶:
- 你可以使用 O(1) 额外内存空间且 O(n) 时间复杂度的算法来找到该树的根节点吗?
方法一:位运算 · Go 实现
思考
给定一棵 叉树的全部节点,求根。根在列表中只出现一次,其余节点还会作为某个父亲的孩子再出现一次。用哈希表记录所有孩子后,列表中未出现在孩子集合里的节点即为根,但需要额外线性空间。
每个非根值出现偶数次、根值出现奇数次,异或恰好消去成对出现的值。遍历每个节点及其孩子,将全部值异或到 ,再在列表中找回值为 的节点即可,额外空间为常数。
对于一棵 N 叉树的节点,如果该节点是根节点,那么该节点只会出现一次在数组 tree 中;而如果该节点不是根节点,那么该节点会出现两次,一次在数组 tree 中,一次在该节点的父节点的 children 数组中。
因此,我们可以遍历数组 tree,计算每个节点的值以及其所有子节点的值的异或和,记录在变量 中。遍历结束后,我们得到的 就是根节点的值。
接下来,我们再遍历数组 tree,找到值为 的节点,即为根节点,返回即可。
时间复杂度 ,空间复杂度 。其中 为数组 tree 的长度。
/**
 * Definition for a Node.
 * type Node struct {
 *     Val int
 *     Children []*Node
 * }
 */

func findRoot(tree []*Node) *Node {
	x := 0
	for _, node := range tree {
		x ^= node.Val
		for _, child := range node.Children {
			x ^= child.Val
		}
	}
	for i := 0; ; i++ {
		if tree[i].Val == x {
			return tree[i]
		}
	}
}1516. 移动 N 叉树的子树 🔒
题目、示例与约束
给定一棵没有重复值的 N 叉树 的根节点 root ,以及其中的两个节点 p 和 q。
移动节点 p 及其子树,使节点 p 成为节点 q 的直接子节点。如果 p 已经是 q 的直接子节点,则请勿改动任何节点。节点 p 必须是节点 q 的子节点列表的最后一项。
返回改动后的树的根节点。
节点 p 和 q 可能是下列三种情况之一:
- 节点
q在节点p的子树中。 - 节点
p在节点q的子树中。 - 节点
p不在节点q的子树中,且节点q也不在节点p的子树中。
在第 2 种和第 3 种情况中,你只需要移动 p (及其子树),使 p 成为 q 的子节点。但是在第 1 种情况中,树的节点可能会断连,因此你还需要重新连接这些节点。请在解题前仔细阅读示例。
N 叉树的输入序列以层序遍历的形式给出,每组子节点用 null 分隔(见示例)。
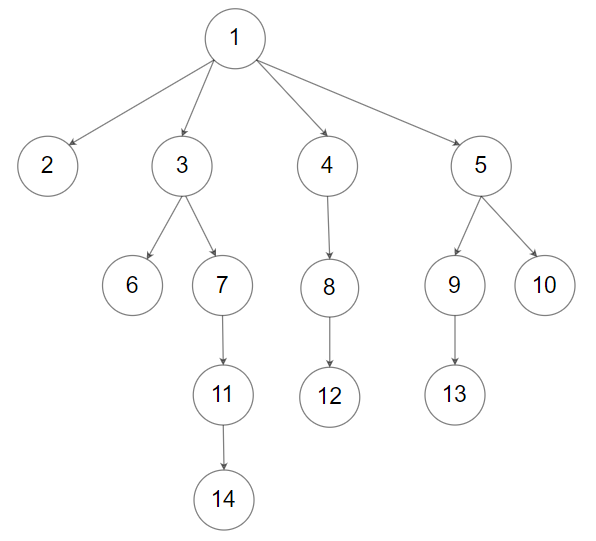
例如,上面的树会被序列化为 [1,null,2,3,4,5,null,null,6,7,null,8,null,9,10,null,null,11,null,12,null,13,null,null,14]。
示例 1:
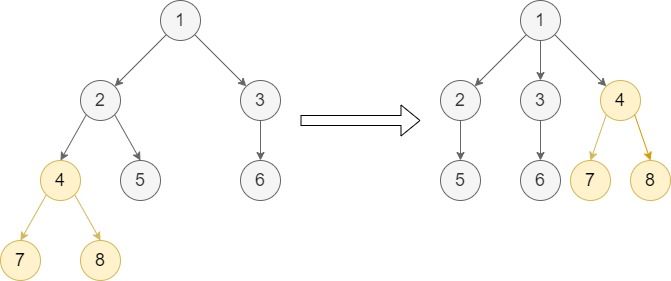
输入: root = [1,null,2,3,null,4,5,null,6,null,7,8], p = 4, q = 1
输出: [1,null,2,3,4,null,5,null,6,null,7,8]
解释: 该示例属于第二种情况,节点 p 在节点 q 的子树中。我们可以移动节点 p 及其子树,使 p 成为节点 q 的直接子节点。
注意,节点 4 是节点 1 的最后一个子节点。
示例 2:
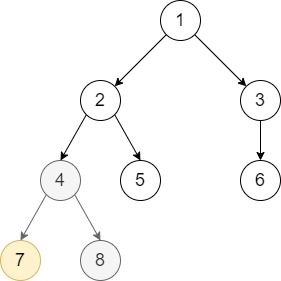
输入: root = [1,null,2,3,null,4,5,null,6,null,7,8], p = 7, q = 4
输出: [1,null,2,3,null,4,5,null,6,null,7,8]
解释: 节点 7 已经是节点 4 的直接子节点,因此我们不改动任何节点。
示例 3:
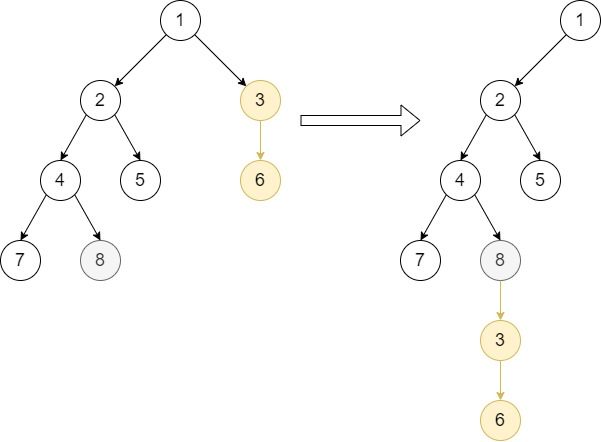
输入: root = [1,null,2,3,null,4,5,null,6,null,7,8], p = 3, q = 8
输出: [1,null,2,null,4,5,null,7,8,null,null,null,3,null,6]
解释: 该示例属于第三种情况,节点 p 不在节点 q 的子树中,反之亦然。我们可以移动节点 3 及其子树,使之成为节点 8 的子节点。
示例 4:
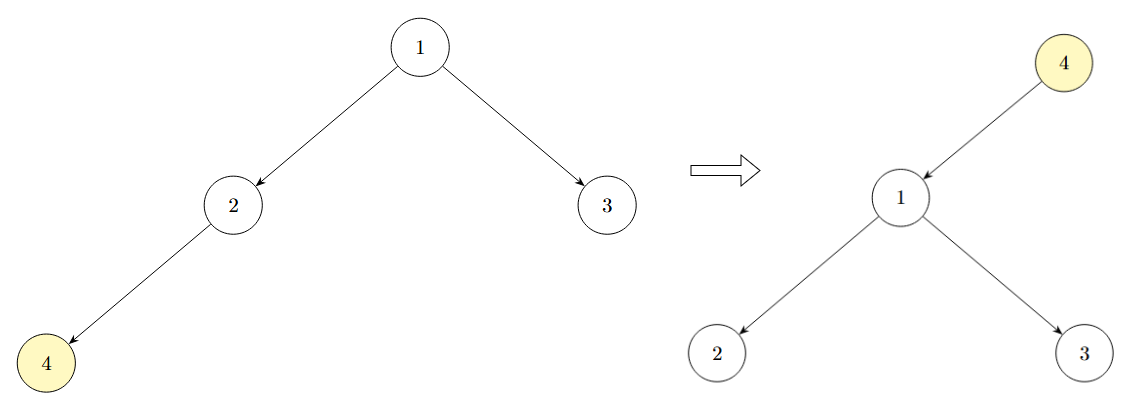
输入:root = [1,null,2,3,null,4], p = 1, q = 4
输出:[4,null,1,null,2,3]
解释:该示例属于第一种情况,因为节点 q 在节点 p 的子树中。断开节点 4 与其父节点,并将节点 1 及其子树移动,使其成为节点 4 的子节点。
提示:
- 节点的总数在
[2, 1000]间。 - 每个节点都有 唯一 的值。
p != nullq != nullp和q是两个不同的节点(即p != q)。
方法一:Go 解法(本站整理) · Go 实现
根据题意整理:本地 Doocs 实现围栏为空,按题意及其祖先关系提示实现。给 root 加一个只用于操作的虚拟父节点,遍历建立 parent 映射。若 p 已经是 q 的直接孩子,原样返回,不改变孩子顺序。否则沿 q 的父链判断其是否在 p 子树内:若不在,摘下 p 后追加到 q;若在,先从原父节点摘下 q,用 q 替换 p 在原父节点中的位置,再把 p 追加到 q 的孩子末尾。这一步既避免环,也保留所有其他孩子的相对顺序;虚拟父节点统一处理 p 为根时返回 q。
变量与复杂度:N 为节点数,parent 为父指针映射,dummy 为虚拟父节点,descendant 表示 q 是否属于 p 子树。遍历、父链检查及孩子切片移动总时间 O(N),辅助空间 O(N),满足 N≤1000。
平台接口:moveSubTree(root, p, q *Node) *Node;平台 Node 含 Val int、Children []*Node,类型仅在 testCode 定义。题意要求就地调整已有节点,返回节点身份与原树一致;不以节点值代替指针定位。
出处与许可:基于 Doocs 原题及参考资料,固定提交 91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011;Go 代码及本说明按 CC BY-SA 4.0 共享。
// 依据 Doocs/leetcode 题目与参考资料进行 Go 改写/整理。
// 来源:https://github.com/doocs/leetcode/blob/91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011/solution/1500-1599/1516.Move%20Sub-Tree%20of%20N-Ary%20Tree/README.md
// 许可:CC BY-SA 4.0,https://creativecommons.org/licenses/by-sa/4.0/

func moveSubTree(root, p, q *Node) *Node {
	dummy := &Node{Children: []*Node{root}}
	parent := map[*Node]*Node{root: dummy}
	stack := []*Node{root}
	for len(stack) > 0 {
		node := stack[len(stack)-1]
		stack = stack[:len(stack)-1]
		for _, child := range node.Children {
			parent[child] = node
			stack = append(stack, child)
		}
	}
	if parent[p] == q {
		return root
	}
	descendant := false
	for node := q; node != dummy; node = parent[node] {
		if node == p {
			descendant = true
			break
		}
	}
	remove := func(par, child *Node) {
		for i, c := range par.Children {
			if c == child {
				copy(par.Children[i:], par.Children[i+1:])
				par.Children[len(par.Children)-1] = nil
				par.Children = par.Children[:len(par.Children)-1]
				return
			}
		}
	}
	if descendant {
		remove(parent[q], q)
		for i, child := range parent[p].Children {
			if child == p {
				parent[p].Children[i] = q
				break
			}
		}
	} else {
		remove(parent[p], p)
	}
	q.Children = append(q.Children, p)
	return dummy.Children[0]
}1519. 子树中标签相同的节点数
题目、示例与约束
给你一棵树(即,一个连通的无环无向图),这棵树由编号从 0 到 n - 1 的 n 个节点组成,且恰好有 n - 1 条 edges 。树的根节点为节点 0 ,树上的每一个节点都有一个标签,也就是字符串 labels 中的一个小写字符(编号为 i 的 节点的标签就是 labels[i] )
边数组 edges 以 edges[i] = [ai, bi] 的形式给出,该格式表示节点 ai 和 bi 之间存在一条边。
返回一个大小为 n 的数组,其中 ans[i] 表示第 i 个节点的子树中与节点 i 标签相同的节点数。
树 T 中的子树是由 T 中的某个节点及其所有后代节点组成的树。
示例 1:
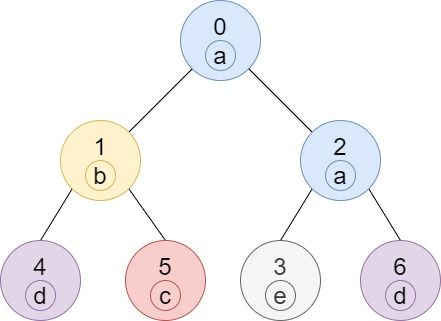
输入:n = 7, edges = [[0,1],[0,2],[1,4],[1,5],[2,3],[2,6]], labels = "abaedcd"
输出:[2,1,1,1,1,1,1]
解释:节点 0 的标签为 'a' ,以 'a' 为根节点的子树中,节点 2 的标签也是 'a' ,因此答案为 2 。注意树中的每个节点都是这棵子树的一部分。
节点 1 的标签为 'b' ,节点 1 的子树包含节点 1、4 和 5,但是节点 4、5 的标签与节点 1 不同,故而答案为 1(即,该节点本身)。
示例 2:
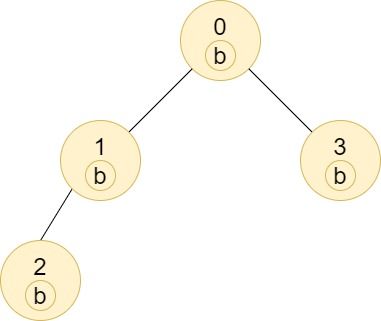
输入:n = 4, edges = [[0,1],[1,2],[0,3]], labels = "bbbb"
输出:[4,2,1,1]
解释:节点 2 的子树中只有节点 2 ,所以答案为 1 。
节点 3 的子树中只有节点 3 ,所以答案为 1 。
节点 1 的子树中包含节点 1 和 2 ,标签都是 'b' ,因此答案为 2 。
节点 0 的子树中包含节点 0、1、2 和 3,标签都是 'b',因此答案为 4 。
示例 3:
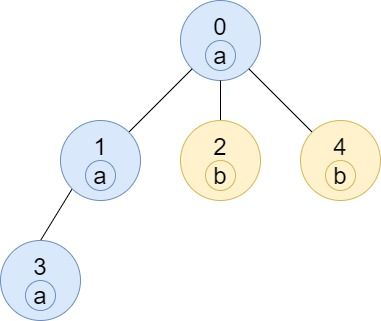
输入:n = 5, edges = [[0,1],[0,2],[1,3],[0,4]], labels = "aabab"
输出:[3,2,1,1,1]
提示:
1 <= n <= 10^5edges.length == n - 1edges[i].length == 20 <= ai, bi < nai != bilabels.length == nlabels仅由小写英文字母组成
方法一:DFS · Go 实现
思考
对每个节点统计其树中与自身标签相同的节点数。 ,若对每个节点单独再遍历子树,总时间平方级。标签只有 种,适合在一次深度优先中维护全局计数。
进入节点 前记下标签 的当前出现次数,离开时再读一次,两者之差便是该子树内该标签的出现次数。先减后加的写法把「进入快照」存在 里,回溯后加上最新计数即可,额外空间仅为字母表大小。
我们先将边数组转换为邻接表 。
接下来我们从根节点 开始遍历其子树,过程中维护一个计数器 ,用于统计当前各个字母出现的次数。
在访问某个节点 时,我们先将 减去 ,然后将 加 ,表示当前节点 的标签出现了一次。接下来递归访问其子节点,最后将 加上 。也即是说,我们将每个点离开时的计数器值减去每个点进来时的计数器值,就得到了以该点为根的子树中各个字母出现的次数。
时间复杂度 ,空间复杂度 。其中 为节点数;而 为字符集大小,本题中 。
func countSubTrees(n int, edges [][]int, labels string) []int {
	g := make([][]int, n)
	for _, e := range edges {
		a, b := e[0], e[1]
		g[a] = append(g[a], b)
		g[b] = append(g[b], a)
	}
	ans := make([]int, n)
	cnt := [26]int{}
	var dfs func(int, int)
	dfs = func(i, fa int) {
		k := labels[i] - 'a'
		ans[i] -= cnt[k]
		cnt[k]++
		for _, j := range g[i] {
			if j != fa {
				dfs(j, i)
			}
		}
		ans[i] += cnt[k]
	}
	dfs(0, -1)
	return ans
}
方法二:显式栈 · Go 实现
思考
对每个节点统计其子树中与自身标签相同的节点数。 ,对每个节点再单独遍历子树是平方时间。一条链上第一次递归总是走向唯一的孩子,深度就是 ,会超出默认递归上限。
标签只有 种。进入节点时该标签计数的增量,到离开时正好覆盖整棵子树。
因此用显式栈做后序。进入时先把当前计数从 中减去,计数加一,再压入离开标记和子节点。离开时把最新计数加回 ,差值就是子树内该标签的出现次数。
我们先将边数组转换为邻接表 。
用显式栈从根节点 遍历,并维护计数器 。进入节点 时,先将 减去 ,再把该标签的计数加 ,然后压入离开标记和子节点,这样子节点会先处理完。离开时把 加回 。两次计数之差就是以 为根的子树中该标签的出现次数。
时间复杂度 ,空间复杂度 。其中 为节点数。
func countSubTrees(n int, edges [][]int, labels string) []int {
	g := make([][]int, n)
	for _, e := range edges {
		a, b := e[0], e[1]
		g[a] = append(g[a], b)
		g[b] = append(g[b], a)
	}
	ans := make([]int, n)
	cnt := [26]int{}
	stk := [][3]int{{0, -1, 0}}
	for len(stk) > 0 {
		cur := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		i, fa, state := cur[0], cur[1], cur[2]
		k := labels[i] - 'a'
		if state == 0 {
			ans[i] -= cnt[k]
			cnt[k]++
			stk = append(stk, [3]int{i, fa, 1})
			for _, j := range g[i] {
				if j != fa {
					stk = append(stk, [3]int{j, i, 0})
				}
			}
		} else {
			ans[i] += cnt[k]
		}
	}
	return ans
}1522. N 叉树的直径 🔒
题目、示例与约束
给定一棵 N 叉树 的根节点 root ,计算这棵树的直径长度。
N 叉树的直径指的是树中任意两个节点间路径中 最长 路径的长度。这条路径可能经过根节点,也可能不经过根节点。
(N 叉树的输入序列以层序遍历的形式给出,每组子节点用 null 分隔)
示例 1:
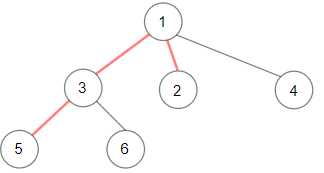
输入:root = [1,null,3,2,4,null,5,6]
输出:3
解释:直径如图中红线所示。
示例 2:
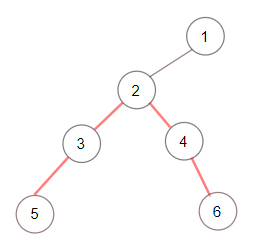
输入:root = [1,null,2,null,3,4,null,5,null,6]
输出:4
示例 3:
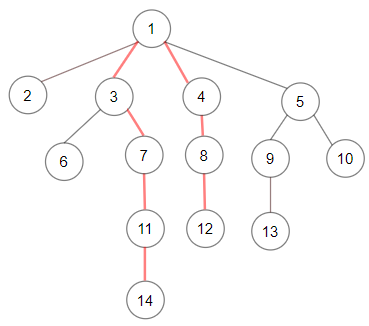
输入: root = [1,null,2,3,4,5,null,null,6,7,null,8,null,9,10,null,null,11,null,12,null,13,null,null,14]
输出: 7
提示:
- N 叉树的深度小于或等于
1000。 - 节点的总个数在
[0, 10^4]间。
方法一:DFS(后序求直径) · Go 实现
思考
求 叉树直径,即最远两点的距离。树的规模可达数千,两次任意遍历若实现不当会重复走边。直径必经过某节点的两条最深子树路径。
后序 DFS 对每个节点收集子节点高度,用最大的两个高度之和更新全局直径,并返回该节点高度。一次遍历同时得到所有候选,无需建额外图。
后序遍历每个节点,记录两棵最深子树的高度 、 ,用 更新直径。子树高度为最深孩子高度加 。
时间复杂度 ,空间复杂度 。其中 为节点个数。
/**
 * Definition for a Node.
 * type Node struct {
 *     Val int
 *     Children []*Node
 * }
 */

func diameter(root *Node) int {
	ans := 0
	var dfs func(root *Node) int
	dfs = func(root *Node) int {
		if root == nil {
			return 0
		}
		m1, m2 := 0, 0
		for _, child := range root.Children {
			t := dfs(child)
			if t > m1 {
				m2, m1 = m1, t
			} else if t > m2 {
				m2 = t
			}
		}
		ans = max(ans, m1+m2)
		return 1 + m1
	}
	dfs(root)
	return ans
}
方法二:建图 + 两次 DFS · Go 实现
思考
方法一把直径计算耦合在树形递归里,若输入只保证邻接关系、或希望复用一般图的直径算法,则不够直接。先把 叉树展开为无向图,任选一点找最远点,再从该点找最远点,第二次距离即为直径。两次 DFS 与树形 DP 渐近相同,只是换了一种实现。
把 叉树建成无向图,从任意节点 DFS 找到最远点,再从该点 DFS 一次,两次搜索得到的最远距离即为树的直径。
时间复杂度 ,空间复杂度 。其中 为节点个数。
/**
 * Definition for a Node.
 * type Node struct {
 *     Val int
 *     Children []*Node
 * }
 */

func diameter(root *Node) int {
	g := make(map[*Node][]*Node)
	vis := make(map[*Node]bool)
	next := root
	ans := 0
	var build func(root *Node)
	build = func(root *Node) {
		if root == nil {
			return
		}
		for _, child := range root.Children {
			g[root] = append(g[root], child)
			g[child] = append(g[child], root)
			build(child)
		}
	}
	build(root)
	var dfs func(u *Node, t int)
	dfs = func(u *Node, t int) {
		if vis[u] {
			return
		}
		vis[u] = true
		if t > ans {
			ans = t
			next = u
		}
		if vs, ok := g[u]; ok {
			for _, v := range vs {
				dfs(v, t+1)
			}
		}
	}
	dfs(next, 0)
	vis = make(map[*Node]bool)
	dfs(next, 0)
	return ans
}
方法三:显式栈(后序求直径) · Go 实现
思考
求 叉树直径,即任意两点间的最长路径长度。深度可达 ,沿一条单孩子链做后序递归时,调用深度等于节点数,链长达到 就会超出 Python 的递归上限。每个节点只依赖孩子已经算完的高度:用最大的两个孩子高度之和更新直径,自身高度是最深孩子高度加 。因此用栈保存节点和状态。状态 先压入结束标记再压入孩子,孩子先完成;状态 读取孩子高度,更新直径,并记下当前节点的高度。
从根开始做后序遍历。栈里存放节点和状态。状态为 时,把同一节点以状态 压回,再把非空孩子压入。状态为 时,孩子高度都已写入表中,取出最大的两个 、 ,用 更新直径,并把当前高度记为 。根为空时直径为 。
时间复杂度 ,空间复杂度 。其中 为节点个数。
/**
 * Definition for a Node.
 * type Node struct {
 *     Val int
 *     Children []*Node
 * }
 */

func diameter(root *Node) int {
	if root == nil {
		return 0
	}
	type frame struct {
		node  *Node
		state int
	}
	ans := 0
	height := map[*Node]int{}
	stk := []frame{{root, 0}}
	for len(stk) > 0 {
		f := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		if f.state == 0 {
			stk = append(stk, frame{f.node, 1})
			children := f.node.Children
			for i := len(children) - 1; i >= 0; i-- {
				if children[i] != nil {
					stk = append(stk, frame{children[i], 0})
				}
			}
		} else {
			m1, m2 := 0, 0
			for _, child := range f.node.Children {
				t := height[child]
				if t > m1 {
					m2, m1 = m1, t
				} else if t > m2 {
					m2 = t
				}
			}
			ans = max(ans, m1+m2)
			height[f.node] = m1 + 1
		}
	}
	return ans
}
方法四:建图 + 两次显式栈 · Go 实现
思考
方法一已经在树上用孩子高度求出直径。若希望沿用一般树的两次最远点搜索,需要先把 叉树展开成无向图。建图和两次搜索若沿链递归,深度同样达到 。建图用栈按父子边连成无向边,搜索时在压栈时标记,避免从无向边走回父亲。第一次从根走到最远点,第二次从该点再走到最远点,第二次的距离就是直径。
先用栈遍历整棵树,把每条父子边写成两条无向边。然后做两次显式栈搜索:从起点出发,弹出节点时用当前距离更新最远点,并把尚未访问的邻居连同距离加一压入栈。第一次起点是根,第二次起点是第一次得到的最远点。第二次的最远距离即为直径。
时间复杂度 ,空间复杂度 。其中 为节点个数。
/**
 * Definition for a Node.
 * type Node struct {
 *     Val int
 *     Children []*Node
 * }
 */

func diameter(root *Node) int {
	if root == nil {
		return 0
	}
	g := map[*Node][]*Node{}
	seen := map[*Node]bool{root: true}
	stk := []*Node{root}
	for len(stk) > 0 {
		u := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		for _, child := range u.Children {
			if child == nil || seen[child] {
				continue
			}
			seen[child] = true
			g[u] = append(g[u], child)
			g[child] = append(g[child], u)
			stk = append(stk, child)
		}
	}
	farthest := func(start *Node) (int, *Node) {
		type frame struct {
			node *Node
			dist int
		}
		vis := map[*Node]bool{start: true}
		walk := []frame{{start, 0}}
		best, node := 0, start
		for len(walk) > 0 {
			f := walk[len(walk)-1]
			walk = walk[:len(walk)-1]
			if f.dist > best {
				best, node = f.dist, f.node
			}
			for _, v := range g[f.node] {
				if !vis[v] {
					vis[v] = true
					walk = append(walk, frame{v, f.dist + 1})
				}
			}
		}
		return best, node
	}
	_, nxt := farthest(root)
	ans, _ := farthest(nxt)
	return ans
}1530. 好叶子节点对的数量
题目、示例与约束
给你二叉树的根节点 root 和一个整数 distance 。
如果二叉树中两个 叶 节点之间的 最短路径长度 小于或者等于 distance ,那它们就可以构成一组 好叶子节点对 。
返回树中 好叶子节点对的数量 。
示例 1:
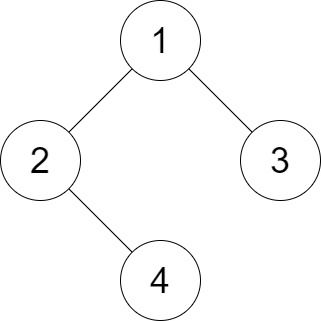
输入:root = [1,2,3,null,4], distance = 3
输出:1
解释:树的叶节点是 3 和 4 ,它们之间的最短路径的长度是 3 。这是唯一的好叶子节点对。
示例 2:
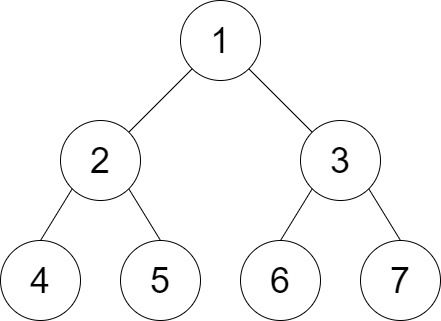
输入:root = [1,2,3,4,5,6,7], distance = 3
输出:2
解释:好叶子节点对为 [4,5] 和 [6,7] ,最短路径长度都是 2 。但是叶子节点对 [4,6] 不满足要求,因为它们之间的最短路径长度为 4 。
示例 3:
输入:root = [7,1,4,6,null,5,3,null,null,null,null,null,2], distance = 3
输出:1
解释:唯一的好叶子节点对是 [2,5] 。
示例 4:
输入:root = [100], distance = 1
输出:0
示例 5:
输入:root = [1,1,1], distance = 2
输出:1
提示:
tree的节点数在[1, 2^10]范围内。- 每个节点的值都在
[1, 100]之间。 1 <= distance <= 10
方法一:递归 · Go 实现
思考
统计叶到叶距离不超过 的对数。若对每对叶子求 LCA,叶子数平方再乘树高,在最坏链状树上偏大。一对好叶子要么同在一侧子树,要么分属左右子树。
答案拆成左子树内部、右子树内部、以及跨越根的三部分。跨越部分只需左右两侧「到当前根距离为 」的叶子计数,对距离之和不超过限制的桶做乘积。 ,桶很小,递归统计即可。
题目求一个二叉树好叶子节点的对数,答案可以拆分为三部分之和:左子树好叶子节点的对数、右子树好叶子节点的对数,以及左子树叶子节点与右子树叶子节点组成的好叶子节点的对数。
递归求解即可。
时间复杂度 ,其中 是二叉树的节点数,而 和 分别是二叉树的高度和距离限制。空间复杂度 ,为递归栈空间。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func countPairs(root *TreeNode, distance int) int {
	if root == nil {
		return 0
	}
	ans := countPairs(root.Left, distance) + countPairs(root.Right, distance)
	cnt1 := make([]int, distance)
	cnt2 := make([]int, distance)
	dfs(root.Left, cnt1, 1)
	dfs(root.Right, cnt2, 1)
	for i, v1 := range cnt1 {
		for j, v2 := range cnt2 {
			if i+j <= distance {
				ans += v1 * v2
			}
		}
	}
	return ans
}

func dfs(root *TreeNode, cnt []int, i int) {
	if root == nil || i >= len(cnt) {
		return
	}
	if root.Left == nil && root.Right == nil {
		cnt[i]++
		return
	}
	dfs(root.Left, cnt, i+1)
	dfs(root.Right, cnt, i+1)
}1597. 根据中缀表达式构造二叉表达式树 🔒
题目、示例与约束
二叉表达式树 是一种表达算术表达式的二叉树。二叉表达式树中的每一个节点都有零个或两个子节点。 叶节点(有 0 个子节点的节点)表示操作数,非叶节点(有 2 个子节点的节点)表示运算符: '+' (加)、 '-' (减)、 '*' (乘)和 '/' (除)。
对于每一个运算符为 o 的非叶节点,对应的 中缀表达式 为 (A o B),其中 A 是左子树所表达的表达式, B 是右子树所表达的表达式。
给定一个 中缀表达式 字符串 s,其中包含操作数、上面提到的运算符,以及括号 '(' 与 ')' 。
返回一个有效的 二叉表达式树,其 中序遍历 序列对应表达式 s 消除括号后的序列(详情参见下面的示例)。
注意,表达式的一般解析顺序适用于 s,即优先解析括号内的表达式,然后解析乘除法,最后解析加减法。
同时,操作数在 s 和树的中序遍历中 出现顺序相同 。
示例 1:
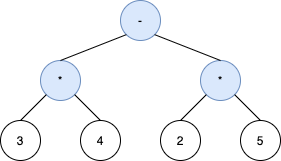
输入:s = "3*4-2*5"
输出:[-,*,*,3,4,2,5]
解释:上面是唯一一种有效的二叉表达式树,其中序遍历生成 s 。
示例 2:
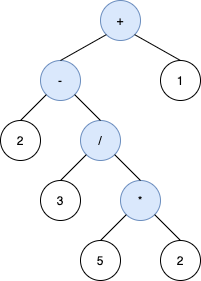
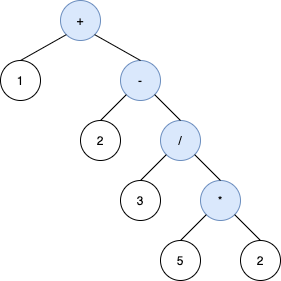
输入:s = "2-3/(5*2)+1" 输出:[+,-,1,2,/,null,null,null,null,3,*,null,null,5,2] 解释:上面的树的中序遍历为 2-3/5*2+1 ,与 s 消除括号后相同。该树还会生成正确的结果,其操作数的顺序与 s 中出现的顺序相同。 下面的树也是一个有效的二叉表达式树,具有与 s 相同的中序遍历,但它不是一个有效的答案,因为它的求值结果不同。下面的树也是无效的。尽管它的计算结果相等并与上述树等效,但其中序遍历不会产生 s ,并且其操作数与 s 中的顺序也不相同。
示例 3:
输入:s = "1+2+3+4+5"
输出:[+,+,5,+,4,null,null,+,3,null,null,1,2]
解释:二叉树 [+,+,5,+,+,null,null,1,2,3,4] 也是诸多有效的二叉表达式树之一。
提示:
1 <= s.length <= 100s中包含数字和字符'('、')'、'+'、'-'、'*'、'/'。s中的操作数 恰好 是一位数字。- 题目数据保证
s是一个有效的表达式。
方法一:Go 解法(本站整理) · Go 实现
根据题意整理:源文只有双栈思考,没有非空实现。用节点栈保存操作数、运算符栈保存尚未归约的符号;遇到新运算符时先归约优先级更高或相同的栈顶,从而保证左结合。括号限定归约范围。归约时先弹右孩子、再弹左孩子。n 为字符串长度,时间 O(n),辅助空间 O(n)。平台 Node 约定为 struct { Val byte; Left, Right *Node },测试提供该类型;入口 expTree。
出处:Doocs 原题与题解,固定提交 91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011;题意、参考及本 Go 改写采用 CC BY-SA 4.0。
// 题意与参考:Doocs LeetCode,CC BY-SA 4.0。
// https://github.com/doocs/leetcode/blob/91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011/solution/1500-1599/1597.Build%20Binary%20Expression%20Tree%20From%20Infix%20Expression/README.md
// Go 实现与测试沿用 CC BY-SA 4.0;来源性质见配套说明。
func expTree(s string) *Node {
	nodes := []*Node{}
	ops := []byte{}
	priority := func(c byte) int {
		if c == '+' || c == '-' {
			return 1
		}
		if c == '*' || c == '/' {
			return 2
		}
		return 0
	}
	reduce := func() {
		n := len(nodes)
		r, l := nodes[n-1], nodes[n-2]
		op := ops[len(ops)-1]
		ops = ops[:len(ops)-1]
		nodes = append(nodes[:n-2], &Node{Val: op, Left: l, Right: r})
	}
	for i := 0; i < len(s); i++ {
		c := s[i]
		switch {
		case c >= '0' && c <= '9':
			nodes = append(nodes, &Node{Val: c})
		case c == '(':
			ops = append(ops, c)
		case c == ')':
			for ops[len(ops)-1] != '(' {
				reduce()
			}
			ops = ops[:len(ops)-1]
		default:
			for len(ops) > 0 && ops[len(ops)-1] != '(' && priority(ops[len(ops)-1]) >= priority(c) {
				reduce()
			}
			ops = append(ops, c)
		}
	}
	for len(ops) > 0 {
		reduce()
	}
	return nodes[0]
}1602. 找到二叉树中最近的右侧节点 🔒
题目、示例与约束
给定一棵二叉树的根节点 root 和树中的一个节点 u ,返回与 u 所在层中距离最近的右侧节点,当 u 是所在层中最右侧的节点,返回 null 。
示例 1:
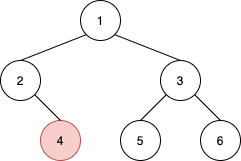
输入:root = [1,2,3,null,4,5,6], u = 4
输出:5
解释:节点 4 所在层中,最近的右侧节点是节点 5。
示例 2:
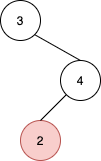
输入:root = [3,null,4,2], u = 2
输出:null
解释:2 的右侧没有节点。
示例 3:
输入:root = [1], u = 1
输出:null
示例 4:
输入:root = [3,4,2,null,null,null,1], u = 4
输出:2
提示:
- 树中节点个数的范围是
[1, 105]。 1 <= Node.val <= 105- 树中所有节点的值是唯一的。
u是以root为根的二叉树的一个节点。
方法一:BFS · Go 实现
思考
所求是与 同层且紧邻其右侧的结点。若先求出 的深度再扫描整层,需要两次遍历或额外存储各层结点。
层序遍历本身按从左到右给出同一层的相邻关系:当队列中弹出 时,若本层尚未结束,队首即为右邻。
为此用 BFS,按层弹出;发现 后根据本层剩余结点数决定返回队首或 。
我们可以使用广度优先搜索,从根节点开始搜索,当搜索到节点 时,返回队列中的下一个节点。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func findNearestRightNode(root *TreeNode, u *TreeNode) *TreeNode {
	q := []*TreeNode{root}
	for len(q) > 0 {
		for i := len(q); i > 0; i-- {
			root = q[0]
			q = q[1:]
			if root == u {
				if i > 1 {
					return q[0]
				}
				return nil
			}
			if root.Left != nil {
				q = append(q, root.Left)
			}
			if root.Right != nil {
				q = append(q, root.Right)
			}
		}
	}
	return nil
}
方法二:DFS · Go 实现
思考
方法一依赖队列保存整层,空间随宽度增长。先序 DFS 按「左子再右子」访问同层结点,顺序与从左到右一致。
因此首次遇到 时记下深度 ,之后第一个同深度结点即为右邻,可用递归实现且不必显式分层。
DFS 先序遍历二叉树,首次搜索到 时,标记目前层数 ,下次遇到同一层的节点时,即为目标节点。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func findNearestRightNode(root *TreeNode, u *TreeNode) *TreeNode {
	d := 0
	var ans *TreeNode
	var dfs func(*TreeNode, int)
	dfs = func(root *TreeNode, i int) {
		if root == nil || ans != nil {
			return
		}
		if d == i {
			ans = root
			return
		}
		if root == u {
			d = i
			return
		}
		dfs(root.Left, i+1)
		dfs(root.Right, i+1)
	}
	dfs(root, 1)
	return ans
}1609. 奇偶树
题目、示例与约束
如果一棵二叉树满足下述几个条件,则可以称为 奇偶树 :
- 二叉树根节点所在层下标为
0,根的子节点所在层下标为1,根的孙节点所在层下标为2,依此类推。 - 偶数下标 层上的所有节点的值都是 奇 整数,从左到右按顺序 严格递增
- 奇数下标 层上的所有节点的值都是 偶 整数,从左到右按顺序 严格递减
给你二叉树的根节点,如果二叉树为 奇偶树 ,则返回 true ,否则返回 false 。
示例 1:
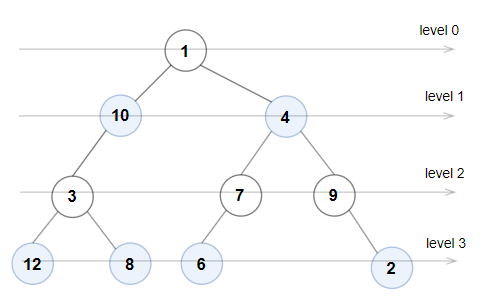
输入:root = [1,10,4,3,null,7,9,12,8,6,null,null,2]
输出:true
解释:每一层的节点值分别是:
0 层:[1]
1 层:[10,4]
2 层:[3,7,9]
3 层:[12,8,6,2]
由于 0 层和 2 层上的节点值都是奇数且严格递增,而 1 层和 3 层上的节点值都是偶数且严格递减,因此这是一棵奇偶树。
示例 2:
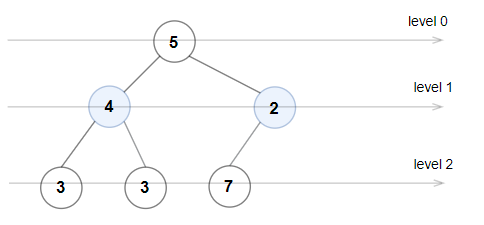
输入:root = [5,4,2,3,3,7]
输出:false
解释:每一层的节点值分别是:
0 层:[5]
1 层:[4,2]
2 层:[3,3,7]
2 层上的节点值不满足严格递增的条件,所以这不是一棵奇偶树。
示例 3:
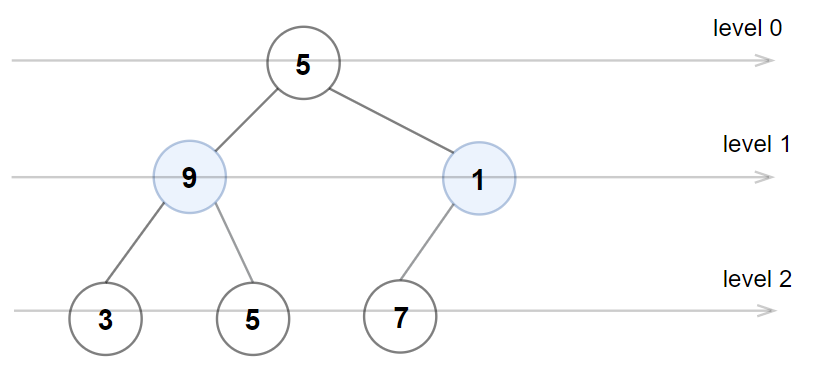
输入:root = [5,9,1,3,5,7]
输出:false
解释:1 层上的节点值应为偶数。
示例 4:
输入:root = [1]
输出:true
示例 5:
输入:root = [11,8,6,1,3,9,11,30,20,18,16,12,10,4,2,17]
输出:true
提示:
- 树中节点数在范围
[1, 105]内 1 <= Node.val <= 106
方法一:BFS · Go 实现
思考
偶数层须为严格递增的奇数,奇数层须为严格递减的偶数,判断依赖「同一层从左到右的相邻值」。层序遍历恰好按层提供这一顺序。
结点可达 ,一次 BFS 即可,不必按层物化数组。
用队列分层,层内维护前驱 与奇偶标志 ,不满足奇偶或单调性则立即返回。
BFS 逐层遍历,每层按照奇偶性判断,每层的节点值都是偶数或奇数,且严格递增或递减。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func isEvenOddTree(root *TreeNode) bool {
	even := true
	q := []*TreeNode{root}
	for len(q) > 0 {
		var prev int = 1e7
		if even {
			prev = 0
		}
		for n := len(q); n > 0; n-- {
			root = q[0]
			q = q[1:]
			if even && (root.Val%2 == 0 || prev >= root.Val) {
				return false
			}
			if !even && (root.Val%2 == 1 || prev <= root.Val) {
				return false
			}
			prev = root.Val
			if root.Left != nil {
				q = append(q, root.Left)
			}
			if root.Right != nil {
				q = append(q, root.Right)
			}
		}
		even = !even
	}
	return true
}
方法二:DFS · Go 实现
思考
方法一用队列保存一层。先序 DFS 同样按从左到右访问同层结点,只需记住每层最近一次见到的值。
哈希表 以深度为键记录前驱,递归时同步检查奇偶与单调,空间转为递归栈而非显式队列。
DFS 先序遍历二叉树,同样根据节点所在层的奇偶性判断是否满足条件,遍历过程中用哈希表记录每一层最近访问到的节点值。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func isEvenOddTree(root *TreeNode) bool {
	d := map[int]int{}
	var dfs func(*TreeNode, int) bool
	dfs = func(root *TreeNode, i int) bool {
		if root == nil {
			return true
		}
		even := i%2 == 0
		prev, ok := d[i]
		if !ok {
			if even {
				prev = 0
			} else {
				prev = 10000000
			}
		}
		if even && (root.Val%2 == 0 || prev >= root.Val) {
			return false
		}
		if !even && (root.Val%2 == 1 || prev <= root.Val) {
			return false
		}
		d[i] = root.Val
		return dfs(root.Left, i+1) && dfs(root.Right, i+1)
	}
	return dfs(root, 0)
}1612. 检查两棵二叉表达式树是否等价 🔒
题目、示例与约束
二叉表达式树是一种表达算术表达式的二叉树。二叉表达式树中的每一个节点都有零个或两个子节点。 叶节点(有 0 个子节点的节点)表示操作数,非叶节点(有 2 个子节点的节点)表示运算符。在本题中,我们只考虑 '+' 运算符(即加法)。
给定两棵二叉表达式树的根节点 root1 和 root2 。如果两棵二叉表达式树等价,返回 true ,否则返回 false 。
当两棵二叉搜索树中的变量取任意值,分别求得的值都相等时,我们称这两棵二叉表达式树是等价的。
示例 1:
输入: root1 = [x], root2 = [x]
输出: true
示例 2:
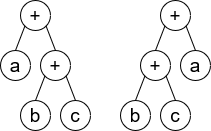
输入:root1 = [+,a,+,null,null,b,c], root2 = [+,+,a,b,c]
输出:true
解释:a + (b + c) == (b + c) + a
示例 3:
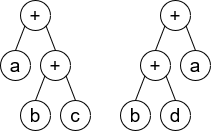
输入: root1 = [+,a,+,null,null,b,c], root2 = [+,+,a,b,d]
输出: false
解释: a + (b + c) != (b + d) + a
提示:
- 两棵树中的节点个数相等,且节点个数为范围
[1, 4999]内的奇数。 Node.val是'+'或小写英文字母。- 给定的树保证是有效的二叉表达式树。
进阶:当你的答案需同时支持 '-' 运算符(减法)时,你该如何修改你的答案
方法一:Go 解法(本站整理) · Go 实现
基于 Doocs 参考改写。题目只允许加法,因此树的形状和加法次序不影响结果;分别累加和扣减 26 个变量的出现次数,全部为零即等价。n 为两棵树的总节点数,h 为最大树高,时间 O(n),递归栈 O(h),计数数组 O(1)。平台 Node 为 struct { Val byte; Left, Right *Node };叶子为小写字母,内部节点为加号。
出处:Doocs 原题与题解,固定提交 91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011;题意、参考及本 Go 改写采用 CC BY-SA 4.0。
// 题意与参考:Doocs LeetCode,CC BY-SA 4.0。
// https://github.com/doocs/leetcode/blob/91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011/solution/1600-1699/1612.Check%20If%20Two%20Expression%20Trees%20are%20Equivalent/README.md
// Go 实现与测试沿用 CC BY-SA 4.0;来源性质见配套说明。
func checkEquivalence(root1, root2 *Node) bool {
	var count [26]int
	var visit func(*Node, int)
	visit = func(n *Node, delta int) {
		if n == nil {
			return
		}
		if n.Val == '+' {
			visit(n.Left, delta)
			visit(n.Right, delta)
		} else {
			count[n.Val-'a'] += delta
		}
	}
	visit(root1, 1)
	visit(root2, -1)
	for _, v := range count {
		if v != 0 {
			return false
		}
	}
	return true
}继续阅读
- 实践案例
- 实践案例
- 实践案例