
LeetCode Go · 堆与优先队列(2)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 17 题 · 点击题目展开,先独立思考,再查看解法。
2402. 会议室 III
题目、示例与约束
给你一个整数 n ,共有编号从 0 到 n - 1 的 n 个会议室。
给你一个二维整数数组 meetings ,其中 meetings[i] = [starti, endi] 表示一场会议将会在 半闭 时间区间 [starti, endi) 举办。所有 starti 的值 互不相同 。
会议将会按以下方式分配给会议室:
- 每场会议都会在未占用且编号 最小 的会议室举办。
- 如果没有可用的会议室,会议将会延期,直到存在空闲的会议室。延期会议的持续时间和原会议持续时间 相同 。
- 当会议室处于未占用状态时,将会优先提供给原 开始 时间更早的会议。
返回举办最多次会议的房间 编号 。如果存在多个房间满足此条件,则返回编号 最小 的房间。
半闭区间 [a, b) 是 a 和 b 之间的区间,包括 a 但 不包括 b 。
示例 1:
输入:n = 2, meetings = [[0,10],[1,5],[2,7],[3,4]]
输出:0
解释:
- 在时间 0 ,两个会议室都未占用,第一场会议在会议室 0 举办。
- 在时间 1 ,只有会议室 1 未占用,第二场会议在会议室 1 举办。
- 在时间 2 ,两个会议室都被占用,第三场会议延期举办。
- 在时间 3 ,两个会议室都被占用,第四场会议延期举办。
- 在时间 5 ,会议室 1 的会议结束。第三场会议在会议室 1 举办,时间周期为 [5,10) 。
- 在时间 10 ,两个会议室的会议都结束。第四场会议在会议室 0 举办,时间周期为 [10,11) 。
会议室 0 和会议室 1 都举办了 2 场会议,所以返回 0 。
示例 2:
输入:n = 3, meetings = [[1,20],[2,10],[3,5],[4,9],[6,8]]
输出:1
解释:
- 在时间 1 ,所有三个会议室都未占用,第一场会议在会议室 0 举办。
- 在时间 2 ,会议室 1 和 2 未占用,第二场会议在会议室 1 举办。
- 在时间 3 ,只有会议室 2 未占用,第三场会议在会议室 2 举办。
- 在时间 4 ,所有三个会议室都被占用,第四场会议延期举办。
- 在时间 5 ,会议室 2 的会议结束。第四场会议在会议室 2 举办,时间周期为 [5,10) 。
- 在时间 6 ,所有三个会议室都被占用,第五场会议延期举办。
- 在时间 10 ,会议室 1 和 2 的会议结束。第五场会议在会议室 1 举办,时间周期为 [10,12) 。
会议室 1 和会议室 2 都举办了 2 场会议,所以返回 1 。
提示:
1 <= n <= 1001 <= meetings.length <= 105meetings[i].length == 20 <= starti < endi <= 5 * 105starti的所有值 互不相同
方法一:优先队列(小根堆) · Go 实现
思考
、 ,若每次为会议线性扫描全部会议室找最早空闲者,时间为 ,在上限附近偏紧。会议开始时间互不相同,必须按时间顺序分配。
空闲会议室只需按编号取最小者,占用中的会议室则按结束时间出队。用两个堆分别维护这两类:会议按开始时间排序后,先把已结束的房间归还空闲堆;有空闲则取编号最小者,否则取出最早结束的那间并顺延时长。顺延后的结束时刻等于上一场结束时刻加上会议时长,连续占用可以超过 ,因此该时刻用 位整数。
我们定义两个优先队列,分别表示空闲会议室、使用中的会议室。其中:空闲会议室 依据下标排序;而使用中的会议室 依据结束时间、下标排序。
先对会议按照开始时间排序,然后遍历会议,对于每个会议:
- 若有使用中的会议室小于当前等于会议的开始时间,将其加入到空闲会议室队列 中;
- 若当前有空闲会议室,那么在空闲队列 中取出权重最小的会议室,将其加入使用中的队列 中;
- 若当前没有空闲会议室,那么在使用队列 中找出最早结束时间且下标最小的会议室,重新加入使用中的队列 中。
时间复杂度 ,空间复杂度 ,其中 和 分别为会议室数量和会议数量。
相似题目:
func mostBooked(n int, meetings [][]int) int {
	sort.Slice(meetings, func(i, j int) bool { return meetings[i][0] < meetings[j][0] })
	idle := hp{make([]int, n)}
	for i := 0; i < n; i++ {
		idle.IntSlice[i] = i
	}
	busy := hp2{}
	cnt := make([]int, n)
	for _, v := range meetings {
		s, e := v[0], v[1]
		for len(busy) > 0 && busy[0].end <= s {
			heap.Push(&idle, heap.Pop(&busy).(pair).i)
		}
		var i int
		if idle.Len() > 0 {
			i = heap.Pop(&idle).(int)
			heap.Push(&busy, pair{e, i})
		} else {
			x := heap.Pop(&busy).(pair)
			i = x.i
			heap.Push(&busy, pair{x.end + e - s, i})
		}
		cnt[i]++
	}
	ans := 0
	for i, v := range cnt {
		if cnt[ans] < v {
			ans = i
		}
	}
	return ans
}

type hp struct{ sort.IntSlice }

func (h *hp) Push(v any) { h.IntSlice = append(h.IntSlice, v.(int)) }
func (h *hp) Pop() any {
	a := h.IntSlice
	v := a[len(a)-1]
	h.IntSlice = a[:len(a)-1]
	return v
}

type pair struct{ end, i int }
type hp2 []pair

func (h hp2) Len() int { return len(h) }
func (h hp2) Less(i, j int) bool {
	a, b := h[i], h[j]
	return a.end < b.end || a.end == b.end && a.i < b.i
}
func (h hp2) Swap(i, j int) { h[i], h[j] = h[j], h[i] }
func (h *hp2) Push(v any)   { *h = append(*h, v.(pair)) }
func (h *hp2) Pop() any { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }2456. 最流行的视频创作者
题目、示例与约束
给你两个字符串数组 creators 和 ids ,和一个整数数组 views ,所有数组的长度都是 n 。平台上第 i 个视频者是 creator[i] ,视频分配的 id 是 ids[i] ,且播放量为 views[i] 。
视频创作者的 流行度 是该创作者的 所有 视频的播放量的 总和 。请找出流行度 最高 创作者以及该创作者播放量 最大 的视频的 id 。
- 如果存在多个创作者流行度都最高,则需要找出所有符合条件的创作者。
- 如果某个创作者存在多个播放量最高的视频,则只需要找出字典序最小的
id。
返回一个二维字符串数组 answer ,其中 answer[i] = [creatori, idi] 表示 creatori 的流行度 最高 且其最流行的视频 id 是 idi ,可以按任何顺序返回该结果。
示例 1:
输入:creators = ["alice","bob","alice","chris"], ids = ["one","two","three","four"], views = [5,10,5,4]
输出:[["alice","one"],["bob","two"]]
解释:
alice 的流行度是 5 + 5 = 10 。
bob 的流行度是 10 。
chris 的流行度是 4 。
alice 和 bob 是流行度最高的创作者。
bob 播放量最高的视频 id 为 "two" 。
alice 播放量最高的视频 id 是 "one" 和 "three" 。由于 "one" 的字典序比 "three" 更小,所以结果中返回的 id 是 "one" 。
示例 2:
输入:creators = ["alice","alice","alice"], ids = ["a","b","c"], views = [1,2,2]
输出:[["alice","b"]]
解释:
id 为 "b" 和 "c" 的视频都满足播放量最高的条件。
由于 "b" 的字典序比 "c" 更小,所以结果中返回的 id 是 "b" 。
提示:
n == creators.length == ids.length == views.length1 <= n <= 1051 <= creators[i].length, ids[i].length <= 5creators[i]和ids[i]仅由小写英文字母组成0 <= views[i] <= 105
方法一:哈希表 · Go 实现
思考
,按创作者聚合总播放量,并记录其播放最高、字典序最小的视频。哈希表 累加播放, 保存当前最优视频下标;再取总播放的最大值,筛出并列的创作者。
我们遍历三个数组,用哈希表 统计每个创作者的播放量总和,用哈希表 记录每个创作者播放量最大的视频的下标。
然后,我们遍历哈希表 ,找出最大的播放量 ;接着再次遍历哈希表 ,找出播放量为 的创作者,将其加入答案数组中。
时间复杂度 ,空间复杂度 。其中 为视频数量。
func mostPopularCreator(creators []string, ids []string, views []int) (ans [][]string) {
	cnt := map[string]int{}
	d := map[string]int{}
	for k, c := range creators {
		i, v := ids[k], views[k]
		cnt[c] += v
		if j, ok := d[c]; !ok || views[j] < v || (views[j] == v && ids[j] > i) {
			d[c] = k
		}
	}
	mx := 0
	for _, x := range cnt {
		if mx < x {
			mx = x
		}
	}
	for c, x := range cnt {
		if x == mx {
			ans = append(ans, []string{c, ids[d[c]]})
		}
	}
	return
}2500. 删除每行中的最大值
题目、示例与约束
给你一个 m x n 大小的矩阵 grid ,由若干正整数组成。
执行下述操作,直到 grid 变为空矩阵:
- 从每一行删除值最大的元素。如果存在多个这样的值,删除其中任何一个。
- 将删除元素中的最大值与答案相加。
注意 每执行一次操作,矩阵中列的数据就会减 1 。
返回执行上述操作后的答案。
示例 1:
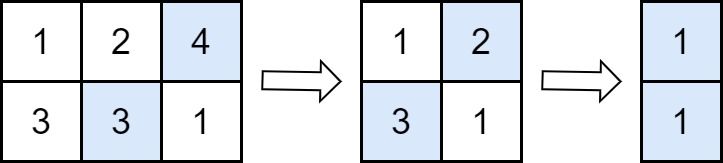
输入:grid = [[1,2,4],[3,3,1]]
输出:8
解释:上图展示在每一步中需要移除的值。
- 在第一步操作中,从第一行删除 4 ,从第二行删除 3(注意,有两个单元格中的值为 3 ,我们可以删除任一)。在答案上加 4 。
- 在第二步操作中,从第一行删除 2 ,从第二行删除 3 。在答案上加 3 。
- 在第三步操作中,从第一行删除 1 ,从第二行删除 1 。在答案上加 1 。
最终,答案 = 4 + 3 + 1 = 8 。
示例 2:

输入:grid = [[10]]
输出:10
解释:上图展示在每一步中需要移除的值。
- 在第一步操作中,从第一行删除 10 。在答案上加 10 。
最终,答案 = 10 。
提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 501 <= grid[i][j] <= 100
方法一:排序 · Go 实现
思考
每次操作要从每一行删去当前最大值,再把这些被删值中的最大者累加到答案。若按题意逐轮扫描,则每轮在各行找最大值需 ,共 轮,在 时尚可接受,但同一行被删去的序列其实就是该行降序排列的结果。
因此先将每一行升序排序,第 次操作对应各行的第 个元素(从右往左),答案即为按列取最大值之和。排序后用 按列聚合即可,无需再模拟删除。
由于每一次操作都是从每一行中删除最大值,然后取最大值加到答案中,因此我们可以先对每一行进行排序。
接下来遍历每一列,取每一列的最大值,然后将其加到答案中即可。
时间复杂度 ,空间复杂度 。其中 和 分别是矩阵的行数和列数。
func deleteGreatestValue(grid [][]int) (ans int) {
	for _, row := range grid {
		sort.Ints(row)
	}
	for j := range grid[0] {
		t := 0
		for i := range grid {
			if t < grid[i][j] {
				t = grid[i][j]
			}
		}
		ans += t
	}
	return
}2512. 奖励最顶尖的 K 名学生
题目、示例与约束
给你两个字符串数组 positive_feedback 和 negative_feedback ,分别包含表示正面的和负面的词汇。不会 有单词同时是正面的和负面的。
一开始,每位学生分数为 0 。每个正面的单词会给学生的分数 加 3 分,每个负面的词会给学生的分数 减 1 分。
给你 n 个学生的评语,用一个下标从 0 开始的字符串数组 report 和一个下标从 0 开始的整数数组 student_id 表示,其中 student_id[i] 表示这名学生的 ID ,这名学生的评语是 report[i] 。每名学生的 ID 互不相同。
给你一个整数 k ,请你返回按照得分 从高到低 最顶尖的 k 名学生。如果有多名学生分数相同,ID 越小排名越前。
示例 1:
输入:positive_feedback = ["smart","brilliant","studious"], negative_feedback = ["not"], report = ["this student is studious","the student is smart"], student_id = [1,2], k = 2
输出:[1,2]
解释:
两名学生都有 1 个正面词汇,都得到 3 分,学生 1 的 ID 更小所以排名更前。
示例 2:
输入:positive_feedback = ["smart","brilliant","studious"], negative_feedback = ["not"], report = ["this student is not studious","the student is smart"], student_id = [1,2], k = 2
输出:[2,1]
解释:
- ID 为 1 的学生有 1 个正面词汇和 1 个负面词汇,所以得分为 3-1=2 分。
- ID 为 2 的学生有 1 个正面词汇,得分为 3 分。
学生 2 分数更高,所以返回 [2,1] 。
提示:
1 <= positive_feedback.length, negative_feedback.length <= 1041 <= positive_feedback[i].length, negative_feedback[j].length <= 100positive_feedback[i]和negative_feedback[j]都只包含小写英文字母。positive_feedback和negative_feedback中不会有相同单词。n == report.length == student_id.length1 <= n <= 104report[i]只包含小写英文字母和空格' '。report[i]中连续单词之间有单个空格隔开。1 <= report[i].length <= 1001 <= student_id[i] <= 109student_id[i]的值 互不相同 。1 <= k <= n
方法一:哈希表 + 排序 · Go 实现
思考
每名学生的得分由报告中正面词 、负面词 累加得到,再按得分降序、编号升序取前 名。若每次在词表中线性查找,词表与报告长度乘积在约束下偏大。
把正、负词放入集合后, 判断每个单词。将 收集起来按 排序,截取前 个编号即可。
我们可以将正面的单词存入哈希表 中,将负面的单词存入哈希表 中。
然后遍历 ,对于每个学生,我们将其得分存入数组 中,数组中的每个元素为一个二元组 ,其中 表示学生的得分,而 表示学生的 ID。
最后我们对数组 按照得分从高到低排序,如果得分相同则按照 ID 从小到大排序,然后取出前 个学生的 ID 即可。
时间复杂度 ,空间复杂度 。其中 为学生数量, 和 分别为正面和负面单词的数量, 为单词的平均长度。
func topStudents(positive_feedback []string, negative_feedback []string, report []string, student_id []int, k int) (ans []int) {
	ps := map[string]bool{}
	ns := map[string]bool{}
	for _, s := range positive_feedback {
		ps[s] = true
	}
	for _, s := range negative_feedback {
		ns[s] = true
	}
	arr := [][2]int{}
	for i, sid := range student_id {
		t := 0
		for _, w := range strings.Split(report[i], " ") {
			if ps[w] {
				t += 3
			} else if ns[w] {
				t -= 1
			}
		}
		arr = append(arr, [2]int{t, sid})
	}
	sort.Slice(arr, func(i, j int) bool { return arr[i][0] > arr[j][0] || (arr[i][0] == arr[j][0] && arr[i][1] < arr[j][1]) })
	for _, v := range arr[:k] {
		ans = append(ans, v[1])
	}
	return
}2532. 过桥的时间
题目、示例与约束
共有 k 位工人计划将 n 个箱子从右侧的(旧)仓库移动到左侧的(新)仓库。给你两个整数 n 和 k,以及一个二维整数数组 time ,数组的大小为 k x 4 ,其中 time[i] = [righti, picki, lefti, puti] 。
一条河将两座仓库分隔,只能通过一座桥通行。旧仓库位于河的右岸,新仓库在河的左岸。开始时,所有 k 位工人都在桥的左侧等待。为了移动这些箱子,第 i 位工人(下标从 0 开始)可以:
- 从左岸(新仓库)跨过桥到右岸(旧仓库),用时
righti分钟。 - 从旧仓库选择一个箱子,并返回到桥边,用时
picki分钟。不同工人可以同时搬起所选的箱子。 - 从右岸(旧仓库)跨过桥到左岸(新仓库),用时
lefti分钟。 - 将箱子放入新仓库,并返回到桥边,用时
puti分钟。不同工人可以同时放下所选的箱子。
如果满足下面任一条件,则认为工人 i 的 效率低于 工人 j :
lefti + righti > leftj + rightjlefti + righti == leftj + rightj且i > j
工人通过桥时需要遵循以下规则:
- 同时只能有一名工人过桥。
- 当桥梁未被使用时,优先让右侧 效率最低 的工人(已经拿起盒子的工人)过桥。如果不是,优先让左侧 效率最低 的工人通过。
- 如果左侧已经派出足够的工人来拾取所有剩余的箱子,则 不会 再从左侧派出工人。
请你返回最后一个箱子 到达桥左侧 的时间。
示例 1:
输入:n = 1, k = 3, time = [[1,1,2,1],[1,1,3,1],[1,1,4,1]]
输出:6
解释:
从 0 到 1 分钟:工人 2 通过桥到达右侧。
从 1 到 2 分钟:工人 2 从右侧仓库拿起箱子。
从 2 到 6 分钟:工人 2 通过桥到达左侧。
从 6 到 7 分钟:工人 2 向左侧仓库放下箱子。
整个过程在 7 分钟后结束。我们返回 6 因为该问题要求的是最后一名工人到达桥梁左侧的时间。
示例 2:
输入:n = 3, k = 2, time = [[1,5,1,8],[10,10,10,10]]
输出:37
解释:

最后一个盒子在37秒时到达左侧。请注意,我们并 没有 放下最后一个箱子,因为那样会花费更多时间,而且它们已经和工人们一起在左边。
提示:
1 <= n, k <= 104time.length == ktime[i].length == 41 <= lefti, picki, righti, puti <= 1000
方法一:优先队列(大小根堆) + 模拟 · Go 实现
思考
桥同时只能过一人,右岸等待优先,同岸则过桥时间之和更大者优先。箱子数为 ,工人状态随时间在两岸等待与装卸之间切换,直接按秒推进在时间范围 下不可行。
按过桥时间和将工人排序,下标越大越慢,等待队列用大根堆取最慢者。装卸完成时间用小根堆,到期后回到对应等待堆。当前两岸都无人可过时,把时钟跳到下一完成时刻。右岸有人则让其先回左岸;否则派左岸的人带下一箱过去。最后一箱送回左岸的时刻即为答案。
我们先将工人按照效率从高到底排序,这样,下标越大的工人,效率越低。
接下来,我们用四个优先队列模拟工人的状态:
wait_in_left:大根堆,存储当前在左岸等待的工人的下标;wait_in_right:大根堆,存储当前在右岸等待的工人的下标;work_in_left:小根堆,存储当前在左岸工作的工人放好箱子的时间以及工人的下标;work_in_right:小根堆,存储当前在右岸工作的工人拿好箱子的时间以及工人的下标。
初始时,所有工人都在左岸,因此 wait_in_left 中存储所有工人的下标。用变量 cur 记录当前时间。
然后,我们模拟整个过程。我们先判断当前时刻,work_in_left 是否有工人已经放好箱子,如果有,我们将工人放入 wait_in_left 中,然后将工人从 work_in_left 中移除。同理,我们再判断 work_in_right 是否有工人已经放好箱子,如果有,我们将工人放入 wait_in_right 中,然后将工人从 work_in_right 中移除。
接着,我们判断当前时刻是否有工人在左岸等待,记为 left_to_go,同时,我们判断当前时刻是否有工人在右岸等待,记为 right_to_go。如果不存在等待过岸的工人,我们直接将 cur 更新为下一个工人放好箱子的时间,然后继续模拟过程。
如果 right_to_go 为 true,我们从 wait_in_right 中取出一个工人,更新 cur 为当前时间加上该工人从右岸过左岸的时间,如果此时所有工人都已经过了右岸,我们直接将 cur 作为答案返回;否则,我们将该工人放入 work_in_left 中。
如果 left_to_go 为 true,我们从 wait_in_left 中取出一个工人,更新 cur 为当前时间加上该工人从左岸过右岸的时间,然后将该工人放入 work_in_right 中,并且将箱子数量减一。
循环上述过程,直到箱子数量为零,此时 cur 即为答案。
时间复杂度 ,空间复杂度 。其中 和 分别为工人数量和箱子数量。
func findCrossingTime(n int, k int, time [][]int) int {
	sort.SliceStable(time, func(i, j int) bool { return time[i][0]+time[i][2] < time[j][0]+time[j][2] })
	waitInLeft := hp{}
	waitInRight := hp{}
	workInLeft := hp2{}
	workInRight := hp2{}
	for i := range time {
		heap.Push(&waitInLeft, i)
	}
	cur := 0
	for {
		for len(workInLeft) > 0 {
			if workInLeft[0].t > cur {
				break
			}
			heap.Push(&waitInLeft, heap.Pop(&workInLeft).(pair).i)
		}
		for len(workInRight) > 0 {
			if workInRight[0].t > cur {
				break
			}
			heap.Push(&waitInRight, heap.Pop(&workInRight).(pair).i)
		}
		leftToGo := n > 0 && waitInLeft.Len() > 0
		rightToGo := waitInRight.Len() > 0
		if !leftToGo && !rightToGo {
			nxt := 1 << 30
			if len(workInLeft) > 0 {
				nxt = min(nxt, workInLeft[0].t)
			}
			if len(workInRight) > 0 {
				nxt = min(nxt, workInRight[0].t)
			}
			cur = nxt
			continue
		}
		if rightToGo {
			i := heap.Pop(&waitInRight).(int)
			cur += time[i][2]
			if n == 0 && waitInRight.Len() == 0 && len(workInRight) == 0 {
				return cur
			}
			heap.Push(&workInLeft, pair{cur + time[i][3], i})
		} else {
			i := heap.Pop(&waitInLeft).(int)
			cur += time[i][0]
			n--
			heap.Push(&workInRight, pair{cur + time[i][1], i})
		}
	}
}

type hp struct{ sort.IntSlice }

func (h hp) Less(i, j int) bool { return h.IntSlice[i] > h.IntSlice[j] }
func (h *hp) Push(v any)        { h.IntSlice = append(h.IntSlice, v.(int)) }
func (h *hp) Pop() any {
	a := h.IntSlice
	v := a[len(a)-1]
	h.IntSlice = a[:len(a)-1]
	return v
}

type pair struct{ t, i int }
type hp2 []pair

func (h hp2) Len() int           { return len(h) }
func (h hp2) Less(i, j int) bool { return h[i].t < h[j].t }
func (h hp2) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp2) Push(v any)        { *h = append(*h, v.(pair)) }
func (h *hp2) Pop() any { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }2558. 从数量最多的堆取走礼物
题目、示例与约束
给你一个整数数组 gifts ,表示各堆礼物的数量。每一秒,你需要执行以下操作:
- 选择礼物数量最多的那一堆。
- 如果不止一堆都符合礼物数量最多,从中选择任一堆即可。
- 将堆中的礼物数量减少到堆中原来礼物数量的平方根,向下取整。
返回在 k 秒后剩下的礼物数量。
示例 1:
输入:gifts = [25,64,9,4,100], k = 4
输出:29
解释:
按下述方式取走礼物:
- 在第一秒,选中最后一堆,剩下 10 个礼物。
- 接着第二秒选中第二堆礼物,剩下 8 个礼物。
- 然后选中第一堆礼物,剩下 5 个礼物。
- 最后,再次选中最后一堆礼物,剩下 3 个礼物。
最后剩下的礼物数量分别是 [5,8,9,4,3] ,所以,剩下礼物的总数量是 29 。
示例 2:
输入:gifts = [1,1,1,1], k = 4
输出:4
解释:
在本例中,不管选中哪一堆礼物,都必须剩下 1 个礼物。
也就是说,你无法获取任一堆中的礼物。
所以,剩下礼物的总数量是 4 。
提示:
1 <= gifts.length <= 1031 <= gifts[i] <= 1091 <= k <= 103
方法一:优先队列(大根堆) · Go 实现
思考
每次把当前最多的一堆礼物改成 ,共 次,求剩余总和。每次扫描找最大堆, 尚可,但堆能直接给出当前最大。
大根堆弹出堆顶、压回其平方根(向下取整),重复 次后再求和。Python 用相反数模拟。
我们将数组 转存到大根堆中,然后循环 次,每次取出堆顶元素,将堆顶元素开根号的结果再放入堆中。
最后累加堆中所有元素之和作为答案。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func pickGifts(gifts []int, k int) (ans int64) {
	h := &hp{gifts}
	heap.Init(h)
	for ; k > 0; k-- {
		gifts[0] = int(math.Sqrt(float64(gifts[0])))
		heap.Fix(h, 0)
	}
	for _, x := range gifts {
		ans += int64(x)
	}
	return
}

type hp struct{ sort.IntSlice }

func (h hp) Less(i, j int) bool { return h.IntSlice[i] > h.IntSlice[j] }
func (hp) Pop() (_ any)         { return }
func (hp) Push(any) {}2593. 标记所有元素后数组的分数
题目、示例与约束
给你一个数组 nums ,它包含若干正整数。
一开始分数 score = 0 ,请你按照下面算法求出最后分数:
- 从数组中选择最小且没有被标记的整数。如果有相等元素,选择下标最小的一个。
- 将选中的整数加到
score中。 - 标记 被选中元素,如果有相邻元素,则同时标记 与它相邻的两个元素 。
- 重复此过程直到数组中所有元素都被标记。
请你返回执行上述算法后最后的分数。
示例 1:
输入:nums = [2,1,3,4,5,2]
输出:7
解释:我们按照如下步骤标记元素:
- 1 是最小未标记元素,所以标记它和相邻两个元素:[2,1,3,4,5,2] 。
- 2 是最小未标记元素,所以标记它和左边相邻元素:[2,1,3,4,5,2] 。
- 4 是仅剩唯一未标记的元素,所以我们标记它:[2,1,3,4,5,2] 。
总得分为 1 + 2 + 4 = 7 。
示例 2:
输入:nums = [2,3,5,1,3,2]
输出:5
解释:我们按照如下步骤标记元素:
- 1 是最小未标记元素,所以标记它和相邻两个元素:[2,3,5,1,3,2] 。
- 2 是最小未标记元素,由于有两个 2 ,我们选择最左边的一个 2 ,也就是下标为 0 处的 2 ,以及它右边相邻的元素:[2,3,5,1,3,2] 。
- 2 是仅剩唯一未标记的元素,所以我们标记它:[2,3,5,1,3,2] 。
总得分为 1 + 2 + 2 = 5 。
提示:
1 <= nums.length <= 1051 <= nums[i] <= 106
方法一:优先队列(小根堆) · Go 实现
思考
反复选出未标记的最小元素(并列取最左)加入分数,并标记它与左右邻居,直至全部标记。每次线性找最小是平方级。
小根堆按 弹出全局最小未标记者。标记其邻域后,堆顶若已标记则继续弹出。每个元素至多入堆一次。
我们用一个优先队列维护数组中未被标记的元素,队列中每一项为一个二元组 ,其中 和 分别表示数组中的元素值和下标,用一个数组 记录数组中的元素是否被标记。
每次从队列中取出最小的元素 ,我们将 加入答案,然后标记 位置的元素,以及 位置的左右相邻元素,即 和 位置的元素。接下来判断堆顶元素是否被标记,如果被标记则弹出堆顶元素,直到堆顶元素未被标记,或者堆为空。
最后返回答案即可。
时间复杂度 ,空间复杂度 。其中 为数组的长度。
func findScore(nums []int) (ans int64) {
	h := hp{}
	for i, x := range nums {
		heap.Push(&h, pair{x, i})
	}
	n := len(nums)
	vis := make([]bool, n)
	for len(h) > 0 {
		p := heap.Pop(&h).(pair)
		x, i := p.x, p.i
		ans += int64(x)
		vis[i] = true
		for _, j := range []int{i - 1, i + 1} {
			if j >= 0 && j < n {
				vis[j] = true
			}
		}
		for len(h) > 0 && vis[h[0].i] {
			heap.Pop(&h)
		}
	}
	return
}

type pair struct{ x, i int }
type hp []pair

func (h hp) Len() int           { return len(h) }
func (h hp) Less(i, j int) bool { return h[i].x < h[j].x || (h[i].x == h[j].x && h[i].i < h[j].i) }
func (h hp) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)        { *h = append(*h, v.(pair)) }
func (h *hp) Pop() any          { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }
方法二:排序 · Go 实现
思考
方法一用堆动态取最小。操作顺序其实就是按 的静态序,事先排序后依次检查:未被邻域波及则计入并标记左右。避免堆的弹出循环。
我们可以创建一个下标数组 ,其中 ,然后我们对数组 按照数组 中的元素值进行排序,如果元素值相同,则按照下标值进行排序。
接下来创建一个长度为 的数组 ,其中 ,表示数组中的元素是否被标记。
我们遍历下标数组 ,对于数组中的每一个下标 ,如果 为 ,则表示 位置的元素未被标记,我们将 加入答案,然后标记 位置的元素,以及 位置的左右相邻元素,即 和 位置的元素。继续遍历下标数组 ,直到遍历结束。
最后返回答案即可。
时间复杂度 ,空间复杂度 。其中 为数组的长度。
func findScore(nums []int) (ans int64) {
	n := len(nums)
	idx := make([]int, n)
	for i := range idx {
		idx[i] = i
	}
	sort.Slice(idx, func(i, j int) bool {
		i, j = idx[i], idx[j]
		return nums[i] < nums[j] || (nums[i] == nums[j] && i < j)
	})
	vis := make([]bool, n+2)
	for _, i := range idx {
		if !vis[i+1] {
			ans += int64(nums[i])
			vis[i], vis[i+2] = true, true
		}
	}
	return
}2679. 矩阵中的和
题目、示例与约束
给你一个下标从 0 开始的二维整数数组 nums 。一开始你的分数为 0 。你需要执行以下操作直到矩阵变为空:
- 矩阵中每一行选取最大的一个数,并删除它。如果一行中有多个最大的数,选择任意一个并删除。
- 在步骤 1 删除的所有数字中找到最大的一个数字,将它添加到你的 分数 中。
请你返回最后的 分数 。
示例 1:
输入:nums = [[7,2,1],[6,4,2],[6,5,3],[3,2,1]]
输出:15
解释:第一步操作中,我们删除 7 ,6 ,6 和 3 ,将分数增加 7 。下一步操作中,删除 2 ,4 ,5 和 2 ,将分数增加 5 。最后删除 1 ,2 ,3 和 1 ,将分数增加 3 。所以总得分为 7 + 5 + 3 = 15 。
示例 2:
输入:nums = [[1]]
输出:1
解释:我们删除 1 并将分数增加 1 ,所以返回 1 。
提示:
1 <= nums.length <= 3001 <= nums[i].length <= 5000 <= nums[i][j] <= 103
方法一:排序 · Go 实现
思考
每轮从每行删一个当前最大并累加这些最大中的最大者。若每轮都找行最大, 偏高。各行排序后,同一列位置对应「第 大」的对齐,列最大值之和即总得分。
我们可以先遍历矩阵的每一行,将每一行排序。
接下来,遍历矩阵的每一列,找到每一列的最大值,将这些最大值相加即可。
时间复杂度 ,空间复杂度 。其中 和 分别是矩阵的行数和列数。
func matrixSum(nums [][]int) (ans int) {
	for _, row := range nums {
		sort.Ints(row)
	}
	for i := 0; i < len(nums[0]); i++ {
		mx := 0
		for _, row := range nums {
			mx = max(mx, row[i])
		}
		ans += mx
	}
	return
}2974. 最小数字游戏
题目、示例与约束
你有一个下标从 0 开始、长度为 偶数 的整数数组 nums ,同时还有一个空数组 arr 。Alice 和 Bob 决定玩一个游戏,游戏中每一轮 Alice 和 Bob 都会各自执行一次操作。游戏规则如下:
- 每一轮,Alice 先从
nums中移除一个 最小 元素,然后 Bob 执行同样的操作。 - 接着,Bob 会将移除的元素添加到数组
arr中,然后 Alice 也执行同样的操作。 - 游戏持续进行,直到
nums变为空。
返回结果数组 arr 。
示例 1:
输入:nums = [5,4,2,3]
输出:[3,2,5,4]
解释:第一轮,Alice 先移除 2 ,然后 Bob 移除 3 。然后 Bob 先将 3 添加到 arr 中,接着 Alice 再将 2 添加到 arr 中。于是 arr = [3,2] 。
第二轮开始时,nums = [5,4] 。Alice 先移除 4 ,然后 Bob 移除 5 。接着他们都将元素添加到 arr 中,arr 变为 [3,2,5,4] 。
示例 2:
输入:nums = [2,5]
输出:[5,2]
解释:第一轮,Alice 先移除 2 ,然后 Bob 移除 5 。然后 Bob 先将 5 添加到 arr 中,接着 Alice 再将 2 添加到 arr 中。于是 arr = [5,2] 。
提示:
1 <= nums.length <= 1001 <= nums[i] <= 100nums.length % 2 == 0
方法一:模拟 + 优先队列(小根堆) · Go 实现
思考
每轮取出两个当前最小数,却按「先放较大、再放较小」写入答案。等价于反复弹出堆顶两个元素并交换顺序追加。 且为偶数,堆模拟与题面过程一致。
我们可以将数组 中的元素依次放入一个小根堆中,每次从小根堆中取出两个元素 和 ,然后依次将 和 放入答案数组中,直到小根堆为空。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func numberGame(nums []int) (ans []int) {
	pq := &hp{nums}
	heap.Init(pq)
	for pq.Len() > 0 {
		a := heap.Pop(pq).(int)
		b := heap.Pop(pq).(int)
		ans = append(ans, b)
		ans = append(ans, a)
	}
	return
}

type hp struct{ sort.IntSlice }

func (h *hp) Less(i, j int) bool { return h.IntSlice[i] < h.IntSlice[j] }
func (h *hp) Pop() interface{} {
	old := h.IntSlice
	n := len(old)
	x := old[n-1]
	h.IntSlice = old[0 : n-1]
	return x
}
func (h *hp) Push(x interface{}) {
	h.IntSlice = append(h.IntSlice, x.(int))
}
方法二:排序 + 交换 · Go 实现
思考
方法一维护堆,但全局最小值序列在排序后即确定:相邻的 正是每轮弹出的一对。交换这两位后写入,无需动态结构。时间仍由排序主导。
我们可以将数组 排序,然后遍历数组,每次交换相邻的两个元素,直到遍历结束,返回交换后的数组。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func numberGame(nums []int) []int {
	sort.Ints(nums)
	for i := 0; i < len(nums); i += 2 {
		nums[i], nums[i+1] = nums[i+1], nums[i]
	}
	return nums
}3066. 超过阈值的最少操作数 II
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums 和一个整数 k 。
你可以对 nums 执行一些操作,在一次操作中,你可以:
- 选择
nums中 最小 的两个整数x和y。 - 将
x和y从nums中删除。 - 将
min(x, y) * 2 + max(x, y)添加到数组中的任意位置。
注意,只有当 nums 至少 包含两个元素时,你才可以执行以上操作。
你需要使数组中的所有元素都 大于或等于 k ,请你返回需要的 最少 操作次数。
示例 1:
输入:nums = [2,11,10,1,3], k = 10
输出:2
解释:
- 第一次操作中,我们删除元素 1 和 2 ,然后添加
1 * 2 + 2到nums中,nums变为[4, 11, 10, 3]。 - 第二次操作中,我们删除元素 3 和 4 ,然后添加
3 * 2 + 4到nums中,nums变为[10, 11, 10]。
此时,数组中的所有元素都大于等于 10 ,所以我们停止操作。
可以证明使数组中所有元素都大于等于 10 需要的最少操作次数为 2 。
示例 2:
输入:nums = [1,1,2,4,9], k = 20
输出:4
解释:
- 第一次操作后,
nums变为[2, 4, 9, 3]。 - 第二次操作后,
nums变为[7, 4, 9]。 - 第三次操作后,
nums变为[15, 9]。 - 第四次操作后,
nums变为[33]。
此时,nums 中的所有元素都大于等于 20 ,所以我们停止操作。
可以证明使数组中所有元素都大于等于 20 需要的最少操作次数为 4 。
提示:
2 <= nums.length <= 2 * 1051 <= nums[i] <= 1091 <= k <= 109- 输入保证答案一定存在,也就是说,在进行某些次数的操作后,数组中所有元素都大于等于
k。
方法一:优先队列(小根堆) · Go 实现
思考
每次取最小的两个数 ,放入 ,直到最小值 。 ,不能每次线性找最小。
操作总是消耗当前最小的两个,用小根堆即可按定义模拟。
堆化后循环弹出两个、压入 ,直到堆顶达到 。
我们可以使用优先队列(小根堆)来模拟这个过程。
具体地,我们先将数组中的元素加入优先队列 中。然后我们不断地从优先队列中取出两个最小的元素 和 ,将 放回优先队列中。每次操作后,我们将操作次数加一。当队列中的元素个数小于 或者队列中的最小元素大于等于 时,我们停止操作。
时间复杂度 ,空间复杂度 。其中 为数组长度。
func minOperations(nums []int, k int) (ans int) {
	pq := &hp{nums}
	heap.Init(pq)
	for ; pq.Len() > 1 && pq.IntSlice[0] < k; ans++ {
		x, y := heap.Pop(pq).(int), heap.Pop(pq).(int)
		heap.Push(pq, x*2+y)
	}
	return
}

type hp struct{ sort.IntSlice }

func (h *hp) Less(i, j int) bool { return h.IntSlice[i] < h.IntSlice[j] }
func (h *hp) Pop() interface{} {
	old := h.IntSlice
	n := len(old)
	x := old[n-1]
	h.IntSlice = old[0 : n-1]
	return x
}
func (h *hp) Push(x interface{}) {
	h.IntSlice = append(h.IntSlice, x.(int))
}3080. 执行操作标记数组中的元素
题目、示例与约束
给你一个长度为 n 下标从 0 开始的正整数数组 nums 。
同时给你一个长度为 m 的二维操作数组 queries ,其中 queries[i] = [indexi, ki] 。
一开始,数组中的所有元素都 未标记 。
你需要依次对数组执行 m 次操作,第 i 次操作中,你需要执行:
- 如果下标
indexi对应的元素还没标记,那么标记这个元素。 - 然后标记
ki个数组中还没有标记的 最小 元素。如果有元素的值相等,那么优先标记它们中下标较小的。如果少于ki个未标记元素存在,那么将它们全部标记。
请你返回一个长度为 m 的数组 answer ,其中 answer[i]是第 i 次操作后数组中还没标记元素的 和 。
示例 1:
输入:nums = [1,2,2,1,2,3,1], queries = [[1,2],[3,3],[4,2]]
输出:[8,3,0]
解释:
我们依次对数组做以下操作:
- 标记下标为
1的元素,同时标记2个未标记的最小元素。标记完后数组为nums = [1,2,2,1,2,3,1]。未标记元素的和为2 + 2 + 3 + 1 = 8。 - 标记下标为
3的元素,由于它已经被标记过了,所以我们忽略这次标记,同时标记最靠前的3个未标记的最小元素。标记完后数组为nums = [1,2,2,1,2,3,1]。未标记元素的和为3。 - 标记下标为
4的元素,由于它已经被标记过了,所以我们忽略这次标记,同时标记最靠前的2个未标记的最小元素。标记完后数组为nums = [1,2,2,1,2,3,1]。未标记元素的和为0。
示例 2:
输入:nums = [1,4,2,3], queries = [[0,1]]
输出:[7]
解释:我们执行一次操作,将下标为 0 处的元素标记,并且标记最靠前的 1 个未标记的最小元素。标记完后数组为 nums = [1,4,2,3] 。未标记元素的和为 4 + 3 = 7 。
提示:
n == nums.lengthm == queries.length1 <= m <= n <= 1051 <= nums[i] <= 105queries[i].length == 20 <= indexi, ki <= n - 1
方法一:排序 + 模拟 · Go 实现
思考
每次先标记指定下标,再标记当前未标记中最小的 个(同值取更小下标)。 ,不能每次重新选最小。
未标记最小值的顺序是固定的,可预先按 排序,用指针只向前走。
维护总和与标记数组,查询时先处理指定下标,再从排序数组上继续弹出 个未标记值。
我们先计算出数组 的总和 ,定义一个数组 用来标记数组中的元素是否被标记过,初始化所有元素都未被标记。
然后我们创建一个数组 ,数组中的每个元素是一个二元组 ,表示数组中的第 个元素的值为 。我们对数组 按照元素的值进行排序,如果元素的值相等,我们按照下标从小到大的顺序进行排序。
接下来我们遍历数组 ,对于每个查询 ,我们首先判断下标 对应的元素是否被标记过,如果没有被标记过,我们将其标记,并且将 减去下标 对应的元素的值。然后我们遍历数组 ,对于每个元素 ,如果元素 没有被标记过,我们将其标记,并且将 减去元素 对应的值 ,直到 为 或者数组 遍历完。然后我们将 加入答案数组中。
遍历完所有的查询后,我们就得到了答案数组。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func unmarkedSumArray(nums []int, queries [][]int) []int64 {
	n := len(nums)
	var s int64
	for _, x := range nums {
		s += int64(x)
	}
	mark := make([]bool, n)
	arr := make([][2]int, 0, n)
	for i, x := range nums {
		arr = append(arr, [2]int{x, i})
	}
	sort.Slice(arr, func(i, j int) bool {
		if arr[i][0] == arr[j][0] {
			return arr[i][1] < arr[j][1]
		}
		return arr[i][0] < arr[j][0]
	})
	ans := make([]int64, len(queries))
	j := 0
	for i, q := range queries {
		index, k := q[0], q[1]
		if !mark[index] {
			mark[index] = true
			s -= int64(nums[index])
		}
		for ; k > 0 && j < n; j++ {
			if !mark[arr[j][1]] {
				mark[arr[j][1]] = true
				s -= int64(arr[j][0])
				k--
			}
		}
		ans[i] = s
	}
	return ans
}3092. 最高频率的 ID
题目、示例与约束
你需要在一个集合里动态记录 ID 的出现频率。给你两个长度都为 n 的整数数组 nums 和 freq ,nums 中每一个元素表示一个 ID ,对应的 freq 中的元素表示这个 ID 在集合中此次操作后需要增加或者减少的数目。
- 增加 ID 的数目:如果
freq[i]是正数,那么freq[i]个 ID 为nums[i]的元素在第i步操作后会添加到集合中。 - 减少 ID 的数目:如果
freq[i]是负数,那么-freq[i]个 ID 为nums[i]的元素在第i步操作后会从集合中删除。
请你返回一个长度为 n 的数组 ans ,其中 ans[i] 表示第 i 步操作后出现频率最高的 ID 数目 ,如果在某次操作后集合为空,那么 ans[i] 为 0 。
示例 1:
输入:nums = [2,3,2,1], freq = [3,2,-3,1]
输出:[3,3,2,2]
解释:
第 0 步操作后,有 3 个 ID 为 2 的元素,所以 ans[0] = 3 。
第 1 步操作后,有 3 个 ID 为 2 的元素和 2 个 ID 为 3 的元素,所以 ans[1] = 3 。
第 2 步操作后,有 2 个 ID 为 3 的元素,所以 ans[2] = 2 。
第 3 步操作后,有 2 个 ID 为 3 的元素和 1 个 ID 为 1 的元素,所以 ans[3] = 2 。
示例 2:
输入:nums = [5,5,3], freq = [2,-2,1]
输出:[2,0,1]
解释:
第 0 步操作后,有 2 个 ID 为 5 的元素,所以 ans[0] = 2 。
第 1 步操作后,集合中没有任何元素,所以 ans[1] = 0 。
第 2 步操作后,有 1 个 ID 为 3 的元素,所以 ans[2] = 1 。
提示:
1 <= nums.length == freq.length <= 1051 <= nums[i] <= 105-105 <= freq[i] <= 105freq[i] != 0- 输入保证任何操作后,集合中的元素出现次数不会为负数。
方法一:哈希表 + 优先队列(大根堆) · Go 实现
思考
动态维护每个 ID 的次数,每次操作后输出当前最大次数。 ,不能每次扫描。
次数可增可减,堆无法直接改旧值。把过期次数记入懒删除表,堆顶若已过期则弹出。
哈希表存真实次数,另一表记某次次数被作废的个数;每次把新次数压入大根堆并清理堆顶。
我们用一个哈希表 来记录每个 ID 的出现次数,用一个哈希表 来记录每个次数需要被删除的个数。用一个优先队列 来维护出现次数的最大值。
每一次操作 ,我们需要更新 的出现次数 ,这意味着 在 中的值需要增加 ,表示该次数需要删除的个数增加 。然后我们更新 的值,将 加上 。然后我们更新后的 的值加入优先队列 中。然后我们检查优先队列 的堆顶元素,如果 中对应的次数需要删除的个数大于 ,我们就将堆顶元素弹出。最后,我们判断优先队列是否为空,如果不为空,堆顶元素就是出现次数的最大值,我们将其加入答案数组中。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func mostFrequentIDs(nums []int, freq []int) []int64 {
	n := len(nums)
	cnt := map[int]int{}
	lazy := map[int]int{}
	ans := make([]int64, n)
	pq := hp{}
	heap.Init(&pq)
	for i, x := range nums {
		f := freq[i]
		lazy[cnt[x]]++
		cnt[x] += f
		heap.Push(&pq, cnt[x])
		for pq.Len() > 0 && lazy[pq.IntSlice[0]] > 0 {
			lazy[pq.IntSlice[0]]--
			heap.Pop(&pq)
		}
		if pq.Len() > 0 {
			ans[i] = int64(pq.IntSlice[0])
		}
	}
	return ans
}

type hp struct{ sort.IntSlice }

func (h hp) Less(i, j int) bool { return h.IntSlice[i] > h.IntSlice[j] }
func (h *hp) Push(v any)        { h.IntSlice = append(h.IntSlice, v.(int)) }
func (h *hp) Pop() any {
	a := h.IntSlice
	v := a[len(a)-1]
	h.IntSlice = a[:len(a)-1]
	return v
}3264. K 次乘运算后的最终数组 I
题目、示例与约束
给你一个整数数组 nums ,一个整数 k 和一个整数 multiplier 。
你需要对 nums 执行 k 次操作,每次操作中:
- 找到
nums中的 最小 值x,如果存在多个最小值,选择最 前面 的一个。 - 将
x替换为x * multiplier。
请你返回执行完 k 次乘运算之后,最终的 nums 数组。
示例 1:
输入:nums = [2,1,3,5,6], k = 5, multiplier = 2
输出:[8,4,6,5,6]
解释:
| 操作 | 结果 |
|---|---|
| 1 次操作后 | [2, 2, 3, 5, 6] |
| 2 次操作后 | [4, 2, 3, 5, 6] |
| 3 次操作后 | [4, 4, 3, 5, 6] |
| 4 次操作后 | [4, 4, 6, 5, 6] |
| 5 次操作后 | [8, 4, 6, 5, 6] |
示例 2:
输入:nums = [1,2], k = 3, multiplier = 4
输出:[16,8]
解释:
| 操作 | 结果 |
|---|---|
| 1 次操作后 | [4, 2] |
| 2 次操作后 | [4, 8] |
| 3 次操作后 | [16, 8] |
提示:
1 <= nums.length <= 1001 <= nums[i] <= 1001 <= k <= 101 <= multiplier <= 5
方法一:优先队列(小根堆)+ 模拟 · Go 实现
思考
每次把最小值乘上 (并列取更小下标)。 都很小,模拟 次即可。找最小值若每次线性扫,常数仍可接受,堆更贴题意。
堆中存 ,弹出最小者原地乘回再压入。 轮后数组即为最终状态。
我们可以用一个小根堆来维护数组 中的元素,每次从小根堆中取出最小值,将其乘以 后再放回小根堆中。在实现过程中,我们往小根堆插入的是元素的下标,然后自定义比较函数,使得小根堆按照 中元素的大小作为第一关键字,下标作为第二关键字进行排序。
最后,我们返回数组 即可。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func getFinalState(nums []int, k int, multiplier int) []int {
	h := &hp{nums: nums}
	for i := range nums {
		heap.Push(h, i)
	}

	for k > 0 {
		i := heap.Pop(h).(int)
		nums[i] *= multiplier
		heap.Push(h, i)
		k--
	}

	return nums
}

type hp struct {
	sort.IntSlice
	nums []int
}

func (h *hp) Less(i, j int) bool {
	if h.nums[h.IntSlice[i]] == h.nums[h.IntSlice[j]] {
		return h.IntSlice[i] < h.IntSlice[j]
	}
	return h.nums[h.IntSlice[i]] < h.nums[h.IntSlice[j]]
}

func (h *hp) Pop() any {
	old := h.IntSlice
	n := len(old)
	x := old[n-1]
	h.IntSlice = old[:n-1]
	return x
}

func (h *hp) Push(x any) {
	h.IntSlice = append(h.IntSlice, x.(int))
}3266. K 次乘运算后的最终数组 II
题目、示例与约束
给你一个整数数组 nums ,一个整数 k 和一个整数 multiplier 。
你需要对 nums 执行 k 次操作,每次操作中:
- 找到
nums中的 最小 值x,如果存在多个最小值,选择最 前面 的一个。 - 将
x替换为x * multiplier。
k 次操作以后,你需要将 nums 中每一个数值对 109 + 7 取余。
请你返回执行完 k 次乘运算以及取余运算之后,最终的 nums 数组。
示例 1:
输入:nums = [2,1,3,5,6], k = 5, multiplier = 2
输出:[8,4,6,5,6]
解释:
| 操作 | 结果 |
|---|---|
| 1 次操作后 | [2, 2, 3, 5, 6] |
| 2 次操作后 | [4, 2, 3, 5, 6] |
| 3 次操作后 | [4, 4, 3, 5, 6] |
| 4 次操作后 | [4, 4, 6, 5, 6] |
| 5 次操作后 | [8, 4, 6, 5, 6] |
| 取余操作后 | [8, 4, 6, 5, 6] |
示例 2:
输入:nums = [100000,2000], k = 2, multiplier = 1000000
输出:[999999307,999999993]
解释:
| 操作 | 结果 |
|---|---|
| 1 次操作后 | [100000, 2000000000] |
| 2 次操作后 | [100000000000, 2000000000] |
| 取余操作后 | [999999307, 999999993] |
提示:
1 <= nums.length <= 1041 <= nums[i] <= 1091 <= k <= 1091 <= multiplier <= 106
方法一:优先队列(小根堆)+ 模拟 · Go 实现
思考
规则与 I 相同,但 ,不能逐次模拟。注意到一旦所有值都不小于原数组最大值 ,之后每次都是「当前最小变为新的最大」,每 次恰好每人一轮。
先用堆把仍小于 的元素乘到 或用尽 。剩余次数按 与 分配,快速幂写入并取模。 时直接返回。
我们记数组 的长度为 ,最大值为 。
我们首先通过利用优先队列(小根堆),模拟操作,直到完成 次操作或者堆中所有元素都大于等于 。
此时,数组所有元素值都小于 ,由于 且 ,所以 ,是在 位整数范围内的。
接下来,我们的每一次操作,都会将数组中的最小元素变成最大元素,因此在每 次连续操作后,数组中的每个元素都恰好执行了一次乘法操作。
因此,我们在模拟过后,剩余 次操作,那么数组中最小的 个元素将会执行 次乘法操作,其余的元素将会执行 次乘法操作。
最后,我们将数组中的每个元素乘上对应的乘法次数,再取模 即可,可以通过快速幂来计算。
时间复杂度 ,空间复杂度 。其中 为数组 的长度,而 为数组 中的最大值。
func getFinalState(nums []int, k int, multiplier int) []int {
	if multiplier == 1 {
		return nums
	}
	n := len(nums)
	pq := make(hp, n)
	for i, x := range nums {
		pq[i] = pair{x, i}
	}
	heap.Init(&pq)
	m := slices.Max(nums)
	for ; k > 0 && pq[0].x < m; k-- {
		x := pq[0]
		heap.Pop(&pq)
		x.x *= multiplier
		heap.Push(&pq, x)
	}
	const mod int = 1e9 + 7

	for i := range nums {
		p := heap.Pop(&pq).(pair)
		x, j := p.x, p.i
		power := k / n
		if i < k%n {
			power++
		}
		nums[j] = (x % mod) * qpow(multiplier, power, mod) % mod
	}
	return nums
}

func qpow(a, n, mod int) int {
	ans := 1 % mod
	a = a % mod
	for n > 0 {
		if n&1 == 1 {
			ans = (ans * a) % mod
		}
		a = (a * a) % mod
		n >>= 1
	}
	return int(ans)
}

type pair struct{ x, i int }
type hp []pair

func (h hp) Len() int           { return len(h) }
func (h hp) Less(i, j int) bool { return h[i].x < h[j].x || h[i].x == h[j].x && h[i].i < h[j].i }
func (h hp) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(x any)        { *h = append(*h, x.(pair)) }
func (h *hp) Pop() (x any) { a := *h; x = a[len(a)-1]; *h = a[:len(a)-1]; return x }3275. 第 K 近障碍物查询
题目、示例与约束
有一个无限大的二维平面。
给你一个正整数 k ,同时给你一个二维数组 queries ,包含一系列查询:
queries[i] = [x, y]:在平面上坐标(x, y)处建一个障碍物,数据保证之前的查询 不会 在这个坐标处建立任何障碍物。
每次查询后,你需要找到离原点第 k 近 障碍物到原点的 距离 。
请你返回一个整数数组 results ,其中 results[i] 表示建立第 i 个障碍物以后,离原地第 k 近障碍物距离原点的距离。如果少于 k 个障碍物,results[i] == -1 。
注意,一开始 没有 任何障碍物。
坐标在 (x, y) 处的点距离原点的距离定义为 |x| + |y| 。
示例 1:
输入:queries = [[1,2],[3,4],[2,3],[-3,0]], k = 2
输出:[-1,7,5,3]
解释:
最初,不存在障碍物。
queries[0]之后,少于 2 个障碍物。queries[1]之后, 两个障碍物距离原点的距离分别为 3 和 7 。queries[2]之后,障碍物距离原点的距离分别为 3 ,5 和 7 。queries[3]之后,障碍物距离原点的距离分别为 3,3,5 和 7 。
示例 2:
输入:queries = [[5,5],[4,4],[3,3]], k = 1
输出:[10,8,6]
解释:
queries[0]之后,只有一个障碍物,距离原点距离为 10 。queries[1]之后,障碍物距离原点距离分别为 8 和 10 。queries[2]之后,障碍物距离原点的距离分别为 6, 8 和10 。
提示:
1 <= queries.length <= 2 * 105- 所有
queries[i]互不相同。 -109 <= queries[i][0], queries[i][1] <= 1091 <= k <= 105
方法一:优先队列(大根堆) · Go 实现
思考
障碍逐个出现,每次问当前第 近的曼哈顿距离。 ,若每次排序则过慢。只需维持最小的 个距离,其中最大者即第 近。
大根堆存这 个距离的相反数(或负距离)。不足 个时答案为 ,超过则弹出堆顶。在线 每次。
我们可以使用一个优先队列(大根堆)来维护离原点最近的 个障碍物。
遍历 ,每次计算 和 的绝对值之和,然后将其加入优先队列。如果优先队列的大小超过 ,则弹出堆顶元素。如果当前优先队列的大小等于 ,则将堆顶元素加入答案数组,否则将 加入答案数组。
遍历结束后,返回答案数组即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func resultsArray(queries [][]int, k int) (ans []int) {
	pq := &hp{}
	for _, q := range queries {
		x := abs(q[0]) + abs(q[1])
		pq.push(x)
		if pq.Len() > k {
			pq.pop()
		}
		if pq.Len() == k {
			ans = append(ans, pq.IntSlice[0])
		} else {
			ans = append(ans, -1)
		}
	}
	return
}

func abs(x int) int {
	if x < 0 {
		return -x
	}
	return x
}

type hp struct{ sort.IntSlice }

func (h hp) Less(i, j int) bool { return h.IntSlice[i] > h.IntSlice[j] }
func (h *hp) Push(v any)        { h.IntSlice = append(h.IntSlice, v.(int)) }
func (h *hp) Pop() any {
	a := h.IntSlice
	v := a[len(a)-1]
	h.IntSlice = a[:len(a)-1]
	return v
}
func (h *hp) push(v int) { heap.Push(h, v) }
func (h *hp) pop() int { return heap.Pop(h).(int) }3478. 选出和最大的 K 个元素
题目、示例与约束
给你两个整数数组,nums1 和 nums2,长度均为 n,以及一个正整数 k 。
对从 0 到 n - 1 每个下标 i ,执行下述操作:
- 找出所有满足
nums1[j]小于nums1[i]的下标j。 - 从这些下标对应的
nums2[j]中选出 至多k个,并 最大化 这些值的总和作为结果。
返回一个长度为 n 的数组 answer ,其中 answer[i] 表示对应下标 i 的结果。
示例 1:
输入:nums1 = [4,2,1,5,3], nums2 = [10,20,30,40,50], k = 2
输出:[80,30,0,80,50]
解释:
- 对于
i = 0:满足nums1[j] < nums1[0]的下标为[1, 2, 4],选出其中值最大的两个,结果为50 + 30 = 80。 - 对于
i = 1:满足nums1[j] < nums1[1]的下标为[2],只能选择这个值,结果为30。 - 对于
i = 2:不存在满足nums1[j] < nums1[2]的下标,结果为0。 - 对于
i = 3:满足nums1[j] < nums1[3]的下标为[0, 1, 2, 4],选出其中值最大的两个,结果为50 + 30 = 80。 - 对于
i = 4:满足nums1[j] < nums1[4]的下标为[1, 2],选出其中值最大的两个,结果为30 + 20 = 50。
示例 2:
输入:nums1 = [2,2,2,2], nums2 = [3,1,2,3], k = 1
输出:[0,0,0,0]
解释:由于 nums1 中的所有元素相等,不存在满足条件 nums1[j] < nums1[i],所有位置的结果都是 0 。
提示:
n == nums1.length == nums2.length1 <= n <= 1051 <= nums1[i], nums2[i] <= 1061 <= k <= n
方法一:排序 + 优先队列(小根堆) · Go 实现
思考
对每个下标 ,在 的下标中选至多 个 求最大和。 ,不能对每个 单独筛选。
按 排序后,可用的 只增不减,适合用大小为 的小根堆维护当前最大 元之和。
指针 把所有严格更小的 对应的 入堆,堆溢出则减去堆顶。当前堆和写入该 的答案。
我们可以将数组 转换成一个数组 ,其中每个元素是一个二元组 ,表示 的值为 。然后对数组 按照 进行升序排序。
我们使用一个小根堆 来维护数组 中的元素,初始时 为空。用一个变量 来记录 中的元素之和。另外,我们用一个指针 来维护当前需要添加到 中的元素在数组 中的位置。
我们遍历数组 ,对于第 个元素 ,我们将所有满足 并且 的元素 添加到 中,并将这些元素的和加到 中。如果 的大小超过了 ,我们将 中的最小元素弹出,并将其从 中减去。然后,我们更新 的值为 。
遍历结束后,返回答案数组 。
时间复杂度 ,空间复杂度 。其中 为数组长度。
func findMaxSum(nums1 []int, nums2 []int, k int) []int64 {
	n := len(nums1)
	arr := make([][2]int, n)
	for i, x := range nums1 {
		arr[i] = [2]int{x, i}
	}
	ans := make([]int64, n)
	sort.Slice(arr, func(i, j int) bool { return arr[i][0] < arr[j][0] })
	pq := hp{}
	var s int64
	j := 0
	for h, e := range arr {
		x, i := e[0], e[1]
		for j < h && arr[j][0] < x {
			y := nums2[arr[j][1]]
			heap.Push(&pq, y)
			s += int64(y)
			if pq.Len() > k {
				s -= int64(heap.Pop(&pq).(int))
			}
			j++
		}
		ans[i] = s
	}
	return ans
}

type hp struct{ sort.IntSlice }

func (h hp) Less(i, j int) bool { return h.IntSlice[i] < h.IntSlice[j] }
func (h *hp) Push(v any)        { h.IntSlice = append(h.IntSlice, v.(int)) }
func (h *hp) Pop() any {
	a := h.IntSlice
	v := a[len(a)-1]
	h.IntSlice = a[:len(a)-1]
	return v
}4065. 移除不同值重排数组
题目、示例与约束
给你一个整数数组 nums。
初始时,你有一个 空 数组 ans。重复执行以下操作,直到 nums 变为 空 :
- 找出当前
nums中 所有不同 的值。 - 将当前
nums中每个 不同 的值各移除一个,并按 升序 将这些值依次添加到ans中。
返回数组 ans。
示例 1:
输入: nums = [3,1,3,2,1,3]
输出: [1,2,3,1,3,3]
解释:
| 操作 | 添加到 ans 的值 |
操作后的 nums |
操作后的 ans |
|---|---|---|---|
| 1 | 1, 2, 3 | [3, 1, 3] |
[1, 2, 3] |
| 2 | 1, 3 | [3] |
[1, 2, 3, 1, 3] |
| 3 | 3 | [] |
[1, 2, 3, 1, 3, 3] |
此时 nums 已为空,因此答案为 [1, 2, 3, 1, 3, 3]。
示例 2:
输入: nums = [7,7,4,4,4]
输出: [4,7,4,7,4]
解释:
| 操作 | 添加到 ans 的值 |
操作后的 nums |
操作后的 ans |
|---|---|---|---|
| 1 | 4, 7 | [7, 4, 4] |
[4, 7] |
| 2 | 4, 7 | [4] |
[4, 7, 4, 7] |
| 3 | 4 | [] |
[4, 7, 4, 7, 4] |
此时 nums 已为空,因此答案为 [4, 7, 4, 7, 4]。
提示:
1 <= nums.length <= 1001 <= nums[i] <= 100
方法一:计数 · Go 实现
思考
和每个元素都不超过 ,按题意一轮轮取出剩余的不同值是来得及的。每一轮都要收集当前还在的值并按升序各删一个,若直接在原数组里查找再删除,下标会不断挪动。
一个值被取走的次数就是它的出现次数,每一轮内部的先后只由数值大小决定,与原来的下标无关。
因此先按值计数。值域是 ,从小到大扫描,次数仍为正就写入答案并减一。外层重复到答案长度等于 ,每一遍扫描对应一轮操作。
设 , 为值 的出现次数。第 轮(从 计)按升序取走所有当时仍有剩余的值,也就是最初出现次数大于 的那些值。
用长度为 的数组记下次数。答案还不满 个元素时,把 从 扫到 : 就把 追加进答案,并把次数减一。一轮扫描对应一次操作,追加的顺序就是升序。
时间复杂度 ,空间复杂度 。
func rearrangeArray(nums []int) []int {
	mx := slices.Max(nums)

	cnt := make([]int, mx+1)
	for _, x := range nums {
		cnt[x]++
	}

	ans := make([]int, 0, len(nums))
	for len(ans) < len(nums) {
		for x := 1; x <= mx; x++ {
			if cnt[x] > 0 {
				ans = append(ans, x)
				cnt[x]--
			}
		}
	}
	return ans
}继续阅读
- 实践案例
- 实践案例
- 实践案例