
LeetCode Go · 堆与优先队列(1)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
215. 数组中的第K个最大元素
题目、示例与约束
给定整数数组 nums 和整数 k,请返回数组中第 k 个最大的元素。
请注意,你需要找的是数组排序后的第 k 个最大的元素,而不是第 k 个不同的元素。
你必须设计并实现时间复杂度为 O(n) 的算法解决此问题。
示例 1:
输入: [3,2,1,5,6,4], k = 2
输出: 5
示例 2:
输入: [3,2,3,1,2,4,5,5,6], k = 4
输出: 4
提示:
1 <= k <= nums.length <= 105-104 <= nums[i] <= 104
方法一:快速选择 · Go 实现
思考
全排序后取第 大可行,但多做了对其余位置的排序。快速选择只关心第 大所在的那一侧。
每次按基准划分后,仅递归包含目标名次的区间。实现上将第 大转为第 小。
快速选择算法是一种在未排序的数组中查找第 k 个最大元素或最小元素的算法。它的基本思想是每次选择一个基准元素,将数组分为两部分,一部分的元素都比基准元素小,另一部分的元素都比基准元素大,然后根据基准元素的位置,决定继续在左边还是右边查找,直到找到第 k 个最大元素。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func findKthLargest(nums []int, k int) int {
	k = len(nums) - k
	var quickSort func(l, r int) int
	quickSort = func(l, r int) int {
		if l == r {
			return nums[l]
		}
		i, j := l-1, r+1
		x := nums[(l+r)>>1]
		for i < j {
			for {
				i++
				if nums[i] >= x {
					break
				}
			}
			for {
				j--
				if nums[j] <= x {
					break
				}
			}
			if i < j {
				nums[i], nums[j] = nums[j], nums[i]
			}
		}
		if j < k {
			return quickSort(j+1, r)
		}
		return quickSort(l, j)
	}
	return quickSort(0, len(nums)-1)
}
方法二:优先队列(小根堆) · Go 实现
思考
快速选择平均线性,最坏可达平方。若只需第 大,可维护大小为 的小根堆。
扫过数组后堆中为最大的 个数,堆顶即第 大,时间为 。
我们可以维护一个大小为 的小根堆 ,然后遍历数组 ,将数组中的元素依次加入到小根堆中,当小根堆的大小超过 时,我们将堆顶元素弹出,这样最终小根堆中的 个元素就是数组中的 个最大元素,堆顶元素就是第 个最大元素。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func findKthLargest(nums []int, k int) int {
	minQ := hp{}
	for _, x := range nums {
		heap.Push(&minQ, x)
		if minQ.Len() > k {
			heap.Pop(&minQ)
		}
	}
	return minQ.IntSlice[0]
}

type hp struct{ sort.IntSlice }

func (h hp) Less(i, j int) bool { return h.IntSlice[i] < h.IntSlice[j] }
func (h *hp) Push(v any)        { h.IntSlice = append(h.IntSlice, v.(int)) }
func (h *hp) Pop() any {
	a := h.IntSlice
	v := a[len(a)-1]
	h.IntSlice = a[:len(a)-1]
	return v
}
方法三:计数排序 · Go 实现
思考
堆仍有对数因子。值域有界时,先统计每个值的出现次数,再从大到小累加次数,直到凑满 。
时间与数组长度及值域上界成正比,无需比较排序。
我们可以使用计数排序的思想,统计数组 中每个元素出现的次数,记录在哈希表 中,然后从大到小遍历元素 ,每次减去出现的次数 ,直到 小于等于 ,此时的元素 就是数组中的第 个最大元素。
时间复杂度 ,空间复杂度 。其中 为数组 的长度,而 为数组 中元素的最大值。
func findKthLargest(nums []int, k int) int {
	cnt := map[int]int{}
	m := -(1 << 30)
	for _, x := range nums {
		cnt[x]++
		m = max(m, x)
	}
	for i := m; ; i-- {
		k -= cnt[i]
		if k <= 0 {
			return i
		}
	}

}347. 前 K 个高频元素
题目、示例与约束
给你一个整数数组 nums 和一个整数 k ,请你返回其中出现频率前 k 高的元素。你可以按 任意顺序 返回答案。
示例 1:
输入:nums = [1,1,1,2,2,3], k = 2
输出:[1,2]
示例 2:
输入:nums = [1], k = 1
输出:[1]
示例 3:
输入:nums = [1,2,1,2,1,2,3,1,3,2], k = 2
输出:[1,2]
提示:
1 <= nums.length <= 105-104 <= nums[i] <= 104k的取值范围是[1, 数组中不相同的元素的个数]- 题目数据保证答案唯一,换句话说,数组中前
k个高频元素的集合是唯一的
进阶:你所设计算法的时间复杂度 必须 优于 O(n log n) ,其中 n 是数组大小。
方法一:哈希表 + 优先队列(小根堆) · Go 实现
思考
前 个高频元素。全排序为 。只需前 ,用频次堆或选择即可。
先计数,再取频次最高的 个。Python 中
Counter.most_common(k)即小根堆/堆选择,时间 。
我们可以使用一个哈希表 统计每个元素出现的次数,然后使用一个小根堆(优先队列)来保存前 个高频元素。
我们首先遍历一遍数组,统计每个元素出现的次数,然后遍历哈希表,将元素和出现次数存入小根堆中。如果小根堆的大小超过了 ,我们就将堆顶元素弹出,保证堆的大小始终为 。
最后,我们将小根堆中的元素依次弹出,放入结果数组中即可。
时间复杂度 ,空间复杂度 。其中 是数组的长度。
func topKFrequent(nums []int, k int) []int {
	cnt := map[int]int{}
	for _, x := range nums {
		cnt[x]++
	}
	pq := hp{}
	for x, c := range cnt {
		heap.Push(&pq, pair{x, c})
		if pq.Len() > k {
			heap.Pop(&pq)
		}
	}
	ans := make([]int, k)
	for i := 0; i < k; i++ {
		ans[i] = heap.Pop(&pq).(pair).v
	}
	return ans
}

type pair struct{ v, cnt int }
type hp []pair

func (h hp) Len() int           { return len(h) }
func (h hp) Less(i, j int) bool { return h[i].cnt < h[j].cnt }
func (h hp) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)        { *h = append(*h, v.(pair)) }
func (h *hp) Pop() any { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }373. 查找和最小的 K 对数字
题目、示例与约束
给定两个以 非递减顺序排列 的整数数组 nums1 和 nums2 , 以及一个整数 k 。
定义一对值 (u,v),其中第一个元素来自 nums1,第二个元素来自 nums2 。
请找到和最小的 k 个数对 (u1,v1), (u2,v2) ... (uk,vk) 。
示例 1:
输入: nums1 = [1,7,11], nums2 = [2,4,6], k = 3
输出: [[1,2],[1,4],[1,6]]
解释: 返回序列中的前 3 对数:
     [1,2],[1,4],[1,6],[7,2],[7,4],[11,2],[7,6],[11,4],[11,6]
示例 2:
输入: nums1 = [1,1,2], nums2 = [1,2,3], k = 2
输出: [[1,1],[1,1]]
解释: 返回序列中的前 2 对数:
     [1,1],[1,1],[1,2],[2,1],[1,2],[2,2],[1,3],[1,3],[2,3]
提示:
1 <= nums1.length, nums2.length <= 105-109 <= nums1[i], nums2[i] <= 109nums1和nums2均为 升序排列1 <= k <= 104k <= nums1.length * nums2.length
方法一 · Go 实现
思考
两升序数组中和最小的 对。枚举全部对再排序为 。固定 后, 增大则和增大,可用堆弹出当前最小并只扩展 。
先把 对 入堆。每次弹出一对,若 合法则压入同 的下一列。至多 次弹出。
func kSmallestPairs(nums1, nums2 []int, k int) (ans [][]int) {
	m, n := len(nums1), len(nums2)
	h := hp{nil, nums1, nums2}
	for i := 0; i < k && i < m; i++ {
		h.data = append(h.data, pair{i, 0})
	}
	for h.Len() > 0 && len(ans) < k {
		p := heap.Pop(&h).(pair)
		i, j := p.i, p.j
		ans = append(ans, []int{nums1[i], nums2[j]})
		if j+1 < n {
			heap.Push(&h, pair{i, j + 1})
		}
	}
	return
}

type pair struct{ i, j int }
type hp struct {
	data         []pair
	nums1, nums2 []int
}

func (h hp) Len() int { return len(h.data) }
func (h hp) Less(i, j int) bool {
	a, b := h.data[i], h.data[j]
	return h.nums1[a.i]+h.nums2[a.j] < h.nums1[b.i]+h.nums2[b.j]
}
func (h hp) Swap(i, j int) { h.data[i], h.data[j] = h.data[j], h.data[i] }
func (h *hp) Push(v any)   { h.data = append(h.data, v.(pair)) }
func (h *hp) Pop() any { a := h.data; v := a[len(a)-1]; h.data = a[:len(a)-1]; return v }451. 根据字符出现频率排序
题目、示例与约束
给定一个字符串 s ,根据字符出现的 频率 对其进行 降序排序 。一个字符出现的 频率 是它出现在字符串中的次数。
返回 已排序的字符串 。如果有多个答案,返回其中任何一个。
示例 1:
输入: s = "tree"
输出: "eert"
解释: 'e'出现两次,'r'和't'都只出现一次。
因此'e'必须出现在'r'和't'之前。此外,"eetr"也是一个有效的答案。
示例 2:
输入: s = "cccaaa"
输出: "cccaaa"
解释: 'c'和'a'都出现三次。此外,"aaaccc"也是有效的答案。
注意"cacaca"是不正确的,因为相同的字母必须放在一起。
示例 3:
输入: s = "Aabb"
输出: "bbAa"
解释: 此外,"bbaA"也是一个有效的答案,但"Aabb"是不正确的。
注意'A'和'a'被认为是两种不同的字符。
提示:
1 <= s.length <= 5 * 105s由大小写英文字母和数字组成
方法一:哈希表 + 排序 · Go 实现
思考
按出现次数降序重排字符,相同次数的相对次序任意。计数后若用桶按次数收集,需要次数上界;字符种类很少,直接排序键值对即可。
哈希表统计频次,按次数降序排序,再把字符重复 次拼接。
排序对象是不同字符而不是整个串,复杂度随字符集而非 的全串排序。
我们用哈希表 统计字符串 中每个字符出现的次数,然后将 中的键值对按照出现次数降序排序,最后按照排序后的顺序拼接字符串即可。
时间复杂度 ,空间复杂度 ,其中 为字符串 的长度,而 为不同字符的个数。
func frequencySort(s string) string {
	cnt := map[byte]int{}
	for i := range s {
		cnt[s[i]]++
	}
	cs := make([]byte, 0, len(s))
	for c := range cnt {
		cs = append(cs, c)
	}
	sort.Slice(cs, func(i, j int) bool { return cnt[cs[i]] > cnt[cs[j]] })
	ans := make([]byte, 0, len(s))
	for _, c := range cs {
		ans = append(ans, bytes.Repeat([]byte{c}, cnt[c])...)
	}
	return string(ans)
}506. 相对名次
题目、示例与约束
给你一个长度为 n 的整数数组 score ,其中 score[i] 是第 i 位运动员在比赛中的得分。所有得分都 互不相同 。
运动员将根据得分 决定名次 ,其中名次第 1 的运动员得分最高,名次第 2 的运动员得分第 2 高,依此类推。运动员的名次决定了他们的获奖情况:
- 名次第
1的运动员获金牌"Gold Medal"。 - 名次第
2的运动员获银牌"Silver Medal"。 - 名次第
3的运动员获铜牌"Bronze Medal"。 - 从名次第
4到第n的运动员,只能获得他们的名次编号(即,名次第x的运动员获得编号"x")。
使用长度为 n 的数组 answer 返回获奖,其中 answer[i] 是第 i 位运动员的获奖情况。
示例 1:
输入:score = [5,4,3,2,1]
输出:["Gold Medal","Silver Medal","Bronze Medal","4","5"]
解释:名次为 [1st, 2nd, 3rd, 4th, 5th] 。
示例 2:
输入:score = [10,3,8,9,4]
输出:["Gold Medal","5","Bronze Medal","Silver Medal","4"]
解释:名次为 [1st, 5th, 3rd, 2nd, 4th] 。
提示:
n == score.length1 <= n <= 1040 <= score[i] <= 106score中的所有值 互不相同
方法一:排序 · Go 实现
思考
名次由分数从高到低决定,前三名要换成奖牌字符串。直接对分数排序会丢失下标,无法写回原顺序。
为此对下标按分数降序排序,再按排名填入对应位置:前三名用固定奖牌,其余写成名次数字。一次排序即可同时得到名次与原下标。
我们使用一个数组 存储 到 的下标,然后对 进行排序,排序规则为:按照 的值从大到小排序。
然后我们定义一个数组 ,遍历 ,对于每个下标 ,如果 小于 ,则 为 ,否则为 。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func findRelativeRanks(score []int) []string {
	n := len(score)
	idx := make([][]int, n)
	for i := 0; i < n; i++ {
		idx[i] = []int{score[i], i}
	}
	sort.Slice(idx, func(i1, i2 int) bool {
		return idx[i1][0] > idx[i2][0]
	})
	ans := make([]string, n)
	top3 := []string{"Gold Medal", "Silver Medal", "Bronze Medal"}
	for i := 0; i < n; i++ {
		if i < 3 {
			ans[idx[i][1]] = top3[i]
		} else {
			ans[idx[i][1]] = strconv.Itoa(i + 1)
		}
	}
	return ans
}759. 员工空闲时间 🔒
题目、示例与约束
给定员工的 schedule 列表,表示每个员工的工作时间。
每个员工都有一个非重叠的时间段 Intervals 列表,这些时间段已经排好序。
返回表示 所有 员工的 共同,正数长度的空闲时间 的有限时间段的列表,同样需要排好序。
示例 1:
输入:schedule = [[[1,2],[5,6]],[[1,3]],[[4,10]]]
输出:[[3,4]]
解释:
共有 3 个员工,并且所有共同的
空间时间段是 [-inf, 1], [3, 4], [10, inf]。
我们去除所有包含 inf 的时间段,因为它们不是有限的时间段。
示例 2:
输入:schedule = [[[1,3],[6,7]],[[2,4]],[[2,5],[9,12]]]
输出:[[5,6],[7,9]]
(尽管我们用 [x, y] 的形式表示 Intervals ,内部的对象是 Intervals 而不是列表或数组。例如,schedule[0][0].start = 1, schedule[0][0].end = 2,并且 schedule[0][0][0] 是未定义的)
而且,答案中不包含 [5, 5] ,因为长度为 0。
注:
schedule和schedule[i]为长度范围在[1, 50]的列表。0 <= schedule[i].start < schedule[i].end <= 10^8。
注:输入类型于 2019 年 4 月 15 日 改变。请重置为默认代码的定义以获取新方法。
方法一:区间合并 · Go 实现
思考
求所有员工都空闲的交集空隙。每人的区间已各自有序,但跨人之后整体并不有序。人数与区间总数有限,全部摊平再处理即可。
全体都忙的时段是所有忙区间的并。并集之间的空隙即所有人都空闲的时间。
按起点排序后做一次区间合并,再取相邻合并段之间 。
我们可以将所有员工的工作时间区间合并成一个列表,然后对该列表进行排序并合并重叠的区间。最后,遍历合并后的区间列表,找出相邻区间之间的空闲时间段。
时间复杂度 ,空间复杂度 。其中 和 分别为员工数量和每个员工的工作时间区间数量。
/**
 * Definition for an Interval.
 * type Interval struct {
 *     Start int
 *     End   int
 * }
 */

func employeeFreeTime(schedule [][]*Interval) []*Interval {
	var intervals []*Interval
	for _, e := range schedule {
		intervals = append(intervals, e...)
	}

	sort.Slice(intervals, func(i, j int) bool {
		if intervals[i].Start == intervals[j].Start {
			return intervals[i].End < intervals[j].End
		}
		return intervals[i].Start < intervals[j].Start
	})

	merged := []*Interval{intervals[0]}
	for _, cur := range intervals[1:] {
		last := merged[len(merged)-1]
		if last.End < cur.Start {
			merged = append(merged, cur)
		} else if cur.End > last.End {
			last.End = cur.End
		}
	}

	var ans []*Interval
	for i := 1; i < len(merged); i++ {
		a, b := merged[i-1], merged[i]
		ans = append(ans, &Interval{Start: a.End, End: b.Start})
	}

	return ans
}912. 排序数组
题目、示例与约束
给你一个整数数组 nums,请你将该数组升序排列。
你必须在 不使用任何内置函数 的情况下解决问题,时间复杂度为 O(nlog(n)),并且空间复杂度尽可能小。
示例 1:
输入:nums = [5,2,3,1]
输出:[1,2,3,5]
解释:数组排序后,某些数字的位置没有改变(例如,2 和 3),而其他数字的位置发生了改变(例如,1 和 5)。
示例 2:
输入:nums = [5,1,1,2,0,0]
输出:[0,0,1,1,2,5]
解释:请注意,nums 的值不一定唯一。
提示:
1 <= nums.length <= 5 * 104-5 * 104 <= nums[i] <= 5 * 104
方法一:快速排序 · Go 实现
思考
,需要平均 的排序,且不能依赖会超时或超空间的朴素算法。三路快排按随机主元划分小于、等于、大于三段,避免大量重复值导致退化,再递归两侧。
快速排序是一种高效的排序算法。它的基本思想是通过一趟排序将待排序的数据分割成独立的两部分,其中一部分的所有数据都比另外一部分的所有数据都要小,然后再按此方法对这两部分数据分别进行快速排序,整个排序过程可以递归进行,以此达到整个数据变成有序序列。
时间复杂度 ,空间复杂度 。其中 为数组长度。
func sortArray(nums []int) []int {
	quickSort(nums, 0, len(nums)-1)
	return nums
}

func quickSort(nums []int, l, r int) {
	if l >= r {
		return
	}
	i, j := l-1, r+1
	x := nums[(l+r)>>1]
	for i < j {
		for {
			i++
			if nums[i] >= x {
				break
			}
		}
		for {
			j--
			if nums[j] <= x {
				break
			}
		}
		if i < j {
			nums[i], nums[j] = nums[j], nums[i]
		}
	}
	quickSort(nums, l, j)
	quickSort(nums, j+1, r)
}
方法二:归并排序 · Go 实现
思考
快排平均很快,最坏仍可能不平衡,且不是稳定排序。归并每次折半再线性合并,时间稳定为 ,需要线性辅助数组。
归并排序是一种分治算法,其思想是将待排序的数据序列不断地折半拆分,直到每个数据块只有一个元素为止,然后再按照拆分的顺序将每个数据块两两合并,在合并的过程中进行排序,最终得到一个有序的数据序列。
归并排序是一种稳定的排序算法,时间复杂度为 ,空间复杂度为 。其中 为数组长度。
func sortArray(nums []int) []int {
	mergeSort(nums, 0, len(nums)-1)
	return nums
}

func mergeSort(nums []int, l, r int) {
	if l >= r {
		return
	}
	mid := (l + r) >> 1
	mergeSort(nums, l, mid)
	mergeSort(nums, mid+1, r)
	i, j, k := l, mid+1, 0
	tmp := make([]int, r-l+1)
	for i <= mid && j <= r {
		if nums[i] <= nums[j] {
			tmp[k] = nums[i]
			i++
		} else {
			tmp[k] = nums[j]
			j++
		}
		k++
	}
	for ; i <= mid; i++ {
		tmp[k] = nums[i]
		k++
	}
	for ; j <= r; j++ {
		tmp[k] = nums[j]
		k++
	}
	for i = l; i <= r; i++ {
		nums[i] = tmp[i-l]
	}
}973. 最接近原点的 K 个点
题目、示例与约束
给定一个数组 points ,其中 points[i] = [xi, yi] 表示 X-Y 平面上的一个点,并且是一个整数 k ,返回离原点 (0,0) 最近的 k 个点。
这里,平面上两点之间的距离是 欧几里德距离( √(x1 - x2)2 + (y1 - y2)2 )。
你可以按 任何顺序 返回答案。除了点坐标的顺序之外,答案 确保 是 唯一 的。
示例 1:
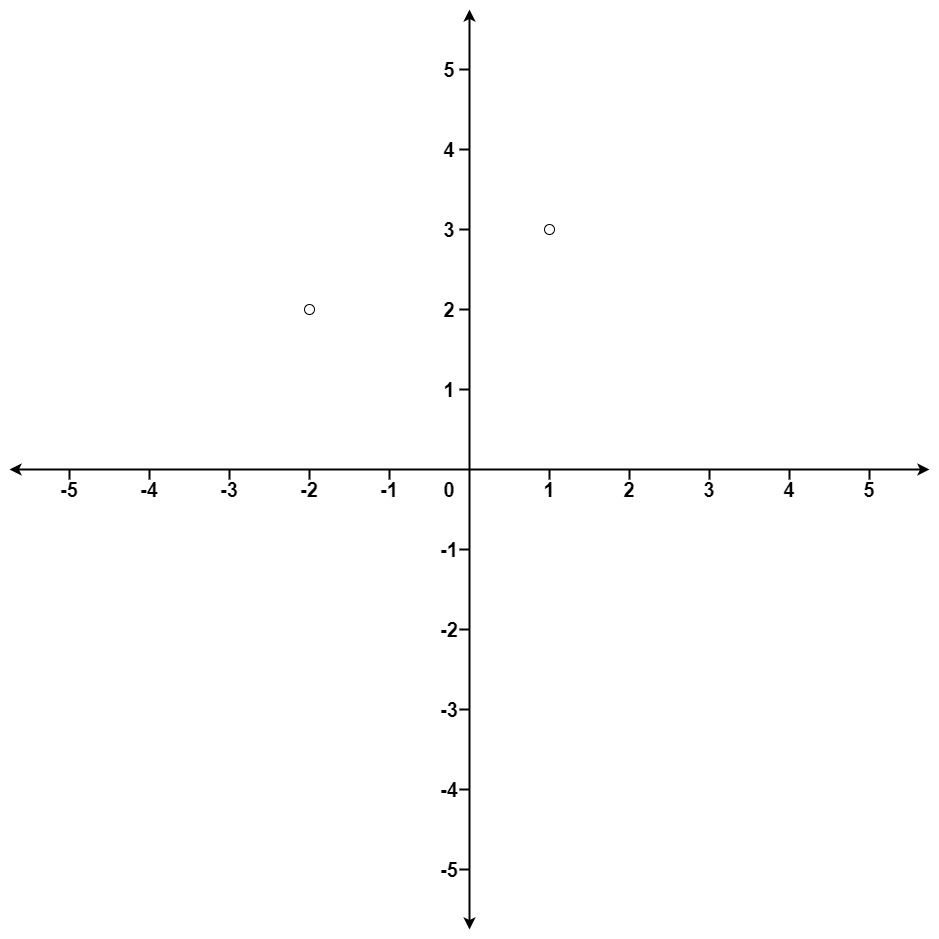
输入:points = [[1,3],[-2,2]], k = 1
输出:[[-2,2]]
解释:
(1, 3) 和原点之间的距离为 sqrt(10),
(-2, 2) 和原点之间的距离为 sqrt(8),
由于 sqrt(8) < sqrt(10),(-2, 2) 离原点更近。
我们只需要距离原点最近的 K = 1 个点,所以答案就是 [[-2,2]]。
示例 2:
输入:points = [[3,3],[5,-1],[-2,4]], k = 2
输出:[[3,3],[-2,4]]
(答案 [[-2,4],[3,3]] 也会被接受。)
提示:
1 <= k <= points.length <= 104-104 < xi, yi < 104
方法一:自定义排序 · Go 实现
思考
求距原点最近的 个点。按欧氏距离排序后取前 个即可, 时 可接受。
我们将所有点按照与原点的距离从小到大排序,然后取前 个点即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func kClosest(points [][]int, k int) [][]int {
	sort.Slice(points, func(i, j int) bool {
		return math.Hypot(float64(points[i][0]), float64(points[i][1])) < math.Hypot(float64(points[j][0]), float64(points[j][1]))
	})
	return points[:k]
}
方法二:优先队列(大根堆) · Go 实现
思考
全排序多做了后面 个点的顺序。用大小为 的大根堆只保留当前最近的 个,时间 。
我们可以使用一个优先队列(大根堆)来维护距离原点最近的 个点。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func kClosest(points [][]int, k int) [][]int {
	maxQ := hp{}
	for i, p := range points {
		dist := math.Hypot(float64(p[0]), float64(p[1]))
		heap.Push(&maxQ, pair{dist, i})
		if len(maxQ) > k {
			heap.Pop(&maxQ)
		}
	}
	ans := make([][]int, k)
	for i, p := range maxQ {
		ans[i] = points[p.i]
	}
	return ans
}

type pair struct {
	dist float64
	i    int
}

type hp []pair

func (h hp) Len() int { return len(h) }
func (h hp) Less(i, j int) bool {
	a, b := h[i], h[j]
	return a.dist > b.dist
}
func (h hp) Swap(i, j int) { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)   { *h = append(*h, v.(pair)) }
func (h *hp) Pop() any     { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }
方法三:二分查找 · Go 实现
思考
堆仍有对数因子。距离越大则点数单调不减,可二分距离阈值,统计不超过该距离的点数是否达到 ,再收集所有距离 临界值的点。
我们注意到,随着距离的增大,点的数量是递增的。这存在一个临界值,使得在这个值之前的点的数量小于等于 ,而在这个值之后的点的数量大于 。
因此,我们可以使用二分查找,枚举距离。每一次二分查找,我们统计出距离小于等于当前距离的点的数量,如果数量大于等于 ,则说明临界值在左侧,我们令右边界等于当前距离;否则,临界值在右侧,我们令左边界等于当前距禽加一。
二分查找结束后,我们只需要返回距离小于等于左边界的点即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度,而 为距离的最大值。
func kClosest(points [][]int, k int) (ans [][]int) {
	n := len(points)
	dist := make([]int, n)
	l, r := 0, 0
	for i, p := range points {
		dist[i] = p[0]*p[0] + p[1]*p[1]
		r = max(r, dist[i])
	}
	for l < r {
		mid := (l + r) >> 1
		cnt := 0
		for _, d := range dist {
			if d <= mid {
				cnt++
			}
		}
		if cnt >= k {
			r = mid
		} else {
			l = mid + 1
		}
	}
	for i, p := range points {
		if dist[i] <= l {
			ans = append(ans, p)
		}
	}
	return
}1046. 最后一块石头的重量
题目、示例与约束
有一堆石头,每块石头的重量都是正整数。
每一回合,从中选出两块 最重的 石头,然后将它们一起粉碎。假设石头的重量分别为 x 和 y,且 x <= y。那么粉碎的可能结果如下:
- 如果
x == y,那么两块石头都会被完全粉碎; - 如果
x != y,那么重量为x的石头将会完全粉碎,而重量为y的石头新重量为y-x。
最后,最多只会剩下一块石头。返回此石头的重量。如果没有石头剩下,就返回 0。
示例:
输入:[2,7,4,1,8,1]
输出:1
解释:
先选出 7 和 8,得到 1,所以数组转换为 [2,4,1,1,1],
再选出 2 和 4,得到 2,所以数组转换为 [2,1,1,1],
接着是 2 和 1,得到 1,所以数组转换为 [1,1,1],
最后选出 1 和 1,得到 0,最终数组转换为 [1],这就是最后剩下那块石头的重量。
提示:
1 <= stones.length <= 301 <= stones[i] <= 1000
方法一:优先队列(大根堆) · Go 实现
思考
每次取最重的两块相撞, 不大但若每次扫描找最大则重复比较。优先队列能在对数时间内取出当前最大。
把所有重量取负后放入小根堆以模拟大根堆。弹出两个值 ,若不等则把 压回,直到不足两块。
堆空返回 ,否则返回堆顶的相反数。
我们将数组 stones 所有元素放入大根堆,然后执行循环操作,每次弹出两个元素 和 ,如果 ,将 放入大根堆。当堆元素个数小于 时,退出循环。
最后如果存在堆顶元素,则将其返回,否则返回 。
时间复杂度 ,空间复杂度 。其中 是数组 stones 的长度。
func lastStoneWeight(stones []int) int {
	q := &hp{stones}
	heap.Init(q)
	for q.Len() > 1 {
		y, x := q.pop(), q.pop()
		if x != y {
			q.push(y - x)
		}
	}
	if q.Len() > 0 {
		return q.IntSlice[0]
	}
	return 0
}

type hp struct{ sort.IntSlice }

func (h hp) Less(i, j int) bool { return h.IntSlice[i] > h.IntSlice[j] }
func (h *hp) Push(v any)        { h.IntSlice = append(h.IntSlice, v.(int)) }
func (h *hp) Pop() any {
	a := h.IntSlice
	v := a[len(a)-1]
	h.IntSlice = a[:len(a)-1]
	return v
}
func (h *hp) push(v int) { heap.Push(h, v) }
func (h *hp) pop() int { return heap.Pop(h).(int) }1057. 校园自行车分配 🔒
题目、示例与约束
在 X-Y 平面上表示的校园中,有 n 名工人和 m 辆自行车,其中 n <= m。
给定一个长度为 n 的数组 workers ,其中 worker [i] = [xi, yi] 表示第 i 个工人的位置。你也得到一个长度为 m 的自行车数组 bikers ,其中 bikes[j] = [xj, yj] 是第 j 辆自行车的位置。所有给定的位置都是 唯一 的。
我们需要为每位工人分配一辆自行车。在所有可用的自行车和工人中,我们选取彼此之间 曼哈顿距离 最短的工人自行车对 (workeri, bikej) ,并将其中的自行车分配給工人。
如果有多个 (workeri, bikej) 对之间的 曼哈顿距离 相同,那么我们选择 工人索引最小 的那对。类似地,如果有多种不同的分配方法,则选择 自行车索引最小 的一对。不断重复这一过程,直到所有工人都分配到自行车为止。
返回长度为 n 的向量 answer,其中 answer[i] 是第 i 位工人分配到的自行车的索引(从 0 开始)。
给定两点 p1 和 p2 之间的 曼哈顿距离 为 Manhattan(p1, p2) = |p1.x - p2.x| + |p1.y - p2.y|。
示例 1:
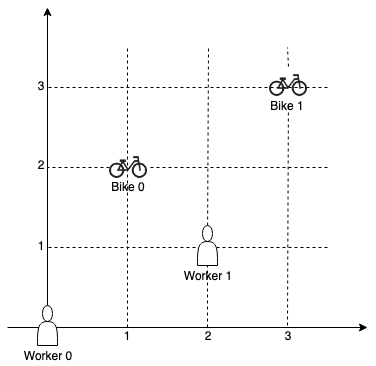
输入:workers = [[0,0],[2,1]], bikes = [[1,2],[3,3]]
输出:[1,0]
解释:工人 1 分配到自行车 0,因为他们最接近且不存在冲突,工人 0 分配到自行车 1 。所以输出是 [1,0]。
示例 2:
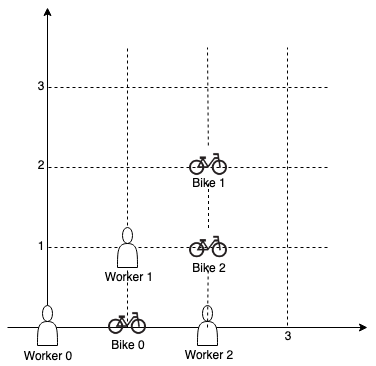
输入:workers = [[0,0],[1,1],[2,0]], bikes = [[1,0],[2,2],[2,1]]
输出:[0,2,1]
解释:工人 0 首先分配到自行车 0 。工人 1 和工人 2 与自行车 2 距离相同,因此工人 1 分配到自行车 2,工人 2 将分配到自行车 1 。因此输出为 [0,2,1]。
提示:
n == workers.lengthm == bikes.length1 <= n <= m <= 1000workers[i].length == bikes[j].length == 20 <= xi, yi < 10000 <= xj, yj < 1000- 所有工人和自行车的位置都不相同
方法一:排序 · Go 实现
思考
每人分一辆最近的车,距离并列时工人编号小者优先,再并列则车编号小者优先。 ,枚举全部 对后排序即可按规则依次分配。
三元组 排序后,遇到双方都尚未分配则配对。
访问数组保证每人每车只用一次。
先计算每个工人和每个自行车之间的曼哈顿距离,然后按照曼哈顿距离从小到大排序,遍历排序后的数组,如果当前工人和自行车都未被分配,则分配给当前工人和自行车。
时间复杂度 。其中 和 分别为工人和自行车的数量。
func assignBikes(workers [][]int, bikes [][]int) []int {
	n, m := len(workers), len(bikes)
	type tuple struct{ d, i, j int }
	arr := make([]tuple, n*m)
	for i, k := 0, 0; i < n; i++ {
		for j := 0; j < m; j++ {
			d := abs(workers[i][0]-bikes[j][0]) + abs(workers[i][1]-bikes[j][1])
			arr[k] = tuple{d, i, j}
			k++
		}
	}
	sort.Slice(arr, func(i, j int) bool {
		if arr[i].d != arr[j].d {
			return arr[i].d < arr[j].d
		}
		if arr[i].i != arr[j].i {
			return arr[i].i < arr[j].i
		}
		return arr[i].j < arr[j].j
	})
	vis1, vis2 := make([]bool, n), make([]bool, m)
	ans := make([]int, n)
	for _, e := range arr {
		i, j := e.i, e.j
		if !vis1[i] && !vis2[j] {
			vis1[i], vis2[j] = true, true
			ans[i] = j
		}
	}
	return ans
}

func abs(x int) int {
	if x < 0 {
		return -x
	}
	return x
}1086. 前五科的均分 🔒
题目、示例与约束
给你一个不同学生的分数列表 items,其中 items[i] = [IDi, scorei] 表示 IDi 的学生的一科分数,你需要计算每个学生 最高的五科 成绩的 平均分。
返回答案 result 以数对数组形式给出,其中 result[j] = [IDj, topFiveAveragej] 表示 IDj 的学生和他 最高的五科 成绩的 平均分。result 需要按 IDj 递增的 顺序排列 。
学生 最高的五科 成绩的 平均分 的计算方法是将最高的五科分数相加,然后用 整数除法 除以 5 。
示例 1:
输入:items = [[1,91],[1,92],[2,93],[2,97],[1,60],[2,77],[1,65],[1,87],[1,100],[2,100],[2,76]]
输出:[[1,87],[2,88]]
解释:
ID = 1 的学生分数为 91、92、60、65、87 和 100 。前五科的平均分 (100 + 92 + 91 + 87 + 65) / 5 = 87
ID = 2 的学生分数为 93、97、77、100 和 76 。前五科的平均分 (100 + 97 + 93 + 77 + 76) / 5 = 88.6,但是由于使用整数除法,结果转换为 88
示例 2:
输入:items = [[1,100],[7,100],[1,100],[7,100],[1,100],[7,100],[1,100],[7,100],[1,100],[7,100]]
输出:[[1,100],[7,100]]
提示:
1 <= items.length <= 1000items[i].length == 21 <= IDi <= 10000 <= scorei <= 100- 对于每个
IDi,至少 存在五个分数
方法一:排序 · Go 实现
思考
每名学生至少五门成绩,要最高五门的整数平均,并按编号升序输出。先按人收集分数再取最大的五门即可。
哈希表存各人的分数列表,扫到的最大编号为 。从 到 依序对存在的列表用
nlargest(5)求和整除 。空编号自然跳过,输出已按编号有序。
我们先用一个哈希表或数组 记录每个学生的分数列表,然后从小到大遍历学生的编号,对于每个学生,我们将他的分数列表排序,然后取最高的五个分数求平均值即可。
时间复杂度 ,空间复杂度 。其中 是学生的数量。
func highFive(items [][]int) (ans [][]int) {
	d := make([][]int, 1001)
	for _, item := range items {
		i, x := item[0], item[1]
		d[i] = append(d[i], x)
	}
	for i := 1; i <= 1000; i++ {
		if len(d[i]) > 0 {
			sort.Ints(d[i])
			s := 0
			for j := len(d[i]) - 1; j >= len(d[i])-5; j-- {
				s += d[i][j]
			}
			ans = append(ans, []int{i, s / 5})
		}
	}
	return ans
}1094. 拼车
题目、示例与约束
车上最初有 capacity 个空座位。车 只能 向一个方向行驶(也就是说,不允许掉头或改变方向)
给定整数 capacity 和一个数组 trips , trips[i] = [numPassengersi, fromi, toi] 表示第 i 次旅行有 numPassengersi 乘客,接他们和放他们的位置分别是 fromi 和 toi 。这些位置是从汽车的初始位置向东的公里数。
乘客在接上新乘客之前会被放下。在路线的每个点,车内乘客总数不得超过 capacity。
当且仅当你可以在所有给定的行程中接送所有乘客时,返回 true,否则请返回 false。
示例 1:
输入:trips = [[2,1,5],[3,3,7]], capacity = 4
输出:false
示例 2:
输入:trips = [[2,1,5],[3,3,7]], capacity = 5
输出:true
提示:
1 <= trips.length <= 1000trips[i].length == 31 <= numPassengersi <= 1000 <= fromi < toi <= 10001 <= capacity <= 105
方法一:差分数组 · Go 实现
思考
每个行程在 上增加乘客,判断全程是否都不超过容量。站点坐标 ,适合差分数组而不是按时间排序扫描。
在起点加人数、终点减人数,再对差分数组求前缀和,检查每个位置是否 。
数组开到最大终点即可,空位点前缀不变。
我们可以利用差分数组的思想,将每个行程的乘客数加到起点,减去终点,最后我们只需要判断差分数组的前缀和是否都不大于车的最大载客量即可。
时间复杂度 ,空间复杂度 。其中 是行程数,而 是行程中最大的终点,本题中 。
func carPooling(trips [][]int, capacity int) bool {
	d := [1001]int{}
	for _, trip := range trips {
		x, f, t := trip[0], trip[1], trip[2]
		d[f] += x
		d[t] -= x
	}
	s := 0
	for _, x := range d {
		s += x
		if s > capacity {
			return false
		}
	}
	return true
}1354. 多次求和构造目标数组
题目、示例与约束
给你一个整数数组 target 。一开始,你有一个数组 A ,它的所有元素均为 1 ,你可以执行以下操作:
- 令
x为你数组里所有元素的和 - 选择满足
0 <= i < target.size的任意下标i,并让A数组里下标为i处的值为x。 - 你可以重复该过程任意次
如果能从 A 开始构造出目标数组 target ,请你返回 True ,否则返回 False 。
示例 1:
输入:target = [9,3,5]
输出:true
解释:从 [1, 1, 1] 开始
[1, 1, 1], 和为 3 ,选择下标 1
[1, 3, 1], 和为 5, 选择下标 2
[1, 3, 5], 和为 9, 选择下标 0
[9, 3, 5] 完成
示例 2:
输入:target = [1,1,1,2]
输出:false
解释:不可能从 [1,1,1,1] 出发构造目标数组。
示例 3:
输入:target = [8,5]
输出:true
提示:
N == target.length1 <= target.length <= 5 * 10^41 <= target[i] <= 10^9
方法一:逆向构造 + 优先队列(大根堆) · Go 实现
思考
从全 反复把某位置换成当前数组和,问能否得到 。正向不知选哪一维, 且值可达 。逆向时每一步必须还原当前最大值: 由「其余和 」替换而来,故上一值是 (避免线性递减)。大根堆反复替换直到全为 ,或 、 时失败。
我们发现,如果从数组 开始正向构造目标数组 ,每次都不好确定选择哪个下标 ,问题比较复杂。而如果我们从数组 开始逆向构造,每次构造都一定是选择当前数组中最大的元素,这样就可以保证每次构造都是唯一的,问题比较简单。
因此,我们可以使用优先队列(大根堆)来存储数组 中的元素,用一个变量 记录数组 中所有元素的和。每次从优先队列中取出最大的元素 ,计算当前数组中除 以外的所有元素之和 ,如果 或者 ,则说明无法构造目标数组 ,返回 false。否则,我们计算 ,如果 ,则令 ,否则令 ,将 加入优先队列中,并更新 的值,重复上述操作,直到优先队列中的所有元素都变为 ,此时返回 true。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func isPossible(target []int) bool {
	pq := &hp{target}
	s := 0
	for _, x := range target {
		s += x
	}
	heap.Init(pq)
	for target[0] > 1 {
		mx := target[0]
		t := s - mx
		if t < 1 || mx-t < 1 {
			return false
		}
		x := mx % t
		if x == 0 {
			x = t
		}
		target[0] = x
		heap.Fix(pq, 0)
		s = s - mx + x
	}
	return true
}

type hp struct{ sort.IntSlice }

func (h hp) Less(i, j int) bool { return h.IntSlice[i] > h.IntSlice[j] }
func (hp) Pop() (_ any)         { return }
func (hp) Push(any) {}1424. 对角线遍历 II
题目、示例与约束
给你一个列表 nums ,里面每一个元素都是一个整数列表。请你依照下面各图的规则,按顺序返回 nums 中对角线上的整数。
示例 1:
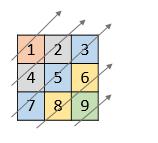
输入:nums = [[1,2,3],[4,5,6],[7,8,9]]
输出:[1,4,2,7,5,3,8,6,9]
示例 2:
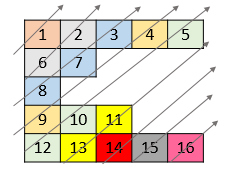
输入:nums = [[1,2,3,4,5],[6,7],[8],[9,10,11],[12,13,14,15,16]]
输出:[1,6,2,8,7,3,9,4,12,10,5,13,11,14,15,16]
示例 3:
输入:nums = [[1,2,3],[4],[5,6,7],[8],[9,10,11]]
输出:[1,4,2,5,3,8,6,9,7,10,11]
示例 4:
输入:nums = [[1,2,3,4,5,6]]
输出:[1,2,3,4,5,6]
提示:
1 <= nums.length <= 10^51 <= nums[i].length <= 10^51 <= nums[i][j] <= 10^9nums中最多有10^5个数字。
方法一:排序 · Go 实现
思考
矩阵行长度不一,总元素达 ,按对角线模拟指针容易越界。同一对角线上 相同,对角线按 递增,同一条内按 递增(即从上到下、从右到左的遍历顺序)。
把每个值做成三元组 排序后取出第三维,即可得到题目要求的顺序。
我们观察到:
- 每一条对角线上的 的值都是相同的;
- 下一条对角线的 的值比前一条对角线的大;
- 在同一条对角线中的 是相同的,而 值是从小到大递增。
因此,我们将所有数字以 的形式存进 ,然后按照前两项排序。最后返回 所有元素下标为 的值组成的数组即可。
时间复杂度 ,其中 是数组 中元素的个数。空间复杂度 。
func findDiagonalOrder(nums [][]int) []int {
	arr := [][]int{}
	for i, row := range nums {
		for j, v := range row {
			arr = append(arr, []int{i + j, j, v})
		}
	}
	sort.Slice(arr, func(i, j int) bool {
		if arr[i][0] == arr[j][0] {
			return arr[i][1] < arr[j][1]
		}
		return arr[i][0] < arr[j][0]
	})
	ans := []int{}
	for _, v := range arr {
		ans = append(ans, v[2])
	}
	return ans
}1464. 数组中两元素的最大乘积
题目、示例与约束
给你一个整数数组 nums。
请你选择数组的两个 不同 下标 i 和 j,
返回 (nums[i] - 1) * (nums[j] - 1) 的 最大值。
示例 1:
输入:nums = [3,4,5,2]
输出:12
解释:如果选择下标 i=1 和 j=2(下标从 0 开始),则可以获得最大值,(nums[1]-1)*(nums[2]-1) = (4-1)*(5-1) = 3*4 = 12 。
示例 2:
输入:nums = [1,5,4,5]
输出:16
解释:选择下标 i=1 和 j=3(下标从 0 开始),则可以获得最大值 (5-1)*(5-1) = 16 。
示例 3:
输入:nums = [3,7]
输出:12
提示:
2 <= nums.length <= 5001 <= nums[i] <= 10^3
方法一:暴力枚举 · Go 实现
思考
,枚举所有无序对计算 的最大值即可。
双重循环,枚举所有的下标对,求出 的最大值。其中 。
时间复杂度 。
func maxProduct(nums []int) int {
	ans := 0
	for i, a := range nums {
		for _, b := range nums[i+1:] {
			t := (a - 1) * (b - 1)
			if ans < t {
				ans = t
			}
		}
	}
	return ans
}
方法二:排序 · Go 实现
思考
方法一平方级。乘积随两数增大而增大,排序后取最大的两个即可。
对 进行排序,取最后两个元素,计算乘积 即可。
时间复杂度 。
func maxProduct(nums []int) int {
	sort.Ints(nums)
	n := len(nums)
	return (nums[n-1] - 1) * (nums[n-2] - 1)
}
方法三:一次遍历 · Go 实现
思考
方法二仍需排序。一遍扫描维护最大值与次大值,即可在线性时间内得到同样的两个数。
遍历 ,维护最大值 和次大值 。遍历结束,返回 。
func maxProduct(nums []int) int {
	a, b := 0, 0
	for _, v := range nums {
		if v > a {
			b, a = a, v
		} else if v > b {
			b = v
		}
	}
	return (a - 1) * (b - 1)
}1606. 找到处理最多请求的服务器
题目、示例与约束
你有 k 个服务器,编号为 0 到 k-1 ,它们可以同时处理多个请求组。每个服务器有无穷的计算能力但是 不能同时处理超过一个请求 。请求分配到服务器的规则如下:
- 第
i(序号从 0 开始)个请求到达。 - 如果所有服务器都已被占据,那么该请求被舍弃(完全不处理)。
- 如果第
(i % k)个服务器空闲,那么对应服务器会处理该请求。 - 否则,将请求安排给下一个空闲的服务器(服务器构成一个环,必要的话可能从第 0 个服务器开始继续找下一个空闲的服务器)。比方说,如果第
i个服务器在忙,那么会查看第(i+1)个服务器,第(i+2)个服务器等等。
给你一个 严格递增 的正整数数组 arrival ,表示第 i 个任务的到达时间,和另一个数组 load ,其中 load[i] 表示第 i 个请求的工作量(也就是服务器完成它所需要的时间)。你的任务是找到 最繁忙的服务器 。最繁忙定义为一个服务器处理的请求数是所有服务器里最多的。
请你返回包含所有 最繁忙服务器 序号的列表,你可以以任意顺序返回这个列表。
示例 1:
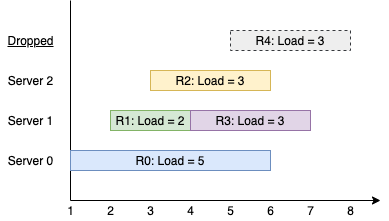
输入:k = 3, arrival = [1,2,3,4,5], load = [5,2,3,3,3]
输出:[1]
解释:
所有服务器一开始都是空闲的。
前 3 个请求分别由前 3 台服务器依次处理。
请求 3 进来的时候,服务器 0 被占据,所以它被安排到下一台空闲的服务器,也就是服务器 1 。
请求 4 进来的时候,由于所有服务器都被占据,该请求被舍弃。
服务器 0 和 2 分别都处理了一个请求,服务器 1 处理了两个请求。所以服务器 1 是最忙的服务器。
示例 2:
输入:k = 3, arrival = [1,2,3,4], load = [1,2,1,2]
输出:[0]
解释:
前 3 个请求分别被前 3 个服务器处理。
请求 3 进来,由于服务器 0 空闲,它被服务器 0 处理。
服务器 0 处理了两个请求,服务器 1 和 2 分别处理了一个请求。所以服务器 0 是最忙的服务器。
示例 3:
输入:k = 3, arrival = [1,2,3], load = [10,12,11]
输出:[0,1,2]
解释:每个服务器分别处理了一个请求,所以它们都是最忙的服务器。
示例 4:
输入:k = 3, arrival = [1,2,3,4,8,9,10], load = [5,2,10,3,1,2,2]
输出:[1]
示例 5:
输入:k = 1, arrival = [1], load = [1]
输出:[0]
提示:
1 <= k <= 1051 <= arrival.length, load.length <= 105arrival.length == load.length1 <= arrival[i], load[i] <= 109arrival保证 严格递增 。
方法一:有序集合 + 优先队列 · Go 实现
思考
请求数与服务器数均可到 ,对每个请求线性扫描 台机器会超时。需要在空闲集合中快速找到编号不小于 的第一台,若无则回到编号最小者。
忙机按结束时间出队后应立刻回到空闲集合,因此用优先队列维护 ,用有序集合维护空闲编号。
请求到达时先释放所有已完成的任务,再在 上 ;同时用数组 统计处理次数,最后收集达到最大值的编号。
题目求的是最繁忙的服务器列表,因此可以想到用哈希表记录每个服务器处理的任务数,然后获取所有处理了最大任务数 mx 的服务器列表即可。关键的问题就在于,求出每个任务分配给了哪台服务器处理。
我们用 有序集合 free 存放所有的空闲服务器,优先队列 busy 存放正在处理请求的服务器的处理结束时间和对应的服务器编号,即二元组 (end, server),优先队列满足队首元素的处理结束时间最小,用一个哈希表 cnt 记录每台服务器处理的任务数。
当第 i 个请求到达时,如果 busy 不为空,我们循环判断 busy 队首的任务结束时间是否小于等于当前请求的到达时间 arrival[i],即 start。如果是,说明队首任务在此时刻已经处理结束,可以从 busy 队列中移出,循环判断。
接下来,如果 free 为空,说明当前没有空闲服务器能够处理第 i 个请求,直接 continue 丢弃;否则,查找 free 中大于等于 i % k 的第一个服务器,如果查找成功,那么由该服务器来处理该请求,否则,由 free 的第一个服务器(编号最小)来处理。假设该服务器是 server, 那么 cnt[server] 加 1,同时将二元组 (end, server) 放入优先队列 busy 中,并且将该 server 中有序集合 free 中移出。
最后,只需要获取 cnt 中的最大值 mx,找出处理了 mx 个任务数的服务器列表,即为答案。
func busiestServers(k int, arrival, load []int) (ans []int) {
	free := redblacktree.NewWithIntComparator()
	for i := 0; i < k; i++ {
		free.Put(i, nil)
	}
	busy := hp{}
	cnt := make([]int, k)
	for i, t := range arrival {
		for len(busy) > 0 && busy[0].end <= t {
			free.Put(busy[0].server, nil)
			heap.Pop(&busy)
		}
		if free.Size() == 0 {
			continue
		}
		p, _ := free.Ceiling(i % k)
		if p == nil {
			p = free.Left()
		}
		server := p.Key.(int)
		cnt[server]++
		heap.Push(&busy, pair{t + load[i], server})
		free.Remove(server)
	}
	mx := slices.Max(cnt)
	for i, v := range cnt {
		if v == mx {
			ans = append(ans, i)
		}
	}
	return
}

type pair struct{ end, server int }
type hp []pair

func (h hp) Len() int           { return len(h) }
func (h hp) Less(i, j int) bool { return h[i].end < h[j].end }
func (h hp) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)        { *h = append(*h, v.(pair)) }
func (h *hp) Pop() any { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }1738. 找出第 K 大的异或坐标值
题目、示例与约束
给你一个二维矩阵 matrix 和一个整数 k ,矩阵大小为 m x n 由非负整数组成。
矩阵中坐标 (a, b) 的 目标值 可以通过对所有元素 matrix[i][j] 执行异或运算得到,其中 i 和 j 满足 0 <= i <= a < m 且 0 <= j <= b < n(下标从 0 开始计数)。
请你找出 matrix 的所有坐标中第 k 大的目标值(k 的值从 1 开始计数)。
示例 1:
输入:matrix = [[5,2],[1,6]], k = 1
输出:7
解释:坐标 (0,1) 的目标值是 5 XOR 2 = 7 ,为最大的目标值。
示例 2:
输入:matrix = [[5,2],[1,6]], k = 2
输出:5
解释:坐标 (0,0) 的目标值是 5 = 5 ,为第 2 大的目标值。
示例 3:
输入:matrix = [[5,2],[1,6]], k = 3
输出:4
解释:坐标 (1,0) 的目标值是 5 XOR 1 = 4 ,为第 3 大的目标值。
示例 4:
输入:matrix = [[5,2],[1,6]], k = 4
输出:0
解释:坐标 (1,1) 的目标值是 5 XOR 2 XOR 1 XOR 6 = 0 ,为第 4 大的目标值。
提示:
m == matrix.lengthn == matrix[i].length1 <= m, n <= 10000 <= matrix[i][j] <= 1061 <= k <= m * n
方法一:二维前缀异或 + 排序或快速选择 · Go 实现
思考
坐标 的值是左上矩形的异或。直接对每个矩形重算是 , 不可行。
二维前缀异或满足 ,可 列出全部值。
在列表上取第 大(排序或堆选择)即可。
我们定义一个二维前缀异或数组 ,其中 表示矩阵前 行和前 列的元素异或运算的结果,即:
而 可以由 , 和 三个元素计算得到,即:
我们遍历矩阵,计算出所有的 ,然后将其排序,最后返回第 大的元素即可。如果不想使用排序,也可以使用快速选择算法,这样可以优化时间复杂度。
时间复杂度 或 ,空间复杂度 。其中 和 分别是矩阵的行数和列数。
func kthLargestValue(matrix [][]int, k int) int {
	m, n := len(matrix), len(matrix[0])
	s := make([][]int, m+1)
	for i := range s {
		s[i] = make([]int, n+1)
	}
	var ans []int
	for i := 0; i < m; i++ {
		for j := 0; j < n; j++ {
			s[i+1][j+1] = s[i+1][j] ^ s[i][j+1] ^ s[i][j] ^ matrix[i][j]
			ans = append(ans, s[i+1][j+1])
		}
	}
	sort.Ints(ans)
	return ans[len(ans)-k]
}1801. 积压订单中的订单总数
题目、示例与约束
给你一个二维整数数组 orders ,其中每个 orders[i] = [pricei, amounti, orderTypei] 表示有 amounti 笔类型为 orderTypei 、价格为 pricei 的订单。
订单类型 orderTypei 可以分为两种:
0表示这是一批采购订单buy1表示这是一批销售订单sell
注意,orders[i] 表示一批共计 amounti 笔的独立订单,这些订单的价格和类型相同。对于所有有效的 i ,由 orders[i] 表示的所有订单提交时间均早于 orders[i+1] 表示的所有订单。
存在由未执行订单组成的 积压订单 。积压订单最初是空的。提交订单时,会发生以下情况:
- 如果该订单是一笔采购订单
buy,则可以查看积压订单中价格 最低 的销售订单sell。如果该销售订单sell的价格 低于或等于 当前采购订单buy的价格,则匹配并执行这两笔订单,并将销售订单sell从积压订单中删除。否则,采购订单buy将会添加到积压订单中。 - 反之亦然,如果该订单是一笔销售订单
sell,则可以查看积压订单中价格 最高 的采购订单buy。如果该采购订单buy的价格 高于或等于 当前销售订单sell的价格,则匹配并执行这两笔订单,并将采购订单buy从积压订单中删除。否则,销售订单sell将会添加到积压订单中。
输入所有订单后,返回积压订单中的 订单总数 。由于数字可能很大,所以需要返回对 109 + 7 取余的结果。
示例 1:
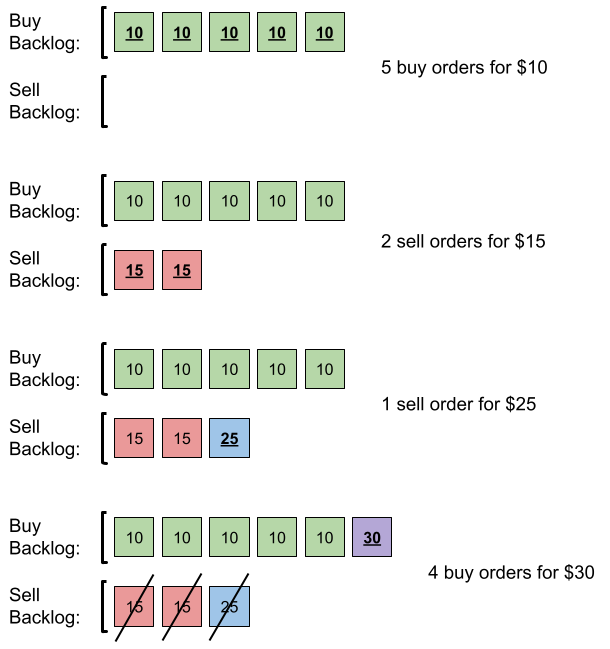
输入:orders = [[10,5,0],[15,2,1],[25,1,1],[30,4,0]]
输出:6
解释:输入订单后会发生下述情况:
- 提交 5 笔采购订单,价格为 10 。没有销售订单,所以这 5 笔订单添加到积压订单中。
- 提交 2 笔销售订单,价格为 15 。没有采购订单的价格大于或等于 15 ,所以这 2 笔订单添加到积压订单中。
- 提交 1 笔销售订单,价格为 25 。没有采购订单的价格大于或等于 25 ,所以这 1 笔订单添加到积压订单中。
- 提交 4 笔采购订单,价格为 30 。前 2 笔采购订单与价格最低(价格为 15)的 2 笔销售订单匹配,从积压订单中删除这 2 笔销售订单。第 3 笔采购订单与价格最低的 1 笔销售订单匹配,销售订单价格为 25 ,从积压订单中删除这 1 笔销售订单。积压订单中不存在更多销售订单,所以第 4 笔采购订单需要添加到积压订单中。
最终,积压订单中有 5 笔价格为 10 的采购订单,和 1 笔价格为 30 的采购订单。所以积压订单中的订单总数为 6 。
示例 2:
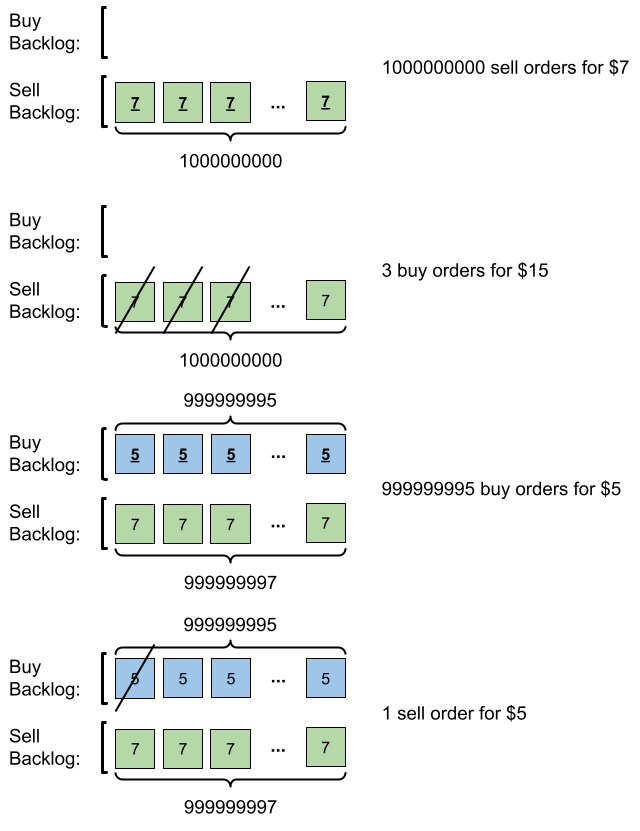
输入:orders = [[7,1000000000,1],[15,3,0],[5,999999995,0],[5,1,1]]
输出:999999984
解释:输入订单后会发生下述情况:
- 提交 109 笔销售订单,价格为 7 。没有采购订单,所以这 109 笔订单添加到积压订单中。
- 提交 3 笔采购订单,价格为 15 。这些采购订单与价格最低(价格为 7 )的 3 笔销售订单匹配,从积压订单中删除这 3 笔销售订单。
- 提交 999999995 笔采购订单,价格为 5 。销售订单的最低价为 7 ,所以这 999999995 笔订单添加到积压订单中。
- 提交 1 笔销售订单,价格为 5 。这笔销售订单与价格最高(价格为 5 )的 1 笔采购订单匹配,从积压订单中删除这 1 笔采购订单。
最终,积压订单中有 (1000000000-3) 笔价格为 7 的销售订单,和 (999999995-1) 笔价格为 5 的采购订单。所以积压订单中的订单总数为 1999999991 ,等于 999999984 % (109 + 7) 。
提示:
1 <= orders.length <= 105orders[i].length == 31 <= pricei, amounti <= 109orderTypei为0或1
方法一:优先队列(大小根堆) + 模拟 · Go 实现
思考
每笔订单都可能与当前积压中价格更优的对手盘成交,剩余部分再进入积压。若每次成交都线性扫描全部积压订单,单次匹配可至 ,整体为 。 ,无法接受。
采购只要不高于报价的最低卖单,销售只要不低于报价的最高买单。为此分别用小根堆维护卖单、大根堆维护买单,堆顶即当前最优对手价。按输入顺序弹出并扣减数量,未成交部分再入堆,最后统计两堆剩余数量并对 取模。
我们可以使用优先队列(大小根堆)维护当前的积压订单,其中大根堆 buy 维护积压的采购订单,小根堆 sell 维护积压的销售订单。堆中每个元素是一个二元组 ,表示价格为 price 的订单数量为 amount。
接下来,我们遍历订单数组 orders ,根据题意模拟即可。
遍历结束后,我们将 buy 和 sell 中的订单数量相加,即为最终的积压订单数量。注意答案可能很大,需要对 取模。
时间复杂度 ,空间复杂度 。其中 是 orders 的长度。
func getNumberOfBacklogOrders(orders [][]int) (ans int) {
	sell := hp{}
	buy := hp{}
	for _, e := range orders {
		p, a, t := e[0], e[1], e[2]
		if t == 0 {
			for a > 0 && len(sell) > 0 && sell[0].p <= p {
				q := heap.Pop(&sell).(pair)
				x, y := q.p, q.a
				if a >= y {
					a -= y
				} else {
					heap.Push(&sell, pair{x, y - a})
					a = 0
				}
			}
			if a > 0 {
				heap.Push(&buy, pair{-p, a})
			}
		} else {
			for a > 0 && len(buy) > 0 && -buy[0].p >= p {
				q := heap.Pop(&buy).(pair)
				x, y := q.p, q.a
				if a >= y {
					a -= y
				} else {
					heap.Push(&buy, pair{x, y - a})
					a = 0
				}
			}
			if a > 0 {
				heap.Push(&sell, pair{p, a})
			}
		}
	}
	const mod int = 1e9 + 7
	for len(buy) > 0 {
		ans += heap.Pop(&buy).(pair).a
	}
	for len(sell) > 0 {
		ans += heap.Pop(&sell).(pair).a
	}
	return ans % mod
}

type pair struct{ p, a int }
type hp []pair

func (h hp) Len() int           { return len(h) }
func (h hp) Less(i, j int) bool { return h[i].p < h[j].p }
func (h hp) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)        { *h = append(*h, v.(pair)) }
func (h *hp) Pop() any { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }1834. 单线程 CPU
题目、示例与约束
给你一个二维数组 tasks ,用于表示 n 项从 0 到 n - 1 编号的任务。其中 tasks[i] = [enqueueTimei, processingTimei] 意味着第 i 项任务将会于 enqueueTimei 时进入任务队列,需要 processingTimei 的时长完成执行。
现有一个单线程 CPU ,同一时间只能执行 最多一项 任务,该 CPU 将会按照下述方式运行:
- 如果 CPU 空闲,且任务队列中没有需要执行的任务,则 CPU 保持空闲状态。
- 如果 CPU 空闲,但任务队列中有需要执行的任务,则 CPU 将会选择 执行时间最短 的任务开始执行。如果多个任务具有同样的最短执行时间,则选择下标最小的任务开始执行。
- 一旦某项任务开始执行,CPU 在 执行完整个任务 前都不会停止。
- CPU 可以在完成一项任务后,立即开始执行一项新任务。
返回 CPU 处理任务的顺序。
示例 1:
输入:tasks = [[1,2],[2,4],[3,2],[4,1]]
输出:[0,2,3,1]
解释:事件按下述流程运行:
- time = 1 ,任务 0 进入任务队列,可执行任务项 = {0}
- 同样在 time = 1 ,空闲状态的 CPU 开始执行任务 0 ,可执行任务项 = {}
- time = 2 ,任务 1 进入任务队列,可执行任务项 = {1}
- time = 3 ,任务 2 进入任务队列,可执行任务项 = {1, 2}
- 同样在 time = 3 ,CPU 完成任务 0 并开始执行队列中用时最短的任务 2 ,可执行任务项 = {1}
- time = 4 ,任务 3 进入任务队列,可执行任务项 = {1, 3}
- time = 5 ,CPU 完成任务 2 并开始执行队列中用时最短的任务 3 ,可执行任务项 = {1}
- time = 6 ,CPU 完成任务 3 并开始执行任务 1 ,可执行任务项 = {}
- time = 10 ,CPU 完成任务 1 并进入空闲状态
示例 2:
输入:tasks = [[7,10],[7,12],[7,5],[7,4],[7,2]]
输出:[4,3,2,0,1]
解释:事件按下述流程运行:
- time = 7 ,所有任务同时进入任务队列,可执行任务项  = {0,1,2,3,4}
- 同样在 time = 7 ,空闲状态的 CPU 开始执行任务 4 ,可执行任务项 = {0,1,2,3}
- time = 9 ,CPU 完成任务 4 并开始执行任务 3 ,可执行任务项 = {0,1,2}
- time = 13 ,CPU 完成任务 3 并开始执行任务 2 ,可执行任务项 = {0,1}
- time = 18 ,CPU 完成任务 2 并开始执行任务 0 ,可执行任务项 = {1}
- time = 28 ,CPU 完成任务 0 并开始执行任务 1 ,可执行任务项 = {}
- time = 40 ,CPU 完成任务 1 并进入空闲状态
提示:
tasks.length == n1 <= n <= 1051 <= enqueueTimei, processingTimei <= 109
方法一:排序 + 优先队列(小根堆) · Go 实现
思考
CPU 空闲时在已到达任务中选处理时间最短、下标最小者,求执行顺序。若每次在全部任务中扫描,单次 ,总时间 。 ,无法通过。
按入队时间排序,用小根堆存放当前已到达任务的 。时间跳到下一任务或堆顶任务结束,再把新到达者入堆。堆保证每次取出的即调度规则所选任务。
我们先将任务按照 enqueueTime 从小到大排序,接下来用一个优先队列(小根堆)维护当前可执行的任务,队列中的元素为 (processingTime, index),即任务的执行时间和任务的编号。另外用一个变量 表示当前时间,初始值为 。
接下来我们模拟任务的执行过程。
如果当前队列为空,说明当前没有可执行的任务,我们将 更新为下一个任务的 enqueueTime 与当前时间 中的较大值。接下来将所有 enqueueTime 小于等于 的任务加入队列。
然后从队列中取出一个任务,将其编号加入答案数组,然后将 更新为当前时间 与当前任务的执行时间之和。
循环上述过程,直到队列为空,且所有任务都已经加入过队列。
时间复杂度 ,其中 为任务的数量。
func getOrder(tasks [][]int) (ans []int) {
	for i := range tasks {
		tasks[i] = append(tasks[i], i)
	}
	sort.Slice(tasks, func(i, j int) bool { return tasks[i][0] < tasks[j][0] })
	q := hp{}
	i, t, n := 0, 0, len(tasks)
	for len(q) > 0 || i < n {
		if len(q) == 0 {
			t = max(t, tasks[i][0])
		}
		for i < n && tasks[i][0] <= t {
			heap.Push(&q, pair{tasks[i][1], tasks[i][2]})
			i++
		}
		p := heap.Pop(&q).(pair)
		ans = append(ans, p.i)
		t += p.t
	}
	return
}

type pair struct{ t, i int }
type hp []pair

func (h hp) Len() int           { return len(h) }
func (h hp) Less(i, j int) bool { return h[i].t < h[j].t || (h[i].t == h[j].t && h[i].i < h[j].i) }
func (h hp) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)        { *h = append(*h, v.(pair)) }
func (h *hp) Pop() any { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }1878. 矩阵中最大的三个菱形和
题目、示例与约束
给你一个 m x n 的整数矩阵 grid 。
菱形和 指的是 grid 中一个正菱形 边界 上的元素之和。本题中的菱形必须为正方形旋转45度,且四个角都在一个格子当中。下图是四个可行的菱形,每个菱形和应该包含的格子都用了相应颜色标注在图中。
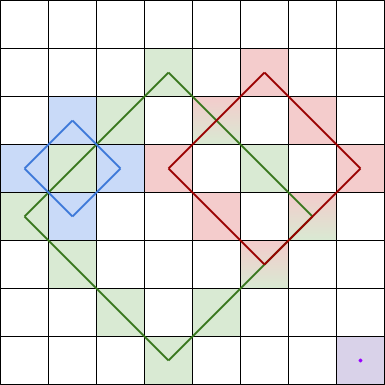
注意,菱形可以是一个面积为 0 的区域,如上图中右下角的紫色菱形所示。
请你按照 降序 返回 grid 中三个最大的 互不相同的菱形和 。如果不同的和少于三个,则将它们全部返回。
示例 1:
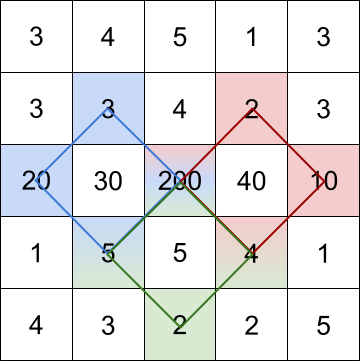
输入:grid = [[3,4,5,1,3],[3,3,4,2,3],[20,30,200,40,10],[1,5,5,4,1],[4,3,2,2,5]]
输出:[228,216,211]
解释:最大的三个菱形和如上图所示。
- 蓝色:20 + 3 + 200 + 5 = 228
- 红色:200 + 2 + 10 + 4 = 216
- 绿色:5 + 200 + 4 + 2 = 211
示例 2:
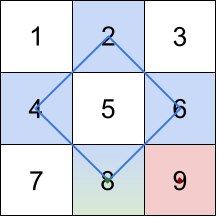
输入:grid = [[1,2,3],[4,5,6],[7,8,9]]
输出:[20,9,8]
解释:最大的三个菱形和如上图所示。
- 蓝色:4 + 2 + 6 + 8 = 20
- 红色:9 (右下角红色的面积为 0 的菱形)
- 绿色:8 (下方中央面积为 0 的菱形)
示例 3:
输入:grid = [[7,7,7]]
输出:[7]
解释:所有三个可能的菱形和都相同,所以返回 [7] 。
提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 1001 <= grid[i][j] <= 105
方法一:枚举菱形中心点 + 前缀和 + 有序集合 · Go 实现
思考
求网格中菱形(含边长为 的单格)按和去重后最大的三个值。枚举每个菱形再暴力求和,边长循环会使常数过大。
预处理两条对角线前缀和,枚举中心与边长即可 求出四条边的和(顶点注意去重)。有序集合只保留最大的三个不同和。
我们可以预处理得到两个前缀和数组 和 ,其中 表示以 为末尾的左上对角线上的元素之和,而 表示以 为末尾的右上对角线上的元素之和。
接下来,我们枚举每个位置 ,先将 加入有序集合 中,然后枚举菱形的边长 ,那么以 为中心点、边长为 的菱形的和为:
我们将这个值加入有序集合 中,同时保证有序集合 的大小不超过 ,最后将有序集合 中的元素逆序输出即可。
时间复杂度 ,空间复杂度 。其中 和 分别是矩阵的行数和列数。
func getBiggestThree(grid [][]int) []int {
	m, n := len(grid), len(grid[0])
	s1 := make([][]int, m+1)
	s2 := make([][]int, m+1)
	for i := range s1 {
		s1[i] = make([]int, n+2)
		s2[i] = make([]int, n+2)
	}
	for i := 1; i <= m; i++ {
		for j := 1; j <= n; j++ {
			s1[i][j] = s1[i-1][j-1] + grid[i-1][j-1]
			s2[i][j] = s2[i-1][j+1] + grid[i-1][j-1]
		}
	}

	ss := treemap.NewWithIntComparator()
	for i := 1; i <= m; i++ {
		for j := 1; j <= n; j++ {
			l := min(i-1, m-i, j-1, n-j)
			ss.Put(grid[i-1][j-1], nil)
			for k := 1; k <= l; k++ {
				a := s1[i+k][j] - s1[i][j-k]
				b := s1[i][j+k] - s1[i-k][j]
				c := s2[i][j-k] - s2[i-k][j]
				d := s2[i+k][j] - s2[i][j+k]
				ss.Put(a+b+c+d-grid[i+k-1][j-1]+grid[i-k-1][j-1], nil)
			}
			for ss.Size() > 3 {
				x, _ := ss.Min()
				ss.Remove(x.(int))
			}
		}
	}
	ans := make([]int, ss.Size())
	for i, k := range ss.Keys() {
		ans[len(ans)-i-1] = k.(int)
	}
	return ans
}1882. 使用服务器处理任务
题目、示例与约束
给你两个 下标从 0 开始 的整数数组 servers 和 tasks ,长度分别为 n 和 m 。servers[i] 是第 i 台服务器的 权重 ,而 tasks[j] 是处理第 j 项任务 所需要的时间(单位:秒)。
你正在运行一个仿真系统,在处理完所有任务后,该系统将会关闭。每台服务器只能同时处理一项任务。第 0 项任务在第 0 秒可以开始处理,相应地,第 j 项任务在第 j 秒可以开始处理。处理第 j 项任务时,你需要为它分配一台 权重最小 的空闲服务器。如果存在多台相同权重的空闲服务器,请选择 下标最小 的服务器。如果一台空闲服务器在第 t 秒分配到第 j 项任务,那么在 t + tasks[j] 时它将恢复空闲状态。
如果没有空闲服务器,则必须等待,直到出现一台空闲服务器,并 尽可能早 地处理剩余任务。 如果有多项任务等待分配,则按照 下标递增 的顺序完成分配。
如果同一时刻存在多台空闲服务器,可以同时将多项任务分别分配给它们。
构建长度为 m 的答案数组 ans ,其中 ans[j] 是第 j 项任务分配的服务器的下标。
返回答案数组 ans 。
示例 1:
输入:servers = [3,3,2], tasks = [1,2,3,2,1,2]
输出:[2,2,0,2,1,2]
解释:事件按时间顺序如下:
- 0 秒时,第 0 项任务加入到任务队列,使用第 2 台服务器处理到 1 秒。
- 1 秒时,第 2 台服务器空闲,第 1 项任务加入到任务队列,使用第 2 台服务器处理到 3 秒。
- 2 秒时,第 2 项任务加入到任务队列,使用第 0 台服务器处理到 5 秒。
- 3 秒时,第 2 台服务器空闲,第 3 项任务加入到任务队列,使用第 2 台服务器处理到 5 秒。
- 4 秒时,第 4 项任务加入到任务队列,使用第 1 台服务器处理到 5 秒。
- 5 秒时,所有服务器都空闲,第 5 项任务加入到任务队列,使用第 2 台服务器处理到 7 秒。
示例 2:
输入:servers = [5,1,4,3,2], tasks = [2,1,2,4,5,2,1]
输出:[1,4,1,4,1,3,2]
解释:事件按时间顺序如下:
- 0 秒时,第 0 项任务加入到任务队列,使用第 1 台服务器处理到 2 秒。
- 1 秒时,第 1 项任务加入到任务队列,使用第 4 台服务器处理到 2 秒。
- 2 秒时,第 1 台和第 4 台服务器空闲,第 2 项任务加入到任务队列,使用第 1 台服务器处理到 4 秒。
- 3 秒时,第 3 项任务加入到任务队列,使用第 4 台服务器处理到 7 秒。
- 4 秒时,第 1 台服务器空闲,第 4 项任务加入到任务队列,使用第 1 台服务器处理到 9 秒。
- 5 秒时,第 5 项任务加入到任务队列,使用第 3 台服务器处理到 7 秒。
- 6 秒时,第 6 项任务加入到任务队列,使用第 2 台服务器处理到 7 秒。
提示:
servers.length == ntasks.length == m1 <= n, m <= 2 * 1051 <= servers[i], tasks[j] <= 2 * 105
方法一:优先队列(小根堆) · Go 实现
思考
任务按时间 到达,空闲时选权重最小、下标最小的服务器;若都忙则等最早空闲者。每次线性找服务器为 ,任务数达 不可行。
空闲堆存 ,忙碌堆存 。到第 个任务时先把已完成的搬回空闲堆;若仍无空闲,则从忙碌堆取出最早结束者并接上该任务。同一台服务器被连续占用时,空闲时刻是任务时长之和,最大约为 ,因此该字段用 位整数。
我们用一个小根堆 来维护所有的空闲服务器,其中每个元素是一个二元组 ,表示第 台服务器的权重为 。用一个小根堆 来维护所有的忙碌服务器,其中每个元素是一个三元组 ,表示第 台服务器在第 秒恢复空闲,权重为 。初始时我们将所有的服务器加入到 中。
接下来,我们遍历所有的任务,对于第 项任务,我们首先将所有在第 秒或之前恢复空闲的服务器从 中移除,添加到 中。然后我们从 中取出一个权重最小的服务器,将其加入到 中,处理第 项任务。如果 为空,我们从 中取出一个恢复时间最早的服务器,将其加入到 中,处理第 项任务。
遍历结束后,我们得到了答案数组 。
时间复杂度 ,其中 为服务器的数量, 为任务的数量。空间复杂度 。其中 和 分别为服务器和任务的数量。
相似题目:
func assignTasks(servers []int, tasks []int) (ans []int) {
	idle := hp{}
	busy := hp2{}
	for i, x := range servers {
		heap.Push(&idle, pair{x, i})
	}
	for j, t := range tasks {
		for len(busy) > 0 && busy[0].w <= j {
			p := heap.Pop(&busy).(tuple)
			heap.Push(&idle, pair{p.s, p.i})
		}
		if idle.Len() > 0 {
			p := heap.Pop(&idle).(pair)
			ans = append(ans, p.i)
			heap.Push(&busy, tuple{j + t, p.s, p.i})
		} else {
			p := heap.Pop(&busy).(tuple)
			ans = append(ans, p.i)
			heap.Push(&busy, tuple{p.w + t, p.s, p.i})
		}
	}
	return
}

type pair struct {
	s int
	i int
}

type hp []pair

func (h hp) Len() int { return len(h) }
func (h hp) Less(i, j int) bool {
	a, b := h[i], h[j]
	return a.s < b.s || a.s == b.s && a.i < b.i
}
func (h hp) Swap(i, j int) { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)   { *h = append(*h, v.(pair)) }
func (h *hp) Pop() any     { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }

type tuple struct {
	w int
	s int
	i int
}

type hp2 []tuple

func (h hp2) Len() int { return len(h) }
func (h hp2) Less(i, j int) bool {
	a, b := h[i], h[j]
	return a.w < b.w || a.w == b.w && (a.s < b.s || a.s == b.s && a.i < b.i)
}
func (h hp2) Swap(i, j int) { h[i], h[j] = h[j], h[i] }
func (h *hp2) Push(v any)   { *h = append(*h, v.(tuple)) }
func (h *hp2) Pop() any { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }1942. 最小未被占据椅子的编号
题目、示例与约束
有 n 个朋友在举办一个派对,这些朋友从 0 到 n - 1 编号。派对里有 无数 张椅子,编号为 0 到 infinity 。当一个朋友到达派对时,他会占据 编号最小 且未被占据的椅子。
- 比方说,当一个朋友到达时,如果椅子
0,1和5被占据了,那么他会占据2号椅子。
当一个朋友离开派对时,他的椅子会立刻变成未占据状态。如果同一时刻有另一个朋友到达,可以立即占据这张椅子。
给你一个下标从 0 开始的二维整数数组 times ,其中 times[i] = [arrivali, leavingi] 表示第 i 个朋友到达和离开的时刻,同时给你一个整数 targetFriend 。所有到达时间 互不相同 。
请你返回编号为 targetFriend 的朋友占据的 椅子编号 。
示例 1:
输入:times = [[1,4],[2,3],[4,6]], targetFriend = 1
输出:1
解释:
- 朋友 0 时刻 1 到达,占据椅子 0 。
- 朋友 1 时刻 2 到达,占据椅子 1 。
- 朋友 1 时刻 3 离开,椅子 1 变成未占据。
- 朋友 0 时刻 4 离开,椅子 0 变成未占据。
- 朋友 2 时刻 4 到达,占据椅子 0 。
朋友 1 占据椅子 1 ,所以返回 1 。
示例 2:
输入:times = [[3,10],[1,5],[2,6]], targetFriend = 0
输出:2
解释:
- 朋友 1 时刻 1 到达,占据椅子 0 。
- 朋友 2 时刻 2 到达,占据椅子 1 。
- 朋友 0 时刻 3 到达,占据椅子 2 。
- 朋友 1 时刻 5 离开,椅子 0 变成未占据。
- 朋友 2 时刻 6 离开,椅子 1 变成未占据。
- 朋友 0 时刻 10 离开,椅子 2 变成未占据。
朋友 0 占据椅子 2 ,所以返回 2 。
提示:
n == times.length2 <= n <= 104times[i].length == 21 <= arrivali < leavingi <= 1050 <= targetFriend <= n - 1- 每个
arrivali时刻 互不相同 。
方法一:优先队列(小根堆) · Go 实现
思考
按到达顺序分配当前最小空椅,离开后椅子归还。若每次扫描全部椅子, 之外还要线性找空位,常数偏大。
空闲椅号与「离开时间、椅号」分别用小根堆维护。处理到达时先弹出所有已离开者归还椅号,再取堆顶空椅。
目标朋友取到椅号即可停止。排序加堆操作为 。
我们首先将每个朋友的到达时间、离开时间和编号组成一个三元组,然后按到达时间排序。
我们使用一个小根堆 来存储当前空闲的椅子编号,初始时,我们将 加入 中。使用一个小根堆 存储二元组 ,其中 表示离开时间,而 表示椅子编号。
遍历每个朋友的到达时间、离开时间和编号,对于每个朋友,我们首先将所有离开时间小于等于当前朋友到达时间的朋友从 中弹出,将他们占据的椅子编号加入 中。然后我们从 中弹出一个椅子编号,将其分配给当前朋友,将 加入 中。如果当前朋友的编号等于 ,我们返回当前分配的椅子编号。
时间复杂度 ,空间复杂度 。其中 为朋友的个数。
func smallestChair(times [][]int, targetFriend int) int {
	idle := hp{}
	busy := hp2{}
	for i := range times {
		times[i] = append(times[i], i)
		heap.Push(&idle, i)
	}
	sort.Slice(times, func(i, j int) bool { return times[i][0] < times[j][0] })
	for _, e := range times {
		arrival, leaving, i := e[0], e[1], e[2]
		for len(busy) > 0 && busy[0].t <= arrival {
			heap.Push(&idle, heap.Pop(&busy).(pair).i)
		}
		j := heap.Pop(&idle).(int)
		if i == targetFriend {
			return j
		}
		heap.Push(&busy, pair{leaving, j})
	}
	return -1
}

type hp struct{ sort.IntSlice }

func (h hp) Less(i, j int) bool { return h.IntSlice[i] < h.IntSlice[j] }
func (h *hp) Push(v any)        { h.IntSlice = append(h.IntSlice, v.(int)) }
func (h *hp) Pop() any {
	a := h.IntSlice
	v := a[len(a)-1]
	h.IntSlice = a[:len(a)-1]
	return v
}

type pair struct{ t, i int }
type hp2 []pair

func (h hp2) Len() int           { return len(h) }
func (h hp2) Less(i, j int) bool { return h[i].t < h[j].t || (h[i].t == h[j].t && h[i].i < h[j].i) }
func (h hp2) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp2) Push(v any)        { *h = append(*h, v.(pair)) }
func (h *hp2) Pop() any { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }1985. 找出数组中的第 K 大整数
题目、示例与约束
给你一个字符串数组 nums 和一个整数 k 。nums 中的每个字符串都表示一个不含前导零的整数。
返回 nums 中表示第 k 大整数的字符串。
注意:重复的数字在统计时会视为不同元素考虑。例如,如果 nums 是 ["1","2","2"],那么 "2" 是最大的整数,"2" 是第二大的整数,"1" 是第三大的整数。
示例 1:
输入:nums = ["3","6","7","10"], k = 4
输出:"3"
解释:
nums 中的数字按非递减顺序排列为 ["3","6","7","10"]
其中第 4 大整数是 "3"
示例 2:
输入:nums = ["2","21","12","1"], k = 3
输出:"2"
解释:
nums 中的数字按非递减顺序排列为 ["1","2","12","21"]
其中第 3 大整数是 "2"
示例 3:
输入:nums = ["0","0"], k = 2
输出:"0"
解释:
nums 中的数字按非递减顺序排列为 ["0","0"]
其中第 2 大整数是 "0"
提示:
1 <= k <= nums.length <= 1041 <= nums[i].length <= 100nums[i]仅由数字组成nums[i]不含任何前导零
方法一:排序或快速选择 · Go 实现
思考
元素是十进制字符串,不能按字典序比较。转成整数后求第 大, 不大时堆选择即可。
按整数值取前 再取末元。
我们可以将 数组中的字符串按照整数从大到小排序,然后取第 个元素即可。也可以使用快速选择算法,找到第 大的整数。
时间复杂度 或 ,其中 是 数组的长度。空间复杂度 或 。
func kthLargestNumber(nums []string, k int) string {
	sort.Slice(nums, func(i, j int) bool {
		a, b := nums[i], nums[j]
		if len(a) == len(b) {
			return a > b
		}
		return len(a) > len(b)
	})
	return nums[k-1]
}2015. 每段建筑物的平均高度 🔒
题目、示例与约束
一条完全笔直的街道由一条数字线表示。街道上有建筑物,由二维整数阵列 buildings 表示,其中 buildings[i] = [starti, endi, heighti]。这意味着在 半封闭的位置[starti,endi) 有一座高度为 heighti 的建筑。
你想用 最少 数量的非重叠 部分 来 描述 街道上建筑物的高度。街道可以用2D整数数组 street 来表示,其中 street[j] = [leftj, rightj, averagej] 描述了道路的 半封闭区域 [leftj, rightj) ,该段中建筑物的 平均 高度为 averagej 。
- 例如,如果
buildings = [[1,5,2],[3,10,4]],street = [[1,3,2],[3,5,3],[5,10,4]]可以表示街道,因为:- 从 1 到 3 ,只有第一栋建筑的平均高度为
2 / 1 = 2。 - 从 3 到 5 ,第一和第二栋建筑的平均高度均为
(2+4) / 2 = 3。 - 从 5 到 10 ,只有第二栋建筑的平均高度为
4 / 1 = 4。
- 从 1 到 3 ,只有第一栋建筑的平均高度为
给定 buildings ,返回如上所述的二维整数矩阵 street ( 不包括 街道上没有建筑物的任何区域)。您可以按 任何顺序 返回数组。
n 个元素的 平均值 是 n 个元素除以 n 的 总和 (整数除法)。
半闭合段 [a, b) 是点 a 和 b 之间的数字线的截面,包括 点 a ,不包括 点 b 。
示例1:
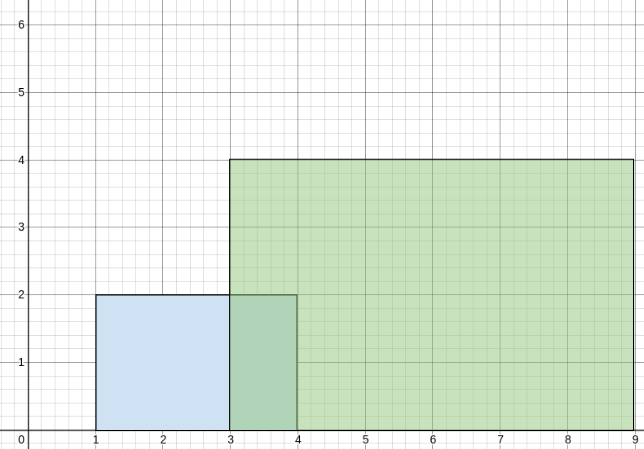
输入: buildings = [[1,4,2],[3,9,4]]
输出: [[1,3,2],[3,4,3],[4,9,4]]
解释:
从 1 到 3 ,只有第一栋建筑的平均高度为 2 / 1 = 2。
从 3 到 4 ,第一和第二栋建筑的平均高度均为(2+4)/ 2 = 3。
从 4 到 9 ,只有第二栋建筑的平均高度为 4 / 1 = 4。
示例 2:
输入: buildings = [[1,3,2],[2,5,3],[2,8,3]]
输出: [[1,3,2],[3,8,3]]
解释:
从 1 到 2 ,只有第一栋建筑的平均高度为 2 / 1 = 2。
从 2 到 3 ,这三座建筑的平均高度均为 (2+3+3) / 3 = 2。
从 3 到 5 ,第二和第三栋楼都在那里,平均高度为 (3+3) / 2 = 3。
从 5 到 8 ,只有最后一栋建筑的平均高度为 3 / 1 = 3。
从 1 到 3 的平均高度是相同的,所以我们可以把它们分成一个部分。
从 3 到 8 的平均高度是相同的,所以我们可以把它们分成一个部分。
示例 3:
输入: buildings = [[1,2,1],[5,6,1]]
输出: [[1,2,1],[5,6,1]]
解释:
从 1 到 2 ,只有第一栋建筑的平均高度为 1 / 1 = 1。
从 2 到 5 ,没有建筑物,因此不包括在输出中。
从 5 到 6 ,只有第二栋建筑的平均高度为 1 / 1 = 1。
我们无法将这些部分组合在一起,因为没有建筑的空白空间将这些部分隔开。
提示:
1 <= buildings.length <= 105buildings[i].length == 30 <= starti < endi <= 1081 <= heighti <= 105
方法一:差分思想 + 哈希表 · Go 实现
思考
建筑物左右端点稀疏, 不大但坐标范围可能很宽,不能开真实差分数组。每个区间对起点加高度、对终点减高度,并对建筑物个数做同样的差分。
按坐标排序扫过去,维护当前高度和 与栋数 ,平均为 。相邻段平均相同则合并端点。
哈希表记录变更,排序键值后一次扫描输出。
我们可以利用差分思想,用一个哈希表 记录每个位置的建筑物数量变化,用另一个哈希表 记录每个位置的高度变化。
接下来,我们对哈希表 按照键值进行排序,用一个变量 记录当前位置的高度和,用一个变量 记录当前位置的建筑物数量。
然后遍历哈希表 ,对于每个位置,如果 不为 0,说明此前有建筑物,我们计算出平均高度,如果当前位置的建筑物与上个建筑物的平均高度相同,则合并,否则加入结果集。
最后返回结果集即可。
时间复杂度 ,空间复杂度 。其中 为建筑物数量。
func averageHeightOfBuildings(buildings [][]int) [][]int {
	cnt := make(map[int]int)
	d := make(map[int]int)

	for _, e := range buildings {
		start, end, height := e[0], e[1], e[2]
		cnt[start]++
		cnt[end]--
		d[start] += height
		d[end] -= height
	}

	s, m := 0, 0
	last := -1
	var ans [][]int

	keys := make([]int, 0, len(d))
	for k := range d {
		keys = append(keys, k)
	}
	sort.Ints(keys)

	for _, k := range keys {
		v := d[k]
		if m > 0 {
			avg := s / m
			if len(ans) > 0 && ans[len(ans)-1][2] == avg && ans[len(ans)-1][1] == last {
				ans[len(ans)-1][1] = k
			} else {
				ans = append(ans, []int{last, k, avg})
			}
		}
		s += v
		m += cnt[k]
		last = k
	}

	return ans
}2099. 找到和最大的长度为 K 的子序列
题目、示例与约束
给你一个整数数组 nums 和一个整数 k 。你需要找到 nums 中长度为 k 的 子序列 ,且这个子序列的 和最大 。
请你返回 任意 一个长度为 k 的整数子序列。
子序列 定义为从一个数组里删除一些元素后,不改变剩下元素的顺序得到的数组。
示例 1:
输入:nums = [2,1,3,3], k = 2
输出:[3,3]
解释:
子序列有最大和:3 + 3 = 6 。
示例 2:
输入:nums = [-1,-2,3,4], k = 3
输出:[-1,3,4]
解释:
子序列有最大和:-1 + 3 + 4 = 6 。
示例 3:
输入:nums = [3,4,3,3], k = 2
输出:[3,4]
解释:
子序列有最大和:3 + 4 = 7 。
另一个可行的子序列为 [4, 3] 。
提示:
1 <= nums.length <= 1000-105 <= nums[i] <= 1051 <= k <= nums.length
方法一:排序 · Go 实现
思考
要和最大且保持相对顺序。等价于选出值最大的 个下标,再按原下标排序。 ,对下标按值排序即可。
取排序后的最后 个下标,再按位置升序读出元素。
我们先创建一个索引数组 ,数组中的每个元素是数组 的下标。然后我们根据数组 的值对索引数组 进行排序,排序的规则是 ,其中 和 是索引数组 中的两个下标。
排序完成后,我们取索引数组 的最后 个元素,这 个元素对应的就是数组 中最大的 个元素。然后我们对这 个下标进行排序,得到的就是最大的 个元素在数组 中的顺序。
时间复杂度 ,空间复杂度 。其中 为数组的长度。
func maxSubsequence(nums []int, k int) []int {
	idx := slices.Clone(make([]int, len(nums)))
	for i := range idx {
		idx[i] = i
	}
	slices.SortFunc(idx, func(i, j int) int { return nums[i] - nums[j] })
	slices.Sort(idx[len(idx)-k:])
	ans := make([]int, k)
	for i := range ans {
		ans[i] = nums[idx[len(idx)-k+i]]
	}
	return ans
}2231. 按奇偶性交换后的最大数字
题目、示例与约束
给你一个正整数 num 。你可以交换 num 中 奇偶性 相同的任意两位数字(即,都是奇数或者偶数)。
返回交换 任意 次之后 num 的 最大 可能值。
示例 1:
输入:num = 1234
输出:3412
解释:交换数字 3 和数字 1 ,结果得到 3214 。
交换数字 2 和数字 4 ,结果得到 3412 。
注意,可能存在其他交换序列,但是可以证明 3412 是最大可能值。
注意,不能交换数字 4 和数字 1 ,因为它们奇偶性不同。
示例 2:
输入:num = 65875
输出:87655
解释:交换数字 8 和数字 6 ,结果得到 85675 。
交换数字 5 和数字 7 ,结果得到 87655 。
注意,可能存在其他交换序列,但是可以证明 87655 是最大可能值。
提示:
1 <= num <= 109
方法一:计数 · Go 实现
思考
只允许交换奇偶性相同的数位,要使十进制值最大。 ,数位很少,但若搜索所有合法排列仍显多余。同一奇偶类内部可以任意重排,因此每位应换成该类中尚未使用的最大数码。
先统计 到 的出现次数。从左到右看原数每一位的奇偶,从 或 起向下找仍有剩余的同奇偶数码写入答案。按位重构即可。
我们可以用一个长度为 的数组 统计整数 中所有数字出现的次数,用一个下标数组 记录当前最大可用偶数和奇数,初始时 为 。
接下来,我们依次遍历整数 的每个数字,如果数字为奇数,则取 下标为 对应的数字,否则取下标为 对应的数字。如果该数字出现的次数为 ,则需要将数字减 ,继续判断,直到存在满足条件的数。然后,我们更新答案,以及数字出现的次数,继续遍历,直到遍历到整数 。
时间复杂度 ,空间复杂度 。
func largestInteger(num int) int {
	s := []byte(fmt.Sprint(num))
	cnt := [10]int{}

	for _, c := range s {
		cnt[c-'0']++
	}

	idx := [2]int{8, 9}
	ans := 0

	for _, c := range s {
		x := int(c - '0')
		for cnt[idx[x&1]] == 0 {
			idx[x&1] -= 2
		}
		ans = ans*10 + idx[x&1]
		cnt[idx[x&1]]--
	}

	return ans
}2342. 数位和相等数对的最大和
题目、示例与约束
给你一个下标从 0 开始的数组 nums ,数组中的元素都是 正 整数。请你选出两个下标 i 和 j(i != j),且 nums[i] 的数位和 与 nums[j] 的数位和相等。
请你找出所有满足条件的下标 i 和 j ,找出并返回 nums[i] + nums[j] 可以得到的 最大值。如果不存在这样的下标对,返回 -1。
示例 1:
输入:nums = [18,43,36,13,7]
输出:54
解释:满足条件的数对 (i, j) 为:
- (0, 2) ,两个数字的数位和都是 9 ,相加得到 18 + 36 = 54 。
- (1, 4) ,两个数字的数位和都是 7 ,相加得到 43 + 7 = 50 。
所以可以获得的最大和是 54 。
示例 2:
输入:nums = [10,12,19,14]
输出:-1
解释:不存在满足条件的数对,返回 -1 。
提示:
1 <= nums.length <= 1051 <= nums[i] <= 109
方法一:哈希表 · Go 实现
思考
要在数位和相同的数中选两个使和最大。 ,不能两两比较。同一数位和只需记住迄今最大值。
遍历时算出数位和 ,若 已有记录则用「记录值 」更新答案,再把记录改成更大的那个。数位和不超过 ,也可用数组代替哈希表。
我们可以用一个哈希表 记录每个数位和对应的最大值,初始化一个答案变量 。
接下来,我们遍历数组 ,对于每个数 ,我们计算它的数位和 ,如果 在哈希表 中存在,那么我们就更新答案 。然后更新哈希表 。
最后返回答案 即可。
由于 中的元素最大为 ,因此数位和最大为 ,我们可以直接定义一个长度为 的数组 来代替哈希表。
时间复杂度 ,空间复杂度 ,其中 是数组 的长度,而 和 分别是数组 中的元素的最大值和数位和的最大值。本题中 , 。
func maximumSum(nums []int) int {
	d := [100]int{}
	ans := -1
	for _, v := range nums {
		x := 0
		for y := v; y > 0; y /= 10 {
			x += y % 10
		}
		if d[x] > 0 {
			ans = max(ans, d[x]+v)
		}
		d[x] = max(d[x], v)
	}
	return ans
}2343. 裁剪数字后查询第 K 小的数字
题目、示例与约束
给你一个下标从 0 开始的字符串数组 nums ,其中每个字符串 长度相等 且只包含数字。
再给你一个下标从 0 开始的二维整数数组 queries ,其中 queries[i] = [ki, trimi] 。对于每个 queries[i] ,你需要:
- 将
nums中每个数字 裁剪 到剩下 最右边trimi个数位。 - 在裁剪过后的数字中,找到
nums中第ki小数字对应的 下标 。如果两个裁剪后数字一样大,那么下标 更小 的数字视为更小的数字。 - 将
nums中每个数字恢复到原本字符串。
请你返回一个长度与 queries 相等的数组 answer,其中 answer[i]是第 i 次查询的结果。
提示:
- 裁剪到剩下最右边
x个数位的意思是不断删除最左边的数位,直到剩下x个数位。 nums中的字符串可能会有前导 0 。
示例 1:
输入:nums = ["102","473","251","814"], queries = [[1,1],[2,3],[4,2],[1,2]]
输出:[2,2,1,0]
解释:
1. 裁剪到只剩 1 个数位后,nums = ["2","3","1","4"] 。最小的数字是 1 ,下标为 2 。
2. 裁剪到剩 3 个数位后,nums 没有变化。第 2 小的数字是 251 ,下标为 2 。
3. 裁剪到剩 2 个数位后,nums = ["02","73","51","14"] 。第 4 小的数字是 73 ,下标为 1 。
4. 裁剪到剩 2 个数位后,最小数字是 2 ,下标为 0 。
   注意,裁剪后数字 "02" 值为 2 。
示例 2:
输入:nums = ["24","37","96","04"], queries = [[2,1],[2,2]]
输出:[3,0]
解释:
1. 裁剪到剩 1 个数位,nums = ["4","7","6","4"] 。第 2 小的数字是 4 ,下标为 3 。
   有两个 4 ,下标为 0 的 4 视为小于下标为 3 的 4 。
2. 裁剪到剩 2 个数位,nums 不变。第二小的数字是 24 ,下标为 0 。
提示:
1 <= nums.length <= 1001 <= nums[i].length <= 100nums[i]只包含数字。- 所有
nums[i].length的长度 相同 。 1 <= queries.length <= 100queries[i].length == 21 <= ki <= nums.length1 <= trimi <= nums[0].length
进阶:你能使用 基数排序算法 解决此问题吗?这种解法的复杂度又是多少?
方法一:模拟 · Go 实现
思考
每次查询只看每个数最右侧 位,再取第 小的原下标。数组与查询规模有限,按查询模拟排序即可。
对每个 取出后缀字符串并带原下标排序,答案为第 个的下标。字符串比较自然处理前导零。
根据题意,我们可以模拟裁剪过程,然后对裁剪后的字符串进行排序,最后根据下标找到对应的数字即可。
时间复杂度 ,空间复杂度 。其中 和 分别为 和 的长度,而 为 字符串的长度。
func smallestTrimmedNumbers(nums []string, queries [][]int) []int {
	type pair struct {
		s string
		i int
	}
	ans := make([]int, len(queries))
	t := make([]pair, len(nums))
	for i, q := range queries {
		for j, s := range nums {
			t[j] = pair{s[len(s)-q[1]:], j}
		}
		sort.Slice(t, func(i, j int) bool { a, b := t[i], t[j]; return a.s < b.s || a.s == b.s && a.i < b.i })
		ans[i] = t[q[0]-1].i
	}
	return ans
}2344. 使数组可以被整除的最少删除次数
题目、示例与约束
给你两个正整数数组 nums 和 numsDivide 。你可以从 nums 中删除任意数目的元素。
请你返回使 nums 中 最小 元素可以整除 numsDivide 中所有元素的 最少 删除次数。如果无法得到这样的元素,返回 -1 。
如果 y % x == 0 ,那么我们说整数 x 整除 y 。
示例 1:
输入:nums = [2,3,2,4,3], numsDivide = [9,6,9,3,15]
输出:2
解释:
[2,3,2,4,3] 中最小元素是 2 ,它无法整除 numsDivide 中所有元素。
我们从 nums 中删除 2 个大小为 2 的元素,得到 nums = [3,4,3] 。
[3,4,3] 中最小元素为 3 ,它可以整除 numsDivide 中所有元素。
可以证明 2 是最少删除次数。
示例 2:
输入:nums = [4,3,6], numsDivide = [8,2,6,10]
输出:-1
解释:
我们想 nums 中的最小元素可以整除 numsDivide 中的所有元素。
没有任何办法可以达到这一目的。
提示:
1 <= nums.length, numsDivide.length <= 1051 <= nums[i], numsDivide[i] <= 109
方法一:数学 + 排序 · Go 实现
思考
删去若干元素后,剩下的最小值须整除 中每一个。该最小值必是 的因子。 可达 。
先求 ,再将 升序扫描,第一个整除 的值之前的个数即为删除次数;若没有则无解。
如果一个元素能整除数组 numsDivide 所有元素,那么这个元素是所有 的最大公约数 的因子。因此,我们可以先求出 numsDivide 的最大公约数 。
接下来,将数组 nums 排序,然后从头到尾遍历数组 nums,找到第一个是最大公约数 的因子的元素,返回当前元素下标即可。
时间复杂度 ,其中 和 分别是数组 nums 和 numsDivide 的长度,而 是数组 numsDivide 中的最大值。
func minOperations(nums []int, numsDivide []int) int {
	x := 0
	for _, v := range numsDivide {
		x = gcd(x, v)
	}
	sort.Ints(nums)
	for i, v := range nums {
		if x%v == 0 {
			return i
		}
	}
	return -1
}

func gcd(a, b int) int {
	if b == 0 {
		return a
	}
	return gcd(b, a%b)
}
方法二:数学 + 枚举(无需排序) · Go 实现
思考
方法一为找最小合法因子而排序。直接扫描得到能整除 的最小 ,再数小于 的元素,时间降为线性。
求出 numsDivide 的最大公约数 后,直接遍历 nums 找到能整除 的最小元素 ,再统计小于 的元素个数。无需排序。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 nums 和 numsDivide 的长度,而 是数组 numsDivide 中的最大值。
func minOperations(nums []int, numsDivide []int) int {
	x := 0
	for _, v := range numsDivide {
		x = gcd(x, v)
	}
	y := 1 << 30
	for _, v := range nums {
		if x%v == 0 {
			y = min(y, v)
		}
	}
	if y == 1<<30 {
		return -1
	}
	ans := 0
	for _, v := range nums {
		if v < y {
			ans++
		}
	}
	return ans
}

func gcd(a, b int) int {
	if b == 0 {
		return a
	}
	return gcd(b, a%b)
}2386. 找出数组的第 K 大和
题目、示例与约束
给你一个整数数组 nums 和一个 正 整数 k 。你可以选择数组的任一 子序列 并且对其全部元素求和。
数组的 第 k 大和 定义为:可以获得的第 k 个 最大 子序列和(子序列和允许出现重复)
返回数组的 第 k 大和 。
子序列是一个可以由其他数组删除某些或不删除元素派生而来的数组,且派生过程不改变剩余元素的顺序。
注意:空子序列的和视作 0 。
示例 1:
输入:nums = [2,4,-2], k = 5
输出:2
解释:所有可能获得的子序列和列出如下,按递减顺序排列:
6、4、4、2、2、0、0、-2
数组的第 5 大和是 2 。
示例 2:
输入:nums = [1,-2,3,4,-10,12], k = 16
输出:10
解释:数组的第 16 大和是 10 。
提示:
n == nums.length1 <= n <= 105-109 <= nums[i] <= 1091 <= k <= min(2000, 2n)
方法一:优先队列(小根堆) · Go 实现
思考
子序列和的第 大。最大和 是全体正数之和,其余和等于 减去某段绝对值子序列。 且 ,不能枚举 。
把绝对值排序后,用小根堆按不降顺序展开子序列和:每次弹出 ,再压入「加上 」与「用 替换 」。第 次弹出后堆顶即第 小的减去量。
首先,我们找到最大的子序和 ,即所有正数之和。
可以发现,其他子序列的和,都可以看成在这个最大子序列和之上,减去其他部分子序列之和得到。因此,我们可以将问题转换为求第 小的子序列和。
只需要将所有数的绝对值升序排列,之后建立小根堆,存储二元组 ,表示当前和为 ,且下一个待选择的数字的下标为 的子序列。
每次取出堆顶,并放入两种新情况:一是再选择下一位,二是选择下一位并且不选择本位。
由于数组是从小到大排序,这种方式能够不重不漏地按序遍历完所有的子序列和。
时间复杂度 。其中 是数组 的长度。空间复杂度 。
func kSum(nums []int, k int) int64 {
	mx := 0
	for i, x := range nums {
		if x > 0 {
			mx += x
		} else {
			nums[i] *= -1
		}
	}
	sort.Ints(nums)
	h := &hp{{0, 0}}
	for k > 1 {
		k--
		p := heap.Pop(h).(pair)
		if p.i < len(nums) {
			heap.Push(h, pair{p.sum + nums[p.i], p.i + 1})
			if p.i > 0 {
				heap.Push(h, pair{p.sum + nums[p.i] - nums[p.i-1], p.i + 1})
			}
		}
	}
	return int64(mx) - int64((*h)[0].sum)
}

type pair struct{ sum, i int }
type hp []pair

func (h hp) Len() int           { return len(h) }
func (h hp) Less(i, j int) bool { return h[i].sum < h[j].sum }
func (h hp) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)        { *h = append(*h, v.(pair)) }
func (h *hp) Pop() any { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }继续阅读
- 实践案例
- 实践案例
- 实践案例