
LeetCode Go · 二分查找(6)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
2970. 统计移除递增子数组的数目 I
题目、示例与约束
给你一个下标从 0 开始的 正 整数数组 nums 。
如果 nums 的一个子数组满足:移除这个子数组后剩余元素 严格递增 ,那么我们称这个子数组为 移除递增 子数组。比方说,[5, 3, 4, 6, 7] 中的 [3, 4] 是一个移除递增子数组,因为移除该子数组后,[5, 3, 4, 6, 7] 变为 [5, 6, 7] ,是严格递增的。
请你返回 nums 中 移除递增 子数组的总数目。
注意 ,剩余元素为空的数组也视为是递增的。
子数组 指的是一个数组中一段非空且连续的元素序列。
示例 1:
输入:nums = [1,2,3,4]
输出:10
解释:10 个移除递增子数组分别为:[1], [2], [3], [4], [1,2], [2,3], [3,4], [1,2,3], [2,3,4] 和 [1,2,3,4]。移除任意一个子数组后,剩余元素都是递增的。注意,空数组不是移除递增子数组。
示例 2:
输入:nums = [6,5,7,8]
输出:7
解释:7 个移除递增子数组分别为:[5], [6], [5,7], [6,5], [5,7,8], [6,5,7] 和 [6,5,7,8] 。
nums 中只有这 7 个移除递增子数组。
示例 3:
输入:nums = [8,7,6,6]
输出:3
解释:3 个移除递增子数组分别为:[8,7,6], [7,6,6] 和 [8,7,6,6] 。注意 [8,7] 不是移除递增子数组因为移除 [8,7] 后 nums 变为 [6,6] ,它不是严格递增的。
提示:
1 <= nums.length <= 501 <= nums[i] <= 50
方法一:双指针 · Go 实现
思考
删除一段后剩余须严格递增,即剩余为递增前缀、递增后缀,或二者拼接且衔接处仍递增。先找到最长严格递增前缀右端 ;若已覆盖全数组,则任意子数组都可删,答案为 。
否则从右扫递增后缀,左指针 回退到 ,每个后缀起点贡献 种前缀(含空前缀)。 ,双指针已足够,并与 II 共用。
根据题目描述,移除一个子数组后,剩余元素严格递增,那么存在以下几种情况:
- 剩余元素仅包含数组 的前缀(可以为空);
- 剩余元素仅包含数组 的后缀;
- 剩余元素包含数组 的前缀和后缀。
其中第 和第 种情况可以合并为一种情况,即剩余元素包含数组 的后缀。即一共有以下两种情况:
- 剩余元素仅包含数组 的前缀(可以为空);
- 剩余元素包含数组 的后缀。
我们先考虑第一种情况,即剩余元素仅包含数组 的前缀。我们可以用一个指针 指向数组 的最长递增前缀的最后一个元素,即 ,那么剩余元素的个数为 ,其中 为数组 的长度。因此,对于这种情况,要使得剩余元素严格递增,我们可以选择移除以下子数组:
- ;
- ;
- ;
- ;
- ;
- 。
这一共有 种情况,因此对于这种情况,移除递增子数组的数目为 。
再考虑第二种情况,即剩余元素包含数组 的后缀。我们可以用一个指针 指向数组 的递增后缀的第一个元素,我们在 的范围内枚举 作为递增后缀的第一个元素,每一次,我们需要移动指针 使得 ,那么移除递增子数组的数组增加 。当 时,我们停止枚举,因为此时后缀不是严格递增。
时间复杂度 ,其中 是数组 的长度。空间复杂度 。
func incremovableSubarrayCount(nums []int) int {
	i, n := 0, len(nums)
	for i+1 < n && nums[i] < nums[i+1] {
		i++
	}
	if i == n-1 {
		return n * (n + 1) / 2
	}
	ans := i + 2
	for j := n - 1; j > 0; j-- {
		for i >= 0 && nums[i] >= nums[j] {
			i--
		}
		ans += i + 2
		if nums[j-1] >= nums[j] {
			break
		}
	}
	return ans
}2972. 统计移除递增子数组的数目 II
题目、示例与约束
给你一个下标从 0 开始的 正 整数数组 nums 。
如果 nums 的一个子数组满足:移除这个子数组后剩余元素 严格递增 ,那么我们称这个子数组为 移除递增 子数组。比方说,[5, 3, 4, 6, 7] 中的 [3, 4] 是一个移除递增子数组,因为移除该子数组后,[5, 3, 4, 6, 7] 变为 [5, 6, 7] ,是严格递增的。
请你返回 nums 中 移除递增 子数组的总数目。
注意 ,剩余元素为空的数组也视为是递增的。
子数组 指的是一个数组中一段连续的元素序列。
示例 1:
输入:nums = [1,2,3,4]
输出:10
解释:10 个移除递增子数组分别为:[1], [2], [3], [4], [1,2], [2,3], [3,4], [1,2,3], [2,3,4] 和 [1,2,3,4]。移除任意一个子数组后,剩余元素都是递增的。注意,空数组不是移除递增子数组。
示例 2:
输入:nums = [6,5,7,8]
输出:7
解释:7 个移除递增子数组分别为:[5], [6], [5,7], [6,5], [5,7,8], [6,5,7] 和 [6,5,7,8] 。
nums 中只有这 7 个移除递增子数组。
示例 3:
输入:nums = [8,7,6,6]
输出:3
解释:3 个移除递增子数组分别为:[8,7,6], [7,6,6] 和 [8,7,6,6] 。注意 [8,7] 不是移除递增子数组因为移除 [8,7] 后 nums 变为 [6,6] ,它不是严格递增的。
提示:
1 <= nums.length <= 1051 <= nums[i] <= 109
方法一:双指针 · Go 实现
思考
题意与 I 相同,但 ,三重枚举不可行。剩余部分仍只能是递增前缀、递增后缀或其衔接,双指针对前缀右端与后缀左端各移动至多一次。
算法与 I 一致:整段递增则返回三角形数,否则后缀指针左移、前缀指针回退并累加。总时间 。
根据题目描述,移除一个子数组后,剩余元素严格递增,那么存在以下几种情况:
- 剩余元素仅包含数组 的前缀(可以为空);
- 剩余元素仅包含数组 的后缀;
- 剩余元素包含数组 的前缀和后缀。
其中第 和第 种情况可以合并为一种情况,即剩余元素包含数组 的后缀。即一共有以下两种情况:
- 剩余元素仅包含数组 的前缀(可以为空);
- 剩余元素包含数组 的后缀。
我们先考虑第一种情况,即剩余元素仅包含数组 的前缀。我们可以用一个指针 指向数组 的最长递增前缀的最后一个元素,即 ,那么剩余元素的个数为 ,其中 为数组 的长度。因此,对于这种情况,要使得剩余元素严格递增,我们可以选择移除以下子数组:
- ;
- ;
- ;
- ;
- ;
- 。
这一共有 种情况,因此对于这种情况,移除递增子数组的数目为 。
再考虑第二种情况,即剩余元素包含数组 的后缀。我们可以用一个指针 指向数组 的递增后缀的第一个元素,我们在 的范围内枚举 作为递增后缀的第一个元素,每一次,我们需要移动指针 使得 ,那么移除递增子数组的数组增加 。当 时,我们停止枚举,因为此时后缀不是严格递增。
时间复杂度 ,其中 是数组 的长度。空间复杂度 。
func incremovableSubarrayCount(nums []int) int64 {
	i, n := 0, len(nums)
	for i+1 < n && nums[i] < nums[i+1] {
		i++
	}
	if i == n-1 {
		return int64(n * (n + 1) / 2)
	}
	ans := int64(i + 2)
	for j := n - 1; j > 0; j-- {
		for i >= 0 && nums[i] >= nums[j] {
			i--
		}
		ans += int64(i + 2)
		if nums[j-1] >= nums[j] {
			break
		}
	}
	return ans
}2981. 找出出现至少三次的最长特殊子字符串 I
题目、示例与约束
给你一个仅由小写英文字母组成的字符串 s 。
如果一个字符串仅由单一字符组成,那么它被称为 特殊 字符串。例如,字符串 "abc" 不是特殊字符串,而字符串 "ddd"、"zz" 和 "f" 是特殊字符串。
返回在 s 中出现 至少三次 的 最长特殊子字符串 的长度,如果不存在出现至少三次的特殊子字符串,则返回 -1 。
子字符串 是字符串中的一个连续 非空 字符序列。
示例 1:
输入:s = "aaaa"
输出:2
解释:出现三次的最长特殊子字符串是 "aa" :子字符串 "aaaa"、"aaaa" 和 "aaaa"。
可以证明最大长度是 2 。
示例 2:
输入:s = "abcdef"
输出:-1
解释:不存在出现至少三次的特殊子字符串。因此返回 -1 。
示例 3:
输入:s = "abcaba"
输出:1
解释:出现三次的最长特殊子字符串是 "a" :子字符串 "abcaba"、"abcaba" 和 "abcaba"。
可以证明最大长度是 1 。
提示:
3 <= s.length <= 50s仅由小写英文字母组成。
方法一:二分查找 + 滑动窗口计数 · Go 实现
思考
特殊子串由同一字符组成。长度 可行则 也可行,故二分 。一段连续相同字符长度为 时,其中长为 的子串有 个,按字符累加后看是否达到 。
,二分再线性计数即可。
我们注意到,如果一个长度为 且出现至少三次的特殊子字符串存在,那么长度为 的特殊子字符串也一定存在,这存在着单调性,因此我们可以使用二分查找的方法来找到最长的特殊子字符串。
我们定义二分查找的左边界 ,右边界 ,其中 是字符串的长度。每次二分查找的过程中,我们取 ,如果长度为 的特殊子字符串存在,那么我们就将左边界更新为 ,否则我们就将右边界更新为 。在二分查找的过程中,我们使用滑动窗口来计算特殊子字符串的个数。
具体地,我们设计一个函数 ,表示长度为 且出现至少三次的特殊子字符串是否存在。
在函数 中,我们定义一个哈希表或长度为 的数组 ,其中 表示长度为 ,且由第 个小写字母组成的特殊子字符串的个数。我们遍历字符串 ,如果当前遍历到的字符为 ,那么我们将指针 向右移动,直到 ,此时 就是一个长度为 的特殊子字符串,我们将 增加 ,然后将指针 更新为 。
在遍历结束之后,我们遍历数组 ,如果存在 ,那么就说明长度为 且出现至少三次的特殊子字符串存在,我们返回 ,否则返回 。
时间复杂度 ,空间复杂度 ,其中 是字符串 的长度,而 表示字符集的大小,本题中字符集为小写英文字母,因此 。
func maximumLength(s string) int {
	n := len(s)
	l, r := 0, n
	check := func(x int) bool {
		cnt := [26]int{}
		for i := 0; i < n; {
			j := i + 1
			for j < n && s[j] == s[i] {
				j++
			}
			k := s[i] - 'a'
			cnt[k] += max(0, j-i-x+1)
			if cnt[k] >= 3 {
				return true
			}
			i = j
		}
		return false
	}
	for l < r {
		mid := (l + r + 1) >> 1
		if check(mid) {
			l = mid
		} else {
			r = mid - 1
		}
	}
	if l == 0 {
		return -1
	}
	return l
}2982. 找出出现至少三次的最长特殊子字符串 II
题目、示例与约束
给你一个仅由小写英文字母组成的字符串 s 。
如果一个字符串仅由单一字符组成,那么它被称为 特殊 字符串。例如,字符串 "abc" 不是特殊字符串,而字符串 "ddd"、"zz" 和 "f" 是特殊字符串。
返回在 s 中出现 至少三次 的 最长特殊子字符串 的长度,如果不存在出现至少三次的特殊子字符串,则返回 -1 。
子字符串 是字符串中的一个连续 非空 字符序列。
示例 1:
输入:s = "aaaa"
输出:2
解释:出现三次的最长特殊子字符串是 "aa" :子字符串 "aaaa"、"aaaa" 和 "aaaa"。
可以证明最大长度是 2 。
示例 2:
输入:s = "abcdef"
输出:-1
解释:不存在出现至少三次的特殊子字符串。因此返回 -1 。
示例 3:
输入:s = "abcaba"
输出:1
解释:出现三次的最长特殊子字符串是 "a" :子字符串 "abcaba"、"abcaba" 和 "abcaba"。
可以证明最大长度是 1 。
提示:
3 <= s.length <= 5 * 105s仅由小写英文字母组成。
方法一:二分查找 + 滑动窗口计数 · Go 实现
思考
题意与 I 相同,但 ,不能对每个长度暴力建表。可行性对长度仍单调,二分 后对每段 run 用 计数,总检查 。
实现与 I 的方法一相同,仅数据范围要求必须采用对数轮而非把所有子串放入哈希表。
我们注意到,如果一个长度为 且出现至少三次的特殊子字符串存在,那么长度为 的特殊子字符串也一定存在,这存在着单调性,因此我们可以使用二分查找的方法来找到最长的特殊子字符串。
我们定义二分查找的左边界 ,右边界 ,其中 是字符串的长度。每次二分查找的过程中,我们取 ,如果长度为 的特殊子字符串存在,那么我们就将左边界更新为 ,否则我们就将右边界更新为 。在二分查找的过程中,我们使用滑动窗口来计算特殊子字符串的个数。
具体地,我们设计一个函数 ,表示长度为 且出现至少三次的特殊子字符串是否存在。
在函数 中,我们定义一个哈希表或长度为 的数组 ,其中 表示长度为 ,且由第 个小写字母组成的特殊子字符串的个数。我们遍历字符串 ,如果当前遍历到的字符为 ,那么我们将指针 向右移动,直到 ,此时 就是一个长度为 的特殊子字符串,我们将 增加 ,然后将指针 更新为 。
在遍历结束之后,我们遍历数组 ,如果存在 ,那么就说明长度为 且出现至少三次的特殊子字符串存在,我们返回 ,否则返回 。
时间复杂度 ,空间复杂度 ,其中 是字符串 的长度,而 表示字符集的大小,本题中字符集为小写英文字母,因此 。
func maximumLength(s string) int {
	n := len(s)
	l, r := 0, n
	check := func(x int) bool {
		cnt := [26]int{}
		for i := 0; i < n; {
			j := i + 1
			for j < n && s[j] == s[i] {
				j++
			}
			k := s[i] - 'a'
			cnt[k] += max(0, j-i-x+1)
			if cnt[k] >= 3 {
				return true
			}
			i = j
		}
		return false
	}
	for l < r {
		mid := (l + r + 1) >> 1
		if check(mid) {
			l = mid
		} else {
			r = mid - 1
		}
	}
	if l == 0 {
		return -1
	}
	return l
}3006. 找出数组中的美丽下标 I
题目、示例与约束
给你一个下标从 0 开始的字符串 s 、字符串 a 、字符串 b 和一个整数 k 。
如果下标 i 满足以下条件,则认为它是一个 美丽下标:
0 <= i <= s.length - a.lengths[i..(i + a.length - 1)] == a- 存在下标
j使得:0 <= j <= s.length - b.lengths[j..(j + b.length - 1)] == b|j - i| <= k
以数组形式按 从小到大排序 返回美丽下标。
示例 1:
输入:s = "isawsquirrelnearmysquirrelhouseohmy", a = "my", b = "squirrel", k = 15
输出:[16,33]
解释:存在 2 个美丽下标:[16,33]。
- 下标 16 是美丽下标,因为 s[16..17] == "my" ,且存在下标 4 ,满足 s[4..11] == "squirrel" 且 |16 - 4| <= 15 。
- 下标 33 是美丽下标,因为 s[33..34] == "my" ,且存在下标 18 ,满足 s[18..25] == "squirrel" 且 |33 - 18| <= 15 。
因此返回 [16,33] 作为结果。
示例 2:
输入:s = "abcd", a = "a", b = "a", k = 4
输出:[0]
解释:存在 1 个美丽下标:[0]。
- 下标 0 是美丽下标,因为 s[0..0] == "a" ,且存在下标 0 ,满足 s[0..0] == "a" 且 |0 - 0| <= 4 。
因此返回 [0] 作为结果。
提示:
1 <= k <= s.length <= 1051 <= a.length, b.length <= 10s、a、和b只包含小写英文字母。
方法一 · Go 实现
思考
,而 ,朴素在每个位置比较模式可行,但随后对出现位置两两判定 会达到平方级。
模式匹配可用 KMP 在线性时间内列出 、 的全部出现下标。两组下标均单调,对每个 只需在 的列表上推进指针,寻找距离不超过 的最近 。
代码先求前缀函数再搜索,随后用双指针扫描两份出现列表。
func beautifulIndices(s string, a string, b string, k int) []int {

	s_len := len(s)
	a_len := len(a)
	b_len := len(b)

	final := make([]int, 0)
	lps_a := make([]int, a_len)
	lps_b := make([]int, b_len)
	a_index := make([]int, 0)
	b_index := make([]int, 0)

	var pat func(lps []int, s_l int, pattern string)

	pat = func(lps []int, s_l int, pattern string) {

		l := 0
		lps[0] = 0
		i := 1

		for i < s_l {
			if pattern[i] == pattern[l] {
				l++
				lps[i] = l
				i++
			} else {
				if l != 0 {
					l = lps[l-1]
				} else {
					lps[i] = l
					i++
				}
			}
		}
	}

	pat(lps_a, a_len, a)
	pat(lps_b, b_len, b)

	var kmp func(pat string, pat_l int, lps []int, index *[]int)

	kmp = func(pat string, pat_l int, lps []int, index *[]int) {
		i := 0
		j := 0
		for s_len-i >= pat_l-j {
			if s[i] == pat[j] {
				i++
				j++
			}
			if j == pat_l {
				*index = append(*index, i-pat_l)
				j = lps[j-1]
			} else if s[i] != pat[j] {
				if j != 0 {
					j = lps[j-1]
				} else {
					i++
				}
			}
		}
	}

	kmp(a, a_len, lps_a, &a_index)
	kmp(b, b_len, lps_b, &b_index)

	// fmt.Println(a_index, b_index)

	i := 0
	j := 0

	for i < len(a_index) && j < len(b_index) {
		if a_index[i]+k >= b_index[j] && a_index[i]-k <= b_index[j] {
			final = append(final, a_index[i])
			i++
		} else if a_index[i]-k > b_index[j] {
			j++
		} else {
			i++
		}
	}

	return final
}3008. 找出数组中的美丽下标 II
题目、示例与约束
给你一个下标从 0 开始的字符串 s 、字符串 a 、字符串 b 和一个整数 k 。
如果下标 i 满足以下条件,则认为它是一个 美丽下标 :
0 <= i <= s.length - a.lengths[i..(i + a.length - 1)] == a- 存在下标
j使得:0 <= j <= s.length - b.lengths[j..(j + b.length - 1)] == b|j - i| <= k
以数组形式按 从小到大排序 返回美丽下标。
示例 1:
输入:s = "isawsquirrelnearmysquirrelhouseohmy", a = "my", b = "squirrel", k = 15
输出:[16,33]
解释:存在 2 个美丽下标:[16,33]。
- 下标 16 是美丽下标,因为 s[16..17] == "my" ,且存在下标 4 ,满足 s[4..11] == "squirrel" 且 |16 - 4| <= 15 。
- 下标 33 是美丽下标,因为 s[33..34] == "my" ,且存在下标 18 ,满足 s[18..25] == "squirrel" 且 |33 - 18| <= 15 。
因此返回 [16,33] 作为结果。
示例 2:
输入:s = "abcd", a = "a", b = "a", k = 4
输出:[0]
解释:存在 1 个美丽下标:[0]。
- 下标 0 是美丽下标,因为 s[0..0] == "a" ,且存在下标 0 ,满足 s[0..0] == "a" 且 |0 - 0| <= 4 。
因此返回 [0] 作为结果。
提示:
1 <= k <= s.length <= 5 * 1051 <= a.length, b.length <= 5 * 105s、a、和b只包含小写英文字母。
方法一 · Go 实现
思考
与 I 相同,但 、 可与 同阶且达到 ,朴素匹配与平方配对均不可用。
KMP 对任意模式长度仍是线性的,出现下标依然有序,因而同一套「KMP + 双指针」在更大约束下仍然成立。
实现与 I 一致:分别对 、 求前缀函数并搜索,再在两份有序列表上推进。
func beautifulIndices(s string, a string, b string, k int) []int {

	s_len := len(s)
	a_len := len(a)
	b_len := len(b)

	final := make([]int, 0)
	lps_a := make([]int, a_len)
	lps_b := make([]int, b_len)
	a_index := make([]int, 0)
	b_index := make([]int, 0)

	var pat func(lps []int, s_l int, pattern string)

	pat = func(lps []int, s_l int, pattern string) {

		l := 0
		lps[0] = 0
		i := 1

		for i < s_l {
			if pattern[i] == pattern[l] {
				l++
				lps[i] = l
				i++
			} else {
				if l != 0 {
					l = lps[l-1]
				} else {
					lps[i] = l
					i++
				}
			}
		}
	}

	pat(lps_a, a_len, a)
	pat(lps_b, b_len, b)

	var kmp func(pat string, pat_l int, lps []int, index *[]int)

	kmp = func(pat string, pat_l int, lps []int, index *[]int) {
		i := 0
		j := 0
		for s_len-i >= pat_l-j {
			if s[i] == pat[j] {
				i++
				j++
			}
			if j == pat_l {
				*index = append(*index, i-pat_l)
				j = lps[j-1]
			} else if s[i] != pat[j] {
				if j != 0 {
					j = lps[j-1]
				} else {
					i++
				}
			}
		}
	}

	kmp(a, a_len, lps_a, &a_index)
	kmp(b, b_len, lps_b, &b_index)

	// fmt.Println(a_index, b_index)

	i := 0
	j := 0

	for i < len(a_index) && j < len(b_index) {
		if a_index[i]+k >= b_index[j] && a_index[i]-k <= b_index[j] {
			final = append(final, a_index[i])
			i++
		} else if a_index[i]-k > b_index[j] {
			j++
		} else {
			i++
		}
	}

	return final
}3048. 标记所有下标的最早秒数 I
题目、示例与约束
给你两个下标从 1 开始的整数数组 nums 和 changeIndices ,数组的长度分别为 n 和 m 。
一开始,nums 中所有下标都是未标记的,你的任务是标记 nums 中 所有 下标。
从第 1 秒到第 m 秒(包括 第 m 秒),对于每一秒 s ,你可以执行以下操作 之一 :
- 选择范围
[1, n]中的一个下标i,并且将nums[i]减少1。 - 如果
nums[changeIndices[s]]等于0,标记 下标changeIndices[s]。 - 什么也不做。
请你返回范围 [1, m] 中的一个整数,表示最优操作下,标记 nums 中 所有 下标的 最早秒数 ,如果无法标记所有下标,返回 -1 。
示例 1:
输入:nums = [2,2,0], changeIndices = [2,2,2,2,3,2,2,1] 输出:8 解释:这个例子中,我们总共有 8 秒。按照以下操作标记所有下标: 第 1 秒:选择下标 1 ,将 nums[1] 减少 1 。nums 变为 [1,2,0] 。 第 2 秒:选择下标 1 ,将 nums[1] 减少 1 。nums 变为 [0,2,0] 。 第 3 秒:选择下标 2 ,将 nums[2] 减少 1 。nums 变为 [0,1,0] 。 第 4 秒:选择下标 2 ,将 nums[2] 减少 1 。nums 变为 [0,0,0] 。 第 5 秒,标记 changeIndices[5] ,也就是标记下标 3 ,因为 nums[3] 等于 0 。 第 6 秒,标记 changeIndices[6] ,也就是标记下标 2 ,因为 nums[2] 等于 0 。 第 7 秒,什么也不做。 第 8 秒,标记 changeIndices[8] ,也就是标记下标 1 ,因为 nums[1] 等于 0 。 现在所有下标已被标记。 最早可以在第 8 秒标记所有下标。 所以答案是 8 。
示例 2:
输入:nums = [1,3], changeIndices = [1,1,1,2,1,1,1] 输出:6 解释:这个例子中,我们总共有 7 秒。按照以下操作标记所有下标: 第 1 秒:选择下标 2 ,将 nums[2] 减少 1 。nums 变为 [1,2] 。 第 2 秒:选择下标 2 ,将 nums[2] 减少 1 。nums 变为 [1,1] 。 第 3 秒:选择下标 2 ,将 nums[2] 减少 1 。nums 变为 [1,0] 。 第 4 秒:标记 changeIndices[4] ,也就是标记下标 2 ,因为 nums[2] 等于 0 。 第 5 秒:选择下标 1 ,将 nums[1] 减少 1 。nums 变为 [0,0] 。 第 6 秒:标记 changeIndices[6] ,也就是标记下标 1 ,因为 nums[1] 等于 0 。 现在所有下标已被标记。 最早可以在第 6 秒标记所有下标。 所以答案是 6 。
示例 3:
Input: nums = [0,1], changeIndices = [2,2,2]
Output: -1
Explanation: 这个例子中,无法标记所有下标,因为下标 1 不在 changeIndices 中。
所以答案是 -1 。
提示:
1 <= n == nums.length <= 20000 <= nums[i] <= 1091 <= m == changeIndices.length <= 20001 <= changeIndices[i] <= n
方法一:二分查找 · Go 实现
思考
第 秒只能把 对应的值减一或标记(需已为 )。 。能在 秒完成则更长时间也能完成。
每个下标应尽量在其于前 秒中最后一次出现时再标记,以便把更早的秒用来减其它数。
对 二分:用最后出现时刻表模拟,非最后出现的秒当作一次减一额度;最后出现时额度必须够 。
我们注意到,如果我们能够在 秒内标记所有下标,那么我们也能在 秒内标记所有下标。因此,我们可以使用二分查找的方法找到最早的秒数。
我们定义二分查找的左右边界分别为 和 ,其中 是数组 changeIndices 的长度。对于每一个 ,我们检查是否能在 秒内标记所有下标。如果能,我们将右边界移动到 ,否则我们将左边界移动到 。最终,我们判定左边界是否大于 ,如果是则返回 ,否则返回左边界。
题目的关键在于如何判断是否能在 秒内标记所有下标。我们可以使用一个数组 记录每一个下标最晚需要被标记的时间,用一个变量 记录当前可以减少的次数,用一个变量 记录已经被标记的下标的数量。
我们遍历数组 changeIndices 的前 个元素,对于每一个元素 ,如果 ,那么我们需要检查 是否大于等于 ,如果是,我们将 减去 ,并且将 加一;否则,我们返回 False。如果 ,那么我们可以暂时不标记下标,因此将 加一。最后,我们检查 是否等于 ,如果是,我们返回 True,否则返回 False。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 nums 和 changeIndices 的长度。
func earliestSecondToMarkIndices(nums []int, changeIndices []int) int {
	n, m := len(nums), len(changeIndices)
	l := sort.Search(m+1, func(t int) bool {
		last := make([]int, n+1)
		for s, i := range changeIndices[:t] {
			last[i] = s
		}
		decrement, marked := 0, 0
		for s, i := range changeIndices[:t] {
			if last[i] == s {
				if decrement < nums[i-1] {
					return false
				}
				decrement -= nums[i-1]
				marked++
			} else {
				decrement++
			}
		}
		return marked == n
	})
	if l > m {
		return -1
	}
	return l
}3113. 边界元素是最大值的子数组数目
题目、示例与约束
给你一个 正 整数数组 nums 。
请你求出 nums 中有多少个子数组,满足子数组中 第一个 和 最后一个 元素都是这个子数组中的 最大 值。
示例 1:
输入:nums = [1,4,3,3,2]
输出:6
解释:
总共有 6 个子数组满足第一个元素和最后一个元素都是子数组中的最大值:
- 子数组
[1,4,3,3,2],最大元素为 1 ,第一个和最后一个元素都是 1 。 - 子数组
[1,4,3,3,2],最大元素为 4 ,第一个和最后一个元素都是 4 。 - 子数组
[1,4,3,3,2],最大元素为 3 ,第一个和最后一个元素都是 3 。 - 子数组
[1,4,3,3,2],最大元素为 3 ,第一个和最后一个元素都是 3 。 - 子数组
[1,4,3,3,2],最大元素为 2 ,第一个和最后一个元素都是 2 。 - 子数组
[1,4,3,3,2],最大元素为 3 ,第一个和最后一个元素都是 3 。
所以我们返回 6 。
示例 2:
输入:nums = [3,3,3]
输出:6
解释:
总共有 6 个子数组满足第一个元素和最后一个元素都是子数组中的最大值:
- 子数组
[3,3,3],最大元素为 3 ,第一个和最后一个元素都是 3 。 - 子数组
[3,3,3],最大元素为 3 ,第一个和最后一个元素都是 3 。 - 子数组
[3,3,3],最大元素为 3 ,第一个和最后一个元素都是 3 。 - 子数组
[3,3,3],最大元素为 3 ,第一个和最后一个元素都是 3 。 - 子数组
[3,3,3],最大元素为 3 ,第一个和最后一个元素都是 3 。 - 子数组
[3,3,3],最大元素为 3 ,第一个和最后一个元素都是 3 。
所以我们返回 6 。
示例 3:
输入:nums = [1]
输出:1
解释:
nums 中只有一个子数组 [1] ,最大元素为 1 ,第一个和最后一个元素都是 1 。
所以我们返回 1 。
提示:
1 <= nums.length <= 1051 <= nums[i] <= 109
方法一:单调栈 · Go 实现
思考
合法子数组要求两端相等且为区间最大值。枚举两端再检查中间最大值,时间为 ,在 较大时偏慢。
以当前值 为两端时,中间不能出现更大的数。从左扫描时,上一个更大元素会隔断所有以 为右端的更长段。
维护单调递减栈,栈中记录值及其连续可延伸次数。弹出所有小于 的段后,若栈顶等于 则次数加一,否则新开一段。每次把栈顶次数加入答案,即统计了全部以 为右边界的合法子数组。
我们考虑以数组 中的每个元素 作为子数组的边界元素且最大值的情况。
每个长度为 的子数组都满足条件,而对于长度大于 的子数组,子数组中的所有元素都不能大于边界元素 ,我们可以用单调栈来实现。
我们维护一个从栈底到栈顶单调递减的栈,单调栈的每个元素是一个二元组 ,表示元素 且以 为边界元素且最大值的子数组的个数为 。
我们从左到右遍历数组 ,对于每个元素 ,我们不断地将栈顶元素弹出,直到栈为空或者栈顶元素的第一个元素大于等于 。如果栈为空,或者栈顶元素的第一个元素大于 ,说明当前遇到第一个边界元素为 且最大值的子数组,该子数组的长度为 ,所以我们将 入栈。如果栈顶元素的第一个元素等于 ,说明当前遇到的边界元素为 且最大值的子数组,我们将栈顶元素的第二个元素加 。然后,我们将栈顶元素的第二个元素加到答案中。
遍历结束后,返回答案即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func numberOfSubarrays(nums []int) (ans int64) {
	stk := [][2]int{}
	for _, x := range nums {
		for len(stk) > 0 && stk[len(stk)-1][0] < x {
			stk = stk[:len(stk)-1]
		}
		if len(stk) == 0 || stk[len(stk)-1][0] > x {
			stk = append(stk, [2]int{x, 1})
		} else {
			stk[len(stk)-1][1]++
		}
		ans += int64(stk[len(stk)-1][1])
	}
	return
}3116. 单面值组合的第 K 小金额
题目、示例与约束
给你一个整数数组 coins 表示不同面额的硬币,另给你一个整数 k 。
你有无限量的每种面额的硬币。但是,你 不能 组合使用不同面额的硬币。
返回使用这些硬币能制造的 第 kth 小 金额。
示例 1:
输入: coins = [3,6,9], k = 3
输出: 9
解释:给定的硬币可以制造以下金额:
3元硬币产生3的倍数:3, 6, 9, 12, 15等。
6元硬币产生6的倍数:6, 12, 18, 24等。
9元硬币产生9的倍数:9, 18, 27, 36等。
所有硬币合起来可以产生:3, 6, 9, 12, 15等。
示例 2:
输入:coins = [5,2], k = 7
输出:12
解释:给定的硬币可以制造以下金额:
5元硬币产生5的倍数:5, 10, 15, 20等。
2元硬币产生2的倍数:2, 4, 6, 8, 10, 12等。
所有硬币合起来可以产生:2, 4, 5, 6, 8, 10, 12, 14, 15等。
提示:
1 <= coins.length <= 151 <= coins[i] <= 251 <= k <= 2 * 109coins包含两两不同的整数。
方法一:二分查找 + 容斥原理 · Go 实现
思考
每个金额是某一种面值的正整数倍。若按从小到大生成所有倍数,最小公倍数会让序列极长, 最大可达 ,无法枚举。
「不超过 的合法金额个数」随 单调不减,故可二分最小的 使得个数至少为 。个数本身由容斥给出:奇数个面值的最小公倍数贡献加,偶数个贡献减。
面值个数不超过 ,用二进制枚举子集并累加 即可实现 。二分上界取 量级,即可得到第 小金额。
我们可以将题目转化为:找到最小的正整数 ,使得小于等于 的且满足条件的数的个数恰好为 个。如果 满足条件,那么对任意 的 也满足条件,这存在单调性,因此我们可以使用二分查找,找到最小的满足条件的 。
我们定义一个函数 check(x),用来判断小于等于 的且满足条件的数的个数是否大于等于 。我们需要计算有多少个数可以由 中的数组合得到。
假设 为 ,根据容斥原理,小于等于 的满足条件的数的个数为:
如果 为 ,小于等于 的满足条件的数的个数为:
可以看到,我们需要累加所有任意奇数个数的情况,减去所有任意偶数个数的情况。
由于 ,我们可以使用二进制枚举的方式,枚举所有的子集,计算满足条件的数的个数,我们记为 。如果 ,那么我们需要找到最小的 ,使得 为真。
在二分查找开始时,我们定义二分查找的左边界 ,右边界 ,然后我们不断地将中间值 代入 check 函数中,如果 check(mid) 为真,那么我们将右边界 更新为 ,否则我们将左边界 更新为 。最终返回 。
时间复杂度 ,其中 是数组 的长度,而 是数组 中的最大值。
func findKthSmallest(coins []int, k int) int64 {
	var r int = 1e11
	n := len(coins)
	ans := sort.Search(r, func(mx int) bool {
		cnt := 0
		for i := 1; i < 1<<n; i++ {
			v := 1
			for j, x := range coins {
				if i>>j&1 == 1 {
					v = lcm(v, x)
					if v > mx {
						break
					}
				}
			}
			m := bits.OnesCount(uint(i))
			if m%2 == 1 {
				cnt += mx / v
			} else {
				cnt -= mx / v
			}
		}
		return cnt >= k
	})
	return int64(ans)
}

func gcd(a, b int) int {
	if b == 0 {
		return a
	}
	return gcd(b, a%b)
}

func lcm(a, b int) int {
	return a * b / gcd(a, b)
}3134. 找出唯一性数组的中位数
题目、示例与约束
给你一个整数数组 nums 。数组 nums 的 唯一性数组 是一个按元素从小到大排序的数组,包含了 nums 的所有非空 子数组 中不同元素的个数。
换句话说,这是由所有 0 <= i <= j < nums.length 的 distinct(nums[i..j]) 组成的递增数组。
其中,distinct(nums[i..j]) 表示从下标 i 到下标 j 的子数组中不同元素的数量。
返回 nums 唯一性数组 的 中位数 。
注意,数组的 中位数 定义为有序数组的中间元素。如果有两个中间元素,则取值较小的那个。
示例 1:
输入:nums = [1,2,3]
输出:1
解释:
nums 的唯一性数组为 [distinct(nums[0..0]), distinct(nums[1..1]), distinct(nums[2..2]), distinct(nums[0..1]), distinct(nums[1..2]), distinct(nums[0..2])],即 [1, 1, 1, 2, 2, 3] 。唯一性数组的中位数为 1 ,因此答案是 1 。
示例 2:
输入:nums = [3,4,3,4,5]
输出:2
解释:
nums 的唯一性数组为 [1, 1, 1, 1, 1, 2, 2, 2, 2, 2, 2, 2, 3, 3, 3] 。唯一性数组的中位数为 2 ,因此答案是 2 。
示例 3:
输入:nums = [4,3,5,4]
输出:2
解释:
nums 的唯一性数组为 [1, 1, 1, 1, 2, 2, 2, 3, 3, 3] 。唯一性数组的中位数为 2 ,因此答案是 2 。
提示:
1 <= nums.length <= 1051 <= nums[i] <= 105
方法一:二分查找 + 双指针 · Go 实现
思考
唯一性数组含全部 个子数组的不同元素个数,显式构造后再取中位数不可行。
子数组不同元素个数 的个数随 单调,中位数即第一个使该个数达到一半的 。滑动窗口可在线性时间内统计「不同元素 」的子数组数。
因此对 二分,窗口右端纳入新值,当种类超过 时左端右移,累加 。个数达到 即合法。
我们记数组 的长度为 ,那么唯一性数组的长度为 ,而唯一性数组的中位数就是这 个数中的第 小的数字。
考虑唯一性数组中,有多少个数小于等于 。随着 的增大,只会有越来越多的数小于等于 。这存在着单调性,因此,我们可以二分枚举 ,找到第一个 ,满足唯一性数组中小于等于 的数的个数大于等于 ,这个 就是唯一性数组的中位数。
我们定义二分查找的左边界 ,右边界 ,然后进行二分查找,对于每个 ,我们检查唯一性数组中小于等于 的数的个数是否大于等于 。我们通过函数 来实现这一点。
函数 的实现思路如下:
由于子数组越长,不同元素的个数越多,因此,我们可以利用双指针维护一个滑动窗口,使得窗口中的子数组的不同元素的个数不超过 。具体地,我们维护一个哈希表 , 表示窗口中元素 的个数。我们使用两个指针 和 ,其中 表示窗口的左边界,而 表示窗口的右边界。初始时 。
我们枚举 ,对于每个 ,我们将 加入窗口中,并更新 。如果窗口中的不同元素的个数超过了 ,我们需要将 右移,直到窗口中的不同元素的个数不超过 。此时,右端点为 ,而左端点为 的子数组都是满足条件的,一共有 个子数组。我们将这个数量累加到 中,如果 大于等于 ,那么说明唯一性数组中小于等于 的数的个数大于等于 ,我们返回 ,否则返回 。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func medianOfUniquenessArray(nums []int) int {
	n := len(nums)
	m := (1 + n) * n / 2
	return sort.Search(n, func(mx int) bool {
		cnt := map[int]int{}
		l, k := 0, 0
		for r, x := range nums {
			cnt[x]++
			for len(cnt) > mx {
				y := nums[l]
				cnt[y]--
				if cnt[y] == 0 {
					delete(cnt, y)
				}
				l++
			}
			k += r - l + 1
			if k >= (m+1)/2 {
				return true
			}
		}
		return false
	})
}3143. 正方形中的最多点数
题目、示例与约束
给你一个二维数组 points 和一个字符串 s ,其中 points[i] 表示第 i 个点的坐标,s[i] 表示第 i 个点的 标签 。
如果一个正方形的中心在 (0, 0) ,所有边都平行于坐标轴,且正方形内 不 存在标签相同的两个点,那么我们称这个正方形是 合法 的。
请你返回 合法 正方形中可以包含的 最多 点数。
注意:
- 如果一个点位于正方形的边上或者在边以内,则认为该点位于正方形内。
- 正方形的边长可以为零。
示例 1:
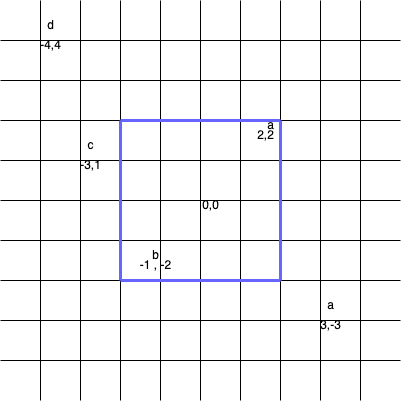
输入:points = [[2,2],[-1,-2],[-4,4],[-3,1],[3,-3]], s = "abdca"
输出:2
解释:
边长为 4 的正方形包含两个点 points[0] 和 points[1] 。
示例 2:
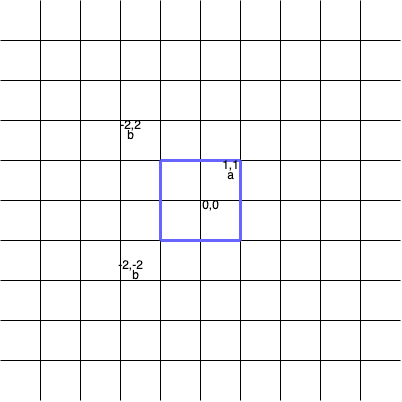
输入:points = [[1,1],[-2,-2],[-2,2]], s = "abb"
输出:1
解释:
边长为 2 的正方形包含 1 个点 points[0] 。
示例 3:
输入:points = [[1,1],[-1,-1],[2,-2]], s = "ccd"
输出:0
解释:
任何正方形都无法只包含 points[0] 和 points[1] 中的一个点,所以合法正方形中都不包含任何点。
提示:
1 <= s.length, points.length <= 105points[i].length == 2-109 <= points[i][0], points[i][1] <= 109s.length == points.lengthpoints中的点坐标互不相同。s只包含小写英文字母。
方法一:哈希表 + 排序 · Go 实现
思考
正方形以原点为中心、边平行坐标轴,内部标签须互异,求最多点数。枚举边长再检查标签,边长取值多达坐标范围。
点 被边长 的正方形盖住当且仅当 。按 从小到大加入点,一旦出现重复标签便不能再扩大。
用哈希表按 分桶并升序遍历:一层内若有标签已出现则返回此前点数,否则把本层全部加入已见集合。
对于一个点 ,我们可以将其映射到以原点为中心的第一象限,即 。这样,我们就可以将所有的点映射到第一象限,然后按照点到原点的距离进行排序。
我们可以使用哈希表 来存储所有点到原点的距离,然后按照距离进行排序。对于每个距离 ,我们将所有距离为 的点放在一起,然后遍历这些点,如果有两个点的标签相同,那么这个正方形是不合法的,直接返回答案。否则,我们将这些点加入到答案中。
时间复杂度 ,空间复杂度 。其中 是点的数量。
func maxPointsInsideSquare(points [][]int, s string) (ans int) {
	g := map[int][]int{}
	for i, p := range points {
		key := max(p[0], -p[0], p[1], -p[1])
		g[key] = append(g[key], i)
	}
	vis := [26]bool{}
	keys := []int{}
	for k := range g {
		keys = append(keys, k)
	}
	sort.Ints(keys)
	for _, k := range keys {
		idx := g[k]
		for _, i := range idx {
			j := s[i] - 'a'
			if vis[j] {
				return
			}
			vis[j] = true
		}
		ans += len(idx)
	}
	return
}3145. 大数组元素的乘积
题目、示例与约束
一个非负整数 x 的 强数组 指的是满足元素为 2 的幂且元素总和为 x 的最短有序数组。下表说明了如何确定 强数组 的示例。可以证明,x 对应的强数组是独一无二的。
| 数字 | 二进制表示 | 强数组 |
|---|---|---|
| 1 | 00001 | [1] |
| 8 | 01000 | [8] |
| 10 | 01010 | [2, 8] |
| 13 | 01101 | [1, 4, 8] |
| 23 | 10111 | [1, 2, 4, 16] |
我们将每一个升序的正整数 i (即1,2,3等等)的 强数组 连接得到数组 big_nums ,big_nums 开始部分为 [1, 2, 1, 2, 4, 1, 4, 2, 4, 1, 2, 4, 8, ...] 。
给你一个二维整数数组 queries ,其中 queries[i] = [fromi, toi, modi] ,你需要计算 (big_nums[fromi] * big_nums[fromi + 1] * ... * big_nums[toi]) % modi 。
请你返回一个整数数组 answer ,其中 answer[i] 是第 i 个查询的答案。
示例 1:
输入:queries = [[1,3,7]]
输出:[4]
解释:
只有一个查询。
big_nums[1..3] = [2,1,2] 。它们的乘积为 4。结果为 4 % 7 = 4。
示例 2:
输入:queries = [[2,5,3],[7,7,4]]
输出:[2,2]
解释:
有两个查询。
第一个查询:big_nums[2..5] = [1,2,4,1] 。它们的乘积为 8 。结果为 8 % 3 = 2。
第二个查询:big_nums[7] = 2 。结果为 2 % 4 = 2。
提示:
1 <= queries.length <= 500queries[i].length == 30 <= queries[i][0] <= queries[i][1] <= 10151 <= queries[i][2] <= 105
方法一:二分查找 + 位运算 · Go 实现
思考
强数组把每个正整数的置位幂次顺次拼接, 的乘积是 的幂次和。区间可达 ,不能物化数组。
幂次前缀和 满足区间和 。 的强数组长度与幂次和可由最高位分段闭式累加,从而对下标二分出对应的 。
预处理到 位的前缀计数 与幂次和 ,二分最大的 使其强数组长度小于 ,再补上剩余若干低位。每个询问返回 。
连续的正整数数字对应的强整数数组连接得到数组 ,题目需要我们求出对于每个查询 ,子数组 的乘积对 取模的结果。由于子数组每个元素都是 的幂,这等价于求子数组的幂次之和 ,然后计算 。例如,对于子数组 ,即 ,其幂次之和为 ,所以 就是我们要求的结果。
因此,我们不妨将 转换为幂次数组,即对于子数组 ,我们将其转换为 。这样,问题转换为求幂次数组的子数组之和,即 ,其中 表示 的幂次之和,也即是前缀和。
接下来,就是根据下标 计算 的值。我们可以使用二分查找的方法,先找到强数组长度和小于 的最大数字,然后再计算剩下的数字的幂次之和。
我们根据题目描述,列出数字 的强整数:
| 8() | 4() | 2() | () | |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 1 | <span style="color: red;">0</span> | <span style="color: red;">0</span> | <span style="color: red;">0</span> | <span style="color: red;">1</span> |
| 2 | <span style="color: blue;">0</span> | <span style="color: blue;">0</span> | <span style="color: blue;">1</span> | <span style="color: blue;">0</span> |
| 3 | <span style="color: blue;">0</span> | <span style="color: blue;">0</span> | <span style="color: blue;">1</span> | <span style="color: blue;">1</span> |
| 4 | <span style="color: green;">0</span> | <span style="color: green;">1</span> | <span style="color: green;">0</span> | <span style="color: green;">0</span> |
| 5 | <span style="color: green;">0</span> | <span style="color: green;">1</span> | <span style="color: green;">0</span> | <span style="color: green;">1</span> |
| 6 | <span style="color: green;">0</span> | <span style="color: green;">1</span> | <span style="color: green;">1</span> | <span style="color: green;">0</span> |
| 7 | <span style="color: green;">0</span> | <span style="color: green;">1</span> | <span style="color: green;">1</span> | <span style="color: green;">1</span> |
| 8 | <span style="color: yellow;">1</span> | <span style="color: yellow;">0</span> | <span style="color: yellow;">0</span> | <span style="color: yellow;">0</span> |
| 9 | <span style="color: yellow;">1</span> | <span style="color: yellow;">0</span> | <span style="color: yellow;">0</span> | <span style="color: yellow;">1</span> |
| 10 | <span style="color: yellow;">1</span> | <span style="color: yellow;">0</span> | <span style="color: yellow;">1</span> | <span style="color: yellow;">0</span> |
| 11 | <span style="color: yellow;">1</span> | <span style="color: yellow;">0</span> | <span style="color: yellow;">1</span> | <span style="color: yellow;">1</span> |
| 12 | <span style="color: yellow;">1</span> | <span style="color: yellow;">1</span> | <span style="color: yellow;">0</span> | <span style="color: yellow;">0</span> |
| 13 | <span style="color: yellow;">1</span> | <span style="color: yellow;">1</span> | <span style="color: yellow;">0</span> | <span style="color: yellow;">1</span> |
| 14 | <span style="color: yellow;">1</span> | <span style="color: yellow;">1</span> | <span style="color: yellow;">1</span> | <span style="color: yellow;">0</span> |
将数字按照 的区间划分为不同的颜色,可以发现,区间 的数字,相当于在区间 的数字基础上,每个数字加上 。我们可以根据这个规律,计算出 的前 组的所有数字的强数组个数之和 和幂次之和 。
接下来,对于任何数字,我们考虑如何计算其强数组的个数和幂次之和。我们可以通过二进制的方式,从最高位开始,诸位计算。例如,对于数字 ,前 个数字的结果可以由 和 计算得到,而剩下的 的结果,相当于给 的所有数字,即 的所有数字的强数组增加 ,问题转换为计算 的所有数字的强数组的个数和幂次之和。这样,我们可以计算出任意数字的强数组的个数和幂次之和。
最后,我们可以根据 的值,利用快速幂的方法,计算出 的结果。
时间复杂度 ,空间复杂度 。其中 为查询的个数,而 为数字的上界,本题中 。
const m = 50

var cnt [m + 1]int64
var s [m + 1]int64
var p int64 = 1

func init() {
	cnt[0] = 0
	s[0] = 0
	for i := 1; i <= m; i++ {
		cnt[i] = cnt[i-1]*2 + p
		s[i] = s[i-1]*2 + p*(int64(i)-1)
		p *= 2
	}
}

func numIdxAndSum(x int64) (int64, int64) {
	var idx, totalSum int64
	for x > 0 {
		i := 63 - bits.LeadingZeros64(uint64(x))
		idx += cnt[i]
		totalSum += s[i]
		x -= 1 << i
		totalSum += (x + 1) * int64(i)
		idx += x + 1
	}
	return idx, totalSum
}

func f(i int64) int64 {
	l, r := int64(0), int64(1)<<m
	for l < r {
		mid := (l + r + 1) >> 1
		idx, _ := numIdxAndSum(mid)
		if idx < i {
			l = mid
		} else {
			r = mid - 1
		}
	}

	_, totalSum := numIdxAndSum(l)
	idx, _ := numIdxAndSum(l)
	i -= idx
	x := l + 1
	for j := int64(0); j < i; j++ {
		y := x & -x
		totalSum += int64(bits.TrailingZeros64(uint64(y)))
		x -= y
	}
	return totalSum
}

func qpow(a, n, mod int64) int64 {
	ans := int64(1) % mod
	a = a % mod
	for n > 0 {
		if n&1 == 1 {
			ans = (ans * a) % mod
		}
		a = (a * a) % mod
		n >>= 1
	}
	return ans
}

func findProductsOfElements(queries [][]int64) []int {
	ans := make([]int, len(queries))
	for i, q := range queries {
		left, right, mod := q[0], q[1], q[2]
		power := f(right+1) - f(left)
		ans[i] = int(qpow(2, power, mod))
	}
	return ans
}3152. 特殊数组 II
题目、示例与约束
如果数组的每一对相邻元素都是两个奇偶性不同的数字,则该数组被认为是一个 特殊数组 。
你有一个整数数组 nums 和一个二维整数矩阵 queries,对于 queries[i] = [fromi, toi],请你帮助你检查 子数组 nums[fromi..toi] 是不是一个 特殊数组 。
返回布尔数组 answer,如果 nums[fromi..toi] 是特殊数组,则 answer[i] 为 true ,否则,answer[i] 为 false 。
示例 1:
输入:nums = [3,4,1,2,6], queries = [[0,4]]
输出:[false]
解释:
子数组是 [3,4,1,2,6]。2 和 6 都是偶数。
示例 2:
输入:nums = [4,3,1,6], queries = [[0,2],[2,3]]
输出:[false,true]
解释:
- 子数组是
[4,3,1]。3 和 1 都是奇数。因此这个查询的答案是false。 - 子数组是
[1,6]。只有一对:(1,6),且包含了奇偶性不同的数字。因此这个查询的答案是true。
提示:
1 <= nums.length <= 1051 <= nums[i] <= 1051 <= queries.length <= 105queries[i].length == 20 <= queries[i][0] <= queries[i][1] <= nums.length - 1
方法一:记录每个位置的最左特殊数组位置 · Go 实现
思考
多次询问一段是否特殊。每次再扫区间会达到 。
一段特殊当且仅当其中每对相邻都变号。令 为 能向左延伸到的最远特殊起点,则询问 合法当且仅当 。
一次从左扫描:相邻变号则 ,否则 。每个询问 判定。
我们可以定义一个数组 来记录每个位置的最左特殊数组位置,初始时 。然后我们从左到右遍历数组 ,如果 和 的奇偶性不同,那么 。
最后我们遍历每个查询,判断 是否成立即可。
时间复杂度 ,空间复杂度 。其中 是数组的长度。
func isArraySpecial(nums []int, queries [][]int) (ans []bool) {
	n := len(nums)
	d := make([]int, n)
	for i := range d {
		d[i] = i
	}
	for i := 1; i < len(nums); i++ {
		if nums[i]%2 != nums[i-1]%2 {
			d[i] = d[i-1]
		}
	}
	for _, q := range queries {
		ans = append(ans, d[q[1]] <= q[0])
	}
	return
}3155. 可升级服务器的最大数量 🔒
题目、示例与约束
你有 n 个数据中心并且需要升级他们的服务器。
给定四个长度为 n 的数组 count,upgrade,sell 和 money,分别针对每个数据中心表示:
- 服务器的数量
- 升级单个服务器的成本
- 出售服务器获得的钱
- 你最初拥有的钱
返回一个数组 answer,其中对于每个数据中心,answer 中相应的元素代表可以升级的 最大 服务器数量。
请注意,一个数据中心的资金 不能 用于另一个数据中心。
示例 1:
输入:count = [4,3], upgrade = [3,5], sell = [4,2], money = [8,9]
输出:[3,2]
解释:
对于第一个数据中心,如果我们出售一台服务器,我们将会有 8 + 4 = 12 单位的钱并且我们能够升级其余的 3 台服务器。
对于第二个数据中心,如果我们出售一台服务器,我们将会有 9 + 2 = 11 单位的钱并且我们能够升级其余的 2 台服务器。
示例 2:
输入:count = [1], upgrade = [2], sell = [1], money = [1]
输出:[0]
提示:
1 <= count.length == upgrade.length == sell.length == money.length <= 1051 <= count[i], upgrade[i], sell[i], money[i] <= 105
方法一:数学 · Go 实现
思考
每个机房可卖掉部分服务器筹资再升级其余。对升级台数 枚举到 亦可,但机房数多时不如直接求解。
卖掉 台加上现金,须付 。整理得 ,且 。
对每个机房取该上界与台数的较小者。整数除法 naturally 向下取整。
对于每个数据中心,我们假设可以升级 台服务器,那么 。即 。又因为 ,所以我们取两者的最小值即可。
时间复杂度 ,其中 为数组的长度。忽略答案数组的空间消耗,空间复杂度 。
func maxUpgrades(count []int, upgrade []int, sell []int, money []int) (ans []int) {
	for i, cnt := range count {
		ans = append(ans, min(cnt, (cnt*sell[i]+money[i])/(upgrade[i]+sell[i])))
	}
	return
}3231. 要删除的递增子序列的最小数量 🔒
题目、示例与约束
给定一个整数数组 nums,你可以执行任意次下面的操作:
- 从数组删除一个 严格递增 的 子序列。
您的任务是找到使数组为 空 所需的 最小 操作数。
示例 1:
输入:nums = [5,3,1,4,2]
输出:3
解释:
我们删除子序列 [1, 2],[3, 4],[5]。
示例 2:
输入:nums = [1,2,3,4,5]
输出:1
示例 3:
输入:nums = [5,4,3,2,1]
输出:5
提示:
1 <= nums.length <= 1051 <= nums[i] <= 105
方法一:贪心 + 二分查找 · Go 实现
思考
每次删一个严格递增子序列,求最少次数。 ,枚举划分不可行。最少删次等于数组按「可接在某个递增尾巴后」贪心后所形成的链数,而这与最长不升子序列长度相同。
维护各链的末元(单调不升),对每个 二分接到第一个末元小于 的链上,否则新开一链。最终链数即答案。
我们从左到右遍历数组 ,对于每个元素 ,我们需要贪心地将其追加到前面序列中最后一个元素小于 的最大值后面。如果找不到这样的元素,则说明当前元素 比前面序列中的所有元素都小,我们需要新开辟一个序列,将 放入其中。
这样分析下来,我们可以发现,前面序列中的最后一个元素呈单调递减的状态。因此,我们可以使用二分查找来找到前面序列中最后一个元素小于 的第一个元素位置,然后将 放入该位置。
最终,我们返回序列的个数即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func minOperations(nums []int) int {
	g := []int{}
	for _, x := range nums {
		l, r := 0, len(g)
		for l < r {
			mid := (l + r) >> 1
			if g[mid] < x {
				r = mid
			} else {
				l = mid + 1
			}
		}
		if l == len(g) {
			g = append(g, x)
		} else {
			g[l] = x
		}
	}
	return len(g)
}3261. 统计满足 K 约束的子字符串数量 II
题目、示例与约束
给你一个 二进制 字符串 s 和一个整数 k。
另给你一个二维整数数组 queries ,其中 queries[i] = [li, ri] 。
如果一个 二进制字符串 满足以下任一条件,则认为该字符串满足 k 约束:
- 字符串中
0的数量最多为k。 - 字符串中
1的数量最多为k。
返回一个整数数组 answer ,其中 answer[i] 表示 s[li..ri] 中满足 k 约束 的 子字符串 的数量。
示例 1:
输入:s = "0001111", k = 2, queries = [[0,6]]
输出:[26]
解释:
对于查询 [0, 6], s[0..6] = "0001111" 的所有子字符串中,除 s[0..5] = "000111" 和 s[0..6] = "0001111" 外,其余子字符串都满足 k 约束。
示例 2:
输入:s = "010101", k = 1, queries = [[0,5],[1,4],[2,3]]
输出:[15,9,3]
解释:
s 的所有子字符串中,长度大于 3 的子字符串都不满足 k 约束。
提示:
1 <= s.length <= 105s[i]是'0'或'1'1 <= k <= s.length1 <= queries.length <= 105queries[i] == [li, ri]0 <= li <= ri < s.length- 所有查询互不相同
方法一:滑动窗口 + 前缀和 · Go 实现
思考
单次查询的 -约束计数可用 I 的滑窗在线性内完成,但查询达 、 亦 ,必须预处理。对每个左端,右端的合法范围是一段前缀,滑窗可求出每个 右边第一个非法位置 。
再让 为「右端 」的合法子串个数。询问 拆成「左端为 且右端不超过 的三角形个数」加上 。预处理 ,询问 。
我们用两个变量 和 分别记录当前窗口内的 和 的个数,指针 和 分别标识窗口的左右边界。用一个数组 记录每个位置 右边第一个不满足 约束的位置,初始时 。另外,用一个长度为 的前缀和数组 记录以前 个位置作为右边界的满足 约束的子字符串的个数。
当我们右移窗口时,如果窗口内的 和 的个数都大于 ,我们将 更新为 ,表示位置 右边第一个不满足 约束的位置。然后我们将 右移一位,直到窗口内的 和 的个数都不大于 。此时,我们可以计算出以 为右边界的满足 约束的子字符串的个数,即 ,我们更新到前缀和数组中。
最后,对于每个查询 ,我们首先找出 右边第一个不满足 约束的位置 ,那么 ,那么 的所有子字符串都满足 约束,个数为 ,然后,我们计算以 为右边界的满足 约束的子字符串的个数,即 ,最后将两者相加即可。
时间复杂度 ,空间复杂度 。其中 和 分别为字符串 的长度和查询数组 的长度。
func countKConstraintSubstrings(s string, k int, queries [][]int) (ans []int64) {
	cnt := [2]int{}
	n := len(s)
	d := make([]int, n)
	for i := range d {
		d[i] = n
	}
	pre := make([]int, n+1)
	for i, j := 0, 0; j < n; j++ {
		cnt[s[j]-'0']++
		for cnt[0] > k && cnt[1] > k {
			d[i] = j
			cnt[s[i]-'0']--
			i++
		}
		pre[j+1] = pre[j] + j - i + 1
	}
	for _, q := range queries {
		l, r := q[0], q[1]
		p := min(r+1, d[l])
		a := (1 + p - l) * (p - l) / 2
		b := pre[r+1] - pre[p]
		ans = append(ans, int64(a+b))
	}
	return
}3288. 最长上升路径的长度
题目、示例与约束
给你一个长度为 n 的二维整数数组 coordinates 和一个整数 k ,其中 0 <= k < n 。
coordinates[i] = [xi, yi] 表示二维平面里一个点 (xi, yi) 。
如果一个点序列 (x1, y1), (x2, y2), (x3, y3), ..., (xm, ym) 满足以下条件,那么我们称它是一个长度为 m 的 上升序列 :
- 对于所有满足
1 <= i < m的i都有xi < xi + 1且yi < yi + 1。 - 对于所有
1 <= i <= m的i对应的点(xi, yi)都在给定的坐标数组里。
请你返回包含坐标 coordinates[k] 的 最长上升路径 的长度。
示例 1:
输入:coordinates = [[3,1],[2,2],[4,1],[0,0],[5,3]], k = 1
输出:3
解释:
(0, 0) ,(2, 2) ,(5, 3) 是包含坐标 (2, 2) 的最长上升路径。
示例 2:
输入:coordinates = [[2,1],[7,0],[5,6]], k = 2
输出:2
解释:
(2, 1) ,(5, 6) 是包含坐标 (5, 6) 的最长上升路径。
提示:
1 <= n == coordinates.length <= 105coordinates[i].length == 20 <= coordinates[i][0], coordinates[i][1] <= 109coordinates中的元素 互不相同 。0 <= k <= n - 1
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
设 。
仔细读题:我们要选的并不是 的子序列,所以可以排序。
按照 从小到大排序,问题变成计算 的 LIS。
⚠注意:对于 相同的点,要按照 从大到小排序。这可以保证在计算 LIS 时,对于相同的 ,我们至多选一个 。
然后选择 且 或者 且 的 计算 LIS。
关于 LIS 的二分算法,请看【基础算法精讲 20】。
本题视频讲解(第四题),欢迎点赞关注~
复杂度分析
- 时间复杂度:,其中 是 的长度。
- 空间复杂度:。
思考题
返回一个长为 的数组,表示 时原问题的答案。
欢迎在评论区分享你的思路/代码。
更多相似题目,见下面动态规划题单中的「§4.2 最长递增子序列(LIS)」。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/最短路/最小生成树/二分图/基环树/欧拉路径)
- 动态规划(入门/背包/状态机/划分/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与一般树(前后指针/快慢指针/DFS/BFS/直径/LCA)
import (
	"cmp"
	"slices"
	"sort"
)

// https://space.bilibili.com/206214
func maxPathLength(coordinates [][]int, k int) int {
	kx, ky := coordinates[k][0], coordinates[k][1]
	slices.SortFunc(coordinates, func(a, b []int) int { return cmp.Or(a[0]-b[0], b[1]-a[1]) })

	g := []int{}
	for _, p := range coordinates {
		x, y := p[0], p[1]
		if x < kx && y < ky || x > kx && y > ky {
			j := sort.SearchInts(g, y)
			if j < len(g) {
				g[j] = y
			} else {
				g = append(g, y)
			}
		}
	}
	return len(g) + 1 // 算上 coordinates[k]
}3312. 查询排序后的最大公约数
题目、示例与约束
给你一个长度为 n 的整数数组 nums 和一个整数数组 queries 。
gcdPairs 表示数组 nums 中所有满足 0 <= i < j < n 的数对 (nums[i], nums[j]) 的 最大公约数 升序 排列构成的数组。
对于每个查询 queries[i] ,你需要找到 gcdPairs 中下标为 queries[i] 的元素。
请你返回一个整数数组 answer ,其中 answer[i] 是 gcdPairs[queries[i]] 的值。
gcd(a, b) 表示 a 和 b 的 最大公约数 。
示例 1:
输入:nums = [2,3,4], queries = [0,2,2]
输出:[1,2,2]
解释:
gcdPairs = [gcd(nums[0], nums[1]), gcd(nums[0], nums[2]), gcd(nums[1], nums[2])] = [1, 2, 1].
升序排序后得到 gcdPairs = [1, 1, 2] 。
所以答案为 [gcdPairs[queries[0]], gcdPairs[queries[1]], gcdPairs[queries[2]]] = [1, 2, 2] 。
示例 2:
输入:nums = [4,4,2,1], queries = [5,3,1,0]
输出:[4,2,1,1]
解释:
gcdPairs 升序排序后得到 [1, 1, 1, 2, 2, 4] 。
示例 3:
输入:nums = [2,2], queries = [0,0]
输出:[2,2]
解释:
gcdPairs = [2] 。
提示:
2 <= n == nums.length <= 1051 <= nums[i] <= 5 * 1041 <= queries.length <= 1050 <= queries[i] < n * (n - 1) / 2
方法一:预处理 + 前缀和 + 二分查找 · Go 实现
思考
询问的是所有无序对 GCD 升序后的第 项。 ,不能枚举数对。
对数论计数可先算「GCD 为 的倍数」再容斥:倍数个数为 时先加 ,再从大到小减去 ,得到恰为 的对数。
对 做前缀和后,每个询问二分第一个超过 的位置即为答案。
我们可以预处理得到数组 中的所有数对的最大公约数的出现次数,记录在数组 中。然后,我们计算数组 的前缀和。最后,对于每个查询,我们可以通过二分查找在数组 中找到第一个大于 的元素的下标,即为答案。
我们用 表示数组 中的最大值,用 记录数组 中每个数的出现次数。我们用 表示数组 中最大公约数等于 的数对个数。为了计算 ,我们可以按照以下步骤进行:
- 计算数组 中 的倍数的出现次数 ,那么从这些元素中任选两个元素组成的数对一定满足最大公约数是 的倍数,即 需要增加 ;
- 我们需要排除最大公约数是 的倍数且大于 的数对,因此,对于 的倍数 ,我们需要减去 。
以上需要我们从大到小遍历 ,这样才能保证我们在计算 时已经计算了所有的 。
最后,我们计算数组 的前缀和,然后对于每个查询,我们可以通过二分查找在数组 中找到第一个大于 的元素的下标,即为答案。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 的长度和最大值,而 是查询的数量。
func gcdValues(nums []int, queries []int64) (ans []int) {
	mx := slices.Max(nums)
	cnt := make([]int, mx+1)
	cntG := make([]int, mx+1)
	for _, x := range nums {
		cnt[x]++
	}
	for i := mx; i > 0; i-- {
		var v int
		for j := i; j <= mx; j += i {
			v += cnt[j]
			cntG[i] -= cntG[j]
		}
		cntG[i] += v * (v - 1) / 2
	}
	for i := 2; i <= mx; i++ {
		cntG[i] += cntG[i-1]
	}
	for _, q := range queries {
		ans = append(ans, sort.SearchInts(cntG, int(q)+1))
	}
	return
}3323. 通过插入区间最小化连通组 🔒
题目、示例与约束
给定一个 2 维数组 intervals,其中 intervals[i] = [starti, endi] 表示区间 i 的开头和结尾。另外还给定一个整数 k。
你必须向数组 恰好添加一个 新的区间 [startnew, endnew] 使得:
- 新区间的长度,
endnew - startnew最多为k。 - 在添加之后,
intervals中 连通组 的数量 最少。
区间的 连通组 是一起覆盖了从最小点到最大点的连续范围,中间没有间隙的区间的最大集合。下面是一些例子:
- 区间组
[[1, 2], [2, 5], [3, 3]]是连通的,因为它们一起覆盖了 1 到 5 的范围,中间没有任何间隔。 - 然而,区间组
[[1, 2], [3, 4]]不是连通的,因为(2, 3)段没有被覆盖。
返回在数组 恰好添加一个 新区间后,连通组的 最小 数量。
示例 1:
输入:intervals = [[1,3],[5,6],[8,10]], k = 3
输出:2
解释:
在添加区间 [3, 5] 后,我们有两个连通组:[[1, 3], [3, 5], [5, 6]] 和 [[8, 10]]。
示例 2:
输入:intervals = [[5,10],[1,1],[3,3]], k = 1
输出:3
解释:
在添加区间 [1, 1] 后,我们有三个连通组:[[1, 1], [1, 1]],[[3, 3]],和 [[5, 10]]。
提示:
1 <= intervals.length <= 105intervals[i] == [starti, endi]1 <= starti <= endi <= 1091 <= k <= 109
方法一:排序 + 二分查找 · Go 实现
思考
插入一条长度至多为 的区间,使合并后的连通块尽量少。 ,需先把相交区间合并,再考虑一次插入能「桥接」多少段。
合并后各段互不相交。以第 段的右端 为起点,第一条左端 的段之前都可以被这条长为 的桥连上。
对每个 二分该右端 ,连通块变为 ,取最小即可。
首先,我们对给定的区间集合 按照区间的左端点进行排序,然后合并所有相交的区间,得到一个新的区间集合 。
那么我们可以将初始答案设为 的长度。
接下来,我们枚举 中的每一个区间 ,我们可以通过二分查找,在 中找到第一个左端点大于等于 的区间,设其下标为 ,那么我们可以将答案更新,即 。
最终,我们返回答案 即可。
时间复杂度 ,空间复杂度 。其中 为区间的数量。
func minConnectedGroups(intervals [][]int, k int) int {
	sort.Slice(intervals, func(i, j int) bool { return intervals[i][0] < intervals[j][0] })
	merged := [][]int{}
	for _, interval := range intervals {
		s, e := interval[0], interval[1]
		if len(merged) == 0 || merged[len(merged)-1][1] < s {
			merged = append(merged, interval)
		} else {
			merged[len(merged)-1][1] = max(merged[len(merged)-1][1], e)
		}
	}
	ans := len(merged)
	for i, interval := range merged {
		j := sort.Search(len(merged), func(j int) bool { return merged[j][0] >= interval[1]+k+1 })
		ans = min(ans, len(merged)-(j-i-1))
	}
	return ans
}3344. 最大尺寸数组 🔒
题目、示例与约束
给定一个正整数 s,令 A 为一个 n × n × n 的三维数组,其中每个元素 A[i][j][k] 定义为:
A[i][j][k] = i * (j OR k),其中0 <= i, j, k < n。
返回使数组 A 中所有元素的和不超过 s 的 最大的 n。
示例 1:
输入:s = 10
输出:2
解释:
n = 2时数组A的元素:A[0][0][0] = 0 * (0 OR 0) = 0A[0][0][1] = 0 * (0 OR 1) = 0A[0][1][0] = 0 * (1 OR 0) = 0A[0][1][1] = 0 * (1 OR 1) = 0A[1][0][0] = 1 * (0 OR 0) = 0A[1][0][1] = 1 * (0 OR 1) = 1A[1][1][0] = 1 * (1 OR 0) = 1A[1][1][1] = 1 * (1 OR 1) = 1
- 数组
A中元素的总和为 3,没有超过 10,所以n的最大值为 2。
示例 2:
输入:s = 0
输出:1
解释:
n = 1时数组A的元素:A[0][0][0] = 0 * (0 OR 0) = 0
- 数组
A中元素的总和为 0,没有超过 0,所以n的最大值为 1。
提示:
0 <= s <= 1015
方法一:预处理 + 二分查找 · Go 实现
思考
随 单调,求最大的 使 。 ,直接三重循环不可行,但可估出 不超过约 。
将 提出后, 等于 的同类形式。预处理 的递推前缀即可。
二分最大 使 。
我们可以粗略估算出 的最大值,对于 ,结果的和大致为 ,再与 的每个 相乘,结果约等于 ,要使得 ,那么 。
因此,我们不妨预处理出 ,然后使用二分查找找到最大的 ,使得 。
时间复杂度方面,预处理的时间复杂度为 ,二分查找的时间复杂度为 ,因此总时间复杂度为 。空间复杂度为 。
const MX = 1330

var f [MX]int64

func init() {
	f[0] = 0
	for i := 1; i < MX; i++ {
		f[i] = f[i-1] + int64(i)
		for j := 0; j < i; j++ {
			f[i] += 2 * int64(i|j)
		}
	}
}

func maxSizedArray(s int64) int {
	l, r := 1, MX
	for l < r {
		m := (l + r + 1) >> 1
		if f[m-1]*int64(m-1)*int64(m)/2 <= s {
			l = m
		} else {
			r = m - 1
		}
	}
	return l
}3346. 执行操作后元素的最高频率 I
题目、示例与约束
给你一个整数数组 nums 和两个整数 k 和 numOperations 。
你必须对 nums 执行 操作 numOperations 次。每次操作中,你可以:
- 选择一个下标
i,它在之前的操作中 没有 被选择过。 - 将
nums[i]增加范围[-k, k]中的一个整数。
在执行完所有操作以后,请你返回 nums 中出现 频率最高 元素的出现次数。
一个元素 x 的 频率 指的是它在数组中出现的次数。
示例 1:
输入:nums = [1,4,5], k = 1, numOperations = 2
输出:2
解释:
通过以下操作得到最高频率 2 :
- 将
nums[1]增加 0 ,nums变为[1, 4, 5]。 - 将
nums[2]增加 -1 ,nums变为[1, 4, 4]。
示例 2:
输入:nums = [5,11,20,20], k = 5, numOperations = 1
输出:2
解释:
通过以下操作得到最高频率 2 :
- 将
nums[1]增加 0 。
提示:
1 <= nums.length <= 1051 <= nums[i] <= 1050 <= k <= 1050 <= numOperations <= nums.length
方法一:差分 · Go 实现
思考
每个 可变成 内任一整数,至多改 次,使某个值频率最大。 ,不能枚举目标再扫数组。
目标 能吸引所有区间覆盖 的元素;其中已经等于 的不必改。差分数组在 加一、 减一,并在 处插 以便统计原值。
按坐标排序做前缀和得覆盖数 ,频率为 ,取最大。
根据题目描述,对于数组 中的每个元素 ,我们可以将其变为 范围内的任意整数。我们希望通过对 中的若干元素进行操作,使得某个整数在数组中出现的次数最多。
题目可以转化为,将每个元素 对应的区间 的所有元素进行合并,找出合并后区间中包含最多原始元素的整数。这可以通过差分数组来实现。
我们使用一个字典 来记录差分数组。对于每个元素 ,我们在差分数组中执行以下操作:
- 在位置 处加 ,表示从这个位置开始,有一个新的区间开始。
- 在位置 处减 ,表示从这个位置开始,有一个区间结束。
- 在位置 处加 ,确保位置 存在于差分数组中,方便后续计算。
同时,我们还需要记录每个元素在原始数组中出现的次数,使用字典 来实现。
接下来,我们对差分数组进行前缀和计算,得到每个位置上有多少个区间覆盖。对于每个位置 ,我们计算其覆盖的区间数 。接下来分类讨论:
- 如果 在原始数组中出现过,对于 自身的操作,没有意义,因此会有 个其他的元素可以通过操作变为 ,但最多只能操作 次,所以该位置的最大频率为 。
- 如果 在原始数组中没有出现过,那么最多只能通过操作 次将其他元素变为 ,因此该位置的最大频率为 。
综合以上两种情况,我们可以统一表示为 。
最后,我们遍历所有位置,计算出每个位置的最大频率,并取其中的最大值作为答案。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func maxFrequency(nums []int, k int, numOperations int) (ans int) {
	cnt := make(map[int]int)
	d := make(map[int]int)
	for _, x := range nums {
		cnt[x]++
		d[x] = d[x]
		d[x-k]++
		d[x+k+1]--
	}

	s := 0
	keys := make([]int, 0, len(d))
	for key := range d {
		keys = append(keys, key)
	}
	sort.Ints(keys)
	for _, x := range keys {
		s += d[x]
		ans = max(ans, min(s, cnt[x]+numOperations))
	}

	return
}3347. 执行操作后元素的最高频率 II
题目、示例与约束
给你一个整数数组 nums 和两个整数 k 和 numOperations 。
你必须对 nums 执行 操作 numOperations 次。每次操作中,你可以:
- 选择一个下标
i,它在之前的操作中 没有 被选择过。 - 将
nums[i]增加范围[-k, k]中的一个整数。
在执行完所有操作以后,请你返回 nums 中出现 频率最高 元素的出现次数。
一个元素 x 的 频率 指的是它在数组中出现的次数。
示例 1:
输入:nums = [1,4,5], k = 1, numOperations = 2
输出:2
解释:
通过以下操作得到最高频率 2 :
- 将
nums[1]增加 0 ,nums变为[1, 4, 5]。 - 将
nums[2]增加 -1 ,nums变为[1, 4, 4]。
示例 2:
输入:nums = [5,11,20,20], k = 5, numOperations = 1
输出:2
解释:
通过以下操作得到最高频率 2 :
- 将
nums[1]增加 0 。
提示:
1 <= nums.length <= 1051 <= nums[i] <= 1090 <= k <= 1090 <= numOperations <= nums.length
方法一:差分 · Go 实现
思考
题意与 I 相同,但 与 可至 ,不能开真实数组,只能用有序映射做离散差分。
覆盖关系不变:仍在 、 与 三处打点,排序后扫前缀和。
频率公式同为 ,实现与 I 共用。
根据题目描述,对于数组 中的每个元素 ,我们可以将其变为 范围内的任意整数。我们希望通过对 中的若干元素进行操作,使得某个整数在数组中出现的次数最多。
题目可以转化为,将每个元素 对应的区间 的所有元素进行合并,找出合并后区间中包含最多原始元素的整数。这可以通过差分数组来实现。
我们使用一个字典 来记录差分数组。对于每个元素 ,我们在差分数组中执行以下操作:
- 在位置 处加 ,表示从这个位置开始,有一个新的区间开始。
- 在位置 处减 ,表示从这个位置开始,有一个区间结束。
- 在位置 处加 ,确保位置 存在于差分数组中,方便后续计算。
同时,我们还需要记录每个元素在原始数组中出现的次数,使用字典 来实现。
接下来,我们对差分数组进行前缀和计算,得到每个位置上有多少个区间覆盖。对于每个位置 ,我们计算其覆盖的区间数 。接下来分类讨论:
- 如果 在原始数组中出现过,对于 自身的操作,没有意义,因此会有 个其他的元素可以通过操作变为 ,但最多只能操作 次,所以该位置的最大频率为 。
- 如果 在原始数组中没有出现过,那么最多只能通过操作 次将其他元素变为 ,因此该位置的最大频率为 。
综合以上两种情况,我们可以统一表示为 。
最后,我们遍历所有位置,计算出每个位置的最大频率,并取其中的最大值作为答案。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func maxFrequency(nums []int, k int, numOperations int) (ans int) {
	cnt := make(map[int]int)
	d := make(map[int]int)
	for _, x := range nums {
		cnt[x]++
		d[x] = d[x]
		d[x-k]++
		d[x+k+1]--
	}

	s := 0
	keys := make([]int, 0, len(d))
	for key := range d {
		keys = append(keys, key)
	}
	sort.Ints(keys)
	for _, x := range keys {
		s += d[x]
		ans = max(ans, min(s, cnt[x]+numOperations))
	}

	return
}3350. 检测相邻递增子数组 II
题目、示例与约束
给你一个由 n 个整数组成的数组 nums ,请你找出 k 的 最大值,使得存在 两个 相邻 且长度为 k 的 严格递增 子数组。具体来说,需要检查是否存在从下标 a 和 b (a < b) 开始的 两个 子数组,并满足下述全部条件:
- 这两个子数组
nums[a..a + k - 1]和nums[b..b + k - 1]都是 严格递增 的。 - 这两个子数组必须是 相邻的,即
b = a + k。
返回 k 的 最大可能 值。
子数组 是数组中的一个连续 非空 的元素序列。
示例 1:
输入:nums = [2,5,7,8,9,2,3,4,3,1]
输出:3
解释:
- 从下标 2 开始的子数组是
[7, 8, 9],它是严格递增的。 - 从下标 5 开始的子数组是
[2, 3, 4],它也是严格递增的。 - 这两个子数组是相邻的,因此 3 是满足题目条件的 最大
k值。
示例 2:
输入:nums = [1,2,3,4,4,4,4,5,6,7]
输出:2
解释:
- 从下标 0 开始的子数组是
[1, 2],它是严格递增的。 - 从下标 2 开始的子数组是
[3, 4],它也是严格递增的。 - 这两个子数组是相邻的,因此 2 是满足题目条件的 最大
k值。
提示:
2 <= nums.length <= 2 * 105-109 <= nums[i] <= 109
方法一:一次遍历 · Go 实现
思考
在 I 的判定之外,要求最大的 。 ,必须在同一次断裂扫描中维护答案。
候选仍是「单段对半切」与「两段取短」,与 I 相同,只是把判定改成取最大。
扫描结束时的 即为所求 。
我们可以使用一次遍历来计算最大的相邻递增子数组长度 。具体地,我们维护三个变量 和 分别表示当前递增子数组和上一个递增子数组的长度,而 表示最大的相邻递增子数组长度。
每当遇到一个非递增的位置时,我们就更新 ,将 赋值给 ,并将 重置为 。更新 的公式为 ,表示相邻递增子数组要么来自当前递增子数组长度的一半,要么来自前一个递增子数组和当前递增子数组的较小值。
最后我们只需要返回 即可。
时间复杂度 ,其中 是数组的长度。空间复杂度 。
func maxIncreasingSubarrays(nums []int) (ans int) {
	pre, cur := 0, 0
	for i, x := range nums {
		cur++
		if i == len(nums)-1 || x >= nums[i+1] {
			ans = max(ans, max(cur/2, min(pre, cur)))
			pre, cur = cur, 0
		}
	}
	return
}3356. 零数组变换 II
题目、示例与约束
给你一个长度为 n 的整数数组 nums 和一个二维数组 queries,其中 queries[i] = [li, ri, vali]。
每个 queries[i] 表示在 nums 上执行以下操作:
- 将
nums中[li, ri]范围内的每个下标对应元素的值 最多 减少vali。 - 每个下标的减少的数值可以独立选择。
零数组 是指所有元素都等于 0 的数组。
返回 k 可以取到的 最小非负 值,使得在 顺序 处理前 k 个查询后,nums 变成 零数组。如果不存在这样的 k,则返回 -1。
示例 1:
输入: nums = [2,0,2], queries = [[0,2,1],[0,2,1],[1,1,3]]
输出: 2
解释:
- 对于 i = 0(l = 0, r = 2, val = 1):
- 在下标
[0, 1, 2]处分别减少[1, 0, 1]。 - 数组将变为
[1, 0, 1]。
- 在下标
- 对于 i = 1(l = 0, r = 2, val = 1):
- 在下标
[0, 1, 2]处分别减少[1, 0, 1]。 - 数组将变为
[0, 0, 0],这是一个零数组。因此,k的最小值为 2。
- 在下标
示例 2:
输入: nums = [4,3,2,1], queries = [[1,3,2],[0,2,1]]
输出: -1
解释:
- 对于 i = 0(l = 1, r = 3, val = 2):
- 在下标
[1, 2, 3]处分别减少[2, 2, 1]。 - 数组将变为
[4, 1, 0, 0]。
- 在下标
- 对于 i = 1(l = 0, r = 2, val = 1):
- 在下标
[0, 1, 2]处分别减少[1, 1, 0]。 - 数组将变为
[3, 0, 0, 0],这不是一个零数组。
- 在下标
提示:
1 <= nums.length <= 1050 <= nums[i] <= 5 * 1051 <= queries.length <= 105queries[i].length == 30 <= li <= ri < nums.length1 <= vali <= 5
方法一:差分数组 + 二分查找 · Go 实现
思考
与 I 不同,询问带权且必须取前缀中最短的一段。前缀越长越容易归零,存在单调性。
对长度 做可行性判定时,仍用差分数组写入前 个 ,再检查覆盖是否处处足够。
二分最小可行 ;若 个仍不够则返回 。
我们注意到,查询的个数越多,越容易使得数组变成零数组,这存在单调性。因此,我们可以二分枚举查询的个数,判断在前 k 个查询下,是否可以将数组变成零数组。
我们定义二分查找的左边界 和右边界 ,初始时 , ,其中 是查询的个数。我们定义一个函数 ,表示在前 个查询下,是否可以将数组变成零数组。我们可以使用差分数组来维护每个元素的值。
定义一个长度为 的数组 ,初始值全部为 。对于前 个查询的每个查询 ,我们将 加 ,将 减 。
然后我们遍历数组 在 范围内的每个元素,累加前缀和 ,如果 ,说明 不能转换为零数组,返回 。
我们在二分查找的过程中,如果 返回 ,说明可以将数组变成零数组,我们就将右边界 更新为 ,否则将左边界 更新为 。
最后,我们判断 是否大于 ,如果是,则返回 -1,否则返回 。
时间复杂度 ,空间复杂度 。其中 和 分别为数组 和 的长度。
func minZeroArray(nums []int, queries [][]int) int {
	n, m := len(nums), len(queries)
	l := sort.Search(m+1, func(k int) bool {
		d := make([]int, n+1)
		for _, q := range queries[:k] {
			l, r, val := q[0], q[1], q[2]
			d[l] += val
			d[r+1] -= val
		}
		s := 0
		for i, x := range nums {
			s += d[i]
			if x > s {
				return false
			}
		}
		return true
	})
	if l > m {
		return -1
	}
	return l
}3398. 字符相同的最短子字符串 I
题目、示例与约束
给你一个长度为 n 的二进制字符串 s 和一个整数 numOps。
你可以对 s 执行以下操作,最多 numOps 次:
- 选择任意下标
i(其中0 <= i < n),并 翻转s[i],即如果s[i] == '1',则将s[i]改为'0',反之亦然。
你需要 最小化 s 的最长 相同 子字符串 的长度,相同子字符串 是指子字符串中的所有字符都 相同。
返回执行所有操作后可获得的 最小 长度。
示例 1:
输入: s = "000001", numOps = 1
输出: 2
解释:
将 s[2] 改为 '1',s 变为 "001001"。最长的所有字符相同的子串为 s[0..1] 和 s[3..4]。
示例 2:
输入: s = "0000", numOps = 2
输出: 1
解释:
将 s[0] 和 s[2] 改为 '1',s 变为 "1010"。
示例 3:
输入: s = "0101", numOps = 0
输出: 1
提示:
1 <= n == s.length <= 1000s仅由'0'和'1'组成。0 <= numOps <= n
方法一 · Go 实现
思考
至多翻转 位,使最长的相同字符段尽量短。 ,对目标长度 二分。
时只能变成
0101...或1010...,取与 差异较小的那种。 时,每段连续相同字符长度为 则至少翻 次。若总翻转次数不超过 ,则 可行。二分最小可行 。
func minLength(s string, numOps int) int {
	check := func(m int) bool {
		m++
		cnt := 0
		if m == 1 {
			t := "01"
			for i := range s {
				if s[i] == t[i&1] {
					cnt++
				}
			}
			cnt = min(cnt, len(s)-cnt)
		} else {
			k := 0
			for i := range s {
				k++
				if i == len(s)-1 || s[i] != s[i+1] {
					cnt += k / (m + 1)
					k = 0
				}
			}
		}
		return cnt <= numOps
	}
	return 1 + sort.Search(len(s), func(m int) bool { return check(m) })
}3399. 字符相同的最短子字符串 II
题目、示例与约束
给你一个长度为 n 的二进制字符串 s 和一个整数 numOps。
你可以对 s 执行以下操作,最多 numOps 次:
- 选择任意下标
i(其中0 <= i < n),并 翻转s[i],即如果s[i] == '1',则将s[i]改为'0',反之亦然。
你需要 最小化 s 的最长 相同 子字符串 的长度,相同子字符串是指子字符串中的所有字符都相同。
返回执行所有操作后可获得的 最小 长度。
示例 1:
输入: s = "000001", numOps = 1
输出: 2
解释:
将 s[2] 改为 '1',s 变为 "001001"。最长的所有字符相同的子串为 s[0..1] 和 s[3..4]。
示例 2:
输入: s = "0000", numOps = 2
输出: 1
解释:
将 s[0] 和 s[2] 改为 '1',s 变为 "1010"。
示例 3:
输入: s = "0101", numOps = 0
输出: 1
提示:
1 <= n == s.length <= 105s仅由'0'和'1'组成。0 <= numOps <= n
方法一 · Go 实现
思考
题意与 I 相同,仅规模更大,但判定仍是 ,对 二分后总复杂度 ,足以覆盖更长的串。
与 的计数方式不变:交替串取较小差异,其余按 估计翻转次数。
因此实现与 I 共用,无需改数据结构。
func minLength(s string, numOps int) int {
	check := func(m int) bool {
		m++
		cnt := 0
		if m == 1 {
			t := "01"
			for i := range s {
				if s[i] == t[i&1] {
					cnt++
				}
			}
			cnt = min(cnt, len(s)-cnt)
		} else {
			k := 0
			for i := range s {
				k++
				if i == len(s)-1 || s[i] != s[i+1] {
					cnt += k / (m + 1)
					k = 0
				}
			}
		}
		return cnt <= numOps
	}
	return 1 + sort.Search(len(s), func(m int) bool { return check(m) })
}3453. 分割正方形 I
题目、示例与约束
给你一个二维整数数组 squares ,其中 squares[i] = [xi, yi, li] 表示一个与 x 轴平行的正方形的左下角坐标和正方形的边长。
找到一个最小的 y 坐标,它对应一条水平线,该线需要满足它以上正方形的总面积 等于 该线以下正方形的总面积。
答案如果与实际答案的误差在 10-5 以内,将视为正确答案。
注意:正方形 可能会 重叠。重叠区域应该被 多次计数 。
示例 1:
输入: squares = [[0,0,1],[2,2,1]]
输出: 1.00000
解释:
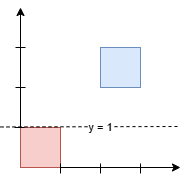
任何在 y = 1 和 y = 2 之间的水平线都会有 1 平方单位的面积在其上方,1 平方单位的面积在其下方。最小的 y 坐标是 1。
示例 2:
输入: squares = [[0,0,2],[1,1,1]]
输出: 1.16667
解释:
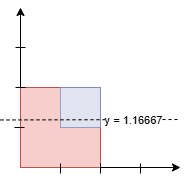
面积如下:
- 线下的面积:
7/6 * 2 (红色) + 1/6 (蓝色) = 15/6 = 2.5。 - 线上的面积:
5/6 * 2 (红色) + 5/6 (蓝色) = 15/6 = 2.5。
由于线以上和线以下的面积相等,输出为 7/6 = 1.16667。
提示:
1 <= squares.length <= 5 * 104squares[i] = [xi, yi, li]squares[i].length == 30 <= xi, yi <= 1091 <= li <= 109- 所有正方形的总面积不超过
1012。
方法一:二分查找 · Go 实现
思考
要用水平线把正方形总面积二等分。面积随切割线高度单调增加,总面积 ,坐标很大,离散枚举高度不可行。
实数域上的单调性适合二分。判定函数计算直线 以下被切到的面积是否已达一半。
对每个正方形,若底边低于 ,贡献边长乘以切入深度(不超过边长)。二分至误差 ,返回右端。
根据题意,我们需要找到一个水平线,使得该线以上正方形的总面积等于该线以下正方形的总面积。由于随着 坐标的增加,线以下的面积会增加,线以上的面积会减少,因此我们可以使用二分查找来找到这个水平线的 坐标。
我们定义二分查找的左边界 ,右边界 ,即所有正方形的最高点。然后我们计算中间点 ,并计算该水平线以下的面积。如果该面积大于等于总面积的一半,则说明我们需要向下移动右边界 ,否则向上移动左边界 。我们重复这个过程,直到左右边界的差小于一个很小的值(例如 )。
时间复杂度 ,其中 是正方形的数量,而 , 。空间复杂度 。
func separateSquares(squares [][]int) float64 {
	s := 0.0
	check := func(y1 float64) bool {
		t := 0.0
		for _, a := range squares {
			y := a[1]
			l := a[2]
			if float64(y) < y1 {
				h := min(float64(l), y1-float64(y))
				t += float64(l) * h
			}
		}
		return t >= s/2.0
	}
	l, r := 0.0, 0.0
	for _, a := range squares {
		s += float64(a[2] * a[2])
		r = max(r, float64(a[1]+a[2]))
	}

	const eps = 1e-5
	for r-l > eps {
		mid := (l + r) / 2.0
		if check(mid) {
			r = mid
		} else {
			l = mid
		}
	}
	return r
}3455. 最短匹配子字符串
题目、示例与约束
给你一个字符串 s 和一个模式字符串 p,其中 p 恰好 包含 两个 '*' 字符。
p 中的 '*' 匹配零个或多个字符的任何序列。
返回 s 中与 p 匹配的 最短 子字符串的长度。如果没有这样的子字符串,返回 -1。
子字符串 是字符串中的一个连续字符序列(空子字符串也被认为是合法字符串)。
示例 1:
输入: s = "abaacbaecebce", p = "ba*c*ce"
输出: 8
解释:
在 s 中,p 的最短匹配子字符串是 "baecebce"。
示例 2:
输入: s = "baccbaadbc", p = "cc*baa*adb"
输出: -1
解释:
在 s 中没有匹配的子字符串。
示例 3:
输入: s = "a", p = "**"
输出: 0
解释:
空子字符串是最短的匹配子字符串。
示例 4:
输入: s = "madlogic", p = "*adlogi*"
输出: 6
解释:
在 s 中,p 的最短匹配子字符串是 "adlogi"。
提示:
1 <= s.length <= 1052 <= p.length <= 105s仅包含小写英文字母。p仅包含小写英文字母,并且恰好包含两个'*'。
方法一 · Go 实现
思考
恰含两个 ,把模式拆成三段字面量 、 、 。 ,不能对每个起点做朴素匹配。
最短匹配由三段在 中的出现位置决定:找到 的一次出现后,在其右侧找最早的 ,再找最早的 。
用 KMP 或 Z 函数预处理三段的全部出现下标,再对 的每个出现做双指针推进 、 。长度取 的右端减 的左端,没有则返回 。
按两个 把模式拆成三段字面量 、 、 ,三段都可以为空。用 KMP 求出每一段在 中的全部起始下标。空串在 每个位置都能匹配。
对 的每个起点 ,用双指针取不早于 的最早 起点 ,再取不早于 的最早 起点 。这次匹配的长度是 。所有起点里的最小值就是答案;一次都配不上则返回 。
更靠后的 只会把 推向右边,所以对固定的 ,最早的 配上最早的 就是最短的。
时间复杂度 ,空间复杂度 。其中 和 分别是 和 的长度。
func shortestMatchingSubstring(s string, p string) int {
	star := 0
	for p[star] != '*' {
		star++
	}
	star2 := star + 1
	for p[star2] != '*' {
		star2++
	}
	a, b, c := p[:star], p[star+1:star2], p[star2+1:]
	A, B, C := matchStarts(s, a), matchStarts(s, b), matchStarts(s, c)
	ans := len(s) + 1
	j, k := 0, 0
	for _, i := range A {
		for j < len(B) && B[j] < i+len(a) {
			j++
		}
		if j == len(B) {
			break
		}
		for k < len(C) && C[k] < B[j]+len(b) {
			k++
		}
		if k == len(C) {
			break
		}
		ans = min(ans, C[k]+len(c)-i)
	}
	if ans > len(s) {
		return -1
	}
	return ans
}

func matchStarts(s, pat string) []int {
	n := len(s)
	if pat == "" {
		res := make([]int, n+1)
		for i := 0; i <= n; i++ {
			res[i] = i
		}
		return res
	}
	m := len(pat)
	lps := make([]int, m)
	for i, length := 1, 0; i < m; {
		if pat[i] == pat[length] {
			length++
			lps[i] = length
			i++
		} else if length > 0 {
			length = lps[length-1]
		} else {
			i++
		}
	}
	res := make([]int, 0)
	for i, j := 0, 0; i < n; {
		if s[i] == pat[j] {
			i++
			j++
			if j == m {
				res = append(res, i-m)
				j = lps[j-1]
			}
		} else if j > 0 {
			j = lps[j-1]
		} else {
			i++
		}
	}
	return res
}3464. 正方形上的点之间的最大距离
题目、示例与约束
给你一个整数 side,表示一个正方形的边长,正方形的四个角分别位于笛卡尔平面的 (0, 0) ,(0, side) ,(side, 0) 和 (side, side) 处。
同时给你一个 正整数 k 和一个二维整数数组 points,其中 points[i] = [xi, yi] 表示一个点在正方形边界上的坐标。
你需要从 points 中选择 k 个元素,使得任意两个点之间的 最小 曼哈顿距离 最大化 。
返回选定的 k 个点之间的 最小 曼哈顿距离的 最大 可能值。
两个点 (xi, yi) 和 (xj, yj) 之间的曼哈顿距离为 |xi - xj| + |yi - yj|。
示例 1:
输入: side = 2, points = [[0,2],[2,0],[2,2],[0,0]], k = 4
输出: 2
解释:

选择所有四个点。
示例 2:
输入: side = 2, points = [[0,0],[1,2],[2,0],[2,2],[2,1]], k = 4
输出: 1
解释:
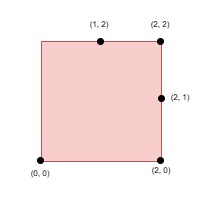
选择点 (0, 0) ,(2, 0) ,(2, 2) 和 (2, 1)。
示例 3:
输入: side = 2, points = [[0,0],[0,1],[0,2],[1,2],[2,0],[2,2],[2,1]], k = 5
输出: 1
解释:
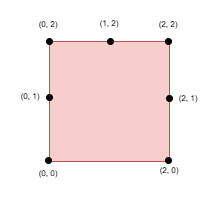
选择点 (0, 0) ,(0, 1) ,(0, 2) ,(1, 2) 和 (2, 2)。
提示:
1 <= side <= 1094 <= points.length <= min(4 * side, 15 * 103)points[i] == [xi, yi]- 输入产生方式如下:
points[i]位于正方形的边界上。- 所有
points[i]都 互不相同 。
4 <= k <= min(25, points.length)
方法一:二分答案 + 坐标映射 + 贪心 · Go 实现
思考
在正方形边界上选 个点,最大化两两相邻(含首尾)的最小弧长。边长很大,点至多 , 。
最小化最大值的对偶适合二分。把边界展开成周长为 的环,距离变成一维差。
对候选距离 ,枚举起点并贪心二分跳 次,同时限制终点不超过 ,保证闭环。可行则升高 。
由于题目要求最大化最小距离,我们可以通过二分答案的方式来寻找最优解。
首先,为了简化逻辑,我们将正方形边界上的二维坐标 映射到一维数轴 上。映射规则如下:
- 若 ,映射值为 ;
- 若 ,映射值为 ;
- 若 ,映射值为 ;
- 否则,映射值为 。
映射后,将所有坐标点排序得到数组 。由于是在正方形周长上选取点,这本质上是一个环形问题。
在二分过程中,对于给定的最小距离 ,我们通过 函数验证其可行性:
- 遍历 中的每个点作为第一个点 。
- 限制选点范围的终点为 ,确保选出的最后一个点回到起点 的环绕距离也至少为 。
- 随后贪心地进行 次跳转,每次利用二分查找快速定位下一个距离当前位置至少为 的点。
- 如果能在满足 限制的情况下选够 个点,则该距离 可行。
时间复杂度 ,空间复杂度 。其中 为点集 的长度。
func maxDistance(side int, points [][]int, k int) int {
	nums := make([]int64, 0, len(points))
	for _, p := range points {
		x, y := int64(p[0]), int64(p[1])
		s := int64(side)
		if x == 0 {
			nums = append(nums, y)
		} else if y == s {
			nums = append(nums, s+x)
		} else if x == s {
			nums = append(nums, s*3-y)
		} else {
			nums = append(nums, s*4-x)
		}
	}
	sort.Slice(nums, func(i, j int) bool {
		return nums[i] < nums[j]
	})

	check := func(lo int) bool {
		total := int64(side) * 4
		l64 := int64(lo)
		for _, start := range nums {
			end := start + total - l64
			cur := start
			ok := true
			for i := 0; i < k-1; i++ {
				target := cur + l64
				idx := sort.Search(len(nums), func(i int) bool {
					return nums[i] >= target
				})
				if idx == len(nums) || nums[idx] > end {
					ok = false
					break
				}
				cur = nums[idx]
			}
			if ok {
				return true
			}
		}
		return false
	}

	l, r := 1, side
	for l < r {
		mid := (l + r + 1) >> 1
		if check(mid) {
			l = mid
		} else {
			r = mid - 1
		}
	}
	return l
}3488. 距离最小相等元素查询
题目、示例与约束
给你一个 环形 数组 nums 和一个数组 queries 。
对于每个查询 i ,你需要找到以下内容:
- 数组
nums中下标queries[i]处的元素与 任意 其他下标j(满足nums[j] == nums[queries[i]])之间的 最小 距离。如果不存在这样的下标j,则该查询的结果为-1。
返回一个数组 answer,其大小与 queries 相同,其中 answer[i] 表示查询i的结果。
示例 1:
输入: nums = [1,3,1,4,1,3,2], queries = [0,3,5]
输出: [2,-1,3]
解释:
- 查询 0:下标
queries[0] = 0处的元素为nums[0] = 1。最近的相同值下标为 2,距离为 2。 - 查询 1:下标
queries[1] = 3处的元素为nums[3] = 4。不存在其他包含值 4 的下标,因此结果为 -1。 - 查询 2:下标
queries[2] = 5处的元素为nums[5] = 3。最近的相同值下标为 1,距离为 3(沿着循环路径:5 -> 6 -> 0 -> 1)。
示例 2:
输入: nums = [1,2,3,4], queries = [0,1,2,3]
输出: [-1,-1,-1,-1]
解释:
数组 nums 中的每个值都是唯一的,因此没有下标与查询的元素值相同。所有查询的结果均为 -1。
提示:
1 <= queries.length <= nums.length <= 1051 <= nums[i] <= 1060 <= queries[i] < nums.length
方法一:环形数组 + 哈希表 · Go 实现
思考
环形数组上查询每个下标到最近相同值的距离。 ,不能对每个询问扫描。
把数组复制一份接到后面,环就变成直线上的相邻两次出现。
正反各扫一遍,用哈希表记左右最近同值,写入 。原下标取 与 的较小者;距离 表示只有自己,答案为 。
根据题目描述,我们需要找出数组每个元素与上一个相同元素的最小距离,以及与下一个相同元素的最小距离。并且,由于数组是循环的,所以我们需要考虑数组的环形特性,我们可以将数组扩展为原数组的两倍,然后使用哈希表 和 分别记录每个元素上一次出现的位置和下一次出现的位置,计算出每个位置的元素与另一个相同元素的最小距离,记录在数组 中。最后,我们遍历查询,对于每个查询 ,我们取 和 中的最小值,如果该值大于等于 ,则说明不存在与查询元素相同的元素,返回 ,否则返回该值。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func solveQueries(nums []int, queries []int) []int {
	n := len(nums)
	m := n * 2
	d := make([]int, m)
	for i := range d {
		d[i] = m
	}

	left := make(map[int]int)
	for i := 0; i < m; i++ {
		x := nums[i%n]
		if idx, exists := left[x]; exists {
			d[i] = min(d[i], i-idx)
		}
		left[x] = i
	}

	right := make(map[int]int)
	for i := m - 1; i >= 0; i-- {
		x := nums[i%n]
		if idx, exists := right[x]; exists {
			d[i] = min(d[i], idx-i)
		}
		right[x] = i
	}

	for i := 0; i < n; i++ {
		d[i] = min(d[i], d[i+n])
	}

	ans := make([]int, len(queries))
	for i, query := range queries {
		if d[query] >= n {
			ans[i] = -1
		} else {
			ans[i] = d[query]
		}
	}
	return ans
}继续阅读
- 实践案例
- 实践案例
- 实践案例