
LeetCode Go · 二分查找(5)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
2226. 每个小孩最多能分到多少糖果
题目、示例与约束
给你一个 下标从 0 开始 的整数数组 candies 。数组中的每个元素表示大小为 candies[i] 的一堆糖果。你可以将每堆糖果分成任意数量的 子堆 ,但 无法 再将两堆合并到一起。
另给你一个整数 k 。你需要将这些糖果分配给 k 个小孩,使每个小孩分到 相同 数量的糖果。每个小孩可以拿走 至多一堆 糖果,有些糖果可能会不被分配。
返回每个小孩可以拿走的 最大糖果数目 。
示例 1:
输入:candies = [5,8,6], k = 3
输出:5
解释:可以将 candies[1] 分成大小分别为 5 和 3 的两堆,然后把 candies[2] 分成大小分别为 5 和 1 的两堆。现在就有五堆大小分别为 5、5、3、5 和 1 的糖果。可以把 3 堆大小为 5 的糖果分给 3 个小孩。可以证明无法让每个小孩得到超过 5 颗糖果。
示例 2:
输入:candies = [2,5], k = 11
输出:0
解释:总共有 11 个小孩,但只有 7 颗糖果,但如果要分配糖果的话,必须保证每个小孩至少能得到 1 颗糖果。因此,最后每个小孩都没有得到糖果,答案是 0 。
提示:
1 <= candies.length <= 1051 <= candies[i] <= 1071 <= k <= 1012
方法一:二分查找 · Go 实现
思考
每名儿童得到的糖果数必须相同,且只能来自同一堆的连续分割。 可达 ,不能按人模拟。若每人能分到 颗,则也能分到任意更小的正整数,答案关于 单调。
在 上二分 :一堆大小为 的糖可切出 份,总和不少于 则可行。注意 表示无法分配,二分下界取 即可覆盖。
我们注意到,如果每个小孩能分到糖果数 ,那么对于任意 ,每个小孩也能分到 颗糖果。因此,我们可以使用二分查找的方法找到最大的 ,使得每个小孩能分到 颗糖果。
我们定义二分查找的左边界 ,右边界 ,其中 表示数组 中的最大值。在二分查找的过程中,我们每次取 的中间值 ,然后计算每个小孩能分到的糖果数 的总和,如果总和大于等于 ,则说明每个小孩能分到 颗糖果,此时我们更新左边界 ,否则我们更新右边界 。最终,当 时,我们找到了最大的 。
时间复杂度 ,其中 表示数组 的长度,而 表示数组 中的最大值。空间复杂度 。
func maximumCandies(candies []int, k int64) int {
	return sort.Search(1e7, func(v int) bool {
		v++
		var cnt int64
		for _, x := range candies {
			cnt += int64(x / v)
		}
		return cnt < k
	})
}2251. 花期内花的数目
题目、示例与约束
给你一个下标从 0 开始的二维整数数组 flowers ,其中 flowers[i] = [starti, endi] 表示第 i 朵花的 花期 从 starti 到 endi (都 包含)。同时给你一个下标从 0 开始大小为 n 的整数数组 people ,people[i] 是第 i 个人来看花的时间。
请你返回一个大小为 n 的整数数组 answer ,其中 answer[i]是第 i 个人到达时在花期内花的 数目 。
示例 1:
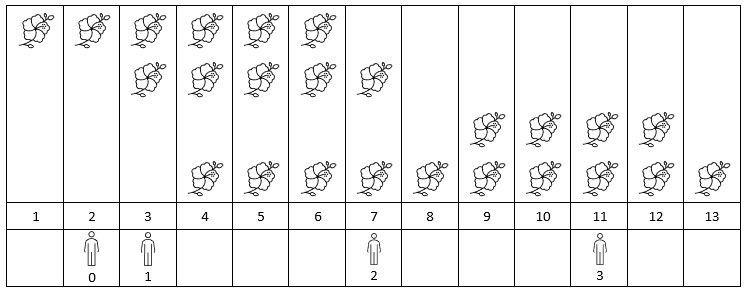
输入:flowers = [[1,6],[3,7],[9,12],[4,13]], people = [2,3,7,11]
输出:[1,2,2,2]
解释:上图展示了每朵花的花期时间,和每个人的到达时间。
对每个人,我们返回他们到达时在花期内花的数目。
示例 2:
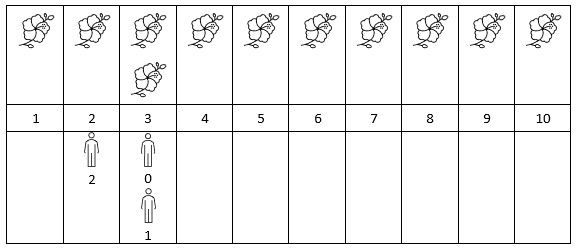
输入:flowers = [[1,10],[3,3]], people = [3,3,2]
输出:[2,2,1]
解释:上图展示了每朵花的花期时间,和每个人的到达时间。
对每个人,我们返回他们到达时在花期内花的数目。
提示:
1 <= flowers.length <= 5 * 104flowers[i].length == 21 <= starti <= endi <= 1091 <= people.length <= 5 * 1041 <= people[i] <= 109
方法一:排序 + 二分查找 · Go 实现
思考
每位访客到达时,统计仍在花期的花数。花与人均为 ,时间戳达 ,不能按天模拟。一朵花在 开放当且仅当 ,即「已开放数减去已凋谢数」。
把所有 、 分别排序。对到达时刻 ,用 数出已开放的花,用 数出结束时间小于 的花,二者之差即答案。
我们将花按照开始时间和结束时间分别排序,然后对于每个人,我们可以使用二分查找来找到他们到达时在花期内花的数目。就是说,找出在每个人到达时,已经开花的花的数目,减去在每个人到达时,已经凋谢的花的数目,即可得到答案。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 和 的长度。
func fullBloomFlowers(flowers [][]int, people []int) (ans []int) {
	n := len(flowers)
	start := make([]int, n)
	end := make([]int, n)
	for i, f := range flowers {
		start[i] = f[0]
		end[i] = f[1]
	}
	sort.Ints(start)
	sort.Ints(end)
	for _, p := range people {
		r := sort.SearchInts(start, p+1)
		l := sort.SearchInts(end, p)
		ans = append(ans, r-l)
	}
	return
}
方法二:差分 + 排序 + 离线查询 · Go 实现
思考
方法一对每个询问独立二分。也可以把花期差分离线处理:在 加一、在 减一,按时间排序后与按到达时间排序的询问一起扫描。
指针扫过不超过当前 的差分点并累加,即可得到该时刻的开放数。时间同阶,少了对每次询问的两次二分。
我们可以利用差分来维护每个时间点的花的数目。接下来,我们将 按照到达时间从小到大排序,在每个人到达时,我们对差分数组进行前缀和运算,就可以得到答案。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 和 的长度。
func fullBloomFlowers(flowers [][]int, people []int) []int {
	d := map[int]int{}
	for _, f := range flowers {
		d[f[0]]++
		d[f[1]+1]--
	}
	ts := []int{}
	for t := range d {
		ts = append(ts, t)
	}
	sort.Ints(ts)
	m := len(people)
	idx := make([]int, m)
	for i := range idx {
		idx[i] = i
	}
	sort.Slice(idx, func(i, j int) bool { return people[idx[i]] < people[idx[j]] })
	ans := make([]int, m)
	s, i := 0, 0
	for _, j := range idx {
		t := people[j]
		for i < len(ts) && ts[i] <= t {
			s += d[ts[i]]
			i++
		}
		ans[j] = s
	}
	return ans
}2300. 咒语和药水的成功对数
题目、示例与约束
给你两个正整数数组 spells 和 potions ,长度分别为 n 和 m ,其中 spells[i] 表示第 i 个咒语的能量强度,potions[j] 表示第 j 瓶药水的能量强度。
同时给你一个整数 success 。一个咒语和药水的能量强度 相乘 如果 大于等于 success ,那么它们视为一对 成功 的组合。
请你返回一个长度为 n 的整数数组 pairs,其中 pairs[i] 是能跟第 i 个咒语成功组合的 药水 数目。
示例 1:
输入:spells = [5,1,3], potions = [1,2,3,4,5], success = 7
输出:[4,0,3]
解释:
- 第 0 个咒语:5 * [1,2,3,4,5] = [5,10,15,20,25] 。总共 4 个成功组合。
- 第 1 个咒语:1 * [1,2,3,4,5] = [1,2,3,4,5] 。总共 0 个成功组合。
- 第 2 个咒语:3 * [1,2,3,4,5] = [3,6,9,12,15] 。总共 3 个成功组合。
所以返回 [4,0,3] 。
示例 2:
输入:spells = [3,1,2], potions = [8,5,8], success = 16
输出:[2,0,2]
解释:
- 第 0 个咒语:3 * [8,5,8] = [24,15,24] 。总共 2 个成功组合。
- 第 1 个咒语:1 * [8,5,8] = [8,5,8] 。总共 0 个成功组合。
- 第 2 个咒语:2 * [8,5,8] = [16,10,16] 。总共 2 个成功组合。
所以返回 [2,0,2] 。
提示:
n == spells.lengthm == potions.length1 <= n, m <= 1051 <= spells[i], potions[i] <= 1051 <= success <= 1010
方法一:排序 + 二分查找 · Go 实现
思考
若对每个咒语扫描全部药水,时间复杂度为 。 ,无法通过。
固定咒语 后,成功条件化为 ,只取决于药水强度的单调分界。为此先将药水升序排列,再用二分定位第一瓶满足阈值的药水,其后整段后缀均可配对。每个咒语只需一次对数查找。
我们可以对药水数组进行排序,然后遍历咒语数组,对于每个咒语 ,利用二分查找找到第一个大于等于 的药水,下标记为 ,那么药水的长度减去 即为能跟该咒语成功组合的药水数目。
时间复杂度 ,空间复杂度 。其中 和 分别为药水数组和咒语数组的长度。
func successfulPairs(spells []int, potions []int, success int64) (ans []int) {
	sort.Ints(potions)
	m := len(potions)
	for _, v := range spells {
		i := sort.Search(m, func(i int) bool { return int64(potions[i]*v) >= success })
		ans = append(ans, m-i)
	}
	return ans
}2302. 统计得分小于 K 的子数组数目
题目、示例与约束
一个数组的 分数 定义为数组之和 乘以 数组的长度。
- 比方说,
[1, 2, 3, 4, 5]的分数为(1 + 2 + 3 + 4 + 5) * 5 = 75。
给你一个正整数数组 nums 和一个整数 k ,请你返回 nums 中分数 严格小于 k 的 非空整数子数组数目。
子数组 是数组中的一个连续元素序列。
示例 1:
输入:nums = [2,1,4,3,5], k = 10
输出:6
解释:
有 6 个子数组的分数小于 10 :
- [2] 分数为 2 * 1 = 2 。
- [1] 分数为 1 * 1 = 1 。
- [4] 分数为 4 * 1 = 4 。
- [3] 分数为 3 * 1 = 3 。
- [5] 分数为 5 * 1 = 5 。
- [2,1] 分数为 (2 + 1) * 2 = 6 。
注意,子数组 [1,4] 和 [4,3,5] 不符合要求,因为它们的分数分别为 10 和 36,但我们要求子数组的分数严格小于 10 。
示例 2:
输入:nums = [1,1,1], k = 5
输出:5
解释:
除了 [1,1,1] 以外每个子数组分数都小于 5 。
[1,1,1] 分数为 (1 + 1 + 1) * 3 = 9 ,大于 5 。
所以总共有 5 个子数组得分小于 5 。
提示:
1 <= nums.length <= 1051 <= nums[i] <= 1051 <= k <= 1015
方法一:前缀和 + 二分查找 · Go 实现
思考
子数组评分为和与长度之积。枚举全部子数组需 , 不可行。元素均为正,故固定右端后,窗口越长积分越大,合法左端构成前缀。
用前缀和把任意区间和变成常数查询,再对长度二分,找到使 的最大 。每个右端点贡献 个子数组。
我们先计算出数组 的前缀和数组 ,其中 表示数组 前 个元素的和。
接下来,我们枚举数组 每个元素作为子数组的最后一个元素,对于每个元素,我们可以通过二分查找的方式找到最大的长度 ,使得 。那么以该元素为最后一个元素的子数组个数即为 ,我们将所有的 相加即为答案。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func countSubarrays(nums []int, k int64) (ans int64) {
	n := len(nums)
	s := make([]int64, n+1)
	for i, x := range nums {
		s[i+1] = s[i] + int64(x)
	}
	for i := 1; i <= n; i++ {
		l, r := 0, i
		for l < r {
			mid := (l + r + 1) >> 1
			if (s[i]-s[i-mid])*int64(mid) < k {
				l = mid
			} else {
				r = mid - 1
			}
		}
		ans += int64(l)
	}
	return
}
方法二:双指针 · Go 实现
思考
方法一额外需要前缀数组,且每个右端点付出对数代价。正数保证积分随左端右移单调下降,因此左指针只需前进、不必回退。维护窗口和,一次扫过即可在线性时间内统计合法子数组。
我们可以使用双指针的方式,维护一个滑动窗口,使得窗口内的元素和小于 。那么以当前元素为最后一个元素的子数组个数即为窗口的长度,我们将所有的窗口长度相加即为答案。
时间复杂度 ,其中 为数组 的长度。空间复杂度 。
func countSubarrays(nums []int, k int64) (ans int64) {
	s, j := 0, 0
	for i, x := range nums {
		s += x
		for int64(s*(i-j+1)) >= k {
			s -= nums[j]
			j++
		}
		ans += int64(i - j + 1)
	}
	return
}2332. 坐上公交的最晚时间
题目、示例与约束
给你一个下标从 0 开始长度为 n 的整数数组 buses ,其中 buses[i] 表示第 i 辆公交车的出发时间。同时给你一个下标从 0 开始长度为 m 的整数数组 passengers ,其中 passengers[j] 表示第 j 位乘客的到达时间。所有公交车出发的时间互不相同,所有乘客到达的时间也互不相同。
给你一个整数 capacity ,表示每辆公交车 最多 能容纳的乘客数目。
每位乘客都会排队搭乘下一辆有座位的公交车。如果你在 y 时刻到达,公交在 x 时刻出发,满足 y <= x 且公交没有满,那么你可以搭乘这一辆公交。最早 到达的乘客优先上车。
返回你可以搭乘公交车的最晚到达公交站时间。你 不能 跟别的乘客同时刻到达。
注意:数组 buses 和 passengers 不一定是有序的。
示例 1:
输入:buses = [10,20], passengers = [2,17,18,19], capacity = 2
输出:16
解释:
第 1 辆公交车载着第 1 位乘客。
第 2 辆公交车载着你和第 2 位乘客。
注意你不能跟其他乘客同一时间到达,所以你必须在第二位乘客之前到达。
示例 2:
输入:buses = [20,30,10], passengers = [19,13,26,4,25,11,21], capacity = 2
输出:20
解释:
第 1 辆公交车载着第 4 位乘客。
第 2 辆公交车载着第 6 位和第 2 位乘客。
第 3 辆公交车载着第 1 位乘客和你。
提示:
n == buses.lengthm == passengers.length1 <= n, m, capacity <= 1052 <= buses[i], passengers[i] <= 109buses中的元素 互不相同 。passengers中的元素 互不相同 。
方法一:模拟 · Go 实现
思考
要在不与他人撞车的前提下最晚到达。车辆与乘客均可达 ,须先排序再线性模拟上车。
按发车时刻依次让已到达乘客上车,记下末班剩余空位。若有空位则从末班时刻往前避开已有乘客;否则从最后上车者的时刻往前找空隙。
我们先排序,然后用双指针模拟乘客上车的过程:遍历公交车 ,乘客遵循“先到先上车”的原则。
模拟结束后,判断最后一班公交车是否还有空位:
- 若有空位,我们可以在公交车发车时 到达公交站;若此时有人,可以顺着往前找到没人到达的时刻;
- 若无空位,我们可以找到上一个上车的乘客,顺着他往前找到没人到达的时刻。
时间复杂度 ,空间复杂度 。其中 和 分别是公交车和乘客的数量。
func latestTimeCatchTheBus(buses []int, passengers []int, capacity int) int {
	sort.Ints(buses)
	sort.Ints(passengers)
	j, c := 0, 0
	for _, t := range buses {
		c = capacity
		for c > 0 && j < len(passengers) && passengers[j] <= t {
			j++
			c--
		}
	}
	j--
	ans := buses[len(buses)-1]
	if c == 0 {
		ans = passengers[j]
	}
	for j >= 0 && ans == passengers[j] {
		ans--
		j--
	}
	return ans
}2354. 优质数对的数目
题目、示例与约束
给你一个下标从 0 开始的正整数数组 nums 和一个正整数 k 。
如果满足下述条件,则数对 (num1, num2) 是 优质数对 :
num1和num2都 在数组nums中存在。num1 OR num2和num1 AND num2的二进制表示中值为 1 的位数之和大于等于k,其中OR是按位 或 操作,而AND是按位 与 操作。
返回 不同 优质数对的数目。
如果 a != c 或者 b != d ,则认为 (a, b) 和 (c, d) 是不同的两个数对。例如,(1, 2) 和 (2, 1) 不同。
注意:如果 num1 在数组中至少出现 一次 ,则满足 num1 == num2 的数对 (num1, num2) 也可以是优质数对。
示例 1:
输入:nums = [1,2,3,1], k = 3
输出:5
解释:有如下几个优质数对:
- (3, 3):(3 AND 3) 和 (3 OR 3) 的二进制表示都等于 (11) 。值为 1 的位数和等于 2 + 2 = 4 ,大于等于 k = 3 。
- (2, 3) 和 (3, 2): (2 AND 3) 的二进制表示等于 (10) ,(2 OR 3) 的二进制表示等于 (11) 。值为 1 的位数和等于 1 + 2 = 3 。
- (1, 3) 和 (3, 1): (1 AND 3) 的二进制表示等于 (01) ,(1 OR 3) 的二进制表示等于 (11) 。值为 1 的位数和等于 1 + 2 = 3 。
所以优质数对的数目是 5 。
示例 2:
输入:nums = [5,1,1], k = 10
输出:0
解释:该数组中不存在优质数对。
提示:
1 <= nums.length <= 1051 <= nums[i] <= 1091 <= k <= 60
方法一 · Go 实现
思考
优秀数对满足 。该式恒等于 。 ,且数对与顺序、取值集合有关,须先去重。
对去重后的值按位数计数。枚举每个 的位数 ,累加所有 使 的个数。每个有序对(含相等)都被计一次。
func countExcellentPairs(nums []int, k int) int64 {
	s := map[int]bool{}
	for _, v := range nums {
		s[v] = true
	}
	cnt := make([]int, 32)
	for v := range s {
		t := bits.OnesCount(uint(v))
		cnt[t]++
	}
	ans := 0
	for v := range s {
		t := bits.OnesCount(uint(v))
		for i, x := range cnt {
			if t+i >= k {
				ans += x
			}
		}
	}
	return int64(ans)
}2387. 行排序矩阵的中位数 🔒
题目、示例与约束
给定一个包含 奇数 个整数的 m x n 矩阵 grid,其中每一行按 非递减 的顺序排序,返回矩阵的 中位数。
你必须以 O(m * log(n)) 的时间复杂度来解决这个问题。
示例 1:
输入: grid = [[1,1,2],[2,3,3],[1,3,4]]
输出: 2
解释: 矩阵的元素按顺序排列为 1,1,1,2,2,3,3,3,4。中位数是 2。
示例 2:
输入: grid = [[1,1,3,3,4]]
输出: 3
解释: 矩阵的元素按顺序排列为 1,1,3,3,4。中位数是 3。
提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 500m和n都是奇数。1 <= grid[i][j] <= 106grid[i]按非递减顺序排序
方法一:两次二分查找 · Go 实现
思考
每行有序,求整个矩阵的中位数。不必展开排序。中位数是第 小的值,值域已知时可对值二分。
判定 时,对每行 统计 的个数。个数达到目标则中位数不大于 。外层再对值域二分。
中位数实际上是排序后第 个数。
我们二分枚举矩阵的元素 ,统计网格中大于该元素的个数 ,如果 ,说明中位数在 的左侧(包含 ),否则在右侧。
时间复杂度 ,其中 和 分别为网格的行数和列数,而 为网格中的最大元素。空间复杂度 。
func matrixMedian(grid [][]int) int {
	m, n := len(grid), len(grid[0])

	count := func(x int) int {
		cnt := 0
		for _, row := range grid {
			left, right := 0, n
			for left < right {
				mid := (left + right) >> 1
				if row[mid] > x {
					right = mid
				} else {
					left = mid + 1
				}
			}
			cnt += left
		}
		return cnt
	}
	left, right := 0, 1000010
	target := (m*n + 1) >> 1
	for left < right {
		mid := (left + right) >> 1
		if count(mid) >= target {
			right = mid
		} else {
			left = mid + 1
		}
	}
	return left
}2398. 预算内的最多机器人数目
题目、示例与约束
你有 n 个机器人,给你两个下标从 0 开始的整数数组 chargeTimes 和 runningCosts ,两者长度都为 n 。第 i 个机器人充电时间为 chargeTimes[i] 单位时间,花费 runningCosts[i] 单位时间运行。再给你一个整数 budget 。
运行 k 个机器人 总开销 是 max(chargeTimes) + k * sum(runningCosts) ,其中 max(chargeTimes) 是这 k 个机器人中最大充电时间,sum(runningCosts) 是这 k 个机器人的运行时间之和。
请你返回在 不超过 budget 的前提下,你 最多 可以运行的 连续 的机器人数目为多少。
示例 1:
输入:chargeTimes = [3,6,1,3,4], runningCosts = [2,1,3,4,5], budget = 25
输出:3
解释:
可以在 budget 以内运行所有单个机器人或者连续运行 2 个机器人。
选择前 3 个机器人,可以得到答案最大值 3 。总开销是 max(3,6,1) + 3 * sum(2,1,3) = 6 + 3 * 6 = 24 ,小于 25 。
可以看出无法在 budget 以内连续运行超过 3 个机器人,所以我们返回 3 。
示例 2:
输入:chargeTimes = [11,12,19], runningCosts = [10,8,7], budget = 19
输出:0
解释:即使运行任何一个单个机器人,还是会超出 budget,所以我们返回 0 。
提示:
chargeTimes.length == runningCosts.length == n1 <= n <= 5 * 1041 <= chargeTimes[i], runningCosts[i] <= 1051 <= budget <= 1015
方法一:双指针 + 单调队列 · Go 实现
思考
连续一段机器人的花费是窗口最大充电时间加上长度乘运行费用和。 ,枚举窗口并求最大会超时。费用随窗口变长而增加,左端只需右移。
右指针扩张时用单调队列维护充电时间最大值,并用和 维护运行费用。超预算则弹出过期下标并右移左端。窗口长度的最大值即答案。
问题实际上是求滑动窗口内的最大值,可以用单调队列来求解。
我们只需要二分枚举窗口 的大小,找到一个最大的 ,使得满足题目要求。
实现过程中,实际上不需要进行二分枚举,只需要将固定窗口改为双指针非固定窗口即可。
时间复杂度 ,空间复杂度 ,其中 是题目中机器人的数目。
func maximumRobots(chargeTimes []int, runningCosts []int, budget int64) (ans int) {
	q := Deque{}
	s := int64(0)
	l := 0
	for r, t := range chargeTimes {
		s += int64(runningCosts[r])
		for !q.Empty() && chargeTimes[q.Back()] <= t {
			q.PopBack()
		}
		q.PushBack(r)
		for !q.Empty() && int64(r-l+1)*s+int64(chargeTimes[q.Front()]) > budget {
			if q.Front() == l {
				q.PopFront()
			}
			s -= int64(runningCosts[l])
			l++
		}
		ans = max(ans, r-l+1)
	}
	return
}

// template
type Deque struct{ l, r []int }

func (q Deque) Empty() bool {
	return len(q.l) == 0 && len(q.r) == 0
}

func (q Deque) Size() int {
	return len(q.l) + len(q.r)
}

func (q *Deque) PushFront(v int) {
	q.l = append(q.l, v)
}

func (q *Deque) PushBack(v int) {
	q.r = append(q.r, v)
}

func (q *Deque) PopFront() (v int) {
	if len(q.l) > 0 {
		q.l, v = q.l[:len(q.l)-1], q.l[len(q.l)-1]
	} else {
		v, q.r = q.r[0], q.r[1:]
	}
	return
}

func (q *Deque) PopBack() (v int) {
	if len(q.r) > 0 {
		q.r, v = q.r[:len(q.r)-1], q.r[len(q.r)-1]
	} else {
		v, q.l = q.l[0], q.l[1:]
	}
	return
}

func (q Deque) Front() int {
	if len(q.l) > 0 {
		return q.l[len(q.l)-1]
	}
	return q.r[0]
}

func (q Deque) Back() int {
	if len(q.r) > 0 {
		return q.r[len(q.r)-1]
	}
	return q.l[0]
}

func (q Deque) Get(i int) int {
	if i < len(q.l) {
		return q.l[len(q.l)-1-i]
	}
	return q.r[i-len(q.l)]
}2411. 按位或最大的最小子数组长度
题目、示例与约束
给你一个长度为 n 下标从 0 开始的数组 nums ,数组中所有数字均为非负整数。对于 0 到 n - 1 之间的每一个下标 i ,你需要找出 nums 中一个 最小 非空子数组,它的起始位置为 i (包含这个位置),同时有 最大 的 按位或运算值 。
- 换言之,令
Bij表示子数组nums[i...j]的按位或运算的结果,你需要找到一个起始位置为i的最小子数组,这个子数组的按位或运算的结果等于max(Bik),其中i <= k <= n - 1。
一个数组的按位或运算值是这个数组里所有数字按位或运算的结果。
请你返回一个大小为 n 的整数数组 answer,其中 answer[i]是开始位置为 i ,按位或运算结果最大,且 最短 子数组的长度。
子数组 是数组里一段连续非空元素组成的序列。
示例 1:
输入:nums = [1,0,2,1,3]
输出:[3,3,2,2,1]
解释:
任何位置开始,最大按位或运算的结果都是 3 。
- 下标 0 处,能得到结果 3 的最短子数组是 [1,0,2] 。
- 下标 1 处,能得到结果 3 的最短子数组是 [0,2,1] 。
- 下标 2 处,能得到结果 3 的最短子数组是 [2,1] 。
- 下标 3 处,能得到结果 3 的最短子数组是 [1,3] 。
- 下标 4 处,能得到结果 3 的最短子数组是 [3] 。
所以我们返回 [3,3,2,2,1] 。
示例 2:
输入:nums = [1,2]
输出:[2,1]
解释:
下标 0 处,能得到最大按位或运算值的最短子数组长度为 2 。
下标 1 处,能得到最大按位或运算值的最短子数组长度为 1 。
所以我们返回 [2,1] 。
提示:
n == nums.length1 <= n <= 1050 <= nums[i] <= 109
方法一:逆序遍历 · Go 实现
思考
对每个起点 向右扫描求最短使 OR 最大的子数组,最坏 , 不可行。从 出发的最大 OR 由「每一位最靠左的 」决定,这些位置只会出现在 右侧。
倒序扫描,用长度 的数组记下每位最近一次出现 的下标。若当前位已是 则更新该下标;否则该位必须延伸到更右侧的记录,子数组长度取这些延伸的最大值。
要找到每个以 作为起始位置的最短子数组,满足或运算结果最大,那么必须让这个结果的 尽可能多。
我们用一个 位大小的数组 来记录每一位 最早出现的位置。
逆序遍历数组 ,对于 数字中的第 位,如果为 ,那么 就是 。否则如果 不为 ,说明右侧找到了满足第 位为 的数字,更新长度。
时间复杂度 。其中 为数组 的长度,而 为数组 中的最大值。
func smallestSubarrays(nums []int) []int {
	n := len(nums)
	f := make([]int, 32)
	for i := range f {
		f[i] = -1
	}
	ans := make([]int, n)
	for i := n - 1; i >= 0; i-- {
		t := 1
		for j := 0; j < 32; j++ {
			if ((nums[i] >> j) & 1) == 1 {
				f[j] = i
			} else if f[j] != -1 {
				t = max(t, f[j]-i+1)
			}
		}
		ans[i] = t
	}
	return ans
}2454. 下一个更大元素 IV
题目、示例与约束
给你一个下标从 0 开始的非负整数数组 nums 。对于 nums 中每一个整数,你必须找到对应元素的 第二大 整数。
如果 nums[j] 满足以下条件,那么我们称它为 nums[i] 的 第二大 整数:
j > inums[j] > nums[i]- 恰好存在 一个
k满足i < k < j且nums[k] > nums[i]。
如果不存在 nums[j] ,那么第二大整数为 -1 。
- 比方说,数组
[1, 2, 4, 3]中,1的第二大整数是4,2的第二大整数是3,3和4的第二大整数是-1。
请你返回一个整数数组 answer ,其中 answer[i]是 nums[i] 的第二大整数。
示例 1:
输入:nums = [2,4,0,9,6]
输出:[9,6,6,-1,-1]
解释:
下标为 0 处:2 的右边,4 是大于 2 的第一个整数,9 是第二个大于 2 的整数。
下标为 1 处:4 的右边,9 是大于 4 的第一个整数,6 是第二个大于 4 的整数。
下标为 2 处:0 的右边,9 是大于 0 的第一个整数,6 是第二个大于 0 的整数。
下标为 3 处:右边不存在大于 9 的整数,所以第二大整数为 -1 。
下标为 4 处:右边不存在大于 6 的整数,所以第二大整数为 -1 。
所以我们返回 [9,6,6,-1,-1] 。
示例 2:
输入:nums = [3,3]
输出:[-1,-1]
解释:
由于每个数右边都没有更大的数,所以我们返回 [-1,-1] 。
提示:
1 <= nums.length <= 1050 <= nums[i] <= 109
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
前置知识:单调栈
请看视频讲解:单调栈【基础算法精讲 26】,欢迎点赞关注~
思路
本题要找「下下个更大元素」。注意不是下一个更大元素的下一个更大元素( 找 ),而是右边第二个大于当前元素的数( 且 找 )。
首先回想一下,怎么找下一个更大元素,即右侧最近的更大元素。
使用视频中讲的第二种做法,从左到右遍历数组,用一个(递减)单调栈 维护遍历过的元素,如果当前元素 比栈顶大,那么栈顶的下一个更大元素就是 ,并弹出栈顶。
在这个做法中,栈顶元素弹出后,就没有用了。但对于本题,我们需要的正是弹出去的元素!
再用一个(递减)单调栈 记录从 中弹出去的元素。继续向后遍历,如果又找到一个元素 比 的栈顶大,那么栈顶的下下个更大元素就是 ,并弹出栈顶。
以示例 1 为例,其中 和 维护每轮循环结束时的栈中元素, 为答案:
遍历到 时,发现它比 的栈顶 大,说明 在找到一个比 大的元素 后,又找到了一个比 大的元素 ,即 的下下个更大元素是 ,所以 。
遍历到 时,发现它比 的栈顶 和 大,同理,。
算法
- 初始化 数组,长度和 相同,初始值均为 。
- 初始化两个空栈 和 。
- 从左到右遍历 。
- 设 。如果 比 的栈顶大,则栈顶元素对应的答案为 ,并弹出 的栈顶。
- 如果 比 的栈顶大,则弹出 的栈顶,并移入 的栈顶。由于要保证 也是一个递减的单调栈,我们可以直接把一整段从 中弹出的元素插入到 的末尾。
- 把 加到 的栈顶。代码实现时,为方便记录答案,改为把 的下标 加到栈顶。
答疑
问:为什么可以直接把从 中弹出的元素加到 ,如果加入的数比 的栈顶大,不就破坏了 的单调性吗?
答: 仍然是单调的。注意在弹出 栈顶之前,我们已经把 栈顶的小于 的数都弹出了,而后面从 栈顶弹出的数,都是比 小的,而 此时 的栈顶,根据不等式的传递性,从 栈顶弹出的数,也同样比 的栈顶小,所以这些数入栈后, 仍然是单调的。
复杂度分析
- 时间复杂度:,其中 为 的长度。每个元素至多入栈出栈各两次。
- 空间复杂度:。
题单
单调栈
- 739. 每日温度(单调栈模板题)
- 1475. 商品折扣后的最终价格
- 496. 下一个更大元素 I
- 503. 下一个更大元素 II
- 1019. 链表中的下一个更大节点 1571
- 901. 股票价格跨度 1709
- 1124. 表现良好的最长时间段 1908
- 456. 132 模式 ~2000
- 2866. 美丽塔 II 2072
- 2454. 下一个更大元素 IV 2175
- 2289. 使数组按非递减顺序排列 2482
- 2832. 每个元素为最大值的最大范围(会员题)
矩形系列
字典序最小
贡献法(计算所有子数组的……的和)
- 907. 子数组的最小值之和 1976
- 2104. 子数组范围和(最大值-最小值) 做法 ~2000
- 1856. 子数组最小乘积的最大值 2051
- 2818. 操作使得分最大 2397
- 2281. 巫师的总力量和(最小值*和) 2621
欢迎关注 B站@灵茶山艾府
更多精彩题解,请看 往期题解精选(已分类)
// https://space.bilibili.com/206214
func secondGreaterElement(nums []int) []int {
	ans := make([]int, len(nums))
	for i := range ans {
		ans[i] = -1
	}
	s, t := []int{}, []int{}
	for i, x := range nums {
		for len(t) > 0 && nums[t[len(t)-1]] < x {
			ans[t[len(t)-1]] = x
			t = t[:len(t)-1]
		}
		j := len(s) - 1
		for j >= 0 && nums[s[j]] < x {
			j--
		}
		t = append(t, s[j+1:]...)
		s = append(s[:j+1], i)
	}
	return ans
}2513. 最小化两个数组中的最大值
题目、示例与约束
给你两个数组 arr1 和 arr2 ,它们一开始都是空的。你需要往它们中添加正整数,使它们满足以下条件:
arr1包含uniqueCnt1个 互不相同 的正整数,每个整数都 不能 被divisor1整除 。arr2包含uniqueCnt2个 互不相同 的正整数,每个整数都 不能 被divisor2整除 。arr1和arr2中的元素 互不相同 。
给你 divisor1 ,divisor2 ,uniqueCnt1 和 uniqueCnt2 ,请你返回两个数组中 最大元素 的 最小值 。
示例 1:
输入:divisor1 = 2, divisor2 = 7, uniqueCnt1 = 1, uniqueCnt2 = 3
输出:4
解释:
我们可以把前 4 个自然数划分到 arr1 和 arr2 中。
arr1 = [1] 和 arr2 = [2,3,4] 。
可以看出两个数组都满足条件。
最大值是 4 ,所以返回 4 。
示例 2:
输入:divisor1 = 3, divisor2 = 5, uniqueCnt1 = 2, uniqueCnt2 = 1
输出:3
解释:
arr1 = [1,2] 和 arr2 = [3] 满足所有条件。
最大值是 3 ,所以返回 3 。
示例 3:
输入:divisor1 = 2, divisor2 = 4, uniqueCnt1 = 8, uniqueCnt2 = 2
输出:15
解释:
最终数组为 arr1 = [1,3,5,7,9,11,13,15] 和 arr2 = [2,6] 。
上述方案是满足所有条件的最优解。
提示:
2 <= divisor1, divisor2 <= 1051 <= uniqueCnt1, uniqueCnt2 < 1092 <= uniqueCnt1 + uniqueCnt2 <= 109
方法一 · Go 实现
思考
要在正整数中为两个数组分别选出指定个数的互异元素,且第一数组不能含 的倍数、第二数组不能含 的倍数,最小化所用到的最大整数。最大值可达很大,不能从 起逐个分配。
若上界 可行,则更大的上界也可行,故对 二分。 中不能被 整除的个数为 。第一、第二数组分别需要足够多的非倍数,且两数组合计不能超过 中不能同时被二者整除(即不能被 整除)的个数。 找出最小可行 。
func minimizeSet(divisor1 int, divisor2 int, uniqueCnt1 int, uniqueCnt2 int) int {
	divisor := lcm(divisor1, divisor2)
	left, right := 1, 10000000000
	for left < right {
		mid := (left + right) >> 1
		cnt1 := mid/divisor1*(divisor1-1) + mid%divisor1
		cnt2 := mid/divisor2*(divisor2-1) + mid%divisor2
		cnt := mid/divisor*(divisor-1) + mid%divisor
		if cnt1 >= uniqueCnt1 && cnt2 >= uniqueCnt2 && cnt >= uniqueCnt1+uniqueCnt2 {
			right = mid
		} else {
			left = mid + 1
		}
	}
	return left
}

func lcm(a, b int) int {
	return a * b / gcd(a, b)
}

func gcd(a, b int) int {
	if b == 0 {
		return a
	}
	return gcd(b, a%b)
}2529. 正整数和负整数的最大计数
题目、示例与约束
给你一个按 非递减顺序 排列的数组 nums ,返回正整数数目和负整数数目中的最大值。
- 换句话讲,如果
nums中正整数的数目是pos,而负整数的数目是neg,返回pos和neg二者中的最大值。
注意:0 既不是正整数也不是负整数。
示例 1:
输入:nums = [-2,-1,-1,1,2,3]
输出:3
解释:共有 3 个正整数和 3 个负整数。计数得到的最大值是 3 。
示例 2:
输入:nums = [-3,-2,-1,0,0,1,2]
输出:3
解释:共有 2 个正整数和 3 个负整数。计数得到的最大值是 3 。
示例 3:
输入:nums = [5,20,66,1314]
输出:4
解释:共有 4 个正整数和 0 个负整数。计数得到的最大值是 4 。
提示:
1 <= nums.length <= 2000-2000 <= nums[i] <= 2000nums按 非递减顺序 排列。
进阶:你可以设计并实现时间复杂度为 O(log(n)) 的算法解决此问题吗?
方法一:遍历 · Go 实现
思考
求正数个数与负数个数的较大值, 不计。 ,一次遍历即可分别累加。
我们可以直接遍历数组,统计正整数和负整数的个数 和 ,返回 和 中的较大值即可。
时间复杂度 ,其中 为数组长度。空间复杂度 。
func maximumCount(nums []int) int {
	var a, b int
	for _, x := range nums {
		if x > 0 {
			a++
		} else if x < 0 {
			b++
		}
	}
	return max(a, b)
}
方法二:二分查找 · Go 实现
思考
方法一未利用数组已非递减。正数是 的后缀,负数是 的前缀,即下界分别为 与 的位置。两次 即可在对数时间内得到两个计数。
由于数组是按非递减顺序排列的,因此可以使用二分查找找到第一个大于等于 的元素的下标 以及第一个大于等于 的元素的下标 ,那么正整数的个数 ,负整数的个数 ,返回 和 中的较大值即可。
时间复杂度 ,其中 为数组长度。空间复杂度 。
func maximumCount(nums []int) int {
	a := len(nums) - sort.SearchInts(nums, 1)
	b := sort.SearchInts(nums, 0)
	return max(a, b)
}2540. 最小公共值
题目、示例与约束
给你两个整数数组 nums1 和 nums2 ,它们已经按非降序排序,请你返回两个数组的 最小公共整数 。如果两个数组 nums1 和 nums2 没有公共整数,请你返回 -1 。
如果一个整数在两个数组中都 至少出现一次 ,那么这个整数是数组 nums1 和 nums2 公共 的。
示例 1:
输入:nums1 = [1,2,3], nums2 = [2,4]
输出:2
解释:两个数组的最小公共元素是 2 ,所以我们返回 2 。
示例 2:
输入:nums1 = [1,2,3,6], nums2 = [2,3,4,5]
输出:2
解释:两个数组中的公共元素是 2 和 3 ,2 是较小值,所以返回 2 。
提示:
1 <= nums1.length, nums2.length <= 1051 <= nums1[i], nums2[j] <= 109nums1和nums2都是 非降序 的。
方法一:双指针 · Go 实现
思考
两数组均已升序且各自无重复,求最小的公共元素。把一侧放入集合再扫描另一侧,额外占用线性空间。
双指针同时前进:相等即当前值为最小公共元;较小一侧右移。至多各走一遍,空间常数。
遍历两个数组,如果两个指针指向的元素相等,则返回该元素;如果两个指针指向的元素不相等,则将指向较小元素的指针右移一位,直到找到相等的元素或者遍历完数组。
时间复杂度 ,其中 和 分别是两个数组的长度。空间复杂度 。
func getCommon(nums1 []int, nums2 []int) int {
	m, n := len(nums1), len(nums2)
	for i, j := 0, 0; i < m && j < n; {
		if nums1[i] == nums2[j] {
			return nums1[i]
		}
		if nums1[i] < nums2[j] {
			i++
		} else {
			j++
		}
	}
	return -1
}2555. 两个线段获得的最多奖品
题目、示例与约束
在 X轴 上有一些奖品。给你一个整数数组 prizePositions ,它按照 非递减 顺序排列,其中 prizePositions[i] 是第 i 件奖品的位置。数轴上一个位置可能会有多件奖品。再给你一个整数 k 。
你可以同时选择两个端点为整数的线段。每个线段的长度都必须是 k 。你可以获得位置在任一线段上的所有奖品(包括线段的两个端点)。注意,两个线段可能会有相交。
- 比方说
k = 2,你可以选择线段[1, 3]和[2, 4],你可以获得满足1 <= prizePositions[i] <= 3或者2 <= prizePositions[i] <= 4的所有奖品 i 。
请你返回在选择两个最优线段的前提下,可以获得的 最多 奖品数目。
示例 1:
输入:prizePositions = [1,1,2,2,3,3,5], k = 2
输出:7
解释:这个例子中,你可以选择线段 [1, 3] 和 [3, 5] ,获得 7 个奖品。
示例 2:
输入:prizePositions = [1,2,3,4], k = 0 输出:2 解释:这个例子中,一个选择是选择线段[3, 3]和[4, 4],获得 2 个奖品。
提示:
1 <= prizePositions.length <= 1051 <= prizePositions[i] <= 1090 <= k <= 109prizePositions有序非递减。
方法一:动态规划 + 二分查找 · Go 实现
思考
两条长不超过 的线段覆盖奖品坐标,求最多覆盖个数,线段可重叠。枚举两条线段的端点是四次方级。
奖品坐标已有序。固定第二条线段右端为第 个奖品时,左端由 得到,覆盖 个。第一条必须完全落在这 个奖品之前,其最优值由前缀 给出。边扫边更新 为“右端不超过 的单条线段最优”。
我们定义 表示在前 个奖品中,选择一个长度为 的线段,可以获得的最多奖品数目。初始时 。定义答案变量 。
接下来,我们枚举每个奖品的位置 ,通过二分查找,找到最左边的奖品下标 ,使得 。此时,我们更新答案 ,并更新 。
最后,返回 即可。
时间复杂度 ,空间复杂度 。其中 为奖品数目。
func maximizeWin(prizePositions []int, k int) (ans int) {
	n := len(prizePositions)
	f := make([]int, n+1)
	for i, x := range prizePositions {
		j := sort.Search(n, func(h int) bool { return prizePositions[h] >= x-k })
		ans = max(ans, f[j]+i-j+1)
		f[i+1] = max(f[i], i-j+1)
	}
	return
}2563. 统计公平数对的数目
题目、示例与约束
给你一个下标从 0 开始、长度为 n 的整数数组 nums ,和两个整数 lower 和 upper ,返回 公平数对的数目 。
如果 (i, j) 数对满足以下情况,则认为它是一个 公平数对 :
0 <= i < j < n,且lower <= nums[i] + nums[j] <= upper
示例 1:
输入:nums = [0,1,7,4,4,5], lower = 3, upper = 6
输出:6
解释:共计 6 个公平数对:(0,3)、(0,4)、(0,5)、(1,3)、(1,4) 和 (1,5) 。
示例 2:
输入:nums = [1,7,9,2,5], lower = 11, upper = 11
输出:1
解释:只有单个公平数对:(2,3) 。
提示:
1 <= nums.length <= 105nums.length == n-109 <= nums[i] <= 109-109 <= lower <= upper <= 109
方法一:排序 + 二分查找 · Go 实现
思考
统计满足 的无序对。双重循环在 时不可行。
和只与取值有关,排序不改变答案。固定 后,另一侧落在 ,两次下界之差即个数,下标从 起以免重复。
我们先对数组 nums 按照升序排序,然后枚举 nums[i],对于每个 nums[i],我们通过二分查找找到 nums[j] 的下界 j,即第一个满足 nums[j] >= lower - nums[i] 的下标,然后再通过二分查找找到 nums[k] 的下界 k,即第一个满足 nums[k] >= upper - nums[i] + 1 的下标,那么 [j, k) 即为 nums[j] 满足 lower <= nums[i] + nums[j] <= upper 的下标范围,这些下标对应的 nums[j] 的个数即为 k - j,将其累加到答案中即可。注意 。
时间复杂度 ,空间复杂度 。其中 为数组 nums 的长度。
func countFairPairs(nums []int, lower int, upper int) (ans int64) {
	sort.Ints(nums)
	for i, x := range nums {
		j := sort.Search(len(nums), func(h int) bool { return h > i && nums[h] >= lower-x })
		k := sort.Search(len(nums), func(h int) bool { return h > i && nums[h] >= upper-x+1 })
		ans += int64(k - j)
	}
	return
}2565. 最少得分子序列
题目、示例与约束
给你两个字符串 s 和 t 。
你可以从字符串 t 中删除任意数目的字符。
如果没有从字符串 t 中删除字符,那么得分为 0 ,否则:
- 令
left为删除字符中的最小下标。 - 令
right为删除字符中的最大下标。
字符串的得分为 right - left + 1 。
请你返回使 t 成为 s 子序列的最小得分。
一个字符串的 子序列 是从原字符串中删除一些字符后(也可以一个也不删除),剩余字符不改变顺序得到的字符串。(比方说 "ace" 是 "abcde" 的子序列,但是 "aec" 不是)。
示例 1:
输入:s = "abacaba", t = "bzaa"
输出:1
解释:这个例子中,我们删除下标 1 处的字符 "z" (下标从 0 开始)。
字符串 t 变为 "baa" ,它是字符串 "abacaba" 的子序列,得分为 1 - 1 + 1 = 1 。
1 是能得到的最小得分。
示例 2:
输入:s = "cde", t = "xyz"
输出:3
解释:这个例子中,我们将下标为 0, 1 和 2 处的字符 "x" ,"y" 和 "z" 删除(下标从 0 开始)。
字符串变成 "" ,它是字符串 "cde" 的子序列,得分为 2 - 0 + 1 = 3 。
3 是能得到的最小得分。
提示:
1 <= s.length, t.length <= 105s和t都只包含小写英文字母。
方法一:前后缀预处理 + 二分查找 · Go 实现
思考
从 中删一段 (可为空或整串),使剩下的左右两段能作为 的不相交子序列拼起来,最小化删除长度。枚举删段再匹配是平方级以上。
删除长度越大越容易成功,故对长度 二分。 为贪心匹配 时用到的 最左下标, 为匹配 时用到的 最右下标。删掉 后若 ,两段在 上不重叠。
根据题目我们知道,删除字符的下标范围是 [left, right],最优的做法一定是删除 [left, right] 范围内的所有字符。也就是说,我们要删除字符串 中的一个子串,使得字符串 的剩余前缀可以匹配字符串 的前缀,字符串 的剩余后缀可以匹配字符串 的后缀,且字符串 的前后缀不相交。注意,这里的匹配指的是子序列匹配。
因此,我们可以先预处理得到数组 和 ,其中 表示字符串 的前缀 中,最少与字符串前 个字符匹配;同理 表示字符串 的后缀 中,最多与字符串后 个字符匹配。
而删除字符的长度具备单调性,如果删除长度为 的字符串后,满足条件,那么删除长度为 的字符串也一定满足条件。因此,我们可以使用二分查找的方法,找到最小的满足条件的长度。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度。
func minimumScore(s string, t string) int {
	m, n := len(s), len(t)
	f := make([]int, n)
	g := make([]int, n)
	for i := range f {
		f[i] = 1 << 30
		g[i] = -1
	}
	for i, j := 0, 0; i < m && j < n; i++ {
		if s[i] == t[j] {
			f[j] = i
			j++
		}
	}
	for i, j := m-1, n-1; i >= 0 && j >= 0; i-- {
		if s[i] == t[j] {
			g[j] = i
			j--
		}
	}
	return sort.Search(n+1, func(x int) bool {
		for k := 0; k < n; k++ {
			i, j := k-1, k+x
			l, r := -1, m+1
			if i >= 0 {
				l = f[i]
			}
			if j < n {
				r = g[j]
			}
			if l < r {
				return true
			}
		}
		return false
	})
}2594. 修车的最少时间
题目、示例与约束
给你一个整数数组 ranks ,表示一些机械工的 能力值 。ranksi 是第 i 位机械工的能力值。能力值为 r 的机械工可以在 r * n2 分钟内修好 n 辆车。
同时给你一个整数 cars ,表示总共需要修理的汽车数目。
请你返回修理所有汽车 最少 需要多少时间。
注意:所有机械工可以同时修理汽车。
示例 1:
输入:ranks = [4,2,3,1], cars = 10
输出:16
解释:
- 第一位机械工修 2 辆车,需要 4 * 2 * 2 = 16 分钟。
- 第二位机械工修 2 辆车,需要 2 * 2 * 2 = 8 分钟。
- 第三位机械工修 2 辆车,需要 3 * 2 * 2 = 12 分钟。
- 第四位机械工修 4 辆车,需要 1 * 4 * 4 = 16 分钟。
16 分钟是修理完所有车需要的最少时间。
示例 2:
输入:ranks = [5,1,8], cars = 6
输出:16
解释:
- 第一位机械工修 1 辆车,需要 5 * 1 * 1 = 5 分钟。
- 第二位机械工修 4 辆车,需要 1 * 4 * 4 = 16 分钟。
- 第三位机械工修 1 辆车,需要 8 * 1 * 1 = 8 分钟。
16 分钟时修理完所有车需要的最少时间。
提示:
1 <= ranks.length <= 1051 <= ranks[i] <= 1001 <= cars <= 106
方法一:二分查找 · Go 实现
思考
第 名工人修 辆车耗时 ,工人并行,求修完 辆的最短时间。分配方案很多,时间范围达 。
时间越长能修的车越多,故对 二分。时刻 时工人 能修 辆,总和达到 则可行。 给出最小 。
我们注意到,修车时间越长,修理的汽车数目也越多。因此,我们可以将修车时间作为二分查找的目标,二分查找修车时间的最小值。
我们定义二分查找的左右边界分别为 , 。接下来二分枚举修车时间 ,每个机械工可以修理的汽车数目为 ,其中 表示向下取整。如果修理的汽车数目大于等于 ,则说明修车时间 可行,我们将右边界缩小至 ,否则将左边界增大至 。
最终,我们返回左边界即可。
时间复杂度 ,空间复杂度 。其中 为机械工的数量,而 为二分查找的上界。
func repairCars(ranks []int, cars int) int64 {
	return int64(sort.Search(ranks[0]*cars*cars, func(t int) bool {
		cnt := 0
		for _, r := range ranks {
			cnt += int(math.Sqrt(float64(t / r)))
		}
		return cnt >= cars
	}))
}2602. 使数组元素全部相等的最少操作次数
题目、示例与约束
给你一个正整数数组 nums 。
同时给你一个长度为 m 的整数数组 queries 。第 i 个查询中,你需要将 nums 中所有元素变成 queries[i] 。你可以执行以下操作 任意 次:
- 将数组里一个元素 增大 或者 减小
1。
请你返回一个长度为 m 的数组 answer ,其中 answer[i]是将 nums 中所有元素变成 queries[i] 的 最少 操作次数。
注意,每次查询后,数组变回最开始的值。
示例 1:
输入:nums = [3,1,6,8], queries = [1,5]
输出:[14,10]
解释:第一个查询,我们可以执行以下操作:
- 将 nums[0] 减小 2 次,nums = [1,1,6,8] 。
- 将 nums[2] 减小 5 次,nums = [1,1,1,8] 。
- 将 nums[3] 减小 7 次,nums = [1,1,1,1] 。
第一个查询的总操作次数为 2 + 5 + 7 = 14 。
第二个查询,我们可以执行以下操作:
- 将 nums[0] 增大 2 次,nums = [5,1,6,8] 。
- 将 nums[1] 增大 4 次,nums = [5,5,6,8] 。
- 将 nums[2] 减小 1 次,nums = [5,5,5,8] 。
- 将 nums[3] 减小 3 次,nums = [5,5,5,5] 。
第二个查询的总操作次数为 2 + 4 + 1 + 3 = 10 。
示例 2:
输入:nums = [2,9,6,3], queries = [10]
输出:[20]
解释:我们可以将数组中所有元素都增大到 10 ,总操作次数为 8 + 1 + 4 + 7 = 20 。
提示:
n == nums.lengthm == queries.length1 <= n, m <= 1051 <= nums[i], queries[i] <= 109
方法一:排序 + 前缀和 + 二分查找 · Go 实现
思考
每次查询要把全体元素改成同一个目标 ,一次操作增减 。若对每个查询线性扫一遍 , ,总时间 不可接受。
元素之间互不影响,操作次数等于 。排序后, 将数组分成小于 与大于 两段,两段的绝对偏差均可由前缀和在 内算出。
因此先排序并做前缀和,再对每个 二分出分界下标,分别累计抬升与压低的代价。
我们先将数组 进行排序,并计算出长度为 的前缀和数组 ,其中 表示数组 中前 个元素的和。
接下来,遍历每个查询 ,我们需要将所有大于 的元素减小到 ,将所有小于 的元素增大到 。
我们可以通过二分查找找到数组 中第一个大于 的元素的下标 ,则有 个元素需要减小到 ,这些元素的和为 ,这些元素的和需要减去 个 ,因此,这些元素减小到 的总操作次数为 。
同理,我们可以找到数组 中第一个大于等于 的元素的下标 ,则有 个元素需要增大到 ,这些元素的和为 ,因此,这些元素增大到 的总操作次数为 。
最后,将这两个总操作次数相加,即为将数组 中所有元素变成 的最少操作次数,即 。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func minOperations(nums []int, queries []int) (ans []int64) {
	sort.Ints(nums)
	n := len(nums)
	s := make([]int, n+1)
	for i, x := range nums {
		s[i+1] = s[i] + x
	}
	for _, x := range queries {
		i := sort.SearchInts(nums, x+1)
		t := s[n] - s[i] - (n-i)*x
		i = sort.SearchInts(nums, x)
		t += x*i - s[i]
		ans = append(ans, int64(t))
	}
	return
}2604. 吃掉所有谷子的最短时间 🔒
题目、示例与约束
一条线上有 n 只母鸡和 m 颗谷子。给定两个整数数组 hens 和 grains ,它们的大小分别为 n 和 m ,表示母鸡和谷子的初始位置。
如果一只母鸡和一颗谷子在同一个位置,那么这只母鸡可以吃掉这颗谷子。吃掉一颗谷子的时间可以忽略不计。一只母鸡也可以吃掉多颗谷子。
在 1 秒钟内,一只母鸡可以向左或向右移动 1 个单位。母鸡可以同时且独立地移动。
如果母鸡行动得当,返回吃掉所有谷子的 最短 时间。
示例 1 :
输入:hens = [3,6,7], grains = [2,4,7,9]
输出:2
解释:
母鸡吃掉所有谷子的一种方法如下:
- 第一只母鸡在 1 秒钟内吃掉位置 2 处的谷子。
- 第二只母鸡在 2 秒钟内吃掉位置 4 处的谷子。
- 第三只母鸡在 2 秒钟内吃掉位置 7 和 9 处的谷子。
所以,需要的最长时间为2秒。
可以证明,在2秒钟之前,母鸡不能吃掉所有谷子。
示例 2 :
输入:hens = [4,6,109,111,213,215], grains = [5,110,214]
输出:1
解释:
母鸡吃掉所有谷子的一种方法如下:
- 第一只母鸡在 1 秒钟内吃掉位置 5 处的谷子。
- 第四只母鸡在 1 秒钟内吃掉位置 110 处的谷子。
- 第六只母鸡在 1 秒钟内吃掉位置 214 处的谷子。
- 其他母鸡不动。
所以,需要的最长时间为 1 秒。
提示:
1 <= hens.length, grains.length <= 2*1040 <= hens[i], grains[j] <= 109
方法一:排序 + 二分查找 · Go 实现
思考
若干只鸡同时出发吃完所有谷物,一只鸡一段连续行程的耗时取决于折返。若枚举每只鸡负责哪一段谷物,划分方案随只数指数增长; ,不可直接搜索。
时间 具有单调性:能在 内吃完则更大时间亦可。排序后,位置更左的谷物应优先交给更左的鸡,于是可用双指针检验给定 。
对每只鸡,根据谷物在其左或右计算折返代价,尽量向右多吃,直到下一粒会超过 。二分最小可行 即可。
我们先将鸡和谷物按照位置从小到大排序,接下来二分枚举时间 ,找到一个最小的 使得所有谷物能在 秒内被吃完。
对于每个鸡,我们用指针 指向当前还未被吃的谷物中最左边的谷物,记当前鸡的位置为 ,谷物的位置为 ,则有以下几种情况:
- 如果 ,我们记 ,如果 ,那么当前谷物无法被吃掉,直接返回
false。否则,我们向右移动指针 ,直到 或者 。此时我们需要判断鸡是否能吃到 指向的谷物,如果能吃到,我们继续向右移动指针 ,直到 或者 。 - 如果 ,我们向右移动指针 ,直到 或者 。
如果 ,说明所有谷物都被吃完了,返回 true,否则返回 false。
时间复杂度 ,空间复杂度 。其中 和 分别为鸡和谷物的数量,而 为所有鸡和谷物的位置的最大值。
func minimumTime(hens []int, grains []int) int {
	sort.Ints(hens)
	sort.Ints(grains)
	m := len(grains)
	l, r := 0, abs(hens[0]-grains[0])+grains[m-1]-grains[0]
	check := func(t int) bool {
		j := 0
		for _, x := range hens {
			if j == m {
				return true
			}
			y := grains[j]
			if y <= x {
				d := x - y
				if d > t {
					return false
				}
				for j < m && grains[j] <= x {
					j++
				}
				for j < m && min(d, grains[j]-x)+grains[j]-y <= t {
					j++
				}
			} else {
				for j < m && grains[j]-x <= t {
					j++
				}
			}
		}
		return j == m
	}
	for l < r {
		mid := (l + r) >> 1
		if check(mid) {
			r = mid
		} else {
			l = mid + 1
		}
	}
	return l
}

func abs(x int) int {
	if x < 0 {
		return -x
	}
	return x
}2702. 使数字变为非正数的最小操作次数 🔒
题目、示例与约束
给定一个 下标从0开始 的整数数组 nums,以及两个整数 x 和 y。在每一次操作中,你需要选择一个满足条件 0 <= i < nums.length 的下标 i ,并执行以下操作:
- 将
nums[i]减去x。 - 将除了下标为
i的位置外,其他位置的值都减去y。
返回使得 nums 中的所有整数都 小于等于零 所需的最小操作次数。
示例 1:
输入:nums = [3,4,1,7,6], x = 4, y = 2
输出:3
解释:你需要进行三次操作。其中一种最优操作序列如下:
操作 1: 选择 i = 3。 然后, nums = [1,2,-1,3,4].
操作 2: 选择 i = 3。 然后, nums = [-1,0,-3,-1,2].
操作 3: 选择 i = 4。 然后, nums = [-3,-2,-5,-3,-2].
现在,nums 中的所有数字都是非正数。因此,返回 3。
示例 2:
输入:nums = [1,2,1], x = 2, y = 1 输出:1 解释:我们可以在i = 1处执行一次操作,得到nums = [0,0,0]。所有正数都被移除,因此返回 1。
提示:
1 <= nums.length <= 1051 <= nums[i] <= 1091 <= y < x <= 109
方法一:二分查找 · Go 实现
思考
每次可选一个下标减 ,其余位置减 。若枚举每次打在哪一个数上,状态随操作次数增长,而 与操作次数均可到 量级,直接模拟不可行。
操作次数 具有单调性:若 次能使全部变为非正,则更多次数亦可。因此对 二分。判定时先假定每个数都享受了 次全局减 ,仍为正的部分必须用「额外减 」补齐,将这些次数求和并与 比较即可。
我们注意到,如果一个操作次数 能够使得所有的数都小于等于 ,那么对于任意 ,操作次数 也能够使得所有的数都小于等于 。因此我们可以使用二分查找的方法找到最小的操作次数。
我们定义二分查找的左边界 ,右边界 。每一次二分查找,我们找到中间值 ,然后判断是否存在一种操作方法使得操作次数不超过 ,使得所有的数都小于等于 。如果存在,那么我们就更新右边界 ,否则我们就更新左边界 。最终当 时,我们就找到了最小的操作次数,返回 即可。
问题的关键在于如何判断是否存在一种操作方法使得操作次数不超过 ,使得所有的数都小于等于 。我们可以使用贪心的方法来判断是否存在这样的操作方法。
我们遍历数组中的每一个数 ,如果 ,那么我们不需要进行任何操作。否则,我们需要的操作次数为 。我们将所有的操作次数相加,如果小于等于 ,那么就说明存在一种操作方法使得操作次数不超过 ,使得所有的数都小于等于 。
时间复杂度 ,其中 和 分别是数组的长度和数组中的最大值。空间复杂度 。
func minOperations(nums []int, x int, y int) int {
	check := func(t int) bool {
		cnt := 0
		for _, v := range nums {
			if v > t*y {
				cnt += (v - t*y + x - y - 1) / (x - y)
			}
		}
		return cnt <= t
	}

	l, r := 0, slices.Max(nums)
	for l < r {
		mid := (l + r) >> 1
		if check(mid) {
			r = mid
		} else {
			l = mid + 1
		}
	}
	return l
}2779. 数组的最大美丽值
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums 和一个 非负 整数 k 。
在一步操作中,你可以执行下述指令:
- 在范围
[0, nums.length - 1]中选择一个 此前没有选过 的下标i。 - 将
nums[i]替换为范围[nums[i] - k, nums[i] + k]内的任一整数。
数组的 美丽值 定义为数组中由相等元素组成的最长子序列的长度。
对数组 nums 执行上述操作任意次后,返回数组可能取得的 最大 美丽值。
注意:你 只 能对每个下标执行 一次 此操作。
数组的 子序列 定义是:经由原数组删除一些元素(也可能不删除)得到的一个新数组,且在此过程中剩余元素的顺序不发生改变。
示例 1:
输入:nums = [4,6,1,2], k = 2
输出:3
解释:在这个示例中,我们执行下述操作:
- 选择下标 1 ,将其替换为 4(从范围 [4,8] 中选出),此时 nums = [4,4,1,2] 。
- 选择下标 3 ,将其替换为 4(从范围 [0,4] 中选出),此时 nums = [4,4,1,4] 。
执行上述操作后,数组的美丽值是 3(子序列由下标 0 、1 、3 对应的元素组成)。
可以证明 3 是我们可以得到的由相等元素组成的最长子序列长度。
示例 2:
输入:nums = [1,1,1,1], k = 10
输出:4
解释:在这个示例中,我们无需执行任何操作。
数组 nums 的美丽值是 4(整个数组)。
提示:
1 <= nums.length <= 1050 <= nums[i], k <= 105
方法一:差分数组 · Go 实现
思考
每个数可变成 内任一整数,美丽值是能变成同一值的最多元素个数。枚举目标值再判断每个数能否覆盖,值域与 都到 时偏慢。
一个数能覆盖的目标区间是 (整体平移 后)。差分数组在左端 、右端外 ,前缀和的最大值即重叠最多的目标。
我们注意到,对于每一次操作,区间 内的所有元素都会增加 ,因此我们可以使用差分数组来记录这些操作对美丽值的贡献。
题目中 可能为负数,我们统一将所有元素加上 ,保证结果为非负数。因此,我们可以创建一个长度为 的差分数组 。
接下来,遍历数组 ,对于当前遍历到的元素 ,我们将 增加 ,将 减少 。这样,我们就可以通过 数组计算出每个位置的前缀和,即为每个位置的美丽值。找到最大的美丽值即可。
时间复杂度 ,空间复杂度 。其中 是数组 的长度,而 是数组 中的最大值。
func maximumBeauty(nums []int, k int) (ans int) {
	m := slices.Max(nums)
	m += k*2 + 2
	d := make([]int, m)
	for _, x := range nums {
		d[x]++
		d[x+k*2+1]--
	}
	s := 0
	for _, x := range d {
		s += x
		if ans < s {
			ans = s
		}
	}
	return
}2817. 限制条件下元素之间的最小绝对差
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums 和一个整数 x 。
请你找到数组中下标距离至少为 x 的两个元素的 差值绝对值 的 最小值 。
换言之,请你找到两个下标 i 和 j ,满足 abs(i - j) >= x 且 abs(nums[i] - nums[j]) 的值最小。
请你返回一个整数,表示下标距离至少为 x 的两个元素之间的差值绝对值的 最小值 。
示例 1:
输入:nums = [4,3,2,4], x = 2
输出:0
解释:我们选择 nums[0] = 4 和 nums[3] = 4 。
它们下标距离满足至少为 2 ,差值绝对值为最小值 0 。
0 是最优解。
示例 2:
输入:nums = [5,3,2,10,15], x = 1
输出:1
解释:我们选择 nums[1] = 3 和 nums[2] = 2 。
它们下标距离满足至少为 1 ,差值绝对值为最小值 1 。
1 是最优解。
示例 3:
输入:nums = [1,2,3,4], x = 3
输出:3
解释:我们选择 nums[0] = 1 和 nums[3] = 4 。
它们下标距离满足至少为 3 ,差值绝对值为最小值 3 。
3 是最优解。
提示:
1 <= nums.length <= 1051 <= nums[i] <= 1090 <= x < nums.length
方法一:有序集合 · Go 实现
思考
要求下标距离至少为 的两数之差的最小绝对值。若对每个 在 中线性扫描,复杂度偏高。有序集合保存已经落后至少 的元素,对 查询前驱与后继,即可在对数时间内得到最近点。
我们创建一个有序集合,用于存储距离当前下标至少为 的元素。
接下来,我们从下标 开始枚举,每次将 加入到有序集合中。然后找出有序集合中与 最接近的两个元素,它们的差值绝对值的最小值就是答案。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func minAbsoluteDifference(nums []int, x int) int {
	rbt := redblacktree.NewWithIntComparator()
	ans := 1 << 30
	for i := x; i < len(nums); i++ {
		rbt.Put(nums[i-x], nil)
		c, _ := rbt.Ceiling(nums[i])
		f, _ := rbt.Floor(nums[i])
		if c != nil {
			ans = min(ans, c.Key.(int)-nums[i])
		}
		if f != nil {
			ans = min(ans, nums[i]-f.Key.(int))
		}
	}
	return ans
}2819. 购买巧克力后的最小相对损失 🔒
题目、示例与约束
现给定一个整数数组 prices,表示巧克力的价格;以及一个二维整数数组 queries,其中 queries[i] = [ki, mi]。
Alice 和 Bob 去买巧克力,Alice 提出了一种付款方式,而 Bob 同意了。
对于每个 queries[i] ,它的条件如下:
- 如果一块巧克力的价格 小于等于
ki,那么 Bob 为它付款。 - 否则,Bob 为其中
ki部分付款,而 Alice 为 剩余 部分付款。
Bob 想要选择 恰好 mi 块巧克力,使得他的 相对损失最小 。更具体地说,如果总共 Alice 付款了 ai,Bob 付款了 bi,那么 Bob 希望最小化 bi - ai。
返回一个整数数组 ans,其中 ans[i] 是 Bob 在 queries[i] 中可能的 最小相对损失 。
示例 1:
输入:prices = [1,9,22,10,19], queries = [[18,4],[5,2]]
输出:[34,-21]
解释:对于第一个 query,Bob 选择价格为 [1,9,10,22] 的巧克力。他付了 1 + 9 + 10 + 18 = 38,Alice 付了 0 + 0 + 0 + 4 = 4。因此,Bob 的相对损失是 38 - 4 = 34。
对于第二个 query,Bob 选择价格为 [19,22] 的巧克力。他付了 5 + 5 = 10,Alice 付了 14 + 17 = 31。因此,Bob 的相对损失是 10 - 31 = -21。
可以证明这些是可能的最小相对损失。
示例 2:
输入:prices = [1,5,4,3,7,11,9], queries = [[5,4],[5,7],[7,3],[4,5]]
输出:[4,16,7,1]
解释:对于第一个 query,Bob 选择价格为 [1,3,9,11] 的巧克力。他付了 1 + 3 + 5 + 5 = 14,Alice 付了 0 + 0 + 4 + 6 = 10。因此,Bob 的相对损失是 14 - 10 = 4。
对于第二个 query,Bob 必须选择所有的巧克力。他付了 1 + 5 + 4 + 3 + 5 + 5 + 5 = 28,Alice 付了 0 + 0 + 0 + 0 + 2 + 6 + 4 = 12。因此,Bob 的相对损失是 28 - 12 = 16。
对于第三个 query,Bob 选择价格为 [1,3,11] 的巧克力。他付了 1 + 3 + 7 = 11,Alice 付了 0 + 0 + 4 = 4。因此,Bob 的相对损失是 11 - 4 = 7。
对于第四个 query,Bob 选择价格为 [1,3,7,9,11] 的巧克力。他付了 1 + 3 + 4 + 4 + 4 = 16,Alice 付了 0 + 0 + 3 + 5 + 7 = 15。因此,Bob 的相对损失是 16 - 15 = 1。
可以证明这些是可能的最小相对损失。
示例 3:
输入:prices = [5,6,7], queries = [[10,1],[5,3],[3,3]]
输出:[5,12,0]
解释:对于第一个 query,Bob 选择价格为 5 的巧克力。他付了 5,Alice 付了 0。因此,Bob 的相对损失是 5 - 0 = 5。
对于第二个 query,Bob 必须选择所有的巧克力。他付了 5 + 5 + 5 = 15,Alice 付了 0 + 1 + 2 = 3。因此,Bob 的相对损失是 15 - 3 = 12。
对于第三个 query,Bob 必须选择所有的巧克力。他付了 3 + 3 + 3 = 9,Alice 付了 2 + 3 + 4 = 9。因此,Bob 的相对损失是 9 - 9 = 0。
可以证明这些是可能的最小相对损失。
提示:
1 <= prices.length == n <= 1051 <= prices[i] <= 1091 <= queries.length <= 105queries[i].length == 21 <= ki <= 1091 <= mi <= n
方法一:排序 + 二分查找 + 前缀和 · Go 实现
思考
每次询问在阈值 下购买 块巧克力。相对损失在 时为价格本身,在 时为 。最优组合是若干最便宜的与若干最贵的;排序并维护前缀和后,二分分界点即可在每次询问中算出损失。
根据题目描述,我们可以知道:
如果 ,那么 Bob 需要支付 ,而 Alice 不需要支付。因此 Bob 的相对损失为 。在这种情况下,Bob 应该选择价格较低的巧克力,才能最小化相对损失。
如果 ,那么 Bob 需要支付 ,而 Alice 需要支付 。因此 Bob 的相对损失为 。在这种情况下,Bob 应该选择价格较高的巧克力,才能最小化相对损失。
因此,我们先对价格数组 进行排序,然后预处理出前缀和数组 ,其中 表示前 个巧克力的价格之和。
接下来,对于每个询问 ,我们先使用二分查找,找到第一个价格大于 的巧克力的下标 。然后,再利用二分查找,找到左侧应该选择的巧克力的数量 ,那么右侧应该选择的巧克力的数量就是 。此时,Bob 的相对损失为 。
上述第二次二分查找的过程中,我们需要判断 ,其中 表示右侧应该选择的巧克力的数量。如果该不等式成立,那么说明选择 位置的巧克力的相对损失较低,此时更新 。否则,说明 位置的巧克力的相对损失较高,此时更新 。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 和 的长度。
func minimumRelativeLosses(prices []int, queries [][]int) []int64 {
	n := len(prices)
	sort.Ints(prices)
	s := make([]int, n+1)
	for i, x := range prices {
		s[i+1] = s[i] + x
	}
	f := func(k, m int) int {
		l, r := 0, sort.Search(n, func(i int) bool { return prices[i] > k })
		if r > m {
			r = m
		}
		for l < r {
			mid := (l + r) >> 1
			right := m - mid
			if prices[mid] < 2*k-prices[n-right] {
				l = mid + 1
			} else {
				r = mid
			}
		}
		return l
	}
	ans := make([]int64, len(queries))
	for i, q := range queries {
		k, m := q[0], q[1]
		l := f(k, m)
		r := m - l
		ans[i] = int64(s[l] + 2*k*r - (s[n] - s[n-r]))
	}
	return ans
}2824. 统计和小于目标的下标对数目
题目、示例与约束
n 的整数数组 nums 和一个整数 target ,请你返回满足 0 <= i < j < n 且 nums[i] + nums[j] < target 的下标对 (i, j) 的数目。
示例 1:
输入:nums = [-1,1,2,3,1], target = 2
输出:3
解释:总共有 3 个下标对满足题目描述:
- (0, 1) ,0 < 1 且 nums[0] + nums[1] = 0 < target
- (0, 2) ,0 < 2 且 nums[0] + nums[2] = 1 < target
- (0, 4) ,0 < 4 且 nums[0] + nums[4] = 0 < target
注意 (0, 3) 不计入答案因为 nums[0] + nums[3] 不是严格小于 target 。
示例 2:
输入:nums = [-6,2,5,-2,-7,-1,3], target = -2
输出:10
解释:总共有 10 个下标对满足题目描述:
- (0, 1) ,0 < 1 且 nums[0] + nums[1] = -4 < target
- (0, 3) ,0 < 3 且 nums[0] + nums[3] = -8 < target
- (0, 4) ,0 < 4 且 nums[0] + nums[4] = -13 < target
- (0, 5) ,0 < 5 且 nums[0] + nums[5] = -7 < target
- (0, 6) ,0 < 6 且 nums[0] + nums[6] = -3 < target
- (1, 4) ,1 < 4 且 nums[1] + nums[4] = -5 < target
- (3, 4) ,3 < 4 且 nums[3] + nums[4] = -9 < target
- (3, 5) ,3 < 5 且 nums[3] + nums[5] = -3 < target
- (4, 5) ,4 < 5 且 nums[4] + nums[5] = -8 < target
- (4, 6) ,4 < 6 且 nums[4] + nums[6] = -4 < target
提示:
1 <= nums.length == n <= 50-50 <= nums[i], target <= 50
方法一:排序 + 二分查找 · Go 实现
思考
不大时两重循环亦可,但排序后对每个右端点 二分查找满足 的 的个数,可将比较化为有序前缀上的下界查询。
我们先对数组 进行排序,然后枚举 ,在 的范围内使用二分查找第一个大于等于 的下标 ,那么 的范围内的所有下标 都满足条件,因此答案增加 。
遍历结束后,我们返回答案。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func countPairs(nums []int, target int) (ans int) {
	sort.Ints(nums)
	for j, x := range nums {
		i := sort.SearchInts(nums[:j], target-x)
		ans += i
	}
	return
}2831. 找出最长等值子数组
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums 和一个整数 k 。
如果子数组中所有元素都相等,则认为子数组是一个 等值子数组 。注意,空数组是 等值子数组 。
从 nums 中删除最多 k 个元素后,返回可能的最长等值子数组的长度。
子数组 是数组中一个连续且可能为空的元素序列。
示例 1:
输入:nums = [1,3,2,3,1,3], k = 3
输出:3
解释:最优的方案是删除下标 2 和下标 4 的元素。
删除后,nums 等于 [1, 3, 3, 3] 。
最长等值子数组从 i = 1 开始到 j = 3 结束,长度等于 3 。
可以证明无法创建更长的等值子数组。
示例 2:
输入:nums = [1,1,2,2,1,1], k = 2
输出:4
解释:最优的方案是删除下标 2 和下标 3 的元素。
删除后,nums 等于 [1, 1, 1, 1] 。
数组自身就是等值子数组,长度等于 4 。
可以证明无法创建更长的等值子数组。
提示:
1 <= nums.length <= 1051 <= nums[i] <= nums.length0 <= k <= nums.length
方法一:哈希表 + 双指针 · Go 实现
思考
等值子数组允许删除至多 个其它元素。窗口内「非众数」个数超过 时即不合法。用哈希表维护频次并记录窗口内最大频次 ,当 时右移左端;最终 即为最长等值长度。
我们用双指针维护一个单调变长的窗口,用哈希表维护窗口中每个元素出现的次数。
窗口中的所有元素个数减去窗口中出现次数最多的元素个数,就是窗口中需要删除的元素个数。
每一次,我们将右指针指向的元素加入窗口,然后更新哈希表,同时更新窗口中出现次数最多的元素个数。当窗口中需要删除的元素个数超过了 时,我们就移动一次左指针,然后更新哈希表。
遍历结束后,返回出现次数最多的元素个数即可。
时间复杂度 ,空间复杂度 。其中 是数组的长度。
func longestEqualSubarray(nums []int, k int) int {
	cnt := map[int]int{}
	mx, l := 0, 0
	for r, x := range nums {
		cnt[x]++
		mx = max(mx, cnt[x])
		if r-l+1-mx > k {
			cnt[nums[l]]--
			l++
		}
	}
	return mx
}
方法二:哈希表 + 双指针(写法二) · Go 实现
思考
方法一在同一窗口内同时维护所有值的频次。若先按值收集下标,则每个值上的双指针只统计「该值下标之间夹杂的其它位置」,语义更直接,复杂度同为线性。
我们可以用一个哈希表 维护每个元素的下标列表。
接下来,我们枚举每个元素作为等值元素,我们从哈希表 中取出这个元素的下标列表 ,然后我们定义两个指针 和 ,用于维护一个窗口,使得窗口内的元素个数减去等值元素的个数,结果不超过 。那么我们只需要求出最大的满足条件的窗口即可。
时间复杂度 ,空间复杂度 。其中 是数组的长度。
func longestEqualSubarray(nums []int, k int) (ans int) {
	g := make([][]int, len(nums)+1)
	for i, x := range nums {
		g[x] = append(g[x], i)
	}
	for _, ids := range g {
		l := 0
		for r := range ids {
			for ids[r]-ids[l]-(r-l) > k {
				l++
			}
			ans = max(ans, r-l+1)
		}
	}
	return
}2838. 英雄可以获得的最大金币数 🔒
题目、示例与约束
在一场战斗中,n 位英雄正在试图击败 m 个怪物。你将得到两个下标从 1 开始的 正整数 数组 heroes 和 monsters,长度分别为 n 和 m。数组 heroes[i] 代表第 i 位英雄的力量,而 monsters[i] 代表第 i 个怪物的力量。
如果 monsters[j] <= heroes[i],则第 i 位英雄可以击败第 j 个怪物。
你还将获得一个下标从 1 开始的 正整数 数组 coins,长度为 m 。数组 coins[i] 表示每位英雄在击败第 i 个怪物后可以获得的金币数。
返回一个长度为 n 的数组 ans,其中 ans[i] 是第 i 位英雄从这场战斗中能收集到的 最大 金币数。
注意
- 击败怪物后,英雄的生命值不会减少。
- 多位英雄可以击败同一个怪物,但每个怪物只能被同一位英雄击败一次。
示例 1:
输入:heroes = [1,4,2], monsters = [1,1,5,2,3], coins = [2,3,4,5,6]
输出:[5,16,10]
解释:对于每位英雄,我们列出了所有他可以击败的怪物的下标:
第 1 位英雄:[1,2],因为这位英雄的力量为 1,且 monsters[1], monsters[2] <= 1。因此这位英雄收集的金币为 coins[1] + coins[2] = 5 金币。
第 2 位英雄:[1,2,4,5],因为这位英雄的力量为 4,且 monsters[1], monsters[2], monsters[4], monsters[5] <= 4。因此这位英雄收集的金币为 coins[1] + coins[2] + coins[4] + coins[5] = 16 金币。
第 3 位英雄:[1,2,4],因为这位英雄的力量为 2,且 monsters[1], monsters[2], monsters[4] <= 2。因此这位英雄收集的金币为 coins[1] + coins[2] + coins[4] = 10 金币。
因此答案为 [5,16,10]。
示例 2:
输入:heroes = [5], monsters = [2,3,1,2], coins = [10,6,5,2]
输出:[23]
解释:这位英雄可以击败所有怪物,因为 monsters[i] <= 5。所以他收集了所有的金币:coins[1] + coins[2] + coins[3] + coins[4] = 23,因此答案为 [23]。
示例 3:
输入:heroes = [4,4], monsters = [5,7,8], coins = [1,1,1]
输出:[0,0]
解释:在这个例子中,没有英雄可以击败怪物。因此答案为 [0,0] 。
提示:
1 <= n == heroes.length <= 1051 <= m == monsters.length <= 105coins.length == m1 <= heroes[i], monsters[i], coins[i] <= 109
方法一:排序 + 前缀和 + 二分查找 · Go 实现
思考
英雄可击败所有战力不超过自身的怪物并取其金币。将怪物按战力排序并做金币前缀和后,对每个英雄二分最大可击败下标,前缀和即为其收益。
我们可以将怪物和金币按照怪物的战斗力从小到大排序,然后使用前缀和计算每个英雄打败前 个怪物可以获得的金币总数。
接下来,对于每个英雄,我们可以使用二分查找找到他可以打败的最大的怪物,然后使用前缀和计算他可以获得的金币总数即可。
时间复杂度 ,空间复杂度 。其中 和 分别是怪物和英雄的数量。
func maximumCoins(heroes []int, monsters []int, coins []int) (ans []int64) {
	m := len(monsters)
	idx := make([]int, m)
	for i := range idx {
		idx[i] = i
	}
	sort.Slice(idx, func(i, j int) bool { return monsters[idx[i]] < monsters[idx[j]] })
	s := make([]int64, m+1)
	for i, j := range idx {
		s[i+1] = s[i] + int64(coins[j])
	}
	for _, h := range heroes {
		i := sort.Search(m, func(i int) bool { return monsters[idx[i]] > h })
		ans = append(ans, s[i])
	}
	return
}2861. 最大合金数
题目、示例与约束
假设你是一家合金制造公司的老板,你的公司使用多种金属来制造合金。现在共有 n 种不同类型的金属可以使用,并且你可以使用 k 台机器来制造合金。每台机器都需要特定数量的每种金属来创建合金。
对于第 i 台机器而言,创建合金需要 composition[i][j] 份 j 类型金属。最初,你拥有 stock[x] 份 x 类型金属,而每购入一份 x 类型金属需要花费 cost[x] 的金钱。
给你整数 n、k、budget,下标从 1 开始的二维数组 composition,两个下标从 1 开始的数组 stock 和 cost,请你在预算不超过 budget 金钱的前提下,最大化 公司制造合金的数量。
所有合金都需要由同一台机器制造。
返回公司可以制造的最大合金数。
示例 1:
输入:n = 3, k = 2, budget = 15, composition = [[1,1,1],[1,1,10]], stock = [0,0,0], cost = [1,2,3]
输出:2
解释:最优的方法是使用第 1 台机器来制造合金。
要想制造 2 份合金,我们需要购买:
- 2 份第 1 类金属。
- 2 份第 2 类金属。
- 2 份第 3 类金属。
总共需要 2 * 1 + 2 * 2 + 2 * 3 = 12 的金钱,小于等于预算 15 。
注意,我们最开始时候没有任何一类金属,所以必须买齐所有需要的金属。
可以证明在示例条件下最多可以制造 2 份合金。
示例 2:
输入:n = 3, k = 2, budget = 15, composition = [[1,1,1],[1,1,10]], stock = [0,0,100], cost = [1,2,3]
输出:5
解释:最优的方法是使用第 2 台机器来制造合金。
要想制造 5 份合金,我们需要购买:
- 5 份第 1 类金属。
- 5 份第 2 类金属。
- 0 份第 3 类金属。
总共需要 5 * 1 + 5 * 2 + 0 * 3 = 15 的金钱,小于等于预算 15 。
可以证明在示例条件下最多可以制造 5 份合金。
示例 3:
输入:n = 2, k = 3, budget = 10, composition = [[2,1],[1,2],[1,1]], stock = [1,1], cost = [5,5]
输出:2
解释:最优的方法是使用第 3 台机器来制造合金。
要想制造 2 份合金,我们需要购买:
- 1 份第 1 类金属。
- 1 份第 2 类金属。
总共需要 1 * 5 + 1 * 5 = 10 的金钱,小于等于预算 10 。
可以证明在示例条件下最多可以制造 2 份合金。
提示:
1 <= n, k <= 1000 <= budget <= 108composition.length == kcomposition[i].length == n1 <= composition[i][j] <= 100stock.length == cost.length == n0 <= stock[i] <= 1081 <= cost[i] <= 100
方法一:二分查找 · Go 实现
思考
全部合金须由同一台机器制造。产量越大花费越多,故对每台机器二分产量 ,用库存与单价计算补料费用是否不超过预算,再在所有机器中取最大可行 。
我们注意到,所有合金都需要由同一台机器制造,因此我们可以枚举使用哪一台机器来制造合金。
对于每一台机器,我们可以使用二分查找的方法找出最大的整数 ,使得我们可以使用这台机器制造 份合金。找出所有 中的最大值即为答案。
时间复杂度 ,其中 是二分查找的上界,本题中 。空间复杂度 。
func maxNumberOfAlloys(n int, k int, budget int, composition [][]int, stock []int, cost []int) int {
	isValid := func(target int) bool {
		for _, currMachine := range composition {
			remain := budget
			for i, x := range currMachine {
				need := max(0, x*target-stock[i])
				remain -= need * cost[i]
			}
			if remain >= 0 {
				return true
			}
		}
		return false
	}

	l, r := 0, budget+stock[0]
	for l < r {
		mid := (l + r + 1) >> 1
		if isValid(mid) {
			l = mid
		} else {
			r = mid - 1
		}
	}
	return l
}2936. 包含相等值数字块的数量 🔒
题目、示例与约束
给定一个整数数组 nums,其 下标从 0 开始。对于 nums,有以下性质:
- 所有相同值的元素都是相邻的。换句话说,如果存在两个下标
i < j,使得nums[i] == nums[j],那么对于所有下标k,满足i < k < j,都有nums[k] == nums[i]。
由于 nums 是一个非常大的数组,这里提供了一个 BigArray 类的实例,该实例具有以下函数:
int at(long long index): 返回nums[i]的值。long long size(): 返回nums.length。
让我们把数组分成 最大 的块,使得每个块包含 相等的值。返回这些块的数量。
请注意,如果要使用自定义测试测试解决方案,对于 nums.length > 10 的测试行为是未定义的。
示例 1:
输入:nums = [3,3,3,3,3]
输出:1
解释:这里只有一个块,也就是整个数组(因为所有数字都相等),即:[3,3,3,3,3]。因此答案是 1。
示例 2:
输入:nums = [1,1,1,3,9,9,9,2,10,10]
输出:5
解释:这里有 5 个块:
块号 1: [1,1,1,3,9,9,9,2,10,10]
块号 2: [1,1,1,3,9,9,9,2,10,10]
块号 3: [1,1,1,3,9,9,9,2,10,10]
块号 4: [1,1,1,3,9,9,9,2,10,10]
块号 5: [1,1,1,3,9,9,9,2,10,10]
因此答案是 5。
示例 3:
输入:nums = [1,2,3,4,5,6,7]
输出:7
解释:由于所有数字都是不同的,这里有 7 个块,每个元素代表一个块。因此答案是 7。
提示:
1 <= nums.length <= 10151 <= nums[i] <= 109- 在生成的输入中所有相同值的元素是相邻的。
nums的所有元素之和最多为1015。
方法一:Go 解法(本站整理) · Go 实现
基于 Doocs 逐块二分参考改写。由于每个值仅出现于一个连续块,谓词 at(j) != at(i) 在 [i,n) 上单调;二分出当前块之后的第一个位置。相邻值已不同时直接跳过一个元素。b 为块数,n 为数组长度,时间 O(b log n)、辅助空间 O(1),索引始终使用 int64 以覆盖 10^15。平台 BigArray 提供 At(index int64) int 和 Size() int64,入口 countBlocks 接收 *BigArray;测试用压缩区间 mock 验证超大索引,不展开巨大数组。
出处:Doocs 原题与题解,固定提交 91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011;题意、参考及本 Go 改写采用 CC BY-SA 4.0。
// 题意与参考:Doocs LeetCode,CC BY-SA 4.0。
// https://github.com/doocs/leetcode/blob/91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011/solution/2900-2999/2936.Number%20of%20Equal%20Numbers%20Blocks/README.md
// Go 实现与测试沿用 CC BY-SA 4.0;来源性质见配套说明。
func countBlocks(nums *BigArray) int {
	n := nums.Size()
	ans := 0
	for i := int64(0); i < n; {
		ans++
		value := nums.At(i)
		if i+1 < n && nums.At(i+1) != value {
			i++
			continue
		}
		lo, hi := i+1, n
		for lo < hi {
			mid := lo + (hi-lo)/2
			if nums.At(mid) == value {
				lo = mid + 1
			} else {
				hi = mid
			}
		}
		i = lo
	}
	return ans
}2941. 子数组的最大 GCD-Sum 🔒
题目、示例与约束
给定一个整数数组 nums 和一个整数 k.
数组 a 的 gcd-sum 计算方法如下:
- 设
s为a的所有元素的和。 - 设
g为a的所有元素的 最大公约数。 a的 gcd-sum 等于s * g.
返回 nums 的至少包含 k 个元素的子数组的 最大 gcd-sum。
示例 1:
输入:nums = [2,1,4,4,4,2], k = 2
输出:48
解释:我们选择子数组 [4,4,4],该数组的 gcd-sum 为 4 * (4 + 4 + 4) = 48。
可以证明我们无法选择任何其他 gcd-sum 大于 48 的子数组。
示例 2:
输入:nums = [7,3,9,4], k = 1
输出:81
解释:我们选择子数组 [9],该数组的 gcd-sum 为 9 * 9 = 81。
可以证明我们无法选择任何其他 gcd-sum 大于 81 的子数组。
提示:
n == nums.length1 <= n <= 1051 <= nums[i] <= 1061 <= k <= n
方法一 · Go 实现
思考
子数组得分是「元素和 最大公约数」,长度至少为 。枚举所有子数组并求 GCD 在 较大时不可行。注意到将右端延伸一位时,历史 GCD 只减不增,且不同 GCD 值至多 个。
用数组 保存「该 GCD 首次出现的左端」。读入 后与旧对做 ,去重得到新的 ,再并上 。对长度达到 的段,用前缀和乘以该 GCD 更新答案。
func maxGcdSum(nums []int, k int) int64 {
	n := len(nums)
	s := make([]int64, n+1)
	s[0] = 0
	for i, x := range nums {
		s[i+1] = s[i] + int64(x)
	}
	type pair [2]int
	var f []pair
	var ans int64
	for i := 0; i < n; i++ {
		var g []pair
		for _, p := range f {
			j, x := p[0], p[1]
			y := int(gcd(int(x), nums[i]))
			if len(g) == 0 || g[len(g)-1][1] != y {
				g = append(g, pair{j, y})
			}
		}
		f = g
		f = append(f, pair{i, nums[i]})
		for _, p := range f {
			j, x := p[0], p[1]
			if i-j+1 >= k {
				ans = max(ans, (s[i+1]-s[j])*int64(x))
			}
		}
	}
	return ans
}

func gcd(a, b int) int {
	if b == 0 {
		return a
	}
	return gcd(b, a%b)
}2968. 执行操作使频率分数最大
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums 和一个整数 k 。
你可以对数组执行 至多 k 次操作:
- 从数组中选择一个下标
i,将nums[i]增加 或者 减少1。
最终数组的频率分数定义为数组中众数的 频率 。
请你返回你可以得到的 最大 频率分数。
众数指的是数组中出现次数最多的数。一个元素的频率指的是数组中这个元素的出现次数。
示例 1:
输入:nums = [1,2,6,4], k = 3
输出:3
解释:我们可以对数组执行以下操作:
- 选择 i = 0 ,将 nums[0] 增加 1 。得到数组 [2,2,6,4] 。
- 选择 i = 3 ,将 nums[3] 减少 1 ,得到数组 [2,2,6,3] 。
- 选择 i = 3 ,将 nums[3] 减少 1 ,得到数组 [2,2,6,2] 。
元素 2 是最终数组中的众数,出现了 3 次,所以频率分数为 3 。
3 是所有可行方案里的最大频率分数。
示例 2:
输入:nums = [1,4,4,2,4], k = 0
输出:3
解释:我们无法执行任何操作,所以得到的频率分数是原数组中众数的频率 3 。
提示:
1 <= nums.length <= 1051 <= nums[i] <= 1090 <= k <= 1014
方法一:排序 + 前缀和 + 二分查找 · Go 实现
思考
最多花 次 把尽量多的数变成同一个值。排序后最优是一段连续子数组都改到其中位数。长度 可行则更短也可行,故二分长度。
前缀和在 内算一段改到中位的代价。 时 次检查可接受。
题目求的是在最多进行 次操作的情况下,我们能得到的众数的最大频率。如果我们将数组 按照从小到大的顺序排列,那么最好就是将一段连续的数字都变成同一个数,这样可以使得操作次数较少,并且众数的频率较高。
因此,我们不妨先对数组 进行排序。
接下来,我们再分析,如果一个频率 是可行的,那么对于任意 ,频率 也是可行的,这存在着单调性。因此,我们可以通过二分查找,找到最大的满足条件的频率。
我们二分枚举频率,定义二分查找的左边界 ,右边界 ,其中 是数组的长度。每次二分查找的过程中,我们取中间值 ,然后判断 中是否存在一个长度为 的连续子数组,使得这个子数组中的所有元素都变成这个子数组的中位数,且操作次数不超过 。如果存在,那么我们就将左边界 更新为 ,否则我们就将右边界 更新为 。
为了判断是否存在这样的子数组,我们可以使用前缀和。我们首先定义两个指针 和 ,初始时 , 。那么 到 这一段的元素都变成 ,所需要的操作次数为 ,其中:
我们可以通过前缀和数组 来计算 ,从而在 的时间内计算出 和 。
时间复杂度 ,空间复杂度 。其中 是数组的长度。
func maxFrequencyScore(nums []int, k int64) int {
	sort.Ints(nums)
	n := len(nums)
	s := make([]int64, n+1)
	for i := 1; i <= n; i++ {
		s[i] = s[i-1] + int64(nums[i-1])
	}

	l, r := 0, n
	for l < r {
		mid := (l + r + 1) >> 1
		ok := false

		for i := 0; i <= n-mid; i++ {
			j := i + mid
			x := int64(nums[(i+j)/2])
			left := (int64((i+j)/2-i) * x) - (s[(i+j)/2] - s[i])
			right := (s[j] - s[(i+j)/2]) - (int64(j-(i+j)/2) * x)

			if left+right <= k {
				ok = true
				break
			}
		}

		if ok {
			l = mid
		} else {
			r = mid - 1
		}
	}

	return l
}继续阅读
- 实践案例
- 实践案例
- 实践案例