
LeetCode Go · 双指针(3)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
1842. 下个由相同数字构成的回文串 🔒
题目、示例与约束
给你一个很长的数字回文串 num ,返回 大于 num、由相同数字重新组合而成的最小 回文串。
如果不存在这样的回文串,则返回空串 ""。
回文串 是正读和反读都一样的字符串。
示例 1:
输入:num = "1221"
输出:"2112"
解释:下个比 "1221" 大的回文串是 "2112"。
示例 2:
输入:num = "32123"
输出:""
解释:不存在通过重组 "32123" 的数字可得、比 "32123" 还大的回文串。
示例 3:
输入:num = "45544554"
输出:"54455445"
解释:下个比 "45544554" 还要大的回文串是 "54455445"。
提示:
1 <= num.length <= 105num是回文串。
方法一:求前一半的下一个排列 · Go 实现
思考
要在相同数字的回文中找严格更大的下一个回文。对整个串求下一排列会破坏回文对称,且可能用到后半段的进位。
回文由前半唯一决定。对前半求下一个排列;若不存在则无解。再把前半镜像到后半,即得到下一个回文。
根据题目描述,我们只需要求出前一半的下一个排列,然后遍历前一半,对称赋值后半部分即可。
时间复杂度 ,空间复杂度 。其中 为字符串长度。
func nextPalindrome(num string) string {
	nums := []byte(num)
	n := len(nums)
	if !nextPermutation(nums) {
		return ""
	}
	for i := 0; i < n/2; i++ {
		nums[n-1-i] = nums[i]
	}
	return string(nums)
}

func nextPermutation(nums []byte) bool {
	n := len(nums) / 2
	i := n - 2
	for i >= 0 && nums[i] >= nums[i+1] {
		i--
	}
	if i < 0 {
		return false
	}
	j := n - 1
	for j >= 0 && nums[j] <= nums[i] {
		j--
	}
	nums[i], nums[j] = nums[j], nums[i]
	for i, j = i+1, n-1; i < j; i, j = i+1, j-1 {
		nums[i], nums[j] = nums[j], nums[i]
	}
	return true
}1861. 旋转盒子
题目、示例与约束
给你一个 m x n 的字符矩阵 boxGrid ,它表示一个箱子的侧视图。箱子的每一个格子可能为:
'#'表示石头'*'表示固定的障碍物'.'表示空位置
这个箱子被 顺时针旋转 90 度 ,由于重力原因,部分石头的位置会发生改变。每个石头会垂直掉落,直到它遇到障碍物,另一个石头或者箱子的底部。重力 不会 影响障碍物的位置,同时箱子旋转不会产生惯性 ,也就是说石头的水平位置不会发生改变。
题目保证初始时 boxGrid 中的石头要么在一个障碍物上,要么在另一个石头上,要么在箱子的底部。
请你返回一个 n x m 的矩阵,表示按照上述旋转后,箱子内的结果。
示例 1:
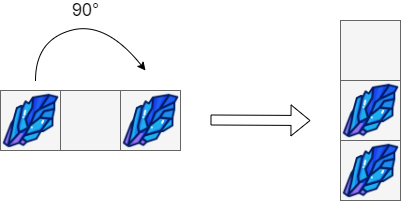
输入:box = [["#",".","#"]]
输出:[["."],
      ["#"],
      ["#"]]
示例 2:
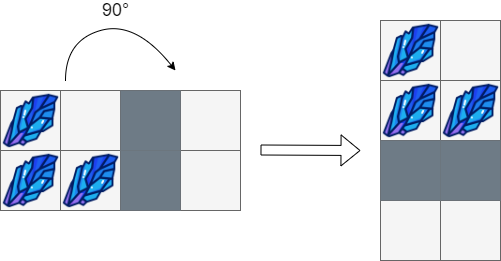
输入:box = [["#",".","*","."],
            ["#","#","*","."]]
输出:[["#","."],
      ["#","#"],
      ["*","*"],
      [".","."]]
示例 3:
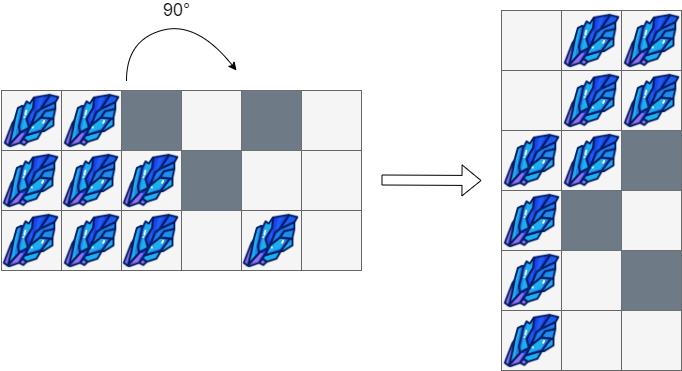
输入:box = [["#","#","*",".","*","."],
            ["#","#","#","*",".","."],
            ["#","#","#",".","#","."]]
输出:[[".","#","#"],
      [".","#","#"],
      ["#","#","*"],
      ["#","*","."],
      ["#",".","*"],
      ["#",".","."]]
提示:
m == boxGrid.lengthn == boxGrid[i].length1 <= m, n <= 500boxGrid[i][j]只可能是'#','*'或者'.'。
方法一:队列模拟 · Go 实现
思考
先顺时针转 ,再让石头在重力下下落,障碍挡住下落。逐格模拟下落可能反复移动同一颗石头。
旋转后按列从底向上扫描:空位下标入队,遇石头则与队首空位交换,遇障碍清空队列。每格处理一次,石头落到它能到达的最低空位。
我们先将矩阵顺时针旋转 90 度,然后模拟每一列石头的下落过程。
具体地,我们使用一个队列 来存储当前列中空位置的行号。遍历每一列,我们从下往上扫描,如果遇到一个石头,我们就将它掉落到 中第一个空位置,并将这个空位置从 中移除,由于当前位置变成了空位置,我们就将它的行号加入 中;如果遇到一个障碍物,我们就清空 ,因为石头无法穿过障碍物;如果遇到一个空位置,我们就将它的行号加入 中。
时间复杂度 ,空间复杂度 。其中 和 分别是矩阵的行数和列数。
func rotateTheBox(boxGrid [][]byte) [][]byte {
	m, n := len(boxGrid), len(boxGrid[0])
	ans := make([][]byte, n)
	for i := range ans {
		ans[i] = make([]byte, m)
	}
	for i := 0; i < m; i++ {
		for j := 0; j < n; j++ {
			ans[j][m-i-1] = boxGrid[i][j]
		}
	}
	for j := 0; j < m; j++ {
		q := []int{}
		for i := n - 1; i >= 0; i-- {
			if ans[i][j] == '*' {
				q = []int{}
			} else if ans[i][j] == '.' {
				q = append(q, i)
			} else if len(q) > 0 {
				ans[q[0]][j] = '#'
				q = q[1:]
				ans[i][j] = '.'
				q = append(q, i)
			}
		}
	}
	return ans
}1868. 两个行程编码数组的积 🔒
题目、示例与约束
行程编码(Run-length encoding)是一种压缩算法,能让一个含有许多段连续重复数字的整数类型数组 nums 以一个(通常更小的)二维数组 encoded 表示。每个 encoded[i] = [vali, freqi] 表示 nums 中第 i 段重复数字,其中 vali 是该段重复数字,重复了 freqi 次。
- 例如,
nums = [1,1,1,2,2,2,2,2]可表示称行程编码数组encoded = [[1,3],[2,5]]。对此数组的另一种读法是“三个1,后面有五个2”。
两个行程编码数组 encoded1 和 encoded2 的积可以按下列步骤计算:
- 将
encoded1和encoded2分别扩展成完整数组nums1和nums2。 - 创建一个新的数组
prodNums,长度为nums1.length并设prodNums[i] = nums1[i] * nums2[i]。 - 将
prodNums压缩成一个行程编码数组并返回之。
给定两个行程编码数组 encoded1 和 encoded2 ,分别表示完整数组 nums1 和 nums2 。nums1 和 nums2 的长度相同。 每一个 encoded1[i] = [vali, freqi] 表示 nums1 中的第 i 段,每一个 encoded2[j] = [valj, freqj] 表示 nums2 中的第 j 段。
返回 encoded1 和 encoded2 的乘积。
注:行程编码数组需压缩成可能的最小长度。
示例 1:
输入: encoded1 = [[1,3],[2,3]], encoded2 = [[6,3],[3,3]]
输出: [[6,6]]
解释n: encoded1 扩展为 [1,1,1,2,2,2] ,encoded2 扩展为 [6,6,6,3,3,3]。
prodNums = [6,6,6,6,6,6],压缩成行程编码数组 [[6,6]]。
示例 2:
输入: encoded1 = [[1,3],[2,1],[3,2]], encoded2 = [[2,3],[3,3]]
输出: [[2,3],[6,1],[9,2]]
解释: encoded1 扩展为 [1,1,1,2,3,3] ,encoded2 扩展为 [2,2,2,3,3,3]。
prodNums = [2,2,2,6,9,9],压缩成行程编码数组 [[2,3],[6,1],[9,2]]。
提示:
1 <= encoded1.length, encoded2.length <= 105encoded1[i].length == 2encoded2[j].length == 2- 对于每一个
encoded1[i],1 <= vali, freqi <= 104 - 对于每一个
encoded2[j],1 <= valj, freqj <= 104 encoded1和encoded2表示的完整数组长度相同。
方法一:双指针 · Go 实现
思考
两段行程编码表示等长数组,求对应位置乘积后再压缩。若先展开再相乘,长度可达 ,无法物化。
双指针对齐两段:每次取剩余频次的较小值 ,产生一段乘积 ,能与答案末段合并则合并。同时扣减两侧频次,耗尽则推进指针。全程只扫描编码本身。
我们用两个指针 和 分别指向两个数组的当前位置,然后开始模拟乘法的过程。
对于当前位置 和 ,我们取 ,表示当前位置的乘积的频次,然后将 ,表示当前位置的乘积的值。如果当前位置的乘积的值 和上一个位置的乘积的值相同,则将当前位置的乘积的频次加到上一个位置的乘积的频次上,否则将当前位置的乘积的值和频次加到答案数组中。然后我们将 和 分别减去 ,如果 或 减为 ,则将对应的指针向后移动一位。
最后返回答案数组即可。
时间复杂度 ,其中 和 分别是两个数组的长度。忽略答案数组的空间消耗,空间复杂度 。
func findRLEArray(encoded1 [][]int, encoded2 [][]int) (ans [][]int) {
	j := 0
	for _, e := range encoded1 {
		vi, fi := e[0], e[1]
		for fi > 0 {
			f := min(fi, encoded2[j][1])
			v := vi * encoded2[j][0]
			if len(ans) > 0 && ans[len(ans)-1][0] == v {
				ans[len(ans)-1][1] += f
			} else {
				ans = append(ans, []int{v, f})
			}
			fi -= f
			encoded2[j][1] -= f
			if encoded2[j][1] == 0 {
				j++
			}
		}
	}
	return
}1960. 两个回文子字符串长度的最大乘积
题目、示例与约束
给你一个下标从 0 开始的字符串 s ,你需要找到两个 不重叠的回文 子字符串,它们的长度都必须为 奇数 ,使得它们长度的乘积最大。
更正式地,你想要选择四个整数 i ,j ,k ,l ,使得 0 <= i <= j < k <= l < s.length ,且子字符串 s[i...j] 和 s[k...l] 都是回文串且长度为奇数。s[i...j] 表示下标从 i 到 j 且 包含 两端下标的子字符串。
请你返回两个不重叠回文子字符串长度的 最大 乘积。
回文字符串 指的是一个从前往后读和从后往前读一模一样的字符串。子字符串 指的是一个字符串中一段连续字符。
示例 1:
输入:s = "ababbb"
输出:9
解释:子字符串 "aba" 和 "bbb" 为奇数长度的回文串。乘积为 3 * 3 = 9 。
示例 2:
输入:s = "zaaaxbbby"
输出:9
解释:子字符串 "aaa" 和 "bbb" 为奇数长度的回文串。乘积为 3 * 3 = 9 。
提示:
2 <= s.length <= 105s只包含小写英文字母。
方法一 · Go 实现
思考
两个不相交的奇回文子串长度乘积最大。枚举分割点后再对两侧跑马拉车以外的平方算法会超时。
先用马拉车得到每个中心的最长奇回文半径,再推到「以 为右端/左端的最长回文」。前缀取最大得到分割点左侧最长,后缀同理。
分割点枚举时左右最大值相乘即可。
func maxProduct(s string) int64 {
	n := len(s)
	hlen := make([]int, n)
	center, right := 0, 0

	for i := 0; i < n; i++ {
		if i < right {
			mirror := 2*center - i
			if mirror >= 0 && mirror < n {
				hlen[i] = min(right-i, hlen[mirror])
			}
		}
		for i-1-hlen[i] >= 0 && i+1+hlen[i] < n && s[i-1-hlen[i]] == s[i+1+hlen[i]] {
			hlen[i]++
		}
		if i+hlen[i] > right {
			center = i
			right = i + hlen[i]
		}
	}

	prefix := make([]int, n)
	suffix := make([]int, n)

	for i := 0; i < n; i++ {
		r := i + hlen[i]
		if r < n {
			prefix[r] = max(prefix[r], 2*hlen[i]+1)
		}
		l := i - hlen[i]
		if l >= 0 {
			suffix[l] = max(suffix[l], 2*hlen[i]+1)
		}
	}

	for i := 1; i < n; i++ {
		if n-i-1 >= 0 {
			prefix[n-i-1] = max(prefix[n-i-1], prefix[n-i]-2)
		}
		suffix[i] = max(suffix[i], suffix[i-1]-2)
	}

	for i := 1; i < n; i++ {
		prefix[i] = max(prefix[i-1], prefix[i])
		suffix[n-i-1] = max(suffix[n-i], suffix[n-i-1])
	}

	var res int64
	for i := 1; i < n; i++ {
		prod := int64(prefix[i-1]) * int64(suffix[i])
		if prod > res {
			res = prod
		}
	}

	return res
}1961. 检查字符串是否为数组前缀
题目、示例与约束
给你一个字符串 s 和一个字符串数组 words ,请你判断 s 是否为 words 的 前缀字符串 。
字符串 s 要成为 words 的 前缀字符串 ,需要满足:s 可以由 words 中的前 k(k 为 正数 )个字符串按顺序相连得到,且 k 不超过 words.length 。
如果 s 是 words 的 前缀字符串 ,返回 true ;否则,返回 false 。
示例 1:
输入:s = "iloveleetcode", words = ["i","love","leetcode","apples"]
输出:true
解释:
s 可以由 "i"、"love" 和 "leetcode" 相连得到。
示例 2:
输入:s = "iloveleetcode", words = ["apples","i","love","leetcode"]
输出:false
解释:
数组的前缀相连无法得到 s 。
提示:
1 <= words.length <= 1001 <= words[i].length <= 201 <= s.length <= 1000words[i]和s仅由小写英文字母组成
方法一:遍历 · Go 实现
思考
必须等于 某个前缀的拼接,多一个或少一个词都不行。累加词长,长度首次等于 时比较拼接结果。
长度始终对不上则不是前缀字符串。不必在中途逐字符比对,一次拼接即可。
我们遍历数组 ,用一个变量 记录当前已经拼接的字符串,如果 的长度大于 的长度,说明 不是 的前缀字符串,返回 ;如果 的长度等于 的长度,返回 是否等于 。
遍历结束后,如果 的长度小于 的长度,说明 不是 的前缀字符串,返回 。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度。
func isPrefixString(s string, words []string) bool {
	t := strings.Builder{}
	for _, w := range words {
		t.WriteString(w)
		if t.Len() > len(s) {
			return false
		}
		if t.Len() == len(s) {
			return t.String() == s
		}
	}
	return false
}2000. 反转单词前缀
题目、示例与约束
给你一个下标从 0 开始的字符串 word 和一个字符 ch 。找出 ch 第一次出现的下标 i ,反转 word 中从下标 0 开始、直到下标 i 结束(含下标 i )的那段字符。如果 word 中不存在字符 ch ,则无需进行任何操作。
- 例如,如果
word = "abcdefd"且ch = 'd',那么你应该 反转 从下标 0 开始、直到下标3结束(含下标3)。结果字符串将会是"dcbaefd"。
返回 结果字符串 。
示例 1:
输入:word = "abcdefd", ch = 'd'
输出:"dcbaefd"
解释:"d" 第一次出现在下标 3 。
反转从下标 0 到下标 3(含下标 3)的这段字符,结果字符串是 "dcbaefd" 。
示例 2:
输入:word = "xyxzxe", ch = 'z'
输出:"zxyxxe"
解释:"z" 第一次也是唯一一次出现是在下标 3 。
反转从下标 0 到下标 3(含下标 3)的这段字符,结果字符串是 "zxyxxe" 。
示例 3:
输入:word = "abcd", ch = 'z'
输出:"abcd"
解释:"z" 不存在于 word 中。
无需执行反转操作,结果字符串是 "abcd" 。
提示:
1 <= word.length <= 250word由小写英文字母组成ch是一个小写英文字母
方法一:模拟 · Go 实现
思考
字符串长度 ,线性定位 并反转前缀即可。若 不出现,则结果就是原串,无需额外处理。
关键在于只翻转「首次出现位置」及其左侧,右侧保持不动。
find一次扫描得到下标 ;若 则直接返回。因此用切片 得到含 的反转前缀,再拼接 。
我们先找到字符 第一次出现的下标 ,然后反转从下标 开始、直到下标 结束(含下标 )的那段字符,最后将反转后的字符串与下标 开始的字符串拼接即可。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度。
func reversePrefix(word string, ch byte) string {
	j := strings.IndexByte(word, ch)
	if j < 0 {
		return word
	}
	s := []byte(word)
	for i := 0; i < j; i++ {
		s[i], s[j] = s[j], s[i]
		j--
	}
	return string(s)
}2105. 给植物浇水 II
题目、示例与约束
Alice 和 Bob 打算给花园里的 n 株植物浇水。植物排成一行,从左到右进行标记,编号从 0 到 n - 1 。其中,第 i 株植物的位置是 x = i 。
每一株植物都需要浇特定量的水。Alice 和 Bob 每人有一个水罐,最初是满的 。他们按下面描述的方式完成浇水:
- Alice 按 从左到右 的顺序给植物浇水,从植物
0开始。Bob 按 从右到左 的顺序给植物浇水,从植物n - 1开始。他们 同时 给植物浇水。 - 无论需要多少水,为每株植物浇水所需的时间都是相同的。
- 如果 Alice/Bob 水罐中的水足以 完全 灌溉植物,他们 必须 给植物浇水。否则,他们 首先(立即)重新装满罐子,然后给植物浇水。
- 如果 Alice 和 Bob 到达同一株植物,那么当前水罐中水 更多 的人会给这株植物浇水。如果他俩水量相同,那么 Alice 会给这株植物浇水。
给你一个下标从 0 开始的整数数组 plants ,数组由 n 个整数组成。其中,plants[i] 为第 i 株植物需要的水量。另有两个整数 capacityA 和 capacityB 分别表示 Alice 和 Bob 水罐的容量。返回两人浇灌所有植物过程中重新灌满水罐的 次数 。
示例 1:
输入:plants = [2,2,3,3], capacityA = 5, capacityB = 5
输出:1
解释:
- 最初,Alice 和 Bob 的水罐中各有 5 单元水。
- Alice 给植物 0 浇水,Bob 给植物 3 浇水。
- Alice 和 Bob 现在分别剩下 3 单元和 2 单元水。
- Alice 有足够的水给植物 1 ,所以她直接浇水。Bob 的水不够给植物 2 ,所以他先重新装满水,再浇水。
所以,两人浇灌所有植物过程中重新灌满水罐的次数 = 0 + 0 + 1 + 0 = 1 。
示例 2:
输入:plants = [2,2,3,3], capacityA = 3, capacityB = 4
输出:2
解释:
- 最初,Alice 的水罐中有 3 单元水,Bob 的水罐中有 4 单元水。
- Alice 给植物 0 浇水,Bob 给植物 3 浇水。
- Alice 和 Bob 现在都只有 1 单元水,并分别需要给植物 1 和植物 2 浇水。
- 由于他们的水量均不足以浇水,所以他们重新灌满水罐再进行浇水。
所以,两人浇灌所有植物过程中重新灌满水罐的次数 = 0 + 1 + 1 + 0 = 2 。
示例 3:
输入:plants = [5], capacityA = 10, capacityB = 8
输出:0
解释:
- 只有一株植物
- Alice 的水罐有 10 单元水,Bob 的水罐有 8 单元水。因此 Alice 的水罐中水更多,她会给这株植物浇水。
所以,两人浇灌所有植物过程中重新灌满水罐的次数 = 0 。
提示:
n == plants.length1 <= n <= 1051 <= plants[i] <= 106max(plants[i]) <= capacityA, capacityB <= 109
方法一:双指针 + 模拟 · Go 实现
思考
Alice 与 Bob 分别从两端走向中间,每人浇到一株植物前必须保证罐中水量足够,否则先灌满再浇。过程由位置唯一确定,没有分枝决策,直接模拟即可。
,每人至多经过 株植物,用双指针相向移动并维护当前水量 、 ,即可在线性时间内统计灌满次数。
当两指针相遇时,剩余的一株由当前水量较多者浇;若二者都不足则再灌满一次。相遇之前各自独立判断并扣减水量。
我们用两个变量 和 分别表示 Alice 和 Bob 的水量,初始时 , 。然后用两个指针 和 分别指向植物数组的头尾,然后模拟 Alice 和 Bob 从两端向中间浇水的过程。
当 时,我们分别判断 Alice 和 Bob 的水量是否足够浇水,如果不够,我们就重新灌满水罐。然后更新 和 的水量,同时移动指针 和 。最后我们还需要判断 和 是否相等,如果相等,我们还需要判断 是否小于植物的水量,如果小于,我们需要再次重新灌满水罐。
时间复杂度 ,其中 是植物数组的长度。空间复杂度 。
func minimumRefill(plants []int, capacityA int, capacityB int) (ans int) {
	a, b := capacityA, capacityB
	i, j := 0, len(plants)-1
	for ; i < j; i, j = i+1, j-1 {
		if a < plants[i] {
			ans++
			a = capacityA
		}
		a -= plants[i]
		if b < plants[j] {
			ans++
			b = capacityB
		}
		b -= plants[j]
	}
	if i == j && max(a, b) < plants[i] {
		ans++
	}
	return
}2108. 找出数组中的第一个回文字符串
题目、示例与约束
给你一个字符串数组 words ,找出并返回数组中的 第一个回文字符串 。如果不存在满足要求的字符串,返回一个 空字符串 "" 。
回文字符串 的定义为:如果一个字符串正着读和反着读一样,那么该字符串就是一个 回文字符串 。
示例 1:
输入:words = ["abc","car","ada","racecar","cool"]
输出:"ada"
解释:第一个回文字符串是 "ada" 。
注意,"racecar" 也是回文字符串,但它不是第一个。
示例 2:
输入:words = ["notapalindrome","racecar"]
输出:"racecar"
解释:第一个也是唯一一个回文字符串是 "racecar" 。
示例 3:
输入:words = ["def","ghi"]
输出:""
解释:不存在回文字符串,所以返回一个空字符串。
提示:
1 <= words.length <= 1001 <= words[i].length <= 100words[i]仅由小写英文字母组成
方法一:模拟 · Go 实现
思考
需要返回数组中第一个回文串。单词总长有限,按顺序检查即可,无需预处理。
判断回文可将串与其反转比较,或用首尾双指针;任一处不等即否。
我们从左到右遍历 ,返回第一个满足 的单词,若都不回文则返回空串。
我们遍历数组 words,对于每个字符串 w,判断其是否为回文字符串,如果是,则返回 w,否则继续遍历。
判断一个字符串是否为回文字符串,可以使用双指针,分别指向字符串的首尾,向中间移动,判断对应的字符是否相等。如果遍历完整个字符串,都没有发现不相等的字符,则该字符串为回文字符串。
时间复杂度 ,其中 为数组 words 中所有字符串的长度之和。空间复杂度 。
func firstPalindrome(words []string) string {
	for _, w := range words {
		ok := true
		for i, j := 0, len(w)-1; i < j && ok; i, j = i+1, j-1 {
			if w[i] != w[j] {
				ok = false
			}
		}
		if ok {
			return w
		}
	}
	return ""
}2109. 向字符串添加空格
题目、示例与约束
给你一个下标从 0 开始的字符串 s ,以及一个下标从 0 开始的整数数组 spaces 。
数组 spaces 描述原字符串中需要添加空格的下标。每个空格都应该插入到给定索引处的字符值 之前 。
- 例如,
s = "EnjoyYourCoffee"且spaces = [5, 9],那么我们需要在'Y'和'C'之前添加空格,这两个字符分别位于下标5和下标9。因此,最终得到"Enjoy Your Coffee"。
请你添加空格,并返回修改后的字符串。
示例 1:
输入:s = "LeetcodeHelpsMeLearn", spaces = [8,13,15]
输出:"Leetcode Helps Me Learn"
解释:
下标 8、13 和 15 对应 "LeetcodeHelpsMeLearn" 中加粗斜体字符。
接着在这些字符前添加空格。
示例 2:
输入:s = "icodeinpython", spaces = [1,5,7,9]
输出:"i code in py thon"
解释:
下标 1、5、7 和 9 对应 "icodeinpython" 中加粗斜体字符。
接着在这些字符前添加空格。
示例 3:
输入:s = "spacing", spaces = [0,1,2,3,4,5,6]
输出:" s p a c i n g"
解释:
字符串的第一个字符前可以添加空格。
提示:
1 <= s.length <= 3 * 105s仅由大小写英文字母组成1 <= spaces.length <= 3 * 1050 <= spaces[i] <= s.length - 1spaces中的所有值 严格递增
方法一:双指针 · Go 实现
思考
要在给定下标处插入空格且保持原相对顺序。若每次对字符串做插入,后面字符反复移动,总代价可达二次。
已递增,与 的下标同步扫描即可在线性时间内决定每个位置是否先写空格。
用指针 指向下一个空格位置,遍历 时若当前下标等于 则先追加空格,再追加字符,最后拼接。
我们可以用双指针 和 分别指向字符串 和数组 的头部,然后从头到尾遍历字符串 ,当 等于 时,我们往结果字符串中添加一个空格,然后 自增 。接下来,我们将 添加到结果字符串中,然后 自增 。继续这个过程,直到遍历完字符串 。
时间复杂度 ,空间复杂度 。其中 和 分别是字符串 和数组 的长度。
func addSpaces(s string, spaces []int) string {
	var ans []byte
	for i, j := 0, 0; i < len(s); i++ {
		if j < len(spaces) && i == spaces[j] {
			ans = append(ans, ' ')
			j++
		}
		ans = append(ans, s[i])
	}
	return string(ans)
}2122. 还原原数组
题目、示例与约束
Alice 有一个下标从 0 开始的数组 arr ,由 n 个正整数组成。她会选择一个任意的 正整数 k 并按下述方式创建两个下标从 0 开始的新整数数组 lower 和 higher :
- 对每个满足
0 <= i < n的下标i,lower[i] = arr[i] - k - 对每个满足
0 <= i < n的下标i,higher[i] = arr[i] + k
不幸地是,Alice 丢失了全部三个数组。但是,她记住了在数组 lower 和 higher 中出现的整数,但不知道每个整数属于哪个数组。请你帮助 Alice 还原原数组。
给你一个由 2n 个整数组成的整数数组 nums ,其中 恰好 n 个整数出现在 lower ,剩下的出现在 higher ,还原并返回 原数组 arr 。如果出现答案不唯一的情况,返回 任一 有效数组。
注意:生成的测试用例保证存在 至少一个 有效数组 arr 。
示例 1:
输入:nums = [2,10,6,4,8,12]
输出:[3,7,11]
解释:
如果 arr = [3,7,11] 且 k = 1 ,那么 lower = [2,6,10] 且 higher = [4,8,12] 。
组合 lower 和 higher 得到 [2,6,10,4,8,12] ,这是 nums 的一个排列。
另一个有效的数组是 arr = [5,7,9] 且 k = 3 。在这种情况下,lower = [2,4,6] 且 higher = [8,10,12] 。
示例 2:
输入:nums = [1,1,3,3]
输出:[2,2]
解释:
如果 arr = [2,2] 且 k = 1 ,那么 lower = [1,1] 且 higher = [3,3] 。
组合 lower 和 higher 得到 [1,1,3,3] ,这是 nums 的一个排列。
注意,数组不能是 [1,3] ,因为在这种情况下,获得 [1,1,3,3] 唯一可行的方案是 k = 0 。
这种方案是无效的,k 必须是一个正整数。
示例 3:
输入:nums = [5,435]
输出:[220]
解释:
唯一可行的组合是 arr = [220] 且 k = 215 。在这种情况下,lower = [5] 且 higher = [435] 。
提示:
2 * n == nums.length1 <= n <= 10001 <= nums[i] <= 109- 生成的测试用例保证存在 至少一个 有效数组
arr
方法一 · Go 实现
思考
是原数组每个元素加减 后的多重集合。 未知,若枚举所有可能的配对,状态过多。较低的一半与较高的一半应能按同一 一一匹配。
排序后最小元素必是某个 ,因而 只能是 ,其中 取使差为正偶数的位置。对每个候选 ,用双指针在有序数组上贪心配对 与 。
一旦配出 对,均值序列即为原数组。
func recoverArray(nums []int) []int {
	sort.Ints(nums)
	for i, n := 1, len(nums); i < n; i++ {
		d := nums[i] - nums[0]
		if d == 0 || d%2 == 1 {
			continue
		}
		vis := make([]bool, n)
		vis[i] = true
		ans := []int{(nums[0] + nums[i]) >> 1}
		for l, r := 1, i+1; r < n; l, r = l+1, r+1 {
			for l < n && vis[l] {
				l++
			}
			for r < n && nums[r]-nums[l] < d {
				r++
			}
			if r == n || nums[r]-nums[l] > d {
				break
			}
			vis[r] = true
			ans = append(ans, (nums[l]+nums[r])>>1)
		}
		if len(ans) == (n >> 1) {
			return ans
		}
	}
	return []int{}
}2149. 按符号重排数组
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums ,数组长度为 偶数 ,由数目 相等 的正整数和负整数组成。
你需要返回满足下述条件的数组 nums:
- 任意 连续 的两个整数 符号相反
- 对于符号相同的所有整数,保留 它们在
nums中的 顺序 。 - 重排后数组以正整数开头。
重排元素满足上述条件后,返回修改后的数组。
示例 1:
输入:nums = [3,1,-2,-5,2,-4]
输出:[3,-2,1,-5,2,-4]
解释:
nums 中的正整数是 [3,1,2] ,负整数是 [-2,-5,-4] 。
重排的唯一可行方案是 [3,-2,1,-5,2,-4],能满足所有条件。
像 [1,-2,2,-5,3,-4]、[3,1,2,-2,-5,-4]、[-2,3,-5,1,-4,2] 这样的其他方案是不正确的,因为不满足一个或者多个条件。
示例 2:
输入:nums = [-1,1]
输出:[1,-1]
解释:
1 是 nums 中唯一一个正整数,-1 是 nums 中唯一一个负整数。
所以 nums 重排为 [1,-1] 。
提示:
2 <= nums.length <= 2 * 105nums.length是 偶数1 <= |nums[i]| <= 105nums由 相等 数量的正整数和负整数组成
不需要原地进行修改。
方法一:双指针 · Go 实现
思考
正负各半,要求交替且各自保持相对顺序。若先拆成两个队列再交错合并,需要额外数组;题目也允许直接按目标下标写入。
偶数下标放正数、奇数下标放负数,分别用指针 、 按原顺序填入。
一次遍历即可得到新数组。
我们先创建一个长度为 的数组 ,然后使用两个指针 和 分别指向 的偶数下标和奇数下标,初始时 , 。
遍历数组 ,如果当前元素 为正整数,则将 放入 ,并将 增加 ;否则将 放入 ,并将 增加 。
最后返回 即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func rearrangeArray(nums []int) []int {
	ans := make([]int, len(nums))
	i, j := 0, 1
	for _, x := range nums {
		if x > 0 {
			ans[i] = x
			i += 2
		} else {
			ans[j] = x
			j += 2
		}
	}
	return ans
}2161. 根据给定数字划分数组
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums 和一个整数 pivot 。请你将 nums 重新排列,使得以下条件均成立:
- 所有小于
pivot的元素都出现在所有大于pivot的元素 之前 。 - 所有等于
pivot的元素都出现在小于和大于pivot的元素 中间 。 - 小于
pivot的元素之间和大于pivot的元素之间的 相对顺序 不发生改变。- 更正式的,考虑每一对
pi,pj,pi是初始时位置i元素的新位置,pj是初始时位置j元素的新位置。如果i < j且两个元素 都 小于(或大于)pivot,那么pi < pj。
- 更正式的,考虑每一对
请你返回重新排列 nums 数组后的结果数组。
示例 1:
输入:nums = [9,12,5,10,14,3,10], pivot = 10
输出:[9,5,3,10,10,12,14]
解释:
元素 9 ,5 和 3 小于 pivot ,所以它们在数组的最左边。
元素 12 和 14 大于 pivot ,所以它们在数组的最右边。
小于 pivot 的元素的相对位置和大于 pivot 的元素的相对位置分别为 [9, 5, 3] 和 [12, 14] ,它们在结果数组中的相对顺序需要保留。
示例 2:
输入:nums = [-3,4,3,2], pivot = 2
输出:[-3,2,4,3]
解释:
元素 -3 小于 pivot ,所以在数组的最左边。
元素 4 和 3 大于 pivot ,所以它们在数组的最右边。
小于 pivot 的元素的相对位置和大于 pivot 的元素的相对位置分别为 [-3] 和 [4, 3] ,它们在结果数组中的相对顺序需要保留。
提示:
1 <= nums.length <= 105-106 <= nums[i] <= 106pivot等于nums中的一个元素。
方法一:模拟 · Go 实现
思考
相对 分成小于、等于、大于三段,且各段保持原相对顺序。稳定划分一次扫描即可。
三个列表按出现顺序收集,再拼接。
额外空间与 同阶。
我们可以遍历数组 ,按顺序找出所有小于 的元素,所有等于 的元素,以及所有大于 的元素,然后将它们按照题目要求的顺序拼接起来。
时间复杂度 ,其中 为数组 的长度。忽略答案数组的空间消耗,空间复杂度 。
func pivotArray(nums []int, pivot int) []int {
	var ans []int
	for _, x := range nums {
		if x < pivot {
			ans = append(ans, x)
		}
	}
	for _, x := range nums {
		if x == pivot {
			ans = append(ans, x)
		}
	}
	for _, x := range nums {
		if x > pivot {
			ans = append(ans, x)
		}
	}
	return ans
}2200. 找出数组中的所有 K 近邻下标
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums 和两个整数 key 和 k 。K 近邻下标 是 nums 中的一个下标 i ,并满足至少存在一个下标 j 使得 |i - j| <= k 且 nums[j] == key 。
以列表形式返回按 递增顺序 排序的所有 K 近邻下标。
示例 1:
输入:nums = [3,4,9,1,3,9,5], key = 9, k = 1 输出:[1,2,3,4,5,6] 解释:因此,nums[2] == key且nums[5] == key。 - 对下标 0 ,|0 - 2| > k且|0 - 5| > k,所以不存在j使得|0 - j| <= k且nums[j] == key。所以 0 不是一个 K 近邻下标。 - 对下标 1 ,|1 - 2| <= k且nums[2] == key,所以 1 是一个 K 近邻下标。 - 对下标 2 ,|2 - 2| <= k且nums[2] == key,所以 2 是一个 K 近邻下标。 - 对下标 3 ,|3 - 2| <= k且nums[2] == key,所以 3 是一个 K 近邻下标。 - 对下标 4 ,|4 - 5| <= k且nums[5] == key,所以 4 是一个 K 近邻下标。 - 对下标 5 ,|5 - 5| <= k且nums[5] == key,所以 5 是一个 K 近邻下标。 - 对下标 6 ,|6 - 5| <= k且nums[5] == key,所以 6 是一个 K 近邻下标。 因此,按递增顺序返回 [1,2,3,4,5,6] 。
示例 2:
输入:nums = [2,2,2,2,2], key = 2, k = 2 输出:[0,1,2,3,4] 解释:对nums的所有下标 i ,总存在某个下标 j 使得|i - j| <= k且nums[j] == key,所以每个下标都是一个 K 近邻下标。 因此,返回 [0,1,2,3,4] 。
提示:
1 <= nums.length <= 10001 <= nums[i] <= 1000key是数组nums中的一个整数1 <= k <= nums.length
方法一:枚举 · Go 实现
思考
题目要求所有与某个 下标距离不超过 的位置。若对每个 都向左右各看 格,或对每个 再扫一遍全数组判断是否存在合格的 ,时间均为 。 ,该复杂度可以通过。
真正需要判断的只是「区间 内是否出现过 」,不必列出全部配对。因此固定 后枚举 ,一旦发现 且 即可收入 并结束内层循环。
我们在 的范围内枚举下标 ,对于每个下标 ,我们在 的范围内枚举下标 ,如果 且 ,那么 就是一个 K 近邻下标,我们将 加入答案数组中,然后跳出内层循环,枚举下一个下标 。
时间复杂度 ,其中 是数组 的长度。空间复杂度 。
func findKDistantIndices(nums []int, key int, k int) (ans []int) {
	for i := range nums {
		for j, x := range nums {
			if abs(i-j) <= k && x == key {
				ans = append(ans, i)
				break
			}
		}
	}
	return ans
}

func abs(x int) int {
	if x < 0 {
		return -x
	}
	return x
}
方法二:预处理 + 二分查找 · Go 实现
思考
方法一对每个 都重新扫描,没有利用 的出现位置可以预先收集这一事实。 虽小,仍可将「区间内是否存在 」从线性查询降为对数查询。
先扫一遍数组,把所有等于 的下标按升序记入 。对每个 ,在有序的 上二分查找是否存在落在 内的下标:左端用 ,右端用 。若左右指针仍满足 ,则 合法。时间降为 。
我们可以预处理得到所有等于 的元素的下标,记录在数组 中。数组 中的所有下标元素是按照升序排列的,
接下来,我们枚举下标 ,对于每个下标 ,我们可以使用二分查找的方法在数组 中查找 范围内的元素,如果存在元素,那么 就是一个 K 近邻下标,我们将 加入答案数组中。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func findKDistantIndices(nums []int, key int, k int) (ans []int) {
	idx := []int{}
	for i, x := range nums {
		if x == key {
			idx = append(idx, i)
		}
	}
	for i := range nums {
		l := sort.SearchInts(idx, i-k)
		r := sort.SearchInts(idx, i+k+1) - 1
		if l <= r {
			ans = append(ans, i)
		}
	}
	return
}
方法三:双指针 · Go 实现
思考
方法二已经避免重复扫描 ,但仍要维护下标数组,并对每个 做两次二分。注意到 从左到右递增时,满足 且 的最左下标也只会右移。
为此用指针 单调前进:当 ,或当前格不是 时将 加一。若前进后仍有 ,则 是 K 近邻下标。一遍扫描即可,额外空间 。
我们枚举下标 ,用一个指针 指向满足 且 的最小下标,如果 存在且 ,那么 就是一个 K 近邻下标,我们将 加入答案数组中。
时间复杂度 ,其中 是数组 的长度。空间复杂度 。
func findKDistantIndices(nums []int, key int, k int) (ans []int) {
	n := len(nums)
	for i, j := 0, 0; i < n; i++ {
		for j < i-k || (j < n && nums[j] != key) {
			j++
		}
		if j < n && j <= i+k {
			ans = append(ans, i)
		}
	}
	return
}2330. 验证回文串 IV 🔒
题目、示例与约束
给你一个下标从 0 开始、仅由小写英文字母组成的字符串 s 。在一步操作中,你可以将 s 中的任一字符更改为其他任何字符。
如果你能在 恰 执行一到两步操作后使 s 变成一个回文,则返回 true ,否则返回 false 。
示例 1:
输入: s = "abcdba"
输出: true
解释: 能让 s 变成回文,且只用了一步操作的方案如下:
- 将 s[2] 变成 'd' ,得到 s = "abddba" 。
执行一步操作让 s 变成一个回文,所以返回 true 。
示例 2:
输入: s = "aa"
输出: true
解释: 能让 s 变成回文,且只用了两步操作的方案如下:
- 将 s[0] 变成 'b' ,得到 s = "ba" 。
- 将 s[1] 变成 'b' ,得到s = "bb" 。
执行两步操作让 s 变成一个回文,所以返回 true 。
示例 3:
输入: s = "abcdef"
输出: false
解释: 不存在能在两步操作以内将 s 变成回文的办法,所以返回 false 。
提示:
1 <= s.length <= 105s仅由小写英文字母组成
方法一:双指针 · Go 实现
思考
至多改两个字符使 成回文。 ,不能枚举修改位置。一次修改最多修复一对对称位置。
双指针从两端对进,统计 的对数。不超过两对则可在两次操作内改成回文。
我们可以使用双指针 和 ,分别指向字符串的头尾,然后向中间移动,统计不同字符的个数,如果不同字符的个数大于 ,则返回 ,否则返回 。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度。
func makePalindrome(s string) bool {
	cnt := 0
	i, j := 0, len(s)-1
	for ; i < j; i, j = i+1, j-1 {
		if s[i] != s[j] {
			cnt++
		}
	}
	return cnt <= 2
}2337. 移动片段得到字符串
题目、示例与约束
给你两个字符串 start 和 target ,长度均为 n 。每个字符串 仅 由字符 'L'、'R' 和 '_' 组成,其中:
- 字符
'L'和'R'表示片段,其中片段'L'只有在其左侧直接存在一个 空位 时才能向 左 移动,而片段'R'只有在其右侧直接存在一个 空位 时才能向 右 移动。 - 字符
'_'表示可以被 任意'L'或'R'片段占据的空位。
如果在移动字符串 start 中的片段任意次之后可以得到字符串 target ,返回 true ;否则,返回 false 。
示例 1:
输入:start = "_L__R__R_", target = "L______RR"
输出:true
解释:可以从字符串 start 获得 target ,需要进行下面的移动:
- 将第一个片段向左移动一步,字符串现在变为 "L___R__R_" 。
- 将最后一个片段向右移动一步,字符串现在变为 "L___R___R" 。
- 将第二个片段向右移动三步,字符串现在变为 "L______RR" 。
可以从字符串 start 得到 target ,所以返回 true 。
示例 2:
输入:start = "R_L_", target = "__LR"
输出:false
解释:字符串 start 中的 'R' 片段可以向右移动一步得到 "_RL_" 。
但是,在这一步之后,不存在可以移动的片段,所以无法从字符串 start 得到 target 。
示例 3:
输入:start = "_R", target = "R_"
输出:false
解释:字符串 start 中的片段只能向右移动,所以无法从字符串 start 得到 target 。
提示:
n == start.length == target.length1 <= n <= 105start和target由字符'L'、'R'和'_'组成
方法一:双指针 · Go 实现
思考
L只能左移、R只能右移,且二者不能穿过对方。 ,模拟逐步移动过慢。去掉空位后,两串的字母序列必须相同。抽出非
_字符及其下标。对应字母不同则失败;L的起点不能在目标右侧,R不能在目标左侧。
替换操作实际上是将 L 往左移动(L 左边为 _ 时才能移动),R 往右移动(R 右边是 _ 时才能移动),但 L 无法穿过 R。所以,如果去掉 start 和 target 中的所有 _,剩下的字符应该是相同的,否则返回 false。
我们使用双指针 和 从头到尾遍历 start 和 target:
- 如果当前字符为
L且 ,那么这个L无法向右移动,返回false; - 如果当前字符为
R且 ,那么这个R无法向左移动,返回false。
如果双指针均遍历到末尾,返回 true。
时间复杂度 ,其中 表示字符串 start 或 target 的长度。
相似题目:
func canChange(start string, target string) bool {
	f := func(s string) [][]int {
		res := [][]int{}
		for i, c := range s {
			if c == 'L' {
				res = append(res, []int{1, i})
			} else if c == 'R' {
				res = append(res, []int{2, i})
			}
		}
		return res
	}

	a, b := f(start), f(target)
	if len(a) != len(b) {
		return false
	}
	for i, x := range a {
		y := b[i]
		if x[0] != y[0] {
			return false
		}
		if x[0] == 1 && x[1] < y[1] {
			return false
		}
		if x[0] == 2 && x[1] > y[1] {
			return false
		}
	}
	return true
}
方法二 · Go 实现
思考
方法一先物化两份位置列表。双指针同步跳过
_,在原串上做同一组下标比较,省去额外数组,逻辑不变。
func canChange(start string, target string) bool {
	n := len(start)
	i, j := 0, 0
	for {
		for i < n && start[i] == '_' {
			i++
		}
		for j < n && target[j] == '_' {
			j++
		}
		if i == n && j == n {
			return true
		}
		if i == n || j == n || start[i] != target[j] {
			return false
		}
		if start[i] == 'L' && i < j {
			return false
		}
		if start[i] == 'R' && i > j {
			return false
		}
		i, j = i+1, j+1
	}
}2367. 等差三元组的数目
题目、示例与约束
给你一个下标从 0 开始、严格递增 的整数数组 nums 和一个正整数 diff 。如果满足下述全部条件,则三元组 (i, j, k) 就是一个 等差三元组 :
i < j < k,nums[j] - nums[i] == diff且nums[k] - nums[j] == diff
返回不同 等差三元组 的数目。
示例 1:
输入:nums = [0,1,4,6,7,10], diff = 3
输出:2
解释:
(1, 4, 7) 是等差三元组:7 - 4 == 3 且 4 - 1 == 3 。
(2, 4, 5) 是等差三元组:10 - 7 == 3 且 7 - 4 == 3 。
示例 2:
输入:nums = [4,5,6,7,8,9], diff = 2
输出:2
解释:
(0, 2, 4) 是等差三元组:8 - 6 == 2 且 6 - 4 == 2 。
(1, 3, 5) 是等差三元组:9 - 7 == 2 且 7 - 5 == 2 。
提示:
3 <= nums.length <= 2000 <= nums[i] <= 2001 <= diff <= 50nums严格 递增
方法一:暴力枚举 · Go 实现
思考
严格递增数组中数公差为 的三元组。 ,三重枚举可以通过。
用组合枚举三个下标,判断两段差是否都等于 。
我们注意到,数组 的长度只有不超过 ,因此可以直接暴力枚举 , , ,判断是否满足条件,若满足,累加三元组数目。
时间复杂度 ,其中 为数组 的长度。空间复杂度 。
func arithmeticTriplets(nums []int, diff int) (ans int) {
	n := len(nums)
	for i := 0; i < n; i++ {
		for j := i + 1; j < n; j++ {
			for k := j + 1; k < n; k++ {
				if nums[j]-nums[i] == diff && nums[k]-nums[j] == diff {
					ans++
				}
			}
		}
	}
	return
}
方法二:数组或哈希表 · Go 实现
思考
方法一为立方。值域与长度都很小,放入集合后枚举 并查询 、 ,降为线性。
我们可以先将 中的元素存入哈希表或数组 中,然后枚举 中的每个元素 ,判断 , 是否也在 中,若是,累加三元组数目。
枚举结束后,返回答案。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func arithmeticTriplets(nums []int, diff int) (ans int) {
	vis := [301]bool{}
	for _, x := range nums {
		vis[x] = true
	}
	for _, x := range nums {
		if vis[x+diff] && vis[x+diff+diff] {
			ans++
		}
	}
	return
}2396. 严格回文的数字
题目、示例与约束
如果一个整数 n 在 b 进制下(b 为 2 到 n - 2 之间的所有整数)对应的字符串 全部 都是 回文的 ,那么我们称这个数 n 是 严格回文 的。
给你一个整数 n ,如果 n 是 严格回文 的,请返回 true ,否则返回 false 。
如果一个字符串从前往后读和从后往前读完全相同,那么这个字符串是 回文的 。
示例 1:
输入:n = 9
输出:false
解释:在 2 进制下:9 = 1001 ,是回文的。
在 3 进制下:9 = 100 ,不是回文的。
所以,9 不是严格回文数字,我们返回 false 。
注意在 4, 5, 6 和 7 进制下,n = 9 都不是回文的。
示例 2:
输入:n = 4
输出:false
解释:我们只考虑 2 进制:4 = 100 ,不是回文的。
所以我们返回 false 。
提示:
4 <= n <= 105
方法一:脑筋急转弯 · Go 实现
思考
要求 在每一个 进制下都是回文。 ,可先看特殊进制而非真的转换所有进制。
的二进制为 ; 时 进制为 。两者都不是回文,因此恒为假。
当 时,二进制表示为 ,不是回文串;
当 时,此时 进制表示为 ,不是回文串。
因此,我们可以直接返回 false。
时间复杂度 ,空间复杂度 。
func isStrictlyPalindromic(n int) bool {
	return false
}2441. 与对应负数同时存在的最大正整数
题目、示例与约束
给你一个 不包含 任何零的整数数组 nums ,找出自身与对应的负数都在数组中存在的最大正整数 k 。
返回正整数 k ,如果不存在这样的整数,返回 -1 。
示例 1:
输入:nums = [-1,2,-3,3]
输出:3
解释:3 是数组中唯一一个满足题目要求的 k 。
示例 2:
输入:nums = [-1,10,6,7,-7,1]
输出:7
解释:数组中存在 1 和 7 对应的负数,7 的值更大。
示例 3:
输入:nums = [-10,8,6,7,-2,-3]
输出:-1
解释:不存在满足题目要求的 k ,返回 -1 。
提示:
1 <= nums.length <= 1000-1000 <= nums[i] <= 1000nums[i] != 0
方法一:哈希表 · Go 实现
思考
,判断 与 是否同时出现。放入集合后遍历集合,取同时存在相反数的最大正值;没有则 。
我们可以用哈希表 记录数组中出现的所有元素,用一个变量 记录满足题目要求的最大正整数,初始时 。
接下来,我们遍历哈希表 中的每个元素 ,如果 中存在 ,那么我们就更新 。
遍历结束后,返回 即可。
时间复杂度 ,空间复杂度 。其中 是数组的长度。
func findMaxK(nums []int) int {
	ans := -1
	s := map[int]bool{}
	for _, x := range nums {
		s[x] = true
	}
	for x := range s {
		if s[-x] && ans < x {
			ans = x
		}
	}
	return ans
}2460. 对数组执行操作
题目、示例与约束
给你一个下标从 0 开始的数组 nums ,数组大小为 n ,且由 非负 整数组成。
你需要对数组执行 n - 1 步操作,其中第 i 步操作(从 0 开始计数)要求对 nums 中第 i 个元素执行下述指令:
- 如果
nums[i] == nums[i + 1],则nums[i]的值变成原来的2倍,nums[i + 1]的值变成0。否则,跳过这步操作。
在执行完 全部 操作后,将所有 0 移动 到数组的 末尾 。
- 例如,数组
[1,0,2,0,0,1]将所有0移动到末尾后变为[1,2,1,0,0,0]。
返回结果数组。
注意 操作应当 依次有序 执行,而不是一次性全部执行。
示例 1:
输入:nums = [1,2,2,1,1,0]
输出:[1,4,2,0,0,0]
解释:执行以下操作:
- i = 0: nums[0] 和 nums[1] 不相等,跳过这步操作。
- i = 1: nums[1] 和 nums[2] 相等,nums[1] 的值变成原来的 2 倍,nums[2] 的值变成 0 。数组变成 [1,4,0,1,1,0] 。
- i = 2: nums[2] 和 nums[3] 不相等,所以跳过这步操作。
- i = 3: nums[3] 和 nums[4] 相等,nums[3] 的值变成原来的 2 倍,nums[4] 的值变成 0 。数组变成 [1,4,0,2,0,0] 。
- i = 4: nums[4] 和 nums[5] 相等,nums[4] 的值变成原来的 2 倍,nums[5] 的值变成 0 。数组变成 [1,4,0,2,0,0] 。
执行完所有操作后,将 0 全部移动到数组末尾,得到结果数组 [1,4,2,0,0,0] 。
示例 2:
输入:nums = [0,1]
输出:[1,0]
解释:无法执行任何操作,只需要将 0 移动到末尾。
提示:
2 <= nums.length <= 20000 <= nums[i] <= 1000
方法一:模拟 · Go 实现
思考
,按题意从左到右合并相等相邻项(左倍增、右置零),再把非零稳定排序到左侧。两遍线性扫描即可。
我们直接根据题意模拟即可。
首先,我们遍历数组 ,对于任意相邻的两个元素 和 ,如果 ,那么我们将 的值变为原来的 倍,同时将 的值变为 。
然后,我们创建一个长度为 的答案数组 ,并将 中所有非零元素按顺序放入 中。
最后,返回答案数组 即可。
时间复杂度 ,其中 是数组 的长度。忽略答案的空间消耗,空间复杂度 。
func applyOperations(nums []int) []int {
	n := len(nums)
	for i := 0; i < n-1; i++ {
		if nums[i] == nums[i+1] {
			nums[i] <<= 1
			nums[i+1] = 0
		}
	}
	ans := make([]int, n)
	i := 0
	for _, x := range nums {
		if x > 0 {
			ans[i] = x
			i++
		}
	}
	return ans
}2462. 雇佣 K 位工人的总代价
题目、示例与约束
给你一个下标从 0 开始的整数数组 costs ,其中 costs[i] 是雇佣第 i 位工人的代价。
同时给你两个整数 k 和 candidates 。我们想根据以下规则恰好雇佣 k 位工人:
- 总共进行
k轮雇佣,且每一轮恰好雇佣一位工人。 - 在每一轮雇佣中,从最前面
candidates和最后面candidates人中选出代价最小的一位工人,如果有多位代价相同且最小的工人,选择下标更小的一位工人。- 比方说,
costs = [3,2,7,7,1,2]且candidates = 2,第一轮雇佣中,我们选择第4位工人,因为他的代价最小[3,2,7,7,1,2]。 - 第二轮雇佣,我们选择第
1位工人,因为他们的代价与第4位工人一样都是最小代价,而且下标更小,[3,2,7,7,2]。注意每一轮雇佣后,剩余工人的下标可能会发生变化。
- 比方说,
- 如果剩余员工数目不足
candidates人,那么下一轮雇佣他们中代价最小的一人,如果有多位代价相同且最小的工人,选择下标更小的一位工人。 - 一位工人只能被选择一次。
返回雇佣恰好 k 位工人的总代价。
示例 1:
输入:costs = [17,12,10,2,7,2,11,20,8], k = 3, candidates = 4
输出:11
解释:我们总共雇佣 3 位工人。总代价一开始为 0 。
- 第一轮雇佣,我们从 [17,12,10,2,7,2,11,20,8] 中选择。最小代价是 2 ,有两位工人,我们选择下标更小的一位工人,即第 3 位工人。总代价是 0 + 2 = 2 。
- 第二轮雇佣,我们从 [17,12,10,7,2,11,20,8] 中选择。最小代价是 2 ,下标为 4 ,总代价是 2 + 2 = 4 。
- 第三轮雇佣,我们从 [17,12,10,7,11,20,8] 中选择,最小代价是 7 ,下标为 3 ,总代价是 4 + 7 = 11 。注意下标为 3 的工人同时在最前面和最后面 4 位工人中。
总雇佣代价是 11 。
示例 2:
输入:costs = [1,2,4,1], k = 3, candidates = 3
输出:4
解释:我们总共雇佣 3 位工人。总代价一开始为 0 。
- 第一轮雇佣,我们从 [1,2,4,1] 中选择。最小代价为 1 ,有两位工人,我们选择下标更小的一位工人,即第 0 位工人,总代价是 0 + 1 = 1 。注意,下标为 1 和 2 的工人同时在最前面和最后面 3 位工人中。
- 第二轮雇佣,我们从 [2,4,1] 中选择。最小代价为 1 ,下标为 2 ,总代价是 1 + 1 = 2 。
- 第三轮雇佣,少于 3 位工人,我们从剩余工人 [2,4] 中选择。最小代价是 2 ,下标为 0 。总代价为 2 + 2 = 4 。
总雇佣代价是 4 。
提示:
1 <= costs.length <= 1051 <= costs[i] <= 1051 <= k, candidates <= costs.length
方法一:优先队列(小根堆) · Go 实现
思考
每次从两端各 人中选最便宜者,共 次, 。若两端覆盖整段,直接取全局最小的 个。
否则用堆同时放入左右候选(带下标以免跨界)。弹出一人后,从该侧尚未入堆的下一人补入。左右指针相遇则不再补充。
我们首先判断 是否大于等于 ,如果是,我们直接返回前 个最小的工人的代价之和。
否则,我们使用一个小根堆 来维护前 个工人和后 个工人的代价。
我们首先将前 个工人的代价以及对应的下标加入小根堆 中,然后将后 个工人的代价以及对应的下标加入小根堆 中。用两个指针 和 分别指向前后待选工人的下标,初始时 , 。
然后我们进行 次循环,每次从小根堆 中取出代价最小的工人,将其代价加入答案,如果 ,说明前后待选工人已经全部被选完,直接跳过。否则,如果当前工人的下标小于 ,说明是前面的工人,我们将第 个工人的代价以及下标加入小根堆 中,然后 加一;否则,我们将第 个工人的代价以及下标加入小根堆 中,然后 减一。
循环结束后,返回答案即可。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func totalCost(costs []int, k int, candidates int) (ans int64) {
	n := len(costs)
	if candidates*2 > n {
		sort.Ints(costs)
		for _, x := range costs[:k] {
			ans += int64(x)
		}
		return
	}
	pq := hp{}
	for i, x := range costs[:candidates] {
		heap.Push(&pq, pair{x, i})
		heap.Push(&pq, pair{costs[n-i-1], n - i - 1})
	}
	l, r := candidates, n-candidates-1
	for ; k > 0; k-- {
		p := heap.Pop(&pq).(pair)
		ans += int64(p.cost)
		if l > r {
			continue
		}
		if p.i < l {
			heap.Push(&pq, pair{costs[l], l})
			l++
		} else {
			heap.Push(&pq, pair{costs[r], r})
			r--
		}
	}
	return
}

type pair struct{ cost, i int }
type hp []pair

func (h hp) Len() int { return len(h) }
func (h hp) Less(i, j int) bool {
	return h[i].cost < h[j].cost || (h[i].cost == h[j].cost && h[i].i < h[j].i)
}
func (h hp) Swap(i, j int) { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)   { *h = append(*h, v.(pair)) }
func (h *hp) Pop() any { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }2465. 不同的平均值数目
题目、示例与约束
给你一个下标从 0 开始长度为 偶数 的整数数组 nums 。
只要 nums 不是 空数组,你就重复执行以下步骤:
- 找到
nums中的最小值,并删除它。 - 找到
nums中的最大值,并删除它。 - 计算删除两数的平均值。
两数 a 和 b 的 平均值 为 (a + b) / 2 。
- 比方说,
2和3的平均值是(2 + 3) / 2 = 2.5。
返回上述过程能得到的 不同 平均值的数目。
注意 ,如果最小值或者最大值有重复元素,可以删除任意一个。
示例 1:
输入:nums = [4,1,4,0,3,5]
输出:2
解释:
1. 删除 0 和 5 ,平均值是 (0 + 5) / 2 = 2.5 ,现在 nums = [4,1,4,3] 。
2. 删除 1 和 4 ,平均值是 (1 + 4) / 2 = 2.5 ,现在 nums = [4,3] 。
3. 删除 3 和 4 ,平均值是 (3 + 4) / 2 = 3.5 。
2.5 ,2.5 和 3.5 之中总共有 2 个不同的数,我们返回 2 。
示例 2:
输入:nums = [1,100]
输出:1
解释:
删除 1 和 100 后只有一个平均值,所以我们返回 1 。
提示:
2 <= nums.length <= 100nums.length是偶数。0 <= nums[i] <= 100
方法一:排序 · Go 实现
思考
每次取当前最小与最大,平均值种类数即不同的 个数(差 倍只是常数)。 ,排序后首尾配对,用集合去重。
题目中要求每次找到数组 中的最小值和最大值,然后删除它们,再计算删除两数的平均值。因此,我们可以先对数组 进行排序,然后每次取数组的首尾元素,计算它们的和,用哈希表或数组 记录每个和出现的次数,最后统计不同的和的个数即可。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func distinctAverages(nums []int) (ans int) {
	sort.Ints(nums)
	n := len(nums)
	s := map[int]struct{}{}
	for i := 0; i < n>>1; i++ {
		s[nums[i]+nums[n-i-1]] = struct{}{}
	}
	return len(s)
}
方法二 · Go 实现
思考
方法一用集合长度。改为哈希计数,第一次出现某和时答案加一,种类数相同。
func distinctAverages(nums []int) (ans int) {
	sort.Ints(nums)
	n := len(nums)
	cnt := [201]int{}
	for i := 0; i < n>>1; i++ {
		x := nums[i] + nums[n-i-1]
		cnt[x]++
		if cnt[x] == 1 {
			ans++
		}
	}
	return
}2491. 划分技能点相等的团队
题目、示例与约束
给你一个正整数数组 skill ,数组长度为 偶数 n ,其中 skill[i] 表示第 i 个玩家的技能点。将所有玩家分成 n / 2 个 2 人团队,使每一个团队的技能点之和 相等 。
团队的 化学反应 等于团队中玩家的技能点 乘积 。
返回所有团队的 化学反应 之和,如果无法使每个团队的技能点之和相等,则返回 -1 。
示例 1:
输入:skill = [3,2,5,1,3,4]
输出:22
解释:
将玩家分成 3 个团队 (1, 5), (2, 4), (3, 3) ,每个团队的技能点之和都是 6 。
所有团队的化学反应之和是 1 * 5 + 2 * 4 + 3 * 3 = 5 + 8 + 9 = 22 。
示例 2:
输入:skill = [3,4]
输出:12
解释:
两个玩家形成一个团队,技能点之和是 7 。
团队的化学反应是 3 * 4 = 12 。
示例 3:
输入:skill = [1,1,2,3]
输出:-1
解释:
无法将玩家分成每个团队技能点都相等的若干个 2 人团队。
提示:
2 <= skill.length <= 105skill.length是偶数1 <= skill[i] <= 1000
方法一:排序 · Go 实现
思考
每队两人技能和必须相同,故和只能是全局最小加最大。 ,排序后双指针配对,和不同则无解,否则累加乘积。
要使得所有 人团队的技能点相等,最小值一定需要跟最大值匹配。因此,我们将数组 skill 排序,然后用双指针 和 分别指向数组的首位,两两匹配,判断其和是否均为同一个数。
若不是,说明技能点无法相等,直接返回 ,否则,将化学反应累加到答案中。
遍历结束,返回答案即可。
时间复杂度 ,空间复杂度 。其中 是数组 skill 的长度。
func dividePlayers(skill []int) (ans int64) {
	sort.Ints(skill)
	n := len(skill)
	t := skill[0] + skill[n-1]
	for i, j := 0, n-1; i < j; i, j = i+1, j-1 {
		if skill[i]+skill[j] != t {
			return -1
		}
		ans += int64(skill[i] * skill[j])
	}
	return
}
方法二:计数 · Go 实现
思考
方法一需要排序。总技能若不能被队数整除则无解,目标和 。哈希配对 与 ,线性完成,空间换时间。
时间复杂度 ,空间复杂度 。其中 是数组 skill 的长度。
func dividePlayers(skill []int) int64 {
	s := 0
	for _, v := range skill {
		s += v
	}
	m := len(skill) >> 1
	if s%m != 0 {
		return -1
	}
	t := s / m
	d := [1010]int{}
	ans := 0
	for _, v := range skill {
		if d[t-v] > 0 {
			ans += v * (t - v)
			d[t-v]--
			m--
		} else {
			d[v]++
		}
	}
	if m == 0 {
		return int64(ans)
	}
	return -1
}2511. 最多可以摧毁的敌人城堡数目
题目、示例与约束
给你一个长度为 n ,下标从 0 开始的整数数组 forts ,表示一些城堡。forts[i] 可以是 -1 ,0 或者 1 ,其中:
-1表示第i个位置 没有 城堡。0表示第i个位置有一个 敌人 的城堡。1表示第i个位置有一个你控制的城堡。
现在,你需要决定,将你的军队从某个你控制的城堡位置 i 移动到一个空的位置 j ,满足:
0 <= i, j <= n - 1- 军队经过的位置 只有 敌人的城堡。正式的,对于所有
min(i,j) < k < max(i,j)的k,都满足forts[k] == 0。
当军队移动时,所有途中经过的敌人城堡都会被 摧毁 。
请你返回 最多 可以摧毁的敌人城堡数目。如果 无法 移动你的军队,或者没有你控制的城堡,请返回 0 。
示例 1:
输入:forts = [1,0,0,-1,0,0,0,0,1]
输出:4
解释:
- 将军队从位置 0 移动到位置 3 ,摧毁 2 个敌人城堡,位置分别在 1 和 2 。
- 将军队从位置 8 移动到位置 3 ,摧毁 4 个敌人城堡。
4 是最多可以摧毁的敌人城堡数目,所以我们返回 4 。
示例 2:
输入:forts = [0,0,1,-1]
输出:0
解释:由于无法摧毁敌人的城堡,所以返回 0 。
提示:
1 <= forts.length <= 1000-1 <= forts[i] <= 1
方法一:双指针 · Go 实现
思考
一次移动必须从己方城堡出发、穿过一段连续空地、停在敌方城堡,俘虏的是中间的 。 ,枚举所有起终点即可,但不必对每个 都重新向右扫描。
用指针 停在非零格子,再让 跳过随后的 落到下一非零格。若两端异号,则中间长度 可更新答案,然后把 接到 ,整段只走一遍。
我们用指针 遍历数组 ,指针 从 的下一个位置开始遍历,直到遇到第一个非 的位置,即 。如果 ,那么我们可以将军队在 和 之间移动,摧毁 个敌人城堡。我们用变量 记录最多可以摧毁的敌人城堡数目即可。
时间复杂度 ,空间复杂度 。其中 为数组 forts 的长度。
func captureForts(forts []int) (ans int) {
	n := len(forts)
	i := 0
	for i < n {
		j := i + 1
		if forts[i] != 0 {
			for j < n && forts[j] == 0 {
				j++
			}
			if j < n && forts[i]+forts[j] == 0 {
				ans = max(ans, j-i-1)
			}
		}
		i = j
	}
	return
}2562. 找出数组的串联值
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums 。
现定义两个数字的 串联 是由这两个数值串联起来形成的新数字。
- 例如,
15和49的串联是1549。
nums 的 串联值 最初等于 0 。执行下述操作直到 nums 变为空:
- 如果
nums的长度大于 1,分别选中nums中的第一个元素和最后一个元素,将二者串联得到的值加到nums的 串联值 上,然后从nums中删除第一个和最后一个元素。例如,如果nums是[1, 2, 4, 5, 6],将 16 添加到串联值。 - 如果
nums中仅存在一个元素,则将该元素的值加到nums的串联值上,然后删除这个元素。
返回执行完所有操作后 nums 的串联值。
示例 1:
输入:nums = [7,52,2,4]
输出:596
解释:在执行任一步操作前,nums 为 [7,52,2,4] ,串联值为 0 。
 - 在第一步操作中:
我们选中第一个元素 7 和最后一个元素 4 。
二者的串联是 74 ,将其加到串联值上,所以串联值等于 74 。
接着我们从 nums 中移除这两个元素,所以 nums 变为 [52,2] 。
 - 在第二步操作中:
我们选中第一个元素 52 和最后一个元素 2 。
二者的串联是 522 ,将其加到串联值上,所以串联值等于 596 。
接着我们从 nums 中移除这两个元素,所以 nums 变为空。
由于串联值等于 596 ,所以答案就是 596 。
示例 2:
输入:nums = [5,14,13,8,12]
输出:673
解释:在执行任一步操作前,nums 为 [5,14,13,8,12] ,串联值为 0 。
- 在第一步操作中:
我们选中第一个元素 5 和最后一个元素 12 。
二者的串联是 512 ,将其加到串联值上,所以串联值等于 512 。
接着我们从 nums 中移除这两个元素,所以 nums 变为 [14,13,8] 。
- 在第二步操作中:
我们选中第一个元素 14 和最后一个元素 8 。
二者的串联是 148 ,将其加到串联值上,所以串联值等于 660 。
接着我们从 nums 中移除这两个元素,所以 nums 变为 [13] 。
- 在第三步操作中:
nums 只有一个元素,所以我们选中 13 并将其加到串联值上,所以串联值等于 673 。
接着我们从 nums 中移除这个元素,所以 nums 变为空。
由于串联值等于 673 ,所以答案就是 673 。
提示:
1 <= nums.length <= 10001 <= nums[i] <= 104
方法一:模拟 · Go 实现
思考
反复取两端元素拼接成一个整数并累加,奇数长度时最后剩下中间值。 不大,按题意用双指针模拟,字符串拼接后再转回整数即可。
从数组两端开始,每次取出一个元素,将其与另一个元素拼接,然后将拼接后的结果加到答案中。重复这个过程,直到数组为空。
时间复杂度 ,空间复杂度 。其中 和 分别是数组的长度和数组中的最大值。
func findTheArrayConcVal(nums []int) (ans int64) {
	i, j := 0, len(nums)-1
	for ; i < j; i, j = i+1, j-1 {
		x, _ := strconv.Atoi(strconv.Itoa(nums[i]) + strconv.Itoa(nums[j]))
		ans += int64(x)
	}
	if i == j {
		ans += int64(nums[i])
	}
	return
}2570. 合并两个二维数组 - 求和法
题目、示例与约束
给你两个 二维 整数数组 nums1 和 nums2.
nums1[i] = [idi, vali]表示编号为idi的数字对应的值等于vali。nums2[i] = [idi, vali]表示编号为idi的数字对应的值等于vali。
每个数组都包含 互不相同 的 id ,并按 id 以 递增 顺序排列。
请你将两个数组合并为一个按 id 以递增顺序排列的数组,并符合下述条件:
- 只有在两个数组中至少出现过一次的 id 才能包含在结果数组内。
- 每个 id 在结果数组中 只能出现一次 ,并且其对应的值等于两个数组中该 id 所对应的值求和。如果某个数组中不存在该 id ,则假定其对应的值等于
0。
返回结果数组。返回的数组需要按 id 以递增顺序排列。
示例 1:
输入:nums1 = [[1,2],[2,3],[4,5]], nums2 = [[1,4],[3,2],[4,1]]
输出:[[1,6],[2,3],[3,2],[4,6]]
解释:结果数组中包含以下元素:
- id = 1 ,对应的值等于 2 + 4 = 6 。
- id = 2 ,对应的值等于 3 。
- id = 3 ,对应的值等于 2 。
- id = 4 ,对应的值等于 5 + 1 = 6 。
示例 2:
输入:nums1 = [[2,4],[3,6],[5,5]], nums2 = [[1,3],[4,3]]
输出:[[1,3],[2,4],[3,6],[4,3],[5,5]]
解释:不存在共同 id ,在结果数组中只需要包含每个 id 和其对应的值。
提示:
1 <= nums1.length, nums2.length <= 200nums1[i].length == nums2[j].length == 21 <= idi, vali <= 1000- 数组中的 id 互不相同
- 数据均按 id 以严格递增顺序排列
方法一:计数 + 枚举 · Go 实现
思考
两个已按 升序的二元组数组合并,相同 的值相加。双指针归并可行,但 ,用计数器累加后再按键排序更直接。
我们可以用一个哈希表或数组 cnt 统计两个数组中每个数字出现的次数。
然后我们从小到大枚举 cnt 中的每个数字,如果该数字出现的次数大于 ,则将其加入答案数组中。
时间复杂度 ,空间复杂度 。其中 和 分别是两个数组的长度;而 是两个数组中数字的最大值,本题中 。
func mergeArrays(nums1 [][]int, nums2 [][]int) (ans [][]int) {
	cnt := [1001]int{}
	for _, x := range nums1 {
		cnt[x[0]] += x[1]
	}
	for _, x := range nums2 {
		cnt[x[0]] += x[1]
	}
	for i, x := range cnt {
		if x > 0 {
			ans = append(ans, []int{i, x})
		}
	}
	return
}2825. 循环增长使字符串子序列等于另一个字符串
题目、示例与约束
给你一个下标从 0 开始的字符串 str1 和 str2 。
一次操作中,你选择 str1 中的若干下标。对于选中的每一个下标 i ,你将 str1[i] 循环 递增,变成下一个字符。也就是说 'a' 变成 'b' ,'b' 变成 'c' ,以此类推,'z' 变成 'a' 。
如果执行以上操作 至多一次 ,可以让 str2 成为 str1 的子序列,请你返回 true ,否则返回 false 。
注意:一个字符串的子序列指的是从原字符串中删除一些(可以一个字符也不删)字符后,剩下字符按照原本先后顺序组成的新字符串。
示例 1:
输入:str1 = "abc", str2 = "ad"
输出:true
解释:选择 str1 中的下标 2 。
将 str1[2] 循环递增,得到 'd' 。
因此,str1 变成 "abd" 且 str2 现在是一个子序列。所以返回 true 。
示例 2:
输入:str1 = "zc", str2 = "ad"
输出:true
解释:选择 str1 中的下标 0 和 1 。
将 str1[0] 循环递增得到 'a' 。
将 str1[1] 循环递增得到 'd' 。
因此,str1 变成 "ad" 且 str2 现在是一个子序列。所以返回 true 。
示例 3:
输入:str1 = "ab", str2 = "d"
输出:false
解释:这个例子中,没法在执行一次操作的前提下,将 str2 变为 str1 的子序列。
所以返回 false 。
提示:
1 <= str1.length <= 1051 <= str2.length <= 105str1和str2只包含小写英文字母。
方法一:双指针 · Go 实现
思考
须成为 的子序列,且每位至多做一次循环加一。从左到右扫描 ,若当前字符或其后继等于 的待匹配位则推进指针;指针走完即成功。
本题实际上需要我们判断一个字符串 是否为另一个字符串 的子序列,只不过字符之间可以不完全匹配,如果两个字符相同,或者一个字符是另一个字符的下一个字符,就可以匹配。
时间复杂度 ,其中 和 分别是字符串 和 的长度。空间复杂度 。
func canMakeSubsequence(str1 string, str2 string) bool {
	i, n := 0, len(str2)
	for _, c := range str1 {
		d := byte('a')
		if c != 'z' {
			d = byte(c + 1)
		}
		if i < n && (str2[i] == byte(c) || str2[i] == d) {
			i++
		}
	}
	return i == n
}2903. 找出满足差值条件的下标 I
题目、示例与约束
给你一个下标从 0 开始、长度为 n 的整数数组 nums ,以及整数 indexDifference 和整数 valueDifference 。
你的任务是从范围 [0, n - 1] 内找出 2 个满足下述所有条件的下标 i 和 j :
abs(i - j) >= indexDifference且abs(nums[i] - nums[j]) >= valueDifference
返回整数数组 answer。如果存在满足题目要求的两个下标,则 answer = [i, j] ;否则,answer = [-1, -1] 。如果存在多组可供选择的下标对,只需要返回其中任意一组即可。
注意:i 和 j 可能 相等 。
示例 1:
输入:nums = [5,1,4,1], indexDifference = 2, valueDifference = 4
输出:[0,3]
解释:在示例中,可以选择 i = 0 和 j = 3 。
abs(0 - 3) >= 2 且 abs(nums[0] - nums[3]) >= 4 。
因此,[0,3] 是一个符合题目要求的答案。
[3,0] 也是符合题目要求的答案。
示例 2:
输入:nums = [2,1], indexDifference = 0, valueDifference = 0
输出:[0,0]
解释:
在示例中,可以选择 i = 0 和 j = 0 。
abs(0 - 0) >= 0 且 abs(nums[0] - nums[0]) >= 0 。
因此,[0,0] 是一个符合题目要求的答案。
[0,1]、[1,0] 和 [1,1] 也是符合题目要求的答案。
示例 3:
输入:nums = [1,2,3], indexDifference = 2, valueDifference = 4
输出:[-1,-1]
解释:在示例中,可以证明无法找出 2 个满足所有条件的下标。
因此,返回 [-1,-1] 。
提示:
1 <= n == nums.length <= 1000 <= nums[i] <= 500 <= indexDifference <= 1000 <= valueDifference <= 50
方法一:双指针 + 维护最大最小值 · Go 实现
思考
,枚举全部下标对并检查间距与差值即可。注意到合法对必须满足 ,因此对每个右端点 ,只需在 中寻找与 差值足够大的值。
该前缀只需维护最小值与最大值的下标 、 。扫描时先纳入刚进入窗口的 ,再判断 或 是否达到 。一次遍历即可给出任意一组下标。
我们用两个指针 和 来维护一个间隔为 的滑动窗口,其中指针 和 分别指向窗口的左右边界。初始时 指向 ,而 指向 。
我们用 和 来维护指针 左侧区间的最小值下标和最大值下标。
当指针 向右移动时,我们需要更新 和 。如果 ,则 更新为 ;如果 ,则 更新为 。更新完 和 后,我们就可以判断是否找到了满足条件的下标对。如果 ,则找到了满足条件的下标对 ;如果 ,则找到了满足条件的下标对 。
如果指针 移动到了数组的末尾,说明没有找到满足条件的下标对,返回 。
时间复杂度 ,其中 是数组的长度。空间复杂度 。
func findIndices(nums []int, indexDifference int, valueDifference int) []int {
	mi, mx := 0, 0
	for i := indexDifference; i < len(nums); i++ {
		j := i - indexDifference
		if nums[j] < nums[mi] {
			mi = j
		}
		if nums[j] > nums[mx] {
			mx = j
		}
		if nums[i]-nums[mi] >= valueDifference {
			return []int{mi, i}
		}
		if nums[mx]-nums[i] >= valueDifference {
			return []int{mx, i}
		}
	}
	return []int{-1, -1}
}2905. 找出满足差值条件的下标 II
题目、示例与约束
给你一个下标从 0 开始、长度为 n 的整数数组 nums ,以及整数 indexDifference 和整数 valueDifference 。
你的任务是从范围 [0, n - 1] 内找出 2 个满足下述所有条件的下标 i 和 j :
abs(i - j) >= indexDifference且abs(nums[i] - nums[j]) >= valueDifference
返回整数数组 answer。如果存在满足题目要求的两个下标,则 answer = [i, j] ;否则,answer = [-1, -1] 。如果存在多组可供选择的下标对,只需要返回其中任意一组即可。
注意:i 和 j 可能 相等 。
示例 1:
输入:nums = [5,1,4,1], indexDifference = 2, valueDifference = 4
输出:[0,3]
解释:在示例中,可以选择 i = 0 和 j = 3 。
abs(0 - 3) >= 2 且 abs(nums[0] - nums[3]) >= 4 。
因此,[0,3] 是一个符合题目要求的答案。
[3,0] 也是符合题目要求的答案。
示例 2:
输入:nums = [2,1], indexDifference = 0, valueDifference = 0
输出:[0,0]
解释:
在示例中,可以选择 i = 0 和 j = 0 。
abs(0 - 0) >= 0 且 abs(nums[0] - nums[0]) >= 0 。
因此,[0,0] 是一个符合题目要求的答案。
[0,1]、[1,0] 和 [1,1] 也是符合题目要求的答案。
示例 3:
输入:nums = [1,2,3], indexDifference = 2, valueDifference = 4
输出:[-1,-1]
解释:在示例中,可以证明无法找出 2 个满足所有条件的下标。
因此,返回 [-1,-1] 。
提示:
1 <= n == nums.length <= 1050 <= nums[i] <= 1090 <= indexDifference <= 1050 <= valueDifference <= 109
方法一 · Go 实现
思考
题意与 I 相同,但 ,双重循环不可行。合法右端点 对应的左端集合仍是前缀 ,该前缀的最值随 单调扩张。
为此只需在扫描过程中维护前缀最小值、最大值的下标,并随时检验与 的差。时间 ,与 I 的实现一致,仅数据范围迫使必须采用这一线性写法。
func findIndices(nums []int, indexDifference int, valueDifference int) []int {
	mi, mx := 0, 0
	for i := indexDifference; i < len(nums); i++ {
		j := i - indexDifference
		if nums[j] < nums[mi] {
			mi = j
		}
		if nums[j] > nums[mx] {
			mx = j
		}
		if nums[i]-nums[mi] >= valueDifference {
			return []int{mi, i}
		}
		if nums[mx]-nums[i] >= valueDifference {
			return []int{mx, i}
		}
	}
	return []int{-1, -1}
}3069. 将元素分配到两个数组中 I
题目、示例与约束
给你一个下标从 1 开始、包含 不同 整数的数组 nums ,数组长度为 n 。
你需要通过 n 次操作,将 nums 中的所有元素分配到两个数组 arr1 和 arr2 中。在第一次操作中,将 nums[1] 追加到 arr1 。在第二次操作中,将 nums[2] 追加到 arr2 。之后,在第 i 次操作中:
- 如果
arr1的最后一个元素 大于arr2的最后一个元素,就将nums[i]追加到arr1。否则,将nums[i]追加到arr2。
通过连接数组 arr1 和 arr2 形成数组 result 。连接两个数组是将第二个数组追加到第一个数组的末尾;例如,将 [1,2,3] 与 [4,5,6] 连接得到 [1,2,3,4,5,6]。
返回数组 result 。
示例 1:
输入:nums = [2,1,3]
输出:[2,3,1]
解释:在前两次操作后,arr1 = [2] ,arr2 = [1] 。
在第 3 次操作中,由于 arr1 的最后一个元素大于 arr2 的最后一个元素(2 > 1),将 nums[3] 追加到 arr1 。
3 次操作后,arr1 = [2,3] ,arr2 = [1] 。
因此,连接形成的数组 result 是 [2,3,1] 。
示例 2:
输入:nums = [5,4,3,8]
输出:[5,3,4,8]
解释:在前两次操作后,arr1 = [5] ,arr2 = [4] 。
在第 3 次操作中,由于 arr1 的最后一个元素大于 arr2 的最后一个元素(5 > 4),将 nums[3] 追加到 arr1 ,因此 arr1 变为 [5,3] 。
在第 4 次操作中,由于 arr2 的最后一个元素大于 arr1 的最后一个元素(4 > 3),将 nums[4] 追加到 arr2 ,因此 arr2 变为 [4,8] 。
4 次操作后,arr1 = [5,3] ,arr2 = [4,8] 。
因此,连接形成的数组 result 是 [5,3,4,8] 。
提示:
3 <= n <= 501 <= nums[i] <= 100nums中的所有元素都互不相同。
方法一:模拟 · Go 实现
思考
前两个元素分到两数组,之后总是追加到当前末项较大的那一边。 ,按规则模拟。
只需比较两数组的最后一个元素,不必回顾历史。
扫完后拼接 。
我们创建两个数组 和 ,分别存放数组 中的元素,初始时 中只有 , 中只有 。
然后遍历 下标从 开始的元素,如果 的最后一个元素大于 的最后一个元素,就将当前元素追加到 ,否则追加到 。
最后将 中的元素追加到 中,返回 。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func resultArray(nums []int) []int {
	arr1 := []int{nums[0]}
	arr2 := []int{nums[1]}
	for _, x := range nums[2:] {
		if arr1[len(arr1)-1] > arr2[len(arr2)-1] {
			arr1 = append(arr1, x)
		} else {
			arr2 = append(arr2, x)
		}
	}
	return append(arr1, arr2...)
}3132. 找出与数组相加的整数 II
题目、示例与约束
给你两个整数数组 nums1 和 nums2。
如果 nums1 中存在两个元素,移除这两个元素并将 x 加到 nums1 剩余的所有元素上(如果 x 是负数,则减去 x),得到的数组与 nums2 相等,则称 nums2 可以从 nums1 通过一个整数 x 到达。当两个数组包含相同的整数且频率相同时,它们被认为是 相等 的。
返回能够实现数组相等的 最小 整数 x 。
保证 nums1 至少可以通过一个 x 到达 nums2。
示例 1:
输入:nums1 = [4,20,16,12,8], nums2 = [14,18,10]
输出:-2
解释:
移除 nums1 中下标为 [0,4] 的两个元素,并且每个元素与 -2 相加后,nums1 变为 [18,14,10] ,与 nums2 相等。
示例 2:
输入:nums1 = [3,5,5,3], nums2 = [7,7]
输出:2
解释:
移除 nums1 中下标为 [0,3] 的两个元素,并且每个元素与 2 相加后,nums1 变为 [7,7] ,与 nums2 相等。
提示:
3 <= nums1.length <= 200nums2.length == nums1.length - 20 <= nums1[i], nums2[i] <= 1000- 保证
nums1至少可以通过一个x到达nums2。
方法一:排序 + 枚举 + 双指针 · Go 实现
思考
从 删两个元素后再整体加 得到 。枚举删除哪一对是 ,再验证匹配。
排序后, 只能是 减去 的前三个候选之一:被删的两个数若都大于最小保留值,才可能跳过前两项。
对每个候选 用双指针扫描,统计无法对齐的个数,不超过 则可行。取可行 的最小值。
我们首先对数组 和 进行排序,由于我们需要从 中移除两个元素,因此我们只需要考虑 的前三个元素,分别记为 ,我们可以枚举 的第一个元素 ,那么我们可以得到 ,其中 。然后我们可以通过双指针的方法来判断是否存在一个整数 ,使得 和 相等,取满足条件的最小的 即可。
时间复杂度 ,空间复杂度 。其中 为数组的长度。
func minimumAddedInteger(nums1 []int, nums2 []int) int {
	sort.Ints(nums1)
	sort.Ints(nums2)
	ans := 1 << 30
	f := func(x int) bool {
		i, j, cnt := 0, 0, 0
		for i < len(nums1) && j < len(nums2) {
			if nums2[j]-nums1[i] != x {
				cnt++
			} else {
				j++
			}
			i++
		}
		return cnt <= 2
	}
	for _, a := range nums1[:3] {
		x := nums2[0] - a
		if f(x) {
			ans = min(ans, x)
		}
	}
	return ans
}继续阅读
- 实践案例
- 实践案例
- 实践案例