
LeetCode Go · 字典树(1)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
14. 最长公共前缀
题目、示例与约束
编写一个函数来查找字符串数组中的最长公共前缀。
如果不存在公共前缀,返回空字符串 ""。
示例 1:
输入:strs = ["flower","flow","flight"]
输出:"fl"
示例 2:
输入:strs = ["dog","racecar","car"]
输出:""
解释:输入不存在公共前缀。
提示:
1 <= strs.length <= 2000 <= strs[i].length <= 200strs[i]如果非空,则仅由小写英文字母组成
方法一:字符比较 · Go 实现
思考
拿第一个字符串作为候选前缀,再依次用其余字符串去截短它,时间复杂度为 。 ,可以接受。字典树也能维护公共前缀,但对这道题而言结构过重。
公共前缀只会变短:某一列一旦对不上,更长的前缀不可能存在。把各串按列对齐,第 列全部相同,才可能把前缀延长到位置 。因此以 为基准按列比较,遇到长度不够或字符不同就立即返回,不必先建树。
我们以第一个字符串 为基准,依次比较后面的字符串的第 个字符是否与 的第 个字符相同,如果相同则继续比较下一个字符,否则返回 的前 个字符。
遍历结束,说明所有字符串的前 个字符都相同,返回 即可。
时间复杂度 ,其中 和 分别为字符串数组的长度以及字符串的最小长度。空间复杂度 。
func longestCommonPrefix(strs []string) string {
	n := len(strs)
	for i := range strs[0] {
		for j := 1; j < n; j++ {
			if len(strs[j]) <= i || strs[j][i] != strs[0][i] {
				return strs[0][:i]
			}
		}
	}
	return strs[0]
}139. 单词拆分
题目、示例与约束
给你一个字符串 s 和一个字符串列表 wordDict 作为字典。如果可以利用字典中出现的一个或多个单词拼接出 s 则返回 true。
注意:不要求字典中出现的单词全部都使用,并且字典中的单词可以重复使用。
示例 1:
输入: s = "leetcode", wordDict = ["leet", "code"]
输出: true
解释: 返回 true 因为 "leetcode" 可以由 "leet" 和 "code" 拼接成。
示例 2:
输入: s = "applepenapple", wordDict = ["apple", "pen"]
输出: true
解释: 返回 true 因为 "applepenapple" 可以由 "apple" "pen" "apple" 拼接成。
     注意,你可以重复使用字典中的单词。
示例 3:
输入: s = "catsandog", wordDict = ["cats", "dog", "sand", "and", "cat"]
输出: false
提示:
1 <= s.length <= 3001 <= wordDict.length <= 10001 <= wordDict[i].length <= 20s和wordDict[i]仅由小写英文字母组成wordDict中的所有字符串 互不相同
方法一:哈希表 + 动态规划 · Go 实现
思考
判断 能否拆成词典中的词。 ,回溯所有切分会重复计算同一后缀。 表示前缀 能否拆分:枚举切点 ,若 为真且 在词典中则成功。词典放进哈希集合,判断子串是否成词为期望 。
我们定义 表示字符串 的前 个字符能否拆分成 中的单词,初始时 ,其余为 。答案为 。
考虑 ,如果存在 使得 ,则 。为了优化效率,我们可以使用哈希表存储 中的单词,这样可以快速判断 是否在 中。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度。
func wordBreak(s string, wordDict []string) bool {
	words := map[string]bool{}
	for _, w := range wordDict {
		words[w] = true
	}
	n := len(s)
	f := make([]bool, n+1)
	f[0] = true
	for i := 1; i <= n; i++ {
		for j := 0; j < i; j++ {
			if f[j] && words[s[j:i]] {
				f[i] = true
				break
			}
		}
	}
	return f[n]
}
方法二:前缀树 + 动态规划 · Go 实现
思考
方法一每次切分都要切片并查表,子串哈希是 。词放进前缀树后,从位置 沿树往前走,只有树上的边才继续,避免无用切片,时间降为 。
我们先将 中的单词存入前缀树中,然后使用动态规划求解。
我们定义 表示从字符串 的第 个字符开始往后拆分,能否拆分成 中的单词,初始时 ,其余为 。答案为 。
接下来,我们从大到小枚举 ,对于每个 ,我们从 开始往后拆分,如果 在前缀树中,且 ,则 。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度。
type trie struct {
	children [26]*trie
	isEnd    bool
}

func newTrie() *trie {
	return &trie{}
}

func (t *trie) insert(w string) {
	node := t
	for _, c := range w {
		c -= 'a'
		if node.children[c] == nil {
			node.children[c] = newTrie()
		}
		node = node.children[c]
	}
	node.isEnd = true
}

func wordBreak(s string, wordDict []string) bool {
	trie := newTrie()
	for _, w := range wordDict {
		trie.insert(w)
	}
	n := len(s)
	f := make([]bool, n+1)
	f[n] = true
	for i := n - 1; i >= 0; i-- {
		node := trie
		for j := i; j < n; j++ {
			k := s[j] - 'a'
			if node.children[k] == nil {
				break
			}
			node = node.children[k]
			if node.isEnd && f[j+1] {
				f[i] = true
				break
			}
		}
	}
	return f[0]
}140. 单词拆分 II
题目、示例与约束
给定一个字符串 s 和一个字符串字典 wordDict ,在字符串 s 中增加空格来构建一个句子,使得句子中所有的单词都在词典中。以任意顺序 返回所有这些可能的句子。
注意:词典中的同一个单词可能在分段中被重复使用多次。
示例 1:
输入:s = "catsanddog", wordDict = ["cat","cats","and","sand","dog"]
输出:["cats and dog","cat sand dog"]
示例 2:
输入:s = "pineapplepenapple", wordDict = ["apple","pen","applepen","pine","pineapple"]
输出:["pine apple pen apple","pineapple pen apple","pine applepen apple"]
解释: 注意你可以重复使用字典中的单词。
示例 3:
输入:s = "catsandog", wordDict = ["cats","dog","sand","and","cat"]
输出:[]
提示:
1 <= s.length <= 201 <= wordDict.length <= 10001 <= wordDict[i].length <= 10s和wordDict[i]仅有小写英文字母组成wordDict中所有字符串都 不同
方法一:前缀树 + DFS · Go 实现
思考
不但要能拆,还要列出全部句子。 ,方案数有限。把词插入前缀树后,从当前后缀枚举下一个词结束位置,命中则递归剩余部分,把词序列拼成句子。树用于快速判断前缀是否成词。
type Trie struct {
	children [26]*Trie
	isEnd    bool
}

func newTrie() *Trie {
	return &Trie{}
}
func (this *Trie) insert(word string) {
	node := this
	for _, c := range word {
		c -= 'a'
		if node.children[c] == nil {
			node.children[c] = newTrie()
		}
		node = node.children[c]
	}
	node.isEnd = true
}
func (this *Trie) search(word string) bool {
	node := this
	for _, c := range word {
		c -= 'a'
		if node.children[c] == nil {
			return false
		}
		node = node.children[c]
	}
	return node.isEnd
}

func wordBreak(s string, wordDict []string) []string {
	trie := newTrie()
	for _, w := range wordDict {
		trie.insert(w)
	}
	var dfs func(string) [][]string
	dfs = func(s string) [][]string {
		res := [][]string{}
		if len(s) == 0 {
			res = append(res, []string{})
			return res
		}
		for i := 1; i <= len(s); i++ {
			if trie.search(s[:i]) {
				for _, v := range dfs(s[i:]) {
					v = append([]string{s[:i]}, v...)
					res = append(res, v)
				}
			}
		}
		return res
	}
	res := dfs(s)
	ans := []string{}
	for _, v := range res {
		ans = append(ans, strings.Join(v, " "))
	}
	return ans
}212. 单词搜索 II
题目、示例与约束
给定一个 m x n 二维字符网格 board 和一个单词(字符串)列表 words, 返回所有二维网格上的单词 。
单词必须按照字母顺序,通过 相邻的单元格 内的字母构成,其中“相邻”单元格是那些水平相邻或垂直相邻的单元格。同一个单元格内的字母在一个单词中不允许被重复使用。
示例 1:
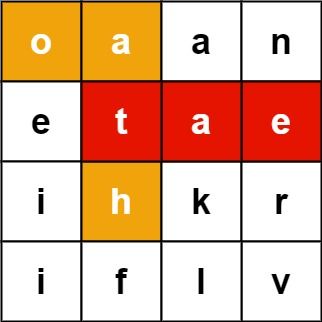
输入:board = [["o","a","a","n"],["e","t","a","e"],["i","h","k","r"],["i","f","l","v"]], words = ["oath","pea","eat","rain"]
输出:["eat","oath"]
示例 2:
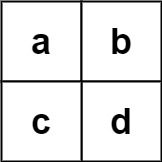
输入:board = [["a","b"],["c","d"]], words = ["abcb"]
输出:[]
提示:
m == board.lengthn == board[i].length1 <= m, n <= 12board[i][j]是一个小写英文字母1 <= words.length <= 3 * 1041 <= words[i].length <= 10words[i]由小写英文字母组成words中的所有字符串互不相同
方法一:前缀树 + DFS · Go 实现
思考
对每个单词在棋盘上单独 DFS,会在相同前缀上重复搜索。先把 建成前缀树,即可在格子扩展时同步走树并剪枝。
从每个格子出发,沿树上存在的边四向搜索;走到词尾则记录答案,并将 置为 以免重复输出。
我们首先将 words 中的单词构建成前缀树,前缀树的每个节点包含一个长度为 的数组 children,表示该节点的子节点,数组的下标表示子节点对应的字符,数组的值表示子节点的引用。同时,每个节点还包含一个整数 ref,表示该节点对应的单词在 words 中的引用,如果该节点不是单词的结尾,则 ref 的值为 。
接下来,我们对于 board 中的每个单元格,从该单元格出发,进行深度优先搜索,搜索过程中,如果当前单词不是前缀树中的单词,则剪枝,如果当前单词是前缀树中的单词,则将该单词加入答案,并将该单词在前缀树中的引用置为 ,表示该单词已经被找到,不需要再次搜索。
最后,我们将答案返回即可。
时间复杂度 ,空间复杂度 。其中 和 分别是 board 的行数和列数。而 和 分别是 words 中的单词的平均长度和单词的个数。
type Trie struct {
	children [26]*Trie
	ref      int
}

func newTrie() *Trie {
	return &Trie{ref: -1}
}
func (this *Trie) insert(w string, ref int) {
	node := this
	for _, c := range w {
		c -= 'a'
		if node.children[c] == nil {
			node.children[c] = newTrie()
		}
		node = node.children[c]
	}
	node.ref = ref
}

func findWords(board [][]byte, words []string) (ans []string) {
	trie := newTrie()
	for i, w := range words {
		trie.insert(w, i)
	}
	m, n := len(board), len(board[0])
	var dfs func(*Trie, int, int)
	dfs = func(node *Trie, i, j int) {
		idx := board[i][j] - 'a'
		if node.children[idx] == nil {
			return
		}
		node = node.children[idx]
		if node.ref != -1 {
			ans = append(ans, words[node.ref])
			node.ref = -1
		}
		c := board[i][j]
		board[i][j] = '#'
		dirs := [5]int{-1, 0, 1, 0, -1}
		for k := 0; k < 4; k++ {
			x, y := i+dirs[k], j+dirs[k+1]
			if x >= 0 && x < m && y >= 0 && y < n && board[x][y] != '#' {
				dfs(node, x, y)
			}
		}
		board[i][j] = c
	}
	for i := 0; i < m; i++ {
		for j := 0; j < n; j++ {
			dfs(trie, i, j)
		}
	}
	return
}336. 回文对
题目、示例与约束
给定一个由唯一字符串构成的 0 索引 数组 words 。
回文对 是一对整数 (i, j) ,满足以下条件:
0 <= i, j < words.length,i != j,并且words[i] + words[j](两个字符串的连接)是一个回文串。
返回一个数组,它包含 words 中所有满足 回文对 条件的字符串。
你必须设计一个时间复杂度为 O(sum of words[i].length) 的算法。
示例 1:
输入:words = ["abcd","dcba","lls","s","sssll"]
输出:[[0,1],[1,0],[3,2],[2,4]]
解释:可拼接成的回文串为 ["dcbaabcd","abcddcba","slls","llssssll"]
示例 2:
输入:words = ["bat","tab","cat"]
输出:[[0,1],[1,0]]
解释:可拼接成的回文串为 ["battab","tabbat"]
示例 3:
输入:words = ["a",""]
输出:[[0,1],[1,0]]
提示:
1 <= words.length <= 50000 <= words[i].length <= 300words[i]由小写英文字母组成
方法一:哈希表 · Go 实现
思考
两词拼接为回文。若枚举所有有序对再检测,词数与长度乘积过大。把一词切开,若一侧已是回文,则另一侧的逆串若在词表中即可配对。
哈希表记下每个词的下标。对 的每个切点,前缀为回文则找后缀逆,后缀为回文则找前缀逆;切点 只计一侧以免空串重复。代码按切点同时检查两侧。
用哈希表记下每个单词的下标。枚举单词 的切分位置 ,记前缀 、后缀 。
- 若后缀 是回文,且前缀 的逆序串在哈希表中,则该逆序串接在 左侧后构成回文。
- 若 且前缀 是回文,且后缀 的逆序串在哈希表中,则该逆序串接在 右侧后构成回文。 时前缀为空,不再从这一侧配对,避免空串被重复统计。
时间复杂度 ,空间复杂度 。
func palindromePairs(words []string) [][]int {
	d := map[string]int{}
	for i, w := range words {
		d[w] = i
	}
	var ans [][]int
	for i, w := range words {
		for j := 0; j <= len(w); j++ {
			a, b := w[:j], w[j:]
			ra, rb := reverse(a), reverse(b)
			if k, ok := d[ra]; ok && k != i && b == rb {
				ans = append(ans, []int{i, k})
			}
			if j > 0 {
				if k, ok := d[rb]; ok && k != i && a == ra {
					ans = append(ans, []int{k, i})
				}
			}
		}
	}
	return ans
}

func reverse(s string) string {
	b := []byte(s)
	for i, j := 0, len(b)-1; i < j; i, j = i+1, j-1 {
		b[i], b[j] = b[j], b[i]
	}
	return string(b)
}386. 字典序排数
题目、示例与约束
给你一个整数 n ,按字典序返回范围 [1, n] 内所有整数。
你必须设计一个时间复杂度为 O(n) 且使用 O(1) 额外空间的算法。
示例 1:
输入:n = 13
输出:[1,10,11,12,13,2,3,4,5,6,7,8,9]
示例 2:
输入:n = 2
输出:[1,2]
提示:
1 <= n <= 5 * 104
方法一:迭代 · Go 实现
思考
输出 的字典序。排序全部数字为 。十叉树上前序遍历即字典序。
从 出发:能乘 则深入下一层;否则若个位为 或 则回退,再加一到兄弟。迭代 次恰好枚举每个数一次。
我们首先定义一个变量 ,初始时 。然后我们从 开始迭代,每次迭代都将 添加到答案数组中。然后,如果 ,我们将 更新为 ;否则,如果 或者 ,我们就循环将 除以 。循环结束后,我们将 加一。继续迭代,直到我们添加了 个数到答案数组中。
时间复杂度 ,其中 是给定的整数 。忽略答案数组的空间消耗,空间复杂度 。
func lexicalOrder(n int) (ans []int) {
	v := 1
	for i := 0; i < n; i++ {
		ans = append(ans, v)
		if v*10 <= n {
			v *= 10
		} else {
			for v%10 == 9 || v+1 > n {
				v /= 10
			}
			v++
		}
	}
	return
}421. 数组中两个数的最大异或值
题目、示例与约束
给你一个整数数组 nums ,返回 nums[i] XOR nums[j] 的最大运算结果,其中 0 ≤ i ≤ j < n 。
示例 1:
输入:nums = [3,10,5,25,2,8]
输出:28
解释:最大运算结果是 5 XOR 25 = 28.
示例 2:
输入:nums = [14,70,53,83,49,91,36,80,92,51,66,70]
输出:127
提示:
1 <= nums.length <= 2 * 1050 <= nums[i] <= 231 - 1
方法一:前缀树 · Go 实现
思考
两两求异或最大值是 , 可达 。异或希望从高位起尽量取相反位。
把每个数按二进制从高到低插入前缀树,查询 时优先走向相反位,才能在该位得到 。 位足够覆盖题目范围。
先插入再建查询,或边插边查均可;对每个 在树中走一遍,相当于在已插入的数里找最大异或对象。
题目是求两个元素的异或最大值,可以从最高位开始考虑。
我们把数组中的每个元素 看作一个 位的 串,按二进制从高位到低位的顺序,插入前缀树(最低位为叶子节点)。
搜索 时,尽量走相反的 字符指针的策略,因为异或运算的法则是相同得 ,不同得 ,所以我们尽可能往与 当前位相反的字符方向走,才能得到能和 产生最大异或值的结果。
时间复杂度 ,空间复杂度 ,其中 是数组 的长度,而 是数组中元素的最大值。
type Trie struct {
	children [2]*Trie
}

func newTrie() *Trie {
	return &Trie{}
}

func (t *Trie) insert(x int) {
	node := t
	for i := 30; i >= 0; i-- {
		v := x >> i & 1
		if node.children[v] == nil {
			node.children[v] = newTrie()
		}
		node = node.children[v]
	}
}

func (t *Trie) search(x int) int {
	node := t
	ans := 0
	for i := 30; i >= 0; i-- {
		v := x >> i & 1
		if node.children[v^1] != nil {
			ans |= 1 << i
			node = node.children[v^1]
		} else {
			node = node.children[v]
		}
	}
	return ans
}

func findMaximumXOR(nums []int) (ans int) {
	trie := newTrie()
	for _, x := range nums {
		trie.insert(x)
		ans = max(ans, trie.search(x))
	}
	return ans
}425. 单词方块 🔒
题目、示例与约束
给定一个单词集合 words (没有重复),找出并返回其中所有的 单词方块 。 words 中的同一个单词可以被 多次 使用。你可以按 任意顺序 返回答案。
一个单词序列形成了一个有效的 单词方块 的意思是指从第 k 行和第 k 列 0 <= k < max(numRows, numColumns) 来看都是相同的字符串。
- 例如,单词序列
["ball","area","lead","lady"]形成了一个单词方块,因为每个单词从水平方向看和从竖直方向看都是相同的。
示例 1:
输入:words = ["area","lead","wall","lady","ball"]
输出: [["ball","area","lead","lady"],
["wall","area","lead","lady"]]
解释:
输出包含两个单词方块,输出的顺序不重要,只需要保证每个单词方块内的单词顺序正确即可。
示例 2:
输入:words = ["abat","baba","atan","atal"]
输出:[["baba","abat","baba","atal"],
["baba","abat","baba","atan"]]
解释:
输出包含两个单词方块,输出的顺序不重要,只需要保证每个单词方块内的单词顺序正确即可。
提示:
1 <= words.length <= 10001 <= words[i].length <= 4words[i]长度相同words[i]只由小写英文字母组成words[i]都 各不相同
方法一:前缀树 + DFS · Go 实现
思考
单词方块第 行的前缀由已选各行的第 列决定。对每个位置扫描全部单词会重复比较相同前缀。
把单词插入前缀树,并在路径节点上记录单词下标。DFS 填行:当前行号为已选行数,用各行该列字母拼出前缀,一次取出全部候选。
行数等于单词长度时收解。先建树再搜索,前缀查询从线性扫描变成沿树下降。
根据已添加单词确定下一个单词的前缀,继续进行搜索。
比如已经添加了两个单词 和 ,要添加下一个单词,我们首先要获取下一个单词的前缀,第一个字母是第一个单词的第三个位置 ,第二个字母是第二个单词的第三个位置 ,这样就构成了前缀 。然后找出所有前缀为 的单词,作为下一个单词。
type Trie struct {
	children [26]*Trie
	v        []int
}

func newTrie() *Trie {
	return &Trie{}
}
func (this *Trie) insert(word string, i int) {
	node := this
	for _, c := range word {
		c -= 'a'
		if node.children[c] == nil {
			node.children[c] = newTrie()
		}
		node = node.children[c]
		node.v = append(node.v, i)
	}
}
func (this *Trie) search(word string) []int {
	node := this
	for _, c := range word {
		c -= 'a'
		if node.children[c] == nil {
			return []int{}
		}
		node = node.children[c]
	}
	return node.v
}

func wordSquares(words []string) [][]string {
	trie := newTrie()
	for i, w := range words {
		trie.insert(w, i)
	}
	ans := [][]string{}
	var dfs func([]string)
	dfs = func(t []string) {
		if len(t) == len(words[0]) {
			cp := make([]string, len(t))
			copy(cp, t)
			ans = append(ans, cp)
			return
		}
		idx := len(t)
		pref := []byte{}
		for _, v := range t {
			pref = append(pref, v[idx])
		}
		indexes := trie.search(string(pref))
		for _, i := range indexes {
			t = append(t, words[i])
			dfs(t)
			t = t[:len(t)-1]
		}
	}
	for _, w := range words {
		dfs([]string{w})
	}
	return ans
}440. 字典序的第K小数字
题目、示例与约束
给定整数 n 和 k,返回 [1, n] 中字典序第 k 小的数字。
示例 1:
输入: n = 13, k = 2
输出: 10
解释: 字典序的排列是 [1, 10, 11, 12, 13, 2, 3, 4, 5, 6, 7, 8, 9],所以第二小的数字是 10。
示例 2:
输入: n = 1, k = 1
输出: 1
提示:
1 <= k <= n <= 109
方法一:字典树计数 + 贪心构造 · Go 实现
思考
可达 ,不能列出再排序。字典序对应一棵十叉子树:结点 的孩子是 (不超过 )。
在当前前缀 上统计子树大小:把 逐层乘 并与 取交。若子树大小 ,则整棵跳过并 ;否则进入孩子 且 减一(消耗前缀本身)。
先把 减一表示从 出发已选中当前前缀。按层计数避免枚举子树中的每个整数。
本题要求在区间 中,按字典序排序后,找到第 小的数字。由于 的范围非常大(最多可达 ),我们无法直接枚举所有数字后排序。因此我们采用贪心 + 字典树模拟的策略。
我们将 看作一棵 十叉字典树(Trie):
- 每个节点是一个前缀,根节点为空串;
- 节点的子节点是当前前缀拼接上 ;
- 例如前缀 会有子节点 ,而 会有 ;
- 这种结构天然符合字典序遍历。
根
├── 1
│   ├── 10
│   ├── 11
│   ├── ...
├── 2
├── ...
我们使用变量 表示当前前缀,初始为 。每次我们尝试向下扩展前缀,直到找到第 小的数字。
每次我们计算当前前缀下有多少个合法数字(即以 为前缀、且不超过 的整数个数),记作 :
- 如果 :说明目标不在这棵子树中,跳过整棵子树,前缀右移: ,并更新 ;
- 否则:说明目标在当前前缀的子树中,进入下一层: ,并消耗一个前缀: 。
每一层我们将当前区间扩大 倍,向下延伸到更长的前缀,直到超出 。
时间复杂度 ,空间复杂度 。
func findKthNumber(n int, k int) int {
	count := func(curr int) int {
		next := curr + 1
		cnt := 0
		for curr <= n {
			cnt += min(n-curr+1, next-curr)
			next *= 10
			curr *= 10
		}
		return cnt
	}
	curr := 1
	k--
	for k > 0 {
		cnt := count(curr)
		if k >= cnt {
			k -= cnt
			curr++
		} else {
			k--
			curr *= 10
		}
	}
	return curr
}472. 连接词
题目、示例与约束
给你一个 不含重复 单词的字符串数组 words ,请你找出并返回 words 中的所有 连接词 。
连接词 定义为:一个完全由给定数组中的至少两个较短单词(不一定是不同的两个单词)组成的字符串。
示例 1:
输入:words = ["cat","cats","catsdogcats","dog","dogcatsdog","hippopotamuses","rat","ratcatdogcat"]
输出:["catsdogcats","dogcatsdog","ratcatdogcat"]
解释:"catsdogcats" 由 "cats", "dog" 和 "cats" 组成;
     "dogcatsdog" 由 "dog", "cats" 和 "dog" 组成;
     "ratcatdogcat" 由 "rat", "cat", "dog" 和 "cat" 组成。
示例 2:
输入:words = ["cat","dog","catdog"]
输出:["catdog"]
提示:
1 <= words.length <= 1041 <= words[i].length <= 30words[i]仅由小写英文字母组成。words中的所有字符串都是 唯一 的。1 <= sum(words[i].length) <= 105
方法一:前缀树 + DFS · Go 实现
思考
连接词由至少两个更短的词典单词拼成。对每个词枚举分割点并查集合, 与长度都会偏大。
按长度排序后,短词先入前缀树。当前词在树上 DFS:走到单词结尾就对后缀递归;整词能切完则是连接词,否则把自己插入树中。
连接词不再插入,因为更长的词总可以拆到更短的原子词。空串是递归成功的出口。
判断一个单词是不是连接词,需要判断这个单词是否完全由至少两个给定数组中的更短的非空单词(可以重复)组成。判断更短的单词是否在给定数组中,可以使用字典树实现。
首先将 按照字符串的长度递增的顺序排序,排序后可以确保当遍历到任意单词时,比该单词短的单词一定都已经遍历过,因此可以根据已经遍历过的全部单词判断当前单词是不是连接词。
在将 排序之后,遍历 ,跳过空字符串,对于每个非空单词,判断该单词是不是连接词,如果是连接词则将该单词加入结果数组,如果不是连接词则将该单词加入字典树。
判断一个单词是不是连接词的做法是在字典树中深度优先搜索。从该单词的第一个字符(即下标 处的字符)开始,在字典树中依次搜索每个字符对应的结点,可能有以下几种情况:
- 如果一个字符对应的结点是单词的结尾,则找到了一个更短的单词,从该字符的后一个字符开始搜索下一个更短的单词;
- 如果一个字符对应的结点在字典树中不存在,则当前的搜索结果失败,回到上一个单词的结尾继续搜索。
如果找到一个更短的单词且这个更短的单词的最后一个字符是当前单词的最后一个字符,则当前单词是连接词。由于数组 中没有重复的单词,因此在判断一个单词是不是连接词时,该单词一定没有加入字典树,由此可以确保判断连接词的条件成立。
说明:由于一个连接词由多个更短的非空单词组成,如果存在一个较长的连接词的组成部分之一是一个较短的连接词,则一定可以将这个较短的连接词换成多个更短的非空单词,因此不需要将连接词加入字典树。
type Trie struct {
	children [26]*Trie
	isEnd    bool
}

func newTrie() *Trie {
	return &Trie{}
}
func (this *Trie) insert(word string) {
	node := this
	for _, c := range word {
		c -= 'a'
		if node.children[c] == nil {
			node.children[c] = newTrie()
		}
		node = node.children[c]
	}
	node.isEnd = true
}

func findAllConcatenatedWordsInADict(words []string) (ans []string) {
	sort.Slice(words, func(i, j int) bool { return len(words[i]) < len(words[j]) })
	trie := newTrie()
	var dfs func(string) bool
	dfs = func(w string) bool {
		if w == "" {
			return true
		}
		node := trie
		for i, c := range w {
			c -= 'a'
			if node.children[c] == nil {
				return false
			}
			node = node.children[c]
			if node.isEnd && dfs(w[i+1:]) {
				return true
			}
		}
		return false
	}
	for _, w := range words {
		if dfs(w) {
			ans = append(ans, w)
		} else {
			trie.insert(w)
		}
	}
	return
}527. 单词缩写 🔒
题目、示例与约束
给你一个字符串数组 words ,该数组由 互不相同 的若干字符串组成,请你找出并返回每个单词的 最小缩写 。
生成缩写的规则如下:
- 初始缩写由起始字母+省略字母的数量+结尾字母组成。
- 若存在冲突,亦即多于一个单词有同样的缩写,则使用更长的前缀代替首字母,直到从单词到缩写的映射唯一。换而言之,最终的缩写必须只能映射到一个单词。
- 若缩写并不比原单词更短,则保留原样。
示例 1:
输入: words = ["like", "god", "internal", "me", "internet", "interval", "intension", "face", "intrusion"]
输出: ["l2e","god","internal","me","i6t","interval","inte4n","f2e","intr4n"]
示例 2:
输入:words = ["aa","aaa"]
输出:["aa","aaa"]
提示:
1 <= words.length <= 4002 <= words[i].length <= 400words[i]由小写英文字母组成words中的所有字符串 互不相同
方法一:分组字典树 · Go 实现
思考
缩写形如「首字母 + 中间长度 + 尾字母」,冲突时要加长前缀直到唯一。对每对单词比较前缀在 时尚可,但要反复求最长公共前缀。
只有长度与尾字母都相同的单词才会缩写冲突,故按 分组。组内插入字典树并在节点上计数;查询时走到计数为 的深度就是可区分前缀长度。短于「缩写所能节省」时退回原词。
我们注意到,如果两个单词的缩写相同,那么它们的首尾字母一定相同,并且它们的长度一定相同。因此,我们可以将所有的单词按照长度以及末尾字母进行分组,对于每组单词,我们使用字典树存储这组单词的信息。
字典树的每个节点结构如下:
children:长度为 的数组,表示该节点的所有子节点。cnt:表示经过该节点的单词数量。
对于每个单词,我们将其插入到字典树中,同时记录每个节点的 cnt 值。
在查询时,我们从根节点开始,对于当前的字母,如果其对应的子节点的 cnt 值为 ,那么我们就找到了唯一的缩写,我们返回当前前缀的长度即可。否则,我们继续向下遍历。遍历结束后,如果我们没有找到唯一的缩写,那么我们返回原单词的长度。在得到所有单词的前缀长度后,我们判断单词的缩写是否比原单词更短,如果是,那么我们将其加入答案中,否则我们将原单词加入答案中。
时间复杂度 ,空间复杂度 ,其中 为所有单词的长度和。
type Trie struct {
	children [26]*Trie
	cnt      int
}

func (t *Trie) insert(w string) {
	node := t
	for _, c := range w {
		idx := c - 'a'
		if node.children[idx] == nil {
			node.children[idx] = &Trie{}
		}
		node = node.children[idx]
		node.cnt++
	}
}

func (t *Trie) search(w string) int {
	node := t
	ans := 0
	for _, c := range w {
		ans++
		idx := c - 'a'
		node = node.children[idx]
		if node.cnt == 1 {
			return ans
		}
	}
	return len(w)
}

func wordsAbbreviation(words []string) (ans []string) {
	tries := make(map[[2]int]*Trie)
	for _, w := range words {
		key := [2]int{len(w), int(w[len(w)-1] - 'a')}
		_, exists := tries[key]
		if !exists {
			tries[key] = &Trie{}
		}
		tries[key].insert(w)
	}

	for _, w := range words {
		m := len(w)
		key := [2]int{m, int(w[m-1] - 'a')}
		cnt := tries[key].search(w)
		if cnt+2 >= m {
			ans = append(ans, w)
		} else {
			abbr := w[:cnt] + fmt.Sprintf("%d", m-cnt-1) + w[m-1:]
			ans = append(ans, abbr)
		}
	}
	return
}616. 给字符串添加加粗标签 🔒
题目、示例与约束
给定字符串 s 和字符串数组 words。
对于 s 内部的子字符串,若其存在于 words 数组中, 则通过添加闭合的粗体标签 <b> 和 </b> 进行加粗标记。
- 如果两个这样的子字符串重叠,你应该仅使用一对闭合的粗体标签将它们包围起来。
- 如果被粗体标签包围的两个子字符串是连续的,你应该将它们合并。
返回添加加粗标签后的字符串 s 。
示例 1:
输入: s = "abcxyz123", words = ["abc","123"]
输出:"<b>abc</b>xyz<b>123</b>"
解释:两个单词字符串是 s 的子字符串,如下所示: "abcxyz123"。
我们在每个子字符串之前添加<b>,在每个子字符串之后添加</b>。
示例 2:
输入:s = "aaabbb", words = ["aa","b"]
输出:"<b>aaabbb</b>"
解释:
"aa"作为子字符串出现了两次: "aaabbb" 和 "aaabbb"。
"b"作为子字符串出现了三次: "aaabbb"、"aaabbb" 和 "aaabbb"。
我们在每个子字符串之前添加<b>,在每个子字符串之后添加</b>: "<b>a<b>a</b>a</b><b>b</b><b>b</b><b>b</b>"。
由于前两个<b>重叠,把它们合并得到: "<b>aaa</b><b>b</b><b>b</b><b>b</b>"。
由于现在这四个<b>是连续的,把它们合并得到: "<b>aaabbb</b>"。
提示:
1 <= s.length <= 10000 <= words.length <= 1001 <= words[i].length <= 1000s和words[i]由英文字母和数字组成words中的所有值 互不相同
注:此题与「758 - 字符串中的加粗单词」相同 - https://leetcode.cn/problems/bold-words-in-string
方法一:前缀树 + 区间合并 · Go 实现
思考
单词集合要在 中标出所有出现区间并加粗,区间可能重叠。对每个词做朴素匹配是 ,且合并区间还要另写一遍。
把单词插入字典树,从每个起点沿树走可一次扫出该起点的全部结束位置。得到区间后按左端合并,再与原文拼接
<b>。
相似题目:
type Trie struct {
	children [128]*Trie
	isEnd    bool
}

func newTrie() *Trie {
	return &Trie{}
}

func (this *Trie) insert(word string) {
	node := this
	for _, c := range word {
		if node.children[c] == nil {
			node.children[c] = newTrie()
		}
		node = node.children[c]
	}
	node.isEnd = true
}

func addBoldTag(s string, words []string) string {
	trie := newTrie()
	for _, w := range words {
		trie.insert(w)
	}
	n := len(s)
	var pairs [][]int
	for i := range s {
		node := trie
		for j := i; j < n; j++ {
			if node.children[s[j]] == nil {
				break
			}
			node = node.children[s[j]]
			if node.isEnd {
				pairs = append(pairs, []int{i, j})
			}
		}
	}
	if len(pairs) == 0 {
		return s
	}
	var t [][]int
	st, ed := pairs[0][0], pairs[0][1]
	for i := 1; i < len(pairs); i++ {
		a, b := pairs[i][0], pairs[i][1]
		if ed+1 < a {
			t = append(t, []int{st, ed})
			st, ed = a, b
		} else {
			ed = max(ed, b)
		}
	}
	t = append(t, []int{st, ed})
	var ans strings.Builder
	i, j := 0, 0
	for i < n {
		if j == len(t) {
			ans.WriteString(s[i:])
			break
		}
		st, ed = t[j][0], t[j][1]
		if i < st {
			ans.WriteString(s[i:st])
		}
		ans.WriteString("<b>")
		ans.WriteString(s[st : ed+1])
		ans.WriteString("</b>")
		i = ed + 1
		j++
	}
	return ans.String()
}648. 单词替换
题目、示例与约束
在英语中,我们有一个叫做 词根(root) 的概念,可以词根 后面 添加其他一些词组成另一个较长的单词——我们称这个词为 衍生词 (derivative)。例如,词根 help,跟随着 继承词 "ful",可以形成新的单词 "helpful"。
现在,给定一个由许多 词根 组成的词典 dictionary 和一个用空格分隔单词形成的句子 sentence。你需要将句子中的所有 衍生词 用 词根 替换掉。如果 衍生词 有许多可以形成它的 词根,则用 最短 的 词根 替换它。
你需要输出替换之后的句子。
示例 1:
输入:dictionary = ["cat","bat","rat"], sentence = "the cattle was rattled by the battery"
输出:"the cat was rat by the bat"
示例 2:
输入:dictionary = ["a","b","c"], sentence = "aadsfasf absbs bbab cadsfafs"
输出:"a a b c"
提示:
1 <= dictionary.length <= 10001 <= dictionary[i].length <= 100dictionary[i]仅由小写字母组成。1 <= sentence.length <= 106sentence仅由小写字母和空格组成。sentence中单词的总量在范围[1, 1000]内。sentence中每个单词的长度在范围[1, 1000]内。sentence中单词之间由一个空格隔开。sentence没有前导或尾随空格。
方法一:前缀树 · Go 实现
思考
句子中每个词要用词典里最短词根替换。对每个词扫描全部词根是 。
词根插入字典树,沿单词往下走,第一次碰到
is_end即最短词根。所有词共享前缀比较。
我们可以使用前缀树来存储词典中的所有词根。定义前缀树节点类 ,其中包含一个长度为 的数组 来存储子节点,以及一个布尔变量 来标记是否为一个完整的词根。
对于每个词根,我们将其插入前缀树中。对于句子中的每个单词,我们在前缀树中搜索其最短的词根,如果找到了,则替换该单词,否则保持不变。
时间复杂度 ,空间复杂度 ,其中 和 分别是词典中词根的数量和平均长度,而 是句子中单词的总长度。
type Trie struct {
	children [26]*Trie
	isEnd    bool
}

func (t *Trie) insert(w string) {
	node := t
	for _, c := range w {
		idx := c - 'a'
		if node.children[idx] == nil {
			node.children[idx] = &Trie{}
		}
		node = node.children[idx]
	}
	node.isEnd = true
}

func (t *Trie) search(w string) string {
	node := t
	for i, c := range w {
		idx := c - 'a'
		if node.children[idx] == nil {
			return w
		}
		node = node.children[idx]
		if node.isEnd {
			return w[:i+1]
		}
	}
	return w
}

func replaceWords(dictionary []string, sentence string) string {
	trie := &Trie{}
	for _, w := range dictionary {
		trie.insert(w)
	}

	words := strings.Split(sentence, " ")
	for i, w := range words {
		words[i] = trie.search(w)
	}
	return strings.Join(words, " ")
}692. 前K个高频单词
题目、示例与约束
给定一个单词列表 words 和一个整数 k ,返回前 k 个出现次数最多的单词。
返回的答案应该按单词出现频率由高到低排序。如果不同的单词有相同出现频率, 按字典顺序 排序。
示例 1:
输入: words = ["i", "love", "leetcode", "i", "love", "coding"], k = 2
输出: ["i", "love"]
解析: "i" 和 "love" 为出现次数最多的两个单词,均为2次。
    注意,按字母顺序 "i" 在 "love" 之前。
示例 2:
输入: ["the", "day", "is", "sunny", "the", "the", "the", "sunny", "is", "is"], k = 4
输出: ["the", "is", "sunny", "day"]
解析: "the", "is", "sunny" 和 "day" 是出现次数最多的四个单词,
    出现次数依次为 4, 3, 2 和 1 次。
注意:
1 <= words.length <= 5001 <= words[i].length <= 10words[i]由小写英文字母组成。k的取值范围是[1, 不同 words[i] 的数量]
进阶:尝试以 O(n log k) 时间复杂度和 O(n) 空间复杂度解决。
方法一:哈希表 + 排序 · Go 实现
思考
要频率最高的 个词,频率相同按字典序。堆可以 ,词数不大时全排序更直接。
计数后按 排序,取前 个键。
我们可以用一个哈希表 记录每一个单词出现的次数,然后对哈希表中的键值对按照值进行排序,如果值相同,按照键进行排序。
最后取出前 个键即可。
时间复杂度 ,空间复杂度 。其中 为单词的个数。
func topKFrequent(words []string, k int) (ans []string) {
	cnt := map[string]int{}
	for _, w := range words {
		cnt[w]++
	}
	for w := range cnt {
		ans = append(ans, w)
	}
	sort.Slice(ans, func(i, j int) bool { a, b := ans[i], ans[j]; return cnt[a] > cnt[b] || cnt[a] == cnt[b] && a < b })
	return ans[:k]
}720. 词典中最长的单词
题目、示例与约束
给出一个字符串数组 words 组成的一本英语词典。返回能够通过 words 中其它单词逐步添加一个字母来构造得到的 words 中最长的单词。
若其中有多个可行的答案,则返回答案中字典序最小的单词。若无答案,则返回空字符串。
请注意,单词应该从左到右构建,每个额外的字符都添加到前一个单词的结尾。
示例 1:
输入:words = ["w","wo","wor","worl", "world"]
输出:"world"
解释: 单词"world"可由"w", "wo", "wor", 和 "worl"逐步添加一个字母组成。
示例 2:
输入:words = ["a", "banana", "app", "appl", "ap", "apply", "apple"]
输出:"apple"
解释:"apply" 和 "apple" 都能由词典中的单词组成。但是 "apple" 的字典序小于 "apply"
提示:
1 <= words.length <= 10001 <= words[i].length <= 30- 所有输入的字符串
words[i]都只包含小写字母。
方法一:字典树 · Go 实现
思考
要找能由词典中其他词每次加一个字母拼出的最长词,并列时取字典序最小者。词数与总长都不大,但若对每个词反复在集合里查全部前缀,比较与去重都容易写繁。
「每次加一个字母」等价于该词的每个前缀都是词典中的完整词。把全部词插入字典树后,沿路径检查每个节点是否都标了词尾,即可一次判断。
先建树再扫一遍单词,用 验证前缀链,同时按长度优先、同长取更小字典序更新答案。总时间与字符数成正比。
我们可以使用字典树来存储所有的单词,然后遍历所有的单词,判断当前单词是否可以由字典树中的其他单词逐步添加一个字母组成,找出满足条件的最长的,且字典序最小的单词。
时间复杂度 ,空间复杂度 ,其中 是所有单词的长度之和。
type Trie struct {
	children [26]*Trie
	isEnd    bool
}

func (t *Trie) insert(w string) {
	node := t
	for i := 0; i < len(w); i++ {
		idx := w[i] - 'a'
		if node.children[idx] == nil {
			node.children[idx] = &Trie{}
		}
		node = node.children[idx]
	}
	node.isEnd = true
}

func (t *Trie) search(w string) bool {
	node := t
	for i := 0; i < len(w); i++ {
		idx := w[i] - 'a'
		if node.children[idx] == nil || !node.children[idx].isEnd {
			return false
		}
		node = node.children[idx]
	}
	return true
}

func longestWord(words []string) string {
	trie := &Trie{}
	for _, w := range words {
		trie.insert(w)
	}

	ans := ""
	for _, w := range words {
		if trie.search(w) && (len(ans) < len(w) || (len(ans) == len(w) && w < ans)) {
			ans = w
		}
	}
	return ans
}758. 字符串中的加粗单词 🔒
题目、示例与约束
给定一个关键词集合 words 和一个字符串 s,将所有 s 中出现的关键词 words[i] 加粗。所有在标签 <b> 和 <b> 中的字母都会加粗。
加粗后返回 s 。返回的字符串需要使用尽可能少的标签,当然标签应形成有效的组合。
示例 1:
输入: words = ["ab","bc"], s = "aabcd"
输出: "a<b>abc</b>d"
解释: 注意返回 "a<b>a<b>b</b>c</b>d" 会使用更多的标签,因此是错误的。
示例 2:
输入: words = ["ab","cb"], s = "aabcd"
输出: "a<b>ab</b>cd"
提示:
1 <= s.length <= 5000 <= words.length <= 501 <= words[i].length <= 10s和words[i]由小写英文字母组成
注:此题与「616 - 给字符串添加加粗标签」相同 - https://leetcode.cn/problems/add-bold-tag-in-string/
方法一:前缀树 + 区间合并 · Go 实现
思考
把 中出现过的词典单词加上粗体标签,重叠或相邻的区间要合并。单词可用字典树一次扫出全部出现区间。
从每个起点沿字典树走,走到词尾就记录 。再按左端扫描,能与当前段相连或重叠则扩右端,否则封段。
最后按合并后的区间在原串中插入
<b>与</b>。
相似题目:
type Trie struct {
	children [128]*Trie
	isEnd    bool
}

func newTrie() *Trie {
	return &Trie{}
}

func (this *Trie) insert(word string) {
	node := this
	for _, c := range word {
		if node.children[c] == nil {
			node.children[c] = newTrie()
		}
		node = node.children[c]
	}
	node.isEnd = true
}

func boldWords(words []string, s string) string {
	trie := newTrie()
	for _, w := range words {
		trie.insert(w)
	}
	n := len(s)
	var pairs [][]int
	for i := range s {
		node := trie
		for j := i; j < n; j++ {
			if node.children[s[j]] == nil {
				break
			}
			node = node.children[s[j]]
			if node.isEnd {
				pairs = append(pairs, []int{i, j})
			}
		}
	}
	if len(pairs) == 0 {
		return s
	}
	var t [][]int
	st, ed := pairs[0][0], pairs[0][1]
	for i := 1; i < len(pairs); i++ {
		a, b := pairs[i][0], pairs[i][1]
		if ed+1 < a {
			t = append(t, []int{st, ed})
			st, ed = a, b
		} else {
			ed = max(ed, b)
		}
	}
	t = append(t, []int{st, ed})
	var ans strings.Builder
	i, j := 0, 0
	for i < n {
		if j == len(t) {
			ans.WriteString(s[i:])
			break
		}
		st, ed = t[j][0], t[j][1]
		if i < st {
			ans.WriteString(s[i:st])
		}
		ans.WriteString("<b>")
		ans.WriteString(s[st : ed+1])
		ans.WriteString("</b>")
		i = ed + 1
		j++
	}
	return ans.String()
}792. 匹配子序列的单词数
题目、示例与约束
给定字符串 s 和字符串数组 words, 返回 words[i] 中是s的子序列的单词个数 。
字符串的 子序列 是从原始字符串中生成的新字符串,可以从中删去一些字符(可以是none),而不改变其余字符的相对顺序。
- 例如,
“ace”是“abcde”的子序列。
示例 1:
输入: s = "abcde", words = ["a","bb","acd","ace"]
输出: 3
解释: 有三个是 s 的子序列的单词: "a", "acd", "ace"。
Example 2:
输入: s = "dsahjpjauf", words = ["ahjpjau","ja","ahbwzgqnuk","tnmlanowax"]
输出: 2
提示:
1 <= s.length <= 5 * 1041 <= words.length <= 50001 <= words[i].length <= 50words[i]和 s 都只由小写字母组成。
方法一:分桶 · Go 实现
思考
长 ,对每个词在 上双指针可能反复扫 。把词按「下一个待匹配字母」分到 个桶,扫 时只推进当前字母的桶。
词匹配完则计数,否则把剩余后缀丢进新首字母的桶。每个词的每个字符只处理一次。
题目中字符串 的数据规模最高达到 ,如果暴力枚举 中的每个字符串 ,判断其是否为 的子序列,很有可能会超时。
我们不妨将 中的所有单词根据首字母来分桶,即:把所有单词按照首字母分到 个桶中,每个桶中存储的是所有以该字母开头的所有单词。
比如对于 words = ["a", "bb", "acd", "ace"],我们得到以下的分桶结果:
a: ["a", "acd", "ace"]
b: ["bb"]
然后我们从 的第一个字符开始遍历,假设当前字符为 'a',我们从 'a' 开头的桶中取出所有单词。对于取出的每个单词,如果此时单词长度为 ,说明该单词已经匹配完毕,我们将答案加 ;否则我们将单词的首字母去掉,然后放入下一个字母开头的桶中,比如对于单词 "acd",去掉首字母 'a' 后,我们将其放入 'c' 开头的桶中。这一轮结束后,分桶结果变为:
c: ["cd", "ce"]
b: ["bb"]
遍历完 后,我们就得到了答案。
实际上,每个桶可以只存储单词的下标 以及该单词当前匹配到的位置 ,这样可以节省空间。
时间复杂度 ,空间复杂度 。其中 和 分别为 和 的长度,而 为 的长度。
func numMatchingSubseq(s string, words []string) (ans int) {
	d := [26][]string{}
	for _, w := range words {
		d[w[0]-'a'] = append(d[w[0]-'a'], w)
	}
	for _, c := range s {
		q := d[c-'a']
		d[c-'a'] = nil
		for _, t := range q {
			if len(t) == 1 {
				ans++
			} else {
				d[t[1]-'a'] = append(d[t[1]-'a'], t[1:])
			}
		}
	}
	return
}
方法二:分桶(下标指针) · Go 实现
思考
方法一切片后缀会产生新串。改为存 ,语义相同、少分配。
按当前待匹配字符把单词下标放进队列,扫 时推进指针。
func numMatchingSubseq(s string, words []string) (ans int) {
	type pair struct{ i, j int }
	d := [26][]pair{}
	for i, w := range words {
		d[w[0]-'a'] = append(d[w[0]-'a'], pair{i, 0})
	}
	for _, c := range s {
		q := d[c-'a']
		d[c-'a'] = nil
		for _, p := range q {
			i, j := p.i, p.j+1
			if j == len(words[i]) {
				ans++
			} else {
				d[words[i][j]-'a'] = append(d[words[i][j]-'a'], pair{i, j})
			}
		}
	}
	return
}
方法三:二分查找 · Go 实现
思考
分桶要同时挂起所有词。也可预处理 中每个字母的下标列表,对每个词在列表上二分找下一个更大下标。
单次判断 ,实现更简单,不必维护队列。
先用数组或哈希表 存放字符串 每个字符的下标,即 为 中所有字符 的下标组成的数组。
然后我们遍历 中的每个单词 ,通过二分查找判断 是否为 的子序列,是则答案加 。判断逻辑如下:
- 定义指针 表示当前指向字符串 的第 个字符,初始化为 。
- 遍历字符串 中的每个字符 ,在 中二分查找第一个大于 的位置 ,如果不存在,则说明 不是 的子序列,直接跳出循环;否则,将 更新为 ,继续遍历下一个字符。
- 如果遍历完 中的所有字符,说明 是 的子序列。
时间复杂度 ,空间复杂度 。其中 和 分别为 和 的长度,而 为 的长度。
func numMatchingSubseq(s string, words []string) (ans int) {
	d := [26][]int{}
	for i, c := range s {
		d[c-'a'] = append(d[c-'a'], i)
	}
	check := func(w string) bool {
		i := -1
		for _, c := range w {
			t := d[c-'a']
			j := sort.SearchInts(t, i+1)
			if j == len(t) {
				return false
			}
			i = t[j]
		}
		return true
	}
	for _, w := range words {
		if check(w) {
			ans++
		}
	}
	return
}820. 单词的压缩编码
题目、示例与约束
单词数组 words 的 有效编码 由任意助记字符串 s 和下标数组 indices 组成,且满足:
words.length == indices.length- 助记字符串
s以'#'字符结尾 - 对于每个下标
indices[i],s的一个从indices[i]开始、到下一个'#'字符结束(但不包括'#')的 子字符串 恰好与words[i]相等
给你一个单词数组 words ,返回成功对 words 进行编码的最小助记字符串 s 的长度 。
示例 1:
输入:words = ["time", "me", "bell"]
输出:10
解释:一组有效编码为 s = "time#bell#" 和 indices = [0, 2, 5] 。
words[0] = "time" ,s 开始于 indices[0] = 0 到下一个 '#' 结束的子字符串,如加粗部分所示 "time#bell#"
words[1] = "me" ,s 开始于 indices[1] = 2 到下一个 '#' 结束的子字符串,如加粗部分所示 "time#bell#"
words[2] = "bell" ,s 开始于 indices[2] = 5 到下一个 '#' 结束的子字符串,如加粗部分所示 "time#bell#"
示例 2:
输入:words = ["t"]
输出:2
解释:一组有效编码为 s = "t#" 和 indices = [0] 。
提示:
1 <= words.length <= 20001 <= words[i].length <= 7words[i]仅由小写字母组成
方法一:前缀树 · Go 实现
思考
编码是若干单词加
#的拼接,较短词若是较长词的后缀则可被其编码覆盖。直接对每对单词做后缀判断在规模上偏冗余。把单词倒序插入 Trie,公共后缀会落在同一条路径上。只有叶子对应的单词需要单独编码,长度贡献为单词长加一;非叶子已被更长单词覆盖。
题目大意:充分利用重叠的后缀,使有效编码尽可能短。
判断当前单词是否是其他单词的后缀,若是,就不用写入助记字符串中,否则需要写入并且加上一个 # 后缀。
type trie struct {
	children [26]*trie
}

func minimumLengthEncoding(words []string) int {
	root := new(trie)
	for _, w := range words {
		cur := root
		for i := len(w) - 1; i >= 0; i-- {
			if cur.children[w[i]-'a'] == nil {
				cur.children[w[i]-'a'] = new(trie)
			}
			cur = cur.children[w[i]-'a']
		}
	}
	return dfs(root, 1)
}

func dfs(cur *trie, l int) int {
	isLeaf, ans := true, 0
	for i := 0; i < 26; i++ {
		if cur.children[i] != nil {
			isLeaf = false
			ans += dfs(cur.children[i], l+1)
		}
	}
	if isLeaf {
		ans += l
	}
	return ans
}
方法二 · Go 实现
思考
方法一先建完整 Trie,再 DFS 统计叶子。若按长度降序插入倒序单词,更长的词先占据路径;后插入的词若整条路径已存在,说明它是某个更长词的后缀,贡献为 ,否则贡献长度加一。
这样在插入时即可累加答案,省去第二遍 DFS。
type Trie struct {
	children [26]*Trie
}

func newTrie() *Trie {
	return &Trie{}
}

func (this *Trie) insert(w string) int {
	node := this
	pref := true
	for i := len(w) - 1; i >= 0; i-- {
		idx := w[i] - 'a'
		if node.children[idx] == nil {
			pref = false
			node.children[idx] = newTrie()
		}
		node = node.children[idx]
	}
	if pref {
		return 0
	}
	return len(w) + 1
}

func minimumLengthEncoding(words []string) int {
	sort.Slice(words, func(i, j int) bool { return len(words[i]) > len(words[j]) })
	trie := newTrie()
	ans := 0
	for _, w := range words {
		ans += trie.insert(w)
	}
	return ans
}1023. 驼峰式匹配
题目、示例与约束
给你一个字符串数组 queries,和一个表示模式的字符串 pattern,请你返回一个布尔数组 answer 。只有在待查项 queries[i] 与模式串 pattern 匹配时, answer[i] 才为 true,否则为 false。
如果可以将 小写字母 插入模式串 pattern 得到待查询项 queries[i],那么待查询项与给定模式串匹配。您可以在模式串中的任何位置插入字符,也可以选择不插入任何字符。
示例 1:
输入:queries = ["FooBar","FooBarTest","FootBall","FrameBuffer","ForceFeedBack"], pattern = "FB"
输出:[true,false,true,true,false]
示例:
"FooBar" 可以这样生成:"F" + "oo" + "B" + "ar"。
"FootBall" 可以这样生成:"F" + "oot" + "B" + "all".
"FrameBuffer" 可以这样生成:"F" + "rame" + "B" + "uffer".
示例 2:
输入:queries = ["FooBar","FooBarTest","FootBall","FrameBuffer","ForceFeedBack"], pattern = "FoBa"
输出:[true,false,true,false,false]
解释:
"FooBar" 可以这样生成:"Fo" + "o" + "Ba" + "r".
"FootBall" 可以这样生成:"Fo" + "ot" + "Ba" + "ll".
示例 3:
输入:queries = ["FooBar","FooBarTest","FootBall","FrameBuffer","ForceFeedBack"], pattern = "FoBaT"
输出:[false,true,false,false,false]
解释:
"FooBarTest" 可以这样生成:"Fo" + "o" + "Ba" + "r" + "T" + "est".
提示:
1 <= pattern.length, queries.length <= 1001 <= queries[i].length <= 100queries[i]和pattern由英文字母组成
方法一:双指针 · Go 实现
思考
对每个查询用正则或逐字符状态机匹配模式, 与串长均不超过 ,线性检查足够。匹配规则是:模式中的字符必须按序出现,查询里多出来的只能是小写插入。
双指针沿查询与模式前进:查询指针在失配且当前为小写时跳过插入;若用尽或遇上无法跳过的大写,则不匹配。模式耗尽后,查询残余也必须全是小写。
对每个查询调用该检查,得到布尔数组。
我们可以遍历 queries 中的每个字符串,判断其是否与 pattern 匹配,若匹配则将 true 加入答案数组,否则加入 false。
接下来,我们实现一个 函数,用于判断字符串 和 是否匹配。
我们可以使用双指针 和 ,分别指向两个字符串的首字符,然后遍历两个字符串。如果指针 和 指向的字符不同,并且 为小写字母,则指针 循环向后移动一位。
如果指针 已经到达字符串 的末尾,或者指针 和 指向的字符不同,则返回 false。否则,指针 和 同时向后移动一位。当指针 到达字符串 的末尾时,我们需要判断字符串 中剩余的字符是否都为小写字母,若是则返回 true,否则返回 false。
时间复杂度 ,其中 和 分别为数组 queries 的长度和字符串 pattern 的长度。
func camelMatch(queries []string, pattern string) (ans []bool) {
	check := func(s, t string) bool {
		m, n := len(s), len(t)
		i, j := 0, 0
		for ; j < n; i, j = i+1, j+1 {
			for i < m && s[i] != t[j] && (s[i] >= 'a' && s[i] <= 'z') {
				i++
			}
			if i == m || s[i] != t[j] {
				return false
			}
		}
		for i < m && s[i] >= 'a' && s[i] <= 'z' {
			i++
		}
		return i == m
	}
	for _, q := range queries {
		ans = append(ans, check(q, pattern))
	}
	return
}1065. 字符串的索引对 🔒
题目、示例与约束
给出 字符串 text 和 字符串列表 words, 返回所有的索引对 [i, j] 使得子字符串 text[i]...text[j](包括 i 和 j)属于字符串列表 words。
按顺序返回索引对 [i, j](即,按它们的第一个坐标进行排序,如果相同,则按它们的第二个坐标对它们进行排序)。
示例 1:
输入: text = "thestoryofleetcodeandme", words = ["story","fleet","leetcode"]
输出: [[3,7],[9,13],[10,17]]
示例 2:
输入: text = "ababa", words = ["aba","ab"]
输出: [[0,1],[0,2],[2,3],[2,4]]
解释:
注意,返回的配对可以有交叉,比如,"aba" 既在 [0,2] 中也在 [2,4] 中
提示:
1 <= text.length <= 1001 <= words.length <= 201 <= words[i].length <= 50text和words[i]都只包含小写字母。- 保证
words中的字符串无重复。
方法一:暴力枚举 · Go 实现
思考
对 每个子串查询是否落在单词表中。文本与单词都不长,把单词放入集合后枚举全部 切片即可。
集合给出 平均查询,按下标序枚举自然有序。
func indexPairs(text string, words []string) (ans [][]int) {
	s := map[string]bool{}
	for _, w := range words {
		s[w] = true
	}
	n := len(text)
	for i := 0; i < n; i++ {
		for j := i; j < n; j++ {
			if s[text[i:j+1]] {
				ans = append(ans, []int{i, j})
			}
		}
	}
	return
}
方法二:前缀树 · Go 实现
思考
枚举全部切片在文本较长时做许多失败查询。单词共享前缀时,从每个起点沿前缀树走,失配即可停止。
先把单词插入字典树,对每个 从根向右延伸,遇到结束标记则记录 。
相似题目:
type Trie struct {
	children [26]*Trie
	isEnd    bool
}

func newTrie() *Trie {
	return &Trie{}
}

func (this *Trie) insert(word string) {
	node := this
	for _, c := range word {
		idx := int(c - 'a')
		if node.children[idx] == nil {
			node.children[idx] = newTrie()
		}
		node = node.children[idx]
	}
	node.isEnd = true
}

func indexPairs(text string, words []string) [][]int {
	trie := newTrie()
	for _, w := range words {
		trie.insert(w)
	}
	n := len(text)
	var ans [][]int
	for i := range text {
		node := trie
		for j := i; j < n; j++ {
			idx := int(text[j] - 'a')
			if node.children[idx] == nil {
				break
			}
			node = node.children[idx]
			if node.isEnd {
				ans = append(ans, []int{i, j})
			}
		}
	}
	return ans
}1178. 猜字谜
题目、示例与约束
外国友人仿照中国字谜设计了一个英文版猜字谜小游戏,请你来猜猜看吧。
字谜的迷面 puzzle 按字符串形式给出,如果一个单词 word 符合下面两个条件,那么它就可以算作谜底:
- 单词
word中包含谜面puzzle的第一个字母。 - 单词
word中的每一个字母都可以在谜面puzzle中找到。
例如,如果字谜的谜面是 "abcdefg",那么可以作为谜底的单词有 "faced", "cabbage", 和 "baggage";而 "beefed"(不含字母 "a")以及 "based"(其中的 "s" 没有出现在谜面中)都不能作为谜底。
返回一个答案数组 answer,数组中的每个元素 answer[i] 是在给出的单词列表 words 中可以作为字谜迷面 puzzles[i] 所对应的谜底的单词数目。
示例:
输入:
words = ["aaaa","asas","able","ability","actt","actor","access"],
puzzles = ["aboveyz","abrodyz","abslute","absoryz","actresz","gaswxyz"]
输出:[1,1,3,2,4,0]
解释:
1 个单词可以作为 "aboveyz" 的谜底 : "aaaa"
1 个单词可以作为 "abrodyz" 的谜底 : "aaaa"
3 个单词可以作为 "abslute" 的谜底 : "aaaa", "asas", "able"
2 个单词可以作为 "absoryz" 的谜底 : "aaaa", "asas"
4 个单词可以作为 "actresz" 的谜底 : "aaaa", "asas", "actt", "access"
没有单词可以作为 "gaswxyz" 的谜底,因为列表中的单词都不含字母 'g'。
提示:
1 <= words.length <= 10^54 <= words[i].length <= 501 <= puzzles.length <= 10^4puzzles[i].length == 7words[i][j],puzzles[i][j]都是小写英文字母。- 每个
puzzles[i]所包含的字符都不重复。
方法一:状态压缩 + 哈希表 + 子集枚举 · Go 实现
思考
合法单词的字母集合是谜面集合的子集,且必须含谜面首字母。单词与谜面均短、字母种类少,可压成位掩码。先统计每个单词掩码的出现次数;谜面长度固定为 ,枚举其子集并累加含首字母的那些掩码计数。对单词枚举全部谜面则过大。
根据题目描述,对于字谜数组 中的每一个字谜 ,我们需要统计有多少个单词 包含了字谜 的第一个字母,且 的每一个字母都可以在 中找到。
由于每个单词重复的字母只需要统计一次,因此,我们可以使用二进制状态压缩的方法,将每个单词 转换成一个二进制数 ,其中 的第 位为 ,当且仅当字母 在单词 中出现过。我们用哈希表 统计所有单词的状态压缩后的值出现的次数。
接下来,遍历字谜数组 ,对于每一个字谜 ,我们注意到其长度固定为 ,因此我们只需要枚举 的子集,如果该子集包含 的第一个字母,那么我们查找其在哈希表中对应的值并累加到当前字谜的答案中。
遍历结束后,我们就可以得到字谜数组 中每个字谜对应的谜底数量,将其返回即可。
时间复杂度 ,空间复杂度 。其中 和 分别为数组 和 的长度,而 和 分别为数组 中单词的最大长度和数组 中字谜的长度。
func findNumOfValidWords(words []string, puzzles []string) (ans []int) {
	cnt := map[int]int{}
	for _, w := range words {
		mask := 0
		for _, c := range w {
			mask |= 1 << (c - 'a')
		}
		cnt[mask]++
	}
	for _, p := range puzzles {
		mask := 0
		for _, c := range p {
			mask |= 1 << (c - 'a')
		}
		x, i := 0, p[0]-'a'
		for j := mask; j > 0; j = (j - 1) & mask {
			if j>>i&1 > 0 {
				x += cnt[j]
			}
		}
		ans = append(ans, x)
	}
	return
}1233. 删除子文件夹
题目、示例与约束
你是一位系统管理员,手里有一份文件夹列表 folder,你的任务是要删除该列表中的所有 子文件夹,并以 任意顺序 返回剩下的文件夹。
如果文件夹 folder[i] 位于另一个文件夹 folder[j] 下,那么 folder[i] 就是 folder[j] 的 子文件夹 。folder[j] 的子文件夹必须以 folder[j] 开头,后跟一个 "/"。例如,"/a/b" 是 "/a" 的一个子文件夹,但 "/b" 不是 "/a/b/c" 的一个子文件夹。
文件夹的「路径」是由一个或多个按以下格式串联形成的字符串:'/' 后跟一个或者多个小写英文字母。
- 例如,
"/leetcode"和"/leetcode/problems"都是有效的路径,而空字符串和"/"不是。
示例 1:
输入:folder = ["/a","/a/b","/c/d","/c/d/e","/c/f"]
输出:["/a","/c/d","/c/f"]
解释:"/a/b" 是 "/a" 的子文件夹,而 "/c/d/e" 是 "/c/d" 的子文件夹。
示例 2:
输入:folder = ["/a","/a/b/c","/a/b/d"]
输出:["/a"]
解释:文件夹 "/a/b/c" 和 "/a/b/d" 都会被删除,因为它们都是 "/a" 的子文件夹。
示例 3:
输入: folder = ["/a/b/c","/a/b/ca","/a/b/d"]
输出: ["/a/b/c","/a/b/ca","/a/b/d"]
提示:
1 <= folder.length <= 4 * 1042 <= folder[i].length <= 100folder[i]只包含小写字母和'/'folder[i]总是以字符'/'起始folder每个元素都是 唯一 的
方法一:排序 · Go 实现
思考
子文件夹在字典序下一定排在其父文件夹之后,且以父路径加 为前缀。 达 ,两两检查前缀过慢。
排序后只需与答案中最近保留的文件夹比较:若当前路径是它的子孙则丢弃,否则它本身是新的根文件夹。排序把父子关系变成相邻前缀关系,一遍扫描即可。
我们先将数组 folder 按照字典序排序,然后遍历数组,对于当前遍历到的文件夹 ,如果它的长度大于等于答案数组中最后一个文件夹的长度,并且它的前缀包含答案数组的最后一个文件夹再加上一个 /,则说明 是答案数组中最后一个文件夹的子文件夹,我们不需要将其加入答案数组中。否则,我们将 加入答案数组中。
遍历结束后,答案数组中的文件夹即为题目要求的答案。
时间复杂度 ,空间复杂度 。其中 和 分别为数组 folder 的长度和数组 folder 中字符串的最大长度。
func removeSubfolders(folder []string) []string {
	sort.Strings(folder)
	ans := []string{folder[0]}
	for _, f := range folder[1:] {
		m, n := len(ans[len(ans)-1]), len(f)
		if m >= n || !(ans[len(ans)-1] == f[:m] && f[m] == '/') {
			ans = append(ans, f)
		}
	}
	return ans
}
方法二:字典树 · Go 实现
思考
排序依赖全局字典序,比较字符串前缀的常数较大。字典树按路径分量插入,节点标记文件夹终点;搜索时一旦碰到终点便整棵子树都是子文件夹,无需再往下走。时间与路径总长成正比,省去排序。
我们可以使用字典树存储数组 folder 中的所有文件夹。字典树的每个节点包含 children 字段,用于存储当前节点的子节点,以及 fid 字段,用于存储当前节点对应的文件夹在数组 folder 中的下标。
对于数组 folder 中的每个文件夹 ,我们先将 按照 / 分割成若干个子串,然后从根节点开始,依次将子串加入字典树中。接下来,我们从根节点开始搜索字典树,如果当前节点的 fid 字段不为 -1,则说明当前节点对应的文件夹是答案数组中的一个文件夹,我们将其加入答案数组并且返回。否则,我们递归地搜索当前节点的所有子节点,最终返回答案数组。
时间复杂度 ,空间复杂度 。其中 和 分别为数组 folder 的长度和数组 folder 中字符串的最大长度。
type Trie struct {
	children map[string]*Trie
	fid      int
}

func newTrie() *Trie {
	return &Trie{map[string]*Trie{}, -1}
}

func (this *Trie) insert(fid int, f string) {
	node := this
	ps := strings.Split(f, "/")
	for _, p := range ps[1:] {
		if _, ok := node.children[p]; !ok {
			node.children[p] = newTrie()
		}
		node = node.children[p]
	}
	node.fid = fid
}

func (this *Trie) search() (ans []int) {
	var dfs func(*Trie)
	dfs = func(root *Trie) {
		if root.fid != -1 {
			ans = append(ans, root.fid)
			return
		}
		for _, child := range root.children {
			dfs(child)
		}
	}
	dfs(this)
	return
}

func removeSubfolders(folder []string) (ans []string) {
	trie := newTrie()
	for i, f := range folder {
		trie.insert(i, f)
	}
	for _, i := range trie.search() {
		ans = append(ans, folder[i])
	}
	return
}1268. 搜索推荐系统
题目、示例与约束
给你一个产品数组 products 和一个字符串 searchWord ,products 数组中每个产品都是一个字符串。
请你设计一个推荐系统,在依次输入单词 searchWord 的每一个字母后,推荐 products 数组中前缀与 searchWord 相同的最多三个产品。如果前缀相同的可推荐产品超过三个,请按字典序返回最小的三个。
请你以二维列表的形式,返回在输入 searchWord 每个字母后相应的推荐产品的列表。
示例 1:
输入:products = ["mobile","mouse","moneypot","monitor","mousepad"], searchWord = "mouse"
输出:[
["mobile","moneypot","monitor"],
["mobile","moneypot","monitor"],
["mouse","mousepad"],
["mouse","mousepad"],
["mouse","mousepad"]
]
解释:按字典序排序后的产品列表是 ["mobile","moneypot","monitor","mouse","mousepad"]
输入 m 和 mo,由于所有产品的前缀都相同,所以系统返回字典序最小的三个产品 ["mobile","moneypot","monitor"]
输入 mou, mous 和 mouse 后系统都返回 ["mouse","mousepad"]
示例 2:
输入:products = ["havana"], searchWord = "havana"
输出:[["havana"],["havana"],["havana"],["havana"],["havana"],["havana"]]
示例 3:
输入:products = ["bags","baggage","banner","box","cloths"], searchWord = "bags"
输出:[["baggage","bags","banner"],["baggage","bags","banner"],["baggage","bags"],["bags"]]
示例 4:
输入:products = ["havana"], searchWord = "tatiana"
输出:[[],[],[],[],[],[],[]]
提示:
1 <= products.length <= 10001 <= Σ products[i].length <= 2 * 10^4products[i]中所有的字符都是小写英文字母。1 <= searchWord.length <= 1000searchWord中所有字符都是小写英文字母。
方法一:排序 + 前缀树 · Go 实现
思考
每多输入一个字母,要给出当前前缀下字典序最小的三个商品。商品数 ,可先排序再插入前缀树,使每个节点按插入顺序最多留下三个下标,它们即该前缀的前三名。
沿 走树,把途经节点上的下标表映射回商品名。排序保证插入顺序即字典序,前缀树保证按前缀定位。
题目要求在输入 searchWord 的每一个字母后,推荐 products 数组中前缀与 searchWord 相同的最多三个产品。如果前缀相同的可推荐产品超过三个,按字典序返回最小的三个。
找前缀相同的产品,可以使用前缀树;而要返回字典序最小的三个产品,我们可以先对 products 数组进行排序,然后将排序后的数组下标存入前缀树中。
前缀树的每个节点维护以下信息:
children:这是一个长度为 的数组,用于存储当前节点的子节点,children[i]表示当前节点的子节点中字符为i + 'a'的节点。v:这是一个数组,用于存储当前节点的子节点中的字符在products数组中的下标,最多存储三个下标。
搜索时,我们从前缀树的根节点开始,找到每一个前缀对应的下标数组,将其存入结果数组中。最后只需要将每个下标数组中的下标对应到 products 数组中即可。
时间复杂度 ,空间复杂度 。其中 是 products 数组所有字符串的长度之和,而 和 分别是 products 数组的长度和 searchWord 的长度。
type Trie struct {
	children [26]*Trie
	v        []int
}

func newTrie() *Trie {
	return &Trie{}
}
func (this *Trie) insert(w string, i int) {
	node := this
	for _, c := range w {
		c -= 'a'
		if node.children[c] == nil {
			node.children[c] = newTrie()
		}
		node = node.children[c]
		if len(node.v) < 3 {
			node.v = append(node.v, i)
		}
	}
}

func (this *Trie) search(w string) [][]int {
	node := this
	n := len(w)
	ans := make([][]int, n)
	for i, c := range w {
		c -= 'a'
		if node.children[c] == nil {
			break
		}
		node = node.children[c]
		ans[i] = node.v
	}
	return ans
}

func suggestedProducts(products []string, searchWord string) (ans [][]string) {
	sort.Strings(products)
	trie := newTrie()
	for i, w := range products {
		trie.insert(w, i)
	}
	for _, v := range trie.search(searchWord) {
		t := []string{}
		for _, i := range v {
			t = append(t, products[i])
		}
		ans = append(ans, t)
	}
	return
}1316. 不同的循环子字符串
题目、示例与约束
给你一个字符串 text ,请你返回满足下述条件的 不同 非空子字符串的数目:
- 可以写成某个字符串与其自身相连接的形式(即,可以写为
a + a,其中a是某个字符串)。
例如,abcabc 就是 abc 和它自身连接形成的。
示例 1:
输入:text = "abcabcabc"
输出:3
解释:3 个子字符串分别为 "abcabc","bcabca" 和 "cabcab" 。
示例 2:
输入:text = "leetcodeleetcode"
输出:2
解释:2 个子字符串为 "ee" 和 "leetcodeleetcode" 。
提示:
1 <= text.length <= 2000text只包含小写英文字母。
方法一:字符串哈希 · Go 实现
思考
统计形如 的不同子串个数。 ,枚举所有偶数长子串再逐字符比较两半,最坏接近 。子串相等可用字符串哈希在 判定。
预处理前缀哈希后,枚举左右端点使长度为偶数,比较两半哈希;用集合去重哈希值,集合大小即为不同回声子串个数。
字符串哈希是把一个任意长度的字符串映射成一个非负整数,并且其冲突的概率几乎为 0。字符串哈希用于计算字符串哈希值,快速判断两个字符串是否相等。
取一固定值 BASE,把字符串看作是 BASE 进制数,并分配一个大于 0 的数值,代表每种字符。一般来说,我们分配的数值都远小于 BASE。例如,对于小写字母构成的字符串,可以令 a=1, b=2, ..., z=26。取一固定值 MOD,求出该 BASE 进制对 M 的余数,作为该字符串的 hash 值。
一般来说,取 BASE=131 或者 BASE=13331,此时 hash 值产生的冲突概率极低。只要两个字符串 hash 值相同,我们就认为两个字符串是相等的。通常 MOD 取 2^64,C++ 里,可以直接使用 unsigned long long 类型存储这个 hash 值,在计算时不处理算术溢出问题,产生溢出时相当于自动对 2^64 取模,这样可以避免低效取模运算。
除了在极特殊构造的数据上,上述 hash 算法很难产生冲突,一般情况下上述 hash 算法完全可以出现在题目的标准答案中。我们还可以多取一些恰当的 BASE 和 MOD 的值(例如大质数),多进行几组 hash 运算,当结果都相同时才认为原字符串相等,就更加难以构造出使这个 hash 产生错误的数据。
func distinctEchoSubstrings(text string) int {
	n := len(text)
	base := 131
	h := make([]int, n+10)
	p := make([]int, n+10)
	p[0] = 1
	for i, c := range text {
		t := int(c-'a') + 1
		p[i+1] = p[i] * base
		h[i+1] = h[i]*base + t
	}
	get := func(l, r int) int {
		return h[r] - h[l-1]*p[r-l+1]
	}
	vis := map[int]bool{}
	for i := 0; i < n-1; i++ {
		for j := i + 1; j < n; j += 2 {
			k := (i + j) >> 1
			a, b := get(i+1, k+1), get(k+2, j+1)
			if a == b {
				vis[a] = true
			}
		}
	}
	return len(vis)
}1698. 字符串的不同子字符串个数 🔒
题目、示例与约束
给定一个字符串 s,返回 s 的不同子字符串的个数。
字符串的 子字符串 是由原字符串删除开头若干个字符(可能是 0 个)并删除结尾若干个字符(可能是 0 个)形成的字符串。
示例 1:
输入:s = "aabbaba"
输出:21
解释:不同子字符串的集合是 ["a","b","aa","bb","ab","ba","aab","abb","bab","bba","aba","aabb","abba","bbab","baba","aabba","abbab","bbaba","aabbab","abbaba","aabbaba"]
示例 2:
输入:s = "abcdefg"
输出:28
提示:
1 <= s.length <= 500s由小写英文字母组成。
进阶:你可以以 O(n) 时间复杂度解决此问题吗?
方法一:暴力枚举 · Go 实现
思考
统计本质不同子串个数。长度 较小,枚举全部 个子串丢进集合即可,字符串切片使总时间接近 ,对本规模足够。
枚举所有子串,使用哈希表记录不同子串的个数。
时间复杂度 ,空间复杂度 。其中 为字符串长度。
func countDistinct(s string) int {
	ss := map[string]struct{}{}
	for i := range s {
		for j := i + 1; j <= len(s); j++ {
			ss[s[i:j]] = struct{}{}
		}
	}
	return len(ss)
}
方法二:字符串哈希 · Go 实现
思考
方法一比较的是整段字符串。多项式哈希可在 得到任意子串指纹,枚举左右端点把哈希值放入集合,将比较降为整数,时间 。
字符串哈希是把一个任意长度的字符串映射成一个非负整数,并且其冲突的概率几乎为 0。字符串哈希用于计算字符串哈希值,快速判断两个字符串是否相等。
取一固定值 BASE,把字符串看作是 BASE 进制数,并分配一个大于 0 的数值,代表每种字符。一般来说,我们分配的数值都远小于 BASE。例如,对于小写字母构成的字符串,可以令 a=1, b=2, ..., z=26。取一固定值 MOD,求出该 BASE 进制对 M 的余数,作为该字符串的 hash 值。
一般来说,取 BASE=131 或者 BASE=13331,此时 hash 值产生的冲突概率极低。只要两个字符串 hash 值相同,我们就认为两个字符串是相等的。通常 MOD 取 2^64,C++ 里,可以直接使用 unsigned long long 类型存储这个 hash 值,在计算时不处理算术溢出问题,产生溢出时相当于自动对 2^64 取模,这样可以避免低效取模运算。
除了在极特殊构造的数据上,上述 hash 算法很难产生冲突,一般情况下上述 hash 算法完全可以出现在题目的标准答案中。我们还可以多取一些恰当的 BASE 和 MOD 的值(例如大质数),多进行几组 hash 运算,当结果都相同时才认为原字符串相等,就更加难以构造出使这个 hash 产生错误的数据。
时间复杂度 ,空间复杂度 。其中 为字符串长度。
func countDistinct(s string) int {
	n := len(s)
	p := make([]int, n+10)
	h := make([]int, n+10)
	p[0] = 1
	base := 131
	for i, c := range s {
		p[i+1] = p[i] * base
		h[i+1] = h[i]*base + int(c)
	}
	ss := map[int]struct{}{}
	for i := 1; i <= n; i++ {
		for j := i; j <= n; j++ {
			ss[h[j]-h[i-1]*p[j-i+1]] = struct{}{}
		}
	}
	return len(ss)
}1707. 与数组中元素的最大异或值
题目、示例与约束
给你一个由非负整数组成的数组 nums 。另有一个查询数组 queries ,其中 queries[i] = [xi, mi] 。
第 i 个查询的答案是 xi 和任何 nums 数组中不超过 mi 的元素按位异或(XOR)得到的最大值。换句话说,答案是 max(nums[j] XOR xi) ,其中所有 j 均满足 nums[j] <= mi 。如果 nums 中的所有元素都大于 mi,最终答案就是 -1 。
返回一个整数数组 answer 作为查询的答案,其中 answer.length == queries.length 且 answer[i] 是第 i 个查询的答案。
示例 1:
输入:nums = [0,1,2,3,4], queries = [[3,1],[1,3],[5,6]]
输出:[3,3,7]
解释:
1) 0 和 1 是仅有的两个不超过 1 的整数。0 XOR 3 = 3 而 1 XOR 3 = 2 。二者中的更大值是 3 。
2) 1 XOR 2 = 3.
3) 5 XOR 2 = 7.
示例 2:
输入:nums = [5,2,4,6,6,3], queries = [[12,4],[8,1],[6,3]]
输出:[15,-1,5]
提示:
1 <= nums.length, queries.length <= 105queries[i].length == 20 <= nums[j], xi, mi <= 109
方法一:离线查询 + 0-1 字典树 · Go 实现
思考
每个询问要在 的约束下最大化 。在线对每个询问扫描数组是 , 无法接受。
询问互不依赖且与 的顺序无关。按 排序后,可把「不超过 的数」单调插入同一棵结构。
将 排序,用指针把 的数插入 - 字典树;在树上贪心走相反位即可得到最大异或。空树时答案为 。
根据题目描述我们知道,每个查询相互独立,并且查询的结果与 中的元素顺序无关,因此,我们考虑将所有的查询按照 从小到大排序,并且将 从小到大排序。
接下来,我们使用一个 字典树来维护 中的元素。我们用一个指针 来记录当前字典树中的元素,初始时 。对于每个查询 ,我们不断地将 中的元素插入到字典树中,直到 ,此时我们就可以在字典树中查询到所有不超过 的元素,我们将其中与 异或值最大的元素的异或值作为答案。
时间复杂度 ,空间复杂度 ,其中 和 分别是数组 和 的长度,而 是数组 中的最大值,本题中 。
type Trie struct {
	children [2]*Trie
}

func NewTrie() *Trie {
	return &Trie{}
}

func (t *Trie) insert(x int) {
	node := t
	for i := 30; i >= 0; i-- {
		v := x >> i & 1
		if node.children[v] == nil {
			node.children[v] = NewTrie()
		}
		node = node.children[v]
	}
}

func (t *Trie) search(x int) int {
	node := t
	ans := 0
	for i := 30; i >= 0; i-- {
		v := x >> i & 1
		if node.children[v^1] != nil {
			ans |= 1 << i
			node = node.children[v^1]
		} else if node.children[v] != nil {
			node = node.children[v]
		} else {
			return -1
		}
	}
	return ans
}

func maximizeXor(nums []int, queries [][]int) []int {
	sort.Ints(nums)
	n := len(queries)
	idx := make([]int, n)
	for i := 0; i < n; i++ {
		idx[i] = i
	}
	sort.Slice(idx, func(i, j int) bool {
		return queries[idx[i]][1] < queries[idx[j]][1]
	})
	ans := make([]int, n)
	trie := NewTrie()
	j := 0
	for _, i := range idx {
		x, m := queries[i][0], queries[i][1]
		for j < len(nums) && nums[j] <= m {
			trie.insert(nums[j])
			j++
		}
		ans[i] = trie.search(x)
	}
	return ans
}1803. 统计异或值在范围内的数对有多少
题目、示例与约束
给你一个整数数组 nums (下标 从 0 开始 计数)以及两个整数:low 和 high ,请返回 漂亮数对 的数目。
漂亮数对 是一个形如 (i, j) 的数对,其中 0 <= i < j < nums.length 且 low <= (nums[i] XOR nums[j]) <= high 。
示例 1:
输入:nums = [1,4,2,7], low = 2, high = 6
输出:6
解释:所有漂亮数对 (i, j) 列出如下:
    - (0, 1): nums[0] XOR nums[1] = 5
    - (0, 2): nums[0] XOR nums[2] = 3
    - (0, 3): nums[0] XOR nums[3] = 6
    - (1, 2): nums[1] XOR nums[2] = 6
    - (1, 3): nums[1] XOR nums[3] = 3
    - (2, 3): nums[2] XOR nums[3] = 5
示例 2:
输入:nums = [9,8,4,2,1], low = 5, high = 14 输出:8 解释:所有漂亮数对 (i, j) 列出如下: - (0, 2): nums[0] XOR nums[2] = 13 - (0, 3): nums[0] XOR nums[3] = 11 - (0, 4): nums[0] XOR nums[4] = 8 - (1, 2): nums[1] XOR nums[2] = 12 - (1, 3): nums[1] XOR nums[3] = 10 - (1, 4): nums[1] XOR nums[4] = 9 - (2, 3): nums[2] XOR nums[3] = 6 - (2, 4): nums[2] XOR nums[4] = 5
提示:
1 <= nums.length <= 2 * 1041 <= nums[i] <= 2 * 1041 <= low <= high <= 2 * 104
方法一:0-1 字典树 · Go 实现
思考
需要统计满足 的下标对数目。若枚举全部数对再判断异或,时间复杂度为 。 ,无法通过。
区间计数可改写成「异或小于 的对数」减去「异或小于 的对数」。将已处理的数按二进制从高到低插入 - 字典树,并在节点上记录子树大小。查询时根据 的当前位决定:该位为 则可把与 同位的整棵子树计入答案,再走向相反位;该位为 则只能走向相同位。对每个 先查询再插入,避免与自身配对。
对于这种区间 统计的问题,我们可以考虑将其转换为统计 和 的问题,然后相减即可得到答案。
在这道题中,我们可以统计有多少数对的异或值小于 ,然后再统计有多少数对的异或值小于 ,相减的结果就是异或值在区间 之间的数对数量。
另外,对于数组异或计数问题,我们通常可以使用“0-1 字典树”来解决。
字典树的节点定义如下:
children[0]和children[1]分别表示当前节点的左右子节点;cnt表示以当前节点为结尾的数的数量。
在字典树中,我们还定义了以下两个函数:
其中一个函数是 ,表示将数 插入到字典树中。该函数将数字 按照二进制位从高到低的顺序,插入到“0-1 字典树”中。如果当前二进制位为 ,则插入到左子节点,否则插入到右子节点。然后将节点的计数值 加 。
另一个函数是 ,表示在字典树中查找与 异或值小于 的数量。该函数从字典树的根节点 node 开始,遍历 的二进制位,从高到低,记当前 的二进制位的数为 。如果当前 的二进制位为 ,此时我们可以直接将答案加上与 的当前二进制位 相同的子节点的计数值 ,然后将当前节点移动到与 的当前二进制位 不同的子节点,即 node = node.children[v ^ 1]。继续遍历下一位。如果当前 的二进制位为 ,此时我们只能将当前节点移动到与 的当前二进制位 相同的子节点,即 node = node.children[v]。继续遍历下一位。遍历完 的二进制位后,返回答案。
有了以上两个函数,我们就可以解决本题了。
我们遍历数组 nums,对于每个数 ,我们先在字典树中查找与 异或值小于 的数量,然后在字典树中查找与 异或值小于 的数对数量,将两者的差值加到答案中。接着将 插入到字典树中。继续遍历下一个数 ,直到遍历完数组 nums。最后返回答案即可。
时间复杂度 ,空间复杂度 。其中 为数组 nums 的长度,而 为数组 nums 中的最大值。本题中我们直接取 。
type Trie struct {
	children [2]*Trie
	cnt      int
}

func newTrie() *Trie {
	return &Trie{}
}

func (this *Trie) insert(x int) {
	node := this
	for i := 15; i >= 0; i-- {
		v := (x >> i) & 1
		if node.children[v] == nil {
			node.children[v] = newTrie()
		}
		node = node.children[v]
		node.cnt++
	}
}

func (this *Trie) search(x, limit int) (ans int) {
	node := this
	for i := 15; i >= 0 && node != nil; i-- {
		v := (x >> i) & 1
		if (limit >> i & 1) == 1 {
			if node.children[v] != nil {
				ans += node.children[v].cnt
			}
			node = node.children[v^1]
		} else {
			node = node.children[v]
		}
	}
	return
}

func countPairs(nums []int, low int, high int) (ans int) {
	tree := newTrie()
	for _, x := range nums {
		ans += tree.search(x, high+1) - tree.search(x, low)
		tree.insert(x)
	}
	return
}1858. 包含所有前缀的最长单词 🔒
题目、示例与约束
给定一个字符串数组 words,找出 words 中所有的前缀都在 words 中的最长字符串。
- 例如,令
words = ["a", "app", "ap"]。字符串"app"含前缀"ap"和"a",都在words中。
返回符合上述要求的字符串。如果存在多个(符合条件的)相同长度的字符串,返回字典序中最小的字符串,如果这样的字符串不存在,返回 ""。
示例 1:
输入: words = ["k","ki","kir","kira", "kiran"]
输出: "kiran"
解释: "kiran" 含前缀 "kira"、 "kir"、 "ki"、 和 "k",这些前缀都出现在 words 中。
示例 2:
输入: words = ["a", "banana", "app", "appl", "ap", "apply", "apple"]
输出: "apple"
解释: "apple" 和 "apply" 都在 words 中含有各自的所有前缀。
然而,"apple" 在字典序中更小,所以我们返回之。
示例 3:
输入: words = ["abc", "bc", "ab", "qwe"]
输出: ""
提示:
1 <= words.length <= 1051 <= words[i].length <= 1051 <= sum(words[i].length) <= 105words[i]只包含小写英文字母。
方法一:前缀树 · Go 实现
思考
要找最长且所有前缀都在词表中的单词,并列取字典序最小。对每个词再扫描词表检查前缀, 会重复平方。
把全部单词插入前缀树并标记结尾。查询一个词时,沿路径检查每个节点都是结尾,即其所有前缀均在词表中。再按长度与字典序更新答案。
我们定义一个前缀树,前缀树每个节点有两个属性,一个是长度为 的子节点数组 ,另一个是是否为单词结尾的标记 。
我们遍历 ,对于每个单词 ,我们从根节点开始遍历,如果当前节点的子节点数组中没有 的第一个字符,我们就创建一个新的节点,然后继续遍历 的下一个字符,直到遍历完 ,我们将当前节点的 标记为 。
接下来我们遍历 ,对于每个单词 ,我们从根节点开始遍历,如果当前节点的子节点数组的 字段为 ,说明 的某个前缀不在 中,我们返回 。否则继续遍历 的下一个字符,直到遍历完 ,我们返回 。
时间复杂度 ,空间复杂度 。其中 是单词 的长度。
type Trie struct {
	children [26]*Trie
	isEnd    bool
}

func newTrie() *Trie {
	return &Trie{}
}

func (t *Trie) insert(w string) {
	node := t
	for _, c := range w {
		idx := c - 'a'
		if node.children[idx] == nil {
			node.children[idx] = newTrie()
		}
		node = node.children[idx]
	}
	node.isEnd = true
}

func (t *Trie) search(w string) bool {
	node := t
	for _, c := range w {
		idx := c - 'a'
		node = node.children[idx]
		if !node.isEnd {
			return false
		}
	}
	return true
}

func longestWord(words []string) string {
	trie := newTrie()
	for _, w := range words {
		trie.insert(w)
	}
	ans := ""
	for _, w := range words {
		if (len(w) > len(ans) || (len(w) == len(ans) && w < ans)) && trie.search(w) {
			ans = w
		}
	}
	return ans
}1938. 查询最大基因差
题目、示例与约束
给你一棵 n 个节点的有根树,节点编号从 0 到 n - 1 。每个节点的编号表示这个节点的 独一无二的基因值 (也就是说节点 x 的基因值为 x)。两个基因值的 基因差 是两者的 异或和 。给你整数数组 parents ,其中 parents[i] 是节点 i 的父节点。如果节点 x 是树的 根 ,那么 parents[x] == -1 。
给你查询数组 queries ,其中 queries[i] = [nodei, vali] 。对于查询 i ,请你找到 vali 和 pi 的 最大基因差 ,其中 pi 是节点 nodei 到根之间的任意节点(包含 nodei 和根节点)。更正式的,你想要最大化 vali XOR pi 。
请你返回数组 ans ,其中 ans[i] 是第 i 个查询的答案。
示例 1:
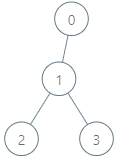
输入:parents = [-1,0,1,1], queries = [[0,2],[3,2],[2,5]]
输出:[2,3,7]
解释:查询数组处理如下:
- [0,2]:最大基因差的对应节点为 0 ,基因差为 2 XOR 0 = 2 。
- [3,2]:最大基因差的对应节点为 1 ,基因差为 2 XOR 1 = 3 。
- [2,5]:最大基因差的对应节点为 2 ,基因差为 5 XOR 2 = 7 。
示例 2:
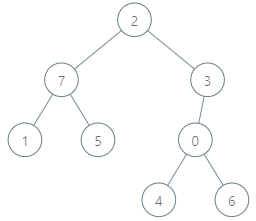
输入:parents = [3,7,-1,2,0,7,0,2], queries = [[4,6],[1,15],[0,5]]
输出:[6,14,7]
解释:查询数组处理如下:
- [4,6]:最大基因差的对应节点为 0 ,基因差为 6 XOR 0 = 6 。
- [1,15]:最大基因差的对应节点为 1 ,基因差为 15 XOR 1 = 14 。
- [0,5]:最大基因差的对应节点为 2 ,基因差为 5 XOR 2 = 7 。
提示:
2 <= parents.length <= 105- 对于每个 不是 根节点的
i,有0 <= parents[i] <= parents.length - 1。 parents[root] == -11 <= queries.length <= 3 * 1040 <= nodei <= parents.length - 10 <= vali <= 2 * 105
方法一:Go 实现(灵茶山艾府) · Go 实现
本站根据 Go 源码整理,非作者原文。
思路:先把查询按目标节点分组。沿树做深度优先遍历,进入节点时把其编号加入二进制字典树,退出时减少对应路径的计数,因此有效元素始终是当前节点及其祖先。回答异或最大值查询时,从高位到低位优先选择与查询位相反、且计数为正的分支。
复杂度:设树有 n 个节点、q 个查询,处理位数为 B(源码为 18)。时间为 O((n+q)B),辅助空间为 O(nB+n+q),包含字典树、查询分组和递归栈。删除只减计数、不释放字典树节点,因此空间不能只按当前树高估计。
/* 离线+字典树
离线,将查询按照 $\textit{node}_i$ 分组。
根据 $\textit{parents}$ 建树,然后从根开始 DFS,每访问一个节点 $v$,就将其插入 trie 树,然后回答当前节点 $v$ 对应的所有询问,最后在递归结束时将 $v$ 从 trie 中删去。
*/

// github.com/EndlessCheng/codeforces-go
type node struct {
	son [2]*node
	cnt int
}
type trie struct{ root *node }

func (t *trie) put(v int) *node {
	o := t.root
	for i := 17; i >= 0; i-- {
		b := v >> i & 1
		if o.son[b] == nil {
			o.son[b] = &node{}
		}
		o = o.son[b]
		o.cnt++
	}
	return o
}

func (t *trie) del(v int) *node {
	o := t.root
	for i := 17; i >= 0; i-- {
		o = o.son[v>>i&1]
		o.cnt-- // 删除操作只需要减少 cnt 就行,cnt 为 0 就视作删掉了该节点
	}
	return o
}

func (t *trie) maxXor(v int) (ans int) {
	o := t.root
	for i := 17; i >= 0; i-- {
		b := v >> i & 1
		if o.son[b^1] != nil && o.son[b^1].cnt > 0 {
			ans |= 1 << i
			b ^= 1
		}
		o = o.son[b]
	}
	return
}

func maxGeneticDifference(parents []int, queries [][]int) []int {
	n := len(parents)
	// 建树
	g := make([][]int, n)
	var root int
	for v, pa := range parents {
		if pa == -1 {
			root = v
		} else {
			g[pa] = append(g[pa], v)
		}
	}

	// 离线,将查询分组
	type query struct{ val, i int }
	qs := make([][]query, n)
	for i, q := range queries {
		qs[q[0]] = append(qs[q[0]], query{q[1], i})
	}

	ans := make([]int, len(queries))
	t := &trie{&node{}}
	// 遍历整棵树,每访问一个节点就将其插入 trie 树,访问结束时将其从 trie 中删去
	var dfs func(int)
	dfs = func(v int) {
		t.put(v)
		for _, q := range qs[v] {
			ans[q.i] = t.maxXor(q.val)
		}
		for _, w := range g[v] {
			dfs(w)
		}
		t.del(v)
	}
	dfs(root)
	return ans
}1948. 删除系统中的重复文件夹
题目、示例与约束
由于一个漏洞,文件系统中存在许多重复文件夹。给你一个二维数组 paths,其中 paths[i] 是一个表示文件系统中第 i 个文件夹的绝对路径的数组。
- 例如,
["one", "two", "three"]表示路径"/one/two/three"。
如果两个文件夹(不需要在同一层级)包含 非空且相同的 子文件夹 集合 并具有相同的子文件夹结构,则认为这两个文件夹是相同文件夹。相同文件夹的根层级 不 需要相同。如果存在两个(或两个以上)相同 文件夹,则需要将这些文件夹和所有它们的子文件夹 标记 为待删除。
- 例如,下面文件结构中的文件夹
"/a"和"/b"相同。它们(以及它们的子文件夹)应该被 全部 标记为待删除:/a/a/x/a/x/y/a/z/b/b/x/b/x/y/b/z
- 然而,如果文件结构中还包含路径
"/b/w",那么文件夹"/a"和"/b"就不相同。注意,即便添加了新的文件夹"/b/w",仍然认为"/a/x"和"/b/x"相同。
一旦所有的相同文件夹和它们的子文件夹都被标记为待删除,文件系统将会 删除 所有上述文件夹。文件系统只会执行一次删除操作。执行完这一次删除操作后,不会删除新出现的相同文件夹。
返回二维数组 ans ,该数组包含删除所有标记文件夹之后剩余文件夹的路径。路径可以按 任意顺序 返回。
示例 1:
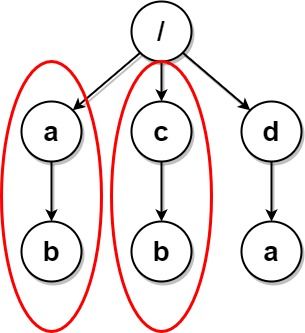
输入:paths = [["a"],["c"],["d"],["a","b"],["c","b"],["d","a"]]
输出:[["d"],["d","a"]]
解释:文件结构如上所示。
文件夹 "/a" 和 "/c"(以及它们的子文件夹)都会被标记为待删除,因为它们都包含名为 "b" 的空文件夹。
示例 2:
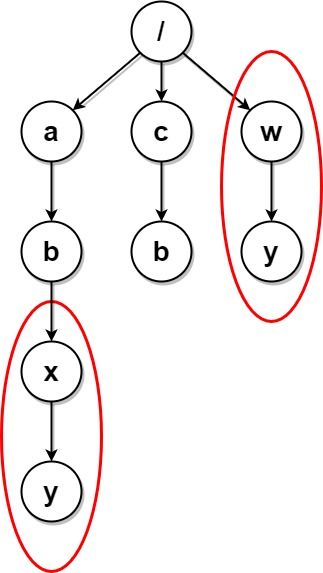
输入:paths = [["a"],["c"],["a","b"],["c","b"],["a","b","x"],["a","b","x","y"],["w"],["w","y"]]
输出:[["c"],["c","b"],["a"],["a","b"]]
解释:文件结构如上所示。
文件夹 "/a/b/x" 和 "/w"(以及它们的子文件夹)都会被标记为待删除,因为它们都包含名为 "y" 的空文件夹。
注意,文件夹 "/a" 和 "/c" 在删除后变为相同文件夹,但这两个文件夹不会被删除,因为删除只会进行一次,且它们没有在删除前被标记。
示例 3:
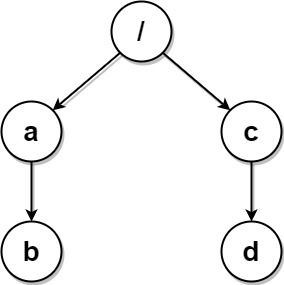
输入:paths = [["a","b"],["c","d"],["c"],["a"]]
输出:[["c"],["c","d"],["a"],["a","b"]]
解释:文件系统中所有文件夹互不相同。
注意,返回的数组可以按不同顺序返回文件夹路径,因为题目对顺序没有要求。
示例 4:
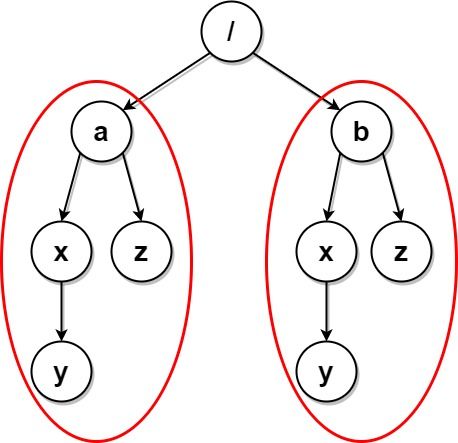
输入:paths = [["a"],["a","x"],["a","x","y"],["a","z"],["b"],["b","x"],["b","x","y"],["b","z"]]
输出:[]
解释:文件结构如上所示。
文件夹 "/a/x" 和 "/b/x"(以及它们的子文件夹)都会被标记为待删除,因为它们都包含名为 "y" 的空文件夹。
文件夹 "/a" 和 "/b"(以及它们的子文件夹)都会被标记为待删除,因为它们都包含一个名为 "z" 的空文件夹以及上面提到的文件夹 "x" 。
示例 5:
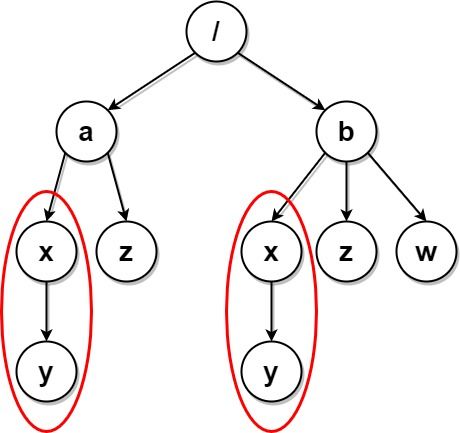
输入:paths = [["a"],["a","x"],["a","x","y"],["a","z"],["b"],["b","x"],["b","x","y"],["b","z"],["b","w"]]
输出:[["b"],["b","w"],["b","z"],["a"],["a","z"]]
解释:本例与上例的结构基本相同,除了新增 "/b/w" 文件夹。
文件夹 "/a/x" 和 "/b/x" 仍然会被标记,但 "/a" 和 "/b" 不再被标记,因为 "/b" 中有名为 "w" 的空文件夹而 "/a" 没有。
注意,"/a/z" 和 "/b/z" 不会被标记,因为相同子文件夹的集合必须是非空集合,但这两个文件夹都是空的。
提示:
1 <= paths.length <= 2 * 1041 <= paths[i].length <= 5001 <= paths[i][j].length <= 101 <= sum(paths[i][j].length) <= 2 * 105path[i][j]由小写英文字母组成- 不会存在两个路径都指向同一个文件夹的情况
- 对于不在根层级的任意文件夹,其父文件夹也会包含在输入中
方法一:字典树 + DFS · Go 实现
思考
两棵子树结构(含子文件夹名)相同则整棵删除。路径条数与深度较大,不能两两序列化比较所有子树对。
先把路径插入字典树,再 DFS 把每个结点的子树编码为排序后的字符串。相同编码的结点互相标记删除。
第二次 DFS 跳过已删结点,收集仍存在的根到叶路径。
我们可以使用字典树来存储文件夹的结构,字典树的每个节点数据如下:
children:一个字典,键为子文件夹的名称,值为对应的子节点。deleted:一个布尔值,表示该节点是否被标记为待删除。
我们将所有路径插入到字典树中,然后使用 DFS 遍历字典树,构建每个子树的字符串表示。对于每个子树,如果它的字符串表示已经存在于一个全局字典中,则将该节点和全局字典中的对应节点都标记为待删除。最后,再次使用 DFS 遍历字典树,将未被标记的节点的路径添加到结果列表中。
type Trie struct {
	children map[string]*Trie
	deleted  bool
}

func NewTrie() *Trie {
	return &Trie{
		children: make(map[string]*Trie),
	}
}

func deleteDuplicateFolder(paths [][]string) (ans [][]string) {
	root := NewTrie()
	for _, path := range paths {
		cur := root
		for _, name := range path {
			if _, exists := cur.children[name]; !exists {
				cur.children[name] = NewTrie()
			}
			cur = cur.children[name]
		}
	}

	g := make(map[string]*Trie)

	var dfs func(*Trie) string
	dfs = func(node *Trie) string {
		if len(node.children) == 0 {
			return ""
		}
		var subs []string
		for name, child := range node.children {
			subs = append(subs, name+"("+dfs(child)+")")
		}
		sort.Strings(subs)
		s := strings.Join(subs, "")
		if existingNode, exists := g[s]; exists {
			node.deleted = true
			existingNode.deleted = true
		} else {
			g[s] = node
		}
		return s
	}

	var dfs2 func(*Trie, []string)
	dfs2 = func(node *Trie, path []string) {
		if node.deleted {
			return
		}
		if len(path) > 0 {
			ans = append(ans, append([]string{}, path...))
		}
		for name, child := range node.children {
			dfs2(child, append(path, name))
		}
	}

	dfs(root)
	dfs2(root, []string{})
	return ans
}继续阅读
- 实践案例
- 实践案例
- 实践案例