
LeetCode Go · 树与二叉树(3)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
543. 二叉树的直径
题目、示例与约束
给你一棵二叉树的根节点,返回该树的 直径 。
二叉树的 直径 是指树中任意两个节点之间最长路径的 长度 。这条路径可能经过也可能不经过根节点 root 。
两节点之间路径的 长度 由它们之间边数表示。
示例 1:
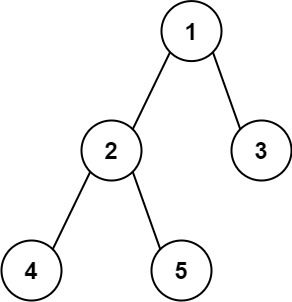
输入:root = [1,2,3,4,5]
输出:3
解释:3 ,取路径 [4,2,1,3] 或 [5,2,1,3] 的长度。
示例 2:
输入:root = [1,2]
输出:1
提示:
- 树中节点数目在范围
[1, 104]内 -100 <= Node.val <= 100
方法一:枚举 + DFS · Go 实现
思考
直径是任意两点路径的最长边数。枚举所有点对再求路径不现实。任一直径必经过某节点,等于该节点左右子树高度之和。
DFS 返回子树高度,并在回溯时用 更新全局答案,同时向父节点返回 。每个节点只访问一次,高度与直径一起算出。
我们可以枚举二叉树的每个节点,以该节点为根节点,计算其左右子树的最大深度 和 ,则该节点的直径为 。取所有节点的直径的最大值即为二叉树的直径。
时间复杂度 ,空间复杂度 。其中 为二叉树的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func diameterOfBinaryTree(root *TreeNode) (ans int) {
	var dfs func(root *TreeNode) int
	dfs = func(root *TreeNode) int {
		if root == nil {
			return 0
		}
		l, r := dfs(root.Left), dfs(root.Right)
		ans = max(ans, l+r)
		return 1 + max(l, r)
	}
	dfs(root)
	return
}545. 二叉树的边界 🔒
题目、示例与约束
二叉树的 边界 是由 根节点 、左边界 、按从左到右顺序的 叶节点 和 逆序的右边界 ,按顺序依次连接组成。
左边界 是满足下述定义的节点集合:
- 根节点的左子节点在左边界中。如果根节点不含左子节点,那么左边界就为 空 。
- 如果一个节点在左边界中,并且该节点有左子节点,那么它的左子节点也在左边界中。
- 如果一个节点在左边界中,并且该节点 不含 左子节点,那么它的右子节点就在左边界中。
- 最左侧的叶节点 不在 左边界中。
右边界 定义方式与 左边界 相同,只是将左替换成右。即,右边界是根节点右子树的右侧部分;叶节点 不是 右边界的组成部分;如果根节点不含右子节点,那么右边界为 空 。
叶节点 是没有任何子节点的节点。对于此问题,根节点 不是 叶节点。
给你一棵二叉树的根节点 root ,按顺序返回组成二叉树 边界 的这些值。
示例 1:
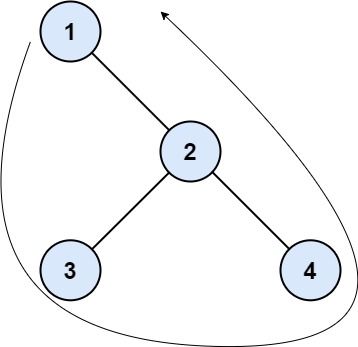
输入:root = [1,null,2,3,4]
输出:[1,3,4,2]
解释:
- 左边界为空,因为二叉树不含左子节点。
- 右边界是 [2] 。从根节点的右子节点开始的路径为 2 -> 4 ,但 4 是叶节点,所以右边界只有 2 。
- 叶节点从左到右是 [3,4] 。
按题目要求依序连接得到结果 [1] + [] + [3,4] + [2] = [1,3,4,2] 。
示例 2:
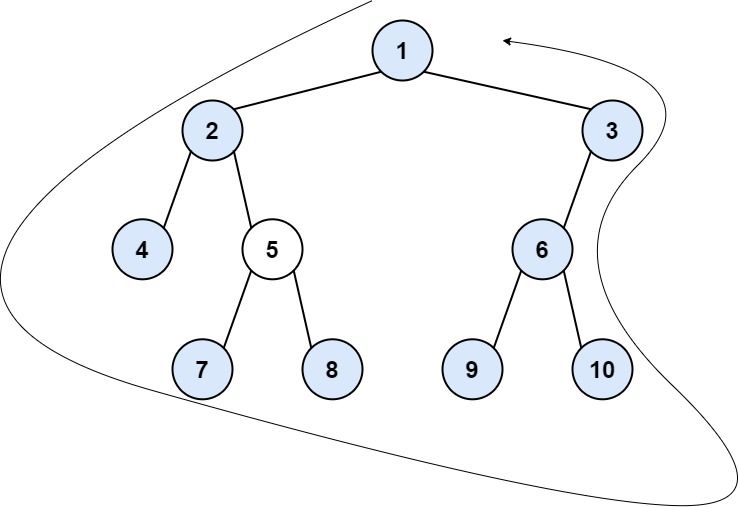
输入:root = [1,2,3,4,5,6,null,null,null,7,8,9,10]
输出:[1,2,4,7,8,9,10,6,3]
解释:
- 左边界为 [2] 。从根节点的左子节点开始的路径为 2 -> 4 ,但 4 是叶节点,所以左边界只有 2 。
- 右边界是 [3,6] ,逆序为 [6,3] 。从根节点的右子节点开始的路径为 3 -> 6 -> 10 ,但 10 是叶节点。
- 叶节点从左到右是 [4,7,8,9,10]
按题目要求依序连接得到结果 [1] + [2] + [4,7,8,9,10] + [6,3] = [1,2,4,7,8,9,10,6,3] 。
提示:
- 树中节点的数目在范围
[1, 104]内 -1000 <= Node.val <= 1000
方法一:DFS · Go 实现
思考
边界由逆时针的左边界、底端叶子、右边界组成,根只计一次,叶子不与左右边界重复。一次遍历难以同时满足三种方向与去重。
分三次 DFS:左链优先走左(无左走右)且不含叶子;叶子单独收集;右链优先走右且事后反转。根若不是叶子则先放入答案,再拼接三段。三种角色用参数 区分。
首先,如果树只有一个节点,那么直接返回这个节点的值的列表。
否则,我们可以通过深度优先搜索,找到二叉树的左边界、叶节点和右边界。
具体地,我们可以通过一个递归函数 来找到这三个部分。在 函数中,我们需要传入一个列表 ,一个节点 和一个整数 ,其中 用来存储当前部分的节点值,而 和 分别表示当前节点和当前部分的类型(左边界, 叶节点或右边界)。
函数的具体实现如下:
- 如果 为空,那么直接返回。
- 如果 ,那么我们需要找到左边界。如果 不是叶节点,那么我们将 的值加入到 中。如果 有左子节点,那么我们递归地调用 函数,传入 , 的左子节点和 。否则,我们递归地调用 函数,传入 , 的右子节点和 。
- 如果 ,那么我们需要找到叶节点。如果 是叶节点,那么我们将 的值加入到 中。否则,我们递归地调用 函数,传入 , 的左子节点和 ,以及 , 的右子节点和 。
- 如果 ,那么我们需要找到右边界。如果 不是叶节点,那么我们将 的值加入到 中,如果 有右子节点,那么我们递归地调用 函数,传入 , 的右子节点和 。否则,我们递归地调用 函数,传入 , 的左子节点和 。
我们分别调用 函数,找到左边界、叶节点和右边界,然后将这三个部分连接起来,即可得到答案。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func boundaryOfBinaryTree(root *TreeNode) []int {
	ans := []int{root.Val}
	if root.Left == root.Right {
		return ans
	}

	left, leaves, right := []int{}, []int{}, []int{}

	var dfs func(nums *[]int, root *TreeNode, i int)
	dfs = func(nums *[]int, root *TreeNode, i int) {
		if root == nil {
			return
		}
		if i == 0 {
			if root.Left != root.Right {
				*nums = append(*nums, root.Val)
				if root.Left != nil {
					dfs(nums, root.Left, i)
				} else {
					dfs(nums, root.Right, i)
				}
			}
		} else if i == 1 {
			if root.Left == root.Right {
				*nums = append(*nums, root.Val)
			} else {
				dfs(nums, root.Left, i)
				dfs(nums, root.Right, i)
			}
		} else {
			if root.Left != root.Right {
				*nums = append(*nums, root.Val)
				if root.Right != nil {
					dfs(nums, root.Right, i)
				} else {
					dfs(nums, root.Left, i)
				}
			}
		}
	}

	dfs(&left, root.Left, 0)
	dfs(&leaves, root, 1)
	dfs(&right, root.Right, 2)

	ans = append(ans, left...)
	ans = append(ans, leaves...)
	for i := len(right) - 1; i >= 0; i-- {
		ans = append(ans, right[i])
	}

	return ans
}549. 二叉树最长连续序列 II 🔒
题目、示例与约束
给定二叉树的根 root ,返回树中最长连续路径的长度。
连续路径是路径中相邻节点的值相差 1 的路径。此路径可以是增加或减少。
- 例如,
[1,2,3,4]和[4,3,2,1]都被认为有效,但路径[1,2,4,3]无效。
另一方面,路径可以是子-父-子顺序,不一定是父子顺序。
示例 1:
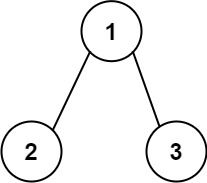
输入: root = [1,2,3]
输出: 2
解释: 最长的连续路径是 [1, 2] 或者 [2, 1]。
示例 2:
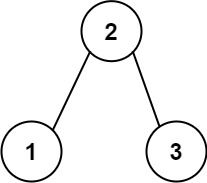
输入: root = [2,1,3]
输出: 3
解释: 最长的连续路径是 [1, 2, 3] 或者 [3, 2, 1]。
提示:
- 树上所有节点的值都在
[1, 3 * 104]范围内。 -3 * 104 <= Node.val <= 3 * 104
方法一 · Go 实现
思考
路径可以在节点处拐弯,既可递增也可递减,因此不是单向的「父到子」链。对每个节点若再搜索整条路径会重复。
DFS 返回「以该节点为端点、向父方向能延伸的最长递增 / 递减长度」。根据子节点值与当前值的差 更新两段长度,答案取 (节点本身计了两次)。向上只回传单侧长度,供父节点拼接。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func longestConsecutive(root *TreeNode) int {
	ans := 0
	var dfs func(root *TreeNode) []int
	dfs = func(root *TreeNode) []int {
		if root == nil {
			return []int{0, 0}
		}
		incr, decr := 1, 1
		left := dfs(root.Left)
		right := dfs(root.Right)
		if root.Left != nil {
			if root.Left.Val+1 == root.Val {
				incr = left[0] + 1
			}
			if root.Left.Val-1 == root.Val {
				decr = left[1] + 1
			}
		}
		if root.Right != nil {
			if root.Right.Val+1 == root.Val {
				incr = max(incr, right[0]+1)
			}
			if root.Right.Val-1 == root.Val {
				decr = max(decr, right[1]+1)
			}
		}
		ans = max(ans, incr+decr-1)
		return []int{incr, decr}
	}
	dfs(root)
	return ans
}558. 四叉树交集
题目、示例与约束
二进制矩阵中的所有元素不是 0 就是 1 。
给你两个四叉树,quadTree1 和 quadTree2。其中 quadTree1 表示一个 n * n 二进制矩阵,而 quadTree2 表示另一个 n * n 二进制矩阵。
请你返回一个表示 n * n 二进制矩阵的四叉树,它是 quadTree1 和 quadTree2 所表示的两个二进制矩阵进行 按位逻辑或运算 的结果。
注意,当 isLeaf 为 False 时,你可以把 True 或者 False 赋值给节点,两种值都会被判题机制 接受 。
四叉树数据结构中,每个内部节点只有四个子节点。此外,每个节点都有两个属性:
val:储存叶子结点所代表的区域的值。1 对应 True,0 对应 False;isLeaf: 当这个节点是一个叶子结点时为 True,如果它有 4 个子节点则为 False 。
class Node {
    public boolean val;
    public boolean isLeaf;
    public Node topLeft;
    public Node topRight;
    public Node bottomLeft;
    public Node bottomRight;
}
我们可以按以下步骤为二维区域构建四叉树:
- 如果当前网格的值相同(即,全为
0或者全为1),将isLeaf设为 True ,将val设为网格相应的值,并将四个子节点都设为 Null 然后停止。 - 如果当前网格的值不同,将
isLeaf设为 False, 将val设为任意值,然后如下图所示,将当前网格划分为四个子网格。 - 使用适当的子网格递归每个子节点。
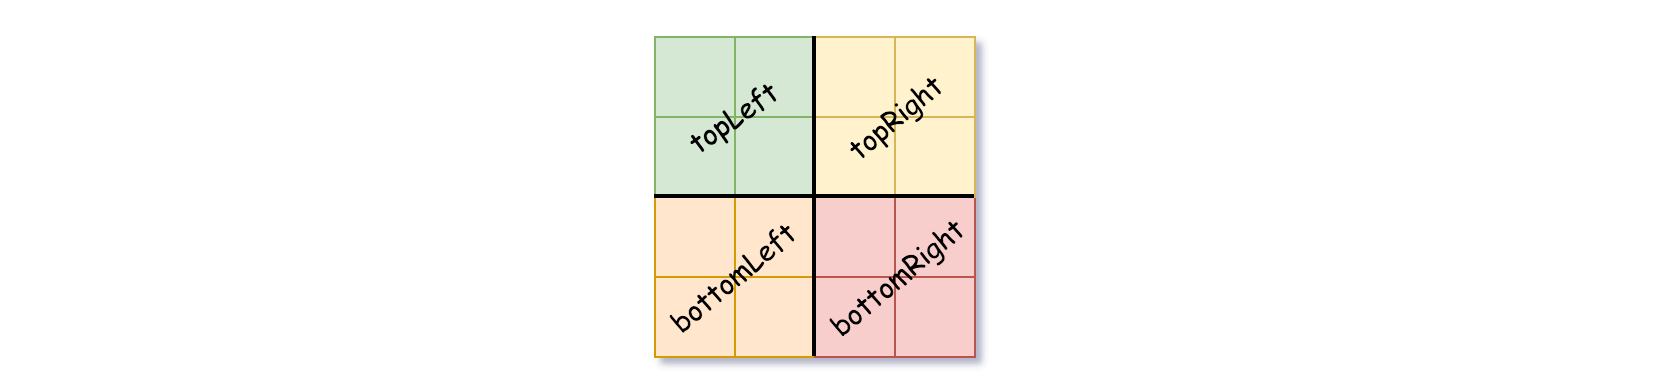
如果你想了解更多关于四叉树的内容,可以参考 百科。
四叉树格式:
输出为使用层序遍历后四叉树的序列化形式,其中 null 表示路径终止符,其下面不存在节点。
它与二叉树的序列化非常相似。唯一的区别是节点以列表形式表示 [isLeaf, val] 。
如果 isLeaf 或者 val 的值为 True ,则表示它在列表 [isLeaf, val] 中的值为 1 ;如果 isLeaf 或者 val 的值为 False ,则表示值为 0 。
示例 1:
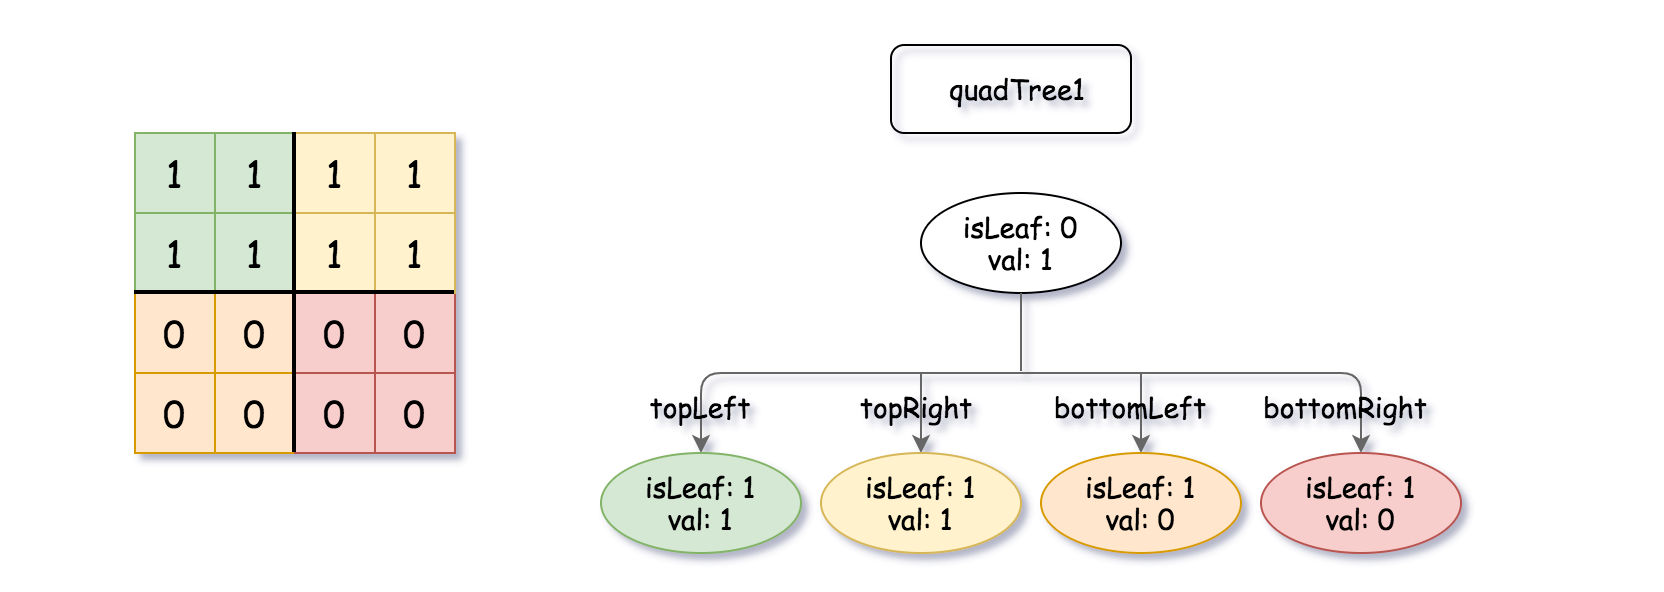
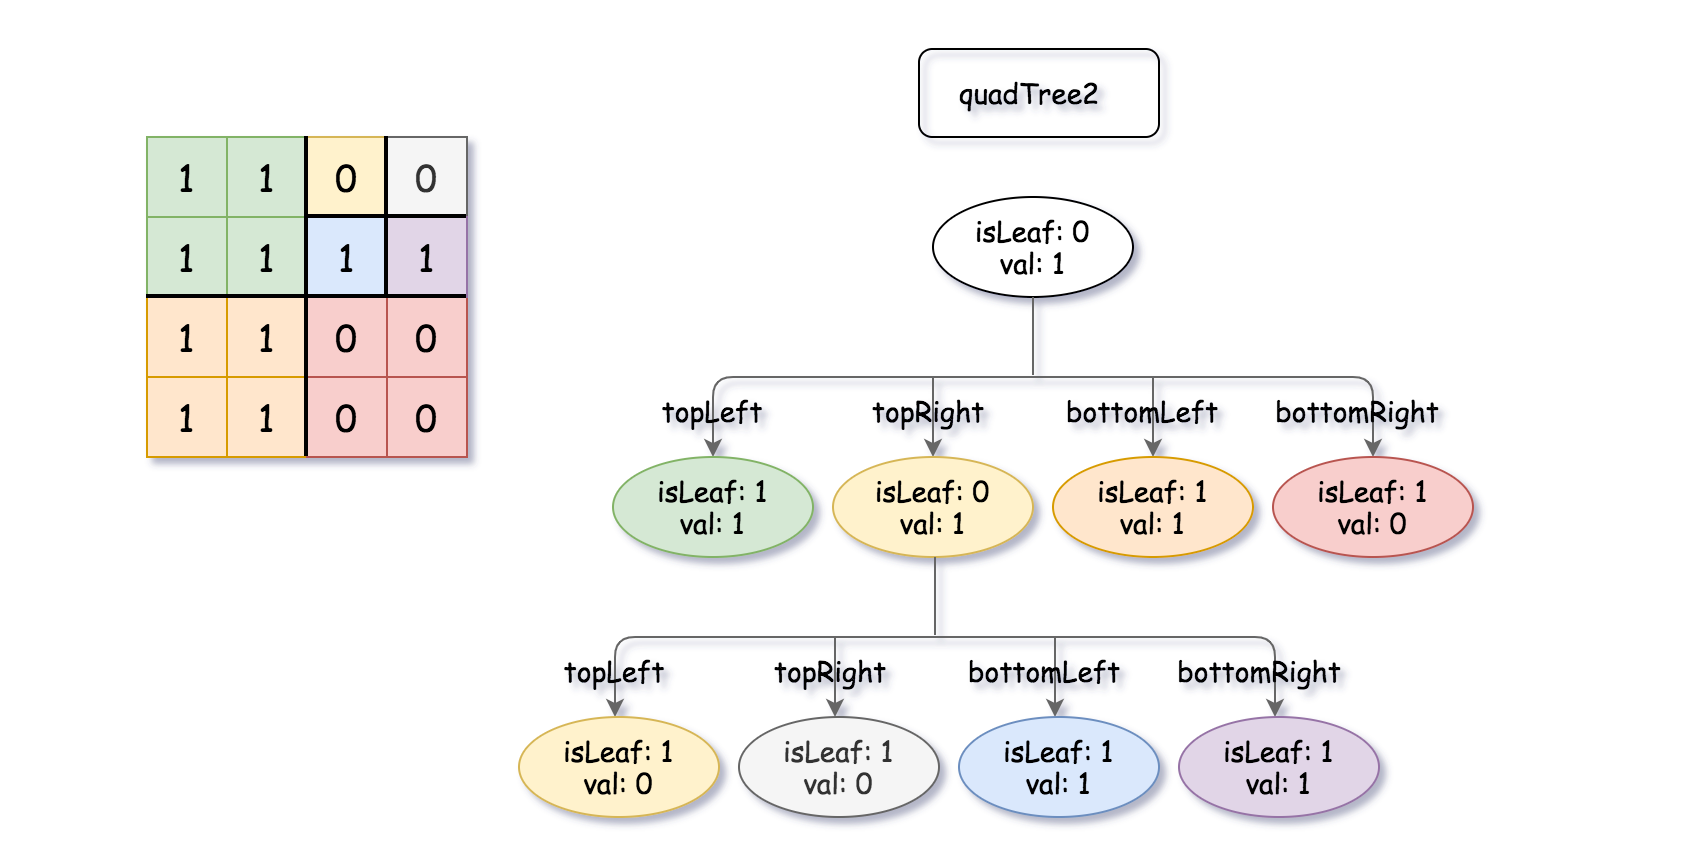
输入:quadTree1 = [[0,1],[1,1],[1,1],[1,0],[1,0]]
, quadTree2 = [[0,1],[1,1],[0,1],[1,1],[1,0],null,null,null,null,[1,0],[1,0],[1,1],[1,1]]
输出:[[0,0],[1,1],[1,1],[1,1],[1,0]]
解释:quadTree1 和 quadTree2 如上所示。由四叉树所表示的二进制矩阵也已经给出。
如果我们对这两个矩阵进行按位逻辑或运算,则可以得到下面的二进制矩阵,由一个作为结果的四叉树表示。
注意,我们展示的二进制矩阵仅仅是为了更好地说明题意,你无需构造二进制矩阵来获得结果四叉树。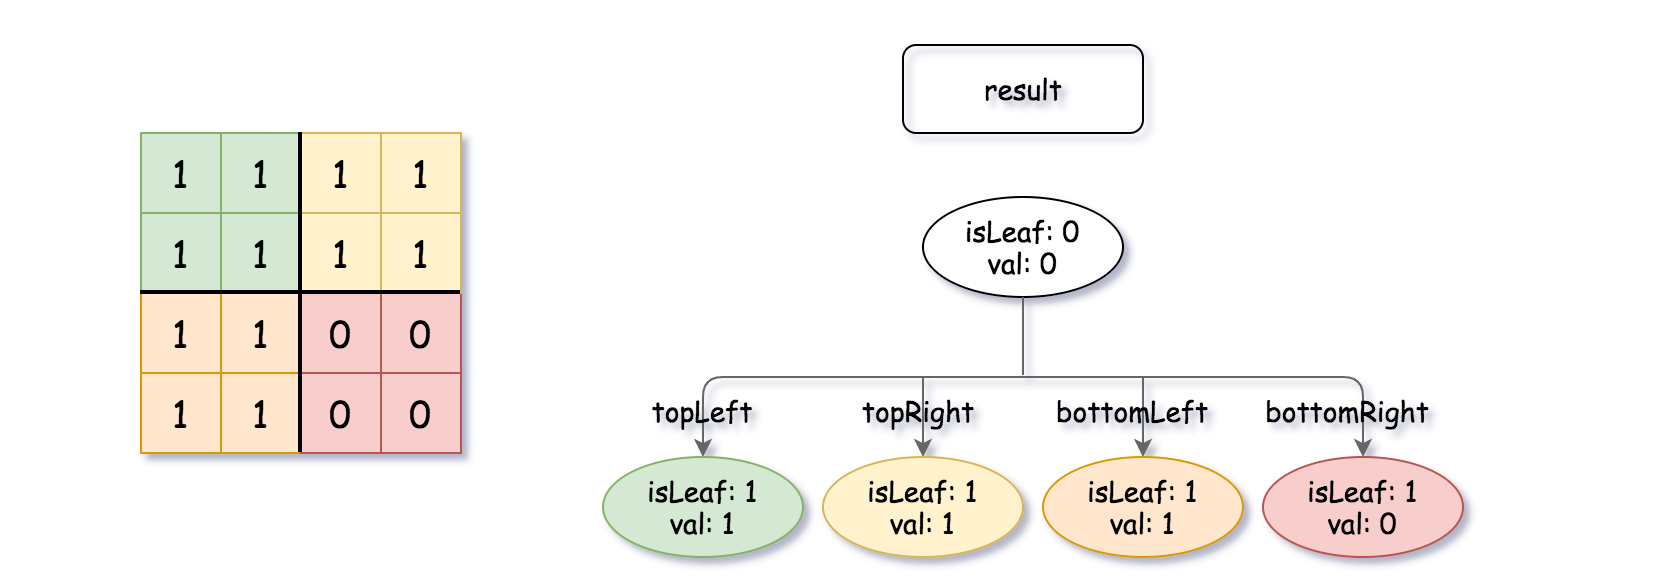
示例 2:
输入:quadTree1 = [[1,0]]
, quadTree2 = [[1,0]]
输出:[[1,0]]
解释:两个数所表示的矩阵大小都为 1*1,值全为 0
结果矩阵大小为 1*1,值全为 0 。
提示:
quadTree1和quadTree2都是符合题目要求的四叉树,每个都代表一个n * n的矩阵。n == 2x,其中0 <= x <= 9.
方法一 · Go 实现
思考
四叉树表示的两幅网格做按位或。若逐格展开再压缩,会丢掉树的结构。叶子可以短路:一方是值为真的叶子则结果就是它;双方都是叶子则或后仍是叶子。
否则对四个象限递归。若四个孩子都是同值叶子,再合并成一个叶子,以保持四叉树的规范形态。
/**
 * Definition for a QuadTree node.
 * type Node struct {
 *     Val bool
 *     IsLeaf bool
 *     TopLeft *Node
 *     TopRight *Node
 *     BottomLeft *Node
 *     BottomRight *Node
 * }
 */

func intersect(quadTree1 *Node, quadTree2 *Node) *Node {
	var dfs func(*Node, *Node) *Node
	dfs = func(t1, t2 *Node) *Node {
		if t1.IsLeaf && t2.IsLeaf {
			return &Node{Val: t1.Val || t2.Val, IsLeaf: true}
		}
		if t1.IsLeaf {
			if t1.Val {
				return t1
			}
			return t2
		}
		if t2.IsLeaf {
			if t2.Val {
				return t2
			}
			return t1
		}
		res := &Node{}
		res.TopLeft = dfs(t1.TopLeft, t2.TopLeft)
		res.TopRight = dfs(t1.TopRight, t2.TopRight)
		res.BottomLeft = dfs(t1.BottomLeft, t2.BottomLeft)
		res.BottomRight = dfs(t1.BottomRight, t2.BottomRight)
		isLeaf := res.TopLeft.IsLeaf && res.TopRight.IsLeaf && res.BottomLeft.IsLeaf && res.BottomRight.IsLeaf
		sameVal := res.TopLeft.Val == res.TopRight.Val && res.TopRight.Val == res.BottomLeft.Val && res.BottomLeft.Val == res.BottomRight.Val
		if isLeaf && sameVal {
			res = res.TopLeft
		}
		return res
	}

	return dfs(quadTree1, quadTree2)
}559. N 叉树的最大深度
题目、示例与约束
给定一个 N 叉树,找到其最大深度。
最大深度是指从根节点到最远叶子节点的最长路径上的节点总数。
N 叉树输入按层序遍历序列化表示,每组子节点由空值分隔(请参见示例)。
示例 1:
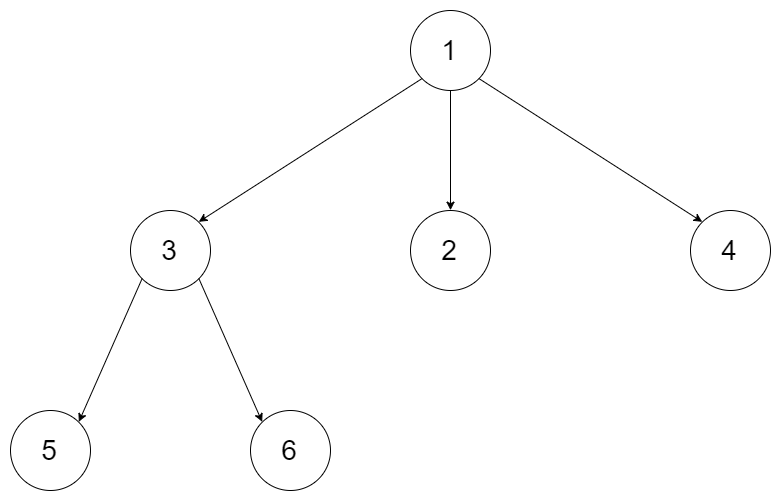
输入:root = [1,null,3,2,4,null,5,6]
输出:3
示例 2:
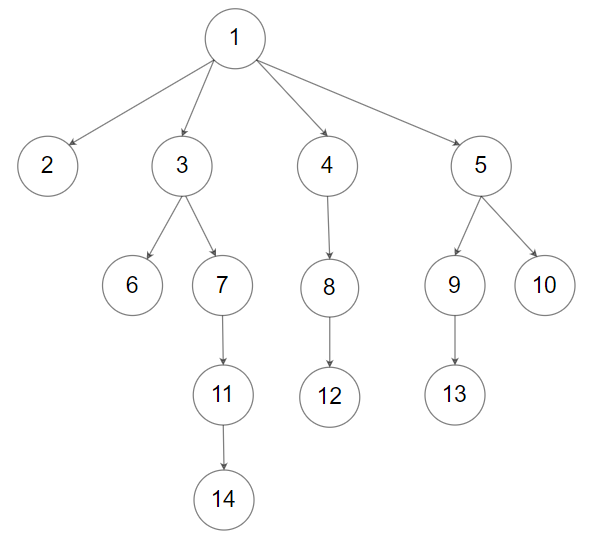
输入:root = [1,null,2,3,4,5,null,null,6,7,null,8,null,9,10,null,null,11,null,12,null,13,null,null,14]
输出:5
提示:
- 树的深度不会超过
1000。 - 树的节点数目位于
[0, 104]之间。
方法一:递归 · Go 实现
思考
N 叉树深度是根到最深叶子的边数加一。与二叉树相同,取所有孩子深度的最大值再加一。
空节点深度为 。遍历
children递归求深度,维护最大值。每个节点访问一次。
我们首先判断 是否为空,若为空则返回 0。否则我们初始化一个变量 用来记录子节点的最大深度,然后遍历 的所有子节点,递归调用 函数,更新 的值。最后返回 即可。
时间复杂度 ,空间复杂度 。其中 为节点的数量。
/**
 * Definition for a Node.
 * type Node struct {
 *     Val int
 *     Children []*Node
 * }
 */

func maxDepth(root *Node) int {
	if root == nil {
		return 0
	}
	mx := 0
	for _, child := range root.Children {
		mx = max(mx, maxDepth(child))
	}
	return 1 + mx
}563. 二叉树的坡度
题目、示例与约束
给你一个二叉树的根节点 root ,计算并返回 整个树 的坡度 。
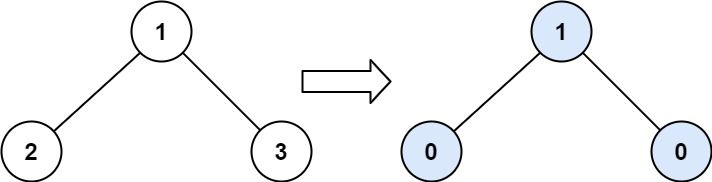
一个树的 节点的坡度 定义即为,该节点左子树的节点之和和右子树节点之和的 差的绝对值 。如果没有左子树的话,左子树的节点之和为 0 ;没有右子树的话也是一样。空结点的坡度是 0 。
整个树 的坡度就是其所有节点的坡度之和。
示例 1:
输入:root = [1,2,3]
输出:1
解释:
节点 2 的坡度:|0-0| = 0(没有子节点)
节点 3 的坡度:|0-0| = 0(没有子节点)
节点 1 的坡度:|2-3| = 1(左子树就是左子节点,所以和是 2 ;右子树就是右子节点,所以和是 3 )
坡度总和:0 + 0 + 1 = 1
示例 2:
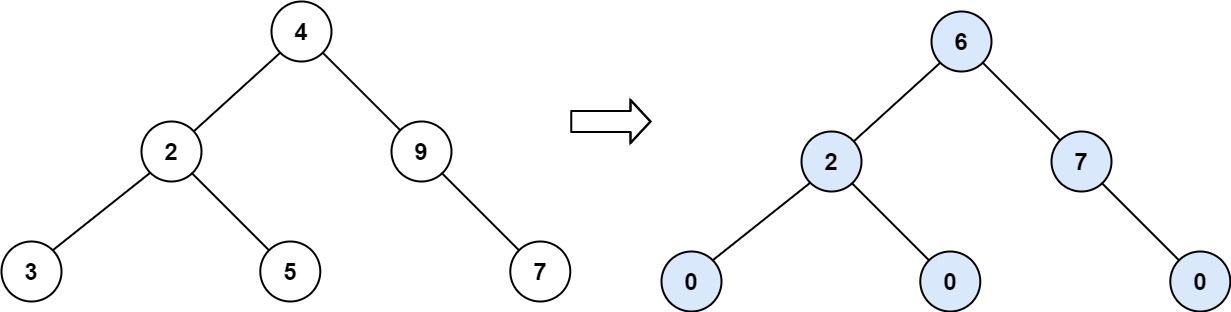
输入:root = [4,2,9,3,5,null,7]
输出:15
解释:
节点 3 的坡度:|0-0| = 0(没有子节点)
节点 5 的坡度:|0-0| = 0(没有子节点)
节点 7 的坡度:|0-0| = 0(没有子节点)
节点 2 的坡度:|3-5| = 2(左子树就是左子节点,所以和是 3 ;右子树就是右子节点,所以和是 5 )
节点 9 的坡度:|0-7| = 7(没有左子树,所以和是 0 ;右子树正好是右子节点,所以和是 7 )
节点 4 的坡度:|(3+5+2)-(9+7)| = |10-16| = 6(左子树值为 3、5 和 2 ,和是 10 ;右子树值为 9 和 7 ,和是 16 )
坡度总和:0 + 0 + 0 + 2 + 7 + 6 = 15
示例 3:
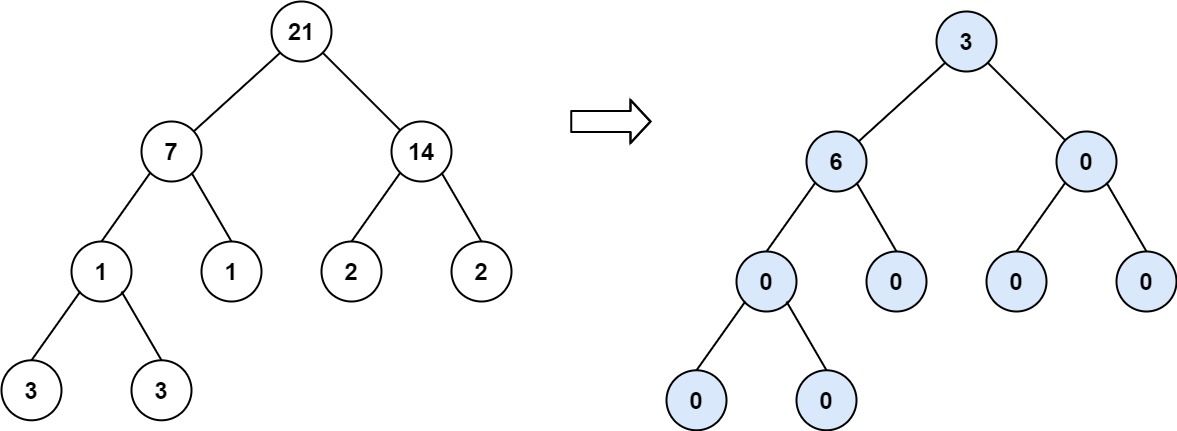
输入:root = [21,7,14,1,1,2,2,3,3]
输出:9
提示:
- 树中节点数目的范围在
[0, 104]内 -1000 <= Node.val <= 1000
方法一:递归 · Go 实现
思考
坡度是左右子树节点和之差的绝对值,整棵树的坡度是各节点坡度之和。每个节点都需要两棵子树的和,适合后序。
DFS 返回子树节点和,回溯时把 加进答案,并向上返回 。一次遍历同时求出所有坡度。
我们设计一个函数 ,用来计算以当前节点为根节点的子树的节点之和。在 函数中,我们首先判断当前节点是否为空,若为空则返回 0。然后递归调用 函数计算左子树的节点之和 和右子树的节点之和 。接着计算当前节点的坡度,即 ,并将其加到答案中。最后返回当前节点的节点之和 。
在主函数中,我们初始化答案为 0,然后调用 函数计算整个树的坡度,并返回答案。
时间复杂度 ,空间复杂度 。其中 为节点的数量。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func findTilt(root *TreeNode) (ans int) {
	var dfs func(*TreeNode) int
	dfs = func(root *TreeNode) int {
		if root == nil {
			return 0
		}
		l, r := dfs(root.Left), dfs(root.Right)
		ans += abs(l - r)
		return l + r + root.Val
	}
	dfs(root)
	return
}

func abs(x int) int {
	if x < 0 {
		return -x
	}
	return x
}572. 另一棵树的子树
题目、示例与约束
给你两棵二叉树 root 和 subRoot 。检验 root 中是否包含和 subRoot 具有相同结构和节点值的子树。如果存在,返回 true ;否则,返回 false 。
二叉树 tree 的一棵子树包括 tree 的某个节点和这个节点的所有后代节点。tree 也可以看做它自身的一棵子树。
示例 1:
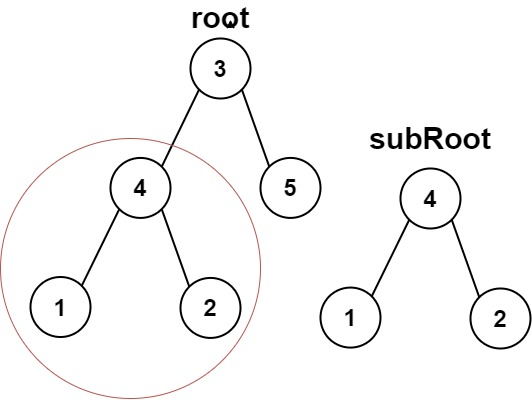
输入:root = [3,4,5,1,2], subRoot = [4,1,2]
输出:true
示例 2:
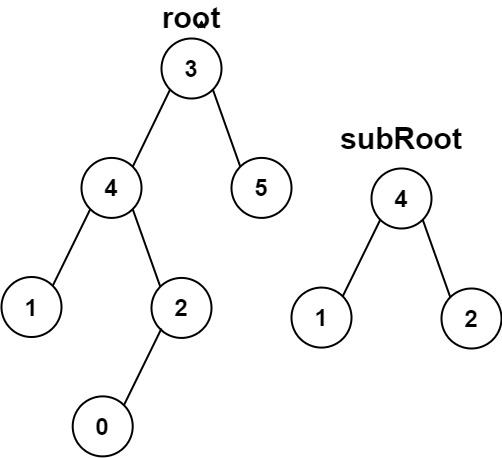
输入:root = [3,4,5,1,2,null,null,null,null,0], subRoot = [4,1,2]
输出:false
提示:
root树上的节点数量范围是[1, 2000]subRoot树上的节点数量范围是[1, 1000]-104 <= root.val <= 104-104 <= subRoot.val <= 104
方法一:DFS · Go 实现
思考
判断 是否等于 的某一棵子树。对每个节点做一次树相等比较,最坏 ,在本题规模下可接受。
same同时走两棵树比较结构与值。外层 DFS 在每个节点调用same,命中即返回真。先比根再比左右,短路失败分支。
我们定义一个辅助函数 ,用于判断以 为根节点的树和以 为根节点的树是否相等。如果两棵树的根节点的值相等,并且它们的左子树和右子树也分别相等,那么这两棵树是相等的。
在 函数中,我们首先判断 是否为空,如果为空,则返回 。否则,我们判断 和 是否相等,如果相等,则返回 。否则,我们递归地判断 的左子树和右子树是否包含 。
时间复杂度 ,空间复杂度 。其中 和 分别是树 和树 的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func isSubtree(root *TreeNode, subRoot *TreeNode) bool {
	var same func(p, q *TreeNode) bool
	same = func(p, q *TreeNode) bool {
		if p == nil || q == nil {
			return p == q
		}
		return p.Val == q.Val && same(p.Left, q.Left) && same(p.Right, q.Right)
	}
	if root == nil {
		return false
	}
	return same(root, subRoot) || isSubtree(root.Left, subRoot) || isSubtree(root.Right, subRoot)
}582. 杀掉进程 🔒
题目、示例与约束
系统中存在 n 个进程,形成一个有根树结构。给你两个整数数组 pid 和 ppid ,其中 pid[i] 是第 i 个进程的 ID ,ppid[i] 是第 i 个进程的父进程 ID 。
每一个进程只有 一个父进程 ,但是可能会有 一个或者多个子进程 。只有一个进程的 ppid[i] = 0 ,意味着这个进程 没有父进程 。
当一个进程 被杀掉 的时候,它所有的子进程和后代进程都要被杀掉。
给你一个整数 kill 表示要杀掉进程的 ID ,返回被杀掉的进程的 ID 列表。可以按 任意顺序 返回答案。
示例 1:
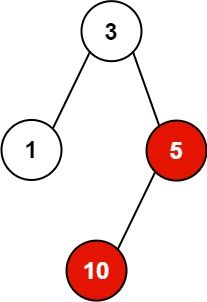
输入:pid = [1,3,10,5], ppid = [3,0,5,3], kill = 5
输出:[5,10]
解释:涂为红色的进程是应该被杀掉的进程。
示例 2:
输入:pid = [1], ppid = [0], kill = 1
输出:[1]
提示:
n == pid.lengthn == ppid.length1 <= n <= 5 * 1041 <= pid[i] <= 5 * 1040 <= ppid[i] <= 5 * 104- 仅有一个进程没有父进程
pid中的所有值 互不相同- 题目数据保证
kill在pid中
方法一:DFS · Go 实现
思考
杀掉一个进程会杀掉它的整棵子进程树。父子关系由两个平行数组给出,宜先建成邻接表。
存 的孩子。从
kill出发 DFS/BFS,沿子边收集全部节点。每个进程至多进入一次。
我们先根据 和 构建出图 ,其中 表示进程 的所有子进程。然后从进程 开始,进行深度优先搜索,即可得到所有被杀掉的进程。
时间复杂度 ,空间复杂度 。其中 是进程的数量。
func killProcess(pid []int, ppid []int, kill int) (ans []int) {
	g := map[int][]int{}
	for i, p := range ppid {
		g[p] = append(g[p], pid[i])
	}
	var dfs func(int)
	dfs = func(i int) {
		ans = append(ans, i)
		for _, j := range g[i] {
			dfs(j)
		}
	}
	dfs(kill)
	return
}
方法二:显式栈 · Go 实现
思考
杀掉一个进程会把它的全部后代一起杀掉。父子关系由两个平行数组给出, 最大为 ,先建成每个进程的子进程列表更方便遍历。沿一条父子链递归收集时,调用深度等于进程数,链长达到 就会超出 Python 的递归上限。因此用栈保存待访问的进程:弹出时记入答案,再把子进程按相反顺序压入,收集顺序就与沿子列表的先序遍历相同。树没有环,每个进程只入栈一次。
先根据 和 建图, 表示进程 的所有子进程。从进程 开始用显式栈遍历。弹出进程 时把它加入答案,再把它的子进程按相反顺序压入栈,这样后弹出的是子列表中靠前的进程。每个后代都会被收集一次。题目允许按任意顺序返回答案。
时间复杂度 ,空间复杂度 。其中 是进程的数量。
func killProcess(pid []int, ppid []int, kill int) (ans []int) {
	g := map[int][]int{}
	for i, p := range ppid {
		g[p] = append(g[p], pid[i])
	}
	stk := []int{kill}
	for len(stk) > 0 {
		i := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		ans = append(ans, i)
		children := g[i]
		for k := len(children) - 1; k >= 0; k-- {
			stk = append(stk, children[k])
		}
	}
	return
}589. N 叉树的前序遍历
题目、示例与约束
给定一个 n 叉树的根节点 root ,返回 其节点值的 前序遍历 。
n 叉树 在输入中按层序遍历进行序列化表示,每组子节点由空值 null 分隔(请参见示例)。
示例 1:
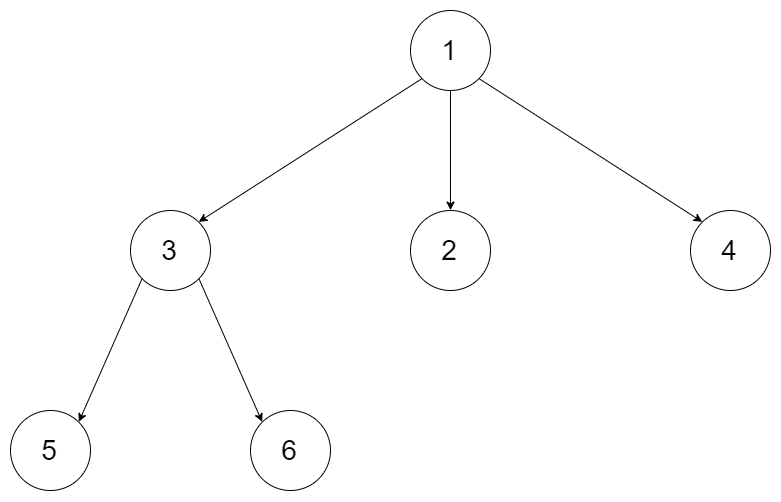
输入:root = [1,null,3,2,4,null,5,6]
输出:[1,3,5,6,2,4]
示例 2:
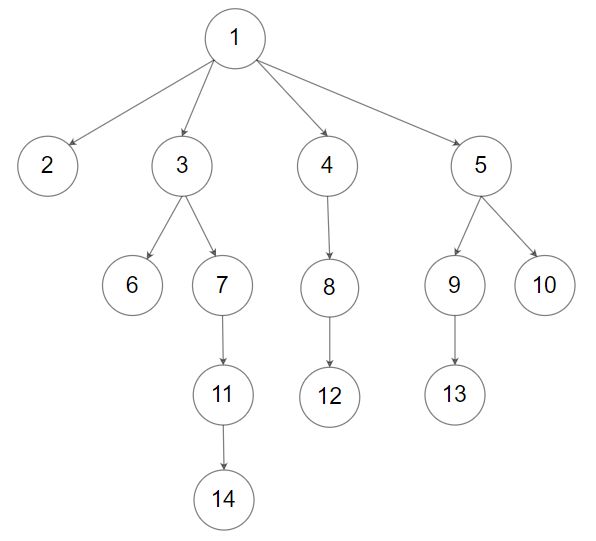
输入:root = [1,null,2,3,4,5,null,null,6,7,null,8,null,9,10,null,null,11,null,12,null,13,null,null,14]
输出:[1,2,3,6,7,11,14,4,8,12,5,9,13,10]
提示:
- 节点总数在范围
[0, 104]内 0 <= Node.val <= 104- n 叉树的高度小于或等于
1000
进阶:递归法很简单,你可以使用迭代法完成此题吗?
方法一:递归 · Go 实现
思考
N 叉树前序是根、再从左到右的子树。递归按定义写即可。
先把根值放入答案,再依次递归每个孩子。空树返回空列表。每个节点访问一次。
我们可以递归地遍历整棵树。对于每个节点,先将节点的值加入答案,然后对该节点的每个子节点递归地调用函数。
时间复杂度 ,空间复杂度 。其中 为节点数。
/**
 * Definition for a Node.
 * type Node struct {
 *     Val int
 *     Children []*Node
 * }
 */

func preorder(root *Node) (ans []int) {
	var dfs func(*Node)
	dfs = func(root *Node) {
		if root == nil {
			return
		}
		ans = append(ans, root.Val)
		for _, child := range root.Children {
			dfs(child)
		}
	}
	dfs(root)
	return
}
方法二:迭代(栈实现) · Go 实现
思考
方法一已经用显式栈做前序,孩子从右往左入栈,使最左孩子先弹出。
本节是同一遍历。弹出即访问,再把孩子逆序入栈,顺序与定义中的前序一致。
本节同样用栈得到前序遍历。
我们使用一个栈来帮助我们得到前序遍历,我们首先把根节点入栈,因为前序遍历是根节点、左子树、右子树,栈的特点是先进后出,所以我们先把节点的值加入答案,然后对该节点的每个子节点按照从右到左的顺序依次入栈。循环直到栈为空。
时间复杂度 ,空间复杂度 。其中 为节点数。
/**
 * Definition for a Node.
 * type Node struct {
 *     Val int
 *     Children []*Node
 * }
 */

func preorder(root *Node) (ans []int) {
	if root == nil {
		return
	}
	stk := []*Node{root}
	for len(stk) > 0 {
		node := stk[len(stk)-1]
		ans = append(ans, node.Val)
		stk = stk[:len(stk)-1]
		children := node.Children
		for i := len(children) - 1; i >= 0; i-- {
			stk = append(stk, children[i])
		}
	}
	return
}
方法三:显式栈 · Go 实现
思考
N 叉树前序是先根、再从左到右的子树。按定义递归时,一条高度为 的链会把调用栈用尽,而高度上限正是 。
瓶颈是这条单孩子链:每次只进入下一个孩子,调用深度与高度同阶。
前序在进入孩子之前就已经记下当前节点,因此不必等孩子返回。
用显式栈保存待访问节点。弹出后先写入答案,再把孩子从右往左压栈,最左孩子最先弹出,顺序与定义一致。空树直接返回空列表。
我们用栈模拟前序遍历。先将根入栈,弹出节点后把值加入答案,再按从右到左的顺序把孩子入栈,直到栈空。
时间复杂度 ,空间复杂度 。其中 为节点数。
/**
 * Definition for a Node.
 * type Node struct {
 *     Val int
 *     Children []*Node
 * }
 */

func preorder(root *Node) (ans []int) {
	if root == nil {
		return
	}
	stk := []*Node{root}
	for len(stk) > 0 {
		node := stk[len(stk)-1]
		ans = append(ans, node.Val)
		stk = stk[:len(stk)-1]
		children := node.Children
		for i := len(children) - 1; i >= 0; i-- {
			stk = append(stk, children[i])
		}
	}
	return
}590. N 叉树的后序遍历
题目、示例与约束
给定一个 n 叉树的根节点 root ,返回 其节点值的 后序遍历 。
n 叉树 在输入中按层序遍历进行序列化表示,每组子节点由空值 null 分隔(请参见示例)。
示例 1:
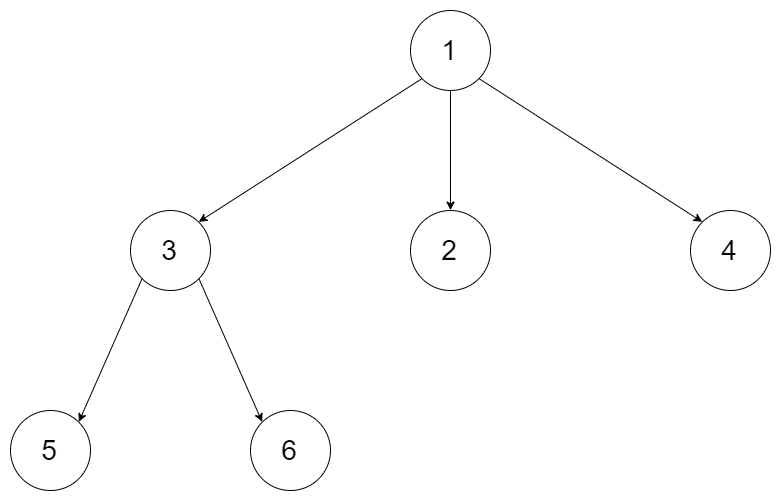
输入:root = [1,null,3,2,4,null,5,6]
输出:[5,6,3,2,4,1]
示例 2:
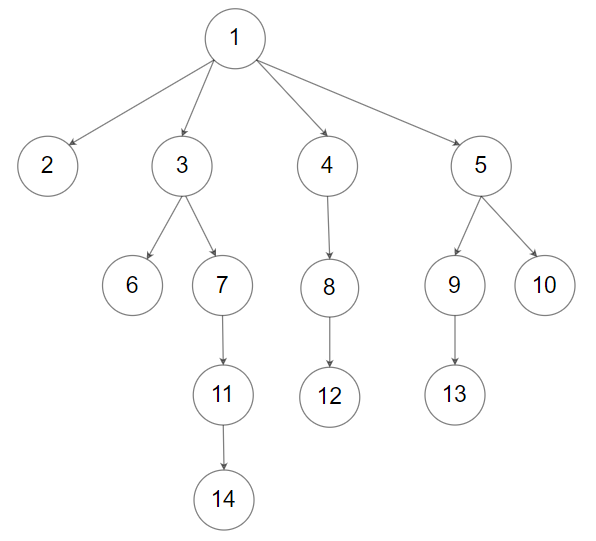
输入:root = [1,null,2,3,4,5,null,null,6,7,null,8,null,9,10,null,null,11,null,12,null,13,null,null,14]
输出:[2,6,14,11,7,3,12,8,4,13,9,10,5,1]
提示:
- 节点总数在范围
[0, 104]内 0 <= Node.val <= 104- n 叉树的高度小于或等于
1000
进阶:递归法很简单,你可以使用迭代法完成此题吗?
方法一:递归 · Go 实现
思考
N 叉树后序是从左到右的子树、再根。递归先孩子后自己。
对每个孩子递归,再把根值加入答案。空树返回空列表。
我们可以递归地遍历整棵树。对于每个节点,先对该节点的每个子节点递归地调用函数,然后将节点的值加入答案。
时间复杂度 ,空间复杂度 。其中 为节点数。
/**
 * Definition for a Node.
 * type Node struct {
 *     Val int
 *     Children []*Node
 * }
 */

func postorder(root *Node) (ans []int) {
	var dfs func(*Node)
	dfs = func(root *Node) {
		if root == nil {
			return
		}
		for _, child := range root.Children {
			dfs(child)
		}
		ans = append(ans, root.Val)
	}
	dfs(root)
	return
}
方法二:迭代(栈实现) · Go 实现
思考
方法一已经用显式栈先记下根、再从左到右压孩子,最后反转得到后序。
本节是同一遍历。弹出即记录,孩子从左到右入栈,整段反转后是左-右-根。
本节同样用栈得到后序遍历。
我们使用一个栈来帮助我们得到后序遍历,我们首先把根节点入栈,因为后序遍历是左子树、右子树、根节点,栈的特点是先进后出,所以我们先把节点的值加入答案,然后对该节点的每个子节点按照从左到右的顺序依次入栈,这样可以得到根节点、右子树、左子树的遍历结果。最后把答案反转即可得到后序遍历的结果。
时间复杂度 ,空间复杂度 。其中 为节点数。
/**
 * Definition for a Node.
 * type Node struct {
 *     Val int
 *     Children []*Node
 * }
 */

func postorder(root *Node) []int {
	var ans []int
	if root == nil {
		return ans
	}
	stk := []*Node{root}
	for len(stk) > 0 {
		root = stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		ans = append([]int{root.Val}, ans...)
		for _, child := range root.Children {
			stk = append(stk, child)
		}
	}
	return ans
}
方法三:显式栈 · Go 实现
思考
N 叉树后序是从左到右的子树、再根。按定义递归时,一条高度为 的链会把调用栈用尽,而高度上限正是 。
瓶颈是这条单孩子链:孩子先于根处理,调用深度与高度同阶。
先记下根、再从左到右把孩子压栈,得到的是根-右-左。整段反转之后就是左-右-根。
因此用显式栈完成这段遍历。弹出后先写入答案,再从左到右把孩子入栈,栈空后反转答案。空树直接返回空列表。
我们用栈模拟后序遍历。先将根入栈,弹出节点后把值加入答案,再按从左到右的顺序把孩子入栈。这样得到根、右子树、左子树的顺序,最后把答案反转,即为后序。
时间复杂度 ,空间复杂度 。其中 为节点数。
/**
 * Definition for a Node.
 * type Node struct {
 *     Val int
 *     Children []*Node
 * }
 */

func postorder(root *Node) []int {
	var ans []int
	if root == nil {
		return ans
	}
	stk := []*Node{root}
	for len(stk) > 0 {
		root = stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		ans = append([]int{root.Val}, ans...)
		for _, child := range root.Children {
			stk = append(stk, child)
		}
	}
	return ans
}606. 根据二叉树创建字符串
题目、示例与约束
给定二叉树的根节点 root,你的任务是按照一组特定的格式规则创建该树的字符串表示。该表示应基于二叉树的前序遍历,并且必须遵循以下规则:
-
节点表示:树中的每个节点都应使用其整数值表示。
-
子节点的括号表示:如果一个节点至少有一个子节点(左子节点或右子节点),则其子节点应使用括号表示。具体来说:
- 如果一个节点存在左子节点,则应将左子节点的表示放在括号中,并紧跟在当前节点的值之后。
- 如果一个节点存在右子节点,则也应将右子节点的表示放在括号中。右子节点对应的括号应位于左子节点对应括号之后。
-
省略空括号:最终的树字符串表示中,应省略所有空括号对(即
()),但有一种特殊情况除外:当一个节点存在右子节点但不存在左子节点时,必须保留一对空括号,以表示左子节点缺失。这样可以保证字符串表示与原二叉树结构之间的一一对应关系。总而言之,当一个节点只有左子节点或者没有任何子节点时,应省略空括号对。但是,当一个节点只有右子节点而没有左子节点时,必须在右子节点的表示之前添加一对空括号,以准确表示树的结构。
示例 1:
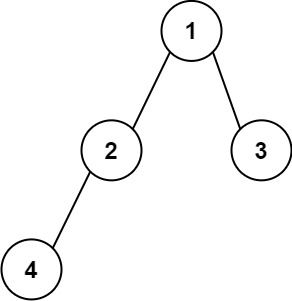
输入: root = [1,2,3,4]
输出: "1(2(4))(3)"
解释: 原本需要表示为 "1(2(4)())(3()())",但需要省略所有空括号对。因此最终得到 "1(2(4))(3)"。
示例 2:
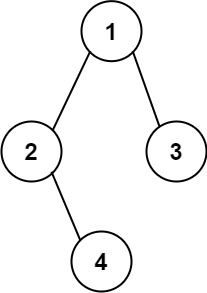
输入: root = [1,2,3,null,4] 输出: "1(2()(4))(3)" 解释: 与第一个示例基本相同,不同之处在于2后面的()是必须保留的,因为它表示节点2不存在左子节点,但存在右子节点。
提示:
- 树中节点的数量范围为
[1, 104]。 -1000 <= Node.val <= 1000
方法一 · Go 实现
思考
前序遍历加括号可以还原结构,但空括号规则不对称:仅有左子树时要写一对括号,仅有右子树时左侧的空括号不能省。
因此递归按三种情形输出:叶子只写值;无右子树只包左;否则左右都包。这样省略规则与题意一致。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func tree2str(root *TreeNode) string {
	if root == nil {
		return ""
	}
	if root.Left == nil && root.Right == nil {
		return strconv.Itoa(root.Val)
	}
	if root.Right == nil {
		return strconv.Itoa(root.Val) + "(" + tree2str(root.Left) + ")"
	}
	return strconv.Itoa(root.Val) + "(" + tree2str(root.Left) + ")(" + tree2str(root.Right) + ")"
}
方法二:显式栈前序遍历 · Go 实现
思考
把二叉树写成带括号的前序字符串,递归按三种情形输出即可:叶子只写值,没有右孩子时只包左子树,否则左右都包。较短的树上这样是对的。
结点个数可达 。左链使这次前序按结点个数递归,调用栈会溢出。先拼出子树字符串再接回父结点,还会把同一段字符复制多次。
写出顺序已经由前序和空括号规则决定,并不需要子树先返回一整段字符串。
因此用一个缓冲区和显式栈。进入结点时写入当前值;不是叶子就写下左括号,压入结束标记和左孩子。左子树结束后补右括号,有右孩子时再包一层。叶子只留下值,只有右孩子时左侧是一对空括号。
我们用显式栈按前序把结点写入同一个字符串。进入结点时先写值。若左右都空,该结点结束。否则先写左括号,压入“左子树已结束”的标记,再压入左孩子。标记弹出时补上右括号;若右孩子存在,再写左括号并压入右孩子和对应的结束标记。
时间复杂度 ,空间复杂度 。其中 为二叉树的结点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func tree2str(root *TreeNode) string {
	var b strings.Builder
	type frame struct {
		node  *TreeNode
		state int
	}
	stk := []frame{{root, 0}}
	for len(stk) > 0 {
		cur := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		node, state := cur.node, cur.state
		if state == 0 {
			if node == nil {
				continue
			}
			b.WriteString(strconv.Itoa(node.Val))
			if node.Left == nil && node.Right == nil {
				continue
			}
			b.WriteByte('(')
			stk = append(stk, frame{node, 1}, frame{node.Left, 0})
			continue
		}
		if state == 1 {
			b.WriteByte(')')
			if node.Right != nil {
				b.WriteByte('(')
				stk = append(stk, frame{node, 2}, frame{node.Right, 0})
			}
			continue
		}
		b.WriteByte(')')
	}
	return b.String()
}617. 合并二叉树
题目、示例与约束
给你两棵二叉树: root1 和 root2 。
想象一下,当你将其中一棵覆盖到另一棵之上时,两棵树上的一些节点将会重叠(而另一些不会)。你需要将这两棵树合并成一棵新二叉树。合并的规则是:如果两个节点重叠,那么将这两个节点的值相加作为合并后节点的新值;否则,不为 null 的节点将直接作为新二叉树的节点。
返回合并后的二叉树。
注意: 合并过程必须从两个树的根节点开始。
示例 1:
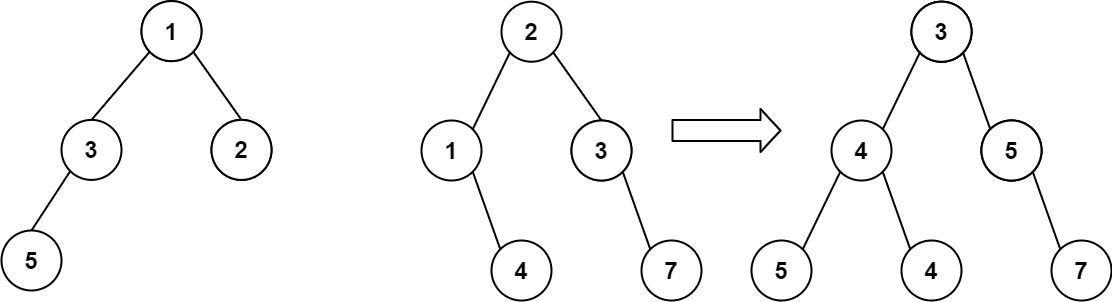
输入:root1 = [1,3,2,5], root2 = [2,1,3,null,4,null,7]
输出:[3,4,5,5,4,null,7]
示例 2:
输入:root1 = [1], root2 = [1,2]
输出:[2,2]
提示:
- 两棵树中的节点数目在范围
[0, 2000]内 -104 <= Node.val <= 104
方法一:递归 · Go 实现
思考
对应节点相加,缺的一侧整棵保留。结构与递归定义一致。
一侧为空则返回另一侧;否则新建节点,值为两节点之和,再递归合并左右子树。
递归合并两棵树的节点。
- 如果其中一棵树的当前节点为空,则返回另一棵树的当前节点作为合并后节点。
- 如果两棵树的当前节点都不为空,则将它们的值相加作为合并后节点的新值,然后递归合并它们的左右子节点。
时间复杂度 ,空间复杂度 。其中 是两棵树的节点数的最小值。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func mergeTrees(root1 *TreeNode, root2 *TreeNode) *TreeNode {
	if root1 == nil {
		return root2
	}
	if root2 == nil {
		return root1
	}
	node := &TreeNode{Val: root1.Val + root2.Val}
	node.Left = mergeTrees(root1.Left, root2.Left)
	node.Right = mergeTrees(root1.Right, root2.Right)
	return node
}623. 在二叉树中增加一行
题目、示例与约束
给定一个二叉树的根 root 和两个整数 val 和 depth ,在给定的深度 depth 处添加一个值为 val 的节点行。
注意,根节点 root 位于深度 1 。
加法规则如下:
- 给定整数
depth,对于深度为depth - 1的每个非空树节点cur,创建两个值为val的树节点作为cur的左子树根和右子树根。 cur原来的左子树应该是新的左子树根的左子树。cur原来的右子树应该是新的右子树根的右子树。- 如果
depth == 1意味着depth - 1根本没有深度,那么创建一个树节点,值val作为整个原始树的新根,而原始树就是新根的左子树。
示例 1:
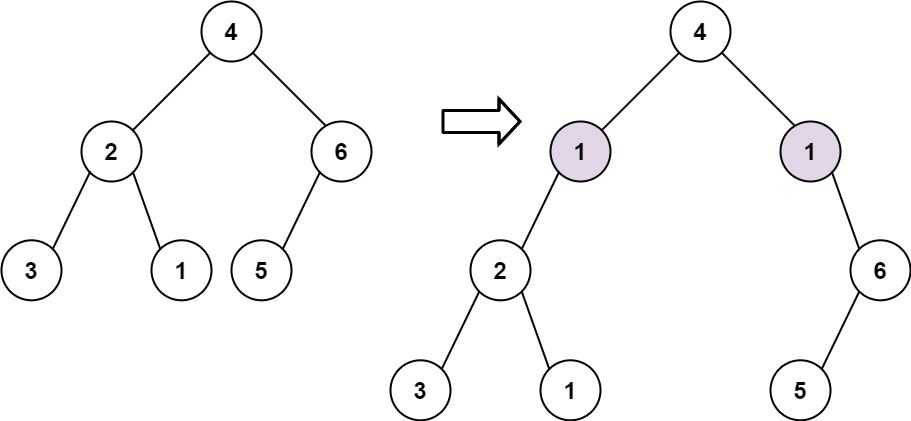
输入: root = [4,2,6,3,1,5], val = 1, depth = 2
输出: [4,1,1,2,null,null,6,3,1,5]
示例 2:
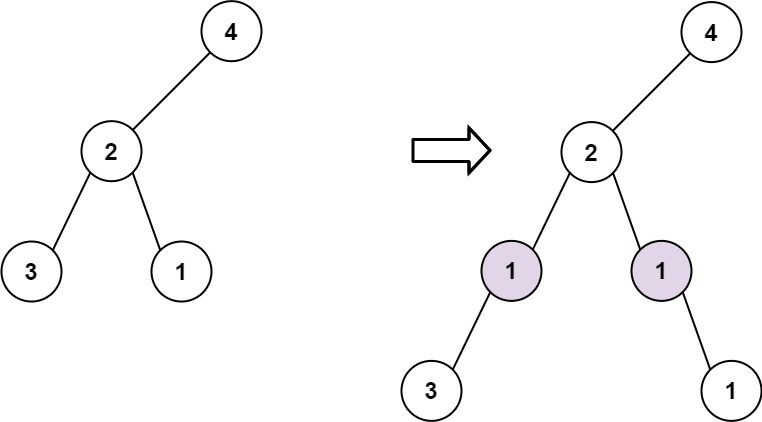
输入: root = [4,2,null,3,1], val = 1, depth = 3
输出:  [4,2,null,1,1,3,null,null,1]
提示:
- 节点数在
[1, 104]范围内 - 树的深度在
[1, 104]范围内 -100 <= Node.val <= 100-105 <= val <= 1051 <= depth <= the depth of tree + 1
方法一:DFS · Go 实现
思考
要在第 层插入新行,原第 层变为新节点的孩子。整树重建代价过高。
时新节点直接作为根。否则 DFS 走到深度 ,把原左右孩子挂到新建节点上即可,更深的子树不用动。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func addOneRow(root *TreeNode, val int, depth int) *TreeNode {
	if depth == 1 {
		return &TreeNode{Val: val, Left: root}
	}
	var dfs func(root *TreeNode, d int)
	dfs = func(root *TreeNode, d int) {
		if root == nil {
			return
		}
		if d == depth-1 {
			l, r := &TreeNode{Val: val, Left: root.Left}, &TreeNode{Val: val, Right: root.Right}
			root.Left, root.Right = l, r
			return
		}
		dfs(root.Left, d+1)
		dfs(root.Right, d+1)
	}
	dfs(root, 1)
	return root
}
方法二:BFS · Go 实现
思考
方法一递归到目标层。若希望按层推进、避免递归栈,可用队列 BFS 走到第 层,再对队中节点同样挂接左右新节点。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func addOneRow(root *TreeNode, val int, depth int) *TreeNode {
	if depth == 1 {
		return &TreeNode{val, root, nil}
	}
	q := []*TreeNode{root}
	i := 0
	for len(q) > 0 {
		i++
		for k := len(q); k > 0; k-- {
			node := q[0]
			q = q[1:]
			if node.Left != nil {
				q = append(q, node.Left)
			}
			if node.Right != nil {
				q = append(q, node.Right)
			}
			if i == depth-1 {
				node.Left = &TreeNode{val, node.Left, nil}
				node.Right = &TreeNode{val, nil, node.Right}
			}
		}
	}
	return root
}637. 二叉树的层平均值
题目、示例与约束
给定一个非空二叉树的根节点 root , 以数组的形式返回每一层节点的平均值。与实际答案相差 10-5 以内的答案可以被接受。
示例 1:
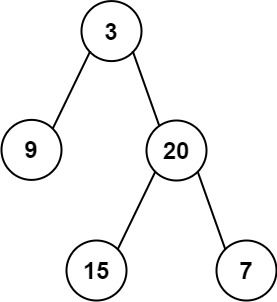
输入:root = [3,9,20,null,null,15,7]
输出:[3.00000,14.50000,11.00000]
解释:第 0 层的平均值为 3,第 1 层的平均值为 14.5,第 2 层的平均值为 11 。
因此返回 [3, 14.5, 11] 。
示例 2:
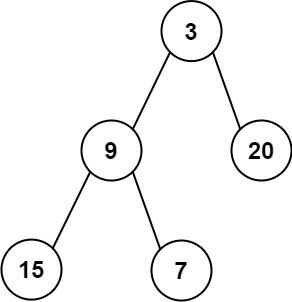
输入:root = [3,9,20,15,7]
输出:[3.00000,14.50000,11.00000]
提示:
- 树中节点数量在
[1, 104]范围内 -231 <= Node.val <= 231 - 1
方法一:BFS · Go 实现
思考
按层求平均值,自然按层遍历。节点数可达 ,一次 BFS 即可。
队列每次取出整层,累加后除以层大小,并把孩子入队。
我们可以使用广度优先搜索的方法,遍历每一层的节点,计算每一层的平均值。
具体地,我们定义一个队列 ,初始时将根节点加入队列。每次将队列中的所有节点取出,计算这些节点的平均值,加入答案数组中,并将这些节点的子节点加入队列。重复这一过程,直到队列为空。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func averageOfLevels(root *TreeNode) []float64 {
	q := []*TreeNode{root}
	ans := []float64{}
	for len(q) > 0 {
		n := len(q)
		s := 0
		for i := 0; i < n; i++ {
			root = q[0]
			q = q[1:]
			s += root.Val
			if root.Left != nil {
				q = append(q, root.Left)
			}
			if root.Right != nil {
				q = append(q, root.Right)
			}
		}
		ans = append(ans, float64(s)/float64(n))
	}
	return ans
}
方法二:DFS · Go 实现
思考
BFS 需要队列。DFS 按深度累加 ,最后再相除,不显式分层,结果相同。
我们也可以使用深度优先搜索的方法,来计算每一层的平均值。
具体地,我们定义一个数组 ,其中 是一个二元组,表示第 层的节点值之和以及节点个数。我们对树进行深度优先搜索,对于每一个节点,我们将节点的值加到对应的 中,并将节点个数加一。最后,对于每一个 ,我们计算平均值,加入答案数组中。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func averageOfLevels(root *TreeNode) []float64 {
	s := []int{}
	cnt := []int{}
	var dfs func(root *TreeNode, i int)
	dfs = func(root *TreeNode, i int) {
		if root == nil {
			return
		}
		if len(s) == i {
			s = append(s, root.Val)
			cnt = append(cnt, 1)
		} else {
			s[i] += root.Val
			cnt[i]++
		}
		dfs(root.Left, i+1)
		dfs(root.Right, i+1)
	}
	dfs(root, 0)
	ans := []float64{}
	for i, t := range s {
		ans = append(ans, float64(t)/float64(cnt[i]))
	}
	return ans
}652. 寻找重复的子树
题目、示例与约束
给你一棵二叉树的根节点 root ,返回所有 重复的子树 。
对于同一类的重复子树,你只需要返回其中任意 一棵 的根结点即可。
如果两棵树具有 相同的结构 和 相同的结点值 ,则认为二者是 重复 的。
示例 1:
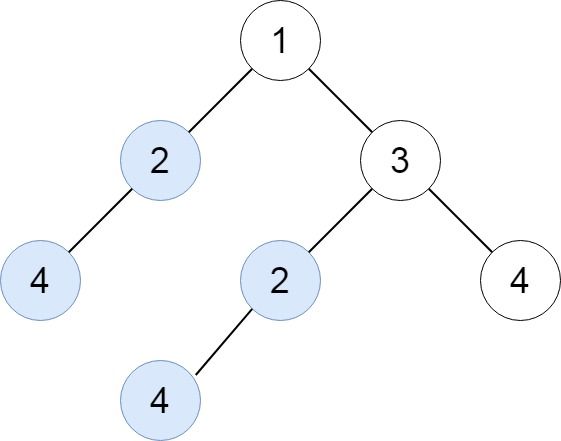
输入:root = [1,2,3,4,null,2,4,null,null,4]
输出:[[2,4],[4]]
示例 2:
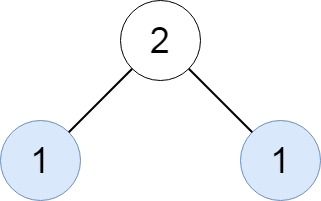
输入:root = [2,1,1]
输出:[[1]]
示例 3:
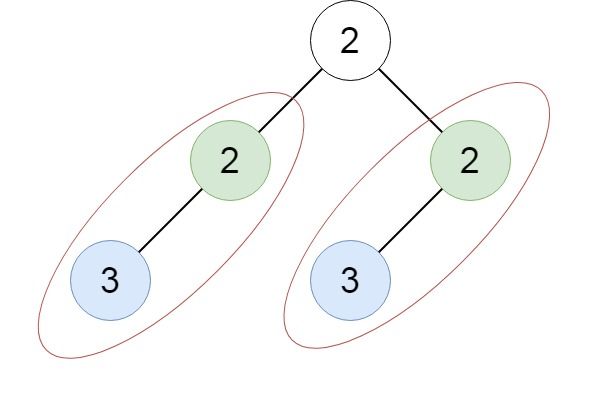
输入:root = [2,2,2,3,null,3,null]
输出:[[2,3],[3]]
提示:
- 树中的结点数在
[1, 5000]范围内。 -200 <= Node.val <= 200
方法一:后序遍历 · Go 实现
思考
两棵子树相同当结构与值都相同。两两比较子树是平方级,且同构判定本身不便。
后序把子树序列化成字符串,用计数表记录;某序列第一次变成 时把根加入答案,避免同一形态重复输出。
后序遍历,序列化每个子树,用哈希表判断序列化的字符串出现次数是否等于 2,若是,说明这棵子树重复。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func findDuplicateSubtrees(root *TreeNode) []*TreeNode {
	var ans []*TreeNode
	counter := make(map[string]int)
	var dfs func(root *TreeNode) string
	dfs = func(root *TreeNode) string {
		if root == nil {
			return "#"
		}
		v := strconv.Itoa(root.Val) + "," + dfs(root.Left) + "," + dfs(root.Right)
		counter[v]++
		if counter[v] == 2 {
			ans = append(ans, root)
		}
		return v
	}
	dfs(root)
	return ans
}653. 两数之和 IV - 输入二叉搜索树
题目、示例与约束
给定一个二叉搜索树 root 和一个目标结果 k,如果二叉搜索树中存在两个元素且它们的和等于给定的目标结果,则返回 true。
示例 1:
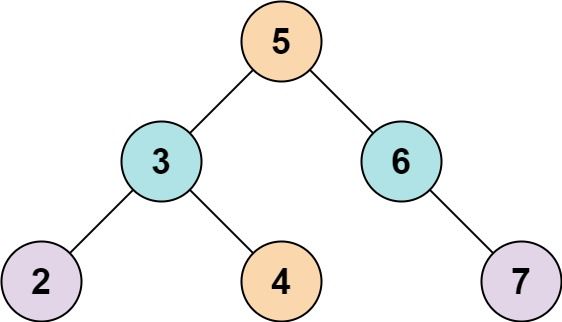
输入: root = [5,3,6,2,4,null,7], k = 9
输出: true
示例 2:
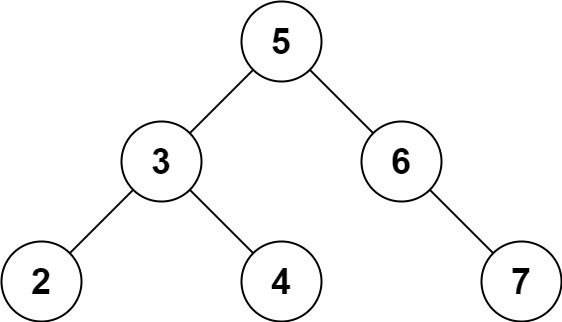
输入: root = [5,3,6,2,4,null,7], k = 28
输出: false
提示:
- 二叉树的节点个数的范围是
[1, 104]. -104 <= Node.val <= 104- 题目数据保证,输入的
root是一棵 有效 的二叉搜索树 -105 <= k <= 105
方法一:哈希表 + DFS · Go 实现
思考
在 BST 中找两数之和为 。中序后双指针可以,但要先收集全部值。
遍历时用集合记下已访节点,若 已出现则成功。不必利用 BST 序,一次 DFS 即可。
DFS 遍历二叉搜索树,对于每个节点,判断 k - node.val 是否在哈希表中,如果在,则返回 true,否则将 node.val 加入哈希表中。
时间复杂度 ,空间复杂度 。其中 为二叉搜索树的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func findTarget(root *TreeNode, k int) bool {
	vis := map[int]bool{}
	var dfs func(*TreeNode) bool
	dfs = func(root *TreeNode) bool {
		if root == nil {
			return false
		}
		if vis[k-root.Val] {
			return true
		}
		vis[root.Val] = true
		return dfs(root.Left) || dfs(root.Right)
	}
	return dfs(root)
}
方法二:哈希表 + BFS · Go 实现
思考
方法一递归。层序 BFS 配同一集合,判定逻辑不变,只是改成迭代。
与方法一类似,只是使用 BFS 遍历二叉搜索树。
时间复杂度 ,空间复杂度 。其中 为二叉搜索树的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func findTarget(root *TreeNode, k int) bool {
	q := []*TreeNode{root}
	vis := map[int]bool{}
	for len(q) > 0 {
		for n := len(q); n > 0; n-- {
			node := q[0]
			q = q[1:]
			if vis[k-node.Val] {
				return true
			}
			vis[node.Val] = true
			if node.Left != nil {
				q = append(q, node.Left)
			}
			if node.Right != nil {
				q = append(q, node.Right)
			}
		}
	}
	return false
}
方法三:哈希表 + 显式栈 · Go 实现
思考
在二叉搜索树里找两个结点,值之和为 。先中序收集再双指针可以,但要额外存下全部值。遍历时用集合记下已经见过的值,遇到 减去当前值就成功。较短的树上一次深度优先即可,也不必利用二叉搜索树的顺序。
结点个数可达 。左链使这次遍历按结点个数递归,调用栈会溢出。
每个结点只依赖已经访问过的值,不需要先算完子树再返回。先看自己,再看左右孩子,判定不变。
因此用显式栈做深度优先。弹出结点时先查 减去当前值,再把当前值放进集合,然后压入右孩子和左孩子。集合只属于这一次调用。
我们用哈希表记录已经访问的结点值,并用显式栈做深度优先遍历。弹出一个结点时,若 减去当前值已经在表中,则返回 ;否则把当前值放入表中,再把非空的右孩子和左孩子压栈。
时间复杂度 ,空间复杂度 。其中 为二叉搜索树的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func findTarget(root *TreeNode, k int) bool {
	vis := map[int]bool{}
	stk := []*TreeNode{}
	if root != nil {
		stk = append(stk, root)
	}
	for len(stk) > 0 {
		node := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		if vis[k-node.Val] {
			return true
		}
		vis[node.Val] = true
		if node.Right != nil {
			stk = append(stk, node.Right)
		}
		if node.Left != nil {
			stk = append(stk, node.Left)
		}
	}
	return false
}654. 最大二叉树
题目、示例与约束
给定一个不重复的整数数组 nums 。 最大二叉树 可以用下面的算法从 nums 递归地构建:
- 创建一个根节点,其值为
nums中的最大值。 - 递归地在最大值 左边 的 子数组前缀上 构建左子树。
- 递归地在最大值 右边 的 子数组后缀上 构建右子树。
返回 nums 构建的 最大二叉树 。
示例 1:
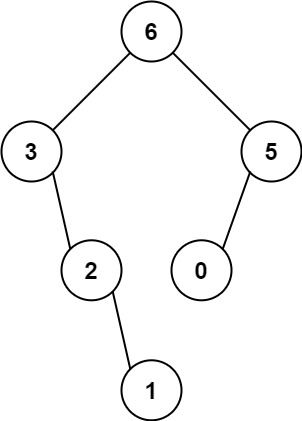
输入:nums = [3,2,1,6,0,5]
输出:[6,3,5,null,2,0,null,null,1]
解释:递归调用如下所示:
- [3,2,1,6,0,5] 中的最大值是 6 ,左边部分是 [3,2,1] ,右边部分是 [0,5] 。
    - [3,2,1] 中的最大值是 3 ,左边部分是 [] ,右边部分是 [2,1] 。
        - 空数组,无子节点。
        - [2,1] 中的最大值是 2 ,左边部分是 [] ,右边部分是 [1] 。
            - 空数组,无子节点。
            - 只有一个元素,所以子节点是一个值为 1 的节点。
    - [0,5] 中的最大值是 5 ,左边部分是 [0] ,右边部分是 [] 。
        - 只有一个元素,所以子节点是一个值为 0 的节点。
        - 空数组,无子节点。
示例 2:
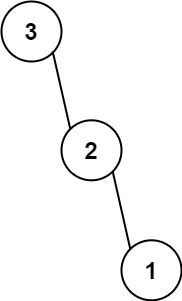
输入:nums = [3,2,1]
输出:[3,null,2,null,1]
提示:
1 <= nums.length <= 10000 <= nums[i] <= 1000nums中的所有整数 互不相同
方法一:递归 · Go 实现
思考
根是区间最大值,左右递归同一规则。每次线性找最大值,最坏 ,但 可通过。
对当前数组取
max与下标,切开左右再递归即可对应定义。
先找到数组 的最大元素所在的位置 ,将 作为根节点,然后递归左右两侧的子数组,构建左右子树。
时间复杂度 ,空间复杂度 ,其中 是数组的长度。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func constructMaximumBinaryTree(nums []int) *TreeNode {
	var dfs func(l, r int) *TreeNode
	dfs = func(l, r int) *TreeNode {
		if l > r {
			return nil
		}
		i := l
		for j := l; j <= r; j++ {
			if nums[i] < nums[j] {
				i = j
			}
		}
		root := &TreeNode{Val: nums[i]}
		root.Left = dfs(l, i-1)
		root.Right = dfs(i+1, r)
		return root
	}
	return dfs(0, len(nums)-1)
}
方法二:线段树 · Go 实现
思考
方法一每次找最大值是线性。线段树把区间最大查询降到 ,再按下标切开递归,总时间 。
方法一中,每次查找区间最大值,需要 的时间,我们可以借助线段树,将每次查询区间最大值的时间降至 。
最多需要查询 次,因此,总的时间复杂度为 ,空间复杂度 ,其中 是数组的长度。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func constructMaximumBinaryTree(nums []int) *TreeNode {
	d := make([]int, 1010)
	for i, v := range nums {
		d[v] = i + 1
	}
	tree := newSegmentTree(nums)
	var dfs func(l, r int) *TreeNode
	dfs = func(l, r int) *TreeNode {
		if l > r {
			return nil
		}
		val := tree.query(1, l, r)
		root := &TreeNode{Val: val}
		root.Left = dfs(l, d[val]-1)
		root.Right = dfs(d[val]+1, r)
		return root
	}

	return dfs(1, len(nums))
}

type node struct {
	l int
	r int
	v int
}

type segmentTree struct {
	nums []int
	tr   []*node
}

func newSegmentTree(nums []int) *segmentTree {
	n := len(nums)
	tr := make([]*node, n<<2)
	for i := range tr {
		tr[i] = &node{}
	}
	t := &segmentTree{nums, tr}
	t.build(1, 1, n)
	return t
}

func (t *segmentTree) build(u, l, r int) {
	t.tr[u].l, t.tr[u].r = l, r
	if l == r {
		t.tr[u].v = t.nums[l-1]
		return
	}
	mid := (l + r) >> 1
	t.build(u<<1, l, mid)
	t.build(u<<1|1, mid+1, r)
	t.pushup(u)
}

func (t *segmentTree) query(u, l, r int) int {
	if t.tr[u].l >= l && t.tr[u].r <= r {
		return t.tr[u].v
	}
	mid := (t.tr[u].l + t.tr[u].r) >> 1
	v := 0
	if l <= mid {
		v = t.query(u<<1, l, r)
	}
	if r > mid {
		v = max(v, t.query(u<<1|1, l, r))
	}
	return v
}

func (t *segmentTree) pushup(u int) {
	t.tr[u].v = max(t.tr[u<<1].v, t.tr[u<<1|1].v)
}
方法三:单调栈 · Go 实现
思考
线段树仍要建树。从左到右扫,单调递减栈维护「左侧最近更大元」:弹出的最后节点成为当前左孩子,栈顶则把当前收为右孩子。一次入出栈即建完。
题目表达了一个意思:如果 中间有一个数字 ,找出它左右两侧最大的数,这两个最大的数应该比 小。
了解单调栈的朋友,或许会注意到:
当我们尝试向栈中压入一个数字 时,如果栈顶元素比 小,则循环弹出栈顶元素,并记录最后一个弹出的元素 。那么循环结束, 必须位于 的左侧,因为 是 的左侧最大的数。令 指向 。
如果此时存在栈顶元素,栈顶元素一定大于 。 成为栈顶元素的候选右子树节点。令 指向 。然后 入栈。
遍历结束,栈底元素成为树的根节点。
时间复杂度 ,空间复杂度 。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func constructMaximumBinaryTree(nums []int) *TreeNode {
	stk := []*TreeNode{}
	for _, v := range nums {
		node := &TreeNode{Val: v}
		var last *TreeNode
		for len(stk) > 0 && stk[len(stk)-1].Val < v {
			last = stk[len(stk)-1]
			stk = stk[:len(stk)-1]
		}
		node.Left = last
		if len(stk) > 0 {
			stk[len(stk)-1].Right = node
		}
		stk = append(stk, node)
	}
	return stk[0]
}
方法四:显式栈 · Go 实现
思考
根是区间最大值,左右子树遵守同一规则。 ,每次线性扫描最大值是 ,时间上可以通过。递增数组的最大值总在右端,第一次调用总是处理左侧剩下的 个元素,递归深度就是 ,会超出默认递归上限。
一段区间的根只由左右端点决定,不需要把子数组复制出来。
因此用下标区间 表示当前段,栈里保存待建区间以及它挂在父节点的哪一侧。弹出区间后线性找出最大值建成节点,再把右区间和左区间压栈,左区间后进先出。空区间直接跳过。
在下标区间 上线性找出最大值的下标 ,以 为根。左子树对应 ,右子树对应 。待建区间放在显式栈里:弹出一个区间后建好根,再把右区间和左区间压栈。空区间直接跳过。初始区间是 。
时间复杂度 ,空间复杂度 ,其中 是数组的长度。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func constructMaximumBinaryTree(nums []int) *TreeNode {
	type frame struct {
		l, r, side int
		parent     *TreeNode
	}
	n := len(nums)
	var root *TreeNode
	stk := []frame{{0, n - 1, 0, nil}}
	for len(stk) > 0 {
		cur := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		if cur.l > cur.r {
			continue
		}
		i := cur.l
		for j := cur.l; j <= cur.r; j++ {
			if nums[j] > nums[i] {
				i = j
			}
		}
		node := &TreeNode{Val: nums[i]}
		if cur.parent == nil {
			root = node
		} else if cur.side == 0 {
			cur.parent.Left = node
		} else {
			cur.parent.Right = node
		}
		stk = append(stk, frame{i + 1, cur.r, 1, node}, frame{cur.l, i - 1, 0, node})
	}
	return root
}
方法五:线段树 + 显式栈 · Go 实现
思考
方法一已经用显式栈按区间最大值建树,但每次找最大值仍是线性扫描。线段树把区间最大查询降到 。左区间仍可能连成 层,所以切开左右子树也放在同一个显式栈上,总时间 。
方法一中,每次查找区间最大值,需要 的时间,我们可以借助线段树,将每次查询区间最大值的时间降至 。左右子树的区间放进显式栈,弹出时用线段树取出该区间的最大值并建节点。
最多需要查询 次,因此,总的时间复杂度为 ,空间复杂度 ,其中 是数组的长度。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func constructMaximumBinaryTree(nums []int) *TreeNode {
	d := make([]int, 1010)
	for i, v := range nums {
		d[v] = i + 1
	}
	tree := newSegmentTree(nums)
	type frame struct {
		l, r, side int
		parent     *TreeNode
	}
	var root *TreeNode
	stk := []frame{{1, len(nums), 0, nil}}
	for len(stk) > 0 {
		cur := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		if cur.l > cur.r {
			continue
		}
		val := tree.query(1, cur.l, cur.r)
		node := &TreeNode{Val: val}
		if cur.parent == nil {
			root = node
		} else if cur.side == 0 {
			cur.parent.Left = node
		} else {
			cur.parent.Right = node
		}
		i := d[val]
		stk = append(stk, frame{i + 1, cur.r, 1, node}, frame{cur.l, i - 1, 0, node})
	}
	return root
}

type node struct {
	l int
	r int
	v int
}

type segmentTree struct {
	nums []int
	tr   []*node
}

func newSegmentTree(nums []int) *segmentTree {
	n := len(nums)
	tr := make([]*node, n<<2)
	for i := range tr {
		tr[i] = &node{}
	}
	t := &segmentTree{nums, tr}
	t.build(1, 1, n)
	return t
}

func (t *segmentTree) build(u, l, r int) {
	t.tr[u].l, t.tr[u].r = l, r
	if l == r {
		t.tr[u].v = t.nums[l-1]
		return
	}
	mid := (l + r) >> 1
	t.build(u<<1, l, mid)
	t.build(u<<1|1, mid+1, r)
	t.pushup(u)
}

func (t *segmentTree) query(u, l, r int) int {
	if t.tr[u].l >= l && t.tr[u].r <= r {
		return t.tr[u].v
	}
	mid := (t.tr[u].l + t.tr[u].r) >> 1
	v := 0
	if l <= mid {
		v = t.query(u<<1, l, r)
	}
	if r > mid {
		v = max(v, t.query(u<<1|1, l, r))
	}
	return v
}

func (t *segmentTree) pushup(u int) {
	t.tr[u].v = max(t.tr[u<<1].v, t.tr[u<<1|1].v)
}655. 输出二叉树
题目、示例与约束
给你一棵二叉树的根节点 root ,请你构造一个下标从 0 开始、大小为 m x n 的字符串矩阵 res ,用以表示树的 格式化布局 。构造此格式化布局矩阵需要遵循以下规则:
- 树的 高度 为
height,矩阵的行数m应该等于height + 1。 - 矩阵的列数
n应该等于2height+1 - 1。 - 根节点 需要放置在 顶行 的 正中间 ,对应位置为
res[0][(n-1)/2]。 - 对于放置在矩阵中的每个节点,设对应位置为
res[r][c],将其左子节点放置在res[r+1][c-2height-r-1],右子节点放置在res[r+1][c+2height-r-1]。 - 继续这一过程,直到树中的所有节点都妥善放置。
- 任意空单元格都应该包含空字符串
""。
返回构造得到的矩阵 res 。
示例 1:
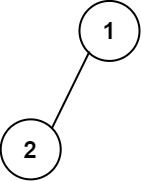
输入:root = [1,2]
输出:
[["","1",""],
 ["2","",""]]
示例 2:
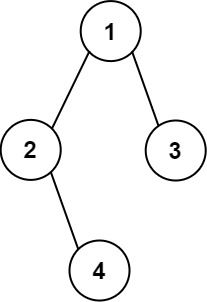
输入:root = [1,2,3,null,4]
输出:
[["","","","1","","",""],
 ["","2","","","","3",""],
 ["","","4","","","",""]]
提示:
- 树中节点数在范围
[1, 210]内 -99 <= Node.val <= 99- 树的深度在范围
[1, 10]内
方法一:两次 DFS · Go 实现
思考
要把树画进 的矩阵,列位置由高度公式给出。必须先知道 才能定宽度。
第一次 DFS 求高,按公式开矩阵;第二次 DFS 把节点写到 ,左右孩子列偏移 。
先通过 DFS 求二叉树的高度 (高度从 0 开始),然后根据 求得结果列表的行数 和列数 。
根据 , 初始化结果列表 ans,然后 DFS 遍历二叉树,依次在每个位置填入二叉树节点值(字符串形式)即可。
时间复杂度 ,空间复杂度 。其中 是二叉树的高度。忽略结果返回值的空间消耗。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func printTree(root *TreeNode) [][]string {
	var height func(root *TreeNode) int
	height = func(root *TreeNode) int {
		if root == nil {
			return -1
		}
		return 1 + max(height(root.Left), height(root.Right))
	}
	h := height(root)
	m, n := h+1, (1<<(h+1))-1
	ans := make([][]string, m)
	for i := range ans {
		ans[i] = make([]string, n)
		for j := range ans[i] {
			ans[i][j] = ""
		}
	}
	var dfs func(root *TreeNode, r, c int)
	dfs = func(root *TreeNode, r, c int) {
		if root == nil {
			return
		}
		ans[r][c] = strconv.Itoa(root.Val)
		dfs(root.Left, r+1, c-int(math.Pow(float64(2), float64(h-r-1))))
		dfs(root.Right, r+1, c+int(math.Pow(float64(2), float64(h-r-1))))
	}

	dfs(root, 0, (n-1)/2)
	return ans
}
方法二:两次 BFS · Go 实现
思考
高度与填表都可以改成 BFS:按层数得 ,再带坐标入队填写,避免递归。
方法一中,我们是通过 DFS 来求二叉树的高度,我们也可以改成 BFS 的方式,逐层往下扩展,那么扩展的层数就是二叉树的高度。
同样,我们初始化结果列表 ans,然后 BFS 遍历二叉树,依次在每个位置填入二叉树节点值(字符串形式)即可。
时间复杂度 ,空间复杂度 。其中 是二叉树的高度。忽略结果返回值的空间消耗。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func printTree(root *TreeNode) [][]string {
	h := height(root)
	m, n := h+1, (1<<(h+1))-1
	ans := make([][]string, m)
	for i := range ans {
		ans[i] = make([]string, n)
		for j := range ans[i] {
			ans[i][j] = ""
		}
	}
	q := []tuple{tuple{root, 0, (n - 1) / 2}}
	for len(q) > 0 {
		p := q[0]
		q = q[1:]
		root := p.node
		r, c := p.r, p.c
		ans[r][c] = strconv.Itoa(root.Val)
		if root.Left != nil {
			q = append(q, tuple{root.Left, r + 1, c - int(math.Pow(float64(2), float64(h-r-1)))})
		}
		if root.Right != nil {
			q = append(q, tuple{root.Right, r + 1, c + int(math.Pow(float64(2), float64(h-r-1)))})
		}
	}
	return ans
}

func height(root *TreeNode) int {
	h := -1
	q := []*TreeNode{root}
	for len(q) > 0 {
		h++
		for n := len(q); n > 0; n-- {
			root := q[0]
			q = q[1:]
			if root.Left != nil {
				q = append(q, root.Left)
			}
			if root.Right != nil {
				q = append(q, root.Right)
			}
		}
	}
	return h
}

type tuple struct {
	node *TreeNode
	r    int
	c    int
}662. 二叉树最大宽度
题目、示例与约束
给你一棵二叉树的根节点 root ,返回树的 最大宽度 。
树的 最大宽度 是所有层中最大的 宽度 。
每一层的 宽度 被定义为该层最左和最右的非空节点(即,两个端点)之间的长度。将这个二叉树视作与满二叉树结构相同,两端点间会出现一些延伸到这一层的 null 节点,这些 null 节点也计入长度。
题目数据保证答案将会在 32 位 带符号整数范围内。
示例 1:
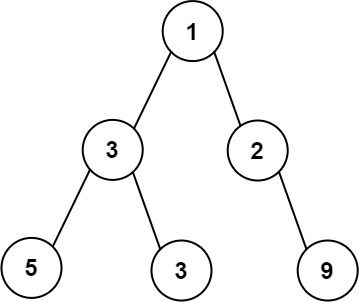
输入:root = [1,3,2,5,3,null,9]
输出:4
解释:最大宽度出现在树的第 3 层,宽度为 4 (5,3,null,9) 。
示例 2:
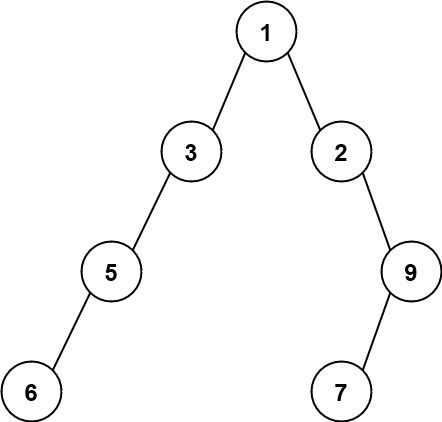
输入:root = [1,3,2,5,null,null,9,6,null,7]
输出:7
解释:最大宽度出现在树的第 4 层,宽度为 7 (6,null,null,null,null,null,7) 。
示例 3:
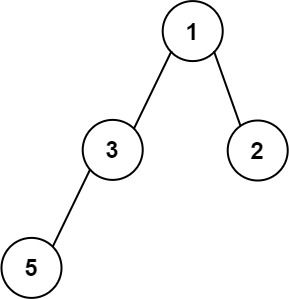
输入:root = [1,3,2,5]
输出:2
解释:最大宽度出现在树的第 2 层,宽度为 2 (3,2) 。
提示:
- 树中节点的数目范围是
[1, 3000] -100 <= Node.val <= 100
方法一:BFS · Go 实现
思考
层宽定义为该层最左到最右编号之差加一,中间空位也算。只存节点无法看到空洞。
给根编号 ,左孩子 、右孩子 。BFS 一层内队尾编号减队首再加一,取全局最大。
对节点进行编号,初始根节点编号为 。
对于一个编号为 i 的节点,它的左节点编号为 i<<1,右节点编号为 i<<1|1。
采用 BFS 进行层序遍历,求每层的宽度时,用该层的最大节点编号减去最小节点编号再加一即可。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func widthOfBinaryTree(root *TreeNode) int {
	q := []pair{{root, 1}}
	ans := 0
	for len(q) > 0 {
		ans = max(ans, q[len(q)-1].i-q[0].i+1)
		for n := len(q); n > 0; n-- {
			p := q[0]
			q = q[1:]
			root = p.node
			if root.Left != nil {
				q = append(q, pair{root.Left, p.i << 1})
			}
			if root.Right != nil {
				q = append(q, pair{root.Right, p.i<<1 | 1})
			}
		}
	}
	return ans
}

type pair struct {
	node *TreeNode
	i    int
}
方法二:DFS · Go 实现
思考
BFS 要队列。DFS 记下每层第一次访问的编号,之后用当前编号减该值加一更新答案,编号规则相同。
定义 dfs(root, depth, i) 表示从深度为 depth,且编号为 i 的节点 root 开始往下搜索。记录每一层最先访问到的节点的编号。访问到当前层其它节点时,求当前节点编号与当前层最小编号的差再加一,更新当前层的最大宽度。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func widthOfBinaryTree(root *TreeNode) int {
	ans := 1
	t := []int{}
	var dfs func(root *TreeNode, depth, i int)
	dfs = func(root *TreeNode, depth, i int) {
		if root == nil {
			return
		}
		if len(t) == depth {
			t = append(t, i)
		} else {
			ans = max(ans, i-t[depth]+1)
		}
		dfs(root.Left, depth+1, i<<1)
		dfs(root.Right, depth+1, i<<1|1)
	}
	dfs(root, 0, 1)
	return ans
}663. 均匀树划分 🔒
题目、示例与约束
给你一棵二叉树的根节点 root,如果你可以通过去掉原始树上的一条边将树分成两棵节点值之和相等的子树,则返回 true。
示例 1:
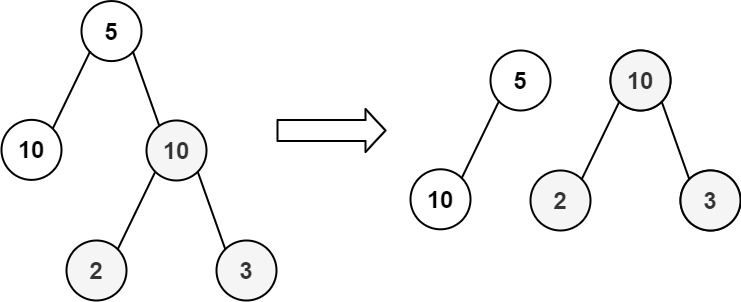
输入:root = [5,10,10,null,null,2,3]
输出:true
示例 2:
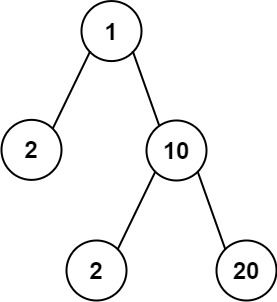
输入:root = [1,2,10,null,null,2,20]
输出:false
解释:在树上移除一条边无法将树分成两棵节点值之和相等的子树。
提示:
- 树中节点数目在
[1, 104]范围内。 -105 <= Node.val <= 105
方法一 · Go 实现
思考
删一条边使两棵子树节点和相等。枚举每条边再分别求和是平方级。
一次后序得到整树和 ;若 为奇数则不可能。记下除根以外的所有子树和,存在 即说明可在该子树处切开。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func checkEqualTree(root *TreeNode) bool {
	var seen []int
	var sum func(root *TreeNode) int
	sum = func(root *TreeNode) int {
		if root == nil {
			return 0
		}
		l, r := sum(root.Left), sum(root.Right)
		s := l + r + root.Val
		seen = append(seen, s)
		return s
	}

	s := sum(root)
	if s%2 != 0 {
		return false
	}
	seen = seen[:len(seen)-1]
	for _, v := range seen {
		if v == s/2 {
			return true
		}
	}
	return false
}666. 路径总和 IV 🔒
题目、示例与约束
对于一棵深度小于 5 的树,可以用一组三位十进制整数来表示。给定一个由三位数组成的 递增 的数组 nums 表示一棵深度小于 5 的二叉树,对于每个整数:
- 百位上的数字表示这个节点的深度
d,1 <= d <= 4。 - 十位上的数字表示这个节点在当前层所在的位置
p,1 <= p <= 8。位置编号与一棵 满二叉树 的位置编号相同。 - 个位上的数字表示这个节点的权值
v,0 <= v <= 9。
返回从 根 到所有 叶子结点 的 路径 之 和。
保证 给定的数组表示一个有效的连接二叉树。
示例 1:
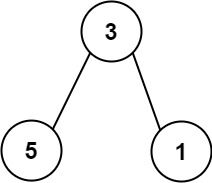
输入: nums = [113, 215, 221]
输出: 12
解释: 列表所表示的树如上所示。
路径和 = (3 + 5) + (3 + 1) = 12。
示例 2:
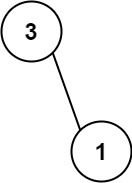
输入: nums = [113, 221]
输出: 4
解释: 列表所表示的树如上所示。
路径和 = (3 + 1) = 4。
提示:
1 <= nums.length <= 15110 <= nums[i] <= 489nums表示深度小于5的有效二叉树nums以升序排序。
方法一 · Go 实现
思考
树用三位整数编码深度、位置与值,要求根到叶路径和。先建指针树再遍历偏绕。
用 做键放入哈希表,从 出发按公式走到左右孩子;两边都不存在则累加当前路径和。
func pathSum(nums []int) int {
	ans := 0
	mp := make(map[int]int)
	for _, num := range nums {
		mp[num/10] = num % 10
	}
	var dfs func(node, t int)
	dfs = func(node, t int) {
		if v, ok := mp[node]; ok {
			t += v
			d, p := node/10, node%10
			l := (d+1)*10 + (p * 2) - 1
			r := l + 1
			if _, ok1 := mp[l]; !ok1 {
				if _, ok2 := mp[r]; !ok2 {
					ans += t
					return
				}
			}
			dfs(l, t)
			dfs(r, t)
		}
	}
	dfs(11, 0)
	return ans
}669. 修剪二叉搜索树
题目、示例与约束
给你二叉搜索树的根节点 root ,同时给定最小边界low 和最大边界 high。通过修剪二叉搜索树,使得所有节点的值在[low, high]中。修剪树 不应该 改变保留在树中的元素的相对结构 (即,如果没有被移除,原有的父代子代关系都应当保留)。 可以证明,存在 唯一的答案 。
所以结果应当返回修剪好的二叉搜索树的新的根节点。注意,根节点可能会根据给定的边界发生改变。
示例 1:
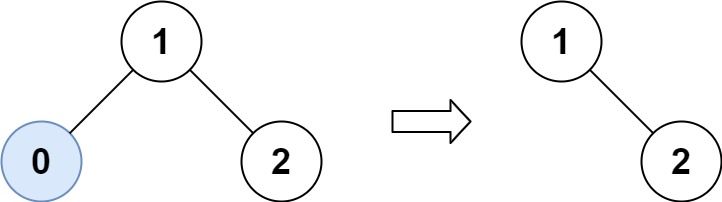
输入:root = [1,0,2], low = 1, high = 2
输出:[1,null,2]
示例 2:
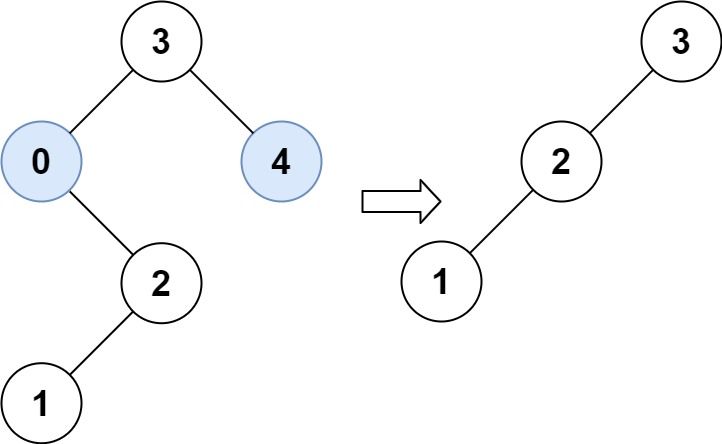
输入:root = [3,0,4,null,2,null,null,1], low = 1, high = 3
输出:[3,2,null,1]
提示:
- 树中节点数在范围
[1, 104]内 0 <= Node.val <= 104- 树中每个节点的值都是 唯一 的
- 题目数据保证输入是一棵有效的二叉搜索树
0 <= low <= high <= 104
方法一:递归 · Go 实现
思考
BST 中删掉不在 的节点并保持 BST。因有序,整棵左/右子树可一次性丢弃。
根偏大则答案全在左子树,偏小则全在右;落在区间内则递归修剪左右并接回。
判断 root.val 与 low 和 high 的大小关系:
- 若
root.val大于high,说明当前root节点与其右子树所有节点的值均大于high,那么递归修剪root.left即可; - 若
root.val小于low,说明当前root节点与其左子树所有节点的值均小于low,那么递归修剪root.right即可; - 若
root.val在[low, high]之间,说明当前root应该保留,递归修剪root.left,root.right,并且返回root。
递归的终止条件是 root 节点为空。
时间复杂度 ,空间复杂度 。其中 是二叉搜索树的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func trimBST(root *TreeNode, low int, high int) *TreeNode {
	if root == nil {
		return root
	}
	if root.Val > high {
		return trimBST(root.Left, low, high)
	}
	if root.Val < low {
		return trimBST(root.Right, low, high)
	}
	root.Left = trimBST(root.Left, low, high)
	root.Right = trimBST(root.Right, low, high)
	return root
}
方法二:迭代 · Go 实现
思考
递归最坏线性栈。先把根沿 BST 滑到区间内,再分别沿左右链:过小的左孩子用其右子替换,过大的右孩子用其左子替换,额外空间为常数。
我们先循环判断 root,若 root.val 不在 [low, high] 之间,那么直接将 root 置为对应的左孩子或右孩子,循环直至 root 为空或者 root.val 在 [low, high] 之间。
若此时 root 为空,直接返回。否则,说明 root 是一个需要保留的节点。接下来只需要分别迭代修剪 root 的左右子树。
以左子树 node = root.left 为例:
- 若
node.left.val小于low,那么node.left及其左孩子均不满足条件,我们直接将node.left置为node.left.right; - 否则,我们将
node置为node.left; - 循环判断,直至
node.left为空。
右子树的修剪过程与之类似。
时间复杂度 ,空间复杂度 。其中 是二叉搜索树的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func trimBST(root *TreeNode, low int, high int) *TreeNode {
	for root != nil && (root.Val < low || root.Val > high) {
		if root.Val < low {
			root = root.Right
		} else {
			root = root.Left
		}
	}
	if root == nil {
		return nil
	}
	node := root
	for node.Left != nil {
		if node.Left.Val < low {
			node.Left = node.Left.Right
		} else {
			node = node.Left
		}
	}
	node = root
	for node.Right != nil {
		if node.Right.Val > high {
			node.Right = node.Right.Left
		} else {
			node = node.Right
		}
	}
	return root
}671. 二叉树中第二小的节点
题目、示例与约束
给定一个非空特殊的二叉树,每个节点都是正数,并且每个节点的子节点数量只能为 2 或 0。如果一个节点有两个子节点的话,那么该节点的值等于两个子节点中较小的一个。
更正式地说,即 root.val = min(root.left.val, root.right.val) 总成立。
给出这样的一个二叉树,你需要输出所有节点中的 第二小的值 。
如果第二小的值不存在的话,输出 -1 。
示例 1:
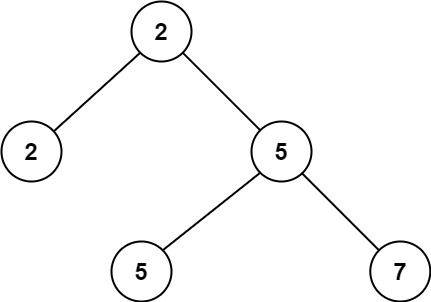
输入:root = [2,2,5,null,null,5,7]
输出:5
解释:最小的值是 2 ,第二小的值是 5 。
示例 2:
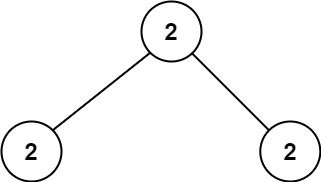
输入:root = [2,2,2]
输出:-1
解释:最小的值是 2, 但是不存在第二小的值。
提示:
- 树中节点数目在范围
[1, 25]内 1 <= Node.val <= 231 - 1- 对于树中每个节点
root.val == min(root.left.val, root.right.val)
方法一:DFS · Go 实现
思考
特殊二叉树中每个内点等于两子之一的较小者,求严格次小值。不必排序整树。
根值即全局最小。DFS 收集所有大于根的节点,取其中最小者;没有则返回 。
直接 DFS 遍历二叉树,找到大于 root.val 的最小值。若不存在,则返回 -1。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func findSecondMinimumValue(root *TreeNode) int {
	ans, v := -1, root.Val
	var dfs func(*TreeNode)
	dfs = func(root *TreeNode) {
		if root == nil {
			return
		}
		dfs(root.Left)
		dfs(root.Right)
		if root.Val > v {
			if ans == -1 || ans > root.Val {
				ans = root.Val
			}
		}
	}
	dfs(root)
	return ans
}687. 最长同值路径
题目、示例与约束
给定一个二叉树的 root ,返回 最长的路径的长度 ,这个路径中的 每个节点具有相同值 。 这条路径可以经过也可以不经过根节点。
两个节点之间的路径长度 由它们之间的边数表示。
示例 1:
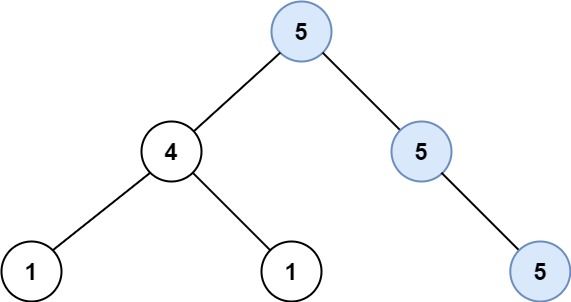
输入:root = [5,4,5,1,1,5]
输出:2
示例 2:
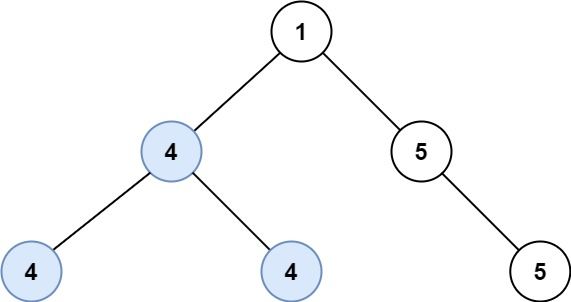
输入:root = [1,4,5,4,4,5]
输出:2
提示:
- 树的节点数的范围是
[0, 104] -1000 <= Node.val <= 1000- 树的深度将不超过
1000
方法一:DFS · Go 实现
思考
同值路径可以在某节点拐弯,长度按边计。只做根到叶会漏掉「左右拼起来」的路径。
DFS 返回向下延伸的最长同值边数:孩子同值才加一,否则置 。用 更新全局答案,向上只传 。
我们设计一个函数 ,表示以 节点作为路径的其中一个端点,向下延伸的最长同值路径长度。
在 中,我们首先递归调用 和 ,得到两个返回值 和 。这两个返回值分别代表了以 节点的左孩子和右孩子为路径的其中一个端点,向下延伸的最长同值路径长度。
如果 存在左孩子且 ,那么在 的左孩子为路径的其中一个端点,向下延伸的最长同值路径长度应为 ;否则,这个长度为 。如果 存在右孩子且 ,那么在 的右孩子为路径的其中一个端点,向下延伸的最长同值路径长度应为 ;否则,这个长度为 。
在递归调用完左右孩子之后,我们更新答案为 ,即以 为端点的路径经过 的最长同值路径长度。
最后, 函数返回以 为端点的向下延伸的最长同值路径长度,即 。
在主函数中,我们调用 ,即可得到答案。
时间复杂度 ,空间复杂度 。其中 为二叉树的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func longestUnivaluePath(root *TreeNode) (ans int) {
	var dfs func(*TreeNode) int
	dfs = func(root *TreeNode) int {
		if root == nil {
			return 0
		}
		l, r := dfs(root.Left), dfs(root.Right)
		if root.Left != nil && root.Left.Val == root.Val {
			l++
		} else {
			l = 0
		}
		if root.Right != nil && root.Right.Val == root.Val {
			r++
		} else {
			r = 0
		}
		ans = max(ans, l+r)
		return max(l, r)
	}
	dfs(root)
	return
}690. 员工的重要性
题目、示例与约束
你有一个保存员工信息的数据结构,它包含了员工唯一的 id ,重要度和直系下属的 id 。
给定一个员工数组 employees,其中:
employees[i].id是第i个员工的 ID。employees[i].importance是第i个员工的重要度。employees[i].subordinates是第i名员工的直接下属的 ID 列表。
给定一个整数 id 表示一个员工的 ID,返回这个员工和他所有下属的重要度的 总和。
示例 1:
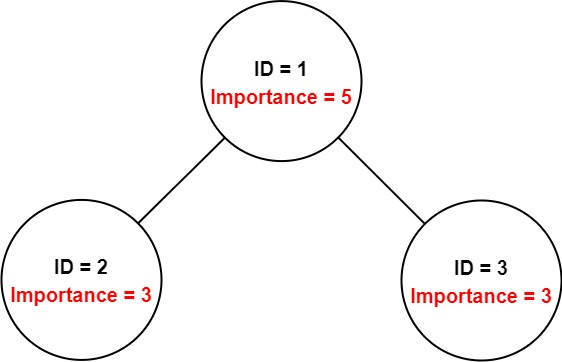
输入:employees = [[1,5,[2,3]],[2,3,[]],[3,3,[]]], id = 1
输出:11
解释:
员工 1 自身的重要度是 5 ,他有两个直系下属 2 和 3 ,而且 2 和 3 的重要度均为 3 。因此员工 1 的总重要度是 5 + 3 + 3 = 11 。
示例 2:
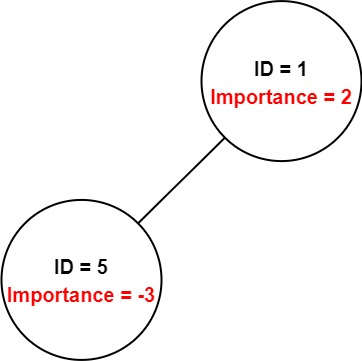
输入:employees = [[1,2,[5]],[5,-3,[]]], id = 5
输出:-3
解释:员工 5 的重要度为 -3 并且没有直接下属。
因此,员工 5 的总重要度为 -3。
提示:
1 <= employees.length <= 20001 <= employees[i].id <= 2000- 所有的
employees[i].id互不相同。 -100 <= employees[i].importance <= 100- 一名员工最多有一名直接领导,并可能有多名下属。
employees[i].subordinates中的 ID 都有效。
方法一:哈希表 + DFS · Go 实现
思考
重要度是自身加全部下属的递归和。员工以列表给出,按 id 查找下属是线性。
先把 id 映到对象,再从给定 id DFS:返回
importance加上各下属递归结果之和。
我们用一个哈希表 存储所有员工的信息,其中键是员工的 ID,值是员工对象。然后我们从给定的员工 ID 开始深度优先搜索,每次遍历到一个员工时,将该员工的重要度加到答案中,并递归遍历该员工的所有下属,将下属的重要度也加到答案中。
时间复杂度 ,空间复杂度 。其中 是员工的数量。
/**
 * Definition for Employee.
 * type Employee struct {
 *     Id int
 *     Importance int
 *     Subordinates []int
 * }
 */

func getImportance(employees []*Employee, id int) int {
	d := map[int]*Employee{}
	for _, e := range employees {
		d[e.Id] = e
	}
	var dfs func(int) int
	dfs = func(i int) int {
		s := d[i].Importance
		for _, j := range d[i].Subordinates {
			s += dfs(j)
		}
		return s
	}
	return dfs(id)
}700. 二叉搜索树中的搜索
题目、示例与约束
给定二叉搜索树(BST)的根节点 root 和一个整数值 val。
你需要在 BST 中找到节点值等于 val 的节点。 返回以该节点为根的子树。 如果节点不存在,则返回 null 。
示例 1:
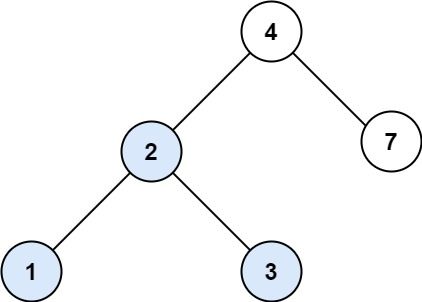
输入:root = [4,2,7,1,3], val = 2
输出:[2,1,3]
示例 2:
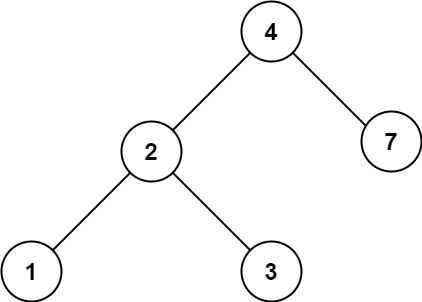
输入:root = [4,2,7,1,3], val = 5
输出:[]
提示:
- 树中节点数在
[1, 5000]范围内 1 <= Node.val <= 107root是二叉搜索树1 <= val <= 107
方法一:递归 · Go 实现
思考
题目要求返回值为 的节点及其整棵子树。节点数不超过 ,整树扫描在时间上可以接受,但会丢掉二叉搜索树「左小右大」这一结构。
若当前节点值已经等于目标,答案就是它本身;若更大,目标只可能在左子树,反之只可能在右子树。因此每次比较后只需进入一侧,不必同时展开两棵子树。
递归自然对应这一过程:空节点或命中则返回当前节点,否则按大小关系进入左或右。最坏仍可能走到一条链,时间与栈空间均为 。
我们判断当前节点是否为空或者当前节点的值是否等于目标值,如果是则返回当前节点。
否则,如果当前节点的值大于目标值,则递归搜索左子树,否则递归搜索右子树。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
 func searchBST(root *TreeNode, val int) *TreeNode {
    if root == nil || root.Val == val {
        return root
    }
    if root.Val > val {
        return searchBST(root.Left, val)
    }
    return searchBST(root.Right, val)
}701. 二叉搜索树中的插入操作
题目、示例与约束
给定二叉搜索树(BST)的根节点 root 和要插入树中的值 value ,将值插入二叉搜索树。 返回插入后二叉搜索树的根节点。 输入数据 保证 ,新值和原始二叉搜索树中的任意节点值都不同。
注意,可能存在多种有效的插入方式,只要树在插入后仍保持为二叉搜索树即可。 你可以返回 任意有效的结果 。
示例 1:
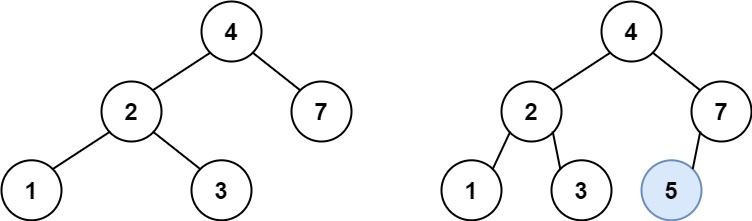
输入:root = [4,2,7,1,3], val = 5
输出:[4,2,7,1,3,5]
解释:另一个满足题目要求可以通过的树是: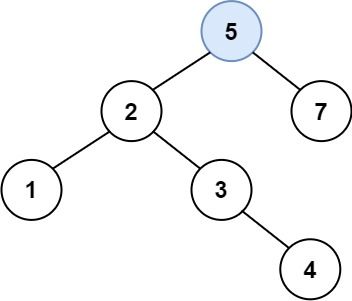
示例 2:
输入:root = [40,20,60,10,30,50,70], val = 25
输出:[40,20,60,10,30,50,70,null,null,25]
示例 3:
输入:root = [4,2,7,1,3,null,null,null,null,null,null], val = 5
输出:[4,2,7,1,3,5]
提示:
- 树中的节点数将在
[0, 104]的范围内。 -108 <= Node.val <= 108- 所有值
Node.val是 独一无二 的。 -108 <= val <= 108- 保证
val在原始BST中不存在。
方法一:递归 · Go 实现
思考
需要在二叉搜索树中插入一个尚未出现的值,并返回新的根。节点数不超过 ,任意正确的插入路径都可以通过。
插入位置由 BST 的有序性唯一确定:沿比较路径走到空位,在该处挂上新节点即可,无需旋转或重构。空树则新节点自身即为根。
因此按当前值与 的大小递归进入左或右子树,并把返回的子树根接回当前节点。最坏沿一条链下降,时间与栈空间均为 。
如果根节点为空,我们直接创建一个新节点,值为 ,并返回。
如果根节点的值大于 ,我们递归地将 插入到左子树中,并将左子树的根节点更新为返回后的根节点。
如果根节点的值小于 ,我们递归地将 插入到右子树中,并将右子树的根节点更新为返回后的根节点。
时间复杂度 ,空间复杂度 。其中 是二叉树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func insertIntoBST(root *TreeNode, val int) *TreeNode {
	if root == nil {
		return &TreeNode{Val: val}
	}
	if root.Val > val {
		root.Left = insertIntoBST(root.Left, val)
	} else {
		root.Right = insertIntoBST(root.Right, val)
	}
	return root
}742. 二叉树最近的叶节点 🔒
题目、示例与约束
给定一个 每个结点的值互不相同 的二叉树,和一个目标整数值 k,返回 树中与目标值 k 最近的叶结点 。
与叶结点最近 表示在二叉树中到达该叶节点需要行进的边数与到达其它叶结点相比最少。而且,当一个结点没有孩子结点时称其为叶结点。
示例 1:
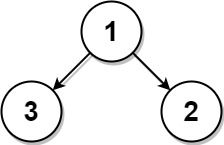
输入:root = [1, 3, 2], k = 1
输出: 2
解释: 2 和 3 都是距离目标 1 最近的叶节点。
示例 2:

输入:root = [1], k = 1
输出:1
解释:最近的叶节点是根结点自身。
示例 3:
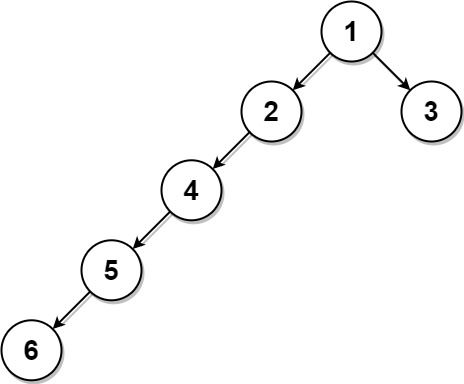
输入:root = [1,2,3,4,null,null,null,5,null,6], k = 2
输出:3
解释:值为 3(而不是值为 6)的叶节点是距离结点 2 的最近结点。
提示:
- 二叉树节点数在
[1, 1000]范围内 1 <= Node.val <= 1000- 每个节点值都 不同
- 给定的二叉树中有某个结点使得
node.val == k
方法一:DFS + BFS · Go 实现
思考
求与值为 的节点最近的叶子。叶子可能在子树里,也可能要先上到父亲再下到另一枝。只在树上向下搜会漏掉。
把树当成无向图后,从 出发的最短路第一次碰到的叶子就是答案。节点值互异,建图方便。
DFS 记下每个节点与父节点的双向边,再从 做 BFS,出队时若左右皆空则返回。时间 。
我们首先使用深度优先搜索构建一个无向图 ,其中 表示与节点 相邻的节点集合。然后我们从节点 开始进行广度优先搜索,直到找到一个叶节点为止,即为答案。
时间复杂度 ,空间复杂度 。其中 为二叉树节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func findClosestLeaf(root *TreeNode, k int) int {
	g := map[*TreeNode][]*TreeNode{}
	var dfs func(*TreeNode, *TreeNode)
	dfs = func(root, fa *TreeNode) {
		if root != nil {
			g[root] = append(g[root], fa)
			g[fa] = append(g[fa], root)
			dfs(root.Left, root)
			dfs(root.Right, root)
		}
	}
	dfs(root, nil)
	q := []*TreeNode{}
	vis := map[*TreeNode]bool{}
	for node := range g {
		if node != nil && node.Val == k {
			q = append(q, node)
			vis[node] = true
			break
		}
	}
	for {
		node := q[0]
		q = q[1:]
		if node != nil {
			if node.Left == node.Right {
				return node.Val
			}
			for _, nxt := range g[node] {
				if !vis[nxt] {
					vis[nxt] = true
					q = append(q, nxt)
				}
			}
		}
	}
}776. 拆分二叉搜索树 🔒
题目、示例与约束
给你一棵二叉搜索树(BST)的根结点 root 和一个整数 target 。请将该树按要求拆分为两个子树:其中第一个子树结点的值都必须小于等于给定的目标值;另一个子树结点的值都必须大于目标值;树中并非一定要存在值为 target 的结点。
除此之外,树中大部分结构都需要保留,也就是说原始树中父节点 p 的任意子节点 c ,假如拆分后它们仍在同一个子树中,那么结点 p 应仍为 c 的父结点。
按顺序返回 两个子树的根结点的数组 。
示例 1:
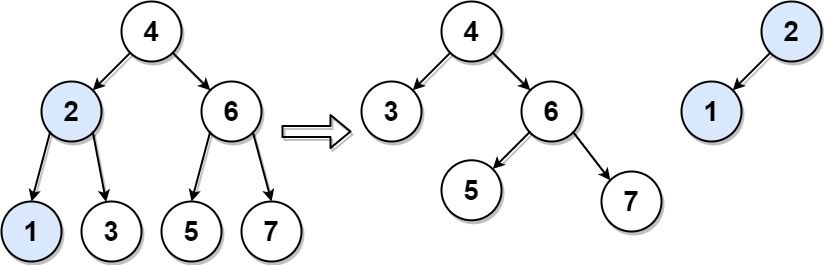
输入:root = [4,2,6,1,3,5,7], target = 2
输出:[[2,1],[4,3,6,null,null,5,7]]
示例 2:
输入: root = [1], target = 1
输出: [[1],[]]
提示:
- 二叉搜索树节点个数在
[1, 50]范围内 0 <= Node.val, target <= 1000
方法一:递归 · Go 实现
思考
按阈值把 BST 拆成 与 两棵,仍保持 BST。节点很少,递归按根与阈值的关系切开即可。
根 则整棵左子树都在较小那棵,只需拆右子树,把较小的右半接回根。根较大则对称拆左子树。
返回一对根指针。空树返回两个空。
判断 root 节点的情况:
- 若
root为空,直接返回[null, null]; - 若
root.val <= target,说明root及其左孩子所有节点的值均小于等于target,那么我们递归root.right,得到ans。然后将root.right指向ans[0],最后返回[root, ans[1]]; - 若
root.val > target,说明root及其右孩子所有节点的值均大于target,那么我们递归root.left,得到ans。然后将root.left指向ans[1],最后返回[ans[0], root]。
时间复杂度 ,空间复杂度 。其中 是二叉搜索树的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func splitBST(root *TreeNode, target int) []*TreeNode {
	if root == nil {
		return []*TreeNode{nil, nil}
	}
	if root.Val <= target {
		ans := splitBST(root.Right, target)
		root.Right = ans[0]
		ans[0] = root
		return ans
	} else {
		ans := splitBST(root.Left, target)
		root.Left = ans[1]
		ans[1] = root
		return ans
	}
}783. 二叉搜索树节点最小距离
题目、示例与约束
给你一个二叉搜索树的根节点 root ,返回 树中任意两不同节点值之间的最小差值 。
差值是一个正数,其数值等于两值之差的绝对值。
示例 1:
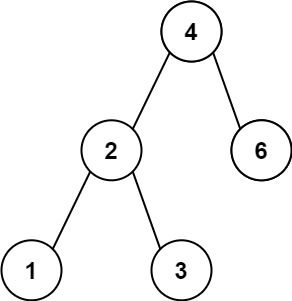
输入:root = [4,2,6,1,3]
输出:1
示例 2:
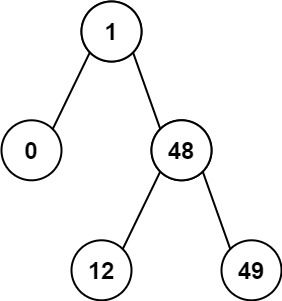
输入:root = [1,0,48,null,null,12,49]
输出:1
提示:
- 树中节点的数目范围是
[2, 100] 0 <= Node.val <= 105
注意:本题与 530:https://leetcode.cn/problems/minimum-absolute-difference-in-bst/ 相同
方法一:中序遍历 · Go 实现
思考
求 BST 中任意两节点差的最小值。节点很少,但任意两点比较没有必要:中序是递增序列,最小差只可能出现在相邻中序值之间。
递归中序,记下前驱 ,用当前值减它更新答案。
题目需要我们求任意两个节点值之间的最小差值,而二叉搜索树的中序遍历是一个递增序列,因此我们只需要求中序遍历中相邻两个节点值之间的最小差值即可。
我们可以使用递归的方法来实现中序遍历,过程中用一个变量 来保存前一个节点的值,这样我们就可以在遍历的过程中求出相邻两个节点值之间的最小差值。
时间复杂度 ,空间复杂度 。其中 为二叉搜索树的节点个数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */
func minDiffInBST(root *TreeNode) int {
	const inf int = 1 << 30
	ans, pre := inf, -inf
	var dfs func(*TreeNode)
	dfs = func(root *TreeNode) {
		if root == nil {
			return
		}
		dfs(root.Left)
		ans = min(ans, root.Val-pre)
		pre = root.Val
		dfs(root.Right)
	}
	dfs(root)
	return ans
}继续阅读
- 实践案例
- 实践案例
- 实践案例