
LeetCode Go · 字符串(2)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
1078. Bigram 分词
题目、示例与约束
给出第一个词 first 和第二个词 second,考虑在某些文本 text 中可能以 "first second third" 形式出现的情况,其中 second 紧随 first 出现,third 紧随 second 出现。
对于每种这样的情况,将第三个词 "third" 添加到答案中,并返回答案。
示例 1:
输入:text = "alice is a good girl she is a good student", first = "a", second = "good"
输出:["girl","student"]
示例 2:
输入:text = "we will we will rock you", first = "we", second = "will"
输出:["we","rock"]
提示:
1 <= text.length <= 1000text由小写英文字母和空格组成text中的所有单词之间都由 单个空格字符 分隔1 <= first.length, second.length <= 10first和second由小写英文字母组成text不包含任何前缀或尾随空格。
方法一:字符串分割 · Go 实现
思考
要找紧跟在给定二元词之后的第三个词。文本已由单空格分隔,先切成词数组再检查三元组即可,长度 。
对每个 看 ,前两个分别等于 则收集第三个。
一次线性扫描得到全部出现。
我们可以将字符串 按照空格分割成字符串数组 ,然后遍历 ,如果 和 分别等于 和 ,那么就将 添加到答案中。
遍历结束后,返回答案列表。
时间复杂度 ,空间复杂度 ,其中 是 的长度。
func findOcurrences(text string, first string, second string) (ans []string) {
	words := strings.Split(text, " ")
	n := len(words)
	for i := 0; i < n-2; i++ {
		if words[i] == first && words[i+1] == second {
			ans = append(ans, words[i+2])
		}
	}
	return
}1108. IP 地址无效化
题目、示例与约束
给你一个有效的 IPv4 地址 address,返回这个 IP 地址的无效化版本。
所谓无效化 IP 地址,其实就是用 "[.]" 代替了每个 "."。
示例 1:
输入:address = "1.1.1.1"
输出:"1[.]1[.]1[.]1"
示例 2:
输入:address = "255.100.50.0"
输出:"255[.]100[.]50[.]0"
提示:
- 给出的
address是一个有效的 IPv4 地址
方法一:直接替换 · Go 实现
思考
题目只要求把每个
.换成[.],并不需要校验或拆分各段。一次线性替换(或库函数replace)即可,时间与地址长度成正比。
我们直接将字符串中的 '.' 替换为 '[.]' 即可。
时间复杂度 ,其中 为字符串的长度。忽略答案的空间消耗,空间复杂度 。
func defangIPaddr(address string) string {
	return strings.Replace(address, ".", "[.]", -1)
}1119. 删去字符串中的元音 🔒
题目、示例与约束
给你一个字符串 s ,请你删去其中的所有元音字母 'a','e','i','o','u',并返回这个新字符串。
示例 1:
输入:s = "leetcodeisacommunityforcoders"
输出:"ltcdscmmntyfrcdrs"
示例 2:
输入:s = "aeiou"
输出:""
提示:
1 <= S.length <= 1000s仅由小写英文字母组成
方法一:模拟 · Go 实现
思考
过滤元音是逐字符判定,一次扫描并跳过
aeiou即可拼出结果。多次调用替换函数会重复遍历,没有必要。
我们直接按照题目要求,遍历字符串,将不是元音字母的字符拼接到结果字符串中即可。
时间复杂度 ,其中 为字符串的长度。忽略答案字符串的空间消耗,空间复杂度 。
func removeVowels(s string) string {
	ans := []rune{}
	for _, c := range s {
		if !(c == 'a' || c == 'e' || c == 'i' || c == 'o' || c == 'u') {
			ans = append(ans, c)
		}
	}
	return string(ans)
}1309. 解码字母到整数映射
题目、示例与约束
给你一个字符串 s,它由数字('0' - '9')和 '#' 组成。我们希望按下述规则将 s 映射为一些小写英文字符:
- 字符(
'a'-'i')分别用('1'-'9')表示。 - 字符(
'j'-'z')分别用('10#'-'26#')表示。
返回映射之后形成的新字符串。
题目数据保证映射始终唯一。
示例 1:
输入:s = "10#11#12"
输出:"jkab"
解释:"j" -> "10#" , "k" -> "11#" , "a" -> "1" , "b" -> "2".
示例 2:
输入:s = "1326#"
输出:"acz"
提示:
1 <= s.length <= 1000s[i]只包含数字('0'-'9')和'#'字符。s是映射始终存在的有效字符串。
方法一:模拟 · Go 实现
思考
映射规则有两种长度: – 对应单个数字, – 带
#占三位。若一律按一位解读,遇到10#会被拆错。因此扫描时先看 是否为#:是则取两位数字,否则取一位,指针相应前进 或 。
我们直接模拟即可。
遍历字符串 ,对于当前遍历到的下标 ,如果 且 为 #,则将 和 组成的字符串转换为整数,加上 a 的 ASCII 码值减去 1,然后转换为字符,添加到结果数组中,并将 增加 3;否则,将 转换为整数,加上 a 的 ASCII 码值减去 1,然后转换为字符,添加到结果数组中,并将 增加 1。
最后将结果数组转换为字符串返回即可。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度。
func freqAlphabets(s string) string {
	var ans []byte
	for i, n := 0, len(s); i < n; {
		if i+2 < n && s[i+2] == '#' {
			num := (int(s[i])-'0')*10 + int(s[i+1]) - '0'
			ans = append(ans, byte(num+int('a')-1))
			i += 3
		} else {
			num := int(s[i]) - '0'
			ans = append(ans, byte(num+int('a')-1))
			i += 1
		}
	}
	return string(ans)
}1324. 竖直打印单词
题目、示例与约束
给你一个字符串 s。请你按照单词在 s 中的出现顺序将它们全部竖直返回。
单词应该以字符串列表的形式返回,必要时用空格补位,但输出尾部的空格需要删除(不允许尾随空格)。
每个单词只能放在一列上,每一列中也只能有一个单词。
示例 1:
输入:s = "HOW ARE YOU"
输出:["HAY","ORO","WEU"]
解释:每个单词都应该竖直打印。
 "HAY"
 "ORO"
 "WEU"
示例 2:
输入:s = "TO BE OR NOT TO BE"
输出:["TBONTB","OEROOE","   T"]
解释:题目允许使用空格补位,但不允许输出末尾出现空格。
"TBONTB"
"OEROOE"
"   T"
示例 3:
输入:s = "CONTEST IS COMING"
输出:["CIC","OSO","N M","T I","E N","S G","T"]
提示:
1 <= s.length <= 200s仅含大写英文字母。- 题目数据保证两个单词之间只有一个空格。
方法一:模拟 · Go 实现
思考
按列读取空格分词后的单词,列宽为最长词长,较短词用空格补齐,且每列末尾空格要删掉。先求出最大长度 ,再对列号 收集各词第 个字符(越界则为空格),从末尾弹出空格后拼成一行。
我们先将字符串 按空格分割成单词数组 ,然后遍历单词数组,找出最长的单词长度 。
接下来我们从第 到第 个字符,分别从单词数组中取出对应的字符,如果当前单词长度不足,则用空格补齐,放到一个字符串 中。最后将 去掉末尾的空格,加入答案数组中即可。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度。
func printVertically(s string) (ans []string) {
	words := strings.Split(s, " ")
	n := 0
	for _, w := range words {
		n = max(n, len(w))
	}
	for j := 0; j < n; j++ {
		t := []byte{}
		for _, w := range words {
			if j < len(w) {
				t = append(t, w[j])
			} else {
				t = append(t, ' ')
			}
		}
		for len(t) > 0 && t[len(t)-1] == ' ' {
			t = t[:len(t)-1]
		}
		ans = append(ans, string(t))
	}
	return
}1374. 生成每种字符都是奇数个的字符串
题目、示例与约束
给你一个整数 n,请你返回一个含 n 个字符的字符串,其中每种字符在该字符串中都恰好出现 奇数次 。
返回的字符串必须只含小写英文字母。如果存在多个满足题目要求的字符串,则返回其中任意一个即可。
示例 1:
输入:n = 4
输出:"pppz"
解释:"pppz" 是一个满足题目要求的字符串,因为 'p' 出现 3 次,且 'z' 出现 1 次。当然,还有很多其他字符串也满足题目要求,比如:"ohhh" 和 "love"。
示例 2:
输入:n = 2
输出:"xy"
解释:"xy" 是一个满足题目要求的字符串,因为 'x' 和 'y' 各出现 1 次。当然,还有很多其他字符串也满足题目要求,比如:"ag" 和 "ur"。
示例 3:
输入:n = 7
输出:"holasss"
提示:
1 <= n <= 500
方法一:构造 · Go 实现
思考
构造长为 的串,使每个出现过的字符次数均为奇数。 为奇数时 个
'a'已满足;为偶数时,奇数个'a'再加一个'b',两种字符次数都是奇数。
如果 为奇数,那么直接构造 个 'a' 即可。
如果 为偶数,那么构造 个 'a' 和 个 'b' 即可。
时间复杂度 ,空间复杂度 。其中 为字符串长度。
func generateTheString(n int) string {
	ans := strings.Repeat("a", n-1)
	if n%2 == 0 {
		ans += "b"
	} else {
		ans += "a"
	}
	return ans
}1392. 最长快乐前缀
题目、示例与约束
「快乐前缀」 是在原字符串中既是 非空 前缀也是后缀(不包括原字符串自身)的字符串。
给你一个字符串 s,请你返回它的 最长快乐前缀。如果不存在满足题意的前缀,则返回一个空字符串 "" 。
示例 1:
输入:s = "level"
输出:"l"
解释:不包括 s 自己,一共有 4 个前缀("l", "le", "lev", "leve")和 4 个后缀("l", "el", "vel", "evel")。最长的既是前缀也是后缀的字符串是 "l" 。
示例 2:
输入:s = "ababab"
输出:"abab"
解释:"abab" 是最长的既是前缀也是后缀的字符串。题目允许前后缀在原字符串中重叠。
提示:
1 <= s.length <= 105s只含有小写英文字母
方法一:字符串哈希 · Go 实现
思考
最长真前缀且同时为后缀。 时从短到长逐一比较是平方级。从最长的真前缀开始,检查 是否等于 ,第一次相等即为最长快乐前缀;若都不相等则空串。
字符串哈希是把一个任意长度的字符串映射成一个非负整数,并且其冲突的概率几乎为 0。字符串哈希用于计算字符串哈希值,快速判断两个字符串是否相等。
取一固定值 BASE,把字符串看作是 BASE 进制数,并分配一个大于 0 的数值,代表每种字符。一般来说,我们分配的数值都远小于 BASE。例如,对于小写字母构成的字符串,可以令 a=1, b=2, ..., z=26。取一固定值 MOD,求出该 BASE 进制对 M 的余数,作为该字符串的 hash 值。
一般来说,取 BASE=131 或者 BASE=13331,此时 hash 值产生的冲突概率极低。只要两个字符串 hash 值相同,我们就认为两个字符串是相等的。通常 MOD 取 2^64,C++ 里,可以直接使用 unsigned long long 类型存储这个 hash 值,在计算时不处理算术溢出问题,产生溢出时相当于自动对 2^64 取模,这样可以避免低效取模运算。
除了在极特殊构造的数据上,上述 hash 算法很难产生冲突,一般情况下上述 hash 算法完全可以出现在题目的标准答案中。我们还可以多取一些恰当的 BASE 和 MOD 的值(例如大质数),多进行几组 hash 运算,当结果都相同时才认为原字符串相等,就更加难以构造出使这个 hash 产生错误的数据。
func longestPrefix(s string) string {
	base := 131
	n := len(s)
	p := make([]int, n+10)
	h := make([]int, n+10)
	p[0] = 1
	for i, c := range s {
		p[i+1] = p[i] * base
		h[i+1] = h[i]*base + int(c)
	}
	for l := n - 1; l > 0; l-- {
		prefix, suffix := h[l], h[n]-h[n-l]*p[l]
		if prefix == suffix {
			return s[:l]
		}
	}
	return ""
}
方法二:KMP 算法 · Go 实现
思考
逐长度比较最坏仍要扫完整段。KMP 的 数组恰为「真前缀等于真后缀」的最长长度:在 末尾加分隔符后求 ,末位即为所求长度,线性完成。
根据题目描述,我们需要找到一个字符串的最长快乐前缀,即找到一个字符串的最长前缀,使得这个前缀同时也是这个字符串的后缀。我们可以使用 KMP 算法来解决这个问题。
时间复杂度 ,空间复杂度 。其中 为字符串的长度。
func longestPrefix(s string) string {
	s += "#"
	n := len(s)
	next := make([]int, n)
	next[0], next[1] = -1, 0
	for i, j := 2, 0; i < n; {
		if s[i-1] == s[j] {
			j++
			next[i] = j
			i++
		} else if j > 0 {
			j = next[j]
		} else {
			next[i] = 0
			i++
		}
	}
	return s[:next[n-1]]
}1408. 数组中的字符串匹配
题目、示例与约束
给你一个字符串数组 words ,数组中的每个字符串都可以看作是一个单词。请你按 任意 顺序返回 words 中是其他单词的 子字符串 的所有单词。
示例 1:
输入:words = ["mass","as","hero","superhero"]
输出:["as","hero"]
解释:"as" 是 "mass" 的子字符串,"hero" 是 "superhero" 的子字符串。
["hero","as"] 也是有效的答案。
示例 2:
输入:words = ["leetcode","et","code"]
输出:["et","code"]
解释:"et" 和 "code" 都是 "leetcode" 的子字符串。
示例 3:
输入:words = ["blue","green","bu"]
输出:[]
提示:
1 <= words.length <= 1001 <= words[i].length <= 30words[i]仅包含小写英文字母。- 题目数据 保证
words的每个字符串都是独一无二的。
方法一:暴力枚举 · Go 实现
思考
且每个词长度不超过 ,对每个词检查它是否出现在其余某个词中,时间约为 ,约束下可以接受。
不必构造字典树或 KMP:词互不相同,直接双重枚举并用子串判定即可收集答案。
我们直接枚举所有的字符串 ,判断其是否为其他字符串的子串,如果是,将其加入答案。
时间复杂度 ,空间复杂度 。其中 为字符串数组的长度。
func stringMatching(words []string) []string {
	ans := []string{}
	for i, w1 := range words {
		for j, w2 := range words {
			if i != j && strings.Contains(w2, w1) {
				ans = append(ans, w1)
				break
			}
		}
	}
	return ans
}1417. 重新格式化字符串
题目、示例与约束
给你一个混合了数字和字母的字符串 s,其中的字母均为小写英文字母。
请你将该字符串重新格式化,使得任意两个相邻字符的类型都不同。也就是说,字母后面应该跟着数字,而数字后面应该跟着字母。
请你返回 重新格式化后 的字符串;如果无法按要求重新格式化,则返回一个 空字符串 。
示例 1:
输入:s = "a0b1c2"
输出:"0a1b2c"
解释:"0a1b2c" 中任意两个相邻字符的类型都不同。 "a0b1c2", "0a1b2c", "0c2a1b" 也是满足题目要求的答案。
示例 2:
输入:s = "leetcode"
输出:""
解释:"leetcode" 中只有字母,所以无法满足重新格式化的条件。
示例 3:
输入:s = "1229857369"
输出:""
解释:"1229857369" 中只有数字,所以无法满足重新格式化的条件。
示例 4:
输入:s = "covid2019"
输出:"c2o0v1i9d"
示例 5:
输入:s = "ab123"
输出:"1a2b3"
提示:
1 <= s.length <= 500s仅由小写英文字母和/或数字组成。
方法一:模拟 · Go 实现
思考
要求字母与数字严格交错。先把两类字符分开,若数量之差超过 ,不可能排成目标串。
让较长的一类放在奇数位置(下标从 的偶数位),两两拼接,多出的一个字符接在末尾。 ,线性扫描即可。
将字符串 中的所有字符分成“数字”、“字母”两类,分别放入 , 两个数组中。
比较 , 两个数组的长度,若 长度小于 ,则交换 , 。接着判断两个数组长度差,若超过 ,则返回空字符串。
接着同时遍历两个数组,依次添加 , 中对应字符到答案中。遍历结束,若 长度大于 ,则添加 的最后一个字符到答案中。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度。
func reformat(s string) string {
	a := []byte{}
	b := []byte{}
	for _, c := range s {
		if unicode.IsLetter(c) {
			a = append(a, byte(c))
		} else {
			b = append(b, byte(c))
		}
	}
	if len(a) < len(b) {
		a, b = b, a
	}
	if len(a)-len(b) > 1 {
		return ""
	}
	var ans strings.Builder
	for i := range b {
		ans.WriteByte(a[i])
		ans.WriteByte(b[i])
	}
	if len(a) > len(b) {
		ans.WriteByte(a[len(a)-1])
	}
	return ans.String()
}1419. 数青蛙
题目、示例与约束
给你一个字符串 croakOfFrogs,它表示不同青蛙发出的蛙鸣声(字符串 "croak" )的组合。由于同一时间可以有多只青蛙呱呱作响,所以 croakOfFrogs 中会混合多个 “croak” 。
请你返回模拟字符串中所有蛙鸣所需不同青蛙的最少数目。
要想发出蛙鸣 "croak",青蛙必须 依序 输出 ‘c’, ’r’, ’o’, ’a’, ’k’ 这 5 个字母。如果没有输出全部五个字母,那么它就不会发出声音。如果字符串 croakOfFrogs 不是由若干有效的 "croak" 字符混合而成,请返回 -1 。
示例 1:
输入:croakOfFrogs = "croakcroak"
输出:1
解释:一只青蛙 “呱呱” 两次
示例 2:
输入:croakOfFrogs = "crcoakroak"
输出:2
解释:最少需要两只青蛙,“呱呱” 声用黑体标注
第一只青蛙 "crcoakroak"
第二只青蛙 "crcoakroak"
示例 3:
输入:croakOfFrogs = "croakcrook"
输出:-1
解释:给出的字符串不是 "croak" 的有效组合。
提示:
1 <= croakOfFrogs.length <= 105- 字符串中的字符只有
'c','r','o','a'或者'k'
方法一:计数 + 模拟 · Go 实现
思考
若干青蛙的
croak交错出现,长度为 ,不能回溯匹配每一只青蛙。五个字母必须按 的顺序推进。用长度为 的计数表示当前停在各阶段的叫声。遇到 表示新开一只未完成的青蛙;遇到后续字母必须消耗前一阶段,否则非法。 完成一只,并发数减一。
答案是过程中未完成青蛙数的最大值;结束时若仍有未完成者,或长度不是 的倍数,则返回 。
我们注意到,如果字符串 croakOfFrogs 是由若干有效的 "croak" 字符混合而成,那么它的长度一定是 的倍数。因此,如果字符串的长度不是 的倍数,可以直接返回 。
接下来,我们将 'c', 'r', 'o', 'a', 'k' 这 个字母分别对应下标 到 ,用一个长度为 的数组 记录字符串 croakOfFrogs 中每个字母出现的次数,其中 表示当前下标为 的字母出现的次数。另外,我们定义一个整数变量 表示当前未完成蛙鸣的青蛙的数目,需要的青蛙的最少数目 即为 的最大值。
我们遍历字符串 croakOfFrogs 中的每个字母 ,找到 对应的下标 ,然后将 加 。接下来,根据 值的不同,我们分别进行如下操作:
- 如果 ,那么当前有一个新的青蛙开始蛙鸣,因此令 的值加 ,然后我们更新 ;
- 否则,如果 ,那么表示当前没有青蛙可以发出字母 ,无法完成蛙鸣,返回 ,否则我们令 减 。如果 ,那么表示青蛙已经完成了一个蛙鸣,因此令 的值减 。
遍历结束后,如果 ,那么说明青蛙已经完成了所有的蛙鸣,返回 ,否则返回 。
时间复杂度 ,空间复杂度 。其中 是字符串 croakOfFrogs 的长度;而 是字符集的大小,本题中 。
func minNumberOfFrogs(croakOfFrogs string) int {
	n := len(croakOfFrogs)
	if n%5 != 0 {
		return -1
	}
	idx := [26]int{}
	for i, c := range "croak" {
		idx[c-'a'] = i
	}
	cnt := [5]int{}
	ans, x := 0, 0
	for _, c := range croakOfFrogs {
		i := idx[c-'a']
		cnt[i]++
		if i == 0 {
			x++
			ans = max(ans, x)
		} else {
			cnt[i-1]--
			if cnt[i-1] < 0 {
				return -1
			}
			if i == 4 {
				x--
			}
		}
	}
	if x > 0 {
		return -1
	}
	return ans
}1446. 连续字符
题目、示例与约束
给你一个字符串 s ,字符串的「能量」定义为:只包含一种字符的最长非空子字符串的长度。
请你返回字符串 s 的 能量。
示例 1:
输入:s = "leetcode"
输出:2
解释:子字符串 "ee" 长度为 2 ,只包含字符 'e' 。
示例 2:
输入:s = "abbcccddddeeeeedcba"
输出:5
解释:子字符串 "eeeee" 长度为 5 ,只包含字符 'e' 。
提示:
1 <= s.length <= 500s只包含小写英文字母。
方法一:遍历计数 · Go 实现
思考
,一遍扫描统计当前相同字符的连续长度 ,遇不同字符则重置,维护最大值。
我们定义一个变量 ,表示当前连续字符的长度,初始时 。
接下来,我们从字符串 的第二个字符开始遍历,如果当前字符与上一个字符相同,那么 ,然后更新答案 ;否则 。
最后返回答案 即可。
时间复杂度 ,其中 是字符串 的长度。空间复杂度 。
func maxPower(s string) int {
	ans, t := 1, 1
	for i := 1; i < len(s); i++ {
		if s[i] == s[i-1] {
			t++
			ans = max(ans, t)
		} else {
			t = 1
		}
	}
	return ans
}1507. 转变日期格式
题目、示例与约束
给你一个字符串 date ,它的格式为 Day Month Year ,其中:
Day是集合{"1st", "2nd", "3rd", "4th", ..., "30th", "31st"}中的一个元素。Month是集合{"Jan", "Feb", "Mar", "Apr", "May", "Jun", "Jul", "Aug", "Sep", "Oct", "Nov", "Dec"}中的一个元素。Year的范围在 [1900, 2100]之间。
请你将字符串转变为 YYYY-MM-DD 的格式,其中:
YYYY表示 4 位的年份。MM表示 2 位的月份。DD表示 2 位的天数。
示例 1:
输入:date = "20th Oct 2052"
输出:"2052-10-20"
示例 2:
输入:date = "6th Jun 1933"
输出:"1933-06-06"
示例 3:
输入:date = "26th May 1960"
输出:"1960-05-26"
提示:
- 给定日期保证是合法的,所以不需要处理异常输入。
方法一:模拟 · Go 实现
思考
输入日期格式固定为「日 月 年」,输出为 --,无需搜索或动态规划,按字段改写即可。
按空格拆成三年、月、日三段后倒序,使年份就位。月份用连续拼接的英文缩写定位,下标整除 再加一得到月序号;日期去掉序数后缀并补零。三段用短横线连接即得标准日期。
将字符串按空格分割为三个部分,分别为 day、month 和 year,然后拼接为 YYYY-MM-DD 的格式。
时间复杂度 ,空间复杂度 。
func reformatDate(date string) string {
	s := strings.Split(date, " ")
	day, _ := strconv.Atoi(s[0][:len(s[0])-2])
	months := " JanFebMarAprMayJunJulAugSepOctNovDec"
	month := strings.Index(months, s[1])/3 + 1
	year, _ := strconv.Atoi(s[2])
	return fmt.Sprintf("%d-%02d-%02d", year, month, day)
}1528. 重新排列字符串
题目、示例与约束
给你一个字符串 s 和一个 长度相同 的整数数组 indices 。
请你重新排列字符串 s ,其中第 i 个字符需要移动到 indices[i] 指示的位置。
返回重新排列后的字符串。
示例 1:
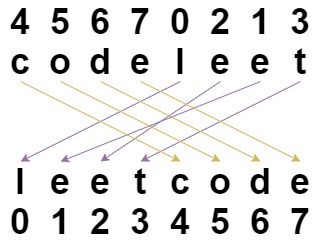
输入:s = "codeleet", indices = [4,5,6,7,0,2,1,3]
输出:"leetcode"
解释:如图所示,"codeleet" 重新排列后变为 "leetcode" 。
示例 2:
输入:s = "abc", indices = [0,1,2]
输出:"abc"
解释:重新排列后,每个字符都还留在原来的位置上。
提示:
s.length == indices.length == n1 <= n <= 100s仅包含小写英文字母0 <= indices[i] < nindices的所有的值都是 唯一 的
方法一:模拟 · Go 实现
思考
字符 应放到下标 。就地交换需要处理置换环,实现更绕,而 不大,允许另开数组。
预分配与 等长的结果数组,按 一次写入每个字符,再拼接。每个位置恰被赋值一次,顺序无关。
我们创建一个与字符串长度相同的字符数组或字符串 ,然后遍历字符串 ,将每个字符 放置到 的 位置上。最后将字符数组或字符串 拼接成最终结果并返回。
时间复杂度 ,空间复杂度 ,其中 是字符串的长度。
func restoreString(s string, indices []int) string {
	ans := make([]rune, len(s))
	for i, c := range s {
		ans[indices[i]] = c
	}
	return string(ans)
}1545. 找出第 N 个二进制字符串中的第 K 位
题目、示例与约束
给你两个正整数 n 和 k,二进制字符串 Sn 的形成规则如下:
S1 = "0"- 当
i > 1时,Si = Si-1 + "1" + reverse(invert(Si-1))
其中 + 表示串联操作,reverse(x) 返回反转 x 后得到的字符串,而 invert(x) 则会翻转 x 中的每一位(0 变为 1,而 1 变为 0)。
例如,符合上述描述的序列的前 4 个字符串依次是:
S1 = "0"S2 = "011"S3 = "0111001"S4 = "011100110110001"
请你返回 Sn 的 第 k 位字符 ,题目数据保证 k 一定在 Sn 长度范围以内。
示例 1:
输入:n = 3, k = 1
输出:"0"
解释:S3 为 "0111001",其第 1 位为 "0" 。
示例 2:
输入:n = 4, k = 11
输出:"1"
解释:S4 为 "011100110110001",其第 11 位为 "1" 。
示例 3:
输入:n = 1, k = 1
输出:"0"
示例 4:
输入:n = 2, k = 3
输出:"1"
提示:
1 <= n <= 201 <= k <= 2n - 1
方法一:分类讨论 + 递归 · Go 实现
思考
由 「 」 反转取反的 构成,长度 。 ,整串长达百万,不必真正构造。
第 位若为 则必是中点( 为 的幂);若在左半,等于 的第 位;若在右半,等于左半对称位取反。按这三种情况递归,深度为 。
我们可以发现,对于 ,其前半部分和 是一样的,而后半部分是 的反转取反。因此我们可以设计一个函数 ,表示第 个字符串的第 位字符。答案即为 。
函数 的计算过程如下:
- 如果 ,那么答案为 ;
- 如果 是 的幂次方,那么答案为 ;
- 如果 ,说明 在前半部分,答案为 ;
- 否则,答案为 ,其中 表示异或运算。
时间复杂度 ,空间复杂度 。其中 为题目给定的 。
func findKthBit(n int, k int) byte {
	var dfs func(n, k int) int
	dfs = func(n, k int) int {
		if k == 1 {
			return 0
		}
		if k&(k-1) == 0 {
			return 1
		}
		m := 1 << n
		if k*2 < m-1 {
			return dfs(n-1, k)
		}
		return dfs(n-1, m-k) ^ 1
	}
	return byte('0' + dfs(n, k))
}1556. 千位分隔数
题目、示例与约束
给你一个整数 n,请你每隔三位添加点(即 "." 符号)作为千位分隔符,并将结果以字符串格式返回。
示例 1:
输入:n = 987
输出:"987"
示例 2:
输入:n = 1234
输出:"1.234"
示例 3:
输入:n = 123456789
输出:"123.456.789"
示例 4:
输入:n = 0
输出:"0"
提示:
0 <= n < 2^31
方法一:模拟 · Go 实现
思考
从低位每三位插入一个点作为千分位。整数转字符串后再切分需要处理长度为 的倍数等边界,从低位取余更直接。
反复 取出个位并计数,每满三位且仍有更高位时追加点号,最后反转字符序列。循环次数为位数,即 。
直接按照题目要求模拟即可。
时间复杂度 ,忽略答案的空间消耗,空间复杂度 。
func thousandSeparator(n int) string {
	cnt := 0
	ans := []byte{}
	for {
		v := n % 10
		n /= 10
		ans = append(ans, byte('0'+v))
		if n == 0 {
			break
		}
		cnt++
		if cnt == 3 {
			ans = append(ans, '.')
			cnt = 0
		}
	}
	for i, j := 0, len(ans)-1; i < j; i, j = i+1, j-1 {
		ans[i], ans[j] = ans[j], ans[i]
	}
	return string(ans)
}1576. 替换所有的问号
题目、示例与约束
给你一个仅包含小写英文字母和 '?' 字符的字符串 s,请你将所有的 '?' 转换为若干小写字母,使最终的字符串不包含任何 连续重复 的字符。
注意:你 不能 修改非 '?' 字符。
题目测试用例保证 除 '?' 字符 之外,不存在连续重复的字符。
在完成所有转换(可能无需转换)后返回最终的字符串。如果有多个解决方案,请返回其中任何一个。可以证明,在给定的约束条件下,答案总是存在的。
示例 1:
输入:s = "?zs"
输出:"azs"
解释:该示例共有 25 种解决方案,从 "azs" 到 "yzs" 都是符合题目要求的。只有 "z" 是无效的修改,因为字符串 "zzs" 中有连续重复的两个 'z' 。
示例 2:
输入:s = "ubv?w"
输出:"ubvaw"
解释:该示例共有 24 种解决方案,只有替换成 "v" 和 "w" 不符合题目要求。因为 "ubvvw" 和 "ubvww" 都包含连续重复的字符。
提示:
-
1 <= s.length <= 100 -
s仅包含小写英文字母和'?'字符
方法一:模拟 · Go 实现
思考
把问号换成小写字母,使没有相邻重复。问号两侧至多两个不同字符,字母表有 个,只需在 中找一个与左右都不同的即可。
从左到右替换:对每个 试三个候选,跳过与 或尚未替换的 相同者。先写左边保证后续位置看到的左邻已经确定。
我们遍历字符串,对于每个位置,如果该位置是 ?,则枚举字符 'a'、'b'、'c',如果该字符 与前后字符都不相同,则将该位置替换为该字符,否则继续枚举下一个字符。
遍历结束后,返回字符串即可。
时间复杂度 ,其中 为字符串的长度。忽略答案的空间消耗,空间复杂度 。
func modifyString(s string) string {
	n := len(s)
	cs := []byte(s)
	for i := range s {
		if cs[i] == '?' {
			for c := byte('a'); c <= byte('c'); c++ {
				if (i > 0 && cs[i-1] == c) || (i+1 < n && cs[i+1] == c) {
					continue
				}
				cs[i] = c
				break
			}
		}
	}
	return string(cs)
}1592. 重新排列单词间的空格
题目、示例与约束
给你一个字符串 text ,该字符串由若干被空格包围的单词组成。每个单词由一个或者多个小写英文字母组成,并且两个单词之间至少存在一个空格。题目测试用例保证 text 至少包含一个单词 。
请你重新排列空格,使每对相邻单词之间的空格数目都 相等 ,并尽可能 最大化 该数目。如果不能重新平均分配所有空格,请 将多余的空格放置在字符串末尾 ,这也意味着返回的字符串应当与原 text 字符串的长度相等。
返回 重新排列空格后的字符串 。
示例 1:
输入:text = "  this   is  a sentence "
输出:"this   is   a   sentence"
解释:总共有 9 个空格和 4 个单词。可以将 9 个空格平均分配到相邻单词之间,相邻单词间空格数为:9 / (4-1) = 3 个。
示例 2:
输入:text = " practice   makes   perfect"
输出:"practice   makes   perfect "
解释:总共有 7 个空格和 3 个单词。7 / (3-1) = 3 个空格加上 1 个多余的空格。多余的空格需要放在字符串的末尾。
示例 3:
输入:text = "hello   world"
输出:"hello   world"
示例 4:
输入:text = "  walks  udp package   into  bar a"
输出:"walks  udp  package  into  bar  a "
示例 5:
输入:text = "a"
输出:"a"
提示:
1 <= text.length <= 100text由小写英文字母和' '组成text中至少包含一个单词
方法一:字符串模拟 · Go 实现
思考
把原串里的空格尽量均分到单词之间,多出的空格放在末尾。单词数与空格数都可由一次扫描得到,无需复杂结构。
统计空格并用 取出单词。仅一个单词时全部空格跟在后面;否则 得到间隔空格与余数,用间隔拼接单词后再追加余数。
我们先统计字符串 中的空格数,记为 。将 按空格分割成字符串数组 。然后计算相邻字符串之间需要拼接的空格数,进行拼接。最后将剩余的空格拼接在末尾。
时间复杂度 ,空间复杂度 ,其中 表示字符串 的长度。
func reorderSpaces(text string) string {
	cnt := strings.Count(text, " ")
	words := strings.Fields(text)
	m := len(words) - 1
	if m == 0 {
		return words[0] + strings.Repeat(" ", cnt)
	}
	return strings.Join(words, strings.Repeat(" ", cnt/m)) + strings.Repeat(" ", cnt%m)
}1629. 按键持续时间最长的键
题目、示例与约束
LeetCode 设计了一款新式键盘,正在测试其可用性。测试人员将会点击一系列键(总计 n 个),每次一个。
给你一个长度为 n 的字符串 keysPressed ,其中 keysPressed[i] 表示测试序列中第 i 个被按下的键。releaseTimes 是一个升序排列的列表,其中 releaseTimes[i] 表示松开第 i 个键的时间。字符串和数组的 下标都从 0 开始 。第 0 个键在时间为 0 时被按下,接下来每个键都 恰好 在前一个键松开时被按下。
测试人员想要找出按键 持续时间最长 的键。第 i 次按键的持续时间为 releaseTimes[i] - releaseTimes[i - 1] ,第 0 次按键的持续时间为 releaseTimes[0] 。
注意,测试期间,同一个键可以在不同时刻被多次按下,而每次的持续时间都可能不同。
请返回单次按键 持续时间最长 的键,如果有多个这样的键,则返回 按字母顺序排列最大 的那个键。
示例 1:
输入:releaseTimes = [9,29,49,50], keysPressed = "cbcd"
输出:'c'
解释:按键顺序和持续时间如下:
按下 'c' ,持续时间 9(时间 0 按下,时间 9 松开)
按下 'b' ,持续时间 29 - 9 = 20(松开上一个键的时间 9 按下,时间 29 松开)
按下 'c' ,持续时间 49 - 29 = 20(松开上一个键的时间 29 按下,时间 49 松开)
按下 'd' ,持续时间 50 - 49 = 1(松开上一个键的时间 49 按下,时间 50 松开)
按键持续时间最长的键是 'b' 和 'c'(第二次按下时),持续时间都是 20
'c' 按字母顺序排列比 'b' 大,所以答案是 'c'
示例 2:
输入:releaseTimes = [12,23,36,46,62], keysPressed = "spuda"
输出:'a'
解释:按键顺序和持续时间如下:
按下 's' ,持续时间 12
按下 'p' ,持续时间 23 - 12 = 11
按下 'u' ,持续时间 36 - 23 = 13
按下 'd' ,持续时间 46 - 36 = 10
按下 'a' ,持续时间 62 - 46 = 16
按键持续时间最长的键是 'a' ,持续时间 16
提示:
releaseTimes.length == nkeysPressed.length == n2 <= n <= 10001 <= releaseTimes[i] <= 109releaseTimes[i] < releaseTimes[i+1]keysPressed仅由小写英文字母组成
方法一 · Go 实现
思考
按键时长由相邻释放时间之差给出,序列长度不超过 ,一遍扫描即可同时维护最长时长与对应字符。
时长严格更大则更新;相等则取字典序更大的键。第一个键的时长就是 。
func slowestKey(releaseTimes []int, keysPressed string) byte {
	ans := keysPressed[0]
	mx := releaseTimes[0]
	for i := 1; i < len(releaseTimes); i++ {
		d := releaseTimes[i] - releaseTimes[i-1]
		if d > mx || (d == mx && keysPressed[i] > ans) {
			mx = d
			ans = keysPressed[i]
		}
	}
	return ans
}1662. 检查两个字符串数组是否相等
题目、示例与约束
给你两个字符串数组 word1 和 word2 。如果两个数组表示的字符串相同,返回 true ;否则,返回 false 。
数组表示的字符串 是由数组中的所有元素 按顺序 连接形成的字符串。
示例 1:
输入:word1 = ["ab", "c"], word2 = ["a", "bc"]
输出:true
解释:
word1 表示的字符串为 "ab" + "c" -> "abc"
word2 表示的字符串为 "a" + "bc" -> "abc"
两个字符串相同,返回 true
示例 2:
输入:word1 = ["a", "cb"], word2 = ["ab", "c"]
输出:false
示例 3:
输入:word1  = ["abc", "d", "defg"], word2 = ["abcddefg"]
输出:true
提示:
1 <= word1.length, word2.length <= 1031 <= word1[i].length, word2[i].length <= 1031 <= sum(word1[i].length), sum(word2[i].length) <= 103word1[i]和word2[i]由小写字母组成
方法一:字符串拼接 · Go 实现
思考
两个数组拼接后是否相等。总长很小,直接 再比较即可。
将两个数组中的字符串拼接成两个字符串,然后比较两个字符串是否相等。
时间复杂度 ,空间复杂度 。其中 为数组中字符串的总长度。
func arrayStringsAreEqual(word1 []string, word2 []string) bool {
	return strings.Join(word1, "") == strings.Join(word2, "")
}
方法二:直接遍历 · Go 实现
思考
方法一生成了两个新串。用四指针在原数组上逐字符比较,空间降为 :字符不等立即失败,走到串尾则切到下一单词。
方法一中,我们是将两个数组中的字符串拼接成两个新的字符串,有额外的空间开销。我们也可以直接遍历两个数组,逐个字符比较。
我们使用两个指针 和 分别指向两个字符串数组,用另外两个指针 和 分别指向字符串对应的字符。初始时 。
每次比较 和 ,如果不相等,直接返回 false。否则,将 和 分别加 ,如果 或 超出了对应的字符串的长度,将对应的字符串指针 或 加 ,然后将 和 重置为 。
如果两个字符串数组遍历完毕,返回 true,否则返回 false。
时间复杂度 ,空间复杂度 。其中 为数组中字符串的总长度。
func arrayStringsAreEqual(word1 []string, word2 []string) bool {
	var i, j, x, y int
	for i < len(word1) && j < len(word2) {
		if word1[i][x] != word2[j][y] {
			return false
		}
		x, y = x+1, y+1
		if x == len(word1[i]) {
			x, i = 0, i+1
		}
		if y == len(word2[j]) {
			y, j = 0, j+1
		}
	}
	return i == len(word1) && j == len(word2)
}1678. 设计 Goal 解析器
题目、示例与约束
请你设计一个可以解释字符串 command 的 Goal 解析器 。command 由 "G"、"()" 和/或 "(al)" 按某种顺序组成。Goal 解析器会将 "G" 解释为字符串 "G"、"()" 解释为字符串 "o" ,"(al)" 解释为字符串 "al" 。然后,按原顺序将经解释得到的字符串连接成一个字符串。
给你字符串 command ,返回 Goal 解析器 对 command 的解释结果。
示例 1:
输入:command = "G()(al)"
输出:"Goal"
解释:Goal 解析器解释命令的步骤如下所示:
G -> G
() -> o
(al) -> al
最后连接得到的结果是 "Goal"
示例 2:
输入:command = "G()()()()(al)"
输出:"Gooooal"
示例 3:
输入:command = "(al)G(al)()()G"
输出:"alGalooG"
提示:
1 <= command.length <= 100command由"G"、"()"和/或"(al)"按某种顺序组成
方法一:字符串替换 · Go 实现
思考
命令只由
G、()、(al)拼成,长度不超过 。把()换成o、(al)换成al即完成解析。
根据题意,只需要将字符串 command 中的 "()" 替换为 'o',"(al)" 替换为 "al" 即可。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度。
func interpret(command string) string {
	command = strings.ReplaceAll(command, "()", "o")
	command = strings.ReplaceAll(command, "(al)", "al")
	return command
}
方法二:字符串遍历 · Go 实现
思考
方法一依赖两次替换生成新串。单指针扫描:
G原样收下,()输出o,否则输出al,少一次整串分配。
我们也可以遍历字符串 command,对于每个字符 :
- 如果是
'G',直接将 添加到结果串中; - 如果是
'(',判断下一个字符是否是')',若是,将'o'添加到结果串中,否则,将"al"添加到结果串中。
遍历结束,返回结果串即可。
时间复杂度 ,其中 是字符串 的长度。空间复杂度 。
func interpret(command string) string {
	ans := &strings.Builder{}
	for i, c := range command {
		if c == 'G' {
			ans.WriteRune(c)
		} else if c == '(' {
			if command[i+1] == ')' {
				ans.WriteByte('o')
			} else {
				ans.WriteString("al")
			}
		}
	}
	return ans.String()
}1694. 重新格式化电话号码
题目、示例与约束
给你一个字符串形式的电话号码 number 。number 由数字、空格 ' '、和破折号 '-' 组成。
请你按下述方式重新格式化电话号码。
- 首先,删除 所有的空格和破折号。
- 其次,将数组从左到右 每 3 个一组 分块,直到 剩下 4 个或更少数字。剩下的数字将按下述规定再分块:
- 2 个数字:单个含 2 个数字的块。
- 3 个数字:单个含 3 个数字的块。
- 4 个数字:两个分别含 2 个数字的块。
最后用破折号将这些块连接起来。注意,重新格式化过程中 不应该 生成仅含 1 个数字的块,并且 最多 生成两个含 2 个数字的块。
返回格式化后的电话号码。
示例 1:
输入:number = "1-23-45 6"
输出:"123-456"
解释:数字是 "123456"
步骤 1:共有超过 4 个数字,所以先取 3 个数字分为一组。第 1 个块是 "123" 。
步骤 2:剩下 3 个数字,将它们放入单个含 3 个数字的块。第 2 个块是 "456" 。
连接这些块后得到 "123-456" 。
示例 2:
输入:number = "123 4-567"
输出:"123-45-67"
解释:数字是 "1234567".
步骤 1:共有超过 4 个数字,所以先取 3 个数字分为一组。第 1 个块是 "123" 。
步骤 2:剩下 4 个数字,所以将它们分成两个含 2 个数字的块。这 2 块分别是 "45" 和 "67" 。
连接这些块后得到 "123-45-67" 。
示例 3:
输入:number = "123 4-5678"
输出:"123-456-78"
解释:数字是 "12345678" 。
步骤 1:第 1 个块 "123" 。
步骤 2:第 2 个块 "456" 。
步骤 3:剩下 2 个数字,将它们放入单个含 2 个数字的块。第 3 个块是 "78" 。
连接这些块后得到 "123-456-78" 。
示例 4:
输入:number = "12"
输出:"12"
示例 5:
输入:number = "--17-5 229 35-39475 "
输出:"175-229-353-94-75"
提示:
2 <= number.length <= 100number由数字和字符'-'及' '组成。number中至少含 2 个数字。
方法一:简单模拟 · Go 实现
思考
先去掉空格与短横,再按每 位分组;余 位时把最后两组改成 ,余 位则单独一组。
清洗后按 切片,处理余数,最后用短横拼接。
我们先按照题意,去除字符串中的所有空格和破折号。
记当前字符串长度为 ,然后从前往后遍历字符串,每 个字符为一组,将其加入结果字符串中,共取 组。
若最后剩余 个字符,则将前面的最后一组的最后一个字符与该字符组成一个新的两个字符的组,加入结果字符串中;若最后剩余 个字符,直接将这连个字符组成一个新的组,加入结果字符串中。
最后将所有组之间加上破折号,返回结果字符串即可。
时间复杂度 ,空间复杂度 。其中 为字符串长度。
func reformatNumber(number string) string {
	number = strings.ReplaceAll(number, " ", "")
	number = strings.ReplaceAll(number, "-", "")
	n := len(number)
	ans := []string{}
	for i := 0; i < n/3; i++ {
		ans = append(ans, number[i*3:i*3+3])
	}
	if n%3 == 1 {
		ans[len(ans)-1] = ans[len(ans)-1][:2]
		ans = append(ans, number[n-2:])
	} else if n%3 == 2 {
		ans = append(ans, number[n-2:])
	}
	return strings.Join(ans, "-")
}1704. 判断字符串的两半是否相似
题目、示例与约束
给你一个偶数长度的字符串 s 。将其拆分成长度相同的两半,前一半为 a ,后一半为 b 。
两个字符串 相似 的前提是它们都含有相同数目的元音('a','e','i','o','u','A','E','I','O','U')。注意,s 可能同时含有大写和小写字母。
如果 a 和 b 相似,返回 true ;否则,返回 false 。
示例 1:
输入:s = "book"
输出:true
解释:a = "bo" 且 b = "ok" 。a 中有 1 个元音,b 也有 1 个元音。所以,a 和 b 相似。
示例 2:
输入:s = "textbook"
输出:false
解释:a = "text" 且 b = "book" 。a 中有 1 个元音,b 中有 2 个元音。因此,a 和 b 不相似。
注意,元音 o 在 b 中出现两次,记为 2 个。
提示:
2 <= s.length <= 1000s.length是偶数s由 大写和小写 字母组成
方法一:计数 · Go 实现
思考
只需比较前半与后半的元音个数是否相等。串长不超过 ,一次扫描足够。
用集合保存大小写元音,同步遍历左右两半:左半出现元音则计数加一,右半出现则减一。最终计数为零当且仅当两边元音一样多。
遍历字符串,若字符串前半段的元音个数等于后半段的元音个数,则返回 true,否则返回 false。
时间复杂度 ,其中 为字符串的长度。空间复杂度 ,其中 为元音字母的个数。
func halvesAreAlike(s string) bool {
	vowels := map[byte]bool{}
	for _, c := range "aeiouAEIOU" {
		vowels[byte(c)] = true
	}
	cnt, n := 0, len(s)>>1
	for i := 0; i < n; i++ {
		if vowels[s[i]] {
			cnt++
		}
		if vowels[s[i+n]] {
			cnt--
		}
	}
	return cnt == 0
}1758. 生成交替二进制字符串的最少操作数
题目、示例与约束
给你一个仅由字符 '0' 和 '1' 组成的字符串 s 。一步操作中,你可以将任一 '0' 变成 '1' ,或者将 '1' 变成 '0' 。
交替字符串 定义为:如果字符串中不存在相邻两个字符相等的情况,那么该字符串就是交替字符串。例如,字符串 "010" 是交替字符串,而字符串 "0100" 不是。
返回使 s 变成 交替字符串 所需的 最少 操作数。
示例 1:
输入:s = "0100"
输出:1
解释:如果将最后一个字符变为 '1' ,s 就变成 "0101" ,即符合交替字符串定义。
示例 2:
输入:s = "10"
输出:0
解释:s 已经是交替字符串。
示例 3:
输入:s = "1111"
输出:2
解释:需要 2 步操作得到 "0101" 或 "1010" 。
提示:
1 <= s.length <= 104s[i]是'0'或'1'
方法一:一次遍历 · Go 实现
思考
目标只有两种交替串: 与 。对其中一种的修改次数为 ,另一种恰为 。
一次遍历统计与 的差异,答案取 与 的较小者。
根据题意,如果得到交替字符串 01010101... 所需要的操作数为 ,那么得到交替字符串 10101010... 所需要的操作数为 。
因此,我们只需要遍历一次字符串 ,统计出 的值,那么答案即为 。
时间复杂度 ,其中 为字符串 的长度。空间复杂度 。
func minOperations(s string) int {
	cnt := 0
	for i, c := range s {
		if c != []rune("01")[i&1] {
			cnt++
		}
	}
	return min(cnt, len(s)-cnt)
}1773. 统计匹配检索规则的物品数量
题目、示例与约束
给你一个数组 items ,其中 items[i] = [typei, colori, namei] ,描述第 i 件物品的类型、颜色以及名称。
另给你一条由两个字符串 ruleKey 和 ruleValue 表示的检索规则。
如果第 i 件物品能满足下述条件之一,则认为该物品与给定的检索规则 匹配 :
ruleKey == "type"且ruleValue == typei。ruleKey == "color"且ruleValue == colori。ruleKey == "name"且ruleValue == namei。
统计并返回 匹配检索规则的物品数量 。
示例 1:
输入:items = [["phone","blue","pixel"],["computer","silver","lenovo"],["phone","gold","iphone"]], ruleKey = "color", ruleValue = "silver"
输出:1
解释:只有一件物品匹配检索规则,这件物品是 ["computer","silver","lenovo"] 。
示例 2:
输入:items = [["phone","blue","pixel"],["computer","silver","phone"],["phone","gold","iphone"]], ruleKey = "type", ruleValue = "phone"
输出:2
解释:只有两件物品匹配检索规则,这两件物品分别是 ["phone","blue","pixel"] 和 ["phone","gold","iphone"] 。注意,["computer","silver","phone"] 未匹配检索规则。
提示:
1 <= items.length <= 1041 <= typei.length, colori.length, namei.length, ruleValue.length <= 10ruleKey等于"type"、"color"或"name"- 所有字符串仅由小写字母组成
方法一:计数模拟 · Go 实现
思考
规则键只有 三种,对应物品三元组的三个下标。扫一遍计数匹配即可。
用键的首字母映射到 ,统计 的个数。
由于 ruleKey 只可能是 "type"、"color" 或 "name",我们可以直接取 ruleKey 的第一个字符来确定 item 的下标 。然后遍历 items 数组,统计 item[i] == ruleValue 的个数即可。
时间复杂度 ,空间复杂度 。其中 为 items 的长度。
func countMatches(items [][]string, ruleKey string, ruleValue string) (ans int) {
	i := map[byte]int{'t': 0, 'c': 1, 'n': 2}[ruleKey[0]]
	for _, v := range items {
		if v[i] == ruleValue {
			ans++
		}
	}
	return
}1784. 检查二进制字符串字段
题目、示例与约束
给你一个二进制字符串 s ,该字符串 不含前导零 。
如果 s 包含 零个或一个由连续的 '1' 组成的字段 ,返回 true 。否则,返回 false 。
示例 1:
输入:s = "1001"
输出:false
解释:由连续若干个 '1' 组成的字段数量为 2,返回 false
示例 2:
输入:s = "110"
输出:true
提示:
1 <= s.length <= 100s[i] 为'0'或'1's[0]为'1'
方法一:脑筋急转弯 · Go 实现
思考
串以 开头且无前导零。多于一段 当且仅当中间出现过 之后又出现 ,即存在子串 。
判断 是否出现即可,不必分段计数。
注意到字符串 不含前导零,说明 以 '1' 开头。
若字符串 存在 "01" 串,那么 就是形如 "1...01..." 的字符串,此时 出现了至少两个连续的 '1' 片段,不满足题意,返回 。
若字符串 不存在 "01" 串,那么 只能是形如 "1..1000..." 的字符串,此时 只有一个连续的 '1' 片段,满足题意,返回 。
因此,只需要判断字符串 是否存在 "01" 串即可。
时间复杂度 。其中 为字符串 的长度。空间复杂度 。
func checkOnesSegment(s string) bool {
	return !strings.Contains(s, "01")
}1816. 截断句子
题目、示例与约束
句子 是一个单词列表,列表中的单词之间用单个空格隔开,且不存在前导或尾随空格。每个单词仅由大小写英文字母组成(不含标点符号)。
- 例如,
"Hello World"、"HELLO"和"hello world hello world"都是句子。
给你一个句子 s 和一个整数 k ,请你将 s 截断 ,使截断后的句子仅含 前 k 个单词。返回 截断 s 后得到的句子。
示例 1:
输入:s = "Hello how are you Contestant", k = 4
输出:"Hello how are you"
解释:
s 中的单词为 ["Hello", "how" "are", "you", "Contestant"]
前 4 个单词为 ["Hello", "how", "are", "you"]
因此,应当返回 "Hello how are you"
示例 2:
输入:s = "What is the solution to this problem", k = 4
输出:"What is the solution"
解释:
s 中的单词为 ["What", "is" "the", "solution", "to", "this", "problem"]
前 4 个单词为 ["What", "is", "the", "solution"]
因此,应当返回 "What is the solution"
示例 3:
输入:s = "chopper is not a tanuki", k = 5
输出:"chopper is not a tanuki"
提示:
1 <= s.length <= 500k的取值范围是[1, s 中单词的数目]s仅由大小写英文字母和空格组成s中的单词之间由单个空格隔开- 不存在前导或尾随空格
方法二:模拟 · Go 实现
思考
方法一产生了中间数组。若只关心截断位置,从左扫描并在遇到空格时将 减一, 变为 时当前下标即为第 个单词之后的空格,返回其前缀;若扫描结束 仍为正,则整句不足 个单词,原串即为答案。额外空间可降为 。
我们从前往后遍历字符串 ,对于当前遍历到的字符 ,如果 是空格,那么 自减 ,当 为 时,说明已经截取了 个单词,截取字符串 返回即可。
遍历结束,返回 即可。
时间复杂度 ,其中 为字符串 的长度。忽略答案的空间消耗,空间复杂度 。
func truncateSentence(s string, k int) string {
	for i, c := range s {
		if c == ' ' {
			k--
		}
		if k == 0 {
			return s[:i]
		}
	}
	return s
}1844. 将所有数字用字符替换
题目、示例与约束
给你一个下标从 0 开始的字符串 s ,它的 偶数 下标处为小写英文字母,奇数 下标处为数字。
定义一个函数 shift(c, x) ,其中 c 是一个字符且 x 是一个数字,函数返回字母表中 c 后面第 x 个字符。
- 比方说,
shift('a', 5) = 'f'和shift('x', 0) = 'x'。
对于每个 奇数 下标 i ,你需要将数字 s[i] 用 shift(s[i-1], s[i]) 替换。
请你替换所有数字以后,将字符串 s 返回。题目 保证 shift(s[i-1], s[i]) 不会超过 'z' 。
示例 1:
输入:s = "a1c1e1"
输出:"abcdef"
解释:数字被替换结果如下:
- s[1] -> shift('a',1) = 'b'
- s[3] -> shift('c',1) = 'd'
- s[5] -> shift('e',1) = 'f'
示例 2:
输入:s = "a1b2c3d4e"
输出:"abbdcfdhe"
解释:数字被替换结果如下:
- s[1] -> shift('a',1) = 'b'
- s[3] -> shift('b',2) = 'd'
- s[5] -> shift('c',3) = 'f'
- s[7] -> shift('d',4) = 'h'
提示:
1 <= s.length <= 100s只包含小写英文字母和数字。- 对所有 奇数 下标处的
i,满足shift(s[i-1], s[i]) <= 'z'。
方法一:模拟 · Go 实现
思考
奇数下标的数字表示把前一个字母后移的步数。规则局部且互不依赖。
按步长 遍历奇数下标,用前一字符的编码加上该数字写回即可。
遍历字符串,对于奇数下标的字符,将其替换为前一个字符后移对应位数的字符。
最后返回替换后的字符串。
时间复杂度 ,其中 为字符串 的长度。忽略答案的空间消耗,空间复杂度 。
func replaceDigits(s string) string {
	cs := []byte(s)
	for i := 1; i < len(s); i += 2 {
		cs[i] = cs[i-1] + cs[i] - '0'
	}
	return string(cs)
}1869. 哪种连续子字符串更长
题目、示例与约束
给你一个二进制字符串 s 。如果字符串中由 1 组成的 最长 连续子字符串 严格长于 由 0 组成的 最长 连续子字符串,返回 true ;否则,返回 false 。
- 例如,
s = "110100010"中,由1组成的最长连续子字符串的长度是2,由0组成的最长连续子字符串的长度是3。
注意,如果字符串中不存在 0 ,此时认为由 0 组成的最长连续子字符串的长度是 0 。字符串中不存在 1 的情况也适用此规则。
示例 1:
输入:s = "1101" 输出:true 解释: 由1组成的最长连续子字符串的长度是 2:"1101" 由0组成的最长连续子字符串的长度是 1:"1101" 由 1 组成的子字符串更长,故返回 true 。
示例 2:
输入:s = "111000" 输出:false 解释: 由1组成的最长连续子字符串的长度是 3:"111000" 由0组成的最长连续子字符串的长度是 3:"111000" 由 1 组成的子字符串不比由 0 组成的子字符串长,故返回 false 。
示例 3:
输入:s = "110100010" 输出:false 解释: 由1组成的最长连续子字符串的长度是 2:"110100010" 由0组成的最长连续子字符串的长度是 3:"110100010" 由 1 组成的子字符串不比由 0 组成的子字符串长,故返回 false 。
提示:
1 <= s.length <= 100s[i]不是'0'就是'1'
方法一:两次遍历 · Go 实现
思考
比较由 组成的最长连续段与由 组成的最长连续段。一次扫描同时维护两种计数即可,分开写更清晰。
函数 扫一遍统计字符 的最长连续长度。比较 与 即可。
我们设计一个函数 ,表示字符串 中由 组成的最长连续子字符串的长度。如果 ,那么返回 true,否则返回 false。
时间复杂度 ,其中 是字符串 的长度。空间复杂度 。
func checkZeroOnes(s string) bool {
	f := func(x rune) int {
		cnt, mx := 0, 0
		for _, c := range s {
			if c == x {
				cnt++
				mx = max(mx, cnt)
			} else {
				cnt = 0
			}
		}
		return mx
	}
	return f('1') > f('0')
}1880. 检查某单词是否等于两单词之和
题目、示例与约束
字母的 字母值 取决于字母在字母表中的位置,从 0 开始 计数。即,'a' -> 0、'b' -> 1、'c' -> 2,以此类推。
对某个由小写字母组成的字符串 s 而言,其 数值 就等于将 s 中每个字母的 字母值 按顺序 连接 并 转换 成对应整数。
- 例如,
s = "acb",依次连接每个字母的字母值可以得到"021",转换为整数得到21。
给你三个字符串 firstWord、secondWord 和 targetWord ,每个字符串都由从 'a' 到 'j' (含 'a' 和 'j' )的小写英文字母组成。
如果 firstWord 和 secondWord 的 数值之和 等于 targetWord 的数值,返回 true ;否则,返回 false 。
示例 1:
输入:firstWord = "acb", secondWord = "cba", targetWord = "cdb"
输出:true
解释:
firstWord 的数值为 "acb" -> "021" -> 21
secondWord 的数值为 "cba" -> "210" -> 210
targetWord 的数值为 "cdb" -> "231" -> 231
由于 21 + 210 == 231 ,返回 true
示例 2:
输入:firstWord = "aaa", secondWord = "a", targetWord = "aab"
输出:false
解释:
firstWord 的数值为 "aaa" -> "000" -> 0
secondWord 的数值为 "a" -> "0" -> 0
targetWord 的数值为 "aab" -> "001" -> 1
由于 0 + 0 != 1 ,返回 false
示例 3:
输入:firstWord = "aaa", secondWord = "a", targetWord = "aaaa"
输出:true
解释:
firstWord 的数值为 "aaa" -> "000" -> 0
secondWord 的数值为 "a" -> "0" -> 0
targetWord 的数值为 "aaaa" -> "0000" -> 0
由于 0 + 0 == 0 ,返回 true
提示:
1 <= firstWord.length,secondWord.length,targetWord.length <= 8firstWord、secondWord和targetWord仅由从'a'到'j'(含'a'和'j')的小写英文字母组成。
方法一:字符串转数字 · Go 实现
思考
把字母 看成数字 ,判断两词数值之和是否等于第三词。数值由字母顺序拼接而成,不必借助额外映射表。
函数 按十进制累加 ,再比较 与 。
我们定义一个函数 ,用来计算字符串 的数值。对于字符串 中的每个字符 ,我们将其转换为对应的数字 ,然后将 依次连接起来,最后转换为整数。
最后,我们只需要判断 是否等于 即可。
时间复杂度 ,其中 为题目中所有字符串的长度之和。空间复杂度 。
func isSumEqual(firstWord string, secondWord string, targetWord string) bool {
	f := func(s string) (ans int) {
		for _, c := range s {
			ans = ans*10 + int(c-'a')
		}
		return
	}
	return f(firstWord)+f(secondWord) == f(targetWord)
}1933. 判断字符串是否可分解为值均等的子串 🔒
题目、示例与约束
一个字符串的所有字符都是一样的,被称作等值字符串。
- 举例,
"1111"和"33"就是等值字符串。 - 相比之下,
"123"就不是等值字符串。
规则:给出一个数字字符串s,将字符串分解成一些等值字符串,如果有且仅有一个等值子字符串长度为2,其他的等值子字符串的长度都是3.
如果能够按照上面的规则分解字符串s,就返回真,否则返回假。
子串就是原字符串中连续的字符序列。
示例 1:
输入: s = "000111000"
输出: false
解释:  s只能被分解长度为3的等值子字符串。
示例 2:
输入: s = "00011111222"
输出: true
解释: s 能被分解为 ["000","111","11","222"].
示例 3:
输入: s = "01110002223300"
输出: false
解释: 一个不能被分解的原因是在开头有一个0.
提示:
1 <= s.length <= 1000s仅包含数字。
方法一:双指针 · Go 实现
思考
等值段只能拆成长度 或 ,且全局恰好一段长度为 。枚举切分点为指数级,但同一字符必须连续处理。
双指针求出每段长度:模 余 无法拆成 、 ;余 则消耗唯一的长度 段,出现两次即失败。
扫完后必须恰好用过一次余 ,否则不合法。
遍历字符串 ,用双指针 和 统计每个等值子字符串的长度。若长度模 余 ,说明该子字符串长度不符合要求,返回 false;若长度模 余 ,说明出现了长度为 的子字符串,若此前已经出现过长度为 的子字符串,返回 false,否则将 的值赋给 ,继续遍历。
遍历结束后,判断是否出现过长度为 的子字符串,若没有,返回 false,否则返回 true。
时间复杂度 ,其中 为字符串 的长度。空间复杂度 。
func isDecomposable(s string) bool {
	i, n := 0, len(s)
	cnt2 := 0
	for i < n {
		j := i
		for j < n && s[j] == s[i] {
			j++
		}
		if (j-i)%3 == 1 {
			return false
		}
		if (j-i)%3 == 2 {
			cnt2++
			if cnt2 > 1 {
				return false
			}
		}
		i = j
	}
	return cnt2 == 1
}继续阅读
- 实践案例
- 实践案例
- 实践案例