
LeetCode Go · 栈与队列(1)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
20. 有效的括号
题目、示例与约束
给定一个只包括 '(',')','{','}','[',']' 的字符串 s ,判断字符串是否有效。
有效字符串需满足:
- 左括号必须用相同类型的右括号闭合。
- 左括号必须以正确的顺序闭合。
- 每个右括号都有一个对应的相同类型的左括号。
示例 1:
输入:s = "()"
输出:true
示例 2:
输入:s = "()[]{}"
输出:true
示例 3:
输入:s = "(]"
输出:false
示例 4:
输入:s = "([])"
输出:true
示例 5:
输入:s = "([)]"
输出:false
提示:
1 <= s.length <= 104s仅由括号'()[]{}'组成
方法一:栈 · Go 实现
思考
把已经相邻的 、 和 反复从字符串中删去,直到不能再删,结果是正确的。每一轮都要重新扫描, 时最坏会退化成 ,括号层层嵌套时也容易超时。
瓶颈在于配对并不只看相邻的两个字符。后出现的左括号必须先被闭合,更早的左括号还要留在原处;像 这种交错,局部删除已经无法把字符串消成空串。
于是匹配是后进先出的:当前右括号唯一合法的对象,就是最近一个尚未闭合的左括号。栈用来记录这些尚未完成的匹配。读到左括号时,把与之对应的右括号压入栈顶,也就是把下一次允许出现的右括号放在最上面;读到右括号时只和栈顶比较。不相等说明类型或顺序已经错了。扫完之后栈里还有元素,则说明仍有左括号没有闭合。
用哈希表 记录每种左括号对应的右括号,用栈 保存尚未匹配的右括号。从左到右扫描字符串 。当前字符是左括号时,将 中对应的右括号压入 ;当前字符是右括号时,若 为空,或弹出的栈顶与该字符不相等,则返回 false。
扫描结束后,若 为空,说明每一对括号都按正确的类型和顺序闭合,返回 true;否则仍有左括号没有闭合,返回 false。
时间复杂度 ,空间复杂度 ,其中 为字符串 的长度。
func isValid(s string) bool {
	stk := []byte{}
	d := map[byte]byte{'(': ')', '[': ']', '{': '}'}
	for i := 0; i < len(s); i++ {
		c := s[i]
		if v, ok := d[c]; ok {
			stk = append(stk, v)
		} else if len(stk) == 0 || stk[len(stk)-1] != c {
			return false
		} else {
			stk = stk[:len(stk)-1]
		}
	}
	return len(stk) == 0
}71. 简化路径
题目、示例与约束
给你一个字符串 path ,表示指向某一文件或目录的 Unix 风格 绝对路径 (以 '/' 开头),请你将其转化为 更加简洁的规范路径。
在 Unix 风格的文件系统中规则如下:
- 一个点
'.'表示当前目录本身。 - 此外,两个点
'..'表示将目录切换到上一级(指向父目录)。 - 任意多个连续的斜杠(即,
'//'或'///')都被视为单个斜杠'/'。 - 任何其他格式的点(例如,
'...'或'....')均被视为有效的文件/目录名称。
返回的 简化路径 必须遵循下述格式:
- 始终以斜杠
'/'开头。 - 两个目录名之间必须只有一个斜杠
'/'。 - 最后一个目录名(如果存在)不能 以
'/'结尾。 - 此外,路径仅包含从根目录到目标文件或目录的路径上的目录(即,不含
'.'或'..')。
返回简化后得到的 规范路径 。
示例 1:
输入:path = "/home/"
输出:"/home"
解释:
应删除尾随斜杠。
示例 2:
输入:path = "/home//foo/"
输出:"/home/foo"
解释:
多个连续的斜杠被单个斜杠替换。
示例 3:
输入:path = "/home/user/Documents/../Pictures"
输出:"/home/user/Pictures"
解释:
两个点 ".." 表示上一级目录(父目录)。
示例 4:
输入:path = "/../"
输出:"/"
解释:
不可能从根目录上升一级目录。
示例 5:
输入:path = "/.../a/../b/c/../d/./"
输出:"/.../b/d"
解释:
"..." 在这个问题中是一个合法的目录名。
提示:
1 <= path.length <= 3000path由英文字母,数字,'.','/'或'_'组成。path是一个有效的 Unix 风格绝对路径。
方法一:栈 · Go 实现
思考
Unix 风格路径由目录名与斜杠组成,规范过程需要消除多余斜杠、当前目录
'.'以及返回上级'..'。反复字符串替换在 时时间上可以接受,但连续斜杠与连续'..'叠加时规则交叉,顺序不易一次写对。路径的本质是目录的进退:有效名字应能被
'..'撤销,空段与'.'不改变当前位置。这是后进先出的结构,因此用栈保存从根到当前的目录序列。按'/'切分后逐段处理,根之上不能再退,最后将栈中目录拼成规范路径。
我们先将路径按照 '/' 分割成若干个子串,然后遍历每个子串,根据子串的内容进行如下操作:
- 若子串为空,或者为
'.',则不做任何操作,因为'.'表示当前目录; - 若子串为
'..',则需要将栈顶元素弹出,因为'..'表示上一级目录; - 若子串为其他字符串,则将该子串入栈,因为该子串表示当前目录的子目录。
最后,我们将栈中的所有元素按照从栈底到栈顶的顺序拼接成字符串,即为简化后的规范路径。
时间复杂度 ,空间复杂度 。其中 为路径的长度。
func simplifyPath(path string) string {
	var stk []string
	for _, s := range strings.Split(path, "/") {
		if s == "" || s == "." {
			continue
		}
		if s == ".." {
			if len(stk) > 0 {
				stk = stk[0 : len(stk)-1]
			}
		} else {
			stk = append(stk, s)
		}
	}
	return "/" + strings.Join(stk, "/")
}84. 柱状图中最大的矩形
题目、示例与约束
给定 n 个非负整数,用来表示柱状图中各个柱子的高度。每个柱子彼此相邻,且宽度为 1 。
求在该柱状图中,能够勾勒出来的矩形的最大面积。
示例 1:
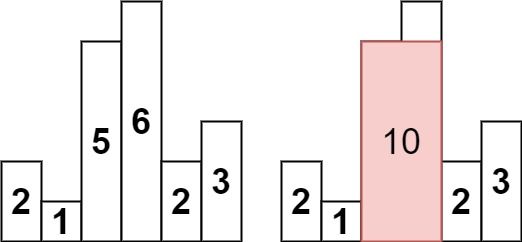
输入:heights = [2,1,5,6,2,3]
输出:10
解释:最大的矩形为图中红色区域,面积为 10
示例 2:
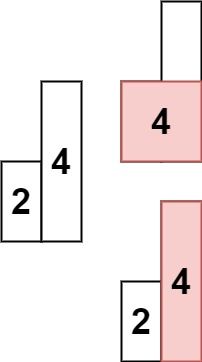
输入: heights = [2,4]
输出: 4
提示:
1 <= heights.length <=1050 <= heights[i] <= 104
方法一:单调栈 · Go 实现
思考
若枚举左右边界 ,高度取区间最小值,面积为 ,时间复杂度为 。 ,无法通过。
可以改换枚举对象:以第 根柱作为矩形的最矮柱,宽度就是它向左右延伸到第一根更矮柱之间的距离。求每个位置「左右两侧最近的更小值」,适合用单调栈:栈中下标对应的高度单调递增,遇到更矮的柱便弹出,同时得到被弹柱的右边界,栈顶即为左边界。每根柱入栈、出栈各一次,线性即可扫完。
我们可以枚举每根柱子的高度 作为矩形的高度,利用单调栈,向左右两边找第一个高度小于 的下标 , 。那么此时矩形面积为 ,求最大值即可。
时间复杂度 ,空间复杂度 。其中 表示 的长度。
单调栈常见模型:找出每个数左/右边离它最近的且比它大/小的数。模板:
stk = []
for i in range(n):
    while stk and check(stk[-1], i):
        stk.pop()
stk.append(i)func largestRectangleArea(heights []int) int {
res, n := 0, len(heights)
var stk []int
left, right := make([]int, n), make([]int, n)
for i := range right {
right[i] = n
}
for i, h := range heights {
for len(stk) > 0 && heights[stk[len(stk)-1]] >= h {
right[stk[len(stk)-1]] = i
stk = stk[:len(stk)-1]
}
if len(stk) > 0 {
left[i] = stk[len(stk)-1]
} else {
left[i] = -1
}
stk = append(stk, i)
}
for i, h := range heights {
res = max(res, h*(right[i]-left[i]-1))
}
return res
}150. 逆波兰表达式求值
题目、示例与约束
给你一个字符串数组 tokens ,表示一个根据 逆波兰表示法 表示的算术表达式。
请你计算该表达式。返回一个表示表达式值的整数。
注意:
- 有效的算符为
'+'、'-'、'*'和'/'。 - 每个操作数(运算对象)都可以是一个整数或者另一个表达式。
- 两个整数之间的除法总是 向零截断 。
- 表达式中不含除零运算。
- 输入是一个根据逆波兰表示法表示的算术表达式。
- 答案及所有中间计算结果可以用 32 位 整数表示。
示例 1:
输入:tokens = ["2","1","+","3","*"]
输出:9
解释:该算式转化为常见的中缀算术表达式为:((2 + 1) * 3) = 9
示例 2:
输入:tokens = ["4","13","5","/","+"]
输出:6
解释:该算式转化为常见的中缀算术表达式为:(4 + (13 / 5)) = 6
示例 3:
输入:tokens = ["10","6","9","3","+","-11","*","/","*","17","+","5","+"]
输出:22
解释:该算式转化为常见的中缀算术表达式为:
  ((10 * (6 / ((9 + 3) * -11))) + 17) + 5
= ((10 * (6 / (12 * -11))) + 17) + 5
= ((10 * (6 / -132)) + 17) + 5
= ((10 * 0) + 17) + 5
= (0 + 17) + 5
= 17 + 5
= 22
提示:
1 <= tokens.length <= 104tokens[i]是一个算符("+"、"-"、"*"或"/"),或是在范围[-200, 200]内的一个整数
逆波兰表达式:
逆波兰表达式是一种后缀表达式,所谓后缀就是指算符写在后面。
- 平常使用的算式则是一种中缀表达式,如
( 1 + 2 ) * ( 3 + 4 )。 - 该算式的逆波兰表达式写法为
( ( 1 2 + ) ( 3 4 + ) * )。
逆波兰表达式主要有以下两个优点:
- 去掉括号后表达式无歧义,上式即便写成
1 2 + 3 4 + *也可以依据次序计算出正确结果。 - 适合用栈操作运算:遇到数字则入栈;遇到算符则取出栈顶两个数字进行计算,并将结果压入栈中
方法一 · Go 实现
思考
逆波兰式把运算符写在操作数后面,求值顺序已经确定,不必处理括号与优先级。 。遇到数字入栈,遇到运算符弹出两个操作数计算再压回,栈中始终是尚未消费的中间结果,最后只剩答案。
func evalRPN(tokens []string) int {
	// https://github.com/emirpasic/gods#arraystack
	stk := arraystack.New()
	for _, token := range tokens {
		if len(token) > 1 || token[0] >= '0' && token[0] <= '9' {
			num, _ := strconv.Atoi(token)
			stk.Push(num)
		} else {
			y := popInt(stk)
			x := popInt(stk)
			switch token {
			case "+":
				stk.Push(x + y)
			case "-":
				stk.Push(x - y)
			case "*":
				stk.Push(x * y)
			default:
				stk.Push(x / y)
			}
		}
	}
	return popInt(stk)
}

func popInt(stack *arraystack.Stack) int {
	v, _ := stack.Pop()
	return v.(int)
}224. 基本计算器
题目、示例与约束
给你一个字符串表达式 s ,请你实现一个基本计算器来计算并返回它的值。
注意:不允许使用任何将字符串作为数学表达式计算的内置函数,比如 eval() 。
示例 1:
输入:s = "1 + 1"
输出:2
示例 2:
输入:s = " 2-1 + 2 "
输出:3
示例 3:
输入:s = "(1+(4+5+2)-3)+(6+8)"
输出:23
提示:
1 <= s.length <= 3 * 105s由数字、'+'、'-'、'('、')'、和' '组成s表示一个有效的表达式'+'不能用作一元运算(例如,"+1"和"+(2 + 3)"无效)'-'可以用作一元运算(即"-1"和"-(2 + 3)"是有效的)- 输入中不存在两个连续的操作符
- 每个数字和运行的计算将适合于一个有符号的 32位 整数
方法一:栈 · Go 实现
思考
表达式含括号与正负号,不能从左到右直接累加。括号内是一段独立求和,需要在进入时保存外层结果与符号。
用栈在遇到 时压入当前 与 ,括号内重新累计;遇到 再弹出,把内层结果乘上外层符号后加回。数字按当前符号并入 。
我们用一个栈 来保存当前的计算结果和操作符,用一个变量 保存当前的符号,变量 保存最终的计算结果。
接下来,我们遍历字符串 的每一个字符:
- 如果当前字符是数字,那么我们用一个循环将后面的连续数字都读进来,然后用当前的符号将其加或者减到 中。
- 如果当前字符是
'+',我们修改变量 为正号。 - 如果当前字符是
'-',我们修改变量 为负号。 - 如果当前字符是
'(',我们把当前的 和 入栈,并分别置空置 1,重新开始计算新的 和 。 - 如果当前字符是
')',我们弹出栈顶的两个元素,一个是操作符,一个是括号前计算好的数字,我们将当前的数字乘上操作符,再加上之前的数字,作为新的 。
遍历完字符串 之后,我们返回 。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度。
func calculate(s string) (ans int) {
	stk := []int{}
	sign := 1
	n := len(s)
	for i := 0; i < n; i++ {
		switch s[i] {
		case ' ':
		case '+':
			sign = 1
		case '-':
			sign = -1
		case '(':
			stk = append(stk, ans)
			stk = append(stk, sign)
			ans, sign = 0, 1
		case ')':
			ans *= stk[len(stk)-1]
			stk = stk[:len(stk)-1]
			ans += stk[len(stk)-1]
			stk = stk[:len(stk)-1]
		default:
			x := 0
			j := i
			for ; j < n && '0' <= s[j] && s[j] <= '9'; j++ {
				x = x*10 + int(s[j]-'0')
			}
			ans += sign * x
			i = j - 1
		}
	}
	return
}227. 基本计算器 II
题目、示例与约束
给你一个字符串表达式 s ,请你实现一个基本计算器来计算并返回它的值。
整数除法仅保留整数部分。
你可以假设给定的表达式总是有效的。所有中间结果将在 [-231, 231 - 1] 的范围内。
注意:不允许使用任何将字符串作为数学表达式计算的内置函数,比如 eval() 。
示例 1:
输入:s = "3+2*2"
输出:7
示例 2:
输入:s = " 3/2 "
输出:1
示例 3:
输入:s = " 3+5 / 2 "
输出:5
提示:
1 <= s.length <= 3 * 105s由整数和算符('+', '-', '*', '/')组成,中间由一些空格隔开s表示一个有效表达式- 表达式中的所有整数都是非负整数,且在范围
[0, 231 - 1]内 - 题目数据 保证 答案是一个 32-bit 整数
方法一:栈 · Go 实现
思考
乘除优先于加减,且无括号,不能把每个数直接加到答案上。把加减看成向栈中放入带符号的项,乘除则立即与栈顶合并。
用 记住上一运算符,读完一个数后按 入栈或改栈顶,最后对栈求和。
遍历字符串 ,并用变量 sign 记录每个数字之前的运算符,对于第一个数字,其之前的运算符视为加号。每次遍历到数字末尾时,根据 sign 来决定计算方式:
- 加号:将数字压入栈;
- 减号:将数字的相反数压入栈;
- 乘除号:计算数字与栈顶元素,并将栈顶元素替换为计算结果。
遍历结束后,将栈中元素求和即为答案。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度。
func calculate(s string) int {
	sign := '+'
	stk := []int{}
	v := 0
	for i, c := range s {
		digit := '0' <= c && c <= '9'
		if digit {
			v = v*10 + int(c-'0')
		}
		if i == len(s)-1 || !digit && c != ' ' {
			switch sign {
			case '+':
				stk = append(stk, v)
			case '-':
				stk = append(stk, -v)
			case '*':
				stk[len(stk)-1] *= v
			case '/':
				stk[len(stk)-1] /= v
			}
			sign = c
			v = 0
		}
	}
	ans := 0
	for _, v := range stk {
		ans += v
	}
	return ans
}387. 字符串中的第一个唯一字符
题目、示例与约束
给定一个字符串 s ,找到 它的第一个不重复的字符,并返回它的索引 。如果不存在,则返回 -1 。
示例 1:
输入: s = "leetcode"
输出: 0
示例 2:
输入: s = "loveleetcode"
输出: 2
示例 3:
输入: s = "aabb"
输出: -1
提示:
1 <= s.length <= 105s只包含小写字母
方法一:计数 · Go 实现
思考
第一个只出现一次的字符下标。一次扫描无法同时知道后面是否还会出现。
先计数,再从左找频次为 的位置;没有则 。两遍线性,空间为字母表大小。
我们用一个哈希表或者一个长度为 的数组 来存储每个字符出现的次数,然后从头开始遍历每个字符 ,如果 为 ,则返回 。
遍历结束后,如果没有找到符合条件的字符,返回 。
时间复杂度 ,其中 是字符串的长度。空间复杂度 ,其中 是字符集,本题中字符集为小写字母,所以 。
func firstUniqChar(s string) int {
	cnt := [26]int{}
	for _, c := range s {
		cnt[c-'a']++
	}
	for i, c := range s {
		if cnt[c-'a'] == 1 {
			return i
		}
	}
	return -1
}394. 字符串解码
题目、示例与约束
给定一个经过编码的字符串,返回它解码后的字符串。
编码规则为: k[encoded_string],表示其中方括号内部的 encoded_string 正好重复 k 次。注意 k 保证为正整数。
你可以认为输入字符串总是有效的;输入字符串中没有额外的空格,且输入的方括号总是符合格式要求的。
此外,你可以认为原始数据不包含数字,所有的数字只表示重复的次数 k ,例如不会出现像 3a 或 2[4] 的输入。
测试用例保证输出的长度不会超过 105。
示例 1:
输入:s = "3[a]2[bc]"
输出:"aaabcbc"
示例 2:
输入:s = "3[a2[c]]"
输出:"accaccacc"
示例 3:
输入:s = "2[abc]3[cd]ef"
输出:"abcabccdcdcdef"
示例 4:
输入:s = "abc3[cd]xyz"
输出:"abccdcdcdxyz"
提示:
1 <= s.length <= 30s由小写英文字母、数字和方括号'[]'组成s保证是一个 有效 的输入。s中所有整数的取值范围为[1, 300]
方法一:Go 实现(halfrost) · Go 实现
本次根据原始 Go 源码整理的中文说明,非 halfrost 书籍原文。
扫描输入并用字符串切片作为栈。读到右方括号时,先弹出本层片段,再向前读取完整的重复次数,将展开后的字符串放回栈中;最终拼接栈内各段。嵌套结构由栈逐层展开,重复次数也可以是多位数。
import (
	"strconv"
)

func decodeString(s string) string {
	stack, res := []string{}, ""
	for _, str := range s {
		if len(stack) == 0 || (len(stack) > 0 && str != ']') {
			stack = append(stack, string(str))
		} else {
			tmp := ""
			for stack[len(stack)-1] != "[" {
				tmp = stack[len(stack)-1] + tmp
				stack = stack[:len(stack)-1]
			}
			stack = stack[:len(stack)-1]
			index, repeat := 0, ""
			for index = len(stack) - 1; index >= 0; index-- {
				if stack[index] >= "0" && stack[index] <= "9" {
					repeat = stack[index] + repeat
				} else {
					break
				}
			}
			nums, _ := strconv.Atoi(repeat)
			copyTmp := tmp
			for i := 0; i < nums-1; i++ {
				tmp += copyTmp
			}
			for i := 0; i < len(repeat)-1; i++ {
				stack = stack[:len(stack)-1]
			}
			stack[index+1] = tmp
		}
	}
	for _, s := range stack {
		res += s
	}
	return res
}439. 三元表达式解析器 🔒
题目、示例与约束
给定一个表示任意嵌套三元表达式的字符串 expression ,求值并返回其结果。
你可以总是假设给定的表达式是有效的,并且只包含数字, '?' , ':' , 'T' 和 'F' ,其中 'T' 为真, 'F' 为假。表达式中的所有数字都是 一位 数(即在 [0,9] 范围内)。
条件表达式从右到左分组(大多数语言中都是这样),表达式的结果总是为数字,'T' 或 'F' 。
示例 1:
输入: expression = "T?2:3"
输出: "2"
解释: 如果条件为真,结果为 2;否则,结果为 3。
示例 2:
输入: expression = "F?1:T?4:5"
输出: "4"
解释: 条件表达式自右向左结合。使用括号的话,相当于:
 "(F ? 1 : (T ? 4 : 5))" --> "(F ? 1 : 4)" --> "4"
or "(F ? 1 : (T ? 4 : 5))" --> "(T ? 4 : 5)" --> "4"
示例 3:
输入: expression = "T?T?F:5:3"
输出: "F"
解释: 条件表达式自右向左结合。使用括号的话,相当于:
"(T ? (T ? F : 5) : 3)" --> "(T ? F : 3)" --> "F"
"(T ? (T ? F : 5) : 3)" --> "(T ? F : 5)" --> "F"
提示:
5 <= expression.length <= 104expression由数字,'T','F','?'和':'组成- 保证 了表达式是一个有效的三元表达式,并且每个数字都是 一位数
方法一:栈 · Go 实现
思考
三元式右结合: 应先算内层。从左扫描需要预读整段真假分支,括号匹配式的递归较重。
从右向左:普通字符入栈,跳过冒号;遇到问号则下一字符是条件,按 保留栈顶两个结果中的一个。
右到左使内层先求值,栈顶始终是已经化简的叶子,最后只剩一个字符。
我们从右到左遍历字符串 expression,对于当前遍历到的字符 :
- 如果 是字符
':',则跳过; - 如果 是字符
'?',那么意味着下一个即将遍历到的字符是条件表达式的条件,我们用一个布尔变量cond标记; - 如果 的上一个遍历到的字符是
'?',也即布尔变量cond为true,那么我们判断当前字符 是否为字符'T',如果是,那么我们要保留栈顶第一个元素,弹出栈顶第二个元素;否则,我们要保留栈顶第二个元素,弹出栈顶第一个元素。最后,将cond置为false; - 否则,我们将当前字符 入栈。
最后,栈中只剩下一个元素,即为表达式的结果。
时间复杂度 ,空间复杂度 。其中 为字符串 expression 的长度。
func parseTernary(expression string) string {
	stk := []byte{}
	cond := false
	for i := len(expression) - 1; i >= 0; i-- {
		c := expression[i]
		if c == ':' {
			continue
		}
		if c == '?' {
			cond = true
		} else {
			if cond {
				if c == 'T' {
					x := stk[len(stk)-1]
					stk = stk[:len(stk)-2]
					stk = append(stk, x)
				} else {
					stk = stk[:len(stk)-1]
				}
				cond = false
			} else {
				stk = append(stk, c)
			}
		}
	}
	return string(stk[0])
}496. 下一个更大元素 I
题目、示例与约束
nums1 中数字 x 的 下一个更大元素 是指 x 在 nums2 中对应位置 右侧 的 第一个 比 x 大的元素。
给你两个 没有重复元素 的数组 nums1 和 nums2 ,下标从 0 开始计数,其中nums1 是 nums2 的子集。
对于每个 0 <= i < nums1.length ,找出满足 nums1[i] == nums2[j] 的下标 j ,并且在 nums2 确定 nums2[j] 的 下一个更大元素 。如果不存在下一个更大元素,那么本次查询的答案是 -1 。
返回一个长度为 nums1.length 的数组 ans 作为答案,满足 ans[i] 是如上所述的 下一个更大元素 。
示例 1:
输入:nums1 = [4,1,2], nums2 = [1,3,4,2].
输出:[-1,3,-1]
解释:nums1 中每个值的下一个更大元素如下所述:
- 4 ,用加粗斜体标识,nums2 = [1,3,4,2]。不存在下一个更大元素,所以答案是 -1 。
- 1 ,用加粗斜体标识,nums2 = [1,3,4,2]。下一个更大元素是 3 。
- 2 ,用加粗斜体标识,nums2 = [1,3,4,2]。不存在下一个更大元素,所以答案是 -1 。
示例 2:
输入:nums1 = [2,4], nums2 = [1,2,3,4].
输出:[3,-1]
解释:nums1 中每个值的下一个更大元素如下所述:
- 2 ,用加粗斜体标识,nums2 = [1,2,3,4]。下一个更大元素是 3 。
- 4 ,用加粗斜体标识,nums2 = [1,2,3,4]。不存在下一个更大元素,所以答案是 -1 。
提示:
1 <= nums1.length <= nums2.length <= 10000 <= nums1[i], nums2[i] <= 104nums1和nums2中所有整数 互不相同nums1中的所有整数同样出现在nums2中
进阶:你可以设计一个时间复杂度为 O(nums1.length + nums2.length) 的解决方案吗?
方法一:单调栈 · Go 实现
思考
是 的子集,求各自在 中下一个更大元。对每个 的值在 里向右扫是 。
从右向左扫 ,维护单调递减栈:弹出所有更小的栈顶后,栈顶就是当前值的下一个更大元,记入哈希表。再按 查表。
栈里从顶到底递增(右到左扫时保持递减栈),每个元素入出栈一次。先处理 再回答 ,避免重复扫描。
我们可以从右往左遍历数组 ,维护一个从栈顶到栈底单调递增的栈 ,并且用哈希表 记录每个元素的下一个更大元素。
遍历到元素 时,如果栈不为空且栈顶元素小于 ,我们就不断弹出栈顶元素,直到栈为空或者栈顶元素大于等于 。此时,如果栈不为空,栈顶元素就是 的下一个更大元素,否则 没有下一个更大元素。
最后我们遍历数组 ,根据哈希表 得到答案。
时间复杂度 ,空间复杂度 。其中 和 分别为数组 和 的长度。
func nextGreaterElement(nums1 []int, nums2 []int) (ans []int) {
	stk := []int{}
	d := map[int]int{}
	for i := len(nums2) - 1; i >= 0; i-- {
		x := nums2[i]
		for len(stk) > 0 && stk[len(stk)-1] < x {
			stk = stk[:len(stk)-1]
		}
		if len(stk) > 0 {
			d[x] = stk[len(stk)-1]
		}
		stk = append(stk, x)
	}
	for _, x := range nums1 {
		if v, ok := d[x]; ok {
			ans = append(ans, v)
		} else {
			ans = append(ans, -1)
		}
	}
	return
}503. 下一个更大元素 II
题目、示例与约束
给定一个循环数组 nums ( nums[nums.length - 1] 的下一个元素是 nums[0] ),返回 nums 中每个元素的 下一个更大元素 。
数字 x 的 下一个更大的元素 是按数组遍历顺序,这个数字之后的第一个比它更大的数,这意味着你应该循环地搜索它的下一个更大的数。如果不存在,则输出 -1 。
示例 1:
输入: nums = [1,2,1]
输出: [2,-1,2]
解释: 第一个 1 的下一个更大的数是 2;
数字 2 找不到下一个更大的数;
第二个 1 的下一个最大的数需要循环搜索,结果也是 2。
示例 2:
输入: nums = [1,2,3,4,3]
输出: [2,3,4,-1,4]
提示:
1 <= nums.length <= 104-109 <= nums[i] <= 109
方法一:单调栈 · Go 实现
思考
对每个位置找右侧第一个更大元素,朴素向右扫描是 ,在 的循环数组上偏紧。循环意味着下标 之后要回到开头。
从右往左维护单调递减栈,栈中存放「尚未被更小元素消耗」的候选。数组走两遍即可把环展开成线性下标,取模写回原位置。栈保证每个元素至多进出一次,因此是线性时间。
题目需要我们找到每个元素的下一个更大元素,那么我们可以从后往前遍历数组,这样可以将问题为求上一个更大元素。另外,由于数组是循环的,我们可以将数组遍历两次。
具体地,我们从下标 开始向前遍历数组,其中 是数组的长度。然后,我们记 ,其中 表示取模运算。如果栈不为空且栈顶元素小于等于 ,那么我们就不断地弹出栈顶元素,直到栈为空或者栈顶元素大于 。此时,栈顶元素就是 的上一个更大元素,我们将其赋给 。最后,我们将 入栈。继续遍历下一个元素。
遍历结束后,我们就可以得到数组 ,它是数组 中每个元素的下一个更大元素。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func nextGreaterElements(nums []int) []int {
	n := len(nums)
	ans := make([]int, n)
	for i := range ans {
		ans[i] = -1
	}
	stk := []int{}
	for i := n*2 - 1; i >= 0; i-- {
		j := i % n
		for len(stk) > 0 && stk[len(stk)-1] <= nums[j] {
			stk = stk[:len(stk)-1]
		}
		if len(stk) > 0 {
			ans[j] = stk[len(stk)-1]
		}
		stk = append(stk, nums[j])
	}
	return ans
}591. 标签验证器
题目、示例与约束
给定一个表示代码片段的字符串,你需要实现一个验证器来解析这段代码,并返回它是否合法。合法的代码片段需要遵守以下的所有规则:
- 代码必须被合法的闭合标签包围。否则,代码是无效的。
- 闭合标签(不一定合法)要严格符合格式:
<TAG_NAME>TAG_CONTENT</TAG_NAME>。其中,<TAG_NAME>是起始标签,</TAG_NAME>是结束标签。起始和结束标签中的 TAG_NAME 应当相同。当且仅当 TAG_NAME 和 TAG_CONTENT 都是合法的,闭合标签才是合法的。 - 合法的
TAG_NAME仅含有大写字母,长度在范围 [1,9] 之间。否则,该TAG_NAME是不合法的。 - 合法的
TAG_CONTENT可以包含其他合法的闭合标签,cdata (请参考规则7)和任意字符(注意参考规则1)除了不匹配的<、不匹配的起始和结束标签、不匹配的或带有不合法 TAG_NAME 的闭合标签。否则,TAG_CONTENT是不合法的。 - 一个起始标签,如果没有具有相同 TAG_NAME 的结束标签与之匹配,是不合法的。反之亦然。不过,你也需要考虑标签嵌套的问题。
- 一个
<,如果你找不到一个后续的>与之匹配,是不合法的。并且当你找到一个<或</时,所有直到下一个>的前的字符,都应当被解析为 TAG_NAME(不一定合法)。 - cdata 有如下格式:
<![CDATA[CDATA_CONTENT]]>。CDATA_CONTENT的范围被定义成<![CDATA[和后续的第一个]]>之间的字符。 CDATA_CONTENT可以包含任意字符。cdata 的功能是阻止验证器解析CDATA_CONTENT,所以即使其中有一些字符可以被解析为标签(无论合法还是不合法),也应该将它们视为常规字符。
示例 1:
输入:code = "<DIV>This is the first line <![CDATA[<div>]]></DIV>"
输出:true
解释:
代码被闭合的标签包围:<DIV> 和 </DIV>。
TAG_NAME 是合法的,TAG_CONTENT 只包含一些字母和 cdata。
尽管 CDATA_CONTENT 有一个非法 TAG_NAME 的未匹配开始标签,它可以被认为是普通文本,不被解析为一个标签。
所以 TAG_CONTENT 是合法的,并且代码是合法的。因此返回 true。
示例 2:
输入:code = "<DIV>>>  ![cdata[]] <![CDATA[<div>]>]]>]]>>]</DIV>"
输出:true
解释:
我们首先将代码分割为:start_tag|tag_content|end_tag。
start_tag -> "<DIV>"
end_tag -> "</DIV>"
tag_content 也可以被分割为:text1|cdata|text2。
text1 -> ">>  ![cdata[]] "
cdata -> "<![CDATA[<div>]>]]>",其中 CDATA_CONTENT 是 "<div>]>"
text2 -> "]]>>]"
start_tag 不是 "<DIV>>>" 的原因是规则 6。
cdata 不是 "<![CDATA[<div>]>]]>]]>" 的原因是规则 7。
示例 3:
输入:code = "<A>  <B> </A>   </B>"
输出:false
解释:不平衡。如果 "<A>" 是闭合的,那么 "<B>" 一定没有匹配,反之亦然。
提示:
1 <= code.length <= 500code只包含英文字母,数字,'<','>','/','!','[',']','.'和' '。
方法一:栈模拟 · Go 实现
思考
标签要正确嵌套,CDATA 原样跳过,且整段必须是一个闭合的标签树。正则难以处理嵌套与 CDATA。
用栈存尚未闭合的标签名。遇到
<![CDATA[找到配对]]>并跳过;遇到结束标签则必须与栈顶相同;开始标签名需为 到 个大写字母。栈一旦在中途空掉说明有额外文本。结束时栈应为空。
func isValid(code string) bool {
	var stk []string
	for i := 0; i < len(code); i++ {
		if i > 0 && len(stk) == 0 {
			return false
		}
		if strings.HasPrefix(code[i:], "<![CDATA[") {
			n := strings.Index(code[i+9:], "]]>")
			if n == -1 {
				return false
			}
			i += n + 11
		} else if strings.HasPrefix(code[i:], "</") {
			if len(stk) == 0 {
				return false
			}
			j := i + 2
			n := strings.IndexByte(code[j:], '>')
			if n == -1 {
				return false
			}
			t := code[j : j+n]
			last := stk[len(stk)-1]
			stk = stk[:len(stk)-1]
			if !check(t) || last != t {
				return false
			}
			i += n + 2
		} else if strings.HasPrefix(code[i:], "<") {
			j := i + 1
			n := strings.IndexByte(code[j:], '>')
			if n == -1 {
				return false
			}
			t := code[j : j+n]
			if !check(t) {
				return false
			}
			stk = append(stk, t)
			i += n + 1
		}
	}
	return len(stk) == 0
}

func check(tag string) bool {
	n := len(tag)
	if n < 1 || n > 9 {
		return false
	}
	for _, c := range tag {
		if c < 'A' || c > 'Z' {
			return false
		}
	}
	return true
}636. 函数的独占时间
题目、示例与约束
有一个 单线程 CPU 正在运行一个含有 n 道函数的程序。每道函数都有一个位于 0 和 n-1 之间的唯一标识符。
函数调用 存储在一个 调用栈 上 :当一个函数调用开始时,它的标识符将会推入栈中。而当一个函数调用结束时,它的标识符将会从栈中弹出。标识符位于栈顶的函数是 当前正在执行的函数 。每当一个函数开始或者结束时,将会记录一条日志,包括函数标识符、是开始还是结束、以及相应的时间戳。
给你一个由日志组成的列表 logs ,其中 logs[i] 表示第 i 条日志消息,该消息是一个按 "{function_id}:{"start" | "end"}:{timestamp}" 进行格式化的字符串。例如,"0:start:3" 意味着标识符为 0 的函数调用在时间戳 3 的 起始开始执行 ;而 "1:end:2" 意味着标识符为 1 的函数调用在时间戳 2 的 末尾结束执行。注意,函数可以 调用多次,可能存在递归调用 。
函数的 独占时间 定义是在这个函数在程序所有函数调用中执行时间的总和,调用其他函数花费的时间不算该函数的独占时间。例如,如果一个函数被调用两次,一次调用执行 2 单位时间,另一次调用执行 1 单位时间,那么该函数的 独占时间 为 2 + 1 = 3 。
以数组形式返回每个函数的 独占时间 ,其中第 i 个下标对应的值表示标识符 i 的函数的独占时间。
示例 1:
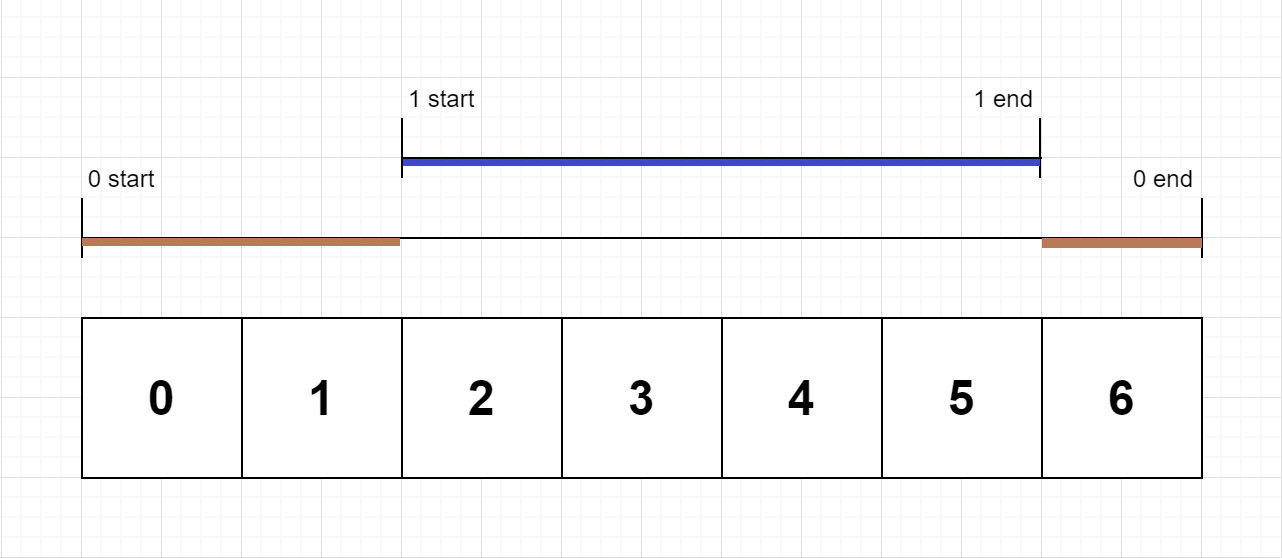
输入:n = 2, logs = ["0:start:0","1:start:2","1:end:5","0:end:6"]
输出:[3,4]
解释:
函数 0 在时间戳 0 的起始开始执行,执行 2 个单位时间,于时间戳 1 的末尾结束执行。
函数 1 在时间戳 2 的起始开始执行,执行 4 个单位时间,于时间戳 5 的末尾结束执行。
函数 0 在时间戳 6 的开始恢复执行,执行 1 个单位时间。
所以函数 0 总共执行 2 + 1 = 3 个单位时间,函数 1 总共执行 4 个单位时间。
示例 2:
输入:n = 1, logs = ["0:start:0","0:start:2","0:end:5","0:start:6","0:end:6","0:end:7"]
输出:[8]
解释:
函数 0 在时间戳 0 的起始开始执行,执行 2 个单位时间,并递归调用它自身。
函数 0(递归调用)在时间戳 2 的起始开始执行,执行 4 个单位时间。
函数 0(初始调用)恢复执行,并立刻再次调用它自身。
函数 0(第二次递归调用)在时间戳 6 的起始开始执行,执行 1 个单位时间。
函数 0(初始调用)在时间戳 7 的起始恢复执行,执行 1 个单位时间。
所以函数 0 总共执行 2 + 4 + 1 + 1 = 8 个单位时间。
示例 3:
输入:n = 2, logs = ["0:start:0","0:start:2","0:end:5","1:start:6","1:end:6","0:end:7"]
输出:[7,1]
解释:
函数 0 在时间戳 0 的起始开始执行,执行 2 个单位时间,并递归调用它自身。
函数 0(递归调用)在时间戳 2 的起始开始执行,执行 4 个单位时间。
函数 0(初始调用)恢复执行,并立刻调用函数 1 。
函数 1 在时间戳 6 的起始开始执行,执行 1 个单位时间,于时间戳 6 的末尾结束执行。
函数 0(初始调用)在时间戳 7 的起始恢复执行,执行 1 个单位时间,于时间戳 7 的末尾结束执行。
所以函数 0 总共执行 2 + 4 + 1 = 7 个单位时间,函数 1 总共执行 1 个单位时间。
提示:
1 <= n <= 1002 <= logs.length <= 5000 <= function_id < n0 <= timestamp <= 109- 两个开始事件不会在同一时间戳发生
- 两个结束事件不会在同一时间戳发生
- 每道函数都有一个对应
"start"日志的"end"日志
方法一:栈 + 模拟 · Go 实现
思考
函数可嵌套,日志给出起止时刻,要求每函数的独占时间。若按时间轴逐秒模拟,区间可达 。
嵌套结构对应栈:新函数启动时,把栈顶已跑过的片段结算到
pre;结束时把闭区间 加给自己,并把pre接到 。一次扫完日志。
我们定义一个栈 ,用于存储当前正在执行的函数的标识符。同时,我们定义一个数组 ,用于存储每个函数的独占时间,初始时每个函数的独占时间都为 。用一个变量 记录上一个时间戳。
遍历日志数组,对于每一条日志,我们首先将其按照冒号分隔,得到函数标识符 ,操作类型 和时间戳 。
如果 为 ,则表示函数 开始执行,我们需要判断栈是否为空,如果不为空,则将栈顶函数的独占时间增加 ,然后将 入栈,更新 为 ;如果 为 ,则表示函数 结束执行,我们将栈顶函数的独占时间增加 ,然后将栈顶元素出栈,更新 为 。
最后返回数组 即可。
时间复杂度 ,空间复杂度 。其中 为日志数组的长度。
func exclusiveTime(n int, logs []string) []int {
	ans := make([]int, n)
	stk := []int{}
	pre := 0
	for _, log := range logs {
		parts := strings.Split(log, ":")
		i, _ := strconv.Atoi(parts[0])
		cur, _ := strconv.Atoi(parts[2])
		if parts[1][0] == 's' {
			if len(stk) > 0 {
				ans[stk[len(stk)-1]] += cur - pre
			}
			stk = append(stk, i)
			pre = cur
		} else {
			ans[stk[len(stk)-1]] += cur - pre + 1
			stk = stk[:len(stk)-1]
			pre = cur + 1
		}
	}
	return ans
}682. 棒球比赛
题目、示例与约束
你现在是一场采用特殊赛制棒球比赛的记录员。这场比赛由若干回合组成,过去几回合的得分可能会影响以后几回合的得分。
比赛开始时,记录是空白的。你会得到一个记录操作的字符串列表 ops,其中 ops[i] 是你需要记录的第 i 项操作,ops 遵循下述规则:
- 整数
x- 表示本回合新获得分数x "+"- 表示本回合新获得的得分是前两次得分的总和。题目数据保证记录此操作时前面总是存在两个有效的分数。"D"- 表示本回合新获得的得分是前一次得分的两倍。题目数据保证记录此操作时前面总是存在一个有效的分数。"C"- 表示前一次得分无效,将其从记录中移除。题目数据保证记录此操作时前面总是存在一个有效的分数。
请你返回记录中所有得分的总和。
示例 1:
输入:ops = ["5","2","C","D","+"]
输出:30
解释:
"5" - 记录加 5 ,记录现在是 [5]
"2" - 记录加 2 ,记录现在是 [5, 2]
"C" - 使前一次得分的记录无效并将其移除,记录现在是 [5].
"D" - 记录加 2 * 5 = 10 ,记录现在是 [5, 10].
"+" - 记录加 5 + 10 = 15 ,记录现在是 [5, 10, 15].
所有得分的总和 5 + 10 + 15 = 30
示例 2:
输入:ops = ["5","-2","4","C","D","9","+","+"]
输出:27
解释:
"5" - 记录加 5 ,记录现在是 [5]
"-2" - 记录加 -2 ,记录现在是 [5, -2]
"4" - 记录加 4 ,记录现在是 [5, -2, 4]
"C" - 使前一次得分的记录无效并将其移除,记录现在是 [5, -2]
"D" - 记录加 2 * -2 = -4 ,记录现在是 [5, -2, -4]
"9" - 记录加 9 ,记录现在是 [5, -2, -4, 9]
"+" - 记录加 -4 + 9 = 5 ,记录现在是 [5, -2, -4, 9, 5]
"+" - 记录加 9 + 5 = 14 ,记录现在是 [5, -2, -4, 9, 5, 14]
所有得分的总和 5 + -2 + -4 + 9 + 5 + 14 = 27
示例 3:
输入:ops = ["1"]
输出:1
提示:
1 <= ops.length <= 1000ops[i]为"C"、"D"、"+",或者一个表示整数的字符串。整数范围是[-3 * 104, 3 * 104]- 对于
"+"操作,题目数据保证记录此操作时前面总是存在两个有效的分数 - 对于
"C"和"D"操作,题目数据保证记录此操作时前面总是存在一个有效的分数
方法一:栈 + 模拟 · Go 实现
思考
操作依赖「上一分」「上两分」或撤销,顺序扫描时必须能取到最近记录。
栈保存每回合得分:
+取栈顶两项之和,D翻倍栈顶,C弹出,数字入栈。最后求和。
我们可以使用栈来模拟这个过程。
遍历 ,对于每个操作:
- 如果是
+,则将栈顶两个元素相加,然后将结果入栈; - 如果是
D,则将栈顶元素的值乘以 2,然后将结果入栈; - 如果是
C,则将栈顶元素出栈; - 如果是数字,将数字入栈。
最后,将栈中的所有元素求和即为答案。
时间复杂度 ,空间复杂度 。其中 为 的长度。
func calPoints(operations []string) (ans int) {
	var stk []int
	for _, op := range operations {
		n := len(stk)
		switch op {
		case "+":
			stk = append(stk, stk[n-1]+stk[n-2])
		case "D":
			stk = append(stk, stk[n-1]*2)
		case "C":
			stk = stk[:n-1]
		default:
			num, _ := strconv.Atoi(op)
			stk = append(stk, num)
		}
	}
	for _, x := range stk {
		ans += x
	}
	return
}726. 原子的数量
题目、示例与约束
给你一个字符串化学式 formula ,返回 每种原子的数量 。
原子总是以一个大写字母开始,接着跟随 0 个或任意个小写字母,表示原子的名字。
如果数量大于 1,原子后会跟着数字表示原子的数量。如果数量等于 1 则不会跟数字。
- 例如,
"H2O"和"H2O2"是可行的,但"H1O2"这个表达是不可行的。
两个化学式连在一起可以构成新的化学式。
- 例如
"H2O2He3Mg4"也是化学式。
由括号括起的化学式并佐以数字(可选择性添加)也是化学式。
- 例如
"(H2O2)"和"(H2O2)3"是化学式。
返回所有原子的数量,格式为:第一个(按字典序)原子的名字,跟着它的数量(如果数量大于 1),然后是第二个原子的名字(按字典序),跟着它的数量(如果数量大于 1),以此类推。
示例 1:
输入:formula = "H2O"
输出:"H2O"
解释:原子的数量是 {'H': 2, 'O': 1}。
示例 2:
输入:formula = "Mg(OH)2"
输出:"H2MgO2"
解释:原子的数量是 {'H': 2, 'Mg': 1, 'O': 2}。
示例 3:
输入:formula = "K4(ON(SO3)2)2"
输出:"K4N2O14S4"
解释:原子的数量是 {'K': 4, 'N': 2, 'O': 14, 'S': 4}。
提示:
1 <= formula.length <= 1000formula由英文字母、数字、'('和')'组成formula总是有效的化学式
方法一 · Go 实现
思考
化学式含括号与下标,需要统计每种原子的个数并按名字排序输出。公式长度 ,递归下降或栈都可以处理嵌套。
括号的倍数作用在整个子式上,从右往左扫描时,先遇到的下标可以立刻乘进当前倍数:遇
)把当前倍数压栈并乘上下标,遇(再弹出恢复。按此逆向累加:数字拼成 ,元素名(含后续小写)计入 。最后对键排序,个数为 时省略数字。
func countOfAtoms(formula string) string {
	cnt := map[string]int{}
	var stack []int
	multiplier, freq := 1, 0
	for i := len(formula) - 1; i >= 0; i-- {
		c := formula[i]
		if c >= 'a' && c <= 'z' {
			end := i
			i--
			for i >= 0 && formula[i] >= 'a' && formula[i] <= 'z' {
				i--
			}
			cnt[formula[i:end+1]] += max(freq, 1) * multiplier
			freq = 0
		} else if c >= 'A' && c <= 'Z' {
			cnt[formula[i:i+1]] += max(freq, 1) * multiplier
			freq = 0
		} else if c >= '0' && c <= '9' {
			freq = int(c - '0')
			p := 10
			for i-1 >= 0 && formula[i-1] >= '0' && formula[i-1] <= '9' {
				i--
				freq += p * int(formula[i]-'0')
				p *= 10
			}
		} else if c == ')' {
			stack = append(stack, multiplier)
			multiplier *= max(freq, 1)
			freq = 0
		} else {
			multiplier = stack[len(stack)-1]
			stack = stack[:len(stack)-1]
		}
	}
	keys := make([]string, 0, len(cnt))
	for k := range cnt {
		keys = append(keys, k)
	}
	sort.Strings(keys)
	ans := []byte{}
	for _, key := range keys {
		ans = append(ans, key...)
		if cnt[key] > 1 {
			ans = append(ans, strconv.Itoa(cnt[key])...)
		}
	}
	return string(ans)
}735. 小行星碰撞
题目、示例与约束
给定一个整数数组 asteroids,表示在同一行的小行星。数组中小行星的索引表示它们在空间中的相对位置。
对于数组中的每一个元素,其绝对值表示小行星的大小,正负表示小行星的移动方向(正表示向右移动,负表示向左移动)。每一颗小行星以相同的速度移动。
找出碰撞后剩下的所有小行星。碰撞规则:两个小行星相互碰撞,较小的小行星会爆炸。如果两颗小行星大小相同,则两颗小行星都会爆炸。两颗移动方向相同的小行星,永远不会发生碰撞。
示例 1:
输入:asteroids = [5,10,-5]
输出:[5,10]
解释:10 和 -5 碰撞后只剩下 10 。 5 和 10 永远不会发生碰撞。
示例 2:
输入:asteroids = [8,-8]
输出:[]
解释:8 和 -8 碰撞后,两者都发生爆炸。
示例 3:
输入:asteroids = [10,2,-5]
输出:[10]
解释:2 和 -5 发生碰撞后剩下 -5 。10 和 -5 发生碰撞后剩下 10 。
示例 4:
输入:asteroids = [3,5,-6,2,-1,4]
输出:[-6,2,4]
解释:小行星 -6 使小行星 3 和 5 爆炸,然后继续向左移动。在另一边,小行星 2 摧毁了小行星 -1。由于 2 和 4 都向右移动,它们永远不会相撞。
提示:
2 <= asteroids.length <= 104-1000 <= asteroids[i] <= 1000asteroids[i] != 0
方法一:栈 · Go 实现
思考
行星只在「右行遇到左行」时相撞,同向或相离都不会撞。 ,模拟每一对碰撞需要按存活序列处理,栈正好保存仍向右、尚未被摧毁的行星。
正数不会与左侧相撞,直接入栈。负数则不断与栈顶的正数比质量:栈顶更小则爆炸并继续,相等则双方消失,栈顶更大则当前行星消失。
从左到右扫一遍,每个行星至多入栈出栈一次,时间 。
我们从左到右遍历每个小行星 ,由于每个小行星可能与之前的多个小行星发生碰撞,考虑用栈来存储。
- 对于当前小行星,如果 ,那么它一定不会跟前面的小行星发生碰撞,我们可以直接将 入栈。
- 否则,如果栈不为空并且栈顶元素大于 ,且栈顶元素小于 ,那么栈顶元素对应的小行星会发生爆炸,我们循环将栈顶元素出栈,直到不满足条件。此时如果栈顶元素等于 ,那么两个小行星会发生爆炸,只需要将栈顶元素出栈即可;如果栈为空,或者栈顶元素小于 ,那么当前小行星不会发生碰撞,我们将 入栈。
最后我们返回栈中的元素即为答案。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func asteroidCollision(asteroids []int) (stk []int) {
	for _, x := range asteroids {
		if x > 0 {
			stk = append(stk, x)
		} else {
			for len(stk) > 0 && stk[len(stk)-1] > 0 && stk[len(stk)-1] < -x {
				stk = stk[:len(stk)-1]
			}
			if len(stk) > 0 && stk[len(stk)-1] == -x {
				stk = stk[:len(stk)-1]
			} else if len(stk) == 0 || stk[len(stk)-1] < 0 {
				stk = append(stk, x)
			}
		}
	}
	return
}736. Lisp 语法解析
题目、示例与约束
给你一个类似 Lisp 语句的字符串表达式 expression,求出其计算结果。
表达式语法如下所示:
- 表达式可以为整数,let 表达式,add 表达式,mult 表达式,或赋值的变量。表达式的结果总是一个整数。
- (整数可以是正整数、负整数、0)
- let 表达式采用
"(let v1 e1 v2 e2 ... vn en expr)"的形式,其中let总是以字符串"let"来表示,接下来会跟随一对或多对交替的变量和表达式,也就是说,第一个变量v1被分配为表达式e1的值,第二个变量v2被分配为表达式e2的值,依次类推;最终let表达式的值为expr表达式的值。 - add 表达式表示为
"(add e1 e2)",其中add总是以字符串"add"来表示,该表达式总是包含两个表达式e1、e2,最终结果是e1表达式的值与e2表达式的值之 和 。 - mult 表达式表示为
"(mult e1 e2)",其中mult总是以字符串"mult"表示,该表达式总是包含两个表达式e1、e2,最终结果是e1表达式的值与e2表达式的值之 积 。 - 在该题目中,变量名以小写字符开始,之后跟随 0 个或多个小写字符或数字。为了方便,
"add","let","mult"会被定义为 "关键字" ,不会用作变量名。 - 最后,要说一下作用域的概念。计算变量名所对应的表达式时,在计算上下文中,首先检查最内层作用域(按括号计),然后按顺序依次检查外部作用域。测试用例中每一个表达式都是合法的。有关作用域的更多详细信息,请参阅示例。
示例 1:
输入:expression = "(let x 2 (mult x (let x 3 y 4 (add x y))))"
输出:14
解释:
计算表达式 (add x y), 在检查变量 x 值时,
在变量的上下文中由最内层作用域依次向外检查。
首先找到 x = 3, 所以此处的 x 值是 3 。
示例 2:
输入:expression = "(let x 3 x 2 x)"
输出:2
解释:let 语句中的赋值运算按顺序处理即可。
示例 3:
输入:expression = "(let x 1 y 2 x (add x y) (add x y))"
输出:5
解释:
第一个 (add x y) 计算结果是 3,并且将此值赋给了 x 。
第二个 (add x y) 计算结果是 3 + 2 = 5 。
提示:
1 <= expression.length <= 2000exprssion中不含前导和尾随空格expressoin中的不同部分(token)之间用单个空格进行分隔- 答案和所有中间计算结果都符合 32-bit 整数范围
- 测试用例中的表达式均为合法的且最终结果为整数
方法一:递归 · Go 实现
思考
表达式含整数、 、 、 与嵌套作用域,长度 ,需要按语法求值。把整串拆成令牌后再处理也可以,直接在原串上递进下标同样线性。
会引入绑定且内层覆盖外层,求值结束后必须撤销,因此每个变量用栈保存历史值。 / 则是对两个子表达式求值后运算。
递归函数 看当前记号:非括号则解析变量或整数;否则按
let/add/mult分派,解析变量名与嵌套 ,在 的绑定表 上入栈出栈。一次扫描完成。
时间复杂度 。
func evaluate(expression string) int {
	i, n := 0, len(expression)
	scope := map[string][]int{}

	parseVar := func() string {
		j := i
		for ; i < n && expression[i] != ' ' && expression[i] != ')'; i++ {
		}
		return expression[j:i]
	}

	parseInt := func() int {
		sign, v := 1, 0
		if expression[i] == '-' {
			sign = -1
			i++
		}
		for ; i < n && expression[i] >= '0' && expression[i] <= '9'; i++ {
			v = (v * 10) + int(expression[i]-'0')
		}
		return sign * v
	}

	var eval func() int
	eval = func() int {
		if expression[i] != '(' {
			if unicode.IsLower(rune(expression[i])) {
				t := scope[parseVar()]
				return t[len(t)-1]
			}
			return parseInt()
		}
		i++
		ans := 0
		if expression[i] == 'l' {
			i += 4
			vars := []string{}
			for {
				v := parseVar()
				if expression[i] == ')' {
					t := scope[v]
					ans = t[len(t)-1]
					break
				}
				i++
				vars = append(vars, v)
				scope[v] = append(scope[v], eval())
				i++
				if !unicode.IsLower(rune(expression[i])) {
					ans = eval()
					break
				}
			}
			for _, v := range vars {
				scope[v] = scope[v][:len(scope[v])-1]
			}
		} else {
			add := expression[i] == 'a'
			if add {
				i += 4
			} else {
				i += 5
			}
			a := eval()
			i++
			b := eval()
			if add {
				ans = a + b
			} else {
				ans = a * b
			}
		}
		i++
		return ans
	}
	return eval()
}739. 每日温度
题目、示例与约束
给定一个整数数组 temperatures ,表示每天的温度,返回一个数组 answer ,其中 answer[i] 是指对于第 i 天,下一个更高温度出现在几天后。如果气温在这之后都不会升高,请在该位置用 0 来代替。
示例 1:
输入: temperatures = [73,74,75,71,69,72,76,73]
输出: [1,1,4,2,1,1,0,0]
示例 2:
输入: temperatures = [30,40,50,60]
输出: [1,1,1,0]
示例 3:
输入: temperatures = [30,60,90]
输出: [1,1,0]
提示:
1 <= temperatures.length <= 10530 <= temperatures[i] <= 100
方法一:单调栈 · Go 实现
思考
对每个位置求右侧下一个更高温度的距离。 ,对每个下标向右扫描是 。
这是「右侧下一个更大元」:用单调栈保存尚未找到答案、温度递减的下标。从右往左扫时,弹出所有不大于当前温度的栈顶,新的栈顶即是下一个更暖的一天。
栈中下标对应温度从顶到底递增。每个下标进出一次,时间 。
本题需要我们找出每个元素右边第一个比它大的元素的位置,这是一个典型的单调栈应用场景。
我们从右往左遍历数组 ,维护一个从栈顶到栈底温度单调递增的栈 ,栈中存储的是数组元素的下标。对于每个元素 ,我们不断将其与栈顶元素进行比较,如果栈顶元素对应的温度小于等于 ,那么循环将栈顶元素弹出,直到栈为空或者栈顶元素对应的温度大于 。此时,栈顶元素就是右边第一个比 大的元素,距离为 ,我们更新答案数组。然后将 入栈,继续遍历。
遍历结束后,返回答案数组即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func dailyTemperatures(temperatures []int) []int {
	n := len(temperatures)
	ans := make([]int, n)
	stk := []int{}
	for i := n - 1; i >= 0; i-- {
		for len(stk) > 0 && temperatures[stk[len(stk)-1]] <= temperatures[i] {
			stk = stk[:len(stk)-1]
		}
		if len(stk) > 0 {
			ans[i] = stk[len(stk)-1] - i
		}
		stk = append(stk, i)
	}
	return ans
}770. 基本计算器 IV
题目、示例与约束
给定一个表达式如 expression = "e + 8 - a + 5" 和一个求值映射,如 {"e": 1}(给定的形式为 evalvars = ["e"] 和 evalints = [1]),返回表示简化表达式的标记列表,例如 ["-1*a","14"]
- 表达式交替使用块和符号,每个块和符号之间有一个空格。
- 块要么是括号中的表达式,要么是变量,要么是非负整数。
- 变量是一个由小写字母组成的字符串(不包括数字)。请注意,变量可以是多个字母,并注意变量从不具有像
"2x"或"-x"这样的前导系数或一元运算符 。
表达式按通常顺序进行求值:先是括号,然后求乘法,再计算加法和减法。
- 例如,
expression = "1 + 2 * 3"的答案是["7"]。
输出格式如下:
- 对于系数非零的每个自变量项,我们按字典排序的顺序将自变量写在一个项中。
- 例如,我们永远不会写像
“b*a*c”这样的项,只写“a*b*c”。
- 例如,我们永远不会写像
- 项的次数等于被乘的自变量的数目,并计算重复项。我们先写出答案的最大次数项,用字典顺序打破关系,此时忽略词的前导系数。
- 例如,
"a*a*b*c"的次数为 4。
- 例如,
- 项的前导系数直接放在左边,用星号将它与变量分隔开(如果存在的话)。前导系数 1 仍然要打印出来。
- 格式良好的一个示例答案是
["-2*a*a*a", "3*a*a*b", "3*b*b", "4*a", "5*c", "-6"]。 - 系数为
0的项(包括常数项)不包括在内。- 例如,
“0”的表达式输出为[]。
- 例如,
注意:你可以假设给定的表达式均有效。所有中间结果都在区间 [-231, 231 - 1] 内。
示例 1:
输入:expression = "e + 8 - a + 5", evalvars = ["e"], evalints = [1]
输出:["-1*a","14"]
示例 2:
输入:expression = "e - 8 + temperature - pressure",
evalvars = ["e", "temperature"], evalints = [1, 12]
输出:["-1*pressure","5"]
示例 3:
输入:expression = "(e + 8) * (e - 8)", evalvars = [], evalints = []
输出:["1*e*e","-64"]
提示:
1 <= expression.length <= 250expression由小写英文字母,数字'+','-','*','(',')',' '组成expression不包含任何前空格或后空格expression中的所有符号都用一个空格隔开0 <= evalvars.length <= 1001 <= evalvars[i].length <= 20evalvars[i]由小写英文字母组成evalints.length == evalvars.length-100 <= evalints[i] <= 100
方法一:Go 解法(本站整理) · Go 实现
本站根据题意与 Doocs 参考思路整理为 Go,非上游原文。按 CC BY-SA 4.0 共享。
根据题意补写递归下降解析器,按因子、乘积、加减表达式三个层次处理优先级与括号。多项式用“已排序变量序列→系数”的映射表示;常数的变量序列为空。乘法两两合并变量并排序,加减合并同类项,最后按次数降序和变量字典序输出非零项。复杂度取决于展开后的项数:一次 P 项与 Q 项的乘法为 O(PQ·D log D),D 是合并后的变量数;空间与保留的单项式及变量总量成正比,多项式展开可能呈指数增长。
import (
	"sort"
	"strconv"
	"strings"
)

type polynomial map[string]int

func plus(a, b polynomial, sign int) polynomial {
	r := polynomial{}
	for k, v := range a {
		r[k] = v
	}
	for k, v := range b {
		r[k] += sign * v
	}
	return r
}
func multiply(a, b polynomial) polynomial {
	r := polynomial{}
	for x, ca := range a {
		if ca == 0 {
			continue
		}
		for y, cb := range b {
			if cb == 0 {
				continue
			}
			vars := []string{}
			if x != "" {
				vars = append(vars, strings.Split(x, "*")...)
			}
			if y != "" {
				vars = append(vars, strings.Split(y, "*")...)
			}
			sort.Strings(vars)
			r[strings.Join(vars, "*")] += ca * cb
		}
	}
	return r
}
func basicCalculatorIV(expression string, evalvars []string, evalints []int) []string {
	values := map[string]int{}
	for i, k := range evalvars {
		values[k] = evalints[i]
	}
	pos := 0
	skip := func() {
		for pos < len(expression) && expression[pos] == ' ' {
			pos++
		}
	}
	var expr, term, atom func() polynomial
	atom = func() polynomial {
		skip()
		if expression[pos] == '(' {
			pos++
			p := expr()
			skip()
			pos++
			return p
		}
		start := pos
		if expression[pos] >= '0' && expression[pos] <= '9' {
			for pos < len(expression) && expression[pos] >= '0' && expression[pos] <= '9' {
				pos++
			}
			v, _ := strconv.Atoi(expression[start:pos])
			return polynomial{"": v}
		}
		for pos < len(expression) && expression[pos] >= 'a' && expression[pos] <= 'z' {
			pos++
		}
		word := expression[start:pos]
		if v, ok := values[word]; ok {
			return polynomial{"": v}
		}
		return polynomial{word: 1}
	}
	term = func() polynomial {
		p := atom()
		for {
			skip()
			if pos == len(expression) || expression[pos] != '*' {
				return p
			}
			pos++
			p = multiply(p, atom())
		}
	}
	expr = func() polynomial {
		p := term()
		for {
			skip()
			if pos == len(expression) || (expression[pos] != '+' && expression[pos] != '-') {
				return p
			}
			sign := 1
			if expression[pos] == '-' {
				sign = -1
			}
			pos++
			p = plus(p, term(), sign)
		}
	}
	p := expr()
	keys := []string{}
	for k, v := range p {
		if v != 0 {
			keys = append(keys, k)
		}
	}
	degree := func(k string) int {
		if k == "" {
			return 0
		}
		return strings.Count(k, "*") + 1
	}
	sort.Slice(keys, func(i, j int) bool {
		a, b := degree(keys[i]), degree(keys[j])
		if a != b {
			return a > b
		}
		return keys[i] < keys[j]
	})
	ans := make([]string, 0, len(keys))
	for _, k := range keys {
		s := strconv.Itoa(p[k])
		if k != "" {
			s += "*" + k
		}
		ans = append(ans, s)
	}
	return ans
}772. 基本计算器 III 🔒
题目、示例与约束
实现一个基本的计算器来计算简单的表达式字符串。
表达式字符串只包含非负整数,算符 +、-、*、/ ,左括号 ( 和右括号 ) 。整数除法需要 向下截断 。
你可以假定给定的表达式总是有效的。所有的中间结果的范围均满足 [-231, 231 - 1] 。
注意:你不能使用任何将字符串作为表达式求值的内置函数,比如 eval() 。
示例 1:
输入:s = "1+1"
输出:2
示例 2:
输入:s = "6-4/2"
输出:4
示例 3:
输入:s = "2*(5+5*2)/3+(6/2+8)"
输出:21
提示:
1 <= s <= 104s由整数、'+'、'-'、'*'、'/'、'('和')'组成s是一个 有效的 表达式
方法一 · Go 实现
思考
表达式含加减乘除与括号,长度 ,需要按优先级求值。乘除应立即与栈顶结合,加减只把带符号的数入栈,最后求和。
括号相当于子表达式:遇到
(递归算完到),返回值当作当前数字。队列顺序消费字符,避免反复切片。记下上一个运算符,在运算符或结束时把 按该运算压栈。整数除法向零取整。
func calculate(s string) int {
	q := []byte(s)
	var dfs func() int
	dfs = func() int {
		num, sign := 0, byte('+')
		var stk []int
		for len(q) > 0 {
			c := q[0]
			q = q[1:]
			if c >= '0' && c <= '9' {
				num = num*10 + int(c-'0')
			}
			if c == '(' {
				num = dfs()
			}
			if c == '+' || c == '-' || c == '*' || c == '/' || c == ')' || len(q) == 0 {
				switch sign {
				case '+':
					stk = append(stk, num)
				case '-':
					stk = append(stk, -num)
				case '*':
					stk[len(stk)-1] *= num
				default:
					stk[len(stk)-1] /= num
				}
				num, sign = 0, c
			}
			if c == ')' {
				break
			}
		}
		ans := 0
		for _, x := range stk {
			ans += x
		}
		return ans
	}
	return dfs()
}853. 车队
题目、示例与约束
在一条单行道上,有 n 辆车开往同一目的地。目的地是几英里以外的 target 。
给定两个整数数组 position 和 speed ,长度都是 n ,其中 position[i] 是第 i 辆车的位置, speed[i] 是第 i 辆车的速度(单位是英里/小时)。
一辆车永远不会超过前面的另一辆车,但它可以追上去,并以较慢车的速度在另一辆车旁边行驶。
车队 是指并排行驶的一辆或几辆汽车。车队的速度是车队中 最慢 的车的速度。
即便一辆车在 target 才赶上了一个车队,它们仍然会被视作是同一个车队。
返回到达目的地的车队数量 。
示例 1:
输入:target = 12, position = [10,8,0,5,3], speed = [2,4,1,1,3]
输出:3
解释:
- 从 10(速度为 2)和 8(速度为 4)开始的车会组成一个车队,它们在 12 相遇。车队在
target形成。 - 从 0(速度为 1)开始的车不会追上其它任何车,所以它自己是一个车队。
- 从 5(速度为 1) 和 3(速度为 3)开始的车组成一个车队,在 6 相遇。车队以速度 1 移动直到它到达
target。
示例 2:
输入:target = 10, position = [3], speed = [3]
输出:1
解释:
只有一辆车,因此只有一个车队。示例 3:
输入:target = 100, position = [0,2,4], speed = [4,2,1]
输出:1
解释:
- 从 0(速度为 4) 和 2(速度为 2)开始的车组成一个车队,在 4 相遇。从 4 开始的车(速度为 1)移动到了 5。
- 然后,在 4(速度为 2)的车队和在 5(速度为 1)的车成为一个车队,在 6 相遇。车队以速度 1 移动直到它到达
target。
提示:
n == position.length == speed.length1 <= n <= 1050 < target <= 1060 <= position[i] < targetposition中每个值都 不同0 < speed[i] <= 106
方法一:排序 · Go 实现
思考
靠近终点的车不能被后方超越,后方若更早到达则会追上并成同一车队。 ,模拟超车过程过慢。
按位置从近到远看到达时间:若当前车用时大于前方车队用时,则自成一队并更新车队时间;否则并入前方。车队数即答案。
我们将车辆按照位置降序排序,这样我们只需要比较相邻两辆车的到达时间即可。
我们初始化一个变量 表示上一辆车到达终点的时间,如果当前车辆到达终点的时间大于 ,说明当前车辆无法追上前面的车辆,因此需要另外开一个车队,否则当前车辆会与前面的车辆组成一个车队。
时间复杂度 ,空间复杂度 。其中 是车辆的数量。
func carFleet(target int, position []int, speed []int) (ans int) {
	n := len(position)
	idx := make([]int, n)
	for i := range idx {
		idx[i] = i
	}
	sort.Slice(idx, func(i, j int) bool { return position[idx[j]] < position[idx[i]] })
	var pre float64
	for _, i := range idx {
		t := float64(target-position[i]) / float64(speed[i])
		if t > pre {
			ans++
			pre = t
		}
	}
	return
}856. 括号的分数
题目、示例与约束
给定一个平衡括号字符串 S,按下述规则计算该字符串的分数:
()得 1 分。AB得A + B分,其中 A 和 B 是平衡括号字符串。(A)得2 * A分,其中 A 是平衡括号字符串。
示例 1:
输入: "()"
输出: 1
示例 2:
输入: "(())"
输出: 2
示例 3:
输入: "()()"
输出: 2
示例 4:
输入: "(()(()))"
输出: 6
提示:
S是平衡括号字符串,且只含有(和)。2 <= S.length <= 50
方法一:计数 · Go 实现
思考
分值按嵌套深度以 为底累加:最内层 为 ,每多一层翻倍。不必建树或用栈模拟完整求值。
扫描时用 记录当前深度,遇到 这一对时把 加入答案。其余右括号只回退深度。
我们通过观察发现,() 是唯一贡献分数的结构,外括号只是为该结构添加了一些乘数。所以我们只需要关心 ()。
我们用 维护当前括号的深度,对于每个 (,我们将深度加一,对于每个 ),我们将深度减一。当我们遇到 () 时,我们将 加到答案中。
我们举个实际的例子,以 (()(())) 为例,我们首先找到内部两个闭合括号 (),然后将分数加上对应的 。实际上,我们是在计算 (()) + ((())) 的分数。
( ( ) ( ( ) ) )
  ^ ^   ^ ^

( ( ) ) + ( ( ( ) ) )
  ^ ^         ^ ^
时间复杂度 ,空间复杂度 。其中 是字符串的长度。
括号相关类型题:
func scoreOfParentheses(s string) int {
	ans, d := 0, 0
	for i, c := range s {
		if c == '(' {
			d++
		} else {
			d--
			if s[i-1] == '(' {
				ans += 1 << d
			}
		}
	}
	return ans
}880. 索引处的解码字符串
题目、示例与约束
给定一个编码字符串 s 。请你找出 解码字符串 并将其写入磁带。解码时,从编码字符串中 每次读取一个字符 ,并采取以下步骤:
- 如果所读的字符是字母,则将该字母写在磁带上。
- 如果所读的字符是数字(例如
d),则整个当前磁带总共会被重复写d-1次。
现在,对于给定的编码字符串 s 和索引 k,查找并返回解码字符串中的第 k 个字母。
示例 1:
输入:s = "leet2code3", k = 10
输出:"o"
解释:
解码后的字符串为 "leetleetcodeleetleetcodeleetleetcode"。
字符串中的第 10 个字母是 "o"。
示例 2:
输入:s = "ha22", k = 5
输出:"h"
解释:
解码后的字符串为 "hahahaha"。第 5 个字母是 "h"。
示例 3:
输入:s = "a2345678999999999999999", k = 1
输出:"a"
解释:
解码后的字符串为 "a" 重复 8301530446056247680 次。第 1 个字母是 "a"。
提示:
2 <= s.length <= 100s只包含小写字母与数字2到9。s以字母开头。1 <= k <= 109- 题目保证
k小于或等于解码字符串的长度。 - 解码后的字符串保证少于
263个字母。
方法一:逆向思维 · Go 实现
思考
解码串由字母与重复数字生成,长度可达 量级, 达 ,不能真正展开。第 个字符由最后一次使长度覆盖 的操作决定。
先正向累加解码长度 ,再逆向:数字把 对当前长度取模并缩短 ,字母在 时即为所求。这样只走两遍原串。
我们可以先计算出解码字符串的总长度 ,然后从后向前遍历字符串,每次更新 为 ,直到 为 且当前字符为字母,返回当前字符。否则,如果当前字符为数字,则将 除以该数字。如果当前字符为字母,则将 减 。
时间复杂度 ,其中 为字符串的长度。空间复杂度 。
func decodeAtIndex(s string, k int) string {
	m := 0
	for _, c := range s {
		if c >= '0' && c <= '9' {
			m *= int(c - '0')
		} else {
			m++
		}
	}
	for i := len(s) - 1; ; i-- {
		k %= m
		if k == 0 && s[i] >= 'a' && s[i] <= 'z' {
			return string(s[i])
		}
		if s[i] >= '0' && s[i] <= '9' {
			m /= int(s[i] - '0')
		} else {
			m--
		}
	}
}946. 验证栈序列
题目、示例与约束
给定 pushed 和 popped 两个序列,每个序列中的 值都不重复,只有当它们可能是在最初空栈上进行的推入 push 和弹出 pop 操作序列的结果时,返回 true;否则,返回 false 。
示例 1:
输入:pushed = [1,2,3,4,5], popped = [4,5,3,2,1]
输出:true
解释:我们可以按以下顺序执行:
push(1), push(2), push(3), push(4), pop() -> 4,
push(5), pop() -> 5, pop() -> 3, pop() -> 2, pop() -> 1
示例 2:
输入:pushed = [1,2,3,4,5], popped = [4,3,5,1,2]
输出:false
解释:1 不能在 2 之前弹出。
提示:
1 <= pushed.length <= 10000 <= pushed[i] <= 1000pushed的所有元素 互不相同popped.length == pushed.lengthpopped是pushed的一个排列
方法一:栈模拟 · Go 实现
思考
判断 是否为某次入栈顺序下的合法出栈。元素互不相同,按 入栈,栈顶与下一个应出元素相等就弹出。能弹出全部则序列合法。
我们遍历 数组,对于当前遍历到的元素 ,我们将其压入栈 中,然后判断栈顶元素是否和 数组中下一个要弹出的元素相等,如果相等,我们就将栈顶元素弹出并将 数组中下一个要弹出的元素的索引 加一。最后,如果要弹出的元素都能按照 数组的顺序弹出,返回 ,否则返回 。
时间复杂度 ,空间复杂度 。其中 为 数组的长度。
func validateStackSequences(pushed []int, popped []int) bool {
	stk := []int{}
	i := 0
	for _, x := range pushed {
		stk = append(stk, x)
		for len(stk) > 0 && stk[len(stk)-1] == popped[i] {
			stk = stk[:len(stk)-1]
			i++
		}
	}
	return i == len(popped)
}950. 按递增顺序显示卡牌
题目、示例与约束
牌组中的每张卡牌都对应有一个唯一的整数。你可以按你想要的顺序对这套卡片进行排序。
最初,这些卡牌在牌组里是正面朝下的(即,未显示状态)。
现在,重复执行以下步骤,直到显示所有卡牌为止:
- 从牌组顶部抽一张牌,显示它,然后将其从牌组中移出。
- 如果牌组中仍有牌,则将下一张处于牌组顶部的牌放在牌组的底部。
- 如果仍有未显示的牌,那么返回步骤 1。否则,停止行动。
返回能以递增顺序显示卡牌的牌组顺序。
答案中的第一张牌被认为处于牌堆顶部。
示例:
输入:[17,13,11,2,3,5,7]
输出:[2,13,3,11,5,17,7]
解释:
我们得到的牌组顺序为 [17,13,11,2,3,5,7](这个顺序不重要),然后将其重新排序。
重新排序后,牌组以 [2,13,3,11,5,17,7] 开始,其中 2 位于牌组的顶部。
我们显示 2,然后将 13 移到底部。牌组现在是 [3,11,5,17,7,13]。
我们显示 3,并将 11 移到底部。牌组现在是 [5,17,7,13,11]。
我们显示 5,然后将 17 移到底部。牌组现在是 [7,13,11,17]。
我们显示 7,并将 13 移到底部。牌组现在是 [11,17,13]。
我们显示 11,然后将 17 移到底部。牌组现在是 [13,17]。
我们展示 13,然后将 17 移到底部。牌组现在是 [17]。
我们显示 17。
由于所有卡片都是按递增顺序排列显示的,所以答案是正确的。
提示:
1 <= A.length <= 10001 <= A[i] <= 10^6- 对于所有的
i != j,A[i] != A[j]
方法一:队列模拟 · Go 实现
思考
揭示过程是“取出队首、把新队首放到队尾”。正向模拟需要知道初始排列,而目标是递增揭示。把过程反过来:对已排序的牌从大到小,先把当前队尾转到队首(若队列非空),再把该牌插入队首,即得到初始牌序。
根据题目描述,我们知道,数组 deck 逆序排列后的序列就是最终的结果。我们可以从最终结果入手,逆向推导出卡片顺序。
遍历逆序排列后的数组 deck,先判断队列是否为空,若不为空,则将队尾元素移动到队首,然后将当前元素入队(题目中的逆过程)。若为空,则直接将当前元素入队。
最后,将队列中的元素依次出队,即可得到最终的结果。
时间复杂度 ,空间复杂度 。其中 为数组 deck 的长度。
func deckRevealedIncreasing(deck []int) []int {
	sort.Sort(sort.Reverse(sort.IntSlice(deck)))
	q := []int{}
	for _, v := range deck {
		if len(q) > 0 {
			q = append([]int{q[len(q)-1]}, q[:len(q)-1]...)
		}
		q = append([]int{v}, q...)
	}
	return q
}1003. 检查替换后的词是否有效
题目、示例与约束
s ,请你判断它是否 有效 。
字符串 s 有效 需要满足:假设开始有一个空字符串 t = "" ,你可以执行 任意次 下述操作将 t 转换为 s :
- 将字符串
"abc"插入到t中的任意位置。形式上,t变为tleft + "abc" + tright,其中t == tleft + tright。注意,tleft和tright可能为 空 。
如果字符串 s 有效,则返回 true;否则,返回 false。
示例 1:
输入:s = "aabcbc"
输出:true
解释:
"" -> "abc" -> "aabcbc"
因此,"aabcbc" 有效。
示例 2:
输入:s = "abcabcababcc"
输出:true
解释:
"" -> "abc" -> "abcabc" -> "abcabcabc" -> "abcabcababcc"
因此,"abcabcababcc" 有效。
示例 3:
输入:s = "abccba"
输出:false
解释:执行操作无法得到 "abccba" 。
提示:
1 <= s.length <= 2 * 104s由字母'a'、'b'和'c'组成
方法一:栈 · Go 实现
思考
反复在 中查找并删除 可以得到答案,但 时每轮扫描都是线性,最坏接近平方。长度若不是 的倍数,则无论怎样插入都不可能由空串得到 ,可立即判否。
有效串由在任意位置插入 生成,因而从左到右读入时,一旦栈顶三字符恰好组成 ,它们对应一次刚完成的插入,应当消去。
用栈模拟这一过程:每个字符入栈后检查栈顶,能消则弹掉三段。扫完后栈空当且仅当整串可由插入还原。
我们观察题目中的操作,可以发现,每一次都会在字符串的任意位置插入字符串 ,所以每次插入操作之后,字符串的长度都会增加 。如果字符串 有效,那么它的长度一定是 的倍数。因此,我们先对字符串 的长度进行判断,如果不是 的倍数,那么 一定无效,可以直接返回 。
接下来我们遍历字符串 的每个字符 ,我们先将字符 压入栈 中。如果此时栈 的长度大于等于 ,并且栈顶的三个元素组成了字符串 ,那么我们就将栈顶的三个元素弹出。然后继续遍历字符串 的下一个字符。
遍历结束之后,如果栈 为空,那么说明字符串 有效,返回 ;否则,返回 。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度。
func isValid(s string) bool {
	if len(s)%3 > 0 {
		return false
	}
	t := []byte{}
	for i := range s {
		t = append(t, s[i])
		if len(t) >= 3 && string(t[len(t)-3:]) == "abc" {
			t = t[:len(t)-3]
		}
	}
	return len(t) == 0
}1006. 笨阶乘
题目、示例与约束
通常,正整数 n 的阶乘是所有小于或等于 n 的正整数的乘积。例如,factorial(10) = 10 * 9 * 8 * 7 * 6 * 5 * 4 * 3 * 2 * 1。
相反,我们设计了一个笨阶乘 clumsy:在整数的递减序列中,我们以一个固定顺序的操作符序列来依次替换原有的乘法操作符:乘法(*),除法(/),加法(+)和减法(-)。
例如,clumsy(10) = 10 * 9 / 8 + 7 - 6 * 5 / 4 + 3 - 2 * 1。然而,这些运算仍然使用通常的算术运算顺序:我们在任何加、减步骤之前执行所有的乘法和除法步骤,并且按从左到右处理乘法和除法步骤。
另外,我们使用的除法是地板除法(floor division),所以 10 * 9 / 8 等于 11。这保证结果是一个整数。
实现上面定义的笨函数:给定一个整数 N,它返回 N 的笨阶乘。
示例 1:
输入:4
输出:7
解释:7 = 4 * 3 / 2 + 1
示例 2:
输入:10
输出:12
解释:12 = 10 * 9 / 8 + 7 - 6 * 5 / 4 + 3 - 2 * 1
提示:
1 <= N <= 10000-2^31 <= answer <= 2^31 - 1(答案保证符合 32 位整数。)
方法一:栈 + 模拟 · Go 实现
思考
按定义从 递减套用 即可,但乘除优先于加减,直接从左到右累加会算错。 ,一次线性扫描足够,关键是把不同优先级拆开。
乘、除必须立刻与前一个操作数结合,加、减只是向结果放入正负项,可延后到最后再求和。
用栈保存当前待结算的项,并以 轮转四种运算:乘除时弹出栈顶运算后再压回,加减则压入 或 ,最后把栈中元素相加。
笨阶乘的计算过程可以看作是一个栈的模拟过程。
我们定义一个栈 stk,初始时我们将 入栈,定义一个变量 ,表示当前的操作符,初始时 。
然后我们从 开始,枚举 ,根据当前的 的值,决定如何处理 :
- 当 时,表示乘法操作,我们将栈顶元素出栈,与 相乘后再入栈;
- 当 时,表示除法操作,我们将栈顶元素出栈,与 相除后取整数部分再入栈;
- 当 时,表示加法操作,我们直接将 入栈;
- 当 时,表示减法操作,我们将 入栈。
接着我们更新 。
最后,我们将栈中的元素累加即为答案。
时间复杂度 ,空间复杂度 。其中 为题目给定的整数 。
func clumsy(n int) (ans int) {
	stk := []int{n}
	k := 0
	for x := n - 1; x > 0; x-- {
		switch k {
		case 0:
			stk[len(stk)-1] *= x
		case 1:
			stk[len(stk)-1] /= x
		case 2:
			stk = append(stk, x)
		case 3:
			stk = append(stk, -x)
		}
		k = (k + 1) % 4
	}
	for _, x := range stk {
		ans += x
	}
	return
}1021. 删除最外层的括号
题目、示例与约束
有效括号字符串为空 ""、"(" + A + ")" 或 A + B ,其中 A 和 B 都是有效的括号字符串,+ 代表字符串的连接。
- 例如,
"","()","(())()"和"(()(()))"都是有效的括号字符串。
如果有效字符串 s 非空,且不存在将其拆分为 s = A + B 的方法,我们称其为原语(primitive),其中 A 和 B 都是非空有效括号字符串。
给出一个非空有效字符串 s,考虑将其进行原语化分解,使得:s = P_1 + P_2 + ... + P_k,其中 P_i 是有效括号字符串原语。
对 s 进行原语化分解,删除分解中每个原语字符串的最外层括号,返回 s 。
示例 1:
输入:s = "(()())(())"
输出:"()()()"
解释:
输入字符串为 "(()())(())",原语化分解得到 "(()())" + "(())",
删除每个部分中的最外层括号后得到 "()()" + "()" = "()()()"。
示例 2:
输入:s = "(()())(())(()(()))"
输出:"()()()()(())"
解释:
输入字符串为 "(()())(())(()(()))",原语化分解得到 "(()())" + "(())" + "(()(()))",
删除每个部分中的最外层括号后得到 "()()" + "()" + "()(())" = "()()()()(())"。
示例 3:
输入:s = "()()"
输出:""
解释:
输入字符串为 "()()",原语化分解得到 "()" + "()",
删除每个部分中的最外层括号后得到 "" + "" = ""。
提示:
1 <= s.length <= 105s[i]为'('或')'s是一个有效括号字符串
方法一:计数 · Go 实现
思考
先按原语拆分再去掉每段最外层括号可以得到答案, 通常为 量级时多次切分没有必要。原语的最外层左右括号恰好出现在深度从 进入 、以及从 回到 之时。
因此用一个深度计数器扫描:遇到左括号先加一,仅当深度大于 时保留;遇到右括号先减一,仅当减完后仍为正时保留。
一次遍历即可拼出结果,额外空间除答案外为常数。
遍历字符串,遇到左括号 '(' 计数器加一,此时计数器不为 时,说明当前括号不是最外层括号,将其加入结果字符串。遇到右括号 ')' 计数器减一,此时计数器不为 时,说明当前括号不是最外层括号,将其加入结果字符串。
时间复杂度 ,其中 为字符串长度。忽略答案字符串的空间开销,空间复杂度 。
func removeOuterParentheses(s string) string {
	ans := []rune{}
	cnt := 0
	for _, c := range s {
		if c == '(' {
			cnt++
			if cnt > 1 {
				ans = append(ans, c)
			}
		} else {
			cnt--
			if cnt > 0 {
				ans = append(ans, c)
			}
		}
	}
	return string(ans)
}
方法二 · Go 实现
思考
方法一按括号种类分别判断是否写入,实现上要写两处对称条件。深度大于 时当前字符一定属于某段内部,无论它是左还是右。
统一成「先按左括号更新深度,深度大于 则写入,再按右括号回退」,与方法一同一计数,只是把写入收成一处。
func removeOuterParentheses(s string) string {
	ans := []rune{}
	cnt := 0
	for _, c := range s {
		if c == '(' {
			cnt++
		}
		if cnt > 1 {
			ans = append(ans, c)
		}
		if c == ')' {
			cnt--
		}
	}
	return string(ans)
}1047. 删除字符串中的所有相邻重复项
题目、示例与约束
给出由小写字母组成的字符串 s,重复项删除操作 会选择两个相邻且相同的字母,并删除它们。
在 s 上反复执行重复项删除操作,直到无法继续删除。
在完成所有重复项删除操作后返回最终的字符串。答案保证唯一。
示例 1:
输入:"abbaca"
输出:"ca"
解释:
例如,在 "abbaca" 中,我们可以删除 "bb" 由于两字母相邻且相同,这是此时唯一可以执行删除操作的重复项。之后我们得到字符串 "aaca",其中又只有 "aa" 可以执行重复项删除操作,所以最后的字符串为 "ca"。
示例 2:
输入:s = "azxxzy"
输出:"ay"
提示:
1 <= s.length <= 105s仅由小写英文字母组成。
方法一:栈 · Go 实现
思考
反复扫描删除相邻相等对, 时可能多次重扫。一次删除后新的相邻对应立即可见,适合用栈维护「当前压缩结果」。
读入字符若与栈顶相同则弹出(消掉这一对),否则入栈。
扫完后栈中剩余字符即为消除完毕的串。
遍历字符串 s 中的每个字符 c,若栈为空或者栈顶值不等于字符 c,将 c 入栈,否则栈顶元素出栈。
最后返回栈中元素所组成的字符串。
时间复杂度 ,空间复杂度 。其中 是字符串 s 的长度。
func removeDuplicates(s string) string {
	stk := []rune{}
	for _, c := range s {
		if len(stk) > 0 && stk[len(stk)-1] == c {
			stk = stk[:len(stk)-1]
		} else {
			stk = append(stk, c)
		}
	}
	return string(stk)
}1063. 有效子数组的数目 🔒
题目、示例与约束
给定一个整数数组 nums ,返回满足下面条件的 非空、连续 子数组的数目:
- 子数组 是数组的 连续 部分。
- 子数组最左边的元素不大于子数组中的其他元素 。
示例 1:
输入:nums = [1,4,2,5,3]
输出:11
解释:有 11 个有效子数组,分别是:[1],[4],[2],[5],[3],[1,4],[2,5],[1,4,2],[2,5,3],[1,4,2,5],[1,4,2,5,3] 。
示例 2:
输入:nums = [3,2,1]
输出:3
解释:有 3 个有效子数组,分别是:[3],[2],[1] 。
示例 3:
输入:nums = [2,2,2]
输出:6
解释:有 6 个有效子数组,分别为是:[2],[2],[2],[2,2],[2,2],[2,2,2] 。
提示:
1 <= nums.length <= 5 * 1040 <= nums[i] <= 105
方法一:单调栈 · Go 实现
思考
子数组合法当且仅当左端是最小值。对每个左端 ,右端可延伸到下一个更小元素之前。 ,应在线性时间内求出每个 右侧第一个更小位置。
从右往左维护递增的下标栈,弹出所有不小于 的栈顶后,栈顶(或 )即为边界,贡献为边界减 。
先写入 再求和,与定义一致。
题目实际上是求解每个位置 的右边第一个小于 的位置 ,那么以 为左端点的有效子数组的个数就是 。
我们可以使用单调栈来求解右边第一个小于 的位置 ,具体做法是从右往左遍历数组,维护一个从栈顶到栈底严格单调递减的栈。如果栈不为空,并且栈顶元素大于等于 ,那么就将栈顶元素出栈,直到栈为空或者栈顶元素小于 ,此时栈顶元素就是右边第一个小于 的位置 ,如果栈为空,那么 。
接下来,我们将 入栈,继续遍历数组,直到遍历结束,最后我们就可以得到每个位置 的右边第一个小于 的位置 ,从而得到以 为左端点的有效子数组的个数 ,将所有的 累加即可得到答案。
时间复杂度 ,空间复杂度 。其中 是数组的长度。
func validSubarrays(nums []int) (ans int) {
	n := len(nums)
	right := make([]int, n)
	for i := range right {
		right[i] = n
	}
	stk := []int{}
	for i := n - 1; i >= 0; i-- {
		for len(stk) > 0 && nums[stk[len(stk)-1]] >= nums[i] {
			stk = stk[:len(stk)-1]
		}
		if len(stk) > 0 {
			right[i] = stk[len(stk)-1]
		}
		stk = append(stk, i)
	}
	for i, j := range right {
		ans += j - i
	}
	return
}
方法二 · Go 实现
思考
方法一额外开了 数组。逆序扫描时边界立刻用于累加,不必存下来。
同一单调栈上把 直接加入答案。
func validSubarrays(nums []int) (ans int) {
	n := len(nums)
	stk := []int{}
	for i := n - 1; i >= 0; i-- {
		for len(stk) > 0 && nums[stk[len(stk)-1]] >= nums[i] {
			stk = stk[:len(stk)-1]
		}
		ans -= i
		if len(stk) > 0 {
			ans += stk[len(stk)-1]
		} else {
			ans += n
		}
		stk = append(stk, i)
	}
	return
}继续阅读
- 实践案例
- 实践案例
- 实践案例