
LeetCode Go · 排序与分治(1)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
56. 合并区间
题目、示例与约束
以数组 intervals 表示若干个区间的集合,其中单个区间为 intervals[i] = [starti, endi] 。请你合并所有重叠的区间,并返回 一个不重叠的区间数组,该数组需恰好覆盖输入中的所有区间 。
示例 1:
输入:intervals = [[1,3],[2,6],[8,10],[15,18]]
输出:[[1,6],[8,10],[15,18]]
解释:区间 [1,3] 和 [2,6] 重叠, 将它们合并为 [1,6].
示例 2:
输入:intervals = [[1,4],[4,5]]
输出:[[1,5]]
解释:区间 [1,4] 和 [4,5] 可被视为重叠区间。
示例 3:
输入:intervals = [[4,7],[1,4]]
输出:[[1,7]]
解释:区间 [1,4] 和 [4,7] 可被视为重叠区间。
提示:
1 <= intervals.length <= 104intervals[i].length == 20 <= starti <= endi <= 104
方法一:排序 + 一次遍历 · Go 实现
思考
重叠关系在无序时难以定位。若反复任取区间与其余区间两两合并,最坏时间 ,且合并顺序杂乱。 偏紧。
按左端点排序后,一个区间只会与「当前尚未闭合的那段」重叠:后续区间的起点更大,不可能跳过中间再叠回来。
因此排序后扫一遍,用一对端点维护正在合并的区间,一旦与下一个断开就写入答案。
我们可以将区间按照左端点升序排列,然后遍历区间进行合并操作。
具体的合并操作如下。
我们先将第一个区间加入答案,然后依次考虑之后的每个区间:
- 如果答案数组中最后一个区间的右端点小于当前考虑区间的左端点,说明两个区间不会重合,因此我们可以直接将当前区间加入答案数组末尾;
- 否则,说明两个区间重合,我们需要用当前区间的右端点更新答案数组中最后一个区间的右端点,将其置为二者的较大值。
最后,我们返回答案数组即可。
时间复杂度 ,空间复杂度 。其中 为区间个数。
func merge(intervals [][]int) (ans [][]int) {
	sort.Slice(intervals, func(i, j int) bool {
		return intervals[i][0] < intervals[j][0]
	})
	st, ed := intervals[0][0], intervals[0][1]
	for _, e := range intervals[1:] {
		if ed < e[0] {
			ans = append(ans, []int{st, ed})
			st, ed = e[0], e[1]
		} else if ed < e[1] {
			ed = e[1]
		}
	}
	ans = append(ans, []int{st, ed})
	return ans
}
方法二 · Go 实现
思考
方法一已按左端排序并一次扫描完成合并,但额外维护了一对端点,区间闭合时才写入,结束时还要再补一次。
可以将「当前区间」直接放在答案末尾:先将第一个区间放入 ,之后只更新末尾右端点或追加新区间,从而少一组变量、少一次收尾。
func merge(intervals [][]int) (ans [][]int) {
	sort.Slice(intervals, func(i, j int) bool { return intervals[i][0] < intervals[j][0] })
	ans = append(ans, intervals[0])
	for _, e := range intervals[1:] {
		if ans[len(ans)-1][1] < e[0] {
			ans = append(ans, e)
		} else {
			ans[len(ans)-1][1] = max(ans[len(ans)-1][1], e[1])
		}
	}
	return
}164. 最大间距
题目、示例与约束
给定一个无序的数组 nums,返回 数组在排序之后,相邻元素之间最大的差值 。如果数组元素个数小于 2,则返回 0 。
您必须编写一个在「线性时间」内运行并使用「线性额外空间」的算法。
示例 1:
输入: nums = [3,6,9,1]
输出: 3
解释: 排序后的数组是 [1,3,6,9], 其中相邻元素 (3,6) 和 (6,9) 之间都存在最大差值 3。
示例 2:
输入: nums = [10]
输出: 0
解释: 数组元素个数小于 2,因此返回 0。
提示:
1 <= nums.length <= 1050 <= nums[i] <= 109
方法一:桶排序 · Go 实现
思考
求排序后相邻元素的最大差,要求线性时间。比较排序是 , 。相邻差的最大值至少是 ,以该值为桶宽做桶排序:同一桶内的差小于这个下界,答案只可能出现在相邻非空桶的「后桶最小减前桶最大」。每个桶只记最小与最大。
假设数组 有 个元素,所有元素从小到大依次是 到 ,最大间距是 。考虑数组中的最大元素和最小元素之差。
因此 ,即最大间距至少为 。
可以利用桶排序的思想,设定桶的大小(即每个桶最多包含的不同元素个数)为 ,将元素按照元素值均匀分布到各个桶内,则同一个桶内的任意两个元素之差小于 ,差为 的两个元素一定在两个不同的桶内。对于每个桶,维护桶内的最小值和最大值,初始时每个桶内的最小值和最大值分别是正无穷和负无穷,表示桶内没有元素。
遍历数组 中的所有元素。对于每个元素,根据该元素与最小元素之差以及桶的大小计算该元素应该分到的桶的编号,可以确保编号小的桶内的元素都小于编号大的桶内的元素,使用元素值更新元素所在的桶内的最小值和最大值。
遍历数组结束之后,每个非空的桶内的最小值和最大值都可以确定。按照桶的编号从小到大的顺序依次遍历每个桶,当前的桶的最小值和上一个非空的桶的最大值是排序后的相邻元素,计算两个相邻元素之差,并更新最大间距。遍历桶结束之后即可得到最大间距。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func maximumGap(nums []int) int {
	n := len(nums)
	if n < 2 {
		return 0
	}
	inf := 0x3f3f3f3f
	mi, mx := inf, -inf
	for _, v := range nums {
		mi = min(mi, v)
		mx = max(mx, v)
	}
	bucketSize := max(1, (mx-mi)/(n-1))
	bucketCount := (mx-mi)/bucketSize + 1
	buckets := make([][]int, bucketCount)
	for i := range buckets {
		buckets[i] = []int{inf, -inf}
	}
	for _, v := range nums {
		i := (v - mi) / bucketSize
		buckets[i][0] = min(buckets[i][0], v)
		buckets[i][1] = max(buckets[i][1], v)
	}
	ans := 0
	prev := inf
	for _, bucket := range buckets {
		if bucket[0] > bucket[1] {
			continue
		}
		ans = max(ans, bucket[0]-prev)
		prev = bucket[1]
	}
	return ans
}252. 会议室 🔒
题目、示例与约束
给定一个会议时间安排的数组 intervals ,其中 intervals[i] = [starti, endi]。
一个人可以参加所有会议,只要没有两个会议的时间段重叠。在时间 t 结束的会议和在时间 t 开始的会议不重叠。
如果一个人能够参加这里面的全部会议,返回 true,否则返回 false。
示例 1:
输入:intervals = [[0,30],[5,10],[15,20]]
输出:false
示例 2:
输入:intervals = [[7,10],[2,4]]
输出:true
提示:
0 <= intervals.length <= 104intervals[i].length == 20 <= starti < endi <= 106
方法一:排序 · Go 实现
思考
一人无法同时参加两场重叠会议。按开始时间排序后,只需检查相邻会议是否满足前一场结束不晚于后一场开始。
我们将会议按照开始时间进行排序,然后遍历排序后的会议,如果当前会议的开始时间小于前一个会议的结束时间,则说明两个会议有重叠,返回 ,否则继续遍历。
如果遍历结束都没有发现重叠的会议,则返回 。
时间复杂度 ,空间复杂度 。其中 为会议数量。
func canAttendMeetings(intervals [][]int) bool {
	sort.Slice(intervals, func(i, j int) bool {
		return intervals[i][0] < intervals[j][0]
	})
	for i := 1; i < len(intervals); i++ {
		if intervals[i][0] < intervals[i-1][1] {
			return false
		}
	}
	return true
}274. H 指数
题目、示例与约束
给你一个整数数组 citations ,其中 citations[i] 表示研究者的第 i 篇论文被引用的次数。计算并返回该研究者的 h 指数。
根据维基百科上 h 指数的定义:h 代表“高引用次数” ,一名科研人员的 h 指数 是指他(她)至少发表了 h 篇论文,并且 至少 有 h 篇论文被引用次数大于等于 h 。如果 h 有多种可能的值,h 指数 是其中最大的那个。
示例 1:
输入:citations = [3,0,6,1,5]输出:3 解释:给定数组表示研究者总共有5篇论文,每篇论文相应的被引用了3, 0, 6, 1, 5次。 由于研究者有3篇论文每篇 至少 被引用了3次,其余两篇论文每篇被引用 不多于3次,所以她的 h 指数是3。
示例 2:
输入:citations = [1,3,1]
输出:1
提示:
n == citations.length1 <= n <= 50000 <= citations[i] <= 1000
方法一:排序 · Go 实现
思考
指数是最大的 使得至少 篇论文引用不少于 。降序排序后, 即满足,从大到小找第一个即可。
我们可以先对数组 citations 按照元素值从大到小进行排序。然后我们从大到小枚举 值,如果某个 值满足 ,则说明有至少 篇论文分别被引用了至少 次,直接返回 即可。如果没有找到这样的 值,说明所有的论文都没有被引用,返回 。
时间复杂度 ,空间复杂度 。其中 是数组 citations 的长度。
func hIndex(citations []int) int {
	sort.Ints(citations)
	n := len(citations)
	for h := n; h > 0; h-- {
		if citations[n-h] >= h {
			return h
		}
	}
	return 0
}
方法二:计数 + 求和 · Go 实现
思考
排序为 。 不超过 ,可把引用次数封顶为 后计数,从大到小累加篇数,第一次 即答案。
我们可以使用一个长度为 的数组 ,其中 表示引用次数为 的论文的篇数。我们遍历数组 citations,将引用次数大于 的论文都当作引用次数为 的论文,然后将每篇论文的引用次数作为下标,将 中对应的元素值加 。这样我们就统计出了每个引用次数对应的论文篇数。
接下来,我们从大到小枚举 值,将 中下标为 的元素值加到变量 中,其中 表示引用次数大于等于 的论文篇数。如果 ,说明至少有 篇论文分别被引用了至少 次,直接返回 即可。
时间复杂度 ,空间复杂度 。其中 是数组 citations 的长度。
func hIndex(citations []int) int {
	n := len(citations)
	cnt := make([]int, n+1)
	for _, x := range citations {
		cnt[min(x, n)]++
	}
	for h, s := n, 0; ; h-- {
		s += cnt[h]
		if s >= h {
			return h
		}
	}
}
方法三:二分查找 · Go 实现
思考
“至少 篇引用 ”对 单调,可二分最大可行 。每次统计 的篇数以决定收缩哪一侧。
我们注意到,如果存在一个 值满足至少有 篇论文至少被引用 次,那么对于任意一个 ,都有至少 篇论文至少被引用 次。因此我们可以使用二分查找的方法,找到最大的 值,使得至少有 篇论文至少被引用 次。
我们定义二分查找的左边界 ,右边界 。每次我们取 ,其中 表示对 向下取整。然后我们统计数组 citations 中大于等于 的元素的个数,记为 。如果 ,说明至少有 篇论文至少被引用 次,此时我们将左边界 变为 ,否则我们将右边界 变为 。当左边界 等于右边界 时,我们找到了最大的 值,即为 或 。
时间复杂度 ,其中 是数组 citations 的长度。空间复杂度 。
func hIndex(citations []int) int {
	l, r := 0, len(citations)
	for l < r {
		mid := (l + r + 1) >> 1
		s := 0
		for _, x := range citations {
			if x >= mid {
				s++
			}
		}
		if s >= mid {
			l = mid
		} else {
			r = mid - 1
		}
	}
	return l
}414. 第三大的数
题目、示例与约束
给定一个整数数组 nums。
返回此数组中 第三大的数 。如果不存在,则返回数组中 最大 的数。
示例 1:
输入:[3, 2, 1]
输出:1
解释:第三大的数是 1 。
示例 2:
输入:[1, 2]
输出:2
解释:第三大的数不存在, 所以返回最大的数 2 。
示例 3:
输入:[2, 2, 3, 1]
输出:1
解释:注意,要求返回第三大的数,是指在所有不同数字中排第三大的数。
此例中存在两个值为 2 的数,它们都排第二。在所有不同数字中排第三大的数为 1 。
提示:
1 <= nums.length <= 104-231 <= nums[i] <= 231 - 1
进阶:你能设计一个时间复杂度 O(n) 的解决方案吗?
方法一:一次遍历 · Go 实现
思考
求第三大且需去重。排序后去重再取下标可行,但题目希望线性时间、常数空间。
维护三个变量 ,遇到已记录的值跳过,插入时整体右移。遍历结束若 仍为哨兵,说明不足三个不同值,返回最大值。
相等必须跳过,否则同一数字会占满三个槽位。
我们可以使用三个变量 , , 分别表示数组中的第一大、第二大和第三大的数。初始时,我们将这三个变量都赋值为负无穷大。
然后,我们遍历数组中的每个数,对于每个数,我们将其与 , , 进行比较,根据比较的结果更新这三个变量。具体地,我们遍历数组中的每个数,对于每个数:
- 如果这个数等于 , , 中的任何一个,我们跳过这个数;
- 如果这个数大于 ,我们将 , , 的值更新为 , , 这个数;
- 如果这个数大于 ,我们将 , 的值更新为 , 这个数;
- 如果这个数大于 ,我们将 的值更新为这个数。
最后,如果 的值没有被更新,说明数组中不存在第三大的数,那么我们返回 ,否则我们返回 。
时间复杂度 ,其中 是数组 nums 的长度。空间复杂度 。
func thirdMax(nums []int) int {
	m1, m2, m3 := math.MinInt64, math.MinInt64, math.MinInt64
	for _, num := range nums {
		if num == m1 || num == m2 || num == m3 {
			continue
		}
		if num > m1 {
			m3, m2, m1 = m2, m1, num
		} else if num > m2 {
			m3, m2 = m2, num
		} else if num > m3 {
			m3 = num
		}
	}
	if m3 != math.MinInt64 {
		return m3
	}
	return m1
}747. 至少是其他数字两倍的最大数
题目、示例与约束
给你一个整数数组 nums ,其中总是存在 唯一的 一个最大整数 。
请你找出数组中的最大元素并检查它是否 至少是数组中每个其他数字的两倍 。如果是,则返回 最大元素的下标 ,否则返回 -1 。
示例 1:
输入:nums = [3,6,1,0]
输出:1
解释:6 是最大的整数,对于数组中的其他整数,6 至少是数组中其他元素的两倍。6 的下标是 1 ,所以返回 1 。
示例 2:
输入:nums = [1,2,3,4]
输出:-1
解释:4 没有超过 3 的两倍大,所以返回 -1 。
提示:
2 <= nums.length <= 500 <= nums[i] <= 100nums中的最大元素是唯一的
方法一:遍历 · Go 实现
思考
判断唯一最大值是否至少是其余元素的两倍。长度不超过 ,找出最大与次大比较即可。
最大值唯一,故只需 。取最大的两个数,再用 找回 的下标。
我们可以遍历数组 ,找到数组中的最大值 和第二大的值 ,如果 ,则返回 的下标,否则返回 。
我们也可以先找到数组中的最大值 ,同时找到最大值 的下标 。然后再遍历一次数组,如果发现 以外的元素 满足 ,则返回 。否则遍历结束后返回 。
时间复杂度 ,其中 是数组 的长度。空间复杂度 。
func dominantIndex(nums []int) int {
	k := 0
	for i, x := range nums {
		if nums[k] < x {
			k = i
		}
	}
	for i, x := range nums {
		if k != i && nums[k] < x*2 {
			return -1
		}
	}
	return k
}761. 特殊的二进制字符串
题目、示例与约束
特殊的二进制字符串 是具有以下两个性质的二进制序列:
0的数量与1的数量相等。- 二进制序列的每一个前缀码中
1的数量要大于等于0的数量。
给定一个特殊的二进制字符串 s。
一次移动操作包括选择字符串 s 中的两个连续的、非空的、特殊子串,并交换它们。两个字符串是连续的,如果第一个字符串的最后一个字符与第二个字符串的第一个字符的索引相差正好为 1。
返回在字符串上应用任意次操作后可能得到的字典序最大的字符串。
示例 1:
输入: S = "11011000"
输出: "11100100"
解释:
将子串 "10" (在 s[1] 出现) 和 "1100" (在 s[3] 出现)进行交换。
这是在进行若干次操作后按字典序排列最大的结果。
示例 2:
输入:s = "10"
输出:"10"
提示:
1 <= s.length <= 50s[i]为'0'或'1'。s是一个特殊的二进制字符串。
方法一:递归 + 排序 · Go 实现
思考
特殊二进制串与合法括号串同构: 配 。交换相邻特殊子串可使字典序变大,长度仅 ,但应利用递归结构而非枚举交换。
整串由若干并列的「 特殊串 」组成,内部仍是特殊串。要最大,应把各段内部先最大化,再按字典序从大到小拼接。
用计数找到每个平衡段,对去掉外壳后的内部递归,得到的列表逆序排序后连接。
我们可以把特殊的二进制序列看作“有效的括号”,其中 代表左括号,而 代表右括号。例如,"11011000" 可以看作:"(()(()))"。
交换两个连续非空的特殊子串,相当于交换两个相邻的有效括号,我们可以使用递归来解决这个问题。
我们将字符串 中的每个“有效的括号”都看作一部分,递归处理,最后进行排序,得到最终答案。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度。
func makeLargestSpecial(s string) string {
	if s == "" {
		return ""
	}
	ans := sort.StringSlice{}
	cnt := 0
	for i, j := 0, 0; i < len(s); i++ {
		if s[i] == '1' {
			cnt++
		} else {
			cnt--
		}
		if cnt == 0 {
			ans = append(ans, "1"+makeLargestSpecial(s[j+1:i])+"0")
			j = i + 1
		}
	}
	sort.Sort(sort.Reverse(ans))
	return strings.Join(ans, "")
}937. 重新排列日志文件
题目、示例与约束
给你一个日志数组 logs。每条日志都是以空格分隔的字串,其第一个字为字母与数字混合的 标识符 。
有两种不同类型的日志:
- 字母日志:除标识符之外,所有字均由小写字母组成
- 数字日志:除标识符之外,所有字均由数字组成
请按下述规则将日志重新排序:
- 所有 字母日志 都排在 数字日志 之前。
- 字母日志 在内容不同时,忽略标识符后,按内容 字典顺序 排序;在内容相同时,按标识符排序。
- 数字日志 应该保留原来的相对顺序。
返回日志的 最终 顺序。
示例 1:
输入:logs = ["dig1 8 1 5 1","let1 art can","dig2 3 6","let2 own kit dig","let3 art zero"]
输出:["let1 art can","let3 art zero","let2 own kit dig","dig1 8 1 5 1","dig2 3 6"]
解释:
字母日志的内容都不同,所以顺序为 "art can", "art zero", "own kit dig" 。
数字日志保留原来的相对顺序 "dig1 8 1 5 1", "dig2 3 6" 。
示例 2:
输入:logs = ["a1 9 2 3 1","g1 act car","zo4 4 7","ab1 off key dog","a8 act zoo"]
输出:["g1 act car","a8 act zoo","ab1 off key dog","a1 9 2 3 1","zo4 4 7"]
提示:
1 <= logs.length <= 1003 <= logs[i].length <= 100logs[i]中,字与字之间都用 单个 空格分隔- 题目数据保证
logs[i]都有一个标识符,并且在标识符之后至少存在一个字
方法一:自定义排序 · Go 实现
思考
字母日志按内容再按标识符排序,数字日志保持原相对顺序且整体在后。用稳定的自定义键:字母日志键为 ,数字日志键为 ,一次排序即可。
我们可以使用自定义排序的方法,将日志分为两类:字母日志和数字日志。
对于字母日志,我们需要按照题目要求进行排序,即先按内容排序,再按标识符排序。
对于数字日志,我们只需要保留原来的相对顺序。
时间复杂度 ,空间复杂度 。其中 是日志的数量。
func reorderLogFiles(logs []string) []string {
	sort.SliceStable(logs, func(i, j int) bool {
		log1, log2 := logs[i], logs[j]
		idx1 := strings.IndexByte(log1, ' ')
		idx2 := strings.IndexByte(log2, ' ')
		id1, content1 := log1[:idx1], log1[idx1+1:]
		id2, content2 := log2[:idx2], log2[idx2+1:]

		isLetter1 := 'a' <= content1[0] && content1[0] <= 'z'
		isLetter2 := 'a' <= content2[0] && content2[0] <= 'z'

		if isLetter1 && isLetter2 {
			if content1 != content2 {
				return content1 < content2
			}
			return id1 < id2
		}

		return isLetter1 && !isLetter2
	})

	return logs
}1051. 高度检查器
题目、示例与约束
学校打算为全体学生拍一张年度纪念照。根据要求,学生需要按照 非递减 的高度顺序排成一行。
排序后的高度情况用整数数组 expected 表示,其中 expected[i] 是预计排在这一行中第 i 位的学生的高度(下标从 0 开始)。
给你一个整数数组 heights ,表示 当前学生站位 的高度情况。heights[i] 是这一行中第 i 位学生的高度(下标从 0 开始)。
返回满足 heights[i] != expected[i] 的 下标数量 。
示例:
输入:heights = [1,1,4,2,1,3]
输出:3
解释:
高度:[1,1,4,2,1,3]
预期:[1,1,1,2,3,4]
下标 2 、4 、5 处的学生高度不匹配。
示例 2:
输入:heights = [5,1,2,3,4]
输出:5
解释:
高度:[5,1,2,3,4]
预期:[1,2,3,4,5]
所有下标的对应学生高度都不匹配。
示例 3:
输入:heights = [1,2,3,4,5]
输出:0
解释:
高度:[1,2,3,4,5]
预期:[1,2,3,4,5]
所有下标的对应学生高度都匹配。
提示:
1 <= heights.length <= 1001 <= heights[i] <= 100
方法一:排序 · Go 实现
思考
不在位的学生数等于原序列与非降序排列在对应位置上不同的个数。 ,排序后逐位比较即可。
复制一份排序得到 ,统计与 不等的下标个数。
我们可以先对学生的高度进行排序,然后比较排序后的高度和原始高度,统计不同的位置即可。
时间复杂度 ,空间复杂度 。其中 是学生的数量。
func heightChecker(heights []int) (ans int) {
	expected := slices.Clone(heights)
	sort.Ints(expected)
	for i, v := range heights {
		if v != expected[i] {
			ans++
		}
	}
	return
}
方法二:计数排序 · Go 实现
思考
比较排序需要 与额外数组。高度只有 到 ,计数排序能在线性时间内生成应有序列。
统计每个高度的次数,再按高度从小到大展开,与原数组并行扫描,遇不同则累加。
由于题目中学生高度不超过 ,因此可以使用计数排序。这里我们用一个长度 的数组 统计每个高度 出现的次数。
时间复杂度 ,空间复杂度 。其中 是学生的数量,而 是学生的最大高度,本题中 。
func heightChecker(heights []int) int {
	cnt := make([]int, 101)
	for _, h := range heights {
		cnt[h]++
	}
	ans := 0
	for i, j := 0, 0; i < 101; i++ {
		for cnt[i] > 0 {
			cnt[i]--
			if heights[j] != i {
				ans++
			}
			j++
		}
	}
	return ans
}1200. 最小绝对差
题目、示例与约束
给你个整数数组 arr,其中每个元素都 不相同。
请你找到所有具有最小绝对差的元素对,并且按升序的顺序返回。
每对元素对 [a,b] 如下:
a , b均为数组arr中的元素a < bb - a等于arr中任意两个元素的最小绝对差
示例 1:
输入:arr = [4,2,1,3]
输出:[[1,2],[2,3],[3,4]]
示例 2:
输入:arr = [1,3,6,10,15]
输出:[[1,3]]
示例 3:
输入:arr = [3,8,-10,23,19,-4,-14,27]
输出:[[-14,-10],[19,23],[23,27]]
提示:
2 <= arr.length <= 10^5-10^6 <= arr[i] <= 10^6
方法一:排序 · Go 实现
思考
若枚举全部数对计算绝对差,时间复杂度为 。 时不可行。
注意到排序后任意两数之差不小于它们之间相邻对的差,因此全局最小绝对差只可能出现在相邻元素上。
为此先将 排序,一遍扫描相邻差得到最小值 ,再收集所有差恰为 的相邻对。排序决定了候选集合,两次线性扫描分别求极值与收集答案。
根据题目描述,我们需要找出数组 中任意两个元素的最小绝对差,因此我们可以先对数组 排序,随后遍历相邻元素,得到最小绝对差 。
最后我们再遍历相邻元素,找出所有最小绝对差等于 的元素对。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func minimumAbsDifference(arr []int) (ans [][]int) {
	sort.Ints(arr)
	mi := 1 << 30
	n := len(arr)
	for i := 0; i < n-1; i++ {
		if t := arr[i+1] - arr[i]; t < mi {
			mi = t
		}
	}
	for i := 0; i < n-1; i++ {
		if arr[i+1]-arr[i] == mi {
			ans = append(ans, []int{arr[i], arr[i+1]})
		}
	}
	return
}1274. 矩形内船只的数目 🔒
题目、示例与约束
(此题是 交互式问题 )
在用笛卡尔坐标系表示的二维海平面上,有一些船。每一艘船都在一个整数点上,且每一个整数点最多只有 1 艘船。
有一个函数 Sea.hasShips(topRight, bottomLeft) ,输入参数为右上角和左下角两个点的坐标,当且仅当这两个点所表示的矩形区域(包含边界)内至少有一艘船时,这个函数才返回 true ,否则返回 false 。
给你矩形的右上角 topRight 和左下角 bottomLeft 的坐标,请你返回此矩形内船只的数目。题目保证矩形内 至多只有 10 艘船。
调用函数 hasShips 超过400次 的提交将被判为 错误答案(Wrong Answer) 。同时,任何尝试绕过评测系统的行为都将被取消比赛资格。
示例 1:
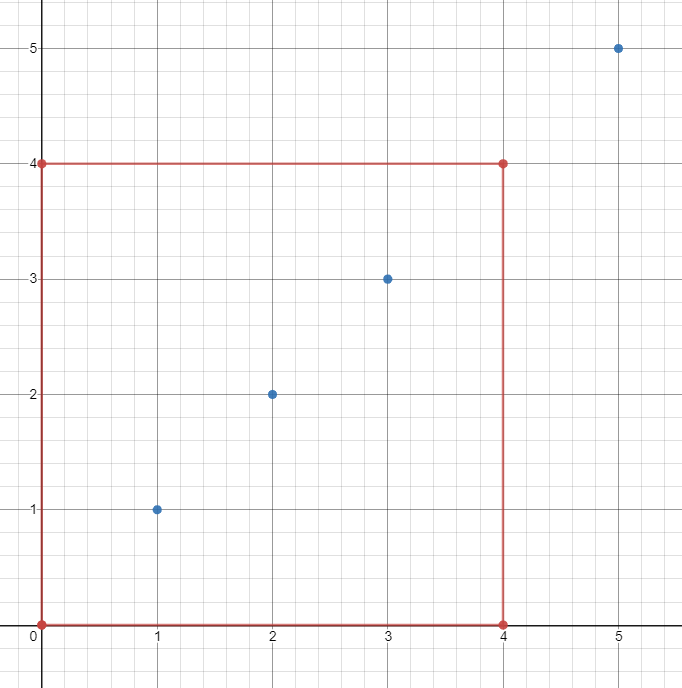
输入:
ships = [[1,1],[2,2],[3,3],[5,5]], topRight = [4,4], bottomLeft = [0,0]
输出:3
解释:在 [0,0] 到 [4,4] 的范围内总共有 3 艘船。
示例 2:
输入:ans = [[1,1],[2,2],[3,3]], topRight = [1000,1000], bottomLeft = [0,0]
输出:3
提示:
ships数组只用于评测系统内部初始化。你必须“蒙着眼睛”解决这个问题。你无法得知ships的信息,所以只能通过调用hasShips接口来求解。0 <= bottomLeft[0] <= topRight[0] <= 10000 <= bottomLeft[1] <= topRight[1] <= 1000topRight != bottomLeft
方法一:递归 + 分治 · Go 实现
思考
只能调用 ,矩形内船不超过 艘。空矩形不必再分;单格且有船则计 。否则四等分继续。分治把询问集中在真正有船的象限,复杂度随船数与矩形直径的对数增长。
由于矩形内最多只有 艘船,所以我们可以将矩形划分为四个子矩形,分别求出每个子矩形内船只的数目 🔒,然后将四个子矩形内船只的数目 🔒 相加即可。如果一个子矩形内没有船只,那么就不需要再继续划分了。
时间复杂度 ,空间复杂度 。其中 为船只的数目,而 和 分别为矩形的长和宽。
/**
 * // This is Sea's API interface.
 * // You should not implement it, or speculate about its implementation
 * type Sea struct {
 *     func hasShips(topRight, bottomLeft []int) bool {}
 * }
 */

func countShips(sea Sea, topRight, bottomLeft []int) int {
	x1, y1 := bottomLeft[0], bottomLeft[1]
	x2, y2 := topRight[0], topRight[1]
	if x1 > x2 || y1 > y2 {
		return 0
	}
	if !sea.hasShips(topRight, bottomLeft) {
		return 0
	}
	if x1 == x2 && y1 == y2 {
		return 1
	}
	midx := (x1 + x2) >> 1
	midy := (y1 + y2) >> 1
	a := countShips(sea, topRight, []int{midx + 1, midy + 1})
	b := countShips(sea, []int{midx, y2}, []int{x1, midy + 1})
	c := countShips(sea, []int{midx, midy}, bottomLeft)
	d := countShips(sea, []int{x2, midy}, []int{midx + 1, y1})
	return a + b + c + d
}1288. 删除被覆盖区间
题目、示例与约束
给你一个区间列表,请你删除列表中被其他区间所覆盖的区间。
只有当 c <= a 且 b <= d 时,我们才认为区间 [a,b) 被区间 [c,d) 覆盖。
在完成所有删除操作后,请你返回列表中剩余区间的数目。
示例:
输入:intervals = [[1,4],[3,6],[2,8]]
输出:2
解释:区间 [3,6] 被区间 [2,8] 覆盖,所以它被删除了。
提示:
1 <= intervals.length <= 10000 <= intervals[i][0] < intervals[i][1] <= 10^5- 对于所有的
i != j:intervals[i] != intervals[j]
方法一:排序 · Go 实现
思考
判断区间是否被另一个完全覆盖。按左端升序、左端相同时右端降序排序后,靠前的区间不可能被后面更窄的区间盖住。只需维护已见最大右端:当前右端更大则不被覆盖。排序把二维包含变成一维右端比较。
我们可以按照区间的左端点升序排序,如果左端点相同,则按照右端点降序排序。
排序后,我们可以遍历区间,如果当前区间的右端点大于之前的右端点,说明当前区间不被覆盖,答案加一。
时间复杂度 ,空间复杂度 。其中 是区间的数量。
func removeCoveredIntervals(intervals [][]int) (ans int) {
	sort.Slice(intervals, func(i, j int) bool {
		if intervals[i][0] == intervals[j][0] {
			return intervals[i][1] > intervals[j][1]
		}
		return intervals[i][0] < intervals[j][0]
	})
	pre := math.MinInt32
	for _, e := range intervals {
		cur := e[1]
		if cur > pre {
			ans++
			pre = cur
		}
	}
	return
}1329. 将矩阵按对角线排序
题目、示例与约束
矩阵对角线 是一条从矩阵最上面行或者最左侧列中的某个元素开始的对角线,沿右下方向一直到矩阵末尾的元素。例如,矩阵 mat 有 6 行 3 列,从 mat[2][0] 开始的 矩阵对角线 将会经过 mat[2][0]、mat[3][1] 和 mat[4][2] 。
给你一个 m * n 的整数矩阵 mat ,请你将同一条 矩阵对角线 上的元素按升序排序后,返回排好序的矩阵。
示例 1:
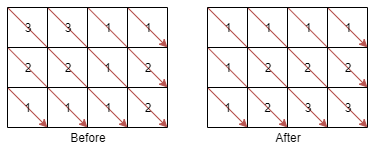
输入:mat = [[3,3,1,1],[2,2,1,2],[1,1,1,2]]
输出:[[1,1,1,1],[1,2,2,2],[1,2,3,3]]
示例 2:
输入:mat = [[11,25,66,1,69,7],[23,55,17,45,15,52],[75,31,36,44,58,8],[22,27,33,25,68,4],[84,28,14,11,5,50]]
输出:[[5,17,4,1,52,7],[11,11,25,45,8,69],[14,23,25,44,58,15],[22,27,31,36,50,66],[84,28,75,33,55,68]]
提示:
m == mat.lengthn == mat[i].length1 <= m, n <= 1001 <= mat[i][j] <= 100
方法一:排序 · Go 实现
思考
同一对角线上 为常量。分别抽出每条对角线排序再写回即可。用 把对角线映到非负下标,收集元素后逆序排序,再按原位置弹出,保证从左上到右下递增。
我们可以将矩阵中的每条对角线看作一个数组,然后对这些数组进行排序,最后再将排序后的元素填回原矩阵中。
具体地,我们记矩阵的行数为 ,列数为 。由于同一条对角线上的任意两个元素 和 满足 ,我们可以根据 的值来确定每条对角线。为了保证值为正数,我们加上一个偏移量 ,即 。
最后,我们将每条对角线上的元素排序后填回原矩阵中即可。
时间复杂度 ,空间复杂度 。其中 和 分别是矩阵的行数和列数。
func diagonalSort(mat [][]int) [][]int {
	m, n := len(mat), len(mat[0])
	g := make([][]int, m+n)
	for i, row := range mat {
		for j, x := range row {
			g[m-i+j] = append(g[m-i+j], x)
		}
	}
	for _, e := range g {
		sort.Sort(sort.Reverse(sort.IntSlice(e)))
	}
	for i, row := range mat {
		for j := range row {
			k := len(g[m-i+j])
			mat[i][j] = g[m-i+j][k-1]
			g[m-i+j] = g[m-i+j][:k-1]
		}
	}
	return mat
}1333. 餐厅过滤器
题目、示例与约束
给你一个餐馆信息数组 restaurants,其中 restaurants[i] = [idi, ratingi, veganFriendlyi, pricei, distancei]。你必须使用以下三个过滤器来过滤这些餐馆信息。
其中素食者友好过滤器 veganFriendly 的值可以为 true 或者 false,如果为 true 就意味着你应该只包括 veganFriendlyi 为 true 的餐馆,为 false 则意味着可以包括任何餐馆。此外,我们还有最大价格 maxPrice 和最大距离 maxDistance 两个过滤器,它们分别考虑餐厅的价格因素和距离因素的最大值。
过滤后返回餐馆的 id,按照 rating 从高到低排序。如果 rating 相同,那么按 id 从高到低排序。简单起见, veganFriendlyi 和 veganFriendly 为 true 时取值为 1,为 false 时,取值为 0 。
示例 1:
输入:restaurants = [[1,4,1,40,10],[2,8,0,50,5],[3,8,1,30,4],[4,10,0,10,3],[5,1,1,15,1]], veganFriendly = 1, maxPrice = 50, maxDistance = 10
输出:[3,1,5]
解释:
这些餐馆为:
餐馆 1 [id=1, rating=4, veganFriendly=1, price=40, distance=10]
餐馆 2 [id=2, rating=8, veganFriendly=0, price=50, distance=5]
餐馆 3 [id=3, rating=8, veganFriendly=1, price=30, distance=4]
餐馆 4 [id=4, rating=10, veganFriendly=0, price=10, distance=3]
餐馆 5 [id=5, rating=1, veganFriendly=1, price=15, distance=1]
在按照 veganFriendly = 1, maxPrice = 50 和 maxDistance = 10 进行过滤后,我们得到了餐馆 3, 餐馆 1 和 餐馆 5(按评分从高到低排序)。
示例 2:
输入:restaurants = [[1,4,1,40,10],[2,8,0,50,5],[3,8,1,30,4],[4,10,0,10,3],[5,1,1,15,1]], veganFriendly = 0, maxPrice = 50, maxDistance = 10
输出:[4,3,2,1,5]
解释:餐馆与示例 1 相同,但在 veganFriendly = 0 的过滤条件下,应该考虑所有餐馆。
示例 3:
输入:restaurants = [[1,4,1,40,10],[2,8,0,50,5],[3,8,1,30,4],[4,10,0,10,3],[5,1,1,15,1]], veganFriendly = 0, maxPrice = 30, maxDistance = 3
输出:[4,5]
提示:
1 <= restaurants.length <= 10^4restaurants[i].length == 51 <= idi, ratingi, pricei, distancei <= 10^51 <= maxPrice, maxDistance <= 10^5veganFriendlyi和veganFriendly的值为 0 或 1 。- 所有
idi各不相同。
方法一:排序 · Go 实现
思考
先按素食、价格、距离过滤,再按评分、编号降序输出。过滤与排序彼此独立:先按 排序,再线性筛掉不满足约束的餐厅,输出顺序即为题面要求。
我们先将数组 restaurants 按照 rating 和 id 两个维度进行排序,然后再按照题目给定的条件进行筛选即可。
时间复杂度 ,空间复杂度 。其中 是数组 restaurants 的长度。
func filterRestaurants(restaurants [][]int, veganFriendly int, maxPrice int, maxDistance int) (ans []int) {
	sort.Slice(restaurants, func(i, j int) bool {
		a, b := restaurants[i], restaurants[j]
		if a[1] != b[1] {
			return a[1] > b[1]
		}
		return a[0] > b[0]
	})
	for _, r := range restaurants {
		if r[2] >= veganFriendly && r[3] <= maxPrice && r[4] <= maxDistance {
			ans = append(ans, r[0])
		}
	}
	return
}1451. 重新排列句子中的单词
题目、示例与约束
「句子」是一个用空格分隔单词的字符串。给你一个满足下述格式的句子 text :
- 句子的首字母大写
text中的每个单词都用单个空格分隔。
请你重新排列 text 中的单词,使所有单词按其长度的升序排列。如果两个单词的长度相同,则保留其在原句子中的相对顺序。
请同样按上述格式返回新的句子。
示例 1:
输入:text = "Leetcode is cool"
输出:"Is cool leetcode"
解释:句子中共有 3 个单词,长度为 8 的 "Leetcode" ,长度为 2 的 "is" 以及长度为 4 的 "cool" 。
输出需要按单词的长度升序排列,新句子中的第一个单词首字母需要大写。
示例 2:
输入:text = "Keep calm and code on"
输出:"On and keep calm code"
解释:输出的排序情况如下:
"On" 2 个字母。
"and" 3 个字母。
"keep" 4 个字母,因为存在长度相同的其他单词,所以它们之间需要保留在原句子中的相对顺序。
"calm" 4 个字母。
"code" 4 个字母。
示例 3:
输入:text = "To be or not to be"
输出:"To be or to be not"
提示:
text以大写字母开头,然后包含若干小写字母以及单词间的单个空格。1 <= text.length <= 10^5
方法一:排序 · Go 实现
思考
按单词长度升序重排,长度相同保持原相对顺序,且句首仍需大写。 ,切开后把首词小写,按
len稳定排序,再把新的首词标题化。
将 text 按空格切分为字符串数组 words,并将 words[0] 转为小写。然后对 words 进行排序(这里需要确保长度相同的情况下,相对顺序保持不变,因此是一种稳定排序)。
排完序后,对 words[0] 首字母转为大写。最后将 words 所有字符串用空格拼接成一个字符串。
时间复杂度 。
func arrangeWords(text string) string {
	words := strings.Split(text, " ")
	words[0] = strings.ToLower(words[0])
	sort.SliceStable(words, func(i, j int) bool { return len(words[i]) < len(words[j]) })
	words[0] = strings.Title(words[0])
	return strings.Join(words, " ")
}1491. 去掉最低工资和最高工资后的工资平均值
题目、示例与约束
给你一个整数数组 salary ,数组里每个数都是 唯一 的,其中 salary[i] 是第 i 个员工的工资。
请你返回去掉最低工资和最高工资以后,剩下员工工资的平均值。
示例 1:
输入:salary = [4000,3000,1000,2000]
输出:2500.00000
解释:最低工资和最高工资分别是 1000 和 4000 。
去掉最低工资和最高工资以后的平均工资是 (2000+3000)/2= 2500
示例 2:
输入:salary = [1000,2000,3000]
输出:2000.00000
解释:最低工资和最高工资分别是 1000 和 3000 。
去掉最低工资和最高工资以后的平均工资是 (2000)/1= 2000
示例 3:
输入:salary = [6000,5000,4000,3000,2000,1000]
输出:3500.00000
示例 4:
输入:salary = [8000,9000,2000,3000,6000,1000]
输出:4750.00000
提示:
3 <= salary.length <= 10010^3 <= salary[i] <= 10^6salary[i]是唯一的。- 与真实值误差在
10^-5以内的结果都将视为正确答案。
方法一:模拟 · Go 实现
思考
且工资互异。总和减去最小、最大后再除以 。
按题意模拟即可。
遍历数组,求出最大值和最小值,并且累加和,然后求出去掉最大值和最小值后的平均值。
时间复杂度 。其中 为数组 salary 的长度。空间复杂度 。
func average(salary []int) float64 {
	s := 0
	mi, mx := 10000000, 0
	for _, v := range salary {
		s += v
		mi = min(mi, v)
		mx = max(mx, v)
	}
	s -= (mi + mx)
	return float64(s) / float64(len(salary)-2)
}1502. 判断能否形成等差数列
题目、示例与约束
给你一个数字数组 arr 。
如果一个数列中,任意相邻两项的差总等于同一个常数,那么这个数列就称为 等差数列 。
如果可以重新排列数组形成等差数列,请返回 true ;否则,返回 false 。
示例 1:
输入:arr = [3,5,1]
输出:true
解释:对数组重新排序得到 [1,3,5] 或者 [5,3,1] ,任意相邻两项的差分别为 2 或 -2 ,可以形成等差数列。
示例 2:
输入:arr = [1,2,4]
输出:false
解释:无法通过重新排序得到等差数列。
提示:
2 <= arr.length <= 1000-10^6 <= arr[i] <= 10^6
方法一:排序 + 遍历 · Go 实现
思考
判断数组能否重排成等差数列,一种直接做法是枚举所有排列再检查公差,排列数为 ,即便 只有一千也会过大。重排后相邻差必须相同,因此只需确定一种规范顺序。
将数组排序后,公差只能是相邻两项之差。从左到右核验每一对相邻差是否等于首项差即可。排序代价可接受,随后一次线性扫描便能判定。
我们可以先将数组 排序,然后计算前两项的差值 ,接着遍历数组,判断相邻两项的差是否等于 。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func canMakeArithmeticProgression(arr []int) bool {
	sort.Ints(arr)
	d := arr[1] - arr[0]
	for i := 2; i < len(arr); i++ {
		if arr[i]-arr[i-1] != d {
			return false
		}
	}
	return true
}
方法二:哈希表 + 数学 · Go 实现
思考
方法一依赖排序,时间为 。若等差数列存在,则公差由最小值 与最大值 唯一确定为 ,且须为整数。将元素放入哈希表后,只需检查 是否均出现,从而在线性时间内完成判定。
我们先找出数组 中的最小值 和最大值 ,如果数组 可以重排成等差数列,那么公差 必须为整数。
我们可以用哈希表来记录数组 中的所有元素,然后遍历 ,判断 是否在哈希表中,如果不在,说明数组 不能重排成等差数列,返回 false。否则遍历完数组后,返回 true。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func canMakeArithmeticProgression(arr []int) bool {
	a, b := slices.Min(arr), slices.Max(arr)
	n := len(arr)
	if (b-a)%(n-1) != 0 {
		return false
	}
	d := (b - a) / (n - 1)
	s := map[int]bool{}
	for _, x := range arr {
		s[x] = true
	}
	for i := 0; i < n; i++ {
		if !s[a+i*d] {
			return false
		}
	}
	return true
}1619. 删除某些元素后的数组均值
题目、示例与约束
给你一个整数数组 arr ,请你删除最小 5% 的数字和最大 5% 的数字后,剩余数字的平均值。
与 标准答案 误差在 10-5 的结果都被视为正确结果。
示例 1:
输入:arr = [1,2,2,2,2,2,2,2,2,2,2,2,2,2,2,2,2,2,2,3]
输出:2.00000
解释:删除数组中最大和最小的元素后,所有元素都等于 2,所以平均值为 2 。
示例 2:
输入:arr = [6,2,7,5,1,2,0,3,10,2,5,0,5,5,0,8,7,6,8,0]
输出:4.00000
示例 3:
输入:arr = [6,0,7,0,7,5,7,8,3,4,0,7,8,1,6,8,1,1,2,4,8,1,9,5,4,3,8,5,10,8,6,6,1,0,6,10,8,2,3,4]
输出:4.77778
示例 4:
输入:arr = [9,7,8,7,7,8,4,4,6,8,8,7,6,8,8,9,2,6,0,0,1,10,8,6,3,3,5,1,10,9,0,7,10,0,10,4,1,10,6,9,3,6,0,0,2,7,0,6,7,2,9,7,7,3,0,1,6,1,10,3]
输出:5.27778
示例 5:
输入:arr = [4,8,4,10,0,7,1,3,7,8,8,3,4,1,6,2,1,1,8,0,9,8,0,3,9,10,3,10,1,10,7,3,2,1,4,9,10,7,6,4,0,8,5,1,2,1,6,2,5,0,7,10,9,10,3,7,10,5,8,5,7,6,7,6,10,9,5,10,5,5,7,2,10,7,7,8,2,0,1,1]
输出:5.29167
提示:
20 <= arr.length <= 1000arr.length是20的 倍数0 <= arr[i] <= 105
方法一:模拟 · Go 实现
思考
需要去掉最小与最大各 后求均值。数组长度是 的倍数且至多一千量级,排序后直接切片即可。
排序后两端各丢掉 个元素,对中间一段求和再平均,并按题意保留五位小数。
直接模拟。
先对数组 arr 排序,然后截取中间的 90% 个元素,求平均值。
时间复杂度 。其中 为数组 arr 的长度。
func trimMean(arr []int) float64 {
	sort.Ints(arr)
	n := len(arr)
	sum := 0.0
	for i := n / 20; i < n-n/20; i++ {
		sum += float64(arr[i])
	}
	return sum / (float64(n) * 0.9)
}1637. 两点之间不包含任何点的最宽垂直区域
题目、示例与约束
给你 n 个二维平面上的点 points ,其中 points[i] = [xi, yi] ,请你返回两点之间内部不包含任何点的 最宽垂直区域 的宽度。
垂直区域 的定义是固定宽度,而 y 轴上无限延伸的一块区域(也就是高度为无穷大)。 最宽垂直区域 为宽度最大的一个垂直区域。
请注意,垂直区域 边上 的点 不在 区域内。
示例 1:
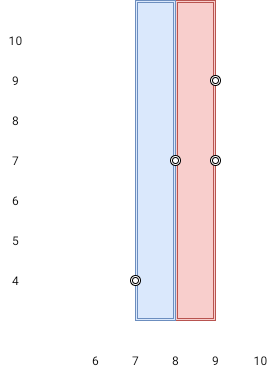
输入:points = [[8,7],[9,9],[7,4],[9,7]]
输出:1
解释:红色区域和蓝色区域都是最优区域。
示例 2:
输入:points = [[3,1],[9,0],[1,0],[1,4],[5,3],[8,8]]
输出:3
提示:
n == points.length2 <= n <= 105points[i].length == 20 <= xi, yi <= 109
方法一:排序 · Go 实现
思考
竖直区域的宽度只取决于相邻点的横坐标之差, 达 ,按 排序后扫一遍相邻差即可。
纵坐标不影响宽度,排序后取 。
我们可以对数组 按照 升序排列,获取相邻点之间 的差值的最大值。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func maxWidthOfVerticalArea(points [][]int) (ans int) {
	sort.Slice(points, func(i, j int) bool { return points[i][0] < points[j][0] })
	for i, p := range points[1:] {
		ans = max(ans, p[0]-points[i][0])
	}
	return
}
方法二:桶排序 · Go 实现
思考
方法一排序是 。最大间隙至少为 ,用该值作桶宽时,答案只可能出现在相邻非空桶的「后桶最小减前桶最大」。
桶内维护最小、最大横坐标,线性扫桶即可,期望 。
方法一中排序的时间复杂度为 ,其实我们可以利用桶排序的思想,将时间复杂度降低到 。
我们将数组 的横坐标放入数组 中。
假设数组 有 个元素,所有元素从小到大依次是 到 ,最大间距是 。考虑数组中的最大元素和最小元素之差:
因此 ,即最大间距至少为 。
可以利用桶排序的思想,设定桶的大小(即每个桶最多包含的不同元素个数)为 ,将元素按照元素值均匀分布到各个桶内,则同一个桶内的任意两个元素之差小于 ,差为 的两个元素一定在两个不同的桶内。对于每个桶,维护桶内的最小值和最大值,初始时每个桶内的最小值和最大值分别是正无穷和负无穷,表示桶内没有元素。
遍历数组 中的所有元素。对于每个元素,根据该元素与最小元素之差以及桶的大小计算该元素应该分到的桶的编号,可以确保编号小的桶内的元素都小于编号大的桶内的元素,使用元素值更新元素所在的桶内的最小值和最大值。
遍历数组结束之后,每个非空的桶内的最小值和最大值都可以确定。按照桶的编号从小到大的顺序依次遍历每个桶,当前的桶的最小值和上一个非空的桶的最大值是排序后的相邻元素,计算两个相邻元素之差,并更新最大间距。遍历桶结束之后即可得到最大间距。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func maxWidthOfVerticalArea(points [][]int) (ans int) {
	n := len(points)
	nums := make([]int, 0, n)
	for _, p := range points {
		nums = append(nums, p[0])
	}
	const inf = 1 << 30
	mi, mx := inf, -inf
	for _, v := range nums {
		mi = min(mi, v)
		mx = max(mx, v)
	}
	bucketSize := max(1, (mx-mi)/(n-1))
	bucketCount := (mx-mi)/bucketSize + 1
	buckets := make([][]int, bucketCount)
	for i := range buckets {
		buckets[i] = []int{inf, -inf}
	}
	for _, v := range nums {
		i := (v - mi) / bucketSize
		buckets[i][0] = min(buckets[i][0], v)
		buckets[i][1] = max(buckets[i][1], v)
	}
	prev := inf
	for _, bucket := range buckets {
		if bucket[0] > bucket[1] {
			continue
		}
		ans = max(ans, bucket[0]-prev)
		prev = bucket[1]
	}
	return ans
}1859. 将句子排序
题目、示例与约束
一个 句子 指的是一个序列的单词用单个空格连接起来,且开头和结尾没有任何空格。每个单词都只包含小写或大写英文字母。
我们可以给一个句子添加 从 1 开始的单词位置索引 ,并且将句子中所有单词 打乱顺序 。
- 比方说,句子
"This is a sentence"可以被打乱顺序得到"sentence4 a3 is2 This1"或者"is2 sentence4 This1 a3"。
给你一个 打乱顺序 的句子 s ,它包含的单词不超过 9 个,请你重新构造并得到原本顺序的句子。
示例 1:
输入:s = "is2 sentence4 This1 a3"
输出:"This is a sentence"
解释:将 s 中的单词按照初始位置排序,得到 "This1 is2 a3 sentence4" ,然后删除数字。
示例 2:
输入:s = "Myself2 Me1 I4 and3"
输出:"Me Myself and I"
解释:将 s 中的单词按照初始位置排序,得到 "Me1 Myself2 and3 I4" ,然后删除数字。
提示:
2 <= s.length <= 200s只包含小写和大写英文字母、空格以及从1到9的数字。s中单词数目为1到9个。s中的单词由单个空格分隔。s不包含任何前导或者后缀空格。
方法一:字符串分割 · Go 实现
思考
打乱后的单词末尾带有原位置编号,需要还原句子。编号范围与单词数一致,一次放置即可。
按空格切开后,用末位数字减一作为下标写入数组,去掉数字再按序拼接。
我们先将字符串 按照空格分割,得到字符串数组 ,然后遍历数组 ,将每个单词的最后一个字符减去字符 '1',得到的结果作为单词的索引,将单词的前缀作为单词的内容,最后将单词按照索引顺序拼接起来即可。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度。
func sortSentence(s string) string {
	ws := strings.Split(s, " ")
	ans := make([]string, len(ws))
	for _, w := range ws {
		ans[w[len(w)-1]-'1'] = w[:len(w)-1]
	}
	return strings.Join(ans, " ")
}1887. 使数组元素相等的减少操作次数
题目、示例与约束
给你一个整数数组 nums ,你的目标是令 nums 中的所有元素相等。完成一次减少操作需要遵照下面的几个步骤:
- 找出
nums中的 最大 值。记这个值为largest并取其下标i(下标从 0 开始计数)。如果有多个元素都是最大值,则取最小的i。 - 找出
nums中的 下一个最大 值,这个值 严格小于largest,记为nextLargest。 - 将
nums[i]减少到nextLargest。
返回使 nums 中的所有元素相等的操作次数。
示例 1:
输入:nums = [5,1,3]
输出:3
解释:需要 3 次操作使 nums 中的所有元素相等:
1. largest = 5 下标为 0 。nextLargest = 3 。将 nums[0] 减少到 3 。nums = [3,1,3] 。
2. largest = 3 下标为 0 。nextLargest = 1 。将 nums[0] 减少到 1 。nums = [1,1,3] 。
3. largest = 3 下标为 2 。nextLargest = 1 。将 nums[2] 减少到 1 。nums = [1,1,1] 。
示例 2:
输入:nums = [1,1,1]
输出:0
解释:nums 中的所有元素已经是相等的。
示例 3:
输入:nums = [1,1,2,2,3]
输出:4
解释:需要 4 次操作使 nums 中的所有元素相等:
1. largest = 3 下标为 4 。nextLargest = 2 。将 nums[4] 减少到 2 。nums = [1,1,2,2,2] 。
2. largest = 2 下标为 2 。nextLargest = 1 。将 nums[2] 减少到 1 。nums = [1,1,1,2,2] 。
3. largest = 2 下标为 3 。nextLargest = 1 。将 nums[3] 减少到 1 。nums = [1,1,1,1,2] 。
4. largest = 2 下标为 4 。nextLargest = 1 。将 nums[4] 减少到 1 。nums = [1,1,1,1,1] 。
提示:
1 <= nums.length <= 5 * 1041 <= nums[i] <= 5 * 104
方法一:排序 · Go 实现
思考
每次把当前最大值改成严格次大值,求使全数组相等的次数。一次操作只影响一个最大值,枚举每次操作会很慢。
排序后,每遇到一个新的更大值,之后所有元素要多降一档。用 记录已经出现过的「台阶」数,每个元素累加当前 。
我们首先对数组 进行排序,然后从数组的第二个元素开始遍历,如果当前元素和前一个元素不相等,那么我们就将 加一,表示我们需要将当前元素减小到最小值的操作次数。然后我们将 加上 ,继续遍历下一个元素。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func reductionOperations(nums []int) (ans int) {
	sort.Ints(nums)
	cnt := 0
	for i, x := range nums[1:] {
		if x != nums[i] {
			cnt++
		}
		ans += cnt
	}
	return
}1913. 两个数对之间的最大乘积差
题目、示例与约束
两个数对 (a, b) 和 (c, d) 之间的 乘积差 定义为 (a * b) - (c * d) 。
- 例如,
(5, 6)和(2, 7)之间的乘积差是(5 * 6) - (2 * 7) = 16。
给你一个整数数组 nums ,选出四个 不同的 下标 w、x、y 和 z ,使数对 (nums[w], nums[x]) 和 (nums[y], nums[z]) 之间的 乘积差 取到 最大值 。
返回以这种方式取得的乘积差中的 最大值 。
示例 1:
输入:nums = [5,6,2,7,4]
输出:34
解释:可以选出下标为 1 和 3 的元素构成第一个数对 (6, 7) 以及下标 2 和 4 构成第二个数对 (2, 4)
乘积差是 (6 * 7) - (2 * 4) = 34
示例 2:
输入:nums = [4,2,5,9,7,4,8]
输出:64
解释:可以选出下标为 3 和 6 的元素构成第一个数对 (9, 8) 以及下标 1 和 5 构成第二个数对 (2, 4)
乘积差是 (9 * 8) - (2 * 4) = 64
提示:
4 <= nums.length <= 1041 <= nums[i] <= 104
方法一 · Go 实现
思考
四元组枚举为 。差值 要最大,应使乘积尽可能大的一对与尽可能小的一对。
排序后最大两数之积减最小两数之积即所求,下标自然互不相同。 不大,排序即可。
func maxProductDifference(nums []int) int {
	sort.Ints(nums)
	n := len(nums)
	return nums[n-1]*nums[n-2] - nums[0]*nums[1]
}2148. 元素计数
题目、示例与约束
给你一个整数数组 nums ,统计并返回在 nums 中同时至少具有一个严格较小元素和一个严格较大元素的元素数目。
示例 1:
输入:nums = [11,7,2,15]
输出:2
解释:元素 7 :严格较小元素是元素 2 ,严格较大元素是元素 11 。
元素 11 :严格较小元素是元素 7 ,严格较大元素是元素 15 。
总计有 2 个元素都满足在 nums 中同时存在一个严格较小元素和一个严格较大元素。
示例 2:
输入:nums = [-3,3,3,90]
输出:2
解释:元素 3 :严格较小元素是元素 -3 ,严格较大元素是元素 90 。
由于有两个元素的值为 3 ,总计有 2 个元素都满足在 nums 中同时存在一个严格较小元素和一个严格较大元素。
提示:
1 <= nums.length <= 100-105 <= nums[i] <= 105
方法一:求最小值和最大值 · Go 实现
思考
一个元素要同时存在严格更小与严格更大者,当且仅当它不是全局最小或最大。统计不等于两端极值的个数即可。
先求 、 ,再数满足 的元素。
两遍线性扫描,常数空间。
根据题目描述,我们可以先求出数组 的最小值 和最大值 ,然后遍历数组 ,统计满足 的元素个数即可。
时间复杂度 ,其中 是数组 的长度。空间复杂度 。
func countElements(nums []int) (ans int) {
	mi := slices.Min(nums)
	mx := slices.Max(nums)
	for _, x := range nums {
		if mi < x && x < mx {
			ans++
		}
	}
	return
}2164. 对奇偶下标分别排序
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums 。根据下述规则重排 nums 中的值:
- 按 非递增 顺序排列
nums奇数下标 上的所有值。- 举个例子,如果排序前
nums = [4,1,2,3],对奇数下标的值排序后变为[4,3,2,1]。奇数下标1和3的值按照非递增顺序重排。
- 举个例子,如果排序前
- 按 非递减 顺序排列
nums偶数下标 上的所有值。- 举个例子,如果排序前
nums = [4,1,2,3],对偶数下标的值排序后变为[2,1,4,3]。偶数下标0和2的值按照非递减顺序重排。
- 举个例子,如果排序前
返回重排 nums 的值之后形成的数组。
示例 1:
输入:nums = [4,1,2,3]
输出:[2,3,4,1]
解释:
首先,按非递增顺序重排奇数下标(1 和 3)的值。
所以,nums 从 [4,1,2,3] 变为 [4,3,2,1] 。
然后,按非递减顺序重排偶数下标(0 和 2)的值。
所以,nums 从 [4,1,2,3] 变为 [2,3,4,1] 。
因此,重排之后形成的数组是 [2,3,4,1] 。
示例 2:
输入:nums = [2,1]
输出:[2,1]
解释:
由于只有一个奇数下标和一个偶数下标,所以不会发生重排。
形成的结果数组是 [2,1] ,和初始数组一样。
提示:
1 <= nums.length <= 1001 <= nums[i] <= 100
方法一:排序 · Go 实现
思考
偶数下标升序、奇数下标降序,两组互不干扰。分别取出排序再写回即可。
切片 与 排序后赋回。
时间由排序主导。
我们可以将奇数下标和偶数下标分别取出来,然后对奇数下标的数组进行非递增排序,对偶数下标的数组进行非递减排序,最后再将两个数组合并即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func sortEvenOdd(nums []int) []int {
	n := len(nums)
	var a []int
	var b []int
	for i, v := range nums {
		if i%2 == 0 {
			a = append(a, v)
		} else {
			b = append(b, v)
		}
	}
	ans := make([]int, n)
	sort.Ints(a)
	sort.Slice(b, func(i, j int) bool {
		return b[i] > b[j]
	})
	for i, j := 0, 0; j < len(a); i, j = i+2, j+1 {
		ans[i] = a[j]
	}
	for i, j := 1, 0; j < len(b); i, j = i+2, j+1 {
		ans[i] = b[j]
	}
	return ans
}2191. 将杂乱无章的数字排序
题目、示例与约束
给你一个下标从 0 开始的整数数组 mapping ,它表示一个十进制数的映射规则,mapping[i] = j 表示这个规则下将数位 i 映射为数位 j 。
一个整数 映射后的值 为将原数字每一个数位 i (0 <= i <= 9)映射为 mapping[i] 。
另外给你一个整数数组 nums ,请你将数组 nums 中每个数按照它们映射后对应数字非递减顺序排序后返回。
注意:
- 如果两个数字映射后对应的数字大小相同,则将它们按照输入中的 相对顺序 排序。
nums中的元素只有在排序的时候需要按照映射后的值进行比较,返回的值应该是输入的元素本身。
示例 1:
输入:mapping = [8,9,4,0,2,1,3,5,7,6], nums = [991,338,38]
输出:[338,38,991]
解释:
将数字 991 按照如下规则映射:
1. mapping[9] = 6 ,所有数位 9 都会变成 6 。
2. mapping[1] = 9 ,所有数位 1 都会变成 9 。
所以,991 映射的值为 669 。
338 映射为 007 ,去掉前导 0 后得到 7 。
38 映射为 07 ,去掉前导 0 后得到 7 。
由于 338 和 38 映射后的值相同,所以它们的前后顺序保留原数组中的相对位置关系,338 在 38 的前面。
所以,排序后的数组为 [338,38,991] 。
示例 2:
输入:mapping = [0,1,2,3,4,5,6,7,8,9], nums = [789,456,123]
输出:[123,456,789]
解释:789 映射为 789 ,456 映射为 456 ,123 映射为 123 。所以排序后数组为 [123,456,789] 。
提示:
mapping.length == 100 <= mapping[i] <= 9mapping[i]的值 互不相同 。1 <= nums.length <= 3 * 1040 <= nums[i] < 109
方法一:自定义排序 · Go 实现
思考
按映射后的十进制值排序,映射值相同则保持原相对顺序。需稳定地比较映射值。
对每个原数按位换成映射数字得到 ,与原下标组成键 排序,再按下标取回原数。 单独映射,避免空循环。
从低位拼 时用权 保证数位顺序。
我们遍历数组 中的每个元素 ,将其映射后的值 与下标 一起存入数组 中,然后对数组 进行排序,最后将排序后的数组 中的下标 取出,转换为原数组 中的元素 即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func sortJumbled(mapping []int, nums []int) (ans []int) {
	n := len(nums)
	f := func(x int) (y int) {
		if x == 0 {
			return mapping[0]
		}
		for k := 1; x > 0; x /= 10 {
			v := mapping[x%10]
			y = k*v + y
			k *= 10
		}
		return
	}
	arr := make([][2]int, n)
	for i, x := range nums {
		arr[i] = [2]int{f(x), i}
	}
	sort.Slice(arr, func(i, j int) bool { return arr[i][0] < arr[j][0] || arr[i][0] == arr[j][0] && arr[i][1] < arr[j][1] })
	for _, p := range arr {
		ans = append(ans, nums[p[1]])
	}
	return
}2274. 不含特殊楼层的最大连续楼层数
题目、示例与约束
Alice 管理着一家公司,并租用大楼的部分楼层作为办公空间。Alice 决定将一些楼层作为 特殊楼层 ,仅用于放松。
给你两个整数 bottom 和 top ,表示 Alice 租用了从 bottom 到 top(含 bottom 和 top 在内)的所有楼层。另给你一个整数数组 special ,其中 special[i] 表示 Alice 指定用于放松的特殊楼层。
返回不含特殊楼层的 最大 连续楼层数。
示例 1:
输入:bottom = 2, top = 9, special = [4,6]
输出:3
解释:下面列出的是不含特殊楼层的连续楼层范围:
- (2, 3) ,楼层数为 2 。
- (5, 5) ,楼层数为 1 。
- (7, 9) ,楼层数为 3 。
因此,返回最大连续楼层数 3 。
示例 2:
输入:bottom = 6, top = 8, special = [7,6,8]
输出:0
解释:每层楼都被规划为特殊楼层,所以返回 0 。
提示
1 <= special.length <= 1051 <= bottom <= special[i] <= top <= 109special中的所有值 互不相同
方法一:排序 · Go 实现
思考
特殊楼层把 切成若干空段,求最长空段。楼层编号达 ,不能逐层扫描。空段只出现在相邻特殊楼层之间,以及两端到边界。
排序特殊楼层后,答案是 、 以及相邻差减一的最大值。
我们可以将特殊楼层按照升序排序,然后计算相邻两个特殊楼层之间的楼层数,最后再计算第一个特殊楼层和 之间的楼层数,以及最后一个特殊楼层和 之间的楼层数,取这些楼层数的最大值即可。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func maxConsecutive(bottom int, top int, special []int) int {
	sort.Ints(special)
	ans := max(special[0]-bottom, top-special[len(special)-1])
	for i, x := range special[1:] {
		ans = max(ans, x-special[i]-1)
	}
	return ans
}2545. 根据第 K 场考试的分数排序
题目、示例与约束
班里有 m 位学生,共计划组织 n 场考试。给你一个下标从 0 开始、大小为 m x n 的整数矩阵 score ,其中每一行对应一位学生,而 score[i][j] 表示第 i 位学生在第 j 场考试取得的分数。矩阵 score 包含的整数 互不相同 。
另给你一个整数 k 。请你按第 k 场考试分数从高到低完成对这些学生(矩阵中的行)的排序。
返回排序后的矩阵。
示例 1:
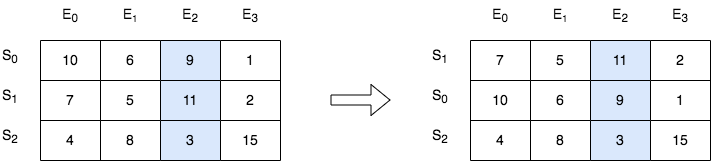
输入:score = [[10,6,9,1],[7,5,11,2],[4,8,3,15]], k = 2
输出:[[7,5,11,2],[10,6,9,1],[4,8,3,15]]
解释:在上图中,S 表示学生,E 表示考试。
- 下标为 1 的学生在第 2 场考试取得的分数为 11 ,这是考试的最高分,所以 TA 需要排在第一。
- 下标为 0 的学生在第 2 场考试取得的分数为 9 ,这是考试的第二高分,所以 TA 需要排在第二。
- 下标为 2 的学生在第 2 场考试取得的分数为 3 ,这是考试的最低分,所以 TA 需要排在第三。
示例 2:
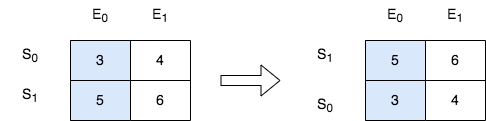
输入:score = [[3,4],[5,6]], k = 0
输出:[[5,6],[3,4]]
解释:在上图中,S 表示学生,E 表示考试。
- 下标为 1 的学生在第 0 场考试取得的分数为 5 ,这是考试的最高分,所以 TA 需要排在第一。
- 下标为 0 的学生在第 0 场考试取得的分数为 3 ,这是考试的最低分,所以 TA 需要排在第二。
提示:
m == score.lengthn == score[i].length1 <= m, n <= 2501 <= score[i][j] <= 105score由 不同 的整数组成0 <= k < n
方法一:排序 · Go 实现
思考
按第 门成绩降序重排学生行。行互不影响,对行做一次排序即可,键取 。
我们直接将 按照第 列的分数从大到小排序,然后返回即可。
时间复杂度 ,空间复杂度 。其中 为 的行数。
func sortTheStudents(score [][]int, k int) [][]int {
	sort.Slice(score, func(i, j int) bool { return score[i][k] > score[j][k] })
	return score
}2580. 统计将重叠区间合并成组的方案数
题目、示例与约束
给你一个二维整数数组 ranges ,其中 ranges[i] = [starti, endi] 表示 starti 到 endi 之间(包括二者)的所有整数都包含在第 i 个区间中。
你需要将 ranges 分成 两个 组(可以为空),满足:
- 每个区间只属于一个组。
- 两个有 交集 的区间必须在 同一个 组内。
如果两个区间有至少 一个 公共整数,那么这两个区间是 有交集 的。
- 比方说,区间
[1, 3]和[2, 5]有交集,因为2和3在两个区间中都被包含。
请你返回将 ranges 划分成两个组的 总方案数 。由于答案可能很大,将它对 109 + 7 取余 后返回。
示例 1:
输入:ranges = [[6,10],[5,15]]
输出:2
解释:
两个区间有交集,所以它们必须在同一个组内。
所以有两种方案:
- 将两个区间都放在第 1 个组中。
- 将两个区间都放在第 2 个组中。
示例 2:
输入:ranges = [[1,3],[10,20],[2,5],[4,8]]
输出:4
解释:
区间 [1,3] 和 [2,5] 有交集,所以它们必须在同一个组中。
同理,区间 [2,5] 和 [4,8] 也有交集,所以它们也必须在同一个组中。
所以总共有 4 种分组方案:
- 所有区间都在第 1 组。
- 所有区间都在第 2 组。
- 区间 [1,3] ,[2,5] 和 [4,8] 在第 1 个组中,[10,20] 在第 2 个组中。
- 区间 [1,3] ,[2,5] 和 [4,8] 在第 2 个组中,[10,20] 在第 1 个组中。
提示:
1 <= ranges.length <= 105ranges[i].length == 20 <= starti <= endi <= 109
方法一:排序 + 计数 + 快速幂 · Go 实现
思考
两个区间只要有重叠就必须分到同一组,求分成两组的方案数。枚举 种分配在 下不可行。
重叠关系具有传递性:排序后合并,每个连通块必须整块放入某一组。块与块不相交,故每块独立选组,方案数为 ,用快速幂取模。
我们可以先对区间进行排序,相交的区间进行合并,统计有多少个不相交的区间,记为 。
每个不相交的区间可以选择放在第一组或第二组,所以方案数为 。注意到 可能很大,所以需要对 取模。这里可以使用快速幂求解。
时间复杂度 ,空间复杂度 。其中 为区间个数。
我们也可以不使用快速幂,一旦发现有新的不相交的区间,就将方案数乘 后对 取模。
func countWays(ranges [][]int) int {
	sort.Slice(ranges, func(i, j int) bool { return ranges[i][0] < ranges[j][0] })
	cnt, mx := 0, -1
	for _, e := range ranges {
		if e[0] > mx {
			cnt++
		}
		if mx < e[1] {
			mx = e[1]
		}
	}
	qpow := func(a, n, mod int) int {
		ans := 1
		for ; n > 0; n >>= 1 {
			if n&1 == 1 {
				ans = ans * a % mod
			}
			a = a * a % mod
		}
		return ans
	}
	return qpow(2, cnt, 1e9+7)
}
方法二 · Go 实现
思考
方法一先计数再幂。发现新块时当场把答案乘 ,省去单独的幂运算,合并逻辑不变。
func countWays(ranges [][]int) int {
	sort.Slice(ranges, func(i, j int) bool { return ranges[i][0] < ranges[j][0] })
	ans, mx := 1, -1
	const mod = 1e9 + 7
	for _, e := range ranges {
		if e[0] > mx {
			ans = ans * 2 % mod
		}
		if mx < e[1] {
			mx = e[1]
		}
	}
	return ans
}2655. 寻找最大长度的未覆盖区间 🔒
题目、示例与约束
现给你一个长度为 n 的 索引从 0 开始的 数组 nums 和一个 索引从 0 开始的 2 维数组 ranges ,ranges 是 nums 的子区间列表(子区间可能 重叠 )。
每行 ranges[i] 恰好有两个元素:
ranges[i][0]表示第i个区间的起始位置(包含)ranges[i][1]表示第i个区间的结束位置(包含)
这些区间覆盖了 nums 的一些元素,并留下了一些 未覆盖 的元素。你的任务是找到所有 最大长度 的未覆盖区间。
返回按起始点 升序排序 的未覆盖区间的二维数组 answer 。
所有 最大长度 的 未覆盖 区间指满足两个条件:
- 每个未覆盖的元素应该属于 恰好 一个子区间。
- 不存在两个区间 (l1,r1) 和 (l2,r2) 使得 r1+1=l2 。
示例 1 :
输入:n = 10, ranges = [[3,5],[7,8]]
输出:[[0,2],[6,6],[9,9]]
解释:区间 (3,5) 和 (7,8) 都被覆盖,因此如果我们将 nums 简化为一个二进制数组,其中 0 表示未覆盖的元素,1 表示覆盖的元素,则数组变为[0,0,0,1,1,1,0,1,1,0],在其中我们可以观察到区间 (0,2),(6,6)和(9,9)未被覆盖。
示例 2 :
输入:n = 3, ranges = [[0,2]]
输出:[]
解释:在这个例子中,整个 nums 数组都被覆盖,没有未覆盖的元素,所以输出是一个空数组。
示例 3 :
输入:n = 7, ranges = [[2,4],[0,3]]
输出:[[5,6]]
解释:区间 (0,3) 和 (2,4) 都被覆盖,因此如果我们将 nums 简化为一个二进制数组,其中 0 表示未覆盖的元素,1 表示覆盖的元素,则数组变为[1,1,1,1,1,0,0],在其中我们可以观察到区间 (5,6) 未被覆盖。
提示:
1 <= n <= 1090 <= ranges.length <= 106ranges[i].length = 20 <= ranges[i][j] <= n - 1ranges[i][0] <= ranges[i][1]
方法一:排序 · Go 实现
思考
求 中未被任何给定区间覆盖的极大连续段。无序时难以合并,两两判断 , 不可行。
按左端排序后,用已覆盖最右 扫一遍:当前左端与 断开则输出空隙,再延伸 。收尾时补上通向 的空隙。
我们将所有的区间按照左端点从小到大排序,然后从左到右遍历所有的区间,维护一个变量 表示当前已经被覆盖的最右端点,初始时 。
如果当前区间的左端点大于 ,那么说明 是一个未被覆盖的区间,我们将其加入答案数组中。然后我们更新 为当前区间的右端点,继续遍历下一个区间。当遍历完所有的区间后,如果 ,那么说明 是一个未被覆盖的区间,我们将其加入答案数组中。
最后我们将答案数组返回即可。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func findMaximalUncoveredRanges(n int, ranges [][]int) (ans [][]int) {
	sort.Slice(ranges, func(i, j int) bool { return ranges[i][0] < ranges[j][0] })
	last := -1
	for _, r := range ranges {
		if last+1 < r[0] {
			ans = append(ans, []int{last + 1, r[0] - 1})
		}
		last = max(last, r[1])
	}
	if last+1 < n {
		ans = append(ans, []int{last + 1, n - 1})
	}
	return
}2733. 既不是最小值也不是最大值
题目、示例与约束
给你一个整数数组 nums ,数组由 不同正整数 组成,请你找出并返回数组中 任一 既不是 最小值 也不是 最大值 的数字,如果不存在这样的数字,返回 -1 。
返回所选整数。
示例 1:
输入:nums = [3,2,1,4]
输出:2
解释:在这个示例中,最小值是 1 ,最大值是 4 。因此,2 或 3 都是有效答案。
示例 2:
输入:nums = [1,2]
输出:-1
解释:由于不存在既不是最大值也不是最小值的数字,我们无法选出满足题目给定条件的数字。因此,不存在答案,返回 -1 。
示例 3:
输入:nums = [2,1,3]
输出:2
解释:2 既不是最小值,也不是最大值,这个示例只有这一个有效答案。
提示:
1 <= nums.length <= 1001 <= nums[i] <= 100nums中的所有数字互不相同
方法一:模拟 · Go 实现
思考
返回数组中既非最小也非最大的任一元素,不存在则返回 。排序后取中间项可行,但只需避开两端。
先求 与 ,再扫一遍取出第一个落在开区间 内的值。
我们可以先找到数组中的最小值和最大值,分别记为 和 。然后遍历数组,找到第一个不等于 且不等于 的数字,返回即可。
时间复杂度 ,其中 是数组的长度。空间复杂度 。
func findNonMinOrMax(nums []int) int {
	mi, mx := slices.Min(nums), slices.Max(nums)
	for _, x := range nums {
		if x != mi && x != mx {
			return x
		}
	}
	return -1
}继续阅读
- 实践案例
- 实践案例
- 实践案例