
LeetCode Go · 区间数据结构(1)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
218. 天际线问题
题目、示例与约束
城市的 天际线 是从远处观看该城市中所有建筑物形成的轮廓的外部轮廓。给你所有建筑物的位置和高度,请返回 由这些建筑物形成的 天际线 。
每个建筑物的几何信息由数组 buildings 表示,其中三元组 buildings[i] = [lefti, righti, heighti] 表示:
lefti是第i座建筑物左边缘的x坐标。righti是第i座建筑物右边缘的x坐标。heighti是第i座建筑物的高度。
你可以假设所有的建筑都是完美的长方形,在高度为 0 的绝对平坦的表面上。
天际线 应该表示为由 “关键点” 组成的列表,格式 [[x1,y1],[x2,y2],...] ,并按 x 坐标 进行 排序 。关键点是水平线段的左端点。列表中最后一个点是最右侧建筑物的终点,y 坐标始终为 0 ,仅用于标记天际线的终点。此外,任何两个相邻建筑物之间的地面都应被视为天际线轮廓的一部分。
注意:输出天际线中不得有连续的相同高度的水平线。例如 [...[2 3], [4 5], [7 5], [11 5], [12 7]...] 是不正确的答案;三条高度为 5 的线应该在最终输出中合并为一个:[...[2 3], [4 5], [12 7], ...]
示例 1:
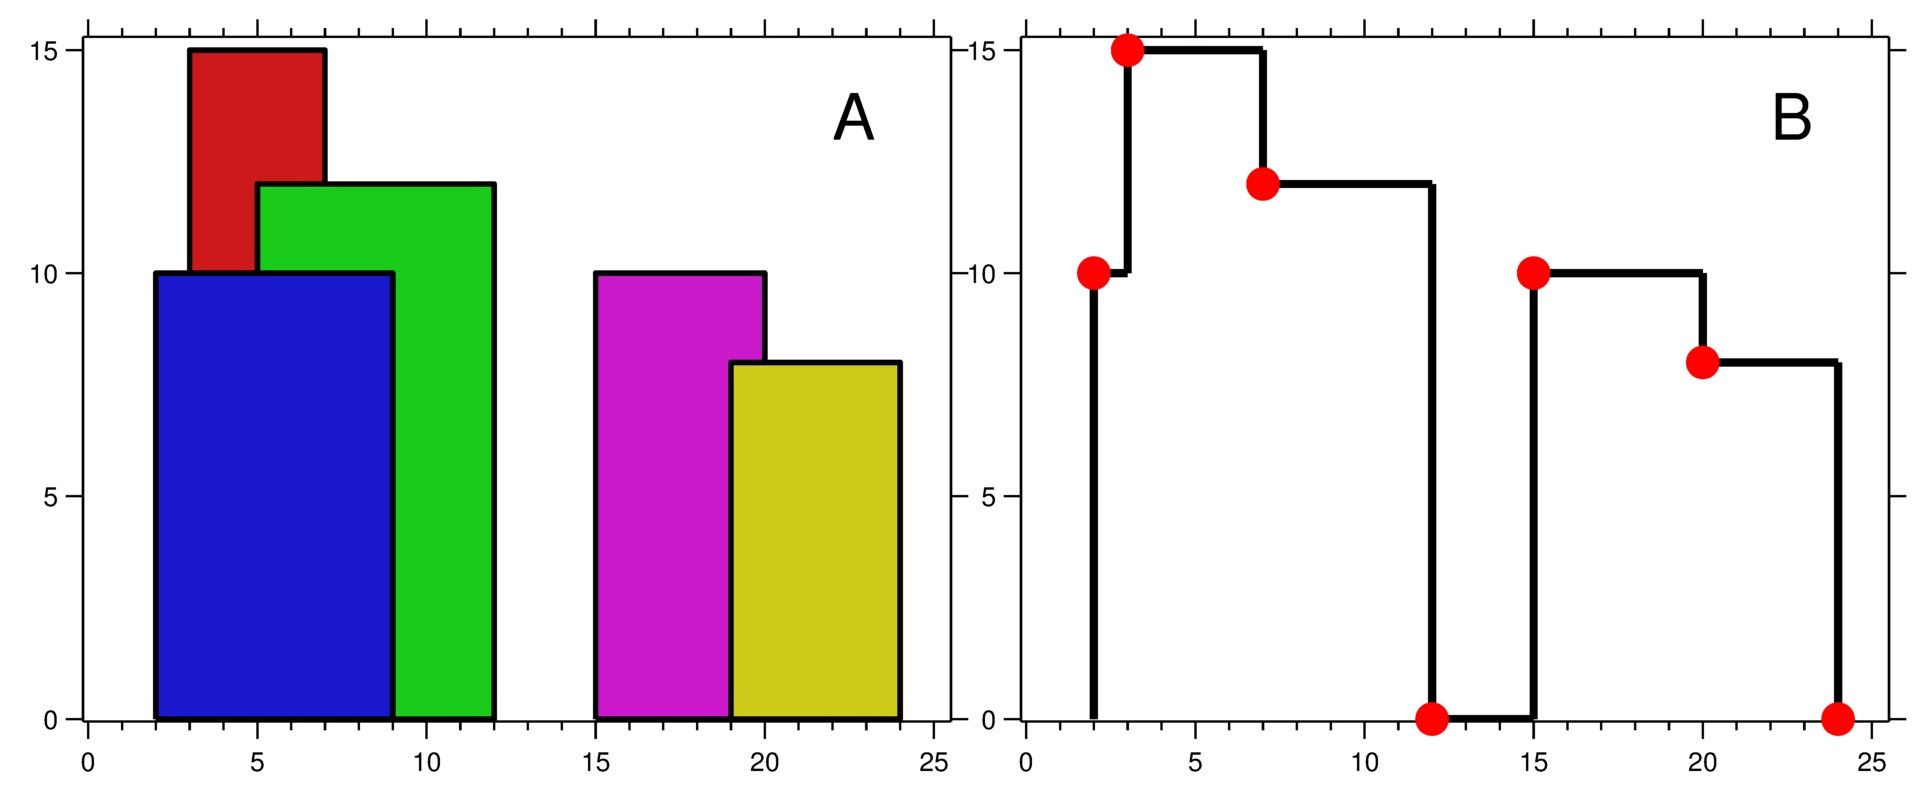
输入:buildings = [[2,9,10],[3,7,15],[5,12,12],[15,20,10],[19,24,8]]
输出:[[2,10],[3,15],[7,12],[12,0],[15,10],[20,8],[24,0]]
解释:
图 A 显示输入的所有建筑物的位置和高度,
图 B 显示由这些建筑物形成的天际线。图 B 中的红点表示输出列表中的关键点。
示例 2:
输入:buildings = [[0,2,3],[2,5,3]]
输出:[[0,3],[5,0]]
提示:
1 <= buildings.length <= 1040 <= lefti < righti <= 231 - 11 <= heighti <= 231 - 1buildings按lefti非递减排序
方法一:扫描线+优先队列 · Go 实现
思考
建筑互相遮挡,按每个横坐标比较全部高度不可行。轮廓只在左右边界处可能变化,可将这些竖线作为扫描事件。
按横坐标排序后扫描,用优先队列维护当前仍覆盖该线的最高建筑;高度变化处输出关键点,相邻同高则合并。
记录下所有建筑物的左右边界线,升序排序之后得到序列 lines。对于每一个边界线 lines[i],找出所有包含 lines[i] 的建筑物,并确保建筑物的左边界小于等于 lines[i],右边界大于 lines[i],则这些建筑物中高度最高的建筑物的高度就是该线轮廓点的高度。可以使用建筑物的高度构建优先队列(大根堆),同时需要注意高度相同的轮廓点需要合并为一个。
type Matrix struct{ left, right, height int }
type Queue []Matrix

func (q Queue) Len() int           { return len(q) }
func (q Queue) Top() Matrix        { return q[0] }
func (q Queue) Swap(i, j int)      { q[i], q[j] = q[j], q[i] }
func (q Queue) Less(i, j int) bool { return q[i].height > q[j].height }
func (q *Queue) Push(x any)        { *q = append(*q, x.(Matrix)) }
func (q *Queue) Pop() any {
	old, x := *q, (*q)[len(*q)-1]
	*q = old[:len(old)-1]
	return x
}

func getSkyline(buildings [][]int) [][]int {
	skys, lines, pq := make([][]int, 0), make([]int, 0), &Queue{}
	heap.Init(pq)
	for _, v := range buildings {
		lines = append(lines, v[0], v[1])
	}
	sort.Ints(lines)
	city, n := 0, len(buildings)
	for _, line := range lines {
		// 将所有符合条件的矩形加入队列
		for ; city < n && buildings[city][0] <= line && buildings[city][1] > line; city++ {
			v := Matrix{left: buildings[city][0], right: buildings[city][1], height: buildings[city][2]}
			heap.Push(pq, v)
		}
		// 从队列移除不符合条件的矩形
		for pq.Len() > 0 && pq.Top().right <= line {
			heap.Pop(pq)
		}
		high := 0
		// 队列为空说明是最右侧建筑物的终点,其轮廓点为 (line, 0)
		if pq.Len() != 0 {
			high = pq.Top().height
		}
		// 如果该点高度和前一个轮廓点一样的话,直接忽略
		if len(skys) > 0 && skys[len(skys)-1][1] == high {
			continue
		}
		skys = append(skys, []int{line, high})
	}
	return skys
}315. 计算右侧小于当前元素的个数
题目、示例与约束
给你一个整数数组 nums ,按要求返回一个新数组 counts 。数组 counts 有该性质: counts[i] 的值是 nums[i] 右侧小于 nums[i] 的元素的数量。
示例 1:
输入:nums = [5,2,6,1]
输出:[2,1,1,0]
解释:
5 的右侧有 2 个更小的元素 (2 和 1)
2 的右侧仅有 1 个更小的元素 (1)
6 的右侧有 1 个更小的元素 (1)
1 的右侧有 0 个更小的元素
示例 2:
输入:nums = [-1]
输出:[0]
示例 3:
输入:nums = [-1,-1]
输出:[0,0]
提示:
1 <= nums.length <= 105-104 <= nums[i] <= 104
方法一:树状数组 · Go 实现
思考
对每个位置统计右侧更小元素个数。若对每个 再扫一遍右侧,为 。该计数等价于动态维护已出现值的前缀频次。
自右向左遍历:离散化后把当前值插入树状数组,再查询秩小于它的个数。先插入再查 仍只统计严格更小者。最后将答案翻转回原序。
树状数组,也称作“二叉索引树”(Binary Indexed Tree)或 Fenwick 树。 它可以高效地实现如下两个操作:
- 单点更新
update(x, delta): 把序列 x 位置的数加上一个值 delta; - 前缀和查询
query(x):查询序列[1,...x]区间的区间和,即位置 x 的前缀和。
这两个操作的时间复杂度均为 。
树状数组最基本的功能就是求比某点 x 小的点的个数(这里的比较是抽象的概念,可以是数的大小、坐标的大小、质量的大小等等)。
比如给定数组 a[5] = {2, 5, 3, 4, 1},求 b[i] = 位置 i 左边小于等于 a[i] 的数的个数。对于此例,b[5] = {0, 1, 1, 2, 0}。
解决方案是直接遍历数组,每个位置先求出 query(a[i]),然后再修改树状数组 update(a[i], 1) 即可。当数的范围比较大时,需要进行离散化,即先进行去重并排序,然后对每个数字进行编号。
type BinaryIndexedTree struct {
	n int
	c []int
}

func newBinaryIndexedTree(n int) *BinaryIndexedTree {
	c := make([]int, n+1)
	return &BinaryIndexedTree{n, c}
}

func (this *BinaryIndexedTree) lowbit(x int) int {
	return x & -x
}

func (this *BinaryIndexedTree) update(x, delta int) {
	for x <= this.n {
		this.c[x] += delta
		x += this.lowbit(x)
	}
}

func (this *BinaryIndexedTree) query(x int) int {
	s := 0
	for x > 0 {
		s += this.c[x]
		x -= this.lowbit(x)
	}
	return s
}

func countSmaller(nums []int) []int {
	s := make(map[int]bool)
	for _, v := range nums {
		s[v] = true
	}
	var alls []int
	for v := range s {
		alls = append(alls, v)
	}
	sort.Ints(alls)
	m := make(map[int]int)
	for i, v := range alls {
		m[v] = i + 1
	}
	ans := make([]int, len(nums))
	tree := newBinaryIndexedTree(len(alls))
	for i := len(nums) - 1; i >= 0; i-- {
		x := m[nums[i]]
		tree.update(x, 1)
		ans[i] = tree.query(x - 1)
	}
	return ans
}
方法二:线段树 · Go 实现
思考
树状数组维护的是值域前缀和。线段树按值域划分,单点加一、查询 同样在 内完成,语义与方法一相同,结点改为显式区间和。
线段树将整个区间分割为多个不连续的子区间,子区间的数量不超过 log(width)。更新某个元素的值,只需要更新 log(width) 个区间,并且这些区间都包含在一个包含该元素的大区间内。
- 线段树的每个节点代表一个区间;
- 线段树具有唯一的根节点,代表的区间是整个统计范围,如
[1, N]; - 线段树的每个叶子节点代表一个长度为 1 的元区间
[x, x]; - 对于每个内部节点
[l, r],它的左儿子是[l, mid],右儿子是[mid + 1, r], 其中mid = ⌊(l + r) / 2⌋(即向下取整)。
type node struct {
	l, r, v int
}

type segmentTree struct {
	tr []node
}

func newSegmentTree(n int) *segmentTree {
	t := &segmentTree{tr: make([]node, n<<2)}
	t.build(1, 1, n)
	return t
}

func (t *segmentTree) build(u, l, r int) {
	t.tr[u].l, t.tr[u].r = l, r
	if l == r {
		return
	}
	mid := (l + r) >> 1
	t.build(u<<1, l, mid)
	t.build(u<<1|1, mid+1, r)
}

func (t *segmentTree) modify(u, x, v int) {
	if t.tr[u].l == x && t.tr[u].r == x {
		t.tr[u].v += v
		return
	}
	mid := (t.tr[u].l + t.tr[u].r) >> 1
	if x <= mid {
		t.modify(u<<1, x, v)
	} else {
		t.modify(u<<1|1, x, v)
	}
	t.pushup(u)
}

func (t *segmentTree) pushup(u int) {
	t.tr[u].v = t.tr[u<<1].v + t.tr[u<<1|1].v
}

func (t *segmentTree) query(u, l, r int) int {
	if t.tr[u].l >= l && t.tr[u].r <= r {
		return t.tr[u].v
	}
	mid := (t.tr[u].l + t.tr[u].r) >> 1
	v := 0
	if l <= mid {
		v += t.query(u<<1, l, r)
	}
	if r > mid {
		v += t.query(u<<1|1, l, r)
	}
	return v
}

func countSmaller(nums []int) []int {
	s := map[int]struct{}{}
	for _, v := range nums {
		s[v] = struct{}{}
	}
	alls := make([]int, 0, len(s))
	for v := range s {
		alls = append(alls, v)
	}
	sort.Ints(alls)
	m := map[int]int{}
	for i, v := range alls {
		m[v] = i + 1
	}
	tree := newSegmentTree(len(alls))
	ans := make([]int, len(nums))
	for i := len(nums) - 1; i >= 0; i-- {
		x := m[nums[i]]
		tree.modify(1, x, 1)
		ans[i] = tree.query(1, 1, x-1)
	}
	return ans
}
方法三:归并排序 · Go 实现
思考
前两种方法依赖离散化与额外结构。归并时左侧元素一旦不大于右侧当前值,右侧已消费的 个元素均比它小且下标更大,正好累加到该位置的「右侧更小」计数。无需值域树,时间仍为 。
在归并排序的合并阶段,当左侧元素 右侧元素 时,
说明右侧恰好有 个元素比 小,因此将 累加到左侧元素的计数中。
当右侧元素全部清空,其体现右侧所有元素均小于剩余左侧元素,累加右侧数组长度到每个剩余左侧元素的计数即可。
注意:C++做超大数组的归并排序时,有内存爆炸风险,需使用 缓存数组 避免Memory Limit Exceeded。
type Pair struct {
	val   int
	index int
}

var (
	tmp   []Pair
	count []int
)

func countSmaller(nums []int) []int {
	tmp, count = make([]Pair, len(nums)), make([]int, len(nums))
	array := make([]Pair, len(nums))
	for i, v := range nums {
		array[i] = Pair{val: v, index: i}
	}
	sorted(array, 0, len(array)-1)
	return count
}

func sorted(arr []Pair, low, high int) {
	if low >= high {
		return
	}
	mid := low + (high-low)/2
	sorted(arr, low, mid)
	sorted(arr, mid+1, high)
	merge(arr, low, mid, high)
}

func merge(arr []Pair, low, mid, high int) {
	left, right := low, mid+1
	idx := low
	for left <= mid && right <= high {
		if arr[left].val <= arr[right].val {
			count[arr[left].index] += right - mid - 1
			tmp[idx], left = arr[left], left+1
		} else {
			tmp[idx], right = arr[right], right+1
		}
		idx++
	}
	for left <= mid {
		count[arr[left].index] += right - mid - 1
		tmp[idx] = arr[left]
		idx, left = idx+1, left+1
	}
	for right <= high {
		tmp[idx] = arr[right]
		idx, right = idx+1, right+1
	}
	// 排序
	for i := low; i <= high; i++ {
		arr[i] = tmp[i]
	}
}327. 区间和的个数
题目、示例与约束
给你一个整数数组 nums 以及两个整数 lower 和 upper 。求数组中,值位于范围 [lower, upper] (包含 lower 和 upper)之内的 区间和的个数 。
区间和 S(i, j) 表示在 nums 中,位置从 i 到 j 的元素之和,包含 i 和 j (i ≤ j)。
示例 1:
输入:nums = [-2,5,-1], lower = -2, upper = 2
输出:3
解释:存在三个区间:[0,0]、[2,2] 和 [0,2] ,对应的区间和分别是:-2 、-1 、2 。
示例 2:
输入:nums = [0], lower = 0, upper = 0
输出:1
提示:
1 <= nums.length <= 105-231 <= nums[i] <= 231 - 1-105 <= lower <= upper <= 105- 题目数据保证答案是一个 32 位 的整数
方法一:前缀和 + 树状数组 · Go 实现
思考
统计和落在 的子数组个数。子数组和为前缀差,枚举两端为 。对当前前缀 ,需要已知前缀中有多少落在 。
把所有 、 、 离散化,树状数组维护已出现前缀的频次。先查询区间个数,再插入当前 ,保证只用到左侧前缀。
题目要求区间和,因此我们可以先求出前缀和数组 ,其中 表示 中前 个元素的和。那么对于任意的 , 就是 中下标在 的元素之和。
而 ,可以转换为 ,也就是说,对于当前前缀和 ,我们需要统计 中有多少个下标 满足 。
我们可以用树状数组来维护每个前缀和出现的次数,这样对于每个前缀和 ,我们只需要查询树状数组中有多少个前缀和 满足 即可。
时间复杂度 ,空间复杂度 。其中 为数组长度。
type BinaryIndexedTree struct {
	n int
	c []int
}

func newBinaryIndexedTree(n int) *BinaryIndexedTree {
	c := make([]int, n+1)
	return &BinaryIndexedTree{n, c}
}

func (this *BinaryIndexedTree) update(x, delta int) {
	for x <= this.n {
		this.c[x] += delta
		x += x & -x
	}
}

func (this *BinaryIndexedTree) query(x int) int {
	s := 0
	for x > 0 {
		s += this.c[x]
		x -= x & -x
	}
	return s
}

func countRangeSum(nums []int, lower int, upper int) (ans int) {
	n := len(nums)
	s := make([]int, n+1)
	for i, x := range nums {
		s[i+1] = s[i] + x
	}
	arr := make([]int, (n+1)*3)
	for i, j := 0, 0; i <= n; i, j = i+1, j+3 {
		arr[j] = s[i]
		arr[j+1] = s[i] - lower
		arr[j+2] = s[i] - upper
	}
	sort.Ints(arr)
	m := 0
	for i := range arr {
		if i == 0 || arr[i] != arr[i-1] {
			arr[m] = arr[i]
			m++
		}
	}
	arr = arr[:m]
	tree := newBinaryIndexedTree(m)
	for _, x := range s {
		l := sort.SearchInts(arr, x-upper) + 1
		r := sort.SearchInts(arr, x-lower) + 1
		ans += tree.query(r) - tree.query(l-1)
		tree.update(sort.SearchInts(arr, x)+1, 1)
	}
	return
}406. 根据身高重建队列
题目、示例与约束
假设有打乱顺序的一群人站成一个队列,数组 people 表示队列中一些人的属性(不一定按顺序)。每个 people[i] = [hi, ki] 表示第 i 个人的身高为 hi ,前面 正好 有 ki 个身高大于或等于 hi 的人。
请你重新构造并返回输入数组 people 所表示的队列。返回的队列应该格式化为数组 queue ,其中 queue[j] = [hj, kj] 是队列中第 j 个人的属性(queue[0] 是排在队列前面的人)。
示例 1:
输入:people = [[7,0],[4,4],[7,1],[5,0],[6,1],[5,2]]
输出:[[5,0],[7,0],[5,2],[6,1],[4,4],[7,1]]
解释:
编号为 0 的人身高为 5 ,没有身高更高或者相同的人排在他前面。
编号为 1 的人身高为 7 ,没有身高更高或者相同的人排在他前面。
编号为 2 的人身高为 5 ,有 2 个身高更高或者相同的人排在他前面,即编号为 0 和 1 的人。
编号为 3 的人身高为 6 ,有 1 个身高更高或者相同的人排在他前面,即编号为 1 的人。
编号为 4 的人身高为 4 ,有 4 个身高更高或者相同的人排在他前面,即编号为 0、1、2、3 的人。
编号为 5 的人身高为 7 ,有 1 个身高更高或者相同的人排在他前面,即编号为 1 的人。
因此 [[5,0],[7,0],[5,2],[6,1],[4,4],[7,1]] 是重新构造后的队列。
示例 2:
输入:people = [[6,0],[5,0],[4,0],[3,2],[2,2],[1,4]]
输出:[[4,0],[5,0],[2,2],[3,2],[1,4],[6,0]]
提示:
1 <= people.length <= 20000 <= hi <= 1060 <= ki < people.length- 题目数据确保队列可以被重建
方法一 · Go 实现
思考
表示前面恰有 个身高不小于 的人。若先排矮的,后插入的高的人会改变已在队列中的人的 。
按身高降序、 升序插入:队列里已有的人都更高或等高,把新人插到下标 ,恰好满足「前面有 个更高或等身高的人」,且不会破坏已放置者的相对计数。
高的人先就位,矮的人插入时对更高者不可见,这是操作顺序成立的原因。
func reconstructQueue(people [][]int) [][]int {
	sort.Slice(people, func(i, j int) bool {
		a, b := people[i], people[j]
		return a[0] > b[0] || a[0] == b[0] && a[1] < b[1]
	})
	var ans [][]int
	for _, p := range people {
		i := p[1]
		ans = append(ans[:i], append([][]int{p}, ans[i:]...)...)
	}
	return ans
}493. 翻转对
题目、示例与约束
给定一个数组 nums ,如果 i < j 且 nums[i] > 2*nums[j] 我们就将 (i, j) 称作一个重要翻转对。
你需要返回给定数组中的重要翻转对的数量。
示例 1:
输入: [1,3,2,3,1]
输出: 2
示例 2:
输入: [2,4,3,5,1]
输出: 3
注意:
- 给定数组的长度不会超过
50000。 - 输入数组中的所有数字都在32位整数的表示范围内。
方法一:归并排序 · Go 实现
思考
重要翻转对满足 且 。双重循环是 。归并时左右两半已有序,可以在合并前数跨半对。
先递归左右,再对右半每个 推进左指针直到 ,剩下的左半都构成翻转对。然后再按值归并。
计数与归并分开:计数用 比较,归并用原值,两者条件不同。
归并排序的过程中,如果左边的数大于右边的数,则右边的数与左边的数之后的数都构成逆序对。
时间复杂度 ,空间复杂度 。其中 为数组长度。
func reversePairs(nums []int) int {
	n := len(nums)
	t := make([]int, n)
	var mergeSort func(l, r int) int
	mergeSort = func(l, r int) int {
		if l >= r {
			return 0
		}
		mid := (l + r) >> 1
		ans := mergeSort(l, mid) + mergeSort(mid+1, r)
		i, j, k := l, mid+1, 0
		for i <= mid && j <= r {
			if nums[i] <= nums[j]*2 {
				i++
			} else {
				ans += mid - i + 1
				j++
			}
		}
		i, j = l, mid+1
		for i <= mid && j <= r {
			if nums[i] <= nums[j] {
				t[k] = nums[i]
				k, i = k+1, i+1
			} else {
				t[k] = nums[j]
				k, j = k+1, j+1
			}
		}
		for ; i <= mid; i, k = i+1, k+1 {
			t[k] = nums[i]
		}
		for ; j <= r; j, k = j+1, k+1 {
			t[k] = nums[j]
		}
		for i = l; i <= r; i++ {
			nums[i] = t[i-l]
		}
		return ans
	}
	return mergeSort(0, n-1)
}
方法二:树状数组 · Go 实现
思考
方法一改写数组。离散化 与 后,从右向左把 插入树状数组,查询小于 的个数,即右侧有多少 满足条件。
不破坏原数组相对位置的语义之外的结构,动态维护「已扫过的 」。
树状数组,也称作“二叉索引树”(Binary Indexed Tree)或 Fenwick 树。 它可以高效地实现如下两个操作:
- 单点更新
update(x, delta): 把序列 x 位置的数加上一个值 delta; - 前缀和查询
query(x):查询序列[1,...x]区间的区间和,即位置 x 的前缀和。
这两个操作的时间复杂度均为 。
树状数组最基本的功能就是求比某点 x 小的点的个数(这里的比较是抽象的概念,可以是数的大小、坐标的大小、质量的大小等等)。
比如给定数组 a[5] = {2, 5, 3, 4, 1},求 b[i] = 位置 i 左边小于等于 a[i] 的数的个数。对于此例,b[5] = {0, 1, 1, 2, 0}。
解决方案是直接遍历数组,每个位置先求出 query(a[i]),然后再修改树状数组 update(a[i], 1) 即可。当数的范围比较大时,需要进行离散化,即先进行去重并排序,然后对每个数字进行编号。
type BinaryIndexedTree struct {
	n int
	c []int
}

func newBinaryIndexedTree(n int) *BinaryIndexedTree {
	c := make([]int, n+1)
	return &BinaryIndexedTree{n, c}
}

func (this *BinaryIndexedTree) lowbit(x int) int {
	return x & -x
}

func (this *BinaryIndexedTree) update(x, delta int) {
	for x <= this.n {
		this.c[x] += delta
		x += this.lowbit(x)
	}
}

func (this *BinaryIndexedTree) query(x int) int {
	s := 0
	for x > 0 {
		s += this.c[x]
		x -= this.lowbit(x)
	}
	return s
}

func reversePairs(nums []int) int {
	s := make(map[int]bool)
	for _, num := range nums {
		s[num] = true
		s[num*2] = true
	}
	var alls []int
	for num := range s {
		alls = append(alls, num)
	}
	sort.Ints(alls)
	m := make(map[int]int)
	for i, num := range alls {
		m[num] = i + 1
	}
	tree := newBinaryIndexedTree(len(m))
	ans := 0
	for i := len(nums) - 1; i >= 0; i-- {
		ans += tree.query(m[nums[i]] - 1)
		tree.update(m[nums[i]*2], 1)
	}
	return ans
}673. 最长递增子序列的个数
题目、示例与约束
给定一个未排序的整数数组 nums , 返回最长递增子序列的个数 。
注意 这个数列必须是 严格 递增的。
示例 1:
输入: [1,3,5,4,7]
输出: 2
解释: 有两个最长递增子序列,分别是 [1, 3, 4, 7] 和[1, 3, 5, 7]。
示例 2:
输入: [2,2,2,2,2]
输出: 5
解释: 最长递增子序列的长度是1,并且存在5个子序列的长度为1,因此输出5。
提示:
1 <= nums.length <= 2000-106 <= nums[i] <= 106
方法一:动态规划 · Go 实现
思考
既要 LIS 长度也要条数。只记长度会漏掉并列最长的组合。 ,平方 DP 可过。
、 分别为以 结尾的最长长度与条数。 时按 更新或累加。最后把长度为全局最大的 相加。
我们定义 表示以 结尾的最长递增子序列的长度,定义 表示以 结尾的最长递增子序列的个数。初始时 , 。另外,定义 表示最长递增子序列的长度,定义 表示最长递增子序列的个数。
对于每一个 ,我们枚举 中的所有元素 ,如果 ,则 可以接在 后面,形成一个更长的递增子序列。如果 ,说明以 结尾的最长递增子序列的长度增加了,那么我们需要更新 ,并且 。如果 ,说明我们找到了一条长度与之前相同的最长递增子序列,那么我们需要将 增加 。然后,如果 ,说明最长递增子序列的长度增加了,那么我们需要更新 ,并且 。如果 ,说明我们找到了一条长度与之前相同的最长递增子序列,那么我们需要将 增加 。
最后,我们返回 即可。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func findNumberOfLIS(nums []int) (ans int) {
	n, mx := len(nums), 0
	f := make([]int, n)
	cnt := make([]int, n)
	for i := range f {
		f[i], cnt[i] = 1, 1
	}
	for i, x := range nums {
		for j, y := range nums[:i] {
			if y < x {
				if f[i] < f[j]+1 {
					f[i] = f[j] + 1
					cnt[i] = cnt[j]
				} else if f[i] == f[j]+1 {
					cnt[i] += cnt[j]
				}
			}
		}
		if mx < f[i] {
			mx = f[i]
			ans = cnt[i]
		} else if mx == f[i] {
			ans += cnt[i]
		}
	}
	return
}
方法二:树状数组 · Go 实现
思考
平方枚举前驱是瓶颈。值域离散后,树状数组按值维护「更小元素上的最长长度与条数」,查询与更新各 。
我们可以用树状数组维护前缀区间的最长递增子序列的长度和个数。我们将数组 中的元素去重并排序,得到数组 ,然后我们枚举 中的每一个元素 ,在数组 中二分查找 的位置 ,然后查询 的最长递增子序列的长度和个数,记为 和 ,然后更新 的最长递增子序列的长度和个数为 和 。最后,我们查询 的最长递增子序列的长度和个数,其中 是数组 的长度,即为答案。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
type BinaryIndexedTree struct {
	n int
	c []int
	d []int
}

func newBinaryIndexedTree(n int) BinaryIndexedTree {
	return BinaryIndexedTree{
		n: n,
		c: make([]int, n+1),
		d: make([]int, n+1),
	}
}

func (bit *BinaryIndexedTree) update(x, v, cnt int) {
	for x <= bit.n {
		if bit.c[x] < v {
			bit.c[x] = v
			bit.d[x] = cnt
		} else if bit.c[x] == v {
			bit.d[x] += cnt
		}
		x += x & -x
	}
}

func (bit *BinaryIndexedTree) query(x int) (int, int) {
	v, cnt := 0, 0
	for x > 0 {
		if bit.c[x] > v {
			v = bit.c[x]
			cnt = bit.d[x]
		} else if bit.c[x] == v {
			cnt += bit.d[x]
		}
		x -= x & -x
	}
	return v, cnt
}

func findNumberOfLIS(nums []int) int {
	arr := append([]int(nil), nums...)
	sort.Ints(arr)
	k := 0
	for _, x := range arr {
		if k == 0 || arr[k-1] != x {
			arr[k] = x
			k++
		}
	}
	arr = arr[:k]
	m := len(arr)
	tree := newBinaryIndexedTree(m)
	for _, x := range nums {
		i := sort.SearchInts(arr, x) + 1
		v, cnt := tree.query(i - 1)
		tree.update(i, v+1, max(cnt, 1))
	}
	_, ans := tree.query(m)
	return ans
}683. K 个关闭的灯泡 🔒
题目、示例与约束
n 个灯泡排成一行,编号从 1 到 n 。最初,所有灯泡都关闭。每天 只打开一个 灯泡,直到 n 天后所有灯泡都打开。
给你一个长度为 n 的灯泡数组 bulbs ,其中 bulbs[i] = x 意味着在第 (i+1) 天,我们会把在位置 x 的灯泡打开,其中 i 从 0 开始,x 从 1 开始。
给你一个整数 k ,请返回恰好有两个打开的灯泡,且它们中间 正好 有 k 个 全部关闭的 灯泡的 最小的天数 。如果不存在这种情况,返回 -1 。
示例 1:
输入:
bulbs = [1,3,2],k = 1
输出:2
解释:
第一天 bulbs[0] = 1,打开第一个灯泡 [1,0,0]
第二天 bulbs[1] = 3,打开第三个灯泡 [1,0,1]
第三天 bulbs[2] = 2,打开第二个灯泡 [1,1,1]
返回2,因为在第二天,两个打开的灯泡之间恰好有一个关闭的灯泡。
示例 2:
输入:bulbs = [1,2,3],k = 1
输出:-1
提示:
n == bulbs.length1 <= n <= 2 * 1041 <= bulbs[i] <= nbulbs是一个由从1到n的数字构成的排列0 <= k <= 2 * 104
方法一:树状数组 · Go 实现
思考
按开花顺序,问哪一天首次出现两朵已开的花中间恰有 个空位。枚举已开对是平方级。
树状数组维护已开位置的前缀个数。当天开花 后,若 已开且其间前缀差为 ,即中间全空。
我们可以使用树状数组来维护区间和,每一次打开灯泡,我们就在树状数组中更新对应位置的值,然后查询当前位置左边 个灯泡是否都是关闭的,并且第 个灯泡是否已经打开;或者查询当前位置右边 个灯泡是否都是关闭的,并且第 个灯泡是否已经打开。如果满足这两个条件之一,那么就说明当前位置是一个符合要求的位置,我们就可以返回当前的天数。
时间复杂度 ,空间复杂度 。其中 是灯泡的数量。
type BinaryIndexedTree struct {
	n int
	c []int
}

func newBinaryIndexedTree(n int) *BinaryIndexedTree {
	c := make([]int, n+1)
	return &BinaryIndexedTree{n, c}
}

func (this *BinaryIndexedTree) update(x, delta int) {
	for ; x <= this.n; x += x & -x {
		this.c[x] += delta
	}
}

func (this *BinaryIndexedTree) query(x int) (s int) {
	for ; x > 0; x -= x & -x {
		s += this.c[x]
	}
	return
}

func kEmptySlots(bulbs []int, k int) int {
	n := len(bulbs)
	tree := newBinaryIndexedTree(n)
	vis := make([]bool, n+1)
	for i, x := range bulbs {
		tree.update(x, 1)
		vis[x] = true
		i++
		y := x - k - 1
		if y > 0 && vis[y] && tree.query(x-1)-tree.query(y) == 0 {
			return i
		}
		y = x + k + 1
		if y <= n && vis[y] && tree.query(y-1)-tree.query(x) == 0 {
			return i
		}
	}
	return -1
}699. 掉落的方块
题目、示例与约束
在二维平面上的 x 轴上,放置着一些方块。
给你一个二维整数数组 positions ,其中 positions[i] = [lefti, sideLengthi] 表示:第 i 个方块边长为 sideLengthi ,其左侧边与 x 轴上坐标点 lefti 对齐。
每个方块都从一个比目前所有的落地方块更高的高度掉落而下。方块沿 y 轴负方向下落,直到着陆到 另一个正方形的顶边 或者是 x 轴上 。一个方块仅仅是擦过另一个方块的左侧边或右侧边不算着陆。一旦着陆,它就会固定在原地,无法移动。
在每个方块掉落后,你必须记录目前所有已经落稳的 方块堆叠的最高高度 。
返回一个整数数组 ans ,其中 ans[i] 表示在第 i 块方块掉落后堆叠的最高高度。
示例 1:
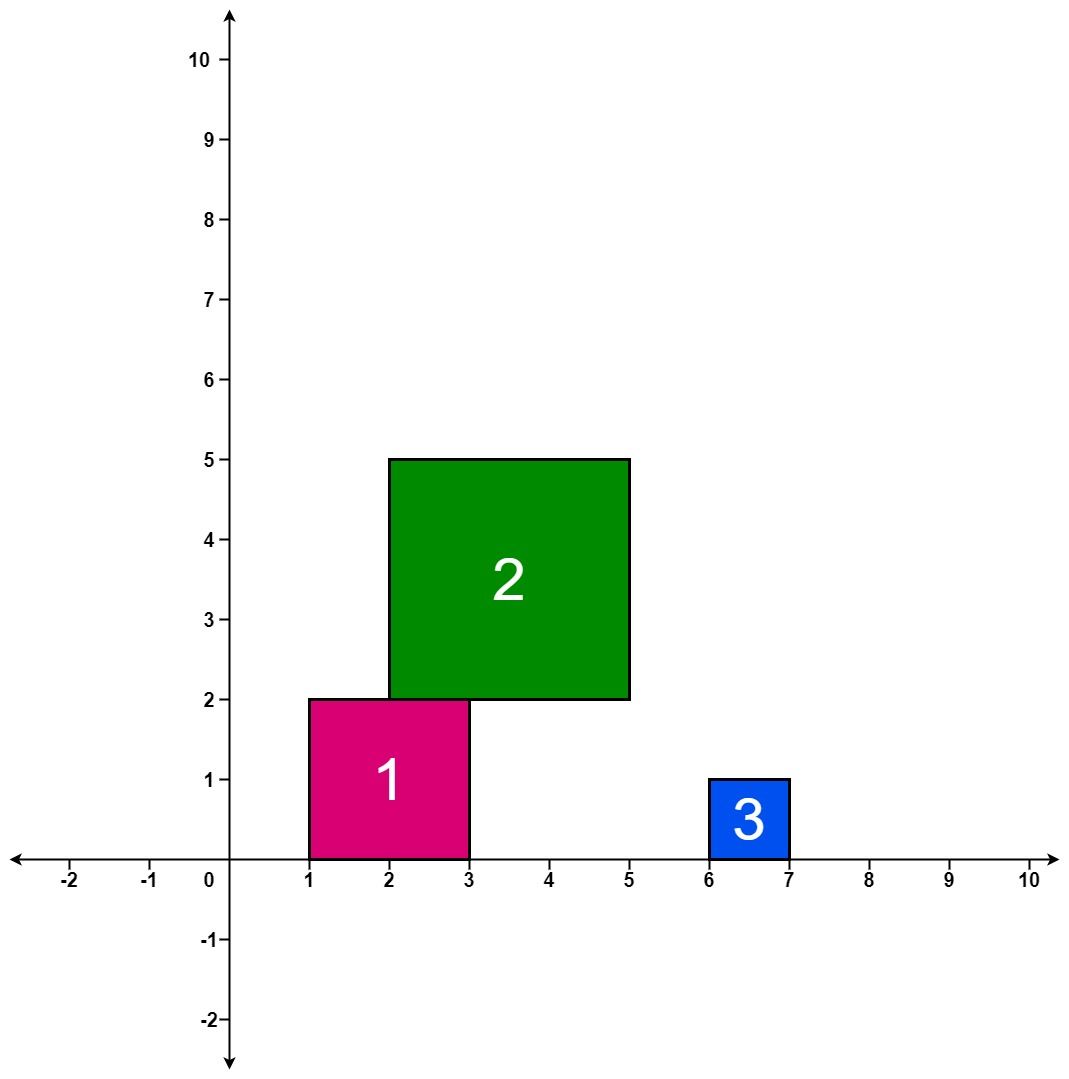
输入:positions = [[1,2],[2,3],[6,1]]
输出:[2,5,5]
解释:
第 1 个方块掉落后,最高的堆叠由方块 1 组成,堆叠的最高高度为 2 。
第 2 个方块掉落后,最高的堆叠由方块 1 和 2 组成,堆叠的最高高度为 5 。
第 3 个方块掉落后,最高的堆叠仍然由方块 1 和 2 组成,堆叠的最高高度为 5 。
因此,返回 [2, 5, 5] 作为答案。
示例 2:
输入:positions = [[100,100],[200,100]]
输出:[100,100]
解释:
第 1 个方块掉落后,最高的堆叠由方块 1 组成,堆叠的最高高度为 100 。
第 2 个方块掉落后,最高的堆叠可以由方块 1 组成也可以由方块 2 组成,堆叠的最高高度为 100 。
因此,返回 [100, 100] 作为答案。
注意,方块 2 擦过方块 1 的右侧边,但不会算作在方块 1 上着陆。
提示:
1 <= positions.length <= 10001 <= lefti <= 1081 <= sideLengthi <= 106
方法一:线段树 · Go 实现
思考
方块依次落下,底边落在已有最高处,求每次落后的全局最大高度。坐标达 ,不能开数组;若每次与此前所有方块求交, 在 时勉强。
动态开点线段树维护区间最大高度:查询 得落地高度再加边长,并区间赋值回去。懒标记保证覆盖更新,同时维护全局最大。
根据题目描述,我们需要维护一个区间集合,支持区间的修改和查询操作。这种情况下,我们可以使用线段树来解决。
线段树将整个区间分割为多个不连续的子区间,子区间的数量不超过 ,其中 是区间的长度。更新某个元素的值,只需要更新 个区间,并且这些区间都包含在一个包含该元素的大区间内。区间修改时,需要使用懒标记保证效率。
- 线段树的每个节点代表一个区间;
- 线段树具有唯一的根节点,代表的区间是整个统计范围,如 ;
- 线段树的每个叶子节点代表一个长度为 1 的元区间 ;
- 对于每个内部节点 ,它的左儿子是 ,右儿子是 , 其中 ;
对于本题,线段树节点维护的信息有:
- 区间中方块的最大高度
- 懒标记
另外,由于数轴范围很大,达到 ,因此我们采用动态开点。
时间复杂度方面,每次查询和修改的时间复杂度为 ,总时间复杂度为 。空间复杂度为 。
type node struct {
	left      *node
	right     *node
	l, mid, r int
	v, add    int
}

func newNode(l, r int) *node {
	return &node{
		l:   l,
		r:   r,
		mid: (l + r) >> 1,
	}
}

type segmentTree struct {
	root *node
}

func newSegmentTree() *segmentTree {
	return &segmentTree{
		root: newNode(1, 1e9),
	}
}

func (t *segmentTree) modify(l, r, v int, n *node) {
	if l > r {
		return
	}
	if n.l >= l && n.r <= r {
		n.v = v
		n.add = v
		return
	}
	t.pushdown(n)
	if l <= n.mid {
		t.modify(l, r, v, n.left)
	}
	if r > n.mid {
		t.modify(l, r, v, n.right)
	}
	t.pushup(n)
}

func (t *segmentTree) query(l, r int, n *node) int {
	if l > r {
		return 0
	}
	if n.l >= l && n.r <= r {
		return n.v
	}
	t.pushdown(n)
	v := 0
	if l <= n.mid {
		v = max(v, t.query(l, r, n.left))
	}
	if r > n.mid {
		v = max(v, t.query(l, r, n.right))
	}
	return v
}

func (t *segmentTree) pushup(n *node) {
	n.v = max(n.left.v, n.right.v)
}

func (t *segmentTree) pushdown(n *node) {
	if n.left == nil {
		n.left = newNode(n.l, n.mid)
	}
	if n.right == nil {
		n.right = newNode(n.mid+1, n.r)
	}
	if n.add != 0 {
		n.left.add = n.add
		n.right.add = n.add
		n.left.v = n.add
		n.right.v = n.add
		n.add = 0
	}
}

func fallingSquares(positions [][]int) []int {
	ans := make([]int, len(positions))
	t := newSegmentTree()
	mx := 0
	for i, p := range positions {
		l, w, r := p[0], p[1], p[0]+p[1]-1
		h := t.query(l, r, t.root) + w
		mx = max(mx, h)
		ans[i] = mx
		t.modify(l, r, h, t.root)
	}
	return ans
}850. 矩形面积 II
题目、示例与约束
给你一个轴对齐的二维数组 rectangles 。 对于 rectangle[i] = [x1, y1, x2, y2],其中 (xi1, yi1) 是该矩形 左下角 的坐标, (xi2, yi2) 是该矩形 右上角 的坐标。
计算平面中所有 rectangles 所覆盖的 总面积 。任何被两个或多个矩形覆盖的区域应只计算 一次 。
返回 总面积 。因为答案可能太大,返回 109 + 7 的 模 。
示例 1:
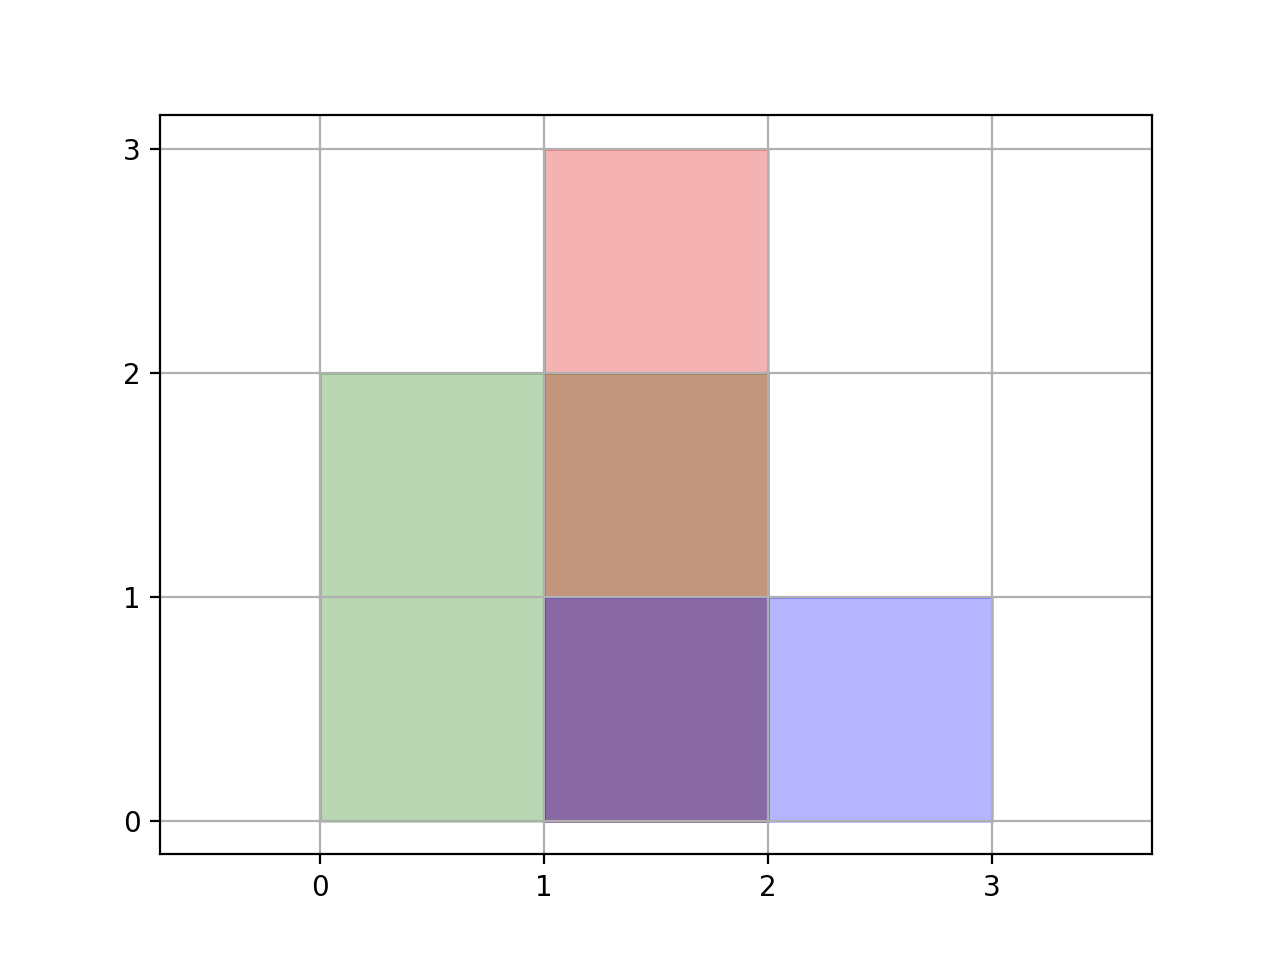
输入:rectangles = [[0,0,2,2],[1,0,2,3],[1,0,3,1]]
输出:6
解释:如图所示,三个矩形覆盖了总面积为 6 的区域。
从(1,1)到(2,2),绿色矩形和红色矩形重叠。
从(1,0)到(2,3),三个矩形都重叠。
示例 2:
输入:rectangles = [[0,0,1000000000,1000000000]]
输出:49
解释:答案是 1018 对 (109 + 7) 取模的结果, 即 49 。
提示:
1 <= rectangles.length <= 200rectanges[i].length = 40 <= xi1, yi1, xi2, yi2 <= 109xi1 <= xi2yi1 <= yi2- 所有矩阵面积不为 0。
方法一:离散化 + 线段树 + 扫描线 · Go 实现
思考
求矩形并的面积,坐标达 、矩形至多 个。两两容斥项数随交集增多而难以控制,沿 扫描更稳:把每条左右边界当成事件,中间夹着的是当前被覆盖的 向长度。
将 坐标离散化后,用线段树维护「覆盖次数 的纵坐标长度」。按 排序扫描,相邻事件的 乘树中覆盖长度即这一竖条的面积。
线段树将整个区间分割为多个不连续的子区间,子区间的数量不超过 。更新某个元素的值,只需要更新 个区间,并且这些区间都包含在一个包含该元素的大区间内。区间修改时,需要使用懒标记保证效率。
- 线段树的每个节点代表一个区间;
- 线段树具有唯一的根节点,代表的区间是整个统计范围,如 ;
- 线段树的每个叶子节点代表一个长度为 1 的元区间 ;
- 对于每个内部节点 ,它的左儿子是 ,右儿子是 , 其中 (即向下取整)。
对于本题,线段树节点维护的信息有:
- 区间被覆盖的次数
cnt; - 区间被覆盖的长度
len。
另外,由于本题利用了扫描线本身的特性,因此,区间修改时,不需要懒标记,也无须进行 pushdown 操作。
func rectangleArea(rectangles [][]int) int {
	var mod int = 1e9 + 7
	segs := [][]int{}
	alls := map[int]bool{}
	for _, e := range rectangles {
		x1, y1, x2, y2 := e[0], e[1], e[2], e[3]
		segs = append(segs, []int{x1, y1, y2, 1})
		segs = append(segs, []int{x2, y1, y2, -1})
		alls[y1] = true
		alls[y2] = true
	}
	nums := []int{}
	for v := range alls {
		nums = append(nums, v)
	}
	sort.Ints(nums)
	sort.Slice(segs, func(i, j int) bool { return segs[i][0] < segs[j][0] })
	m := map[int]int{}
	for i, v := range nums {
		m[v] = i
	}
	tree := newSegmentTree(nums)
	ans := 0
	for i, e := range segs {
		x, y1, y2, k := e[0], e[1], e[2], e[3]
		if i > 0 {
			ans += tree.query() * (x - segs[i-1][0])
			ans %= mod
		}
		tree.modify(1, m[y1], m[y2]-1, k)
	}
	return ans
}

type node struct {
	l      int
	r      int
	cnt    int
	length int
}

type segmentTree struct {
	tr   []*node
	nums []int
}

func newSegmentTree(nums []int) *segmentTree {
	n := len(nums) - 1
	tr := make([]*node, n<<2)
	for i := range tr {
		tr[i] = &node{}
	}
	t := &segmentTree{tr, nums}
	t.build(1, 0, n-1)
	return t
}

func (t *segmentTree) build(u, l, r int) {
	t.tr[u].l, t.tr[u].r = l, r
	if l == r {
		return
	}
	mid := (l + r) >> 1
	t.build(u<<1, l, mid)
	t.build(u<<1|1, mid+1, r)
}

func (t *segmentTree) modify(u, l, r, k int) {
	if t.tr[u].l >= l && t.tr[u].r <= r {
		t.tr[u].cnt += k
	} else {
		mid := (t.tr[u].l + t.tr[u].r) >> 1
		if l <= mid {
			t.modify(u<<1, l, r, k)
		}
		if r > mid {
			t.modify(u<<1|1, l, r, k)
		}
	}
	t.pushup(u)
}

func (t *segmentTree) query() int {
	return t.tr[1].length
}

func (t *segmentTree) pushup(u int) {
	if t.tr[u].cnt > 0 {
		t.tr[u].length = t.nums[t.tr[u].r+1] - t.nums[t.tr[u].l]
	} else if t.tr[u].l == t.tr[u].r {
		t.tr[u].length = 0
	} else {
		t.tr[u].length = t.tr[u<<1].length + t.tr[u<<1|1].length
	}
}1395. 统计作战单位数
题目、示例与约束
n 名士兵站成一排。每个士兵都有一个 独一无二 的评分 rating 。
从中选出 3 个士兵组成一个作战单位,规则如下:
- 从队伍中选出下标分别为
i、j、k的 3 名士兵,他们的评分分别为rating[i]、rating[j]、rating[k] - 作战单位需满足:
rating[i] < rating[j] < rating[k]或者rating[i] > rating[j] > rating[k],其中0 <= i < j < k < n
请你返回按上述条件组建的作战单位的方案数。
示例 1:
输入:rating = [2,5,3,4,1]
输出:3
解释:我们可以组建三个作战单位 (2,3,4)、(5,4,1)、(5,3,1) 。
示例 2:
输入:rating = [2,1,3]
输出:0
解释:根据题目条件,我们无法组建作战单位。
示例 3:
输入:rating = [1,2,3,4]
输出:4
提示:
n == rating.length3 <= n <= 10001 <= rating[i] <= 10^5rating中的元素都是唯一的
方法一:枚举中间元素 · Go 实现
思考
统计严格递增或递减的三元组。 ,枚举三个下标为立方级。固定中间士兵 ,左边更小个数 与右边更大个数 的乘积是递增队伍,左边更大与右边更小的乘积是递减队伍。对每个中间位置各扫两侧即可。
我们可以枚举数组 中每个元素 作为中间元素,然后统计左边比它小的元素的个数 ,右边比它大的元素的个数 ,那么以该元素为中间元素的作战单位的个数为 ,累加到答案中即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func numTeams(rating []int) (ans int) {
	n := len(rating)
	for i, b := range rating {
		l, r := 0, 0
		for _, a := range rating[:i] {
			if a < b {
				l++
			}
		}
		for _, c := range rating[i+1:] {
			if c > b {
				r++
			}
		}
		ans += l * r
		ans += (i - l) * (n - i - 1 - r)
	}
	return
}
方法二:树状数组 · Go 实现
思考
方法一对每个中点扫描两侧,总时间 。值域离散化后,树状数组可以 查询左侧更小、右侧更大的个数:先把全体插入右侧树,扫到 时移到左侧树,再查前缀。
我们可以用两个树状数组分别维护数组 中每个元素的左边比它小的元素的个数 ,右边比它大的元素的个数 ,然后统计以该元素为中间元素的作战单位的个数为 ,累加到答案中即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
type BinaryIndexedTree struct {
	n int
	c []int
}

func newBinaryIndexedTree(n int) *BinaryIndexedTree {
	c := make([]int, n+1)
	return &BinaryIndexedTree{n, c}
}

func (this *BinaryIndexedTree) update(x, delta int) {
	for x <= this.n {
		this.c[x] += delta
		x += x & -x
	}
}

func (this *BinaryIndexedTree) query(x int) int {
	s := 0
	for x > 0 {
		s += this.c[x]
		x -= x & -x
	}
	return s
}

func numTeams(rating []int) (ans int) {
	nums := make([]int, len(rating))
	copy(nums, rating)
	sort.Ints(nums)
	m := 0
	for i, x := range nums {
		if i == 0 || x != nums[i-1] {
			nums[m] = x
			m++
		}
	}
	nums = nums[:m]
	tree1 := newBinaryIndexedTree(m)
	tree2 := newBinaryIndexedTree(m)
	for _, x := range rating {
		tree2.update(sort.SearchInts(nums, x)+1, 1)
	}
	n := len(rating)
	for i, v := range rating {
		x := sort.SearchInts(nums, v) + 1
		tree1.update(x, 1)
		tree2.update(x, -1)
		l := tree1.query(x - 1)
		r := n - i - 1 - tree2.query(x)
		ans += l * r
		ans += (i - l) * (n - i - 1 - r)
	}
	return
}1409. 查询带键的排列
题目、示例与约束
给定一个正整数数组 queries ,其取值范围在 1 到 m 之间。 请你根据以下规则按顺序处理所有 queries[i](从 i=0 到 i=queries.length-1):
- 首先,你有一个排列
P=[1,2,3,...,m]。 - 对于当前的
i,找到queries[i]在排列P中的位置(从 0 开始索引),然后将它移到排列P的开头(即下标为 0 处)。注意,queries[i]的查询结果是queries[i]在P中移动前的位置。
返回一个数组,包含从给定 queries 中查询到的结果。
示例 1:
输入:queries = [3,1,2,1], m = 5
输出:[2,1,2,1]
解释:处理 queries 的过程如下:
对于 i=0: queries[i]=3, P=[1,2,3,4,5], 3 在 P 中的位置是 2,然后我们把 3 移动到 P 的开头,得到 P=[3,1,2,4,5] 。
对于 i=1: queries[i]=1, P=[3,1,2,4,5], 1 在 P 中的位置是 1,然后我们把 1 移动到 P 的开头,得到 P=[1,3,2,4,5] 。
对于 i=2: queries[i]=2, P=[1,3,2,4,5], 2 在 P 中的位置是 2,然后我们把 2 移动到 P 的开头,得到 P=[2,1,3,4,5] 。
对于 i=3: queries[i]=1, P=[2,1,3,4,5], 1 在 P 中的位置是 1,然后我们把 1 移动到 P 的开头,得到 P=[1,2,3,4,5] 。
因此,包含结果的数组为 [2,1,2,1] 。
示例 2:
输入:queries = [4,1,2,2], m = 4
输出:[3,1,2,0]
示例 3:
输入:queries = [7,5,5,8,3], m = 8
输出:[6,5,0,7,5]
提示:
1 <= m <= 10^31 <= queries.length <= m1 <= queries[i] <= m
方法一:模拟 · Go 实现
思考
,每次查询在长度为 的排列中定位元素并移到队首,单次 ,总体 可以通过。
用列表维护当前排列,
index得到位置后弹出并插入开头,按查询顺序记下这些位置。
题目数据规模不大,可以直接模拟。
func processQueries(queries []int, m int) []int {
	p := make([]int, m)
	for i := range p {
		p[i] = i + 1
	}
	ans := []int{}
	for _, v := range queries {
		j := 0
		for i := range p {
			if p[i] == v {
				j = i
				break
			}
		}
		ans = append(ans, j)
		p = append(p[:j], p[j+1:]...)
		p = append([]int{v}, p...)
	}
	return ans
}
方法二:树状数组 · Go 实现
思考
方法一每次线性扫描定位,当查询次数与 同阶时常数偏大。若能在 内回答「某元素左侧还有多少个元素」,即可加速。
将初始排列放在一段下标 上,每次把查询值搬到更靠前的空位。树状数组维护各位置是否占用,查询前缀和即得当前下标。
树状数组,也称作“二叉索引树”(Binary Indexed Tree)或 Fenwick 树。 它可以高效地实现如下两个操作:
- 单点更新
update(x, delta): 把序列 x 位置的数加上一个值 delta; - 前缀和查询
query(x):查询序列[1,...x]区间的区间和,即位置 x 的前缀和。
这两个操作的时间复杂度均为 。
树状数组最基本的功能就是求比某点 x 小的点的个数(这里的比较是抽象的概念,可以是数的大小、坐标的大小、质量的大小等等)。
比如给定数组 a[5] = {2, 5, 3, 4, 1},求 b[i] = 位置 i 左边小于等于 a[i] 的数的个数。对于此例,b[5] = {0, 1, 1, 2, 0}。
解决方案是直接遍历数组,每个位置先求出 query(a[i]),然后再修改树状数组 update(a[i], 1) 即可。当数的范围比较大时,需要进行离散化,即先进行去重并排序,然后对每个数字进行编号。
type BinaryIndexedTree struct {
	n int
	c []int
}

func newBinaryIndexedTree(n int) *BinaryIndexedTree {
	c := make([]int, n+1)
	return &BinaryIndexedTree{n, c}
}

func (this *BinaryIndexedTree) lowbit(x int) int {
	return x & -x
}

func (this *BinaryIndexedTree) update(x, delta int) {
	for x <= this.n {
		this.c[x] += delta
		x += this.lowbit(x)
	}
}

func (this *BinaryIndexedTree) query(x int) int {
	s := 0
	for x > 0 {
		s += this.c[x]
		x -= this.lowbit(x)
	}
	return s
}

func processQueries(queries []int, m int) []int {
	n := len(queries)
	pos := make([]int, m+1)
	tree := newBinaryIndexedTree(m + n)
	for i := 1; i <= m; i++ {
		pos[i] = n + i
		tree.update(n+i, 1)
	}
	ans := []int{}
	for i, v := range queries {
		j := pos[v]
		tree.update(j, -1)
		ans = append(ans, tree.query(j))
		pos[v] = n - i
		tree.update(n-i, 1)
	}
	return ans
}1505. 最多 K 次交换相邻数位后得到的最小整数
题目、示例与约束
给定一个字符串 num 表示非常大的整数和一个整数 k。你可以交换这个整数相邻数位的数字 最多 k 次。
请你返回你能得到的最小整数,并以字符串形式返回。
示例 1:
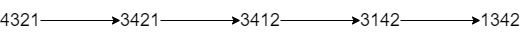
输入:num = "4321", k = 4
输出:"1342"
解释:4321 通过 4 次交换相邻数位得到最小整数的步骤如上图所示。
示例 2:
输入:num = "100", k = 1
输出:"010"
解释:输出可以包含前导 0 ,但输入保证不会有前导 0 。
示例 3:
输入:num = "36789", k = 1000
输出:"36789"
解释:不需要做任何交换。
提示:
1 <= num.length <= 3 * 104num只包含 数字 且不含有 前导 0 。1 <= k <= 109
方法一:贪心算法 + 树状数组 · Go 实现
思考
相邻交换至多 次后要得到字典序最小的数字串。 可达 ,而 ,逐次模拟交换既不可能按 计步,也不能对每个位置暴力搬移。
从左到右构造答案时,当前位应换成能够在剩余次数内到达该位的最小数字。将某一尚未使用的数位 搬到位置 ,代价等于它与 之间尚未被取走的数位个数。
为此按数字 – 分别记下原始下标队列;树状数组维护「哪些原位置已被取走」。枚举候选数字时,用树状数组在 内算出真实距离,若不超过剩余 则选用并更新。这样每位只检查常数个数字,总时间 。
树状数组,也称作“二叉索引树”(Binary Indexed Tree)或 Fenwick 树。 它可以高效地实现如下两个操作:
- 单点更新
update(x, delta): 把序列 x 位置的数加上一个值 delta; - 前缀和查询
query(x):查询序列[1,...x]区间的区间和,即位置 x 的前缀和。
这两个操作的时间复杂度均为 。
对于本题,要想得到在 k 次交换内字典序最小整数,我们可以「贪心」地从 num 的最高位开始考虑,即希望 num 的最高位尽可能小。我们可以依次枚举 0~9,对于当前枚举到的数位 x,判断是否可以将某个位置上的 x 通过最多 k 次交换移动到最高位。由于每一次交换只能交换相邻位置的两个数字,因此将一个距离最高位为 s 的数位移动到最高位,需要 s 次交换操作。例如当 num = 97620 时,0 与最高位的距离为 4,我们可以通过 4 次交换操作把 0 移动到最高位。
这样的交换操作相当于把 0 移动到最高位,同时将 0 之前的所有数位向后移动了一位。
我们接下来考虑次高位。与最高位类似,我们选择最小的数位 x,使得它与次高位的距离不超过 k',其中 k' 是 k 扣除最高位交换后的剩余次数。
考虑上面 num = 97620 的例子,此时我们应当选择 x=2 交换至次高位。然而我们发现,经过第一次的交换操作,2 所在的位置发生了变化!在 num 中,2 与次高位的距离为 2,而将 0 交换至最高位后,2 与次高位的距离增加了 1,变为 3。这是因为 0 从 2 的后面「转移」到了 2 的前面,使得 2 向后移动了一位。因此,x 实际所在的位置,等于 x 初始时在 num 中的位置,加上 x 后面发生交换的数位个数。这里的「x 后面发生交换的数位个数」,就可以使用树状数组进行维护。
解题思路如下:
- 用
pos[x]按照高位到低位的顺序,存放所有 x 在 num 中出现的位置; - 从高到低遍历每一个位置。对于位置 i,我们从小到大枚举交换的数位 x。
pos[x]中的首个元素即为与当前位置距离最近的 x 的位置:- 记 j 为
pos[x]中的首元素,那么num[j](也即是 x)当前实际所在的位置,等于 j 加上 j 后面发现交换的数位个数。我们使用树状数组查询区间[j + 1, n],那么 num[j] 与位置 i 的实际距离 dist 为:tree.query(n) - tree.query(j) + j - i。 - 如果 dist 小于等于 k,那么我们可以将 x 交换至位置 i。我们使用树状数组更新单点 j,将对应的值增加 1,表示该位置的数位发生了变换。随后更新 k 值,以及将 j 从
pos[x]中移除。
- 记 j 为
- 遍历结束后,我们就得到了答案。
type BinaryIndexedTree struct {
	n int
	c []int
}

func newBinaryIndexedTree(n int) *BinaryIndexedTree {
	c := make([]int, n+1)
	return &BinaryIndexedTree{n, c}
}

func (this *BinaryIndexedTree) lowbit(x int) int {
	return x & -x
}

func (this *BinaryIndexedTree) update(x, delta int) {
	for x <= this.n {
		this.c[x] += delta
		x += this.lowbit(x)
	}
}

func (this *BinaryIndexedTree) query(x int) int {
	s := 0
	for x > 0 {
		s += this.c[x]
		x -= this.lowbit(x)
	}
	return s
}

func minInteger(num string, k int) string {
	pos := make([][]int, 10)
	for i, c := range num {
		pos[c-'0'] = append(pos[c-'0'], i+1)
	}
	n := len(num)
	tree := newBinaryIndexedTree(n)
	var ans strings.Builder
	for i := 1; i <= n; i++ {
		for v := 0; v < 10; v++ {
			if len(pos[v]) > 0 {
				j := pos[v][0]
				dist := tree.query(n) - tree.query(j) + j - i
				if dist <= k {
					k -= dist
					pos[v] = pos[v][1:]
					ans.WriteByte(byte(v + '0'))
					tree.update(j, 1)
					break
				}
			}
		}
	}
	return ans.String()
}1521. 找到最接近目标值的函数值
题目、示例与约束
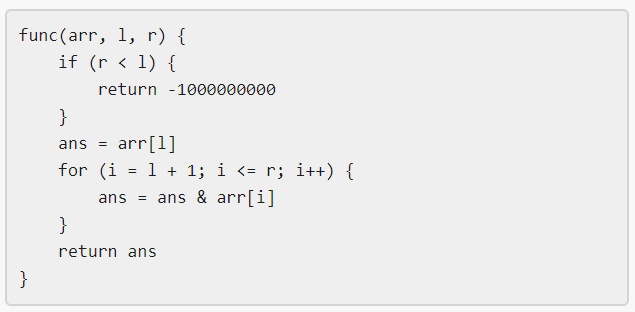
Winston 构造了一个如上所示的函数 func 。他有一个整数数组 arr 和一个整数 target ,他想找到让 |func(arr, l, r) - target| 最小的 l 和 r 。
请你返回 |func(arr, l, r) - target| 的最小值。
请注意, func 的输入参数 l 和 r 需要满足 0 <= l, r < arr.length 。
示例 1:
输入:arr = [9,12,3,7,15], target = 5
输出:2
解释:所有可能的 [l,r] 数对包括 [[0,0],[1,1],[2,2],[3,3],[4,4],[0,1],[1,2],[2,3],[3,4],[0,2],[1,3],[2,4],[0,3],[1,4],[0,4]], Winston 得到的相应结果为 [9,12,3,7,15,8,0,3,7,0,0,3,0,0,0] 。最接近 5 的值是 7 和 3,所以最小差值为 2 。
示例 2:
输入:arr = [1000000,1000000,1000000], target = 1
输出:999999
解释:Winston 输入函数的所有可能 [l,r] 数对得到的函数值都为 1000000 ,所以最小差值为 999999 。
示例 3:
输入:arr = [1,2,4,8,16], target = 0
输出:0
提示:
1 <= arr.length <= 10^51 <= arr[i] <= 10^60 <= target <= 10^7
方法一:哈希表 + 枚举 · Go 实现
思考
函数 是子数组的按位与,要求它与 的绝对差最小。子数组有 个, ,全部求出不可行。
从固定右端向左延伸时,按位与只减不增,且不同值至多 个,因为每次变化至少少掉一个 比特。用集合维护「以当前下标为右端的所有与值」,由上一列的与值再与 得到,同时更新与 的最小偏差。
根据题目描述,我们知道,函数 实际上就是数组 下标 到 的元素的按位与运算的结果,即 。
如果我们每次固定右端点 ,那么左端点 的范围是 。由于按位与之和随着 的减小而单调递减,并且 的值不超过 ,因此区间 最多只有 种不同的值。因此,我们可以用一个集合来维护所有的 的值。当我们从 遍历到 时,以 为右端点的值,就是集合中每个值与 进行按位与运算得到的值,再加上 本身。因此,我们只需要枚举集合中的每个值,与 进行按位与运算,就可以得到以 为右端点的所有值,将每个值与 相减后取绝对值,就可以得到以 为右端点的所有值与 的差的绝对值,其中的最小值就是答案。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 的长度和数组 中的最大值。
相似题目:
func closestToTarget(arr []int, target int) int {
	ans := abs(arr[0] - target)
	pre := map[int]bool{arr[0]: true}
	for _, x := range arr {
		cur := map[int]bool{x: true}
		for y := range pre {
			cur[x&y] = true
		}
		for y := range cur {
			ans = min(ans, abs(y-target))
		}
		pre = cur
	}
	return ans
}

func abs(x int) int {
	if x < 0 {
		return -x
	}
	return x
}1649. 通过指令创建有序数组
题目、示例与约束
给你一个整数数组 instructions ,你需要根据 instructions 中的元素创建一个有序数组。一开始你有一个空的数组 nums ,你需要 从左到右 遍历 instructions 中的元素,将它们依次插入 nums 数组中。每一次插入操作的 代价 是以下两者的 较小值 :
nums中 严格小于instructions[i]的数字数目。nums中 严格大于instructions[i]的数字数目。
比方说,如果要将 3 插入到 nums = [1,2,3,5] ,那么插入操作的 代价 为 min(2, 1) (元素 1 和 2 小于 3 ,元素 5 大于 3 ),插入后 nums 变成 [1,2,3,3,5] 。
请你返回将 instructions 中所有元素依次插入 nums 后的 总最小代价 。由于答案会很大,请将它对 109 + 7 取余 后返回。
示例 1:
输入:instructions = [1,5,6,2]
输出:1
解释:一开始 nums = [] 。
插入 1 ,代价为 min(0, 0) = 0 ,现在 nums = [1] 。
插入 5 ,代价为 min(1, 0) = 0 ,现在 nums = [1,5] 。
插入 6 ,代价为 min(2, 0) = 0 ,现在 nums = [1,5,6] 。
插入 2 ,代价为 min(1, 2) = 1 ,现在 nums = [1,2,5,6] 。
总代价为 0 + 0 + 0 + 1 = 1 。
示例 2:
输入:instructions = [1,2,3,6,5,4]
输出:3
解释:一开始 nums = [] 。
插入 1 ,代价为 min(0, 0) = 0 ,现在 nums = [1] 。
插入 2 ,代价为 min(1, 0) = 0 ,现在 nums = [1,2] 。
插入 3 ,代价为 min(2, 0) = 0 ,现在 nums = [1,2,3] 。
插入 6 ,代价为 min(3, 0) = 0 ,现在 nums = [1,2,3,6] 。
插入 5 ,代价为 min(3, 1) = 1 ,现在 nums = [1,2,3,5,6] 。
插入 4 ,代价为 min(3, 2) = 2 ,现在 nums = [1,2,3,4,5,6] 。
总代价为 0 + 0 + 0 + 0 + 1 + 2 = 3 。
示例 3:
输入:instructions = [1,3,3,3,2,4,2,1,2] 输出:4 解释:一开始 nums = [] 。 插入 1 ,代价为 min(0, 0) = 0 ,现在 nums = [1] 。 插入 3 ,代价为 min(1, 0) = 0 ,现在 nums = [1,3] 。 插入 3 ,代价为 min(1, 0) = 0 ,现在 nums = [1,3,3] 。 插入 3 ,代价为 min(1, 0) = 0 ,现在 nums = [1,3,3,3] 。 插入 2 ,代价为 min(1, 3) = 1 ,现在 nums = [1,2,3,3,3] 。 插入 4 ,代价为 min(5, 0) = 0 ,现在 nums = [1,2,3,3,3,4] 。 插入 2 ,代价为 min(1, 4) = 1 ,现在 nums = [1,2,2,3,3,3,4] 。 插入 1 ,代价为 min(0, 6) = 0 ,现在 nums = [1,1,2,2,3,3,3,4] 。 插入 2 ,代价为 min(2, 4) = 2 ,现在 nums = [1,1,2,2,2,3,3,3,4] 。 总代价为 0 + 0 + 0 + 0 + 1 + 0 + 1 + 0 + 2 = 4 。
提示:
1 <= instructions.length <= 1051 <= instructions[i] <= 105
方法一:树状数组 · Go 实现
思考
每次插入的代价是已有序列中严格更小与严格更大个数的较小值,插入次数 ,朴素统计是平方级。
值域也是 ,树状数组可在 内查询前缀个数并单点加一。
插入 前,代价为 ,再 ,总和取模。
树状数组,也称作“二叉索引树”(Binary Indexed Tree)或 Fenwick 树。 它可以高效地实现如下两个操作:
- 单点更新
update(x, delta): 把序列 x 位置的数加上一个值 delta; - 前缀和查询
query(x):查询序列[1,...x]区间的区间和,即位置 x 的前缀和。
这两个操作的时间复杂度均为 。
树状数组最基本的功能就是求比某点 x 小的点的个数(这里的比较是抽象的概念,可以是数的大小、坐标的大小、质量的大小等等)。
比如给定数组 a[5] = {2, 5, 3, 4, 1},求 b[i] = 位置 i 左边小于等于 a[i] 的数的个数。对于此例,b[5] = {0, 1, 1, 2, 0}。
解决方案是直接遍历数组,每个位置先求出 query(a[i]),然后再修改树状数组 update(a[i], 1) 即可。当数的范围比较大时,需要进行离散化,即先进行去重并排序,然后对每个数字进行编号。
type BinaryIndexedTree struct {
	n int
	c []int
}

func newBinaryIndexedTree(n int) *BinaryIndexedTree {
	c := make([]int, n+1)
	return &BinaryIndexedTree{n, c}
}

func (this *BinaryIndexedTree) update(x, delta int) {
	for x <= this.n {
		this.c[x] += delta
		x += x & -x
	}
}

func (this *BinaryIndexedTree) query(x int) int {
	s := 0
	for x > 0 {
		s += this.c[x]
		x -= x & -x
	}
	return s
}

func createSortedArray(instructions []int) (ans int) {
	m := slices.Max(instructions)
	tree := newBinaryIndexedTree(m)
	const mod = 1e9 + 7
	for i, x := range instructions {
		cost := min(tree.query(x-1), i-tree.query(x))
		ans = (ans + cost) % mod
		tree.update(x, 1)
	}
	return
}1687. 从仓库到码头运输箱子
题目、示例与约束
你有一辆货运卡车,你需要用这一辆车把一些箱子从仓库运送到码头。这辆卡车每次运输有 箱子数目的限制 和 总重量的限制 。
给你一个箱子数组 boxes 和三个整数 portsCount, maxBoxes 和 maxWeight ,其中 boxes[i] = [portsi, weighti] 。
portsi表示第i个箱子需要送达的码头,weightsi是第i个箱子的重量。portsCount是码头的数目。maxBoxes和maxWeight分别是卡车每趟运输箱子数目和重量的限制。
箱子需要按照 数组顺序 运输,同时每次运输需要遵循以下步骤:
- 卡车从
boxes队列中按顺序取出若干个箱子,但不能违反maxBoxes和maxWeight限制。 - 对于在卡车上的箱子,我们需要 按顺序 处理它们,卡车会通过 一趟行程 将最前面的箱子送到目的地码头并卸货。如果卡车已经在对应的码头,那么不需要 额外行程 ,箱子也会立马被卸货。
- 卡车上所有箱子都被卸货后,卡车需要 一趟行程 回到仓库,从箱子队列里再取出一些箱子。
卡车在将所有箱子运输并卸货后,最后必须回到仓库。
请你返回将所有箱子送到相应码头的 最少行程 次数。
示例 1:
输入:boxes = [[1,1],[2,1],[1,1]], portsCount = 2, maxBoxes = 3, maxWeight = 3
输出:4
解释:最优策略如下:
- 卡车将所有箱子装上车,到达码头 1 ,然后去码头 2 ,然后再回到码头 1 ,最后回到仓库,总共需要 4 趟行程。
所以总行程数为 4 。
注意到第一个和第三个箱子不能同时被卸货,因为箱子需要按顺序处理(也就是第二个箱子需要先被送到码头 2 ,然后才能处理第三个箱子)。
示例 2:
输入:boxes = [[1,2],[3,3],[3,1],[3,1],[2,4]], portsCount = 3, maxBoxes = 3, maxWeight = 6
输出:6
解释:最优策略如下:
- 卡车首先运输第一个箱子,到达码头 1 ,然后回到仓库,总共 2 趟行程。
- 卡车运输第二、第三、第四个箱子,到达码头 3 ,然后回到仓库,总共 2 趟行程。
- 卡车运输第五个箱子,到达码头 2 ,回到仓库,总共 2 趟行程。
总行程数为 2 + 2 + 2 = 6 。
示例 3:
输入:boxes = [[1,4],[1,2],[2,1],[2,1],[3,2],[3,4]], portsCount = 3, maxBoxes = 6, maxWeight = 7
输出:6
解释:最优策略如下:
- 卡车运输第一和第二个箱子,到达码头 1 ,然后回到仓库,总共 2 趟行程。
- 卡车运输第三和第四个箱子,到达码头 2 ,然后回到仓库,总共 2 趟行程。
- 卡车运输第五和第六个箱子,到达码头 3 ,然后回到仓库,总共 2 趟行程。
总行程数为 2 + 2 + 2 = 6 。
示例 4:
输入:boxes = [[2,4],[2,5],[3,1],[3,2],[3,7],[3,1],[4,4],[1,3],[5,2]], portsCount = 5, maxBoxes = 5, maxWeight = 7
输出:14
解释:最优策略如下:
- 卡车运输第一个箱子,到达码头 2 ,然后回到仓库,总共 2 趟行程。
- 卡车运输第二个箱子,到达码头 2 ,然后回到仓库,总共 2 趟行程。
- 卡车运输第三和第四个箱子,到达码头 3 ,然后回到仓库,总共 2 趟行程。
- 卡车运输第五个箱子,到达码头 3 ,然后回到仓库,总共 2 趟行程。
- 卡车运输第六和第七个箱子,到达码头 3 ,然后去码头 4 ,然后回到仓库,总共 3 趟行程。
- 卡车运输第八和第九个箱子,到达码头 1 ,然后去码头 5 ,然后回到仓库,总共 3 趟行程。
总行程数为 2 + 2 + 2 + 2 + 3 + 3 = 14 。
提示:
1 <= boxes.length <= 1051 <= portsCount, maxBoxes, maxWeight <= 1051 <= portsi <= portsCount1 <= weightsi <= maxWeight
方法一:动态规划 · Go 实现
思考
箱子必须按序连续装车,每趟有件数、重量上限,行程包含往返仓库以及相邻不同码头的跳转。 为送完前 箱的最少行程,枚举上一趟的分界 。
码头跳转次数用前缀和 在 内得到,再加上往返的 。 达 时该 转移仅作为正确但不实用的基线。
我们定义 表示把前 个箱子从仓库运送到相应码头的最少行程数,那么答案就是 。
箱子需要按数组顺序运输,每一次运输,卡车会按顺序取出连续的几个箱子,然后依次送往对应的码头,全部送达之后,又回到了仓库。
因此,我们可以枚举上一次运输的最后一个箱子的编号 ,那么 就可以从 转移而来,转移的时候,我们需要考虑以下几个问题:
- 从 转移过来的时候,卡车上的箱子数量不能超过
- 从 转移过来的时候,卡车上的箱子总重量不能超过
状态转移方程为:
其中 表示通过一次运输,把 这些箱子送往对应的码头所需要的行程数。这部分行程数可以通过前缀和快速计算出来。
简单举个例子,假设我们取出了 这三个箱子,需要送往 这三个码头,那么我们首先要从仓库到 号码头,然后再从 号码头到 号码头,最后再从 号码头回到仓库。可以发现,从仓库到码头,以及从码头到仓库,需要花费 趟行程,而从码头到码头的行程数,取决于相邻两个码头是否相同,如果不相同,那么行程数会增加 ,否则不变。因此,我们可以通过前缀和,计算出码头之间的行程数,再加上首尾两趟行程,就能把 这些箱子送往对应的码头所需要的行程数计算出来。
时间复杂度 ,空间复杂度 。其中 是箱子的数量。本题数据规模达到 ,该做法会超出时间限制。
func boxDelivering(boxes [][]int, portsCount int, maxBoxes int, maxWeight int) int {
	n := len(boxes)
	ws := make([]int, n+1)
	cs := make([]int, n)
	for i, box := range boxes {
		p, w := box[0], box[1]
		ws[i+1] = ws[i] + w
		if i < n-1 {
			t := 0
			if p != boxes[i+1][0] {
				t++
			}
			cs[i+1] = cs[i] + t
		}
	}
	f := make([]int, n+1)
	for i := 1; i <= n; i++ {
		f[i] = 1 << 30
		for j := max(0, i-maxBoxes); j < i; j++ {
			if ws[i]-ws[j] <= maxWeight {
				f[i] = min(f[i], f[j]+cs[i-1]-cs[j]+2)
			}
		}
	}
	return f[n]
}
方法二:动态规划 + 单调队列优化 · Go 实现
思考
方法一在窗口 上求 的最小,且还受重量前缀约束。单调队列维护候选 ,使转移摊还 。
队首超出件数或重量则弹出,队尾按 保持递增,总时间 。
本题数据规模达到 ,方法一的时间复杂度为 ,会超出时间限制。我们仔细观察:
实际上我们是要在 这个窗口内找到一个 ,使得 的值最小,求滑动窗口的最小值,一种常用的做法是使用单调队列,可以在 时间内获取到满足条件的最小值。
时间复杂度 ,空间复杂度 。其中 是题目中箱子的数量。
func boxDelivering(boxes [][]int, portsCount int, maxBoxes int, maxWeight int) int {
	n := len(boxes)
	ws := make([]int, n+1)
	cs := make([]int, n)
	for i, box := range boxes {
		p, w := box[0], box[1]
		ws[i+1] = ws[i] + w
		if i < n-1 {
			t := 0
			if p != boxes[i+1][0] {
				t++
			}
			cs[i+1] = cs[i] + t
		}
	}
	f := make([]int, n+1)
	q := []int{0}
	for i := 1; i <= n; i++ {
		for len(q) > 0 && (i-q[0] > maxBoxes || ws[i]-ws[q[0]] > maxWeight) {
			q = q[1:]
		}
		if len(q) > 0 {
			f[i] = cs[i-1] + f[q[0]] - cs[q[0]] + 2
		}
		if i < n {
			for len(q) > 0 && f[q[len(q)-1]]-cs[q[len(q)-1]] >= f[i]-cs[i] {
				q = q[:len(q)-1]
			}
			q = append(q, i)
		}
	}
	return f[n]
}1964. 找出到每个位置为止最长的有效障碍赛跑路线
题目、示例与约束
你打算构建一些障碍赛跑路线。给你一个 下标从 0 开始 的整数数组 obstacles ,数组长度为 n ,其中 obstacles[i] 表示第 i 个障碍的高度。
对于每个介于 0 和 n - 1 之间(包含 0 和 n - 1)的下标 i ,在满足下述条件的前提下,请你找出 obstacles 能构成的最长障碍路线的长度:
- 你可以选择下标介于
0到i之间(包含0和i)的任意个障碍。 - 在这条路线中,必须包含第
i个障碍。 - 你必须按障碍在
obstacles中的 出现顺序 布置这些障碍。 - 除第一个障碍外,路线中每个障碍的高度都必须和前一个障碍 相同 或者 更高 。
返回长度为 n 的答案数组 ans ,其中 ans[i] 是上面所述的下标 i 对应的最长障碍赛跑路线的长度。
示例 1:
输入:obstacles = [1,2,3,2]
输出:[1,2,3,3]
解释:每个位置的最长有效障碍路线是:
- i = 0: [1], [1] 长度为 1
- i = 1: [1,2], [1,2] 长度为 2
- i = 2: [1,2,3], [1,2,3] 长度为 3
- i = 3: [1,2,3,2], [1,2,2] 长度为 3
示例 2:
输入:obstacles = [2,2,1]
输出:[1,2,1]
解释:每个位置的最长有效障碍路线是:
- i = 0: [2], [2] 长度为 1
- i = 1: [2,2], [2,2] 长度为 2
- i = 2: [2,2,1], [1] 长度为 1
示例 3:
输入:obstacles = [3,1,5,6,4,2]
输出:[1,1,2,3,2,2]
解释:每个位置的最长有效障碍路线是:
- i = 0: [3], [3] 长度为 1
- i = 1: [3,1], [1] 长度为 1
- i = 2: [3,1,5], [3,5] 长度为 2, [1,5] 也是有效的障碍赛跑路线
- i = 3: [3,1,5,6], [3,5,6] 长度为 3, [1,5,6] 也是有效的障碍赛跑路线
- i = 4: [3,1,5,6,4], [3,4] 长度为 2, [1,4] 也是有效的障碍赛跑路线
- i = 5: [3,1,5,6,4,2], [1,2] 长度为 2
提示:
n == obstacles.length1 <= n <= 1051 <= obstacles[i] <= 107
方法一:树状数组 · Go 实现
思考
每位障碍要接在左侧不更高的最长上升序列之后。朴素对左侧枚举为 , 不可行。
值域离散化后,树状数组维护「高度 的最长长度」。查询 的前缀最大再加一,并回写该高度。
每位 。
我们可以用树状数组维护一个最长递增子序列的长度数组。
然后对于每个障碍,我们在树状数组中查询小于等于当前障碍的最长递增子序列的长度,假设为 ,那么当前障碍的最长递增子序列的长度为 ,我们将 添加到答案数组中,并将 更新到树状数组。
时间复杂度 ,空间复杂度 。其中 为障碍的数量。
type BinaryIndexedTree struct {
	n int
	c []int
}

func NewBinaryIndexedTree(n int) *BinaryIndexedTree {
	return &BinaryIndexedTree{n, make([]int, n+1)}
}

func (bit *BinaryIndexedTree) update(x, v int) {
	for x <= bit.n {
		bit.c[x] = max(bit.c[x], v)
		x += x & -x
	}
}

func (bit *BinaryIndexedTree) query(x int) (s int) {
	for x > 0 {
		s = max(s, bit.c[x])
		x -= x & -x
	}
	return
}

func longestObstacleCourseAtEachPosition(obstacles []int) (ans []int) {
	nums := slices.Clone(obstacles)
	sort.Ints(nums)
	n := len(nums)
	tree := NewBinaryIndexedTree(n)
	for k, x := range obstacles {
		i := sort.SearchInts(nums, x) + 1
		ans = append(ans, tree.query(i)+1)
		tree.update(i, ans[k])
	}
	return
}2031. 1 比 0 多的子数组个数 🔒
题目、示例与约束
给你一个只包含 0 和 1 的数组 nums,请返回 1 的数量 大于 0 的数量的子数组的个数。由于答案可能很大,请返回答案对 109 + 7 取余 的结果。
一个 子数组 指的是原数组中连续的一个子序列。
示例 1:
输入: nums = [0,1,1,0,1]
输出: 9
解释:
长度为 1 的、1 的数量大于 0 的数量的子数组有: [1], [1], [1]
长度为 2 的、1 的数量大于 0 的数量的子数组有: [1,1]
长度为 3 的、1 的数量大于 0 的数量的子数组有: [0,1,1], [1,1,0], [1,0,1]
长度为 4 的、1 的数量大于 0 的数量的子数组有: [1,1,0,1]
长度为 5 的、1 的数量大于 0 的数量的子数组有: [0,1,1,0,1]
示例 2:
输入: nums = [0]
输出: 0
解释:
没有子数组的 1 的数量大于 0 的数量。
示例 3:
输入: nums = [1]
输出: 1
解释:
长度为 1 的、1 的数量大于 0 的数量的子数组有: [1]
提示:
1 <= nums.length <= 1050 <= nums[i] <= 1
方法一:前缀和 + 树状数组 · Go 实现
思考
将 视为 后,子数组 多于 当且仅当前缀和严格上升。枚举右端时,需统计历史前缀中小于当前 的个数。 较大时,有序插入须对数结构。
前缀和取值在 ,平移 后可用树状数组做前缀计数。初始放入 一次,每步先查询再更新,并对 取模。
题目需要我们统计所有子数组中 的数量大于 的数量的子数组的个数,如果我们将数组中的元素 看作 ,那么题目就变成了统计所有子数组中元素和大于 的子数组的个数。
求子数组的元素和,可以使用前缀和来实现。为了统计所有子数组中元素和大于 的子数组的个数,我们可以用树状数组维护每个前缀和出现的次数。初始时前缀和为 的次数为 。
接下来,我们遍历数组 ,用变量 记录当前的前缀和,用变量 记录答案。对于每个位置 ,更新前缀和 ,然后我们在树状数组中查询 范围内的前缀和出现的次数,将其加到 中,然后在树状数组中更新 出现的次数。
最后返回 即可。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
type BinaryIndexedTree struct {
	n int
	c []int
}

func newBinaryIndexedTree(n int) *BinaryIndexedTree {
	return &BinaryIndexedTree{n: n, c: make([]int, n+1)}
}

func (bit *BinaryIndexedTree) update(x, v int) {
	for ; x <= bit.n; x += x & -x {
		bit.c[x] += v
	}
}

func (bit *BinaryIndexedTree) query(x int) (s int) {
	for ; x > 0; x -= x & -x {
		s += bit.c[x]
	}
	return
}

func subarraysWithMoreZerosThanOnes(nums []int) (ans int) {
	n := len(nums)
	base := n + 1
	tree := newBinaryIndexedTree(n + base)
	tree.update(base, 1)
	const mod = int(1e9) + 7
	s := 0
	for _, x := range nums {
		if x == 0 {
			s--
		} else {
			s++
		}
		ans += tree.query(s - 1 + base)
		ans %= mod
		tree.update(s+base, 1)
	}
	return
}2158. 每天绘制新区域的数量 🔒
题目、示例与约束
有一幅细长的画,可以用数轴来表示。 给你一个长度为 n 、下标从 0 开始的二维整数数组 paint ,其中 paint[i] = [starti, endi] 表示在第 i 天你需要绘制 starti 和 endi 之间的区域。
多次绘制同一区域会导致不均匀,因此每个区域最多只能绘制 一次 。
返回一个长度为 n 的整数数组 worklog,其中 worklog[i] 是你在第 i 天绘制的 新 区域的数量。
示例 1:
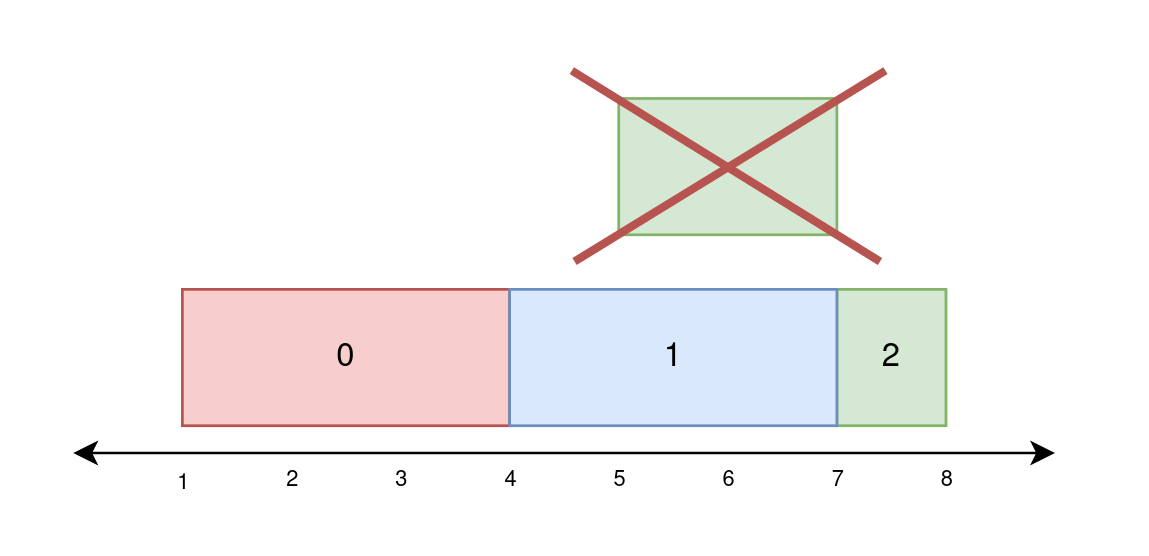
输入:paint = [[1,4],[4,7],[5,8]]
输出:[3,3,1]
解释:
在第 0 天,绘制 1 到 4 之间的所有内容。
第 0 天绘制的新区域数量为 4 - 1 = 3 。
在第 1 天,绘制 4 到 7 之间的所有内容。
第 1 天绘制的新区域数量为 7 - 4 = 3 。
在第 2 天,绘制 7 到 8 之间的所有内容。
5 到 7 之间的所有内容都已在第 1 天绘制完毕。
第 2 天绘制的新区域数量为 8 - 7 = 1 。
示例 2:
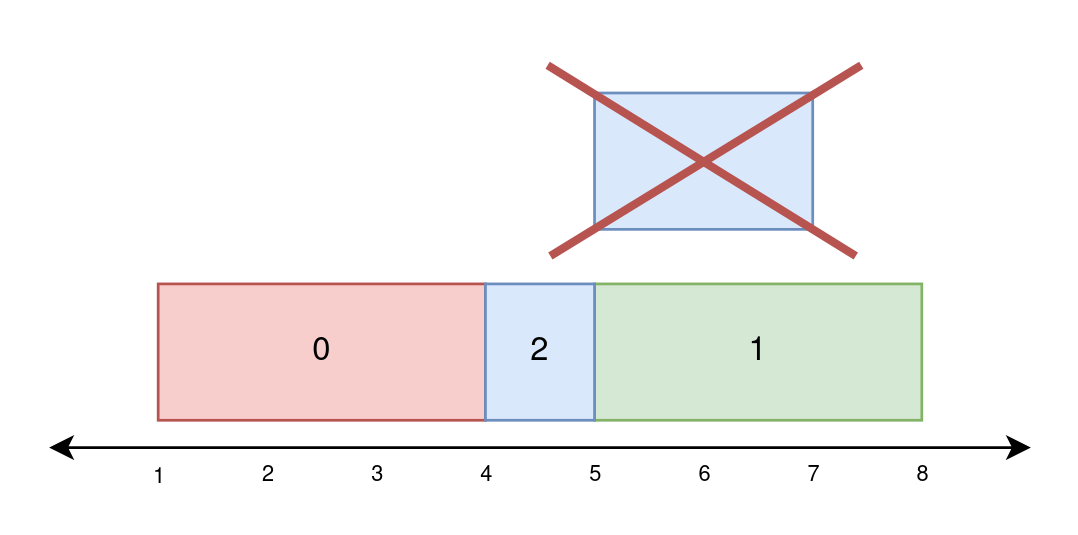
输入:paint = [[1,4],[5,8],[4,7]]
输出:[3,3,1]
解释:
在第 0 天,绘制 1 到 4 之间的所有内容。
第 0 天绘制的新区域数量为 4 - 1 = 3 。
第 1 天,绘制 5 到 8 之间的所有内容。
第 1 天绘制的新区域数量为 8 - 5 = 3 。
在第 2 天,绘制 4 到 5 之间的所有内容。
5 到 7 之间的所有内容都已在第 1 天绘制完毕。
第 2 天绘制的新区域数量为 5 - 4 = 1 。
示例 3:
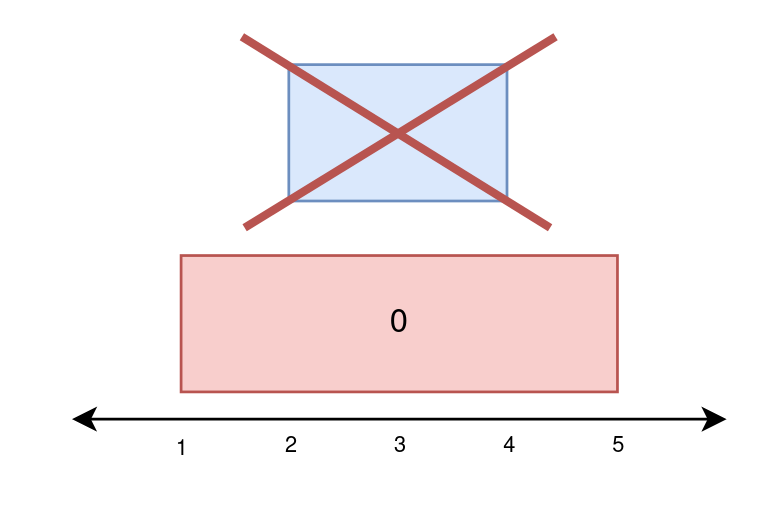
输入:paint = [[1,5],[2,4]]
输出:[4,0]
解释:
在第 0 天,绘制 1 到 5 之间的所有内容。
第 0 天绘制的新区域数量为 5 - 1 = 4 。
在第 1 天,什么都不画,因为第 0 天已经画了 2 到 4 之间的所有内容。
第 1 天绘制的新区域数量为 0 。
提示:
1 <= paint.length <= 105paint[i].length == 20 <= starti < endi <= 5 * 104
方法一:Go 解法(本站整理) · Go 实现
基于 Doocs 区间覆盖线段树参考改写。线段树节点记录区间已经涂色的长度;已全涂的节点无需再次访问。查询更新 [start,end) 时,若完全覆盖节点,新增长度为区间长度减去已涂长度,并将节点标成全涂;部分覆盖时递归左右并汇总。只从未涂变成已涂,不需要下推已经全涂的节点。n 为天数、U 为最大终点,时间 O(n log U),空间 O(U)。入口 amountPainted;右端点不包含。
出处:Doocs 原题与题解,固定提交 91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011;题意、参考及本 Go 改写采用 CC BY-SA 4.0。
// 题意与参考:Doocs LeetCode,CC BY-SA 4.0。
// https://github.com/doocs/leetcode/blob/91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011/solution/2100-2199/2158.Amount%20of%20New%20Area%20Painted%20Each%20Day/README.md
// Go 实现与测试沿用 CC BY-SA 4.0;来源性质见配套说明。
func amountPainted(paint [][]int) []int {
	limit := 0
	for _, p := range paint {
		if p[1] > limit {
			limit = p[1]
		}
	}
	covered := make([]int, 4*limit+4)
	var update func(int, int, int, int, int) int
	update = func(node, l, r, ql, qr int) int {
		if qr <= l || r <= ql || covered[node] == r-l {
			return 0
		}
		if ql <= l && r <= qr {
			fresh := r - l - covered[node]
			covered[node] = r - l
			return fresh
		}
		mid := (l + r) / 2
		fresh := update(node*2, l, mid, ql, qr) + update(node*2+1, mid, r, ql, qr)
		covered[node] = covered[node*2] + covered[node*2+1]
		return fresh
	}
	ans := make([]int, len(paint))
	for i, p := range paint {
		ans[i] = update(1, 0, limit, p[0], p[1])
	}
	return ans
}2179. 统计数组中好三元组数目
题目、示例与约束
给你两个下标从 0 开始且长度为 n 的整数数组 nums1 和 nums2 ,两者都是 [0, 1, ..., n - 1] 的 排列 。
好三元组 指的是 3 个 互不相同 的值,且它们在数组 nums1 和 nums2 中出现顺序保持一致。换句话说,如果我们将 pos1v 记为值 v 在 nums1 中出现的位置,pos2v 为值 v 在 nums2 中的位置,那么一个好三元组定义为 0 <= x, y, z <= n - 1 ,且 pos1x < pos1y < pos1z 和 pos2x < pos2y < pos2z 都成立的 (x, y, z) 。
请你返回好三元组的 总数目 。
示例 1:
输入:nums1 = [2,0,1,3], nums2 = [0,1,2,3]
输出:1
解释:
总共有 4 个三元组 (x,y,z) 满足 pos1x < pos1y < pos1z ,分别是 (2,0,1) ,(2,0,3) ,(2,1,3) 和 (0,1,3) 。
这些三元组中,只有 (0,1,3) 满足 pos2x < pos2y < pos2z 。所以只有 1 个好三元组。
示例 2:
输入:nums1 = [4,0,1,3,2], nums2 = [4,1,0,2,3]
输出:4
解释:总共有 4 个好三元组 (4,0,3) ,(4,0,2) ,(4,1,3) 和 (4,1,2) 。
提示:
n == nums1.length == nums2.length3 <= n <= 1050 <= nums1[i], nums2[i] <= n - 1nums1和nums2是[0, 1, ..., n - 1]的排列。
方法一:树状数组 · Go 实现
思考
好三元组在两个排列中相对顺序一致。枚举三元组为 , 不可行。固定中间值后,左侧应是「在 中已出现、且在 中位置更前」的个数,右侧对称。
按 顺序插入 中的位置,树状数组查询该位置前缀已插入数,以及后缀尚未插入数,乘积即该中间值的贡献。
位置从 编号,每处理完一个值就 。
对于本题,我们先用 pos 记录每个数在 nums2 中的位置,然后依次对 nums1 中的每个元素进行处理。
考虑以当前数字作为三元组中间数字的好三元组的数目。第一个数字需要是之前已经遍历过的,并且在 nums2 中的位置比当前数字更靠前的;第三个数字需要是当前还没有遍历过的,并且在 nums2 中的位置比当前数字更靠后的。
以 nums1 = [4,0,1,3,2], nums2 = [4,1,0,2,3]为例,考虑我们的遍历过程:
- 首先处理 4,此时 nums2 中出现情况为
[4,X,X,X,X],4 之前有值的个数是 0,4 之后没有值的个数有 4 个。因此以 4 为中间数字能形成 0 个好三元组。 - 接下来是 0,此时 nums2 中出现情况为
[4,X,0,X,X],0 之前有值的个数是 1,0 之后没有值的个数有 2 个。因此以 0 为中间数字能形成 2 个好三元组。 - 接下来是 1,此时 nums2 中出现情况为
[4,1,0,X,X],1 之前有值的个数是 1,0 之后没有值的个数有 2 个。因此以 1 为中间数字能形成 2 个好三元组。 - ...
- 最后是 2,此时 nums2 中出现情况为
[4,1,0,2,3],2 之前有值的个数是 4,2 之后没有值的个数是 0。因此以 2 为中间数字能形成 0 个好三元组。
我们可以用树状数组来更新 nums2 中各个位置数字的出现情况,快速算出每个数字左侧 1 的个数,以及右侧 0 的个数。
树状数组,也称作“二叉索引树”(Binary Indexed Tree)或 Fenwick 树。 它可以高效地实现如下两个操作:
- 单点更新
update(x, delta): 把序列 x 位置的数加上一个值 delta; - 前缀和查询
query(x):查询序列[1,...x]区间的区间和,即位置 x 的前缀和。
这两个操作的时间复杂度均为 。因此,整体的时间复杂度为 ,其中 为数组 的长度。空间复杂度 。
type BinaryIndexedTree struct {
	n int
	c []int
}

func newBinaryIndexedTree(n int) *BinaryIndexedTree {
	c := make([]int, n+1)
	return &BinaryIndexedTree{n, c}
}

func (this *BinaryIndexedTree) lowbit(x int) int {
	return x & -x
}

func (this *BinaryIndexedTree) update(x, delta int) {
	for x <= this.n {
		this.c[x] += delta
		x += this.lowbit(x)
	}
}

func (this *BinaryIndexedTree) query(x int) int {
	s := 0
	for x > 0 {
		s += this.c[x]
		x -= this.lowbit(x)
	}
	return s
}

func goodTriplets(nums1 []int, nums2 []int) int64 {
	n := len(nums1)
	pos := make([]int, n)
	for i, v := range nums2 {
		pos[v] = i + 1
	}
	tree := newBinaryIndexedTree(n)
	var ans int64
	for _, num := range nums1 {
		p := pos[num]
		left := tree.query(p)
		right := n - p - (tree.query(n) - tree.query(p))
		ans += int64(left) * int64(right)
		tree.update(p, 1)
	}
	return ans
}
方法二:线段树 · Go 实现
思考
方法一用树状数组维护前缀插入数。同一前缀和也可用线段树单点加、区间求和完成,渐近复杂度相同,常数与实现不同。
结点存储区间内已出现的个数,查询 与 的未出现数,乘积累加后将该点加一。
题解给出线段树作为对照实现。
我们也可以用线段树来实现。线段树是一种数据结构,能够高效地进行区间查询和更新操作。它的基本思想是将一个区间划分为多个子区间,并且每个子区间都可以用一个节点来表示。
线段树将整个区间分割为多个不连续的子区间,子区间的数量不超过 log(width)。更新某个元素的值,只需要更新 log(width) 个区间,并且这些区间都包含在一个包含该元素的大区间内。
- 线段树的每个节点代表一个区间;
- 线段树具有唯一的根节点,代表的区间是整个统计范围,如
[1, N]; - 线段树的每个叶子节点代表一个长度为 1 的元区间
[x, x]; - 对于每个内部节点
[l, r],它的左儿子是[l, mid],右儿子是[mid + 1, r], 其中mid = ⌊(l + r) / 2⌋(即向下取整)。
时间复杂度 ,其中 为数组 的长度。空间复杂度 。
type Node struct {
	l, r, v int
}

type SegmentTree struct {
	tr []Node
}

func NewSegmentTree(n int) *SegmentTree {
	tr := make([]Node, 4*n)
	st := &SegmentTree{tr: tr}
	st.build(1, 1, n)
	return st
}

func (st *SegmentTree) build(u, l, r int) {
	st.tr[u].l = l
	st.tr[u].r = r
	if l == r {
		return
	}
	mid := (l + r) >> 1
	st.build(u<<1, l, mid)
	st.build(u<<1|1, mid+1, r)
}

func (st *SegmentTree) modify(u, x, v int) {
	if st.tr[u].l == x && st.tr[u].r == x {
		st.tr[u].v += v
		return
	}
	mid := (st.tr[u].l + st.tr[u].r) >> 1
	if x <= mid {
		st.modify(u<<1, x, v)
	} else {
		st.modify(u<<1|1, x, v)
	}
	st.pushup(u)
}

func (st *SegmentTree) pushup(u int) {
	st.tr[u].v = st.tr[u<<1].v + st.tr[u<<1|1].v
}

func (st *SegmentTree) query(u, l, r int) int {
	if st.tr[u].l >= l && st.tr[u].r <= r {
		return st.tr[u].v
	}
	mid := (st.tr[u].l + st.tr[u].r) >> 1
	res := 0
	if l <= mid {
		res += st.query(u<<1, l, r)
	}
	if r > mid {
		res += st.query(u<<1|1, l, r)
	}
	return res
}

func goodTriplets(nums1 []int, nums2 []int) int64 {
	n := len(nums1)
	pos := make(map[int]int)
	for i, v := range nums2 {
		pos[v] = i + 1
	}

	tree := NewSegmentTree(n)
	var ans int64

	for _, num := range nums1 {
		p := pos[num]
		left := tree.query(1, 1, p)
		right := n - p - (tree.query(1, 1, n) - tree.query(1, 1, p))
		ans += int64(left * right)
		tree.modify(1, p, 1)
	}

	return ans
}2193. 得到回文串的最少操作次数
题目、示例与约束
给你一个只包含小写英文字母的字符串 s 。
每一次 操作 ,你可以选择 s 中两个 相邻 的字符,并将它们交换。
请你返回将 s 变成回文串的 最少操作次数 。
注意 ,输入数据会确保 s 一定能变成一个回文串。
示例 1:
输入:s = "aabb"
输出:2
解释:
我们可以将 s 变成 2 个回文串,"abba" 和 "baab" 。
- 我们可以通过 2 次操作得到 "abba" :"aabb" -> "abab" -> "abba" 。
- 我们可以通过 2 次操作得到 "baab" :"aabb" -> "abab" -> "baab" 。
因此,得到回文串的最少总操作次数为 2 。
示例 2:
输入:s = "letelt"
输出:2
解释:
通过 2 次操作从 s 能得到回文串 "lettel" 。
其中一种方法是:"letelt" -> "letetl" -> "lettel" 。
其他回文串比方说 "tleelt" 也可以通过 2 次操作得到。
可以证明少于 2 次操作,无法得到回文串。
提示:
1 <= s.length <= 2000s只包含小写英文字母。s可以通过有限次操作得到一个回文串。
方法一:贪心 · Go 实现
思考
相邻交换把串变成回文,保证有解。交换次数等于把配对字符移到对称位置的距离之和。搜索全部交换序列过长, 可用 贪心。
固定左端字符 ,在右侧找最近的 并邻接交换到右端,去掉头尾后变成子问题。若左侧字符在右侧没有配对(奇数次字符),则把它换到正中,代价为到中点的距离。
每次对外层字母配对不劣于先处理内层,因而该贪心最优。
由于题目保证原串一定可以变成回文串,那么原串中最多只有一种字母出现奇数次。如果有一种字母出现奇数次,那么将该字母中排在最中间的字符移动到字符串中间,剩下的字符可以转化为所有字母均出现偶数次的情况。
贪心算法是:每次固定字符串最左边的字母 不变,找出距离字符串右侧最近的 ,把它交换到字符串最右边。这样字符串的头尾字母就相等了。把字符串的头尾去掉,就变成了子问题。把所有子问题的答案加起来就是最少交换次数。
由于数据范围较小,通过 的模拟即可通过本题。
证明:
构造回文串的过程,实际上是每次选择一对字母并把它们交换到字符串头尾的过程。考虑字母 和字母 哪个先选,分以下情况讨论:
- 字母 和 的位置满足 。如果先把 换到头尾,再把 换到头尾,那么需要 次交换;如果先换 再换 ,那么需要 次交换。显然先换 更优。
- 字母 和 的位置满足 。如果先换 再换 ,那么需要 次交换;如果先换 再换 ,那么需要 次交换。先换哪个都一样。
- 字母 和 的位置满足 。如果先换 再换 ,那么需要 次交换;如果先换 再换 ,那么需要 次交换。先换哪个都一样。
上述讨论可以得到结论:每次交换最外边出现的字母不劣。因此贪心解法成立。
func minMovesToMakePalindrome(s string) int {
	cs := []byte(s)
	ans, n := 0, len(s)
	for i, j := 0, n-1; i < j; i++ {
		even := false
		for k := j; k != i; k-- {
			if cs[i] == cs[k] {
				even = true
				for ; k < j; k++ {
					cs[k], cs[k+1] = cs[k+1], cs[k]
					ans++
				}
				j--
				break
			}
		}
		if !even {
			ans += n/2 - i
		}
	}
	return ans
}2213. 由单个字符重复的最长子字符串
题目、示例与约束
给你一个下标从 0 开始的字符串 s 。另给你一个下标从 0 开始、长度为 k 的字符串 queryCharacters ,一个下标从 0 开始、长度也是 k 的整数 下标 数组 queryIndices ,这两个都用来描述 k 个查询。
第 i 个查询会将 s 中位于下标 queryIndices[i] 的字符更新为 queryCharacters[i] 。
返回一个长度为 k 的数组 lengths ,其中 lengths[i] 是在执行第 i 个查询 之后 s 中仅由 单个字符重复 组成的 最长子字符串 的 长度 。
示例 1:
输入:s = "babacc", queryCharacters = "bcb", queryIndices = [1,3,3]
输出:[3,3,4]
解释:
- 第 1 次查询更新后 s = "bbbacc" 。由单个字符重复组成的最长子字符串是 "bbb" ,长度为 3 。
- 第 2 次查询更新后 s = "bbbccc" 。由单个字符重复组成的最长子字符串是 "bbb" 或 "ccc",长度为 3 。
- 第 3 次查询更新后 s = "bbbbcc" 。由单个字符重复组成的最长子字符串是 "bbbb" ,长度为 4 。
因此,返回 [3,3,4] 。
示例 2:
输入:s = "abyzz", queryCharacters = "aa", queryIndices = [2,1]
输出:[2,3]
解释:
- 第 1 次查询更新后 s = "abazz" 。由单个字符重复组成的最长子字符串是 "zz" ,长度为 2 。
- 第 2 次查询更新后 s = "aaazz" 。由单个字符重复组成的最长子字符串是 "aaa" ,长度为 3 。
因此,返回 [2,3] 。
提示:
1 <= s.length <= 105s由小写英文字母组成k == queryCharacters.length == queryIndices.length1 <= k <= 105queryCharacters由小写英文字母组成0 <= queryIndices[i] < s.length
方法一:线段树 · Go 实现
思考
每次单点改写后都要回答整串中「同一字符连续段」的最大长度。 与询问次数均为 ,每次重扫或重建游程都会超时。单点修改只影响邻近游程,需要能在对数时间内合并左右信息。
线段树每个节点维护区间左端连续长 、右端连续长 、以及区间内最长连续长 。向上合并时,若左右子区间在中缝处字符相同,则可以拼出跨越中点的新段,并在整段被同字符填满时延长前缀或后缀。
修改落到叶子后沿路径 ,再查询根节点的 。单次 ,总时间 。
线段树将整个区间分割为多个不连续的子区间,子区间的数量不超过 。更新某个元素的值,只需要更新 个区间,并且这些区间都包含在一个包含该元素的大区间内。区间修改时,需要使用懒标记保证效率。
- 线段树的每个节点代表一个区间;
- 线段树具有唯一的根节点,代表的区间是整个统计范围,如 ;
- 线段树的每个叶子节点代表一个长度为 的元区间 ;
- 对于每个内部节点 ,它的左儿子是 ,右儿子是 , 其中 ;
对于本题,线段树节点维护的信息有:
- 前缀最长连续字符个数 ;
- 后缀最长连续字符个数 ;
- 区间最长连续字符个数 。
- 区间左端点 和右端点 。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度。
type Node struct {
	l, r         int
	lmx, rmx, mx int
}

type SegmentTree struct {
	s  []byte
	tr []*Node
}

func NewNode(l, r int) *Node {
	return &Node{l: l, r: r, lmx: 1, rmx: 1, mx: 1}
}

func NewSegmentTree(s string) *SegmentTree {
	n := len(s)
	tree := &SegmentTree{s: []byte(s), tr: make([]*Node, n<<2)}
	tree.build(1, 1, n)
	return tree
}

func (tree *SegmentTree) build(u, l, r int) {
	tree.tr[u] = NewNode(l, r)
	if l == r {
		return
	}
	mid := (l + r) >> 1
	tree.build(u<<1, l, mid)
	tree.build(u<<1|1, mid+1, r)
	tree.pushup(u)
}

func (tree *SegmentTree) modify(u, x int, v byte) {
	if tree.tr[u].l == x && tree.tr[u].r == x {
		tree.s[x-1] = v
		return
	}
	mid := (tree.tr[u].l + tree.tr[u].r) >> 1
	if x <= mid {
		tree.modify(u<<1, x, v)
	} else {
		tree.modify(u<<1|1, x, v)
	}
	tree.pushup(u)
}

func (tree *SegmentTree) query(u, l, r int) int {
	if tree.tr[u].l >= l && tree.tr[u].r <= r {
		return tree.tr[u].mx
	}
	mid := (tree.tr[u].l + tree.tr[u].r) >> 1
	ans := 0
	if r <= mid {
		ans = tree.query(u<<1, l, r)
	} else if l > mid {
		ans = max(ans, tree.query(u<<1|1, l, r))
	} else {
		ans = max(tree.query(u<<1, l, r), tree.query(u<<1|1, l, r))
	}
	return ans
}

func (tree *SegmentTree) pushup(u int) {
	root := tree.tr[u]
	left := tree.tr[u<<1]
	right := tree.tr[u<<1|1]
	root.mx = max(left.mx, right.mx)
	root.lmx = left.lmx
	root.rmx = right.rmx
	a := left.r - left.l + 1
	b := right.r - right.l + 1
	if tree.s[left.r-1] == tree.s[right.l-1] {
		if left.lmx == a {
			root.lmx += right.lmx
		}
		if right.rmx == b {
			root.rmx += left.rmx
		}
		root.mx = max(root.mx, left.rmx+right.lmx)
	}
}

func longestRepeating(s string, queryCharacters string, queryIndices []int) (ans []int) {
	tree := NewSegmentTree(s)
	n := len(s)
	for i, v := range queryCharacters {
		x := queryIndices[i] + 1
		tree.modify(1, x, byte(v))
		ans = append(ans, tree.query(1, 1, n))
	}
	return
}2250. 统计包含每个点的矩形数目
题目、示例与约束
给你一个二维整数数组 rectangles ,其中 rectangles[i] = [li, hi] 表示第 i 个矩形长为 li 高为 hi 。给你一个二维整数数组 points ,其中 points[j] = [xj, yj] 是坐标为 (xj, yj) 的一个点。
第 i 个矩形的 左下角 在 (0, 0) 处,右上角 在 (li, hi) 。
请你返回一个整数数组 count ,长度为 points.length,其中 count[j]是 包含 第 j 个点的矩形数目。
如果 0 <= xj <= li 且 0 <= yj <= hi ,那么我们说第 i 个矩形包含第 j 个点。如果一个点刚好在矩形的 边上 ,这个点也被视为被矩形包含。
示例 1:
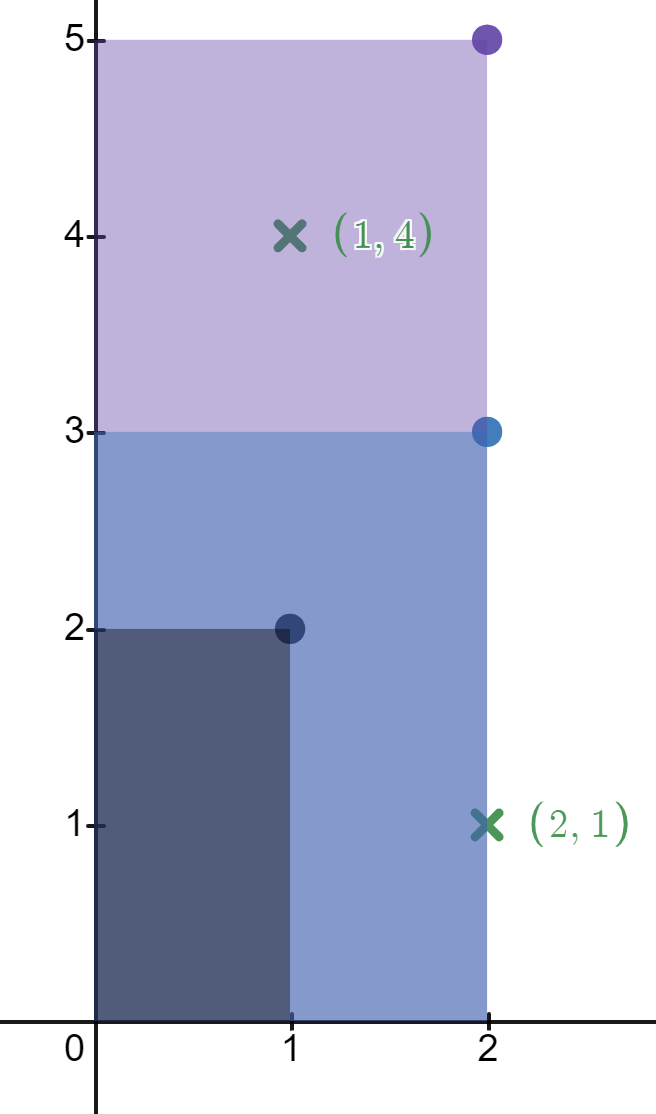
输入:rectangles = [[1,2],[2,3],[2,5]], points = [[2,1],[1,4]]
输出:[2,1]
解释:
第一个矩形不包含任何点。
第二个矩形只包含一个点 (2, 1) 。
第三个矩形包含点 (2, 1) 和 (1, 4) 。
包含点 (2, 1) 的矩形数目为 2 。
包含点 (1, 4) 的矩形数目为 1 。
所以,我们返回 [2, 1] 。
示例 2:
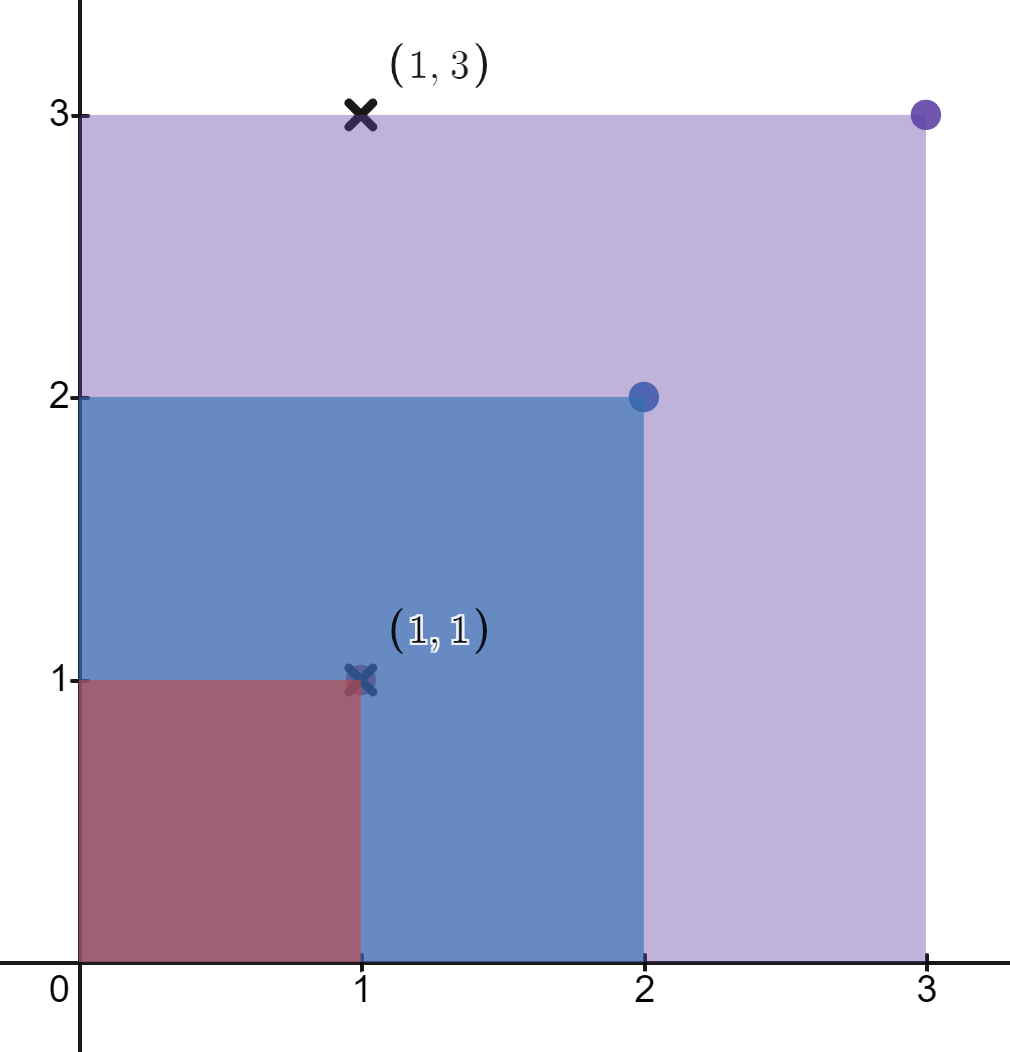
输入:rectangles = [[1,1],[2,2],[3,3]], points = [[1,3],[1,1]]
输出:[1,3]
解释:
第一个矩形只包含点 (1, 1) 。
第二个矩形只包含点 (1, 1) 。
第三个矩形包含点 (1, 3) 和 (1, 1) 。
包含点 (1, 3) 的矩形数目为 1 。
包含点 (1, 1) 的矩形数目为 3 。
所以,我们返回 [1, 3] 。
提示:
1 <= rectangles.length, points.length <= 5 * 104rectangles[i].length == points[j].length == 21 <= li, xj <= 1091 <= hi, yj <= 100- 所有
rectangles互不相同 。 - 所有
points互不相同 。
方法一:排序 + 二分 · Go 实现
思考
矩形从原点出发,问每个点被多少矩形包含。矩形与询问均达 ,高只有 ,宽可达 。对每个点扫描全部矩形不可行。高度很小,可按高度分组。
把矩形宽度按高度放入列表并排序。询问点 能被高度 且宽度 的矩形盖住,于是对 从 到 做一次下界查找。单点 。
func countRectangles(rectangles [][]int, points [][]int) []int {
	n := 101
	d := make([][]int, 101)
	for _, r := range rectangles {
		d[r[1]] = append(d[r[1]], r[0])
	}
	for _, v := range d {
		sort.Ints(v)
	}
	var ans []int
	for _, p := range points {
		x, y := p[0], p[1]
		cnt := 0
		for h := y; h < n; h++ {
			xs := d[h]
			left, right := 0, len(xs)
			for left < right {
				mid := (left + right) >> 1
				if xs[mid] >= x {
					right = mid
				} else {
					left = mid + 1
				}
			}
			cnt += len(xs) - left
		}
		ans = append(ans, cnt)
	}
	return ans
}2407. 最长递增子序列 II
题目、示例与约束
给你一个整数数组 nums 和一个整数 k 。
找到 nums 中满足以下要求的最长子序列:
- 子序列 严格递增
- 子序列中相邻元素的差值 不超过
k。
请你返回满足上述要求的 最长子序列 的长度。
子序列 是从一个数组中删除部分元素后,剩余元素不改变顺序得到的数组。
示例 1:
输入:nums = [4,2,1,4,3,4,5,8,15], k = 3
输出:5
解释:
满足要求的最长子序列是 [1,3,4,5,8] 。
子序列长度为 5 ,所以我们返回 5 。
注意子序列 [1,3,4,5,8,15] 不满足要求,因为 15 - 8 = 7 大于 3 。
示例 2:
输入:nums = [7,4,5,1,8,12,4,7], k = 5
输出:4
解释:
满足要求的最长子序列是 [4,5,8,12] 。
子序列长度为 4 ,所以我们返回 4 。
示例 3:
输入:nums = [1,5], k = 1
输出:1
解释:
满足要求的最长子序列是 [1] 。
子序列长度为 1 ,所以我们返回 1 。
提示:
1 <= nums.length <= 1051 <= nums[i], k <= 105
方法一:线段树 · Go 实现
思考
经典 LIS 为 , 无法通过,且本题还要求相邻差不超过 。以值 结尾的最长长度等于区间 上的最大 再加一,需要在值域上做区间最值查询与单点更新。
值域为 ,用线段树维护 的区间最大值:对每个 先查询再更新,即可在 内完成。
我们假设 表示以数字 结尾的最长递增子序列的长度。
我们遍历数组 中的每个元素 ,有状态转移方程: ,其中 的取值范围是 。
因此,我们需要一个数据结构,来维护区间的最大值,不难想到使用线段树。
线段树将整个区间分割为多个不连续的子区间,子区间的数量不超过 。更新某个元素的值,只需要更新 个区间,并且这些区间都包含在一个包含该元素的大区间内。
- 线段树的每个节点代表一个区间;
- 线段树具有唯一的根节点,代表的区间是整个统计范围,如 ;
- 线段树的每个叶子节点代表一个长度为 的元区间 ;
- 对于每个内部节点 ,它的左儿子是 ,右儿子是 , 其中 。
对于本题,线段树节点维护的信息是区间范围内的最大值。
时间复杂度 。其中 是数组 的长度。
func lengthOfLIS(nums []int, k int) int {
	mx := slices.Max(nums)
	tree := newSegmentTree(mx)
	ans := 1
	for _, v := range nums {
		t := tree.query(1, v-k, v-1) + 1
		ans = max(ans, t)
		tree.modify(1, v, t)
	}
	return ans
}

type node struct {
	l int
	r int
	v int
}

type segmentTree struct {
	tr []*node
}

func newSegmentTree(n int) *segmentTree {
	tr := make([]*node, n<<2)
	for i := range tr {
		tr[i] = &node{}
	}
	t := &segmentTree{tr}
	t.build(1, 1, n)
	return t
}

func (t *segmentTree) build(u, l, r int) {
	t.tr[u].l, t.tr[u].r = l, r
	if l == r {
		return
	}
	mid := (l + r) >> 1
	t.build(u<<1, l, mid)
	t.build(u<<1|1, mid+1, r)
	t.pushup(u)
}

func (t *segmentTree) modify(u, x, v int) {
	if t.tr[u].l == x && t.tr[u].r == x {
		t.tr[u].v = v
		return
	}
	mid := (t.tr[u].l + t.tr[u].r) >> 1
	if x <= mid {
		t.modify(u<<1, x, v)
	} else {
		t.modify(u<<1|1, x, v)
	}
	t.pushup(u)
}

func (t *segmentTree) query(u, l, r int) int {
	if t.tr[u].l >= l && t.tr[u].r <= r {
		return t.tr[u].v
	}
	mid := (t.tr[u].l + t.tr[u].r) >> 1
	v := 0
	if l <= mid {
		v = t.query(u<<1, l, r)
	}
	if r > mid {
		v = max(v, t.query(u<<1|1, l, r))
	}
	return v
}

func (t *segmentTree) pushup(u int) {
	t.tr[u].v = max(t.tr[u<<1].v, t.tr[u<<1|1].v)
}2426. 满足不等式的数对数目
题目、示例与约束
给你两个下标从 0 开始的整数数组 nums1 和 nums2 ,两个数组的大小都为 n ,同时给你一个整数 diff ,统计满足以下条件的 数对 (i, j) :
0 <= i < j <= n - 1且nums1[i] - nums1[j] <= nums2[i] - nums2[j] + diff.
请你返回满足条件的 数对数目 。
示例 1:
输入:nums1 = [3,2,5], nums2 = [2,2,1], diff = 1
输出:3
解释:
总共有 3 个满足条件的数对:
1. i = 0, j = 1:3 - 2 <= 2 - 2 + 1 。因为 i < j 且 1 <= 1 ,这个数对满足条件。
2. i = 0, j = 2:3 - 5 <= 2 - 1 + 1 。因为 i < j 且 -2 <= 2 ,这个数对满足条件。
3. i = 1, j = 2:2 - 5 <= 2 - 1 + 1 。因为 i < j 且 -3 <= 2 ,这个数对满足条件。
所以,我们返回 3 。
示例 2:
输入:nums1 = [3,-1], nums2 = [-2,2], diff = -1
输出:0
解释:
没有满足条件的任何数对,所以我们返回 0 。
提示:
n == nums1.length == nums2.length2 <= n <= 105-104 <= nums1[i], nums2[i] <= 104-104 <= diff <= 104
方法一:树状数组 · Go 实现
思考
不等式 ( )在 下不能双重循环。令 ,即统计左侧有多少 。
值域经平移后可用树状数组维护已出现的 。按 从左到右:先查询不超过 的个数,再把 插入。
我们将题目的不等式转换一下,得到 ,因此,如果我们对两个数组对应位置的元素求差值,得到另一个数组 ,那么题目就转换为求 中满足 的数对数目。
我们可以从小到大枚举 ,找出前面有多少个数满足 ,这样就可以求出数对数目。我们可以使用树状数组来维护前缀和,这样就可以在 的时间内求出前面有多少个数满足 。
时间复杂度 。
type BinaryIndexedTree struct {
	n int
	c []int
}

func newBinaryIndexedTree(n int) *BinaryIndexedTree {
	c := make([]int, n+1)
	return &BinaryIndexedTree{n, c}
}

func (this *BinaryIndexedTree) lowbit(x int) int {
	return x & -x
}

func (this *BinaryIndexedTree) update(x, delta int) {
	for x <= this.n {
		this.c[x] += delta
		x += this.lowbit(x)
	}
}

func (this *BinaryIndexedTree) query(x int) int {
	s := 0
	for x > 0 {
		s += this.c[x]
		x -= this.lowbit(x)
	}
	return s
}

func numberOfPairs(nums1 []int, nums2 []int, diff int) int64 {
	tree := newBinaryIndexedTree(100000)
	ans := 0
	for i := range nums1 {
		v := nums1[i] - nums2[i]
		ans += tree.query(v + diff + 40000)
		tree.update(v+40000, 1)
	}
	return int64(ans)
}2519. 统计 K-Big 索引的数量 🔒
题目、示例与约束
给定一个 下标从0开始 的整数数组 nums 和一个正整数 k 。
如果满足以下条件,我们称下标 i 为 k-big :
- 存在至少
k个不同的索引idx1,满足idx1 < i且nums[idx1] < nums[i]。 - 存在至少
k个不同的索引idx2,满足idx2 > i且nums[idx2] < nums[i]。
返回 k-big 索引的数量。
示例 1 :
输入:nums = [2,3,6,5,2,3], k = 2
输出:2
解释:在nums中只有两个 2-big 的索引:
- i = 2 --> 有两个有效的 idx1: 0 和 1。有三个有效的 idx2: 2、3 和 4。
- i = 3 --> 有两个有效的 idx1: 0 和 1。有两个有效的 idx2: 3 和 4。
示例 2 :
输入:nums = [1,1,1], k = 3
输出:0
解释:在 nums 中没有 3-big 的索引
提示:
1 <= nums.length <= 1051 <= nums[i], k <= nums.length
方法一:树状数组 · Go 实现
思考
下标 是 -big 当且仅当左侧有至少 个严格更小的数、右侧亦然。对每个 扫描左右在 时为平方级。
值域可离散到 ,用树状数组维护“某个值出现了多少次”。先把全部元素插入右侧树,从左到右扫描时先从右侧删去当前值,查询两侧小于 的个数,再把 插入左侧树。每个下标 。
我们维护两个树状数组,一个记录当前位置左边小于当前位置的数的个数,另一个记录当前位置右边小于当前位置的数的个数。
遍历数组,对于当前位置,如果左边小于当前位置的数的个数大于等于 ,且右边小于当前位置的数的个数大于等于 ,则当前位置是 ,答案加一。
时间复杂度 ,空间复杂度 。其中 为数组长度。
type BinaryIndexedTree struct {
	n int
	c []int
}

func newBinaryIndexedTree(n int) *BinaryIndexedTree {
	c := make([]int, n+1)
	return &BinaryIndexedTree{n, c}
}

func (this *BinaryIndexedTree) update(x, delta int) {
	for x <= this.n {
		this.c[x] += delta
		x += x & -x
	}
}

func (this *BinaryIndexedTree) query(x int) int {
	s := 0
	for x > 0 {
		s += this.c[x]
		x -= x & -x
	}
	return s
}

func kBigIndices(nums []int, k int) (ans int) {
	n := len(nums)
	tree1 := newBinaryIndexedTree(n)
	tree2 := newBinaryIndexedTree(n)
	for _, v := range nums {
		tree2.update(v, 1)
	}
	for _, v := range nums {
		tree2.update(v, -1)
		if tree1.query(v-1) >= k && tree2.query(v-1) >= k {
			ans++
		}
		tree1.update(v, 1)
	}
	return
}2552. 统计上升四元组
题目、示例与约束
给你一个长度为 n 下标从 0 开始的整数数组 nums ,它包含 1 到 n 的所有数字,请你返回上升四元组的数目。
如果一个四元组 (i, j, k, l) 满足以下条件,我们称它是上升的:
0 <= i < j < k < l < n且nums[i] < nums[k] < nums[j] < nums[l]。
示例 1:
输入:nums = [1,3,2,4,5]
输出:2
解释:
- 当 i = 0 ,j = 1 ,k = 2 且 l = 3 时,有 nums[i] < nums[k] < nums[j] < nums[l] 。
- 当 i = 0 ,j = 1 ,k = 2 且 l = 4 时,有 nums[i] < nums[k] < nums[j] < nums[l] 。
没有其他的四元组,所以我们返回 2 。
示例 2:
输入:nums = [1,2,3,4]
输出:0
解释:只存在一个四元组 i = 0 ,j = 1 ,k = 2 ,l = 3 ,但是 nums[j] < nums[k] ,所以我们返回 0 。
提示:
4 <= nums.length <= 40001 <= nums[i] <= nums.lengthnums中所有数字 互不相同 ,nums是一个排列。
方法一:枚举 + 预处理 · Go 实现
思考
统计满足 且 的四元组。四重循环在 时不可行;枚举 后两侧计数仍可能到 。
固定 从右往左扫 时,大于 的后缀个数可以递减维护,得到 ;对称地固定 从右往左扫 ,得到左侧小于 的 。仅当 时二者相乘计入答案,总时间 。
我们可以枚举四元组中的 和 ,那么问题转化为,对于当前的 和 :
- 统计有多少个 满足 且 ;
- 统计有多少个 满足 且 。
我们可以使用两个二维数组 和 分别记录这两个信息。其中 表示有多少个 满足 且 ,而 表示有多少个 满足 且 。
那么答案就是所有的 的和。
时间复杂度为 ,空间复杂度为 。其中 是数组的长度。
func countQuadruplets(nums []int) int64 {
	n := len(nums)
	f := make([][]int, n)
	g := make([][]int, n)
	for i := range f {
		f[i] = make([]int, n)
		g[i] = make([]int, n)
	}
	for j := 1; j < n-2; j++ {
		cnt := 0
		for l := j + 1; l < n; l++ {
			if nums[l] > nums[j] {
				cnt++
			}
		}
		for k := j + 1; k < n-1; k++ {
			if nums[j] > nums[k] {
				f[j][k] = cnt
			} else {
				cnt--
			}
		}
	}
	ans := 0
	for k := 2; k < n-1; k++ {
		cnt := 0
		for i := 0; i < k; i++ {
			if nums[i] < nums[k] {
				cnt++
			}
		}
		for j := k - 1; j > 0; j-- {
			if nums[j] > nums[k] {
				g[j][k] = cnt
				ans += f[j][k] * g[j][k]
			} else {
				cnt--
			}
		}
	}
	return int64(ans)
}2569. 更新数组后处理求和查询
题目、示例与约束
给你两个下标从 0 开始的数组 nums1 和 nums2 ,和一个二维数组 queries 表示一些操作。总共有 3 种类型的操作:
- 操作类型 1 为
queries[i] = [1, l, r]。你需要将nums1从下标l到下标r的所有0反转成1并且所有1反转成0。l和r下标都从 0 开始。 - 操作类型 2 为
queries[i] = [2, p, 0]。对于0 <= i < n中的所有下标,令nums2[i] = nums2[i] + nums1[i] * p。 - 操作类型 3 为
queries[i] = [3, 0, 0]。求nums2中所有元素的和。
请你返回一个 数组,包含 所有第三种操作类型 的答案。
示例 1:
输入:nums1 = [1,0,1], nums2 = [0,0,0], queries = [[1,1,1],[2,1,0],[3,0,0]]
输出:[3]
解释:第一个操作后 nums1 变为 [1,1,1] 。第二个操作后,nums2 变成 [1,1,1] ,所以第三个操作的答案为 3 。所以返回 [3] 。
示例 2:
输入:nums1 = [1], nums2 = [5], queries = [[2,0,0],[3,0,0]]
输出:[5]
解释:第一个操作后,nums2 保持不变为 [5] ,所以第二个操作的答案是 5 。所以返回 [5] 。
提示:
1 <= nums1.length,nums2.length <= 105nums1.length = nums2.length1 <= queries.length <= 105queries[i].length = 30 <= l <= r <= nums1.length - 10 <= p <= 1060 <= nums1[i] <= 10 <= nums2[i] <= 109
方法一:线段树 · Go 实现
思考
三类操作: 的区间 翻转; 整体加上 ;查询 。 ,不能对每次翻转扫区间。
只需一个变量: 的区间和决定第二次操作的增量。线段树维护 的区间 的个数,懒标记表示整段翻转,翻转后区间和变为长度减去原和。第三次操作把当前 记下即可。
根据题目描述:
- 操作 是把数组
nums1的下标区间 的所有数反转,即把 变成 ,把 变成 。 - 操作 是求数组
nums2的所有数之和。 - 操作 是把数组
nums2的所有数之和加上 乘以数组nums1所有数之和,即 。
因此,我们实际上只需要维护数组 nums1 的区间和即可,我们可以通过线段树来实现。
我们定义线段树的每个节点为 Node,每个节点包含如下属性:
l:节点的左端点,下标从 开始。r:节点的右端点,下标从 开始。s:节点的区间和。lazy:节点的懒标记。
线段树主要有以下几个操作:
build(u, l, r):建立线段树。pushdown(u):下传懒标记。pushup(u):用子节点的信息更新父节点的信息。modify(u, l, r):修改区间和,本题中是反转区间中的每个数,那么区间和 。query(u, l, r):查询区间和。
我们先算出数组 nums2 的所有数之和,记为 。
执行操作 时,我们只需要调用 modify(1, l + 1, r + 1) 即可。
执行操作 时,我们更新 即可。
执行操作 时,我们只需要将 加入答案数组即可。
时间复杂度 ,空间复杂度 。其中 和 分别为数组 nums1 和 queries 的长度。
type node struct {
	l, r, s, lazy int
}

type segmentTree struct {
	nums []int
	tr   []*node
}

func newSegmentTree(nums []int) *segmentTree {
	n := len(nums)
	tr := make([]*node, n<<2)
	for i := range tr {
		tr[i] = &node{}
	}
	t := &segmentTree{nums, tr}
	t.build(1, 1, n)
	return t
}

func (t *segmentTree) build(u, l, r int) {
	t.tr[u].l, t.tr[u].r = l, r
	if l == r {
		t.tr[u].s = t.nums[l-1]
		return
	}
	mid := (l + r) >> 1
	t.build(u<<1, l, mid)
	t.build(u<<1|1, mid+1, r)
	t.pushup(u)
}

func (t *segmentTree) modify(u, l, r int) {
	if t.tr[u].l >= l && t.tr[u].r <= r {
		t.tr[u].lazy ^= 1
		t.tr[u].s = t.tr[u].r - t.tr[u].l + 1 - t.tr[u].s
		return
	}
	t.pushdown(u)
	mid := (t.tr[u].l + t.tr[u].r) >> 1
	if l <= mid {
		t.modify(u<<1, l, r)
	}
	if r > mid {
		t.modify(u<<1|1, l, r)
	}
	t.pushup(u)
}

func (t *segmentTree) query(u, l, r int) int {
	if t.tr[u].l >= l && t.tr[u].r <= r {
		return t.tr[u].s
	}
	t.pushdown(u)
	mid := (t.tr[u].l + t.tr[u].r) >> 1
	res := 0
	if l <= mid {
		res += t.query(u<<1, l, r)
	}
	if r > mid {
		res += t.query(u<<1|1, l, r)
	}
	return res
}

func (t *segmentTree) pushup(u int) {
	t.tr[u].s = t.tr[u<<1].s + t.tr[u<<1|1].s
}

func (t *segmentTree) pushdown(u int) {
	if t.tr[u].lazy == 1 {
		mid := (t.tr[u].l + t.tr[u].r) >> 1
		t.tr[u<<1].s = mid - t.tr[u].l + 1 - t.tr[u<<1].s
		t.tr[u<<1].lazy ^= 1
		t.tr[u<<1|1].s = t.tr[u].r - mid - t.tr[u<<1|1].s
		t.tr[u<<1|1].lazy ^= 1
		t.tr[u].lazy ^= 1
	}
}

func handleQuery(nums1 []int, nums2 []int, queries [][]int) (ans []int64) {
	tree := newSegmentTree(nums1)
	var s int64
	for _, x := range nums2 {
		s += int64(x)
	}
	for _, q := range queries {
		if q[0] == 1 {
			tree.modify(1, q[1]+1, q[2]+1)
		} else if q[0] == 2 {
			s += int64(q[1] * tree.query(1, 1, len(nums1)))
		} else {
			ans = append(ans, s)
		}
	}
	return
}2659. 将数组清空
题目、示例与约束
给你一个包含若干 互不相同 整数的数组 nums ,你需要执行以下操作 直到数组为空 :
- 如果数组中第一个元素是当前数组中的 最小值 ,则删除它。
- 否则,将第一个元素移动到数组的 末尾 。
请你返回需要多少个操作使 nums 为空。
示例 1:
输入:nums = [3,4,-1]
输出:5
| Operation | Array |
|---|---|
| 1 | [4, -1, 3] |
| 2 | [-1, 3, 4] |
| 3 | [3, 4] |
| 4 | [4] |
| 5 | [] |
示例 2:
输入:nums = [1,2,4,3]
输出:5
| Operation | Array |
|---|---|
| 1 | [2, 4, 3] |
| 2 | [4, 3] |
| 3 | [3, 4] |
| 4 | [4] |
| 5 | [] |
示例 3:
输入:nums = [1,2,3]
输出:3
| Operation | Array |
|---|---|
| 1 | [2, 3] |
| 2 | [3] |
| 3 | [] |
提示:
1 <= nums.length <= 105-109 <= nums[i] <= 109nums中的元素 互不相同 。
方法一:哈希表 + 排序 + 树状数组 · Go 实现
思考
每次可循环左移或删除当前最小值,求清空次数。直接模拟每次旋转, 不可行。删除顺序即升序,代价是相邻两个最小值在环上的距离,并扣除中间已删位置。
记录原下标后排序,用有序列表维护已删下标,间隔 减去其间已删个数;若后一个下标更靠前,还需加上本轮剩余长度(绕环一周)。
我们先用哈希表 记录数组 中每个元素的位置,接下来对数组 进行排序,那么数组最小值的下标为 ,移动到数组的第一个位置并且删除,需要 次操作,因此初始答案为 。
接下来,我们遍历排序后的数组 ,相邻两个元素 和 的下标分别为 , 。那么将第二个元素 移动到数组第一个位置并且删除所需要的操作数,等于两个下标的间隔,减去两个下标之间此前删除的下标个数,累加操作数到答案中。我们可以用树状数组或者有序列表维护已删除的下标,这样就可以在 的时间内求出两个下标之间已删除的下标个数。注意,如果 ,那么需要额外增加 次操作,其中 是当前遍历到的位置。
遍历结束后,返回操作数 即可。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
type BinaryIndexedTree struct {
	n int
	c []int
}

func newBinaryIndexedTree(n int) *BinaryIndexedTree {
	c := make([]int, n+1)
	return &BinaryIndexedTree{n, c}
}

func (this *BinaryIndexedTree) update(x, delta int) {
	for x <= this.n {
		this.c[x] += delta
		x += x & -x
	}
}

func (this *BinaryIndexedTree) query(x int) int {
	s := 0
	for x > 0 {
		s += this.c[x]
		x -= x & -x
	}
	return s
}

func countOperationsToEmptyArray(nums []int) int64 {
	n := len(nums)
	pos := map[int]int{}
	for i, x := range nums {
		pos[x] = i
	}
	sort.Ints(nums)
	tree := newBinaryIndexedTree(n)
	ans := pos[nums[0]] + 1
	for k := 0; k < n-1; k++ {
		i, j := pos[nums[k]], pos[nums[k+1]]
		d := j - i - (tree.query(j+1) - tree.query(i+1))
		if i > j {
			d += n - k
		}
		ans += d
		tree.update(i+1, 1)
	}
	return int64(ans)
}2736. 最大和查询
题目、示例与约束
给你两个长度为 n 、下标从 0 开始的整数数组 nums1 和 nums2 ,另给你一个下标从 1 开始的二维数组 queries ,其中 queries[i] = [xi, yi] 。
对于第 i 个查询,在所有满足 nums1[j] >= xi 且 nums2[j] >= yi 的下标 j (0 <= j < n) 中,找出 nums1[j] + nums2[j] 的 最大值 ,如果不存在满足条件的 j 则返回 -1 。
返回数组 answer ,其中 answer[i] 是第 i 个查询的答案。
示例 1:
输入:nums1 = [4,3,1,2], nums2 = [2,4,9,5], queries = [[4,1],[1,3],[2,5]] 输出:[6,10,7] 解释: 对于第 1 个查询:xi = 4且yi = 1,可以选择下标j = 0,此时nums1[j] >= 4且nums2[j] >= 1。nums1[j] + nums2[j]等于 6 ,可以证明 6 是可以获得的最大值。 对于第 2 个查询:xi = 1且yi = 3,可以选择下标j = 2,此时nums1[j] >= 1且nums2[j] >= 3。nums1[j] + nums2[j]等于 10 ,可以证明 10 是可以获得的最大值。 对于第 3 个查询:xi = 2且yi = 5,可以选择下标j = 3,此时nums1[j] >= 2且nums2[j] >= 5。nums1[j] + nums2[j]等于 7 ,可以证明 7 是可以获得的最大值。 因此,我们返回[6,10,7]。
示例 2:
输入:nums1 = [3,2,5], nums2 = [2,3,4], queries = [[4,4],[3,2],[1,1]]
输出:[9,9,9]
解释:对于这个示例,我们可以选择下标 j = 2 ,该下标可以满足每个查询的限制。
示例 3:
输入:nums1 = [2,1], nums2 = [2,3], queries = [[3,3]] 输出:[-1] 解释:示例中的查询xi= 3 且yi= 3 。对于每个下标 j ,都只满足 nums1[j] <xi或者 nums2[j] <yi。因此,不存在答案。
提示:
nums1.length == nums2.lengthn == nums1.length1 <= n <= 1051 <= nums1[i], nums2[i] <= 1091 <= queries.length <= 105queries[i].length == 2xi == queries[i][1]yi == queries[i][2]1 <= xi, yi <= 109
方法一:树状数组 · Go 实现
思考
每个询问要在 且 的点中最大化 。点数与询问均为 ,对每个询问扫描全部点不可行。
这是二维偏序上的最大值。将点与询问都按第一维降序处理,则扫描到询问 时,所有 的点已插入。树状数组在离散化后的 上维护前缀最大和(将坐标反转后变成前缀),查询 的最大和。
本题属于二维偏序问题。
二维偏序是这样一类问题:给定若干个点对 , , , ,并定义某种偏序关系,现在给定点 ,求满足偏序关系的点对 中的数量/最值。即:
二维偏序的一般解决方法是排序一维,用数据结构处理第二维(这种数据结构一般是树状数组)。
对于本题,我们可以创建一个数组 ,其中 ,然后对 按照 从大到小的顺序排序,将查询 也按照 从大到小的顺序排序。
接下来,遍历每个查询 ,对于当前查询,我们循环将 中所有大于等于 的元素的 的值插入到树状数组中,树状数组维护的是离散化后的 的区间中 的最大值。那么我们只需要在树状数组中查询大于等于离散化后的 区间对应的最大值即可。注意,由于树状数组维护的是前缀最大值,所以我们在实现上,可以将 反序插入到树状数组中。
时间复杂度 ,空间复杂度 。其中 是数组 的长度,而 是数组 的长度。
相似题目:
type BinaryIndexedTree struct {
	n int
	c []int
}

func NewBinaryIndexedTree(n int) BinaryIndexedTree {
	c := make([]int, n+1)
	for i := range c {
		c[i] = -1
	}
	return BinaryIndexedTree{n: n, c: c}
}

func (bit *BinaryIndexedTree) update(x, v int) {
	for x <= bit.n {
		bit.c[x] = max(bit.c[x], v)
		x += x & -x
	}
}

func (bit *BinaryIndexedTree) query(x int) int {
	mx := -1
	for x > 0 {
		mx = max(mx, bit.c[x])
		x -= x & -x
	}
	return mx
}

func maximumSumQueries(nums1 []int, nums2 []int, queries [][]int) []int {
	n, m := len(nums1), len(queries)
	nums := make([][2]int, n)
	for i := range nums {
		nums[i] = [2]int{nums1[i], nums2[i]}
	}
	sort.Slice(nums, func(i, j int) bool { return nums[j][0] < nums[i][0] })
	sort.Ints(nums2)
	idx := make([]int, m)
	for i := range idx {
		idx[i] = i
	}
	sort.Slice(idx, func(i, j int) bool { return queries[idx[j]][0] < queries[idx[i]][0] })
	tree := NewBinaryIndexedTree(n)
	ans := make([]int, m)
	j := 0
	for _, i := range idx {
		x, y := queries[i][0], queries[i][1]
		for ; j < n && nums[j][0] >= x; j++ {
			k := n - sort.SearchInts(nums2, nums[j][1])
			tree.update(k, nums[j][0]+nums[j][1])
		}
		k := n - sort.SearchInts(nums2, y)
		ans[i] = tree.query(k)
	}
	return ans
}2907. 价格递增的最大利润三元组 I 🔒
题目、示例与约束
给定两个长度为 n 的 下标从 0 开始 的数组 prices 和 profits。商店里有 n 件商品,其中第 i 件商品的价格为 prices[i],利润为 profits[i]。
我们必须按照以下条件选择三件商品:
prices[i] < prices[j] < prices[k],其中i < j < k。
如果我们选择满足上述条件的索引 i,j 和 k 的商品,那么利润就是 profits[i] + profits[j] + profits[k]。
返回我们能得到的最大利润,如果无法选择三件满足条件的商品,则返回 -1。
示例 1:
输入: prices = [10,2,3,4], profits = [100,2,7,10]
输出: 19
解释: 我们不能选择索引为 i=0 的商品,因为不存在索引 j 和 k 满足条件。
所以我们能选择的唯一三元组是索引为 1,2 和 3 的商品,这是一个有效的选择,因为 prices[1] < prices[2] < prices[3]。
答案就是它们的利润之和,即 2 + 7 + 10 = 19。
示例 2:
输入: prices = [1,2,3,4,5], profits = [1,5,3,4,6]
输出: 15
解释: 我们可以选择任意三件商品,因为对于每个索引三元组 i,j 和 k 满足 i < j < k,条件都成立。
因此我们能得到的最大利润就是三件最赚钱的商品,它们的索引分别是 1,3 和 4。
答案就是它们的利润之和,即 5 + 4 + 6 = 15。
示例 3:
输入: prices = [4,3,2,1], profits = [33,20,19,87]
输出: -1
解释: 我们不能选择任何满足条件的索引三元组,所以我们返回 -1。
提示:
3 <= prices.length == profits.length <= 20001 <= prices[i] <= 1061 <= profits[i] <= 106
方法一:枚举中间元素 · Go 实现
思考
合法三元组要求价格严格递增。枚举中间下标 后,左侧只需价格更小的最大利润,右侧只需价格更大的最大利润;两者均可在 内扫出。 较小时 足够。
若左侧或右侧不存在合法元素,则该 无效。对所有合法 取 的最大值。
我们可以枚举中间元素 ,然后再枚举左边元素 和右边元素 。对于每个 ,我们需要找到最大的 和最大的 ,使得 。我们记 为 左边的最大值,而 为 右边的最大值。如果存在,那么我们更新答案为 。
时间复杂度 ,其中 为数组长度。空间复杂度 。
func maxProfit(prices []int, profits []int) int {
	n := len(prices)
	ans := -1
	for j, x := range profits {
		left, right := 0, 0
		for i := 0; i < j; i++ {
			if prices[i] < prices[j] {
				left = max(left, profits[i])
			}
		}
		for k := j + 1; k < n; k++ {
			if prices[j] < prices[k] {
				right = max(right, profits[k])
			}
		}
		if left > 0 && right > 0 {
			ans = max(ans, left+x+right)
		}
	}
	return ans
}
方法二:树状数组 · Go 实现
思考
方法一对每个中间下标线性扫描左右,总时间 。把「价格小于 的最大利润」看成前缀最值查询,可用树状数组在离散或值域上维护。
从左到右查询并插入,得到每个位置左侧更低价格的最大利润;从右到左对价格取对称后再做一次,得到右侧。枚举中间项即可在 内完成。
我们可以用两个树状数组分别维护每个价格左边以及右边的最大利润,然后枚举中间的价格,通过树状数组查询左右两边的最大利润,最后取最大值即可。
时间复杂度 ,空间复杂度 。其中 是数组 的长度,而 是数组 中的最大值,本题中 。
由于 的长度不超过 ,而 的取值达到 ,因此,我们可以对 进行离散化处理,这样可以将空间复杂度降低到 。
type BinaryIndexedTree struct {
	n int
	c []int
}

func NewBinaryIndexedTree(n int) BinaryIndexedTree {
	c := make([]int, n+1)
	return BinaryIndexedTree{n: n, c: c}
}

func (bit *BinaryIndexedTree) update(x, v int) {
	for x <= bit.n {
		bit.c[x] = max(bit.c[x], v)
		x += x & -x
	}
}

func (bit *BinaryIndexedTree) query(x int) int {
	mx := 0
	for x > 0 {
		mx = max(mx, bit.c[x])
		x -= x & -x
	}
	return mx
}

func maxProfit(prices []int, profits []int) int {
	n := len(prices)
	left := make([]int, n)
	right := make([]int, n)
	m := slices.Max(prices)

	tree1 := NewBinaryIndexedTree(m + 1)
	tree2 := NewBinaryIndexedTree(m + 1)

	for i, x := range prices {
		left[i] = tree1.query(x - 1)
		tree1.update(x, profits[i])
	}

	for i := n - 1; i >= 0; i-- {
		x := m + 1 - prices[i]
		right[i] = tree2.query(x - 1)
		tree2.update(x, profits[i])
	}

	ans := -1

	for i := 0; i < n; i++ {
		if left[i] > 0 && right[i] > 0 {
			ans = max(ans, left[i]+profits[i]+right[i])
		}
	}

	return ans
}
方法三 · Go 实现
思考
方法二直接以价格为树状数组下标,若价格稀疏或上界偏大,则数组过长。先对价格去重排序,用名次作为下标,查询与更新的语义不变,空间与 同阶。
type BinaryIndexedTree struct {
	n int
	c []int
}

func NewBinaryIndexedTree(n int) BinaryIndexedTree {
	c := make([]int, n+1)
	return BinaryIndexedTree{n: n, c: c}
}

func (bit *BinaryIndexedTree) update(x, v int) {
	for x <= bit.n {
		bit.c[x] = max(bit.c[x], v)
		x += x & -x
	}
}

func (bit *BinaryIndexedTree) query(x int) int {
	mx := 0
	for x > 0 {
		mx = max(mx, bit.c[x])
		x -= x & -x
	}
	return mx
}

func maxProfit(prices []int, profits []int) int {
	n := len(prices)
	left := make([]int, n)
	right := make([]int, n)
	s := make([]int, n)
	copy(s, prices)
	sort.Ints(s)
	m := 0
	for i, x := range s {
		if i == 0 || x != s[i-1] {
			s[m] = x
			m++
		}
	}

	tree1 := NewBinaryIndexedTree(m + 1)
	tree2 := NewBinaryIndexedTree(m + 1)

	for i, x := range prices {
		x = sort.SearchInts(s[:m], x) + 1
		left[i] = tree1.query(x - 1)
		tree1.update(x, profits[i])
	}

	for i := n - 1; i >= 0; i-- {
		x := m + 1 - (sort.SearchInts(s[:m], prices[i]) + 1)
		right[i] = tree2.query(x - 1)
		tree2.update(x, profits[i])
	}

	ans := -1

	for i := 0; i < n; i++ {
		if left[i] > 0 && right[i] > 0 {
			ans = max(ans, left[i]+profits[i]+right[i])
		}
	}

	return ans
}继续阅读
- 实践案例
- 实践案例
- 实践案例