
LeetCode Go · 前缀和(2)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
1943. 描述绘画结果
题目、示例与约束
给你一个细长的画,用数轴表示。这幅画由若干有重叠的线段表示,每个线段有 独一无二 的颜色。给你二维整数数组 segments ,其中 segments[i] = [starti, endi, colori] 表示线段为 半开区间 [starti, endi) 且颜色为 colori 。
线段间重叠部分的颜色会被 混合 。如果有两种或者更多颜色混合时,它们会形成一种新的颜色,用一个 集合 表示这个混合颜色。
- 比方说,如果颜色
2,4和6被混合,那么结果颜色为{2,4,6}。
为了简化题目,你不需要输出整个集合,只需要用集合中所有元素的 和 来表示颜色集合。
你想要用 最少数目 不重叠 半开区间 来 表示 这幅混合颜色的画。这些线段可以用二维数组 painting 表示,其中 painting[j] = [leftj, rightj, mixj] 表示一个 半开区间[leftj, rightj) 的颜色 和 为 mixj 。
- 比方说,这幅画由
segments = [[1,4,5],[1,7,7]]组成,那么它可以表示为painting = [[1,4,12],[4,7,7]],因为:[1,4)由颜色{5,7}组成(和为12),分别来自第一个线段和第二个线段。[4,7)由颜色{7}组成,来自第二个线段。
请你返回二维数组 painting ,它表示最终绘画的结果(没有 被涂色的部分不出现在结果中)。你可以按 任意顺序 返回最终数组的结果。
半开区间 [a, b) 是数轴上点 a 和点 b 之间的部分,包含 点 a 且 不包含 点 b 。
示例 1:
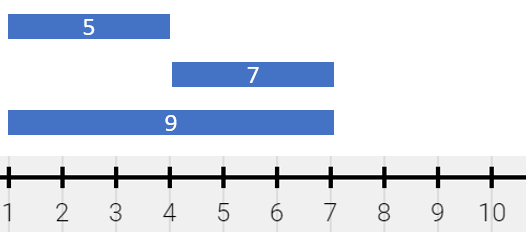
输入:segments = [[1,4,5],[4,7,7],[1,7,9]]
输出:[[1,4,14],[4,7,16]]
解释:绘画结果可以表示为:
- [1,4) 颜色为 {5,9} (和为 14),分别来自第一和第二个线段。
- [4,7) 颜色为 {7,9} (和为 16),分别来自第二和第三个线段。
示例 2:
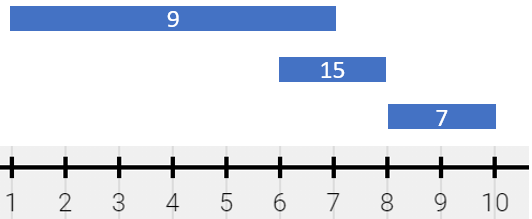
输入:segments = [[1,7,9],[6,8,15],[8,10,7]]
输出:[[1,6,9],[6,7,24],[7,8,15],[8,10,7]]
解释:绘画结果可以以表示为:
- [1,6) 颜色为 9 ,来自第一个线段。
- [6,7) 颜色为 {9,15} (和为 24),来自第一和第二个线段。
- [7,8) 颜色为 15 ,来自第二个线段。
- [8,10) 颜色为 7 ,来自第三个线段。
示例 3:
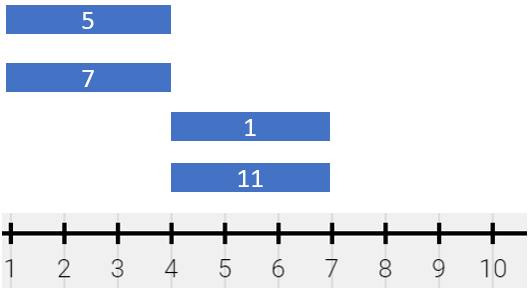
输入:segments = [[1,4,5],[1,4,7],[4,7,1],[4,7,11]]
输出:[[1,4,12],[4,7,12]]
解释:绘画结果可以表示为:
- [1,4) 颜色为 {5,7} (和为 12),分别来自第一和第二个线段。
- [4,7) 颜色为 {1,11} (和为 12),分别来自第三和第四个线段。
注意,只返回一个单独的线段 [1,7) 是不正确的,因为混合颜色的集合不相同。
提示:
1 <= segments.length <= 2 * 104segments[i].length == 31 <= starti < endi <= 1051 <= colori <= 109- 每种颜色
colori互不相同。
方法一:差分数组 · Go 实现
思考
重叠区间混色,输出每种颜色连续且非空的段。按段切分再扫描重叠为 。
端点处颜色增减可用差分:左端加色、右端减色。将端点排序后做前缀和,相邻端点之间若和不为零即为一段混色。
哈希记录差分,排序后线性扫一遍即可。
func splitPainting(segments [][]int) [][]int64 {
	d := make(map[int]int64)
	for _, seg := range segments {
		d[seg[0]] += int64(seg[2])
		d[seg[1]] -= int64(seg[2])
	}
	dList := make([]int, 0, len(d))
	for k := range d {
		dList = append(dList, k)
	}
	sort.Ints(dList)

	var ans [][]int64

	i := dList[0]
	cur := d[i]
	for j := 1; j < len(dList); j++ {
		it := d[dList[j]]
		if cur > 0 {
			ans = append(ans, []int64{int64(i), int64(dList[j]), cur})
		}
		cur += it
		i = dList[j]
	}

	return ans
}1983. 范围和相等的最宽索引对 🔒
题目、示例与约束
给定两个 以0为索引 的二进制数组 nums1 和 nums2 。找出 最宽 的索引对 (i, j) ,使的 i <= j 并且 nums1[i] + nums1[i+1] + ... + nums1[j] == nums2[i] + nums2[i+1] + ... + nums2[j]。
最宽 的指标对是指在 i 和 j 之间的 距离最大 的指标对。一对指标之间的 距离 定义为 j - i + 1 。
返回 最宽 索引对的 距离 。如果没有满足条件的索引对,则返回 0 。
示例 1:
输入: nums1 = [1,1,0,1], nums2 = [0,1,1,0]
输出: 3
解释:
如果i = 1, j = 3:
Nums1 [1] + Nums1 [2] + Nums1[3] = 1 + 0 + 1 = 2。
Nums2 [1] + Nums2 [2] + Nums2[3] = 1 + 1 + 0 = 2。
i和j之间的距离是j - i + 1 = 3 - 1 + 1 = 3。
示例 2:
输入: nums1 = [0,1], nums2 = [1,1]
输出: 1
解释:
If i = 1 and j = 1:
nums1[1] = 1。
nums2[1] = 1。
i和j之间的距离是j - i + 1 = 1 - 1 + 1 = 1。
示例 3:
输入: nums1 = [0], nums2 = [1]
输出: 0
解释:
没有满足要求的索引对。
提示:
n == nums1.length == nums2.length1 <= n <= 105nums1[i]仅为0或1.nums2[i]仅为0或1.
方法一:前缀和 + 哈希表 · Go 实现
思考
两段区间和相等等价于对应位置差分数组的子段和为 。求最长和为 的子数组可用前缀和首次出现位置。
哈希记下每个前缀和最早下标,再次出现时更新跨度。
我们观察到,对于任意的索引对 ,如果 ,那么 。如果我们将数组 与数组 对应位置的元素相减,得到一个新的数组 ,那么问题转换为在数组 中找到一个最长的子数组,使得子数组的和为 。这可以通过前缀和 + 哈希表的方法求解。
我们定义一个变量 表示当前 的前缀和,用一个哈希表 保存每个前缀和第一次出现的位置。初始时 , 。
接下来,我们遍历数组 中的每个元素 ,计算 的值,然后检查哈希表中是否存在 ,如果哈希表存在 ,那么说明存在一个子数组 ,使得子数组的和为 ,我们更新答案为 。否则,我们将 的值加入哈希表中,表示 第一次出现的位置为 。
遍历结束,即可得到最终的答案。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func widestPairOfIndices(nums1 []int, nums2 []int) (ans int) {
	d := map[int]int{0: -1}
	s := 0
	for i := range nums1 {
		s += nums1[i] - nums2[i]
		if j, ok := d[s]; ok {
			ans = max(ans, i-j)
		} else {
			d[s] = i
		}
	}
	return
}1991. 找到数组的中间位置
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums ,请你找到 最左边 的中间位置 middleIndex (也就是所有可能中间位置下标最小的一个)。
中间位置 middleIndex 是满足 nums[0] + nums[1] + ... + nums[middleIndex-1] == nums[middleIndex+1] + nums[middleIndex+2] + ... + nums[nums.length-1] 的数组下标。
如果 middleIndex == 0 ,左边部分的和定义为 0 。类似的,如果 middleIndex == nums.length - 1 ,右边部分的和定义为 0 。
请你返回满足上述条件 最左边 的 middleIndex ,如果不存在这样的中间位置,请你返回 -1 。
示例 1:
输入:nums = [2,3,-1,8,4]
输出:3
解释:
下标 3 之前的数字和为:2 + 3 + -1 = 4
下标 3 之后的数字和为:4 = 4
示例 2:
输入:nums = [1,-1,4]
输出:2
解释:
下标 2 之前的数字和为:1 + -1 = 0
下标 2 之后的数字和为:0
示例 3:
输入:nums = [2,5]
输出:-1
解释:
不存在符合要求的 middleIndex 。
示例 4:
输入:nums = [1]
输出:0
解释:
下标 0 之前的数字和为:0
下标 0 之后的数字和为:0
提示:
1 <= nums.length <= 100-1000 <= nums[i] <= 1000
注意:本题与主站 724 题相同:https://leetcode.cn/problems/find-pivot-index/
方法一:前缀和 · Go 实现
思考
中间下标使左右和相等。预计算总和后从左扫描:先从右侧减去当前值再比较,相等则返回,否则累加到左侧。
避免每次重新求和,空间常数。
我们定义两个变量 和 ,分别表示数组 中下标 左侧元素之和和右侧元素之和。初始时 ,而 。
我们遍历数组 ,对于当前遍历到的数字 ,我们更新 ,此时如果 ,说明当前下标 就是中间位置,直接返回即可。否则,我们更新 ,继续遍历下一个数字。
遍历结束,如果没有找到中间位置,返回 。
时间复杂度 ,其中 为数组 的长度。空间复杂度 。
相似题目:
func findMiddleIndex(nums []int) int {
	l, r := 0, 0
	for _, x := range nums {
		r += x
	}
	for i, x := range nums {
		r -= x
		if l == r {
			return i
		}
		l += x
	}
	return -1
}2017. 网格游戏
题目、示例与约束
给你一个下标从 0 开始的二维数组 grid ,数组大小为 2 x n ,其中 grid[r][c] 表示矩阵中 (r, c) 位置上的点数。现在有两个机器人正在矩阵上参与一场游戏。
两个机器人初始位置都是 (0, 0) ,目标位置是 (1, n-1) 。每个机器人只会 向右 ((r, c) 到 (r, c + 1)) 或 向下 ((r, c) 到 (r + 1, c)) 。
游戏开始,第一个 机器人从 (0, 0) 移动到 (1, n-1) ,并收集路径上单元格的全部点数。对于路径上所有单元格 (r, c) ,途经后 grid[r][c] 会重置为 0 。然后,第二个 机器人从 (0, 0) 移动到 (1, n-1) ,同样收集路径上单元的全部点数。注意,它们的路径可能会存在相交的部分。
第一个 机器人想要打击竞争对手,使 第二个 机器人收集到的点数 最小化 。与此相对,第二个 机器人想要 最大化 自己收集到的点数。两个机器人都发挥出自己的 最佳水平 的前提下,返回 第二个 机器人收集到的 点数 。
示例 1:
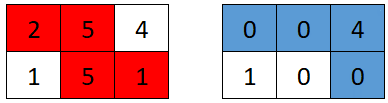
输入:grid = [[2,5,4],[1,5,1]]
输出:4
解释:第一个机器人的最佳路径如红色所示,第二个机器人的最佳路径如蓝色所示。
第一个机器人访问过的单元格将会重置为 0 。
第二个机器人将会收集到 0 + 0 + 4 + 0 = 4 个点。
示例 2:
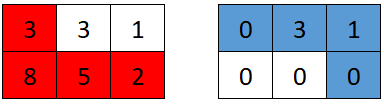
输入:grid = [[3,3,1],[8,5,2]]
输出:4
解释:第一个机器人的最佳路径如红色所示,第二个机器人的最佳路径如蓝色所示。
第一个机器人访问过的单元格将会重置为 0 。
第二个机器人将会收集到 0 + 3 + 1 + 0 = 4 个点。
示例 3:
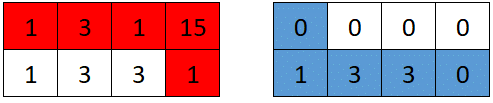
输入:grid = [[1,3,1,15],[1,3,3,1]]
输出:7
解释:第一个机器人的最佳路径如红色所示,第二个机器人的最佳路径如蓝色所示。
第一个机器人访问过的单元格将会重置为 0 。
第二个机器人将会收集到 0 + 1 + 3 + 3 + 0 = 7 个点。
提示:
grid.length == 2n == grid[r].length1 <= n <= 5 * 1041 <= grid[r][c] <= 105
方法一:前缀和 · Go 实现
思考
两行网格,第一个机器人从左上到右下只能先右后下再右,拐弯列 唯一决定其路径。第二个机器人在剩余格子中取最优,只会走「第一行 右侧」或「第二行 左侧」之一。
,枚举 须 得到两段和。用第一行剩余后缀 与第二行已走前缀 ,第二个机器人得 。
第一个机器人要最小化该值,故对每个 取 。
我们注意到,如果确定了第一个机器人拐头向下的位置 ,那么第二个机器人的最优路径也就确定了,第二个机器人的最优路径就是第一行从 到 的前缀和,或者第二行从 到 的前缀和,取两者的最大值。
我们先计算第一行的后缀点数和,记为 ,第二行的前缀点数和记为 ,初始时 , 。
然后我们枚举第一个机器人拐头向下的位置 ,此时更新 , 那么第二个机器人的最优路径和就是 ,我们取所有 对应的 的最小值即可。然后更新 。
枚举结束后,返回答案即可。
时间复杂度 ,空间复杂度 。其中 是网格的列数。
func gridGame(grid [][]int) int64 {
	ans := math.MaxInt64
	s1, s2 := 0, 0
	for _, v := range grid[0] {
		s1 += v
	}
	for j, v := range grid[0] {
		s1 -= v
		ans = min(ans, max(s1, s2))
		s2 += grid[1][j]
	}
	return int64(ans)
}2021. 街上最亮的位置 🔒
题目、示例与约束
一条街上有很多的路灯,路灯的坐标由数组 lights 的形式给出。 每个 lights[i] = [positioni, rangei] 代表坐标为 positioni 的路灯照亮的范围为 [positioni - rangei, positioni + rangei] (包括顶点)。
位置 p 的亮度由能够照到 p的路灯的数量来决定的。
给出 lights, 返回最亮的位置 。如果有很多,返回坐标最小的。
示例 1:
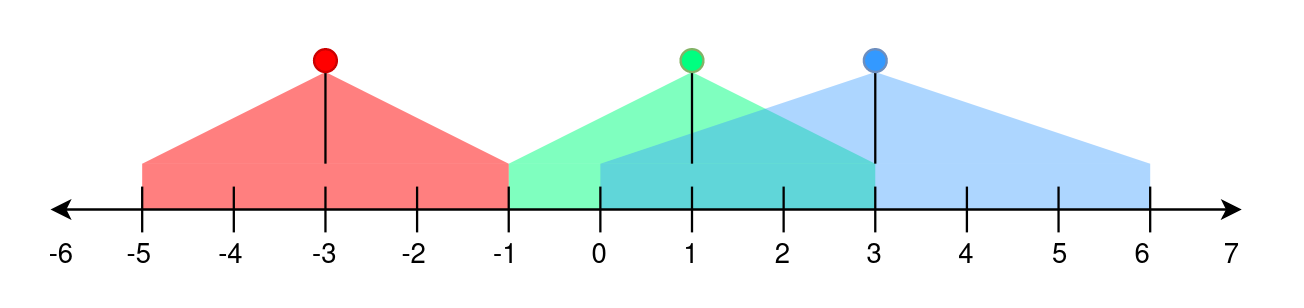
输入: lights = [[-3,2],[1,2],[3,3]]
输出: -1
解释:
第一个路灯照亮的范围是[(-3) - 2, (-3) + 2] = [-5, -1].
第二个路灯照亮的范围是 [1 - 2, 1 + 2] = [-1, 3].
第三个路灯照亮的范围是 [3 - 3, 3 + 3] = [0, 6].

坐标-1被第一个和第二个路灯照亮,亮度为2
坐标0,1,2都被第二个和第三个路灯照亮,亮度为2.
对于以上坐标,-1最小,所以返回-1
示例 2:
输入: lights = [[1,0],[0,1]]
输出: 1
示例 3:
输入: lights = [[1,2]]
输出: -1
提示:
1 <= lights.length <= 105lights[i].length == 2-108 <= positioni <= 1080 <= rangei <= 108
方法一:差分数组 + 哈希表 + 排序 · Go 实现
思考
每个路灯照亮 ,求亮度最大的最左位置。坐标范围大,不能开真实数组;路灯数决定了变更点个数。
差分在 加一、 减一,哈希表收集后按坐标排序扫描,维护前缀和 与历史最大 。
创新高时更新答案位置。
我们可以将每个路灯照亮的范围看作是一个区间,区间左端点 ,区间右端点 。我们可以利用差分数组的思想,对于每个区间 ,将位置 的值加 ,将位置 的值减 ,用哈希表维护每个位置的变化值。
然后从小到大遍历每个位置,计算当前位置的亮度 ,如果此前的最大亮度 ,则更新最大亮度 ,并记录当前位置 。
最后返回 即可。
时间复杂度 ,空间复杂度 。其中 为 的长度。
func brightestPosition(lights [][]int) (ans int) {
	d := map[int]int{}
	for _, x := range lights {
		l, r := x[0]-x[1], x[0]+x[1]
		d[l]++
		d[r+1]--
	}
	keys := make([]int, 0, len(d))
	for i := range d {
		keys = append(keys, i)
	}
	sort.Ints(keys)
	mx, s := 0, 0
	for _, i := range keys {
		s += d[i]
		if mx < s {
			mx = s
			ans = i
		}
	}
	return
}2025. 分割数组的最多方案数
题目、示例与约束
给你一个下标从 0 开始且长度为 n 的整数数组 nums 。分割 数组 nums 的方案数定义为符合以下两个条件的 pivot 数目:
1 <= pivot < nnums[0] + nums[1] + ... + nums[pivot - 1] == nums[pivot] + nums[pivot + 1] + ... + nums[n - 1]
同时给你一个整数 k 。你可以将 nums 中 一个 元素变为 k 或 不改变 数组。
请你返回在 至多 改变一个元素的前提下,最多 有多少种方法 分割 nums 使得上述两个条件都满足。
示例 1:
输入:nums = [2,-1,2], k = 3
输出:1
解释:一个最优的方案是将 nums[0] 改为 k 。数组变为 [3,-1,2] 。
有一种方法分割数组:
- pivot = 2 ,我们有分割 [3,-1 | 2]:3 + -1 == 2 。
示例 2:
输入:nums = [0,0,0], k = 1
输出:2
解释:一个最优的方案是不改动数组。
有两种方法分割数组:
- pivot = 1 ,我们有分割 [0 | 0,0]:0 == 0 + 0 。
- pivot = 2 ,我们有分割 [0,0 | 0]: 0 + 0 == 0 。
示例 3:
输入:nums = [22,4,-25,-20,-15,15,-16,7,19,-10,0,-13,-14], k = -33
输出:4
解释:一个最优的方案是将 nums[2] 改为 k 。数组变为 [22,4,-33,-20,-15,15,-16,7,19,-10,0,-13,-14] 。
有四种方法分割数组。
提示:
n == nums.length2 <= n <= 105-105 <= k, nums[i] <= 105
方法一:前缀和 + 哈希表 · Go 实现
思考
分割要求左右和相等,即某个前缀等于总和一半。 ,至多改一个位置为 ,不能对每个改法再扫一遍前缀。
不改时,若总和为偶数,答案是前缀恰为半和的个数(不含末尾)。改 为 时,左侧前缀不变、右侧每个前缀加 ,合法切分分别对应两个不同的目标前缀。
用 、 维护当前下标两侧的前缀计数,从左扫到右即可在线性时间内取最大值。
我们可以先预处理得到数组 对应的前缀和数组 ,其中 表示数组 的和。那么数组所有元素之和为 。
如果不修改数组 ,那么两个子数组的和相等的条件是 必须为偶数,如果 为偶数,那么我们求出 。
如果修改数组 ,那么我们可以枚举每一个修改的位置 ,将 修改为 ,那么数组总和的变化量 ,此时 左侧部分的和保持不变,那么合法的分割要满足 ,即 ;而右侧部分的每个前缀和都增加了 ,那么合法的分割要满足 ,即 。我们用哈希表 和 分别记录左侧部分和右侧部分每个前缀和出现的次数,那么我们可以求出 。
最后,我们返回 即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func waysToPartition(nums []int, k int) (ans int) {
	n := len(nums)
	s := make([]int, n)
	s[0] = nums[0]
	right := map[int]int{}
	for i := range nums[:n-1] {
		right[s[i]]++
		s[i+1] = s[i] + nums[i+1]
	}
	if s[n-1]%2 == 0 {
		ans = right[s[n-1]/2]
	}
	left := map[int]int{}
	for i, x := range nums {
		d := k - x
		if (s[n-1]+d)%2 == 0 {
			t := left[(s[n-1]+d)/2] + right[(s[n-1]-d)/2]
			if ans < t {
				ans = t
			}
		}
		left[s[i]]++
		right[s[i]]--
	}
	return
}2083. 求以相同字母开头和结尾的子串总数 🔒
题目、示例与约束
给你一个仅由小写英文字母组成的, 下标从 0 开始的字符串 s 。返回 s 中以相同字符开头和结尾的子字符串总数。
子字符串是字符串中连续的非空字符序列。
示例 1:
输入:s = "abcba"
输出:7
解释:
以相同字母开头和结尾的长度为 1 的子串是:"a"、"b"、"c"、"b" 和 "a" 。
以相同字母开头和结尾的长度为 3 的子串是:"bcb" 。
以相同字母开头和结尾的长度为 5 的子串是:"abcba" 。
示例 2:
输入:s = "abacad"
输出:9
解释:
以相同字母开头和结尾的长度为 1 的子串是:"a"、"b"、"a"、"c"、"a" 和 "d" 。
以相同字母开头和结尾的长度为 3 的子串是:"aba" 和 "aca" 。
以相同字母开头和结尾的长度为 5 的子串是:"abaca" 。
示例 3:
输入:s = "a"
输出:1
解释:
只有一个,以相同字母开头和结尾的长度为 1 的子串是:"a"。
提示:
1 <= s.length <= 105s仅包含小写英文字母。
方法一:数组或哈希表 · Go 实现
思考
子串起点终点同字母。枚举两端是平方, 。以某字母结尾的子串个数等于该字母至此出现次数(含单字符)。
边走边累加计数器,每见到 先加一再把新频次加入答案。
我们可以用哈希表或者一个长度为 的数组 来记录每个字符出现的次数。
遍历字符串 ,对于每个字符 ,我们将 的值加 ,然后将 的值加到答案中。
最后返回答案即可。
时间复杂度 ,其中 是字符串 的长度。空间复杂度 ,其中 是字符集,这里是小写英文字母,所以 。
func numberOfSubstrings(s string) (ans int64) {
	cnt := [26]int{}
	for _, c := range s {
		c -= 'a'
		cnt[c]++
		ans += int64(cnt[c])
	}
	return ans
}2121. 相同元素的间隔之和
题目、示例与约束
给你一个下标从 0 开始、由 n 个整数组成的数组 arr 。
arr 中两个元素的 间隔 定义为它们下标之间的 绝对差 。更正式地,arr[i] 和 arr[j] 之间的间隔是 |i - j| 。
返回一个长度为 n 的数组 intervals ,其中 intervals[i] 是 arr[i] 和 arr 中每个相同元素(与 arr[i] 的值相同)的 间隔之和 。
注意:|x| 是 x 的绝对值。
示例 1:
输入:arr = [2,1,3,1,2,3,3]
输出:[4,2,7,2,4,4,5]
解释:
- 下标 0 :另一个 2 在下标 4 ,|0 - 4| = 4
- 下标 1 :另一个 1 在下标 3 ,|1 - 3| = 2
- 下标 2 :另两个 3 在下标 5 和 6 ,|2 - 5| + |2 - 6| = 7
- 下标 3 :另一个 1 在下标 1 ,|3 - 1| = 2
- 下标 4 :另一个 2 在下标 0 ,|4 - 0| = 4
- 下标 5 :另两个 3 在下标 2 和 6 ,|5 - 2| + |5 - 6| = 4
- 下标 6 :另两个 3 在下标 2 和 5 ,|6 - 2| + |6 - 5| = 5
示例 2:
输入:arr = [10,5,10,10]
输出:[5,0,3,4]
解释:
- 下标 0 :另两个 10 在下标 2 和 3 ,|0 - 2| + |0 - 3| = 5
- 下标 1 :只有这一个 5 在数组中,所以到相同元素的间隔之和是 0
- 下标 2 :另两个 10 在下标 0 和 3 ,|2 - 0| + |2 - 3| = 3
- 下标 3 :另两个 10 在下标 0 和 2 ,|3 - 0| + |3 - 2| = 4
提示:
n == arr.length1 <= n <= 1051 <= arr[i] <= 105
注意:本题与 2615. 等值距离和 相同。
方法一 · Go 实现
思考
对每个下标 ,需要所有 满足 的 之和。按值分组后,朴素对组内两两求和是 ,在 时不可行。
同一值的下标有序,记为 。相邻两项的差 会使左侧 个点各增加 、右侧 个点各减少 ,因而可以从「全部相对第一个下标的距离和」递推到组内每一个位置。
按值收集下标,先算 ,再沿组扫一遍按上式更新并写入答案。
func getDistances(arr []int) []int64 {
	d := make(map[int][]int)
	n := len(arr)
	for i, v := range arr {
		d[v] = append(d[v], i)
	}
	ans := make([]int64, n)
	for _, v := range d {
		m := len(v)
		val := 0
		for _, e := range v {
			val += e
		}
		val -= m * v[0]
		for i, p := range v {
			delta := 0
			if i >= 1 {
				delta = v[i] - v[i-1]
			}
			val += i*delta - (m-i)*delta
			ans[p] = int64(val)
		}
	}
	return ans
}2145. 统计隐藏数组数目
题目、示例与约束
给你一个下标从 0 开始且长度为 n 的整数数组 differences ,它表示一个长度为 n + 1 的 隐藏 数组 相邻 元素之间的 差值 。更正式的表述为:我们将隐藏数组记作 hidden ,那么 differences[i] = hidden[i + 1] - hidden[i] 。
同时给你两个整数 lower 和 upper ,它们表示隐藏数组中所有数字的值都在 闭 区间 [lower, upper] 之间。
- 比方说,
differences = [1, -3, 4],lower = 1,upper = 6,那么隐藏数组是一个长度为4且所有值都在1和6(包含两者)之间的数组。[3, 4, 1, 5]和[4, 5, 2, 6]都是符合要求的隐藏数组。[5, 6, 3, 7]不符合要求,因为它包含大于6的元素。[1, 2, 3, 4]不符合要求,因为相邻元素的差值不符合给定数据。
请你返回 符合 要求的隐藏数组的数目。如果没有符合要求的隐藏数组,请返回 0 。
示例 1:
输入:differences = [1,-3,4], lower = 1, upper = 6
输出:2
解释:符合要求的隐藏数组为:
- [3, 4, 1, 5]
- [4, 5, 2, 6]
所以返回 2 。
示例 2:
输入:differences = [3,-4,5,1,-2], lower = -4, upper = 5
输出:4
解释:符合要求的隐藏数组为:
- [-3, 0, -4, 1, 2, 0]
- [-2, 1, -3, 2, 3, 1]
- [-1, 2, -2, 3, 4, 2]
- [0, 3, -1, 4, 5, 3]
所以返回 4 。
示例 3:
输入:differences = [4,-7,2], lower = 3, upper = 6
输出:0
解释:没有符合要求的隐藏数组,所以返回 0 。
提示:
n == differences.length1 <= n <= 105-105 <= differences[i] <= 105-105 <= lower <= upper <= 105
方法一:前缀和 · Go 实现
思考
相邻差已给定,隐数组在平移意义下形状固定,合法起点必须使全程落在 。若枚举起点再模拟,值域可达 量级以外的平移,且 也大。
设首项为 做前缀和,记最小、最大前缀为 、 。真实首项 需满足 ,个数为区间长度与 的较大者。
一遍扫描维护前缀极值即可。
由于数组 已经确定,那么数组 的元素最大值与最小值之差也是固定的,我们只要确保差值不超过 即可。
我们不妨假设数组 的第一个元素为 ,那么 ,其中 。记数组 的最大值为 ,最小值为 ,如果 ,那么我们就可以构造出一个合法的 数组,可以构造的个数为 。否则,无法构造出合法的 数组,返回 。
时间复杂度 ,其中 是数组 的长度。空间复杂度 。
func numberOfArrays(differences []int, lower int, upper int) int {
	x, mi, mx := 0, 0, 0
	for _, d := range differences {
		x += d
		mi = min(mi, x)
		mx = max(mx, x)
	}
	return max(0, upper-lower-(mx-mi)+1)
}2219. 数组的最大总分 🔒
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums ,数组长度为 n 。
nums 在下标 i (0 <= i < n)处的 总分 等于下面两个分数中的 最大值 :
nums前i + 1个元素的总和nums后n - i个元素的总和
返回数组 nums 在任一下标处能取得的 最大总分 。
示例 1:
输入:nums = [4,3,-2,5]
输出:10
解释:
下标 0 处的最大总分是 max(4, 4 + 3 + -2 + 5) = max(4, 10) = 10 。
下标 1 处的最大总分是 max(4 + 3, 3 + -2 + 5) = max(7, 6) = 7 。
下标 2 处的最大总分是 max(4 + 3 + -2, -2 + 5) = max(5, 3) = 5 。
下标 3 处的最大总分是 max(4 + 3 + -2 + 5, 5) = max(10, 5) = 10 。
nums 可取得的最大总分是 10 。
示例 2:
输入:nums = [-3,-5]
输出:-3
解释:
下标 0 处的最大总分是 max(-3, -3 + -5) = max(-3, -8) = -3 。
下标 1 处的最大总分是 max(-3 + -5, -5) = max(-8, -5) = -5 。
nums 可取得的最大总分是 -3 。
提示:
n == nums.length1 <= n <= 105-105 <= nums[i] <= 105
方法一:前缀和 · Go 实现
思考
下标 的得分为「 左侧含自身的前缀和」与「 右侧含自身的后缀和」中的较大者,要求所有 上的最大得分。 ,对每个 重新求和不可行。
两个和都可以在扫描时维护:先记下总和 ,再从左往右把 加入前缀 ,此时 与 恰是当前下标的两个候选,取较大者更新答案,然后从 中减去 。一遍即可。
我们可以使用两个变量 和 分别表示数组的前缀和和后缀和,初始时 , 。
接下来,我们遍历数组 ,对于每个元素 ,我们将 增加 ,并更新答案 ,然后将 减少 。
遍历结束后,返回答案 即可。
时间复杂度 ,其中 是数组 的长度。空间复杂度 。
func maximumSumScore(nums []int) int64 {
	l, r := 0, 0
	for _, x := range nums {
		r += x
	}
	ans := math.MinInt64
	for _, x := range nums {
		l += x
		ans = max(ans, max(l, r))
		r -= x
	}
	return int64(ans)
}2237. 计算街道上满足所需亮度的位置数量 🔒
题目、示例与约束
给你一个整数 n。一条完全笔直的街道用一条从 0 到 n - 1 的数轴表示。给你一个二维整数数组 lights,表示街道上的路灯。每个 lights[i] = [positioni, rangei] 表示在位置 positioni 有一盏路灯,从 [max(0, positioni - rangei), min(n - 1, positioni + rangei)] (包含边界) 开始照亮该区域。
位置 p 的 亮度 定义为点亮位置 p 的路灯的数量。给定一个大小为 n 的整数数组 requirement,数组的 下标从 0 开始,其中 requirement[i] 是街道上第 i 个位置的最小 亮度。
返回街道上 0 到 n - 1 之间 亮度至少满足 requirement[i] 的位置 i 的数量。
示例 1:
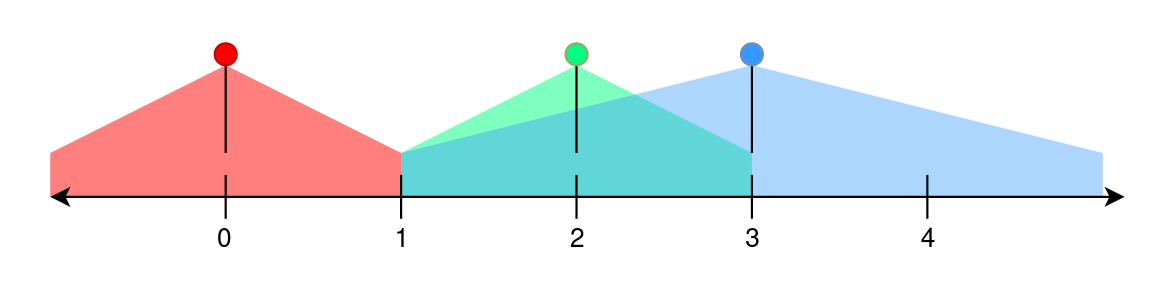
输入: n = 5, lights = [[0,1],[2,1],[3,2]], requirement = [0,2,1,4,1]
输出: 4
解释:
- 第一盏路灯照亮区域范围为 [max(0,0 - 1), min(n - 1,0 + 1)] =[0,1](含边界)。
- 第二盏路灯的点亮范围为 [max(0,2 - 1), min(n - 1,2 + 1)] =[1,3](含边界)。
- 第三盏路灯照亮区域范围为 [max(0,3 - 2), min(n - 1,3 + 2)] =[1,4](含边界)。

- 位置 0 被第一盏路灯覆盖。它被 1 个路灯覆盖,大于 requirement[0]。
- 位置 1 被第一、第二和第三个路灯覆盖。被 3 个路灯覆盖,大于 requirement[1]。
- 位置 2 由第二和第三路灯覆盖。被 2 个路灯覆盖,大于 requirement[2]。
- 位置 3 由第二和第三路灯覆盖。它被 2 个路灯覆盖,比 requirement[3] 少。
- 位置 4 被第三个路灯覆盖。它被 1 盏路灯覆盖,等于 requirement[4]。

位置 0、1、2、4 满足要求,因此返回4。
示例 2:
输入: n = 1, lights = [[0,1]], requirement = [2]
输出: 0
解释:
- 第一盏路灯照亮区域范围为 [max(0,0 - 1), min(n - 1,0 + 1)] =[0,0](含边界)。
- 位置 0 被第一盏路灯覆盖。它被 1 个路灯覆盖,比 requirement[0] 少。
- 返回0,因为没有位置满足亮度要求。
提示:
1 <= n <= 1051 <= lights.length <= 1050 <= positioni < n0 <= rangei <= 105requirement.length == n0 <= requirement[i] <= 105
方法一:差分数组 · Go 实现
思考
每盏灯照亮一段区间,要统计亮度不低于要求的位置数。若对每盏灯遍历其覆盖范围, 与灯数同阶时可达平方。区间加一是差分数组的典型操作。
对每盏灯在 加一、在右端下一格减一,再对 做前缀和即得每个位置的亮度,与 逐格比较即可。
对一段连续的区间 同时加上一个值 ,可以通过差分数组来实现。
我们定义一个长度为 的数组 ,接下来对于每个路灯,我们计算出它的左边界 和右边界 ,然后将 加上 ,将 减去 。
然后,我们对 进行前缀和运算,对于每个位置 ,如果 的前缀和大于等于 ,则说明该位置满足要求,将答案加一。
最后返回答案即可。
时间复杂度 ,空间复杂度 。其中 为路灯数量。
func meetRequirement(n int, lights [][]int, requirement []int) (ans int) {
	d := make([]int, n+1)
	for _, e := range lights {
		i, j := max(0, e[0]-e[1]), min(n-1, e[0]+e[1])
		d[i]++
		d[j+1]--
	}
	s := 0
	for i, r := range requirement {
		s += d[i]
		if s >= r {
			ans++
		}
	}
	return
}2245. 转角路径的乘积中最多能有几个尾随零
题目、示例与约束
给你一个二维整数数组 grid ,大小为 m x n,其中每个单元格都含一个正整数。
转角路径 定义为:包含至多一个弯的一组相邻单元。具体而言,路径应该完全 向水平方向 或者 向竖直方向 移动过弯(如果存在弯),而不能访问之前访问过的单元格。在过弯之后,路径应当完全朝 另一个 方向行进:如果之前是向水平方向,那么就应该变为向竖直方向;反之亦然。当然,同样不能访问之前已经访问过的单元格。
一条路径的 乘积 定义为:路径上所有值的乘积。
请你从 grid 中找出一条乘积中尾随零数目最多的转角路径,并返回该路径中尾随零的数目。
注意:
- 水平 移动是指向左或右移动。
- 竖直 移动是指向上或下移动。
示例 1:
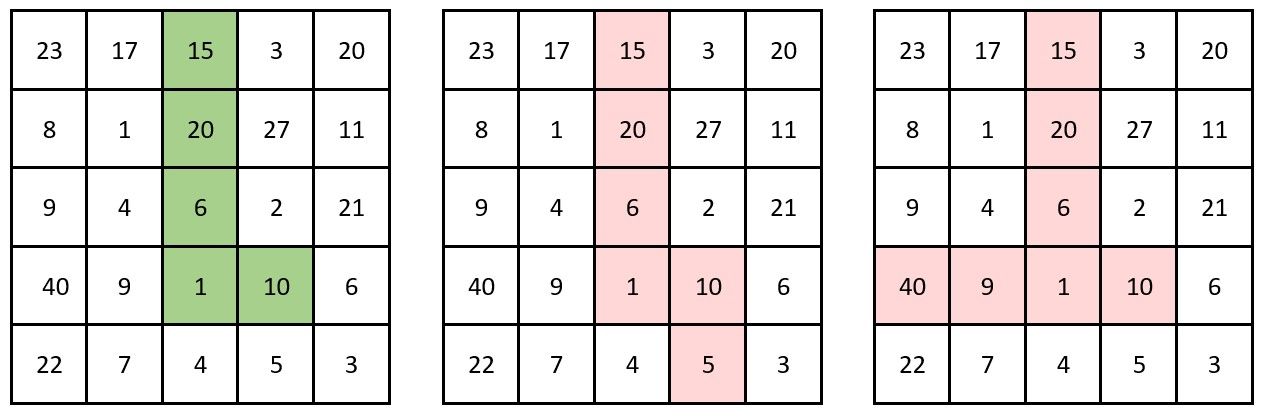
输入:grid = [[23,17,15,3,20],[8,1,20,27,11],[9,4,6,2,21],[40,9,1,10,6],[22,7,4,5,3]]
输出:3
解释:左侧的图展示了一条有效的转角路径。
其乘积为 15 * 20 * 6 * 1 * 10 = 18000 ,共计 3 个尾随零。
可以证明在这条转角路径的乘积中尾随零数目最多。

中间的图不是一条有效的转角路径,因为它有不止一个弯。
右侧的图也不是一条有效的转角路径,因为它需要重复访问已经访问过的单元格。
示例 2:
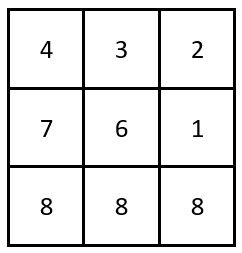
输入:grid = [[4,3,2],[7,6,1],[8,8,8]]
输出:0
解释:网格如上图所示。
不存在乘积含尾随零的转角路径。
提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 1051 <= m * n <= 1051 <= grid[i][j] <= 1000
方法一:前缀和 + 枚举拐点 · Go 实现
思考
路径只能先水平再竖直(或相反),拐角尾零取决于路径上 与 个数的较小值。 ,枚举路径上的格子会超时。拐角一旦固定,路径就是「该行的一段前缀或后缀」加上「该列的一段前缀或后缀」。
预处理每行、每列的 、 前缀和后,枚举拐点 ,用前缀和拼出四种「左/右 + 上/下」组合(拐点本身只计一次),取 的最大值。
首先我们要明确,对于一个乘积,尾随零的个数取决于因子中 和 的个数的较小值。另外,每一条转角路径应该覆盖尽可能多的数,因此,它一定是从某个边界出发,到达某个拐点,再到达另一个边界。
因此,我们可以创建四个二维数组 , , , 来记录每一行和每一列中 和 的个数。其中:
r2[i][j]表示第 行中从第 列到第 列的 的个数;c2[i][j]表示第 列中从第 行到第 行的 的个数;r5[i][j]表示第 行中从第 列到第 列的 的个数;c5[i][j]表示第 列中从第 行到第 行的 的个数。
接下来,我们遍历二维数组 grid,对于每个数,我们计算它的 和 的个数,然后更新四个二维数组。
然后,我们枚举拐点 ,对于每个拐点,我们计算四个值,其中:
a表示从 右移到 ,再从 拐头向上移动到 的路径中 的个数和 的个数的较小值;b表示从 右移到 ,再从 拐头向下移动到 的路径中 的个数和 的个数的较小值;c表示从 左移到 ,再从 拐头向上移动到 的路径中 的个数和 的个数的较小值;d表示从 左移到 ,再从 拐头向下移动到 的路径中 的个数和 的个数的较小值。
每一次枚举,我们取这四个值的最大值,然后更新答案。
最后,我们返回答案即可。
时间复杂度 ,空间复杂度 。其中 和 分别是二维数组 grid 的行数和列数。
func maxTrailingZeros(grid [][]int) (ans int) {
	m, n := len(grid), len(grid[0])
	r2 := get(m+1, n+1)
	c2 := get(m+1, n+1)
	r5 := get(m+1, n+1)
	c5 := get(m+1, n+1)
	for i := 1; i <= m; i++ {
		for j := 1; j <= n; j++ {
			x := grid[i-1][j-1]
			s2, s5 := 0, 0
			for ; x%2 == 0; x /= 2 {
				s2++
			}
			for ; x%5 == 0; x /= 5 {
				s5++
			}
			r2[i][j] = r2[i][j-1] + s2
			c2[i][j] = c2[i-1][j] + s2
			r5[i][j] = r5[i][j-1] + s5
			c5[i][j] = c5[i-1][j] + s5
		}
	}
	for i := 1; i <= m; i++ {
		for j := 1; j <= n; j++ {
			a := min(r2[i][j]+c2[i-1][j], r5[i][j]+c5[i-1][j])
			b := min(r2[i][j]+c2[m][j]-c2[i][j], r5[i][j]+c5[m][j]-c5[i][j])
			c := min(r2[i][n]-r2[i][j]+c2[i][j], r5[i][n]-r5[i][j]+c5[i][j])
			d := min(r2[i][n]-r2[i][j-1]+c2[m][j]-c2[i][j], r5[i][n]-r5[i][j-1]+c5[m][j]-c5[i][j])
			ans = max(ans, max(a, max(b, max(c, d))))
		}
	}
	return
}

func get(m, n int) [][]int {
	f := make([][]int, m)
	for i := range f {
		f[i] = make([]int, n)
	}
	return f
}2256. 最小平均差
题目、示例与约束
给你一个下标从 0 开始长度为 n 的整数数组 nums 。
下标 i 处的 平均差 指的是 nums 中 前 i + 1 个元素平均值和 后 n - i - 1 个元素平均值的 绝对差 。两个平均值都需要 向下取整 到最近的整数。
请你返回产生 最小平均差 的下标。如果有多个下标最小平均差相等,请你返回 最小 的一个下标。
注意:
- 两个数的 绝对差 是两者差的绝对值。
-
n个元素的平均值是n个元素之 和 除以(整数除法)n。 0个元素的平均值视为0。
示例 1:
输入:nums = [2,5,3,9,5,3]
输出:3
解释:
- 下标 0 处的平均差为:|2 / 1 - (5 + 3 + 9 + 5 + 3) / 5| = |2 / 1 - 25 / 5| = |2 - 5| = 3 。
- 下标 1 处的平均差为:|(2 + 5) / 2 - (3 + 9 + 5 + 3) / 4| = |7 / 2 - 20 / 4| = |3 - 5| = 2 。
- 下标 2 处的平均差为:|(2 + 5 + 3) / 3 - (9 + 5 + 3) / 3| = |10 / 3 - 17 / 3| = |3 - 5| = 2 。
- 下标 3 处的平均差为:|(2 + 5 + 3 + 9) / 4 - (5 + 3) / 2| = |19 / 4 - 8 / 2| = |4 - 4| = 0 。
- 下标 4 处的平均差为:|(2 + 5 + 3 + 9 + 5) / 5 - 3 / 1| = |24 / 5 - 3 / 1| = |4 - 3| = 1 。
- 下标 5 处的平均差为:|(2 + 5 + 3 + 9 + 5 + 3) / 6 - 0| = |27 / 6 - 0| = |4 - 0| = 4 。
下标 3 处的平均差为最小平均差,所以返回 3 。
示例 2:
输入:nums = [0]
输出:0
解释:
唯一的下标是 0 ,所以我们返回 0 。
下标 0 处的平均差为:|0 / 1 - 0| = |0 - 0| = 0 。
提示:
1 <= nums.length <= 1050 <= nums[i] <= 105
方法一:遍历 · Go 实现
思考
对每个分割点求左右两段整数平均值之差的绝对值,取最小者的最左下标。 ,每点重新求和不可行。左右和可以一边扫描一边维护。
先记下总和 ,从左往右把 加入 并从 减去。左段长度为 ,右段为空时平均视为 。记下差值最小的下标。
我们直接遍历数组 ,对于每个下标 ,维护前 个元素的和 和后 个元素的和 ,计算平均差的绝对值 ,如果 小于当前最小值 ,则更新答案 和最小值 。
遍历结束后,返回答案即可。
时间复杂度 ,其中 是数组 的长度。空间复杂度 。
func minimumAverageDifference(nums []int) (ans int) {
	n := len(nums)
	pre, suf := 0, 0
	for _, x := range nums {
		suf += x
	}
	mi := suf
	for i, x := range nums {
		pre += x
		suf -= x
		a := pre / (i + 1)
		b := 0
		if n-i-1 != 0 {
			b = suf / (n - i - 1)
		}
		if t := abs(a - b); t < mi {
			ans = i
			mi = t
		}
	}
	return
}

func abs(x int) int {
	if x < 0 {
		return -x
	}
	return x
}2270. 分割数组的方案数
题目、示例与约束
给你一个下标从 0 开始长度为 n 的整数数组 nums 。
如果以下描述为真,那么 nums 在下标 i 处有一个 合法的分割 :
- 前
i + 1个元素的和 大于等于 剩下的n - i - 1个元素的和。 - 下标
i的右边 至少有一个 元素,也就是说下标i满足0 <= i < n - 1。
请你返回 nums 中的 合法分割 方案数。
示例 1:
输入:nums = [10,4,-8,7]
输出:2
解释:
总共有 3 种不同的方案可以将 nums 分割成两个非空的部分:
- 在下标 0 处分割 nums 。那么第一部分为 [10] ,和为 10 。第二部分为 [4,-8,7] ,和为 3 。因为 10 >= 3 ,所以 i = 0 是一个合法的分割。
- 在下标 1 处分割 nums 。那么第一部分为 [10,4] ,和为 14 。第二部分为 [-8,7] ,和为 -1 。因为 14 >= -1 ,所以 i = 1 是一个合法的分割。
- 在下标 2 处分割 nums 。那么第一部分为 [10,4,-8] ,和为 6 。第二部分为 [7] ,和为 7 。因为 6 < 7 ,所以 i = 2 不是一个合法的分割。
所以 nums 中总共合法分割方案受为 2 。
示例 2:
输入:nums = [2,3,1,0]
输出:2
解释:
总共有 2 种 nums 的合法分割:
- 在下标 1 处分割 nums 。那么第一部分为 [2,3] ,和为 5 。第二部分为 [1,0] ,和为 1 。因为 5 >= 1 ,所以 i = 1 是一个合法的分割。
- 在下标 2 处分割 nums 。那么第一部分为 [2,3,1] ,和为 6 。第二部分为 [0] ,和为 0 。因为 6 >= 0 ,所以 i = 2 是一个合法的分割。
提示:
2 <= nums.length <= 105-105 <= nums[i] <= 105
方法一:前缀和 · Go 实现
思考
合法分割要求左段和不少于右段和,且右段非空。 ,不能对每个切点重新求和。左右两段之和等于总和 ,条件即前缀和 。
先算 ,再扫前 个元素累加 并计数。一遍线性完成。
我们首先计算数组 的总和 ,然后遍历数组 的前 个元素,用变量 记录前缀和,如果 ,则将答案加一。
遍历结束后,返回答案即可。
时间复杂度 ,其中 为数组 的长度。空间复杂度 。
func waysToSplitArray(nums []int) (ans int) {
	var s, t int
	for _, x := range nums {
		s += x
	}
	for _, x := range nums[:len(nums)-1] {
		t += x
		if t >= s-t {
			ans++
		}
	}
	return
}2381. 字母移位 II
题目、示例与约束
给你一个小写英文字母组成的字符串 s 和一个二维整数数组 shifts ,其中 shifts[i] = [starti, endi, directioni] 。对于每个 i ,将 s 中从下标 starti 到下标 endi (两者都包含)所有字符都进行移位运算,如果 directioni = 1 将字符向后移位,如果 directioni = 0 将字符向前移位。
将一个字符 向后 移位的意思是将这个字符用字母表中 下一个 字母替换(字母表视为环绕的,所以 'z' 变成 'a')。类似的,将一个字符 向前 移位的意思是将这个字符用字母表中 前一个 字母替换(字母表是环绕的,所以 'a' 变成 'z' )。
请你返回对 s 进行所有移位操作以后得到的最终字符串。
示例 1:
输入:s = "abc", shifts = [[0,1,0],[1,2,1],[0,2,1]]
输出:"ace"
解释:首先,将下标从 0 到 1 的字母向前移位,得到 s = "zac" 。
然后,将下标从 1 到 2 的字母向后移位,得到 s = "zbd" 。
最后,将下标从 0 到 2 的字符向后移位,得到 s = "ace" 。
示例 2:
输入:s = "dztz", shifts = [[0,0,0],[1,1,1]]
输出:"catz"
解释:首先,将下标从 0 到 0 的字母向前移位,得到 s = "cztz" 。
最后,将下标从 1 到 1 的字符向后移位,得到 s = "catz" 。
提示:
1 <= s.length, shifts.length <= 5 * 104shifts[i].length == 30 <= starti <= endi < s.length0 <= directioni <= 1s只包含小写英文字母。
方法一:差分数组 · Go 实现
思考
多次对区间做加减一的循环移位。 与操作数达 ,不能每次真的改一段。
差分数组在 加方向、 减方向,前缀和得到每位净移位,再对 取模写回字母。
用差分数组 记录区间的变化,然后对 求前缀和,得到每个下标 的变化量 。
然后将原字符串中每个字符加上对应的 ,最终得到一个新的字符串。
时间复杂度 。其中 是原字符串 的长度,而 是移位操作 的长度。
func shiftingLetters(s string, shifts [][]int) string {
	n := len(s)
	d := make([]int, n+1)
	for _, e := range shifts {
		if e[2] == 0 {
			e[2]--
		}
		d[e[0]] += e[2]
		d[e[1]+1] -= e[2]
	}
	for i := 1; i <= n; i++ {
		d[i] += d[i-1]
	}
	ans := []byte{}
	for i, c := range s {
		j := (int(c-'a') + d[i]%26 + 26) % 26
		ans = append(ans, byte('a'+j))
	}
	return string(ans)
}2391. 收集垃圾的最少总时间
题目、示例与约束
给你一个下标从 0 开始的字符串数组 garbage ,其中 garbage[i] 表示第 i 个房子的垃圾集合。garbage[i] 只包含字符 'M' ,'P' 和 'G' ,但可能包含多个相同字符,每个字符分别表示一单位的金属、纸和玻璃。垃圾车收拾 一 单位的任何一种垃圾都需要花费 1 分钟。
同时给你一个下标从 0 开始的整数数组 travel ,其中 travel[i] 是垃圾车从房子 i 行驶到房子 i + 1 需要的分钟数。
城市里总共有三辆垃圾车,分别收拾三种垃圾。每辆垃圾车都从房子 0 出发,按顺序 到达每一栋房子。但它们 不是必须 到达所有的房子。
任何时刻只有 一辆 垃圾车处在使用状态。当一辆垃圾车在行驶或者收拾垃圾的时候,另外两辆车 不能 做任何事情。
请你返回收拾完所有垃圾需要花费的 最少 总分钟数。
示例 1:
输入:garbage = ["G","P","GP","GG"], travel = [2,4,3]
输出:21
解释:
收拾纸的垃圾车:
1. 从房子 0 行驶到房子 1
2. 收拾房子 1 的纸垃圾
3. 从房子 1 行驶到房子 2
4. 收拾房子 2 的纸垃圾
收拾纸的垃圾车总共花费 8 分钟收拾完所有的纸垃圾。
收拾玻璃的垃圾车:
1. 收拾房子 0 的玻璃垃圾
2. 从房子 0 行驶到房子 1
3. 从房子 1 行驶到房子 2
4. 收拾房子 2 的玻璃垃圾
5. 从房子 2 行驶到房子 3
6. 收拾房子 3 的玻璃垃圾
收拾玻璃的垃圾车总共花费 13 分钟收拾完所有的玻璃垃圾。
由于没有金属垃圾,收拾金属的垃圾车不需要花费任何时间。
所以总共花费 8 + 13 = 21 分钟收拾完所有垃圾。
示例 2:
输入:garbage = ["MMM","PGM","GP"], travel = [3,10]
输出:37
解释:
收拾金属的垃圾车花费 7 分钟收拾完所有的金属垃圾。
收拾纸的垃圾车花费 15 分钟收拾完所有的纸垃圾。
收拾玻璃的垃圾车花费 15 分钟收拾完所有的玻璃垃圾。
总共花费 7 + 15 + 15 = 37 分钟收拾完所有的垃圾。
提示:
2 <= garbage.length <= 105garbage[i]只包含字母'M','P'和'G'。1 <= garbage[i].length <= 10travel.length == garbage.length - 11 <= travel[i] <= 100
方法一:哈希表 + 前缀和 · Go 实现
思考
三辆车各收一种垃圾,都必须从房屋 开到该种垃圾最后出现的房屋。收集时间等于所有字符数,行驶时间只取决于最远下标。 。
一遍扫过累加字符串长度,并用哈希表记下每种垃圾的最后下标。再对 做前缀和,在「恰为某车终点」的位置加上该前缀。
根据题目描述,每一辆垃圾车从房子 出发,收集其中一种垃圾,按顺序前进,直到到达该种垃圾最后出现的房子下标为止。
因此,我们可以用一个哈希表 记录每种垃圾最后出现的房子下标。我们假设第 种垃圾最后一次出现在第 个房子,那么第 辆车所需要的行驶时间为 。注意,如果 ,则不需要行驶时间。我们通过前缀和累计所有车辆的行驶时间,加上每种垃圾的总收集时间,即可得到答案。
时间复杂度 ,空间复杂度 ,其中 和 分别是垃圾的数量和种类。本题中 。
func garbageCollection(garbage []string, travel []int) (ans int) {
	last := map[byte]int{}
	for i, s := range garbage {
		ans += len(s)
		for j := range s {
			last[s[j]] = i
		}
	}
	ts := 0
	for i := 1; i <= len(travel); i++ {
		ts += travel[i-1]
		for _, j := range last {
			if i == j {
				ans += ts
			}
		}
	}
	return
}2428. 沙漏的最大总和
题目、示例与约束
给你一个大小为 m x n 的整数矩阵 grid 。
按以下形式将矩阵的一部分定义为一个 沙漏 :
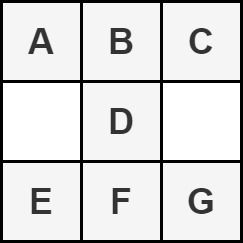
返回沙漏中元素的 最大 总和。
注意:沙漏无法旋转且必须整个包含在矩阵中。
示例 1:
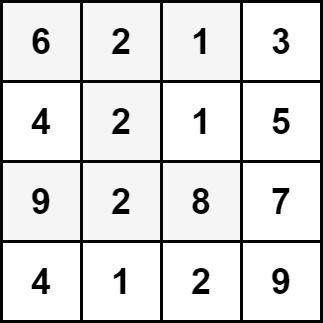
输入:grid = [[6,2,1,3],[4,2,1,5],[9,2,8,7],[4,1,2,9]]
输出:30
解释:上图中的单元格表示元素总和最大的沙漏:6 + 2 + 1 + 2 + 9 + 2 + 8 = 30 。
示例 2:
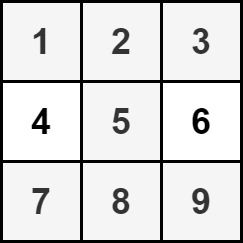
输入:grid = [[1,2,3],[4,5,6],[7,8,9]]
输出:35
解释:上图中的单元格表示元素总和最大的沙漏:1 + 2 + 3 + 5 + 7 + 8 + 9 = 35 。
提示:
m == grid.lengthn == grid[i].length3 <= m, n <= 1500 <= grid[i][j] <= 106
方法一:枚举 · Go 实现
思考
沙漏是固定 挖去中间行两端。矩阵至多 ,枚举每个中心 累加七个格子即可,时间 。
我们观察题目发现,每个沙漏就是一个 的矩阵挖去中间行的首尾两个元素。因此,我们可以从左上角开始,枚举每个沙漏的中间坐标 ,然后计算沙漏的元素和,取其中的最大值即可。
时间复杂度 ,其中 和 分别是矩阵的行数和列数。空间复杂度 。
func maxSum(grid [][]int) (ans int) {
	m, n := len(grid), len(grid[0])
	for i := 1; i < m-1; i++ {
		for j := 1; j < n-1; j++ {
			s := -grid[i][j-1] - grid[i][j+1]
			for x := i - 1; x <= i+1; x++ {
				for y := j - 1; y <= j+1; y++ {
					s += grid[x][y]
				}
			}
			ans = max(ans, s)
		}
	}
	return
}2483. 商店的最少代价
题目、示例与约束
给你一个顾客访问商店的日志,用一个下标从 0 开始且只包含字符 'N' 和 'Y' 的字符串 customers 表示:
- 如果第
i个字符是'Y',它表示第i小时有顾客到达。 - 如果第
i个字符是'N',它表示第i小时没有顾客到达。
如果商店在第 j 小时关门(0 <= j <= n),代价按如下方式计算:
- 在开门期间,如果某一个小时没有顾客到达,代价增加
1。 - 在关门期间,如果某一个小时有顾客到达,代价增加
1。
请你返回在确保代价 最小 的前提下,商店的 最早 关门时间。
注意,商店在第 j 小时关门表示在第 j 小时以及之后商店处于关门状态。
示例 1:
输入:customers = "YYNY"
输出:2
解释:
- 第 0 小时关门,总共 1+1+0+1 = 3 代价。
- 第 1 小时关门,总共 0+1+0+1 = 2 代价。
- 第 2 小时关门,总共 0+0+0+1 = 1 代价。
- 第 3 小时关门,总共 0+0+1+1 = 2 代价。
- 第 4 小时关门,总共 0+0+1+0 = 1 代价。
在第 2 或第 4 小时关门代价都最小。由于第 2 小时更早,所以最优关门时间是 2 。
示例 2:
输入:customers = "NNNNN"
输出:0
解释:最优关门时间是 0 ,因为自始至终没有顾客到达。
示例 3:
输入:customers = "YYYY"
输出:4
解释:最优关门时间是 4 ,因为每一小时均有顾客到达。
提示:
1 <= customers.length <= 105customers只包含字符'Y'和'N'。
方法一:枚举 · Go 实现
思考
第 小时关门的罚分为:此前每个
N一次、此后每个Y一次。 ,从「零点即关」的罚分(全部Y)出发,每向后推一小时:该小时是N则开门罚 ,是Y则少一次关门罚。取罚分最小的最早 。
如果商店在第 小时关门,那么代价为 中字符 'Y' 的数量,我们初始化答案变量 为 ,代价变量 为 中字符 'Y' 的数量。
接下来,我们枚举商店在第 小时关门( )。如果 为 'N',说明在开门期间没有顾客到达,代价增加 ;否则说明在关门期间有顾客到达,代价减少 。如果当前代价 小于最小代价 ,我们将答案变量 更新为 ,并将最小代价 更新为当前代价 。
遍历结束后,返回答案变量 即可。
时间复杂度 ,其中 为字符串 的长度。空间复杂度 。
func bestClosingTime(customers string) int {
	ans := 0
	cost := strings.Count(customers, "Y")
	mn := cost
	for j := 1; j <= len(customers); j++ {
		c := customers[j-1]
		if c == 'N' {
			cost++
		} else {
			cost--
		}
		if cost < mn {
			ans = j
			mn = cost
		}
	}
	return ans
}2485. 找出中枢整数
题目、示例与约束
给你一个正整数 n ,找出满足下述条件的 中枢整数 x :
1和x之间的所有元素之和等于x和n之间所有元素之和。
返回中枢整数 x 。如果不存在中枢整数,则返回 -1 。题目保证对于给定的输入,至多存在一个中枢整数。
示例 1:
输入:n = 8
输出:6
解释:6 是中枢整数,因为 1 + 2 + 3 + 4 + 5 + 6 = 6 + 7 + 8 = 21 。
示例 2:
输入:n = 1
输出:1
解释:1 是中枢整数,因为 1 = 1 。
示例 3:
输入:n = 4
输出:-1
解释:可以证明不存在满足题目要求的整数。
提示:
1 <= n <= 1000
方法一:枚举 · Go 实现
思考
,中枢 满足 。枚举 比较两边乘积形式 与 即可。
我们可以直接在 的范围内枚举 ,判断以下等式是否成立。若成立,则 为中枢整数,直接返回 即可。
时间复杂度 ,其中 为给定的正整数 。空间复杂度 。
func pivotInteger(n int) int {
	for x := 1; x <= n; x++ {
		if (1+x)*x == (x+n)*(n-x+1) {
			return x
		}
	}
	return -1
}
方法二:数学 · Go 实现
思考
方法一已线性枚举。等式化简为 ,故检查该三角形数是否完全平方: 且 。常数时间。
我们可以将上述等式进行变形,得到:
即:
如果 为整数,则 为中枢整数,否则不存在中枢整数。
时间复杂度 ,空间复杂度 。
func pivotInteger(n int) int {
	y := n * (n + 1) / 2
	x := int(math.Sqrt(float64(y)))
	if x*x == y {
		return x
	}
	return -1
}2488. 统计中位数为 K 的子数组
题目、示例与约束
给你一个长度为 n 的数组 nums ,该数组由从 1 到 n 的 不同 整数组成。另给你一个正整数 k 。
统计并返回 nums 中的 中位数 等于 k 的非空子数组的数目。
注意:
- 数组的中位数是按 递增 顺序排列后位于 中间 的那个元素,如果数组长度为偶数,则中位数是位于中间靠 左 的那个元素。
- 例如,
[2,3,1,4]的中位数是2,[8,4,3,5,1]的中位数是4。
- 例如,
- 子数组是数组中的一个连续部分。
示例 1:
输入:nums = [3,2,1,4,5], k = 4
输出:3
解释:中位数等于 4 的子数组有:[4]、[4,5] 和 [1,4,5] 。
示例 2:
输入:nums = [2,3,1], k = 3
输出:1
解释:[3] 是唯一一个中位数等于 3 的子数组。
提示:
n == nums.length1 <= n <= 1051 <= nums[i], k <= nnums中的整数互不相同
方法一:遍历 + 计数 · Go 实现
思考
数组是 的排列,中位数为 的子数组必须包含 ,且其中大于 与小于 的个数之差为 (奇数长)或 (偶数长)。 ,从 的位置向右统计差 的出现次数,再向左用 与 配对。
单独一侧差在 的段也计入。哈希表存右侧差的频次。
我们先找到中位数 在数组中的位置 ,然后从 开始向两边遍历,统计中位数为 的子数组的数目。
定义一个答案变量 ,表示中位数为 的子数组的数目。初始时 ,表示当前有一个长度为 的子数组,其中位数为 。另外,定义一个计数器 ,用于统计当前遍历过的数组中,「比 大的元素的个数」与「比 小的元素的个数」的差值的个数。
接下来,从 开始向右遍历,我们维护一个变量 ,表示当前右侧子数组中「比 大的元素的个数」与「比 小的元素的个数」的差值。如果 ,则当前右侧子数组的中位数为 ,答案变量 自增 。然后,我们将 的值加入计数器 中。
同理,从 开始向左遍历,同样维护一个变量 ,表示当前左侧子数组中「比 大的元素的个数」与「比 小的元素的个数」的差值。如果 ,则当前左侧子数组的中位数为 ,答案变量 自增 。如果 或 也在计数器中,说明当前存在跨越 左右两侧的子数组,其中位数为 ,答案变量 增加计数器中对应的值,即 。
最后,返回答案变量 即可。
时间复杂度 ,空间复杂度 。其中 为数组的长度。
在编码上,我们可以直接开一个长度为 的数组,用于统计当前数组中,比 大的元素的个数与比 小的元素的个数的差值,每一次我们将差值加上 ,即可将差值的范围从 转换为 。
func countSubarrays(nums []int, k int) int {
	i, n := 0, len(nums)
	for nums[i] != k {
		i++
	}
	ans := 1
	cnt := make([]int, n<<1|1)
	x := 0
	for j := i + 1; j < n; j++ {
		if nums[j] > k {
			x++
		} else {
			x--
		}
		if x >= 0 && x <= 1 {
			ans++
		}
		cnt[x+n]++
	}
	x = 0
	for j := i - 1; j >= 0; j-- {
		if nums[j] > k {
			x++
		} else {
			x--
		}
		if x >= 0 && x <= 1 {
			ans++
		}
		ans += cnt[-x+n] + cnt[-x+1+n]
	}
	return ans
}2489. 固定比率的子字符串数 🔒
题目、示例与约束
给定一个二进制字符串 s 和两个整数 num1 和 num2。num1 和 num2 为互质。
比率子串 是 s 的子串,其中子串中 0 的数量与 1 的数量之比正好是 num1 : num2。
- 例如,如果
num1 = 2和num2 = 3,那么"01011"和"1110000111"是比率子串,而"11000"不是。
返回 s 的 非空 比率子串的个数。
注意:
- 子串 是字符串中连续的字符序列。
- 如果
gcd(x, y) == 1,则x和y为 互质,其中gcd(x, y)为x和y的最大公约数。
示例 1:
输入: s = "0110011", num1 = 1, num2 = 2
输出: 4
解释: 有 4 个非空的比率子串。
- 子字符串 s[0..2]: "0110011"。它包含一个 0 和两个 1。比例是 1:2。
- 子字符串 s[1..4]: "0110011"。它包含一个 0 和两个 1。比例是 1:2。
- 子字符串 s[4..6]: "0110011"。它包含一个 0 和两个 1。比例是 1:2。
- 子字符串 s[1..6]: "0110011"。它包含两个 0 和四个 1。比例是 2:4 == 1:2。
它可以显示没有更多的比率子串。
示例 2:
输入: s = "10101", num1 = 3, num2 = 1
输出: 0
解释: s 没有比率子串,返回 0。
提示:
1 <= s.length <= 1051 <= num1, num2 <= s.lengthnum1和num2互质。
方法一:前缀和 + 计数 · Go 实现
思考
子串中 、 个数之比等于 ,即 在左右端相同。前缀该线性式相等的下标对即可。
哈希统计该式的出现次数,初值 表示空前缀。扫到每个位置先累加再更新计数。
我们用 表示字符串 中 的个数,用 表示字符串 中 的个数。子串符合条件,需要满足
其中 。我们可以将上式转化为
遍历到下标 时,我们只需要统计有多少个下标 满足上式即可。因此,我们可以用哈希表记录 出现的次数,遍历到下标 时,只需要统计 出现的次数即可。
哈希表初始时只有一个键值对 。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度。
func fixedRatio(s string, num1 int, num2 int) int64 {
	n0, n1 := 0, 0
	ans := 0
	cnt := map[int]int{0: 1}
	for _, c := range s {
		if c == '0' {
			n0++
		} else {
			n1++
		}
		x := n1*num1 - n0*num2
		ans += cnt[x]
		cnt[x]++
	}
	return int64(ans)
}2536. 子矩阵元素加 1
题目、示例与约束
给你一个正整数 n ,表示最初有一个 n x n 、下标从 0 开始的整数矩阵 mat ,矩阵中填满了 0 。
另给你一个二维整数数组 query 。针对每个查询 query[i] = [row1i, col1i, row2i, col2i] ,请你执行下述操作:
- 找出 左上角 为
(row1i, col1i)且 右下角 为(row2i, col2i)的子矩阵,将子矩阵中的 每个元素 加1。也就是给所有满足row1i <= x <= row2i和col1i <= y <= col2i的mat[x][y]加1。
返回执行完所有操作后得到的矩阵 mat 。
示例 1:
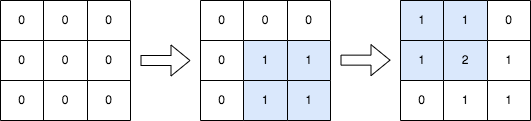
输入:n = 3, queries = [[1,1,2,2],[0,0,1,1]]
输出:[[1,1,0],[1,2,1],[0,1,1]]
解释:上图所展示的分别是:初始矩阵、执行完第一个操作后的矩阵、执行完第二个操作后的矩阵。
- 第一个操作:将左上角为 (1, 1) 且右下角为 (2, 2) 的子矩阵中的每个元素加 1 。
- 第二个操作:将左上角为 (0, 0) 且右下角为 (1, 1) 的子矩阵中的每个元素加 1 。
示例 2:
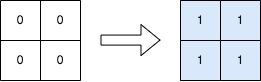
输入:n = 2, queries = [[0,0,1,1]]
输出:[[1,1],[1,1]]
解释:上图所展示的分别是:初始矩阵、执行完第一个操作后的矩阵。
- 第一个操作:将矩阵中的每个元素加 1 。
提示:
1 <= n <= 5001 <= queries.length <= 1040 <= row1i <= row2i < n0 <= col1i <= col2i < n
方法一:二维差分 · Go 实现
思考
要对若干子矩阵统一加一。若对每个查询遍历矩形内部, 与 达 时偏慢。
二维差分把一次矩形加一变成四个角上的 修改:左上 ,右下外侧对角 ,另外两角 。全部查询处理完后再做二维前缀和还原矩阵。
二维差分数组是一种用于高效处理二维数组区间更新的技巧。我们可以通过维护一个与原矩阵大小相同的差分矩阵来实现对子矩阵的快速更新。
假设我们有一个二维差分矩阵 ,初始时所有元素均为 。对于每个查询 ,我们可以通过以下步骤更新差分矩阵:
- 在位置 加 。
- 在位置 减 ,前提是 。
- 在位置 减 ,前提是 。
- 在位置 加 ,前提是 且 。
完成所有查询后,我们需要通过前缀和的方式将差分矩阵转换回原矩阵。即,对于每个位置 ,我们计算:
时间复杂度 ,其中 和 分别是 的长度和给定的 。忽略答案的空间消耗,空间复杂度 。
func rangeAddQueries(n int, queries [][]int) [][]int {
	mat := make([][]int, n)
	for i := range mat {
		mat[i] = make([]int, n)
	}
	for _, q := range queries {
		x1, y1, x2, y2 := q[0], q[1], q[2], q[3]
		mat[x1][y1]++
		if x2+1 < n {
			mat[x2+1][y1]--
		}
		if y2+1 < n {
			mat[x1][y2+1]--
		}
		if x2+1 < n && y2+1 < n {
			mat[x2+1][y2+1]++
		}
	}
	for i := 0; i < n; i++ {
		for j := 0; j < n; j++ {
			if i > 0 {
				mat[i][j] += mat[i-1][j]
			}
			if j > 0 {
				mat[i][j] += mat[i][j-1]
			}
			if i > 0 && j > 0 {
				mat[i][j] -= mat[i-1][j-1]
			}
		}
	}
	return mat
}2559. 统计范围内的元音字符串数
题目、示例与约束
给你一个下标从 0 开始的字符串数组 words 以及一个二维整数数组 queries 。
每个查询 queries[i] = [li, ri] 会要求我们统计在 words 中下标在 li 到 ri 范围内(包含 这两个值)并且以元音开头和结尾的字符串的数目。
返回一个整数数组,其中数组的第 i 个元素对应第 i 个查询的答案。
注意:元音字母是 'a'、'e'、'i'、'o' 和 'u' 。
示例 1:
输入:words = ["aba","bcb","ece","aa","e"], queries = [[0,2],[1,4],[1,1]]
输出:[2,3,0]
解释:以元音开头和结尾的字符串是 "aba"、"ece"、"aa" 和 "e" 。
查询 [0,2] 结果为 2(字符串 "aba" 和 "ece")。
查询 [1,4] 结果为 3(字符串 "ece"、"aa"、"e")。
查询 [1,1] 结果为 0 。
返回结果 [2,3,0] 。
示例 2:
输入:words = ["a","e","i"], queries = [[0,2],[0,1],[2,2]]
输出:[3,2,1]
解释:每个字符串都满足这一条件,所以返回 [3,2,1] 。
提示:
1 <= words.length <= 1051 <= words[i].length <= 40words[i]仅由小写英文字母组成sum(words[i].length) <= 3 * 1051 <= queries.length <= 1050 <= queries[j][0] <= queries[j][1] < words.length
方法一:预处理 + 二分查找 · Go 实现
思考
若干区间查询:有多少单词首尾都是元音。每次现场判断区间内每个单词, 与 达 时过慢。
预处理出所有满足条件的下标,有序存放。一次查询变成“有多少下标落在 ”,两次二分之差即可。
我们可以预处理出所有以元音开头和结尾的字符串的下标,按顺序记录在数组 中。
接下来,我们遍历每个查询 ,通过二分查找在 中找到第一个大于等于 的下标 ,以及第一个大于 的下标 ,那么当前查询的答案就是 。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 和 的长度。
func vowelStrings(words []string, queries [][]int) []int {
	vowels := map[byte]bool{'a': true, 'e': true, 'i': true, 'o': true, 'u': true}
	nums := []int{}
	for i, w := range words {
		if vowels[w[0]] && vowels[w[len(w)-1]] {
			nums = append(nums, i)
		}
	}
	ans := make([]int, len(queries))
	for i, q := range queries {
		l, r := q[0], q[1]
		ans[i] = sort.SearchInts(nums, r+1) - sort.SearchInts(nums, l)
	}
	return ans
}
方法二:前缀和 · Go 实现
思考
方法一每次查询仍需对数开销。把是否为元音串写成 前缀和后,区间计数就是 ,单次 。
我们可以创建一个长度为 的前缀和数组 ,其中 表示数组 的前 个字符串中以元音开头和结尾的字符串的数目。初始时 。
接下来,我们遍历数组 ,如果当前字符串以元音开头和结尾,那么 ,否则 。
最后,我们遍历每个查询 ,那么当前查询的答案就是 。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 和 的长度。
func vowelStrings(words []string, queries [][]int) []int {
	vowels := map[byte]bool{'a': true, 'e': true, 'i': true, 'o': true, 'u': true}
	n := len(words)
	s := make([]int, n+1)
	for i, w := range words {
		x := 0
		if vowels[w[0]] && vowels[w[len(w)-1]] {
			x = 1
		}
		s[i+1] = s[i] + x
	}
	ans := make([]int, len(queries))
	for i, q := range queries {
		l, r := q[0], q[1]
		ans[i] = s[r+1] - s[l]
	}
	return ans
}2574. 左右元素和的差值
题目、示例与约束
给你一个下标从 0 开始的长度为 n 的整数数组 nums。
定义两个数组 leftSum 和 rightSum,其中:
leftSum[i]是数组nums中下标i左侧元素之和。如果不存在对应的元素,leftSum[i] = 0。rightSum[i]是数组nums中下标i右侧元素之和。如果不存在对应的元素,rightSum[i] = 0。
返回长度为 n 数组 answer,其中 answer[i] = |leftSum[i] - rightSum[i]|。
示例 1:
输入:nums = [10,4,8,3]
输出:[15,1,11,22]
解释:数组 leftSum 为 [0,10,14,22] 且数组 rightSum 为 [15,11,3,0] 。
数组 answer 为 [|0 - 15|,|10 - 11|,|14 - 3|,|22 - 0|] = [15,1,11,22] 。
示例 2:
输入:nums = [1]
输出:[0]
解释:数组 leftSum 为 [0] 且数组 rightSum 为 [0] 。
数组 answer 为 [|0 - 0|] = [0] 。
提示:
1 <= nums.length <= 10001 <= nums[i] <= 105
方法一:前缀和 · Go 实现
思考
每位输出左侧和与右侧和之差的绝对值。预存左右前缀数组可行,但一次扫描即可:先把总和放在右侧,经过 时先从右侧减去再记 ,最后把 并入左侧。
我们定义变量 表示数组 中下标 左侧元素之和,变量 表示数组 中下标 右侧元素之和。初始时 , 。
遍历数组 ,对于当前遍历到的数字 ,我们更新 ,此时 和 分别表示数组 中下标 左侧元素之和和右侧元素之和。我们将 和 的差的绝对值加入答案数组 中,然后更新 。
遍历结束,返回答案数组 即可。
时间复杂度 ,其中 是数组 的长度。空间复杂度 ,不考虑返回值的空间。
相似题目:
func leftRightDifference(nums []int) []int {
	l, r := 0, 0
	for _, x := range nums {
		r += x
	}
	n := len(nums)
	ans := make([]int, n)
	for i, x := range nums {
		r -= x
		ans[i] = abs(l - r)
		l += x
	}
	return ans
}

func abs(x int) int {
	if x < 0 {
		return -x
	}
	return x
}2615. 等值距离和
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums。
现有一个长度等于 nums.length 的数组 arr 。对于满足 nums[j] == nums[i] 且 j != i 的所有 j ,arr[i] 等于所有 |i - j| 之和。如果不存在这样的 j ,则令 arr[i] 等于 0 。
返回数组 arr 。
示例 1:
输入:nums = [1,3,1,1,2]
输出:[5,0,3,4,0]
解释:
i = 0 ,nums[0] == nums[2] 且 nums[0] == nums[3] 。因此,arr[0] = |0 - 2| + |0 - 3| = 5 。
i = 1 ,arr[1] = 0 因为不存在值等于 3 的其他下标。
i = 2 ,nums[2] == nums[0] 且 nums[2] == nums[3] 。因此,arr[2] = |2 - 0| + |2 - 3| = 3 。
i = 3 ,nums[3] == nums[0] 且 nums[3] == nums[2] 。因此,arr[3] = |3 - 0| + |3 - 2| = 4 。
i = 4 ,arr[4] = 0 因为不存在值等于 2 的其他下标。
示例 2:
输入:nums = [0,5,3]
输出:[0,0,0]
解释:因为 nums 中的元素互不相同,对于所有 i ,都有 arr[i] = 0 。
提示:
1 <= nums.length <= 1050 <= nums[i] <= 109
注意:本题与 2121. 相同元素的间隔之和 相同。
方法一:哈希表 + 前缀和 · Go 实现
思考
对每个下标求它与所有同值下标的距离和。若对每个位置扫描全体同值下标, 时最坏平方。
同一值的下标已有序。相邻两项距离变化时,左侧贡献按左侧个数增加,右侧贡献按右侧个数减少,可用两个累加器线性扫过该组。
先按值收集下标列表,再对每组做这次前缀转移。
我们先用哈希表 记录数组 中每个元素对应的下标列表,即 表示数组 中所有值为 的下标列表。
对于哈希表 中的每个值列表 ,我们可以计算出 中每个下标 对应的 的值。对于第一个下标 ,右边所有下标距离 的和 。接下来我们遍历 ,每一次计算得到 ,然后更新 和 ,即 ,而 。
遍历结束后,我们得到了数组 中每个元素对应的 的值,即 。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func distance(nums []int) []int64 {
	n := len(nums)
	ans := make([]int64, n)
	d := map[int][]int{}
	for i, x := range nums {
		d[x] = append(d[x], i)
	}
	for _, idx := range d {
		m := len(idx)
		left, right := 0, -m*idx[0]
		for _, i := range idx {
			right += i
		}
		for i := range idx {
			ans[idx[i]] = int64(left + right)
			if i+1 < m {
				left += (idx[i+1] - idx[i]) * (i + 1)
				right -= (idx[i+1] - idx[i]) * (m - i - 1)
			}
		}
	}
	return ans
}2640. 一个数组所有前缀的分数
题目、示例与约束
定义一个数组 arr 的 转换数组 conver 为:
conver[i] = arr[i] + max(arr[0..i]),其中max(arr[0..i])是满足0 <= j <= i的所有arr[j]中的最大值。
定义一个数组 arr 的 分数 为 arr 转换数组中所有元素的和。
给你一个下标从 0 开始长度为 n 的整数数组 nums ,请你返回一个长度为 n 的数组 ans ,其中 ans[i]是前缀 nums[0..i] 的分数。
示例 1:
输入:nums = [2,3,7,5,10]
输出:[4,10,24,36,56]
解释:
对于前缀 [2] ,转换数组为 [4] ,所以分数为 4 。
对于前缀 [2, 3] ,转换数组为 [4, 6] ,所以分数为 10 。
对于前缀 [2, 3, 7] ,转换数组为 [4, 6, 14] ,所以分数为 24 。
对于前缀 [2, 3, 7, 5] ,转换数组为 [4, 6, 14, 12] ,所以分数为 36 。
对于前缀 [2, 3, 7, 5, 10] ,转换数组为 [4, 6, 14, 12, 20] ,所以分数为 56 。
示例 2:
输入:nums = [1,1,2,4,8,16]
输出:[2,4,8,16,32,64]
解释:
对于前缀 [1] ,转换数组为 [2] ,所以分数为 2 。
对于前缀 [1, 1],转换数组为 [2, 2] ,所以分数为 4 。
对于前缀 [1, 1, 2],转换数组为 [2, 2, 4] ,所以分数为 8 。
对于前缀 [1, 1, 2, 4],转换数组为 [2, 2, 4, 8] ,所以分数为 16 。
对于前缀 [1, 1, 2, 4, 8],转换数组为 [2, 2, 4, 8, 16] ,所以分数为 32 。
对于前缀 [1, 1, 2, 4, 8, 16],转换数组为 [2, 2, 4, 8, 16, 32] ,所以分数为 64 。
提示:
1 <= nums.length <= 1051 <= nums[i] <= 109
方法一:前缀和 · Go 实现
思考
前缀分数定义为该前缀转换数组的前缀和,转换值是 加上截至 的最大值。若每个前缀都重新求最大再求和, 会平方。
最大值 可在扫描中维护,当前转换值加上上一前缀分数即得 。一次遍历同时完成转换与前缀和。
我们用变量 记录数组 中前 个元素的最大值,用数组 记录数组 中前 个元素的分数。
接下来,遍历数组 ,对于每个元素 ,我们更新 ,即 ,然后更新 ,如果 ,则 ,否则 。
时间复杂度 ,其中 为数组 的长度。忽略答案数组的空间消耗,空间复杂度 。
func findPrefixScore(nums []int) []int64 {
	n := len(nums)
	ans := make([]int64, n)
	mx := 0
	for i, x := range nums {
		mx = max(mx, x)
		ans[i] = int64(x + mx)
		if i > 0 {
			ans[i] += ans[i-1]
		}
	}
	return ans
}2731. 移动机器人
题目、示例与约束
有一些机器人分布在一条无限长的数轴上,他们初始坐标用一个下标从 0 开始的整数数组 nums 表示。当你给机器人下达命令时,它们以每秒钟一单位的速度开始移动。
给你一个字符串 s ,每个字符按顺序分别表示每个机器人移动的方向。'L' 表示机器人往左或者数轴的负方向移动,'R' 表示机器人往右或者数轴的正方向移动。
当两个机器人相撞时,它们开始沿着原本相反的方向移动。
请你返回指令重复执行 d 秒后,所有机器人之间两两距离之和。由于答案可能很大,请你将答案对 109 + 7 取余后返回。
注意:
- 对于坐标在
i和j的两个机器人,(i,j)和(j,i)视为相同的坐标对。也就是说,机器人视为无差别的。 - 当机器人相撞时,它们 立即改变 它们的前进方向,这个过程不消耗任何时间。
-
当两个机器人在同一时刻占据相同的位置时,就会相撞。
-
例如,如果一个机器人位于位置 0 并往右移动,另一个机器人位于位置 2 并往左移动,下一秒,它们都将占据位置 1,并改变方向。再下一秒钟后,第一个机器人位于位置 0 并往左移动,而另一个机器人位于位置 2 并往右移动。
-
例如,如果一个机器人位于位置 0 并往右移动,另一个机器人位于位置 1 并往左移动,下一秒,第一个机器人位于位置 0 并往左行驶,而另一个机器人位于位置 1 并往右移动。
-
示例 1:
输入:nums = [-2,0,2], s = "RLL", d = 3
输出:8
解释:
1 秒后,机器人的位置为 [-1,-1,1] 。现在下标为 0 的机器人开始往左移动,下标为 1 的机器人开始往右移动。
2 秒后,机器人的位置为 [-2,0,0] 。现在下标为 1 的机器人开始往左移动,下标为 2 的机器人开始往右移动。
3 秒后,机器人的位置为 [-3,-1,1] 。
下标为 0 和 1 的机器人之间距离为 abs(-3 - (-1)) = 2 。
下标为 0 和 2 的机器人之间的距离为 abs(-3 - 1) = 4 。
下标为 1 和 2 的机器人之间的距离为 abs(-1 - 1) = 2 。
所有机器人对之间的总距离为 2 + 4 + 2 = 8 。
示例 2:
输入:nums = [1,0], s = "RL", d = 2
输出:5
解释:
1 秒后,机器人的位置为 [2,-1] 。
2 秒后,机器人的位置为 [3,-2] 。
两个机器人的距离为 abs(-2 - 3) = 5 。
提示:
2 <= nums.length <= 105-2 * 109 <= nums[i] <= 2 * 1090 <= d <= 109nums.length == s.lengths只包含'L'和'R'。nums[i]互不相同。
方法一:脑筋急转弯 + 排序 · Go 实现
思考
机器人沿直线移动,相撞后立刻换向,求 秒后两两距离之和。模拟每秒碰撞在坐标范围很大时无法进行。
换向后的轨迹与对穿而不转向相同,故可各自沿原方向走出 再排序。有序坐标上,第 个点对答案的贡献是 减去其左侧坐标和,一次扫描累加后取模。
两个机器人相撞后,它们会立即改变方向,实际上相当于两个机器人继续往原来的方向移动。因此,我们遍历数组 ,按照字符串 的指令,将每个机器人的位置加上或减去 ,然后对数组 进行排序。
接下来,我们从小到大枚举每个机器人的位置,计算出当前机器人与前面所有机器人的距离之和,即为答案。
时间复杂度 ,空间复杂度 。其中 是机器人的数目。
func sumDistance(nums []int, s string, d int) (ans int) {
	for i, c := range s {
		if c == 'R' {
			nums[i] += d
		} else {
			nums[i] -= d
		}
	}
	sort.Ints(nums)
	sum := 0
	const mod int = 1e9 + 7
	for i, x := range nums {
		ans = (ans + i*x - sum) % mod
		sum += x
	}
	return
}2772. 使数组中的所有元素都等于零
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums 和一个正整数 k 。
你可以对数组执行下述操作 任意次 :
- 从数组中选出长度为
k的 任一 子数组,并将子数组中每个元素都 减去1。
如果你可以使数组中的所有元素都等于 0 ,返回 true ;否则,返回 false 。
子数组 是数组中的一个非空连续元素序列。
示例 1:
输入:nums = [2,2,3,1,1,0], k = 3
输出:true
解释:可以执行下述操作:
- 选出子数组 [2,2,3] ,执行操作后,数组变为 nums = [1,1,2,1,1,0] 。
- 选出子数组 [2,1,1] ,执行操作后,数组变为 nums = [1,1,1,0,0,0] 。
- 选出子数组 [1,1,1] ,执行操作后,数组变为 nums = [0,0,0,0,0,0] 。
示例 2:
输入:nums = [1,3,1,1], k = 2
输出:false
解释:无法使数组中的所有元素等于 0 。
提示:
1 <= k <= nums.length <= 1050 <= nums[i] <= 106
方法一:差分数组 + 前缀和 · Go 实现
思考
每次把长度为 的窗口同时减 ,问能否把数组减成全零。模拟每次减一会超时,且必须从左到右确定每个位置被减的次数。
最左的非零位置 只能靠覆盖 的窗口来消掉,次数即为当前值。差分数组记录这段区间减操作,扫描时用前缀和还原实际值;若变负或窗口越界则失败。
我们先考虑 的第一个元素 :
- 如果 ,那么我们可以不用操作;
- 如果 ,那么我们需要对 操作 次,使得 中的元素都减去 ,这样 就变成了 。
对一段连续的元素同时进行加减操作,我们可以使用差分数组来维护这些操作,我们用 表示差分数组,对差分数组求前缀和,就可以得到每个位置的数值的变化量。
因此,我们遍历 ,对于每个元素 ,当前位置的变化量 ,我们将 加上 ,就得到了当前 的实际值。
- 如果 ,那么无须进行操作,直接跳过。
- 如果 ,或者 ,说明经过前面的操作, 已经变成了负数,或者 越界,那么无法使得 中的所有元素都等于 ,返回
false。否则,我们需要将 这段区间的所有元素都减去 ,因此我们将 减去 ,并将 加上 。 - 继续遍历下一个元素。
遍历结束,说明可以使得 中的所有元素都等于 ,返回 true。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func checkArray(nums []int, k int) bool {
	n := len(nums)
	d := make([]int, n+1)
	s := 0
	for i, x := range nums {
		s += d[i]
		x += s
		if x == 0 {
			continue
		}
		if x < 0 || i+k > n {
			return false
		}
		s -= x
		d[i+k] += x
	}
	return true
}2845. 统计趣味子数组的数目
题目、示例与约束
给你一个下标从 0 开始的整数数组 nums ,以及整数 modulo 和整数 k 。
请你找出并统计数组中 趣味子数组 的数目。
如果 子数组 nums[l..r] 满足下述条件,则称其为 趣味子数组 :
- 在范围
[l, r]内,设cnt为满足nums[i] % modulo == k的索引i的数量。并且cnt % modulo == k。
以整数形式表示并返回趣味子数组的数目。
注意:子数组是数组中的一个连续非空的元素序列。
示例 1:
输入:nums = [3,2,4], modulo = 2, k = 1
输出:3
解释:在这个示例中,趣味子数组分别是:
子数组 nums[0..0] ,也就是 [3] 。
- 在范围 [0, 0] 内,只存在 1 个下标 i = 0 满足 nums[i] % modulo == k 。
- 因此 cnt = 1 ,且 cnt % modulo == k 。
子数组 nums[0..1] ,也就是 [3,2] 。
- 在范围 [0, 1] 内,只存在 1 个下标 i = 0 满足 nums[i] % modulo == k 。
- 因此 cnt = 1 ,且 cnt % modulo == k 。
子数组 nums[0..2] ,也就是 [3,2,4] 。
- 在范围 [0, 2] 内,只存在 1 个下标 i = 0 满足 nums[i] % modulo == k 。
- 因此 cnt = 1 ,且 cnt % modulo == k 。
可以证明不存在其他趣味子数组。因此,答案为 3 。
示例 2:
输入:nums = [3,1,9,6], modulo = 3, k = 0
输出:2
解释:在这个示例中,趣味子数组分别是:
子数组 nums[0..3] ,也就是 [3,1,9,6] 。
- 在范围 [0, 3] 内,只存在 3 个下标 i = 0, 2, 3 满足 nums[i] % modulo == k 。
- 因此 cnt = 3 ,且 cnt % modulo == k 。
子数组 nums[1..1] ,也就是 [1] 。
- 在范围 [1, 1] 内,不存在下标满足 nums[i] % modulo == k 。
- 因此 cnt = 0 ,且 cnt % modulo == k 。
可以证明不存在其他趣味子数组,因此答案为 2 。
提示:
1 <= nums.length <= 1051 <= nums[i] <= 1091 <= modulo <= 1090 <= k < modulo
方法一:哈希表 + 前缀和 · Go 实现
思考
子数组中满足 的下标个数再模 后等于 。把满足条件的位置看成 ,问题化为前缀和 满足 。哈希表统计前缀和模 的出现次数,即可在扫描时累加配对。
题目要求一个区间内满足 的索引 的数量,我们可以将数组 转换为一个 数组 ,其中 表示 ,否则 。
那么对于一个区间 ,我们可以通过前缀和数组 来计算 中 的数量,即 ,其中 。
我们用哈希表 记录前缀和 出现的次数,初始时 。
接下来,我们遍历数组 ,计算前缀和 ,将 出现的次数累加到答案中,然后将 出现的次数加 。
遍历结束后,返回答案即可。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func countInterestingSubarrays(nums []int, modulo int, k int) (ans int64) {
	arr := make([]int, len(nums))
	for i, x := range nums {
		if x%modulo == k {
			arr[i] = 1
		}
	}
	cnt := map[int]int{}
	cnt[0] = 1
	s := 0
	for _, x := range arr {
		s += x
		ans += int64(cnt[(s-k+modulo)%modulo])
		cnt[s%modulo]++
	}
	return
}2848. 与车相交的点
题目、示例与约束
给你一个下标从 0 开始的二维整数数组 nums 表示汽车停放在数轴上的坐标。对于任意下标 i,nums[i] = [starti, endi] ,其中 starti 是第 i 辆车的起点,endi 是第 i 辆车的终点。
返回数轴上被车 任意部分 覆盖的整数点的数目。
示例 1:
输入:nums = [[3,6],[1,5],[4,7]]
输出:7
解释:从 1 到 7 的所有点都至少与一辆车相交,因此答案为 7 。
示例 2:
输入:nums = [[1,3],[5,8]]
输出:7
解释:1、2、3、5、6、7、8 共计 7 个点满足至少与一辆车相交,因此答案为 7 。
提示:
1 <= nums.length <= 100nums[i].length == 21 <= starti <= endi <= 100
方法一:差分数组 · Go 实现
思考
坐标范围不超过 ,覆盖点数可用差分数组统计:区间左端加一、右端后一位减一,前缀和为正的位置即被至少一辆车覆盖。
根据题目描述,我们需要给每个区间 增加一个车辆,我们可以使用差分数组来实现。
我们定义一个长度为 的数组 ,对于每个区间 ,我们将 加 ,将 减 。
最后,我们对 进行前缀和运算,统计前缀和大于 的个数即可。
时间复杂度 ,空间复杂度 ,其中 是给定数组的长度,而 是数组中的最大值,本题中 。
func numberOfPoints(nums [][]int) (ans int) {
	d := [102]int{}
	for _, e := range nums {
		start, end := e[0], e[1]
		d[start]++
		d[end+1]--
	}
	s := 0
	for _, x := range d {
		s += x
		if s > 0 {
			ans++
		}
	}
	return
}
方法二:哈希表 + 差分 + 排序 · Go 实现
思考
方法一依赖坐标上界。范围更大时用哈希表只记录差分的非零位置,排序后扫描即可,空间随区间个数而非坐标上界增长。
如果题目的区间范围较大,我们可以使用哈希表来存储区间的起点和终点,然后对哈希表的键进行排序,再进行前缀和统计。
时间复杂度 ,空间复杂度 。其中 为给定数组的长度。
func numberOfPoints(nums [][]int) (ans int) {
	d := map[int]int{}
	for _, e := range nums {
		start, end := e[0], e[1]
		d[start]++
		d[end+1]--
	}
	keys := []int{}
	for k := range d {
		keys = append(keys, k)
	}
	s, last := 0, 0
	sort.Ints(keys)
	for _, cur := range keys {
		if s > 0 {
			ans += cur - last
		}
		s += d[cur]
		last = cur
	}
	return
}继续阅读
- 实践案例
- 实践案例
- 实践案例