
LeetCode Go · 链表(1)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
2. 两数相加
题目、示例与约束
给你两个 非空 的链表,表示两个非负的整数。它们每位数字都是按照 逆序 的方式存储的,并且每个节点只能存储 一位 数字。
请你将两个数相加,并以相同形式返回一个表示和的链表。
你可以假设除了数字 0 之外,这两个数都不会以 0 开头。
示例 1:
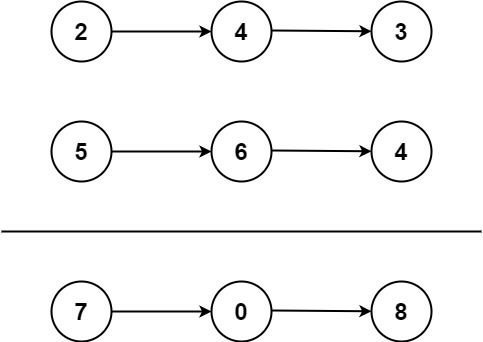
输入:l1 = [2,4,3], l2 = [5,6,4]
输出:[7,0,8]
解释:342 + 465 = 807.
示例 2:
输入:l1 = [0], l2 = [0]
输出:[0]
示例 3:
输入:l1 = [9,9,9,9,9,9,9], l2 = [9,9,9,9]
输出:[8,9,9,9,0,0,0,1]
提示:
- 每个链表中的节点数在范围
[1, 100]内 0 <= Node.val <= 9- 题目数据保证列表表示的数字不含前导零
方法一:模拟 · Go 实现
思考
题目已经将个位放在链表头部,按位逆序存放,本质上就是竖式加法。若先把链表转成整数再相加,反而绕开了这一结构,也需要处理大整数。
两条链的长度可能不同,最高位还可能产生额外进位。每一位都是「当前两位数字(缺省为 )与进位 之和」,再拆出个位和新的进位。从哑节点依次接上答案节点,两个指针同步前进;循环条件应为 、 或 仍未结束,否则像 这样的情况会丢失最后的进位。
我们同时遍历两个链表 和 ,并使用变量 表示当前是否有进位。
每次遍历时,我们取出对应链表的当前位,计算它们与进位 的和,然后更新进位的值,最后将当前位的值加入答案链表。如果两个链表都遍历完了,并且进位为 时,遍历结束。
最后我们返回答案链表的头节点即可。
时间复杂度 ,其中 和 分别为两个链表的长度。我们需要遍历两个链表的全部位置,而处理每个位置只需要 的时间。忽略答案的空间消耗,空间复杂度 。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func addTwoNumbers(l1 *ListNode, l2 *ListNode) *ListNode {
	dummy := &ListNode{}
	carry := 0
	cur := dummy
	for l1 != nil || l2 != nil || carry != 0 {
		s := carry
		if l1 != nil {
			s += l1.Val
		}
		if l2 != nil {
			s += l2.Val
		}
		carry = s / 10
		cur.Next = &ListNode{s % 10, nil}
		cur = cur.Next
		if l1 != nil {
			l1 = l1.Next
		}
		if l2 != nil {
			l2 = l2.Next
		}
	}
	return dummy.Next
}19. 删除链表的倒数第 N 个结点
题目、示例与约束
给你一个链表,删除链表的倒数第 n 个结点,并且返回链表的头结点。
示例 1:
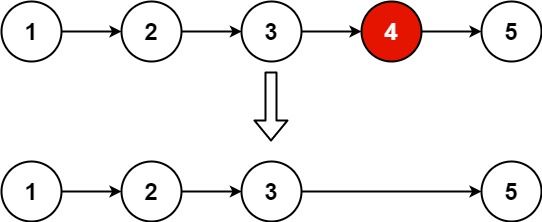
输入:head = [1,2,3,4,5], n = 2
输出:[1,2,3,5]
示例 2:
输入:head = [1], n = 1
输出:[]
示例 3:
输入:head = [1,2], n = 1
输出:[1]
提示:
- 链表中结点的数目为
sz 1 <= sz <= 300 <= Node.val <= 1001 <= n <= sz
进阶:你能尝试使用一趟扫描实现吗?
方法一:快慢指针 · Go 实现
思考
先遍历一遍得到长度 ,再走 步删除结点,时间复杂度为 。在 的范围内可以接受,但题目进阶要求一趟扫描。
不到末尾就无法确定倒数第 个结点的位置,而删除还需要它的前驱。我们可以让快指针先走出 步的间距,再与慢指针一起前进:快指针到达表尾时,慢指针恰好停在待删结点的前驱。设置虚拟头结点,可使删除头结点与删除中间结点共用同一套逻辑。
我们定义两个指针 fast 和 slow,初始时都指向链表的虚拟头结点 dummy。
接着 fast 指针先向前移动 步,然后 fast 和 slow 指针同时向前移动,直到 fast 指针到达链表的末尾。此时 slow.next 指针指向的结点就是倒数第 n 个结点的前驱结点,将其删除即可。
时间复杂度 ,其中 为链表的长度。空间复杂度 。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func removeNthFromEnd(head *ListNode, n int) *ListNode {
	dummy := &ListNode{0, head}
	fast, slow := dummy, dummy
	for ; n > 0; n-- {
		fast = fast.Next
	}
	for fast.Next != nil {
		slow, fast = slow.Next, fast.Next
	}
	slow.Next = slow.Next.Next
	return dummy.Next
}21. 合并两个有序链表
题目、示例与约束
将两个升序链表合并为一个新的 升序 链表并返回。新链表是通过拼接给定的两个链表的所有节点组成的。
示例 1:
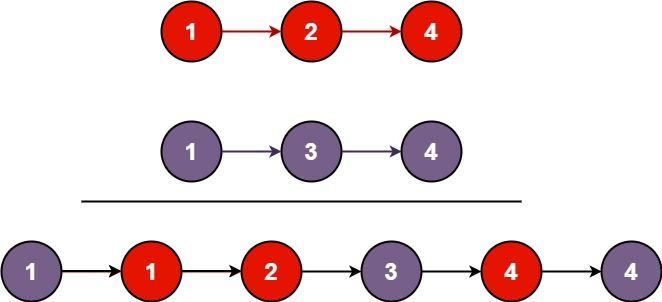
输入:l1 = [1,2,4], l2 = [1,3,4]
输出:[1,1,2,3,4,4]
示例 2:
输入:l1 = [], l2 = []
输出:[]
示例 3:
输入:l1 = [], l2 = [0]
输出:[0]
提示:
- 两个链表的节点数目范围是
[0, 50] -100 <= Node.val <= 100l1和l2均按 非递减顺序 排列
方法一:递归 · Go 实现
思考
两条链表均已按非递减排列。若取出全部节点值再排序并重建,时间复杂度为 ,且没有利用有序这一条件。
合并时,答案的下一个节点必为当前两个头结点中的较小者。选定之后,剩余部分仍是两条有序链表,与原问题同构;若其中一侧已空,则另一侧整段即为剩余结果。
因此问题具有最优子结构,可以用递归求解:每次留下较小的头,再合并两条剩余链表。递归深度与节点总数同阶,本题长度不超过 ,额外空间 可以接受。
我们先判断链表 和 是否为空,若其中一个为空,则返回另一个链表。否则,我们比较 和 的头节点:
- 若 的头节点的值小于等于 的头节点的值,则递归调用函数 ,并将 的头节点与返回的链表头节点相连,返回 的头节点。
- 否则,递归调用函数 ,并将 的头节点与返回的链表头节点相连,返回 的头节点。
时间复杂度 ,空间复杂度 。其中 和 分别为两个链表的长度。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func mergeTwoLists(list1 *ListNode, list2 *ListNode) *ListNode {
	if list1 == nil {
		return list2
	}
	if list2 == nil {
		return list1
	}
	if list1.Val <= list2.Val {
		list1.Next = mergeTwoLists(list1.Next, list2)
		return list1
	} else {
		list2.Next = mergeTwoLists(list1, list2.Next)
		return list2
	}
}
方法二:迭代 · Go 实现
思考
方法一已经在线性时间内完成合并,但递归栈与节点数同阶。我们可以用常数额外空间完成同一选择过程。
注意到每一步仍是比较两个头、接上较小者。设置虚拟头与尾指针,在循环中反复执行这一选择,直至某一条耗尽,再把另一条剩余部分接到尾部即可。时间复杂度与方法一相同,空间降至 。
我们也可以用迭代的方式来实现两个排序链表的合并。
我们先定义一个虚拟头节点 ,然后循环遍历两个链表,比较两个链表的头节点,将较小的节点添加到 的末尾,直到其中一个链表为空,然后将另一个链表的剩余部分添加到 的末尾。
最后返回 即可。
时间复杂度 ,其中 和 分别为两个链表的长度。忽略答案链表的空间消耗,空间复杂度 。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func mergeTwoLists(list1 *ListNode, list2 *ListNode) *ListNode {
	dummy := &ListNode{}
	curr := dummy
	for list1 != nil && list2 != nil {
		if list1.Val <= list2.Val {
			curr.Next = list1
			list1 = list1.Next
		} else {
			curr.Next = list2
			list2 = list2.Next
		}
		curr = curr.Next
	}
	if list1 != nil {
		curr.Next = list1
	} else {
		curr.Next = list2
	}
	return dummy.Next
}23. 合并 K 个升序链表
题目、示例与约束
给你一个链表数组,每个链表都已经按升序排列。
请你将所有链表合并到一个升序链表中,返回合并后的链表。
示例 1:
输入:lists = [[1,4,5],[1,3,4],[2,6]]
输出:[1,1,2,3,4,4,5,6]
解释:链表数组如下:
[
  1->4->5,
  1->3->4,
  2->6
]
将它们合并到一个有序链表中得到。
1->1->2->3->4->4->5->6
示例 2:
输入:lists = []
输出:[]
示例 3:
输入:lists = [[]]
输出:[]
提示:
k == lists.length0 <= k <= 10^40 <= lists[i].length <= 500-10^4 <= lists[i][j] <= 10^4lists[i]按 升序 排列lists[i].length的总和不超过10^4
方法一:优先队列(小根堆) · Go 实现
思考
若将 条链表依次两两合并,总节点 时最坏时间 。在 的范围下无法通过。全部取出排序再建表虽为 ,却没有利用每条链表已经有序这一条件。
任意时刻,下一步该接到答案上的节点只可能是各链表当前的头。若每次线性扫描这 个候选,乘上 个节点便回到 。
因此用小根堆维护至多 个候选头:每次取出最小者接到结果尾部,再把它的后继(若存在)入堆。每个节点进出堆各一次,时间 。
我们可以创建一个小根堆来 维护所有链表的头节点,每次从小根堆中取出值最小的节点,添加到结果链表的末尾,然后将该节点的下一个节点加入堆中,重复上述步骤直到堆为空。
时间复杂度 ,空间复杂度 。其中 是所有链表节点数目的总和,而 是题目给定的链表数目。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func mergeKLists(lists []*ListNode) *ListNode {
	pq := hp{}
	for _, head := range lists {
		if head != nil {
			pq = append(pq, head)
		}
	}
	heap.Init(&pq)
	dummy := &ListNode{}
	cur := dummy
	for len(pq) > 0 {
		cur.Next = heap.Pop(&pq).(*ListNode)
		cur = cur.Next
		if cur.Next != nil {
			heap.Push(&pq, cur.Next)
		}
	}
	return dummy.Next
}

type hp []*ListNode

func (h hp) Len() int           { return len(h) }
func (h hp) Less(i, j int) bool { return h[i].Val < h[j].Val }
func (h hp) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)        { *h = append(*h, v.(*ListNode)) }
func (h *hp) Pop() any { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }24. 两两交换链表中的节点
题目、示例与约束
给你一个链表,两两交换其中相邻的节点,并返回交换后链表的头节点。你必须在不修改节点内部的值的情况下完成本题(即,只能进行节点交换)。
示例 1:
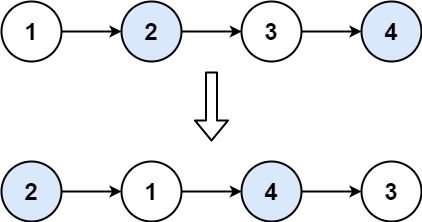
输入:head = [1,2,3,4]
输出:[2,1,4,3]
示例 2:
输入:head = []
输出:[]
示例 3:
输入:head = [1]
输出:[1]
提示:
- 链表中节点的数目在范围
[0, 100]内 0 <= Node.val <= 100
方法一:递归 · Go 实现
思考
题目要求不能修改节点内部的值,必须实际交换指针。节点数不超过 ,任何正确的指针接法在时间上都可以接受。
一对节点交换完成后,从原来的第三个节点起与原问题同构,且新头一定是原来的第二个节点。若先处理后面再回头改当前这对,便不必在一次操作里同时维护整条链的全部断点。
因此可以递归:先处理 ,再把当前这对反过来接到那段结果上。空表或仅有一个节点无法成对,作为递归出口直接返回。
我们可以通过递归的方式实现两两交换链表中的节点。
递归的终止条件是链表中没有节点,或者链表中只有一个节点,此时无法进行交换,直接返回该节点。
否则,我们递归交换链表 ,记交换后的头节点为 ,然后我们记 的下一个节点为 ,然后令 指向 ,而 指向 ,最后返回 。
时间复杂度 ,空间复杂度 ,其中 是链表的长度。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func swapPairs(head *ListNode) *ListNode {
	if head == nil || head.Next == nil {
		return head
	}
	t := swapPairs(head.Next.Next)
	p := head.Next
	p.Next = head
	head.Next = t
	return p
}
方法二:迭代 · Go 实现
思考
方法一的递归深度与节点对数成正比,额外空间为 。同一对内的指针改写可以在循环中完成,从而将额外空间降至 。
为此设置虚拟头钉住链表起点,用指针 、 每次处理 后面的两个节点,处理完后前进一对。时间复杂度仍为 。
我们设置一个虚拟头节点 ,初始时指向 ,然后设置两个指针 和 ,初始时 指向 ,而 指向 。
接下来,我们遍历链表,每次需要交换 后面的两个节点,因此我们先判断 和 是否为空,若不为空,则进行交换,否则终止循环。
时间复杂度 ,空间复杂度 ,其中 是链表的长度。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func swapPairs(head *ListNode) *ListNode {
	dummy := &ListNode{Next: head}
	pre, cur := dummy, head
	for cur != nil && cur.Next != nil {
		t := cur.Next
		cur.Next = t.Next
		t.Next = cur
		pre.Next = t
		pre, cur = cur, cur.Next
	}
	return dummy.Next
}25. K 个一组翻转链表
题目、示例与约束
给你链表的头节点 head ,每 k 个节点一组进行翻转,请你返回修改后的链表。
k 是一个正整数,它的值小于或等于链表的长度。如果节点总数不是 k 的整数倍,那么请将最后剩余的节点保持原有顺序。
你不能只是单纯的改变节点内部的值,而是需要实际进行节点交换。
示例 1:
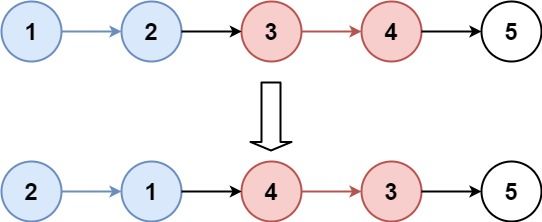
输入:head = [1,2,3,4,5], k = 2
输出:[2,1,4,3,5]
示例 2:
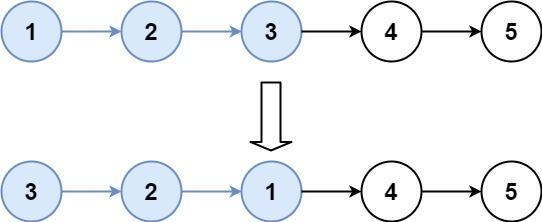
输入:head = [1,2,3,4,5], k = 3
输出:[3,2,1,4,5]
提示:
- 链表中的节点数目为
n 1 <= k <= n <= 50000 <= Node.val <= 1000
进阶:你可以设计一个只用 O(1) 额外内存空间的算法解决此问题吗?
方法一:模拟 · Go 实现
思考
题目进阶要求额外空间 。若按组递归翻转, 时时间可以接受,但递归栈会随组数增长,不满足进阶条件。
一组内部就是普通的链表翻转;组与组之间只需记住上一组的尾。真正需要先确认的是当前组是否凑满 个——不足则保持原序,够则摘下翻转后再接回。
因此从虚拟头出发,每次先走 步探测:若够 个则翻转该段并重接;若不够则结束。探测、翻转与重接都是指针操作,额外空间 。
我们可以根据题意,模拟整个翻转的过程。
首先,我们定义一个辅助函数 ,用于翻转一个链表。然后,我们定义一个虚拟头结点 ,并将其 指针指向 。
接着,我们遍历链表,每次遍历 个节点,若剩余节点不足 个,则不进行翻转。否则,我们将 个节点取出,然后调用 函数翻转这 个节点。然后将翻转后的链表与原链表连接起来。继续遍历下一个 个节点,直到遍历完整个链表。
时间复杂度 ,其中 为链表的长度。空间复杂度 。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func reverseKGroup(head *ListNode, k int) *ListNode {
	dummy := &ListNode{Next: head}
	pre := dummy

	for pre != nil {
		cur := pre
		for i := 0; i < k; i++ {
			cur = cur.Next
			if cur == nil {
				return dummy.Next
			}
		}

		node := pre.Next
		nxt := cur.Next
		cur.Next = nil
		pre.Next = reverse(node)
		node.Next = nxt
		pre = node
	}
	return dummy.Next
}

func reverse(head *ListNode) *ListNode {
	var dummy *ListNode
	cur := head
	for cur != nil {
		nxt := cur.Next
		cur.Next = dummy
		dummy = cur
		cur = nxt
	}
	return dummy
}61. 旋转链表
题目、示例与约束
给你一个链表的头节点 head ,旋转链表,将链表每个节点向右移动 k 个位置。
示例 1:
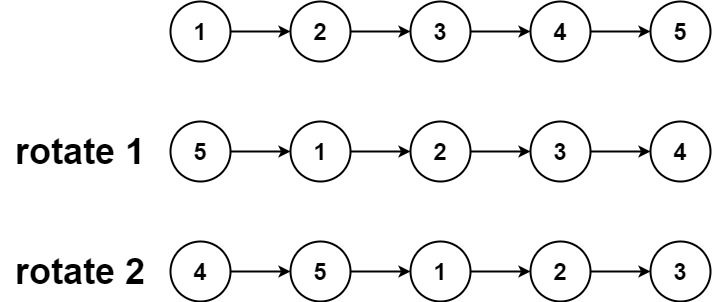
输入:head = [1,2,3,4,5], k = 2
输出:[4,5,1,2,3]
示例 2:
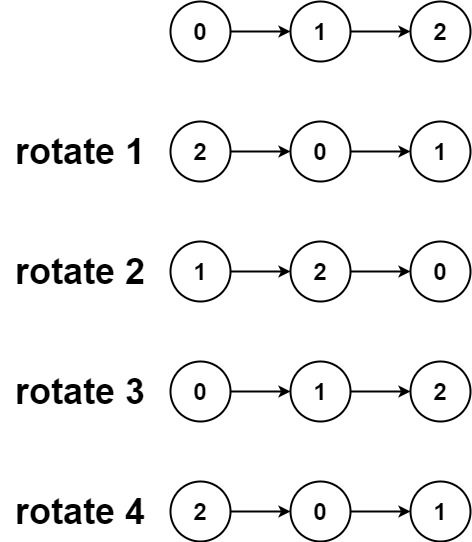
输入:head = [0,1,2], k = 4
输出:[2,0,1]
提示:
- 链表中节点的数目在范围
[0, 500]内 -100 <= Node.val <= 1000 <= k <= 2 * 109
方法一:快慢指针 + 链表拼接 · Go 实现
思考
链表没有随机下标,若拷入数组再右移重建,节点数 ,额外空间可以接受。然而 最大可达 ,不能按次旋转。
注意到向右旋转 次与旋转 次等价,新的头节点即为倒数第 个节点。因此需要先求出 ,再定位断开位置。为此可以让快指针先走出有效的 步,再与慢指针同步前进,直至快指针到达尾节点,此时慢指针恰停在新头的前驱。随后只需改动若干指针即可完成拼接,额外空间为 。
我们先判断链表节点数是否小于 ,如果是,直接返回 即可。
否则,我们先统计链表节点数 ,然后将 对 取模,得到 的有效值。
如果 的有效值为 ,说明链表不需要旋转,直接返回 即可。
否则,我们用快慢指针,让快指针先走 步,然后快慢指针同时走,直到快指针走到链表尾部,此时慢指针的下一个节点就是新的链表头节点。
最后,我们将链表拼接起来即可。
时间复杂度 ,其中 是链表节点数,空间复杂度 。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func rotateRight(head *ListNode, k int) *ListNode {
	if head == nil || head.Next == nil {
		return head
	}
	cur := head
	n := 0
	for cur != nil {
		cur = cur.Next
		n++
	}
	k %= n
	if k == 0 {
		return head
	}
	fast, slow := head, head
	for i := 0; i < k; i++ {
		fast = fast.Next
	}
	for fast.Next != nil {
		fast = fast.Next
		slow = slow.Next
	}
	ans := slow.Next
	slow.Next = nil
	fast.Next = head
	return ans
}82. 删除排序链表中的重复元素 II
题目、示例与约束
给定一个 已排序 的链表的头节点 head。
删除原始链表中所有 重复 数字的节点,只留下 不同 的数字。
返回 已排序 的链表。
示例 1:
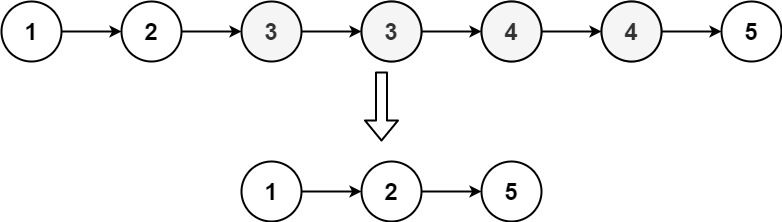
输入:head = [1,2,3,3,4,4,5]
输出:[1,2,5]
示例 2:
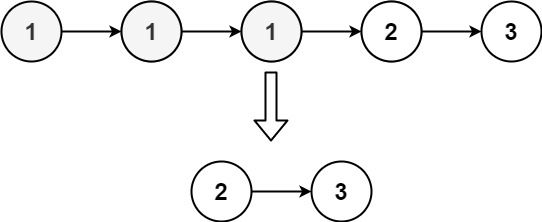
输入:head = [1,1,1,2,3]
输出:[2,3]
提示:
- 链表中节点数目在范围
[0, 300]内 -100 <= Node.val <= 100- 题目数据保证链表已经按升序 排列
方法一:一次遍历 · Go 实现
思考
用哈希表统计频次,再重建一条只含出现一次的节点,可以得到答案, 时间也足够。这样做没有利用「已排序、重复必然相邻」,还需要 额外空间。
同一值在链表中挤成一段,扫到一段就能决定整段去留。头节点也可能被删除,因此引入哑节点;整段都删时前驱不能跟着前进。为此让 停在上一段保留节点, 滑过当前值段:若 仍是 ,说明这段只有一个,前驱前进;否则整段丢弃。
我们先创建一个虚拟头节点 ,令 ,然后创建指针 指向 ,指针 指向 ,开始遍历链表。
当 指向的节点值与 指向的节点值相同时,我们就让 不断向后移动,直到 指向的节点值与 指向的节点值不相同时,停止移动。此时,我们判断 是否等于 ,如果相等,说明 与 之间没有重复节点,我们就让 移动到 的位置;否则,说明 与 之间有重复节点,我们就让 指向 。然后让 继续向后移动。继续上述操作,直到 为空,遍历结束。
最后,返回 即可。
时间复杂度 ,其中 为链表的长度。空间复杂度 。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func deleteDuplicates(head *ListNode) *ListNode {
	dummy := &ListNode{Next: head}
	pre, cur := dummy, head
	for cur != nil {
		for cur.Next != nil && cur.Next.Val == cur.Val {
			cur = cur.Next
		}
		if pre.Next == cur {
			pre = cur
		} else {
			pre.Next = cur.Next
		}
		cur = cur.Next
	}
	return dummy.Next
}83. 删除排序链表中的重复元素
题目、示例与约束
给定一个已排序的链表的头 head , 删除所有重复的元素,使每个元素只出现一次 。返回 已排序的链表 。
示例 1:
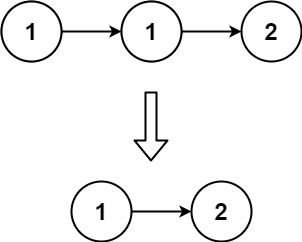
输入:head = [1,1,2]
输出:[1,2]
示例 2:
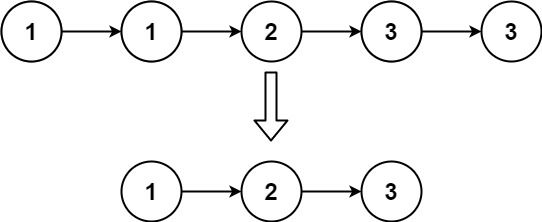
输入:head = [1,1,2,3,3]
输出:[1,2,3]
提示:
- 链表中节点数目在范围
[0, 300]内 -100 <= Node.val <= 100- 题目数据保证链表已经按升序 排列
方法一:一次遍历 · Go 实现
思考
放入集合再重建链表可以得到答案, 时间足够,但没有利用有序、重复相邻的性质,还需要额外空间。
同一值挤在一起,只需把 跳过相同值,不必另开链表。与上一题不同,本题要保留第一次出现的节点,因此单指针走一遍即可:相等则删除下一个,不等才前进。头节点一定保留,无需哑节点。
我们用一个指针 来遍历链表。如果当前 与 对应的元素相同,我们就将 的 指针指向 的下下个节点。否则,说明链表中 对应的元素是不重复的,因此可以将 指针移动到下一个节点。
遍历结束后,返回链表的头节点即可。
时间复杂度 ,其中 是链表的长度。空间复杂度 。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func deleteDuplicates(head *ListNode) *ListNode {
	cur := head
	for cur != nil && cur.Next != nil {
		if cur.Val == cur.Next.Val {
			cur.Next = cur.Next.Next
		} else {
			cur = cur.Next
		}
	}
	return head
}86. 分隔链表
题目、示例与约束
给你一个链表的头节点 head 和一个特定值 x ,请你对链表进行分隔,使得所有 小于 x 的节点都出现在 大于或等于 x 的节点之前。
你应当 保留 两个分区中每个节点的初始相对位置。
示例 1:
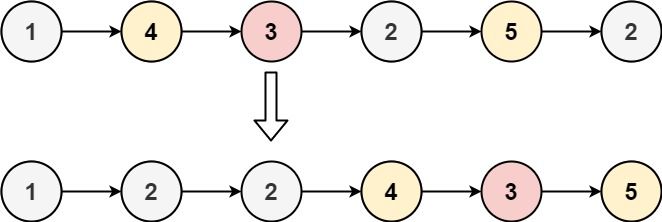
输入:head = [1,4,3,2,5,2], x = 3
输出:[1,2,2,4,3,5]
示例 2:
输入:head = [2,1], x = 2
输出:[1,2]
提示:
- 链表中节点的数目在范围
[0, 200]内 -100 <= Node.val <= 100-200 <= x <= 200
方法一:模拟 · Go 实现
思考
若先收集所有小于 的节点,再收集其余节点并重建链表,结果正确, 时间上也没有压力。然而这样要么拷贝节点,要么二次遍历,还容易打乱分区内部的相对次序。
题目要求的是稳定划分:小于 的相对顺序、以及大于等于 的相对顺序都不变。因此只需一遍扫描,把节点按取值分流到两条链上,最后把较小一侧的尾接到较大一侧的头。
指针接到原节点即可,不必另开值拷贝;较大一侧的尾要置空,以免与原后继成环。
我们创建两个链表 和 ,一个用来存储小于 的节点,另一个用来存储大于等于 的节点。然后我们将它们拼接起来。
时间复杂度 ,其中 是原链表的长度。空间复杂度 。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func partition(head *ListNode, x int) *ListNode {
	l, r := &ListNode{}, &ListNode{}
	tl, tr := l, r
	for ; head != nil; head = head.Next {
		if head.Val < x {
			tl.Next = head
			tl = tl.Next
		} else {
			tr.Next = head
			tr = tr.Next
		}
	}
	tr.Next = nil
	tl.Next = r.Next
	return l.Next
}92. 反转链表 II
题目、示例与约束
head 和两个整数 left 和 right ,其中 left <= right 。请你反转从位置 left 到位置 right 的链表节点,返回 反转后的链表 。
示例 1:
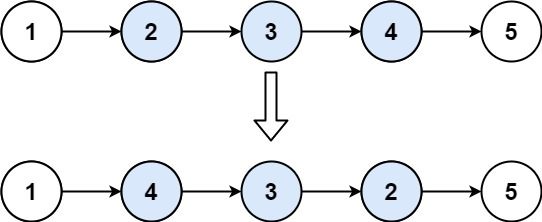
输入:head = [1,2,3,4,5], left = 2, right = 4
输出:[1,4,3,2,5]
示例 2:
输入:head = [5], left = 1, right = 1
输出:[5]
提示:
- 链表中节点数目为
n 1 <= n <= 500-500 <= Node.val <= 5001 <= left <= right <= n
进阶: 你可以使用一趟扫描完成反转吗?
方法一:模拟 · Go 实现
思考
可以把 整段切出、反转后再接回去,但 时头结点会被换掉,还要同时记住多个断点,容易写漏。进阶要求一趟扫描完成。
若把区间内的结点依次头插到区间前驱之后,即可就地反转,不必单独再拼接。虚拟头挡住 的边界:先走到第 个结点,再把头插做 次。
定义一个虚拟头结点 dummy,指向链表的头结点 head,然后定义一个指针 pre 指向 dummy,从虚拟头结点开始遍历链表,遍历到第 left 个结点时,将 pre 指向该结点,然后从该结点开始遍历 right - left + 1 次,将遍历到的结点依次插入到 pre 的后面,最后返回 dummy.next 即可。
时间复杂度 ,空间复杂度 。其中 为链表的长度。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func reverseBetween(head *ListNode, left int, right int) *ListNode {
	if head.Next == nil || left == right {
		return head
	}
	dummy := &ListNode{0, head}
	pre := dummy
	for i := 0; i < left-1; i++ {
		pre = pre.Next
	}
	p, q := pre, pre.Next
	cur := q
	for i := 0; i < right-left+1; i++ {
		t := cur.Next
		cur.Next = pre
		pre = cur
		cur = t
	}
	p.Next = pre
	q.Next = cur
	return dummy.Next
}138. 随机链表的复制
题目、示例与约束
给你一个长度为 n 的链表,每个节点包含一个额外增加的随机指针 random ,该指针可以指向链表中的任何节点或空节点。
构造这个链表的 深拷贝。 深拷贝应该正好由 n 个 全新 节点组成,其中每个新节点的值都设为其对应的原节点的值。新节点的 next 指针和 random 指针也都应指向复制链表中的新节点,并使原链表和复制链表中的这些指针能够表示相同的链表状态。复制链表中的指针都不应指向原链表中的节点 。
例如,如果原链表中有 X 和 Y 两个节点,其中 X.random --> Y 。那么在复制链表中对应的两个节点 x 和 y ,同样有 x.random --> y 。
返回复制链表的头节点。
用一个由 n 个节点组成的链表来表示输入/输出中的链表。每个节点用一个 [val, random_index] 表示:
val:一个表示Node.val的整数。random_index:随机指针指向的节点索引(范围从0到n-1);如果不指向任何节点,则为null。
你的代码 只 接受原链表的头节点 head 作为传入参数。
示例 1:
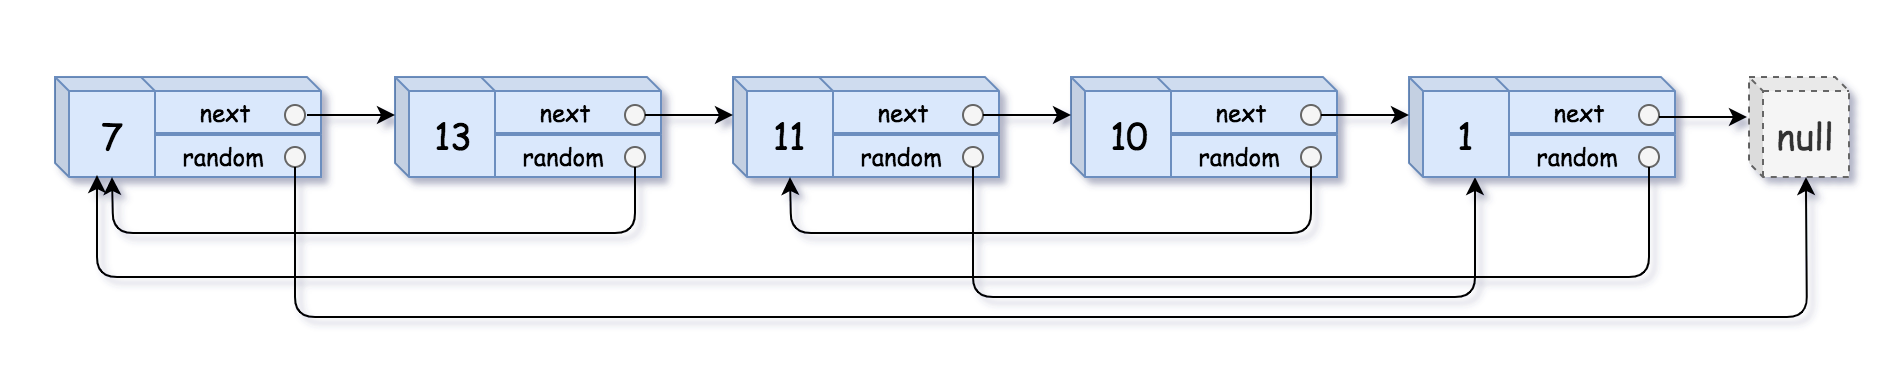
输入:head = [[7,null],[13,0],[11,4],[10,2],[1,0]]
输出:[[7,null],[13,0],[11,4],[10,2],[1,0]]
示例 2:
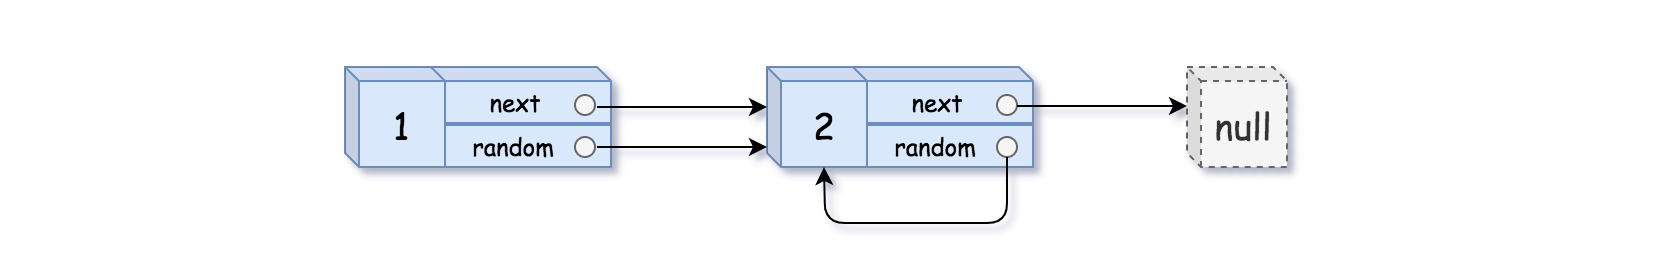
输入:head = [[1,1],[2,1]]
输出:[[1,1],[2,1]]
示例 3:
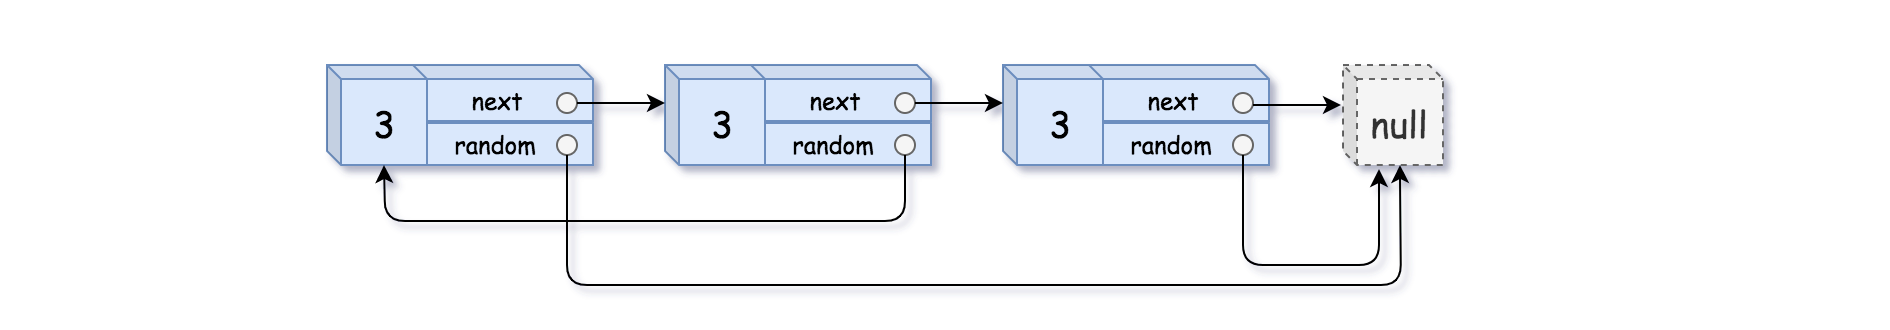
输入:head = [[3,null],[3,0],[3,null]]
输出:[[3,null],[3,0],[3,null]]
提示:
0 <= n <= 1000-104 <= Node.val <= 104Node.random为null或指向链表中的节点。
方法一:哈希表 + 模拟 · Go 实现
思考
复制带随机指针的链表。随机指针可能指向任意节点或空,先复制 再复制 时,目标节点可能尚未建出。 。
第一遍沿 建新链,并用哈希表记下原节点到副本的映射;第二遍按映射接好 。
我们可以定义一个虚拟头节点 ,用一个指针 指向虚拟头节点,然后遍历链表,将链表中的每个节点都复制一份,并将每个节点及其复制节点的对应关系存储在哈希表 中,同时连接好复制节点的 指针。
接下来再遍历链表,根据哈希表中存储的对应关系,将复制节点的 指针连接好。
时间复杂度 ,空间复杂度 。其中 为链表的长度。
/**
 * Definition for a Node.
 * type Node struct {
 *     Val int
 *     Next *Node
 *     Random *Node
 * }
 */

func copyRandomList(head *Node) *Node {
	dummy := &Node{}
	tail := dummy
	d := map[*Node]*Node{}
	for cur := head; cur != nil; cur = cur.Next {
		node := &Node{Val: cur.Val}
		d[cur] = node
		tail.Next = node
		tail = node
	}
	for cur := head; cur != nil; cur = cur.Next {
		if cur.Random != nil {
			d[cur].Random = d[cur.Random]
		}
	}
	return dummy.Next
}
方法二:模拟(空间优化) · Go 实现
思考
方法一的哈希表是 空间。把每个副本插在原节点后面,原节点与副本在链上相邻, 的对应关系变为 。拆链后得到复制链表,不再需要哈希表。
在方法一中,我们使用了额外的哈希表来存储原节点和复制节点的对应关系,我们也可以不使用额外的空间,具体做法如下:
- 遍历原链表,对于每个节点,复制一个新节点并将其插入到原节点和原节点的下一个节点之间。
- 再次遍历链表,根据原节点的 指针,设置新节点的 指针。
- 最后将链表拆分为原链表和复制链表。
时间复杂度 ,其中 为链表的长度。忽略答案链表的空间占用,空间复杂度 。
/**
 * Definition for a Node.
 * type Node struct {
 *     Val int
 *     Next *Node
 *     Random *Node
 * }
 */

func copyRandomList(head *Node) *Node {
	if head == nil {
		return nil
	}
	for cur := head; cur != nil; {
		node := &Node{cur.Val, cur.Next, nil}
		cur.Next = node
		cur = node.Next
	}
	for cur := head; cur != nil; cur = cur.Next.Next {
		if cur.Random != nil {
			cur.Next.Random = cur.Random.Next
		}
	}
	ans := head.Next
	for cur := head; cur.Next != nil; {
		node := cur.Next
		cur.Next = node.Next
		cur = node
	}
	return ans
}141. 环形链表
题目、示例与约束
给你一个链表的头节点 head ,判断链表中是否有环。
如果链表中有某个节点,可以通过连续跟踪 next 指针再次到达,则链表中存在环。 为了表示给定链表中的环,评测系统内部使用整数 pos 来表示链表尾连接到链表中的位置(索引从 0 开始)。注意:pos 不作为参数进行传递 。仅仅是为了标识链表的实际情况。
如果链表中存在环 ,则返回 true 。 否则,返回 false 。
示例 1:
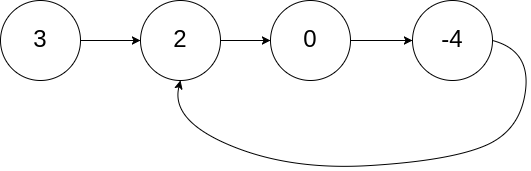
输入:head = [3,2,0,-4], pos = 1
输出:true
解释:链表中有一个环,其尾部连接到第二个节点。
示例 2:
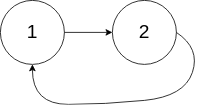
输入:head = [1,2], pos = 0
输出:true
解释:链表中有一个环,其尾部连接到第一个节点。
示例 3:

输入:head = [1], pos = -1
输出:false
解释:链表中没有环。
提示:
- 链表中节点的数目范围是
[0, 104] -105 <= Node.val <= 105pos为-1或者链表中的一个 有效索引 。
进阶:你能用 O(1)(即,常量)内存解决此问题吗?
方法一:哈希表 · Go 实现
思考
判断链表是否有环。 。走过的节点放进哈希表,再次出现即有环;走到空则无环。实现直接,空间 。进阶要求常数空间。
我们可以遍历链表,用一个哈希表 记录每个节点。当某个节点二次出现时,则表示存在环,直接返回 true。否则链表遍历结束,返回 false。
时间复杂度 ,空间复杂度 。其中 是链表中的节点数。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func hasCycle(head *ListNode) bool {
	s := map[*ListNode]bool{}
	for ; head != nil; head = head.Next {
		if s[head] {
			return true
		}
		s[head] = true
	}
	return false
}
方法二:快慢指针 · Go 实现
思考
方法一要用线性额外空间。快指针每次两步、慢指针一步,有环则两者必在环内相遇,无环则快指针先到末尾。只需两个指针。
我们定义快慢指针 和 ,初始时均指向 。
快指针每次走两步,慢指针每次走一步,不断循环。当快慢指针相遇时,说明链表存在环。如果循环结束依然没有相遇,说明链表不存在环。
时间复杂度 ,其中 是链表中的节点数。空间复杂度 。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func hasCycle(head *ListNode) bool {
	slow, fast := head, head
	for fast != nil && fast.Next != nil {
		slow, fast = slow.Next, fast.Next.Next
		if slow == fast {
			return true
		}
	}
	return false
}142. 环形链表 II
题目、示例与约束
给定一个链表的头节点 head ,返回链表开始入环的第一个节点。 如果链表无环,则返回 null。
如果链表中有某个节点,可以通过连续跟踪 next 指针再次到达,则链表中存在环。 为了表示给定链表中的环,评测系统内部使用整数 pos 来表示链表尾连接到链表中的位置(索引从 0 开始)。如果 pos 是 -1,则在该链表中没有环。注意:pos 不作为参数进行传递,仅仅是为了标识链表的实际情况。
不允许修改 链表。
示例 1:
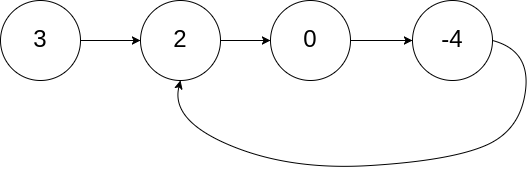
输入:head = [3,2,0,-4], pos = 1
输出:返回索引为 1 的链表节点
解释:链表中有一个环,其尾部连接到第二个节点。
示例 2:
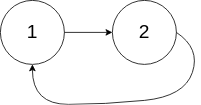
输入:head = [1,2], pos = 0
输出:返回索引为 0 的链表节点
解释:链表中有一个环,其尾部连接到第一个节点。
示例 3:

输入:head = [1], pos = -1
输出:返回 null
解释:链表中没有环。
提示:
- 链表中节点的数目范围在范围
[0, 104]内 -105 <= Node.val <= 105pos的值为-1或者链表中的一个有效索引
进阶:你是否可以使用 O(1) 空间解决此题?
方法一:快慢指针 · Go 实现
思考
不但要判断有环,还要返回入环节点。哈希表记下首次出现的节点即可,但进阶要 空间。 。
快慢指针相遇后,一个指针回到头、另一个留在相遇点,两者同速前进,相遇处即入口:头到入口的距离等于相遇点再走回入口的距离。
我们先利用快慢指针判断链表是否有环,如果有环的话,快慢指针一定会相遇,且相遇的节点一定在环中。
如果没有环,快指针会先到达链表尾部,直接返回 null 即可。
如果有环,我们再定义一个答案指针 指向链表头部,然后让 和慢指针一起向前走,每次走一步,直到 和慢指针相遇,相遇的节点即为环的入口节点。
为什么这样能找到环的入口节点呢?
我们不妨假设链表头节点到环入口的距离为 ,环入口到相遇节点的距离为 ,相遇节点到环入口的距离为 ,那么慢指针走过的距离为 ,快指针走过的距离为 ,其中 是快指针在环中绕了 圈。
<p><img src="https://fastly.jsdelivr.net/gh/doocs/leetcode@main/solution/0100-0199/0142.Linked List Cycle II/images/linked-list-cycle-ii.png" /></p>
由于快指针速度是慢指针的 倍,因此有 ,可以推出 ,即 。
也即是说,如果我们定义一个答案指针 指向链表头部,然后 和慢指针一起向前走,那么它们一定会在环入口相遇。
时间复杂度 ,其中 是链表中节点的数目。空间复杂度 。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func detectCycle(head *ListNode) *ListNode {
	fast, slow := head, head
	for fast != nil && fast.Next != nil {
		slow = slow.Next
		fast = fast.Next.Next
		if slow == fast {
			ans := head
			for ans != slow {
				ans = ans.Next
				slow = slow.Next
			}
			return ans
		}
	}
	return nil
}143. 重排链表
题目、示例与约束
给定一个单链表 L 的头节点 head ,单链表 L 表示为:
L0 → L1 → … → Ln - 1 → Ln
请将其重新排列后变为:
L0 → Ln → L1 → Ln - 1 → L2 → Ln - 2 → …
不能只是单纯的改变节点内部的值,而是需要实际的进行节点交换。
示例 1:

输入:head = [1,2,3,4]
输出:[1,4,2,3]
示例 2:

输入:head = [1,2,3,4,5]
输出:[1,5,2,4,3]
提示:
- 链表的长度范围为
[1, 5 * 104] 1 <= node.val <= 1000
方法一:快慢指针 + 反转链表 + 合并链表 · Go 实现
思考
要把链表重排成 。放进数组按下标重接是 空间。 。
后半段需要倒序穿插到前半段:快慢指针找到中点并断开,反转后半,再与前半交替合并。三次线性扫描,原地完成。
我们先用快慢指针找到链表的中点,然后将链表的后半部分反转,最后将左右两个链表合并。
时间复杂度 ,其中 是链表的长度。空间复杂度 。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func reorderList(head *ListNode) {
	// 快慢指针找到链表中点
	fast, slow := head, head
	for fast.Next != nil && fast.Next.Next != nil {
		slow, fast = slow.Next, fast.Next.Next
	}

	// cur 指向右半部分链表
	cur := slow.Next
	slow.Next = nil

	// 反转右半部分链表
	var pre *ListNode
	for cur != nil {
		t := cur.Next
		cur.Next = pre
		pre, cur = cur, t
	}
	cur = head

	// 此时 cur, pre 分别指向链表左右两半的第一个节点
	// 合并
	for pre != nil {
		t := pre.Next
		pre.Next = cur.Next
		cur.Next = pre
		cur, pre = pre.Next, t
	}
}147. 对链表进行插入排序
题目、示例与约束
给定单个链表的头 head ,使用 插入排序 对链表进行排序,并返回 排序后链表的头 。
插入排序 算法的步骤:
- 插入排序是迭代的,每次只移动一个元素,直到所有元素可以形成一个有序的输出列表。
- 每次迭代中,插入排序只从输入数据中移除一个待排序的元素,找到它在序列中适当的位置,并将其插入。
- 重复直到所有输入数据插入完为止。
下面是插入排序算法的一个图形示例。部分排序的列表(黑色)最初只包含列表中的第一个元素。每次迭代时,从输入数据中删除一个元素(红色),并就地插入已排序的列表中。
对链表进行插入排序。
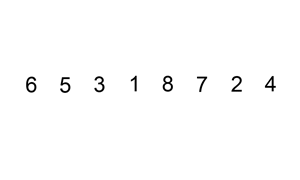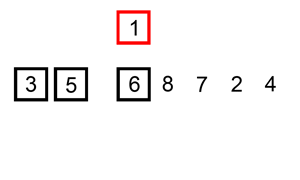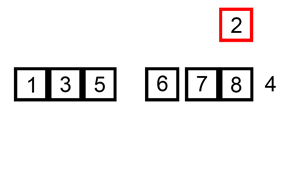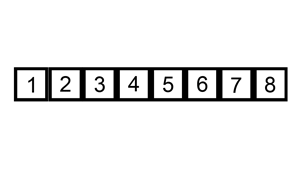
示例 1:
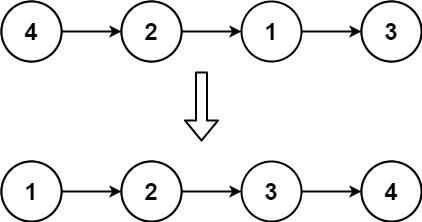
输入: head = [4,2,1,3]
输出: [1,2,3,4]
示例 2:
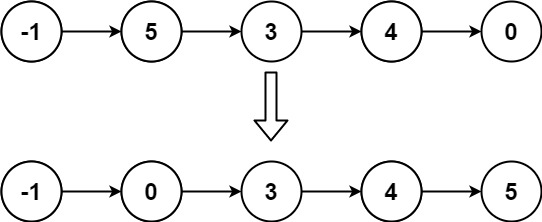
输入: head = [-1,5,3,4,0]
输出: [-1,0,3,4,5]
提示:
- 列表中的节点数在
[1, 5000]范围内 -5000 <= Node.val <= 5000
方法一 · Go 实现
思考
对链表做插入排序。 ,平方时间可以接受。数组排序再重建链表不是题目要求的插入过程。
已排序前缀用 盯着末尾:当前值更大则直接延长;否则从哑节点起找到第一个大于它的位置,把节点摘下插入。哑节点避免头部插入的分支。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func insertionSortList(head *ListNode) *ListNode {
	if head == nil || head.Next == nil {
		return head
	}
	dummy := &ListNode{head.Val, head}
	pre, cur := dummy, head
	for cur != nil {
		if pre.Val <= cur.Val {
			pre = cur
			cur = cur.Next
			continue
		}
		p := dummy
		for p.Next.Val <= cur.Val {
			p = p.Next
		}
		t := cur.Next
		cur.Next = p.Next
		p.Next = cur
		pre.Next = t
		cur = t
	}
	return dummy.Next
}148. 排序链表
题目、示例与约束
给你链表的头结点 head ,请将其按 升序 排列并返回 排序后的链表 。
示例 1:
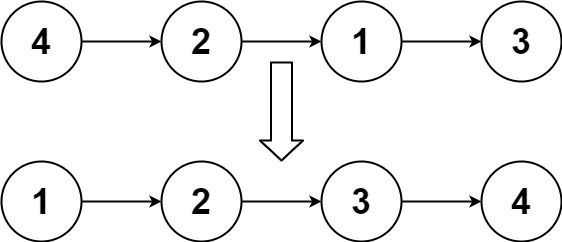
输入:head = [4,2,1,3]
输出:[1,2,3,4]
示例 2:
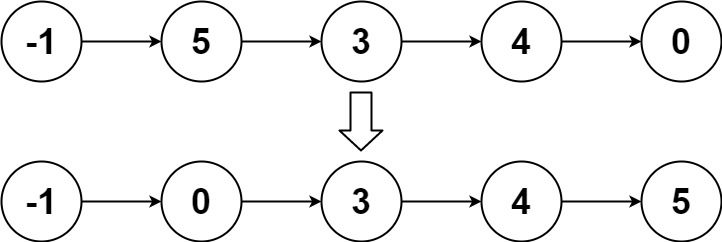
输入:head = [-1,5,3,4,0]
输出:[-1,0,3,4,5]
示例 3:
输入:head = []
输出:[]
提示:
- 链表中节点的数目在范围
[0, 5 * 104]内 -105 <= Node.val <= 105
进阶:你可以在 O(n log n) 时间复杂度和常数级空间复杂度下,对链表进行排序吗?
方法一:归并排序 · Go 实现
思考
链表排序,进阶要求 时间、常数空间。随机访问缺失,快排交换不方便; 。归并只需要顺序访问:快慢指针断开中点,递归排序两半再线性合并。递归栈是 ,满足时间要求。
我们可以用归并排序的思想来解决。
首先,我们利用快慢指针找到链表的中点,将链表从中点处断开,形成两个独立的子链表 和 。
然后,我们递归地对 和 进行排序,最后将 和 合并为一个有序链表。
时间复杂度 ,空间复杂度 。其中 是链表的长度。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func sortList(head *ListNode) *ListNode {
	if head == nil || head.Next == nil {
		return head
	}
	slow, fast := head, head.Next
	for fast != nil && fast.Next != nil {
		slow, fast = slow.Next, fast.Next.Next
	}
	l1 := head
	l2 := slow.Next
	slow.Next = nil
	l1 = sortList(l1)
	l2 = sortList(l2)
	dummy := &ListNode{}
	tail := dummy
	for l1 != nil && l2 != nil {
		if l1.Val <= l2.Val {
			tail.Next = l1
			l1 = l1.Next
		} else {
			tail.Next = l2
			l2 = l2.Next
		}
		tail = tail.Next
	}
	if l1 != nil {
		tail.Next = l1
	} else {
		tail.Next = l2
	}
	return dummy.Next
}160. 相交链表
题目、示例与约束
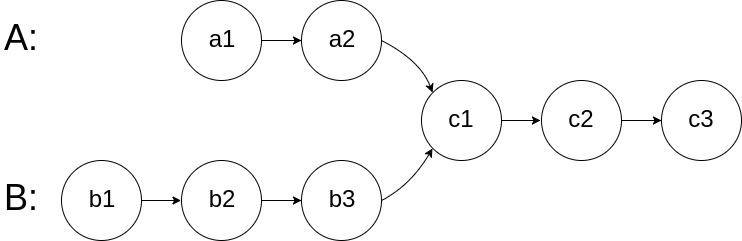
给你两个单链表的头节点 headA 和 headB ,请你找出并返回两个单链表相交的起始节点。如果两个链表不存在相交节点,返回 null 。
图示两个链表在节点 c1 开始相交:
题目数据 保证 整个链式结构中不存在环。
注意,函数返回结果后,链表必须 保持其原始结构 。
自定义评测:
评测系统 的输入如下(你设计的程序 不适用 此输入):
intersectVal- 相交的起始节点的值。如果不存在相交节点,这一值为0listA- 第一个链表listB- 第二个链表skipA- 在listA中(从头节点开始)跳到交叉节点的节点数skipB- 在listB中(从头节点开始)跳到交叉节点的节点数
评测系统将根据这些输入创建链式数据结构,并将两个头节点 headA 和 headB 传递给你的程序。如果程序能够正确返回相交节点,那么你的解决方案将被 视作正确答案 。
示例 1:
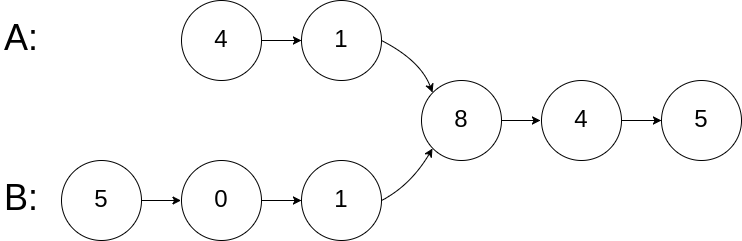
输入:intersectVal = 8, listA = [4,1,8,4,5], listB = [5,6,1,8,4,5], skipA = 2, skipB = 3
输出:Intersected at '8'
解释:相交节点的值为 8 (注意,如果两个链表相交则不能为 0)。
从各自的表头开始算起,链表 A 为 [4,1,8,4,5],链表 B 为 [5,6,1,8,4,5]。
在 A 中,相交节点前有 2 个节点;在 B 中,相交节点前有 3 个节点。
— 请注意相交节点的值不为 1,因为在链表 A 和链表 B 之中值为 1 的节点 (A 中第二个节点和 B 中第三个节点) 是不同的节点。换句话说,它们在内存中指向两个不同的位置,而链表 A 和链表 B 中值为 8 的节点 (A 中第三个节点,B 中第四个节点) 在内存中指向相同的位置。
示例 2:
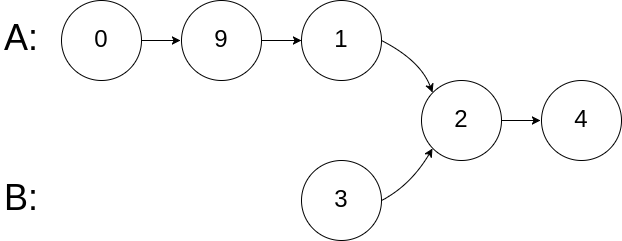
输入:intersectVal = 2, listA = [1,9,1,2,4], listB = [3,2,4], skipA = 3, skipB = 1
输出:Intersected at '2'
解释:相交节点的值为 2 (注意,如果两个链表相交则不能为 0)。
从各自的表头开始算起,链表 A 为 [1,9,1,2,4],链表 B 为 [3,2,4]。
在 A 中,相交节点前有 3 个节点;在 B 中,相交节点前有 1 个节点。
示例 3:
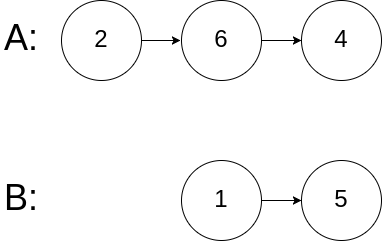
输入:intersectVal = 0, listA = [2,6,4], listB = [1,5], skipA = 3, skipB = 2
输出:No intersection
解释:从各自的表头开始算起,链表 A 为 [2,6,4],链表 B 为 [1,5]。
由于这两个链表不相交,所以 intersectVal 必须为 0,而 skipA 和 skipB 可以是任意值。
这两个链表不相交,因此返回 null 。
提示:
listA中节点数目为mlistB中节点数目为n1 <= m, n <= 3 * 1041 <= Node.val <= 1050 <= skipA <= m0 <= skipB <= n- 如果
listA和listB没有交点,intersectVal为0 - 如果
listA和listB有交点,intersectVal == listA[skipA] == listB[skipB]
进阶:你能否设计一个时间复杂度 O(m + n) 、仅用 O(1) 内存的解决方案?
方法一:双指针 · Go 实现
思考
找两链表第一个公共节点。哈希记下一条链再扫另一条是 时间、 空间;进阶要 内存。 。
两条指针走完各自的链后改走另一条,路程都是 ,若有交点则在交点相遇,否则同时走到空。不必先算长度。
我们使用两个指针 , 分别指向两个链表 , 。
同时遍历链表,当 到达链表 的末尾时,重新定位到链表 的头节点;当 到达链表 的末尾时,重新定位到链表 的头节点。
若两指针相遇,所指向的结点就是第一个公共节点。若没相遇,说明两链表无公共节点,此时两个指针都指向 null,返回其中一个即可。
时间复杂度 ,其中 和 分别是链表 和 的长度。空间复杂度 。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func getIntersectionNode(headA, headB *ListNode) *ListNode {
	a, b := headA, headB
	for a != b {
		if a == nil {
			a = headB
		} else {
			a = a.Next
		}
		if b == nil {
			b = headA
		} else {
			b = b.Next
		}
	}
	return a
}203. 移除链表元素
题目、示例与约束
head 和一个整数 val ,请你删除链表中所有满足 Node.val == val 的节点,并返回 新的头节点 。
示例 1:
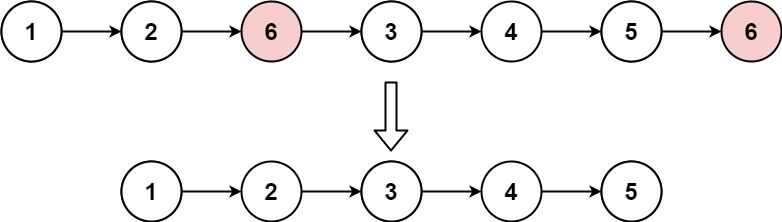
输入:head = [1,2,6,3,4,5,6], val = 6
输出:[1,2,3,4,5]
示例 2:
输入:head = [], val = 1
输出:[]
示例 3:
输入:head = [7,7,7,7], val = 7
输出:[]
提示:
- 列表中的节点数目在范围
[0, 104]内 1 <= Node.val <= 500 <= val <= 50
方法一 · Go 实现
思考
删除值为 的结点只需改前驱指针,但头结点本身可能被删,直接维护 要分多种情况。
为此在链表前加哑结点,用 观察后继:若后继值等于 则跳过该结点,否则前进。最后返回 。
func removeElements(head *ListNode, val int) *ListNode {
	dummy := new(ListNode)
	dummy.Next = head
	p := dummy
	for p.Next != nil {
		if p.Next.Val == val {
			p.Next = p.Next.Next
		} else {
			p = p.Next
		}
	}
	return dummy.Next
}206. 反转链表
题目、示例与约束
head ,请你反转链表,并返回反转后的链表。
示例 1:

输入:head = [1,2,3,4,5]
输出:[5,4,3,2,1]
示例 2:
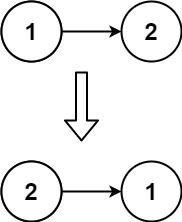
输入:head = [1,2]
输出:[2,1]
示例 3:
输入:head = []
输出:[]
提示:
- 链表中节点的数目范围是
[0, 5000] -5000 <= Node.val <= 5000
进阶:链表可以选用迭代或递归方式完成反转。你能否用两种方法解决这道题?
方法一:头插法 · Go 实现
思考
把结点依次放入数组再反向重建可行,但只需改指针。头插可在一次遍历中完成反转:当前结点不断插到哑结点之后。
遍历结束时 即为新头,空间为常数。
我们创建一个虚拟头节点 ,然后遍历链表,将每个节点依次插入 的下一个节点。遍历结束,返回 。
时间复杂度 ,其中 为链表的长度。空间复杂度 。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func reverseList(head *ListNode) *ListNode {
	dummy := &ListNode{}
	curr := head
	for curr != nil {
		next := curr.Next
		curr.Next = dummy.Next
		dummy.Next = curr
		curr = next
	}
	return dummy.Next
}
方法二:递归 · Go 实现
思考
头插已是线性迭代。也可先递归反转后继链表,再把当前结点接到新尾之后。
指针操作更短,但系统栈占用 空间。
递归反转链表的第二个节点到尾部的所有节点,然后 插在反转后的链表的尾部。
时间复杂度 ,空间复杂度 。其中 为链表的长度。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func reverseList(head *ListNode) *ListNode {
	if head == nil || head.Next == nil {
		return head
	}
	ans := reverseList(head.Next)
	head.Next.Next = head
	head.Next = nil
	return ans
}234. 回文链表
题目、示例与约束
给你一个单链表的头节点 head ,请你判断该链表是否为回文链表。如果是,返回 true ;否则,返回 false 。
示例 1:
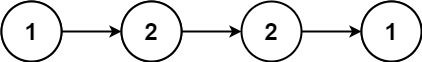
输入:head = [1,2,2,1]
输出:true
示例 2:
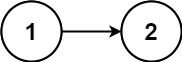
输入:head = [1,2]
输出:false
提示:
- 链表中节点数目在范围
[1, 105]内 0 <= Node.val <= 9
进阶:你能否用 O(n) 时间复杂度和 O(1) 空间复杂度解决此题?
方法一:快慢指针 · Go 实现
思考
放入数组再比较首尾可行,但要求常数空间。回文关于中点对称,可先找中点、反转后半,再与前半逐一比较。
快慢指针定位中点后原地反转后半段,比较结束后不必恢复。
我们可以先用快慢指针找到链表的中点,接着反转右半部分的链表。然后同时遍历前后两段链表,若前后两段链表节点对应的值不等,说明不是回文链表,否则说明是回文链表。
时间复杂度 ,其中 为链表的长度。空间复杂度 。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func isPalindrome(head *ListNode) bool {
	slow, fast := head, head.Next
	for fast != nil && fast.Next != nil {
		slow, fast = slow.Next, fast.Next.Next
	}
	var pre *ListNode
	cur := slow.Next
	for cur != nil {
		t := cur.Next
		cur.Next = pre
		pre = cur
		cur = t
	}
	for pre != nil {
		if pre.Val != head.Val {
			return false
		}
		pre, head = pre.Next, head.Next
	}
	return true
}237. 删除链表中的节点
题目、示例与约束
有一个单链表的 head,我们想删除它其中的一个节点 node。
给你一个需要删除的节点 node 。你将 无法访问 第一个节点 head。
链表的所有值都是 唯一的,并且保证给定的节点 node 不是链表中的最后一个节点。
删除给定的节点。注意,删除节点并不是指从内存中删除它。这里的意思是:
- 给定节点的值不应该存在于链表中。
- 链表中的节点数应该减少 1。
node前面的所有值顺序相同。node后面的所有值顺序相同。
自定义测试:
- 对于输入,你应该提供整个链表
head和要给出的节点node。node不应该是链表的最后一个节点,而应该是链表中的一个实际节点。 - 我们将构建链表,并将节点传递给你的函数。
- 输出将是调用你函数后的整个链表。
示例 1:
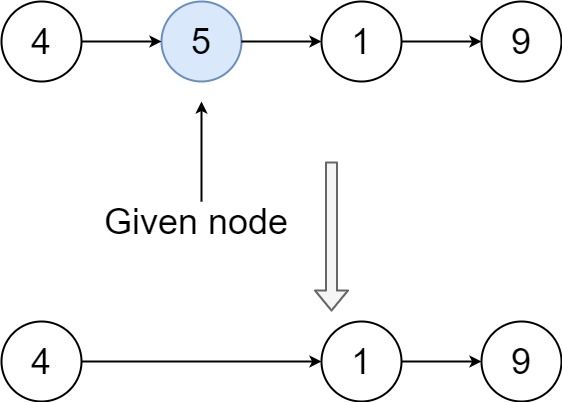
输入:head = [4,5,1,9], node = 5
输出:[4,1,9]
解释:指定链表中值为 5 的第二个节点,那么在调用了你的函数之后,该链表应变为 4 -> 1 -> 9
示例 2:
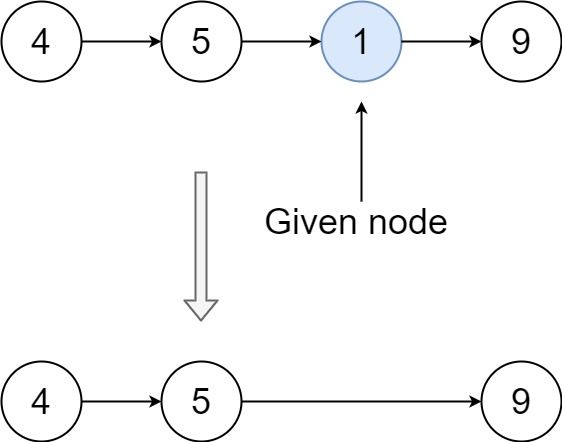
输入:head = [4,5,1,9], node = 1
输出:[4,5,9]
解释:指定链表中值为 1 的第三个节点,那么在调用了你的函数之后,该链表应变为 4 -> 5 -> 9
提示:
- 链表中节点的数目范围是
[2, 1000] -1000 <= Node.val <= 1000- 链表中每个节点的值都是 唯一 的
- 需要删除的节点
node是 链表中的节点 ,且 不是末尾节点
方法一:节点赋值 · Go 实现
思考
只给定待删结点、没有前驱,无法改前驱的 。可将后继的值抄到当前结点,再跳过后继,效果等同删除。
我们可以将当前节点的值替换为下一个节点的值,然后删除下一个节点。这样就可以达到删除当前节点的目的。
时间复杂度 ,空间复杂度 。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func deleteNode(node *ListNode) {
	node.Val = node.Next.Val
	node.Next = node.Next.Next
}328. 奇偶链表
题目、示例与约束
给定单链表的头节点 head ,将所有索引为奇数的节点和索引为偶数的节点分别分组,保持它们原有的相对顺序,然后把偶数索引节点分组连接到奇数索引节点分组之后,返回重新排序的链表。
第一个节点的索引被认为是 奇数 , 第二个节点的索引为 偶数 ,以此类推。
请注意,偶数组和奇数组内部的相对顺序应该与输入时保持一致。
你必须在 O(1) 的额外空间复杂度和 O(n) 的时间复杂度下解决这个问题。
示例 1:
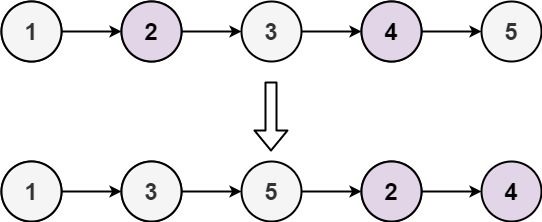
输入: head = [1,2,3,4,5]
输出: [1,3,5,2,4]
示例 2:
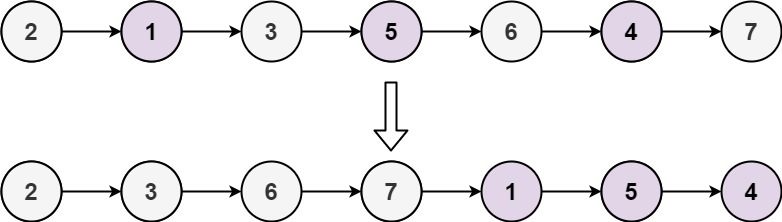
输入: head = [2,1,3,5,6,4,7]
输出: [2,3,6,7,1,5,4]
提示:
n ==链表中的节点数0 <= n <= 104-106 <= Node.val <= 106
方法一:一次遍历 · Go 实现
思考
按原相对顺序把奇下标结点接到偶下标结点之前。额外数组重串即可,但题目希望 空间。
用 、 分别钉住奇、偶链尾, 记下偶链头。反复把 的后继接到 后、再把新的后继接到 后,直到偶链耗尽。最后 接回偶链。
我们可以用两个指针 和 分别表示奇数节点和偶数节点的尾节点。初始时,指针 指向链表的头节点 ,指针 指向链表的第二个节点 。另外,我们用一个指针 指向偶数节点的头节点 ,即指针 的初始位置。
遍历链表,我们将指针 指向 的下一个节点,即 ,然后将指针 向后移动一位,即 ;将指针 指向 的下一个节点,即 ,然后将指针 向后移动一位,即 。继续遍历,直到 到达链表的末尾。
最后,我们将奇数节点的尾节点 指向偶数节点的头节点 ,即 ,然后返回链表的头节点 即可。
时间复杂度 ,其中 是链表的长度,需要遍历链表一次。空间复杂度 。只需要维护有限的指针。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func oddEvenList(head *ListNode) *ListNode {
	if head == nil {
		return nil
	}
	a := head
	b, c := head.Next, head.Next
	for b != nil && b.Next != nil {
		a.Next = b.Next
		a = a.Next
		b.Next = a.Next
		b = b.Next
	}
	a.Next = c
	return head
}369. 给单链表加一 🔒
题目、示例与约束
给定一个用链表表示的非负整数, 然后将这个整数 再加上 1 。
这些数字的存储是这样的:最高位有效的数字位于链表的首位 head 。
示例 1:
输入: head = [1,2,3]
输出: [1,2,4]
示例 2:
输入: head = [0]
输出: [1]
提示:
- 链表中的节点数在
[1, 100]的范围内。 0 <= Node.val <= 9- 由链表表示的数字不包含前导零,除了零本身。
方法一:链表遍历 · Go 实现
思考
链表表示的非负整数加一。转成数组再重建需 额外空间。进位只影响末尾连续的 。
设哑结点以免最高位进位丢头。一次扫描记下最后一个非 ,将其加一,其后一律置 。若哑结点变为 则它就是新头。
我们先设置一个虚拟头节点 ,初始时 的值为 ,并且 的后继节点为链表 。
接下来,我们从虚拟头节点开始遍历链表,找到最后一个不为 的节点,将其值加 ,并将该节点之后的所有节点的值置为 。
最后,我们判断虚拟头节点的值是否为 ,如果为 ,则返回 ,否则返回 的后继节点。
时间复杂度 ,其中 是链表的长度。空间复杂度 。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func plusOne(head *ListNode) *ListNode {
	dummy := &ListNode{0, head}
	target := dummy
	for head != nil {
		if head.Val != 9 {
			target = head
		}
		head = head.Next
	}
	target.Val++
	for target = target.Next; target != nil; target = target.Next {
		target.Val = 0
	}
	if dummy.Val == 1 {
		return dummy
	}
	return dummy.Next
}382. 链表随机节点
题目、示例与约束
给你一个单链表,随机选择链表的一个节点,并返回相应的节点值。每个节点 被选中的概率一样 。
实现 Solution 类:
Solution(ListNode head)使用整数数组初始化对象。int getRandom()从链表中随机选择一个节点并返回该节点的值。链表中所有节点被选中的概率相等。
示例:
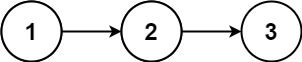
输入
["Solution", "getRandom", "getRandom", "getRandom", "getRandom", "getRandom"]
[[[1, 2, 3]], [], [], [], [], []]
输出
[null, 1, 3, 2, 2, 3]

解释
Solution solution = new Solution([1, 2, 3]);
solution.getRandom(); // 返回 1
solution.getRandom(); // 返回 3
solution.getRandom(); // 返回 2
solution.getRandom(); // 返回 2
solution.getRandom(); // 返回 3
// getRandom() 方法应随机返回 1、2、3中的一个,每个元素被返回的概率相等。
提示:
- 链表中的节点数在范围
[1, 104]内 -104 <= Node.val <= 104- 至多调用
getRandom方法104次
进阶:
- 如果链表非常大且长度未知,该怎么处理?
- 你能否在不使用额外空间的情况下解决此问题?
方法一 · Go 实现
思考
链表未知长度,等概率返回一结点值。先数长度再随机下标需两遍。水塘抽样一遍即可。
扫到第 个结点时以 替换答案。每个位置最终被选中的概率均为 。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
type Solution struct {
	head *ListNode
}

func Constructor(head *ListNode) Solution {
	return Solution{head}
}

func (this *Solution) GetRandom() int {
	n, ans := 0, 0
	for node := this.head; node != nil; node = node.Next {
		n++
		x := 1 + rand.Intn(n)
		if n == x {
			ans = node.Val
		}
	}
	return ans
}

/**
 * Your Solution object will be instantiated and called as such:
 * obj := Constructor(head);
 * param_1 := obj.GetRandom();
*/430. 扁平化多级双向链表
题目、示例与约束
你会得到一个双链表,其中包含的节点有一个下一个指针、一个前一个指针和一个额外的 子指针 。这个子指针可能指向一个单独的双向链表,也包含这些特殊的节点。这些子列表可以有一个或多个自己的子列表,以此类推,以生成如下面的示例所示的 多层数据结构 。
给定链表的头节点 head ,将链表 扁平化 ,以便所有节点都出现在单层双链表中。让 curr 是一个带有子列表的节点。子列表中的节点应该出现在扁平化列表中的 curr 之后 和 curr.next 之前 。
返回 扁平列表的 head 。列表中的节点必须将其 所有 子指针设置为 null 。
示例 1:
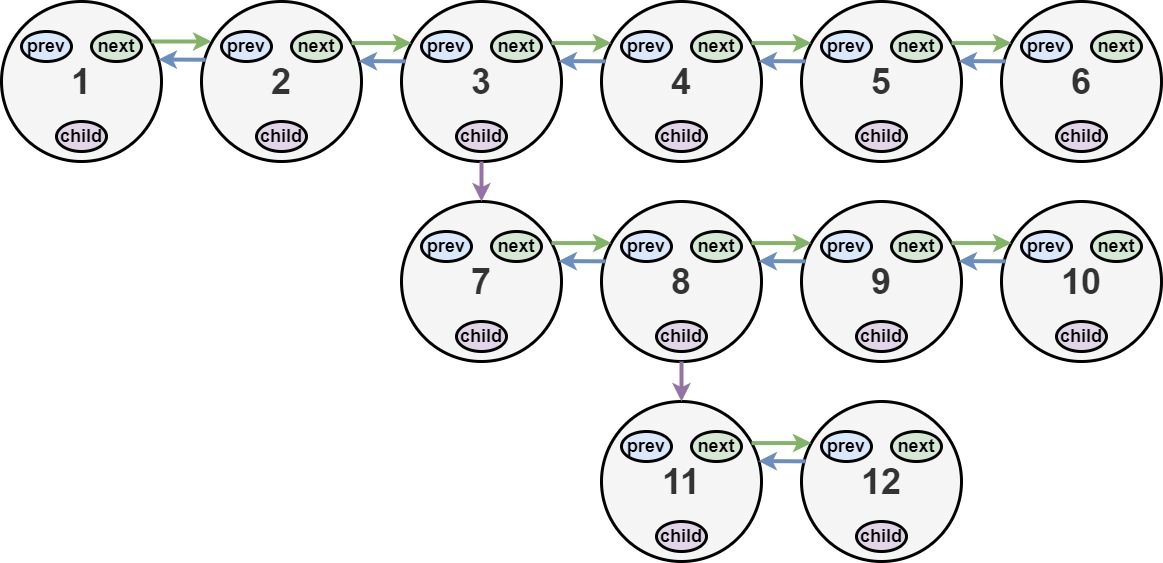
输入:head = [1,2,3,4,5,6,null,null,null,7,8,9,10,null,null,11,12]
输出:[1,2,3,7,8,11,12,9,10,4,5,6]
解释:输入的多级列表如上图所示。
扁平化后的链表如下图:
示例 2:
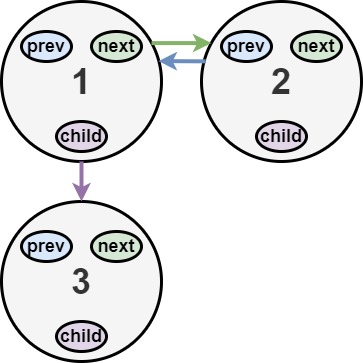
输入:head = [1,2,null,3]
输出:[1,3,2]
解释:输入的多级列表如上图所示。
扁平化后的链表如下图: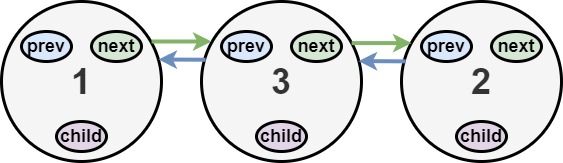
示例 3:
输入:head = []
输出:[]
说明:输入中可能存在空列表。
提示:
- 节点数目不超过
1000 1 <= Node.val <= 105
如何表示测试用例中的多级链表?
以 示例 1 为例:
 1---2---3---4---5---6--NULL
         |
         7---8---9---10--NULL
             |
             11--12--NULL
序列化其中的每一级之后:
[1,2,3,4,5,6,null]
[7,8,9,10,null]
[11,12,null]
为了将每一级都序列化到一起,我们需要每一级中添加值为 null 的元素,以表示没有节点连接到上一级的上级节点。
[1,2,3,4,5,6,null]
[null,null,7,8,9,10,null]
[null,11,12,null]
合并所有序列化结果,并去除末尾的 null 。
[1,2,3,4,5,6,null,null,null,7,8,9,10,null,null,11,12]
方法一:Go 解法(本站整理) · Go 实现
本站根据题意与 Doocs 参考思路整理为 Go,非上游原文。按 CC BY-SA 4.0 共享。
深度优先展开每个子链表,递归返回其尾节点。把整个子链表插在当前节点与原 Next 之间,修复两个方向的指针,再清空 Child。每个节点处理一次,时间 O(N),递归空间 O(D),D 为子链嵌套深度。Node 的 Val、Prev、Next、Child 字段由平台提供。
func flatten(head *Node) *Node {
	var visit func(*Node) *Node
	visit = func(first *Node) *Node {
		var tail *Node
		for cur := first; cur != nil; {
			next := cur.Next
			if cur.Child != nil {
				child := cur.Child
				end := visit(child)
				cur.Next = child
				child.Prev = cur
				cur.Child = nil
				end.Next = next
				if next != nil {
					next.Prev = end
				}
				tail = end
			} else {
				tail = cur
			}
			cur = next
		}
		return tail
	}
	visit(head)
	if head != nil {
		head.Prev = nil
	}
	return head
}445. 两数相加 II
题目、示例与约束
给你两个 非空 链表来代表两个非负整数。数字最高位位于链表开始位置。它们的每个节点只存储一位数字。将这两数相加会返回一个新的链表。
你可以假设除了数字 0 之外,这两个数字都不会以零开头。
示例1:
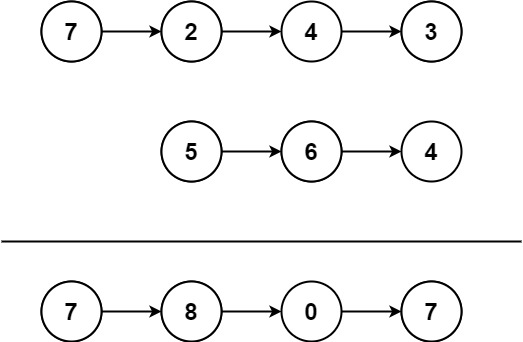
输入:l1 = [7,2,4,3], l2 = [5,6,4]
输出:[7,8,0,7]
示例2:
输入:l1 = [2,4,3], l2 = [5,6,4]
输出:[8,0,7]
示例3:
输入:l1 = [0], l2 = [0]
输出:[0]
提示:
- 链表的长度范围为
[1, 100] 0 <= node.val <= 9- 输入数据保证链表代表的数字无前导 0
进阶:如果输入链表不能翻转该如何解决?
方法一:翻转 · Go 实现
思考
链表高位在前,不能像「两数相加」那样直接从头部进位。先反转再加需要再反转回来,改指针较多。
把两条链的值依次压栈,从栈顶(低位)弹出相加,新结点头插到答案前面,进位留到下一轮。栈空仍有进位则再插一位。
栈把低位变成先处理的一端,头插自动得到高位在前的结果,无需三次反转链表。
手动翻转链表 l1 与 l2,将此题转换为 2. 两数相加,相加过程一致。对于最后返回的结果链表也需要进行翻转,共计三次。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func addTwoNumbers(l1 *ListNode, l2 *ListNode) *ListNode {
	s1, s2 := arraystack.New(), arraystack.New()
	for l1 != nil {
		s1.Push(l1.Val)
		l1 = l1.Next
	}
	for l2 != nil {
		s2.Push(l2.Val)
		l2 = l2.Next
	}
	carry, dummy := 0, new(ListNode)
	for !s1.Empty() || !s2.Empty() || carry > 0 {
		s := carry
		v, ok := s1.Pop()
		if ok {
			s += v.(int)
		}
		v, ok = s2.Pop()
		if ok {
			s += v.(int)
		}
		// node := &ListNode{s % 10, dummy.Next}
		// dummy.Next = node
		dummy.Next = &ListNode{s % 10, dummy.Next}
		carry = s / 10
	}
	return dummy.Next
}708. 循环有序列表的插入 🔒
题目、示例与约束
给定循环单调非递减列表中的一个点,写一个函数向这个列表中插入一个新元素 insertVal ,使这个列表仍然是循环非降序的。
给定的可以是这个列表中任意一个顶点的指针,并不一定是这个列表中最小元素的指针。
如果有多个满足条件的插入位置,你可以选择任意一个位置插入新的值,插入后整个列表仍然保持有序。
如果列表为空(给定的节点是 null),你需要创建一个循环有序列表并返回这个节点。否则,请返回原先给定的节点。
示例 1:
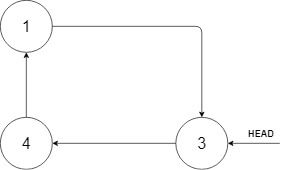
输入:head = [3,4,1], insertVal = 2
输出:[3,4,1,2]
解释:在上图中,有一个包含三个元素的循环有序列表,你获得值为 3 的节点的指针,我们需要向表中插入元素 2 。新插入的节点应该在 1 和 3 之间,插入之后,整个列表如上图所示,最后返回节点 3 。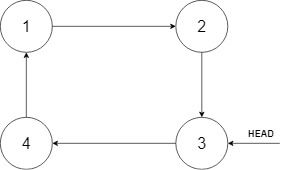
示例 2:
输入:head = [], insertVal = 1
输出:[1]
解释:列表为空(给定的节点是 null),创建一个循环有序列表并返回这个节点。
示例 3:
输入:head = [1], insertVal = 0
输出:[1,0]
提示:
0 <= Number of Nodes <= 5 * 104-106 <= Node.val, insertVal <= 106
方法一 · Go 实现
思考
在非降序的循环链表中插入一个值。节点数可达 ,需要在一圈内找到插入缝隙。空表时新节点自环即可。
有序环上存在唯一的「下降沿」:从最大值连回最小值。插入点要么落在某一段升序中间,要么恰好越过这条下降沿(新值不小于最大值或不大于最小值)。
为此用相邻指针 、 绕环一周,满足上述两种条件之一便停下;若全程单调则插在起点前,循环自然落到最后一对。接上新节点后返回原头。
/**
 * Definition for a Node.
 * type Node struct {
 *     Val int
 *     Next *Node
 * }
 */

func insert(head *Node, x int) *Node {
	node := &Node{Val: x}
	if head == nil {
		node.Next = node
		return node
	}
	prev, curr := head, head.Next
	for curr != head {
		if (prev.Val <= x && x <= curr.Val) || (prev.Val > curr.Val && (x >= prev.Val || x <= curr.Val)) {
			break
		}
		prev, curr = curr, curr.Next
	}
	prev.Next = node
	node.Next = curr
	return head
}725. 分隔链表
题目、示例与约束
给你一个头结点为 head 的单链表和一个整数 k ,请你设计一个算法将链表分隔为 k 个连续的部分。
每部分的长度应该尽可能的相等:任意两部分的长度差距不能超过 1 。这可能会导致有些部分为 null 。
这 k 个部分应该按照在链表中出现的顺序排列,并且排在前面的部分的长度应该大于或等于排在后面的长度。
返回一个由上述 k 部分组成的数组。
示例 1:
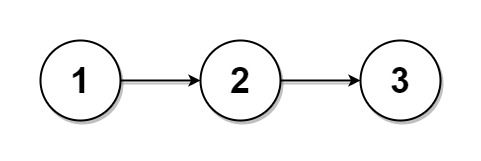
输入:head = [1,2,3], k = 5
输出:[[1],[2],[3],[],[]]
解释:
第一个元素 output[0] 为 output[0].val = 1 ,output[0].next = null 。
最后一个元素 output[4] 为 null ,但它作为 ListNode 的字符串表示是 [] 。
示例 2:
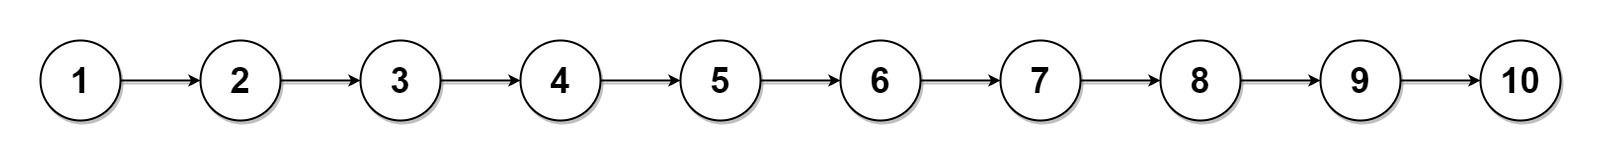
输入:head = [1,2,3,4,5,6,7,8,9,10], k = 3
输出:[[1,2,3,4],[5,6,7],[8,9,10]]
解释:
输入被分成了几个连续的部分,并且每部分的长度相差不超过 1 。前面部分的长度大于等于后面部分的长度。
提示:
- 链表中节点的数目在范围
[0, 1000] 0 <= Node.val <= 10001 <= k <= 50
方法一:模拟 · Go 实现
思考
把链表尽量均匀地分成 段,多出来的节点分给前面的部分。长度不超过 ,先数长度再切是直接的。
平均每段 ,余数 决定前若干段多一个。空位用空指针补齐到 段。
第二遍按算出的长度走到每段末尾,断开 并记下下一段头。只需两次遍历。
我们先遍历链表,得到链表的长度 ,然后我们计算出平均长度 和余数 。那么对于前 个部分,每个部分的长度为 ,其余部分的长度为 。
接下来,我们只需要遍历链表,将链表分割成 个部分即可。
时间复杂度 ,空间复杂度 。其中 为链表的长度。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func splitListToParts(head *ListNode, k int) []*ListNode {
	n := 0
	for cur := head; cur != nil; cur = cur.Next {
		n++
	}

	cnt := n / k
	mod := n % k
	ans := make([]*ListNode, k)
	cur := head

	for i := 0; i < k && cur != nil; i++ {
		ans[i] = cur
		m := cnt
		if i < mod {
			m++
		}
		for j := 1; j < m; j++ {
			cur = cur.Next
		}
		next := cur.Next
		cur.Next = nil
		cur = next
	}

	return ans
}817. 链表组件
题目、示例与约束
给你一个链表的头节点 head,该链表包含唯一的整数值,以及一个整数数组 nums,它是链表值的一个子集。
返回列表 nums 中组件的个数,这里对组件的定义为:链表中一段最长连续结点的值(该值必须在列表 nums 中)构成的集合。
示例 1:
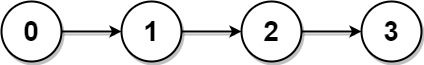
输入: head = [0,1,2,3], nums = [0,1,3]
输出: 2
解释: 链表中,0 和 1 是相连接的,且 nums 中不包含 2,所以 [0, 1] 是 nums 的一个组件,同理 [3] 也是一个组件,故返回 2。
示例 2:
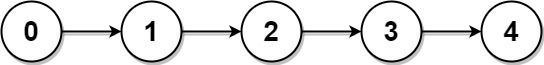
输入: head = [0,1,2,3,4], nums = [0,3,1,4]
输出: 2
解释: 链表中,0 和 1 是相连接的,3 和 4 是相连接的,所以 [0, 1] 和 [3, 4] 是两个组件,故返回 2。
提示:
- 链表中节点数为
n 1 <= n <= 1040 <= Node.val < nNode.val中所有值 不同1 <= nums.length <= n0 <= nums[i] < nnums中所有值 不同
方法一:哈希表 + 链表一次遍历 · Go 实现
思考
连通分量是 中值在链表上连续出现的极大段。 ,把 放入集合后沿链表扫一遍即可,无需建图。
跳过不在集合中的结点;每遇到一段在集合中的连续结点计为一个分量,并滑过整段。分量个数即为答案。
题目中需要判断链表中节点的值是否在数组 nums 中,因此我们可以使用哈希表 存储数组 nums 中的值。
然后遍历链表,找到第一个在哈希表 中的节点,然后从该节点开始遍历,直到遇到不在哈希表 中的节点,这样就找到了一个组件,然后继续遍历链表,直到遍历完整个链表。
时间复杂度 ,空间复杂度 。其中 为链表的节点个数。
/**
 * Definition for singly-linked list.
 * type ListNode struct {
 *     Val int
 *     Next *ListNode
 * }
 */
func numComponents(head *ListNode, nums []int) int {
	s := map[int]bool{}
	for _, v := range nums {
		s[v] = true
	}
	ans := 0
	for head != nil {
		for head != nil && !s[head.Val] {
			head = head.Next
		}
		if head != nil {
			ans++
		}
		for head != nil && s[head.Val] {
			head = head.Next
		}
	}
	return ans
}继续阅读
- 实践案例
- 实践案例
- 实践案例