
LeetCode Go · 哈希表(1)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
1. 两数之和
题目、示例与约束
给定一个整数数组 nums 和一个整数目标值 target,请你在该数组中找出 和为目标值 target 的那 两个 整数,并返回它们的数组下标。
你可以假设每种输入只会对应一个答案,并且你不能使用两次相同的元素。
你可以按任意顺序返回答案。
示例 1:
输入:nums = [2,7,11,15], target = 9
输出:[0,1]
解释:因为 nums[0] + nums[1] == 9 ,返回 [0, 1] 。
示例 2:
输入:nums = [3,2,4], target = 6
输出:[1,2]
示例 3:
输入:nums = [3,3], target = 6
输出:[0,1]
提示:
2 <= nums.length <= 104-109 <= nums[i] <= 109-109 <= target <= 109- 只会存在一个有效答案
进阶:你可以想出一个时间复杂度小于 O(n2) 的算法吗?
方法一:哈希表 · Go 实现
思考
若枚举所有数对,时间复杂度为 。在 的数据范围下可以接受,但题目进阶要求更优的算法。
对当前元素 ,我们需要判断此前是否出现过 。这是一个查找问题,使用哈希表可以将查找从线性扫描降至期望常数时间。遍历数组的同时,将「值 下标」写入哈希表:遇到 时先查询 是否已经出现,若已出现则返回两个下标,否则再将 插入。
插入的时机需要注意:必须先查询、再插入。若先插入再查询,当 且 时,会把同一个下标使用两次。先查后插,配到的一定是更早出现的下标。
我们可以使用一个哈希表 来存储每个元素及其对应的索引。
遍历数组 ,对于当前元素 ,我们首先判断 是否在哈希表 中,如果在 中,说明 值已经找到,返回 的索引和 即可。
时间复杂度 ,空间复杂度 ,其中 为数组 的长度。
func twoSum(nums []int, target int) []int {
	d := map[int]int{}
	for i := 0; ; i++ {
		x := nums[i]
		y := target - x
		if j, ok := d[y]; ok {
			return []int{j, i}
		}
		d[x] = i
	}
}36. 有效的数独
题目、示例与约束
请你判断一个 9 x 9 的数独是否有效。只需要 根据以下规则 ,验证已经填入的数字是否有效即可。
- 数字
1-9在每一行只能出现一次。 - 数字
1-9在每一列只能出现一次。 - 数字
1-9在每一个以粗实线分隔的3x3宫内只能出现一次。(请参考示例图)
注意:
- 一个有效的数独(部分已被填充)不一定是可解的。
- 只需要根据以上规则,验证已经填入的数字是否有效即可。
- 空白格用
'.'表示。
示例 1:

输入:board =
[["5","3",".",".","7",".",".",".","."]
,["6",".",".","1","9","5",".",".","."]
,[".","9","8",".",".",".",".","6","."]
,["8",".",".",".","6",".",".",".","3"]
,["4",".",".","8",".","3",".",".","1"]
,["7",".",".",".","2",".",".",".","6"]
,[".","6",".",".",".",".","2","8","."]
,[".",".",".","4","1","9",".",".","5"]
,[".",".",".",".","8",".",".","7","9"]]
输出:true
示例 2:
输入:board =
[["8","3",".",".","7",".",".",".","."]
,["6",".",".","1","9","5",".",".","."]
,[".","9","8",".",".",".",".","6","."]
,["8",".",".",".","6",".",".",".","3"]
,["4",".",".","8",".","3",".",".","1"]
,["7",".",".",".","2",".",".",".","6"]
,[".","6",".",".",".",".","2","8","."]
,[".",".",".","4","1","9",".",".","5"]
,[".",".",".",".","8",".",".","7","9"]]
输出:false
解释:除了第一行的第一个数字从 5 改为 8 以外,空格内其他数字均与 示例1 相同。 但由于位于左上角的 3x3 宫内有两个 8 存在, 因此这个数独是无效的。
提示:
board.length == 9board[i].length == 9board[i][j]是一位数字(1-9)或者'.'
方法一:一次遍历 · Go 实现
思考
对每个已填数字再扫描它所在的行、列与宫,棋盘仅为 ,时间可以接受。同一行、列、宫却会被反复访问。
判定有效性只需知道「这一行 / 列 / 宫是否已经出现过数字 」。我们可以用三张布尔表 、 、 在一次遍历中记录,其中宫号 。若碰到已经出现过的数字,立即返回假。
有效的数独满足以下三个条件:
- 每一行中的数字都不重复;
- 每一列中的数字都不重复;
- 每一个 的宫格中的数字都不重复。
遍历数独,对于每个数字,判断其所在的行、列 以及 的宫格是否已经出现过该数字,如果是,则返回 false。遍历结束,返回 true。
时间复杂度 ,空间复杂度 ,其中 是数独中的空格数。本题中 。
func isValidSudoku(board [][]byte) bool {
	row, col, sub := [9][9]bool{}, [9][9]bool{}, [9][9]bool{}
	for i := 0; i < 9; i++ {
		for j := 0; j < 9; j++ {
			num := board[i][j] - byte('1')
			if num < 0 || num > 9 {
				continue
			}
			k := i/3*3 + j/3
			if row[i][num] || col[j][num] || sub[k][num] {
				return false
			}
			row[i][num] = true
			col[j][num] = true
			sub[k][num] = true
		}
	}
	return true
}41. 缺失的第一个正数
题目、示例与约束
给你一个未排序的整数数组 nums ,请你找出其中没有出现的最小的正整数。
O(n) 并且只使用常数级别额外空间的解决方案。
示例 1:
输入:nums = [1,2,0]
输出:3
解释:范围 [1,2] 中的数字都在数组中。
示例 2:
输入:nums = [3,4,-1,1]
输出:2
解释:1 在数组中,但 2 没有。
示例 3:
输入:nums = [7,8,9,11,12]
输出:1
解释:最小的正数 1 没有出现。
提示:
1 <= nums.length <= 105-231 <= nums[i] <= 231 - 1
方法一:原地交换 · Go 实现
思考
题目要求 时间且只用常数额外空间。若用哈希集合记下出现过的数,再从 起逐个查询缺失值,时间满足,但额外空间为 , ,无法满足空间约束。
真正需要记录的是 中哪些值出现过:缺失的最小正整数一定落在 ,超出该范围的数可以忽略。数组下标本身即可充当这张出现表。
因此,当 时,将 交换到下标 。原地交换把原数组当作哈希,再线性扫描即可找到第一个空洞。
我们假设数组 长度为 ,那么最小的正整数一定在 之间。我们可以遍历数组,将数组中的每个数 交换到它应该在的位置上,即 应该在的位置为 。如果 不在 之间,那么我们就不用管它。
遍历结束后,我们再遍历数组,如果 不等于 ,那么 就是我们要找的最小的正整数。
时间复杂度 ,其中 是数组的长度。空间复杂度 。
func firstMissingPositive(nums []int) int {
	n := len(nums)
	for i := range nums {
		for 0 < nums[i] && nums[i] <= n && nums[i] != nums[nums[i]-1] {
			nums[i], nums[nums[i]-1] = nums[nums[i]-1], nums[i]
		}
	}
	for i, x := range nums {
		if x != i+1 {
			return i + 1
		}
	}
	return n + 1
}49. 字母异位词分组
题目、示例与约束
给你一个字符串数组,请你将 字母异位词 组合在一起。可以按任意顺序返回结果列表。
示例 1:
输入: strs = ["eat", "tea", "tan", "ate", "nat", "bat"]
输出: [["bat"],["nat","tan"],["ate","eat","tea"]]
解释:
- 在 strs 中没有字符串可以通过重新排列来形成
"bat"。 - 字符串
"nat"和"tan"是字母异位词,因为它们可以重新排列以形成彼此。 - 字符串
"ate","eat"和"tea"是字母异位词,因为它们可以重新排列以形成彼此。
示例 2:
输入: strs = [""]
输出: [[""]]
示例 3:
输入: strs = ["a"]
输出: [["a"]]
提示:
1 <= strs.length <= 1040 <= strs[i].length <= 100strs[i]仅包含小写字母
方法一:哈希表 · Go 实现
思考
若两两判断是否字母异位,即使对每个串先排序再比较,时间仍为 。 、 ,平方比较容易超时。
一组异位词排序后得到同一个串,该串可以作为分组的键,不必再成对比较。
因此以排序后的字符串为键、原串列表为值,扫一遍放入哈希表。同一键自然聚到一起。
- 遍历字符串,对每个字符串按照字符字典序排序,得到一个新的字符串。
- 以新字符串为
key,[str]为value,存入哈希表当中(HashMap<String, List<String>>)。 - 后续遍历得到相同
key时,将其加入到对应的value当中即可。
以 strs = ["eat", "tea", "tan", "ate", "nat", "bat"] 为例,遍历结束时,哈希表的状况:
| key | value |
|---|---|
"aet" |
["eat", "tea", "ate"] |
"ant" |
["tan", "nat"] |
"abt" |
["bat"] |
最后返回哈希表的 value 列表即可。
时间复杂度 。其中 和 分别是字符串数组的长度和字符串的最大长度。
func groupAnagrams(strs []string) (ans [][]string) {
	d := map[string][]string{}
	for _, s := range strs {
		t := []byte(s)
		sort.Slice(t, func(i, j int) bool { return t[i] < t[j] })
		k := string(t)
		d[k] = append(d[k], s)
	}
	for _, v := range d {
		ans = append(ans, v)
	}
	return
}
方法二:计数 · Go 实现
思考
方法一对每个串排序,单串 。字母只有 个小写, ,排序中的对数因子可以省去。
缺的是更便宜的键。统计每个字母出现次数,以长度为 的计数元组作为键,哈希分组方式不变,单串处理变为线性。
我们也可以将方法一中的排序部分改为计数,也就是说,将每个字符串 中的字符以及出现的次数作为 key,将字符串 作为 value 存入哈希表当中。
时间复杂度 。其中 和 分别是字符串数组的长度和字符串的最大长度,而 是字符集的大小,本题中 。
func groupAnagrams(strs []string) (ans [][]string) {
	d := map[[26]int][]string{}
	for _, s := range strs {
		cnt := [26]int{}
		for _, c := range s {
			cnt[c-'a']++
		}
		d[cnt] = append(d[cnt], s)
	}
	for _, v := range d {
		ans = append(ans, v)
	}
	return
}73. 矩阵置零
题目、示例与约束
给定一个 m x n 的矩阵,如果一个元素为 0 ,则将其所在行和列的所有元素都设为 0 。请使用 原地 算法。
示例 1:
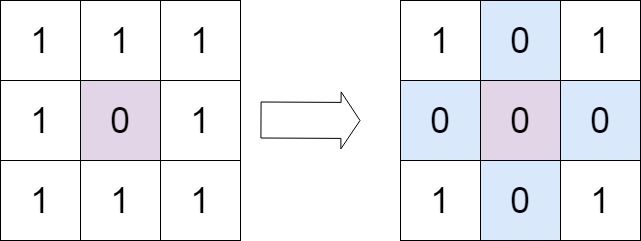
输入:matrix = [[1,1,1],[1,0,1],[1,1,1]]
输出:[[1,0,1],[0,0,0],[1,0,1]]
示例 2:
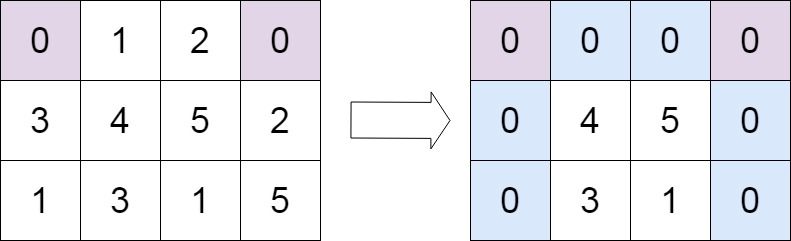
输入:matrix = [[0,1,2,0],[3,4,5,2],[1,3,1,5]]
输出:[[0,0,0,0],[0,4,5,0],[0,3,1,0]]
提示:
m == matrix.lengthn == matrix[0].length1 <= m, n <= 200-231 <= matrix[i][j] <= 231 - 1
进阶:
- 一个直观的解决方案是使用
O(mn)的额外空间,但这并不是一个好的解决方案。 - 一个简单的改进方案是使用
O(m + n)的额外空间,但这仍然不是最好的解决方案。 - 你能想出一个仅使用常量空间的解决方案吗?
方法一:数组标记 · Go 实现
思考
若遇到 立刻把该行该列清零,尚未扫描到的原有 会被覆盖,后续无法区分哪些零是原始的。另开一份 矩阵再写回可以避免混淆,但进阶已经否定这笔空间。 ,两遍扫描在时间上可行。
因此先记录「哪些行、哪些列应当置零」,再统一修改。长度为 的行标记与长度为 的列标记已经足够:第一遍遇零只打标,第二遍按标记置零。额外空间从 降到 ,尚未达到进阶要求的常数空间。
设矩阵的行数和列数分别为 和 。我们用长度为 的数组 和长度为 的数组 记录哪些行、列需要被置零。
先遍历矩阵,遇到零元素就把对应行、列标记为 。即若 ,则 。
再遍历一遍矩阵,根据 和 的标记更新元素。若 或 为 ,就把 置零。
时间复杂度 ,空间复杂度 。其中 和 分别为矩阵的行数和列数。
func setZeroes(matrix [][]int) {
	row := make([]bool, len(matrix))
	col := make([]bool, len(matrix[0]))
	for i := range matrix {
		for j, x := range matrix[i] {
			if x == 0 {
				row[i] = true
				col[j] = true
			}
		}
	}
	for i := range matrix {
		for j := range matrix[i] {
			if row[i] || col[j] {
				matrix[i][j] = 0
			}
		}
	}
}
方法二:原地标记 · Go 实现
思考
方法一仍需 的标记数组,而进阶要求 额外空间。
矩阵的第一行与第一列本身可以充当行、列标记。由于这两条带同时保存原有数据,必须先用 、 记下它们自身是否含零,再处理内部,最后才根据 、 清零第一行与第一列,以免标记被提前覆盖。
方法一中使用了额外的数组标记待清零的行和列,实际上我们也可以直接用矩阵的第一行和第一列来标记,不需要开辟额外的数组空间。
由于第一行、第一列用来做标记,它们的值可能会因为标记而发生改变,因此,我们需要额外的变量 , 来标记第一行、第一列是否需要被清零。
时间复杂度 ,空间复杂度 。其中 和 分别为矩阵的行数和列数。
func setZeroes(matrix [][]int) {
	m, n := len(matrix), len(matrix[0])
	i0, j0 := false, false
	for j := 0; j < n; j++ {
		if matrix[0][j] == 0 {
			i0 = true
			break
		}
	}
	for i := 0; i < m; i++ {
		if matrix[i][0] == 0 {
			j0 = true
			break
		}
	}
	for i := 1; i < m; i++ {
		for j := 1; j < n; j++ {
			if matrix[i][j] == 0 {
				matrix[i][0], matrix[0][j] = 0, 0
			}
		}
	}
	for i := 1; i < m; i++ {
		for j := 1; j < n; j++ {
			if matrix[i][0] == 0 || matrix[0][j] == 0 {
				matrix[i][j] = 0
			}
		}
	}
	if i0 {
		for j := 0; j < n; j++ {
			matrix[0][j] = 0
		}
	}
	if j0 {
		for i := 0; i < m; i++ {
			matrix[i][0] = 0
		}
	}
}169. 多数元素
题目、示例与约束
给定一个大小为 n 的数组 nums ,返回其中的多数元素。多数元素是指在数组中出现次数 大于 ⌊ n/2 ⌋ 的元素。
你可以假设数组是非空的,并且给定的数组总是存在多数元素。
示例 1:
输入:nums = [3,2,3]
输出:3
示例 2:
输入:nums = [2,2,1,1,1,2,2]
输出:2
提示:
n == nums.length1 <= n <= 5 * 104-109 <= nums[i] <= 109- 输入保证数组中一定有一个多数元素。
进阶:尝试设计时间复杂度为 O(n)、空间复杂度为 O(1) 的算法解决此问题。
方法一:摩尔投票法 · Go 实现
思考
多数元素出现次数超过 ,题目保证存在。哈希计数或排序都能做,进阶要 时间、 空间。 。
摩尔投票把不同元素两两抵消:计数器归零就换候选人。多数元素无法被完全抵消,一趟结束后的候选人即答案,无需第二趟确认。
摩尔投票法的基本步骤如下:
初始化元素 ,并初始化计数器 。接下来,对于输入列表中每一个元素 :
- 如果 ,那么 并且 ;
- 否则,如果 ,那么 ,否则 。
一般而言,摩尔投票法需要对输入的列表进行两次遍历。在第一次遍历中,我们生成候选值 ,如果存在多数,那么该候选值就是多数值。在第二次遍历中,只需要简单地计算候选值的频率,以确认是否是多数值。由于本题已经明确说明存在多数值,所以第一次遍历结束后,直接返回 即可,无需二次遍历确认是否是多数值。
时间复杂度 ,其中 是数组 的长度。空间复杂度 。
func majorityElement(nums []int) int {
	var cnt, m int
	for _, x := range nums {
		if cnt == 0 {
			m, cnt = x, 1
		} else {
			if m == x {
				cnt++
			} else {
				cnt--
			}
		}
	}
	return m
}205. 同构字符串
题目、示例与约束
给定两个字符串 s 和 t ,判断它们是否是同构的。
如果 s 中的字符可以按某种映射关系替换得到 t ,那么这两个字符串是同构的。
每个出现的字符都应当映射到另一个字符,同时不改变字符的顺序。不同字符不能映射到同一个字符上,相同字符只能映射到同一个字符上,字符可以映射到自己本身。
示例 1:
输入:s = "egg", t = "add"
输出:true
解释:
字符串 s 和 t 可以通过以下方式变得相同:
- 将
'e'映射为'a'。 - 将
'g'映射为'd'。
示例 2:
输入:s = "f11", t = "b23"
输出:false
解释:
字符串 s 和 t 无法变得相同,因为 '1' 需要同时映射到 '2' 和 '3'。
示例 3:
输入:s = "paper", t = "title"
输出:true
提示:
1 <= s.length <= 5 * 104t.length == s.lengths和t由任意有效的 ASCII 字符组成
方法一:哈希表或数组 · Go 实现
思考
同构要求 与 的字符一一对应;仅记录单向映射无法发现多对一。两串等长且字符集有限,一遍扫描即可判定。
为此维护 分别记录 与 ,一旦与已有映射冲突则返回否,否则更新后继续。
我们可以用两个哈希表或数组 和 记录 和 中字符的映射关系。
遍历 和 ,如果 和 中对应的字符映射关系不同,则返回 false,否则更新 和 中对应的字符映射关系。遍历结束,说明 和 是同构的,返回 true。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度;而 为字符集大小,本题中 。
func isIsomorphic(s string, t string) bool {
	d1 := [256]int{}
	d2 := [256]int{}
	for i := range s {
		if d1[s[i]] != d2[t[i]] {
			return false
		}
		d1[s[i]] = i + 1
		d2[t[i]] = i + 1
	}
	return true
}217. 存在重复元素
题目、示例与约束
nums 。如果任一值在数组中出现 至少两次 ,返回 true ;如果数组中每个元素互不相同,返回 false 。
示例 1:
输入:nums = [1,2,3,1]
输出:true
解释:
元素 1 在下标 0 和 3 出现。
示例 2:
输入:nums = [1,2,3,4]
输出:false
解释:
所有元素都不同。
示例 3:
输入:nums = [1,1,1,3,3,4,3,2,4,2]
输出:true
提示:
1 <= nums.length <= 105-109 <= nums[i] <= 109
方法一:排序 · Go 实现
思考
双重循环比较任意一对元素可行,但 较大时偏慢。相等元素在排序后必然相邻。
为此先排序,再检查相邻两项是否相等。
我们先对数组 nums 进行排序。
然后遍历数组,如果存在相邻两个元素相同,说明数组中存在重复元素,直接返回 true。
否则,遍历结束,返回 false。
时间复杂度 。其中 是数组 nums 的长度。
func containsDuplicate(nums []int) bool {
	sort.Ints(nums)
	for i, v := range nums[1:] {
		if v == nums[i] {
			return true
		}
	}
	return false
}
方法二:哈希表 · Go 实现
思考
排序改变相对次序且为 。只需判定是否出现过,哈希表一次扫描即可。
元素第二次进入集合则存在重复。
遍历数组,将出现过的元素记录在哈希表 中。若元素第二次出现时,说明数组中存在重复元素,直接返回 true。
时间复杂度 ,空间复杂度 。其中 是数组 nums 的长度。
func containsDuplicate(nums []int) bool {
	s := map[int]bool{}
	for _, v := range nums {
		if s[v] {
			return true
		}
		s[v] = true
	}
	return false
}229. 多数元素 II
题目、示例与约束
给定一个大小为 n 的整数数组,找出其中所有出现超过 ⌊n / 3⌋ 次的元素。
示例 1:
输入:nums = [3,2,3]
输出:[3]
示例 2:
输入:nums = [1]
输出:[1]
示例 3:
输入:nums = [1,2]
输出:[1,2]
提示:
1 <= nums.length <= 5 * 104-109 <= nums[i] <= 109
进阶:尝试设计时间复杂度为 O(n)、空间复杂度为 O(1)的算法解决此问题。
方法一 · Go 实现
思考
出现超过 次的值至多两个,哈希计数可行但要用额外空间。Boyer–Moore 可同时维护两个候选及其抵消计数。
扫描时与候选相同则加票,否则在两计数均为正时同时减一;最后再扫一遍确认真实次数。
func majorityElement(nums []int) []int {
	var n1, n2 int
	m1, m2 := 0, 1
	for _, m := range nums {
		if m == m1 {
			n1++
		} else if m == m2 {
			n2++
		} else if n1 == 0 {
			m1, n1 = m, 1
		} else if n2 == 0 {
			m2, n2 = m, 1
		} else {
			n1, n2 = n1-1, n2-1
		}
	}
	n1, n2 = 0, 0
	for _, m := range nums {
		if m == m1 {
			n1++
		} else if m == m2 {
			n2++
		}
	}
	var ans []int
	if n1 > len(nums)/3 {
		ans = append(ans, m1)
	}
	if n2 > len(nums)/3 {
		ans = append(ans, m2)
	}
	return ans
}242. 有效的字母异位词
题目、示例与约束
给定两个字符串 s 和 t ,编写一个函数来判断 t 是否是 s 的 字母异位词。
示例 1:
输入: s = "anagram", t = "nagaram"
输出: true
示例 2:
输入: s = "rat", t = "car"
输出: false
提示:
1 <= s.length, t.length <= 5 * 104s和t仅包含小写字母
进阶: 如果输入字符串包含 unicode 字符怎么办?你能否调整你的解法来应对这种情况?
方法一:计数 · Go 实现
思考
字母异位词当且仅当字符计数相同。长度不等则可立即否决。
统计 的频次,再扫 递减;若某字符减到负数则不是。
我们先判断两个字符串的长度是否相等,如果不相等,说明两个字符串中的字符肯定不同,返回 false。
否则,我们用哈希表或者一个长度为 的数组来记录字符串 中每个字符出现的次数,然后遍历另一个字符串 ,每遍历到一个字符,就将哈希表中对应的字符次数减一,如果减一后的次数小于 ,说明该字符在两个字符串中出现的次数不同,返回 false。如果遍历完两个字符串后,哈希表中的所有字符次数都为 ,说明两个字符串中的字符出现次数相同,返回 true。
时间复杂度 ,空间复杂度 ,其中 是字符串的长度;而 是字符集的大小,本题中 。
func isAnagram(s string, t string) bool {
	if len(s) != len(t) {
		return false
	}
	cnt := [26]int{}
	for i := 0; i < len(s); i++ {
		cnt[s[i]-'a']++
		cnt[t[i]-'a']--
	}
	for _, v := range cnt {
		if v != 0 {
			return false
		}
	}
	return true
}249. 移位字符串分组 🔒
题目、示例与约束
对字符串进行 “移位” 的操作:
- 右移:将字符串中每个字母都变为其在字母表中 后续 的字母,其中用 'a' 替换 'z'。比如,
"abc"能够右移为"bcd","xyz"能够右移为"yza"。 - 左移:将字符串中每个字母都变为其在字母表中 之前 的字母,其中用 'z' 替换 'a'。比如,
"bcd"能够左移为"abc","yza"能够左移为"xyz"。
我们可以不断地向两个方向移动字符串,形成 无限的移位序列。
- 例如,移动
"abc"来形成序列:... <-> "abc" <-> "bcd" <-> ... <-> "xyz" <-> "yza" <-> ... <-> "zab" <-> "abc" <-> ...
给定一个字符串数组 strings,将属于相同移位序列的所有 strings[i] 进行分组。你可以以 任意顺序 返回答案。
示例 1:
输入:strings = ["abc","bcd","acef","xyz","az","ba","a","z"]
输出:[["acef"],["a","z"],["abc","bcd","xyz"],["az","ba"]]
示例 2:
输入:strings = ["a"]
输出:[["a"]]
提示:
1 <= strings.length <= 2001 <= strings[i].length <= 50strings[i]只包含小写英文字母。
方法一:哈希表 · Go 实现
思考
同一移位组的字符串,相邻字母差值序列相同。把每个串平移到以 开头,即可作为分组键。
哈希表按该规范串归类,最后输出各组。
我们用一个哈希表 来存储每个字符串移位后且首位为 'a' 的字符串。即 表示所有字符串移位后字符串为 的字符串集合。
我们遍历每个字符串,对于每个字符串,我们计算其移位后的字符串 ,然后将其加入到 中。
最后,我们将 中的所有值取出来,即为答案。
时间复杂度 ,空间复杂度 ,其中 为所有字符串的长度之和。
func groupStrings(strings []string) [][]string {
	g := make(map[string][]string)
	for _, s := range strings {
		t := []byte(s)
		diff := t[0] - 'a'
		for i := range t {
			t[i] -= diff
			if t[i] < 'a' {
				t[i] += 26
			}
		}
		g[string(t)] = append(g[string(t)], s)
	}
	ans := make([][]string, 0, len(g))
	for _, v := range g {
		ans = append(ans, v)
	}
	return ans
}290. 单词规律
题目、示例与约束
给定一种规律 pattern 和一个字符串 s ,判断 s 是否遵循相同的规律。
这里的 遵循 指完全匹配,例如, pattern 里的每个字母和字符串 s 中的每个非空单词之间存在着双向连接的对应规律。具体来说:
pattern中的每个字母都 恰好 映射到s中的一个唯一单词。s中的每个唯一单词都 恰好 映射到pattern中的一个字母。- 没有两个字母映射到同一个单词,也没有两个单词映射到同一个字母。
示例1:
输入: pattern ="abba", s ="dog cat cat dog"输出: true
示例 2:
输入:pattern ="abba", s ="dog cat cat fish"输出: false
示例 3:
输入: pattern ="aaaa", s ="dog cat cat dog"输出: false
提示:
1 <= pattern.length <= 300pattern只包含小写英文字母1 <= s.length <= 3000s只包含小写英文字母和' 's不包含 任何前导或尾随对空格s中每个单词都被 单个空格 分隔
方法一:哈希表 · Go 实现
思考
模式与单词须一一对应,长度不等则否。与同构字符串相同,用两张表分别记录字符到单词、单词到字符。
一旦与已有映射冲突则失败。
我们先将字符串 按照空格分割成单词数组 ,如果 和 的长度不相等,直接返回 false。否则,我们使用两个哈希表 和 ,分别记录 和 中每个字符和单词的对应关系。
接下来,我们遍历 和 ,对于每个字符 和单词 ,如果 中存在 的映射,且映射的单词不是 ,或者 中存在 的映射,且映射的字符不是 ,则返回 false。否则,我们将 和 的映射分别加入 和 中。
遍历结束后,返回 true。
时间复杂度 ,空间复杂度 。其中 和 分别是 和字符串 的长度。
func wordPattern(pattern string, s string) bool {
	ws := strings.Split(s, " ")
	if len(ws) != len(pattern) {
		return false
	}
	d1 := map[rune]string{}
	d2 := map[string]rune{}
	for i, a := range pattern {
		b := ws[i]
		if v, ok := d1[a]; ok && v != b {
			return false
		}
		if v, ok := d2[b]; ok && v != a {
			return false
		}
		d1[a] = b
		d2[b] = a
	}
	return true
}299. 猜数字游戏
题目、示例与约束
你在和朋友一起玩 猜数字(Bulls and Cows)游戏,该游戏规则如下:
写出一个秘密数字,并请朋友猜这个数字是多少。朋友每猜测一次,你就会给他一个包含下述信息的提示:
- 猜测数字中有多少位属于数字和确切位置都猜对了(称为 "Bulls",公牛),
- 有多少位属于数字猜对了但是位置不对(称为 "Cows",奶牛)。也就是说,这次猜测中有多少位非公牛数字可以通过重新排列转换成公牛数字。
给你一个秘密数字 secret 和朋友猜测的数字 guess ,请你返回对朋友这次猜测的提示。
提示的格式为 "xAyB" ,x 是公牛个数, y 是奶牛个数,A 表示公牛,B 表示奶牛。
请注意秘密数字和朋友猜测的数字都可能含有重复数字。
示例 1:
输入:secret = "1807", guess = "7810"
输出:"1A3B"
解释:数字和位置都对(公牛)用 '|' 连接,数字猜对位置不对(奶牛)的采用斜体加粗标识。
"1807"
  |
"7810"
示例 2:
输入:secret = "1123", guess = "0111"
输出:"1A1B"
解释:数字和位置都对(公牛)用 '|' 连接,数字猜对位置不对(奶牛)的采用斜体加粗标识。
"1123"        "1123"
  |      or     |
"0111"        "0111"
注意,两个不匹配的 1 中,只有一个会算作奶牛(数字猜对位置不对)。通过重新排列非公牛数字,其中仅有一个 1 可以成为公牛数字。
提示:
1 <= secret.length, guess.length <= 1000secret.length == guess.lengthsecret和guess仅由数字组成
方法一:计数 · Go 实现
思考
公牛是同位置同数字,母牛是数字出现但位置不同。先统计同位置匹配数 ,对其余位置分别计数。
每个数字对母牛的贡献为两侧计数的最小值,求和得 。
我们创建两个计数器 和 ,分别用来统计秘密数字和朋友猜测的数字中每个数字出现的次数。同时,我们创建一个变量 来统计公牛的数量。
然后我们遍历秘密数字和朋友猜测的数字,如果当前数字相同,我们就将 加一。否则,我们分别将秘密数字和朋友猜测的数字中的当前数字的计数加一。
最后,我们遍历 中的每个数字,取 和 中当前数字的计数的最小值,然后将这个最小值加到变量 中。
最后,我们返回 和 的值。
时间复杂度 ,其中 是秘密数字和朋友猜测的数字的长度。空间复杂度 ,其中 是字符集的大小,本题中字符集为数字,所以 。
func getHint(secret string, guess string) string {
	x, y := 0, 0
	cnt1 := [10]int{}
	cnt2 := [10]int{}
	for i, c := range secret {
		a, b := int(c-'0'), int(guess[i]-'0')
		if a == b {
			x++
		} else {
			cnt1[a]++
			cnt2[b]++
		}
	}
	for i, c := range cnt1 {
		y += min(c, cnt2[i])

	}
	return fmt.Sprintf("%dA%dB", x, y)
}311. 稀疏矩阵的乘法 🔒
题目、示例与约束
给定两个 稀疏矩阵 :大小为 m x k 的稀疏矩阵 mat1 和大小为 k x n 的稀疏矩阵 mat2 ,返回 mat1 x mat2 的结果。你可以假设乘法总是可能的。
示例 1:
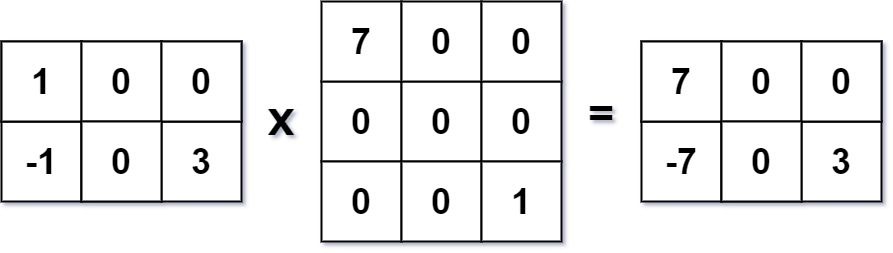
输入:mat1 = [[1,0,0],[-1,0,3]], mat2 = [[7,0,0],[0,0,0],[0,0,1]]
输出:[[7,0,0],[-7,0,3]]
示例 2:
输入:mat1 = [[0]], mat2 = [[0]]
输出:[[0]]
提示:
m == mat1.lengthk == mat1[i].length == mat2.lengthn == mat2[i].length1 <= m, n, k <= 100-100 <= mat1[i][j], mat2[i][j] <= 100
方法一:直接相乘 · Go 实现
思考
矩阵乘法按定义对每个 累加 维内积,规模受约束时 可接受。稀疏矩阵中大量乘积为零,但仍按三层循环完整计算。
为此先写出三重循环,保证语义正确,再考虑跳过零元。
我们可以直接按照矩阵乘法的定义,计算出结果矩阵中的每一个元素。
时间复杂度 ,空间复杂度 。其中 和 分别是矩阵 的行数和矩阵 的列数,而 是矩阵 的列数或矩阵 的行数。
func multiply(mat1 [][]int, mat2 [][]int) [][]int {
	m, n := len(mat1), len(mat2[0])
	ans := make([][]int, m)
	for i := range ans {
		ans[i] = make([]int, n)
	}
	for i := 0; i < m; i++ {
		for j := 0; j < n; j++ {
			for k := 0; k < len(mat2); k++ {
				ans[i][j] += mat1[i][k] * mat2[k][j]
			}
		}
	}
	return ans
}
方法二:预处理 · Go 实现
思考
方法一仍会把零与任意数相乘。将两矩阵压成每行非零 列表后,只对非零对累加 。零元不再进入内层,常数显著下降,最坏仍为 。
我们可以预处理出两个矩阵的稀疏表示,即 表示矩阵 第 行中所有非零元素的列下标和值,而 表示矩阵 第 行中所有非零元素的列下标和值。
接下来,我们遍历每一行 ,遍历 中的每一个元素 ,遍历 中的每一个元素 ,那么最终 就会对应到结果矩阵中的 ,我们将所有的结果累加即可。
时间复杂度 ,空间复杂度 。其中 和 分别是矩阵 的行数和矩阵 的列数,而 是矩阵 的列数或矩阵 的行数。
func multiply(mat1 [][]int, mat2 [][]int) [][]int {
	m, n := len(mat1), len(mat2[0])
	ans := make([][]int, m)
	for i := range ans {
		ans[i] = make([]int, n)
	}
	f := func(mat [][]int) [][][2]int {
		m, n := len(mat), len(mat[0])
		g := make([][][2]int, m)
		for i := range g {
			g[i] = make([][2]int, 0, n)
			for j := range mat[i] {
				if mat[i][j] != 0 {
					g[i] = append(g[i], [2]int{j, mat[i][j]})
				}
			}
		}
		return g
	}
	g1, g2 := f(mat1), f(mat2)
	for i := range g1 {
		for _, p := range g1[i] {
			k, x := p[0], p[1]
			for _, q := range g2[k] {
				j, y := q[0], q[1]
				ans[i][j] += x * y
			}
		}
	}
	return ans
}383. 赎金信
题目、示例与约束
给你两个字符串:ransomNote 和 magazine ,判断 ransomNote 能不能由 magazine 里面的字符构成。
如果可以,返回 true ;否则返回 false 。
magazine 中的每个字符只能在 ransomNote 中使用一次。
示例 1:
输入:ransomNote = "a", magazine = "b"
输出:false
示例 2:
输入:ransomNote = "aa", magazine = "ab"
输出:false
示例 3:
输入:ransomNote = "aa", magazine = "aab"
输出:true
提示:
1 <= ransomNote.length, magazine.length <= 105ransomNote和magazine由小写英文字母组成
方法一:哈希表或数组 · Go 实现
思考
判断
ransomNote的字母是否都能从magazine中取出。多重集合包含关系。统计杂志字母频次,再扫勒索信逐个减一;任一字母减成负数则不够。字母表大小为 。
我们可以用一个哈希表或长度为 的数组 记录字符串 magazine 中所有字符出现的次数。然后遍历字符串 ransomNote,对于其中的每个字符 ,我们将其从 的次数减 ,如果减 之后的次数小于 ,说明 在 magazine 中出现的次数不够,因此无法构成 ransomNote,返回 即可。
否则,遍历结束后,说明 ransomNote 中的每个字符都可以在 magazine 中找到对应的字符,因此返回 。
时间复杂度 ,空间复杂度 。其中 和 分别为字符串 ransomNote 和 magazine 的长度;而 为字符集的大小,本题中 。
func canConstruct(ransomNote string, magazine string) bool {
	cnt := [26]int{}
	for _, c := range magazine {
		cnt[c-'a']++
	}
	for _, c := range ransomNote {
		cnt[c-'a']--
		if cnt[c-'a'] < 0 {
			return false
		}
	}
	return true
}442. 数组中重复的数据
题目、示例与约束
给你一个长度为 n 的整数数组 nums ,其中 nums 的所有整数都在范围 [1, n] 内,且每个整数出现 最多两次 。请你找出所有出现 两次 的整数,并以数组形式返回。
你必须设计并实现一个时间复杂度为 O(n) 且仅使用常量额外空间(不包括存储输出所需的空间)的算法解决此问题。
示例 1:
输入:nums = [4,3,2,7,8,2,3,1]
输出:[2,3]
示例 2:
输入:nums = [1,1,2]
输出:[1]
示例 3:
输入:nums = [1]
输出:[]
提示:
n == nums.length1 <= n <= 1051 <= nums[i] <= nnums中的每个元素出现 一次 或 两次
方法一 · Go 实现
思考
每个值落在 且至多出现两次,进阶要求线性时间、常数额外空间。哈希表能找重复,但多用 空间。
把 交换到下标 (循环排序)。结束后位置 上若不是 ,则该值是多出来的重复。
交换持续到 ,重复值会与已就位的那个撞车而停下,不会死循环。
func findDuplicates(nums []int) []int {
	for i := range nums {
		for nums[i] != nums[nums[i]-1] {
			nums[i], nums[nums[i]-1] = nums[nums[i]-1], nums[i]
		}
	}
	var ans []int
	for i, v := range nums {
		if v != i+1 {
			ans = append(ans, v)
		}
	}
	return ans
}448. 找到所有数组中消失的数字
题目、示例与约束
给你一个含 n 个整数的数组 nums ,其中 nums[i] 在区间 [1, n] 内。请你找出所有在 [1, n] 范围内但没有出现在 nums 中的数字,并以数组的形式返回结果。
示例 1:
输入:nums = [4,3,2,7,8,2,3,1]
输出:[5,6]
示例 2:
输入:nums = [1,1]
输出:[2]
提示:
n == nums.length1 <= n <= 1051 <= nums[i] <= n
进阶:你能在不使用额外空间且时间复杂度为 O(n) 的情况下解决这个问题吗? 你可以假定返回的数组不算在额外空间内。
方法一:数组或哈希表 · Go 实现
思考
值域为 ,缺的是集合差。哈希集合记录出现过的数,再扫一遍 。线性时间,额外 空间。
进阶要求常数空间,这一解先保证正确。
我们可以使用数组或哈希表记录数组中的数字,然后遍历 [1, n] 区间内的数字,若数字不存在于数组或哈希表中,则说明数组中缺失该数字,将其添加到结果列表中。
时间复杂度 ,空间复杂度 。其中 为数组长度。
func findDisappearedNumbers(nums []int) (ans []int) {
	n := len(nums)
	s := make([]bool, n+1)
	for _, x := range nums {
		s[x] = true
	}
	for i := 1; i <= n; i++ {
		if !s[i] {
			ans = append(ans, i)
		}
	}
	return
}
方法二:原地修改 · Go 实现
思考
方法一多用一个集合。值 可以把下标 标成负数表示「出现过」,最后仍为正的位置 对应缺失的 。取绝对值再标记,避免把已标记的值再当正下标。
我们可以遍历数组 ,将 位置的数字标记为负数,表示数组 出现过。最后遍历数组 ,若 为正数,则说明数组中缺失 ,将其添加到结果列表中。
遍历结束后,返回结果列表即可。
时间复杂度 ,空间复杂度 。其中 为数组长度。
func findDisappearedNumbers(nums []int) (ans []int) {
	n := len(nums)
	for _, x := range nums {
		i := abs(x) - 1
		if nums[i] > 0 {
			nums[i] = -nums[i]
		}
	}
	for i := 0; i < n; i++ {
		if nums[i] > 0 {
			ans = append(ans, i+1)
		}
	}
	return
}

func abs(x int) int {
	if x < 0 {
		return -x
	}
	return x
}454. 四数相加 II
题目、示例与约束
给你四个整数数组 nums1、nums2、nums3 和 nums4 ,数组长度都是 n ,请你计算有多少个元组 (i, j, k, l) 能满足:
0 <= i, j, k, l < nnums1[i] + nums2[j] + nums3[k] + nums4[l] == 0
示例 1:
输入:nums1 = [1,2], nums2 = [-2,-1], nums3 = [-1,2], nums4 = [0,2]
输出:2
解释:
两个元组如下:
1. (0, 0, 0, 1) -> nums1[0] + nums2[0] + nums3[0] + nums4[1] = 1 + (-2) + (-1) + 2 = 0
2. (1, 1, 0, 0) -> nums1[1] + nums2[1] + nums3[0] + nums4[0] = 2 + (-1) + (-1) + 0 = 0
示例 2:
输入:nums1 = [0], nums2 = [0], nums3 = [0], nums4 = [0]
输出:1
提示:
n == nums1.lengthn == nums2.lengthn == nums3.lengthn == nums4.length1 <= n <= 200-228 <= nums1[i], nums2[i], nums3[i], nums4[i] <= 228
方法一:哈希表 · Go 实现
思考
四重循环是 , 不可行。和为 可拆成两对: 。
哈希表统计 所有两两和的次数,再枚举 累加 。
两两枚举是 ,把四元组查找变成哈希查询。
我们可以将数组 和 中的元素 和 相加,将所有可能的和存储在哈希表 中,其中键为两数之和,值为两数之和出现的次数。
然后我们遍历数组 和 中的元素 和 ,令 为目标值,那么答案即为 的累加和。
时间复杂度 ,空间复杂度 ,其中 是数组的长度。
func fourSumCount(nums1 []int, nums2 []int, nums3 []int, nums4 []int) (ans int) {
	cnt := map[int]int{}
	for _, a := range nums1 {
		for _, b := range nums2 {
			cnt[a+b]++
		}
	}
	for _, c := range nums3 {
		for _, d := range nums4 {
			ans += cnt[-(c + d)]
		}
	}
	return
}500. 键盘行
题目、示例与约束
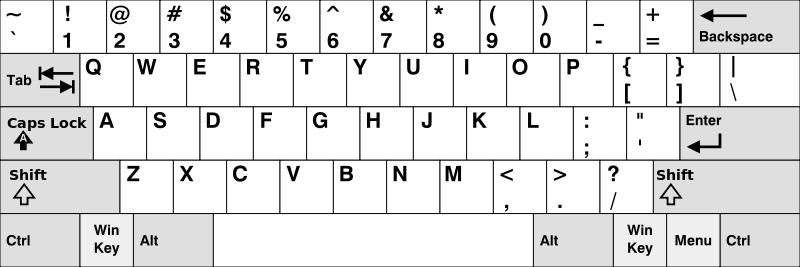
给你一个字符串数组 words ,只返回可以使用在 美式键盘 同一行的字母打印出来的单词。键盘如下图所示。
请注意,字符串 不区分大小写,相同字母的大小写形式都被视为在同一行。
美式键盘 中:
- 第一行由字符
"qwertyuiop"组成。 - 第二行由字符
"asdfghjkl"组成。 - 第三行由字符
"zxcvbnm"组成。
示例 1:
输入:words = ["Hello","Alaska","Dad","Peace"]
输出:["Alaska","Dad"]
解释:
由于不区分大小写,"a" 和 "A" 都在美式键盘的第二行。
示例 2:
输入:words = ["omk"]
输出:[]
示例 3:
输入:words = ["adsdf","sfd"]
输出:["adsdf","sfd"]
提示:
1 <= words.length <= 201 <= words[i].length <= 100words[i]由英文字母(小写和大写字母)组成
方法二:字符映射 · Go 实现
思考
集合判断已经是线性扫描,但每个单词都要新建集合并做三次子集比较,常数偏大。
将二十六字母预先映射到行号后,只需核对单词内所有字母是否与首字母同行。映射表长度为字符集大小,判断仍是一遍扫描,实现更直接。
将每个键盘行的字符映射到对应的行号,再判断单词中所有字母是否落在同一行。
时间复杂度 ,空间复杂度 。其中 为所有字符串的长度之和;而 为字符集的大小,本题中 。
func findWords(words []string) (ans []string) {
	s := "12210111011122000010020202"
	for _, w := range words {
		x := s[unicode.ToLower(rune(w[0]))-'a']
		ok := true
		for _, c := range w[1:] {
			if s[unicode.ToLower(c)-'a'] != x {
				ok = false
				break
			}
		}
		if ok {
			ans = append(ans, w)
		}
	}
	return
}531. 孤独像素 I 🔒
题目、示例与约束
给你一个大小为 m x n 的图像 picture ,图像由黑白像素组成,'B' 表示黑色像素,'W' 表示白色像素,请你统计并返回图像中 黑色 孤独像素的数量。
黑色孤独像素 的定义为:如果黑色像素 'B' 所在的同一行和同一列不存在其他黑色像素,那么这个黑色像素就是黑色孤独像素。
示例 1:
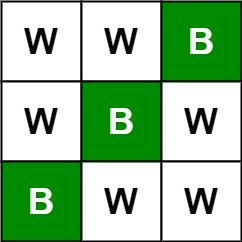
输入:picture = [["W","W","B"],["W","B","W"],["B","W","W"]]
输出:3
解释:全部三个 'B' 都是黑色的孤独像素
示例 2:
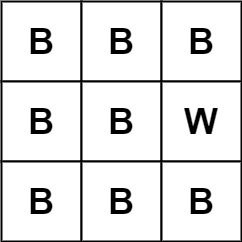
输入:picture = [["B","B","B"],["B","B","W"],["B","B","B"]]
输出:0
提示:
m == picture.lengthn == picture[i].length1 <= m, n <= 500picture[i][j]为'W'或'B'
方法一:计数 + 枚举 · Go 实现
思考
孤独黑像素要求其所在行、列都只有这一个
B。对每个B再扫一行一列是 ,偏慢。先统计每行每列的
B个数,再扫一遍:若格子是B且行列计数均为 ,则计入答案。两遍扫描,时间为 。
根据题目描述,我们需要统计每一行和每一列的黑色像素数量,分别记录在数组 和 中。然后我们遍历每一个黑色像素,检查其所在的行和列是否只有一个黑色像素,如果是则将答案加一。
时间复杂度 ,空间复杂度 。其中 和 分别是矩阵的行数和列数。
func findLonelyPixel(picture [][]byte) (ans int) {
	rows := make([]int, len(picture))
	cols := make([]int, len(picture[0]))
	for i, row := range picture {
		for j, x := range row {
			if x == 'B' {
				rows[i]++
				cols[j]++
			}
		}
	}
	for i, row := range picture {
		for j, x := range row {
			if x == 'B' && rows[i] == 1 && cols[j] == 1 {
				ans++
			}
		}
	}
	return
}533. 孤独像素 II 🔒
题目、示例与约束
给你一个大小为 m x n 的二维字符数组 picture ,表示一张黑白图像,数组中的 'B' 表示黑色像素,'W' 表示白色像素。另给你一个整数 target ,请你找出并返回符合规则的 黑色 孤独像素的数量。
黑色孤独像素是指位于某一特定位置 (r, c) 的字符 'B' ,其中:
- 行
r和列c中的黑色像素恰好有target个。 - 列
c中所有黑色像素所在的行必须和行r完全相同。
示例 1:

输入:picture = [["W","B","W","B","B","W"],["W","B","W","B","B","W"],["W","B","W","B","B","W"],["W","W","B","W","B","W"]], target = 3
输出:6
解释:所有绿色的 'B' 都是我们所求的像素(第 1 列和第 3 列的所有 'B' )
以行 r = 0 和列 c = 1 的 'B' 为例:
- 规则 1 ,行 r = 0 和列 c = 1 都恰好有 target = 3 个黑色像素
- 规则 2 ,列 c = 1 的黑色像素分别位于行 0,行 1 和行 2。和行 r = 0 完全相同。
示例 2:

输入:picture = [["W","W","B"],["W","W","B"],["W","W","B"]], target = 1
输出:0
提示:
m == picture.lengthn == picture[i].length1 <= m, n <= 200picture[i][j]为'W'或'B'1 <= target <= min(m, n)
方法一:计数 · Go 实现
思考
除行、列恰有 个
B外,还要求该列上每个B所在行的图案完全相同。逐列再比所有行会重复扫描。先统计每行黑点数,并按列记录出现
B的行号。对一列,取其中一个行模板:若该列的行数等于模板的黑点数 ,且这些行与模板逐格相同,则这一列贡献 个像素。行相等用整行比较,避免逐格重写。
题目中条件二相当于要求对于每一列中所有包含黑色像素的行,这些行完全相同。
因此,我们可以用一个邻接表 来存储每一列中所有包含黑色像素的行,即 表示第 列中所有包含黑色像素的行的集合。另外,用一个数组 来存储每一行中黑色像素的数量。
接下来,我们遍历每一列,对于每一列,我们找到第一个包含黑色像素的行 ,如果这一行中黑色像素的数量不等于 ,那么这一列不可能包含孤独像素,直接跳过。否则,我们检查这一列中所有包含黑色像素的行是否和第 行完全相同,如果是,则这一列中所有的黑色像素都是孤独像素,答案加上 。
遍历结束后,返回答案即可。
时间复杂度 ,空间复杂度 。其中 和 分别是矩阵的行数和列数。
func findBlackPixel(picture [][]byte, target int) (ans int) {
	m := len(picture)
	n := len(picture[0])
	g := make([][]int, n)
	rows := make([]int, m)
	for i, row := range picture {
		for j, x := range row {
			if x == 'B' {
				rows[i]++
				g[j] = append(g[j], i)
			}
		}
	}
	for j := 0; j < n; j++ {
		if len(g[j]) == 0 || rows[g[j][0]] != target {
			continue
		}
		i1 := g[j][0]
		ok := 0
		if len(g[j]) == rows[i1] {
			ok = target
			for _, i2 := range g[j] {
				if !bytes.Equal(picture[i1], picture[i2]) {
					ok = 0
					break
				}
			}
		}
		ans += ok
	}
	return
}554. 砖墙
题目、示例与约束
你的面前有一堵矩形的、由 n 行砖块组成的砖墙。这些砖块高度相同(也就是一个单位高)但是宽度不同。每一行砖块的宽度之和相等。
你现在要画一条 自顶向下 的、穿过 最少 砖块的垂线。如果你画的线只是从砖块的边缘经过,就不算穿过这块砖。你不能沿着墙的两个垂直边缘之一画线,这样显然是没有穿过一块砖的。
给你一个二维数组 wall ,该数组包含这堵墙的相关信息。其中,wall[i] 是一个代表从左至右每块砖的宽度的数组。你需要找出怎样画才能使这条线 穿过的砖块数量最少 ,并且返回 穿过的砖块数量 。
示例 1:
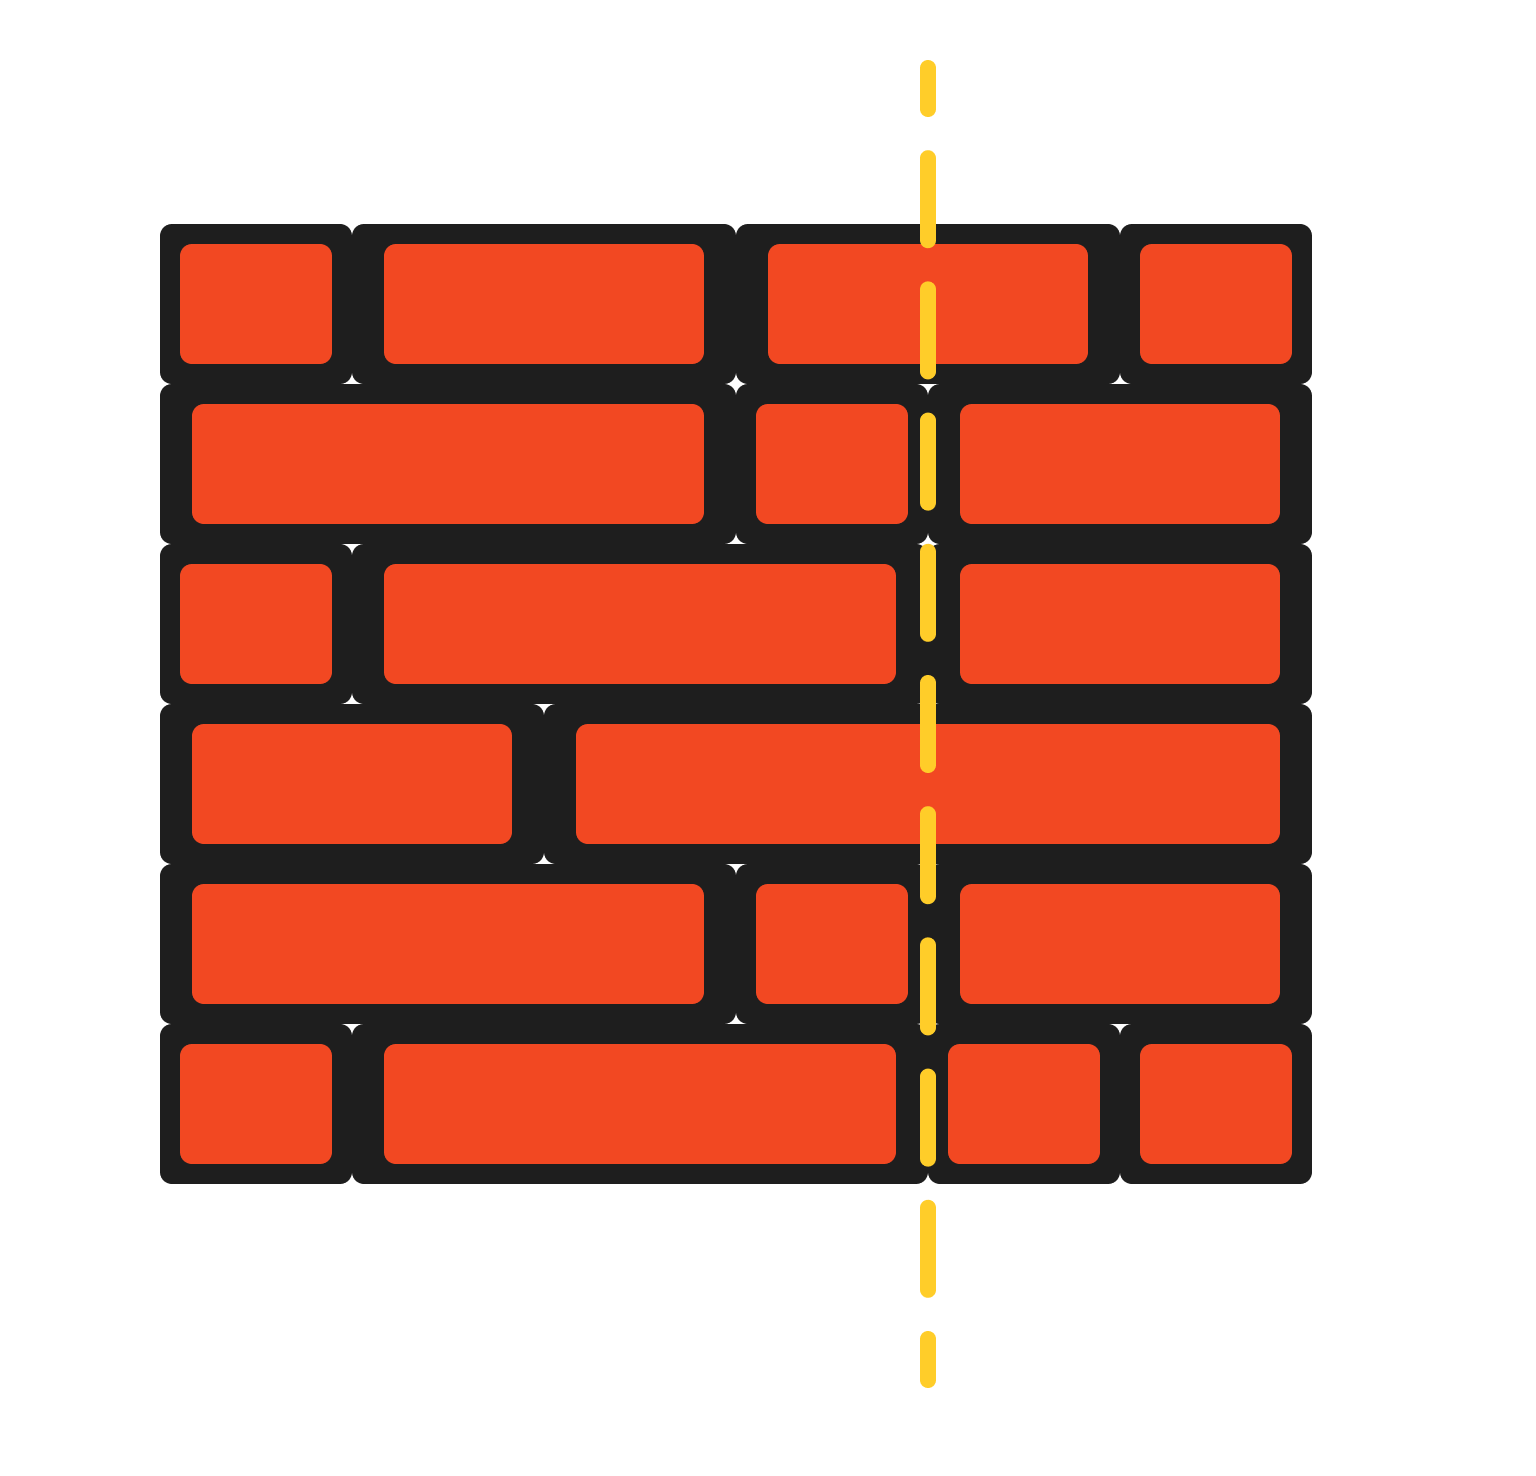
输入:wall = [[1,2,2,1],[3,1,2],[1,3,2],[2,4],[3,1,2],[1,3,1,1]]
输出:2
示例 2:
输入:wall = [[1],[1],[1]]
输出:3
提示:
n == wall.length1 <= n <= 1041 <= wall[i].length <= 1041 <= sum(wall[i].length) <= 2 * 104- 对于每一行
i,sum(wall[i])是相同的 1 <= wall[i][j] <= 231 - 1
方法一:哈希表 + 前缀和 · Go 实现
思考
穿过整面墙,不穿过砖的内部时,穿过的砖数 = 行数 该缝对齐的行数。枚举每条竖直缝再数行,会重复计算。
对各行(不含最后一块砖)做前缀和,哈希统计每个缝位置出现的次数。出现最多的缝穿过的砖最少,答案为行数减该次数。墙边缘不计入,否则穿过 块砖,题目不允许。缝的位置是若干砖宽之和,宽度可达 ,前缀和会超过 。Java 与 C++ 用 64 位整数累加;32 位求和会把相差 的两条缝记成同一个键。
我们可以用一个哈希表 记录每一行除了最后一个砖块以外的前缀和,其中键为前缀和的值,值为该前缀和出现的次数。
遍历每一行,对于当前行的每一个砖块,我们将其加到当前的前缀和上,然后更新 。
最后我们遍历 ,找出出现次数最多的前缀和,这就是穿过的砖块数量最少的情况。最后答案即为砖墙的行数减去穿过的砖块数量。
时间复杂度 ,空间复杂度 。其中 和 分别是砖墙的行数和砖墙的砖块数。
func leastBricks(wall [][]int) int {
	cnt := map[int]int{}
	for _, row := range wall {
		s := 0
		for _, x := range row[:len(row)-1] {
			s += x
			cnt[s]++
		}
	}
	mx := 0
	for _, x := range cnt {
		mx = max(mx, x)
	}
	return len(wall) - mx
}575. 分糖果
题目、示例与约束
Alice 有 n 枚糖,其中第 i 枚糖的类型为 candyType[i] 。Alice 注意到她的体重正在增长,所以前去拜访了一位医生。
医生建议 Alice 要少摄入糖分,只吃掉她所有糖的 n / 2 即可(n 是一个偶数)。Alice 非常喜欢这些糖,她想要在遵循医生建议的情况下,尽可能吃到最多不同种类的糖。
给你一个长度为 n 的整数数组 candyType ,返回: Alice 在仅吃掉 n / 2 枚糖的情况下,可以吃到糖的 最多 种类数。
示例 1:
输入:candyType = [1,1,2,2,3,3]
输出:3
解释:Alice 只能吃 6 / 2 = 3 枚糖,由于只有 3 种糖,她可以每种吃一枚。
示例 2:
输入:candyType = [1,1,2,3]
输出:2
解释:Alice 只能吃 4 / 2 = 2 枚糖,不管她选择吃的种类是 [1,2]、[1,3] 还是 [2,3],她只能吃到两种不同类的糖。
示例 3:
输入:candyType = [6,6,6,6]
输出:1
解释:Alice 只能吃 4 / 2 = 2 枚糖,尽管她能吃 2 枚,但只能吃到 1 种糖。
提示:
n == candyType.length2 <= n <= 104n是一个偶数-105 <= candyType[i] <= 105
方法一:哈希表 · Go 实现
思考
Alice 只能拿一半糖果,希望种类尽量多。种类数超过 时,多出来的种类也拿不到。
用集合(或哈希表)统计不同种类数,答案为 。不必真正模拟分配。
我们用一个哈希表来存储糖果的种类,如果糖果的种类数小于 ,那么 Alice 最多可以吃到的糖果种类数就是糖果的种类数;否则,Alice 最多可以吃到的糖果种类数就是 。
时间复杂度 ,空间复杂度 。其中 为糖果的数量。
func distributeCandies(candyType []int) int {
	s := hashset.New()
	for _, c := range candyType {
		s.Add(c)
	}
	return min(len(candyType)>>1, s.Size())
}599. 两个列表的最小索引总和
题目、示例与约束
给定两个字符串数组 list1 和 list2,找到 索引和最小的公共字符串。
公共字符串 是同时出现在 list1 和 list2 中的字符串。
具有 最小索引和的公共字符串 是指,如果它在 list1[i] 和 list2[j] 中出现,那么 i + j 应该是所有其他 公共字符串 中的最小值。
返回所有 具有最小索引和的公共字符串。以 任何顺序 返回答案。
示例 1:
输入: list1 = ["Shogun", "Tapioca Express", "Burger King", "KFC"],list2 = ["Piatti", "The Grill at Torrey Pines", "Hungry Hunter Steakhouse", "Shogun"]
输出: ["Shogun"]
解释: 唯一的公共字符串是 “Shogun”。
示例 2:
输入:list1 = ["Shogun", "Tapioca Express", "Burger King", "KFC"],list2 = ["KFC", "Shogun", "Burger King"]
输出: ["Shogun"]
解释: 具有最小索引和的公共字符串是 “Shogun”,它有最小的索引和 = (0 + 1) = 1。
示例 3:
输入:list1 = ["happy","sad","good"], list2 = ["sad","happy","good"]
输出:["sad","happy"]
解释:有三个公共字符串:
"happy" 索引和 = (0 + 1) = 1.
"sad" 索引和 = (1 + 0) = 1.
"good" 索引和 = (2 + 2) = 4.
最小索引和的字符串是 "sad" 和 "happy"。
提示:
1 <= list1.length, list2.length <= 10001 <= list1[i].length, list2[i].length <= 30list1[i]和list2[i]由空格' '和英文字母组成。list1的所有字符串都是 唯一 的。list2中的所有字符串都是 唯一 的。
方法一:哈希表 · Go 实现
思考
两列表的共同字符串中,下标和最小的全部留下。对每个共同串扫描另一表求下标是 。
把
list2做成「字符串 → 下标」哈希表,扫list1时查表得到下标和。维护当前最小和,相等则追加,更小则重置答案。一次哈希后线性扫描。
我们用一个哈希表 记录 中的字符串和它们的下标,用一个变量 记录最小的下标和。
然后遍历 ,对于每个字符串 ,如果 在 中出现,那么我们计算 在 中的下标 和在 中的下标 ,如果 ,我们就更新答案数组 为 ,并且更新 为 ;如果 ,我们就将 加入答案数组 。
遍历结束后,返回答案数组 即可。
func findRestaurant(list1 []string, list2 []string) []string {
	d := map[string]int{}
	for i, s := range list2 {
		d[s] = i
	}
	ans := []string{}
	mi := 1 << 30
	for i, s := range list1 {
		if j, ok := d[s]; ok {
			if i+j < mi {
				mi = i + j
				ans = []string{s}
			} else if i+j == mi {
				ans = append(ans, s)
			}
		}
	}
	return ans
}609. 在系统中查找重复文件
题目、示例与约束
给你一个目录信息列表 paths ,包括目录路径,以及该目录中的所有文件及其内容,请你按路径返回文件系统中的所有重复文件。答案可按 任意顺序 返回。
一组重复的文件至少包括 两个 具有完全相同内容的文件。
输入 列表中的单个目录信息字符串的格式如下:
"root/d1/d2/.../dm f1.txt(f1_content) f2.txt(f2_content) ... fn.txt(fn_content)"
这意味着,在目录 root/d1/d2/.../dm 下,有 n 个文件 ( f1.txt, f2.txt ... fn.txt ) 的内容分别是 ( f1_content, f2_content ... fn_content ) 。注意:n >= 1 且 m >= 0 。如果 m = 0 ,则表示该目录是根目录。
输出 是由 重复文件路径组 构成的列表。其中每个组由所有具有相同内容文件的文件路径组成。文件路径是具有下列格式的字符串:
"directory_path/file_name.txt"
示例 1:
输入:paths = ["root/a 1.txt(abcd) 2.txt(efgh)","root/c 3.txt(abcd)","root/c/d 4.txt(efgh)","root 4.txt(efgh)"]
输出:[["root/a/2.txt","root/c/d/4.txt","root/4.txt"],["root/a/1.txt","root/c/3.txt"]]
示例 2:
输入:paths = ["root/a 1.txt(abcd) 2.txt(efgh)","root/c 3.txt(abcd)","root/c/d 4.txt(efgh)"]
输出:[["root/a/2.txt","root/c/d/4.txt"],["root/a/1.txt","root/c/3.txt"]]
提示:
1 <= paths.length <= 2 * 1041 <= paths[i].length <= 30001 <= sum(paths[i].length) <= 5 * 105paths[i]由英文字母、数字、字符'/'、'.'、'('、')'和' '组成- 你可以假设在同一目录中没有任何文件或目录共享相同的名称。
- 你可以假设每个给定的目录信息代表一个唯一的目录。目录路径和文件信息用单个空格分隔。
进阶:
- 假设您有一个真正的文件系统,您将如何搜索文件?广度搜索还是宽度搜索?
- 如果文件内容非常大(GB级别),您将如何修改您的解决方案?
- 如果每次只能读取 1 kb 的文件,您将如何修改解决方案?
- 修改后的解决方案的时间复杂度是多少?其中最耗时的部分和消耗内存的部分是什么?如何优化?
- 如何确保您发现的重复文件不是误报?
方法一:哈希表 · Go 实现
思考
重复由文件内容相等定义,路径格式把目录和「文件名(内容)」挤在同一字符串里。两两比较内容在路径数较大时代价过高。
按空格拆目录与文件,再按括号切开文件名与内容,以内容为键收集路径。长度大于 的桶即重复组。
我们创建一个哈希表 ,其中键是文件内容,值是具有相同内容的文件路径列表。
接下来,我们遍历 ,对于每个路径,我们将其分割成目录路径和文件信息。对于每个文件信息,我们提取出文件名和文件内容,并将文件路径添加到哈希表 中对应文件内容的列表中。
最后,我们返回哈希表 中所有具有多个文件路径的值。
时间复杂度为 ,空间复杂度为 ,其中 是 的长度。
func findDuplicate(paths []string) [][]string {
	d := map[string][]string{}
	for _, p := range paths {
		ps := strings.Split(p, " ")
		for i := 1; i < len(ps); i++ {
			j := strings.IndexByte(ps[i], '(')
			content := ps[i][j+1 : len(ps[i])-1]
			name := ps[0] + "/" + ps[i][:j]
			d[content] = append(d[content], name)
		}
	}
	ans := [][]string{}
	for _, e := range d {
		if len(e) > 1 {
			ans = append(ans, e)
		}
	}
	return ans
}697. 数组的度
题目、示例与约束
给定一个非空且只包含非负数的整数数组 nums,数组的 度 的定义是指数组里任一元素出现频数的最大值。
你的任务是在 nums 中找到与 nums 拥有相同大小的度的最短连续子数组,返回其长度。
示例 1:
输入:nums = [1,2,2,3,1]
输出:2
解释:
输入数组的度是 2 ,因为元素 1 和 2 的出现频数最大,均为 2 。
连续子数组里面拥有相同度的有如下所示:
[1, 2, 2, 3, 1], [1, 2, 2, 3], [2, 2, 3, 1], [1, 2, 2], [2, 2, 3], [2, 2]
最短连续子数组 [2, 2] 的长度为 2 ,所以返回 2 。
示例 2:
输入:nums = [1,2,2,3,1,4,2]
输出:6
解释:
数组的度是 3 ,因为元素 2 重复出现 3 次。
所以 [2,2,3,1,4,2] 是最短子数组,因此返回 6 。
提示:
nums.length在1到50,000范围内。nums[i]是一个在0到49,999范围内的整数。
方法一:哈希表 · Go 实现
思考
数组的度是众数出现次数,要最短子数组保持同一度。该子数组必须覆盖某个众数的首次与末次出现。
计数得度,再记每个值的左右端点。只对达到度的值算 ,取最小。
遍历数组,用哈希表记录数组每个元素出现的次数,以及首次、末次出现的位置。然后遍历哈希表,获取元素出现次数最多(可能有多个)且首末位置差最小的数。
时间复杂度 ,空间复杂度 。其中 为数组长度。
func findShortestSubArray(nums []int) int {
	cnt := map[int]int{}
	left := map[int]int{}
	right := map[int]int{}
	var degree int
	for i, v := range nums {
		cnt[v]++
		if degree < cnt[v] {
			degree = cnt[v]
		}
		if _, ok := left[v]; !ok {
			left[v] = i
		}
		right[v] = i
	}
	ans := 100000
	for v, c := range cnt {
		if c == degree {
			t := right[v] - left[v] + 1
			if ans > t {
				ans = t
			}
		}
	}
	return ans
}
方法二 · Go 实现
思考
方法一一次遍历同时记下左右端。也可先求出度与众数集合,再对每个众数单独扫首末下标。实现拆成若干辅助函数,复杂度同阶。
func findShortestSubArray(nums []int) (ans int) {
	ans = 50000
	numsMap := make(map[int]int, len(nums))
	for _, num := range nums {
		numsMap[num]++
	}
	var maxDegree int
	for _, num := range numsMap {
		maxDegree = max(num, maxDegree)
	}
	degreeNums := getMaxDegreeElem(maxDegree, numsMap)
	for _, num := range degreeNums {
		f := findSubArray(num, nums)
		ans = min(ans, f)
	}
	return
}

func findSubArray(target int, nums []int) int {
	start := getStartIdx(target, nums)
	end := getEndIdx(target, nums)
	return (end - start) + 1
}

func getStartIdx(target int, nums []int) (start int) {
	for idx, num := range nums {
		if num == target {
			start = idx
			break
		}
	}
	return start
}

func getEndIdx(target int, nums []int) (end int) {
	for i := len(nums) - 1; i > 0; i-- {
		if nums[i] == target {
			end = i
			break
		}
	}
	return
}

func getMaxDegreeElem(maxDegree int, numsMap map[int]int) []int {
	var ans []int
	for key, value := range numsMap {
		if value == maxDegree {
			ans = append(ans, key)
		}
	}
	return ans
}734. 句子相似性 🔒
题目、示例与约束
我们可以将一个句子表示为一个单词数组,例如,句子 "I am happy with leetcode" 可以表示为 arr = ["I","am",happy","with","leetcode"]
给定两个句子 sentence1 和 sentence2 分别表示为一个字符串数组,并给定一个字符串对 similarPairs ,其中 similarPairs[i] = [xi, yi] 表示两个单词 xi and yi 是相似的。
如果 sentence1 和 sentence2 相似则返回 true ,如果不相似则返回 false 。
两个句子是相似的,如果:
- 它们具有 相同的长度 (即相同的字数)
sentence1[i]和sentence2[i]是相似的
请注意,一个词总是与它自己相似,也请注意,相似关系是不可传递的。例如,如果单词 a 和 b 是相似的,单词 b 和 c 也是相似的,那么 a 和 c 不一定相似 。
示例 1:
输入: sentence1 = ["great","acting","skills"], sentence2 = ["fine","drama","talent"], similarPairs = [["great","fine"],["drama","acting"],["skills","talent"]]
输出: true
解释: 这两个句子长度相同,每个单词都相似。
示例 2:
输入: sentence1 = ["great"], sentence2 = ["great"], similarPairs = []
输出: true
解释: 一个单词和它本身相似。
示例 3:
输入: sentence1 = ["great"], sentence2 = ["doubleplus","good"], similarPairs = [["great","doubleplus"]]
输出: false
解释: 因为它们长度不同,所以返回false。
提示:
1 <= sentence1.length, sentence2.length <= 10001 <= sentence1[i].length, sentence2[i].length <= 20sentence1[i]和sentence2[i]只包含大小写英文字母0 <= similarPairs.length <= 2000similarPairs[i].length == 21 <= xi.length, yi.length <= 20- 所有对
(xi, yi)都是 不同 的
方法一:哈希表 · Go 实现
思考
两句等长时,对应位置要么相同,要么是给定的相似对。相似关系不传递。线性扫一遍即可,需要快速判断一对词是否相似。
把 放进集合,查询为 。对无序对要同时存放两种顺序,或查询时试两个方向。
长度不同直接否;否则逐位比较,既不相同也不在集合中则失败。
我们首先判断 和 的长度是否相等,如果不相等则返回 。
然后我们使用一个哈希表 来存储所有相似的单词对,对于 中的每一个单词对 ,我们将 和 加入到哈希表 中。
接下来我们遍历 和 ,对于每一个位置 ,如果 不等于 ,并且 和 都不在哈希表 中,那么返回 。
如果遍历结束后都没有返回 ,说明 和 是相似的,返回 。
时间复杂度 ,空间复杂度 ,其中 为题目中所有字符串的长度之和。
func areSentencesSimilar(sentence1 []string, sentence2 []string, similarPairs [][]string) bool {
	if len(sentence1) != len(sentence2) {
		return false
	}
	s := map[string]bool{}
	for _, p := range similarPairs {
		s[p[0]+"#"+p[1]] = true
	}
	for i, x := range sentence1 {
		y := sentence2[i]
		if x != y && !s[x+"#"+y] && !s[y+"#"+x] {
			return false
		}
	}
	return true
}748. 最短补全词
题目、示例与约束
给你一个字符串 licensePlate 和一个字符串数组 words ,请你找出 words 中的 最短补全词 。
补全词 是一个包含 licensePlate 中所有字母的单词。忽略 licensePlate 中的 数字和空格 。不区分大小写。如果某个字母在 licensePlate 中出现不止一次,那么该字母在补全词中的出现次数应当一致或者更多。
例如:licensePlate = "aBc 12c",那么它的补全词应当包含字母 'a'、'b' (忽略大写)和两个 'c' 。可能的 补全词 有 "abccdef"、"caaacab" 以及 "cbca" 。
请返回 words 中的 最短补全词 。题目数据保证一定存在一个最短补全词。当有多个单词都符合最短补全词的匹配条件时取 words 中 第一个 出现的那个。
示例 1:
输入:licensePlate = "1s3 PSt", words = ["step", "steps", "stripe", "stepple"]
输出:"steps"
解释:最短补全词应该包括 "s"、"p"、"s"(忽略大小写) 以及 "t"。
"step" 包含 "t"、"p",但只包含一个 "s",所以它不符合条件。
"steps" 包含 "t"、"p" 和两个 "s"。
"stripe" 缺一个 "s"。
"stepple" 缺一个 "s"。
因此,"steps" 是唯一一个包含所有字母的单词,也是本例的答案。
示例 2:
输入:licensePlate = "1s3 456", words = ["looks", "pest", "stew", "show"]
输出:"pest"
解释:licensePlate 只包含字母 "s" 。所有的单词都包含字母 "s" ,其中 "pest"、"stew"、和 "show" 三者最短。答案是 "pest" ,因为它是三个单词中在 words 里最靠前的那个。
提示:
1 <= licensePlate.length <= 7licensePlate由数字、大小写字母或空格' '组成1 <= words.length <= 10001 <= words[i].length <= 15words[i]由小写英文字母组成
方法一:计数 · Go 实现
思考
单词需覆盖车牌中的字母(忽略大小写与非字母),并在满足条件者中取最短、先出现的。词数 、词长短,计数比较即可。
先统计车牌字母频次,再扫单词:更长或同样长的跳过(以保留更早的最短词),再用计数判断是否覆盖。
字母表大小为 ,单次判断线性于词长。
我们先用哈希表或者一个长度为 的数组 统计字符串 licensePlate 中每个字母出现的次数,注意这里我们统一将字母转换为小写进行计数。
然后,我们遍历数组 words 中的每个单词 ,如果单词 的长度比答案 的长度长,那么我们直接跳过该单词。否则,我们再用哈希表或者一个长度为 的数组 统计单词 中每个字母出现的次数。如果对于任意一个字母, 中该字母出现的次数小于 中该字母出现的次数,那么我们也可以直接跳过该单词。否则,我们就找到了一个满足条件的单词,我们更新答案 为当前单词 。
时间复杂度 ,空间复杂度 ,其中 是数组 words 的长度,而 是字符集,这里字符集为所有小写字母,因此 。
func shortestCompletingWord(licensePlate string, words []string) (ans string) {
	cnt := [26]int{}
	for _, c := range licensePlate {
		if unicode.IsLetter(c) {
			cnt[unicode.ToLower(c)-'a']++
		}
	}
	for _, w := range words {
		if len(ans) > 0 && len(ans) <= len(w) {
			continue
		}
		t := [26]int{}
		for _, c := range w {
			t[c-'a']++
		}
		ok := true
		for i, v := range cnt {
			if t[i] < v {
				ok = false
				break
			}
		}
		if ok {
			ans = w
		}
	}
	return
}760. 找出变位映射 🔒
题目、示例与约束
给你两个整数数组 nums1 和 nums2,其中 nums2 是 nums1 的一个 变位词 。两个数组都可能包含重复元素。
返回一个下标映射数组 mapping,它将 nums1 映射到 nums2,其中 mapping[i] = j 表示 nums1 中的第 i 个元素出现在 nums2 的第 j 个下标上。如果有多个答案,返回 任意一个 。
数组 a 是数组 b 的一个 变位词 意味着 b 是通过将 a 中元素的顺序随机打乱生成的。
示例 1:
输入:nums1 = [12,28,46,32,50], nums2 = [50,12,32,46,28]
输出:[1,4,3,2,0]
解释:因为 nums1 中的第 0 个元素出现在 nums2[1] 上,所以 mapping[0] = 1,而 nums1 中的第 1 个元素出现在 nums2[4] 上,所以 mapping[1] = 4,以此类推。
示例 2:
输入:nums1 = [84,46], nums2 = [84,46]
输出:[0,1]
提示:
1 <= nums1.length <= 100nums2.length == nums1.length0 <= nums1[i], nums2[i] <= 105nums2是nums1的一个变位词。
方法一:哈希表 · Go 实现
思考
两数组互为变位词,求 各元素在 中的一个下标。长度 ,对每个值扫描也可以,哈希一次即可 。
先记下 中每个值的下标(后者覆盖前者即可),再按 取值。题目允许任意合法映射。
我们用一个哈希表 来存储数组 中每个元素及其对应的下标。然后我们遍历数组 ,对于每个元素 ,我们从哈希表 中获取其对应的下标并存入结果数组中。
时间复杂度 ,空间复杂度 ,其中 是数组的长度。
func anagramMappings(nums1 []int, nums2 []int) []int {
	d := map[int]int{}
	for i, x := range nums2 {
		d[x] = i
	}
	ans := make([]int, len(nums1))
	for i, x := range nums1 {
		ans[i] = d[x]
	}
	return ans
}771. 宝石与石头
题目、示例与约束
给你一个字符串 jewels 代表石头中宝石的类型,另有一个字符串 stones 代表你拥有的石头。 stones 中每个字符代表了一种你拥有的石头的类型,你想知道你拥有的石头中有多少是宝石。
字母区分大小写,因此 "a" 和 "A" 是不同类型的石头。
示例 1:
输入:jewels = "aA", stones = "aAAbbbb"
输出:3
示例 2:
输入:jewels = "z", stones = "ZZ"
输出:0
提示:
1 <= jewels.length, stones.length <= 50jewels和stones仅由英文字母组成jewels中的所有字符都是 唯一的
方法一:哈希表或数组 · Go 实现
思考
统计石头里有多少属于宝石。长度 ,把宝石放进集合后对每块石头查询。大小写视为不同。
我们可以先用一个哈希表或数组 记录所有宝石的类型。然后遍历所有石头,如果当前石头是宝石,就将答案加一。
时间复杂度 ,空间复杂度 ,其中 和 分别是字符串 和 的长度,而 是字符集,本题中字符集为所有大小写英文字母的集合。
func numJewelsInStones(jewels string, stones string) (ans int) {
	s := [128]int{}
	for _, c := range jewels {
		s[c] = 1
	}
	for _, c := range stones {
		ans += s[c]
	}
	return
}继续阅读
- 实践案例
- 实践案例
- 实践案例