
LeetCode Go · 图与最短路径(4)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
2646. 最小化旅行的价格总和
题目、示例与约束
现有一棵无向、无根的树,树中有 n 个节点,按从 0 到 n - 1 编号。给你一个整数 n 和一个长度为 n - 1 的二维整数数组 edges ,其中 edges[i] = [ai, bi] 表示树中节点 ai 和 bi 之间存在一条边。
每个节点都关联一个价格。给你一个整数数组 price ,其中 price[i] 是第 i 个节点的价格。
给定路径的 价格总和 是该路径上所有节点的价格之和。
另给你一个二维整数数组 trips ,其中 trips[i] = [starti, endi] 表示您从节点 starti 开始第 i 次旅行,并通过任何你喜欢的路径前往节点 endi 。
在执行第一次旅行之前,你可以选择一些 非相邻节点 并将价格减半。
返回执行所有旅行的最小价格总和。
示例 1:
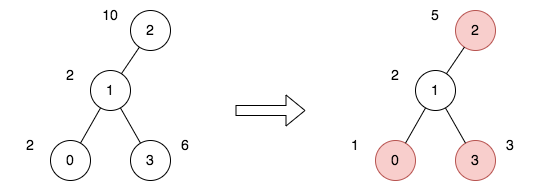
输入:n = 4, edges = [[0,1],[1,2],[1,3]], price = [2,2,10,6], trips = [[0,3],[2,1],[2,3]]
输出:23
解释:
上图表示将节点 2 视为根之后的树结构。第一个图表示初始树,第二个图表示选择节点 0 、2 和 3 并使其价格减半后的树。
第 1 次旅行,选择路径 [0,1,3] 。路径的价格总和为 1 + 2 + 3 = 6 。
第 2 次旅行,选择路径 [2,1] 。路径的价格总和为 2 + 5 = 7 。
第 3 次旅行,选择路径 [2,1,3] 。路径的价格总和为 5 + 2 + 3 = 10 。
所有旅行的价格总和为 6 + 7 + 10 = 23 。可以证明,23 是可以实现的最小答案。
示例 2:
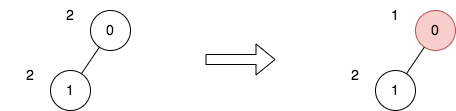
输入:n = 2, edges = [[0,1]], price = [2,2], trips = [[0,0]]
输出:1
解释:
上图表示将节点 0 视为根之后的树结构。第一个图表示初始树,第二个图表示选择节点 0 并使其价格减半后的树。
第 1 次旅行,选择路径 [0] 。路径的价格总和为 1 。
所有旅行的价格总和为 1 。可以证明,1 是可以实现的最小答案。
提示:
1 <= n <= 50edges.length == n - 10 <= ai, bi <= n - 1edges表示一棵有效的树price.length == nprice[i]是一个偶数1 <= price[i] <= 10001 <= trips.length <= 1000 <= starti, endi <= n - 1
方法一:树形 DP · Go 实现
思考
每条旅行路径上的点计价,相邻点不能同时半价。先枚举路径再搜索半价集合, 且旅行次数 ,路径统计可接受,半价方案则需树上 DP。
先对每条旅行做 DFS,把经过次数记入 。再做树形 DP:节点不半价时子节点任选较优,节点半价时子节点必须原价。根上取两种决策的较小者。
我们可以统计每一次旅行经过的节点,记录在数组 中,其中 表示所有旅行中经过节点 的次数。我们设计一个函数 ,表示从节点 开始搜索,最终到达节点 ,过程中记录所有经过的节点。其中 表示节点 的父节点。
接下来,我们再设计一个函数 ,表示从节点 开始搜索,返回将节点 的价格不减半或者减半后的最小价格总和。其中 表示节点 的父节点。
我们从节点 开始,对于每一个节点 ,我们可以选择不将其价格减半,也可以选择将其价格减半,分别记为 , 。
对于节点 的所有邻接节点 ,我们依然可以选择不将其价格减半,也可以选择将其价格减半,那么 。如果节点 价格不减半,那么节点 价格可以不减半,也可以减半,因此 ;如果节点 价格减半,那么节点 价格必须不减半,因此 。
最后,函数 的返回值为 。
在主函数中,我们调用函数 ,返回值为 ,那么最终的答案即为 。
时间复杂度 ,空间复杂度 。其中 和 分别为旅行次数以及节点数。
func minimumTotalPrice(n int, edges [][]int, price []int, trips [][]int) int {
	g := make([][]int, n)
	for _, e := range edges {
		a, b := e[0], e[1]
		g[a] = append(g[a], b)
		g[b] = append(g[b], a)
	}
	cnt := make([]int, n)
	var dfs func(int, int, int) bool
	dfs = func(i, fa, k int) bool {
		cnt[i]++
		if i == k {
			return true
		}
		ok := false
		for _, j := range g[i] {
			if j != fa {
				ok = dfs(j, i, k)
				if ok {
					break
				}
			}
		}
		if !ok {
			cnt[i]--
		}
		return ok
	}
	for _, t := range trips {
		start, end := t[0], t[1]
		dfs(start, -1, end)
	}
	var dfs2 func(int, int) (int, int)
	dfs2 = func(i, fa int) (int, int) {
		a := price[i] * cnt[i]
		b := a >> 1
		for _, j := range g[i] {
			if j != fa {
				x, y := dfs2(j, i)
				a += min(x, y)
				b += x
			}
		}
		return a, b
	}
	a, b := dfs2(0, -1)
	return min(a, b)
}2662. 前往目标的最小代价
题目、示例与约束
给你一个数组 start ,其中 start = [startX, startY] 表示你的初始位置位于二维空间上的 (startX, startY) 。另给你一个数组 target ,其中 target = [targetX, targetY] 表示你的目标位置 (targetX, targetY) 。
从位置 (x1, y1) 到空间中任一其他位置 (x2, y2) 的 代价 是 |x2 - x1| + |y2 - y1| 。
给你一个二维数组 specialRoads ,表示空间中存在的一些 特殊路径。其中 specialRoads[i] = [x1i, y1i, x2i, y2i, costi] 表示第 i 条特殊路径可以从 (x1i, y1i) 到 (x2i, y2i) ,但成本等于 costi 。你可以使用每条特殊路径任意次数。
返回从 (startX, startY) 到 (targetX, targetY) 所需的 最小 代价。
示例 1:
输入:start = [1,1], target = [4,5], specialRoads = [[1,2,3,3,2],[3,4,4,5,1]]
输出:5
解释:
- (1,1) 到 (1,2) 花费为 |1 - 1| + |2 - 1| = 1。
- (1,2) 到 (3,3)。使用
specialRoads[0]花费为 2。 - (3,3) 到 (3,4) 花费为 |3 - 3| + |4 - 3| = 1。
- (3,4) 到 (4,5)。使用
specialRoads[1]花费为 1。
所以总花费是 1 + 2 + 1 + 1 = 5。
示例 2:
输入:start = [3,2], target = [5,7], specialRoads = [[5,7,3,2,1],[3,2,3,4,4],[3,3,5,5,5],[3,4,5,6,6]]
输出:7
解释:
不使用任何特殊路径,直接从开始到结束位置是最优的,花费为 |5 - 3| + |7 - 2| = 7。
注意 specialRoads[0] 直接从 (5,7) 到 (3,2)。
示例 3:
输入:start = [1,1], target = [10,4], specialRoads = [[4,2,1,1,3],[1,2,7,4,4],[10,3,6,1,2],[6,1,1,2,3]]
输出:8
解释:
- (1,1) 到 (1,2) 花费为 |1 - 1| + |2 - 1| = 1。
- (1,2) 到 (7,4)。使用
specialRoads[1]花费为 4。 - (7,4) 到 (10,4) 花费为 |10 - 7| + |4 - 4| = 3。
提示:
start.length == target.length == 21 <= startX <= targetX <= 1051 <= startY <= targetY <= 1051 <= specialRoads.length <= 200specialRoads[i].length == 5startX <= x1i, x2i <= targetXstartY <= y1i, y2i <= targetY1 <= costi <= 105
方法一:Dijkstra · Go 实现
思考
平面上可按曼哈顿距离任意走,也可走给定特殊路。状态若取全部格点则无限。最优路径只需在起点、终点与特殊路端点之间转移。
从起点 Dijkstra:到达 后,既可直接付曼哈顿距离到终点,也可先走到某条特殊路入口再跳到其出口。访问过的点不再扩展。
特殊路数量 ,堆中状态可接受。
我们可以发现,对于访问到的每个坐标点 ,假设从起点到 的最小代价为 。如果选择直接移动到 ,那么总代价就是 。如果选择经过某条特殊路径 ,那么我们需要可以花费 的代价,从 移动到 。
因此,我们可以使用 Dijkstra 算法求出从起点到所有点的最小代价,然后从中选择最小的那个。
我们定义一个优先队列 ,队列中的每一个元素是一个三元组 ,表示从起点到 的最小代价为 。初始时,我们将 加入队列中。
在每一步中,我们取出队首元素 ,此时我们可以更新答案,即 。然后我们枚举所有的特殊路径 ,将 加入队列中。
最后当队列为空时,我们就可以得到答案。
时间复杂度 ,空间复杂度 。其中 是特殊路径的数量。
func minimumCost(start []int, target []int, specialRoads [][]int) int {
	ans := 1 << 30
	const n int = 1e6
	pq := hp{{0, start[0], start[1]}}
	vis := map[int]bool{}
	for len(pq) > 0 {
		p := pq[0]
		heap.Pop(&pq)
		d, x, y := p.d, p.x, p.y
		if vis[x*n+y] {
			continue
		}
		vis[x*n+y] = true
		ans = min(ans, d+dist(x, y, target[0], target[1]))
		for _, r := range specialRoads {
			x1, y1, x2, y2, cost := r[0], r[1], r[2], r[3], r[4]
			heap.Push(&pq, tuple{d + dist(x, y, x1, y1) + cost, x2, y2})
		}
	}
	return ans
}

func dist(x1, y1, x2, y2 int) int {
	return abs(x1-x2) + abs(y1-y2)
}

func abs(x int) int {
	if x < 0 {
		return -x
	}
	return x
}

type tuple struct {
	d, x, y int
}
type hp []tuple

func (h hp) Len() int           { return len(h) }
func (h hp) Less(i, j int) bool { return h[i].d < h[j].d }
func (h hp) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)        { *h = append(*h, v.(tuple)) }
func (h *hp) Pop() any { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }2699. 修改图中的边权
题目、示例与约束
给你一个 n 个节点的 无向带权连通 图,节点编号为 0 到 n - 1 ,再给你一个整数数组 edges ,其中 edges[i] = [ai, bi, wi] 表示节点 ai 和 bi 之间有一条边权为 wi 的边。
部分边的边权为 -1(wi = -1),其他边的边权都为 正 数(wi > 0)。
你需要将所有边权为 -1 的边都修改为范围 [1, 2 * 109] 中的 正整数 ,使得从节点 source 到节点 destination 的 最短距离 为整数 target 。如果有 多种 修改方案可以使 source 和 destination 之间的最短距离等于 target ,你可以返回任意一种方案。
如果存在使 source 到 destination 最短距离为 target 的方案,请你按任意顺序返回包含所有边的数组(包括未修改边权的边)。如果不存在这样的方案,请你返回一个 空数组 。
注意:你不能修改一开始边权为正数的边。
示例 1:
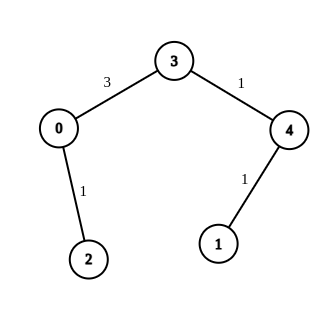
输入:n = 5, edges = [[4,1,-1],[2,0,-1],[0,3,-1],[4,3,-1]], source = 0, destination = 1, target = 5
输出:[[4,1,1],[2,0,1],[0,3,3],[4,3,1]]
解释:上图展示了一个满足题意的修改方案,从 0 到 1 的最短距离为 5 。
示例 2:
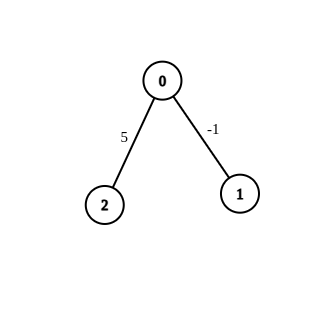
输入:n = 3, edges = [[0,1,-1],[0,2,5]], source = 0, destination = 2, target = 6
输出:[]
解释:上图是一开始的图。没有办法通过修改边权为 -1 的边,使得 0 到 2 的最短距离等于 6 ,所以返回一个空数组。
示例 3:
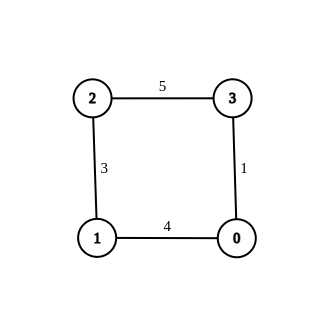
输入:n = 4, edges = [[1,0,4],[1,2,3],[2,3,5],[0,3,-1]], source = 0, destination = 2, target = 6
输出:[[1,0,4],[1,2,3],[2,3,5],[0,3,1]]
解释:上图展示了一个满足题意的修改方案,从 0 到 2 的最短距离为 6 。
提示:
1 <= n <= 1001 <= edges.length <= n * (n - 1) / 2edges[i].length == 30 <= ai, bi < nwi = -1或者1 <= wi <= 107ai != bi0 <= source, destination < nsource != destination1 <= target <= 109- 输入的图是连通图,且没有自环和重边。
方法一:最短路(Dijkstra 算法) · Go 实现
思考
要把 边改成正权,使 到 的最短路恰为 。乱改边权组合过多; 允许反复 Dijkstra。
先忽略 边:若已有正权最短路小于 ,无解;等于则把其余 边设成上限以免抄近路。大于则逐条把 边暂设为 再求最短路,一旦 就把该边补到恰好 ,其后的 边封顶。
全程仍短于目标则失败。
我们先不考虑边权为 的边,使用 Dijkstra 算法求出从 到 的最短距离 。
如果 ,说明存在一条完全由正权边组成的最短路径,此时无论我们如何修改边权为 的边,都无法使得 到 的最短距离等于 ,因此不存在满足题意的修改方案,返回一个空数组即可。
如果 ,说明存在一条完全由正权边组成的、长度为 的最短路径,此时我们可以将所有边权为 的边修改为最大值 即可。
如果 ,我们可以尝试往图中加入一条边权为 的边,将边权设置为 ,然后再次使用 Dijkstra 算法求出从 到 的最短距离 。
- 如果最短距离 ,说明加入这条边后,可以使得最短路变短,而且最短路也一定经过这条边,那么我们只需要将这条边的边权改为 ,就可以使得最短路等于 。然后我们将其余的边权为 的边修改为最大值 即可。
- 如果最短距离 ,说明加入这条边后,最短路不会变短,那么我们贪心地将这条边的边权保持为 ,然后继续尝试加入其余的边权为 的边。
时间复杂度 ,空间复杂度 。其中 是图中的点数。
func modifiedGraphEdges(n int, edges [][]int, source int, destination int, target int) [][]int {
	const inf int = 2e9
	dijkstra := func(edges [][]int) int {
		g := make([][]int, n)
		dist := make([]int, n)
		vis := make([]bool, n)
		for i := range g {
			g[i] = make([]int, n)
			for j := range g[i] {
				g[i][j] = inf
			}
			dist[i] = inf
		}
		dist[source] = 0
		for _, e := range edges {
			a, b, w := e[0], e[1], e[2]
			if w == -1 {
				continue
			}
			g[a][b], g[b][a] = w, w
		}
		for i := 0; i < n; i++ {
			k := -1
			for j := 0; j < n; j++ {
				if !vis[j] && (k == -1 || dist[j] < dist[k]) {
					k = j
				}
			}
			vis[k] = true
			for j := 0; j < n; j++ {
				dist[j] = min(dist[j], dist[k]+g[k][j])
			}
		}
		return dist[destination]
	}
	d := dijkstra(edges)
	if d < target {
		return [][]int{}
	}
	ok := d == target
	for _, e := range edges {
		if e[2] > 0 {
			continue
		}
		if ok {
			e[2] = inf
			continue
		}
		e[2] = 1
		d := dijkstra(edges)
		if d <= target {
			ok = true
			e[2] += target - d
		}
	}
	if ok {
		return edges
	}
	return [][]int{}
}2714. 找到 K 次跨越的最短路径 🔒
题目、示例与约束
现给定一个正整数 n ,它表示一个 索引从 0 开始的无向带权连接图 的节点数,以及一个 索引从 0 开始的二维数组 edges ,其中 edges[i] = [ui, vi, wi] 表示节点 ui 和 vi 之间存在权重为 wi 的边。
还给定两个节点 s 和 d ,以及一个正整数 k ,你的任务是找到从 s 到 d 的 最短 路径,但你可以 最多 跨越 k 条边。换句话说,将 最多 k 条边的权重设为 0,然后找到从 s 到 d 的 最短 路径。
返回满足给定条件的从 s 到 d 的 最短 路径的长度。
示例 1:
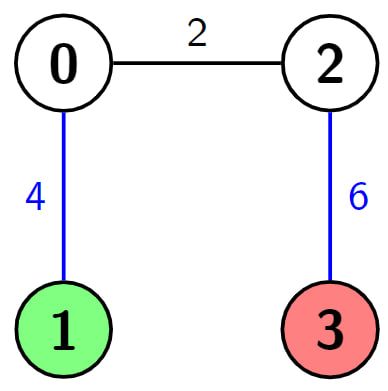
输入:n = 4, edges = [[0,1,4],[0,2,2],[2,3,6]], s = 1, d = 3, k = 2
输出:2
解释:在这个例子中,只有一条从节点1(绿色节点)到节点3(红色节点)的路径,即(1->0->2->3),其长度为4 + 2 + 6 = 12。现在我们可以将两条边的权重设为 0,即将蓝色边的权重设为 0,那么路径的长度就变为 0 + 2 + 0 = 2。可以证明 2 是我们在给定条件下能够达到的最小路径长度。
示例 2:
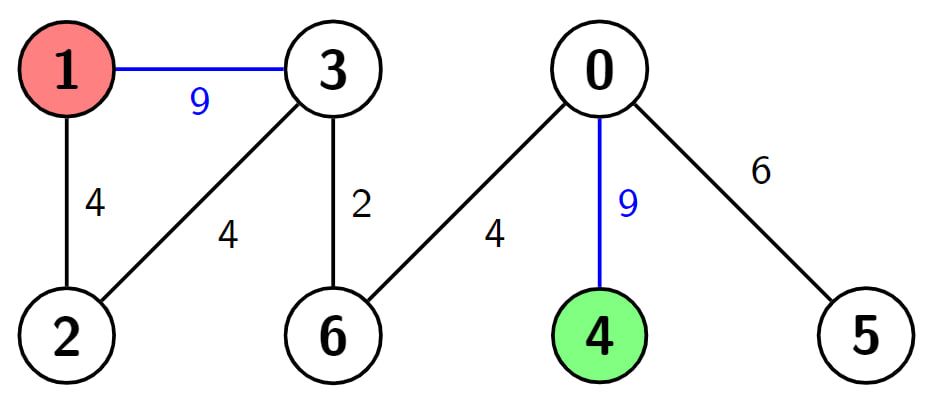
输入:n = 7, edges = [[3,1,9],[3,2,4],[4,0,9],[0,5,6],[3,6,2],[6,0,4],[1,2,4]], s = 4, d = 1, k = 2
输出:6
解释:在这个例子中,有两条从节点4(绿色节点)到节点1(红色节点)的路径,分别是(4->0->6->3->2->1)和(4->0->6->3->1)。第一条路径的长度为 9 + 4 + 2 + 4 + 4 = 23,第二条路径的长度为 9 + 4 + 2 + 9 = 24。现在,如果我们将蓝色边的权重设为 0,那么最短路径的长度就变为 0 + 4 + 2 + 0 = 6。可以证明 6 是我们在给定条件下能够达到的最小路径长度。
示例 3:
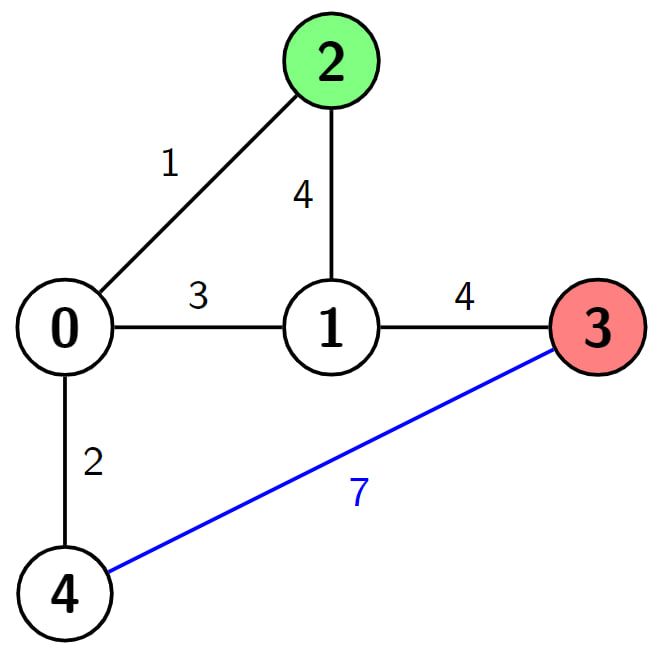
输入:n = 5, edges = [[0,4,2],[0,1,3],[0,2,1],[2,1,4],[1,3,4],[3,4,7]], s = 2, d = 3, k = 1
输出:3
解释:在这个例子中,从节点2(绿色节点)到节点3(红色节点)有4条路径,分别是(2->1->3)、(2->0->1->3)、(2->1->0->4->3)和(2->0->4->3)。前两条路径的长度为4 + 4 = 1 + 3 + 4 = 8,第三条路径的长度为4 + 3 + 2 + 7 = 16,最后一条路径的长度为1 + 2 + 7 = 10。现在,如果我们将蓝色边的权重设为 0,那么最短路径的长度就为1 + 2 + 0 = 3。可以证明在给定条件下,3 是我们能够达到的最小路径长度。
提示:
2 <= n <= 500n - 1 <= edges.length <= n * (n - 1) / 2edges[i].length = 30 <= edges[i][0], edges[i][1] <= n - 11 <= edges[i][2] <= 1060 <= s, d, k <= n - 1s != d- 输入的生成确保图是 连通 的,并且没有 重复的边 或 自环。
方法一:Dijkstra 算法 · Go 实现
思考
求 到 的最短路,至多 条边的权可视为 。普通最短路状态只有顶点,无法记录还剩几次免费跨越。 不大,可把已用跨越次数并入状态。
对 跑 Dijkstra:沿边 可付费走到 ,或在 时零权走到 。终点处对所有 取最小距离。
我们先根据给定的边构造出图 ,其中 表示节点 的所有邻居节点以及对应的边权重。
然后我们使用 Dijkstra 算法求出从节点 到节点 的最短路径,但是在这里我们需要对 Dijkstra 算法进行一些修改:
- 我们需要记录每个节点 到节点 的最短路径长度,但是由于我们可以最多跨越 条边,所以我们需要记录每个节点 到节点 的最短路径长度,以及跨越的边数 ,即 表示从节点 到节点 的最短路径长度,且跨越的边数为 。
- 我们需要使用优先队列来维护当前的最短路径,但是由于我们需要记录跨越的边数,所以我们需要使用三元组 来表示当前的最短路径,其中 表示当前的最短路径长度,而 和 分别表示当前的节点和跨越的边数。
最后我们只需要返回 中的最小值即可。
时间复杂度 ,空间复杂度 。其中 表示节点数,而 表示最多跨越的边数。
func shortestPathWithHops(n int, edges [][]int, s int, d int, k int) int {
	g := make([][][2]int, n)
	for _, e := range edges {
		u, v, w := e[0], e[1], e[2]
		g[u] = append(g[u], [2]int{v, w})
		g[v] = append(g[v], [2]int{u, w})
	}
	pq := hp{{0, s, 0}}
	dist := make([][]int, n)
	for i := range dist {
		dist[i] = make([]int, k+1)
		for j := range dist[i] {
			dist[i][j] = math.MaxInt32
		}
	}
	dist[s][0] = 0
	for len(pq) > 0 {
		p := heap.Pop(&pq).(tuple)
		dis, u, t := p.dis, p.u, p.t
		for _, e := range g[u] {
			v, w := e[0], e[1]
			if t+1 <= k && dist[v][t+1] > dis {
				dist[v][t+1] = dis
				heap.Push(&pq, tuple{dis, v, t + 1})
			}
			if dist[v][t] > dis+w {
				dist[v][t] = dis + w
				heap.Push(&pq, tuple{dis + w, v, t})
			}
		}
	}
	return slices.Min(dist[d])
}

type tuple struct{ dis, u, t int }
type hp []tuple

func (h hp) Len() int           { return len(h) }
func (h hp) Less(i, j int) bool { return h[i].dis < h[j].dis }
func (h hp) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)        { *h = append(*h, v.(tuple)) }
func (h *hp) Pop() any { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }2737. 找到最近的标记节点 🔒
题目、示例与约束
给定一个正整数 n ,表示一个 索引从 0 开始的有向加权 图的节点数量,以及一个 索引从 0 开始的二维数组 edges ,其中 edges[i] = [ui, vi, wi] 表示从节点 ui 到节点 vi 的一条权重为 wi 的边。
并给定一个节点 s 和一个节点数组 marked ;你的任务是找到从 s 到 marked 中 任何 节点的 最短 距离。
返回一个整数,表示从 s 到 marked 中任何节点的最短距离,如果从 s 到任何标记节点没有路径,则返回 -1 。
示例 1:
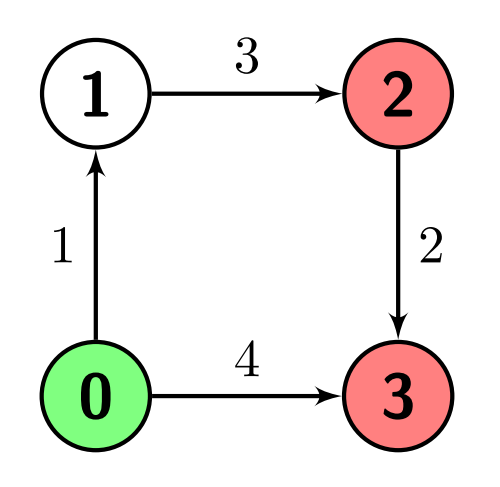
输入:n = 4, edges = [[0,1,1],[1,2,3],[2,3,2],[0,3,4]], s = 0, marked = [2,3]
输出:4
解释:从节点 0(绿色节点)到节点 2(红色节点)有一条路径,即 0->1->2,距离为 1 + 3 = 4。
从节点 0 到节点 3(红色节点)有两条路径,即 0->1->2->3 和 0->3,分别距离为 1 + 3 + 2 = 6 和 4。
它们中的最小值是 4。
示例 2:
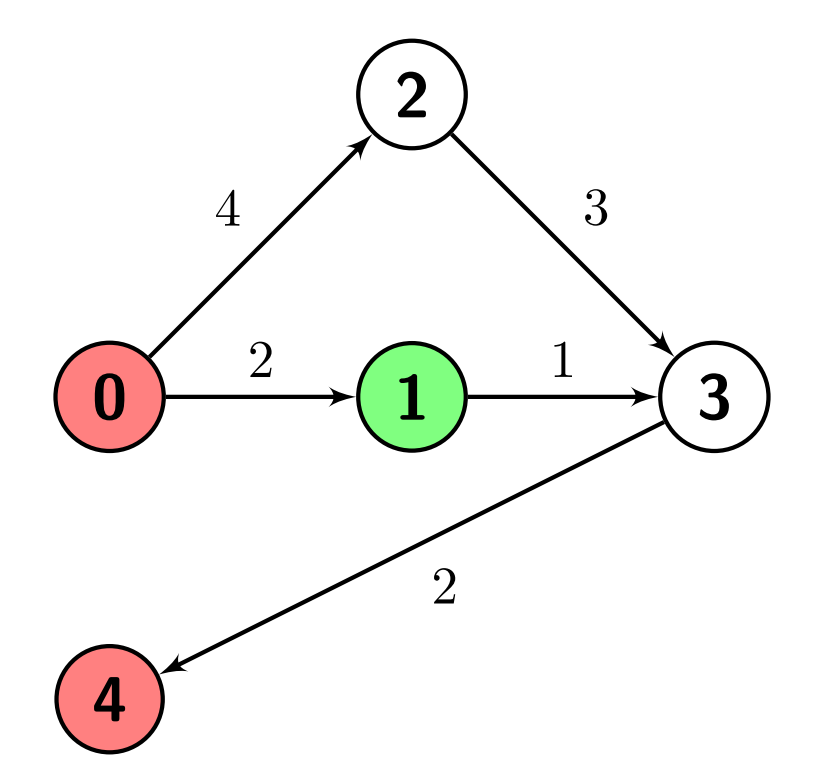
输入:n = 5, edges = [[0,1,2],[0,2,4],[1,3,1],[2,3,3],[3,4,2]], s = 1, marked = [0,4]
输出:3
解释:从节点 1(绿色节点)到节点 0(红色节点)没有路径。
从节点 1 到节点 4(红色节点)有一条路径,即 1->3->4,距离为 1 + 2 = 3。
因此答案是 3。
示例 3:
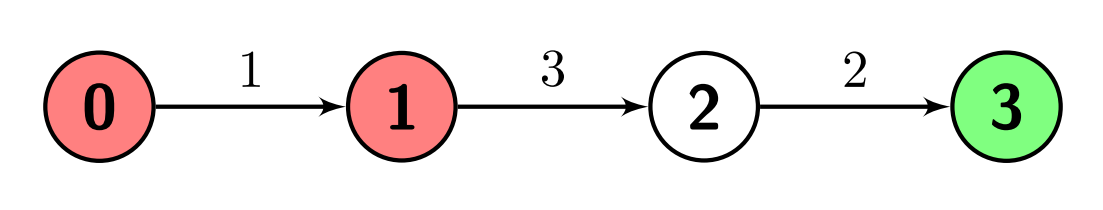
输入:n = 4, edges = [[0,1,1],[1,2,3],[2,3,2]], s = 3, marked = [0,1]
输出:-1
解释:从节点 3(绿色节点)到任何一个标记节点(红色节点)都没有路径,因此答案是 -1。
提示:
2 <= n <= 5001 <= edges.length <= 104edges[i].length = 30 <= edges[i][0], edges[i][1] <= n - 11 <= edges[i][2] <= 1061 <= marked.length <= n - 10 <= s, marked[i] <= n - 1s != marked[i]- 如果
i != j则marked[i] != marked[j] - 图中可能有 重复的边 。
- 图的生成不会出现 自环 。
方法一:Dijkstra 算法 · Go 实现
思考
有向带权图上求从 到任一标记点的最短距离。点数较小,可用邻接矩阵上的经典 Dijkstra,而不必建堆。
反复选出未标记的最近顶点并松弛出边,最后在标记集合上取 的最小;若仍为无穷则不可达。
我们先根据题目中提供的边的信息,建立一个邻接矩阵 ,其中 表示节点 到节点 的距离,如果不存在这样的边,则 为正无穷。
然后我们就可以使用 Dijkstra 算法求出从起点 到所有节点的最短距离,记为 。
最后我们遍历所有的标记节点,找到距离最小的标记节点,如果距离为正无穷,则返回 。
时间复杂度 ,空间复杂度 。其中 为节点数。
func minimumDistance(n int, edges [][]int, s int, marked []int) int {
	const inf = 1 << 29
	g := make([][]int, n)
	dist := make([]int, n)
	for i := range g {
		g[i] = make([]int, n)
		for j := range g[i] {
			g[i][j] = inf
		}
		dist[i] = inf
	}
	dist[s] = 0
	for _, e := range edges {
		u, v, w := e[0], e[1], e[2]
		g[u][v] = min(g[u][v], w)
	}
	vis := make([]bool, n)
	for _ = range g {
		t := -1
		for j := 0; j < n; j++ {
			if !vis[j] && (t == -1 || dist[j] < dist[t]) {
				t = j
			}
		}
		vis[t] = true
		for j := 0; j < n; j++ {
			dist[j] = min(dist[j], dist[t]+g[t][j])
		}
	}
	ans := inf
	for _, i := range marked {
		ans = min(ans, dist[i])
	}
	if ans >= inf {
		return -1
	}
	return ans
}2858. 可以到达每一个节点的最少边反转次数
题目、示例与约束
给你一个 n 个点的 简单有向图 (没有重复边的有向图),节点编号为 0 到 n - 1 。如果这些边是双向边,那么这个图形成一棵 树 。
给你一个整数 n 和一个 二维 整数数组 edges ,其中 edges[i] = [ui, vi] 表示从节点 ui 到节点 vi 有一条 有向边 。
边反转 指的是将一条边的方向反转,也就是说一条从节点 ui 到节点 vi 的边会变为一条从节点 vi 到节点 ui 的边。
对于范围 [0, n - 1] 中的每一个节点 i ,你的任务是分别 独立 计算 最少 需要多少次 边反转 ,从节点 i 出发经过 一系列有向边 ,可以到达所有的节点。
请你返回一个长度为 n 的整数数组 answer ,其中 answer[i]表示从节点 i 出发,可以到达所有节点的 最少边反转 次数。
示例 1:
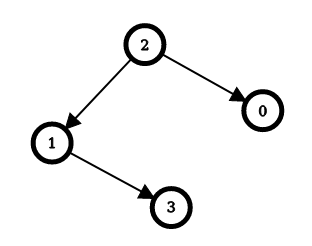
输入:n = 4, edges = [[2,0],[2,1],[1,3]]
输出:[1,1,0,2]
解释:上图表示了与输入对应的简单有向图。
对于节点 0 :反转 [2,0] ,从节点 0 出发可以到达所有节点。
所以 answer[0] = 1 。
对于节点 1 :反转 [2,1] ,从节点 1 出发可以到达所有节点。
所以 answer[1] = 1 。
对于节点 2 :不需要反转就可以从节点 2 出发到达所有节点。
所以 answer[2] = 0 。
对于节点 3 :反转 [1,3] 和 [2,1] ,从节点 3 出发可以到达所有节点。
所以 answer[3] = 2 。
示例 2:
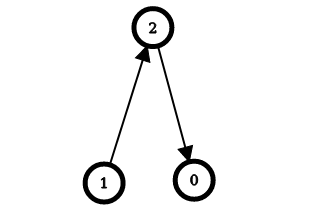
输入:n = 3, edges = [[1,2],[2,0]]
输出:[2,0,1]
解释:上图表示了与输入对应的简单有向图。
对于节点 0 :反转 [2,0] 和 [1,2] ,从节点 0 出发可以到达所有节点。
所以 answer[0] = 2 。
对于节点 1 :不需要反转就可以从节点 2 出发到达所有节点。
所以 answer[1] = 0 。
对于节点 2 :反转 [1,2] ,从节点 2 出发可以到达所有节点。
所以 answer[2] = 1 。
提示:
2 <= n <= 105edges.length == n - 1edges[i].length == 20 <= ui == edges[i][0] < n0 <= vi == edges[i][1] < nui != vi- 输入保证如果边是双向边,可以得到一棵树。
方法一:树形 DP · Go 实现
思考
以每个结点为根,统计把整棵树定向为自己可达所需的最少翻边。先以 为根 DFS,把逆边计入 ;换根时沿边走一步,答案增减 或 ,一次再 DFS 即可得到全部根的答案。
时间复杂度 ,空间复杂度 。
func minEdgeReversals(n int, edges [][]int) []int {
	g := make([][][2]int, n)
	for _, e := range edges {
		x, y := e[0], e[1]
		g[x] = append(g[x], [2]int{y, 1})
		g[y] = append(g[y], [2]int{x, -1})
	}
	ans := make([]int, n)
	var dfs func(int, int)
	var dfs2 func(int, int)
	dfs = func(i, fa int) {
		for _, ne := range g[i] {
			j, k := ne[0], ne[1]
			if j != fa {
				if k < 0 {
					ans[0]++
				}
				dfs(j, i)
			}
		}
	}
	dfs2 = func(i, fa int) {
		for _, ne := range g[i] {
			j, k := ne[0], ne[1]
			if j != fa {
				ans[j] = ans[i] + k
				dfs2(j, i)
			}
		}
	}
	dfs(0, -1)
	dfs2(0, -1)
	return ans
}
方法二:换根 + 显式栈 · Go 实现
思考
以每个结点为根,统计把整棵树定向为从该点可达所需的最少翻边。 ,对每个根各搜一次是 ;从 递归统计逆边,链上的调用深度就是 ,会超出递归栈。
先把有向边 记成从 走向 的权 、从 走回 的权 。以 为根时,走向孩子的权为负就说明这条边背离根,需要翻一次。换根走到孩子 时,答案变成 :权 表示原来顺着走、换根后要翻,权 表示原来要翻、换根后不用再翻。
两次遍历都用显式栈,从父节点走向孩子。第一次只累加根 的逆边,第二次按上面的增量写下每个新根。栈里保存 ,父节点的答案写好之后再处理孩子。
时间复杂度 ,空间复杂度 。
func minEdgeReversals(n int, edges [][]int) []int {
	g := make([][][2]int, n)
	for _, e := range edges {
		x, y := e[0], e[1]
		g[x] = append(g[x], [2]int{y, 1})
		g[y] = append(g[y], [2]int{x, -1})
	}
	ans := make([]int, n)
	stk := [][2]int{{0, -1}}
	for len(stk) > 0 {
		cur := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		i, fa := cur[0], cur[1]
		for _, ne := range g[i] {
			j, k := ne[0], ne[1]
			if j != fa {
				if k < 0 {
					ans[0]++
				}
				stk = append(stk, [2]int{j, i})
			}
		}
	}
	stk = append(stk, [2]int{0, -1})
	for len(stk) > 0 {
		cur := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		i, fa := cur[0], cur[1]
		for _, ne := range g[i] {
			j, k := ne[0], ne[1]
			if j != fa {
				ans[j] = ans[i] + k
				stk = append(stk, [2]int{j, i})
			}
		}
	}
	return ans
}2876. 有向图访问计数
题目、示例与约束
现有一个有向图,其中包含 n 个节点,节点编号从 0 到 n - 1 。此外,该图还包含了 n 条有向边。
给你一个下标从 0 开始的数组 edges ,其中 edges[i] 表示存在一条从节点 i 到节点 edges[i] 的边。
想象在图上发生以下过程:
- 你从节点
x开始,通过边访问其他节点,直到你在 此过程 中再次访问到之前已经访问过的节点。
返回数组 answer 作为答案,其中 answer[i] 表示如果从节点 i 开始执行该过程,你可以访问到的不同节点数。
示例 1:
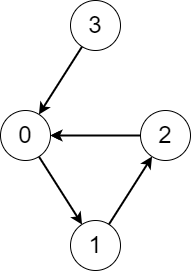
输入:edges = [1,2,0,0]
输出:[3,3,3,4]
解释:从每个节点开始执行该过程,记录如下:
- 从节点 0 开始,访问节点 0 -> 1 -> 2 -> 0 。访问的不同节点数是 3 。
- 从节点 1 开始,访问节点 1 -> 2 -> 0 -> 1 。访问的不同节点数是 3 。
- 从节点 2 开始,访问节点 2 -> 0 -> 1 -> 2 。访问的不同节点数是 3 。
- 从节点 3 开始,访问节点 3 -> 0 -> 1 -> 2 -> 0 。访问的不同节点数是 4 。
示例 2:
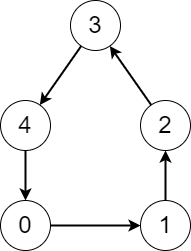
输入:edges = [1,2,3,4,0]
输出:[5,5,5,5,5]
解释:无论从哪个节点开始,在这个过程中,都可以访问到图中的每一个节点。
提示:
n == edges.length2 <= n <= 1050 <= edges[i] <= n - 1edges[i] != i
方法一:基环树 + 遍历搜索 · Go 实现
思考
每个结点出度为 ,图由基环加外向树构成。从某点沿唯一边走,若走回本次路径则先遇到环,环上答案为环长,环外为到环距离加环长;若走到已算完的结点,则接上已知答案即可。
我们可以用一个数组 记录每个节点的答案,用一个数组 记录每个节点的访问次序。
遍历每个节点 ,如果当前节点 未被访问,我们就从节点 开始遍历,此时有两种情况:
- 如果遍历过程中,遇到了当前节点出发时走过的节点,那么此次遍历,一定是先走到了环内,然后沿着环走了一圈。对于环外的节点,其答案就是环的长度加上节点到环的距离;对于环内的节点,其答案就是环的长度。
- 如果遍历过程中,遇到了此前节点出发时走过的节点,那么对于每个走过的节点,其答案就是当前节点到此节点的距离,加上此节点的答案。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func countVisitedNodes(edges []int) []int {
	n := len(edges)
	ans := make([]int, n)
	vis := make([]int, n)
	for i := range ans {
		if ans[i] == 0 {
			cnt, j := 0, i
			for vis[j] == 0 {
				cnt++
				vis[j] = cnt
				j = edges[j]
			}
			cycle, total := 0, cnt+ans[j]
			if ans[j] == 0 {
				cycle = cnt - vis[j] + 1
			}
			j = i
			for ans[j] == 0 {
				ans[j] = max(total, cycle)
				total--
				j = edges[j]
			}
		}
	}
	return ans
}2924. 找到冠军 II
题目、示例与约束
一场比赛中共有 n 支队伍,按从 0 到 n - 1 编号。每支队伍也是 有向无环图(DAG) 上的一个节点。
给你一个整数 n 和一个下标从 0 开始、长度为 m 的二维整数数组 edges 表示这个有向无环图,其中 edges[i] = [ui, vi] 表示图中存在一条从 ui 队到 vi 队的有向边。
从 a 队到 b 队的有向边意味着 a 队比 b 队 强 ,也就是 b 队比 a 队 弱 。
在这场比赛中,如果不存在某支强于 a 队的队伍,则认为 a 队将会是 冠军 。
如果这场比赛存在 唯一 一个冠军,则返回将会成为冠军的队伍。否则,返回 -1 。
注意
- 环 是形如
a1, a2, ..., an, an+1的一个序列,且满足:节点a1与节点an+1是同一个节点;节点a1, a2, ..., an互不相同;对于范围[1, n]中的每个i,均存在一条从节点ai到节点ai+1的有向边。 - 有向无环图 是不存在任何环的有向图。
示例 1:
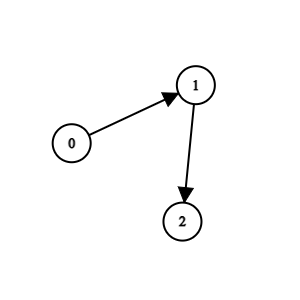
输入:n = 3, edges = [[0,1],[1,2]]
输出:0
解释:1 队比 0 队弱。2 队比 1 队弱。所以冠军是 0 队。
示例 2:
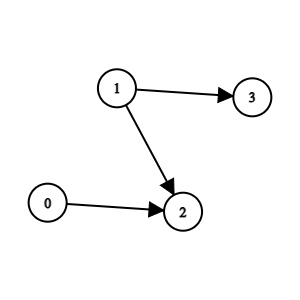
输入:n = 4, edges = [[0,2],[1,3],[1,2]]
输出:-1
解释:2 队比 0 队和 1 队弱。3 队比 1 队弱。但是 1 队和 0 队之间不存在强弱对比。所以答案是 -1 。
提示:
1 <= n <= 100m == edges.length0 <= m <= n * (n - 1) / 2edges[i].length == 20 <= edge[i][j] <= n - 1edges[i][0] != edges[i][1]- 生成的输入满足:如果
a队比b队强,就不存在b队比a队强 - 生成的输入满足:如果
a队比b队强,b队比c队强,那么a队比c队强
方法一:统计入度 · Go 实现
思考
关系改为 DAG 上的有向边「更强者指向较弱者」,冠军是唯一入度为 的点;若不唯一则不存在。 ,扫一遍边统计入度即可。
入度为 的个数不是 时返回 ,否则返回该下标。
根据题目描述,我们只需要统计每个节点的入度,记录在数组 中。如果只有一个节点的入度为 ,那么这个节点就是冠军,否则不存在唯一的冠军。
时间复杂度 ,空间复杂度 。其中 是节点的数量。
func findChampion(n int, edges [][]int) int {
	indeg := make([]int, n)
	for _, e := range edges {
		indeg[e[1]]++
	}
	ans, cnt := -1, 0
	for i, x := range indeg {
		if x == 0 {
			cnt++
			ans = i
		}
	}
	if cnt == 1 {
		return ans
	}
	return -1
}2959. 关闭分部的可行集合数目
题目、示例与约束
一个公司在全国有 n 个分部,它们之间有的有道路连接。一开始,所有分部通过这些道路两两之间互相可以到达。
公司意识到在分部之间旅行花费了太多时间,所以它们决定关闭一些分部(也可能不关闭任何分部),同时保证剩下的分部之间两两互相可以到达且最远距离不超过 maxDistance 。
两个分部之间的 距离 是通过道路长度之和的 最小值 。
给你整数 n ,maxDistance 和下标从 0 开始的二维整数数组 roads ,其中 roads[i] = [ui, vi, wi] 表示一条从 ui 到 vi 长度为 wi的 无向 道路。
请你返回关闭分部的可行方案数目,满足每个方案里剩余分部之间的最远距离不超过 maxDistance。
注意,关闭一个分部后,与之相连的所有道路不可通行。
注意,两个分部之间可能会有多条道路。
示例 1:
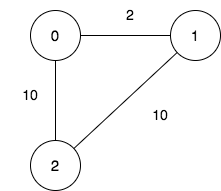
输入:n = 3, maxDistance = 5, roads = [[0,1,2],[1,2,10],[0,2,10]]
输出:5
解释:可行的关闭分部方案有:
- 关闭分部集合 [2] ,剩余分部为 [0,1] ,它们之间的距离为 2 。
- 关闭分部集合 [0,1] ,剩余分部为 [2] 。
- 关闭分部集合 [1,2] ,剩余分部为 [0] 。
- 关闭分部集合 [0,2] ,剩余分部为 [1] 。
- 关闭分部集合 [0,1,2] ,关闭后没有剩余分部。
总共有 5 种可行的关闭方案。
示例 2:
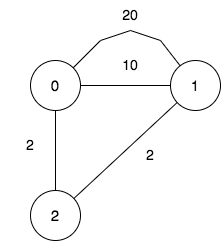
输入:n = 3, maxDistance = 5, roads = [[0,1,20],[0,1,10],[1,2,2],[0,2,2]]
输出:7
解释:可行的关闭分部方案有:
- 关闭分部集合 [] ,剩余分部为 [0,1,2] ,它们之间的最远距离为 4 。
- 关闭分部集合 [0] ,剩余分部为 [1,2] ,它们之间的距离为 2 。
- 关闭分部集合 [1] ,剩余分部为 [0,2] ,它们之间的距离为 2 。
- 关闭分部集合 [0,1] ,剩余分部为 [2] 。
- 关闭分部集合 [1,2] ,剩余分部为 [0] 。
- 关闭分部集合 [0,2] ,剩余分部为 [1] 。
- 关闭分部集合 [0,1,2] ,关闭后没有剩余分部。
总共有 7 种可行的关闭方案。
示例 3:
输入:n = 1, maxDistance = 10, roads = []
输出:2
解释:可行的关闭分部方案有:
- 关闭分部集合 [] ,剩余分部为 [0] 。
- 关闭分部集合 [0] ,关闭后没有剩余分部。
总共有 2 种可行的关闭方案。
提示:
1 <= n <= 101 <= maxDistance <= 1050 <= roads.length <= 1000roads[i].length == 30 <= ui, vi <= n - 1ui != vi1 <= wi <= 1000- 一开始所有分部之间通过道路互相可以到达。
方法一:二进制枚举 + Floyd 算法 · Go 实现
思考
关闭若干分部后,留下的点两两最短路不得超过 。 ,子集仅 个,可枚举掩码。对每个子集用仍开放的边跑 Floyd,再检查子集内距离。
重边取最短。空集与单点视为合法(Floyd 对角置 )。
我们注意到 ,所以我们不妨考虑使用二进制枚举的方法来枚举所有的分部集合。
对于每个分部集合,我们可以使用 Floyd 算法来计算出剩余分部之间的最短距离,然后判断是否满足题目要求即可。具体地,我们先枚举中间点 ,再枚举起点 和终点 ,如果 ,那么我们就用更短的距离 更新 。
时间复杂度 ,空间复杂度 。其中 和 分别是分部数量和道路数量。
func numberOfSets(n int, maxDistance int, roads [][]int) (ans int) {
	for mask := 0; mask < 1<<n; mask++ {
		g := make([][]int, n)
		for i := range g {
			g[i] = make([]int, n)
			for j := range g[i] {
				g[i][j] = 1 << 29
			}
		}
		for _, e := range roads {
			u, v, w := e[0], e[1], e[2]
			if mask>>u&1 == 1 && mask>>v&1 == 1 {
				g[u][v] = min(g[u][v], w)
				g[v][u] = min(g[v][u], w)
			}
		}
		for k := 0; k < n; k++ {
			if mask>>k&1 == 1 {
				g[k][k] = 0
				for i := 0; i < n; i++ {
					for j := 0; j < n; j++ {
						g[i][j] = min(g[i][j], g[i][k]+g[k][j])
					}
				}
			}
		}
		ok := 1
		for i := 0; i < n && ok == 1; i++ {
			for j := 0; j < n && ok == 1; j++ {
				if mask>>i&1 == 1 && mask>>j&1 == 1 && g[i][j] > maxDistance {
					ok = 0
				}
			}
		}
		ans += ok
	}
	return
}2976. 转换字符串的最小成本 I
题目、示例与约束
给你两个下标从 0 开始的字符串 source 和 target ,它们的长度均为 n 并且由 小写 英文字母组成。
另给你两个下标从 0 开始的字符数组 original 和 changed ,以及一个整数数组 cost ,其中 cost[i] 代表将字符 original[i] 更改为字符 changed[i] 的成本。
你从字符串 source 开始。在一次操作中,如果 存在 任意 下标 j 满足 cost[j] == z 、original[j] == x 以及 changed[j] == y 。你就可以选择字符串中的一个字符 x 并以 z 的成本将其更改为字符 y 。
返回将字符串 source 转换为字符串 target 所需的 最小 成本。如果不可能完成转换,则返回 -1 。
注意,可能存在下标 i 、j 使得 original[j] == original[i] 且 changed[j] == changed[i] 。
示例 1:
输入:source = "abcd", target = "acbe", original = ["a","b","c","c","e","d"], changed = ["b","c","b","e","b","e"], cost = [2,5,5,1,2,20]
输出:28
解释:将字符串 "abcd" 转换为字符串 "acbe" :
- 更改下标 1 处的值 'b' 为 'c' ,成本为 5 。
- 更改下标 2 处的值 'c' 为 'e' ,成本为 1 。
- 更改下标 2 处的值 'e' 为 'b' ,成本为 2 。
- 更改下标 3 处的值 'd' 为 'e' ,成本为 20 。
产生的总成本是 5 + 1 + 2 + 20 = 28 。
可以证明这是可能的最小成本。
示例 2:
输入:source = "aaaa", target = "bbbb", original = ["a","c"], changed = ["c","b"], cost = [1,2]
输出:12
解释:要将字符 'a' 更改为 'b':
- 将字符 'a' 更改为 'c',成本为 1
- 将字符 'c' 更改为 'b',成本为 2
产生的总成本是 1 + 2 = 3。
将所有 'a' 更改为 'b',产生的总成本是 3 * 4 = 12 。
示例 3:
输入:source = "abcd", target = "abce", original = ["a"], changed = ["e"], cost = [10000]
输出:-1
解释:无法将 source 字符串转换为 target 字符串,因为下标 3 处的值无法从 'd' 更改为 'e' 。
提示:
1 <= source.length == target.length <= 105source、target均由小写英文字母组成1 <= cost.length== original.length == changed.length <= 2000original[i]、changed[i]是小写英文字母1 <= cost[i] <= 106original[i] != changed[i]
方法一:Floyd 算法 · Go 实现
思考
每次把一个字母改成另一个,有代价,求 到 的最小总价。字母仅 个,改写可串联,故需任意字母对的最短路。Floyd 在 内求出 。
逐位累加;若某对不可达则整体无解。重边取最小代价。串长 ,预处理与扫描分离。
根据题目描述,我们可以将每个字母看作一个节点,每对字母的转换成本看作一条有向边。那么我们先初始化一个 的二维数组 ,其中 表示字母 转换成字母 的最小成本。初始时 ,如果 ,那么 。
然后我们遍历数组 , 和 ,对于每个下标 ,我们将 转换成 的成本 更新到 中,取最小值。
接下来,我们使用 Floyd 算法计算出 中任意两个节点之间的最小成本。最后,我们遍历字符串 和 ,如果 ,并且 ,那么说明无法完成转换,返回 。否则,我们将 累加到答案中。
遍历结束后,返回答案即可。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 和 的长度;而 是字母表的大小,即 。
func minimumCost(source string, target string, original []byte, changed []byte, cost []int) (ans int64) {
	const inf = 1 << 29
	g := make([][]int, 26)
	for i := range g {
		g[i] = make([]int, 26)
		for j := range g[i] {
			if i == j {
				g[i][j] = 0
			} else {
				g[i][j] = inf
			}
		}
	}

	for i := 0; i < len(original); i++ {
		x := int(original[i] - 'a')
		y := int(changed[i] - 'a')
		z := cost[i]
		g[x][y] = min(g[x][y], z)
	}

	for k := 0; k < 26; k++ {
		for i := 0; i < 26; i++ {
			for j := 0; j < 26; j++ {
				g[i][j] = min(g[i][j], g[i][k]+g[k][j])
			}
		}
	}
	n := len(source)
	for i := 0; i < n; i++ {
		x := int(source[i] - 'a')
		y := int(target[i] - 'a')
		if x != y {
			if g[x][y] >= inf {
				return -1
			}
			ans += int64(g[x][y])
		}
	}
	return
}3015. 按距离统计房屋对数目 I
题目、示例与约束
给你三个 正整数 n 、x 和 y 。
在城市中,存在编号从 1 到 n 的房屋,由 n 条街道相连。对所有 1 <= i < n ,都存在一条街道连接编号为 i 的房屋与编号为 i + 1 的房屋。另存在一条街道连接编号为 x 的房屋与编号为 y 的房屋。
对于每个 k(1 <= k <= n),你需要找出所有满足要求的 房屋对 [house1, house2] ,即从 house1 到 house2 需要经过的 最少 街道数为 k 。
返回一个下标从 1 开始且长度为 n 的数组 result ,其中 result[k] 表示所有满足要求的房屋对的数量,即从一个房屋到另一个房屋需要经过的 最少 街道数为 k 。
注意,x 与 y 可以 相等 。
示例 1:
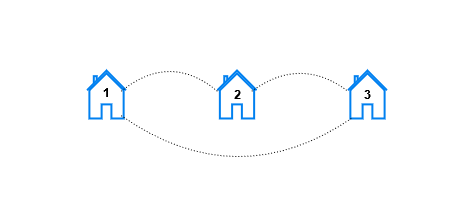
输入:n = 3, x = 1, y = 3
输出:[6,0,0]
解释:让我们检视每个房屋对
- 对于房屋对 (1, 2),可以直接从房屋 1 到房屋 2。
- 对于房屋对 (2, 1),可以直接从房屋 2 到房屋 1。
- 对于房屋对 (1, 3),可以直接从房屋 1 到房屋 3。
- 对于房屋对 (3, 1),可以直接从房屋 3 到房屋 1。
- 对于房屋对 (2, 3),可以直接从房屋 2 到房屋 3。
- 对于房屋对 (3, 2),可以直接从房屋 3 到房屋 2。
示例 2:
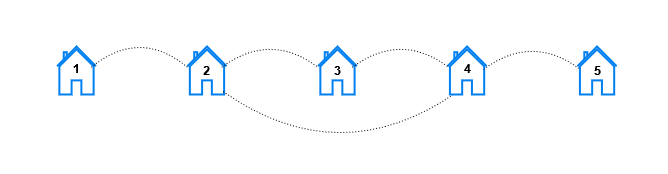
输入:n = 5, x = 2, y = 4
输出:[10,8,2,0,0]
解释:对于每个距离 k ,满足要求的房屋对如下:
- 对于 k == 1,满足要求的房屋对有 (1, 2), (2, 1), (2, 3), (3, 2), (2, 4), (4, 2), (3, 4), (4, 3), (4, 5), 以及 (5, 4)。
- 对于 k == 2,满足要求的房屋对有 (1, 3), (3, 1), (1, 4), (4, 1), (2, 5), (5, 2), (3, 5), 以及 (5, 3)。
- 对于 k == 3,满足要求的房屋对有 (1, 5),以及 (5, 1) 。
- 对于 k == 4 和 k == 5,不存在满足要求的房屋对。
示例 3:
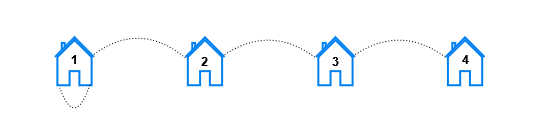
输入:n = 4, x = 1, y = 1
输出:[6,4,2,0]
解释:对于每个距离 k ,满足要求的房屋对如下:
- 对于 k == 1,满足要求的房屋对有 (1, 2), (2, 1), (2, 3), (3, 2), (3, 4), 以及 (4, 3)。
- 对于 k == 2,满足要求的房屋对有 (1, 3), (3, 1), (2, 4), 以及 (4, 2)。
- 对于 k == 3,满足要求的房屋对有 (1, 4), 以及 (4, 1)。
- 对于 k == 4,不存在满足要求的房屋对。
提示:
2 <= n <= 1001 <= x, y <= n
方法一:枚举 · Go 实现
思考
,任意两点最短路可用枚举。图是一条链外加边 。
到 的最短路只有三种:沿链、 ,以及 。
枚举有序对并在三种距离中取最小,将对应桶加 以同时计入 。
我们可以枚举每个点对 ,那么从 到 的最短距离为 ,我们将该距离的出现次数加 ,因为 和 都是满足要求的点对。
时间复杂度 ,其中 是题目给定的 。忽略答案数组的空间消耗,空间复杂度 。
func countOfPairs(n int, x int, y int) []int {
	ans := make([]int, n)
	x, y = x-1, y-1
	for i := 0; i < n; i++ {
		for j := i + 1; j < n; j++ {
			a := j - i
			b := abs(x-i) + abs(y-j) + 1
			c := abs(x-j) + abs(y-i) + 1
			ans[min(a, min(b, c))-1] += 2
		}
	}
	return ans
}

func abs(x int) int {
	if x < 0 {
		return -x
	}
	return x
}3017. 按距离统计房屋对数目 II
题目、示例与约束
给你三个 正整数 n 、x 和 y 。
在城市中,存在编号从 1 到 n 的房屋,由 n 条街道相连。对所有 1 <= i < n ,都存在一条街道连接编号为 i 的房屋与编号为 i + 1 的房屋。另存在一条街道连接编号为 x 的房屋与编号为 y 的房屋。
对于每个 k(1 <= k <= n),你需要找出所有满足要求的 房屋对 [house1, house2] ,即从 house1 到 house2 需要经过的 最少 街道数为 k 。
返回一个下标从 1 开始且长度为 n 的数组 result ,其中 result[k] 表示所有满足要求的房屋对的数量,即从一个房屋到另一个房屋需要经过的 最少 街道数为 k 。
注意,x 与 y 可以 相等 。
示例 1:
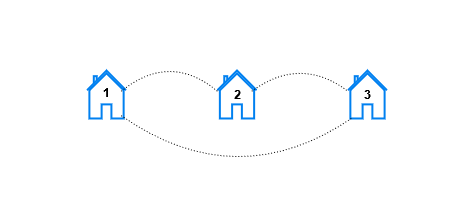
输入:n = 3, x = 1, y = 3
输出:[6,0,0]
解释:让我们检视每个房屋对
- 对于房屋对 (1, 2),可以直接从房屋 1 到房屋 2。
- 对于房屋对 (2, 1),可以直接从房屋 2 到房屋 1。
- 对于房屋对 (1, 3),可以直接从房屋 1 到房屋 3。
- 对于房屋对 (3, 1),可以直接从房屋 3 到房屋 1。
- 对于房屋对 (2, 3),可以直接从房屋 2 到房屋 3。
- 对于房屋对 (3, 2),可以直接从房屋 3 到房屋 2。
示例 2:
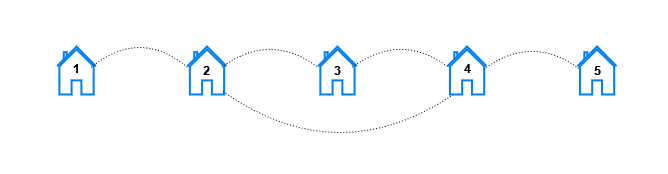
输入:n = 5, x = 2, y = 4
输出:[10,8,2,0,0]
解释:对于每个距离 k ,满足要求的房屋对如下:
- 对于 k == 1,满足要求的房屋对有 (1, 2), (2, 1), (2, 3), (3, 2), (2, 4), (4, 2), (3, 4), (4, 3), (4, 5), 以及 (5, 4)。
- 对于 k == 2,满足要求的房屋对有 (1, 3), (3, 1), (1, 4), (4, 1), (2, 5), (5, 2), (3, 5), 以及 (5, 3)。
- 对于 k == 3,满足要求的房屋对有 (1, 5),以及 (5, 1) 。
- 对于 k == 4 和 k == 5,不存在满足要求的房屋对。
示例 3:
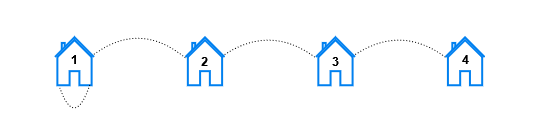
输入:n = 4, x = 1, y = 1
输出:[6,4,2,0]
解释:对于每个距离 k ,满足要求的房屋对如下:
- 对于 k == 1,满足要求的房屋对有 (1, 2), (2, 1), (2, 3), (3, 2), (3, 4), 以及 (4, 3)。
- 对于 k == 2,满足要求的房屋对有 (1, 3), (3, 1), (2, 4), 以及 (4, 2)。
- 对于 k == 3,满足要求的房屋对有 (1, 4), 以及 (4, 1)。
- 对于 k == 4,不存在满足要求的房屋对。
提示:
2 <= n <= 1051 <= x, y <= n
方法一 · Go 实现
思考
升至 ,I 中 枚举不再可行。图仍是链加一条边,距离分布有封闭结构。
若 ,额外边无用,答案就是链上距离的计数。否则中间形成长为 的环,两侧各有一条尾巴。
分别累加「纯链」「环内」「尾巴到环」三类点对的距离直方图,按环长奇偶处理直径上的折半,避免重复计数。
func countOfPairs(n int, x int, y int) []int64 {
	if x > y {
		x, y = y, x
	}
	A := make([]int64, n)
	for i := 1; i <= n; i++ {
		A[0] += 2
		A[min(int64(i-1), int64(math.Abs(float64(i-y)))+int64(x))] -= 1
		A[min(int64(n-i), int64(math.Abs(float64(i-x)))+1+int64(n-y))] -= 1
		A[min(int64(math.Abs(float64(i-x))), int64(math.Abs(float64(y-i)))+1)] += 1
		A[min(int64(math.Abs(float64(i-x)))+1, int64(math.Abs(float64(y-i))))] += 1
		r := max(int64(x-i), 0) + max(int64(i-y), 0)
		A[r+int64((y-x+0)/2)] -= 1
		A[r+int64((y-x+1)/2)] -= 1
	}
	for i := 1; i < n; i++ {
		A[i] += A[i-1]
	}

	return A
}3112. 访问消失节点的最少时间
题目、示例与约束
给你一个二维数组 edges 表示一个 n 个点的无向图,其中 edges[i] = [ui, vi, lengthi] 表示节点 ui 和节点 vi 之间有一条需要 lengthi 单位时间通过的无向边。
同时给你一个数组 disappear ,其中 disappear[i] 表示节点 i 从图中消失的时间点,在那一刻及以后,你无法再访问这个节点。
注意,图有可能一开始是不连通的,两个节点之间也可能有多条边。
请你返回数组 answer ,answer[i] 表示从节点 0 到节点 i 需要的 最少 单位时间。如果从节点 0 出发 无法 到达节点 i ,那么 answer[i] 为 -1 。
示例 1:
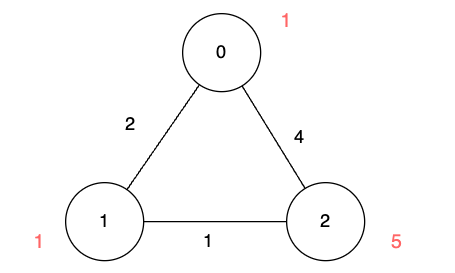
输入:n = 3, edges = [[0,1,2],[1,2,1],[0,2,4]], disappear = [1,1,5]
输出:[0,-1,4]
解释:
我们从节点 0 出发,目的是用最少的时间在其他节点消失之前到达它们。
- 对于节点 0 ,我们不需要任何时间,因为它就是我们的起点。
- 对于节点 1 ,我们需要至少 2 单位时间,通过
edges[0]到达。但当我们到达的时候,它已经消失了,所以我们无法到达它。 - 对于节点 2 ,我们需要至少 4 单位时间,通过
edges[2]到达。
示例 2:
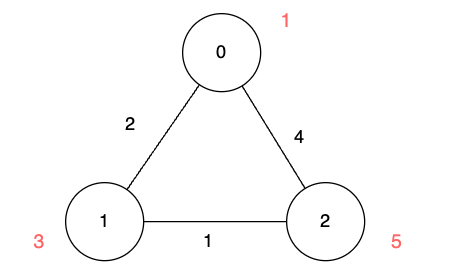
输入:n = 3, edges = [[0,1,2],[1,2,1],[0,2,4]], disappear = [1,3,5]
输出:[0,2,3]
解释:
我们从节点 0 出发,目的是用最少的时间在其他节点消失之前到达它们。
- 对于节点 0 ,我们不需要任何时间,因为它就是我们的起点。
- 对于节点 1 ,我们需要至少 2 单位时间,通过
edges[0]到达。 - 对于节点 2 ,我们需要至少 3 单位时间,通过
edges[0]和edges[1]到达。
示例 3:
输入:n = 2, edges = [[0,1,1]], disappear = [1,1]
输出:[0,-1]
解释:
当我们到达节点 1 的时候,它恰好消失,所以我们无法到达节点 1 。
提示:
1 <= n <= 5 * 1040 <= edges.length <= 105edges[i] == [ui, vi, lengthi]0 <= ui, vi <= n - 11 <= lengthi <= 105disappear.length == n1 <= disappear[i] <= 105
方法一:堆优化的 Dijkstra · Go 实现
思考
节点会在给定时刻消失,到达时间必须严格早于消失时刻。朴素对每个节点单独搜路会重复松弛同一条边。
这仍是单源最短路:边权非负,只需在松弛时额外要求 。不满足则该边不可用。
因此建无向图后用堆优化 Dijkstra 从 出发更新 ,最后将 的距离留下,否则记为 。
我们先创建一个邻接表 ,用于存储图的边。然后创建一个数组 ,用于存储从节点 到其他节点的最短距离。初始化 ,其余节点的距离初始化为无穷大。
然后,我们使用 Dijkstra 算法计算从节点 到其他节点的最短距离。具体步骤如下:
- 创建一个优先队列 ,用于存储节点的距离和节点编号,初始时将节点 加入队列,距离为 。
- 从队列中取出一个节点 ,如果 的距离 大于 ,说明 已经被更新过了,直接跳过。
- 遍历节点 的所有邻居节点 ,如果 且 ,则更新 ,并将节点 加入队列。
- 重复步骤 2 和步骤 3,直到队列为空。
最后,我们遍历 数组,如果 ,则 ,否则 。
时间复杂度 ,空间复杂度 。其中 是边的数量。
func minimumTime(n int, edges [][]int, disappear []int) []int {
	g := make([][]pair, n)
	for _, e := range edges {
		u, v, w := e[0], e[1], e[2]
		g[u] = append(g[u], pair{v, w})
		g[v] = append(g[v], pair{u, w})
	}

	dist := make([]int, n)
	for i := range dist {
		dist[i] = 1 << 30
	}
	dist[0] = 0

	pq := hp{{0, 0}}

	for len(pq) > 0 {
		du, u := pq[0].dis, pq[0].u
		heap.Pop(&pq)

		if du > dist[u] {
			continue
		}

		for _, nxt := range g[u] {
			v, w := nxt.dis, nxt.u
			if dist[v] > dist[u]+w && dist[u]+w < disappear[v] {
				dist[v] = dist[u] + w
				heap.Push(&pq, pair{dist[v], v})
			}
		}
	}

	ans := make([]int, n)
	for i := 0; i < n; i++ {
		if dist[i] < disappear[i] {
			ans[i] = dist[i]
		} else {
			ans[i] = -1
		}
	}

	return ans
}

type pair struct{ dis, u int }
type hp []pair

func (h hp) Len() int           { return len(h) }
func (h hp) Less(i, j int) bool { return h[i].dis < h[j].dis }
func (h hp) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)        { *h = append(*h, v.(pair)) }
func (h *hp) Pop() any { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }3123. 最短路径中的边
题目、示例与约束
给你一个 n 个节点的无向带权图,节点编号为 0 到 n - 1 。图中总共有 m 条边,用二维数组 edges 表示,其中 edges[i] = [ai, bi, wi] 表示节点 ai 和 bi 之间有一条边权为 wi 的边。
对于节点 0 为出发点,节点 n - 1 为结束点的所有最短路,你需要返回一个长度为 m 的 boolean 数组 answer ,如果 edges[i] 至少 在其中一条最短路上,那么 answer[i] 为 true ,否则 answer[i] 为 false 。
请你返回数组 answer 。
注意,图可能不连通。
示例 1:
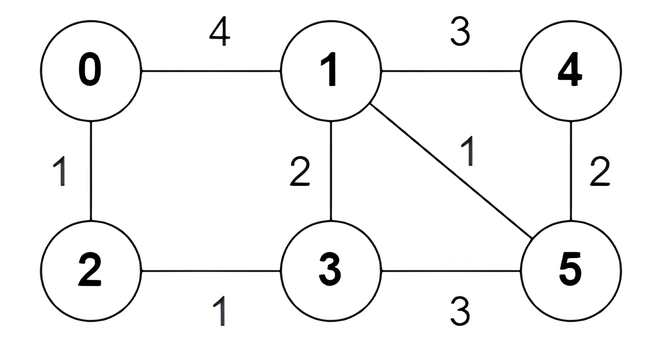
输入:n = 6, edges = [[0,1,4],[0,2,1],[1,3,2],[1,4,3],[1,5,1],[2,3,1],[3,5,3],[4,5,2]]
输出:[true,true,true,false,true,true,true,false]
解释:
以下为节点 0 出发到达节点 5 的 所有 最短路:
- 路径
0 -> 1 -> 5:边权和为4 + 1 = 5。 - 路径
0 -> 2 -> 3 -> 5:边权和为1 + 1 + 3 = 5。 - 路径
0 -> 2 -> 3 -> 1 -> 5:边权和为1 + 1 + 2 + 1 = 5。
示例 2:
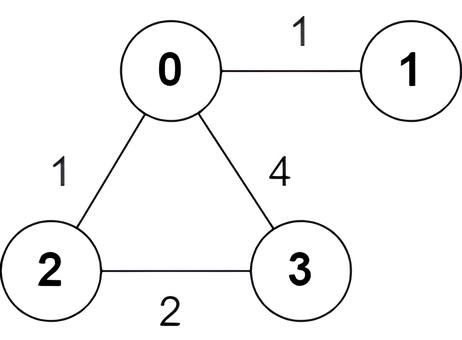
输入:n = 4, edges = [[2,0,1],[0,1,1],[0,3,4],[3,2,2]]
输出:[true,false,false,true]
解释:
只有一条从节点 0 出发到达节点 3 的最短路 0 -> 2 -> 3 ,边权和为 1 + 2 = 3 。
提示:
2 <= n <= 5 * 104m == edges.length1 <= m <= min(5 * 104, n * (n - 1) / 2)0 <= ai, bi < nai != bi1 <= wi <= 105- 图中没有重边。
方法一:堆优化的 Dijkstra · Go 实现
思考
要判断每条边是否落在 到 的某条最短路上。对每条边单独重算最短路会把 Dijkstra 重复 次。
边 在最短路上,当且仅当 (或对称),其中 是从终点出发的距离。无向图中从终点沿 回溯即可标出全部这样的边。
因此先用堆优化 Dijkstra 求出 ,再从 广度优先,把满足松弛等式的边标为真。不可达则全部为假。
我们先创建一个邻接表 ,用于存储图的边。然后创建一个数组 ,用于存储从节点 到其他节点的最短距离。初始化 ,其余节点的距离初始化为无穷大。
然后,我们使用 Dijkstra 算法计算从节点 到其他节点的最短距离。具体步骤如下:
- 创建一个优先队列 ,用于存储节点的距离和节点编号,初始时将节点 加入队列,距离为 。
- 从队列中取出一个节点 ,如果 的距离 大于 ,说明 已经被更新过了,直接跳过。
- 遍历节点 的所有邻居节点 ,如果 ,则更新 ,并将节点 加入队列。
- 重复步骤 2 和步骤 3,直到队列为空。
接着,我们创建一个长度为 的答案数组 ,初始时所有元素都为 。如果 为无穷大,说明节点 无法到达节点 ,直接返回 。否则,我们从节点 开始,遍历所有的边,如果边 满足 ,则将 置为 ,并将节点 加入队列。
最后,返回答案即可。
时间复杂度 ,空间复杂度 ,其中 和 分别为节点数和边数。
func findAnswer(n int, edges [][]int) []bool {
	g := make([][][3]int, n)
	for i, e := range edges {
		a, b, w := e[0], e[1], e[2]
		g[a] = append(g[a], [3]int{b, w, i})
		g[b] = append(g[b], [3]int{a, w, i})
	}
	dist := make([]int, n)
	const inf int = 1e18
	for i := range dist {
		dist[i] = inf
	}
	dist[0] = 0
	pq := hp{{0, 0}}
	for len(pq) > 0 {
		p := heap.Pop(&pq).(pair)
		da, a := p.dis, p.u
		if da > dist[a] {
			continue
		}
		for _, e := range g[a] {
			b, w := e[0], e[1]
			if dist[b] > dist[a]+w {
				dist[b] = dist[a] + w
				heap.Push(&pq, pair{dist[b], b})
			}
		}
	}
	ans := make([]bool, len(edges))
	if dist[n-1] == inf {
		return ans
	}
	q := []int{n - 1}
	for len(q) > 0 {
		a := q[0]
		q = q[1:]
		for _, e := range g[a] {
			b, w, i := e[0], e[1], e[2]
			if dist[a] == dist[b]+w {
				ans[i] = true
				q = append(q, b)
			}
		}
	}
	return ans
}

type pair struct{ dis, u int }
type hp []pair

func (h hp) Len() int           { return len(h) }
func (h hp) Less(i, j int) bool { return h[i].dis < h[j].dis }
func (h hp) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)        { *h = append(*h, v.(pair)) }
func (h *hp) Pop() any { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }3203. 合并两棵树后的最小直径
题目、示例与约束
给你两棵 无向 树,分别有 n 和 m 个节点,节点编号分别为 0 到 n - 1 和 0 到 m - 1 。给你两个二维整数数组 edges1 和 edges2 ,长度分别为 n - 1 和 m - 1 ,其中 edges1[i] = [ai, bi] 表示在第一棵树中节点 ai 和 bi 之间有一条边,edges2[i] = [ui, vi] 表示在第二棵树中节点 ui 和 vi 之间有一条边。
你必须在第一棵树和第二棵树中分别选一个节点,并用一条边连接它们。
请你返回添加边后得到的树中,最小直径 为多少。
一棵树的 直径 指的是树中任意两个节点之间的最长路径长度。
示例 1: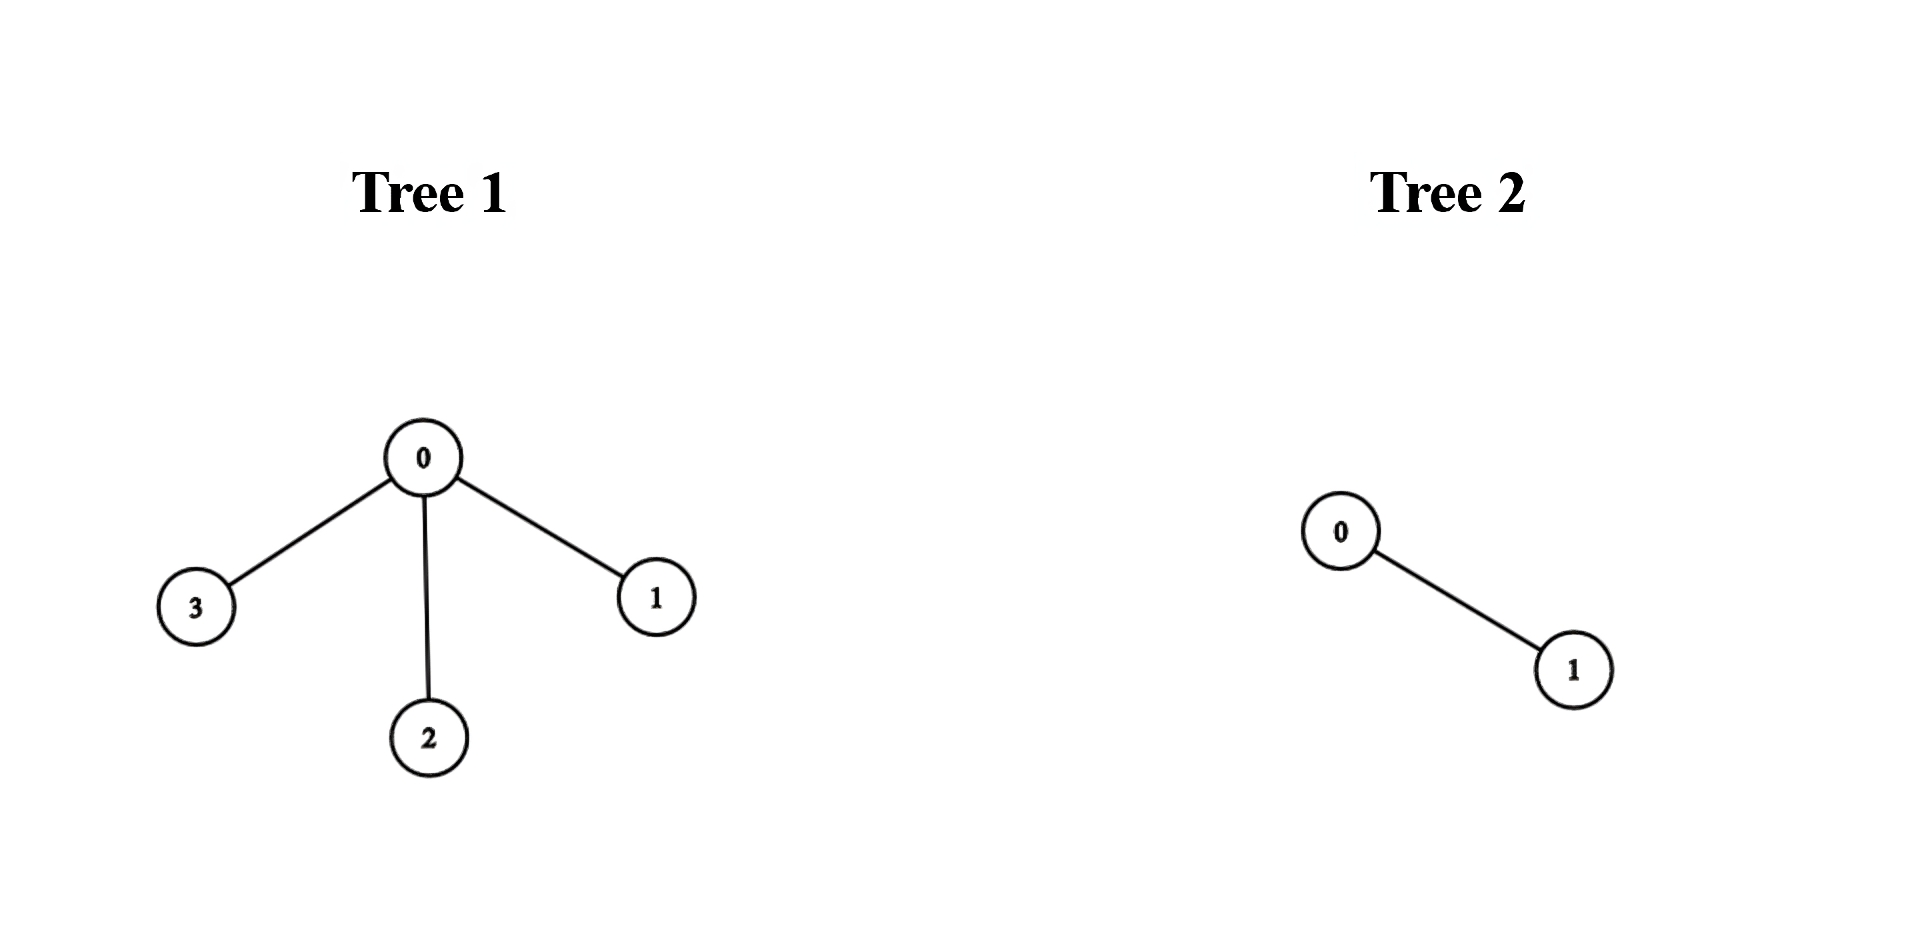
输入:edges1 = [[0,1],[0,2],[0,3]], edges2 = [[0,1]]
输出:3
解释:
将第一棵树中的节点 0 与第二棵树中的任意节点连接,得到一棵直径为 3 的树。
示例 2: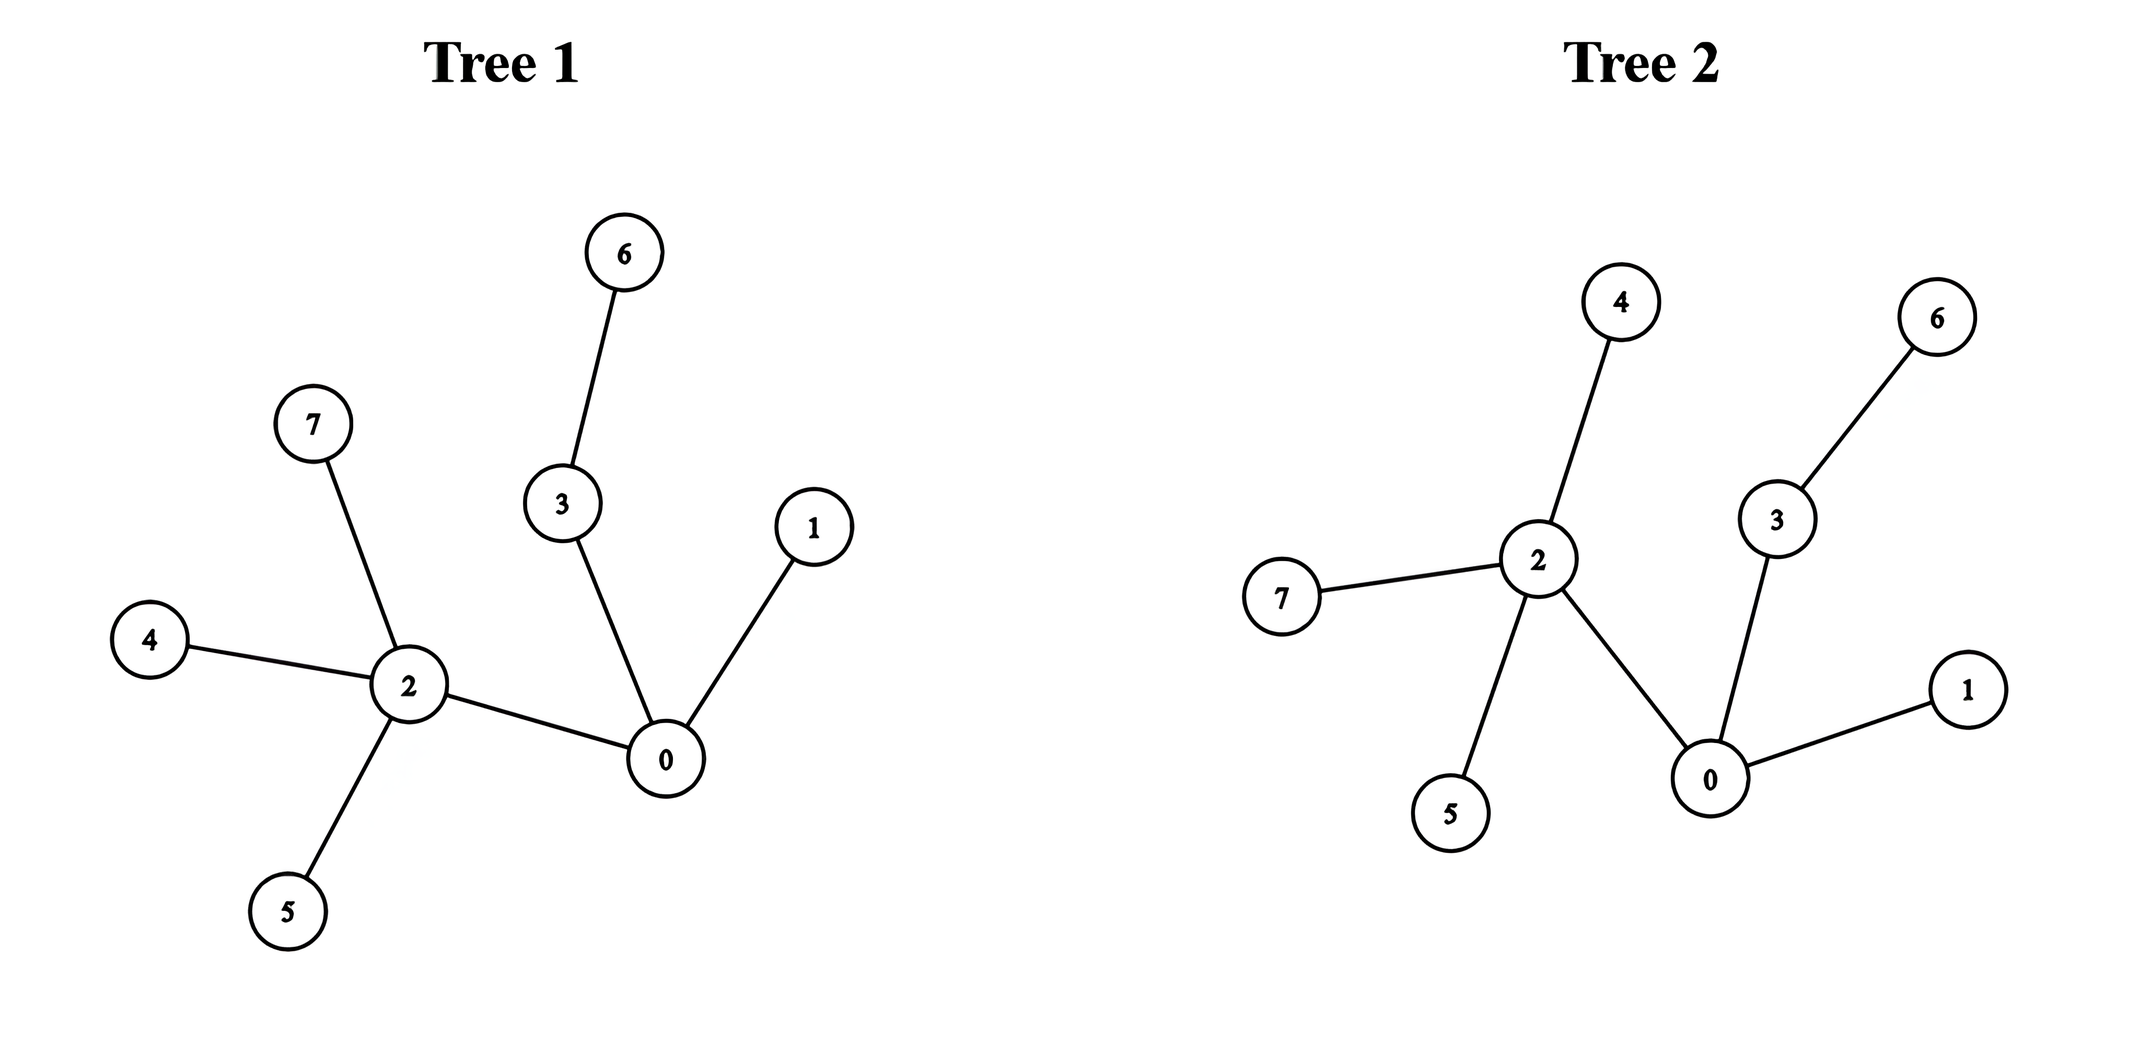
输入:edges1 = [[0,1],[0,2],[0,3],[2,4],[2,5],[3,6],[2,7]], edges2 = [[0,1],[0,2],[0,3],[2,4],[2,5],[3,6],[2,7]]
输出:5
解释:
将第一棵树中的节点 0 和第二棵树中的节点 0 连接,可以得到一棵直径为 5 的树。
提示:
1 <= n, m <= 105edges1.length == n - 1edges2.length == m - 1edges1[i].length == edges2[i].length == 2edges1[i] = [ai, bi]0 <= ai, bi < nedges2[i] = [ui, vi]0 <= ui, vi < m- 输入保证
edges1和edges2分别表示一棵合法的树。
方法一:两次 DFS · Go 实现
思考
需要在两棵树之间加一条边,使新树直径最小。 ,若枚举连接端点再求直径,则次数为 量级,无法接受。
新直径只有两类:仍落在某一棵原树内,即 ;或穿过新边,此时最优是把两边的中心附近连起来,长度为两棵树半径之和再加 。因此只要求出两棵树的直径。树上任取一点走最远到达 ,再从 走最远到达 , 到 即为直径,两次 DFS 即可,总时间线性。
我们记 和 分别为两棵树的直径,那么合并后的树的直径有以下两种情况:
- 合并后的树的直径为原始的一棵树的直径,即 ;
- 合并后的树的直径经过原始的两棵树。我们分别计算原始的两棵树的半径 和 ,那么合并后的树的直径为 。
我们取这两种情况的最大值即可。
在计算树的直径时,我们可以使用两次 DFS。首先我们任选一点出发,找到距离该点最远的点,记为 。然后从点 出发,找到距离点 最远的点,记为 。可以证明,点 和点 之间的路径即为树的直径。
时间复杂度 ,空间复杂度 。其中 和 分别为两棵树的节点数。
func minimumDiameterAfterMerge(edges1 [][]int, edges2 [][]int) int {
	d1 := treeDiameter(edges1)
	d2 := treeDiameter(edges2)
	return max(d1, d2, (d1+1)/2+(d2+1)/2+1)
}

func treeDiameter(edges [][]int) (ans int) {
	n := len(edges) + 1
	g := make([][]int, n)
	for _, e := range edges {
		a, b := e[0], e[1]
		g[a] = append(g[a], b)
		g[b] = append(g[b], a)
	}
	a := 0
	var dfs func(i, fa, t int)
	dfs = func(i, fa, t int) {
		for _, j := range g[i] {
			if j != fa {
				dfs(j, i, t+1)
			}
		}
		if ans < t {
			ans = t
			a = i
		}
	}
	dfs(0, -1, 0)
	dfs(a, -1, 0)
	return
}
方法二:两次显式栈 · Go 实现
思考
需要在两棵树之间加一条边,使新树直径最小。 ,若枚举连接端点再求直径,则次数为 量级,无法接受。从任意点递归走到最远点,链上的调用深度就是 ,会超出递归栈。
新直径只有两类:仍落在某一棵原树内,即 ;或穿过新边,此时最优是把两边的中心附近连起来,长度为两棵树半径之和再加 。因此只要求出两棵树的直径。
显式栈任取一点走到最远的 ,再从 走到最远的 , 到 即为直径。两棵树各走两次,总时间线性。
我们记 和 分别为两棵树的直径,那么合并后的树的直径有以下两种情况:
- 合并后的树的直径为原始的一棵树的直径,即 ;
- 合并后的树的直径经过原始的两棵树。我们分别计算原始的两棵树的半径 和 ,那么合并后的树的直径为 。
我们取这两种情况的最大值即可。
在计算树的直径时,用显式栈走两次。首先任选一点出发,找到距离该点最远的点,记为 。然后从点 出发,找到距离点 最远的点,记为 。可以证明,点 和点 之间的路径即为树的直径。
时间复杂度 ,空间复杂度 。其中 和 分别为两棵树的节点数。
func minimumDiameterAfterMerge(edges1 [][]int, edges2 [][]int) int {
	d1 := treeDiameter(edges1)
	d2 := treeDiameter(edges2)
	return max(d1, d2, (d1+1)/2+(d2+1)/2+1)
}

func treeDiameter(edges [][]int) int {
	n := len(edges) + 1
	g := make([][]int, n)
	for _, e := range edges {
		a, b := e[0], e[1]
		g[a] = append(g[a], b)
		g[b] = append(g[b], a)
	}
	farthest := func(start int) (int, int) {
		ans, node := 0, start
		stk := [][3]int{{start, -1, 0}}
		for len(stk) > 0 {
			cur := stk[len(stk)-1]
			stk = stk[:len(stk)-1]
			i, fa, t := cur[0], cur[1], cur[2]
			if ans < t {
				ans, node = t, i
			}
			for _, j := range g[i] {
				if j != fa {
					stk = append(stk, [3]int{j, i, t + 1})
				}
			}
		}
		return ans, node
	}
	_, a := farthest(0)
	ans, _ := farthest(a)
	return ans
}3241. 标记所有节点需要的时间
题目、示例与约束
给你一棵 无向 树,树中节点从 0 到 n - 1 编号。同时给你一个长度为 n - 1 的二维整数数组 edges ,其中 edges[i] = [ui, vi] 表示节点 ui 和 vi 在树中有一条边。
一开始,所有 节点都 未标记 。对于节点 i :
- 当
i是奇数时,如果时刻x - 1该节点有 至少 一个相邻节点已经被标记了,那么节点i会在时刻x被标记。 - 当
i是偶数时,如果时刻x - 2该节点有 至少 一个相邻节点已经被标记了,那么节点i会在时刻x被标记。
请你返回一个数组 times ,表示如果你在时刻 t = 0 标记节点 i ,那么时刻 times[i] 时,树中所有节点都会被标记。
请注意,每个 times[i] 的答案都是独立的,即当你标记节点 i 时,所有其他节点都未标记。
示例 1:
输入:edges = [[0,1],[0,2]]
输出:[2,4,3]
解释:
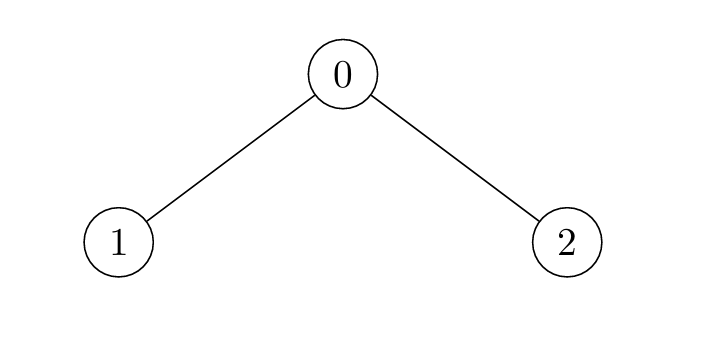
- 对于
i = 0:- 节点 1 在时刻
t = 1被标记,节点 2 在时刻t = 2被标记。
- 节点 1 在时刻
- 对于
i = 1:- 节点 0 在时刻
t = 2被标记,节点 2 在时刻t = 4被标记。
- 节点 0 在时刻
- 对于
i = 2:- 节点 0 在时刻
t = 2被标记,节点 1 在时刻t = 3被标记。
- 节点 0 在时刻
示例 2:
输入:edges = [[0,1]]
输出:[1,2]
解释:
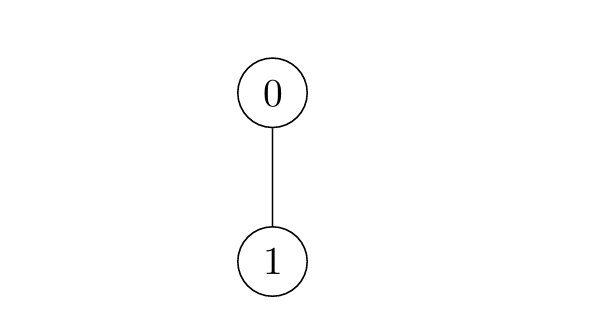
- 对于
i = 0:- 节点 1 在时刻
t = 1被标记。
- 节点 1 在时刻
- 对于
i = 1:- 节点 0 在时刻
t = 2被标记。
- 节点 0 在时刻
示例 3:
输入:edges = [[2,4],[0,1],[2,3],[0,2]]
输出:[4,6,3,5,5]
解释:

提示:
2 <= n <= 105edges.length == n - 1edges[i].length == 20 <= edges[i][0], edges[i][1] <= n - 1- 输入保证
edges表示一棵合法的树。
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
前置知识:【图解】一张图秒懂换根 DP!
本题相当于对每个节点,计算以该节点为根时,树的高度(最大深度)。
其中从 的有向边的边权为 ,即当 是奇数时,边权为 ;当 是偶数时,边权为 。
⚠注意:如果 和 的奇偶性不同,那么从 的有向边和从 的有向边的边权是不一样的。
考虑换根 DP。
首先,通过一次 DFS,计算以 为根节点时,树的最大深度。
在 DFS 的过程中,额外保存:
- 子树 的最大深度 。
- 子树 的次大深度 。
- 子树 通过其儿子 取到的最大深度。
然后,再通过一次 DFS,计算出本题的答案。
对于节点 ,其答案是以下两种情况的最大值:
- 子树 的最大深度。
- 往上走到某个节点(可以再往下拐弯)的路径长度。
对于第二种情况,可以作为 DFS 的一个参数 。
如果 的儿子 ,那么往下传入的参数更新为
如果 的儿子 ,那么往下传入的参数更新为
注:我把【图解】一张图秒懂换根 DP 这题叫做第一类换根 DP,本题需要额外维护次大信息,我称其为第二类换根 DP。
本题视频讲解 第四题,欢迎点赞关注~
复杂度分析
- 时间复杂度:,其中 是 的长度。
- 空间复杂度:。
相似题目
更多相似题目,见下面 DP 题单中的「换根 DP」。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/基环树/最短路/最小生成树/网络流)
- 动态规划(入门/背包/划分/状态机/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
欢迎关注 B站@灵茶山艾府
// https://space.bilibili.com/206214
func timeTaken(edges [][]int) []int {
	n := len(edges) + 1
	g := make([][]int, n)
	for _, e := range edges {
		x, y := e[0], e[1]
		g[x] = append(g[x], y)
		g[y] = append(g[y], x)
	}

	// subRes[x] 保存子树 x 的最大深度 maxD,次大深度 maxD2,以及最大深度要往儿子 y 走
	subRes := make([]struct{ maxD, maxD2, y int }, n)
	// 计算 subRes[x]
	var dfs func(int, int)
	dfs = func(x, fa int) {
		res := &subRes[x]
		for _, y := range g[x] {
			if y == fa {
				continue
			}
			dfs(y, x)
			w := 2 - y%2 // 从 x 到 y 的边权
			maxD := subRes[y].maxD + w // 从 x 出发,往 y 方向的最大深度
			if maxD > res.maxD {
				res.maxD2 = res.maxD
				res.maxD = maxD
				res.y = y
			} else if maxD > res.maxD2 {
				res.maxD2 = maxD
			}
		}
	}
	dfs(0, -1)

	// ans[x] 表示当 x 是树根时,整棵树的最大深度
	ans := make([]int, n)
	// 计算 ans[x]
	var reroot func(int, int, int)
	reroot = func(x, fa, fromUp int) {
		sub := subRes[x]
		ans[x] = max(sub.maxD, fromUp)
		for _, y := range g[x] {
			if y == fa {
				continue
			}
			// 站在 x 的角度,不往 y 走,能走多远?
			// 要么往上走(fromUp),要么往除了 y 的其余子树走(mx),二者取最大值
			mx := sub.maxD
			if y == sub.y { // 对于 y 来说,上面要选次大的
				mx = sub.maxD2
			}
			w := 2 - x%2 // 从 y 到 x 的边权
			reroot(y, x, max(fromUp, mx)+w) // 对于 y 来说,加上从 y 到 x 的边权
		}
	}
	reroot(0, -1, 0)
	return ans
}3243. 新增道路查询后的最短距离 I
题目、示例与约束
给你一个整数 n 和一个二维整数数组 queries。
有 n 个城市,编号从 0 到 n - 1。初始时,每个城市 i 都有一条单向道路通往城市 i + 1( 0 <= i < n - 1)。
queries[i] = [ui, vi] 表示新建一条从城市 ui 到城市 vi 的单向道路。每次查询后,你需要找到从城市 0 到城市 n - 1 的最短路径的长度。
返回一个数组 answer,对于范围 [0, queries.length - 1] 中的每个 i,answer[i] 是处理完前 i + 1 个查询后,从城市 0 到城市 n - 1 的最短路径的长度。
示例 1:
输入: n = 5, queries = [[2, 4], [0, 2], [0, 4]]
输出: [3, 2, 1]
解释:
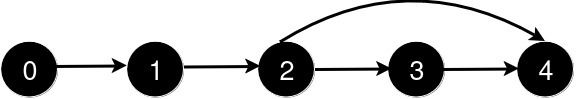
新增一条从 2 到 4 的道路后,从 0 到 4 的最短路径长度为 3。
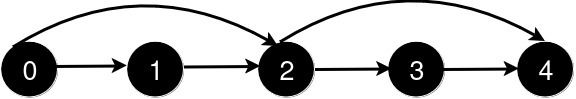
新增一条从 0 到 2 的道路后,从 0 到 4 的最短路径长度为 2。
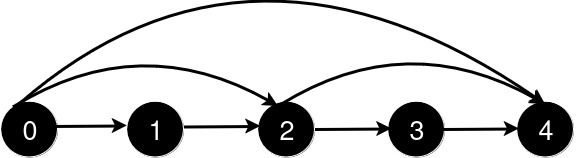
新增一条从 0 到 4 的道路后,从 0 到 4 的最短路径长度为 1。
示例 2:
输入: n = 4, queries = [[0, 3], [0, 2]]
输出: [1, 1]
解释:
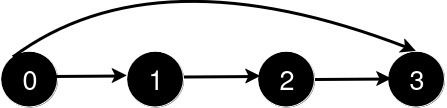
新增一条从 0 到 3 的道路后,从 0 到 3 的最短路径长度为 1。
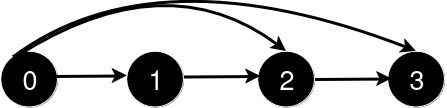
新增一条从 0 到 2 的道路后,从 0 到 3 的最短路径长度仍为 1。
提示:
3 <= n <= 5001 <= queries.length <= 500queries[i].length == 20 <= queries[i][0] < queries[i][1] < n1 < queries[i][1] - queries[i][0]- 查询中没有重复的道路。
方法一:BFS · Go 实现
思考
初始为链 ,每次加一条向前的边后问 到 的最短路。 ,每次重新最短路可以接受。
边权为 ,BFS 即可。加边后从 再搜一层,把距离写入答案。总时间 。
我们先建立一个有向图 ,其中 表示从城市 出发可以到达的城市列表,初始时,每个城市 都有一条单向道路通往城市 。
然后,我们对每个查询 ,将 添加到 的可达城市列表中,然后使用 BFS 求出从城市 到城市 的最短路径长度,将结果添加到答案数组中。
最后返回答案数组即可。
时间复杂度 ,空间复杂度 。其中 和 分别为城市数量和查询数量。
func shortestDistanceAfterQueries(n int, queries [][]int) []int {
	g := make([][]int, n)
	for i := range g {
		g[i] = append(g[i], i+1)
	}
	bfs := func(i int) int {
		q := []int{i}
		vis := make([]bool, n)
		vis[i] = true
		for d := 0; ; d++ {
			for k := len(q); k > 0; k-- {
				u := q[0]
				if u == n-1 {
					return d
				}
				q = q[1:]
				for _, v := range g[u] {
					if !vis[v] {
						vis[v] = true
						q = append(q, v)
					}
				}
			}
		}
	}
	ans := make([]int, len(queries))
	for i, q := range queries {
		g[q[0]] = append(g[q[0]], q[1])
		ans[i] = bfs(0)
	}
	return ans
}3244. 新增道路查询后的最短距离 II
题目、示例与约束
给你一个整数 n 和一个二维整数数组 queries。
有 n 个城市,编号从 0 到 n - 1。初始时,每个城市 i 都有一条单向道路通往城市 i + 1( 0 <= i < n - 1)。
queries[i] = [ui, vi] 表示新建一条从城市 ui 到城市 vi 的单向道路。每次查询后,你需要找到从城市 0 到城市 n - 1 的最短路径的长度。
所有查询中不会存在两个查询都满足 queries[i][0] < queries[j][0] < queries[i][1] < queries[j][1]。
返回一个数组 answer,对于范围 [0, queries.length - 1] 中的每个 i,answer[i] 是处理完前 i + 1 个查询后,从城市 0 到城市 n - 1 的最短路径的长度。
示例 1:
输入: n = 5, queries = [[2, 4], [0, 2], [0, 4]]
输出: [3, 2, 1]
解释:
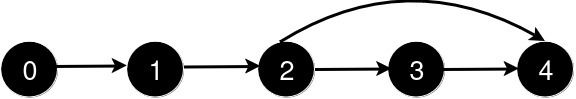
新增一条从 2 到 4 的道路后,从 0 到 4 的最短路径长度为 3。
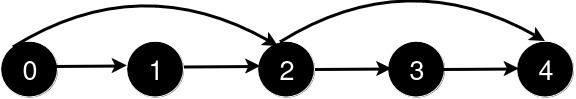
新增一条从 0 到 2 的道路后,从 0 到 4 的最短路径长度为 2。
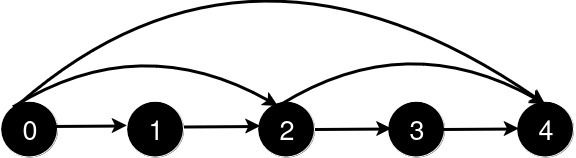
新增一条从 0 到 4 的道路后,从 0 到 4 的最短路径长度为 1。
示例 2:
输入: n = 4, queries = [[0, 3], [0, 2]]
输出: [1, 1]
解释:
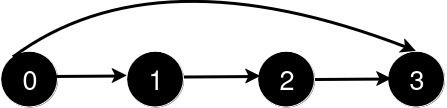
新增一条从 0 到 3 的道路后,从 0 到 3 的最短路径长度为 1。
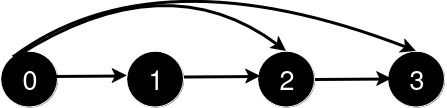
新增一条从 0 到 2 的道路后,从 0 到 3 的最短路径长度仍为 1。
提示:
3 <= n <= 1051 <= queries.length <= 105queries[i].length == 20 <= queries[i][0] < queries[i][1] < n1 < queries[i][1] - queries[i][0]- 查询中不存在重复的道路。
- 不存在两个查询都满足
i != j且queries[i][0] < queries[j][0] < queries[i][1] < queries[j][1]。
方法一:贪心 + 记录跳转位置 · Go 实现
思考
与上一题类似,但查询保证新边互不交叉覆盖,规模更大,每次 BFS 不再可行。一条 会吃掉中间所有必须经过的城市,最短路长度减少被覆盖的点数。
用 表示 当前跳到的下一城。若新边真正缩短,则沿 把 内旧跳重置并减少 。每个位置至多被删一次,总时间线性。
我们定义一个长度为 的数组 ,其中 表示从城市 可以到达的下一个城市的编号。初始时 。
对于每次查询 ,如果此前已经连通了 和 ,且 ,那么我们可以跳过这次查询。否则,我们需要将 到 这些城市的下一个城市编号设置为 ,并将 设置为 。
在这个过程中,我们维护一个变量 ,表示从城市 到城市 的最短路径的长度。初始时 。每一次,如果我们将 这些城市的下一个城市编号设置为 ,那么 就会减少 。
时间复杂度 ,空间复杂度 。其中 和 分别是城市数量和查询数量。
func shortestDistanceAfterQueries(n int, queries [][]int) (ans []int) {
	nxt := make([]int, n-1)
	for i := range nxt {
		nxt[i] = i + 1
	}
	cnt := n - 1
	for _, q := range queries {
		u, v := q[0], q[1]
		if nxt[u] > 0 && nxt[u] < v {
			i := nxt[u]
			for i < v {
				cnt--
				nxt[i], i = 0, nxt[i]
			}
			nxt[u] = v
		}
		ans = append(ans, cnt)
	}
	return
}3286. 穿越网格图的安全路径
题目、示例与约束
给你一个 m x n 的二进制矩形 grid 和一个整数 health 表示你的健康值。
你开始于矩形的左上角 (0, 0) ,你的目标是矩形的右下角 (m - 1, n - 1) 。
你可以在矩形中往上下左右相邻格子移动,但前提是你的健康值始终是 正数 。
对于格子 (i, j) ,如果 grid[i][j] = 1 ,那么这个格子视为 不安全 的,会使你的健康值减少 1 。
如果你可以到达最终的格子,请你返回 true ,否则返回 false 。
注意 ,当你在最终格子的时候,你的健康值也必须为 正数 。
示例 1:
输入:grid = [[0,1,0,0,0],[0,1,0,1,0],[0,0,0,1,0]], health = 1
输出:true
解释:
沿着下图中灰色格子走,可以安全到达最终的格子。
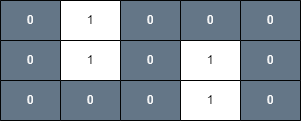
示例 2:
输入:grid = [[0,1,1,0,0,0],[1,0,1,0,0,0],[0,1,1,1,0,1],[0,0,1,0,1,0]], health = 3
输出:false
解释:
健康值最少为 4 才能安全到达最后的格子。
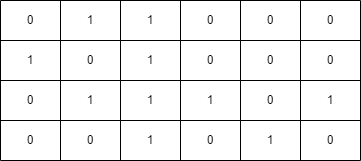
示例 3:
输入:grid = [[1,1,1],[1,0,1],[1,1,1]], health = 5
输出:true
解释:
沿着下图中灰色格子走,可以安全到达最终的格子。
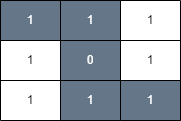
任何不经过格子 (1, 1) 的路径都是不安全的,因为你的健康值到达最终格子时,都会小于等于 0 。
提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 502 <= m * n1 <= health <= m + ngrid[i][j]要么是 0 ,要么是 1 。
方法一:BFS · Go 实现
思考
格子 消耗 点生命,需以剩余生命为正走到终点。 ,普通 BFS 只记到达与否不够,因为更少消耗的路径可能后到。
为到达该格的最小消耗,松弛成功则入队。边权为 ,队列 BFS 仍正确。终点消耗小于 则可行。
我们定义一个二维数组 ,其中 表示从左上角到达 位置的最小健康值。初始时,我们将 设为 ,并将 加入队列 中。
随后我们不断取出队列中的元素 ,并尝试向四个方向移动。如果移动到了一个合法的位置 ,且从 移动到 的健康值消耗更小,那么我们就可以更新 ,并将 加入队列 中。
最终,当队列为空时,我们就可以得到 ,即从左上角到达右下角的最小健康值。如果这个值小于 ,那么我们就可以到达右下角,否则我们无法到达。
时间复杂度 ,空间复杂度 。其中 和 分别是矩形的行数和列数。
func findSafeWalk(grid [][]int, health int) bool {
	m, n := len(grid), len(grid[0])
	dist := make([][]int, m)
	for i := range dist {
		dist[i] = make([]int, n)
		for j := range dist[i] {
			dist[i][j] = math.MaxInt32
		}
	}
	dist[0][0] = grid[0][0]
	q := [][2]int{{0, 0}}
	dirs := []int{-1, 0, 1, 0, -1}
	for len(q) > 0 {
		curr := q[0]
		q = q[1:]
		x, y := curr[0], curr[1]
		for i := 0; i < 4; i++ {
			nx, ny := x+dirs[i], y+dirs[i+1]
			if nx >= 0 && nx < m && ny >= 0 && ny < n && dist[nx][ny] > dist[x][y]+grid[nx][ny] {
				dist[nx][ny] = dist[x][y] + grid[nx][ny]
				q = append(q, [2]int{nx, ny})
			}
		}
	}
	return dist[m-1][n-1] < health
}3310. 移除可疑的方法
题目、示例与约束
你正在维护一个项目,该项目有 n 个方法,编号从 0 到 n - 1。
给你两个整数 n 和 k,以及一个二维整数数组 invocations,其中 invocations[i] = [ai, bi] 表示方法 ai 调用了方法 bi。
已知如果方法 k 存在一个已知的 bug。那么方法 k 以及它直接或间接调用的任何方法都被视为 可疑方法 ,我们需要从项目中移除这些方法。
只有当一组方法没有被这组之外的任何方法调用时,这组方法才能被移除。
返回一个数组,包含移除所有 可疑方法 后剩下的所有方法。你可以以任意顺序返回答案。如果无法移除 所有 可疑方法,则 不 移除任何方法。
示例 1:
输入: n = 4, k = 1, invocations = [[1,2],[0,1],[3,2]]
输出: [0,1,2,3]
解释:
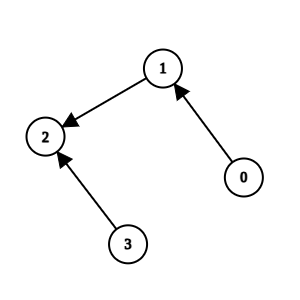
方法 2 和方法 1 是可疑方法,但它们分别直接被方法 3 和方法 0 调用。由于方法 3 和方法 0 不是可疑方法,我们无法移除任何方法,故返回所有方法。
示例 2:
输入: n = 5, k = 0, invocations = [[1,2],[0,2],[0,1],[3,4]]
输出: [3,4]
解释:
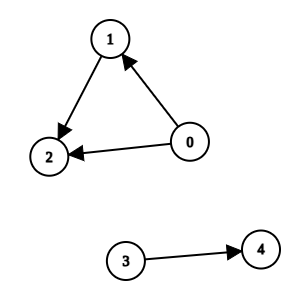
方法 0、方法 1 和方法 2 是可疑方法,且没有被任何其他方法直接调用。我们可以移除它们。
示例 3:
输入: n = 3, k = 2, invocations = [[1,2],[0,1],[2,0]]
输出: []
解释:
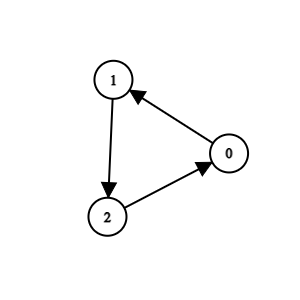
所有方法都是可疑方法。我们可以移除它们。
提示:
1 <= n <= 1050 <= k <= n - 10 <= invocations.length <= 2 * 105invocations[i] == [ai, bi]0 <= ai, bi <= n - 1ai != biinvocations[i] != invocations[j]
方法一:两次 DFS · Go 实现
思考
从 沿调用边可达的方法是可疑的,但不能删除仍被干净方法调用的节点,否则会误伤整块可达代码。图规模允许线性遍历。
第一次沿有向边从 标记可疑闭包。第二次从所有尚未标记的点出发,沿无向边把被干净方法触及的节点撤销标记。
两次遍历后仍保持可疑的方法才真正删除,其余下标即为答案。
我们可以先从 出发,找到所有可疑方法,用数组 记录。然后再从 到 遍历,从所有不可疑方法出发,将所有可达的方法标记为不可疑方法。最后返回所有不可疑方法。
时间复杂度 ,空间复杂度 。其中 和 分别表示方法数量和调用关系数量。
func remainingMethods(n int, k int, invocations [][]int) []int {
	suspicious := make([]bool, n)
	vis := make([]bool, n)
	f := make([][]int, n)
	g := make([][]int, n)

	for _, e := range invocations {
		a, b := e[0], e[1]
		f[a] = append(f[a], b)
		f[b] = append(f[b], a)
		g[a] = append(g[a], b)
	}

	var dfs func(int)
	dfs = func(i int) {
		suspicious[i] = true
		for _, j := range g[i] {
			if !suspicious[j] {
				dfs(j)
			}
		}
	}

	dfs(k)

	var dfs2 func(int)
	dfs2 = func(i int) {
		vis[i] = true
		for _, j := range f[i] {
			if !vis[j] {
				suspicious[j] = false
				dfs2(j)
			}
		}
	}

	for i := 0; i < n; i++ {
		if !suspicious[i] && !vis[i] {
			dfs2(i)
		}
	}

	var ans []int
	for i := 0; i < n; i++ {
		if !suspicious[i] {
			ans = append(ans, i)
		}
	}

	return ans
}
方法二:两次显式栈 · Go 实现
思考
从 沿调用边可达的方法是可疑的,但不能删除仍被干净方法调用的节点。 ,图上线性遍历即可。
从 递归走进被调方法,链上的调用深度就是 ,会超出递归栈。可疑集合和后来被撤销的集合都只取决于可达性,与邻居顺序无关。
因此两次都改用显式栈。第一次沿有向边从 标记可疑闭包,入栈时打标记。第二次从所有尚未标记的点出发,沿无向边把被干净方法触及的节点撤销标记。两次之后仍可疑的方法删除,其余下标即为答案。
我们可以先用显式栈从 出发,沿有向调用边找出所有可疑方法,用数组 记录,入栈时打上标记。然后再从 到 遍历,从所有不可疑方法出发,沿无向边用显式栈把可达的方法标回不可疑。最后返回所有不可疑方法。
时间复杂度 ,空间复杂度 。其中 和 分别表示方法数量和调用关系数量。
func remainingMethods(n int, k int, invocations [][]int) []int {
	suspicious := make([]bool, n)
	vis := make([]bool, n)
	f := make([][]int, n)
	g := make([][]int, n)
	for _, e := range invocations {
		a, b := e[0], e[1]
		f[a] = append(f[a], b)
		f[b] = append(f[b], a)
		g[a] = append(g[a], b)
	}
	suspicious[k] = true
	stk := []int{k}
	for len(stk) > 0 {
		i := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		for _, j := range g[i] {
			if !suspicious[j] {
				suspicious[j] = true
				stk = append(stk, j)
			}
		}
	}
	for i := 0; i < n; i++ {
		if suspicious[i] || vis[i] {
			continue
		}
		vis[i] = true
		stk = []int{i}
		for len(stk) > 0 {
			u := stk[len(stk)-1]
			stk = stk[:len(stk)-1]
			for _, j := range f[u] {
				if !vis[j] {
					suspicious[j] = false
					vis[j] = true
					stk = append(stk, j)
				}
			}
		}
	}
	var ans []int
	for i := 0; i < n; i++ {
		if !suspicious[i] {
			ans = append(ans, i)
		}
	}
	return ans
}3311. 构造符合图结构的二维矩阵
题目、示例与约束
给你一个二维整数数组 edges ,它表示一棵 n 个节点的 无向 图,其中 edges[i] = [ui, vi] 表示节点 ui 和 vi 之间有一条边。
请你构造一个二维矩阵,满足以下条件:
- 矩阵中每个格子 一一对应 图中
0到n - 1的所有节点。 - 矩阵中两个格子相邻(横 的或者 竖 的)当且仅当 它们对应的节点在
edges中有边连接。
题目保证 edges 可以构造一个满足上述条件的二维矩阵。
请你返回一个符合上述要求的二维整数数组,如果存在多种答案,返回任意一个。
示例 1:
输入:n = 4, edges = [[0,1],[0,2],[1,3],[2,3]]
输出:[[3,1],[2,0]]
解释:

示例 2:
输入:n = 5, edges = [[0,1],[1,3],[2,3],[2,4]]
输出:[[4,2,3,1,0]]
解释:

示例 3:
输入:n = 9, edges = [[0,1],[0,4],[0,5],[1,7],[2,3],[2,4],[2,5],[3,6],[4,6],[4,7],[6,8],[7,8]]
输出:[[8,6,3],[7,4,2],[1,0,5]]
解释:

提示:
2 <= n <= 5 * 1041 <= edges.length <= 105edges[i] = [ui, vi]0 <= ui < vi < n- 图中的边互不相同。
- 输入保证
edges可以形成一个符合上述条件的二维矩阵。
方法一 · Go 实现
思考
输入保证是网格图。 ,不能回溯填格。度数刻画位置: 度为单行端点, 度为角落或单行内部, 度为边界, 度为内部。
先按度数构造第一行:存在 度则整图是一行;否则从 度角落沿「度数小于 」的边走出第一行。
此后每一行由上一行各点尚未访问的邻居唯一确定,逐行铺满即可。
func constructGridLayout(n int, edges [][]int) [][]int {
	g := make([][]int, n)
	for _, e := range edges {
		u, v := e[0], e[1]
		g[u] = append(g[u], v)
		g[v] = append(g[v], u)
	}

	deg := make([]int, 5)
	for i := range deg {
		deg[i] = -1
	}

	for x := 0; x < n; x++ {
		deg[len(g[x])] = x
	}

	var row []int
	if deg[1] != -1 {
		row = append(row, deg[1])
	} else if deg[4] == -1 {
		x := deg[2]
		for _, y := range g[x] {
			if len(g[y]) == 2 {
				row = append(row, x, y)
				break
			}
		}
	} else {
		x := deg[2]
		row = append(row, x)
		pre := x
		x = g[x][0]
		for len(g[x]) > 2 {
			row = append(row, x)
			for _, y := range g[x] {
				if y != pre && len(g[y]) < 4 {
					pre = x
					x = y
					break
				}
			}
		}
		row = append(row, x)
	}

	ans := [][]int{row}
	vis := make([]bool, n)
	rowSize := len(row)
	for i := 0; i < n/rowSize-1; i++ {
		for _, x := range row {
			vis[x] = true
		}
		nxt := []int{}
		for _, x := range row {
			for _, y := range g[x] {
				if !vis[y] {
					nxt = append(nxt, y)
					break
				}
			}
		}
		ans = append(ans, nxt)
		row = nxt
	}

	return ans
}3341. 到达最后一个房间的最少时间 I
题目、示例与约束
有一个地窖,地窖中有 n x m 个房间,它们呈网格状排布。
给你一个大小为 n x m 的二维数组 moveTime ,其中 moveTime[i][j] 表示房间开启并可达所需的 最小 秒数。你在时刻 t = 0 时从房间 (0, 0) 出发,每次可以移动到 相邻 的一个房间。在 相邻 房间之间移动需要的时间为 1 秒。
请你返回到达房间 (n - 1, m - 1) 所需要的 最少 时间。
如果两个房间有一条公共边(可以是水平的也可以是竖直的),那么我们称这两个房间是 相邻 的。
示例 1:
输入:moveTime = [[0,4],[4,4]]
输出:6
解释:
需要花费的最少时间为 6 秒。
- 在时刻
t == 4,从房间(0, 0)移动到房间(1, 0),花费 1 秒。 - 在时刻
t == 5,从房间(1, 0)移动到房间(1, 1),花费 1 秒。
示例 2:
输入:moveTime = [[0,0,0],[0,0,0]]
输出:3
解释:
需要花费的最少时间为 3 秒。
- 在时刻
t == 0,从房间(0, 0)移动到房间(1, 0),花费 1 秒。 - 在时刻
t == 1,从房间(1, 0)移动到房间(1, 1),花费 1 秒。 - 在时刻
t == 2,从房间(1, 1)移动到房间(1, 2),花费 1 秒。
示例 3:
输入:moveTime = [[0,1],[1,2]]
输出:3
提示:
2 <= n == moveTime.length <= 502 <= m == moveTime[i].length <= 500 <= moveTime[i][j] <= 109
方法一:Dijkstra 算法 · Go 实现
思考
进入格子 不得早于 ,且每步耗时 。边权非负但依赖到达时间,BFS 不再正确。
,以时间为关键字的 Dijkstra 足够。松弛式为 。
优先队列弹出终点时即为最短时间。
我们定义一个二维数组 ,其中 表示从起点到达房间 所需的最少时间。初始时,我们将 数组中的所有元素设为无穷大,然后将起点 的 值设为 。
我们使用优先队列 存储每一个状态,其中每个状态由三个值 组成,表示从起点到达房间 所需的时间为 。初始时,我们将起点 加入到 中。
在每一次迭代中,我们取出 中的队首元素 ,如果 是终点,那么我们返回 。如果 大于 ,那么我们跳过这个状态。否则,我们枚举 的四个相邻位置 ,如果 在地图内,那么我们计算从 到 的最终时间 ,如果 小于 ,那么我们更新 的值,并将 加入到 中。
时间复杂度 ,空间复杂度 。其中 和 分别是地图的行数和列数。
func minTimeToReach(moveTime [][]int) int {
	n, m := len(moveTime), len(moveTime[0])
	dist := make([][]int, n)
	for i := range dist {
		dist[i] = make([]int, m)
		for j := range dist[i] {
			dist[i][j] = math.MaxInt32
		}
	}
	dist[0][0] = 0

	pq := &hp{}
	heap.Init(pq)
	heap.Push(pq, tuple{0, 0, 0})

	dirs := []int{-1, 0, 1, 0, -1}
	for {
		p := heap.Pop(pq).(tuple)
		d, i, j := p.dis, p.x, p.y

		if i == n-1 && j == m-1 {
			return d
		}
		if d > dist[i][j] {
			continue
		}

		for k := 0; k < 4; k++ {
			x, y := i+dirs[k], j+dirs[k+1]
			if x >= 0 && x < n && y >= 0 && y < m {
				t := max(moveTime[x][y], dist[i][j]) + 1
				if dist[x][y] > t {
					dist[x][y] = t
					heap.Push(pq, tuple{t, x, y})
				}
			}
		}
	}
}

type tuple struct{ dis, x, y int }
type hp []tuple

func (h hp) Len() int           { return len(h) }
func (h hp) Less(i, j int) bool { return h[i].dis < h[j].dis }
func (h hp) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)        { *h = append(*h, v.(tuple)) }
func (h *hp) Pop() (v any) { a := *h; *h, v = a[:len(a)-1], a[len(a)-1]; return }3342. 到达最后一个房间的最少时间 II
题目、示例与约束
有一个地窖,地窖中有 n x m 个房间,它们呈网格状排布。
给你一个大小为 n x m 的二维数组 moveTime ,其中 moveTime[i][j] 表示在这个时刻 以后 你才可以 开始 往这个房间 移动 。你在时刻 t = 0 时从房间 (0, 0) 出发,每次可以移动到 相邻 的一个房间。在 相邻 房间之间移动需要的时间为:第一次花费 1 秒,第二次花费 2 秒,第三次花费 1 秒,第四次花费 2 秒……如此 往复 。
请你返回到达房间 (n - 1, m - 1) 所需要的 最少 时间。
如果两个房间有一条公共边(可以是水平的也可以是竖直的),那么我们称这两个房间是 相邻 的。
示例 1:
输入:moveTime = [[0,4],[4,4]]
输出:7
解释:
需要花费的最少时间为 7 秒。
- 在时刻
t == 4,从房间(0, 0)移动到房间(1, 0),花费 1 秒。 - 在时刻
t == 5,从房间(1, 0)移动到房间(1, 1),花费 2 秒。
示例 2:
输入:moveTime = [[0,0,0,0],[0,0,0,0]]
输出:6
解释:
需要花费的最少时间为 6 秒。
- 在时刻
t == 0,从房间(0, 0)移动到房间(1, 0),花费 1 秒。 - 在时刻
t == 1,从房间(1, 0)移动到房间(1, 1),花费 2 秒。 - 在时刻
t == 3,从房间(1, 1)移动到房间(1, 2),花费 1 秒。 - 在时刻
t == 4,从房间(1, 2)移动到房间(1, 3),花费 2 秒。
示例 3:
输入:moveTime = [[0,1],[1,2]]
输出:4
提示:
2 <= n == moveTime.length <= 7502 <= m == moveTime[i].length <= 7500 <= moveTime[i][j] <= 109
方法一:Dijkstra 算法 · Go 实现
思考
与 I 相比,奇偶步交替耗时 与 ,且网格更大。最短路模型不变,只是边权变成 。
恰为到达 后下一步的奇偶:从 出发,下一步耗时 ,再下一步耗时 ,与坐标奇偶一致。
仍用 Dijkstra 按时间松弛;终点首次出堆即为答案。
我们定义一个二维数组 ,其中 表示从起点到达房间 所需的最少时间。初始时,我们将 数组中的所有元素设为无穷大,然后将起点 的 值设为 。
我们使用优先队列 存储每一个状态,其中每个状态由三个值 组成,表示从起点到达房间 所需的时间为 。初始时,我们将起点 加入到 中。
在每一次迭代中,我们取出 中的队首元素 ,如果 是终点,那么我们返回 。如果 大于 ,那么我们跳过这个状态。否则,我们枚举 的四个相邻位置 ,如果 在地图内,那么我们计算从 到 的最终时间 ,如果 小于 ,那么我们更新 的值,并将 加入到 中。
时间复杂度 ,空间复杂度 。其中 和 分别是地图的行数和列数。
func minTimeToReach(moveTime [][]int) int {
	n, m := len(moveTime), len(moveTime[0])
	dist := make([][]int, n)
	for i := range dist {
		dist[i] = make([]int, m)
		for j := range dist[i] {
			dist[i][j] = math.MaxInt32
		}
	}
	dist[0][0] = 0

	pq := &hp{}
	heap.Init(pq)
	heap.Push(pq, tuple{0, 0, 0})

	dirs := []int{-1, 0, 1, 0, -1}
	for {
		p := heap.Pop(pq).(tuple)
		d, i, j := p.dis, p.x, p.y

		if i == n-1 && j == m-1 {
			return d
		}
		if d > dist[i][j] {
			continue
		}

		for k := 0; k < 4; k++ {
			x, y := i+dirs[k], j+dirs[k+1]
			if x >= 0 && x < n && y >= 0 && y < m {
				t := max(moveTime[x][y], dist[i][j]) + (i+j)%2 + 1
				if dist[x][y] > t {
					dist[x][y] = t
					heap.Push(pq, tuple{t, x, y})
				}
			}
		}
	}
}

type tuple struct{ dis, x, y int }
type hp []tuple

func (h hp) Len() int           { return len(h) }
func (h hp) Less(i, j int) bool { return h[i].dis < h[j].dis }
func (h hp) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)        { *h = append(*h, v.(tuple)) }
func (h *hp) Pop() (v any) { a := *h; *h, v = a[:len(a)-1], a[len(a)-1]; return }3377. 使两个整数相等的数位操作
题目、示例与约束
给你两个整数 n 和 m ,两个整数有 相同的 数位数目。
你可以执行以下操作 任意 次:
- 从
n中选择 任意一个 不是 9 的数位,并将它 增加 1 。 - 从
n中选择 任意一个 不是 0 的数位,并将它 减少 1 。
任意时刻,整数 n 都不能是一个 质数 ,意味着一开始以及每次操作以后 n 都不能是质数。
进行一系列操作的代价为 n 在变化过程中 所有 值之和。
请你返回将 n 变为 m 需要的 最小 代价,如果无法将 n 变为 m ,请你返回 -1 。
示例 1:
输入:n = 10, m = 12
输出:85
解释:
我们执行以下操作:
- 增加第一个数位,得到
n = 20。 - 增加第二个数位,得到
n = 21。 - 增加第二个数位,得到
n = 22。 - 减少第一个数位,得到
n = 12。
示例 2:
输入:n = 4, m = 8
输出:-1
解释:
无法将 n 变为 m 。
示例 3:
输入:n = 6, m = 2
输出:-1
解释:
由于 2 已经是质数,我们无法将 n 变为 m 。
提示:
1 <= n, m < 104n和m包含的数位数目相同。
方法一 · Go 实现
思考
每次把某个数位加一或减一(不得有前导零),且不能走到质数,代价为经过的数值之和,求 到 的最小代价。值不超过 ,可在隐式图上最短路。
先筛出 内的质数。 或 为质数则无解。其余每位 作为边,边权为到达的新值。
Dijkstra 以累计和为关键字;第一次弹出 即为最小和。
import (
	"container/heap"
	"strconv"
)

type MinHeap [][]int

func (h MinHeap) Len() int            { return len(h) }
func (h MinHeap) Less(i, j int) bool { return h[i][0] < h[j][0] }
func (h MinHeap) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *MinHeap) Push(x interface{}) {
	*h = append(*h, x.([]int))
}
func (h *MinHeap) Pop() interface{} {
	old := *h
	n := len(old)
	x := old[n-1]
	*h = old[0 : n-1]
	return x
}

var sieve []bool

func runSieve() {
	sieve = make([]bool, 100000)
	for i := range sieve {
		sieve[i] = true
	}
	sieve[0], sieve[1] = false, false
	for i := 2; i < 100000; i++ {
		if sieve[i] {
			for j := 2 * i; j < 100000; j += i {
				sieve[j] = false
			}
		}
	}
}

func solve(n int, m int) int {
	pq := &MinHeap{}
	heap.Init(pq)
	heap.Push(pq, []int{n, n})
	visited := make(map[int]bool)

	for pq.Len() > 0 {
		top := heap.Pop(pq).([]int)
		sum, cur := top[0], top[1]

		if visited[cur] {
			continue
		}
		visited[cur] = true

		if cur == m {
			return sum
		}

		s := []rune(strconv.Itoa(cur))
		for i := 0; i < len(s); i++ {
			c := s[i]

			if s[i] < '9' {
				s[i]++
				next, _ := strconv.Atoi(string(s))
				if !sieve[next] && !visited[next] {
					heap.Push(pq, []int{sum + next, next})
				}
				s[i] = c
			}

			if s[i] > '0' && !(i == 0 && s[i] == '1') {
				s[i]--
				next, _ := strconv.Atoi(string(s))
				if !sieve[next] && !visited[next] {
					heap.Push(pq, []int{sum + next, next})
				}
				s[i] = c
			}
		}
	}

	return -1
}

func minOperations(n int, m int) int {
	runSieve()
	if sieve[n] || sieve[m] {
		return -1
	}
	return solve(n, m)
}3383. 施法所需最低符文数量 🔒
题目、示例与约束
Alice 刚刚从巫师学校毕业,并且希望施展一个魔法咒语来庆祝。魔法咒语包含某些需要集中魔力的焦点,其中一些焦点含有作为咒语能量源的魔法水晶。焦点可以通过 有向符文 进行连接,这些符文将魔力流从一个焦点传输到另一个焦点。
给定一个整数 n 表示焦点的数量,以及一个整数数组 crystals,其中 crystals[i] 表示有魔法水晶的焦点。同时给定两个整数数组 flowFrom 和 flowTo,表示存在的 有向符文。第 ith 个符文允许魔力流从焦点 flowFrom[i] 传输到焦点 flowTo[i]。
你需要找到 Alice 必须添加到她的咒语中的定向符文数量,使得每个焦点要么:
- 包含 一个魔法水晶。
- 从其它焦点 接收 魔力流。
返回她所需要添加的 最少 有向符文数量。
示例 1:
输入:n = 6, crystals = [0], flowFrom = [0,1,2,3], flowTo = [1,2,3,0]
输出:2
解释:
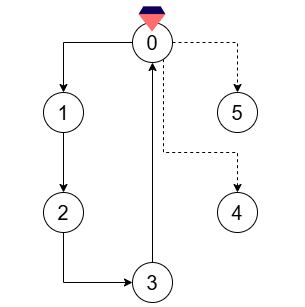
添加两个有向符文:
- 从焦点 0 到焦点 4。
- 从焦点 0 到焦点 5。
示例 2:
输入:n = 7, crystals = [3,5], flowFrom = [0,1,2,3,5], flowTo = [1,2,0,4,6]
输出:1
解释:
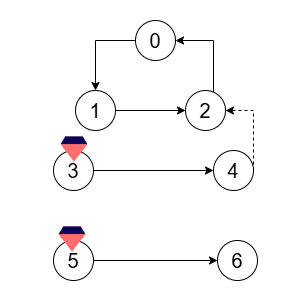
添加从焦点 4 到焦点 2 的有向符文。
提示:
2 <= n <= 1051 <= crystals.length <= n0 <= crystals[i] <= n - 11 <= flowFrom.length == flowTo.length <= min(2 * 105, (n * (n - 1)) / 2)0 <= flowFrom[i], flowTo[i] <= n - 1flowFrom[i] != flowTo[i]- 所有的有向符文 互不相同。
方法一 · Go 实现
思考
有向图中晶体已点亮其可达点,问最少再加几条从「已亮」出发的边,使全图可达。 ,先把已亮闭包 BFS 掉。
剩余点按 DFS 完成序倒序处理,相当于在缩点后的 DAG 上从汇点往回看源。
每个尚未被照亮的完成序节点需要一条新符文,再 BFS 扩大闭包。这样每条新边都连接一个尚未覆盖的弱连通源。
func minRunesToAdd(n int, crystals []int, flowFrom []int, flowTo []int) (ans int) {
	g := make([][]int, n)
	for i := 0; i < len(flowFrom); i++ {
		a, b := flowFrom[i], flowTo[i]
		g[a] = append(g[a], b)
	}

	vis := make([]int, n)
	for _, x := range crystals {
		vis[x] = 1
	}

	bfs := func(q []int) {
		for len(q) > 0 {
			a := q[0]
			q = q[1:]
			for _, b := range g[a] {
				if vis[b] == 1 {
					continue
				}
				vis[b] = 1
				q = append(q, b)
			}
		}
	}

	seq := []int{}
	var dfs func(a int)
	dfs = func(a int) {
		vis[a] = 2
		for _, b := range g[a] {
			if vis[b] > 0 {
				continue
			}
			dfs(b)
		}
		seq = append(seq, a)
	}

	q := crystals
	bfs(q)

	for i := 0; i < n; i++ {
		if vis[i] == 0 {
			dfs(i)
		}
	}

	for i, j := 0, len(seq)-1; i < j; i, j = i+1, j-1 {
		seq[i], seq[j] = seq[j], seq[i]
	}
	for _, i := range seq {
		if vis[i] == 2 {
			q = []int{i}
			vis[i] = 1
			bfs(q)
			ans++
		}
	}
	return
}3385. 破解锁的最少时间 II 🔒
题目、示例与约束
Bob 被困在了一个地窖里,他需要破解 n 个锁才能逃出地窖,每一个锁都需要一定的 能量 才能打开。每一个锁需要的能量存放在一个数组 strength 里,其中 strength[i] 表示打开第 i 个锁需要的能量。
Bob 有一把剑,它具备以下的特征:
- 一开始剑的能量为 0 。
- 剑的能量增加因子
X一开始的值为 1 。 - 每分钟,剑的能量都会增加当前的
X值。 - 打开第
i把锁,剑的能量需要到达 至少strength[i]。 - 打开一把锁以后,剑的能量会变回 0 ,
X的值会增加 1。
你的任务是打开所有 n 把锁并逃出地窖,请你求出需要的 最少 分钟数。
请你返回 Bob 打开所有 n 把锁需要的 最少 时间。
示例 1:
输入:strength = [3,4,1]
输出:4
解释:
| 时间 | 能量 | X | 操作 | 更新后的 X |
|---|---|---|---|---|
| 0 | 0 | 1 | 什么也不做 | 1 |
| 1 | 1 | 1 | 打开第 3 把锁 | 2 |
| 2 | 2 | 2 | 什么也不做 | 2 |
| 3 | 4 | 2 | 打开第 2 把锁 | 3 |
| 4 | 3 | 3 | 打开第 1 把锁 | 3 |
无法用少于 4 分钟打开所有的锁,所以答案为 4 。
示例 2:
输入:strength = [2,5,4]
输出:6
解释:
| 时间 | 能量 | X | 操作 | 更新后的 X |
|---|---|---|---|---|
| 0 | 0 | 1 | 什么也不做 | 1 |
| 1 | 1 | 1 | 什么也不做 | 1 |
| 2 | 2 | 1 | 打开第 1 把锁 | 2 |
| 3 | 2 | 2 | 什么也不做 | 2 |
| 4 | 4 | 2 | 打开第 3 把锁 | 3 |
| 5 | 3 | 3 | 什么也不做 | 3 |
| 6 | 6 | 3 | 打开第 2 把锁 | 4 |
无法用少于 6 分钟打开所有的锁,所以答案为 6。
提示:
n == strength.length1 <= n <= 801 <= strength[i] <= 106
方法一 · Go 实现
思考
与 I 相同,第 把锁在能量为 时耗时 ,但 ,状压不可行。这是锁与「第几次破」之间的最小权匹配。
左部为锁,右部为次序 ,边权为该锁排在该次序时的耗时。源汇容量为 ,保证一一对应。
最小费用最大流求出匹配总权,即为最短总时间。
type mcfEdge struct {
	dst, cap, cost, rev int
}

type MCFGraph struct {
	n int
	g [][]mcfEdge
}

func NewMCFGraph(n int) *MCFGraph {
	return &MCFGraph{n: n, g: make([][]mcfEdge, n)}
}

func (m *MCFGraph) AddEdge(src, dst, cap, cost int) {
	i := len(m.g[src])
	j := len(m.g[dst])
	m.g[src] = append(m.g[src], mcfEdge{dst: dst, cap: cap, cost: cost, rev: j})
	m.g[dst] = append(m.g[dst], mcfEdge{dst: src, cap: 0, cost: -cost, rev: i})
}

func (m *MCFGraph) Flow(s, t, flowLimit int) (int, int) {
	res := m.slope(s, t, flowLimit)
	return res[len(res)-1][0], res[len(res)-1][1]
}

type mcfItem struct{ dist, v int }
type mcfPQ []mcfItem

func (p mcfPQ) Len() int           { return len(p) }
func (p mcfPQ) Less(i, j int) bool { return p[i].dist < p[j].dist }
func (p mcfPQ) Swap(i, j int)      { p[i], p[j] = p[j], p[i] }
func (p *mcfPQ) Push(x any)        { *p = append(*p, x.(mcfItem)) }
func (p *mcfPQ) Pop() any {
	old := *p
	x := old[len(old)-1]
	*p = old[:len(old)-1]
	return x
}

func (m *MCFGraph) slope(s, t, flowLimit int) [][2]int {
	dual := make([]int, m.n)
	pv := make([]int, m.n)
	pe := make([]int, m.n)
	refineDual := func() bool {
		dist := make([]int, m.n)
		vis := make([]bool, m.n)
		for i := range dist {
			dist[i] = math.MaxInt32
		}
		pq := &mcfPQ{{0, s}}
		heap.Init(pq)
		dist[s] = 0
		for pq.Len() > 0 {
			cur := heap.Pop(pq).(mcfItem)
			if vis[cur.v] {
				continue
			}
			vis[cur.v] = true
			if cur.v == t {
				break
			}
			dualV := dual[cur.v]
			for i := range m.g[cur.v] {
				e := &m.g[cur.v][i]
				w := e.dst
				if vis[w] || e.cap == 0 {
					continue
				}
				newDist := cur.dist + e.cost - dual[w] + dualV
				if newDist < dist[w] {
					dist[w] = newDist
					pv[w] = cur.v
					pe[w] = i
					heap.Push(pq, mcfItem{newDist, w})
				}
			}
		}
		if !vis[t] {
			return false
		}
		distT := dist[t]
		for v := 0; v < m.n; v++ {
			if vis[v] {
				dual[v] -= distT - dist[v]
			}
		}
		return true
	}

	flow, cost := 0, 0
	prevCostPerFlow := math.MinInt32
	result := [][2]int{{0, 0}}
	for flow < flowLimit {
		if !refineDual() {
			break
		}
		f := flowLimit - flow
		for v := t; v != s; v = pv[v] {
			if cap := m.g[pv[v]][pe[v]].cap; cap < f {
				f = cap
			}
		}
		for v := t; v != s; v = pv[v] {
			e := &m.g[pv[v]][pe[v]]
			e.cap -= f
			m.g[v][e.rev].cap += f
		}
		c := -dual[s]
		flow += f
		cost += f * c
		if c == prevCostPerFlow {
			result = result[:len(result)-1]
		}
		result = append(result, [2]int{flow, cost})
		prevCostPerFlow = c
	}
	return result
}

func findMinimumTime(strength []int) int {
	n := len(strength)
	s := n * 2
	t := s + 1
	g := NewMCFGraph(t + 1)
	for i := 0; i < n; i++ {
		g.AddEdge(s, i, 1, 0)
		g.AddEdge(i+n, t, 1, 0)
		for j := 0; j < n; j++ {
			g.AddEdge(i, j+n, 1, (strength[i]-1)/(j+1)+1)
		}
	}
	_, cost := g.Flow(s, t, n)
	return cost
}3387. 两天自由外汇交易后的最大货币数
题目、示例与约束
给你一个字符串 initialCurrency,表示初始货币类型,并且你一开始拥有 1.0 单位的 initialCurrency。
另给你四个数组,分别表示货币对(字符串)和汇率(实数):
pairs1[i] = [startCurrencyi, targetCurrencyi]表示在 第 1 天,可以按照汇率rates1[i]将startCurrencyi转换为targetCurrencyi。pairs2[i] = [startCurrencyi, targetCurrencyi]表示在 第 2 天,可以按照汇率rates2[i]将startCurrencyi转换为targetCurrencyi。- 此外,每种
targetCurrency都可以以汇率1 / rate转换回对应的startCurrency。
你可以在 第 1 天 使用 rates1 进行任意次数的兑换(包括 0 次),然后在 第 2 天 使用 rates2 再进行任意次数的兑换(包括 0 次)。
返回在两天兑换后,最大可能拥有的 initialCurrency 的数量。
注意:汇率是有效的,并且第 1 天和第 2 天的汇率之间相互独立,不会产生矛盾。
示例 1:
输入: initialCurrency = "EUR", pairs1 = [["EUR","USD"],["USD","JPY"]], rates1 = [2.0,3.0], pairs2 = [["JPY","USD"],["USD","CHF"],["CHF","EUR"]], rates2 = [4.0,5.0,6.0]
输出: 720.00000
解释:
根据题目要求,需要最大化最终的 EUR 数量,从 1.0 EUR 开始:
- 第 1 天:
- 将 EUR 换成 USD,得到 2.0 USD。
- 将 USD 换成 JPY,得到 6.0 JPY。
- 第 2 天:
- 将 JPY 换成 USD,得到 24.0 USD。
- 将 USD 换成 CHF,得到 120.0 CHF。
- 最后将 CHF 换回 EUR,得到 720.0 EUR。
示例 2:
输入: initialCurrency = "NGN", pairs1 = [["NGN","EUR"]], rates1 = [9.0], pairs2 = [["NGN","EUR"]], rates2 = [6.0]
输出: 1.50000
解释:
在第 1 天将 NGN 换成 EUR,并在第 2 天用反向汇率将 EUR 换回 NGN,可以最大化最终的 NGN 数量。
示例 3:
输入: initialCurrency = "USD", pairs1 = [["USD","EUR"]], rates1 = [1.0], pairs2 = [["EUR","JPY"]], rates2 = [10.0]
输出: 1.00000
解释:
在这个例子中,不需要在任何一天进行任何兑换。
提示:
1 <= initialCurrency.length <= 3initialCurrency仅由大写英文字母组成。1 <= n == pairs1.length <= 101 <= m == pairs2.length <= 10pairs1[i] == [startCurrencyi, targetCurrencyi]pairs2[i] == [startCurrencyi, targetCurrencyi]1 <= startCurrencyi.length, targetCurrencyi.length <= 3startCurrencyi和targetCurrencyi仅由大写英文字母组成。rates1.length == nrates2.length == m1.0 <= rates1[i], rates2[i] <= 10.0- 输入保证两个转换图在各自的天数中没有矛盾或循环。
- 输入保证输出 最大 为
5 * 1010。
方法一 · Go 实现
思考
两天使用两套汇率,可在货币图上任意兑换,求回到初始货币的最大数量。货币种类很少,从初始货币 DFS/BFS 即可得到当天每种货币的最大数量。
汇率双向:正边权为 ,反边权为 。无环套利保证一次遍历就能得到从初始货币出发的最大倍率。
第一天得到 ,第二天要把 换回初始货币,倍率为 。对所有 取 的最大者。
type Pair struct {
	Key   string
	Value float64
}

func maxAmount(initialCurrency string, pairs1 [][]string, rates1 []float64, pairs2 [][]string, rates2 []float64) (ans float64) {
	d1 := build(pairs1, rates1, initialCurrency)
	d2 := build(pairs2, rates2, initialCurrency)
	for currency, rate := range d2 {
		if val, found := d1[currency]; found {
			ans = max(ans, val/rate)
		}
	}
	return
}

func build(pairs [][]string, rates []float64, init string) map[string]float64 {
	g := make(map[string][]Pair)
	d := make(map[string]float64)

	for i := 0; i < len(pairs); i++ {
		a := pairs[i][0]
		b := pairs[i][1]
		r := rates[i]
		g[a] = append(g[a], Pair{Key: b, Value: r})
		g[b] = append(g[b], Pair{Key: a, Value: 1.0 / r})
	}

	dfs(g, d, init, 1.0)
	return d
}

func dfs(g map[string][]Pair, d map[string]float64, a string, v float64) {
	if _, found := d[a]; found {
		return
	}

	d[a] = v
	for _, pair := range g[a] {
		b := pair.Key
		r := pair.Value
		if _, found := d[b]; !found {
			dfs(g, d, b, v*r)
		}
	}
}3419. 图的最大边权的最小值
题目、示例与约束
给你两个整数 n 和 threshold ,同时给你一个 n 个节点的 有向 带权图,节点编号为 0 到 n - 1 。这个图用 二维 整数数组 edges 表示,其中 edges[i] = [Ai, Bi, Wi] 表示节点 Ai 到节点 Bi 之间有一条边权为 Wi的有向边。
你需要从这个图中删除一些边(也可能 不 删除任何边),使得这个图满足以下条件:
- 所有其他节点都可以到达节点 0 。
- 图中剩余边的 最大 边权值尽可能小。
- 每个节点都 至多 有
threshold条出去的边。
请你返回删除必要的边后,最大 边权的 最小值 为多少。如果无法满足所有的条件,请你返回 -1 。
示例 1:
输入:n = 5, edges = [[1,0,1],[2,0,2],[3,0,1],[4,3,1],[2,1,1]], threshold = 2
输出:1
解释:
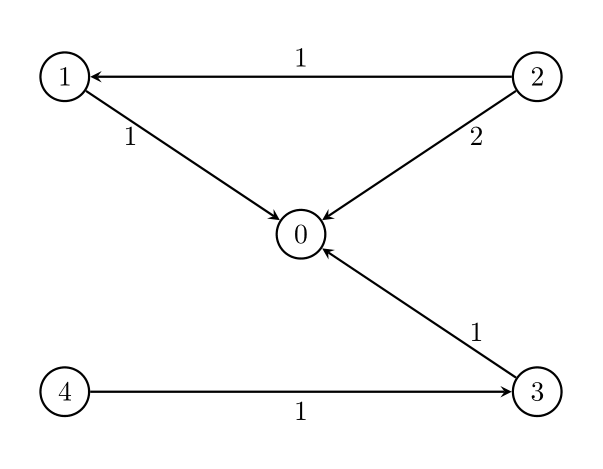
删除边 2 -> 0 。剩余边中的最大值为 1 。
示例 2:
输入:n = 5, edges = [[0,1,1],[0,2,2],[0,3,1],[0,4,1],[1,2,1],[1,4,1]], threshold = 1
输出:-1
解释:
无法从节点 2 到节点 0 。
示例 3:
输入:n = 5, edges = [[1,2,1],[1,3,3],[1,4,5],[2,3,2],[3,4,2],[4,0,1]], threshold = 1
输出:2
解释:
删除边 1 -> 3 和 1 -> 4 。剩余边中的最大值为 2 。
示例 4:
输入:n = 5, edges = [[1,2,1],[1,3,3],[1,4,5],[2,3,2],[4,0,1]], threshold = 1
输出:-1
提示:
2 <= n <= 1051 <= threshold <= n - 11 <= edges.length <= min(105, n * (n - 1) / 2).edges[i].length == 30 <= Ai, Bi < nAi != Bi1 <= Wi <= 106- 一对节点之间 可能 会有多条边,但它们的权值互不相同。
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
等价转换
把图中的每条边反向,那么原问题等价于删边之后:
- 从 出发,必须能访问到所有点。
- 每个点的入度至多为 。
在这种情况下,由于从 出发,在不访问重复节点的情况下,DFS 过程是一棵树(叫做 DFS 树),每个节点都只有一个父节点(除了根节点 没有父节点)。所以一定存在一种删边方案,使得每个点的入度恰好为 (除了根节点 没有入度),因此我们一定能满足 的要求。
所以 是多余的。
注意题目保证 。
方法一:二分答案 + DFS
设最大边权为 。
由于 越大,越能够从 出发,访问到所有点。据此,可以二分猜答案。
于是问题变成:
- 从 出发,只经过边权 的边,能否访问到所有点。
DFS 即可,过程中统计访问到的节点个数(或者剩余未访问的节点个数)。
关于二分算法的原理,请看 二分查找 红蓝染色法【基础算法精讲 04】。
细节
下面代码采用开区间二分,这仅仅是二分的一种写法,使用闭区间或者半闭半开区间都是可以的。
- 开区间左端点初始值:。一定无法访问其他节点。
- 开区间右端点初始值:所有边权的最大值 。如果最终答案为所有边权的最大值 ,那么返回 。
具体请看 视频讲解,欢迎点赞关注~
复杂度分析
- 时间复杂度:,其中 是 的长度, 是所有边权的最大值。
- 空间复杂度:。
方法二:Dijkstra
前置知识:Dijkstra 算法介绍。
也可以从 出发,每次走当前能访问到的边中,边权最小的边,这类似 Dijkstra 求最短路。
本题是计算路径边权最大值,把 Dijkstra 算法中的 改成 即可。
最终答案为 。
答疑
问:能否只用 DFS 做?每次优先访问边权小的边。
答:有反例,具体见 视频讲解。
复杂度分析
- 时间复杂度:,其中 是 的长度。
- 空间复杂度:。
思考题
把题目中的「出去的边」改成「进来的边」,要怎么做?
注意当 的时候,这等价于找一条哈密顿路径,是 NP 完全问题。可以用状压 DP 解决,但必须限制数据范围 。
相似题目
- 1631. 最小体力消耗路径 1948
- 778. 水位上升的泳池中游泳 2097
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/基环树/最短路/最小生成树/网络流)
- 动态规划(入门/背包/划分/状态机/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA/一般树)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
欢迎关注 B站@灵茶山艾府
import (
	"container/heap"
	"math"
	"slices"
	"sort"
)

// https://space.bilibili.com/206214
func minMaxWeight(n int, edges [][]int, _ int) int {
	if len(edges) < n-1 {
		return -1
	}

	type edge struct{ to, w int }
	g := make([][]edge, n)
	for _, e := range edges {
		x, y, w := e[0], e[1], e[2]
		g[y] = append(g[y], edge{x, w})
	}

	dis := make([]int, n)
	for i := range dis {
		dis[i] = math.MaxInt
	}
	dis[0] = 0
	h := hp{{}}
	for len(h) > 0 {
		p := heap.Pop(&h).(pair)
		x := p.x
		d := p.dis
		if d > dis[x] {
			continue
		}
		for _, e := range g[x] {
			y := e.to
			newD := max(d, e.w)
			if newD < dis[y] {
				dis[y] = newD
				heap.Push(&h, pair{newD, y})
			}
		}
	}
	ans := slices.Max(dis)
	if ans == math.MaxInt {
		return -1
	}
	return ans
}

type pair struct{ dis, x int }
type hp []pair

func (h hp) Len() int           { return len(h) }
func (h hp) Less(i, j int) bool { return h[i].dis < h[j].dis }
func (h hp) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)        { *h = append(*h, v.(pair)) }
func (h *hp) Pop() (v any)      { a := *h; *h, v = a[:len(a)-1], a[len(a)-1]; return }

func minMaxWeight2(n int, edges [][]int, _ int) int {
	if len(edges) < n-1 {
		return -1
	}

	type edge struct{ to, w int }
	g := make([][]edge, n)
	maxW := 0
	for _, e := range edges {
		x, y, w := e[0], e[1], e[2]
		g[y] = append(g[y], edge{x, w})
		maxW = max(maxW, w)
	}

	vis := make([]int, n)
	ans := 1 + sort.Search(maxW, func(upper int) bool {
		upper++
		left := n
		var dfs func(int)
		dfs = func(x int) {
			vis[x] = upper
			left--
			for _, e := range g[x] {
				if e.w <= upper && vis[e.to] != upper {
					dfs(e.to)
				}
			}
		}
		dfs(0)
		return left == 0
	})
	if ans > maxW {
		ans = -1
	}
	return ans
}3435. 最短公共超序列的字母出现频率
题目、示例与约束
给你一个字符串数组 words 。请你找到 words 所有 最短公共超序列 ,且确保它们互相之间无法通过排列得到。
最短公共超序列 指的是一个字符串,words 中所有字符串都是它的子序列,且它的长度 最短 。
请你返回一个二维整数数组 freqs ,表示所有的最短公共超序列,其中 freqs[i] 是一个长度为 26 的数组,它依次表示一个最短公共超序列的所有小写英文字母的出现频率。你可以以任意顺序返回这个频率数组。
排列 指的是一个字符串中所有字母重新安排顺序以后得到的字符串。
一个 子序列 是从一个字符串中删除一些(也可以不删除)字符后,剩余字符不改变顺序连接得到的 非空 字符串。
示例 1:
输入:words = ["ab","ba"]
输出:[[1,2,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0],[2,1,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0]]
解释:
两个最短公共超序列分别是 "aba" 和 "bab" 。输出分别是两者的字母出现频率。
示例 2:
输入:words = ["aa","ac"]
输出:[[2,0,1,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0]]
解释:
两个最短公共超序列分别是 "aac" 和 "aca" 。由于它们互为排列,所以只保留 "aac" 。
示例 3:
输入:words = ["aa","bb","cc"]
输出:[[2,2,2,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0]]
解释:
"aabbcc" 和它所有的排列都是最短公共超序列。
提示:
1 <= words.length <= 256words[i].length == 2words中所有字符串由不超过 16 个互不相同的小写英文字母组成。words中的字符串互不相同。
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
构造
由于每个字符串的长度都是 ,如果一个字母在公共超序列中出现 次,那么把这个字母加到最左边和最右边,即可满足所有字符串。例如把字母 加到最左边和最右边,那么所有 和 都能满足。这个性质对于多个出现 次的字母也成立。
如果字母的出现次数超过 ,那么去掉中间的多余字母也能满足要求。所以每个字母在公共超序列中的出现次数要么是 ,要么是 。
枚举子集
枚举出现 次的字母(枚举子集),那么其余字母只出现 次。
这里用二进制和位运算实现。用二进制压缩字母的出现次数,二进制从低到高第 位是 表示该字母(如果有)在公共超序列中出现 次,是 表示该字母在公共超序列中出现 次。具体请看 从集合论到位运算,常见位运算技巧分类总结。
建图
下面只考虑两个字母都只出现 次的字符串。
对于字符串 ,相当于一条约束: 必须在 的左边。
如果有 这三个字符串,把「 必须在 的左边」和「 必须在 的左边」合并,得到「 必须在 的左边」,但同时 意味着「 必须在 的左边」。如果每个字母都只在公共超序列中出现 次,这是无法做到的。换句话说,如果这些约束形成了一个环状结构,就不符合要求,因为我们规定这些字母只能出现 次。
一般地,把「 必须在 的左边」这个规则抽象成有向图,也就是连一条从 到 的有向边,那么问题变成:
- 这个有向图是否有环?
做法见 207. 课程表,可以用三色标记法或者拓扑排序解决,详见 我的题解。
如果无环(也就是有向无环图),则说明我们当前枚举的子集是合法的,加入答案候选项中。
答案候选项中的大小最小的那些集合,即为最终答案。
具体请看 视频讲解,欢迎点赞关注~
优化
如果 ,那么这个字母一定要出现两次,不需要枚举其只出现一次的情况。
为方便计算,这里改成在子集中的字母出现一次,不在子集中的字母出现两次。
复杂度分析
- 时间复杂度:,其中 是 的长度, 是字母种类数。枚举 个子集,每个子集需要 的时间跑 DFS。
- 空间复杂度:。返回值不计入。由于 ,所以空间复杂度以 为主。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/最短路/最小生成树/二分图/基环树/欧拉路径)
- 动态规划(入门/背包/状态机/划分/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA/一般树)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
import (
	"math/bits"
)

// https://space.bilibili.com/206214
func supersequences(words []string) [][]int {
	// 收集有哪些字母,同时建图
	all, mask2 := 0, 0
	g := [26][]int{}
	for _, s := range words {
		x, y := int(s[0]-'a'), int(s[1]-'a')
		all |= 1<<x | 1<<y
		if x == y {
			mask2 |= 1 << x
		}
		g[x] = append(g[x], y)
	}

	// 判断是否有环
	hasCycle := func(sub int) bool {
		color := [26]int8{}
		var dfs func(int) bool
		dfs = func(x int) bool {
			color[x] = 1
			for _, y := range g[x] {
				// 只遍历在 sub 中的字母
				if sub>>y&1 == 0 {
					continue
				}
				if color[y] == 1 || color[y] == 0 && dfs(y) {
					return true
				}
			}
			color[x] = 2
			return false
		}
		for i, c := range color {
			// 只遍历在 sub 中的字母
			if c == 0 && sub>>i&1 > 0 && dfs(i) {
				return true
			}
		}
		return false
	}

	set := map[int]struct{}{}
	maxSize := 0
	mask1 := all ^ mask2
	// 枚举 mask1 的所有子集 sub
	for sub, ok := mask1, true; ok; ok = sub != mask1 {
		size := bits.OnesCount(uint(sub))
		// 剪枝:如果 size < maxSize 就不需要判断了
		if size >= maxSize && !hasCycle(sub) {
			if size > maxSize {
				maxSize = size
				clear(set)
			}
			set[sub] = struct{}{}
		}
		sub = (sub - 1) & mask1
	}

	ans := make([][]int, 0, len(set)) // 预分配空间
	for sub := range set {
		cnt := make([]int, 26)
		for i := range cnt {
			cnt[i] = all>>i&1 + (all^sub)>>i&1
		}
		ans = append(ans, cnt)
	}
	return ans
}

func supersequences2(words []string) (ans [][]int) {
	// 收集有哪些字母,同时建图
	all := 0
	g := [26][]int{}
	for _, s := range words {
		x, y := int(s[0]-'a'), int(s[1]-'a')
		all |= 1<<x | 1<<y
		g[x] = append(g[x], y)
	}

	// 判断是否有环
	hasCycle := func(sub int) bool {
		color := [26]int8{}
		var dfs func(int) bool
		dfs = func(x int) bool {
			color[x] = 1
			for _, y := range g[x] {
				// 只遍历不在 sub 中的字母
				if sub>>y&1 > 0 {
					continue
				}
				if color[y] == 1 || color[y] == 0 && dfs(y) {
					return true
				}
			}
			color[x] = 2
			return false
		}
		for i, c := range color {
			// 只遍历不在 sub 中的字母
			if c == 0 && sub>>i&1 == 0 && dfs(i) {
				return true
			}
		}
		return false
	}

	// 快速跳转到下一个要枚举的字母
	nxt := [27]int{26: 26}
	for i := 25; i >= 0; i-- {
		if all>>i&1 > 0 {
			nxt[i] = i
		} else {
			nxt[i] = nxt[i+1]
		}
	}

	type pair struct{ i, sub int }
	q := []pair{{nxt[0], 0}}
	for {
		for _, p := range q {
			if !hasCycle(p.sub) {
				cnt := make([]int, 26)
				for i := range cnt {
					cnt[i] = all>>i&1 + p.sub>>i&1
				}
				ans = append(ans, cnt)
			}
		}
		if ans != nil {
			return
		}
		tmp := q
		q = nil
		for _, p := range tmp {
			for j := p.i; j < 26; j = nxt[j+1] {
				q = append(q, pair{nxt[j+1], p.sub | 1<<j})
			}
		}
	}
}3481. 应用替换 🔒
题目、示例与约束
给定一个 replacements 映射和一个可能包含格式为 %var% 占位符 的字符串 text,其中每个 var 对应 replacements 中的一个键。每个替换值本身可能包含 一个或多个 此类占位符。每个 占位符 都被与其相应的替换键对应的值替换。
返回完全替换后 不 含任何 占位符 的 text 字符串。
示例 1:
输入:replacements = [["A","abc"],["B","def"]], text = "%A%_%B%"
输出:"abc_def"
解释:
- 映射将
"A"与"abc"关联,并将"B"与"def"关联。 - 用
"abc"替换文本中的%A%,并用"def"替换文本中的%B%。 - 最终文本变为
"abc_def"。
示例 2:
输入:replacements = [["A","bce"],["B","ace"],["C","abc%B%"]], text = "%A%_%B%_%C%"
输出:"bce_ace_abcace"
解释:
- 映射将
"A"与"bce"关联,"B"与"ace"关联,以及"C"与"abc%B%"关联。 - 用
"bce"替换文本中的%A%,并用"ace"替换文本中的%B%。 - 接着,对于
%C%,用"ace"替换"abc%B%"中的%B%来得到"abcace"。 - 最终文本变为
"bce_ace_abcace"。
提示:
1 <= replacements.length <= 10replacements中的每个元素是一个双值列表[key, value],其中:key是一个大写英语字母。value是一个最多有 8 个字符,可能包含 0 个或更多格式为%<key>%的占位符的非空字符串。
- 所有的替换键互不相同。
text字符串是通过从替换映射中随机串联所有 key 占位符(格式为%<key>%)而形成的,以虚线分隔。text.length == 4 * replacements.length - 1text或任何替换值中的每个占位符对应replacements映射中的一个键。- 替换键之间没有循环依赖。
方法一:哈希表 + 递归 · Go 实现
思考
占位符 要换成映射值,而值里还可以再套占位符。替换键无环且至多 个,递归展开即可。
若只做一层替换,嵌套占位符会留下百分号。先建哈希表,再对当前串找一对 。
取出中间的键,先完全展开 ,再拼回左右两侧并继续处理右段。题面保证每个占位符都有定义。
我们用一个哈希表 来存储替换的映射关系,然后定义一个函数 来递归地替换字符串中的占位符。
函数 的执行逻辑如下:
- 在字符串 中查找第一个占位符的起始位置 ,如果找不到,则返回 ;
- 在字符串 中查找第一个占位符的结束位置 ,如果找不到,则返回 ;
- 截取占位符的键值 ,然后递归地替换占位符的值 ;
- 返回替换后的字符串。
在主函数中,我们调用 函数,传入文本字符串 ,并返回结果。
时间复杂度 ,空间复杂度 。其中 为替换映射的长度,而 和 分别为文本字符串的长度和占位符的平均长度。
func applySubstitutions(replacements [][]string, text string) string {
	d := make(map[string]string)
	for _, e := range replacements {
		d[e[0]] = e[1]
	}
	var dfs func(string) string
	dfs = func(s string) string {
		i := strings.Index(s, "%")
		if i == -1 {
			return s
		}
		j := strings.Index(s[i+1:], "%")
		if j == -1 {
			return s
		}
		j += i + 1
		key := s[i+1 : j]
		replacement := dfs(d[key])
		return s[:i] + replacement + dfs(s[j+1:])
	}

	return dfs(text)
}继续阅读
- 实践案例
- 实践案例
- 实践案例