
LeetCode Go · 图与最短路径(2)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
1245. 树的直径 🔒
题目、示例与约束
给你这棵「无向树」,请你测算并返回它的「直径」:这棵树上最长简单路径的 边数。
我们用一个由所有「边」组成的数组 edges 来表示一棵无向树,其中 edges[i] = [u, v] 表示节点 u 和 v 之间的双向边。
树上的节点都已经用 {0, 1, ..., edges.length} 中的数做了标记,每个节点上的标记都是独一无二的。
示例 1:
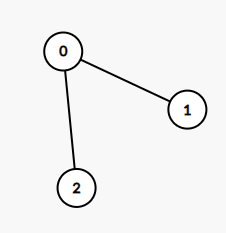
输入:edges = [[0,1],[0,2]]
输出:2
解释:
这棵树上最长的路径是 1 - 0 - 2,边数为 2。
示例 2:
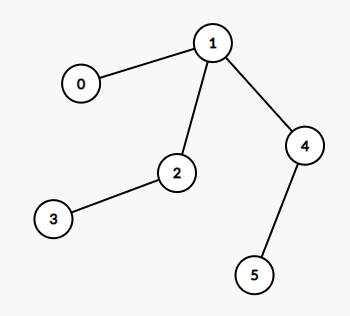
输入:edges = [[0,1],[1,2],[2,3],[1,4],[4,5]]
输出:4
解释:
这棵树上最长的路径是 3 - 2 - 1 - 4 - 5,边数为 4。
提示:
0 <= edges.length < 10^4edges[i][0] != edges[i][1]0 <= edges[i][j] <= edges.lengthedges会形成一棵无向树
方法一:两次 DFS · Go 实现
思考
树的直径是最长简单路径。 ,枚举所有端点对过慢。树上任意点出发的最远点必为某条直径的一端,再从该端走最远即得直径。
两次 DFS:第一次从 找到最远点 ,第二次从 得到距离即为直径长度。树无环,DFS 与 BFS 等价于求最远点。
我们首先任选一个节点,从该节点开始进行深度优先搜索,找到距离该节点最远的节点,记为节点 。然后从节点 开始进行深度优先搜索,找到距离节点 最远的节点,记为节点 。可以证明,节点 和节点 之间的路径即为树的直径。
时间复杂度 ,空间复杂度 。其中 为节点数。
相似题目:
func treeDiameter(edges [][]int) (ans int) {
	n := len(edges) + 1
	g := make([][]int, n)
	for _, e := range edges {
		a, b := e[0], e[1]
		g[a] = append(g[a], b)
		g[b] = append(g[b], a)
	}
	a := 0
	var dfs func(i, fa, t int)
	dfs = func(i, fa, t int) {
		for _, j := range g[i] {
			if j != fa {
				dfs(j, i, t+1)
			}
		}
		if ans < t {
			ans = t
			a = i
		}
	}
	dfs(0, -1, 0)
	dfs(a, -1, 0)
	return
}
方法二:两次显式栈 · Go 实现
思考
树的直径是最长简单路径的边数。 ,枚举所有端点对再两两求距离无法接受。从任意一点走到最远的点,一定是某条直径的一个端点,再从该端点走到最远就得到直径长度。沿一条链递归时调用深度等于节点数,长度达到 就会超出 Python 的递归上限。因此每次搜索用栈保存 :弹出时若距离更大就记下当前点,再把其余邻接点以距离加一压入。第一次从 得到端点 ,第二次从 得到的最远距离就是直径。
我们从节点 出发,用显式栈找出离它最远的节点 ,再从 做同样的搜索。第二次得到的最远距离就是树的直径。
栈里每个元素是 ,表示走到节点 、父节点为 、已经经过 条边。弹出后如果 更大,就更新最远点和答案,然后把除父节点以外的邻接点以距离 压入。树没有环,每个节点只会入栈一次。同距离的端点哪一个先被记下,不影响第二次搜索的长度。
时间复杂度 ,空间复杂度 。其中 为节点数。
相似题目:
func treeDiameter(edges [][]int) int {
	n := len(edges) + 1
	g := make([][]int, n)
	for _, e := range edges {
		a, b := e[0], e[1]
		g[a] = append(g[a], b)
		g[b] = append(g[b], a)
	}
	farthest := func(start int) (int, int) {
		ans, node := 0, start
		stk := [][3]int{{start, -1, 0}}
		for len(stk) > 0 {
			cur := stk[len(stk)-1]
			stk = stk[:len(stk)-1]
			i, fa, t := cur[0], cur[1], cur[2]
			if ans < t {
				ans, node = t, i
			}
			for _, j := range g[i] {
				if j != fa {
					stk = append(stk, [3]int{j, i, t + 1})
				}
			}
		}
		return node, ans
	}
	node, _ := farthest(0)
	_, ans := farthest(node)
	return ans
}1298. 你能从盒子里获得的最大糖果数
题目、示例与约束
给你 n 个盒子,每个盒子的格式为 [status, candies, keys, containedBoxes] ,其中:
- 状态字
status[i]:整数,如果box[i]是开的,那么是 1 ,否则是 0 。 - 糖果数
candies[i]: 整数,表示box[i]中糖果的数目。 - 钥匙
keys[i]:数组,表示你打开box[i]后,可以得到一些盒子的钥匙,每个元素分别为该钥匙对应盒子的下标。 - 内含的盒子
containedBoxes[i]:整数,表示放在box[i]里的盒子所对应的下标。
给你一个整数数组 initialBoxes,包含你最初拥有的盒子。你可以拿走每个 已打开盒子 里的所有糖果,并且可以使用其中的钥匙去开启新的盒子,并且可以使用在其中发现的其他盒子。
请你按照上述规则,返回可以获得糖果的 最大数目 。
示例 1:
输入:status = [1,0,1,0], candies = [7,5,4,100], keys = [[],[],[1],[]], containedBoxes = [[1,2],[3],[],[]], initialBoxes = [0]
输出:16
解释:
一开始你有盒子 0 。你将获得它里面的 7 个糖果和盒子 1 和 2。
盒子 1 目前状态是关闭的,而且你还没有对应它的钥匙。所以你将会打开盒子 2 ,并得到里面的 4 个糖果和盒子 1 的钥匙。
在盒子 1 中,你会获得 5 个糖果和盒子 3 ,但是你没法获得盒子 3 的钥匙所以盒子 3 会保持关闭状态。
你总共可以获得的糖果数目 = 7 + 4 + 5 = 16 个。
示例 2:
输入:status = [1,0,0,0,0,0], candies = [1,1,1,1,1,1], keys = [[1,2,3,4,5],[],[],[],[],[]], containedBoxes = [[1,2,3,4,5],[],[],[],[],[]], initialBoxes = [0]
输出:6
解释:
你一开始拥有盒子 0 。打开它你可以找到盒子 1,2,3,4,5 和它们对应的钥匙。
打开这些盒子,你将获得所有盒子的糖果,所以总糖果数为 6 个。
示例 3:
输入:status = [1,1,1], candies = [100,1,100], keys = [[],[0,2],[]], containedBoxes = [[],[],[]], initialBoxes = [1]
输出:1
示例 4:
输入:status = [1], candies = [100], keys = [[]], containedBoxes = [[]], initialBoxes = []
输出:0
示例 5:
输入:status = [1,1,1], candies = [2,3,2], keys = [[],[],[]], containedBoxes = [[],[],[]], initialBoxes = [2,1,0]
输出:7
提示:
1 <= status.length <= 1000status.length == candies.length == keys.length == containedBoxes.length == nstatus[i]要么是0要么是1。1 <= candies[i] <= 10000 <= keys[i].length <= status.length0 <= keys[i][j] < status.lengthkeys[i]中的值都是互不相同的。0 <= containedBoxes[i].length <= status.length0 <= containedBoxes[i][j] < status.lengthcontainedBoxes[i]中的值都是互不相同的。- 每个盒子最多被一个盒子包含。
0 <= initialBoxes.length <= status.length0 <= initialBoxes[i] < status.length
方法一:BFS + 哈希集合 · Go 实现
思考
开盒子需要先拥有该盒且状态为开(或已有钥匙)。盒子、钥匙互相嵌套, ,适合按「当前能打开的盒子」做 BFS。
集合 记录拥有的盒子, 防止重复处理。队列只放已打开且未处理的盒子:取出后用钥匙把关闭盒打开,并用其中嵌套盒扩充 。初始开启盒入队并累加糖果,之后每打开一盒加一次糖果。
题目给定一批盒子,每个盒子可能有状态(开/关)、糖果、钥匙、以及其他盒子。我们的目标是通过初始给定的一些盒子,尽可能多地打开更多盒子,并收集其中的糖果。可以通过获得钥匙来解锁新盒子,通过盒子中嵌套的盒子来获取更多资源。
我们采用 BFS 的方式模拟整个探索过程。
我们用一个队列 表示当前可以访问的、已经开启 的盒子;用两个集合 和 分别记录我们拥有的所有盒子和已经处理过的盒子,防止重复。
初始时,将所有 添加到 中,如果初始盒子状态为开启,立即加入队列 并累计糖果;
然后进行 BFS,依次从 中取出盒子:
- 获取盒子中的钥匙 ,将能解锁的盒子加入队列;
- 收集盒子中包含的其他盒子 ,如果状态是开启的且未处理过,则立即处理;
每个盒子最多处理一次,糖果累计一次,最终返回总糖果数 。
时间复杂度 ,空间复杂度 ,其中 是盒子的总数。
func maxCandies(status []int, candies []int, keys [][]int, containedBoxes [][]int, initialBoxes []int) (ans int) {
	q := []int{}
	has := make(map[int]bool)
	took := make(map[int]bool)
	for _, box := range initialBoxes {
		has[box] = true
		if status[box] == 1 {
			q = append(q, box)
			took[box] = true
			ans += candies[box]
		}
	}
	for len(q) > 0 {
		box := q[0]
		q = q[1:]
		for _, k := range keys[box] {
			if status[k] == 0 {
				status[k] = 1
				if has[k] && !took[k] {
					q = append(q, k)
					took[k] = true
					ans += candies[k]
				}
			}
		}
		for _, b := range containedBoxes[box] {
			has[b] = true
			if status[b] == 1 && !took[b] {
				q = append(q, b)
				took[b] = true
				ans += candies[b]
			}
		}
	}
	return
}1311. 获取你好友已观看的视频
题目、示例与约束
有 n 个人,每个人都有一个 0 到 n-1 的唯一 id 。
给你数组 watchedVideos 和 friends ,其中 watchedVideos[i] 和 friends[i] 分别表示 id = i 的人观看过的视频列表和他的好友列表。
Level 1 的视频包含所有你好友观看过的视频,level 2 的视频包含所有你好友的好友观看过的视频,以此类推。一般的,Level 为 k 的视频包含所有从你出发,最短距离为 k 的好友观看过的视频。
给定你的 id 和一个 level 值,请你找出所有指定 level 的视频,并将它们按观看频率升序返回。如果有频率相同的视频,请将它们按字母顺序从小到大排列。
示例 1:
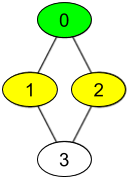
输入:watchedVideos = [["A","B"],["C"],["B","C"],["D"]], friends = [[1,2],[0,3],[0,3],[1,2]], id = 0, level = 1
输出:["B","C"]
解释:
你的 id 为 0(绿色),你的朋友包括(黄色):
id 为 1 -> watchedVideos = ["C"]
id 为 2 -> watchedVideos = ["B","C"]
你朋友观看过视频的频率为:
B -> 1
C -> 2
示例 2:
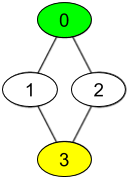
输入:watchedVideos = [["A","B"],["C"],["B","C"],["D"]], friends = [[1,2],[0,3],[0,3],[1,2]], id = 0, level = 2
输出:["D"]
解释:
你的 id 为 0(绿色),你朋友的朋友只有一个人,他的 id 为 3(黄色)。
提示:
n == watchedVideos.length == friends.length2 <= n <= 1001 <= watchedVideos[i].length <= 1001 <= watchedVideos[i][j].length <= 80 <= friends[i].length < n0 <= friends[i][j] < n0 <= id < n1 <= level < n- 如果
friends[i]包含j,那么friends[j]包含i
方法一:BFS · Go 实现
思考
需要恰好 跳的好友所看视频,并按出现次数、名称排序。沿好友关系盲目深搜难以卡在精确层数,也容易重复访问。从 做 轮广度优先,第 轮结束时队列里恰为该层好友。
再用计数表统计这些人所看视频,按 排序后输出名称。访问集合避免同一人进入多层。
我们可以使用广度优先搜索的方法,从 出发,找到所有距离为 的好友,然后统计这些好友观看的视频。
具体地,我们可以使用一个队列 来存储当前层的好友,初始时将 加入队列 中,用一个哈希表或者布尔数组 来记录已经访问过的好友,然后进行 次循环,每次循环将队列中的所有好友出队,并将他们的好友加入队列,直到找到所有距禒为 的好友。
然后,我们使用一个哈希表 来统计这些好友观看的视频及其频率,最后将哈希表中的键值对按照频率升序排序,如果频率相同,则按照视频名称升序排序。最后返回排序后的视频名称列表。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 和 的长度,而 是所有好友观看的视频数量。
func watchedVideosByFriends(watchedVideos [][]string, friends [][]int, id int, level int) []string {
	q := []int{id}
	n := len(friends)
	vis := make([]bool, n)
	vis[id] = true
	for level > 0 {
		level--
		nextQ := []int{}
		for _, i := range q {
			for _, j := range friends[i] {
				if !vis[j] {
					vis[j] = true
					nextQ = append(nextQ, j)
				}
			}
		}
		q = nextQ
	}
	cnt := make(map[string]int)
	for _, i := range q {
		for _, v := range watchedVideos[i] {
			cnt[v]++
		}
	}
	ans := []string{}
	for key := range cnt {
		ans = append(ans, key)
	}
	sort.Slice(ans, func(i, j int) bool {
		if cnt[ans[i]] == cnt[ans[j]] {
			return ans[i] < ans[j]
		}
		return cnt[ans[i]] < cnt[ans[j]]
	})
	return ans
}1334. 阈值距离内邻居最少的城市
题目、示例与约束
有 n 个城市,按从 0 到 n-1 编号。给你一个边数组 edges,其中 edges[i] = [fromi, toi, weighti] 代表 fromi 和 toi 两个城市之间的双向加权边,距离阈值是一个整数 distanceThreshold。
返回在路径距离限制为 distanceThreshold 以内可到达城市最少的城市。如果有多个这样的城市,则返回编号最大的城市。
注意,连接城市 i 和 j 的路径的距离等于沿该路径的所有边的权重之和。
示例 1:
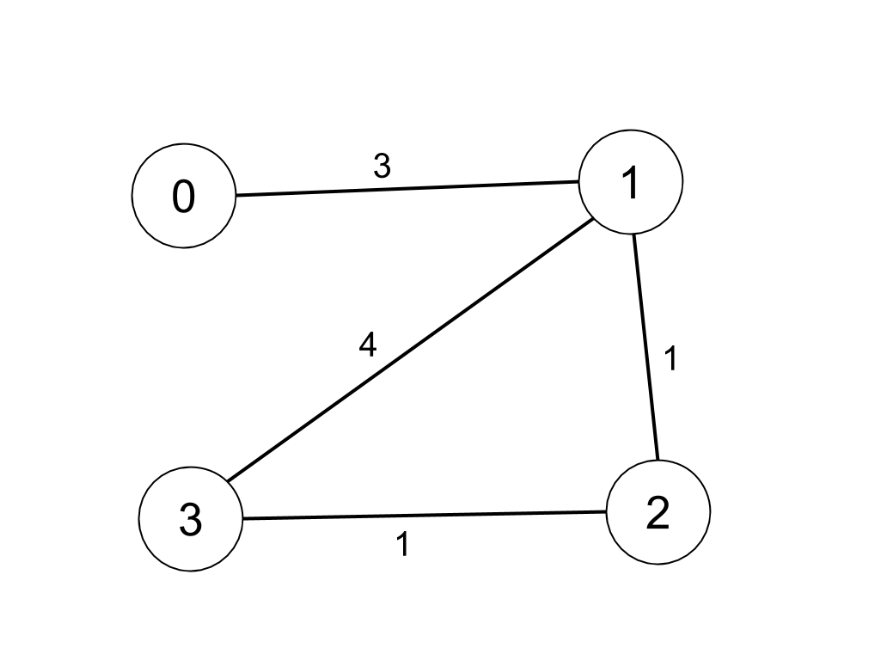
输入:n = 4, edges = [[0,1,3],[1,2,1],[1,3,4],[2,3,1]], distanceThreshold = 4
输出:3
解释:城市分布图如上。
每个城市阈值距离 distanceThreshold = 4 内的邻居城市分别是:
城市 0 -> [城市 1, 城市 2]
城市 1 -> [城市 0, 城市 2, 城市 3]
城市 2 -> [城市 0, 城市 1, 城市 3]
城市 3 -> [城市 1, 城市 2]
城市 0 和 3 在阈值距离 4 以内都有 2 个邻居城市,但是我们必须返回城市 3,因为它的编号最大。
示例 2:
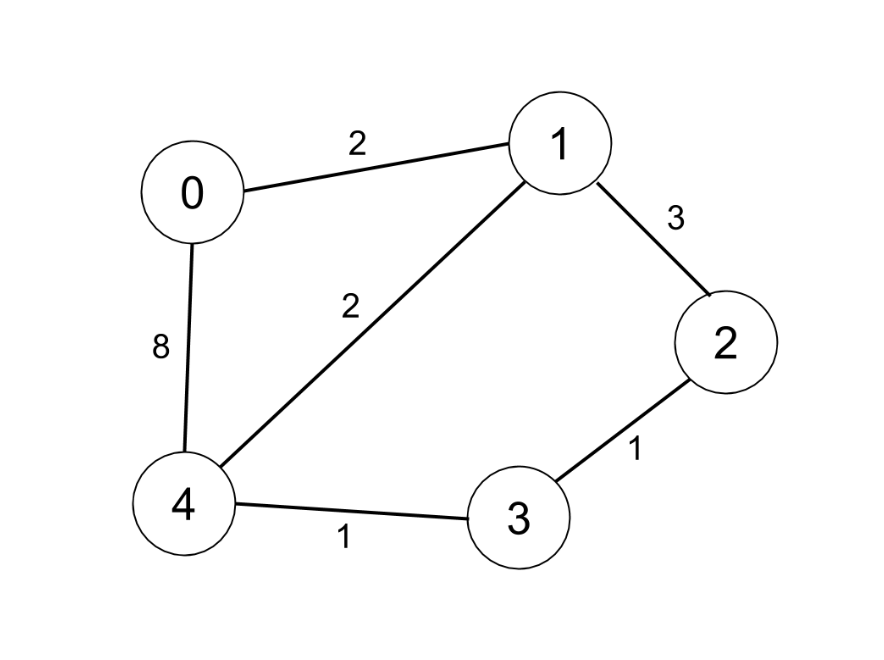
输入:n = 5, edges = [[0,1,2],[0,4,8],[1,2,3],[1,4,2],[2,3,1],[3,4,1]], distanceThreshold = 2
输出:0
解释:城市分布图如上。
每个城市阈值距离 distanceThreshold = 2 内的邻居城市分别是:
城市 0 -> [城市 1]
城市 1 -> [城市 0, 城市 4]
城市 2 -> [城市 3, 城市 4]
城市 3 -> [城市 2, 城市 4]
城市 4 -> [城市 1, 城市 2, 城市 3]
城市 0 在阈值距离 2 以内只有 1 个邻居城市。
提示:
2 <= n <= 1001 <= edges.length <= n * (n - 1) / 2edges[i].length == 30 <= fromi < toi < n1 <= weighti, distanceThreshold <= 10^4- 所有
(fromi, toi)都是不同的。
方法一:Dijkstra 算法 · Go 实现
思考
对每个城市统计阈值内可达城市数,取个数最少且编号最大者。 ,可对每个起点做最短路。建邻接矩阵后,从编号大到小跑 Dijkstra,统计 的个数,遇到更小计数就更新答案,从而在并列时保留较大编号。
我们可以枚举每个城市 作为起点,使用 Dijkstra 算法求出从 到其他城市的最短距离,然后统计距离不超过阈值的城市个数,最后取最小的个数且编号最大的城市。
时间复杂度 ,空间复杂度 。其中 为城市个数。
func findTheCity(n int, edges [][]int, distanceThreshold int) int {
	g := make([][]int, n)
	dist := make([]int, n)
	vis := make([]bool, n)
	const inf int = 1e7
	for i := range g {
		g[i] = make([]int, n)
		for j := range g[i] {
			g[i][j] = inf
		}
	}
	for _, e := range edges {
		f, t, w := e[0], e[1], e[2]
		g[f][t], g[t][f] = w, w
	}

	dijkstra := func(u int) (cnt int) {
		for i := range vis {
			vis[i] = false
			dist[i] = inf
		}
		dist[u] = 0
		for i := 0; i < n; i++ {
			k := -1
			for j := 0; j < n; j++ {
				if !vis[j] && (k == -1 || dist[j] < dist[k]) {
					k = j
				}
			}
			vis[k] = true
			for j := 0; j < n; j++ {
				dist[j] = min(dist[j], dist[k]+g[k][j])
			}
		}
		for _, d := range dist {
			if d <= distanceThreshold {
				cnt++
			}
		}
		return
	}

	ans, cnt := n, inf
	for i := n - 1; i >= 0; i-- {
		if t := dijkstra(i); t < cnt {
			cnt = t
			ans = i
		}
	}
	return ans
}
方法二:Floyd 算法 · Go 实现
思考
逐源 Dijkstra 要跑 遍。Floyd 一次求出全源最短路,之后对每行统计不超过阈值的个数即可,实现更直,渐近仍为 。
我们定义 表示城市 到城市 的最短距离,初始时 , ,然后我们遍历所有边,对于每条边 ,我们令 。
接下来,我们用 Floyd 算法求出任意两点之间的最短距离。具体地,我们先枚举中间点 ,再枚举起点 和终点 ,如果 ,那么我们就用更短的距离 更新 。
最后,我们枚举每个城市 作为起点,统计距离不超过阈值的城市个数,最后取最小的个数且编号最大的城市。
时间复杂度 ,空间复杂度 。其中 为城市个数。
func findTheCity(n int, edges [][]int, distanceThreshold int) int {
	g := make([][]int, n)
	const inf int = 1e7
	for i := range g {
		g[i] = make([]int, n)
		for j := range g[i] {
			g[i][j] = inf
		}
	}

	for _, e := range edges {
		f, t, w := e[0], e[1], e[2]
		g[f][t], g[t][f] = w, w
	}

	for k := 0; k < n; k++ {
		g[k][k] = 0
		for i := 0; i < n; i++ {
			for j := 0; j < n; j++ {
				g[i][j] = min(g[i][j], g[i][k]+g[k][j])
			}
		}
	}

	ans, cnt := n, n+1
	for i := n - 1; i >= 0; i-- {
		t := 0
		for _, x := range g[i] {
			if x <= distanceThreshold {
				t++
			}
		}
		if t < cnt {
			cnt, ans = t, i
		}
	}

	return ans
}1368. 使网格图至少有一条有效路径的最小代价
题目、示例与约束
给你一个 m x n 的网格图 grid 。 grid 中每个格子都有一个数字,对应着从该格子出发下一步走的方向。 grid[i][j] 中的数字可能为以下几种情况:
- 1 ,下一步往右走,也就是你会从
grid[i][j]走到grid[i][j + 1] - 2 ,下一步往左走,也就是你会从
grid[i][j]走到grid[i][j - 1] - 3 ,下一步往下走,也就是你会从
grid[i][j]走到grid[i + 1][j] - 4 ,下一步往上走,也就是你会从
grid[i][j]走到grid[i - 1][j]
注意网格图中可能会有 无效数字 ,因为它们可能指向 grid 以外的区域。
一开始,你会从最左上角的格子 (0,0) 出发。我们定义一条 有效路径 为从格子 (0,0) 出发,每一步都顺着数字对应方向走,最终在最右下角的格子 (m - 1, n - 1) 结束的路径。有效路径 不需要是最短路径 。
你可以花费 cost = 1 的代价修改一个格子中的数字,但每个格子中的数字 只能修改一次 。
请你返回让网格图至少有一条有效路径的最小代价。
示例 1:
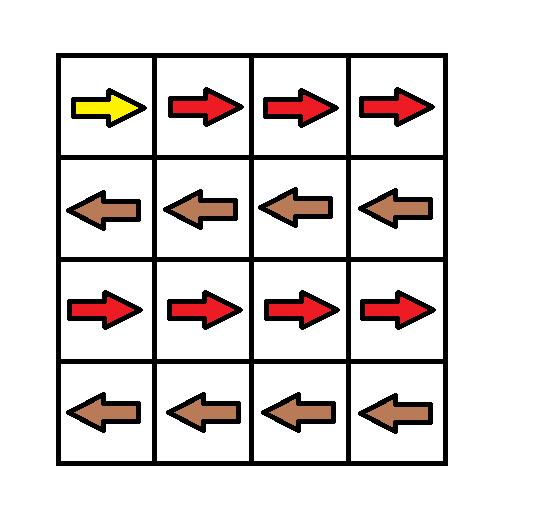
输入:grid = [[1,1,1,1],[2,2,2,2],[1,1,1,1],[2,2,2,2]]
输出:3
解释:你将从点 (0, 0) 出发。
到达 (3, 3) 的路径为: (0, 0) --> (0, 1) --> (0, 2) --> (0, 3) 花费代价 cost = 1 使方向向下 --> (1, 3) --> (1, 2) --> (1, 1) --> (1, 0) 花费代价 cost = 1 使方向向下 --> (2, 0) --> (2, 1) --> (2, 2) --> (2, 3) 花费代价 cost = 1 使方向向下 --> (3, 3)
总花费为 cost = 3.
示例 2:
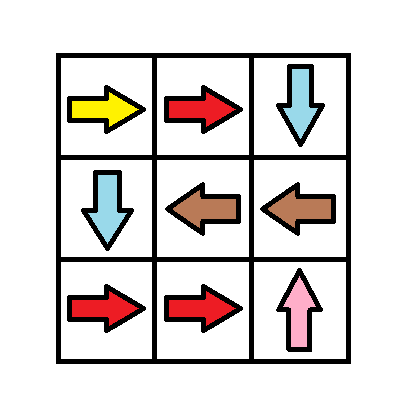
输入:grid = [[1,1,3],[3,2,2],[1,1,4]]
输出:0
解释:不修改任何数字你就可以从 (0, 0) 到达 (2, 2) 。
示例 3:
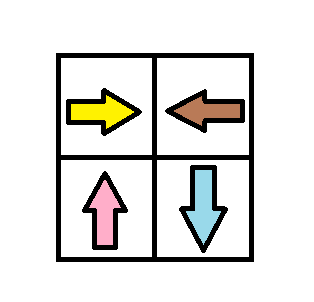
输入:grid = [[1,2],[4,3]]
输出:1
示例 4:
输入:grid = [[2,2,2],[2,2,2]]
输出:3
示例 5:
输入:grid = [[4]]
输出:0
提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 100
方法一:双端队列 BFS · Go 实现
思考
格子箭头指定下一步,改一个箭头代价为 ,求到右下的最少修改。普通最短路带堆是 。边权只有 (沿箭头)和 (改方向),可用 0-1 BFS:沿箭头的邻居插入队首且代价不变,改方向的插入队尾且代价加一。首次到达终点即为最少修改。
本题实际上也是最短路模型,只不过求解的是改变方向的最小次数。
在一个边权只有 0、1 的无向图中搜索最短路径可以使用双端队列进行 BFS。其原理是当前可以扩展到的点的权重为 0 时,将其加入队首;权重为 1 时,将其加入队尾。
如果某条边权值为 0,那么新拓展出的节点权值就和当前队首节点权值相同,显然可以作为下一次拓展的起点。
func minCost(grid [][]int) int {
	m, n := len(grid), len(grid[0])
	q := doublylinkedlist.New()
	q.Add([]int{0, 0, 0})
	dirs := [][]int{{0, 0}, {0, 1}, {0, -1}, {1, 0}, {-1, 0}}
	vis := make([][]bool, m)
	for i := range vis {
		vis[i] = make([]bool, n)
	}
	for !q.Empty() {
		v, _ := q.Get(0)
		p := v.([]int)
		q.Remove(0)
		i, j, d := p[0], p[1], p[2]
		if i == m-1 && j == n-1 {
			return d
		}
		if vis[i][j] {
			continue
		}
		vis[i][j] = true
		for k := 1; k <= 4; k++ {
			x, y := i+dirs[k][0], j+dirs[k][1]
			if x >= 0 && x < m && y >= 0 && y < n {
				if grid[i][j] == k {
					q.Insert(0, []int{x, y, d})
				} else {
					q.Add([]int{x, y, d + 1})
				}
			}
		}
	}
	return -1
}1377. T 秒后青蛙的位置
题目、示例与约束
给你一棵由 n 个顶点组成的无向树,顶点编号从 1 到 n。青蛙从 顶点 1 开始起跳。规则如下:
- 在一秒内,青蛙从它所在的当前顶点跳到另一个 未访问 过的顶点(如果它们直接相连)。
- 青蛙无法跳回已经访问过的顶点。
- 如果青蛙可以跳到多个不同顶点,那么它跳到其中任意一个顶点上的机率都相同。
- 如果青蛙不能跳到任何未访问过的顶点上,那么它每次跳跃都会停留在原地。
无向树的边用数组 edges 描述,其中 edges[i] = [ai, bi] 意味着存在一条直接连通 ai 和 bi 两个顶点的边。
返回青蛙在 t 秒后位于目标顶点 target 上的概率。与实际答案相差不超过 10-5 的结果将被视为正确答案。
示例 1:
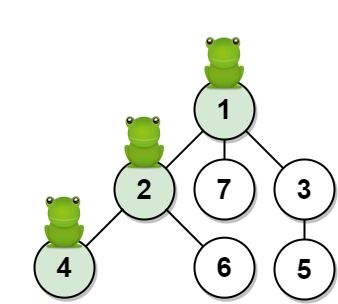
输入:n = 7, edges = [[1,2],[1,3],[1,7],[2,4],[2,6],[3,5]], t = 2, target = 4
输出:0.16666666666666666
解释:上图显示了青蛙的跳跃路径。青蛙从顶点 1 起跳,第 1 秒 有 1/3 的概率跳到顶点 2 ,然后第 2 秒 有 1/2 的概率跳到顶点 4,因此青蛙在 2 秒后位于顶点 4 的概率是 1/3 * 1/2 = 1/6 = 0.16666666666666666 。
示例 2:
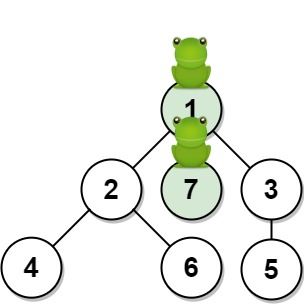
输入:n = 7, edges = [[1,2],[1,3],[1,7],[2,4],[2,6],[3,5]], t = 1, target = 7
输出:0.3333333333333333
解释:上图显示了青蛙的跳跃路径。青蛙从顶点 1 起跳,有 1/3 = 0.3333333333333333 的概率能够 1 秒 后跳到顶点 7 。
提示:
1 <= n <= 100edges.length == n - 1edges[i].length == 21 <= ai, bi <= n1 <= t <= 501 <= target <= n
方法一:BFS · Go 实现
思考
树上青蛙每秒等概率跳到未访问邻居,求 秒在 的概率。路径唯一,按秒 BFS 即可携带概率。出队时若已是目标:无未访问邻居或时间用尽则停在此处,返回当前概率,否则还会跳走,概率为 。否则把概率均分给未访问邻居并标记访问。
我们先根据题目给出的无向树的边,建立一个邻接表 ,其中 表示顶点 的所有相邻顶点。
然后,我们定义以下数据结构:
- 队列 ,用于存储每一轮搜索的顶点及其概率,初始时 ,表示青蛙在顶点 的概率为 ;
- 数组 ,用于记录每个顶点是否被访问过,初始时 ,其余元素均为 。
接下来,我们开始进行广度优先搜索。
在每一轮搜索中,我们每次取出队首元素 ,其中 和 分别表示当前顶点及其概率。当前顶点 的相邻顶点中未被访问过的顶点的个数记为 。
- 如果 ,说明青蛙已经到达目标顶点,此时我们判断青蛙是否在 秒到达目标顶点,或者不到 秒到达目标顶点但是无法再跳跃到其它顶点(即 或者 )。如果是,则返回 ,否则返回 。
- 如果 ,那么我们将概率 均分给 的所有未被访问过的相邻顶点,然后将这些顶点加入队列 中,并且将这些顶点标记为已访问。
在一轮搜索结束后,我们将 减少 ,然后继续进行下一轮搜索,直到队列为空或者 。
最后,若青蛙仍然没有到达目标顶点,那么我们返回 。
时间复杂度 ,空间复杂度 。其中 是无向树的顶点数。
func frogPosition(n int, edges [][]int, t int, target int) float64 {
	g := make([][]int, n+1)
	for _, e := range edges {
		u, v := e[0], e[1]
		g[u] = append(g[u], v)
		g[v] = append(g[v], u)
	}
	type pair struct {
		u int
		p float64
	}
	q := []pair{{1, 1}}
	vis := make([]bool, n+1)
	vis[1] = true
	for ; len(q) > 0 && t >= 0; t-- {
		for k := len(q); k > 0; k-- {
			u, p := q[0].u, q[0].p
			q = q[1:]
			cnt := len(g[u])
			if u != 1 {
				cnt--
			}
			if u == target {
				if cnt*t == 0 {
					return p
				}
				return 0
			}
			for _, v := range g[u] {
				if !vis[v] {
					vis[v] = true
					q = append(q, pair{v, p / float64(cnt)})
				}
			}
		}
	}
	return 0
}1462. 课程表 IV
题目、示例与约束
你总共需要上 numCourses 门课,课程编号依次为 0 到 numCourses-1 。你会得到一个数组 prerequisite ,其中 prerequisites[i] = [ai, bi] 表示如果你想选 bi 课程,你 必须 先选 ai 课程。
- 有的课会有直接的先修课程,比如如果想上课程
1,你必须先上课程0,那么会以[0,1]数对的形式给出先修课程数对。
先决条件也可以是 间接 的。如果课程 a 是课程 b 的先决条件,课程 b 是课程 c 的先决条件,那么课程 a 就是课程 c 的先决条件。
你也得到一个数组 queries ,其中 queries[j] = [uj, vj]。对于第 j 个查询,您应该回答课程 uj 是否是课程 vj 的先决条件。
返回一个布尔数组 answer ,其中 answer[j] 是第 j 个查询的答案。
示例 1:
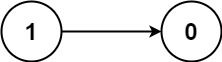
输入:numCourses = 2, prerequisites = [[1,0]], queries = [[0,1],[1,0]]
输出:[false,true]
解释:[1, 0] 数对表示在你上课程 0 之前必须先上课程 1。
课程 0 不是课程 1 的先修课程,但课程 1 是课程 0 的先修课程。
示例 2:
输入:numCourses = 2, prerequisites = [], queries = [[1,0],[0,1]]
输出:[false,false]
解释:没有先修课程对,所以每门课程之间是独立的。
示例 3:
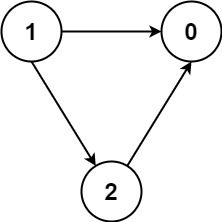
输入:numCourses = 3, prerequisites = [[1,2],[1,0],[2,0]], queries = [[1,0],[1,2]]
输出:[true,true]
提示:
2 <= numCourses <= 1000 <= prerequisites.length <= (numCourses * (numCourses - 1) / 2)prerequisites[i].length == 20 <= ai, bi <= numCourses - 1ai != bi- 每一对
[ai, bi]都 不同 - 先修课程图中没有环。
1 <= queries.length <= 1040 <= ui, vi <= numCourses - 1ui != vi
方法一:Floyd 算法 · Go 实现
思考
查询多组「 是否为 的先修」,即有向图可达性。课程数通常不大,用布尔邻接矩阵跑 Floyd,枚举中转点闭包全部可达对,查询 。
我们创建一个二维数组 ,其中 表示节点 到节点 是否可达。
接下来,我们遍历先修课程数组 ,对于其中的每一项 ,我们将 设为 。
然后,我们使用 Floyd 算法计算出所有节点对之间的可达性。
具体地,我们使用三重循环,首先枚举中间点 ,接下来枚举起点 ,最后枚举终点 。对于每一次循环,如果节点 到节点 可达,且节点 到节点 可达,那么节点 到节点 也是可达的,我们将 设为 。
在计算完所有节点对之间的可达性之后,对于每一个查询 ,我们直接返回 即可。
时间复杂度 ,空间复杂度 。其中 为节点数。
func checkIfPrerequisite(n int, prerequisites [][]int, queries [][]int) (ans []bool) {
	f := make([][]bool, n)
	for i := range f {
		f[i] = make([]bool, n)
	}
	for _, p := range prerequisites {
		f[p[0]][p[1]] = true
	}
	for k := 0; k < n; k++ {
		for i := 0; i < n; i++ {
			for j := 0; j < n; j++ {
				f[i][j] = f[i][j] || (f[i][k] && f[k][j])
			}
		}
	}
	for _, q := range queries {
		ans = append(ans, f[q[0]][q[1]])
	}
	return
}
方法二:拓扑排序 · Go 实现
思考
方法一是 的全源闭包。按拓扑序把祖先的可达集合并到后继,同样得到 ,更贴合 DAG 的依赖方向,常数通常更好。
与方法一类似,我们创建一个二维数组 ,其中 表示节点 到节点 是否可达。另外,我们创建一个邻接表 ,其中 表示节点 的所有后继节点;创建一个数组 ,其中 表示节点 的入度。
接下来,我们遍历先修课程数组 ,对于其中的每一项 ,我们更新邻接表 和入度数组 。
然后,我们使用拓扑排序计算出所有节点对之间的可达性。
定义一个队列 ,初始时将所有入度为 的节点加入队列中。随后不断进行以下操作:取出队首节点 ,然后遍历 中的所有节点 ,将 设为 。接下来,我们枚举节点 ,如果 为 ,那么我们也将 设为 。在这之后,我们将 的入度减少 。如果此时 的入度为 ,那么我们就将 加入队列中。
在计算完所有节点对之间的可达性之后,对于每一个查询 ,我们直接返回 即可。
时间复杂度 ,空间复杂度 。其中 为节点数。
func checkIfPrerequisite(n int, prerequisites [][]int, queries [][]int) (ans []bool) {
	f := make([][]bool, n)
	for i := range f {
		f[i] = make([]bool, n)
	}
	g := make([][]int, n)
	indeg := make([]int, n)
	for _, p := range prerequisites {
		a, b := p[0], p[1]
		g[a] = append(g[a], b)
		indeg[b]++
	}
	q := []int{}
	for i, x := range indeg {
		if x == 0 {
			q = append(q, i)
		}
	}
	for len(q) > 0 {
		i := q[0]
		q = q[1:]
		for _, j := range g[i] {
			f[i][j] = true
			for h := 0; h < n; h++ {
				f[h][j] = f[h][j] || f[h][i]
			}
			indeg[j]--
			if indeg[j] == 0 {
				q = append(q, j)
			}
		}
	}
	for _, q := range queries {
		ans = append(ans, f[q[0]][q[1]])
	}
	return
}1466. 重新规划路线
题目、示例与约束
n 座城市,从 0 到 n-1 编号,其间共有 n-1 条路线。因此,要想在两座不同城市之间旅行只有唯一一条路线可供选择(路线网形成一颗树)。去年,交通运输部决定重新规划路线,以改变交通拥堵的状况。
路线用 connections 表示,其中 connections[i] = [a, b] 表示从城市 a 到 b 的一条有向路线。
今年,城市 0 将会举办一场大型比赛,很多游客都想前往城市 0 。
请你帮助重新规划路线方向,使每个城市都可以访问城市 0 。返回需要变更方向的最小路线数。
题目数据 保证 每个城市在重新规划路线方向后都能到达城市 0 。
示例 1:
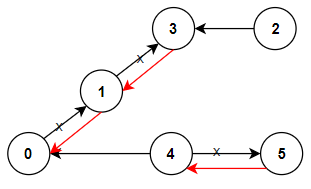
输入:n = 6, connections = [[0,1],[1,3],[2,3],[4,0],[4,5]]
输出:3
解释:更改以红色显示的路线的方向,使每个城市都可以到达城市 0 。
示例 2:
输入:n = 5, connections = [[1,0],[1,2],[3,2],[3,4]]
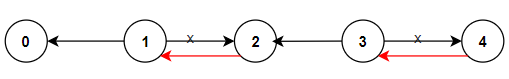
输出:2
解释:更改以红色显示的路线的方向,使每个城市都可以到达城市 0 。
示例 3:
输入:n = 3, connections = [[1,0],[2,0]]
输出:0
提示:
2 <= n <= 5 * 10^4connections.length == n-1connections[i].length == 20 <= connections[i][0], connections[i][1] <= n-1connections[i][0] != connections[i][1]
方法一:DFS · Go 实现
思考
忽略方向后是一棵树,要把所有边改成指向 。从 向外走时,沿原方向离开的边必须翻转。建图时正向记代价 、反向记 ,DFS 累加代价。
题目给定的路线图中有 个节点和 条边,如果我们忽略边的方向,那么这 个节点构成了一棵树。而题目需要我们改变某些边的方向,使得每个节点都能到达节点 。
我们不妨考虑从节点 出发,到达其他所有节点。方向与题目描述相反,意味着我们在构建图的时候,对于有向边 ,我们应该视为有向边 。也即是说,如果要从 到 ,我们需要变更一次方向;如果要从 到 ,则不需要变更方向。
接下来,我们只需要从节点 出发,搜索其他所有节点,过程中,如果遇到需要变更方向的边,则累加一次变更方向的次数。
时间复杂度 ,空间复杂度 。其中 是题目中节点的数量。
func minReorder(n int, connections [][]int) int {
	g := make([][][2]int, n)
	for _, e := range connections {
		a, b := e[0], e[1]
		g[a] = append(g[a], [2]int{b, 1})
		g[b] = append(g[b], [2]int{a, 0})
	}
	var dfs func(int, int) int
	dfs = func(a, fa int) (ans int) {
		for _, e := range g[a] {
			if b, c := e[0], e[1]; b != fa {
				ans += c + dfs(b, a)
			}
		}
		return
	}
	return dfs(0, -1)
}
方法二:BFS · Go 实现
思考
方法一已经用显式栈遍历同一张邻接表。广搜从 按层向外,第一次见到邻点时加上边权,访问顺序与栈不同。
我们可以使用广度优先搜索的方法,从节点 出发,搜索其他所有节点,过程中,如果遇到需要变更方向的边,则累加一次变更方向的次数。
时间复杂度 ,空间复杂度 。其中 是题目中节点的数量。
func minReorder(n int, connections [][]int) (ans int) {
	g := make([][][2]int, n)
	for _, e := range connections {
		a, b := e[0], e[1]
		g[a] = append(g[a], [2]int{b, 1})
		g[b] = append(g[b], [2]int{a, 0})
	}
	q := []int{0}
	vis := make([]bool, n)
	vis[0] = true
	for len(q) > 0 {
		a := q[0]
		q = q[1:]
		for _, e := range g[a] {
			b, c := e[0], e[1]
			if !vis[b] {
				vis[b] = true
				q = append(q, b)
				ans += c
			}
		}
	}
	return
}
方法三:显式栈 · Go 实现
思考
忽略方向后这是一棵树。从 向外走时,沿原方向离开的边必须翻转。 可以到 。一条链上第一次递归总是走向唯一的孩子,深度就是 ,会超出默认递归上限。
每条树边的代价在离开父节点时就已经确定,不必等子树返回后再相加。
因此用显式栈从 遍历。弹出节点后,对每个不是父节点的邻点加上边权并压栈。正向边权为 ,反向边权为 。
题目给定的路线图中有 个节点和 条边,如果我们忽略边的方向,那么这 个节点构成了一棵树。而题目需要我们改变某些边的方向,使得每个节点都能到达节点 。
我们不妨考虑从节点 出发,到达其他所有节点。方向与题目描述相反,意味着我们在构建图的时候,对于有向边 ,我们应该视为有向边 。也即是说,如果要从 到 ,我们需要变更一次方向;如果要从 到 ,则不需要变更方向。
用显式栈从节点 遍历。弹出一个节点后,对每个不是父节点的邻点,把边权累加进答案,再将该邻点压栈。正向边的权为 ,反向边的权为 。
时间复杂度 ,空间复杂度 。其中 是题目中节点的数量。
func minReorder(n int, connections [][]int) (ans int) {
	g := make([][][2]int, n)
	for _, e := range connections {
		a, b := e[0], e[1]
		g[a] = append(g[a], [2]int{b, 1})
		g[b] = append(g[b], [2]int{a, 0})
	}
	stk := [][2]int{{0, -1}}
	for len(stk) > 0 {
		cur := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		a, fa := cur[0], cur[1]
		for _, e := range g[a] {
			b, c := e[0], e[1]
			if b != fa {
				ans += c
				stk = append(stk, [2]int{b, a})
			}
		}
	}
	return
}1494. 并行课程 II
题目、示例与约束
给你一个整数 n 表示某所大学里课程的数目,编号为 1 到 n ,数组 relations 中, relations[i] = [xi, yi] 表示一个先修课的关系,也就是课程 xi 必须在课程 yi 之前上。同时你还有一个整数 k 。
在一个学期中,你 最多 可以同时上 k 门课,前提是这些课的先修课在之前的学期里已经上过了。
请你返回上完所有课最少需要多少个学期。题目保证一定存在一种上完所有课的方式。
示例 1:
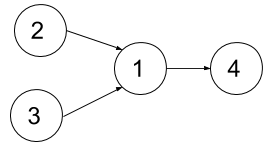
输入:n = 4, relations = [[2,1],[3,1],[1,4]], k = 2
输出:3
解释:上图展示了题目输入的图。在第一个学期中,我们可以上课程 2 和课程 3 。然后第二个学期上课程 1 ,第三个学期上课程 4 。
示例 2:
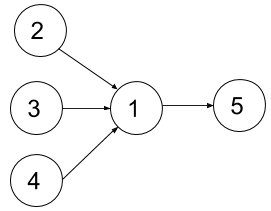
输入:n = 5, relations = [[2,1],[3,1],[4,1],[1,5]], k = 2
输出:4
解释:上图展示了题目输入的图。一个最优方案是:第一学期上课程 2 和 3,第二学期上课程 4 ,第三学期上课程 1 ,第四学期上课程 5 。
示例 3:
输入:n = 11, relations = [], k = 2
输出:6
提示:
1 <= n <= 151 <= k <= n0 <= relations.length <= n * (n-1) / 2relations[i].length == 21 <= xi, yi <= nxi != yi- 所有先修关系都是不同的,也就是说
relations[i] != relations[j]。 - 题目输入的图是个有向无环图。
方法一:状态压缩 + BFS + 子集枚举 · Go 实现
思考
,每学期至多修 门且须满足先修。状态是已修课程的二进制集合,边权均为 ,最短学期数即 BFS 层数。
当前可修的是先修已全部完成且尚未修的课。若不超过 门则全部修;否则枚举恰好 门的子集入队。终点为除 号空位外的全 。
我们用数组 表示课程 的先修课程的集合。由于数据规模 ,我们可以用一个整数的二进制位(状态压缩)来表示集合,其中第 位为 表示课程 是课程 的先修课程。
我们用一个状态变量 表示当前已经上过的课程的集合,初始时 。如果 ,表示所有课程都上过了,返回当前学期即可。
如果课程 的先修课程 的集合是 的子集,说明课程 可以上。这样我们可以找到当前 状态的下一个状态 ,表示后续学期可以上的课程集合。
如果 的二进制表示中 的个数小于等于 ,说明后续学期可以上的课程数不超过 ,我们就可以将 加入队列中。否则,说明后续学期可以上的课程数超过 ,那么我们就应该从后续可以上的课程中选择 门课程,这样才能保证后续学期可以上的课程数不超过 。我们可以枚举 的所有子集,将子集加入队列中。
时间复杂度 ,空间复杂度 。其中 是题目给定的课程数。
func minNumberOfSemesters(n int, relations [][]int, k int) int {
	d := make([]int, n+1)
	for _, e := range relations {
		d[e[1]] |= 1 << e[0]
	}
	type pair struct{ v, t int }
	q := []pair{pair{0, 0}}
	vis := map[int]bool{0: true}
	for len(q) > 0 {
		p := q[0]
		q = q[1:]
		cur, t := p.v, p.t
		if cur == (1<<(n+1))-2 {
			return t
		}
		nxt := 0
		for i := 1; i <= n; i++ {
			if (cur & d[i]) == d[i] {
				nxt |= 1 << i
			}
		}
		nxt ^= cur
		if bits.OnesCount(uint(nxt)) <= k {
			if !vis[nxt|cur] {
				vis[nxt|cur] = true
				q = append(q, pair{nxt | cur, t + 1})
			}
		} else {
			x := nxt
			for nxt > 0 {
				if bits.OnesCount(uint(nxt)) == k && !vis[nxt|cur] {
					vis[nxt|cur] = true
					q = append(q, pair{nxt | cur, t + 1})
				}
				nxt = (nxt - 1) & x
			}
		}
	}
	return 0
}1514. 概率最大的路径
题目、示例与约束
给你一个由 n 个节点(下标从 0 开始)组成的无向加权图,该图由一个描述边的列表组成,其中 edges[i] = [a, b] 表示连接节点 a 和 b 的一条无向边,且该边遍历成功的概率为 succProb[i] 。
指定两个节点分别作为起点 start 和终点 end ,请你找出从起点到终点成功概率最大的路径,并返回其成功概率。
如果不存在从 start 到 end 的路径,请 返回 0 。只要答案与标准答案的误差不超过 1e-5 ,就会被视作正确答案。
示例 1:
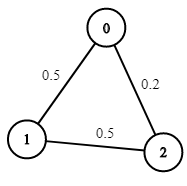
输入:n = 3, edges = [[0,1],[1,2],[0,2]], succProb = [0.5,0.5,0.2], start = 0, end = 2
输出:0.25000
解释:从起点到终点有两条路径,其中一条的成功概率为 0.2 ,而另一条为 0.5 * 0.5 = 0.25
示例 2:
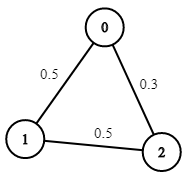
输入:n = 3, edges = [[0,1],[1,2],[0,2]], succProb = [0.5,0.5,0.3], start = 0, end = 2
输出:0.30000
示例 3:
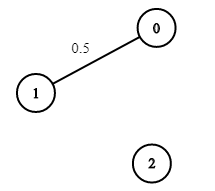
输入:n = 3, edges = [[0,1]], succProb = [0.5], start = 0, end = 2
输出:0.00000
解释:节点 0 和 节点 2 之间不存在路径
提示:
2 <= n <= 10^40 <= start, end < nstart != end0 <= a, b < na != b0 <= succProb.length == edges.length <= 2*10^40 <= succProb[i] <= 1- 每两个节点之间最多有一条边
方法一:堆优化 Dijkstra 算法 · Go 实现
思考
在无向带权图上求从起点到终点的最大成功概率,边权为乘法意义下的成功率。 、 ,枚举全部简单路径不可行。
若把边权看成代价的相反数,问题与最短路同构:概率沿路径相乘,且均在 内,越长通常越小,满足最优子结构。用最大堆按当前概率松弛邻接边,即 Dijkstra 的最大化版本;堆中以相反数模拟大根堆,首次确定终点时即为答案。
我们可以使用 Dijkstra 算法求解最短路径,这里我们稍微修改一下,求解最大概率路径。
我们可以使用一个优先队列(大根堆) 来存储从起点到各个节点的概率以及节点编号。初始时我们将起点的概率设为 ,其余节点的概率设为 ,然后将起点加入到 中。
在每一次的迭代中,我们取出 中概率最大的节点 ,以及 的概率 。如果节点 的概率已经大于 ,那么我们就可以跳过这个节点。否则我们遍历 的所有邻接边 。如果 的概率小于 的概率乘以 的概率,那么我们就可以更新 的概率,并将 加入到 中。
最终,我们可以得到从起点到终点的最大概率。
时间复杂度 ,空间复杂度 。其中 为边的数量。
func maxProbability(n int, edges [][]int, succProb []float64, start_node int, end_node int) float64 {
	g := make([][]pair, n)
	for i, e := range edges {
		a, b := e[0], e[1]
		p := succProb[i]
		g[a] = append(g[a], pair{p, b})
		g[b] = append(g[b], pair{p, a})
	}
	pq := hp{{1, start_node}}
	dist := make([]float64, n)
	dist[start_node] = 1
	for len(pq) > 0 {
		p := heap.Pop(&pq).(pair)
		w, a := p.p, p.a
		if dist[a] > w {
			continue
		}
		for _, e := range g[a] {
			b, p := e.a, e.p
			if nw := w * p; nw > dist[b] {
				dist[b] = nw
				heap.Push(&pq, pair{nw, b})
			}
		}
	}
	return dist[end_node]
}

type pair struct {
	p float64
	a int
}
type hp []pair

func (h hp) Len() int           { return len(h) }
func (h hp) Less(i, j int) bool { return h[i].p > h[j].p }
func (h hp) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(x any)        { *h = append(*h, x.(pair)) }
func (h *hp) Pop() (x any) { a := *h; x = a[len(a)-1]; *h = a[:len(a)-1]; return }1548. 图中最相似的路径 🔒
题目、示例与约束
我们有 n 座城市和 m 条双向道路 roads ,其中 roads[i] = [ai, bi] 连接城市 ai 和城市 bi。每个城市的名称由字符串数组 names 中给出的三个大写英文字母组成。从任意城市 x 出发,你可以到达任意城市 y ,其中 y != x (即:城市和道路形成一张无向连通图)。
给定一个字符串数组 targetPath,你需要找出图中与 targetPath 的 长度相同 且 编辑距离最小 的路径。
你需要返回 编辑距离最小的路径中节点的顺序 。该路径应当与 targetPath 的长度相等,且路径需有效(即: ans[i] 和 ans[i + 1] 间应存在直接连通的道路)。如果有多个答案,返回任意一个。
编辑距离 的定义如下:
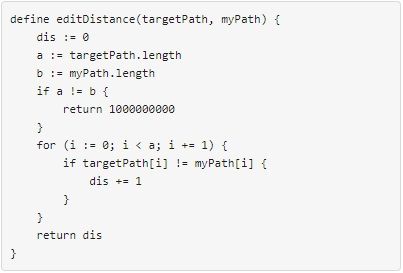
示例 1:
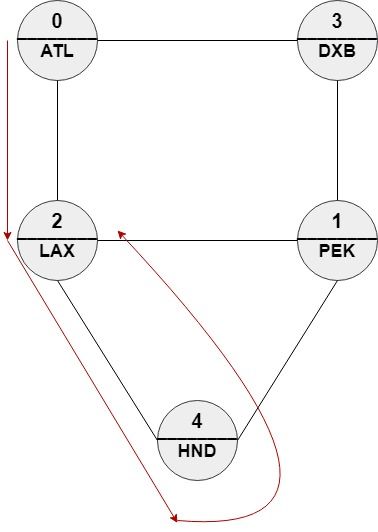
输入:n = 5, roads = [[0,2],[0,3],[1,2],[1,3],[1,4],[2,4]], names = ["ATL","PEK","LAX","DXB","HND"], targetPath = ["ATL","DXB","HND","LAX"]
输出:[0,2,4,2]
解释:[0,2,4,2], [0,3,0,2] 和 [0,3,1,2] 都是正确答案。
[0,2,4,2] 等价于 ["ATL","LAX","HND","LAX"] ,与 targetPath 的编辑距离 = 1。
[0,3,0,2] 等价于 ["ATL","DXB","ATL","LAX"] ,与 targetPath 的编辑距离 = 1。
[0,3,1,2] 等价于 ["ATL","DXB","PEK","LAX"] ,与 targetPath 的编辑距离 = 1。
示例 2:
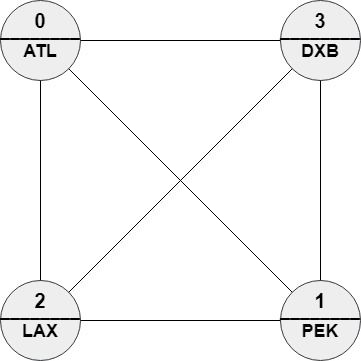
输入:n = 4, roads = [[1,0],[2,0],[3,0],[2,1],[3,1],[3,2]], names = ["ATL","PEK","LAX","DXB"], targetPath = ["ABC","DEF","GHI","JKL","MNO","PQR","STU","VWX"]
输出:[0,1,0,1,0,1,0,1]
解释:任意路径与 targetPath 的编辑距离都等于 8。
示例 3:
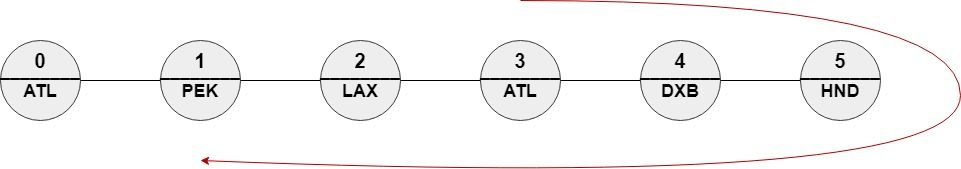
输入:n = 6, roads = [[0,1],[1,2],[2,3],[3,4],[4,5]], names = ["ATL","PEK","LAX","ATL","DXB","HND"], targetPath = ["ATL","DXB","HND","DXB","ATL","LAX","PEK"]
输出:[3,4,5,4,3,2,1]
解释:[3,4,5,4,3,2,1] 是唯一与 targetPath 的编辑距离 = 0 的路径。
该路径等价于 ["ATL","DXB","HND","DXB","ATL","LAX","PEK"]
提示:
2 <= n <= 100m == roads.lengthn - 1 <= m <= (n * (n - 1) / 2)0 <= ai, bi <= n - 1ai != bi- 给定的图保证是连通的,任意两个节点至多有一个直接连通的道路。
names.length == nnames[i].length == 3names[i]包含大写英文字母。- 可能有两个名称相同的城市。
1 <= targetPath.length <= 100targetPath[i].length == 3targetPath[i]由大写英文字母组成。
进阶:如果路径中每个节点只可访问一次,你该如何修改你的答案?
方法一:动态规划 · Go 实现
思考
在城市图上找一条与 等长的路径,使对应位置城市名不同的次数最少。路径长度为 ,城市数为 ,枚举全部路径不可行。
令 表示走完目标前 步且当前停在城市 的最小编辑距离。转移只来自 的邻居 ,并加上当前名字是否匹配。同时记下前驱以便从最优终点回溯整条路径。
我们先根据给定的道路构建一个邻接表 ,其中 表示与城市 直接相连的城市列表。
然后我们定义 表示一条已经对齐 、并且停在城市 的路径的最小编辑距离。
那么我们可以得到状态转移方程:
在状态转移的过程中,我们记录下每个状态的前驱城市,最后根据前驱城市数组 从后往前还原出最优路径。
时间复杂度 ,空间复杂度 。其中 和 分别是 和 的长度。
func mostSimilar(n int, roads [][]int, names []string, targetPath []string) []int {
	g := make([][]int, n)
	for _, r := range roads {
		a, b := r[0], r[1]
		g[a] = append(g[a], b)
		g[b] = append(g[b], a)
	}
	m := len(targetPath)
	const inf = 1 << 30
	f := make([][]int, m)
	pre := make([][]int, m)
	for i := range f {
		f[i] = make([]int, n)
		pre[i] = make([]int, n)
		for j := range f[i] {
			f[i][j] = inf
			pre[i][j] = -1
		}
	}
	for j, s := range names {
		if targetPath[0] != s {
			f[0][j] = 1
		} else {
			f[0][j] = 0
		}
	}
	for i := 1; i < m; i++ {
		for j := 0; j < n; j++ {
			for _, k := range g[j] {
				t := f[i-1][k]
				if targetPath[i] != names[j] {
					t++
				}
				if t < f[i][j] {
					f[i][j] = t
					pre[i][j] = k
				}
			}
		}
	}
	mi, k := inf, 0
	for j := 0; j < n; j++ {
		if f[m-1][j] < mi {
			mi = f[m-1][j]
			k = j
		}
	}
	ans := make([]int, m)
	for i := m - 1; i >= 0; i-- {
		ans[i] = k
		k = pre[i][k]
	}
	return ans
}1557. 可以到达所有点的最少点数目
题目、示例与约束
给你一个 有向无环图 , n 个节点编号为 0 到 n-1 ,以及一个边数组 edges ,其中 edges[i] = [fromi, toi] 表示一条从点 fromi 到点 toi 的有向边。
找到最小的点集使得从这些点出发能到达图中所有点。题目保证解存在且唯一。
你可以以任意顺序返回这些节点编号。
示例 1:

输入:n = 6, edges = [[0,1],[0,2],[2,5],[3,4],[4,2]]
输出:[0,3]
解释:从单个节点出发无法到达所有节点。从 0 出发我们可以到达 [0,1,2,5] 。从 3 出发我们可以到达 [3,4,2,5] 。所以我们输出 [0,3] 。
示例 2:
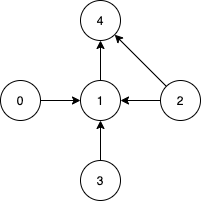
输入:n = 5, edges = [[0,1],[2,1],[3,1],[1,4],[2,4]]
输出:[0,2,3]
解释:注意到节点 0,3 和 2 无法从其他节点到达,所以我们必须将它们包含在结果点集中,这些点都能到达节点 1 和 4 。
提示:
2 <= n <= 10^51 <= edges.length <= min(10^5, n * (n - 1) / 2)edges[i].length == 20 <= fromi, toi < n- 所有点对
(fromi, toi)互不相同。
方法一:统计入度为 0 的点 · Go 实现
思考
在有向无环图中选尽量少的点,使从它们出发能到达全部节点。 与边数达 ,不能枚举点集。
入度为 的点无法被其他点到达,必须选入。其余点都有入边,沿 DAG 一定能从某个零入度点走到。因此答案恰好是全部入度为 的顶点。
我们注意到,所有入度为 的点都一定属于最小点集,因为它们没有任何入边。而由于题目给定的是一张有向无环图,因此所有入度不为 的点一定存在一条入边,也即一定能从某个入度为 的点出发到达。因此我们只需要找到所有入度为 的点即可。
时间复杂度 ,空间复杂度 。其中 和 分别是节点数和边数。
func findSmallestSetOfVertices(n int, edges [][]int) (ans []int) {
	cnt := make([]int, n)
	for _, e := range edges {
		cnt[e[1]]++
	}
	for i, c := range cnt {
		if c == 0 {
			ans = append(ans, i)
		}
	}
	return
}1568. 使陆地分离的最少天数
题目、示例与约束
给你一个大小为 m x n ,由若干 0 和 1 组成的二维网格 grid ,其中 1 表示陆地, 0 表示水。岛屿 由水平方向或竖直方向上相邻的 1 (陆地)连接形成。
如果 恰好只有一座岛屿 ,则认为陆地是 连通的 ;否则,陆地就是 分离的 。
一天内,可以将 任何单个 陆地单元(1)更改为水单元(0)。
返回使陆地分离的最少天数。
示例 1:
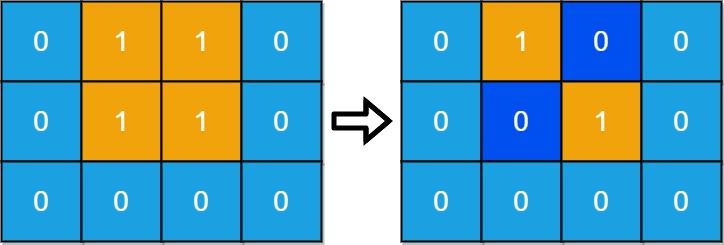
输入:grid = [[0,1,1,0],[0,1,1,0],[0,0,0,0]]
输出:2
解释:至少需要 2 天才能得到分离的陆地。
将陆地 grid[1][1] 和 grid[0][2] 更改为水,得到两个分离的岛屿。
示例 2:
输入:grid = [[1,1]]
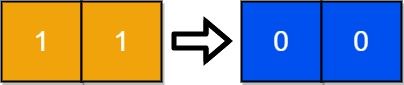
输出:2
解释:如果网格中都是水,也认为是分离的 ([[1,1]] -> [[0,0]]),0 岛屿。
提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 30grid[i][j]为0或1
方法一:脑筋急转弯 · Go 实现
思考
每次可将一块陆地变成水,求使网格不再恰有一座岛的最少天数。网格很小,但答案有更强的结构:任意岛屿至多挖两块陆地就能拆开(例如挖掉一个角上相邻的两格)。
因此答案只可能是 、 或 。先 DFS 计数,若不是恰好一座岛则返回 。再依次把每一块陆地临时挖掉并重新计数,一旦不再是一座岛则返回 。否则必须挖两块,返回 。
观察发现,我们总是可以通过把角落相邻的两个陆地变成水,使得岛屿分离。因此,答案只可能是 0,1 或 2。
我们跑一遍 DFS,统计当前岛屿的数量,如果数量不等于 ,也就是说不满足恰好只有一座岛屿,那么答案就是 0。
否则,我们遍历每一块陆地,把它变成水,然后再跑一遍 DFS,看看岛屿的数量是否不等于 1,如果不等于 1,说明这块陆地变成水后,岛屿分离了,答案就是 1。
遍历结束,说明必须要把两块陆地变成水,才能使得岛屿分离,因此答案就是 2。
时间复杂度 ,其中 和 分别是 grid 的行数和列数。
func minDays(grid [][]int) int {
	m, n := len(grid), len(grid[0])
	dirs := []int{-1, 0, 1, 0, -1}

	var dfs func(i, j int)
	dfs = func(i, j int) {
		grid[i][j] = 2
		for k := 0; k < 4; k++ {
			x, y := i+dirs[k], j+dirs[k+1]
			if x >= 0 && x < m && y >= 0 && y < n && grid[x][y] == 1 {
				dfs(x, y)
			}
		}
	}

	count := func() int {
		cnt := 0
		for i := 0; i < m; i++ {
			for j := 0; j < n; j++ {
				if grid[i][j] == 1 {
					dfs(i, j)
					cnt++
				}
			}
		}
		for i := 0; i < m; i++ {
			for j := 0; j < n; j++ {
				if grid[i][j] == 2 {
					grid[i][j] = 1
				}
			}
		}
		return cnt
	}

	if count() != 1 {
		return 0
	}
	for i := 0; i < m; i++ {
		for j := 0; j < n; j++ {
			if grid[i][j] == 1 {
				grid[i][j] = 0
				if count() != 1 {
					return 1
				}
				grid[i][j] = 1
			}
		}
	}
	return 2
}1591. 奇怪的打印机 II
题目、示例与约束
给你一个奇怪的打印机,它有如下两个特殊的打印规则:
- 每一次操作时,打印机会用同一种颜色打印一个矩形的形状,每次打印会覆盖矩形对应格子里原本的颜色。
- 一旦矩形根据上面的规则使用了一种颜色,那么 相同的颜色不能再被使用 。
给你一个初始没有颜色的 m x n 的矩形 targetGrid ,其中 targetGrid[row][col] 是位置 (row, col) 的颜色。
如果你能按照上述规则打印出矩形 targetGrid ,请你返回 true ,否则返回 false 。
示例 1:
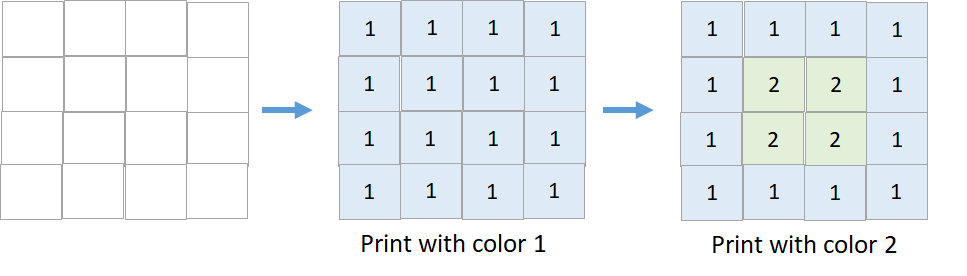
输入:targetGrid = [[1,1,1,1],[1,2,2,1],[1,2,2,1],[1,1,1,1]]
输出:true
示例 2:

输入:targetGrid = [[1,1,1,1],[1,1,3,3],[1,1,3,4],[5,5,1,4]]
输出:true
示例 3:
输入:targetGrid = [[1,2,1],[2,1,2],[1,2,1]]
输出:false
解释:没有办法得到 targetGrid ,因为每一轮操作使用的颜色互不相同。
示例 4:
输入:targetGrid = [[1,1,1],[3,1,3]]
输出:false
提示:
m == targetGrid.lengthn == targetGrid[i].length1 <= m, n <= 601 <= targetGrid[row][col] <= 60
方法一:Go 实现(灵茶山艾府) · Go 实现
本站根据 Go 源码整理,非作者原文。
思路:先求每种颜色的最小包围矩形,再枚举两种颜色并扫描矩形交集。若交集中同时出现这两种颜色,则无论谁后打印都会覆盖另一种,直接判定失败;若只出现颜色 v,就要求另一种颜色先于 v 打印,并添加有向依赖边。最后做拓扑排序,存在未消除的入度就说明依赖成环。
复杂度:设网格为 R 行 S 列,颜色值域大小为 C(源码为 60)。两两颜色检查最多各扫描整个网格,时间上界为 O(C²RS),辅助空间为 O(C²),用于边界、依赖图和拓扑队列。这里按源码的两两矩形扫描计算。
// github.com/EndlessCheng/codeforces-go
func isPrintable(a [][]int) (ans bool) {
	var mix, miy, mxx, mxy [61]int
	for i := 1; i < 61; i++ {
		mix[i] = 99
		miy[i] = 99
	}
	for i, row := range a {
		for j, v := range row {
			mix[v] = min(mix[v], i)
			miy[v] = min(miy[v], j)
			mxx[v] = max(mxx[v], i)
			mxy[v] = max(mxy[v], j)
		}
	}
	g := [61][]int{}
	deg := [61]int{-1}
	for v := 1; v < 60; v++ {
		if mix[v] == 99 {
			continue
		}
		for w := v + 1; w < 61; w++ {
			if mix[w] == 99 {
				continue
			}
			up, down, l, r := max(mix[v], mix[w]), min(mxx[v], mxx[w]), max(miy[v], miy[w]), min(mxy[v], mxy[w])
			if up > down || l > r {
				continue
			}
			hasV, hasW := false, false
			for _, row := range a[up : down+1] {
				for _, x := range row[l : r+1] {
					if x == v {
						if hasW {
							return
						}
						hasV = true
					} else if x == w {
						if hasV {
							return
						}
						hasW = true
					}
				}
			}
			if hasV {
				g[w] = append(g[w], v)
				deg[v]++
			} else if hasW {
				g[v] = append(g[v], w)
				deg[w]++
			}
		}
	}
	q := []int{}
	for i, d := range deg[:] {
		if d == 0 {
			q = append(q, i)
		}
	}
	for len(q) > 0 {
		v := q[0]
		q = q[1:]
		for _, w := range g[v] {
			if deg[w]--; deg[w] == 0 {
				q = append(q, w)
			}
		}
	}
	for _, d := range deg[1:] {
		if d > 0 {
			return
		}
	}
	return true
}

func min(a, b int) int {
	if a < b {
		return a
	}
	return b
}

func max(a, b int) int {
	if a > b {
		return a
	}
	return b
}1615. 最大网络秩
题目、示例与约束
n 座城市和一些连接这些城市的道路 roads 共同组成一个基础设施网络。每个 roads[i] = [ai, bi] 都表示在城市 ai 和 bi 之间有一条双向道路。
两座不同城市构成的 城市对 的 网络秩 定义为:与这两座城市 直接 相连的道路总数。如果存在一条道路直接连接这两座城市,则这条道路只计算 一次 。
整个基础设施网络的 最大网络秩 是所有不同城市对中的 最大网络秩 。
给你整数 n 和数组 roads,返回整个基础设施网络的 最大网络秩 。
示例 1:
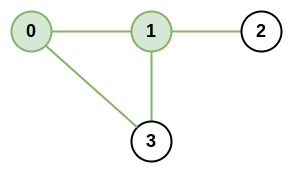
输入:n = 4, roads = [[0,1],[0,3],[1,2],[1,3]]
输出:4
解释:城市 0 和 1 的网络秩是 4,因为共有 4 条道路与城市 0 或 1 相连。位于 0 和 1 之间的道路只计算一次。
示例 2:
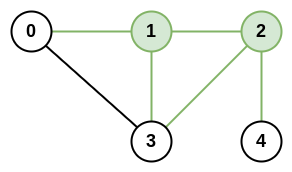
输入:n = 5, roads = [[0,1],[0,3],[1,2],[1,3],[2,3],[2,4]]
输出:5
解释:共有 5 条道路与城市 1 或 2 相连。
示例 3:
输入:n = 8, roads = [[0,1],[1,2],[2,3],[2,4],[5,6],[5,7]]
输出:5
解释:2 和 5 的网络秩为 5,注意并非所有的城市都需要连接起来。
提示:
2 <= n <= 1000 <= roads.length <= n * (n - 1) / 2roads[i].length == 20 <= ai, bi <= n-1ai != bi- 每对城市之间 最多只有一条 道路相连
方法一:计数 · Go 实现
思考
网络秩是两座城市的度数之和,若它们之间有边则再减一以免重复计算。城市数量通常不大,枚举所有无序对即可。
若每对城市都回头扫描道路列表,判断相邻的代价会乘上道路条数。
建边时用一维数组 累加度数,用二维数组 以 记下是否相邻。枚举 时秩为 ,二重循环取最大值。
我们可以用一维数组 记录每个城市的度,用二维数组 记录每对城市之间是否有道路相连,如果城市 和城市 之间有道路相连,则 ,否则 。
接下来,我们枚举每对城市 ,其中 ,计算它们的网络秩,即 ,取其中的最大值即为答案。
时间复杂度 ,空间复杂度 。其中 是城市的数量。
func maximalNetworkRank(n int, roads [][]int) (ans int) {
	g := make([][]int, n)
	cnt := make([]int, n)
	for i := range g {
		g[i] = make([]int, n)
	}
	for _, r := range roads {
		a, b := r[0], r[1]
		g[a][b], g[b][a] = 1, 1
		cnt[a]++
		cnt[b]++
	}
	for a := 0; a < n; a++ {
		for b := a + 1; b < n; b++ {
			ans = max(ans, cnt[a]+cnt[b]-g[a][b])
		}
	}
	return
}1719. 重构一棵树的方案数
题目、示例与约束
给你一个数组 pairs ,其中 pairs[i] = [xi, yi] ,并且满足:
pairs中没有重复元素xi < yi
令 ways 为满足下面条件的有根树的方案数:
- 树所包含的所有节点值都在
pairs中。 - 一个数对
[xi, yi]出现在pairs中 当且仅当xi是yi的祖先或者yi是xi的祖先。 - 注意:构造出来的树不一定是二叉树。
两棵树被视为不同的方案当存在至少一个节点在两棵树中有不同的父节点。
请你返回:
- 如果
ways == 0,返回0。 - 如果
ways == 1,返回1。 - 如果
ways > 1,返回2。
一棵 有根树 指的是只有一个根节点的树,所有边都是从根往外的方向。
我们称从根到一个节点路径上的任意一个节点(除去节点本身)都是该节点的 祖先 。根节点没有祖先。
示例 1:
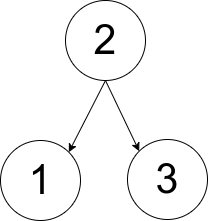
输入:pairs = [[1,2],[2,3]]
输出:1
解释:如上图所示,有且只有一个符合规定的有根树。
示例 2:
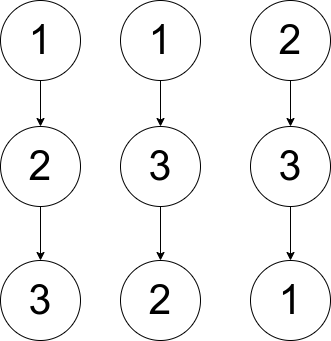
输入:pairs = [[1,2],[2,3],[1,3]]
输出:2
解释:有多个符合规定的有根树,其中三个如上图所示。
示例 3:
输入:pairs = [[1,2],[2,3],[2,4],[1,5]]
输出:0
解释:没有符合规定的有根树。
提示:
1 <= pairs.length <= 1051 <= xi < yi <= 500pairs中的元素互不相同。
方法一 · Go 实现
思考
数对给出祖先关系:边出现当且仅当一方是另一方的祖先。需要判断这样的有根树有 、 还是多于 棵。
度数(邻接对数)越大的点越靠近根。将点按度数升序排列后,每个点的父候选是度数不更小且与之相邻的点。
检验该候选是否覆盖当前点的全部邻接;多个点无法找到父则不能成树。若存在度数相同的父子,则方案多于一;否则恰好一棵。
func checkWays(pairs [][]int) int {
	g := make([][]bool, 510)
	v := make([][]int, 510)
	for i := range g {
		g[i] = make([]bool, 510)
	}
	for _, p := range pairs {
		x, y := p[0], p[1]
		g[x][y] = true
		g[y][x] = true
		v[x] = append(v[x], y)
		v[y] = append(v[y], x)
	}
	var nodes []int
	for i := 1; i <= 500; i++ {
		if len(v[i]) > 0 {
			nodes = append(nodes, i)
			g[i][i] = true
		}
	}
	sort.Slice(nodes, func(i, j int) bool {
		return len(v[nodes[i]]) < len(v[nodes[j]])
	})
	equal := false
	root := 0
	for i, x := range nodes {
		j := i + 1
		for ; j < len(nodes) && !g[x][nodes[j]]; j++ {
		}
		if j < len(nodes) {
			y := nodes[j]
			if len(v[x]) == len(v[y]) {
				equal = true
			}
			for _, z := range v[x] {
				if !g[y][z] {
					return 0
				}
			}
		} else {
			root++
		}
	}
	if root > 1 {
		return 0
	}
	if equal {
		return 2
	}
	return 1
}1728. 猫和老鼠 II
题目、示例与约束
一只猫和一只老鼠在玩一个叫做猫和老鼠的游戏。
它们所处的环境设定是一个 rows x cols 的方格 grid ,其中每个格子可能是一堵墙、一块地板、一位玩家(猫或者老鼠)或者食物。
- 玩家由字符
'C'(代表猫)和'M'(代表老鼠)表示。 - 地板由字符
'.'表示,玩家可以通过这个格子。 - 墙用字符
'#'表示,玩家不能通过这个格子。 - 食物用字符
'F'表示,玩家可以通过这个格子。 - 字符
'C','M'和'F'在grid中都只会出现一次。
猫和老鼠按照如下规则移动:
- 老鼠 先移动 ,然后两名玩家轮流移动。
- 每一次操作时,猫和老鼠可以跳到上下左右四个方向之一的格子,他们不能跳过墙也不能跳出
grid。 catJump和mouseJump是猫和老鼠分别跳一次能到达的最远距离,它们也可以跳小于最大距离的长度。- 它们可以停留在原地。
- 老鼠可以跳跃过猫的位置。
游戏有 4 种方式会结束:
- 如果猫跟老鼠处在相同的位置,那么猫获胜。
- 如果猫先到达食物,那么猫获胜。
- 如果老鼠先到达食物,那么老鼠获胜。
- 如果老鼠不能在 1000 次操作以内到达食物,那么猫获胜。
给你 rows x cols 的矩阵 grid 和两个整数 catJump 和 mouseJump ,双方都采取最优策略,如果老鼠获胜,那么请你返回 true ,否则返回 false 。
示例 1:
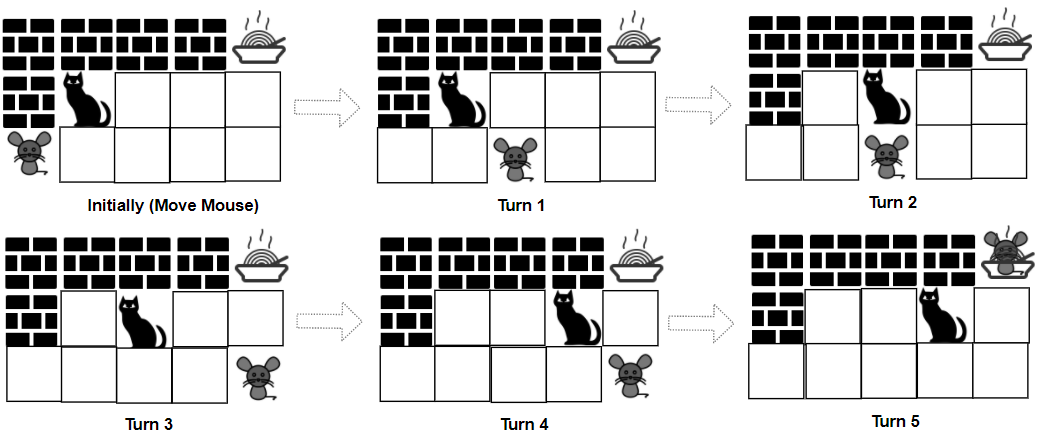
输入:grid = ["####F","#C...","M...."], catJump = 1, mouseJump = 2
输出:true
解释:猫无法抓到老鼠,也没法比老鼠先到达食物。
示例 2:
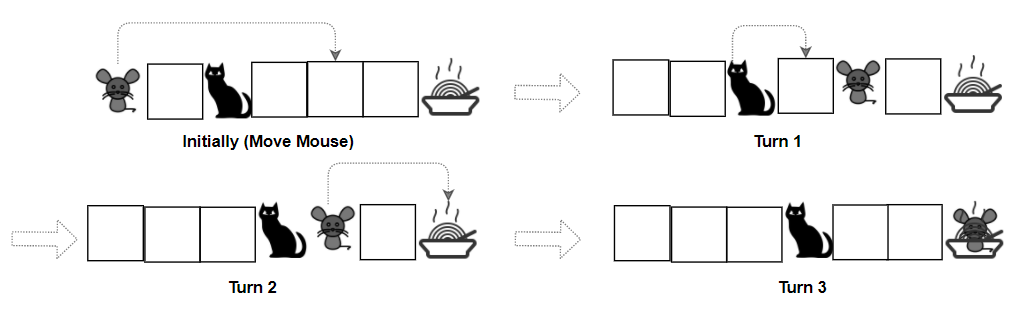
输入:grid = ["M.C...F"], catJump = 1, mouseJump = 4
输出:true
示例 3:
输入:grid = ["M.C...F"], catJump = 1, mouseJump = 3
输出:false
示例 4:
输入:grid = ["C...#","...#F","....#","M...."], catJump = 2, mouseJump = 5
输出:false
示例 5:
输入:grid = [".M...","..#..","#..#.","C#.#.","...#F"], catJump = 3, mouseJump = 1
输出:true
提示:
rows == grid.lengthcols = grid[i].length1 <= rows, cols <= 8grid[i][j]只包含字符'C','M','F','.'和'#'。grid中只包含一个'C','M'和'F'。1 <= catJump, mouseJump <= 8
方法一:拓扑排序 · Go 实现
思考
状态由鼠位、猫位与行棋方决定,规则含跳跃与停留。从初态正向搜索需处理循环与 步上限,判定复杂。
终点、同格、猫先到食物等局面胜负已知。从这些终局沿「上一步可能位置」反推,可确定每个状态的必胜或必败。
记录每个状态的出度:当前行棋方若能一步走到己方已胜的局面则立刻胜;否则出度减尽仍全是对方胜,则必败。初始鼠走时若结果为鼠胜则返回真。
根据题目描述,游戏中的状态由老鼠的位置、猫的位置和移动方决定。当状态为以下情况,可以直接确定胜负:
- 当猫和老鼠的位置相同时,猫获胜,这是猫的必胜状态,老鼠的必败状态。
- 当猫先到达食物时,猫获胜,这是猫的必胜状态,老鼠的必败状态。
- 当老鼠先到达食物时,老鼠获胜,这是老鼠的必胜状态,猫的必败状态。
为了得到初始状态的游戏结果,需要从边界状态开始遍历所有的状态。每个状态包含老鼠的位置、猫的位置和移动方,根据当前状态可以得到上一轮的所有可能状态,上一轮状态的移动方和当前状态的移动方相反,上一轮状态的移动方在上一轮状态的位置和当前状态的位置不同。
我们用元组 表示本轮的状态,用 表示上一轮可能的状态,那么上一轮的所有可能状态有:
- 如果本轮的移动方是老鼠,那么上一轮的移动方是猫,上一轮的老鼠位置是本轮老鼠位置,上一轮的猫位置是本轮猫位置的所有邻接点。
- 如果本轮的移动方是猫,那么上一轮的移动方是老鼠,上一轮的猫位置是本轮猫位置,上一轮的老鼠位置是本轮老鼠位置的所有邻接点。
初始时,除了边界状态以外,其他所有状态的结果都是未知的。我们从边界状态开始,对于每个状态,得到上一轮的所有可能状态并更新结果,更新的逻辑如下:
- 如果上一轮的移动方与本轮的获胜方相同,那么上一轮的移动方可以到达当前状态并获胜,直接更新上一轮的状态为本轮的获胜方。
- 如果上一轮的移动方与本轮的获胜方不同,且上一轮的移动方可以到达的所有状态都是上一轮的移动方的必败状态,那么我们将上一轮的状态更新为本轮的获胜方。
对于第 个更新逻辑,我们需要记录每个状态的度。初始时,每个状态的度表示该状态的移动方可以移动到的结点数,即移动方所在节点的相邻结点数,如果移动方是猫且所在结点与洞相邻则需要将该状态的度减 。
当所有状态的结果都更新完毕时,初始状态的结果即为最终结果。
时间复杂度 ,空间复杂度 。其中 和 分别是矩阵的行数和列数。
func canMouseWin(grid []string, catJump int, mouseJump int) bool {
	m, n := len(grid), len(grid[0])
	catStart, mouseStart, food := 0, 0, 0
	dirs := []int{-1, 0, 1, 0, -1}
	gMouse := make([][]int, m*n)
	gCat := make([][]int, m*n)

	for i := 0; i < m; i++ {
		for j := 0; j < n; j++ {
			c := grid[i][j]
			if c == '#' {
				continue
			}
			v := i*n + j
			if c == 'C' {
				catStart = v
			} else if c == 'M' {
				mouseStart = v
			} else if c == 'F' {
				food = v
			}
			for d := 0; d < 4; d++ {
				a, b := dirs[d], dirs[d+1]
				for k := 0; k <= mouseJump; k++ {
					x, y := i+k*a, j+k*b
					if !(0 <= x && x < m && 0 <= y && y < n && grid[x][y] != '#') {
						break
					}
					gMouse[v] = append(gMouse[v], x*n+y)
				}
				for k := 0; k <= catJump; k++ {
					x, y := i+k*a, j+k*b
					if !(0 <= x && x < m && 0 <= y && y < n && grid[x][y] != '#') {
						break
					}
					gCat[v] = append(gCat[v], x*n+y)
				}
			}
		}
	}
	return calc(gMouse, gCat, mouseStart, catStart, food) == 1
}

func calc(gMouse, gCat [][]int, mouseStart, catStart, hole int) int {
	n := len(gMouse)
	degree := make([][][]int, n)
	ans := make([][][]int, n)
	for i := 0; i < n; i++ {
		degree[i] = make([][]int, n)
		ans[i] = make([][]int, n)
		for j := 0; j < n; j++ {
			degree[i][j] = make([]int, 2)
			ans[i][j] = make([]int, 2)
			degree[i][j][0] = len(gMouse[i])
			degree[i][j][1] = len(gCat[j])
		}
	}

	q := list.New()
	for i := 0; i < n; i++ {
		ans[hole][i][1] = 1
		ans[i][hole][0] = 2
		ans[i][i][1] = 2
		ans[i][i][0] = 2
		q.PushBack([]int{hole, i, 1})
		q.PushBack([]int{i, hole, 0})
		q.PushBack([]int{i, i, 0})
		q.PushBack([]int{i, i, 1})
	}

	for q.Len() > 0 {
		front := q.Front()
		q.Remove(front)
		state := front.Value.([]int)
		m, c, t := state[0], state[1], state[2]
		currentAns := ans[m][c][t]
		for _, prevState := range getPrevStates(gMouse, gCat, m, c, t, ans) {
			pm, pc, pt := prevState[0], prevState[1], prevState[2]
			if pt == currentAns-1 {
				ans[pm][pc][pt] = currentAns
				q.PushBack([]int{pm, pc, pt})
			} else {
				degree[pm][pc][pt]--
				if degree[pm][pc][pt] == 0 {
					ans[pm][pc][pt] = currentAns
					q.PushBack([]int{pm, pc, pt})
				}
			}
		}
	}
	return ans[mouseStart][catStart][0]
}

func getPrevStates(gMouse, gCat [][]int, m, c, t int, ans [][][]int) [][]int {
	pt := t ^ 1
	pre := [][]int{}
	if pt == 1 {
		for _, pc := range gCat[c] {
			if ans[m][pc][1] == 0 {
				pre = append(pre, []int{m, pc, pt})
			}
		}
	} else {
		for _, pm := range gMouse[m] {
			if ans[pm][c][0] == 0 {
				pre = append(pre, []int{pm, c, pt})
			}
		}
	}
	return pre
}1761. 一个图中连通三元组的最小度数
题目、示例与约束
给你一个无向图,整数 n 表示图中节点的数目,edges 数组表示图中的边,其中 edges[i] = [ui, vi] ,表示 ui 和 vi 之间有一条无向边。
一个 连通三元组 指的是 三个 节点组成的集合且这三个点之间 两两 有边。
连通三元组的度数 是所有满足此条件的边的数目:一个顶点在这个三元组内,而另一个顶点不在这个三元组内。
请你返回所有连通三元组中度数的 最小值 ,如果图中没有连通三元组,那么返回 -1 。
示例 1:
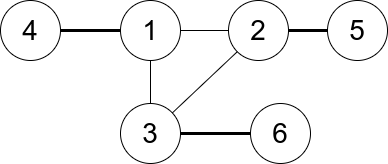
输入:n = 6, edges = [[1,2],[1,3],[3,2],[4,1],[5,2],[3,6]]
输出:3
解释:只有一个三元组 [1,2,3] 。构成度数的边在上图中已被加粗。
示例 2:
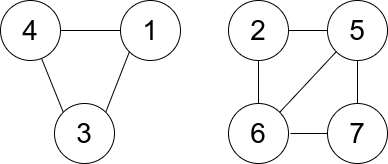
输入:n = 7, edges = [[1,3],[4,1],[4,3],[2,5],[5,6],[6,7],[7,5],[2,6]]
输出:0
解释:有 3 个三元组:
1) [1,4,3],度数为 0 。
2) [2,5,6],度数为 2 。
3) [5,6,7],度数为 2 。
提示:
2 <= n <= 400edges[i].length == 21 <= edges.length <= n * (n-1) / 21 <= ui, vi <= nui != vi- 图中没有重复的边。
方法一:暴力枚举 · Go 实现
思考
连通三元组的度为三结点度数之和减 。图规模允许 枚举三角形。
邻接矩阵判边、 存度数。枚举 且三边都在时更新 。无三角形则返回 。
我们先将所有边存入邻接矩阵 中,再将每个节点的度数存入数组 中。初始化答案 。
然后枚举所有的三元组 ,其中 ,如果 ,则说明这三个节点构成了一个连通三元组,此时更新答案为 。
枚举完所有的三元组后,如果答案仍然为 ,说明图中不存在连通三元组,返回 ,否则返回答案。
时间复杂度 ,空间复杂度 。其中 为节点数。
func minTrioDegree(n int, edges [][]int) int {
	g := make([][]bool, n)
	deg := make([]int, n)
	for i := range g {
		g[i] = make([]bool, n)
	}
	for _, e := range edges {
		u, v := e[0]-1, e[1]-1
		g[u][v], g[v][u] = true, true
		deg[u]++
		deg[v]++
	}
	ans := 1 << 30
	for i := 0; i < n; i++ {
		for j := i + 1; j < n; j++ {
			if g[i][j] {
				for k := j + 1; k < n; k++ {
					if g[i][k] && g[j][k] {
						ans = min(ans, deg[i]+deg[j]+deg[k]-6)
					}
				}
			}
		}
	}
	if ans == 1<<30 {
		return -1
	}
	return ans
}1782. 统计点对的数目
题目、示例与约束
给你一个无向图,无向图由整数 n ,表示图中节点的数目,和 edges 组成,其中 edges[i] = [ui, vi] 表示 ui 和 vi 之间有一条无向边。同时给你一个代表查询的整数数组 queries 。
第 j 个查询的答案是满足如下条件的点对 (a, b) 的数目:
a < bcnt是与a或者b相连的边的数目,且cnt严格大于queries[j]。
请你返回一个数组 answers ,其中 answers.length == queries.length 且 answers[j] 是第 j 个查询的答案。
请注意,图中可能会有 多重边 。
示例 1:

输入:n = 4, edges = [[1,2],[2,4],[1,3],[2,3],[2,1]], queries = [2,3]
输出:[6,5]
解释:每个点对中,与至少一个点相连的边的数目如上图所示。
answers[0] = 6。所有的点对(a, b)中边数和都大于2,故有6个;
answers[1] = 5。所有的点对(a, b)中除了(3,4)边数等于3,其它点对边数和都大于3,故有5个。
示例 2:
输入:n = 5, edges = [[1,5],[1,5],[3,4],[2,5],[1,3],[5,1],[2,3],[2,5]], queries = [1,2,3,4,5]
输出:[10,10,9,8,6]
提示:
2 <= n <= 2 * 1041 <= edges.length <= 1051 <= ui, vi <= nui != vi1 <= queries.length <= 200 <= queries[j] < edges.length
方法一:哈希表 + 排序 + 二分查找 · Go 实现
思考
点对 的「关联边数」为 减去 之间的重边。询问多, 中等,不能对每个询问枚举全部点对。
度数排序后,对每个 二分有多少 满足 。再减去那些「度数和够大但去掉重边后不够」的点对。
根据题目,我们可以知道,与点对 相连的边数等于“与 相连的边数”加上“与 相连的边数”,再减去同时与 和 相连的边数。
因此,我们可以先用数组 统计与每个点相连的边数,用哈希表 统计每个点对的数量。
然后,对于每个查询 ,我们可以枚举 ,对于每个 ,我们可以通过二分查找找到第一个满足 的 ,先将数量累加到当前查询的答案中,然后减去一部分重复的边。
时间复杂度 ,空间复杂度 。其中 和 分别是点数和边数,而 是查询数。
func countPairs(n int, edges [][]int, queries []int) []int {
	cnt := make([]int, n)
	g := map[int]int{}
	for _, e := range edges {
		a, b := e[0]-1, e[1]-1
		cnt[a]++
		cnt[b]++
		if a > b {
			a, b = b, a
		}
		g[a*n+b]++
	}
	s := make([]int, n)
	copy(s, cnt)
	sort.Ints(s)
	ans := make([]int, len(queries))
	for i, t := range queries {
		for j, x := range s {
			k := sort.Search(n, func(h int) bool { return s[h] > t-x && h > j })
			ans[i] += n - k
		}
		for k, v := range g {
			a, b := k/n, k%n
			if cnt[a]+cnt[b] > t && cnt[a]+cnt[b]-v <= t {
				ans[i]--
			}
		}
	}
	return ans
}1786. 从第一个节点出发到最后一个节点的受限路径数
题目、示例与约束
现有一个加权无向连通图。给你一个正整数 n ,表示图中有 n 个节点,并按从 1 到 n 给节点编号;另给你一个数组 edges ,其中每个 edges[i] = [ui, vi, weighti] 表示存在一条位于节点 ui 和 vi 之间的边,这条边的权重为 weighti 。
从节点 start 出发到节点 end 的路径是一个形如 [z0, z1, z2, ..., zk] 的节点序列,满足 z0 = start 、zk = end 且在所有符合 0 <= i <= k-1 的节点 zi 和 zi+1 之间存在一条边。
路径的距离定义为这条路径上所有边的权重总和。用 distanceToLastNode(x) 表示节点 n 和 x 之间路径的最短距离。受限路径 为满足 distanceToLastNode(zi) > distanceToLastNode(zi+1) 的一条路径,其中 0 <= i <= k-1 。
返回从节点 1 出发到节点 n 的 受限路径数 。由于数字可能很大,请返回对 109 + 7 取余 的结果。
示例 1:
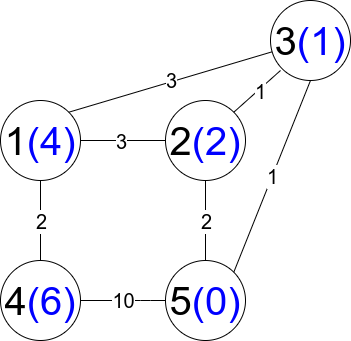
输入:n = 5, edges = [[1,2,3],[1,3,3],[2,3,1],[1,4,2],[5,2,2],[3,5,1],[5,4,10]]
输出:3
解释:每个圆包含黑色的节点编号和蓝色的 distanceToLastNode 值。三条受限路径分别是:
1) 1 --> 2 --> 5
2) 1 --> 2 --> 3 --> 5
3) 1 --> 3 --> 5
示例 2:
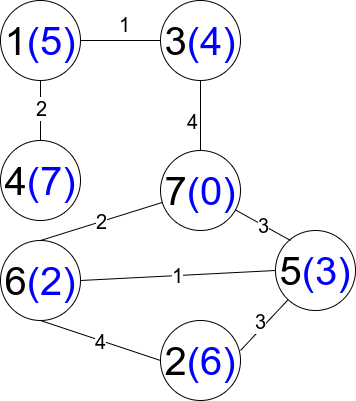
输入:n = 7, edges = [[1,3,1],[4,1,2],[7,3,4],[2,5,3],[5,6,1],[6,7,2],[7,5,3],[2,6,4]]
输出:1
解释:每个圆包含黑色的节点编号和蓝色的 distanceToLastNode 值。唯一一条受限路径是:1 --> 3 --> 7 。
提示:
1 <= n <= 2 * 104n - 1 <= edges.length <= 4 * 104edges[i].length == 31 <= ui, vi <= nui != vi1 <= weighti <= 105- 任意两个节点之间至多存在一条边
- 任意两个节点之间至少存在一条路径
方法一:堆优化 Dijkstra + 记忆化搜索 · Go 实现
思考
限制路径要求沿途到 的最短路严格下降。先要求出每个点到 的距离,再在这张「距离递减」的 DAG 上计数。
从 做堆优化 Dijkstra 得到 。记忆化 :走向 更小的邻居,到达 计 ,对 取模。
const inf = math.MaxInt32
const mod = 1e9 + 7

type pair struct {
	first  int
	second int
}

var _ heap.Interface = (*pairs)(nil)

type pairs []pair

func (a pairs) Len() int { return len(a) }
func (a pairs) Less(i int, j int) bool {
	return a[i].first < a[j].first || a[i].first == a[j].first && a[i].second < a[j].second
}
func (a pairs) Swap(i int, j int) { a[i], a[j] = a[j], a[i] }
func (a *pairs) Push(x any)       { *a = append(*a, x.(pair)) }
func (a *pairs) Pop() any         { l := len(*a); t := (*a)[l-1]; *a = (*a)[:l-1]; return t }

func countRestrictedPaths(n int, edges [][]int) int {
	g := make([]pairs, n+1)
	for _, e := range edges {
		u, v, w := e[0], e[1], e[2]
		g[u] = append(g[u], pair{v, w})
		g[v] = append(g[v], pair{u, w})
	}
	dist := make([]int, n+1)
	f := make([]int, n+1)
	for i := range dist {
		dist[i] = inf
		f[i] = -1
	}
	dist[n] = 0
	h := make(pairs, 0)
	heap.Push(&h, pair{0, n})
	for len(h) > 0 {
		u := heap.Pop(&h).(pair).second
		for _, ne := range g[u] {
			v, w := ne.first, ne.second
			if dist[v] > dist[u]+w {
				dist[v] = dist[u] + w
				heap.Push(&h, pair{dist[v], v})
			}
		}
	}
	var dfs func(int) int
	dfs = func(i int) int {
		if f[i] != -1 {
			return f[i]
		}
		if i == n {
			return 1
		}
		ans := 0
		for _, ne := range g[i] {
			j := ne.first
			if dist[i] > dist[j] {
				ans = (ans + dfs(j)) % mod
			}
		}
		f[i] = ans
		return ans
	}
	return dfs(1)
}
方法三:堆优化 Dijkstra + 动态规划 · Go 实现
思考
限制路径要求沿途到 的最短路严格下降。若对每个点记忆化搜索,只走向距离更小的邻居,一条 个点的链会把调用栈拉到 ,超出递归上限。
瓶颈在这条下降链本身:每一步都进入尚未算完的更近点,搜索深度与 同阶。
这些下降边构成有向无环图,点 的方案数只依赖距离严格更小的邻居。
因此先从 做堆优化 Dijkstra 得到 ,再把节点按 升序处理。令 ,对其余点把已算完的 加进来,并对 取模。距离更小的点排在前面,依赖在累加时已经就绪。
先从 做堆优化 Dijkstra,再按到 的最短路从小到大递推限制路径数,并对 取模。
const inf = math.MaxInt32
const mod = 1e9 + 7

type pair struct {
	first  int
	second int
}

var _ heap.Interface = (*pairs)(nil)

type pairs []pair

func (a pairs) Len() int { return len(a) }
func (a pairs) Less(i int, j int) bool {
	return a[i].first < a[j].first || a[i].first == a[j].first && a[i].second < a[j].second
}
func (a pairs) Swap(i int, j int) { a[i], a[j] = a[j], a[i] }
func (a *pairs) Push(x any)       { *a = append(*a, x.(pair)) }
func (a *pairs) Pop() any         { l := len(*a); t := (*a)[l-1]; *a = (*a)[:l-1]; return t }

func countRestrictedPaths(n int, edges [][]int) int {
	g := make([]pairs, n+1)
	for _, e := range edges {
		u, v, w := e[0], e[1], e[2]
		g[u] = append(g[u], pair{v, w})
		g[v] = append(g[v], pair{u, w})
	}
	dist := make([]int, n+1)
	for i := range dist {
		dist[i] = inf
	}
	dist[n] = 0
	h := make(pairs, 0)
	heap.Push(&h, pair{0, n})
	for len(h) > 0 {
		u := heap.Pop(&h).(pair).second
		for _, ne := range g[u] {
			v, w := ne.first, ne.second
			if dist[v] > dist[u]+w {
				dist[v] = dist[u] + w
				heap.Push(&h, pair{dist[v], v})
			}
		}
	}
	order := make([]int, n)
	for i := range order {
		order[i] = i + 1
	}
	sort.Slice(order, func(a, b int) bool { return dist[order[a]] < dist[order[b]] })
	f := make([]int, n+1)
	f[n] = 1
	for _, i := range order {
		for _, ne := range g[i] {
			j := ne.first
			if dist[i] > dist[j] {
				f[i] = (f[i] + f[j]) % mod
			}
		}
	}
	return f[1]
}1791. 找出星型图的中心节点
题目、示例与约束
有一个无向的 星型 图,由 n 个编号从 1 到 n 的节点组成。星型图有一个 中心 节点,并且恰有 n - 1 条边将中心节点与其他每个节点连接起来。
给你一个二维整数数组 edges ,其中 edges[i] = [ui, vi] 表示在节点 ui 和 vi 之间存在一条边。请你找出并返回 edges 所表示星型图的中心节点。
示例 1:
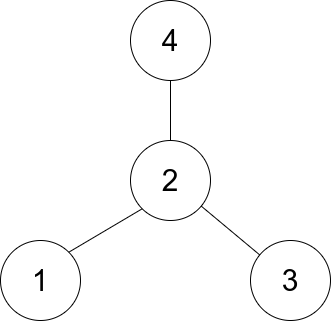
输入:edges = [[1,2],[2,3],[4,2]]
输出:2
解释:如上图所示,节点 2 与其他每个节点都相连,所以节点 2 是中心节点。
示例 2:
输入:edges = [[1,2],[5,1],[1,3],[1,4]]
输出:1
提示:
3 <= n <= 105edges.length == n - 1edges[i].length == 21 <= ui, vi <= nui != vi- 题目数据给出的
edges表示一个有效的星型图
方法一:直接比较前两条边的点 · Go 实现
思考
星图中心与其余所有点相连,因此任意两条边都经过中心。不必建图。
看第一条边的两个端点,哪个出现在第二条边里,那个就是中心。
中心点的特点是,它与其他所有点都相连,因此只要比较前两条边的点,如果有相同的点,那么这个点就是中心点。
时间复杂度 ,空间复杂度 。
func findCenter(edges [][]int) int {
	a, b := edges[0][0], edges[0][1]
	c, d := edges[1][0], edges[1][1]
	if a == c || a == d {
		return a
	}
	return b
}1810. 隐藏网格下的最小消耗路径 🔒
题目、示例与约束
这是一个交互问题。
有一个机器人存在于网格中,你需要通过不断尝试使他从初始单元到达目标单元。网格的规格为m x n,并且每个单元的属性值要不为空,要不已被占用。题目保证初始网格和目标网格不同且均为空。
每个单元格都有消耗值,你需要在每次移动至此单元格后支付该费用。在机器人启动前,初始单元的费用不被计算在内。
你需要找到机器人移动至目标网格的最小总消耗。但可惜的是你并不知道网格的尺寸、初始单元和目标单元。你只允许通过询问GridMaster类获得信息。
GridMaster类存在以下功能:
boolean canMove(char direction)当机器人可以向这个方向移动时,返回true;反之返回false。int move(char direction)沿该方向移动机器人,并返回移动到该单元的消耗值。如果此移动将机器人移动到被占有的单元格或离开网格,则移动将被忽略,机器人将保持在相同的位置,函数将返回-1。boolean isTarget():如果机器人当前位于目标单元格上,则返回true;反之返回false。
请注意,上述函数中的方向应该是{ 'U'、'D'、'L'、'R' }中的字符,分别表示向上、向下、左和右方向。
返回使机器人从其初始起始单元到目标单元的最小总消耗。如果单元格之间不存在有效路径,则返回-1。
测试实例:
测试输入一个大小为m x n的二维数组 grid 和四个int型参数 r1, c1, r2, 和 c2 :
grid[i][j] == 0表示网格(i, j)已被占用。grid[i][j] >= 1表示网格单元(i, j)为空并且grid[i][j]的值为移动至此网格的成本值。(r1, c1)为初始单元。(r2, c2)为目标单元。
请注意,你将无法在你的代码中获知这些信息。
示例 1:
输入: grid = [[2,3],[1,1]], r1 = 0, c1 = 1, r2 = 1, c2 = 0
输出: 2
解释: 其中一种可能路径描述如下:
机器人最开始站在单元格 (0, 1) ,用 3 表示
- master.canMove('U') 返回 false
- master.canMove('D') 返回 true
- master.canMove('L') 返回 true
- master.canMove('R') 返回 false
- master.move('L') 机器人移动到单元格 (0, 0) 并返回 2
- master.isTarget() 返回 false
- master.canMove('U') 返回 false
- master.canMove('D') 返回 true
- master.canMove('L') 返回 false
- master.canMove('R') 返回 true
- master.move('D') 机器人移动到单元格 (1, 0) 并返回 1
- master.isTarget() 返回 true
- master.move('L') 机器人不移动并返回 -1
- master.move('R') 机器人移动到单元格 (1, 1) 并返回 1
现在我们知道了机器人达到目标单元(1, 0)的最小消耗成本为2。
示例 2:
输入: grid = [[0,3,1],[3,4,2],[1,2,0]], r1 = 2, c1 = 0, r2 = 0, c2 = 2
输出: 9
解释: 最小消耗路径为 (2,0) -> (2,1) -> (1,1) -> (1,2) -> (0,2).
示例 3:
输入: grid = [[1,0],[0,1]], r1 = 0, c1 = 0, r2 = 1, c2 = 1
输出: -1
解释: 不存在可使机器人到达目标单元的路径。
提示:
1 <= n, m <= 100m == grid.lengthn == grid[i].length0 <= grid[i][j] <= 100
方法一:Go 解法(本站整理) · Go 实现
基于 Doocs DFS 建图加 Dijkstra 参考改写。显式 DFS 驱动机器人并回退,记录每个可达格的进入费用;Move 的返回值就是目标格费用,起点初始费用不计。建图后用最小堆求最小费用,可重复弹出的过期状态直接丢弃。V 为可达格数,时间 O(V log V),空间 O(V)。平台 GridMaster 方法为 CanMove(byte) bool、Move(byte) int、IsTarget() bool;方向 U/R/D/L,入口接收 *GridMaster。测试 mock 检查合法移动与最终位置,不访问网络。
出处:Doocs 原题与题解,固定提交 91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011;题意、参考及本 Go 改写采用 CC BY-SA 4.0。
// 题意与参考:Doocs LeetCode,CC BY-SA 4.0。
// https://github.com/doocs/leetcode/blob/91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011/solution/1800-1899/1810.Minimum%20Path%20Cost%20in%20a%20Hidden%20Grid/README.md
// Go 实现与测试沿用 CC BY-SA 4.0;来源性质见配套说明。
import "container/heap"

type position struct{ x, y int }
type costState struct {
	p    position
	cost int
}
type costHeap []costState

func (h costHeap) Len() int           { return len(h) }
func (h costHeap) Less(i, j int) bool { return h[i].cost < h[j].cost }
func (h costHeap) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *costHeap) Push(x any)        { *h = append(*h, x.(costState)) }
func (h *costHeap) Pop() any          { a := *h; x := a[len(a)-1]; *h = a[:len(a)-1]; return x }
func findShortestPath(master *GridMaster) int {
	type frame struct {
		p    position
		next int
		back byte
	}
	dirs := []byte{'U', 'R', 'D', 'L'}
	dx := []int{-1, 0, 1, 0}
	dy := []int{0, 1, 0, -1}
	start := position{}
	costs := map[position]int{start: 0}
	stack := []frame{{p: start}}
	target := start
	found := master.IsTarget()
	for len(stack) > 0 {
		f := &stack[len(stack)-1]
		if f.next == 4 {
			back := f.back
			stack = stack[:len(stack)-1]
			if back != 0 {
				master.Move(back)
			}
			continue
		}
		d := f.next
		f.next++
		p := position{f.p.x + dx[d], f.p.y + dy[d]}
		if _, ok := costs[p]; ok || !master.CanMove(dirs[d]) {
			continue
		}
		costs[p] = master.Move(dirs[d])
		if master.IsTarget() {
			target = p
			found = true
		}
		stack = append(stack, frame{p: p, back: dirs[(d+2)%4]})
	}
	if !found {
		return -1
	}
	dist := map[position]int{start: 0}
	h := &costHeap{{start, 0}}
	for h.Len() > 0 {
		s := heap.Pop(h).(costState)
		if dist[s.p] != s.cost {
			continue
		}
		if s.p == target {
			return s.cost
		}
		for d := 0; d < 4; d++ {
			p := position{s.p.x + dx[d], s.p.y + dy[d]}
			c, ok := costs[p]
			if !ok {
				continue
			}
			next := s.cost + c
			old, exists := dist[p]
			if !exists || next < old {
				dist[p] = next
				heap.Push(h, costState{p, next})
			}
		}
	}
	return -1
}1820. 最多邀请的个数 🔒
题目、示例与约束
某一个班级有 m 个男孩和 n 个女孩,即将举行一个派对。
给定一个 m x n 的整数矩阵 grid ,其中 grid[i][j] 等于 0 或 1 。 若 grid[i][j] == 1 ,则表示第 i 个男孩可以邀请第 j 个女孩参加派对。 一个男孩最多可以邀请一个女孩,一个女孩最多可以接受一个男孩的一个邀请。
返回可能的最多邀请的个数。
示例 1:
输入: grid = [[1,1,1],
               [1,0,1],
               [0,0,1]]
输出: 3
解释: 按下列方式邀请:
- 第 1 个男孩邀请第 2 个女孩。
- 第 2 个男孩邀请第 1 个女孩。
- 第 3 个男孩邀请第 3 个女孩。
示例 2:
输入: grid = [[1,0,1,0],
               [1,0,0,0],
               [0,0,1,0],
               [1,1,1,0]]
输出: 3
解释: 按下列方式邀请:
- 第 1 个男孩邀请第 3 个女孩。
- 第 2 个男孩邀请第 1 个女孩。
- 第 3 个男孩未邀请任何人。
- 第 4 个男孩邀请第 2 个女孩。
提示:
grid.length == mgrid[i].length == n1 <= m, n <= 200grid[i][j]是0或1之一。
方法一:匈牙利算法 · Go 实现
思考
男孩与女孩的邀请关系构成二分图,每人至多配对一次,求最大配对数。若枚举全部匹配方案,状态数为指数级, 不可行。
这是经典的二分图最大匹配。匈牙利算法从每个未匹配的左部点寻找增广路:对右侧候选人做 DFS,若对方未匹配或能给其原配再找到新对象,则改写匹配。每个左部点至多尝试一次完整搜索,总时间可接受。
本题属于二分图最大匹配问题,适合用匈牙利算法来求解。
匈牙利算法的核心思想是,不断地从未匹配的点出发,寻找增广路径,直到没有增广路径为止,就得到了最大匹配。
时间复杂度 。
func maximumInvitations(grid [][]int) int {
	m, n := len(grid), len(grid[0])
	var vis map[int]bool
	match := make([]int, n)
	for i := range match {
		match[i] = -1
	}
	var find func(i int) bool
	find = func(i int) bool {
		for j, v := range grid[i] {
			if v == 1 && !vis[j] {
				vis[j] = true
				if match[j] == -1 || find(match[j]) {
					match[j] = i
					return true
				}
			}
		}
		return false
	}
	ans := 0
	for i := 0; i < m; i++ {
		vis = map[int]bool{}
		if find(i) {
			ans++
		}
	}
	return ans
}1857. 有向图中最大颜色值
题目、示例与约束
给你一个 有向图 ,它含有 n 个节点和 m 条边。节点编号从 0 到 n - 1 。
给你一个字符串 colors ,其中 colors[i] 是小写英文字母,表示图中第 i 个节点的 颜色 (下标从 0 开始)。同时给你一个二维数组 edges ,其中 edges[j] = [aj, bj] 表示从节点 aj 到节点 bj 有一条 有向边 。
图中一条有效 路径 是一个点序列 x1 -> x2 -> x3 -> ... -> xk ,对于所有 1 <= i < k ,从 xi 到 xi+1 在图中有一条有向边。路径的 颜色值 是路径中 出现次数最多 颜色的节点数目。
请你返回给定图中有效路径里面的 最大颜色值 。如果图中含有环,请返回 -1 。
示例 1:
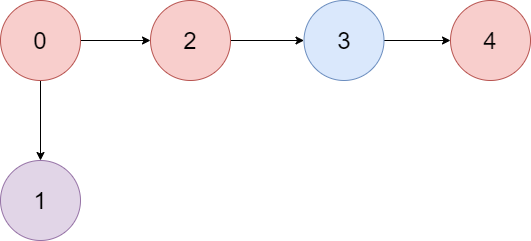
输入:colors = "abaca", edges = [[0,1],[0,2],[2,3],[3,4]]
输出:3
解释:路径 0 -> 2 -> 3 -> 4 含有 3 个颜色为 "a" 的节点(上图中的红色节点)。
示例 2:
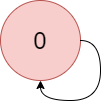
输入:colors = "a", edges = [[0,0]]
输出:-1
解释:从 0 到 0 有一个环。
提示:
n == colors.lengthm == edges.length1 <= n <= 1050 <= m <= 105colors只含有小写英文字母。0 <= aj, bj < n
方法一:拓扑排序 + 动态规划 · Go 实现
思考
有向图路径上某种颜色出现次数的最大值,若存在环则无解。路径条数指数级, ,不能枚举路径。
拓扑序保证每个点在其前驱之后处理。 表示到达 时颜色 的最大次数,沿出边把 维取 并加上终点自身颜色。若出队点数不足 则有环。
求出每个点的入度,进行拓扑排序。
定义一个二维数组 ,其中 表示从起点到 点,颜色为 的节点数目。
从 点出发,遍历所有出边 ,更新 ,其中 是 点的颜色。
答案为数组 中的最大值。
如果图中有环,则无法遍历完所有点,返回 。
时间复杂度 ,空间复杂度 。其中 是字母表大小,这里为 ,而且 和 分别是节点数和边数。
func largestPathValue(colors string, edges [][]int) int {
	n := len(colors)
	g := make([][]int, n)
	indeg := make([]int, n)
	for _, e := range edges {
		a, b := e[0], e[1]
		g[a] = append(g[a], b)
		indeg[b]++
	}
	q := []int{}
	dp := make([][]int, n)
	for i := range dp {
		dp[i] = make([]int, 26)
	}
	for i, v := range indeg {
		if v == 0 {
			q = append(q, i)
			c := colors[i] - 'a'
			dp[i][c]++
		}
	}
	cnt := 0
	ans := 1
	for len(q) > 0 {
		i := q[0]
		q = q[1:]
		cnt++
		for _, j := range g[i] {
			indeg[j]--
			if indeg[j] == 0 {
				q = append(q, j)
			}
			c := int(colors[j] - 'a')
			for k := 0; k < 26; k++ {
				t := 0
				if c == k {
					t = 1
				}
				dp[j][k] = max(dp[j][k], dp[i][k]+t)
				ans = max(ans, dp[j][k])
			}
		}
	}
	if cnt == n {
		return ans
	}
	return -1
}1916. 统计为蚁群构筑房间的不同顺序
题目、示例与约束
你是一只蚂蚁,负责为蚁群构筑 n 间编号从 0 到 n-1 的新房间。给你一个 下标从 0 开始 且长度为 n 的整数数组 prevRoom 作为扩建计划。其中,prevRoom[i] 表示在构筑房间 i 之前,你必须先构筑房间 prevRoom[i] ,并且这两个房间必须 直接 相连。房间 0 已经构筑完成,所以 prevRoom[0] = -1 。扩建计划中还有一条硬性要求,在完成所有房间的构筑之后,从房间 0 可以访问到每个房间。
你一次只能构筑 一个 房间。你可以在 已经构筑好的 房间之间自由穿行,只要这些房间是 相连的 。如果房间 prevRoom[i] 已经构筑完成,那么你就可以构筑房间 i。
返回你构筑所有房间的 不同顺序的数目 。由于答案可能很大,请返回对 109 + 7 取余 的结果。
示例 1:
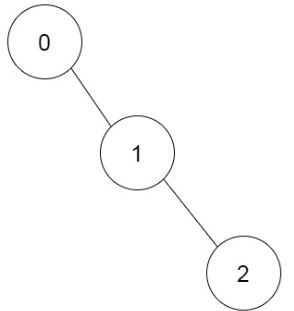
输入:prevRoom = [-1,0,1]
输出:1
解释:仅有一种方案可以完成所有房间的构筑:0 → 1 → 2
示例 2:
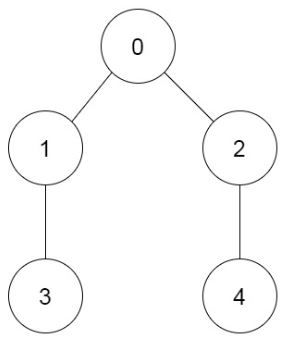
输入:prevRoom = [-1,0,0,1,2]
输出:6
解释:
有 6 种不同顺序:
0 → 1 → 3 → 2 → 4
0 → 2 → 4 → 1 → 3
0 → 1 → 2 → 3 → 4
0 → 1 → 2 → 4 → 3
0 → 2 → 1 → 3 → 4
0 → 2 → 1 → 4 → 3
提示:
n == prevRoom.length2 <= n <= 105prevRoom[0] == -1- 对于所有的
1 <= i < n,都有0 <= prevRoom[i] < n - 题目保证所有房间都构筑完成后,从房间
0可以访问到每个房间
方法一 · Go 实现
思考
建造顺序必须尊重树形先序约束,合法序列是该有根树的拓扑序。枚举排列再检验在 时不可行。
子树内部的建造顺序相互独立,合并两棵子树时只需在合并后的位置中为其中一棵选择下标,方案数为组合数。多子树则从左到右陆续合并。
DFS 返回子树大小,对每个结点用 把已合并大小 与新子树大小 相乘,并对模数取余。
func waysToBuildRooms(prevRoom []int) int {
	const mod = 1_000_000_007
	n := len(prevRoom)
	g := make([][]int, n)
	for i := 1; i < n; i++ {
		g[prevRoom[i]] = append(g[prevRoom[i]], i)
	}
	fact := make([]int, n+1)
	invFact := make([]int, n+1)
	fact[0] = 1
	for i := 1; i <= n; i++ {
		fact[i] = fact[i-1] * i % mod
	}
	qpow := func(a, n int) int {
		res := 1
		for ; n > 0; n >>= 1 {
			if n&1 == 1 {
				res = res * a % mod
			}
			a = a * a % mod
		}
		return res
	}
	invFact[n] = qpow(fact[n], mod-2)
	for i := n; i > 0; i-- {
		invFact[i-1] = invFact[i] * i % mod
	}
	comb := func(n, k int) int {
		return fact[n] * invFact[k] % mod * invFact[n-k] % mod
	}
	ans := 1
	var dfs func(int) int
	dfs = func(u int) int {
		merged := 0
		for _, v := range g[u] {
			cn := dfs(v)
			if merged != 0 {
				ans = ans * comb(merged+cn, cn) % mod
			}
			merged += cn
		}
		return merged + 1
	}
	dfs(0)
	return ans
}1928. 规定时间内到达终点的最小花费
题目、示例与约束
一个国家有 n 个城市,城市编号为 0 到 n - 1 ,题目保证 所有城市 都由双向道路 连接在一起 。道路由二维整数数组 edges 表示,其中 edges[i] = [xi, yi, timei] 表示城市 xi 和 yi 之间有一条双向道路,耗费时间为 timei 分钟。两个城市之间可能会有多条耗费时间不同的道路,但是不会有道路两头连接着同一座城市。
每次经过一个城市时,你需要付通行费。通行费用一个长度为 n 且下标从 0 开始的整数数组 passingFees 表示,其中 passingFees[j] 是你经过城市 j 需要支付的费用。
一开始,你在城市 0 ,你想要在 maxTime 分钟以内 (包含 maxTime 分钟)到达城市 n - 1 。旅行的 费用 为你经过的所有城市 通行费之和 (包括 起点和终点城市的通行费)。
给你 maxTime,edges 和 passingFees ,请你返回完成旅行的 最小费用 ,如果无法在 maxTime 分钟以内完成旅行,请你返回 -1 。
示例 1:
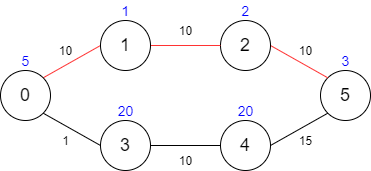
输入:maxTime = 30, edges = [[0,1,10],[1,2,10],[2,5,10],[0,3,1],[3,4,10],[4,5,15]], passingFees = [5,1,2,20,20,3]
输出:11
解释:最优路径为 0 -> 1 -> 2 -> 5 ,总共需要耗费 30 分钟,需要支付 11 的通行费。
示例 2:
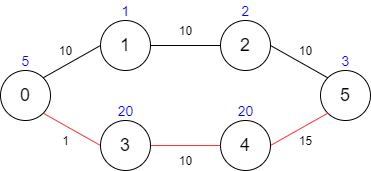
输入:maxTime = 29, edges = [[0,1,10],[1,2,10],[2,5,10],[0,3,1],[3,4,10],[4,5,15]], passingFees = [5,1,2,20,20,3]
输出:48
解释:最优路径为 0 -> 3 -> 4 -> 5 ,总共需要耗费 26 分钟,需要支付 48 的通行费。
你不能选择路径 0 -> 1 -> 2 -> 5 ,因为这条路径耗费的时间太长。
示例 3:
输入:maxTime = 25, edges = [[0,1,10],[1,2,10],[2,5,10],[0,3,1],[3,4,10],[4,5,15]], passingFees = [5,1,2,20,20,3]
输出:-1
解释:无法在 25 分钟以内从城市 0 到达城市 5 。
提示:
1 <= maxTime <= 1000n == passingFees.length2 <= n <= 1000n - 1 <= edges.length <= 10000 <= xi, yi <= n - 11 <= timei <= 10001 <= passingFees[j] <= 1000- 图中两个节点之间可能有多条路径。
- 图中不含有自环。
方法一:动态规划 · Go 实现
思考
边权含时间与过路费两维,最短路若只优化费用会超时限,只优化时间则费用不是最小。 、 ,可用时间作为一层 DP。
令 为恰好用时 到达城市 的最小费用。按时间升序,对每条边做一次松弛,相当于在「时间—城市」图上的最短路。
终点在所有可行时间上取最小费用,不存在则返回 。
我们定义 表示经过 分钟,从城市 到达城市 的最小花费。初始时 ,其余的 。
接下来,我们在 的时间范围内,遍历所有的边,对于每一条边 ,如果 ,那么我们:
- 可以先经过 分钟,从城市 到达城市 ,然后再经过 分钟,从城市 到达城市 ,再加上到达城市 的通行费,即 ;
- 也可以先经过 分钟,从城市 到达城市 ,然后再经过 分钟,从城市 到达城市 ,再加上到达城市 的通行费,即 。
最终答案即为 ,其中 。如果答案为 ,则返回 。
时间复杂度 ,其中 和 分别是边的数量和城市的数量。空间复杂度 。
func minCost(maxTime int, edges [][]int, passingFees []int) int {
	m, n := maxTime, len(passingFees)
	f := make([][]int, m+1)
	const inf int = 1 << 30
	for i := range f {
		f[i] = make([]int, n)
		for j := range f[i] {
			f[i][j] = inf
		}
	}
	f[0][0] = passingFees[0]
	for i := 1; i <= m; i++ {
		for _, e := range edges {
			x, y, t := e[0], e[1], e[2]
			if t <= i {
				f[i][x] = min(f[i][x], f[i-t][y]+passingFees[x])
				f[i][y] = min(f[i][y], f[i-t][x]+passingFees[y])
			}
		}
	}
	ans := inf
	for i := 1; i <= m; i++ {
		ans = min(ans, f[i][n-1])
	}
	if ans == inf {
		return -1
	}
	return ans
}1976. 到达目的地的方案数
题目、示例与约束
你在一个城市里,城市由 n 个路口组成,路口编号为 0 到 n - 1 ,某些路口之间有 双向 道路。输入保证你可以从任意路口出发到达其他任意路口,且任意两个路口之间最多有一条路。
给你一个整数 n 和二维整数数组 roads ,其中 roads[i] = [ui, vi, timei] 表示在路口 ui 和 vi 之间有一条需要花费 timei 时间才能通过的道路。你想知道花费 最少时间 从路口 0 出发到达路口 n - 1 的方案数。
请返回花费 最少时间 到达目的地的 路径数目 。由于答案可能很大,将结果对 109 + 7 取余 后返回。
示例 1:
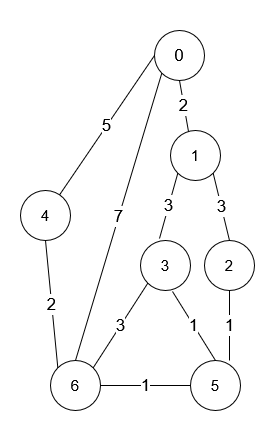
输入:n = 7, roads = [[0,6,7],[0,1,2],[1,2,3],[1,3,3],[6,3,3],[3,5,1],[6,5,1],[2,5,1],[0,4,5],[4,6,2]]
输出:4
解释:从路口 0 出发到路口 6 花费的最少时间是 7 分钟。
四条花费 7 分钟的路径分别为:
- 0 ➝ 6
- 0 ➝ 4 ➝ 6
- 0 ➝ 1 ➝ 2 ➝ 5 ➝ 6
- 0 ➝ 1 ➝ 3 ➝ 5 ➝ 6
示例 2:
输入:n = 2, roads = [[1,0,10]]
输出:1
解释:只有一条从路口 0 到路口 1 的路,花费 10 分钟。
提示:
1 <= n <= 200n - 1 <= roads.length <= n * (n - 1) / 2roads[i].length == 30 <= ui, vi <= n - 11 <= timei <= 109ui != vi- 任意两个路口之间至多有一条路。
- 从任意路口出发,你能够到达其他任意路口。
方法一:朴素 Dijkstra 算法 · Go 实现
思考
既要最短路又要统计条数。 ,朴素 Dijkstra 的 可接受,不必堆优化。
松弛时若找到更短距离则重置方案数为来源点数;若距离相同则累加。终点方案数对 取模。
我们定义以下几个数组,其中:
g表示图的邻接矩阵,g[i][j]表示点i到点j的最短路径长度,初始时全部为 ,而g[0][0]为 ;然后我们遍历roads,将g[u][v]和g[v][u]更新为t;dist[i]表示从起点到点i的最短路径长度,初始时全部为 ,而dist[0]为 ;f[i]表示从起点到点i的最短路径的条数,初始时全部为 ,而f[0]为 ;vis[i]表示点i是否已经被访问过,初始时全部为False。
然后,我们使用朴素 Dijkstra 算法求出从起点到终点的最短路径长度,过程中同时记录下每个点的最短路径的条数。
最后,我们返回 f[n - 1] 即可。由于答案可能很大,我们需要对 取模。
时间复杂度 ,空间复杂度 。其中 为点的个数。
func countPaths(n int, roads [][]int) int {
	const inf = math.MaxInt64 / 2
	const mod = int(1e9 + 7)

	g := make([][]int, n)
	dist := make([]int, n)
	for i := range g {
		g[i] = make([]int, n)
		for j := range g[i] {
			g[i][j] = inf
			dist[i] = inf
		}
	}

	for _, r := range roads {
		u, v, t := r[0], r[1], r[2]
		g[u][v] = t
		g[v][u] = t
	}

	f := make([]int, n)
	vis := make([]bool, n)
	f[0] = 1
	g[0][0] = 0
	dist[0] = 0

	for i := 0; i < n; i++ {
		t := -1
		for j := 0; j < n; j++ {
			if !vis[j] && (t == -1 || dist[j] < dist[t]) {
				t = j
			}
		}
		vis[t] = true
		for j := 0; j < n; j++ {
			if j == t {
				continue
			}
			ne := dist[t] + g[t][j]
			if dist[j] > ne {
				dist[j] = ne
				f[j] = f[t]
			} else if dist[j] == ne {
				f[j] = (f[j] + f[t]) % mod
			}
		}
	}
	return f[n-1]
}2039. 网络空闲的时刻
题目、示例与约束
给你一个有 n 个服务器的计算机网络,服务器编号为 0 到 n - 1 。同时给你一个二维整数数组 edges ,其中 edges[i] = [ui, vi] 表示服务器 ui 和 vi 之间有一条信息线路,在 一秒 内它们之间可以传输 任意 数目的信息。再给你一个长度为 n 且下标从 0 开始的整数数组 patience 。
题目保证所有服务器都是 相通 的,也就是说一个信息从任意服务器出发,都可以通过这些信息线路直接或间接地到达任何其他服务器。
编号为 0 的服务器是 主 服务器,其他服务器为 数据 服务器。每个数据服务器都要向主服务器发送信息,并等待回复。信息在服务器之间按 最优 线路传输,也就是说每个信息都会以 最少时间 到达主服务器。主服务器会处理 所有 新到达的信息并 立即 按照每条信息来时的路线 反方向 发送回复信息。
在 0 秒的开始,所有数据服务器都会发送各自需要处理的信息。从第 1 秒开始,每 一秒最 开始 时,每个数据服务器都会检查它是否收到了主服务器的回复信息(包括新发出信息的回复信息):
- 如果还没收到任何回复信息,那么该服务器会周期性 重发 信息。数据服务器
i每patience[i]秒都会重发一条信息,也就是说,数据服务器i在上一次发送信息给主服务器后的patience[i]秒 后 会重发一条信息给主服务器。 - 否则,该数据服务器 不会重发 信息。
当没有任何信息在线路上传输或者到达某服务器时,该计算机网络变为 空闲 状态。
请返回计算机网络变为 空闲 状态的 最早秒数 。
示例 1:
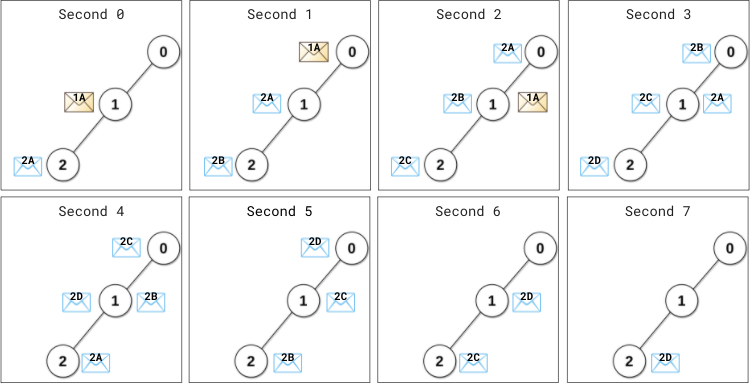
输入:edges = [[0,1],[1,2]], patience = [0,2,1]
输出:8
解释:
0 秒最开始时,
- 数据服务器 1 给主服务器发出信息(用 1A 表示)。
- 数据服务器 2 给主服务器发出信息(用 2A 表示)。

1 秒时,
- 信息 1A 到达主服务器,主服务器立刻处理信息 1A 并发出 1A 的回复信息。
- 数据服务器 1 还没收到任何回复。距离上次发出信息过去了 1 秒(1 < patience[1] = 2),所以不会重发信息。
- 数据服务器 2 还没收到任何回复。距离上次发出信息过去了 1 秒(1 == patience[2] = 1),所以它重发一条信息(用 2B 表示)。

2 秒时,
- 回复信息 1A 到达服务器 1 ,服务器 1 不会再重发信息。
- 信息 2A 到达主服务器,主服务器立刻处理信息 2A 并发出 2A 的回复信息。
- 服务器 2 重发一条信息(用 2C 表示)。
...
4 秒时,
- 回复信息 2A 到达服务器 2 ,服务器 2 不会再重发信息。
...
7 秒时,回复信息 2D 到达服务器 2 。

从第 8 秒开始,不再有任何信息在服务器之间传输,也不再有信息到达服务器。
所以第 8 秒是网络变空闲的最早时刻。
示例 2:
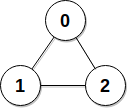
输入:edges = [[0,1],[0,2],[1,2]], patience = [0,10,10]
输出:3
解释:数据服务器 1 和 2 第 2 秒初收到回复信息。
从第 3 秒开始,网络变空闲。
提示:
n == patience.length2 <= n <= 105patience[0] == 0- 对于
1 <= i < n,满足1 <= patience[i] <= 105 1 <= edges.length <= min(105, n * (n - 1) / 2)edges[i].length == 20 <= ui, vi < nui != vi- 不会有重边。
- 每个服务器都直接或间接与别的服务器相连。
方法一:BFS · Go 实现
思考
边权均为 ,到主服务器的时延由最短路决定。 ,从 做 BFS 得到距离 ,往返为 。服务器按 重发,最后一封在收到回复前发出。
最后发出时刻为 ,加上回程与 秒处理。对所有结点取最大。
图无向且连通,一次 BFS 足够。
我们先根据二维数组 构建无向图 ,其中 表示节点 的所有邻居节点。
然后,我们可以使用广度优先搜索的方式,找出每个节点 距离主服务器的最短距离 ,那么节点 发出信息后,最早能收到回复的时间为 。由于每个数据服务器 每隔 会重发一条信息,因此,每个数据服务器最后一次发出信息的时间为 ,那么最后收到回复的时间为 ,再加上 秒的处理时间,即为该数据服务器变为空闲的最早时间。我们找出最晚的这个时间,即为计算机网络变为空闲的最早时间。
时间复杂度 ,空间复杂度 。其中 为节点数。
func networkBecomesIdle(edges [][]int, patience []int) (ans int) {
	n := len(patience)
	g := make([][]int, n)
	for _, e := range edges {
		u, v := e[0], e[1]
		g[u] = append(g[u], v)
		g[v] = append(g[v], u)
	}
	q := []int{0}
	vis := make([]bool, n)
	vis[0] = true
	for d := 1; len(q) > 0; d++ {
		t := d * 2
		for i := len(q); i > 0; i-- {
			u := q[0]
			q = q[1:]
			for _, v := range g[u] {
				if !vis[v] {
					vis[v] = true
					q = append(q, v)
					ans = max(ans, (t-1)/patience[v]*patience[v]+t+1)
				}
			}
		}
	}
	return
}2045. 到达目的地的第二短时间
题目、示例与约束
城市用一个 双向连通 图表示,图中有 n 个节点,从 1 到 n 编号(包含 1 和 n)。图中的边用一个二维整数数组 edges 表示,其中每个 edges[i] = [ui, vi] 表示一条节点 ui 和节点 vi 之间的双向连通边。每组节点对由 最多一条 边连通,顶点不存在连接到自身的边。穿过任意一条边的时间是 time 分钟。
每个节点都有一个交通信号灯,每 change 分钟改变一次,从绿色变成红色,再由红色变成绿色,循环往复。所有信号灯都 同时 改变。你可以在 任何时候 进入某个节点,但是 只能 在节点 信号灯是绿色时 才能离开。如果信号灯是 绿色 ,你 不能 在节点等待,必须离开。
第二小的值 是 严格大于 最小值的所有值中最小的值。
- 例如,
[2, 3, 4]中第二小的值是3,而[2, 2, 4]中第二小的值是4。
给你 n、edges、time 和 change ,返回从节点 1 到节点 n 需要的 第二短时间 。
注意:
- 你可以 任意次 穿过任意顶点,包括
1和n。 - 你可以假设在 启程时 ,所有信号灯刚刚变成 绿色 。
示例 1:
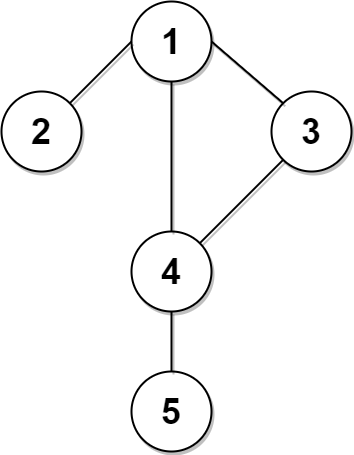
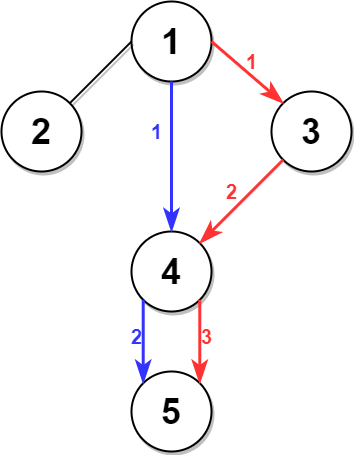
输入:n = 5, edges = [[1,2],[1,3],[1,4],[3,4],[4,5]], time = 3, change = 5
输出:13
解释:
上面的左图展现了给出的城市交通图。
右图中的蓝色路径是最短时间路径。
花费的时间是:
- 从节点 1 开始,总花费时间=0
- 1 -> 4:3 分钟,总花费时间=3
- 4 -> 5:3 分钟,总花费时间=6
因此需要的最小时间是 6 分钟。

右图中的红色路径是第二短时间路径。
- 从节点 1 开始,总花费时间=0
- 1 -> 3:3 分钟,总花费时间=3
- 3 -> 4:3 分钟,总花费时间=6
- 在节点 4 等待 4 分钟,总花费时间=10
- 4 -> 5:3 分钟,总花费时间=13
因此第二短时间是 13 分钟。
示例 2:
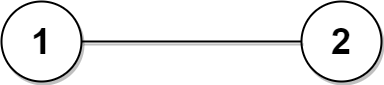
输入:n = 2, edges = [[1,2]], time = 3, change = 2
输出:11
解释:
最短时间路径是 1 -> 2 ,总花费时间 = 3 分钟
第二短时间路径是 1 -> 2 -> 1 -> 2 ,总花费时间 = 11 分钟
提示:
2 <= n <= 104n - 1 <= edges.length <= min(2 * 104, n * (n - 1) / 2)edges[i].length == 21 <= ui, vi <= nui != vi- 不含重复边
- 每个节点都可以从其他节点直接或者间接到达
1 <= time, change <= 103
方法一:Go 实现(灵茶山艾府) · Go 实现
本站根据 Go 源码整理,非作者原文。
思路:建立无向图,为每个节点记录最早到达时间和严格更晚的第二个到达时间。所有边耗时相同、信号灯同步,因此可用队列按经过边数逐层扩展;每次先判断当前是否为红灯,必要时等到下一次绿灯,再加上走一条边的时间。重复的到达时间不计入次短。若源码最终没有记录目的地的次短时间,就从最短时间再模拟一次沿边往返。
复杂度:设节点数为 n,边数为 m。每个节点至多扩展两个有效到达状态,每条邻接边只被检查常数次,时间为 O(n+m),辅助空间为 O(n+m)。
/* BFS 求次短路,附详细注释
 */

// github.com/EndlessCheng/codeforces-go
func secondMinimum(n int, edges [][]int, time, change int) int {
	g := make([][]int, n)
	for _, e := range edges { // 建图
		v, w := e[0]-1, e[1]-1
		g[v] = append(g[v], w)
		g[w] = append(g[w], v)
	}

	// 传入当前时间 d,返回到达下一个节点的时间
	next := func(d int) int {
		if times := d / change; times%2 == 1 { // 如果红绿灯切换次数为奇数,则现在是红灯
			return (times+1)*change + time // 等绿灯再出发
		}
		return d + time // 绿灯,直接出发
	}

	dis := make([][2]int, n) // 距离数组同时存 [最短路, 次短路]
	for i := 1; i < n; i++ {
		dis[i] = [2]int{1e9, 1e9}
	}
	dis[0] = [2]int{}
	type pair struct{ v, d int }
	q := []pair{{}}
	for len(q) > 0 { // BFS 求最短路和次短路
		p := q[0] // 取队首
		q = q[1:]
		for _, w := range g[p.v] {
			d := next(p.d) // 到达节点 w 的时间
			if d < dis[w][0] { // 比最短路小,就更新最短路
				q = append(q, pair{w, d})
				dis[w][0], d = d, dis[w][0] // 将 d 替换为原来的最短路,用于下面更新次短路
			}
			if dis[w][0] < d && d < dis[w][1] { // d 比最短路大又比次短路小,就更新次短路
				q = append(q, pair{w, d})
				dis[w][1] = d
			}
		}
	}
	if dis[n-1][1] < 1e9 {
		return dis[n-1][1]
	}
	return next(next(dis[n-1][0])) // 没有次短路,就在最短路的基础上额外往返一次
}2050. 并行课程 III
题目、示例与约束
给你一个整数 n ,表示有 n 节课,课程编号从 1 到 n 。同时给你一个二维整数数组 relations ,其中 relations[j] = [prevCoursej, nextCoursej] ,表示课程 prevCoursej 必须在课程 nextCoursej 之前 完成(先修课的关系)。同时给你一个下标从 0 开始的整数数组 time ,其中 time[i] 表示完成第 (i+1) 门课程需要花费的 月份 数。
请你根据以下规则算出完成所有课程所需要的 最少 月份数:
- 如果一门课的所有先修课都已经完成,你可以在 任意 时间开始这门课程。
- 你可以 同时 上 任意门课程 。
请你返回完成所有课程所需要的 最少 月份数。
注意:测试数据保证一定可以完成所有课程(也就是先修课的关系构成一个有向无环图)。
示例 1:
输入:n = 3, relations = [[1,3],[2,3]], time = [3,2,5]
输出:8
解释:上图展示了输入数据所表示的先修关系图,以及完成每门课程需要花费的时间。
你可以在月份 0 同时开始课程 1 和 2 。
课程 1 花费 3 个月,课程 2 花费 2 个月。
所以,最早开始课程 3 的时间是月份 3 ,完成所有课程所需时间为 3 + 5 = 8 个月。
示例 2:
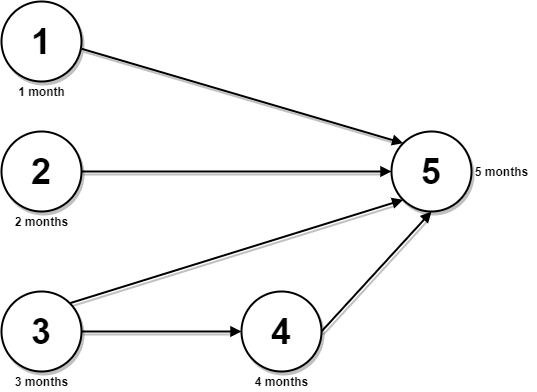
输入:n = 5, relations = [[1,5],[2,5],[3,5],[3,4],[4,5]], time = [1,2,3,4,5]
输出:12
解释:上图展示了输入数据所表示的先修关系图,以及完成每门课程需要花费的时间。
你可以在月份 0 同时开始课程 1 ,2 和 3 。
在月份 1,2 和 3 分别完成这三门课程。
课程 4 需在课程 3 之后开始,也就是 3 个月后。课程 4 在 3 + 4 = 7 月完成。
课程 5 需在课程 1,2,3 和 4 之后开始,也就是在 max(1,2,3,7) = 7 月开始。
所以完成所有课程所需的最少时间为 7 + 5 = 12 个月。
提示:
1 <= n <= 5 * 1040 <= relations.length <= min(n * (n - 1) / 2, 5 * 104)relations[j].length == 21 <= prevCoursej, nextCoursej <= nprevCoursej != nextCoursej- 所有的先修课程对
[prevCoursej, nextCoursej]都是 互不相同 的。 time.length == n1 <= time[i] <= 104- 先修课程图是一个有向无环图。
方法一:拓扑排序 + 动态规划 · Go 实现
思考
课程带先修关系与学时,完成时间为最长依赖链上的学时和。 ,不能枚举路径。入度为零的课可立即开始,其完成时间为自身学时。
拓扑序下, ,即所有先修都结束后再学 。答案为所有 的最大。
队列处理入度,保证每个点在先修齐全后更新一次。
我们首先根据给定的先修课程关系,构建出一个有向无环图,对该图进行拓扑排序,然后根据拓扑排序的结果,使用动态规划求出完成所有课程所需要的最少时间。
我们定义以下几个数据结构或变量:
- 邻接表 存储有向无环图,同时使用一个数组 存储每个节点的入度;
- 队列 存储所有入度为 的节点;
- 数组 存储每个节点的最早完成时间,初始时 ;
- 变量 记录最终的答案,初始时 ;
当 非空时,依次取出队首节点 ,遍历 中的每个节点 ,更新 ,同时更新 ,并将 的入度减 ,如果此时 的入度为 ,则将 加入队列 中;
最终返回 。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func minimumTime(n int, relations [][]int, time []int) int {
	g := make([][]int, n)
	indeg := make([]int, n)
	for _, e := range relations {
		a, b := e[0]-1, e[1]-1
		g[a] = append(g[a], b)
		indeg[b]++
	}
	f := make([]int, n)
	q := []int{}
	ans := 0
	for i, v := range indeg {
		if v == 0 {
			q = append(q, i)
			f[i] = time[i]
			ans = max(ans, time[i])
		}
	}
	for len(q) > 0 {
		i := q[0]
		q = q[1:]
		for _, j := range g[i] {
			indeg[j]--
			if indeg[j] == 0 {
				q = append(q, j)
			}
			f[j] = max(f[j], f[i]+time[j])
			ans = max(ans, f[j])
		}
	}
	return ans
}继续阅读
- 实践案例
- 实践案例
- 实践案例