
LeetCode Go · 动态规划(17)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
3352. 统计小于 N 的 K 可约简整数
题目、示例与约束
给你一个 二进制 字符串 s,它表示数字 n 的二进制形式。
同时,另给你一个整数 k。
如果整数 x 可以通过最多 k 次下述操作约简到 1 ,则将整数 x 称为 k-可约简 整数:
- 将
x替换为其二进制表示中的置位数(即值为 1 的位)。
例如,数字 6 的二进制表示是 "110"。一次操作后,它变为 2(因为 "110" 中有两个置位)。再对 2(二进制为 "10")进行操作后,它变为 1(因为 "10" 中有一个置位)。
返回小于 n 的正整数中有多少个是 k-可约简 整数。
由于答案可能很大,返回结果需要对 109 + 7 取余。
二进制中的置位是指二进制表示中值为 1 的位。
示例 1:
输入: s = "111", k = 1
输出: 3
解释:
n = 7。小于 7 的 1-可约简整数有 1,2 和 4。
示例 2:
输入: s = "1000", k = 2
输出: 6
解释:
n = 8。小于 8 的 2-可约简整数有 1,2,3,4,5 和 6。
示例 3:
输入: s = "1", k = 3
输出: 0
解释:
小于 n = 1 的正整数不存在,因此答案为 0。
提示:
1 <= s.length <= 800s中没有前导零。s仅由字符'0'和'1'组成。1 <= k <= 5
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
题意
定义 为 的二进制表示中的 的个数。
定义 为使 的最少嵌套(迭代)次数。也就是不断地把 更新为 ,最少要更新多少次,才能使 变成 。
例如 ,因为 。
计算 中有多少个数 满足 。
思路
根据定义,我们有
设 的长度为 。从小到大递推(写一个线性 DP),即可算出 的所有 值。注意题目要求数字小于 ,所以不可能有 个 。
对于满足 的所有 ,我们需要计算, 中有多少个二进制数,恰好有 个 ?
这些恰好有 个 的二进制数,满足 。
这可以用数位 DP 解决。原理请看 数位 DP 通用模板。
⚠注意:本题需要严格小于 ,这可以用 判断:递归到 时,若仍有 ,则返回 。此外,我们只关心 的个数,是否有前导零无影响,所以无需 参数。
代码实现时,可以定义 ,上文中 可以简化为 。
记得取模。
关于取模的知识点,见 模运算的世界:当加减乘除遇上取模。
本题视频讲解,欢迎点赞关注~
复杂度分析
- 时间复杂度:,其中 是 的长度。
- 空间复杂度:。
更多相似题目,见下面动态规划题单中的「十、数位 DP」。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/最短路/最小生成树/二分图/基环树/欧拉路径)
- 动态规划(入门/背包/状态机/划分/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与一般树(前后指针/快慢指针/DFS/BFS/直径/LCA)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
import "math/bits"

// https://space.bilibili.com/206214
func countKReducibleNumbers(s string, k int) (ans int) {
	const mod = 1_000_000_007
	n := len(s)
	memo := make([][]int, n)
	for i := range memo {
		memo[i] = make([]int, n)
		for j := range memo[i] {
			memo[i][j] = -1
		}
	}
	var dfs func(int, int, bool) int
	dfs = func(i, left1 int, isLimit bool) (res int) {
		if i == n {
			if !isLimit && left1 == 0 {
				return 1
			}
			return
		}
		if !isLimit {
			p := &memo[i][left1]
			if *p >= 0 {
				return *p
			}
			defer func() { *p = res }()
		}
		up := 1
		if isLimit {
			up = int(s[i] - '0')
		}
		for d := 0; d <= min(up, left1); d++ {
			res += dfs(i+1, left1-d, isLimit && d == up)
		}
		return res % mod
	}

	f := make([]int, n)
	for i := 1; i < n; i++ {
		f[i] = f[bits.OnesCount(uint(i))] + 1
		if f[i] <= k {
			// 计算有多少个二进制数恰好有 i 个 1
			ans += dfs(0, i, true)
		}
	}
	return ans % mod
}3363. 最多可收集的水果数目
题目、示例与约束
有一个游戏,游戏由 n x n 个房间网格状排布组成。
给你一个大小为 n x n 的二维整数数组 fruits ,其中 fruits[i][j] 表示房间 (i, j) 中的水果数目。有三个小朋友 一开始 分别从角落房间 (0, 0) ,(0, n - 1) 和 (n - 1, 0) 出发。
每一位小朋友都会 恰好 移动 n - 1 次,并到达房间 (n - 1, n - 1) :
- 从
(0, 0)出发的小朋友每次移动从房间(i, j)出发,可以到达(i + 1, j + 1),(i + 1, j)和(i, j + 1)房间之一(如果存在)。 - 从
(0, n - 1)出发的小朋友每次移动从房间(i, j)出发,可以到达房间(i + 1, j - 1),(i + 1, j)和(i + 1, j + 1)房间之一(如果存在)。 - 从
(n - 1, 0)出发的小朋友每次移动从房间(i, j)出发,可以到达房间(i - 1, j + 1),(i, j + 1)和(i + 1, j + 1)房间之一(如果存在)。
当一个小朋友到达一个房间时,会把这个房间里所有的水果都收集起来。如果有两个或者更多小朋友进入同一个房间,只有一个小朋友能收集这个房间的水果。当小朋友离开一个房间时,这个房间里不会再有水果。
请你返回三个小朋友总共 最多 可以收集多少个水果。
示例 1:
输入:fruits = [[1,2,3,4],[5,6,8,7],[9,10,11,12],[13,14,15,16]]
输出:100
解释:
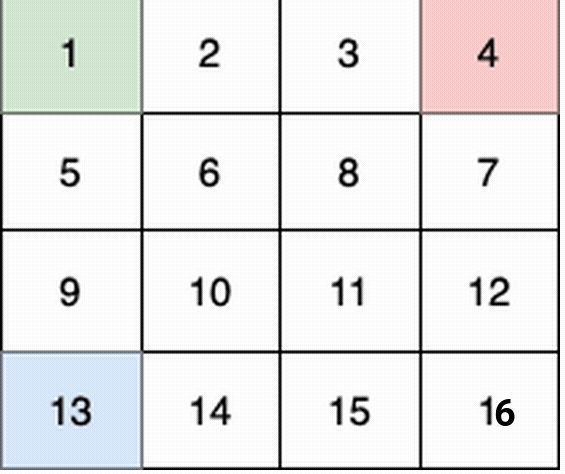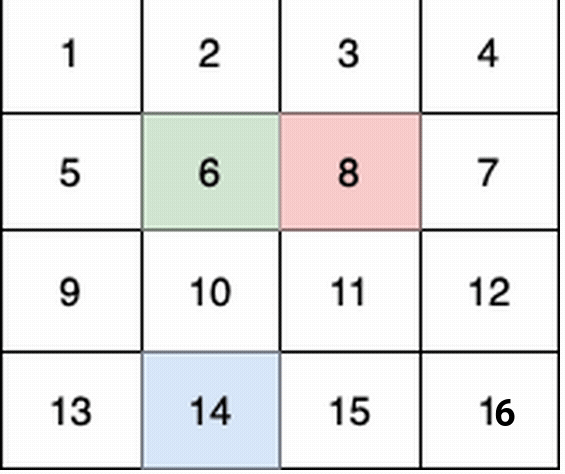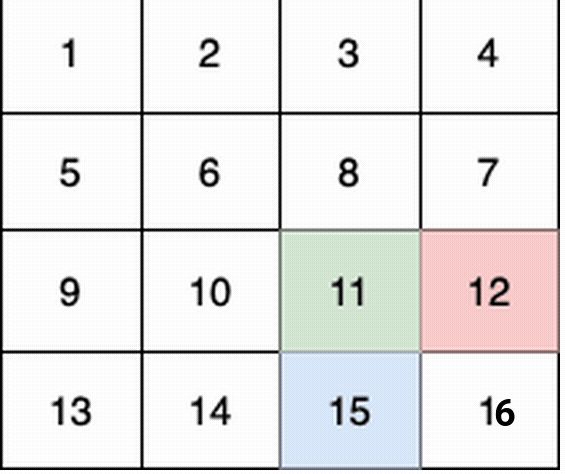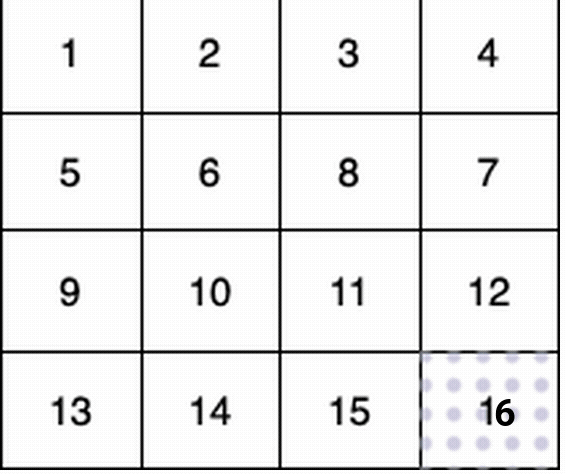
这个例子中:
- 第 1 个小朋友(绿色)的移动路径为
(0,0) -> (1,1) -> (2,2) -> (3, 3)。 - 第 2 个小朋友(红色)的移动路径为
(0,3) -> (1,2) -> (2,3) -> (3, 3)。 - 第 3 个小朋友(蓝色)的移动路径为
(3,0) -> (3,1) -> (3,2) -> (3, 3)。
他们总共能收集 1 + 6 + 11 + 16 + 4 + 8 + 12 + 13 + 14 + 15 = 100 个水果。
示例 2:
输入:fruits = [[1,1],[1,1]]
输出:4
解释:
这个例子中:
- 第 1 个小朋友移动路径为
(0,0) -> (1,1)。 - 第 2 个小朋友移动路径为
(0,1) -> (1,1)。 - 第 3 个小朋友移动路径为
(1,0) -> (1,1)。
他们总共能收集 1 + 1 + 1 + 1 = 4 个水果。
提示:
2 <= n == fruits.length == fruits[i].length <= 10000 <= fruits[i][j] <= 1000
方法一:动态规划 · Go 实现
思考
三人同时走 步汇合。从 出发者只能沿主对角线,另外两人分别被限制在对角线上侧与下侧,途中房间不重叠。
对角线的水果直接求和。上三角与下三角各自做 DP: 由上方(或左方)相邻三格转移,并加上 。
两人在到达终点前一格处停止,答案为对角线和加上 与 。
根据题目描述,从 出发的小朋友要想在 步后到达 ,那么他只能走主对角线上的房间 ,即 。而从 出发的小朋友只能走主对角线以上的房间,而从 出发的小朋友只能走主对角线以下的房间。这意味着三个小朋友除了在 到达终点外,其他房间都不会有多个小朋友重复进入。
我们可以用动态规划的方式,计算从 和 出发的小朋友达到 时,能收集到的水果数。定义 表示小朋友到达 时能收集到的水果数。
对于从 出发的小朋友,状态转移方程为:
注意,只有当 时, 才是有效的。
对于从 出发的小朋友,状态转移方程为:
同样,只有当 时, 才是有效的。
最后,答案为 ,即主对角线上的水果数加上两个小朋友到达 和 时能收集到的水果数。
时间复杂度 ,空间复杂度 。其中 为房间的边长。
func maxCollectedFruits(fruits [][]int) int {
	n := len(fruits)
	const inf = 1 << 29
	f := make([][]int, n)
	for i := range f {
		f[i] = make([]int, n)
		for j := range f[i] {
			f[i][j] = -inf
		}
	}

	f[0][n-1] = fruits[0][n-1]
	for i := 1; i < n; i++ {
		for j := i + 1; j < n; j++ {
			f[i][j] = max(f[i-1][j], f[i-1][j-1]) + fruits[i][j]
			if j+1 < n {
				f[i][j] = max(f[i][j], f[i-1][j+1]+fruits[i][j])
			}
		}
	}

	f[n-1][0] = fruits[n-1][0]
	for j := 1; j < n; j++ {
		for i := j + 1; i < n; i++ {
			f[i][j] = max(f[i][j-1], f[i-1][j-1]) + fruits[i][j]
			if i+1 < n {
				f[i][j] = max(f[i][j], f[i+1][j-1]+fruits[i][j])
			}
		}
	}

	ans := f[n-2][n-1] + f[n-1][n-2]
	for i := 0; i < n; i++ {
		ans += fruits[i][i]
	}

	return ans
}3366. 最小数组和
题目、示例与约束
给你一个整数数组 nums 和三个整数 k、op1 和 op2。
你可以对 nums 执行以下操作:
- 操作 1:选择一个下标
i,将nums[i]除以 2,并 向上取整 到最接近的整数。你最多可以执行此操作op1次,并且每个下标最多只能执行一次。 - 操作 2:选择一个下标
i,仅当nums[i]大于或等于k时,从nums[i]中减去k。你最多可以执行此操作op2次,并且每个下标最多只能执行一次。
注意: 两种操作可以应用于同一下标,但每种操作最多只能应用一次。
返回在执行任意次数的操作后,nums 中所有元素的 最小 可能 和 。
示例 1:
输入: nums = [2,8,3,19,3], k = 3, op1 = 1, op2 = 1
输出: 23
解释:
- 对
nums[1] = 8应用操作 2,使nums[1] = 5。 - 对
nums[3] = 19应用操作 1,使nums[3] = 10。 - 结果数组变为
[2, 5, 3, 10, 3],在应用操作后具有最小可能和 23。
示例 2:
输入: nums = [2,4,3], k = 3, op1 = 2, op2 = 1
输出: 3
解释:
- 对
nums[0] = 2应用操作 1,使nums[0] = 1。 - 对
nums[1] = 4应用操作 1,使nums[1] = 2。 - 对
nums[2] = 3应用操作 2,使nums[2] = 0。 - 结果数组变为
[1, 2, 0],在应用操作后具有最小可能和 3。
提示:
1 <= nums.length <= 1000 <= nums[i] <= 1050 <= k <= 1050 <= op1, op2 <= nums.length
方法一:动态规划 · Go 实现
思考
对每个数可使用「除二向上取整」与「减 」两种操作,次数分别不超过 ,求最小数组和。 ,三维 DP 可行。
为处理前 个数、用了 次操作一与 次操作二的最小和。单个数还可两种操作连用,顺序不同结果不同,需都枚举。
答案为最后一层所有 的最小值。
为了方便描述,我们将题目给定的 记为 。
接下来,定义 表示前 个数中,使用了 次操作 1 和 次操作 2 的最小和。初始时 ,其余 。
考虑 如何进行状态转移,我们可以枚举第 个数 ,然后考虑 的取值对 的影响:
- 如果 不使用操作 1 和操作 2,那么 ;
- 如果 ,那么可以使用操作 1,此时 ;
- 如果 并且 ,那么可以使用操作 2,此时 ;
- 如果 并且 ,那么可以同时使用操作 1 和操作 2。如果先使用操作 1,那么 变为 ,如果 ,那么可以使用操作 2,此时 ;如果先使用操作 2,那么 变为 ,如果 ,那么可以使用操作 1,此时 。
最终答案为 ,如果为 ,则输出 。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func minArraySum(nums []int, d int, op1 int, op2 int) int {
	n := len(nums)
	const inf = int(1e9)
	f := make([][][]int, n+1)
	for i := range f {
		f[i] = make([][]int, op1+1)
		for j := range f[i] {
			f[i][j] = make([]int, op2+1)
			for k := range f[i][j] {
				f[i][j][k] = inf
			}
		}
	}
	f[0][0][0] = 0
	for i := 1; i <= n; i++ {
		x := nums[i-1]
		for j := 0; j <= op1; j++ {
			for k := 0; k <= op2; k++ {
				f[i][j][k] = f[i-1][j][k] + x
				if j > 0 {
					f[i][j][k] = min(f[i][j][k], f[i-1][j-1][k]+(x+1)/2)
				}
				if k > 0 && x >= d {
					f[i][j][k] = min(f[i][j][k], f[i-1][j][k-1]+(x-d))
				}
				if j > 0 && k > 0 {
					y := (x + 1) / 2
					if y >= d {
						f[i][j][k] = min(f[i][j][k], f[i-1][j-1][k-1]+(y-d))
					}
					if x >= d {
						f[i][j][k] = min(f[i][j][k], f[i-1][j-1][k-1]+(x-d+1)/2)
					}
				}
			}
		}
	}
	ans := inf
	for j := 0; j <= op1; j++ {
		for k := 0; k <= op2; k++ {
			ans = min(ans, f[n][j][k])
		}
	}
	return ans
}3376. 破解锁的最少时间 I
题目、示例与约束
Bob 被困在了一个地窖里,他需要破解 n 个锁才能逃出地窖,每一个锁都需要一定的 能量 才能打开。每一个锁需要的能量存放在一个数组 strength 里,其中 strength[i] 表示打开第 i 个锁需要的能量。
Bob 有一把剑,它具备以下的特征:
- 一开始剑的能量为 0 。
- 剑的能量增加因子
x一开始的值为 1 。 - 每分钟,剑的能量都会增加当前的
x值。 - 打开第
i把锁,剑的能量需要到达 至少strength[i]。 - 打开一把锁以后,剑的能量会变回 0 ,
x的值会增加一个给定的值k。
你的任务是打开所有 n 把锁并逃出地窖,请你求出需要的 最少 分钟数。
请你返回 Bob 打开所有 n 把锁需要的 最少 时间。
示例 1:
输入:strength = [3,4,1], k = 1
输出:4
解释:
| 时间 | 能量 | x | 操作 | 更新后的 x |
|---|---|---|---|---|
| 0 | 0 | 1 | 什么也不做 | 1 |
| 1 | 1 | 1 | 打开第 3 把锁 | 2 |
| 2 | 2 | 2 | 什么也不做 | 2 |
| 3 | 4 | 2 | 打开第 2 把锁 | 3 |
| 4 | 3 | 3 | 打开第 1 把锁 | 3 |
无法用少于 4 分钟打开所有的锁,所以答案为 4 。
示例 2:
输入:strength = [2,5,4], k = 2
输出:5
解释:
| 时间 | 能量 | x | 操作 | 更新后的 x |
|---|---|---|---|---|
| 0 | 0 | 1 | 什么也不做 | 1 |
| 1 | 1 | 1 | 什么也不做 | 1 |
| 2 | 2 | 1 | 打开第 1 把锁 | 3 |
| 3 | 3 | 3 | 什么也不做 | 3 |
| 4 | 6 | 3 | 打开第 2 把锁 | 5 |
| 5 | 5 | 5 | 打开第 3 把锁 | 7 |
无法用少于 5 分钟打开所有的锁,所以答案为 5 。
提示:
n == strength.length1 <= n <= 81 <= k <= 101 <= strength[i] <= 106
方法一 · Go 实现
思考
锁的顺序影响能量: 从 起每次破锁后增加 。 ,可对排列状压。
表示已破集合为 的最短时间。当前能量为 ,枚举未破的锁 ,耗时 。
全破时返回 。状态 、转移 ,足以覆盖约束。
func findMinimumTime(strength []int, K int) int {
	n := len(strength)
	f := make([]int, 1<<n)
	for i := range f {
		f[i] = -1
	}
	var dfs func(int) int
	dfs = func(i int) int {
		if i == 1<<n-1 {
			return 0
		}
		if f[i] != -1 {
			return f[i]
		}
		x := 1 + K*bits.OnesCount(uint(i))
		f[i] = 1 << 30
		for j, s := range strength {
			if i>>j&1 == 0 {
				f[i] = min(f[i], dfs(i|1<<j)+(s+x-1)/x)
			}
		}
		return f[i]
	}
	return dfs(0)
}3388. 统计数组中的美丽分割
题目、示例与约束
给你一个整数数组 nums 。
如果数组 nums 的一个分割满足以下条件,我们称它是一个 美丽 分割:
- 数组
nums分为三段 非空子数组:nums1,nums2和nums3,三个数组nums1,nums2和nums3按顺序连接可以得到nums。 - 子数组
nums1是子数组nums2的 前缀 或者nums2是nums3的 前缀。
请你返回满足以上条件的分割 数目 。
子数组 指的是一个数组里一段连续 非空 的元素。
前缀 指的是一个数组从头开始到中间某个元素结束的子数组。
示例 1:
输入:nums = [1,1,2,1]
输出:2
解释:
美丽分割如下:
nums1 = [1],nums2 = [1,2],nums3 = [1]。nums1 = [1],nums2 = [1],nums3 = [2,1]。
示例 2:
输入:nums = [1,2,3,4]
输出:0
解释:
没有美丽分割。
提示:
1 <= nums.length <= 50000 <= nums[i] <= 50
方法一:LCP + 枚举 · Go 实现
思考
把数组切成三段,要求第一段是第二段的前缀,或第二段是第三段的前缀。 ,枚举两个切点为 ,但每次朴素比较前缀会再乘线性。
预处理 为两个后缀的最长公共前缀,倒序由 递推,之后比较变为 。
对切点 检查 或 (并满足长度不超过后段)。
我们可以预处理 表示 和 的最长公共前缀长度。初始时 。
接下来,我们倒序枚举 和 ,对于每一对 和 ,如果 ,那么我们可以得到 。
最后,我们枚举第一个子数组的结尾位置 (不包括位置 ),以及第二个子数组的结尾位置 (不包括位置 ),那么第一个子数组的长度为 ,第二个子数组的长度为 ,第三个子数组的长度为 。如果 且 ,或者 且 ,那么这个分割是美丽的,答案加一。
枚举结束后,答案即为美丽的分割数目。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func beautifulSplits(nums []int) (ans int) {
    n := len(nums)
    lcp := make([][]int, n+1)
    for i := range lcp {
        lcp[i] = make([]int, n+1)
    }

    for i := n - 1; i >= 0; i-- {
        for j := n - 1; j > i; j-- {
            if nums[i] == nums[j] {
                lcp[i][j] = lcp[i+1][j+1] + 1
            }
        }
    }

    for i := 1; i < n-1; i++ {
        for j := i + 1; j < n; j++ {
            a := i <= j-i && lcp[0][i] >= i
            b := j-i <= n-j && lcp[i][j] >= j-i
            if a || b {
                ans++
            }
        }
    }

    return
}3389. 使字符频率相等的最少操作次数
题目、示例与约束
给你一个字符串 s 。
如果字符串 t 中的字符出现次数相等,那么我们称 t 为 好的 。
你可以执行以下操作 任意次 :
- 从
s中删除一个字符。 - 往
s中添加一个字符。 - 将
s中一个字母变成字母表中下一个字母。
注意 ,第三个操作不能将 'z' 变为 'a' 。
请你返回将 s 变 好 的 最少 操作次数。
示例 1:
输入:s = "acab"
输出:1
解释:
删掉一个字符 'a' ,s 变为好的。
示例 2:
输入:s = "wddw"
输出:0
解释:
s 一开始就是好的,所以不需要执行任何操作。
示例 3:
输入:s = "aaabc"
输出:2
解释:
通过以下操作,将 s 变好:
- 将一个
'a'变为'b'。 - 往
s中插入一个'c'。
提示:
1 <= s.length <= 2 * 104s只包含小写英文字母。
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
核心思路
- 统计 每种字母的个数,记到一个长为 的 数组中。
- 设 。枚举每种字母都变成 ,其中 。
- 每种字母的个数要么变成 ,要么变成 。
- 分析性质(下文细说),发现需要写一个线性 DP,决策:
- 当前字母的个数单独变成 或者 ;
- 当前字母和下一个字母的个数一起考虑,变成 或者 。
分析性质
比如 a 出现了 次,b 出现了 次,。
- 如果 和 都单独变成 (使用操作一和操作二),那么需要操作 次。
- 使用 次操作三,先把 变成 ,把 变成 ,然后再使用 次操作一,一共使用 次操作,就可以把 和 都变成 。
所以关键在于,通过恰当地使用操作三,节省操作次数。
注意操作三只能用于相邻的两种字母,不能用于连续三种或更多种字母。比如把一个 a 变成 b,然后再把这个 b 变成 c,共执行 次操作三,这等价于 次操作二和 次操作一,我们不会得到更优的结果。
设当前字母出现了 次,下一个字母出现了 次。
分类讨论:
- 单独操作 :讨论变成 还是 ,需要操作 次。
- 如果 ,由于操作三会把 变大,我们后面还要再把 变小,这不如直接单独操作 和 。所以这种情况不考虑操作三。
- 如果 :
- 如果 ,那么可以把 和 都变成 ,操作 次。
- 如果 ,那么可以把 变成 , 变成 ,操作 次。
动态规划
我们不知道哪些字母之间要使用操作三,所以把所有情况全部枚举一遍。由于有大量重复子问题,用动态规划减少计算量。
比如单独操作字母 a,那么子问题为操作字母 b 到 z 的最小操作次数。
比如同时操作字母 a 和 b,那么子问题为操作字母 c 到 z 的最小操作次数。
故定义 表示操作第 到 种字母的最小操作次数。这里 从 开始。
设 。单独操作 ,有 。
设 。如果 ,分类讨论:
- 如果 ,那么可以把 和 都变成 ,有 。
- 如果 ,那么可以把 变成 , 变成 ,有 。
初始值:。
答案:。
具体请看 视频讲解,欢迎点赞关注~
优化前
优化一
如果 ,无需操作,。
如果 ,只需单独操作 ,。
这个优化对 Python 十分显著,其他语言不明显。
复杂度分析
- 时间复杂度:,其中 是 的长度, 是字符集合的大小。
- 空间复杂度:。
优化二
不需要枚举那么多种 ,只需考虑如下数字:
- 。变成 中的某个数。
- 。操作三把 变成 ,把 变成 。
- 。操作三把 和 都变成 ,取平均值最优。
- 。同上。
如此修改后,即使题目给你一堆询问,每个询问要你计算 的一个子串的答案,也能轻松应对。(提示:前缀和)
复杂度分析
- 时间复杂度:,其中 是 的长度, 是字符集合的大小。
- 空间复杂度:。
变形题
- 写代码,实现优化二中提到的变形。
- 如果可以把 z 改成 a,要怎么做?提示:213. 打家劫舍 II。
- 如果每种操作都有相应的次数限制呢?即额外输入 。
- 如果每种操作都有相应的代价呢?即额外输入 。
更多相似题目,见下面动态规划题单中的「§7.1 一维 DP」。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/最短路/最小生成树/二分图/基环树/欧拉路径)
- 【本题相关】动态规划(入门/背包/状态机/划分/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA/一般树)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
import "slices"

// https://space.bilibili.com/206214
func makeStringGood(s string) int {
	cnt := [26]int{}
	for _, b := range s {
		cnt[b-'a']++
	}

	targets := map[int]struct{}{}
	targets[cnt[0]] = struct{}{}
	for i := 1; i < len(cnt); i++ {
		x, y := cnt[i-1], cnt[i]
		targets[y] = struct{}{}
		targets[x+y] = struct{}{}
		targets[(x+y)/2] = struct{}{}
		targets[(x+y+1)/2] = struct{}{}
	}

	ans := len(s) // target = 0 时的答案
	f := [27]int{}
	for target := range targets {
		f[25] = min(cnt[25], abs(cnt[25]-target))
		for i := 24; i >= 0; i-- {
			x := cnt[i]
			if x == 0 {
				f[i] = f[i+1]
				continue
			}
			// 单独操作 x(变成 target 或 0)
			f[i] = f[i+1] + min(x, abs(x-target))
			// x 变成 target 或 0,y 变成 target
			y := cnt[i+1]
			if 0 < y && y < target { // 只有当 y 需要变大时,才去执行第三种操作
				if x > target { // x 变成 target
					f[i] = min(f[i], f[i+2]+max(x-target, target-y))
				} else { // x 变成 0
					f[i] = min(f[i], f[i+2]+max(x, target-y))
				}
			}
		}
		ans = min(ans, f[0])
	}
	return ans
}

func abs(x int) int { if x < 0 { return -x }; return x }

func makeStringGoodAC(s string) int {
	cnt := [26]int{}
	for _, b := range s {
		cnt[b-'a']++
	}
	m := slices.Max(cnt[:])

	ans := len(s) // target = 0 时的答案
	f := [27]int{}
	for target := 1; target <= m; target++ {
		f[25] = min(cnt[25], abs(cnt[25]-target))
		for i := 24; i >= 0; i-- {
			x := cnt[i]
			if x == 0 {
				f[i] = f[i+1]
				continue
			}
			// 单独操作 x(变成 target 或 0)
			f[i] = f[i+1] + min(x, abs(x-target))
			// x 变成 target 或 0,y 变成 target
			y := cnt[i+1]
			if 0 < y && y < target { // 只有当 y 需要变大时,才去执行第三种操作
				if x > target { // x 变成 target
					f[i] = min(f[i], f[i+2]+max(x-target, target-y))
				} else { // x 变成 0
					f[i] = min(f[i], f[i+2]+max(x, target-y))
				}
			}
		}
		ans = min(ans, f[0])
	}
	return ans
}

func makeStringGood2(s string) int {
	n := len(s)
	cnt := [26]int{}
	for _, b := range s {
		cnt[b-'a']++
	}
	mx := slices.Max(cnt[:])

	ans := n
	for target := 0; target <= mx; target++ {
		calcOp := func(v int) int { return min(v, abs(target-v)) }
		memo := [26]int{}
		for i := range memo {
			memo[i] = -1
		}
		var dfs func(int) int
		dfs = func(i int) (res int) {
			if i >= 26 {
				return
			}
			p := &memo[i]
			if *p != -1 {
				return *p
			}
			defer func() { *p = res }()
			x := cnt[i]
			if x == 0 {
				return dfs(i + 1)
			}
			if i == 25 {
				return dfs(i+1) + calcOp(x)
			}
			y := cnt[i+1]
			mn := calcOp(x) + calcOp(y)
			// 只有当 y 需要变大时,才去执行第三种操作
			if y < target {
				if x > target { // x 夹带着第三种操作,变成 target
					mn = min(mn, max(x-target, target-y))
				} else { // x 夹带着第三种操作,变成 0
					mn = min(mn, max(x, target-y))
				}
			}
			return min(dfs(i+1)+calcOp(x), dfs(i+2)+mn)
		}
		ans = min(ans, dfs(0))
	}
	return ans
}3393. 统计异或值为给定值的路径数目
题目、示例与约束
给你一个大小为 m x n 的二维整数数组 grid 和一个整数 k 。
你的任务是统计满足以下 条件 且从左上格子 (0, 0) 出发到达右下格子 (m - 1, n - 1) 的路径数目:
- 每一步你可以向右或者向下走,也就是如果格子存在的话,可以从格子
(i, j)走到格子(i, j + 1)或者格子(i + 1, j)。 - 路径上经过的所有数字
XOR异或值必须 等于k。
请你返回满足上述条件的路径总数。
由于答案可能很大,请你将答案对 109 + 7 取余 后返回。
示例 1:
输入:grid = [[2, 1, 5], [7, 10, 0], [12, 6, 4]], k = 11
输出:3
解释:
3 条路径分别为:
(0, 0) → (1, 0) → (2, 0) → (2, 1) → (2, 2)(0, 0) → (1, 0) → (1, 1) → (1, 2) → (2, 2)(0, 0) → (0, 1) → (1, 1) → (2, 1) → (2, 2)
示例 2:
输入:grid = [[1, 3, 3, 3], [0, 3, 3, 2], [3, 0, 1, 1]], k = 2
输出:5
解释:
5 条路径分别为:
(0, 0) → (1, 0) → (2, 0) → (2, 1) → (2, 2) → (2, 3)(0, 0) → (1, 0) → (1, 1) → (2, 1) → (2, 2) → (2, 3)(0, 0) → (1, 0) → (1, 1) → (1, 2) → (1, 3) → (2, 3)(0, 0) → (0, 1) → (1, 1) → (1, 2) → (2, 2) → (2, 3)(0, 0) → (0, 1) → (0, 2) → (1, 2) → (2, 2) → (2, 3)
示例 3:
输入:grid = [[1, 1, 1, 2], [3, 0, 3, 2], [3, 0, 2, 2]], k = 10
输出:0
提示:
1 <= m == grid.length <= 3001 <= n == grid[r].length <= 3000 <= grid[r][c] < 160 <= k < 16
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
前置知识:动态规划入门:从记忆化搜索到递推【基础算法精讲 17】。
方法一:记忆化搜索
本题由于值域范围小,可以把路径的 XOR 值作为 DP 的第三个参数,即定义 表示从左上角 到当前位置 ,路径 XOR 值为 的方案数。
设从左上角 到 的路径 XOR 值为 ,那么必须满足
异或运算和加减法是一样的,可以移项,得
其中 表示异或运算。
分类讨论怎么到达 :
- 如果是从左边过来,根据上文的公式,有 。
- 如果是从上边过来,则 。
两条路径互斥,根据加法原理,有
倒序递归是为了方便后面 1:1 翻译成正序的递推。
递归边界:
- 。出界,方案数为 。
- ,其余 。左上角 到它自己的方案数是 ,路径 XOR 值为 。
递归入口:。
细节
设 为 的最大值,其二进制长度为 。
那么 就是 XOR 能取到的最大值。
如果 ,那么直接返回 。
注:也可以用所有 的 OR,作为 XOR 可以取到的最大值。
具体请看 视频讲解,欢迎点赞关注~
复杂度分析
- 时间复杂度:,其中 和 分别为 的行数和列数,。由于每个状态只会计算一次,动态规划的时间复杂度 状态个数 单个状态的计算时间。本题状态个数等于 ,单个状态的计算时间为 ,所以总的时间复杂度为 。
- 空间复杂度:。保存多少状态,就需要多少空间。
方法二:递推
我们可以去掉递归中的「递」,只保留「归」的部分,即自底向上计算。
具体来说, 的定义和 的定义是一样的,都表示从左上角 到当前位置 ,路径 XOR 值为 的方案数。这里 是为了把 和 也翻译过来,这样我们可以把 和 作为初始值。
相应的递推式(状态转移方程)也和 一样:
初始值:
- ,翻译自递归边界 。
- 其余为 。
也可以初始化 ,这样无需在递推时特判左上角。
答案为 ,翻译自递归入口 。
复杂度分析
- 时间复杂度:,其中 和 分别为 的行数和列数,。
- 空间复杂度:。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/基环树/最短路/最小生成树/网络流)
- 动态规划(入门/背包/划分/状态机/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
欢迎关注 B站@灵茶山艾府
// https://space.bilibili.com/206214
func countPathsWithXorValue(grid [][]int, k int) int {
	const mod = 1_000_000_007
	u := 0
	for _, row := range grid {
		for _, val := range row {
			u |= val
		}
	}
	if k > u {
		return 0
	}

	m, n := len(grid), len(grid[0])
	f := make([][][]int, m+1)
	for i := range f {
		f[i] = make([][]int, n+1)
		for j := range f[i] {
			f[i][j] = make([]int, u+1)
		}
	}
	f[1][1][grid[0][0]] = 1
	for i, row := range grid {
		for j, val := range row {
			for x := range u + 1 {
				f[i+1][j+1][x] += (f[i+1][j][x^val] + f[i][j+1][x^val]) % mod
			}
		}
	}
	return f[m][n][k]
}

func countPathsWithXorValue2(grid [][]int, k int) int {
	const mod = 1_000_000_007
	u := 0
	for _, row := range grid {
		for _, val := range row {
			u |= val
		}
	}
	if k > u {
		return 0
	}

	m, n := len(grid), len(grid[0])
	memo := make([][][]int, m)
	for i := range memo {
		memo[i] = make([][]int, n)
		for j := range memo[i] {
			memo[i][j] = make([]int, u+1)
			for x := range memo[i][j] {
				memo[i][j][x] = -1
			}
		}
	}
	var dfs func(int, int, int) int
	dfs = func(i, j, x int) int {
		if i < 0 || j < 0 {
			return 0
		}
		val := grid[i][j]
		if i == 0 && j == 0 {
			if x == val {
				return 1
			}
			return 0
		}
		p := &memo[i][j][x]
		if *p != -1 {
			return *p
		}
		*p = (dfs(i, j-1, x^val) + dfs(i-1, j, x^val)) % mod
		return *p
	}
	return dfs(m-1, n-1, k)
}3409. 最长相邻绝对差递减子序列
题目、示例与约束
给你一个整数数组 nums 。
你的任务是找到 nums 中的 最长 子序列 seq ,这个子序列中相邻元素的 绝对差 构成一个 非递增 整数序列。换句话说,nums 中的序列 seq0, seq1, seq2, ..., seqm 满足 |seq1 - seq0| >= |seq2 - seq1| >= ... >= |seqm - seqm - 1| 。
请你返回这个子序列的长度。
示例 1:
输入:nums = [16,6,3]
输出:3
解释:
最长子序列是 [16, 6, 3] ,相邻绝对差值为 [10, 3] 。
示例 2:
输入:nums = [6,5,3,4,2,1]
输出:4
解释:
最长子序列是 [6, 4, 2, 1] ,相邻绝对差值为 [2, 2, 1] 。
示例 3:
输入:nums = [10,20,10,19,10,20]
输出:5
解释:
最长子序列是 [10, 20, 10, 19, 10] ,相邻绝对差值为 [10, 10, 9, 9] 。
提示:
2 <= nums.length <= 1041 <= nums[i] <= 300
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
考虑用下标、绝对差构建状态。
尝试定义 表示以 结尾的、最后两个数之差为 的子序列的最长长度。注意这意味着子序列倒数第二个数是 或者 。
这已经有 个状态了( 为 的最大值减最小值),再算上枚举转移来源(枚举子序列倒数第二第三的两数之差),时间复杂度就是 ,会超时。
注意到,题目要求绝对差是非递增的,所以我们枚举的倒数第二第三的两数之差,必须 。如果维护 的后缀最大值,就可以 转移了。
不妨直接用 表示后缀最大值,即定义 表示以 结尾的、最后两个数之差至少为 的子序列的最长长度。
分类讨论:
- 单独形成一个子序列,那么 。
- 子序列最后两数之差严格大于 ,也就是至少为 ,那么 。
- 子序列最后两数之差恰好等于 ,那么子序列倒数第二个数是 或者 ,并且子序列倒数第二第三的两数之差至少为 ,那么 。其中 表示 上一次出现的下标。
注:只考虑上一次出现的下标,是因为 越大,子序列就越长。
所有情况取最大值,得
注:由于 需要从 转移过来,所以 要倒序枚举。
最终答案为所有 的最大值。
具体请看 视频讲解,欢迎点赞关注~
优化前
复杂度分析
- 时间复杂度:,其中 是 的长度,。
- 空间复杂度:。
优化
可以去掉,改成定义 表示以元素 结尾的、最后两个数之差至少为 的子序列的最长长度。
状态转移方程改成
⚠注意: 的时候要单独处理,否则转移方程中的 会重复累加。更简单的做法是,用一个变量 表示 ,具体见代码。
复杂度分析
- 时间复杂度:,其中 是 的长度,。
- 空间复杂度:。
更多相似题目,见下面动态规划题单中的「§7.5 多维 DP」。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/最短路/最小生成树/二分图/基环树/欧拉路径)
- 【本题相关】动态规划(入门/背包/状态机/划分/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA/一般树)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
import (
	"math"
	"slices"
)

// https://space.bilibili.com/206214
func longestSubsequence(nums []int) (ans int) {
	mx := slices.Max(nums)
	maxD := mx - slices.Min(nums)
	f := make([][]int, mx+1)
	for i := range f {
		f[i] = make([]int, maxD+1)
		for j := range f[i] {
			f[i][j] = math.MinInt
		}
	}

	for _, x := range nums {
		fx := 1
		for j := maxD; j >= 0; j-- {
			if x-j >= 0 {
				fx = max(fx, f[x-j][j]+1)
			}
			if x+j <= mx {
				fx = max(fx, f[x+j][j]+1)
			}
			f[x][j] = fx
			ans = max(ans, fx)
		}
	}
	return
}

func longestSubsequence2(nums []int) (ans int) {
	mx := slices.Max(nums)
	maxD := mx - slices.Min(nums)
	f := make([][]int, len(nums))
	for i := range f {
		f[i] = make([]int, maxD+2)
	}
	last := make([]int, mx+1)
	for i := range last {
		last[i] = -1
	}

	for i, x := range nums {
		for j := maxD; j >= 0; j-- {
			f[i][j] = max(f[i][j+1], 1)
			if x-j >= 0 && last[x-j] >= 0 {
				f[i][j] = max(f[i][j], f[last[x-j]][j]+1)
			}
			if x+j <= mx && last[x+j] >= 0 {
				f[i][j] = max(f[i][j], f[last[x+j]][j]+1)
			}
			ans = max(ans, f[i][j])
		}
		last[x] = i
	}
	return
}3414. 不重叠区间的最大得分
题目、示例与约束
给你一个二维整数数组 intervals,其中 intervals[i] = [li, ri, weighti]。区间 i 的起点为 li,终点为 ri,权重为 weighti。你最多可以选择 4 个互不重叠 的区间。所选择区间的 得分 定义为这些区间权重的总和。
返回一个至多包含 4 个下标且 字典序最小 的数组,表示从 intervals 中选中的互不重叠且得分最大的区间。
如果两个区间没有任何重叠点,则称二者 互不重叠 。特别地,如果两个区间共享左边界或右边界,也认为二者重叠。
示例 1:
输入: intervals = [[1,3,2],[4,5,2],[1,5,5],[6,9,3],[6,7,1],[8,9,1]]
输出: [2,3]
解释:
可以选择下标为 2 和 3 的区间,其权重分别为 5 和 3。
示例 2:
输入: intervals = [[5,8,1],[6,7,7],[4,7,3],[9,10,6],[7,8,2],[11,14,3],[3,5,5]]
输出: [1,3,5,6]
解释:
可以选择下标为 1、3、5 和 6 的区间,其权重分别为 7、6、3 和 5。
提示:
1 <= intervals.length <= 5 * 104intervals[i].length == 3intervals[i] = [li, ri, weighti]1 <= li <= ri <= 1091 <= weighti <= 109
方法一:排序 + 二分查找 + 动态规划 · Go 实现
思考
在加权区间中选出至多四个互不重叠的区间,使权重和最大,并在同分时取字典序最小的下标序列。 ,子集枚举不可行。
这是带「最多选 个」限制的加权区间调度。按左端点排序后,下一个不冲突区间可用二分找到。
状态 表示从第 个区间起还能再选 个。转移为「跳过」或「选中并跳到 」。同时比较权重与下标序列,保证字典序最小。
我们先把区间复制出来并记下原始下标,再按左端点从小到大排序。对每个区间 ,用二分找到第一个左端点严格大于 右端点的位置 (端点重合视为重叠)。
令 表示从第 个区间起最多再选 个区间能得到的最大权重,并用 保存对应的字典序最小下标序列。从后往前转移:不选第 个区间则继承 ;选中则把原始下标插入 ,并加上当前权重。取权重更大的方案,权重相同时取下标序列字典序更小者。答案为 。
时间复杂度 ,空间复杂度 。最多选择 个区间,插入与比较下标序列的代价可视为常数。
func maximumWeight(intervals [][]int) []int {
	n := len(intervals)
	arr := make([][4]int, n)
	for i, e := range intervals {
		arr[i] = [4]int{e[0], e[1], e[2], i}
	}
	sort.Slice(arr, func(i, j int) bool {
		if arr[i][0] != arr[j][0] {
			return arr[i][0] < arr[j][0]
		}
		return arr[i][1] < arr[j][1]
	})
	nxt := make([]int, n)
	for i := 0; i < n; i++ {
		l, r := i+1, n
		for l < r {
			mid := (l + r) >> 1
			if arr[mid][0] > arr[i][1] {
				r = mid
			} else {
				l = mid + 1
			}
		}
		nxt[i] = l
	}
	f := make([][5]int64, n+1)
	g := make([][5][]int, n+1)
	for i := n - 1; i >= 0; i-- {
		for k := 1; k < 5; k++ {
			s1, a1 := f[i+1][k], g[i+1][k]
			a2 := append([]int(nil), g[nxt[i]][k-1]...)
			x := arr[i][3]
			j := sort.SearchInts(a2, x)
			a2 = append(a2, 0)
			copy(a2[j+1:], a2[j:])
			a2[j] = x
			s2 := f[nxt[i]][k-1] + int64(arr[i][2])
			if s2 > s1 || (s2 == s1 && lessInts(a2, a1)) {
				f[i][k] = s2
				g[i][k] = a2
			} else {
				f[i][k] = s1
				g[i][k] = a1
			}
		}
	}
	return g[0][4]
}

func lessInts(a, b []int) bool {
	m := min(len(a), len(b))
	for i := 0; i < m; i++ {
		if a[i] != b[i] {
			return a[i] < b[i]
		}
	}
	return len(a) < len(b)
}3418. 机器人可以获得的最大金币数
题目、示例与约束
给你一个 m x n 的网格。一个机器人从网格的左上角 (0, 0) 出发,目标是到达网格的右下角 (m - 1, n - 1)。在任意时刻,机器人只能向右或向下移动。
网格中的每个单元格包含一个值 coins[i][j]:
- 如果
coins[i][j] >= 0,机器人可以获得该单元格的金币。 - 如果
coins[i][j] < 0,机器人会遇到一个强盗,强盗会抢走该单元格数值的 绝对值 的金币。
机器人有一项特殊能力,可以在行程中 最多感化 2个单元格的强盗,从而防止这些单元格的金币被抢走。
注意:机器人的总金币数可以是负数。
返回机器人在路径上可以获得的 最大金币数 。
示例 1:
输入: coins = [[0,1,-1],[1,-2,3],[2,-3,4]]
输出: 8
解释:
一个获得最多金币的最优路径如下:
- 从
(0, 0)出发,初始金币为0(总金币 =0)。 - 移动到
(0, 1),获得1枚金币(总金币 =0 + 1 = 1)。 - 移动到
(1, 1),遇到强盗抢走2枚金币。机器人在此处使用一次感化能力,避免被抢(总金币 =1)。 - 移动到
(1, 2),获得3枚金币(总金币 =1 + 3 = 4)。 - 移动到
(2, 2),获得4枚金币(总金币 =4 + 4 = 8)。
示例 2:
输入: coins = [[10,10,10],[10,10,10]]
输出: 40
解释:
一个获得最多金币的最优路径如下:
- 从
(0, 0)出发,初始金币为10(总金币 =10)。 - 移动到
(0, 1),获得10枚金币(总金币 =10 + 10 = 20)。 - 移动到
(0, 2),再获得10枚金币(总金币 =20 + 10 = 30)。 - 移动到
(1, 2),获得10枚金币(总金币 =30 + 10 = 40)。
提示:
m == coins.lengthn == coins[i].length1 <= m, n <= 500-1000 <= coins[i][j] <= 1000
方法一:记忆化搜索 · Go 实现
思考
机器人从左上走到右下,只能向右或向下,并至多感化两次强盗(把负格当作 )。网格 ,若再乘上感化次数,状态量约为 ,记忆化可行。
朴素路径计数不含「在此格是否动用一次感化」这一维,会把不同剩余次数的最优混在一起。
状态 表示从该格出发、仍可感化 次的最大收益。转移先加上本格金币再走向下或右;若本格为负且 ,还可不取本格金币并消耗一次感化。终点按剩余次数决定是否把负数抬成 。
我们设计一个函数 ,表示机器人从 出发,还剩下 次感化机会时,能够获得的最大金币数。机器人只能向右或向下移动,因此 的值只与 和 有关。
- 如果 或 ,表示机器人走出了网格,此时返回一个极小值。
- 如果 且 ,表示机器人到达了网格的右下角,此时如果 ,则机器人可以选择感化当前位置的强盗,因此返回 ;如果 ,则机器人不能感化当前位置的强盗,因此返回 。
- 如果 ,表示当前位置有强盗,此时如果 ,则机器人可以选择感化当前位置的强盗,因此返回 ;如果 ,则机器人不能感化当前位置的强盗,因此返回 。
根据上述分析,我们可以编写出记忆化搜索的代码。
时间复杂度 ,空间复杂度 。其中 和 分别是二维数组 的行数和列数,而 是感化机会的状态数,本题中 。
func maximumAmount(coins [][]int) int {
	m, n := len(coins), len(coins[0])
	f := make([][][]int, m)
	for i := range f {
		f[i] = make([][]int, n)
		for j := range f[i] {
			f[i][j] = make([]int, 3)
			for k := range f[i][j] {
				f[i][j][k] = math.MinInt32
			}
		}
	}
	var dfs func(i, j, k int) int
	dfs = func(i, j, k int) int {
		if i >= m || j >= n {
			return math.MinInt32 / 2
		}
		if f[i][j][k] != math.MinInt32 {
			return f[i][j][k]
		}
		if i == m-1 && j == n-1 {
			if k > 0 {
				return max(0, coins[i][j])
			}
			return coins[i][j]
		}
		ans := coins[i][j] + max(dfs(i+1, j, k), dfs(i, j+1, k))
		if coins[i][j] < 0 && k > 0 {
			ans = max(ans, max(dfs(i+1, j, k-1), dfs(i, j+1, k-1)))
		}
		f[i][j][k] = ans
		return ans
	}
	return dfs(0, 0, 2)
}3428. 最多 K 个元素的子序列的最值之和
题目、示例与约束
给你一个整数数组 nums 和一个正整数 k,返回所有长度最多为 k 的 子序列 中 最大值 与 最小值 之和的总和。
非空子序列 是指从另一个数组中删除一些或不删除任何元素(且不改变剩余元素的顺序)得到的数组。
由于答案可能非常大,请返回对 109 + 7 取余数的结果。
示例 1:
输入: nums = [1,2,3], k = 2
输出: 24
解释:
数组 nums 中所有长度最多为 2 的子序列如下:
| 子序列 | 最小值 | 最大值 | 和 |
|---|---|---|---|
[1] |
1 | 1 | 2 |
[2] |
2 | 2 | 4 |
[3] |
3 | 3 | 6 |
[1, 2] |
1 | 2 | 3 |
[1, 3] |
1 | 3 | 4 |
[2, 3] |
2 | 3 | 5 |
| 总和 | 24 |
因此,输出为 24。
示例 2:
输入: nums = [5,0,6], k = 1
输出: 22
解释:
对于长度恰好为 1 的子序列,最小值和最大值均为元素本身。因此,总和为 5 + 5 + 0 + 0 + 6 + 6 = 22。
示例 3:
输入: nums = [1,1,1], k = 2
输出: 12
解释:
子序列 [1, 1] 和 [1] 各出现 3 次。对于所有这些子序列,最小值和最大值均为 1。因此,总和为 12。
提示:
1 <= nums.length <= 1050 <= nums[i] <= 1091 <= k <= min(100, nums.length)
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
由于我们只关心子序列中的最值,所以元素顺序不影响答案,可以先把数组排序。
排序后,假设 是子序列的最大值,这样的子序列有多少个?
我们可以从下标 中选至多 个数,作为子序列的其他元素。这样的选法总共有
个。
由于 很小,直接暴力计算上式。
于是 对答案的贡献为
同理可以枚举 作为子序列的最小值,从右边选数字,做法同上。
技巧:根据对称性, 作为最小值时,子序列个数和 作为最大值的个数是一样的,所以二者可以一同计算。
代码实现
- 关于组合数,我们需要预处理阶乘及其逆元,然后利用公式 计算。
- 关于逆元的知识点,见 模运算的世界:当加减乘除遇上取模,包含费马小定理的数学证明。
具体请看 视频讲解,欢迎点赞关注~
优化前
复杂度分析
忽略预处理的时间和空间。
- 时间复杂度:,其中 是 的长度。
- 空间复杂度:。忽略排序的栈开销。
优化
对于和式
考虑怎么通过 递推得到 :
- 如果 ,那么我们相当于在 ,也就是包含至多 个数的子序列的基础上,多了一个数。对于 中的每个子序列,这个数都可以选或不选,所以有
- 如果 ,那么我们相当于在 ,也就是包含至多 个数的子序列的基础上,多了一个数。这个数可以选也可以不选,如果选,那么前面的子序列不能包含恰好 个数,要减掉,也就是减去从 个数中选出 个数的方案数,所以有
这样可以 递推和式,不需要 暴力去算。
初始值 。
代码实现时, 可以优化成一个变量。
复杂度分析
忽略预处理的时间和空间。
- 时间复杂度:,其中 是 的长度。瓶颈在排序上。
- 空间复杂度:。忽略排序的栈开销。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/最短路/最小生成树/二分图/基环树/欧拉路径)
- 动态规划(入门/背包/状态机/划分/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 【本题相关】数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA/一般树)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
import "slices"

// https://space.bilibili.com/206214
const mod = 1_000_000_007
const mx = 100_000

var f [mx]int    // f[i] = i!
var invF [mx]int // invF[i] = i!^-1

func init() {
	f[0] = 1
	for i := 1; i < mx; i++ {
		f[i] = f[i-1] * i % mod
	}

	invF[mx-1] = pow(f[mx-1], mod-2)
	for i := mx - 1; i > 0; i-- {
		invF[i-1] = invF[i] * i % mod
	}
}

func pow(x, n int) int {
	res := 1
	for ; n > 0; n /= 2 {
		if n%2 > 0 {
			res = res * x % mod
		}
		x = x * x % mod
	}
	return res
}

func comb(n, m int) int {
	if m > n {
		return 0
	}
	return f[n] * invF[m] % mod * invF[n-m] % mod
}

func minMaxSums(nums []int, k int) (ans int) {
	slices.Sort(nums)
	s := 1
	for i, x := range nums {
		ans = (ans + s*(x+nums[len(nums)-1-i])) % mod
		s = (s*2 - comb(i, k-1) + mod) % mod
	}
	return
}3429. 粉刷房子 IV
题目、示例与约束
给你一个 偶数 整数 n,表示沿直线排列的房屋数量,以及一个大小为 n x 3 的二维数组 cost,其中 cost[i][j] 表示将第 i 个房屋涂成颜色 j + 1 的成本。
如果房屋满足以下条件,则认为它们看起来 漂亮:
- 不存在 两个 涂成相同颜色的相邻房屋。
- 距离行两端 等距 的房屋不能涂成相同的颜色。例如,如果
n = 6,则位置(0, 5)、(1, 4)和(2, 3)的房屋被认为是等距的。
返回使房屋看起来 漂亮 的 最低 涂色成本。
示例 1:
输入: n = 4, cost = [[3,5,7],[6,2,9],[4,8,1],[7,3,5]]
输出: 9
解释:
最佳涂色顺序为 [1, 2, 3, 2],对应的成本为 [3, 2, 1, 3]。满足以下条件:
- 不存在涂成相同颜色的相邻房屋。
- 位置 0 和 3 的房屋(等距于两端)涂成不同的颜色
(1 != 2)。 - 位置 1 和 2 的房屋(等距于两端)涂成不同的颜色
(2 != 3)。
使房屋看起来漂亮的最低涂色成本为 3 + 2 + 1 + 3 = 9。
示例 2:
输入: n = 6, cost = [[2,4,6],[5,3,8],[7,1,9],[4,6,2],[3,5,7],[8,2,4]]
输出: 18
解释:
最佳涂色顺序为 [1, 3, 2, 3, 1, 2],对应的成本为 [2, 8, 1, 2, 3, 2]。满足以下条件:
- 不存在涂成相同颜色的相邻房屋。
- 位置 0 和 5 的房屋(等距于两端)涂成不同的颜色
(1 != 2)。 - 位置 1 和 4 的房屋(等距于两端)涂成不同的颜色
(3 != 1)。 - 位置 2 和 3 的房屋(等距于两端)涂成不同的颜色
(2 != 3)。
使房屋看起来漂亮的最低涂色成本为 2 + 8 + 1 + 2 + 3 + 2 = 18。
提示:
2 <= n <= 105n是偶数。cost.length == ncost[i].length == 30 <= cost[i][j] <= 105
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
一、寻找子问题
原问题是涂下标在 内的房子的最低成本。
由于有等距异色的要求,考虑左右同时开工,涂 和 这两个房子。
枚举房子 和 的颜色 和 ,问题变成涂剩余房子的最低成本。这样就找到了子问题。
二、状态定义与状态转移方程
为方便把记忆化搜索翻译成递推,从里向外涂色。
定义 表示涂前后各 个房子的最低成本,其中下标 房子的颜色为 ,下标 房子的颜色为 。
枚举房子 和 的颜色 和 ,问题变成涂前后各 个房子的最低成本,即 。
累加成本,取最小值,得
其中 且 且 。
递归边界:。
递归入口:,这是原问题,也是答案。其中 保证一开始的涂色不受约束。注意题目保证 是偶数。
具体请看 视频讲解,欢迎点赞关注~
三、递归搜索 + 保存递归返回值 = 记忆化搜索
考虑到整个递归过程中有大量重复递归调用(递归入参相同)。由于递归函数没有副作用,同样的入参无论计算多少次,算出来的结果都是一样的,因此可以用记忆化搜索来优化:
- 如果一个状态(递归入参)是第一次遇到,那么可以在返回前,把状态及其结果记到一个 数组中。
- 如果一个状态不是第一次遇到( 中保存的结果不等于 的初始值),那么可以直接返回 中保存的结果。
注意: 数组的初始值一定不能等于要记忆化的值!例如初始值设置为 ,并且要记忆化的 也等于 ,那就没法判断 到底表示第一次遇到这个状态,还是表示之前遇到过了,从而导致记忆化失效。一般把初始值设置为 。
Python 用户可以无视上面这段,直接用
@cache装饰器。
具体请看视频讲解 动态规划入门:从记忆化搜索到递推,其中包含把记忆化搜索 1:1 翻译成递推的技巧。
复杂度分析
- 时间复杂度:,其中 。由于每个状态只会计算一次,动态规划的时间复杂度 状态个数 单个状态的计算时间。本题状态个数等于 ,单个状态的计算时间为 ,所以总的时间复杂度为 。
- 空间复杂度:。保存多少状态,就需要多少空间。
四、1:1 翻译成递推
的定义和 的定义是一样的,都表示涂前后各 个房子的最低成本,其中下标 房子的颜色为 ,下标 房子的颜色为 。这里写 是为了把 这个状态也翻译过来,这样我们可以把 作为初始值。
相应的递推式(状态转移方程)也和 一样:
其中 且 且 。
初始值 。
答案可以枚举最里面一对房子的颜色,取最小值,即 的最小值。
复杂度分析
- 时间复杂度:,其中 。
- 空间复杂度:。
注:利用滚动数组,可以把空间复杂度优化至 。
更多相似题目,见下面动态规划题单中的「§7.5 多维 DP」。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/最短路/最小生成树/二分图/基环树/欧拉路径)
- 【本题相关】动态规划(入门/背包/状态机/划分/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA/一般树)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
import (
	"math"
	"slices"
)

func minCost(n int, cost [][]int) int64 {
	f := make([][3][3]int, n/2+1)
	for i, row := range cost[:n/2] {
		row2 := cost[n-1-i]
		for preJ := range 3 {
			for preK := range 3 {
				res := math.MaxInt
				for j, c1 := range row {
					if j == preJ {
						continue
					}
					for k, c2 := range row2 {
						if k != preK && k != j {
							res = min(res, f[i][j][k]+c1+c2)
						}
					}
				}
				f[i+1][preJ][preK] = res
			}
		}
	}

	// 枚举所有初始颜色,取最小值
	res := math.MaxInt
	for _, row := range f[n/2] {
		res = min(res, slices.Min(row[:]))
	}
	return int64(res)
}

func minCost2(n int, cost [][]int) int64 {
	memo := make([][4][4]int, n/2)
	for i := range memo {
		for j := range memo[i] {
			for k := range memo[i][j] {
				memo[i][j][k] = -1
			}
		}
	}
	var dfs func(int, int, int) int
	dfs = func(i, preJ, preK int) (res int) {
		if i < 0 {
			return
		}
		p := &memo[i][preJ][preK]
		if *p != -1 {
			return *p
		}
		res = math.MaxInt
		for j, c1 := range cost[i] {
			if j == preJ {
				continue
			}
			for k, c2 := range cost[n-1-i] {
				if k != preK && k != j {
					res = min(res, dfs(i-1, j, k)+c1+c2)
				}
			}
		}
		*p = res
		return
	}
	return int64(dfs(n/2-1, 3, 3))
}3434. 子数组操作后的最大频率
题目、示例与约束
给你一个长度为 n 的数组 nums ,同时给你一个整数 k 。
你可以对 nums 执行以下操作 一次 :
- 选择一个子数组
nums[i..j],其中0 <= i <= j <= n - 1。 - 选择一个整数
x并将nums[i..j]中 所有 元素都增加x。
请你返回执行以上操作以后数组中 k 出现的 最大 频率。
子数组 是一个数组中一段连续 非空 的元素序列。
示例 1:
输入:nums = [1,2,3,4,5,6], k = 1
输出:2
解释:
将 nums[2..5] 增加 -5 后,1 在数组 [1, 2, -2, -1, 0, 1] 中的频率为最大值 2 。
示例 2:
输入:nums = [10,2,3,4,5,5,4,3,2,2], k = 10
输出:4
解释:
将 nums[1..9] 增加 8 以后,10 在数组 [10, 10, 11, 12, 13, 13, 12, 11, 10, 10] 中的频率为最大值 4 。
提示:
1 <= n == nums.length <= 1051 <= nums[i] <= 501 <= k <= 50
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
方法一:枚举 + 状态机 DP
考虑把子数组中等于 的元素都变成 。
由于 至多有 种不同元素,可以枚举 (或者 中的不同元素)。
可以分为三段:
- 左:被修改的子数组的左边。
- 中:被修改的子数组。
- 右:被修改的子数组的右边。
用状态机 DP 计算 到 最多有多少个数可以等于 :
- 表示左,或者说 在被修改的子数组的左侧,此时只能统计等于 的元素个数。
- 表示左+中,或者说 在被修改的子数组中,此时只能统计等于 的元素个数,这些数被修改成 。注意不能统计子数组中的 的个数,因为子数组中的 会被修改成别的数。
- 表示左+中+右,或者说 在被修改的子数组的右侧,此时只能统计等于 的元素个数。
从左到右遍历 ,设 ,考虑转移来源:
- 「左」只能从「左」转移过来。如果 ,那么不选白不选,问题变成 到 最多有多少个数可以等于 ,即状态 ,所以有转移方程 。如果 ,那么 。
- 「左+中」可以从「左+中」或者「左」转移过来。同上,问题变成 到 最多有多少个数可以等于 。如果 ,那么 ,否则 。这里从 转移过来,表示 也在被修改的子数组中;从 转移过来,表示 是被修改的子数组的第一个数。
- 「左+中+右」可以从「左+中+右」或者「左+中」转移过来。同上,问题变成 到 最多有多少个数可以等于 。如果 ,那么 ,否则 。这里从 转移过来,表示 也在被修改的子数组的右边;从 转移过来,表示 是被修改的子数组的最后一个数。
初始值 。本题子数组所有数都增加 相当于没有操作,这也等价于子数组可以是空的。既然允许空子数组,那么初始化成 也可以。
答案为 。最后一个数可以在「中」也可以在「右」。
代码实现时,第一个维度可以优化掉,三个状态按照 的顺序倒着更新,理由同 0-1 背包。
具体请看 视频讲解,欢迎点赞关注~
复杂度分析
- 时间复杂度:,其中 是 的长度, 是 中的不同元素个数。
- 空间复杂度:。
方法二:状态机 DP 优化(一次遍历)
和 的定义不变。
设 。用 存储方法一中的 时的 状态,转移方程为
其余 不变(懒更新)。
额外定义 表示 的最大值。
那么 的转移方程为
写法一
写法二
把 和 合并成一个变量 。当 的时候,把 加一。转移方程中的 无需计算,因为两个变量已经合二为一。
此外, 的时候不需要计算 ,因为这个状态等价于统计 的个数,这也是 统计的内容。
复杂度分析
- 时间复杂度:,其中 是 的长度, 是 中的不同元素个数。注意创建数组需要 的时间。
- 空间复杂度:。
变形题
改成可以修改两个不相交的子数组呢?
在 视频讲解 第三题的最后讲了怎么做。
更多相似题目,见下面动态规划题单中的「五、状态机 DP」。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/最短路/最小生成树/二分图/基环树/欧拉路径)
- 【本题相关】动态规划(入门/背包/状态机/划分/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA/一般树)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
func maxFrequency(nums []int, k int) int {
	f0, maxF12 := 0, 0
	f1 := [51]int{}
	for _, x := range nums {
		if x == k {
			maxF12++
			f0++
		} else {
			f1[x] = max(f1[x], f0) + 1
			maxF12 = max(maxF12, f1[x])
		}
	}
	return maxF12
}

func maxFrequency2(nums []int, k int) int {
	var f0, maxF1, f2 int
	f1 := [51]int{}
	for _, x := range nums {
		f2 = max(f2, maxF1)
		f1[x] = max(f1[x], f0) + 1
		if x == k {
			f2++
			f0++
		}
		maxF1 = max(maxF1, f1[x])
	}
	return max(maxF1, f2)
}

func maxFrequency1(nums []int, k int) (ans int) {
	set := map[int]struct{}{}
	for _, x := range nums {
		set[x] = struct{}{}
	}

	for target := range set {
		var f0, f1, f2 int
		for _, x := range nums {
			f2 = max(f2, f1) + b2i(x == k)
			f1 = max(f1, f0) + b2i(x == target)
			f0 += b2i(x == k)
		}
		ans = max(ans, f1, f2)
	}
	return
}

func b2i(b bool) int {
	if b {
		return 1
	}
	return 0
}3441. 变成好标题的最少代价
题目、示例与约束
给你一个长度为 n 的字符串 caption 。如果字符串中 每一个 字符都位于连续出现 至少 3 次 的组中,那么我们称这个字符串是 好 标题。
比方说:
"aaabbb"和"aaaaccc"都是 好 标题。"aabbb"和"ccccd"都 不是 好标题。
你可以对字符串执行以下操作 任意 次:
选择一个下标 i(其中 0 <= i < n )然后将该下标处的字符变为:
- 该字符在字母表中 前 一个字母(前提是
caption[i] != 'a') - 该字符在字母表中 后 一个字母(
caption[i] != 'z')
你的任务是用 最少 操作次数将 caption 变为 好 标题。如果存在 多种 好标题,请返回它们中 字典序最小 的一个。如果 无法 得到好标题,请你返回一个空字符串 "" 。
a 和 b 中,如果两个字符串第一个不同的字符处,字符串 a 的字母比 b 的字母在字母表里出现的顺序更早,那么我们称字符串 a 的 字典序 比 b 小 。如果两个字符串前 min(a.length, b.length) 个字符都相同,那么较短的一个字符串字典序比另一个字符串小。
示例 1:
输入:caption = "cdcd"
输出:"cccc"
解释:
无法用少于 2 个操作将字符串变为好标题。2 次操作得到好标题的方案包括:
"dddd":将caption[0]和caption[2]变为它们后一个字符'd'。"cccc":将caption[1]和caption[3]变为它们前一个字符'c'。
由于 "cccc" 字典序比 "dddd" 小,所以返回 "cccc" 。
示例 2:
输入:caption = "aca"
输出:"aaa"
解释:
无法用少于 2 个操作将字符串变为好标题。2 次操作得到好标题的方案包括:
- 操作 1:将
caption[1]变为'b',caption = "aba"。 - 操作 2:将
caption[1]变为'a',caption = "aaa"。
所以返回 "aaa" 。
示例 3:
输入:caption = "bc"
输出:""
解释:
由于字符串的长度小于 3 ,无法将字符串变为好标题。
提示:
1 <= caption.length <= 5 * 104caption只包含小写英文字母。
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
一、寻找子问题
为方便描述,下文把字符串 简称为 。
首先,如果 的长度小于 ,无解,返回空字符串。下文讨论 长度至少为 的情况。
我们要解决的问题(原问题)是:
- 把 的每个连续相同段的长度都变成 的最少操作次数。
为了让答案的字典序最小,从左到右思考。
枚举 变成哪个字母。比如变成 ,那么:
- 如果 也是 ,那么问题变成:在 的前提下, 到 的最少操作次数。
- 什么时候可以枚举其他字母?如果 和 也是 ,就可以保证 一定在一个长度至少为 的连续相同子串中,这样 就可以枚举其他字母 了,问题变成:在 的前提下, 到 的最少操作次数。
这些问题都是和原问题相似的、规模更小的子问题,可以用递归解决。
二、状态定义与状态转移方程
根据上面的讨论,我们需要在递归过程中跟踪以下信息:
- :剩余子串从 到 。
- :规定 变成字母 。
因此,定义状态为 ,表示在 的前提下, 到 的最少操作次数。
分类讨论:
- 也是 ,问题变成:在 的前提下, 到 的最少操作次数,即 。
- 和 也是 ,但 是字母 ,问题变成:在 的前提下, 到 的最少操作次数,即 。注意这要求 到 的长度至少是 ,也就是 ,即 。
这两种情况取最小值,就得到了 ,即
注意无需判断 ,这不会得到比 更优的答案。
递归边界:。
递归入口:。
三、递归搜索 + 保存递归返回值 = 记忆化搜索
考虑到整个递归过程中有大量重复递归调用(递归入参相同)。由于递归函数没有副作用,同样的入参无论计算多少次,算出来的结果都是一样的,因此可以用记忆化搜索来优化:
- 如果一个状态(递归入参)是第一次遇到,那么可以在返回前,把状态及其结果记到一个 数组中。
- 如果一个状态不是第一次遇到( 中保存的结果不等于 的初始值),那么可以直接返回 中保存的结果。
注意: 数组的初始值一定不能等于要记忆化的值!例如初始值设置为 ,并且要记忆化的 也等于 ,那就没法判断 到底表示第一次遇到这个状态,还是表示之前遇到过了,从而导致记忆化失效。一般把初始值设置为 。
Python 用户可以无视上面这段,直接用
@cache装饰器。
具体请看视频讲解 动态规划入门:从记忆化搜索到递推,其中包含把记忆化搜索 1:1 翻译成递推的技巧。
为方便大家理解,这里先给出计算最少操作次数的代码。输出具体方案在下文的递推中实现。
复杂度分析
- 时间复杂度:,其中 是 的长度, 是字符集合的大小。由于每个状态只会计算一次,动态规划的时间复杂度 状态个数 单个状态的计算时间。本题状态个数等于 ,单个状态的计算时间为 ,所以总的时间复杂度为 。
- 空间复杂度:。保存多少状态,就需要多少空间。
四、1:1 翻译成递推
我们可以去掉递归中的「递」,只保留「归」的部分,即自底向上计算。
具体来说, 的定义和 的定义是一样的,都表示在 的前提下, 到 的最少操作次数。
相应的递推式(状态转移方程)也和 一样:
初始值 ,翻译自递归边界 。
先把上面的记忆化搜索 1:1 翻译过来,然后讨论优化和输出具体方案。
五、时间优化 + 输出具体方案
把 保存到 中,于是转移方程优化成
这样时间复杂度就优化至 了。
本题还需要输出具体方案,这可以在递归的过程中,用一个 数组记录每个状态 的最优决策来自哪。
此外,我们还需要知道 等于哪个 ,这里的 是多少。这需要在计算最小值的过程中,把对应的 保存到 中。
于是,当上面代码中出现 的情况时,需要比较 和 的大小关系,如果前者更小,那么要从 转移过来。
答疑
问:为什么要倒着递推?
答:题目要计算最小字典序,比较规则是:如果两个字符串下标 处的字母相同,我们就需要根据后面的信息判断到底谁大谁小。只有倒着递推,我们才能获取到后面的信息。
最终代码:
复杂度分析
- 时间复杂度:,其中 是 的长度, 是字符集合的大小。
- 空间复杂度:。
六、另一种思路:中位数贪心 + DP
注意到,对于长度 的子串:
- 长为 的子串可以拆分成两个长为 的子串,这两个子串是互相独立的,可以分别计算最小修改次数。
- 长为 的子串可以拆分成长为 和 的子串,两个子串分别计算最小修改次数。
- 长为 的子串可以拆分成长为 和 ,或者 和 的子串,两个子串分别计算最小修改次数。
- ……
所以本题的「基本元素」只有长为 的子串,换句话说,问题相当于:
- 把 划分成若干长为 的子串,把每个子串中的字母都变成相同的,求最小操作次数。
这可以用划分型 DP 解决。
定义 表示后缀 到 的最小操作次数。
枚举第一个子串的长度 :
- 长为 的子串,设其中字母分别为 ,不妨设 ,根据 中位数贪心及其证明,把所有数变成中位数 是最优的,最小操作次数为 。
- 长为 的子串,设其中字母分别为 ,不妨设 ,同理可得最小操作次数为 ,都变成 。注意变成 到 中的字母操作次数都是最小的,由于本题要求答案字典序最小,所以变成 。
- 长为 的子串,设其中字母分别为 ,不妨设 ,同理可得最小操作次数为 ,都变成 。
那么有
其中 对应上面长为 的子串的最小操作次数。
初始值 。
为了输出具体方案,需要额外比较字典序的大小。
为此,额外定义 表示 要变成的字母。
仍然枚举第一个子串的长度 :
- 长为 的子串(设字母分别为 ,已排序),算上 要变成的字母 ,那么前 个字母分别为 。
- 长为 的子串(设字母分别为 ,已排序),算上 要变成的字母 ,那么前 个字母分别为 。
- 长为 的子串(设字母分别为 ,已排序),算上 要变成的字母 ,那么前 个字母分别为 。
取前 个字母的最小字典序,即为最终的转移来源。
问:为什么不考虑第 个字母?
答:这是因为,如果前 个字母都一样,那么可以拆分成两个长为 的子串,所以可以去掉前 个字母, 的最优决策就等同于 的最优决策。对于 而言,第 个字母的最优值,就是 的第 个字母的最优值,这已经在 中计算好了。
由于前 个字母都是一样的,我们可以只比较第 个到第 个字母的字典序。
优化前
优化
把四个字母压缩到一个 中,这样可以快速比较字典序。
复杂度分析
- 时间复杂度:,其中 是 的长度。这个算法也可以理解成是一个 或者 的算法,其中 。
- 空间复杂度:。
更多相似题目,见下面动态规划题单中的「六、状态机 DP」「§5.2 最优划分」「§7.6 多维 DP」和「专题:输出具体方案」。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/基环树/最短路/最小生成树/网络流)
- 动态规划(入门/背包/划分/状态机/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA/一般树)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
欢迎关注 B站@灵茶山艾府
import (
	"bytes"
	"math"
	"slices"
)

// https://space.bilibili.com/206214
func minCostGoodCaption(s string) string {
	n := len(s)
	if n < 3 {
		return ""
	}

	f := make([]int, n+1)
	f[n-1], f[n-2] = math.MaxInt/2, math.MaxInt/2
	t := make([]byte, n+1)
	size := make([]uint8, n)

	for i := n - 3; i >= 0; i-- {
		sub := []byte(s[i : i+3])
		slices.Sort(sub)
		a, b, c := sub[0], sub[1], sub[2]
		s3 := int(t[i+3])
		res := f[i+3] + int(c-a)
		mask := int(b)<<24 | s3<<16 | s3<<8 | s3 // 4 个 byte 压缩成一个 int,方便比较字典序
		size[i] = 3

		if i+4 <= n {
			sub := []byte(s[i : i+4])
			slices.Sort(sub)
			a, b, c, d := sub[0], sub[1], sub[2], sub[3]
			s4 := int(t[i+4])
			res4 := f[i+4] + int(c-a+d-b)
			mask4 := int(b)<<24 | int(b)<<16 | s4<<8 | s4
			if res4 < res || res4 == res && mask4 < mask {
				res, mask = res4, mask4
				size[i] = 4
			}
		}

		if i+5 <= n {
			sub := []byte(s[i : i+5])
			slices.Sort(sub)
			a, b, c, d, e := sub[0], sub[1], sub[2], sub[3], sub[4]
			res5 := f[i+5] + int(d-a+e-b)
			mask5 := int(c)<<24 | int(c)<<16 | int(c)<<8 | int(t[i+5])
			if res5 < res || res5 == res && mask5 < mask {
				res, mask = res5, mask5
				size[i] = 5
			}
		}

		f[i] = res
		t[i] = byte(mask >> 24)
	}

	ans := make([]byte, 0, n)
	for i := 0; i < n; i += int(size[i]) {
		ans = append(ans, bytes.Repeat([]byte{t[i]}, int(size[i]))...)
	}
	return string(ans)
}

func minCostGoodCaption3(s string) string {
	n := len(s)
	if n < 3 {
		return ""
	}

	f := make([]int, n+1)
	f[n-1], f[n-2] = math.MaxInt/2, math.MaxInt/2
	t := make([]byte, n+1)
	size := make([]uint8, n)

	for i := n - 3; i >= 0; i-- {
		sub := []byte(s[i : i+3])
		slices.Sort(sub)
		a, b, c := sub[0], sub[1], sub[2]
		s3 := int(t[i+3])
		res := []int{f[i+3] + int(c-a), int(b), s3, s3, s3}
		size[i] = 3

		if i+4 <= n {
			sub := []byte(s[i : i+4])
			slices.Sort(sub)
			a, b, c, d := sub[0], sub[1], sub[2], sub[3]
			s4 := int(t[i+4])
			tp := []int{f[i+4] + int(c-a+d-b), int(b), int(b), s4, s4}
			if slices.Compare(tp, res) < 0 {
				res = tp
				size[i] = 4
			}
		}

		if i+5 <= n {
			sub := []byte(s[i : i+5])
			slices.Sort(sub)
			a, b, c, d, e := sub[0], sub[1], sub[2], sub[3], sub[4]
			tp := []int{f[i+5] + int(d-a+e-b), int(c), int(c), int(c), int(t[i+5])}
			if slices.Compare(tp, res) < 0 {
				res = tp
				size[i] = 5
			}
		}

		f[i] = res[0]
		t[i] = byte(res[1])
	}

	ans := make([]byte, 0, n)
	for i := 0; i < n; i += int(size[i]) {
		ans = append(ans, bytes.Repeat([]byte{t[i]}, int(size[i]))...)
	}
	return string(ans)
}

func minCostGoodCaption2(s string) string {
	n := len(s)
	if n < 3 {
		return ""
	}

	f := make([][26]int, n+1)
	minJ := make([]int, n+1)
	nxt := make([][26]int, n+1)
	for i := n - 1; i >= 0; i-- {
		mn := math.MaxInt
		for j := 0; j < 26; j++ {
			res := f[i+1][j] + abs(int(s[i]-'a')-j)
			res2 := math.MaxInt
			if i <= n-6 {
				res2 = f[i+3][minJ[i+3]] + abs(int(s[i]-'a')-j) + abs(int(s[i+1]-'a')-j) + abs(int(s[i+2]-'a')-j)
			}
			if res2 < res || res2 == res && minJ[i+3] < j {
				res = res2
				nxt[i][j] = minJ[i+3]
			} else {
				nxt[i][j] = j
			}
			f[i][j] = res
			if res < mn {
				mn = res
				minJ[i] = j
			}
		}
	}

	ans := make([]byte, n)
	i, j := 0, minJ[0]
	for i < n {
		ans[i] = 'a' + byte(j)
		k := nxt[i][j]
		if k == j {
			i++
		} else {
			ans[i+1] = ans[i]
			ans[i+2] = ans[i]
			i += 3
			j = k
		}
	}
	return string(ans)
}

func abs(x int) int {
	if x < 0 {
		return -x
	}
	return x
}

func minCostGoodCaption1(s string) string {
	n := len(s)
	if n < 3 {
		return ""
	}

	memo := make([][27]int, n)
	from := make([][27]int, n)
	for i := range memo {
		for j := range memo[i] {
			memo[i][j] = -1
		}
	}
	var dfs func(int, int) int
	dfs = func(i, j int) (res int) {
		if i == n {
			return
		}
		p := &memo[i][j]
		if *p != -1 {
			return *p
		}
		defer func() { *p = res }()

		x := int(s[i] - 'a')

		if i > n-3 {
			from[i][j] = j
			return dfs(i+1, j) + abs(x-j)
		}

		res = math.MaxInt
		for k := range 26 {
			var r int
			if k == j {
				r = dfs(i+1, k) + abs(x-k)
			} else {
				r = dfs(i+3, k) + abs(x-k) + abs(int(s[i+1]-'a')-k) + abs(int(s[i+2]-'a')-k)
			}
			if r < res {
				res = r
				from[i][j] = k
			}
		}
		return
	}
	dfs(0, 26)

	ans := make([]byte, n)
	i, j := 0, 26
	for i < n {
		k := from[i][j]
		ans[i] = 'a' + byte(k)
		if k == j {
			i++
		} else {
			ans[i+1] = ans[i]
			ans[i+2] = ans[i+1]
			i += 3
			j = k
		}
	}
	return string(ans)
}3444. 使数组包含目标值倍数的最少增量
题目、示例与约束
给你两个数组 nums 和 target 。
在一次操作中,你可以将 nums 中的任意一个元素递增 1 。
返回要使 target 中的每个元素在 nums 中 至少 存在一个倍数所需的 最少操作次数 。
示例 1:
输入:nums = [1,2,3], target = [4]
输出:1
解释:
满足题目条件的最少操作次数是 1 。
- 将 3 增加到 4 ,需要 1 次操作,4 是目标值 4 的倍数。
示例 2:
输入:nums = [8,4], target = [10,5]
输出:2
解释:
满足题目条件的最少操作次数是 2 。
- 将 8 增加到 10 ,需要 2 次操作,10 是目标值 5 和 10 的倍数。
示例 3:
输入:nums = [7,9,10], target = [7]
输出:0
解释:
数组中已经包含目标值 7 的一个倍数,不需要执行任何额外操作。
提示:
1 <= nums.length <= 5 * 1041 <= target.length <= 4target.length <= nums.length1 <= nums[i], target[i] <= 104
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
一、寻找子问题
原问题:
- 把 中的某些数变成 中各个元素的倍数。
考虑 :
- 不修改,那么问题变成把 到 中的某些数变成 中各个元素的倍数。
- 修改,考虑从 中选出一个非空子集 ,把 变成 中的所有数的倍数,也就是 的 LCM(最小公倍数)的倍数。问题变成把 到 中的某些数变成剩余集合 中各个元素的倍数。其中 符号表示集合的差。
二、状态设计与状态转移方程
根据上面的讨论,我们需要在递归过程中跟踪以下信息:
- :可以修改的是 到 中的数。
- : 剩余元素的下标组成的集合。
因此,定义状态为 ,表示把 到 中的某些数变成 中相应元素的倍数,需要的最少操作次数。
考虑 改或不改:
- 不改:问题变成把 到 中的某些数变成 中相应元素的倍数,需要的最少操作次数,即 。
- 改:枚举 的非空子集 ,把 变成 中的所有数的倍数,也就是 的 LCM(最小公倍数)的倍数。接下来要解决的问题是,把 到 中的某些数变成 中相应元素的倍数,需要的最少操作次数,即 。
这两种情况取最小值,就得到了 ,即
其中 为把 通过 操作变成 的倍数的最少操作次数,这等于
上式兼顾了 是 的倍数和 不是 的倍数两种情况。
递归边界:
- 。
- ,其中 。用 表示不合法的状态,从而保证 不会取到不合法的状态。
递归入口:,这是原问题,也是答案。其中全集 ,其中 是 的长度。
细节:
- 个两两互质的数的 LCM 至多约为 ,这超过了 32 位整数最大值,要用 64 位整数。
- 用二进制表示集合,原理见 从集合论到位运算,常见位运算技巧分类总结。
- 预处理 所有子集的 LCM 以加快计算效率。这可以再写一个状压 DP:对于子集 的 LCM,可以取 最高位对应数字,与 去掉最高位后的子集的 LCM,二者计算 LCM。这比直接暴力枚举所有子集,再遍历子集计算 LCM 的时间复杂度更优,具体见后面的时间复杂度分析。
本题视频讲解,欢迎点赞关注~
三、记忆化搜索
复杂度分析
同递推的复杂度分析。
四、1:1 翻译成递推
复杂度分析
- 时间复杂度:,其中 是 的长度, 是 的长度。我们枚举了 的所有子集,由于元素个数为 的集合有 个,其子集有 个,根据二项式定理,,所以内层循环的时间复杂度为 。预处理 LCM 的时间复杂度为 (),与 DP 相比可以忽略。其中 是因为预处理的循环次数之和为 。
- 空间复杂度:。
五、空间优化
观察上面的状态转移方程,在计算 时,只会用到 ,不会用到比 更早的状态。
因此可以像 0-1 背包 那样,去掉第一个维度,把 和 保存到同一个数组中。
复杂度分析
- 时间复杂度:,其中 是 的长度, 是 的长度。
- 空间复杂度:。
六、时间优化
对于每个非空子集的 ,计算前 小的操作次数 (其中 是 中的数)。要修改的数一定在这 个 中。如果最小的被其他非空子集使用了,那么我们可以选次小的;如果次小也被其他非空子集使用了,那么选第三小的;如果第三小的也被其他非空子集使用了,那么选第四小的。由于 只有 个数,所以只需要计算前 小的操作次数。这可以用最大堆实现。
把这些 在 中的下标记录到一个哈希表 中。注意这一共只有 个候选项,远远小于 的长度。
在 上跑状压 DP,只需要 的时间。
剪枝:如果 比 还要大,并且也比 大,那么这样的子集无需计算候选项,因为拆开算操作次数更优。
剪枝后,这个算法在随机数据下跑得更快(力扣出题喜欢出随机数据)。在随机数据下,有 的概率,任选两个数的 LCM 符合上面的剪枝条件,所以期望只会遍历 次 。
复杂度分析
- 时间复杂度:,其中 是 的长度, 是 的长度。计算候选项 的过程跑了 次 的计算前 小的算法,得到了 个候选项,所以计算 DP 的过程只需要 的时间。注:如果使用快速选择算法代替最大堆,可以做到 的时间复杂度。
- 空间复杂度:。
专题训练
见下面动态规划题单的「§9.4 子集状压 DP」。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/基环树/最短路/最小生成树/网络流)
- 动态规划(入门/背包/划分/状态机/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA/一般树)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
欢迎关注 B站@灵茶山艾府
import (
	"container/heap"
	"math"
	"slices"
)

// https://space.bilibili.com/206214
func minimumIncrements(nums []int, target []int) int {
	m := len(target)
	lcms := make([]int, 1<<m)
	lcms[0] = 1
	for i, t := range target {
		bit := 1 << i
		for mask, l := range lcms[:bit] {
			lcms[bit|mask] = lcm(t, l)
		}
	}

	maxLcm := max(slices.Max(nums)*m, slices.Max(target))
	candidateIndices := map[int]struct{}{}
	for _, l := range lcms[1:] {
		if l > maxLcm {
			continue
		}
		h := hp{}
		for i, x := range nums {
			p := pair{(l - x%l) % l, i}
			if len(h) < m {
				heap.Push(&h, p)
			} else {
				h.update(p)
			}
		}
		for _, p := range h {
			candidateIndices[p.i] = struct{}{}
		}
	}

	f := make([]int, 1<<m)
	for j := 1; j < 1<<m; j++ {
		f[j] = math.MaxInt / 2
	}
	for i := range candidateIndices {
		x := nums[i]
		for j := 1<<m - 1; j > 0; j-- {
			for sub := j; sub > 0; sub = (sub - 1) & j {
				l := lcms[sub]
				f[j] = min(f[j], f[j^sub]+(l-x%l)%l)
			}
		}
	}
	return f[1<<m-1]
}

func gcd(a, b int) int { for a != 0 { a, b = b%a, a }; return b }
func lcm(a, b int) int { return a / gcd(a, b) * b }

type pair struct{ op, i int }
type hp []pair
func (h hp) Len() int           { return len(h) }
func (h hp) Less(i, j int) bool { return h[i].op > h[j].op }
func (h hp) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)        { *h = append(*h, v.(pair)) }
func (hp) Pop() (_ any)         { return }
func (h *hp) update(p pair) {
	if p.op < (*h)[0].op {
		(*h)[0] = p
		heap.Fix(h, 0)
	}
}

func minimumIncrements3(nums []int, target []int) int {
	// 预处理 target 的所有子集的 LCM
	m := len(target)
	lcms := make([]int, 1<<m)
	lcms[0] = 1
	for i, t := range target {
		bit := 1 << i
		for mask, l := range lcms[:bit] {
			lcms[bit|mask] = lcm(t, l)
		}
	}

	f := make([]int, 1<<m)
	for j := 1; j < 1<<m; j++ {
		f[j] = math.MaxInt / 2
	}
	for _, x := range nums {
		for j := 1<<m - 1; j > 0; j-- {
			for sub := j; sub > 0; sub = (sub - 1) & j {
				l := lcms[sub]
				f[j] = min(f[j], f[j^sub]+(l-x%l)%l)
			}
		}
	}
	return f[1<<m-1]
}

func minimumIncrements2(nums []int, target []int) int {
	// 预处理 target 的所有子集的 LCM
	m := len(target)
	lcms := make([]int, 1<<m)
	lcms[0] = 1
	for i, t := range target {
		bit := 1 << i
		for mask, l := range lcms[:bit] {
			lcms[bit|mask] = lcm(t, l)
		}
	}

	n := len(nums)
	f := make([][]int, n+1)
	for i := range f {
		f[i] = make([]int, 1<<m)
	}
	for j := 1; j < 1<<m; j++ {
		f[0][j] = math.MaxInt / 2
	}
	for i, x := range nums {
		for j := 1; j < 1<<m; j++ {
			// 不修改 nums[i]
			f[i+1][j] = f[i][j]
			// 枚举 j 的所有非空子集 sub,把 nums[i] 改成 lcms[sub] 的倍数
			for sub := j; sub > 0; sub = (sub - 1) & j {
				l := lcms[sub]
				f[i+1][j] = min(f[i+1][j], f[i][j^sub]+(l-x%l)%l)
			}
		}
	}
	return f[n][1<<m-1]
}

func minimumIncrements1(nums []int, target []int) int {
	// 计算 target 的所有子集的 LCM
	m := len(target)
	lcms := make([]int, 1<<m)
	lcms[0] = 1
	for i, t := range target {
		bit := 1 << i
		for mask, l := range lcms[:bit] {
			lcms[bit|mask] = lcm(t, l)
		}
	}

	n := len(nums)
	memo := make([][]int, n)
	for i := range memo {
		memo[i] = make([]int, 1<<m)
		for j := range memo[i] {
			memo[i][j] = -1
		}
	}
	var dfs func(int, int) int
	dfs = func(i, j int) (res int) {
		if j == 0 {
			return
		}
		if i < 0 { // 不能有剩余元素
			return math.MaxInt / 2
		}
		p := &memo[i][j]
		if *p != -1 {
			return *p
		}
		defer func() { *p = res }()
		// 不修改 nums[i]
		res = dfs(i-1, j)
		// 枚举 j 的所有非空子集 sub,把 nums[i] 改成 lcms[sub] 的倍数
		for sub := j; sub > 0; sub = (sub - 1) & j {
			l := lcms[sub]
			res = min(res, dfs(i-1, j^sub)+(l-nums[i]%l)%l)
		}
		return
	}
	return dfs(n-1, 1<<m-1)
}3448. 统计可以被最后一个数位整除的子字符串数目
题目、示例与约束
给你一个只包含数字的字符串 s 。
请你返回 s 的最后一位 不是 0 的子字符串中,可以被子字符串最后一位整除的数目。
子字符串 是一个字符串里面一段连续 非空 的字符序列。
注意:子字符串可以有前导 0 。
示例 1:
输入:s = "12936"
输出:11
解释:
子字符串 "29" ,"129" ,"293" 和 "2936" 不能被它们的最后一位整除,总共有 15 个子字符串,所以答案是 15 - 4 = 11 。
示例 2:
输入:s = "5701283"
输出:18
解释:
子字符串 "01" ,"12" ,"701" ,"012" ,"128" ,"5701" ,"7012" ,"0128" ,"57012" ,"70128" ,"570128" 和 "701283" 都可以被它们最后一位数字整除。除此以外,所有长度为 1 且不为 0 的子字符串也可以被它们的最后一位整除。有 6 个这样的子字符串,所以答案为 12 + 6 = 18 。
示例 3:
输入:s = "1010101010"
输出:25
解释:
只有最后一位数字为 '1' 的子字符串可以被它们的最后一位整除,总共有 25 个这样的字符串。
提示:
1 <= s.length <= 105s只包含数字。
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
前言
如何把一个字符串转成 数字?
比如字符串 ,我们可以从左到右遍历 ,初始化 ,利用
不断迭代 ,得到 。
公式推导
下文把 当作数字 到 。
把子串按照末尾数字 分组,那么:
- 以 结尾的子串,相当于在所有以 结尾的子串的末尾添加 。以及 单独算作一个子串。
题目让我们计算是否整除,也就是模 的余数是否为 。用数学公式描述,就是
其中 表示以 结尾的子串的数值。(可能有多个,这里只是表示其中任意一个。)
根据前言中的公式,我们有
代入得
根据 模运算的世界:当加减乘除遇上取模 中的恒等式,上式等价于
这意味着,我们只需要知道以 结尾的子串的数值模 的结果 ,并不需要知道 具体是多少。所以将上式变为
动态规划
根据上面的分析,定义 表示以 结尾的、模 余数为 的子串个数。其中 。
考虑用刷表法转移,在以 结尾的、模 余数为 的子串末尾添加 ,可以得到以 结尾的、模 余数为 的子串,所以有
注:在动态规划中,用转移来源更新当前状态叫查表法,用当前状态更新其他状态叫刷表法。本题在已知余数的情况下,并不好计算从哪些状态转移过来,但是从当前状态转移到哪些状态是很好计算的,所以用刷表法。
初始值 ,对应着 单独形成的子串。
累加以 结尾的、模 余数为 的子串个数,即为答案:
代码实现时, 第一个维度可以去掉,用滚动数组优化。
具体请看 视频讲解,欢迎点赞关注~
复杂度分析
- 时间复杂度:,其中 是 的长度,。
- 空间复杂度:。
更多相似题目,见下面动态规划题单中的「§7.5 多维 DP」。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/最短路/最小生成树/二分图/基环树/欧拉路径)
- 【本题相关】动态规划(入门/背包/状态机/划分/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA/一般树)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
// https://space.bilibili.com/206214
func countSubstrings(s string) (ans int64) {
	f := [10][9]int{}
	for _, c := range s {
		d := int(c - '0')
		for m := 1; m < 10; m++ { // 枚举模数 m
			// 滚动数组计算 f
			nf := [9]int{}
			nf[d%m] = 1
			for rem, fv := range f[m][:m] { // 枚举模 m 的余数 rem
				nf[(rem*10+d)%m] += fv // 刷表法
			}
			f[m] = nf
		}
		// 以 s[i] 结尾的,模 s[i] 余数为 0 的子串个数
		ans += int64(f[d][0])
	}
	return
}3458. 选择 K 个互不重叠的特殊子字符串
题目、示例与约束
给你一个长度为 n 的字符串 s 和一个整数 k,判断是否可以选择 k 个互不重叠的 特殊子字符串 。
特殊子字符串 是满足以下条件的子字符串:
- 子字符串中的任何字符都不应该出现在字符串其余部分中。
- 子字符串不能是整个字符串
s。
注意:所有 k 个子字符串必须是互不重叠的,即它们不能有任何重叠部分。
如果可以选择 k 个这样的互不重叠的特殊子字符串,则返回 true;否则返回 false。
子字符串 是字符串中的连续、非空字符序列。
示例 1:
输入: s = "abcdbaefab", k = 2
输出: true
解释:
- 我们可以选择两个互不重叠的特殊子字符串:
"cd"和"ef"。 "cd"包含字符'c'和'd',它们没有出现在字符串的其他部分。"ef"包含字符'e'和'f',它们没有出现在字符串的其他部分。
示例 2:
输入: s = "cdefdc", k = 3
输出: false
解释:
最多可以找到 2 个互不重叠的特殊子字符串:"e" 和 "f"。由于 k = 3,输出为 false。
示例 3:
输入: s = "abeabe", k = 0
输出: true
提示:
2 <= n == s.length <= 5 * 1040 <= k <= 26s仅由小写英文字母组成。
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
题目要求「子字符串中的任何字符都不应该出现在字符串其余部分中」,所以如果子串包含字母 ,那么最左边的 和最右边的 一定要在子串中。把子串的下标区间记作 。
如果子串中还有字母 ,那么同理,最左边的 和最右边的 也一定要在子串中。如果这些 的下标在 外面,我们就需要扩大 的范围。
如果扩大后,又需要包含其他字母呢?
为了方便分析,把上述问题用有向图建模:
- 设最左边的 和最右边的 对应的下标区间为 。
- 如果区间 包含字母 ,那么连一条从 到 的有向边。预处理字母的下标列表,在列表中二分查找,可以判断区间是否包含某个字母。
- 为什么不是无向边?例如 ,那么 对应的区间并没有包含字母 。
- 图中每个节点(字母)额外保存该字母在 中的最左边的下标和最右边的下标。
建模后,如果子串要包含第 个小写字母,那么最终该子串的下标区间为:
- 从第 个小写字母开始,DFS 这个有向图,所有能访问到的点的对应区间的并集,即为最终子串的下标区间。
上述过程会得到至多 个区间,去掉其中等于 的区间(因为题目要求子字符串不能是整个字符串 ),问题变成:
- 从这些区间中,能否选 个互不重叠的区间?
这和 435. 无重叠区间 是一样的,见 我的题解。求最多可以选多少个互不重叠的区间,返回个数是否 。
本题视频讲解,欢迎点赞关注~
复杂度分析
- 时间复杂度:,其中 是 的长度, 是字符集合的大小。
- 空间复杂度:。
更多相似题目,见下面贪心题单中的「§2.1 不相交区间」。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/最短路/最小生成树/二分图/基环树/欧拉路径)
- 动态规划(入门/背包/状态机/划分/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 【本题相关】贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA/一般树)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
import (
	"slices"
	"sort"
)

// https://space.bilibili.com/206214
func maxSubstringLength(s string, k int) bool {
	if k == 0 { // 提前返回
		return true
	}

	// 记录每种字母的出现位置
	pos := [26][]int{}
	for i, b := range s {
		b -= 'a'
		pos[b] = append(pos[b], i)
	}

	// 构建有向图
	g := [26][]int{}
	for i, p := range pos {
		if p == nil {
			continue
		}
		l, r := p[0], p[len(p)-1]
		for j, q := range pos {
			if j == i {
				continue
			}
			k := sort.SearchInts(q, l)
			// [l,r] 包含第 j 个小写字母
			if k < len(q) && q[k] <= r {
				g[i] = append(g[i], j)
			}
		}
	}

	// 遍历有向图
	vis := [26]bool{}
	var l, r int
	var dfs func(int)
	dfs = func(x int) {
		vis[x] = true
		p := pos[x]
		l = min(l, p[0]) // 合并区间
		r = max(r, p[len(p)-1])
		for _, y := range g[x] {
			if !vis[y] {
				dfs(y)
			}
		}
	}

	intervals := [][2]int{}
	for i, p := range pos {
		if p == nil {
			continue
		}
		// 如果要包含第 i 个小写字母,最终得到的区间是什么?
		vis = [26]bool{}
		l, r = len(s), 0
		dfs(i)
		// 不能选整个 s,即区间 [0,n-1]
		if l > 0 || r < len(s)-1 {
			intervals = append(intervals, [2]int{l, r})
		}
	}

	return maxNonoverlapIntervals(intervals) >= k
}

// 435. 无重叠区间
// 直接计算最多能选多少个区间
func maxNonoverlapIntervals(intervals [][2]int) (ans int) {
	slices.SortFunc(intervals, func(a, b [2]int) int { return a[1] - b[1] })
	preR := 0
	for _, p := range intervals {
		if p[0] >= preR {
			ans++
			preR = p[1]
		}
	}
	return
}3459. 最长 V 形对角线段的长度
题目、示例与约束
给你一个大小为 n x m 的二维整数矩阵 grid,其中每个元素的值为 0、1 或 2。
V 形对角线段 定义如下:
- 线段从
1开始。 - 后续元素按照以下无限序列的模式排列:
2, 0, 2, 0, ...。 - 该线段:
- 起始于某个对角方向(左上到右下、右下到左上、右上到左下或左下到右上)。
- 沿着相同的对角方向继续,保持 序列模式 。
- 在保持 序列模式 的前提下,最多允许 一次顺时针 90 度转向 另一个对角方向。
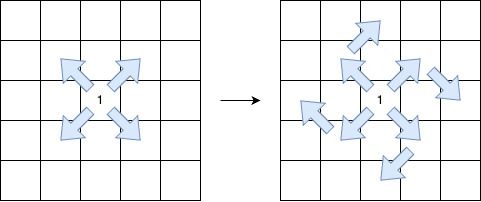
返回最长的 V 形对角线段 的 长度 。如果不存在有效的线段,则返回 0。
示例 1:
输入: grid = [[2,2,1,2,2],[2,0,2,2,0],[2,0,1,1,0],[1,0,2,2,2],[2,0,0,2,2]]
输出: 5
解释:
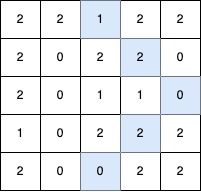
最长的 V 形对角线段长度为 5,路径如下:(0,2) → (1,3) → (2,4),在 (2,4) 处进行 顺时针 90 度转向 ,继续路径为 (3,3) → (4,2)。
示例 2:
输入: grid = [[2,2,2,2,2],[2,0,2,2,0],[2,0,1,1,0],[1,0,2,2,2],[2,0,0,2,2]]
输出: 4
解释:
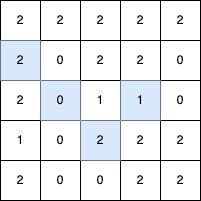
最长的 V 形对角线段长度为 4,路径如下:(2,3) → (3,2),在 (3,2) 处进行 顺时针 90 度转向 ,继续路径为 (2,1) → (1,0)。
示例 3:
输入: grid = [[1,2,2,2,2],[2,2,2,2,0],[2,0,0,0,0],[0,0,2,2,2],[2,0,0,2,0]]
输出: 5
解释:
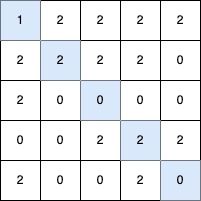
最长的 V 形对角线段长度为 5,路径如下:(0,0) → (1,1) → (2,2) → (3,3) → (4,4)。
示例 4:
输入: grid = [[1]]
输出: 1
解释:
最长的 V 形对角线段长度为 1,路径如下:(0,0)。
提示:
n == grid.lengthm == grid[i].length1 <= n, m <= 500grid[i][j]的值为0、1或2。
方法一:记忆化搜索 · Go 实现
思考
V 形对角线从 出发,沿对角走 ,至多顺时针转一次。网格 ,搜索所有折线会重复经过同一状态。
状态由「上一格、方向、是否还能转」决定,记忆化后每个格子四个方向两种折次,总量线性。
尝试沿 继续,或在 时转到 。从每个 出发四向搜索,加一得到含起点的长度。
我们设计一个函数 ,表示上一个位置为 ,当前方向为 ,剩余可转向次数为 时,返回最长的 V 形对角线段长度。
函数 的执行逻辑如下:
我们首先基于上一个位置以及当前的方向,计算当前得到当前位置 ,然后计算当前目标值 。如果 或 不在矩阵范围内,或者 ,返回 。
否则,我们有两种选择:
- 继续沿着当前方向前进。
- 在当前位置进行顺时针 90 度转向,然后继续前进。
我们可以通过改变方向来实现顺时针 90 度转向。具体来说,如果当前方向为 ,则顺时针 90 度转向后的新方向为 。最后,我们选择这两种选择中的最大值作为当前状态的结果。
在主函数中,我们遍历整个矩阵,对于每个值为 1 的位置,尝试四个方向的搜索,并更新答案。
遍历结束后,返回答案即可。
为了避免重复计算,我们使用记忆化搜索来缓存中间结果。
时间复杂度 ,空间复杂度 。其中 和 分别是矩阵的行数和列数。
func lenOfVDiagonal(grid [][]int) int {
	m, n := len(grid), len(grid[0])
	dirs := []int{1, 1, -1, -1, 1}
	f := make([][][4][2]int, m)
	for i := range f {
		f[i] = make([][4][2]int, n)
	}

	var dfs func(i, j, k, cnt int) int
	dfs = func(i, j, k, cnt int) int {
		if f[i][j][k][cnt] != 0 {
			return f[i][j][k][cnt]
		}

		x := i + dirs[k]
		y := j + dirs[k+1]

		var target int
		if grid[i][j] == 1 {
			target = 2
		} else {
			target = 2 - grid[i][j]
		}

		if x < 0 || x >= m || y < 0 || y >= n || grid[x][y] != target {
			f[i][j][k][cnt] = 0
			return 0
		}

		res := dfs(x, y, k, cnt)
		if cnt > 0 {
			res = max(res, dfs(x, y, (k+1)%4, 0))
		}
		f[i][j][k][cnt] = res + 1
		return res + 1
	}

	ans := 0
	for i := 0; i < m; i++ {
		for j := 0; j < n; j++ {
			if grid[i][j] == 1 {
				for k := 0; k < 4; k++ {
					ans = max(ans, dfs(i, j, k, 1)+1)
				}
			}
		}
	}
	return ans
}3466. 最大硬币收集量 🔒
题目、示例与约束
马里奥在双车道高速公路上行驶,每英里都有硬币。给定两个整数数组,lane1 和 lane2,其中第 i 个下标的值表示他在车道上处于第 i 英里时获得或失去的硬币数量。
- 如果马里奥在车道 1 上处于
i英里处,并且lane1[i] > 0,马里奥获得lane1[i]硬币。 - 如果马里奥在车道 1 上处于
i英里处,并且lane1[i] < 0,马里奥支付通行费并失去abs(lane1[i])个硬币。 - 规则同样对
lane2适用。
马里奥可以在任何地方进入高速公路,并在行驶 至少 一英里后随时退出。马里奥总是从 1 号车道进入高速公路,但 最多 可以换道 2 次。
换道 是指马里奥从车道 1 换到车道 2,反之亦然。
返回马里奥在进行 最多 2 次换道 后 最多 可以获得的硬币数。
注意:马里奥可以在进入高速公路或退出高速公路之前立即切换车道。
示例 1:
输入:lane1 = [1,-2,-10,3], lane2 = [-5,10,0,1]
输出:14
解释:
- 马里奥在车道 1 上行驶了第 1 英里。
- 接着,他切换到车道 2 并继续行驶 2 英里。
- 最后 1 英里他切换回了车道 1。
马里奥收集了 1 + 10 + 0 + 3 = 14 硬币。
示例 2:
输入:lane1 = [1,-1,-1,-1], lane2 = [0,3,4,-5]
输出:8
解释:
- 马里奥从 0 英里处进入车道 1 并行驶了 1 英里。
- 接着,他切换到车道 2 并继续行驶了 2 英里。他在 3 英里处离开高速公路。
他总共收集了 1 + 3 + 4 = 8 硬币。
示例 3:
输入:lane1 = [-5,-4,-3], lane2 = [-1,2,3]
输出:5
解释:
- 马里奥从 1 英里处进入并立即切换到车道 2。他全程保持在这根车道上。
他总共收集了 2 + 3 = 5 硬币。
示例 4:
输入:lane1 = [-3,-3,-3], lane2 = [9,-2,4]
输出:11
解释:
- 马里奥从高速公路的开头进入并立即切换到车道 2。他全程保持在这根车道上。
他总共获得了 9 + (-2) + 4 = 11 硬币。
示例 5:
输入:lane1 = [-10], lane2 = [-2]
输出:-2
解释:
- 由于马里奥必须在高速公路上行驶至少 1 英里,他只在车道 2 上行驶了 1 英里。
他总共获得了 -2 硬币。
提示:
1 <= lane1.length == lane2.length <= 105-109 <= lane1[i], lane2[i] <= 109
方法一:记忆化搜索 · Go 实现
思考
两条车道,至多换道两次,可从任意位置起步并随时离开。 ,枚举路径不可行。
状态需记住位置、所在车道与剩余换道次数;起步位置在外层枚举,避免把「尚未上路」写进状态。
可停在当前格、继续同道,或消耗一次换道(先走再换 / 原地换)。对每个起点取 的最大。
我们设计一个函数 ,表示 Mario 从第 个位置开始,当前在第 条车道上,还可以换道 次的情况下,最多可以获得的硬币数。那么答案就是对于所有的 ,取 的最大值。
函数 的计算方式如下:
- 如果 ,表示已经走到了终点,返回 0;
- 如果不变道,当前可以行驶 1 英里,然后驶出,或者继续行驶,取两者中的最大值,即 ;
- 如果可以变道,有两种选择,一种是行驶 1 英里,然后变道,另一种是直接变道,取这两种情况的最大值,即 。
- 其中 表示当前位置的硬币数。
为了避免重复计算,我们使用记忆化搜索的方法,将已经计算过的结果保存下来。
时间复杂度 ,空间复杂度 。其中 表示车道的长度。
func maxCoins(lane1 []int, lane2 []int) int64 {
	n := len(lane1)
	f := make([][2][3]int64, n)
	for i := range f {
		for j := range f[i] {
			for k := range f[i][j] {
				f[i][j][k] = -1
			}
		}
	}
	var dfs func(int, int, int) int64
	dfs = func(i, j, k int) int64 {
		if i >= n {
			return 0
		}
		if f[i][j][k] != -1 {
			return f[i][j][k]
		}
		x := int64(lane1[i])
		if j == 1 {
			x = int64(lane2[i])
		}
		ans := max(x, dfs(i+1, j, k)+x)
		if k > 0 {
			ans = max(ans, dfs(i+1, j^1, k-1)+x)
			ans = max(ans, dfs(i, j^1, k-1))
		}
		f[i][j][k] = ans
		return ans
	}
	ans := int64(-1e18)
	for i := range lane1 {
		ans = max(ans, dfs(i, 0, 2))
	}
	return ans
}
方法二:动态规划 · Go 实现
思考
两条车道,至多换道两次,可从任意位置起步并随时离开。 ,枚举路径不可行。
状态是英里、车道和剩余换道次数。继续行驶时总会先调用下一英里,调用链深度为 ,栈会溢出。
下一英里与更少的换道次数,在从后往前且换道次数从 填到 时已经就绪。令 为从第 英里、车道 、还剩 次换道的最大得分,答案是所有 的最大值。
令 表示从第 英里出发、当前在车道 、还可以换道 次时最多能获得的硬币数。边界 。答案是所有起点 的最大值。
我们从 填到 。每一英里先把换道次数 从 填到 ,再处理两条车道。设 为车道 在第 英里的硬币数。可以在这一英里后离开,也可以留在同一车道,即 。当 时,还可以先行驶一英里再换道,或在出发前原地换道:
原地换道读的是同一英里上 的状态,该状态已经填完。
时间复杂度 ,空间复杂度 。其中 表示车道的长度。
func maxCoins(lane1 []int, lane2 []int) int64 {
	n := len(lane1)
	f := make([][2][3]int64, n+1)
	for i := n - 1; i >= 0; i-- {
		for k := 0; k < 3; k++ {
			for j := 0; j < 2; j++ {
				x := int64(lane1[i])
				if j == 1 {
					x = int64(lane2[i])
				}
				ans := max(x, f[i+1][j][k]+x)
				if k > 0 {
					ans = max(ans, f[i+1][j^1][k-1]+x)
					ans = max(ans, f[i][j^1][k-1])
				}
				f[i][j][k] = ans
			}
		}
	}
	ans := f[0][0][2]
	for i := 1; i < n; i++ {
		ans = max(ans, f[i][0][2])
	}
	return ans
}3472. 至多 K 次操作后的最长回文子序列
题目、示例与约束
给你一个字符串 s 和一个整数 k。
在一次操作中,你可以将任意位置的字符替换为字母表中相邻的字符(字母表是循环的,因此 'z' 的下一个字母是 'a')。例如,将 'a' 替换为下一个字母结果是 'b',将 'a' 替换为上一个字母结果是 'z';同样,将 'z' 替换为下一个字母结果是 'a',替换为上一个字母结果是 'y'。
返回在进行 最多 k 次操作后,s 的 最长回文子序列 的长度。
子序列 是一个 非空 字符串,可以通过删除原字符串中的某些字符(或不删除任何字符)并保持剩余字符的相对顺序得到。
回文 是正着读和反着读都相同的字符串。
示例 1:
输入: s = "abced", k = 2
输出: 3
解释:
- 将
s[1]替换为下一个字母,得到"acced"。 - 将
s[4]替换为上一个字母,得到"accec"。
子序列 "ccc" 形成一个长度为 3 的回文,这是最长的回文子序列。
示例 2:
输入: s = "aaazzz", k = 4
输出: 6
解释:
- 将
s[0]替换为上一个字母,得到"zaazzz"。 - 将
s[4]替换为下一个字母,得到"zaazaz"。 - 将
s[3]替换为下一个字母,得到"zaaaaz"。
整个字符串形成一个长度为 6 的回文。
提示:
1 <= s.length <= 2001 <= k <= 200s仅由小写英文字母组成。
方法一:记忆化搜索 · Go 实现
思考
操作把一个字母改成相邻字母(可绕 ),最多 次,求最长回文子序列。两端配对的代价是环形字母距离。
经典 LPS 再加一维剩余次数。状态 数量为 ,在约束内可记忆化。
转移:丢掉左或右,或花 把两端配成一对。区间空或单字符为边界。
我们设计一个函数 ,表示在字符串 中最多可以进行 次操作,得到的最长回文子序列的长度。那么答案为 。
函数 的计算过程如下:
- 如果 ,返回 ;
- 如果 ,返回 ;
- 否则,我们可以忽略 或 ,分别计算 和 ;或者我们可以将 和 变成相同的字符,计算 ,其中 是 和 的 ASCII 码差值。
- 返回上述三种情况的最大值。
为了避免重复计算,我们使用记忆化搜索的方法。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度。
func longestPalindromicSubsequence(s string, k int) int {
	n := len(s)
	f := make([][][]int, n)
	for i := range f {
		f[i] = make([][]int, n)
		for j := range f[i] {
			f[i][j] = make([]int, k+1)
			for l := range f[i][j] {
				f[i][j][l] = -1
			}
		}
	}
	var dfs func(int, int, int) int
	dfs = func(i, j, k int) int {
		if i > j {
			return 0
		}
		if i == j {
			return 1
		}
		if f[i][j][k] != -1 {
			return f[i][j][k]
		}
		res := max(dfs(i+1, j, k), dfs(i, j-1, k))
		d := abs(int(s[i]) - int(s[j]))
		t := min(d, 26-d)
		if t <= k {
			res = max(res, 2+dfs(i+1, j-1, k-t))
		}
		f[i][j][k] = res
		return res
	}
	return dfs(0, n-1, k)
}

func abs(x int) int {
	if x < 0 {
		return -x
	}
	return x
}3473. 长度至少为 M 的 K 个子数组之和
题目、示例与约束
给你一个整数数组 nums 和两个整数 k 和 m。
返回数组 nums 中 k 个不重叠子数组的 最大 和,其中每个子数组的长度 至少 为 m。
子数组 是数组中的一个连续序列。
示例 1:
输入: nums = [1,2,-1,3,3,4], k = 2, m = 2
输出: 13
解释:
最优的选择是:
- 子数组
nums[3..5]的和为3 + 3 + 4 = 10(长度为3 >= m)。 - 子数组
nums[0..1]的和为1 + 2 = 3(长度为2 >= m)。
总和为 10 + 3 = 13。
示例 2:
输入: nums = [-10,3,-1,-2], k = 4, m = 1
输出: -10
解释:
最优的选择是将每个元素作为一个子数组。输出为 (-10) + 3 + (-1) + (-2) = -10。
提示:
1 <= nums.length <= 2000-104 <= nums[i] <= 1041 <= k <= floor(nums.length / m)1 <= m <= 3
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
按照划分型 DP 的套路(见 动态规划题单 §5.3 节),定义 表示从长为 的前缀 到 取出 个连续子数组所得到的最大和。
注:这里用左闭右开区间 表示前缀,与前缀和定义相匹配,方便后面做公式变形。
分类讨论:
- 不选 ,问题变成从长为 的前缀 到 取出 个连续子数组所得到的最大和,即 。
- 选 ,也就是子数组 到 ( 是我们枚举的值),问题变成从长为 的前缀 到 取出 个连续子数组所得到的最大和,即 。
二者取最大值,得
其中 是 的前缀和数组(长为 ),原理和定义请看 前缀和讲解。
其中 最小是 ,因为左边有 个长度至少为 的子数组。
初始值:
- ,不选任何子数组,元素和为 。
- 如果 ,那么 ,因为没有足够的数选取 个长度至少为 的子数组。这里用 表示不合法的状态,这样计算 不会取到不合法的状态。实际上只需要初始化 ,因为更前面的状态不会被使用。
答案:。
这样做的时间复杂度为 ,会超时。
由于
故定义 ,并用一个变量 在遍历 的同时维护从 到 的最大 ,那么转移方程优化成
这样就可以做到 时间了。
具体请看 视频讲解,欢迎点赞关注~
滚动数组
复杂度分析
- 时间复杂度:,其中 是 的长度。
- 空间复杂度:。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/最短路/最小生成树/二分图/基环树/欧拉路径)
- 动态规划(入门/背包/状态机/划分/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA/一般树)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
import "math"

// https://space.bilibili.com/206214
func maxSum(nums []int, k, m int) int {
	n := len(nums)
	s := make([]int, n+1)
	for i, x := range nums {
		s[i+1] = s[i] + x // nums 的前缀和
	}

	f := make([]int, n+1)
	g := make([]int, n+1)
	for i := 1; i <= k; i++ {
		g[i*m-1] = math.MinInt
		mx := math.MinInt
		for j := i * m; j <= n-(k-i)*m; j++ {
			mx = max(mx, f[j-m]-s[j-m])
			g[j] = max(g[j-1], mx+s[j])
		}
		f, g = g, f
	}
	return f[n]
}3489. 零数组变换 IV
题目、示例与约束
给你一个长度为 n 的整数数组 nums 和一个二维数组 queries ,其中 queries[i] = [li, ri, vali]。
每个 queries[i] 表示以下操作在 nums 上执行:
- 从数组
nums中选择范围[li, ri]内的一个下标子集。 - 将每个选中下标处的值减去 正好
vali。
零数组 是指所有元素都等于 0 的数组。
返回使得经过前 k 个查询(按顺序执行)后,nums 转变为 零数组 的最小可能 非负 值 k。如果不存在这样的 k,返回 -1。
数组的 子集 是指从数组中选择的一些元素(可能为空)。
示例 1:
输入: nums = [2,0,2], queries = [[0,2,1],[0,2,1],[1,1,3]]
输出: 2
解释:
- 对于查询 0 (l = 0, r = 2, val = 1):
- 将下标
[0, 2]的值减 1。 - 数组变为
[1, 0, 1]。
- 将下标
- 对于查询 1 (l = 0, r = 2, val = 1):
- 将下标
[0, 2]的值减 1。 - 数组变为
[0, 0, 0],这就是一个零数组。因此,最小的k值为 2。
- 将下标
示例 2:
输入: nums = [4,3,2,1], queries = [[1,3,2],[0,2,1]]
输出: -1
解释:
即使执行完所有查询,也无法使 nums 变为零数组。
示例 3:
输入: nums = [1,2,3,2,1], queries = [[0,1,1],[1,2,1],[2,3,2],[3,4,1],[4,4,1]]
输出: 4
解释:
- 对于查询 0 (l = 0, r = 1, val = 1):
- 将下标
[0, 1]的值减 1。 - 数组变为
[0, 1, 3, 2, 1]。
- 将下标
- 对于查询 1 (l = 1, r = 2, val = 1):
- 将下标
[1, 2]的值减 1。 - 数组变为
[0, 0, 2, 2, 1]。
- 将下标
- 对于查询 2 (l = 2, r = 3, val = 2):
- 将下标
[2, 3]的值减 2。 - 数组变为
[0, 0, 0, 0, 1]。
- 将下标
- 对于查询 3 (l = 3, r = 4, val = 1):
- 将下标
4的值减 1。 - 数组变为
[0, 0, 0, 0, 0]。因此,最小的k值为 4。
- 将下标
示例 4:
输入: nums = [1,2,3,2,6], queries = [[0,1,1],[0,2,1],[1,4,2],[4,4,4],[3,4,1],[4,4,5]]
输出: 4
提示:
1 <= nums.length <= 100 <= nums[i] <= 10001 <= queries.length <= 1000queries[i] = [li, ri, vali]0 <= li <= ri < nums.length1 <= vali <= 10
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
方法一:0-1 背包
由于题目让我们选的是范围 内的一个下标子集,所以每个 是互相独立的,可以分别计算。
选出包含 的询问,设这些询问的 组成了数组 ,问题变成:
- 从 的前缀中选一些数,元素和能否恰好等于 ?前缀的意思是,从左到右遍历 ,一旦某个时刻发现可以组成 ,就退出循环。
这是 0-1 背包。416. 分割等和子集 是本题的简单版本。原理见【基础算法精讲 18】。
每个 算出的答案取最大值,即为最终答案。
注意特判 的情况,此时无需操作。
写法一:布尔数组
复杂度分析
- 时间复杂度:,其中 是 的长度, 是 的长度,。
- 空间复杂度:。
写法二:bitset
用 bitset(视作一个二进制数)代替布尔数组。二进制数从低到高第 位是 ,表示布尔数组的第 个数是 ;从低到高第 位是 ,表示布尔数组的第 个数是 。
转移方程等价于,把 中的每个比特位增加 ,即左移 位,然后跟原来 计算 OR。前者对应选择一个值为 的物品,后者对应不选。
判断 是否为 ,等价于判断 的第 位是否为 ,即 (f >> x & 1) == 1。
更多位运算技巧,请看 从集合论到位运算,常见位运算技巧分类总结!
复杂度分析
以下分析,不考虑超出 的比特位。
- 时间复杂度:,其中 是 的长度, 是 的长度,, 或 。
- 空间复杂度:。
方法二:二分答案 + 多重背包 + 二进制优化
由于本题 很小,可以二分答案,统计每个 的出现次数,这样变成多重背包问题,可以用二进制优化。
下面代码采用开区间二分,这仅仅是二分的一种写法,使用闭区间或者半闭半开区间都是可以的。
- 开区间左端点初始值:。一定无法满足要求。
- 开区间左端点初始值(优化):。
- 开区间右端点初始值:,其中 是 的长度。如果二分结果为 ,那么返回 。
注 1:也可以对每个 单独二分,这样可以用到 2861. 最大合金数 的技巧,把当前答案作为二分的下界。(减一后是开区间的左端点)
注 2:方法二理论时间复杂度更优,但实际运行时间不如方法一。
复杂度分析
以下分析,不考虑超出 的比特位。
- 时间复杂度:,其中 是 的长度, 是 的长度,,, 或 。
- 空间复杂度:。
更多相似题目,见下面动态规划题单中的「§3.1 0-1 背包」。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/最短路/最小生成树/二分图/基环树/欧拉路径)
- 【本题相关】动态规划(入门/背包/状态机/划分/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA/一般树)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
import (
	"math/big"
	"slices"
	"sort"
)

// https://space.bilibili.com/206214
func minZeroArray4(nums []int, queries [][]int) int {
	ans := (slices.Max(nums) + 9) / 10
	m := len(queries)
	cnts := make([][11]int, m+1)
	for i, x := range nums {
		if x == 0 {
			continue
		}
		for k, q := range queries {
			cnts[k+1] = cnts[k]
			if q[0] <= i && i <= q[1] {
				cnts[k+1][q[2]]++
			}
		}
		ans += sort.Search(m+1-ans, func(mx int) bool {
			mx += ans
			p := new(big.Int)
			f := big.NewInt(1)
			for v, num := range cnts[mx] {
				for pow2 := 1; num > 0; pow2 *= 2 {
					k := min(pow2, num)
					f.Or(f, p.Lsh(f, uint(v*k)))
					if f.Bit(x) > 0 {
						return true
					}
					num -= k
				}
			}
			return false
		})
		if ans > m {
			return -1
		}
	}
	return ans
}

func minZeroArray32(nums []int, queries [][]int) int {
	m := len(queries)
	cnts := make([][][11]int, m+1)
	cnts[0] = make([][11]int, len(nums))
	for k, q := range queries {
		cnts[k+1] = slices.Clone(cnts[k])
		for i := q[0]; i <= q[1]; i++ {
			cnts[k+1][i][q[2]]++
		}
	}
	ans := sort.Search(m+1, func(mx int) bool {
		p := new(big.Int)
	next:
		for i, x := range nums {
			if x == 0 {
				continue
			}
			// 多重背包(二进制优化)
			f := big.NewInt(1)
			for v, num := range cnts[mx][i] {
				for pow2 := 1; num > 0; pow2 *= 2 {
					k := min(pow2, num)
					f.Or(f, p.Lsh(f, uint(v*k)))
					if f.Bit(x) > 0 {
						continue next
					}
					num -= k
				}
			}
			return false
		}
		return true
	})
	if ans <= m {
		return ans
	}
	return -1
}

func minZeroArray3(nums []int, queries [][]int) int {
	ans := sort.Search(len(queries)+1, func(mx int) bool {
		p := new(big.Int)
	next:
		for i, x := range nums {
			if x == 0 {
				continue
			}
			cnt := [11]int{}
			for _, q := range queries[:mx] {
				if q[0] <= i && i <= q[1] {
					cnt[q[2]]++
				}
			}
			// 多重背包(二进制优化)
			f := big.NewInt(1)
			for v, num := range cnt {
				for pow2 := 1; num > 0; pow2 *= 2 {
					k := min(pow2, num)
					f.Or(f, p.Lsh(f, uint(v*k)))
					if f.Bit(x) > 0 {
						continue next
					}
					num -= k
				}
			}
			return false
		}
		return true
	})
	if ans <= len(queries) {
		return ans
	}
	return -1
}

func minZeroArray2(nums []int, queries [][]int) (ans int) {
	p := new(big.Int)
	for i, x := range nums {
		if x == 0 {
			continue
		}
		f := big.NewInt(1)
		for k, q := range queries {
			if i < q[0] || i > q[1] {
				continue
			}
			f.Or(f, p.Lsh(f, uint(q[2])))
			if f.Bit(x) > 0 {
				ans = max(ans, k+1)
				break
			}
		}
		if f.Bit(x) == 0 {
			return -1
		}
	}
	return
}

func minZeroArray(nums []int, queries [][]int) (ans int) {
	for i, x := range nums {
		if x == 0 {
			continue
		}
		f := make([]bool, x+1)
		f[0] = true
		for k, q := range queries {
			if i < q[0] || i > q[1] {
				continue
			}
			val := q[2]
			for j := x; j >= val; j-- {
				f[j] = f[j] || f[j-val]
			}
			if f[x] {
				ans = max(ans, k+1)
				break
			}
		}
		if !f[x] {
			return -1
		}
	}
	return
}3490. 统计美丽整数的数目
题目、示例与约束
给你两个正整数 l 和 r 。如果正整数每一位上的数字的乘积可以被这些数字之和整除,则认为该整数是一个 美丽整数 。
统计并返回 l 和 r 之间(包括 l 和 r )的 美丽整数 的数目。
示例 1:
输入:l = 10, r = 20
输出:2
解释:
范围内的美丽整数为 10 和 20 。
示例 2:
输入:l = 1, r = 15
输出:10
解释:
范围内的美丽整数为 1、2、3、4、5、6、7、8、9 和 10 。
提示:
1 <= l <= r < 109
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
前置知识:
- 数位 DP v1.0 模板讲解
- 数位 DP v2.0 模板讲解(上下界数位 DP)
注意到,数位之和是很小的,最多 ( 是 的十进制长度),所以可以用数位之和作为 DP 的状态之一。
注意到, 个 到 的数相乘,只有 种不同的乘积(证明见文末),所以可以直接用数位乘积作为 DP 的状态之一。
状态定义。 表示在如下约束时的美丽整数个数:
- 前 个数位已经填完了。
- 之前填的数位乘积为 。
- 之前填的数位之和为 。
- 另外两个参数见模板讲解。
枚举当前数位填 ,那么 变成 , 变成 ,继续递归。
递归边界。如果 :
- 如果 或者 ,返回 。
- 否则找到了一个美丽整数,返回 。
递归入口:。一开始没有填数字,数位乘积为 (乘法单位元),数位之和为 (加法单位元)。
代码实现时,如果 ,且 比 和 的十进制长度之差还小,那么当前数位可以不填。这样就无需 参数了。
具体请看 视频讲解,欢迎点赞关注~
写法一
复杂度分析
- 时间复杂度:,其中 是 的十进制长度,。由于每个状态只会计算一次,动态规划的时间复杂度 状态个数 单个状态的计算时间。本题状态个数为 ,即 的个数 、 的个数 (见文末的证明)、 的个数 三者相乘。单个状态的计算时间为 ,所以总的时间复杂度为 。
- 空间复杂度:。保存多少状态,就需要多少空间。
写法二
转换成 的美丽整数个数,减去 的美丽整数个数。
使用 数位 DP v1.0 模板 解决,这样可以把 写在外面,多个测试数据之间可以复用记忆化搜索的结果。
为了保证可以复用,需要把个位数的下标统一为 ,十位数的下标统一为 ,依此类推。
复杂度分析
同写法一。
有多少个不同乘积
定义 表示 个在 中的整数相乘,有多少个不同的乘积。
如果有 ,那么乘积为 。
下面讨论 个在 中的整数相乘,有多少个不同的乘积。
考虑乘积的质因子分解,即
假设我们选了 个在 中的数,那么有 个 或 ,即 。知道了 的个数就知道了 的个数, 的范围为 ,所以 有 个。
下面讨论在 中(允许重复地)选 个数,有多少个不同的 。
先不考虑数字 。设我们选了 个 中的数:
- 如果 ,那么 的范围为 ,,这有 个 。
- 如果 ,那么 的范围为 , 的范围为 (选 或者 ),这新增了 个 。
- 如果 ,那么 的范围为 , 的范围为 ,其中 的情况之前算过,所以新增了 个 。
- 如果 ,那么 的范围为 , 的范围为 ,其中 的情况之前算过,所以新增了 个 。
- 依此类推,每次会新增 个 ,一直到 。
累加得
然后考虑数字 ,设我们选了 个 中的数:
- 如果 ,那么 的范围为 ,(因为得留一个数出来选 )。只有当 的时候,和 相乘才会产生 个新的 。
- 如果 ,那么 的范围为 ,如果选两个 ,这不会产生新的 。只有选一个 ,且 的时候,和 相乘才会产生 个新的 。
- 依此类推,对于 中的每个 ,都会产生 个新的 ,一共产生了 个新的 。
所以一共有
个不同的 。
枚举 ,得到 的个数为
巧合的是,上式刚好是 的立方和。例如 的时候,结果是今年的年份 。
所以
附:如何用代码计算
更多相似题目,见下面动态规划题单中的「十、数位 DP」。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/最短路/最小生成树/二分图/基环树/欧拉路径)
- 【本题相关】动态规划(入门/背包/状态机/划分/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA/一般树)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
import (
	"slices"
	"strconv"
)

// https://space.bilibili.com/206214
type tuple struct{ i, m, s int }

var memo = map[tuple]int{}
var high []byte

func dfs(i, m, s int, isLimit, isNum bool) (res int) {
	if i < 0 {
		if s == 0 || m%s > 0 {
			return 0
		}
		return 1
	}
	if !isLimit && isNum {
		t := tuple{i, m, s}
		if v, ok := memo[t]; ok {
			return v
		}
		defer func() { memo[t] = res }()
	}

	hi := 9
	if isLimit {
		hi = int(high[i] - '0')
	}

	d := 0
	if !isNum {
		res = dfs(i-1, m, s, false, false) // 什么也不填
		d = 1
	}
	// 枚举填数字 d
	for ; d <= hi; d++ {
		res += dfs(i-1, m*d, s+d, isLimit && d == hi, true)
	}
	return
}

func calc(r int) int {
	high = []byte(strconv.Itoa(r))
	slices.Reverse(high)
	return dfs(len(high)-1, 1, 0, true, false)
}

func beautifulNumbers(l, r int) int {
	return calc(r) - calc(l-1)
}3500. 将数组分割为子数组的最小代价
题目、示例与约束
给你两个长度相等的整数数组 nums 和 cost,和一个整数 k。
你可以将 nums 分割成多个子数组。第 i 个子数组由元素 nums[l..r] 组成,其代价为:
(nums[0] + nums[1] + ... + nums[r] + k * i) * (cost[l] + cost[l + 1] + ... + cost[r])。
注意,i 表示子数组的顺序:第一个子数组为 1,第二个为 2,依此类推。
返回通过任何有效划分得到的 最小 总代价。
子数组 是一个连续的 非空 元素序列。
示例 1:
输入: nums = [3,1,4], cost = [4,6,6], k = 1
输出: 110
解释:
将nums 分割为子数组 [3, 1] 和 [4] ,得到最小总代价。
- 第一个子数组
[3,1]的代价是(3 + 1 + 1 * 1) * (4 + 6) = 50。 - 第二个子数组
[4]的代价是(3 + 1 + 4 + 1 * 2) * 6 = 60。
示例 2:
输入: nums = [4,8,5,1,14,2,2,12,1], cost = [7,2,8,4,2,2,1,1,2], k = 7
输出: 985
解释:
将nums 分割为子数组 [4, 8, 5, 1] ,[14, 2, 2] 和 [12, 1] ,得到最小总代价。
- 第一个子数组
[4, 8, 5, 1]的代价是(4 + 8 + 5 + 1 + 7 * 1) * (7 + 2 + 8 + 4) = 525。 - 第二个子数组
[14, 2, 2]的代价是(4 + 8 + 5 + 1 + 14 + 2 + 2 + 7 * 2) * (2 + 2 + 1) = 250。 - 第三个子数组
[12, 1]的代价是(4 + 8 + 5 + 1 + 14 + 2 + 2 + 12 + 1 + 7 * 3) * (1 + 2) = 210。
提示:
1 <= nums.length <= 1000cost.length == nums.length1 <= nums[i], cost[i] <= 10001 <= k <= 1000
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
式子变形
题目给出的式子有子数组和,我们先用 前缀和 将其简化。
定义 表示 到 的元素和。
定义 表示 到 的元素和。
题目给出的式子转换成
如果能把式子中的 去掉,我们就可以写一个 的划分型 DP。
横看成岭侧成峰,换一个角度看待 。
假设划分成了三段, 的子数组和分别为 。
这三段的 分别为 ,累加得
如此变形后,我们可以把 当作第一段的 ,把 当作第二段的 ,把 当作第三段的 。详细证明见文末的 Abel 求和公式。
换句话说,我们可以跨越时空,把未来要计算的内容,放到现在计算!
式子中的 可以替换成 ,因为 都是 的后缀和。
题目给出的式子替换成
注意上式和原式并不一定相等,但计算所有子数组的上式之和后,是相等的。
方法一:划分型 DP
根据 动态规划题单「§5.2 最优划分」,定义 表示下标 分割后的最小总代价。
枚举最后一个子数组的左端点 ,问题变成下标 分割后的最小总代价,即 。其中 最小是 ,最大是 。
取最小值,有
初始值 。
答案为 。
具体请看 视频讲解,欢迎点赞关注~
复杂度分析
- 时间复杂度:,其中 是 的长度。
- 空间复杂度:。
方法二:斜率优化(凸包优化)
注:以下内容基于点积,和斜率优化本质是一样的。我推荐从点积的角度理解,相比斜率的角度,不需要做麻烦的式子变形,更方便。
前置知识:二维计算几何,凸包,Andrew 算法。
同 3494. 酿造药水需要的最少总时间,方法一中的状态转移方程,也可以改成点积的形式,从而可以用凸包优化。
首先把递推式变形,把 中和 无关的量提出来:
把其中的
改成点积的形式,这样我们能得到来自几何意义上的观察。
设向量 。
设向量 。
那么我们求的是
根据点积的几何意义,我们求的是 在 方向上的投影长度,再乘以 的模长 。由于 是个定值,所以要最小化投影长度。
考虑 的下凸包(用 Andrew 算法计算),在凸包内的点,比凸包顶点的投影长度长(注意 在凸包外面)。所以只需考虑凸包顶点。
由于 是单调递增的,求下凸包无需排序。
这样有一个很好的性质:从左到右遍历凸包顶点, 会先变小再变大(单峰函数)。那么要计算最小值,就类似 852. 山脉数组的峰顶索引,二分首个「上坡」的位置,具体见 我的题解。
实际上不需要二分。由于 是单调递减的,也可以双指针(或者双端队列)。
复杂度分析
- 时间复杂度:,其中 是 的长度。每个点入队出队各至多一次。
- 空间复杂度:。
附:Abel 求和公式
分部积分法
的离散形式,叫做 Abel 求和公式
其中 。
证明:
本题相当于 , 为 的第 个子数组和。那么 就是 的前 个子数组和的前缀和(注意不是 的前缀和)。
假设分割成 个子数组。代入 Abel 求和公式,得
其中 是整个 的元素和, 是 的后缀和。上式相当于 个 的后缀和,这正是题解开头得出的结论。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/最短路/最小生成树/二分图/基环树/欧拉路径)
- 动态规划(入门/背包/状态机/划分/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA/一般树)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
import (
	"math"
)

// https://space.bilibili.com/206214
type vec struct{ x, y int }

func (a vec) sub(b vec) vec { return vec{a.x - b.x, a.y - b.y} }
func (a vec) det(b vec) int { return a.x*b.y - a.y*b.x }
func (a vec) dot(b vec) int { return a.x*b.x + a.y*b.y }

func minimumCost(nums, cost []int, k int) int64 {
	totalCost := 0
	for _, c := range cost {
		totalCost += c
	}

	q := []vec{{}}
	sumNum, sumCost := 0, 0
	for i, x := range nums {
		sumNum += x
		sumCost += cost[i]

		p := vec{-sumNum - k, 1}
		for len(q) > 1 && p.dot(q[0]) >= p.dot(q[1]) {
			q = q[1:]
		}

		// 一边算 DP 一边构建下凸包
		p = vec{sumCost, p.dot(q[0]) + sumNum*sumCost + k*totalCost}
		for len(q) > 1 && q[len(q)-1].sub(q[len(q)-2]).det(p.sub(q[len(q)-1])) <= 0 {
			q = q[:len(q)-1]
		}
		q = append(q, p)
	}
	return int64(q[len(q)-1].y)
}

func minimumCost1(nums, cost []int, k int) int64 {
	n := len(nums)
	s := make([]int, n+1)
	for i, c := range cost {
		s[i+1] = s[i] + c
	}

	f := make([]int, n+1)
	sumNum := 0
	for i, x := range nums {
		i++
		sumNum += x
		res := math.MaxInt
		for j := range i {
			res = min(res, f[j]+sumNum*(s[i]-s[j])+k*(s[n]-s[j]))
		}
		f[i] = res
	}
	return int64(f[n])
}3503. 子字符串连接后的最长回文串 I
题目、示例与约束
给你两个字符串 s 和 t。
你可以从 s 中选择一个子串(可以为空)以及从 t 中选择一个子串(可以为空),然后将它们 按顺序 连接,得到一个新的字符串。
返回可以由上述方法构造出的 最长 回文串的长度。
回文串 是指正着读和反着读都相同的字符串。
子字符串 是指字符串中的一个连续字符序列。
示例 1:
输入: s = "a", t = "a"
输出: 2
解释:
从 s 中选择 "a",从 t 中选择 "a",拼接得到 "aa",这是一个长度为 2 的回文串。
示例 2:
输入: s = "abc", t = "def"
输出: 1
解释:
由于两个字符串的所有字符都不同,最长的回文串只能是任意一个单独的字符,因此答案是 1。
示例 3:
输入: s = "b", t = "aaaa"
输出: 4
解释:
可以选择 "aaaa" 作为回文串,其长度为 4。
示例 4:
输入: s = "abcde", t = "ecdba"
输出: 5
解释:
从 s 中选择 "abc",从 t 中选择 "ba",拼接得到 "abcba",这是一个长度为 5 的回文串。
提示:
1 <= s.length, t.length <= 30s和t仅由小写英文字母组成。
方法一:枚举回文中点 + 动态规划 · Go 实现
思考
与 各自内部的最长回文可用中心扩展在多项式时间内求出,但拼接后的回文还可以左右各取一段,并在一侧再接一个回文核。
将 反转后, 的前缀与反转 的前缀相等,即对应原问题中 的一段与 的一段对称。 记录这对前缀的匹配长度,再接上从该位置出发的最长回文 或 ,即可覆盖「只取一侧」与「两侧匹配后再延长」两类最优。
根据题目描述,连接后的回文串,可以只由字符串 组成,也可以只由字符串 组成,也可以由字符串 和字符串 组成,并且还可能在字符串 或 中多出一部分回文子串。
因此,我们先将字符串 反转,然后预处理出数组 和 ,其中 表示在字符串 中以下标 开始的最长回文子串长度,而 表示在字符串 中以下标 开始的最长回文子串长度。
那么我们可以初始化答案 为 和 中的最大值。
接下来,我们定义 表示以字符串 的第 个字符结尾,以字符串 的第 个字符结尾的回文子串的长度。
对于 ,如果 等于 ,那么有 。然后,我们更新答案:
最后,我们返回答案 即可。
时间复杂度 ,空间复杂度 。其中 和 分别是字符串 和 的长度。
func longestPalindrome(s, t string) int {
	m, n := len(s), len(t)
	t = reverse(t)

	g1, g2 := calc(s), calc(t)
	ans := max(slices.Max(g1), slices.Max(g2))

	f := make([][]int, m+1)
	for i := range f {
		f[i] = make([]int, n+1)
	}

	for i := 1; i <= m; i++ {
		for j := 1; j <= n; j++ {
			if s[i-1] == t[j-1] {
				f[i][j] = f[i-1][j-1] + 1
				a, b := 0, 0
				if i < m {
					a = g1[i]
				}
				if j < n {
					b = g2[j]
				}
				ans = max(ans, f[i][j]*2+a)
				ans = max(ans, f[i][j]*2+b)
			}
		}
	}
	return ans
}

func calc(s string) []int {
	n, g := len(s), make([]int, len(s))
	for i := 0; i < n; i++ {
		expand(s, g, i, i)
		expand(s, g, i, i+1)
	}
	return g
}

func expand(s string, g []int, l, r int) {
	for l >= 0 && r < len(s) && s[l] == s[r] {
		g[l] = max(g[l], r-l+1)
		l, r = l-1, r+1
	}
}

func reverse(s string) string {
	r := []rune(s)
	slices.Reverse(r)
	return string(r)
}3504. 子字符串连接后的最长回文串 II
题目、示例与约束
给你两个字符串 s 和 t。
你可以从 s 中选择一个子串(可以为空)以及从 t 中选择一个子串(可以为空),然后将它们 按顺序 连接,得到一个新的字符串。
返回可以由上述方法构造出的 最长 回文串的长度。
回文串 是指正着读和反着读都相同的字符串。
子字符串 是指字符串中的一个连续字符序列。
示例 1:
输入: s = "a", t = "a"
输出: 2
解释:
从 s 中选择 "a",从 t 中选择 "a",拼接得到 "aa",这是一个长度为 2 的回文串。
示例 2:
输入: s = "abc", t = "def"
输出: 1
解释:
由于两个字符串的所有字符都不同,最长的回文串只能是任意一个单独的字符,因此答案是 1。
示例 3:
输入: s = "b", t = "aaaa"
输出: 4
解释:
可以选择 "aaaa" 作为回文串,其长度为 4。
示例 4:
输入: s = "abcde", t = "ecdba"
输出: 5
解释:
从 s 中选择 "abc",从 t 中选择 "ba",拼接得到 "abcba",这是一个长度为 5 的回文串。
提示:
1 <= s.length, t.length <= 1000s和t仅由小写英文字母组成。
方法一:枚举回文中点 + 动态规划 · Go 实现
思考
与上一题相同,答案仍由「单串回文」与「 的一段对接 的一段后再单侧延长」构成。约束更大,但中心扩展加 的匹配 DP 仍然够用。
因此仍将 反转,预处理 、 ,再用 累加相等前缀并尝试接上剩余回文核。
根据题目描述,连接后的回文串,可以只由字符串 组成,也可以只由字符串 组成,也可以由字符串 和字符串 组成,并且还可能在字符串 或 中多出一部分回文子串。
因此,我们先将字符串 反转,然后预处理出数组 和 ,其中 表示在字符串 中以下标 开始的最长回文子串长度,而 表示在字符串 中以下标 开始的最长回文子串长度。
那么我们可以初始化答案 为 和 中的最大值。
接下来,我们定义 表示以字符串 的第 个字符结尾,以字符串 的第 个字符结尾的回文子串的长度。
对于 ,如果 等于 ,那么有 。然后,我们更新答案:
最后,我们返回答案 即可。
时间复杂度 ,空间复杂度 。其中 和 分别是字符串 和 的长度。
func longestPalindrome(s, t string) int {
	m, n := len(s), len(t)
	t = reverse(t)

	g1, g2 := calc(s), calc(t)
	ans := max(slices.Max(g1), slices.Max(g2))

	f := make([][]int, m+1)
	for i := range f {
		f[i] = make([]int, n+1)
	}

	for i := 1; i <= m; i++ {
		for j := 1; j <= n; j++ {
			if s[i-1] == t[j-1] {
				f[i][j] = f[i-1][j-1] + 1
				a, b := 0, 0
				if i < m {
					a = g1[i]
				}
				if j < n {
					b = g2[j]
				}
				ans = max(ans, f[i][j]*2+a)
				ans = max(ans, f[i][j]*2+b)
			}
		}
	}
	return ans
}

func calc(s string) []int {
	n, g := len(s), make([]int, len(s))
	for i := 0; i < n; i++ {
		expand(s, g, i, i)
		expand(s, g, i, i+1)
	}
	return g
}

func expand(s string, g []int, l, r int) {
	for l >= 0 && r < len(s) && s[l] == s[r] {
		g[l] = max(g[l], r-l+1)
		l, r = l-1, r+1
	}
}

func reverse(s string) string {
	r := []rune(s)
	slices.Reverse(r)
	return string(r)
}3505. 使 K 个子数组内元素相等的最少操作数
题目、示例与约束
给你一个整数数组 nums 和两个整数 x 和 k。你可以执行以下操作任意次(包括零次):
- 将
nums中的任意一个元素加 1 或减 1。
返回为了使 nums 中 至少 包含 k 个长度 恰好 为 x 的不重叠子数组(每个子数组中的所有元素都相等)所需要的 最少 操作数。
子数组 是数组中连续、非空的一段元素。
示例 1:
输入: nums = [5,-2,1,3,7,3,6,4,-1], x = 3, k = 2
输出: 8
解释:
- 进行 3 次操作,将
nums[1]加 3;进行 2 次操作,将nums[3]减 2。得到的数组为[5, 1, 1, 1, 7, 3, 6, 4, -1]。 - 进行 1 次操作,将
nums[5]加 1;进行 2 次操作,将nums[6]减 2。得到的数组为[5, 1, 1, 1, 7, 4, 4, 4, -1]。 - 现在,子数组
[1, 1, 1](下标 1 到 3)和[4, 4, 4](下标 5 到 7)中的所有元素都相等。总共进行了 8 次操作,因此输出为 8。
示例 2:
输入: nums = [9,-2,-2,-2,1,5], x = 2, k = 2
输出: 3
解释:
- 进行 3 次操作,将
nums[4]减 3。得到的数组为[9, -2, -2, -2, -2, 5]。 - 现在,子数组
[-2, -2](下标 1 到 2)和[-2, -2](下标 3 到 4)中的所有元素都相等。总共进行了 3 次操作,因此输出为 3。
提示:
2 <= nums.length <= 105-106 <= nums[i] <= 1062 <= x <= nums.length1 <= k <= 152 <= k * x <= nums.length
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
把数组中的数都变成哪个数最优?
给定数组,每次操作可以把其中一个数加一/减一,把所有数都变成一样的,最少要操作多少次?
把所有数都变成数组的中位数是最优的。
证明。
滑动窗口中位数
见 480. 滑动窗口中位数,这可以用对顶堆做,具体见 我的题解。
如何计算操作次数?
需要额外维护堆中元素之和。
本题 为 (见 480 题解中的定义)的大小。
都变成 的堆顶 ,那么:
- 蓝色面积为 ,其中 为 的元素和。
- 绿色面积为 ,其中 为 的元素和。
操作次数即为面积之和
划分型 DP
根据 动态规划题单「§5.3 约束划分个数」,定义 表示在下标区间 中选 个长为 的子数组的最小操作次数。
分类讨论:
- 子数组不含 ,问题变成下标 中选 个长为 的子数组的最小操作次数,即 。
- 子数组含 ,子数组的左端点为 ,问题变成下标 中选 个长为 的子数组的最小操作次数,即 。
取最小值,有
其中 是滑动窗口算出的距离和(结果保存在子数组左端点)。
初始值 ,。注意不需要初始化 的状态,因为我们不会访问这些状态。
答案为 。
具体请看 视频讲解,欢迎点赞关注~
空间优化
复杂度分析
- 时间复杂度:,其中 是 的长度。
- 空间复杂度:。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/最短路/最小生成树/二分图/基环树/欧拉路径)
- 动态规划(入门/背包/状态机/划分/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA/一般树)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
import (
	"container/heap"
	"math"
	"sort"
)

// https://space.bilibili.com/206214
func minOperations1(nums []int, x, k int) int64 {
	n := len(nums)
	dis := medianSlidingWindow(nums, x)
	f := make([][]int, k+1)
	for i := range f {
		f[i] = make([]int, n+1)
	}
	for i := 1; i <= k; i++ {
		f[i][i*x-1] = math.MaxInt
		for j := i * x; j <= n-(k-i)*x; j++ { // 左右留出足够空间给其他子数组
			f[i][j] = min(f[i][j-1], f[i-1][j-x]+dis[j-x]) // j-x 为子数组左端点
		}
	}
	return int64(f[k][n])
}

func minOperations(nums []int, x, k int) int64 {
	n := len(nums)
	dis := medianSlidingWindow(nums, x)
	f := make([]int, n+1)
	g := make([]int, n+1) // 滚动数组
	for i := 1; i <= k; i++ {
		g[i*x-1] = math.MaxInt
		for j := i * x; j <= n-(k-i)*x; j++ { // 左右留出足够空间给其他子数组
			g[j] = min(g[j-1], f[j-x]+dis[j-x]) // j-x 为子数组左端点
		}
		f, g = g, f
	}
	return int64(f[n])
}

// 480. 滑动窗口中位数(有改动)
// 返回 nums 的所有长为 k 的子数组的(到子数组中位数的)距离和
func medianSlidingWindow(nums []int, k int) []int {
	ans := make([]int, len(nums)-k+1)
	left := newLazyHeap()  // 最大堆(元素取反)
	right := newLazyHeap() // 最小堆

	for i, in := range nums {
		// 1. 进入窗口
		if left.size == right.size {
			left.push(-right.pushPop(in))
		} else {
			right.push(-left.pushPop(-in))
		}

		l := i + 1 - k
		if l < 0 { // 窗口大小不足 k
			continue
		}

		// 2. 计算答案
		v := -left.top()
		s1 := v*left.size + left.sum // sum 取反
		s2 := right.sum - v*right.size
		ans[l] = s1 + s2

		// 3. 离开窗口
		out := nums[l]
		if out <= -left.top() {
			left.remove(-out)
			if left.size < right.size {
				left.push(-right.pop()) // 平衡两个堆的大小
			}
		} else {
			right.remove(out)
			if left.size > right.size+1 {
				right.push(-left.pop()) // 平衡两个堆的大小
			}
		}
	}

	return ans
}

func newLazyHeap() *lazyHeap {
	return &lazyHeap{removeCnt: map[int]int{}}
}

// 懒删除堆
type lazyHeap struct {
	sort.IntSlice
	removeCnt map[int]int // 每个元素剩余需要删除的次数
	size      int         // 实际大小
	sum       int         // 堆中元素总和
}

// 必须实现的两个接口
func (h *lazyHeap) Push(v any) { h.IntSlice = append(h.IntSlice, v.(int)) }
func (h *lazyHeap) Pop() any   { a := h.IntSlice; v := a[len(a)-1]; h.IntSlice = a[:len(a)-1]; return v }

// 删除
func (h *lazyHeap) remove(v int) {
	h.removeCnt[v]++ // 懒删除
	h.size--
	h.sum -= v
}

// 正式执行删除操作
func (h *lazyHeap) applyRemove() {
	for h.removeCnt[h.IntSlice[0]] > 0 {
		h.removeCnt[h.IntSlice[0]]--
		heap.Pop(h)
	}
}

// 查看堆顶
func (h *lazyHeap) top() int {
	h.applyRemove()
	return h.IntSlice[0]
}

// 出堆
func (h *lazyHeap) pop() int {
	h.applyRemove()
	h.size--
	h.sum -= h.IntSlice[0]
	return heap.Pop(h).(int)
}

// 入堆
func (h *lazyHeap) push(v int) {
	if h.removeCnt[v] > 0 {
		h.removeCnt[v]-- // 抵消之前的删除
	} else {
		heap.Push(h, v)
	}
	h.size++
	h.sum += v
}

// push(v) 然后 pop()
func (h *lazyHeap) pushPop(v int) int {
	if h.size > 0 && v > h.top() { // 最小堆,v 比堆顶大就替换堆顶
		h.sum += v - h.IntSlice[0]
		v, h.IntSlice[0] = h.IntSlice[0], v
		heap.Fix(h, 0)
	}
	return v
}3509. 最大化交错和为 K 的子序列乘积
题目、示例与约束
给你一个整数数组 nums 和两个整数 k 与 limit,你的任务是找到一个非空的 子序列,满足以下条件:
- 它的 交错和 等于
k。 - 在乘积 不超过
limit的前提下,最大化 其所有数字的乘积。
返回满足条件的子序列的 乘积 。如果不存在这样的子序列,则返回 -1。
子序列 是指可以通过删除原数组中的某些(或不删除)元素并保持剩余元素顺序得到的新数组。
交错和 是指一个 从下标 0 开始 的数组中,偶数下标 的元素之和减去 奇数下标 的元素之和。
示例 1:
输入: nums = [1,2,3], k = 2, limit = 10
输出: 6
解释:
交错和为 2 的子序列有:
[1, 2, 3]- 交错和:
1 - 2 + 3 = 2 - 乘积:
1 * 2 * 3 = 6
- 交错和:
[2]- 交错和:2
- 乘积:2
在 limit 内的最大乘积是 6。
示例 2:
输入: nums = [0,2,3], k = -5, limit = 12
输出: -1
解释:
不存在交错和恰好为 -5 的子序列。
示例 3:
输入: nums = [2,2,3,3], k = 0, limit = 9
输出: 9
解释:
交错和为 0 的子序列包括:
[2, 2]- 交错和:
2 - 2 = 0 - 乘积:
2 * 2 = 4
- 交错和:
[3, 3]- 交错和:
3 - 3 = 0 - 乘积:
3 * 3 = 9
- 交错和:
[2, 2, 3, 3]- 交错和:
2 - 2 + 3 - 3 = 0 - 乘积:
2 * 2 * 3 * 3 = 36
- 交错和:
子序列 [2, 2, 3, 3] 虽然交错和为 k 且乘积最大,但 36 > 9,超出 limit 。下一个最大且在 limit 范围内的乘积是 9。
提示:
1 <= nums.length <= 1500 <= nums[i] <= 12-105 <= k <= 1051 <= limit <= 5000
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
错误思路
错误思路:DP,把子序列乘积的最大值作为 的返回值。
错误原因:类似背包问题,最大乘积不一定最优,可能较小的乘积与其他数相乘,能够更接近 。
分析
注意到,如果乘积不为 ,那么在乘积不超过 的前提下,子序列至多包含 个大于 的数,以及零个或多个 。
在本题的数据范围下,。因为 个 相乘等于 ,再乘个 就超了。
在两个大于 的数之间的连续的 ,其交错和 的绝对值 。所以子序列中的所有 的交错和的绝对值 。
- 如果大于 的数都是 ,交错和的绝对值 。
- 如果大于 的数都是 ,那么 ,交错和的绝对值 。
可以看出,在乘积不为 且不超过 的情况下,交错和的绝对值其实远小于 的元素和!
此外, 个 中的数相乘,只有 个 的不同乘积。(计算代码见文末)
为什么这么少?因为大于 的质数(及其倍数)是无法得到的。想一想,你能得到 吗?能得到 吗?
如果乘积为 呢?继续向后(递归),乘积仍然为 ,此时只需关注交错和,不同交错和的个数 也很小。
所以,状态个数并不多,直接暴力搜索即可,不用写 DP。
思路
写一个暴搜 ,各个参数分别表示:
- 当前要考虑 选或不选。
- 子序列的交错和为 。
- 子序列的元素积为 。
- 如果选 ,是加 还是减 。
- 子序列是否为空。
分类讨论:
- 不选 ,递归到 。
- 选 ,递归到 。其中 是 或者 ,如果 则加,否则减。这里超过 的乘积一律视作 ,减少状态个数。
递归终点:如果 ,并且 且 且 ,那么用 更新答案的最大值。
递归入口:。加法单位元是 ,乘法单位元是 。
递归过程中,用 哈希表记录访问过的状态,避免重复访问。
此外,我们还有三个优化:
- 如果 的元素和小于 ,说明 太大,一定无法满足要求,直接返回 。
- 在递归过程中,如果发现 ,说明我们已经达到最大值,答案就是 ,不再递归。
- 在递归过程中,如果发现 ,那么我们只能把乘积 变成 。如果此时 ,说明我们能把乘积变成 ,不再递归。
具体请看 视频讲解,欢迎点赞关注~
注:
sum(nums) < abs(k)可以优化成sum(sorted(nums)[-((n + 1) // 2):]) < abs(k)。
复杂度分析
请注意, 个 中的数相乘,只有 个 的不同乘积。
- 时间复杂度:,其中 是 的长度,。其中 对应 或者 的情况,状态个数为交错和的个数; 对应 的情况,状态个数为「乘积个数」与「交错和的个数」的乘积。
- 空间复杂度:。有多少个状态,哈希表就有多大。
附:递推写法
复杂度分析
同上。
附:如何计算不同乘积个数
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/基环树/最短路/最小生成树/网络流)
- 动态规划(入门/背包/划分/状态机/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA/一般树)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
欢迎关注 B站@灵茶山艾府
// https://space.bilibili.com/206214
func maxProduct(nums []int, k, limit int) int {
	total := 0
	for _, x := range nums {
		total += x
	}
	if total < abs(k) { // |k| 太大
		return -1
	}

	ans := -1
	type args struct {
		i, s, m    int
		odd, empty bool
	}
	vis := map[args]bool{}
	var dfs func(int, int, int, bool, bool)
	dfs = func(i, s, m int, odd, empty bool) {
		if ans == limit || m > limit && ans >= 0 { // 无法让 ans 变得更大
			return
		}

		if i == len(nums) {
			if !empty && s == k && m <= limit {
				ans = max(ans, m)
			}
			return
		}

		t := args{i, s, m, odd, empty}
		if vis[t] {
			return
		}
		vis[t] = true

		// 不选 x
		dfs(i+1, s, m, odd, empty)

		// 选 x
		x := nums[i]
		if odd {
			s -= x
		} else {
			s += x
		}
		dfs(i+1, s, min(m*x, limit+1), !odd, false)
	}
	dfs(0, 0, 1, false, true)
	return ans
}

func maxProduct2(nums []int, k, limit int) int {
	// 如果数组和小于 |k|,则返回 -1
	total := 0
	for _, x := range nums {
		total += x
	}
	if total < abs(k) {
		return -1
	}

	// s -> {m}
	oddS := map[int]map[int]struct{}{}
	evenS := map[int]map[int]struct{}{}
	add := func(m map[int]map[int]struct{}, key, val int) {
		if _, ok := m[key]; !ok {
			m[key] = map[int]struct{}{}
		}
		m[key][val] = struct{}{}
	}

	for _, x := range nums {
		// 长为偶数的子序列的计算结果 newEvenS
		newEvenS := map[int]map[int]struct{}{}
		for s, set := range oddS {
			newEvenS[s-x] = map[int]struct{}{}
			for m := range set {
				if m*x <= limit {
					newEvenS[s-x][m*x] = struct{}{}
				}
			}
		}

		// 长为奇数的子序列的计算结果 oddS
		for s, set := range evenS {
			if _, ok := oddS[s+x]; !ok {
				oddS[s+x] = map[int]struct{}{}
			}
			for m := range set {
				if m*x <= limit {
					oddS[s+x][m*x] = struct{}{}
				}
			}
			if x == 0 {
				add(oddS, s, 0)
			}
		}

		// 更新 evenS
		for s, set := range newEvenS {
			if eSet, ok := evenS[s]; ok {
				for m := range set {
					eSet[m] = struct{}{}
				}
			} else {
				evenS[s] = set
			}
			if x == 0 {
				add(evenS, s, 0)
			}
		}

		// 子序列只有一个数的情况
		if x <= limit {
			add(oddS, x, x)
		}

		if set, ok := oddS[k]; ok {
			if _, ok := set[limit]; ok {
				return limit // 提前返回
			}
		}
		if set, ok := evenS[k]; ok {
			if _, ok := set[limit]; ok {
				return limit // 提前返回
			}
		}
	}

	calcMax := func(m map[int]struct{}) int {
		maxVal := -1
		if m != nil {
			for v := range m {
				maxVal = max(maxVal, v)
			}
		}
		return maxVal
	}
	return max(calcMax(oddS[k]), calcMax(evenS[k]))
}

func abs(x int) int {
	if x < 0 {
		return -x
	}
	return x
}3519. 统计逐位非递减的整数
题目、示例与约束
给你两个以字符串形式表示的整数 l 和 r,以及一个整数 b。返回在区间 [l, r] (闭区间)内,以 b 进制表示时,其每一位数字为 非递减 顺序的整数个数。
整数逐位 非递减 需要满足:当按从左到右(从最高有效位到最低有效位)读取时,每一位数字都大于或等于前一位数字。
由于答案可能非常大,请返回对 109 + 7 取余 后的结果。
示例 1:
输入: l = "23", r = "28", b = 8
输出: 3
解释:
- 从 23 到 28 的数字在 8 进制下为:27、30、31、32、33 和 34。
- 其中,27、33 和 34 的数字是非递减的。因此,输出为 3。
示例 2:
输入: l = "2", r = "7", b = 2
输出: 2
解释:
- 从 2 到 7 的数字在 2 进制下为:10、11、100、101、110 和 111。
- 其中,11 和 111 的数字是非递减的。因此,输出为 2。
提示:
1 <= l.length <= r.length <= 1002 <= b <= 10l和r仅由数字(0-9)组成。l表示的值小于或等于r表示的值。l和r不包含前导零。
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
方法一:数位 DP
前置知识:
数位 DP v2.0 视频讲解(上下界数位 DP)
把 和 转成 进制,然后套数位 DP v2.0 模板。
状态定义: 表示构造第 位及其之后数位的合法方案数,其余参数的含义为:
- 表示前一个位置填的数字,初始值为 。
- 表示当前是否受到了 的约束(我们要构造的数字不能超过 )。若为真,则第 位填入的数字至多为 ,否则至多为 ,这个数记作 。如果在受到约束的情况下填了 ,那么后续填入的数字仍会受到 的约束。例如 ,那么 填的是 的话, 的这一位至多填 。
- 表示当前是否受到了 的约束(我们要构造的数字不能低于 )。若为真,则第 位填入的数字至少为 ,否则至少为 ,这个数记作 。如果在受到约束的情况下填了 ,那么后续填入的数字仍会受到 的约束。
状态转移:枚举第 位填数字 。继续递归,把 加一,把 置为 。
递归终点: 时,找到了一个合法数字,返回 。
递归入口:,表示:
- 从最高位开始。
- 假设第一个数字的前面是 ,这样第一个数字不会受到 的约束。
- 一开始要受到 和 的约束(否则就可以随意填了,这肯定不行)。
注:本题答案较小,可以只在返回前取模。(理由见方法二的公式)
本题视频讲解,欢迎点赞关注~
复杂度分析
- 时间复杂度:,其中 ,表示进制转换后的长度, 是 的长度。进制转换的时间复杂度为 。由于每个状态只会计算一次,动态规划的时间复杂度 状态个数 单个状态的计算时间。本题状态个数等于 ,单个状态的计算时间为 ,所以动态规划的时间复杂度为 。
- 空间复杂度:。保存多少状态,就需要多少空间。
方法二:组合数学
假设第 位填了数字 ,并且剩余的 个位置不受约束,那么问题变成:
- 构造长为 的非递减序列,元素范围 ,能构造多少个不同的序列?
根据 3251. 单调数组对的数目 II 我的题解 的方法二,方案数为
为方便计算,考虑用小于 的合法数字个数减去小于 的合法数字个数。
设 进制转换后的字符串为 。
设上一个数位填的是 ,枚举当前位置填数字 ,其中 。剩余数位不受到 的约束,方案数之和为
根据上指标求和恒等式
方案数之和化简为
由于 很小,可以用 递推式 预处理组合数,无需求阶乘及其逆元。
在本题数据范围下,组合数在 64 位整数范围内,无需中途取模,只需在返回前取模。
复杂度分析
预处理的时间和空间忽略不计。
- 时间复杂度:,其中 ,表示进制转换后的长度, 是 的长度。瓶颈在进制转换上。
- 空间复杂度:。
更多相似题目,见下面动态规划题单的「十、数位 DP」和数学题单的「§2.2 组合计数」。
分类题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/最短路/最小生成树/二分图/基环树/欧拉路径)
- 动态规划(入门/背包/状态机/划分/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、二叉树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA/一般树)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
import (
	"fmt"
	"math/big"
	"strings"
)

// https://space.bilibili.com/206214
const mod = 1_000_000_007
const maxN = 333 // 进制转换后的最大长度
const maxB = 10

var comb [maxN + maxB][maxB]int

func init() {
	// 预处理组合数
	for i := 0; i < len(comb); i++ {
		comb[i][0] = 1
		for j := 1; j < min(i+1, maxB); j++ {
			// 注意本题组合数较小,无需取模
			comb[i][j] = comb[i-1][j-1] + comb[i-1][j]
		}
	}
}

func trans(s string, b int, inc bool) string {
	x := &big.Int{}
	fmt.Fscan(strings.NewReader(s), x)
	if inc {
		x.Add(x, big.NewInt(1))
	}
	return x.Text(b) // 转成 b 进制
}

func calc(s string, b int, inc bool) (res int) {
	s = trans(s, b, inc)
	// 计算小于 s 的合法数字个数
	// 为什么是小于?注意下面的代码,我们没有统计每个数位都填 s[i] 的情况
	pre := 0
	for i, d := range s {
		hi := int(d - '0')
		if hi < pre {
			break
		}
		m := len(s) - 1 - i
		res += comb[m+b-pre][b-1-pre] - comb[m+b-hi][b-1-hi]
		pre = hi
	}
	return
}

func countNumbers(l, r string, b int) int {
	// 小于 r+1 的合法数字个数 - 小于 l 的合法数字个数
	return (calc(r, b, true) - calc(l, b, false)) % mod
}3524. 求出数组的 X 值 I
题目、示例与约束
给你一个由 正 整数组成的数组 nums,以及一个 正 整数 k。
你可以对 nums 执行 一次 操作,该操作中可以移除任意 不重叠 的前缀和后缀,使得 nums 仍然 非空 。
你需要找出 nums 的 x 值,即在执行操作后,剩余元素的 乘积 除以 k 后的 余数 为 x 的操作数量。
返回一个大小为 k 的数组 result,其中 result[x] 表示对于 0 <= x <= k - 1,nums 的 x 值。
数组的 前缀 指从数组起始位置开始到数组中任意位置的一段连续子数组。
数组的 后缀 是指从数组中任意位置开始到数组末尾的一段连续子数组。
子数组 是数组中一段连续的元素序列。
注意,在操作中选择的前缀和后缀可以是 空的 。
示例 1:
输入: nums = [1,2,3,4,5], k = 3
输出: [9,2,4]
解释:
- 对于
x = 0,可行的操作包括所有不会移除nums[2] == 3的前后缀移除方式。 - 对于
x = 1,可行操作包括:- 移除空前缀和后缀
[2, 3, 4, 5],nums变为[1]。 - 移除前缀
[1, 2, 3]和后缀[5],nums变为[4]。
- 移除空前缀和后缀
- 对于
x = 2,可行操作包括:- 移除空前缀和后缀
[3, 4, 5],nums变为[1, 2]。 - 移除前缀
[1]和后缀[3, 4, 5],nums变为[2]。 - 移除前缀
[1, 2, 3]和空后缀,nums变为[4, 5]。 - 移除前缀
[1, 2, 3, 4]和空后缀,nums变为[5]。
- 移除空前缀和后缀
示例 2:
输入: nums = [1,2,4,8,16,32], k = 4
输出: [18,1,2,0]
解释:
- 对于
x = 0,唯一 不 得到x = 0的操作有:- 移除空前缀和后缀
[4, 8, 16, 32],nums变为[1, 2]。 - 移除空前缀和后缀
[2, 4, 8, 16, 32],nums变为[1]。 - 移除前缀
[1]和后缀[4, 8, 16, 32],nums变为[2]。
- 移除空前缀和后缀
- 对于
x = 1,唯一的操作是:- 移除空前缀和后缀
[2, 4, 8, 16, 32],nums变为[1]。
- 移除空前缀和后缀
- 对于
x = 2,可行操作包括:- 移除空前缀和后缀
[4, 8, 16, 32],nums变为[1, 2]。 - 移除前缀
[1]和后缀[4, 8, 16, 32],nums变为[2]。
- 移除空前缀和后缀
- 对于
x = 3,没有可行的操作。
示例 3:
输入: nums = [1,1,2,1,1], k = 2
输出: [9,6]
提示:
1 <= nums[i] <= 1091 <= nums.length <= 1051 <= k <= 5
方法一:动态规划 · Go 实现
思考
去掉前缀与后缀后剩下一段子数组,问乘积模 等于各余数的子数组个数。 而 ,应对余数做 DP 而非枚举子数组。
令 为以 结尾、乘积模 为 的个数,由 乘上 转移,并加上只含 的新段。按余数累加即得 。
去掉任意不重叠前缀与后缀后,剩余部分是一段非空子数组。问题转化为:统计乘积模 等于 的子数组个数。
设 表示当前枚举位置上,以该位置结尾、乘积模 为 的子数组个数。从左到右扫描 ,用数组 承接以 结尾的新状态:将每个 转移到 ,再把只含 的子数组计入 。把 累加进答案后令 。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func resultArray(nums []int, k int) []int64 {
	ans := make([]int64, k)
	f := make([]int64, k)
	for _, x := range nums {
		g := make([]int64, k)
		for r, cnt := range f {
			g[r*x%k] += cnt
		}
		g[x%k]++
		for r, cnt := range g {
			ans[r] += cnt
		}
		f = g
	}
	return ans
}继续阅读
- 实践案例
- 实践案例
- 实践案例