
LeetCode Go · 动态规划(15)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
3003. 执行操作后的最大分割数量
题目、示例与约束
给定一个字符串 s 和一个整数 k。
首先,你最多可以更改 s 中的 一处 下标对应字符为另一个小写英文字母。
之后,执行以下分割操作,直到 s 变为 空串:
- 选择
s的最长 前缀,该前缀最多包含k个 不同 字符。 - 从
s中 删除 这个前缀,并将分割数量加一。如果有剩余字符,它们在s中保持原来的顺序。
返回一个整数,表示在 最多 改变一处下标对应字符的情况下,经过操作后得到的最大分割数。
示例 1:
输入:s = "accca", k = 2
输出:3
解释:
最好的方式是把 s[2] 变为除了 a 和 c 之外的东西,比如 b。然后它变成了 "acbca"。
然后我们执行以下操作:
- 最多包含 2 个不同字符的最长前缀是
"ac",我们删除它然后s变为"bca"。 - 现在最多包含 2 个不同字符的最长前缀是
"bc",所以我们删除它然后s变为"a"。 - 最后,我们删除
"a"并且s变成空串,所以该过程结束。
进行操作时,字符串被分成 3 个部分,所以答案是 3。
示例 2:
输入:s = "aabaab", k = 3
输出:1
解释:
一开始 s 包含 2 个不同的字符,所以无论我们改变哪个, 它最多包含 3 个不同字符,因此最多包含 3 个不同字符的最长前缀始终是所有字符,因此答案是 1。
示例 3:
输入:s = "xxyz", k = 1
输出:4
解释:
最好的方式是将 s[0] 或 s[1] 变为 s 中字符以外的东西,例如将 s[0] 变为 w。
然后 s 变为 "wxyz",包含 4 个不同的字符,所以当 k 为 1,它将分为 4 个部分。
提示:
1 <= s.length <= 104s只包含小写英文字母。1 <= k <= 26
方法一:记忆化搜索 · Go 实现
思考
且最多改一个字符,按贪心规则分段。若对每个位置尝试修改再模拟分段,代价约为 ,偏紧。
分段只取决于当前段已出现的字符集合是否超过 。该集合可用 位掩码表示,修改次数仅 或 ,状态量约为 量级,可记忆化。
为此定义 :处理到下标 、当前段掩码为 、仍可修改 次时的最大段数。加入 后若位数超过 则新开一段;若仍有修改额度,再枚举改成哪一个字母。
我们设计一个函数 表示当前处理到字符串 的下标 ,当前前缀中已经包含的字符集合为 ,并且还可以修改 次字符时,能够得到的最大分割数量。那么答案即为 。
函数 的执行逻辑如下:
- 如果 ,说明已经处理完字符串 ,返回 1。
- 计算当前字符 对应的位掩码 ,并计算更新后的字符集合 。
- 如果 中的位数超过 ,说明当前前缀已经包含超过 个不同字符,我们需要进行一次分割,此时分割数量加 1,并递归调用 ;否则,继续递归调用 。
- 如果 ,说明我们还可以修改一次字符。我们尝试将当前字符 修改为任意一个小写字母(共 26 种选择),对于每个选择,计算更新后的字符集合 ,并根据是否超过 个不同字符,选择相应的递归调用方式,更新最大分割数量。
- 使用哈希表缓存已经计算过的状态,避免重复计算。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度,而 为字符集大小。
func maxPartitionsAfterOperations(s string, k int) int {
	n := len(s)
	type tuple struct{ i, cur, t int }
	f := map[tuple]int{}
	var dfs func(i, cur, t int) int
	dfs = func(i, cur, t int) int {
		if i >= n {
			return 1
		}
		key := tuple{i, cur, t}
		if v, ok := f[key]; ok {
			return v
		}
		v := 1 << (s[i] - 'a')
		nxt := cur | v
		var ans int
		if bits.OnesCount(uint(nxt)) > k {
			ans = dfs(i+1, v, t) + 1
		} else {
			ans = dfs(i+1, nxt, t)
		}
		if t > 0 {
			for j := 0; j < 26; j++ {
				nxt = cur | (1 << j)
				if bits.OnesCount(uint(nxt)) > k {
					ans = max(ans, dfs(i+1, 1<<j, 0)+1)
				} else {
					ans = max(ans, dfs(i+1, nxt, 0))
				}
			}
		}
		f[key] = ans
		return ans
	}
	return dfs(0, 0, 1)
}
方法二:动态规划 · Go 实现
思考
,最多改一个字符。对每个位置修改后再按最长前缀分段,大约是 ,已经偏紧。
不修改时的转移总是先调用下一字符。从下标 走到 的链长度就是 。 时 Python 抛出 RecursionError,Java 与 Node 在 时栈溢出。
一段在字符种数即将超过 时被切断,修改机会只有一次,所以每个下标上真正出现的掩码很少。每个状态又只依赖下一字符的答案。
因此先从左到右记下可达的 ,再从右往左填这些状态的最大段数。字符串走完时答案是 。加入当前字符后若位数超过 ,就新开一段并加 ;还有修改额度时,再枚举把当前字符换成哪一个字母。
记状态 表示当前段已经包含的字符掩码是 ,还可以修改 次。答案是下标 处 的最大段数。
先从左到右求出每个下标上可达的状态,起点只有 。设当前字符的位掩码为 。
- 令 。若 的位数超过 ,当前段在这里结束,下一状态的掩码换成 ,修改次数仍是 ;否则下一状态的掩码是 。
- 若 ,再尝试把 改成任意小写字母。对字母 ,令 。位数超过 时,下一状态是掩码 、修改次数 ;否则下一状态是掩码 、修改次数 。
再按 从 降到 ,用同一组转移计算最大段数。 时字符串已经处理完,值为 。切开当前段的那一支要在后继答案上再加 。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度,而 为字符集大小。
func maxPartitionsAfterOperations(s string, k int) int {
	n := len(s)
	masks := make([]int, n)
	for i := 0; i < n; i++ {
		masks[i] = 1 << (s[i] - 'a')
	}
	reach := make([]map[int]struct{}, n+1)
	f := make([]map[int]int, n+1)
	for i := 0; i <= n; i++ {
		reach[i] = map[int]struct{}{}
		f[i] = map[int]int{}
	}
	reach[0][1] = struct{}{}
	for i, v := range masks {
		for key := range reach[i] {
			cur, t := key>>1, key&1
			nxt := cur | v
			if bits.OnesCount(uint(nxt)) > k {
				reach[i+1][(v<<1)|t] = struct{}{}
			} else {
				reach[i+1][(nxt<<1)|t] = struct{}{}
			}
			if t == 1 {
				for j := 0; j < 26; j++ {
					bit := 1 << j
					nxt = cur | bit
					if bits.OnesCount(uint(nxt)) > k {
						reach[i+1][bit<<1] = struct{}{}
					} else {
						reach[i+1][nxt<<1] = struct{}{}
					}
				}
			}
		}
	}
	get := func(i, key int) int {
		if i == n {
			return 1
		}
		return f[i][key]
	}
	for i := n - 1; i >= 0; i-- {
		v := masks[i]
		for key := range reach[i] {
			cur, t := key>>1, key&1
			nxt := cur | v
			var ans int
			if bits.OnesCount(uint(nxt)) > k {
				ans = get(i+1, (v<<1)|t) + 1
			} else {
				ans = get(i+1, (nxt<<1)|t)
			}
			if t == 1 {
				for j := 0; j < 26; j++ {
					bit := 1 << j
					nxt = cur | bit
					if bits.OnesCount(uint(nxt)) > k {
						ans = max(ans, get(i+1, bit<<1)+1)
					} else {
						ans = max(ans, get(i+1, nxt<<1))
					}
				}
			}
			f[i][key] = ans
		}
	}
	return f[0][1]
}3007. 价值和小于等于 K 的最大数字
题目、示例与约束
给你一个整数 k 和一个整数 x 。整数 num 的价值是它的二进制表示中在 x,2x,3x 等位置处 设置位 的数目(从最低有效位开始)。下面的表格包含了如何计算价值的例子。
| x | num | Binary Representation | Price |
|---|---|---|---|
| 1 | 13 | 000001101 | 3 |
| 2 | 13 | 000001101 | 1 |
| 2 | 233 | 011101001 | 3 |
| 3 | 13 | 000001101 | 1 |
| 3 | 362 | 101101010 | 2 |
num 的 累加价值 是从 1 到 num 的数字的 总 价值。如果 num 的累加价值小于或等于 k 则被认为是 廉价 的。
请你返回 最大 的廉价数字。
示例 1:
输入:k = 9, x = 1
输出:6
解释:由下表所示,6 是最大的廉价数字。
| x | num | Binary Representation | Price | Accumulated Price |
|---|---|---|---|---|
| 1 | 1 | 001 | 1 | 1 |
| 1 | 2 | 010 | 1 | 2 |
| 1 | 3 | 011 | 2 | 4 |
| 1 | 4 | 100 | 1 | 5 |
| 1 | 5 | 101 | 2 | 7 |
| 1 | 6 | 110 | 2 | 9 |
| 1 | 7 | 111 | 3 | 12 |
示例 2:
输入:k = 7, x = 2
输出:9
解释:由下表所示,9 是最大的廉价数字。
| x | num | Binary Representation | Price | Accumulated Price |
|---|---|---|---|---|
| 2 | 1 | 0001 | 0 | 0 |
| 2 | 2 | 0010 | 1 | 1 |
| 2 | 3 | 0011 | 1 | 2 |
| 2 | 4 | 0100 | 0 | 2 |
| 2 | 5 | 0101 | 0 | 2 |
| 2 | 6 | 0110 | 1 | 3 |
| 2 | 7 | 0111 | 1 | 4 |
| 2 | 8 | 1000 | 1 | 5 |
| 2 | 9 | 1001 | 1 | 6 |
| 2 | 10 | 1010 | 2 | 8 |
提示:
1 <= k <= 10151 <= x <= 8
方法一:二分查找 + 数位 DP · Go 实现
思考
价值随 单调不减,而 可达 ,不能逐个累加。
判定「 到 的价值是否 」是一个典型的数位计数问题:每一位是否计分只取决于其下标是否为 的倍数。
因此对 二分,并用记忆化按二进制位统计:在受限/非受限下累计已经置位的有价位个数。
我们注意到,如果 增大,数字 到 的总价值也会增大。因此,我们可以使用二分查找的方法找到最大的廉价数字。
我们定义二分查找的左边界 ,由于每 个数中至少有一个数字是有价值的,而总价值不超过 ,因此我们可以设定二分查找的右边界 。
接下来,我们进行二分查找,对于每一个 ,我们使用数位 DP 的方法计算出 到 的总价值,如果总价值不超过 ,则说明 是一个廉价数字,我们将左边界 更新为 ,否则我们将右边界 更新为 。
最后,我们返回左边界 即可。
时间复杂度 ,空间复杂度 。
func findMaximumNumber(k int64, x int) int64 {
	var l, r int64 = 1, 1e17
	var num int64
	var f [65][65]int64
	var dfs func(pos, cnt int, limit bool) int64
	dfs = func(pos, cnt int, limit bool) int64 {
		if pos == 0 {
			return int64(cnt)
		}
		if !limit && f[pos][cnt] != -1 {
			return f[pos][cnt]
		}
		var ans int64
		up := 1
		if limit {
			up = int(num >> (pos - 1) & 1)
		}
		for i := 0; i <= up; i++ {
			v := cnt
			if i == 1 && pos%x == 0 {
				v++
			}
			ans += dfs(pos-1, v, limit && i == up)
		}
		if !limit {
			f[pos][cnt] = ans
		}
		return ans
	}
	for l < r {
		mid := (l + r + 1) >> 1
		num = mid
		m := bits.Len(uint(num))
		for i := range f {
			for j := range f[i] {
				f[i][j] = -1
			}
		}
		if dfs(m, 0, true) <= k {
			l = mid
		} else {
			r = mid - 1
		}
	}
	return l
}3018. 可处理的最大删除操作数 I 🔒
题目、示例与约束
给定一个下标 从 0 开始 的数组 nums 和一个下标 从 0 开始 的数组 queries。
你可以在开始时执行以下操作 最多一次:
- 用
nums的 子序列 替换nums。
我们以给定的queries顺序处理查询;对于queries[i],我们执行以下操作:
- 如果
nums的第一个 和 最后一个元素 小于queries[i],则查询处理 结束。 - 否则,从
nums选择第一个 或 最后一个元素,要求其大于或等于queries[i],然后将其从nums中 删除。
返回通过以最佳方式执行该操作可以处理的 最多 次数。
示例 1:
输入:nums = [1,2,3,4,5], queries = [1,2,3,4,6]
输出:4
解释:我们不执行任何操作,并按如下方式处理查询:
1- 我们选择并移除 nums[0],因为 1 <= 1,那么 nums 就变成 [2,3,4,5]。
2- 我们选择并移除 nums[0],因为 2 <= 2,那么 nums 就变成 [3,4,5]。
3- 我们选择并移除 nums[0],因为 3 <= 3,那么 nums 就变成 [4,5]。
4- 我们选择并移除 nums[0],因为 4 <= 4,那么 nums 就变成 [5]。
5- 我们不能从 nums 中选择任何元素,因为它们不大于或等于 5。
因此,答案为 4。
可以看出,我们不能处理超过 4 个查询。
示例 2:
输入:nums = [2,3,2], queries = [2,2,3]
输出:3
解释:我们不做任何操作,按如下方式处理查询:
1- 我们选择并移除 nums[0],因为 2 <= 2,那么 nums 就变成 [3,2]。
2- 我们选择并移除 nums[1],因为 2 <= 2,那么 nums 就变成 [3]。
3- 我们选择并移除 nums[0],因为 3 <= 3,那么 nums 就变成 []。
因此,答案为 3。
可以看出,我们不能处理超过 3 个查询。
示例 3:
输入:nums = [3,4,3], queries = [4,3,2]
输出:2
解释:首先,我们用 nums 的子序列 [4,3] 替换 nums。
然后,我们可以按如下方式处理查询:
1- 我们选择并移除 nums[0],因为 4 <= 4,那么 nums 就变成 [3]。
2- 我们选择并移除 nums[0],因为 3 <= 3,那么 nums 就变成 []。
3- 我们无法处理更多查询,因为 nums 为空。
因此,答案为 2。
可以看出,我们不能处理超过 2 个查询。
提示:
1 <= nums.length <= 10001 <= queries.length <= 10001 <= nums[i], queries[i] <= 109
方法一:动态规划 · Go 实现
思考
每次只能删当前数组的两端, 。按询问顺序贪心选择左右,无法保证最优。
剩下的总是一段连续区间 ,已处理的询问个数完全由该区间决定。状态数为 。
定义 为区间尚未删除时已处理的询问数,由删掉 或 转移,并在中点收尾时尝试再处理一个。
我们定义 表示区间 的数还没有被删除时,我们能够处理的查询的最大数量。
考虑 :
- 如果 ,此时 的值可以由 转移而来。如果 ,那么我们可以选择删除 ,因此我们有 。
- 如果 ,此时 的值可以由 转移而来。如果 ,那么我们可以选择删除 ,因此我们有 。
- 如果 ,那么我们就可以直接返回 。
最后的答案即为 。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func maximumProcessableQueries(nums []int, queries []int) (ans int) {
	n := len(nums)
	f := make([][]int, n)
	for i := range f {
		f[i] = make([]int, n)
	}
	m := len(queries)
	for i := 0; i < n; i++ {
		for j := n - 1; j >= i; j-- {
			if i > 0 {
				t := 0
				if nums[i-1] >= queries[f[i-1][j]] {
					t = 1
				}
				f[i][j] = max(f[i][j], f[i-1][j]+t)
			}
			if j+1 < n {
				t := 0
				if nums[j+1] >= queries[f[i][j+1]] {
					t = 1
				}
				f[i][j] = max(f[i][j], f[i][j+1]+t)
			}
			if f[i][j] == m {
				return m
			}
		}
	}
	for i := 0; i < n; i++ {
		t := 0
		if nums[i] >= queries[f[i][i]] {
			t = 1
		}
		ans = max(ans, f[i][i]+t)
	}
	return
}3032. 统计各位数字都不同的数字个数 II 🔒
题目、示例与约束
a 和 b ,返回 闭区间 [a, b] 内各位数字都不同的数字个数。
示例 1:
输入:a = 1, b = 20
输出:19
解释:除 11 以外,区间 [1, 20] 内的所有数字的各位数字都不同。因此,答案为 19 。
示例 2:
输入:a = 9, b = 19
输出:10
解释:除 11 以外,区间 [1, 20] 内的所有数字的各位数字都不同。因此,答案为 10 。
示例 3:
输入:a = 80, b = 120
输出:27
解释:区间 [80, 120] 内共有 41 个整数,其中 27 个数字的各位数字都不同。
提示:
1 <= a <= b <= 1000
方法一:状态压缩 + 数位 DP · Go 实现
思考
统计 中各位互不相同的整数。区间可写成 。按位枚举会遇到前导零与重复数字。
用二进制掩码记录已用数字,并带上是否贴上界,即可按数位 DP 计数。 ,状态很少。
记忆化 ,前导零不占用掩码,空掩码表示尚未形成数字。
题目要求统计区间 中的数中有多少个数的数位是唯一的,我们可以使用状态压缩和数位 DP 来解决这个问题。
我们可以用一个函数 来统计 中的数中有多少个数的数位是唯一的,那么答案就是 。
另外,我们可以用一个二进制数来记录数字中出现过的数字,比如数字中出现了 ,那么我们可以用 来表示这个状态。
接下来,我们使用记忆化搜索来实现数位 DP。从起点向下搜索,到最底层得到方案数,一层层向上返回答案并累加,最后从搜索起点得到最终的答案。
基本步骤如下:
- 我们将数字 转换为字符串 ,其中 为最高位,而 为最低位。
- 根据题目信息,设计一个函数 ,其中 表示当前处理的位置, 表示当前数字中出现过的数字, 表示当前位置是否有限制。如果 为真,那么当前位置的数字不能超过 。
答案为 。
时间复杂度 ,空间复杂度 。其中 为 的位数。
func numberCount(a int, b int) int {
	num := strconv.Itoa(b)
	f := make([][1 << 10]int, len(num))
	for i := range f {
		for j := range f[i] {
			f[i][j] = -1
		}
	}
	var dfs func(pos, mask int, limit bool) int
	dfs = func(pos, mask int, limit bool) int {
		if pos >= len(num) {
			if mask != 0 {
				return 1
			}
			return 0
		}
		if !limit && f[pos][mask] != -1 {
			return f[pos][mask]
		}
		up := 9
		if limit {
			up = int(num[pos] - '0')
		}
		ans := 0
		for i := 0; i <= up; i++ {
			if mask>>i&1 == 1 {
				continue
			}
			nxt := mask | 1<<i
			if mask == 0 && i == 0 {
				nxt = 0
			}
			ans += dfs(pos+1, nxt, limit && i == up)
		}
		if !limit {
			f[pos][mask] = ans
		}
		return ans
	}
	y := dfs(0, 0, true)
	num = strconv.Itoa(a - 1)
	for i := range f {
		for j := range f[i] {
			f[i][j] = -1
		}
	}
	x := dfs(0, 0, true)
	return y - x
}
方法二:枚举 · Go 实现
思考
,数位 DP 的状态开销并无必要。
直接枚举区间内每个整数,用集合判断各位是否互异即可,实现更短。
由于 ,可以直接枚举区间 中的每个整数,判断其各位数字是否互不相同。
时间复杂度 ,空间复杂度 。
func numberCount(a int, b int) int {
	count := 0
	for num := a; num <= b; num++ {
		if hasUniqueDigits(num) {
			count++
		}
	}
	return count
}
func hasUniqueDigits(num int) bool {
	digits := strconv.Itoa(num)
	seen := make(map[rune]bool)
	for _, digit := range digits {
		if seen[digit] {
			return false
		}
		seen[digit] = true
	}
	return true
}3040. 相同分数的最大操作数目 II
题目、示例与约束
给你一个整数数组 nums ,如果 nums 至少 包含 2 个元素,你可以执行以下操作中的 任意 一个:
- 选择
nums中最前面两个元素并且删除它们。 - 选择
nums中最后两个元素并且删除它们。 - 选择
nums中第一个和最后一个元素并且删除它们。
一次操作的 分数 是被删除元素的和。
在确保 所有操作分数相同 的前提下,请你求出 最多 能进行多少次操作。
请你返回按照上述要求 最多 可以进行的操作次数。
示例 1:
输入:nums = [3,2,1,2,3,4]
输出:3
解释:我们执行以下操作:
- 删除前两个元素,分数为 3 + 2 = 5 ,nums = [1,2,3,4] 。
- 删除第一个元素和最后一个元素,分数为 1 + 4 = 5 ,nums = [2,3] 。
- 删除第一个元素和最后一个元素,分数为 2 + 3 = 5 ,nums = [] 。
由于 nums 为空,我们无法继续进行任何操作。
示例 2:
输入:nums = [3,2,6,1,4]
输出:2
解释:我们执行以下操作:
- 删除前两个元素,分数为 3 + 2 = 5 ,nums = [6,1,4] 。
- 删除最后两个元素,分数为 1 + 4 = 5 ,nums = [6] 。
至多进行 2 次操作。
提示:
2 <= nums.length <= 20001 <= nums[i] <= 1000
方法一:记忆化搜索 · Go 实现
思考
与 I 不同,每次可删两端、开头两个或末尾两个,分数仍须全程一致。 。
第一次操作只有三种取法,分数 因此只有三种。之后在区间 上的最优次数只依赖 。
对每个 记忆化 ,尝试三种与 相符的删法。答案为 加上三种首次选择的最大值。
分数 的取值有三种情况,分别是 , , 。我们可以针对这三种情况,分别进行记忆化搜索。
我们设计一个函数 ,表示在分数为 的情况下,从下标 到下标 的最大操作次数。函数 的执行过程如下:
- 如果 ,表示区间 的长度小于 ,无法进行任何操作,返回 。
- 如果 ,表示可以删除下标 和下标 的元素,此时最大操作次数为 。
- 如果 ,表示可以删除下标 和下标 的元素,此时最大操作次数为 。
- 如果 ,表示可以删除下标 和下标 的元素,此时最大操作次数为 。
- 返回以上的最大值即可。
最后,我们分别计算三种情况的最大操作次数,取最大值返回即可。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func maxOperations(nums []int) int {
	n := len(nums)
	var g func(i, j, s int) int
	g = func(i, j, s int) int {
		f := make([][]int, n)
		for i := range f {
			f[i] = make([]int, n)
			for j := range f {
				f[i][j] = -1
			}
		}
		var dfs func(i, j int) int
		dfs = func(i, j int) int {
			if j-i < 1 {
				return 0
			}
			if f[i][j] != -1 {
				return f[i][j]
			}
			ans := 0
			if nums[i]+nums[i+1] == s {
				ans = max(ans, 1+dfs(i+2, j))
			}

			if nums[i]+nums[j] == s {
				ans = max(ans, 1+dfs(i+1, j-1))
			}

			if nums[j-1]+nums[j] == s {
				ans = max(ans, 1+dfs(i, j-2))
			}
			f[i][j] = ans
			return ans
		}
		return dfs(i, j)
	}
	a := g(2, n-1, nums[0]+nums[1])
	b := g(0, n-3, nums[n-1]+nums[n-2])
	c := g(1, n-2, nums[0]+nums[n-1])
	return 1 + max(a, b, c)
}3041. 修改数组后最大化数组中的连续元素数目
题目、示例与约束
给你一个下标从 0 开始只包含 正 整数的数组 nums 。
一开始,你可以将数组中 任意数量 元素增加 至多 1 。
修改后,你可以从最终数组中选择 一个或者更多 元素,并确保这些元素升序排序后是 连续 的。比方说,[3, 4, 5] 是连续的,但是 [3, 4, 6] 和 [1, 1, 2, 3] 不是连续的。
请你返回 最多 可以选出的元素数目。
示例 1:
输入:nums = [2,1,5,1,1]
输出:3
解释:我们将下标 0 和 3 处的元素增加 1 ,得到结果数组 nums = [3,1,5,2,1] 。
我们选择元素 [3,1,5,2,1] 并将它们排序得到 [1,2,3] ,是连续元素。
最多可以得到 3 个连续元素。
示例 2:
输入:nums = [1,4,7,10]
输出:1
解释:我们可以选择的最多元素数目是 1 。
提示:
1 <= nums.length <= 1051 <= nums[i] <= 106
方法一:Go 实现(灵茶山艾府) · Go 实现
灵茶山艾府 · 源码 · MIT 许可 · 原题解
视频讲解 第四题,额外讲了另一种做法,以及如何分类思考子序列 DP。
提示 1
把数组排序。
为什么?设我们选的元素在排序后为 ,那么有 ,这意味着 中元素在操作前,必然有 。反证:如果操作前 ,那么操作后 至多和 相等,不会出现 比 多 的情况。
所以可以排序。
提示 2
排序后,我们选的是 中的一个子序列。
定义 表示子序列的最后一个数是 时,子序列的最大长度。
从左到右遍历数组 :
- 如果操作,那么 可以接在末尾为 的子序列后面,即 。
- 如果不操作,那么 可以接在末尾为 的子序列后面,即 。
比如 :
- 遍历到 时,。
- 遍历到 时,。注意要先计算 再计算 (不然这里会算出 )。此时 还是 。
- 遍历到 时,。此时 还是 。
最后返回 的最大值。
复杂度分析
- 时间复杂度:,其中 为 的长度。瓶颈在排序上。
- 空间复杂度:。
分类题单
以下题单没有特定的顺序,可以按照个人喜好刷题。
- 滑动窗口(定长/不定长/多指针)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/贪心/脑筋急转弯)
- 图论算法(DFS/BFS/拓扑排序/最短路/最小生成树/二分图/基环树/欧拉路径)
- 动态规划(入门/背包/状态机/划分/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
欢迎关注 B站@灵茶山艾府
import (
	"slices"
)

// https://space.bilibili.com/206214
func maxSelectedElements(nums []int) (ans int) {
	slices.Sort(nums)
	f := map[int]int{}
	for _, x := range nums {
		f[x+1] = f[x] + 1
		f[x] = f[x-1] + 1
	}
	for _, res := range f {
		ans = max(ans, res)
	}
	return
}3077. K 个不相交子数组的最大能量值
题目、示例与约束
给你一个长度为 n 下标从 0 开始的整数数组 nums 和一个 正奇数 整数 k 。
x 个子数组的能量值定义为 strength = sum[1] * x - sum[2] * (x - 1) + sum[3] * (x - 2) - sum[4] * (x - 3) + ... + sum[x] * 1 ,其中 sum[i] 是第 i 个子数组的和。更正式的,能量值是满足 1 <= i <= x 的所有 i 对应的 (-1)i+1 * sum[i] * (x - i + 1) 之和。
你需要在 nums 中选择 k 个 不相交子数组 ,使得 能量值最大 。
请你返回可以得到的 最大能量值 。
注意,选出来的所有子数组 不 需要覆盖整个数组。
示例 1:
输入:nums = [1,2,3,-1,2], k = 3
输出:22
解释:选择 3 个子数组的最好方式是选择:nums[0..2] ,nums[3..3] 和 nums[4..4] 。能量值为 (1 + 2 + 3) * 3 - (-1) * 2 + 2 * 1 = 22 。
示例 2:
输入:nums = [12,-2,-2,-2,-2], k = 5
输出:64
解释:唯一一种选 5 个不相交子数组的方案是:nums[0..0] ,nums[1..1] ,nums[2..2] ,nums[3..3] 和 nums[4..4] 。能量值为 12 * 5 - (-2) * 4 + (-2) * 3 - (-2) * 2 + (-2) * 1 = 64 。
示例 3:
输入:nums = [-1,-2,-3], k = 1
输出:-1
解释:选择 1 个子数组的最优方案是:nums[0..0] 。能量值为 -1 。
提示:
1 <= n <= 104-109 <= nums[i] <= 1091 <= k <= n1 <= n * k <= 106k是奇数。
方法一:动态规划 · Go 实现
思考
选 个不相交子数组,第 个带权 且符号交替。 ,可接受 DP。
每个位置要决定:不选、接到当前段、或新开一段。新开一段才改变段号与符号。
状态 表示前 个数已选 段、第 个数是否在段内。按符号 与系数 转移。
对于第 个数 ,如果它被选择,且位于第 个子数组,那么它对答案的贡献是 ,我们不妨将 记为 ,那么它对答案的贡献是 。
我们定义 表示从前 $i 个数中选择 个子数组,且第 个数不被选的最大能量值,定义 表示从前 个数中选择 个子数组,且第 个数被选的最大能量值。初始时 ,其余的值都是 。
当 时,我们考虑 如何进行状态转移。
如果第 个数不被选,那么第 个数既可以被选,也可以不被选,所以 。
如果第 个数被选,此时如果第 个数与第 个数位于同一个子数组中,那么 ,否则 。我们取这两种情况的最大值作为 。
最终答案是 。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func maximumStrength(nums []int, k int) int64 {
	n := len(nums)
	f := make([][][]int64, n+1)
	const inf int64 = math.MinInt64 / 2
	for i := range f {
		f[i] = make([][]int64, k+1)
		for j := range f[i] {
			f[i][j] = []int64{inf, inf}
		}
	}
	f[0][0][0] = 0
	for i := 1; i <= n; i++ {
		x := nums[i-1]
		for j := 0; j <= k; j++ {
			sign := int64(-1)
			if j&1 == 1 {
				sign = 1
			}
			val := sign * int64(x) * int64(k-j+1)
			f[i][j][0] = max(f[i-1][j][0], f[i-1][j][1])
			f[i][j][1] = max(f[i][j][1], f[i-1][j][1]+val)
			if j > 0 {
				t := max(f[i-1][j-1][0], f[i-1][j-1][1]) + val
				f[i][j][1] = max(f[i][j][1], t)
			}
		}
	}
	return max(f[n][k][0], f[n][k][1])
}3082. 求出所有子序列的能量和
题目、示例与约束
给你一个长度为 n 的整数数组 nums 和一个 正 整数 k 。
一个整数数组的 能量 定义为和 等于 k 的子序列的数目。
请你返回 nums 中所有子序列的 能量和 。
由于答案可能很大,请你将它对 109 + 7 取余 后返回。
示例 1:
输入: nums = [1,2,3], k = 3
输出: 6
解释:
总共有 5 个能量不为 0 的子序列:
- 子序列
[1,2,3]有2个和为3的子序列:[1,2,3]和[1,2,3]。 - 子序列
[1,2,3]有1个和为3的子序列:[1,2,3]。 - 子序列
[1,2,3]有1个和为3的子序列:[1,2,3]。 - 子序列
[1,2,3]有1个和为3的子序列:[1,2,3]。 - 子序列
[1,2,3]有1个和为3的子序列:[1,2,3]。
所以答案为 2 + 1 + 1 + 1 + 1 = 6 。
示例 2:
输入: nums = [2,3,3], k = 5
输出: 4
解释:
总共有 3 个能量不为 0 的子序列:
- 子序列
[2,3,3]有 2 个子序列和为5:[2,3,3]和[2,3,3]。 - 子序列
[2,3,3]有 1 个子序列和为5:[2,3,3]。 - 子序列
[2,3,3]有 1 个子序列和为5:[2,3,3]。
所以答案为 2 + 1 + 1 = 4 。
示例 3:
输入: nums = [1,2,3], k = 7
输出: 0
解释:不存在和为 7 的子序列,所以 nums 的能量和为 0 。
提示:
1 <= n <= 1001 <= nums[i] <= 1041 <= k <= 100
方法一:动态规划 · Go 实现
思考
对每个子序列 ,再统计 的和为 的子序列个数,最后对所有 求和。 。
元素有三种身份:不在 、在 但不在求和子序列 、在 中。前两种对和的贡献相同,系数均为上一状态。
因此 ,初值 。
题目需要我们在给定数组 中找到所有子序列 ,然后计算每个 的每个子序列 的和等于 的方案数。
我们定义 表示前 个数构成的若干个子序列中,每个子序列的子序列和等于 的方案数。初始时 ,其余位置均为 。
对于第 个数 ,有以下三种情况:
- 不在子序列 中,此时 ;
- 在子序列 ,但不在子序列 中,此时 ;
- 在子序列 ,且在子序列 中,此时 。
综上,状态转移方程为:
最终答案为 。
时间复杂度 ,空间复杂度 。其中 为数组 的长度,而 为给定的正整数。
func sumOfPower(nums []int, k int) int {
	const mod int = 1e9 + 7
	n := len(nums)
	f := make([][]int, n+1)
	for i := range f {
		f[i] = make([]int, k+1)
	}
	f[0][0] = 1
	for i := 1; i <= n; i++ {
		for j := 0; j <= k; j++ {
			f[i][j] = (f[i-1][j] * 2) % mod
			if j >= nums[i-1] {
				f[i][j] = (f[i][j] + f[i-1][j-nums[i-1]]) % mod
			}
		}
	}
	return f[n][k]
}
方法二:动态规划(优化) · Go 实现
思考
方法一的转移只依赖上一行的 与 ,第一维可以去掉。
倒序更新一维数组,避免把本轮已写入的 再次使用,空间降为 。
方法一中的状态转移方程中, 的值只与 和 有关,因此我们可以优化第一维空间,从而将空间复杂度优化为 。
时间复杂度 ,空间复杂度 。其中 为数组 的长度,而 为给定的正整数。
func sumOfPower(nums []int, k int) int {
	const mod int = 1e9 + 7
	f := make([]int, k+1)
	f[0] = 1
	for _, x := range nums {
		for j := k; j >= 0; j-- {
			f[j] = f[j] * 2 % mod
			if j >= x {
				f[j] = (f[j] + f[j-x]) % mod
			}
		}
	}
	return f[k]
}3098. 求出所有子序列的能量和
题目、示例与约束
给你一个长度为 n 的整数数组 nums 和一个 正 整数 k 。
一个 子序列 的 能量 定义为子序列中 任意 两个元素的差值绝对值的 最小值 。
请你返回 nums 中长度 等于 k 的 所有 子序列的 能量和 。
由于答案可能会很大,将答案对 109 + 7 取余 后返回。
示例 1:
输入:nums = [1,2,3,4], k = 3
输出:4
解释:
nums 中总共有 4 个长度为 3 的子序列:[1,2,3] ,[1,3,4] ,[1,2,4] 和 [2,3,4] 。能量和为 |2 - 3| + |3 - 4| + |2 - 1| + |3 - 4| = 4 。
示例 2:
输入:nums = [2,2], k = 2
输出:0
解释:
nums 中唯一一个长度为 2 的子序列是 [2,2] 。能量和为 |2 - 2| = 0 。
示例 3:
输入:nums = [4,3,-1], k = 2
输出:10
解释:
nums 总共有 3 个长度为 2 的子序列:[4,3] ,[4,-1] 和 [3,-1] 。能量和为 |4 - 3| + |4 - (-1)| + |3 - (-1)| = 10 。
提示:
2 <= n == nums.length <= 50-108 <= nums[i] <= 1082 <= k <= n
方法一:记忆化搜索 · Go 实现
思考
子序列能量是其中任意两数差的最小值,求所有长为 的子序列能量之和。 。
排序后相邻被选元素的差才可能成为该子序列的最小差,状态可用「当前位置、上一个选中下标、剩余个数、当前最小差」描述。
记忆化 :不选 则保持 ;选 则用 更新最小差。排序保证差为非负。
由于题目涉及子序列元素的最小差值,我们不妨对数组 进行排序,这样可以方便我们计算子序列元素的最小差值。
接下来,我们设计一个函数 ,表示当前处理到第 个元素,上一个选取的是第 个元素,还需要选取 个元素,当前的最小差值为 时,能量和的值。那么答案就是 。(若上一个选取的是第 个元素,表示之前没有选取过元素)
函数 的执行过程如下:
- 如果 ,表示已经处理完了所有的元素,如果 ,返回 ,否则返回 ;
- 如果剩余的元素个数 不足 个,返回 ;
- 否则,我们可以选择不选取第 个元素,可以获得的能量和为 ;
- 也可以选择选取第 个元素。如果 ,表示之前没有选取过元素,那么可以获得的能量和为 ;否则,可以获得的能量和为 。
- 我们累加上述结果,并对 取模后返回。
为了避免重复计算,我们可以使用记忆化搜索的方法,将已经计算过的结果保存起来。
时间复杂度 ,空间复杂度 。其中 为数组的长度。
func sumOfPowers(nums []int, k int) int {
	const mod int = 1e9 + 7
	sort.Ints(nums)
	n := len(nums)
	f := map[int]int{}
	var dfs func(i, j, k, mi int) int
	dfs = func(i, j, k, mi int) int {
		if i >= n {
			if k == 0 {
				return mi
			}
			return 0
		}
		if n-i < k {
			return 0
		}
		key := mi<<18 | (i << 12) | (j << 6) | k
		if v, ok := f[key]; ok {
			return v
		}
		ans := dfs(i+1, j, k, mi)
		if j == n {
			ans += dfs(i+1, i, k-1, mi)
		} else {
			ans += dfs(i+1, i, k-1, min(mi, nums[i]-nums[j]))
		}
		ans %= mod
		f[key] = ans
		return ans
	}
	return dfs(0, n, k, math.MaxInt)
}3122. 使矩阵满足条件的最少操作次数
题目、示例与约束
给你一个大小为 m x n 的二维矩形 grid 。每次 操作 中,你可以将 任一 格子的值修改为 任意 非负整数。完成所有操作后,你需要确保每个格子 grid[i][j] 的值满足:
- 如果下面相邻格子存在的话,它们的值相等,也就是
grid[i][j] == grid[i + 1][j](如果存在)。 - 如果右边相邻格子存在的话,它们的值不相等,也就是
grid[i][j] != grid[i][j + 1](如果存在)。
请你返回需要的 最少 操作数目。
示例 1:
输入:grid = [[1,0,2],[1,0,2]]
输出:0
解释:
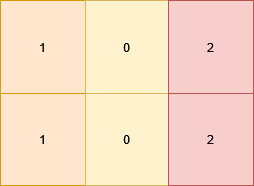
矩阵中所有格子已经满足要求。
示例 2:
输入:grid = [[1,1,1],[0,0,0]]
输出:3
解释:
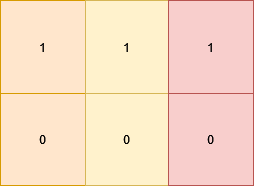
将矩阵变成 [[1,0,1],[1,0,1]] ,它满足所有要求,需要 3 次操作:
- 将
grid[1][0]变为 1 。 - 将
grid[0][1]变为 0 。 - 将
grid[1][2]变为 1 。
示例 3:
输入:grid = [[1],[2],[3]]
输出:2
解释:
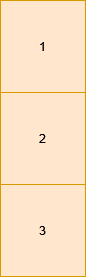
这个矩阵只有一列,我们可以通过 2 次操作将所有格子里的值变为 1 。
提示:
1 <= n, m <= 10000 <= grid[i][j] <= 9
方法一:动态规划 · Go 实现
思考
每列须改为同一数字,且相邻列数字不同。若对每列枚举数字再递归后续列,状态数为 。
列间只有「上一列选了哪个数字」会影响转移,格子取值仅 到 。先统计本列各数字出现次数,改成 的代价为 。
定义 为前 列且第 列取 的最小代价,由 的 转移。最后取 的最小值。
我们注意到,矩阵中格子的值只有 种可能,题目需要我们求出每一列数字相同,且相邻列数字不同的最小操作次数。那么我们只需要考虑将数字修改为 到 的情况即可。
我们定义状态 表示前 列数字,且第 列数字为 的最小操作次数。那么我们可以得到状态转移方程:
其中 表示第 列数字为 的个数。
最后我们只需要求出 的最小值即可。
时间复杂度 ,空间复杂度 。其中 和 分别表示矩阵的行数和列数;而 表示数字的种类数,这里 。
func minimumOperations(grid [][]int) int {
	m, n := len(grid), len(grid[0])
	f := make([][]int, n)
	for i := range f {
		f[i] = make([]int, 10)
		for j := range f[i] {
			f[i][j] = 1 << 29
		}
	}
	for i := 0; i < n; i++ {
		cnt := [10]int{}
		for j := 0; j < m; j++ {
			cnt[grid[j][i]]++
		}
		if i == 0 {
			for j := 0; j < 10; j++ {
				f[i][j] = m - cnt[j]
			}
		} else {
			for j := 0; j < 10; j++ {
				for k := 0; k < 10; k++ {
					if j != k {
						f[i][j] = min(f[i][j], f[i-1][k]+m-cnt[j])
					}
				}
			}
		}
	}
	return slices.Min(f[n-1])
}3129. 找出所有稳定的二进制数组 I
题目、示例与约束
给你 3 个正整数 num_zeros ,num_ones 和 limit 。
一个 二进制数组 arr 如果满足以下条件,那么我们称它是 稳定的 :
- 0 在
arr中出现次数 恰好 为num_zeros。 - 1 在
arr中出现次数 恰好 为num_ones。 arr中每个长度超过limit的 子数组 都 同时 包含 0 和 1 。
请你返回一个整数表示 稳定 二进制数组的 总 数目。
由于答案可能很大,将它对 109 + 7 取余 后返回。
示例 1:
输入:zero = 1, one = 1, limit = 2
输出:2
解释:
两个稳定的二进制数组为 [1,0] 和 [0,1] ,两个数组都有一个 0 和一个 1 ,且没有子数组长度大于 2 。
示例 2:
输入:zero = 1, one = 2, limit = 1
输出:1
解释:
唯一稳定的二进制数组是 [1,0,1] 。
二进制数组 [1,1,0] 和 [0,1,1] 都有长度为 2 且元素全都相同的子数组,所以它们不稳定。
示例 3:
输入:zero = 3, one = 3, limit = 2
输出:14
解释:
所有稳定的二进制数组包括 [0,0,1,0,1,1] ,[0,0,1,1,0,1] ,[0,1,0,0,1,1] ,[0,1,0,1,0,1] ,[0,1,0,1,1,0] ,[0,1,1,0,0,1] ,[0,1,1,0,1,0] ,[1,0,0,1,0,1] ,[1,0,0,1,1,0] ,[1,0,1,0,0,1] ,[1,0,1,0,1,0] ,[1,0,1,1,0,0] ,[1,1,0,0,1,0] 和 [1,1,0,1,0,0] 。
提示:
1 <= zero, one, limit <= 200
方法一:记忆化搜索 · Go 实现
思考
稳定数组要求任意连续相同段长度不超过 。在 个 与 个 上直接回溯,方案数随组合爆炸。
填完后的合法性只依赖剩余 、 个数以及下一位准备填的数字。连续超限等价于「连续填了 个相同位且再往前是另一种位」。
定义 为剩余 个 、 个 且下一位填 的方案。转移为续填同色或改色,并减去超限的那一支。记忆化后状态量为 。
我们设计一个函数 表示还剩下 个 和 个 且接下来待填的数字是 的情况下,满足题目条件的稳定二进制数组的个数。那么答案就是 。
函数 的计算过程如下:
- 如果 或 ,返回 。
- 如果 ,那么当 且 时返回 ,否则返回 。
- 如果 ,那么当 且 时返回 ,否则返回 。
- 如果 ,我们考虑前一个数字是 的情况 和前一个数字是 的情况 ,如果前一个数是 ,那么有可能使得子数组中有超过 个 ,即不允许出现倒数第 个数是 的情况,所以我们要减去这种情况,即 。
- 如果 ,我们考虑前一个数字是 的情况 和前一个数字是 的情况 ,如果前一个数是 ,那么有可能使得子数组中有超过 个 ,即不允许出现倒数第 个数是 的情况,所以我们要减去这种情况,即 。
为了避免重复计算,我们使用记忆化搜索的方法。
时间复杂度 ,空间复杂度 。
func numberOfStableArrays(zero int, one int, limit int) int {
	const mod int = 1e9 + 7
	f := make([][][2]int, zero+1)
	for i := range f {
		f[i] = make([][2]int, one+1)
		for j := range f[i] {
			f[i][j] = [2]int{-1, -1}
		}
	}
	var dfs func(i, j, k int) int
	dfs = func(i, j, k int) int {
		if i < 0 || j < 0 {
			return 0
		}
		if i == 0 {
			if k == 1 && j <= limit {
				return 1
			}
			return 0
		}
		if j == 0 {
			if k == 0 && i <= limit {
				return 1
			}
			return 0
		}
		res := &f[i][j][k]
		if *res != -1 {
			return *res
		}
		if k == 0 {
			*res = (dfs(i-1, j, 0) + dfs(i-1, j, 1) - dfs(i-limit-1, j, 1) + mod) % mod
		} else {
			*res = (dfs(i, j-1, 0) + dfs(i, j-1, 1) - dfs(i, j-limit-1, 0) + mod) % mod
		}
		return *res
	}
	return (dfs(zero, one, 0) + dfs(zero, one, 1)) % mod
}
方法二:动态规划 · Go 实现
思考
方法一的状态转移没有后效,递归与缓存的常系数在 接近上界时偏大。
同一递推可按剩余个数从小到大填表: 表示用掉 个 、 个 且最后一位为 。
边界为只填一种数字且长度不超过 的串。迭代加上模运算后直接读取 。
我们也可以将方法一的记忆化搜索转换为动态规划。
我们定义 表示使用 个 和 个 且最后一个数字是 的稳定二进制数组的个数。那么答案就是 。
初始时,我们有 ,其中 ;有 ,其中 。
状态转移方程如下:
- 。
- 。
时间复杂度 ,空间复杂度 。
func numberOfStableArrays(zero int, one int, limit int) int {
	const mod int = 1e9 + 7
	f := make([][][2]int, zero+1)
	for i := range f {
		f[i] = make([][2]int, one+1)
	}
	for i := 1; i <= min(zero, limit); i++ {
		f[i][0][0] = 1
	}
	for j := 1; j <= min(one, limit); j++ {
		f[0][j][1] = 1
	}
	for i := 1; i <= zero; i++ {
		for j := 1; j <= one; j++ {
			f[i][j][0] = (f[i-1][j][0] + f[i-1][j][1]) % mod
			if i-limit-1 >= 0 {
				f[i][j][0] = (f[i][j][0] - f[i-limit-1][j][1] + mod) % mod
			}
			f[i][j][1] = (f[i][j-1][0] + f[i][j-1][1]) % mod
			if j-limit-1 >= 0 {
				f[i][j][1] = (f[i][j][1] - f[i][j-limit-1][0] + mod) % mod
			}
		}
	}
	return (f[zero][one][0] + f[zero][one][1]) % mod
}3130. 找出所有稳定的二进制数组 II
题目、示例与约束
给你 3 个正整数 num_zeros ,num_ones 和 limit 。
一个 二进制数组 arr 如果满足以下条件,那么我们称它是 稳定的 :
- 0 在
arr中出现次数 恰好 为num_zeros。 - 1 在
arr中出现次数 恰好 为num_ones。 arr中每个长度超过limit的 子数组 都 同时 包含 0 和 1 。
请你返回一个整数,表示 稳定 二进制数组的 总 数目。
由于答案可能很大,将它对 109 + 7 取余 后返回。
示例 1:
输入:zero = 1, one = 1, limit = 2
输出:2
解释:
两个稳定的二进制数组为 [1,0] 和 [0,1] ,两个数组都有一个 0 和一个 1 ,且没有子数组长度大于 2 。
示例 2:
输入:zero = 1, one = 2, limit = 1
输出:1
解释:
唯一稳定的二进制数组是 [1,0,1] 。
二进制数组 [1,1,0] 和 [0,1,1] 都有长度为 2 且元素全都相同的子数组,所以它们不稳定。
示例 3:
输入:zero = 3, one = 3, limit = 2
输出:14
解释:
所有稳定的二进制数组包括 [0,0,1,0,1,1] ,[0,0,1,1,0,1] ,[0,1,0,0,1,1] ,[0,1,0,1,0,1] ,[0,1,0,1,1,0] ,[0,1,1,0,0,1] ,[0,1,1,0,1,0] ,[1,0,0,1,0,1] ,[1,0,0,1,1,0] ,[1,0,1,0,0,1] ,[1,0,1,0,1,0] ,[1,0,1,1,0,0] ,[1,1,0,0,1,0] 和 [1,1,0,1,0,0] 。
提示:
1 <= zero, one, limit <= 1000
方法一:记忆化搜索 · Go 实现
思考
题意与 I 相同,但 、 更大,朴素回溯不可行。稳定约束仍只与剩余个数及下一位有关。
超限项同样是减去「连续 个相同位」的那一支,状态量仍为 。
因此沿用 记忆化,答案对 取模,并在返回前清空缓存以免占用额外空间。
我们设计一个函数 表示还剩下 个 和 个 且接下来待填的数字是 的情况下,满足题目条件的稳定二进制数组的个数。那么答案就是 。
函数 的计算过程如下:
- 如果 或 ,返回 。
- 如果 ,那么当 且 时返回 ,否则返回 。
- 如果 ,那么当 且 时返回 ,否则返回 。
- 如果 ,我们考虑前一个数字是 的情况 和前一个数字是 的情况 ,如果前一个数是 ,那么有可能使得子数组中有超过 个 ,即不允许出现倒数第 个数是 的情况,所以我们要减去这种情况,即 。
- 如果 ,我们考虑前一个数字是 的情况 和前一个数字是 的情况 ,如果前一个数是 ,那么有可能使得子数组中有超过 个 ,即不允许出现倒数第 个数是 的情况,所以我们要减去这种情况,即 。
为了避免重复计算,我们使用记忆化搜索的方法。
时间复杂度 ,空间复杂度 。
func numberOfStableArrays(zero int, one int, limit int) int {
	const mod int = 1e9 + 7
	f := make([][][2]int, zero+1)
	for i := range f {
		f[i] = make([][2]int, one+1)
		for j := range f[i] {
			f[i][j] = [2]int{-1, -1}
		}
	}
	var dfs func(i, j, k int) int
	dfs = func(i, j, k int) int {
		if i < 0 || j < 0 {
			return 0
		}
		if i == 0 {
			if k == 1 && j <= limit {
				return 1
			}
			return 0
		}
		if j == 0 {
			if k == 0 && i <= limit {
				return 1
			}
			return 0
		}
		res := &f[i][j][k]
		if *res != -1 {
			return *res
		}
		if k == 0 {
			*res = (dfs(i-1, j, 0) + dfs(i-1, j, 1) - dfs(i-limit-1, j, 1) + mod) % mod
		} else {
			*res = (dfs(i, j-1, 0) + dfs(i, j-1, 1) - dfs(i, j-limit-1, 0) + mod) % mod
		}
		return *res
	}
	return (dfs(zero, one, 0) + dfs(zero, one, 1)) % mod
}
方法二:动态规划 · Go 实现
思考
方法一已是多项式时间,但递归深度与缓存开销在更大数据下更明显。
将同一转移改成迭代: 按 、 升序填表,边界与 I 中方法二一致。
模运算写在递推里,最终返回 ,避免递归栈。
我们也可以将方法一的记忆化搜索转换为动态规划。
我们定义 表示使用 个 和 个 且最后一个数字是 的稳定二进制数组的个数。那么答案就是 。
初始时,我们有 ,其中 ;有 ,其中 。
状态转移方程如下:
- 。
- 。
时间复杂度 ,空间复杂度 。
func numberOfStableArrays(zero int, one int, limit int) int {
	const mod int = 1e9 + 7
	f := make([][][2]int, zero+1)
	for i := range f {
		f[i] = make([][2]int, one+1)
	}
	for i := 1; i <= min(zero, limit); i++ {
		f[i][0][0] = 1
	}
	for j := 1; j <= min(one, limit); j++ {
		f[0][j][1] = 1
	}
	for i := 1; i <= zero; i++ {
		for j := 1; j <= one; j++ {
			f[i][j][0] = (f[i-1][j][0] + f[i-1][j][1]) % mod
			if i-limit-1 >= 0 {
				f[i][j][0] = (f[i][j][0] - f[i-limit-1][j][1] + mod) % mod
			}
			f[i][j][1] = (f[i][j-1][0] + f[i][j-1][1]) % mod
			if j-limit-1 >= 0 {
				f[i][j][1] = (f[i][j][1] - f[i][j-limit-1][0] + mod) % mod
			}
		}
	}
	return (f[zero][one][0] + f[zero][one][1]) % mod
}3135. 通过添加或删除结尾字符来同化字符串 🔒
题目、示例与约束
给定两个字符串 initial 和 target,你的任务是通过一系列操作改变 initial 以使它与 target 相同。
在一次操作中,您只能在 initial 字符串开头或结尾添加或删除一个字符。
返回将 initial 变为 target 所需的最小 操作次数。
示例 1:
输入:initial = "abcde", target = "cdef"
输出:3
解释:
从 initial 的开头删除 'a' 和 'b' 并添加 'f' 到结尾。
示例 2:
输入:initial = "axxy", target = "yabx"
输出:6
解释:
| 操作 | 结果字符串 |
|---|---|
将 'y' 添加到开头 |
"yaxxy" |
| 从结尾删除 | "yaxx" |
| 从结尾删除 | "yax" |
| 从结尾删除 | "ya" |
将 'b' 添加到结尾 |
"yab" |
将 'x' 添加到结尾 |
"yabx" |
示例 3:
输入:initial = "xyz", target = "xyz"
输出:0
解释:
不需要任何操作,因为字符串已经相等。
提示:
1 <= initial.length, target.length <= 1000initial和target只包含小写英文字母。
方法一:动态规划 · Go 实现
思考
只能删前缀/后缀或在两端添加,本质上是保留一段公共连续子串。枚举 每个子串在 中查找,时间为 。
操作次数等于两端丢掉的字符数加上补齐 其余部分,即 ,其中 为最长公共子串长度。
经典 DP: 表示以 与 结尾的公共子串长,相等则由 转移。取全局最大 即可。
我们不妨假设字符串 initial 和 target 的长度分别为 和 。
根据题目描述,我们只需要求出 initial 和 target 的最长公共子串的长度 ,那么我们可以从 initial 中删除 个字符,然后再添加 个字符,即可将 initial 转换为 target,因此答案为 。
我们可以使用动态规划的方法求出 initial 和 target 的最长公共子串的长度 。我们定义一个二维数组 ,其中 表示以 initial[i - 1] 和 target[j - 1] 结尾的最长公共子串的长度。那么我们可以得到状态转移方程:
那么 ,最终答案为 。
时间复杂度 ,空间复杂度 。其中 和 分别为字符串 initial 和 target 的长度。
func minOperations(initial string, target string) int {
	m, n := len(initial), len(target)
	f := make([][]int, m+1)
	for i := range f {
		f[i] = make([]int, n+1)
	}
	mx := 0
	for i, a := range initial {
		for j, b := range target {
			if a == b {
				f[i+1][j+1] = f[i][j] + 1
				mx = max(mx, f[i+1][j+1])
			}
		}
	}
	return m + n - 2*mx
}3144. 分割字符频率相等的最少子字符串
题目、示例与约束
给你一个字符串 s ,你需要将它分割成一个或者更多的 平衡 子字符串。比方说,s == "ababcc" 那么 ("abab", "c", "c") ,("ab", "abc", "c") 和 ("ababcc") 都是合法分割,但是 ("a", "bab", "cc") ,("aba", "bc", "c") 和 ("ab", "abcc") 不是,不平衡的子字符串用粗体表示。
请你返回 s 最少 能分割成多少个平衡子字符串。
注意:一个 平衡 字符串指的是字符串中所有字符出现的次数都相同。
示例 1:
输入:s = "fabccddg"
输出:3
解释:
我们可以将 s 分割成 3 个子字符串:("fab, "ccdd", "g") 或者 ("fabc", "cd", "dg") 。
示例 2:
输入:s = "abababaccddb"
输出:2
解释:
我们可以将 s 分割成 2 个子字符串:("abab", "abaccddb") 。
提示:
1 <= s.length <= 1000s只包含小写英文字母。
方法一:记忆化搜索 + 哈希表 · Go 实现
思考
要把 切成尽量少的平衡子串,即每段内各字符出现次数相等。枚举全部切法是指数级的, 允许平方转移。
从位置 出发,向右扩展 时可用频次表判断当前段是否平衡:若出现次数的种类数为 ,则该段可切。最优子结构只依赖起点。
因此记忆化 :维护 与 ,每当 仅含一种次数就用 更新。空后缀返回 。
我们设计一个函数 ,表示从字符串 开始分割的最少子字符串数量。那么答案就是 。
函数 的计算过程如下:
如果 ,表示已经处理完了所有字符,返回 。
否则,我们维护一个哈希表 ,表示当前子字符串中每个字符出现的次数。另外,我们还维护一个哈希表 ,表示每个字符出现的次数的频率。
然后我们枚举 从 到 ,表示当前子字符串的结束位置。对于每个 ,我们更新 和 ,然后判断 的大小是否为 ,如果是的话,我们可以从 开始分割,此时答案为 ,我们取所有 中答案的最小值作为函数的返回值。
为了避免重复计算,我们使用记忆化搜索。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度,而 表示字符集的大小,本题中 。
func minimumSubstringsInPartition(s string) int {
	n := len(s)
	f := make([]int, n)
	for i := range f {
		f[i] = -1
	}
	var dfs func(int) int
	dfs = func(i int) int {
		if i >= n {
			return 0
		}
		if f[i] != -1 {
			return f[i]
		}
		cnt := [26]int{}
		freq := map[int]int{}
		f[i] = n - i
		for j := i; j < n; j++ {
			k := int(s[j] - 'a')
			if cnt[k] > 0 {
				freq[cnt[k]]--
				if freq[cnt[k]] == 0 {
					delete(freq, cnt[k])
				}
			}
			cnt[k]++
			freq[cnt[k]]++
			if len(freq) == 1 {
				f[i] = min(f[i], 1+dfs(j+1))
			}
		}
		return f[i]
	}
	return dfs(0)
}
方法二:记忆化搜索(优化) · Go 实现
思考
方法一额外用 哈希表维护「出现次数的次数」,常数偏大,且每种次数的插入删除容易写繁。
平衡条件等价于段长等于「最大频次 种类数」。只需 与当前最大频次 。
扩展 时更新 ,当 再递归。状态仍是起点 ,渐近时间不变而实现更短。
我们可以对方法一进行优化,不需要维护 哈希表,只需要维护一个哈希表 ,表示当前子字符串中每个字符出现的次数。另外,维护两个变量 和 分别表示当前子字符串中的字符种类数和出现次数最多的字符的出现次数。对于一个子串 ,如果 ,那么这个子串就是一个平衡子串。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度,而 表示字符集的大小,本题中 。
func minimumSubstringsInPartition(s string) int {
	n := len(s)
	f := make([]int, n)
	for i := range f {
		f[i] = -1
	}
	var dfs func(int) int
	dfs = func(i int) int {
		if i >= n {
			return 0
		}
		if f[i] != -1 {
			return f[i]
		}
		cnt := [26]int{}
		f[i] = n - i
		k, m := 0, 0
		for j := i; j < n; j++ {
			x := int(s[j] - 'a')
			cnt[x]++
			if cnt[x] == 1 {
				k++
			}
			m = max(m, cnt[x])
			if j-i+1 == k*m {
				f[i] = min(f[i], 1+dfs(j+1))
			}
		}
		return f[i]
	}
	return dfs(0)
}
方法三:动态规划 · Go 实现
思考
方法二已经按后缀记下同一组最少段数。同一转移没有后效,也可以改记成前缀。
令 为前 个字符的最少段数。枚举右端 ,再向左扩 ,用种类数与最大频次判定平衡后用 更新 。
迭代填表后 即为答案,空间降为线性外加一个计数表。
最少段数也可以记在前缀上。定义状态 为对前 个字符进行分割的最少子字符串数量。初始时 ,其余 或者 。
接下来我们枚举 从 到 ,对于每个 ,我们维护一个哈希表 ,表示当前子字符串中每个字符出现的次数。另外,我们维护两个变量 和 分别表示当前子字符串中的字符种类数和出现次数最多的字符的出现次数。对于一个子串 ,如果 ,那么这个子串就是一个平衡子串。此时我们可以从 开始分割,那么 。
最终答案为 。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度,而 表示字符集的大小,本题中 。
func minimumSubstringsInPartition(s string) int {
	n := len(s)
	f := make([]int, n+1)
	for i := range f {
		f[i] = n
	}
	f[0] = 0
	for i := 0; i < n; i++ {
		cnt := [26]int{}
		k, m := 0, 0
		for j := i; j >= 0; j-- {
			x := int(s[j] - 'a')
			cnt[x]++
			if cnt[x] == 1 {
				k++
			}
			m = max(m, cnt[x])
			if i-j+1 == k*m {
				f[i+1] = min(f[i+1], 1+f[j])
			}
		}
	}
	return f[n]
}
方法四:动态规划 + 哈希表 · Go 实现
思考
枚举全部切法是指数级的。字符串长度可以到 ,而单个字符本身就是平衡段,第一次转移总会落到下一个下标,递归深度就是 。一段是否平衡只看这段里各字符的出现次数是否相同,起点 的最少段数只依赖更靠右的答案。于是令 为从 开始的最少段数, ,从右往左扩展右端点,用 与次数的次数 判断,仅一种次数时用 更新。
设 为从下标 开始分割的最少子字符串数量,边界 。从 递减到 。对每个起点维护哈希表 ,记录当前子串里每个字符的出现次数,以及哈希表 ,记录这些出现次数各自出现了多少次。枚举右端点 从 到 ,把 并入当前段并更新两张表。若 的大小为 ,则 是平衡子串,用 更新 。每个字符单独成段一定合法,所以上界可以取 。答案为 。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度,而 表示字符集的大小,本题中 。
func minimumSubstringsInPartition(s string) int {
	n := len(s)
	f := make([]int, n+1)
	for i := n - 1; i >= 0; i-- {
		cnt := [26]int{}
		freq := map[int]int{}
		ans := n - i
		for j := i; j < n; j++ {
			k := int(s[j] - 'a')
			if cnt[k] > 0 {
				freq[cnt[k]]--
				if freq[cnt[k]] == 0 {
					delete(freq, cnt[k])
				}
			}
			cnt[k]++
			freq[cnt[k]]++
			if len(freq) == 1 {
				ans = min(ans, 1+f[j+1])
			}
		}
		f[i] = ans
	}
	return f[0]
}
方法五:动态规划(优化) · Go 实现
思考
方法一每并入一个字符,都要在第二张表里删掉旧次数再插入新次数。平衡其实等价于段长等于最大频次乘以字符种类数,一张 就够。起点 的答案仍只依赖右侧,所以 继续从右往左填写。扩展 时维护种类数 和最大频次 ,当 时用 更新。
方法一里的 可以省去,只维护每个字符的出现次数 ,以及种类数 和最大频次 。 仍表示从下标 开始的最少段数, 。从右往左枚举起点 ,再向右扩展 。若 ,则 平衡,用 更新 。答案为 。
时间复杂度 ,空间复杂度 。其中 为字符串 的长度,而 表示字符集的大小,本题中 。
func minimumSubstringsInPartition(s string) int {
	n := len(s)
	f := make([]int, n+1)
	for i := n - 1; i >= 0; i-- {
		cnt := [26]int{}
		ans := n - i
		k, m := 0, 0
		for j := i; j < n; j++ {
			x := int(s[j] - 'a')
			cnt[x]++
			if cnt[x] == 1 {
				k++
			}
			m = max(m, cnt[x])
			if j-i+1 == k*m {
				ans = min(ans, 1+f[j+1])
			}
		}
		f[i] = ans
	}
	return f[0]
}3147. 从魔法师身上吸取的最大能量
题目、示例与约束
在神秘的地牢中,n 个魔法师站成一排。每个魔法师都拥有一个属性,这个属性可以给你提供能量。有些魔法师可能会给你负能量,即从你身上吸取能量。
你被施加了一种诅咒,当你从魔法师 i 处吸收能量后,你将被立即传送到魔法师 (i + k) 处。这一过程将重复进行,直到你到达一个不存在 (i + k) 的魔法师为止。
换句话说,你将选择一个起点,然后以 k 为间隔跳跃,直到到达魔法师序列的末端,在过程中吸收所有的能量。
给定一个数组 energy 和一个整数k,返回你能获得的 最大 能量。
示例 1:
输入: energy = [5,2,-10,-5,1], k = 3
输出: 3
解释:可以从魔法师 1 开始,吸收能量 2 + 1 = 3。
示例 2:
输入: energy = [-2,-3,-1], k = 2
输出: -1
解释:可以从魔法师 2 开始,吸收能量 -1。
提示:
1 <= energy.length <= 105-1000 <= energy[i] <= 10001 <= k <= energy.length - 1
方法一:枚举 + 逆序遍历 · Go 实现
思考
从某下标出发每次跳 步,能量可正可负,求最大路径和。枚举起点再向前累加是 ,但若从左往右需要先知道后面的最优后缀。
同一余系互不交叉。从每个余系的末端向前走,前缀和(逆序)的最大值即该起点的最优。
因此在 枚举终点,沿 累加并更新全局最大。每个下标恰访问一次。
我们可以在 的范围内枚举终点,然后从终点开始向前遍历,每次累加间隔为 的魔法师的能量值,更新答案。
时间复杂度 ,其中 是数组 的长度。空间复杂度 。
func maximumEnergy(energy []int, k int) int {
	ans := -(1 << 30)
	n := len(energy)
	for i := n - k; i < n; i++ {
		for j, s := i, 0; j >= 0; j -= k {
			s += energy[j]
			ans = max(ans, s)
		}
	}
	return ans
}3148. 矩阵中的最大得分
题目、示例与约束
给你一个由 正整数 组成、大小为 m x n 的矩阵 grid。你可以从矩阵中的任一单元格移动到另一个位于正下方或正右侧的任意单元格(不必相邻)。从值为 c1 的单元格移动到值为 c2 的单元格的得分为 c2 - c1 。
你可以从 任一 单元格开始,并且必须至少移动一次。
返回你能得到的 最大 总得分。
示例 1:
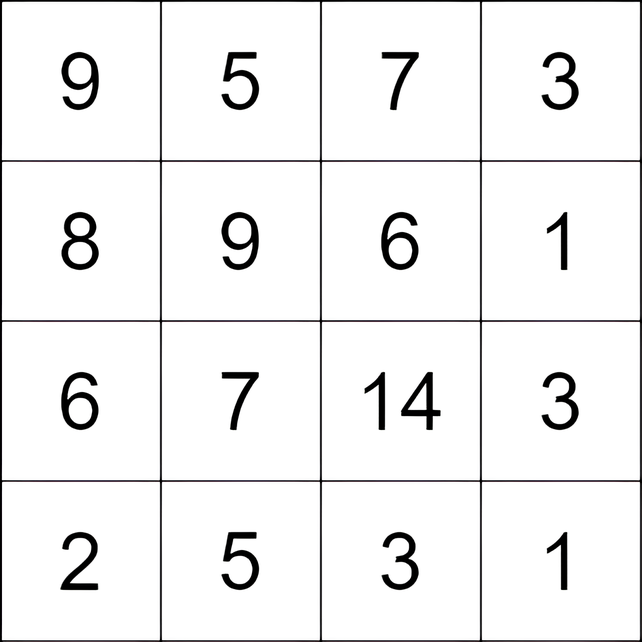
输入:grid = [[9,5,7,3],[8,9,6,1],[6,7,14,3],[2,5,3,1]]
输出:9
解释:从单元格 (0, 1) 开始,并执行以下移动:
- 从单元格 (0, 1) 移动到 (2, 1),得分为 7 - 5 = 2 。
- 从单元格 (2, 1) 移动到 (2, 2),得分为 14 - 7 = 7 。
总得分为 2 + 7 = 9 。
示例 2:
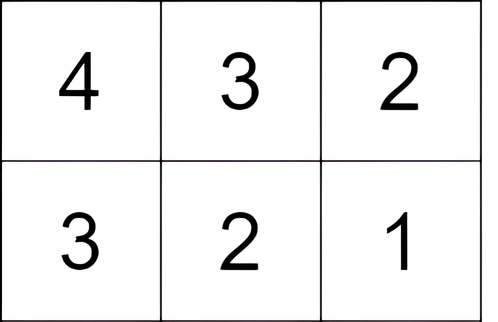
输入:grid = [[4,3,2],[3,2,1]]
输出:-1
解释:从单元格 (0, 0) 开始,执行一次移动:从 (0, 0) 到 (0, 1) 。得分为 3 - 4 = -1 。
提示:
m == grid.lengthn == grid[i].length2 <= m, n <= 10004 <= m * n <= 1051 <= grid[i][j] <= 105
方法一:动态规划 · Go 实现
思考
路径只能向右或向下,得分是相邻差之和,展开后等于终点减起点。枚举所有起点终点是 。
对每个终点,最优起点是其左上方(不含自身)的最小格子。该最小值可由上方与左方的前缀最小值递推。
令 为到达 时路径上见过的最小值(含自身),答案取 的最大者。
根据题目描述,如果我们经过的单元格的值依次是 ,那么我们的得分就是 。因此,问题转化为:对于矩阵的每个单元格 ,如果我们将其作为终点,那么起点的最小值是多少。
我们可以使用动态规划来解决这个问题。我们定义 表示以 为终点的路径的最小值。那么我们可以得到状态转移方程:
那么答案为 的最大值。
时间复杂度 ,空间复杂度 。其中 和 分别是矩阵的行数和列数。
func maxScore(grid [][]int) int {
	m, n := len(grid), len(grid[0])
	f := make([][]int, m)
	for i := range f {
		f[i] = make([]int, n)
	}
	const inf int = 1 << 30
	ans := -inf
	for i, row := range grid {
		for j, x := range row {
			mi := inf
			if i > 0 {
				mi = min(mi, f[i-1][j])
			}
			if j > 0 {
				mi = min(mi, f[i][j-1])
			}
			ans = max(ans, x-mi)
			f[i][j] = min(x, mi)
		}
	}
	return ans
}3149. 找出分数最低的排列
题目、示例与约束
给你一个数组 nums ,它是 [0, 1, 2, ..., n - 1] 的一个排列 。对于任意一个 [0, 1, 2, ..., n - 1] 的排列 perm ,其 分数 定义为:
score(perm) = |perm[0] - nums[perm[1]]| + |perm[1] - nums[perm[2]]| + ... + |perm[n - 1] - nums[perm[0]]|
返回具有 最低 分数的排列 perm 。如果存在多个满足题意且分数相等的排列,则返回其中字典序最小的一个。
示例 1:
输入:nums = [1,0,2]
输出:[0,1,2]
解释:
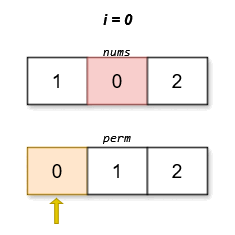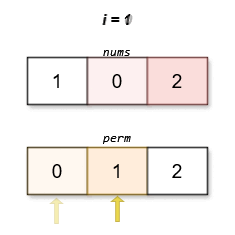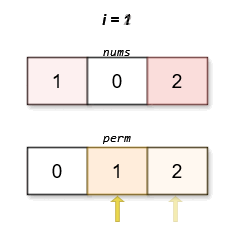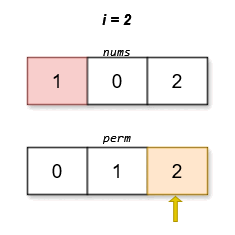
字典序最小且分数最低的排列是 [0,1,2]。这个排列的分数是 |0 - 0| + |1 - 2| + |2 - 1| = 2 。
示例 2:
输入:nums = [0,2,1]
输出:[0,2,1]
解释:
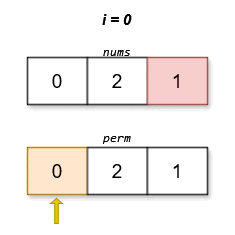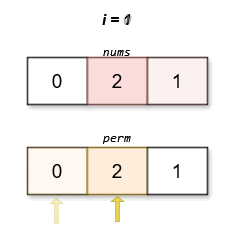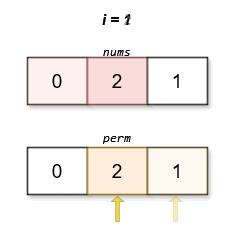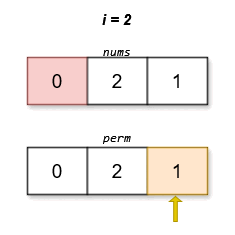
字典序最小且分数最低的排列是 [0,2,1]。这个排列的分数是 |0 - 1| + |2 - 2| + |1 - 0| = 2 。
提示:
2 <= n == nums.length <= 14nums是[0, 1, 2, ..., n - 1]的一个排列。
方法一:记忆化搜索 · Go 实现
思考
排列分数是相邻项 再加闭合项,且要字典序最小。 ,全排列为 不可行。
循环移位不改变分数,字典序最小迫使首位为 。其余位置用子集 与上一个值 即可 DP。
记忆化 枚举未使用的 ,加上 。填满后补上回到 的边。再用同一最优值回溯构造字典序最小序列。
我们注意到,对于任意一个排列 ,把它循环向左移动任意次,得到的排列分数依然是相同的。由于题目要求返回字典序最小的排列,因此我们可以确定排列的第一个元素一定是 。
另外,由于题目的数据范围不超过 ,我们可以考虑使用状态压缩的方法,来表示当前排列选取的数字集合。我们用一个长度为 的二进制数 来表示当前排列选取的数字集合,其中 的第 位为 表示数字 已经被选取,为 表示数字 还未被选取。
我们设计一个函数 ,表示当前排列选取的数字集合为 ,且最后一个选取的数字为 时,得到的排列的最小分数。初始时我们将数字 加入到排列中。
函数 的计算过程如下:
- 如果 的二进制表示中 的个数为 ,即 ,表示所有数字都已经被选取,此时返回 ;
- 否则,我们枚举下一个选取的数字 ,如果数字 还未被选取,那么我们可以将数字 加入到排列中,此时排列的分数为 ,我们需要取所有 中分数的最小值。
最后,我们利用一个函数 来构造得到最小分数的排列。我们首先将数字 加入到排列中,然后枚举下一个选取的数字 ,如果数字 还未被选取,且满足 的值等于 ,那么我们就可以将数字 加入到排列中。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func findPermutation(nums []int) (ans []int) {
	n := len(nums)
	f := make([][]int, 1<<n)
	for i := range f {
		f[i] = make([]int, n)
		for j := range f[i] {
			f[i][j] = -1
		}
	}
	var dfs func(int, int) int
	dfs = func(mask, pre int) int {
		if mask == 1<<n-1 {
			return abs(pre - nums[0])
		}
		if f[mask][pre] != -1 {
			return f[mask][pre]
		}
		res := &f[mask][pre]
		*res = math.MaxInt32
		for cur := 1; cur < n; cur++ {
			if mask>>cur&1 == 0 {
				*res = min(*res, abs(pre-nums[cur])+dfs(mask|1<<cur, cur))
			}
		}
		return *res
	}
	var g func(int, int)
	g = func(mask, pre int) {
		ans = append(ans, pre)
		if mask == 1<<n-1 {
			return
		}
		res := dfs(mask, pre)
		for cur := 1; cur < n; cur++ {
			if mask>>cur&1 == 0 {
				if abs(pre-nums[cur])+dfs(mask|1<<cur, cur) == res {
					g(mask|1<<cur, cur)
					break
				}
			}
		}
	}
	g(1, 0)
	return
}

func abs(x int) int {
	if x < 0 {
		return -x
	}
	return x
}3154. 到达第 K 级台阶的方案数
题目、示例与约束
给你有一个 非负 整数 k 。有一个无限长度的台阶,最低 一层编号为 0 。
Alice 有一个整数 jump ,一开始值为 0 。Alice 从台阶 1 开始,可以使用 任意 次操作,目标是到达第 k 级台阶。假设 Alice 位于台阶 i ,一次 操作 中,Alice 可以:
- 向下走一级到
i - 1,但该操作 不能 连续使用,如果在台阶第 0 级也不能使用。 - 向上走到台阶
i + 2jump处,然后jump变为jump + 1。
请你返回 Alice 到达台阶 k 处的总方案数。
注意,Alice 可能到达台阶 k 处后,通过一些操作重新回到台阶 k 处,这视为不同的方案。
示例 1:
输入:k = 0
输出:2
解释:
2 种到达台阶 0 的方案为:
- Alice 从台阶 1 开始。
- 执行第一种操作,从台阶 1 向下走到台阶 0 。
- Alice 从台阶 1 开始。
- 执行第一种操作,从台阶 1 向下走到台阶 0 。
- 执行第二种操作,向上走 20 级台阶到台阶 1 。
- 执行第一种操作,从台阶 1 向下走到台阶 0 。
示例 2:
输入:k = 1
输出:4
解释:
4 种到达台阶 1 的方案为:
- Alice 从台阶 1 开始,已经到达台阶 1 。
- Alice 从台阶 1 开始。
- 执行第一种操作,从台阶 1 向下走到台阶 0 。
- 执行第二种操作,向上走 20 级台阶到台阶 1 。
- Alice 从台阶 1 开始。
- 执行第二种操作,向上走 20 级台阶到台阶 2 。
- 执行第一种操作,向下走 1 级台阶到台阶 1 。
- Alice 从台阶 1 开始。
- 执行第一种操作,从台阶 1 向下走到台阶 0 。
- 执行第二种操作,向上走 20 级台阶到台阶 1 。
- 执行第一种操作,向下走 1 级台阶到台阶 0 。
- 执行第二种操作,向上走 21 级台阶到台阶 2 。
- 执行第一种操作,向下走 1 级台阶到台阶 1 。
提示:
0 <= k <= 109
方法一:记忆化搜索 · Go 实现
思考
两种操作:向下走一格(不能连续),或向上跳 并令 加一。从 出发到达 的方案数。盲目搜索分支随跳次指数增长。
位置一旦超过 便无法再下来回到 。跳的次数约为 ,状态 很少,其中 标记上次是否刚向下。
记忆化 :到达 先计 ,允许时向下,并始终尝试上跳。越界返回 。
我们设计一个函数 ,表示当前位于第 级台阶,且进行了 次操作 和 次操作 ,到达第 级台阶的方案数。那么答案就是 。
函数 的计算过程如下:
- 如果 ,由于无法连续两次向下走,所以无法再到达第 级台阶,返回 ;
- 如果 ,表示已经到达第 级台阶,答案初始化为 ,然后继续计算;
- 如果 且 ,表示可以向下走,递归计算 ;
- 递归计算 ,累加到答案中。
为了避免重复计算,我们使用记忆化搜索,将已经计算过的状态保存起来。
时间复杂度 ,空间复杂度 。
func waysToReachStair(k int) int {
	f := map[int]int{}
	var dfs func(i, j, jump int) int
	dfs = func(i, j, jump int) int {
		if i > k+1 {
			return 0
		}
		key := (i << 32) | jump<<1 | j
		if v, has := f[key]; has {
			return v
		}
		ans := 0
		if i == k {
			ans++
		}
		if i > 0 && j == 0 {
			ans += dfs(i-1, 1, jump)
		}
		ans += dfs(i+(1<<jump), 0, jump+1)
		f[key] = ans
		return ans
	}
	return dfs(1, 0, 0)
}3176. 求出最长好子序列 I
题目、示例与约束
给你一个整数数组 nums 和一个 非负 整数 k 。如果一个整数序列 seq 满足在下标范围 [0, seq.length - 2] 中 最多只有 k 个下标 i 满足 seq[i] != seq[i + 1] ,那么我们称这个整数序列为 好 序列。
请你返回 nums 中 好 子序列 的最长长度。
示例 1:
输入:nums = [1,2,1,1,3], k = 2
输出:4
解释:
最长好子序列为 [1,2,1,1,3] 。
示例 2:
输入:nums = [1,2,3,4,5,1], k = 0
输出:2
解释:
最长好子序列为 [1,2,3,4,5,1] 。
提示:
1 <= nums.length <= 5001 <= nums[i] <= 1090 <= k <= min(nums.length, 25)
方法一:动态规划 · Go 实现
思考
好子序列允许至多 次相邻值不同。 与 都不大,可对结尾位置与已用不同次数 DP。
转移到 时需看更早的 :值相等则不消耗次数,否则消耗一次。
令 为以 结尾、不同次数不超过 的最长长度,枚举 更新,答案为 。
我们定义 表示以 结尾,且有不超过 个下标满足条件的最长好子序列的长度。初始时 。答案为 ,其中 。
我们考虑如何计算 。我们可以枚举 ,如果 ,那么 ;否则如果 ,那么 。即:
最终答案为 ,其中 。
时间复杂度 ,空间复杂度 。其中 是数组 nums 的长度。
func maximumLength(nums []int, k int) (ans int) {
	f := make([][]int, len(nums))
	for i := range f {
		f[i] = make([]int, k+1)
	}
	for i, x := range nums {
		for h := 0; h <= k; h++ {
			for j, y := range nums[:i] {
				if x == y {
					f[i][h] = max(f[i][h], f[j][h])
				} else if h > 0 {
					f[i][h] = max(f[i][h], f[j][h-1])
				}
			}
			f[i][h]++
		}
		ans = max(ans, f[i][k])
	}
	return
}
方法二:动态规划优化 · Go 实现
思考
方法一对每个 再扫全部 ,在 I 的约束下可通过,但已暴露 的瓶颈。
相等转移只需要「同一值在次数 下的最大 」,不等转移只需要「次数 下的最大与次大(避开当前值)」。
用 与三元组 维护这些最值,把内层 去掉,为 II 的 做准备。
根据方法一的状态转移方程,如果 ,那么我们只需要获取 的最大值,我们可以用一个长度为 的数组 来维护。如果 ,我们需要记录 的最大值对应的 ,最大值和次大值,我们可以用一个长度为 的数组 来维护。
时间复杂度 ,空间复杂度 。其中 是数组 nums 的长度。
func maximumLength(nums []int, k int) int {
	n := len(nums)
	f := make([][]int, n)
	for i := range f {
		f[i] = make([]int, k+1)
	}
	mp := make([]map[int]int, k+1)
	for i := range mp {
		mp[i] = make(map[int]int)
	}
	g := make([][3]int, k+1)
	ans := 0

	for i := 0; i < n; i++ {
		for h := 0; h <= k; h++ {
			f[i][h] = mp[h][nums[i]]
			if h > 0 {
				if g[h-1][0] != nums[i] {
					if g[h-1][1] > f[i][h] {
						f[i][h] = g[h-1][1]
					}
				} else {
					if g[h-1][2] > f[i][h] {
						f[i][h] = g[h-1][2]
					}
				}
			}
			f[i][h]++
			if f[i][h] > mp[h][nums[i]] {
				mp[h][nums[i]] = f[i][h]
			}
			if g[h][0] != nums[i] {
				if f[i][h] >= g[h][1] {
					g[h][2] = g[h][1]
					g[h][1] = f[i][h]
					g[h][0] = nums[i]
				} else if f[i][h] > g[h][2] {
					g[h][2] = f[i][h]
				}
			} else {
				if f[i][h] > g[h][1] {
					g[h][1] = f[i][h]
				}
			}
			if f[i][h] > ans {
				ans = f[i][h]
			}
		}
	}

	return ans
}3177. 求出最长好子序列 II
题目、示例与约束
给你一个整数数组 nums 和一个 非负 整数 k 。如果一个整数序列 seq 满足在范围下标范围 [0, seq.length - 2] 中存在 不超过 k 个下标 i 满足 seq[i] != seq[i + 1] ,那么我们称这个整数序列为 好 序列。
请你返回 nums 中 好 子序列 的最长长度
示例 1:
输入:nums = [1,2,1,1,3], k = 2
输出:4
解释:
最长好子序列为 [1,2,1,1,3] 。
示例 2:
输入:nums = [1,2,3,4,5,1], k = 0
输出:2
解释:
最长好子序列为 [1,2,3,4,5,1] 。
提示:
1 <= nums.length <= 5 * 1031 <= nums[i] <= 1090 <= k <= min(50, nums.length)
方法一:动态规划 · Go 实现
思考
定义与 I 相同,但 更大, 不可用。转移形式并未改变。
相等时取同值历史最大,不等时取 层最大(若最大恰为当前值则改用次大)。
扫到 时用 与 读出 ,再写回这两份最值。答案仍是全程最大的 。
我们定义 表示以 结尾,且有不超过 个下标满足条件的最长好子序列的长度。初始时 。答案为 ,其中 。
我们考虑如何计算 。我们可以枚举 ,如果 ,那么 ;否则如果 ,那么 。即:
最终答案为 ,其中 。
时间复杂度 ,空间复杂度 。其中 是数组 nums 的长度。
由于本题数据范围较大,上述解法会超时,需要进行优化。
根据状态转移方程,如果 ,那么我们只需要获取 的最大值,我们可以用一个长度为 的数组 来维护。如果 ,我们需要记录 的最大值对应的 ,最大值和次大值,我们可以用一个长度为 的数组 来维护。
时间复杂度 ,空间复杂度 。其中 是数组 nums 的长度。
func maximumLength(nums []int, k int) int {
	n := len(nums)
	f := make([][]int, n)
	for i := range f {
		f[i] = make([]int, k+1)
	}
	mp := make([]map[int]int, k+1)
	for i := range mp {
		mp[i] = make(map[int]int)
	}
	g := make([][3]int, k+1)
	ans := 0

	for i := 0; i < n; i++ {
		for h := 0; h <= k; h++ {
			f[i][h] = mp[h][nums[i]]
			if h > 0 {
				if g[h-1][0] != nums[i] {
					if g[h-1][1] > f[i][h] {
						f[i][h] = g[h-1][1]
					}
				} else {
					if g[h-1][2] > f[i][h] {
						f[i][h] = g[h-1][2]
					}
				}
			}
			f[i][h]++
			if f[i][h] > mp[h][nums[i]] {
				mp[h][nums[i]] = f[i][h]
			}
			if g[h][0] != nums[i] {
				if f[i][h] >= g[h][1] {
					g[h][2] = g[h][1]
					g[h][1] = f[i][h]
					g[h][0] = nums[i]
				} else if f[i][h] > g[h][2] {
					g[h][2] = f[i][h]
				}
			} else {
				if f[i][h] > g[h][1] {
					g[h][1] = f[i][h]
				}
			}
			if f[i][h] > ans {
				ans = f[i][h]
			}
		}
	}

	return ans
}3180. 执行操作可获得的最大总奖励 I
题目、示例与约束
给你一个整数数组 rewardValues,长度为 n,代表奖励的值。
最初,你的总奖励 x 为 0,所有下标都是 未标记 的。你可以执行以下操作 任意次 :
- 从区间
[0, n - 1]中选择一个 未标记 的下标i。 - 如果
rewardValues[i]大于 你当前的总奖励x,则将rewardValues[i]加到x上(即x = x + rewardValues[i]),并 标记 下标i。
以整数形式返回执行最优操作能够获得的 最大 总奖励。
示例 1:
输入:rewardValues = [1,1,3,3]
输出:4
解释:
依次标记下标 0 和 2,总奖励为 4,这是可获得的最大值。
示例 2:
输入:rewardValues = [1,6,4,3,2]
输出:11
解释:
依次标记下标 0、2 和 1。总奖励为 11,这是可获得的最大值。
提示:
1 <= rewardValues.length <= 20001 <= rewardValues[i] <= 2000
方法一:排序 + 记忆化搜索 + 二分查找 · Go 实现
思考
每次只能选严格大于当前总分的奖励并加上它。子集枚举是指数的; 与最大值都允许按当前分数搜索。
可选取值随当前分数 单调:不大于 的奖励永远作废。排序后二分出第一项大于 的位置。
记忆化 枚举此后每个 并转到 。分数上界约为 ,状态可接受。
我们可以对奖励值数组 rewardValues 进行排序,然后使用记忆化搜索的方法求解最大总奖励。
我们定义一个函数 ,表示当前总奖励为 时,能够获得的最大总奖励。那么答案为 。
函数 的执行过程如下:
- 二分查找数组
rewardValues中第一个大于 的元素的下标 ; - 遍历数组
rewardValues中从下标 开始的元素,对于每个元素 ,计算 的最大值。 - 将结果返回。
为了避免重复计算,我们使用记忆化数组 f 记录已经计算过的结果。
时间复杂度 ,空间复杂度 。其中 是数组 rewardValues 的长度,而 是数组 rewardValues 中的最大值的两倍。
func maxTotalReward(rewardValues []int) int {
	sort.Ints(rewardValues)
	n := len(rewardValues)
	f := make([]int, rewardValues[n-1]<<1)
	for i := range f {
		f[i] = -1
	}
	var dfs func(int) int
	dfs = func(x int) int {
		if f[x] != -1 {
			return f[x]
		}
		i := sort.SearchInts(rewardValues, x+1)
		f[x] = 0
		for _, v := range rewardValues[i:] {
			f[x] = max(f[x], v+dfs(x+v))
		}
		return f[x]
	}
	return dfs(0)
}
方法二:动态规划 · Go 实现
思考
搜索按可达分数展开,常系数和递归深度仍偏大。能否达到分数 只与是否用过各个 有关。
选 的前提是当前分数小于 ,故 由 在 时置真。
排序去重后一维滚动: ,对每个 更新合法的 。最大的可达 即答案。
我们定义 表示用前 个奖励值,能否得到总奖励 。初始时 ,其余值均为 。
我们考虑第 个奖励值 ,如果我们不选择它,那么 ;如果我们选择它,那么 ,其中 。即状态转移方程为:
最终答案为 。
由于 只与 和 有关,我们可以优化掉第一维,只使用一个一维数组进行状态转移。
时间复杂度 ,空间复杂度 。其中 是数组 rewardValues 的长度,而 是数组 rewardValues 中的最大值的两倍。
func maxTotalReward(rewardValues []int) int {
	slices.Sort(rewardValues)
	nums := slices.Compact(rewardValues)
	n := len(nums)
	m := nums[n-1] << 1
	f := make([]bool, m)
	f[0] = true
	for _, v := range nums {
		for j := 1; j < m; j++ {
			if 0 <= j-v && j-v < v {
				f[j] = f[j] || f[j-v]
			}
		}
	}
	ans := m - 1
	for !f[ans] {
		ans--
	}
	return ans
}
方法三:动态规划 + 位运算 · Go 实现
思考
方法二的内层扫 达到 。转移 (限 )正是「取 的低 位再左移 位」。
用一个整数当位图, 的第 位表示分数 可达。
对每个 执行 ,最后 的最高置位即最大总分,再除以字长后更快。
我们可以对方法二进行优化,定义一个二进制数 保存当前的状态,其中 的第 位为 表示当前总奖励为 是可达的。
观察方法二的状态转移方程 ,这相当于取 的低 位,再左移 位,然后与原来的 进行或运算。
那么答案为 的最高位的位置。
时间复杂度 ,空间复杂度 。其中 是数组 rewardValues 的长度,而 是数组 rewardValues 中的最大值的两倍。整数 或 。
func maxTotalReward(rewardValues []int) int {
	slices.Sort(rewardValues)
	rewardValues = slices.Compact(rewardValues)
	one := big.NewInt(1)
	f := big.NewInt(1)
	p := new(big.Int)
	for _, v := range rewardValues {
		mask := p.Sub(p.Lsh(one, uint(v)), one)
		f.Or(f, p.Lsh(p.And(f, mask), uint(v)))
	}
	return f.BitLen() - 1
}3181. 执行操作可获得的最大总奖励 II
题目、示例与约束
给你一个整数数组 rewardValues,长度为 n,代表奖励的值。
最初,你的总奖励 x 为 0,所有下标都是 未标记 的。你可以执行以下操作 任意次 :
- 从区间
[0, n - 1]中选择一个 未标记 的下标i。 - 如果
rewardValues[i]大于 你当前的总奖励x,则将rewardValues[i]加到x上(即x = x + rewardValues[i]),并 标记 下标i。
以整数形式返回执行最优操作能够获得的 最大 总奖励。
示例 1:
输入:rewardValues = [1,1,3,3]
输出:4
解释:
依次标记下标 0 和 2,总奖励为 4,这是可获得的最大值。
示例 2:
输入:rewardValues = [1,6,4,3,2]
输出:11
解释:
依次标记下标 0、2 和 1。总奖励为 11,这是可获得的最大值。
提示:
1 <= rewardValues.length <= 5 * 1041 <= rewardValues[i] <= 5 * 104
方法一:动态规划 + 位运算 · Go 实现
思考
规则与 I 相同而值域更大,布尔数组 DP 的 不能通过。
仍是「低 位左移 再或回 」,位图一次处理一个字。
排序去重后 ,对每个 做 ,返回 。
我们定义 表示用前 个奖励值,能否得到总奖励 。初始时 ,其余值均为 。
我们考虑第 个奖励值 ,如果我们不选择它,那么 ;如果我们选择它,那么 ,其中 。即状态转移方程为:
最终答案为 。
由于 只与 和 有关,我们可以优化掉第一维,只使用一个一维数组进行状态转移。另外,由于本题数据范围较大,我们需要使用位运算来优化状态转移的效率。
我们定义一个二进制数 保存当前的状态,其中 的第 位为 表示当前总奖励为 是可达的。
观察上述状态转移方程 ,这相当于取 的低 位,再左移 位,然后与原来的 进行或运算。
那么答案为 的最高位的位置。
时间复杂度 ,空间复杂度 。其中 是数组 rewardValues 的长度,而 是数组 rewardValues 中的最大值的两倍。整数 或 。
func maxTotalReward(rewardValues []int) int {
	slices.Sort(rewardValues)
	rewardValues = slices.Compact(rewardValues)
	one := big.NewInt(1)
	f := big.NewInt(1)
	p := new(big.Int)
	for _, v := range rewardValues {
		mask := p.Sub(p.Lsh(one, uint(v)), one)
		f.Or(f, p.Lsh(p.And(f, mask), uint(v)))
	}
	return f.BitLen() - 1
}3183. 达到总和的方法数量 🔒
题目、示例与约束
给定 无限 数量的面值为 1,2,6 的硬币,并且 只有 2 枚硬币面值为 4。
给定一个整数 n ,返回用你持有的硬币达到总和 n 的方法数量。
因为答案可能会很大,将其 取模 109 + 7。
注意 硬币的顺序并不重要,[2, 2, 3] 与 [2, 3, 2] 相同。
示例 1:
输入:n = 4
输出:4
解释:
有四种组合:[1, 1, 1, 1],[1, 1, 2],[2, 2],[4]。
示例 2:
输入:n = 12
输出:22
解释:
注意 [4, 4, 4] 不是 一个有效的组合,因为我们无法使用 4 三次。
示例 3:
输入:n = 5
输出:4
解释:
有四种组合:[1, 1, 1, 1, 1],[1, 1, 1, 2],[1, 2, 2],[1, 4]。
提示:
1 <= n <= 105
方法一:动态规划(完全背包) · Go 实现
思考
硬币为 ,其中 最多用两枚。若四种面值一起完全背包,还要限制 的件数。
先用无限制的 做完全背包得到 ,再用 枚 把 相加。
内层对金额升序更新以保证完全背包。取模后按 是否达到 或 累加。
我们可以先忽略硬币 ,定义硬币数组 coins = [1, 2, 6],然后使用完全背包的思想,定义 表示使用前 种硬币凑成金额 的方案数,初始时 ,然后我们遍历硬币数组 coins,对于每一种硬币 ,我们遍历 到 的金额,更新 。
最后 就是使用硬币 凑成金额 的方案数,然后如果 ,我们考虑选择一个硬币 ,那么方案数就是 ,如果 ,我们再考虑选择两个硬币 ,那么方案数就是 。
注意答案的取模操作。
时间复杂度 ,空间复杂度 。其中 是金额。
func numberOfWays(n int) int {
	const mod int = 1e9 + 7
	coins := []int{1, 2, 6}
	f := make([]int, n+1)
	f[0] = 1
	for _, x := range coins {
		for j := x; j <= n; j++ {
			f[j] = (f[j] + f[j-x]) % mod
		}
	}
	ans := f[n]
	if n >= 4 {
		ans = (ans + f[n-4]) % mod
	}
	if n >= 8 {
		ans = (ans + f[n-8]) % mod
	}
	return ans
}
方法二:预处理 + 动态规划(完全背包) · Go 实现
思考
方法一对每个询问现场跑背包。金额上界固定为 ,多组询问会重复同一张表。
预先算好 的 ,询问变成常数次下标访问。
按 、 或更大分别返回 、 或再加 。
我们可以先预处理出 到 的所有金额的方案数,然后根据 的大小直接返回对应的方案数:
- 如果 ,直接返回 ;
- 如果 ,返回 ;
- 如果 ,返回 。
注意答案的取模操作。
时间复杂度 ,空间复杂度 。其中 是金额。
const (
    m   = 100001
    mod = 1000000007
)

var f [m]int

func init() {
    f[0] = 1
    coins := []int{1, 2, 6}
    for _, x := range coins {
        for j := x; j < m; j++ {
            f[j] = (f[j] + f[j-x]) % mod
        }
    }
}

func numberOfWays(n int) int {
    ans := f[n]
    if n >= 4 {
        ans = (ans + f[n-4]) % mod
    }
    if n >= 8 {
        ans = (ans + f[n-8]) % mod
    }
    return ans
}3186. 施咒的最大总伤害
题目、示例与约束
一个魔法师有许多不同的咒语。
给你一个数组 power ,其中每个元素表示一个咒语的伤害值,可能会有多个咒语有相同的伤害值。
已知魔法师使用伤害值为 power[i] 的咒语时,他们就 不能 使用伤害为 power[i] - 2 ,power[i] - 1 ,power[i] + 1 或者 power[i] + 2 的咒语。
每个咒语最多只能被使用 一次 。
请你返回这个魔法师可以达到的伤害值之和的 最大值 。
示例 1:
输入:power = [1,1,3,4]
输出:6
解释:
可以使用咒语 0,1,3,伤害值分别为 1,1,4,总伤害值为 6 。
示例 2:
输入:power = [7,1,6,6]
输出:13
解释:
可以使用咒语 1,2,3,伤害值分别为 1,6,6,总伤害值为 13 。
提示:
1 <= power.length <= 1051 <= power[i] <= 109
方法一:二分查找 + 记忆化搜索 · Go 实现
思考
选一个伤害 就不能再选 中的其他值,相同 可全选。对每个互异伤害做子集枚举是指数的。
排序后决策变为:跳过当前值的全部副本,或收下它们并跳到第一个大于 的位置。下一位置可用二分预计算。
记忆化 。每个互异伤害只展开一次。
我们可以先对数组 进行排序,用一个哈希表 来记录每个伤害值的出现次数,然后遍历数组 ,对于每个伤害值 ,我们可以得出使用伤害值为 的咒语时,可以使用的下一个伤害值的索引,即第一个大于 的伤害值的索引,我们可以使用二分查找来找到这个索引,记录在数组 中。
接下来,我们定义一个函数 ,用来计算从第 个伤害值开始,可以获得的最大伤害值。
在 函数中,我们可以选择跳过当前伤害值,那么我们可以跳过当前伤害值的所有相同伤害值,直接跳到 ,可以获得的伤害值为 ;或者我们可以选择使用当前伤害值,那么我们可以使用当前伤害值的所有相同伤害值,然后跳到下一个伤害值的索引,可以获得的伤害值为 ,其中 表示第一个大于 的伤害值的索引。我们取这两种情况的最大值作为函数的返回值。
为了避免重复计算,我们可以使用记忆化搜索,将已经计算过的结果保存在数组 中,这样在计算 时,如果 不为 ,则直接返回 。
答案即为 。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func maximumTotalDamage(power []int) int64 {
	n := len(power)
	sort.Ints(power)
	cnt := map[int]int{}
	nxt := make([]int, n)
	f := make([]int64, n)
	for i, x := range power {
		cnt[x]++
		nxt[i] = sort.SearchInts(power, x+3)
	}
	var dfs func(int) int64
	dfs = func(i int) int64 {
		if i >= n {
			return 0
		}
		if f[i] != 0 {
			return f[i]
		}
		a := dfs(i + cnt[power[i]])
		b := int64(power[i]*cnt[power[i]]) + dfs(nxt[i])
		f[i] = max(a, b)
		return f[i]
	}
	return dfs(0)
}
方法二:二分查找 + 动态规划 · Go 实现
思考
选一个伤害 就不能再选 里的其他值,相同的 可以全部收下。 可达 ,按互异伤害做子集枚举是指数的。
排序后,跳过当前值总会先调用更靠后的下标。伤害互异且彼此相邻时,每次只前进 ,调用链长度为 ,栈会溢出。
更靠后的下标在从末尾往前走时已经就绪。令 为从下标 起的最大伤害:跳过落到 ,收下落到第一个大于 的位置,该位置由二分预先算好。
先对数组 排序,用哈希表 记录每个伤害值的出现次数。对每个下标 ,二分找到第一个大于 的位置,记为 。
令 表示从下标 开始能够获得的最大伤害, ,答案为 。
从 填到 。记 。跳过 的全部副本,得到 ;收下这些副本,得到 。下标越过 时该项为 。取较大值:
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func maximumTotalDamage(power []int) int64 {
	n := len(power)
	sort.Ints(power)
	cnt := map[int]int{}
	nxt := make([]int, n)
	f := make([]int64, n+1)
	for i, x := range power {
		cnt[x]++
		nxt[i] = sort.SearchInts(power, x+3)
	}
	for i := n - 1; i >= 0; i-- {
		j := i + cnt[power[i]]
		a := int64(0)
		if j <= n {
			a = f[j]
		}
		b := int64(power[i])*int64(cnt[power[i]]) + f[nxt[i]]
		f[i] = max(a, b)
	}
	return f[0]
}3192. 使二进制数组全部等于 1 的最少操作次数 II
题目、示例与约束
给你一个二进制数组 nums 。
你可以对数组执行以下操作 任意 次(也可以 0 次):
- 选择数组中 任意 一个下标
i,并将从下标i开始一直到数组末尾 所有 元素 反转 。
反转 一个元素指的是将它的值从 0 变 1 ,或者从 1 变 0 。
请你返回将 nums 中所有元素变为 1 的 最少 操作次数。
示例 1:
输入:nums = [0,1,1,0,1]
输出:4
解释:
我们可以执行以下操作:
- 选择下标
i = 1执行操作,得到nums = [0,0,0,1,0]。 - 选择下标
i = 0执行操作,得到nums = [1,1,1,0,1]。 - 选择下标
i = 4执行操作,得到nums = [1,1,1,0,0]。 - 选择下标
i = 3执行操作,得到nums = [1,1,1,1,1]。
示例 2:
输入:nums = [1,0,0,0]
输出:1
解释:
我们可以执行以下操作:
- 选择下标
i = 1执行操作,得到nums = [1,1,1,1]。
提示:
1 <= nums.length <= 1050 <= nums[i] <= 1
方法一:位运算 · Go 实现
思考
一次操作翻转从 到末尾的后缀。从左处理时,右侧已被翻转的奇偶由一个总开关记录即可,不必真改数组。
当前位置的真实值是 。若为 则必须再翻一次后缀,同时把 取反。
线性扫一遍累加翻转次数。每个位置只看一次当前奇偶。
我们注意到,每当我们将某个位置的元素变为 1 时,它的右侧的所有元素都会被反转。因此,我们可以用一个变量 来记录当前位置及其右侧的元素是否被反转,如果被反转,那么 的值为 1,否则为 0。
我们遍历数组 ,对于每个元素 ,我们将 与 进行异或运算,如果 为 0,那么我们需要将 变为 1,我们需要进行反转操作,我们将答案加一,并将 取反。
遍历结束后,我们就可以得到最少操作次数。
时间复杂度 ,其中 为数组 的长度。空间复杂度 。
func minOperations(nums []int) (ans int) {
	v := 0
	for _, x := range nums {
		x ^= v
		if x == 0 {
			v ^= 1
			ans++
		}
	}
	return
}3193. 统计逆序对的数目
题目、示例与约束
给你一个整数 n 和一个二维数组 requirements ,其中 requirements[i] = [endi, cnti] 表示这个要求中的末尾下标和 逆序对 的数目。
整数数组 nums 中一个下标对 (i, j) 如果满足以下条件,那么它们被称为一个 逆序对 :
i < j且nums[i] > nums[j]
请你返回 [0, 1, 2, ..., n - 1] 的 排列 perm 的数目,满足对 所有 的 requirements[i] 都满足 perm[0..endi] 中恰好有 cnti 个逆序对。
由于答案可能会很大,将它对 109 + 7 取余 后返回。
示例 1:
输入:n = 3, requirements = [[2,2],[0,0]]
输出:2
解释:
两个排列为:
[2, 0, 1]- 前缀
[2, 0, 1]的逆序对为(0, 1)和(0, 2)。 - 前缀
[2]的逆序对数目为 0 个。
- 前缀
[1, 2, 0]- 前缀
[1, 2, 0]的逆序对为(0, 2)和(1, 2)。 - 前缀
[1]的逆序对数目为 0 个。
- 前缀
示例 2:
输入:n = 3, requirements = [[2,2],[1,1],[0,0]]
输出:1
解释:
唯一满足要求的排列是 [2, 0, 1] :
- 前缀
[2, 0, 1]的逆序对为(0, 1)和(0, 2)。 - 前缀
[2, 0]的逆序对为(0, 1)。 - 前缀
[2]的逆序对数目为 0 。
示例 3:
输入:n = 2, requirements = [[0,0],[1,0]]
输出:1
解释:
唯一满足要求的排列为 [0, 1] :
- 前缀
[0]的逆序对数目为 0 。 - 前缀
[0, 1]没有逆序对。
提示:
2 <= n <= 3001 <= requirements.length <= nrequirements[i] = [endi, cnti]0 <= endi <= n - 10 <= cnti <= 400- 输入保证至少有一个
i满足endi == n - 1。 - 输入保证所有的
endi互不相同。
方法一:动态规划 · Go 实现
思考
统计满足若干前缀逆序对个数约束的排列数。插入第 个数可与前面 个数构成逆序,全排列 DP 的状态是「已放个数、已有逆序数」。
约束把某些 的逆序数钉死,其余层仍需枚举可能的 。 ,三维枚举可过。
令 为 上逆序数为 的方案。若该层有要求则只填那一列,否则对 累加 。首项逆序必须为 。
我们定义 表示 的排列中,逆序对数量为 的排列数。考虑下标为 的数 与前面 个数的大小关系。如果 比前面 个数小,那么前面的 个数与 都构成了逆序对,逆序对数量为 。因此,我们可以得到状态转移方程:
由于题目要求 的逆序对数量为 ,因此,当我们计算 时,我们只需要计算 即可。其余的 都为 。
时间复杂度 ,空间复杂度 。其中 是逆序对数量的最大值。本题中 。
func numberOfPermutations(n int, requirements [][]int) int {
	req := make([]int, n)
	for i := range req {
		req[i] = -1
	}
	for _, r := range requirements {
		req[r[0]] = r[1]
	}
	if req[0] > 0 {
		return 0
	}
	req[0] = 0
	m := slices.Max(req)
	const mod = int(1e9 + 7)
	f := make([][]int, n)
	for i := range f {
		f[i] = make([]int, m+1)
	}
	f[0][0] = 1
	for i := 1; i < n; i++ {
		l, r := 0, m
		if req[i] >= 0 {
			l, r = req[i], req[i]
		}
		for j := l; j <= r; j++ {
			for k := 0; k <= min(i, j); k++ {
				f[i][j] = (f[i][j] + f[i-1][j-k]) % mod
			}
		}
	}
	return f[n-1][req[n-1]]
}3196. 最大化子数组的总成本
题目、示例与约束
给你一个长度为 n 的整数数组 nums。
子数组 nums[l..r](其中 0 <= l <= r < n)的 成本 定义为:
cost(l, r) = nums[l] - nums[l + 1] + ... + nums[r] * (−1)r − l
你的任务是将 nums 分割成若干子数组,使得所有子数组的成本之和 最大化,并确保每个元素 正好 属于一个子数组。
具体来说,如果 nums 被分割成 k 个子数组,且分割点为索引 i1, i2, ..., ik − 1(其中 0 <= i1 < i2 < ... < ik - 1 < n - 1),则总成本为:
cost(0, i1) + cost(i1 + 1, i2) + ... + cost(ik − 1 + 1, n − 1)
返回在最优分割方式下的子数组成本之和的最大值。
注意:如果 nums 没有被分割,即 k = 1,则总成本即为 cost(0, n - 1)。
示例 1:
输入: nums = [1,-2,3,4]
输出: 10
解释:
一种总成本最大化的方法是将 [1, -2, 3, 4] 分割成子数组 [1, -2, 3] 和 [4]。总成本为 (1 + 2 + 3) + 4 = 10。
示例 2:
输入: nums = [1,-1,1,-1]
输出: 4
解释:
一种总成本最大化的方法是将 [1, -1, 1, -1] 分割成子数组 [1, -1] 和 [1, -1]。总成本为 (1 + 1) + (1 + 1) = 4。
示例 3:
输入: nums = [0]
输出: 0
解释:
无法进一步分割数组,因此答案为 0。
示例 4:
输入: nums = [1,-1]
输出: 2
解释:
选择整个数组,总成本为 1 + 1 = 2,这是可能的最大成本。
提示:
1 <= nums.length <= 105-109 <= nums[i] <= 109
方法一:记忆化搜索 · Go 实现
思考
划分后每段按正负交替计分,段首必须为正。枚举全部切法是指数的。
当前位置能否取负,只取决于上一个数是否已经取负:取负后下一位必须为正。
记忆化 : 表示可以取负。始终尝试 ,若允许再与 取大。
根据题目描述,如果当前数没取反,那么下一个可以取反,也可以不取反;如果当前数取反了,那么下一个只能不取反。
因此,我们定义一个函数 ,表示从第 个数开始,第 个数是否能取反,其中 表示第 个数是否取反。如果 ,表示第 个数不能取反,否则可以取反。答案为 。
函数 的执行过程如下:
- 如果 ,表示已经遍历完了数组,返回 ;
- 否则,第 个数可以不取反,此时答案为 ;如果 ,表示第 个数可以取反,此时答案为 。我们取两者的最大值即可。
为了避免重复计算,我们可以使用记忆化搜索,将已经计算过的结果保存起来。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func maximumTotalCost(nums []int) int64 {
	n := len(nums)
	f := make([][2]int64, n)
	for i := range f {
		f[i] = [2]int64{-1e18, -1e18}
	}
	var dfs func(int, int) int64
	dfs = func(i, j int) int64 {
		if i >= n {
			return 0
		}
		if f[i][j] != -1e18 {
			return f[i][j]
		}
		f[i][j] = int64(nums[i]) + dfs(i+1, 1)
		if j > 0 {
			f[i][j] = max(f[i][j], int64(-nums[i])+dfs(i+1, 0))
		}
		return f[i][j]
	}
	return dfs(0, 0)
}
方法二:动态规划 · Go 实现
思考
方法一从末尾填了一张线性表。两个选择还可以再压成两个滚动值。
为当前不取负的最大, 为取负的最大。不取负时前一位任意,取负时前一位必须不取负。
转移 , 。答案为 ,额外空间降为常数。
我们可以将方法一中的线性表压成两个滚动值。
定义 和 为两个状态,其中 表示当前数不取反的最大值,而 表示当前数取反的最大值。
遍历数组 ,对于第 个数,我们可以根据 和 的状态更新 和 的值:
- 如果当前数不取反,那么 的值为 ,表示当前数不取反,那么前一个数可以取反或不取反;
- 如果当前数取反,那么 的值为 ,表示当前数取反,那么前一个数不能取反
最终答案为 。
时间复杂度 ,其中 是数组 的长度。空间复杂度 。
func maximumTotalCost(nums []int) int64 {
	f, g := math.MinInt64/2, 0
	for _, x := range nums {
		f, g = max(f, g)+x, f-x
	}
	return int64(max(f, g))
}
方法三:动态规划 · Go 实现
思考
划分后每段按正负交替计分,段首必须为正。枚举全部切法是指数的,而 。
当前位置能否取负,只取决于后面的后缀:取正之后下一位可以取负,取负之后下一位必须为正。
按这个递推搜索时仍会先调用下一位置再返回,调用链深度为 ,栈会溢出。
从末尾往前走时,下一位置已经就绪。令 为从 起的最优得分, 表示 可以取负。我们从 填到 ,返回 。
如果当前数没有取负,下一个数既可以取负,也可以不取负;如果当前数取负了,下一个数只能不取负。
令 表示从下标 开始的后缀能得到的最大得分,其中 表示 可以取负, 表示它必须保持为正。答案为 。数组末尾之后 。
下标 可以不取负,得分为 。当 时还可以取负,得分为 。 取这些选择中的较大值。
我们从 往前计算到 。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func maximumTotalCost(nums []int) int64 {
	n := len(nums)
	f := make([][2]int64, n+1)
	for i := n - 1; i >= 0; i-- {
		for j := 0; j < 2; j++ {
			f[i][j] = int64(nums[i]) + f[i+1][1]
			if j == 1 {
				f[i][j] = max(f[i][j], int64(-nums[i])+f[i+1][0])
			}
		}
	}
	return f[0][0]
}3201. 找出有效子序列的最大长度 I
题目、示例与约束
给你一个整数数组 nums。
nums 的子序列 sub 的长度为 x ,如果其满足以下条件,则称其为 有效子序列:
(sub[0] + sub[1]) % 2 == (sub[1] + sub[2]) % 2 == ... == (sub[x - 2] + sub[x - 1]) % 2
返回 nums 的 最长的有效子序列 的长度。
示例 1:
输入: nums = [1,2,3,4]
输出: 4
解释:
最长的有效子序列是 [1, 2, 3, 4]。
示例 2:
输入: nums = [1,2,1,1,2,1,2]
输出: 6
解释:
最长的有效子序列是 [1, 2, 1, 2, 1, 2]。
示例 3:
输入: nums = [1,3]
输出: 2
解释:
最长的有效子序列是 [1, 3]。
提示:
2 <= nums.length <= 2 * 1051 <= nums[i] <= 107
方法一:动态规划 · Go 实现
思考
子序列的合法条件只约束相邻两项之和对 取模相等。本题 ,而 ,若枚举子序列或对每个位置再扫一遍前驱,则无法在时限内完成。
由 可得 ,即奇数位残量相同、偶数位残量相同。合法序列的形态因此被最后两项的残量对 完全刻画。为此维护 :以残量 结尾、倒数第二项残量为 的最长长度。扫到 时枚举目标和 ,由 从 转移,一次线性扫描即可。
我们令 。
根据题目描述,我们可以得知,对于子序列 ,如果满足 。那么 。也即是说,所有奇数项元素对 取模的结果相同,所有偶数项元素对 取模的结果相同。
我们可以使用动态规划的方法解决这个问题。定义状态 表示最后一项对 取模为 ,倒数第二项对 取模为 的最长有效子序列的长度。初始时 。
遍历数组 ,对于每一个数 ,我们得到 。然后我们可以枚举序列连续两个数对 取模结果相同,其中 。那么 的前一个数对 取模结果为 。此时 。
答案为所有 中的最大值。
时间复杂度 ,空间复杂度 。其中 为数组 的长度,而 。
func maximumLength(nums []int) (ans int) {
	k := 2
	f := make([][]int, k)
	for i := range f {
		f[i] = make([]int, k)
	}
	for _, x := range nums {
		x %= k
		for j := 0; j < k; j++ {
			y := (j - x + k) % k
			f[x][y] = f[y][x] + 1
			ans = max(ans, f[x][y])
		}
	}
	return
}3202. 找出有效子序列的最大长度 II
题目、示例与约束
nums 和一个 正 整数 k 。
nums 的一个 子序列 sub 的长度为 x ,如果其满足以下条件,则称其为 有效子序列 :
(sub[0] + sub[1]) % k == (sub[1] + sub[2]) % k == ... == (sub[x - 2] + sub[x - 1]) % k
nums 的 最长有效子序列 的长度。
示例 1:
输入:nums = [1,2,3,4,5], k = 2
输出:5
解释:
最长有效子序列是 [1, 2, 3, 4, 5] 。
示例 2:
输入:nums = [1,4,2,3,1,4], k = 3
输出:4
解释:
最长有效子序列是 [1, 4, 1, 4] 。
提示:
2 <= nums.length <= 1031 <= nums[i] <= 1071 <= k <= 103
方法一:动态规划 · Go 实现
思考
本题将模数从 推广到任意 ,且 。枚举子序列仍不可行,但相邻和同余同样推出奇数位残量相同、偶数位残量相同,状态仍只需最后两项的残量。
,足以对每个数枚举目标和 ,由 更新 。与 时同一套转移,只是表的边长改为 。
根据题目描述,我们可以得知,对于子序列 ,如果满足 。那么 。也即是说,所有奇数项元素对 取模的结果相同,所有偶数项元素对 取模的结果相同。
我们可以使用动态规划的方法解决这个问题。定义状态 表示最后一项对 取模为 ,倒数第二项对 取模为 的最长有效子序列的长度。初始时 。
遍历数组 ,对于每一个数 ,我们得到 。然后我们可以枚举序列连续两个数对 取模结果相同,其中 。那么 的前一个数对 取模结果为 。此时 。
答案为所有 中的最大值。
时间复杂度 ,空间复杂度 。其中 为数组 的长度,而 为给定的正整数。
func maximumLength(nums []int, k int) (ans int) {
	f := make([][]int, k)
	for i := range f {
		f[i] = make([]int, k)
	}
	for _, x := range nums {
		x %= k
		for j := 0; j < k; j++ {
			y := (j - x + k) % k
			f[x][y] = f[y][x] + 1
			ans = max(ans, f[x][y])
		}
	}
	return
}3205. 最大数组跳跃得分 I 🔒
题目、示例与约束
给定一个数组 nums,你必须从索引 0 开始跳跃,直到到达数组的最后一个元素,使得获取 最大 分数。
每一次 跳跃 中,你可以从下标 i 跳到一个 j > i 的下标,并且可以得到 (j - i) * nums[j] 的分数。
返回你能够取得的最大分数。
示例 1:
输入:nums = [1,5,8]
输出:16
解释:
有两种可能的方法可以到达最后一个元素:
0 -> 1 -> 2得分为(1 - 0) * 5 + (2 - 1) * 8 = 13。0 -> 2得分为(2 - 0) * 8 = 16。
示例 2:
输入:nums = [4,5,2,8,9,1,3]
输出:42
解释:
我们可以按 0 -> 4 -> 6 进行跳跃,得分为 (4 - 0) * 9 + (6 - 4) * 3 = 42。
提示:
2 <= nums.length <= 1031 <= nums[i] <= 105
方法一:记忆化搜索 · Go 实现
思考
从下标 出发每次跳到右侧某下标 ,得分为 ,求最大总分。 ,穷举跳跃序列的分支数为指数级,但 的状态数可以接受。
子问题只依赖起点 :一旦到达 ,后续最优与如何到达无关。因此定义 为从 出发的最大得分,枚举 取 的最大值,并用记忆化避免重复。
我们设计一个函数 ,表示从下标 出发,能够获得的最大分数。那么答案就是 。
函数 的执行过程如下:
我们枚举下一个跳跃的位置 ,那么从下标 出发,能够获得的分数就是 ,加上从下标 出发,能够获得的最大分数,总分数就是 。我们枚举所有的 ,取分数的最大值即可。
为了避免重复计算,我们使用记忆化搜索的方法,将已经计算过的 的值保存起来,下次直接返回即可。
时间复杂度 ,空间复杂度 。其中 是数组的长度。
func maxScore(nums []int) int {
	n := len(nums)
	f := make([]int, n)
	var dfs func(int) int
	dfs = func(i int) int {
		if f[i] > 0 {
			return f[i]
		}
		for j := i + 1; j < n; j++ {
			f[i] = max(f[i], (j-i)*nums[j]+dfs(j))
		}
		return f[i]
	}
	return dfs(0)
}
方法二:动态规划 · Go 实现
思考
方法一的转移已经是最优子结构,递归栈与哈希缓存并非必要。将同一递推改成自底向上: 表示从 走到 的最大得分,对每个 枚举前驱 即可,时间仍为 ,实现变为迭代。
我们可以将方法一中的记忆化搜索转换为动态规划。
定义 表示从下标 出发,到下标 结束,能够获得的最大分数。那么答案就是 。
状态转移方程为:
时间复杂度 ,空间复杂度 。其中 是数组的长度。
func maxScore(nums []int) int {
	n := len(nums)
	f := make([]int, n)
	for j := 1; j < n; j++ {
		for i := 0; i < j; i++ {
			f[j] = max(f[j], f[i]+(j-i)*nums[j])
		}
	}
	return f[n-1]
}
方法三:单调栈 · Go 实现
思考
方法二仍花费平方时间。注意到从 出发,若 不是其后第一个不小于当前值的位置,则中间插入一次跳跃不会更优,最优路径只经过单调递减的「下一更大」下标。为此用单调栈扫出这条下标序列,再按相邻跳跃累加分数,时间降为线性。
我们观察发现,对于当前位置 ,我们应该跳到下一个值最大的位置 ,这样才能获得最大的分数。
因此,我们遍历数组 ,维护一个从栈底到栈顶单调递减的栈 。对于当前遍历到的位置 ,如果栈顶元素对应的值小于等于 ,我们就不断地弹出栈顶元素,直到栈为空或者栈顶元素对应的值大于 ,然后将 入栈。
然后,我们初始化答案 和当前位置 ,遍历栈中的元素,每次取出栈顶元素 ,更新答案 ,然后更新 。
最后返回答案 。
时间复杂度 ,空间复杂度 。其中 是数组的长度。
func maxScore(nums []int) (ans int) {
	stk := []int{}
	for i, x := range nums {
		for len(stk) > 0 && nums[stk[len(stk)-1]] <= x {
			stk = stk[:len(stk)-1]
		}
		stk = append(stk, i)
	}
	i := 0
	for _, j := range stk {
		ans += (j - i) * nums[j]
		i = j
	}
	return
}继续阅读
- 实践案例
- 实践案例
- 实践案例