
LeetCode Go · 动态规划(4)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
583. 两个字符串的删除操作
题目、示例与约束
给定两个单词 word1 和 word2 ,返回使得 word1 和 word2 相同所需的最小步数。
每步 可以删除任意一个字符串中的一个字符。
示例 1:
输入: word1 = "sea", word2 = "eat"
输出: 2
解释: 第一步将 "sea" 变为 "ea" ,第二步将 "eat "变为 "ea"
示例 2:
输入:word1 = "leetcode", word2 = "etco"
输出:4
提示:
1 <= word1.length, word2.length <= 500word1和word2只包含小写英文字母
方法一:动态规划 · Go 实现
思考
只能删字符,使两串相等的最少步数,等于两串长度之和减去两倍最长公共子序列。直接求 LCS 或按删除转移均可。
为让前缀 与 相同的最少删除。字符相等则继承 ,否则删一侧并加一。边界是删光另一串的长度。 即答案。
我们定义 表示使得字符串 的前 个字符和字符串 的前 个字符相同的最小删除步数。那么答案为 ,其中 和 分别是字符串 和 的长度。
初始时,如果 ,那么 ;如果 ,那么 。
当 时,如果 ,那么 ;否则 。
最终返回 即可。
时间复杂度 ,空间复杂度 。其中 和 分别是字符串 和 的长度。
func minDistance(word1 string, word2 string) int {
	m, n := len(word1), len(word2)
	f := make([][]int, m+1)
	for i := range f {
		f[i] = make([]int, n+1)
        f[i][0] = i
	}
	for j := 1; j <= n; j++ {
		f[0][j] = j
	}
	for i := 1; i <= m; i++ {
		for j := 1; j <= n; j++ {
			a, b := word1[i-1], word2[j-1]
			if a == b {
				f[i][j] = f[i-1][j-1]
			} else {
				f[i][j] = 1 + min(f[i-1][j], f[i][j-1])
			}
		}
	}
	return f[m][n]
}600. 不含连续1的非负整数
题目、示例与约束
给定一个正整数 n ,请你统计在 [0, n] 范围的非负整数中,有多少个整数的二进制表示中不存在 连续的 1 。
示例 1:
输入: n = 5
输出: 5
解释:
下面列出范围在 [0, 5] 的非负整数与其对应的二进制表示:
0 : 0
1 : 1
2 : 10
3 : 11
4 : 100
5 : 101
其中,只有整数 3 违反规则(有两个连续的 1 ),其他 5 个满足规则。
示例 2:
输入: n = 1
输出: 2
示例 3:
输入: n = 2
输出: 3
提示:
1 <= n <= 109
方法一:数位 DP · Go 实现
思考
若枚举 并逐个检查二进制是否含连续 ,当 达到 时扫描量过大。合法计数只依赖已填位数与前一位是否为 ,与具体数值无关。
因此按二进制从高位向低位填写,状态取 :若 则当前位不能再填 ; 保证不超过 。记忆化后复杂度与位数成正比。
这道题实际上是求在给定区间 中,数字的二进制表示不包含连续的 的个数。个数与数的位数以及每个二进制位上的数字有关。我们可以用数位 DP 的思路来解决这道题。数位 DP 中,数的大小对复杂度的影响很小。
对于区间 问题,我们一般会将其转化为 然后再减去 的问题,即:
不过对于本题而言,我们只需要求出区间 的值即可。
这里我们用记忆化搜索来实现数位 DP。基本步骤如下:
我们首先获取数字 的二进制长度,记为 。然后根据题目信息,我们设计函数 ,其中:
- 数字 表示当前搜索到的位置,我们从数字的最高位开始搜索,即二进制字符串的首字符;
- 数字 表示上一个数字二进制位上的数字,对于本题, 的初始值为 ;
- 布尔值 表示可填的数字的限制,如果无限制,那么可以选择 ,否则,只能选择 。
函数的执行过程如下:
如果 超过了数字 的长度,即 ,说明搜索结束,直接返回 。否则,我们从 到 枚举位置 的数字 ,对于每一个 :
- 如果 和 都为 ,说明有连续的 ,直接跳过;
- 否则,我们递归到下一层,更新 为 ,并将 更新为 与 是否等于 的逻辑与。
最后,我们将所有递归到下一层的结果累加,即为答案。
时间复杂度 ,空间复杂度 。其中 为题目给定的正整数。
相似题目:
func findIntegers(n int) int {
	m := bits.Len(uint(n))
	f := make([][2]int, m)
	for i := range f {
		f[i] = [2]int{-1, -1}
	}
	var dfs func(i, pre int, limit bool) int
	dfs = func(i, pre int, limit bool) int {
		if i < 0 {
			return 1
		}
		if !limit && f[i][pre] != -1 {
			return f[i][pre]
		}
		up := 1
		if limit {
			up = n >> i & 1
		}
		ans := 0
		for j := 0; j <= up; j++ {
			if j == 1 && pre == 1 {
				continue
			}
			ans += dfs(i-1, j, limit && j == up)
		}
		if !limit {
			f[i][pre] = ans
		}
		return ans
	}
	return dfs(m-1, 0, true)
}629. K 个逆序对数组
题目、示例与约束
对于一个整数数组 nums,逆序对是一对满足 0 <= i < j < nums.length 且 nums[i] > nums[j]的整数对 [i, j] 。
给你两个整数 n 和 k,找出所有包含从 1 到 n 的数字,且恰好拥有 k 个 逆序对 的不同的数组的个数。由于答案可能很大,只需要返回对 109 + 7 取余的结果。
示例 1:
输入:n = 3, k = 0
输出:1
解释:
只有数组 [1,2,3] 包含了从1到3的整数并且正好拥有 0 个逆序对。
示例 2:
输入:n = 3, k = 1
输出:2
解释:
数组 [1,3,2] 和 [2,1,3] 都有 1 个逆序对。
提示:
1 <= n <= 10000 <= k <= 1000
方法一:动态规划 + 前缀和 · Go 实现
思考
长度为 、恰有 个逆序对的排列数,若直接枚举排列, 与 可达 ,不可行。
令 为长度 、逆序对 的个数。插入 可新增 个逆序,故 是前一行一段区间之和。用前缀和把转移降到 ,并滚动成一维,总复杂度 。
我们定义 表示数组长度为 ,逆序对数为 的数组个数。初始时 ,其余 。
接下来我们考虑如何得到 。
假设前 个数已经确定,现在要插入数字 ,我们讨论 插入到每个位置的情况:
- 如果 插入到第 个位置,那么逆序对增加了 个,所以 。
- 如果 插入到第 个位置,那么逆序对增加了 个,所以 。
- ...
- 如果 插入到第 个位置,那么逆序对增加了 个,所以 。
- 如果 插入到第 个位置,那么逆序对不变,所以 。
所以 。
我们注意到 的计算实际上涉及到前缀和,因此,我们可以使用前缀和优化计算过程。并且,由于 只与 有关,因此我们可以用一个一维数组来优化空间复杂度。
时间复杂度 ,空间复杂度 。其中 和 分别为数组长度和逆序对数。
func kInversePairs(n int, k int) int {
	f := make([]int, k+1)
	s := make([]int, k+2)
	f[0] = 1
	for i, x := range f {
		s[i+1] = s[i] + x
	}
	const mod = 1e9 + 7
	for i := 1; i <= n; i++ {
		for j := 1; j <= k; j++ {
			f[j] = (s[j+1] - s[max(0, j-(i-1))] + mod) % mod
		}
		for j := 1; j <= k+1; j++ {
			s[j] = (s[j-1] + f[j-1]) % mod
		}
	}
	return f[k]
}634. 寻找数组的错位排列 🔒
题目、示例与约束
在组合数学中,如果一个排列中所有元素都不在原先的位置上,那么这个排列就被称为 错位排列 。
给定一个从 1 到 n 升序排列的数组,返回 不同的错位排列 的数量 。由于答案可能非常大,你只需要将答案对 109+7 取余 输出即可。
示例 1:
输入: n = 3
输出: 2
解释: 原始的数组为 [1,2,3]。两个错位排列的数组为 [2,3,1] 和 [3,1,2]。
示例 2:
输入: n = 2
输出: 1
提示:
1 <= n <= 106
方法一:动态规划 · Go 实现
思考
错排数 可用容斥直接写公式,但取模后除法不方便。递推更稳。
把 放到位置 后, 与 互换或 不回位置 ,得到 。线性扫到 即可。
我们定义 表示长度为 的数组的错位排列的数量。初始时 , 。答案即为 。
对于长度为 的数组,我们考虑将数字 放在哪个位置,假设放在第 个位置,这里有 种选择,那么接下来数字 可以有两种选择:
- 放在第 个位置,那么剩下的 个位置可以有 种错位排列,因此总共有 种错位排列;
- 不放在第 个位置,那么相当于转化为了长度为 的数组的错位排列,因此总共有 种错位排列。
综上,我们有如下状态转移方程:
最终答案即为 。注意答案的取模操作。
时间复杂度 ,其中 为数组的长度。空间复杂度 。
func findDerangement(n int) int {
	f := make([]int, n+1)
	f[0] = 1
	const mod = 1e9 + 7
	for i := 2; i <= n; i++ {
		f[i] = (i - 1) * (f[i-1] + f[i-2]) % mod
	}
	return f[n]
}
方法二:动态规划(空间优化) · Go 实现
思考
转移只读 与 ,两个变量滚动即可把数组省掉。
我们发现,状态转移方程中只与 和 有关,因此我们可以使用两个变量 和 来分别表示 和 ,从而将空间复杂度降低到 。
func findDerangement(n int) int {
	a, b := 1, 0
	const mod = 1e9 + 7
	for i := 2; i <= n; i++ {
		a, b = b, (i-1)*(a+b)%mod
	}
	return b
}638. 大礼包
题目、示例与约束
在 LeetCode 商店中, 有 n 件在售的物品。每件物品都有对应的价格。然而,也有一些大礼包,每个大礼包以优惠的价格捆绑销售一组物品。
给你一个整数数组 price 表示物品价格,其中 price[i] 是第 i 件物品的价格。另有一个整数数组 needs 表示购物清单,其中 needs[i] 是需要购买第 i 件物品的数量。
还有一个数组 special 表示大礼包,special[i] 的长度为 n + 1 ,其中 special[i][j] 表示第 i 个大礼包中内含第 j 件物品的数量,且 special[i][n] (也就是数组中的最后一个整数)为第 i 个大礼包的价格。
返回 确切 满足购物清单所需花费的最低价格,你可以充分利用大礼包的优惠活动。你不能购买超出购物清单指定数量的物品,即使那样会降低整体价格。任意大礼包可无限次购买。
示例 1:
输入:price = [2,5], special = [[3,0,5],[1,2,10]], needs = [3,2]
输出:14
解释:有 A 和 B 两种物品,价格分别为 ¥2 和 ¥5 。
大礼包 1 ,你可以以 ¥5 的价格购买 3A 和 0B 。
大礼包 2 ,你可以以 ¥10 的价格购买 1A 和 2B 。
需要购买 3 个 A 和 2 个 B , 所以付 ¥10 购买 1A 和 2B(大礼包 2),以及 ¥4 购买 2A 。
示例 2:
输入:price = [2,3,4], special = [[1,1,0,4],[2,2,1,9]], needs = [1,2,1]
输出:11
解释:A ,B ,C 的价格分别为 ¥2 ,¥3 ,¥4 。
可以用 ¥4 购买 1A 和 1B ,也可以用 ¥9 购买 2A ,2B 和 1C 。
需要买 1A ,2B 和 1C ,所以付 ¥4 买 1A 和 1B(大礼包 1),以及 ¥3 购买 1B , ¥4 购买 1C 。
不可以购买超出待购清单的物品,尽管购买大礼包 2 更加便宜。
提示:
n == price.length == needs.length1 <= n <= 60 <= price[i], needs[i] <= 101 <= special.length <= 100special[i].length == n + 10 <= special[i][j] <= 50- 生成的输入对于
0 <= j <= n - 1至少有一个special[i][j]非零。
方法一:状态压缩 + 记忆化搜索 · Go 实现
思考
物品种类 、每种至多买 件,暴力枚举每个礼包使用次数会重复大量相同剩余清单。
把每种需求用 位打进一个整数,对剩余清单记忆化:先算原价买完,再尝试每个礼包(分量都不超过剩余)并递归。状态数可接受。
我们注意到,题目中物品的种类 ,而每种物品需要购买的数量不超过 ,我们可以用 个二进制位来表示每种物品需要购买的数量,这样,我们只需要最多 个二进制位来表示整个购物清单。
我们首先将购物清单 转换为一个整数 ,其中第 个物品需要购买的数量存储在 的第 位到第 位。例如,当 时,有 。
然后,我们设计一个函数 ,表示当前购物清单的状态为 时,我们需要花费的最少金额。那么答案即为 。
函数 的计算方法如下:
- 我们首先计算当前购物清单 不使用大礼包时的花费,记为 。
- 然后,我们遍历每一个大礼包 ,如果当前购物清单 能够使用大礼包 ,即 中每种物品的数量都不小于大礼包 中的数量,那么我们可以尝试使用这个大礼包。我们将 中每种物品的数量减去大礼包 中的数量,得到一个新的购物清单 ,然后递归计算 的最少花费,并加上大礼包的价格 ,更新 ,即 。
- 最后,返回 。
为了避免重复计算,我们使用一个哈希表 记录每一个状态 对应的最少花费。
时间复杂度 ,其中 表示物品的种类,而 和 分别表示大礼包的数量以及每种物品的最大需求量。空间复杂度 。
func shoppingOffers(price []int, special [][]int, needs []int) int {
	const bits = 4
	n := len(needs)
	f := make(map[int]int)
	mask := 0
	for i, need := range needs {
		mask |= need << (i * bits)
	}

	var dfs func(int) int
	dfs = func(cur int) int {
		if v, ok := f[cur]; ok {
			return v
		}
		ans := 0
		for i := 0; i < n; i++ {
			ans += price[i] * ((cur >> (i * bits)) & 0xf)
		}
		for _, offer := range special {
			nxt := cur
			ok := true
			for j := 0; j < n; j++ {
				if ((cur >> (j * bits)) & 0xf) < offer[j] {
					ok = false
					break
				}
				nxt -= offer[j] << (j * bits)
			}
			if ok {
				ans = min(ans, offer[n]+dfs(nxt))
			}
		}
		f[cur] = ans
		return ans
	}

	return dfs(mask)
}639. 解码方法 II
题目、示例与约束
一条包含字母 A-Z 的消息通过以下的方式进行了 编码 :
'A' -> "1"
'B' -> "2"
...
'Z' -> "26"
要 解码 一条已编码的消息,所有的数字都必须分组,然后按原来的编码方案反向映射回字母(可能存在多种方式)。例如,"11106" 可以映射为:
"AAJF"对应分组(1 1 10 6)"KJF"对应分组(11 10 6)
注意,像 (1 11 06) 这样的分组是无效的,因为 "06" 不可以映射为 'F' ,因为 "6" 与 "06" 不同。
除了 上面描述的数字字母映射方案,编码消息中可能包含 '*' 字符,可以表示从 '1' 到 '9' 的任一数字(不包括 '0')。例如,编码字符串 "1*" 可以表示 "11"、"12"、"13"、"14"、"15"、"16"、"17"、"18" 或 "19" 中的任意一条消息。对 "1*" 进行解码,相当于解码该字符串可以表示的任何编码消息。
给你一个字符串 s ,由数字和 '*' 字符组成,返回 解码 该字符串的方法 数目 。
由于答案数目可能非常大,返回 109 + 7 的 模 。
示例 1:
输入:s = "*"
输出:9
解释:这一条编码消息可以表示 "1"、"2"、"3"、"4"、"5"、"6"、"7"、"8" 或 "9" 中的任意一条。
可以分别解码成字符串 "A"、"B"、"C"、"D"、"E"、"F"、"G"、"H" 和 "I" 。
因此,"*" 总共有 9 种解码方法。
示例 2:
输入:s = "1*"
输出:18
解释:这一条编码消息可以表示 "11"、"12"、"13"、"14"、"15"、"16"、"17"、"18" 或 "19" 中的任意一条。
每种消息都可以由 2 种方法解码(例如,"11" 可以解码成 "AA" 或 "K")。
因此,"1*" 共有 9 * 2 = 18 种解码方法。
示例 3:
输入:s = "2*"
输出:15
解释:这一条编码消息可以表示 "21"、"22"、"23"、"24"、"25"、"26"、"27"、"28" 或 "29" 中的任意一条。
"21"、"22"、"23"、"24"、"25" 和 "26" 由 2 种解码方法,但 "27"、"28" 和 "29" 仅有 1 种解码方法。
因此,"2*" 共有 (6 * 2) + (3 * 1) = 12 + 3 = 15 种解码方法。
提示:
1 <= s.length <= 105s[i]是0 - 9中的一位数字或字符'*'
方法一 · Go 实现
思考
在 Decode Ways 上多了
*,一位可当 ,两位组合更多。长度 ,不能回溯。仍是线性 DP:当前方案数只依赖前两个位置。按
*与数字的组合分类累加一位、两位解码数,滚动三个变量即可。
const mod int = 1e9 + 7

func numDecodings(s string) int {
	n := len(s)

	// dp[i - 2], dp[i - 1], dp[i]
	a, b, c := 0, 1, 0
	for i := 1; i <= n; i++ {
		// 1 digit
		if s[i-1] == '*' {
			c = 9 * b % mod
		} else if s[i-1] != '0' {
			c = b
		} else {
			c = 0
		}

		// 2 digits
		if i > 1 {
			if s[i-2] == '*' && s[i-1] == '*' {
				c = (c + 15*a) % mod
			} else if s[i-2] == '*' {
				if s[i-1] > '6' {
					c = (c + a) % mod
				} else {
					c = (c + 2*a) % mod
				}
			} else if s[i-1] == '*' {
				if s[i-2] == '1' {
					c = (c + 9*a) % mod
				} else if s[i-2] == '2' {
					c = (c + 6*a) % mod
				}
			} else if s[i-2] != '0' && (s[i-2]-'0')*10+s[i-1]-'0' <= 26 {
				c = (c + a) % mod
			}
		}

		a, b = b, c
	}
	return c
}646. 最长数对链
题目、示例与约束
给你一个由 n 个数对组成的数对数组 pairs ,其中 pairs[i] = [lefti, righti] 且 lefti < righti 。
现在,我们定义一种 跟随 关系,当且仅当 b < c 时,数对 p2 = [c, d] 才可以跟在 p1 = [a, b] 后面。我们用这种形式来构造 数对链 。
找出并返回能够形成的 最长数对链的长度 。
你不需要用到所有的数对,你可以以任何顺序选择其中的一些数对来构造。
示例 1:
输入:pairs = [[1,2], [2,3], [3,4]]
输出:2
解释:最长的数对链是 [1,2] -> [3,4] 。
示例 2:
输入:pairs = [[1,2],[7,8],[4,5]]
输出:3
解释:最长的数对链是 [1,2] -> [4,5] -> [7,8] 。
提示:
n == pairs.length1 <= n <= 1000-1000 <= lefti < righti <= 1000
方法一:排序 + 贪心 · Go 实现
思考
数对链要求严格递增,类似最长递增子序列,DP 为 ,对数可达 以上时希望更快。
按右端点排序后,能接就接:右端越小越容易再接后面的对。一次扫描即得多条链的最大长度。
我们将所有数对按照第二个数的升序排序,用一个变量 维护已经选择的数对的第二个数的最大值。
遍历排序后的数对,如果当前数对的第一个数大于 ,那么我们可以贪心地选择当前数对,答案加一,并将 更新为当前数对的第二个数。
遍历结束后,返回答案即可。
时间复杂度 ,空间复杂度 。其中 为数对的数量。
func findLongestChain(pairs [][]int) (ans int) {
	sort.Slice(pairs, func(i, j int) bool { return pairs[i][1] < pairs[j][1] })
	pre := math.MinInt
	for _, p := range pairs {
		if pre < p[0] {
			ans++
			pre = p[1]
		}
	}
	return
}647. 回文子串
题目、示例与约束
给你一个字符串 s ,请你统计并返回这个字符串中 回文子串 的数目。
回文字符串 是正着读和倒过来读一样的字符串。
子字符串 是字符串中的由连续字符组成的一个序列。
示例 1:
输入:s = "abc"
输出:3
解释:三个回文子串: "a", "b", "c"
示例 2:
输入:s = "aaa"
输出:6
解释:6个回文子串: "a", "a", "a", "aa", "aa", "aaa"
提示:
1 <= s.length <= 1000s由小写英文字母组成
方法一:从中心向两侧扩展回文串 · Go 实现
思考
统计回文子串个数。DP 填 个区间位也能做,但只需计数、不必存表。
枚举 个中心(奇偶长度),向两侧扩展直到失配,每成功一步计一个回文。
我们可以枚举回文串的中心位置,然后向两侧扩展,统计回文串的数量。对于长度为 的字符串,回文串的中心位置共有 个(包括奇数长度和偶数长度的回文串)。对于每个中心位置,我们向两侧扩展,直到不满足回文串的条件为止,统计回文串的数量。
时间复杂度 ,其中 是字符串 的长度。空间复杂度 。
func countSubstrings(s string) int {
	ans, n := 0, len(s)
	for k := 0; k < n*2-1; k++ {
		i, j := k/2, (k+1)/2
		for i >= 0 && j < n && s[i] == s[j] {
			ans++
			i, j = i-1, j+1
		}
	}
	return ans
}
方法二:Manacher 算法 · Go 实现
思考
中心扩展最坏仍是 。Manacher 在插入分隔符后线性求出每个中心的臂长 ,该中心贡献 个回文。
在 Manacher 算法的计算过程中,用 表示以第 位为中心的最大回文长度,以第 位为中心的回文串数量为 。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度。
func countSubstrings(s string) int {
	t := "^#"
	for _, c := range s {
		t += string(c)
		t += "#"
	}
	t += "$"

	n := len(t)
	p := make([]int, n)
	pos, maxRight := 0, 0
	ans := 0

	for i := 1; i < n-1; i++ {
		if maxRight > i {
			mirror := 2*pos - i
			if p[mirror] < maxRight-i {
				p[i] = p[mirror]
			} else {
				p[i] = maxRight - i
			}
		} else {
			p[i] = 1
		}

		for t[i-p[i]] == t[i+p[i]] {
			p[i]++
		}

		if i+p[i] > maxRight {
			maxRight = i + p[i]
			pos = i
		}

		ans += p[i] / 2
	}

	return ans
}650. 两个键的键盘
题目、示例与约束
最初记事本上只有一个字符 'A' 。你每次可以对这个记事本进行两种操作:
Copy All(复制全部):复制这个记事本中的所有字符(不允许仅复制部分字符)。Paste(粘贴):粘贴 上一次 复制的字符。
给你一个数字 n ,你需要使用最少的操作次数,在记事本上输出 恰好 n 个 'A' 。返回能够打印出 n 个 'A' 的最少操作次数。
示例 1:
输入:3
输出:3
解释:
最初, 只有一个字符 'A'。
第 1 步, 使用 Copy All 操作。
第 2 步, 使用 Paste 操作来获得 'AA'。
第 3 步, 使用 Paste 操作来获得 'AAA'。
示例 2:
输入:n = 1
输出:0
提示:
1 <= n <= 1000
方法一:记忆化搜索 · Go 实现
思考
从 1 个
A出发,只靠复制与粘贴得到 个。操作序列对应把当前长度倍增或累加,搜索树很宽。若最后一次是把长度为 的文本粘贴到共 份,则 。对因子记忆化, 为 。
定义 为输出 个字符的最少操作次数。初始化 dfs(1)=0。
当 时,有:
时间复杂度 。
func minSteps(n int) int {
	f := make([]int, n+1)
	for i := range f {
		f[i] = -1
	}
	var dfs func(int) int
	dfs = func(n int) int {
		if n == 1 {
			return 0
		}
		if f[n] != -1 {
			return f[n]
		}
		ans := n
		for i := 2; i*i <= n; i++ {
			if n%i == 0 {
				ans = min(ans, dfs(n/i)+i)
			}
		}
		return ans
	}
	return dfs(n)
}
方法二:动态规划 · Go 实现
思考
记忆化是自顶向下。改成 自底向上枚举因子,转移相同,避免递归。
记忆化搜索也可以改成动态规划。
时间复杂度 。
func minSteps(n int) int {
	dp := make([]int, n+1)
	for i := range dp {
		dp[i] = i
	}
	dp[1] = 0
	for i := 2; i < n+1; i++ {
		for j := 2; j*j <= i; j++ {
			if i%j == 0 {
				dp[i] = min(dp[i], dp[i/j]+j)
			}
		}
	}
	return dp[n]
}651. 四个键的键盘 🔒
题目、示例与约束
假设你有一个特殊的键盘包含下面的按键:
A:在屏幕上打印一个'A'。Ctrl-A:选中整个屏幕。Ctrl-C:复制选中区域到缓冲区。Ctrl-V:将缓冲区内容输出到上次输入的结束位置,并显示在屏幕上。
现在,你可以 最多 按键 n 次(使用上述四种按键),返回屏幕上最多可以显示 'A' 的个数 。
示例 1:
输入: n = 3
输出: 3
解释:
我们最多可以在屏幕上显示三个'A'通过如下顺序按键:
A, A, A
示例 2:
输入: n = 7
输出: 9
解释:
我们最多可以在屏幕上显示九个'A'通过如下顺序按键:
A, A, A, Ctrl A, Ctrl C, Ctrl V, Ctrl V
提示:
1 <= n <= 50
方法一:动态规划 · Go 实现
思考
四个按键含全选与复制,最优序列几乎总是「输入若干 A,再反复粘贴」。穷举按键串长度为 尚可,但状态可用 DP 压掉。
为 次按键的最大
A数。要么全按 A 得 ,要么在 处 Ctrl-A,此后粘贴 次,得到 。
定义 表示前 个按键可以显示的最大个数。
我们可以发现,要显示最多的 A,要么一直按 A,要么以 Ctrl-V 结束。
- 一直按
A的情况,满足 。 - 以
Ctrl-V结束的情况,我们枚举对应的Ctrl-A的位置 ,可以得到 。
时间复杂度 ,空间复杂度 。
func maxA(n int) int {
	dp := make([]int, n+1)
	for i := range dp {
		dp[i] = i
	}
	for i := 3; i < n+1; i++ {
		for j := 2; j < i-1; j++ {
			dp[i] = max(dp[i], dp[j-1]*(i-j))
		}
	}
	return dp[n]
}656. 成本最小路径 🔒
题目、示例与约束
给你一个整数数组 coins(下标从 1 开始)长度为 n,以及一个整数 maxJump。你可以跳到数组 coins 的任意下标 i(满足 coins[i] != -1),访问下标 i 时需要支付 coins[i]。此外,如果你当前位于下标 i,你只能跳到下标 i + k(满足 i + k <= n),其中 k 是范围 [1, maxJump] 内的一个值。
初始时你位于下标 1(coins[1] 不是 -1)。你的目标是找到一条到达下标 n 的成本最小路径。
返回一个整数数组,包含你访问的下标顺序,以便你以最小成本达到下标 n 。如果存在多条成本相同的路径,返回 字典序最小 的路径。如果无法达到下标 n ,返回一个空数组。
路径 p1 = [Pa1, Pa2, ..., Pax] 的长度为 x,路径 p2 = [Pb1, Pb2, ..., Pbx] 的长度为 y ,如果在两条路径的第一个不同的下标 j 处,Paj 小于 Pbj,则 p1 在字典序上小于 p2;如果不存在这样的 j,则较短的路径字典序较小。
示例 1:
输入:coins = [1,2,4,-1,2], maxJump = 2
输出:[1,3,5]
示例 2:
输入:coins = [1,2,4,-1,2], maxJump = 1
输出:[]
提示:
1 <= coins.length <= 1000-1 <= coins[i] <= 100coins[1] != -11 <= maxJump <= 100
方法一:动态规划(逆向) · Go 实现
思考
从下标 跳到末尾,步长不超过 ,避开 ,要最小花费且字典序最小的下标序列。正向记录路径时,花费相同要比较整段前缀。
倒着定义 为从 到终点的最小花费,转移看后面至多 格。还原时从左往右取满足 等于剩余预算的最左下标,自然得到字典序最小路径。
题目需要我们找到从下标 1 到下标 n 的最小花费路径,且字典序最小,我们可以使用动态规划求解。
我们定义 表示从下标 到下标 的最小花费。如果 ,则不存在从下标 到下标 的路径,直接返回空数组即可。否则 。
接下来,我们从下标 开始,逆向遍历数组,对于下标 ,如果 ,则 ,否则 。
然后我们判断 是否为 ,如果是,则不存在一条满足条件的路径,返回空数组即可。否则,我们的总花费为 ,我们从下标 0 开始,向后遍历数组,如果 ,则说明从下标 到下标 的花费为 ,我们将 减去 ,并将下标 加入到结果数组中,直到遍历到下标 ,返回结果数组即可。
时间复杂度 ,空间复杂度 。其中 和 分别为数组的长度和最大跳跃长度。
func cheapestJump(coins []int, maxJump int) (ans []int) {
	n := len(coins)
	if coins[n-1] == -1 {
		return
	}
	f := make([]int, n)
	f[n-1] = coins[n-1]
	const inf = 1 << 30
	for i := n - 2; i >= 0; i-- {
		f[i] = inf
		if coins[i] != -1 {
			for j := i + 1; j < n && j < i+maxJump+1; j++ {
				if f[i] > f[j]+coins[i] {
					f[i] = f[j] + coins[i]
				}
			}
		}
	}
	if f[0] == inf {
		return
	}
	for i, s := 0, f[0]; i < n; i++ {
		if f[i] == s {
			s -= coins[i]
			ans = append(ans, i+1)
		}
	}
	return
}664. 奇怪的打印机
题目、示例与约束
有台奇怪的打印机有以下两个特殊要求:
- 打印机每次只能打印由 同一个字符 组成的序列。
- 每次可以在从起始到结束的任意位置打印新字符,并且会覆盖掉原来已有的字符。
给你一个字符串 s ,你的任务是计算这个打印机打印它需要的最少打印次数。
示例 1:
输入:s = "aaabbb"
输出:2
解释:首先打印 "aaa" 然后打印 "bbb"。
示例 2:
输入:s = "aba"
输出:2
解释:首先打印 "aaa" 然后在第二个位置打印 "b" 覆盖掉原来的字符 'a'。
提示:
1 <= s.length <= 100s由小写英文字母组成
方法一:动态规划 · Go 实现
思考
打印机一次可把一段连续位置打成同一字符,求最少次数。长度为 ,区间划分适合 DP。
为打完 的最少次数。两端同色则可并入上一次印刷,否则枚举切点。按区间长度递推保证子区间已算出。
我们定义 表示打印完成区间 的最少操作数,初始时 ,答案为 ,其中 是字符串 的长度。
考虑 ,如果 ,那么我们在打印 时可以顺便打印 ,这样我们即可忽略字符 ,在区间 内继续进行打印。如果 ,那么我们需要分别完成该区间的打印,即使用 和 ,其中 。于是我们可以列出如下的转移方程:
在枚举时,我们可以从大到小枚举 ,从小到大枚举 ,这样可以保证在计算 时,状态 和 以及 都已经被计算过。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度。
func strangePrinter(s string) int {
	n := len(s)
	f := make([][]int, n)
	for i := range f {
		f[i] = make([]int, n)
		for j := range f[i] {
			f[i][j] = 1 << 30
		}
	}
	for i := n - 1; i >= 0; i-- {
		f[i][i] = 1
		for j := i + 1; j < n; j++ {
			if s[i] == s[j] {
				f[i][j] = f[i][j-1]
			} else {
				for k := i; k < j; k++ {
					f[i][j] = min(f[i][j], f[i][k]+f[k+1][j])
				}
			}
		}
	}
	return f[0][n-1]
}678. 有效的括号字符串
题目、示例与约束
给你一个只包含三种字符的字符串,支持的字符类型分别是 '('、')' 和 '*'。请你检验这个字符串是否为有效字符串,如果是 有效 字符串返回 true 。
有效 字符串符合如下规则:
- 任何左括号
'('必须有相应的右括号')'。 - 任何右括号
')'必须有相应的左括号'('。 - 左括号
'('必须在对应的右括号之前')'。 '*'可以被视为单个右括号')',或单个左括号'(',或一个空字符串""。
示例 1:
输入:s = "()"
输出:true
示例 2:
输入:s = "(*)"
输出:true
示例 3:
输入:s = "(*))"
输出:true
提示:
1 <= s.length <= 100s[i]为'('、')'或'*'
方法一:动态规划 · Go 实现
思考
*可当左、右或空,判断整串是否合法。回溯三种选择在长度 时偏慢。区间 DP: 表示 是否合法。长度为 仅
*为真;更长则「两端能配对且内部合法」或在某处拆成两段合法串。
定义 表示字符串 中下标范围 内的子串是否为有效括号字符串。答案为 。
子串长度为 时,如果字符 为 *,则 为 true,否则为 false。
子串长度大于 时,如果满足下面任意一种情况,则 为 true:
- 子串 的左边界为
(或*,且右边界为*或),且 为有效括号字符串; - 子串 中的任意下标 ,如果 为有效括号字符串,且 为有效括号字符串,则 为有效括号字符串。
时间复杂度 ,空间复杂度 。其中 为字符串 s 的长度。
func checkValidString(s string) bool {
	n := len(s)
	dp := make([][]bool, n)
	for i := range dp {
		dp[i] = make([]bool, n)
		dp[i][i] = s[i] == '*'
	}
	for i := n - 2; i >= 0; i-- {
		for j := i + 1; j < n; j++ {
			a, b := s[i], s[j]
			dp[i][j] = (a == '(' || a == '*') && (b == '*' || b == ')') && (i+1 == j || dp[i+1][j-1])
			for k := i; k < j && !dp[i][j]; k++ {
				dp[i][j] = dp[i][k] && dp[k+1][j]
			}
		}
	}
	return dp[0][n-1]
}
方法二:贪心 + 两遍扫描 · Go 实现
思考
区间 DP 是立方。从左把
(与*都当可匹配存量,遇)必须能减;再从右对)与*同样扫一遍。两遍都过则左右都能配平。
两遍扫描,第一遍从左往右,确定每一个右括号都可以成功配对,第二遍从右往左,确定每一个左括号都可以成功配对。
时间复杂度 ,空间复杂度 。其中 为字符串 s 的长度。
相似题目:
func checkValidString(s string) bool {
	x := 0
	for _, c := range s {
		if c != ')' {
			x++
		} else if x > 0 {
			x--
		} else {
			return false
		}
	}
	x = 0
	for i := len(s) - 1; i >= 0; i-- {
		if s[i] != '(' {
			x++
		} else if x > 0 {
			x--
		} else {
			return false
		}
	}
	return true
}688. 骑士在棋盘上的概率
题目、示例与约束
在一个 n x n 的国际象棋棋盘上,一个骑士从单元格 (row, column) 开始,并尝试进行 k 次移动。行和列是 从 0 开始 的,所以左上单元格是 (0,0) ,右下单元格是 (n - 1, n - 1) 。
象棋骑士有8种可能的走法,如下图所示。每次移动在基本方向上是两个单元格,然后在正交方向上是一个单元格。
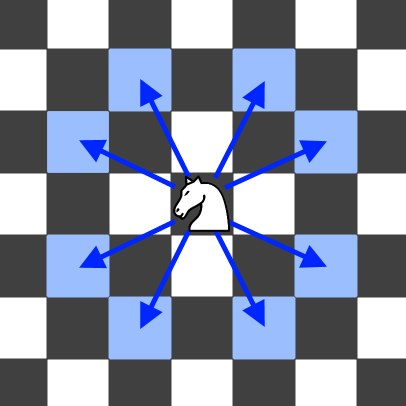
每次骑士要移动时,它都会随机从8种可能的移动中选择一种(即使棋子会离开棋盘),然后移动到那里。
骑士继续移动,直到它走了 k 步或离开了棋盘。
返回 骑士在棋盘停止移动后仍留在棋盘上的概率 。
示例 1:
输入: n = 3, k = 2, row = 0, column = 0
输出: 0.0625
解释: 有两步(到(1,2),(2,1))可以让骑士留在棋盘上。
在每一个位置上,也有两种移动可以让骑士留在棋盘上。
骑士留在棋盘上的总概率是0.0625。
示例 2:
输入: n = 1, k = 0, row = 0, column = 0
输出: 1.00000
提示:
1 <= n <= 250 <= k <= 1000 <= row, column <= n - 1
方法一:动态规划 · Go 实现
思考
骑士走 步仍在 棋盘上的概率。每步 向,搜索树为 , 可达 。
表示从 再走 步仍在棋上的概率。 为 ;否则对八个合法落点累加 。答案为 。
我们定义 表示骑士从 位置出发,走了 步以后还留在棋盘上的概率。那么最终答案就是 。
当 时,骑士一定在棋盘上,概率为 ,即 。
当 时,骑士在 位置上的概率可以由其上一步的 个位置上的概率转移得到,即:
其中 是从 位置可以走到的 个位置中的一个。
最终答案即为 。
时间复杂度 ,空间复杂度 。其中 和 分别是给定的步数和棋盘大小。
func knightProbability(n int, k int, row int, column int) float64 {
	f := make([][][]float64, k+1)
	for h := range f {
		f[h] = make([][]float64, n)
		for i := range f[h] {
			f[h][i] = make([]float64, n)
			for j := range f[h][i] {
				f[0][i][j] = 1
			}
		}
	}
	dirs := [9]int{-2, -1, 2, 1, -2, 1, 2, -1, -2}
	for h := 1; h <= k; h++ {
		for i := 0; i < n; i++ {
			for j := 0; j < n; j++ {
				for p := 0; p < 8; p++ {
					x, y := i+dirs[p], j+dirs[p+1]
					if x >= 0 && x < n && y >= 0 && y < n {
						f[h][i][j] += f[h-1][x][y] / 8
					}
				}
			}
		}
	}
	return f[k][row][column]
}689. 三个无重叠子数组的最大和
题目、示例与约束
给你一个整数数组 nums 和一个整数 k ,找出三个长度为 k 、互不重叠、且全部数字和最大的子数组,并返回这三个子数组。
以下标的数组形式返回结果,数组中的每一项分别指示每个子数组的起始位置(下标从 0 开始)。如果有多个结果,返回字典序最小的一个。
示例 1:
输入:nums = [1,2,1,2,6,7,5,1], k = 2
输出:[0,3,5]
解释:子数组 [1, 2], [2, 6], [7, 5] 对应的起始下标为 [0, 3, 5]。
也可以取 [2, 1], 但是结果 [1, 3, 5] 在字典序上更大。
示例 2:
输入:nums = [1,2,1,2,1,2,1,2,1], k = 2
输出:[0,2,4]
提示:
1 <= nums.length <= 2 * 1041 <= nums[i] < 2161 <= k <= floor(nums.length / 3)
方法一:滑动窗口 · Go 实现
思考
三个长度为 、互不重叠的子数组要总和最大,并返回字典序最小的起点。枚举三个起点是立方级。
三个定长窗口同步右移:维护「目前最好的第一段」以及「最好的前两段」,再与当前第三段相加。窗口顺序保证不重叠且起点偏左。
滑动窗口,枚举第三个子数组的位置,同时维护前两个无重叠子数组的最大和及其位置。
时间复杂度 ,其中 是数组 的长度。空间复杂度 。
func maxSumOfThreeSubarrays(nums []int, k int) []int {
	ans := make([]int, 3)
	s, s1, s2, s3 := 0, 0, 0, 0
	mx1, mx12 := 0, 0
	idx1, idx121, idx122 := 0, 0, 0
	for i := k * 2; i < len(nums); i++ {
		s1 += nums[i-k*2]
		s2 += nums[i-k]
		s3 += nums[i]
		if i >= k*3-1 {
			if s1 > mx1 {
				mx1 = s1
				idx1 = i - k*3 + 1
			}
			if mx1+s2 > mx12 {
				mx12 = mx1 + s2
				idx121 = idx1
				idx122 = i - k*2 + 1
			}
			if mx12+s3 > s {
				s = mx12 + s3
				ans = []int{idx121, idx122, i - k + 1}
			}
			s1 -= nums[i-k*3+1]
			s2 -= nums[i-k*2+1]
			s3 -= nums[i-k+1]
		}
	}
	return ans
}
方法二:预处理前后缀 + 枚举中间子数组 · Go 实现
思考
滑动窗口把三端捆在一起,实现要紧。也可预处理:前缀和加 (左侧最佳 段)与 (右侧最佳 段),再枚举中间段起点,和与下标一次取出。
我们可以预处理得到数组 的前缀和数组 ,其中 ,那么对于任意的 , , 就是子数组 的和。
接下来,我们使用动态规划的方法,维护两个长度为 的数组 和 ,其中 表示 范围内长度为 的子数组的最大和及其起始位置, 表示 范围内长度为 的子数组的最大和及其起始位置。
然后,我们枚举中间子数组的起始位置 ,那么三个子数组的和就是 ,其中 表示 范围内长度为 的子数组的最大和, 表示 范围内长度为 的子数组的最大和, 表示 范围内长度为 的子数组的和。我们找出和的最大值对应的三个子数组的起始位置即可。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func maxSumOfThreeSubarrays(nums []int, k int) (ans []int) {
	n := len(nums)
	s := make([]int, n+1)
	for i := 0; i < n; i++ {
		s[i+1] = s[i] + nums[i]
	}

	pre := make([][]int, n)
	suf := make([][]int, n)

	for i, t, idx := 0, 0, 0; i < n-k+1; i++ {
		cur := s[i+k] - s[i]
		if cur > t {
			pre[i+k-1] = []int{cur, i}
			t, idx = cur, i
		} else {
			pre[i+k-1] = []int{t, idx}
		}
	}

	for i, t, idx := n-k, 0, 0; i >= 0; i-- {
		cur := s[i+k] - s[i]
		if cur >= t {
			suf[i] = []int{cur, i}
			t, idx = cur, i
		} else {
			suf[i] = []int{t, idx}
		}
	}

	for i, t := k, 0; i < n-2*k+1; i++ {
		cur := s[i+k] - s[i] + pre[i-1][0] + suf[i+k][0]
		if cur > t {
			ans = []int{pre[i-1][1], i, suf[i+k][1]}
			t = cur
		}
	}

	return
}691. 贴纸拼词
题目、示例与约束
我们有 n 种不同的贴纸。每个贴纸上都有一个小写的英文单词。
您想要拼写出给定的字符串 target ,方法是从收集的贴纸中切割单个字母并重新排列它们。如果你愿意,你可以多次使用每个贴纸,每个贴纸的数量是无限的。
返回你需要拼出 target 的最小贴纸数量。如果任务不可能,则返回 -1 。
注意:在所有的测试用例中,所有的单词都是从 1000 个最常见的美国英语单词中随机选择的,并且 target 被选择为两个随机单词的连接。
示例 1:
输入: stickers = ["with","example","science"], target = "thehat"
输出:3
解释:
我们可以使用 2 个 "with" 贴纸,和 1 个 "example" 贴纸。
把贴纸上的字母剪下来并重新排列后,就可以形成目标 “thehat“ 了。
此外,这是形成目标字符串所需的最小贴纸数量。
示例 2:
输入:stickers = ["notice","possible"], target = "basicbasic"
输出:-1
解释:我们不能通过剪切给定贴纸的字母来形成目标“basicbasic”。
提示:
n == stickers.length1 <= n <= 501 <= stickers[i].length <= 101 <= target.length <= 15stickers[i]和target由小写英文单词组成
方法一:BFS + 状态压缩 · Go 实现
思考
长度 ,每张贴纸可重复使用。对贴纸次数做搜索会重复同一「已拼出集合」。
用二进制表示 各位是否已覆盖。从 做 BFS,每层尝试每张贴纸把未覆盖字母尽量填上。到达全集的层数即最少贴纸数。
我们注意到,字符串 的长度不超过 ,我们可以使用一个长度为 的二进制数来表示 的每个字符是否被拼出,如果第 位为 ,表示 的第 个字符已经被拼出,否则表示未被拼出。
我们定义一个初始状态 ,表示所有字符都未被拼出,然后我们使用广度优先搜索的方法,从初始状态开始,每次搜索时,我们枚举所有的贴纸,对于每一张贴纸,我们尝试拼出 的每一个字符,如果拼出了某个字符,我们就将对应的二进制数的第 位设置为 ,表示该字符已经被拼出,然后我们继续搜索,直到我们拼出了 的所有字符。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度,而 和 分别是贴纸的数量和贴纸的平均长度。
func minStickers(stickers []string, target string) (ans int) {
	n := len(target)
	q := []int{0}
	vis := make([]bool, 1<<n)
	vis[0] = true
	for ; len(q) > 0; ans++ {
		for m := len(q); m > 0; m-- {
			cur := q[0]
			q = q[1:]
			if cur == 1<<n-1 {
				return
			}
			for _, s := range stickers {
				cnt := [26]int{}
				for _, c := range s {
					cnt[c-'a']++
				}
				nxt := cur
				for i, c := range target {
					if cur>>i&1 == 0 && cnt[c-'a'] > 0 {
						nxt |= 1 << i
						cnt[c-'a']--
					}
				}
				if !vis[nxt] {
					vis[nxt] = true
					q = append(q, nxt)
				}
			}
		}
	}
	return -1
}698. 划分为k个相等的子集
题目、示例与约束
给定一个整数数组 nums 和一个正整数 k,找出是否有可能把这个数组分成 k 个非空子集,其总和都相等。
示例 1:
输入: nums = [4, 3, 2, 3, 5, 2, 1], k = 4
输出: True
说明: 有可能将其分成 4 个子集(5),(1,4),(2,3),(2,3)等于总和。
示例 2:
输入: nums = [1,2,3,4], k = 3
输出: false
提示:
1 <= k <= len(nums) <= 160 < nums[i] < 10000- 每个元素的频率在
[1,4]范围内
方法一:DFS + 剪枝 · Go 实现
思考
划分成 个等和子集。总和不能被 整除则无解。 时回溯可行,但子集装填顺序会重复。
目标和为 ,数组 记各桶当前和。数降序放入:超 则跳过,相邻桶和相同则跳过以免对称搜索。放完所有数即成功。
根据题意,我们需要将数组 划分为 个子集,且每个子集的和相等。因此,先累加 中所有元素的和,如果不能被 整除,说明无法划分为 个子集,提前返回 。
如果能被 整除,不妨将每个子集期望的和记为 ,然后创建一个长度为 的数组 ,表示当前每个子集的和。
对数组 进行降序排序(减少搜索次数),然后从第一个元素开始,依次尝试将其加入到 的每个子集中。这里如果将 加入某个子集 后,子集的和超过 ,说明无法放入,可以直接跳过;另外,如果 与 相等,意味着我们在 的时候已经完成了搜索,也可以跳过当前的搜索。
如果能将所有元素都加入到 中,说明可以划分为 个子集,返回 。
func canPartitionKSubsets(nums []int, k int) bool {
	s := 0
	for _, v := range nums {
		s += v
	}
	if s%k != 0 {
		return false
	}
	s /= k
	cur := make([]int, k)
	n := len(nums)

	var dfs func(int) bool
	dfs = func(i int) bool {
		if i == n {
			return true
		}
		for j := 0; j < k; j++ {
			if j > 0 && cur[j] == cur[j-1] {
				continue
			}
			cur[j] += nums[i]
			if cur[j] <= s && dfs(i+1) {
				return true
			}
			cur[j] -= nums[i]
		}
		return false
	}

	sort.Sort(sort.Reverse(sort.IntSlice(nums)))
	return dfs(0)
}
方法二:状态压缩 + 记忆化搜索 · Go 实现
思考
按桶放数仍可能重复同一已选集合。改用二进制 表示已用元素,当前桶余量 。记忆化 ,数升序以便 时整段剪枝。
与方法一相同,我们依然先判断数组 是否有可能被划分为 个子集。如果不能被 整除,直接返回 。
我们记 为每个子集期望的和,当前元素被划分的情况为 。对于第 个数,若 的第 位为 ,说明第 个元素未被划分。
我们的目标是从全部元素中凑出 个和为 的子集。记当前子集的和为 。在未划分第 个元素时:
- 若 ,说明第 个元素不能被添加到当前子集中,由于我们对 数组进行升序排列,因此数组 从位置 开始的所有元素都不能被添加到当前子集,直接返回 。
- 否则,将第 个元素添加到当前子集中,状态变为 ,然后继续对未划分的元素进行搜索。需要注意的是,若 ,说明恰好可以得到一个和为 的子集,下一步将 归零(可以通过 实现),并继续划分下一个子集。
为了避免重复搜索,我们使用一个长度为 的数组 记录每个状态下的搜索结果。数组 有三个可能的值:
0:表示当前状态还未搜索过;-1:表示当前状态下无法划分为 个子集;1:表示当前状态下可以划分为 个子集。
时间复杂度 ,空间复杂度 。其中 表示数组 的长度。对于每个状态,我们需要遍历数组 ,时间复杂度为 ;状态总数为 ,因此总的时间复杂度为 。
func canPartitionKSubsets(nums []int, k int) bool {
	s := 0
	for _, v := range nums {
		s += v
	}
	if s%k != 0 {
		return false
	}
	s /= k
	n := len(nums)
	f := make([]int, 1<<n)
	mask := (1 << n) - 1

	var dfs func(int, int) bool
	dfs = func(state, t int) bool {
		if state == mask {
			return true
		}
		if f[state] != 0 {
			return f[state] == 1
		}
		for i, v := range nums {
			if (state >> i & 1) == 1 {
				continue
			}
			if t+v > s {
				break
			}
			if dfs(state|1<<i, (t+v)%s) {
				f[state] = 1
				return true
			}
		}
		f[state] = -1
		return false
	}

	sort.Ints(nums)
	return dfs(0, 0)
}
方法三:动态规划 · Go 实现
思考
记忆化是自顶向下。自底向上 表示掩码 能否合法填完若干桶, 为当前桶已装量。枚举未选 转移,避免递归栈。
我们可以使用动态规划的方法求解本题。
我们定义 表示当前选取的数字的状态为 时,是否存在 个子集满足题目要求。初始时 ,答案为 。其中 表示数组 的长度。另外,我们定义 表示当前选取的数字的状态为 时,最后一个子集的和。
我们在 的范围内枚举状态 ,对于每个状态 ,如果 为 ,我们直接跳过即可。否则,我们枚举 数组中的任意一个数 ,如果 ,我们直接跳出枚举循环,因为后面的数更大,无法放入当前子集;否则,如果 的二进制表示的第 位为 ,说明当前 还没有被选取,我们可以将其放入当前子集中,此时状态变为 ,并更新 ,并且 。
最后,我们返回 即可。
时间复杂度 ,空间复杂度 。其中 表示数组 的长度。
func canPartitionKSubsets(nums []int, k int) bool {
	s := 0
	for _, x := range nums {
		s += x
	}
	if s%k != 0 {
		return false
	}
	s /= k
	sort.Ints(nums)
	n := len(nums)
	f := make([]bool, 1<<n)
	cur := make([]int, 1<<n)
	f[0] = true
	for i := 0; i < 1<<n; i++ {
		if !f[i] {
			continue
		}
		for j := 0; j < n; j++ {
			if cur[i]+nums[j] > s {
				break
			}
			if i>>j&1 == 0 {
				f[i|1<<j] = true
				cur[i|1<<j] = (cur[i] + nums[j]) % s
			}
		}
	}
	return f[(1<<n)-1]
}712. 两个字符串的最小ASCII删除和
题目、示例与约束
给定两个字符串s1 和 s2,返回 使两个字符串相等所需删除字符的 ASCII 值的最小和 。
示例 1:
输入: s1 = "sea", s2 = "eat"
输出: 231
解释: 在 "sea" 中删除 "s" 并将 "s" 的值(115)加入总和。
在 "eat" 中删除 "t" 并将 116 加入总和。
结束时,两个字符串相等,115 + 116 = 231 就是符合条件的最小和。
示例 2:
输入: s1 = "delete", s2 = "leet"
输出: 403
解释: 在 "delete" 中删除 "dee" 字符串变成 "let",
将 100[d]+101[e]+101[e] 加入总和。在 "leet" 中删除 "e" 将 101[e] 加入总和。
结束时,两个字符串都等于 "let",结果即为 100+101+101+101 = 403 。
如果改为将两个字符串转换为 "lee" 或 "eet",我们会得到 433 或 417 的结果,比答案更大。
提示:
1 <= s1.length, s2.length <= 1000s1和s2由小写英文字母组成
方法一:动态规划 · Go 实现
思考
要使两串相等,只能删除字符,代价为被删字符的 ASCII 之和。长度至多 ,若对每个对齐位置递归删除,子问题会大量重叠。
这与编辑距离同类:若末字符相同则不必删;否则必须删掉其中一侧的末字符,并累加其码值。空串对另一串的代价是该串全部码值之和。
令 为前缀 与 的最小删除和,按上述转移填表,答案为 。时间与空间均为 。
我们定义 表示使得 的前 个字符和 的前 个字符相等所需删除字符的 ASCII 值的最小和。那么答案就是 。
如果 ,那么 。否则,我们可以删除 或者 中的一个,使得 达到最小。因此,状态转移方程如下:
初始状态为 , 。
最后返回 即可。
时间复杂度 ,空间复杂度 。其中 和 分别是 和 的长度。
相似题目:
func minimumDeleteSum(s1 string, s2 string) int {
	m, n := len(s1), len(s2)
	f := make([][]int, m+1)
	for i := range f {
		f[i] = make([]int, n+1)
	}
	for i, c := range s1 {
		f[i+1][0] = f[i][0] + int(c)
	}
	for j, c := range s2 {
		f[0][j+1] = f[0][j] + int(c)
	}
	for i := 1; i <= m; i++ {
		for j := 1; j <= n; j++ {
			if s1[i-1] == s2[j-1] {
				f[i][j] = f[i-1][j-1]
			} else {
				f[i][j] = min(f[i-1][j]+int(s1[i-1]), f[i][j-1]+int(s2[j-1]))
			}
		}
	}
	return f[m][n]
}714. 买卖股票的最佳时机含手续费
题目、示例与约束
给定一个整数数组 prices,其中 prices[i]表示第 i 天的股票价格 ;整数 fee 代表了交易股票的手续费用。
你可以无限次地完成交易,但是你每笔交易都需要付手续费。如果你已经购买了一个股票,在卖出它之前你就不能再继续购买股票了。
返回获得利润的最大值。
注意:这里的一笔交易指买入持有并卖出股票的整个过程,每笔交易你只需要为支付一次手续费。
示例 1:
输入:prices = [1, 3, 2, 8, 4, 9], fee = 2
输出:8
解释:能够达到的最大利润:
在此处买入 prices[0] = 1
在此处卖出 prices[3] = 8
在此处买入 prices[4] = 4
在此处卖出 prices[5] = 9
总利润: ((8 - 1) - 2) + ((9 - 4) - 2) = 8
示例 2:
输入:prices = [1,3,7,5,10,3], fee = 3
输出:6
提示:
1 <= prices.length <= 5 * 1041 <= prices[i] < 5 * 1040 <= fee < 5 * 104
方法一:记忆化搜索 · Go 实现
思考
可多次买卖,每次完整交易扣除手续费 。天数可达 ,按交易次数展开递归而不记忆,状态会重复计算。
某一天只需区分「持有 / 未持有」:未持有时可买入或跳过,持有时可卖出(扣费)或继续持有。从第 天、状态 出发的最优利润只依赖这两个后继。
定义 并记忆化,边界为天数用尽时利润为 ,答案为 。状态数 ,每个常数转移。
我们设计一个函数 ,表示从第 天开始,状态为 时,能够获得的最大利润。其中 的取值为 ,分别表示当前不持有股票和持有股票。答案即为 。
函数 的执行逻辑如下:
如果 ,那么没有股票可以交易了,此时返回 ;
否则,我们可以选择不交易,此时 。我们也可以进行股票交易,如果此时 ,说明当前持有股票,可以卖出,此时 ;如果此时 ,说明当前不持有股票,可以买入,此时 。取最大值作为函数 的返回值。
答案为 。
为了避免重复计算,我们使用记忆化搜索的方法,用一个数组 记录 的返回值,如果 不为 ,说明已经计算过,直接返回 即可。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func maxProfit(prices []int, fee int) int {
	n := len(prices)
	f := make([][2]int, n)
	for i := range f {
		f[i] = [2]int{-1, -1}
	}
	var dfs func(i, j int) int
	dfs = func(i, j int) int {
		if i >= n {
			return 0
		}
		if f[i][j] != -1 {
			return f[i][j]
		}
		ans := dfs(i+1, j)
		if j > 0 {
			ans = max(ans, prices[i]+dfs(i+1, 0)-fee)
		} else {
			ans = max(ans, -prices[i]+dfs(i+1, 1))
		}
		f[i][j] = ans
		return ans
	}
	return dfs(0, 0)
}
方法二:动态规划 · Go 实现
思考
方法一从末尾填了一张后缀表。同样的选择也可以从左往右写: 为前 天结束时未持有 / 持有的最大利润。未持有由「继续空仓」或「今日卖出并扣费」转移;持有由「继续持有」或「今日买入」转移。
自左向右填表,答案为最后一天空仓。时间仍为 。
我们定义 表示到第 天,且状态为 时,能够获得的最大利润。其中 的取值为 ,分别表示当前不持有股票和持有股票。初始时 , 。
当 时,如果当前不持有股票,那么 可以由 和 转移得到,即 ;如果当前持有股票,那么 可以由 和 转移得到,即 。最终答案为 。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func maxProfit(prices []int, fee int) int {
	n := len(prices)
	f := make([][2]int, n)
	f[0][1] = -prices[0]
	for i := 1; i < n; i++ {
		f[i][0] = max(f[i-1][0], f[i-1][1]+prices[i]-fee)
		f[i][1] = max(f[i-1][1], f[i-1][0]-prices[i])
	}
	return f[n-1][0]
}
方法三:动态规划(空间优化) · Go 实现
思考
方法二的第 天只引用第 天的两个值,整表没有必要保留。
用 滚动,按从左到右的顺序更新,空间降为 。注意同一天内先算出新的未持有利润再算持有,以免用到已覆盖的旧值;代码里用并行赋值保证读到的是更新前的一对。
只与上一天有关,用两个变量滚动即可,空间复杂度 。
func maxProfit(prices []int, fee int) int {
	f0, f1 := 0, -prices[0]
	for _, x := range prices[1:] {
		f0, f1 = max(f0, f1+x-fee), max(f1, f0-x)
	}
	return f0
}
方法四:动态规划 · Go 实现
思考
可多次买卖,每次完整交易扣除手续费 。天数可达 ,按买卖决策树展开会重复大量子问题。
状态只是天数和是否持有。跳过当天总会先调用下一天再返回,调用链长度为 ,栈会溢出。
更靠后的天数在从末尾往前走时已经就绪。令 为从第 天起、持有标记为 的最大利润,从 填到 。卖出扣去 ,买入则进入持有态。
令 表示从第 天开始、状态为 时能够获得的最大利润。 取 或 ,分别表示当前不持有股票和持有股票。答案为 。越过最后一天的利润为 ,因此 。
我们从 填到 。不交易则保留 。若 ,当前持有股票,可以卖出,利润为 。若 ,当前不持有股票,可以买入,利润为 。取较大值:
当 时,
当 时,
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func maxProfit(prices []int, fee int) int {
	n := len(prices)
	f := make([][2]int, n+1)
	for i := n - 1; i >= 0; i-- {
		for j := 0; j < 2; j++ {
			ans := f[i+1][j]
			if j > 0 {
				ans = max(ans, prices[i]+f[i+1][0]-fee)
			} else {
				ans = max(ans, -prices[i]+f[i+1][1])
			}
			f[i][j] = ans
		}
	}
	return f[0][0]
}718. 最长重复子数组
题目、示例与约束
给两个整数数组 nums1 和 nums2 ,返回 两个数组中 公共的 、长度最长的子数组的长度 。
示例 1:
输入:nums1 = [1,2,3,2,1], nums2 = [3,2,1,4,7]
输出:3
解释:长度最长的公共子数组是 [3,2,1] 。
示例 2:
输入:nums1 = [0,0,0,0,0], nums2 = [0,0,0,0,0]
输出:5
提示:
1 <= nums1.length, nums2.length <= 10000 <= nums1[i], nums2[i] <= 100
方法一:动态规划 · Go 实现
思考
求两个数组的最长公共连续子数组。长度均为 ,枚举起点再匹配最坏 ,不能接受;公共子序列的 DP 也不要求连续。
连续意味着只有在两端字符相等时,长度才能由「去掉末元后的公共后缀」加一得到,否则这段后缀长度为 。
令 为以 、 结尾的公共后缀长,相等则 ,否则为 。遍历取全局最大。时间 。
我们定义 表示以 和 结尾的最长公共子数组的长度,那么我们可以得到状态转移方程:
最终的答案即为所有 中的最大值。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 和 的长度。
func findLength(nums1 []int, nums2 []int) (ans int) {
	m, n := len(nums1), len(nums2)
	f := make([][]int, m+1)
	for i := range f {
		f[i] = make([]int, n+1)
	}
	for i := 1; i <= m; i++ {
		for j := 1; j <= n; j++ {
			if nums1[i-1] == nums2[j-1] {
				f[i][j] = f[i-1][j-1] + 1
				if ans < f[i][j] {
					ans = f[i][j]
				}
			}
		}
	}
	return ans
}727. 最小窗口子序列 🔒
题目、示例与约束
给定字符串 s1 和 s2,找出 s1 中最短的连续 子串,使得 s2 是该子串的 子序列 。
如果 s1 中没有窗口可以包含 s2 中的所有字符,返回空字符串 ""。如果有不止一个最短长度的窗口,返回 开始位置最靠左 的那个。
示例 1:
输入:
s1 = "abcdebdde", s2 = "bde"
输出:"bcde"
解释:
"bcde" 是答案,因为它在相同长度的字符串 "bdde" 出现之前。
"deb" 不是一个更短的答案,因为在窗口中必须按顺序出现 T 中的元素。
示例 2:
输入:s1 = "jmeqksfrsdcmsiwvaovztaqenprpvnbstl", s2 = "u"
输出:""
提示:
1 <= s1.length <= 2 * 1041 <= s2.length <= 100s1和s2只包含小写英文字母。
方法一:动态规划 · Go 实现
思考
在 中找最短窗口,使其为 的超序列。 长至 、 长至 ,枚举窗口再双指针匹配偏慢,也难以保证最短。
一旦匹配到 的末字符,真正决定窗口长度的是「这个匹配从 的哪一格开始」。把该起点随匹配进度传下去,即可在每个结束位置还原窗口。
表示 前 个字符匹配 前 个字符时的起点:字符相等则继承 ( 时起点就是 ),否则继承 。扫到 时更新最短区间。
我们定义 表示字符串 的前 个字符包含字符串 的前 个字符时的最短子串的起始位置,如果不存在则为 。
我们可以得到状态转移方程:
接下来我们只需要遍历 ,如果 ,则更新最短子串的起始位置和长度。最后返回最短子串即可。
时间复杂度 ,空间复杂度 。其中 和 分别为字符串 和 的长度。
func minWindow(s1 string, s2 string) string {
	m, n := len(s1), len(s2)
	f := make([][]int, m+1)
	for i := range f {
		f[i] = make([]int, n+1)
	}
	for i := 1; i <= m; i++ {
		for j := 1; j <= n; j++ {
			if s1[i-1] == s2[j-1] {
				if j == 1 {
					f[i][j] = i
				} else {
					f[i][j] = f[i-1][j-1]
				}
			} else {
				f[i][j] = f[i-1][j]
			}
		}
	}
	p, k := 0, m+1
	for i := 1; i <= m; i++ {
		if s1[i-1] == s2[n-1] && f[i][n] > 0 {
			j := f[i][n] - 1
			if i-j < k {
				k = i - j
				p = j
			}
		}
	}
	if k > m {
		return ""
	}
	return s1[p : p+k]
}730. 统计不同回文子序列
题目、示例与约束
给你一个字符串 s ,返回 s 中不同的非空回文子序列个数 。由于答案可能很大,请返回对 109 + 7 取余 的结果。
字符串的子序列可以经由字符串删除 0 个或多个字符获得。
如果一个序列与它反转后的序列一致,那么它是回文序列。
如果存在某个 i , 满足 ai != bi ,则两个序列 a1, a2, ... 和 b1, b2, ... 不同。
示例 1:
输入:s = 'bccb'
输出:6
解释:6 个不同的非空回文子字符序列分别为:'b', 'c', 'bb', 'cc', 'bcb', 'bccb'。
注意:'bcb' 虽然出现两次但仅计数一次。
示例 2:
输入:s = 'abcdabcdabcdabcdabcdabcdabcdabcddcbadcbadcbadcbadcbadcbadcbadcba'
输出:104860361
解释:共有 3104860382 个不同的非空回文子序列,104860361 是对 109 + 7 取余后的值。
提示:
1 <= s.length <= 1000s[i]仅包含'a','b','c'或'd'
方法一:区间 DP · Go 实现
思考
统计不同的回文子序列个数,长度为 且只有四种字母。枚举所有子序列不可行;普通回文子序列 DP 会计重,因为同一字符串可由多段区间产生。
按两端字母分类可以去掉重复:以字符 为两端的回文,由其内部四种字母的回文再包上一层 得到。区间变短后子问题只依赖更短区间。
令 为 中以字母 两端的不同回文数。两端都是该字母则 ,否则向不含该端的一侧收缩。答案为 四项之和。
func countPalindromicSubsequences(s string) int {
	mod := int(1e9) + 7
	n := len(s)
	dp := make([][][]int, n)
	for i := range dp {
		dp[i] = make([][]int, n)
		for j := range dp[i] {
			dp[i][j] = make([]int, 4)
		}
	}
	for i, c := range s {
		dp[i][i][c-'a'] = 1
	}
	for l := 2; l <= n; l++ {
		for i := 0; i+l <= n; i++ {
			j := i + l - 1
			for _, c := range [4]byte{'a', 'b', 'c', 'd'} {
				k := int(c - 'a')
				if s[i] == c && s[j] == c {
					dp[i][j][k] = 2 + (dp[i+1][j-1][0]+dp[i+1][j-1][1]+dp[i+1][j-1][2]+dp[i+1][j-1][3])%mod
				} else if s[i] == c {
					dp[i][j][k] = dp[i][j-1][k]
				} else if s[j] == c {
					dp[i][j][k] = dp[i+1][j][k]
				} else {
					dp[i][j][k] = dp[i+1][j-1][k]
				}
			}
		}
	}
	ans := 0
	for _, v := range dp[0][n-1] {
		ans += v
	}
	return ans % mod
}740. 删除并获得点数
题目、示例与约束
给你一个整数数组 nums ,你可以对它进行一些操作。
每次操作中,选择任意一个 nums[i] ,删除它并获得 nums[i] 的点数。之后,你必须删除 所有 等于 nums[i] - 1 和 nums[i] + 1 的元素。
开始你拥有 0 个点数。返回你能通过这些操作获得的最大点数。
示例 1:
输入:nums = [3,4,2]
输出:6
解释:
你可以执行下列步骤:
- 删除 4 获得 4 个点数,因此 3 也被删除。nums = [2]。
- 之后,删除 2 获得 2 个点数。nums = []。
总共获得 6 个点数。
示例 2:
输入:nums = [2,2,3,3,3,4]
输出:9
解释:
你可以执行下列步骤:
- 删除 3 获得 3 个点数。所有的 2 和 4 也被删除。nums = [3,3]。
- 之后,再次删除 3 获得 3 个点数。nums = [3]。
- 再次删除 3 获得 3 个点数。nums = []。
总共获得 9 个点数。
提示:
1 <= nums.length <= 2 * 1041 <= nums[i] <= 104
方法一 · Go 实现
思考
删除一个值 会同时删掉所有 与 ,并得到所有 的总和。 、值域 ,按每次选择枚举会重复子问题。
同一数值要么全拿要么全不拿,相邻数值互斥,这与打家劫舍相同:把每个值的得分预加到 ,再在值域上做「偷或不偷」。
滚动两个变量表示处理到 、 的最优, 取 与 的较大者。时间与值域成正比。
func deleteAndEarn(nums []int) int {

	max := func(x, y int) int {
		if x > y {
			return x
		}
		return y
	}

	mx := math.MinInt32
	for _, num := range nums {
		mx = max(mx, num)
	}
	total := make([]int, mx+1)
	for _, num := range nums {
		total[num] += num
	}
	first := total[0]
	second := max(total[0], total[1])
	for i := 2; i <= mx; i++ {
		cur := max(first+total[i], second)
		first = second
		second = cur
	}
	return second
}741. 摘樱桃
题目、示例与约束
给你一个 n x n 的网格 grid ,代表一块樱桃地,每个格子由以下三种数字的一种来表示:
0表示这个格子是空的,所以你可以穿过它。1表示这个格子里装着一个樱桃,你可以摘到樱桃然后穿过它。-1表示这个格子里有荆棘,挡着你的路。
请你统计并返回:在遵守下列规则的情况下,能摘到的最多樱桃数:
- 从位置
(0, 0)出发,最后到达(n - 1, n - 1),只能向下或向右走,并且只能穿越有效的格子(即只可以穿过值为0或者1的格子); - 当到达
(n - 1, n - 1)后,你要继续走,直到返回到(0, 0),只能向上或向左走,并且只能穿越有效的格子; - 当你经过一个格子且这个格子包含一个樱桃时,你将摘到樱桃并且这个格子会变成空的(值变为
0); - 如果在
(0, 0)和(n - 1, n - 1)之间不存在一条可经过的路径,则无法摘到任何一个樱桃。
示例 1:
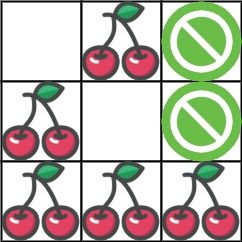
输入:grid = [[0,1,-1],[1,0,-1],[1,1,1]]
输出:5
解释:玩家从 (0, 0) 出发:向下、向下、向右、向右移动至 (2, 2) 。
在这一次行程中捡到 4 个樱桃,矩阵变成 [[0,1,-1],[0,0,-1],[0,0,0]] 。
然后,玩家向左、向上、向上、向左返回起点,再捡到 1 个樱桃。
总共捡到 5 个樱桃,这是最大可能值。
示例 2:
输入:grid = [[1,1,-1],[1,-1,1],[-1,1,1]]
输出:0
提示:
n == grid.lengthn == grid[i].length1 <= n <= 50grid[i][j]为-1、0或1grid[0][0] != -1grid[n - 1][n - 1] != -1
方法一:动态规划 · Go 实现
思考
要从起点走到终点再走回,格子至多 ,两条路径分别搜索状态过多。同一格子的樱桃只能摘一次,分开走两次难以处理重叠。
往返等价于两人同时从起点各走 步:步数相同则列由行决定,状态可压成 。两人落到同一格时樱桃只加一次,障碍格不可达。
由上一步行号 或 、 或 转移,加上当前格的樱桃。答案为 。
根据题目描述,玩家从 出发,到达 后,又重新返回到起始点 ,我们可以视为玩家两次从 出发,到达 。
因此,我们定义 表示两次都走了 步,分别到达 和 时,能够摘到的最多樱桃数。初始时 。其余 的初始值为负无穷。答案为 。
我们可以根据题目描述,得到状态转移方程:
其中 表示 和 位置上的樱桃数,而 分别表示 和 的前一步位置。
时间复杂度 ,空间复杂度 。其中 表示网格的边长。
func cherryPickup(grid [][]int) int {
	n := len(grid)
	f := make([][][]int, (n<<1)-1)
	for i := range f {
		f[i] = make([][]int, n)
		for j := range f[i] {
			f[i][j] = make([]int, n)
		}
	}
	f[0][0][0] = grid[0][0]
	for k := 1; k < (n<<1)-1; k++ {
		for i1 := 0; i1 < n; i1++ {
			for i2 := 0; i2 < n; i2++ {
				f[k][i1][i2] = int(-1e9)
				j1, j2 := k-i1, k-i2
				if j1 < 0 || j1 >= n || j2 < 0 || j2 >= n || grid[i1][j1] == -1 || grid[i2][j2] == -1 {
					continue
				}
				t := grid[i1][j1]
				if i1 != i2 {
					t += grid[i2][j2]
				}
				for x1 := i1 - 1; x1 <= i1; x1++ {
					for x2 := i2 - 1; x2 <= i2; x2++ {
						if x1 >= 0 && x2 >= 0 {
							f[k][i1][i2] = max(f[k][i1][i2], f[k-1][x1][x2]+t)
						}
					}
				}
			}
		}
	}
	return max(0, f[n*2-2][n-1][n-1])
}746. 使用最小花费爬楼梯
题目、示例与约束
给你一个整数数组 cost ,其中 cost[i] 是从楼梯第 i 个台阶向上爬需要支付的费用。
一旦你支付此费用,即可选择向上爬 一个 或者 两个 台阶。
你可以选择从下标为 0 或下标为 1 的台阶开始爬楼梯。
请你计算并返回达到楼梯顶部的 最低 花费,即最后一步之后的那个位置(下标 cost.length)。
示例 1:
输入:cost = [10,15,20]
输出:15
解释:你将从下标为 1 的台阶开始。
- 支付 15 ,向上爬两个台阶,到达楼梯顶部。
总花费为 15 。
示例 2:
输入:cost = [1,100,1,1,1,100,1,1,100,1]
输出:6
解释:你将从下标为 0 的台阶开始。
- 支付 1 ,向上爬两个台阶,到达下标为 2 的台阶。
- 支付 1 ,向上爬两个台阶,到达下标为 4 的台阶。
- 支付 1 ,向上爬两个台阶,到达下标为 6 的台阶。
- 支付 1 ,向上爬一个台阶,到达下标为 7 的台阶。
- 支付 1 ,向上爬两个台阶,到达下标为 9 的台阶。
- 支付 1 ,向上爬一个台阶,到达楼梯顶部。
总花费为 6 。
提示:
2 <= cost.length <= 10000 <= cost[i] <= 999
方法一:记忆化搜索 · Go 实现
思考
可从下标 或 出发,每步跨一或两级并支付当前阶费用。 ,朴素递归会重复计算同一台阶。
从 出发的最小花费只依赖 与 ,越过顶端代价为 。记忆化后每个下标算一次。
答案为 。时间与空间 。
我们设计一个函数 ,表示从第 个阶梯开始爬楼梯所需要的最小花费。那么答案为 。
函数 的执行过程如下:
- 如果 ,表示当前位置已经超过了楼梯顶部,不需要再爬楼梯,返回 ;
- 否则,我们可以选择爬 级楼梯,花费为 ,然后递归调用 ;也可以选择爬 级楼梯,花费为 ,然后递归调用 ;
- 返回两种方案中的最小花费。
为了避免重复计算,我们使用记忆化搜索的方法,将已经计算过的结果保存在数组或哈希表中。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func minCostClimbingStairs(cost []int) int {
	n := len(cost)
	f := make([]int, n)
	for i := range f {
		f[i] = -1
	}
	var dfs func(int) int
	dfs = func(i int) int {
		if i >= n {
			return 0
		}
		if f[i] < 0 {
			f[i] = cost[i] + min(dfs(i+1), dfs(i+2))
		}
		return f[i]
	}
	return min(dfs(0), dfs(1))
}
方法二:动态规划 · Go 实现
思考
方法一已经从楼顶向下填好离开每一级的花费。这里的 改成到达位置 的最小花费,只依赖 与 ,因此按 从小到大填写, 就是楼顶。
我们定义 表示到达第 个阶梯所需要的最小花费,初始时 ,答案即为 。
当 时,我们可以从第 个阶梯使用 步直接到达第 个阶梯,或者从第 个阶梯使用 步到达第 个阶梯,因此我们有状态转移方程:
最终的答案即为 。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func minCostClimbingStairs(cost []int) int {
	n := len(cost)
	f := make([]int, n+1)
	for i := 2; i <= n; i++ {
		f[i] = min(f[i-1]+cost[i-1], f[i-2]+cost[i-2])
	}
	return f[n]
}
方法三:动态规划(空间优化) · Go 实现
思考
只依赖前两项,两个变量滚动即可,空间 。
我们注意到,状态转移方程中的 只和 与 有关,因此我们可以使用两个变量 和 交替地记录 和 的值,这样空间复杂度可以优化到 。
func minCostClimbingStairs(cost []int) int {
	n := len(cost)
	var f, g int
	for i := 2; i <= n; i++ {
		f, g = g, min(f+cost[i-2], g+cost[i-1])
	}
	return g
}
方法四:动态规划 · Go 实现
思考
展开每一步的一阶和两阶,路径数是指数级的。台阶数可以到 ,而第一次递归总是走到下一阶,调用深度就是 。离开台阶 的最小花费只依赖 和 ,越过顶端为 。令 ,从 降到 填写。答案是 。
我们令 表示从第 个阶梯出发爬到楼顶的最小花费。当 时, 。对于 ,
按 从 递减到 计算。答案为 。
时间复杂度 ,空间复杂度 。其中 是数组 的长度。
func minCostClimbingStairs(cost []int) int {
	n := len(cost)
	f := make([]int, n+2)
	for i := n - 1; i >= 0; i-- {
		f[i] = cost[i] + min(f[i+1], f[i+2])
	}
	return min(f[0], f[1])
}750. 角矩形的数量 🔒
题目、示例与约束
给定一个只包含 0 和 1 的 m x n 整数矩阵 grid ,返回 其中 「角矩形 」的数量 。
一个「角矩形」是由四个不同的在矩阵上的 1 形成的 轴对齐 的矩形。注意只有角的位置才需要为 1。
注意:4 个 1 的位置需要是不同的。
示例 1:
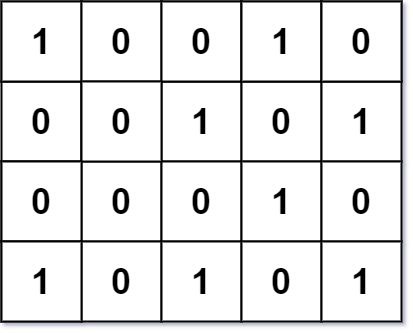
输入:grid = [[1,0,0,1,0],[0,0,1,0,1],[0,0,0,1,0],[1,0,1,0,1]]
输出:1
解释:只有一个角矩形,角的位置为 grid[1][2], grid[1][4], grid[3][2], grid[3][4]。
示例 2:
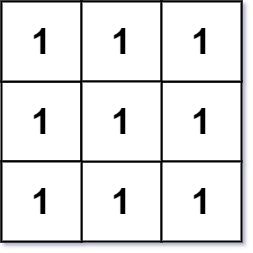
输入:grid = [[1,1,1],[1,1,1],[1,1,1]]
输出:9
解释:这里有 4 个 2x2 的矩形,4 个 2x3 和 3x2 的矩形和 1 个 3x3 的矩形。
示例 3:
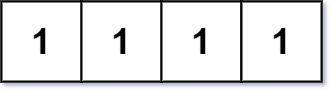
输入:grid = [[1,1,1,1]]
输出:0
解释:矩形必须有 4 个不同的角。
提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 200grid[i][j]不是0就是1- 网格中
1的个数在[1, 6000]范围内
方法一:哈希表 + 枚举 · Go 实现
思考
统计由四个 构成的轴对齐矩形个数。 若枚举四个顶点则过慢; 至多 个,宜利用「一行中的一对 」。
两行能构成矩形,当且仅当某两列在这两行都是 。枚举当前行的每一对 列,此前已出现该列对的行数就是能配成的矩形数。
哈希表统计列对出现次数:当前行累加 ,再把该对加一。时间 。
我们枚举每一行作为矩形的下边,对于当前行,如果列 和列 都是 ,那么我们用哈希表找出此前的所有行中,有多少行的 和 列都是 ,那么就有多少个以 为右下角的矩形,我们将其数量加入答案。然后将 加入哈希表,继续枚举下一对 。
时间复杂度 ,空间复杂度 。其中 和 分别是矩阵的行数和列数。
func countCornerRectangles(grid [][]int) (ans int) {
	n := len(grid[0])
	type pair struct{ x, y int }
	cnt := map[pair]int{}
	for _, row := range grid {
		for i, x := range row {
			if x == 1 {
				for j := i + 1; j < n; j++ {
					if row[j] == 1 {
						t := pair{i, j}
						ans += cnt[t]
						cnt[t]++
					}
				}
			}
		}
	}
	return
}764. 最大加号标志
题目、示例与约束
在一个 n x n 的矩阵 grid 中,除了在数组 mines 中给出的元素为 0,其他每个元素都为 1。mines[i] = [xi, yi]表示 grid[xi][yi] == 0
返回 grid 中包含 1 的最大的 轴对齐 加号标志的阶数 。如果未找到加号标志,则返回 0 。
一个 k 阶由 1 组成的 “轴对称”加号标志 具有中心网格 grid[r][c] == 1 ,以及4个从中心向上、向下、向左、向右延伸,长度为 k-1,由 1 组成的臂。注意,只有加号标志的所有网格要求为 1 ,别的网格可能为 0 也可能为 1 。
示例 1:
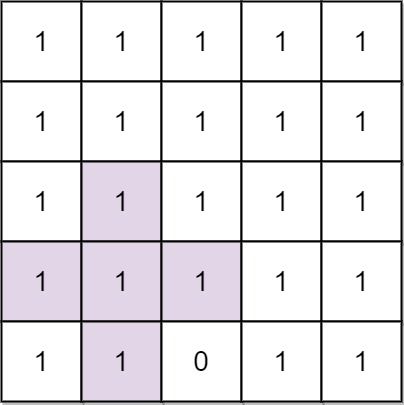
输入: n = 5, mines = [[4, 2]]
输出: 2
解释: 在上面的网格中,最大加号标志的阶只能是2。一个标志已在图中标出。
示例 2:

输入: n = 1, mines = [[0, 0]]
输出: 0
解释: 没有加号标志,返回 0 。
提示:
1 <= n <= 5001 <= mines.length <= 50000 <= xi, yi < n- 每一对
(xi, yi)都 不重复
方法一:动态规划 · Go 实现
思考
在 的网格上找最大阶加号, 对每个中心扩臂偏紧。阶数等于中心向四方向连续 的最小值。
四个方向的连续长度可各做一次线性扫描。把地雷先标成 ,其余初始化为 ,再取与四向计数的最小值。
同一趟里用 与 同时更新左右、上下四个计数,最后取全表最大。时间 。
我们定义 表示以 为中心的最大加号标志的阶数,答案即为所有 的最大值。
我们可以发现,对于每个 ,其最大加号标志的阶数不会超过其上下左右四个方向上连续的 的个数的最小值。因此,我们可以预处理出每个位置上下左右四个方向上连续的 的个数,然后遍历所有的 ,求出 的最大值即可。
时间复杂度 ,空间复杂度 。其中 为网格的边长。
func orderOfLargestPlusSign(n int, mines [][]int) (ans int) {
	dp := make([][]int, n)
	for i := range dp {
		dp[i] = make([]int, n)
		for j := range dp[i] {
			dp[i][j] = n
		}
	}
	for _, e := range mines {
		dp[e[0]][e[1]] = 0
	}
	for i := 0; i < n; i++ {
		var left, right, up, down int
		for j, k := 0, n-1; j < n; j, k = j+1, k-1 {
			left, right, up, down = left+1, right+1, up+1, down+1
			if dp[i][j] == 0 {
				left = 0
			}
			if dp[i][k] == 0 {
				right = 0
			}
			if dp[j][i] == 0 {
				up = 0
			}
			if dp[k][i] == 0 {
				down = 0
			}
			dp[i][j] = min(dp[i][j], left)
			dp[i][k] = min(dp[i][k], right)
			dp[j][i] = min(dp[j][i], up)
			dp[k][i] = min(dp[k][i], down)
		}
	}
	for _, e := range dp {
		ans = max(ans, slices.Max(e))
	}
	return
}773. 滑动谜题
题目、示例与约束
在一个 2 x 3 的板上(board)有 5 块砖瓦,用数字 1~5 来表示, 以及一块空缺用 0 来表示。一次 移动 定义为选择 0 与一个相邻的数字(上下左右)进行交换.
最终当板 board 的结果是 [[1,2,3],[4,5,0]] 谜板被解开。
给出一个谜板的初始状态 board ,返回最少可以通过多少次移动解开谜板,如果不能解开谜板,则返回 -1 。
示例 1:
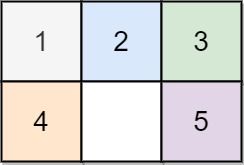
输入:board = [[1,2,3],[4,0,5]]
输出:1
解释:交换 0 和 5 ,1 步完成
示例 2:
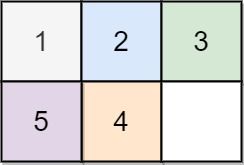
输入:board = [[1,2,3],[5,4,0]]
输出:-1
解释:没有办法完成谜板
示例 3:
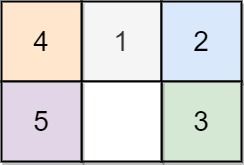
输入:board = [[4,1,2],[5,0,3]]
输出:5
解释:
最少完成谜板的最少移动次数是 5 ,
一种移动路径:
尚未移动: [[4,1,2],[5,0,3]]
移动 1 次: [[4,1,2],[0,5,3]]
移动 2 次: [[0,1,2],[4,5,3]]
移动 3 次: [[1,0,2],[4,5,3]]
移动 4 次: [[1,2,0],[4,5,3]]
移动 5 次: [[1,2,3],[4,5,0]]
提示:
board.length == 2board[i].length == 30 <= board[i][j] <= 5board[i][j]中每个值都 不同
方法一:Go 解法(本站整理) · Go 实现
本站根据题意与 Doocs 参考思路整理为 Go,非上游原文。按 CC BY-SA 4.0 共享。
将 2×3 棋盘编码成六字符状态,用广度优先搜索逐层移动零。每条边都代表一次交换,因此第一次到达目标状态就是最少步数;遍历完仍未到达则无解。最多 6! 个状态,每个状态至多四个邻居,时间和空间均为 O(6!),编码长度为固定常数。
import "strings"

func slidingPuzzle(board [][]int) int {
	start := make([]byte, 0, 6)
	for _, row := range board {
		for _, v := range row {
			start = append(start, byte('0'+v))
		}
	}
	neighbors := [][]int{{1, 3}, {0, 2, 4}, {1, 5}, {0, 4}, {1, 3, 5}, {2, 4}}
	queue := []string{string(start)}
	seen := map[string]bool{string(start): true}
	for steps := 0; len(queue) > 0; steps++ {
		next := []string{}
		for _, s := range queue {
			if s == "123450" {
				return steps
			}
			zero := strings.IndexByte(s, '0')
			for _, p := range neighbors[zero] {
				a := []byte(s)
				a[p], a[zero] = a[zero], a[p]
				v := string(a)
				if !seen[v] {
					seen[v] = true
					next = append(next, v)
				}
			}
		}
		queue = next
	}
	return -1
}788. 旋转数字
题目、示例与约束
我们称一个数 X 为好数, 如果它的每位数字逐个地被旋转 180 度后,我们仍可以得到一个有效的,且和 X 不同的数。要求每位数字都要被旋转。
如果一个数的每位数字被旋转以后仍然还是一个数字, 则这个数是有效的。0, 1, 和 8 被旋转后仍然是它们自己;2 和 5 可以互相旋转成对方(在这种情况下,它们以不同的方向旋转,换句话说,2 和 5 互为镜像);6 和 9 同理,除了这些以外其他的数字旋转以后都不再是有效的数字。
现在我们有一个正整数 N, 计算从 1 到 N 中有多少个数 X 是好数?
示例:
输入: 10
输出: 4
解释:
在[1, 10]中有四个好数: 2, 5, 6, 9。
注意 1 和 10 不是好数, 因为他们在旋转之后不变。
提示:
- N 的取值范围是
[1, 10000]。
方法一:直接枚举 · Go 实现
思考
好数旋转后仍合法且与原数不同。 ,枚举每个数拆位即可。
非法数字直接否;合法数字按映射拼出旋转结果,与原数比较。
一种直观且有效的思路是,直接枚举 中的每个数,判断其是否为好数,若为好数,则答案加一。
那么题目的重点转化为如何判断一个数字 是否为好数。判断的逻辑如下:
我们先用一个长度为 的数组 记录每个有效数字对应的旋转数字,在这道题中,有效数字有 ,分别对应旋转数字 。如果不是有效数字,我们将对应的旋转数字设为 。
然后遍历数字 的每一位数字 ,如果 不是有效数字,说明 不是好数,直接返回 。否则,我们将数字 对应的旋转数字 加入到 中。最后,判断 和 是否相等,若不相等,则说明 是好数,返回 。
时间复杂度 ,其中 为题目给定的数字。空间复杂度 。
相似题目:
func rotatedDigits(n int) int {
	d := []int{0, 1, 5, -1, -1, 2, 9, -1, 8, 6}
	check := func(x int) bool {
		y, t := 0, x
		k := 1
		for ; t > 0; t /= 10 {
			v := t % 10
			if d[v] == -1 {
				return false
			}
			y = d[v]*k + y
			k *= 10
		}
		return x != y
	}
	ans := 0
	for i := 1; i <= n; i++ {
		if check(i) {
			ans++
		}
	}
	return ans
}
方法二:数位 DP · Go 实现
思考
方法一对更大的 会偏慢。合法性只取决于数位,可用数位 DP 统计 。
: 表示是否已出现 , 为上界约束。非法位不递推,末位返回 。
方法一的做法足以通过本题,但时间复杂度较高。如果题目的数据范围达到 级别,则方法一的做法会超出时间限制。
这道题实际上是求在给定区间 中,满足条件的数的个数。条件与数的大小无关,而只与数的组成有关,因此可以使用数位 DP 的思想求解。数位 DP 中,数的大小对复杂度的影响很小。
对于区间 问题,我们一般会将其转化为 然后再减去 的问题,即:
不过对于本题而言,我们只需要求出区间 的值即可。
这里我们用记忆化搜索来实现数位 DP。从起点向下搜索,到最底层得到方案数,一层层向上返回答案并累加,最后从搜索起点得到最终的答案。
基本步骤如下:
我们将数字 转为字符串 。然后定义函数 ,其中 表示数字的位数,数字 表示当前数字是否满足题目要求,布尔值 表示可填的数字的限制。
函数的执行逻辑如下:
如果 大于等于字符串 的长度,返回 ;
否则,我们获取当前位的数字 ,如果 为 ,则 为当前位的数字,否则 为 ;
接下来,我们遍历 ,如果 是有效数字 ,则递归调用 ;如果 是有效数字 ,则递归调用 ;将所有递归调用的结果累加并返回。
时间复杂度 ,空间复杂度 。其中 。
相似题目:
func rotatedDigits(n int) int {
	s := strconv.Itoa(n)
	m := len(s)
	f := make([][2]int, m)
	for i := range f {
		f[i] = [2]int{-1, -1}
	}
	var dfs func(i, ok int, limit bool) int
	dfs = func(i, ok int, limit bool) int {
		if i >= m {
			return ok
		}
		if !limit && f[i][ok] != -1 {
			return f[i][ok]
		}
		up := 9
		if limit {
			up = int(s[i] - '0')
		}
		ans := 0
		for j := 0; j <= up; j++ {
			if j == 0 || j == 1 || j == 8 {
				ans += dfs(i+1, ok, limit && j == up)
			} else if j == 2 || j == 5 || j == 6 || j == 9 {
				ans += dfs(i+1, 1, limit && j == up)
			}
		}
		if !limit {
			f[i][ok] = ans
		}
		return ans
	}
	return dfs(0, 0, true)
}790. 多米诺和托米诺平铺
题目、示例与约束
有两种形状的瓷砖:一种是 2 x 1 的多米诺形,另一种是形如 "L" 的托米诺形。两种形状都可以旋转。

给定整数 n ,返回可以平铺 2 x n 的面板的方法的数量。返回对 109 + 7 取模 的值。
平铺指的是每个正方形都必须有瓷砖覆盖。两个平铺不同,当且仅当面板上有四个方向上的相邻单元中的两个,使得恰好有一个平铺有一个瓷砖占据两个正方形。
示例 1:

输入: n = 3
输出: 5
解释: 五种不同的方法如上所示。
示例 2:
输入: n = 1
输出: 1
提示:
1 <= n <= 1000
方法一:动态规划 · Go 实现
思考
铺满 ,可用多米诺与 L 型三格,方案对 取模。 ,按列枚举形状会重复子问题。
一列有四种填充:全满、只上、只下、全空。转移到第 列只依赖第 列这四态,对应补上一块竖/横/L。
滚动四个变量, 为铺满前 列的方案。初值空板为 。
我们首先要读懂题意,题目实际上是让我们求铺满 的面板的方案数,其中面板上的每个正方形只能被一个瓷砖覆盖。
瓷砖的形状有两种,分别是 2 x 1 型 和 L 型,并且两种瓷砖都可以旋转。我们将旋转后的瓷砖分别记为 1 x 2 型 和 L' 型。
我们定义 表示平铺前 的面板,其中 表示最后一列的状态。最后一列有 种状态,分别是:
- 最后一列铺满,记为
- 最后一列只铺了上方一个瓷砖,记为
- 最后一列只铺了下方一个瓷砖,记为
- 最后一列没有铺瓷砖,记为
那么答案就是 。初始时 ,其余 。
我们考虑铺到第 列,来看看状态转移方程:
当 时,最后一列铺满,可由前一列的 四种状态铺上对应的瓷砖转移而来,即 铺上 1 x 2 型瓷砖,或者 铺上 L' 型瓷砖,或者 铺上 L' 型瓷砖,或者 铺上两块 2 x 1 型瓷砖。因此 。
当 时,最后一列只铺了上方一个瓷砖,可由前一列的 两种状态转移而来,即 铺上 2 x 1 型瓷砖,或者 铺上 L 型瓷砖。因此 。
当 时,最后一列只铺了下方一个瓷砖,可由前一列的 两种状态转移而来,即 铺上 2 x 1 型瓷砖,或者 铺上 L' 型瓷砖。因此 。
当 时,最后一列没有铺瓷砖,可由前一列的 一种状态转移而来。因此 。
可以发现,状态转移方程中只涉及到前一列的状态,因此我们可以使用滚动数组优化空间复杂度。
注意,过程中的状态数值可能会很大,因此需要对 取模。
时间复杂度 ,其中 为面板的列数。空间复杂度 。
func numTilings(n int) int {
	f := [4]int{}
	f[0] = 1
	const mod int = 1e9 + 7
	for i := 1; i <= n; i++ {
		g := [4]int{}
		g[0] = (f[0] + f[1] + f[2] + f[3]) % mod
		g[1] = (f[2] + f[3]) % mod
		g[2] = (f[1] + f[3]) % mod
		g[3] = f[0]
		f = g
	}
	return f[0]
}继续阅读
- 实践案例
- 实践案例
- 实践案例