
LeetCode Go · 动态规划(1)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
5. 最长回文子串
题目、示例与约束
给你一个字符串 s,找到 s 中最长的 回文 子串。
示例 1:
输入:s = "babad"
输出:"bab"
解释:"aba" 同样是符合题意的答案。
示例 2:
输入:s = "cbbd"
输出:"bb"
提示:
1 <= s.length <= 1000s仅由数字和英文字母组成
方法一:动态规划 · Go 实现
思考
若枚举所有子串 再逐一判断是否回文,时间复杂度为 。 ,无法通过。
每个子串若都从两端重新比较,内层更短的区间会被反复判断。回文具有最优子结构: 为回文,当且仅当两端字符相同且 已是回文;长度为 的区间显然成立。
因此可以按区间依赖填表,而不必反复扫描。 依赖于更短的内层,枚举顺序须保证内层先算完;填表过程中记录当前最长回文的起点与长度即可。
我们定义 表示字符串 是否为回文串,初始时 。
接下来,我们定义变量 和 ,其中 表示最长回文串的起始位置, 表示最长回文串的长度。初始时 , 。
考虑 ,如果 ,那么 ;否则 。如果 并且 ,那么我们更新 , 。
由于 依赖于 ,因此我们需要保证 在 之前,因此我们需要从大到小地枚举 ,从小到大地枚举 。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度。
func longestPalindrome(s string) string {
	n := len(s)
	f := make([][]bool, n)
	for i := range f {
		f[i] = make([]bool, n)
		for j := range f[i] {
			f[i][j] = true
		}
	}
	k, mx := 0, 1
	for i := n - 2; i >= 0; i-- {
		for j := i + 1; j < n; j++ {
			f[i][j] = false
			if s[i] == s[j] {
				f[i][j] = f[i+1][j-1]
				if f[i][j] && mx < j-i+1 {
					mx = j - i + 1
					k = i
				}
			}
		}
	}
	return s[k : k+mx]
}
方法二:枚举回文中间点 · Go 实现
思考
方法一的时间复杂度已是 ,但仍需 的二维表。判断某一区间是否回文时,实际只依赖内一层是否回文,不必保存整张表。
注意到回文关于中心对称:固定中心向两侧扩展,直到字符不等,即可得到该中心对应的最长回文。奇数长度与偶数长度的中心不同,需要同时枚举 与 ,否则会遗漏形如
"bb"的子串。扩展得到长度 后,可由中心下标 反推起点,额外空间降至 。
我们可以枚举回文中间点,向两边扩散,找到最长的回文串。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度。
func longestPalindrome(s string) string {
	n := len(s)
	start, mx := 0, 1
	f := func(l, r int) int {
		for l >= 0 && r < n && s[l] == s[r] {
			l, r = l-1, r+1
		}
		return r - l - 1
	}
	for i := range s {
		a, b := f(i, i), f(i, i+1)
		t := max(a, b)
		if mx < t {
			mx = t
			start = i - ((t - 1) >> 1)
		}
	}
	return s[start : start+mx]
}10. 正则表达式匹配
题目、示例与约束
给你一个字符串 s 和一个字符规律 p,请你来实现一个支持 '.' 和 '*' 的正则表达式匹配。
'.'匹配任意单个字符'*'匹配零个或多个前面的那一个元素
返回一个布尔值,表示匹配是否覆盖整个输入字符串(而非部分)。
示例 1:
输入:s = "aa", p = "a"
输出:false
解释:"a" 无法匹配 "aa" 整个字符串。
示例 2:
输入:s = "aa", p = "a*"
输出:true
解释:因为 '*' 代表可以匹配零个或多个前面的那一个元素, 在这里前面的元素就是 'a'。因此,字符串 "aa" 可被视为 'a' 重复了一次。
示例 3:
输入:s = "ab", p = ".*"
输出:true
解释:".*" 表示可匹配零个或多个('*')任意字符('.')。
提示:
1 <= s.length <= 201 <= p.length <= 20s只包含从a-z的小写字母。p只包含从a-z的小写字母,以及字符.和*。- 保证每次出现字符
*时,前面都匹配到有效的字符
方法一:记忆化搜索 · Go 实现
思考
若对模式中的每个
*枚举它匹配 个字符,时间复杂度为指数级。 与 最长仅为 ,但同一对位置会被反复计算,直接枚举难以稳定通过。
*只作用于其前一个元素:要么匹配 次,模式下标前进 ;要么当前字符与该元素相符(含.),再让同一个*继续匹配 的下一个字符。普通字符则必须与 中对应位置一一匹配。因此可以将状态定义为: 从下标 起的后缀与 从下标 起的后缀能否匹配。递归求解时加以记忆化,即可避免同一对 被重复计算。
我们设计一个函数 ,表示从 的第 个字符开始,和 的第 个字符开始是否匹配。那么答案就是 。
函数 的计算过程如下:
- 如果 已经到达 的末尾,那么如果 也到达了 的末尾,那么匹配成功,否则匹配失败。
- 如果 的下一个字符是
'*',我们可以选择匹配 个 字符,那么就是 。如果此时 并且 和 匹配,那么我们可以选择匹配 个 字符,那么就是 。 - 如果 的下一个字符不是
'*',那么如果 并且 和 匹配,那么就是 。否则匹配失败。
过程中,我们可以使用记忆化搜索,避免重复计算。
时间复杂度 ,空间复杂度 。其中 和 分别是 和 的长度。
func isMatch(s string, p string) bool {
	m, n := len(s), len(p)
	f := make([][]int, m+1)
	for i := range f {
		f[i] = make([]int, n+1)
	}
	var dfs func(i, j int) bool
	dfs = func(i, j int) bool {
		if j >= n {
			return i == m
		}
		if f[i][j] != 0 {
			return f[i][j] == 1
		}
		res := -1
		if j+1 < n && p[j+1] == '*' {
			if dfs(i, j+2) || (i < m && (s[i] == p[j] || p[j] == '.') && dfs(i+1, j)) {
				res = 1
			}
		} else if i < m && (s[i] == p[j] || p[j] == '.') && dfs(i+1, j+1) {
			res = 1
		}
		f[i][j] = res
		return res == 1
	}
	return dfs(0, 0)
}
方法二:动态规划 · Go 实现
思考
方法一经记忆化后时间复杂度已是 ,但仍依赖递归,调用栈与常系数都更大。转移没有后效,可以按 、 从小到大填表。
定义 表示 的前 个字符与 的前 个字符是否匹配。空串与空模式匹配;还须允许 去匹配形如
a*这类可以匹配空串的模式,因此外层循环从空串开始。
*的转移与方法一相同:跳过两个模式字符,或在当前字符匹配时再消耗 的一个字符。迭代填完后直接读取 。
我们可以将方法一中的记忆化搜索转换为动态规划。
定义 表示字符串 的前 个字符和字符串 的前 个字符是否匹配。那么答案就是 。初始化 ,表示空字符串和空正则表达式是匹配的。
与方法一类似,我们可以分情况来讨论。
- 如果 是
'*',那么我们可以选择匹配 个 字符,那么就是 。如果此时 和 匹配,那么我们可以选择匹配 个 字符,那么就是 。 - 如果 不是
'*',那么如果 和 匹配,那么就是 。否则匹配失败。
时间复杂度 ,空间复杂度 。其中 和 分别是 和 的长度。
func isMatch(s string, p string) bool {
	m, n := len(s), len(p)
	f := make([][]bool, m+1)
	for i := range f {
		f[i] = make([]bool, n+1)
	}
	f[0][0] = true
	for i := 0; i <= m; i++ {
		for j := 1; j <= n; j++ {
			if p[j-1] == '*' {
				f[i][j] = f[i][j-2]
				if i > 0 && (p[j-2] == '.' || p[j-2] == s[i-1]) {
					f[i][j] = f[i][j] || f[i-1][j]
				}
			} else if i > 0 && (p[j-1] == '.' || p[j-1] == s[i-1]) {
				f[i][j] = f[i-1][j-1]
			}
		}
	}
	return f[m][n]
}22. 括号生成
题目、示例与约束
数字 n 代表生成括号的对数,请你设计一个函数,用于能够生成所有可能的并且 有效的 括号组合。
示例 1:
输入:n = 3
输出:["((()))","(()())","(())()","()(())","()()()"]
示例 2:
输入:n = 1
输出:["()"]
提示:
1 <= n <= 8
方法一:DFS + 剪枝 · Go 实现
思考
合法括号串的长度固定为 。若先枚举所有由左、右括号组成的串再筛出合法者,方案数为 。 时可以接受,但绝大多数前缀已经不可能构成合法序列。
一旦某前缀中右括号多于左括号,或某一侧的个数超过 ,则无论后续如何补全都无法得到合法串。因此只需维护已放入的左、右括号个数 、 ,并始终保证 且二者均不超过 ;当 时收入答案。
为此我们用 DFS 依次尝试追加左括号或右括号,以上述不等式剪枝。搜索空间远小于全枚举,额外空间仅为当前串的 。
题目中 的范围为 ,因此我们直接通过“暴力搜索 + 剪枝”的方式通过本题。
我们设计一个函数 ,其中 和 分别表示左括号和右括号的数量,而 表示当前的括号序列。那么我们可以得到如下的递归结构:
- 如果 或者 或者 ,那么当前括号组合 不合法,直接返回;
- 如果 且 ,那么当前括号组合 合法,将其加入答案数组
ans中,直接返回; - 我们可以选择添加一个左括号,递归执行
dfs(l + 1, r, t + "("); - 我们也可以选择添加一个右括号,递归执行
dfs(l, r + 1, t + ")")。
时间复杂度 ,空间复杂度 。
func generateParenthesis(n int) (ans []string) {
	var dfs func(int, int, string)
	dfs = func(l, r int, t string) {
		if l > n || r > n || l < r {
			return
		}
		if l == n && r == n {
			ans = append(ans, t)
			return
		}
		dfs(l+1, r, t+"(")
		dfs(l, r+1, t+")")
	}
	dfs(0, 0, "")
	return ans
}32. 最长有效括号
题目、示例与约束
给你一个只包含 '(' 和 ')' 的字符串,找出最长有效(格式正确且连续)括号 子串 的长度。
左右括号匹配,即每个左括号都有对应的右括号将其闭合的字符串是格式正确的,比如 "(()())"。
示例 1:
输入:s = "(()"
输出:2
解释:最长有效括号子串是 "()"
示例 2:
输入:s = ")()())"
输出:4
解释:最长有效括号子串是 "()()"
示例 3:
输入:s = ""
输出:0
提示:
0 <= s.length <= 3 * 104s[i]为'('或')'
方法一:动态规划 · Go 实现
思考
枚举每个子串再用栈判定是否有效,时间复杂度为 乃至 。 ,无法通过。
大量子串互相重叠:以某一位置结尾的最长有效括号,可以由更短的有效段拼接得到。因此可以按结尾位置递推。
有效括号串只能以右括号结尾。若 与前一位配成一对,长度即为再往前那段加上 ;若前一位也是右括号,则先跨过已经配好的一段,再判断这段之前是否还能配上一个左括号。我们可以定义 为以 结尾的最长有效长度,按上述两种配对方式转移,答案取 。
我们定义 表示以 结尾的最长有效括号的长度,那么答案就是 。
- 如果 是左括号,那么以 结尾的最长有效括号的长度一定为 ,因此 。
- 如果 是右括号,有以下两种情况:
- 如果 是左括号,那么以 结尾的最长有效括号的长度为 。
- 如果 是右括号,那么以 结尾的最长有效括号的长度为 ,但是还需要考虑 是否是左括号,如果是左括号,那么以 结尾的最长有效括号的长度为 。
因此,我们可以得到状态转移方程:
最后返回 即可。
时间复杂度 ,空间复杂度 。其中 为字符串的长度。
func longestValidParentheses(s string) int {
	n := len(s)
	f := make([]int, n+1)
	for i := 2; i <= n; i++ {
		if s[i-1] == ')' {
			if s[i-2] == '(' {
				f[i] = f[i-2] + 2
			} else if j := i - f[i-1] - 1; j > 0 && s[j-1] == '(' {
				f[i] = f[i-1] + 2 + f[j-1]
			}
		}
	}
	return slices.Max(f)
}
方法二:使用栈 · Go 实现
思考
方法一已经是 时间,但转移需区分「前一位是否为左括号」以及「跨过一段有效括号再向前配对」,下标边界容易遗漏。
我们需要的并非更低的复杂度,而是更贴合配对过程的记录方式:尚未匹配的左括号下标,以及上一段失效从何处开始。栈恰好维护这两类信息:栈底先放入 作为基准,遇左括号压入下标,遇右括号弹出;若栈空则当前位置成为新基准,否则用栈顶更新长度。
- 使用栈来存储左括号的索引,栈底元素初始化为
-1,用于辅助计算有效括号的长度。 - 遍历字符串,对于每个字符:
- 如果是左括号,将当前位置压入栈。
- 如果是右括号,弹出栈顶元素表示匹配了一个左括号。
- 如果栈为空,说明当前右括号无法匹配,将当前位置压入栈作为新的起点。
- 如果栈不为空,计算当前有效括号子串的长度,更新最大长度。
- 最终返回最大长度。
总结:这个算法的关键在于维护一个线,栈内存放的是左括号的索引,通过弹出和压入的操作来更新有效括号子串的长度。
时间复杂度 ,空间复杂度 。其中 为字符串的长度。
func longestValidParentheses(s string) int {
	ans := 0
	stack := []int{-1}
	for i, v := range s {
		if v == '(' {
			stack = append(stack, i)
		} else {
			stack = stack[:len(stack)-1]
			if len(stack) == 0 {
				stack = append(stack, i)
			} else {
				if ans < i-stack[len(stack)-1] {
					ans = i - stack[len(stack)-1]
				}
			}
		}
	}
	return ans
}42. 接雨水
题目、示例与约束
给定 n 个非负整数表示每个宽度为 1 的柱子的高度图,计算按此排列的柱子,下雨之后能接多少雨水。
示例 1:
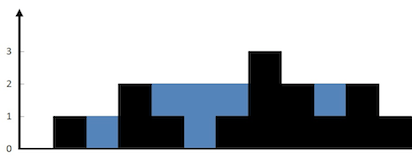
输入:height = [0,1,0,2,1,0,1,3,2,1,2,1]
输出:6
解释:上面是由数组 [0,1,0,2,1,0,1,3,2,1,2,1] 表示的高度图,在这种情况下,可以接 6 个单位的雨水(蓝色部分表示雨水)。
示例 2:
输入:height = [4,2,0,3,2,5]
输出:9
提示:
n == height.length1 <= n <= 2 * 1040 <= height[i] <= 105
方法一:动态规划 · Go 实现
思考
位置 能接的雨水量等于 。若对每个 都向左右重新扫描最高柱,时间复杂度为 。 ,容易超时。
左侧最高只取决于 及其左边,右侧最高只取决于 及其右边,都可以线性预处理。用两个数组分别记录每个位置「含自身」的左侧最高柱与右侧最高柱,再对每个位置取两侧最小值减去自身高度并求和。
我们定义 表示下标 位置及其左边的最高柱子的高度,定义 表示下标 位置及其右边的最高柱子的高度。那么下标 位置能接的雨水量为 。我们遍历数组,计算出 和 ,最后答案为 。
时间复杂度 ,空间复杂度 。其中 为数组的长度。
func trap(height []int) (ans int) {
	n := len(height)
	left := make([]int, n)
	right := make([]int, n)
	left[0], right[n-1] = height[0], height[n-1]
	for i := 1; i < n; i++ {
		left[i] = max(left[i-1], height[i])
		right[n-i-1] = max(right[n-i], height[n-i-1])
	}
	for i, h := range height {
		ans += min(left[i], right[i]) - h
	}
	return
}44. 通配符匹配
题目、示例与约束
s) 和一个字符模式 (p) ,请你实现一个支持 '?' 和 '*' 匹配规则的通配符匹配:'?'可以匹配任何单个字符。'*'可以匹配任意字符序列(包括空字符序列)。
判定匹配成功的充要条件是:字符模式必须能够 完全匹配 输入字符串(而不是部分匹配)。
示例 1:
输入:s = "aa", p = "a"
输出:false
解释:"a" 无法匹配 "aa" 整个字符串。
示例 2:
输入:s = "aa", p = "*"
输出:true
解释:'*' 可以匹配任意字符串。
示例 3:
输入:s = "cb", p = "?a"
输出:false
解释:'?' 可以匹配 'c', 但第二个 'a' 无法匹配 'b'。
提示:
0 <= s.length, p.length <= 2000s仅由小写英文字母组成p仅由小写英文字母、'?'或'*'组成
方法一:记忆化搜索 · Go 实现
思考
按字符递归匹配是自然的:普通字符与
?一对一消耗,*可以对应空串、一个字符或多个字符。若不记忆化,*会在同一位置反复分叉。 ,朴素递归容易超时。同一对下标 会被反复询问,而能否匹配只取决于「 从 起、 从 起」这一对后缀。子问题大量重叠。
因此用 表示该后缀对是否匹配,并将结果记下。
*的三种走法(吞一个字符、同时推进、跳过*)以及普通字符的一对一推进,都是这个状态上的转移。记忆化将搜索压成 。
我们设计一个函数 ,表示从字符串 的第 个字符开始和字符串 的第 个字符开始是否匹配。那么答案就是 。
函数 的执行过程如下:
- 如果 ,那么只有当 或者 且 为真时, 才为真。
- 如果 ,那么 为假。
- 如果 ,那么 为真当且仅当 或 或 中有一个为真。
- 否则 为真当且仅当 或 且 为真。
为了避免重复计算,我们使用记忆化搜索的方法,将 的结果存储在一个哈希表中。
时间复杂度 ,空间复杂度 。其中 和 分别是字符串 和 的长度。
func isMatch(s string, p string) bool {
	m, n := len(s), len(p)
	f := make([][]int, m+1)
	for i := range f {
		f[i] = make([]int, n+1)
	}
	var dfs func(i, j int) bool
	dfs = func(i, j int) bool {
		if i >= m {
			return j >= n || p[j] == '*' && dfs(i, j+1)
		}
		if j >= n {
			return false
		}
		if f[i][j] != 0 {
			return f[i][j] == 1
		}
		f[i][j] = 2
		ok := false
		if p[j] == '*' {
			ok = dfs(i+1, j) || dfs(i+1, j+1) || dfs(i, j+1)
		} else {
			ok = (p[j] == '?' || s[i] == p[j]) && dfs(i+1, j+1)
		}
		if ok {
			f[i][j] = 1
		}
		return ok
	}
	return dfs(0, 0)
}
方法二:动态规划 · Go 实现
思考
方法一已经按前缀从短到长填好同一张匹配表。下面的 与那张表是同一定义。
方法一已经按前缀从短到长填好同一张表。
定义 表示字符串 的前 个字符和字符串 的前 个字符是否匹配。初始时 ,表示两个空字符串是匹配的。对于 ,如果 ,那么 。
接下来我们考虑 和 的情况:
- 如果 ,那么 。
- 否则 。
最终答案为 。
时间复杂度 ,空间复杂度 。其中 和 分别是字符串 和 的长度。
func isMatch(s string, p string) bool {
	m, n := len(s), len(p)
	f := make([][]bool, m+1)
	for i := range f {
		f[i] = make([]bool, n+1)
	}
	f[0][0] = true
	for j := 1; j <= n; j++ {
		if p[j-1] == '*' {
			f[0][j] = f[0][j-1]
		}
	}
	for i := 1; i <= m; i++ {
		for j := 1; j <= n; j++ {
			if p[j-1] == '*' {
				f[i][j] = f[i-1][j] || f[i][j-1] || f[i-1][j-1]
			} else {
				f[i][j] = f[i-1][j-1] && (p[j-1] == '?' || s[i-1] == p[j-1])
			}
		}
	}
	return f[m][n]
}
方法三:动态规划 · Go 实现
思考
按字符递归匹配是自然的:普通字符与
?一对一消耗,*可以对应空串或任意长度。 与 都可以到 ,而*的第一种走法总是先进入 ,调用链的深度等于 ,会超出默认递归上限。同一对下标会被反复询问,而一对前缀能否匹配只取决于更短的前缀。
因此令 表示 的前 个字符与 的前 个字符是否匹配。空串对空串为真,模式侧连续的
*只沿 继承上一格。 与 都从小到大填写,*读取上方、左方和左上方三个已经算过的格子,普通字符只读取左上方,一次正向扫描就完成全部转移。
定义 表示字符串 的前 个字符和字符串 的前 个字符是否匹配。初始时 ,表示两个空字符串是匹配的。对于 ,如果 ,那么 。
接下来我们考虑 和 的情况:
- 如果 ,那么 。
- 否则 。
最终答案为 。
时间复杂度 ,空间复杂度 。其中 和 分别是字符串 和 的长度。
func isMatch(s string, p string) bool {
	m, n := len(s), len(p)
	f := make([][]bool, m+1)
	for i := range f {
		f[i] = make([]bool, n+1)
	}
	f[0][0] = true
	for j := 1; j <= n; j++ {
		if p[j-1] == '*' {
			f[0][j] = f[0][j-1]
		}
	}
	for i := 1; i <= m; i++ {
		for j := 1; j <= n; j++ {
			if p[j-1] == '*' {
				f[i][j] = f[i-1][j] || f[i][j-1] || f[i-1][j-1]
			} else {
				f[i][j] = f[i-1][j-1] && (p[j-1] == '?' || s[i-1] == p[j-1])
			}
		}
	}
	return f[m][n]
}45. 跳跃游戏 II
题目、示例与约束
给定一个长度为 n 的 0 索引整数数组 nums。初始位置在下标 0。
每个元素 nums[i] 表示从索引 i 向后跳转的最大长度。换句话说,如果你在索引 i 处,你可以跳转到任意 (i + j) 处:
0 <= j <= nums[i]且i + j < n
返回到达 n - 1 的最小跳跃次数。测试用例保证可以到达 n - 1。
示例 1:
输入: nums = [2,3,1,1,4] 输出: 2 解释: 跳到最后一个位置的最小跳跃数是2。 从下标为 0 跳到下标为 1 的位置,跳1步,然后跳3步到达数组的最后一个位置。
示例 2:
输入: nums = [2,3,0,1,4]
输出: 2
提示:
1 <= nums.length <= 1040 <= nums[i] <= 1000- 题目保证可以到达
n - 1
方法一:贪心 · Go 实现
思考
若令 为到达下标 的最少跳跃次数,再从每个 去更新其一步可达的区间,最坏时间 。 ,且题目保证可达终点,我们只需终点的最少次数,不必为每个下标都算出精确步数。
第 步能覆盖的位置构成一段连续区间,该段内能探到的最远位置,就是第 步的覆盖右端。维护「当前这一跳的边界」即可按层扩展。
因此线性扫描时记录下一跳能到的最远位置;走到当前边界就不得不跳一次,并把边界更新为该最远位置。按层贪心等价于 BFS,却不必使用队列。
我们可以用变量 记录当前位置能够到达的最远位置,用变量 记录上一次跳跃到的位置,用变量 记录跳跃的次数。
接下来,我们遍历 的每一个位置 ,对于每一个位置 ,我们可以通过 计算出当前位置能够到达的最远位置,我们用 来记录这个最远位置,即 。接下来,判断当前位置是否到达了上一次跳跃的边界,即 ,如果到达了,那么我们就需要进行一次跳跃,将 更新为 ,并且将跳跃次数 增加 。
最后,我们返回跳跃的次数 即可。
时间复杂度 ,其中 是数组的长度。空间复杂度 。
相似题目:
func jump(nums []int) (ans int) {
	mx, last := 0, 0
	for i, x := range nums[:len(nums)-1] {
		mx = max(mx, i+x)
		if last == i {
			ans++
			last = mx
		}
	}
	return
}53. 最大子数组和
题目、示例与约束
给你一个整数数组 nums ,请你找出一个具有最大和的连续子数组(子数组最少包含一个元素),返回其最大和。
子数组 是数组中的一个连续部分。
示例 1:
输入:nums = [-2,1,-3,4,-1,2,1,-5,4]
输出:6
解释:连续子数组 [4,-1,2,1] 的和最大,为 6 。
示例 2:
输入:nums = [1]
输出:1
示例 3:
输入:nums = [5,4,-1,7,8]
输出:23
提示:
1 <= nums.length <= 105-104 <= nums[i] <= 104
进阶:如果你已经实现复杂度为 O(n) 的解法,尝试使用更为精妙的 分治法 求解。
方法一:动态规划 · Go 实现
思考
连续子数组的个数为 。若枚举左右端点再求和,时间复杂度为 乃至 。 ,无法通过。
子数组彼此重叠,每次重新求和会重复计算。固定右端点 时,以 结尾的最优段只有两种选择:若「以 结尾的最大和」为正,则接在其后;否则从 单独开始。
因此以右端点为状态即可线性递推,且每一项只依赖前一项,用一个变量滚动维护,再取全程最大值即可。
我们定义 表示以元素 为结尾的连续子数组的最大和,初始时 ,那么最终我们要求的答案即为 。
考虑 ,其中 ,它的状态转移方程为:
也即:
由于 只与 有关系,因此我们可以只用一个变量 来维护对于当前 的值是多少,然后进行状态转移即可。答案为 。
时间复杂度 ,其中 为数组 的长度。空间复杂度 。
func maxSubArray(nums []int) int {
	ans, f := nums[0], nums[0]
	for _, x := range nums[1:] {
		f = max(f, 0) + x
		ans = max(ans, f)
	}
	return ans
}55. 跳跃游戏
题目、示例与约束
给你一个非负整数数组 nums ,你最初位于数组的 第一个下标 。数组中的每个元素代表你在该位置可以跳跃的最大长度。
判断你是否能够到达最后一个下标,如果可以,返回 true ;否则,返回 false 。
示例 1:
输入:nums = [2,3,1,1,4]
输出:true
解释:可以先跳 1 步,从下标 0 到达下标 1, 然后再从下标 1 跳 3 步到达最后一个下标。
示例 2:
输入:nums = [3,2,1,0,4]
输出:false
解释:无论怎样,总会到达下标为 3 的位置。但该下标的最大跳跃长度是 0 , 所以永远不可能到达最后一个下标。
提示:
1 <= nums.length <= 1040 <= nums[i] <= 105
方法一:贪心 · Go 实现
思考
题目只关心最后一个下标是否可达。从每个位置展开全部跳跃,或用动态规划判断每个下标能否到达,最坏时间均为 。 偏紧,且不必记下中间每一步如何跳。
能到达的下标构成一段前缀:维护当前最远可达位置 ,若出现 ,则之后均不可达。
因此从左扫描,用 更新 ;若能扫完全部下标,终点即可达。
我们用变量 维护当前能够到达的最远下标,初始时 。
我们从左到右遍历数组,对于遍历到的每个位置 ,如果 ,说明当前位置无法到达,直接返回 false。否则,我们可以通过跳跃从位置 到达的最远位置为 ,我们用 更新 的值,即 。
遍历结束,直接返回 true。
时间复杂度 ,其中 为数组的长度。空间复杂度 。
相似题目:
func canJump(nums []int) bool {
	mx := 0
	for i, x := range nums {
		if mx < i {
			return false
		}
		mx = max(mx, i+x)
	}
	return true
}62. 不同路径
题目、示例与约束
一个机器人位于一个 m x n 网格的左上角 (起始点在下图中标记为 “Start” )。
机器人每次只能向下或者向右移动一步。机器人试图达到网格的右下角(在下图中标记为 “Finish” )。
问总共有多少条不同的路径?
示例 1:
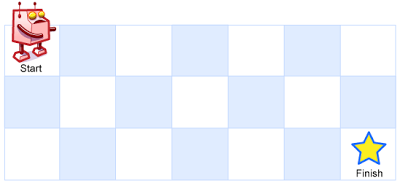
输入:m = 3, n = 7
输出:28
示例 2:
输入:m = 3, n = 2
输出:3
解释:
从左上角开始,总共有 3 条路径可以到达右下角。
1. 向右 -> 向下 -> 向下
2. 向下 -> 向下 -> 向右
3. 向下 -> 向右 -> 向下
示例 3:
输入:m = 7, n = 3
输出:28
示例 4:
输入:m = 3, n = 3
输出:6
提示:
1 <= m, n <= 100- 题目数据保证答案小于等于
2 * 109
方法一:动态规划 · Go 实现
思考
机器人每步只能向右或向下。若从起点直接搜索全部路径,格点规模 ,路径条数可达组合数级别,同一格子会被反复走到,时间无法接受。
注意到到达 的路径只可能来自上方或左方,且两类来源互不重叠。因此可以用 记录走到该格的方案数,按行列顺序填表,保证转移所依赖的状态已经计算完毕。
我们定义 表示从左上角走到 的路径数量,初始时 ,答案为 。
考虑 :
- 如果 ,那么 可以从 走一步到达,因此 ;
- 如果 ,那么 可以从 走一步到达,因此 。
因此,我们有如下的状态转移方程:
最终的答案即为 。
时间复杂度 ,空间复杂度 。其中 和 分别是网格的行数和列数。
func uniquePaths(m int, n int) int {
	f := make([][]int, m)
	for i := range f {
		f[i] = make([]int, n)
	}
	f[0][0] = 1
	for i := 0; i < m; i++ {
		for j := 0; j < n; j++ {
			if i > 0 {
				f[i][j] += f[i-1][j]
			}
			if j > 0 {
				f[i][j] += f[i][j-1]
			}
		}
	}
	return f[m-1][n-1]
}
方法二:动态规划(预处理边界) · Go 实现
思考
方法一对每个格子都要判断上方、左方是否存在,边界处反复走分支。第一行只能从左侧到达、第一列只能从上方到达,这些格子的路径数均为 。预先填好边界后,内部格子即可直接相加,实现更为简洁,渐近复杂度不变。
先把第一行、第一列全部置为 ,再只填内部格子 。时间和空间复杂度仍为 。
func uniquePaths(m int, n int) int {
	f := make([][]int, m)
	for i := range f {
		f[i] = make([]int, n)
		for j := range f[i] {
			f[i][j] = 1
		}
	}
	for i := 1; i < m; i++ {
		for j := 1; j < n; j++ {
			f[i][j] = f[i-1][j] + f[i][j-1]
		}
	}
	return f[m-1][n-1]
}
方法三:动态规划(滚动数组) · Go 实现
思考
前两种方法均需维护整张 表。然而 只依赖上一行的 以及同行左侧的 ,行这一维可以压缩。将状态压成长度为 的一维数组后, 在更新前仍保存上一行的值,与 相加即得到当前行。空间降至 ,时间不变。
只与上一行和左边有关,去掉第一维后用长度为 的一维数组滚动即可。时间复杂度 ,空间复杂度 。
func uniquePaths(m int, n int) int {
	f := make([]int, n+1)
	for i := range f {
		f[i] = 1
	}
	for i := 1; i < m; i++ {
		for j := 1; j < n; j++ {
			f[j] += f[j-1]
		}
	}
	return f[n-1]
}63. 不同路径 II
题目、示例与约束
给定一个 m x n 的整数数组 grid。一个机器人初始位于 左上角(即 grid[0][0])。机器人尝试移动到 右下角(即 grid[m - 1][n - 1])。机器人每次只能向下或者向右移动一步。
网格中的障碍物和空位置分别用 1 和 0 来表示。机器人的移动路径中不能包含 任何 有障碍物的方格。
返回机器人能够到达右下角的不同路径数量。
测试用例保证答案小于等于 2 * 109。
示例 1:
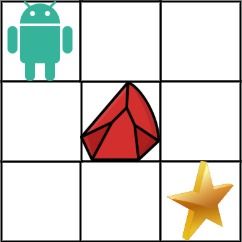
输入:obstacleGrid = [[0,0,0],[0,1,0],[0,0,0]]
输出:2
解释:3x3 网格的正中间有一个障碍物。
从左上角到右下角一共有 2 条不同的路径:
1. 向右 -> 向右 -> 向下 -> 向下
2. 向下 -> 向下 -> 向右 -> 向右
示例 2:
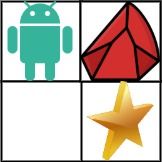
输入:obstacleGrid = [[0,1],[0,0]]
输出:1
提示:
m == obstacleGrid.lengthn == obstacleGrid[i].length1 <= m, n <= 100obstacleGrid[i][j]为0或1
方法一:记忆化搜索 · Go 实现
思考
与「不同路径」相同,每步只能向下或向右。若直接递归搜索, 时同一格子会被反复展开,时间无法接受;网格中还有障碍,第一行、第一列也不再处处可达。
从 出发,越界或遇到障碍则路径数为 ,到达终点则为 ,否则等于向下、向右两支之和。为 加上记忆化后,每个格子只计算一次,时间与空间均为 。
我们设计一个函数 表示从网格 到网格 的路径数。其中 和 分别是网格的行数和列数。
函数 的执行过程如下:
- 如果 或者 ,或者 ,则路径数为 ;
- 如果 且 ,则路径数为 ;
- 否则,路径数为 。
为了避免重复计算,我们可以使用记忆化搜索的方法。
时间复杂度 ,空间复杂度 。其中 和 分别是网格的行数和列数。
func uniquePathsWithObstacles(obstacleGrid [][]int) int {
	m, n := len(obstacleGrid), len(obstacleGrid[0])
	f := make([][]int, m)
	for i := range f {
		f[i] = make([]int, n)
		for j := range f[i] {
			f[i][j] = -1
		}
	}
	var dfs func(i, j int) int
	dfs = func(i, j int) int {
		if i >= m || j >= n || obstacleGrid[i][j] == 1 {
			return 0
		}
		if i == m-1 && j == n-1 {
			return 1
		}
		if f[i][j] == -1 {
			f[i][j] = dfs(i+1, j) + dfs(i, j+1)
		}
		return f[i][j]
	}
	return dfs(0, 0)
}
方法二:动态规划 · Go 实现
思考
方法一记忆化后渐近复杂度已是 ,但仍依赖递归,调用栈较深,常系数也更大。障碍会切断边界上的通路,第一行与第一列不再整段为 ,自底向上按依赖顺序填表即可避开递归,并自然处理障碍格。
我们可以使用动态规划的方法,定义一个二维数组 ,其中 表示从网格 到网格 的路径数。
我们首先初始化 的第一列和第一行的所有值,然后遍历其它行和列,有两种情况:
- 若 ,说明路径数为 ,那么 ;
- 若 ,则 。
最后返回 即可。
时间复杂度 ,空间复杂度 。其中 和 分别是网格的行数和列数。
func uniquePathsWithObstacles(obstacleGrid [][]int) int {
	m, n := len(obstacleGrid), len(obstacleGrid[0])
	f := make([][]int, m)
	for i := 0; i < m; i++ {
		f[i] = make([]int, n)
	}
	for i := 0; i < m && obstacleGrid[i][0] == 0; i++ {
		f[i][0] = 1
	}
	for j := 0; j < n && obstacleGrid[0][j] == 0; j++ {
		f[0][j] = 1
	}
	for i := 1; i < m; i++ {
		for j := 1; j < n; j++ {
			if obstacleGrid[i][j] == 0 {
				f[i][j] = f[i-1][j] + f[i][j-1]
			}
		}
	}
	return f[m-1][n-1]
}64. 最小路径和
题目、示例与约束
给定一个包含非负整数的 m x n 网格 grid ,请找出一条从左上角到右下角的路径,使得路径上的数字总和为最小。
说明:每次只能向下或者向右移动一步。
示例 1:
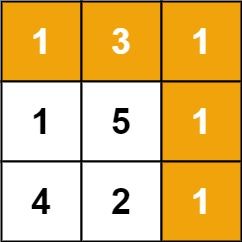
输入:grid = [[1,3,1],[1,5,1],[4,2,1]]
输出:7
解释:因为路径 1→3→1→1→1 的总和最小。
示例 2:
输入:grid = [[1,2,3],[4,5,6]]
输出:12
提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 2000 <= grid[i][j] <= 200
方法一:动态规划 · Go 实现
思考
从左上走到右下、每步只能向右或向下时,若枚举全部路径再取数字和最小者, ,路径条数随格子增长而迅速增加,无法在时限内完成。同一格子会被多条路径反复走到,子问题大量重叠。
因此走到 的最小路径和,必来自其上方或左方的最优值再加上当前格。用 记录该值,边界沿唯一方向累加,内部取两侧最小值,按行填表即可。
我们定义 表示从左上角走到 位置的最小路径和。初始时 ,答案为 。
考虑 :
- 如果 ,那么 ;
- 如果 ,那么 ;
- 如果 且 ,那么 。
最后返回 即可。
时间复杂度 ,空间复杂度 。其中 和 分别是网格的行数和列数。
func minPathSum(grid [][]int) int {
	m, n := len(grid), len(grid[0])
	f := make([][]int, m)
	for i := range f {
		f[i] = make([]int, n)
	}
	f[0][0] = grid[0][0]
	for i := 1; i < m; i++ {
		f[i][0] = f[i-1][0] + grid[i][0]
	}
	for j := 1; j < n; j++ {
		f[0][j] = f[0][j-1] + grid[0][j]
	}
	for i := 1; i < m; i++ {
		for j := 1; j < n; j++ {
			f[i][j] = min(f[i-1][j], f[i][j-1]) + grid[i][j]
		}
	}
	return f[m-1][n-1]
}70. 爬楼梯
题目、示例与约束
假设你正在爬楼梯。需要 n 阶你才能到达楼顶。
每次你可以爬 1 或 2 个台阶。你有多少种不同的方法可以爬到楼顶呢?
示例 1:
输入:n = 2
输出:2
解释:有两种方法可以爬到楼顶。
1. 1 阶 + 1 阶
2. 2 阶
示例 2:
输入:n = 3
输出:3
解释:有三种方法可以爬到楼顶。
1. 1 阶 + 1 阶 + 1 阶
2. 1 阶 + 2 阶
3. 2 阶 + 1 阶
提示:
1 <= n <= 45
方法一:递推 · Go 实现
思考
到达第 阶的最后一步只能是爬 阶或 阶,因此方案数满足 。若直接按此递归, 时同一子问题会被反复展开,时间无法接受。
这与斐波那契数列相同,自底向上递推即可避免重复计算。 只依赖于前两项,用两个变量滚动维护,即可在 时间、 额外空间内得到答案。
我们定义 表示爬到第 阶楼梯的方法数,那么 可以由 和 转移而来,即:
初始条件为 , ,即爬到第 0 阶楼梯的方法数为 1,爬到第 1 阶楼梯的方法数也为 1。
答案即为 。
由于 只与 和 有关,因此我们可以只用两个变量 和 来维护当前的方法数,空间复杂度降低为 。
时间复杂度 ,空间复杂度 。
func climbStairs(n int) int {
	a, b := 0, 1
	for i := 0; i < n; i++ {
		a, b = b, a+b
	}
	return b
}
方法二:矩阵快速幂加速递推 · Go 实现
思考
方法一已经是 ,对本题 足够,但线性递推在 更大时仍偏慢。
线性齐次递推可以写成矩阵乘法: 由 乘上固定的 转移矩阵得到。矩阵快速幂把 次转移压到 ,常数略大,适合需要加速同一递推的场景。
我们设 表示一个 的矩阵 ,其中 和 分别是第 个和第 个斐波那契数。
我们希望根据 推出 。也即是说,我们需要一个矩阵 ,使得 ,即:
由于 ,所以矩阵 的第一列为:
第二列为:
因此有:
我们定义初始矩阵 ,那么 等于 乘以 的结果矩阵中第一行的第一个元素。使用矩阵快速幂求解即可。
时间复杂度 ,空间复杂度 。
type matrix [2][2]int

func climbStairs(n int) int {
	a := matrix{{1, 1}, {1, 0}}
	return pow(a, n-1)[0][0]
}

func mul(a, b matrix) (c matrix) {
	m, n := len(a), len(b[0])
	for i := 0; i < m; i++ {
		for j := 0; j < n; j++ {
			for k := 0; k < len(a[0]); k++ {
				c[i][j] += a[i][k] * b[k][j]
			}
		}
	}
	return
}

func pow(a matrix, n int) matrix {
	res := matrix{{1, 1}, {0, 0}}
	for n > 0 {
		if n&1 == 1 {
			res = mul(res, a)
		}
		a = mul(a, a)
		n >>= 1
	}
	return res
}72. 编辑距离
题目、示例与约束
给你两个单词 word1 和 word2, 请返回将 word1 转换成 word2 所使用的最少操作数 。
你可以对一个单词进行如下三种操作:
- 插入一个字符
- 删除一个字符
- 替换一个字符
示例 1:
输入:word1 = "horse", word2 = "ros"
输出:3
解释:
horse -> rorse (将 'h' 替换为 'r')
rorse -> rose (删除 'r')
rose -> ros (删除 'e')
示例 2:
输入:word1 = "intention", word2 = "execution"
输出:5
解释:
intention -> inention (删除 't')
inention -> enention (将 'i' 替换为 'e')
enention -> exention (将 'n' 替换为 'x')
exention -> exection (将 'n' 替换为 'c')
exection -> execution (插入 'u')
提示:
0 <= word1.length, word2.length <= 500word1和word2由小写英文字母组成
方法一:动态规划 · Go 实现
思考
把 变成 ,每次只能插入、删除或替换一个字符。若在每个位置尝试三种操作并递归处理剩余部分,同一对前缀会被不同路径反复求解, 时时间无法接受。
同一对前缀的最少操作数与到达路径无关,因此可以按前缀长度递推。定义 为将 前 个字符变成 前 个字符的最少操作数:末尾字符相同则无需改动;否则三种操作分别对应删除、插入与替换,取最小值即可。空串到另一串只能全部删除或全部插入。按 、 递增填表, 即为答案。
我们定义 表示将 的前 个字符转换成 的前 个字符所使用的最少操作数。初始时 , 。其中 。
考虑 :
- 如果 ,那么我们只需要考虑将 的前 个字符转换成 的前 个字符所使用的最少操作数,因此 ;
- 否则,我们可以考虑插入、删除、替换操作,那么 。
综上,我们可以得到状态转移方程:
最后,我们返回 即可。
时间复杂度 ,空间复杂度 。其中 和 分别是 和 的长度。
func minDistance(word1 string, word2 string) int {
	m, n := len(word1), len(word2)
	f := make([][]int, m+1)
	for i := range f {
		f[i] = make([]int, n+1)
	}
	for j := 1; j <= n; j++ {
		f[0][j] = j
	}
	for i := 1; i <= m; i++ {
		f[i][0] = i
		for j := 1; j <= n; j++ {
			if word1[i-1] == word2[j-1] {
				f[i][j] = f[i-1][j-1]
			} else {
				f[i][j] = min(f[i-1][j], min(f[i][j-1], f[i-1][j-1])) + 1
			}
		}
	}
	return f[m][n]
}85. 最大矩形
题目、示例与约束
给定一个仅包含 0 和 1 、大小为 rows x cols 的二维二进制矩阵,找出只包含 1 的最大矩形,并返回其面积。
示例 1:
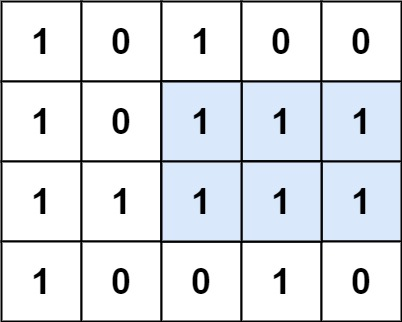
输入:matrix = [["1","0","1","0","0"],["1","0","1","1","1"],["1","1","1","1","1"],["1","0","0","1","0"]]
输出:6
解释:最大矩形如上图所示。
示例 2:
输入:matrix = [["0"]]
输出:0
示例 3:
输入:matrix = [["1"]]
输出:1
提示:
rows == matrix.lengthcols == matrix[0].length1 <= rows, cols <= 200matrix[i][j]为'0'或'1'
方法一:单调栈 · Go 实现
思考
若枚举矩形的左上、右下两个角点,再检查内部是否全为 ,时间复杂度为 。 ,无法通过。
同一片区域会被反复检查。注意到:固定底边所在行 后,第 列向上连续 的个数,恰好是一根柱子的高度。因此每一行都可以化成一道「柱状图中最大的矩形」,而后者已由第 84 题用单调栈在线性时间内解决。
为此我们逐行维护 :当前格为 则高度加一,为 则清零,再对当前直方图求最大矩形。总时间 。
我们把每一行视为柱状图的底部,对每一行求柱状图的最大面积即可。
具体地,我们维护一个与矩阵列数相同的数组 ,其中 表示以当前行为底部、以第 列为高度的柱子的高度。对于每一行,我们遍历每一列:
- 如果当前元素为 '1',则将 加 。
- 如果当前元素为 '0',则将 置为 。
然后,我们使用单调栈算法计算当前柱状图的最大矩形面积,并更新答案。
单调栈的具体做法如下:
- 初始化一个空栈 ,用于存储柱子的索引。
- 初始化两个数组 和 ,分别表示每个柱子左侧和右侧第一个小于当前柱子的柱子的索引。
- 遍历柱子高度数组 ,首先计算每个柱子左侧第一个小于当前柱子的柱子的索引,并存储在 中。
- 然后反向遍历柱子高度数组 ,计算每个柱子右侧第一个小于当前柱子的柱子的索引,并存储在 中。
- 最后,计算每个柱子的最大矩形面积,并更新答案。
时间复杂度 ,其中 表示 的行数, 表示 的列数。
func maximalRectangle(matrix [][]byte) int {
	n := len(matrix[0])
	heights := make([]int, n)
	ans := 0
	for _, row := range matrix {
		for j, v := range row {
			if v == '1' {
				heights[j]++
			} else {
				heights[j] = 0
			}
		}
		ans = max(ans, largestRectangleArea(heights))
	}
	return ans
}

func largestRectangleArea(heights []int) int {
	res, n := 0, len(heights)
	var stk []int
	left, right := make([]int, n), make([]int, n)
	for i := range right {
		right[i] = n
	}
	for i, h := range heights {
		for len(stk) > 0 && heights[stk[len(stk)-1]] >= h {
			right[stk[len(stk)-1]] = i
			stk = stk[:len(stk)-1]
		}
		if len(stk) > 0 {
			left[i] = stk[len(stk)-1]
		} else {
			left[i] = -1
		}
		stk = append(stk, i)
	}
	for i, h := range heights {
		res = max(res, h*(right[i]-left[i]-1))
	}
	return res
}87. 扰乱字符串
题目、示例与约束
s 得到字符串 t :
- 如果字符串的长度为 1 ,算法停止
- 如果字符串的长度 > 1 ,执行下述步骤:
- 在一个随机下标处将字符串分割成两个非空的子字符串。即,如果已知字符串
s,则可以将其分成两个子字符串x和y,且满足s = x + y。 - 随机 决定是要「交换两个子字符串」还是要「保持这两个子字符串的顺序不变」。即,在执行这一步骤之后,
s可能是s = x + y或者s = y + x。 - 在
x和y这两个子字符串上继续从步骤 1 开始递归执行此算法。
- 在一个随机下标处将字符串分割成两个非空的子字符串。即,如果已知字符串
给你两个 长度相等 的字符串 s1 和 s2,判断 s2 是否是 s1 的扰乱字符串。如果是,返回 true ;否则,返回 false 。
示例 1:
输入:s1 = "great", s2 = "rgeat"
输出:true
解释:s1 上可能发生的一种情形是:
"great" --> "gr/eat" // 在一个随机下标处分割得到两个子字符串
"gr/eat" --> "gr/eat" // 随机决定:「保持这两个子字符串的顺序不变」
"gr/eat" --> "g/r / e/at" // 在子字符串上递归执行此算法。两个子字符串分别在随机下标处进行一轮分割
"g/r / e/at" --> "r/g / e/at" // 随机决定:第一组「交换两个子字符串」,第二组「保持这两个子字符串的顺序不变」
"r/g / e/at" --> "r/g / e/ a/t" // 继续递归执行此算法,将 "at" 分割得到 "a/t"
"r/g / e/ a/t" --> "r/g / e/ a/t" // 随机决定:「保持这两个子字符串的顺序不变」
算法终止,结果字符串和 s2 相同,都是 "rgeat"
这是一种能够扰乱 s1 得到 s2 的情形,可以认为 s2 是 s1 的扰乱字符串,返回 true
示例 2:
输入:s1 = "abcde", s2 = "caebd"
输出:false
示例 3:
输入:s1 = "a", s2 = "a"
输出:true
提示:
s1.length == s2.length1 <= s1.length <= 30s1和s2由小写英文字母组成
方法一:记忆化搜索 · Go 实现
思考
按定义递归:枚举分割点,尝试交换或不交换后再递归两边,语义正确。同一对子串却会被反复询问。 ,若不记忆化,搜索树规模过大。
子问题重叠,状态只取决于「 从 起长 的段,能否扰成 从 起长 的段」。扰乱对应某次切分后选择交换或不交换:枚举切分长度 ,要么两段各自对应,要么交叉对应。
将 记忆化后,状态数为 ,每层再枚举切分 ,总时间 。
我们设计一个函数 ,表示字符串 从 开始长度为 的子串是否能变换为字符串 从 开始长度为 的子串。如果能变换,返回 true,否则返回 false。那么答案就是 ,其中 是字符串的长度。
函数 的计算方式如下:
- 如果 ,那么只需要判断 和 是否相等,如果相等返回
true,否则返回false; - 如果 ,我们枚举分割部分的长度 ,那么有两种情况:如果不交换分割的两个子字符串,那么就是 ;如果交换了分割的两个子字符串,那么就是 。如果两种情况中有一种情况成立,那么就说明 成立,返回
true,否则返回false。
最后,我们返回 。
为了避免重复计算,我们可以使用记忆化搜索的方式。
时间复杂度 ,空间复杂度 。其中 是字符串的长度。
func isScramble(s1 string, s2 string) bool {
	n := len(s1)
	f := make([][][]int, n)
	for i := range f {
		f[i] = make([][]int, n)
		for j := range f[i] {
			f[i][j] = make([]int, n+1)
		}
	}
	var dfs func(i, j, k int) bool
	dfs = func(i, j, k int) bool {
		if k == 1 {
			return s1[i] == s2[j]
		}
		if f[i][j][k] != 0 {
			return f[i][j][k] == 1
		}
		f[i][j][k] = 2
		for h := 1; h < k; h++ {
			if (dfs(i, j, h) && dfs(i+h, j+h, k-h)) || (dfs(i+h, j, k-h) && dfs(i, j+k-h, h)) {
				f[i][j][k] = 1
				return true
			}
		}
		return false
	}
	return dfs(0, 0, n)
}
方法二:动态规划(区间 DP) · Go 实现
思考
方法一的转移已经是 ,但递归带调用栈,哈希缓存也有常数开销。 时深度与哈希都偏贵。
可以把同一套转移写成自底向上。 即 的表格:先填长度 ,再按长度递增填满。时间与空间同阶,实现更稳。
我们定义 表示字符串 从 开始长度为 的子串是否能变换为字符串 从 开始长度为 的子串。那么答案就是 ,其中 是字符串的长度。
对于长度为 的子串,如果 ,那么 ,否则 。
接下来,我们从小到大枚举子串的长度 ,从 开始枚举 ,从 开始枚举 ,如果 或者 成立,那么 也成立。
最后,我们返回 。
时间复杂度 ,空间复杂度 。其中 是字符串的长度。
func isScramble(s1 string, s2 string) bool {
	n := len(s1)
	f := make([][][]bool, n)
	for i := range f {
		f[i] = make([][]bool, n)
		for j := 0; j < n; j++ {
			f[i][j] = make([]bool, n+1)
			f[i][j][1] = s1[i] == s2[j]
		}
	}
	for k := 2; k <= n; k++ {
		for i := 0; i <= n-k; i++ {
			for j := 0; j <= n-k; j++ {
				for h := 1; h < k; h++ {
					if (f[i][j][h] && f[i+h][j+h][k-h]) || (f[i+h][j][k-h] && f[i][j+k-h][h]) {
						f[i][j][k] = true
						break
					}
				}
			}
		}
	}
	return f[0][0][n]
}91. 解码方法
题目、示例与约束
一条包含字母 A-Z 的消息通过以下映射进行了 编码 :
"1" -> 'A'

"2" -> 'B'

...

"25" -> 'Y'

"26" -> 'Z'
然而,在 解码 已编码的消息时,你意识到有许多不同的方式来解码,因为有些编码被包含在其它编码当中("2" 和 "5" 与 "25")。
例如,"11106" 可以映射为:
"AAJF",将消息分组为(1, 1, 10, 6)"KJF",将消息分组为(11, 10, 6)- 消息不能分组为
(1, 11, 06),因为"06"不是一个合法编码(只有 "6" 是合法的)。
注意,可能存在无法解码的字符串。
给你一个只含数字的 非空 字符串 s ,请计算并返回 解码 方法的 总数 。如果没有合法的方式解码整个字符串,返回 0。
题目数据保证答案肯定是一个 32 位 的整数。
示例 1:
输入:s = "12"
输出:2
解释:它可以解码为 "AB"(1 2)或者 "L"(12)。
示例 2:
输入:s = "226"
输出:3
解释:它可以解码为 "BZ" (2 26), "VF" (22 6), 或者 "BBF" (2 2 6) 。
示例 3:
输入:s = "06"
输出:0
解释:"06" 无法映射到 "F" ,因为存在前导零("6" 和 "06" 并不等价)。
提示:
1 <= s.length <= 100s只包含数字,并且可能包含前导零。
方法一:动态规划 · Go 实现
思考
递归走到第 位时,可以单独解码 (非 ),或与前一位拼成 – 。 ,若不记忆化,同一前缀会被反复计算,搜索规模过大。
「前 个字符有多少种解法」只取决于更短前缀,且合法划分只有一位或两位两种。结构与爬楼梯相同,约束换成数字编码是否合法。
令 为前 个字符的方案数。空串一种; 不能单独成码, – 才能两位成码。按位递推即可,不必枚举所有划分。
我们定义 表示字符串的前 个字符的解码方法数,初始时 ,其余 。
考虑 如何进行状态转移。
- 如果第 个字符(即 )单独形成编码,那么它对应一种解码方式,即 。前提是 。
- 如果第 个字符和第 个字符组成的字符串在 范围内,那么它们可以作为一个整体,对应一种解码方式,即 。前提是 ,且 在 范围内。
时间复杂度 ,空间复杂度 。其中 是字符串的长度。
func numDecodings(s string) int {
	n := len(s)
	f := make([]int, n+1)
	f[0] = 1
	for i := 1; i <= n; i++ {
		if s[i-1] != '0' {
			f[i] = f[i-1]
		}
		if i > 1 && (s[i-2] == '1' || (s[i-2] == '2' && s[i-1] <= '6')) {
			f[i] += f[i-2]
		}
	}
	return f[n]
}
方法二:动态规划优化 · Go 实现
思考
方法一的递推已经正确。每次转移只用到 与 ,不必保留整张表。用两个变量滚动即可把空间降到 ,时间仍是一遍扫描。
我们注意到,状态 仅与状态 和状态 有关,因此我们可以使用两个变量代替这两个状态,将空间复杂度从 降低至 。时间复杂度仍为 。
func numDecodings(s string) int {
	n := len(s)
	f, g := 0, 1
	for i := 1; i <= n; i++ {
		h := 0
		if s[i-1] != '0' {
			h = g
		}
		if i > 1 && (s[i-2] == '1' || (s[i-2] == '2' && s[i-1] <= '6')) {
			h += f
		}
		f, g = g, h
	}
	return g
}97. 交错字符串
题目、示例与约束
给定三个字符串 s1、s2、s3,请你帮忙验证 s3 是否是由 s1 和 s2 交错 组成的。
两个字符串 s 和 t 交错 的定义与过程如下,其中每个字符串都会被分割成若干 非空 子字符串:
s = s1 + s2 + ... + snt = t1 + t2 + ... + tm|n - m| <= 1- 交错 是
s1 + t1 + s2 + t2 + s3 + t3 + ...或者t1 + s1 + t2 + s2 + t3 + s3 + ...
注意:a + b 意味着字符串 a 和 b 连接。
示例 1:
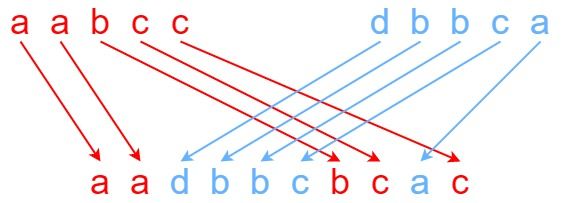
输入:s1 = "aabcc", s2 = "dbbca", s3 = "aadbbcbcac"
输出:true
示例 2:
输入:s1 = "aabcc", s2 = "dbbca", s3 = "aadbbbaccc"
输出:false
示例 3:
输入:s1 = "", s2 = "", s3 = ""
输出:true
提示:
0 <= s1.length, s2.length <= 1000 <= s3.length <= 200s1、s2、和s3都由小写英文字母组成
进阶:您能否仅使用 O(s2.length) 额外的内存空间来解决它?
方法一:记忆化搜索 · Go 实现
思考
交错串要求 由 、 保序穿插而成,长度必须先相等。每一步从 或 取下一个字符,搜索树规模过大。
状态其实只有「 用了几个、 用了几个」:当前位置 对 是确定的。能否继续,取决于 或 是否等于 。对 记忆化后,子问题个数为 。
我们记字符串 的长度为 ,字符串 的长度为 ,如果 ,那么 一定不是 和 的交错字符串,返回 false。
接下来,我们设计一个函数 ,表示从 的第 个字符和 的第 个字符开始,能否交错组成 的剩余部分。那么答案就是 。
函数 的计算过程如下:
如果 并且 ,那么说明 和 都已经遍历完毕,返回 true。
如果 并且 ,那么说明 这个字符是 中的一部分,因此递归地调用 判断 的下一个字符能否和 的当前字符匹配,如果能匹配成功,就返回 true。
同理,如果 并且 ,那么说明 这个字符是 中的一部分,因此递归地调用 判断 的下一个字符能否和 的当前字符匹配,如果能匹配成功,就返回 true。
否则,返回 false。
为了避免重复计算,我们可以使用记忆化搜索。
时间复杂度 ,空间复杂度 。其中 和 分别是字符串 和 的长度。
func isInterleave(s1 string, s2 string, s3 string) bool {
	m, n := len(s1), len(s2)
	if m+n != len(s3) {
		return false
	}

	f := map[int]bool{}
	var dfs func(int, int) bool
	dfs = func(i, j int) bool {
		if i >= m && j >= n {
			return true
		}
		if v, ok := f[i*200+j]; ok {
			return v
		}
		k := i + j
		f[i*200+j] = (i < m && s1[i] == s3[k] && dfs(i+1, j)) || (j < n && s2[j] == s3[k] && dfs(i, j+1))
		return f[i*200+j]
	}
	return dfs(0, 0)
}
方法二:动态规划 · Go 实现
思考
方法一的递归已经给出转移。改成自底向上:令 表示 前 个与 前 个能否拼出 前 个。空串对空串为真,按 、 填表即可,避免递归栈。
我们可以将方法一中的记忆化搜索转化为动态规划。
定义 表示字符串 的前 个字符和字符串 的前 个字符是否能交错组成字符串 的前 个字符。在进行状态转移时,我们可以考虑当前字符是由 的最后一个字符还是 的最后一个字符得到的,因此有状态转移方程:
其中 表示空串是两个空串的交错字符串。
答案即为 。
时间复杂度 ,空间复杂度 。其中 和 分别是字符串 和 的长度。
func isInterleave(s1 string, s2 string, s3 string) bool {
	m, n := len(s1), len(s2)
	if m+n != len(s3) {
		return false
	}
	f := make([][]bool, m+1)
	for i := range f {
		f[i] = make([]bool, n+1)
	}
	f[0][0] = true
	for i := 0; i <= m; i++ {
		for j := 0; j <= n; j++ {
			k := i + j - 1
			if i > 0 && s1[i-1] == s3[k] {
				f[i][j] = f[i-1][j]
			}
			if j > 0 && s2[j-1] == s3[k] {
				f[i][j] = (f[i][j] || f[i][j-1])
			}
		}
	}
	return f[m][n]
}
方法三:滚动数组优化 · Go 实现
思考
方法二仍用 空间。进阶只要 额外空间。 只依赖上一行与本行左侧,一行滚动数组就能放下,对应题目要求的 空间。
我们注意到,状态 只和 、 有关,因此可以使用滚动数组将空间复杂度优化到 。时间复杂度仍为 。
func isInterleave(s1 string, s2 string, s3 string) bool {
	m, n := len(s1), len(s2)
	if m+n != len(s3) {
		return false
	}
	f := make([]bool, n+1)
	f[0] = true
	for i := 0; i <= m; i++ {
		for j := 0; j <= n; j++ {
			k := i + j - 1
			if i > 0 {
				f[j] = (f[j] && s1[i-1] == s3[k])
			}
			if j > 0 {
				f[j] = (f[j] || (s2[j-1] == s3[k] && f[j-1]))
			}
		}
	}
	return f[n]
}115. 不同的子序列
题目、示例与约束
给你两个字符串 s 和 t ,统计并返回在 s 的 子序列 中 t 出现的个数。
测试用例保证结果在 32 位有符号整数范围内。
示例 1:
输入:s = "rabbbit", t = "rabbit"输出:3解释: 如下所示, 有 3 种可以从 s 中得到"rabbit" 的方案。rabbbitrabbbitrabbbit
示例 2:
输入:s = "babgbag", t = "bag"输出:5解释: 如下所示, 有 5 种可以从 s 中得到"bag" 的方案。babgbagbabgbagbabgbagbabgbagbabgbag
提示:
1 <= s.length, t.length <= 1000s和t由英文字母组成
方法一:动态规划 · Go 实现
思考
统计 中有多少子序列等于 。对每个位置选或不选, 与 长度可达 ,朴素递归会重复计算同一后缀对。
子问题只依赖「 用了多长、 匹配了多长」。 表示 前 个字符形成 前 个字符的方案数; 当前字符与 对齐时可以多一条「用掉这对字符」的转移。空 有且仅有一种空子序列。
我们定义 表示字符串 的前 个字符中,子序列构成字符串 的前 个字符的方案数。初始时 ,其中 。
当 时,考虑 的计算:
- 当 时,不能选取 ,因此 ;
- 否则,可以选取 ,此时 。
因此我们有如下的状态转移方程:
最终的答案即为 ,其中 和 分别是字符串 和 的长度。
时间复杂度 ,空间复杂度 。
func numDistinct(s string, t string) int {
	m, n := len(s), len(t)
	f := make([][]int, m+1)
	for i := range f {
		f[i] = make([]int, n+1)
	}
	for i := 0; i <= m; i++ {
		f[i][0] = 1
	}
	for i := 1; i <= m; i++ {
		for j := 1; j <= n; j++ {
			f[i][j] = f[i-1][j]
			if s[i-1] == t[j-1] {
				f[i][j] += f[i-1][j-1]
			}
		}
	}
	return f[m][n]
}
方法二:动态规划优化 · Go 实现
思考
方法一的 只依赖上一行。压缩成一维后,内层必须从大到小更新 ,以免覆盖尚未使用的 。空间降为 。
只与上一行有关,因此可以去掉第一维。内层对 从大到小更新,避免覆盖还未使用的 ,空间复杂度降为 。
func numDistinct(s string, t string) int {
	n := len(t)
	f := make([]int, n+1)
	f[0] = 1
	for _, a := range s {
		for j := n; j > 0; j-- {
			if b := t[j-1]; byte(a) == b {
				f[j] += f[j-1]
			}
		}
	}
	return f[n]
}118. 杨辉三角
题目、示例与约束
给定一个非负整数 numRows,生成「杨辉三角」的前 numRows 行。
在「杨辉三角」中,每个数是它左上方和右上方的数的和。

示例 1:
输入: numRows = 5
输出: [[1],[1,1],[1,2,1],[1,3,3,1],[1,4,6,4,1]]
示例 2:
输入: numRows = 1
输出: [[1]]
提示:
1 <= numRows <= 30
方法一:模拟 · Go 实现
思考
第 行由上一行相邻两项相加得到,两端为 。 ,按行模拟即可。每一行只依赖上一行,依次生成并保存。
我们先创建一个答案数组 ,然后将 的第一行元素设为 。接下来,我们从第二行开始,每一行的开头和结尾元素都是 ,其它 。
时间复杂度 ,其中 为给定的行数。忽略答案的空间消耗,空间复杂度 。
func generate(numRows int) [][]int {
	f := [][]int{[]int{1}}
	for i := 0; i < numRows-1; i++ {
		g := []int{1}
		for j := 1; j < len(f[i]); j++ {
			g = append(g, f[i][j-1]+f[i][j])
		}
		g = append(g, 1)
		f = append(f, g)
	}
	return f
}119. 杨辉三角 II
题目、示例与约束
给定一个非负索引 rowIndex,返回「杨辉三角」的第 rowIndex 行。
在「杨辉三角」中,每个数是它左上方和右上方的数的和。

示例 1:
输入: rowIndex = 3
输出: [1,3,3,1]
示例 2:
输入: rowIndex = 0
输出: [1]
示例 3:
输入: rowIndex = 1
输出: [1,1]
提示:
0 <= rowIndex <= 33
进阶:
你可以优化你的算法到 O(rowIndex) 空间复杂度吗?
方法一:递推 · Go 实现
思考
只要第 行,不必保存整个三角形。进阶还要求 空间。从后往前把 累加 ,右侧已是新行、左侧仍是旧行,一行数组即可滚动到 。
我们创建一个长度为 的数组 ,初始时所有元素均为 。
接下来,我们从第 行开始,从后往前计算当前行的第 个元素的值 ,其中 。
最后返回 即可。
时间复杂度 ,空间复杂度 。其中 是给定的行数。
func getRow(rowIndex int) []int {
	f := make([]int, rowIndex+1)
	for i := range f {
		f[i] = 1
	}
	for i := 2; i < rowIndex+1; i++ {
		for j := i - 1; j > 0; j-- {
			f[j] += f[j-1]
		}
	}
	return f
}120. 三角形最小路径和
题目、示例与约束
给定一个三角形 triangle ,找出自顶向下的最小路径和。
每一步只能移动到下一行中相邻的结点上。相邻的结点 在这里指的是 下标 与 上一层结点下标 相同或者等于 上一层结点下标 + 1 的两个结点。也就是说,如果正位于当前行的下标 i ,那么下一步可以移动到下一行的下标 i 或 i + 1 。
示例 1:
输入:triangle = [[2],[3,4],[6,5,7],[4,1,8,3]]
输出:11
解释:如下面简图所示:
   2
  3 4
 6 5 7
4 1 8 3
自顶向下的最小路径和为 11(即,2 + 3 + 5 + 1 = 11)。
示例 2:
输入:triangle = [[-10]]
输出:-10
提示:
1 <= triangle.length <= 200triangle[0].length == 1triangle[i].length == triangle[i - 1].length + 1-104 <= triangle[i][j] <= 104
进阶:
- 你可以只使用
O(n)的额外空间(n为三角形的总行数)来解决这个问题吗?
方法一:动态规划 · Go 实现
思考
自顶向下每步只能走到下一行相邻位置,枚举路径的数量随行数指数增长。行数不大,但重叠子问题很多:从某格出发的最小路径只依赖它下方两个格子。
自底向上定义 为从该格走到最后一行的最小和,每个格子取下方左右的较小值再加自身,顶点 即答案。
我们定义 表示从三角形底部走到位置 的最小路径和。这里的位置 指的是三角形中第 行第 列(均从 开始编号)的位置。那么我们有如下的状态转移方程:
答案即为 。
func minimumTotal(triangle [][]int) int {
	n := len(triangle)
	f := make([][]int, n+1)
	for i := range f {
		f[i] = make([]int, n+1)
	}
	for i := n - 1; i >= 0; i-- {
		for j := 0; j <= i; j++ {
			f[i][j] = min(f[i+1][j], f[i+1][j+1]) + triangle[i][j]
		}
	}
	return f[0][0]
}
方法二:动态规划(空间优化) · Go 实现
思考
方法一的 只依赖下一行。用一维数组从下往上覆盖,空间从 降到 ,符合进阶要求。
我们注意到,状态 仅与状态 和状态 有关,因此我们可以使用一维数组代替二维数组,将空间复杂度从 降低至 。
时间复杂度 ,空间复杂度 。其中 是三角形的行数。
func minimumTotal(triangle [][]int) int {
	n := len(triangle)
	f := make([]int, n+1)
	for i := n - 1; i >= 0; i-- {
		for j := 0; j <= i; j++ {
			f[j] = min(f[j], f[j+1]) + triangle[i][j]
		}
	}
	return f[0]
}121. 买卖股票的最佳时机
题目、示例与约束
给定一个数组 prices ,它的第 i 个元素 prices[i] 表示一支给定股票第 i 天的价格。
你只能选择 某一天 买入这只股票,并选择在 未来的某一个不同的日子 卖出该股票。设计一个算法来计算你所能获取的最大利润。
返回你可以从这笔交易中获取的最大利润。如果你不能获取任何利润,返回 0 。
示例 1:
输入:[7,1,5,3,6,4]
输出:5
解释:在第 2 天(股票价格 = 1)的时候买入,在第 5 天(股票价格 = 6)的时候卖出,最大利润 = 6-1 = 5 。
     注意利润不能是 7-1 = 6, 因为卖出价格需要大于买入价格;同时,你不能在买入前卖出股票。
示例 2:
输入:prices = [7,6,4,3,1]
输出:0
解释:在这种情况下, 没有交易完成, 所以最大利润为 0。
提示:
1 <= prices.length <= 1050 <= prices[i] <= 104
方法一:枚举 + 维护前缀最小值 · Go 实现
思考
只能买卖一次,枚举所有买入卖出下标对是 ; 可达 。对固定卖出日,最优买入价是它之前的最低价。扫描时维护前缀最小值,用当天价格减它更新答案,再把当天纳入前缀最小。
我们可以枚举数组 每个元素作为卖出价格,那么我们需要在前面找到一个最小值作为买入价格,这样才能使得利润最大化。
因此,我们用一个变量 维护数组 的前缀最小值。接下来遍历数组 ,对于每个元素 ,计算其与前面元素的最小值 的差值,更新答案为差值的最大值。然后更新 。继续遍历数组 ,直到遍历结束。
最后返回答案即可。
时间复杂度 ,其中 是数组 的长度。空间复杂度 。
func maxProfit(prices []int) (ans int) {
	mi := prices[0]
	for _, v := range prices {
		ans = max(ans, v-mi)
		mi = min(mi, v)
	}
	return
}122. 买卖股票的最佳时机 II
题目、示例与约束
给你一个整数数组 prices ,其中 prices[i] 表示某支股票第 i 天的价格。
在每一天,你可以决定是否购买和/或出售股票。你在任何时候 最多 只能持有 一股 股票。然而,你可以在 同一天 多次买卖该股票,但要确保你持有的股票不超过一股。
返回 你能获得的 最大 利润 。
示例 1:
输入:prices = [7,1,5,3,6,4]
输出:7
解释:在第 2 天(股票价格 = 1)的时候买入,在第 3 天(股票价格 = 5)的时候卖出, 这笔交易所能获得利润 = 5 - 1 = 4。
随后,在第 4 天(股票价格 = 3)的时候买入,在第 5 天(股票价格 = 6)的时候卖出, 这笔交易所能获得利润 = 6 - 3 = 3。
最大总利润为 4 + 3 = 7 。
示例 2:
输入:prices = [1,2,3,4,5]
输出:4
解释:在第 1 天(股票价格 = 1)的时候买入,在第 5 天 (股票价格 = 5)的时候卖出, 这笔交易所能获得利润 = 5 - 1 = 4。
最大总利润为 4 。
示例 3:
输入:prices = [7,6,4,3,1]
输出:0
解释:在这种情况下, 交易无法获得正利润,所以不参与交易可以获得最大利润,最大利润为 0。
提示:
1 <= prices.length <= 3 * 1040 <= prices[i] <= 104
方法一:贪心 · Go 实现
思考
可以交易任意次,但不能同时持有。把一段上涨拆成相邻两天的差价再求和,与「谷买峰卖」得到的利润相同。 。因此遍历相邻两天,只累加正差价。
从第二天开始,如果当天股价大于前一天股价,则在前一天买入,当天卖出,即可获得利润。如果当天股价小于前一天股价,则不买入,不卖出。也即是说,所有上涨交易日都做买卖,所有下跌交易日都不做买卖,最终获得的利润是最大的。
时间复杂度 ,其中 为数组 prices 的长度。空间复杂度 。
func maxProfit(prices []int) (ans int) {
	for i, v := range prices[1:] {
		t := v - prices[i]
		if t > 0 {
			ans += t
		}
	}
	return
}
方法二:动态规划 · Go 实现
思考
贪心没有显式状态,不便于推广到有交易次数或冷冻期的变体。用 表示第 天持有或不持有的最大利润,转移是继续持有、今日买入、继续空仓或今日卖出。与方法一答案相同,但状态更一般。
我们设 表示第 天交易完后的最大利润,其中 表示当前是否持有股票,持有股票时 ,不持有股票时 。初始状态为 ,其余状态均为 。
如果当前持有股票,那么可能是前一天就持有股票,今天什么都不做,即 ;也可能是前一天不持有股票,今天买入股票,即 。
如果当前不持有股票,那么可能是前一天就不持有股票,今天什么都不做,即 ;也可能是前一天持有股票,今天卖出股票,即 。
因此,我们可以写出状态转移方程:
最终的答案即为 ,其中 为数组 prices 的长度。
时间复杂度 ,空间复杂度 。其中 为数组 prices 的长度。
func maxProfit(prices []int) int {
	n := len(prices)
	f := make([][2]int, n)
	f[0][0] = -prices[0]
	for i := 1; i < n; i++ {
		f[i][0] = max(f[i-1][0], f[i-1][1]-prices[i])
		f[i][1] = max(f[i-1][1], f[i-1][0]+prices[i])
	}
	return f[n-1][1]
}
方法三:动态规划(空间优化) · Go 实现
思考
方法二第 天只依赖第 天的两个状态,两个变量滚动即可,空间降为 。
我们可以发现,在方法二中,第 天的状态,只与第 天的状态有关,因此我们可以只用两个变量来维护第 天的状态,从而将空间复杂度优化到 。
时间复杂度 ,其中 为数组 prices 的长度。空间复杂度 。
func maxProfit(prices []int) int {
	n := len(prices)
	f := [2]int{-prices[0], 0}
	for i := 1; i < n; i++ {
		g := [2]int{}
		g[0] = max(f[0], f[1]-prices[i])
		g[1] = max(f[1], f[0]+prices[i])
		f = g
	}
	return f[1]
}123. 买卖股票的最佳时机 III
题目、示例与约束
给定一个数组,它的第 i 个元素是一支给定的股票在第 i 天的价格。
设计一个算法来计算你所能获取的最大利润。你最多可以完成 两笔 交易。
注意:你不能同时参与多笔交易(你必须在再次购买前出售掉之前的股票)。
示例 1:
输入:prices = [3,3,5,0,0,3,1,4]
输出:6
解释:在第 4 天(股票价格 = 0)的时候买入,在第 6 天(股票价格 = 3)的时候卖出,这笔交易所能获得利润 = 3-0 = 3 。
     随后,在第 7 天(股票价格 = 1)的时候买入,在第 8 天 (股票价格 = 4)的时候卖出,这笔交易所能获得利润 = 4-1 = 3 。
示例 2:
输入:prices = [1,2,3,4,5]
输出:4
解释:在第 1 天(股票价格 = 1)的时候买入,在第 5 天 (股票价格 = 5)的时候卖出, 这笔交易所能获得利润 = 5-1 = 4 。
     注意你不能在第 1 天和第 2 天接连购买股票,之后再将它们卖出。
     因为这样属于同时参与了多笔交易,你必须在再次购买前出售掉之前的股票。
示例 3:
输入:prices = [7,6,4,3,1]
输出:0
解释:在这个情况下, 没有交易完成, 所以最大利润为 0。
示例 4:
输入:prices = [1]
输出:0
提示:
1 <= prices.length <= 1050 <= prices[i] <= 105
方法一:动态规划 · Go 实现
思考
最多两笔交易,方法二那种「无限次」状态不够用。若三维 DP 记下天数、已完成交易次数与是否持有,空间偏大。注意到合法顺序是「买一、卖一、买二、卖二」,四个变量按这个顺序更新:每一天用已经算好的上一阶段利润转移。同一天买了再卖利润为 ,不影响最优。
我们定义以下几个变量,其中:
f1表示第一次买入股票后的最大利润;f2表示第一次卖出股票后的最大利润;f3表示第二次买入股票后的最大利润;f4表示第二次卖出股票后的最大利润。
遍历过程中,直接使用 f1, f2, f3, f4 计算,考虑的是在同一天买入和卖出时,收益是 ,不会对答案产生影响。
最后返回 f4 即可。
时间复杂度 ,其中 为数组 prices 的长度。空间复杂度 。
func maxProfit(prices []int) int {
	f1, f2, f3, f4 := -prices[0], 0, -prices[0], 0
	for i := 1; i < len(prices); i++ {
		f1 = max(f1, -prices[i])
		f2 = max(f2, f1+prices[i])
		f3 = max(f3, f2-prices[i])
		f4 = max(f4, f3+prices[i])
	}
	return f4
}131. 分割回文串
题目、示例与约束
给你一个字符串 s,请你将 s 分割成一些 子串,使每个子串都是 回文串 。返回 s 所有可能的分割方案。
示例 1:
输入:s = "aab"
输出:[["a","a","b"],["aa","b"]]
示例 2:
输入:s = "a"
输出:[["a"]]
提示:
1 <= s.length <= 16s仅由小写英文字母组成
方法一:预处理 + DFS(回溯) · Go 实现
思考
要列出把 切成回文子串的全部方案。 ,分割方案至多 种,回溯可以接受。每次切一刀再判断回文会重复扫描同一区间。
先用 DP 预处理 表示 是否回文,再从左到右枚举下一个切点:只有 为真才进入下一层。
我们可以使用动态规划,预处理出字符串中的任意子串是否为回文串,即 表示子串 是否为回文串。
接下来,我们设计一个函数 ,表示从字符串的第 个字符开始,分割成若干回文串,当前分割方案为 。
如果 ,说明已经分割完成,我们将 放入答案数组中,然后返回。
否则,我们可以从 开始,从小到大依次枚举结束位置 ,如果 是回文串,那么就把 加入到 中,然后继续递归 ,回溯的时候要弹出 。
时间复杂度 ,空间复杂度 。其中 是字符串的长度。
func partition(s string) (ans [][]string) {
	n := len(s)
	f := make([][]bool, n)
	for i := range f {
		f[i] = make([]bool, n)
		for j := range f[i] {
			f[i][j] = true
		}
	}
	for i := n - 1; i >= 0; i-- {
		for j := i + 1; j < n; j++ {
			f[i][j] = s[i] == s[j] && f[i+1][j-1]
		}
	}
	t := []string{}
	var dfs func(int)
	dfs = func(i int) {
		if i == n {
			ans = append(ans, append([]string(nil), t...))
			return
		}
		for j := i; j < n; j++ {
			if f[i][j] {
				t = append(t, s[i:j+1])
				dfs(j + 1)
				t = t[:len(t)-1]
			}
		}
	}
	dfs(0)
	return
}132. 分割回文串 II
题目、示例与约束
给你一个字符串 s,请你将 s 分割成一些子串,使每个子串都是回文串。
返回符合要求的 最少分割次数 。
示例 1:
输入:s = "aab"
输出:1
解释:只需一次分割就可将 s 分割成 ["aa","b"] 这样两个回文子串。
示例 2:
输入:s = "a"
输出:0
示例 3:
输入:s = "ab"
输出:1
提示:
1 <= s.length <= 2000s仅由小写英文字母组成
方法一:动态规划 · Go 实现
思考
只要最少切几刀,不必列出方案。 ,回溯所有分割不可行。与上一题一样先预处理回文区间。 表示前缀 的最少刀数:枚举最后一个回文段 ,由 转移;整段已是回文则 刀。
我们先预处理得到字符串 的每一个子串 是否为回文串,记录在二维数组 中,其中 表示子串 是否为回文串。
接下来,我们定义 表示字符串 的最少分割次数,初始时 。
接下来,我们考虑 如何进行状态转移。我们可以枚举上一个分割点 ,如果子串 是一个回文串,那么 就可以从 转移而来。如果 ,那么说明 本身就是一个回文串,此时不需要进行分割,即 。因此,状态转移方程如下:
答案即为 ,其中 是字符串 的长度。
时间复杂度 ,空间复杂度 。其中 是字符串 的长度。
func minCut(s string) int {
	n := len(s)
	g := make([][]bool, n)
	f := make([]int, n)
	for i := range g {
		g[i] = make([]bool, n)
		f[i] = i
		for j := range g[i] {
			g[i][j] = true
		}
	}
	for i := n - 1; i >= 0; i-- {
		for j := i + 1; j < n; j++ {
			g[i][j] = s[i] == s[j] && g[i+1][j-1]
		}
	}
	for i := 1; i < n; i++ {
		for j := 0; j <= i; j++ {
			if g[j][i] {
				if j == 0 {
					f[i] = 0
				} else {
					f[i] = min(f[i], f[j-1]+1)
				}
			}
		}
	}
	return f[n-1]
}152. 乘积最大子数组
题目、示例与约束
给你一个整数数组 nums ,请你找出数组中乘积最大的非空连续 子数组(该子数组中至少包含一个数字),并返回该子数组所对应的乘积。
测试用例的答案是一个 32-位 整数。
请注意,一个只包含一个元素的数组的乘积是这个元素的值。
示例 1:
输入: nums = [2,3,-2,4]
输出: 6
解释: 子数组 [2,3] 有最大乘积 6。
示例 2:
输入: nums = [-2,0,-1]
输出: 0
解释: 结果不能为 2, 因为 [-2,-1] 不是子数组。
提示:
1 <= nums.length <= 2 * 104-10 <= nums[i] <= 10nums的任何子数组的乘积都 保证 是一个 32-位 整数
方法一:动态规划 · Go 实现
思考
最大子数组和可以用 Kadane,乘积则不同:负数会让最大变最小、最小变最大,零会切断。 。同时维护以当前位置结尾的最大与最小乘积,新数乘上两者或单独成段,三者取最大/最小。答案是扫描过程中最大乘积的最大值。
我们定义两个变量 和 ,其中 表示以 结尾的乘积最大子数组的乘积,而 表示以 结尾的乘积最小子数组的乘积。初始时 和 都等于 。答案为所有 中的最大值。
从 开始,我们可以考虑将第 个数 添加到前面的乘积最大或者乘积最小的子数组乘积的后面,或者单独作为一个子数组乘积(即此时子数组长度只有 )。我们将此前的乘积最大值记为 ,乘积最小值记为 ,那么 ,而 。接下来,我们更新答案 ,然后继续计算下一个位置。
最后的答案即为 。
时间复杂度 ,其中 是数组 的长度。我们只需要遍历数组一次即可求得答案。空间复杂度 。
func maxProduct(nums []int) int {
	f, g, ans := nums[0], nums[0], nums[0]
	for _, x := range nums[1:] {
		ff, gg := f, g
		f = max(x, max(ff*x, gg*x))
		g = min(x, min(ff*x, gg*x))
		ans = max(ans, f)
	}
	return ans
}174. 地下城游戏
题目、示例与约束
恶魔们抓住了公主并将她关在了地下城 dungeon 的 右下角 。地下城是由 m x n 个房间组成的二维网格。我们英勇的骑士最初被安置在 左上角 的房间里,他必须穿过地下城并通过对抗恶魔来拯救公主。
骑士的初始健康点数为一个正整数。如果他的健康点数在某一时刻降至 0 或以下,他会立即死亡。
有些房间由恶魔守卫,因此骑士在进入这些房间时会失去健康点数(若房间里的值为负整数,则表示骑士将损失健康点数);其他房间要么是空的(房间里的值为 0),要么包含增加骑士健康点数的魔法球(若房间里的值为正整数,则表示骑士将增加健康点数)。
为了尽快解救公主,骑士决定每次只 向右 或 向下 移动一步。
返回确保骑士能够拯救到公主所需的最低初始健康点数。
注意:任何房间都可能对骑士的健康点数造成威胁,也可能增加骑士的健康点数,包括骑士进入的左上角房间以及公主被监禁的右下角房间。
示例 1:
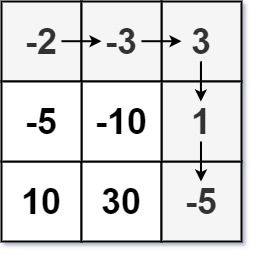
输入:dungeon = [[-2,-3,3],[-5,-10,1],[10,30,-5]]
输出:7
解释:如果骑士遵循最佳路径:右 -> 右 -> 下 -> 下 ,则骑士的初始健康点数至少为 7 。
示例 2:
输入:dungeon = [[0]]
输出:1
提示:
m == dungeon.lengthn == dungeon[i].length1 <= m, n <= 200-1000 <= dungeon[i][j] <= 1000
方法一:动态规划 · Go 实现
思考
骑士只能向右或向下,血量随时至少为 ,求出发前最少初始血量。自顶向下枚举路径在 上不可行。前方需要的血量决定当前最低要求,因此从终点倒推:到达下一格所需血量减去本格收益,再与 取最大,避免出现非正血量。两个方向取更省的那条。
我们定义 表示从 到终点所需的最小初始值,那么 的值可以由 和 得到,即:
初始时 和 都为 ,其他位置的值为最大值。
时间复杂度 ,空间复杂度 。其中 和 分别为地牢的行数和列数。
func calculateMinimumHP(dungeon [][]int) int {
	m, n := len(dungeon), len(dungeon[0])
	dp := make([][]int, m+1)
	for i := range dp {
		dp[i] = make([]int, n+1)
		for j := range dp[i] {
			dp[i][j] = 1 << 30
		}
	}
	dp[m][n-1], dp[m-1][n] = 1, 1
	for i := m - 1; i >= 0; i-- {
		for j := n - 1; j >= 0; j-- {
			dp[i][j] = max(1, min(dp[i+1][j], dp[i][j+1])-dungeon[i][j])
		}
	}
	return dp[0][0]
}188. 买卖股票的最佳时机 IV
题目、示例与约束
给你一个整数数组 prices 和一个整数 k ,其中 prices[i] 是某支给定的股票在第 i 天的价格。
设计一个算法来计算你所能获取的最大利润。你最多可以完成 k 笔交易。也就是说,你最多可以买 k 次,卖 k 次。
注意:你不能同时参与多笔交易(你必须在再次购买前出售掉之前的股票)。
示例 1:
输入:k = 2, prices = [2,4,1]
输出:2
解释:在第 1 天 (股票价格 = 2) 的时候买入,在第 2 天 (股票价格 = 4) 的时候卖出,这笔交易所能获得利润 = 4-2 = 2 。
示例 2:
输入:k = 2, prices = [3,2,6,5,0,3]
输出:7
解释:在第 2 天 (股票价格 = 2) 的时候买入,在第 3 天 (股票价格 = 6) 的时候卖出, 这笔交易所能获得利润 = 6-2 = 4 。
     随后,在第 5 天 (股票价格 = 0) 的时候买入,在第 6 天 (股票价格 = 3) 的时候卖出, 这笔交易所能获得利润 = 3-0 = 3 。
提示:
1 <= k <= 1001 <= prices.length <= 10000 <= prices[i] <= 1000
方法一:记忆化搜索 · Go 实现
思考
最多 笔交易,是「至多两笔」的一般化。 、 ,三维状态可以接受。 :从第 天起、还剩 次买入机会、当前是否持有。不操作总是合法;持有则可卖出(买入次数不变);空仓且还有次数则可买入并消耗一次。记忆化避免重复的 。
我们设计一个函数 ,表示从第 天开始,最多完成 笔交易,以及当前持有股票的状态为 (不持有股票用 表示,持有股票用 表示)时,所能获得的最大利润。答案即为 。
函数 的执行逻辑如下:
- 如果 大于等于 ,直接返回 ;
- 第 天可以不进行任何操作,那么 ;
- 如果 ,那么第 天可以选择卖出股票,那么 ;
- 否则,如果 ,那么第 天可以选择买入股票,那么 。
取上述三种情况的最大值即为 的值。
过程中,我们可以使用记忆化搜索的方法,将每次计算的结果保存下来,避免重复计算。
时间复杂度 ,空间复杂度 。其中 和 分别为数组 的长度和 的值。
func maxProfit(k int, prices []int) int {
	n := len(prices)
	f := make([][][2]int, n)
	for i := range f {
		f[i] = make([][2]int, k+1)
		for j := range f[i] {
			f[i][j] = [2]int{-1, -1}
		}
	}
	var dfs func(i, j, k int) int
	dfs = func(i, j, k int) int {
		if i >= n {
			return 0
		}
		if f[i][j][k] != -1 {
			return f[i][j][k]
		}
		ans := dfs(i+1, j, k)
		if k > 0 {
			ans = max(ans, prices[i]+dfs(i+1, j, 0))
		} else if j > 0 {
			ans = max(ans, -prices[i]+dfs(i+1, j-1, 1))
		}
		f[i][j][k] = ans
		return ans
	}
	return dfs(0, k, 0)
}
方法二:动态规划 · Go 实现
思考
方法一是递归记忆化。改成自底向上: 表示到第 天、已买入 次、是否持有的最大利润。第 天买入记为 ,之后按「卖出 / 继续空仓 / 买入 / 继续持有」转移,与搜索同一状态空间。
我们也可以使用动态规划的方法,定义 表示到第 天时,最多交易 次(这里我们规定交易次数等于买入次数),且当前持有股票的状态为 时,所能获得的最大利润。初始时 。答案即为 。
当 时,股票价格为 ,那么对任意 ,我们有 ,表示第 天买入股票,此时利润为 。
当 时:
- 如果第 天不持有股票,可能是第 天持有股票并且在第 天卖出;或者第 天没持有股票并且第 天不进行任何操作。因此 ;
- 如果第 天持有股票,可能是第 天没持有股票并且在第 天买入;或者第 天持有股票并且第 天不进行任何操作。因此 。
综上,当 时,我们可以得到状态转移方程:
最后答案即为 。
时间复杂度 ,空间复杂度 。其中 和 分别为数组 的长度和 的值。
func maxProfit(k int, prices []int) int {
	n := len(prices)
	f := make([][][2]int, n)
	for i := range f {
		f[i] = make([][2]int, k+1)
	}
	for j := 1; j <= k; j++ {
		f[0][j][1] = -prices[0]
	}
	for i := 1; i < n; i++ {
		for j := 1; j <= k; j++ {
			f[i][j][0] = max(f[i-1][j][1]+prices[i], f[i-1][j][0])
			f[i][j][1] = max(f[i-1][j-1][0]-prices[i], f[i-1][j][1])
		}
	}
	return f[n-1][k][0]
}
方法三:动态规划(空间优化) · Go 实现
思考
方法二第 天只依赖第 天,去掉天数维,用 的 滚动即可。
只与上一天有关,去掉第一维后用 滚动即可,空间复杂度 。
func maxProfit(k int, prices []int) int {
	f := make([][2]int, k+1)
	for j := 1; j <= k; j++ {
		f[j][1] = -prices[0]
	}
	for _, x := range prices[1:] {
		for j := k; j > 0; j-- {
			f[j][0] = max(f[j][1]+x, f[j][0])
			f[j][1] = max(f[j-1][0]-x, f[j][1])
		}
	}
	return f[k][0]
}继续阅读
- 实践案例
- 实践案例
- 实践案例