
LeetCode Go · 数据结构设计(4)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
1670. 设计前中后队列
题目、示例与约束
请你设计一个队列,支持在前,中,后三个位置的 push 和 pop 操作。
请你完成 FrontMiddleBack 类:
FrontMiddleBack()初始化队列。void pushFront(int val)将val添加到队列的 最前面 。void pushMiddle(int val)将val添加到队列的 正中间 。void pushBack(int val)将val添加到队里的 最后面 。int popFront()将 最前面 的元素从队列中删除并返回值,如果删除之前队列为空,那么返回-1。int popMiddle()将 正中间 的元素从队列中删除并返回值,如果删除之前队列为空,那么返回-1。int popBack()将 最后面 的元素从队列中删除并返回值,如果删除之前队列为空,那么返回-1。
请注意当有 两个 中间位置的时候,选择靠前面的位置进行操作。比方说:
- 将
6添加到[1, 2, 3, 4, 5]的中间位置,结果数组为[1, 2, 6, 3, 4, 5]。 - 从
[1, 2, 3, 4, 5, 6]的中间位置弹出元素,返回3,数组变为[1, 2, 4, 5, 6]。
示例 1:
输入:
["FrontMiddleBackQueue", "pushFront", "pushBack", "pushMiddle", "pushMiddle", "popFront", "popMiddle", "popMiddle", "popBack", "popFront"]
[[], [1], [2], [3], [4], [], [], [], [], []]
输出:
[null, null, null, null, null, 1, 3, 4, 2, -1]

解释:
FrontMiddleBackQueue q = new FrontMiddleBackQueue();
q.pushFront(1);   // [1]
q.pushBack(2);    // [1, 2]
q.pushMiddle(3);  // [1, 3, 2]
q.pushMiddle(4);  // [1, 4, 3, 2]
q.popFront();     // 返回 1 -> [4, 3, 2]
q.popMiddle();    // 返回 3 -> [4, 2]
q.popMiddle();    // 返回 4 -> [2]
q.popBack();      // 返回 2 -> []
q.popFront();     // 返回 -1 -> [] (队列为空)
提示:
1 <= val <= 109- 最多调用
1000次pushFront,pushMiddle,pushBack,popFront,popMiddle和popBack。
方法一:两个双端队列 · Go 实现
思考
需要 在队首、队中、队尾插入删除,单列表定位中点是线性的。拆成两个双端队列,前半 、后半 ,并保持 比 长至多 。
插删落在对应半边后调用 挪一个元素。中点在等长时是 尾,否则是 头。
我们用两个双端队列,其中 存储前半部分,而 存储后半部分。每次由 rebalance 函数来维护两个队列的平衡性,即保持 的长度大于等于 的长度,且长度之差不超过 。
在 pushFront、pushMiddle 和 pushBack 函数中,我们只需要将元素添加到 或 中,并调用 rebalance 函数即可。
对于 popFront 函数,我们需要判断 和 是否为空,如果都为空,则返回 ,否则我们需要判断 是否为空,如果不为空,则弹出 的队首元素,否则弹出 的队首元素,并调用 rebalance 函数。
对于 popMiddle 函数,我们需要判断 和 是否为空,如果都为空,则返回 ,否则我们需要判断 和 的长度是否相等,如果相等,则弹出 的队尾元素,否则弹出 的队首元素,并调用 rebalance 函数。
对于 popBack 函数,我们只需要判断 是否为空,如果为空,则返回 ,否则弹出 的队尾元素,并调用 rebalance 函数。
以上操作的时间复杂度均为 ,空间复杂度为 ,其中 是队列中的元素数量。
type FrontMiddleBackQueue struct {
	q1, q2 Deque
}

func Constructor() FrontMiddleBackQueue {
	return FrontMiddleBackQueue{}
}

func (this *FrontMiddleBackQueue) PushFront(val int) {
	this.q1.PushFront(val)
	this.rebalance()
}

func (this *FrontMiddleBackQueue) PushMiddle(val int) {
	this.q1.PushBack(val)
	this.rebalance()
}

func (this *FrontMiddleBackQueue) PushBack(val int) {
	this.q2.PushBack(val)
	this.rebalance()
}

func (this *FrontMiddleBackQueue) PopFront() int {
	if this.q1.Empty() && this.q2.Empty() {
		return -1
	}
	var val int
	if !this.q1.Empty() {
		val = this.q1.PopFront()
	} else {
		val = this.q2.PopFront()
	}
	this.rebalance()
	return val
}

func (this *FrontMiddleBackQueue) PopMiddle() int {
	if this.q1.Empty() && this.q2.Empty() {
		return -1
	}
	var val int
	if this.q1.Size() == this.q2.Size() {
		val = this.q1.PopBack()
	} else {
		val = this.q2.PopFront()
	}
	this.rebalance()
	return val
}

func (this *FrontMiddleBackQueue) PopBack() int {
	if this.q2.Empty() {
		return -1
	}
	val := this.q2.PopBack()
	this.rebalance()
	return val
}

func (this *FrontMiddleBackQueue) rebalance() {
	if this.q1.Size() > this.q2.Size() {
		this.q2.PushFront(this.q1.PopBack())
	}
	if this.q2.Size() > this.q1.Size()+1 {
		this.q1.PushBack(this.q2.PopFront())
	}
}

// template
type Deque struct{ l, r []int }

func (q Deque) Empty() bool {
	return len(q.l) == 0 && len(q.r) == 0
}

func (q Deque) Size() int {
	return len(q.l) + len(q.r)
}

func (q *Deque) PushFront(v int) {
	q.l = append(q.l, v)
}

func (q *Deque) PushBack(v int) {
	q.r = append(q.r, v)
}

func (q *Deque) PopFront() (v int) {
	if len(q.l) > 0 {
		q.l, v = q.l[:len(q.l)-1], q.l[len(q.l)-1]
	} else {
		v, q.r = q.r[0], q.r[1:]
	}
	return
}

func (q *Deque) PopBack() (v int) {
	if len(q.r) > 0 {
		q.r, v = q.r[:len(q.r)-1], q.r[len(q.r)-1]
	} else {
		v, q.l = q.l[0], q.l[1:]
	}
	return
}

func (q Deque) Front() int {
	if len(q.l) > 0 {
		return q.l[len(q.l)-1]
	}
	return q.r[0]
}

func (q Deque) Back() int {
	if len(q.r) > 0 {
		return q.r[len(q.r)-1]
	}
	return q.l[0]
}

func (q Deque) Get(i int) int {
	if i < len(q.l) {
		return q.l[len(q.l)-1-i]
	}
	return q.r[i-len(q.l)]
}

/**
 * Your FrontMiddleBackQueue object will be instantiated and called as such:
 * obj := Constructor();
 * obj.PushFront(val);
 * obj.PushMiddle(val);
 * obj.PushBack(val);
 * param_4 := obj.PopFront();
 * param_5 := obj.PopMiddle();
 * param_6 := obj.PopBack();
*/1724. 检查边长度限制的路径是否存在 II 🔒
题目、示例与约束
一张有 n 个节点的无向图以边的列表 edgeList 的形式定义,其中 edgeList[i] = [ui, vi, disi] 表示一条连接 ui 和 vi ,距离为 disi 的边。注意,同一对节点间可能有多条边,且该图可能不是连通的。
实现 DistanceLimitedPathsExist 类:
DistanceLimitedPathsExist(int n, int[][] edgeList)以给定的无向图初始化对象。boolean query(int p, int q, int limit)当存在一条从p到q的路径,且路径中每条边的距离都严格小于limit时,返回true,否则返回false。
示例 1:
%7B:width=400%7D)

输入:
["DistanceLimitedPathsExist", "query", "query", "query", "query"]
[[6, [[0, 2, 4], [0, 3, 2], [1, 2, 3], [2, 3, 1], [4, 5, 5]]], [2, 3, 2], [1, 3, 3], [2, 0, 3], [0, 5, 6]]
输出:
[null, true, false, true, false]

解释:
DistanceLimitedPathsExist distanceLimitedPathsExist = new DistanceLimitedPathsExist(6, [[0, 2, 4], [0, 3, 2], [1, 2, 3], [2, 3, 1], [4, 5, 5]]);
distanceLimitedPathsExist.query(2, 3, 2); // 返回 true。存在一条从 2 到 3 ,距离为 1 的边,
                                          // 这条边的距离小于 2。
distanceLimitedPathsExist.query(1, 3, 3); // 返回 false。从 1 到 3 之间不存在每条边的距离都
                                          // 严格小于 3 的路径。
distanceLimitedPathsExist.query(2, 0, 3); // 返回 true。存在一条从 2 到 0 的路径,使得每条边的
                                          // 距离 < 3:从 2 到 3 到 0 行进即可。
distanceLimitedPathsExist.query(0, 5, 6); // 返回 false。从 0 到 5 之间不存在路径。
提示:
2 <= n <= 1040 <= edgeList.length <= 104edgeList[i].length == 30 <= ui, vi, p, q <= n-1ui != vip != q1 <= disi, limit <= 109- 最多调用
104次query。
方法一:可持久化并查集 · Go 实现
思考
多次在线询问两点是否能只走权严格小于 的边相通。离线按权排序并查集适合一次性询问,这里询问穿插在构造之后且需反复查询。
把边按权从小到大并入并查集,每次合并记录发生的时刻(即边权)。查询时只沿着「合并时刻 」的父指针跳,等价于只使用权更小的边。
可持久化并查集用 保存结点被挂到父结点的权。 在 之前停止上升,两点根相同则连通。
type PersistentUnionFind struct {
	rank    []int
	parent  []int
	version []int
}

func NewPersistentUnionFind(n int) *PersistentUnionFind {
	rank := make([]int, n)
	parent := make([]int, n)
	version := make([]int, n)

	for i := 0; i < n; i++ {
		parent[i] = i
	}

	return &PersistentUnionFind{
		rank:    rank,
		parent:  parent,
		version: version,
	}
}

func (uf *PersistentUnionFind) find(x int, t int) int {
	if uf.parent[x] == x || uf.version[x] >= t {
		return x
	}
	return uf.find(uf.parent[x], t)
}

func (uf *PersistentUnionFind) union(a, b, t int) bool {
	pa := uf.find(a, int(^uint(0)>>1))
	pb := uf.find(b, int(^uint(0)>>1))

	if pa == pb {
		return false
	}

	if uf.rank[pa] > uf.rank[pb] {
		uf.version[pb] = t
		uf.parent[pb] = pa
	} else {
		uf.version[pa] = t
		uf.parent[pa] = pb
		if uf.rank[pa] == uf.rank[pb] {
			uf.rank[pb]++
		}
	}

	return true
}

type DistanceLimitedPathsExist struct {
	puf *PersistentUnionFind
}

func Constructor(n int, edgeList [][]int) DistanceLimitedPathsExist {
	sort.Slice(edgeList, func(i, j int) bool {
		return edgeList[i][2] < edgeList[j][2]
	})

	puf := NewPersistentUnionFind(n)

	for _, edge := range edgeList {
		puf.union(edge[0], edge[1], edge[2])
	}

	return DistanceLimitedPathsExist{
		puf: puf,
	}
}

func (dle *DistanceLimitedPathsExist) Query(p, q, limit int) bool {
	return dle.puf.find(p, limit) == dle.puf.find(q, limit)
}

/**
 * Your DistanceLimitedPathsExist object will be instantiated and called as such:
 * obj := Constructor(n, edgeList);
 * param_1 := obj.Query(p,q,limit);
*/1756. 设计最近使用(MRU)队列 🔒
题目、示例与约束
设计一种类似队列的数据结构,该数据结构将最近使用的元素移到队列尾部。
实现 MRUQueue 类:
MRUQueue(int n)使用n个元素:[1,2,3,...,n]构造MRUQueue。fetch(int k)将第k个元素(从 1 开始索引)移到队尾,并返回该元素。
示例 1:
输入:
["MRUQueue", "fetch", "fetch", "fetch", "fetch"]
[[8], [3], [5], [2], [8]]
输出:
[null, 3, 6, 2, 2]

解释:
MRUQueue mRUQueue = new MRUQueue(8); // 初始化队列为 [1,2,3,4,5,6,7,8]。
mRUQueue.fetch(3); // 将第 3 个元素 (3) 移到队尾,使队列变为 [1,2,4,5,6,7,8,3] 并返回该元素。
mRUQueue.fetch(5); // 将第 5 个元素 (6) 移到队尾,使队列变为 [1,2,4,5,7,8,3,6] 并返回该元素。
mRUQueue.fetch(2); // 将第 2 个元素 (2) 移到队尾,使队列变为 [1,4,5,7,8,3,6,2] 并返回该元素。
mRUQueue.fetch(8); // 第 8 个元素 (2) 已经在队列尾部了,所以直接返回该元素即可。
提示:
1 <= n <= 20001 <= k <= n- 最多调用
2000次fetch
进阶:找到每次
fetch 的复杂度为 O(n) 的算法比较简单。你可以找到每次 fetch 的复杂度更佳的算法吗?方法二:树状数组 + 二分查找 · Go 实现
思考
方法一每次删除是线性的。若不真正删除、只在末尾追加,则需快速定位「逻辑上的第 个未删除位置」。
树状数组记录各下标被移走的次数,二分第一个满足 的 ,将该值追加到 末尾并在 处标记删除。单次 。
我们用一个数组 维护当前队列中的元素,移动第 个元素时,我们考虑不删除该元素,而是直接将其追加到数组末尾。如果不删除,我们如何知道第 个元素在数组 中的位置呢?
我们可以用一个树状数组维护数组 中每个位置的元素是否被删除,如果第 个位置的元素被删除,那么我们更新树状数组中的第 个位置,表示该位置被移动的次数增加 。这样,我们每次要删除第 个元素时,可以用二分查找,找到第一个满足 的位置 ,即为第 个元素在数组 中的位置。不妨记 ,那么我们将 追加到数组 的末尾,同时更新树状数组中第 个位置的值,表示该位置被移动的次数增加 。最后,我们返回 即可。
时间复杂度 ,空间复杂度 。其中 为队列的长度。
type BinaryIndexedTree struct {
	n int
	c []int
}

func newBinaryIndexedTree(n int) *BinaryIndexedTree {
	c := make([]int, n+1)
	return &BinaryIndexedTree{n, c}
}

func (this *BinaryIndexedTree) update(x, delta int) {
	for x <= this.n {
		this.c[x] += delta
		x += x & -x
	}
}

func (this *BinaryIndexedTree) query(x int) int {
	s := 0
	for x > 0 {
		s += this.c[x]
		x -= x & -x
	}
	return s
}

type MRUQueue struct {
	q    []int
	tree *BinaryIndexedTree
}

func Constructor(n int) MRUQueue {
	q := make([]int, n+1)
	for i := 1; i <= n; i++ {
		q[i] = i
	}
	return MRUQueue{q, newBinaryIndexedTree(n + 2010)}
}

func (this *MRUQueue) Fetch(k int) int {
	l, r := 1, len(this.q)
	for l < r {
		mid := (l + r) >> 1
		if mid-this.tree.query(mid) >= k {
			r = mid
		} else {
			l = mid + 1
		}
	}
	x := this.q[l]
	this.q = append(this.q, x)
	this.tree.update(l, 1)
	return x
}

/**
 * Your MRUQueue object will be instantiated and called as such:
 * obj := Constructor(n);
 * param_1 := obj.Fetch(k);
*/1797. 设计一个验证系统
题目、示例与约束
你需要设计一个包含验证码的验证系统。每一次验证中,用户会收到一个新的验证码,这个验证码在 currentTime 时刻之后 timeToLive 秒过期。如果验证码被更新了,那么它会在 currentTime (可能与之前的 currentTime 不同)时刻延长 timeToLive 秒。
请你实现 AuthenticationManager 类:
AuthenticationManager(int timeToLive)构造AuthenticationManager并设置timeToLive参数。generate(string tokenId, int currentTime)给定tokenId,在当前时间currentTime生成一个新的验证码。renew(string tokenId, int currentTime)将给定tokenId且 未过期 的验证码在currentTime时刻更新。如果给定tokenId对应的验证码不存在或已过期,请你忽略该操作,不会有任何更新操作发生。countUnexpiredTokens(int currentTime)请返回在给定currentTime时刻,未过期 的验证码数目。
如果一个验证码在时刻 t 过期,且另一个操作恰好在时刻 t 发生(renew 或者 countUnexpiredTokens 操作),过期事件 优先于 其他操作。
示例 1:
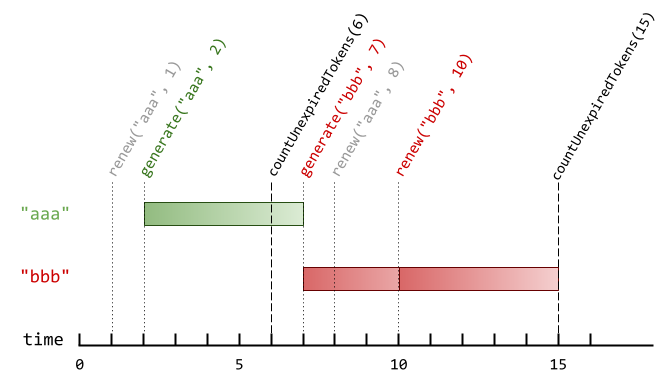
输入: ["AuthenticationManager", "renew", "generate", "countUnexpiredTokens", "generate", "renew", "renew", "countUnexpiredTokens"] [[5], ["aaa", 1], ["aaa", 2], [6], ["bbb", 7], ["aaa", 8], ["bbb", 10], [15]] 输出: [null, null, null, 1, null, null, null, 0] 解释: AuthenticationManager authenticationManager = new AuthenticationManager(5); // 构造 AuthenticationManager ,设置timeToLive= 5 秒。 authenticationManager.renew("aaa", 1); // 时刻 1 时,没有验证码的 tokenId 为 "aaa" ,没有验证码被更新。 authenticationManager.generate("aaa", 2); // 时刻 2 时,生成一个 tokenId 为 "aaa" 的新验证码。 authenticationManager.countUnexpiredTokens(6); // 时刻 6 时,只有 tokenId 为 "aaa" 的验证码未过期,所以返回 1 。 authenticationManager.generate("bbb", 7); // 时刻 7 时,生成一个 tokenId 为 "bbb" 的新验证码。 authenticationManager.renew("aaa", 8); // tokenId 为 "aaa" 的验证码在时刻 7 过期,且 8 >= 7 ,所以时刻 8 的renew 操作被忽略,没有验证码被更新。 authenticationManager.renew("bbb", 10); // tokenId 为 "bbb" 的验证码在时刻 10 没有过期,所以 renew 操作会执行,该 token 将在时刻 15 过期。 authenticationManager.countUnexpiredTokens(15); // tokenId 为 "bbb" 的验证码在时刻 15 过期,tokenId 为 "aaa" 的验证码在时刻 7 过期,所有验证码均已过期,所以返回 0 。
提示:
1 <= timeToLive <= 1081 <= currentTime <= 1081 <= tokenId.length <= 5tokenId只包含小写英文字母。- 所有
generate函数的调用都会包含独一无二的tokenId值。 - 所有函数调用中,
currentTime的值 严格递增 。 - 所有函数的调用次数总共不超过
2000次。
方法一:哈希表 · Go 实现
思考
验证码在生成或续期后于 过期。操作次数有限,用哈希表存过期时刻即可。
生成直接写入;续期仅当尚未过期;计数则扫表统计过期时刻大于查询时刻的条目。
我们可以简单维护一个哈希表 ,键为 tokenId,值为过期时间。
generate操作时,将tokenId作为键,currentTime + timeToLive作为值存入哈希表 中。renew操作时,如果tokenId不在哈希表 中,或者currentTime >= d[tokenId],则忽略该操作;否则,更新d[tokenId]为currentTime + timeToLive。countUnexpiredTokens操作时,遍历哈希表 ,统计未过期的tokenId个数。
时间复杂度方面,generate 和 renew 操作的时间复杂度均为 ,countUnexpiredTokens 操作的时间复杂度为 ,其中 为哈希表 的键值对个数。
空间复杂度为 ,其中 为哈希表 的键值对个数。
type AuthenticationManager struct {
	t int
	d map[string]int
}

func Constructor(timeToLive int) AuthenticationManager {
	return AuthenticationManager{timeToLive, map[string]int{}}
}

func (this *AuthenticationManager) Generate(tokenId string, currentTime int) {
	this.d[tokenId] = currentTime + this.t
}

func (this *AuthenticationManager) Renew(tokenId string, currentTime int) {
	if v, ok := this.d[tokenId]; !ok || v <= currentTime {
		return
	}
	this.Generate(tokenId, currentTime)
}

func (this *AuthenticationManager) CountUnexpiredTokens(currentTime int) int {
	ans := 0
	for _, exp := range this.d {
		if exp > currentTime {
			ans++
		}
	}
	return ans
}

/**
 * Your AuthenticationManager object will be instantiated and called as such:
 * obj := Constructor(timeToLive);
 * obj.Generate(tokenId,currentTime);
 * obj.Renew(tokenId,currentTime);
 * param_3 := obj.CountUnexpiredTokens(currentTime);
*/1804. 实现 Trie (前缀树) II 🔒
题目、示例与约束
前缀树(trie ,发音为 "try")是一个树状的数据结构,用于高效地存储和检索一系列字符串的前缀。前缀树有许多应用,如自动补全和拼写检查。
实现前缀树 Trie 类:
Trie()初始化前缀树对象。void insert(String word)将字符串word插入前缀树中。int countWordsEqualTo(String word)返回前缀树中字符串word的实例个数。int countWordsStartingWith(String prefix)返回前缀树中以prefix为前缀的字符串个数。void erase(String word)从前缀树中移除字符串word。
示例 1:
输入
["Trie", "insert", "insert", "countWordsEqualTo", "countWordsStartingWith", "erase", "countWordsEqualTo", "countWordsStartingWith", "erase", "countWordsStartingWith"]
[[], ["apple"], ["apple"], ["apple"], ["app"], ["apple"], ["apple"], ["app"], ["apple"], ["app"]]
输出
[null, null, null, 2, 2, null, 1, 1, null, 0]

解释
Trie trie = new Trie();
trie.insert("apple");               // 插入 "apple"。
trie.insert("apple");               // 插入另一个 "apple"。
trie.countWordsEqualTo("apple");    // 有两个 "apple" 实例,所以返回 2。
trie.countWordsStartingWith("app"); // "app" 是 "apple" 的前缀,所以返回 2。
trie.erase("apple");                // 移除一个 "apple"。
trie.countWordsEqualTo("apple");    // 现在只有一个 "apple" 实例,所以返回 1。
trie.countWordsStartingWith("app"); // 返回 1
trie.erase("apple");                // 移除 "apple"。现在前缀树是空的。
trie.countWordsStartingWith("app"); // 返回 0
提示:
1 <= word.length, prefix.length <= 2000word和prefix只包含小写英文字母。insert、countWordsEqualTo、countWordsStartingWith和erase总共调用最多3 * 104次。- 保证每次调用
erase时,字符串word总是存在于前缀树中。
方法一:数组实现前缀树 · Go 实现
思考
普通前缀树只回答「是否存在」,本题还要返回某单词的出现次数、某前缀下的单词个数,并支持删除。若每次查询都扫描全部已插入字符串,操作次数与串长的乘积会过大。
在每个节点额外维护两个计数: 为以此节点结尾的单词次数, 为经过该节点的单词次数。插入时沿路径累加 ,终点累加 ;查询单词或前缀只需走到对应节点读取计数;删除则沿路径递减,从而各操作仍与单词长度成正比。
前缀树每个节点包括三部分:
- 指向子节点的指针数组 children,对于本题而言,数组长度为 26,即小写英文字母的数量。
children[0]对应小写字母 a,...,children[25]对应小写字母 z。 - int 变量
v,表示以该节点结尾的字符串个数。 - int 变量
pv,表示以该节点作为前缀节点的字符串个数。
1. 插入字符串
我们从字典树的根开始,插入字符串。对于当前字符对应的子节点,有两种情况:
- 子节点存在。沿着指针移动到子节点,继续处理下一个字符。
- 子节点不存在。创建一个新的子节点,记录在
children数组的对应位置上,然后沿着指针移动到子节点,让子节点的pv值加 1。继续搜索下一个字符。
重复以上步骤,直到处理字符串的最后一个字符,然后将当前节点的 v 值加 1。
时间复杂度 ,其中 为字符串的长度。
2. 查找前缀
我们从字典树的根开始,查找前缀。对于当前字符对应的子节点,有两种情况:
- 子节点存在。沿着指针移动到子节点,继续搜索下一个字符。
- 子节点不存在。说明字典树中不包含该前缀,返回空指针。
重复以上步骤,直到返回空指针或搜索完前缀的最后一个字符。
时间复杂度 ,其中 为字符串的长度。
3. 移除字符串
我们从字典树的根节点开始,依次将对应的子节点的 pv 值减 1,直到搜索完字符串的最后一个字符。然后将当前节点的 v 值减 1。
时间复杂度 ,其中 为字符串的长度。
type Trie struct {
	children [26]*Trie
	v        int
	pv       int
}

func Constructor() (_ Trie) { return }

func (this *Trie) Insert(word string) {
	node := this
	for _, c := range word {
		c -= 'a'
		if node.children[c] == nil {
			node.children[c] = &Trie{}
		}
		node = node.children[c]
		node.pv++
	}
	node.v++
}

func (this *Trie) CountWordsEqualTo(word string) int {
	node := this.search(word)
	if node == nil {
		return 0
	}
	return node.v
}

func (this *Trie) CountWordsStartingWith(prefix string) int {
	node := this.search(prefix)
	if node == nil {
		return 0
	}
	return node.pv
}

func (this *Trie) Erase(word string) {
	node := this
	for _, c := range word {
		c -= 'a'
		node = node.children[c]
		node.pv--
	}
	node.v--
}

func (this *Trie) search(word string) *Trie {
	node := this
	for _, c := range word {
		c -= 'a'
		if node.children[c] == nil {
			return nil
		}
		node = node.children[c]
	}
	return node
}

/**
 * Your Trie object will be instantiated and called as such:
 * obj := Constructor();
 * obj.Insert(word);
 * param_2 := obj.CountWordsEqualTo(word);
 * param_3 := obj.CountWordsStartingWith(prefix);
 * obj.Erase(word);
*/1825. 求出 MK 平均值
题目、示例与约束
给你两个整数 m 和 k ,以及数据流形式的若干整数。你需要实现一个数据结构,计算这个数据流的 MK 平均值 。
MK 平均值 按照如下步骤计算:
- 如果数据流中的整数少于
m个,MK 平均值 为-1,否则将数据流中最后m个元素拷贝到一个独立的容器中。 - 从这个容器中删除最小的
k个数和最大的k个数。 - 计算剩余元素的平均值,并 向下取整到最近的整数 。
请你实现 MKAverage 类:
MKAverage(int m, int k)用一个空的数据流和两个整数m和k初始化 MKAverage 对象。void addElement(int num)往数据流中插入一个新的元素num。int calculateMKAverage()对当前的数据流计算并返回 MK 平均数 ,结果需 向下取整到最近的整数 。
示例 1:
输入:
["MKAverage", "addElement", "addElement", "calculateMKAverage", "addElement", "calculateMKAverage", "addElement", "addElement", "addElement", "calculateMKAverage"]
[[3, 1], [3], [1], [], [10], [], [5], [5], [5], []]
输出:
[null, null, null, -1, null, 3, null, null, null, 5]

解释:
MKAverage obj = new MKAverage(3, 1);
obj.addElement(3);        // 当前元素为 [3]
obj.addElement(1);        // 当前元素为 [3,1]
obj.calculateMKAverage(); // 返回 -1 ,因为 m = 3 ,但数据流中只有 2 个元素
obj.addElement(10);       // 当前元素为 [3,1,10]
obj.calculateMKAverage(); // 最后 3 个元素为 [3,1,10]
                          // 删除最小以及最大的 1 个元素后,容器为 [3]
                          // [3] 的平均值等于 3/1 = 3 ,故返回 3
obj.addElement(5);        // 当前元素为 [3,1,10,5]
obj.addElement(5);        // 当前元素为 [3,1,10,5,5]
obj.addElement(5);        // 当前元素为 [3,1,10,5,5,5]
obj.calculateMKAverage(); // 最后 3 个元素为 [5,5,5]
                          // 删除最小以及最大的 1 个元素后,容器为 [5]
                          // [5] 的平均值等于 5/1 = 5 ,故返回 5
提示:
3 <= m <= 1051 <= k*2 < m1 <= num <= 105addElement与calculateMKAverage总操作次数不超过105次。
方法一:有序集合 + 队列 · Go 实现
思考
要对长度为 的窗口去掉最小与最大各 个数后求平均,且插入频繁。若每次对窗口排序,单次为 ,操作次数大时无法接受。
用队列保存插入顺序,并用三个有序集合分别存放最小 个、中间一段与最大 个,同时维护中间和 。插入或弹出后把溢出的元素在三个集合之间搬移,使两端长度回到 。平均数即为 。
我们可以维护以下数据结构或变量:
- 一个长度为 的队列 ,其中队首元素为最早加入的元素,队尾元素为最近加入的元素;
- 三个有序集合,分别为 , , ,其中 和 分别存储最小的 个元素和最大的 个元素,而 存储剩余的元素;
- 一个变量 ,维护 中所有元素的和;
- 部分编程语言(如 Java, Go)额外维护两个变量 和 ,分别表示 和 中元素的个数。
调用 函数时,顺序执行以下操作:
- 如果 为空,或者 ,则将 加入 中;否则如果 为空,或者 ,则将 加入 中;否则将 加入 中,同时将 的值加到 中。
- 接下来将 加入队列 中,如果此时队列 的长度大于 ,则将队首元素 从队列 中移除,接下来从 , 或 中选择其中一个包含 的集合,将 从该集合中移除,如果该集合为 ,则将 减去 的值。
- 如果 的长度大于 ,则循环将 中的最大值 从 中移除,将 加入 中,同时将 加上 的值。
- 如果 的长度大于 ,则循环将 中的最小值 从 中移除,将 加入 中,同时将 加上 的值。
- 如果 的长度小于 ,并且 不为空,则循环将 中的最小值 从 中移除,将 加入 中,同时将 减去 的值。
- 如果 的长度小于 ,并且 不为空,则循环将 中的最大值 从 中移除,将 加入 中,同时将 减去 的值。
调用 函数时,如果 的长度小于 ,则返回 ,否则返回 。
时间复杂度方面,每次调用 函数的时间复杂度为 ,每次调用 函数的时间复杂度为 。空间复杂度为 。
type MKAverage struct {
	lo, mid, hi  *redblacktree.Tree
	q            []int
	m, k, s      int
	size1, size3 int
}

func Constructor(m int, k int) MKAverage {
	lo := redblacktree.NewWithIntComparator()
	mid := redblacktree.NewWithIntComparator()
	hi := redblacktree.NewWithIntComparator()
	return MKAverage{lo, mid, hi, []int{}, m, k, 0, 0, 0}
}

func (this *MKAverage) AddElement(num int) {
	merge := func(rbt *redblacktree.Tree, key, value int) {
		if v, ok := rbt.Get(key); ok {
			nxt := v.(int) + value
			if nxt == 0 {
				rbt.Remove(key)
			} else {
				rbt.Put(key, nxt)
			}
		} else {
			rbt.Put(key, value)
		}
	}

	if this.lo.Empty() || num <= this.lo.Right().Key.(int) {
		merge(this.lo, num, 1)
		this.size1++
	} else if this.hi.Empty() || num >= this.hi.Left().Key.(int) {
		merge(this.hi, num, 1)
		this.size3++
	} else {
		merge(this.mid, num, 1)
		this.s += num
	}
	this.q = append(this.q, num)
	if len(this.q) > this.m {
		x := this.q[0]
		this.q = this.q[1:]
		if _, ok := this.lo.Get(x); ok {
			merge(this.lo, x, -1)
			this.size1--
		} else if _, ok := this.hi.Get(x); ok {
			merge(this.hi, x, -1)
			this.size3--
		} else {
			merge(this.mid, x, -1)
			this.s -= x
		}
	}
	for ; this.size1 > this.k; this.size1-- {
		x := this.lo.Right().Key.(int)
		merge(this.lo, x, -1)
		merge(this.mid, x, 1)
		this.s += x
	}
	for ; this.size3 > this.k; this.size3-- {
		x := this.hi.Left().Key.(int)
		merge(this.hi, x, -1)
		merge(this.mid, x, 1)
		this.s += x
	}
	for ; this.size1 < this.k && !this.mid.Empty(); this.size1++ {
		x := this.mid.Left().Key.(int)
		merge(this.mid, x, -1)
		this.s -= x
		merge(this.lo, x, 1)
	}
	for ; this.size3 < this.k && !this.mid.Empty(); this.size3++ {
		x := this.mid.Right().Key.(int)
		merge(this.mid, x, -1)
		this.s -= x
		merge(this.hi, x, 1)
	}
}

func (this *MKAverage) CalculateMKAverage() int {
	if len(this.q) < this.m {
		return -1
	}
	return this.s / (this.m - 2*this.k)
}

/**
 * Your MKAverage object will be instantiated and called as such:
 * obj := Constructor(m, k);
 * obj.AddElement(num);
 * param_2 := obj.CalculateMKAverage();
 */
方法二:单有序集合 + 滑动窗口 · Go 实现
思考
方法一要同时维护三棵有序树,实现与平衡条件较繁。也可以只保留一个有序集合表示整个窗口:窗口刚满时建表并累加中间和,之后根据新元素、旧元素落入的名次增量调整 。结构更简单,单次仍是对数时间。
用一个队列记录插入顺序,再用一个有序集合维护当前长度为 的窗口。窗口刚满时一次性建表,并累加去掉最小、最大各 个元素后的中间和;之后每次插入或删除时,根据元素在有序集合中的位置增量调整中间和。
与方法一把窗口拆成三个集合不同,这里只维护一份有序序列。
时间复杂度方面,每次调用 为 ,每次调用 为 。空间复杂度为 。
Java、C++、Go 中 ,用树状数组维护频次即可在对数时间内完成名次查询与第 小查询,语义与有序集合一致。
type MKAverage struct {
	m, k int
	s    int
	q    []int
	c    []int
}

func Constructor(m int, k int) MKAverage {
	return MKAverage{m: m, k: k, c: make([]int, 100001)}
}

func (this *MKAverage) AddElement(num int) {
	this.q = append(this.q, num)
	if len(this.q) == this.m {
		for _, x := range this.q {
			this.update(x, 1)
		}
		for i := this.k; i < this.m-this.k; i++ {
			this.s += this.kth(i)
		}
	} else if len(this.q) > this.m {
		i := this.rank(num)
		if i < this.k {
			this.s += this.kth(this.k - 1)
		} else if i <= this.m-this.k {
			this.s += num
		} else {
			this.s += this.kth(this.m - this.k)
		}
		this.update(num, 1)

		x := this.q[0]
		this.q = this.q[1:]
		i = this.rank(x)
		if i < this.k {
			this.s -= this.kth(this.k)
		} else if i <= this.m-this.k {
			this.s -= x
		} else {
			this.s -= this.kth(this.m - this.k)
		}
		this.update(x, -1)
	}
}

func (this *MKAverage) CalculateMKAverage() int {
	if len(this.q) < this.m {
		return -1
	}
	return this.s / (this.m - this.k*2)
}

func (this *MKAverage) update(x, d int) {
	for ; x < len(this.c); x += x & -x {
		this.c[x] += d
	}
}

func (this *MKAverage) query(x int) (ans int) {
	for ; x > 0; x -= x & -x {
		ans += this.c[x]
	}
	return
}

func (this *MKAverage) rank(x int) int {
	return this.query(x - 1)
}

func (this *MKAverage) kth(k int) int {
	need, idx := k+1, 0
	for p := 1 << 16; p > 0; p >>= 1 {
		nxt := idx + p
		if nxt < len(this.c) && this.c[nxt] < need {
			need -= this.c[nxt]
			idx = nxt
		}
	}
	return idx + 1
}1845. 座位预约管理系统
题目、示例与约束
请你设计一个管理 n 个座位预约的系统,座位编号从 1 到 n 。
请你实现 SeatManager 类:
SeatManager(int n)初始化一个SeatManager对象,它管理从1到n编号的n个座位。所有座位初始都是可预约的。int reserve()返回可以预约座位的 最小编号 ,此座位变为不可预约。void unreserve(int seatNumber)将给定编号seatNumber对应的座位变成可以预约。
示例 1:
输入:
["SeatManager", "reserve", "reserve", "unreserve", "reserve", "reserve", "reserve", "reserve", "unreserve"]
[[5], [], [], [2], [], [], [], [], [5]]
输出:
[null, 1, 2, null, 2, 3, 4, 5, null]

解释:
SeatManager seatManager = new SeatManager(5); // 初始化 SeatManager ,有 5 个座位。
seatManager.reserve();    // 所有座位都可以预约,所以返回最小编号的座位,也就是 1 。
seatManager.reserve();    // 可以预约的座位为 [2,3,4,5] ,返回最小编号的座位,也就是 2 。
seatManager.unreserve(2); // 将座位 2 变为可以预约,现在可预约的座位为 [2,3,4,5] 。
seatManager.reserve();    // 可以预约的座位为 [2,3,4,5] ,返回最小编号的座位,也就是 2 。
seatManager.reserve();    // 可以预约的座位为 [3,4,5] ,返回最小编号的座位,也就是 3 。
seatManager.reserve();    // 可以预约的座位为 [4,5] ,返回最小编号的座位,也就是 4 。
seatManager.reserve();    // 唯一可以预约的是座位 5 ,所以返回 5 。
seatManager.unreserve(5); // 将座位 5 变为可以预约,现在可预约的座位为 [5] 。
提示:
1 <= n <= 1051 <= seatNumber <= n- 每一次对
reserve的调用,题目保证至少存在一个可以预约的座位。 - 每一次对
unreserve的调用,题目保证seatNumber在调用函数前都是被预约状态。 - 对
reserve和unreserve的调用 总共 不超过105次。
方法一:优先队列(小根堆) · Go 实现
思考
要反复取出当前最小的空闲座位,并支持归还。若每次在布尔数组上扫描最小空位,单次可达 ,操作次数大时偏慢。
把全部空闲编号放进小根堆, 弹出堆顶, 把编号推回。两端操作均为对数时间。
我们定义一个优先队列(小根堆) ,用于存储所有可预约的座位编号。初始时,我们将 到 的所有座位编号加入到 中。
调用 reserve 方法时,我们从 中弹出堆顶元素,即可预约的座位编号的最小值。
调用 unreserve 方法时,我们将座位编号加入到 中。
时间复杂度方面,初始化的时间复杂度为 或 ,reserve 和 unreserve 方法的时间复杂度均为 。空间复杂度为 。
type SeatManager struct {
	q hp
}

func Constructor(n int) SeatManager {
	q := hp{}
	for i := 1; i <= n; i++ {
		heap.Push(&q, i)
	}
	return SeatManager{q}
}

func (this *SeatManager) Reserve() int {
	return heap.Pop(&this.q).(int)
}

func (this *SeatManager) Unreserve(seatNumber int) {
	heap.Push(&this.q, seatNumber)
}

type hp struct{ sort.IntSlice }

func (h hp) Less(i, j int) bool { return h.IntSlice[i] < h.IntSlice[j] }
func (h *hp) Push(v any)        { h.IntSlice = append(h.IntSlice, v.(int)) }
func (h *hp) Pop() any {
	a := h.IntSlice
	v := a[len(a)-1]
	h.IntSlice = a[:len(a)-1]
	return v
}

/**
 * Your SeatManager object will be instantiated and called as such:
 * obj := Constructor(n);
 * param_1 := obj.Reserve();
 * obj.Unreserve(seatNumber);
*/1865. 找出和为指定值的下标对
题目、示例与约束
给你两个整数数组 nums1 和 nums2 ,请你实现一个支持下述两类查询的数据结构:
- 累加 ,将一个正整数加到
nums2中指定下标对应元素上。 - 计数 ,统计满足
nums1[i] + nums2[j]等于指定值的下标对(i, j)数目(0 <= i < nums1.length且0 <= j < nums2.length)。
实现 FindSumPairs 类:
FindSumPairs(int[] nums1, int[] nums2)使用整数数组nums1和nums2初始化FindSumPairs对象。void add(int index, int val)将val加到nums2[index]上,即,执行nums2[index] += val。int count(int tot)返回满足nums1[i] + nums2[j] == tot的下标对(i, j)数目。
示例:
输入:
["FindSumPairs", "count", "add", "count", "count", "add", "add", "count"]
[[[1, 1, 2, 2, 2, 3], [1, 4, 5, 2, 5, 4]], [7], [3, 2], [8], [4], [0, 1], [1, 1], [7]]
输出:
[null, 8, null, 2, 1, null, null, 11]

解释:
FindSumPairs findSumPairs = new FindSumPairs([1, 1, 2, 2, 2, 3], [1, 4, 5, 2, 5, 4]);
findSumPairs.count(7);  // 返回 8 ; 下标对 (2,2), (3,2), (4,2), (2,4), (3,4), (4,4) 满足 2 + 5 = 7 ,下标对 (5,1), (5,5) 满足 3 + 4 = 7
findSumPairs.add(3, 2); // 此时 nums2 = [1,4,5,4,5,4]
findSumPairs.count(8);  // 返回 2 ;下标对 (5,2), (5,4) 满足 3 + 5 = 8
findSumPairs.count(4);  // 返回 1 ;下标对 (5,0) 满足 3 + 1 = 4
findSumPairs.add(0, 1); // 此时 nums2 = [2,4,5,4,5,4]
findSumPairs.add(1, 1); // 此时 nums2 = [2,5,5,4,5,4]
findSumPairs.count(7);  // 返回 11 ;下标对 (2,1), (2,2), (2,4), (3,1), (3,2), (3,4), (4,1), (4,2), (4,4) 满足 2 + 5 = 7 ,下标对 (5,3), (5,5) 满足 3 + 4 = 7
提示:
1 <= nums1.length <= 10001 <= nums2.length <= 1051 <= nums1[i] <= 1091 <= nums2[i] <= 1050 <= index < nums2.length1 <= val <= 1051 <= tot <= 109- 最多调用
add和count函数各1000次
方法一:哈希表 · Go 实现
思考
要支持修改 的一个元素,并查询 的对数。 很长,每次查询双层枚举不可行。
长度不超过 ,对其枚举即可。用哈希表维护 的频次: 对每个 累加 ; 时先减旧值再加新值。
我们注意到,数组 的长度不超过 ,数组 的长度达到 ,因此,如果直接暴力枚举所有下标对 ,计算 是否等于指定值 ,那么会超出时间限制。
能否只枚举长度较短的数组 呢?答案是可以的。我们用一个哈希表 统计数组 中每个元素出现的次数,然后枚举数组 中的每个元素 ,计算 的值之和即可。
在调用 方法时,我们需要先将 对应的值从 中减去 ,然后将 的值加上 ,最后将 对应的值加上 。
在调用 方法时,我们只需要遍历数组 ,对于每个元素 ,计算 的值之和即可。
时间复杂度 ,空间复杂度 。其中 和 分别是数组 和 的长度,而 是调用 方法的次数。
type FindSumPairs struct {
	nums1 []int
	nums2 []int
	cnt   map[int]int
}

func Constructor(nums1 []int, nums2 []int) FindSumPairs {
	cnt := map[int]int{}
	for _, x := range nums2 {
		cnt[x]++
	}
	return FindSumPairs{nums1, nums2, cnt}
}

func (this *FindSumPairs) Add(index int, val int) {
	this.cnt[this.nums2[index]]--
	this.nums2[index] += val
	this.cnt[this.nums2[index]]++
}

func (this *FindSumPairs) Count(tot int) (ans int) {
	for _, x := range this.nums1 {
		ans += this.cnt[tot-x]
	}
	return
}

/**
 * Your FindSumPairs object will be instantiated and called as such:
 * obj := Constructor(nums1, nums2);
 * obj.Add(index,val);
 * param_2 := obj.Count(tot);
*/1912. 设计电影租借系统
题目、示例与约束
你有一个电影租借公司和 n 个电影商店。你想要实现一个电影租借系统,它支持查询、预订和返还电影的操作。同时系统还能生成一份当前被借出电影的报告。
所有电影用二维整数数组 entries 表示,其中 entries[i] = [shopi, moviei, pricei] 表示商店 shopi 有一份电影 moviei 的拷贝,租借价格为 pricei 。每个商店有 至多一份 编号为 moviei 的电影拷贝。
系统需要支持以下操作:
- Search:找到拥有指定电影且 未借出 的商店中 最便宜的 5 个 。商店需要按照 价格 升序排序,如果价格相同,则
shopi较小 的商店排在前面。如果查询结果少于 5 个商店,则将它们全部返回。如果查询结果没有任何商店,则返回空列表。 - Rent:从指定商店借出指定电影,题目保证指定电影在指定商店 未借出 。
- Drop:在指定商店返还 之前已借出 的指定电影。
- Report:返回 最便宜的 5 部已借出电影 (可能有重复的电影 ID),将结果用二维列表
res返回,其中res[j] = [shopj, moviej]表示第j便宜的已借出电影是从商店shopj借出的电影moviej。res中的电影需要按 价格 升序排序;如果价格相同,则shopj较小 的排在前面;如果仍然相同,则moviej较小 的排在前面。如果当前借出的电影小于 5 部,则将它们全部返回。如果当前没有借出电影,则返回一个空的列表。
请你实现 MovieRentingSystem 类:
MovieRentingSystem(int n, int[][] entries)将MovieRentingSystem对象用n个商店和entries表示的电影列表初始化。List<Integer> search(int movie)如上所述,返回 未借出 指定movie的商店列表。void rent(int shop, int movie)从指定商店shop借出指定电影movie。void drop(int shop, int movie)在指定商店shop返还之前借出的电影movie。List<List<Integer>> report()如上所述,返回最便宜的 已借出 电影列表。
注意:测试数据保证 rent 操作中指定商店拥有 未借出 的指定电影,且 drop 操作指定的商店 之前已借出 指定电影。
示例 1:
输入:
["MovieRentingSystem", "search", "rent", "rent", "report", "drop", "search"]
[[3, [[0, 1, 5], [0, 2, 6], [0, 3, 7], [1, 1, 4], [1, 2, 7], [2, 1, 5]]], [1], [0, 1], [1, 2], [], [1, 2], [2]]
输出:
[null, [1, 0, 2], null, null, [[0, 1], [1, 2]], null, [0, 1]]

解释:
MovieRentingSystem movieRentingSystem = new MovieRentingSystem(3, [[0, 1, 5], [0, 2, 6], [0, 3, 7], [1, 1, 4], [1, 2, 7], [2, 1, 5]]);
movieRentingSystem.search(1);  // 返回 [1, 0, 2] ,商店 1,0 和 2 有未借出的 ID 为 1 的电影。商店 1 最便宜,商店 0 和 2 价格相同,所以按商店编号排序。
movieRentingSystem.rent(0, 1); // 从商店 0 借出电影 1 。现在商店 0 未借出电影编号为 [2,3] 。
movieRentingSystem.rent(1, 2); // 从商店 1 借出电影 2 。现在商店 1 未借出的电影编号为 [1] 。
movieRentingSystem.report();   // 返回 [[0, 1], [1, 2]] 。商店 0 借出的电影 1 最便宜,然后是商店 1 借出的电影 2 。
movieRentingSystem.drop(1, 2); // 在商店 1 返还电影 2 。现在商店 1 未借出的电影编号为 [1,2] 。
movieRentingSystem.search(2);  // 返回 [0, 1] 。商店 0 和 1 有未借出的 ID 为 2 的电影。商店 0 最便宜,然后是商店 1 。
提示:
1 <= n <= 3 * 1051 <= entries.length <= 1050 <= shopi < n1 <= moviei, pricei <= 104- 每个商店 至多 有一份电影
moviei的拷贝。 search,rent,drop和report的调用 总共 不超过105次。
方法一:有序集合 · Go 实现
思考
与 都要按价格、店铺、影片的字典序取前五,且租还会频繁改集合。每次全表排序在 达 时不可行。
未租出影片按 分桶,桶内以 有序;已租出影片放在全局有序集 。价格另用哈希记下,以便 取到排序键。
租出即从对应桶删除并插入全局集,归还则反向操作。前五元素可直接切片,单次更新为对数时间。
我们定义一个有序集合 ,其中 存储所有未借出的电影 的商店列表,列表中的元素为 ,并按照 升序排序,如果 相同,则按照 升序排序。
另外定义一个哈希表 ,其中 存储商店 中电影 的租借价格。
我们还定义一个有序集合 ,其中存储所有已借出的电影,元素为 ,并按照 升序排序,如果 相同,则按照 升序排序,如果 也相同,则按照 升序排序。
对于 操作,我们遍历 ,将每个商店的电影信息加入到 和 中。时间复杂度为 ,其中 是 的长度。
对于 操作,我们返回 中前 5 个商店的编号。时间复杂度为 。
对于 操作,我们从 中移除 ,并将 加入到 中。时间复杂度为 。
对于 操作,我们从 中移除 ,并将 加入到 中。时间复杂度为 。
对于 操作,我们返回 中前 5 个已借出电影的商店编号和电影编号。时间复杂度为 。
空间复杂度为 。其中 是 的长度。
type MovieRentingSystem struct {
	available map[int]*treeset.Set // movie -> (price, shop)
	priceMap  map[int64]int
	rented    *treeset.Set // (price, shop, movie)
}

func Constructor(n int, entries [][]int) MovieRentingSystem {
	// comparator for (price, shop)
	cmpAvail := func(a, b any) int {
		x := a.([2]int)
		y := b.([2]int)
		if x[0] != y[0] {
			return x[0] - y[0]
		}
		return x[1] - y[1]
	}
	// comparator for (price, shop, movie)
	cmpRented := func(a, b any) int {
		x := a.([3]int)
		y := b.([3]int)
		if x[0] != y[0] {
			return x[0] - y[0]
		}
		if x[1] != y[1] {
			return x[1] - y[1]
		}
		return x[2] - y[2]
	}

	mrs := MovieRentingSystem{
		available: make(map[int]*treeset.Set),
		priceMap:  make(map[int64]int),
		rented:    treeset.NewWith(cmpRented),
	}

	for _, e := range entries {
		shop, movie, price := e[0], e[1], e[2]
		if _, ok := mrs.available[movie]; !ok {
			mrs.available[movie] = treeset.NewWith(cmpAvail)
		}
		mrs.available[movie].Add([2]int{price, shop})
		mrs.priceMap[f(shop, movie)] = price
	}

	return mrs
}

func (this *MovieRentingSystem) Search(movie int) []int {
	res := []int{}
	if _, ok := this.available[movie]; !ok {
		return res
	}
	it := this.available[movie].Iterator()
	it.Begin()
	cnt := 0
	for it.Next() && cnt < 5 {
		pair := it.Value().([2]int)
		res = append(res, pair[1])
		cnt++
	}
	return res
}

func (this *MovieRentingSystem) Rent(shop int, movie int) {
	price := this.priceMap[f(shop, movie)]
	this.available[movie].Remove([2]int{price, shop})
	this.rented.Add([3]int{price, shop, movie})
}

func (this *MovieRentingSystem) Drop(shop int, movie int) {
	price := this.priceMap[f(shop, movie)]
	this.rented.Remove([3]int{price, shop, movie})
	this.available[movie].Add([2]int{price, shop})
}

func (this *MovieRentingSystem) Report() [][]int {
	res := [][]int{}
	it := this.rented.Iterator()
	it.Begin()
	cnt := 0
	for it.Next() && cnt < 5 {
		t := it.Value().([3]int)
		res = append(res, []int{t[1], t[2]})
		cnt++
	}
	return res
}

func f(shop, movie int) int64 {
	return (int64(shop) << 30) | int64(movie)
}

/**
 * Your MovieRentingSystem object will be instantiated and called as such:
 * obj := Constructor(n, entries);
 * param_1 := obj.Search(movie);
 * obj.Rent(shop,movie);
 * obj.Drop(shop,movie);
 * param_4 := obj.Report();
*/1993. 树上的操作
题目、示例与约束
给你一棵 n 个节点的树,编号从 0 到 n - 1 ,以父节点数组 parent 的形式给出,其中 parent[i] 是第 i 个节点的父节点。树的根节点为 0 号节点,所以 parent[0] = -1 ,因为它没有父节点。你想要设计一个数据结构实现树里面对节点的加锁,解锁和升级操作。
数据结构需要支持如下函数:
- Lock:指定用户给指定节点 上锁 ,上锁后其他用户将无法给同一节点上锁。只有当节点处于未上锁的状态下,才能进行上锁操作。
- Unlock:指定用户给指定节点 解锁 ,只有当指定节点当前正被指定用户锁住时,才能执行该解锁操作。
- Upgrade:指定用户给指定节点 上锁 ,并且将该节点的所有子孙节点 解锁 。只有如下 3 个条件 全部 满足时才能执行升级操作:
- 指定节点当前状态为未上锁。
- 指定节点至少有一个上锁状态的子孙节点(可以是 任意 用户上锁的)。
- 指定节点没有任何上锁的祖先节点。
请你实现 LockingTree 类:
LockingTree(int[] parent)用父节点数组初始化数据结构。lock(int num, int user)如果 id 为user的用户可以给节点num上锁,那么返回true,否则返回false。如果可以执行此操作,节点num会被 id 为user的用户 上锁 。unlock(int num, int user)如果 id 为user的用户可以给节点num解锁,那么返回true,否则返回false。如果可以执行此操作,节点num变为 未上锁 状态。upgrade(int num, int user)如果 id 为user的用户可以给节点num升级,那么返回true,否则返回false。如果可以执行此操作,节点num会被 升级 。
示例 1:
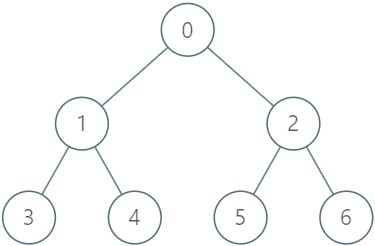
输入:
["LockingTree", "lock", "unlock", "unlock", "lock", "upgrade", "lock"]
[[[-1, 0, 0, 1, 1, 2, 2]], [2, 2], [2, 3], [2, 2], [4, 5], [0, 1], [0, 1]]
输出:
[null, true, false, true, true, true, false]

解释:
LockingTree lockingTree = new LockingTree([-1, 0, 0, 1, 1, 2, 2]);
lockingTree.lock(2, 2);    // 返回 true ,因为节点 2 未上锁。
                           // 节点 2 被用户 2 上锁。
lockingTree.unlock(2, 3);  // 返回 false ,因为用户 3 无法解锁被用户 2 上锁的节点。
lockingTree.unlock(2, 2);  // 返回 true ,因为节点 2 之前被用户 2 上锁。
                           // 节点 2 现在变为未上锁状态。
lockingTree.lock(4, 5);    // 返回 true ,因为节点 4 未上锁。
                           // 节点 4 被用户 5 上锁。
lockingTree.upgrade(0, 1); // 返回 true ,因为节点 0 未上锁且至少有一个被上锁的子孙节点(节点 4)。
                           // 节点 0 被用户 1 上锁,节点 4 变为未上锁。
lockingTree.lock(0, 1);    // 返回 false ,因为节点 0 已经被上锁了。
提示:
n == parent.length2 <= n <= 2000- 对于
i != 0,满足0 <= parent[i] <= n - 1 parent[0] == -10 <= num <= n - 11 <= user <= 104parent表示一棵合法的树。lock,unlock和upgrade的调用 总共 不超过2000次。
方法一:DFS · Go 实现
思考
加锁、解锁是单点更新;升级要求自身与祖先均未锁、且子孙中至少一把锁,成功后解开全部子孙并锁住自身。 ,沿父链与 DFS 子孙均可接受。
数组记下锁的用户,邻接表存孩子。升级先爬父指针拒绝已锁祖先,再 DFS 解锁子孙并记录是否找到锁。
我们定义以下几个变量:
- :记录每个节点的锁定状态,其中 表示节点 的锁定状态,如果节点 未被上锁,则 ,否则 为锁定节点 的用户编号。
- :记录每个节点的父节点。
- :记录每个节点的子节点。
调用 函数时,如果节点 未被上锁,则将节点 上锁,返回 true,否则返回 false。
调用 函数时,如果节点 被上锁且上锁的用户编号为 ,则将节点 解锁,返回 true,否则返回 false。
调用 函数时,我们首先判断节点 及其祖先节点是否被上锁,如果是,则返回 。否则,我们判断节点 的子孙节点是否有被上锁的,如果没有,则返回 false。否则,我们将节点 及其子孙节点解锁,然后将节点 上锁,返回 true。
时间复杂度方面,初始化和 函数的时间复杂度均为 ,而 和 函数的时间复杂度均为 。空间复杂度 。其中 是节点的数量。
type LockingTree struct {
	locked   []int
	parent   []int
	children [][]int
}

func Constructor(parent []int) LockingTree {
	n := len(parent)
	locked := make([]int, n)
	for i := range locked {
		locked[i] = -1
	}
	children := make([][]int, n)
	for i := 1; i < n; i++ {
		children[parent[i]] = append(children[parent[i]], i)
	}
	return LockingTree{locked, parent, children}
}

func (this *LockingTree) Lock(num int, user int) bool {
	if this.locked[num] == -1 {
		this.locked[num] = user
		return true
	}
	return false
}

func (this *LockingTree) Unlock(num int, user int) bool {
	if this.locked[num] == user {
		this.locked[num] = -1
		return true
	}
	return false
}

func (this *LockingTree) Upgrade(num int, user int) bool {
	x := num
	for ; x != -1; x = this.parent[x] {
		if this.locked[x] != -1 {
			return false
		}
	}
	find := false
	var dfs func(int)
	dfs = func(x int) {
		for _, y := range this.children[x] {
			if this.locked[y] != -1 {
				find = true
				this.locked[y] = -1
			}
			dfs(y)
		}
	}
	dfs(num)
	if !find {
		return false
	}
	this.locked[num] = user
	return true
}

/**
 * Your LockingTree object will be instantiated and called as such:
 * obj := Constructor(parent);
 * param_1 := obj.Lock(num,user);
 * param_2 := obj.Unlock(num,user);
 * param_3 := obj.Upgrade(num,user);
 */
方法二:显式栈 · Go 实现
思考
加锁、解锁是单点更新。升级要求自身与祖先都没锁,并且子孙里至少有一把锁,成功后解开全部子孙再锁住自身。 ,祖先可以沿父亲指针向上走;若对子孙递归,链长达到 就会超出 Python 的递归上限。子孙是否上锁与顺序无关,只要每个孩子都被看过。因此升级在确认祖先未锁之后,用栈从当前节点的孩子开始展开:弹出节点时若它被锁就解开并记下找到过锁,再把它的孩子压入栈。至少解开过一把锁,才把当前节点锁给该用户。
我们定义以下几个变量:
- :记录每个节点的锁定状态,其中 表示节点 的锁定状态,如果节点 未被上锁,则 ,否则 为锁定节点 的用户编号。
- :记录每个节点的父节点。
- :记录每个节点的子节点。
调用 函数时,如果节点 未被上锁,则将节点 上锁,返回 true,否则返回 false。
调用 函数时,如果节点 被上锁且上锁的用户编号为 ,则将节点 解锁,返回 true,否则返回 false。
调用 函数时,先从 沿父亲指针向上走。只要 自己或某个祖先已被上锁,就返回 false。否则用显式栈展开 的子孙:弹出节点时,若它被锁就解开并把标记设为已找到锁,再把它的孩子压入栈。若一个被锁的子孙都没有,返回 false。否则把 锁给 ,返回 true。
时间复杂度方面,初始化和 函数的时间复杂度均为 ,而 和 函数的时间复杂度均为 。空间复杂度 。其中 是节点的数量。
type LockingTree struct {
	locked   []int
	parent   []int
	children [][]int
}

func Constructor(parent []int) LockingTree {
	n := len(parent)
	locked := make([]int, n)
	for i := range locked {
		locked[i] = -1
	}
	children := make([][]int, n)
	for i := 1; i < n; i++ {
		children[parent[i]] = append(children[parent[i]], i)
	}
	return LockingTree{locked, parent, children}
}

func (this *LockingTree) Lock(num int, user int) bool {
	if this.locked[num] == -1 {
		this.locked[num] = user
		return true
	}
	return false
}

func (this *LockingTree) Unlock(num int, user int) bool {
	if this.locked[num] == user {
		this.locked[num] = -1
		return true
	}
	return false
}

func (this *LockingTree) Upgrade(num int, user int) bool {
	x := num
	for ; x != -1; x = this.parent[x] {
		if this.locked[x] != -1 {
			return false
		}
	}
	find := false
	stk := append([]int(nil), this.children[num]...)
	for len(stk) > 0 {
		x := stk[len(stk)-1]
		stk = stk[:len(stk)-1]
		if this.locked[x] != -1 {
			find = true
			this.locked[x] = -1
		}
		for _, y := range this.children[x] {
			stk = append(stk, y)
		}
	}
	if !find {
		return false
	}
	this.locked[num] = user
	return true
}

/**
 * Your LockingTree object will be instantiated and called as such:
 * obj := Constructor(parent);
 * param_1 := obj.Lock(num,user);
 * param_2 := obj.Unlock(num,user);
 * param_3 := obj.Upgrade(num,user);
*/2013. 检测正方形
题目、示例与约束
给你一个在 X-Y 平面上的点构成的数据流。设计一个满足下述要求的算法:
- 添加 一个在数据流中的新点到某个数据结构中。可以添加 重复 的点,并会视作不同的点进行处理。
- 给你一个查询点,请你从数据结构中选出三个点,使这三个点和查询点一同构成一个 面积为正 的 轴对齐正方形 ,统计 满足该要求的方案数目。
轴对齐正方形 是一个正方形,除四条边长度相同外,还满足每条边都与 x-轴 或 y-轴 平行或垂直。
实现 DetectSquares 类:
DetectSquares()使用空数据结构初始化对象void add(int[] point)向数据结构添加一个新的点point = [x, y]int count(int[] point)统计按上述方式与点point = [x, y]共同构造 轴对齐正方形 的方案数。
示例:
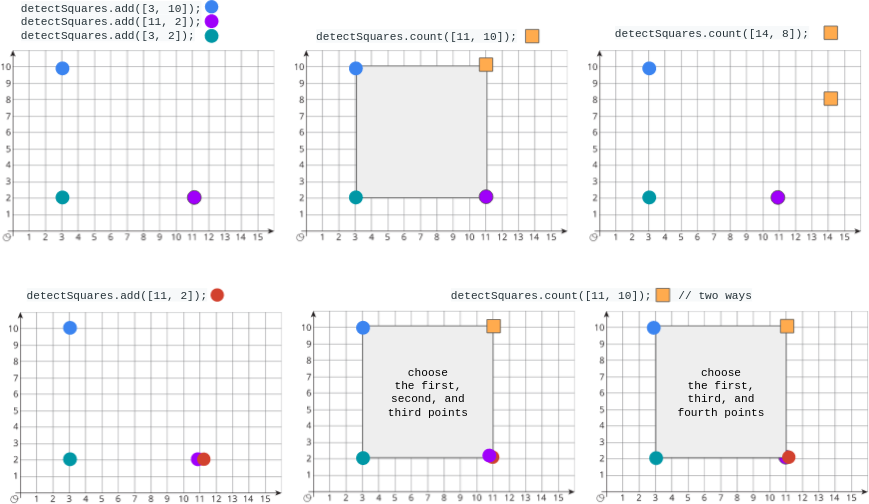
输入:
["DetectSquares", "add", "add", "add", "count", "count", "add", "count"]
[[], [[3, 10]], [[11, 2]], [[3, 2]], [[11, 10]], [[14, 8]], [[11, 2]], [[11, 10]]]
输出:
[null, null, null, null, 1, 0, null, 2]

解释:
DetectSquares detectSquares = new DetectSquares();
detectSquares.add([3, 10]);
detectSquares.add([11, 2]);
detectSquares.add([3, 2]);
detectSquares.count([11, 10]); // 返回 1 。你可以选择:
// - 第一个,第二个,和第三个点
detectSquares.count([14, 8]); // 返回 0 。查询点无法与数据结构中的这些点构成正方形。
detectSquares.add([11, 2]); // 允许添加重复的点。
detectSquares.count([11, 10]); // 返回 2 。你可以选择:
// - 第一个,第二个,和第三个点
// - 第一个,第三个,和第四个点
提示:
point.length == 20 <= x, y <= 1000- 调用
add和count的 总次数 最多为5000
方法一:哈希表 · Go 实现
思考
总调用 ,坐标在 。每次
count若枚举全部三点组合,最坏偏慢且实现繁琐。轴对齐正方形由一条水平边唯一确定另外两点。用 记录重点。对查询 ,枚举已有横坐标 ,边长 ,则上下两个正方形的另外两点坐标随之确定。
方案数为对应三个位置计数的乘积。
add为 ,count对横坐标线性。
我们可以用一个哈希表 维护所有点的信息,其中 表示点 的个数。
当调用 方法时,我们将 的值加 。
当调用 方法时,我们需要获取另外的三个点,构成一个轴对齐正方形。我们可以枚举平行于 轴且与 的距离为 的点 ,如果存在这样的点,根据这两个点,我们可以确定另外两个点为 和 ,或者 和 。我们将这两种情况的方案数累加即可。
时间复杂度方面,调用 方法的时间复杂度为 ,调用 方法的时间复杂度为 ;空间复杂度为 。其中 为数据流中的点的个数。
type DetectSquares struct {
	cnt map[int]map[int]int
}

func Constructor() DetectSquares {
	return DetectSquares{map[int]map[int]int{}}
}

func (this *DetectSquares) Add(point []int) {
	x, y := point[0], point[1]
	if _, ok := this.cnt[x]; !ok {
		this.cnt[x] = map[int]int{}
	}
	this.cnt[x][y]++
}

func (this *DetectSquares) Count(point []int) (ans int) {
	x1, y1 := point[0], point[1]
	if cnt1, ok := this.cnt[x1]; ok {
		for x2, cnt2 := range this.cnt {
			if x2 != x1 {
				d := x2 - x1
				ans += cnt2[y1] * cnt1[y1+d] * cnt2[y1+d]
				ans += cnt2[y1] * cnt1[y1-d] * cnt2[y1-d]
			}
		}
	}
	return
}

/**
 * Your DetectSquares object will be instantiated and called as such:
 * obj := Constructor();
 * obj.Add(point);
 * param_2 := obj.Count(point);
*/2034. 股票价格波动
题目、示例与约束
给你一支股票价格的数据流。数据流中每一条记录包含一个 时间戳 和该时间点股票对应的 价格 。
不巧的是,由于股票市场内在的波动性,股票价格记录可能不是按时间顺序到来的。某些情况下,有的记录可能是错的。如果两个有相同时间戳的记录出现在数据流中,前一条记录视为错误记录,后出现的记录 更正 前一条错误的记录。
请你设计一个算法,实现:
- 更新 股票在某一时间戳的股票价格,如果有之前同一时间戳的价格,这一操作将 更正 之前的错误价格。
- 找到当前记录里 最新股票价格 。最新股票价格 定义为时间戳最晚的股票价格。
- 找到当前记录里股票的 最高价格 。
- 找到当前记录里股票的 最低价格 。
请你实现 StockPrice 类:
StockPrice()初始化对象,当前无股票价格记录。void update(int timestamp, int price)在时间点timestamp更新股票价格为price。int current()返回股票 最新价格 。int maximum()返回股票 最高价格 。int minimum()返回股票 最低价格 。
示例 1:
输入:
["StockPrice", "update", "update", "current", "maximum", "update", "maximum", "update", "minimum"]
[[], [1, 10], [2, 5], [], [], [1, 3], [], [4, 2], []]
输出:
[null, null, null, 5, 10, null, 5, null, 2]

解释:
StockPrice stockPrice = new StockPrice();
stockPrice.update(1, 10); // 时间戳为 [1] ,对应的股票价格为 [10] 。
stockPrice.update(2, 5);  // 时间戳为 [1,2] ,对应的股票价格为 [10,5] 。
stockPrice.current();     // 返回 5 ,最新时间戳为 2 ,对应价格为 5 。
stockPrice.maximum();     // 返回 10 ,最高价格的时间戳为 1 ,价格为 10 。
stockPrice.update(1, 3);  // 之前时间戳为 1 的价格错误,价格更新为 3 。
                          // 时间戳为 [1,2] ,对应股票价格为 [3,5] 。
stockPrice.maximum();     // 返回 5 ,更正后最高价格为 5 。
stockPrice.update(4, 2);  // 时间戳为 [1,2,4] ,对应价格为 [3,5,2] 。
stockPrice.minimum();     // 返回 2 ,最低价格时间戳为 4 ,价格为 2 。
提示:
1 <= timestamp, price <= 109update,current,maximum和minimum总 调用次数不超过105。current,maximum和minimum被调用时,update操作 至少 已经被调用过 一次 。
方法一:哈希表 + 有序集合 · Go 实现
思考
需支持更正历史时刻的价格,并查询当前价、最高价、最低价,总操作 。仅哈希表无法取最值;仅有序集合无法按时间点覆盖。
哈希表 存时刻到价格,有序多重集 存当前所有价格。更新时若时刻已存在,先删旧价再插入新价,并维护最大时刻 。
当前价为 ,最值取 两端。
我们定义以下几个数据结构或变量,其中:
d:表示一个哈希表,用于存储时间戳和对应的价格;ls:表示一个有序集合,用于存储所有的价格;last:表示最后一次更新的时间戳。
那么,我们可以得到以下几个操作:
update(timestamp, price):更新时间戳timestamp对应的价格为price。如果timestamp已经存在,那么我们需要先将其对应的价格从有序集合中删除,再将其更新为price。否则,我们直接将其更新为price。然后,我们需要更新last为max(last, timestamp)。时间复杂度为 。current():返回last对应的价格。时间复杂度为 。maximum():返回有序集合中的最大值。时间复杂度为 。minimum():返回有序集合中的最小值。时间复杂度为 。
空间复杂度为 。其中, 为 update 操作的次数。
type StockPrice struct {
	d    map[int]int
	ls   *redblacktree.Tree
	last int
}

func Constructor() StockPrice {
	return StockPrice{
		d:    make(map[int]int),
		ls:   redblacktree.NewWithIntComparator(),
		last: 0,
	}
}

func (this *StockPrice) Update(timestamp int, price int) {
	merge := func(rbt *redblacktree.Tree, key, value int) {
		if v, ok := rbt.Get(key); ok {
			nxt := v.(int) + value
			if nxt == 0 {
				rbt.Remove(key)
			} else {
				rbt.Put(key, nxt)
			}
		} else {
			rbt.Put(key, value)
		}
	}
	if v, ok := this.d[timestamp]; ok {
		merge(this.ls, v, -1)
	}
	this.d[timestamp] = price
	merge(this.ls, price, 1)
	this.last = max(this.last, timestamp)
}

func (this *StockPrice) Current() int {
	return this.d[this.last]
}

func (this *StockPrice) Maximum() int {
	return this.ls.Right().Key.(int)
}

func (this *StockPrice) Minimum() int {
	return this.ls.Left().Key.(int)
}

/**
 * Your StockPrice object will be instantiated and called as such:
 * obj := Constructor();
 * obj.Update(timestamp,price);
 * param_2 := obj.Current();
 * param_3 := obj.Maximum();
 * param_4 := obj.Minimum();
*/2043. 简易银行系统
题目、示例与约束
你的任务是为一个很受欢迎的银行设计一款程序,以自动化执行所有传入的交易(转账,存款和取款)。银行共有 n 个账户,编号从 1 到 n 。每个账号的初始余额存储在一个下标从 0 开始的整数数组 balance 中,其中第 (i + 1) 个账户的初始余额是 balance[i] 。
请你执行所有 有效的 交易。如果满足下面全部条件,则交易 有效 :
- 指定的账户编号在
1和n之间,且 - 取款或者转账需要的钱的总数 小于或者等于 账户余额。
实现 Bank 类:
Bank(long[] balance)使用下标从 0 开始的整数数组balance初始化该对象。boolean transfer(int account1, int account2, long money)从编号为account1的账户向编号为account2的账户转帐money美元。如果交易成功,返回true,否则,返回false。boolean deposit(int account, long money)向编号为account的账户存款money美元。如果交易成功,返回true;否则,返回false。boolean withdraw(int account, long money)从编号为account的账户取款money美元。如果交易成功,返回true;否则,返回false。
示例:
输入:
["Bank", "withdraw", "transfer", "deposit", "transfer", "withdraw"]
[[[10, 100, 20, 50, 30]], [3, 10], [5, 1, 20], [5, 20], [3, 4, 15], [10, 50]]
输出:
[null, true, true, true, false, false]

解释:
Bank bank = new Bank([10, 100, 20, 50, 30]);
bank.withdraw(3, 10);    // 返回 true ,账户 3 的余额是 $20 ,所以可以取款 $10 。
                         // 账户 3 余额为 $20 - $10 = $10 。
bank.transfer(5, 1, 20); // 返回 true ,账户 5 的余额是 $30 ,所以可以转账 $20 。
                         // 账户 5 的余额为 $30 - $20 = $10 ,账户 1 的余额为 $10 + $20 = $30 。
bank.deposit(5, 20);     // 返回 true ,可以向账户 5 存款 $20 。
                         // 账户 5 的余额为 $10 + $20 = $30 。
bank.transfer(3, 4, 15); // 返回 false ,账户 3 的当前余额是 $10 。
                         // 所以无法转账 $15 。
bank.withdraw(10, 50);   // 返回 false ,交易无效,因为账户 10 并不存在。
提示:
n == balance.length1 <= n, account, account1, account2 <= 1050 <= balance[i], money <= 1012transfer,deposit,withdraw三个函数,每个 最多调用104次
方法一:模拟 · Go 实现
思考
账户数与单次金额范围大,但每笔操作只改一两个余额。用数组按下标存余额,编号从 起故访问 。
转账、取款先判编号合法且余额足够;存款只判编号。各操作 。
我们可以使用一个数组 来存储每个账户的余额。对于每个操作,我们只需要根据题目要求进行相应的判断和更新即可。
对于 操作,我们需要检查账户编号是否合法以及账户余额是否足够,如果满足条件则进行转账操作。
对于 操作,我们只需要检查账户编号是否合法,然后进行存款操作。
对于 操作,我们需要检查账户编号是否合法以及账户余额是否足够,如果满足条件则进行取款操作。
以上每个操作的时间复杂度均为 ,因此整体时间复杂度为 ,其中 是操作次数。空间复杂度 。
type Bank struct {
	balance []int64
	n       int
}

func Constructor(balance []int64) Bank {
	return Bank{balance, len(balance)}
}

func (this *Bank) Transfer(account1 int, account2 int, money int64) bool {
	if account1 > this.n || account2 > this.n || this.balance[account1-1] < money {
		return false
	}
	this.balance[account1-1] -= money
	this.balance[account2-1] += money
	return true
}

func (this *Bank) Deposit(account int, money int64) bool {
	if account > this.n {
		return false
	}
	this.balance[account-1] += money
	return true
}

func (this *Bank) Withdraw(account int, money int64) bool {
	if account > this.n || this.balance[account-1] < money {
		return false
	}
	this.balance[account-1] -= money
	return true
}

/**
 * Your Bank object will be instantiated and called as such:
 * obj := Constructor(balance);
 * param_1 := obj.Transfer(account1,account2,money);
 * param_2 := obj.Deposit(account,money);
 * param_3 := obj.Withdraw(account,money);
*/2069. 模拟行走机器人 II
题目、示例与约束
给你一个在 XY 平面上的 width x height 的网格图,左下角 的格子为 (0, 0) ,右上角 的格子为 (width - 1, height - 1) 。网格图中相邻格子为四个基本方向之一("North","East","South" 和 "West")。一个机器人 初始 在格子 (0, 0) ,方向为 "East" 。
机器人可以根据指令移动指定的 步数 。每一步,它可以执行以下操作。
- 沿着当前方向尝试 往前一步 。
- 如果机器人下一步将到达的格子 超出了边界 ,机器人会 逆时针 转 90 度,然后再尝试往前一步。
如果机器人完成了指令要求的移动步数,它将停止移动并等待下一个指令。
请你实现 Robot 类:
Robot(int width, int height)初始化一个width x height的网格图,机器人初始在(0, 0),方向朝"East"。void step(int num)给机器人下达前进num步的指令。int[] getPos()返回机器人当前所处的格子位置,用一个长度为 2 的数组[x, y]表示。String getDir()返回当前机器人的朝向,为"North","East","South"或者"West"。
示例 1:
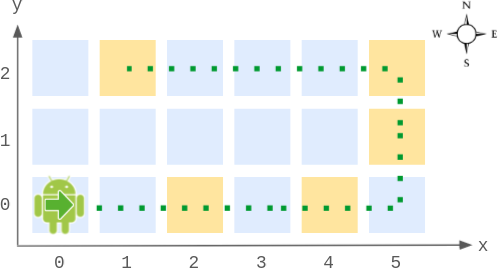
输入:
["Robot", "step", "step", "getPos", "getDir", "step", "step", "step", "getPos", "getDir"]
[[6, 3], [2], [2], [], [], [2], [1], [4], [], []]
输出:
[null, null, null, [4, 0], "East", null, null, null, [1, 2], "West"]

解释:
Robot robot = new Robot(6, 3); // 初始化网格图,机器人在 (0, 0) ,朝东。
robot.step(2);  // 机器人朝东移动 2 步,到达 (2, 0) ,并朝东。
robot.step(2);  // 机器人朝东移动 2 步,到达 (4, 0) ,并朝东。
robot.getPos(); // 返回 [4, 0]
robot.getDir(); // 返回 "East"
robot.step(2);  // 朝东移动 1 步到达 (5, 0) ,并朝东。
                // 下一步继续往东移动将出界,所以逆时针转变方向朝北。
                // 然后,往北移动 1 步到达 (5, 1) ,并朝北。
robot.step(1);  // 朝北移动 1 步到达 (5, 2) ,并朝 北 (不是朝西)。
robot.step(4);  // 下一步继续往北移动将出界,所以逆时针转变方向朝西。
                // 然后,移动 4 步到 (1, 2) ,并朝西。
robot.getPos(); // 返回 [1, 2]
robot.getDir(); // 返回 "West"
提示:
2 <= width, height <= 1001 <= num <= 105step,getPos和getDir总共 调用次数不超过104次。
方法一:分类讨论 · Go 实现
思考
step可达 且调用多次,逐步走格子会超时。机器人只沿矩形边界循环,周长 。位置对 取模后落在四条边上。按累计步数分段还原坐标与朝向。未移动时朝东;回到原点且已移动过则朝南,与「刚走完最后一条边」一致。
我们记 和 ,则机器人的运动轨迹是一个以 为左下角,而 为右上角的矩形的边界。我们可以将机器人的运动轨迹分为四段:
- 从 沿着 轴正方向运动到 ,此时机器人的朝向为 "East"。
- 从 沿着 轴正方向运动到 ,此时机器人的朝向为 "North"。
- 从 沿着 轴负方向运动到 ,此时机器人的朝向为 "West"。
- 从 沿着 轴负方向运动到 ,此时机器人的朝向为 "South"。
因此,我们可以将机器人的运动轨迹看作是一个长度为 的循环。对于每次调用 step(num),我们可以将机器人的当前位置加上 num,然后对 取模,得到机器人的新位置。根据机器人的新位置,我们可以判断出机器人的朝向和坐标。
注意,如果机器人没有移动过,那么它的朝向应该是 "East"。如果机器人移动过,且位置为 ,则机器人的朝向应该是 "South"。
时间复杂度 ,空间复杂度 。
type Robot struct {
	mx, my, p, cur int
	moved          bool
}

func Constructor(width int, height int) Robot {
	mx := width - 1
	my := height - 1
	return Robot{
		mx:    mx,
		my:    my,
		p:     2*mx + 2*my,
		cur:   0,
		moved: false,
	}
}

func (this *Robot) Step(num int) {
	this.moved = true
	this.cur = (this.cur + num) % this.p
}

func (this *Robot) GetPos() []int {
	d := this.cur
	mx, my := this.mx, this.my

	if 0 <= d && d <= mx {
		return []int{d, 0}
	}
	if mx < d && d <= mx+my {
		return []int{mx, d - mx}
	}
	if mx+my < d && d <= 2*mx+my {
		return []int{mx - (d - (mx + my)), my}
	}
	return []int{0, my - (d - (2*mx + my))}
}

func (this *Robot) GetDir() string {
	d := this.cur
	mx, my := this.mx, this.my

	if !this.moved {
		return "East"
	}
	if 1 <= d && d <= mx {
		return "East"
	} else if mx < d && d <= mx+my {
		return "North"
	} else if mx+my < d && d <= 2*mx+my {
		return "West"
	}
	return "South"
}

/**
 * Your Robot object will be instantiated and called as such:
 * obj := Constructor(width, height);
 * obj.Step(num);
 * param_2 := obj.GetPos();
 * param_3 := obj.GetDir();
*/2080. 区间内查询数字的频率
题目、示例与约束
请你设计一个数据结构,它能求出给定子数组内一个给定值的 频率 。
子数组中一个值的 频率 指的是这个子数组中这个值的出现次数。
请你实现 RangeFreqQuery 类:
RangeFreqQuery(int[] arr)用下标从 0 开始的整数数组arr构造一个类的实例。int query(int left, int right, int value)返回子数组arr[left...right]中value的 频率 。
一个 子数组 指的是数组中一段连续的元素。arr[left...right] 指的是 nums 中包含下标 left 和 right 在内 的中间一段连续元素。
示例 1:
输入:
["RangeFreqQuery", "query", "query"]
[[[12, 33, 4, 56, 22, 2, 34, 33, 22, 12, 34, 56]], [1, 2, 4], [0, 11, 33]]
输出:
[null, 1, 2]

解释:
RangeFreqQuery rangeFreqQuery = new RangeFreqQuery([12, 33, 4, 56, 22, 2, 34, 33, 22, 12, 34, 56]);
rangeFreqQuery.query(1, 2, 4); // 返回 1 。4 在子数组 [33, 4] 中出现 1 次。
rangeFreqQuery.query(0, 11, 33); // 返回 2 。33 在整个子数组中出现 2 次。
提示:
1 <= arr.length <= 1051 <= arr[i], value <= 1040 <= left <= right < arr.length- 调用
query不超过105次。
方法一:哈希表 + 二分查找 · Go 实现
思考
静态数组上多次询问区间内某值出现次数。 与询问均为 ,线段树可行,但单值频率只需该值的下标列表。
哈希表记下每个值的升序下标,询问对 做两次二分,差即为个数。
我们用一个哈希表 来存储每个值对应的下标数组。在构造函数中,我们遍历数组 ,将每个值对应的下标加入到哈希表中。
在查询函数中,我们首先判断哈希表中是否存在给定的值。如果不存在,说明该值在数组中不存在,直接返回 。否则,我们获取该值对应的下标数组 。然后我们使用二分查找找到下标数组中第一个大于等于 的下标 ,以及第一个大于 的下标 。最后返回 即可。
时间复杂度方面,构造函数的时间复杂度为 ,查询函数的时间复杂度为 。其中 为数组的长度。空间复杂度为 。
type RangeFreqQuery struct {
	g map[int][]int
}

func Constructor(arr []int) RangeFreqQuery {
	g := make(map[int][]int)
	for i, v := range arr {
		g[v] = append(g[v], i)
	}
	return RangeFreqQuery{g}
}

func (this *RangeFreqQuery) Query(left int, right int, value int) int {
	if idx, ok := this.g[value]; ok {
		l := sort.SearchInts(idx, left)
		r := sort.SearchInts(idx, right+1)
		return r - l
	}
	return 0
}

/**
 * Your RangeFreqQuery object will be instantiated and called as such:
 * obj := Constructor(arr);
 * param_1 := obj.Query(left,right,value);
*/2102. 序列顺序查询
题目、示例与约束
一个观光景点由它的名字 name 和景点评分 score 组成,其中 name 是所有观光景点中 唯一 的字符串,score 是一个整数。景点按照最好到最坏排序。景点评分 越高 ,这个景点越好。如果有两个景点的评分一样,那么 字典序较小 的景点更好。
你需要搭建一个系统,查询景点的排名。初始时系统里没有任何景点。这个系统支持:
- 添加 景点,每次添加 一个 景点。
- 查询 已经添加景点中第
i好 的景点,其中i是系统目前位置查询的次数(包括当前这一次)。- 比方说,如果系统正在进行第
4次查询,那么需要返回所有已经添加景点中第4好的。
- 比方说,如果系统正在进行第
注意,测试数据保证 任意查询时刻 ,查询次数都 不超过 系统中景点的数目。
请你实现 SORTracker 类:
SORTracker()初始化系统。void add(string name, int score)向系统中添加一个名为name评分为score的景点。string get()查询第i好的景点,其中i是目前系统查询的次数(包括当前这次查询)。
示例:
输入:
["SORTracker", "add", "add", "get", "add", "get", "add", "get", "add", "get", "add", "get", "get"]
[[], ["bradford", 2], ["branford", 3], [], ["alps", 2], [], ["orland", 2], [], ["orlando", 3], [], ["alpine", 2], [], []]
输出:
[null, null, null, "branford", null, "alps", null, "bradford", null, "bradford", null, "bradford", "orland"]

解释:
SORTracker tracker = new SORTracker(); // 初始化系统
tracker.add("bradford", 2); // 添加 name="bradford" 且 score=2 的景点。
tracker.add("branford", 3); // 添加 name="branford" 且 score=3 的景点。
tracker.get();              // 从好到坏的景点为:branford ,bradford 。
                            // 注意到 branford 比 bradford 好,因为它的 评分更高 (3 > 2) 。
                            // 这是第 1 次调用 get() ,所以返回最好的景点:"branford" 。
tracker.add("alps", 2);     // 添加 name="alps" 且 score=2 的景点。
tracker.get();              // 从好到坏的景点为:branford, alps, bradford 。
                            // 注意 alps 比 bradford 好,虽然它们评分相同,都为 2 。
                            // 这是因为 "alps" 字典序 比 "bradford" 小。
                            // 返回第 2 好的地点 "alps" ,因为当前为第 2 次调用 get() 。
tracker.add("orland", 2);   // 添加 name="orland" 且 score=2 的景点。
tracker.get();              // 从好到坏的景点为:branford, alps, bradford, orland 。
                            // 返回 "bradford" ,因为当前为第 3 次调用 get() 。
tracker.add("orlando", 3);  // 添加 name="orlando" 且 score=3 的景点。
tracker.get();              // 从好到坏的景点为:branford, orlando, alps, bradford, orland 。
                            // 返回 "bradford".
tracker.add("alpine", 2);   // 添加 name="alpine" 且 score=2 的景点。
tracker.get();              // 从好到坏的景点为:branford, orlando, alpine, alps, bradford, orland 。
                            // 返回 "bradford" 。
tracker.get();              // 从好到坏的景点为:branford, orlando, alpine, alps, bradford, orland 。
                            // 返回 "orland" 。
提示:
name只包含小写英文字母,且每个景点名字互不相同。1 <= name.length <= 101 <= score <= 105- 任意时刻,调用
get的次数都不超过调用add的次数。 - 总共 调用
add和get不超过4 * 104
方法一:Go 实现(灵茶山艾府) · Go 实现
本站根据 Go 源码整理,非作者原文。
思路:用红黑树按分数降序、同分名字字典序升序保存景点。迭代器始终指向下一次 Get 应返回的排名;若新插入景点排在迭代器之前,就把迭代器向前移一位以维持该排名。Get 返回当前位置的名字,再向后移一位。初始的零分哨兵位于所有真实景点之后,统一处理边界。
复杂度:设已加入景点数为 P,最长名字长度为 b。考虑字符串比较,Add 最坏时间为 O(b log(P+1));Get 的迭代器移动最坏为 O(log(P+1)),不能把单次移动一概视为 O(1)。题目中 b≤10,可把名字比较视为常数。树节点和迭代器的辅助空间为 O(P),名字保留已有字符串引用。
import "github.com/emirpasic/gods/trees/redblacktree"

/* 巧妙利用查询的特殊性

为了高效插入数据,我们可以用平衡树来维护所有景点。

注意到每次 `get` 后仅会将查询次数加一,我们可以直接用一个迭代器(指针)$\textit{cur}$ 指向下次查询需要返回的元素。

- 对于添加操作,如果添加的景点排在当前 $\textit{cur}$ 前面,那么移动 $\textit{cur}$ 至其前一个元素,否则不移动 $\textit{cur}$;
- 对于查询操作,每次查询结束后将 $\textit{cur}$ 移至其下一个元素。

代码实现时,可以在初始时插入一个哨兵元素,从而简化判断逻辑。

*/

// github.com/EndlessCheng/codeforces-go
type pair struct {
	score int
	name  string
}

func compare(x, y interface{}) int {
	a, b := x.(pair), y.(pair)
	if a.score > b.score || a.score == b.score && a.name < b.name {
		return -1
	}
	return 1
}

type SORTracker struct {
	*redblacktree.Tree
	cur redblacktree.Iterator
}

func Constructor() SORTracker {
	root := redblacktree.NewWith(compare)
	root.Put(pair{}, nil) // 哨兵
	return SORTracker{root, root.IteratorAt(root.Left())}
}

func (t *SORTracker) Add(name string, score int) {
	p := pair{score, name}
	t.Put(p, nil)
	if compare(p, t.cur.Key()) < 0 {
		t.cur.Prev() // 移动至前一个元素
	}
}

func (t *SORTracker) Get() string {
	name := t.cur.Key().(pair).name
	t.cur.Next() // 移动至下一个元素
	return name
}2166. 设计位集
题目、示例与约束
位集 Bitset 是一种能以紧凑形式存储位的数据结构。
请你实现 Bitset 类。
Bitset(int size)用size个位初始化 Bitset ,所有位都是0。void fix(int idx)将下标为idx的位上的值更新为1。如果值已经是1,则不会发生任何改变。void unfix(int idx)将下标为idx的位上的值更新为0。如果值已经是0,则不会发生任何改变。void flip()翻转 Bitset 中每一位上的值。换句话说,所有值为0的位将会变成1,反之亦然。boolean all()检查 Bitset 中 每一位 的值是否都是1。如果满足此条件,返回true;否则,返回false。boolean one()检查 Bitset 中 是否 至少一位 的值是1。如果满足此条件,返回true;否则,返回false。int count()返回 Bitset 中值为 1 的位的 总数 。String toString()返回 Bitset 的当前组成情况。注意,在结果字符串中,第i个下标处的字符应该与 Bitset 中的第i位一致。
示例:
输入
["Bitset", "fix", "fix", "flip", "all", "unfix", "flip", "one", "unfix", "count", "toString"]
[[5], [3], [1], [], [], [0], [], [], [0], [], []]
输出
[null, null, null, null, false, null, null, true, null, 2, "01010"]

解释
Bitset bs = new Bitset(5); // bitset = "00000".
bs.fix(3);     // 将 idx = 3 处的值更新为 1 ,此时 bitset = "00010" 。
bs.fix(1);     // 将 idx = 1 处的值更新为 1 ,此时 bitset = "01010" 。
bs.flip();     // 翻转每一位上的值,此时 bitset = "10101" 。
bs.all();      // 返回 False ,bitset 中的值不全为 1 。
bs.unfix(0);   // 将 idx = 0 处的值更新为 0 ,此时 bitset = "00101" 。
bs.flip();     // 翻转每一位上的值,此时 bitset = "11010" 。
bs.one();      // 返回 True ,至少存在一位的值为 1 。
bs.unfix(0);   // 将 idx = 0 处的值更新为 0 ,此时 bitset = "01010" 。
bs.count();    // 返回 2 ,当前有 2 位的值为 1 。
bs.toString(); // 返回 "01010" ,即 bitset 的当前组成情况。
提示:
1 <= size <= 1050 <= idx <= size - 1- 至多调用
fix、unfix、flip、all、one、count和toString方法 总共105次 - 至少调用
all、one、count或toString方法一次 - 至多调用
toString方法5次
方法一 · Go 实现
思考
需要支持单点置位、翻转全体、查询全 / 存在 / 计数以及输出。朴素数组在频繁 时要扫 位, 与操作次数都可达 。
同时维护当前串 与其补串 ,翻转改为交换二者,并把计数改成 。单点修改同步更新 、 与 。
直接拼接 。
type Bitset struct {
	a   []byte
	b   []byte
	cnt int
}

func Constructor(size int) Bitset {
	a := bytes.Repeat([]byte{'0'}, size)
	b := bytes.Repeat([]byte{'1'}, size)
	return Bitset{a, b, 0}
}

func (this *Bitset) Fix(idx int) {
	if this.a[idx] == '0' {
		this.a[idx] = '1'
		this.cnt++
	}
	this.b[idx] = '0'
}

func (this *Bitset) Unfix(idx int) {
	if this.a[idx] == '1' {
		this.a[idx] = '0'
		this.cnt--
	}
	this.b[idx] = '1'
}

func (this *Bitset) Flip() {
	this.a, this.b = this.b, this.a
	this.cnt = len(this.a) - this.cnt
}

func (this *Bitset) All() bool {
	return this.cnt == len(this.a)
}

func (this *Bitset) One() bool {
	return this.cnt > 0
}

func (this *Bitset) Count() int {
	return this.cnt
}

func (this *Bitset) ToString() string {
	return string(this.a)
}

/**
 * Your Bitset object will be instantiated and called as such:
 * obj := Constructor(size);
 * obj.Fix(idx);
 * obj.Unfix(idx);
 * obj.Flip();
 * param_4 := obj.All();
 * param_5 := obj.One();
 * param_6 := obj.Count();
 * param_7 := obj.ToString();
*/2227. 加密解密字符串
题目、示例与约束
给你一个字符数组 keys ,由若干 互不相同 的字符组成。还有一个字符串数组 values ,内含若干长度为 2 的字符串。另给你一个字符串数组 dictionary ,包含解密后所有允许的原字符串。请你设计并实现一个支持加密及解密下标从 0 开始字符串的数据结构。
字符串 加密 按下述步骤进行:
- 对字符串中的每个字符
c,先从keys中找出满足keys[i] == c的下标i。 - 在字符串中,用
values[i]替换字符c。
请注意,如果 keys 中不存在字符串中的字符,则无法执行加密过程,返回空字符串 ""。
字符串 解密 按下述步骤进行:
- 将字符串每相邻 2 个字符划分为一个子字符串,对于每个子字符串
s,找出满足values[i] == s的一个下标i。如果存在多个有效的i,从中选择 任意 一个。这意味着一个字符串解密可能得到多个解密字符串。 - 在字符串中,用
keys[i]替换s。
实现 Encrypter 类:
Encrypter(char[] keys, String[] values, String[] dictionary)用keys、values和dictionary初始化Encrypter类。String encrypt(String word1)按上述加密过程完成对word1的加密,并返回加密后的字符串。int decrypt(String word2)统计并返回可以由word2解密得到且出现在dictionary中的字符串数目。
示例:
输入:
["Encrypter", "encrypt", "decrypt"]
[[['a', 'b', 'c', 'd'], ["ei", "zf", "ei", "am"], ["abcd", "acbd", "adbc", "badc", "dacb", "cadb", "cbda", "abad"]], ["abcd"], ["eizfeiam"]]
输出:
[null, "eizfeiam", 2]

解释:
Encrypter encrypter = new Encrypter([['a', 'b', 'c', 'd'], ["ei", "zf", "ei", "am"], ["abcd", "acbd", "adbc", "badc", "dacb", "cadb", "cbda", "abad"]);
encrypter.encrypt("abcd"); // 返回 "eizfeiam"。
                           // 'a' 映射为 "ei",'b' 映射为 "zf",'c' 映射为 "ei",'d' 映射为 "am"。
encrypter.decrypt("eizfeiam"); // return 2.
                              // "ei" 可以映射为 'a' 或 'c',"zf" 映射为 'b',"am" 映射为 'd'。
                              // 因此,解密后可以得到的字符串是 "abad","cbad","abcd" 和 "cbcd"。
                              // 其中 2 个字符串,"abad" 和 "abcd",在 dictionary 中出现,所以答案是 2 。
提示:
1 <= keys.length == values.length <= 26values[i].length == 21 <= dictionary.length <= 1001 <= dictionary[i].length <= 100- 所有
keys[i]和dictionary[i]互不相同 1 <= word1.length <= 20001 <= word2.length <= 200- 所有
word1[i]都出现在keys中 word2.length是偶数keys、values[i]、dictionary[i]、word1和word2只含小写英文字母- 至多调用
encrypt和decrypt总计200次
方法一:哈希表 · Go 实现
思考
加密是把每个字符换成固定的长度为 的串;解密则要数词典里有多少单词加密后等于给定串。词典至多 个词,解密却可能被调用多次,若每次对 做逆映射再与词典比较,重复加密的开销可以预先消掉。
构造时用哈希表记下字符到密文的映射,并把词典中每个词的加密结果计入 。 按映射拼接,遇缺失字符返回空串; 直接查 。解密变为 。
我们用一个哈希表 记录每个字符的加密结果,用另一个哈希表 记录每个加密结果出现的次数。
在构造函数中,我们遍历 和 ,将每个字符和其对应的加密结果存入 中。然后遍历 ,统计每个加密结果出现的次数。时间复杂度 ,其中 和 分别是 和 的长度。
在加密函数中,我们遍历输入字符串 的每个字符,查找其加密结果并拼接起来。如果某个字符没有对应的加密结果,说明无法加密,返回空字符串。时间复杂度 ,其中 是 的长度。
在解密函数中,我们直接返回 中 对应的次数。时间复杂度 。
空间复杂度 。
type Encrypter struct {
	mp  map[byte]string
	cnt map[string]int
}

func Constructor(keys []byte, values []string, dictionary []string) Encrypter {
	mp := map[byte]string{}
	cnt := map[string]int{}
	for i, k := range keys {
		mp[k] = values[i]
	}
	e := Encrypter{mp, cnt}
	for _, v := range dictionary {
		e.cnt[e.Encrypt(v)]++
	}
	return e
}

func (this *Encrypter) Encrypt(word1 string) string {
	var ans strings.Builder
	for _, c := range word1 {
		if v, ok := this.mp[byte(c)]; ok {
			ans.WriteString(v)
		} else {
			return ""
		}
	}
	return ans.String()
}

func (this *Encrypter) Decrypt(word2 string) int {
	return this.cnt[word2]
}

/**
 * Your Encrypter object will be instantiated and called as such:
 * obj := Constructor(keys, values, dictionary);
 * param_1 := obj.Encrypt(word1);
 * param_2 := obj.Decrypt(word2);
*/2241. 设计一个 ATM 机器
题目、示例与约束
一个 ATM 机器,存有 5 种面值的钞票:20 ,50 ,100 ,200 和 500 美元。初始时,ATM 机是空的。用户可以用它存或者取任意数目的钱。
取款时,机器会优先取 较大 数额的钱。
- 比方说,你想取
$300,并且机器里有2张$50的钞票,1张$100的钞票和1张$200的钞票,那么机器会取出$100和$200的钞票。 - 但是,如果你想取
$600,机器里有3张$200的钞票和1张$500的钞票,那么取款请求会被拒绝,因为机器会先取出$500的钞票,然后无法取出剩余的$100。注意,因为有$500钞票的存在,机器 不能 取$200的钞票。
请你实现 ATM 类:
ATM()初始化 ATM 对象。void deposit(int[] banknotesCount)分别存入$20,$50,$100,$200和$500钞票的数目。int[] withdraw(int amount)返回一个长度为5的数组,分别表示$20,$50,$100,$200和$500钞票的数目,并且更新 ATM 机里取款后钞票的剩余数量。如果无法取出指定数额的钱,请返回[-1](这种情况下 不 取出任何钞票)。
示例 1:
输入:
["ATM", "deposit", "withdraw", "deposit", "withdraw", "withdraw"]
[[], [[0,0,1,2,1]], [600], [[0,1,0,1,1]], [600], [550]]
输出:
[null, null, [0,0,1,0,1], null, [-1], [0,1,0,0,1]]

解释:
ATM atm = new ATM();
atm.deposit([0,0,1,2,1]); // 存入 1 张 $100 ,2 张 $200 和 1 张 $500 的钞票。
atm.withdraw(600);        // 返回 [0,0,1,0,1] 。机器返回 1 张 $100 和 1 张 $500 的钞票。机器里剩余钞票的数量为 [0,0,0,2,0] 。
atm.deposit([0,1,0,1,1]); // 存入 1 张 $50 ,1 张 $200 和 1 张 $500 的钞票。
                          // 机器中剩余钞票数量为 [0,1,0,3,1] 。
atm.withdraw(600);        // 返回 [-1] 。机器会尝试取出 $500 的钞票,然后无法得到剩余的 $100 ,所以取款请求会被拒绝。
                          // 由于请求被拒绝,机器中钞票的数量不会发生改变。
atm.withdraw(550);        // 返回 [0,1,0,0,1] ,机器会返回 1 张 $50 的钞票和 1 张 $500 的钞票。
提示:
banknotesCount.length == 50 <= banknotesCount[i] <= 1091 <= amount <= 109- 总共 最多有
5000次withdraw和deposit的调用。 - 函数
withdraw和deposit至少各有 一次 调用。
方法一:模拟 · Go 实现
思考
面额只有五种,存取调用合计 次,金额可达 。按张模拟每一种组合不可行,题目要求尽量用大面额,这正是贪心取整。
用长度为 的数组记下库存。存款按位累加。取款从 到 依次取 张;若最后仍有余额则整笔失败且不改库存,否则再扣减。面额数是常数,单次 。
我们用一个数组 记录钞票面额,用一个数组 记录每种面额的钞票数量。
对于 deposit 操作,我们只需要将对应面额的钞票数量加上即可。时间复杂度 。
对于 withdraw 操作,我们从大到小枚举每种面额的钞票,取出尽可能多且不超过 的钞票,然后将 减去取出的钞票面额之和,如果最后 仍大于 ,说明无法取出 的钞票,返回 即可。否则,返回取出的钞票数量即可。时间复杂度 。
var d = [...]int{20, 50, 100, 200, 500}

const m = len(d)

type ATM [m]int

func Constructor() ATM {
	return ATM{}
}

func (this *ATM) Deposit(banknotesCount []int) {
	for i, x := range banknotesCount {
		this[i] += x
	}
}

func (this *ATM) Withdraw(amount int) []int {
	ans := make([]int, m)
	for i := m - 1; i >= 0; i-- {
		ans[i] = min(amount/d[i], this[i])
		amount -= ans[i] * d[i]
	}
	if amount > 0 {
		return []int{-1}
	}
	for i, x := range ans {
		this[i] -= x
	}
	return ans
}

/**
 * Your ATM object will be instantiated and called as such:
 * obj := Constructor();
 * obj.Deposit(banknotesCount);
 * param_2 := obj.Withdraw(amount);
*/2254. 设计视频共享平台 🔒
题目、示例与约束
你有一个视频分享平台,用户可以上传和删除视频。每个 video 都是 字符串 类型的数字,其中字符串的第 i 位表示视频中第 i 分钟的内容。例如,第一个数字表示视频中第 0 分钟的内容,第二个数字表示视频中第 1 分钟的内容,以此类推。视频的观众也可以喜欢和不喜欢视频。该平台会跟踪每个视频的 观看次数、点赞次数 和 不喜欢次数。
当视频上传时,它与最小可用整数 videoId 相关联,videoId 从 0 开始的。一旦一个视频被删除,与该视频关联的 videoId 就可以用于另一个视频。
实现 VideoSharingPlatform 类:
VideoSharingPlatform()初始化对象。int upload(String video)用户上传一个video. 返回与视频相关联的videoId。void remove(int videoId)如果存在与videoId相关联的视频,则删除该视频。String watch(int videoId, int startMinute, int endMinute)如果有一个视频与videoId相关联,则将该视频的观看次数增加1,并返回视频字符串的子字符串,从startMinute开始,以min(endMinute, video.length - 1)(含边界) 结束。否则,返回"-1"。void like(int videoId)如果存在与videoId相关联的视频,则将与videoId相关联的视频的点赞数增加1。void dislike(int videoId)如果存在与videoId相关联的视频,则将与videoId相关联的视频上的不喜欢次数增加1。int[] getLikesAndDislikes(int videoId)返回一个长度为2,下标从 0 开始 的整型数组,其中values[0]是与videoId相关联的视频上的点赞数,values[1]是不喜欢数。如果没有与videoId相关联的视频,则返回[-1]。int getViews(int videoId)返回与videoId相关联的视频的观看次数,如果没有与videoId相关联的视频,返回-1。
示例 1:
输入
["VideoSharingPlatform", "upload", "upload", "remove", "remove", "upload", "watch", "watch", "like", "dislike", "dislike", "getLikesAndDislikes", "getViews"]
[[], ["123"], ["456"], [4], [0], ["789"], [1, 0, 5], [1, 0, 1], [1], [1], [1], [1], [1]]
输出
[null, 0, 1, null, null, 0, "456", "45", null, null, null, [1, 2], 2]

解释
VideoSharingPlatform videoSharingPlatform = new VideoSharingPlatform();
videoSharingPlatform.upload("123");          // 最小的可用 videoId 是 0,所以返回 0。
videoSharingPlatform.upload("456");          // 最小的可用 videoId 是 1,所以返回 1。
videoSharingPlatform.remove(4);              // 没有与 videoId 4 相关联的视频,所以什么都不做。
videoSharingPlatform.remove(0);              // 删除与 videoId 0 关联的视频。
videoSharingPlatform.upload("789");          // 由于与 videoId 0 相关联的视频被删除,
                                             // 0 是最小的可用 videoId,所以返回 0。
videoSharingPlatform.watch(1, 0, 5);         // 与 videoId 1 关联的视频为 "456"。
                                             // 从分钟 0 到分钟 min(5,3 - 1)= 2 的视频为 "456",因此返回 "456"。
videoSharingPlatform.watch(1, 0, 1);         // 与 videoId 1 关联的视频为 "456"。
                                             // 从分钟 0 到分钟 min(1,3 - 1)= 1 的视频为 "45",因此返回 "45"。
videoSharingPlatform.like(1);                // 增加与 videoId 1 相关的视频的点赞数。
videoSharingPlatform.dislike(1);             // 增加与 videoId 1 相关联的视频的不喜欢的数量。
videoSharingPlatform.dislike(1);             // 增加与 videoId 1 相关联的视频的不喜欢的数量。
videoSharingPlatform.getLikesAndDislikes(1); // 在与 videoId 1 相关的视频中有 1 个喜欢和 2 个不喜欢,因此返回[1,2]。
videoSharingPlatform.getViews(1);            // 与 videoId 1 相关联的视频有 2 个观看数,因此返回2。
示例 2:
输入
["VideoSharingPlatform", "remove", "watch", "like", "dislike", "getLikesAndDislikes", "getViews"]
[[], [0], [0, 0, 1], [0], [0], [0], [0]]
输出
[null, null, "-1", null, null, [-1], -1]

解释
VideoSharingPlatform videoSharingPlatform = new VideoSharingPlatform();
videoSharingPlatform.remove(0);              // 没有与 videoId 0 相关联的视频,所以什么都不做。
videoSharingPlatform.watch(0, 0, 1);         // 没有与 videoId 0 相关联的视频,因此返回 "-1"。
videoSharingPlatform.like(0);                // 没有与 videoId 0 相关联的视频,所以什么都不做。
videoSharingPlatform.dislike(0);             // 没有与 videoId 0 相关联的视频,所以什么都不做。
videoSharingPlatform.getLikesAndDislikes(0); // 没有与 videoId 0 相关联的视频,因此返回 [-1]。
videoSharingPlatform.getViews(0);            // 没有视频与 videoId 0 相关联,因此返回 -1。
提示:
1 <= video.length <= 105- 调用
upload时所有video.length的总和不会超过105 video由数字组成0 <= videoId <= 1050 <= startMinute < endMinute < 105startMinute < video.length- 调用
watch时所有endMinute - startMinute的总和不会超过105。 - 所有函数 总共 最多调用
105次。
方法一:Go 解法(本站整理) · Go 实现
根据题意整理:源文没有非空实现。哈希表保存每个视频及计数,递增编号记录尚未使用的新 ID,最小堆保存已删除可复用的 ID。上传优先取堆顶;删除不存在的视频不入堆,避免重复回收。Watch 截取包含右端的分钟区间并增加一次观看数。q 为操作数、L 为存储的视频总长度,上传和删除 O(log q),其他方法 O(1)(Go 字符串切片共享数据),空间 O(q+L)。提供 VideoSharingPlatform、Constructor 与首字母大写的 Go 方法;删除后复用的 ID 全部计数重新归零。
出处:Doocs 原题与题解,固定提交 91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011;题意、参考及本 Go 改写采用 CC BY-SA 4.0。
// 题意与参考:Doocs LeetCode,CC BY-SA 4.0。
// https://github.com/doocs/leetcode/blob/91ef8c241a5eaabf96f9ca8d45cfb1a338bcb011/solution/2200-2299/2254.Design%20Video%20Sharing%20Platform/README.md
// Go 实现与测试沿用 CC BY-SA 4.0;来源性质见配套说明。
import "container/heap"

type idHeap []int

func (h idHeap) Len() int           { return len(h) }
func (h idHeap) Less(i, j int) bool { return h[i] < h[j] }
func (h idHeap) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }
func (h *idHeap) Push(x any)        { *h = append(*h, x.(int)) }
func (h *idHeap) Pop() any          { a := *h; x := a[len(a)-1]; *h = a[:len(a)-1]; return x }

type video struct {
	content                string
	views, likes, dislikes int
}
type VideoSharingPlatform struct {
	videos map[int]*video
	free   idHeap
	next   int
}

func Constructor() VideoSharingPlatform { return VideoSharingPlatform{videos: map[int]*video{}} }
func (p *VideoSharingPlatform) Upload(s string) int {
	id := p.next
	if p.free.Len() > 0 {
		id = heap.Pop(&p.free).(int)
	} else {
		p.next++
	}
	p.videos[id] = &video{content: s}
	return id
}
func (p *VideoSharingPlatform) Remove(id int) {
	if _, ok := p.videos[id]; ok {
		delete(p.videos, id)
		heap.Push(&p.free, id)
	}
}
func (p *VideoSharingPlatform) Watch(id, start, end int) string {
	v := p.videos[id]
	if v == nil {
		return "-1"
	}
	v.views++
	if end >= len(v.content) {
		end = len(v.content) - 1
	}
	return v.content[start : end+1]
}
func (p *VideoSharingPlatform) Like(id int) {
	if v := p.videos[id]; v != nil {
		v.likes++
	}
}
func (p *VideoSharingPlatform) Dislike(id int) {
	if v := p.videos[id]; v != nil {
		v.dislikes++
	}
}
func (p *VideoSharingPlatform) GetLikesAndDislikes(id int) []int {
	if v := p.videos[id]; v != nil {
		return []int{v.likes, v.dislikes}
	}
	return []int{-1}
}
func (p *VideoSharingPlatform) GetViews(id int) int {
	if v := p.videos[id]; v != nil {
		return v.views
	}
	return -1
}2276. 统计区间中的整数数目
题目、示例与约束
给你区间的 空 集,请你设计并实现满足要求的数据结构:
- 新增:添加一个区间到这个区间集合中。
- 统计:计算出现在 至少一个 区间中的整数个数。
实现 CountIntervals 类:
CountIntervals()使用区间的空集初始化对象void add(int left, int right)添加区间[left, right]到区间集合之中。int count()返回出现在 至少一个 区间中的整数个数。
注意:区间 [left, right] 表示满足 left <= x <= right 的所有整数 x 。
示例 1:
输入
["CountIntervals", "add", "add", "count", "add", "count"]
[[], [2, 3], [7, 10], [], [5, 8], []]
输出
[null, null, null, 6, null, 8]

解释
CountIntervals countIntervals = new CountIntervals(); // 用一个区间空集初始化对象
countIntervals.add(2, 3);  // 将 [2, 3] 添加到区间集合中
countIntervals.add(7, 10); // 将 [7, 10] 添加到区间集合中
countIntervals.count();    // 返回 6
                           // 整数 2 和 3 出现在区间 [2, 3] 中
                           // 整数 7、8、9、10 出现在区间 [7, 10] 中
countIntervals.add(5, 8);  // 将 [5, 8] 添加到区间集合中
countIntervals.count();    // 返回 8
                           // 整数 2 和 3 出现在区间 [2, 3] 中
                           // 整数 5 和 6 出现在区间 [5, 8] 中
                           // 整数 7 和 8 出现在区间 [5, 8] 和区间 [7, 10] 中
                           // 整数 9 和 10 出现在区间 [7, 10] 中
提示:
1 <= left <= right <= 109- 最多调用
add和count方法 总计105次 - 调用
count方法至少一次
方法一:线段树(动态开点) · Go 实现
思考
要维护若干可能重叠的整数区间,支持加入一段并查询已被覆盖的整数个数。坐标到 ,操作 次,不能开数组,也不能每次重建。覆盖次数不重要,区间赋值「整段已覆盖」即可。
动态开点线段树的值域为 ,节点只在访问时创建。修改把区间赋成满覆盖并用懒标记下传;查询根上的覆盖长度。单次 。
根据题目描述,我们需要维护一个区间集合,支持区间的添加和查询操作。对于区间的添加,我们可以使用线段树来维护区间集合。
线段树将整个区间分割为多个不连续的子区间,子区间的数量不超过 。更新某个元素的值,只需要更新 个区间,并且这些区间都包含在一个包含该元素的大区间内。区间修改时,需要使用懒标记保证效率。
- 线段树的每个节点代表一个区间;
- 线段树具有唯一的根节点,代表的区间是整个统计范围,如 ;
- 线段树的每个叶子节点代表一个长度为 的元区间 ;
- 对于每个内部节点 ,它的左儿子是 ,右儿子是 , 其中 (即向下取整)。
由于题目数据范围较大,我们可以使用动态开点的线段树来实现。动态开点的线段树是指,我们只在需要的时候才开点,而不是一开始就开好所有的点,这样可以节省空间。
时间复杂度方面,每次操作的时间复杂度为 。空间复杂度为 。其中 为操作次数,而 为数据范围。
type Node struct {
	left  *Node
	right *Node
	l     int
	r     int
	mid   int
	v     int
	add   int
}

type SegmentTree struct {
	root *Node
}

func newNode(l, r int) *Node {
	return &Node{
		left:  nil,
		right: nil,
		l:     l,
		r:     r,
		mid:   (l + r) / 2,
		v:     0,
		add:   0,
	}
}

func newSegmentTree() *SegmentTree {
	return &SegmentTree{
		root: newNode(1, 1000000001),
	}
}

func (st *SegmentTree) modify(l, r, v int, node *Node) {
	if node == nil {
		node = st.root
	}
	if l > r {
		return
	}
	if node.l >= l && node.r <= r {
		node.v = node.r - node.l + 1
		node.add = v
		return
	}
	st.pushdown(node)
	if l <= node.mid {
		st.modify(l, r, v, node.left)
	}
	if r > node.mid {
		st.modify(l, r, v, node.right)
	}
	st.pushup(node)
}

func (st *SegmentTree) query(l, r int, node *Node) int {
	if node == nil {
		node = st.root
	}
	if l > r {
		return 0
	}
	if node.l >= l && node.r <= r {
		return node.v
	}
	st.pushdown(node)
	v := 0
	if l <= node.mid {
		v += st.query(l, r, node.left)
	}
	if r > node.mid {
		v += st.query(l, r, node.right)
	}
	return v
}

func (st *SegmentTree) pushup(node *Node) {
	node.v = node.left.v + node.right.v
}

func (st *SegmentTree) pushdown(node *Node) {
	if node.left == nil {
		node.left = newNode(node.l, node.mid)
	}
	if node.right == nil {
		node.right = newNode(node.mid+1, node.r)
	}
	if node.add != 0 {
		left := node.left
		right := node.right
		left.add = node.add
		right.add = node.add
		left.v = left.r - left.l + 1
		right.v = right.r - right.l + 1
		node.add = 0
	}
}

type CountIntervals struct {
	tree *SegmentTree
}

func Constructor() CountIntervals {
	return CountIntervals{
		tree: newSegmentTree(),
	}
}

func (ci *CountIntervals) Add(left, right int) {
	ci.tree.modify(left, right, 1, nil)
}

func (ci *CountIntervals) Count() int {
	return ci.tree.query(1, 1000000000, nil)
}

/**
 * Your CountIntervals object will be instantiated and called as such:
 * obj := Constructor();
 * obj.Add(left,right);
 * param_2 := obj.Count();
*/2286. 以组为单位订音乐会的门票
题目、示例与约束
一个音乐会总共有 n 排座位,编号从 0 到 n - 1 ,每一排有 m 个座椅,编号为 0 到 m - 1 。你需要设计一个买票系统,针对以下情况进行座位安排:
- 同一组的
k位观众坐在 同一排座位,且座位连续 。 k位观众中 每一位 都有座位坐,但他们 不一定 坐在一起。
由于观众非常挑剔,所以:
- 只有当一个组里所有成员座位的排数都 小于等于
maxRow,这个组才能订座位。每一组的maxRow可能 不同 。 - 如果有多排座位可以选择,优先选择 最小 的排数。如果同一排中有多个座位可以坐,优先选择号码 最小 的。
请你实现 BookMyShow 类:
BookMyShow(int n, int m),初始化对象,n是排数,m是每一排的座位数。int[] gather(int k, int maxRow)返回长度为2的数组,表示k个成员中 第一个座位 的排数和座位编号,这k位成员必须坐在 同一排座位,且座位连续 。换言之,返回最小可能的r和c满足第r排中[c, c + k - 1]的座位都是空的,且r <= maxRow。如果 无法 安排座位,返回[]。boolean scatter(int k, int maxRow)如果组里所有k个成员 不一定 要坐在一起的前提下,都能在第0排到第maxRow排之间找到座位,那么请返回true。这种情况下,每个成员都优先找排数 最小 ,然后是座位编号最小的座位。如果不能安排所有k个成员的座位,请返回false。
示例 1:
输入:
["BookMyShow", "gather", "gather", "scatter", "scatter"]
[[2, 5], [4, 0], [2, 0], [5, 1], [5, 1]]
输出:
[null, [0, 0], [], true, false]

解释:
BookMyShow bms = new BookMyShow(2, 5); // 总共有 2 排,每排 5 个座位。
bms.gather(4, 0); // 返回 [0, 0]
                  // 这一组安排第 0 排 [0, 3] 的座位。
bms.gather(2, 0); // 返回 []
                  // 第 0 排只剩下 1 个座位。
                  // 所以无法安排 2 个连续座位。
bms.scatter(5, 1); // 返回 True
                   // 这一组安排第 0 排第 4 个座位和第 1 排 [0, 3] 的座位。
bms.scatter(5, 1); // 返回 False
                   // 总共只剩下 1 个座位。
提示:
1 <= n <= 5 * 1041 <= m, k <= 1090 <= maxRow <= n - 1gather和scatter总 调用次数不超过5 * 104次。
方法一:线段树 · Go 实现
思考
要在某一行找到连续 个空位且行号尽量小; 只要从前若干行凑齐 个座位。行数 ,每行座位数达 ,不能按座位开数组,按行线性扫描也会超时。
线段树下标从 的行,节点维护区间剩余座位和 与单行剩余最大值 。 在 上找最左满足 的行,再把该行剩余改为 。 先查区间和是否够,再从前往后逐行扣减。单次对数。
分析题意我们得知:
- 对于
gather(k, maxRow)操作,要求 个人坐在同一行并且座位连续,也就是说,我们要找到最小的行,满足该行的剩余座位大于等于 。 - 对于
scatter(k, maxRow)操作,只需要找到 个座位就行,但是要求这 个座位的行数尽可能小,因此,我们要找到第一个满足剩余座位数大于 的行,进行座位分配,然后继续往后查找。
我们可以用线段树来实现。线段树每个节点的信息有:
l:节点对应的区间左端点r:节点对应的区间右端点s:节点对应的区间总的剩余座位数mx:节点对应的区间最大剩余座位数
注意,线段树节点区间的下标从 开始。
线段树的操作有:
build(u, l, r):建立节点 ,对应区间 ,并递归建立其左右子节点。modify(u, x, v):从节点 开始,找到对应区间 中的第一个满足 的节点,将该节点的s和mx修改为 ,并向上更新。query_sum(u, l, r):从节点 开始,统计对应区间 中的s之和。query_idx(u, l, r, k):从节点 开始,找到对应区间 中的第一个满足mx大于等于 的节点,返回该节点的l。查找时,我们从最大的区间 开始,由于我们要找最左边的满足mx大于等于 的节点。因此,对于当前区间,我们判断前半部分区间的mx是否符合要求,是则说明答案就在前半部分区间,递归查找即可。否则说明答案在后半部分区间,递归查找后半部分区间。pushup(u):利用 的子节点信息更新当前 的信息。
对于 gather(k, maxRow) 操作,我们先用 query_idx(1, 1, n, k) 找到第一个满足剩余座位数大于等于 的行,记为 。然后我们用 query_sum(1, i, i) 得到该行的剩余座位数,记为 。接下来,我们用 modify(1, i, s - k) 将该行的剩余座位数修改为 ,并向上更新。最后,我们返回 即可。
对于 scatter(k, maxRow) 操作,我们先用 query_sum(1, 1, maxRow) 统计前 行的剩余座位数,记为 。如果 ,说明没有足够的座位,返回 false;否则,我们用 query_idx(1, 1, maxRow, 1) 找到第一个满足剩余座位数大于等于 的行,记为 。从该行开始,每次用 query_sum(1, i, i) 得到该行的剩余座位数,记为 。如果 ,我们直接用 modify(1, i, s_i - k) 将该行的剩余座位数修改为 ,并向上更新,然后返回 true。否则,我们更新 ,然后将该行的剩余座位数修改为 ,并向上更新。最后,我们返回 true。
时间复杂度:
- 初始化的时间复杂度为 。
gather(k, maxRow)的时间复杂度为 。scatter(k, maxRow)的时间复杂度为 。
整体时间复杂度为 ,空间复杂度 。其中 和 分别为行数和操作数。
type BookMyShow struct {
	n, m int
	tree *segmentTree
}

func Constructor(n int, m int) BookMyShow {
	return BookMyShow{n, m, newSegmentTree(n, m)}
}

func (this *BookMyShow) Gather(k int, maxRow int) []int {
	maxRow++
	i := this.tree.queryIdx(1, 1, maxRow, k)
	if i == 0 {
		return []int{}
	}
	s := this.tree.querySum(1, i, i)
	this.tree.modify(1, i, s-k)
	return []int{i - 1, this.m - s}
}

func (this *BookMyShow) Scatter(k int, maxRow int) bool {
	maxRow++
	if this.tree.querySum(1, 1, maxRow) < k {
		return false
	}
	i := this.tree.queryIdx(1, 1, maxRow, 1)
	for j := i; j <= this.n; j++ {
		s := this.tree.querySum(1, j, j)
		if s >= k {
			this.tree.modify(1, j, s-k)
			return true
		}
		k -= s
		this.tree.modify(1, j, 0)
	}
	return true
}

type node struct {
	l, r, s, mx int
}

type segmentTree struct {
	tr []*node
	m  int
}

func newSegmentTree(n, m int) *segmentTree {
	tr := make([]*node, n<<2)
	for i := range tr {
		tr[i] = &node{}
	}
	t := &segmentTree{tr, m}
	t.build(1, 1, n)
	return t
}

func (t *segmentTree) build(u, l, r int) {
	t.tr[u].l, t.tr[u].r = l, r
	if l == r {
		t.tr[u].s, t.tr[u].mx = t.m, t.m
		return
	}
	mid := (l + r) >> 1
	t.build(u<<1, l, mid)
	t.build(u<<1|1, mid+1, r)
	t.pushup(u)
}

func (t *segmentTree) modify(u, x, v int) {
	if t.tr[u].l == x && t.tr[u].r == x {
		t.tr[u].s, t.tr[u].mx = v, v
		return
	}
	mid := (t.tr[u].l + t.tr[u].r) >> 1
	if x <= mid {
		t.modify(u<<1, x, v)
	} else {
		t.modify(u<<1|1, x, v)
	}
	t.pushup(u)
}

func (t *segmentTree) querySum(u, l, r int) int {
	if t.tr[u].l >= l && t.tr[u].r <= r {
		return t.tr[u].s
	}
	mid := (t.tr[u].l + t.tr[u].r) >> 1
	v := 0
	if l <= mid {
		v = t.querySum(u<<1, l, r)
	}
	if r > mid {
		v += t.querySum(u<<1|1, l, r)
	}
	return v
}

func (t *segmentTree) queryIdx(u, l, r, k int) int {
	if t.tr[u].mx < k {
		return 0
	}
	if t.tr[u].l == t.tr[u].r {
		return t.tr[u].l
	}
	mid := (t.tr[u].l + t.tr[u].r) >> 1
	if t.tr[u<<1].mx >= k {
		return t.queryIdx(u<<1, l, r, k)
	}
	if r > mid {
		return t.queryIdx(u<<1|1, l, r, k)
	}
	return 0
}

func (t *segmentTree) pushup(u int) {
	t.tr[u].s = t.tr[u<<1].s + t.tr[u<<1|1].s
	t.tr[u].mx = max(t.tr[u<<1].mx, t.tr[u<<1|1].mx)
}

/**
 * Your BookMyShow object will be instantiated and called as such:
 * obj := Constructor(n, m);
 * param_1 := obj.Gather(k,maxRow);
 * param_2 := obj.Scatter(k,maxRow);
*/2296. 设计一个文本编辑器
题目、示例与约束
请你设计一个带光标的文本编辑器,它可以实现以下功能:
- 添加:在光标所在处添加文本。
- 删除:在光标所在处删除文本(模拟键盘的删除键)。
- 移动:将光标往左或者往右移动。
当删除文本时,只有光标左边的字符会被删除。光标会留在文本内,也就是说任意时候 0 <= cursor.position <= currentText.length 都成立。
请你实现 TextEditor 类:
TextEditor()用空文本初始化对象。void addText(string text)将text添加到光标所在位置。添加完后光标在text的右边。int deleteText(int k)删除光标左边k个字符。返回实际删除的字符数目。string cursorLeft(int k)将光标向左移动k次。返回移动后光标左边min(10, len)个字符,其中len是光标左边的字符数目。string cursorRight(int k)将光标向右移动k次。返回移动后光标左边min(10, len)个字符,其中len是光标左边的字符数目。
示例 1:
输入:
["TextEditor", "addText", "deleteText", "addText", "cursorRight", "cursorLeft", "deleteText", "cursorLeft", "cursorRight"]
[[], ["leetcode"], [4], ["practice"], [3], [8], [10], [2], [6]]
输出:
[null, null, 4, null, "etpractice", "leet", 4, "", "practi"]

解释:
TextEditor textEditor = new TextEditor(); // 当前 text 为 "|" 。('|' 字符表示光标)
textEditor.addText("leetcode"); // 当前文本为 "leetcode|" 。
textEditor.deleteText(4); // 返回 4
                          // 当前文本为 "leet|" 。
                          // 删除了 4 个字符。
textEditor.addText("practice"); // 当前文本为 "leetpractice|" 。
textEditor.cursorRight(3); // 返回 "etpractice"
                           // 当前文本为 "leetpractice|".
                           // 光标无法移动到文本以外,所以无法移动。
                           // "etpractice" 是光标左边的 10 个字符。
textEditor.cursorLeft(8); // 返回 "leet"
                          // 当前文本为 "leet|practice" 。
                          // "leet" 是光标左边的 min(10, 4) = 4 个字符。
textEditor.deleteText(10); // 返回 4
                           // 当前文本为 "|practice" 。
                           // 只有 4 个字符被删除了。
textEditor.cursorLeft(2); // 返回 ""
                          // 当前文本为 "|practice" 。
                          // 光标无法移动到文本以外,所以无法移动。
                          // "" 是光标左边的 min(10, 0) = 0 个字符。
textEditor.cursorRight(6); // 返回 "practi"
                           // 当前文本为 "practi|ce" 。
                           // "practi" 是光标左边的 min(10, 6) = 6 个字符。
提示:
1 <= text.length, k <= 40text只含有小写英文字母。- 调用
addText,deleteText,cursorLeft和cursorRight的 总 次数不超过2 * 104次。
进阶:你能设计并实现一个每次调用时间复杂度为 O(k) 的解决方案吗?
方法一:左右栈 · Go 实现
思考
文本编辑器要在光标处插入、删除,并左右移动,总操作量 ,单次文本长 。若用字符串每次拼接,移动光标会反复复制。光标把文本分成左右两段,栈(或数组)在两端摊还 增删。
存光标左侧, 存右侧(栈顶靠近光标)。插入、删除只动 ;左右移动则在两栈之间倒 个字符。返回左侧末尾至多 个字符。
我们可以使用两个栈 和 ,其中栈 存储光标左边的字符,另一个栈 存储光标右边的字符。
- 当调用 方法时,我们将 中的字符依次入栈 。时间复杂度 。
- 当调用 方法时,我们将 中的字符出栈最多 次。时间复杂度 。
- 当调用 方法时,我们将 中的字符出栈最多 次,然后将出栈的字符依次入栈 ,最后返回 栈最多 个字符。时间复杂度 。
- 当调用 方法时,我们将 中的字符出栈最多 次,然后将出栈的字符依次入栈 ,最后返回 栈最多 个字符。时间复杂度 。
type TextEditor struct {
	left, right []byte
}

func Constructor() TextEditor {
	return TextEditor{}
}

func (this *TextEditor) AddText(text string) {
	this.left = append(this.left, text...)
}

func (this *TextEditor) DeleteText(k int) int {
	k = min(k, len(this.left))
	if k < len(this.left) {
		this.left = this.left[:len(this.left)-k]
	} else {
		this.left = []byte{}
	}
	return k
}

func (this *TextEditor) CursorLeft(k int) string {
	k = min(k, len(this.left))
	for ; k > 0; k-- {
		this.right = append(this.right, this.left[len(this.left)-1])
		this.left = this.left[:len(this.left)-1]
	}
	return string(this.left[max(len(this.left)-10, 0):])
}

func (this *TextEditor) CursorRight(k int) string {
	k = min(k, len(this.right))
	for ; k > 0; k-- {
		this.left = append(this.left, this.right[len(this.right)-1])
		this.right = this.right[:len(this.right)-1]
	}
	return string(this.left[max(len(this.left)-10, 0):])
}

/**
 * Your TextEditor object will be instantiated and called as such:
 * obj := Constructor();
 * obj.AddText(text);
 * param_2 := obj.DeleteText(k);
 * param_3 := obj.CursorLeft(k);
 * param_4 := obj.CursorRight(k);
*/2336. 无限集中的最小数字
题目、示例与约束
现有一个包含所有正整数的集合 [1, 2, 3, 4, 5, ...] 。
实现 SmallestInfiniteSet 类:
SmallestInfiniteSet()初始化 SmallestInfiniteSet 对象以包含 所有 正整数。int popSmallest()移除 并返回该无限集中的最小整数。void addBack(int num)如果正整数num不 存在于无限集中,则将一个num添加 到该无限集中。
示例:
输入
["SmallestInfiniteSet", "addBack", "popSmallest", "popSmallest", "popSmallest", "addBack", "popSmallest", "popSmallest", "popSmallest"]
[[], [2], [], [], [], [1], [], [], []]
输出
[null, null, 1, 2, 3, null, 1, 4, 5]

解释
SmallestInfiniteSet smallestInfiniteSet = new SmallestInfiniteSet();
smallestInfiniteSet.addBack(2);    // 2 已经在集合中,所以不做任何变更。
smallestInfiniteSet.popSmallest(); // 返回 1 ,因为 1 是最小的整数,并将其从集合中移除。
smallestInfiniteSet.popSmallest(); // 返回 2 ,并将其从集合中移除。
smallestInfiniteSet.popSmallest(); // 返回 3 ,并将其从集合中移除。
smallestInfiniteSet.addBack(1);    // 将 1 添加到该集合中。
smallestInfiniteSet.popSmallest(); // 返回 1 ,因为 1 在上一步中被添加到集合中,
                                   // 且 1 是最小的整数,并将其从集合中移除。
smallestInfiniteSet.popSmallest(); // 返回 4 ,并将其从集合中移除。
smallestInfiniteSet.popSmallest(); // 返回 5 ,并将其从集合中移除。
提示:
1 <= num <= 1000- 最多调用
popSmallest和addBack方法 共计1000次
方法一:有序集合 + 模拟 · Go 实现
思考
集合初值为全体正整数,但操作次数与数值均不超过 ,实际只会触及 。
用有序集合存放当前仍在的数。弹出即删最小元,加回即插入;有序性保证每次 取得最小值。
我们注意到,题目中集合的元素范围是 ,并且我们需要支持的操作有:
popSmallest:弹出集合中的最小元素addBack:向集合中添加元素
因此,我们可以使用有序集合来模拟,不妨记有序集合为 ,集合中的元素为 ,其中 为有序集合中的元素个数。本题中 。
我们在初始化时,将 中的所有元素加入有序集合中。时间复杂度 。
在 popSmallest 操作中,我们只需要弹出有序集合中的第一个元素即可。单次操作时间复杂度 。
在 addBack 操作中,我们只需要将元素加入有序集合中即可。单次操作时间复杂度 。
空间复杂度 。
type SmallestInfiniteSet struct {
	s *treemap.Map
}

func Constructor() SmallestInfiniteSet {
	s := treemap.NewWithIntComparator()
	for i := 1; i <= 1000; i++ {
		s.Put(i, nil)
	}
	return SmallestInfiniteSet{s}
}

func (this *SmallestInfiniteSet) PopSmallest() int {
	x, _ := this.s.Min()
	this.s.Remove(x.(int))
	return x.(int)
}

func (this *SmallestInfiniteSet) AddBack(num int) {
	this.s.Put(num, nil)
}

/**
 * Your SmallestInfiniteSet object will be instantiated and called as such:
 * obj := Constructor();
 * param_1 := obj.PopSmallest();
 * obj.AddBack(num);
*/2349. 设计数字容器系统
题目、示例与约束
设计一个数字容器系统,可以实现以下功能:
- 在系统中给定下标处 插入 或者 替换 一个数字。
- 返回 系统中给定数字的最小下标。
请你实现一个 NumberContainers 类:
NumberContainers()初始化数字容器系统。void change(int index, int number)在下标index处填入number。如果该下标index处已经有数字了,那么用number替换该数字。int find(int number)返回给定数字number在系统中的最小下标。如果系统中没有number,那么返回-1。
示例:
输入:
["NumberContainers", "find", "change", "change", "change", "change", "find", "change", "find"]
[[], [10], [2, 10], [1, 10], [3, 10], [5, 10], [10], [1, 20], [10]]
输出:
[null, -1, null, null, null, null, 1, null, 2]

解释:
NumberContainers nc = new NumberContainers();
nc.find(10); // 没有数字 10 ,所以返回 -1 。
nc.change(2, 10); // 容器中下标为 2 处填入数字 10 。
nc.change(1, 10); // 容器中下标为 1 处填入数字 10 。
nc.change(3, 10); // 容器中下标为 3 处填入数字 10 。
nc.change(5, 10); // 容器中下标为 5 处填入数字 10 。
nc.find(10); // 数字 10 所在的下标为 1 ,2 ,3 和 5 。因为最小下标为 1 ,所以返回 1 。
nc.change(1, 20); // 容器中下标为 1 处填入数字 20 。注意,下标 1 处之前为 10 ,现在被替换为 20 。
nc.find(10); // 数字 10 所在下标为 2 ,3 和 5 。最小下标为 2 ,所以返回 2 。
提示:
1 <= index, number <= 109- 调用
change和find的 总次数 不超过105次。
方法一:哈希表 + 有序集合 · Go 实现
思考
需要改下标上的数,并查询某数出现的最小下标。操作达 ,线性扫描不可行。
哈希表 记每个下标的当前值,有序集合 记该值的全部下标。修改时先从旧集合删除再插入新集合; 取有序集合首元。
我们用一个哈希表 记录下标和数字的映射关系,用一个哈希表 记录每个数字对应的下标集合,这里我们可以使用有序集合来存储下标,这样我们就可以方便地找到最小下标。
调用 change 方法时,我们先判断下标是否已经存在,如果存在,我们就将原来的数字从对应的下标集合中删除,然后将新的数字添加到对应的下标集合中。时间复杂度 。
调用 find 方法时,我们直接返回对应数字的下标集合的第一个元素即可。时间复杂度 。
空间复杂度 。其中 为数字的个数。
type NumberContainers struct {
	d map[int]int
	g map[int]*redblacktree.Tree
}

func Constructor() NumberContainers {
	return NumberContainers{map[int]int{}, map[int]*redblacktree.Tree{}}
}

func (this *NumberContainers) Change(index int, number int) {
	if oldNumber, ok := this.d[index]; ok {
		this.g[oldNumber].Remove(index)
	}
	this.d[index] = number
	if _, ok := this.g[number]; !ok {
		this.g[number] = redblacktree.NewWithIntComparator()
	}
	this.g[number].Put(index, nil)
}

func (this *NumberContainers) Find(number int) int {
	if ids, ok := this.g[number]; ok && ids.Size() > 0 {
		return ids.Left().Key.(int)
	}
	return -1
}

/**
 * Your NumberContainers object will be instantiated and called as such:
 * obj := Constructor();
 * obj.Change(index,number);
 * param_2 := obj.Find(number);
*/2353. 设计食物评分系统
题目、示例与约束
设计一个支持下述操作的食物评分系统:
- 修改 系统中列出的某种食物的评分。
- 返回系统中某一类烹饪方式下评分最高的食物。
实现 FoodRatings 类:
FoodRatings(String[] foods, String[] cuisines, int[] ratings)初始化系统。食物由foods、cuisines和ratings描述,长度均为n。foods[i]是第i种食物的名字。cuisines[i]是第i种食物的烹饪方式。ratings[i]是第i种食物的最初评分。
void changeRating(String food, int newRating)修改名字为food的食物的评分。String highestRated(String cuisine)返回指定烹饪方式cuisine下评分最高的食物的名字。如果存在并列,返回 字典序较小 的名字。
注意,字符串 x 的字典序比字符串 y 更小的前提是:x 在字典中出现的位置在 y 之前,也就是说,要么 x 是 y 的前缀,或者在满足 x[i] != y[i] 的第一个位置 i 处,x[i] 在字母表中出现的位置在 y[i] 之前。
示例:
输入
["FoodRatings", "highestRated", "highestRated", "changeRating", "highestRated", "changeRating", "highestRated"]
[[["kimchi", "miso", "sushi", "moussaka", "ramen", "bulgogi"], ["korean", "japanese", "japanese", "greek", "japanese", "korean"], [9, 12, 8, 15, 14, 7]], ["korean"], ["japanese"], ["sushi", 16], ["japanese"], ["ramen", 16], ["japanese"]]
输出
[null, "kimchi", "ramen", null, "sushi", null, "ramen"]

解释
FoodRatings foodRatings = new FoodRatings(["kimchi", "miso", "sushi", "moussaka", "ramen", "bulgogi"], ["korean", "japanese", "japanese", "greek", "japanese", "korean"], [9, 12, 8, 15, 14, 7]);
foodRatings.highestRated("korean"); // 返回 "kimchi"
                                    // "kimchi" 是分数最高的韩式料理,评分为 9 。
foodRatings.highestRated("japanese"); // 返回 "ramen"
                                      // "ramen" 是分数最高的日式料理,评分为 14 。
foodRatings.changeRating("sushi", 16); // "sushi" 现在评分变更为 16 。
foodRatings.highestRated("japanese"); // 返回 "sushi"
                                      // "sushi" 是分数最高的日式料理,评分为 16 。
foodRatings.changeRating("ramen", 16); // "ramen" 现在评分变更为 16 。
foodRatings.highestRated("japanese"); // 返回 "ramen"
                                      // "sushi" 和 "ramen" 的评分都是 16 。
                                      // 但是,"ramen" 的字典序比 "sushi" 更小。
提示:
1 <= n <= 2 * 104n == foods.length == cuisines.length == ratings.length1 <= foods[i].length, cuisines[i].length <= 10foods[i]、cuisines[i]由小写英文字母组成1 <= ratings[i] <= 108foods中的所有字符串 互不相同- 在对
changeRating的所有调用中,food是系统中食物的名字。 - 在对
highestRated的所有调用中,cuisine是系统中 至少一种 食物的烹饪方式。 - 最多调用
changeRating和highestRated总计2 * 104次
方法一:哈希表 + 有序集合 · Go 实现
思考
要按菜系查询评分最高、字典序最小的食物,并支持改分。调用达 ,每次线性扫描过慢。
每个菜系用有序集合存 ,另用哈希表记下食物的当前评分与菜系。改分时删除旧二元组、插入新二元组;查询取集合首元的食物名。
我们可以使用哈希表 来存储每种烹饪方式下的食物,其中键是烹饪方式,值是一个有序集合,有序集合的每个元素是一个二元组 ,按照评分从高到低排序,如果评分相同,则按照食物名字的字典序从小到大排序。
我们还可以使用哈希表 来存储每种食物的评分和烹饪方式。即 。
在构造函数中,我们遍历 、 和 ,将每种食物的评分和烹饪方式存储到 和 中。
在 函数中,我们首先获取食物 的原评分 和烹饪方式 ,然后更新 的评分为 ,并从 中删除 ,并将 添加到 中。
在 函数中,我们直接返回 的第一个元素的食物名字即可。
时间复杂度方面,构造函数的时间复杂度为 ,其中 是食物的数量。其余操作的时间复杂度为 。空间复杂度为 。
import (
	"github.com/emirpasic/gods/v2/trees/redblacktree"
)

type pair struct {
	rating int
	food   string
}

type FoodRatings struct {
	d map[string]*redblacktree.Tree[pair, struct{}]
	g map[string]pair
}

func Constructor(foods []string, cuisines []string, ratings []int) FoodRatings {
	d := make(map[string]*redblacktree.Tree[pair, struct{}])
	g := make(map[string]pair)

	for i, food := range foods {
		rating, cuisine := ratings[i], cuisines[i]
		g[food] = pair{rating, cuisine}

		if d[cuisine] == nil {
			d[cuisine] = redblacktree.NewWith[pair, struct{}](func(a, b pair) int {
				return cmp.Or(b.rating-a.rating, strings.Compare(a.food, b.food))
			})
		}
		d[cuisine].Put(pair{rating, food}, struct{}{})
	}

	return FoodRatings{d, g}
}

func (this *FoodRatings) ChangeRating(food string, newRating int) {
	p := this.g[food]
	t := this.d[p.food]

	t.Remove(pair{p.rating, food})
	t.Put(pair{newRating, food}, struct{}{})

	p.rating = newRating
	this.g[food] = p
}

func (this *FoodRatings) HighestRated(cuisine string) string {
	return this.d[cuisine].Left().Key.food
}

/**
 * Your FoodRatings object will be instantiated and called as such:
 * obj := Constructor(foods, cuisines, ratings);
 * obj.ChangeRating(food,newRating);
 * param_2 := obj.HighestRated(cuisine);
*/2408. 设计 SQL
题目、示例与约束
给定两个字符串数组 names 和 columns,大小都为 n。其中 names[i] 是第 i 个表的名称,columns[i] 是第 i 个表的列数。
您需要实现一个支持以下 操作 的类:
- 在特定的表中 插入 一行。插入的每一行都有一个 id。id 是使用自动递增方法分配的,其中第一个插入行的 id 为 1,同一个表中的后续其他行的 id 为上一个插入行的 id (即使它已被删除) 加 1。
- 从指定表中 删除 一行。注意,删除一行 不会 影响下一个插入行的 id。
- 从任何表中 查询 一个特定的单元格并返回其值。
- 从任何表以 csv 格式 导出 所有行。
实现 SQL 类:
SQL(String[] names, int[] columns)- 创建
n个表。
- 创建
bool ins(String name, String[] row)- 将
row插入表name中并返回true。 - 如果
row.length不 匹配列的预期数量,或者name不是 一个合法的表,不进行任何插入并返回false。
- 将
void rmv(String name, int rowId, int columnId)- 从表
name中移除行rowId。 - 如果
name不是 一个合法的表或者没有 id 为rowId的行,不进行删除。
- 从表
String sel(String name, int rowId, int columnId)- 返回表
name中位于特定的rowId和columnId的单元格的值。 - 如果 name 不是 一个合法的表,或者单元格
(rowId, columnId)不合法,返回"<null>"。
- 返回表
String[] exp(String name)- 返回表
name中出现的行。 - 如果
name不是 一个合法的表,返回一个空数组。每一行以字符串表示,每个单元格的值(包括 行的 id)以","分隔。
- 返回表
示例 1:
输入:
["SQL","ins","sel","ins","exp","rmv","sel","exp"]
[[["one","two","three"],[2,3,1]],["two",["first","second","third"]],["two",1,3],["two",["fourth","fifth","sixth"]],["two"],["two",1],["two",2,2],["two"]]
输出:
[null,true,"third",true,["1,first,second,third","2,fourth,fifth,sixth"],null,"fifth",["2,fourth,fifth,sixth"]]
解释:
// 创建 3 张表。
SQL sql = new SQL(["one", "two", "three"], [2, 3, 1]);

// 将 id 为 1 的行添加到表 "two"。返回 True。
sql.ins("two", ["first", "second", "third"]);

// 从表 "two" 中 id 为 1 的行
// 其中第 3 列返回值 "third"。
sql.sel("two", 1, 3);

// 将另外一个 id 为 2 的行添加到表 "two"。返回 True。
sql.ins("two", ["fourth", "fifth", "sixth"]);

// 导出表 "two" 的行。
// 目前表中有两行 id 为 1 和 2 。
sql.exp("two");

// 删除表 "two" 当中的第一行。注意第二行的 id
// 依然为 2。
sql.rmv("two", 1);

// 从表 "two" 中 id 为 2 的行
// 其中第 2 列返回值 "fifth"。
sql.sel("two", 2, 2);

// 导出表 "two" 的行。
// 目前表中有一行 id 为 2。
sql.exp("two");
示例 2:
输入:["SQL","ins","sel","ins","exp","rmv","sel","exp"] [[["one","two","three"],[2,3,1]],["two",["first","second","third"]],["two",1,3],["two",["fourth","fifth","sixth"]],["two"],["two",1],["two",2,2],["two"]]输出:
[null,true,"third",true,["1,first,second,third","2,fourth,fifth,sixth"],null,"fifth",["2,fourth,fifth,sixth"]]解释:
// 创建 3 张表
SQL sQL = new SQL(["one", "two", "three"], [2, 3, 1]);

// 将 id 为 1 的行添加到表 "two"。返回 True。
sQL.ins("two", ["first", "second", "third"]);

// 从表 "two" 中 id 为 1 的行
// 其中第 3 列返回值 "third"。
sQL.sel("two", 1, 3);

// 删除表 "two" 的第一行。
sQL.rmv("two", 1);

// 返回 "<null>" 因为 id 为 1 的单元格
// 已经从表 "two" 中删除。
sQL.sel("two", 1, 2);

// 返回 False 因为列的数量不正确。
sQL.ins("two", ["fourth", "fifth"]);

// 将 id 为 2 的行添加到表 "two"。返回 True。
sQL.ins("two", ["fourth", "fifth", "sixth"]);
提示:
n == names.length == columns.length1 <= n <= 1041 <= names[i].length, row[i].length, name.length <= 10names[i],row[i],name由小写英文字母组成。1 <= columns[i] <= 101 <= row.length <= 10- 所有的
names[i]都是 不同 的。 - 最多调用
ins和rmv2000次。 - 最多调用
sel104次。 - 最多调用
exp500次。
进阶:如果表因多次删除而变得稀疏,您会选择哪种方法?为什么?考虑对内存使用和性能的影响。
方法一:哈希表 · Go 实现
思考
每张表都要保留稳定的行号和列数,删除一行之后其余行的编号保持不变。插入和删除最多 次,不必实现完整的关系型引擎。
若只按下标 存放行,被删单元格仍会被读到,导出也会带上已删除的行。行号在删除之后继续递增,空出来的编号不能再次使用。
因此我们用表名映射到「行号 → 单元格」的哈希表,同时记下每张表的列数和下一个行号。
只在表存在且行宽与列数一致时写入新行。 删掉对应行号。 在表不存在、行已删除或列号越界时返回 。 按行号顺序把仍然存在的行连同行号用逗号拼出来。
分别记录每张表的列数,以及按行号存放的现存数据。直接模拟题目中的 、 、 和 。
插入、删除和查询的平均时间复杂度为 。导出一张表需要扫描其中仍然存在的行。空间与插入的单元格总数成正比。
type SQL struct {
	cols   map[string]int
	rows   map[string]map[int][]string
	nextId map[string]int
}

func Constructor(names []string, columns []int) SQL {
	cols := map[string]int{}
	rows := map[string]map[int][]string{}
	nextId := map[string]int{}
	for i, name := range names {
		cols[name] = columns[i]
		rows[name] = map[int][]string{}
		nextId[name] = 1
	}
	return SQL{cols, rows, nextId}
}

func (this *SQL) Ins(name string, row []string) bool {
	c, ok := this.cols[name]
	if !ok || len(row) != c {
		return false
	}
	id := this.nextId[name]
	this.nextId[name] = id + 1
	cp := append([]string(nil), row...)
	this.rows[name][id] = cp
	return true
}

func (this *SQL) Rmv(name string, rowId int) {
	if table, ok := this.rows[name]; ok {
		delete(table, rowId)
	}
}

func (this *SQL) Sel(name string, rowId int, columnId int) string {
	table, ok := this.rows[name]
	if !ok {
		return "<null>"
	}
	row, ok := table[rowId]
	if !ok || columnId < 1 || columnId > len(row) {
		return "<null>"
	}
	return row[columnId-1]
}

func (this *SQL) Exp(name string) []string {
	table, ok := this.rows[name]
	if !ok || len(table) == 0 {
		return []string{}
	}
	ids := make([]int, 0, len(table))
	for id := range table {
		ids = append(ids, id)
	}
	sort.Ints(ids)
	ans := make([]string, 0, len(ids))
	for _, id := range ids {
		s := strconv.Itoa(id)
		for _, cell := range table[id] {
			s += "," + cell
		}
		ans = append(ans, s)
	}
	return ans
}

/**
 * Your SQL object will be instantiated and called as such:
 * obj := Constructor(names, columns);
 * param_1 := obj.Ins(name,row);
 * obj.Rmv(name,rowId);
 * param_3 := obj.Sel(name,rowId,columnId);
 * param_4 := obj.Exp(name);
*/2424. 最长上传前缀
题目、示例与约束
给你一个 n 个视频的上传序列,每个视频编号为 1 到 n 之间的 不同 数字,你需要依次将这些视频上传到服务器。请你实现一个数据结构,在上传的过程中计算 最长上传前缀 。
如果 闭区间 1 到 i 之间的视频全部都已经被上传到服务器,那么我们称 i 是上传前缀。最长上传前缀指的是符合定义的 i 中的 最大值 。
请你实现 LUPrefix 类:
LUPrefix(int n)初始化一个n个视频的流对象。void upload(int video)上传video到服务器。int longest()返回上述定义的 最长上传前缀 的长度。
示例 1:
输入:
["LUPrefix", "upload", "longest", "upload", "longest", "upload", "longest"]
[[4], [3], [], [1], [], [2], []]
输出:
[null, null, 0, null, 1, null, 3]

解释:
LUPrefix server = new LUPrefix(4);   // 初始化 4个视频的上传流
server.upload(3);                    // 上传视频 3 。
server.longest();                    // 由于视频 1 还没有被上传,最长上传前缀是 0 。
server.upload(1);                    // 上传视频 1 。
server.longest();                    // 前缀 [1] 是最长上传前缀,所以我们返回 1 。
server.upload(2);                    // 上传视频 2 。
server.longest();                    // 前缀 [1,2,3] 是最长上传前缀,所以我们返回 3 。
提示:
1 <= n <= 1051 <= video <= 105video中所有值 互不相同 。upload和longest总调用 次数至多不超过2 * 105次。- 至少会调用
longest一次。
方法一:模拟 · Go 实现
思考
上传与查询各至多 次,每次不能扫描 。最长前缀是从 起连续已上传的最大 ,新视频只有接到 时才会推动 。
用集合记录已上传编号,变量 为当前前缀。上传后若 已在集合中则循环递增。每个编号使 前进至多一次,均摊 。
我们用变量 记录当前的最长上传前缀,用数组或哈希表 记录已经上传的视频。
每次上传视频 video 时,将 s[video] 置为 true,然后循环判断 s[r + 1] 是否为 true,如果是,则更新 。
时间复杂度 ,空间复杂度 。其中 为视频总数。
type LUPrefix struct {
	r int
	s []bool
}

func Constructor(n int) LUPrefix {
	return LUPrefix{0, make([]bool, n+1)}
}

func (this *LUPrefix) Upload(video int) {
	this.s[video] = true
	for this.r+1 < len(this.s) && this.s[this.r+1] {
		this.r++
	}
}

func (this *LUPrefix) Longest() int {
	return this.r
}

/**
 * Your LUPrefix object will be instantiated and called as such:
 * obj := Constructor(n);
 * obj.Upload(video);
 * param_2 := obj.Longest();
*/2502. 设计内存分配器
题目、示例与约束
给你一个整数 n ,表示下标从 0 开始的内存数组的大小。所有内存单元开始都是空闲的。
请你设计一个具备以下功能的内存分配器:
- 分配 一块大小为
size的连续空闲内存单元并赋 idmID。 - 释放 给定 id
mID对应的所有内存单元。
注意:
- 多个块可以被分配到同一个
mID。 - 你必须释放
mID对应的所有内存单元,即便这些内存单元被分配在不同的块中。
实现 Allocator 类:
Allocator(int n)使用一个大小为n的内存数组初始化Allocator对象。int allocate(int size, int mID)找出大小为size个连续空闲内存单元且位于 最左侧 的块,分配并赋 idmID。返回块的第一个下标。如果不存在这样的块,返回-1。int freeMemory(int mID)释放 idmID对应的所有内存单元。返回释放的内存单元数目。
示例:
输入
["Allocator", "allocate", "allocate", "allocate", "freeMemory", "allocate", "allocate", "allocate", "freeMemory", "allocate", "freeMemory"]
[[10], [1, 1], [1, 2], [1, 3], [2], [3, 4], [1, 1], [1, 1], [1], [10, 2], [7]]
输出
[null, 0, 1, 2, 1, 3, 1, 6, 3, -1, 0]

解释
Allocator loc = new Allocator(10); // 初始化一个大小为 10 的内存数组,所有内存单元都是空闲的。
loc.allocate(1, 1); // 最左侧的块的第一个下标是 0 。内存数组变为 [1, , , , , , , , , ]。返回 0 。
loc.allocate(1, 2); // 最左侧的块的第一个下标是 1 。内存数组变为 [1,2, , , , , , , , ]。返回 1 。
loc.allocate(1, 3); // 最左侧的块的第一个下标是 2 。内存数组变为 [1,2,3, , , , , , , ]。返回 2 。
loc.freeMemory(2); // 释放 mID 为 2 的所有内存单元。内存数组变为 [1, ,3, , , , , , , ] 。返回 1 ,因为只有 1 个 mID 为 2 的内存单元。
loc.allocate(3, 4); // 最左侧的块的第一个下标是 3 。内存数组变为 [1, ,3,4,4,4, , , , ]。返回 3 。
loc.allocate(1, 1); // 最左侧的块的第一个下标是 1 。内存数组变为 [1,1,3,4,4,4, , , , ]。返回 1 。
loc.allocate(1, 1); // 最左侧的块的第一个下标是 6 。内存数组变为 [1,1,3,4,4,4,1, , , ]。返回 6 。
loc.freeMemory(1); // 释放 mID 为 1 的所有内存单元。内存数组变为 [ , ,3,4,4,4, , , , ] 。返回 3 ,因为有 3 个 mID 为 1 的内存单元。
loc.allocate(10, 2); // 无法找出长度为 10 个连续空闲内存单元的空闲块,所有返回 -1 。
loc.freeMemory(7); // 释放 mID 为 7 的所有内存单元。内存数组保持原状,因为不存在 mID 为 7 的内存单元。返回 0 。
提示:
1 <= n, size, mID <= 1000- 最多调用
allocate和free方法1000次
方法一:模拟 · Go 实现
思考
分配需在下标最小的连续空闲段中放入 个单元,释放则回收某一 占据的全部单元。 ,即便每次扫描整段内存也只需 。
为此用长度为 的数组标记占用:空闲记 ,分配时累计连续 的个数,凑满 后写入 ;释放时扫一遍把等于 的位置清零并计数。
题目数据范围不大,可以直接用数组模拟内存空间。
初始化时,将数组中的每个元素置为 ,表示空闲。
当调用 allocate 方法时,遍历数组,找到连续的 size 个空闲内存单元,将其置为 mID,并返回第一个下标。
当调用 free 方法时,遍历数组,将所有等于 mID 的内存单元置为 ,表示空闲。
时间复杂度 ,空间复杂度 ,其中 和 分别为内存空间的大小和方法调用的次数。
type Allocator struct {
	m []int
}

func Constructor(n int) Allocator {
	return Allocator{m: make([]int, n)}
}

func (this *Allocator) Allocate(size int, mID int) int {
	cnt := 0
	for i := 0; i < len(this.m); i++ {
		if this.m[i] > 0 {
			cnt = 0
		} else if cnt++; cnt == size {
			for j := i - size + 1; j <= i; j++ {
				this.m[j] = mID
			}
			return i - size + 1
		}
	}
	return -1
}

func (this *Allocator) FreeMemory(mID int) int {
	ans := 0
	for i := 0; i < len(this.m); i++ {
		if this.m[i] == mID {
			this.m[i] = 0
			ans++
		}
	}
	return ans
}

/**
 * Your Allocator object will be instantiated and called as such:
 * obj := Constructor(n);
 * param_1 := obj.Allocate(size,mID);
 * param_2 := obj.FreeMemory(mID);
 */
方法二:哈希表 + 有序集合 · Go 实现
思考
方法一对每次调用都线性扫描整段内存。若只维护已占用区间,则空闲段是相邻占用块之间的空隙。
用有序集合保存占用区间并在两端各放哨兵 与 ,分配时按空隙长度做首次适配;再用哈希表记录每个 对应的若干区间,释放时按块删除。单次代价降为对占用块数量的对数。
我们可以用有序集合维护所有已分配的内存单元的起始下标和结束下标,其中起始下标为键,结束下标为值;另外用哈希表维护 mID 和其对应的内存单元的起始下标。
当调用 allocate 方法时,遍历有序集合,找到第一个长度大于等于 size 的空闲区间,将其分配给 mID,并更新有序集合。然后将 mID 和其对应的内存单元的起始下标加入哈希表。
当调用 free 方法时,从哈希表中找到 mID 对应的内存单元的起始下标,然后将其从有序集合中删除,再将 mID 从哈希表中删除。
时间复杂度 ,空间复杂度 ,其中 和 分别为内存空间的大小和方法调用的次数。
type Allocator struct {
	rbt *redblacktree.Tree
	d   map[int][]int
}

func Constructor(n int) Allocator {
	rbt := redblacktree.NewWithIntComparator()
	rbt.Put(-1, -1)
	rbt.Put(n, n)
	return Allocator{rbt, map[int][]int{}}
}

func (this *Allocator) Allocate(size int, mID int) int {
	s := -1
	it := this.rbt.Iterator()
	for it.Next() {
		v := it.Key().(int)
		if s != -1 {
			e := v - 1
			if e-s+1 >= size {
				this.rbt.Put(s, s+size-1)
				this.d[mID] = append(this.d[mID], s)
				return s
			}
		}
		s = it.Value().(int) + 1
	}
	return -1
}

func (this *Allocator) FreeMemory(mID int) int {
	ans := 0
	for _, s := range this.d[mID] {
		if e, ok := this.rbt.Get(s); ok {
			this.rbt.Remove(s)
			ans += e.(int) - s + 1
		}
	}
	this.d[mID] = []int{}
	return ans
}

/**
 * Your Allocator object will be instantiated and called as such:
 * obj := Constructor(n);
 * param_1 := obj.Allocate(size,mID);
 * param_2 := obj.FreeMemory(mID);
*/2526. 找到数据流中的连续整数
题目、示例与约束
给你一个整数数据流,请你实现一个数据结构,检查数据流中最后 k 个整数是否 等于 给定值 value 。
请你实现 DataStream 类:
DataStream(int value, int k)用两个整数value和k初始化一个空的整数数据流。boolean consec(int num)将num添加到整数数据流。如果后k个整数都等于value,返回true,否则返回false。如果少于k个整数,条件不满足,所以也返回false。
示例 1:
输入:
["DataStream", "consec", "consec", "consec", "consec"]
[[4, 3], [4], [4], [4], [3]]
输出:
[null, false, false, true, false]

解释:
DataStream dataStream = new DataStream(4, 3); // value = 4, k = 3
dataStream.consec(4); // 数据流中只有 1 个整数,所以返回 False 。
dataStream.consec(4); // 数据流中只有 2 个整数
                      // 由于 2 小于 k ,返回 False 。
dataStream.consec(4); // 数据流最后 3 个整数都等于 value, 所以返回 True 。
dataStream.consec(3); // 最后 k 个整数分别是 [4,4,3] 。
                      // 由于 3 不等于 value ,返回 False 。
提示:
1 <= value, num <= 1091 <= k <= 105- 至多调用
consec次数为105次。
方法一:计数 · Go 实现
思考
数据流中要判断最近 个整数是否都等于给定 。保存整段历史再每次切片检查,空间随调用次数增长。
只需连续相等的长度。维护计数器:当前值等于 则加一,否则清零,再与 比较。单次 。
我们可以维护一个计数器 ,记录当前连续整数为 的个数。
调用 consec 方法时,如果 与 相等,我们将 自增 1,否则将 重置为 0。然后判断 是否大于等于 即可。
时间复杂度 ,空间复杂度 。
type DataStream struct {
	val, k, cnt int
}

func Constructor(value int, k int) DataStream {
	return DataStream{value, k, 0}
}

func (this *DataStream) Consec(num int) bool {
	if num == this.val {
		this.cnt++
	} else {
		this.cnt = 0
	}
	return this.cnt >= this.k
}

/**
 * Your DataStream object will be instantiated and called as such:
 * obj := Constructor(value, k);
 * param_1 := obj.Consec(num);
*/继续阅读
- 实践案例
- 实践案例
- 实践案例