
LeetCode Go · 数据结构设计(2)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
381. O(1) 时间插入、删除和获取随机元素 - 允许重复
题目、示例与约束
RandomizedCollection 是一种包含数字集合(可能是重复的)的数据结构。它应该支持插入和删除特定元素,以及删除随机元素。
实现 RandomizedCollection 类:
RandomizedCollection()初始化空的RandomizedCollection对象。bool insert(int val)将一个val项插入到集合中,即使该项已经存在。如果该项不存在,则返回true,否则返回false。bool remove(int val)如果存在,从集合中移除一个val项。如果该项存在,则返回true,否则返回false。注意,如果val在集合中出现多次,我们只删除其中一个。int getRandom()从当前的多个元素集合中返回一个随机元素。每个元素被返回的概率与集合中包含的相同值的数量 线性相关 。
您必须实现类的函数,使每个函数的 平均 时间复杂度为 O(1) 。
注意:生成测试用例时,只有在 RandomizedCollection 中 至少有一项 时,才会调用 getRandom 。
示例 1:
输入
["RandomizedCollection", "insert", "insert", "insert", "getRandom", "remove", "getRandom"]
[[], [1], [1], [2], [], [1], []]
输出
[null, true, false, true, 2, true, 1]

解释
RandomizedCollection collection = new RandomizedCollection();// 初始化一个空的集合。
collection.insert(1);   // 返回 true,因为集合不包含 1。
                        // 将 1 插入到集合中。
collection.insert(1);   // 返回 false,因为集合包含 1。
                        // 将另一个 1 插入到集合中。集合现在包含 [1,1]。
collection.insert(2);   // 返回 true,因为集合不包含 2。
                        // 将 2 插入到集合中。集合现在包含 [1,1,2]。
collection.getRandom(); // getRandom 应当:
                        // 有 2/3 的概率返回 1,
                        // 1/3 的概率返回 2。
collection.remove(1);   // 返回 true,因为集合包含 1。
                        // 从集合中移除 1。集合现在包含 [1,2]。
collection.getRandom(); // getRandom 应该返回 1 或 2,两者的可能性相同。
提示:
-231 <= val <= 231 - 1insert,remove和getRandom最多 总共 被调用2 * 105次- 当调用
getRandom时,数据结构中 至少有一个 元素
方法一:Go 解法(本站整理) · Go 实现
本站根据题意与 Doocs 参考思路整理为 Go,非上游原文。按 CC BY-SA 4.0 共享。
切片保存所有出现次数,值映射到它在切片中的下标集合。删除时用末尾元素填补洞,再同步两种值的下标集合;特别处理被删值等于末尾值的情况。随机选择切片下标,重复值自然按出现次数获得概率。三种操作均为平均 O(1),空间 O(N)。GetRandom 仅在集合非空时调用。
import "math/rand"

type RandomizedCollection struct {
	values    []int
	positions map[int]map[int]struct{}
}

func Constructor() RandomizedCollection {
	return RandomizedCollection{positions: map[int]map[int]struct{}{}}
}
func (s *RandomizedCollection) Insert(val int) bool {
	set, ok := s.positions[val]
	if !ok {
		set = map[int]struct{}{}
		s.positions[val] = set
	}
	set[len(s.values)] = struct{}{}
	s.values = append(s.values, val)
	return !ok
}
func (s *RandomizedCollection) Remove(val int) bool {
	set, ok := s.positions[val]
	if !ok {
		return false
	}
	idx := 0
	for i := range set {
		idx = i
		break
	}
	lastIdx := len(s.values) - 1
	last := s.values[lastIdx]
	delete(set, idx)
	if idx != lastIdx {
		s.values[idx] = last
		delete(s.positions[last], lastIdx)
		s.positions[last][idx] = struct{}{}
	}
	s.values = s.values[:lastIdx]
	if len(set) == 0 {
		delete(s.positions, val)
	}
	return true
}
func (s *RandomizedCollection) GetRandom() int { return s.values[rand.Intn(len(s.values))] }384. 打乱数组
题目、示例与约束
给你一个整数数组 nums ,设计算法来打乱一个没有重复元素的数组。打乱后,数组的所有排列应该是 等可能 的。
实现 Solution class:
Solution(int[] nums)使用整数数组nums初始化对象int[] reset()重设数组到它的初始状态并返回int[] shuffle()返回数组随机打乱后的结果
示例 1:
输入
["Solution", "shuffle", "reset", "shuffle"]
[[[1, 2, 3]], [], [], []]
输出
[null, [3, 1, 2], [1, 2, 3], [1, 3, 2]]

解释
Solution solution = new Solution([1, 2, 3]);
solution.shuffle();    // 打乱数组 [1,2,3] 并返回结果。任何 [1,2,3]的排列返回的概率应该相同。例如,返回 [3, 1, 2]
solution.reset();      // 重设数组到它的初始状态 [1, 2, 3] 。返回 [1, 2, 3]
solution.shuffle();    // 随机返回数组 [1, 2, 3] 打乱后的结果。例如,返回 [1, 3, 2]
提示:
1 <= nums.length <= 50-106 <= nums[i] <= 106nums中的所有元素都是 唯一的- 最多可以调用
104次reset和shuffle
方法一 · Go 实现
思考
实现重置与均匀乱序。重置须保留原数组副本。Fisher–Yates 从左到右把 与 中随机位置交换,每个排列等概。
reset从副本拷回;shuffle就地洗牌后返回。
type Solution struct {
	nums, original []int
}

func Constructor(nums []int) Solution {
	return Solution{nums, append([]int(nil), nums...)}
}

func (this *Solution) Reset() []int {
	copy(this.nums, this.original)
	return this.nums
}

func (this *Solution) Shuffle() []int {
	n := len(this.nums)
	for i := range this.nums {
		j := i + rand.Intn(n-i)
		this.nums[i], this.nums[j] = this.nums[j], this.nums[i]
	}
	return this.nums
}

/**
 * Your Solution object will be instantiated and called as such:
 * obj := Constructor(nums);
 * param_1 := obj.Reset();
 * param_2 := obj.Shuffle();
*/431. 将 N 叉树编码为二叉树 🔒
题目、示例与约束
设计一个算法,可以将 N 叉树编码为二叉树,并能将该二叉树解码为原 N 叉树。一个 N 叉树是指每个节点都有不超过 N 个孩子节点的有根树。类似地,一个二叉树是指每个节点都有不超过 2 个孩子节点的有根树。你的编码 / 解码的算法的实现没有限制,你只需要保证一个 N 叉树可以编码为二叉树且该二叉树可以解码回原始 N 叉树即可。
例如,你可以将下面的 3-叉 树以该种方式编码:
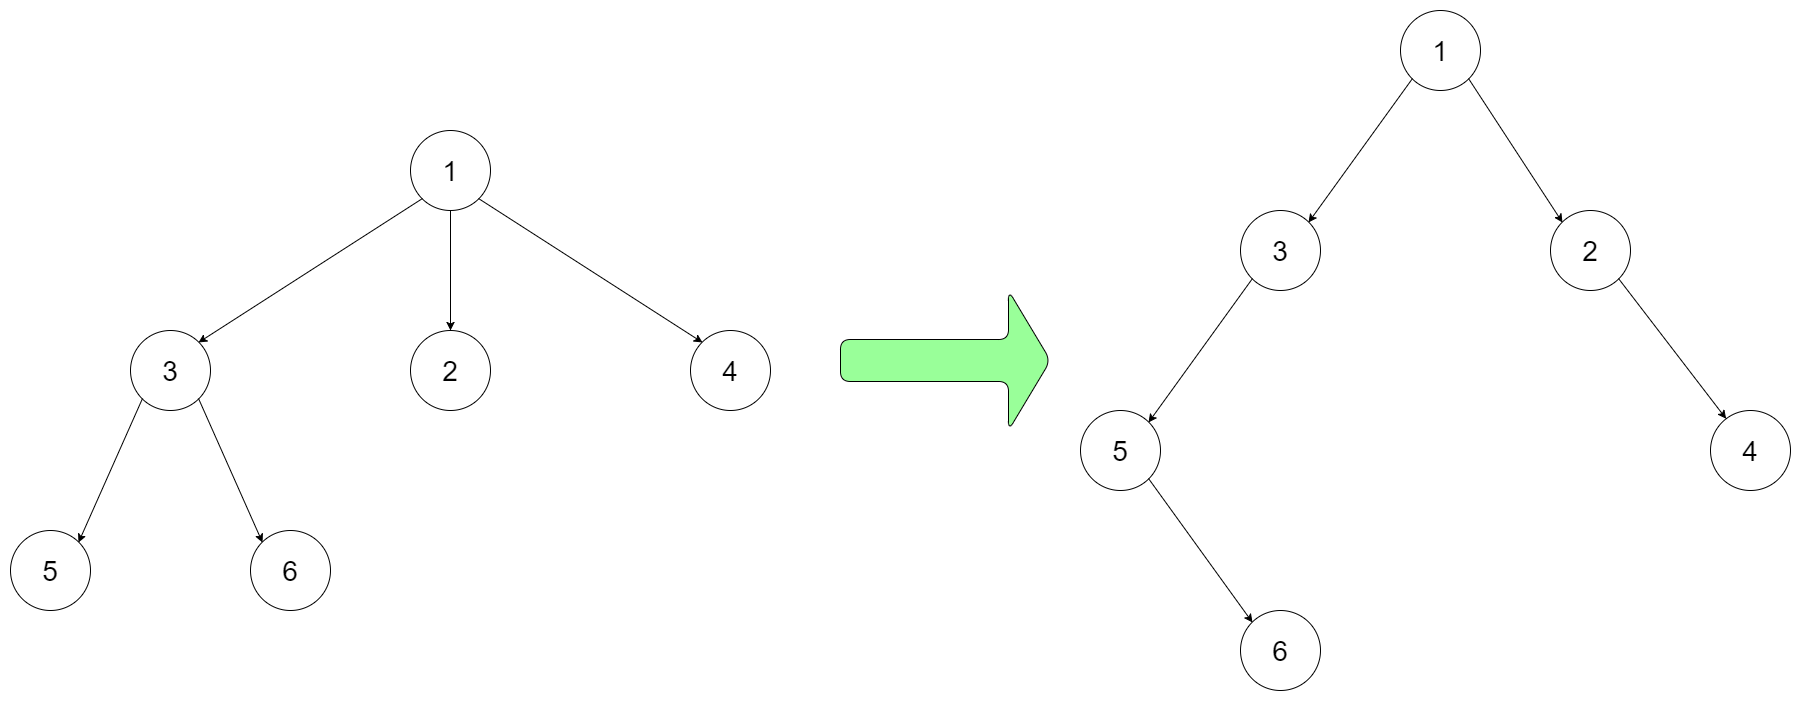
输入:root = [1,null,3,2,4,null,5,6]
注意,上面的方法仅仅是一个例子,可能可行也可能不可行。你没有必要遵循这种形式转化,你可以自己创造和实现不同的方法。
示例 1:
输入:root = [1,null,3,2,4,null,5,6]
输出:[1,null,3,2,4,null,5,6]
示例 2:
输入:root = [1,null,2,3,4,5,null,null,6,7,null,8,null,9,10,null,null,11,null,12,null,13,null,null,14]
输出:[1,null,2,3,4,5,null,null,6,7,null,8,null,9,10,null,null,11,null,12,null,13,null,null,14]
示例 3:
输入:root = []
输出:[]
提示:
N的范围在[1, 104]0 <= Node.val <= 104- N 叉树的高度小于等于
1000。 - 不要使用类成员 / 全局变量 / 静态变量来存储状态。你的编码和解码算法应是无状态的。
方法一:递归 · Go 实现
思考
二叉树只有左右两个指针,却要编码任意多个孩子。孩子之间本身有顺序,可以把「第一个孩子」与「下一个兄弟」分开存放。
编码时左指针指向第一个孩子,右指针沿兄弟链串起其余孩子。解码时从左孩子出发,沿右指针收集兄弟并递归还原。
这一对应可逆:每个 N 叉结点的孩子列表被唯一地写成一条右链,挂在左孩子上。
我们可以将二叉树的左指针指向 N 叉树的第一个孩子,将二叉树的右指针指向 N 叉树的下一个兄弟节点。
时间复杂度 ,空间复杂度 。其中 为 N 叉树的节点数量。
/**
 * Definition for a Node.
 * type Node struct {
 *     Val int
 *     Children []*Node
 * }
 */

/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */

type Codec struct {
}

func Constructor() *Codec {
	return &Codec{}
}

// Encodes an n-ary tree to a binary tree.
func (this *Codec) encode(root *Node) *TreeNode {
	if root == nil {
		return nil
	}
	node := &TreeNode{Val: root.Val}
	if len(root.Children) == 0 {
		return node
	}
	left := this.encode(root.Children[0])
	node.Left = left
	for i := 1; i < len(root.Children); i++ {
		left.Right = this.encode(root.Children[i])
		left = left.Right
	}
	return node
}

// Decodes your binary tree to an n-ary tree.
func (this *Codec) decode(data *TreeNode) *Node {
	if data == nil {
		return nil
	}
	node := &Node{Val: data.Val, Children: []*Node{}}
	if data.Left == nil {
		return node
	}
	left := data.Left
	for left != nil {
		node.Children = append(node.Children, this.decode(left))
		left = left.Right
	}
	return node
}

/**
 * Your Codec object will be instantiated and called as such:
 * obj := Constructor();
 * bst := obj.encode(root);
 * ans := obj.decode(bst);
*/432. 全 O(1) 的数据结构
题目、示例与约束
请你设计一个用于存储字符串计数的数据结构,并能够返回计数最小和最大的字符串。
实现 AllOne 类:
AllOne()初始化数据结构的对象。inc(String key)字符串key的计数增加1。如果数据结构中尚不存在key,那么插入计数为1的key。dec(String key)字符串key的计数减少1。如果key的计数在减少后为0,那么需要将这个key从数据结构中删除。测试用例保证:在减少计数前,key存在于数据结构中。getMaxKey()返回任意一个计数最大的字符串。如果没有元素存在,返回一个空字符串""。getMinKey()返回任意一个计数最小的字符串。如果没有元素存在,返回一个空字符串""。
注意:每个函数都应当满足 O(1) 平均时间复杂度。
示例:
输入
["AllOne", "inc", "inc", "getMaxKey", "getMinKey", "inc", "getMaxKey", "getMinKey"]
[[], ["hello"], ["hello"], [], [], ["leet"], [], []]
输出
[null, null, null, "hello", "hello", null, "hello", "leet"]

解释
AllOne allOne = new AllOne();
allOne.inc("hello");
allOne.inc("hello");
allOne.getMaxKey(); // 返回 "hello"
allOne.getMinKey(); // 返回 "hello"
allOne.inc("leet");
allOne.getMaxKey(); // 返回 "hello"
allOne.getMinKey(); // 返回 "leet"
提示:
1 <= key.length <= 10key由小写英文字母组成- 测试用例保证:在每次调用
dec时,数据结构中总存在key - 最多调用
inc、dec、getMaxKey和getMinKey方法5 * 104次
方法一:Go 解法(本站整理) · Go 实现
本站根据题意与 Doocs 参考思路整理为 Go,非上游原文。按 CC BY-SA 4.0 共享。
双向链表中的桶按计数升序排列,每个桶保存具有该计数的键集合。另用哈希表将键定位到桶。Inc、Dec 只需移动到相邻计数桶,必要时创建桶并删除空桶;首尾桶直接给出最小、最大键。所有操作平均 O(1),空间 O(K),K 是当前键数。
type bucket struct {
	count      int
	keys       map[string]struct{}
	prev, next *bucket
}
type AllOne struct {
	root  *bucket
	where map[string]*bucket
}

func Constructor() AllOne {
	r := &bucket{}
	r.prev = r
	r.next = r
	return AllOne{r, map[string]*bucket{}}
}
func insertAfter(b *bucket, count int) *bucket {
	x := &bucket{count: count, keys: map[string]struct{}{}, prev: b, next: b.next}
	b.next.prev = x
	b.next = x
	return x
}
func removeBucket(b *bucket) { b.prev.next = b.next; b.next.prev = b.prev }
func (s *AllOne) Inc(key string) {
	b := s.where[key]
	if b == nil {
		b = s.root
	}
	next := b.next
	if next == s.root || next.count != b.count+1 {
		next = insertAfter(b, b.count+1)
	}
	next.keys[key] = struct{}{}
	s.where[key] = next
	if b != s.root {
		delete(b.keys, key)
		if len(b.keys) == 0 {
			removeBucket(b)
		}
	}
}
func (s *AllOne) Dec(key string) {
	b := s.where[key]
	if b.count == 1 {
		delete(s.where, key)
	} else {
		prev := b.prev
		if prev == s.root || prev.count != b.count-1 {
			prev = insertAfter(b.prev, b.count-1)
		}
		prev.keys[key] = struct{}{}
		s.where[key] = prev
	}
	delete(b.keys, key)
	if len(b.keys) == 0 {
		removeBucket(b)
	}
}
func (s *AllOne) GetMaxKey() string {
	for k := range s.root.prev.keys {
		return k
	}
	return ""
}
func (s *AllOne) GetMinKey() string {
	for k := range s.root.next.keys {
		return k
	}
	return ""
}449. 序列化和反序列化二叉搜索树
题目、示例与约束
序列化是将数据结构或对象转换为一系列位的过程,以便它可以存储在文件或内存缓冲区中,或通过网络连接链路传输,以便稍后在同一个或另一个计算机环境中重建。
设计一个算法来序列化和反序列化 二叉搜索树 。 对序列化/反序列化算法的工作方式没有限制。 您只需确保二叉搜索树可以序列化为字符串,并且可以将该字符串反序列化为最初的二叉搜索树。
编码的字符串应尽可能紧凑。
示例 1:
输入:root = [2,1,3]
输出:[2,1,3]
示例 2:
输入:root = []
输出:[]
提示:
- 树中节点数范围是
[0, 104] 0 <= Node.val <= 104- 题目数据 保证 输入的树是一棵二叉搜索树。
方法一:先序遍历 · Go 实现
思考
普通二叉树序列化需要空结点占位。BST 的中序已知有序,先序遍历加上值域即可唯一还原,不必存空标记。
序列化只写先序值。反序列化维护区间 :下一个值落在区间内才建结点,并分别对左子树 、右子树 递归。
先序保证下一个合法值一定是当前子树的根;越界则该子树为空,指针不前进。
题目给定的是二叉搜索树,我们知道二叉搜索树的中序遍历是有序的,而通过“先序遍历”和“中序遍历”可以唯一确定一棵二叉树,所以我们可以通过先序遍历的结果和中序遍历的结果来唯一确定一棵二叉搜索树。
在 serialize 方法中,我们使用先序遍历的方式将二叉搜索树序列化为空格分隔的字符串,然后在 deserialize 方法中,我们将字符串按空格分割为数组,然后使用递归的方式来构建二叉搜索树。递归函数为 ,表示当前节点的值必须在 之间,如果当前节点的值不在 之间,则说明这个节点不是当前递归树的节点,返回 None。
时间复杂度 ,空间复杂度 。其中 是二叉搜索树的节点数。
/**
 * Definition for a binary tree node.
 * type TreeNode struct {
 *     Val int
 *     Left *TreeNode
 *     Right *TreeNode
 * }
 */

type Codec struct {
}

func Constructor() Codec {
	return Codec{}
}

// Serializes a tree to a single string.
func (this *Codec) serialize(root *TreeNode) string {
	if root == nil {
		return ""
	}
	data := &strings.Builder{}
	var dfs func(*TreeNode)
	dfs = func(root *TreeNode) {
		if root == nil {
			return
		}
		data.WriteString(strconv.Itoa(root.Val))
		data.WriteByte(' ')
		dfs(root.Left)
		dfs(root.Right)
	}
	dfs(root)
	return data.String()[0 : data.Len()-1]
}

// Deserializes your encoded data to tree.
func (this *Codec) deserialize(data string) *TreeNode {
	if data == "" {
		return nil
	}
	vals := strings.Split(data, " ")
	i := 0
	var dfs func(int, int) *TreeNode
	dfs = func(mi, mx int) *TreeNode {
		if i == len(vals) {
			return nil
		}
		x, _ := strconv.Atoi(vals[i])
		if x < mi || x > mx {
			return nil
		}
		i++
		root := &TreeNode{Val: x}
		root.Left = dfs(mi, x)
		root.Right = dfs(x, mx)
		return root
	}
	return dfs(math.MinInt64, math.MaxInt64)
}

/**
 * Your Codec object will be instantiated and called as such:
 * ser := Constructor()
 * deser := Constructor()
 * tree := ser.serialize(root)
 * ans := deser.deserialize(tree)
 * return ans
*/460. LFU 缓存
题目、示例与约束
请你为 最不经常使用(LFU)缓存算法设计并实现数据结构。
实现 LFUCache 类:
LFUCache(int capacity)- 用数据结构的容量capacity初始化对象int get(int key)- 如果键key存在于缓存中,则获取键的值,否则返回-1。void put(int key, int value)- 如果键key已存在,则变更其值;如果键不存在,请插入键值对。当缓存达到其容量capacity时,则应该在插入新项之前,移除最不经常使用的项。在此问题中,当存在平局(即两个或更多个键具有相同使用频率)时,应该去除 最久未使用 的键。
为了确定最不常使用的键,可以为缓存中的每个键维护一个 使用计数器 。使用计数最小的键是最久未使用的键。
当一个键首次插入到缓存中时,它的使用计数器被设置为 1 (由于 put 操作)。对缓存中的键执行 get 或 put 操作,使用计数器的值将会递增。
函数 get 和 put 必须以 O(1) 的平均时间复杂度运行。
示例:
输入:
["LFUCache", "put", "put", "get", "put", "get", "get", "put", "get", "get", "get"]
[[2], [1, 1], [2, 2], [1], [3, 3], [2], [3], [4, 4], [1], [3], [4]]
输出:
[null, null, null, 1, null, -1, 3, null, -1, 3, 4]

解释:
// cnt(x) = 键 x 的使用计数
// cache=[] 将显示最后一次使用的顺序(最左边的元素是最近的)
LFUCache lfu = new LFUCache(2);
lfu.put(1, 1);   // cache=[1,_], cnt(1)=1
lfu.put(2, 2);   // cache=[2,1], cnt(2)=1, cnt(1)=1
lfu.get(1);      // 返回 1
                 // cache=[1,2], cnt(2)=1, cnt(1)=2
lfu.put(3, 3);   // 去除键 2 ,因为 cnt(2)=1 ,使用计数最小
                 // cache=[3,1], cnt(3)=1, cnt(1)=2
lfu.get(2);      // 返回 -1(未找到)
lfu.get(3);      // 返回 3
                 // cache=[3,1], cnt(3)=2, cnt(1)=2
lfu.put(4, 4);   // 去除键 1 ,1 和 3 的 cnt 相同,但 1 最久未使用
                 // cache=[4,3], cnt(4)=1, cnt(3)=2
lfu.get(1);      // 返回 -1(未找到)
lfu.get(3);      // 返回 3
                 // cache=[3,4], cnt(4)=1, cnt(3)=3
lfu.get(4);      // 返回 4
                 // cache=[3,4], cnt(4)=2, cnt(3)=3
提示:
1 <= capacity <= 1040 <= key <= 1050 <= value <= 109- 最多调用
2 * 105次get和put方法
方法一:双哈希表 + 双向链表 · Go 实现
思考
LFU 要在 内读写,容量满时淘汰频率最低且最久未用的键。单一哈希表能取值,不能同时维护频率与 LRU 次序。
键到结点的哈希表保证查找; 双向链表存放同频结点,新结点插到链表头表示最近。另记 ,淘汰时删该链表尾。
访问或更新后把结点移到 的链表;若原链表空且频率等于 ,最小频率加一。新键频率为 ,最小频率重置为 。
我们定义两个哈希表,其中:
- 哈希表 :用于存储缓存的键值对,哈希表的键 对应到缓存节点 ,方便 时间内获取缓存节点。
- 哈希表 :用于存储使用频率相同的缓存节点的双向链表,哈希表的键 对应到双向链表 ,方便 时间内获取使用频率相同的缓存节点的双向链表。
另外,我们还需要维护一个变量 ,用于记录当前最小的使用频率,方便 时间内获取最小使用频率的缓存节点。
对于 操作:
我们首先判断 是否为 或者 中是否存在键 ,如果不存在则返回 ;否则从 中获取缓存节点 ,并将 的使用频率加 ,最后返回 的值。
对于 操作:
我们首先判断 是否为 ,如果为 则直接返回;
否则判断 中是否存在键 ,如果存在则从 中获取缓存节点 ,更新 的值为 ,并将 的使用频率加 ,最后返回 的值;
如果不存在则判断 的长度是否等于 ,如果等于 则从 中获取使用频率最小的双向链表 ,从 中删除最后一个节点,并且移除该节点对应的键值对。然后创建新的缓存节点 ,将 的使用频率设置为 ,将 添加到 和 中,最后将 设置为 。
时间复杂度方面,操作 和 的时间复杂度都是 。空间复杂度 ,其中 为缓存的容量。
type LFUCache struct {
	cache    map[int]*node
	freqMap  map[int]*list
	minFreq  int
	capacity int
}

func Constructor(capacity int) LFUCache {
	return LFUCache{
		cache:    make(map[int]*node),
		freqMap:  make(map[int]*list),
		capacity: capacity,
	}
}

func (this *LFUCache) Get(key int) int {
	if this.capacity == 0 {
		return -1
	}

	n, ok := this.cache[key]
	if !ok {
		return -1
	}

	this.incrFreq(n)
	return n.val
}

func (this *LFUCache) Put(key int, value int) {
	if this.capacity == 0 {
		return
	}

	n, ok := this.cache[key]
	if ok {
		n.val = value
		this.incrFreq(n)
		return
	}

	if len(this.cache) == this.capacity {
		l := this.freqMap[this.minFreq]
		delete(this.cache, l.removeBack().key)
	}
	n = &node{key: key, val: value, freq: 1}
	this.addNode(n)
	this.cache[key] = n
	this.minFreq = 1
}

func (this *LFUCache) incrFreq(n *node) {
	l := this.freqMap[n.freq]
	l.remove(n)
	if l.empty() {
		delete(this.freqMap, n.freq)
		if n.freq == this.minFreq {
			this.minFreq++
		}
	}
	n.freq++
	this.addNode(n)
}

func (this *LFUCache) addNode(n *node) {
	l, ok := this.freqMap[n.freq]
	if !ok {
		l = newList()
		this.freqMap[n.freq] = l
	}
	l.pushFront(n)
}

type node struct {
	key  int
	val  int
	freq int
	prev *node
	next *node
}

type list struct {
	head *node
	tail *node
}

func newList() *list {
	head := new(node)
	tail := new(node)
	head.next = tail
	tail.prev = head
	return &list{
		head: head,
		tail: tail,
	}
}

func (l *list) pushFront(n *node) {
	n.prev = l.head
	n.next = l.head.next
	l.head.next.prev = n
	l.head.next = n
}

func (l *list) remove(n *node) {
	n.prev.next = n.next
	n.next.prev = n.prev
	n.next = nil
	n.prev = nil
}

func (l *list) removeBack() *node {
	n := l.tail.prev
	l.remove(n)
	return n
}

func (l *list) empty() bool {
	return l.head.next == l.tail
}535. TinyURL 的加密与解密
题目、示例与约束
TinyURL 是一种 URL 简化服务, 比如:当你输入一个 URL https://leetcode.com/problems/design-tinyurl 时,它将返回一个简化的URL http://tinyurl.com/4e9iAk 。请你设计一个类来加密与解密 TinyURL 。
加密和解密算法如何设计和运作是没有限制的,你只需要保证一个 URL 可以被加密成一个 TinyURL ,并且这个 TinyURL 可以用解密方法恢复成原本的 URL 。
实现 Solution 类:
Solution()初始化 TinyURL 系统对象。String encode(String longUrl)返回longUrl对应的 TinyURL 。String decode(String shortUrl)返回shortUrl原本的 URL 。题目数据保证给定的shortUrl是由同一个系统对象加密的。
示例:
输入:url = "https://leetcode.com/problems/design-tinyurl"
输出:"https://leetcode.com/problems/design-tinyurl"

解释:
Solution obj = new Solution();
string tiny = obj.encode(url); // 返回加密后得到的 TinyURL 。
string ans = obj.decode(tiny); // 返回解密后得到的原本的 URL 。
提示:
1 <= url.length <= 104- 题目数据保证
url是一个有效的 URL
方法一:哈希表 · Go 实现
思考
需要可逆的短链:编码后能解码回原 URL。哈希到固定短串可能碰撞,也要处理冲突表。
本题不要求短码不可预测,递增整数即可。哈希表保存
id -> 长链,短链是域名加上该 id;解码时取最后一段当键。编码、解码都是常数时间。
type Codec struct {
	m   map[int]string
	idx int
}

func Constructor() Codec {
	m := map[int]string{}
	return Codec{m, 0}
}

// Encodes a URL to a shortened URL.
func (this *Codec) encode(longUrl string) string {
	this.idx++
	this.m[this.idx] = longUrl
	return "https://tinyurl.com/" + strconv.Itoa(this.idx)
}

// Decodes a shortened URL to its original URL.
func (this *Codec) decode(shortUrl string) string {
	i := strings.LastIndexByte(shortUrl, '/')
	v, _ := strconv.Atoi(shortUrl[i+1:])
	return this.m[v]
}

/**
 * Your Codec object will be instantiated and called as such:
 * obj := Constructor();
 * url := obj.encode(longUrl);
 * ans := obj.decode(url);
*/588. 设计内存文件系统 🔒
题目、示例与约束
设计一个内存文件系统,模拟以下功能:
实现文件系统类:
FileSystem()初始化系统对象List<String> ls(String path)- 如果
path是一个文件路径,则返回一个仅包含该文件名称的列表。 - 如果
path是一个目录路径,则返回该目录中文件和 目录名 的列表。
- 如果
答案应该 按字典顺序 排列。
void mkdir(String path)根据给定的路径创建一个新目录。给定的目录路径不存在。如果路径中的中间目录不存在,您也应该创建它们。void addContentToFile(String filePath, String content)- 如果
filePath不存在,则创建包含给定内容content的文件。 - 如果
filePath已经存在,将给定的内容content附加到原始内容。
- 如果
String readContentFromFile(String filePath)返回filePath下的文件内容。
示例 1:
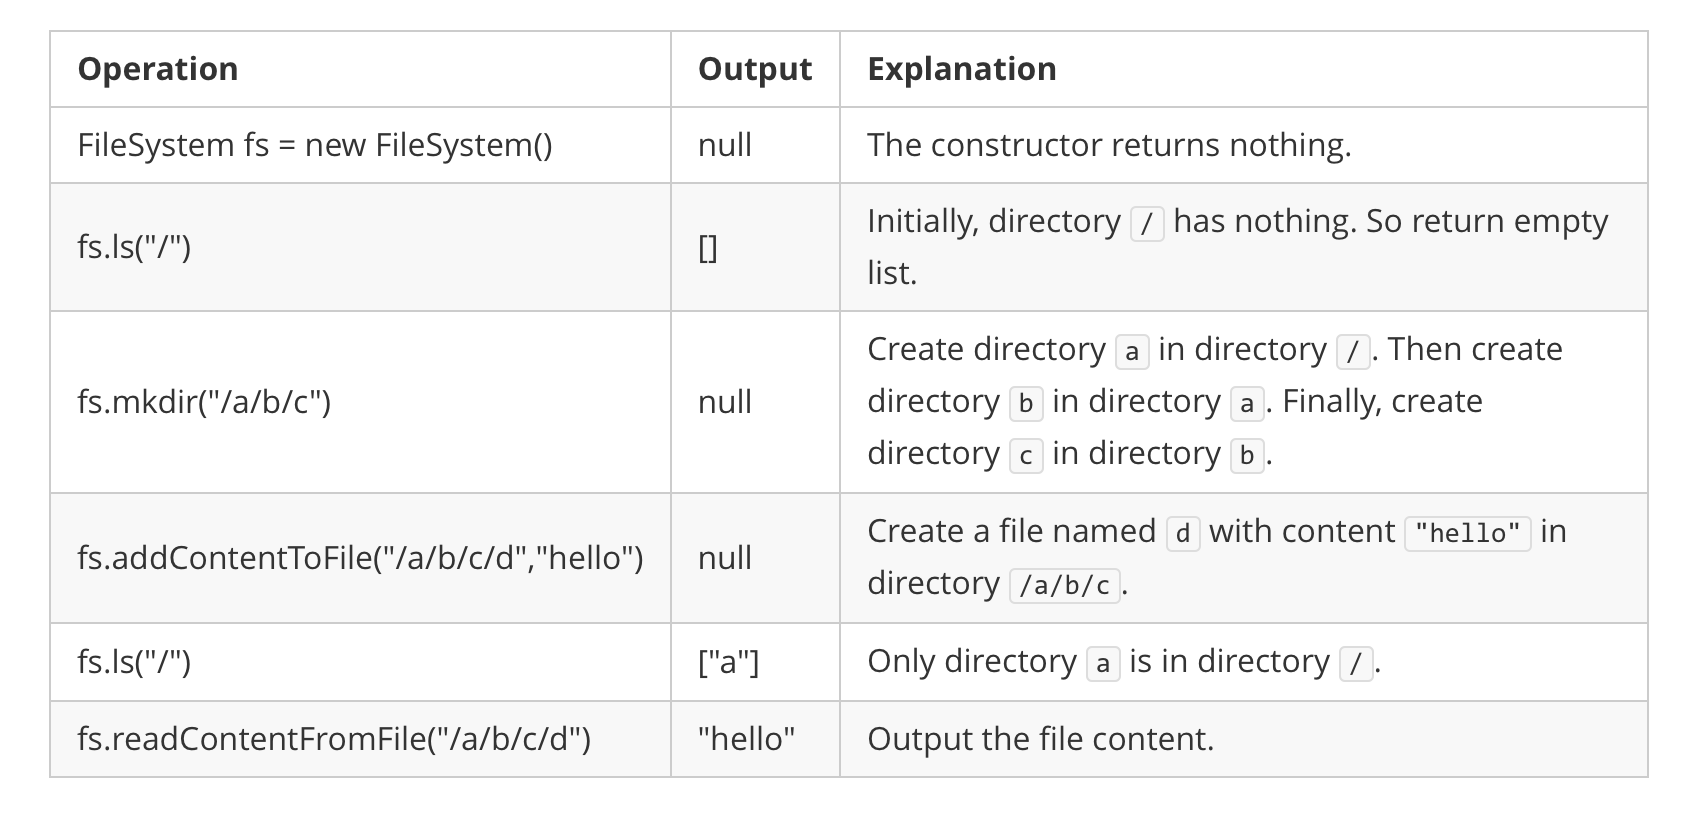
输入:
["FileSystem","ls","mkdir","addContentToFile","ls","readContentFromFile"]
[[],["/"],["/a/b/c"],["/a/b/c/d","hello"],["/"],["/a/b/c/d"]]
输出:
[null,[],null,null,["a"],"hello"]

解释:
FileSystem fileSystem = new FileSystem();
fileSystem.ls("/");                         // 返回 []
fileSystem.mkdir("/a/b/c");
fileSystem.addContentToFile("/a/b/c/d", "hello");
fileSystem.ls("/");                         // 返回 ["a"]
fileSystem.readContentFromFile("/a/b/c/d"); // 返回 "hello"
注意:
1 <= path.length, filePath.length <= 100path和filePath都是绝对路径,除非是根目录‘/’自身,其他路径都是以‘/’开头且 不 以‘/’结束。- 你可以假定所有操作的参数都是有效的,即用户不会获取不存在文件的内容,或者获取不存在文件夹和文件的列表。
- 你可以假定所有文件夹名字和文件名字都只包含小写字母,且同一文件夹下不会有相同名字的文件夹或文件。
- 你可以假定
addContentToFile中的文件的父目录都存在。 1 <= content.length <= 50ls,mkdir,addContentToFile, andreadContentFromFile最多被调用300次
方法一:前缀树 · Go 实现
思考
文件系统要按路径分层:
ls、mkdir、追加与读取。把整棵目录做成哈希表路径可以,但前缀共享与目录列举不自然。字典树按路径分量向下走:每个节点带
children、是否文件、以及文件内容列表。insert沿途建节点,search走到目标。ls对文件返回文件名,对目录返回排序后的子名。路径操作与树深成正比。
哈希表实现前缀树。
type Trie struct {
	name     string
	isFile   bool
	content  strings.Builder
	children map[string]*Trie
}

func newTrie() *Trie {
	m := map[string]*Trie{}
	return &Trie{children: m}
}

func (this *Trie) insert(path string, isFile bool) *Trie {
	node := this
	ps := strings.Split(path, "/")
	for _, p := range ps[1:] {
		if _, ok := node.children[p]; !ok {
			node.children[p] = newTrie()
		}
		node, _ = node.children[p]
	}
	node.isFile = isFile
	if isFile {
		node.name = ps[len(ps)-1]
	}
	return node
}

func (this *Trie) search(path string) *Trie {
	if path == "/" {
		return this
	}
	node := this
	ps := strings.Split(path, "/")
	for _, p := range ps[1:] {
		if _, ok := node.children[p]; !ok {
			return nil
		}
		node, _ = node.children[p]
	}
	return node
}

type FileSystem struct {
	root *Trie
}

func Constructor() FileSystem {
	root := newTrie()
	return FileSystem{root}
}

func (this *FileSystem) Ls(path string) []string {
	var ans []string
	node := this.root.search(path)
	if node == nil {
		return ans
	}
	if node.isFile {
		ans = append(ans, node.name)
		return ans
	}
	for v := range node.children {
		ans = append(ans, v)
	}
	sort.Strings(ans)
	return ans
}

func (this *FileSystem) Mkdir(path string) {
	this.root.insert(path, false)
}

func (this *FileSystem) AddContentToFile(filePath string, content string) {
	node := this.root.insert(filePath, true)
	node.content.WriteString(content)
}

func (this *FileSystem) ReadContentFromFile(filePath string) string {
	node := this.root.search(filePath)
	return node.content.String()
}

/**
 * Your FileSystem object will be instantiated and called as such:
 * obj := Constructor();
 * param_1 := obj.Ls(path);
 * obj.Mkdir(path);
 * obj.AddContentToFile(filePath,content);
 * param_4 := obj.ReadContentFromFile(filePath);
*/604. 迭代压缩字符串 🔒
题目、示例与约束
设计并实现一个迭代压缩字符串的数据结构。给定的压缩字符串的形式是,每个字母后面紧跟一个正整数,表示该字母在原始未压缩字符串中出现的次数。
设计一个数据结构,它支持如下两种操作: next 和 hasNext。
next()- 如果原始字符串中仍有未压缩字符,则返回下一个字符,否则返回空格。hasNext()- 如果原始字符串中存在未压缩的的字母,则返回true,否则返回false。
示例 1:
输入:
["StringIterator", "next", "next", "next", "next", "next", "next", "hasNext", "next", "hasNext"]
[["L1e2t1C1o1d1e1"], [], [], [], [], [], [], [], [], []]
输出:
[null, "L", "e", "e", "t", "C", "o", true, "d", true]

解释:
StringIterator stringIterator = new StringIterator("L1e2t1C1o1d1e1");
stringIterator.next(); // 返回 "L"
stringIterator.next(); // 返回 "e"
stringIterator.next(); // 返回 "e"
stringIterator.next(); // 返回 "t"
stringIterator.next(); // 返回 "C"
stringIterator.next(); // 返回 "o"
stringIterator.hasNext(); // 返回 True
stringIterator.next(); // 返回 "d"
stringIterator.hasNext(); // 返回 True
提示:
1 <= compressedString.length <= 1000compressedString由小写字母、大写字母和数字组成。- 在
compressedString中,单个字符的重复次数在[1,10 ^9]范围内。 next和hasNext的操作数最多为100。
方法一:解析存储 · Go 实现
思考
next可能被多次调用,每次从压缩串现场解析数字,指针管理容易出错且重复扫描。构造时按「字母 + 十进制次数」拆成 列表,查询时只维护下标 并递减次数。摊还后每次 。
将 compressedString 解析成字符 和对应的重复次数 ,存储在数组或列表 中,用 指向当前字符。
然后在 next 和 hasNext 中进行操作。
初始化的时间复杂度为 ,其余操作的时间复杂度为 。其中 为 compressedString 的长度。
type pair struct {
	c byte
	x int
}

type StringIterator struct {
	d []pair
	p int
}

func Constructor(compressedString string) StringIterator {
	n := len(compressedString)
	i := 0
	d := []pair{}
	for i < n {
		c := compressedString[i]
		x := 0
		i++
		for i < n && compressedString[i] >= '0' && compressedString[i] <= '9' {
			x = x*10 + int(compressedString[i]-'0')
			i++
		}
		d = append(d, pair{c, x})
	}
	return StringIterator{d, 0}
}

func (this *StringIterator) Next() byte {
	if !this.HasNext() {
		return ' '
	}
	ans := this.d[this.p].c
	this.d[this.p].x--
	if this.d[this.p].x == 0 {
		this.p++
	}
	return ans
}

func (this *StringIterator) HasNext() bool {
	return this.p < len(this.d) && this.d[this.p].x > 0
}

/**
 * Your StringIterator object will be instantiated and called as such:
 * obj := Constructor(compressedString);
 * param_1 := obj.Next();
 * param_2 := obj.HasNext();
*/622. 设计循环队列
题目、示例与约束
设计你的循环队列实现。 循环队列是一种线性数据结构,其操作表现基于 FIFO(先进先出)原则并且队尾被连接在队首之后以形成一个循环。它也被称为“环形缓冲器”。
循环队列的一个好处是我们可以利用这个队列之前用过的空间。在一个普通队列里,一旦一个队列满了,我们就不能插入下一个元素,即使在队列前面仍有空间。但是使用循环队列,我们能使用这些空间去存储新的值。
你的实现应该支持如下操作:
MyCircularQueue(k): 构造器,设置队列长度为 k 。Front: 从队首获取元素。如果队列为空,返回 -1 。Rear: 获取队尾元素。如果队列为空,返回 -1 。enQueue(value): 向循环队列插入一个元素。如果成功插入则返回真。deQueue(): 从循环队列中删除一个元素。如果成功删除则返回真。isEmpty(): 检查循环队列是否为空。isFull(): 检查循环队列是否已满。
示例:
MyCircularQueue circularQueue = new MyCircularQueue(3); // 设置长度为 3
circularQueue.enQueue(1);  // 返回 true
circularQueue.enQueue(2);  // 返回 true
circularQueue.enQueue(3);  // 返回 true
circularQueue.enQueue(4);  // 返回 false,队列已满
circularQueue.Rear();  // 返回 3
circularQueue.isFull();  // 返回 true
circularQueue.deQueue();  // 返回 true
circularQueue.enQueue(4);  // 返回 true
circularQueue.Rear();  // 返回 4
提示:
- 所有的值都在 0 至 1000 的范围内;
- 操作数将在 1 至 1000 的范围内;
- 请不要使用内置的队列库。
方法一:数组模拟 · Go 实现
思考
循环队列要在定长数组上 入队出队,并区分空与满。只用头尾指针时,二者相等会歧义。
另存 :队头为 ,队尾写在 。空满直接看 与容量,取尾用 。
我们可以使用一个长度为 的数组 来模拟循环队列,用一个指针 记录队首元素的位置,初始时队列为空,而 为 。另外,我们用一个变量 记录队列中元素的个数,初始时 为 。
调用 enQueue 方法时,我们首先检查队列是否已满,即 ,如果满了则直接返回 。否则,我们将元素插入到 的位置,然后 ,表示队列中元素的个数增加了 。最后返回 。
调用 deQueue 方法时,我们首先检查队列是否为空,即 ,如果为空则直接返回 。否则,我们将 ,表示队首元素出队,然后 ,
调用 Front 方法时,我们首先检查队列是否为空,即 ,如果为空则返回 。否则,返回 。
调用 Rear 方法时,我们首先检查队列是否为空,即 ,如果为空则返回 。否则,返回 。
调用 isEmpty 方法时,我们只需判断 即可。
调用 isFull 方法时,我们只需判断 即可。
时间复杂度方面,以上操作的时间复杂度均为 。空间复杂度为 。
type MyCircularQueue struct {
	front    int
	size     int
	capacity int
	q        []int
}

func Constructor(k int) MyCircularQueue {
	q := make([]int, k)
	return MyCircularQueue{0, 0, k, q}
}

func (this *MyCircularQueue) EnQueue(value int) bool {
	if this.IsFull() {
		return false
	}
	idx := (this.front + this.size) % this.capacity
	this.q[idx] = value
	this.size++
	return true
}

func (this *MyCircularQueue) DeQueue() bool {
	if this.IsEmpty() {
		return false
	}
	this.front = (this.front + 1) % this.capacity
	this.size--
	return true
}

func (this *MyCircularQueue) Front() int {
	if this.IsEmpty() {
		return -1
	}
	return this.q[this.front]
}

func (this *MyCircularQueue) Rear() int {
	if this.IsEmpty() {
		return -1
	}
	idx := (this.front + this.size - 1) % this.capacity
	return this.q[idx]
}

func (this *MyCircularQueue) IsEmpty() bool {
	return this.size == 0
}

func (this *MyCircularQueue) IsFull() bool {
	return this.size == this.capacity
}

/**
 * Your MyCircularQueue object will be instantiated and called as such:
 * obj := Constructor(k);
 * param_1 := obj.EnQueue(value);
 * param_2 := obj.DeQueue();
 * param_3 := obj.Front();
 * param_4 := obj.Rear();
 * param_5 := obj.IsEmpty();
 * param_6 := obj.IsFull();
*/631. 设计 Excel 求和公式 🔒
题目、示例与约束
请你设计 Excel 中的基本功能,并实现求和公式。
实现 Excel 类:
Excel(int height, char width):用高度height和宽度width初始化对象。该表格是一个大小为height x width的整数矩阵mat,其中行下标范围是[1, height],列下标范围是['A', width]。初始情况下,所有的值都应该为 零 。void set(int row, char column, int val):将mat[row][column]的值更改为val。int get(int row, char column):返回mat[row][column]的值。int sum(int row, char column, List<String> numbers):将mat[row][column]的值设为由numbers表示的单元格的和,并返回mat[row][column]的值。此求和公式应该 长期作用于 该单元格,直到该单元格被另一个值或另一个求和公式覆盖。其中,numbers[i]的格式可以为:"ColRow":表示某个单元格。- 例如,
"F7"表示单元格mat[7]['F']。
- 例如,
"ColRow1:ColRow2":表示一组单元格。该范围将始终为一个矩形,其中"ColRow1"表示左上角单元格的位置,"ColRow2"表示右下角单元格的位置。- 例如,
"B3:F7"表示3 <= i <= 7和'B' <= j <= 'F'的单元格mat[i][j]。
- 例如,
注意:可以假设不会出现循环求和引用。
- 例如,
mat[1]['A'] == sum(1, "B"),且mat[1]['B'] == sum(1, "A")。
示例 1:
输入:
["Excel", "set", "sum", "set", "get"]
[[3, "C"], [1, "A", 2], [3, "C", ["A1", "A1:B2"]], [2, "B", 2], [3, "C"]]
输出:
[null, null, 4, null, 6]

解释:
执行以下操作:
Excel excel = new Excel(3, "C");
 // 构造一个 3 * 3 的二维数组,所有值初始化为零。
 //   A B C
 // 1 0 0 0
 // 2 0 0 0
 // 3 0 0 0
excel.set(1, "A", 2);
 // 将 mat[1]["A"] 设置为 2 。
 //   A B C
 // 1 2 0 0
 // 2 0 0 0
 // 3 0 0 0
excel.sum(3, "C", ["A1", "A1:B2"]); // 返回 4
 // 将 mat[3]["C"] 设置为 mat[1]["A"] 的值与矩形范围的单元格和的和,该范围的左上角单元格位置为 mat[1]["A"] ,右下角单元格位置为 mat[2]["B"] 。
 //   A B C
 // 1 2 0 0
 // 2 0 0 0
 // 3 0 0 4
excel.set(2, "B", 2);
 // 将 mat[2]["B"] 设置为 2 。注意 mat[3]["C"] 也应该更改。
 //   A B C
 // 1 2 0 0
 // 2 0 2 0
 // 3 0 0 6
excel.get(3, "C"); // 返回 6
提示:
1 <= height <= 26'A' <= width <= 'Z'1 <= row <= height'A' <= column <= width-100 <= val <= 1001 <= numbers.length <= 5numbers[i]的格式为"ColRow"或"ColRow1:ColRow2"。- 最多会对
set、get和sum进行100次调用。
方法一:Go 解法(本站整理) · Go 实现
本站根据题意与 Doocs 参考思路整理为 Go,非上游原文。按 CC BY-SA 4.0 共享。
根据题意实现持久公式。单元格保存普通数值或“被引用格→出现次数”的公式,Set 会移除旧公式。Get 沿无环依赖图递归计算,并在本次查询内记忆化,因此修改基础格后无需维护失效缓存。区间展开时累加重复引用的次数。设可达单元格和依赖边数为 V、E,Get 为 O(V+E),Set 为 O(1);Sum 还需 O(R) 展开引用范围,R 是范围总面积,查询额外空间 O(V)。
import (
	"strconv"
	"strings"
)

type cell struct {
	value   int
	formula map[int]int
}
type Excel struct {
	width int
	cells []cell
}

func Constructor(height int, width byte) Excel {
	w := int(width-'A') + 1
	return Excel{w, make([]cell, height*w)}
}
func (e *Excel) id(row int, col byte) int          { return (row-1)*e.width + int(col-'A') }
func (e *Excel) Set(row int, column byte, val int) { e.cells[e.id(row, column)] = cell{value: val} }
func (e *Excel) Get(row int, column byte) int {
	memo := map[int]int{}
	var value func(int) int
	value = func(id int) int {
		if v, ok := memo[id]; ok {
			return v
		}
		c := e.cells[id]
		v := c.value
		if c.formula != nil {
			v = 0
			for dep, times := range c.formula {
				v += times * value(dep)
			}
		}
		memo[id] = v
		return v
	}
	return value(e.id(row, column))
}
func (e *Excel) Sum(row int, column byte, numbers []string) int {
	refs := map[int]int{}
	decode := func(s string) (int, byte) { r, _ := strconv.Atoi(s[1:]); return r, s[0] }
	for _, s := range numbers {
		bounds := strings.Split(s, ":")
		r1, c1 := decode(bounds[0])
		r2, c2 := r1, c1
		if len(bounds) == 2 {
			r2, c2 = decode(bounds[1])
		}
		for r := r1; r <= r2; r++ {
			for c := c1; c <= c2; c++ {
				refs[e.id(r, c)]++
			}
		}
	}
	e.cells[e.id(row, column)] = cell{formula: refs}
	return e.Get(row, column)
}635. 设计日志存储系统 🔒
题目、示例与约束
你将获得多条日志,每条日志都有唯一的 id 和 timestamp ,timestamp 是形如 Year:Month:Day:Hour:Minute:Second 的字符串,2017:01:01:23:59:59 ,所有值域都是零填充的十进制数。
实现 LogSystem 类:
LogSystem()初始化LogSystem对象void put(int id, string timestamp)给定日志的id和timestamp,将这个日志存入你的存储系统中。int[] retrieve(string start, string end, string granularity)返回在给定时间区间[start, end](包含两端)内的所有日志的id。start、end和timestamp的格式相同,granularity表示考虑的时间粒度(例如,精确到Day、Minute等)。例如start = "2017:01:01:23:59:59"、end = "2017:01:02:23:59:59"且granularity = "Day"意味着需要查找从 Jan. 1st 2017 到 Jan. 2nd 2017 范围内的日志,可以忽略日志的Hour、Minute和Second。
示例:
输入:
["LogSystem", "put", "put", "put", "retrieve", "retrieve"]
[[], [1, "2017:01:01:23:59:59"], [2, "2017:01:01:22:59:59"], [3, "2016:01:01:00:00:00"], ["2016:01:01:01:01:01", "2017:01:01:23:00:00", "Year"], ["2016:01:01:01:01:01", "2017:01:01:23:00:00", "Hour"]]
输出:
[null, null, null, null, [3, 2, 1], [2, 1]]

解释:
LogSystem logSystem = new LogSystem();
logSystem.put(1, "2017:01:01:23:59:59");
logSystem.put(2, "2017:01:01:22:59:59");
logSystem.put(3, "2016:01:01:00:00:00");

// 返回 [3,2,1],返回从 2016 年到 2017 年所有的日志。
logSystem.retrieve("2016:01:01:01:01:01", "2017:01:01:23:00:00", "Year");

// 返回 [2,1],返回从 Jan. 1, 2016 01:XX:XX 到 Jan. 1, 2017 23:XX:XX 之间的所有日志
// 不返回日志 3 因为记录时间 Jan. 1, 2016 00:00:00 超过范围的起始时间
logSystem.retrieve("2016:01:01:01:01:01", "2017:01:01:23:00:00", "Hour");
提示:
1 <= id <= 5002000 <= Year <= 20171 <= Month <= 121 <= Day <= 310 <= Hour <= 230 <= Minute, Second <= 59granularity是这些值["Year", "Month", "Day", "Hour", "Minute", "Second"]之一- 最多调用
500次put和retrieve
方法一:字符串比较 · Go 实现
思考
日志按粒度(年到秒)做闭区间检索。把时间解析成整数再按粒度截断,实现繁琐。
时间戳本身是定长、字典序与时间序一致的字符串。按粒度取前缀长度,直接比较
start[:i] <= ts[:i] <= end[:i]即可。put追加即可。
将日志的 id 和 timestamp 作为元组存入数组中,然后在 retrieve() 方法中,根据 granularity 截取 start 和 end 的相应部分,然后遍历数组,将符合条件的 id 加入结果数组中。
时间复杂度方面,put() 方法的时间复杂度为 ,retrieve() 方法的时间复杂度为 ,其中 为数组的长度。
type LogSystem struct {
	logs []pair
	d    map[string]int
}

func Constructor() LogSystem {
	d := map[string]int{
		"Year":   4,
		"Month":  7,
		"Day":    10,
		"Hour":   13,
		"Minute": 16,
		"Second": 19,
	}
	return LogSystem{[]pair{}, d}
}

func (this *LogSystem) Put(id int, timestamp string) {
	this.logs = append(this.logs, pair{id, timestamp})
}

func (this *LogSystem) Retrieve(start string, end string, granularity string) (ans []int) {
	i := this.d[granularity]
	s, e := start[:i], end[:i]
	for _, log := range this.logs {
		t := log.ts[:i]
		if s <= t && t <= e {
			ans = append(ans, log.id)
		}
	}
	return
}

type pair struct {
	id int
	ts string
}

/**
 * Your LogSystem object will be instantiated and called as such:
 * obj := Constructor();
 * obj.Put(id,timestamp);
 * param_2 := obj.Retrieve(start,end,granularity);
*/641. 设计循环双端队列
题目、示例与约束
设计实现双端队列。
实现 MyCircularDeque 类:
MyCircularDeque(int k):构造函数,双端队列最大为k。boolean insertFront():将一个元素添加到双端队列头部。 如果操作成功返回true,否则返回false。boolean insertLast():将一个元素添加到双端队列尾部。如果操作成功返回true,否则返回false。boolean deleteFront():从双端队列头部删除一个元素。 如果操作成功返回true,否则返回false。boolean deleteLast():从双端队列尾部删除一个元素。如果操作成功返回true,否则返回false。int getFront()):从双端队列头部获得一个元素。如果双端队列为空,返回-1。int getRear():获得双端队列的最后一个元素。 如果双端队列为空,返回-1。boolean isEmpty():若双端队列为空,则返回true,否则返回false。boolean isFull():若双端队列满了,则返回true,否则返回false。
示例 1:
输入
["MyCircularDeque", "insertLast", "insertLast", "insertFront", "insertFront", "getRear", "isFull", "deleteLast", "insertFront", "getFront"]
[[3], [1], [2], [3], [4], [], [], [], [4], []]
输出
[null, true, true, true, false, 2, true, true, true, 4]

解释
MyCircularDeque circularDeque = new MycircularDeque(3); // 设置容量大小为3
circularDeque.insertLast(1);			        // 返回 true
circularDeque.insertLast(2);			        // 返回 true
circularDeque.insertFront(3);			        // 返回 true
circularDeque.insertFront(4);			        // 已经满了,返回 false
circularDeque.getRear();  				// 返回 2
circularDeque.isFull();				        // 返回 true
circularDeque.deleteLast();			        // 返回 true
circularDeque.insertFront(4);			        // 返回 true
circularDeque.getFront();				// 返回 4
提示:
1 <= k <= 10000 <= value <= 1000insertFront,insertLast,deleteFront,deleteLast,getFront,getRear,isEmpty,isFull调用次数不大于2000次
方法一:数组 · Go 实现
思考
定长循环双端队列要在两端 插入删除,并区分空满。链表能做但浪费指针。
与循环队列相同,用数组加 与 :头插时 前移一格,尾插写在 。空满仍看 。
我们可以使用一个数组来实现循环双端队列。我们维护一个指向队头的指针 和一个表示队列中元素个数的变量 ,以及一个表示队列容量的变量 。我们使用一个数组 来存储队列中的元素。
调用 时,首先检查队列是否已满,如果已满则返回 。如果队列不为空,则将 向前移动一个位置(使用模运算实现循环),然后将新元素插入到 位置,并将 加 1。
调用 时,首先检查队列是否已满,如果已满则返回 。如果队列不为空,则计算新元素应该插入的位置(使用 和 计算),将新元素插入到该位置,并将 加 1。
调用 时,首先检查队列是否为空,如果为空则返回 。如果队列不为空,则将 向后移动一个位置(使用模运算实现循环),并将 减 1。
调用 时,首先检查队列是否为空,如果为空则返回 。如果队列不为空,则将 减 1。
调用 时,首先检查队列是否为空,如果为空则返回 。如果队列不为空,则返回 。
调用 时,首先检查队列是否为空,如果为空则返回 。如果队列不为空,则计算队尾元素的位置(使用 和 计算),并返回该位置的元素。
调用 时,检查 是否为 。
调用 时,检查 是否等于 。
以上操作的时间复杂度均为 ,空间复杂度为 ,其中 是队列的容量。
type MyCircularDeque struct {
	q        []int
	size     int
	front    int
	capacity int
}

func Constructor(k int) MyCircularDeque {
	q := make([]int, k)
	return MyCircularDeque{q, 0, 0, k}
}

func (this *MyCircularDeque) InsertFront(value int) bool {
	if this.IsFull() {
		return false
	}
	if !this.IsEmpty() {
		this.front = (this.front - 1 + this.capacity) % this.capacity
	}
	this.q[this.front] = value
	this.size++
	return true
}

func (this *MyCircularDeque) InsertLast(value int) bool {
	if this.IsFull() {
		return false
	}
	idx := (this.front + this.size) % this.capacity
	this.q[idx] = value
	this.size++
	return true
}

func (this *MyCircularDeque) DeleteFront() bool {
	if this.IsEmpty() {
		return false
	}
	this.front = (this.front + 1) % this.capacity
	this.size -= 1
	return true
}

func (this *MyCircularDeque) DeleteLast() bool {
	if this.IsEmpty() {
		return false
	}
	this.size -= 1
	return true
}

func (this *MyCircularDeque) GetFront() int {
	if this.IsEmpty() {
		return -1
	}
	return this.q[this.front]
}

func (this *MyCircularDeque) GetRear() int {
	if this.IsEmpty() {
		return -1
	}
	return this.q[(this.front+this.size-1)%this.capacity]
}

func (this *MyCircularDeque) IsEmpty() bool {
	return this.size == 0
}

func (this *MyCircularDeque) IsFull() bool {
	return this.size == this.capacity
}

/**
 * Your MyCircularDeque object will be instantiated and called as such:
 * obj := Constructor(k);
 * param_1 := obj.InsertFront(value);
 * param_2 := obj.InsertLast(value);
 * param_3 := obj.DeleteFront();
 * param_4 := obj.DeleteLast();
 * param_5 := obj.GetFront();
 * param_6 := obj.GetRear();
 * param_7 := obj.IsEmpty();
 * param_8 := obj.IsFull();
*/642. 设计搜索自动补全系统 🔒
题目、示例与约束
为搜索引擎设计一个搜索自动补全系统。用户会输入一条语句(最少包含一个字母,以特殊字符 '#' 结尾)。
给定一个字符串数组 sentences 和一个整数数组 times ,长度都为 n ,其中 sentences[i] 是之前输入的句子, times[i] 是该句子输入的相应次数。对于除 ‘#’ 以外的每个输入字符,返回前 3 个历史热门句子,这些句子的前缀与已经输入的句子的部分相同。
下面是详细规则:
- 一条句子的热度定义为历史上用户输入这个句子的总次数。
- 返回前
3的句子需要按照热度从高到低排序(第一个是最热门的)。如果有多条热度相同的句子,请按照 ASCII 码的顺序输出(ASCII 码越小排名越前)。 - 如果满足条件的句子个数少于
3,将它们全部输出。 - 如果输入了特殊字符,意味着句子结束了,请返回一个空集合。
实现 AutocompleteSystem 类:
AutocompleteSystem(String[] sentences, int[] times):使用数组sentences和times对对象进行初始化。List<String> input(char c)表示用户输入了字符c。- 如果
c == '#',则返回空数组[],并将输入的语句存储在系统中。 - 返回前
3个历史热门句子,这些句子的前缀与已经输入的句子的部分相同。如果少于3个匹配项,则全部返回。
- 如果
示例 1:
输入
["AutocompleteSystem", "input", "input", "input", "input"]
[[["i love you", "island", "iroman", "i love leetcode"], [5, 3, 2, 2]], ["i"], [" "], ["a"], ["#"]]
输出
[null, ["i love you", "island", "i love leetcode"], ["i love you", "i love leetcode"], [], []]

解释
AutocompleteSystem obj = new AutocompleteSystem(["i love you", "island", "iroman", "i love leetcode"], [5, 3, 2, 2]);
obj.input("i"); // 返回 ["i love you", "island", "i love leetcode"]。有四个句子以"i"开头。其中,"ironman"和"i love leetcode"的热度相同。由于空格的 ASCII 码是 32,而 r 的 ASCII 码是 114,所以“i love leetcode”应排在“ironman”前面。同时我们只需要输出前三句热门句子,因此“ironman”会被忽略。
obj.input(" "); // 返回 ["i love you", "i love leetcode"]。只有两个句子以“i ”为前缀。
obj.input("a"); // 返回 []。没有以“i a”为前缀的句子。
obj.input("#"); // 返回 []。用户完成输入,句子 "i a" 应该被保存为系统中的历史句子。接下来的输入将被视为新的搜索。
提示:
n == sentences.lengthn == times.length1 <= n <= 1001 <= sentences[i].length <= 1001 <= times[i] <= 50c是小写英文字母,'#', 或空格' '- 每个被测试的句子将是一个以字符
'#'结尾的字符c序列。 - 每个被测试的句子的长度范围为
[1,200] - 每个输入句子中的单词用单个空格隔开。
input最多被调用5000次
方法一:Go 解法(本站整理) · Go 实现
本站根据题意与 Doocs 参考思路整理为 Go,非上游原文。按 CC BY-SA 4.0 共享。
字典树节点仅缓存此前缀排名最高的三个句子。完整句子的频次增加时,只有这个句子可能改变沿途节点的前三名,因此每个节点至多比较四个候选。普通输入沿树移动;输入 # 时把当前句子计数加一并重置。排名按频次降序、字典序升序。设句长 L、总存储字符数 S,普通输入平均 O(1),提交句子为 O(L²)(含字符串比较),空间 O(S)。
import "sort"

type trieNode struct {
	children map[byte]*trieNode
	top      []string
}
type AutocompleteSystem struct {
	root, current *trieNode
	frequency     map[string]int
	prefix        []byte
}

func Constructor(sentences []string, times []int) AutocompleteSystem {
	r := &trieNode{children: map[byte]*trieNode{}}
	a := AutocompleteSystem{root: r, current: r, frequency: map[string]int{}}
	for i, s := range sentences {
		a.add(s, times[i])
	}
	return a
}
func (a *AutocompleteSystem) add(s string, count int) {
	a.frequency[s] += count
	n := a.root
	for i := range s {
		if n.children[s[i]] == nil {
			n.children[s[i]] = &trieNode{children: map[byte]*trieNode{}}
		}
		n = n.children[s[i]]
		exists := false
		for _, v := range n.top {
			if v == s {
				exists = true
			}
		}
		if !exists {
			n.top = append(n.top, s)
		}
		sort.Slice(n.top, func(i, j int) bool {
			x, y := n.top[i], n.top[j]
			if a.frequency[x] != a.frequency[y] {
				return a.frequency[x] > a.frequency[y]
			}
			return x < y
		})
		if len(n.top) > 3 {
			n.top = n.top[:3]
		}
	}
}
func (a *AutocompleteSystem) Input(c byte) []string {
	if c == '#' {
		if len(a.prefix) > 0 {
			a.add(string(a.prefix), 1)
		}
		a.prefix = nil
		a.current = a.root
		return []string{}
	}
	a.prefix = append(a.prefix, c)
	if a.current != nil {
		a.current = a.current.children[c]
	}
	if a.current == nil {
		return []string{}
	}
	return append([]string{}, a.current.top...)
}676. 实现一个魔法字典
题目、示例与约束
设计一个使用单词列表进行初始化的数据结构,单词列表中的单词 互不相同 。 如果给出一个单词,请判定能否只将这个单词中一个字母换成另一个字母,使得所形成的新单词存在于你构建的字典中。
实现 MagicDictionary 类:
MagicDictionary()初始化对象void buildDict(String[] dictionary)使用字符串数组dictionary设定该数据结构,dictionary中的字符串互不相同bool search(String searchWord)给定一个字符串searchWord,判定能否只将字符串中 一个 字母换成另一个字母,使得所形成的新字符串能够与字典中的任一字符串匹配。如果可以,返回true;否则,返回false。
示例:
输入
["MagicDictionary", "buildDict", "search", "search", "search", "search"]
[[], [["hello", "leetcode"]], ["hello"], ["hhllo"], ["hell"], ["leetcoded"]]
输出
[null, null, false, true, false, false]

解释
MagicDictionary magicDictionary = new MagicDictionary();
magicDictionary.buildDict(["hello", "leetcode"]);
magicDictionary.search("hello"); // 返回 False
magicDictionary.search("hhllo"); // 将第二个 'h' 替换为 'e' 可以匹配 "hello" ,所以返回 True
magicDictionary.search("hell"); // 返回 False
magicDictionary.search("leetcoded"); // 返回 False
提示:
1 <= dictionary.length <= 1001 <= dictionary[i].length <= 100dictionary[i]仅由小写英文字母组成dictionary中的所有字符串 互不相同1 <= searchWord.length <= 100searchWord仅由小写英文字母组成buildDict仅在search之前调用一次- 最多调用
100次search
方法一:前缀树 + DFS · Go 实现
思考
查询须与词典中某词恰好差一个字母。对每个查询扫全部词,词数与长度乘积在多次查询时偏大。
词插入字典树。搜索时 DFS:能沿原字母走则先走;尚未改过则可改走别的孩子并把 置 。结束时 必须恰为 且在词尾。
我们可以使用前缀树来存储字典中的所有单词,然后对于每个搜索的单词,我们使用深度优先搜索的方法,具体地,我们从前缀树的根节点开始,对于当前遍历到的字母,我们首先判断是否存在与其相同的子节点,如果存在,则继续向下遍历,否则我们需要判断是否还有剩余的修改次数,如果没有,则说明无法匹配,返回 false。如果有剩余的修改次数,我们可以尝试对当前的字母进行修改,然后继续向下遍历,如果当前的字母修改后对应的子节点存在,则说明可以匹配,否则说明无法匹配,返回 false。如果我们遍历到了单词的结尾,且修改次数恰好为 1,那么说明可以匹配,返回 true。
时间复杂度 ,空间复杂度 ,其中 和 分别是字典中的单词数量和单词的平均长度,而 是搜索的单词数量。另外 表示字符集的大小,这里字符集为小写英文字母,因此 。
type Trie struct {
	children [26]*Trie
	isEnd    bool
}

func NewTrie() *Trie {
	return &Trie{}
}

func (t *Trie) Insert(w string) {
	node := t
	for _, c := range w {
		i := c - 'a'
		if node.children[i] == nil {
			node.children[i] = NewTrie()
		}
		node = node.children[i]
	}
	node.isEnd = true
}

func (t *Trie) Search(w string) bool {
	var dfs func(int, *Trie, int) bool
	dfs = func(i int, node *Trie, diff int) bool {
		if i >= len(w) {
			return diff == 1 && node.isEnd
		}
		j := int(w[i] - 'a')
		if node.children[j] != nil && dfs(i+1, node.children[j], diff) {
			return true
		}
		if diff == 0 {
			for k := 0; k < 26; k++ {
				if k != j && node.children[k] != nil && dfs(i+1, node.children[k], 1) {
					return true
				}
			}
		}
		return false
	}
	return dfs(0, t, 0)
}

type MagicDictionary struct {
	trie *Trie
}

func Constructor() MagicDictionary {
	return MagicDictionary{trie: NewTrie()}
}

func (md *MagicDictionary) BuildDict(dictionary []string) {
	for _, w := range dictionary {
		md.trie.Insert(w)
	}
}

func (md *MagicDictionary) Search(searchWord string) bool {
	return md.trie.Search(searchWord)
}

/**
 * Your MagicDictionary object will be instantiated and called as such:
 * obj := Constructor();
 * obj.BuildDict(dictionary);
 * param_2 := obj.Search(searchWord);
*/677. 键值映射
题目、示例与约束
设计一个 map ,满足以下几点:
- 字符串表示键,整数表示值
- 返回具有前缀等于给定字符串的键的值的总和
实现一个 MapSum 类:
MapSum()初始化MapSum对象void insert(String key, int val)插入key-val键值对,字符串表示键key,整数表示值val。如果键key已经存在,那么原来的键值对key-value将被替代成新的键值对。int sum(string prefix)返回所有以该前缀prefix开头的键key的值的总和。
示例 1:
输入:
["MapSum", "insert", "sum", "insert", "sum"]
[[], ["apple", 3], ["ap"], ["app", 2], ["ap"]]
输出:
[null, null, 3, null, 5]

解释:
MapSum mapSum = new MapSum();
mapSum.insert("apple", 3);
mapSum.sum("ap");           // 返回 3 (apple = 3)
mapSum.insert("app", 2);
mapSum.sum("ap");           // 返回 5 (apple + app = 3 + 2 = 5)
提示:
1 <= key.length, prefix.length <= 50key和prefix仅由小写英文字母组成1 <= val <= 1000- 最多调用
50次insert和sum
方法一:哈希表 + 前缀树 · Go 实现
思考
sum(prefix)要所有以该前缀开头的键值之和,且insert会覆盖旧值。每次扫哈希表所有键是线性于键数。字典树节点存子树值和。插入时把 加到路径上;查询走到前缀节点即可。哈希表记下每个键的当前值以便算 。
我们用哈希表 存放键值对,用前缀树 存放键值对的前缀和。前缀树的每个节点包含两个信息:
val:以该节点为前缀的键值对的值的总和children:长度为 的数组,存放该节点的子节点
插入键值对 时,我们先判断哈希表是否存在该键,如果存在,那么前缀树每个节点的 val 都要减去该键原来的值,然后再加上新的值。如果不存在,那么前缀树每个节点的 val 都要加上新的值。
查询前缀和时,我们从前缀树的根节点开始,遍历前缀字符串,如果当前节点的子节点中不存在该字符,那么说明前缀树中不存在该前缀,返回 。否则,继续遍历下一个字符,直到遍历完前缀字符串,返回当前节点的 val。
时间复杂度方面,插入键值对的时间复杂度为 ,其中 为键的长度。查询前缀和的时间复杂度为 ,其中 为前缀的长度。
空间复杂度 ,其中 和 分别是键的数量以及键的最大长度;而 是字符集的大小,本题中 。
type trie struct {
	children [26]*trie
	val      int
}

func (t *trie) insert(w string, x int) {
	for _, c := range w {
		c -= 'a'
		if t.children[c] == nil {
			t.children[c] = &trie{}
		}
		t = t.children[c]
		t.val += x
	}
}

func (t *trie) search(w string) int {
	for _, c := range w {
		c -= 'a'
		if t.children[c] == nil {
			return 0
		}
		t = t.children[c]
	}
	return t.val
}

type MapSum struct {
	d map[string]int
	t *trie
}

func Constructor() MapSum {
	return MapSum{make(map[string]int), &trie{}}
}

func (this *MapSum) Insert(key string, val int) {
	x := val - this.d[key]
	this.d[key] = val
	this.t.insert(key, x)
}

func (this *MapSum) Sum(prefix string) int {
	return this.t.search(prefix)
}

/**
 * Your MapSum object will be instantiated and called as such:
 * obj := Constructor();
 * obj.Insert(key,val);
 * param_2 := obj.Sum(prefix);
*/703. 数据流中的第 K 大元素
题目、示例与约束
设计一个找到数据流中第 k 大元素的类(class)。注意是排序后的第 k 大元素,不是第 k 个不同的元素。
请实现 KthLargest 类:
KthLargest(int k, int[] nums)使用整数k和整数流nums初始化对象。int add(int val)将val插入数据流nums后,返回当前数据流中第k大的元素。
示例 1:
输入:
["KthLargest", "add", "add", "add", "add", "add"]
[[3, [4, 5, 8, 2]], [3], [5], [10], [9], [4]]
输出:[null, 4, 5, 5, 8, 8]
解释:
KthLargest kthLargest = new KthLargest(3, [4, 5, 8, 2]);
kthLargest.add(3); // 返回 4
kthLargest.add(5); // 返回 5
kthLargest.add(10); // 返回 5
kthLargest.add(9); // 返回 8
kthLargest.add(4); // 返回 8
示例 2:
输入:
["KthLargest", "add", "add", "add", "add"]
[[4, [7, 7, 7, 7, 8, 3]], [2], [10], [9], [9]]
输出:[null, 7, 7, 7, 8]
解释:
KthLargest kthLargest = new KthLargest(4, [7, 7, 7, 7, 8, 3]);kthLargest.add(2); // 返回 7
kthLargest.add(10); // 返回 7
kthLargest.add(9); // 返回 7
kthLargest.add(9); // 返回 8
提示:
0 <= nums.length <= 1041 <= k <= nums.length + 1-104 <= nums[i] <= 104-104 <= val <= 104- 最多调用
add方法104次
方法一:优先队列(小根堆) · Go 实现
思考
数据流中持续插入,并随时询问第 大。若每次排序或扫描全部历史, 与询问次数均可到 ,总代价偏高。
第 大只取决于当前最大的 个数,更小的元素永远不会成为答案,不必长期保存。维护大小为 的集合时,堆顶恰好是其中的最小值,也就是全体中的第 大。
因此用小根堆保存这 个数:新元素入堆,超过 个则弹出堆顶。初始化把 依次加入即可,单次 为 。
我们维护一个优先队列(小根堆) 。
初始化时,我们将数组 中的元素依次加入 ,并保持 的大小不超过 。时间复杂度 。
每次加入一个新元素时,如果 的大小超过了 ,我们就将堆顶元素弹出,保证 的大小为 。时间复杂度 。
这样, 中的元素就是数组 中最大的 个元素,堆顶元素就是第 大的元素。
空间复杂度 。
type KthLargest struct {
	k    int
	minQ hp
}

func Constructor(k int, nums []int) KthLargest {
	minQ := hp{}
	this := KthLargest{k, minQ}
	for _, x := range nums {
		this.Add(x)
	}
	return this
}

func (this *KthLargest) Add(val int) int {
	heap.Push(&this.minQ, val)
	if this.minQ.Len() > this.k {
		heap.Pop(&this.minQ)
	}
	return this.minQ.IntSlice[0]
}

type hp struct{ sort.IntSlice }

func (h *hp) Less(i, j int) bool { return h.IntSlice[i] < h.IntSlice[j] }
func (h *hp) Pop() interface{} {
	old := h.IntSlice
	n := len(old)
	x := old[n-1]
	h.IntSlice = old[0 : n-1]
	return x
}
func (h *hp) Push(x interface{}) {
	h.IntSlice = append(h.IntSlice, x.(int))
}

/**
 * Your KthLargest object will be instantiated and called as such:
 * obj := Constructor(k, nums);
 * param_1 := obj.Add(val);
*/705. 设计哈希集合
题目、示例与约束
不使用任何内建的哈希表库设计一个哈希集合(HashSet)。
实现 MyHashSet 类:
void add(key)向哈希集合中插入值key。bool contains(key)返回哈希集合中是否存在这个值key。void remove(key)将给定值key从哈希集合中删除。如果哈希集合中没有这个值,什么也不做。
示例:
输入:
["MyHashSet", "add", "add", "contains", "contains", "add", "contains", "remove", "contains"]
[[], [1], [2], [1], [3], [2], [2], [2], [2]]
输出:
[null, null, null, true, false, null, true, null, false]

解释:
MyHashSet myHashSet = new MyHashSet();
myHashSet.add(1);      // set = [1]
myHashSet.add(2);      // set = [1, 2]
myHashSet.contains(1); // 返回 True
myHashSet.contains(3); // 返回 False ,(未找到)
myHashSet.add(2);      // set = [1, 2]
myHashSet.contains(2); // 返回 True
myHashSet.remove(2);   // set = [1]
myHashSet.contains(2); // 返回 False ,(已移除)
提示:
0 <= key <= 106- 最多调用
104次add、remove和contains
方法一:静态数组实现 · Go 实现
思考
需要实现不含重复键的集合,键的范围是 ,操作次数不超过 。用平衡树或哈希表库函数可以完成,但题目意在自行设计底层存储。
键本身已是非负整数且上界固定,可直接作为下标。开辟长度为 的布尔数组,添加、删除、查询都变成对单个位置的读写,均为 。
空间与值域成正比而非与操作次数成正比,在本题限制下可以接受。
直接创建一个大小为 的数组,初始时数组中的每个元素都为 false,表示哈希集合中不存在该元素。
往哈希集合添加元素时,将数组中对应位置的值置为 true;删除元素时,将数组中对应位置的值置为 false;当查询元素是否存在时,直接返回数组中对应位置的值即可。
以上操作的时间复杂度均为 。
type MyHashSet struct {
	data []bool
}

func Constructor() MyHashSet {
	data := make([]bool, 1000010)
	return MyHashSet{data}
}

func (this *MyHashSet) Add(key int) {
	this.data[key] = true
}

func (this *MyHashSet) Remove(key int) {
	this.data[key] = false
}

func (this *MyHashSet) Contains(key int) bool {
	return this.data[key]
}

/**
 * Your MyHashSet object will be instantiated and called as such:
 * obj := Constructor();
 * obj.Add(key);
 * obj.Remove(key);
 * param_3 := obj.Contains(key);
 */
方法二:数组嵌套链表 · Go 实现
思考
方法一用值域大小的数组换取 ,当值域远大于实际键数时空间浪费明显。本题操作只有 次,真正存放的键很少。
将键对较小的模数取余,散列到固定桶中,每个桶用链表存放冲突键。查找、插入、删除先定位桶再线性扫描该桶,期望长度很短。
取 ,空间降到与桶数同阶,单次操作期望接近常数。
我们也可以开辟一个大小为 SIZE=1000 的数组,数组的每个位置是一个链表。
type MyHashSet struct {
	data []list.List
}

func Constructor() MyHashSet {
	return MyHashSet{make([]list.List, 1000)}
}

func (this *MyHashSet) Add(key int) {
	if this.Contains(key) {
		return
	}
	idx := this.hash(key)
	this.data[idx].PushBack(key)
}

func (this *MyHashSet) Remove(key int) {
	idx := this.hash(key)
	for e := this.data[idx].Front(); e != nil; e = e.Next() {
		if e.Value.(int) == key {
			this.data[idx].Remove(e)
		}
	}
}

func (this *MyHashSet) Contains(key int) bool {
	idx := this.hash(key)
	for e := this.data[idx].Front(); e != nil; e = e.Next() {
		if e.Value.(int) == key {
			return true
		}
	}
	return false
}

func (this *MyHashSet) hash(key int) int {
	return key % len(this.data)
}

/**
 * Your MyHashSet object will be instantiated and called as such:
 * obj := Constructor();
 * obj.Add(key);
 * obj.Remove(key);
 * param_3 := obj.Contains(key);
*/706. 设计哈希映射
题目、示例与约束
不使用任何内建的哈希表库设计一个哈希映射(HashMap)。
实现 MyHashMap 类:
MyHashMap()用空映射初始化对象void put(int key, int value)向 HashMap 插入一个键值对(key, value)。如果key已经存在于映射中,则更新其对应的值value。int get(int key)返回特定的key所映射的value;如果映射中不包含key的映射,返回-1。void remove(key)如果映射中存在key的映射,则移除key和它所对应的value。
示例:
输入:
["MyHashMap", "put", "put", "get", "get", "put", "get", "remove", "get"]
[[], [1, 1], [2, 2], [1], [3], [2, 1], [2], [2], [2]]
输出:
[null, null, null, 1, -1, null, 1, null, -1]

解释:
MyHashMap myHashMap = new MyHashMap();
myHashMap.put(1, 1); // myHashMap 现在为 [[1,1]]
myHashMap.put(2, 2); // myHashMap 现在为 [[1,1], [2,2]]
myHashMap.get(1);    // 返回 1 ,myHashMap 现在为 [[1,1], [2,2]]
myHashMap.get(3);    // 返回 -1(未找到),myHashMap 现在为 [[1,1], [2,2]]
myHashMap.put(2, 1); // myHashMap 现在为 [[1,1], [2,1]](更新已有的值)
myHashMap.get(2);    // 返回 1 ,myHashMap 现在为 [[1,1], [2,1]]
myHashMap.remove(2); // 删除键为 2 的数据,myHashMap 现在为 [[1,1]]
myHashMap.get(2);    // 返回 -1(未找到),myHashMap 现在为 [[1,1]]
提示:
0 <= key, value <= 106- 最多调用
104次put、get和remove方法
方法一:静态数组实现 · Go 实现
思考
需要实现键值映射,键与值均在 ,操作不超过 次。与哈希集合类似,键可直接当作下标。
开辟长度为 的数组,用 表示缺省。 、 、 分别写成赋值、读取和写回 ,均为 。
值域与键域相同,哨兵 不会与合法值冲突。空间按值域分配,在本题限制下可行。
直接创建一个大小为 的数组,初始时数组中的每个元素都为 ,表示哈希表中不存在该键值对。
调用 put 方法时,将数组中对应的位置赋值为 value;调用 get 方法时,返回数组中对应的位置的值;调用 remove 方法时,将数组中对应的位置赋值为 。
以上操作,时间复杂度均为 。
type MyHashMap struct {
	data []int
}

func Constructor() MyHashMap {
	data := make([]int, 1000010)
	for i := range data {
		data[i] = -1
	}
	return MyHashMap{data}
}

func (this *MyHashMap) Put(key int, value int) {
	this.data[key] = value
}

func (this *MyHashMap) Get(key int) int {
	return this.data[key]
}

func (this *MyHashMap) Remove(key int) {
	this.data[key] = -1
}

/**
 * Your MyHashMap object will be instantiated and called as such:
 * obj := Constructor();
 * obj.Put(key,value);
 * param_2 := obj.Get(key);
 * obj.Remove(key);
*/707. 设计链表
题目、示例与约束
你可以选择使用单链表或者双链表,设计并实现自己的链表。
单链表中的节点应该具备两个属性:val 和 next 。val 是当前节点的值,next 是指向下一个节点的指针/引用。
如果是双向链表,则还需要属性 prev 以指示链表中的上一个节点。假设链表中的所有节点下标从 0 开始。
实现 MyLinkedList 类:
MyLinkedList()初始化MyLinkedList对象。int get(int index)获取链表中下标为index的节点的值。如果下标无效,则返回-1。void addAtHead(int val)将一个值为val的节点插入到链表中第一个元素之前。在插入完成后,新节点会成为链表的第一个节点。void addAtTail(int val)将一个值为val的节点追加到链表中作为链表的最后一个元素。void addAtIndex(int index, int val)将一个值为val的节点插入到链表中下标为index的节点之前。如果index等于链表的长度,那么该节点会被追加到链表的末尾。如果index比长度更大,该节点将 不会插入 到链表中。void deleteAtIndex(int index)如果下标有效,则删除链表中下标为index的节点。
示例:
输入
["MyLinkedList", "addAtHead", "addAtTail", "addAtIndex", "get", "deleteAtIndex", "get"]
[[], [1], [3], [1, 2], [1], [1], [1]]
输出
[null, null, null, null, 2, null, 3]

解释
MyLinkedList myLinkedList = new MyLinkedList();
myLinkedList.addAtHead(1);
myLinkedList.addAtTail(3);
myLinkedList.addAtIndex(1, 2);    // 链表变为 1->2->3
myLinkedList.get(1);              // 返回 2
myLinkedList.deleteAtIndex(1);    // 现在,链表变为 1->3
myLinkedList.get(1);              // 返回 3
提示:
0 <= index, val <= 1000- 请不要使用内置的 LinkedList 库。
- 调用
get、addAtHead、addAtTail、addAtIndex和deleteAtIndex的次数不超过2000。
方法一:指针引用实现单链表 · Go 实现
思考
题目禁止使用内置链表库,需要自行支持按下标访问、头尾插入与按位置删除。调用次数不超过 ,每次从头部走 都可以通过。
单链表的瓶颈在于定位第 个节点必须顺序走过前驱。用哑节点统一空表与非空表的插入删除,再用 记录长度,即可把越界判断从遍历中拆出。
头插、尾插都归约为 :先走到目标位置的前驱,再改指针。删除同样先定位前驱。各操作时间由遍历长度决定,为 。
我们创建链表虚拟头节点 dummy,用变量 cnt 记录当前链表节点个数。
具体的方法如下:
get(index):遍历链表,找到第index个节点,返回其值,如果不存在,返回 。时间复杂度 。addAtHead(val):创建新节点,将其插入到虚拟头节点后面。时间复杂度 。addAtTail(val):创建新节点,将其插入到链表尾部。时间复杂度 。addAtIndex(index, val):如果index等于链表长度,则该节点将附加到链表的末尾。如果index大于链表长度,则不会插入节点。如果index小于 ,则在头部插入节点。否则,遍历链表,找到第index个节点的前一个节点,将新节点插入到该节点后面。时间复杂度 。deleteAtIndex(index):如果索引index有效,则删除链表中的第index个节点。否则,不做任何操作。时间复杂度 。
时间复杂度见具体的方法说明。其中 为链表长度。
注意:LeetCode 平台已经内置 ListNode 单链表节点类,可以直接使用。
type MyLinkedList struct {
	dummy *ListNode
	cnt   int
}

func Constructor() MyLinkedList {
	return MyLinkedList{&ListNode{}, 0}
}

func (this *MyLinkedList) Get(index int) int {
	if index < 0 || index >= this.cnt {
		return -1
	}
	cur := this.dummy.Next
	for ; index > 0; index-- {
		cur = cur.Next
	}
	return cur.Val
}

func (this *MyLinkedList) AddAtHead(val int) {
	this.AddAtIndex(0, val)
}

func (this *MyLinkedList) AddAtTail(val int) {
	this.AddAtIndex(this.cnt, val)
}

func (this *MyLinkedList) AddAtIndex(index int, val int) {
	if index > this.cnt {
		return
	}
	pre := this.dummy
	for ; index > 0; index-- {
		pre = pre.Next
	}
	pre.Next = &ListNode{val, pre.Next}
	this.cnt++
}

func (this *MyLinkedList) DeleteAtIndex(index int) {
	if index < 0 || index >= this.cnt {
		return
	}
	pre := this.dummy
	for ; index > 0; index-- {
		pre = pre.Next
	}
	t := pre.Next
	pre.Next = t.Next
	t.Next = nil
	this.cnt--
}

/**
 * Your MyLinkedList object will be instantiated and called as such:
 * obj := Constructor();
 * param_1 := obj.Get(index);
 * obj.AddAtHead(val);
 * obj.AddAtTail(val);
 * obj.AddAtIndex(index,val);
 * obj.DeleteAtIndex(index);
 */
方法二:静态数组实现单链表 · Go 实现
思考
方法一每次插入都动态分配节点。本题节点数很小,分配开销不明显,但在节点更多时频繁 会拉高常数。
预先申请两块平行数组分别存放值与后继下标,用递增的 充当节点池,插入改为在池中取下一空位并改写下标,语义与指针链表相同。
存首元下标, 仍表示长度。时间复杂度与方法一一致,避免了逐次分配。
在方法一中,我们使用了指针引用的方式,每次动态创建一个链表节点。在链表节点数量达到 甚至更大时,频繁执行 new 操作,会大大增加程序的执行耗时。
因此,我们可以使用静态数组来实现单链表,预先申请一块大小略大于数据范围的内存空间,每次插入节点时,从数组中取出一个空闲的位置,将新节点插入到该位置,同时更新该位置的前驱和后继节点的指针引用。
我们定义以下几个变量,其中:
head存放链表头节点的索引,初始时指向 。e存放链表所有节点的值(预先申请)。ne存放链表所有节点的next指针(预先申请)。idx指向当前可分配的节点索引,初始时指向索引 。cnt记录当前链表节点个数,初始时为 。
具体操作可参考以下代码。时间复杂度与方法一相同。
type MyLinkedList struct {
	e    []int
	ne   []int
	idx  int
	head int
	cnt  int
}

func Constructor() MyLinkedList {
	e := make([]int, 1010)
	ne := make([]int, 1010)
	return MyLinkedList{e, ne, 0, -1, 0}
}

func (this *MyLinkedList) Get(index int) int {
	if index < 0 || index >= this.cnt {
		return -1
	}
	i := this.head
	for ; index > 0; index-- {
		i = this.ne[i]
	}
	return this.e[i]
}

func (this *MyLinkedList) AddAtHead(val int) {
	this.e[this.idx] = val
	this.ne[this.idx] = this.head
	this.head = this.idx
	this.idx++
	this.cnt++
}

func (this *MyLinkedList) AddAtTail(val int) {
	this.AddAtIndex(this.cnt, val)
}

func (this *MyLinkedList) AddAtIndex(index int, val int) {
	if index > this.cnt {
		return
	}
	if index <= 0 {
		this.AddAtHead(val)
		return
	}
	i := this.head
	for ; index > 1; index-- {
		i = this.ne[i]
	}
	this.e[this.idx] = val
	this.ne[this.idx] = this.ne[i]
	this.ne[i] = this.idx
	this.idx++
	this.cnt++
}

func (this *MyLinkedList) DeleteAtIndex(index int) {
	if index < 0 || index >= this.cnt {
		return
	}
	this.cnt--
	if index == 0 {
		this.head = this.ne[this.head]
		return
	}
	i := this.head
	for ; index > 1; index-- {
		i = this.ne[i]
	}
	this.ne[i] = this.ne[this.ne[i]]
}

/**
 * Your MyLinkedList object will be instantiated and called as such:
 * obj := Constructor();
 * param_1 := obj.Get(index);
 * obj.AddAtHead(val);
 * obj.AddAtTail(val);
 * obj.AddAtIndex(index,val);
 * obj.DeleteAtIndex(index);
*/715. Range 模块
题目、示例与约束
Range模块是跟踪数字范围的模块。设计一个数据结构来跟踪表示为 半开区间 的范围并查询它们。
半开区间 [left, right) 表示所有 left <= x < right 的实数 x 。
实现 RangeModule 类:
RangeModule()初始化数据结构的对象。void addRange(int left, int right)添加 半开区间[left, right),跟踪该区间中的每个实数。添加与当前跟踪的数字部分重叠的区间时,应当添加在区间[left, right)中尚未跟踪的任何数字到该区间中。boolean queryRange(int left, int right)只有在当前正在跟踪区间[left, right)中的每一个实数时,才返回true,否则返回false。void removeRange(int left, int right)停止跟踪 半开区间[left, right)中当前正在跟踪的每个实数。
示例 1:
输入
["RangeModule", "addRange", "removeRange", "queryRange", "queryRange", "queryRange"]
[[], [10, 20], [14, 16], [10, 14], [13, 15], [16, 17]]
输出
[null, null, null, true, false, true]

解释
RangeModule rangeModule = new RangeModule();
rangeModule.addRange(10, 20);
rangeModule.removeRange(14, 16);
rangeModule.queryRange(10, 14); 返回 true (区间 [10, 14) 中的每个数都正在被跟踪)
rangeModule.queryRange(13, 15); 返回 false(未跟踪区间 [13, 15) 中像 14, 14.03, 14.17 这样的数字)
rangeModule.queryRange(16, 17); 返回 true (尽管执行了删除操作,区间 [16, 17) 中的数字 16 仍然会被跟踪)
提示:
1 <= left < right <= 109- 在单个测试用例中,对
addRange、queryRange和removeRange的调用总数不超过104次
方法一:线段树 · Go 实现
思考
要维护实数轴上半开区间的添加、删除与覆盖查询,端点可达 ,操作约 次。若每次把区间拆成列表再线性合并,单次可能扫过大量片段。
覆盖关系是区间加、区间查的经典形态,线段树能在对数时间内处理。值域太大不能预先建满整棵树,需要动态开点,并用懒标记把整段赋值下推。
节点记录该段是否被完全覆盖。修改时若当前段被询问区间包住,打上添加或删除标记;查询则在完全覆盖时直接返回 ,否则下推后左右与起来。单次 。
根据题目描述,我们需要维护一个区间集合,支持区间的添加、删除和查询操作。对于区间的添加和删除操作,我们可以使用线段树来维护区间集合。
线段树将整个区间分割为多个不连续的子区间,子区间的数量不超过 。更新某个元素的值,只需要更新 个区间,并且这些区间都包含在一个包含该元素的大区间内。区间修改时,需要使用懒标记保证效率。
- 线段树的每个节点代表一个区间;
- 线段树具有唯一的根节点,代表的区间是整个统计范围,如 ;
- 线段树的每个叶子节点代表一个长度为 的元区间 ;
- 对于每个内部节点 ,它的左儿子是 ,右儿子是 , 其中 (即向下取整)。
由于题目数据范围较大,我们可以使用动态开点的线段树来实现。动态开点的线段树是指,我们只在需要的时候才开点,而不是一开始就开好所有的点。这样可以节省空间,但是需要使用懒标记来维护区间修改。
时间复杂度方面,每次操作的时间复杂度为 。空间复杂度为 。其中 为操作次数,而 为数据范围。
const N int = 1e9

type node struct {
	lch   *node
	rch   *node
	added bool
	lazy  int
}

type segmentTree struct {
	root *node
}

func newSegmentTree() *segmentTree {
	return &segmentTree{
		root: new(node),
	}
}

func (t *segmentTree) update(n *node, l, r, i, j, x int) {
	if l >= i && r <= j {
		n.added = x == 1
		n.lazy = x
		return
	}
	t.pushdown(n)
	m := int(uint(l+r) >> 1)
	if i <= m {
		t.update(n.lch, l, m, i, j, x)
	}
	if j > m {
		t.update(n.rch, m+1, r, i, j, x)
	}
	t.pushup(n)
}

func (t *segmentTree) query(n *node, l, r, i, j int) bool {
	if l >= i && r <= j {
		return n.added
	}
	t.pushdown(n)
	v := true
	m := int(uint(l+r) >> 1)
	if i <= m {
		v = v && t.query(n.lch, l, m, i, j)
	}
	if j > m {
		v = v && t.query(n.rch, m+1, r, i, j)
	}
	return v
}

func (t *segmentTree) pushup(n *node) {
	n.added = n.lch.added && n.rch.added
}

func (t *segmentTree) pushdown(n *node) {
	if n.lch == nil {
		n.lch = new(node)
	}
	if n.rch == nil {
		n.rch = new(node)
	}
	if n.lazy != 0 {
		n.lch.added = n.lazy == 1
		n.rch.added = n.lazy == 1
		n.lch.lazy = n.lazy
		n.rch.lazy = n.lazy
		n.lazy = 0
	}
}

type RangeModule struct {
	t *segmentTree
}

func Constructor() RangeModule {
	return RangeModule{
		t: newSegmentTree(),
	}
}

func (this *RangeModule) AddRange(left int, right int) {
	this.t.update(this.t.root, 1, N, left, right-1, 1)
}

func (this *RangeModule) QueryRange(left int, right int) bool {
	return this.t.query(this.t.root, 1, N, left, right-1)
}

func (this *RangeModule) RemoveRange(left int, right int) {
	this.t.update(this.t.root, 1, N, left, right-1, -1)
}

/**
 * Your RangeModule object will be instantiated and called as such:
 * obj := Constructor();
 * obj.AddRange(left,right);
 * param_2 := obj.QueryRange(left,right);
 * obj.RemoveRange(left,right);
*/716. 最大栈 🔒
题目、示例与约束
设计一个最大栈数据结构,既支持栈操作,又支持查找栈中最大元素。
实现 MaxStack 类:
MaxStack()初始化栈对象void push(int x)将元素 x 压入栈中。int pop()移除栈顶元素并返回这个元素。int top()返回栈顶元素,无需移除。int peekMax()检索并返回栈中最大元素,无需移除。int popMax()检索并返回栈中最大元素,并将其移除。如果有多个最大元素,只要移除 最靠近栈顶 的那个。
示例:
输入
["MaxStack", "push", "push", "push", "top", "popMax", "top", "peekMax", "pop", "top"]
[[], [5], [1], [5], [], [], [], [], [], []]
输出
[null, null, null, null, 5, 5, 1, 5, 1, 5]

解释
MaxStack stk = new MaxStack();
stk.push(5);   // [5] - 5 既是栈顶元素,也是最大元素
stk.push(1);   // [5, 1] - 栈顶元素是 1,最大元素是 5
stk.push(5);   // [5, 1, 5] - 5 既是栈顶元素,也是最大元素
stk.top();     // 返回 5,[5, 1, 5] - 栈没有改变
stk.popMax();  // 返回 5,[5, 1] - 栈发生改变,栈顶元素不再是最大元素
stk.top();     // 返回 1,[5, 1] - 栈没有改变
stk.peekMax(); // 返回 5,[5, 1] - 栈没有改变
stk.pop();     // 返回 1,[5] - 此操作后,5 既是栈顶元素,也是最大元素
stk.top();     // 返回 5,[5] - 栈没有改变
提示:
-107 <= x <= 107- 最多调用
104次push、pop、top、peekMax和popMax - 调用
pop、top、peekMax或popMax时,栈中 至少存在一个元素
进阶:
- 试着设计解决方案:调用
top方法的时间复杂度为O(1),调用其他方法的时间复杂度为O(logn)。
方法一:Go 解法(本站整理) · Go 实现
本站根据题意与 Doocs 参考思路整理为 Go,非上游原文。按 CC BY-SA 4.0 共享。
双向链表维持栈顺序,同时用可按下标删除的最大堆索引所有活跃节点。堆按值优先、入栈序号次优,保证 PopMax 删除最靠近栈顶的最大值。节点保存堆下标,Swap 时同步更新,因而普通 Pop 也能 O(log N) 删除堆中任意节点。Top、PeekMax 为 O(1),Push、Pop、PopMax 为 O(log N),空间 O(N)。
import "container/heap"

type entry struct {
	value, order, index int
	prev, next          *entry
}
type maxHeap []*entry

func (h maxHeap) Len() int { return len(h) }
func (h maxHeap) Less(i, j int) bool {
	return h[i].value > h[j].value || (h[i].value == h[j].value && h[i].order > h[j].order)
}
func (h maxHeap) Swap(i, j int) { h[i], h[j] = h[j], h[i]; h[i].index = i; h[j].index = j }
func (h *maxHeap) Push(x any)   { v := x.(*entry); v.index = len(*h); *h = append(*h, v) }
func (h *maxHeap) Pop() any {
	n := len(*h)
	v := (*h)[n-1]
	(*h)[n-1] = nil
	*h = (*h)[:n-1]
	v.index = -1
	return v
}

type MaxStack struct {
	root  *entry
	h     maxHeap
	clock int
}

func Constructor() MaxStack { r := &entry{}; r.prev = r; r.next = r; return MaxStack{root: r} }
func unlink(v *entry)       { v.prev.next = v.next; v.next.prev = v.prev }
func (s *MaxStack) Push(x int) {
	s.clock++
	v := &entry{value: x, order: s.clock, prev: s.root.prev, next: s.root}
	v.prev.next = v
	s.root.prev = v
	heap.Push(&s.h, v)
}
func (s *MaxStack) Pop() int     { v := s.root.prev; unlink(v); heap.Remove(&s.h, v.index); return v.value }
func (s *MaxStack) Top() int     { return s.root.prev.value }
func (s *MaxStack) PeekMax() int { return s.h[0].value }
func (s *MaxStack) PopMax() int { v := heap.Pop(&s.h).(*entry); unlink(v); return v.value }729. 我的日程安排表 I
题目、示例与约束
实现一个 MyCalendar 类来存放你的日程安排。如果要添加的日程安排不会造成 重复预订 ,则可以存储这个新的日程安排。
当两个日程安排有一些时间上的交叉时(例如两个日程安排都在同一时间内),就会产生 重复预订 。
日程可以用一对整数 startTime 和 endTime 表示,这里的时间是半开区间,即 [startTime, endTime), 实数 x 的范围为, startTime <= x < endTime 。
实现 MyCalendar 类:
MyCalendar()初始化日历对象。boolean book(int startTime, int endTime)如果可以将日程安排成功添加到日历中而不会导致重复预订,返回true。否则,返回false并且不要将该日程安排添加到日历中。
示例:
输入:
["MyCalendar", "book", "book", "book"]
[[], [10, 20], [15, 25], [20, 30]]
输出:
[null, true, false, true]

解释:
MyCalendar myCalendar = new MyCalendar();
myCalendar.book(10, 20); // return True
myCalendar.book(15, 25); // return False ,这个日程安排不能添加到日历中,因为时间 15 已经被另一个日程安排预订了。
myCalendar.book(20, 30); // return True ,这个日程安排可以添加到日历中,因为第一个日程安排预订的每个时间都小于 20 ,且不包含时间 20 。
提示:
0 <= start < end <= 109- 每个测试用例,调用
book方法的次数最多不超过1000次。
方法一:有序集合 · Go 实现
思考
日程不可重叠,端点可达 ,调用约 次。每次与已预订区间线性比较可以通过,但查找插入点更适合有序结构。
将区间按结束时间排序后,与 相交的只可能是「第一个结束时间大于 」的那一段:若其开始时间仍小于 ,则冲突。
有序字典以 为键、起点为值。 定位后做一次相交判断,通过则写入。单次 。
我们可以使用有序集合来存储日程安排,有序集合可以在 的时间内完成插入、删除、查找操作。有序集合中的元素,按照日程安排的 从小到大排序。
调用 方法时,我们在有序集合中查找第一个结束时间大于 的日程安排,如果存在并且其开始时间小于 ,则说明存在重复预订,返回 ;否则,将 作为键,将 作为值插入有序集合中,返回 。
时间复杂度 ,空间复杂度 。其中 为日程安排的数量。
type MyCalendar struct {
	rbt *redblacktree.Tree
}

func Constructor() MyCalendar {
	return MyCalendar{
		rbt: redblacktree.NewWithIntComparator(),
	}
}

func (this *MyCalendar) Book(startTime int, endTime int) bool {
	if p, ok := this.rbt.Ceiling(startTime + 1); ok && p.Value.(int) < endTime {
		return false
	}
	this.rbt.Put(endTime, startTime)
	return true
}

/**
 * Your MyCalendar object will be instantiated and called as such:
 * obj := Constructor();
 * param_1 := obj.Book(startTime,endTime);
*/731. 我的日程安排表 II
题目、示例与约束
实现一个程序来存放你的日程安排。如果要添加的时间内不会导致三重预订时,则可以存储这个新的日程安排。
当三个日程安排有一些时间上的交叉时(例如三个日程安排都在同一时间内),就会产生 三重预订。
事件能够用一对整数 startTime 和 endTime 表示,在一个半开区间的时间 [startTime, endTime) 上预定。实数 x 的范围为 startTime <= x < endTime。
实现 MyCalendarTwo 类:
MyCalendarTwo()初始化日历对象。boolean book(int startTime, int endTime)如果可以将日程安排成功添加到日历中而不会导致三重预订,返回true。否则,返回false并且不要将该日程安排添加到日历中。
示例 1:
输入:
["MyCalendarTwo", "book", "book", "book", "book", "book", "book"]
[[], [10, 20], [50, 60], [10, 40], [5, 15], [5, 10], [25, 55]]
输出:
[null, true, true, true, false, true, true]

解释:
MyCalendarTwo myCalendarTwo = new MyCalendarTwo();
myCalendarTwo.book(10, 20); // 返回 True,能够预定该日程。
myCalendarTwo.book(50, 60); // 返回 True,能够预定该日程。
myCalendarTwo.book(10, 40); // 返回 True,该日程能够被重复预定。
myCalendarTwo.book(5, 15);  // 返回 False,该日程导致了三重预定,所以不能预定。
myCalendarTwo.book(5, 10); // 返回 True,能够预定该日程,因为它不使用已经双重预订的时间 10。
myCalendarTwo.book(25, 55); // 返回 True,能够预定该日程,因为时间段 [25, 40) 将被第三个日程重复预定,时间段 [40, 50) 将被单独预定,而时间段 [50, 55) 将被第二个日程重复预定。
提示:
0 <= start < end <= 109- 最多调用
book1000 次。
方法一:差分 · Go 实现
思考
允许双重预订、禁止三重。端点仍到 ,调用 次。若维护每个已订区间再两两查重,需要额外记录双重区间,实现较碎。
覆盖次数随时间的变化可用差分数组描述:起点 、终点 。扫描有序时间点上的前缀和,一旦超过 便拒绝并回滚本次差分。
值域大,用有序字典代替数组即可。每次预订扫描当前关键点,时间 ,总 ,在 次调用下可通过。
我们可以利用差分的思想,将每个时间点的预定情况记录下来,然后遍历所有时间点,统计当前时间点的预定情况,如果预定次数超过 次,则返回 。否则,返回 。
时间复杂度 ,空间复杂度 ,其中 表示日程安排的数量。
type MyCalendarTwo struct {
	rbt *redblacktree.Tree[int, int]
}

func Constructor() MyCalendarTwo {
	return MyCalendarTwo{rbt: redblacktree.New[int, int]()}
}

func (this *MyCalendarTwo) Book(startTime int, endTime int) bool {
	merge := func(x, v int) {
		c, _ := this.rbt.Get(x)
		if c+v == 0 {
			this.rbt.Remove(x)
		} else {
			this.rbt.Put(x, c+v)
		}
	}

	merge(startTime, 1)
	merge(endTime, -1)

	s := 0
	for _, v := range this.rbt.Values() {
		s += v
		if s > 2 {
			merge(startTime, -1)
			merge(endTime, 1)
			return false
		}
	}
	return true
}

/**
 * Your MyCalendarTwo object will be instantiated and called as such:
 * obj := Constructor();
 * param_1 := obj.Book(startTime,endTime);
 */
方法二:线段树 · Go 实现
思考
方法一每次要扫完全部关键点。区间加一、查询区间最大覆盖,正是带懒标记的线段树。
值域 ,动态开点维护区间最大值。先查询 的最大覆盖,若已为 则拒绝,否则区间加一。单次 。
线段树将整个区间分割为多个不连续的子区间,子区间的数量不超过 。更新某个元素的值,只需要更新 个区间,并且这些区间都包含在一个包含该元素的大区间内。区间修改时,需要使用懒标记保证效率。
- 线段树的每个节点代表一个区间;
- 线段树具有唯一的根节点,代表的区间是整个统计范围,如 ;
- 线段树的每个叶子节点代表一个长度为 的元区间 ;
- 对于每个内部节点 ,它的左儿子是 ,右儿子是 , 其中 (即向下取整)。
对于本题,线段树节点维护的信息有:
- 区间范围内被预定的次数的最大值
- 懒标记
由于时间范围为 ,非常大,因此我们采用动态开点。
时间复杂度 ,空间复杂度 ,其中 表示日程安排的数量。
type node struct {
	left      *node
	right     *node
	l, mid, r int
	v, add    int
}

func newNode(l, r int) *node {
	return &node{
		l:   l,
		r:   r,
		mid: int(uint(l+r) >> 1),
	}
}

type segmentTree struct {
	root *node
}

func newSegmentTree() *segmentTree {
	return &segmentTree{
		root: newNode(1, 1e9+1),
	}
}

func (t *segmentTree) modify(l, r, v int, n *node) {
	if l > r {
		return
	}
	if n.l >= l && n.r <= r {
		n.v += v
		n.add += v
		return
	}
	t.pushdown(n)
	if l <= n.mid {
		t.modify(l, r, v, n.left)
	}
	if r > n.mid {
		t.modify(l, r, v, n.right)
	}
	t.pushup(n)
}

func (t *segmentTree) query(l, r int, n *node) int {
	if l > r {
		return 0
	}
	if n.l >= l && n.r <= r {
		return n.v
	}
	t.pushdown(n)
	v := 0
	if l <= n.mid {
		v = max(v, t.query(l, r, n.left))
	}
	if r > n.mid {
		v = max(v, t.query(l, r, n.right))
	}
	return v
}

func (t *segmentTree) pushup(n *node) {
	n.v = max(n.left.v, n.right.v)
}

func (t *segmentTree) pushdown(n *node) {
	if n.left == nil {
		n.left = newNode(n.l, n.mid)
	}
	if n.right == nil {
		n.right = newNode(n.mid+1, n.r)
	}
	if n.add != 0 {
		n.left.add += n.add
		n.right.add += n.add
		n.left.v += n.add
		n.right.v += n.add
		n.add = 0
	}
}

type MyCalendarTwo struct {
	tree *segmentTree
}

func Constructor() MyCalendarTwo {
	return MyCalendarTwo{newSegmentTree()}
}

func (this *MyCalendarTwo) Book(startTime int, endTime int) bool {
	if this.tree.query(startTime+1, endTime, this.tree.root) >= 2 {
		return false
	}
	this.tree.modify(startTime+1, endTime, 1, this.tree.root)
	return true
}

/**
 * Your MyCalendarTwo object will be instantiated and called as such:
 * obj := Constructor();
 * param_1 := obj.Book(startTime,endTime);
*/732. 我的日程安排表 III
题目、示例与约束
当 k 个日程存在一些非空交集时(即, k 个日程包含了一些相同时间),就会产生 k 次预订。
给你一些日程安排 [startTime, endTime) ,请你在每个日程安排添加后,返回一个整数 k ,表示所有先前日程安排会产生的最大 k 次预订。
实现一个 MyCalendarThree 类来存放你的日程安排,你可以一直添加新的日程安排。
MyCalendarThree()初始化对象。int book(int startTime, int endTime)返回一个整数k,表示日历中存在的k次预订的最大值。
示例:
输入:
["MyCalendarThree", "book", "book", "book", "book", "book", "book"]
[[], [10, 20], [50, 60], [10, 40], [5, 15], [5, 10], [25, 55]]
输出:
[null, 1, 1, 2, 3, 3, 3]

解释:
MyCalendarThree myCalendarThree = new MyCalendarThree();
myCalendarThree.book(10, 20); // 返回 1 ,第一个日程安排可以预订并且不存在相交,所以最大 k 次预订是 1 次预订。
myCalendarThree.book(50, 60); // 返回 1 ,第二个日程安排可以预订并且不存在相交,所以最大 k 次预订是 1 次预订。
myCalendarThree.book(10, 40); // 返回 2 ,第三个日程安排 [10, 40) 与第一个日程安排相交,所以最大 k 次预订是 2 次预订。
myCalendarThree.book(5, 15); // 返回 3 ,剩下的日程安排的最大 k 次预订是 3 次预订。
myCalendarThree.book(5, 10); // 返回 3
myCalendarThree.book(25, 55); // 返回 3
提示:
0 <= startTime < endTime <= 109- 每个测试用例,调用
book函数最多不超过400次
方法一:线段树 · Go 实现
思考
每次预订后要返回当前最大重叠次数,调用不超过 。差分扫描也能做,但每次仍需扫完全部关键点。
与「我的日程 II」相同,这是区间加一后的全局最大覆盖。动态开点线段树维护区间最大值,预订即修改,再查询整段即可。
节点存最大值与懒加标记,值域仍是 。单次 。
线段树将整个区间分割为多个不连续的子区间,子区间的数量不超过 。更新某个元素的值,只需要更新 个区间,并且这些区间都包含在一个包含该元素的大区间内。区间修改时,需要使用懒标记保证效率。
- 线段树的每个节点代表一个区间;
- 线段树具有唯一的根节点,代表的区间是整个统计范围,如 ;
- 线段树的每个叶子节点代表一个长度为 的元区间 ;
- 对于每个内部节点 ,它的左儿子是 ,右儿子是 , 其中 (即向下取整)。
对于本题,线段树节点维护的信息有:
- 区间范围内被预定的次数的最大值
- 懒标记
由于时间范围为 ,非常大,因此我们采用动态开点。
时间复杂度 ,空间复杂度 ,其中 表示日程安排的数量。
type node struct {
	left      *node
	right     *node
	l, mid, r int
	v, add    int
}

func newNode(l, r int) *node {
	return &node{
		l:   l,
		r:   r,
		mid: int(uint(l+r) >> 1),
	}
}

type segmentTree struct {
	root *node
}

func newSegmentTree() *segmentTree {
	return &segmentTree{
		root: newNode(1, 1e9+1),
	}
}

func (t *segmentTree) modify(l, r, v int, n *node) {
	if l > r {
		return
	}
	if n.l >= l && n.r <= r {
		n.v += v
		n.add += v
		return
	}
	t.pushdown(n)
	if l <= n.mid {
		t.modify(l, r, v, n.left)
	}
	if r > n.mid {
		t.modify(l, r, v, n.right)
	}
	t.pushup(n)
}

func (t *segmentTree) query(l, r int, n *node) int {
	if l > r {
		return 0
	}
	if n.l >= l && n.r <= r {
		return n.v
	}
	t.pushdown(n)
	v := 0
	if l <= n.mid {
		v = max(v, t.query(l, r, n.left))
	}
	if r > n.mid {
		v = max(v, t.query(l, r, n.right))
	}
	return v
}

func (t *segmentTree) pushup(n *node) {
	n.v = max(n.left.v, n.right.v)
}

func (t *segmentTree) pushdown(n *node) {
	if n.left == nil {
		n.left = newNode(n.l, n.mid)
	}
	if n.right == nil {
		n.right = newNode(n.mid+1, n.r)
	}
	if n.add != 0 {
		n.left.add += n.add
		n.right.add += n.add
		n.left.v += n.add
		n.right.v += n.add
		n.add = 0
	}
}

type MyCalendarThree struct {
	tree *segmentTree
}

func Constructor() MyCalendarThree {
	return MyCalendarThree{newSegmentTree()}
}

func (this *MyCalendarThree) Book(start int, end int) int {
	this.tree.modify(start+1, end, 1, this.tree.root)
	return this.tree.query(1, int(1e9)+1, this.tree.root)
}

/**
 * Your MyCalendarThree object will be instantiated and called as such:
 * obj := Constructor();
 * param_1 := obj.Book(start,end);
*/745. 前缀和后缀搜索
题目、示例与约束
设计一个包含一些单词的特殊词典,并能够通过前缀和后缀来检索单词。
实现 WordFilter 类:
WordFilter(string[] words)使用词典中的单词words初始化对象。f(string pref, string suff)返回词典中具有前缀pref和后缀suff的单词的下标。如果存在不止一个满足要求的下标,返回其中 最大的下标 。如果不存在这样的单词,返回-1。
示例:
输入
["WordFilter", "f"]
[[["apple"]], ["a", "e"]]
输出
[null, 0]
解释
WordFilter wordFilter = new WordFilter(["apple"]);
wordFilter.f("a", "e"); // 返回 0 ,因为下标为 0 的单词:前缀 prefix = "a" 且 后缀 suffix = "e" 。
提示:
1 <= words.length <= 1041 <= words[i].length <= 71 <= pref.length, suff.length <= 7words[i]、pref和suff仅由小写英文字母组成- 最多对函数
f执行104次调用
方法一:暴力哈希 · Go 实现
思考
询问同时匹配前缀与后缀的最大下标。词长不超过 ,词数与询问均为 ,把每个词的全部前缀–后缀对预先存起来,询问即可 。
后出现的词下标更大,按顺序覆盖哈希表即可保留最大下标。空前缀、空后缀也要存,以支持整词匹配的边界。
键为 ,值为下标。 查表,缺失返回 。
遍历 的每个单词 ,将 的所有前缀、后缀对存放到哈希表中。
type WordFilter struct {
	d map[string]int
}

func Constructor(words []string) WordFilter {
	d := map[string]int{}
	for k, w := range words {
		n := len(w)
		for i := 0; i <= n; i++ {
			a := w[:i]
			for j := 0; j <= n; j++ {
				b := w[j:]
				d[a+"."+b] = k
			}
		}
	}
	return WordFilter{d}
}

func (this *WordFilter) F(pref string, suff string) int {
	if v, ok := this.d[pref+"."+suff]; ok {
		return v
	}
	return -1
}

/**
 * Your WordFilter object will be instantiated and called as such:
 * obj := Constructor(words);
 * param_1 := obj.F(pref,suff);
 */
方法二:双前缀树 · Go 实现
思考
方法一把一对前缀后缀都存进哈希,空间是词长平方之和。改用两棵字典树分别索引前缀与反转后缀,节点上记下经过的下标列表。
询问时取出前缀路径与反转后缀路径上的下标序列(均按插入顺序递增),从右同步双指针找最大的公共下标。
词长短,列表也不长,避免了存全部配对。
type Trie struct {
	children [26]*Trie
	indexes  []int
}

func newTrie() *Trie {
	return &Trie{indexes: []int{}}
}
func (this *Trie) insert(word string, i int) {
	node := this
	for _, c := range word {
		idx := c - 'a'
		if node.children[idx] == nil {
			node.children[idx] = newTrie()
		}
		node = node.children[idx]
		node.indexes = append(node.indexes, i)
	}
}

func (this *Trie) search(pref string) []int {
	node := this
	for _, c := range pref {
		idx := c - 'a'
		if node.children[idx] == nil {
			return []int{}
		}
		node = node.children[idx]
	}
	return node.indexes
}

type WordFilter struct {
	p *Trie
	s *Trie
}

func Constructor(words []string) WordFilter {
	p := newTrie()
	s := newTrie()
	for i, w := range words {
		p.insert(w, i)
		s.insert(reverse(w), i)
	}
	return WordFilter{p, s}
}

func (this *WordFilter) F(pref string, suff string) int {
	a := this.p.search(pref)
	b := this.s.search(reverse(suff))
	if len(a) == 0 || len(b) == 0 {
		return -1
	}
	i, j := len(a)-1, len(b)-1
	for i >= 0 && j >= 0 {
		if a[i] == b[j] {
			return a[i]
		}
		if a[i] > b[j] {
			i--
		} else {
			j--
		}
	}
	return -1
}

func reverse(w string) string {
	ww := []byte(w)
	for i, j := 0, len(w)-1; i < j; i++ {
		ww[i], ww[j] = ww[j], ww[i]
		j--
	}
	return string(ww)
}

/**
 * Your WordFilter object will be instantiated and called as such:
 * obj := Constructor(words);
 * param_1 := obj.F(pref,suff);
*/855. 考场就座
题目、示例与约束
在考场里,有 n 个座位排成一行,编号为 0 到 n - 1。
当学生进入考场后,他必须坐在离最近的人最远的座位上。如果有多个这样的座位,他会坐在编号最小的座位上。(另外,如果考场里没有人,那么学生就坐在 0 号座位上。)
设计一个模拟所述考场的类。
实现 ExamRoom 类:
ExamRoom(int n)用座位的数量n初始化考场对象。int seat()返回下一个学生将会入座的座位编号。void leave(int p)指定坐在座位p的学生将离开教室。保证座位p上会有一位学生。
示例 1:
输入:
["ExamRoom", "seat", "seat", "seat", "seat", "leave", "seat"]
[[10], [], [], [], [], [4], []]
输出:
[null, 0, 9, 4, 2, null, 5]
解释:
ExamRoom examRoom = new ExamRoom(10);
examRoom.seat(); // 返回 0,房间里没有人,学生坐在 0 号座位。
examRoom.seat(); // 返回 9,学生最后坐在 9 号座位。
examRoom.seat(); // 返回 4,学生最后坐在 4 号座位。
examRoom.seat(); // 返回 2,学生最后坐在 2 号座位。
examRoom.leave(4);
examRoom.seat(); // 返回 5,学生最后坐在 5 号座位。
提示:
1 <= n <= 109- 保证有学生正坐在座位
p上。 seat和leave最多被调用104次。
方法一:有序集合 + 哈希表 · Go 实现
思考
每次在最大化「到最近已坐者距离」的位置入座,离开则腾空。若每次扫描全部座位, 与操作次数都会偏大。关键是维护空区间,入座只分裂当前最优区间。
有序集合按「区间能提供的距离、左端点」排序,哈希表记下每个端点的左右邻居。入座取堆顶区间中点(端点区间坐到 或 ),离开则合并两侧区间。
考虑到每次 时都需要找到最大距离的座位,我们可以使用有序集合来保存座位区间。有序集合的每个元素为一个二元组 ,表示 和 之间(不包括 和 )的座位可以坐学生。初始时有序集合中只有一个元素 ,表示 之间的座位可以坐学生。
另外,我们使用两个哈希表 和 来维护每个有学生的座位的左右邻居学生,方便我们在 时合并两个座位区间。
时间复杂度 ,空间复杂度 。其中 为考场的座位数。
type ExamRoom struct {
	rbt   *redblacktree.Tree
	left  map[int]int
	right map[int]int
	n     int
}

func Constructor(n int) ExamRoom {
	dist := func(s []int) int {
		if s[0] == -1 || s[1] == n {
			return s[1] - s[0] - 1
		}
		return (s[1] - s[0]) >> 1
	}
	cmp := func(a, b any) int {
		x, y := a.([]int), b.([]int)
		d1, d2 := dist(x), dist(y)
		if d1 == d2 {
			return x[0] - y[0]
		}
		return d2 - d1
	}
	this := ExamRoom{redblacktree.NewWith(cmp), map[int]int{}, map[int]int{}, n}
	this.add([]int{-1, n})
	return this
}

func (this *ExamRoom) Seat() int {
	s := this.rbt.Left().Key.([]int)
	p := (s[0] + s[1]) >> 1
	if s[0] == -1 {
		p = 0
	} else if s[1] == this.n {
		p = this.n - 1
	}
	this.del(s)
	this.add([]int{s[0], p})
	this.add([]int{p, s[1]})
	return p
}

func (this *ExamRoom) Leave(p int) {
	l, _ := this.left[p]
	r, _ := this.right[p]
	this.del([]int{l, p})
	this.del([]int{p, r})
	this.add([]int{l, r})
}

func (this *ExamRoom) add(s []int) {
	this.rbt.Put(s, struct{}{})
	this.left[s[1]] = s[0]
	this.right[s[0]] = s[1]
}

func (this *ExamRoom) del(s []int) {
	this.rbt.Remove(s)
	delete(this.left, s[1])
	delete(this.right, s[0])
}

/**
 * Your ExamRoom object will be instantiated and called as such:
 * obj := Constructor(n);
 * param_1 := obj.Seat();
 * obj.Leave(p);
*/895. 最大频率栈
题目、示例与约束
设计一个类似堆栈的数据结构,将元素推入堆栈,并从堆栈中弹出出现频率最高的元素。
实现 FreqStack 类:
FreqStack()构造一个空的堆栈。void push(int val)将一个整数val压入栈顶。int pop()删除并返回堆栈中出现频率最高的元素。- 如果出现频率最高的元素不只一个,则移除并返回最接近栈顶的元素。
示例 1:
输入:
["FreqStack","push","push","push","push","push","push","pop","pop","pop","pop"],
[[],[5],[7],[5],[7],[4],[5],[],[],[],[]]
输出:[null,null,null,null,null,null,null,5,7,5,4]
解释:
FreqStack = new FreqStack();
freqStack.push (5);//堆栈为 [5]
freqStack.push (7);//堆栈是 [5,7]
freqStack.push (5);//堆栈是 [5,7,5]
freqStack.push (7);//堆栈是 [5,7,5,7]
freqStack.push (4);//堆栈是 [5,7,5,7,4]
freqStack.push (5);//堆栈是 [5,7,5,7,4,5]
freqStack.pop ();//返回 5 ,因为 5 出现频率最高。堆栈变成 [5,7,5,7,4]。
freqStack.pop ();//返回 7 ,因为 5 和 7 出现频率最高,但7最接近顶部。堆栈变成 [5,7,5,4]。
freqStack.pop ();//返回 5 ,因为 5 出现频率最高。堆栈变成 [5,7,4]。
freqStack.pop ();//返回 4 ,因为 4, 5 和 7 出现频率最高,但 4 是最接近顶部的。堆栈变成 [5,7]。
提示:
0 <= val <= 109push和pop的操作数不大于2 * 104。- 输入保证在调用
pop之前堆栈中至少有一个元素。
方法一:哈希表 + 优先队列(大根堆) · Go 实现
思考
弹出当前频率最高且最近压入的值。操作达 ,每次扫描栈不可行。需要同时知道频率与时间戳。
哈希表记频率,优先队列存 。弹出堆顶后把该值频率减一;堆中旧记录因频率过时不会再成为堆顶的有效选择。
根据题目描述,我们需要设计一个支持弹出“出现频率最高”的元素的数据结构。如果存在多个元素出现频率相同,那么弹出最接近栈顶的元素。
我们可以使用哈希表 记录每个元素出现的频率,用一个优先队列(大根堆) 维护元素频率以及对应的压栈时间戳。
执行压栈操作时,我们先将当前时间戳加一,即 ;然后将元素 的频率加一,即 ,最后将三元组 加入优先队列 中。压栈操作的时间复杂度为 。
执行弹栈操作时,我们直接从优先队列 中弹出一个元素即可。由于优先队列 中的元素按照频率降序排序,因此弹出的元素一定是出现频率最高的元素。如果存在多个元素出现频率相同,那么弹出最接近栈顶的元素,即弹出时间戳最大的元素。弹出后,我们将弹出元素的频率减一,即 。弹栈操作的时间复杂度为 。
type FreqStack struct {
	cnt map[int]int
	q   hp
	ts  int
}

func Constructor() FreqStack {
	return FreqStack{map[int]int{}, hp{}, 0}
}

func (this *FreqStack) Push(val int) {
	this.cnt[val]++
	this.ts++
	heap.Push(&this.q, tuple{this.cnt[val], this.ts, val})
}

func (this *FreqStack) Pop() int {
	val := heap.Pop(&this.q).(tuple).val
	this.cnt[val]--
	return val
}

type tuple struct{ cnt, ts, val int }
type hp []tuple

func (h hp) Len() int { return len(h) }
func (h hp) Less(i, j int) bool {
	return h[i].cnt > h[j].cnt || h[i].cnt == h[j].cnt && h[i].ts > h[j].ts
}
func (h hp) Swap(i, j int) { h[i], h[j] = h[j], h[i] }
func (h *hp) Push(v any)   { *h = append(*h, v.(tuple)) }
func (h *hp) Pop() any     { a := *h; v := a[len(a)-1]; *h = a[:len(a)-1]; return v }

/**
 * Your FreqStack object will be instantiated and called as such:
 * obj := Constructor();
 * obj.Push(val);
 * param_2 := obj.Pop();
 */
方法二:双哈希表 · Go 实现
思考
堆里会留下过期的频率记录。若按频率分桶,第 层是一个栈,专放当前频率恰为 的值。
压入时把值推进 层并更新最大频率;弹出只取最高层栈顶,该层空了再降低最大频率。每次操作均摊 。
在方法一中,为了能弹出符合要求的元素,我们维护了一个优先队列,每次都需要对优先队列进行操作,时间复杂度为 。如果我们能够在 的时间内找到符合要求的元素,那么整个数据结构每次操作的时间复杂度就可以降低到 。
实际上,我们可以用一个变量 记录当前出现频率的最大值,用一个哈希表 记录每个出现频率对应的元素列表,与方法一相同,用一个哈希表 记录每个元素出现的频率。
执行压栈操作时,我们将元素的频率加一,即 ,然后将元素 加入哈希表 中对应的频率列表中,即 。如果当前元素的频率大于 ,则更新 ,即 。压栈操作的时间复杂度为 。
执行弹栈操作时,我们从哈希表 中取出频率为 的元素列表,弹出列表中的最后一个元素 ,然后将 从哈希表 中移除,即 。最后将 的频率减一,即 。如果 列表为空,说明当前出现频率最大的元素已经全部弹出,我们需要将 减一,即 。弹栈操作的时间复杂度为 。
type FreqStack struct {
	cnt map[int]int
	d   map[int][]int
	mx  int
}

func Constructor() FreqStack {
	return FreqStack{map[int]int{}, map[int][]int{}, 0}
}

func (this *FreqStack) Push(val int) {
	this.cnt[val]++
	this.d[this.cnt[val]] = append(this.d[this.cnt[val]], val)
	this.mx = max(this.mx, this.cnt[val])
}

func (this *FreqStack) Pop() int {
	val := this.d[this.mx][len(this.d[this.mx])-1]
	this.d[this.mx] = this.d[this.mx][:len(this.d[this.mx])-1]
	this.cnt[val]--
	if len(this.d[this.mx]) == 0 {
		this.mx--
	}
	return val
}

/**
 * Your FreqStack object will be instantiated and called as such:
 * obj := Constructor();
 * obj.Push(val);
 * param_2 := obj.Pop();
*/900. RLE 迭代器
题目、示例与约束
我们可以使用游程编码(即 RLE )来编码一个整数序列。在偶数长度 encoding ( 从 0 开始 )的游程编码数组中,对于所有偶数 i ,encoding[i] 告诉我们非负整数 encoding[i + 1] 在序列中重复的次数。
- 例如,序列
arr = [8,8,8,5,5]可以被编码为encoding =[3,8,2,5]。encoding =[3,8,0,9,2,5]和encoding =[2,8,1,8,2,5]也是arr有效的 RLE 。
给定一个游程长度的编码数组,设计一个迭代器来遍历它。
实现 RLEIterator 类:
RLEIterator(int[] encoded)用编码后的数组初始化对象。int next(int n)以这种方式耗尽后n个元素并返回最后一个耗尽的元素。如果没有剩余的元素要耗尽,则返回-1。
示例 1:
输入:
["RLEIterator","next","next","next","next"]
[[[3,8,0,9,2,5]],[2],[1],[1],[2]]
输出:
[null,8,8,5,-1]
解释:
RLEIterator rLEIterator = new RLEIterator([3, 8, 0, 9, 2, 5]); // 这映射到序列 [8,8,8,5,5]。
rLEIterator.next(2); // 耗去序列的 2 个项,返回 8。现在剩下的序列是 [8, 5, 5]。
rLEIterator.next(1); // 耗去序列的 1 个项,返回 8。现在剩下的序列是 [5, 5]。
rLEIterator.next(1); // 耗去序列的 1 个项,返回 5。现在剩下的序列是 [5]。
rLEIterator.next(2); // 耗去序列的 2 个项,返回 -1。 这是由于第一个被耗去的项是 5,
但第二个项并不存在。由于最后一个要耗去的项不存在,我们返回 -1。
提示:
2 <= encoding.length <= 1000encoding.length为偶0 <= encoding[i] <= 1091 <= n <= 109- 每个测试用例调用
next不高于1000次
方法一:维护两个指针 · Go 实现
思考
游程次数可达 ,若将编码展开成完整序列,空间无法承受;每次
next的 同样可达 ,按元素逐个消耗也不现实。因此必须直接在压缩表示上消耗。当前游程剩余量为 ,若小于待消耗的 ,则整段跳过并把 前进 ;否则只在本段内推进 。两个指针只向前移动,全部查询合计线性扫描一遍编码。
我们定义两个指针 和 ,其中指针 指向当前读取的游程编码,指针 指向当前读取的游程编码中的第几个字符。初始时 , 。
每次调用 next(n) 时,我们判断当前游程编码中剩余的字符数 是否小于 ,若是,则将 减去 ,并将 加 , 置为 ,然后继续判断下一个游程编码;若不是,则将 加 ,并返回 。
若 超出了游程编码的长度,依然没有返回值,则说明没有剩余的元素要耗尽,返回 。
时间复杂度 ,空间复杂度 。其中 是游程编码的长度,而 是调用 next(n) 的次数。
type RLEIterator struct {
	encoding []int
	i, j     int
}

func Constructor(encoding []int) RLEIterator {
	return RLEIterator{encoding, 0, 0}
}

func (this *RLEIterator) Next(n int) int {
	for this.i < len(this.encoding) {
		if this.encoding[this.i]-this.j < n {
			n -= (this.encoding[this.i] - this.j)
			this.i += 2
			this.j = 0
		} else {
			this.j += n
			return this.encoding[this.i+1]
		}
	}
	return -1
}

/**
 * Your RLEIterator object will be instantiated and called as such:
 * obj := Constructor(encoding);
 * param_1 := obj.Next(n);
*/901. 股票价格跨度
题目、示例与约束
设计一种算法,收集某支股票的每日价格报价,并返回该股票当前日期的 价格跨度。
股票在某一天的 价格跨度 是指:从当天开始向前,连续的股票价格小于或等于当天价格的最大天数。
- 例如,如果股票过去四天的价格为
[7,2,1,2],今天的价格为2,那么今天的价格跨度为4,因为从今天开始向前,有连续 4 天的股票价格小于或等于 2。 - 同样,如果股票过去四天的价格为
[7,34,1,2],今天的价格为8,那么今天的价格跨度为3,因为从今天开始向前,有连续 3 天的股票价格小于或等于 8。
实现 StockSpanner 类:
StockSpanner()初始化该类的对象。int next(int price)给定今天的股票价格price,返回今天股票价格的 价格跨度。
示例 1:
输入
["StockSpanner", "next", "next", "next", "next", "next", "next", "next"]
[[], [100], [80], [60], [70], [60], [75], [85]]
输出
[null, 1, 1, 1, 2, 1, 4, 6]

解释
StockSpanner stockSpanner = new StockSpanner();
stockSpanner.next(100); // 返回 1
stockSpanner.next(80);  // 返回 1
stockSpanner.next(60);  // 返回 1
stockSpanner.next(70);  // 返回 2
stockSpanner.next(60);  // 返回 1
stockSpanner.next(75);  // 返回 4,因为包含今天在内的最后 4 天的价格都小于或等于今天的价格 75。
stockSpanner.next(85);  // 返回 6
约束条件:
1 <= price <= 105- 最多会调用
104次next。
方法一:单调栈 · Go 实现
思考
每次查询若从当日向前扫描,直到遇到更大价格,则调用次数较多时合计为平方级。已经被更早价格覆盖的连续段不必重算:若栈顶价格不超过当日 ,其跨度可以并入当日。
为此维护价格从栈底到栈顶单调递减的栈,元素为 。弹出并累加后入栈,每个价格至多进出一次,单次查询均摊常数。
根据题目描述,我们可以知道,对于当日价格 ,从这个价格开始往前找,找到第一个比这个价格大的价格,这两个价格的下标差 就是当日价格的跨度。
这实际上是经典的单调栈模型,找出左侧第一个比当前元素大的元素。
我们维护一个从栈底到栈顶价格单调递减的栈,栈中每个元素存放的是 数据对,其中 表示价格,而 表示当前价格的跨度。
出现价格 时,我们将其与栈顶元素进行比较,如果栈顶元素的价格小于等于 ,则将当日价格的跨度 加上栈顶元素的跨度,然后将栈顶元素出栈,直到栈顶元素的价格大于 ,或者栈为空为止。
最后将 入栈,返回 即可。
时间复杂度 ,空间复杂度 。其中 是调用 next(price) 的次数。
type StockSpanner struct {
	stk []pair
}

func Constructor() StockSpanner {
	return StockSpanner{[]pair{}}
}

func (this *StockSpanner) Next(price int) int {
	cnt := 1
	for len(this.stk) > 0 && this.stk[len(this.stk)-1].price <= price {
		cnt += this.stk[len(this.stk)-1].cnt
		this.stk = this.stk[:len(this.stk)-1]
	}
	this.stk = append(this.stk, pair{price, cnt})
	return cnt
}

type pair struct{ price, cnt int }

/**
 * Your StockSpanner object will be instantiated and called as such:
 * obj := Constructor();
 * param_1 := obj.Next(price);
*/继续阅读
- 实践案例
- 实践案例
- 实践案例