
LeetCode Go · 数组与矩阵(1)
来源与许可
题目版权归 LeetCode;题解来自 Doocs/leetcode,按 CC BY-SA 4.0 共享。补充 Go 代码来自灵茶山艾府、halfrost,保留 MIT 许可及逐题署名。本站提取 Go、调整分类及折叠排版;标注“本站整理”的 Go 解法依据题意与参考思路补写,按 CC BY-SA 4.0 共享。收录日期:2026-10-31;主题源版本:91ef8c241a5e。
本卷 30 题 · 点击题目展开,先独立思考,再查看解法。
54. 螺旋矩阵
题目、示例与约束
给你一个 m 行 n 列的矩阵 matrix ,请按照 顺时针螺旋顺序 ,返回矩阵中的所有元素。
示例 1:
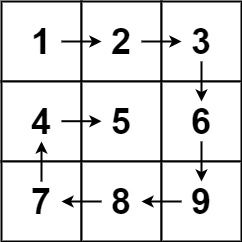
输入:matrix = [[1,2,3],[4,5,6],[7,8,9]]
输出:[1,2,3,6,9,8,7,4,5]
示例 2:
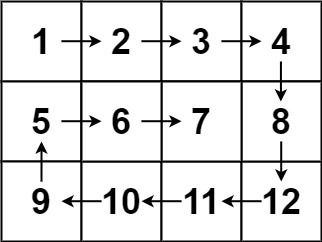
输入:matrix = [[1,2,3,4],[5,6,7,8],[9,10,11,12]]
输出:[1,2,3,4,8,12,11,10,9,5,6,7]
提示:
m == matrix.lengthn == matrix[i].length1 <= m, n <= 10-100 <= matrix[i][j] <= 100
方法一:模拟 · Go 实现
思考
矩阵规模至多 ,按层剥皮、每层四向走一圈再收缩边界可以通过,但剩下一行或一列时边界很容易写错。
螺旋的本质是沿当前方向前进,下一步越界或已访问则右转。四种方向可用数组循环切换,访问过的格子用 标记。
从左上角出发走满 步,即可得到遍历序列。
我们可以模拟整个遍历的过程,用 和 分别表示当前访问到的元素的行和列,用 表示当前的方向,用数组或哈希表 记录每个元素是否被访问过。每次我们访问到一个元素后,将其标记为已访问,然后按照当前的方向前进一步,如果前进一步后发现越界或者已经访问过,则改变方向继续前进,直到遍历完整个矩阵。
时间复杂度 ,空间复杂度 。其中 和 分别是矩阵的行数和列数。
func spiralOrder(matrix [][]int) (ans []int) {
	m, n := len(matrix), len(matrix[0])
	vis := make([][]bool, m)
	for i := range vis {
		vis[i] = make([]bool, n)
	}
	dirs := [5]int{0, 1, 0, -1, 0}
	i, j, k := 0, 0, 0
	for h := m * n; h > 0; h-- {
		ans = append(ans, matrix[i][j])
		vis[i][j] = true
		x, y := i+dirs[k], j+dirs[k+1]
		if x < 0 || x >= m || y < 0 || y >= n || vis[x][y] {
			k = (k + 1) % 4
		}
		i, j = i+dirs[k], j+dirs[k+1]
	}
	return
}
方法二:模拟(空间优化) · Go 实现
思考
方法一已经线性扫完矩阵,但 仍需 额外空间。元素取值范围为 ,访问信息可以编码进格子本身。
将走过的格子加上足够大的偏移,即可用数值是否越出原范围来判断是否访问过,遍历结束后再减回,额外空间降至 。
注意到,题目中矩阵元素取值范围为 ,因此,我们可以将访问过的元素加上一个较大的值,比如 ,这样只需要判断访问的元素是否大于 即可,无需额外的空间记录是否访问过。如果最终需要将访问过的元素恢复原值,可以在遍历结束后再次遍历一遍矩阵,将所有元素减去 。
时间复杂度 ,其中 和 分别是矩阵的行数和列数。空间复杂度 。
func spiralOrder(matrix [][]int) (ans []int) {
	m, n := len(matrix), len(matrix[0])
	dirs := [5]int{0, 1, 0, -1, 0}
	i, j, k := 0, 0, 0
	for h := m * n; h > 0; h-- {
		ans = append(ans, matrix[i][j])
		matrix[i][j] += 300
		x, y := i+dirs[k], j+dirs[k+1]
		if x < 0 || x >= m || y < 0 || y >= n || matrix[x][y] > 100 {
			k = (k + 1) % 4
		}
		i, j = i+dirs[k], j+dirs[k+1]
	}
	for i = 0; i < m; i++ {
		for j = 0; j < n; j++ {
			matrix[i][j] -= 300
		}
	}
	return
}57. 插入区间
题目、示例与约束
给你一个 无重叠的 ,按照区间起始端点排序的区间列表 intervals,其中 intervals[i] = [starti, endi] 表示第 i 个区间的开始和结束,并且 intervals 按照 starti 升序排列。同样给定一个区间 newInterval = [start, end] 表示另一个区间的开始和结束。
如果两个区间 至少 共享一个点,则认为它们是重叠的。
在 intervals 中插入区间 newInterval,使得 intervals 依然按照 starti 升序排列,且区间之间不重叠(如果有必要的话,可以合并区间)。
返回插入之后的 intervals。
注意 你不需要原地修改 intervals。你可以创建一个新数组然后返回它。
示例 1:
输入:intervals = [[1,3],[6,9]], newInterval = [2,5]
输出:[[1,5],[6,9]]
示例 2:
输入:intervals = [[1,2],[3,5],[6,7],[8,10],[12,16]], newInterval = [4,8] 输出:[[1,2],[3,10],[12,16]] 解释:这是因为新的区间[4,8]与[3,5],[6,7],[8,10]重叠。
提示:
0 <= intervals.length <= 104intervals[i].length == 20 <= starti <= endi <= 105intervals根据starti按 升序 排列newInterval.length == 20 <= start <= end <= 105
方法一:排序 + 区间合并 · Go 实现
思考
原区间已按左端排好且互不重叠。将 并入列表后,即可当作普通的「合并区间」处理: ,排序加一次扫描的 可以通过。
这一写法没有用上「已经有序」的条件,但实现最短,把插入化归为已有过程。
我们可以先将新区间 newInterval 加入到区间列表 intervals 中,然后按照区间合并的常规方法进行合并。
时间复杂度 ,空间复杂度 。其中 是区间的数量。
func insert(intervals [][]int, newInterval []int) [][]int {
	merge := func(intervals [][]int) (ans [][]int) {
		sort.Slice(intervals, func(i, j int) bool { return intervals[i][0] < intervals[j][0] })
		ans = append(ans, intervals[0])
		for _, e := range intervals[1:] {
			if ans[len(ans)-1][1] < e[0] {
				ans = append(ans, e)
			} else {
				ans[len(ans)-1][1] = max(ans[len(ans)-1][1], e[1])
			}
		}
		return
	}
	intervals = append(intervals, newInterval)
	return merge(intervals)
}
方法二:一次遍历 · Go 实现
思考
方法一重新排序,没有利用原序列已经有序这一条件,时间多出一个对数因子。
区间已经有序且互不重叠,插入段与原区间的相对位置只有「在左、相交、在右」三类,一次线性扫描即可完成插入与合并,无需再次排序。
我们可以遍历区间列表 intervals,记当前区间为 interval,对于每个区间有三种情况:
- 当前区间在新区间的右侧,即 ,此时如果新区间还没有被加入,那么将新区间加入到答案中,然后将当前区间加入到答案中。
- 当前区间在新区间的左侧,即 ,此时将当前区间加入到答案中。
- 否则,说明当前区间与新区间有交集,我们取当前区间的左端点和新区间的左端点的最小值,以及当前区间的右端点和新区间的右端点的最大值,作为新区间的左右端点,然后继续遍历区间列表。
遍历结束,如果新区间还没有被加入,那么将新区间加入到答案中。
时间复杂度 ,其中 是区间的数量。忽略答案数组的空间消耗,空间复杂度 。
func insert(intervals [][]int, newInterval []int) (ans [][]int) {
	st, ed := newInterval[0], newInterval[1]
	insert := false
	for _, interval := range intervals {
		s, e := interval[0], interval[1]
		if ed < s {
			if !insert {
				ans = append(ans, []int{st, ed})
				insert = true
			}
			ans = append(ans, interval)
		} else if e < st {
			ans = append(ans, interval)
		} else {
			st = min(st, s)
			ed = max(ed, e)
		}
	}
	if !insert {
		ans = append(ans, []int{st, ed})
	}
	return
}59. 螺旋矩阵 II
题目、示例与约束
给你一个正整数 n ,生成一个包含 1 到 n2 所有元素,且元素按顺时针顺序螺旋排列的 n x n 正方形矩阵 matrix 。
示例 1:
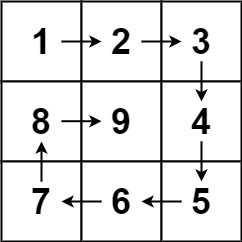
输入:n = 3
输出:[[1,2,3],[8,9,4],[7,6,5]]
示例 2:
输入:n = 1
输出:[[1]]
提示:
1 <= n <= 20
方法一:模拟 · Go 实现
思考
与螺旋读取相对,本题要把 到 按同样顺序填入方阵。若按层填充、每层四条边分别赋值再收缩边界, 可以通过,但边界同样容易写错。
沿当前方向前进,下一步越界或已填则右转。空白格子为 ,已填非零,因此不必另开访问数组。
用方向数组循环四种走法,依次填入即可。
我们可以直接模拟螺旋矩阵的生成过程。
定义一个二维数组 ,用于存储螺旋矩阵。用 和 分别表示当前位置的行号和列号,用 表示当前的方向编号, 表示方向编号与方向的对应关系。
从 开始,依次填入矩阵中的每个位置。每次填入一个位置后,计算下一个位置的行号和列号,如果下一个位置不在矩阵中或者已经被填过,则改变方向,再计算下一个位置的行号和列号。
时间复杂度 ,其中 是矩阵的边长。忽略答案数组的空间消耗,空间复杂度 。
func generateMatrix(n int) [][]int {
	ans := make([][]int, n)
	for i := range ans {
		ans[i] = make([]int, n)
	}
	dirs := [5]int{0, 1, 0, -1, 0}
	i, j, k := 0, 0, 0
	for v := 1; v <= n*n; v++ {
		ans[i][j] = v
		x, y := i+dirs[k], j+dirs[k+1]
		if x < 0 || x >= n || y < 0 || y >= n || ans[x][y] != 0 {
			k = (k + 1) % 4
		}
		i += dirs[k]
		j += dirs[k+1]
	}
	return ans
}157. 用 Read4 读取 N 个字符 🔒
题目、示例与约束
给你一个文件,并且该文件只能通过给定的 read4 方法来读取,请实现一个方法使其能够读取 n 个字符。
read4 方法:
API read4 可以从文件中读取 4 个连续的字符,并且将它们写入缓存数组 buf 中。
返回值为实际读取的字符个数。
注意 read4() 自身拥有文件指针,很类似于 C 语言中的 FILE *fp 。
read4 的定义:
参数类型: char[] buf4
返回类型: int

注意: buf4[] 是目标缓存区不是源缓存区,read4 的返回结果将会复制到 buf4[] 当中。
下列是一些使用 read4 的例子:
File file("abcde"); // 文件名为 "abcde", 初始文件指针 (fp) 指向 'a'
char[] buf4 = new char[4]; // 创建一个缓存区使其能容纳足够的字符
read4(buf4); // read4 返回 4。现在 buf4 = "abcd",fp 指向 'e'
read4(buf4); // read4 返回 1。现在 buf4 = "e",fp 指向文件末尾
read4(buf4); // read4 返回 0。现在 buf = "",fp 指向文件末尾
read 方法:
通过使用 read4 方法,实现 read 方法。该方法可以从文件中读取 n 个字符并将其存储到缓存数组 buf 中。您 不能 直接操作文件。
返回值为实际读取的字符。
read 的定义:
参数类型:   char[] buf, int n
返回类型:   int

注意: buf[] 是目标缓存区不是源缓存区,你需要将结果写入 buf[] 中。
示例 1:
输入: file = "abc", n = 4
输出: 3
解释: 当执行你的 read 方法后,buf 需要包含 "abc"。 文件一共 3 个字符,因此返回 3。 注意 "abc" 是文件的内容,不是 buf 的内容,buf 是你需要写入结果的目标缓存区。
示例 2:
输入: file = "abcde", n = 5
输出: 5
解释: 当执行你的 read 方法后,buf 需要包含 "abcde"。文件共 5 个字符,因此返回 5。
示例 3:
输入: file = "abcdABCD1234", n = 12
输出: 12
解释: 当执行你的 read 方法后,buf 需要包含 "abcdABCD1234"。文件一共 12 个字符,因此返回 12。
示例 4:
输入: file = "leetcode", n = 5
输出: 5
解释: 当执行你的 read 方法后,buf 需要包含 "leetc"。文件中一共 5 个字符,因此返回 5。
提示:
- 你 不能 直接操作该文件,文件只能通过
read4获取而 不能 通过read。 read函数只在每个测试用例调用一次。- 你可以假定目标缓存数组
buf保证有足够的空间存下 n 个字符。
方法一:模拟 · Go 实现
思考
只能通过 读文件,且本题 只调用一次。需要的字符数可能不是 的倍数,最后一次还可能不足 个。循环调用 写入临时缓冲,再拷到目标,凑满 或读到文件末尾即停。
直接模拟读取文件的过程,每次读取 4 个字符,然后将读取的字符存入缓存数组中,直到读取的字符数目达到 n 或者文件读取完毕。
时间复杂度 。其中 为要读取的字符数目。
/**
 * The read4 API is already defined for you.
 *
 *     read4 := func(buf4 []byte) int
 *
 * // Below is an example of how the read4 API can be called.
 * file := File("abcdefghijk") // File is "abcdefghijk", initially file pointer (fp) points to 'a'
 * buf4 := make([]byte, 4) // Create buffer with enough space to store characters
 * read4(buf4) // read4 returns 4. Now buf = ['a','b','c','d'], fp points to 'e'
 * read4(buf4) // read4 returns 4. Now buf = ['e','f','g','h'], fp points to 'i'
 * read4(buf4) // read4 returns 3. Now buf = ['i','j','k',...], fp points to end of file
 */

var solution = func(read4 func([]byte) int) func([]byte, int) int {
	// implement read below.
	return func(buf []byte, n int) int {
		buf4 := make([]byte, 4)
		i, v := 0, 5
		for v >= 4 {
			v = read4(buf4)
			for j := 0; j < v; j++ {
				buf[i] = buf4[j]
				i++
				if i >= n {
					return n
				}
			}
		}
		return i
	}
}158. 用 Read4 读取 N 个字符 II - 多次调用 🔒
题目、示例与约束
给你一个文件 file ,并且该文件只能通过给定的 read4 方法来读取,请实现一个方法使其能够使 read 读取 n 个字符。注意:你的 read 方法可能会被调用多次。
read4 的定义:
read4 API 从文件中读取 4 个连续的字符,然后将这些字符写入缓冲区数组 buf4 。
返回值是读取的实际字符数。
请注意,read4() 有其自己的文件指针,类似于 C 中的 FILE * fp 。
    参数类型: char[] buf4
    返回类型: int

注意: buf4[] 是目标缓存区不是源缓存区,read4 的返回结果将会复制到 buf4[] 当中。
下列是一些使用 read4 的例子:
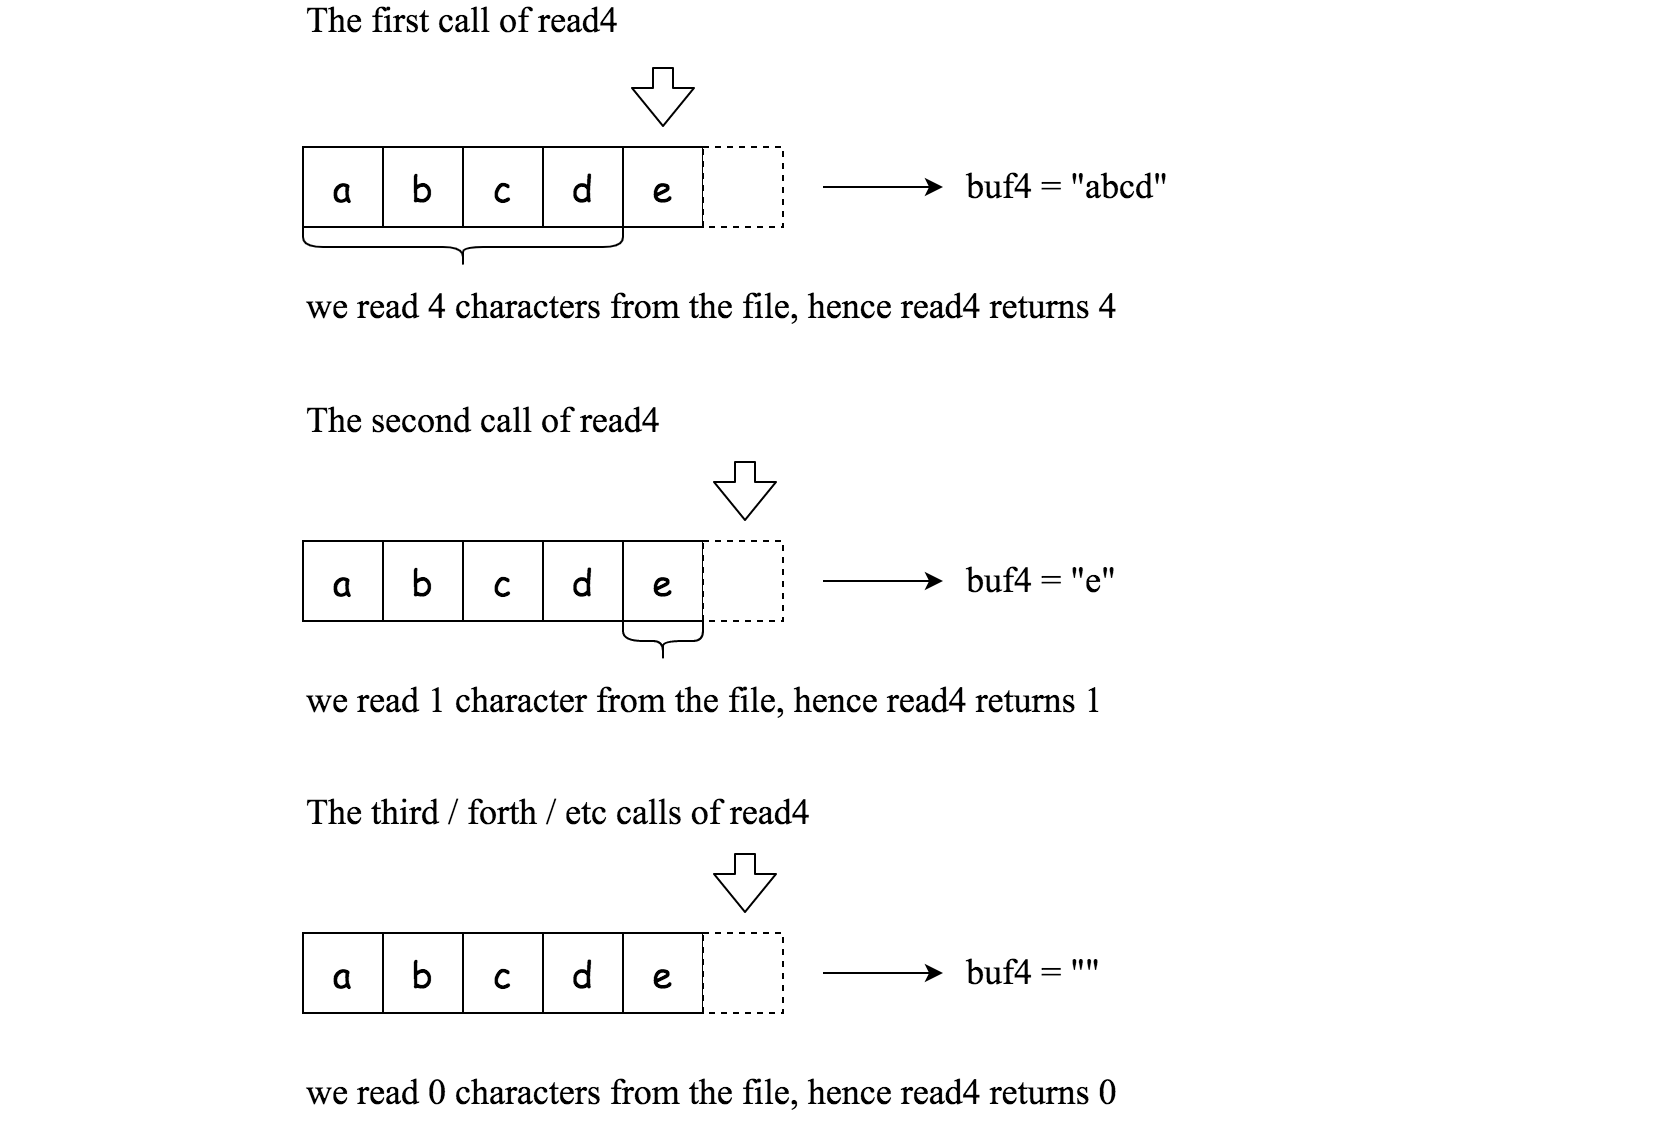
File file("abcde"); // 文件名为 "abcde", 初始文件指针 (fp) 指向 'a'
char[] buf4 = new char[4]; // 创建一个缓存区使其能容纳足够的字符
read4(buf4); // read4 返回 4。现在 buf4 = "abcd",fp 指向 'e'
read4(buf4); // read4 返回 1。现在 buf4 = "e",fp 指向文件末尾
read4(buf4); // read4 返回 0。现在 buf4 = "",fp 指向文件末尾
read 方法:
通过使用 read4 方法,实现 read 方法。该方法可以从文件中读取 n 个字符并将其存储到缓存数组 buf 中。您 不能 直接操作 file 。
返回值为实际读取的字符。
read 的定义:
    参数类型:  char[] buf, int n
    返回类型:  int

注意: buf[] 是目标缓存区不是源缓存区,你需要将结果写入 buf[] 中。
注意:
- 你 不能 直接操作该文件,文件只能通过
read4获取而 不能 通过read。 read函数可以被调用 多次。- 请记得 重置 在 Solution 中声明的类变量(静态变量),因为类变量会 在多个测试用例中保持不变,影响判题准确。请 查阅 这里。
- 你可以假定目标缓存数组
buf保证有足够的空间存下 n 个字符。 - 保证在一个给定测试用例中,
read函数使用的是同一个buf。
示例 1:
输入: file = "abc", queries = [1,2,1]
输出:[1,2,0]
解释:测试用例表示以下场景:
File file("abc");
Solution sol;
sol.read (buf, 1); // 调用 read 方法后,buf 应该包含 “a”。我们从文件中总共读取了 1 个字符,所以返回 1。
sol.read (buf, 2); // 现在 buf 应该包含 "bc"。我们从文件中总共读取了 2 个字符,所以返回 2。
sol.read (buf, 1); // 我们已经到达文件的末尾,不能读取更多的字符。所以返回 0。
假设已经分配了 buf ,并保证有足够的空间存储文件中的所有字符。
示例 2:
输入:file = "abc", queries = [4,1]
输出:[3,0]
解释:测试用例表示以下场景:
File file("abc");
Solution sol;
sol.read (buf, 4); // 调用 read 方法后,buf 应该包含 “abc”。我们从文件中总共读取了 3 个字符,所以返回 3。
sol.read (buf, 1); // 我们已经到达文件的末尾,不能读取更多的字符。所以返回 0。
提示:
1 <= file.length <= 500file由英语字母和数字组成1 <= queries.length <= 101 <= queries[i] <= 500
方法一:模拟 · Go 实现
思考
与上一题不同, 会被多次调用,上次 多读的字符不能丢。把 格缓冲以及已用下标、实际长度做成实例状态:缓冲耗尽再调用 ,否则先消费残留。多次调用之间文件指针只前进一次。
/**
 * The read4 API is already defined for you.
 *
 *     read4 := func(buf4 []byte) int
 *
 * // Below is an example of how the read4 API can be called.
 * file := File("abcdefghijk") // File is "abcdefghijk", initially file pointer (fp) points to 'a'
 * buf4 := make([]byte, 4) // Create buffer with enough space to store characters
 * read4(buf4) // read4 returns 4. Now buf = ['a','b','c','d'], fp points to 'e'
 * read4(buf4) // read4 returns 4. Now buf = ['e','f','g','h'], fp points to 'i'
 * read4(buf4) // read4 returns 3. Now buf = ['i','j','k',...], fp points to end of file
 */

var solution = func(read4 func([]byte) int) func([]byte, int) int {
	buf4 := make([]byte, 4)
	i, size := 0, 0
	// implement read below.
	return func(buf []byte, n int) int {
		j := 0
		for j < n {
			if i == size {
				size = read4(buf4)
				i = 0
				if size == 0 {
					break
				}
			}
			for j < n && i < size {
				buf[j] = buf4[i]
				i, j = i+1, j+1
			}
		}
		return j
	}
}163. 缺失的区间 🔒
题目、示例与约束
给你一个闭区间 [lower, upper] 和一个 按从小到大排序 的整数数组 nums ,其中元素的范围在闭区间 [lower, upper] 当中。
如果一个数字 x 在 [lower, upper] 区间内,并且 x 不在 nums 中,则认为 x 缺失。
返回 准确涵盖所有缺失数字 的 最小排序 区间列表。也就是说,nums 的任何元素都不在任何区间内,并且每个缺失的数字都在其中一个区间内。
示例 1:
输入: nums = [0, 1, 3, 50, 75], lower = 0 , upper = 99
输出: [[2,2],[4,49],[51,74],[76,99]]
解释:返回的区间是:
[2,2]
[4,49]
[51,74]
[76,99]
示例 2:
输入: nums = [-1], lower = -1, upper = -1
输出: []
解释: 没有缺失的区间,因为没有缺失的数字。
提示:
-109 <= lower <= upper <= 1090 <= nums.length <= 100lower <= nums[i] <= uppernums中的所有值 互不相同
方法一:模拟 · Go 实现
思考
在 中找出 没覆盖的区间。数组有序、互不相同且长度不超过 ,按相邻元素的空隙模拟即可:开头、中间、结尾三段分别处理,相邻差大于 就记下一截缺失。
我们直接按照题意模拟即可。
时间复杂度 ,其中 为数组 的长度。忽略答案的空间消耗,空间复杂度 。
func findMissingRanges(nums []int, lower int, upper int) (ans [][]int) {
	n := len(nums)
	if n == 0 {
		return [][]int{{lower, upper}}
	}
	if nums[0] > lower {
		ans = append(ans, []int{lower, nums[0] - 1})
	}
	for i, b := range nums[1:] {
		if a := nums[i]; b-a > 1 {
			ans = append(ans, []int{a + 1, b - 1})
		}
	}
	if nums[n-1] < upper {
		ans = append(ans, []int{nums[n-1] + 1, upper})
	}
	return
}228. 汇总区间
题目、示例与约束
给定一个 无重复元素 的 有序 整数数组 nums 。
区间 [a,b] 是从 a 到 b(包含)的所有整数的集合。
返回 恰好覆盖数组中所有数字 的 最小有序 区间范围列表 。也就是说,nums 的每个元素都恰好被某个区间范围所覆盖,并且不存在属于某个区间但不属于 nums 的数字 x 。
列表中的每个区间范围 [a,b] 应该按如下格式输出:
"a->b",如果a != b"a",如果a == b
示例 1:
输入:nums = [0,1,2,4,5,7]
输出:["0->2","4->5","7"]
解释:区间范围是:
[0,2] --> "0->2"
[4,5] --> "4->5"
[7,7] --> "7"
示例 2:
输入:nums = [0,2,3,4,6,8,9]
输出:["0","2->4","6","8->9"]
解释:区间范围是:
[0,0] --> "0"
[2,4] --> "2->4"
[6,6] --> "6"
[8,9] --> "8->9"
提示:
0 <= nums.length <= 20-231 <= nums[i] <= 231 - 1nums中的所有值都 互不相同nums按升序排列
方法一:双指针 · Go 实现
思考
数组已有序且无重复,连续段即相邻差为 的最长区间。一次扫描即可切分。
双指针 标出一段,直到 ,再格式化为单点或 。
我们可以用双指针 和 找出每个区间的左右端点。
遍历数组,当 且 时,指针 向右移动,否则区间 已经找到,将其加入答案,然后将指针 移动到 的位置,继续寻找下一个区间。
时间复杂度 ,其中 为数组长度。空间复杂度 。
func summaryRanges(nums []int) (ans []string) {
	f := func(i, j int) string {
		if i == j {
			return strconv.Itoa(nums[i])
		}
		return strconv.Itoa(nums[i]) + "->" + strconv.Itoa(nums[j])
	}
	for i, j, n := 0, 0, len(nums); i < n; i = j + 1 {
		j = i
		for j+1 < n && nums[j+1] == nums[j]+1 {
			j++
		}
		ans = append(ans, f(i, j))
	}
	return
}289. 生命游戏
题目、示例与约束
根据 百度百科 , 生命游戏 ,简称为 生命 ,是英国数学家约翰·何顿·康威在 1970 年发明的细胞自动机。
给定一个包含 m × n 个格子的面板,每一个格子都可以看成是一个细胞。每个细胞都具有一个初始状态: 1 即为 活细胞 (live),或 0 即为 死细胞 (dead)。每个细胞与其八个相邻位置(水平,垂直,对角线)的细胞都遵循以下四条生存定律:
- 如果活细胞周围八个位置的活细胞数少于两个,则该位置活细胞死亡;
- 如果活细胞周围八个位置有两个或三个活细胞,则该位置活细胞仍然存活;
- 如果活细胞周围八个位置有超过三个活细胞,则该位置活细胞死亡;
- 如果死细胞周围正好有三个活细胞,则该位置死细胞复活;
下一个状态是通过将上述规则同时应用于当前状态下的每个细胞所形成的,其中细胞的出生和死亡是 同时 发生的。给你 m x n 网格面板 board 的当前状态,返回下一个状态。
给定当前 board 的状态,更新 board 到下一个状态。
注意 你不需要返回任何东西。
示例 1:
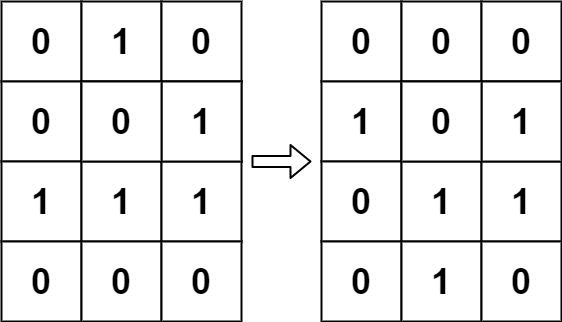
输入:board = [[0,1,0],[0,0,1],[1,1,1],[0,0,0]]
输出:[[0,0,0],[1,0,1],[0,1,1],[0,1,0]]
示例 2:
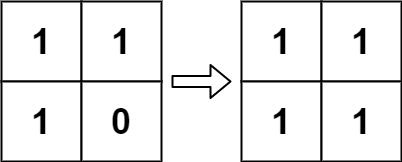
输入:board = [[1,1],[1,0]]
输出:[[1,1],[1,1]]
提示:
m == board.lengthn == board[i].length1 <= m, n <= 25board[i][j]为0或1
进阶:
- 你可以使用原地算法解决本题吗?请注意,面板上所有格子需要同时被更新:你不能先更新某些格子,然后使用它们的更新后的值再更新其他格子。
- 本题中,我们使用二维数组来表示面板。原则上,面板是无限的,但当活细胞侵占了面板边界时会造成问题。你将如何解决这些问题?
方法一:原地标记 · Go 实现
思考
下一状态依赖当前八邻,若当场改写会污染尚未处理的格子。可用中间状态:活变死记 ,死变活记 ,统计邻居时仍把正数视为活。
扫完后再把 落成 、 落成 ,从而原地完成。
我们不妨定义两个新的状态,其中状态 表示活细胞在下一个状态转为死细胞,状态 表示死细胞在下一个状态转为活细胞。那么,对于当前遍历到的格子,如果格子大于 ,就表示当前格子是活细胞,否则就是死细胞。
因此,我们可以遍历整个面板,对于每个格子,统计其周围的活细胞数目,用变量 表示。如果当前格子是活细胞,那么当 或者 时,当前格子的下一个状态是死细胞,即状态 ;如果当前格子是死细胞,那么当 时,当前格子的下一个状态是活细胞,即状态 。
最后,我们再遍历一遍面板,将状态 的格子更新为死细胞,将状态 的格子更新为活细胞。
时间复杂度 ,其中 和 分别是面板的行数和列数。我们需要遍历整个面板。空间复杂度 。
func gameOfLife(board [][]int) {
	m, n := len(board), len(board[0])
	for i := 0; i < m; i++ {
		for j, v := range board[i] {
			live := -v
			for x := i - 1; x <= i+1; x++ {
				for y := j - 1; y <= j+1; y++ {
					if x >= 0 && x < m && y >= 0 && y < n && board[x][y] > 0 {
						live++
					}
				}
			}
			if v == 1 && (live < 2 || live > 3) {
				board[i][j] = 2
			}
			if v == 0 && live == 3 {
				board[i][j] = -1
			}
		}
	}
	for i := 0; i < m; i++ {
		for j, v := range board[i] {
			if v == 2 {
				board[i][j] = 0
			}
			if v == -1 {
				board[i][j] = 1
			}
		}
	}
}422. 有效的单词方块 🔒
题目、示例与约束
给你一个字符串数组 words,如果它能形成一个有效的 单词方块 ,则返回 true 。
有效的单词方块是指此由字符串数组组成的文字方块的 第 k 行 和 第 k 列所显示的字符串完全相同,其中 0 <= k < max(numRows, numColumns) 。
示例 1:
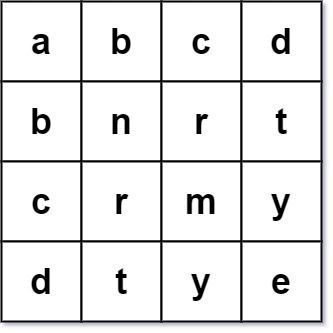
输入: words = ["abcd","bnrt","crmy","dtye"]
输出: true
解释:
第 1 行和第 1 列都读作 "abcd"。
第 2 行和第 2 列都读作 "bnrt"。
第 3 行和第 3 列都读作 "crmy"。
第 4 行和第 4 列都读作 "dtye"。
因此,它构成了一个有效的单词方块。
示例 2:
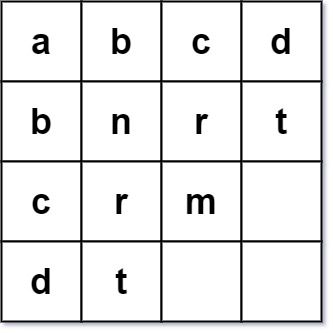
输入: words = ["abcd","bnrt","crm","dt"]
输出: true
解释:
第 1 行和第 1 列都读作 "abcd"。
第 2 行和第 2 列都读作 "bnrt"。
第 3 行和第 3 列都读作 "crm"。
第 4 行和第 4 列都读作 "dt"。
因此,它构成了一个有效的单词方块。
示例 3:
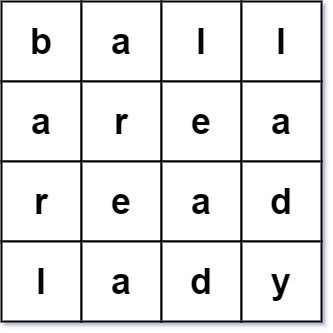
输入: words = ["ball","area","read","lady"]
输出: false
解释:
第 3 行读作 "read" 而第 3 列读作 "lead"。
因此,它不构成一个有效的单词方块。
提示:
1 <= words.length <= 5001 <= words[i].length <= 500words[i]仅由小写英文字母组成。
方法一:遍历检查 · Go 实现
思考
单词方块要求第 行第 列等于第 行第 列。行长可以不同,先构造转置再比较会遇到缺列。
按格检查 与 ,任一下标越界或字符不同即不成立。
越界与 不存在应当作失败,这正是「列看过去不是同一个单词」的含义。
我们观察发现,只要不满足 ,就可以直接返回 false。
因此,我们只需要遍历每一行,然后检查每一行是否满足 即可。注意,如果下标越界,也直接返回 false。
时间复杂度 ,其中 是 的长度。空间复杂度 。
func validWordSquare(words []string) bool {
	m := len(words)
	for i, w := range words {
		for j := range w {
			if j >= m || i >= len(words[j]) || w[j] != words[j][i] {
				return false
			}
		}
	}
	return true
}485. 最大连续 1 的个数
题目、示例与约束
给定一个二进制数组 nums , 计算其中最大连续 1 的个数。
示例 1:
输入:nums = [1,1,0,1,1,1]
输出:3
解释:开头的两位和最后的三位都是连续 1 ,所以最大连续 1 的个数是 3.
示例 2:
输入:nums = [1,0,1,1,0,1]
输出:2
提示:
1 <= nums.length <= 105nums[i]不是0就是1.
方法一:一次遍历 · Go 实现
思考
最长连续 。枚举左右端点再检查是 ,一次扫描即可。
遇 则当前长度加一并更新答案,遇 则清零。
段与段被 隔开,计数器复位后不会把两段接在一起。
我们可以遍历数组,用一个变量 记录当前连续的 1 的个数,用另一个变量 记录最大连续 1 的个数。
当遍历到一个 1 时,将 加一,然后更新 的值为 和 本身的最大值,即 。否则,将 重置为 0。
遍历结束后,返回 的值即可。
时间复杂度 ,其中 为数组的长度。空间复杂度 。
func findMaxConsecutiveOnes(nums []int) (ans int) {
	cnt := 0
	for _, x := range nums {
		if x == 1 {
			cnt++
			ans = max(ans, cnt)
		} else {
			cnt = 0
		}
	}
	return
}495. 提莫攻击
题目、示例与约束
在《英雄联盟》的世界中,有一个叫 “提莫” 的英雄。他的攻击可以让敌方英雄艾希(编者注:寒冰射手)进入中毒状态。
当提莫攻击艾希,艾希的中毒状态正好持续 duration 秒。
正式地讲,提莫在 t 发起攻击意味着艾希在时间区间 [t, t + duration - 1](含 t 和 t + duration - 1)处于中毒状态。如果提莫在中毒影响结束 前 再次攻击,中毒状态计时器将会 重置 ,在新的攻击之后,中毒影响将会在 duration 秒后结束。
给你一个 非递减 的整数数组 timeSeries ,其中 timeSeries[i] 表示提莫在 timeSeries[i] 秒时对艾希发起攻击,以及一个表示中毒持续时间的整数 duration 。
返回艾希处于中毒状态的 总 秒数。
示例 1:
输入:timeSeries = [1,4], duration = 2
输出:4
解释:提莫攻击对艾希的影响如下:
- 第 1 秒,提莫攻击艾希并使其立即中毒。中毒状态会维持 2 秒,即第 1 秒和第 2 秒。
- 第 4 秒,提莫再次攻击艾希,艾希中毒状态又持续 2 秒,即第 4 秒和第 5 秒。
艾希在第 1、2、4、5 秒处于中毒状态,所以总中毒秒数是 4 。
示例 2:
输入:timeSeries = [1,2], duration = 2
输出:3
解释:提莫攻击对艾希的影响如下:
- 第 1 秒,提莫攻击艾希并使其立即中毒。中毒状态会维持 2 秒,即第 1 秒和第 2 秒。
- 第 2 秒,提莫再次攻击艾希,并重置中毒计时器,艾希中毒状态需要持续 2 秒,即第 2 秒和第 3 秒。
艾希在第 1、2、3 秒处于中毒状态,所以总中毒秒数是 3 。
提示:
1 <= timeSeries.length <= 1040 <= timeSeries[i], duration <= 107timeSeries按 非递减 顺序排列
方法一:一次遍历 · Go 实现
思考
每次攻击刷新中毒,持续时间 ,重叠只算一次。模拟每个时刻过慢。
最后一次攻击一定贡献完整 。相邻两次间隔若小于 ,前一次只贡献间隔,否则贡献完整时长。
按相邻差取 ,一次遍历覆盖所有重叠。
我们先考虑最后一次攻击,此次攻击一定可以使得艾希处于中毒状态,所以总中毒时间至少为 duration。
接下来,我们考虑前 次攻击,每一次攻击的中毒持续时间为 ,其中 从 1 开始。我们将这些中毒持续时间累加起来,即为总中毒时间。
时间复杂度 ,空间复杂度 。其中 为数组 timeSeries 的长度。
func findPoisonedDuration(timeSeries []int, duration int) (ans int) {
	ans = duration
	for i, x := range timeSeries[1:] {
		ans += min(duration, x-timeSeries[i])
	}
	return
}498. 对角线遍历
题目、示例与约束
给你一个大小为 m x n 的矩阵 mat ,请以对角线遍历的顺序,用一个数组返回这个矩阵中的所有元素。
示例 1:
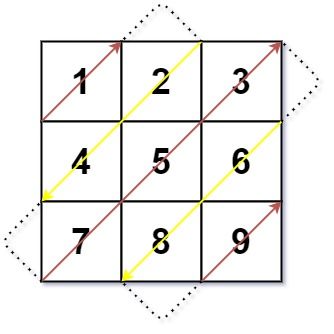
输入:mat = [[1,2,3],[4,5,6],[7,8,9]]
输出:[1,2,4,7,5,3,6,8,9]
示例 2:
输入:mat = [[1,2],[3,4]]
输出:[1,2,3,4]
提示:
m == mat.lengthn == mat[i].length1 <= m, n <= 1041 <= m * n <= 104-105 <= mat[i][j] <= 105
方法一:定点遍历 · Go 实现
思考
按对角线来回遍历矩阵。模拟方向并处理撞边,边界分支较多。对角线条数为 ,每条的起点可以闭式给出。
第 条从右上往左下收进临时数组,起点为 时 ,否则 。 为偶数再反转,以符合题目的往返方向。
先统一往左下走,再用奇偶决定是否翻转,省去在边界上切换方向向量。
对于每一轮 ,我们固定从右上方开始往左下方遍历,得到 。如果 为偶数,再将 逆序。然后将 添加到结果数组 中。
问题的关键在于确定轮数以及每一轮的起始坐标点 。
时间复杂度 。其中 和 分别为矩阵的行数和列数。忽略答案的空间消耗,空间复杂度 。
func findDiagonalOrder(mat [][]int) []int {
	m := len(mat)
	n := len(mat[0])
	ans := make([]int, 0, m*n)
	for k := 0; k < m+n-1; k++ {
		t := make([]int, 0)
		var i, j int
		if k < n {
			i = 0
			j = k
		} else {
			i = k - n + 1
			j = n - 1
		}
		for i < m && j >= 0 {
			t = append(t, mat[i][j])
			i++
			j--
		}
		if k%2 == 0 {
			slices.Reverse(t)
		}
		ans = append(ans, t...)
	}
	return ans
}566. 重塑矩阵
题目、示例与约束
在 MATLAB 中,有一个非常有用的函数 reshape ,它可以将一个 m x n 矩阵重塑为另一个大小不同(r x c)的新矩阵,但保留其原始数据。
给你一个由二维数组 mat 表示的 m x n 矩阵,以及两个正整数 r 和 c ,分别表示想要的重构的矩阵的行数和列数。
重构后的矩阵需要将原始矩阵的所有元素以相同的 行遍历顺序 填充。
如果具有给定参数的 reshape 操作是可行且合理的,则输出新的重塑矩阵;否则,输出原始矩阵。
示例 1:
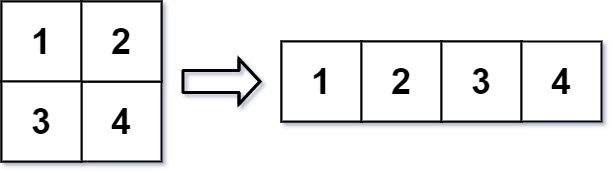
输入:mat = [[1,2],[3,4]], r = 1, c = 4
输出:[[1,2,3,4]]
示例 2:
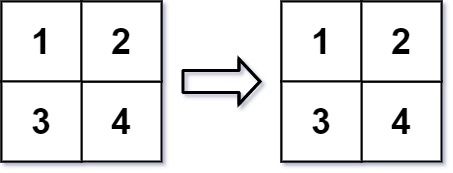
输入:mat = [[1,2],[3,4]], r = 2, c = 4
输出:[[1,2],[3,4]]
提示:
m == mat.lengthn == mat[i].length1 <= m, n <= 100-1000 <= mat[i][j] <= 10001 <= r, c <= 300
方法一:模拟 · Go 实现
思考
重塑只是按行优先把元素重新切成 。元素总数对不上则无法重塑,返回原矩阵。
二维下标与一维序号一一对应:新位置 来自原矩阵的 ,写入 。一次线性搬运即可。
我们先获取原矩阵的行数和列数,分别记为 和 。如果 ,则无法重塑矩阵,直接返回原矩阵。
否则,我们创建一个新矩阵,新矩阵的行数为 ,列数为 。我们从原矩阵的第一个元素开始,按照行优先的顺序遍历原矩阵的所有元素,将遍历到的元素按顺序放入新矩阵中。
遍历完原矩阵的所有元素后,我们即可得到答案。
时间复杂度 ,其中 和 分别是原矩阵的行数和列数。忽略答案的空间消耗,空间复杂度 。
func matrixReshape(mat [][]int, r int, c int) [][]int {
	m, n := len(mat), len(mat[0])
	if m*n != r*c {
		return mat
	}
	ans := make([][]int, r)
	for i := range ans {
		ans[i] = make([]int, c)
	}
	for i := 0; i < m*n; i++ {
		ans[i/c][i%c] = mat[i/n][i%n]
	}
	return ans
}661. 图片平滑器
题目、示例与约束
图像平滑器 是大小为 3 x 3 的过滤器,用于对图像的每个单元格平滑处理,平滑处理后单元格的值为该单元格的平均灰度。
每个单元格的 平均灰度 定义为:该单元格自身及其周围的 8 个单元格的平均值,结果需向下取整。(即,需要计算蓝色平滑器中 9 个单元格的平均值)。
如果一个单元格周围存在单元格缺失的情况,则计算平均灰度时不考虑缺失的单元格(即,需要计算红色平滑器中 4 个单元格的平均值)。
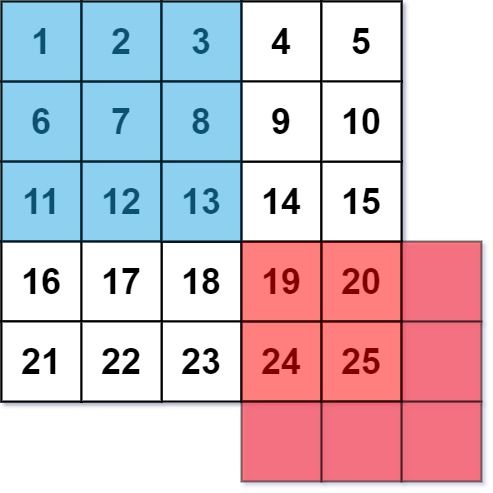
给你一个表示图像灰度的 m x n 整数矩阵 img ,返回对图像的每个单元格平滑处理后的图像 。
示例 1:
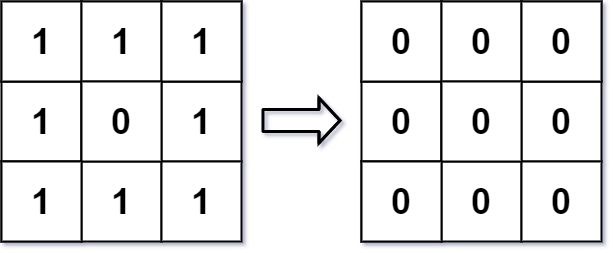
输入:img = [[1,1,1],[1,0,1],[1,1,1]]
输出:[[0, 0, 0],[0, 0, 0], [0, 0, 0]]
解释:
对于点 (0,0), (0,2), (2,0), (2,2): 平均(3/4) = 平均(0.75) = 0
对于点 (0,1), (1,0), (1,2), (2,1): 平均(5/6) = 平均(0.83333333) = 0
对于点 (1,1): 平均(8/9) = 平均(0.88888889) = 0
示例 2:
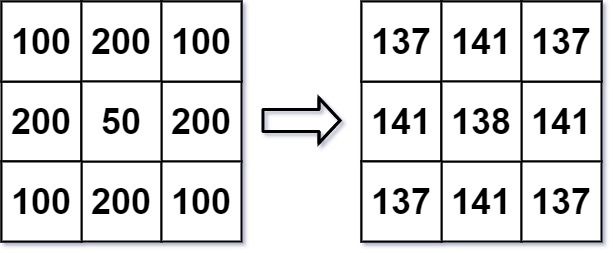
输入: img = [[100,200,100],[200,50,200],[100,200,100]]
输出: [[137,141,137],[141,138,141],[137,141,137]]
解释:
对于点 (0,0), (0,2), (2,0), (2,2): floor((100+200+200+50)/4) = floor(137.5) = 137
对于点 (0,1), (1,0), (1,2), (2,1): floor((200+200+50+200+100+100)/6) = floor(141.666667) = 141
对于点 (1,1): floor((50+200+200+200+200+100+100+100+100)/9) = floor(138.888889) = 138
提示:
m == img.lengthn == img[i].length1 <= m, n <= 2000 <= img[i][j] <= 255
方法一:直接遍历 · Go 实现
思考
每个格子变成自身与周围至多 邻的平均值(向下取整)。图像最大 ,直接按格计算即可。
对 枚举 中越界的跳过,累加和与个数后整除写入新图,避免原地覆盖影响邻居。
我们创建一个大小为 的二维数组 ,其中 表示图像中第 行第 列的单元格的平滑值。
对于 ,我们遍历 中第 行第 列的单元格及其周围的 个单元格,计算它们的和 以及个数 ,然后计算平均值 并将其存入 中。
遍历结束后,我们返回 即可。
时间复杂度 ,其中 和 分别是 的行数和列数。忽略答案数组的空间消耗,空间复杂度 。
func imageSmoother(img [][]int) [][]int {
	m, n := len(img), len(img[0])
	ans := make([][]int, m)
	for i, row := range img {
		ans[i] = make([]int, n)
		for j := range row {
			s, cnt := 0, 0
			for x := i - 1; x <= i+1; x++ {
				for y := j - 1; y <= j+1; y++ {
					if x >= 0 && x < m && y >= 0 && y < n {
						cnt++
						s += img[x][y]
					}
				}
			}
			ans[i][j] = s / cnt
		}
	}
	return ans
}665. 非递减数列
题目、示例与约束
给你一个长度为 n 的整数数组 nums ,请你判断在 最多 改变 1 个元素的情况下,该数组能否变成一个非递减数列。
我们是这样定义一个非递减数列的: 对于数组中任意的 i (0 <= i <= n-2),总满足 nums[i] <= nums[i + 1]。
示例 1:
输入: nums = [4,2,3]
输出: true
解释: 你可以通过把第一个 4 变成 1 来使得它成为一个非递减数列。
示例 2:
输入: nums = [4,2,1]
输出: false
解释: 你不能在只改变一个元素的情况下将其变为非递减数列。
提示:
n == nums.length1 <= n <= 104-105 <= nums[i] <= 105
方法一:两次遍历 · Go 实现
思考
最多改一个数使数组非递减。出现两处下降则无解;一处下降时改左边或改右边都可能。
找到第一处 ,分别尝试把 改成 、把 改成 ,再检查整段是否有序。没有下降则本身已合法。
在最多改变一个元素的情况下,若要将数组变成非递减数列,那么数组最多只能有一个位置,其左右两侧的元素不满足非递减数列的要求。也即数组中只会存在一个位置 ,使得 。
因此,我们可以从左到右遍历数组,找到第一个不满足非递减数列要求的位置 ,然后将 修改为 或者将 修改为 ,再判断修改后的数组是否满足非递减数列的要求。如果满足,则返回 true,否则返回 false。
遍历结束后,如果没有找到不满足非递减数列要求的位置,说明数组本身就是非递减数列,返回 true。
时间复杂度 ,空间复杂度 。其中 为数组的长度。
func checkPossibility(nums []int) bool {
	isSorted := func(nums []int) bool {
		for i, b := range nums[1:] {
			if nums[i] > b {
				return false
			}
		}
		return true
	}
	for i := 0; i < len(nums)-1; i++ {
		a, b := nums[i], nums[i+1]
		if a > b {
			nums[i] = b
			if isSorted(nums) {
				return true
			}
			nums[i] = a
			nums[i+1] = a
			return isSorted(nums)
		}
	}
	return true
}674. 最长连续递增序列
题目、示例与约束
给定一个未经排序的整数数组,找到最长且 连续递增的子序列,并返回该序列的长度。
连续递增的子序列 可以由两个下标 l 和 r(l < r)确定,如果对于每个 l <= i < r,都有 nums[i] < nums[i + 1] ,那么子序列 [nums[l], nums[l + 1], ..., nums[r - 1], nums[r]] 就是连续递增子序列。
示例 1:
输入:nums = [1,3,5,4,7]
输出:3
解释:最长连续递增序列是 [1,3,5], 长度为3。
尽管 [1,3,5,7] 也是升序的子序列, 但它不是连续的,因为 5 和 7 在原数组里被 4 隔开。
示例 2:
输入:nums = [2,2,2,2,2]
输出:1
解释:最长连续递增序列是 [2], 长度为1。
提示:
1 <= nums.length <= 104-109 <= nums[i] <= 109
方法一:一次遍历 · Go 实现
思考
连续递增子数组必须相邻,不必做一般 LIS。一次扫描即可。
用 记当前段长度,相邻递增则加一并更新答案,否则重置为 。
我们可以遍历数组 ,用变量 记录当前连续递增序列的长度。初始时 。
然后,我们从下标 开始,向右遍历数组 。每次遍历时,如果 ,则说明当前元素可以加入到连续递增序列中,因此令 ,然后更新答案为 。否则,说明当前元素无法加入到连续递增序列中,因此令 。
遍历结束后,返回答案 即可。
时间复杂度 ,其中 是数组 的长度。空间复杂度 。
func findLengthOfLCIS(nums []int) int {
	ans, cnt := 1, 1
	for i, x := range nums[1:] {
		if nums[i] < x {
			cnt++
			ans = max(ans, cnt)
		} else {
			cnt = 1
		}
	}
	return ans
}
方法二:双指针 · Go 实现
思考
计数扫描与双指针等价:外指针停在段首,内指针滑到段尾,长度 ,再把外指针跳到 。
我们也可以用双指针 和 找到每一段连续递增序列,找出最长的连续递增序列的长度作为答案。
时间复杂度 ,其中 是数组 的长度。空间复杂度 。
func findLengthOfLCIS(nums []int) int {
	ans := 1
	n := len(nums)
	for i := 0; i < n; {
		j := i + 1
		for j < n && nums[j-1] < nums[j] {
			j++
		}
		ans = max(ans, j-i)
		i = j
	}
	return ans
}717. 1 比特与 2 比特字符
题目、示例与约束
有两种特殊字符:
- 第一种字符可以用一比特
0表示 - 第二种字符可以用两比特(
10或11)表示
给你一个以 0 结尾的二进制数组 bits ,如果最后一个字符必须是一个一比特字符,则返回 true 。
示例 1:
输入: bits = [1, 0, 0]
输出: true
解释: 唯一的解码方式是将其解析为一个两比特字符和一个一比特字符。
所以最后一个字符是一比特字符。
示例 2:
输入:bits = [1,1,1,0]
输出:false
解释:唯一的解码方式是将其解析为两比特字符和两比特字符。
所以最后一个字符不是一比特字符。
提示:
1 <= bits.length <= 1000bits[i]为0或1
方法一:直接遍历 · Go 实现
思考
编码只含 与 、 ,问最后一位是否单独构成一个一比特字符。数组长度有限,从左到右按规则解码即可,无需回溯。
解码无歧义:遇到 必是一比特,遇到 必吞下后一位。因此只需模拟到倒数第二位之前,看停下来的位置是否恰好是最后一位。
下标 每次增加 ,循环条件为 。结束后 当且仅当最后一位是单独的 。
我们可以直接遍历数组 的前 个元素,每次根据当前元素的值决定跳过多少个元素:
- 如果当前元素为 ,则跳过 个元素(表示一个一比特字符);
- 如果当前元素为 ,则跳过 个元素(表示一个两比特字符)。
当遍历结束时,如果当前索引等于 ,则说明最后一个字符是一个一比特字符,返回 ;否则,返回 。
时间复杂度 ,其中 是数组 的长度。空间复杂度 。
func isOneBitCharacter(bits []int) bool {
	i, n := 0, len(bits)
	for i < n-1 {
		i += bits[i] + 1
	}
	return i == n-1
}755. 倒水 🔒
题目、示例与约束
给定一个地形高度图,用一个整数数组 heights 表示,其中 heights[i] 表示索引 i 处的地形高度。每个位置的宽度为 1。同时给定两个整数 volume 和 k,表示有 volume 单位的水将落在索引 k 处。
水首先落在索引 k 处,并停留在该位置当前的最高高度(地形或已有水)之上。然后,它会按照以下规则流动:
- 如果水滴向左移动最终会下降,则向左移动。
- 否则,如果水滴向右移动最终会下降,则向右移动。
- 否则,停留在当前位置并堆积。
这里,“最终会下降”指的是水滴如果沿该方向移动,最终会到达一个更低的高度位置。这里的“高度”是指地形高度加上该位置已有的水量。
可以假设数组两侧边界之外是无限高的地形。此外,每一单位水必须完全位于某一个格子中,不会被均匀分散到多个格子。
示例 1:
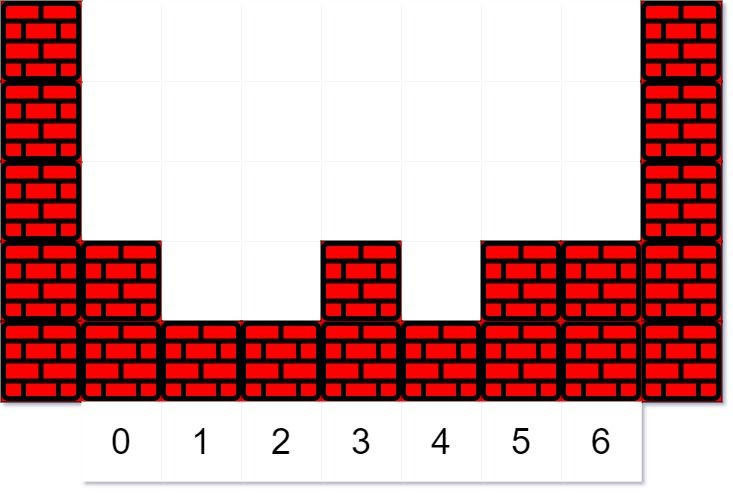
输入:heights = [2,1,1,2,1,2,2], V = 4, K = 3 输出:[2,2,2,3,2,2,2] 解释: 第一个水滴降落在索引 K = 3 上。当向左或向右移动时,水可以移动到相同或更低的高度。(从水平上看,意思是该列的地形高度加上水的高度) 由于向左移动可以最终下落,因此向左移动。(一个水滴 “下落” 的意思是可以相比之前可以进入更低的高度) 由于向左移动不会使其降落,所以停在该位置上。下一个水滴降落在索引 K = 3 上。由于新水滴向左移动可以最终下落,因此向左移动。注意水滴仍然是优先选择向左移动,尽管可以向右移动(而且向右移动可以下落更快)
经过刚才的阶段后,第三个水滴下落。由于向左移动不会最终下落,因此尝试向右移动。由于向右移动可以最终下落,因此向右移动。
最终,第四个水滴下落。由于向左移动不会最终下落,因此尝试向右移动。由于向右移动不会最终下落,因此停在当前位置:
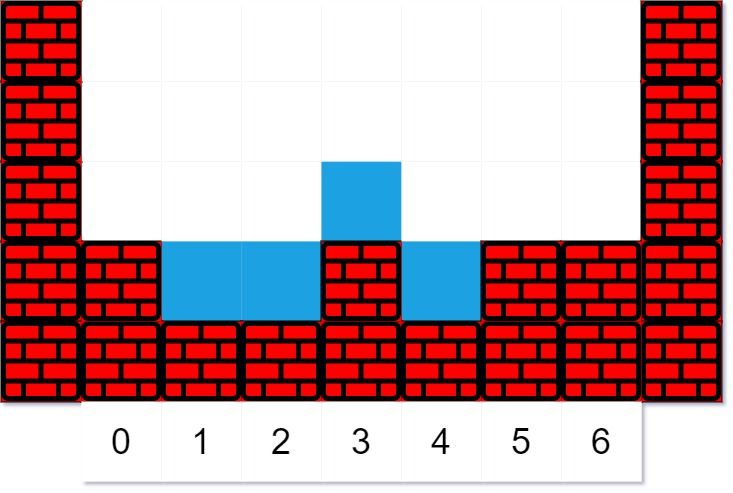
示例 2:
输入:heights = [1,2,3,4], V = 2, K = 2
输出:[2,3,3,4]
解释:
最后的水滴落在索引 1 位置,因为继续向左移动不会使其下降到更低的高度。
示例 3:
输入:heights = [3,1,3], V = 5, K = 1
输出:[4,4,4]
提示:
1 <= heights.length <= 1000 <= heights[i] <= 990 <= volume <= 20000 <= k < heights.length
方法一:模拟 · Go 实现
思考
从下标 逐滴倒水,每滴先尽量向左流到更低处,否则向右,再否则停在 。高度与滴数都不大,按滴模拟。
向某一侧走时,只能走到高度不超过当前的位置,并记下严格更低的最远(实际是最左侧/最右侧的谷底)位置。
先试 再试 ,找到 则该处加一;两侧都不动则 加一。
我们可以模拟每一单位的水滴下落的过程,每次下落时,我们首先尝试向左移动,如果可以移动到更低的高度,则移动到最低的高度处;如果不能移动到更低的高度,则尝试向右移动,如果可以移动到更低的高度,则移动到最低的高度处;如果不能移动到更低的高度,则在当前位置上升。
时间复杂度 $O(v \times n),其中 和 分别是水滴的数量和高度数组的长度。空间复杂度 O(1)$。
func pourWater(heights []int, volume int, k int) []int {
	for ; volume > 0; volume-- {
		find := false
		for _, d := range [2]int{-1, 1} {
			i, j := k, k
			for i+d >= 0 && i+d < len(heights) && heights[i+d] <= heights[i] {
				if heights[i+d] < heights[i] {
					j = i + d
				}
				i += d
			}
			if j != k {
				find = true
				heights[j]++
				break
			}
		}
		if !find {
			heights[k]++
		}
	}
	return heights
}766. 托普利茨矩阵
题目、示例与约束
给你一个 m x n 的矩阵 matrix 。如果这个矩阵是托普利茨矩阵,返回 true ;否则,返回 false 。
如果矩阵上每一条由左上到右下的对角线上的元素都相同,那么这个矩阵是 托普利茨矩阵 。
示例 1:
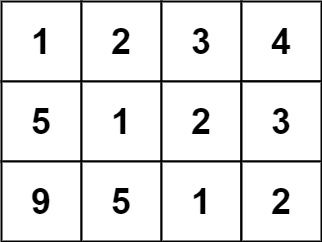
输入:matrix = [[1,2,3,4],[5,1,2,3],[9,5,1,2]]
输出:true
解释:
在上述矩阵中, 其对角线为:
"[9]", "[5, 5]", "[1, 1, 1]", "[2, 2, 2]", "[3, 3]", "[4]"。
各条对角线上的所有元素均相同, 因此答案是 True 。
示例 2:
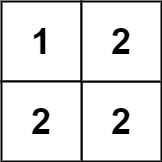
输入:matrix = [[1,2],[2,2]]
输出:false
解释:
对角线 "[1, 2]" 上的元素不同。
提示:
m == matrix.lengthn == matrix[i].length1 <= m, n <= 200 <= matrix[i][j] <= 99
进阶:
- 如果矩阵存储在磁盘上,并且内存有限,以至于一次最多只能将矩阵的一行加载到内存中,该怎么办?
- 如果矩阵太大,以至于一次只能将不完整的一行加载到内存中,该怎么办?
方法一:一次遍历 · Go 实现
思考
托普利茨矩阵要求每条对角线元素相同,即每个格子等于左上角。行列至多 ,逐格比较即可。
从 扫到右下,任一处与 不同则否。首行首列没有左上,不必检查。
根据题目描述,托普利茨矩阵的特点是:矩阵中每个元素都与其左上角的元素相等。因此,我们只需要遍历矩阵中的每个元素,检查它是否与左上角的元素相等即可。
时间复杂度 ,其中 和 分别是矩阵的行数和列数。空间复杂度 。
func isToeplitzMatrix(matrix [][]int) bool {
	m, n := len(matrix), len(matrix[0])
	for i := 1; i < m; i++ {
		for j := 1; j < n; j++ {
			if matrix[i][j] != matrix[i-1][j-1] {
				return false
			}
		}
	}
	return true
}794. 有效的井字游戏
题目、示例与约束
给你一个字符串数组 board 表示井字游戏的棋盘。当且仅当在井字游戏过程中,棋盘有可能达到 board 所显示的状态时,才返回 true 。
井字游戏的棋盘是一个 3 x 3 数组,由字符 ' ','X' 和 'O' 组成。字符 ' ' 代表一个空位。
以下是井字游戏的规则:
- 玩家轮流将字符放入空位(
' ')中。 - 玩家 1 总是放字符
'X',而玩家 2 总是放字符'O'。 'X'和'O'只允许放置在空位中,不允许对已放有字符的位置进行填充。- 当有 3 个相同(且非空)的字符填充任何行、列或对角线时,游戏结束。
- 当所有位置非空时,也算为游戏结束。
- 如果游戏结束,玩家不允许再放置字符。
示例 1:
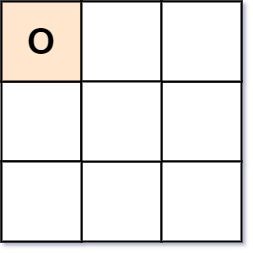
输入:board = ["O  ","   ","   "]
输出:false
解释:玩家 1 总是放字符 "X" 。
示例 2:
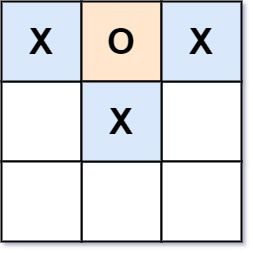
输入:board = ["XOX"," X ","   "]
输出:false
解释:玩家应该轮流放字符。
示例 3:
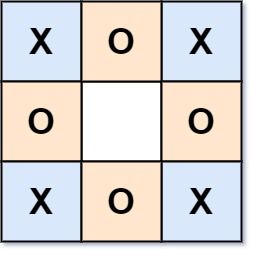
输入:board = ["XOX","O O","XOX"]
输出:true
提示:
board.length == 3board[i].length == 3board[i][j]为'X'、'O'或' '
方法一:分类讨论 · Go 实现
思考
判断 是否可能由 X 先手的对局得到。格子很少,用棋子数与谁已连线约束即可,不必回溯整局。
X 比 O 多 或 枚。X 获胜时必须恰好多一枚(刚落下),O 获胜时枚数必须相等。两者同时按规则获胜会被这些计数排除。
我们先统计当前棋盘上 'X' 和 'O' 的数量,记为 和 。接下来,我们分情况讨论:
- 如果 且 ,则当前棋盘不可能是有效棋盘,返回
false。 - 如果当前棋盘上玩家 1 获胜,但 ,则当前棋盘不可能是有效棋盘,返回
false。 - 如果当前棋盘上玩家 2 获胜,但 ,则当前棋盘不可能是有效棋盘,返回
false。 - 其他情况下,当前棋盘是有效棋盘,返回
true。
时间复杂度 ,空间复杂度 。其中 是棋盘上的格子数。本题中 。
func validTicTacToe(board []string) bool {
	var x, o int
	for _, row := range board {
		for _, c := range row {
			if c == 'X' {
				x++
			} else if c == 'O' {
				o++
			}
		}
	}
	win := func(x byte) bool {
		for i := 0; i < 3; i++ {
			if board[i][0] == x && board[i][1] == x && board[i][2] == x {
				return true
			}
			if board[0][i] == x && board[1][i] == x && board[2][i] == x {
				return true
			}
		}
		if board[0][0] == x && board[1][1] == x && board[2][2] == x {
			return true
		}
		return board[0][2] == x && board[1][1] == x && board[2][0] == x
	}
	if x != o && x-1 != o {
		return false
	}
	if win('X') && x-1 != o {
		return false
	}
	return !(win('O') && x != o)
}835. 图像重叠
题目、示例与约束
给你两个图像 img1 和 img2 ,两个图像的大小都是 n x n ,用大小相同的二进制正方形矩阵表示。二进制矩阵仅由若干 0 和若干 1 组成。
转换 其中一个图像,将所有的 1 向左,右,上,或下滑动任何数量的单位;然后把它放在另一个图像的上面。该转换的 重叠 是指两个图像 都 具有 1 的位置的数目。
请注意,转换 不包括 向任何方向旋转。越过矩阵边界的 1 都将被清除。
最大可能的重叠数量是多少?
示例 1:
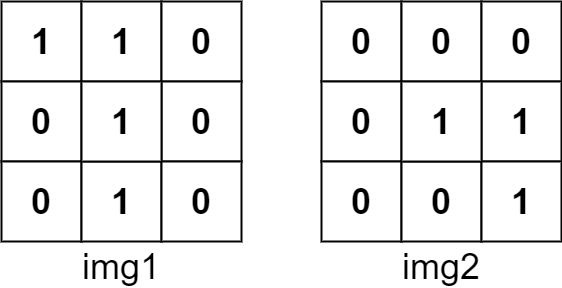
输入:img1 = [[1,1,0],[0,1,0],[0,1,0]], img2 = [[0,0,0],[0,1,1],[0,0,1]] 输出:3 解释:将 img1 向右移动 1 个单位,再向下移动 1 个单位。两个图像都具有
1的位置的数目是 3(用红色标识)。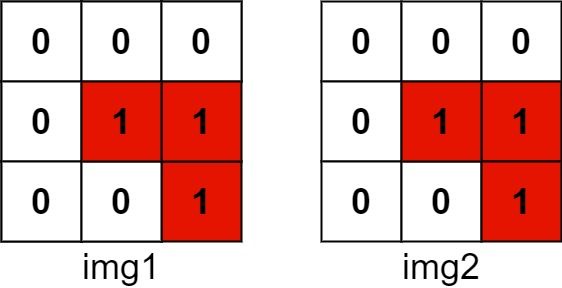
示例 2:
输入:img1 = [[1]], img2 = [[1]]
输出:1
示例 3:
输入:img1 = [[0]], img2 = [[0]]
输出:0
提示:
n == img1.length == img1[i].lengthn == img2.length == img2[i].length1 <= n <= 30img1[i][j]为0或1img2[i][j]为0或1
方法一:枚举 · Go 实现
思考
将 平移后与 重叠的 的个数取最大。 ,枚举平移量再逐格比较可行,但可改为只枚举两图中 的点对。
一对 决定一个平移向量,用计数器统计每个向量出现次数,最大值即最大重叠。全零时计数器为空,返回 。
我们可以枚举 和 的每个 的位置,分别记为 和 。然后我们计算得到偏移量 ,记为 ,用哈希表 记录每个偏移量出现的次数。最后我们遍历哈希表 ,找到出现次数最多的偏移量,即为答案。
时间复杂度 ,空间复杂度 。其中 是 的边长。
func largestOverlap(img1 [][]int, img2 [][]int) (ans int) {
	type pair struct{ x, y int }
	cnt := map[pair]int{}
	for i, row1 := range img1 {
		for j, x1 := range row1 {
			if x1 == 1 {
				for h, row2 := range img2 {
					for k, x2 := range row2 {
						if x2 == 1 {
							t := pair{i - h, j - k}
							cnt[t]++
							ans = max(ans, cnt[t])
						}
					}
				}
			}
		}
	}
	return
}849. 到最近的人的最大距离
题目、示例与约束
给你一个数组 seats 表示一排座位,其中 seats[i] = 1 代表有人坐在第 i 个座位上,seats[i] = 0 代表座位 i 上是空的(下标从 0 开始)。
至少有一个空座位,且至少有一人已经坐在座位上。
亚历克斯希望坐在一个能够使他与离他最近的人之间的距离达到最大化的座位上。
返回他到离他最近的人的最大距离。
示例 1:
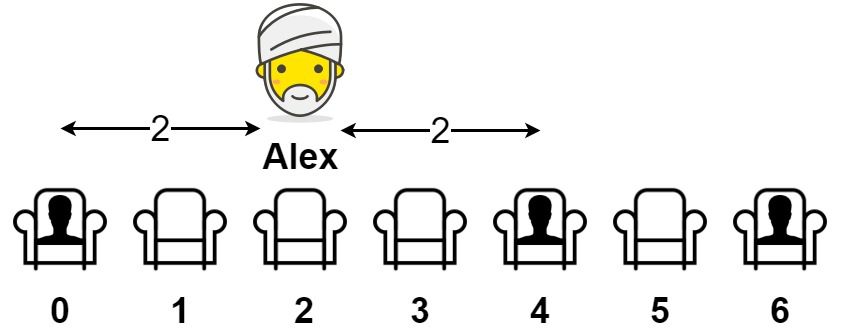
输入:seats = [1,0,0,0,1,0,1]
输出:2
解释:
如果亚历克斯坐在第二个空位(seats[2])上,他到离他最近的人的距离为 2 。
如果亚历克斯坐在其它任何一个空位上,他到离他最近的人的距离为 1 。
因此,他到离他最近的人的最大距离是 2 。
示例 2:
输入:seats = [1,0,0,0]
输出:3
解释:
如果亚历克斯坐在最后一个座位上,他离最近的人有 3 个座位远。
这是可能的最大距离,所以答案是 3 。
示例 3:
输入:seats = [0,1]
输出:1
提示:
2 <= seats.length <= 2 * 104seats[i]为0或1- 至少有一个 空座位
- 至少有一个 座位上有人
方法一:一次遍历 · Go 实现
思考
在空座位中选一个,最大化到最近有人座位的距离。端点空位的距离是到第一个/最后一个有人座位的距离,中间空段的最佳位置在段中点。
一次遍历记录首尾有人下标及相邻有人座位的最大间隔。答案取「最左空段、最右空段、中间间隔的一半」三者最大。
我们定义两个变量 和 分别表示第一个人和最后一个人的位置,用变量 表示两个人之间的最大距离。
然后遍历数组 ,如果当前位置有人,如果此前 更新过,说明此前有人,此时更新 ;如果此前 没有更新过,说明此前没有人,此时更新 。接下来更新 。
最后返回 即可。
时间复杂度 ,其中 为数组 的长度。空间复杂度 。
func maxDistToClosest(seats []int) int {
	first, last := -1, -1
	d := 0
	for i, c := range seats {
		if c == 1 {
			if last != -1 {
				d = max(d, i-last)
			}
			if first == -1 {
				first = i
			}
			last = i
		}
	}
	return max(d/2, max(first, len(seats)-last-1))
}867. 转置矩阵
题目、示例与约束
给你一个二维整数数组 matrix, 返回 matrix 的 转置矩阵 。
矩阵的 转置 是指将矩阵的主对角线翻转,交换矩阵的行索引与列索引。
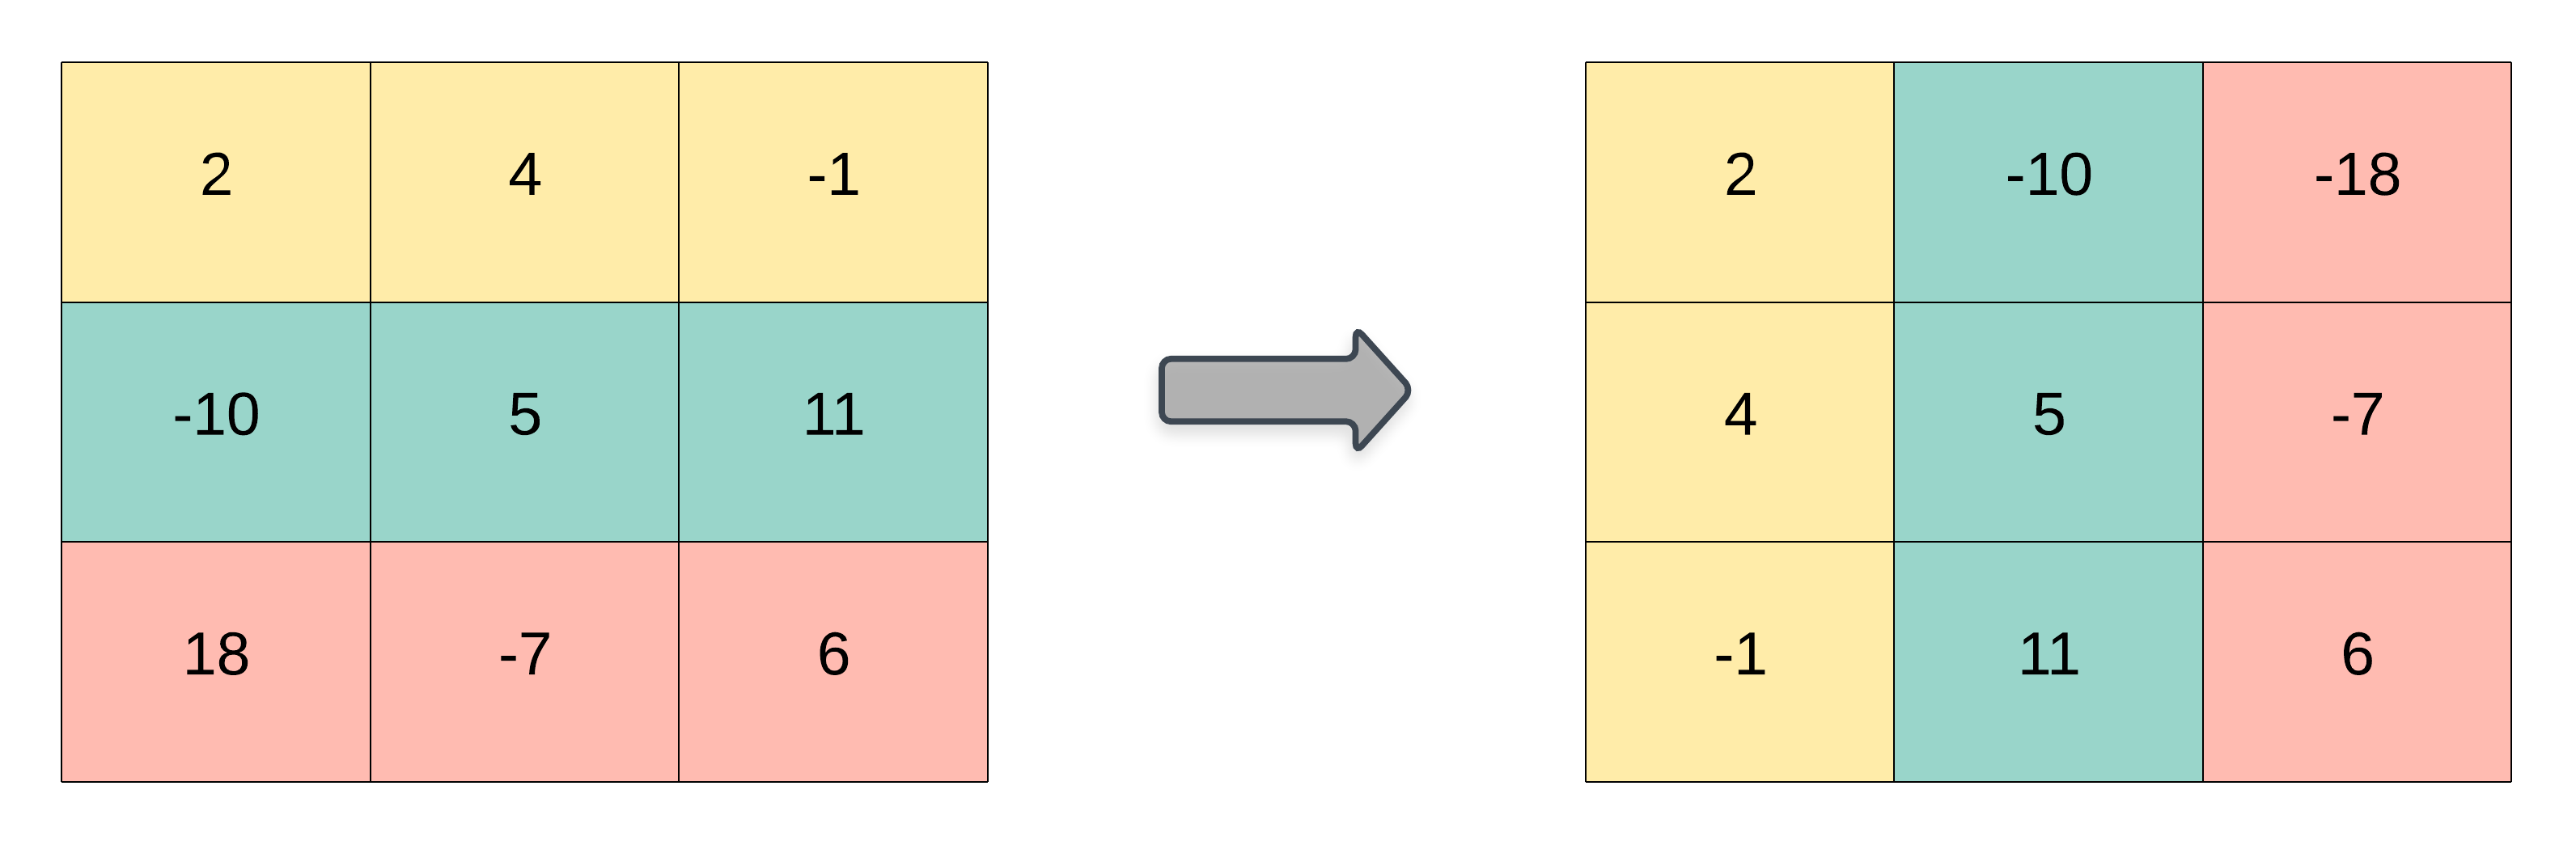
示例 1:
输入:matrix = [[1,2,3],[4,5,6],[7,8,9]]
输出:[[1,4,7],[2,5,8],[3,6,9]]
示例 2:
输入:matrix = [[1,2,3],[4,5,6]]
输出:[[1,4],[2,5],[3,6]]
提示:
m == matrix.lengthn == matrix[i].length1 <= m, n <= 10001 <= m * n <= 105-109 <= matrix[i][j] <= 109
方法一:模拟 · Go 实现
思考
转置即行列互换。矩阵规模有限,按列取出再组成新行即可,无需原地交换。
对矩阵做 展开,每一列变成新的一行。
我们记矩阵 的行数为 ,列数为 。根据转置的定义,转置后的矩阵 的行数为 ,列数为 。
对于 中的任意位置 ,其对应于矩阵 中的位置 。因此,我们遍历矩阵 中的每个元素,将其转置到 中相应的位置。
遍历结束后,返回 即可。
时间复杂度 ,其中 和 分别是矩阵 的行数和列数。忽略答案的空间消耗,空间复杂度 。
func transpose(matrix [][]int) [][]int {
	m, n := len(matrix), len(matrix[0])
	ans := make([][]int, n)
	for i := range ans {
		ans[i] = make([]int, m)
		for j := range ans[i] {
			ans[i][j] = matrix[j][i]
		}
	}
	return ans
}885. 螺旋矩阵 III
题目、示例与约束
在 rows x cols 的网格上,你从单元格 (rStart, cStart) 面朝东面开始。网格的西北角位于第一行第一列,网格的东南角位于最后一行最后一列。
你需要以顺时针按螺旋状行走,访问此网格中的每个位置。每当移动到网格的边界之外时,需要继续在网格之外行走(但稍后可能会返回到网格边界)。
最终,我们到过网格的所有 rows x cols 个空间。
按照访问顺序返回表示网格位置的坐标列表。
示例 1:
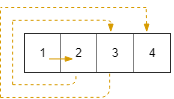
输入:rows = 1, cols = 4, rStart = 0, cStart = 0
输出:[[0,0],[0,1],[0,2],[0,3]]
示例 2:
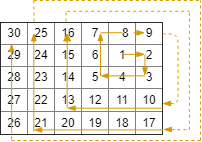
输入:rows = 5, cols = 6, rStart = 1, cStart = 4
输出:[[1,4],[1,5],[2,5],[2,4],[2,3],[1,3],[0,3],[0,4],[0,5],[3,5],[3,4],[3,3],[3,2],[2,2],[1,2],[0,2],[4,5],[4,4],[4,3],[4,2],[4,1],[3,1],[2,1],[1,1],[0,1],[4,0],[3,0],[2,0],[1,0],[0,0]]
提示:
1 <= rows, cols <= 1000 <= rStart < rows0 <= cStart < cols
方法一 · Go 实现
思考
从给定起点按东、南、西、北螺旋走遍网格。步长模式为 ,网格至多 ,模拟即可。
按方向与当前步长前进,落在界内则记录。走完东南后步长加一,走完西北后再加一。收集满 个点即停。
func spiralMatrixIII(rows int, cols int, rStart int, cStart int) [][]int {
	cnt := rows * cols
	ans := [][]int{[]int{rStart, cStart}}
	if cnt == 1 {
		return ans
	}
	for k := 1; ; k += 2 {
		dirs := [][]int{{0, 1, k}, {1, 0, k}, {0, -1, k + 1}, {-1, 0, k + 1}}
		for _, dir := range dirs {
			r, c, dk := dir[0], dir[1], dir[2]
			for dk > 0 {
				rStart += r
				cStart += c
				if rStart >= 0 && rStart < rows && cStart >= 0 && cStart < cols {
					ans = append(ans, []int{rStart, cStart})
					if len(ans) == cnt {
						return ans
					}
				}
				dk--
			}
		}
	}
}896. 单调数列
题目、示例与约束
如果数组是单调递增或单调递减的,那么它是 单调 的。
如果对于所有 i <= j,nums[i] <= nums[j],那么数组 nums 是单调递增的。 如果对于所有 i <= j,nums[i] >= nums[j],那么数组 nums 是单调递减的。
当给定的数组 nums 是单调数组时返回 true,否则返回 false。
示例 1:
输入:nums = [1,2,2,3]
输出:true
示例 2:
输入:nums = [6,5,4,4]
输出:true
示例 3:
输入:nums = [1,3,2]
输出:false
提示:
1 <= nums.length <= 105-105 <= nums[i] <= 105
方法一:一次遍历 · Go 实现
思考
判断数组是否单调不降或不升。 ,一次遍历同时检查两种方向即可。
相邻两两比较,分别验证是否全 或全 ,满足其一即为单调。
遍历数组,如果出现递增或递减的情况,记录下来。判断是否出现过递增和递减的情况,如果都出现过,说明不是单调数组,返回 false。
否则遍历结束,说明是单调数组,返回 true。
时间复杂度 ,其中 为数组长度。空间复杂度 。
func isMonotonic(nums []int) bool {
	asc, desc := false, false
	for i, x := range nums[1:] {
		if nums[i] < x {
			asc = true
		} else if nums[i] > x {
			desc = true
		}
		if asc && desc {
			return false
		}
	}
	return true
}915. 分割数组
题目、示例与约束
给定一个数组 nums ,将其划分为两个连续子数组 left 和 right, 使得:
left中的每个元素都小于或等于right中的每个元素。left和right都是非空的。left的长度要尽可能小。
在完成这样的分组后返回 left 的 长度 。
用例可以保证存在这样的划分方法。
示例 1:
输入:nums = [5,0,3,8,6]
输出:3
解释:left = [5,0,3],right = [8,6]
示例 2:
输入:nums = [1,1,1,0,6,12]
输出:4
解释:left = [1,1,1,0],right = [6,12]
提示:
2 <= nums.length <= 1050 <= nums[i] <= 106- 可以保证至少有一种方法能够按题目所描述的那样对
nums进行划分。
方法一:前缀最大值 + 后缀最小值 · Go 实现
思考
划分点 需满足左侧最大不超过右侧最小。 ,不能对每个 再扫两边。预处理后缀最小值,再从左维护前缀最大,第一次满足 即为最短左段(题目保证存在)。
划分后的两个子数组要满足题目要求,需要保证“数组前缀最大值”小于等于“数组后缀最小值”。
因此,我们可以先预处理出数组的后缀最小值,记录在 mi 数组中。
然后从前往后遍历数组,维护数组前缀的最大值 mx,当遍历到某个位置时,如果数组前缀最大值小于等于数组后缀最小值,那么当前位置就是划分的分界点,直接返回即可。
时间复杂度 ,空间复杂度 。其中 为数组 nums 的长度。
func partitionDisjoint(nums []int) int {
	n := len(nums)
	mi := make([]int, n+1)
	mi[n] = nums[n-1]
	for i := n - 1; i >= 0; i-- {
		mi[i] = min(nums[i], mi[i+1])
	}
	mx := 0
	for i := 1; ; i++ {
		v := nums[i-1]
		mx = max(mx, v)
		if mx <= mi[i] {
			return i
		}
	}
}941. 有效的山脉数组
题目、示例与约束
给定一个整数数组 arr,如果它是有效的山脉数组就返回 true,否则返回 false。
让我们回顾一下,如果 arr 满足下述条件,那么它是一个山脉数组:
arr.length >= 3- 在
0 < i < arr.length - 1条件下,存在i使得:arr[0] < arr[1] < ... arr[i-1] < arr[i]arr[i] > arr[i+1] > ... > arr[arr.length - 1]
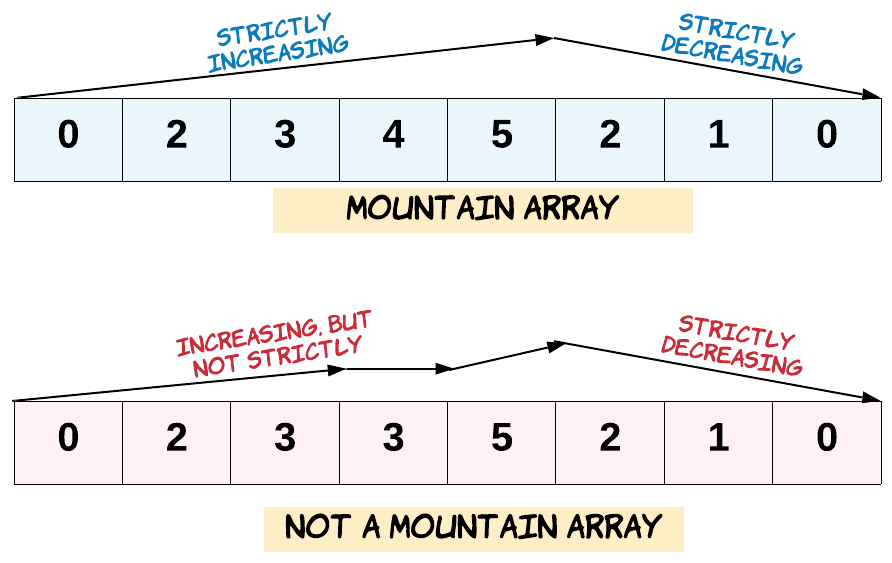
示例 1:
输入:arr = [2,1]
输出:false
示例 2:
输入:arr = [3,5,5]
输出:false
示例 3:
输入:arr = [0,3,2,1]
输出:true
提示:
1 <= arr.length <= 1040 <= arr[i] <= 104
方法一:双指针 · Go 实现
思考
山脉须严格升再严格降,长度至少 。从两端分别走到第一个不升/不降的位置,峰应重合且不能落在端点。左右指针各自只走一趟。
我们首先判断数组的长度是否小于 ,如果小于 ,那么一定不是山脉数组,直接返回 false。
然后,我们使用指针 从数组的左端开始向右移动,直到找到一个位置 ,使得 。然后,我们使用指针 从数组的右端开始向左移动,直到找到一个位置 ,使得 。如果满足条件 ,那么就说明数组 是一个山脉数组。
时间复杂度 ,其中 是数组的长度。空间复杂度 。
func validMountainArray(arr []int) bool {
	n := len(arr)
	if n < 3 {
		return false
	}
	i, j := 0, n-1
	for i+1 < n-1 && arr[i] < arr[i+1] {
		i++
	}
	for j-1 > 0 && arr[j-1] > arr[j] {
		j--
	}
	return i == j
}985. 查询后的偶数和
题目、示例与约束
给出一个整数数组 A 和一个查询数组 queries。
对于第 i 次查询,有 val = queries[i][0], index = queries[i][1],我们会把 val 加到 A[index] 上。然后,第 i 次查询的答案是 A 中偶数值的和。
(此处给定的 index = queries[i][1] 是从 0 开始的索引,每次查询都会永久修改数组 A。)
返回所有查询的答案。你的答案应当以数组 answer 给出,answer[i] 为第 i 次查询的答案。
示例:
输入:A = [1,2,3,4], queries = [[1,0],[-3,1],[-4,0],[2,3]]
输出:[8,6,2,4]
解释:
开始时,数组为 [1,2,3,4]。
将 1 加到 A[0] 上之后,数组为 [2,2,3,4],偶数值之和为 2 + 2 + 4 = 8。
将 -3 加到 A[1] 上之后,数组为 [2,-1,3,4],偶数值之和为 2 + 4 = 6。
将 -4 加到 A[0] 上之后,数组为 [-2,-1,3,4],偶数值之和为 -2 + 4 = 2。
将 2 加到 A[3] 上之后,数组为 [-2,-1,3,6],偶数值之和为 -2 + 6 = 4。
提示:
1 <= A.length <= 10000-10000 <= A[i] <= 100001 <= queries.length <= 10000-10000 <= queries[i][0] <= 100000 <= queries[i][1] < A.length
方法一:模拟 · Go 实现
思考
每次给某一项加 后询问偶数和。若每次重扫数组则偏慢。维护当前偶数和 :修改前若该项为偶则先从 中减去,修改后再视奇偶加回。
我们用一个整型变量 记录数组 中所有偶数的和,初始时 为数组 中所有偶数的和。
对于每次查询 ,我们首先判断 是否为偶数,若 为偶数,则将 减去 ;然后将 加上 ;若 为偶数,则将 加上 ,然后将 加入答案数组。
时间复杂度 ,其中 和 分别为数组 和 的长度。忽略答案数组的空间消耗,空间复杂度 。
func sumEvenAfterQueries(nums []int, queries [][]int) (ans []int) {
	s := 0
	for _, x := range nums {
		if x%2 == 0 {
			s += x
		}
	}
	for _, q := range queries {
		v, i := q[0], q[1]
		if nums[i]%2 == 0 {
			s -= nums[i]
		}
		nums[i] += v
		if nums[i]%2 == 0 {
			s += nums[i]
		}
		ans = append(ans, s)
	}
	return
}999. 可以被一步捕获的棋子数
题目、示例与约束
给定一个 8 x 8 的棋盘,只有一个 白色的车,用字符 'R' 表示。棋盘上还可能存在白色的象 'B' 以及黑色的卒 'p'。空方块用字符 '.' 表示。
车可以按水平或竖直方向(上,下,左,右)移动任意个方格直到它遇到另一个棋子或棋盘的边界。如果它能够在一次移动中移动到棋子的方格,则能够 吃掉 棋子。
注意:车不能穿过其它棋子,比如象和卒。这意味着如果有其它棋子挡住了路径,车就不能够吃掉棋子。
返回白车 攻击 范围内 兵的数量。
示例 1:
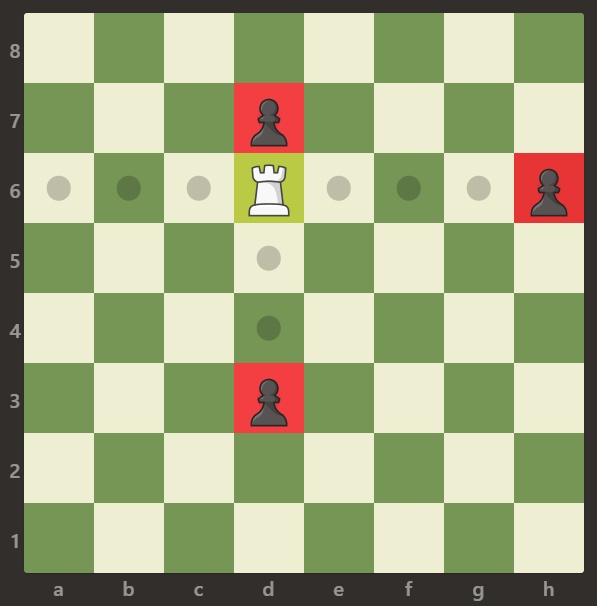
输入:[[".",".",".",".",".",".",".","."],[".",".",".","p",".",".",".","."],[".",".",".","R",".",".",".","p"],[".",".",".",".",".",".",".","."],[".",".",".",".",".",".",".","."],[".",".",".","p",".",".",".","."],[".",".",".",".",".",".",".","."],[".",".",".",".",".",".",".","."]]
输出:3
解释:
在本例中,车能够吃掉所有的卒。
示例 2:
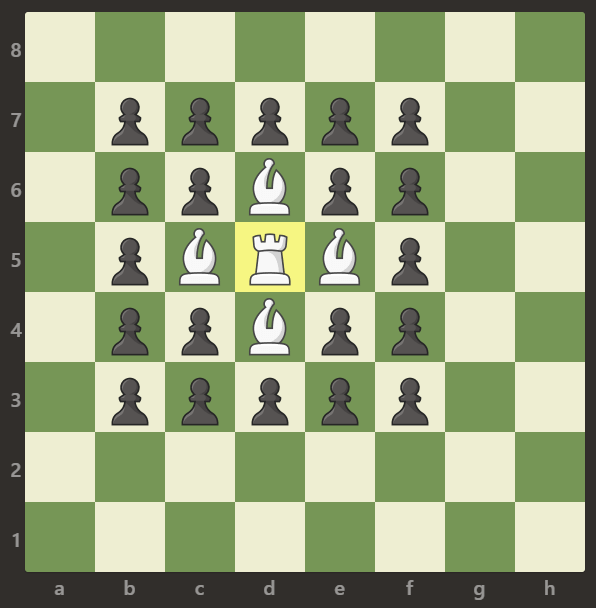
输入:[[".",".",".",".",".",".",".","."],[".","p","p","p","p","p",".","."],[".","p","p","B","p","p",".","."],[".","p","B","R","B","p",".","."],[".","p","p","B","p","p",".","."],[".","p","p","p","p","p",".","."],[".",".",".",".",".",".",".","."],[".",".",".",".",".",".",".","."]]
输出:0
解释:
象阻止了车吃掉任何卒。
示例 3:
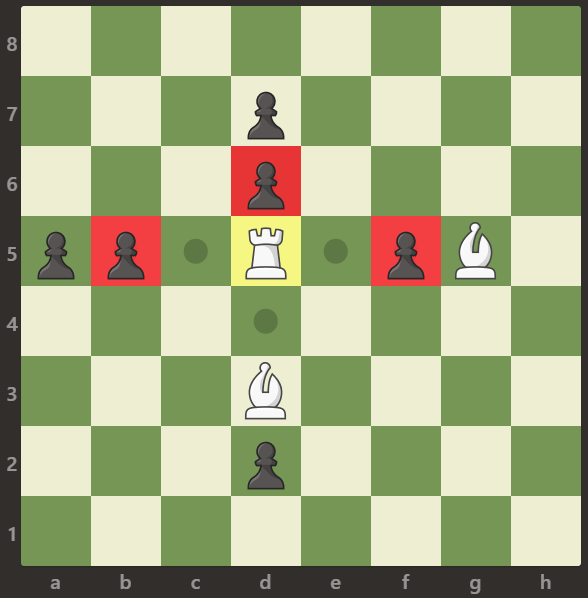
输入:[[".",".",".",".",".",".",".","."],[".",".",".","p",".",".",".","."],[".",".",".","p",".",".",".","."],["p","p",".","R",".","p","B","."],[".",".",".",".",".",".",".","."],[".",".",".","B",".",".",".","."],[".",".",".","p",".",".",".","."],[".",".",".",".",".",".",".","."]]
输出:3
解释:
车可以吃掉位置 b5,d6 和 f5 的卒。
提示:
board.length == 8board[i].length == 8board[i][j]可以是'R','.','B'或'p'- 只有一个格子上存在
board[i][j] == 'R'
方法一:模拟 · Go 实现
思考
棋盘上一辆车,沿直线吃卒、象挡路。先定位
'R',再向四向走:遇象停止,遇卒计数并停止该方向。规模固定,模拟即可。
我们先遍历棋盘,找到车的位置 ,然后从 出发,向上下左右四个方向遍历:
- 如果不是边界且不是象,则继续向前走;
- 如果是卒,则答案加一,并停止该方向的遍历。
遍历完四个方向后,即可得到答案。
时间复杂度 ,其中 和 分别是棋盘的行数和列数,本题中 。空间复杂度 。
func numRookCaptures(board [][]byte) (ans int) {
    dirs := []int{-1, 0, 1, 0, -1}
    n := len(board)
    for i := 0; i < n; i++ {
        for j := 0; j < n; j++ {
            if board[i][j] == 'R' {
                for k := 0; k < 4; k++ {
                    x, y := i + dirs[k], j + dirs[k+1]
                    for x >= 0 && x < n && y >= 0 && y < n && board[x][y] != 'B' {
                        if board[x][y] == 'p' {
                            ans++
                            break
                        }
                        x += dirs[k]
                        y += dirs[k+1]
                    }
                }
                return
            }
        }
    }
    return
}1121. 将数组分成几个递增序列 🔒
题目、示例与约束
给你一个 非递减 的正整数数组 nums 和整数 K,判断该数组是否可以被分成一个或几个 长度至少 为 K 的 不相交的递增子序列。
示例 1:
输入:nums = [1,2,2,3,3,4,4], K = 3
输出:true
解释:
该数组可以分成两个子序列 [1,2,3,4] 和 [2,3,4],每个子序列的长度都至少是 3。
示例 2:
输入:nums = [5,6,6,7,8], K = 3
输出:false
解释:
没有办法根据条件来划分数组。
提示:
1 <= nums.length <= 10^51 <= K <= nums.length1 <= nums[i] <= 10^5
方法一:脑筋急转弯 · Go 实现
思考
数组已非递减,严格递增子序列不能含重复值,故出现次数最多的值必须分到不同子序列。若最多出现 次,则至少需要 条长度不小于 的子序列,因而 是充要条件。
非递减数组中相同值连续,用
groupby即可得到最大段长,不必再开哈希表。
我们假设可以将数组分成 个长度至少为 的严格递增子序列,如果数组中出现次数最多的数字的个数为 ,那么这 个数字必须在不同的子序列中,所以 ,又因为 个子序列的长度至少为 ,因此,子序列的个数越少越好,所以 。那么 ,才能满足题意。因此,我们只需要统计数组中出现次数最多的数字的个数 ,然后判断 即可。如果是,返回 true,否则返回 false。
时间复杂度 ,空间复杂度 。其中 为数组 的长度。
func canDivideIntoSubsequences(nums []int, k int) bool {
	cnt, a := 0, 0
	for _, b := range nums {
		cnt++
		if a != b {
			cnt = 1
		}
		if cnt*k > len(nums) {
			return false
		}
		a = b
	}
	return true
}继续阅读
- 实践案例
- 实践案例
- 实践案例