
Redis:数据结构服务、缓存与部署边界 · 数据类型至集群方案
数据类型
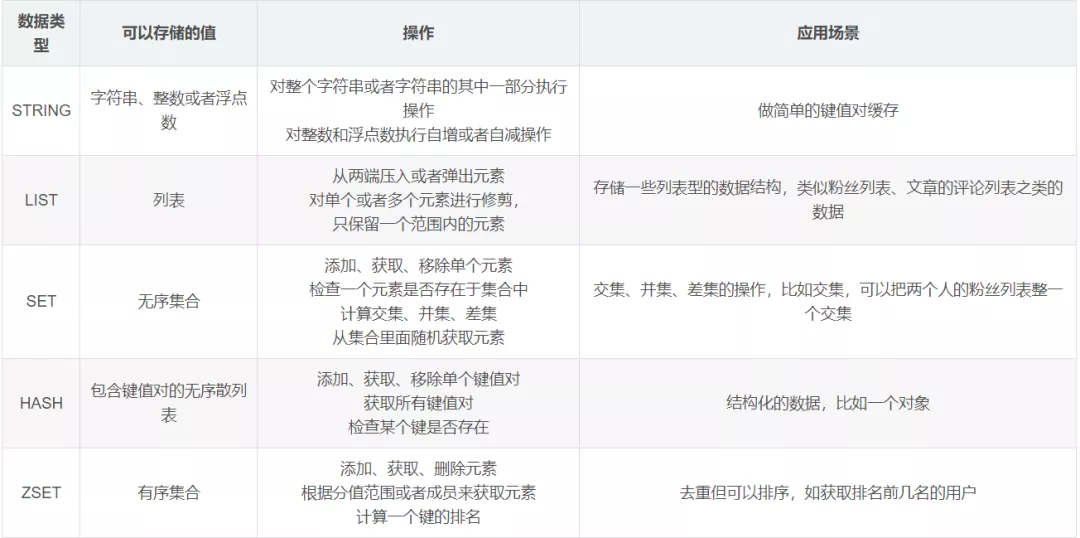
下图仅介绍五种基础结构(string、list、set、zset、hash),不表示当前版本只有这些类型;图像本轮未重新审阅。
应用场景
计数器
可以对 String 进行自增自减运算,从而实现计数器功能。Redis 这种内存型数据库的读写性能非常高,很适合存储频繁读写的计数量。
缓存
将热点数据放到内存中,设置内存的最大使用量以及淘汰策略来保证缓存的命中率。
会话缓存
可以使用 Redis 来统一存储多台应用服务器的会话信息。当应用服务器不再存储用户的会话信息,也就不再具有状态,一个用户可以请求任意一个应用服务器,从而更容易实现高可用性以及可伸缩性。
全页缓存(FPC)
除基本的会话 token 之外,Redis 还提供很简便的 FPC 平台。以 Magento 为例,Magento 提供一个插件来使用 Redis 作为全页缓存后端。此外,对 WordPress 的用户来说,Pantheon 有一个非常好的插件 wp-redis,这个插件能帮助你以最快速度加载你曾浏览过的页面。
查找表
例如 DNS 记录就很适合使用 Redis 进行存储。查找表和缓存类似,也是利用了 Redis 快速的查找特性。但是查找表的内容不能失效,而缓存的内容可以失效,因为缓存不作为可靠的数据来源。
消息队列(发布/订阅功能)
List 提供两端序列操作,可以用 LPUSH/RPOP 演示队列;它的底层编码依版本而变,不宜统一称作双向链表。弹出后消费者崩溃可能丢任务,确认与重投需求应比较Stream及专用消息系统。
分布式锁实现
在分布式场景下,无法使用单机环境下的锁来对多个节点上的进程进行同步。占位可用 SET key token NX PX 设置租约;释放需校验持有者 token,租约过期后的旧持有者也须受资源端约束。裸 SETNX 并不提供完整锁协议,具体失败边界见缓存与锁实践。
其它
Set 可以实现交集、并集等操作,从而实现共同好友等功能。ZSet 可以实现有序性操作,从而实现排行榜等功能。
应用场景总结
- string——适合最简单的 k-v 存储,类似于 memcached 的存储结构,短信验证码,配置信息等,就用这种类型来存储。
- hash——一般 key 为 ID 或者唯一标示,value 对应的就是详情了。如商品详情,个人信息详情,新闻详情等。
- list——因为 list 是有序的,比较适合存储一些有序且数据相对固定的数据。如省市区表、字典表等。因为 list 是有序的,适合根据写入的时间来排序,如:最新的,消息队列等
- set——可以简单的理解为 ID-List 的模式,如微博中一个人有哪些好友,set 最牛的地方在于,可以对两个 set 提供交集、并集、差集操作。例如:查找两个人共同的好友等。
- Sorted Set——是 set 的增强版本,增加了一个 score 参数,自动会根据 score 的值进行排序。比较适合类似于 top 10 等不根据插入的时间来排序的数据。
持久化
提供两种持久化机制 RDB(默认) 和 AOF 机制
RDB(Redis Data Base)
RDB 是默认持久化,按照一定时间将内存中数据把保存硬盘中,会产出数据文件 dump.rdb,时间可以通过配置文件
save参数配置
- 自动触发
save 900 1:表示900 秒内如果至少有 1 个 key 的值变化,则保存
save 300 10:表示300 秒内如果至少有 10 个 key 的值变化,则保存
save 60 10000:表示60 秒内如果至少有 10000 个 key 的值变化,则保存
手动触发
save
该命令会阻塞当前 Redis 服务器,执行 save 命令期间,Redis 不能处理其他命令,直到 RDB 过程完成为止。
显然该命令对于内存比较大的实例会造成长时间阻塞,这是致命的缺陷,为了解决此问题,Redis 提供了第二种方式。
bgsave
执行该命令时,Redis 会在后台异步进行快照操作,快照同时还可以响应客户端请求。具体操作是 Redis 进程执行 fork 操作创建子进程,RDB 持久化过程由子进程负责,完成后自动结束。fork 会暂停主进程,写时复制、磁盘和内存压力还可能增加延迟,不能保证后台快照没有其他性能影响。
基本上 Redis 内部所有的 RDB 操作都是采用 bgsave 命令。
FLUSHALL 会清空全部数据库;它对 RDB 的处理还受持久化配置影响,不能作为备份或普通验证步骤。
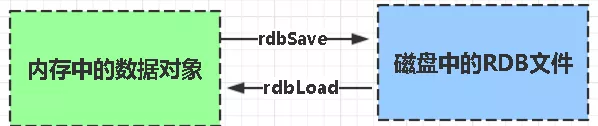
优点:
1、只有一个文件 dump.rdb,方便持久化。
2、容灾性好,一个文件可以保存到安全的磁盘。
3、子进程生成快照时主进程可继续处理请求,但仍有 fork、写时复制及存储竞争成本,不能保证主进程完全无 I/O 或性能不受影响。
4.相对于数据集大时,比 AOF 的启动效率更高。
缺点:
1、数据安全性低。RDB 是间隔一段时间进行持久化,如果持久化之间 redis 发生故障,会发生数据丢失。所以这种方式更适合数据要求不严谨的时候)
2、AOF(Append-only file)持久化方式:是指所有的命令行记录以 redis 命令请 求协议的格式完全持久化存储)保存为 aof 文件
AOF (Append Only File)
每次写命令记录到单独文件日志文件中,当重启讲持久化日志中文件恢复数据
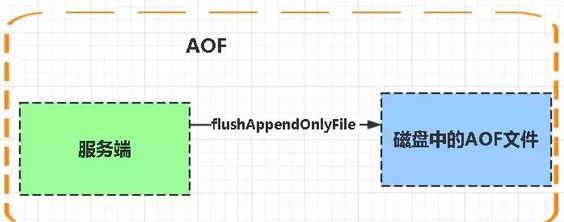
优点:
1、AOF 的数据丢失窗口取决于 appendfsync、系统和存储;always、everysec、no 是不同同步策略,均不能只凭开关推断完整业务安全。
2、redis-check-aof 用于检查和修复 AOF 格式或截断问题,不修复业务一致性;修复可能丢弃损坏位置后的记录,先保留原文件并评估数据损失。
3、rewrite 将历史压缩为等效数据状态。不能把直接删除 AOF 中某条命令当作通用误操作恢复;先保存完整文件,按版本及记录依赖制定独立恢复方案。
缺点:
1、AOF 文件比 RDB 文件大,且恢复速度慢。
2、数据集大的时候,比 rdb 启动效率低。
RDB and AOF
- AOF 文件比 RDB 更新频率高,优先使用 AOF 还原数据。
- AOF 与 RDB 的安全性和体积取决于同步、快照、重写及数据负载,不作统一大小和安全排序
- 两者的写入、后台维护和启动成本应在相同配置及数据量下分别测量
- 如果两个都配了优先加载 AOF
如何选择持久化方式
- 可按恢复要求组合 RDB 与 AOF;两者同时启用时通常优先从 AOF 恢复。不能据此与 PostgreSQL 的事务、复制和持久性保证直接类比。
- 如果你非常关心你的数据, 但仍然可以承受数分钟以内的数据丢失,那么你可以只使用 RDB 持久化。
- 有很多用户都只使用 AOF 持久化,但并不推荐这种方式,因为定时生成 RDB 快照(snapshot)非常便于进行数据库备份, 并且 RDB 恢复数据集的速度也要比 AOF 恢复的速度要快,除此之外,使用 RDB 还可以避免 AOF 程序的 bug。
- 如果你只希望你的数据在服务器运行的时候存在,你也可以不使用任何持久化方式。
事务
127.0.0.1:6379> MULTI
OK
127.0.0.1:6379> SET name lcc
QUEUED
127.0.0.1:6379> get name
QUEUED
127.0.0.1:6379> sadd tags "java" "golang"
QUEUED
127.0.0.1:6379> smembers tag
QUEUED
127.0.0.1:6379> exec
1) OK
2) "lcc"
3) (integer) 2
4) (empty list or set)
127.0.0.1:6379>| 序号 | 命令及描述 |
|---|---|
| 1 | DISCARD 取消事务,放弃执行事务块内的所有命令。 |
| 2 | EXEC 执行所有事务块内的命令。 |
| 3 | MULTI 标记一个事务块的开始。 |
| 4 | UNWATCH 取消 WATCH 命令对所有 key 的监视。 |
| 5 | WATCH key [key ...]] 监视一个(或多个) key ,如果在事务执行之前这个(或这些) key 被其他命令所改动,那么事务将被打断。 |
集群方案
哨兵模式
继续阅读
- 数据与原子性
- 数据与原子性
- 数据与原子性