
Redis:数据结构服务、缓存与部署边界 · Redis 概述至Redis 基础与缓存实践笔记
Redis:数据结构服务、缓存与部署边界
Redis 概述
Redis 是通过网络提供服务的数据结构存储系统。应用发送命令,服务器根据键找到值,并执行对应操作。一个键可以对应字符串、哈希、列表、集合等不同类型的值;类型决定能使用哪些命令。
先理解三个概念
| 概念 | 含义 | 示例 |
|---|---|---|
| 服务端 | 保存数据、执行命令的 Redis 进程 | redis-server |
| 客户端 | 连接服务并发送命令的工具或程序 | redis-cli、应用里的 Redis 客户端库 |
| 键与值 | 键标识一份数据,值承载内容并带有类型 | user:42:name 对应字符串 Ada |
关闭客户端不会停止服务器。同一个键不能同时各存一份 String 和 Hash;对已有 Hash 使用 GET 会得到类型错误,需要使用 Hash 对应的读取命令。
Redis 适合做什么
常见用途包括缓存、计数、去重和排行榜。选型要从访问方式出发:读取完整值、修改某个字段、判断成员存在、按分数取前几名,需要的操作并不相同。
Redis 的访问速度与内存、命令复杂度、数据大小、网络和部署方式有关,不能用一个固定 QPS 代表所有业务。数据主要在内存中,仍需考虑容量限制、过期策略、故障和恢复。
缓存与持久化的关系
作为缓存时,通常可以从数据库等权威数据源重建数据。启用持久化可以帮助 Redis 重启恢复,但不会自动解决缓存与数据库的一致性,也不能替代独立备份。应用需要先明确哪些数据允许丢失、允许陈旧多久,再选择部署和存储方案。
基础阅读顺序
- 安装连接:连接独立实验服务。
- 数据类型:认识类型与选型。
- 键与过期时间:理解命名、TTL 与扫描。
- 常用命令:按用途查找操作。
- 持久化入门:区分 RDB、AOF 与备份。
- 事务与脚本入门:理解多步操作的执行边界。
参考:Redis 数据模型、持久化。
Redis 基础与缓存实践笔记
以下保留原资料的历史版本范围。
历史材料的固定QPS、仅五种类型、BSD许可及VM描述不适用Redis8.2。8.x许可见官方发行文件;当前隔离安装、数据与缓存、RDB/AOF恢复留有此前批次的验证记录,本轮未复跑。下列旧内容仅作历史对照,未完成的复制/分片等专题保持原边界。
本页是旧版学习笔记,性能数字、数据类型数量及单线程等表述依赖版本和部署方式。缓存设计实践可配合下方专题阅读,不应把历史概述当作当前部署规格。
Redis(Remote Dictionary Server)
什么是 Redis
- 是使用 C 语言编写的键值数据结构服务。原笔记的 BSD 许可属于历史版本描述;所用发行版的许可应查对应发行文件。
- 键是字节串,值有不同类型。原笔记列出的字符串、列表、集合、散列表、有序集合是五种基础结构,不是当前版本的全部能力;完整类型见数据类型。
- 与传统数据库不同的是 Redis 的数据是存在内存中的,所以读写速度非常快,因此 redis 被广泛应用于缓存方向,旧文曾以“每秒超过10万次”及“已知最快”概括性能,但没有负载、硬件和版本证据,不能用于当前选型或容量承诺。另外,Redis 也经常用来做分布式锁。除此之外,Redis 支持事务 、持久化、LUA 脚本、LRU 驱动事件、多种集群方案。
Redis 优缺点
优点
- 原文记录读 110000 次/s、写 81000 次/s,未给出测量环境、请求和值大小;这些历史数字不作为通用性能规格。
- 支持数据持久化,支持 AOF 和 RDB 两种持久化方式。
- 单条命令的原子执行与多步业务流程不同;MULTI/EXEC 可让排队命令连续执行,但执行期报错不会回滚其他成功命令,详见事务边界。
- 数据结构丰富,除了支持 string 类型的 value 外还支持 hash、set、zset、list 等数据结构。
- 支持主从复制,主机会自动将数据同步到从机,可以进行读写分离。
缺点
- 数据库容量受到物理内存的限制,不能用作海量数据的高性能读写,因此 Redis 适合的场景主要局限在较小数据量的高性能操作和运算上。
- 故障转移能力取决于部署方式;仅有复制不等于自动切换,Sentinel 或 Cluster 的机制也不能承诺零数据丢失。原文“一概需要手工切IP”不适用于所有部署。
- 主机宕机,宕机前有部分数据未能及时同步到从机,切换 IP 后还会引入数据不一致的问题,降低了系统的可用性。
- Redis 较难支持在线扩容,在集群容量达到上限时在线扩容会变得很复杂。为避免这一问题,运维人员在系统上线时必须确保有足够的空间,这对资源造成了很大的浪费。
为什么要使用 Redis
高性能
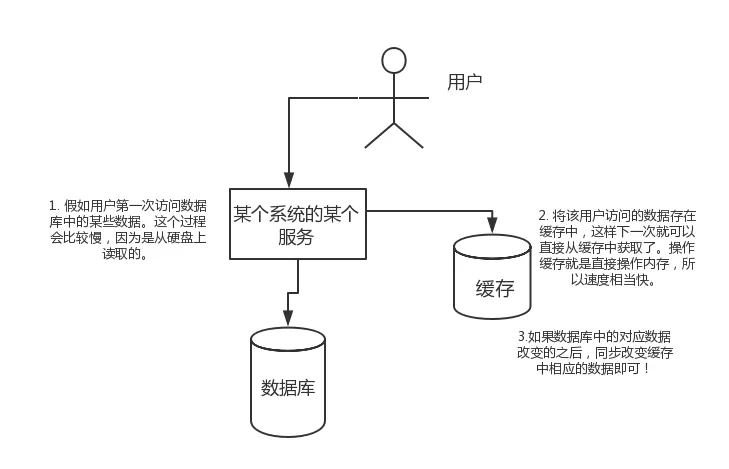
假如用户第一次访问数据库中的某些数据。这个过程会比较慢,因为是从硬盘上读取的。将该用户访问的数据存在数缓存中,这样下一次再访问这些数据的时候就可以直接从缓存中获取了。操作缓存就是直接操作内存,可能减少部分请求的读取成本。数据库改变后仍须设计缓存失效和并发回填策略,不能把双写当作自动一致。
高并发
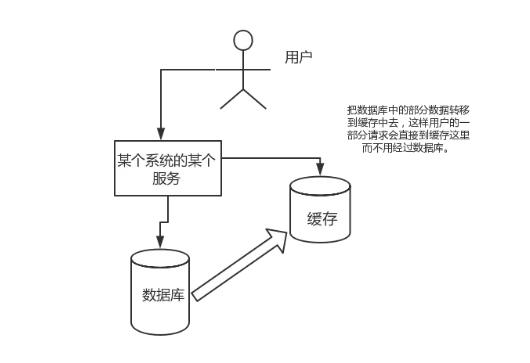
直接操作缓存能够承受的请求是远远大于直接访问数据库的,所以我们可以考虑把数据库中的部分数据转移到缓存中去,这样用户的一部分请求会直接到缓存这里而不用经过数据库。
Redis 为什么这么快
1、完全基于内存,绝大部分请求是纯粹的内存操作,非常快速。数据存在内存中,类似于 HashMap,HashMap 的优势就是按键定位通常较快,但具体命令的复杂度不同,扫描、排序、大集合运算和大值传输仍有成本;
2、数据结构简单,对数据操作也简单,Redis 中的数据结构是专门进行设计的;
3、常规命令主要沿主执行路径处理,网络 I/O、持久化和内存释放还有其他线程或进程参与;不能由“单线程”推导出无阻塞、无同步成本或任意命令都快;
4、使用多路 I/O 复用模型,非阻塞 IO;
5、旧文把“VM机制”列为性能原因,但未给出适用版本和依据,此解释撤回;评估当前性能应观察实际命令、数据大小、内存、网络和延迟。
继续阅读
- 数据与原子性
- 数据与原子性
- 数据与原子性